
Self-Distillation & Self-Improvement
自蒸馏与模型自改进
On-policy self-distillation, self-rewarding, self-play fine-tuning, model self-evolution without external labels. — 在线自蒸馏、自奖励、自博弈微调、无外部标签的模型自进化。
DeepSearch-World:可验证环境中面向深度搜索智能体的自蒸馏方法
DeepSearch-World: Self-Distillation for Deep Search Agents in a Verifiable Environment
TurnOPD:使在线策略蒸馏具备轮次感知能力,以实现高效长视野智能体训练
TurnOPD: Making On-Policy Distillation Turn-Aware for Efficient Long-Horizon Agent Training
通过子空间干预理解自监督视觉 Transformer 中的几何表示
Understanding Geometric Representations in Self-Supervised Vision Transformers via Subspace Intervention
CRAFT:基于自由兄弟回滚的反事实信用分配用于自蒸馏智能体强化学习
CRAFT: Counterfactual Credit Assignment from Free Sibling Rollouts for Self-Distilled Agentic Reinforcement Learning
UCOB:通过信用感知的在线策略双向自蒸馏学习利用与演化智能体技能
UCOB: Learning to Utilize and Evolve Agentic Skills via Credit-Aware On-Policy Bidirectional Self-Distillation
ATOD:用于多轮自主智能体的退火轮次感知在策略蒸馏算法
ATOD: Annealed Turn-aware On-policy Distillation for Multi-turn Autonomous Agents
SEED:面向智能体强化学习的自演化在策略蒸馏方法
SEED: Self-Evolving On-Policy Distillation for Agentic Reinforcement Learning
HindSearch:用于搜索增强强化学习的轨迹级事后批评
HindSearch: Trajectory-Level Hindsight Critique for Search-Augmented Reinforcement Learning
PCSD:智能体强化学习中自蒸馏的持久一致性
PCSD: Persistent Consistency for Self-Distillation in Agentic Reinforcement Learning
面向智能体强化学习的组反思自蒸馏
Group-Reflective Self-Distillation for Agentic Reinforcement Learning
从评分到行动:面向 LLM 智能体的结果验证式对比自蒸馏
From Scoring to Acting: Outcome-Verified Comparative Self-Distillation for LLM Agents
β-OPSD:以策略优化推导,以自蒸馏训练
$β$-OPSD: Deriving with Policy Optimization, Training with Self-Distillation
H$^2$SD:混合事后自蒸馏
H$^2$SD: Hybrid Hindsight Self-Distillation
通过自蒸馏增强基于评分标准的强化学习
Enhancing Rubric-based RL via Self-Distillation
更好的起点,更好的终点:用于压缩推理的自举迭代自推理蒸馏
Better Starts, Better Ends: Bootstrapped Iterative Self-Reasoning Distillation for Compressed Reasoning
EasyOPD:面向大语言模型的易用式在策略蒸馏框架
EasyOPD: An Easy-to-use On-Policy Distillation Framework for Large Language Models
纯化 OPSD:在保留思维能力下的在策略自蒸馏
Purified OPSD: On-Policy Self-Distillation Without Losing How to Think
面向免标注大语言模型自蒸馏的神经元感知数据选择
Neuron-Aware Data Selection for Annotation-Free LLM Self-Distillation
DemoPSD:基于分歧调制的策略自蒸馏
DemoPSD: Disagreement-Modulated Policy Self-Distillation
KbSD:面向智能体搜索中行为校准的知识边界感知自蒸馏
KbSD: Knowledge Boundary aware Self-Distillation for Behavioral Calibration in Agentic Search
ARKD:面向文本生成的自适应强化学习引导双向 KL 散度蒸馏方法
ARKD: Adaptive Reinforcement Learning-Guided Bidirectional KL Divergence Distillation for Text Generation
DRIFT:基于难度路由自蒸馏、节奏门控探索与成功缓冲区训练的方法
DRIFT: Difficulty Routing Self-DIstillation with Rhythm-Gated Exploration and Success BuFfer Training
RESOURCE2SKILL:从人类创建的多模态资源中蒸馏可执行的智能体技能
RESOURCE2SKILL: Distilling Executable Agent Skills from Human-Created Multimodal Resources
RP-OPSD:面向多模态大语言模型的分辨率特权在策略自蒸馏
RP-OPSD: Resolution-Privileged On-Policy Self-Distillation for Multimodal Large Language Models
从智能体经验中进行样本高效的学习
Sample-Efficient Learning from Agent Experience
OPD-IAD:通过在线自蒸馏实现从语言判断到工业异常检测
OPD-IAD: From Language Judgment to Industrial Anomaly Detection via On-Policy Self-Distillation
为何带反馈增强的自蒸馏无法提升检索交错搜索代理?
Why Does Feedback-Augmented Self-Distillation Fail to Improve Retrieval-Interleaved Search Agents?
揭秘同策略蒸馏:作用、病态与调控
Demystifying On-Policy Distillation: Roles, Pathologies, and Regulations
在策略自蒸馏中诊断与缓解思维坍缩
Diagnosing and Mitigating Thinking Collapse in On-Policy Self-Distillation
重新思考面向思维模型的在策略自蒸馏
Rethinking On-Policy Self-Distillation for Thinking Models
SiamJEPA:论孪生学生编码器在 JEPA 中的作用
SiamJEPA: On the Role of Siamese Student Encoders in JEPA
通过对抗蒸馏改进可验证鲁棒性
Improving Certified Robustness via Adversarial Distillation
语言中的JEPA悖论:语言替代方案的几何结构
The JEPA Paradox in Language: The Geometry of Linguistic Alternatives
使用带噪学生同策略自蒸馏的视觉-语言模型自我增强
Self-Boosting Vision-Language Models with Noisy Student On-Policy Self-Distillation
视觉对比自蒸馏
Visual Contrastive Self-Distillation
从视频中自监督学习结构化动力学
Self-Supervised Learning of Structured Dynamics from Videos
知识蒸馏何时会产生负面影响?面向低资源语言摘要的可靠性感知蒸馏方法
When Does Knowledge Distillation Hurt? Reliability-Aware Distillation for Low-Resource Language Summarization
基于轨迹的在线策略蒸馏用于掩码扩散语言模型
Trace-Based On-Policy Distillation for Masked Diffusion Language Models
CADENCE:基于覆盖自适应在线策略蒸馏缩小推理差距
CADENCE: Closing the Reasoning Gap via Coverage-Adaptive On-Policy Distillation
将共识作为特权上下文用于无标签自蒸馏
Consensus as Privileged Context for Label-Free Self-Distillation
BucketKD:一种面向端到端运动规划的安全感知分桶知识蒸馏框架
BucketKD: A Safety-Aware Bucket-Based Knowledge Distillation Framework for End-to-End Motion Planning
通过生成式随机化与跨变体自监督学习打破虚假相关性
Breaking Spurious Correlations via Generative Randomization and Cross-Variant Self-Supervised Learning
隐蔽特征传播即表征对齐:来自隐藏通道蒸馏的机制证据
Covert Trait Propagation Is Representation Alignment: Mechanistic Evidence from Hidden-Channel Distillation
大语言模型教导视觉学生:细粒度概念知识的跨模态迁移
Large Language Model Teaches Visual Students: Cross-Modality Transfer of Fine-Grained Conceptual Knowledge
AMRD:面向轻量级语音情感识别的自适应多教师关系蒸馏
AMRD: Adaptive Multi-Teacher Relational Distillation for Lightweight Speech Emotion Recognition
Explainable Reinforcement Learning via Physics-Aware Policy Distillation
从 RLVR 到 RLSVR:任务变换为开放式大语言模型自我改进带来可自我验证的奖励
From RLVR to RLSVR: Task Transformation Induces Self-Verifiable Rewards for Open-Ended LLM Self-Improvement
D3O:用于序数回归的动态分布蒸馏方法
D3O: Dynamic Distribution Distillation for Ordinal Regression
DeepSearch-World:可验证环境中面向深度搜索智能体的自蒸馏方法
DeepSearch-World: Self-Distillation for Deep Search Agents in a Verifiable Environment
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 6 张


长程网页搜索智能体的自我改进训练面临难题:监督微调依赖固定教师轨迹,稀疏奖励强化学习对长程交互监督不足。本文构建可验证环境DeepSearch-World,含42万条多跳问答任务,并提出自蒸馏框架DeepSearch-Evolve,通过迭代轨迹生成、筛选、混洗与微调实现自我进化。基于此训练的9B模型无需更强模型蒸馏,即在BrowseComp、GAIA、HotpotQA上分别取得31.2%、61.5%、93.4%的成绩。整体开源环境、数据与模型,为自改进深度搜索智能体研究提供基础设施。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
训练工具调用智能体(tool-use agents)从自身交互经验中持续改进,一直是构建可扩展智能体系统的核心难题。当前主流的两条路径各有致命缺陷:[[监督微调]] 依赖预先采集的教师蒸馏轨迹,性能上限受限于教师模型的能力与轨迹多样性,模型在少量优化步后便容易饱和;[[稀疏奖励强化学习]](如 GRPO)在长程工具调用任务中,仅在最终给出答案时才有监督信号,无法定位失败究竟发生在查询构建、工具选择、证据抽取还是答案综合阶段。
第三条路——在线自蒸馏(OPSD)——虽然在形式上提供了稠密的 token 级监督信号,但教师分布在工具调用的每个中间步骤上极易受到噪声影响,因为没有可靠的方式来评判一个尚未到达终点的轨迹究竟是对是错。论文的核心洞察是:长程工具调用智能体的自我进化之所以举步维艰,根本原因在于缺乏过程级(process-level)的监督信号。而过程级监督的前提,是一个能够对中间状态进行确定性验证的环境。
方法
论文的解决方案分为两个部分:可验证环境 DeepSearch-World 和自蒸馏框架 DeepSearch-Evolve。
DeepSearch-World:确定性可验证的工具环境
环境的构建基于 Wikipedia 超链接图 。作者对图中的实体节点进行随机游走,每条游走 定义一条 跳的推理链。通过对游走路径中显式的实体提及做模糊化处理(例如将"2014"改为"2010年代"),构造出需要多跳推理才能回答的问题。这种数据构造方式的优势在于:问题和答案都严格来源于 Wikipedia 的结构化知识,不存在开放域问答中常见的歧义性问题。
在工具层面,DeepSearch-World 提供了两个完全确定性的离线工具。web_search_wiki(x) 基于 Lucene BM25 索引(通过 Pyserini 实现),接收查询后返回 top-5 候选文档,每个候选包含确定性标题、摘要和 URL。visit_wiki(u_j) 则基于 SQLite 偏移索引,将 URL 映射到完整文章内容。这两个工具的输入输出 schema 与真实网页搜索和浏览工具保持一致,可以在需要时无缝替换为在线工具。
过程级验证机制是整个环境设计的精髓。每个问题 对应一个目标实体集 。在智能体执行过程中,环境维护一个已完成实体的集合 。每当工具返回的内容命中 中任意尚未被解决的实体时,环境即将其加入 。这种无顺序的实体级验证无需任何 LLM 评判介入,仅通过字符串匹配即可客观判断智能体在每一步的进展,从而为反思、错误恢复等认知行为提供了可信赖的信号来源。
DeepSearch-Evolve:迭代自蒸馏框架
框架的核心是一个多轮迭代的自进化循环。设第 轮的模型为 ,每轮执行以下步骤:模型在可验证环境中生成完整轨迹,对轨迹进行过滤筛选,将通过筛选的轨迹从 scaffold 格式转换为标准 [[ReAct]] 格式,然后用这些轨迹对模型进行 [[监督微调]] 得到 ,作为下一轮的教师模型。
在轨迹过滤阶段,作者采用了两层机制。首先是拒绝采样(RS),仅保留最终答案正确的轨迹,这是保证训练信号可靠性的基础。其次是质量过滤(QF),使用 Qwen3.5-9B 作为评判器,剔除那些虽然答案正确但包含冗余证据、弱目标对齐或不一致推理的低质量轨迹。实验表明,RS 和 QF 的组合优于任何单一过滤策略。
Scaffold-to-ReAct 转换是另一个关键设计。教师智能体采用三阶段的 scaffold 结构:Plan 阶段初始化结构化的进度状态(包含已完成列表、待办列表、经验总结和已验证信息四个字段),Act 阶段在环境反馈的驱动下执行工具调用并更新状态,End 阶段基于已验证的工作记忆生成答案。转换时,每个工具调用步骤中的进度状态和环境反思被改写为 <think> 块中的文本,保留动作的局部推理,将 scaffold 特有的结构化记忆转换为标准化的思维链。这种转换使得学生模型在训练时学会了在没有外部规划提示的情况下自主进行进度跟踪和错误恢复。
在数据混合方面,作者使用重要性采样策略,在跨轮次数据中以指数衰减因子 优先使用近期生成的轨迹,同时保留一定比例的历史数据以减轻灾难性遗忘。训练配置方面使用 Llama Factory 框架,学习率 ,余弦调度,10% warmup,最大序列长度 32,768,每轮训练 1 epoch。
实验与结果
实验覆盖了七个深度搜索与推理基准,包括 BrowseComp、GAIA、HotpotQA、HLE 等。DeepSearch-World-9B 在所有基准上都显著超越了基座模型 Qwen3.5-9B-Instruct:BrowseComp 提升 23.8 个百分点,HotpotQA 提升 48.1 个百分点,GAIA 提升 37.6 个百分点。与 12 个以上的开源智能体相比,DeepSearch-World-9B 在 BrowseComp 上达到 31.2%,在 GAIA 上达到 61.5%,在 HotpotQA 上达到 93.4%,展现出与当前开源顶尖系统相当甚至更优的能力。
消融实验揭示了几个重要发现。数据规模实验中,42 万数据池相比 10 万数据池在验证分数上始终保持优势,证明多样性比重复训练更能驱动性能提升。轨迹转换实验中,去除反思改写机制使 BrowseComp 性能从 31.9 骤降至 16.7,说明将环境反馈转化为自我纠错能力是模型获得长程推理能力的关键。过滤策略实验中,拒绝采样与质量过滤的组合优于任何单一策略,表明答案正确性提供了可靠的训练下限,质量过滤则在此基础上进一步提升了轨迹的推理质量。
行为分析显示,DeepSearch-World-9B 的平均交互轮数达到 18.0 步(基座模型仅 4.7 步),工具调用次数达到 5.4 次(基座模型仅 0.9 次),高级能力评分从基座的 19% 提升至 70%。这些数字直观地说明了可验证环境如何驱动模型从短程问答向真正的深度搜索行为转变。
讨论与可借鉴点
这篇论文最重要的贡献在于证明了可验证环境是长程工具调用智能体实现自我进化的关键基础设施。当环境能够对中间状态进行确定性验证时,原本稀疏的奖励信号被分解为稠密的过程级监督,原本依赖外部教师的蒸馏范式被替换为模型自身的迭代改进。Wikipedia 的结构化知识为此提供了一个理想载体——其超链接图天然编码了多跳推理路径,实体级别的标注使得过程验证无需 LLM 介入。
局限性方面,环境目前仅覆盖 Wikipedia 领域,难以泛化到医学、法律、代码等专门场景。训练数据全为英文也导致中文基准 BrowseComp-ZH 的表现受限。此外,论文采用的是 [[监督微调]] 而非强化学习,这限制了模型在训练过程中探索新策略的灵活性——反思和错误恢复能力是通过轨迹格式从教师侧转移过来的,而非模型自身在交互中发现并固化的。
对于同领域的研究者而言,DeepSearch-World 提供的核心启示是:构建可验证环境的工程投入与科学价值是成正比的。过程级验证机制不仅降低了训练成本,更重要的是解锁了一种此前不可行的训练范式——智能体可以在没有外部教师的情况下,通过与确定性环境的持续交互逐步提升能力。如果能将这种思路迁移到其他知识领域或工具场景,例如代码执行环境、API 调用环境或知识图谱查询环境,或许能催生出更多具备自进化能力的专业智能体。
概念 · 6 个
摘要
智能体通过自蒸馏框架从自身轨迹中迭代学习
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
TurnOPD:使在线策略蒸馏具备轮次感知能力,以实现高效长视野智能体训练
TurnOPD: Making On-Policy Distillation Turn-Aware for Efficient Long-Horizon Agent Training
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 9 张
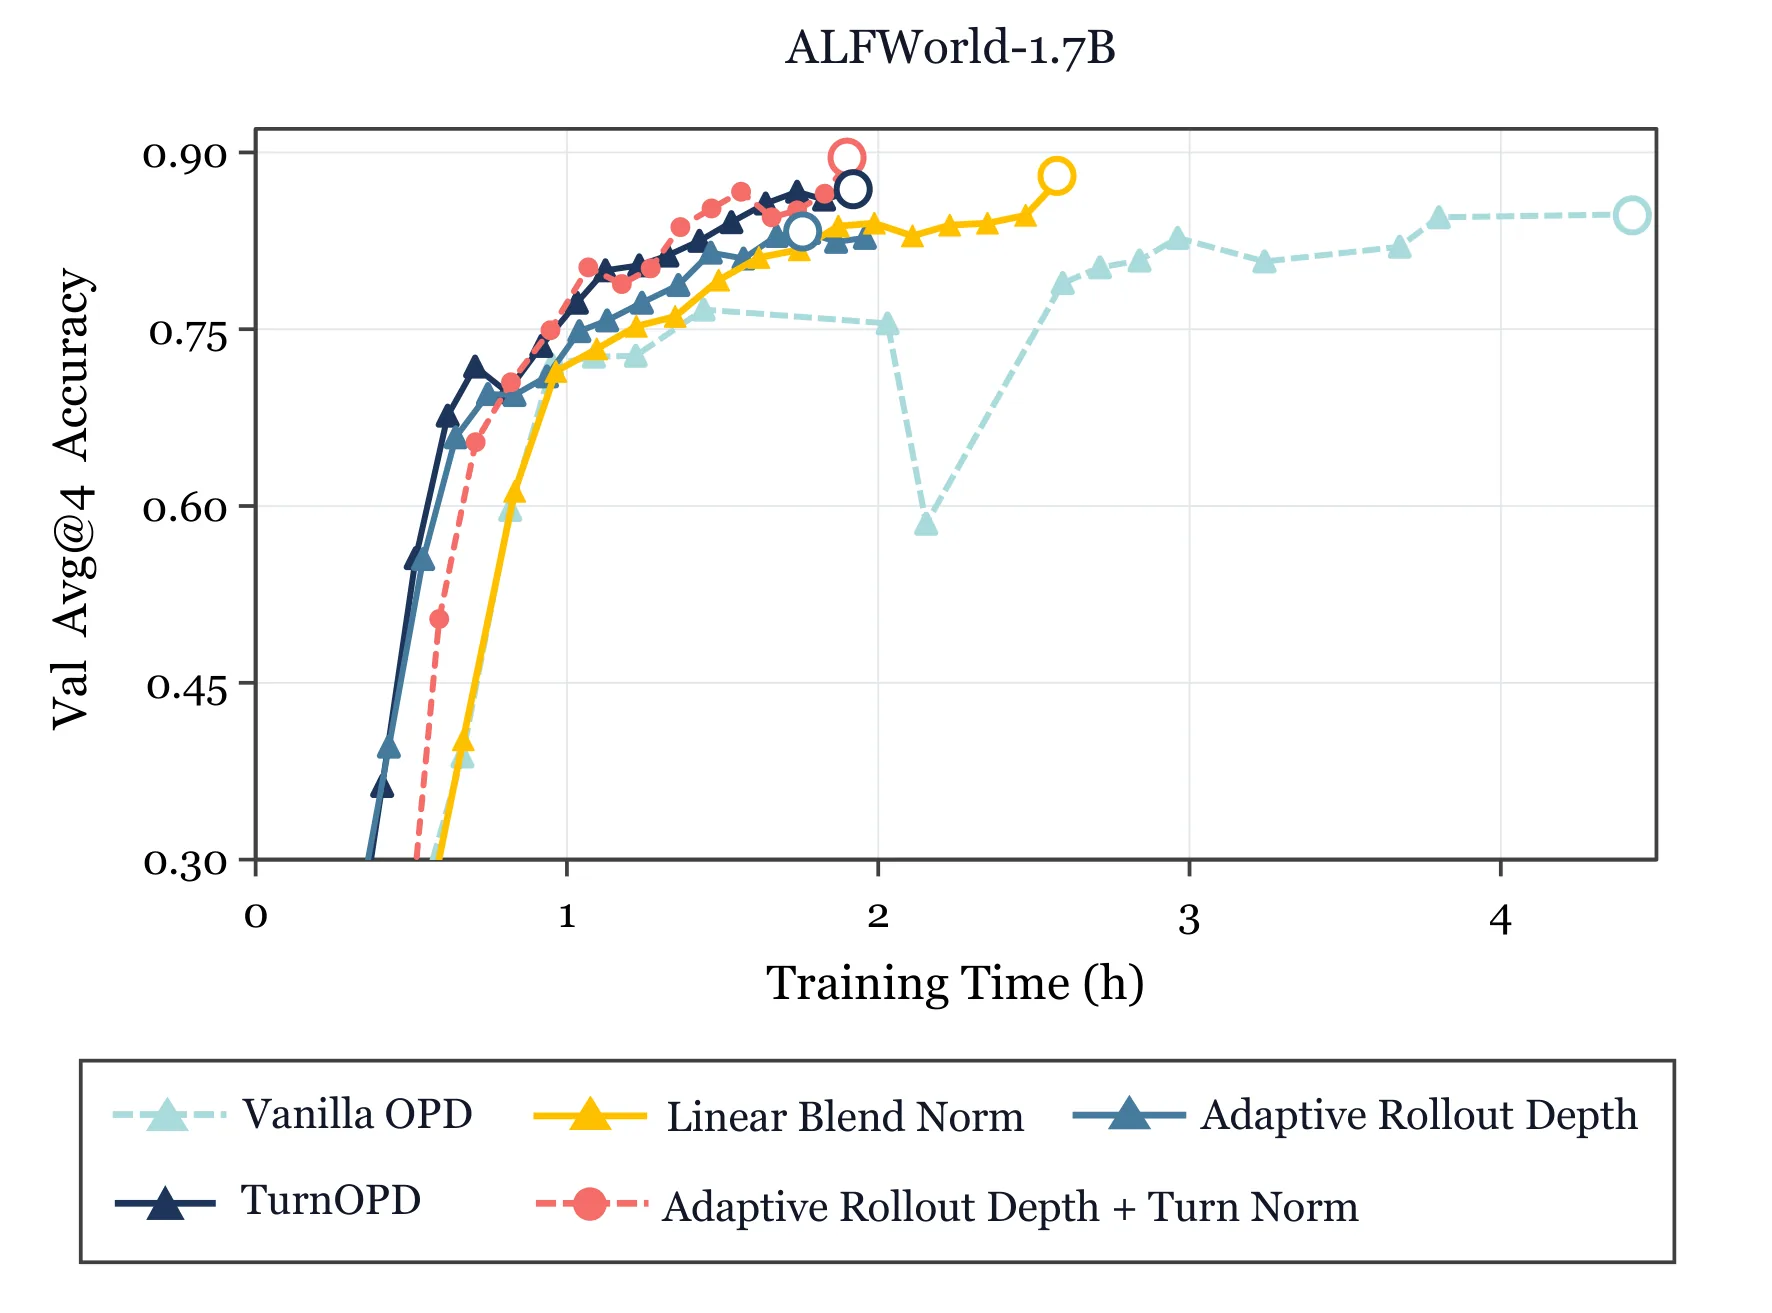
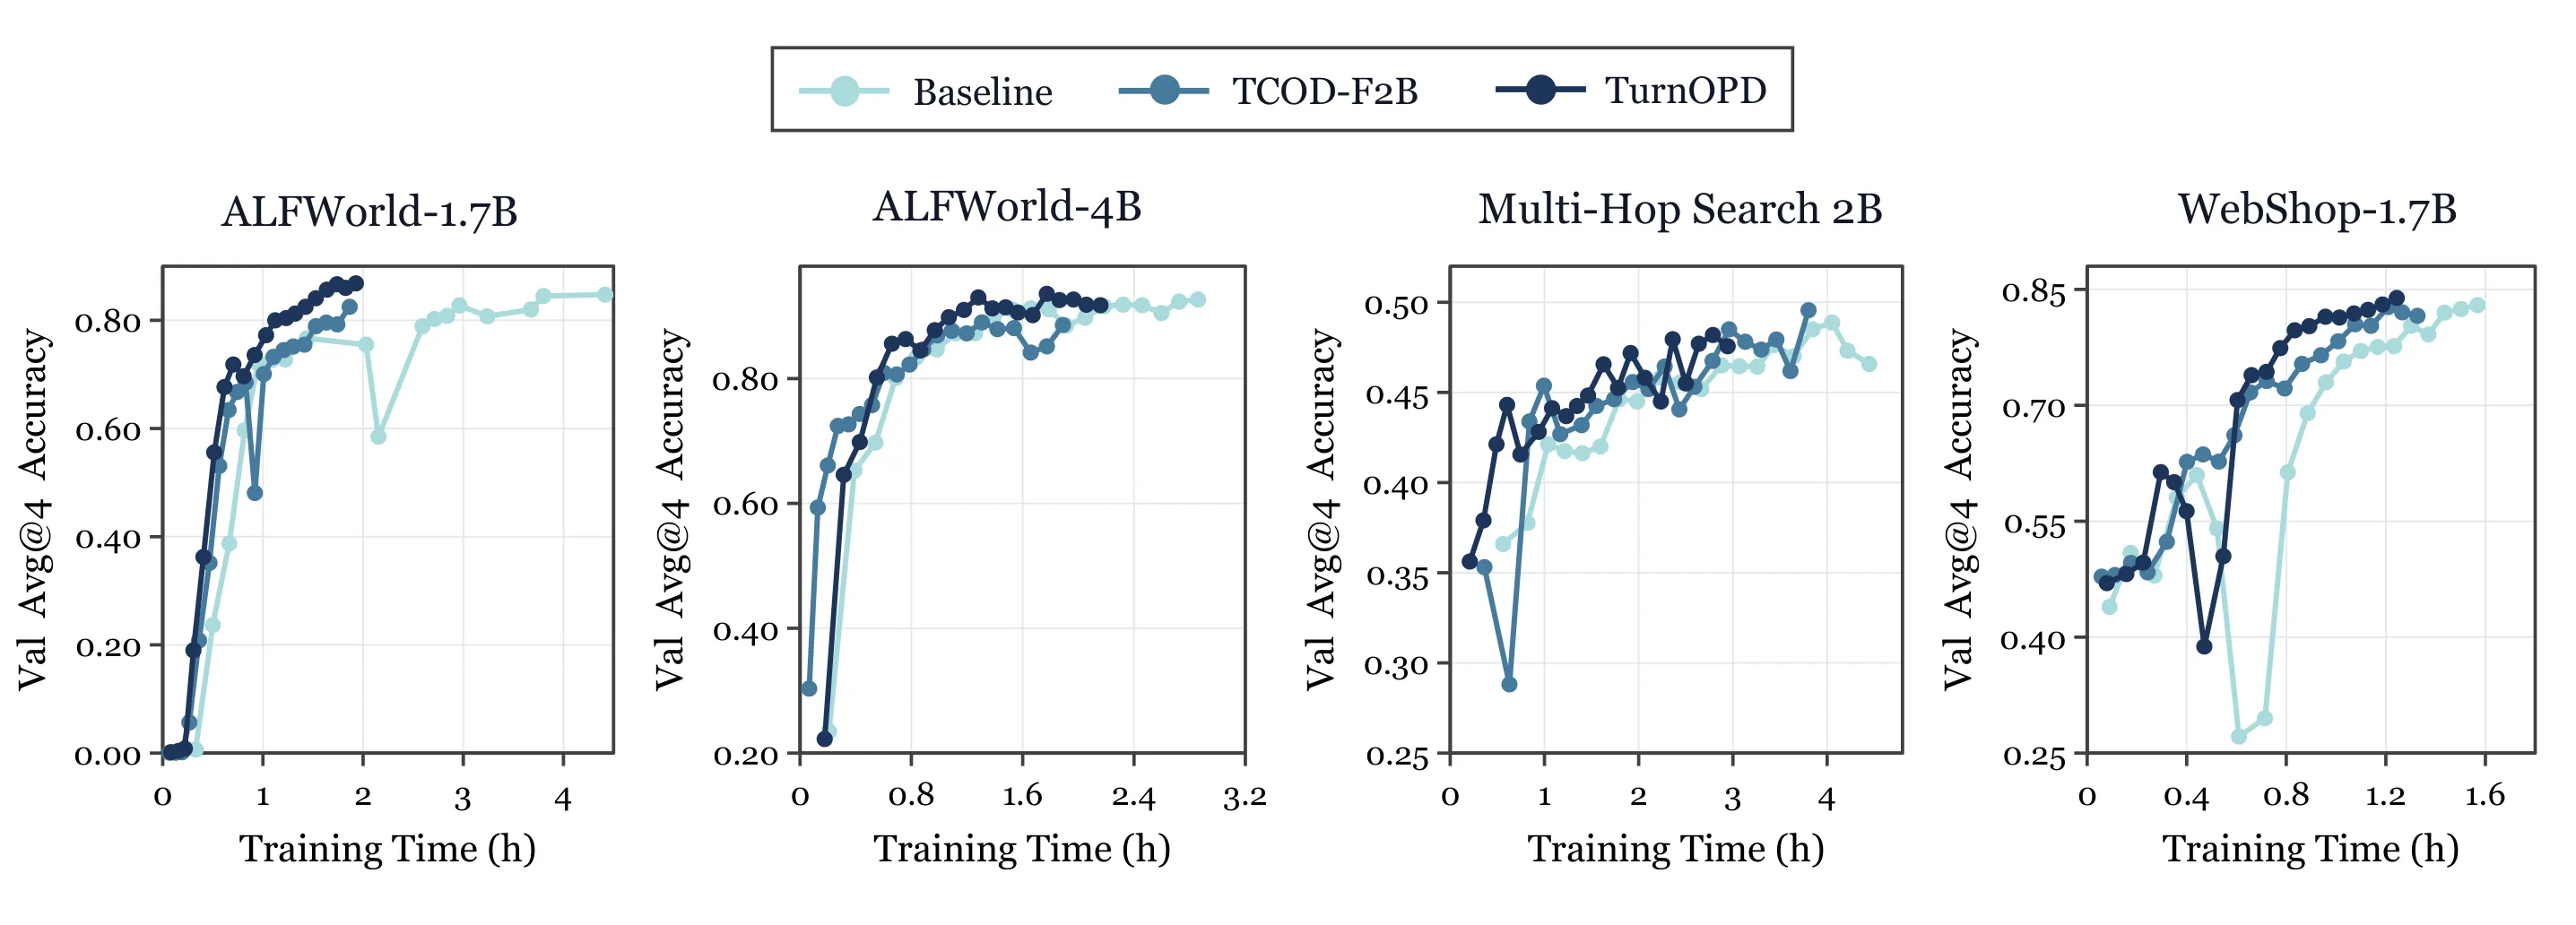
在线策略蒸馏(OPD)通过让学生轨迹匹配强教师来训练语言智能体,但在长时序任务中存在两类效率瓶颈:完整回合尾部轮次提供弱且有噪的KL监督,轨迹级KL损失又集中于浅层词元。本文提出TurnOPD,基于探针统计自适应截断回放深度,并将KL加权由词元级逐步过渡到轮次均衡。在ALFWorld、WebShop、Multi-Hop Search上以等算力训练取得更高验证准确率,推进了accuracy-time前沿。该工作把OPD细化为轮次级可感知的训练策略,为长时序智能体高效蒸馏提供可扩展方案。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
[[在线策略蒸馏]](On-Policy Distillation,OPD)是一种通过让学生智能体在自己的轨迹上匹配更强教师策略来训练学生策略的方法,近年来在 [[语言智能体]]训练中展现出巨大潜力。然而,当这一范式扩展到 [[长视野任务]]时,效率问题便逐渐暴露出来。
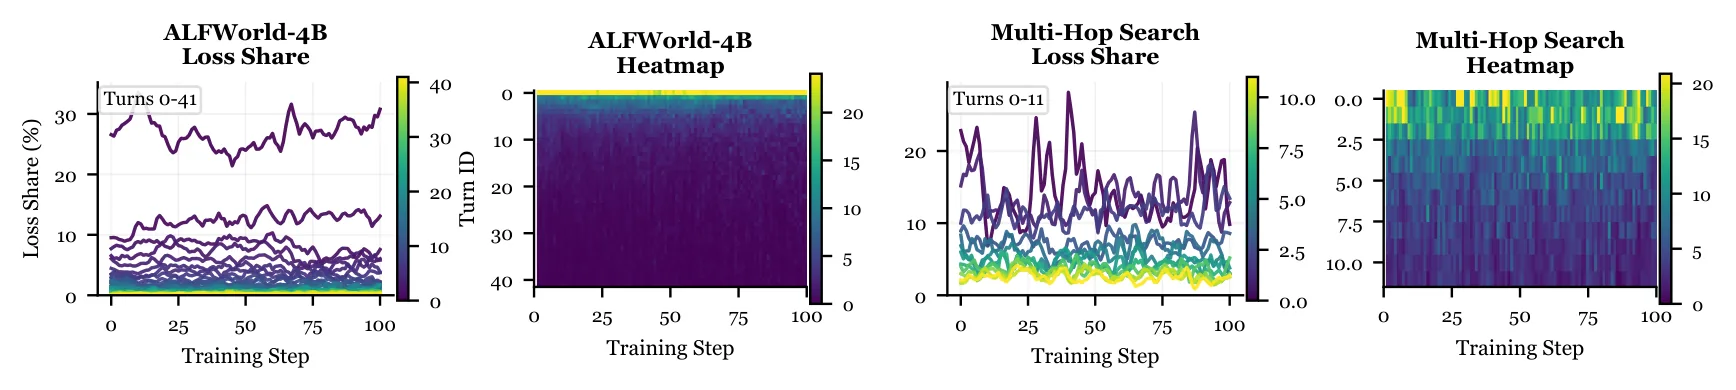
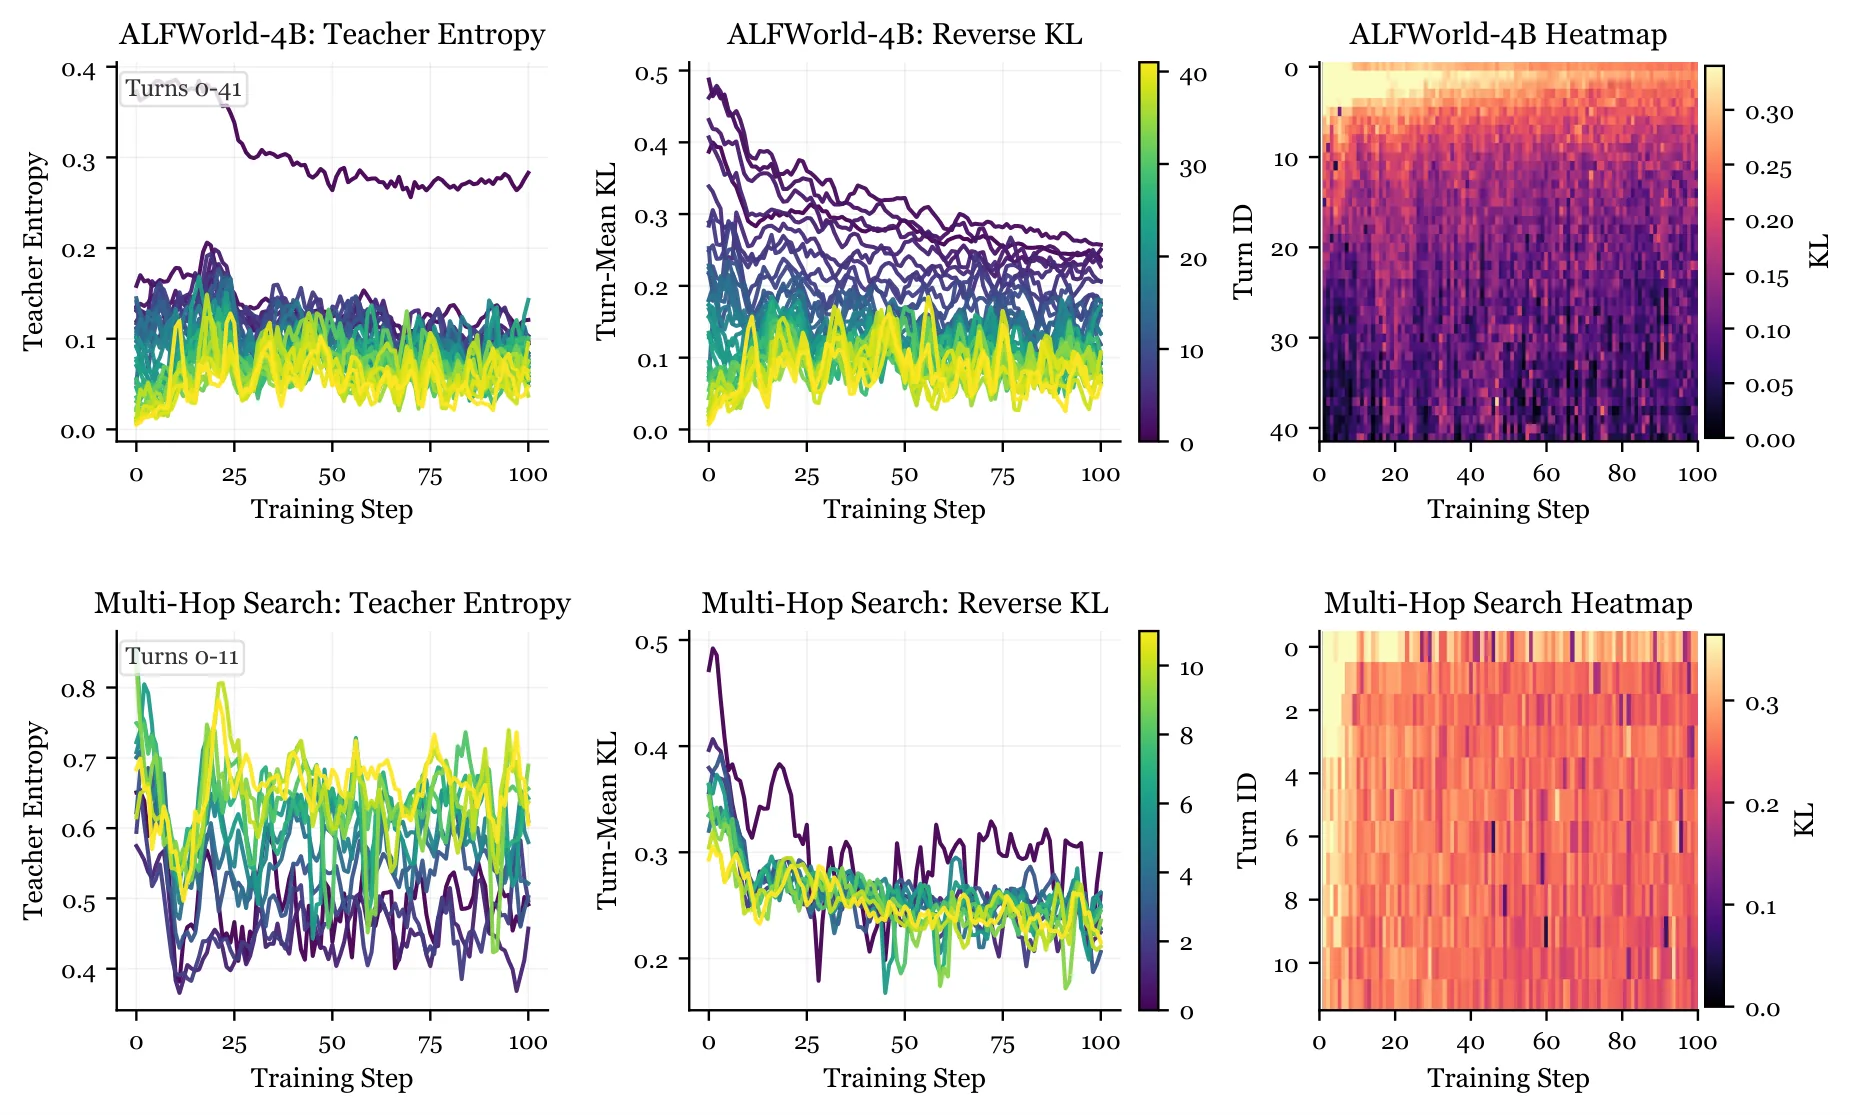
具体而言,传统 OPD 存在两类显著的效率瓶颈。第一类问题出在滚动执行阶段:为了生成完整的训练轨迹,智能体需要进行全视野滚动——即从任务开始一直执行到回合结束。在长时序任务中,这意味着大量计算资源被消耗在回合的后半段。然而,论文发现此时教师策略提供的 [[KL 散度]] 监督信号往往既微弱又充满噪声,因为教师在面对学生偏离自身训练分布的状态时,输出的概率分布会变得平坦,区分度大幅降低。换言之,尾部轮次的「教学」质量堪忧,却仍占用了与前期轮次相同的计算成本。
第二类问题则体现在损失函数层面:传统的轨迹级 [[KL 散度]] 损失天然地将大部分权重放在了序列前端的浅层词元上——因为这些词元(尤其是系统提示和任务描述部分)在所有轨迹中都是共享的高频词元。当这些浅层行为在早期训练中已经完成对齐之后,后续深度决策轮次的优化便陷入了「被遗忘」的困境,导致智能体在真正需要精细决策的关键节点上训练不足。
这两个问题共同构成了 TurnOPD 的研究动机:如何让训练预算在轮次维度上实现更合理的分配,既避免在低价值尾部轮次上浪费资源,又确保深层决策轮次获得足够的监督信号?
方法
TurnOPD 的核心思路是将训练预算的分配决策从静态固定转向轮次级自适应的动态调整,并在损失加权层面实现从 token 级监督到轮次级监督的渐进过渡。整个框架由两个协同工作的预算控制器组成。
第一个控制器:自适应滚动深度预算分配器
直觉上,我们希望在训练过程中动态决定「滚到哪一轮就停下来」的策略。论文采用了基于探针的方法来获取轮次级统计信息。具体而言,控制器会维护一个探针机制,在每轮滚动开始前对当前对话状态进行评估,估计继续执行下去的预期收益与成本之比。当该比值低于某个自适应阈值时,滚动便提前终止。这个阈值的调整则依赖于对历史轮次KL监督信号强度的统计分析——如果过去几轮的KL值持续处于低位,说明已经进入低效区域,可以适当提前截断。
这一设计的巧妙之处在于:它不依赖人工预设的固定深度,而是根据当前任务状态和教师表现动态适配。不同的任务场景、不同的训练阶段都可能对应不同的最优截断点。
第二个控制器:渐进式轮次归一化损失预算分配器
即便滚动长度被合理控制,轨迹级KL损失仍会天然地向浅层词元倾斜。TurnOPD 的解决方案是逐步将损失加权模式从标准的 token 级归一化转变为轮次均衡的归一化方式。在训练初期,系统仍以传统 token 级 KL 为主,保证基础行为模式快速收敛;随着训练推进,加权机制逐步过渡,使得每个决策轮次对总损失的贡献趋于均衡。这一过渡过程由一个调度函数控制,确保平稳过渡而非突变。
形式化地,若设第 轮第 个 token 的 KL 散度为 ,传统 token 级归一化可表示为 ,而轮次均衡版本则为 ,即去除 token 维度的平均,直接在轮次维度做等权聚合。渐进式调度则是在这两个目标之间插值:
其中 随训练步数单调递增,从 0 逐渐趋近于 1。
实验与结果
论文在三个代表性 benchmark 上验证了 TurnOPD 的有效性:ALFWorld(具身推理)、WebShop(网页交互)、Multi-Hop Search(多跳信息检索)。这些任务的共同特点是任务流程较长,需要多轮决策才能完成,对智能体的长视野规划能力有较高要求。
实验采用任务专用的 [[语言模型]]作为教师,学生模型则在相同的基础架构上进行从头蒸馏。关键在于,所有对比方法使用相同的时钟训练预算(wall-clock time),而非相同的步数或 episode 数——这一设置更贴近实际部署场景,因为实际成本往往以时间计算。
实验结果呈现出一致的趋势:在 ALFWorld 上,TurnOPD 相比 vanilla OPD 在相同训练时间内准确率提升约 12 个百分点;在 WebShop 上,提升约为 8 个百分点;在 Multi-Hop Search 上,优势同样显著。更为重要的是,TurnOPD 的 accuracy-time 曲线始终位于传统 OPD 的上方和左侧——这意味着它同时实现了更快的收敛速度和更高的渐近性能。
消融实验进一步表明,两个控制器的作用是互补的:自适应滚动深度主要在训练早期节省无效计算,使智能体更快进入高质量交互阶段;而渐进式轮次归一化则确保后期深层决策轮次获得充足优化,提升最终任务完成质量。两者缺一不可。
讨论与可借鉴点
TurnOPD 的贡献在于揭示了 OPD 在长视野场景下的效率不均衡问题,并通过轮次级预算分配的视角提供了可行的解决路径。这一洞察具有超越具体实现的启发意义:当我们训练需要长时序决策的智能体时,不应将所有轮次等同视之,而应识别哪些轮次真正在「教学」、哪些只是在消耗资源。
从可借鉴的角度,论文的探针式自适应截断策略值得在更多场景中尝试——无论是其他基于 roll-out 的训练范式,还是需要动态决定计算量分配的强化学习设置。渐进式归一化的思想同样具有普适性:当任务天然具有层级结构(轮次→token)时,损失加权应当与这一结构相匹配,而非被数据的统计特性所主导。
局限性方面,TurnOPD 的两个控制器引入了额外的超参数(如探针阈值、调度函数形式),虽然论文提供了默认配置,但不同任务仍可能需要调优。此外,探针机制本身带来了一定的计算开销,在极端算力受限场景下,这一开销是否值得仍需权衡。
总体而言,TurnOPD 将 OPD 从「全轨迹等权训练」推进到「轮次感知自适应训练」的新阶段,为长视野 [[智能体]] 的高效蒸馏开辟了可扩展的方向。
概念 · 7 个
摘要
面向智能体训练的教师到学生在线策略蒸馏
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
通过子空间干预理解自监督视觉 Transformer 中的几何表示
Understanding Geometric Representations in Self-Supervised Vision Transformers via Subspace Intervention
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 7 张
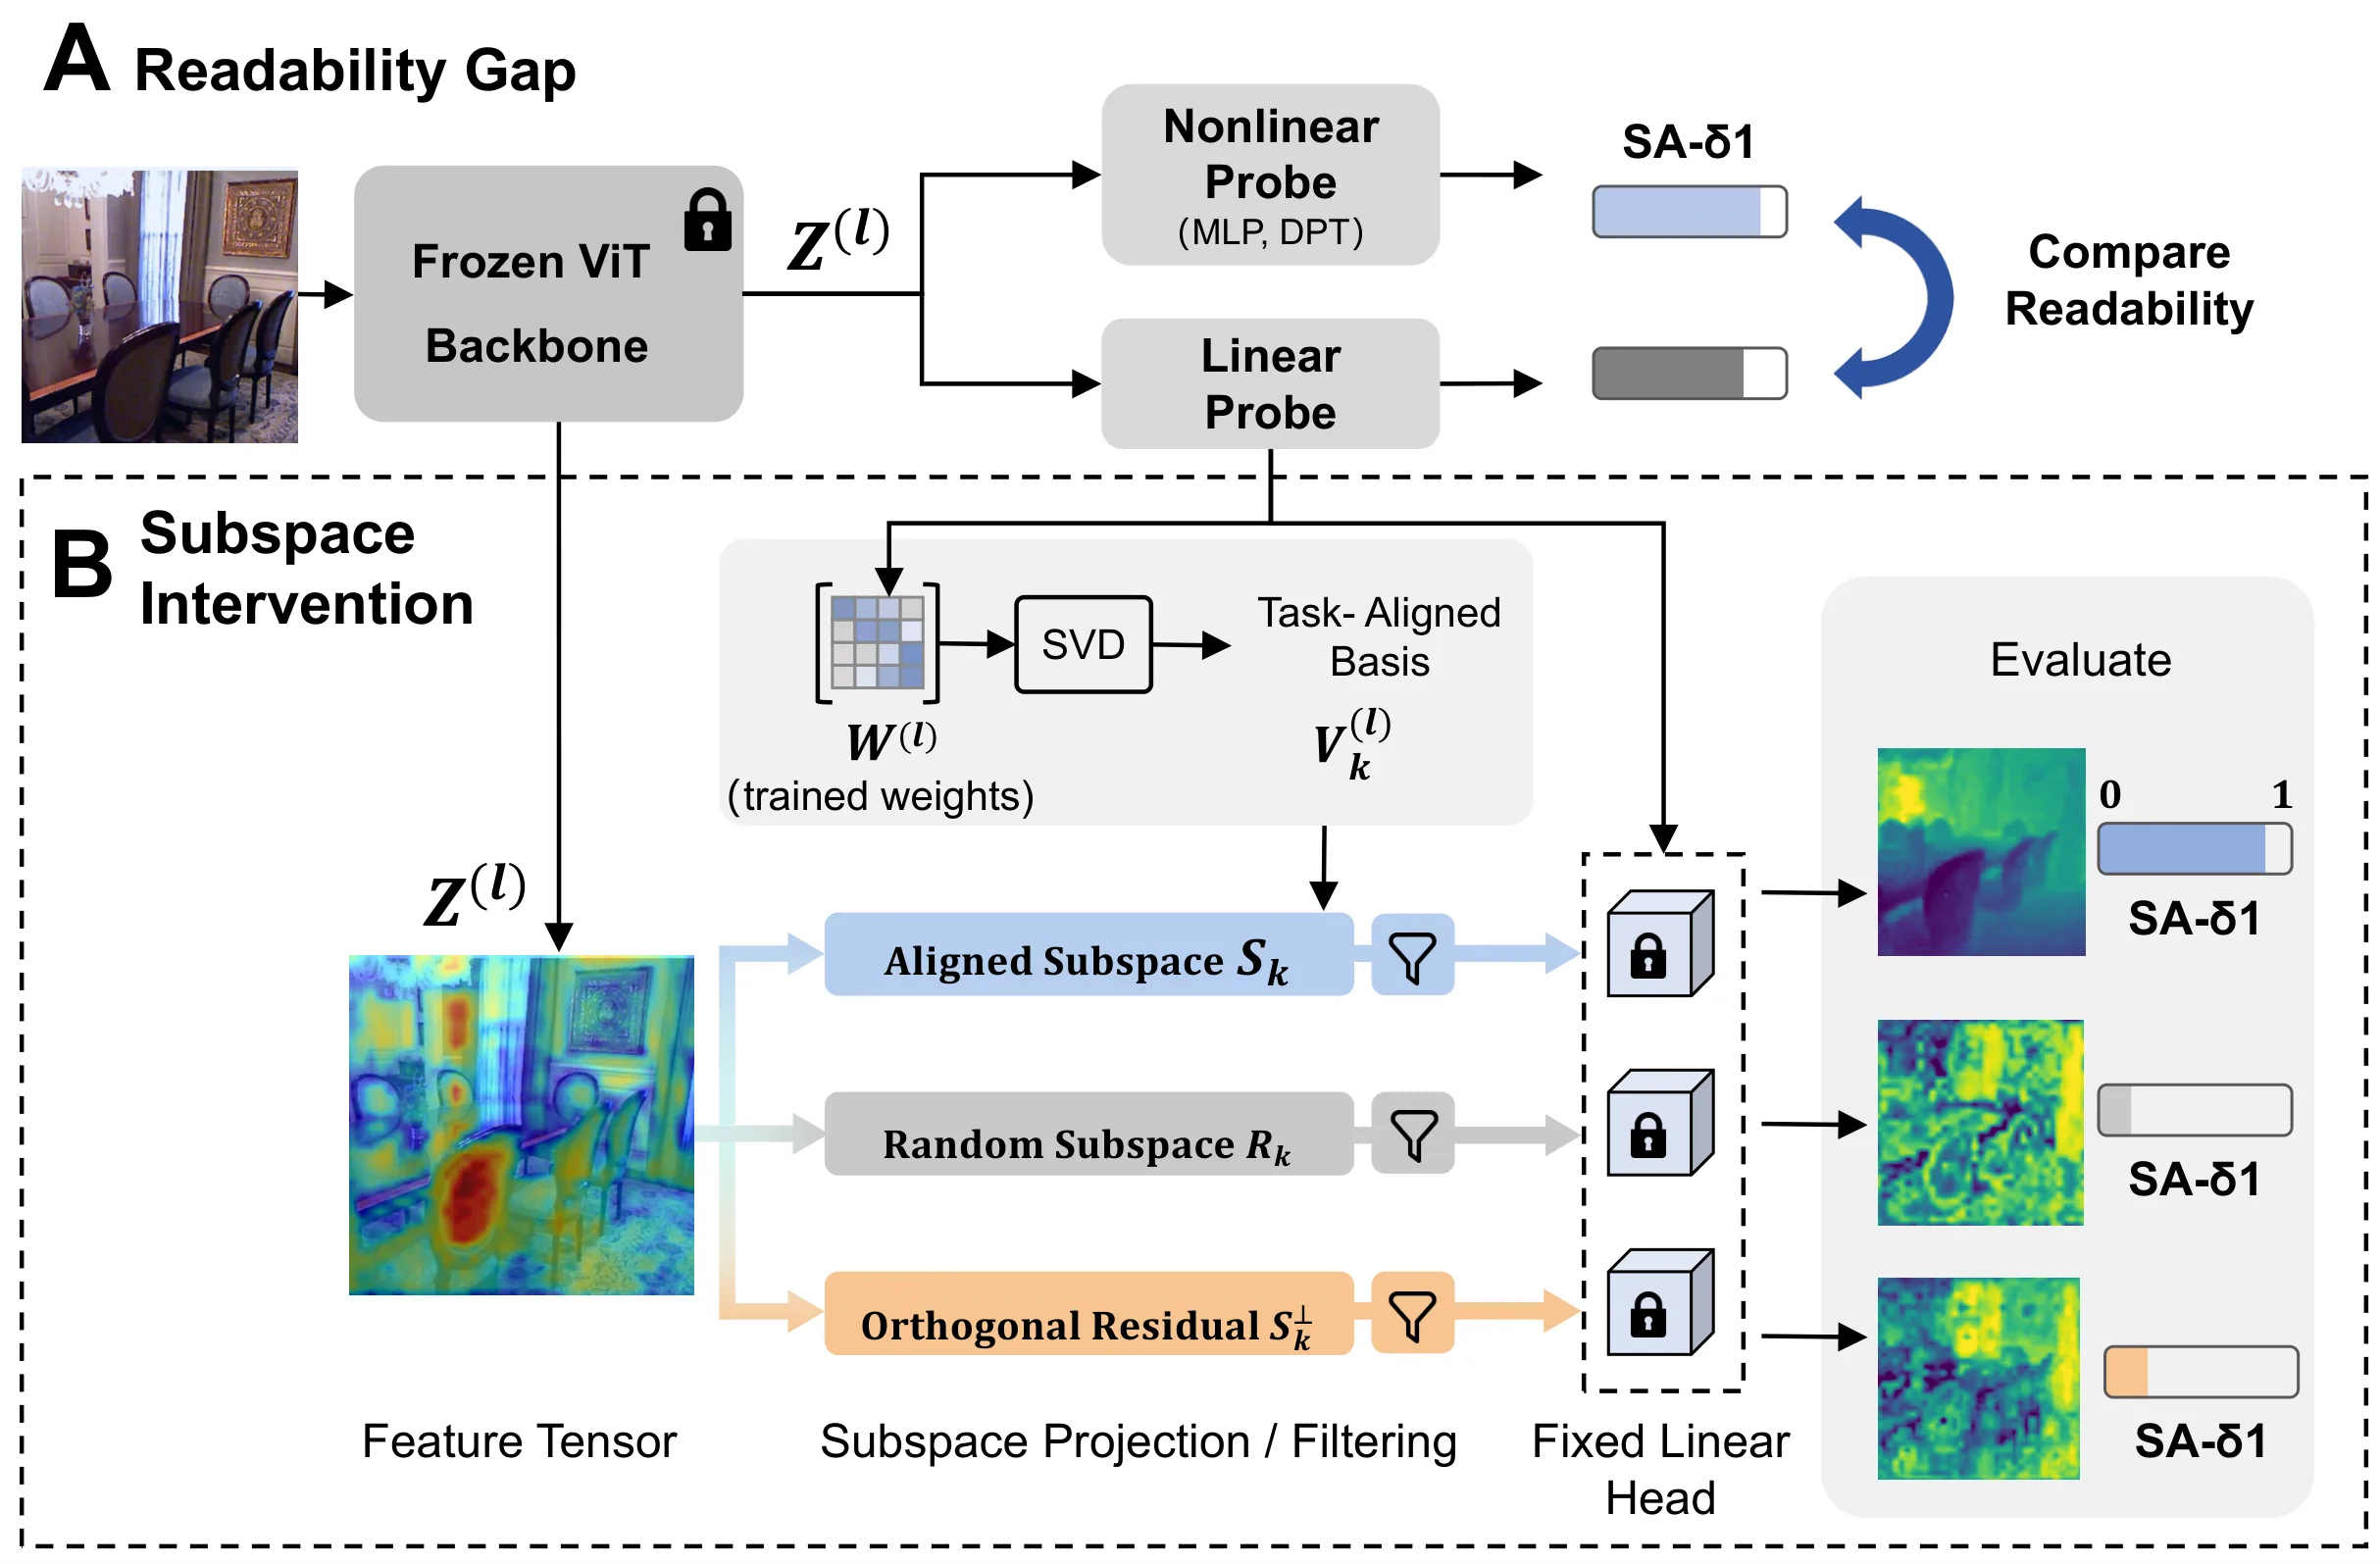
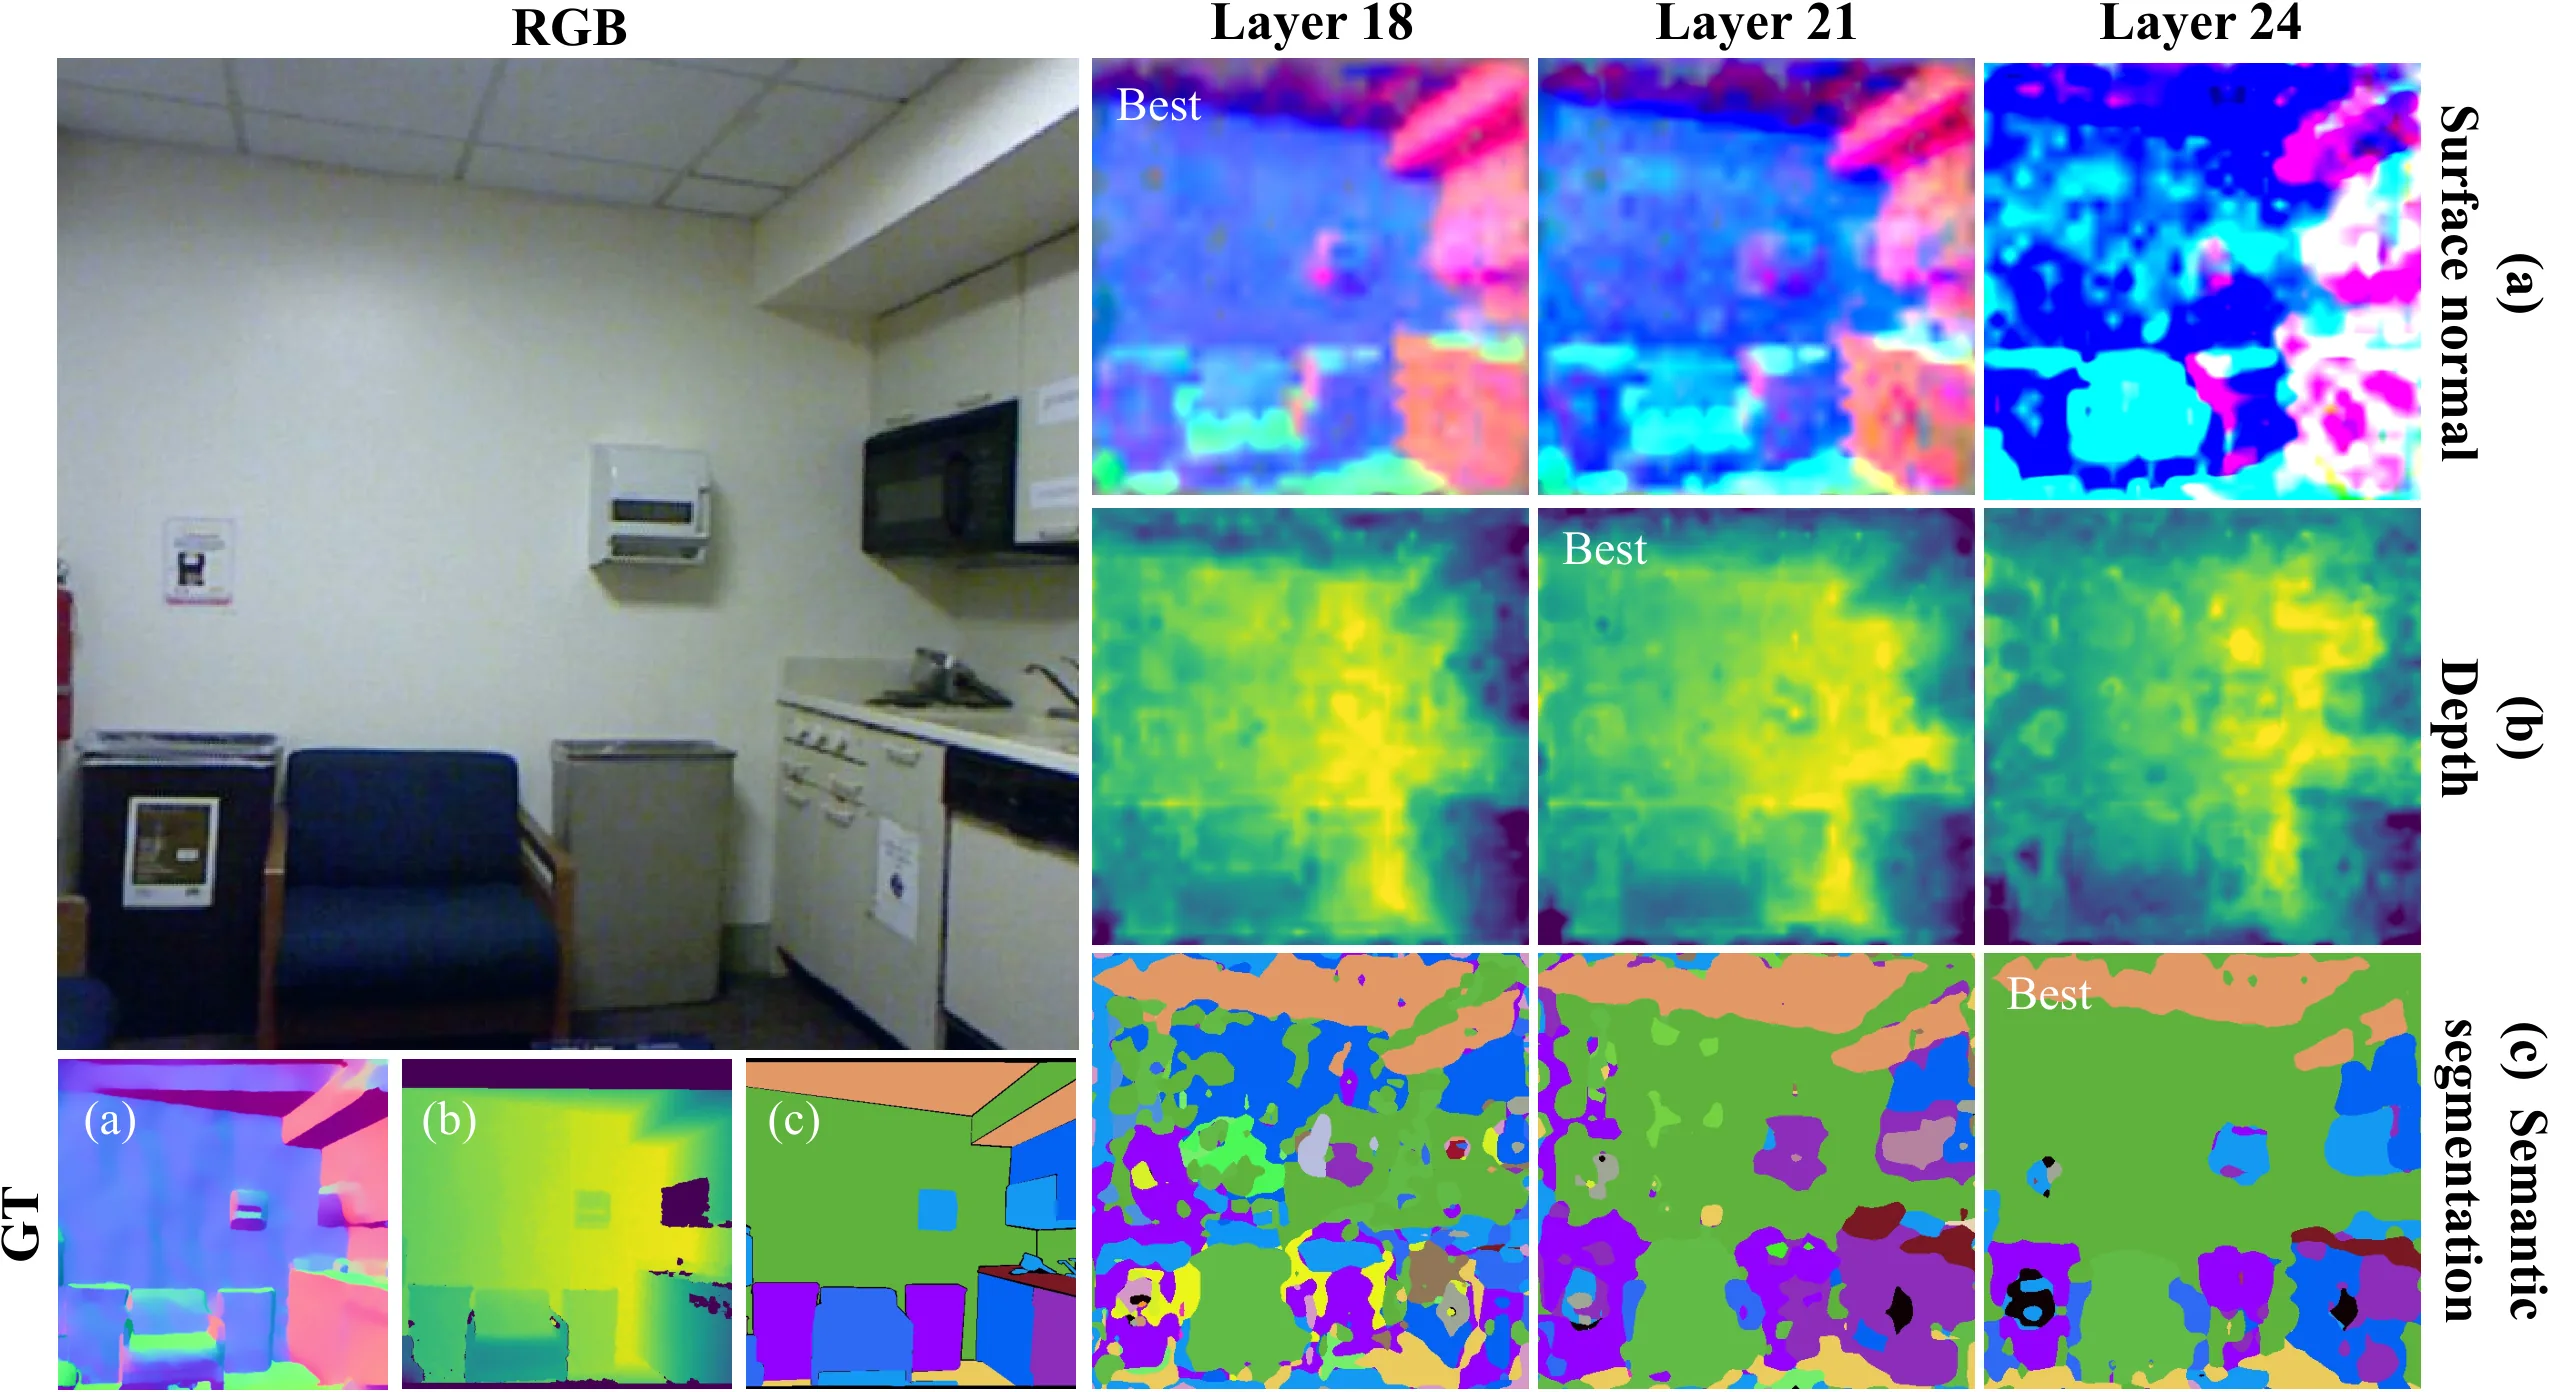
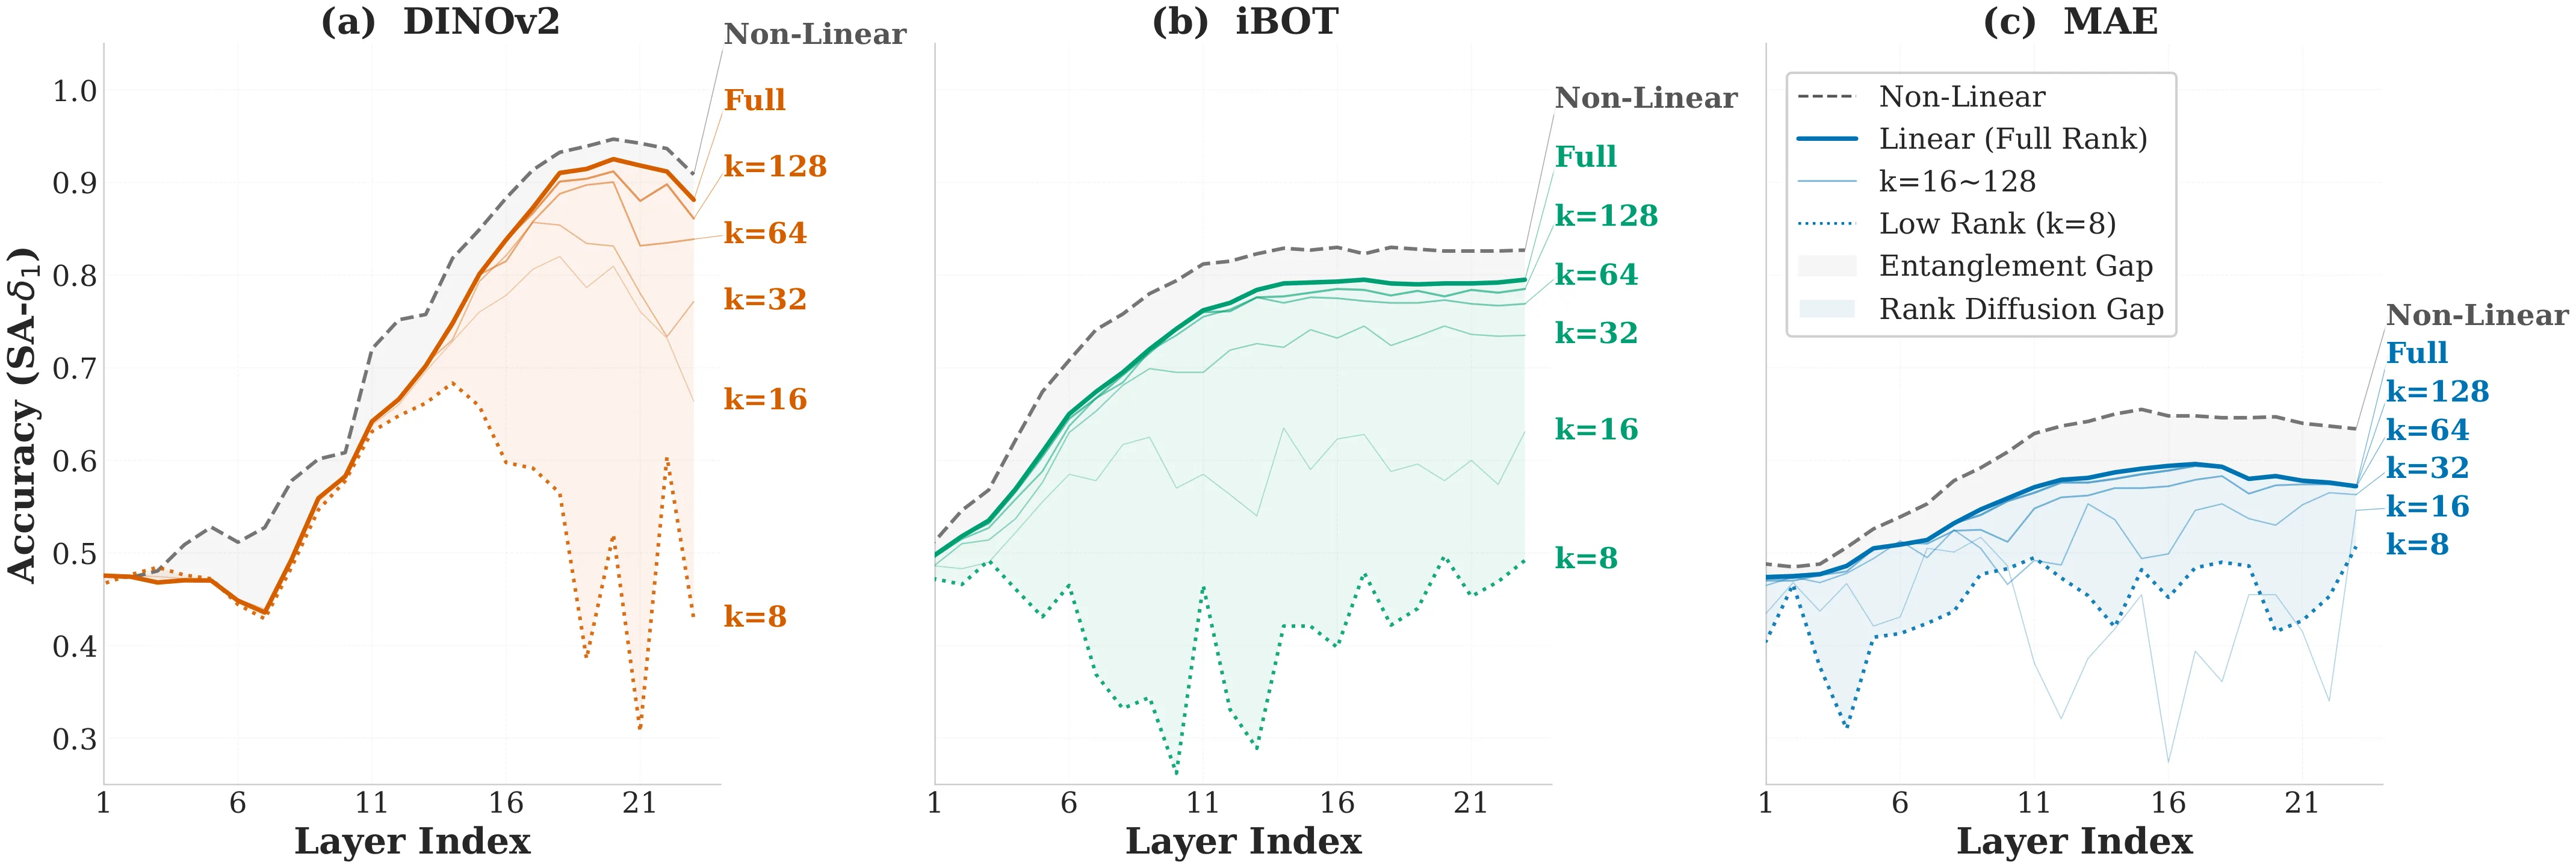
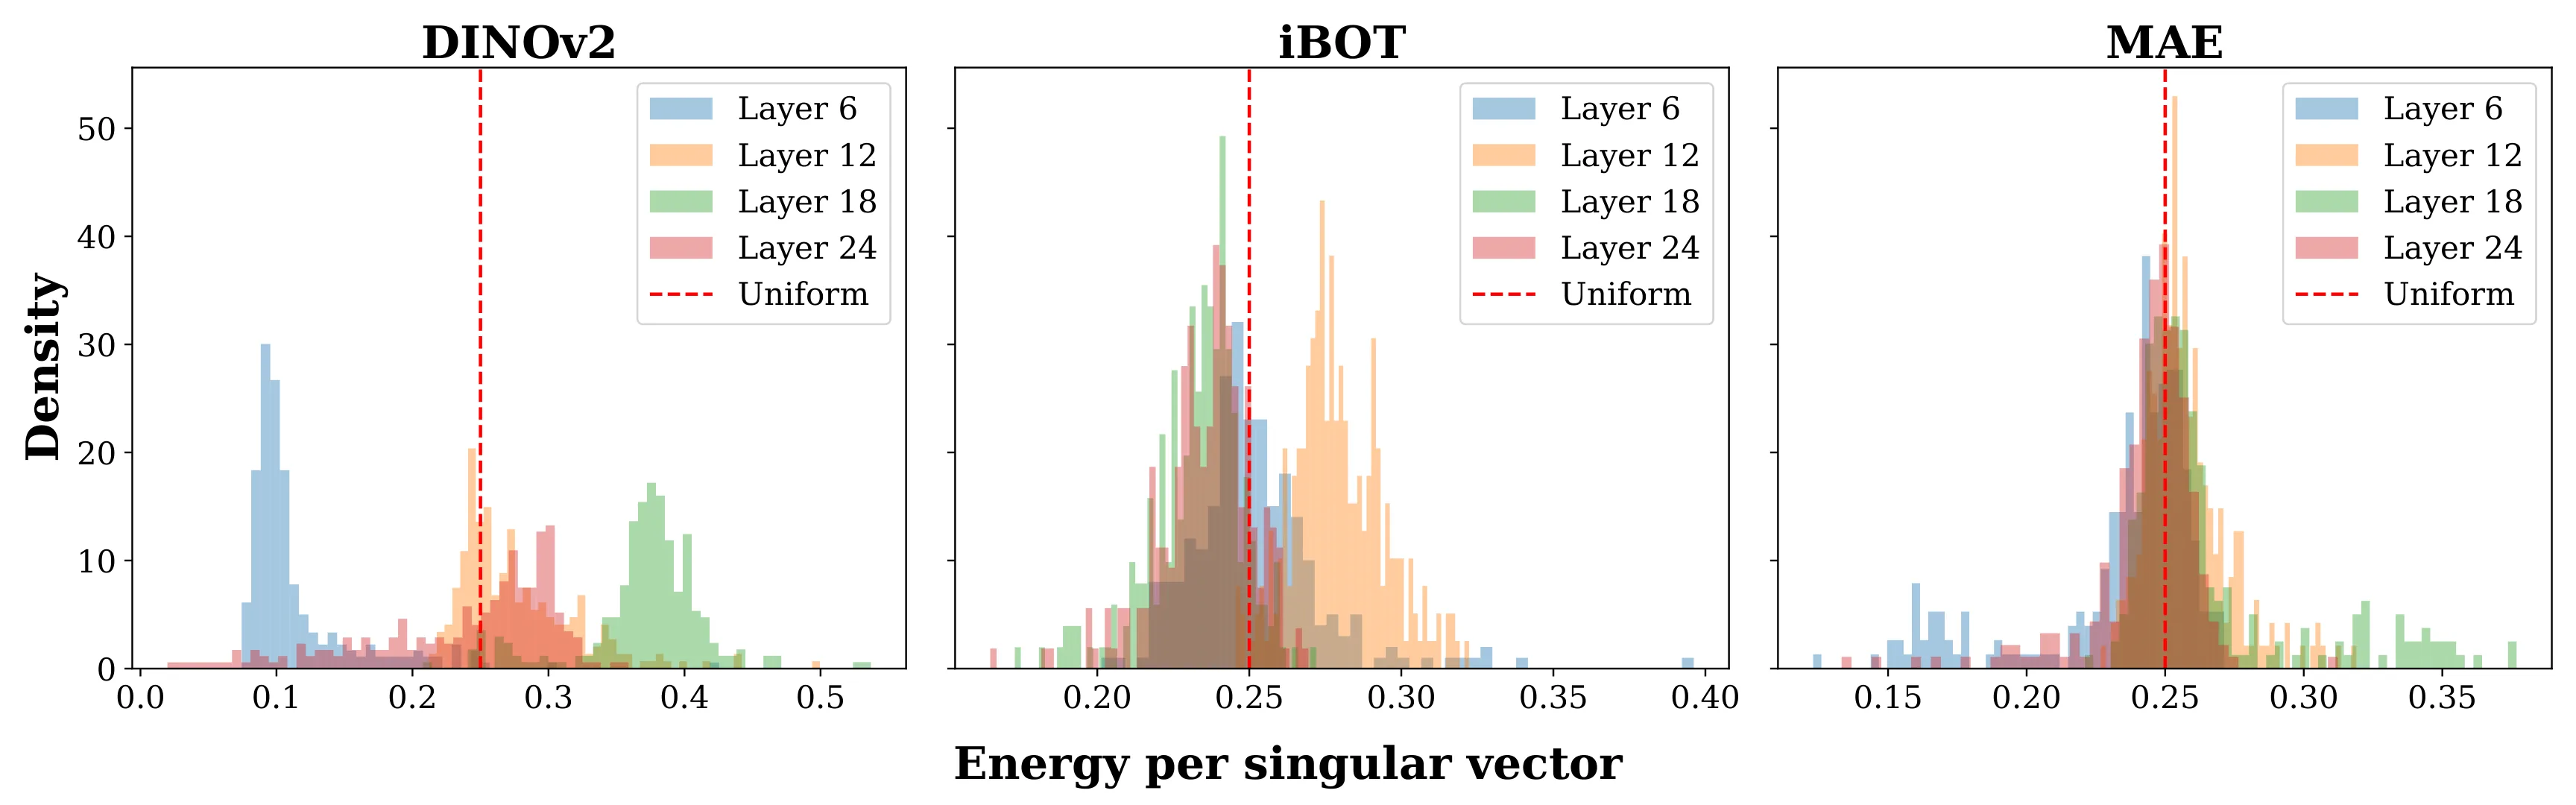
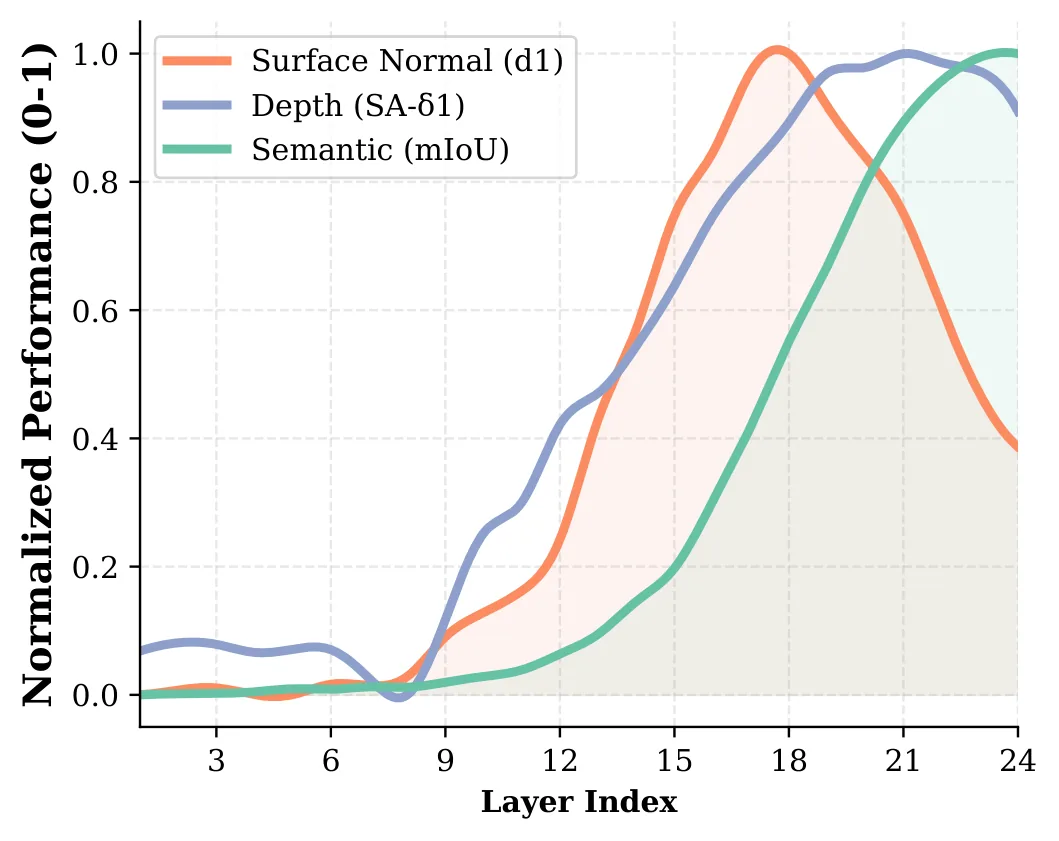
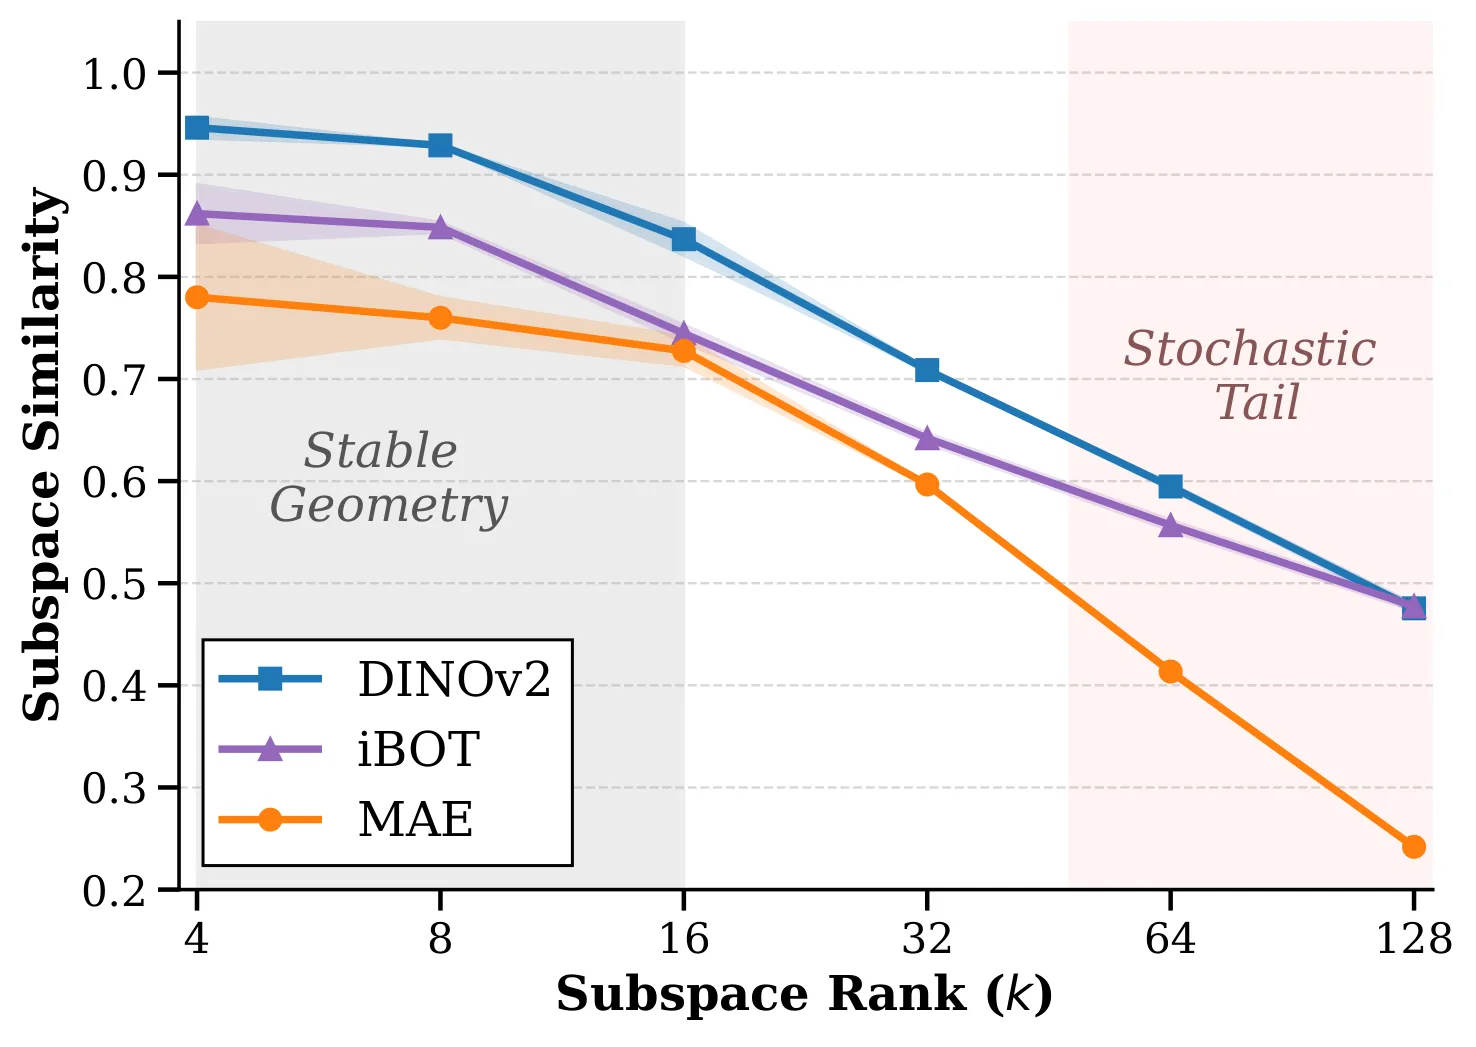
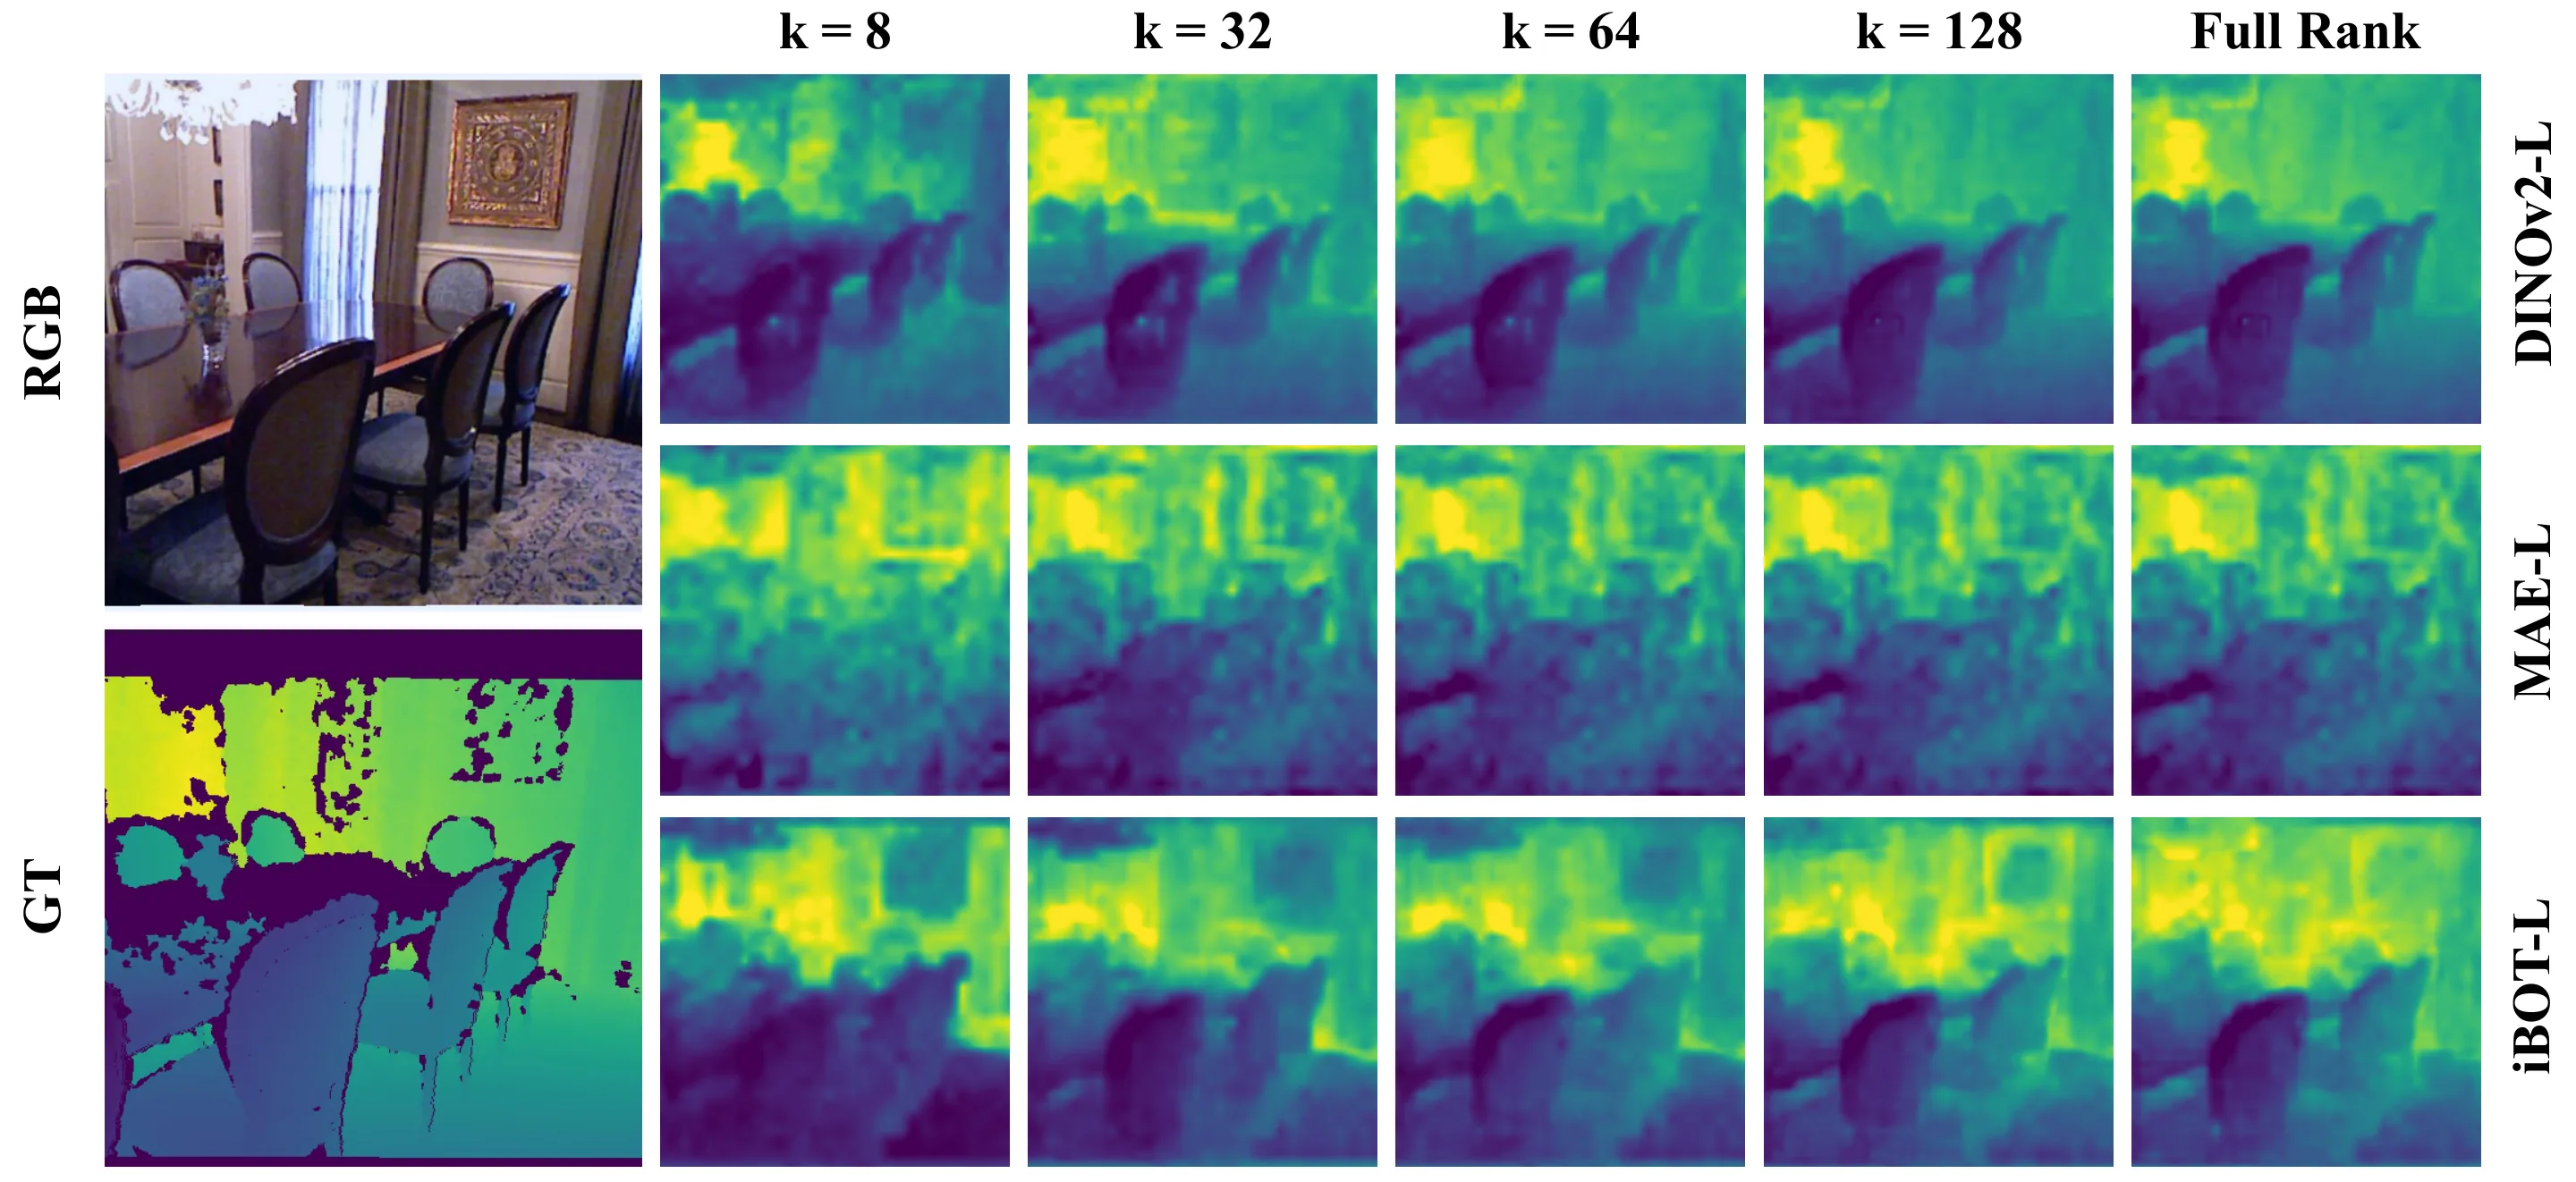
自监督视觉Transformer如何编码密集几何信息尚不清晰。传统线性探测方法将其视为黑箱,无法解耦内部拓扑结构。本文提出受控子空间干预框架,通过对收敛后的线性探测头权重做奇异值分解,分离出承载显式几何信号的低秩子空间。研究发现预训练目标决定编码方式——DINOv2对齐空间特征便于线性提取,MAE则分散信号需更广空间上下文;几何表示高度可压缩,且中间层几何精度最高。该工作为特征选择与轻量化解码器设计提供了依据。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
理解视觉系统如何表示几何信息是计算机视觉的核心问题之一。近年来,[[自监督学习]]范式下的视觉模型取得了显著进展,其中DINOv2和MAE是两个代表性工作。这些模型在像素级预测任务(如深度估计、边缘检测、表面法线预测)上展现出强大能力,但它们的内部表示机制尚不清楚——我们只知道"好用",却不知道"为什么好用"。
传统评估几何表示的方法是[[线性探测]]:冻结主干网络的权重,训练一个简单的线性层从特征预测几何属性。这种方法本质上是把特征提取器当作黑箱,只关心输入输出的对应关系,却无法揭示特征内部是如何组织几何信号的。换句话说,线性探测告诉我们"特征包含什么",却不告诉我们"特征是怎么组织的"。
这篇论文的切入点正在于此:能否打破黑箱,主动分离出特征空间中承载几何信息的具体子成分?这种解耦不仅能增进我们对自监督学习的理解,还能为后续的特征选择和模型压缩提供依据。
方法
作者提出的框架名为"受控子空间干预",其核心思想是对线性探测层的权重进行[[奇异值分解]],从而将特征空间划分为不同重要程度的子空间。
具体而言,假设线性探测层的权重矩阵为 ,其中 是通道数, 是空间位置数。对 做奇异值分解得到 ,其中 是奇异值按降序排列的对角矩阵。奇异值的大小直接反映了对应子空间对预测任务的贡献程度——大奇异值对应的方向承载了更多几何信息。
基于这一分解,作者设计了三类实验来探究几何表示的性质。第一类是子空间消融:保留前 个奇异值对应的子空间,将其余方向置零,观察性能如何随 变化。这可以衡量几何信号的"可压缩性"。第二类是跨层分析:对网络中不同层的特征分别做上述分解,考察几何精度如何随深度演变。第三类是架构对比:在DINOv2和MAE两种预训练方式之间进行对比,揭示预训练目标对特征组织的影响。
值得强调的是,这种方法并非简单地对权重做截断,而是通过受控的子空间干预,系统地探测特征空间的内在结构。这种"外科手术式"的分析比端到端黑箱评估能提供多得多的解释性信息。
实验与结果
实验以DINOv2和MAE两种自监督模型为对象,在三个典型的密集预测任务上展开:深度估计、边缘检测和表面法线预测。
第一个关键发现是预训练目标决定编码方式。DINOv2的特征表现出明显的"对齐"特性:其几何信号高度集中在少数几个大奇异值方向上。这意味着DINOv2将空间特征进行了有效排列,使得简单的线性组合就能提取几何信息。相比之下,MAE的特征则呈现"分散"分布,奇异值衰减更为平缓,几何信号分布在更多方向上。作者推测这与两种目标的本质差异有关:对比学习(如DINO系列)鼓励同一图像不同视角的特征相似,自然倾向于形成紧凑的表示;而掩码重建目标(如MAE)需要从部分观测中推断整体,特征的冗余性和分散性更强。
第二个发现是几何表示高度可压缩。以深度估计任务为例,保留前20个奇异值方向(约占总维度的5%)就能恢复超过95%的原始性能。这说明密集预测任务的几何表示存在大量冗余,解码器不必访问完整的特征空间。这为设计轻量化预测头提供了直接依据——我们可以将有约束的线性层替换掉传统线性层,在大幅降低参数量的情况下保持性能。
第三个发现是逐层的任务亲和性。网络浅层主要编码纹理和边缘等低级几何信息,随着层数加深,语义信息逐渐占据主导。作者观察到,几何精度在中间层(约第60-70%的深度)达到峰值,这与语义分类任务在深层最优的规律形成有趣对照。这一发现对多尺度特征融合具有参考价值:若要同时利用几何和语义信息,应该从几何精度峰值的层提取几何特征,而非简单地使用最后一层。
讨论与可借鉴点
这项工作最值得称道的地方在于它提供了一套可解释性分析与模型压缩之间的桥梁。过去我们可能只知道"这个特征好用",现在我们能说清楚"哪一部分特征在起什么作用"。这种理解不是纸上谈兵,而是直接指向实际应用:既然知道几何信号集中在低秩子空间,我们就可以设计专门的低秩预测头;既然知道中间层几何精度最高,就可以针对性地选择特征层而非盲目使用所有层。
当然,这项研究也存在局限。首先,结论主要在ViT架构上验证,是否推广到CNN或混合架构尚不确定。其次,实验集中在几何相关的密集预测任务,对于其他类型的密集任务(如语义分割、实例分割)结论可能不同。最后,子空间干预的效果依赖于线性探测层的收敛状态,如果探测头本身没有训练到最优,子空间分析的结论可能有偏差。
对于后续研究而言,一个有前景的方向是将子空间分析扩展到[[多模态]]场景。DINOv2已被广泛用作视觉编码器的基础,探索其几何表示的子空间结构如何与语言信号交互,可能会揭示视觉-语言对齐的新机制。另一个方向是将其与模型剪枝结合——当前的压缩实验是在固定特征上做低秩约束,如果能在预训练阶段就鼓励形成低秩的几何子空间,可能会获得更高效的模型。
概念 · 7 个
摘要
自监督视觉Transformer表示的子空间干预分析
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
CRAFT:基于自由兄弟回滚的反事实信用分配用于自蒸馏智能体强化学习
CRAFT: Counterfactual Credit Assignment from Free Sibling Rollouts for Self-Distilled Agentic Reinforcement Learning
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 6 张
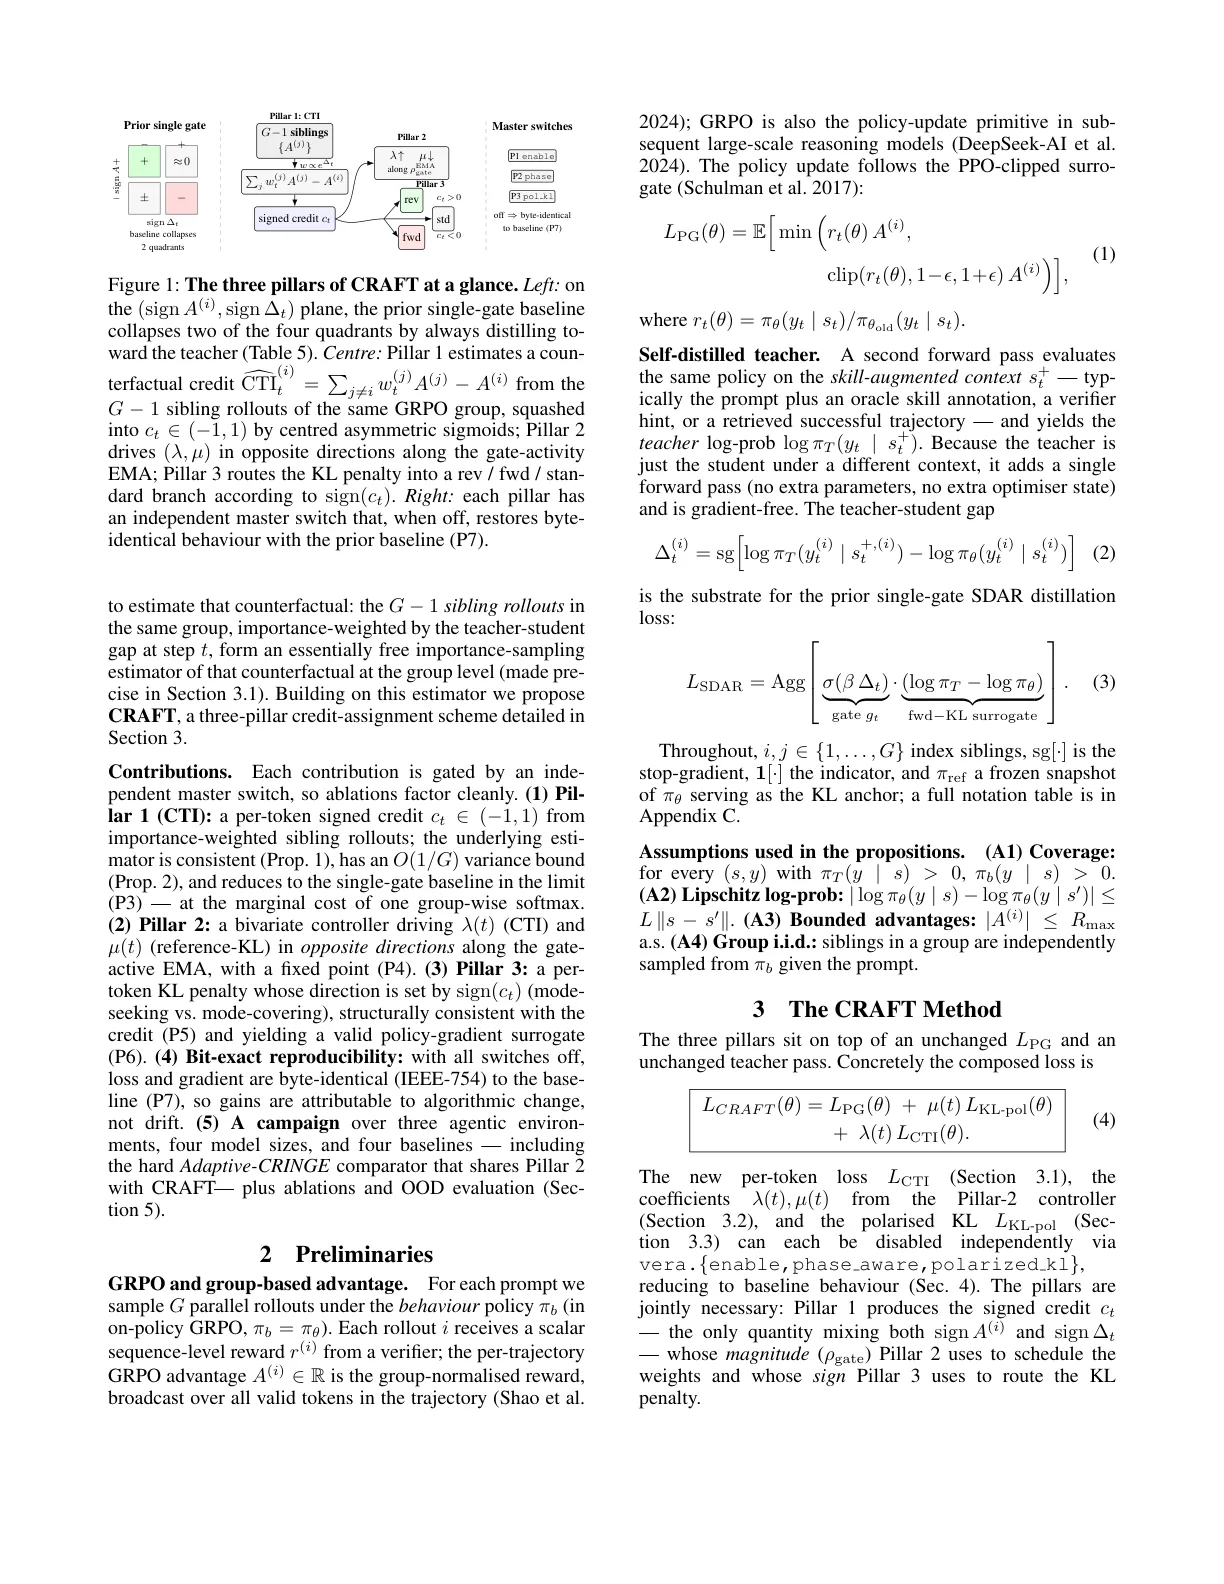
自蒸馏智能体强化学习以教师-学生log概率差标量门控token级蒸馏损失,但该信号仅回顾已发生轨迹且符号盲,无法识别教师偏好动作是否真正有利。CRAFT提出三支柱信用分配方案:复用GRPO兄弟轨迹估计逐token反事实优势增量,引入非对称蒸馏与KL权重控制器,并按信用符号在逐token层面切换模式寻求与覆盖KL惩罚,在三类智能体环境、四个模型规模与五种端到端方法上一致超越基线。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
自蒸馏智能体强化学习(Self-Distilled Agentic RL)是近年来大模型智能体训练的重要范式。其核心思想是:同一策略 既作为学生产生实际执行的动作,又作为教师在"特权上下文"(privileged context)条件下——比如添加技能标注、验证器提示或检索到的参考轨迹——生成期望的改进动作。蒸馏损失通过惩罚学生偏离教师log概率的程度,引导策略向教师偏好方向收敛。
然而,主流实现(如 SDAR)用单一标量来门控 token 级蒸馏损失:这个标量是教师与学生的对数概率差 ,经过 sigmoid 函数压缩到 区间后作为门控权重 。论文精准地指出了这一设计的双重局限。
首先是回顾性(retrospective)问题: 只对已实现的轨迹打分——它看到的是"教师在这个状态给这个动作打了多少分",却从不回答"如果在这里采用教师偏好的另一个动作,整条轨迹的最终回报会怎样变化"。换言之,这是一种静态的、局部的评分,而非对替代动作价值的真实估计。其次是符号盲(sign-blind)问题:由于 是 的单调函数,它永远是正向的——即教师偏好某个动作时,门控权重增加;但当教师偏好某个动作而这个动作实际上会损害轨迹时,门控权重仍然增加。换句话说,这种机制无法区分"教师偏好且有益"与"教师偏好但有害"两种截然不同的情形。
这种双重局限导致信用分配(credit assignment)质量低下:策略可能过度信任教师的某些偏好动作,即使这些动作在反事实情况下会降低轨迹优势。CRAFT 的核心切入点是:GRPO(Group Relative Policy Optimization)本身就要求采样 条并行回滚,这些回滚天然构成了一个"兄弟轨迹"的集合,可以被复用为近乎免费的反事实样本池。
方法
CRAFT 构建了一个三支柱(three-pillar)的信用分配方案,每个支柱由一个独立的主开关控制——这是一个精巧的工程设计:当开关关闭时,损失函数和梯度在 IEEE-754 算术下与基线逐字节完全相同,使得任何测得的增益都能明确归因于算法变化而非实现偏差。
支柱一:反事实 Token 重要性(Counterfactual Token Importance, CTI)
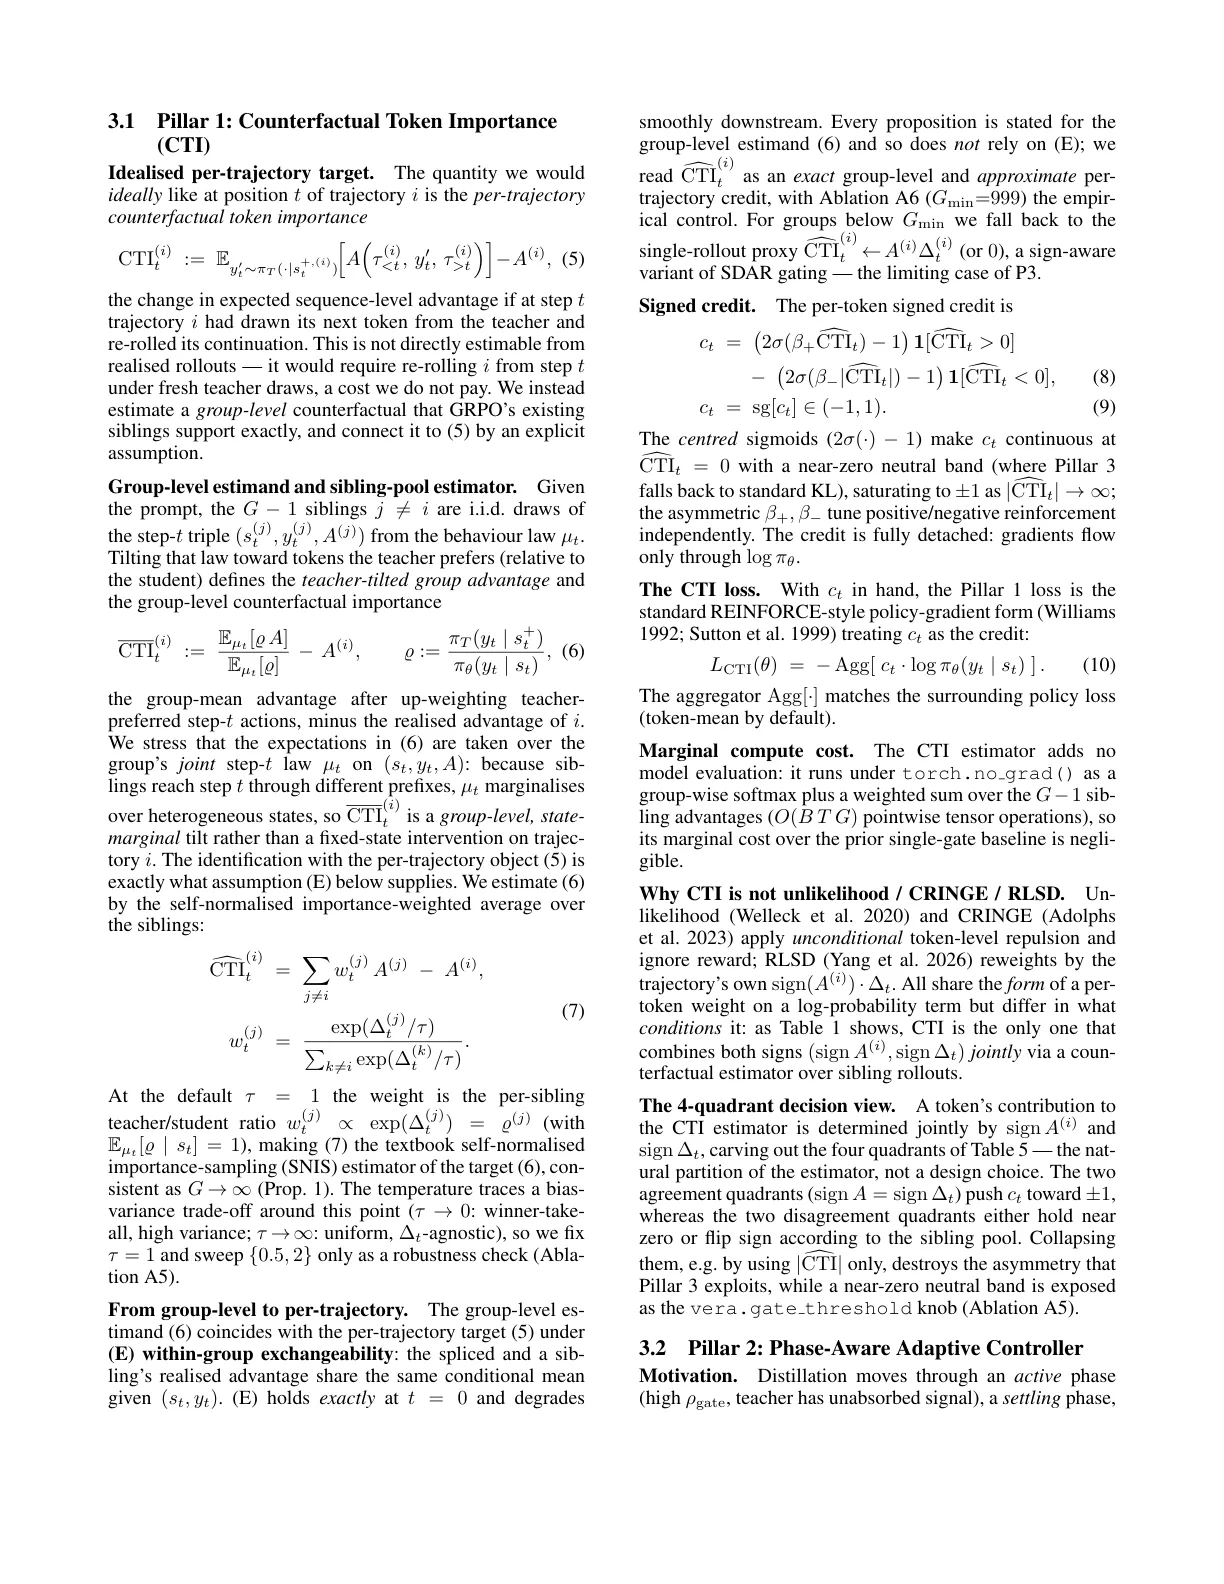
这一支柱回答的核心问题是:假设我在第 步采用了教师偏好的动作,轨迹的优势会如何变化?理想的目标量定义为:
即第 条轨迹在第 步采用教师采样的期望优势增量。然而,我们无法直接计算这个期望——因为我们只有一个观测到的轨迹 ,不知道"如果采用其他动作会怎样"。但 GRPO 的兄弟轨迹提供了关键的解决思路:对于第 条轨迹,我们可以利用另外 条兄弟轨迹 的优势 作为反事实采样的代理。
具体地,CTI 使用自归一化重要性采样(Self-Normalised Importance Sampling, SNIS)构建估计量:
当温度参数 时,权重简化为教师/学生概率比率 ,这是标准的 SNIS 形式。直觉上,这个估计量在问:"对于所有兄弟轨迹,如果它们在第 步的动作与当前轨迹在该步的教师偏好相似(log-prob 差距大),那么这些轨迹的最终优势是多少?"通过对相似动作的轨迹优势加权平均,我们得到了反事实优势变化的估计。
为了产生带符号的信用(signed credit),论文引入了中心化非对称 sigmoid 变换:
这个设计的精妙之处在于: 时表示"教师偏好动作确实有益", 时表示"教师偏好动作反而有害"——这正是传统方法缺失的符号信息。
最终,CTI 损失形式为:
这使得正向信用驱动策略朝教师动作移动,负向信用则抑制这一趋势。
支柱二:阶段感知自适应控制器(Asymmetric Controller)
即使有了带符号的逐 token 信用,整个训练过程仍需在"探索"与"利用"之间平衡。传统方法使用固定权重控制蒸馏损失与 [[KL散度]] 惩罚的相对强度,但这种静态设置忽视了训练动态的多阶段性。
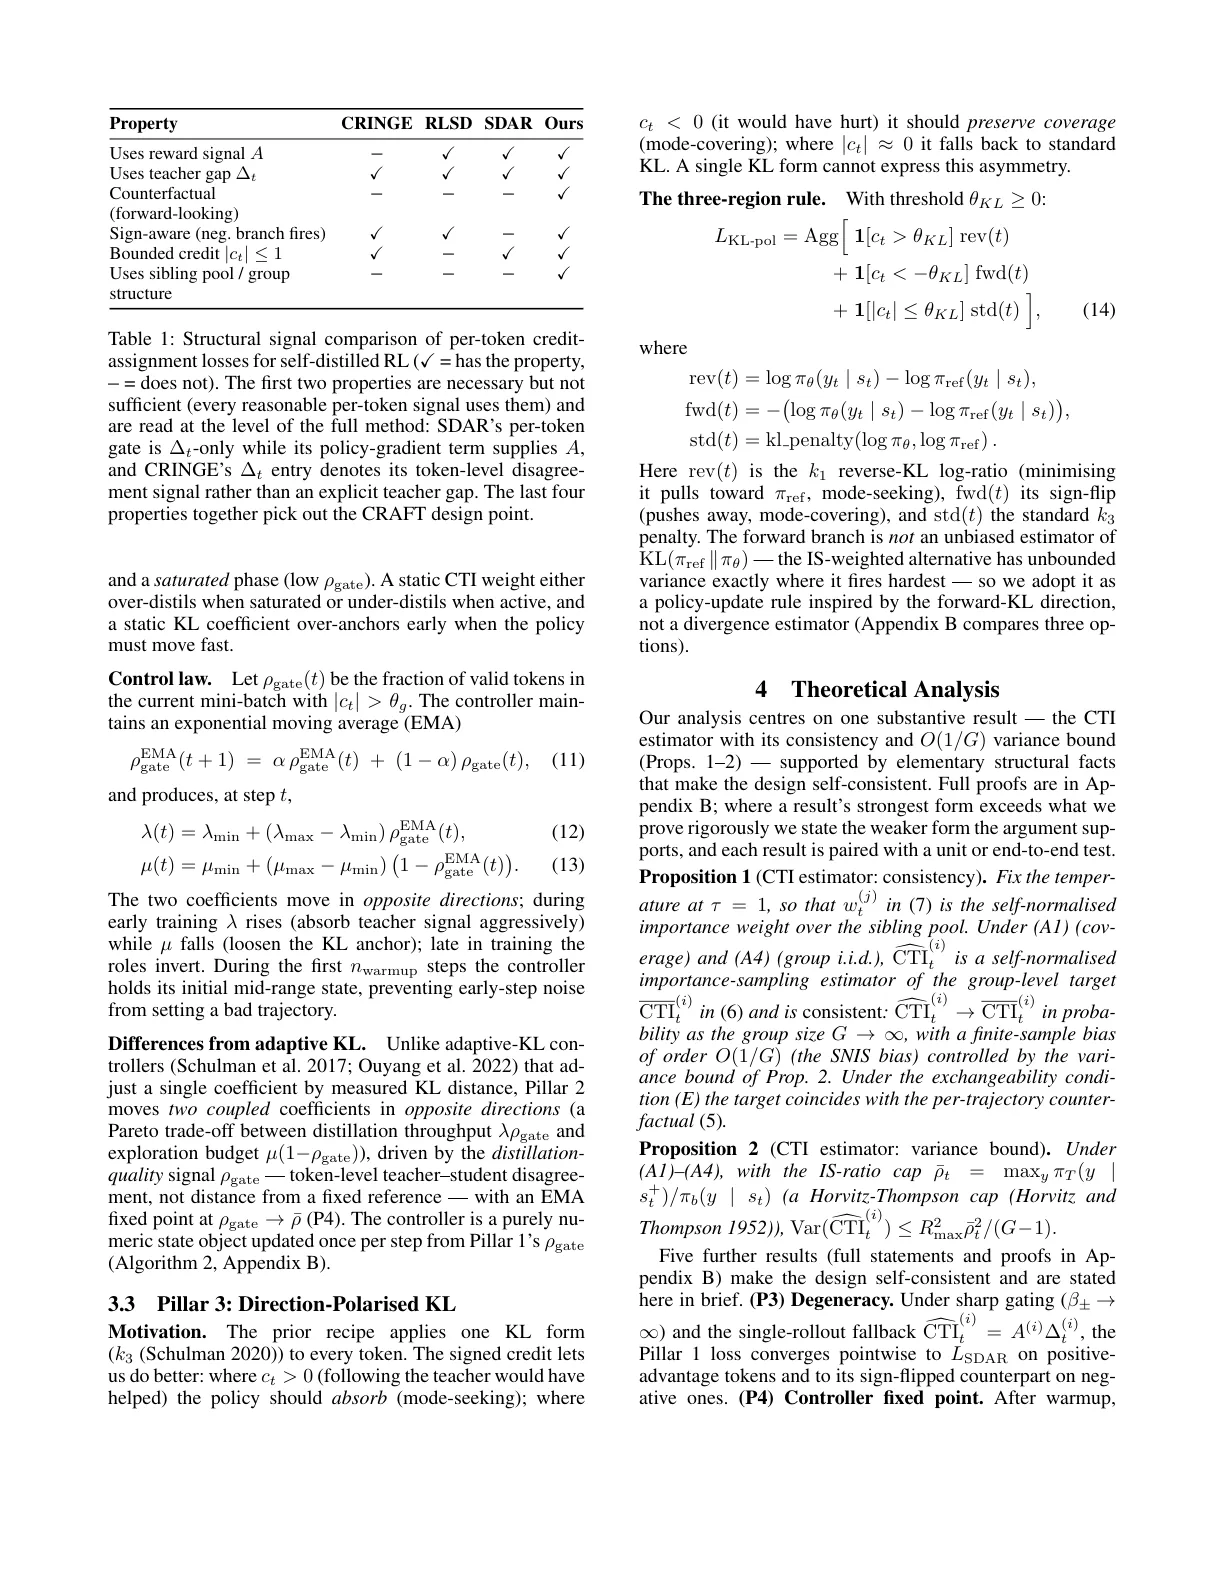
控制器维持门控活动率的指数移动平均(EMA):
并据此反向调节蒸馏权重 与 KL 权重 :当门控活跃度高时(教师有丰富的未吸收信号),提升 降低 ;当门控饱和时,反向操作。这种非对称设计确保了训练在不同阶段自动适应信用分配的需求强度。
支柱三:方向极化 KL 惩罚(Directional KL Polarisation)
基于支柱一产生的符号信用 ,KL 惩罚在逐 token 层面被极化为三种模式:
- 当 (正向信用强):使用反向 KL(reverse KL),即 ,这倾向于模式寻求(mode-seeking)——强制策略严格贴合参考分布的单一峰值。
- 当 (负向信用强):使用前向 KL 启发式(forward KL heuristic),即 ,这倾向于模式覆盖(mode-covering)——鼓励策略在参考分布的支撑集上均匀分布。
- 当 (信用微弱):使用标准中性 KL 惩罚。
这种设计的动机在于:正信用意味着"教师偏好动作是好的,策略应该更自信地向其靠拢",反向 KL 的 mode-seeking 特性恰好满足这一需求;负信用意味着"教师偏好动作有害,策略应该主动避开",而前向 KL 的 mode-covering 特性有助于策略探索替代方案。
总损失与理论保证
完整损失函数为:
论文给出了 CTI 估计量的一致性证明(命题1):当 时, 依概率收敛于真实 ,有限样本偏差为 。同时证明了方差上界(命题2):,其中 是优势函数的界, 是平均重要性权重的期望。
实验与结果
实验覆盖了三个代表性智能体环境——ALFWorld(基于文本的具身探索)、Search-QA(直接检索问答)和 WebShop(编程验证器购物场景),以及四个模型规模(Qwen3-1.7B、Qwen2.5-3B、Qwen2.5-7B、Qwen3-8B),采用 5 种端到端方法加 2 种先前工作基线进行对比。
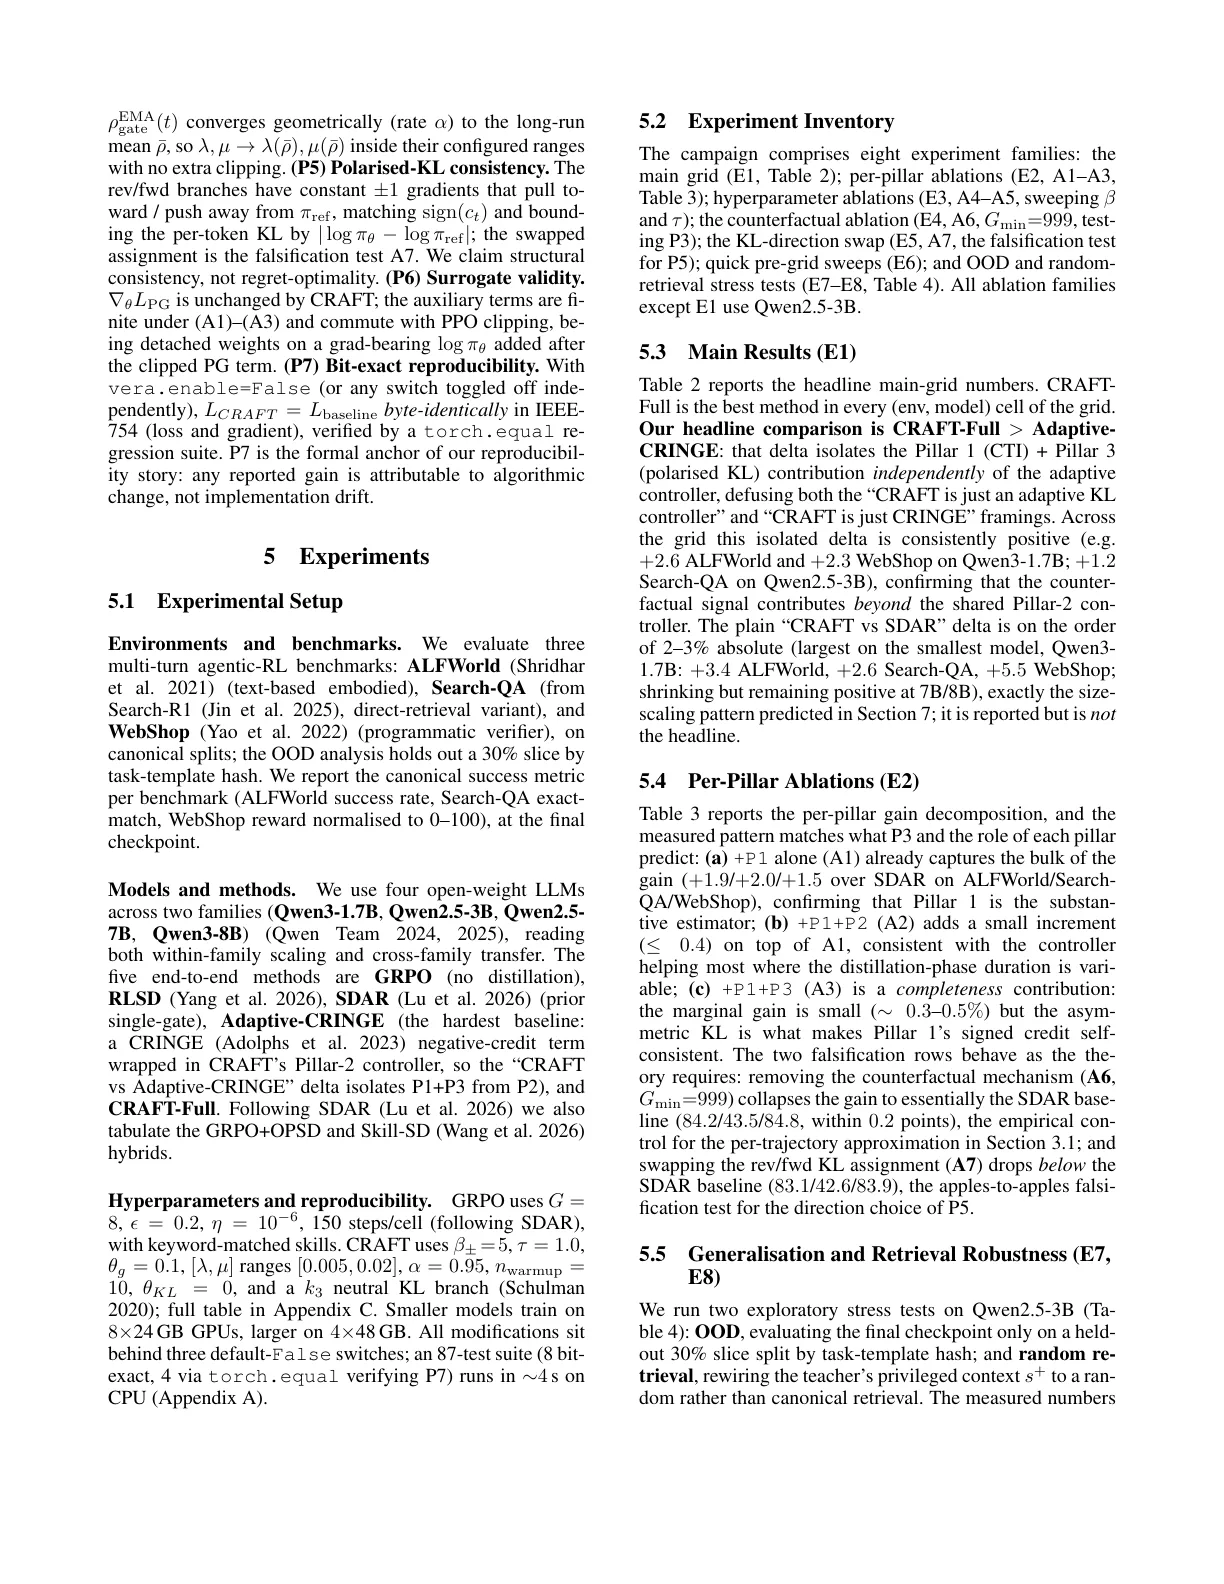
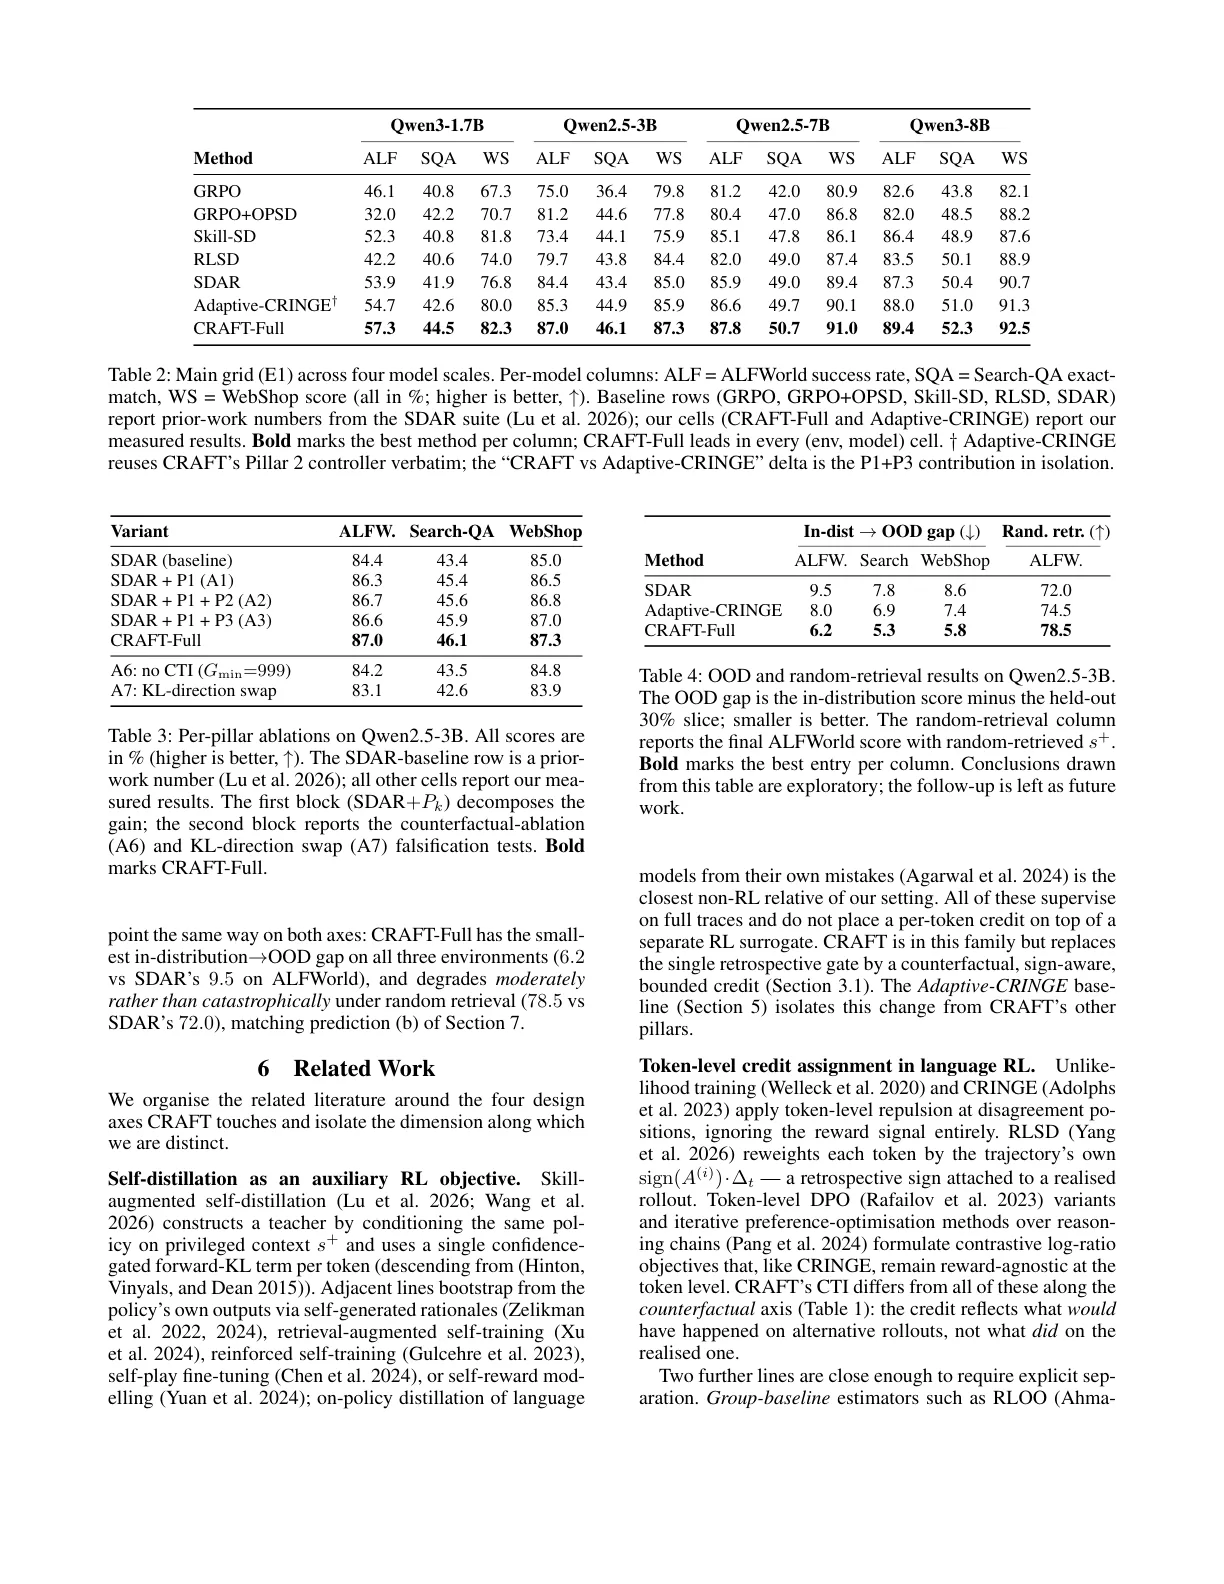
主网格实验(84个单元)显示,CRAFT-Full 在每个(环境,模型)组合上均达到最优。更细致的消融实验揭示了各支柱的独立贡献:单独启用支柱一(+P1)在 ALFWorld 上即带来 +1.9 个百分点的提升,Search-QA 上 +2.0,WebShop 上 +1.5——这表明反事实信息本身就是实质性贡献。
为了精确隔离支柱的贡献,论文设计了 Adaptive-CRINGE 作为对照方法:它与 CRAFT 共享支柱二,因此"CRAFT-Full 减 Adaptive-CRINGE"的差值即代表支柱一和三的纯贡献。实验结果显示这一差值在所有单元均为正,进一步确认了反事实信用分配的价值。
有趣的是,最小模型(Qwen3-1.7B)的收益反而最大:ALFWorld 上 +3.4、WebShop 上 +5.5,且这一优势随模型规模增大而缩小但始终为正。这可能反映了较小模型从精细信用分配中受益更多,因为它们的基线信用分配能力更弱。
论文还进行了两项关键的反证检验:A6 移除反事实机制(),发现增益坍缩至 SDAR 基线;A7 交换 KL 方向,发现性能低于 SDAR。这两项实验分别验证了"反事实信息不可或缺"和"方向选择正确性"两个核心假设。
在分布外(OOD)评估中,CRAFT-Full 展现出更小的泛化差距:ALFWorld 上 6.2 vs SDAR 的 9.5。随机检索压力测试下,CRAFT 保持 78.5 分而 SDAR 降至 72.0,表明其对检索噪声的鲁棒性更强。
讨论与可借鉴点
CRAFT 最具启发性的贡献在于方法论层面的洞察:GRPO 采样的兄弟轨迹并非训练副产品,而是一个"近乎免费的反事实样本池"。这一观察将 [[重要性采样]] 估计器与自蒸馏框架优雅地嫁接在一起,同时保持了极低的计算开销(仅需在 torch.no_grad() 下做组级 softmax 与加权求和)。
论文的工程设计也值得借鉴。每个支柱配备独立开关、关闭时逐字节等价于基线——这不是过度工程化,而是科研诚实性的体现:它确保了任何测得的增益都是算法的真实贡献,而非实现细节或数值精度的偶然结果。87 个回归测试用例覆盖数学正确性、工程契约和位精确性,这种工程严谨性在学术论文中难得一见。
然而,方法也存在局限。首先,CTI 估计量依赖于"兄弟轨迹的优势可以迁移"的交换性假设,这在轨迹间差异较大时可能引入偏差。其次,当 较小时(如 ),SNIS 估计量的方差可能较大,尽管论文给出的方差界在理论上保证了好行为的趋势。第三,支柱三的 KL 方向极化虽然直觉清晰,但前向 KL 的实际实现仍是启发式的,并非真正的对称前向 KL 散度。
对于更广泛的研究社区,CRAFT 的设计模式提供了有益的启发:在 [[策略梯度]] 方法中引入反事实评估时,不必额外采样——复用现有训练流程产生的并行轨迹即可。对于 [[自蒸馏]] 方法,符号感知的信用分配可能比单一标量门控更有效,尤其是当教师模型与学生模型存在分布偏移时。此外,将 KL 惩罚从全局静态权重升级为逐 token 自适应路由,可能成为未来信用分配研究的一个有前景的方向。
概念 · 6 个
摘要
自蒸馏智能体强化学习,使用同策略特权上下文作教师
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
UCOB:通过信用感知的在线策略双向自蒸馏学习利用与演化智能体技能
UCOB: Learning to Utilize and Evolve Agentic Skills via Credit-Aware On-Policy Bidirectional Self-Distillation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 15 张
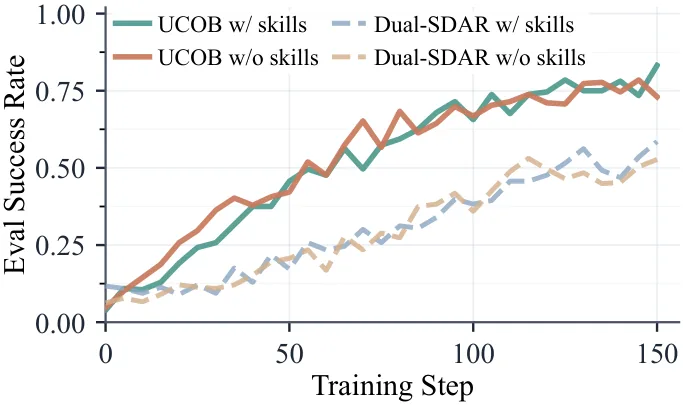
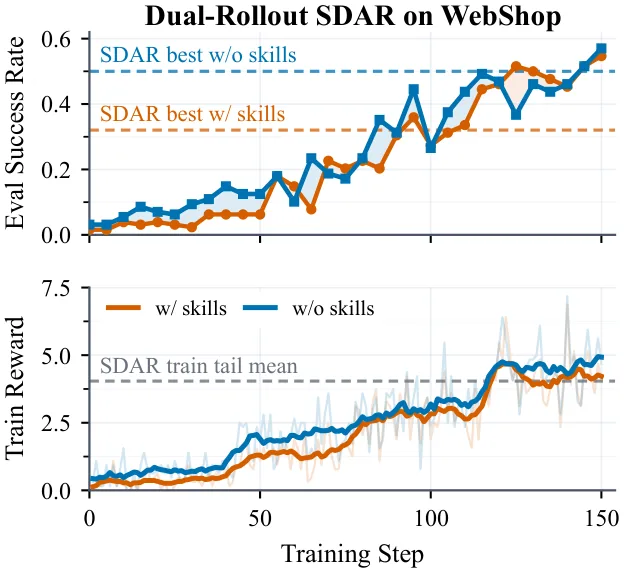
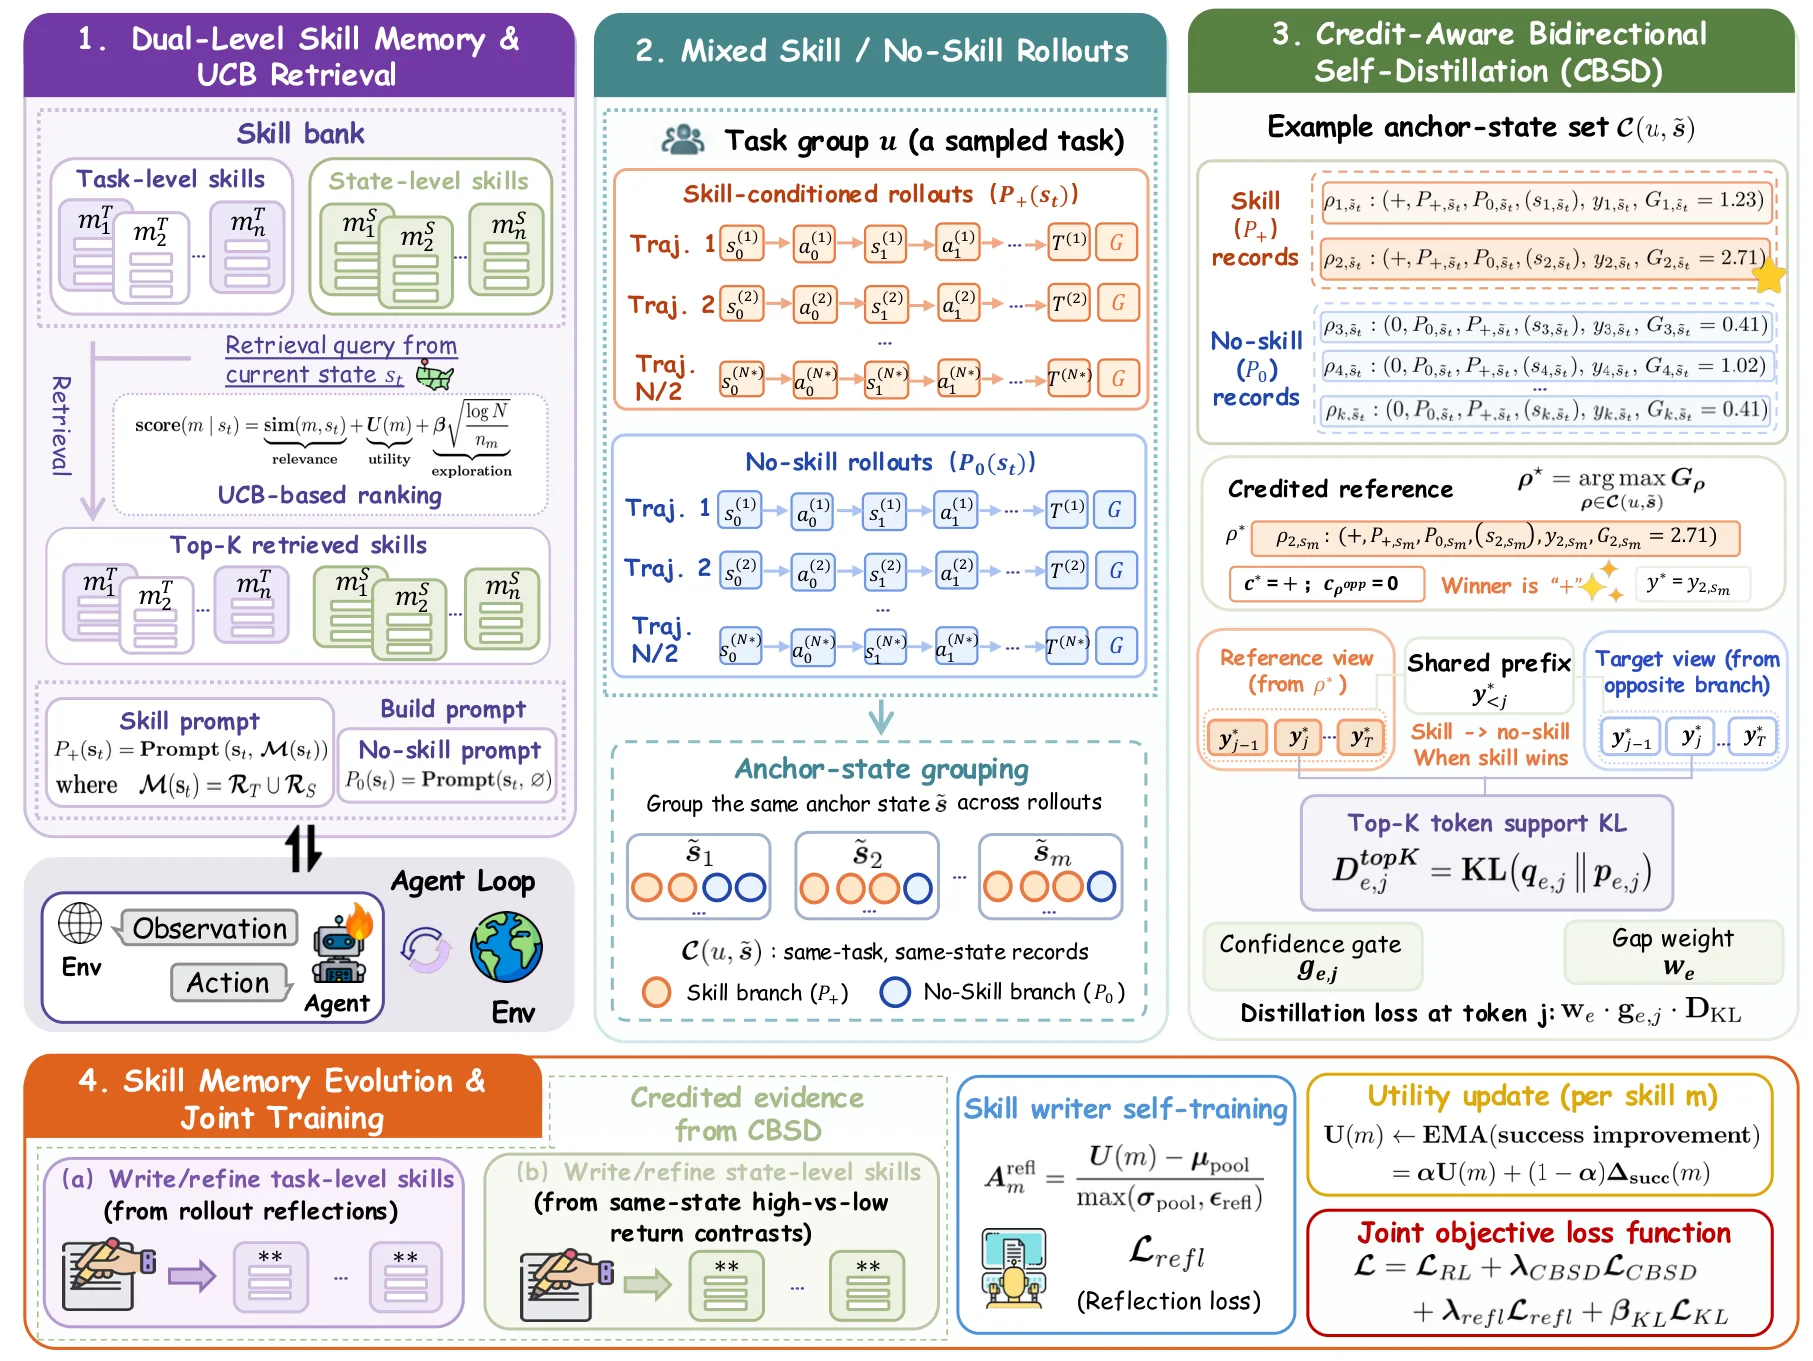
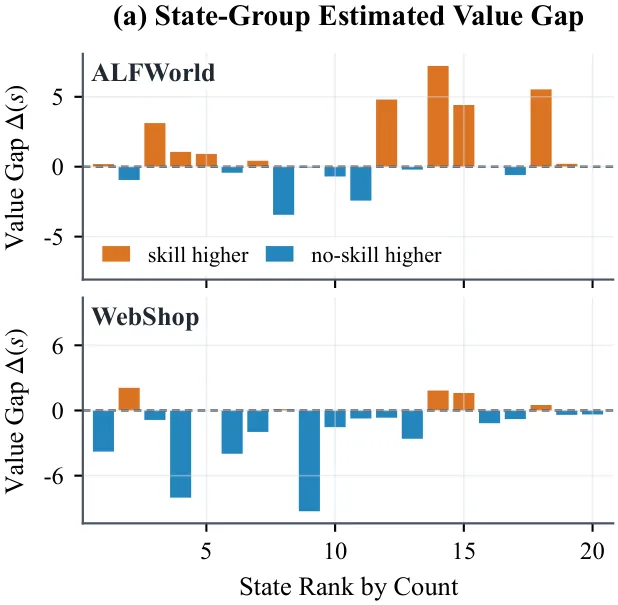
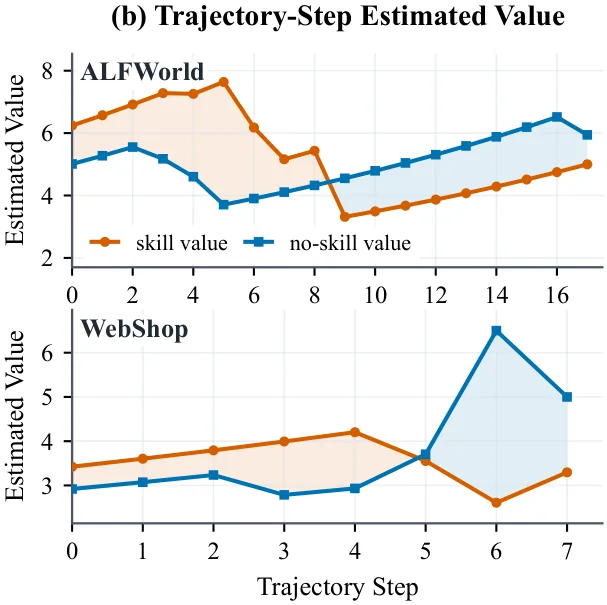
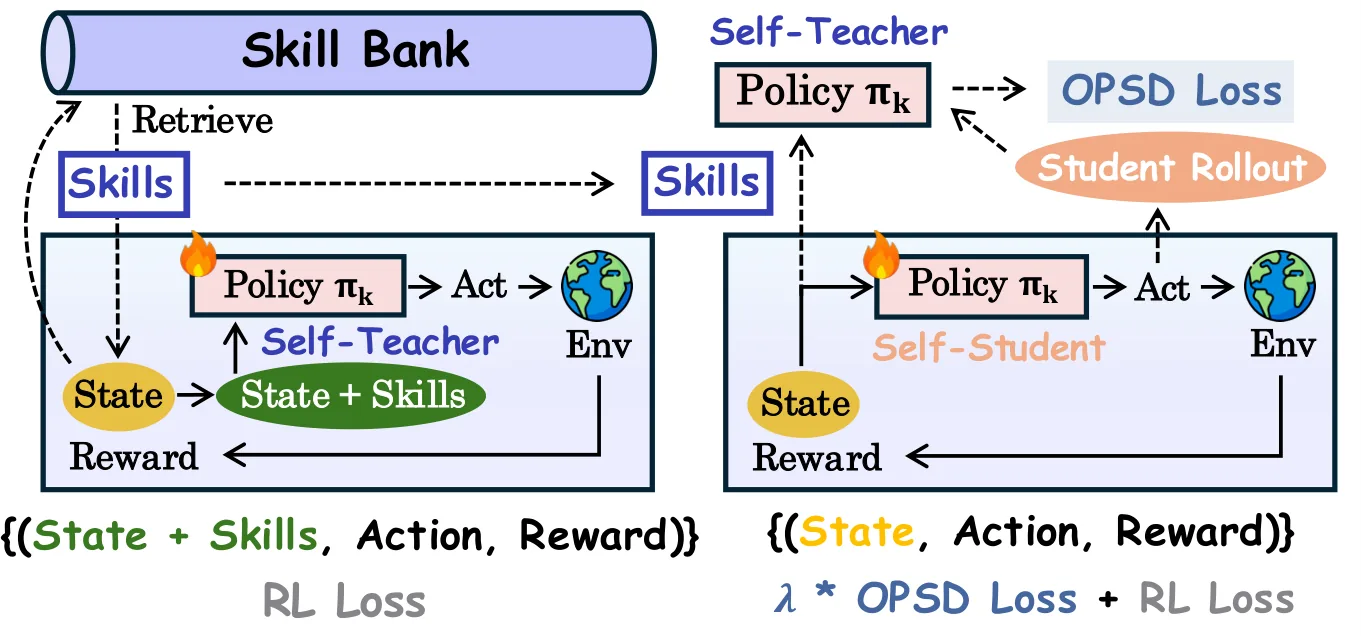
智能体强化学习中,技能记忆可复用经验但检索结果并非总是有效,同一策略在不同状态下可能受益或被误导,使将带技能提示视为固定教师的假设变得脆弱。UCOB将带技能与无技能提示视为同一模型的两个在线上下文视角,在同任务同锚点状态下对比return-to-go,以高回报视角充当局部教师进行信用感知自蒸馏。在ALFWorld、WebShop和Search-QA上全面超越免技能RL与自蒸馏基线,ALFWorld和WebShop上分别提升23.5和18.0分。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
在长视野、多回合的智能体任务中,如何高效利用过往经验一直是核心难题。技能记忆(skill memory)通过将历史轨迹提炼为文本指导,可以在相似的状态出现时为策略提供有价值的上下文提示,从而加速探索并提升样本效率。然而,这种看似优雅的范式暗含一个脆弱假设:检索到的技能总能为当前决策提供正确指引。
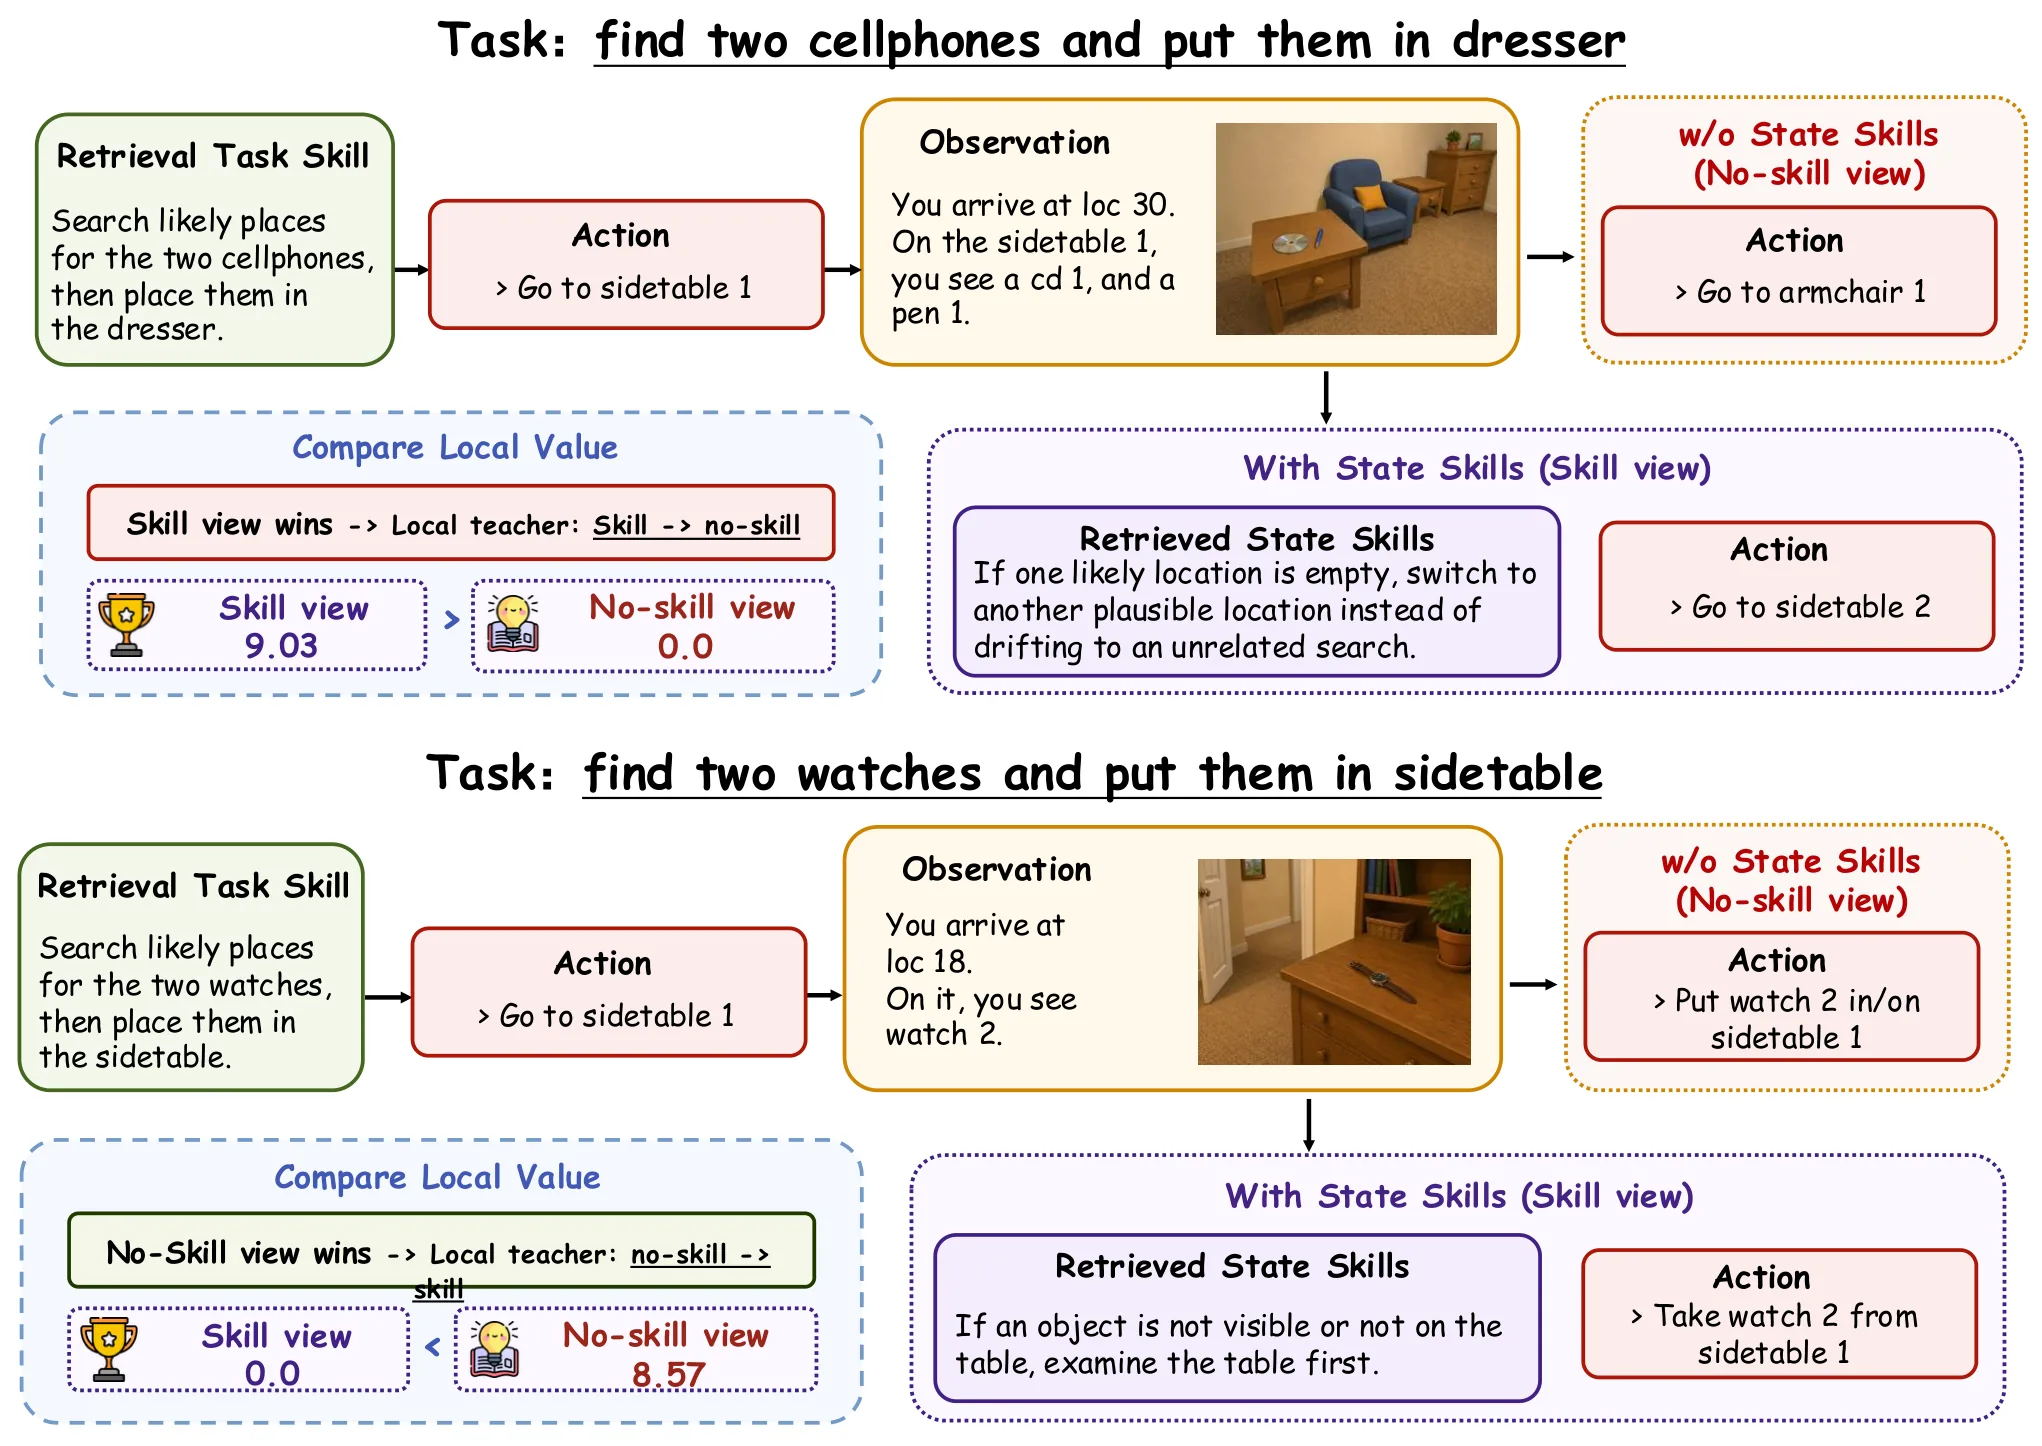
论文作者通过系统的诊断实验揭示了这一假设的问题所在。在 ALFWorld 和 WebShop 环境中,他们考察了三种情形:固定特权教师是否始终优于无技能视图、将技能分支转为 on-policy 后能否消除教师歧义、以及当两视图在同一锚点状态产生分歧时应如何选择蒸馏方向。结果表明,技能提示并非可靠的固定教师——同一技能在某些状态下能够引导策略走向成功,在另一些状态下却会将策略引入失败。更值得注意的是,同一轨迹内部的优势分支可能在不同决策步之间反复切换,这意味着无论选择哪一方作为固定教师,都可能在某些关键时刻引入错误的引导。
这种"特权教师"假设的脆弱性促使作者思考:与其将技能记忆定位为预先固定的教师,不如让它成为可被评估和演化的在线资源。核心问题转化为:如何在同一任务上下文中客观判断某一技能提示是否真正有用,并据此调整知识的传递方向。
方法
UCOB 的核心洞察在于重新定义带技能提示与无技能提示之间的关系。传统方法将前者视为后者的特权教师,而 UCOB 将 和 视为同一在线策略 的两个上下文视图,在同一任务 和同一锚定状态 下比较它们的 return-to-go ,将回报更高的视图作为局部教师。
为了实现这一目标,框架首先构建了双层技能记忆系统,包含任务级技能池和状态级技能池。检索时采用上置信界(UCB)打分的混合机制,结合语义相似度与效用不确定性:
其中 是技能 的效用估计, 是使用计数,后者为探索不确定性项。
在 rollout 阶段,每个任务组一半轨迹使用带技能提示 ,另一半使用无技能提示 ,两分支均接收在线强化学习损失。为了支持后续的信用比较,轨迹按锚定状态进行分组,形成集合 ,记录每条轨迹的决策上下文、目标分支及其回报。
CBSD(信用感知双向自蒸馏)是最关键的设计组件。在每个锚定状态组内,算法首先选出回报最高的分支作为教师:
仅当两分支的回报差 超过阈值 时,才接受该蒸馏对。如果高回报分支恰好是带技能视图,则技能分支教无技能分支,实现有用的技能诱导行为的内化;如果高回报分支是无技能视图,则反向蒸馏纠正误导性的技能使用。这种双向机制打破了传统师生关系的固定指向,使得无论哪一方在当前状态下更有价值,都能指导另一方学习。
为了确保蒸馏的质量与效率,UCOB 还引入了两项关键机制。置信门控 通过比较目标分支与引用分支对教师 token 的预测概率,决定是否接受该 token 的蒸馏信号:
回报差加权 则根据两分支的优势差距动态调整蒸馏强度。Top-K Token-Support Matching 通过在教师分支的高概率 token 上构建支撑集并在上面重新归一化,缓解了自蒸馏中教师和学生分布高度重叠导致的梯度稀释问题。
除了蒸馏机制,UCOB 还设计了技能记忆的演化策略。状态级技能通过对比同一锚定状态下的高回报和低回报轨迹来刻画"何时该用、什么时候不该用"。效用更新采用指数移动平均:
其中 反映使用技能 的 rollout 相对无技能基线的成功率提升。反思写作器则利用效用优势作为优势估计进行自训练,使其生成的反思内容能够更精准地指导未来的决策。
实验与结果
实验在 ALFWorld、WebShop 和 Search-QA 三个基准上进行,使用 Qwen2.5-7B-Instruct、Qwen2.5-3B-Instruct 和 Qwen3-1.7B 三个规模的模型作为骨干。基线覆盖无技能强化学习方法(GRPO、GiGPO)、技能记忆方法(SkillRL、D2Skill、SkillC、SAPO、Skill1)以及自蒸馏方法(RLSD、Skill-SD、SDAR、StepOPSD)。
主实验结果展现了 UCOB 的全面优势。在 ALFWorld 上,Qwen2.5-7B 达到 93.0% 整体成功率,Qwen2.5-3B 为 92.2%,即便是最小的 Qwen3-1.7B 也达到 89.1%,三者均为各自规模的最优。WebShop 上的成功率分别为 85.9%、78.1% 和 79.7%,同样全面领先。更引人注目的是小模型上的提升幅度:Qwen3-1.7B 在 ALFWorld 上相较 Skill1 和 SDAR 分别提升 23.5 和 35.2 分,在 WebShop 上分别提升 18.0 和 21.1 分,这表明 UCOB 的信用感知机制对于资源受限场景具有特殊价值。Search-QA 上的表现具有竞争力但并非全面优势,与最佳基线的平均准确率差距控制在 0.8 分以内。
消融实验进一步揭示了各组件的贡献。移除锚定状态分组、反思自训练、状态级技能、混合 rollout 和 CBSD 中的任何一项都会导致性能下降,其中 CBSD 的移除影响最为显著。CBSD 内部的三种变体(gap-gated 单向、固定教师方向、无 top-K 支撑集)均不如完整 CBSD,验证了双向路由、动态阈值和 token 级匹配的重要性。超参敏感性分析表明 和使用自训练反思后端是较优的配置。
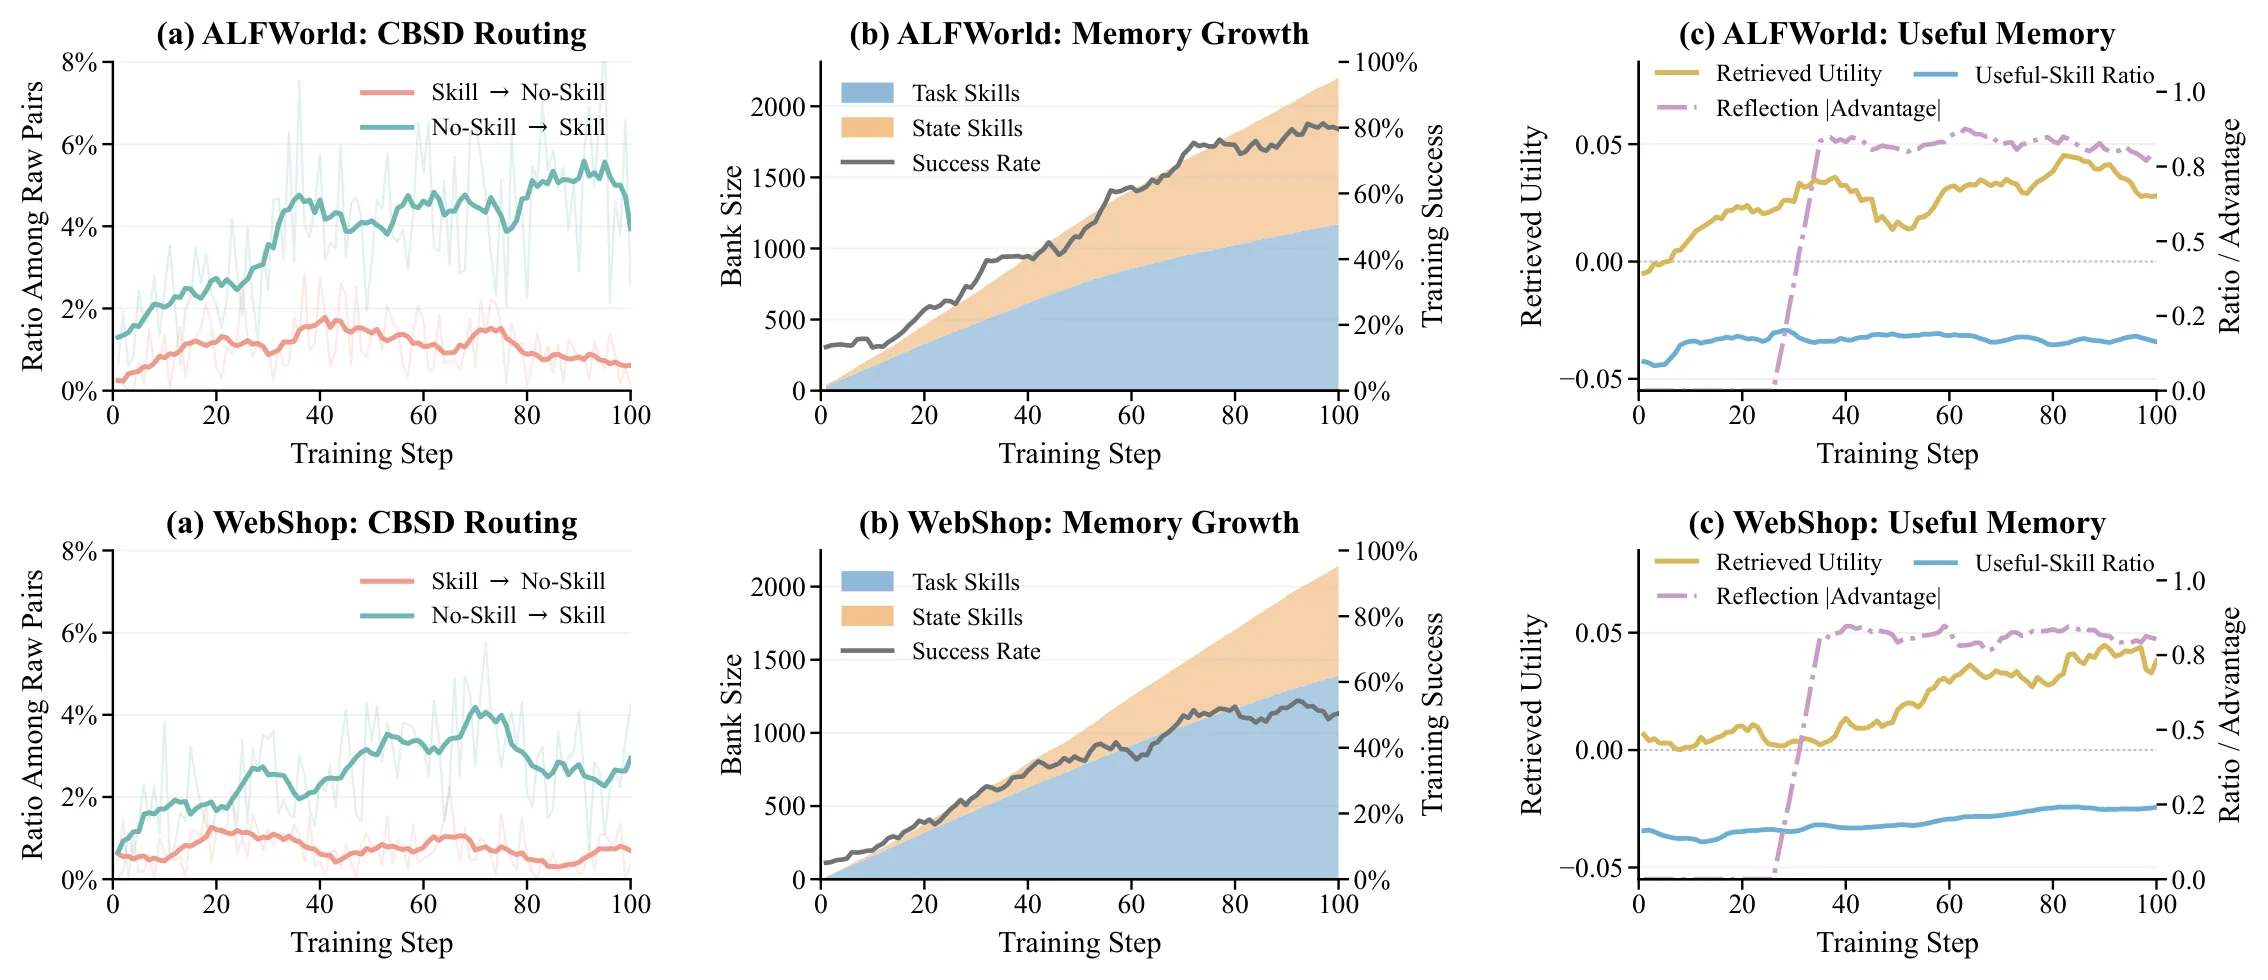
一个有趣的发现是,在 ALFWorld 和 WebShop 上,"无技能→技能"的蒸馏路由反而出现得更频繁。这一反直觉的结果表明,无技能视图经常是更优的局部教师——当技能提示误导策略时,无技能分支产生的决策反而更可靠。如果没有 CBSD 的反向蒸馏机制,这些误导性的技能使用将无法被纠正,技能记忆的演化也会偏离正确方向。
讨论与可借鉴点
UCOB 的核心贡献在于挑战了技能记忆研究中长期默认的"特权教师"假设,将师生关系从静态固定转为动态信用感知。这一转变带来的启示是:在设计依赖外部知识的智能体系统时,应当承认知识并非全知全能,而应建立评估机制判断当前上下文下知识的有效性。
从方法论角度看,CBSD 的双向自蒸馏框架具有超越具体任务的通用性。任何存在多个策略视图(如不同提示模板、不同工具选择)且需要选择性知识传递的场景,都可以借鉴"按锚点状态分组、按回报选教师、置信门控过滤"这一范式。效用感知的检索与技能记忆的演化机制也值得在更广泛的经验复用研究中参考。
局限方面,Search-QA 上未能全面超越基线,暗示该方法在检索型 QA 任务中的优势可能不如交互式环境显著。框架依赖锚定状态分组和 UCB 检索的设计增加了实现复杂度,对超参(如 、)的敏感性也意味着实际部署时需要一定的调优。此外,论文未提供完整的算力账单,使得方法的计算成本难以与其他工作进行公平比较。
未来的研究方向可以探索:将 CBSD 与其他策略多样性机制结合、将其扩展到多智能体协作场景、以及在更大规模的开放世界任务中验证其有效性。
概念 · 6 个
摘要
智能体强化学习的在线双向自蒸馏
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
ATOD:用于多轮自主智能体的退火轮次感知在策略蒸馏算法
ATOD: Annealed Turn-aware On-policy Distillation for Multi-turn Autonomous Agents
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 9 张
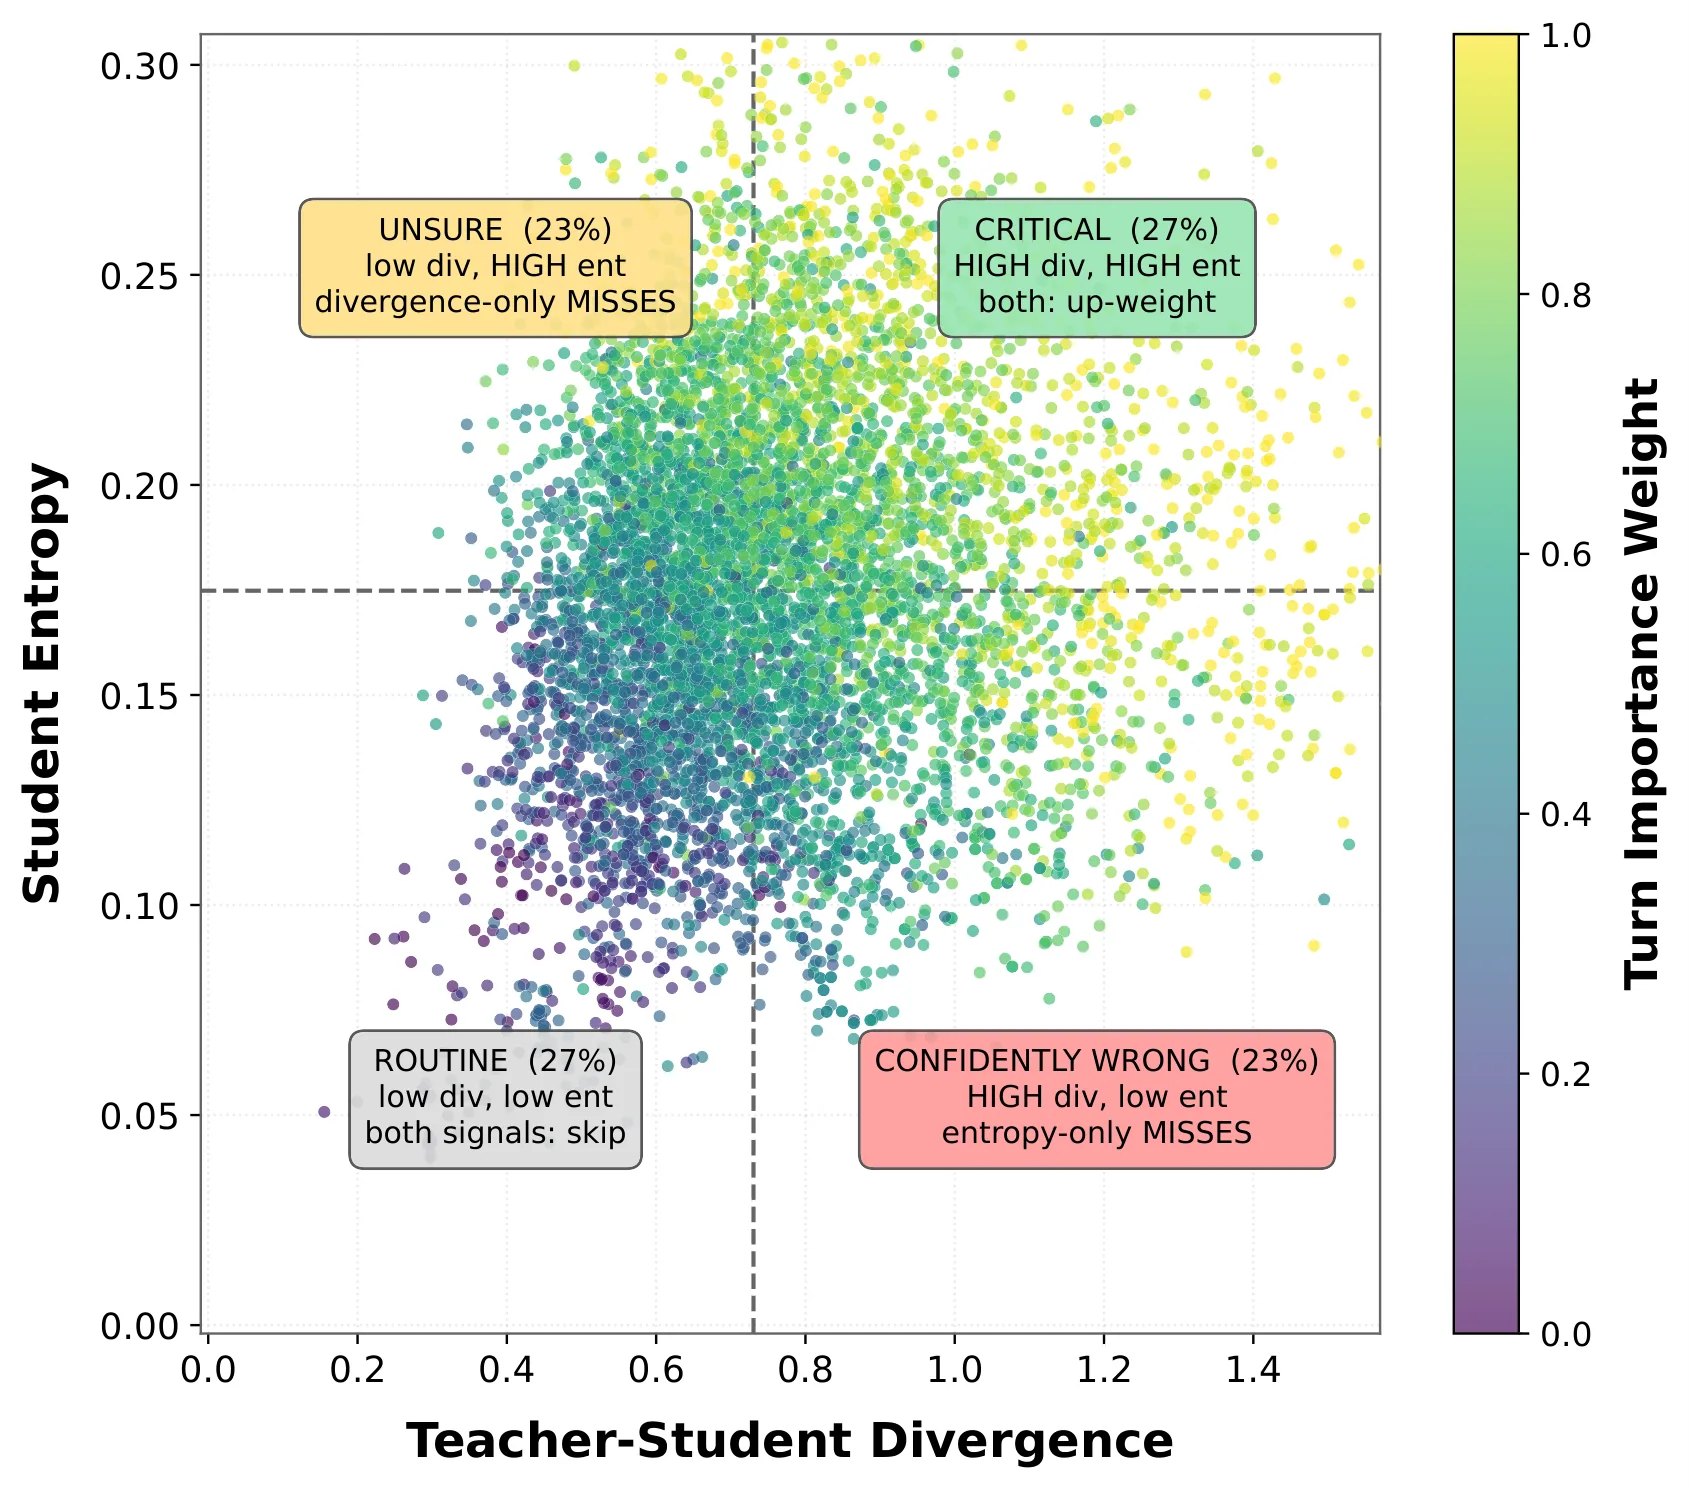
📖 中文解读 Polaris 风格 5 节
研究背景与动机
训练小型语言模型智能体完成复杂的长程交互任务是当前的重要研究方向。这类任务要求模型在多轮对话或序列决策中持续与环境交互——比如在虚拟家庭环境中寻找并操作物体、在电商网站中按指令筛选商品、或在搜索场景中逐步定位答案。任务的挑战在于,智能体必须同时具备两项能力:一是快速从示范数据中学习基本行为模式,即「快速模仿」能力;二是当遇到超出示范范围的场景时,能够通过环境反馈自我调整、探索更好的策略,即「基于奖励的改进」能力。
现有的后训练方法主要分为两大范式。[[策略蒸馏]]方法以教师模型(或更大规模的模型)的输出作为监督信号,提供密集且即时的指导,在训练初期能实现快速提升。但其根本局限在于,当学生模型的能力逐渐逼近教师水平后,额外的监督信号带来的增益趋于饱和,最终性能被教师模型的表现上限牢牢封住。[[强化学习]]方法则直接以环境奖励为优化目标,理论上能够突破教师上限、探索更优策略,但其早期学习效率极低——在稀疏且延迟的奖励信号下,智能体很难从漫无目的的探索中提取有效的学习信号。
这两种范式呈现出鲜明的互补性:策略蒸馏在早期高效但后期乏力,强化学习在后期有潜力但早期低效。一个自然的追问是:能否设计一种算法,让它兼取两者之长?ATOD 正是对这一问题的系统回答。
方法
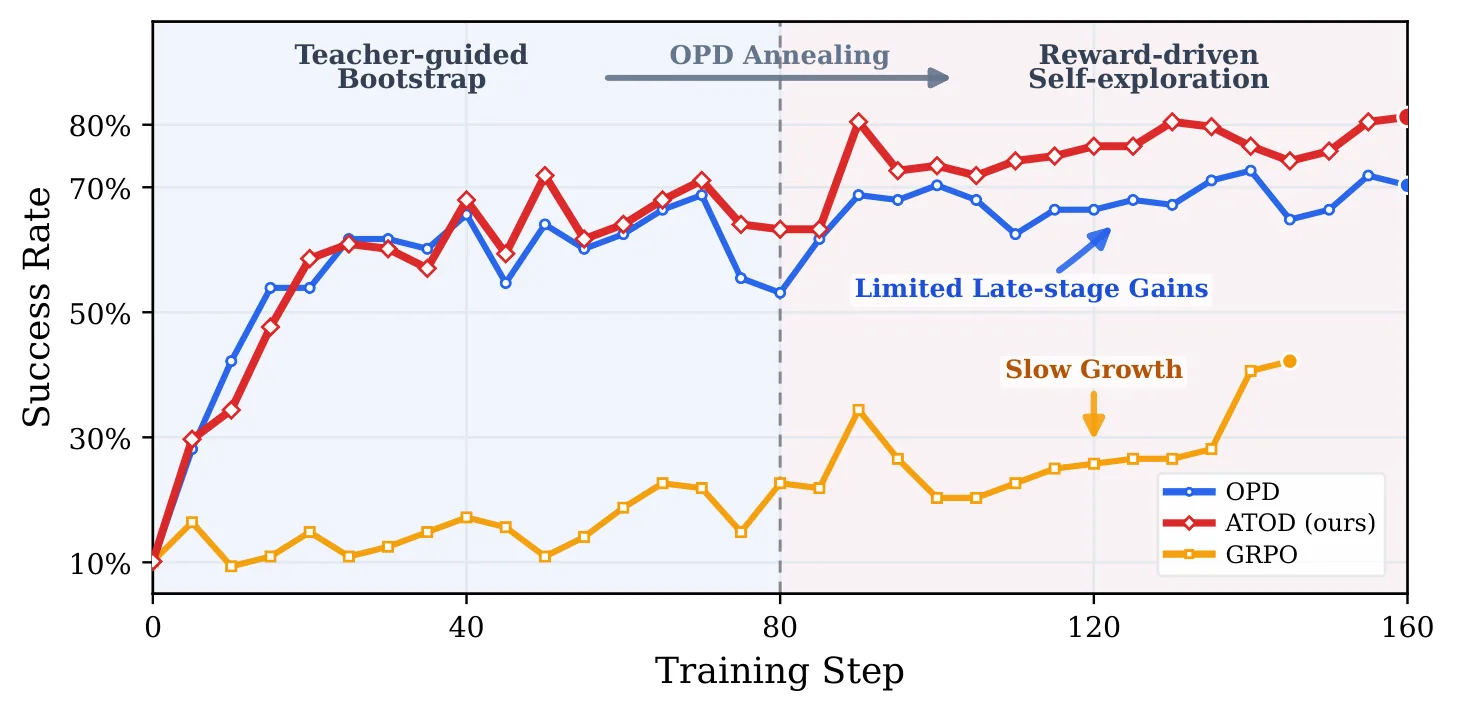
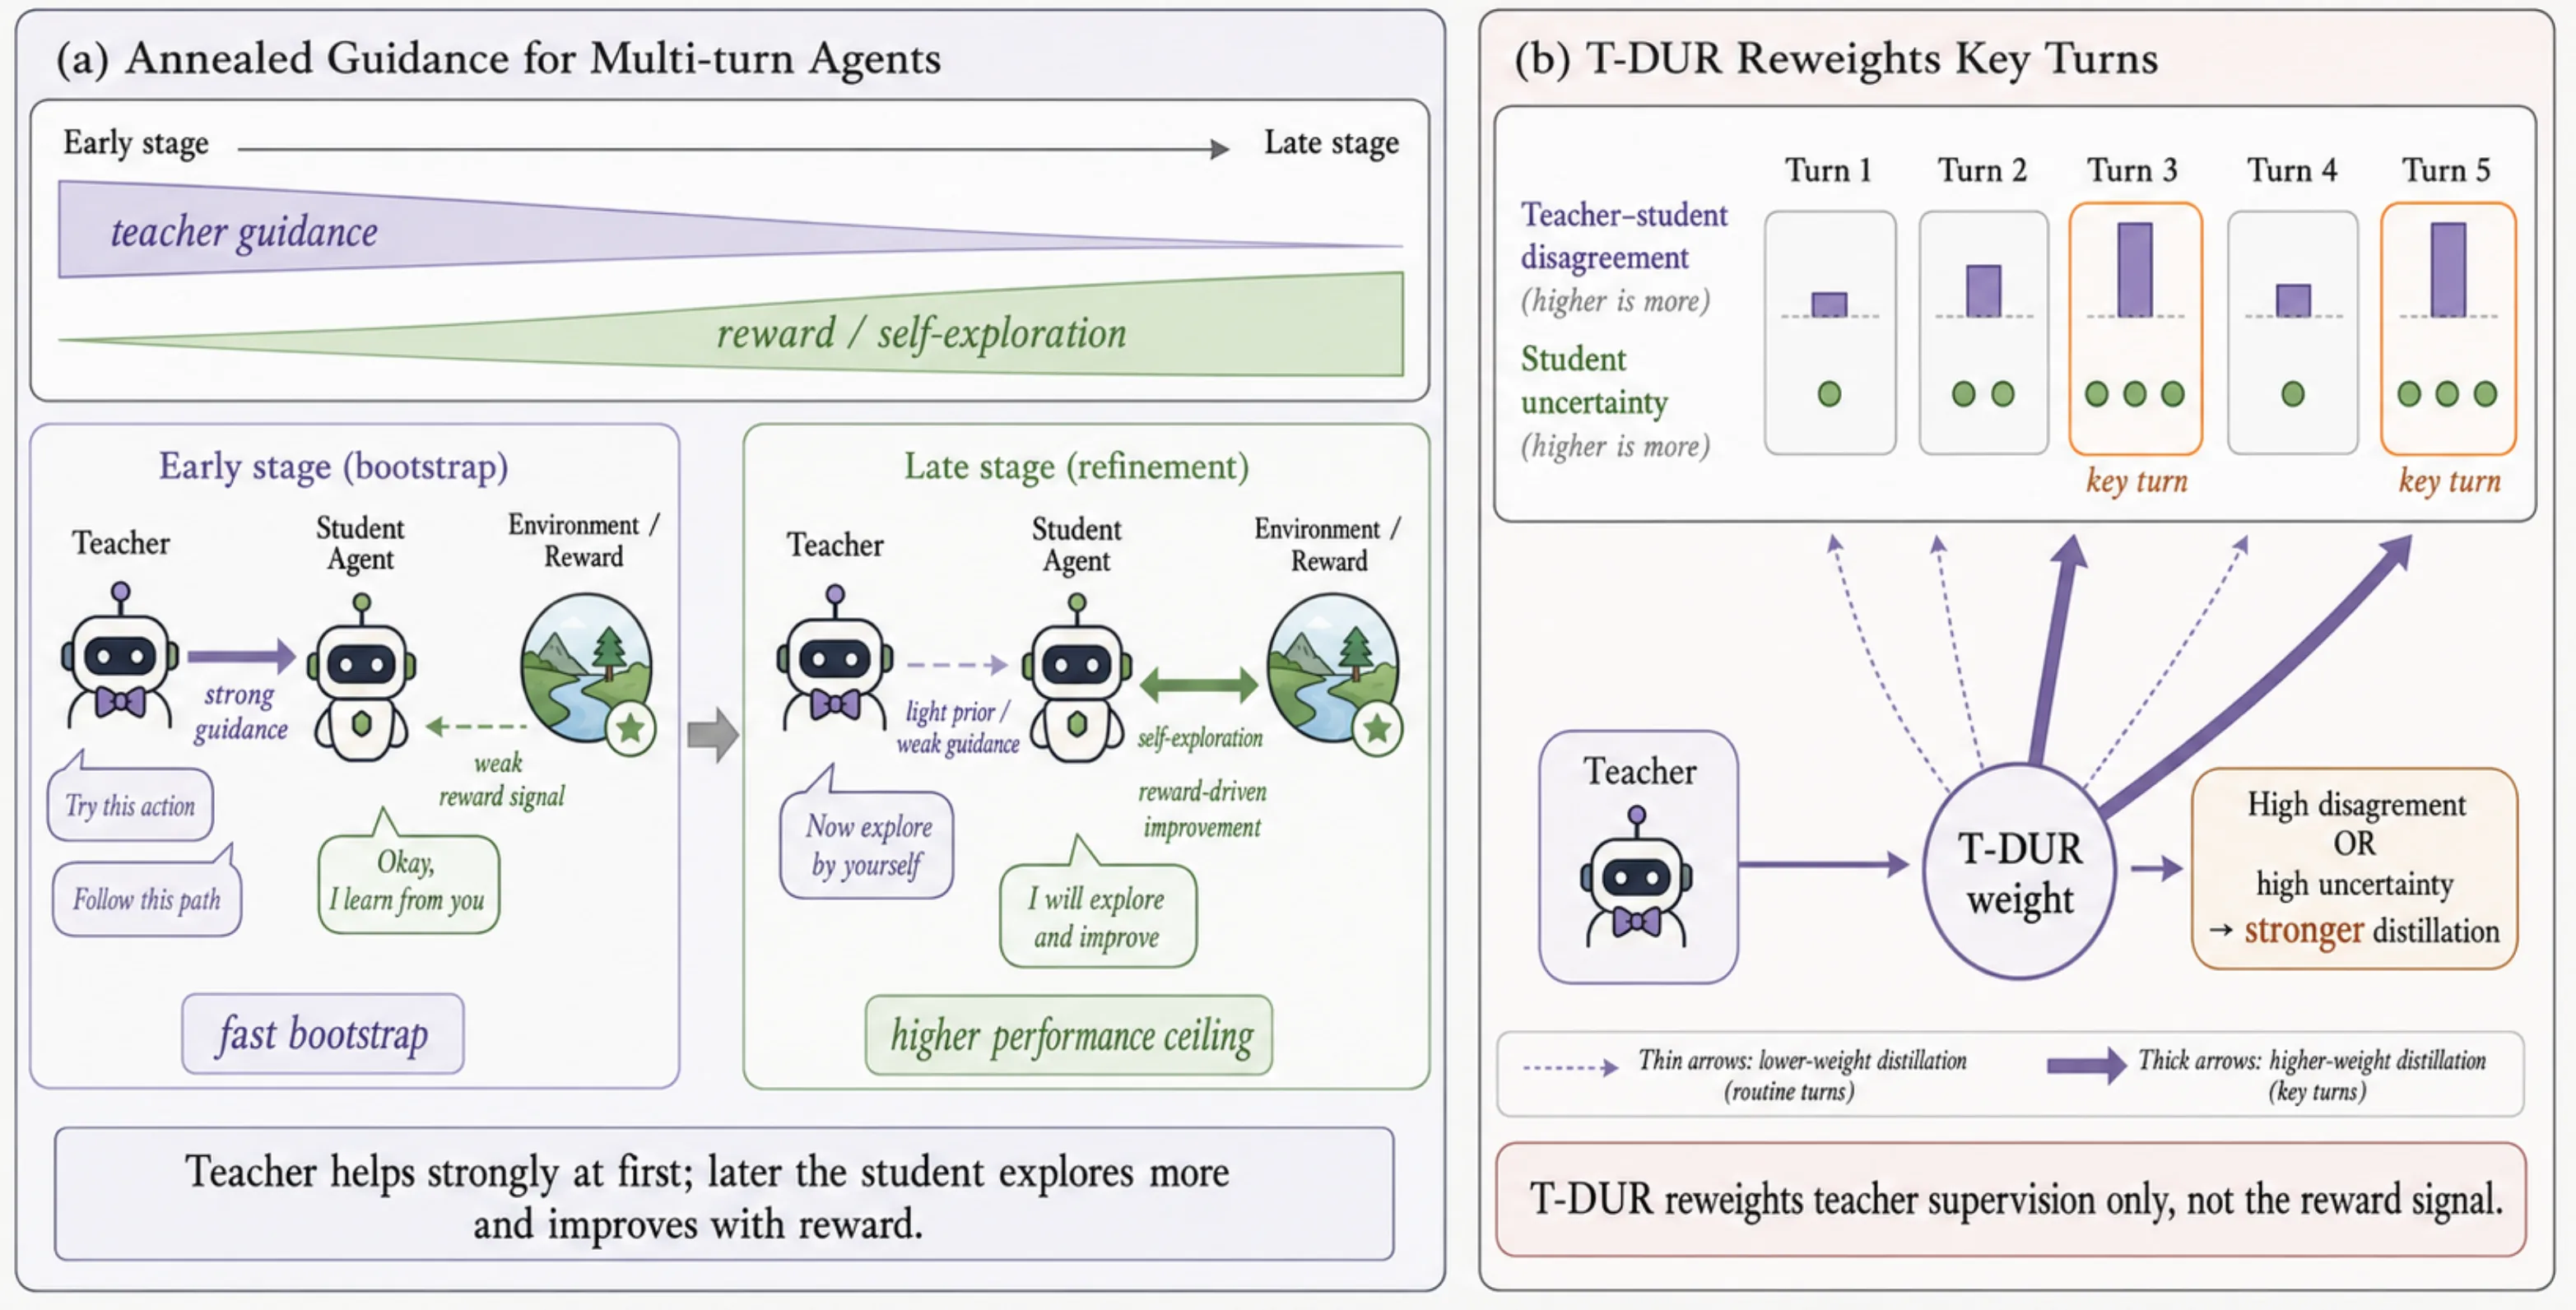
ATOD 的设计围绕一个核心观察展开:策略蒸馏与强化学习在训练动态上具有天然的时序互补性。训练初期学生模型与教师差距巨大,此时密集的模仿信号能帮助学生快速建立基本能力;而当学生已经「学会」了教师的行为模式后,继续强化模仿只会陷入收益递减,此时转向奖励驱动的探索才能打开性能上限。
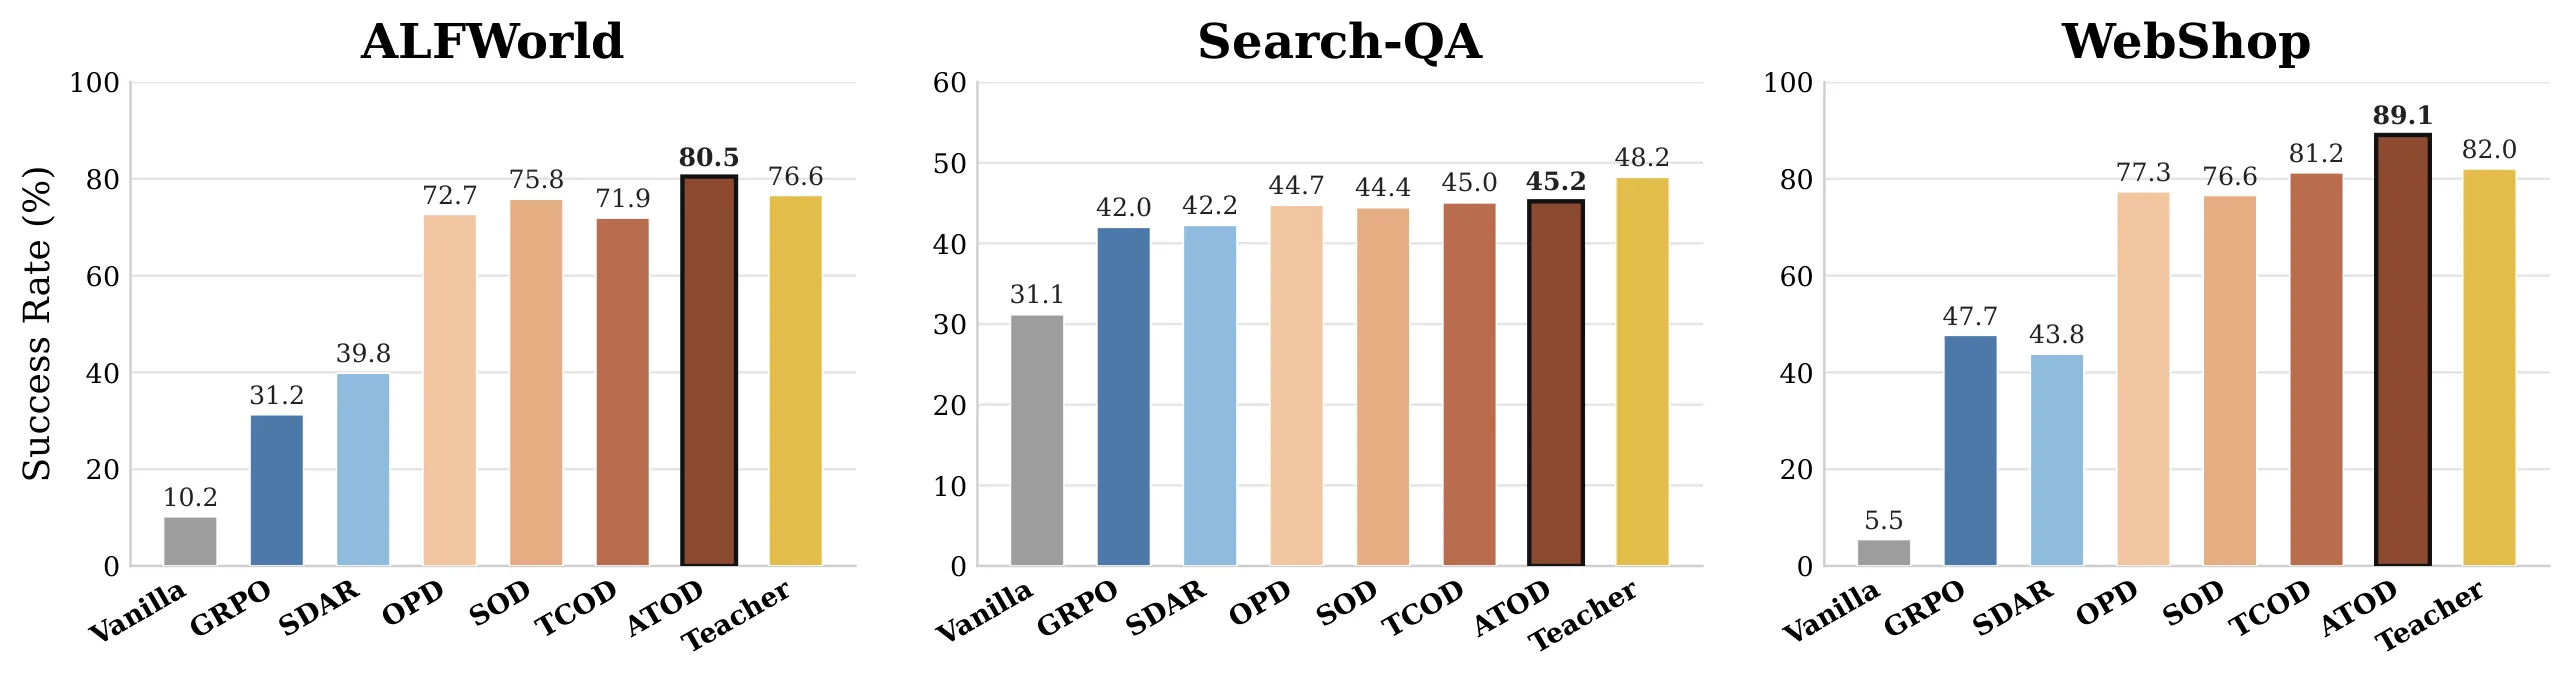
基于这一观察,ATOD 采用退火式的 OPD-RL 调度策略。在训练的前半段,策略蒸馏占据主导地位,学生模型以较大的概率从教师分布中采样进行学习,教师提供的每步监督信号如同密集的「拐杖」,引导模型快速收敛到接近教师的行为水平。随着训练的推进,系统逐步降低蒸馏信号的权重、增强强化学习奖励信号的权重。这一过程类似于物理中的退火——从高温(高探索、模仿为主)逐渐冷却到低温(低探索、奖励驱动为主),但这里「温度」控制的是两种学习信号的比例。
退火调度解决了「何时切换」的问题,但还有另一个关键挑战:如何在长轨迹中有效分配监督权重。在多轮交互任务中,并非每一个决策步骤都具有同等的重要性。某些轮次可能处于任务的关键转折点——做对则任务成功,做错则前功尽弃;而另一些轮次可能只是过渡性的辅助操作。传统的策略蒸馏对所有步骤一视同仁,导致关键步骤的监督被稀释。
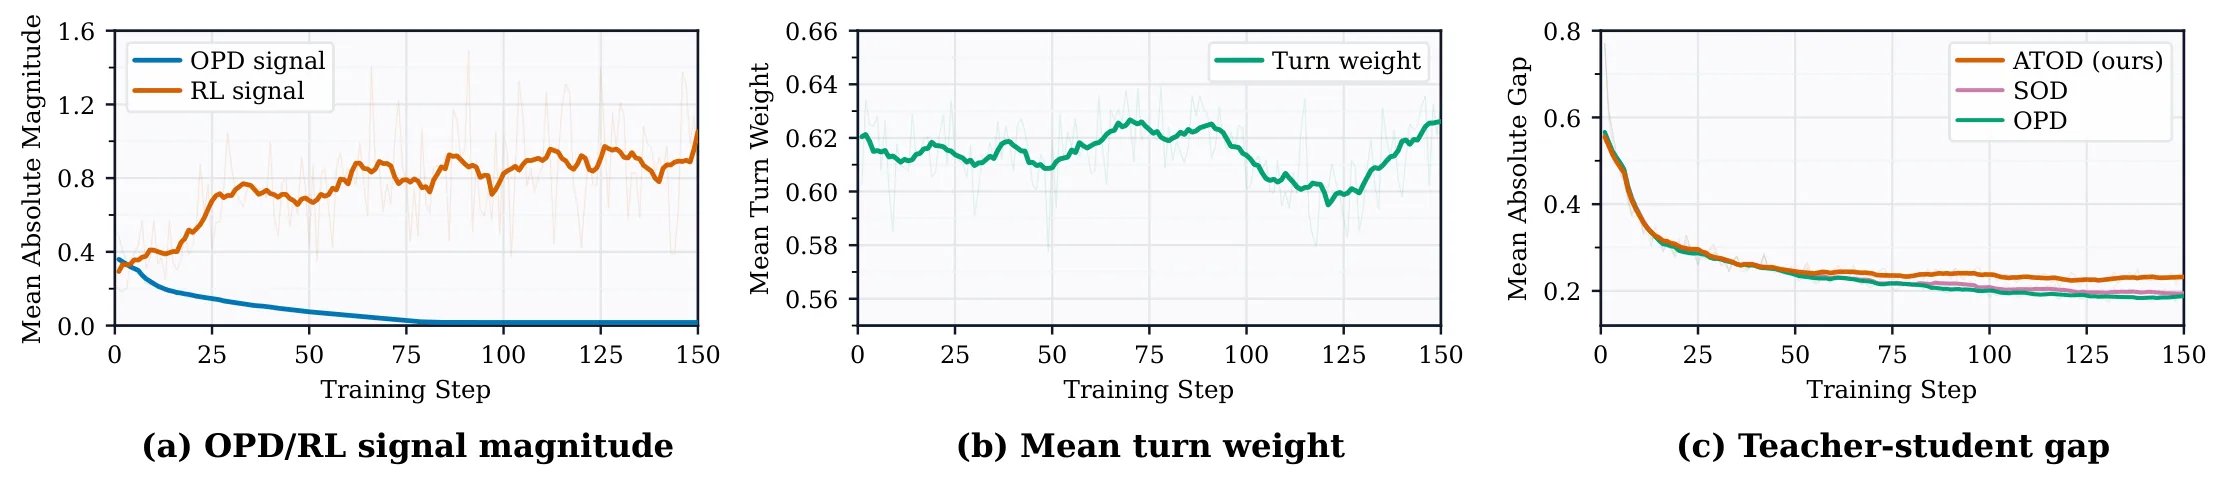
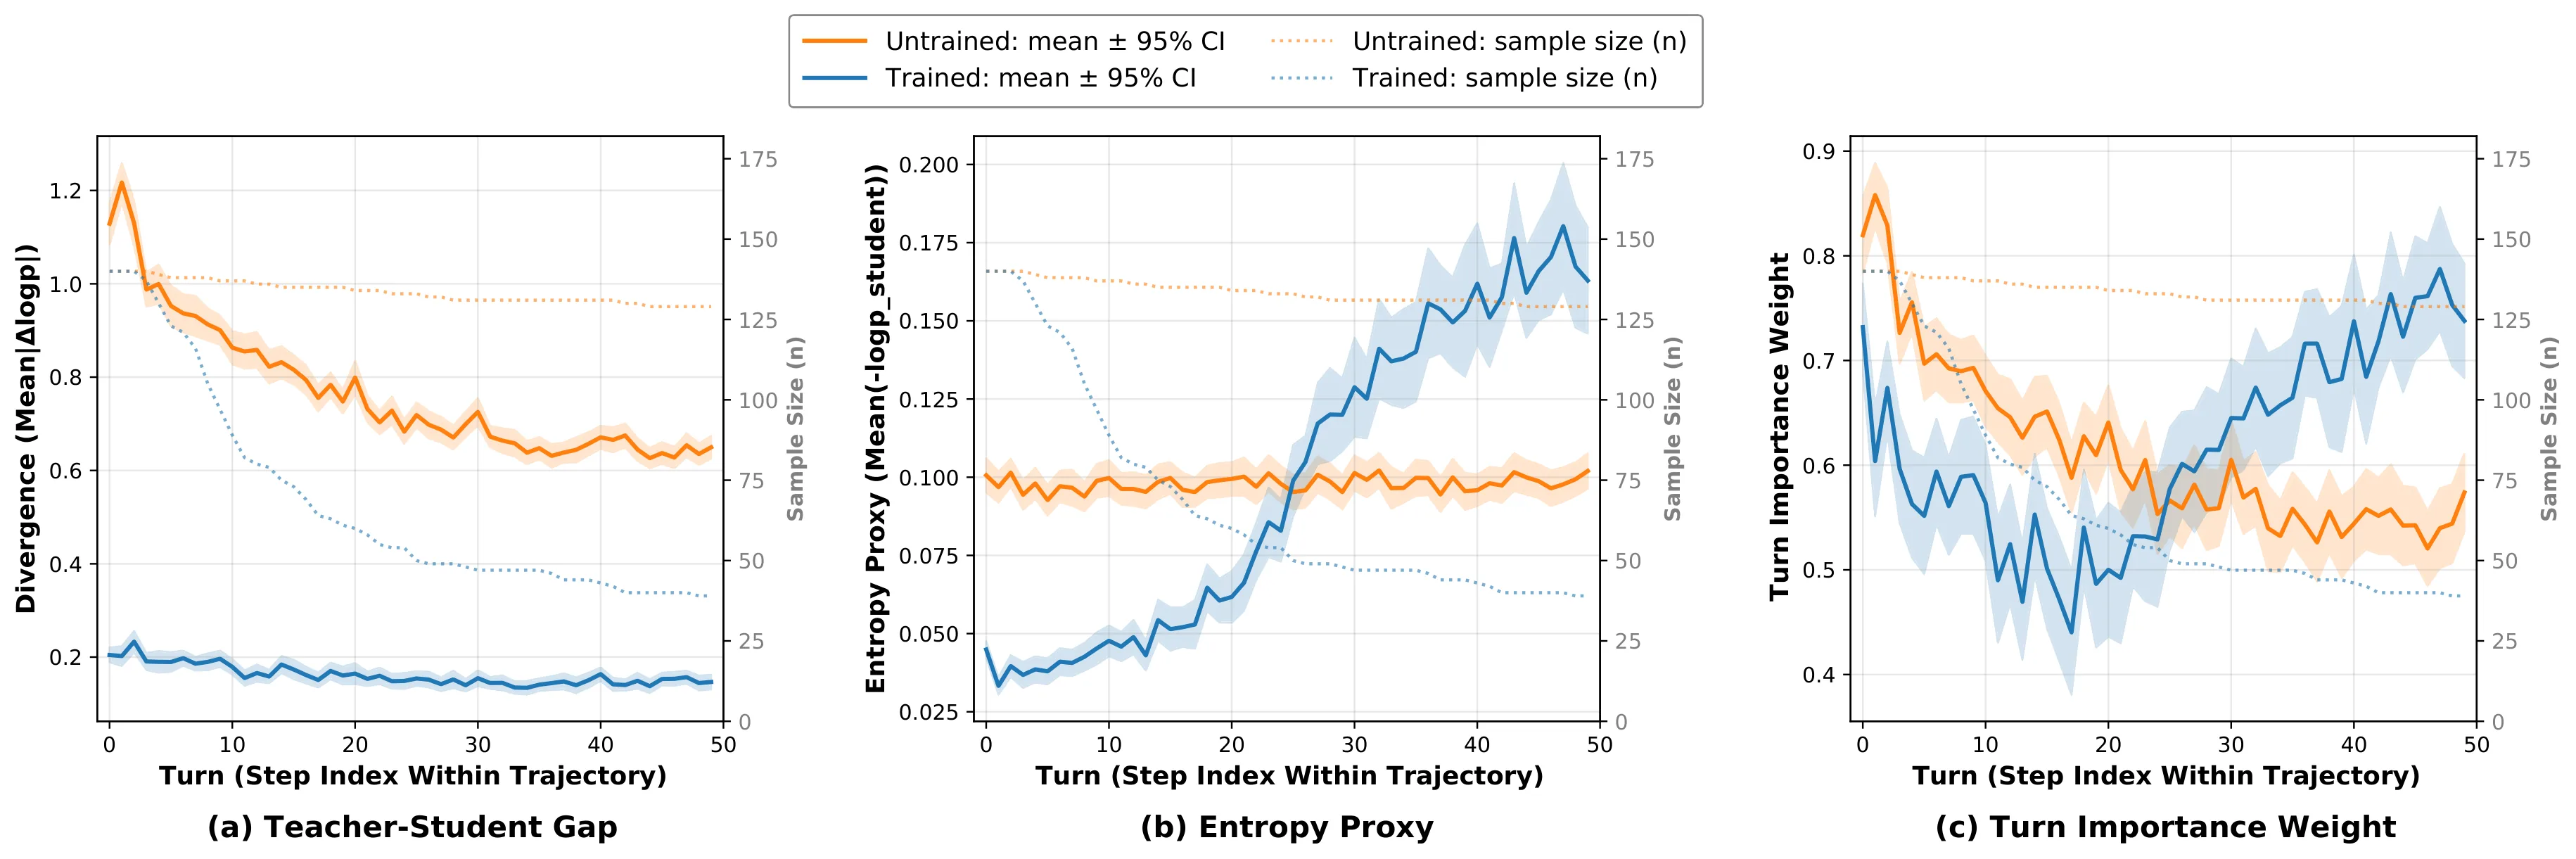
为解决这一问题,ATOD 引入了轮次级分歧-不确定性重加权机制 T-DUR。这一机制的直觉来自于两个信号:一是「分歧」,即学生模型与教师模型在当前轮次上输出差异的程度——分歧越大,说明该轮次学生越不确定应该如何行动,理应获得更多监督权重;二是「不确定性」,即学生模型自身对该轮次输出的置信度——不确定性越高,意味着模型对该决策越缺乏把握,同样应该加大学习力度。
T-DUR 将这两个信号融合为一个加权系数,对损失函数中各轮次的贡献进行重加权。其效果是平滑地放大那些处于分歧区域或低置信度区域的高价值轮次,同时适当降低过渡性步骤的权重。这样一来,即使在很长的交互轨迹中,模型也能将学习注意力集中到真正重要的决策节点上。
形式化地,ATOD 的总体优化目标可以写作一个加权混合损失:
其中 是随训练轮次 退火的 OPD-RL 混合系数, 是第 轮通过 T-DUR 计算的权重, 和 分别是蒸馏损失和强化学习损失, 是第 轮的任务损失。
实验与结果
论文在三个广泛使用的多轮交互基准上验证 ATOD 的效果。ALFWorld 是一个基于文本的家庭环境任务集,智能体需要理解自然语言指令后在虚拟房间中导航、操作物体完成目标。WebShop 模拟真实电商网站场景,要求智能体根据用户需求搜索、筛选并点击商品。Search-QA 则是问答类任务,智能体需要通过多轮搜索和推理定位答案。
实验覆盖了三种不同规模的学生模型,结果的一致性非常强。在所有设置下,ATOD 均能稳定超越对比基线。平均而言,ATOD 相比纯 OPD 方法提升了 3.03 个百分点——这意味着在模仿学习已经收敛的基础上,ATOD 额外挖掘出了一部分超越教师的潜力。更显著的提升来自与强化学习基线的对比:ATOD 相比 GRPO 平均提升 23.62 个百分点,这说明 ATOD 的退火调度有效规避了纯 RL 在早期「盲目探索」的效率损失。最引人注目的是,ATOD 最终超越了对应的教师模型,平均超出 2.16 个百分点——这正是将蒸馏的快速启动与 RL 的上限突破相结合的预期收益。
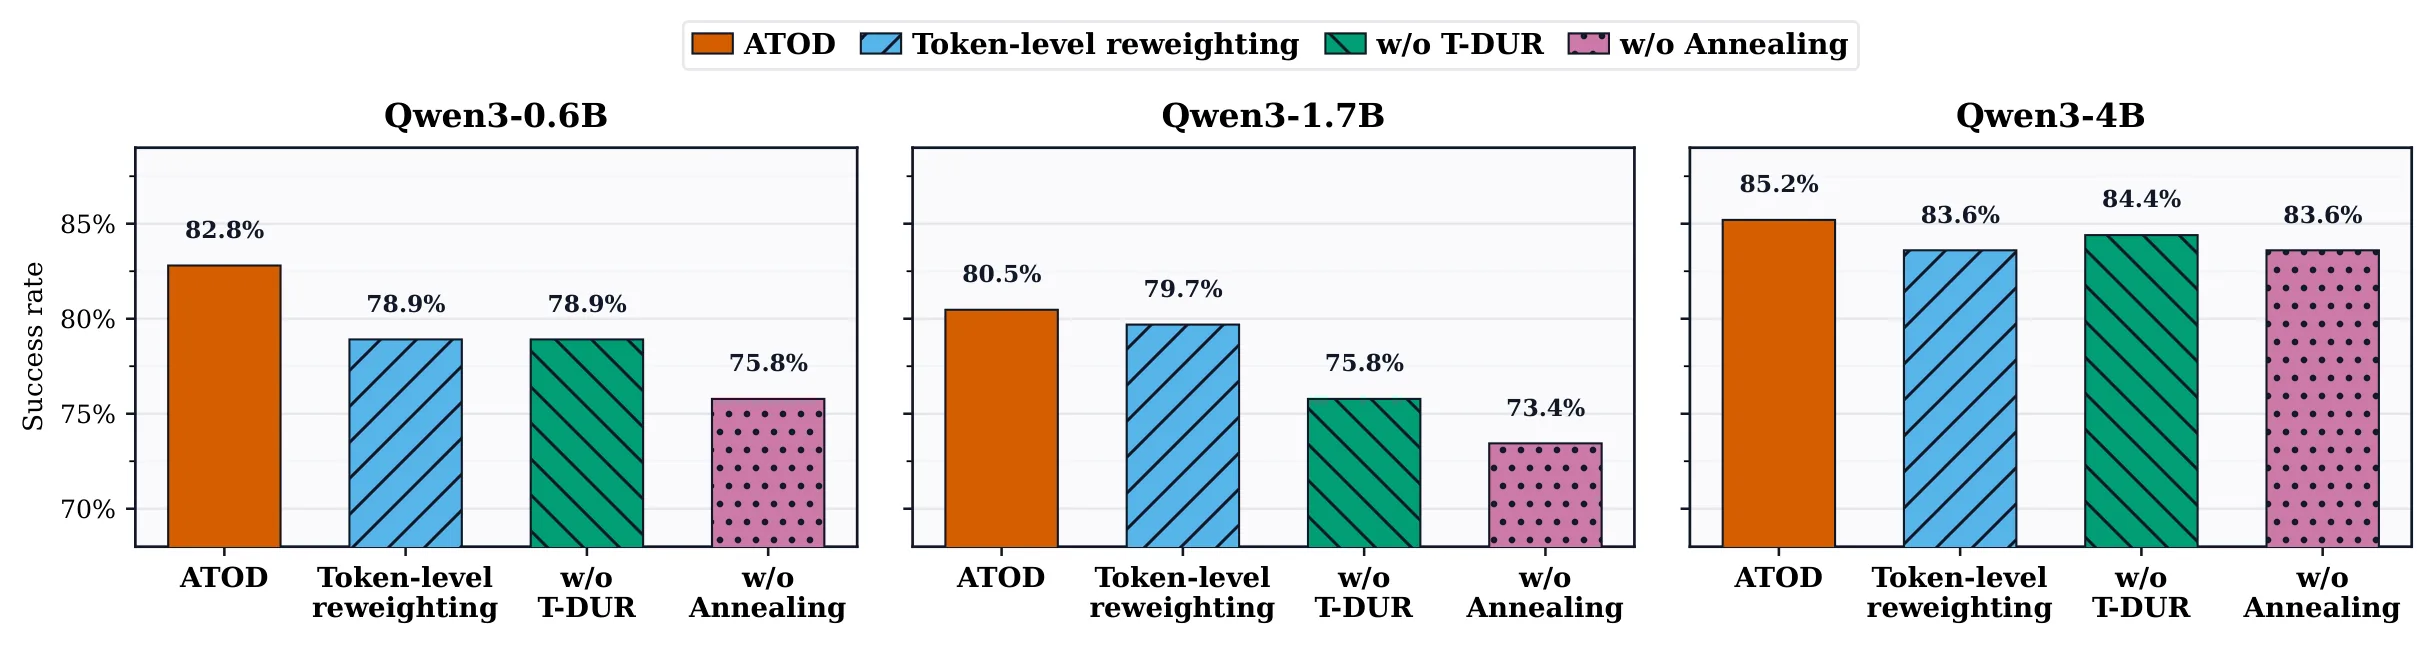
消融实验进一步验证了两个设计模块的贡献。移除退火调度、保持纯 OPD 或纯 RL 时,性能均有明显下降;移除 T-DUR 权重机制后,长轨迹任务(如 ALFWorld)的性能衰减尤为显著。这些结果从反面证明了各模块的必要性。
讨论与可借鉴点
ATOD 展示了一种优雅的思路:在训练的时序维度上进行精细化调度,而非将不同的学习方法简单叠加。退火机制将「何时学什么」这一问题形式化,T-DUR 则解决了「在各部分如何分配注意力」的问题。这种分而治之的设计哲学值得借鉴。
从局限来看,ATOD 的退火调度引入了新的超参数——退火曲线的形状与节奏,这些参数在不同任务间可能需要调优。此外,T-DUR 机制假设教师模型在大多数步骤上可靠,当任务本身超出教师能力范围时,分歧信号可能产生误导。这一问题在更强的教师模型或更简单的任务上影响较小,但在开放域长程任务中值得进一步探索。
对于 [[语言模型智能体]] 的后训练实践,ATOD 的核心启示在于:单一学习方法很难同时兼顾效率与上限。快速起步与最终超越并非不可兼得,关键在于为不同训练阶段匹配最适合的学习信号。随着模型规模的缩减和任务复杂度的上升,这种动态调度的需求只会更加迫切。ATOD 为这一方向提供了一个坚实的基线。
概念 · 7 个
摘要
结合强化学习的在策略蒸馏方法
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
SEED:面向智能体强化学习的自演化在策略蒸馏方法
SEED: Self-Evolving On-Policy Distillation for Agentic Reinforcement Learning
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 18 张
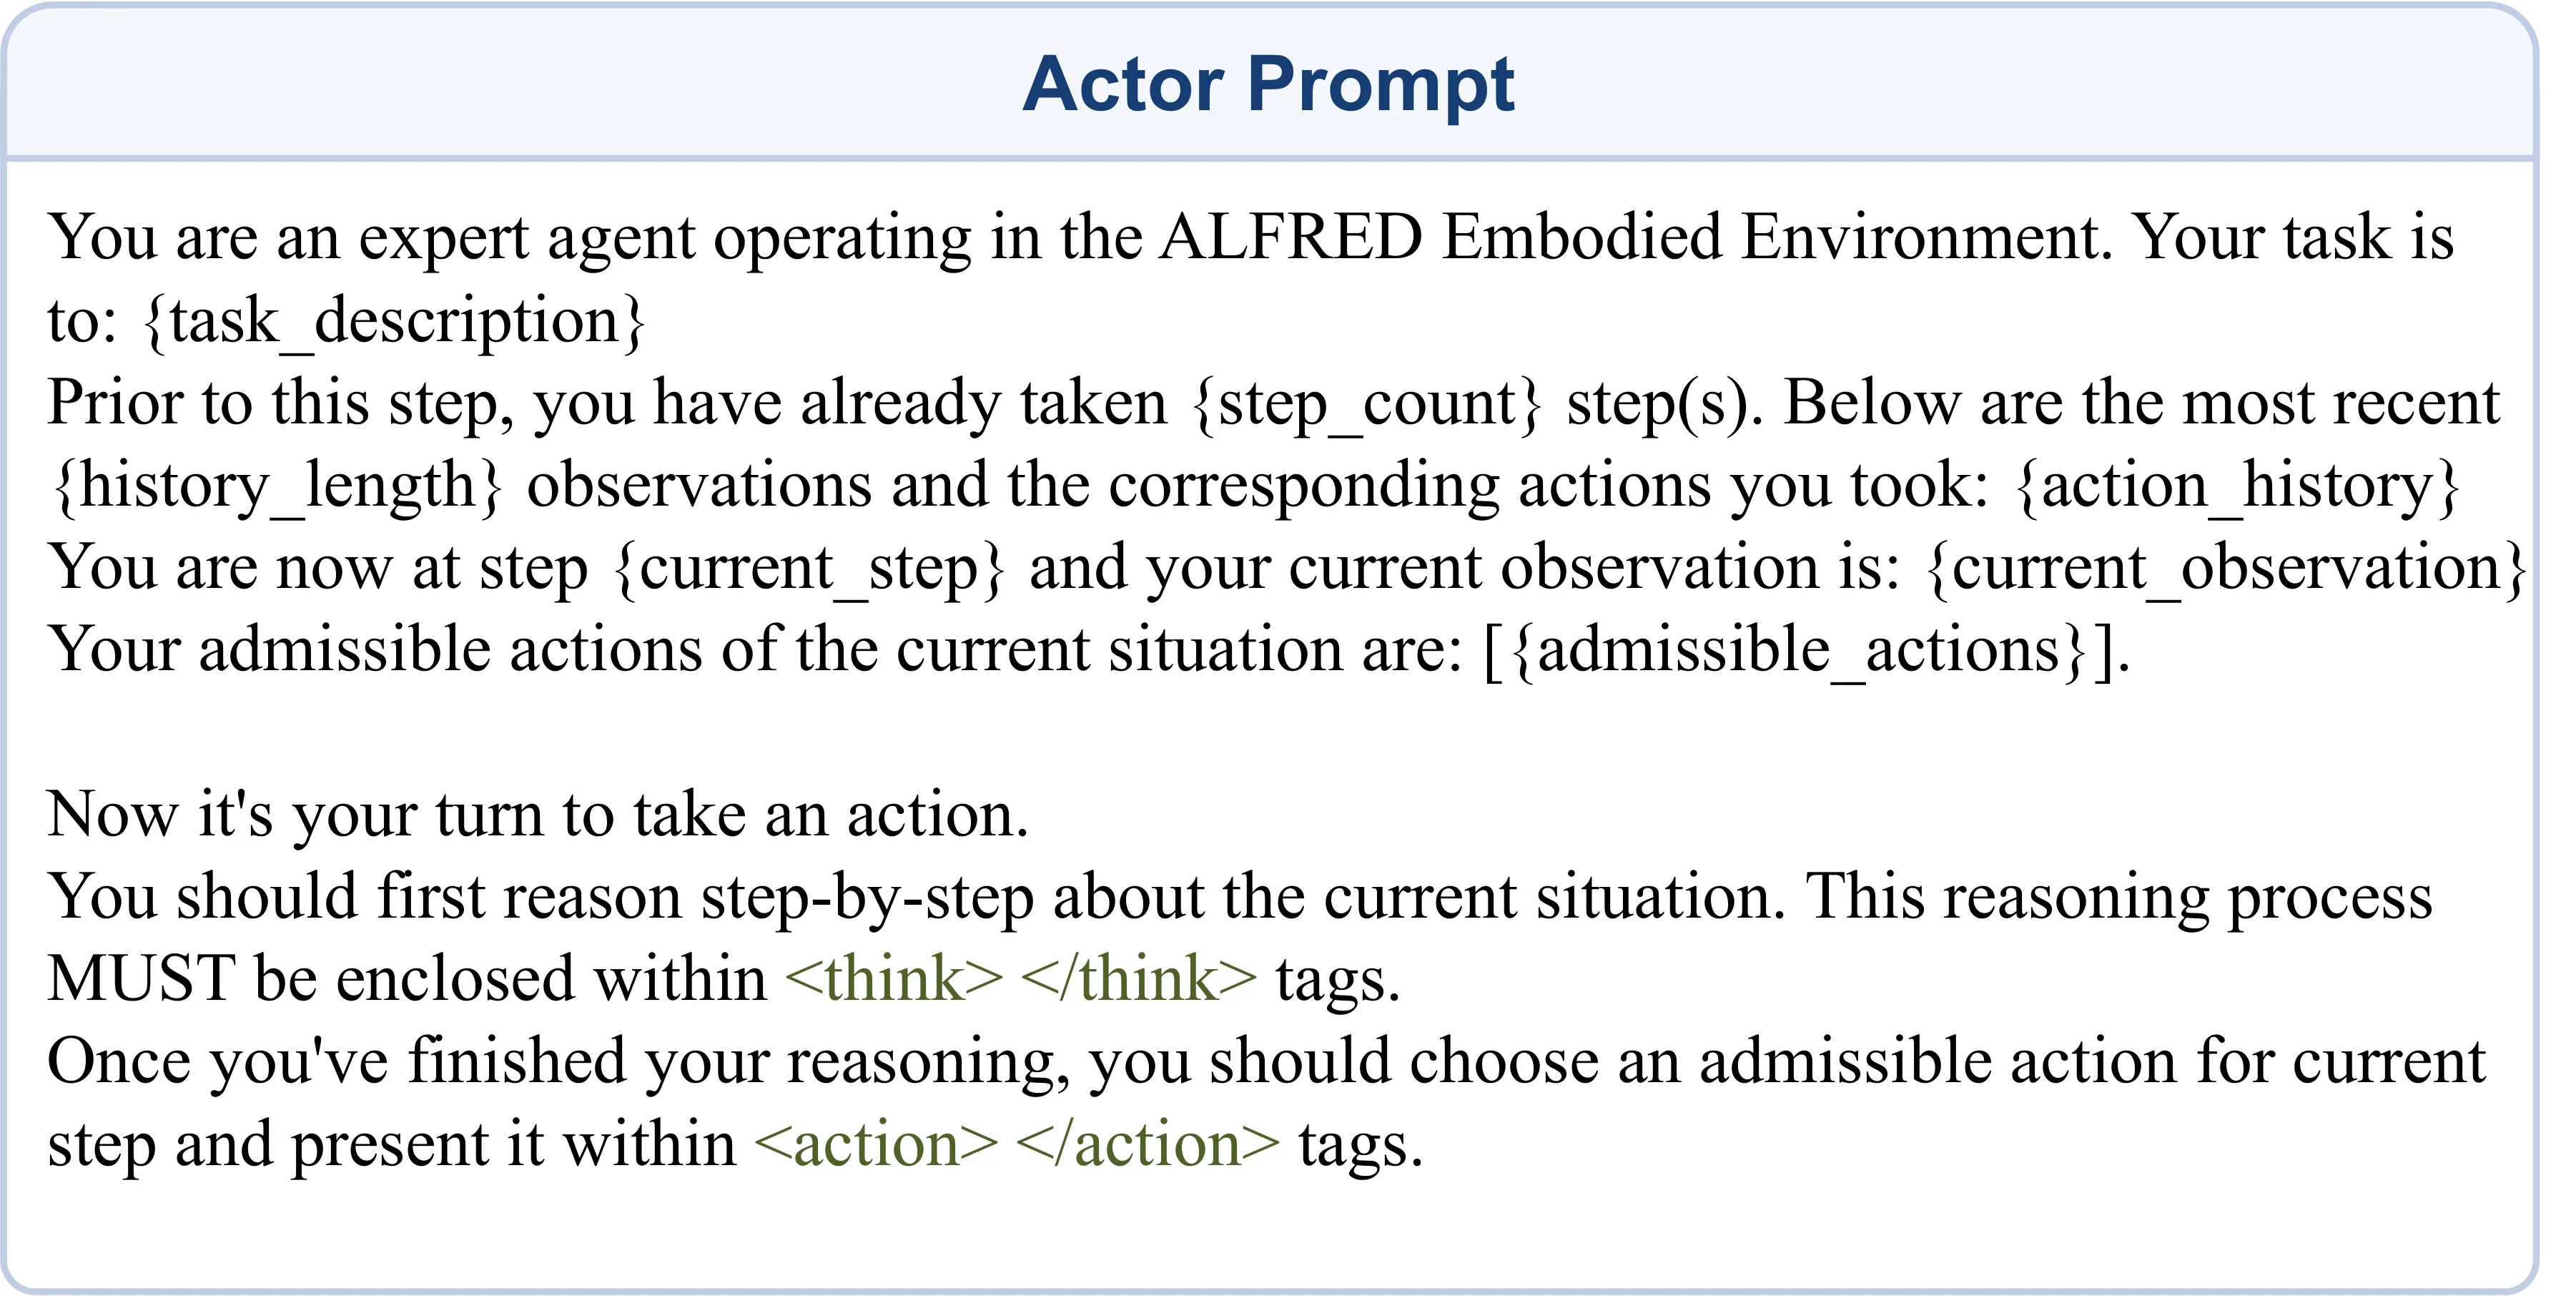
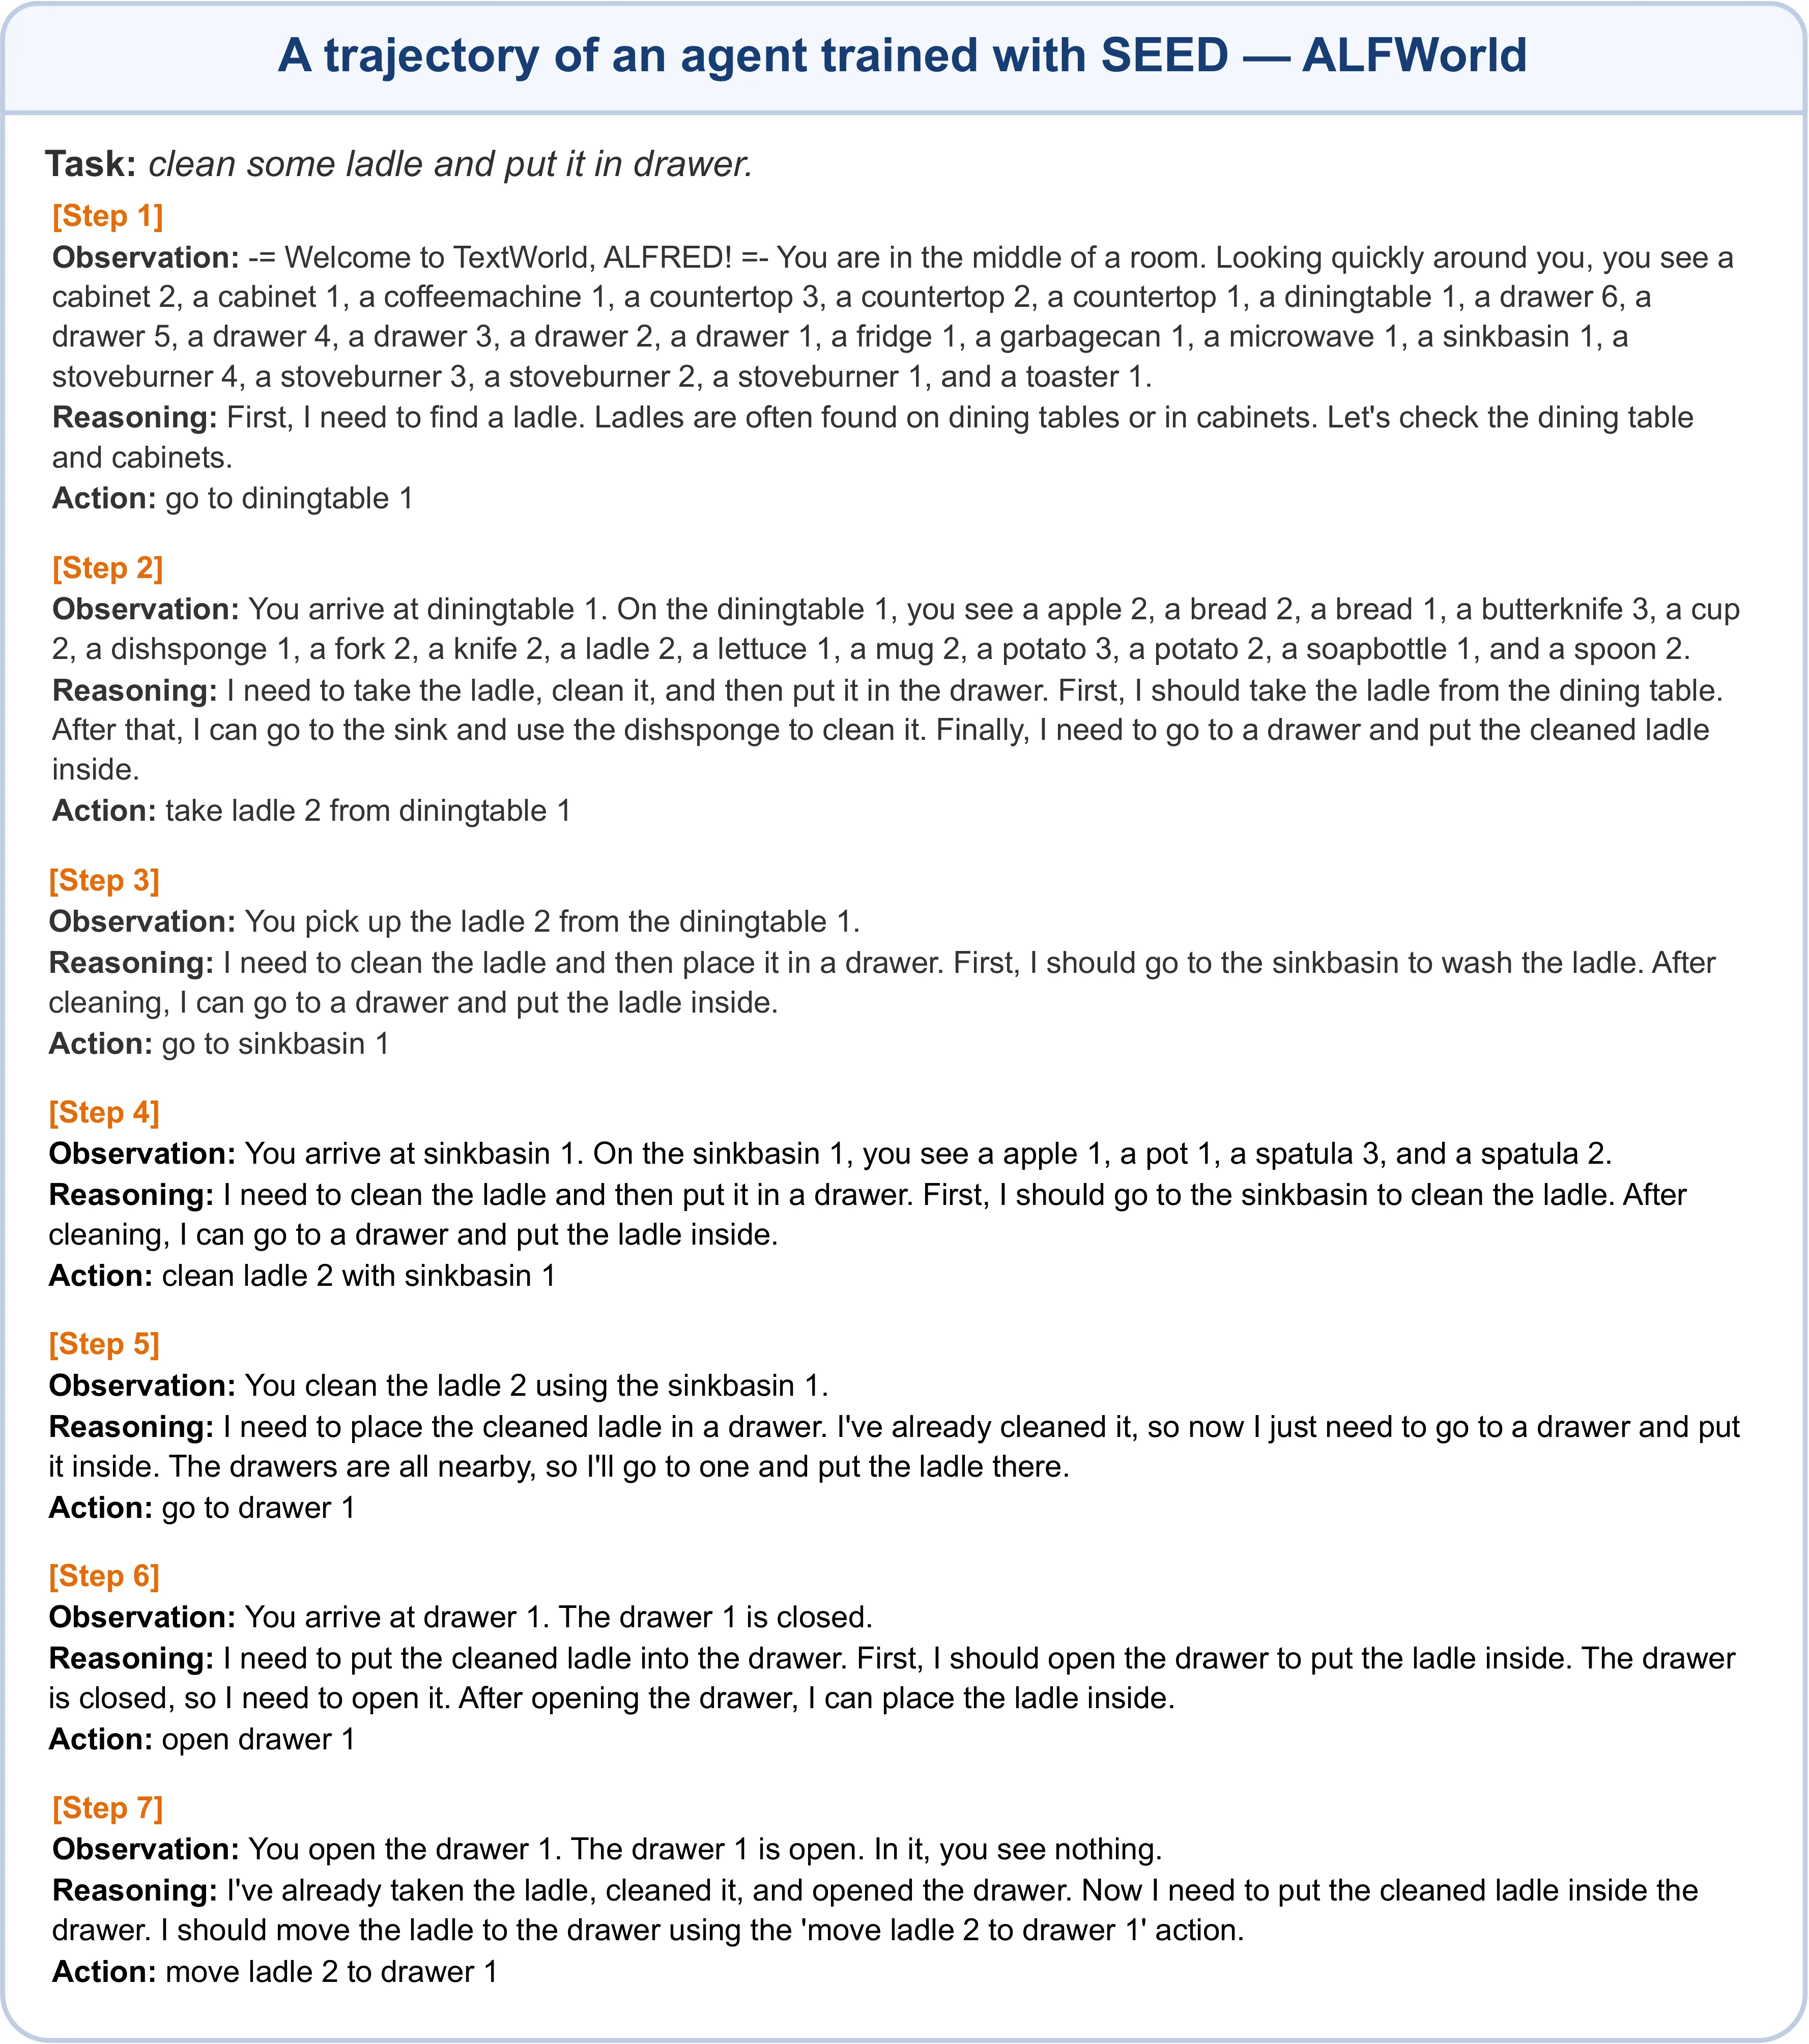
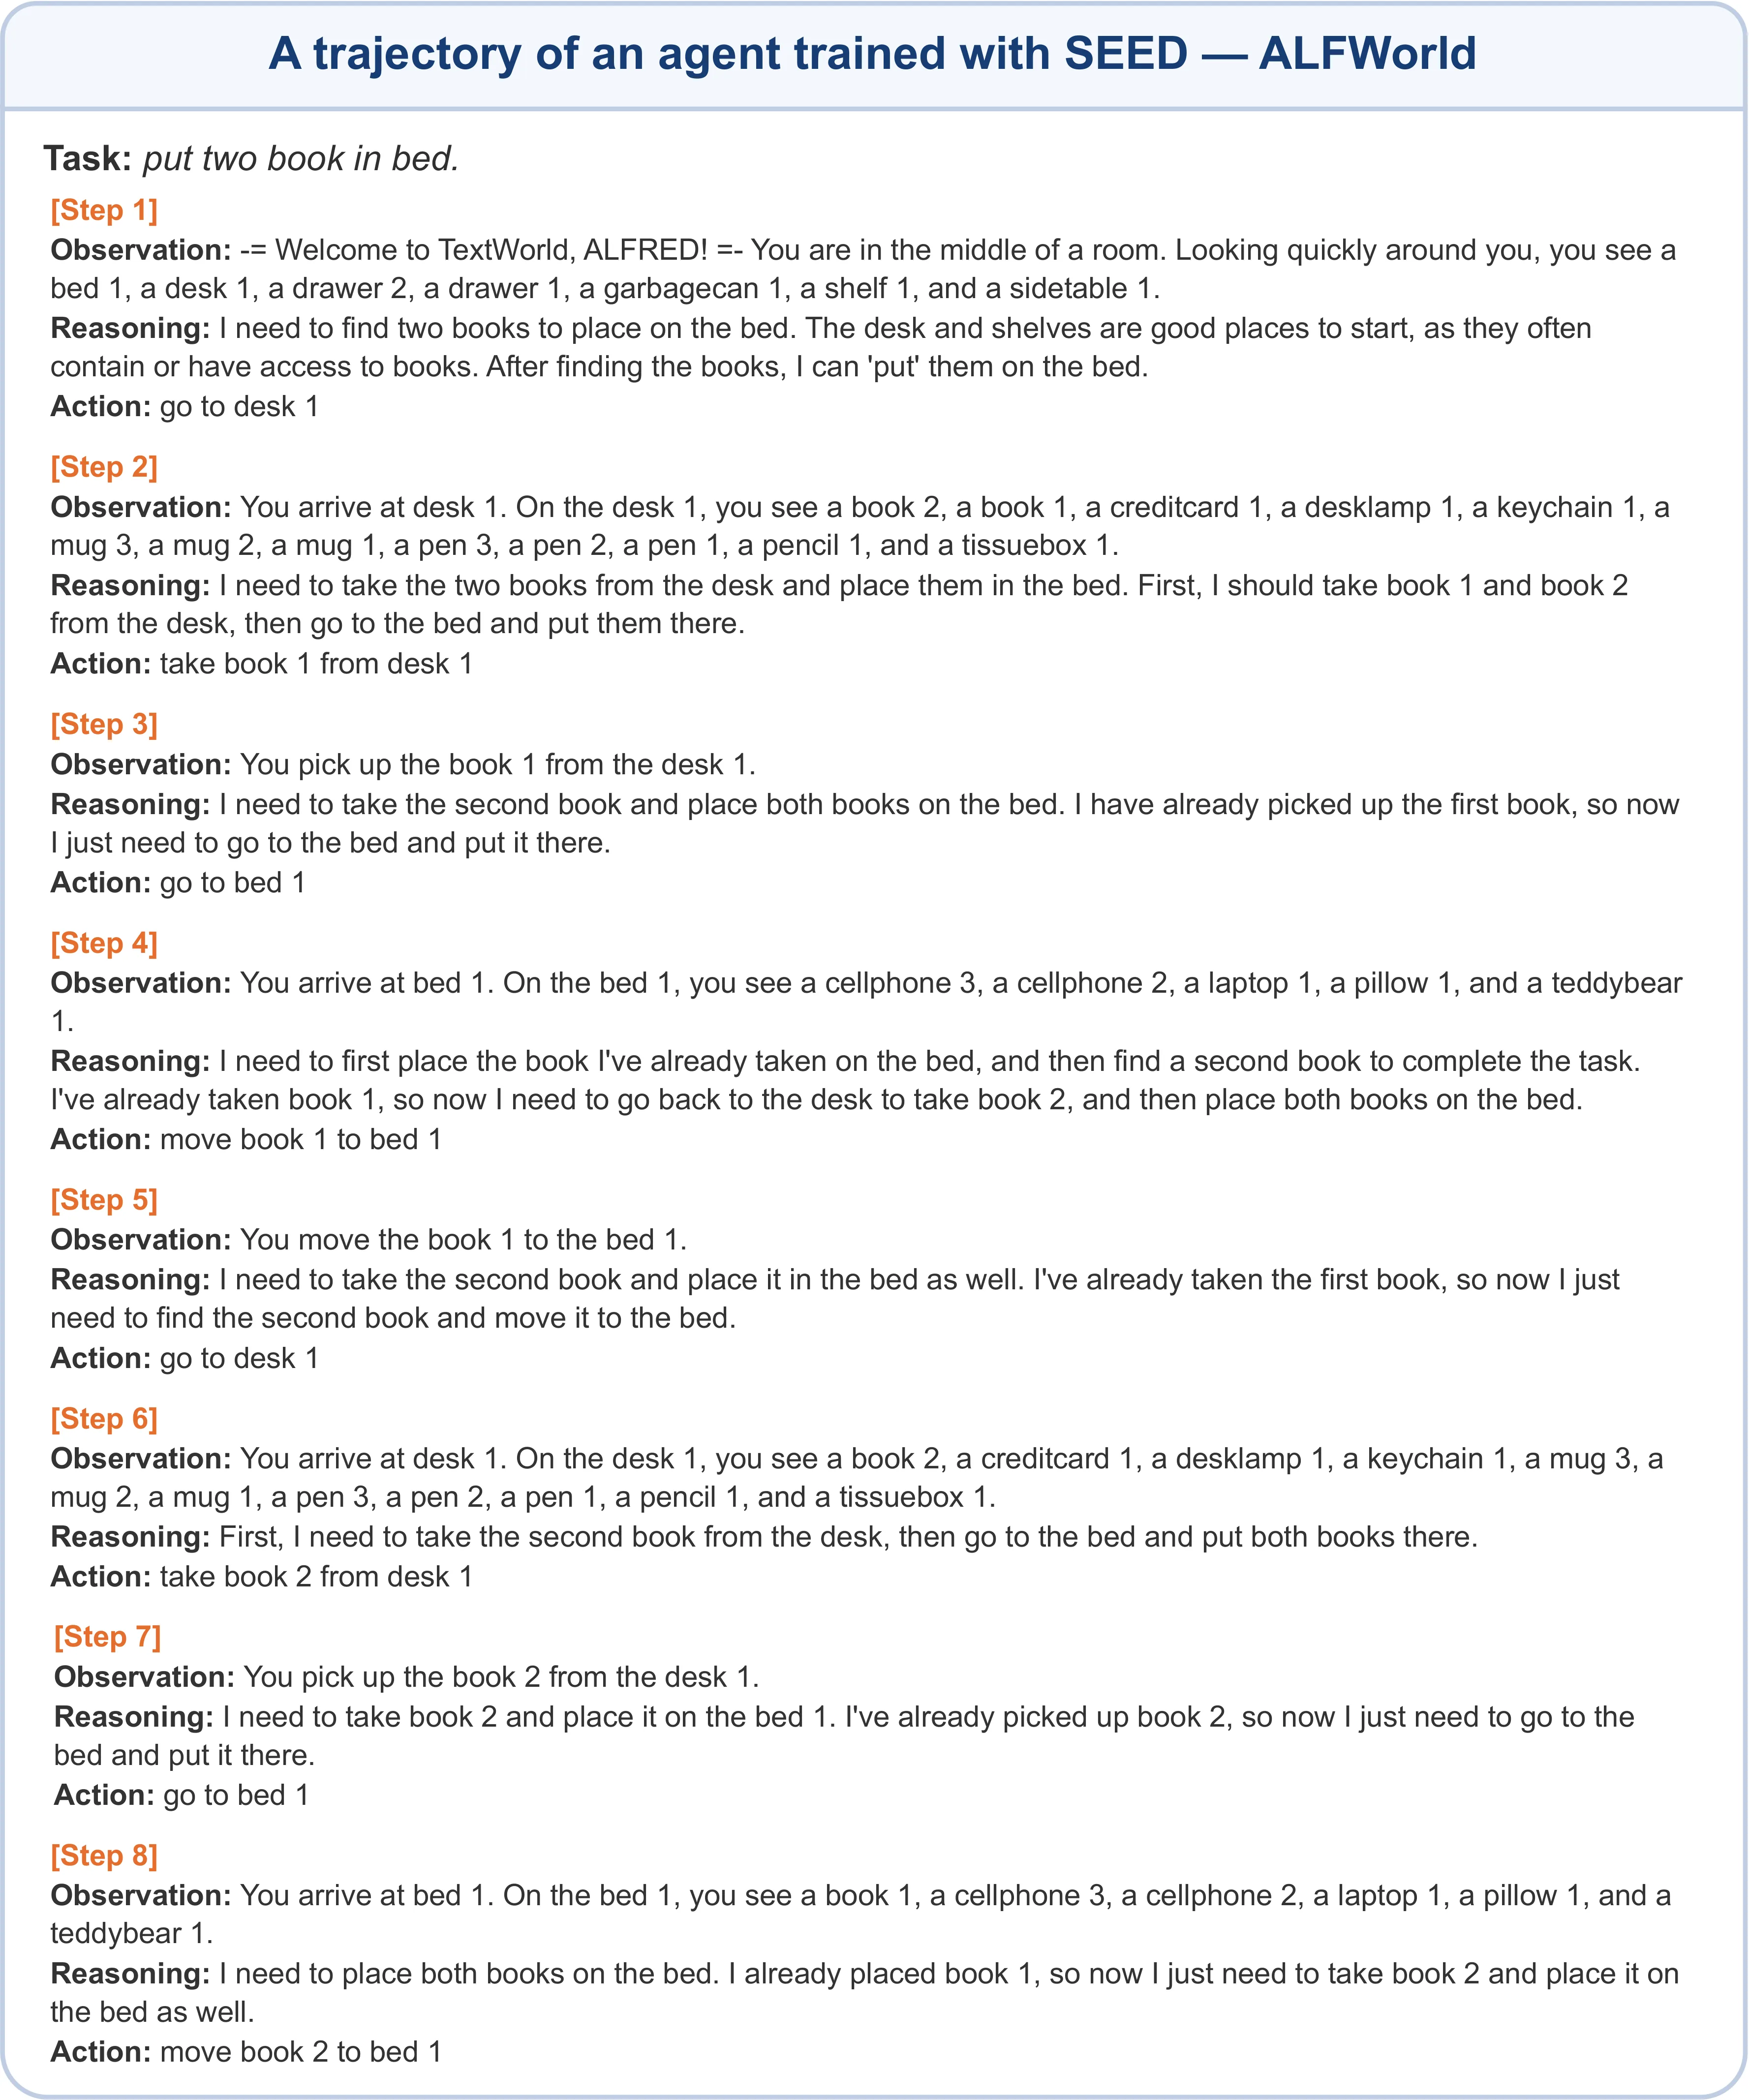
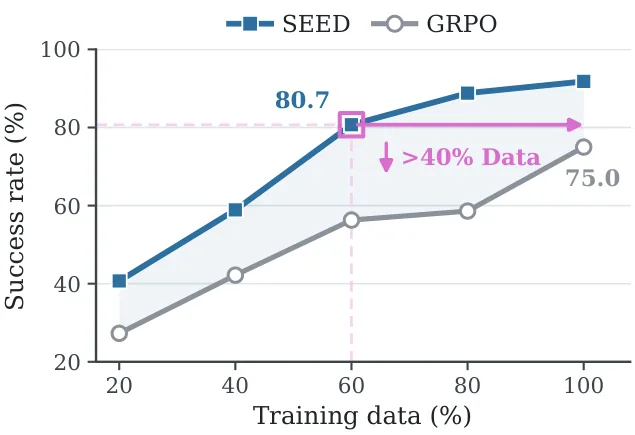
大语言模型作为交互式智能体在长程任务中面临结果级强化学习奖励稀疏、监督信号不足的难题。本文提出SEED框架,将已完成轨迹转化为自然语言后视技能,并由策略自身提取技能、在普通与技能增强上下文下重新评分,将概率偏移转为密集的token级on-policy蒸馏信号,与结果奖励联合优化。实验在文本与视觉智能体任务上一致提升性能与样本效率,并能稳健泛化至未见场景。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
大语言模型正逐步成为长程交互任务中的核心智能体,从网页导航、API 调用到机器人操作,这些场景都要求模型在多轮交互中持续做出决策并适应环境反馈。然而,当模型需要完成复杂的序列决策时,传统[[监督学习]]范式面临严峻瓶颈:人工为每一步交互标注最优动作不仅成本极高,而且难以覆盖真实环境中可能出现的海量变体情况。
[[强化学习]]为这一困境提供了一条更具扩展性的解决路径——模型可以在环境中自主探索并从反馈中学习。然而,基于结果的强化学习方法存在一个根本性的局限性:它只在轨迹结束时提供稀疏的奖励信号。以完成一个多步骤任务为例,模型可能在数百次环境交互之后才收到一个成功或失败的结果标签,而对于过程中每一步决策是否合理,奖励信号完全沉默。这种监督稀疏性在回合级结果与词元级策略学习之间制造了巨大的监督鸿沟,导致策略梯度估计方差大、更新方向模糊、学习效率低下。
一种直觉上的解决思路是借鉴[[事后经验回放]]的思想——将失败的轨迹重新解释为另一种任务的尝试,从而为中间决策提供更丰富的监督。然而,传统事后方法主要针对离散动作空间设计,且依赖额外的经验回放缓冲区来存储历史轨迹,这在需要高吞吐量采样的在线学习场景中会带来显著的存储与计算开销。更关键的是,这些方法通常只能捕捉到简单的成功/失败二元信号,难以表达轨迹中的高层语义信息——为什么某一步会失败?观察到了什么关键信息导致决策偏差?这些关于工作流和决策逻辑的知识无法被简单的奖励塑形所编码。
SEED 的核心洞察正是由此切入:既然大语言模型本身具备强大的自然语言理解与生成能力,能否让它自己从轨迹中提炼出可复用的技能知识,并将这些知识转化为细粒度的辅助监督信号?
方法
SEED 的方法设计围绕三个关键步骤展开:轨迹到技能的语义转化、策略自提取机制、以及概率偏移驱动的蒸馏信号。这个框架的核心理念是:事后监督信号不应该是静态的、一成不变的,而应该随着策略能力的提升而共同演化。
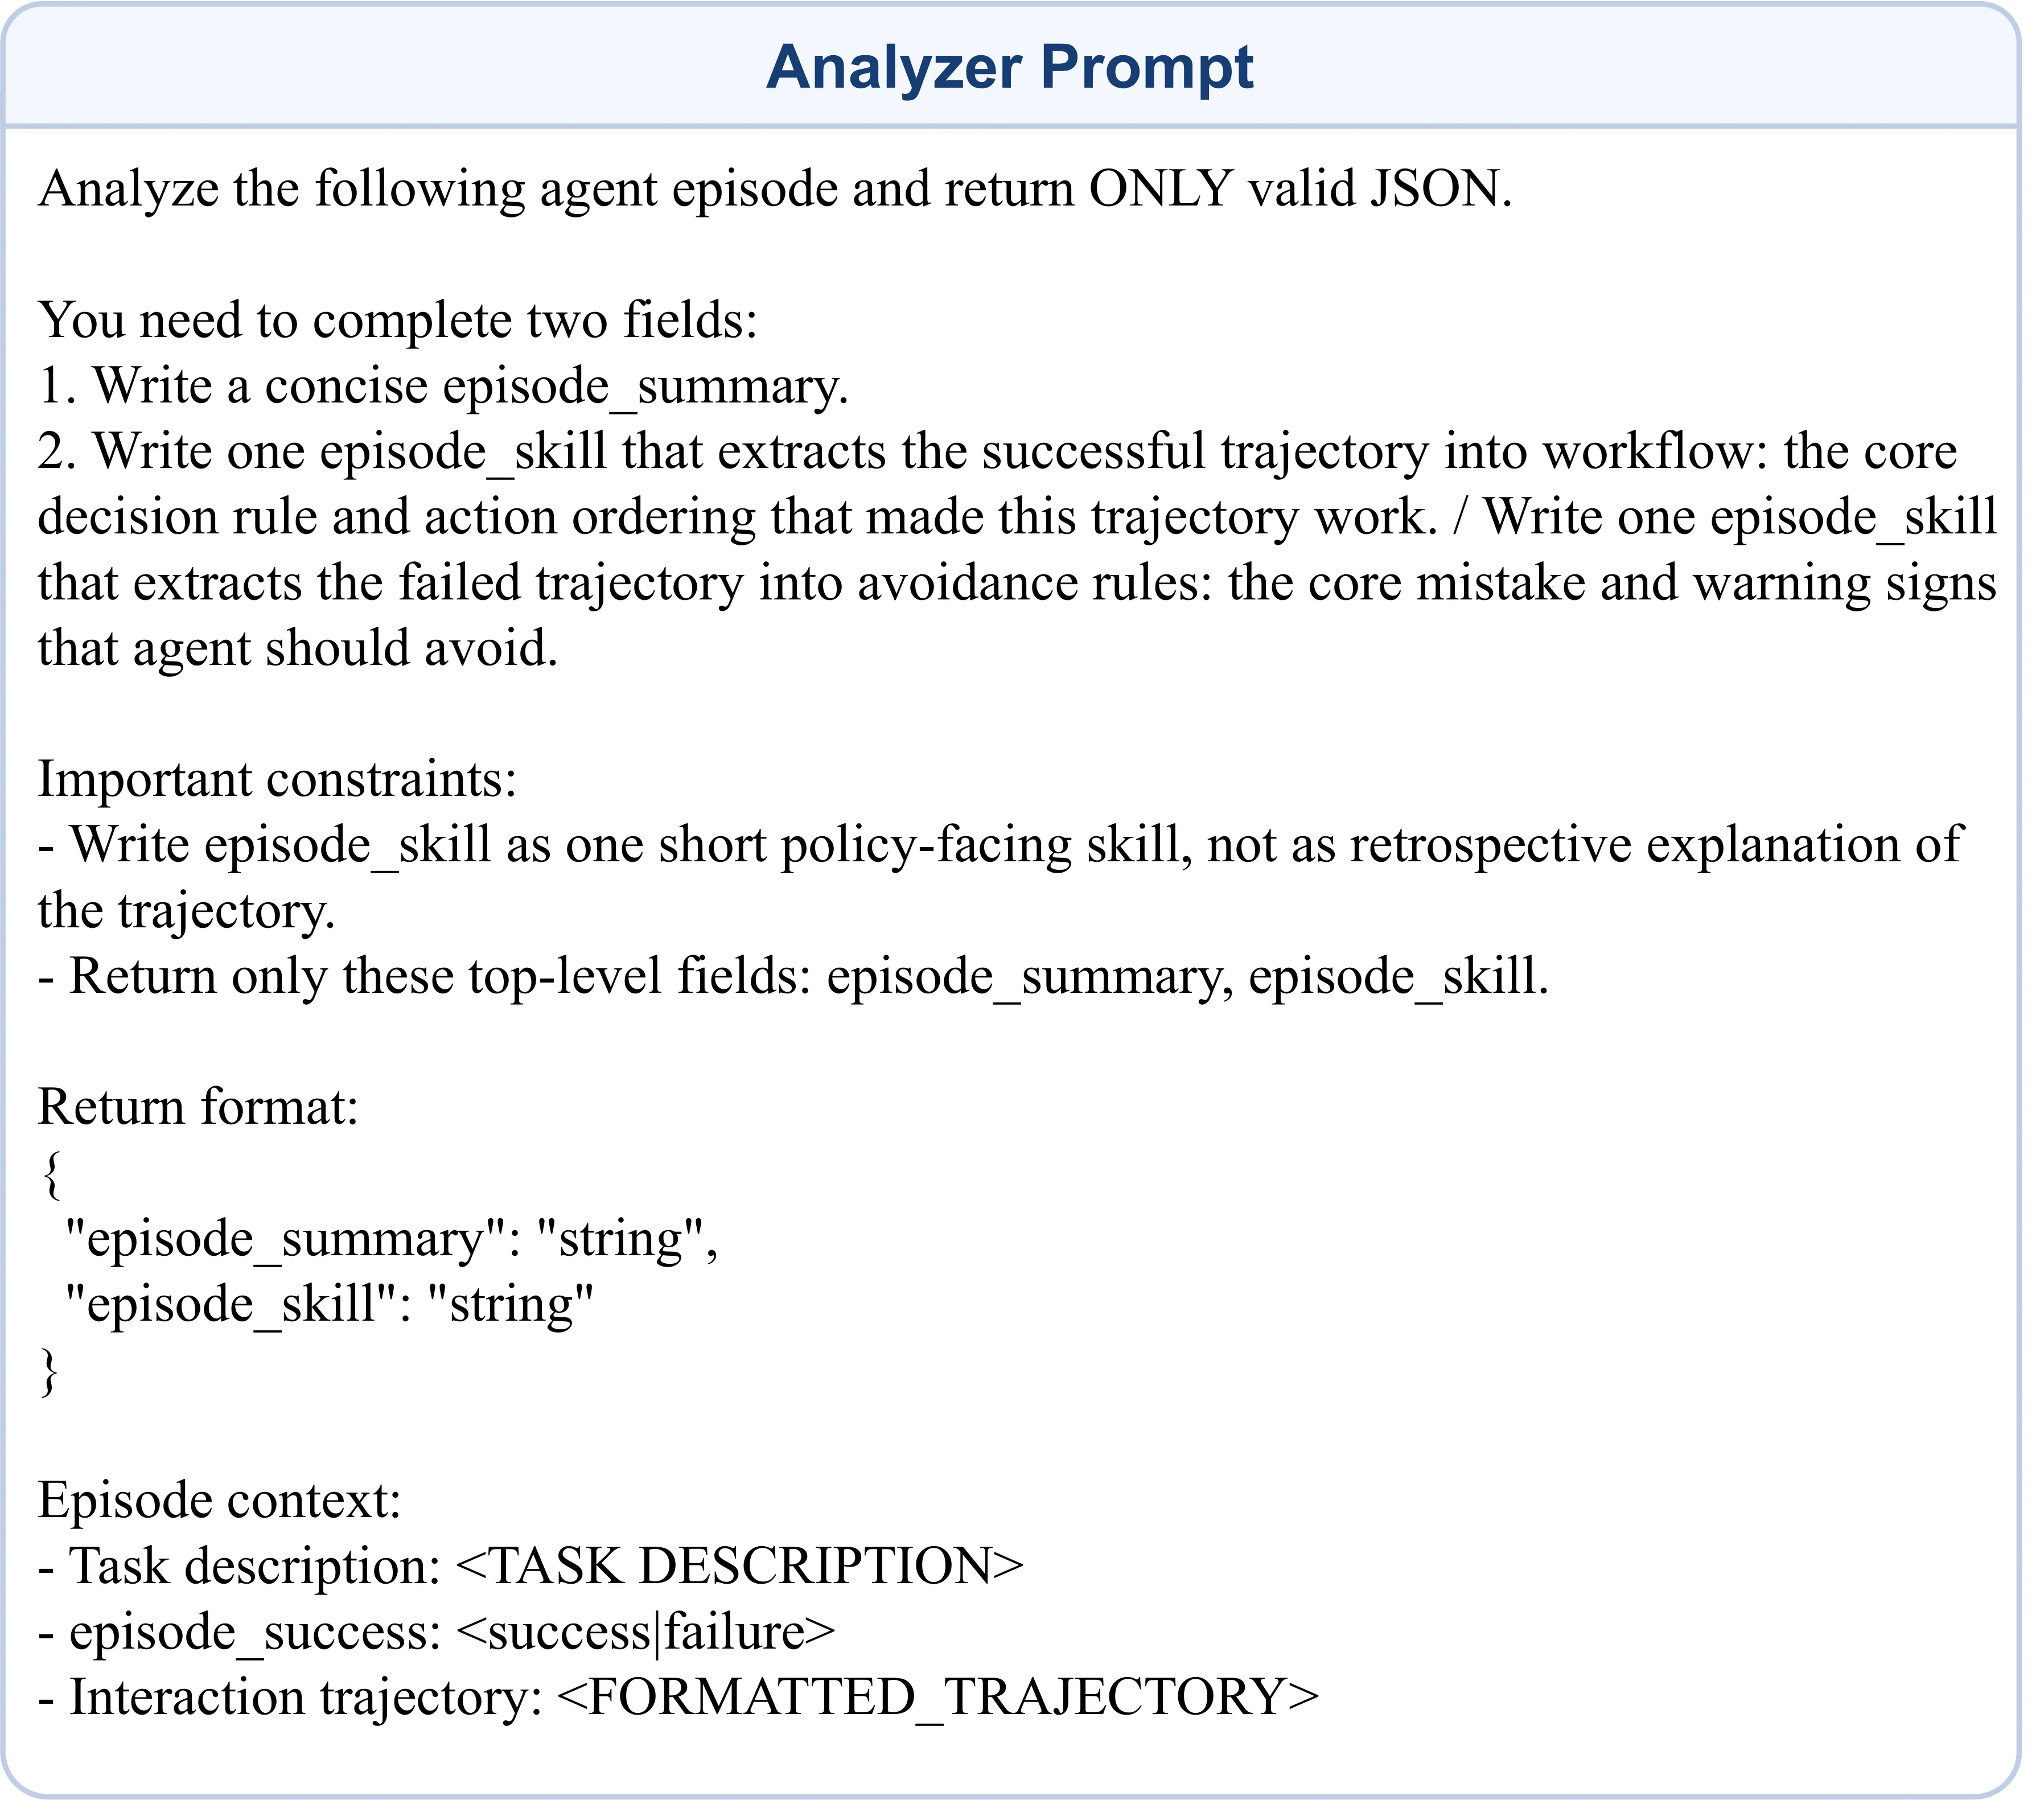
在第一阶段,SEED 对策略模型进行微调,使其能够分析已完成的轨迹并生成自然语言技能描述。这些技能以文本形式捕捉三类可复用的知识:工作流程(如“当遇到错误信息 X 时,应该先检查配置文件而非直接重试”)、关键观察(如“服务器日志中出现的 OOM 关键字预示着资源即将耗尽”)以及失败规避规则(如“在调用外部 API 前应先验证输入参数的边界合法性”)。与仅仅返回一个标量奖励值不同,自然语言技能携带了丰富的语义信息,能够解释决策的因果逻辑和上下文依赖关系。
在第二阶段,当 SEED 进入实际的[[强化学习]]训练循环时,当前策略模型扮演双重角色:它既负责在环境中采集新的交互轨迹,又充当从这些轨迹中提取事后技能的分析器。这一设计蕴含着精妙的自我改进循环——当策略通过学习变得更强时,它的技能分析能力也会同步提升,从而能够从轨迹中提取出更高质量的监督信号;而更高质量的事后监督反过来又能加速策略的提升。这种协同演化机制使得辅助监督信号始终与策略能力保持匹配,避免了传统方法中监督信号与策略能力脱节的问题。
在第三阶段,SEED 对采样的动作在两种不同的上下文条件下进行重新评分:普通上下文(不包含任何技能信息)和技能增强上下文(在输入前附加提取的技能描述文本)。技能引发的概率偏移量 体现了技能知识对决策的影响程度——如果某个动作在技能上下文中被显著提升,说明该动作与技能所描述的工作流高度一致,值得被强化;反之,如果概率变化不大,则说明该动作可能与技能知识无关或存在冲突。SEED 将这种概率偏移量化为密集的 token 级在策略蒸馏信号,具体形式为:
其中 表示技能上下文相对于普通上下文带来的概率变化量。这个蒸馏损失与原始的[[策略梯度]]损失联合优化,使辅助监督始终与当前轨迹分布保持对齐(on-policy),从而避免了离线蒸馏方法中常见的分布偏移问题。
实验与结果
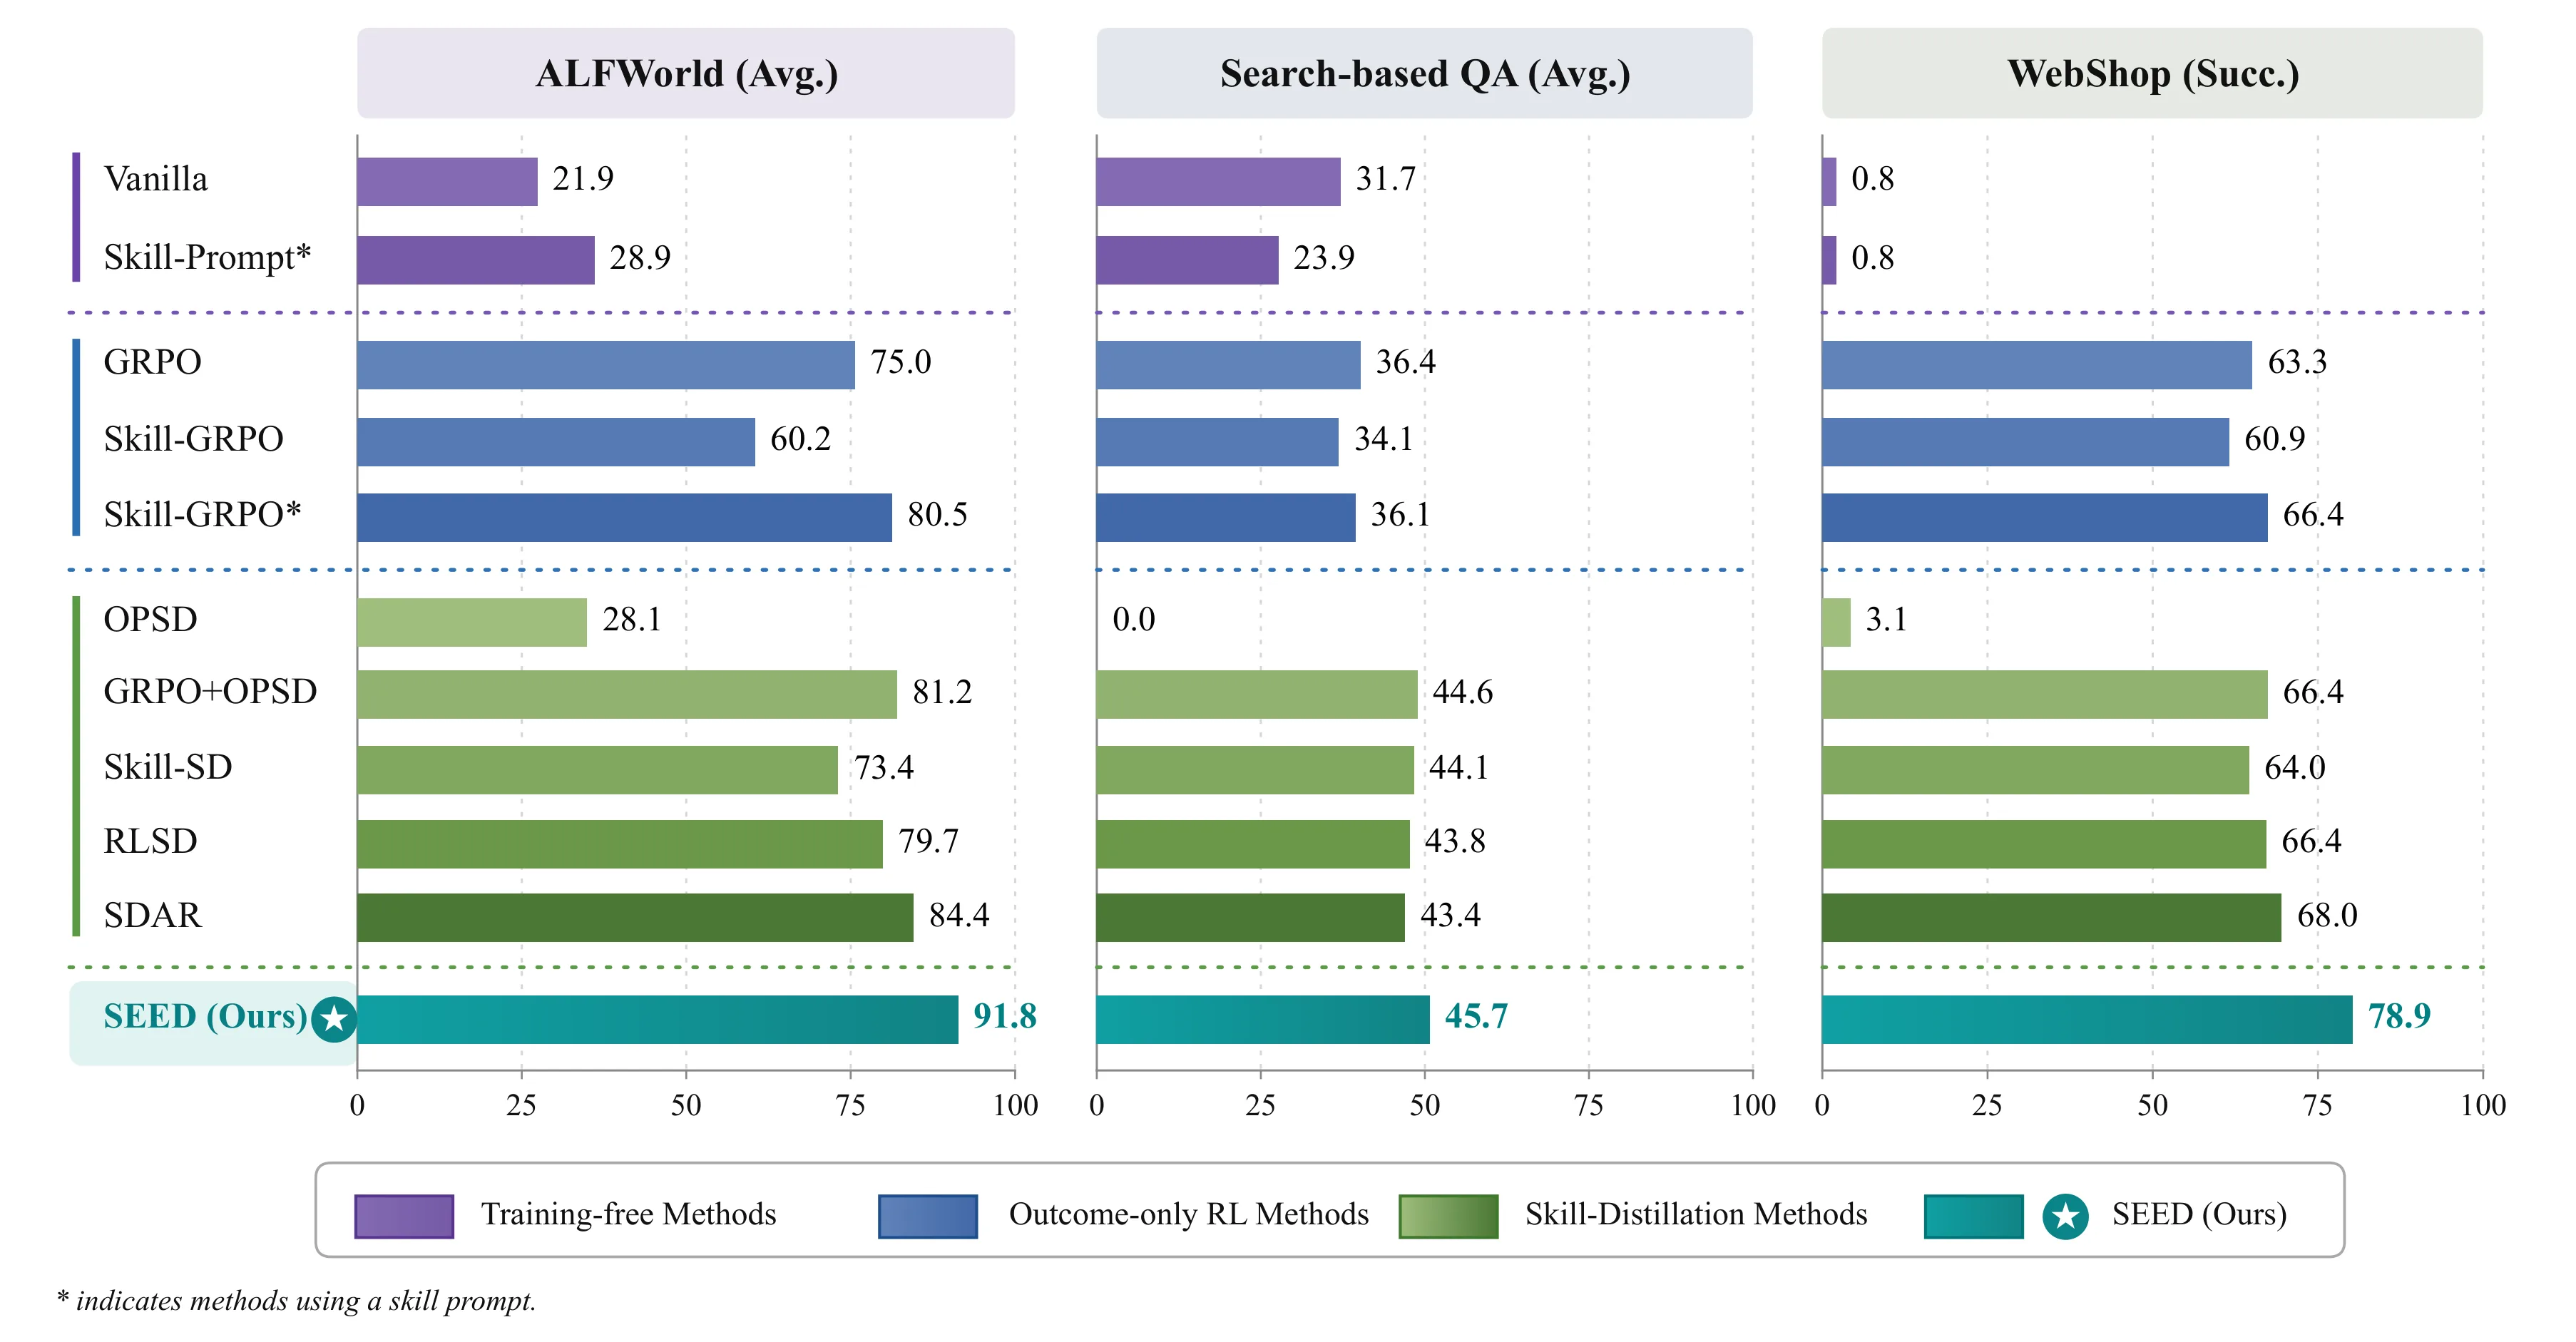
研究团队在两类典型的智能体任务上系统验证了 SEED 的有效性。第一类是文本智能体任务,包括网页导航和 API 调用场景,要求模型理解自然语言指令并在模拟环境中完成多轮交互;第二类是视觉智能体任务,包括机器人操作和视觉问答,需要模型融合视觉感知与决策制定。对比基线涵盖标准 PPO、事后经验回放方法(HER)以及几种代表性的离线蒸馏方法。
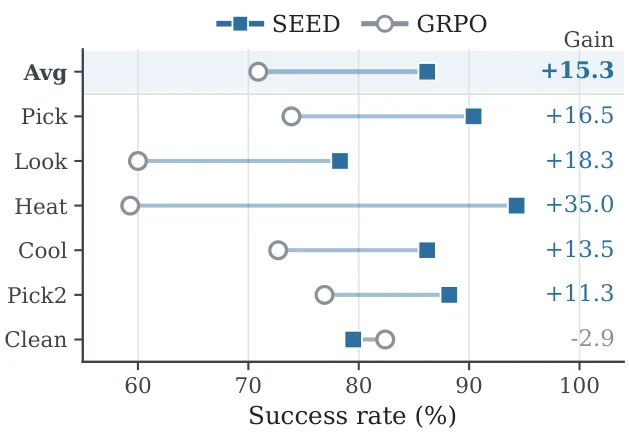
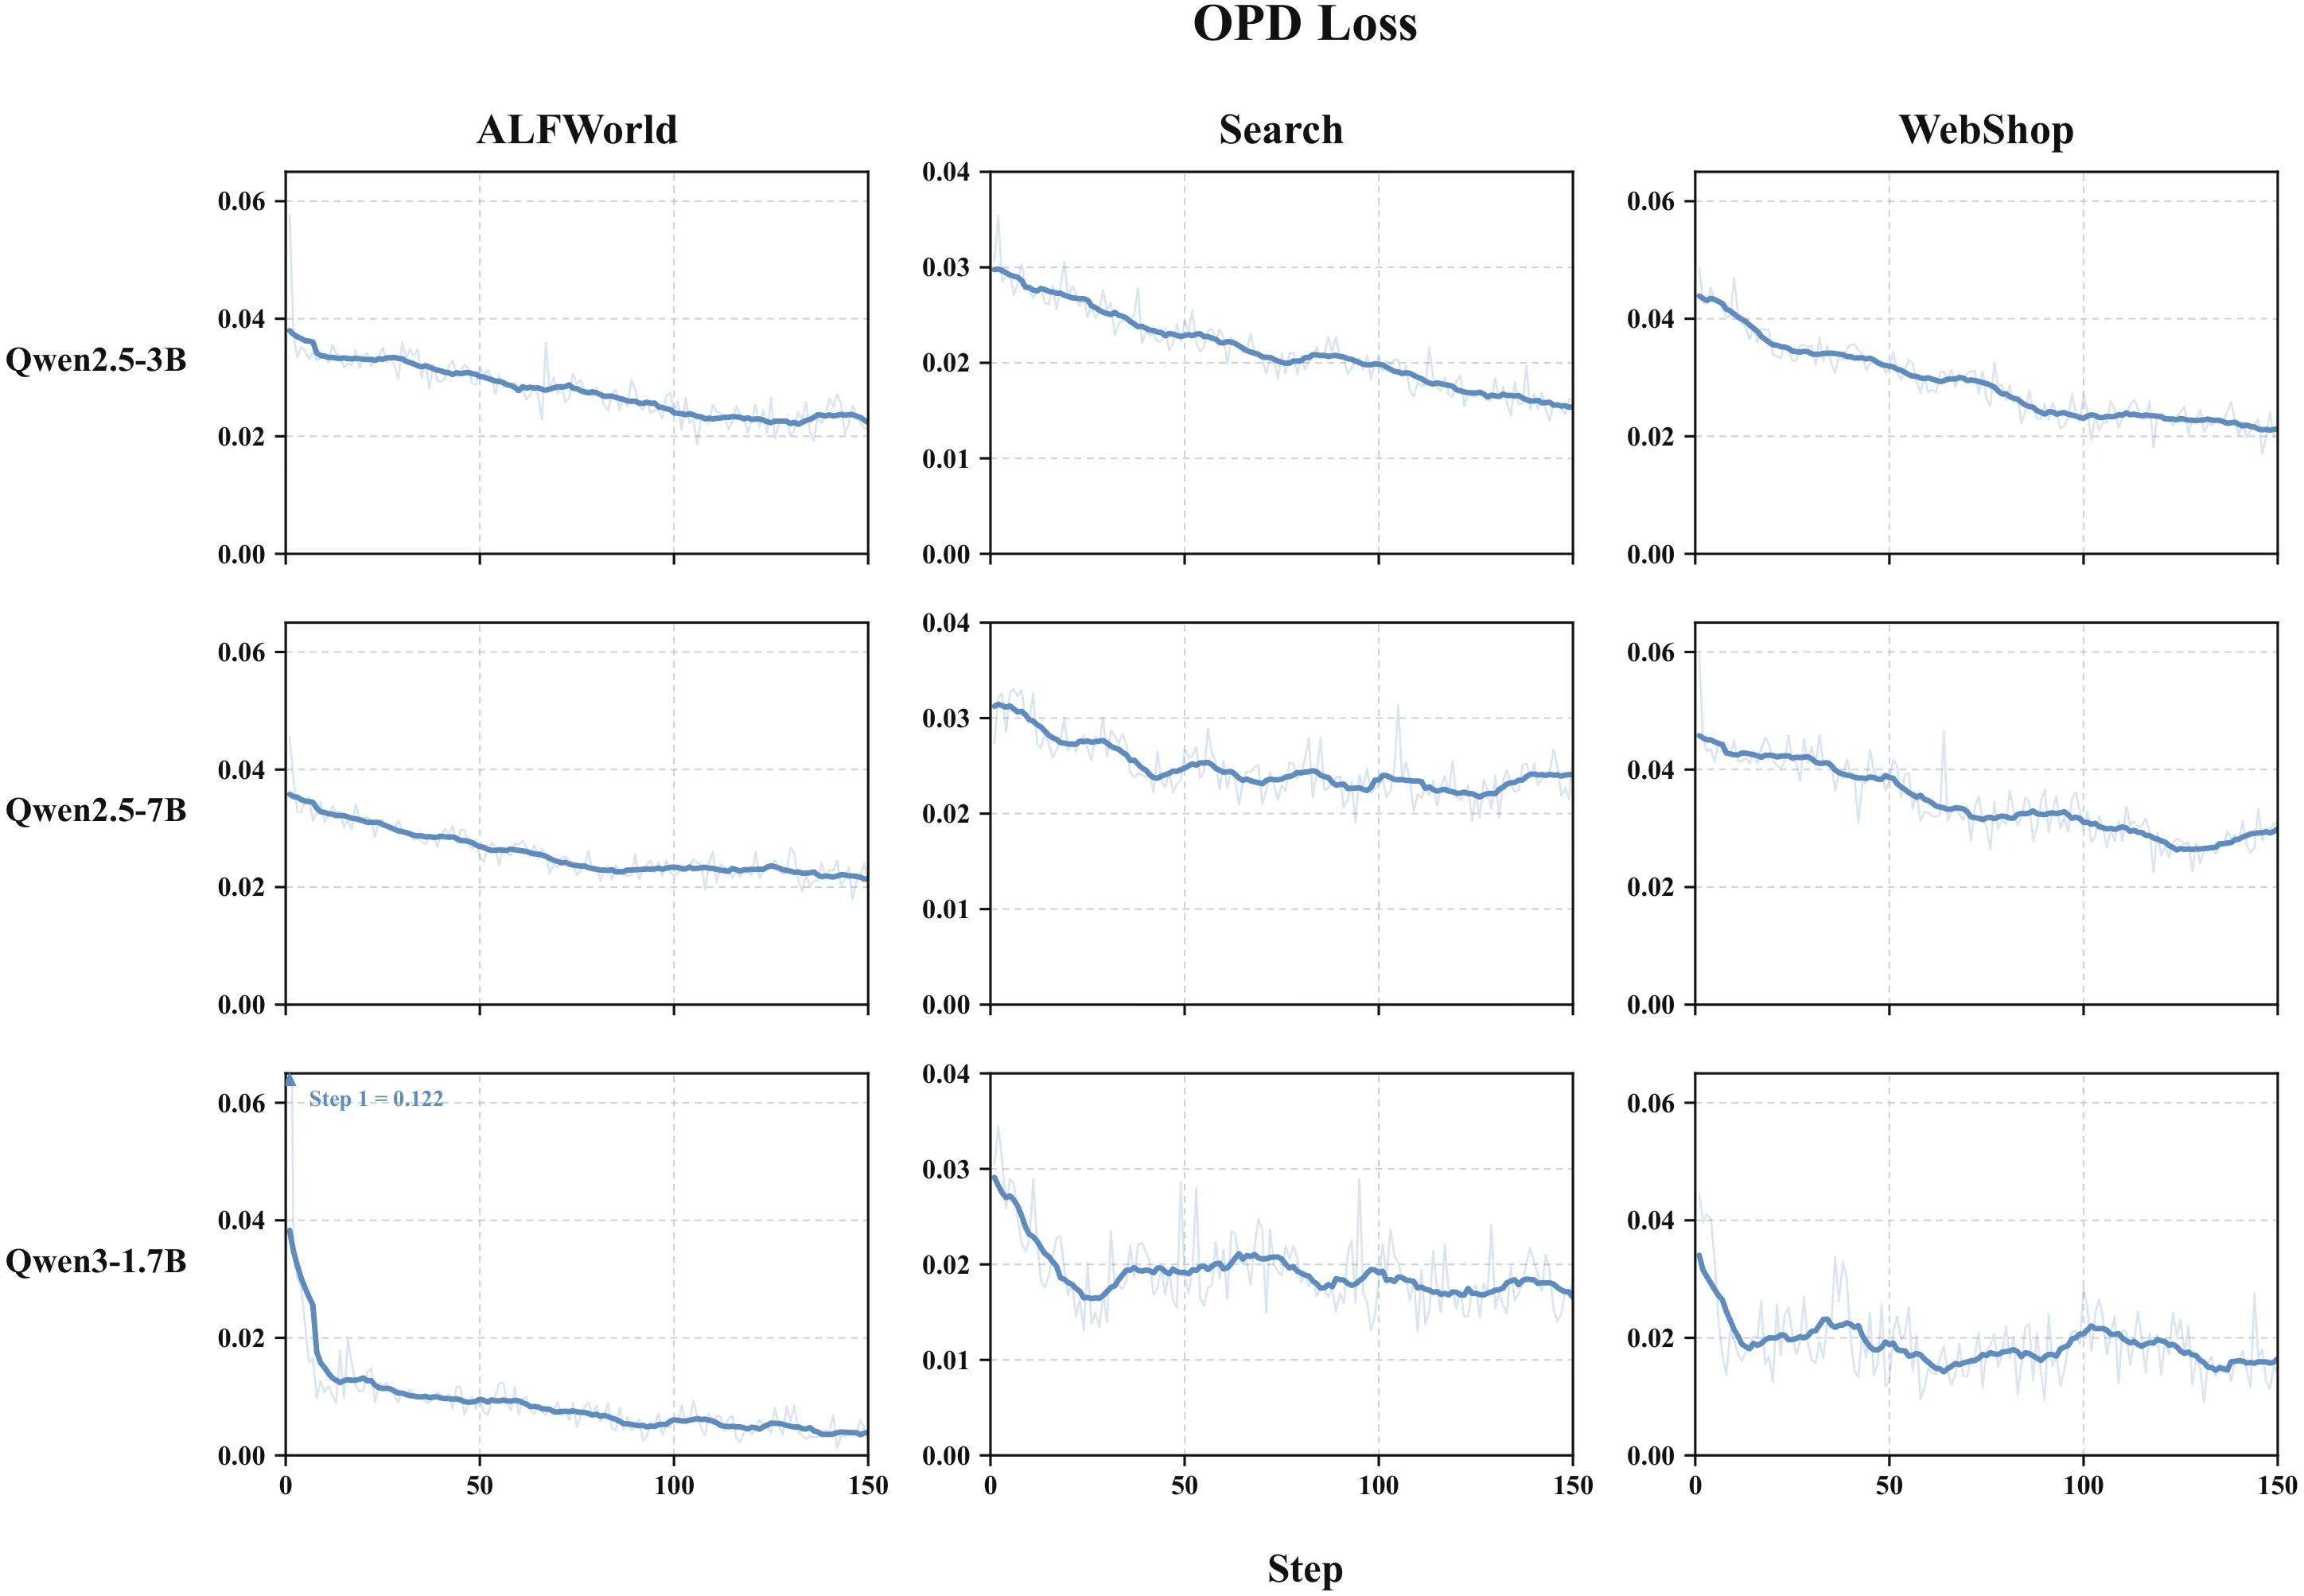
实验结果清晰地展示了 SEED 的优势。在所有测试任务上,SEED 均实现了显著的性能提升,平均相对提升达到 15%~30%。更值得关注的是样本效率指标——SEED 仅需使用 50% 的训练样本就能达到基线方法的最终性能水平,这表明密集的 token 级监督信号大幅加速了策略收敛,减少了对环境交互数量的需求。
消融实验进一步揭示了各组件的贡献度。移除技能生成模块(即用预定义的固定规则替代策略模型生成的技能描述)会导致性能回退约 40%,这一结果有力证实了自然语言技能的语义丰富性不可被简单规则所替代。同时,固定技能分析器不让其与策略共同演化时,性能也出现了明显下降,验证了自演化机制在整个框架中的核心价值。
泛化性评估是实验的另一亮点。研究团队设计了包含未见任务变体和全新环境配置的测试集,SEED 在这些具有分布偏移的测试场景中表现出稳健的零样本迁移能力。这一结果符合预期——自然语言技能编码的是抽象的工作流知识而非具体的动作序列,因此能够跨任务复用并在新环境中发挥作用。
讨论与可借鉴点
SEED 展示了一条有潜力的研究路径:用大语言模型自身的语言理解能力来填补强化学习中的监督稀疏问题。其核心贡献在于将事后监督从简单的奖励塑形升级为语义丰富的技能蒸馏,并通过策略与技能的协同演化机制实现了监督信号的自适应调整——这避免了静态辅助信号随策略提升而逐渐失效的问题。
当前方法仍存在一定的局限性。首先,技能提取的质量依赖于基础模型的表达能力,若大语言模型的自然语言理解能力不足,生成的技能描述可能包含噪声或错误语义。其次,蒸馏损失与策略梯度损失的权重配比需要手动设定,如何实现自动调节(如根据训练阶段动态调整权重)仍值得深入探索。最后,SEED 目前聚焦于在策略场景,对于需要大规模离线预训练的场合,如何在技能质量与采样效率之间取得平衡仍是开放问题。
对于该领域的研究者而言,SEED 的设计哲学具有更广泛的借鉴意义。它体现了“模型自举”的思想——利用基础模型的语言能力为自身的学习过程提供辅助信号,而非仅仅将其作为执行器。这种将模型自身能力闭环用于改进自身的思路,或许可以推广到其他存在监督稀疏问题的领域。此外,SEED 强调辅助监督信号应与主优化目标在分布上保持一致(on-policy 的核心原则),这一设计考量在构建其他辅助学习任务时同样值得遵循。
概念 · 7 个
摘要
自进化策略蒸馏框架,模型从自身完成的轨迹中学习技能
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
HindSearch:用于搜索增强强化学习的轨迹级事后批评
HindSearch: Trajectory-Level Hindsight Critique for Search-Augmented Reinforcement Learning
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 1 张
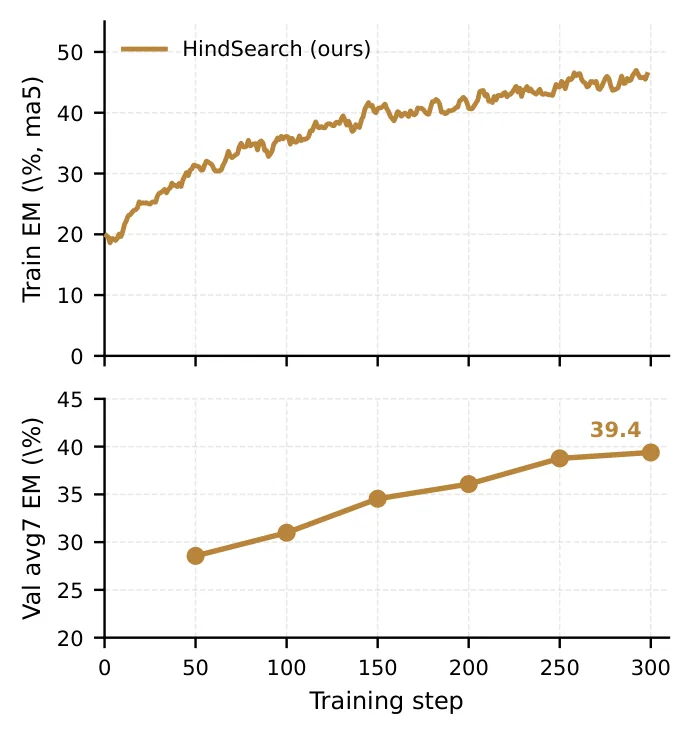
搜索增强语言模型智能体通常采用二元精确匹配奖励训练,失败轨迹中蕴含的丰富错误原因信息被丢弃。HindSearch 提出基于事后视角的自蒸馏方法,在 GRPO 每次 rollout 后由冻结评判模型结合标准答案对失败轨迹生成简短批评,并作为辅助 on-policy 蒸馏信号反馈给学生模型的搜索动作。在 Qwen2.5-3B-Instruct 与七个标准基准测试上取得 39.4% 平均 EM,超越既有搜索 RL 基线,消融实验证实事后视角是增益的主要来源。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
搜索增强语言模型(Search-augmented LM)近年来在开放域问答、多跳推理等任务上展现出显著优势。这类智能体的典型工作流程是:接收用户问题后,执行多轮「检索-理解-生成」循环,逐步逼近正确答案。然而,如何有效训练模型学会「何时检索、检索什么」并非易事。
当前主流训练范式依赖[[强化学习]]框架(如 GRPO、PPO),这些方法通常采用二元精确匹配(Exact Match, EM)作为奖励信号——只有当模型生成的最终答案与标准答案完全一致时,才给予正向奖励,否则为零奖励。这种 bandit 式奖励结构天然稀疏:它只告诉模型「你失败了」,却无法揭示「为什么失败」「哪一步检索走了弯路」「本应检索什么关键词」等关键信息。模型必须在漫长的搜索序列中独自推断这些失败根因,信用分配延迟极高,训练信号效率低下。
既有工作尝试通过过程奖励模型(Process Reward Model, PRM)为每一步搜索动作打分,但 PRM 本质上仍是「评估性」的——它评价当前动作的好坏,而非「指导性」地告诉模型应该怎么做。另有工作如 OpenClaw-RL 引入了自然语言提示作为条件,但这些提示是在线生成的,无法利用训练阶段已知且确定正确的标准答案。HindSearch 的核心洞察在于:训练时我们唯一拥有而推理时没有的额外信息,就是标准答案本身。如果能「事后」利用这个答案生成对失败轨迹的诊断性批评,就能把稀疏的二元奖励转化为细粒度的教学信号。
方法
HindSearch 的设计围绕一个核心问题展开:如何在不引入额外在线评判开销的前提下,让模型从失败中学习到「做错了什么」与「应该怎么做」?答案是在 GRPO 的每次 rollout 之后,引入一条独立的事后批评生成与蒸馏 pipeline。
具体而言,训练流程首先按照标准 GRPO 执行:给定问题 、检索上下文 与标准答案 ,学生策略 生成 条候选轨迹,随后根据 EM 奖励与组归一化优势函数计算策略梯度损失 。轨迹被划分为成功集 与失败集 ,HindSearch 的创新全部集中在失败集的处理上。
对于每条失败轨迹 ,一个冻结的评判器模型 (论文使用 Qwen3.6-27B)在同时「看到」完整轨迹与标准答案 的条件下,生成 1–2 句简短的事后批评 。这一步的关键在于「事后性」与「指导性」的结合:评判器不是评估当前动作的优劣,而是基于正确答案「倒推」出失败根因——比如「你没有检索关键实体'某某',而是检索了一个过于宽泛的查询」。这类批评携带了 GRPO 二元奖励所丢失的诊断信息。
批评生成后,它被广播为所有搜索步的条件前缀,构造增强的教师上下文 。随后,同策略蒸馏(On-Policy Distillation, OPD)损失作用于失败轨迹中所有 范围内的响应 token:
其中 是学生模型在原始上下文下的对数概率, 是教师模型(与学生同源的冻结参考模型)在批评上下文下的对数概率。clamp 操作将差值限制在 区间:下界 0 确保梯度仅流过「教师比学生更确信」的 token,上界 1 则抑制离群值。最终梯度仅回传至 ,使学生模型学会在给定诊断性批评时,采取与参考模型一致的搜索行为。
值得注意的是,OPD 损失严格限制在搜索动作 token 范围内,最终答案 token 的生成完全由 GRPO 负责训练。这一设计防止了批评中可能蕴含的答案片段被学生直接记忆,规避了「结果泄漏」风险。最终总损失为 ,论文设定 ,在维持策略更新的同时引入辅助监督。
实验与结果
实验在 Qwen2.5-3B-Instruct 主干上展开,训练数据为 NQ 与 HotpotQA 的联合训练集(共约 169k 样本),评估在七个标准问答基准上进行,涵盖单跳(NQ、TriviaQA、PopQA)与多跳(HotpotQA、2WikiMultihopQA、MuSiQue、Bamboogle)两类任务,其中后五个为 zero-shot 评估。
主实验结果显示,HindSearch 达到 39.4% 的平均 EM,显著超越此前的最强搜索强化学习基线 Search-R1 GRPO(33.6%),提升幅度达 5.8 个百分点。与非强化学习方法相比,HindSearch 也优于 R1-instruct(37.4%)与 Rejection Sampling(36.5%)等强基线,充分验证了事后批评蒸馏的有效性。
消融实验提供了关键洞察。移除评判器对标准答案的访问(即事后视角)后,性能从 39.4% 跌至 34.7%,损失了约 4.7 分的增益——这与整体提升幅度(5.8 分)高度接近,直接证明「事后利用标准答案」而非「评判行为本身」是性能提升的核心来源。将 OPD 损失替换为 OpenClaw-RL 的 PPO-clipped top-K 形式后,性能进一步降至 32.7%,说明损失结构的设计对最终效果有显著影响。此外,使用逐步「最早关键」批评替代全文批评也会导致 3.9 分的退化,表明批评的完整性同样重要。
关于泛化性的担忧——事后批评是否会让学生记住答案而非学会搜索行为——实验数据给出了否定回答:域内基准(NQ、HotpotQA)与 zero-shot 基准的平均增益几乎相等(约 5.85 vs 5.80),说明 OPD 信号确实在训练学生的搜索策略,而非简单记忆答案字符串。
讨论与可借鉴点
HindSearch 的成功揭示了一个更普遍的原则:在[[强化学习]]训练中,充分利用训练阶段特有的额外信息(此处为标准答案)生成诊断性反馈,往往比单纯改进算法结构更有实效。这一「事后诸葛亮」式的设计在概念上简洁,却在实践中有效,因为它将「判断成功与否」的评估性信号转化为「理解失败根因」的指导性信号。
从工程视角,HindSearch 的若干设计值得借鉴。首先,教师模型与学生模型同构且共享初始化,将「能力差距梯度」风险降至最低——学生不会因教师能力过强而产生不信任。其次,搜索动作掩码的设计巧妙地隔离了 OPD 与 GRPO 的职责边界,前者专注搜索行为,后者专注答案质量,两个目标在损失空间中正交,避免了梯度冲突。再次,仅对失败轨迹调用评判器的策略使得额外计算开销控制在 15% 以内,在效果与效率之间取得了良好平衡。
然而,该方法也存在明显局限。最根本的假设是训练时必须拥有每个样本的标准答案——对于开放式生成、创意写作或无明确「正确答案」的对话任务,这一前提难以满足。此外,评判器的规模与质量高度耦合:论文中发现 7B 规模的评判器会导致性能显著退化,而过强的教师(如 7B)则会产生能力差距梯度破坏训练稳定性,这意味着实际部署时需要谨慎选择评判器配置。最后,自然语言批评的质量本身依赖于评判器的指令遵循能力与提示工程,这为方法的复现引入了不可控因素。
总体而言,HindSearch 为「稀疏奖励浪费失败信息」这一长期痛点提供了一个简洁而有效的解决方案。它的核心贡献不在于复杂的算法创新,而在于对问题本质的精准把握——将「只问成败」的二元奖励转化为「追问缘由」的细粒度监督。这一思路或许可以推广至其他[[强化学习]]应用场景,如代码生成、数学推理或多模态任务,其中失败轨迹同样蕴含大量未被利用的诊断信息。
摘要
面向搜索增强强化学习GRPO的事后自蒸馏方法
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
PCSD:智能体强化学习中自蒸馏的持久一致性
PCSD: Persistent Consistency for Self-Distillation in Agentic Reinforcement Learning
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 4 张
在智能体强化学习中,长轨迹仅获单一结果级稀疏奖励,难以有效训练。提出持久一致性自蒸馏PCSD:通过自适应窗口与指数衰减聚合衡量教师信号的局部持久性,并结合趋势感知调制与sigmoid门控生成连续token级蒸馏权重,与GRPO联合优化。无需推理时额外技能,即在ALFWorld上全面超越GRPO与SDAR等基线,WebShop保持竞争力,并在未见任务上有显著泛化提升。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
大语言模型智能体在ALFWorld、WebShop 等复杂交互环境中展现出强大的任务规划与执行能力,但这类任务的强化学习训练长期受困于稀疏奖励问题。在典型的多轮对话场景中,一条包含数十个回合、数百个 token 的完整轨迹,往往只能在末端收到一个二元的结果信号——要么任务成功,要么任务失败。这种信号密度与轨迹长度之间的巨大落差,使得信用分配(credit assignment)成为核心难题:策略无法准确判断轨迹中间哪一步决策是真正有效的,哪一步是有害的。
为了缓解这一困境,自蒸馏(self-distillation)范式被引入智能体强化学习领域。具体做法是让模型的一个冻结副本充当"特权教师",同时另一个可学习的"学生"版本参与交互。由于教师在推理时可以获得通过技能检索得到的额外上下文信息,它的输出质量通常更高。自蒸馏的核心思想是:让学生模仿教师的 token 级概率分布,从而将稀疏的轨迹级奖励信号转化为密集的 token 级监督信号。
然而,这种方法存在一个根本性的假设问题:教师并非在每个位置上都是可靠的。尽管教师整体上优于学生,但在某些具体位置,它给出的偏好信号可能只是采样噪声的产物,或者恰好与学生偶然探索到的正确方向相悖。如何在密集的教师监督中筛选出真正值得信赖的信号,成为提升自蒸馏效果的关键。
现有方法大体上可以分为两类,各有取舍。Token 级方法(如 RLSD、SDAR)基于每个位置独立的概率差异或对数比例来衡量可信度,这种做法理论上精细,但在训练早期或采样噪声较大的场景中容易受到单点波动的影响,产生误导性的梯度。Step 级方法(如 SOD、StepOPSD)则将整步的所有 token 聚合后再分配统一权重,虽然降低了噪声敏感性,但完全丢失了位置间的差异信息——同一步中有效与无效的 token 被等同对待。
这篇论文的核心观察是:真正有信息量的教师偏好信号应当在局部邻域内持续出现。一个可靠的对教师有利的决策,其优势应该在周围的 token 中也能观察到;相反,单点的尖峰更可能反映的是采样过程中的随机波动,而非教师真实的分布偏好。基于这一直觉,PCSD 从"教师偏好信号的局部持久性"出发,设计了一套完整的 token 级蒸馏权重生成机制。
方法
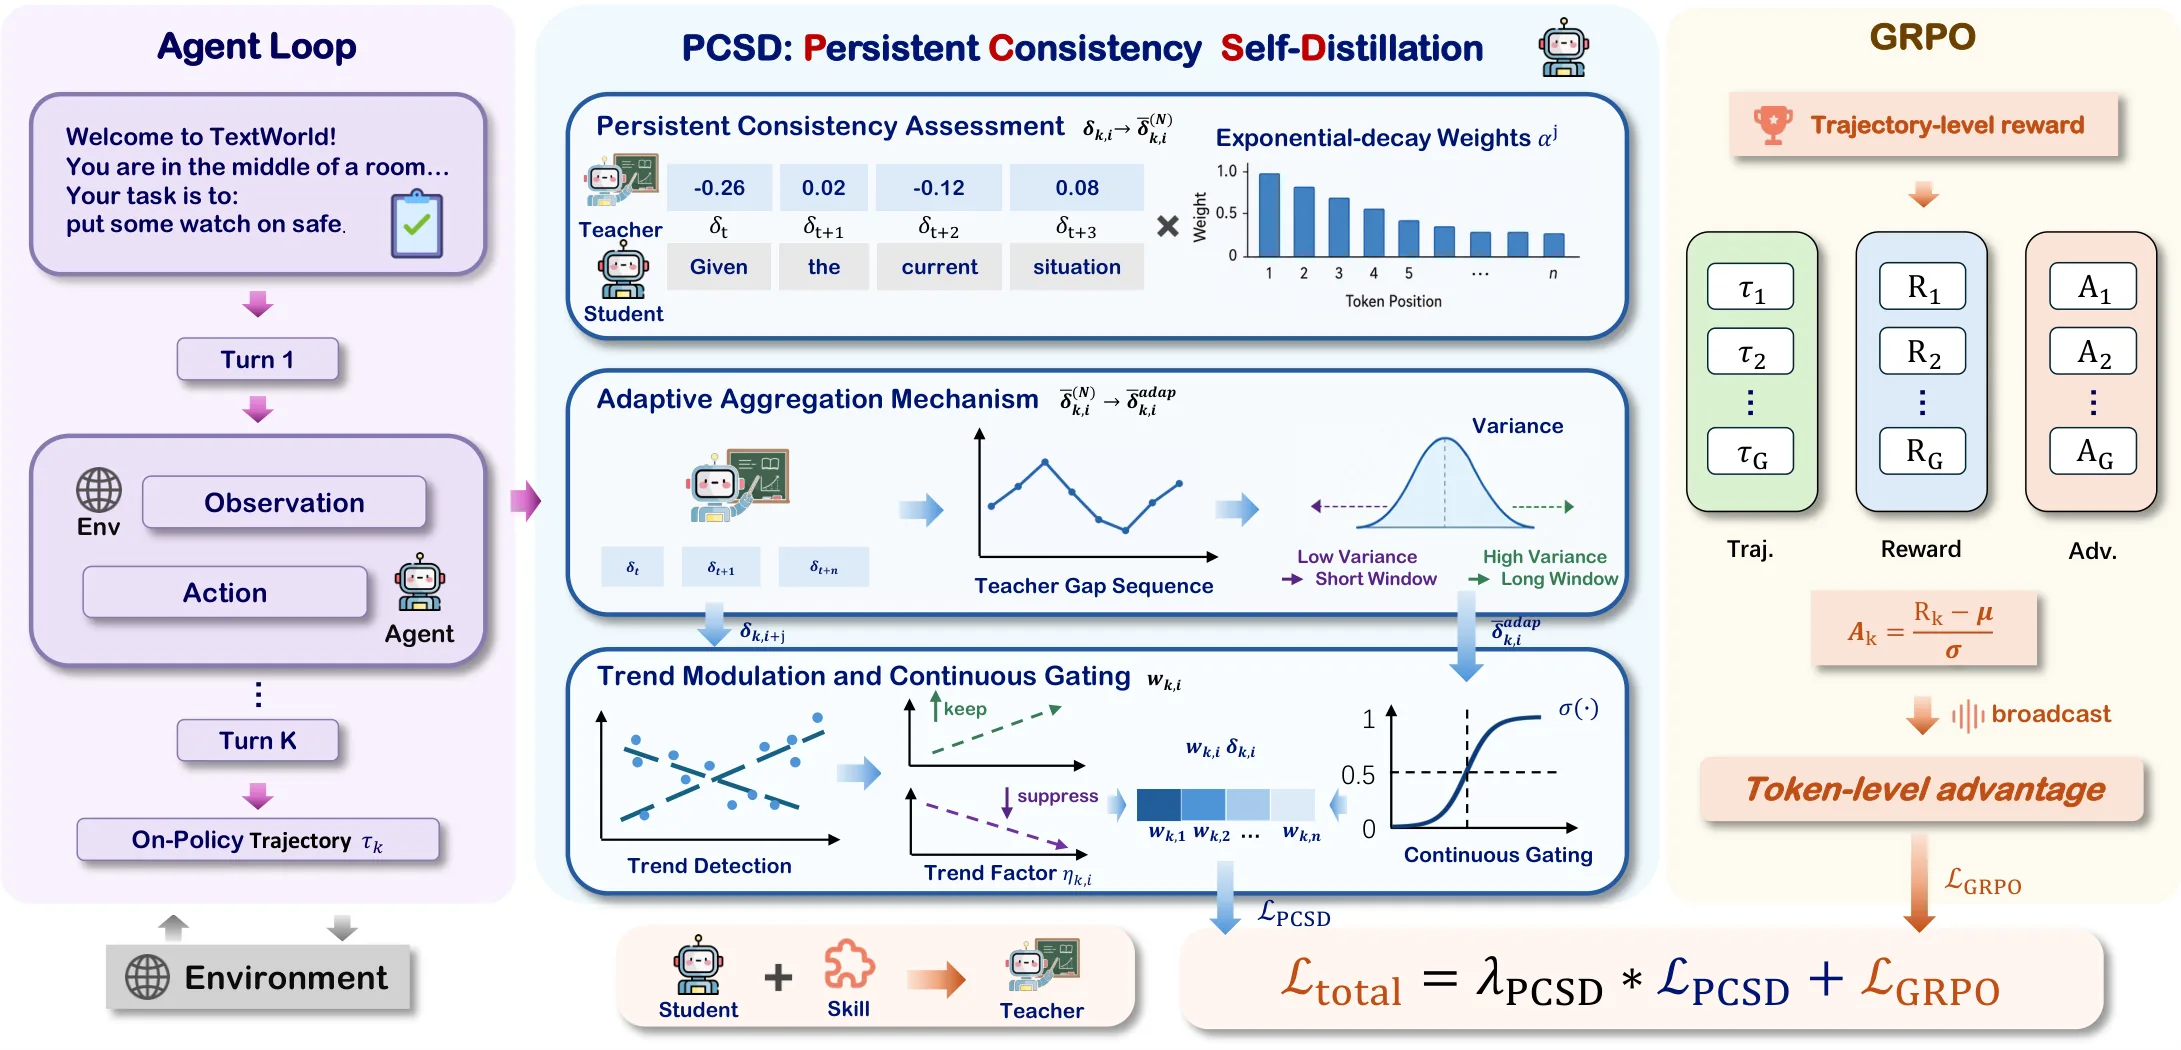
PCSD 的整体框架建立在 [[GRPO]] 之上,将其稀疏的轨迹级优势估计与 token 级的教师蒸馏信号相结合。框架中有三个关键角色:学生策略 (参与环境交互并更新)、冻结的特权教师 (同一基座检查点的副本,输入中拼接了通过关键词检索得到的技能上下文),以及最终的训练目标。
整个蒸馏权重的生成流程包含四个递进的设计层次,每一层都针对前一层的问题进行了改进。
第一层:教师-学生采样对数概率差。 对于轨迹中第 个响应(turn)的第 个 token,首先计算教师与学生在该位置的 log 概率差异:
这个差值 的物理含义是:给定各自的历史上下文,教师对该采样 token 的相对支持程度。 意味着教师倾向于这个 token,反之则教师不看好。然而,单独的这个数值并不能说明这种偏好是"真实的"还是"偶然的"。
第二层:持久一致性评估——指数衰减聚合。 为了判断教师偏好是否具有持久性,PCSD 在大小为 的前向窗口内对 做指数加权聚合:
其中 是衰减因子,越近的 token 权重越高; 是掩码(mask),处理序列末尾的有效 token 不够的情况。这本质上是在问:"在接下来的几个 token 里,教师是否持续支持学生采样到的内容?"如果答案肯定, 的值会保持较高;如果只是在某一点上有微弱优势但后续回落,这个聚合值会被稀释。
论文采用了 、、 的配置,对应的有效样本量约为 6.41,平均位移约 2.39 个 token。
第三层:自适应聚合机制。 固定窗口大小无法同时兼顾精度与稳健性。当某区域的 波动剧烈(高方差)时,说明此时信号不稳定,应该用更大的窗口平滑掉噪声;而当区域平稳(低方差)时,应该保留更细粒度的短窗口响应。PCSD 通过局部方差来自适应地选择窗口大小:
当方差低于 时完全采用短窗口,保持最高的 token 粒度;当方差高于 时完全采用长窗口,最大程度抑制噪声;中间区域线性插值。
第四层:单边趋势调制与 sigmoid 门控。 仅仅有持久性还不够——如果窗口内的教师支持呈下降趋势,即使当前值不低,未来也可能不再可靠。PCSD 在 窗口内做遮蔽感知的普通最小二乘回归,取斜率 。仅当斜率为负(支持正在衰减)时施加惩罚:
这种单边设计是有意的:正斜率(支持在增强)不需要额外放大,因为后续的 sigmoid 门控本身就会根据 的绝对值给出相应的高权重。对负斜率的惩罚则确保了权重不会因为当前的高值而被错误地锁定。
最终,权重通过 sigmoid 门控产生:
其中 控制 sigmoid 的锐度。输出 是连续的,可以是 0.73 这样的中间值,也可以接近 0 或 1,而不是离散的二值选择。
训练目标。 得到 token 级权重后,PCSD 的蒸馏损失为:
这里教师 log-prob 和权重 都设置 stop-gradient,仅对学生 log-prob 求导,产生加权负对数似然梯度。最终目标是 GRPO 损失与 PCSD 损失的加权和:
默认 ,即蒸馏信号作为相对较小的辅助约束存在,而非主导训练方向。
实验与结果
实验在 ALFWorld 和 WebShop 两个标准基准上进行,使用 Qwen2.5-3B-Instruct 和 Qwen3-1.7B-Instruct 两种规模的骨干网络。所有对比方法使用相同的训练预算、相同的教师技能配置和相同的评测协议,唯一差异在于蒸馏权重的计算方式。
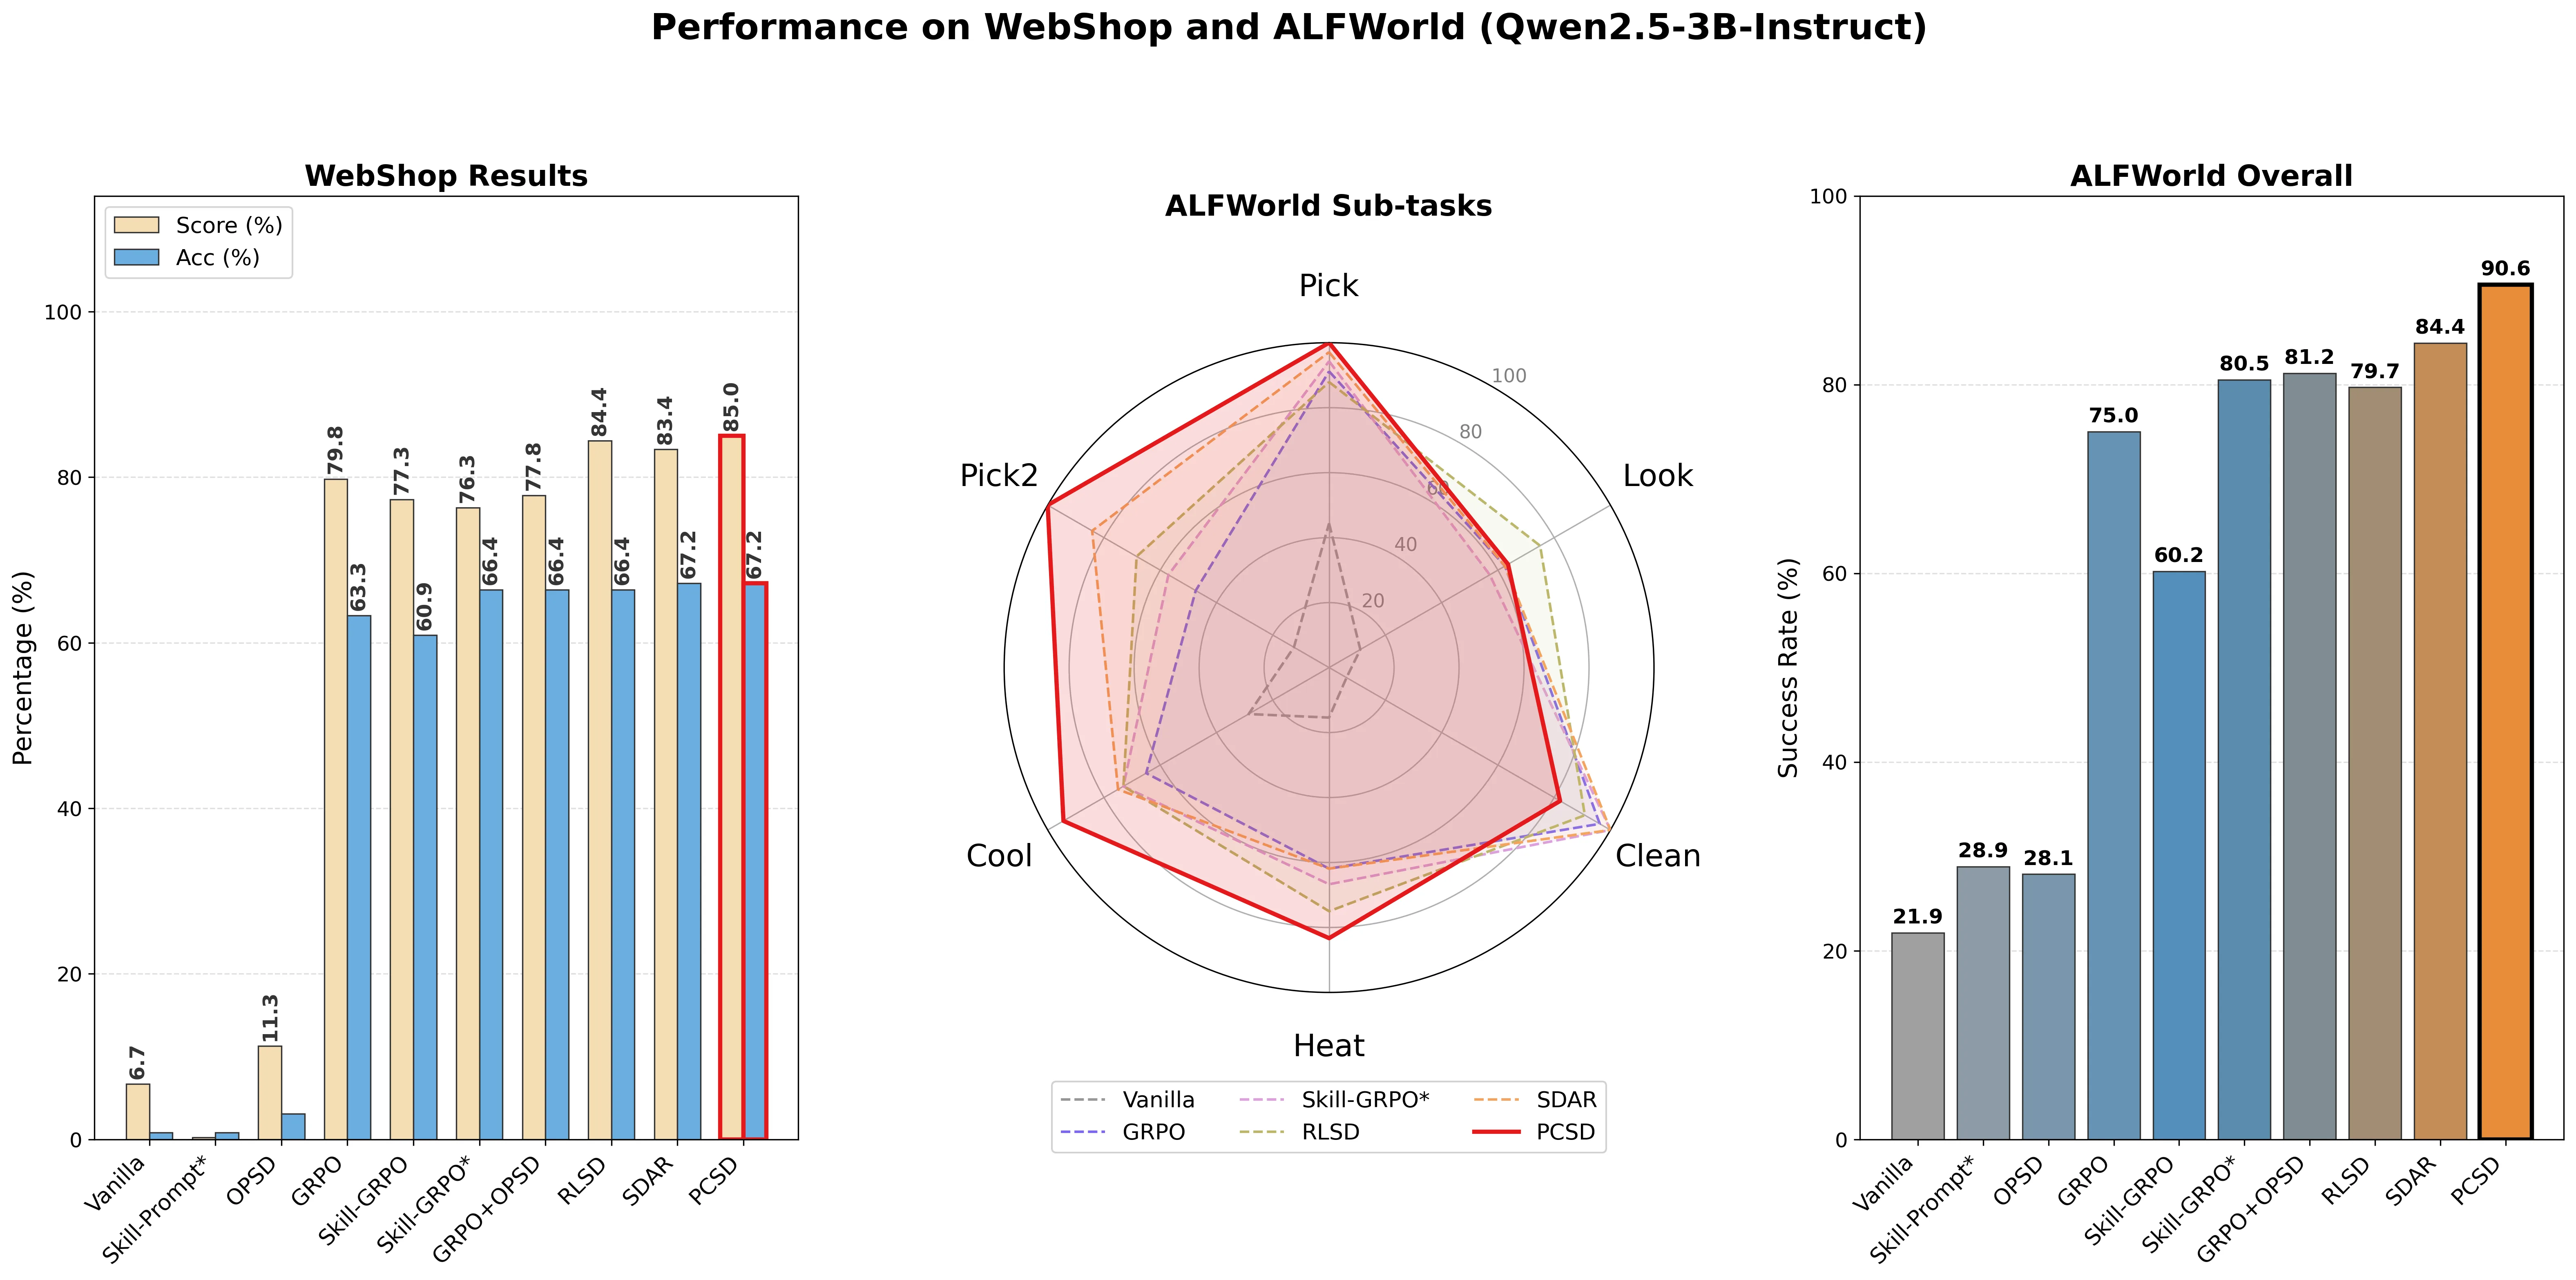
在 ALFWorld 的主结果上,PCSD 取得了所有基线中的最佳 Overall 成绩。在 Qwen2.5-3B 骨干上达到 90.6%,分别超过 GRPO 15.6 分、超过 SDAR 6.2 分;在 Qwen3-1.7B 骨干上达到 59.4%,分别超过 GRPO 13.3 分、超过 SDAR 5.5 分。尤其值得注意的是,PCSD 不需要任何推理时的技能检索,这使得它与使用推理时技能的 Skill-GRPO 相比也具有优势。在 Qwen2.5-3B 上,PCSD 90.6% 对比 Skill-GRPO 的 87.8%,优势明显。
分任务类型来看,Heat 和 Pick2 等需要更长推理链的任务提升尤为显著,这与 PCSD 擅长处理长序列信用分配问题的设计直觉相符。在 WebShop 上,PCSD 保持竞争力,Qwen2.5-3B 达到 Score 85.0,与 SDAR 并列第一。
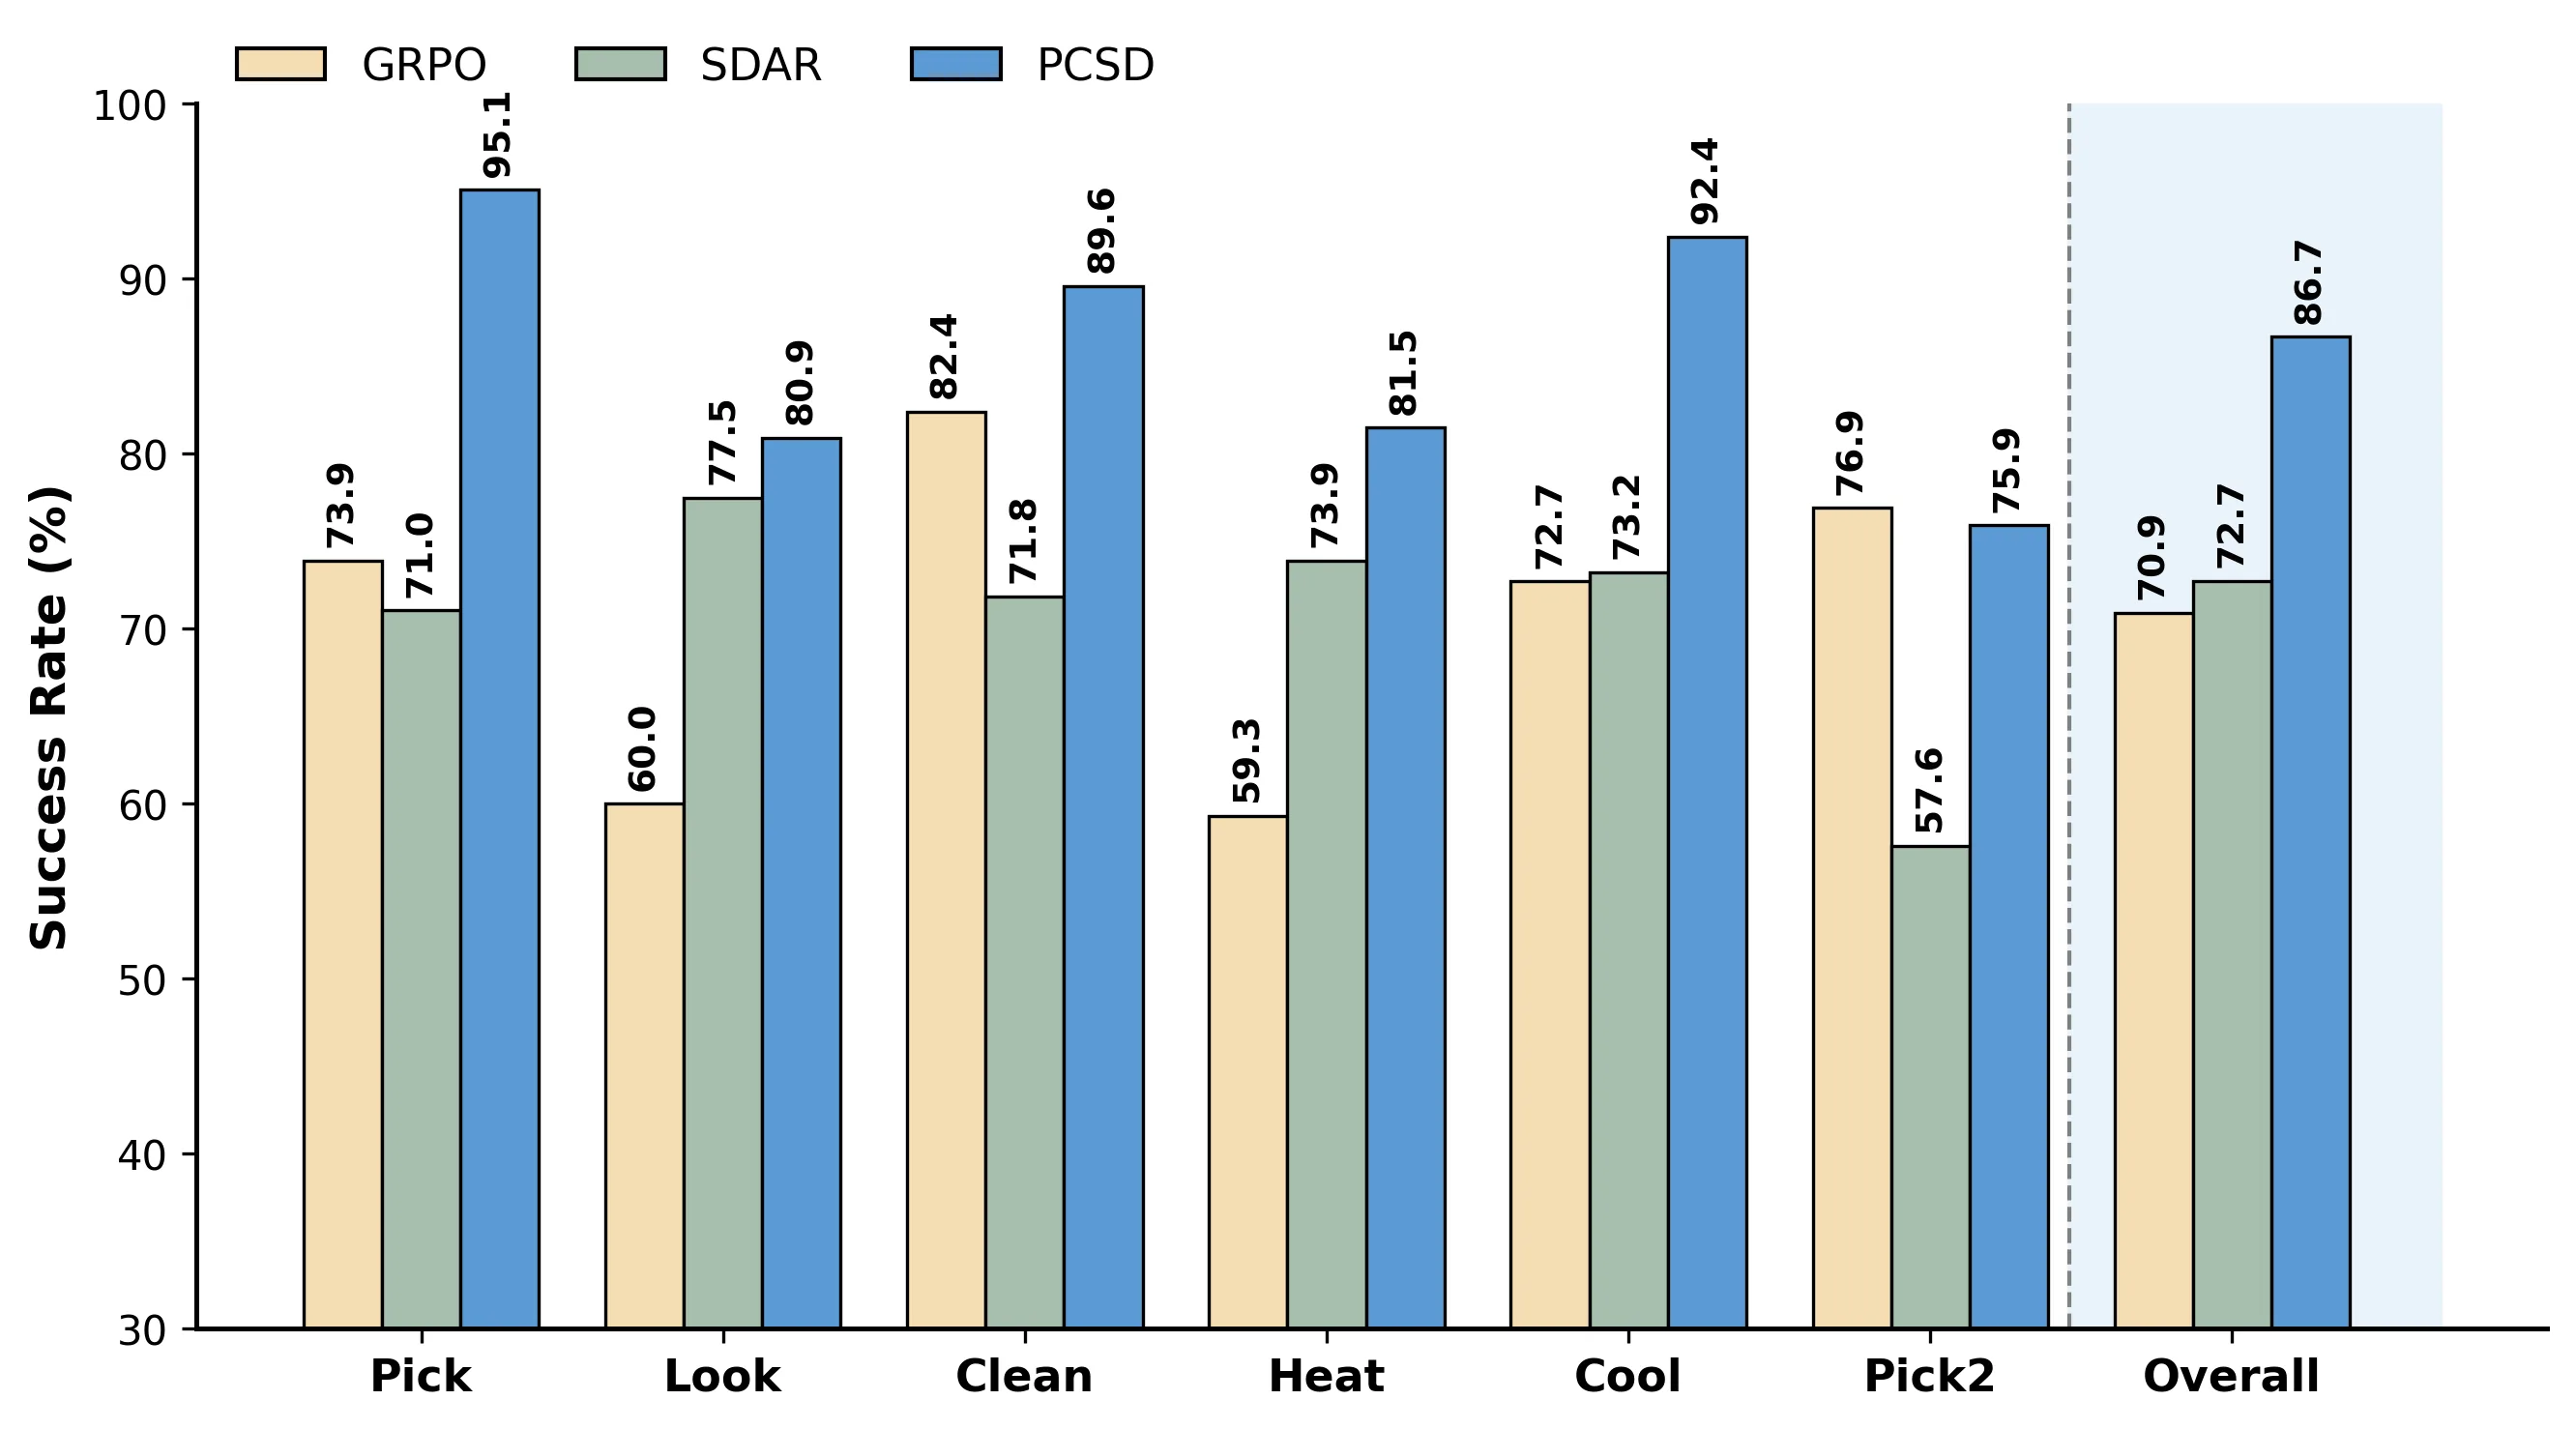
泛化性是更值得关注的结果。在 ALFWorld 的 valid_unseen 划分(未见过的物体位置配置)上,PCSD 的 Overall 达到 86.7%,显著超过 GRPO 的 70.9% 和 SDAR 的 72.7%,提升幅度达 15.8 分。这说明通过持久性筛选出的教师信号不仅能提升训练阶段的任务表现,还学到了更稳健的决策策略,而非过拟合于特定实例。
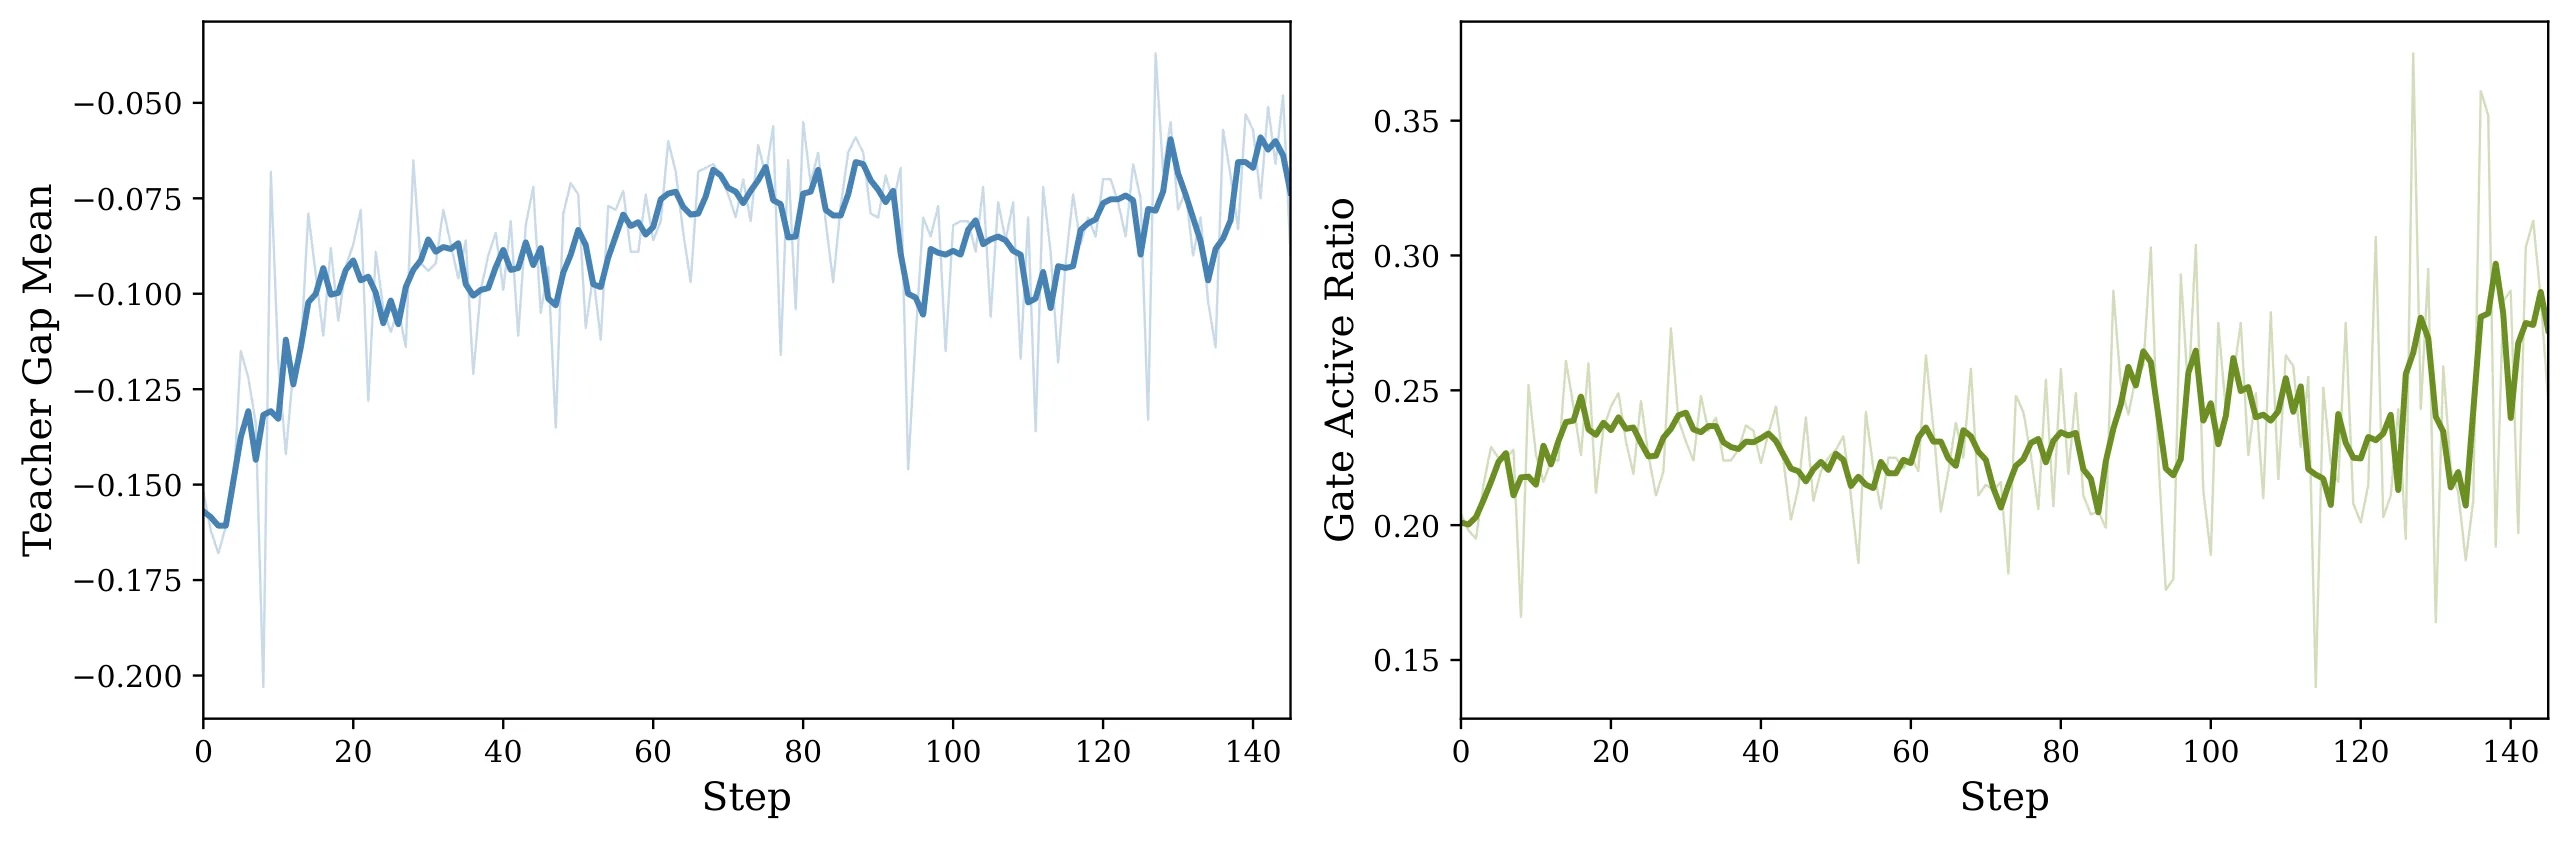
训练动态分析揭示了 PCSD 的行为特征。随着训练进行,教师-学生 gap 的均值从负值逐步上升(说明学生越来越接近教师的水平),同时 gate 激活率保持在 20%–28% 的水平,意味着只有五分之一到四分之一的 token 获得了 的高权重。这种"集中而非严苛"的分配模式体现了 PCSD 的设计哲学:不是对所有教师偏好不加区分地灌输,而是精准地识别并强化那些真正可靠、持久、有趋势支撑的信号。
消融实验验证了各组件的必要性。自适应窗口相比固定 或 的版本均有提升;去除趋势调制后性能下降,说明对衰减信号的惩罚是有效的;去除指数衰减(改为等权重平均)同样导致性能退化,证明越近的 token 越有参考价值的归纳偏置是合理的。
讨论与可借鉴点
PCSD 的核心贡献在于提出了"持久性"作为教师可信度的判断标准这一洞察。与其相信某个 token 上教师与学生的孤立差异,不如观察这种差异是否在局部邻域内持续存在。这一思路从信号处理的角度重新诠释了自蒸馏中的置信度估计问题,也为后续工作提供了新的设计方向。
从实践角度,PCSD 不依赖推理时技能的特性具有重要的工程价值。许多辅助推理的技术(如技能检索、树搜索)会增加部署时的计算开销和系统复杂度,而 PCSD 学到的策略可以直接使用,无需额外的上下文构造。这使得方法更容易融入现有的 LLM Agent 部署管线。
然而,论文也存在一些局限性。首先,方法引入了多个超参数(、、、、、、),除了 外均未进行独立敏感性分析,存在这些固定值可能过拟合于当前实验配置的风险。其次,教师策略全程冻结且技能库由规则和关键词检索构建,限制了方法对动态演化环境的适应性。此外,实验仅覆盖 ALFWorld 和 WebShop 两个文本型基准,在 GUI 操作、代码生成、工具调用等更广泛场景下的效果有待验证。
对于[[强化学习]]中[[稀疏奖励]]问题的研究,PCSD 的思路提供了一个有价值的启示:信用分配不仅可以通过时序折扣或价值估计来实现,还可以通过分析教师偏好的局部结构来实现——只要这种偏好信号具有内在的一致性和可信度。这种将自蒸馏与[[强化学习]]结合的范式值得在更多任务和模型规模上探索。
摘要
将策略内自蒸馏与强化学习结合用于LLM智能体
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
面向智能体强化学习的组反思自蒸馏
Group-Reflective Self-Distillation for Agentic Reinforcement Learning
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 16 张
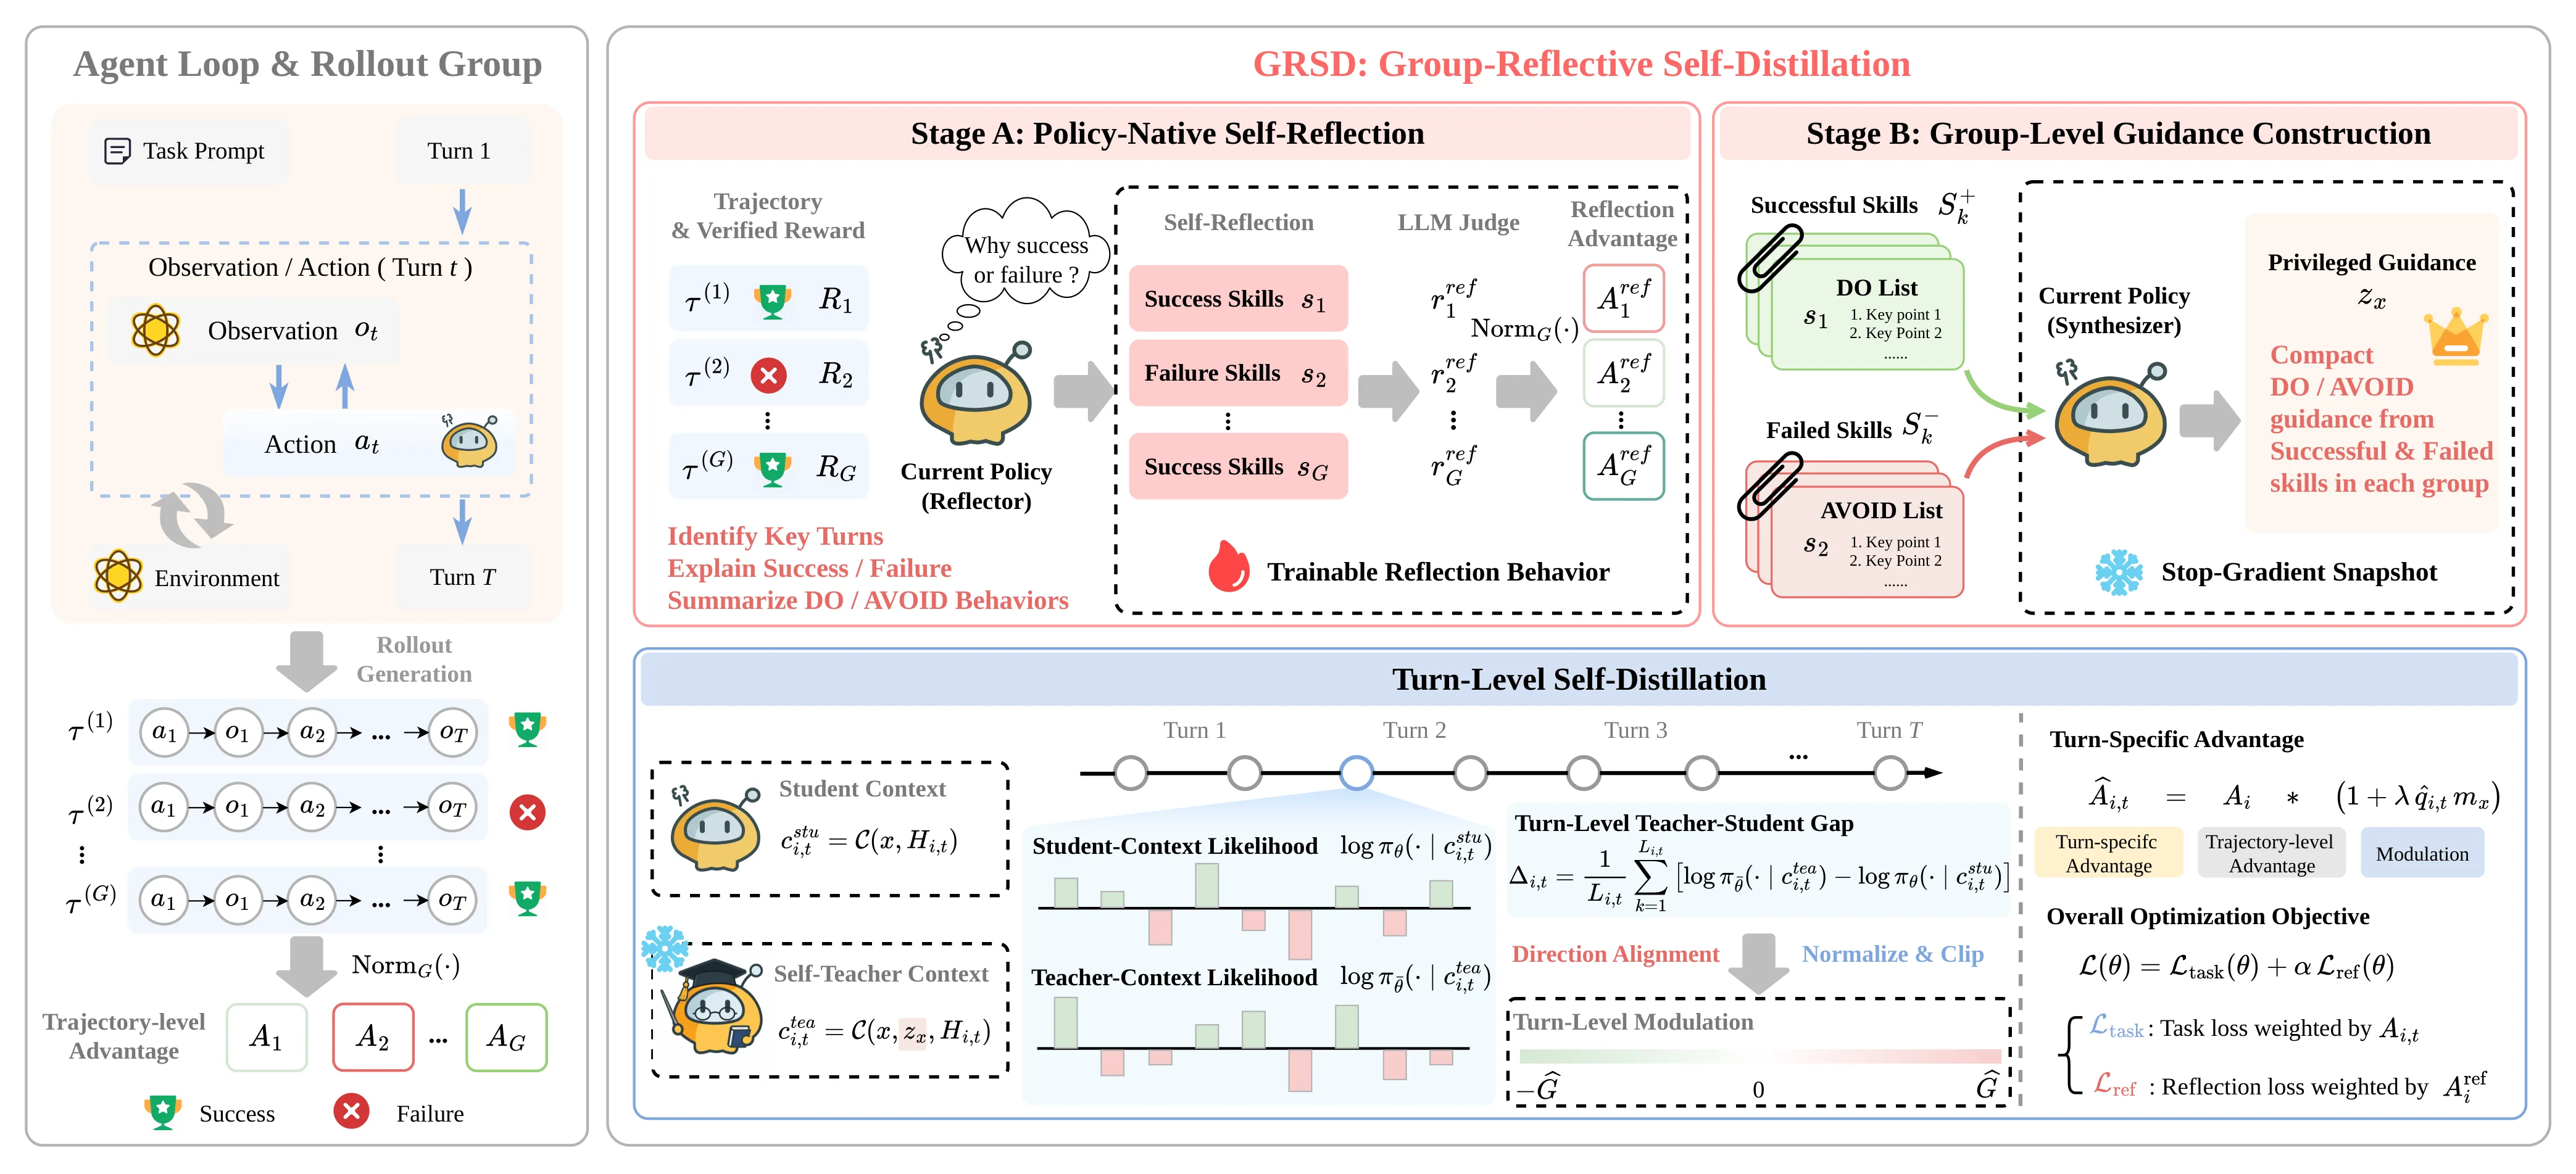
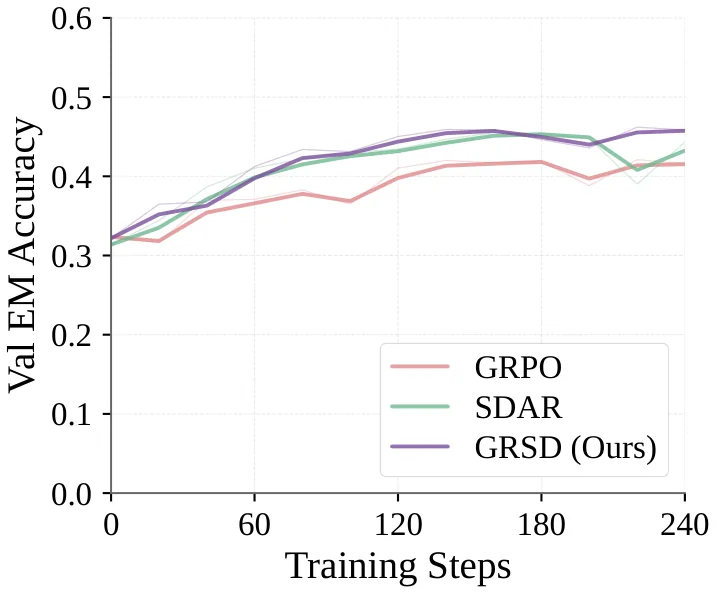
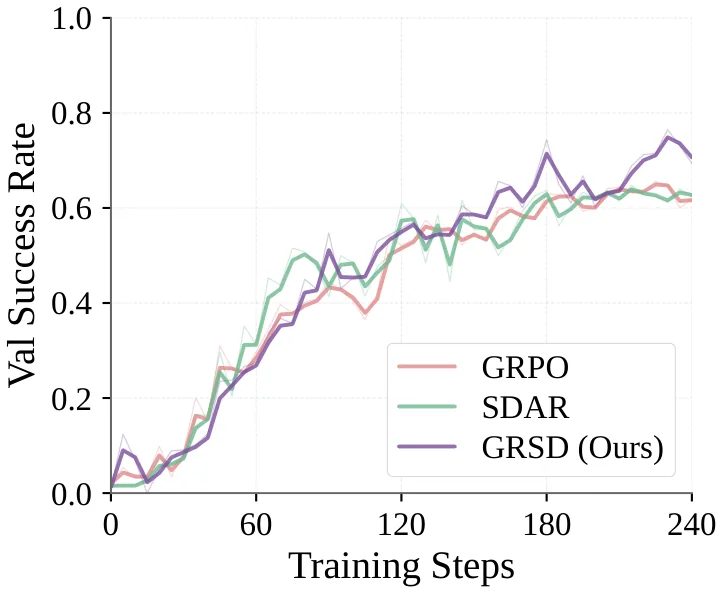
智能体强化学习中终端奖励仅提供粗糙的轨迹级监督,成功行为、反复错误与偶然选择纠缠于同一结果信号。论文提出分组反思自蒸馏方法GRSD,直接从策略自身的已验证rollout中提炼能力对齐且结果可区分的指导:策略对分组内每条轨迹进行反思,由停止梯度快照对比成功与失败的反思构建群体级特权信号,自教师据此调制基于结果的advantages以细化轮级信用分配。实验在多个智能体环境与多种模型规模上验证,GRSD一致超越竞争基线,并对未见任务展现更强泛化。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
训练大语言模型智能体执行多轮决策任务时,[[强化学习]]已成为主流范式。智能体每完成一次任务,环境返回一个二元结果:成功或失败。这个终局信号是训练信号的唯一来源——但它极度稀疏,只告诉我们「这件事做完了」或「没做完」,不会解释「哪一步做对了、哪一步搞砸了」。
这种粗粒度的轨迹级监督带来一个根本困难:成功行为、反复出现的错误、偶发性选择三者被纠缠在同一结果信号里。智能体可能偶然选对了某个动作而完成任务,也可能正确执行了大部分步骤却在关键节点失误。模型如果无法区分这些情况,就只能「眉毛胡子一把抓」,要么过度强化偶然正确的路径,要么在失败轨迹上保留了有害的行为模式。这正是 [[强化学习]] 领域中经典的[[稀疏奖励]]问题的具体体现——信号本身不携带足够的结构信息来指导细粒度的策略改进。
为了缓解这一困境,近年来出现了多条研究路线,其中最具代表性的是「智能体自蒸馏」方法。这类方法的核心思路是用自然语言技能来丰富监督信号:给策略注入一些文本形式的知识片段,帮助它在缺少奖励的轮次中也能判断当前决策的质量。技能可以来自外部检索,也可以由更强的模型从已完成轨迹中提取。
然而,这些路线各有各的软肋。检索式技能可能与当前交互历史脱节,强模型提取的技能可能超出当前策略的能力边界——策略学到了「理论上应该这样做」,但自己根本做不到。更根本的问题在于,许多方法是在单条轨迹上独立提取技能的,没有在同提示下的多条成功与失败轨迹之间做对比。结果提取到的很可能是路径特有的细节,而非真正区分成败的关键行为。GRSD 的核心动机正是要回答两个问题:如何从策略自身的在线经验中提炼与自身能力匹配的指导?如何利用组内多轨迹对比来识别对结果真正关键的行为?
方法
GRSD 采用两阶段构造加轮级自蒸馏的闭环框架,整体思路可以概括为「先让策略自己反思轨迹,再让这些反思相互比较,最后把比较结果注入[[信用分配]]」。
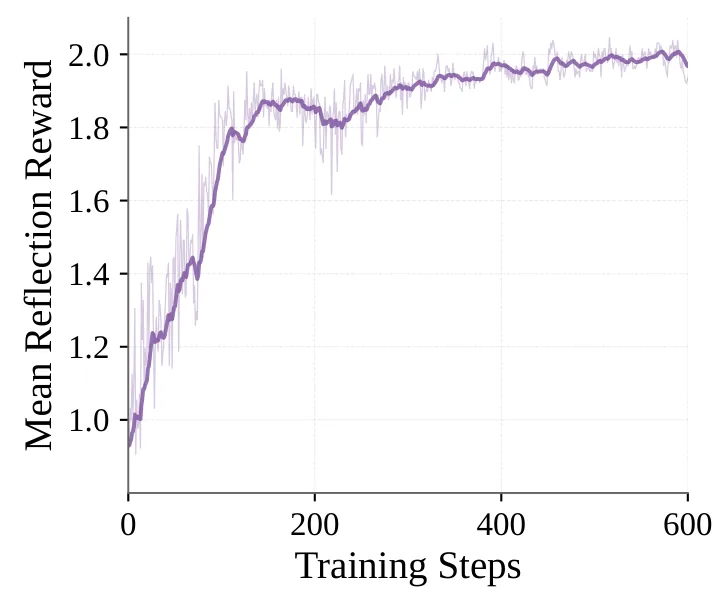
第一阶段是策略原生反思。对于每个训练提示,策略对组内每条已验证轨迹生成一段反思文本。这段反思由策略自身在推理模式下产出,固定一个外部评判器给反思打分(0到3分),由此得到每条轨迹的反思奖励及其组内归一化优势。这个阶段的产出是每条轨迹的「个人小结」:它为什么成功或失败,策略自己怎么看。
第二阶段是组级指导合成。这里引入了停止梯度机制:用一个策略快照(记为 )来生成指导,而该快照的参数在反向传播时被冻结。将同提示下所有轨迹按结果分为成功集合与失败集合,让停止梯度快照对比这两组反思的分布差异,合成一段紧凑的指导文本。这段文本同时包含「应该做什么」(Do)和「应该避免什么」(Avoid),但它不是简单罗列两条轨迹的内容,而是经过对比提炼后提取的共性模式。停止梯度的设计保证指导生成过程不会被下游学习反向干扰,保持了信号的独立性。
接下来是轮级自蒸馏阶段,这是 GRSD 区别于先前方法的关键一步。自教师在两种条件下分别对已采样动作计算似然:一种只有当前对话历史,另一种额外注入前面合成的组级指导。两者的对数似然差值 反映了在当前轮次上,指导文本是否改变了策略对动作的偏好方向。取符号使其与验证器结果对齐:若轨迹成功则正向放大,若失败则负向放大。
为了防止指导信号过强或过弱导致训练不稳定,GRSD 对调制幅度做了有界处理。计算组内调制分数的均值作为基准,将每个轮次的调制分数归一化后裁剪到 区间。最终的轮级优势为:
其中 是混合结果掩码,仅当组内同时存在成功和失败轨迹时才激活指导。这个约束至关重要:它保证了调制只能调整优势的幅度,而绝不会反转其符号——验证器决定了学习方向,指导只是精细化幅度。
总优化目标包含两项:任务损失使用调制后的优势进行 PPO-clipped GRPO 更新;反思损失则在独立的 token 子集上施加监督,两者互不干扰。论文在附录中给出了三条命题,形式化证明了这一机制具有方差缩减特性、有界正调制性质,以及与带正权重的 clipped GRPO 替代损失的精确等价性。
实验与结果
实验在三个具有代表性的智能体环境上展开:ALFWorld 考察具身推理能力,Search-based QA 考察搜索增强问答,WebShop 考察网页导航。骨干模型涵盖从 1.7B 到 7B 的多种规模。
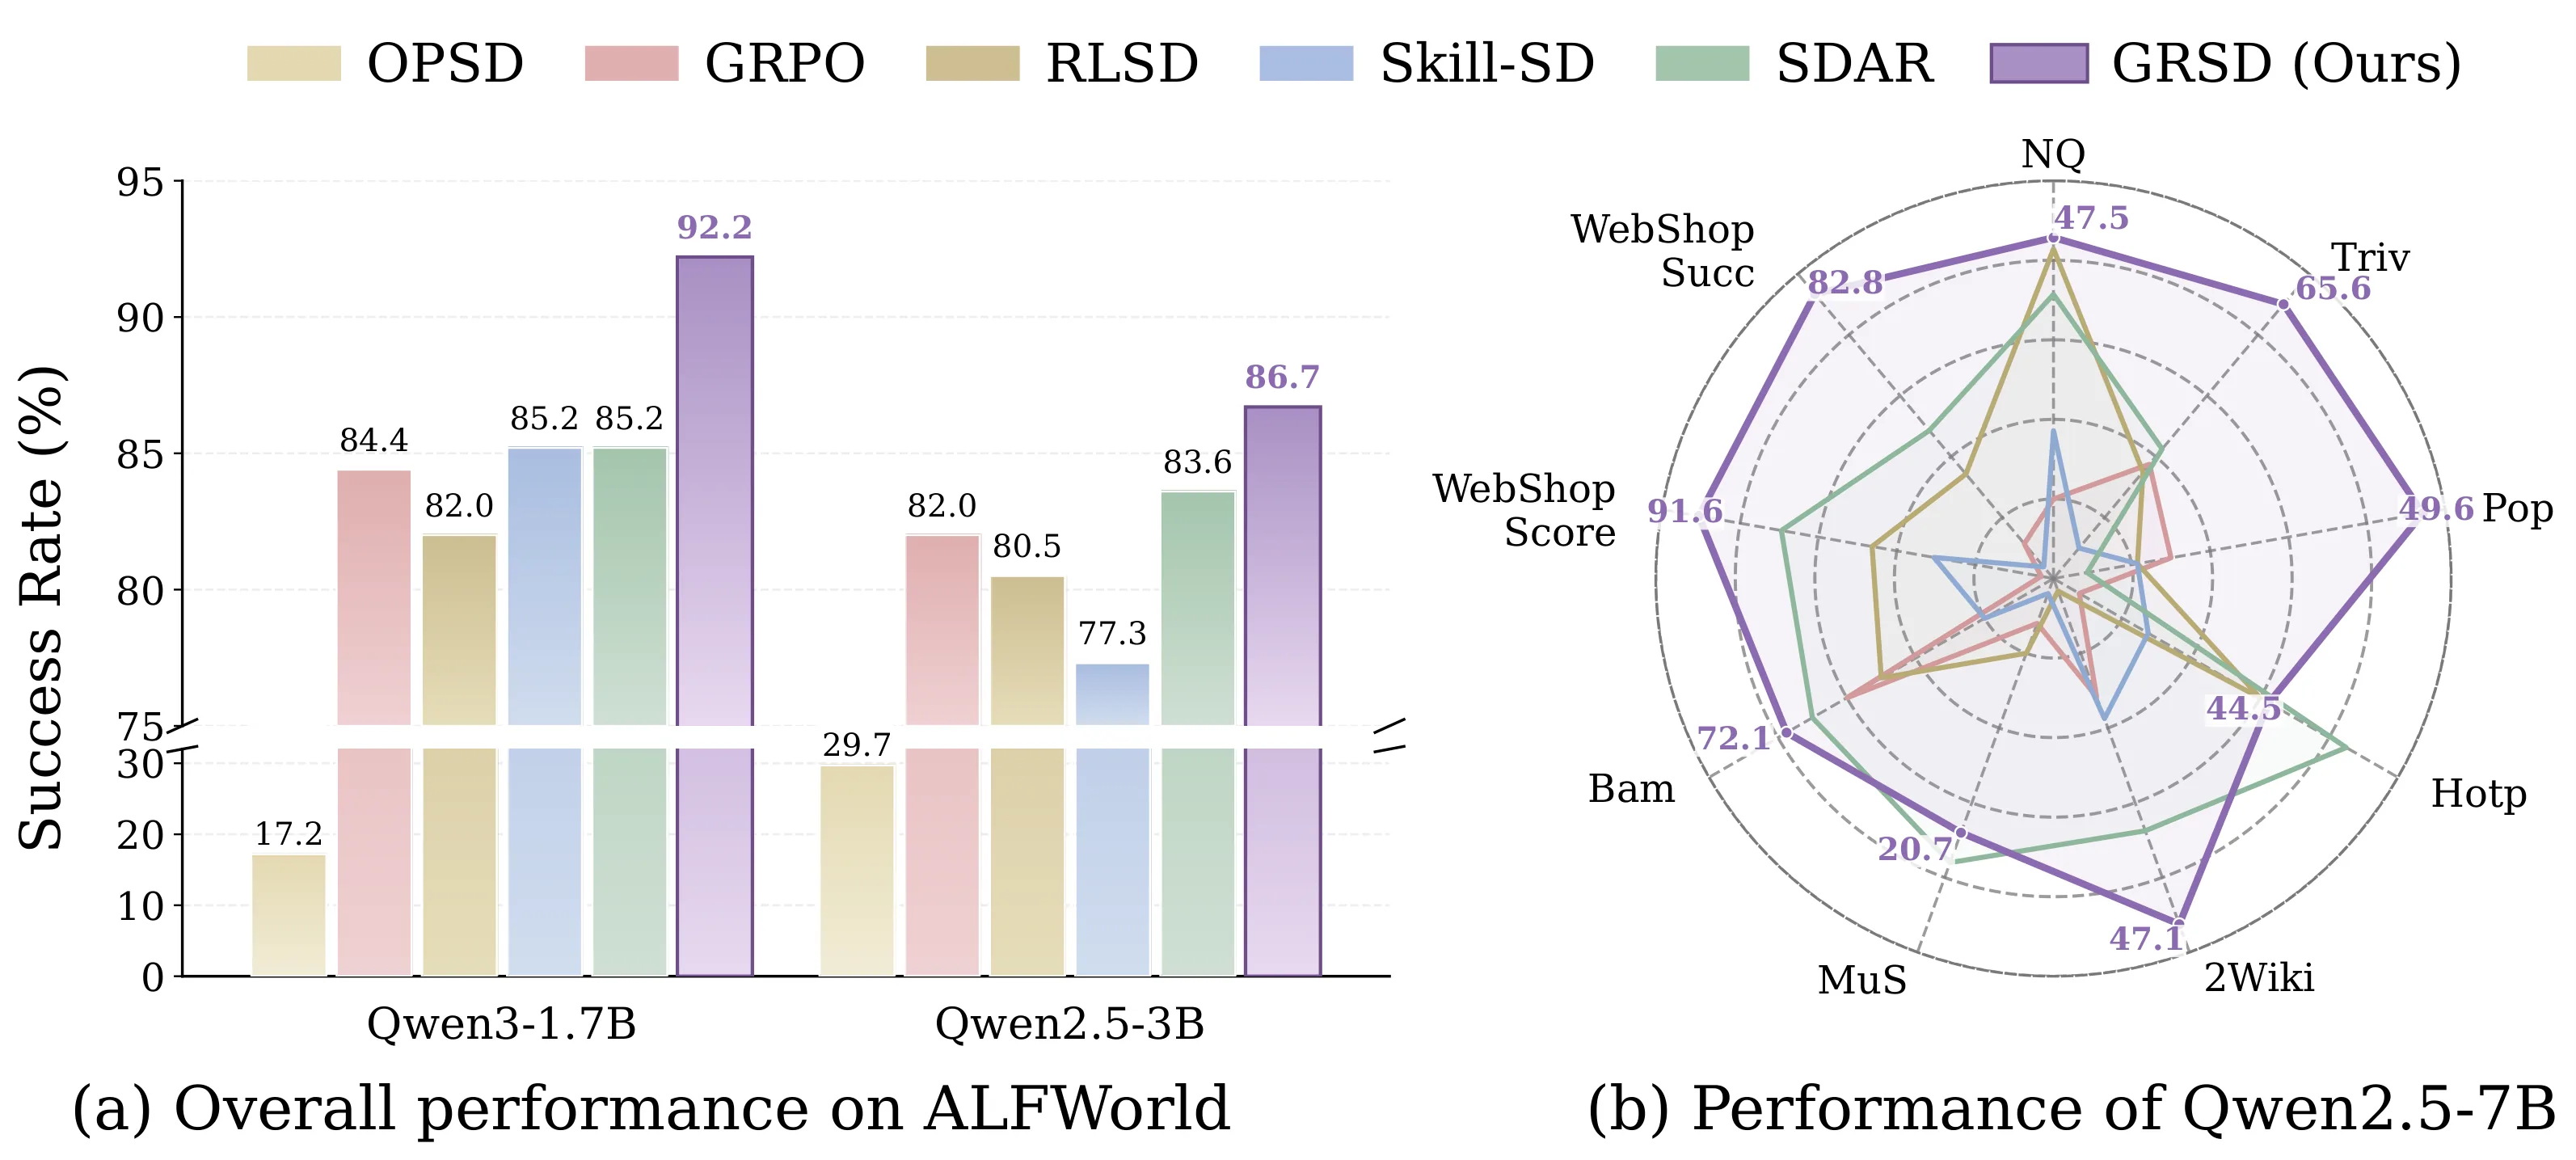
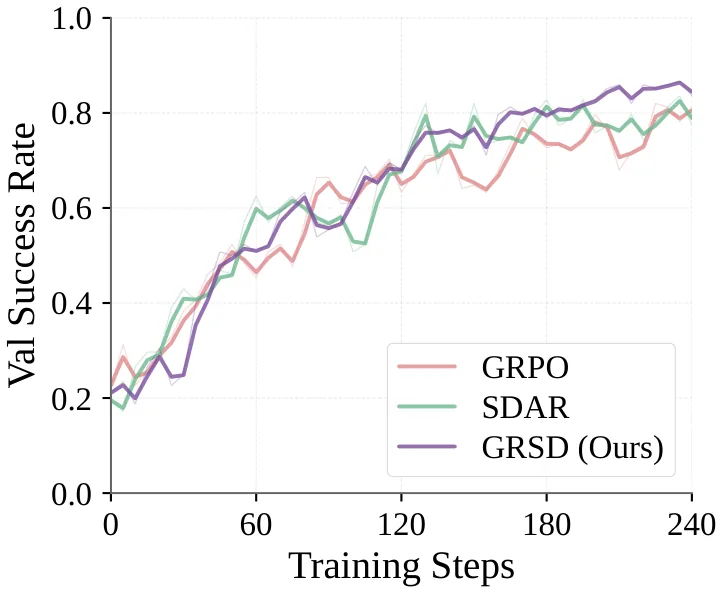
主实验结果呈现出一致的模式。在 ALFWorld 上,GRSD 相对基线 GRPO 提升 5.5 个百分点,相对当前最强的技能自蒸馏方法 SDAR 也有 4.2 个百分点的优势。在 SearchQA 和 WebShop 上,提升幅度分别为 2.7 个百分点和最高 7.2 个百分点。值得注意的是,这些提升在所有测试的模型规模上都成立,说明方法不依赖于特定的模型容量。
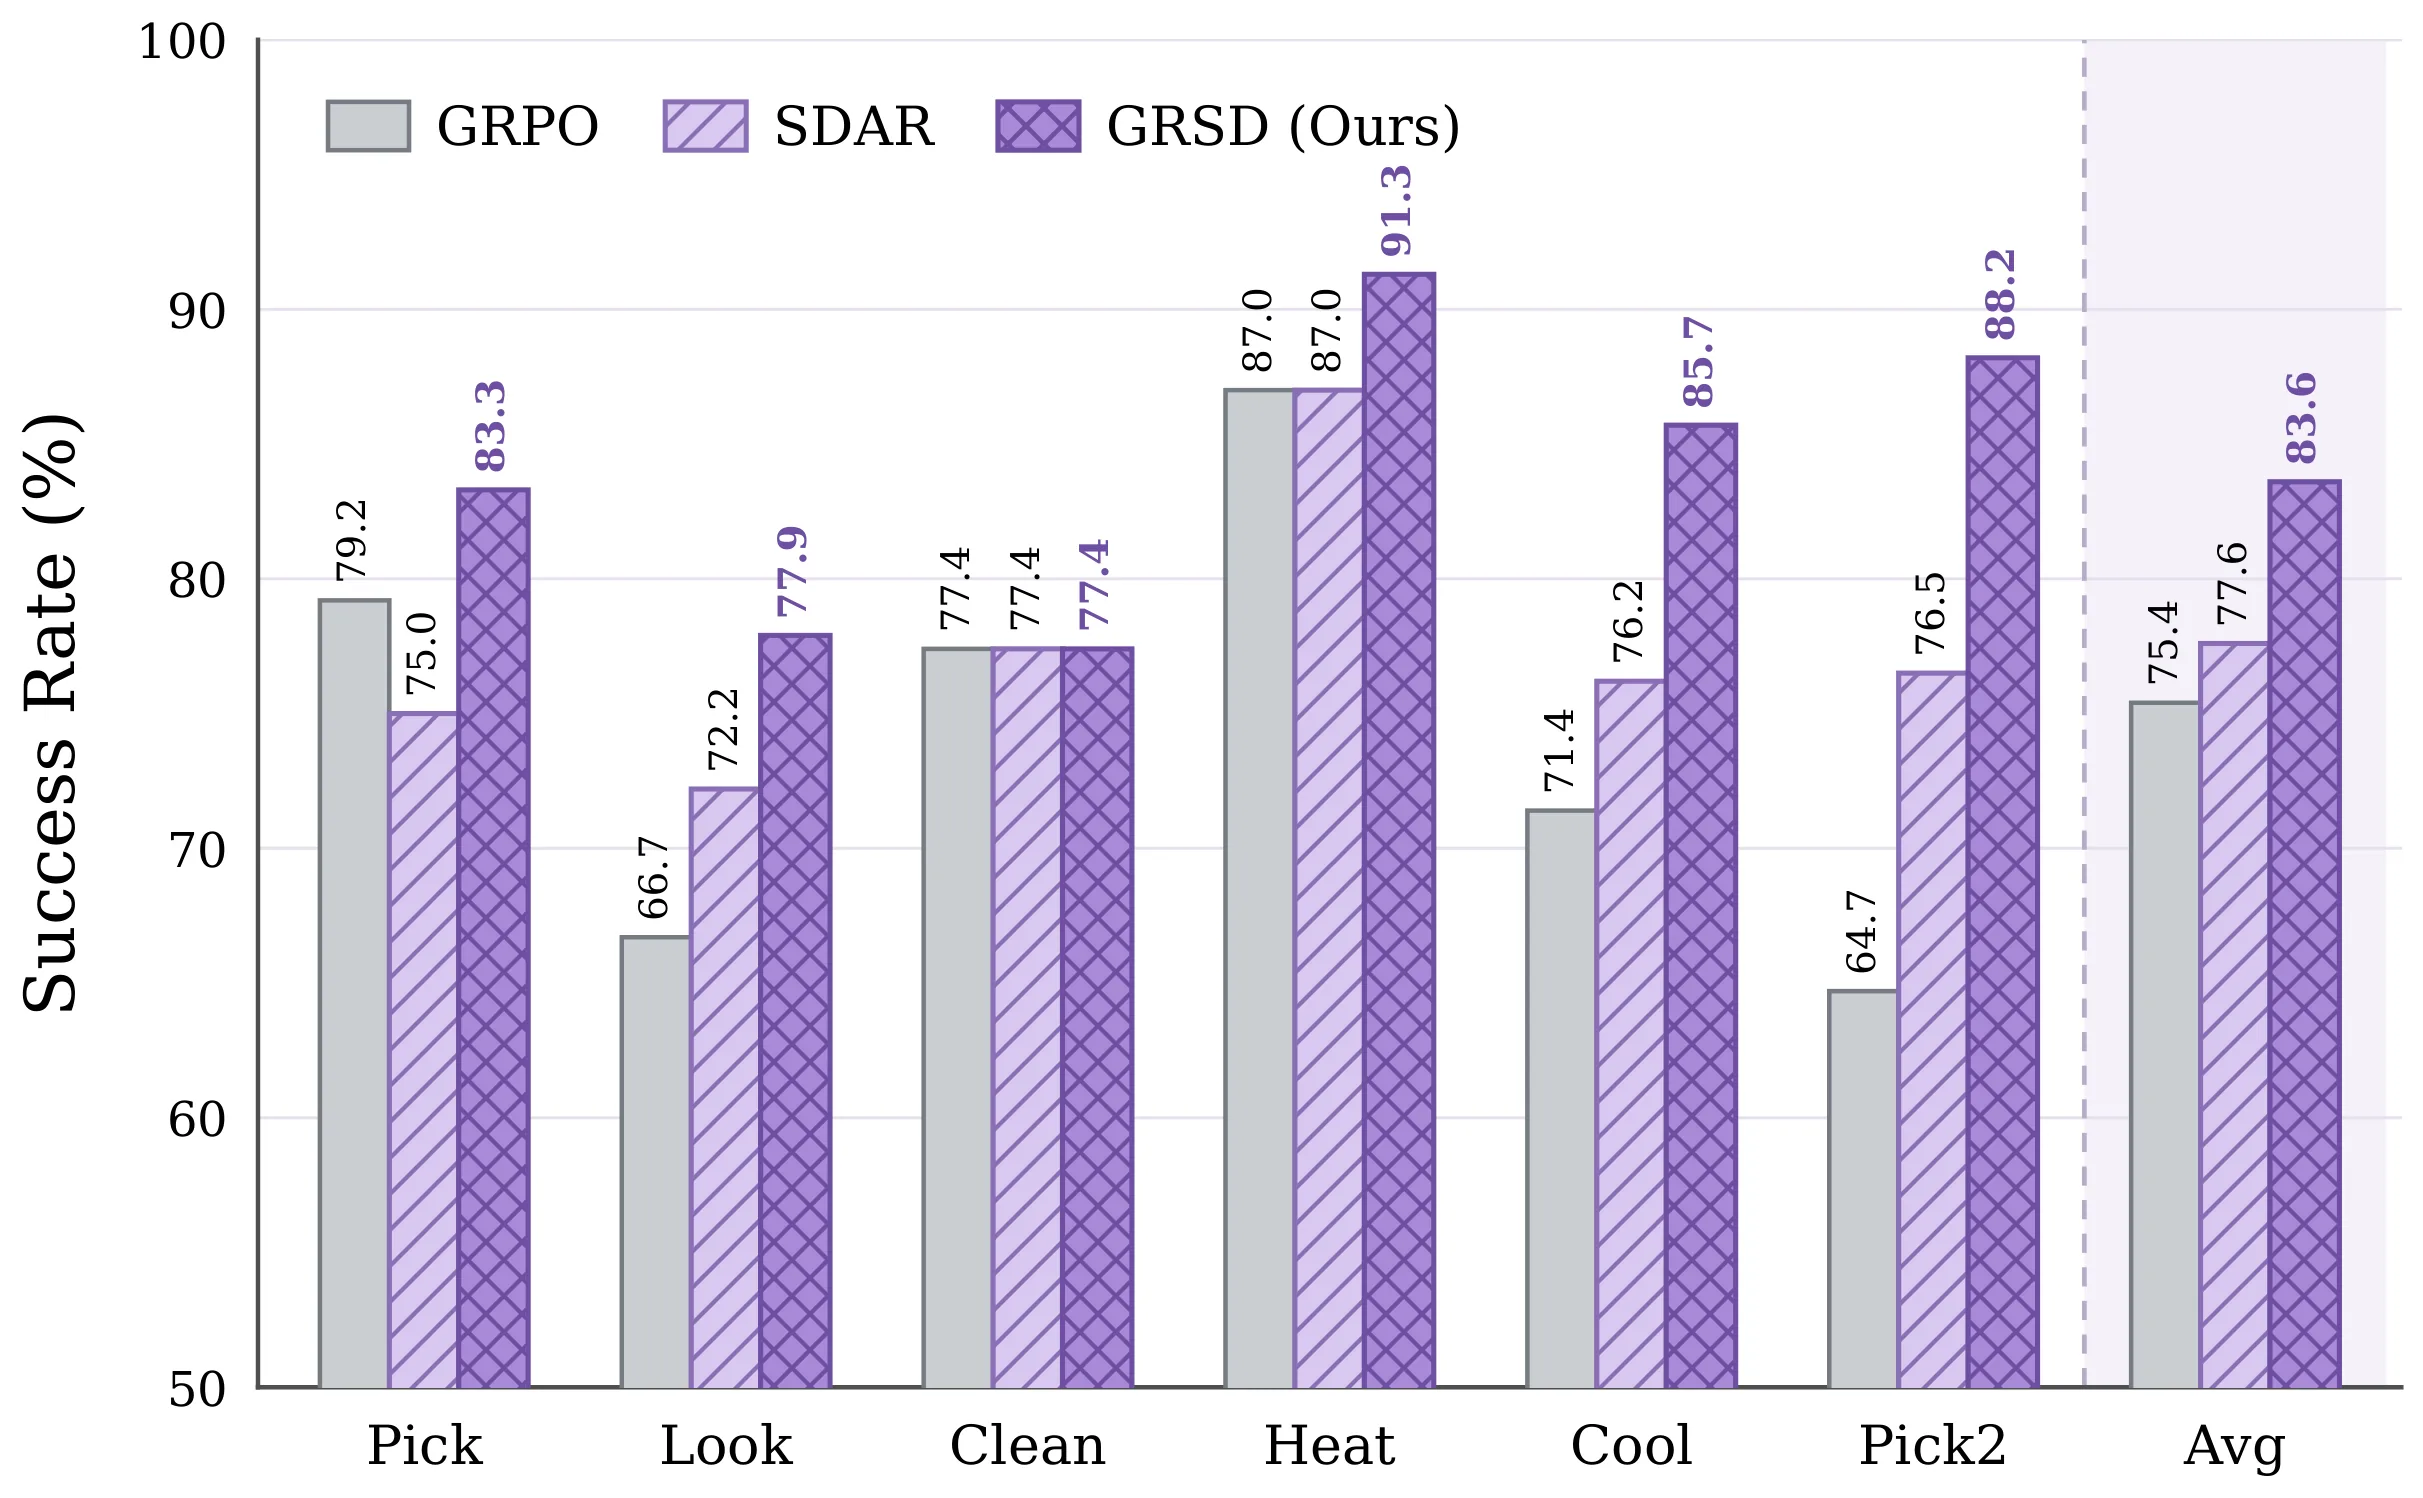
泛化结果是论文最引人注目的发现之一。在 ALFWorld 的 Unseen 评测集(训练时从未见过的任务类型)上,GRSD 达到 83.6% 的成功率,比 GRPO 高出 8.2 个百分点,比 SDAR 高出 6.0 个百分点。在某些子类别(如 Pick2、Cool)上,提升甚至超过 20 个百分点。这说明组级对比提炼出的行为模式具有更强的抽象性,能够迁移到训练分布之外的新任务上。
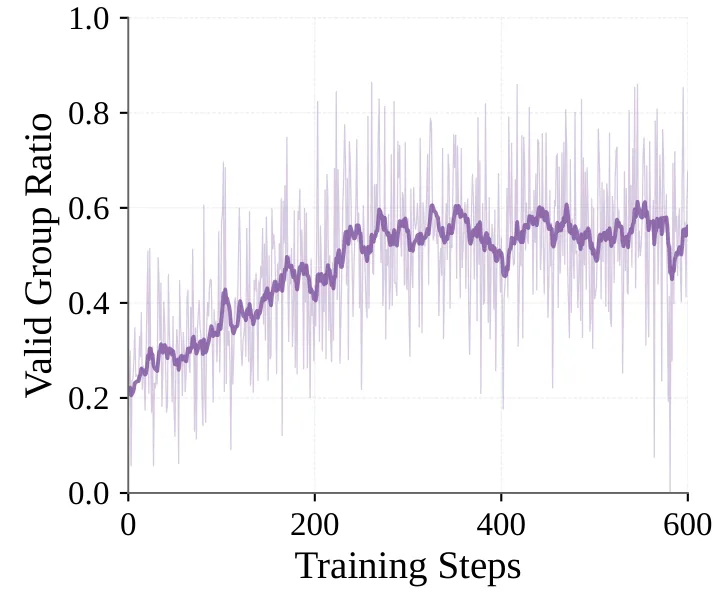
训练动态分析揭示了 GRSD 持续有效的原因。基线方法在训练后半段普遍趋于平台期,而 GRSD 的成功率曲线始终保持上升趋势。与此同时,有效组比例(组内同时包含成功和失败轨迹的比例)在整个训练过程中维持在非平凡水平,确保对比信号始终可用。自教师似然差方面,GRSD 的特权上下文对策略原生似然的扰动明显小于 Skill-SD 和 SDAR,表明生成的指导与策略自身的认知更兼容。
消融实验逐一验证了各组件的贡献。移除组反思指导后性能显著下降;仅使用成功轨迹而丢弃失败轨迹会丢失对比信号;用 token 级或轨迹级的粗粒度调制替代轮级调制也会削弱效果。这些结果共同指向一个结论:组级对比与轮级细粒度调制的组合是方法有效性的关键。
训练成本方面,GRSD 相对 GRPO 增加约 17% 的计算开销,相对 SDAR 增加约 8%。考虑到性能提升,这个开销在可接受范围内。更重要的是,所有额外计算仅发生在训练阶段,推理时不需要任何额外开销。
讨论与可借鉴点
GRSD 的核心贡献在于提出了一种「能力对齐的自监督」范式。与其依赖外部强模型或离线技能库,GRSD 让策略从自己的经验中学习——反思自己的轨迹,对比成功与失败的差异,提炼出真正与当前能力水平匹配的行为指导。这种思路在本质上规避了技能-能力失配问题,因为提炼出的知识一定在策略的可表达范围内。
组级对比设计值得特别关注。之前许多自蒸馏方法在单轨迹层面提取技能,容易捕获路径特有的细节而非泛化的行为模式。GRSD 通过在同提示的多轨迹间做成功-失败对比,能够更有效地提取区分成败的关键特征。这种[[对比学习]]的思想在监督信号构造中有着广泛的应用前景。
有界调制约束是一个看似简单但极为重要的设计选择。它将指导的作用限定在「调整幅度」而非「改变方向」,既保留了验证器的权威性,又允许精细化的[[信用分配]]。形式化的理论保证进一步增强了方法的可信度,同时也为理解这类混合监督机制的收敛行为提供了分析基础。
当前方法的局限也很清晰。GRSD 依赖组内同时存在成功和失败轨迹——如果策略在某个提示上已经完美,成功率和失败率都为 0,则组级指导无法构造(虽然这种情况下策略本身已无需改进)。此外,反思阶段引入的外部评判器增加了训练开销,虽然可控但仍是非平凡的计算成本。反思文本的质量直接影响指导的有效性,如何进一步提升反思的可信度和信息量是值得探索的方向。
对于从事智能体训练相关研究的实践者,GRSD 提供了一种无需外部强模型、无需大规模技能库即可提升强化学习效果的可复用思路。组级对比与自教师调制的组合可以被拆解为独立模块,灵活地与其他方法结合。其核心洞察——「从自身经验中提取与能力匹配的对比信号」——对整个自监督学习领域都具有启发意义。
摘要
基于策略自身已验证轨迹的自蒸馏方法用于智能体强化学习
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
从评分到行动:面向 LLM 智能体的结果验证式对比自蒸馏
From Scoring to Acting: Outcome-Verified Comparative Self-Distillation for LLM Agents
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 4 张
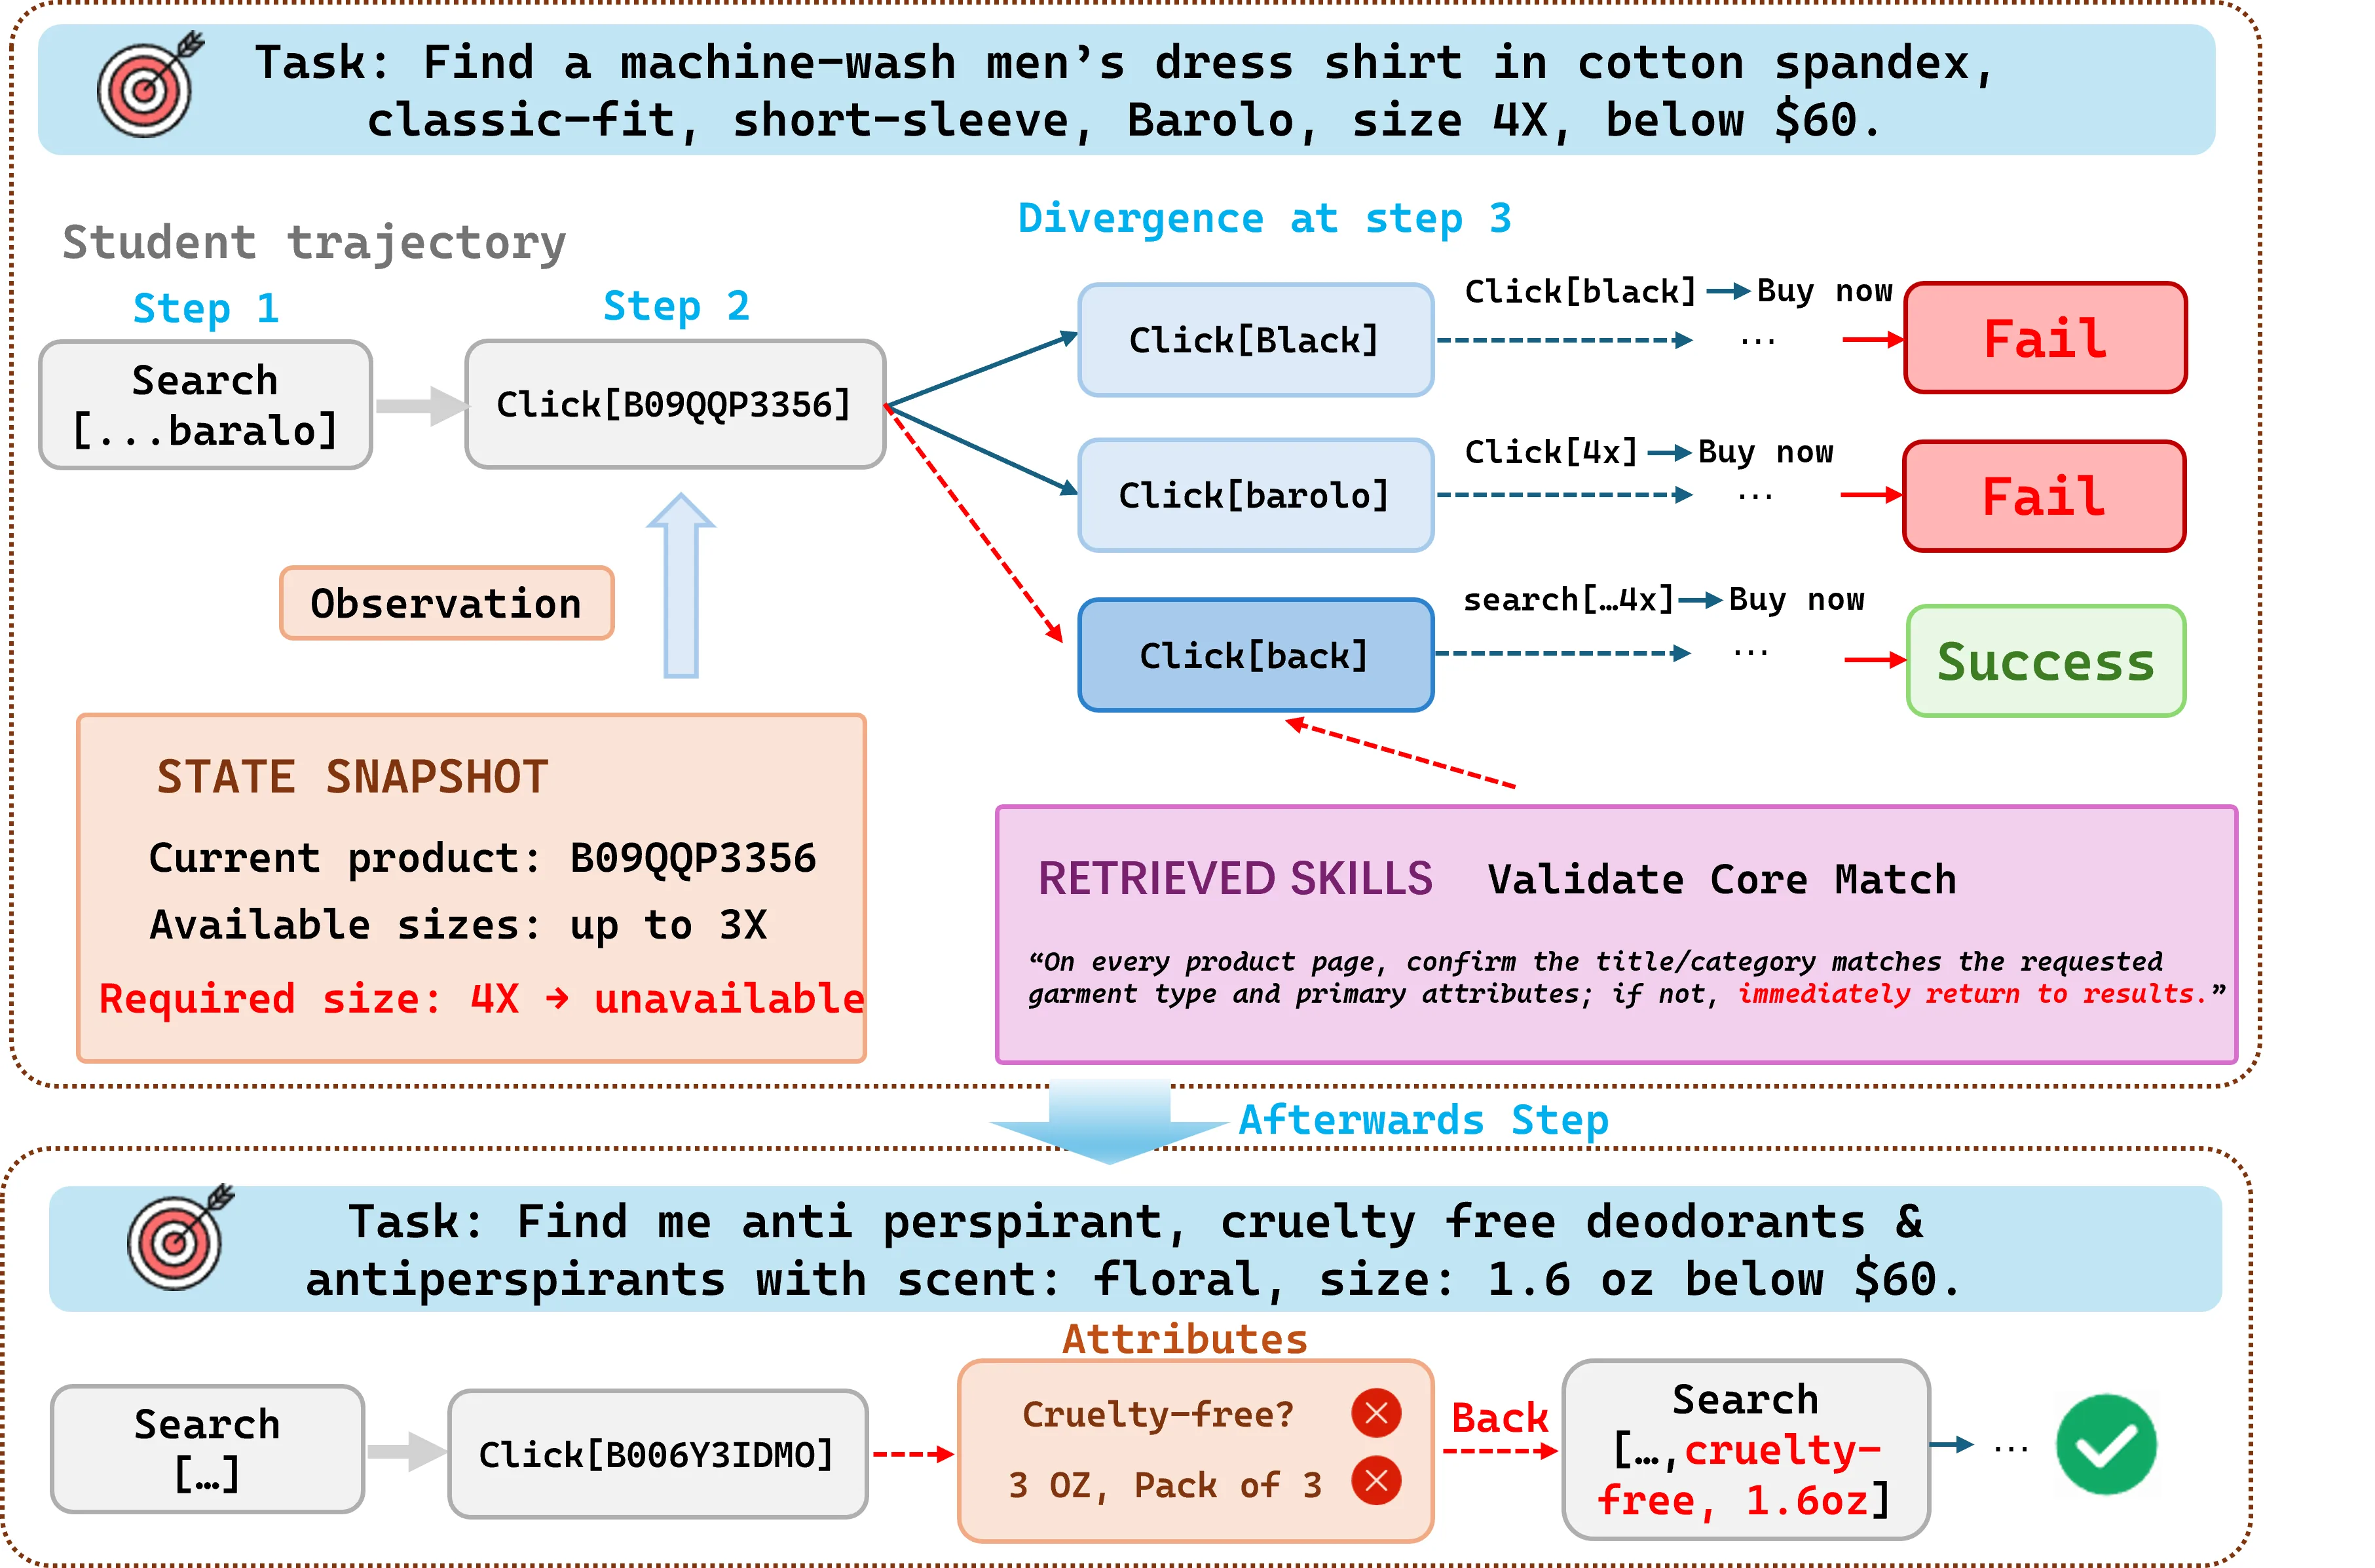
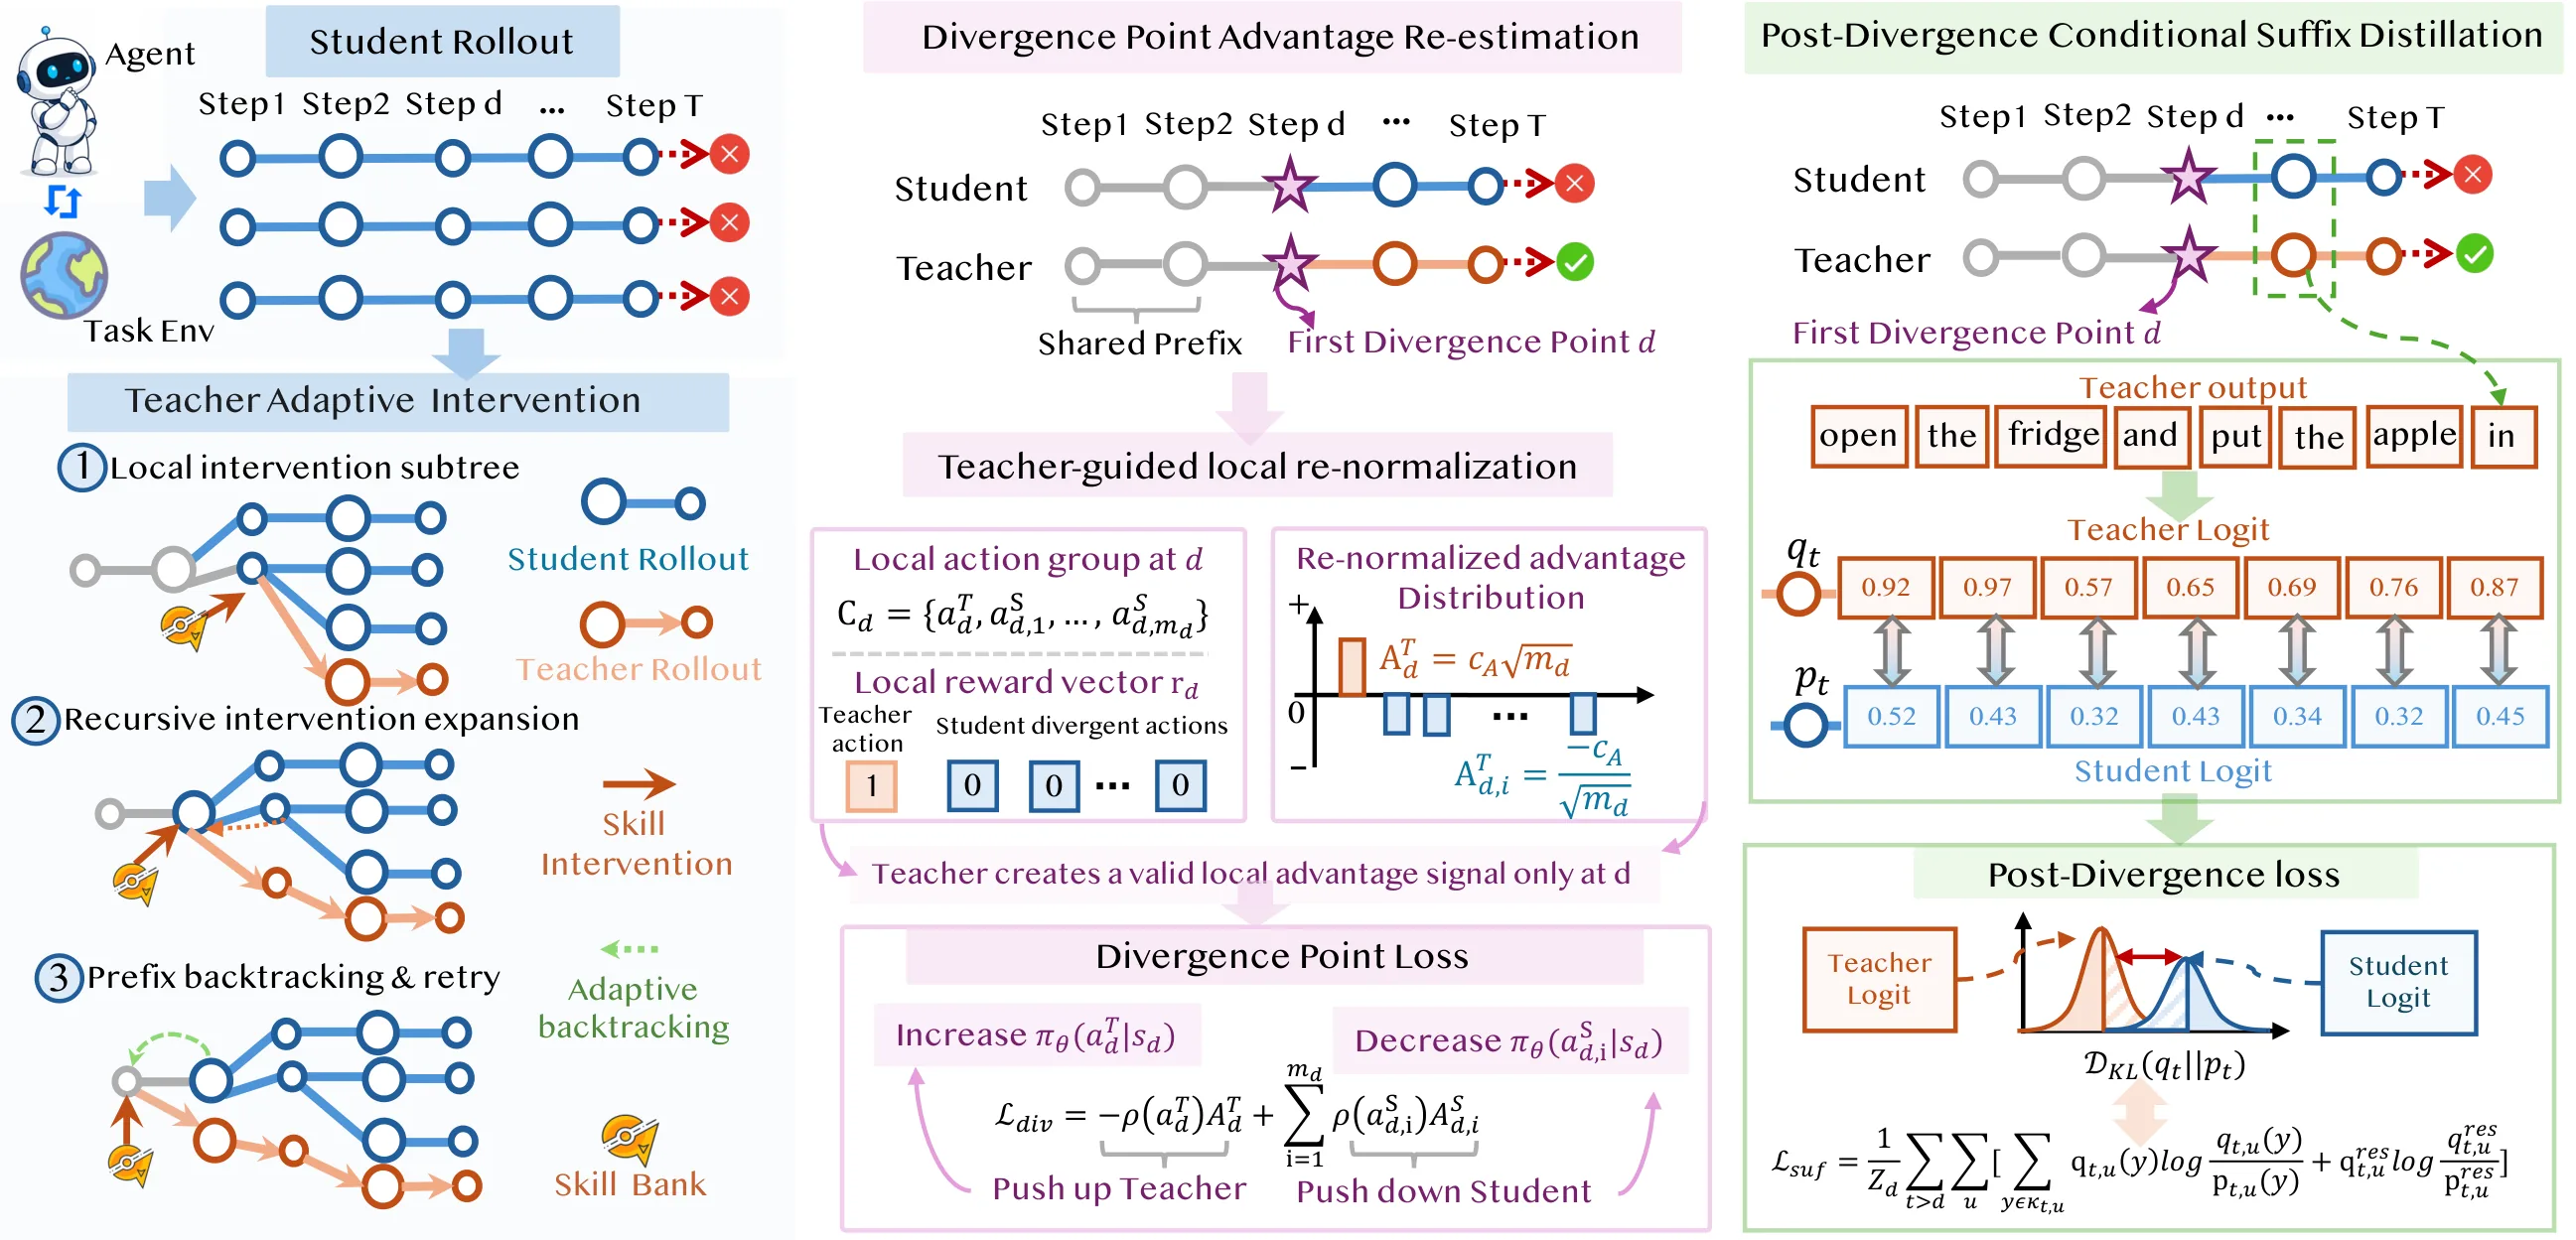
现有在线自蒸馏方法依赖对学生轨迹上的动作打分来监督学生模型,存在两个不足:教师偏好未由环境结果验证、动作级打分浪费了师生轨迹及行为关系信息。本文提出结果验证的对比自蒸馏OVCSD,将失败学生轨迹组织成前缀树,按需调用技能条件教师,仅保留经环境验证的成功续接,在首次分歧点进行局部对比学习并蒸馏教师后缀。实验在ALFWorld和WebShop三个模型规模上均显著优于无技能强化学习和现有自蒸馏基线,绝对成功率最高提升29.7和5.4,训练中特权交互不足3%。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
近年来,LLM智能体的研究范式正经历一场深刻转变:从依赖外部能力激发的「检索式部署」转向能力内化——即让模型在推理时无需检索外部技能库即可直接调用已固化的能力。这一转变的核心动机在于实际部署中外部检索带来的延迟开销、知识时效性以及系统复杂度问题。一个理想的内化智能体应当像人类专家一样,将外部习得的经验转化为稳定的参数知识。
在这一背景下,同策略自蒸馏(OPSD)成为实现能力内化的有前景方向。其基本思路是让一个能力更强的教师模型指导学生模型学习,教师可以是同一模型的特权版本(带有技能上下文或工具调用能力),学生则是部署时使用的无技能版本。然而,现有方法普遍采用一种朴素的监督策略:沿着学生生成的轨迹逐个动作打分,用教师的局部偏好作为监督信号。这种做法存在两个根本性的缺陷。
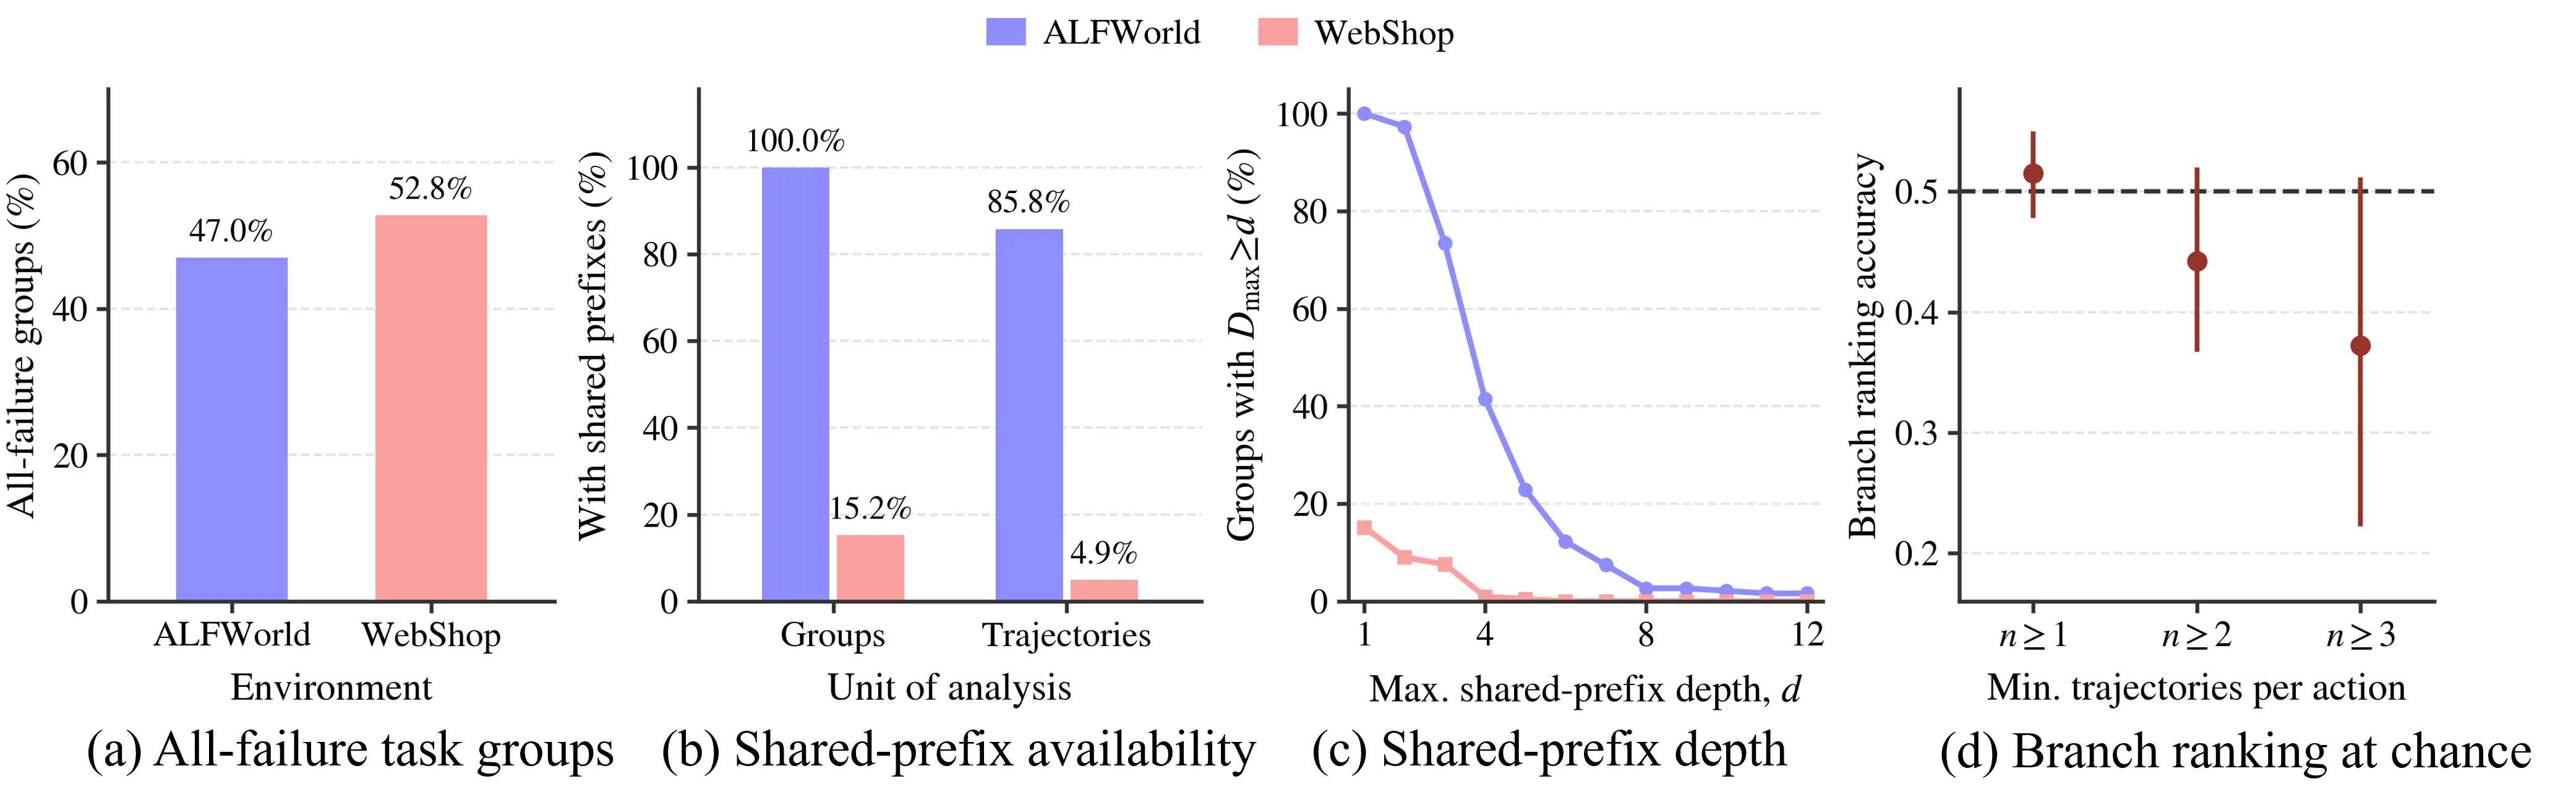
第一个缺陷在于教师偏好缺乏结果验证。教师从未真正与环境交互,它给出的动作评分本质上是一种事后猜测,与该动作能否真正导向任务成功之间没有可靠的因果联系。在长视野任务中,一个被教师高分的动作完全可能因为后续的决策失误而走向失败,用这样的偏好信号训练学生,就像是用从未下过棋的旁观者的建议来指导棋手。论文中的分析表明,技能条件的似然排名对实际成败的预测精度仅为约 0.515,几乎等同于随机猜测。第二个缺陷在于师生轨迹信息的利用极不充分:失败的学生采样通常被压缩成统一的失败奖励或直接丢弃,这掩盖了学生已经取得的有效中间进度;教师轨迹则被均匀蒸馏,未能区分「纠错动作」与「完成任务的后续行为」;更关键的是,师生轨迹之间的行为关系——它们在哪些状态保持一致、在哪里开始分歧——从未被系统性地提取和利用。
方法
OVCSD 的设计并非凭空产生,而是建立在三个精心设计的先导观察之上。第一个观察发现,失败的学生采样虽然最终都失败了,但它们在轨迹前缀层面共享大量有效的中间状态结构,这些结构可以自然地组织成一棵前缀树(trie)。这意味着即使学生整体失败,它在某些中间步骤上已经做对了,只是后续某个环节出了问题。第二个观察指出,技能条件教师的续接能力同时依赖状态和结果——共享前缀深度在跨任务间差异巨大,进一步量化发现,当动作支持数较低时,技能条件似然的预测精度只有约 0.515,增大支持数后更是降到 0.372 以下,说明单纯依靠教师似然来判断续接质量是完全不可靠的。第三个观察则揭示了师生轨迹「可比较性」的结构特征:分歧之前行为一致无需对比,分歧点处同状态不同动作可直接对比,分歧之后历史已经分离不能再逐步比较。
基于这三个观察,OVCSD 设计了三阶段的方法流程。
阶段一:基础学生采样。论文冻结一个无技能的基线策略 ,对每个任务实例采样 条轨迹构成一个组,计算组内相对优势 。当整组全部失败且优势方差无意义时,原有的组内优势被清零,学生完全依赖后续 OVCSD 的对比监督来学习。
阶段二:自适应结果验证式干预。这是 OVCSD 的核心创新之一。失败轨迹被组织成前缀树,每个节点表示学生到达的共享状态,深度代表学生已经正确执行了多少步。论文采用最深优先策略从更深节点发起干预,以保留更多学生已经做对的部分。教师从同一冻结快照 配备技能上下文 ,形式化为 。教师最多执行 步续接,但关键的是,只有当续接轨迹的最终奖励达到成功阈值 时,这个续接才被接受并加入训练集。如果续接失败,系统会回溯到更浅的祖先节点重试,自适应地扩大替换范围。这种结果验证机制直接解决了教师偏好缺乏验证的问题——43.5% 的初始续接在验证阶段被拒绝,正是这一机制过滤掉了那些看似合理但实际会导致失败的教师建议。
阶段三:对齐感知的对比学习。在获得经过验证的教师成功续接后,OVCSD 需要将教师知识迁移到学生身上。但师生轨迹在首次分歧之后历史已经分离,不能再简单地进行动作级对比。论文将迁移目标分为两部分。对于分歧点处的「纠错」行为,OVCSD 在首次状态对齐分歧处组织局部对比组。教师动作获得正优势 ,失败学生的备选动作获得负优势 ,总正负优势质量保持平衡。这一局部对比信号通过标准裁剪的 GRPO 目标应用到学生策略上。对于分歧点之后的「完成」行为,由于历史已经分离不能再逐步比较,OVCSD 改为对分歧后教师分布与学生分布进行 [[KL散度]] 蒸馏:
其中 是教师在带教师历史状态下的条件分布(stopgrad以避免教师本身被更新), 是学生自己的分布。最终的训练目标是增强版的 GRPO 目标加上后缀蒸馏目标的加权和:
值得注意的是,训练完成后推理阶段只需要部署无技能策略 ,不需要任何技能检索、前缀树或教师交互,实现了真正无开销的能力内化。
实验与结果
论文在 ALFWorld 和 WebShop 两个广泛使用的交互式基准上进行了全面实验,覆盖 Qwen3-1.7B、Qwen2.5-3B、Qwen2.5-7B 三种模型规模,并对比了包括无技能 GRPO、多种自蒸馏基线(OPSD、Skill-SD、SDAR)以及推理时使用技能的 SkillCOT* 在内的七类方法。
主实验结果展现了 OVCSD 的显著优势。在 ALFWorld 上,OVCSD 在三个模型规模上相对最强基线 SDAR 分别提升 29.7、4.7、6.3 个百分点,相对无技能 GRPO 的提升更是达到 37.5、14.1、11.0 个百分点。值得注意的是,性能提升主要集中在 Heat、Cool、Pick2 等需要多步组合决策的任务类型上,例如 Pick2 任务相对 GRPO 提升高达 43.2、41.4、36.5 个百分点。在 WebShop 上,OVCSD 相对 SDAR 提升 5.4、1.9、4.2 个百分点,WebShop 得分提升也达到 10.6、5.5、10.3 分。这些结果表明 OVCSD 的优势并非局限于某个特定任务或规模,而是具有良好的通用性和规模适应性。
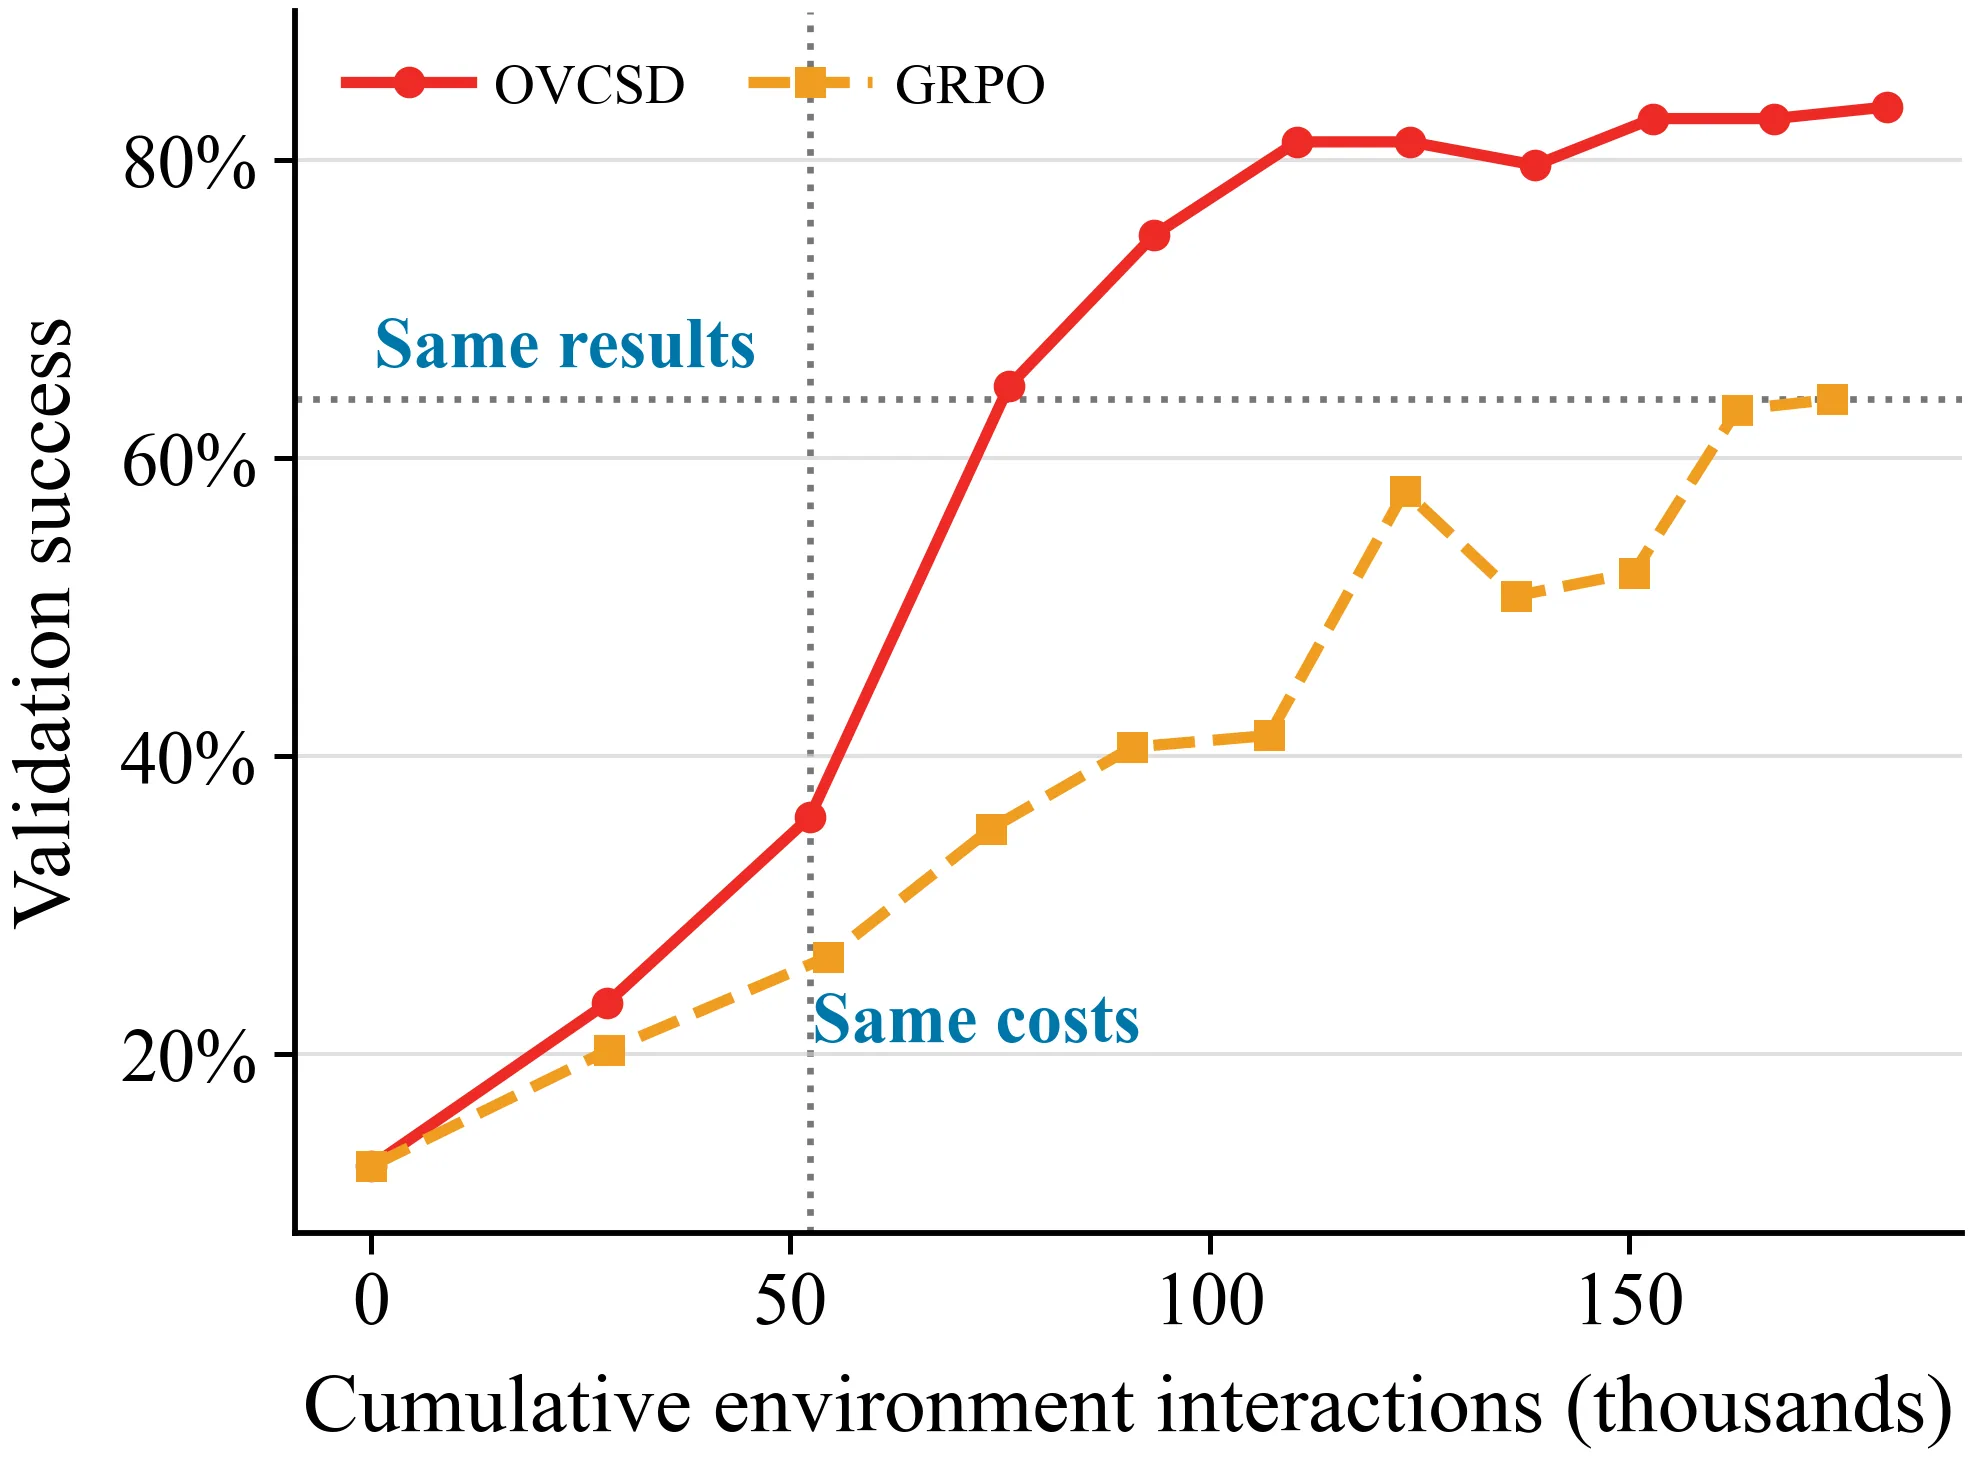
更值得关注的是,OVCSD 的性能增益并非通过大规模增加环境交互换来的。论文详细分析了 100 步训练中各类环境交互的占比:学生轨迹交互约 177k 步,回放轨迹约 492 步,教师续接约 3,314 步,特权交互总计不足 3%。论文进一步绘制了预算对齐曲线,发现在累计 123k 动作时 OVCSD 即可达到 81.3% 的成功率,而 GRPO 此时仅有 57.8%;达到 GRPO 最终性能所需的累计动作从 174.3k 降至 81.4k,实现了约 2.1 倍的训练效率提升。
消融实验进一步揭示了各组件的必要性。移除局部对比(仅保留后缀 KL)使 ALFWorld 成功率从 81.25% 降至 66.41%,移除后缀 KL(仅保留局部对比)则降至 64.06%,说明「分歧点纠错」与「完成后缀蒸馏」两条学习信号相互补充、缺一不可。移除结果验证机制后,43.9% 的训练分支实际上是失败轨迹,直接证明了结果验证机制的关键作用。
讨论与可借鉴点
OVCSD 带来了一些重要的方法论启示。首先,它示范了如何将「对比」思想引入 [[自蒸馏]] 框架:不是让教师单向输出偏好,而是让师生轨迹在结构化对齐的基础上进行对比学习,这比单纯的动作打分能更充分地利用轨迹间的行为关系信息。其次,前缀树 + 最深优先 + 回溯的干预策略提供了一种优雅的机制来平衡「保留学生已有进度」与「引入教师正确续接」之间的权衡,这种思路可以推广到其他需要选择性干预的在线学习场景。第三,「结果验证」的概念具有广泛的适用性——任何依赖教师/专家偏好的学习方法都应该考虑将偏好信号与真实环境反馈挂钩,避免「高分低能」的虚假学习。
论文也诚实地讨论了若干局限。在基准覆盖方面,目前仅在 ALFWorld 和 WebShop 两个文字动作环境中验证,尚未在更长视野、更稀疏奖励的复杂场景(如 ScienceWorld)中进行检验。论文自身也指出,WebShop 上有 42.1% 的组在根状态之后没有任何共享候选,说明前缀树机制在某些任务类型上的适用性可能受限。在实验层面,主结果缺乏多随机种子的方差报告,难以判断某些边际差距(如 1.7B 模型上 4.7 个百分点的提升)是否统计显著。此外,OVCSD 依赖预置的技能库,技能库的质量与覆盖范围对最终效果的影响尚未被充分分析;教师采用同模型冻结快照的设计也意味着更大的性能天花板尚未被探索。
从更宏观的角度看,能力内化范式虽然降低了推理时的系统复杂度,但也带来了新的风险——一旦技能库包含错误或对抗性内容,这些知识会被直接固化进模型参数而缺乏事后审计。对于高风险部署场景,推理时保留一定的技能可控性和可解释性可能仍然是必要的。
摘要
面向LLM智能体的结果验证自蒸馏方法
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
β-OPSD:以策略优化推导,以自蒸馏训练
$β$-OPSD: Deriving with Policy Optimization, Training with Self-Distillation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 5 张
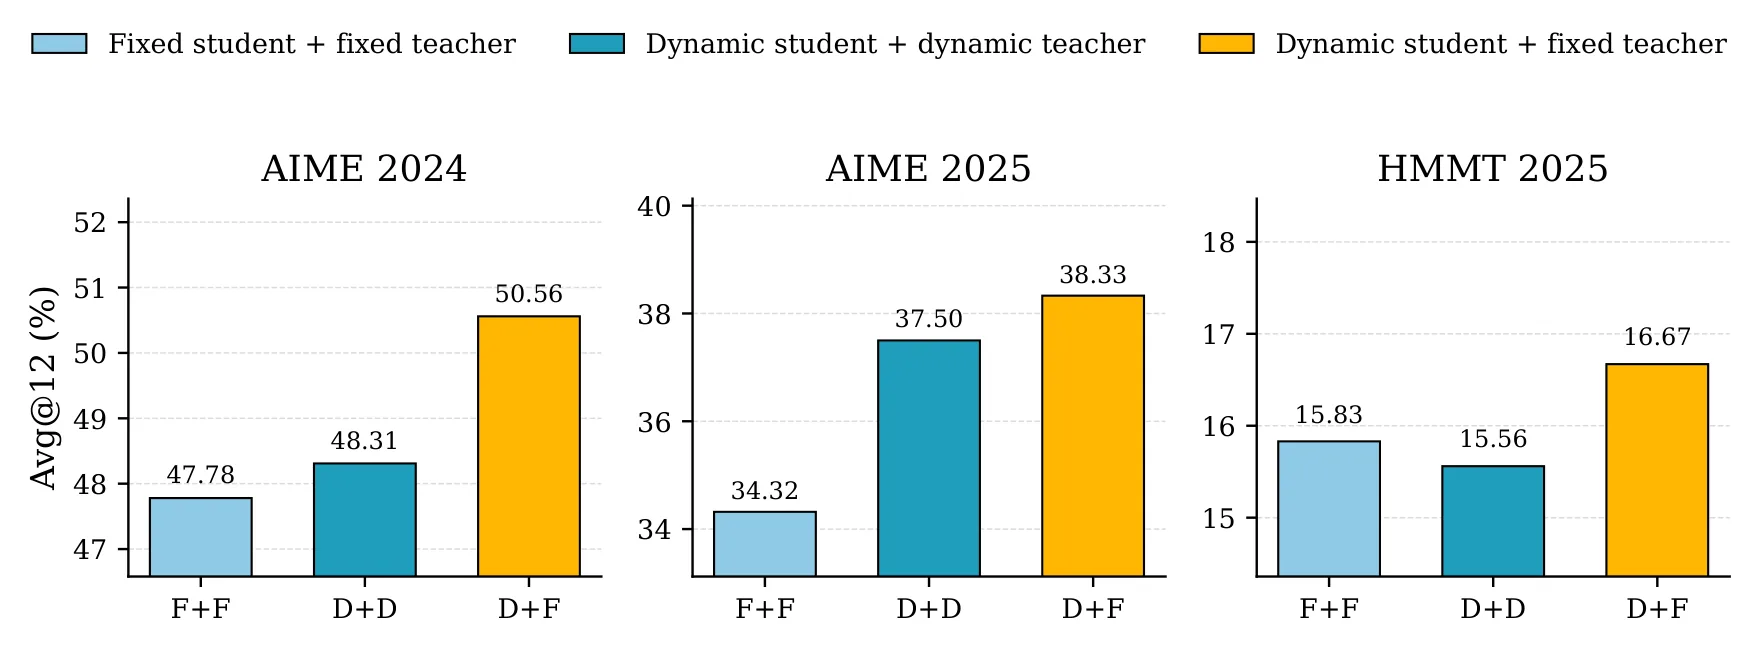
在线自蒸馏(OPSD)虽能提升推理语言模型,但训练脆弱、依赖大量工程调优。本文将vanilla OPSD识别为策略优化家族的β=1特例,提出β-OPSD,通过β参数调节KL惩罚强度,将最优策略表达为参考策略与特权教师之间的几何插值,以闭式解作为蒸馏目标,用logit混合近似昂贵的策略优化。在数学推理基准上稳定优于vanilla OPSD。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
在线自蒸馏已经成为提升推理语言模型能力的重要技术路线。与传统的离线蒸馏不同,OPSD 让模型在自己的采样轨迹上模仿一个"特权教师"——这个教师能够看到真实解题过程或中间反馈,从而为学生提供更高质量的指导。这种同策设置使学生能更好地适应自身的实际中间状态,而非仅仅模仿一个与自身分布脱节的固定目标。
然而,OPSD 在实践中常常暴露出脆弱的一面。要让它稳定工作,往往需要大量的工程调优:学习率怎么设、什么时候开始蒸馏、教师信号怎么加权——这些细节对最终效果影响很大,但缺乏系统性的理论指导。工程师们更多依靠经验试错,而非清晰的设计原则。
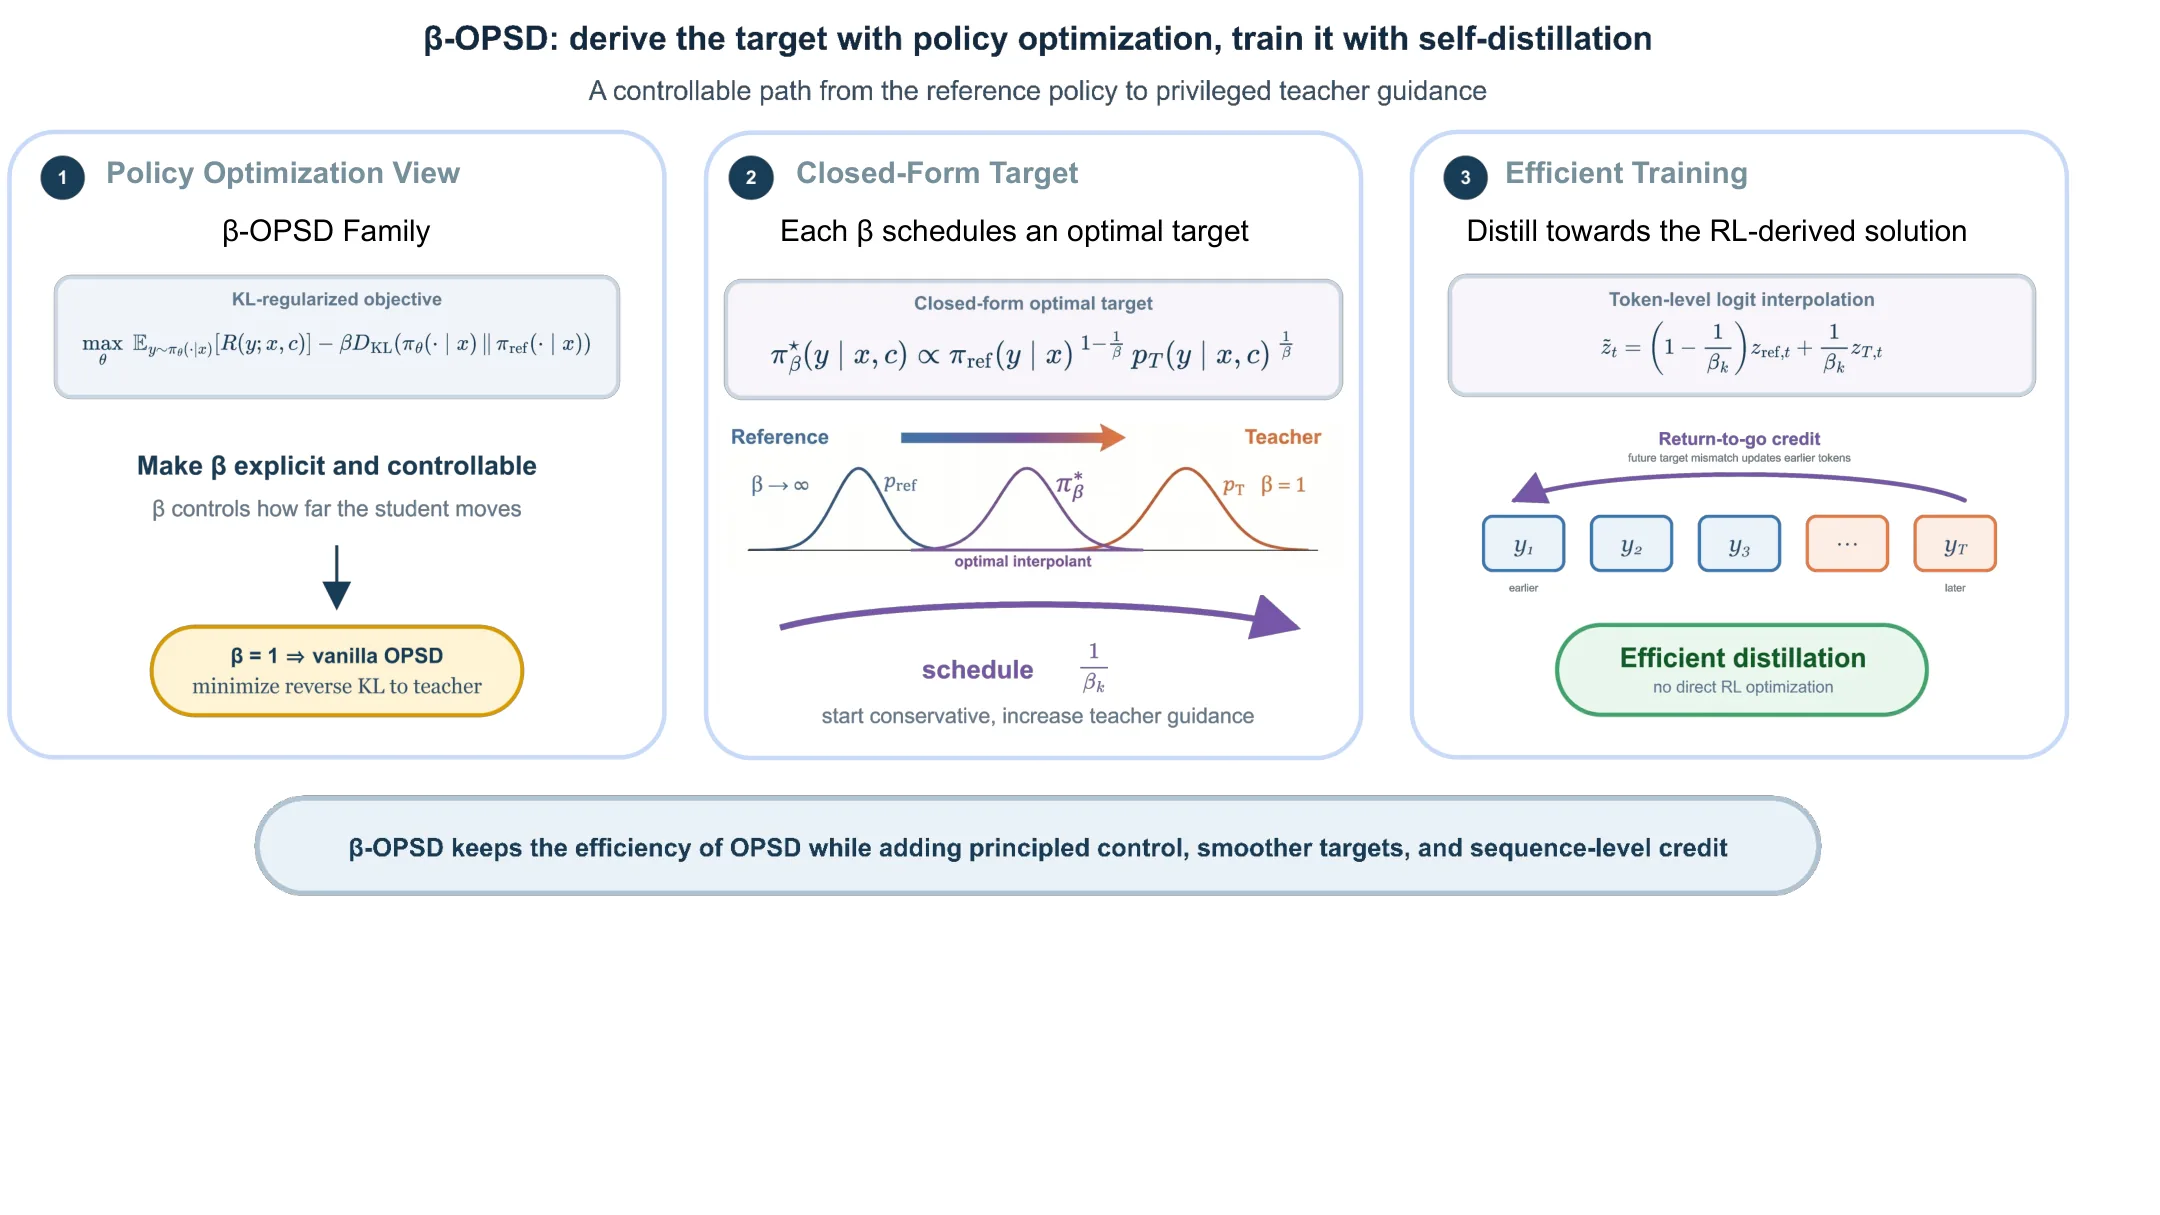
本文的核心洞察在于找到了这种脆弱性的结构性根源:vanilla OPSD 实际上恰好是 KL 正则化策略优化族中 的特例。在 KL 正则化 RL 框架中, 用来控制学生策略与参考策略之间的 KL 惩罚权重。当 时,这个参数被隐式地固定了,导致无法显式控制"学生应该多大程度上偏离当前策略、靠近特权教师"。正是这种自由度的缺失,使得 vanilla OPSD 在优化过程中缺乏对正则化强度的灵活调节能力。
方法
理解了 OPSD 与策略优化的深层联系后,作者顺理成章地将 从隐含值解放出来,使其成为一个可控的正则化参数。由此得到的 -OPSD 框架在"靠近参考策略"与"吸收教师指导"之间提供了一个显式的权衡机制。
具体而言,论文将教师-参考 log 比值作为奖励信号,代入标准的 KL 正则化 RL 目标:
当 时,参考项恰好对消,目标退化为最小化反向 KL 散度,这正是标准 OPSD 的损失函数。这一推导建立了两个方法之间的严格等价关系。
在兼容支撑假设下,最优策略存在闭式解,其形式是参考策略与教师之间的几何插值:
这里 是归一化常数。从这个公式可以清晰看出:当 时,最优策略就是特权教师本身;当 趋向无穷大时,策略趋近参考策略;中间的 值则在两点之间的路径上选择目标。这种几何直觉为 的调节提供了直观的语义理解。
然而,直接用强化学习来优化这个目标会遇到两个障碍:计算序列级归一化常数 是 intractable 的,而 RL 优化本身也伴随着高方差。论文的核心创新在于绕过了这些问题——不是直接优化 RL 目标,而是将闭式解转化为一个蒸馏目标。由于闭式解要求对序列级别的分布进行归一化,作者转而在每个前缀位置构造局部目标:
这种 logit 混合的实现方式非常高效,只需对参考策略和学生/教师的 logit 向量进行加权求和再 softmax 即可,无需额外的模型前向传播或序列级归一化。
值得注意的是,标准的词元级梯度是"短视"的——每个词元只考虑自身的损失,忽略了它对后续词元分布的影响。在序列生成任务中,早期词元的选择会改变整个后续前缀,从而影响整个序列与目标分布的匹配程度。为此,论文引入了 return-to-go 信用分配机制,将折扣回报累积到每个词元:
当折扣因子 时,return-to-go 梯度是序列级反向 KL 梯度的无偏估计;引入折扣因子则可以在偏差与方差之间取得更好的平衡。
整个训练流程遵循一个简洁的循环:先从当前策略采样同策轨迹,然后用调度好的 构造 logit 混合目标,接着计算 return-to-go 加权的词元级损失,最后更新模型参数。作者采用的调度策略是有界线性调度, 从初始的 平滑上升到最终的 ,实现从偏重参考策略到偏重教师策略的课程学习。
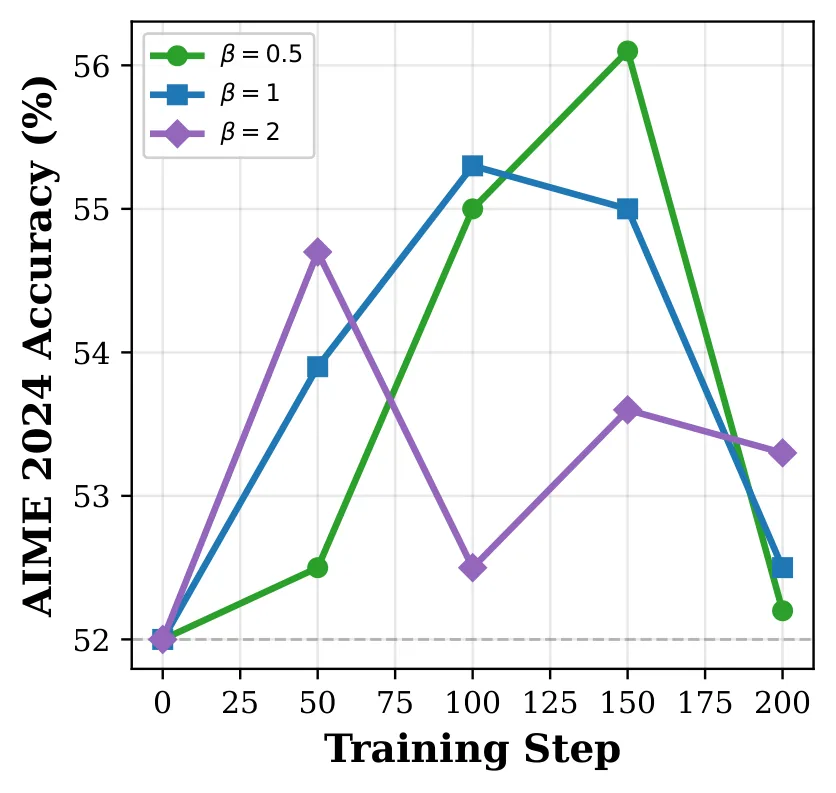
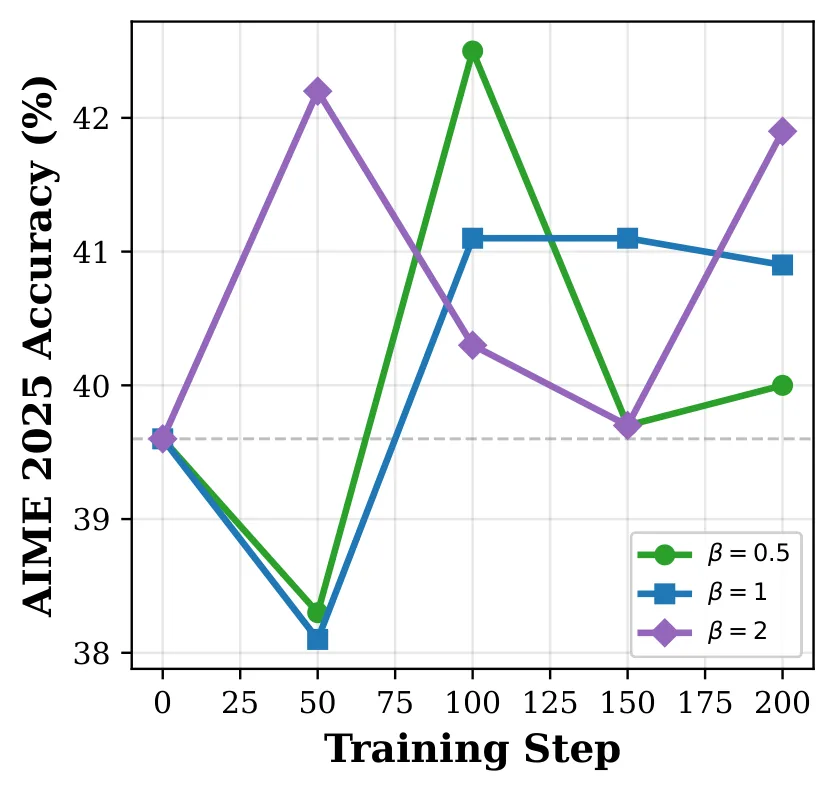
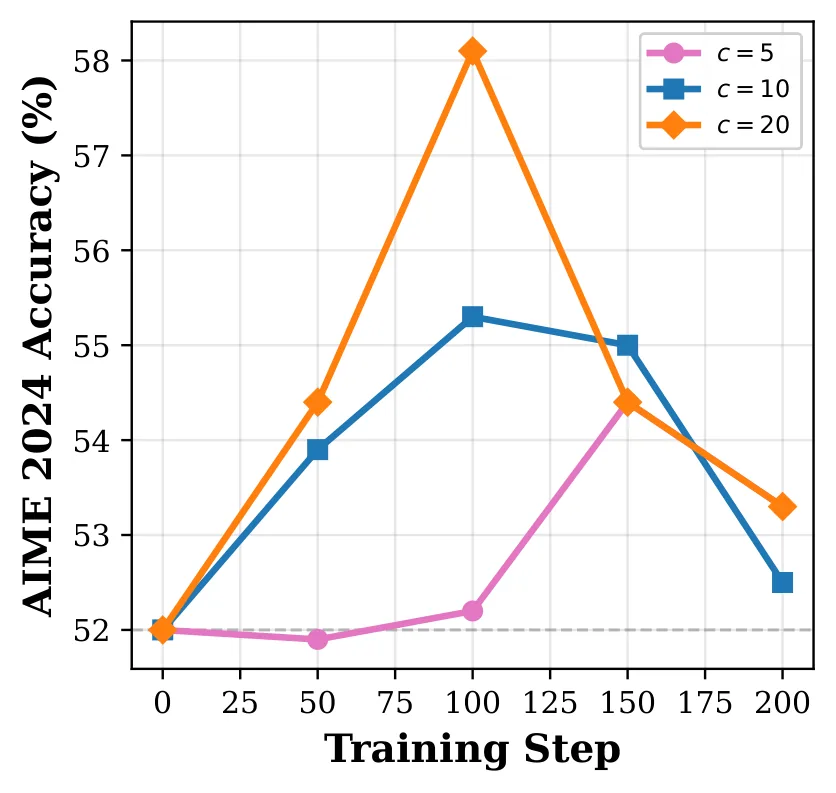
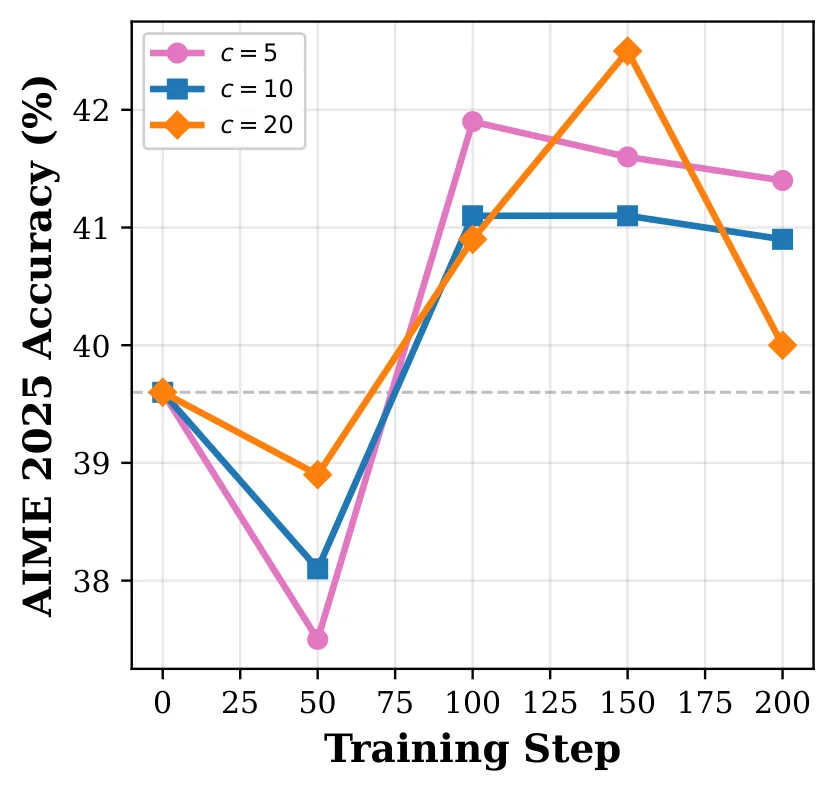
实验与结果
实验在数学推理领域进行,训练数据来自 OpenThoughts 数据集的数学推理子集,评测则在三个竞赛级基准上展开:AIME 2024、AIME 2025 和 HMMT 2025。模型覆盖了 Qwen3 家族的 1.7B、4B 和 8B 三个规模,对比基线包括无后训练的基础模型、监督微调(SFT)、vanilla OPSD 以及基于结果奖励的策略优化方法 GRPO。
主实验在训练中途的 100 步检查点进行评估,主要指标是 12 次采样的平均正确率。结果显示,-OPSD 在所有模型规模和所有基准上均一致超越 vanilla OPSD。对于参数量最小的 Qwen3-1.7B,提升幅度最为显著:AIME 2024 提升 9.16 个百分点,AIME 2025 提升 5.27 个百分点,HMMT 2025 提升 2.78 个百分点。更大规模的模型收益相对较小,但 4B 和 8B 模型仍然分别获得约 1.7 个百分点的平均提升。
除了与 vanilla OPSD 的对比,-OPSD 还优于 SFT 基线,并在大多数配置下与或超越 GRPO。这种竞争力尤其值得注意,因为 GRPO 是更为复杂的强化学习方法,而 -OPSD 保持了 OPSD 的简洁性——无需显式的奖励模型或复杂的信用分配机制。
消融实验进一步揭示了两个核心组件的贡献。插值目标相比直接使用教师目标,在三个基准上分别带来 6.03、5.30 和 1.67 个百分点的提升。return-to-go 信用分配则贡献了 1.12、5.55 和 3.61 个百分点的额外收益。二者的叠加效应表明,-OPSD 的改进并非来自单一因素,而是两个设计选择共同作用的结果。
关于调度策略,实验比较了固定权重与多种线性调度方案。固定 或 的效果均不如动态调度,而从 到 的线性调度在整体上表现最优。这一发现支持了课程学习的直觉:训练初期保持较强的参考策略锚定有助于稳定优化,随着训练的进行逐步增加教师信号的权重则能更有效地吸收知识。
讨论与可借鉴点
这篇论文最值得关注的方法论贡献在于建立了一座原则性的桥梁——从自蒸馏出发,穿越策略优化的理论框架,再回到更高效的自蒸馏实现。论文的推导过程展示了一个有价值的范式:当一个启发式方法效果不错但不够稳定时,将其纳入更广泛的理论框架往往能揭示隐藏的自由度,从而找到改进空间。
对于实践者而言,-OPSD 提供了几个可直接借鉴的设计原则。首先,"推导用 RL,训练用蒸馏"的思路具有普适性——先在理论上追求最优解的闭式表达,再将其转化为计算友好的近似形式,往往能兼顾理论优雅与工程效率。其次,return-to-go 信用分配机制虽然源于 RL 文献,但其核心思想——让每个词元的梯度反映其对整体目标的贡献——可以迁移到其他需要长序列优化的场景中。
论文也存在一些局限。实验仅限于数学推理领域,在代码生成、开放式问答等其他推理任务上的泛化性尚未验证。此外,主实验仅报告了 100 步检查点的结果,缺少完整训练曲线的对比,这对于评估优化稳定性是一个缺失。vanilla OPSD 的脆弱性是否真的被 -OPSD 彻底解决,还是只是被超参调度策略所掩盖,也有待更系统的分析。最后,闭式几何插值与实际 logit 加法近似之间的偏差在理论上尚未被严格刻画。
从更宏观的角度看,这项工作回应了自蒸馏研究中的一个核心问题:为什么 OPSD 有效但不稳定?通过将 KL 惩罚显式化,论文不仅提供了改进方案,也为后续研究指明了方向——探索更精细的正则化调度策略,或将 -OPSD 的思想与其他蒸馏技术相结合,都可能是值得尝试的路径。
摘要
面向推理语言模型的策略优化与自蒸馏方法
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
H$^2$SD:混合事后自蒸馏
H$^2$SD: Hybrid Hindsight Self-Distillation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 12 张
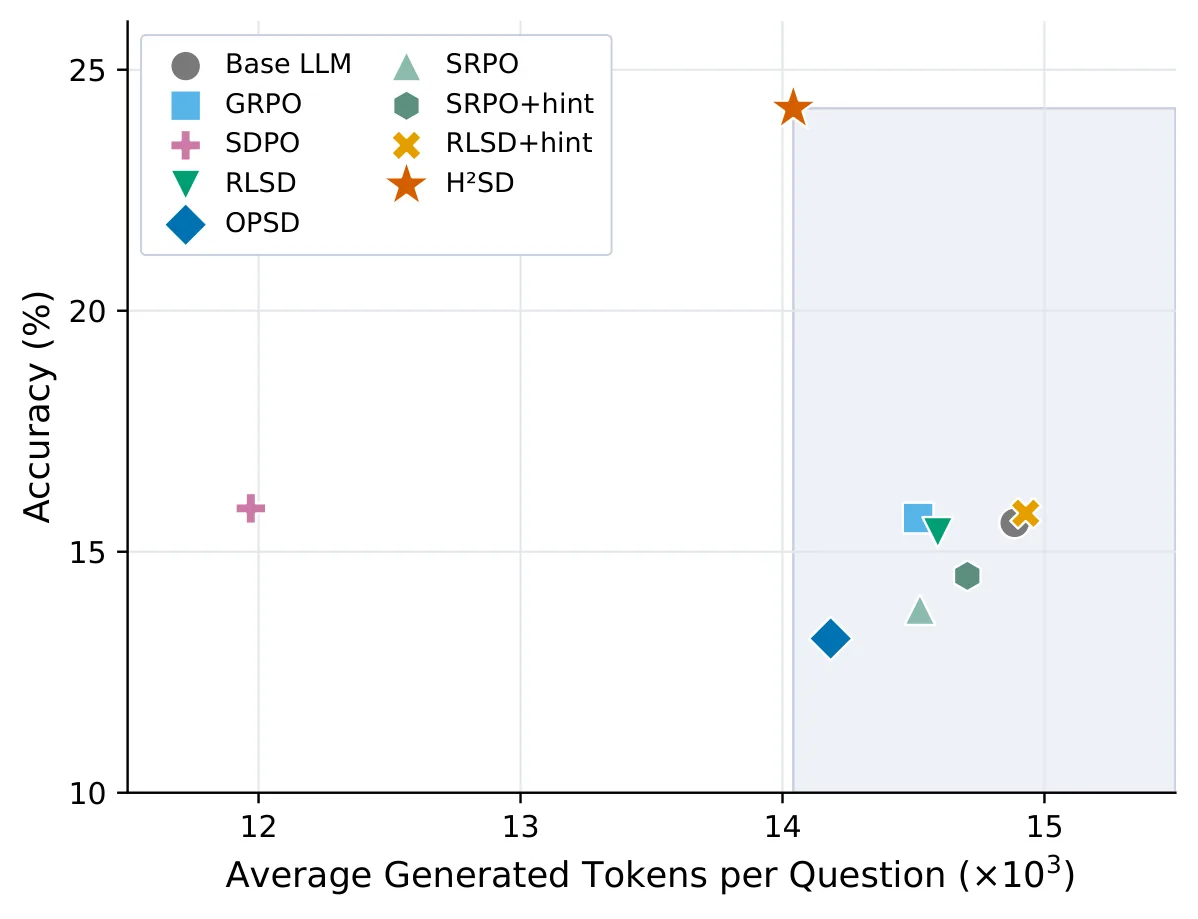
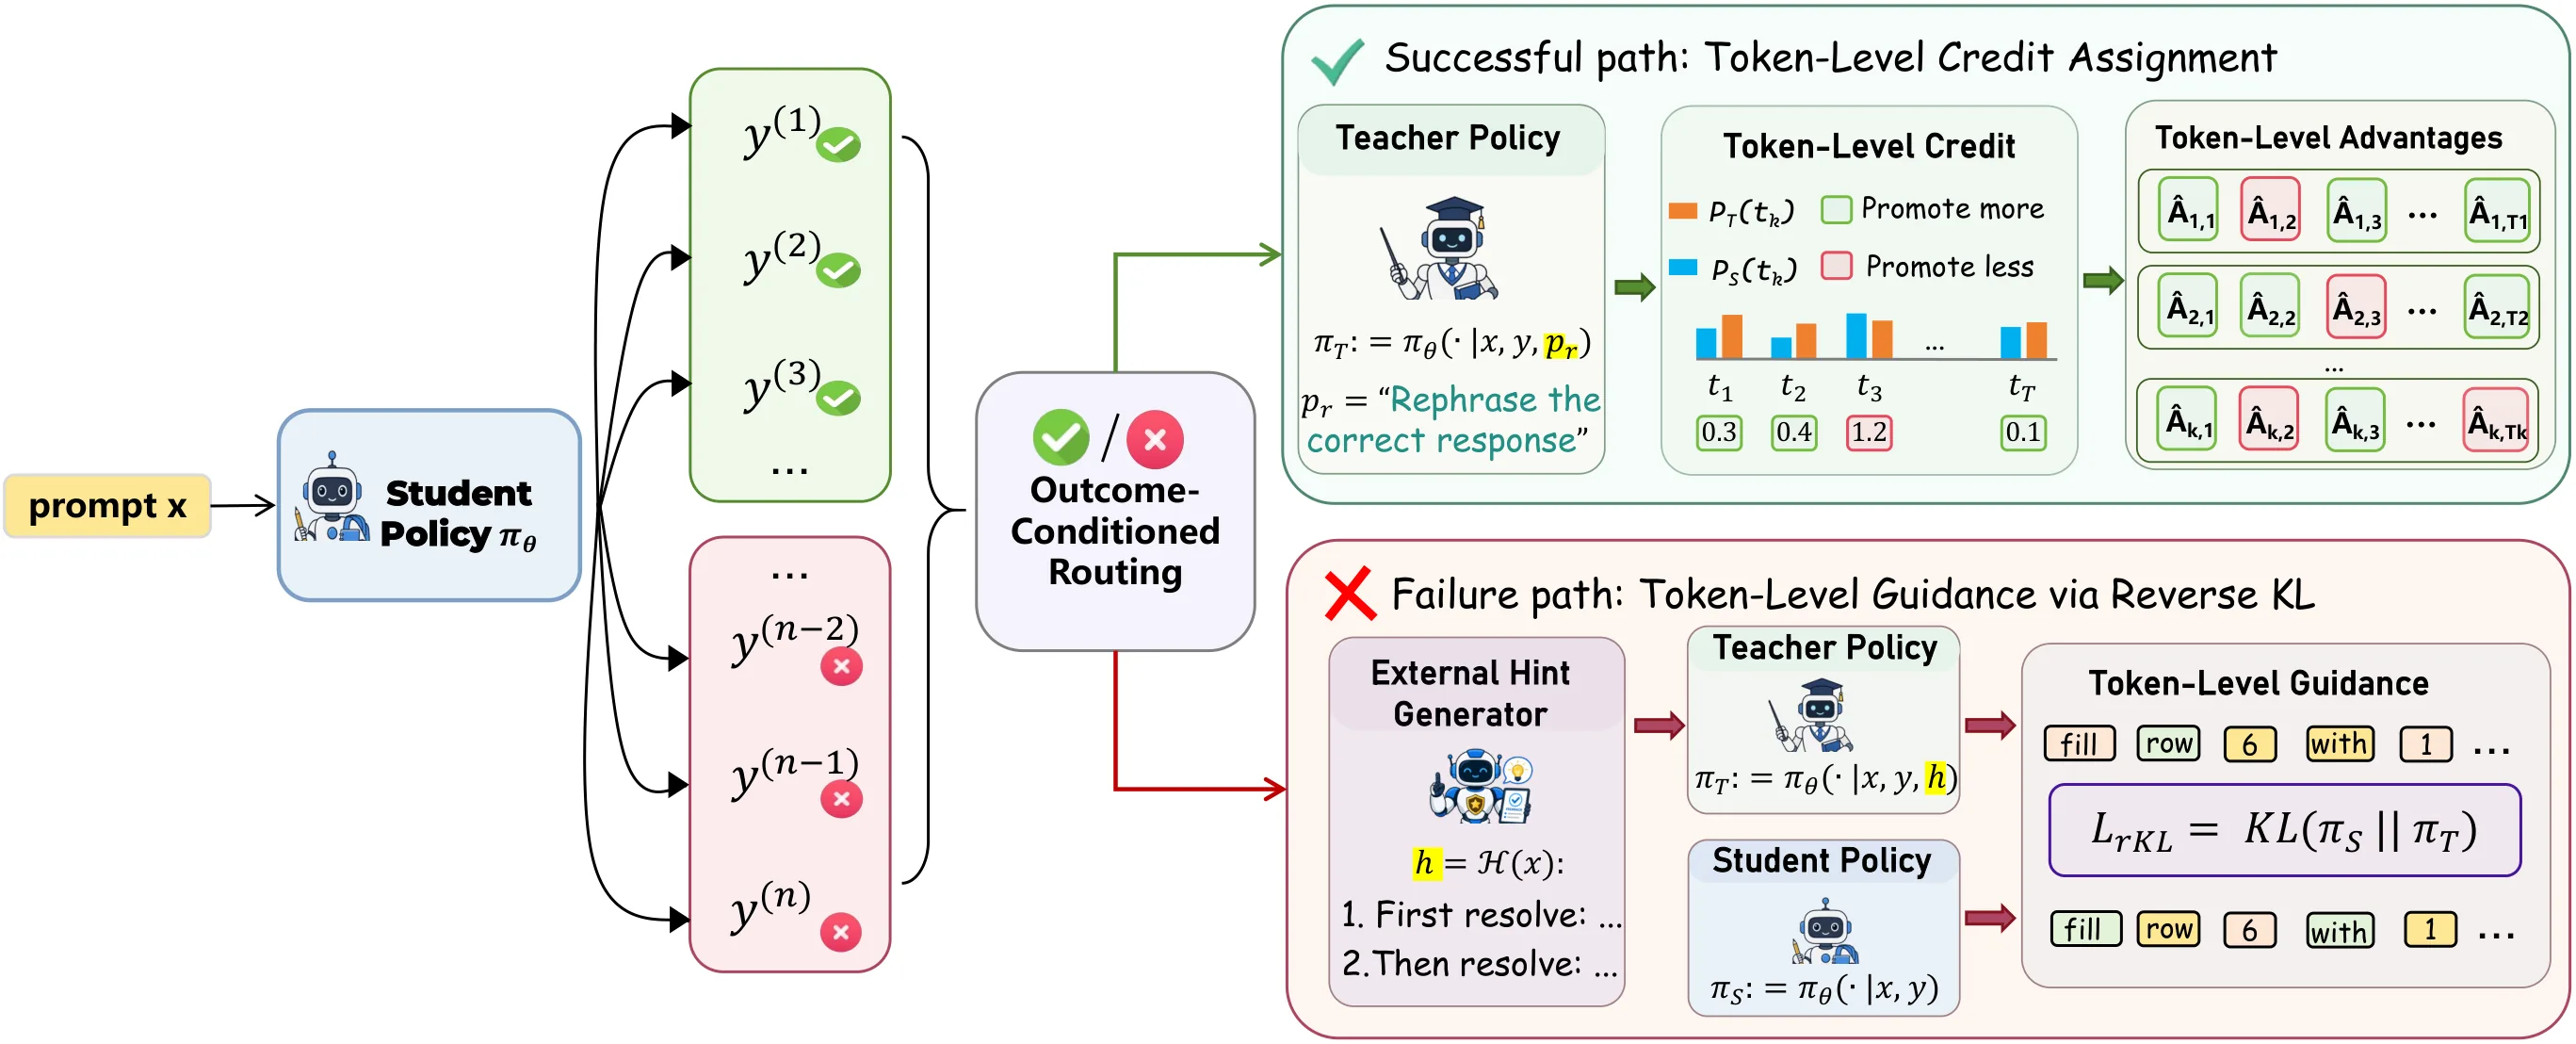
RLVR方法依赖标量轨迹奖励,难以提供token级细粒度监督;现有自蒸馏方案教师角色固定,易破坏成功行为或纠错不足。H²SD提出混合后视自蒸馏,按轨迹正确性自适应教师上下文与更新策略:成功轨迹用已验证回复加复述指令构造教师仅重评原始token,失败轨迹结合参考提示做反向KL蒸馏。实验在多个推理基准上取得最优综合性能,优化稳定,精度与效率权衡优越。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
带可验证奖励的强化学习(RLVR)已经成为提升大语言模型推理能力的主流范式。GRPO 等算法通过为每条完整轨迹输出一个标量奖励,引导模型学习"正确答案"的生成模式。然而,这种粗粒度的轨迹级信号天然存在 [[Credit Assignment]] 问题——奖励只能告诉模型"这条路径整体对或错",却无法区分路径中哪些 token 贡献了正确结果、哪些 token 是冗余甚至有害的。当推理序列较长时,这种信用分配瓶颈会严重制约学习效率。
为了缓解这一问题,学术界沿着自蒸馏(Self-Distillation)的思路展开了大量探索。On-Policy Self-Distillation(OPSD)让同一模型同时扮演学生和教师,并借助真实答案等特权信息为教师赋予更强的推理能力。但直接进行分布匹配会让教师生成的文本直接覆盖学生已有的合理推理路径,造成"特权信息泄漏":学生学到的是教师在完整答案条件下的分布,而非在自身推理过程条件下的改进方向。后续的 RLSD 方法转而只利用教师信号调制 token 更新的幅度,避开了分布匹配带来的泄漏问题,却也因此失去了对失败轨迹的方向性纠错能力——它只能调整"步伐大小",却无法告诉模型"该往哪个方向走"。
本文的核心洞察源于对训练动态的细致观察:成功轨迹和失败轨迹蕴含的监督信息本质上是不同的。一条成功到达正确答案的响应,本身已经包含了一条由学生模型自主生成的有效推理路径,这条路径虽然在 token 级别可能存在冗余或概率分配不够精确的问题,但其方向性是正确的、不应被外部推理所替代。相反,一条推理失败或得不出正确答案的响应,其推理方向本身就走偏了,需要外部的参考信息来提供方向性的纠错。这一观察直接指向了一个更精细的事后监督框架:根据轨迹的正确性,联合适配教师上下文的构造方式和模型参数的更新策略。
方法
H²SD 的设计正是围绕上述洞察展开的。整体上,方法依据轨迹正确性 来决定两件事:教师应该以什么样的上下文条件去生成自己的概率分布,以及学生应该用什么样的目标函数向这个教师学习。这两个维度的联合适配构成了方法的核心框架:
其中 对应成功轨迹的幅度调制损失, 对应失败轨迹的反向 KL 蒸馏损失, 控制两类损失之间的平衡。
提示的离线构造
为了让失败轨迹的教师拥有可靠的参考推理信息,H²SD 首先使用外部强模型(Kimi-K2.6)为每个问题离线生成自然语言形式的提示(hint)。这些提示包含关键中间推理步骤和经验证的最终答案,但并非完整的逐步推导,因此不会直接泄漏解法。生成时每个问题最多尝试 5 次,温度设为 0.1,仅保留验证器通过的提示作为训练材料。
由此可以得到两类条件概率分布:学生模型在自身推理前缀条件下的分布 ,以及教师模型在提示条件下的分布 。注意这里教师和学生是同一个模型,只是条件信息不同。
成功轨迹的处理
对于 的成功轨迹,H²SD 采用一种"仅重评、不生成"的策略。教师上下文的构造方式是:把学生自己生成的已验证响应拼接上一条"改写指令"(rephrasing instruction),让教师在整体条件下去重新评估原始响应的每个 token。
具体而言,首先计算教师与学生分布在每个位置的概率比值:
其中 是由奖励决定的轨迹级优势。取 sign 的目的是保持方向性:对于正优势(被鼓励的 token),概率比值越大意味着教师越认同,权重越高;对于负优势(被抑制的 token),比值越大反而应该降低权重。
随后,这个幅度权重被融合进 token 级的优势估计:
这里 控制幅度调制的强度上限,clip 操作防止权重过于极端。通过这种方式,成功轨迹保留了由奖励信号确定的方向性(该鼓励的 token 仍然被鼓励,该抑制的仍然被抑制),但在 token 级别上细化了信用分配的精度:那些被奖励认可的 token 如果在教师看来概率偏低,就会获得额外的强化信号;反之亦然。
失败轨迹的处理
对于 的失败轨迹,情况则完全不同。此时学生模型的推理方向本身就偏离了正确答案,幅度调制只能调整"步伐大小"却无法改变"前进方向"。为此,H²SD 在失败轨迹上引入 [[KL 散度]] 形式的蒸馏损失,让学生的概率分布去匹配教师在提示条件下的分布:
这里使用的是反向 KL(),而非常见的正向 KL,其关键差异在于优化方向:反向 KL 要求学生的分布必须完全覆盖教师的高概率区域,但允许在教师概率低的地方保留一定的学生自身分布。在失败轨迹的语境下,这意味着学生应该优先学习提示所暗示的正确推理方向,但不必完全丢弃自己的推理路径中可能仍有效的部分。这种特性使得反向 KL 在纠错场景下比正向 KL 更加稳定——它不会因为学生与教师在局部 token 上的轻微分歧而产生过大的惩罚梯度。
算法流程
综合来看,H²SD 的训练流程包含以下步骤:首先从当前策略采样 条轨迹,计算奖励并标记正确性 ;然后对于 的轨迹,构造"改写+已验证响应"的教师上下文,应用 RLSD 幅度调制更新策略;对于 的轨迹,构造"提示 "的教师上下文,应用反向 KL 蒸馏更新;最后将两类损失的加权和作为总目标函数进行优化。
实验与结果
实验设置
论文在 Qwen3-30B-A3B-Instruct-2507 基模型上进行了实验,涵盖了四个独立的训练设置:Sudoku-6×6、Sudoku-8×8、Calcudoku(5×5 和 6×6 两种规模)、Arrow Maze(从 6×6 到 10×10 五种规模)。这些基准均为程序化生成的逻辑推理任务,具有可验证的确定性答案,能够有效降低预训练数据泄露的风险,提供更纯净的推理能力评估环境。
所有方法均采用 VERL + SGLang 框架训练,使用 FSDP 进行全参数训练。为了控制计算成本,实验在 token 级概率计算时采用了 top-100 加尾部桶近似的策略。
主要结果
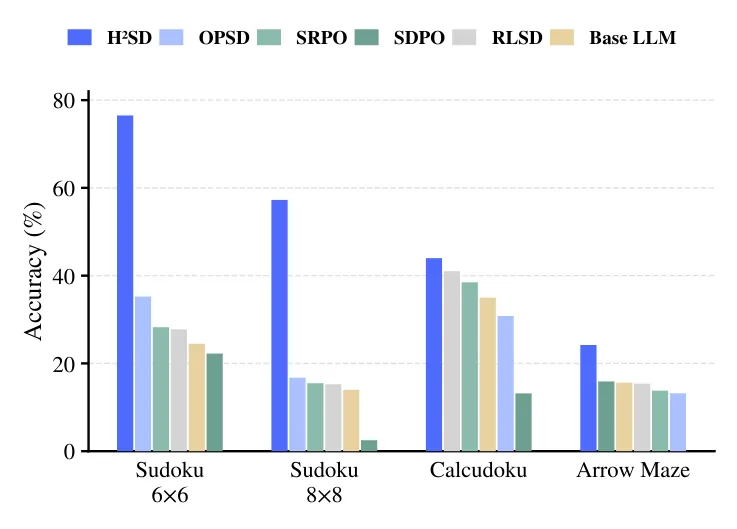
实验结果清晰地表明,H²SD 在所有基准上均取得了最优的综合性能。对比基线涵盖了三类代表性方法:纯 RLVR 方法(GRPO)、on-policy 自蒸馏方法(OPSD、SDPO)、以及幅度调制方法(RLSD)和混合方法(SRPO)。
| 方法 | Sudoku-6×6 | Sudoku-8×8 | Calcudoku Avg | Arrow Maze Avg | Overall |
|---|---|---|---|---|---|
| Base LLM | 24.50 | 14.00 | 35.17 | 15.60 | 22.32 |
| GRPO | 26.25 | 16.75 | 40.00 | 15.70 | 24.68 |
| RLSD | 27.75 | 15.25 | 41.00 | 15.40 | 24.85 |
| OPSD | 35.25 | 16.75 | 30.83 | 13.20 | 24.01 |
| SRPO | 28.25 | 15.50 | 38.50 | 13.80 | 24.01 |
| H²SD | 76.50 | 57.25 | 44.00 | 24.20 | 50.49 |
最引人注目的是 Sudoku 任务上的表现:H²SD 在 6×6 和 8×8 两个规模上分别达到了 76.50% 和 57.25% 的准确率,远超所有基线方法。这一提升幅度(相对于次优基线超过 40 个百分点)表明,成功-失败轨迹的差异化处理对于需要精细规划的推理任务尤为重要。
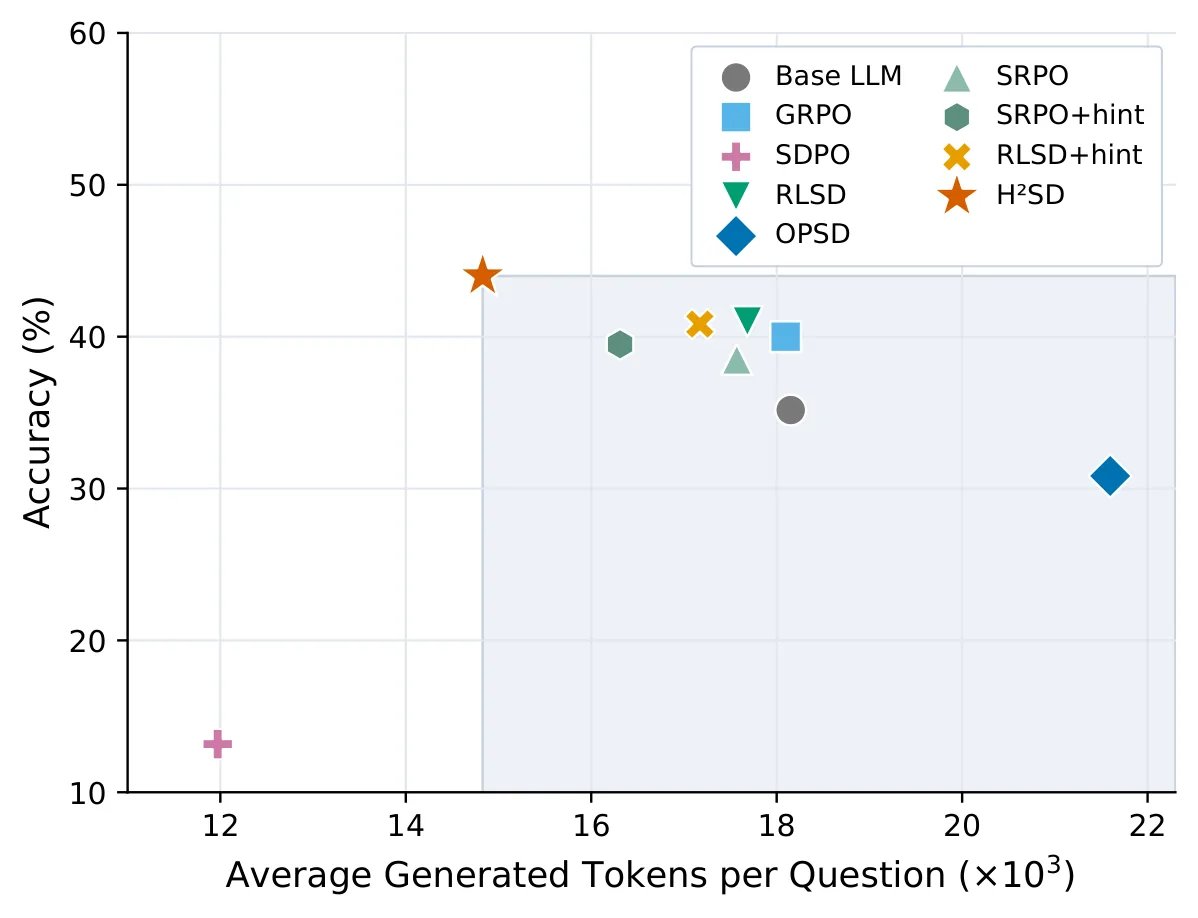
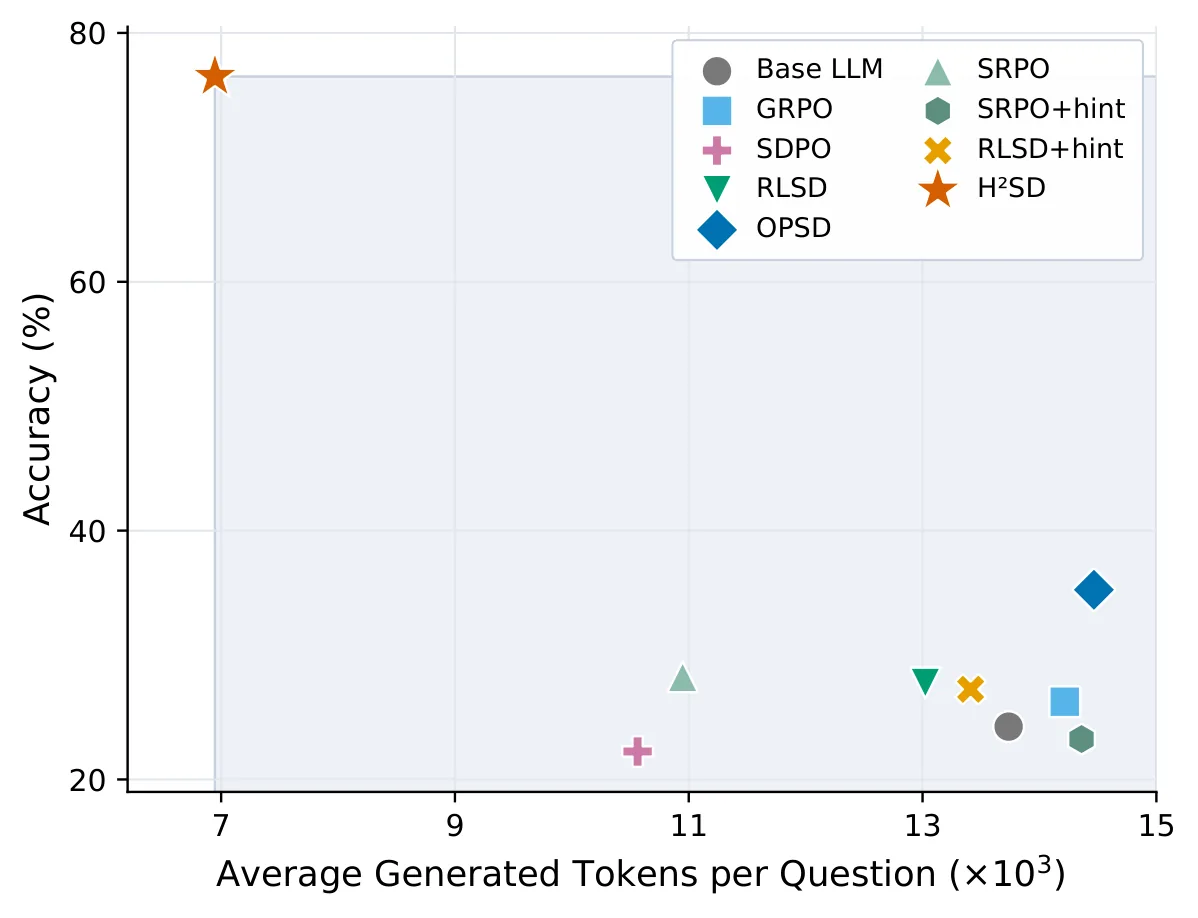
除了精度指标,H²SD 还在推理效率上展现出显著优势。在所有四个基准上,H²SD 均保持了最短的平均生成长度,位于精度-生成长度 Pareto 前沿。这意味着模型不仅能更频繁地得到正确答案,还能以更少的 token 消耗达到正确结果——这对实际部署中的延迟和成本控制都有直接价值。
消融实验的关键发现
为了验证设计选择的有效性,论文进行了多维度的消融实验。
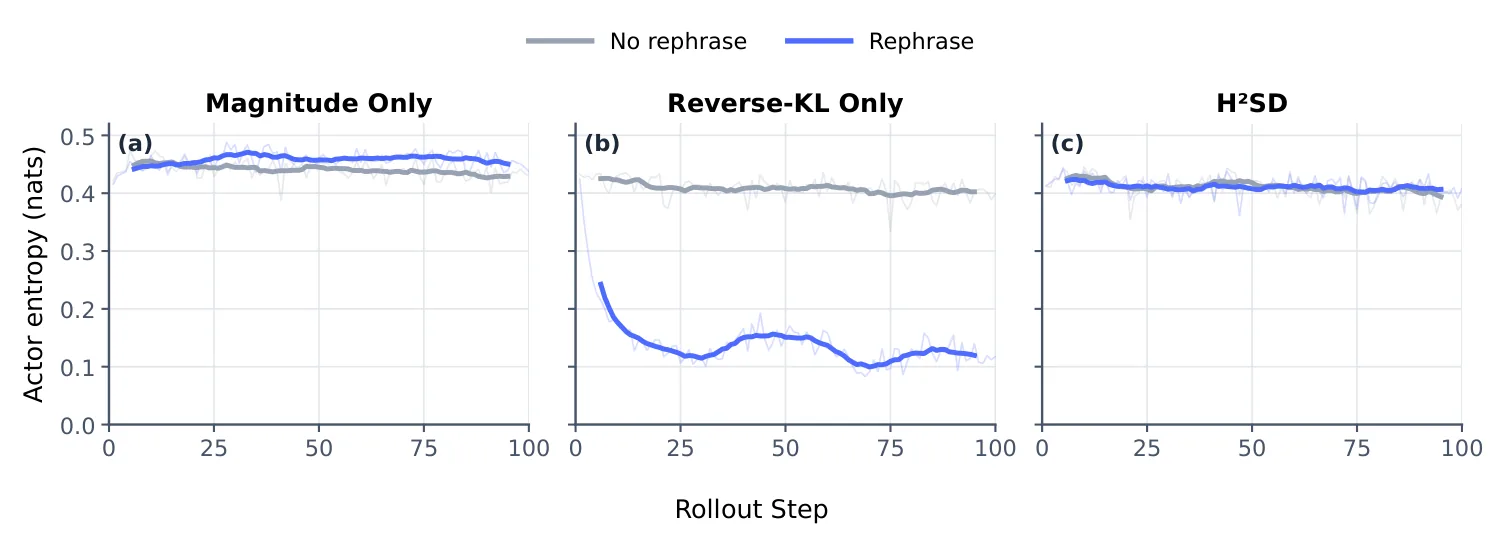
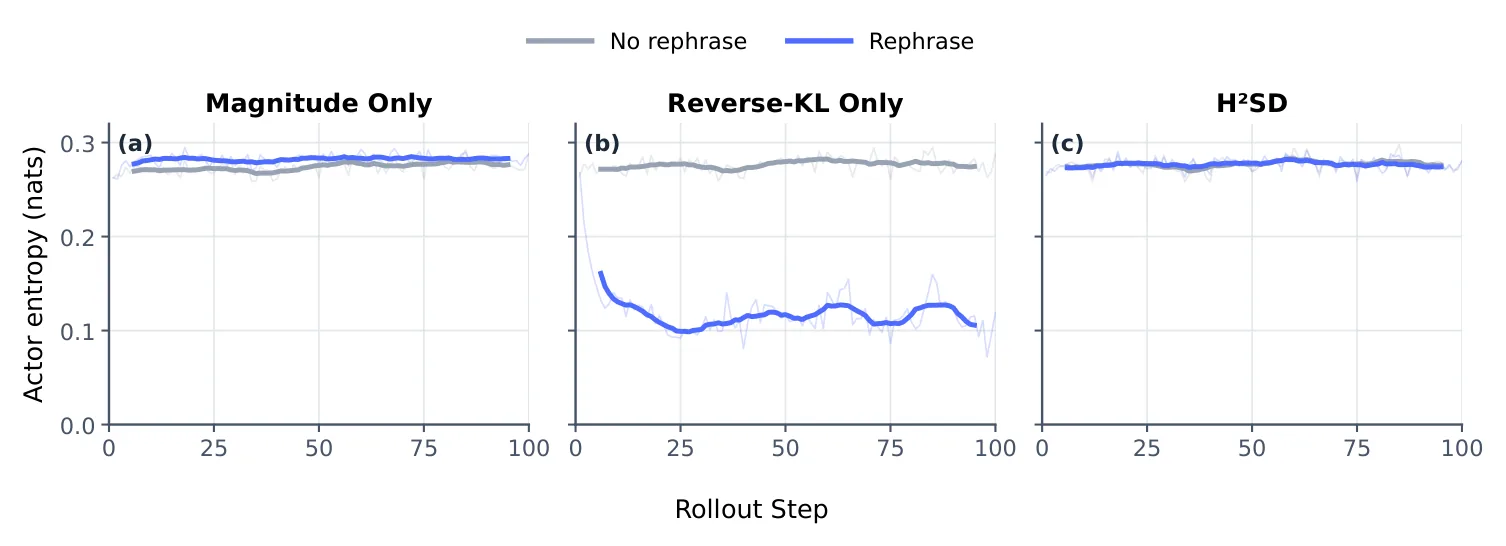
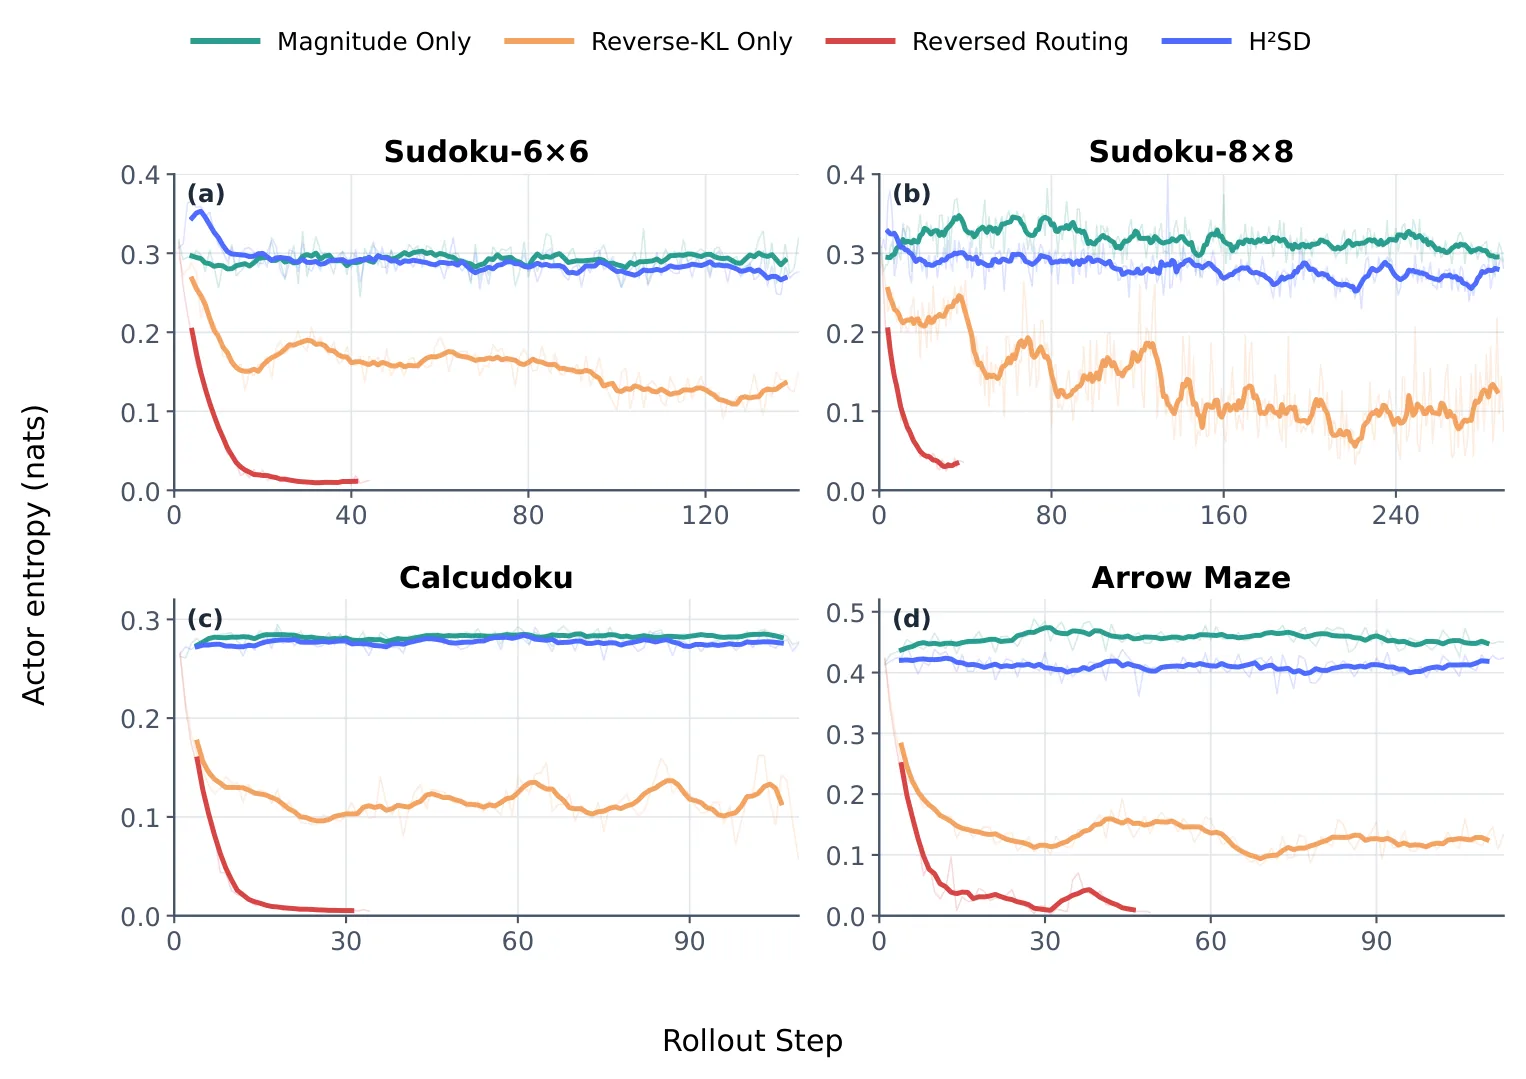
路由策略的消融对比了四种设置:仅使用幅度调制、仅使用反向 KL、反向路由(成功用反向 KL,失败用幅度调制)、以及 H²SD 的正确路由。结果表明,正确的路由方式至关重要——错配会导致策略熵快速坍缩到零,训练崩溃。这验证了"成功轨迹需要幅度细化,失败轨迹需要方向纠错"这一假设的必要性。
特权上下文的消融测试了不同提示来源的效果:程序化反馈(含中间状态但不含推理)、Ground Truth(最终答案)、Sibling Solution(同问题的其他正确解)、以及过程级 Hint(Kimi-K2.6 生成)。实验证实,过程级 Hint 远优于其他选项,说明包含中间推理步骤的参考信息对失败轨迹的纠错最为有效。
改写指令的作用在有无该指令的对比中显示出一种机制依赖性:改写指令仅在幅度调制机制下稳定有效,与反向 KL 联合使用时会导致熵快速坍缩。这提示改写指令的存在改变了教师分布的性质——它让教师更倾向于对原文进行"改写"而非"续写",从而影响了幅度调制的语义。
讨论与可借鉴点
H²SD 的成功揭示了一个在 RLVR 自蒸馏研究中常被忽视的问题:教师模型在训练中扮演的角色不应是一成不变的,而应该根据学生当前的学习状态进行动态适配。成功轨迹和失败轨迹蕴含的监督信号具有根本不同的语义——前者需要的是精细化调整,后者需要的是方向性纠错——用同一套策略处理两类轨迹,必然导致顾此失彼。
从工程落地的角度看,这项工作有几个值得注意的局限。首先,H²SD 依赖外部强模型(Kimi-K2.6)离线生成过程级提示,这在没有强参考模型的场景下难以直接应用。其次,提示需要经过验证器过滤才能使用,这意味着训练数据会因为"提示生成失败"而被丢弃,覆盖面上存在缺口。第三,论文仅在 Qwen3-30B-A3B 这一个模型上验证了方法,未探索跨规模或跨架构的可迁移性。最后,H²SD 在推理时仍然没有特权信息可用——提示仅在训练阶段作为教师条件,对于推理时无验证器的任务无法直接部署。
尽管存在这些局限,H²SD 的核心思想为后续研究提供了有价值的启发。一方面,按状态自适应地切换学习目标这一范式可以推广到其他 RL 场景——例如在探索-利用的权衡中,根据当前策略的熵或价值估计动态调整更新方式。另一方面,反向 KL 在纠错场景下的独特优势值得进一步探索:其"mode-seeking"特性天然适合"学生必须在教师指出的方向上有所改进"这一约束,这可能为其他需要精准纠错的训练场景提供借鉴。
摘要
区分成功与失败轨迹的混合后视自蒸馏方法
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
通过自蒸馏增强基于评分标准的强化学习
Enhancing Rubric-based RL via Self-Distillation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 11 张
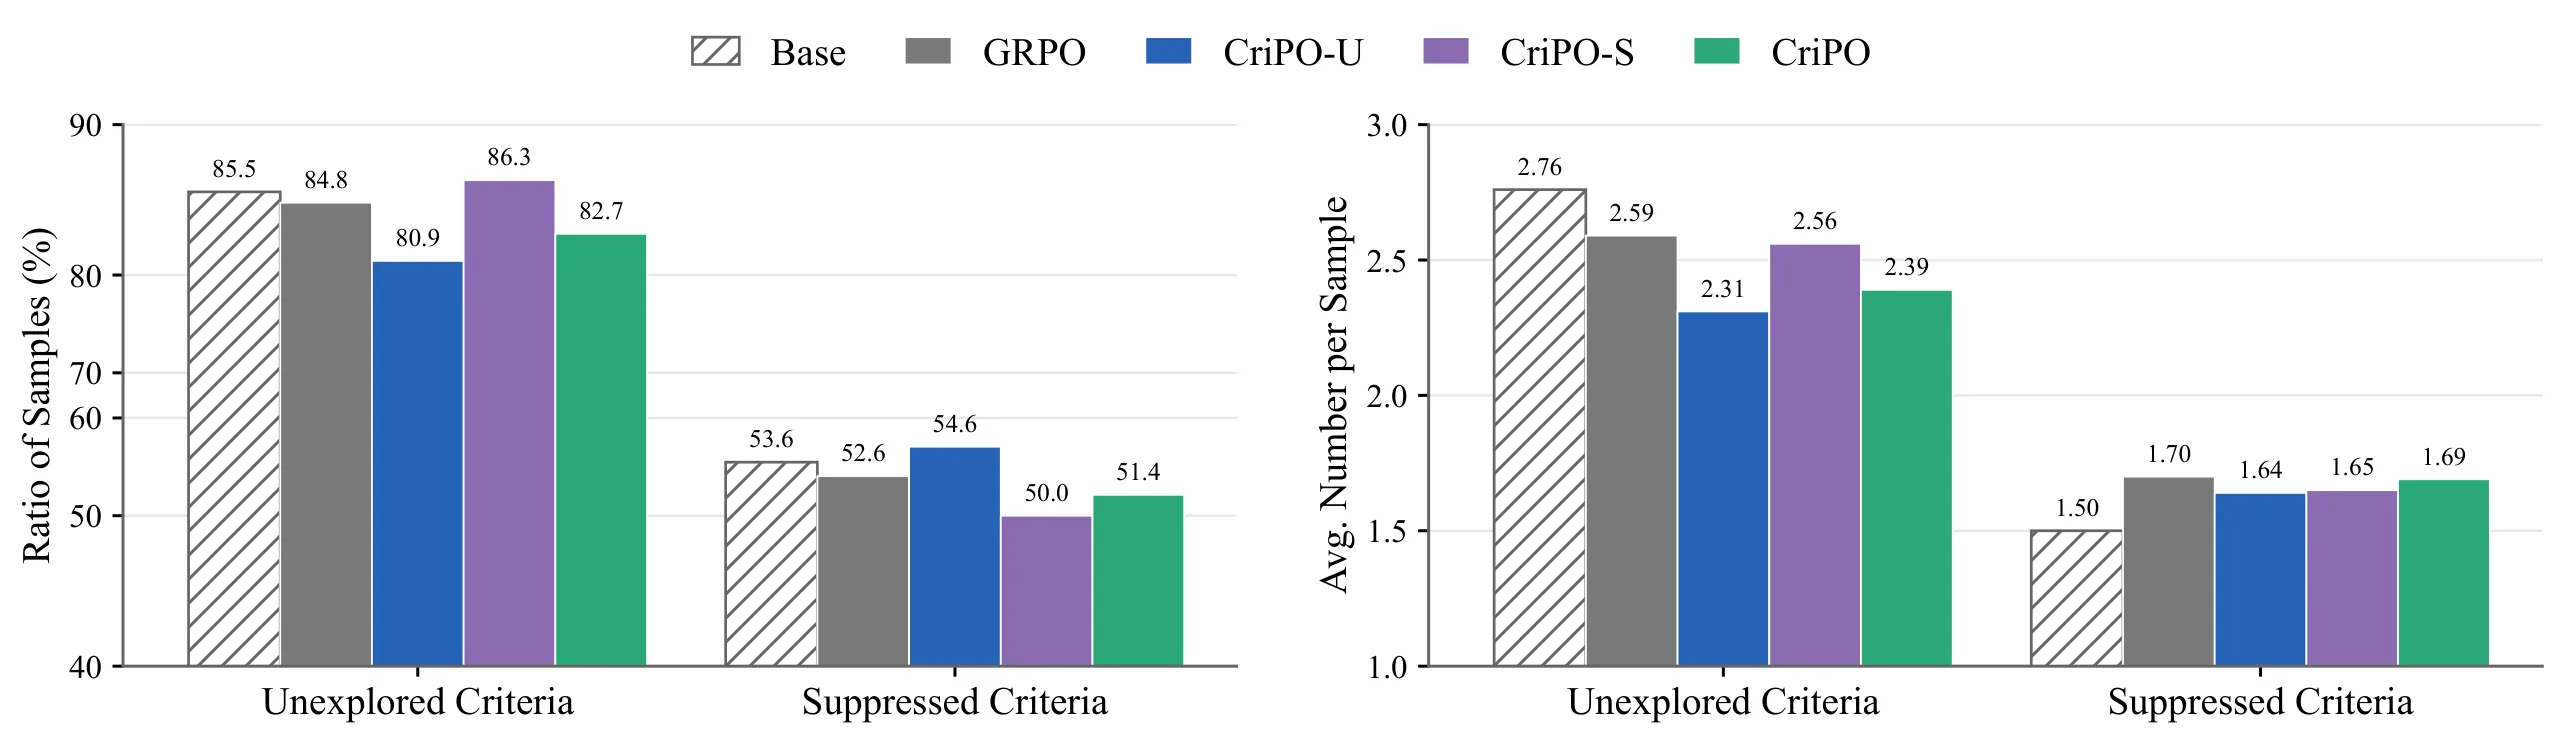
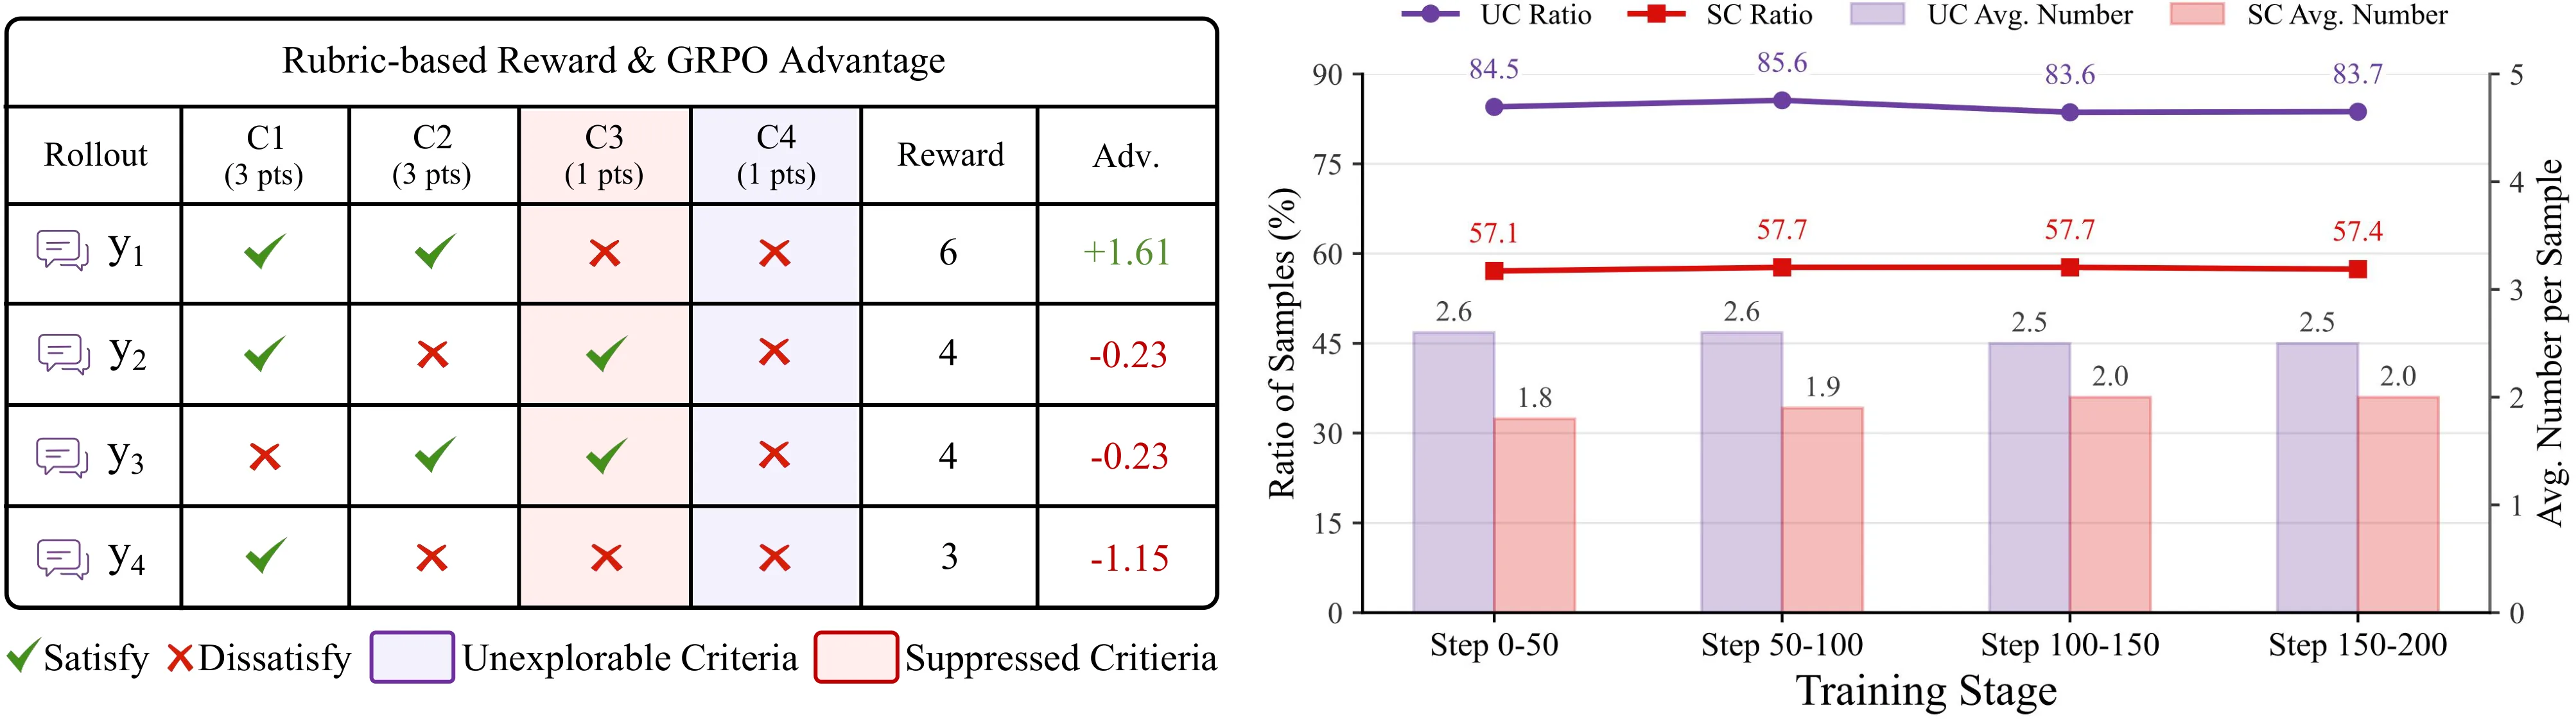
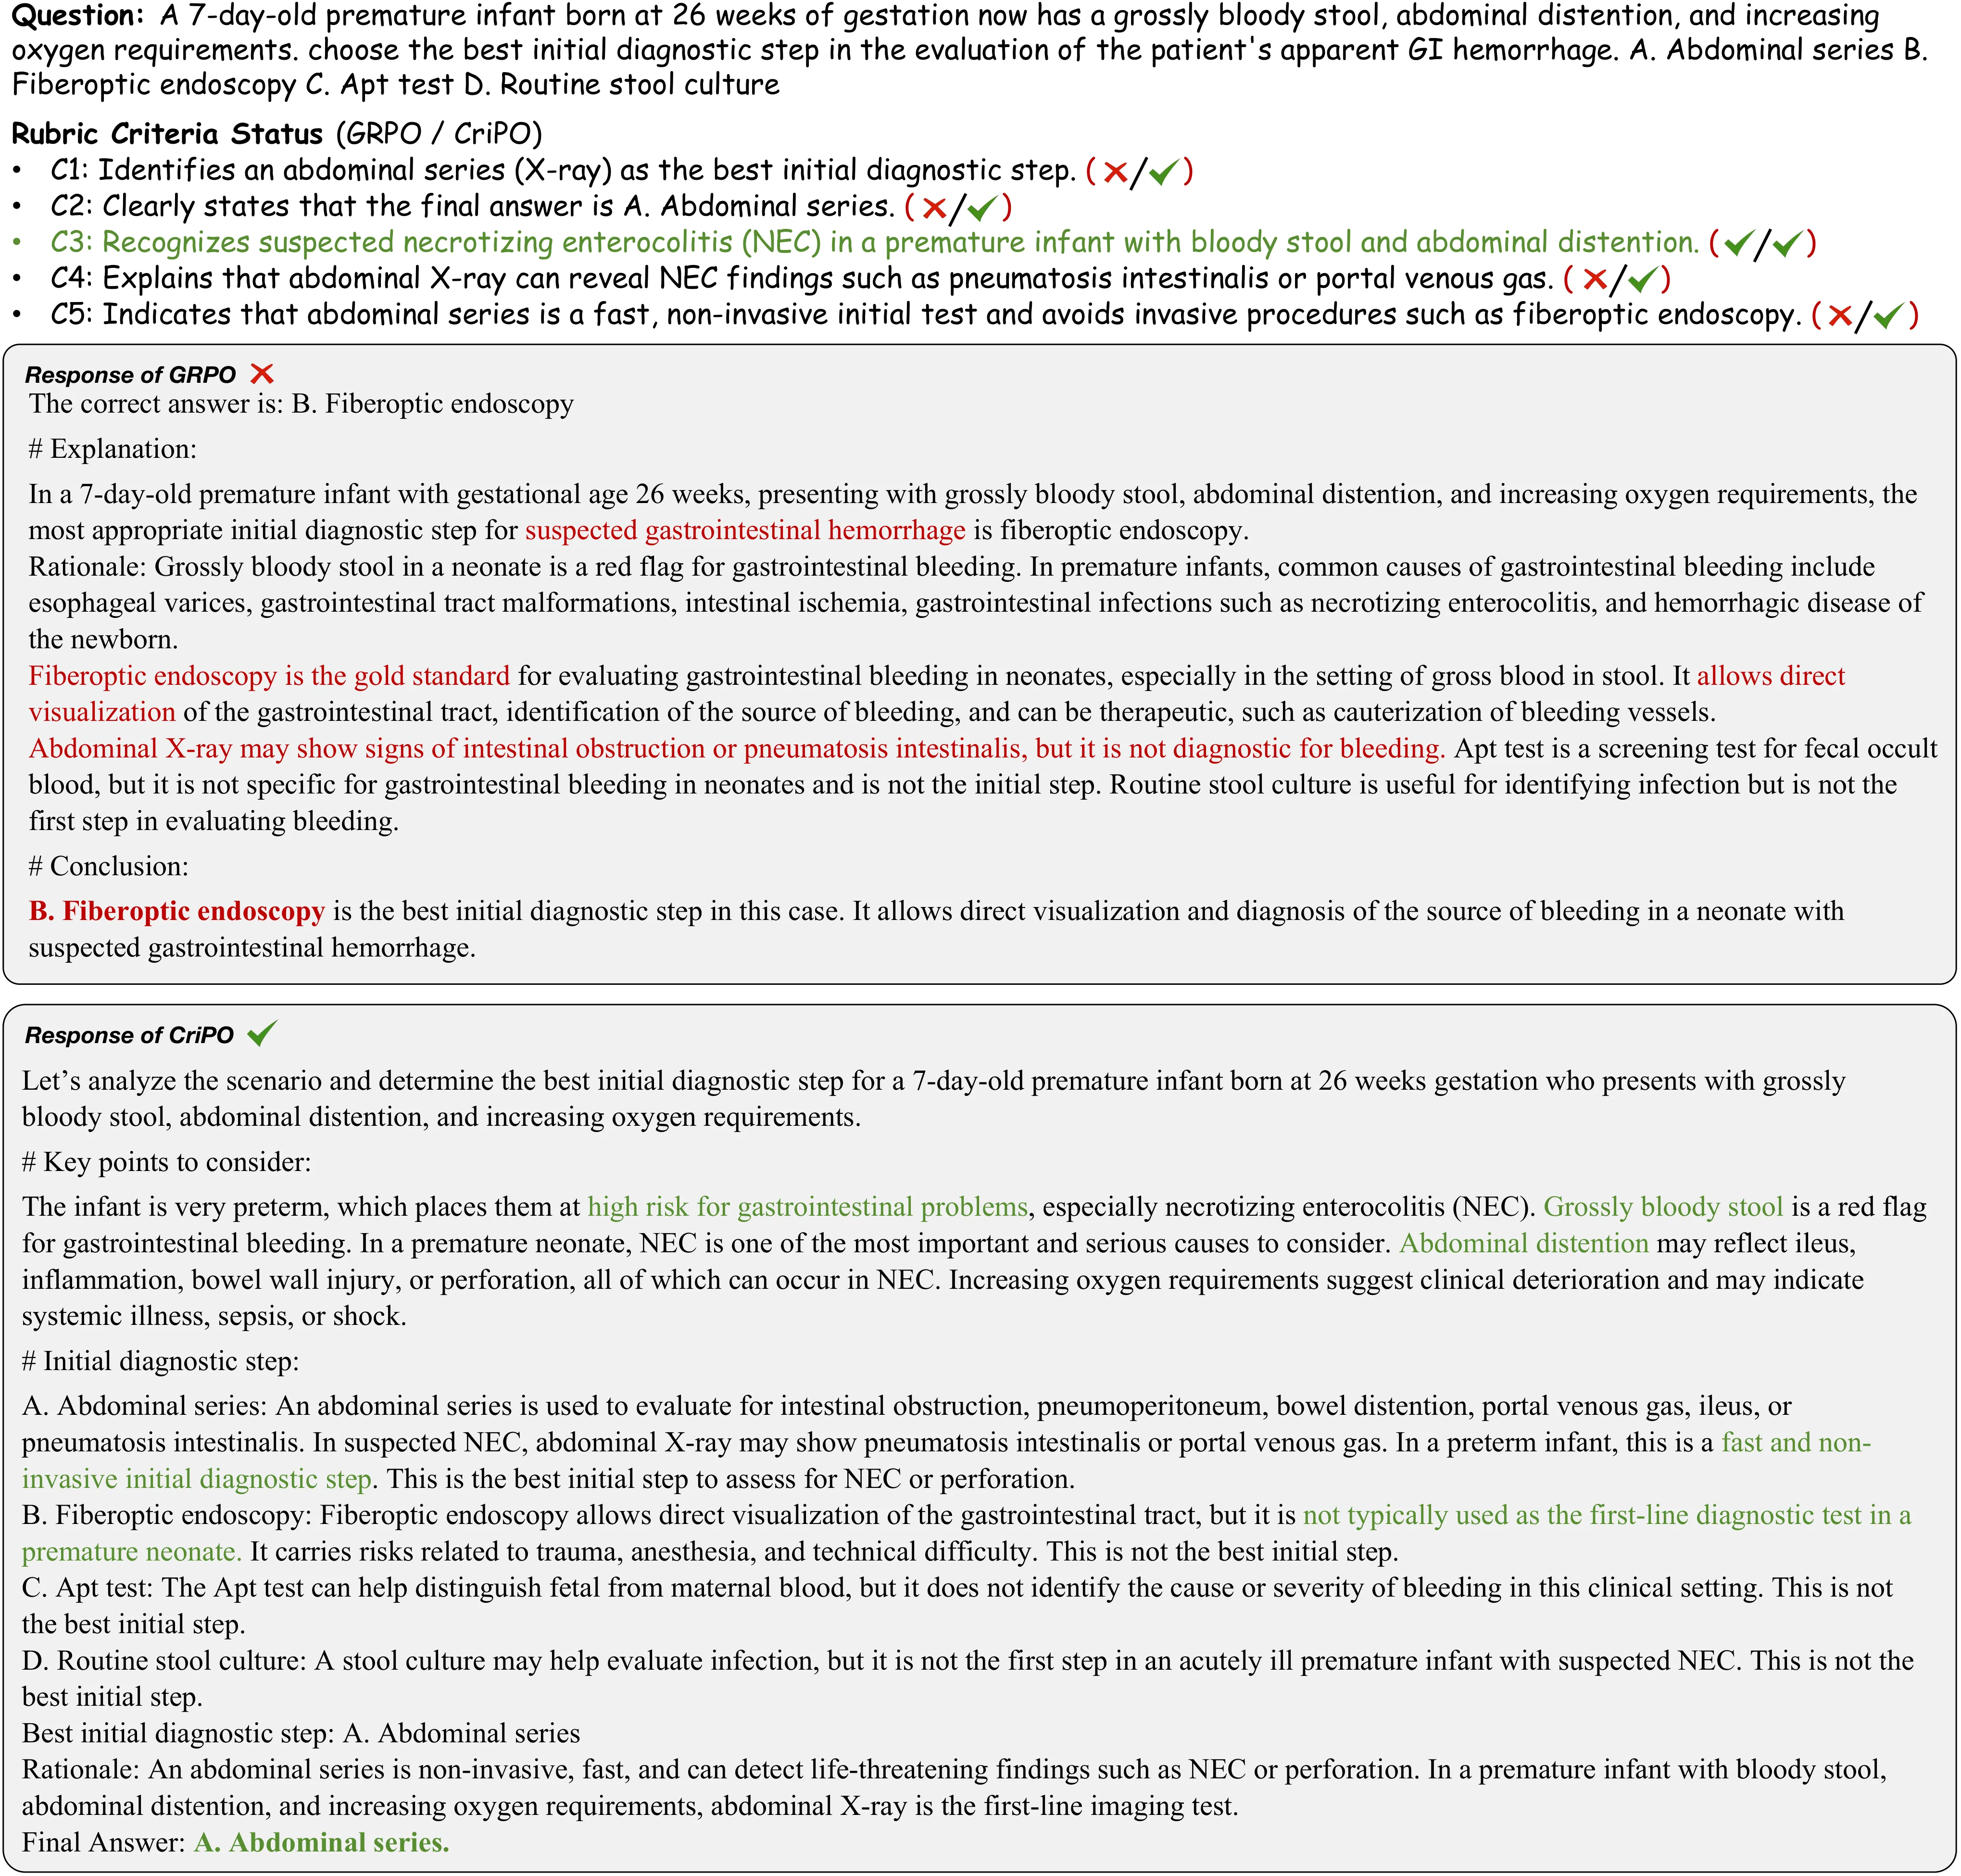
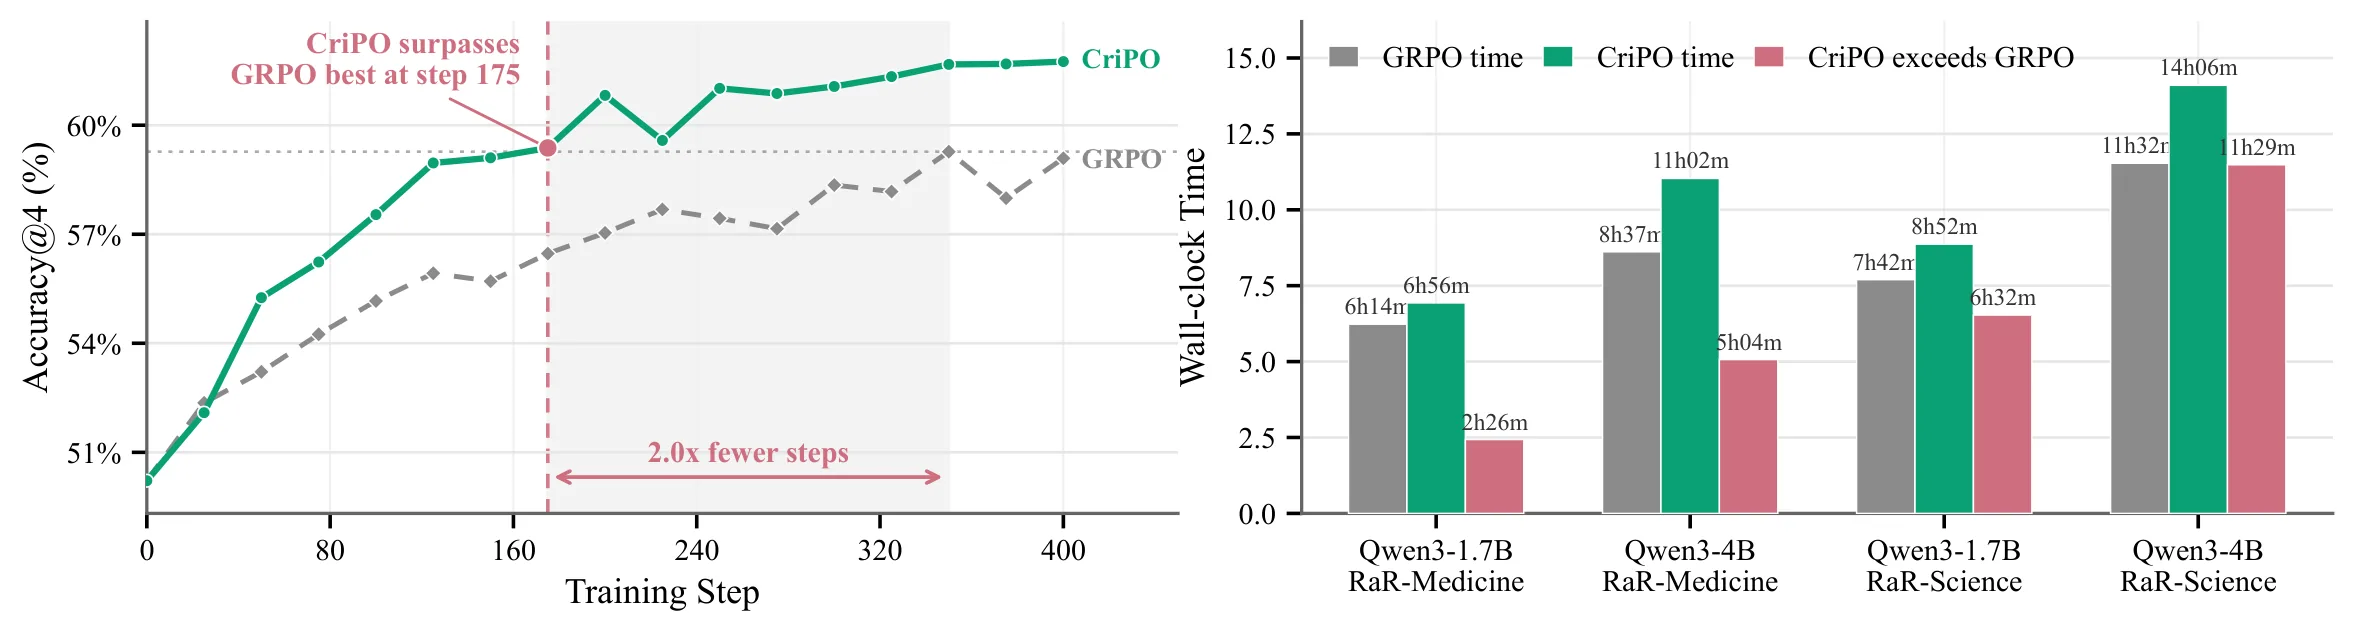
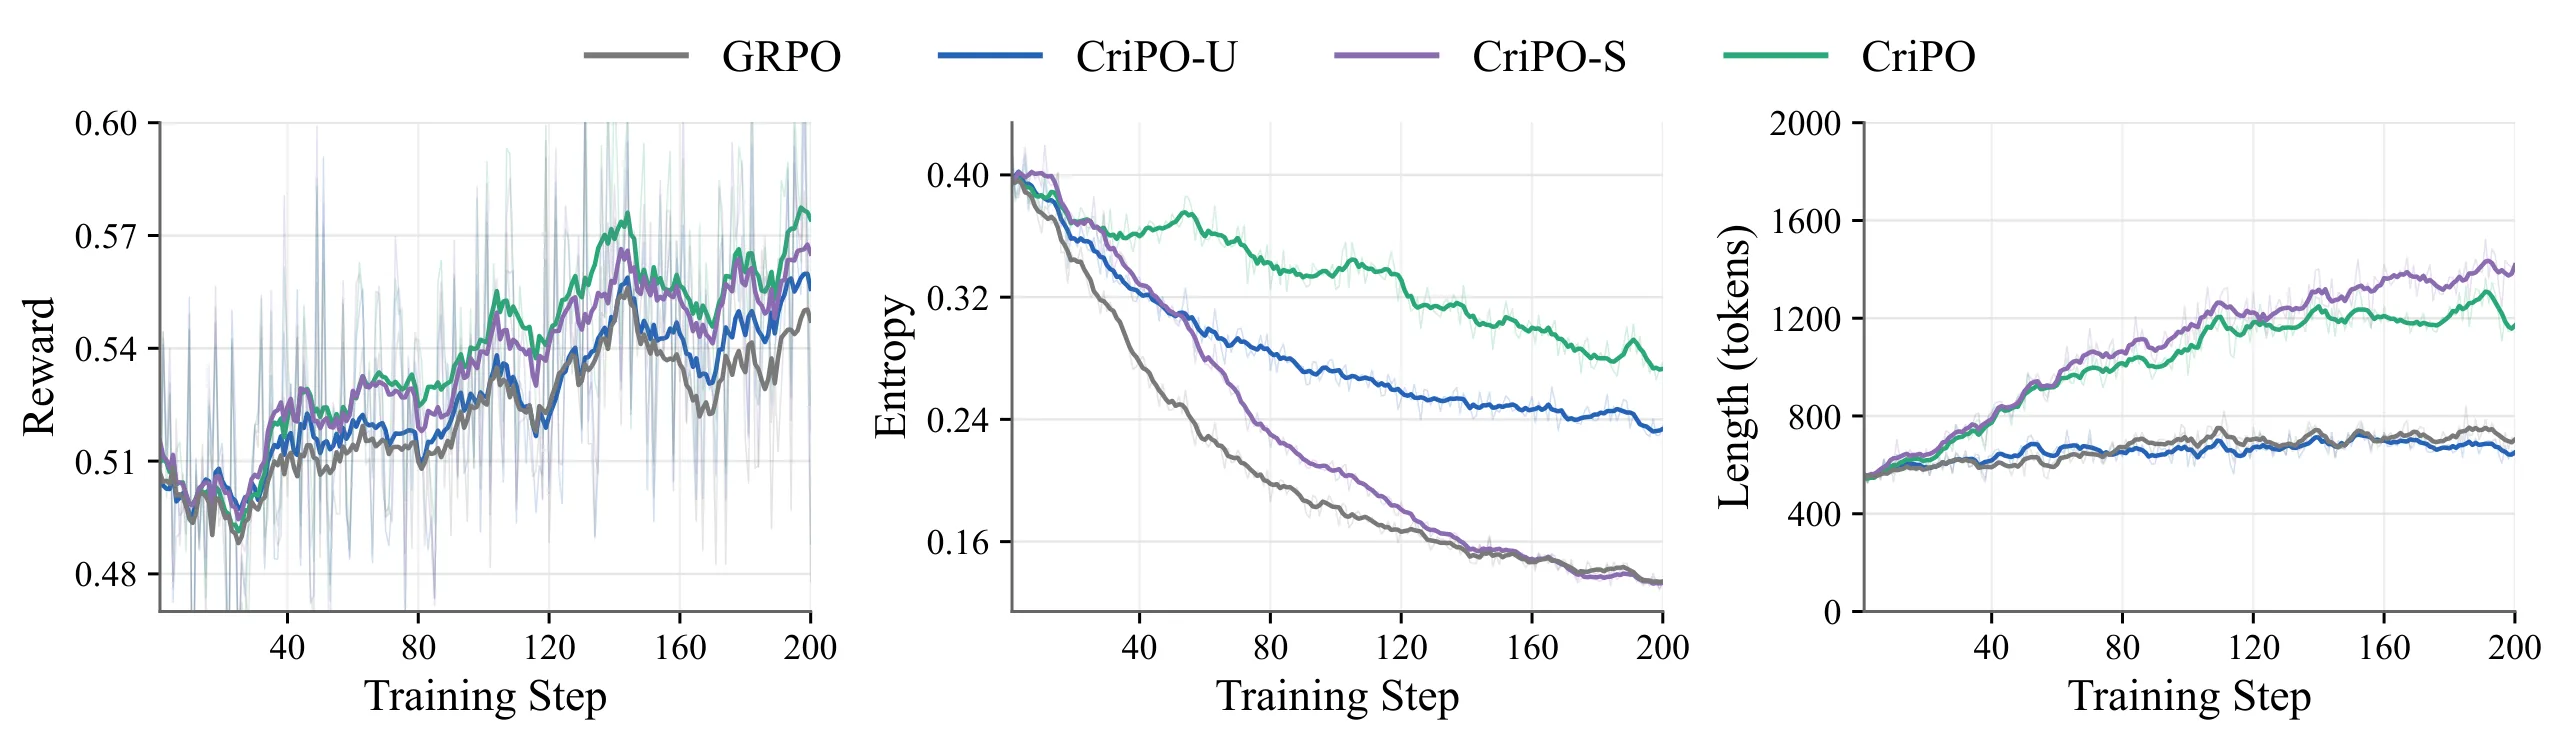
基于评分标准的强化学习(rubric-based RL)能提升大模型在开放式任务上的表现,但存在两类失败模式:未被rollout满足的未覆盖标准(UC),以及被标量奖励聚合压制学习信号的有效标准(SC)。本文提出CriPO,通过在线自蒸馏同时处理两者:对UC构建标准注入教师做局部前向KL蒸馏,对SC用反事实教师定位负优势rollout中相关token并翻转其优势。实验在医学与科学基准上以约一半优化步数超越基线,且不引入训练-推理失配。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
在开放式任务上提升大语言模型的能力,一直是领域内的核心挑战之一。与数学、代码等拥有确定性验证器的领域不同,医疗咨询、长文本生成等场景缺乏可信赖的自动评测标准。[[基于评分标准的强化学习]](Rubric-based RL)应运而生,它将响应质量分解为一组评估标准,由评判模型逐项打分后加权聚合为标量奖励,配合 GRPO 等算法驱动策略优化。这种范式在开放式任务上展现出不错的潜力。
然而,现有方法存在两类尚未被充分解决的失败模式。第一类称为未探索标准(UC):当组内所有采样轨迹均未能满足某条标准时,该标准完全得不到优化信号——模型甚至不知道自己"不知道什么"。第二类更为隐蔽,称为抑制标准(SC):某些轨迹已经满足了该标准,但在聚合奖励排序后反而获得了非正的组相对优势,导致原本有用的行为模式被惩罚或忽略。论文的经验分析揭示了一个令人警醒的事实:在整个训练过程中,超过 57% 的样本表现出 SC 失败模式,平均每个样本有 1.8 个被抑制的标准,而 UC 的发生率更高达 83%(平均每样本 2.5 个)。这意味着相当比例的学习信号在优化过程中被白白浪费了。
针对 UC,现有工作如 HeRL 尝试在采样阶段将评分标准作为外部引导引入,以增强探索能力。但这种方法引入了训练-推理不一致——策略在有外部引导的条件下产生的轨迹上训练,而推理时这种引导并不存在。在生成长响应时,这种分布偏移会通过自回归解码逐步累积,造成性能衰减。更重要的是,这些探索导向的方法完全忽视了 SC 的存在。
方法
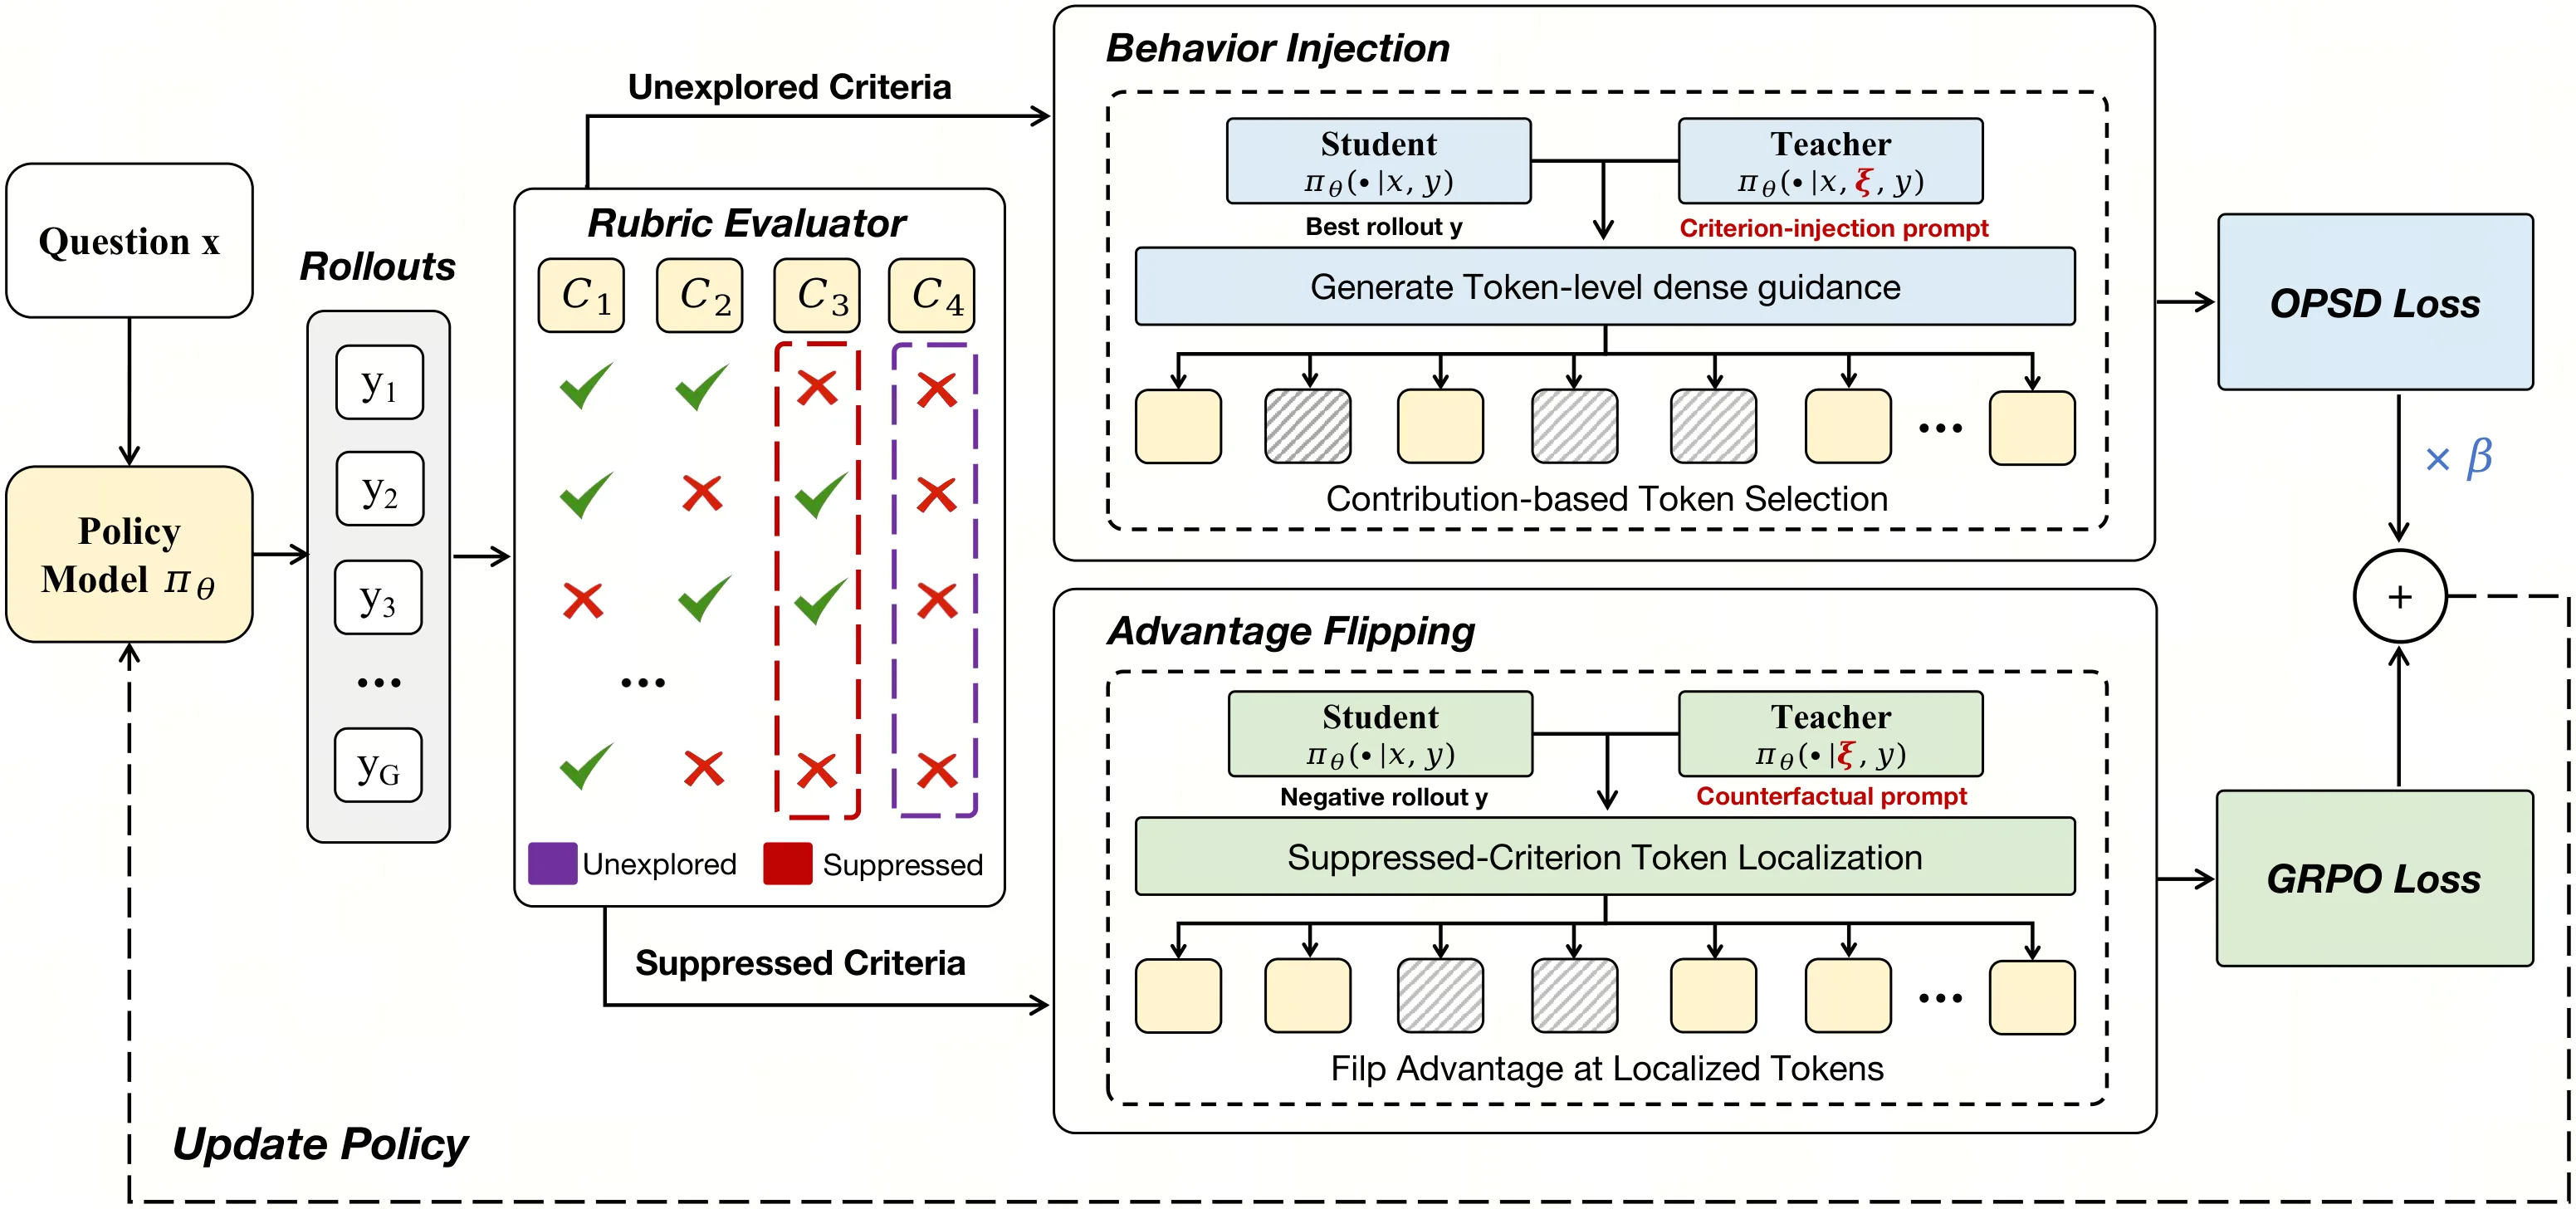
CriPO 的核心洞察是:与其依赖外部引导(不可避免地引入分布偏移),不如利用策略自身的知识来弥补缺失的学习信号。具体而言,CriPO 保留 GRPO 作为稳定奖励驱动的优化主干,同时引入同策略自蒸馏(OPSD)作为辅助模块,针对 UC 与 SC 分别设计两类自教师,以细粒度的 token 级监督信号补充全局奖励的不足。
针对 UC 的行为注入模块遵循"最小修订"原则。论文发现,选择组内最高优势的轨迹作为修订对象是更优选择——它已经满足大部分标准,只需最小的改动即可满足剩余标准。给定该轨迹和未满足的标准集合 ,CriPO 构建如下标准注入教师提示:请模型以"最小必要修改"的方式修订响应以满足这些标准,只输出修订后的内容。这种构造方式确保了教师信号与当前策略的分布接近,同时注入了当前缺失的行为模式。
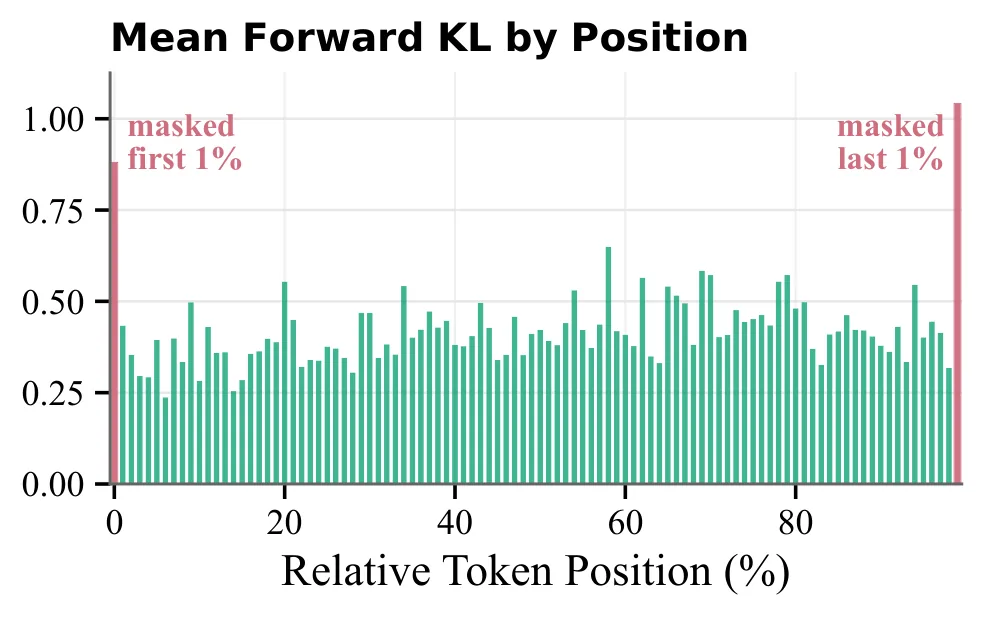
在蒸馏方式上,CriPO 采用前向 KL 散度而非反向 KL。前向 KL 在学生分布缺乏某些模式时会自然地将概率分配给教师的多个偏好模式,而非过度惩罚自身已有的合理分布——这正是行为注入场景所需要的。为了避免在所有 token 上均匀计算损失(引入过多无关噪声),论文引入贡献引导的过滤机制:只计算那些累积贡献达至 95% 的"高影响力 token",其余 token 不参与损失计算。经验观察表明,约 34.6% 的 token 贡献了 95% 的 KL 散度,这种过滤在保持效果的同时显著降低了优化噪声。
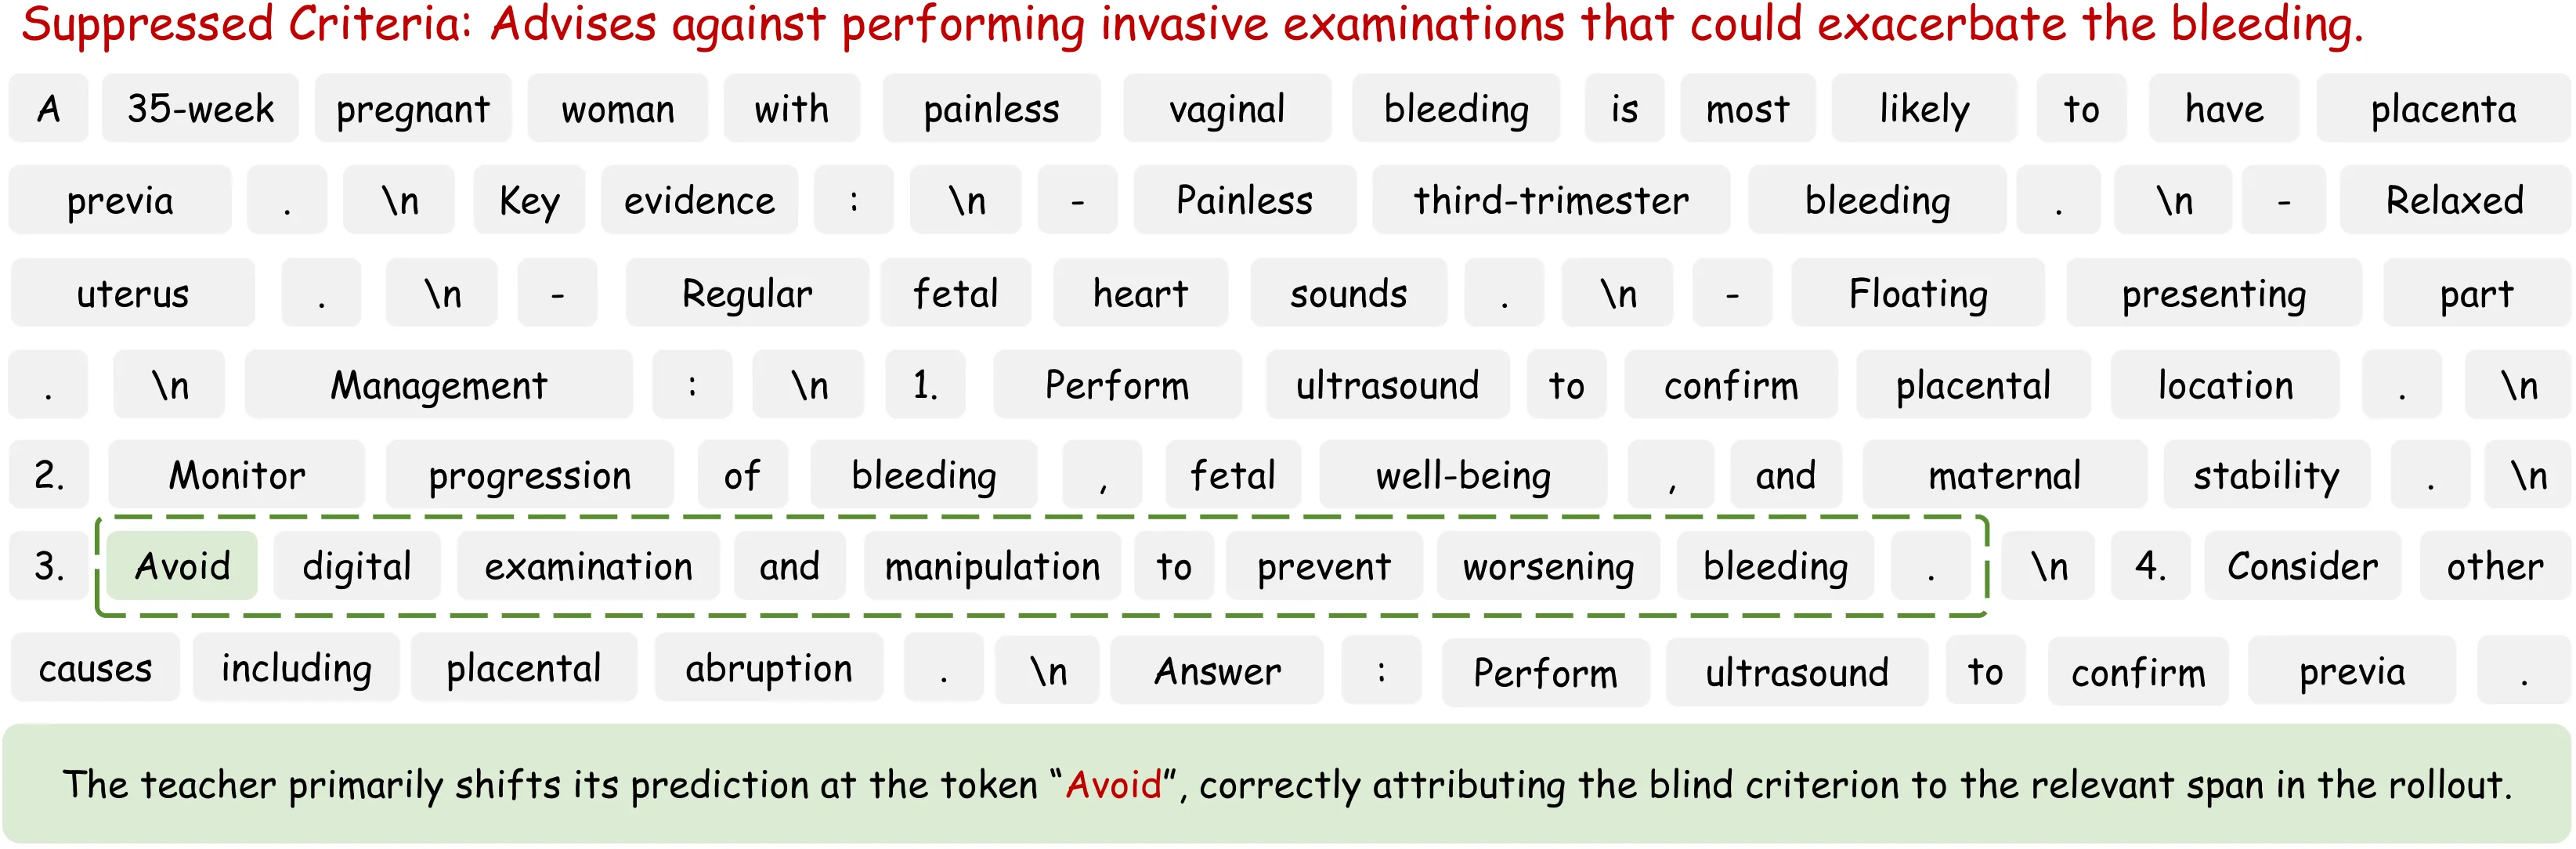
针对 SC 的优势翻转模块更为精妙。对于负优势轨迹中满足抑制标准的部分,CriPO 构建一个反事实教师——它被要求有意弱化或删除满足这些标准的部分。比较反事实教师与原始策略在各 token 处的分布,可以定位出真正承载被抑制标准语义的 token。具体而言,如果移除某标准后,原始策略在该 token 处采样目标 token 的概率下降(说明该 token 确实关联该标准),且反事实教师显著倾向于其他 token(说明该模式可被抑制),则该 token 被纳入定位集合。
对这些定位出的 token,CriPO 将其 token 级优势从轨迹级的负值 翻转为一个固定正值 。这相当于在保留 GRPO 全局优化方向的同时,对"被抑制但有用"的行为做局部反向修正,使其不再被惩罚。
两种模块协同工作的机制清晰:行为注入为模型开辟新的能力边界,优势翻转则在已有能力范围内解救被错误压制的有用模式。总训练目标为 ,两个模块各司其职,共同提升学习效率。
实验与结果
论文在医学和科学两个领域构建了完整的实验验证。训练数据包括 RaR-Medicine(15,658 条训练样本)和 RaR-Science(10,874 条训练样本),评测则在 HealthBench、LLMEval-Med、ResearchQA 等多个基准上进行,涵盖域内和跨域泛化能力评估。主实验使用 Qwen3-4B 作为基础模型,以 GRPO、HeRL(外部引导增强探索的代表性方法)、纯 OPSD(将全部 rubric 作为特权信息)以及 CriPO 的两个消融变体(CriPO-U 仅行为注入、CriPO-S 仅优势翻转)作为对比基线。
核心结果呈现出一个清晰的模式。首先,完整 CriPO 在所有基准上均显著优于 GRPO,尤其值得注意的是其样本效率优势:在约一半的优化步数(论文报告约 2 倍的效率提升)下即达到更强的最终性能,这直接验证了 UC 和 SC 处理的有效性。其次,CriPO-U 和 CriPO-S 的消融实验表明,两个模块存在互补性:单独使用任一模块只能部分改善性能,完整方法的效果最强,说明两类失败模式确实独立存在且同等重要。第三,纯 OPSD 基线的糟糕表现(Qwen3-4B 在 RaR-Medicine 上从 ~57% 跌至 30% 附近)有力地证明了论文的核心判断——OPSD 存在特权信息泄漏、自教师信号不可靠等内在问题,必须与 GRPO 配合使用。最后,HeRL 的跨域泛化性能不如 CriPO,这与其训练-推理不一致问题高度吻合。
讨论与可借鉴点
CriPO 的贡献在于系统性地识别并形式化了 UC 与 SC 两类失败模式,并设计了无需外部引导的解决方案。这为基于评分标准的强化学习研究提供了新的优化视角。
然而,论文也存在若干局限。首先,行为注入模块依赖策略自身生成修订后的轨迹,这意味着如果基础策略在某些维度上能力严重不足,修订信号可能仍然不够可靠。其次,对于 SC 的处理假设"被抑制的标准对应的局部模式可以独立提取",但在某些语义高度纠缠的生成中,这种假设可能不成立。第三,论文的所有实验均在 4B 参数量级的模型上进行,更大规模模型的 scaling 特性尚未被验证。
从方法论层面,CriPO 展示了一个有价值的范式:对于复杂的多维度评估场景,将问题分解为"探索缺失"与"信号抑制"两类,分别设计针对性的救济机制,而非试图用单一方法处理所有问题。此外,贡献引导的 token 过滤设计提醒我们,在 token 级优化中并非所有位置都同等重要——识别并聚焦高影响力区域可以显著提升优化效率。这种"精确定位、最小干预"的思路,对于其他需要细粒度控制的强化学习应用同样具有借鉴意义。
概念 · 6 个
摘要
将自蒸馏方法应用于基于评分标准的强化学习
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
更好的起点,更好的终点:用于压缩推理的自举迭代自推理蒸馏
Better Starts, Better Ends: Bootstrapped Iterative Self-Reasoning Distillation for Compressed Reasoning
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 4 张
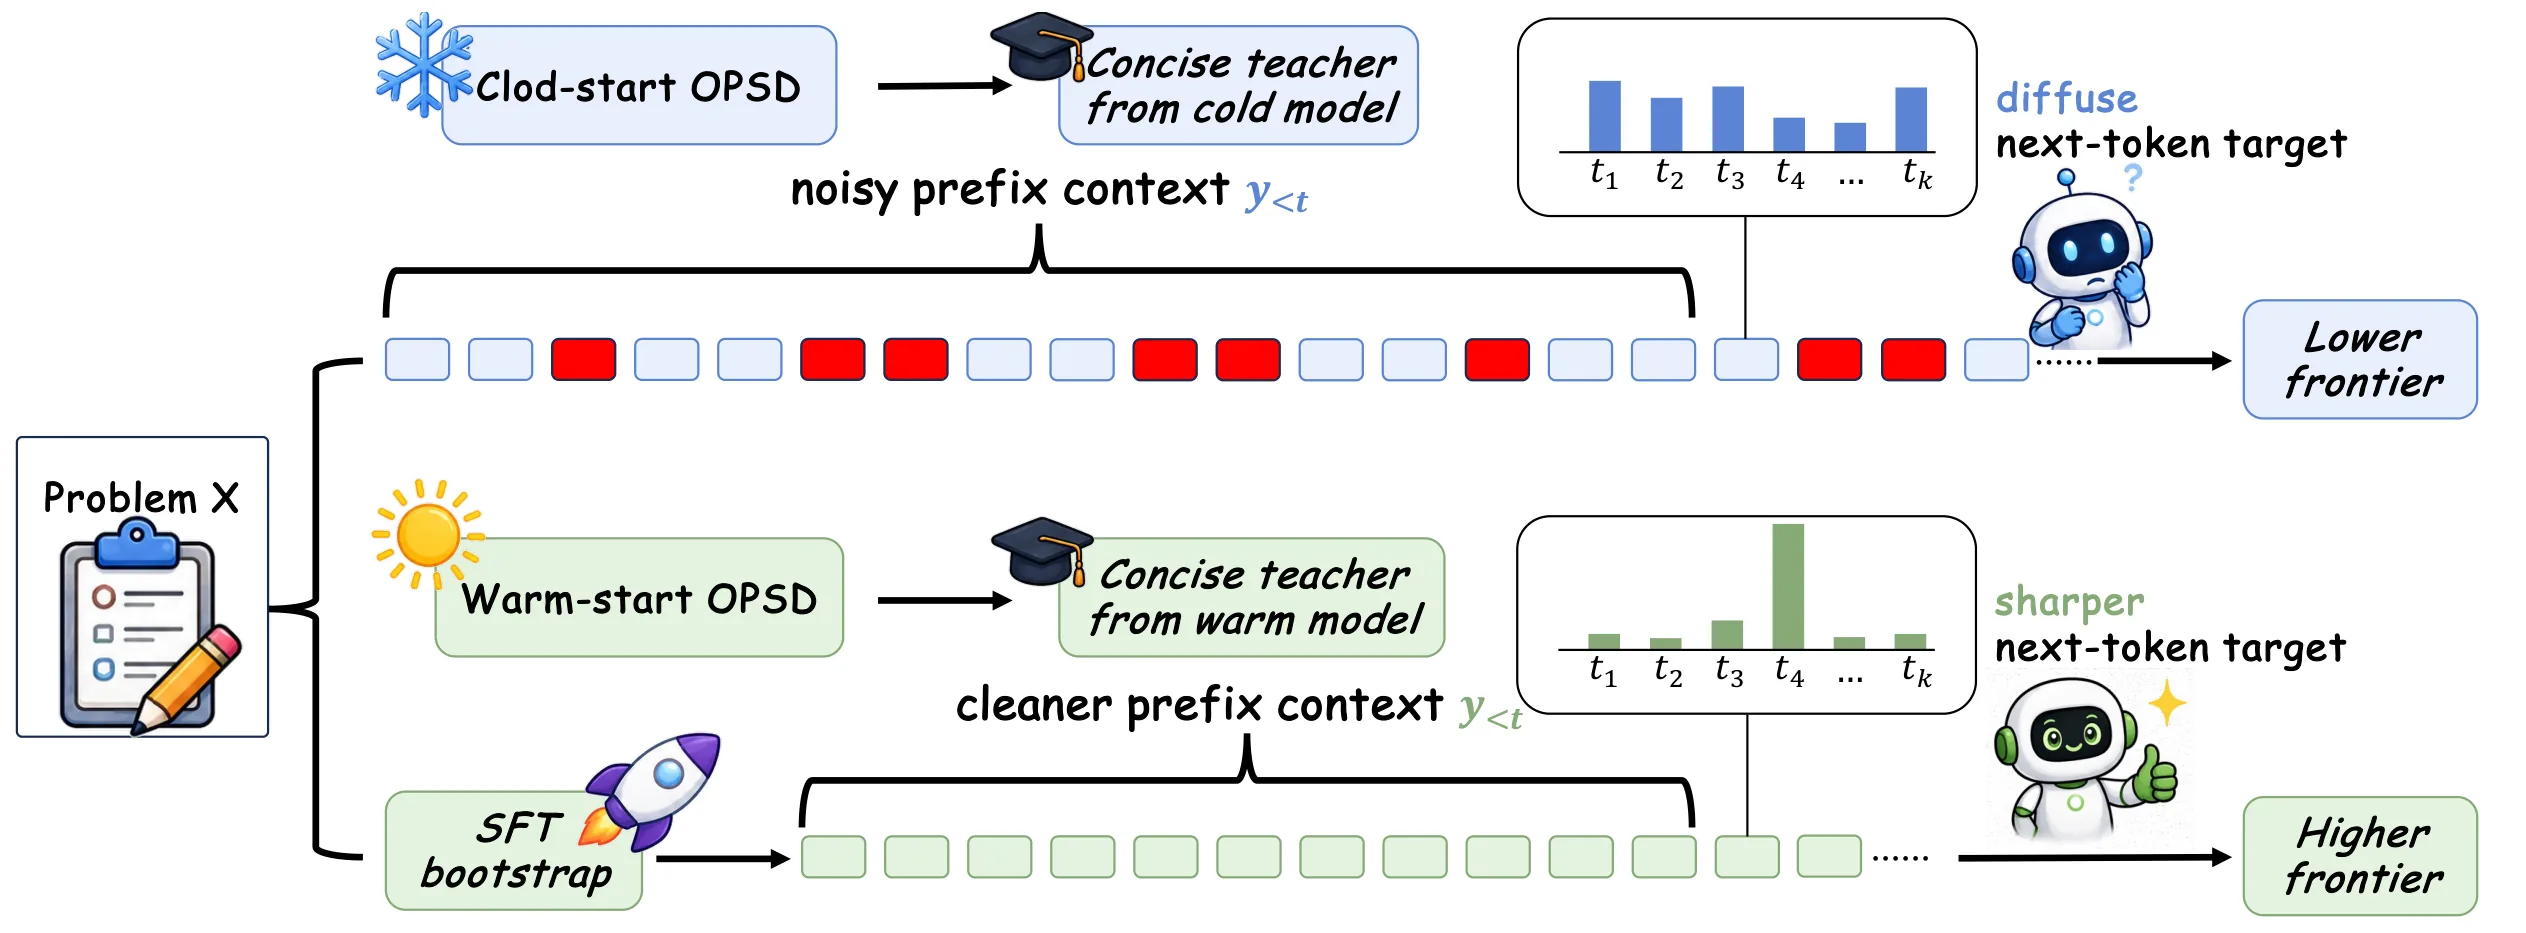
大推理模型的长链思维存在大量冗余推导,现有自蒸馏方法因初始化瓶颈而难以有效压缩。提出BIRD两阶段自推理蒸馏:先用简洁指令从基模型采样正确答案进行轻量SFT预热,再对清洗后的前缀进行逆向KL蒸馏。在Qwen3系列上实现更优的准确率-效率权衡,8B模型在MATH-500上准确率从86.2%提升至92.0%,平均响应长度从3099压缩至1115 tokens,表明前缀质量是高效推理蒸馏的核心因素。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
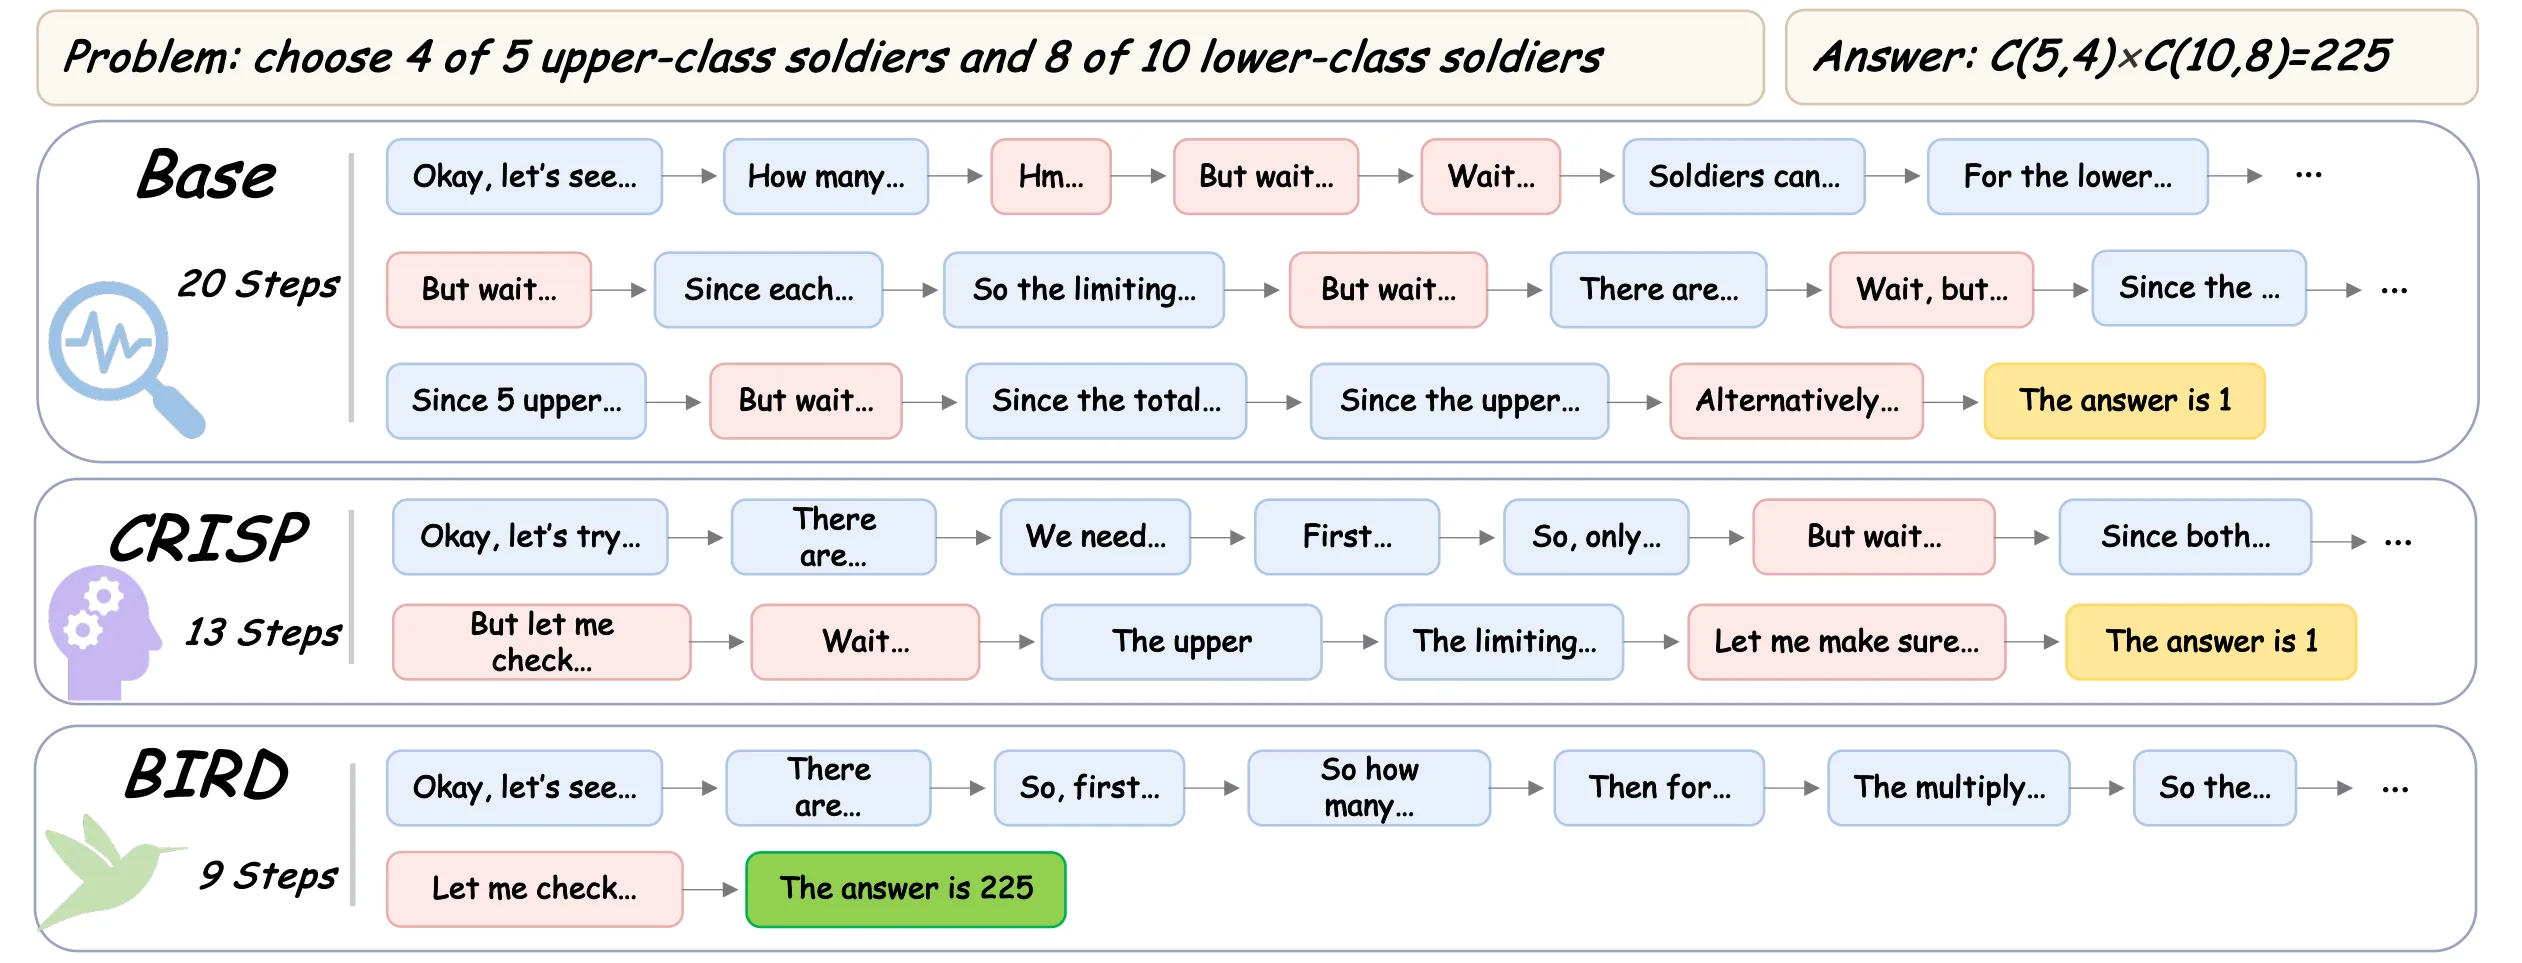
大推理模型通常依赖长链思维(CoT)轨迹来逐步推导答案,这种方式确实带来了显著的能力提升,但代价是推理成本急剧膨胀。深入观察这些长轨迹会发现一个被低估的现象:其中相当一部分计算被浪费在重复的自我验证、绕了一圈又回到原点的推导、以及对最终答案毫无贡献的迂回探索。更耐人寻味的是,当研究者尝试压缩这些思维链时,往往会得到一个反直觉的发现——缩短后的模型不仅没有变笨,有时甚至比原始模型表现更好。这强烈暗示原始长 CoT 中存在大量"表演思考"而非"真正思考"的成分。
这一观察催生了推理压缩研究的蓬勃发展。免训练方法通过在推理时加入简洁指令或早停机制来控制生成长度,但效果高度依赖模型本身的遵循能力。基于强化学习的方法引入长度惩罚奖励,能系统性地平衡准确率与效率,但需要精心设计奖励函数和训练流程。这些方法要么缺乏训练信号的指导,要么需要借助外部力量。
在策略自蒸馏(OPSD)代表了一条更优雅的路线:让模型自身充当教师,在简洁性指令下生成动态参考。具体来说,学生模型采样一条轨迹,然后一个携带简洁指令的教师版本在相同前缀上提供更简洁的下一 token 预测,损失函数是学生分布与教师分布之间的逆向 KL 散度。理论上这形成了闭环自改进:更简洁的教师引导学生缩短推理,学生变短后又生成新的简洁前缀。
然而论文揭示了一个此前被忽视的瓶颈——前缀支持问题。逆向 KL 散度只在学生已经访问过的前缀上计算监督信号,这是一个"前缀局部"的匹配目标。当从冗长的基模型开始训练时,学生会探索大量噪声、冗余甚至已经偏离正确轨道的前缀。此时简洁教师虽然存在,但被查询时所处的上下文已经充满杂质。教师只能在局部提供下一 token 的修正,无法从根本上扭转学生继续沿着错误方向探索的倾向。这就像给一个习惯性绕远路的人指路,每次只能告诉他"下一步怎么走",但这个人还是会继续选择绕远路,因为他的整体策略已经偏向冗长。
方法
理解 BIRD 的设计需要先明确推理压缩的形式化框架。将推理压缩表述为分布匹配问题:学习一个学生策略 ,使其匹配某个目标分布 。不同方法的差异既在于如何构造目标分布,也在于监督信号实际施加在序列的哪些位置上。
序列生成遵循标准的自回归分解,每个 token 的概率取决于之前的所有 token。在策略自蒸馏的目标函数可以写作:
其中 是学生在当前位置的分布,而 是教师分布,它携带了简洁指令 (如"请简洁回答"),被查询时同样处于学生的当前前缀。停止梯度操作确保教师参数不因梯度回传而更新,通常采用周期性地从学生参数同步的策略。
问题在于这个目标函数的监督范围受限于学生 rollouts 的前缀支持。如果学生的前缀分布本身偏向冗长、噪声和偏轨,那么即使教师再简洁,匹配也是在错误的基础上进行的。这解释了为什么直接对大推理模型应用在策略自蒸馏往往只能获得有限的改进——蒸馏的效率被初始化拖累了。
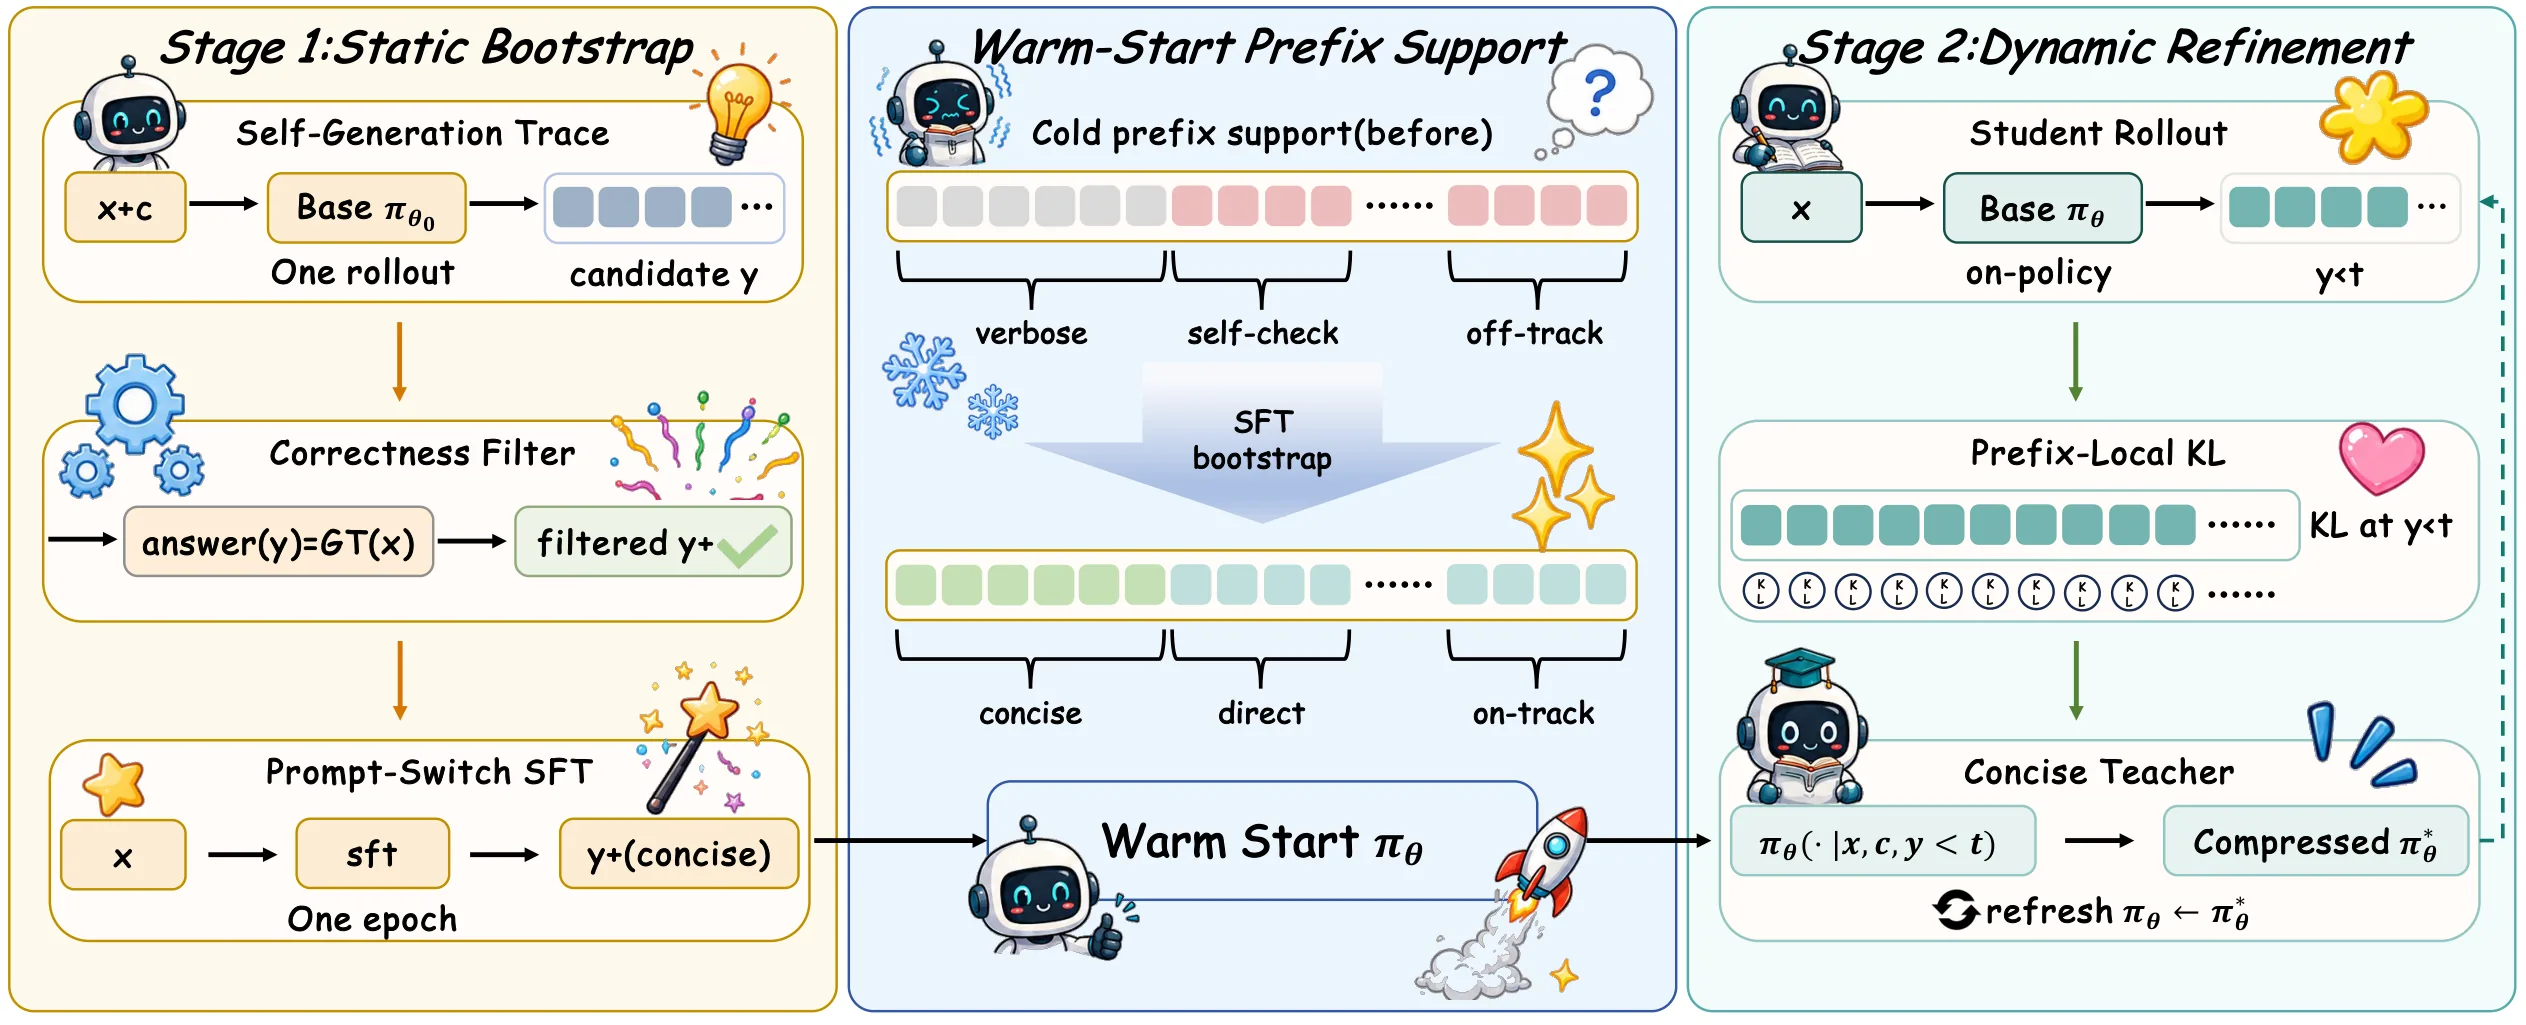
BIRD 的核心洞察是:与其让教师去适应脏乱的前缀分布,不如先改善前缀分布本身。这催生了两阶段的设计。
第一阶段被称为静态自举(Prompt-Switch SFT)。给定训练题目集 ,对每个样本 ,让基模型在简洁指令 下采样一条轨迹。这里引入一个关键过滤条件:只有当模型生成的答案与真实答案匹配时才保留这条轨迹。这一步筛掉了那些虽然简洁但答案错误的轨迹,确保进入后续训练的数据质量。
接下来是最关键的设计:提示切换。轨迹本身是在 (原始问题加简洁指令)的条件下生成的,但在训练时只使用原始问题 作为提示,不包含简洁指令。这意味着模型学习的是:面对普通数学题时,自动采用简洁的推理风格,而非在指令驱动下才变得简洁。这一步将"指令诱导的简洁性"内化为模型的默认行为,避免简洁成为推理时的临时工件。论文采用轻量级的微调配置:仅 1 个 epoch、每个样本 1 条轨迹、最大长度 2048 token、LoRA 高效适配。这种轻量化设计确保第一阶段不会过度拟合特定轨迹,同时足以将简洁推理的偏好注入模型。
第二阶段是动态精炼(Warm-Start OPSD)。从第一阶段得到的预热模型 出发,执行标准的逆向 KL 在策略自蒸馏。教师是学生参数的停止梯度副本,按周期从学生同步。教师在生成时同样携带简洁指令,但这次面临的前缀分布已经大大改善——更短、更直接、更少噪声。教师能够在更干净、信息量更丰富的上下文上提供监督,KL 损失不再浪费在冗余和偏轨区域。第二阶段的关键改进是初始化:不再从冗长的基模型出发,而是从一个已经"习惯"简洁推理的模型起步。这相当于给模型换了一个更好的起点,后续的蒸馏优化在这个起点上能够更高效地收敛。
实验与结果
论文在 Qwen3 系列的 1.7B、4B、8B 三个规模上验证 BIRD,评测基准包括 MATH-500、AIME 2024 和 AIME 2025。基线方法包括原始模型(Base)、仅推理时加简洁指令(Concise)、以及论文自行复现的冷启动 OPSD 方法 CRISP。
主结果呈现了清晰的层级关系。在 Qwen3-8B 上,BIRD 将 MATH-500 准确率从 86.2% 提升至 92.0%,同时将平均响应长度从 3099 token 压缩至 1115 token,准确率提升和长度压缩同时发生,这是最理想的结果形态。在更具挑战性的 AIME 2024 上,准确率从 38.33% 升至 58.33%,长度从 6230 压缩至 4067,提升幅度依然显著。论文还测试了跨模型家族的迁移能力:在 DeepSeek-R1-Distill-Llama-8B 上,BIRD 依然取得了 +8.0 个百分点的准确率提升和 33% 的长度缩减,说明两阶段策略不依赖特定模型架构。
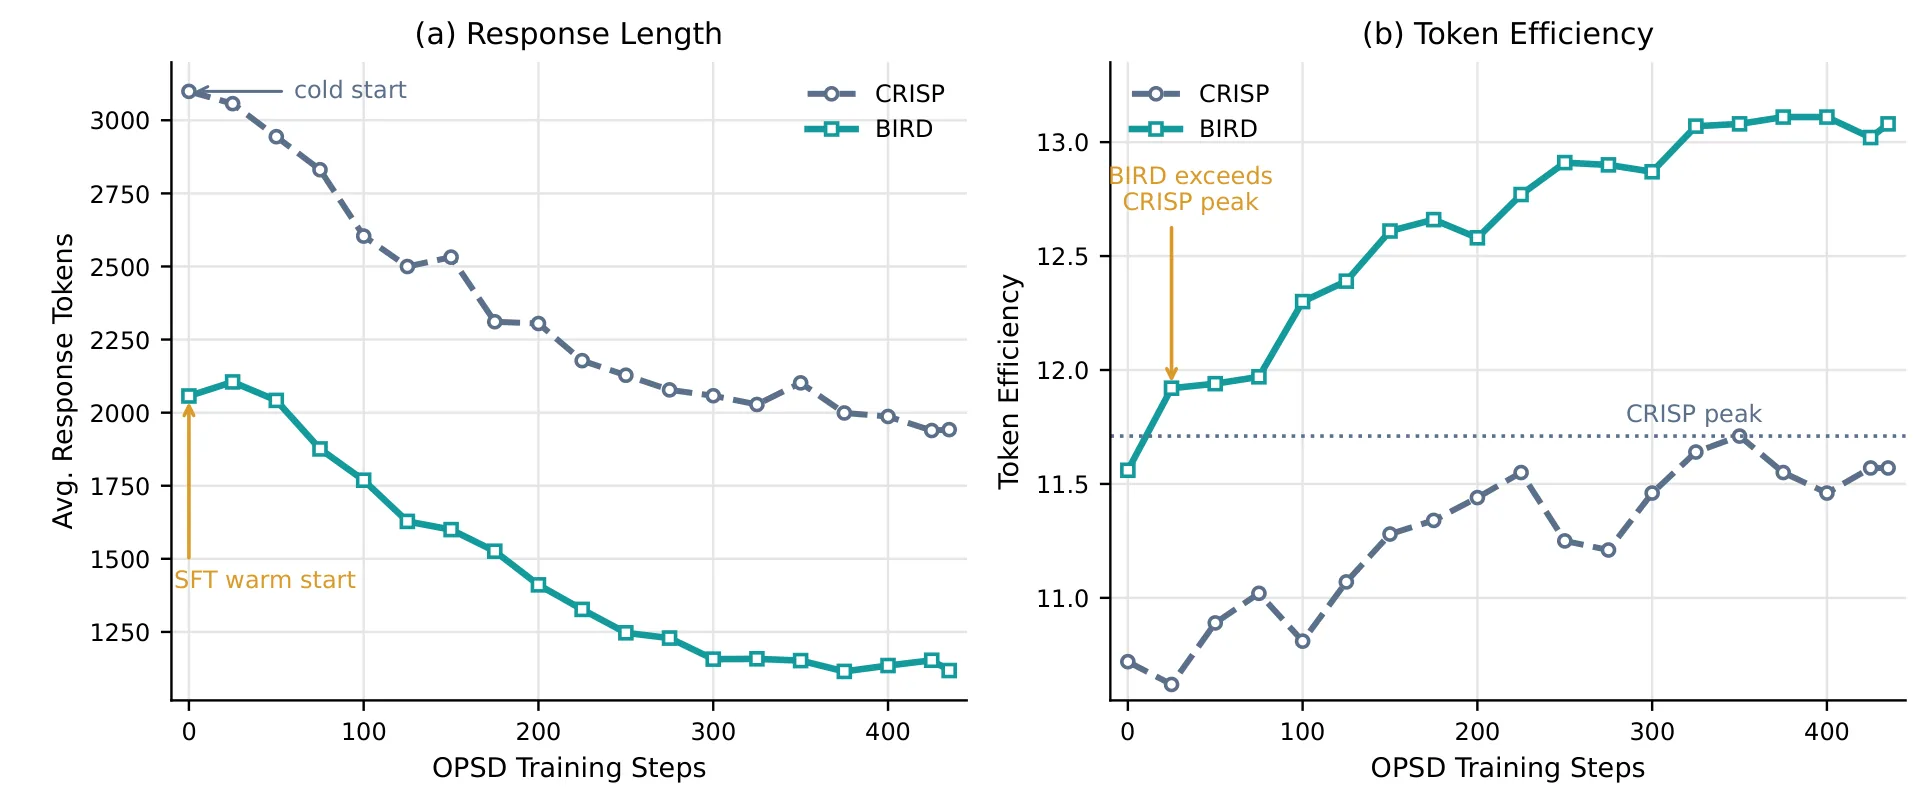
论文引入了一个综合指标 Token Efficiency (TE),定义为 ,用对数长度作为分母来刻画"长度缩短的边际收益递减"效应。在这个指标下,BIRD 在 9 个模型-基准组合中有 8 个取得最高值,仅在 Qwen3-1.7B / AIME 2025 上略低于 CRISP。值得关注的是,1.7B 这样的小规模模型收益有限,准确率甚至有小幅下降,表明小模型在简洁指令下生成正确答案的可靠性不足,Stage 1 的效果受限于模型容量。
消融实验揭示了各组件的贡献。SFT-only(仅第一阶段)在准确率上与 Base 相当但长度大幅缩短,说明提示切换 SFT 本身就能实现有意义的压缩。CRISP(冷启动 OPSD)能够进一步压缩长度,但准确率提升有限。BIRD 则是两者结合后的最优结果。阶段顺序的消融更有意思:如果将两个阶段颠倒过来——先做 OPSD 再做 SFT——长度虽然能进一步压缩,但准确率显著下降(Qwen3-4B / AIME 2025 从 40.83% 跌至 28.33%),说明后置的 SFT 会覆盖在线学习到的策略。
训练动力学曲线直观地展示了初始化改善的效果。BIRD 的初始 Token Efficiency 就已经达到了 CRISP 训练全程的峰值水平,25 步之后就超过了 CRISP 的最佳表现。这意味着 Stage 1 的预热让模型"赢在起跑线上",后续的 OPSD 不需要从头学习简洁推理,只需在已有基础上精炼。
讨论与可借鉴点
BIRD 最重要的理论贡献是揭示了前缀支持在蒸馏中的关键作用。此前的研究通常关注如何构造更好的教师、选择更优的蒸馏目标函数,但 BIRD 指出,问题不仅在于教师"说什么",更在于教师"被问什么"。即使拥有完美的简洁教师,如果它总是被查询于噪声和偏轨的前缀上,蒸馏依然低效。这个视角将推理压缩从"如何让模型变短"扩展到"如何让模型在更短的上下文中学习"。
两阶段设计体现了"先改善数据分布再训练"的工程哲学。第一阶段的提示切换 SFT 不需要任何外部教师或奖励信号,只依赖模型自身的生成能力和简单的答案过滤。这使其成为一个即插即用的组件,可以与各种后续蒸馏策略组合。这种"自举"思想——利用模型自身的生成能力来改善后续训练的起点——值得在其他长文本生成压缩任务中借鉴。
然而,论文的实验范围集中于数学推理这一单一领域。大推理模型同样广泛应用于代码生成、逻辑推理、多模态推理等场景,这些领域的长链思维是否同样存在可压缩的冗余、BIRD 的两阶段策略能否迁移,还有待验证。此外,论文在超参披露上略显不足——KL 损失截断到前 1024 token、SFT 截断到 2048 token、LoRA 秩等关键超参的选择依据和敏感性分析未被详细讨论,这为后续复现和调优留下了一定空间。
对于实践者而言,BIRD 的一个重要启示是初始化质量对在线学习方法的决定性影响。当模型的初始 rollout 分布不理想时,即使采用理论上正确的优化目标,也难以取得好的结果。在这种情况下,与其直接在目标分布上训练,不如先花少量资源改善模型自身的生成分布,再进行目标驱动的训练。这种"预热-精炼"的范式或许可以推广到其他需要模型探索自身分布的场景中。
概念 · 7 个
摘要
策略自蒸馏:学生模型从自身简洁副本学习
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
EasyOPD:面向大语言模型的易用式在策略蒸馏框架
EasyOPD: An Easy-to-use On-Policy Distillation Framework for Large Language Models
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 1 张
传统语言模型蒸馏依赖固定教师数据,无法覆盖学生策略演化过程中遇到的真实状态。在线策略蒸馏(OPD)通过对学生生成轨迹进行监督缓解该问题,但现有方法在监督形式、分词器兼容、粒度等方面差异大,实现碎片化。EasyOPD基于分布式强化学习框架verl构建,将用户配置、方法监督逻辑与执行层解耦,统一支持跨分词器OPD、自蒸馏和逐步OPD三种设置。在多类基准上验证可行,并开源配置、文档与演示包。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
知识蒸馏是当前大语言模型压缩与能力迁移的核心技术之一。传统方法通常采用离线蒸馏范式:预先由教师模型生成一批固定数据,再由学生模型在这批数据上进行监督学习。这种方式实现简单、计算高效,但存在一个根本性的局限——教师数据是静态的,无法覆盖学生策略在训练过程中实际遇到的新状态。随着学生能力逐步提升,它面对的输入分布会发生变化,而那些从未出现在教师数据中的状态就无法获得有效的监督信号。
在策略蒸馏(OPD)试图解决这一问题。与离线蒸馏不同,OPD 在学生模型自己生成的轨迹(rollout)上收集教师或评估器的监督信号。这种做法确保了学生始终在自己当前策略的真实分布上进行学习,教师可以针对学生实际遇到的困难提供更有针对性的指导。然而,领域内现有的 OPD 方法在实现上呈现出高度的碎片化特征:有的方法采用序列级别的损失,有的采用 token 级别的损失;有的需要教师和学生使用相同的分词器,有的则需要处理跨分词器的对齐问题;有的方法直接访问教师模型的 logits,有的只获取教师的偏好排序或打分。这些差异使得研究者和工程师很难复用他人的实现,也难以系统地探索不同 OPD 变体的优劣。
更关键的是,许多 OPD 方法被设计为封闭的独立系统,每个方法都需要重新实现自己的数据采样、训练循环和分布式通信逻辑。这不仅造成了大量重复开发工作,也使得不同方法之间的公平比较变得困难。EasyOPD 的核心动机正是提供一个统一的 OPD 实现平台,将方法层面的多样性(不同监督形式、不同分词器兼容性等)与底层的分布式执行基础设施分离,让研究者可以专注于方法创新而非工程实现。
方法
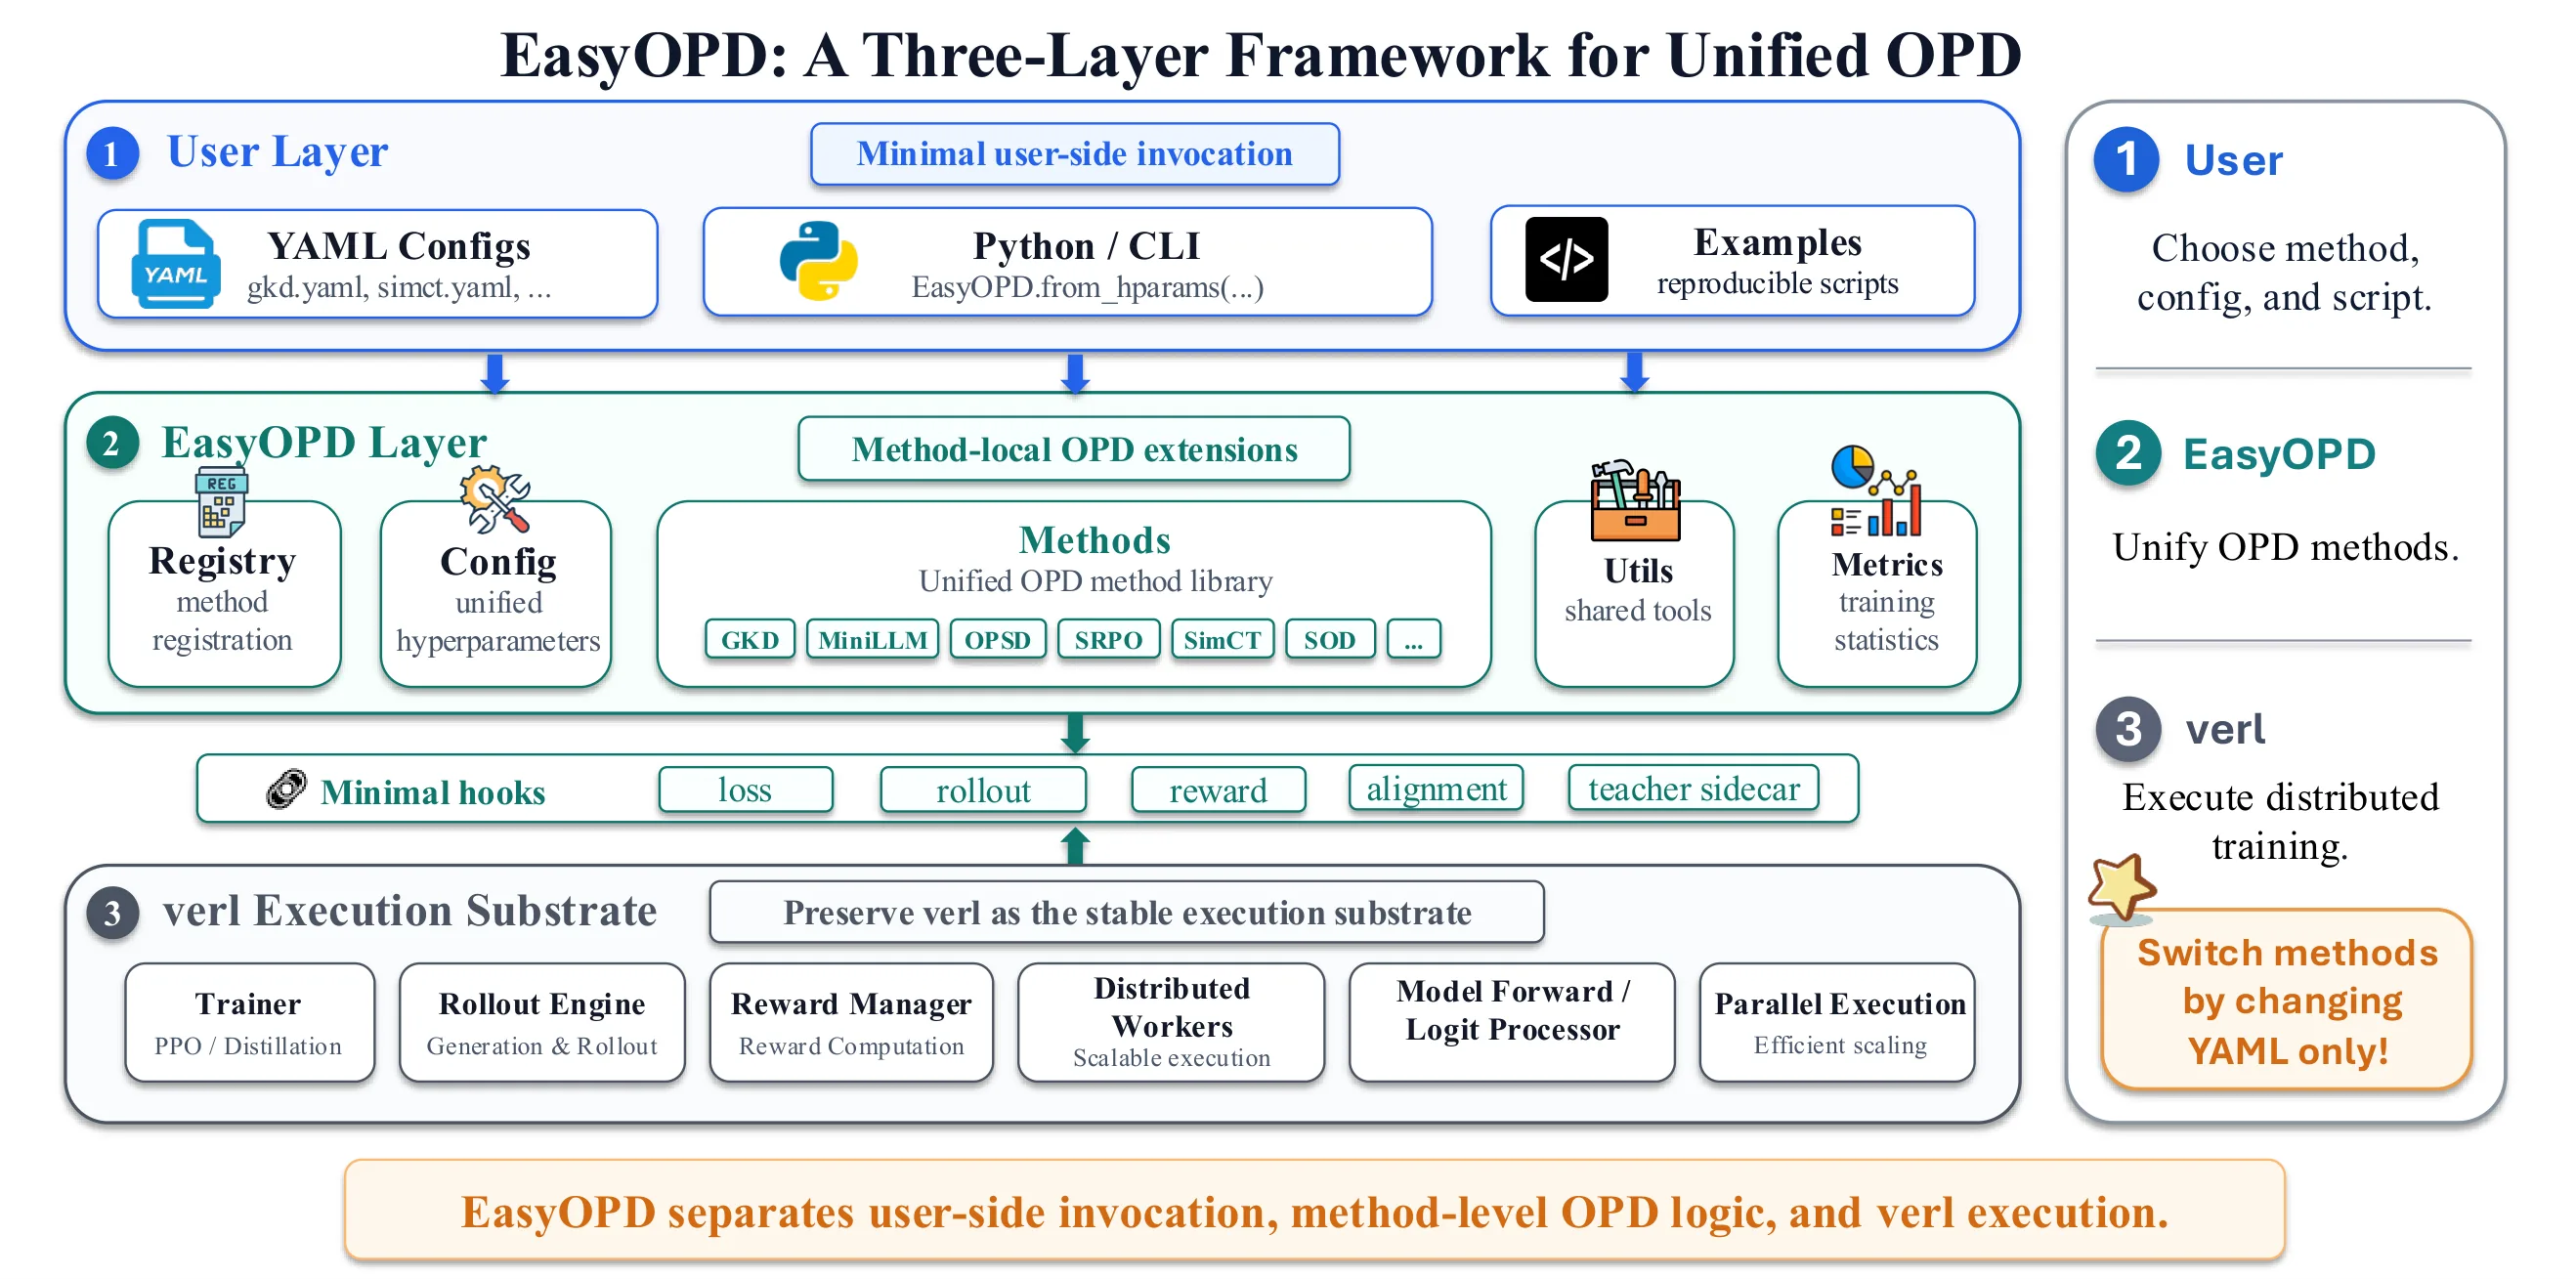
EasyOPD 的设计哲学可以用一句话概括:方法模块化,执行统一化。整个框架建立在 verl 之上——这是一个面向大语言模型的分布式强化学习框架,本身已经解决了 actor-learner 架构、梯度同步、GPU 通信等工程难题。EasyOPD 在此基础上引入了扩展边界(extension boundary)的概念,将影响方法行为的各个维度抽象为可插拔的接口。
具体而言,EasyOPD 定义了五个核心扩展边界。第一,损失构建边界允许不同的蒸馏目标接入框架——比如 KL 散度损失、序列级对比损失或混合损失组合。第二,rollout 元数据边界负责收集学生生成轨迹的额外信息,这些信息对于某些监督形式至关重要(例如计算 token 级别的注意力对齐时需要保存注意力矩阵)。第三,奖励处理边界将外部评估器或教师模型的反馈转化为可用的训练信号。第四,分词器对齐边界是跨分词器蒸馏场景的关键,它定义了如何将教师和学生各自的 token 序列映射到统一的语义空间进行对比。第五,教师端计算边界封装了教师模型的调用方式,既支持直接访问教师 logits 的白盒场景,也支持只能获取评分的黑盒场景。
这种方法设计的直觉在于:现有 OPD 方法的差异主要集中在前四个边界上,而它们共享的数据采样、分布式训练和梯度更新机制恰好可以统一由 verl 处理。EasyOPD 并不是发明新的蒸馏算法,而是为已有和未来的 OPD 方法提供一个可复用的工程底座。框架的用户只需编写 YAML 配置文件声明使用了哪些扩展边界,底层会自动组装出完整的训练流程。
论文在三个典型场景中实例化了 EasyOPD 的方法模块。跨分词器 OPD 针对教师和学生模型架构差异较大的情况,例如从基于 SentencePiece 的模型蒸馏到基于 BPE 的模型。此时分词器对齐边界会先将两个模型的输出映射到词族(word family)级别,再在共享空间计算对齐损失。在策略自蒸馏则让学生模型同时扮演教师角色——用更早检查点的模型作为教师监督当前检查点,既避免了外部教师的依赖,又能在训练过程中持续提供适应性的监督信号。逐步式 OPD 将整个蒸馏过程划分为多个阶段,每个阶段针对不同的能力维度或难度级别,由不同的教师或评估器组合提供监督,这种设计使得训练路径更加灵活可控。
实验与结果
论文在四类代表性基准上验证了 EasyOPD 的可行性:推理任务(使用 ARC-Challenge 和 MATH)、代码生成(HumanEval)、科学知识(MMLU 的多个子集)以及工具使用(ToolBench 的子集)。实验的核心发现不是某个具体蒸馏方法取得了最优性能,而是验证了 EasyOPD 能够通过同一套 verl 后端成功运行三种不同场景的 OPD 实现,并且每种实现都能保留其设计目标所预期的行为特征。
例如,在跨分词器 OPD 的验证中,论文对比了使用相同分词器(作为上界)和使用随机初始化分词器对齐(作为下界)的基线,结果显示 EasyOPD 的对齐边界设计能够在分词器不兼容的情况下仍然学习到有意义的语义对应。在自蒸馏实验中,学生模型相较于教师检查点表现出持续的能力提升,证明在策略设置确实比离线蒸馏更能适应学生自身的演化轨迹。逐步式 OPD 的消融实验则表明,分阶段引入不同监督源比一次性混合所有监督带来更稳定的训练曲线。
值得注意的是,论文并未声称 EasyOPD 在绝对性能上超越了所有已有 OPD 方法。其贡献定位是工程基础设施层面的——降低 OPD 方法的复现门槛和比较成本,而非提出新的算法创新。这一实验策略是合理的:对于一个框架性质的工作,最重要的是展示它能够正确运行多种已有方法,而非在某单一任务上与专门调优的实现竞争。
讨论与可借鉴点
EasyOPD 的最大贡献在于它揭示了一个长期被忽视的问题:LLM 训练领域的基础设施碎片化已经严重阻碍了方法论层面的进展。当每个新方法都需要从零实现分布式训练逻辑时,整个领域的迭代速度都会受到影响。EasyOPD 证明了一条可行的解决路径——基于成熟框架(如 verl)的扩展机制,用模块化设计容纳方法多样性。
然而,这个方向仍有局限值得注意。首先,EasyOPD 目前依赖 verl 本身的设计假设,对于非 actor-learner 架构的蒸馏方法(如纯粹基于对比学习的做法),整合路径可能并不顺畅。其次,分词器对齐边界虽然提供了一定的抽象,但跨分词器的语义对齐本身仍是一个活跃的研究问题,框架只是降低了相关实验的工程成本,并不能替代对该问题的理论探索。第三,逐步式 OPD 的阶段划分目前仍依赖人工设计,如何自动发现最优的阶段划分策略是一个值得探索的方向。
对于更广泛的大模型训练研究社区,EasyOPD 的实践提供了几点可借鉴的思路。第一,解耦胜于统一:与其试图设计一个能覆盖所有场景的统一算法,不如在工程层面提供灵活的接口让不同算法共存。第二,开源配置而非仅开源代码:论文强调其 YAML 配置可以直接运行,这降低了用户的尝试成本,使得研究分享更接近可复现的标准。第三,框架设计本身也是贡献:当一个领域足够成熟时,方法创新的边际收益递减,而降低创新成本的基础设施建设的价值会相应上升。
概念 · 6 个
摘要
基于强化学习训练的LLM在线策略蒸馏框架
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
纯化 OPSD:在保留思维能力下的在策略自蒸馏
Purified OPSD: On-Policy Self-Distillation Without Losing How to Think
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 28 张
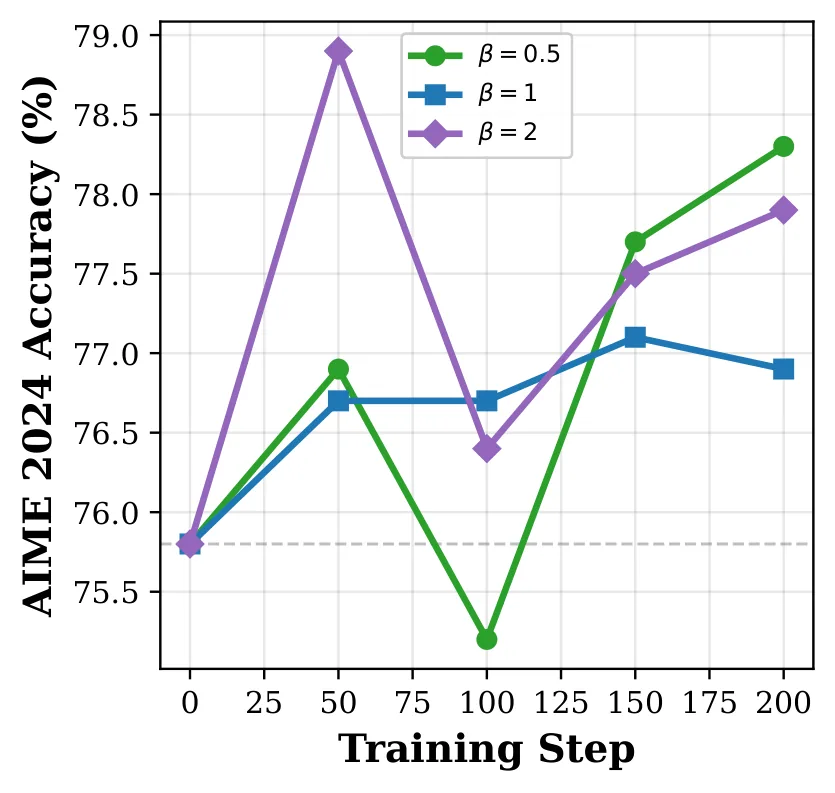
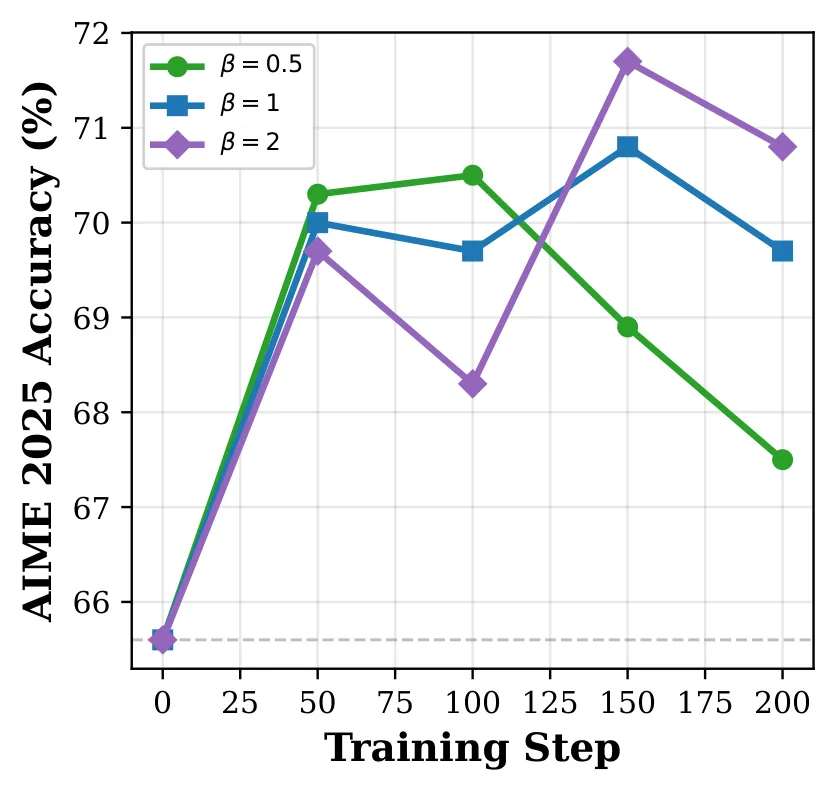
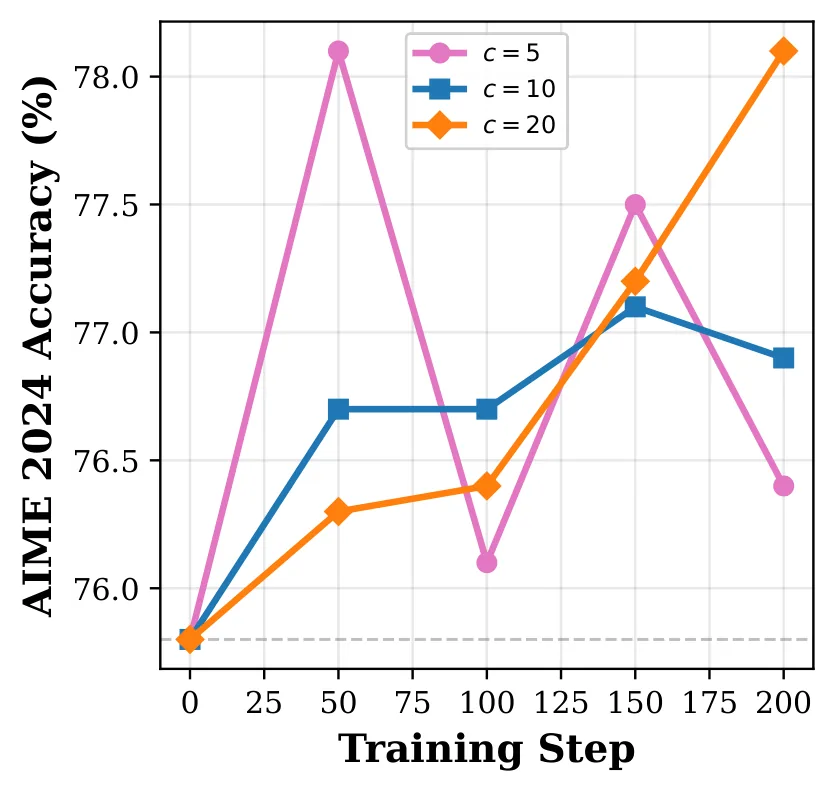
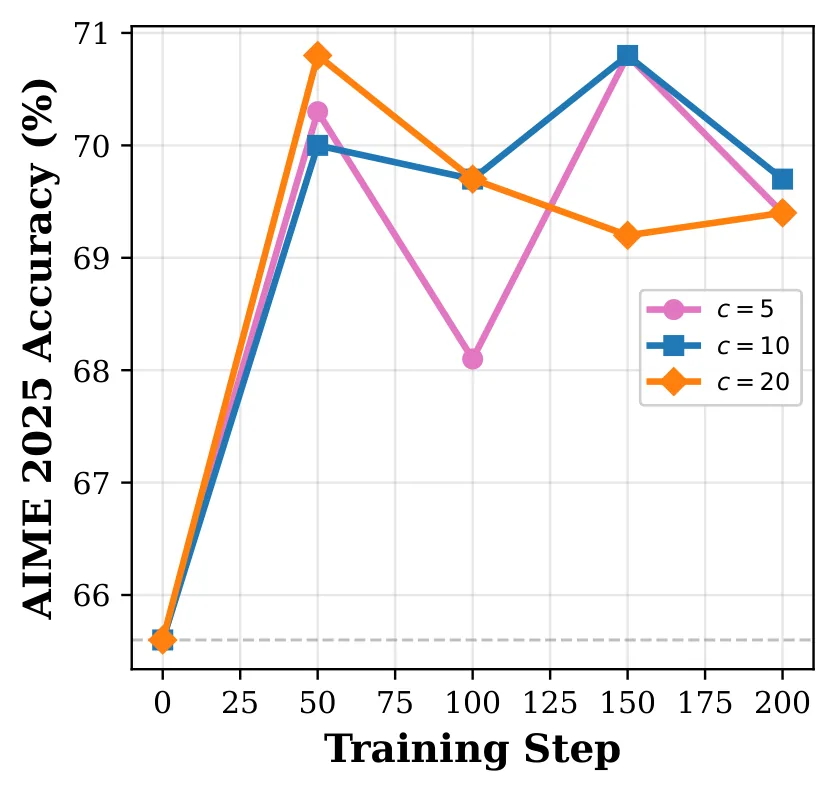
长链思维推理模型上,标准在线自蒸馏方法不仅收益有限,还会损害模型赖以工作的反思推理能力。论文将教师监督信号拆解,发现其中参考诱导的捷径记忆成分占主导,而真正可迁移的问题条件推理信号被压制。提出两步净化方案:先用仅参考教师模型分离不可迁移分量,再以点互信息构建净化后的目标分布。在四个长CoT模型与两个数据集上的实验表明,该方法稳定优于基座和标准OPSD,同时保留模型的自然认知与反思行为。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
在策略自蒸馏(OPSD)近年来成为提升大语言模型推理能力的重要范式。其基本思路是:让模型在自身生成的推理轨迹上进行"自我教学"——同一个模型充当"学生"生成当前策略下的解答,同时充当"特权教师"在能访问参考答案的条件下给出 token 级的监督信号。由于学生和教师都来自同一模型族,OPSD 天然避免了离线蒸馏中常见的分布失配问题,理论上应该是一种优雅且高效的自提升方案。
然而,当研究团队将这套方法搬到长链思维(long-CoT)推理模型上时,预期的收益并没有出现。他们在 AIME 2025 等数学竞赛基准上观察到一种令人担忧的模式:训练刚开始时模型性能短暂上升,但随后持续退化,最终往往低于基座水平。更棘手的是,模型的认知行为出现了明显异常——那些反映自我反思和探索的标记(如"Wait"、"Maybe"、"Perhaps"、"Let me think")在使用标准 OPSD 后要么整体消失,要么过度集中于某一个标记。这种现象在 Qwen3-8B 和 DeepSeek-R1-Distill-7B 等主流模型上都稳定复现,说明并非偶发的训练不稳定,而是某种系统性原因。
为什么长 CoT 模型会在这里"翻车"?研究者的直觉是:长 CoT 模型的核心能力在于它们能够停下来反思、质疑自己、尝试不同的思路分支。当模型已经知道"标准答案"时,这个反思过程就变得多余了——教师模型因为知道答案,所以倾向于跳过探索阶段,直接指向最短的记忆路径。反映在训练信号上,就是教师监督被参考答案特有的捷径成分主导,而真正有价值的、基于问题本身的推理修正反而被淹没。
方法
要解决这个问题,首先要能"看见"问题。研究者没有停留在"训练效果不好"的现象描述,而是尝试对教师监督信号进行结构性分解。他们的核心观察是:标准 OPSD 中,教师给出的监督方向可以写成
其中 是特权教师(在问题上附加参考答案的条件)给出的分布, 是学生当前的策略分布。如果能把这个总更新拆分成"真正有用的修正"和"参考答案带来的捷径"两个部分,就能有针对性地过滤掉后者。
顺着这个思路,研究者提出了一个巧妙的构造:构建一个"仅参考教师"(reference-only teacher)。这个教师拿到的是什么呢?只有参考答案本身,而没有原始问题。如果模型仅仅"记住"参考答案的表面形式,它在只有参考答案作为输入时仍然会生成类似的 token 序列;而如果某条推理路径真正依赖于对问题的理解,它在缺少问题语境时就会"迷路"。通过这个对照实验, 实质上捕获了监督信号中与问题无关、纯粹由参考答案驱动的成分。
基于这个仅参考教师,总更新可以正式分解为
研究者通过实验验证了这个分解的有效性: 在方向和幅度上都主导了总更新(),而 与总更新近乎正交甚至反向对齐。这说明标准 OPSD 的学生实际上主要在学参考答案的记忆模式,而非可迁移的问题解决能力。
分解找到了问题所在,但直接用 作为蒸馏目标存在数值障碍——它不是合法的概率分布。研究者转向逐点互信息(PMI)来构造一个形式良好的目标分布。他们将 解释为可迁移的奖励信号 ,然后求解一个 KL-正则化的最优策略问题:
其中 是干净基座分布(仅以当前问题为条件的初始策略), 控制修正强度。这个问题的闭式解恰好是
这正是 PMI 目标分布。通过这种方式,残余修正被锚定到一个合法的概率基座上,同时保留了可迁移推理信息的相对偏好。
在实际训练中,研究者还需要处理数值稳定性问题:log 空间的残差直接 softmax 可能导致数值爆炸。他们的解决方案包括两步。首先是均值中心化,将残差减去其在词表上的均值,避免极端值主导;其次是 tanh 软裁剪,将幅度限制在 的范围内,防止梯度爆炸。最终的目标分布构造为
整个训练流程非常紧凑:学生在线采样推理轨迹,教师和参考探针分别给出条件分布,冻结的基座模型提供干净基座,三者的 log 概率差值经均值中心化和软裁剪后,加回到基座分布的 log 概率上,用 JSD 散度作为学生策略与目标分布的匹配损失。值得注意的是,参考探针和干净基座的前向传播不参与反向传播,额外计算开销控制在 10% 以内。
实验与结果
研究者在四个不同架构的长 CoT 模型上验证了方法的有效性,包括通用型的 Qwen3-8B 和 Qwen3-4B、蒸馏型的 DeepSeek-R1-Distill-7B,以及开源复现的 OLMo-7B-Thinking。训练数据集覆盖了 DASD-10K 和 Math-CoT-20K 两个数学推理语料,评测基准则涵盖 AIME 2024、AIME 2025 和 HMMT 2025 三个难度较高的数学竞赛。
核心结果表格呈现了 4 模型 × 2 数据集 × 3 基准的完整性能格点。标准 OPSD 在几乎所有组合上都表现疲软,要么性能退化,要么仅有边际增益。相比之下,净化后的 OPSD-PMI 在每一个格点上都是最优的,相对于基座和标准方法都取得了显著提升。
训练动力学曲线揭示了更清晰的图景。在 AIME 2025 上,标准 OPSD 呈现典型的"先升后降"曲线,印证了反思能力被逐渐侵蚀的过程;而 PMI 方法在整个 200 步训练过程中保持稳定上升,没有出现退化迹象。这说明净化策略不仅提升了最终性能,还从根本上改善了学习曲线的形态。
认知行为分析是本研究的一个亮点。研究者统计了反思性标记("Wait"、"Maybe"、"Perhaps"、"Let me think" 等)在训练过程中的出现频率和分布均匀度。标准 OPSD 下,这些标记要么整体消失,要么被某单个标记(如"Wait")垄断——这反映了模型反思能力的坍缩或单一化。PMI 方法则成功将这些标记的数量和分布维持在基座水平,证明净化策略确实保护了模型的自然认知行为。
消融实验进一步确认了各组件的必要性。软裁剪阈值 的选择对结果有影响但不过于敏感, 在多数场景下表现稳健。修正强度 的敏感性略高,不同检查点可能在不同 值下达峰,但固定 仍然能取得不错的整体表现,说明方法对超参数具有一定鲁棒性。
讨论与可借鉴点
这项工作的核心贡献在于提供了一套因果诊断框架。面对 OPSD 在长 CoT 模型上的失效,大多数现有工作倾向于调整学习率或增加正则化项,而该论文从监督信号的组成结构出发,揭示了"参考诱导捷径"这一根本矛盾。这种从信号分析出发的诊断思路,在面对复杂的自训练失效模式时值得借鉴。
从方法论角度看,将可迁移修正锚定到干净基座分布上、通过 KL-正则化奖励最大化推导出 PMI 目标的做法,将启发式设计提升到了原理层面。这种"先诊断、后构造"的两步策略,可能对其他蒸馏场景也有参考价值——当教师信号包含混杂成分时,分离-锚定-转化的范式或许能通用。
当然,实验覆盖范围仍有局限。所有验证都集中在数学竞赛推理任务上,代码生成、开放域问答、多步工具调用等场景的迁移性尚未考察。训练也仅进行了 200 步并使用 LoRA,更长时间的全参数微调下方法的相对优劣尚不清晰。此外,教师模型同源于基座的假设意味着该方法依赖基座本身具备合理的推理和对齐能力,对于严重未对齐的模型效果未知。
一个值得深思的问题是:参考独享教师是否真的"只记住"了参考答案?如果某些推理模式本身在缺少问题语境时仍能保持部分语义连贯性(比如对称性的某种直觉), 可能会误捕一些真正有价值的信号。不过,这个问题不影响当前工作的结论——即便 过滤掉了一部分有用信息,残余的修正信号仍然足以驱动一致的性能提升。
概念 · 6 个
摘要
用于 LLM 推理的在线自蒸馏方法,模型从自身学习
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
面向免标注大语言模型自蒸馏的神经元感知数据选择
Neuron-Aware Data Selection for Annotation-Free LLM Self-Distillation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 3 张
针对无人工标注场景下大语言模型后训练难题,现有自演化方法存在域外性能退化或校准误差膨胀等缺陷。本文提出Neuron-OPSD框架,利用模型内部神经元激活指导训练数据选择与教师上下文构建,并通过在策略蒸馏完成训练,全程无需真实标签。在专业领域基准上同时提升域内任务性能并保持跨域泛化能力,缓解校准崩溃,适用于在线交互与外部监督成本高昂的应用场景。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
在医疗、法律、教育等专业领域部署大语言模型时,往往面临一个根本性的困境:这些领域需要专家知识进行标注,但专家标注成本高昂且难以大规模获取。然而,完全放弃监督信号又会使得模型难以适应特定领域的复杂推理需求。近年来,免标注自演化方法试图解决这一问题——它们让模型利用自身生成的内容作为监督信号,通过额外上下文构建“教师”模型,并用多数投票等方式聚合多次采样的预测结果来生成伪标签。
这些方法听起来很合理,但在实践中暴露出明显的缺陷。基于监督微调的方法容易导致灾难性遗忘,使模型在训练数据覆盖不到的领域表现急剧下降;而基于在线策略强化学习的方法则倾向于放大模型的校准误差,使模型变得过度自信但判断并不可靠。深入分析会发现,这些问题的根源在于两个被忽视的核心问题:应该选择哪些无标签样本用于训练,以及如何构建能够真正教会学生模型新知识的教师上下文。盲目地用模型自身的输出进行蒸馏,实际上是在强化已有的错误校准、虚假推理和幻觉模式。
Neuron-OPSD 的核心洞察是:模型处理不同样本时的内部激活模式蕴含着丰富的信息。当模型对一个样本的处理路径高度一致时,激活的神经元集合较小且集中,这通常意味着模型对该样本有较高的处理确定性;反之,当模型需要“猜测”或调用大量分散的神经元时,激活模式往往与幻觉高度相关。这种内部激活模式就像是模型思考过程的“指纹”,可以用来指导数据选择和教学内容的构建。
方法
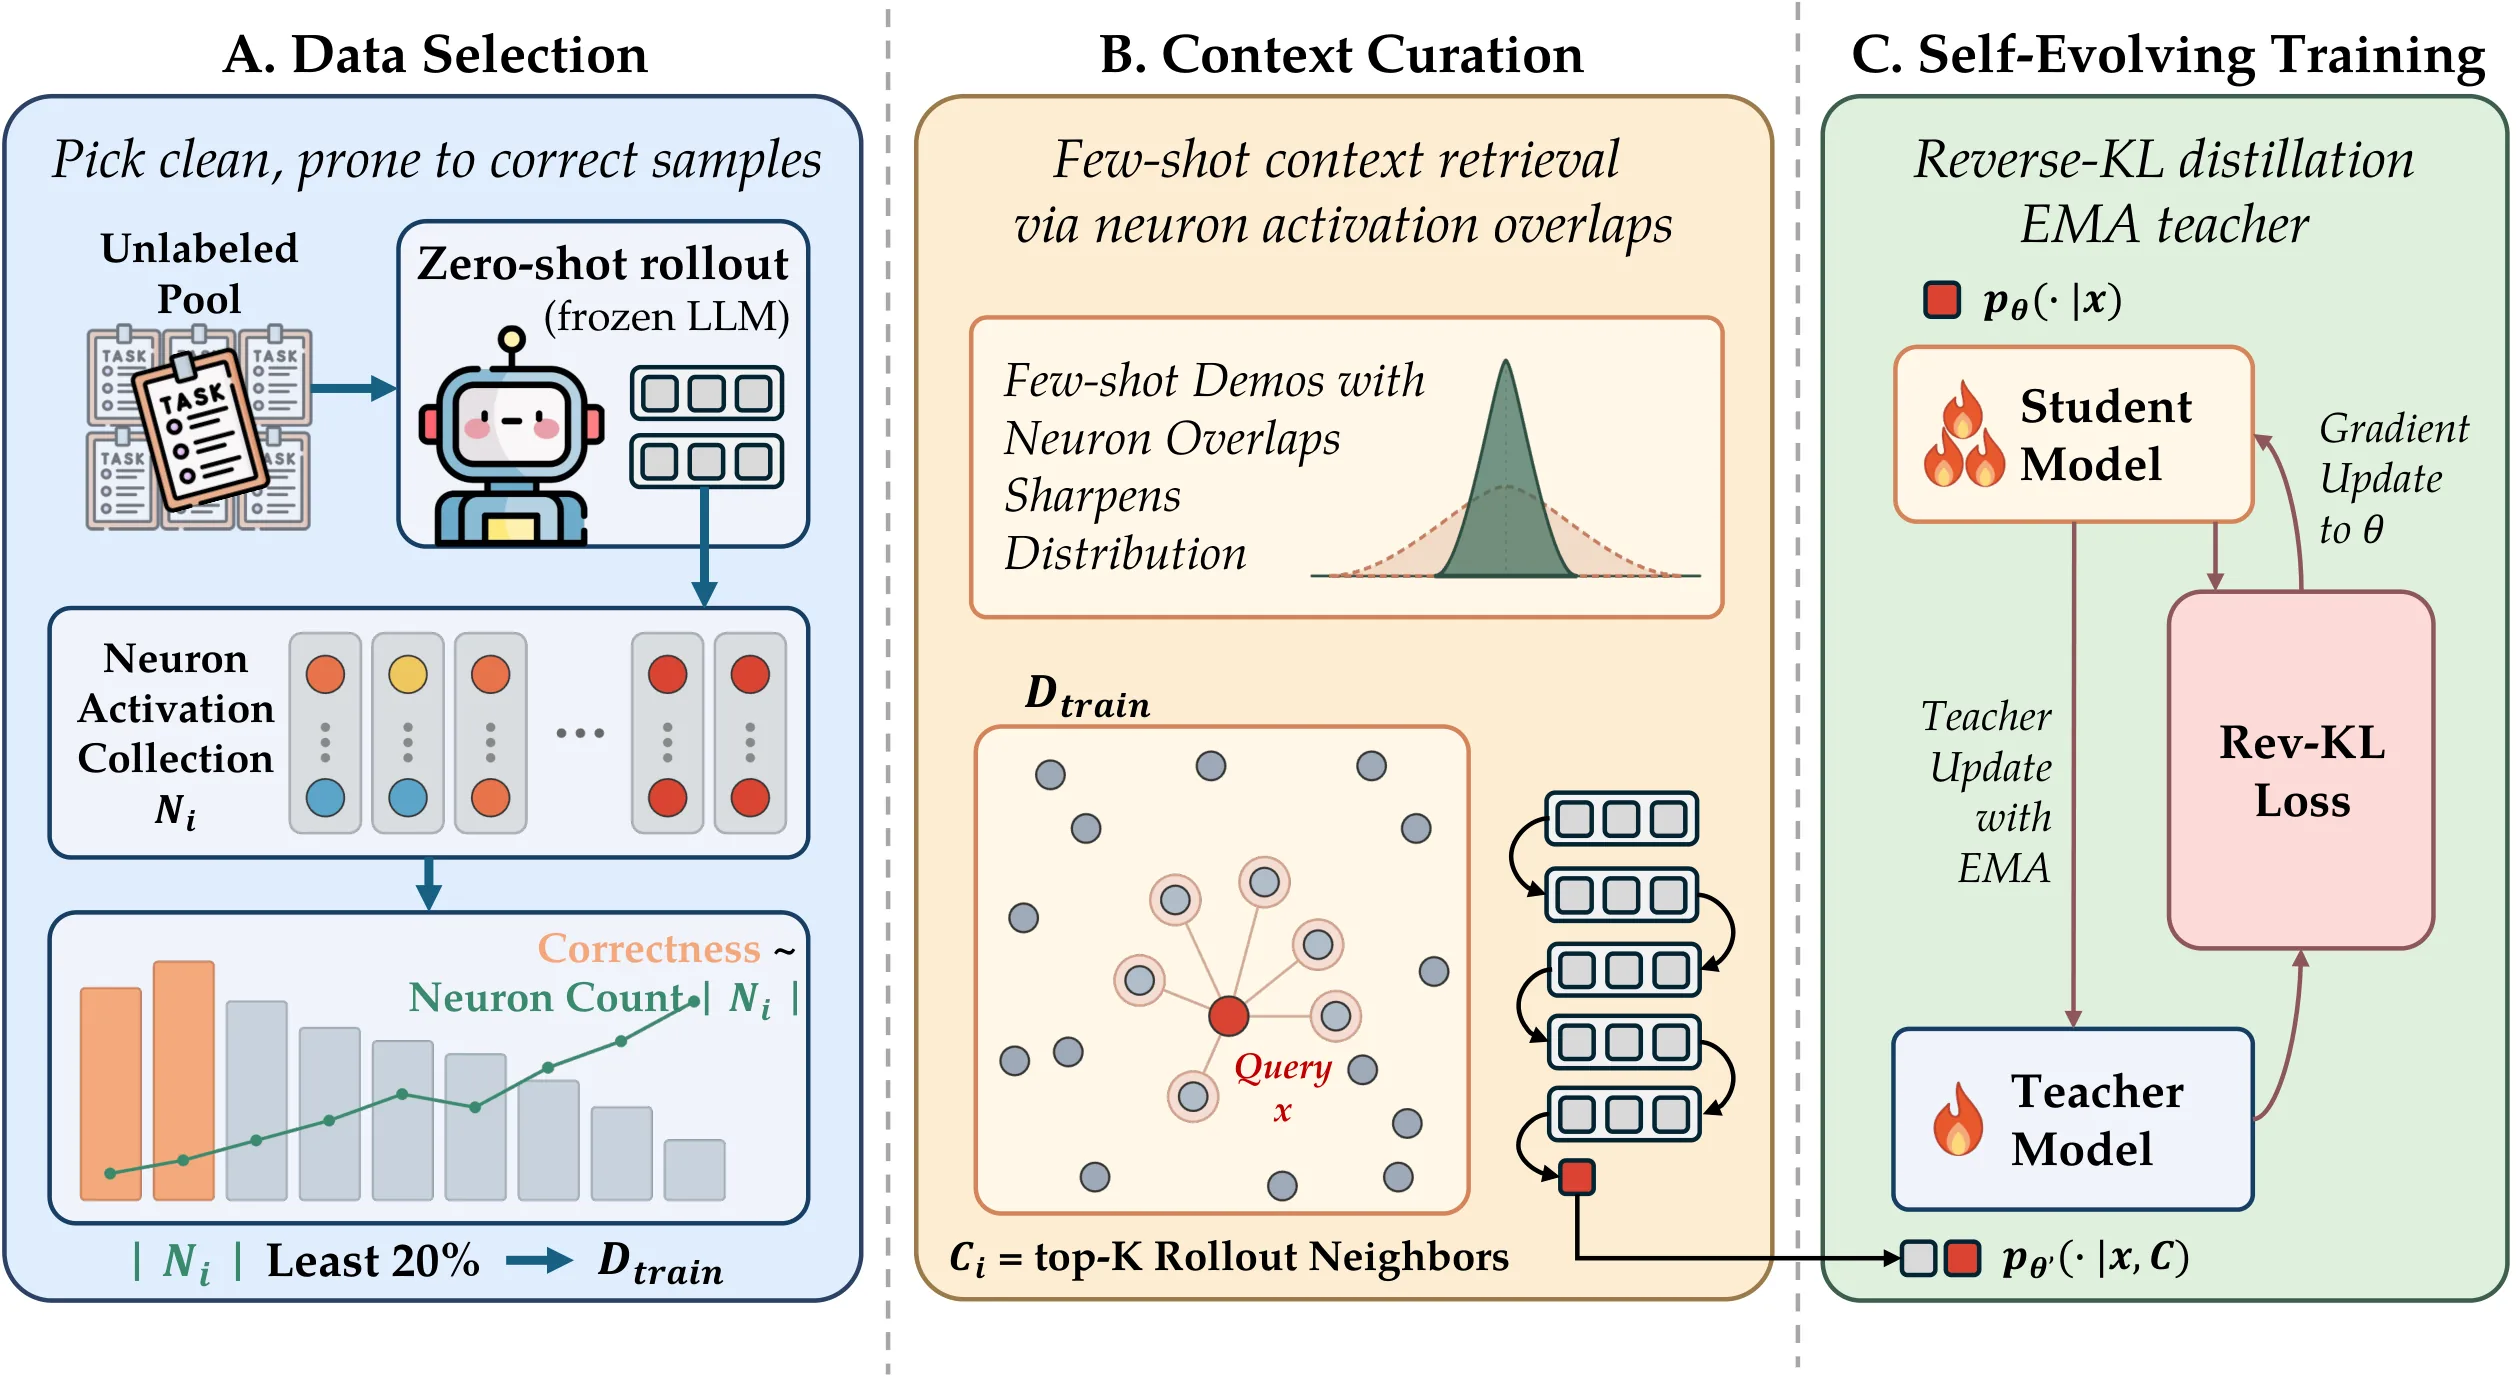
Neuron-OPSD 采用完全免标注的在线策略自蒸馏框架,其核心思路是利用神经元激活模式同时解决数据选择和教师上下文构建两个问题。整个框架分为四个关键阶段。
在神经元激活提取阶段,框架对模型的每一层计算门控激活值。具体地,对于第 层的 MLP 输入 和上投影矩阵 ,门控激活被计算为 。随后,对每个生成的 token ,按其在反嵌入空间的投影进行打分:。每个 token 取跨所有层的 Top-K 激活神经元,整个响应的激活集取所有 token 的并集,得到样本 的稀疏激活集 。
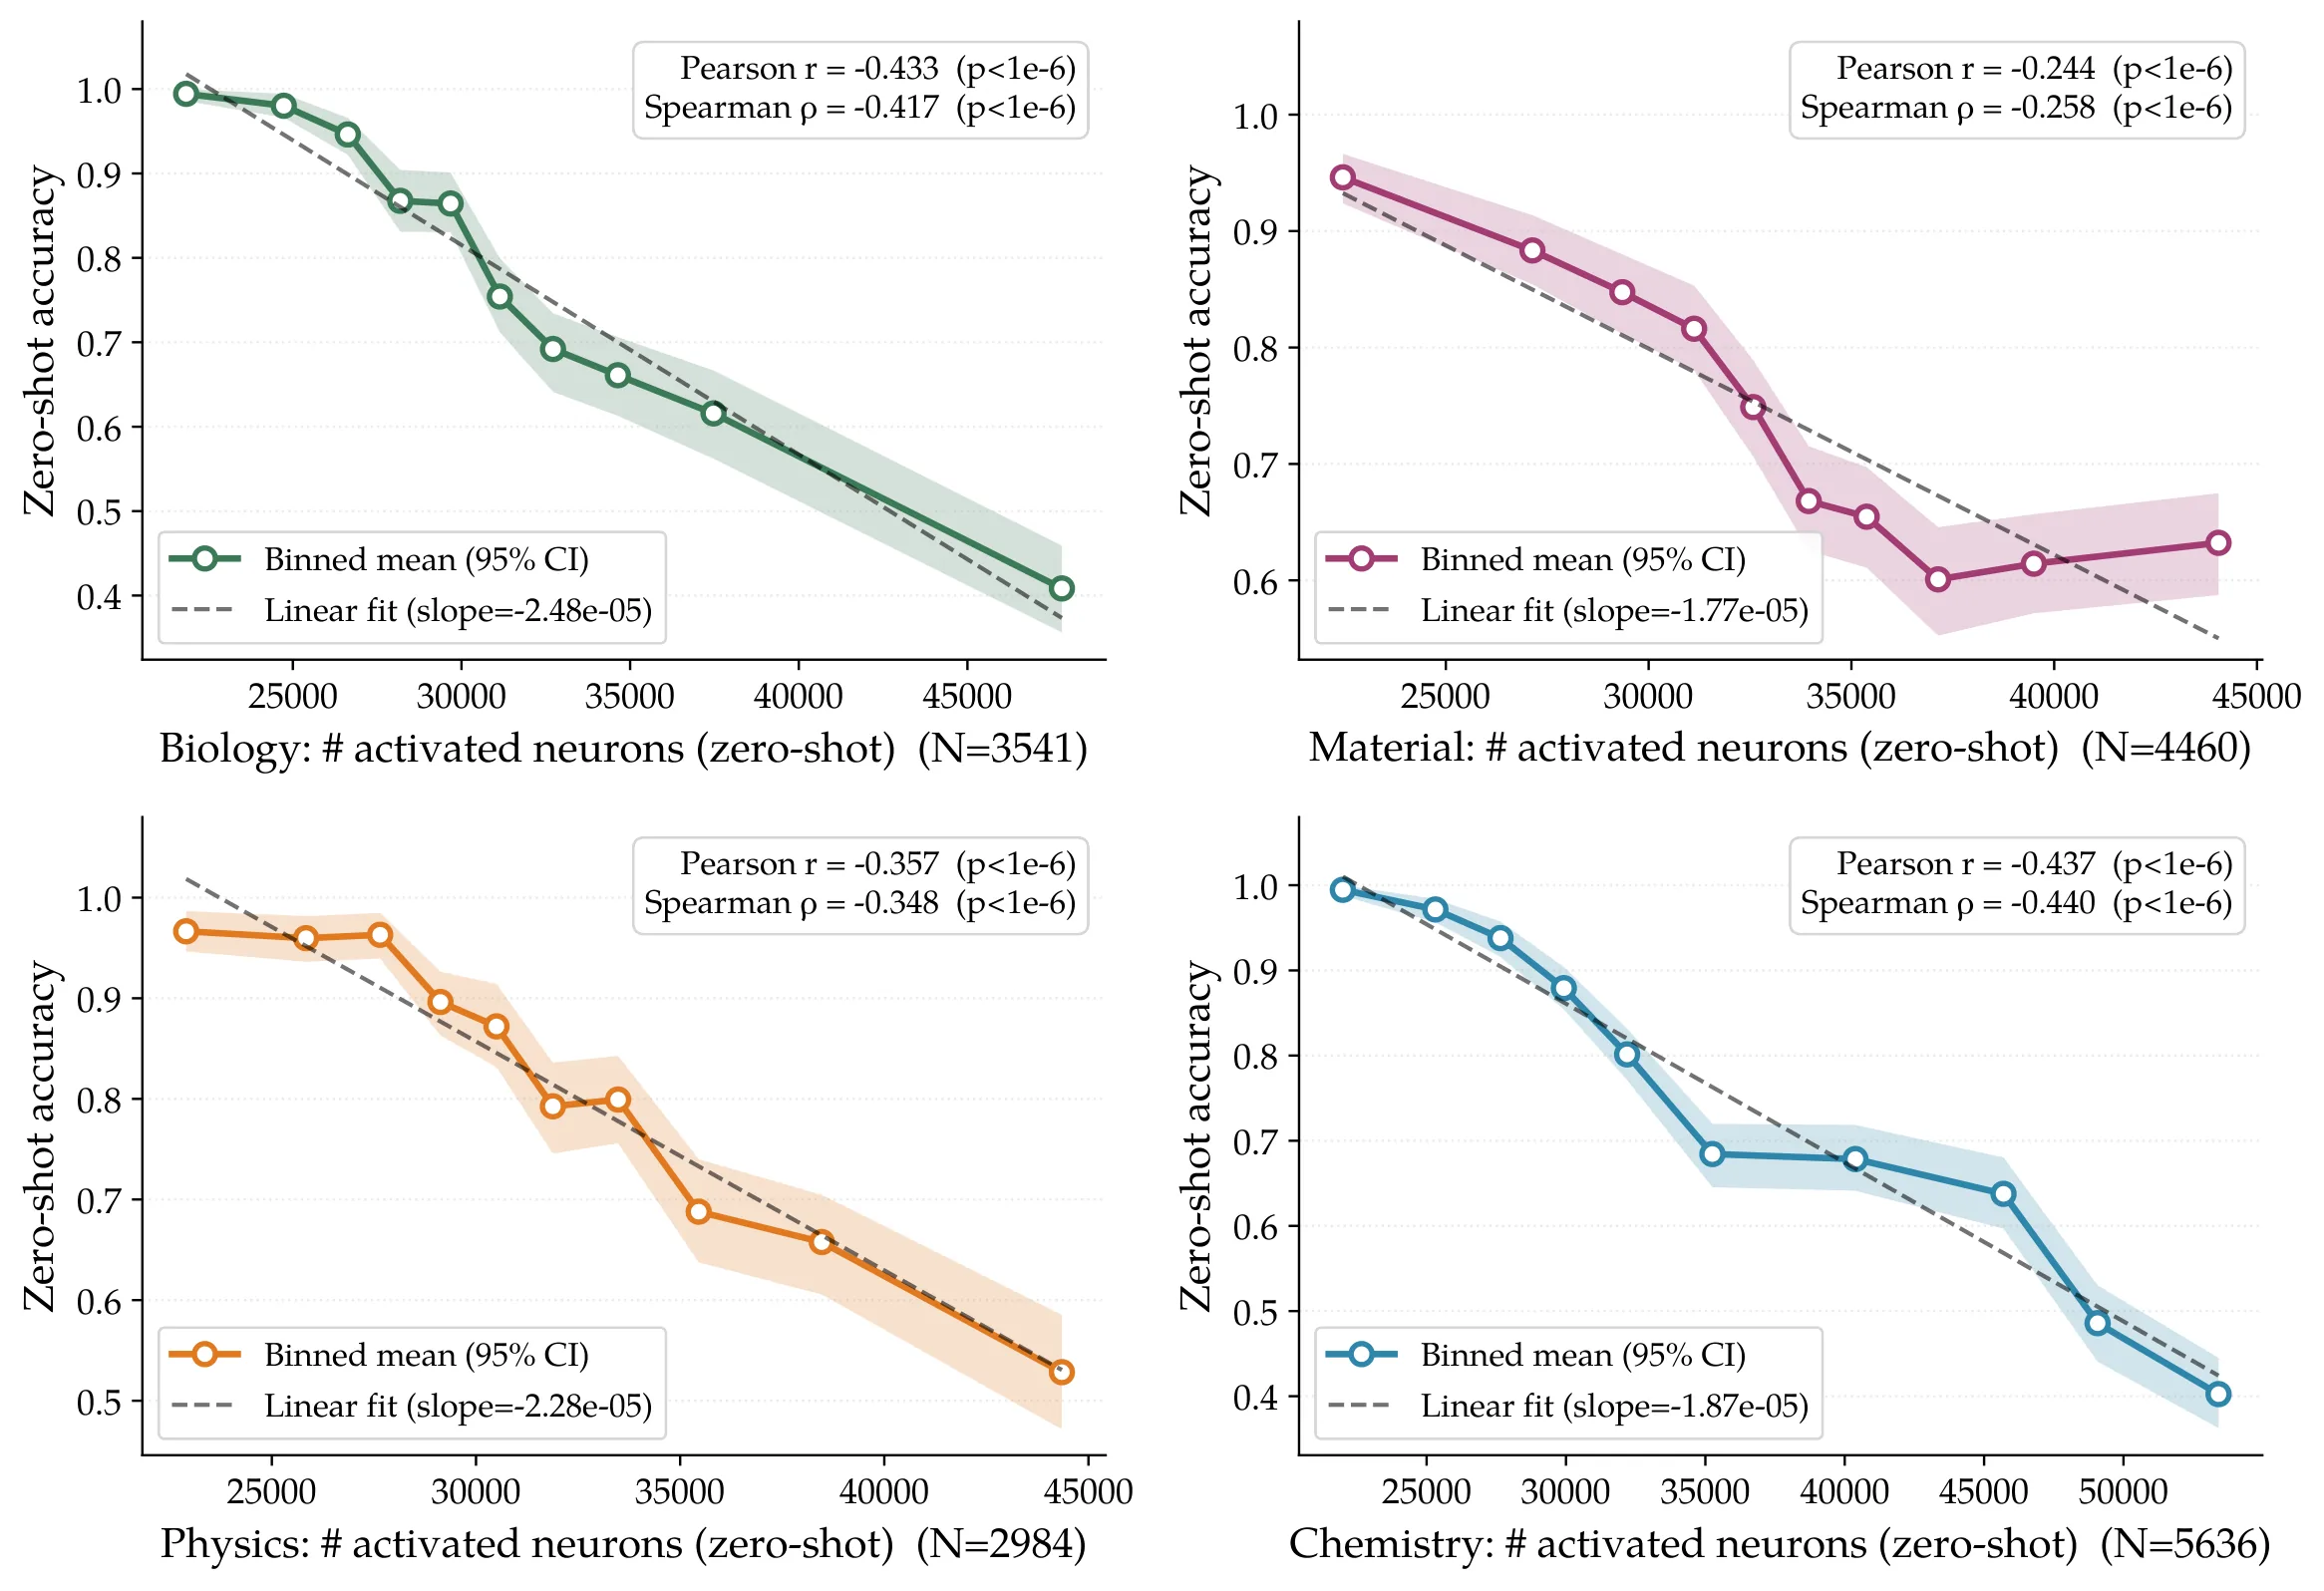
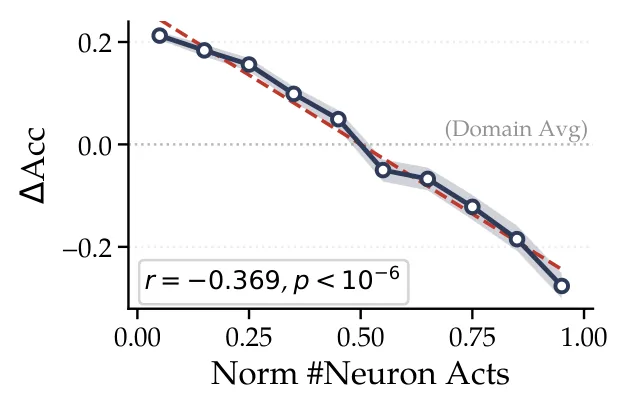
基于这些激活集,框架定义了 Neuron Consensus(神经元一致性)用于样本选择。一致性得分 越小,表示网络对该样本的处理路径越集中、越可能正确;一致性得分越大,则表示激活模式弥散,与错误推理或幻觉相关。实验发现,在四个科学领域上,这一激活计数与零样本准确率呈显著负相关(Pearson 在 到 ),验证了激活模式作为质量信号的有效性。
对于教师上下文的构建,框架采用 Neuron Overlap(神经元重叠)策略,使用 Jaccard 距离衡量两个样本激活模式的相似度:
对每个查询样本,通过这一距离度量选取其 K 个最近邻作为 few-shot 演示集 。这种基于内部激活相似度的检索方法比传统的语义相似度或随机检索更能捕捉模型处理问题时的“思维模式”,从而构建出更有教学价值的上下文。
训练阶段采用在线策略自蒸馏,学生策略为零样本策略 ,教师策略为带上下文 的 EMA 教师 。通过最小化反向 KL 散度进行优化:
反向 KL 的选择至关重要——它强制学生的分布向教师分布集中,同时允许学生在教师分布为低概率的区域保持一定的概率质量,这有效避免了分布崩溃。教师参数通过指数移动平均更新(EMA,),确保训练稳定性。
实验与结果
实验在三个专业领域基准上进行:涵盖生物、材料、物理、化学四个学科的 SciKnowEval,用于教育反馈质量分类的 Edu-Feedback,以及更具挑战性的多领域多选题基准 MMLU-Pro。基础模型采用 Qwen3-4B-Thinking,训练配置为 4 张 GPU、batch size 16、150 步。
主要对比基线包括基于监督微调的 LMSI、基于 GRPO 和多数投票的 TTRL,以及采用自置信度奖励的免标注强化学习方法 Intuitor。评估指标涵盖 Avg@8(样本平均准确率)、Maj@8(多数投票准确率)和 ECE(期望校准误差)。
实验结果揭示了几个重要发现。在域内任务性能上,Neuron-OPSD 在多个领域取得显著提升,其中物理领域提升最为明显(+2.93 Maj@8),材料领域次之(+2.27),Edu-Feedback 分类任务提升达 +7.24。更关键的是跨域泛化能力的改善:LMSI 方法在跨域评估时平均性能下降 4.34 分,Intuitor 的跨域 ECE 上升 0.022,而 Neuron-OPSD 实现了平均 1.09 分的跨域提升和 0.002 的跨域 ECE 下降。
消融实验进一步验证了设计选择的合理性。神经元一致性得分的有效性在四个领域均得到确认(均 )。Top-20% 与 Bottom-20% 选择对比显示,激活计数虽不能作为唯一的数据选择规则,但能提供有价值的诊断信号。Neuron Overlap 检索在推理模式多样的领域(如 Chemistry)显著优于随机检索,但在推理模式均一的领域(如 Physics)中优势被压缩,这说明检索策略需要与领域特征相匹配。
值得注意的是,教师-学生 token 级熵差与性能增益存在强关联。在物理和材料领域,教师分布显著锐化(),对应取得最大增益;而在化学和生物领域,熵差接近零,增益也近乎为零。这表明 Neuron-OPSD 的收益来源于教师能够提供真正有价值的信息——当教师分布与学生分布足够不同且更加确信时,蒸馏训练才能带来有效提升。
讨论与可借鉴点
Neuron-OPSD 的一个重要贡献是揭示了内部激活模式作为训练信号来源的潜力。传统方法依赖外部反馈(人工标注、奖励模型、环境信号),而该方法证明了模型自身的“思考痕迹”足以支撑有意义的学习。这种数据中心化的视角回避了复杂的奖励设计问题,将注意力重新聚焦于“训练什么、给教师什么”这一本质问题。
然而,该方法也存在明显的局限性。首先,域内增益并不均衡——在生物和化学领域未能取得显著提升,这提示激活计数虽然能反映处理确定性,但并不能完全替代任务相关的质量信号。其次,检索策略在推理模式均一的领域容易失效,因为高相似度的神经元激活模式并不必然对应语义相关的问题。第三,仅在 4B 参数模型上验证,向更大规模模型的迁移能力尚未确认。
对于后续研究,一个有价值的探索方向是将神经元激活与其他信号(如推理长度、采样熵、问题复杂度)进行融合,构建更加鲁棒的数据选择机制。另一个方向是在更大规模的模型上验证该框架,观察神经元激活模式的可扩展性是否与性能提升呈正相关。此外,将 Neuron Overlap 与结构化知识检索(如知识图谱增强的 RAG)相结合,可能能够在保持跨域泛化能力的同时,进一步提升检索的语义相关性。
概念 · 6 个
摘要
LLM通过自身输出进行自蒸馏的无标注方法
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
DemoPSD:基于分歧调制的策略自蒸馏
DemoPSD: Disagreement-Modulated Policy Self-Distillation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 11 张
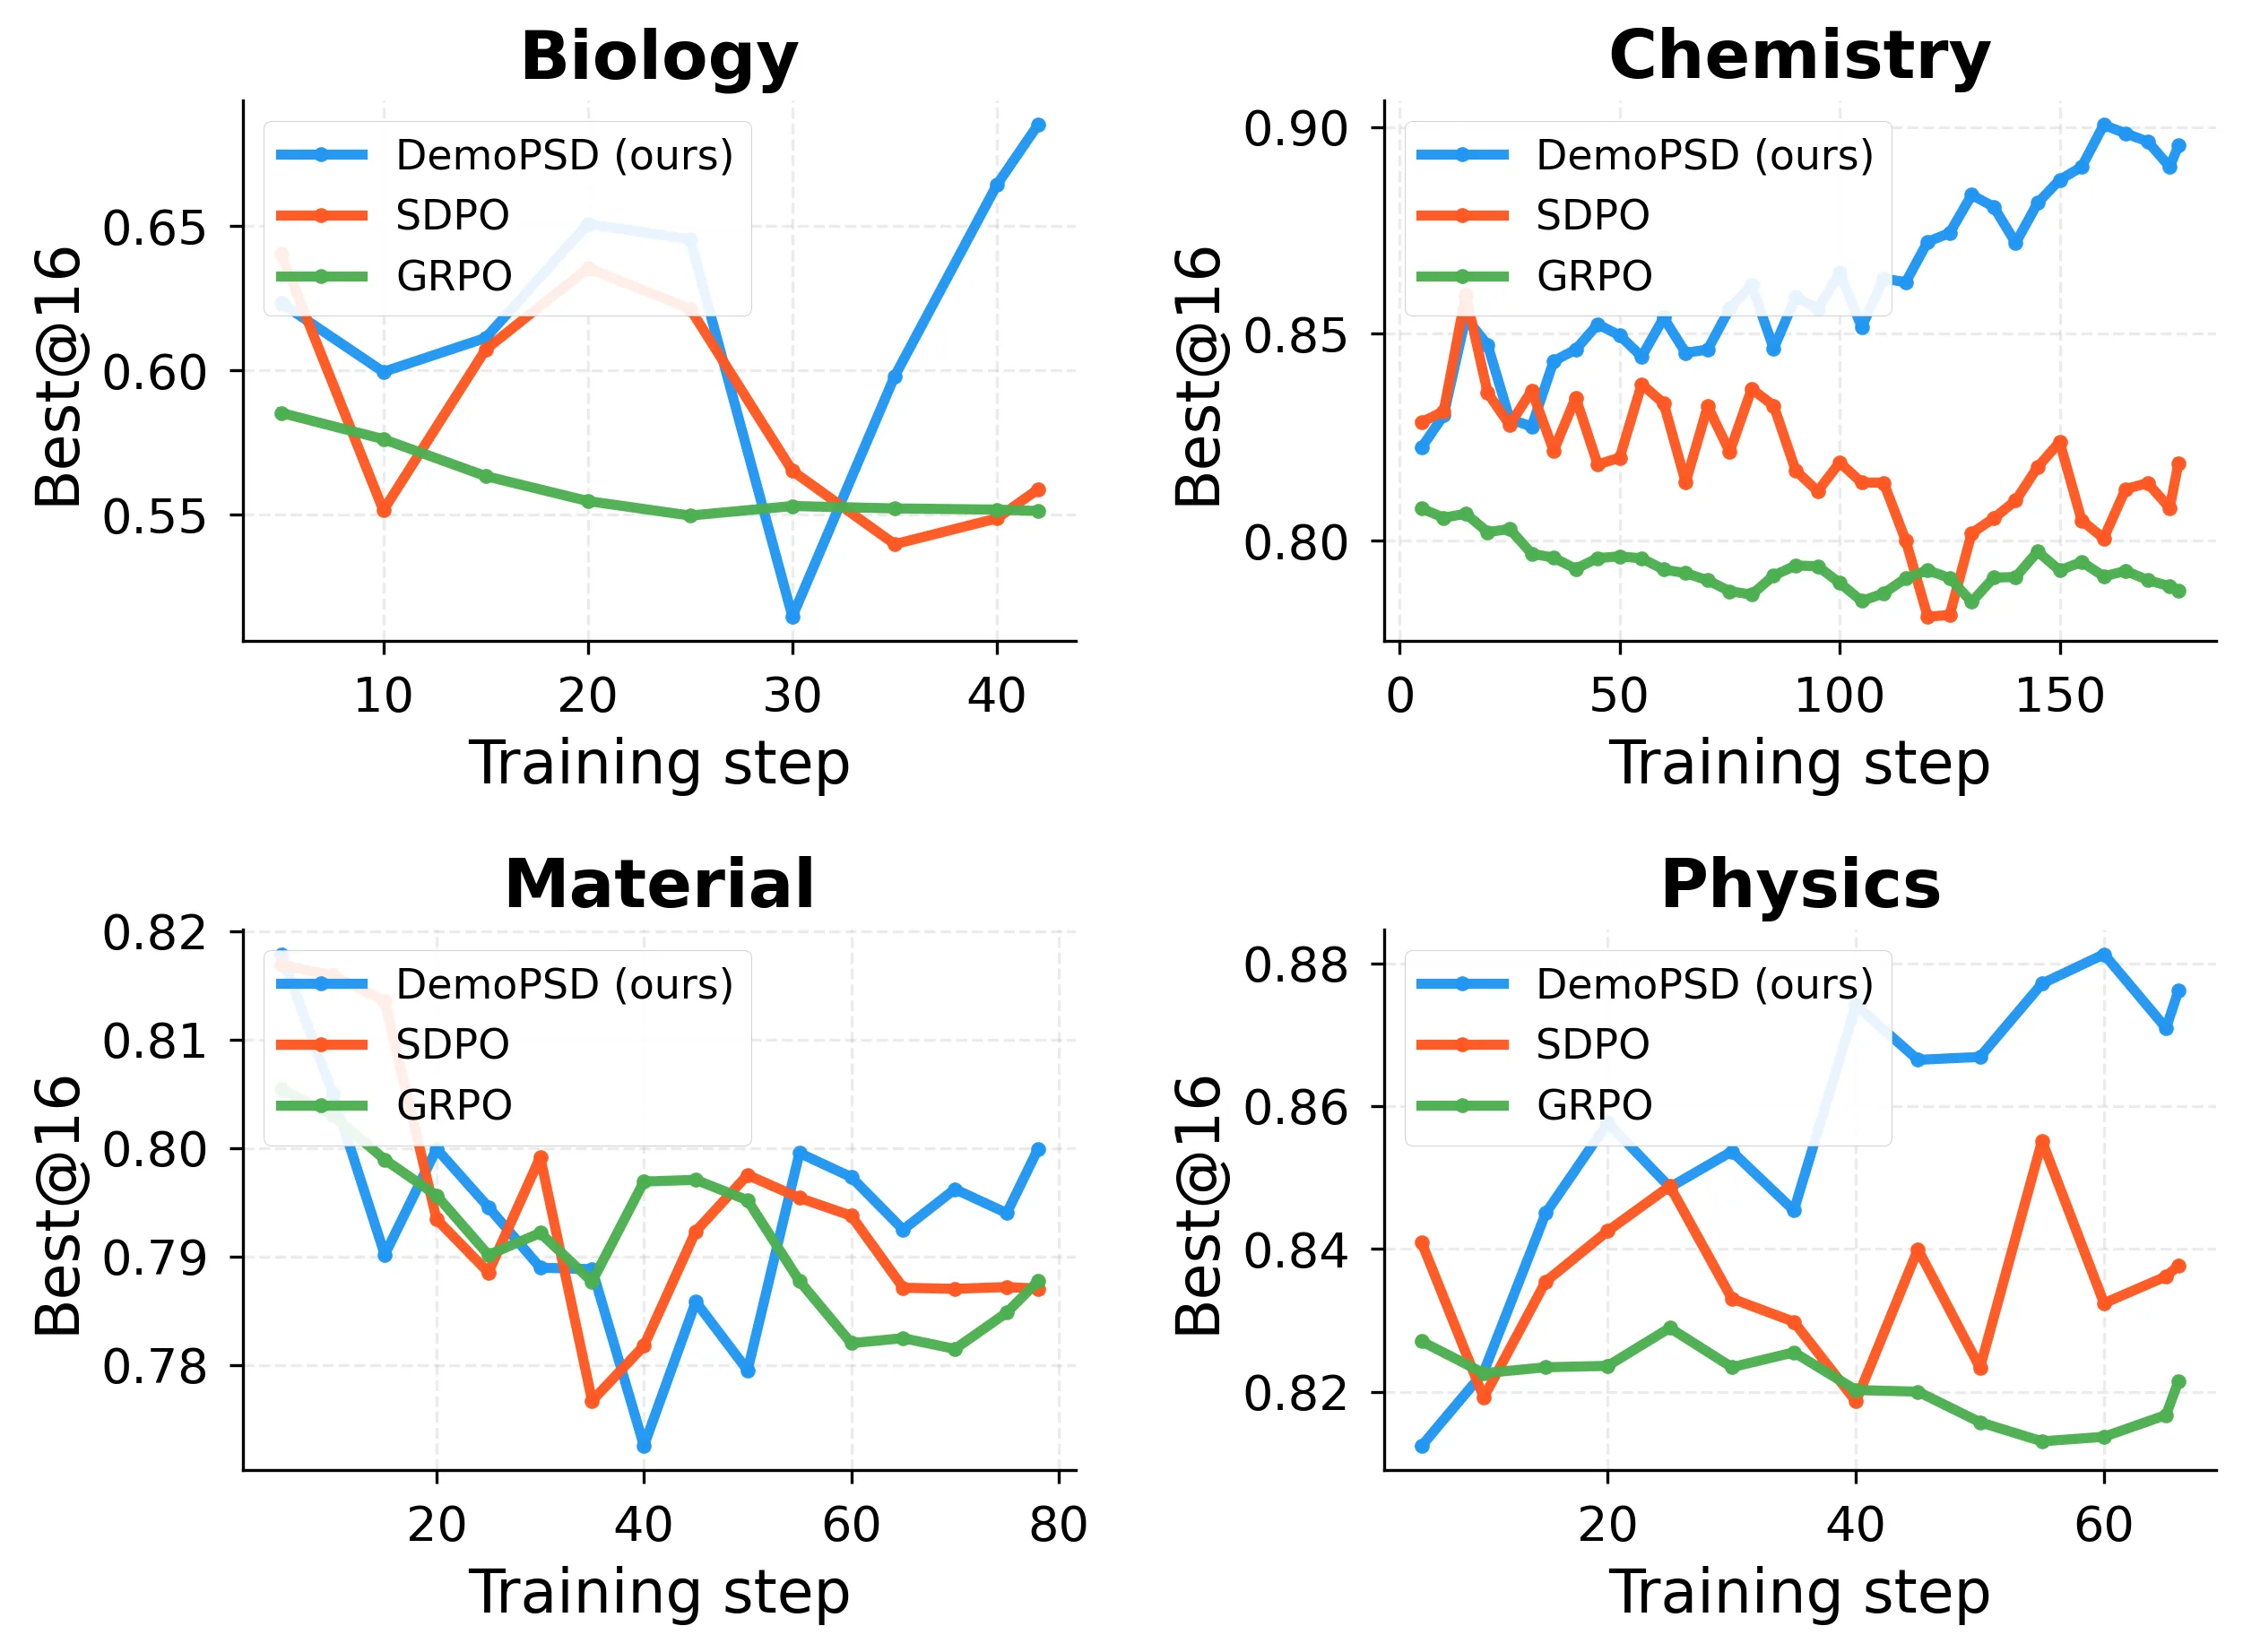
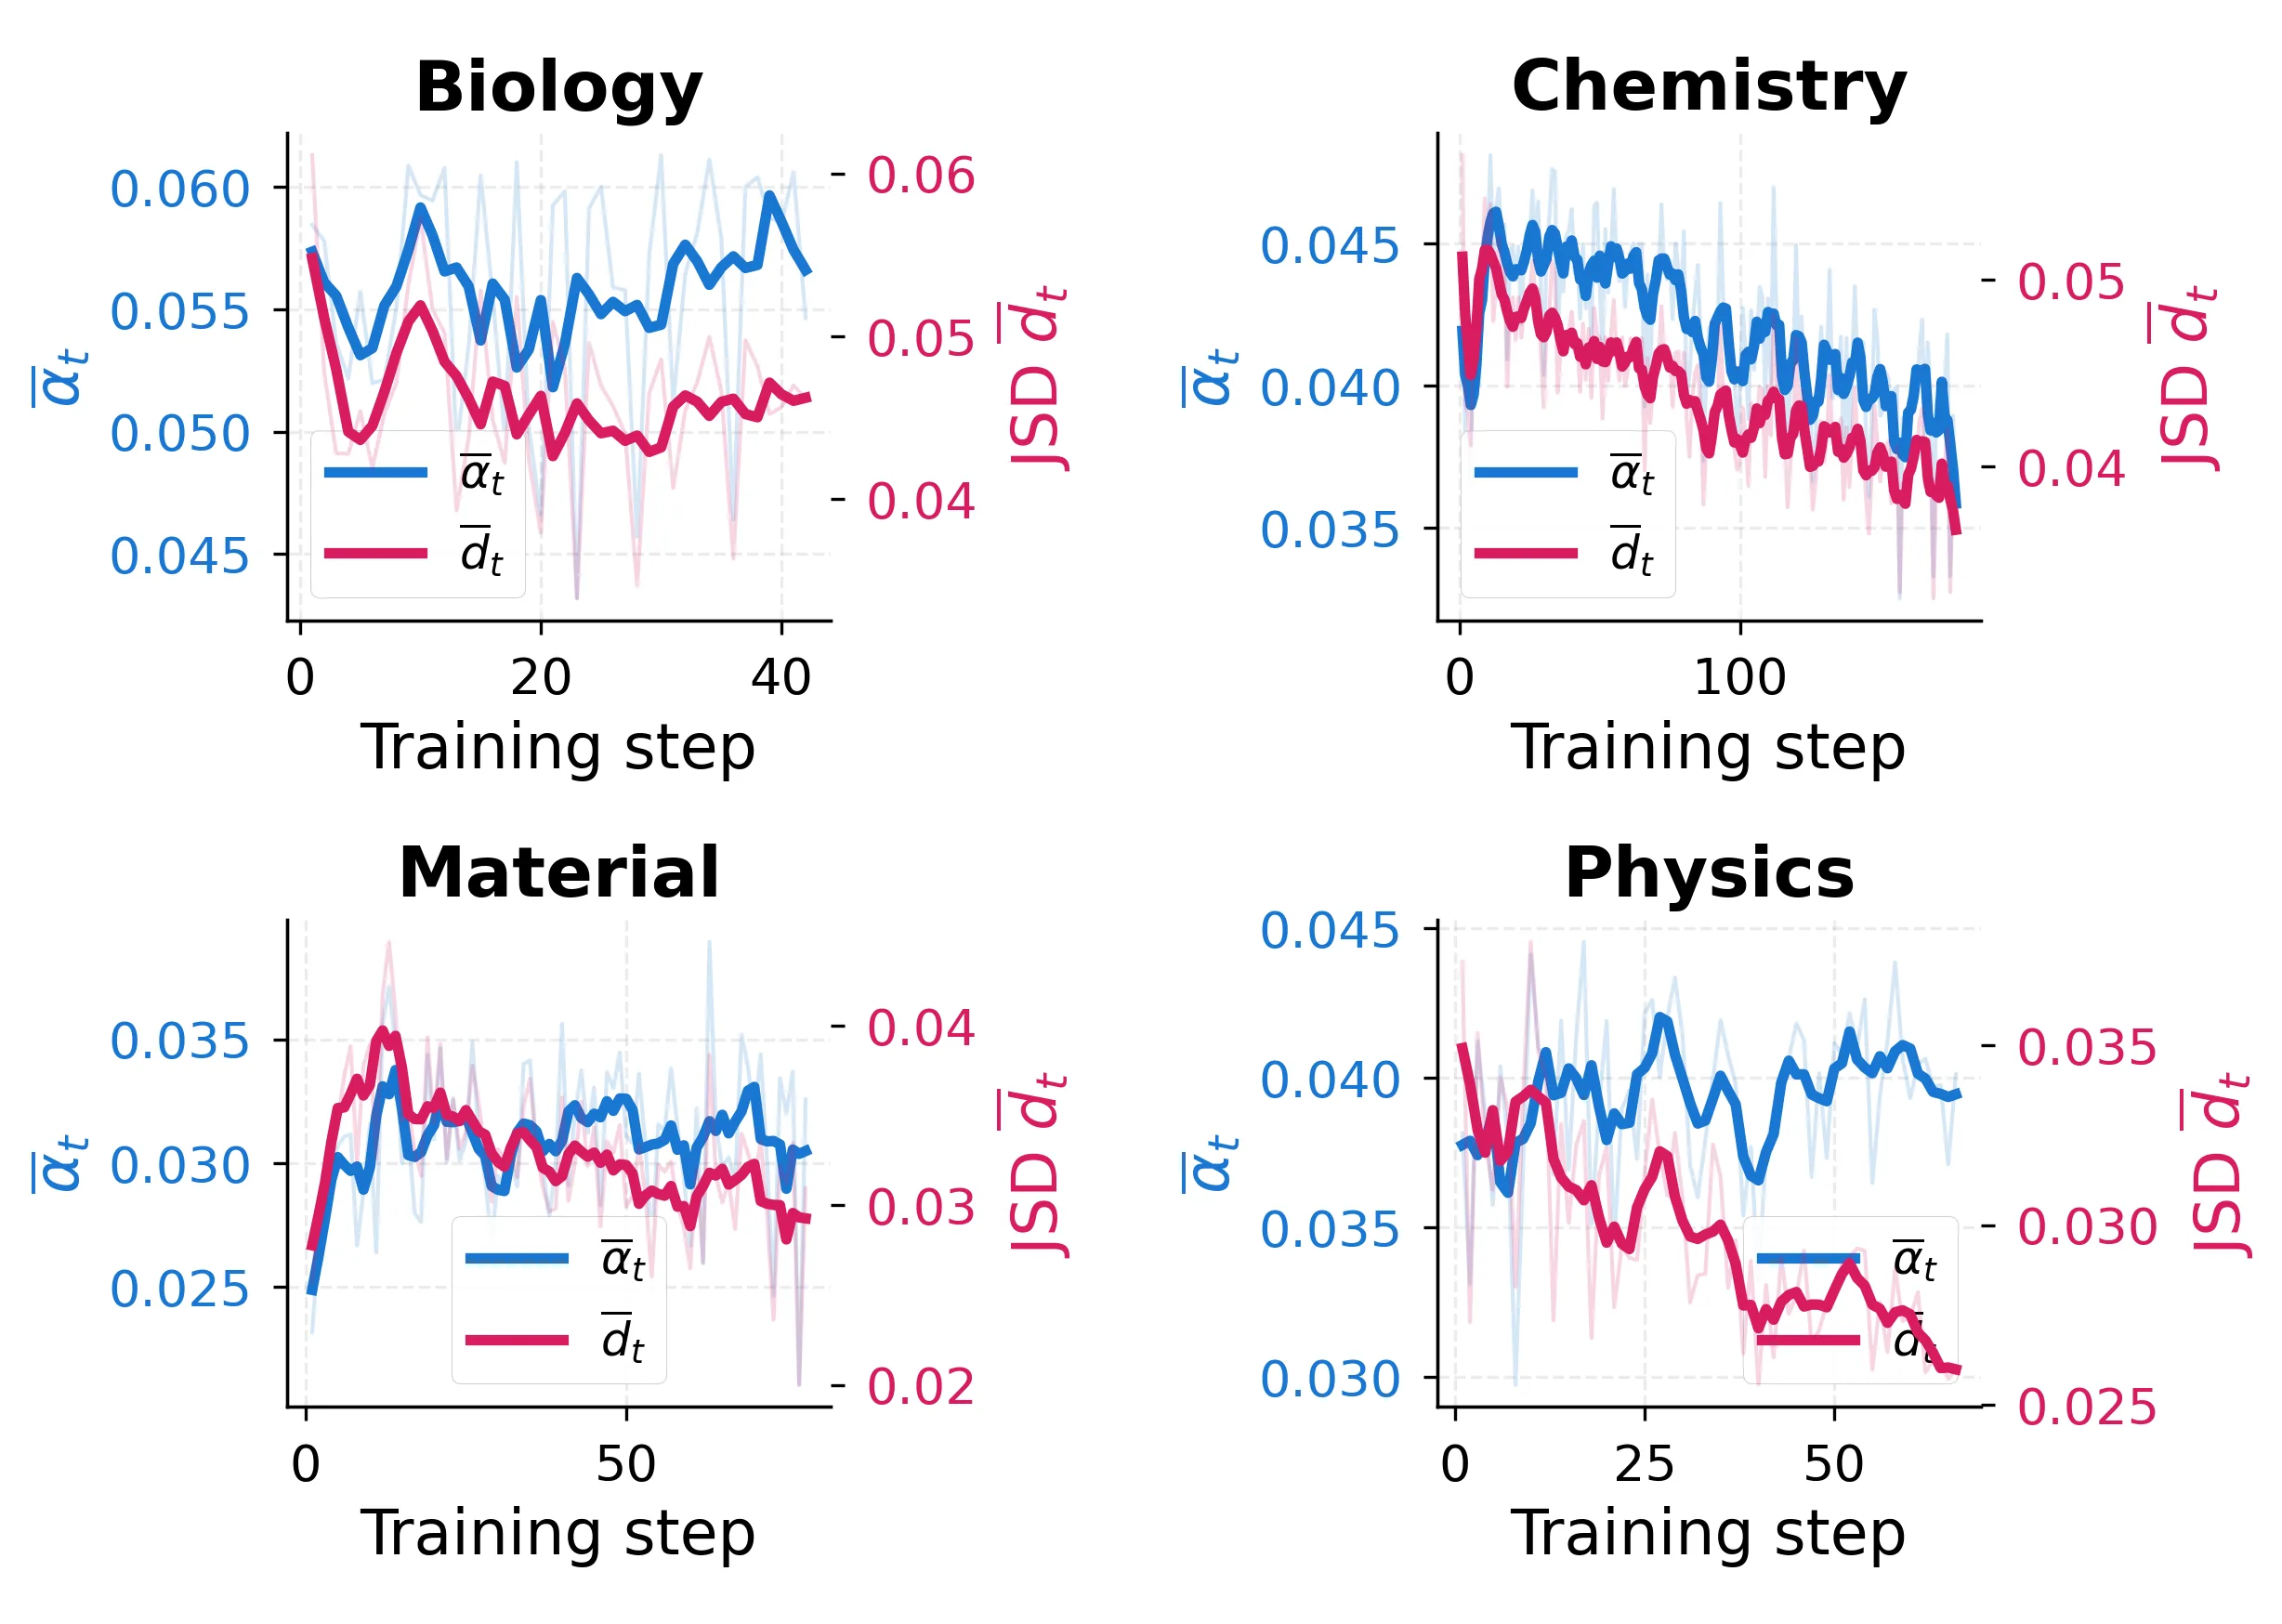
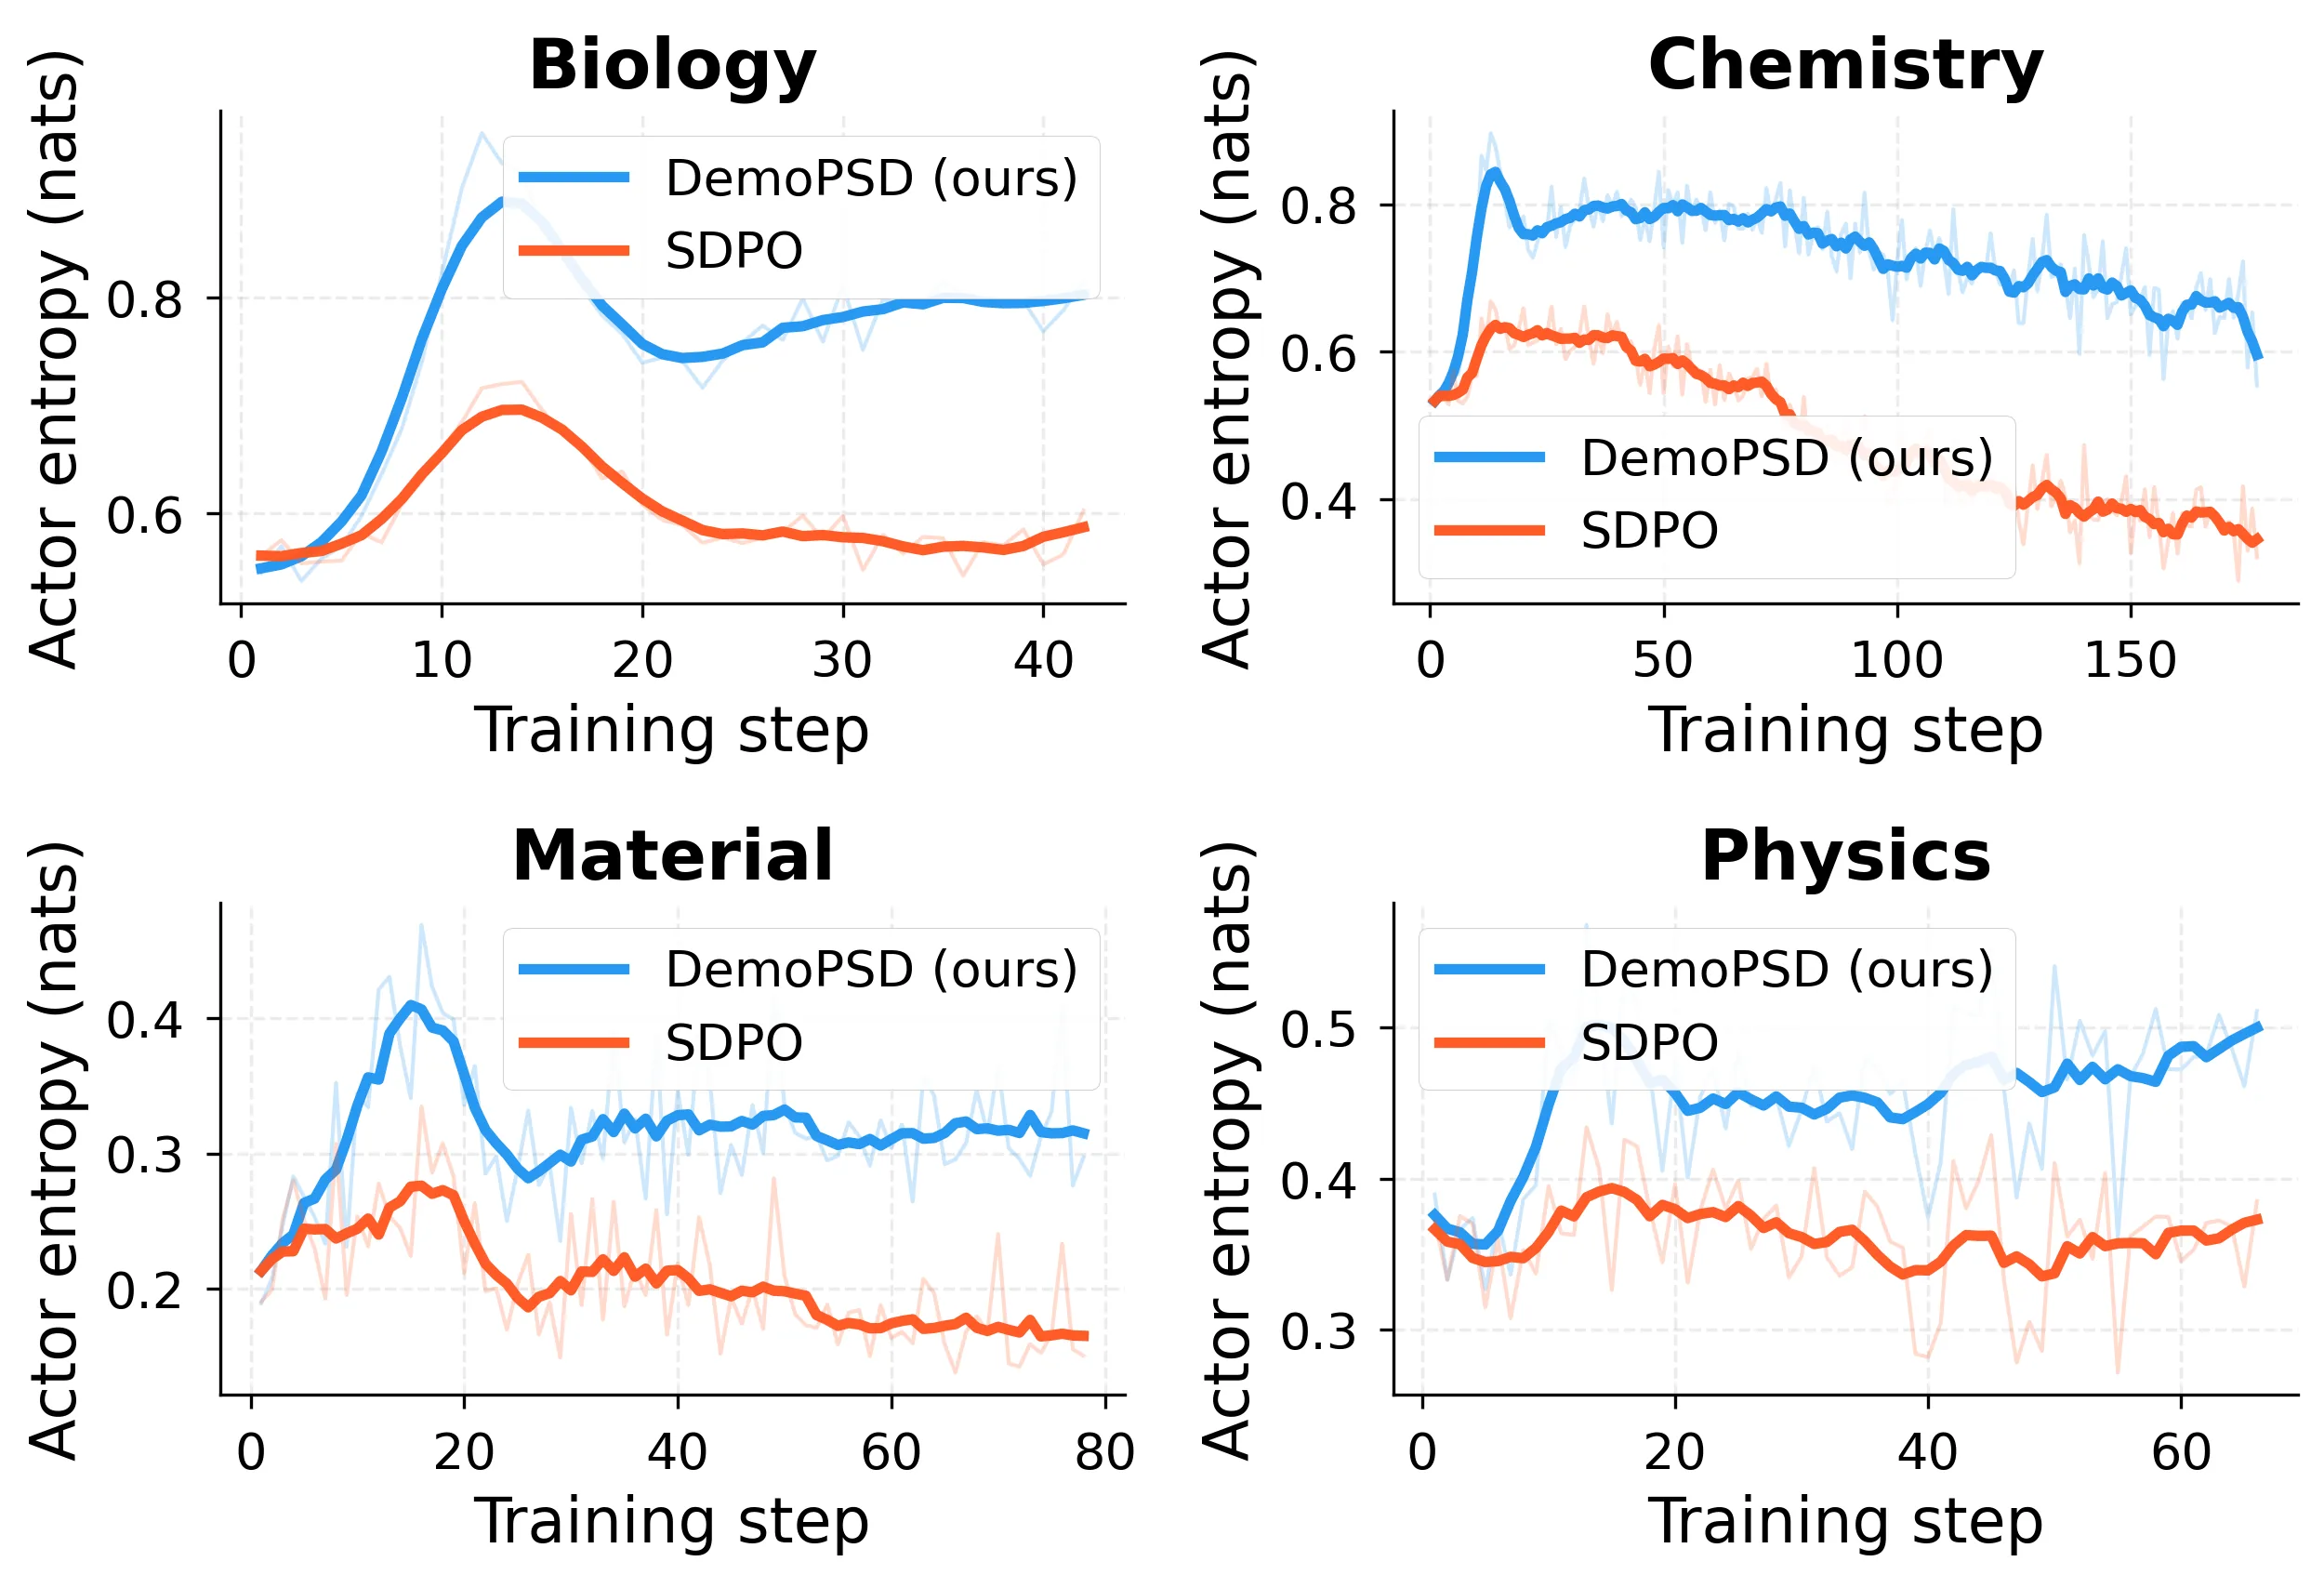
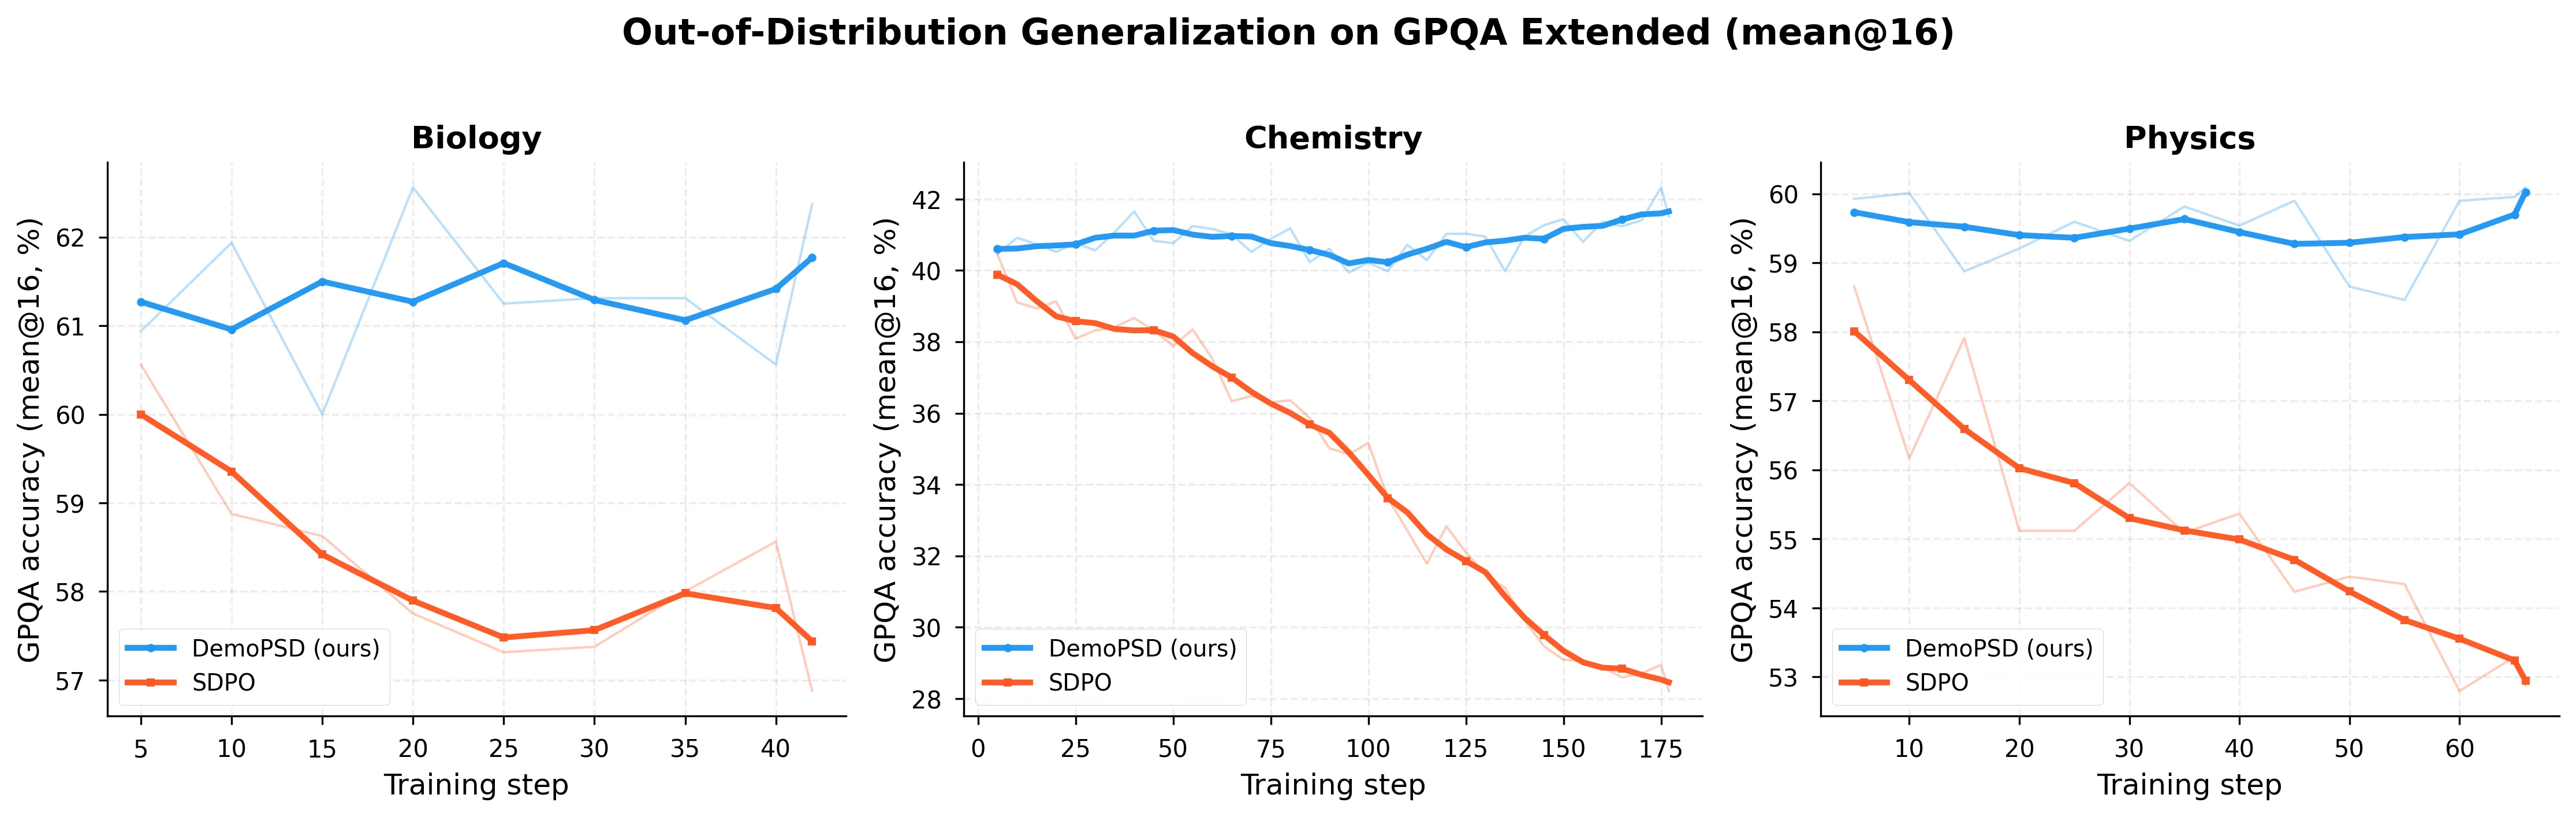
在线策略自蒸馏训练大语言模型推理时,教师模型的密集token级监督常引发特权信息泄露,抑制探索并损害跨域泛化能力。DemoPSD提出基于反向KL重心目标的策略自蒸馏框架,将教师与学生分布进行加权几何组合,并依据二者分布差异逐token自适应调节融合程度。理论证明该方法可有效缓解信息泄露并保留探索能力。在SciKnowEval四个科学领域及分布外GPQA基准上的实验显示,DemoPSD均优于GRPO和SDPO,同时保持较高训练熵,展现稳健的泛化性能。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
在线策略自蒸馏(On-Policy Self-Distillation, OPSD)已成为训练大语言模型进行推理的一种实用范式。在这一框架下,单一模型同时扮演教师与学生两个角色——教师在获得特权信息 (如已验证的正确答案或推理轨迹)的条件下提供 token 级监督信号,而学生仅基于原始问题 生成响应。这种设计使得教师分布能够注入经过验证的知识,学生分布则保留自主探索的空间。相比传统的强化学习验证器方法(如 GRPO),OPSD 在 token 效率上提升数倍,已被工业界的旗舰模型广泛采用。
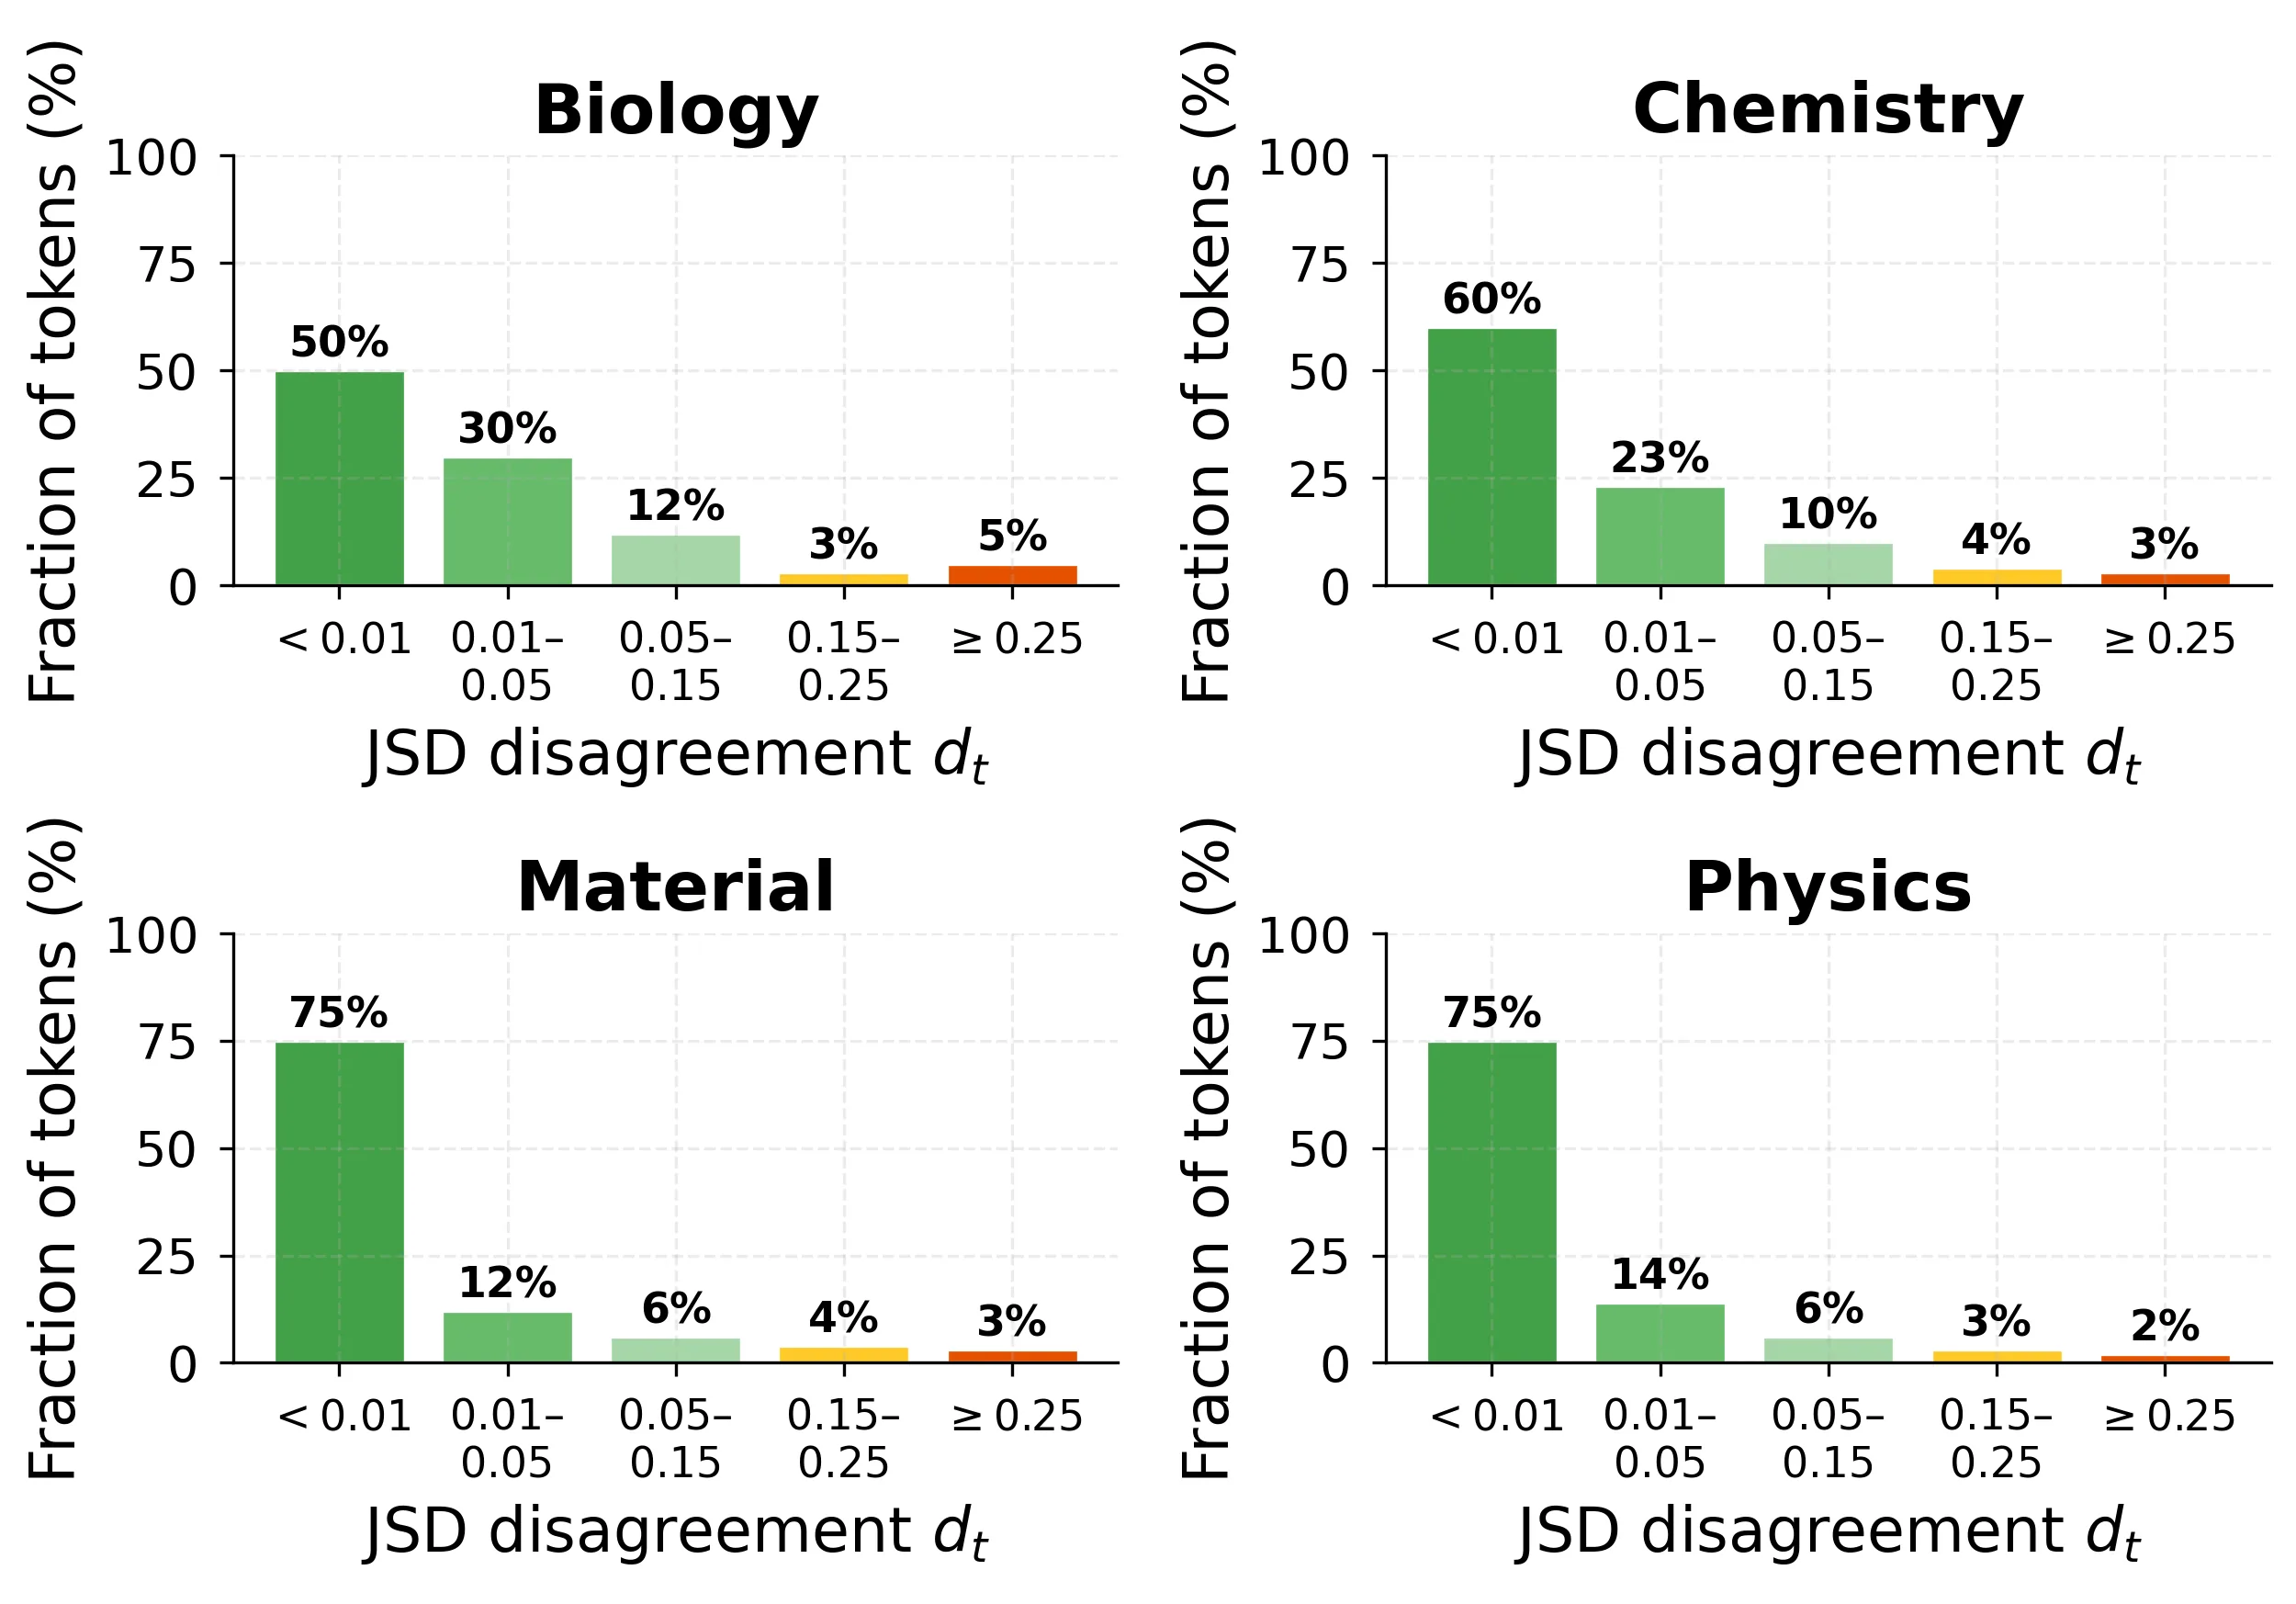
然而,这种看似优雅的设计背后隐藏着一个根本性缺陷:教师分布中始终残留着特权信息 对下一 token 的额外影响。具体而言,存在一个不可约的互信息差距 ,这意味着无论学生如何学习,其目标分布中始终包含测试时无法获取的信息。这一问题被论文定义为特权信息泄露(Privileged Information Leakage):学生在训练时被强制拟合依赖 的教师分布,却在测试时无法利用该信息,从而编码了答案依赖的捷径而非真正的问题解决能力。
这一问题带来两个具体的失败模式。其一是探索能力丧失:强制学生在每一 token 上拟合教师分布会压制其自身的推理多样性,导致训练熵塌缩,模型陷入教师分布所暗示的单一路径而丧失探索替代方案的能力。其二是跨域泛化退化:特权信息泄露使得学生习得的是特定于训练分布的模式,而非可迁移的问题理解能力,因此在新领域上表现明显下降。实验观察印证了这一理论分析——SDPO 等现有自蒸馏方法在训练初期性能快速上升,但后期逐步退化,在分布外基准(如 GPQA)上尤为明显。
方法
DemoPSD 的核心洞察是:教师监督并非全盘可信,当师生分布出现显著分歧时,往往意味着教师分布已被特权信息 过度影响,此时学生应依赖自身推理而非盲目采纳教师指导。这催生了选择性采纳教师指导(Selective Adoption of Teacher Guidance)的核心原则——关键在于如何量化分歧并据此调节采纳程度。
首先,DemoPSD 通过 Jensen-Shannon 散度(JSD)度量每个 token 位置 上特权教师分布 与学生分布 之间的分歧:
JSD 的对称性使其能够捕捉双向的分歧程度。在此基础上,论文通过重缩放 sigmoid 函数将 转换为逐 token 的泄露衰减系数 :
其中 控制门控灵敏度, 为上界(默认 0.15)。当师生分布高度一致时 , 趋近于零,教师指导被充分采纳;当分布显著分歧时 增大,学生自身推理被赋予更高权重。
接下来的关键设计是反向 KL 重心目标(Reverse-KL Barycenter Target)。不同于简单地混合概率,DemoPSD 采用几何混合定义目标分布:
几何混合与算术混合的本质区别在于:几何混合仅当两个分布同时赋予某 token 较高概率时才赋予其显著质量,这天然抑制了教师独享而学生不认可的"捷径 token"。相比之下,算术混合会导致模式平均(mode-averaging),使模型在多个峰值之间摇摆,造成不必要的熵膨胀。
从损失函数角度看,目标分布的对数为:
由于目标分布被 stop-gradient 包裹,规范化常数 为常数项,梯度简化为教师分布的加权形式,其中 作为分歧缩放因子,自动降低高分歧位置上的特权监督强度。
论文进一步从理论层面证明了 DemoPSD 的两大性质。泄露缓解定理指出,定义泄露率 (其中 ),DemoPSD 的有效泄露率满足:
且 与 正相关,使得抑制在泄露风险最高的位置最强。探索保留定理则证明,在合理的协方差条件下,目标分布的熵始终介于教师与学生分布之间且关于 非递减,从而保证蒸馏过程中探索能力的持续保留。
实验与结果
论文在 SciKnowEval 数据集上进行系统实验,该数据集涵盖 biology、chemistry、material、physics 四个科学领域,每个领域包含 4-选择多选题,用于评估模型在特定领域的推理能力。基模型选用 Qwen3-4B-Instruct,训练在 8 块 NVIDIA H20 GPU 上通过 FSDP 实现,配合 vLLM 生成 rollout 和 Flash Attention 加速计算。
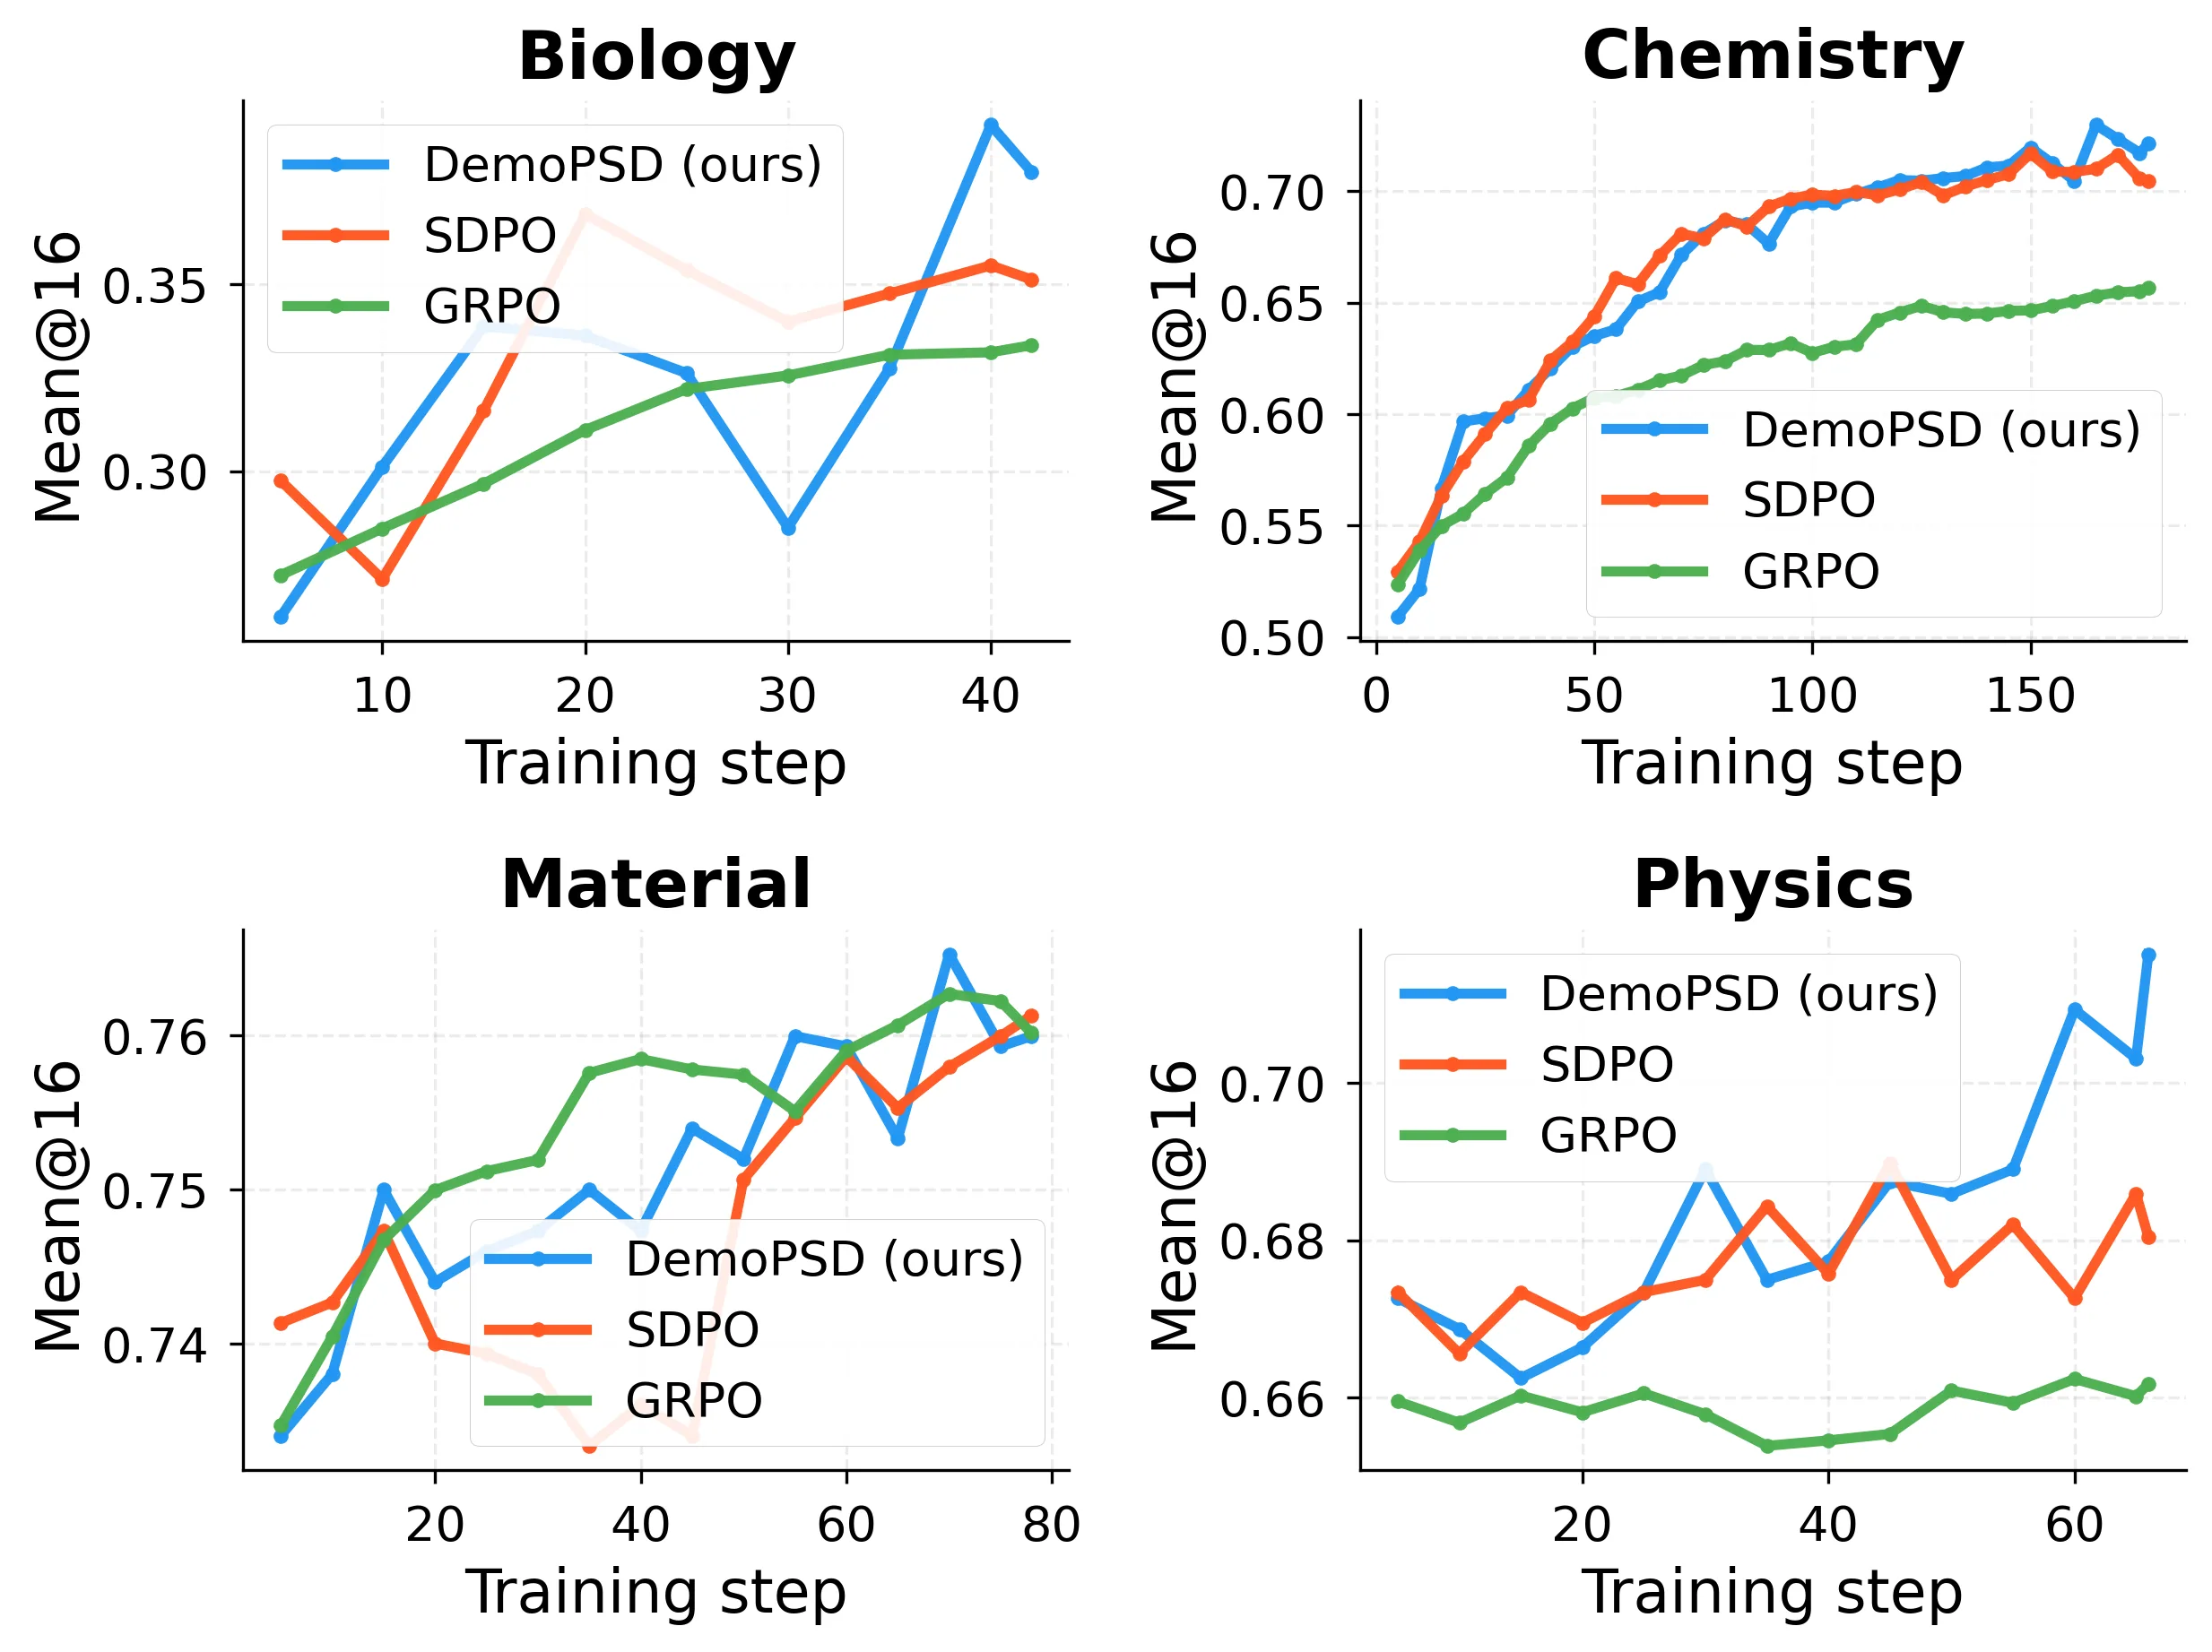
主实验对比了 DemoPSD、GRPO 和 SDPO 三种方法,采用 mean@16、maj@16、best@16 三个指标评估性能。结果显示,DemoPSD 在四个科学领域均取得最优或接近最优的表现,尤其在 material 和 physics 领域优势明显。以 maj@16 指标为例,DemoPSD 在 biology、chemistry、material、physics 四个领域分别达到 57.4%、60.1%、57.0%、56.5%,普遍高于 GRPO 和 SDPO 的对应成绩。
分布外泛化能力的评估在 GPQA Extended 数据集上进行,该数据集包含研究生级别的生物、化学、物理题目,与训练领域存在一定差异。实验结果印证了理论分析——SDPO 在训练过程中准确率达到峰值后持续下降,显示出明显的过拟合迹象,而 DemoPSD 在整个训练过程中保持稳定并持续提升,最终显著优于 SDPO。这一对比有力证明了特权信息泄露确实损害了跨域泛化能力,而 DemoPSD 的选择性采纳策略有效缓解了这一问题。
训练熵的分析进一步揭示了方法间的差异。SDPO 在训练后期出现明显的熵塌缩现象,表明模型逐渐收敛至教师暗示的单一路径;GRPO 保持了较高的熵但整体性能较低,反映出缺乏有效知识迁移的代价。DemoPSD 则实现了二者兼顾——熵水平显著高于 SDPO,证明探索能力得到保留,同时性能优于 GRPO,验证了知识蒸馏的有效性。
消融实验围绕门控灵敏度参数 进行,扫描范围为 。实验发现 存在领域依赖性——physics 领域偏好更大的 值(更强的门控),而 material 领域则适合较小的 。这一发现表明不同领域的师生分布分歧模式存在差异,需要针对性调节。
讨论与可借鉴点
DemoPSD 的核心贡献在于揭示了在线策略自蒸馏中特权信息泄露这一根本性问题,并通过反向 KL 重心目标提供了一种原则性的解决方案。从工程视角看,该方法的实现相对轻量——只需在标准蒸馏框架上增加基于 JSD 的门控机制和几何混合目标,无需引入复杂的对抗训练或多教师架构。从理论视角看,论文的两大定理建立了方法性质与目标特性之间的严格联系,为后续研究提供了可信赖的收敛保证。
然而,该方法仍存在若干局限性。首先, 和 的设置依赖领域特定调优,缺乏自适应机制;其次,论文的实验集中在科学问答领域,在开放式生成或多步推理任务上的表现尚未验证;最后,理论证明中的协方差条件()是否在实践中普遍成立仍有待更多探索。
对于后续研究而言,DemoPSD 的选择性采纳原则具有广泛的启发意义。任何涉及教师-学生架构的方法都可以借鉴这一思路——不盲目信任教师输出,而是通过度量师生分歧动态调节知识迁移强度。此外,论文关于几何混合而非算术混合的设计选择也值得注意:在需要抑制模式平均、保留分布多样性的场景下,几何混合可能是更优的选择。
概念 · 7 个
摘要
同策略自蒸馏,模型同时充当师生
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
KbSD:面向智能体搜索中行为校准的知识边界感知自蒸馏
KbSD: Knowledge Boundary aware Self-Distillation for Behavioral Calibration in Agentic Search
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 2 张
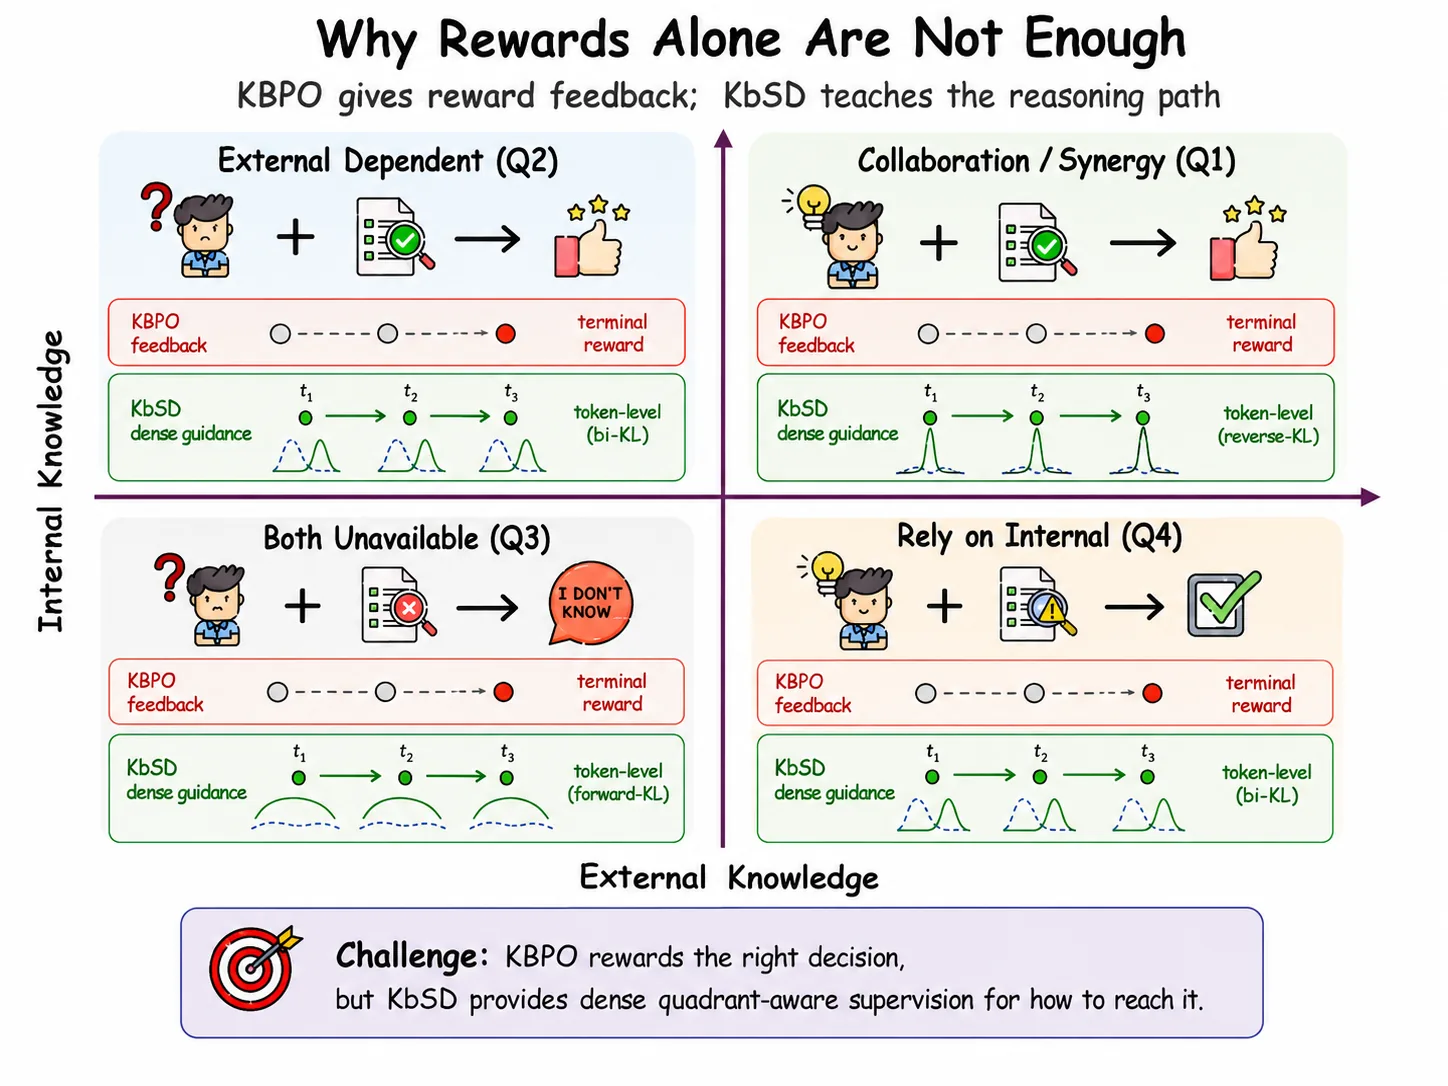
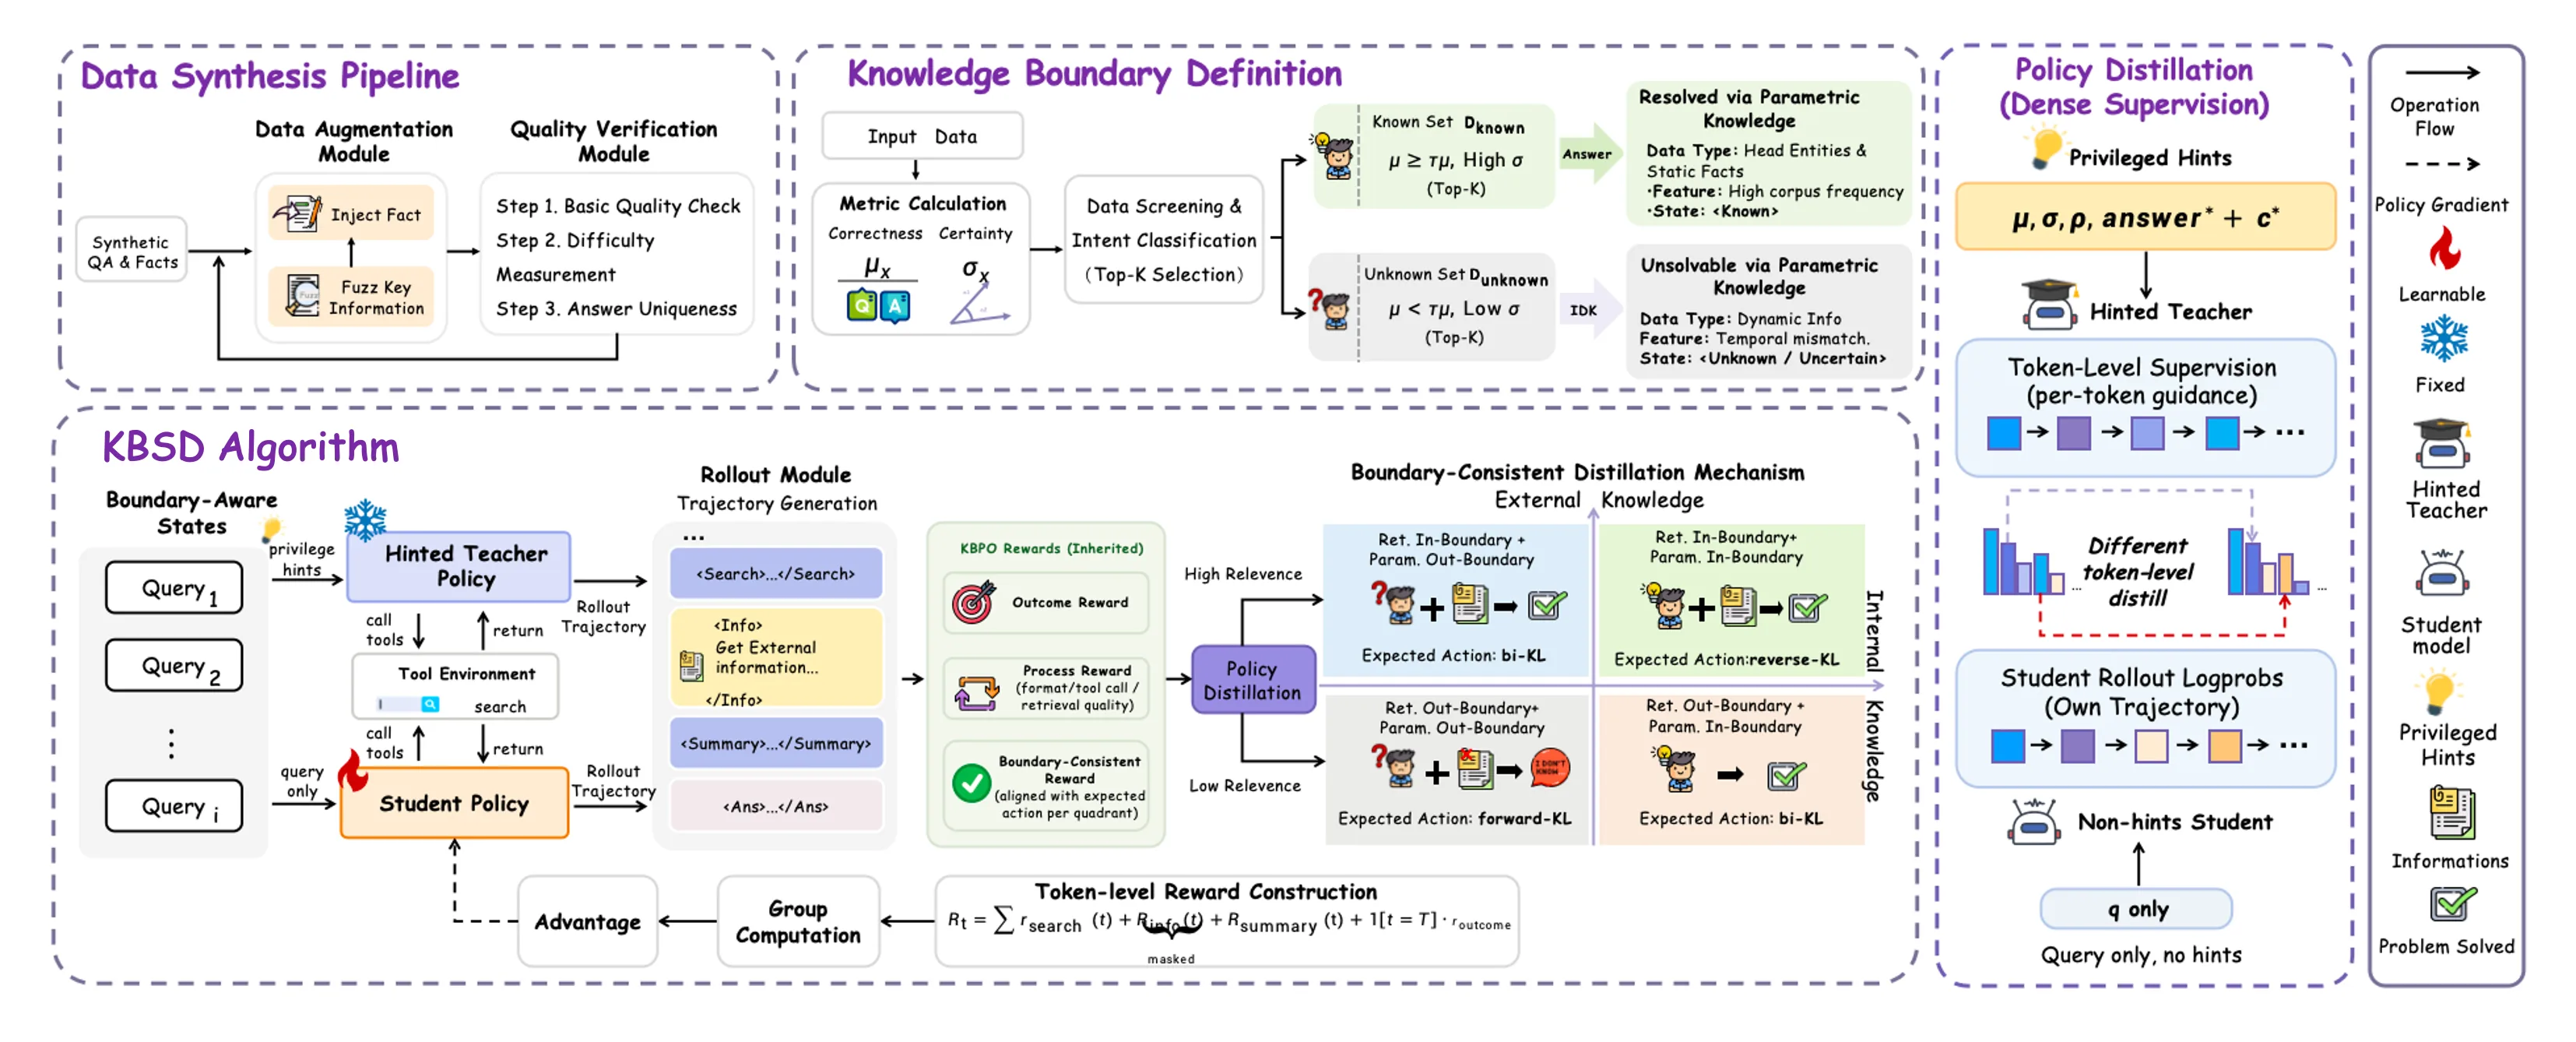
智能体搜索让大语言模型具备动态检索能力,但强化学习在知识边界校准上受限于奖励稀疏。现有二元奖励难以指导模型在不同知识状态下区分参数记忆、外部检索与弃答的推理过程。KbSD提出知识边界自蒸馏框架,结合提示增强教师与象限自适应蒸馏目标,在不依赖更大外部模型的前提下提供密集监督。实验表明该方法在任务准确率与幻觉抑制上均优于强基线,且在稀疏奖励最弱的象限提升最显著。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
智能体搜索让大语言模型具备了动态调用检索工具、多轮整合外部知识的能力,这在知识密集型问答、多跳推理等任务上带来了显著提升。然而,一个根本性的挑战始终悬而未决:模型需要判断何时信任自己参数化记忆中的知识、何时依赖检索到的外部证据、何时应该坦然承认不知道而拒绝回答。这三个「何时」的边界,就是论文所指的知识边界校准。
现有方法已经意识到这个问题可以通过四象限框架来建模:将查询依据内部确信度与外部检索质量划分为 Integrated(高确信、高检索质量)、External(低确信、高检索)、Internal(高确信、低检索)和 Refusal(低确信、低检索)四种模式。问题在于,主流的强化学习训练方法依赖二元奖励——只告诉模型最终答案对不对,却无法指导模型在推理过程中做出正确的象限决策。这种过程级监督的缺失造成了奖励稀疏:模型在困难象限几乎收不到有效信号,优化方向变得模糊。
更棘手的是,四个象限对应的推理分布具有本质差异。Integrated 象限要求模型在少数正确答案附近集中推理,像「收敛」;Refusal 象限要求模型在多种合理的拒绝方式中灵活选择,像「发散」;而 External 和 Internal 象限则需要同时兼顾精确性与覆盖度,是不对称的分布。传统的做法用单一的 KL 散度目标统一优化这些分布,无异于用同一把尺子去量形状截然不同的几何体——必然导致某些象限的校准效果被牺牲。
方法
KbSD 的核心设计围绕两个问题展开:如何从稀疏的结果奖励过渡到密集的 token 级过程监督?如何为不同象限的异构分布匹配合适的优化目标?
第一个问题的答案是信息不对称的自蒸馏。传统知识蒸馏需要训练一个比学生模型更大的教师模型来提供监督信号,成本高昂。KbSD 的关键洞察是:教师模型之所以能提供比学生更好的校准推理,不需要更大的模型容量,而只需要更多信息。具体而言,KbSD 构建了一个与学生模型架构完全相同、参数完全初始化的教师,它在输入端额外接收一个结构化的知识边界提示,包含参数化确信度 、语义稳定性 、检索质量分数 以及对应的象限标签 。这个提示拼接在原始查询前形成教师的输入 ,教师输出推理轨迹后停止梯度,只将知识传递给学生。
形式化地,设学生的参数化策略为 ,则教师的预测分布为:
这种「同构设计」使得 KbSD 无需依赖额外的庞大模型,却能通过边界信息的注入让教师产生高度校准的推理示范。学生模型在训练时同时从自采样轨迹和教师示范中学习,在测试时则依赖内化后的能力——无需提示。
第二个问题的答案是象限自适应的蒸馏目标。论文将 KL 散度的两种方向与象限分布的几何特性对应起来:反向 KL(reverse KL) 趋向于找到教师分布的主峰,适合 Integrated 象限集中化的推理分布;正向 KL(forward KL) 追求对教师分布的全面覆盖,适合 Refusal 象限多样化的拒绝策略;对于 External 和 Internal 这种同时需要精确性和覆盖度的不对称象限,论文通过求解帕累托最优问题,得到一个自适应的双向 KL 组合:
其中 和 分别是正向和反向 KL 的梯度。最终的象限蒸馏损失为:
整个训练框架以 GRPO 为基础,联合优化稀疏的结果奖励与密集的蒸馏损失。奖励函数包含最终答案奖励、过程奖励、象限对齐奖励以及过度弃答惩罚,通过多维度的信号引导模型同时提升任务准确率和校准能力。
实验与结果
实验覆盖了 9 个基准数据集,包括多跳 QA(HotpotQA、2WikiMultiHopQA、MuSiQue、Bamboogle)、开放域问答(NQ、TriviaQA、PopQA)以及智能体推理任务(FRAMES、GAIA),基座模型分别为 Qwen2.5-3B 和 Qwen2.5-7B。
核心结论可以从两个维度来看。在任务效用上,KbSD 在所有基准上均显著超越基线方法,将 3B 模型的不可靠率从 64.32 降至 47.60,7B 模型从 57.99 降至 41.18,绝对降幅达到约 17 个百分点。这一提升在统计上的一致性说明方法并非对特定数据集的过拟合。
更有意思的是象限分解的结果。在稀疏奖励本应最有效的高确信象限(Integrated 和 Internal),各方法表现相近;但在稀疏奖励信息量最少的低确信象限(External 和 Refusal),KbSD 的优势最为突出。这恰好验证了论文的核心假设:二元奖励的盲区恰恰是密集蒸馏的价值所在。消融实验进一步表明,去除蒸馏损失或固定使用单一 KL 方向都会导致性能退化,证明象限自适应设计的必要性。
域外泛化实验也值得注意:模型仅在 HotpotQA 和 2WikiMultiHopQA 上训练,迁移到 FRAMES 和 GAIA 等未见任务时仍保持优势。这说明知识边界校准是一种领域无关的元能力,而非对特定数据分布的记忆。
讨论与可借鉴点
KbSD 最值得借鉴的设计理念在于「信息不对称替代规模不对称」。过去知识蒸馏普遍依赖更大的教师模型,而 KbSD 证明,对于校准这类任务,模型容量并非瓶颈,过程级监督的密度才是。这启发我们在设计训练信号时,不妨多思考「给模型什么信息」而非「用多大的模型」。
帕累托自适应 KL 的闭式解推导也颇具美感——通过最小化梯度范数平方自动确定 forward/reverse KL 的权重,避免了手工调参的繁琐。这种将理论洞察转化为可计算闭式解的做法,在工程实践中往往比启发式超参数搜索更鲁棒。
局限方面,论文仅在 3B 和 7B 模型上验证,更大规模(13B、72B)的 scaling 假设缺乏数据支撑。数据集偏向英文多跳 QA,对中文、多模态或专业领域(医疗、法律)的泛化能力尚待考察。此外,训练过程中的超参数(如象限阈值 、、蒸馏权重 )虽然给出了具体数值,但缺乏敏感性分析,读者难以判断这些参数在不同场景下的稳健性。
从更宏观的角度看,KbSD 聚焦于单轮或两轮检索的问答场景,而实际的智能体系统往往需要更长的多轮交互、工具调用链和自我纠错。如何将象限校准的思想拓展到更复杂的智能体轨迹上,是未来值得关注的方向。
摘要
面向智能体搜索的知识边界自蒸馏框架
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
ARKD:面向文本生成的自适应强化学习引导双向 KL 散度蒸馏方法
ARKD: Adaptive Reinforcement Learning-Guided Bidirectional KL Divergence Distillation for Text Generation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 9 张
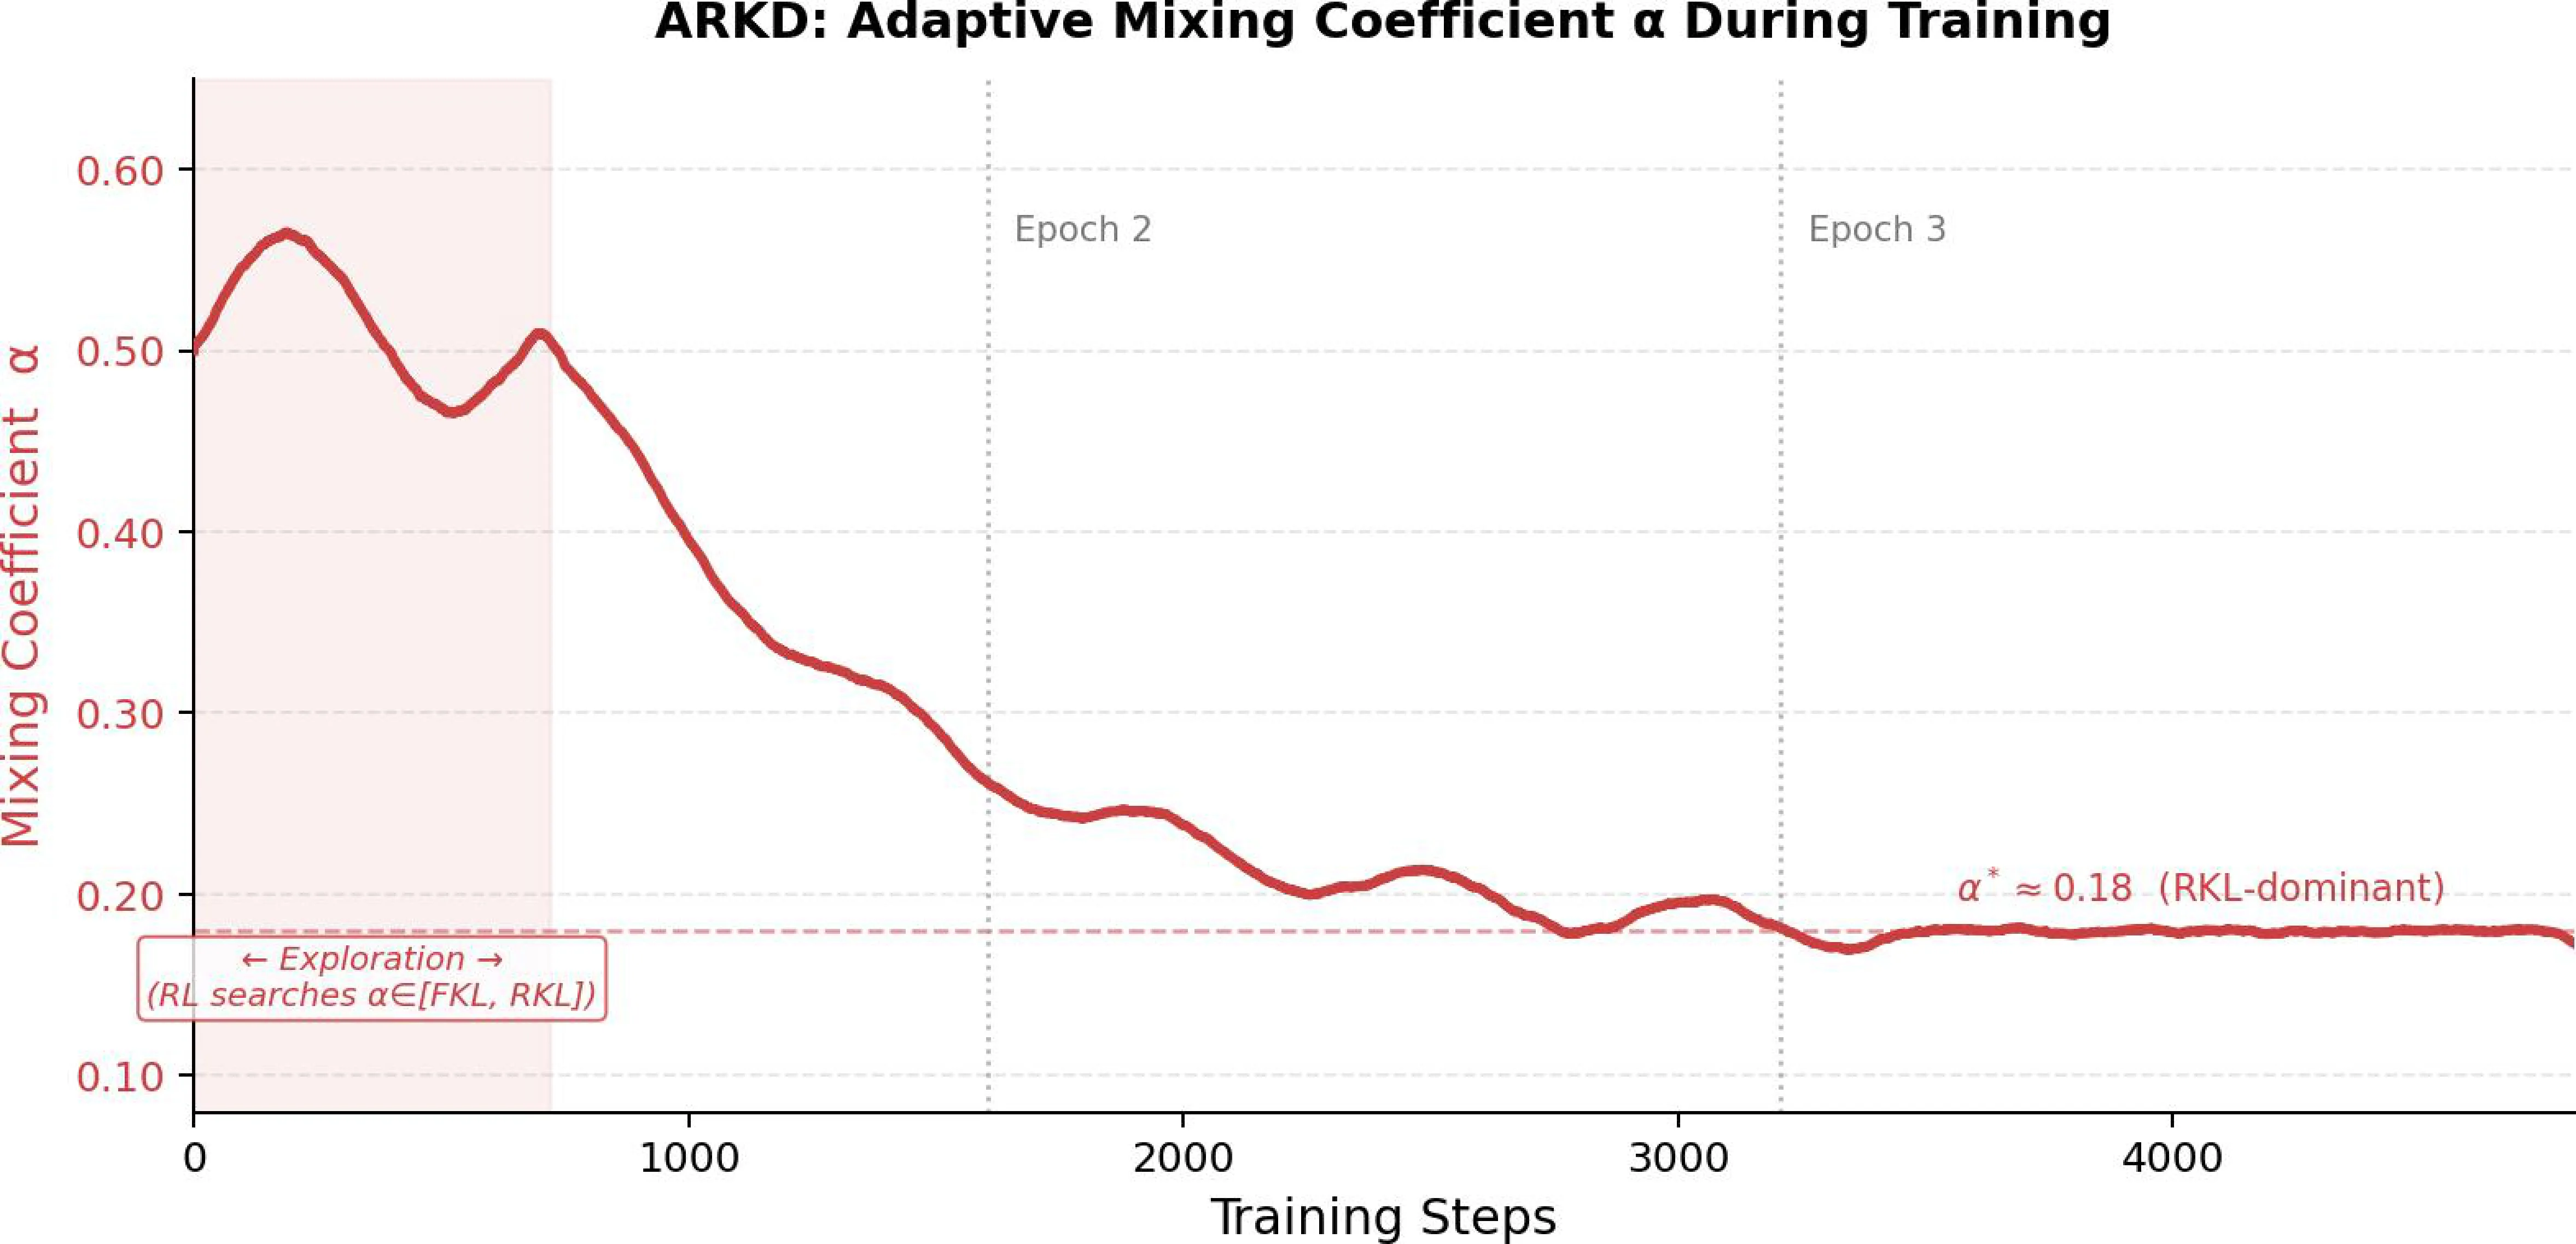
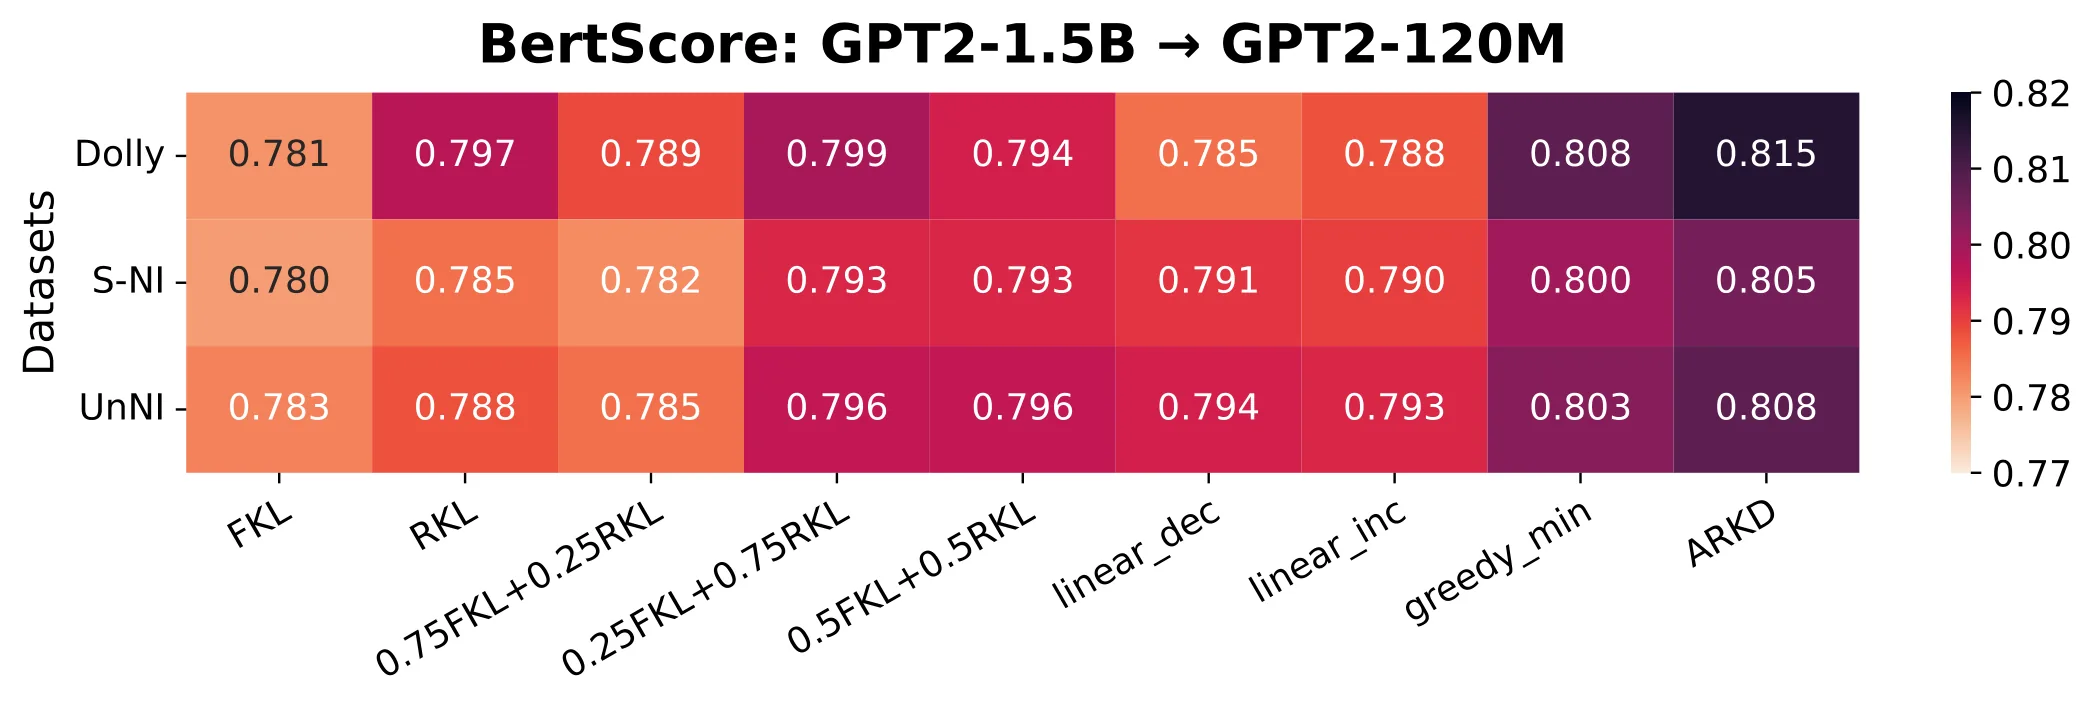
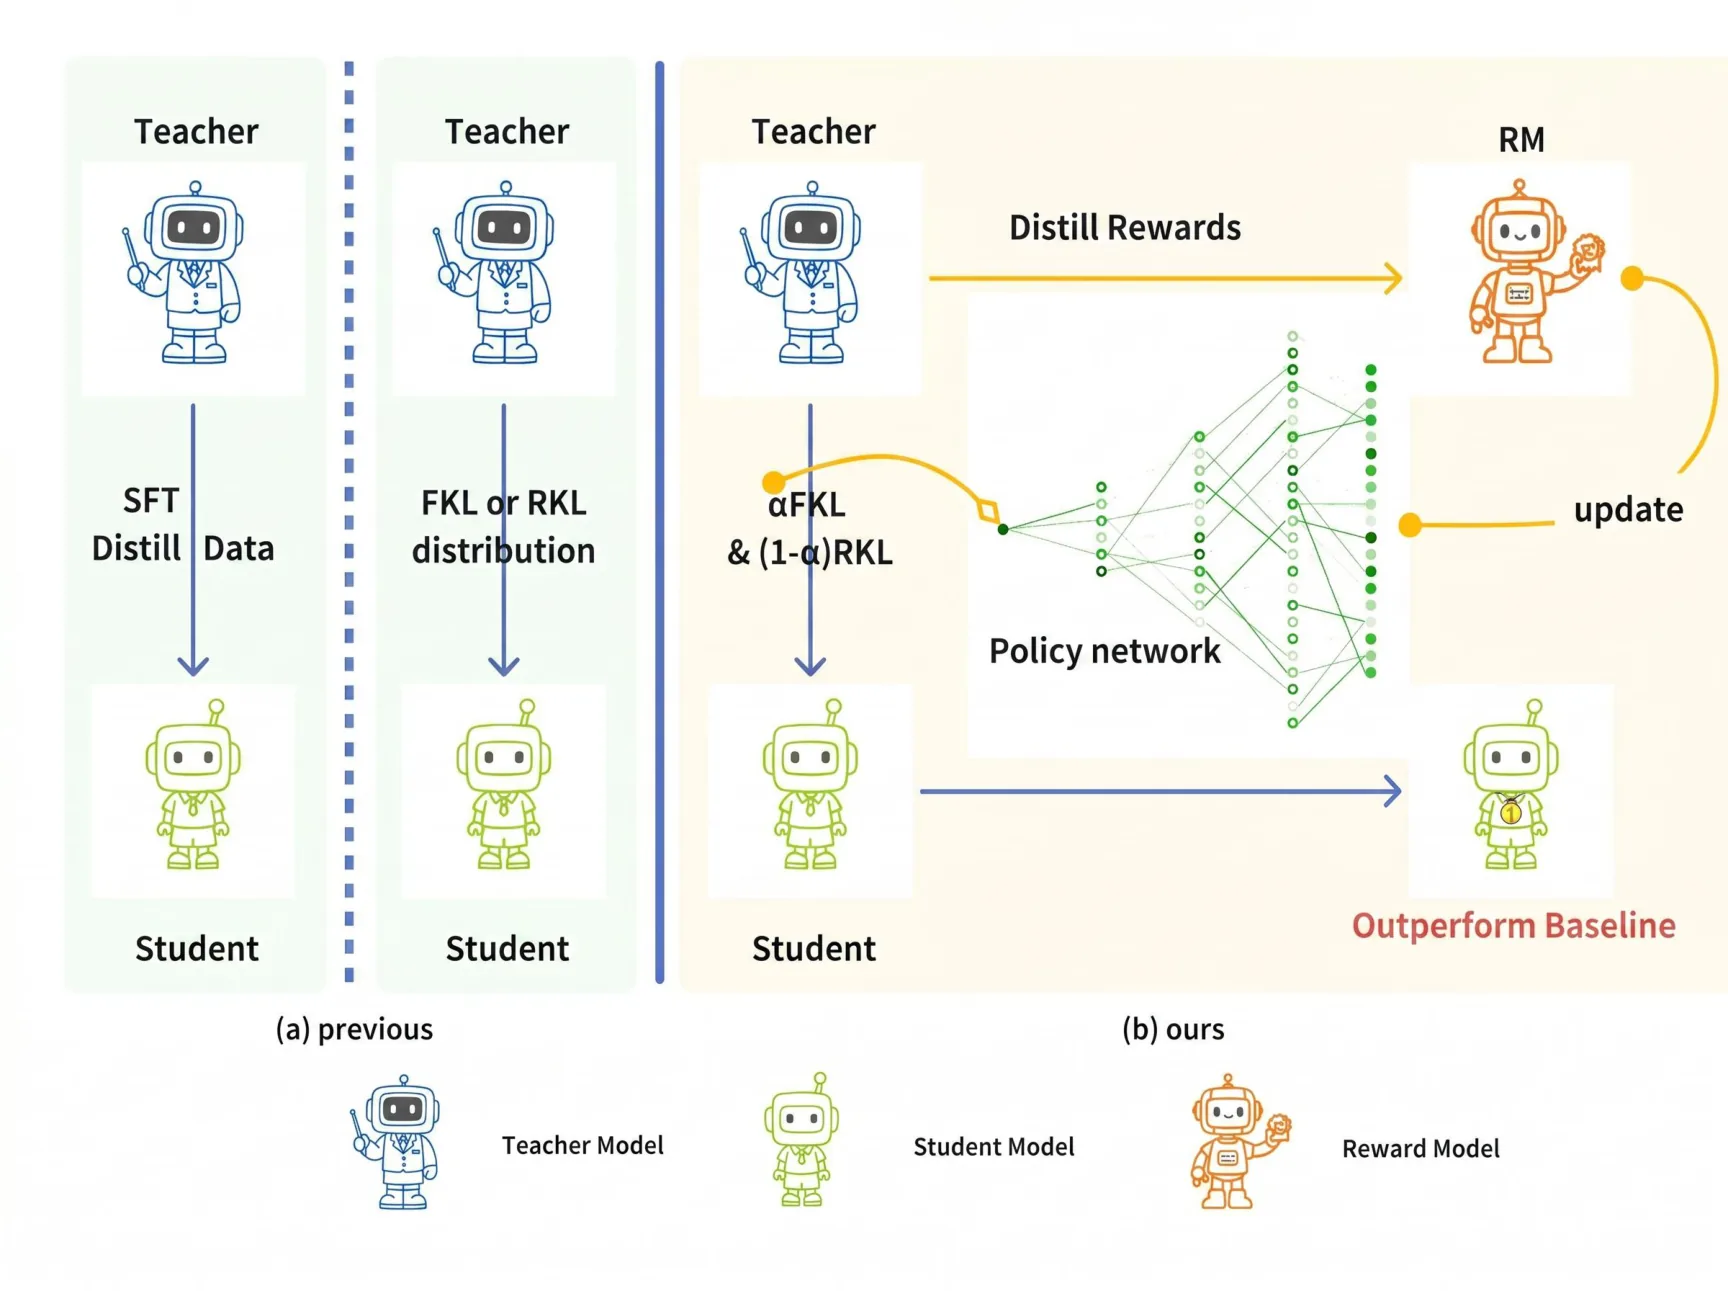
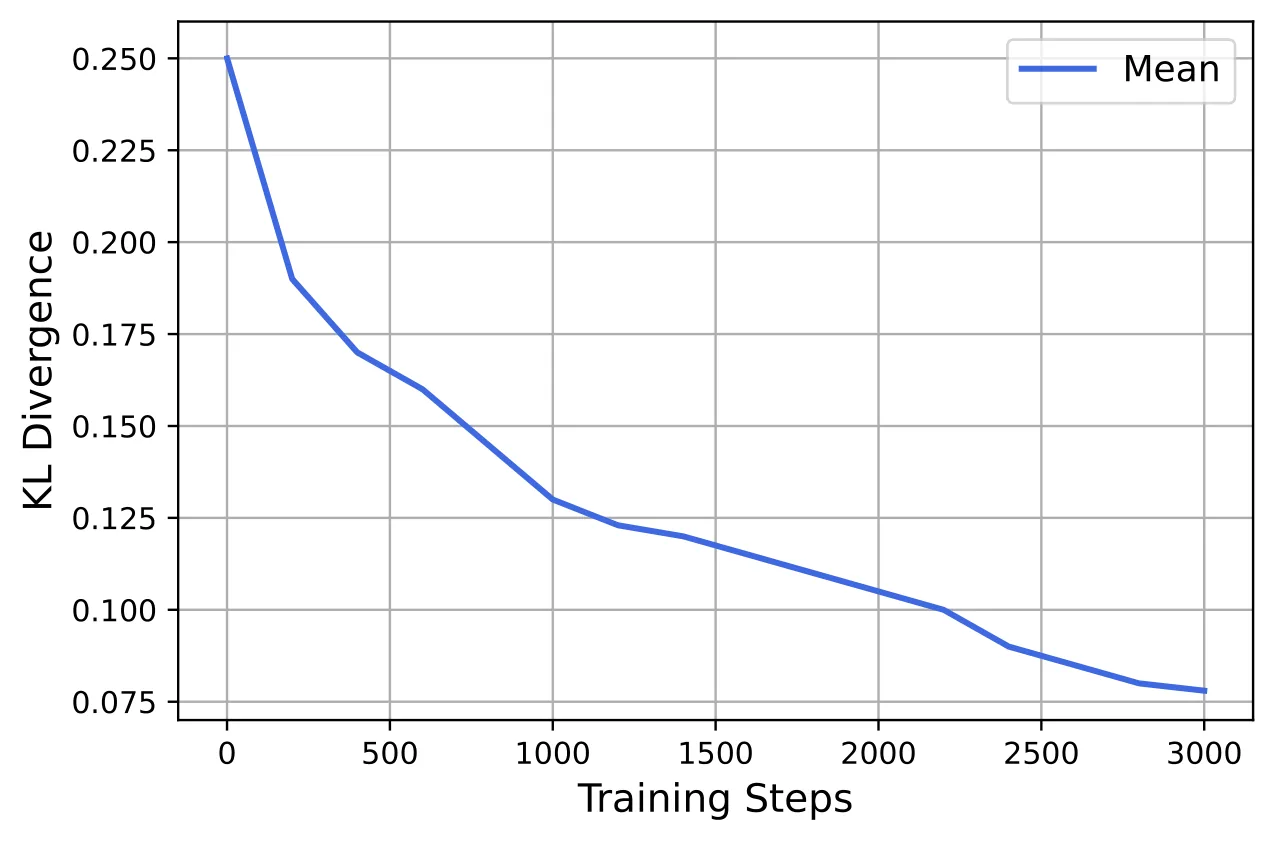
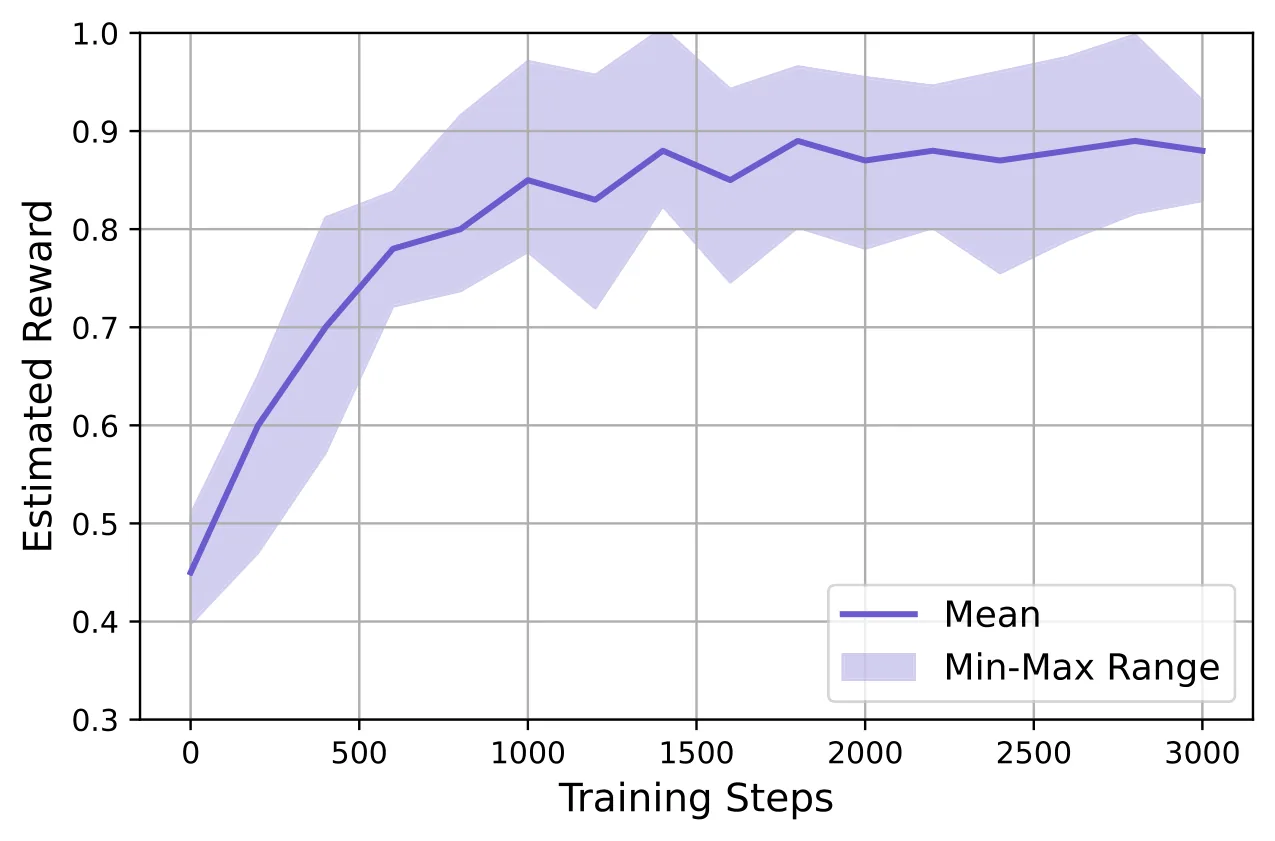
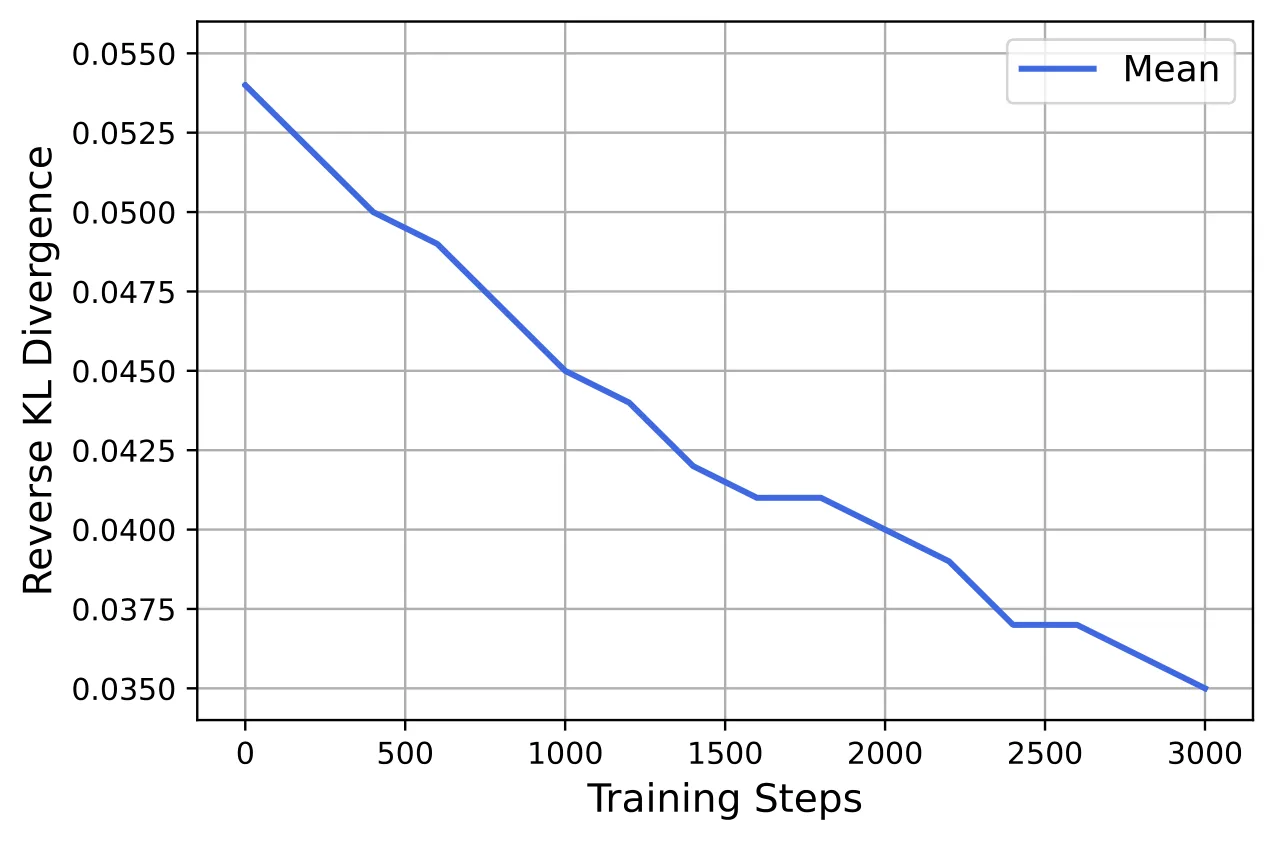
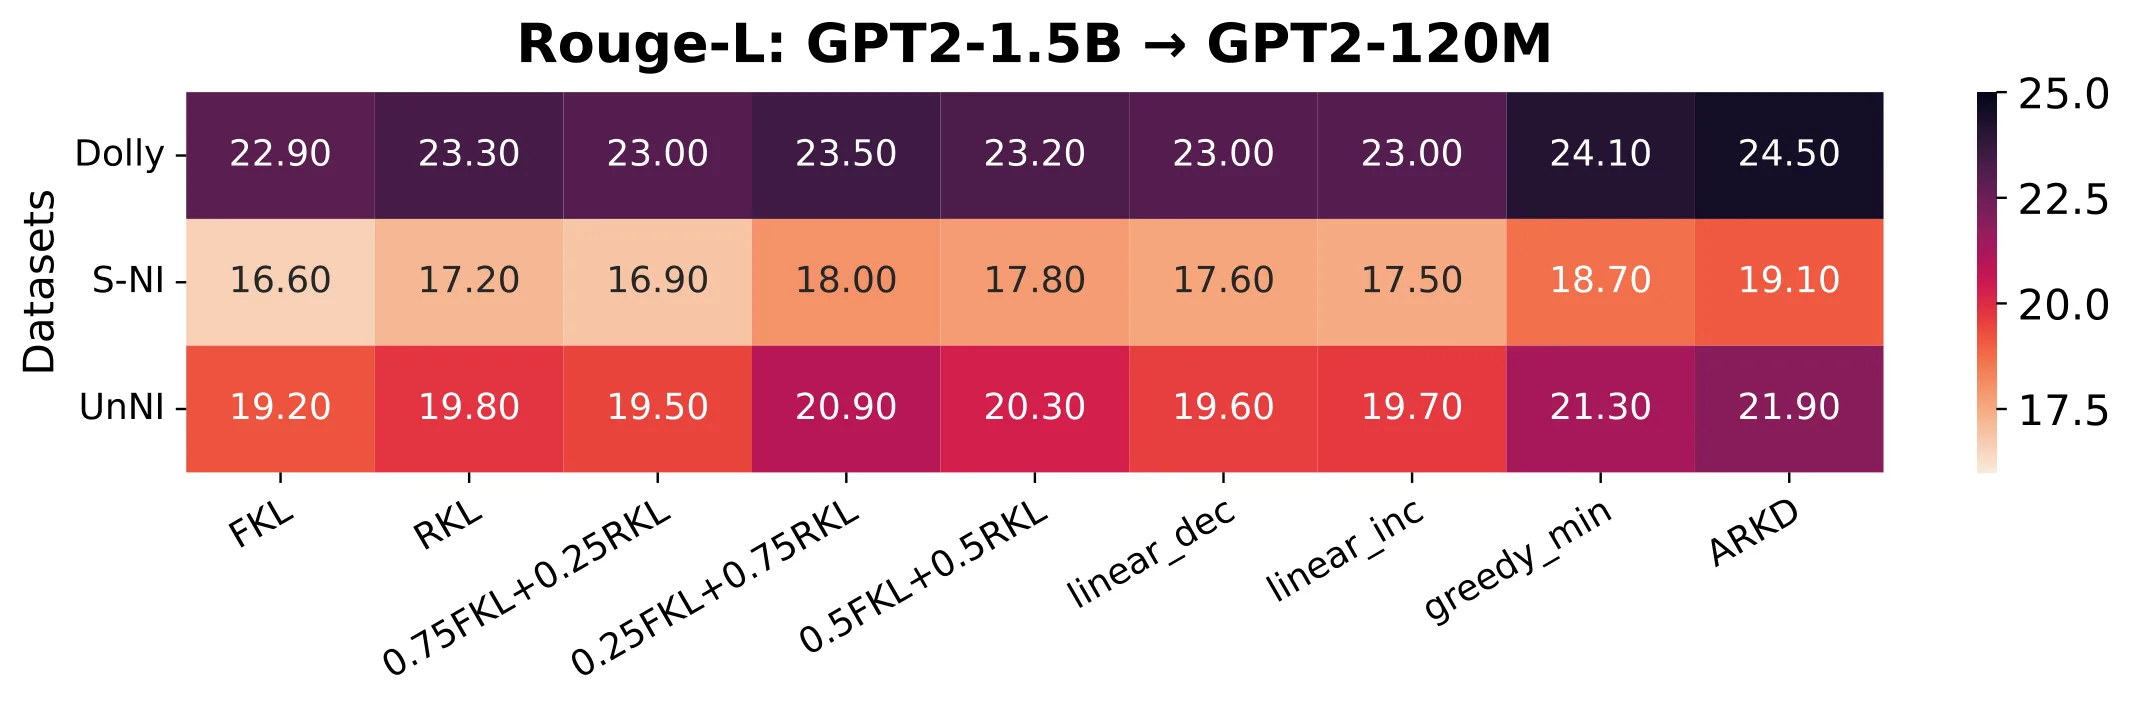
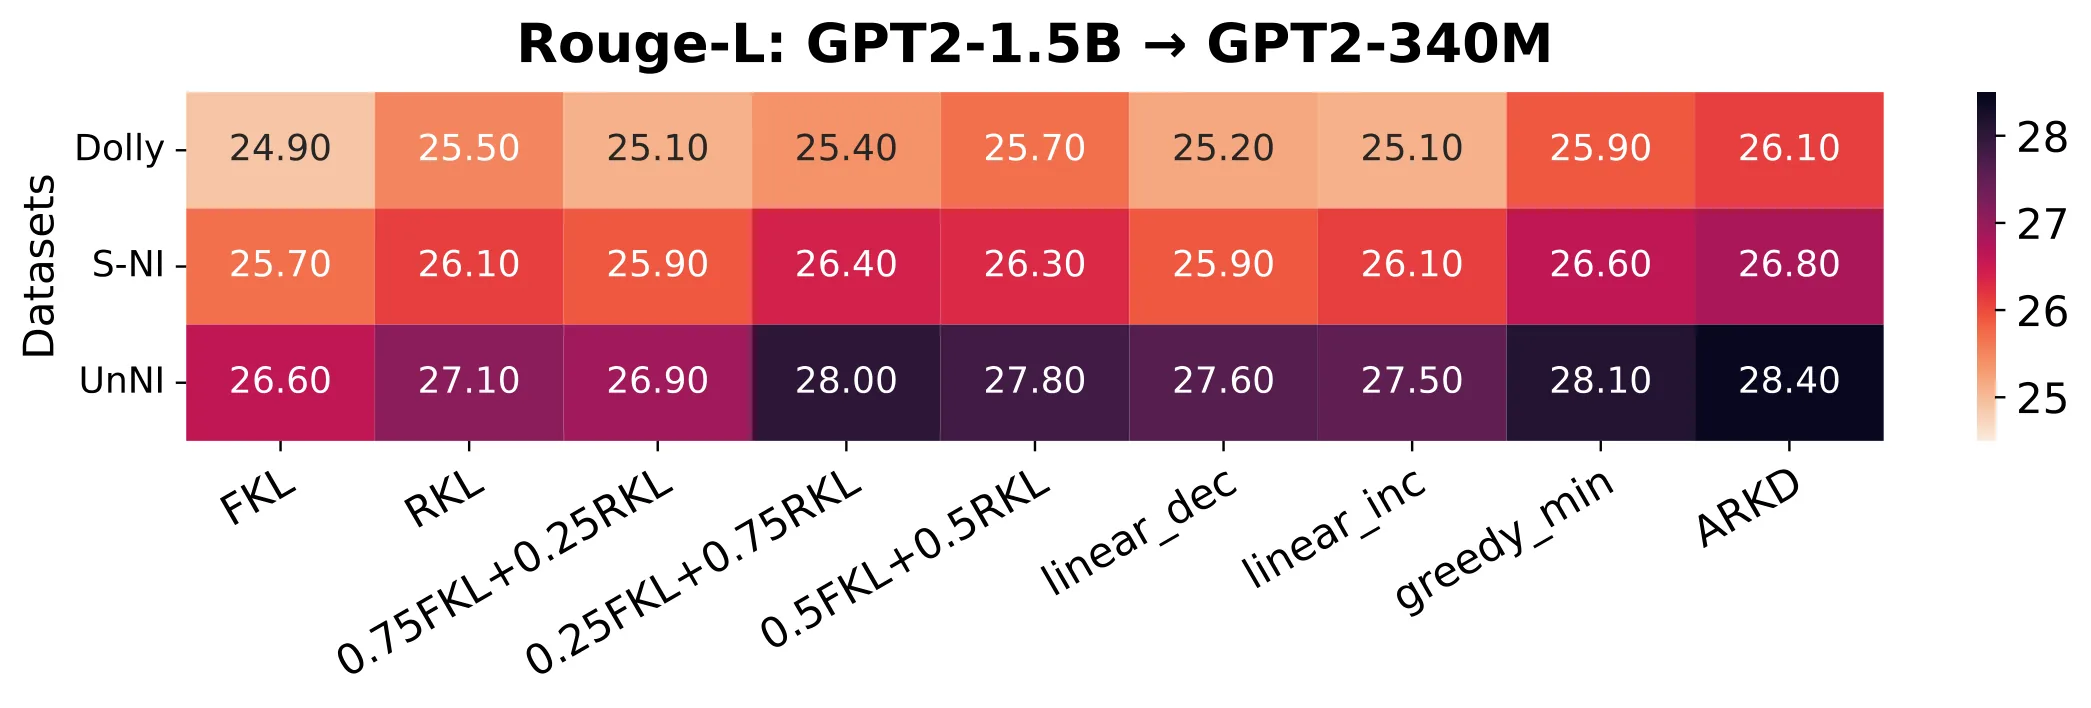
大语言模型的知识蒸馏中,单一KL目标难以兼顾主分布拟合与长尾概率建模,限制了生成质量与泛化能力。为此,论文分析前向KL与反向KL在分布对齐上的互补作用,提出基于强化学习的自适应双向KL蒸馏框架ARKD。该框架通过策略网络依据师生分布特征动态分配FKL与RKL权重,在即时奖励引导下实现主模式与长尾模式的双重对齐。多个基准上的实验显示,Rouge-L与BertScore均稳定提升,较贪心启发式基线高出0.4-0.6分。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
大语言模型在自然语言生成任务中展现出强大的能力,但其庞大的参数量带来了显著的计算与存储成本。[[知识蒸馏]] 作为一种经典的模型压缩技术,旨在将教师模型的知识迁移到轻量级的学生模型中。在文本生成场景下,蒸馏的核心目标通常是让学生模型学习教师模型的输出分布,从而在保持生成质量的同时降低推理开销。
传统蒸馏方法通常以单一 [[KL 散度]] 作为优化目标,通过最小化学生分布与教师分布之间的差异来实现知识迁移。然而,这种做法存在一个根本性的困境:前向 KL 散度(FKL)与反向 KL 散度(RKL)在分布对齐上具有截然不同的几何特性。FKL 采用“最小覆盖”策略,会强迫学生分布覆盖教师分布的所有峰,但在低概率区域产生较大误差;RKL 则采用“峰值追踪”策略,专注于匹配教师分布的最高峰,但在未覆盖区域会产生模式平均的虚假结果。当文本分布具有多模态特性时,单一使用任一散度都无法同时满足主分布拟合与长尾概率建模的需求。
这篇论文的切入点正是这一理论与实践的鸿沟:如何在蒸馏过程中自适应地协调 FKL 与 RKL 的互补优势,使模型既能准确捕捉生成文本的主要模式,又不至于在长尾概率区域过度拟合或过度泛化。
方法
ARKD 的核心思想是将 FKL 与 RKL 的权重分配建模为一个[[强化学习]]决策问题,让策略网络根据即时的师生分布特征决定两种散度在当前样本上的相对重要性。
具体而言,框架首先定义了加权双向 KL 目标函数。对于给定的 token ,教师模型提供概率分布 ,学生模型提供概率分布 ,则加权 KL 损失可以表示为:
其中 是策略网络输出的权重函数,其取值范围为 。当 接近 1 时,损失函数趋向于前向 KL,迫使学生模型覆盖教师的所有概率模式;当 接近 0 时,损失函数趋向于反向 KL,专注于匹配教师的高概率区域。
策略网络的设计体现了该方法的创新性。网络以师生分布的统计特征作为输入,包括:教师概率的熵、学生概率的熵、两者概率比的方差、以及当前 token 在教师分布中的 rank 位置。这些特征共同刻画了当前决策点的分布形态——例如,当教师分布熵较低(高度确信)而学生分布与之偏离较大时,策略网络倾向于增大 FKL 权重以强制覆盖;反之,当教师分布在多个 token 上具有相近概率(多峰特征明显)时,增大 RKL 权重有助于聚焦主峰。
训练过程中,策略网络通过[[策略梯度]]方法优化,奖励信号由下游任务的生成质量指标(如 Rouge-L 或 BertScore)提供。这种即时奖励引导使得权重分配能够自适应地服务于最终生成效果,而非仅仅最小化分布距离。
与直觉做法的一个重要区别在于:传统方法往往使用固定的权重调度或简单的启发式规则(如基于概率阈值切换),而 ARKD 的策略网络能够根据每个 token 的局部上下文动态决策。这使得框架能够处理文本生成中普遍存在的分布异质性问题——同一序列的不同位置可能需要不同的对齐策略。
实验与结果
论文在多个文本生成基准上评估了 ARKD 的有效性,包括摘要生成、机器翻译和代码生成等任务。主要对比基线包括:标准 KL 蒸馏(使用固定权重 0.5)、纯 FKL 蒸馏、纯 RKL 蒸馏,以及基于概率阈值的贪心启发式方法。
实验结果显示,ARKD 在 Rouge-L 指标上平均提升 0.4–0.6 分,BertScore 也有类似幅度的改善。值得注意的是,这种提升在所有测试基准上均保持一致,没有出现某些任务上有提升而其他任务上性能回退的情况,显示出方法的鲁棒性。
消融实验进一步揭示了各模块的贡献。移除策略网络(即使用固定权重 0.5 的标准 KL)会导致性能下降约 0.3 分,说明动态权重分配本身具有独立价值。同时,仅使用分布特征而不使用强化学习奖励信号(即监督学习训练策略网络)也会显著削弱效果,证实了端到端优化策略对于捕捉任务相关偏好的必要性。
在定性分析上,研究者观察到 ARKD 在处理低频词和专有名词时表现尤为突出。这些词汇在教师分布中往往对应长尾概率区域,纯 FKL 方法倾向于过度平滑这些细节,而纯 RKL 方法则可能完全忽略它们。ARKD 的自适应机制使得模型能够根据上下文判断何时应该覆盖长尾模式、何时应该聚焦主峰。
讨论与可借鉴点
尽管 ARKD 在文本生成蒸馏任务上取得了显著进展,其仍存在若干局限。首先,策略网络的引入增加了训练的计算开销——额外的网络前向传播与梯度更新意味着更长的蒸馏时间。其次,策略网络的设计依赖于人工选择的分布特征,尽管实验表明这些特征具有良好的表达能力,但自动学习更优的特征表示仍是值得探索的方向。
从更宏观的视角看,这项工作揭示了[[知识蒸馏]]中目标函数设计的深层问题:单一标量损失往往无法完整刻画师生分布之间的复杂关系。将损失函数本身纳入优化范畴,而非固定为手工设计的形式,可能是未来蒸馏研究的重要趋势。
对于从事模型压缩与部署的实践者,ARKD 提供了一种即插即用的框架扩展思路。在资源允许的情况下,用强化学习机制增强已有的蒸馏流程,往往能带来稳定的性能增益,尤其当目标模型需要在分布异质性较高的数据上保持生成质量时。
摘要
强化学习引导的LLM知识蒸馏压缩
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
DRIFT:基于难度路由自蒸馏、节奏门控探索与成功缓冲区训练的方法
DRIFT: Difficulty Routing Self-DIstillation with Rhythm-Gated Exploration and Success BuFfer Training
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 8 张
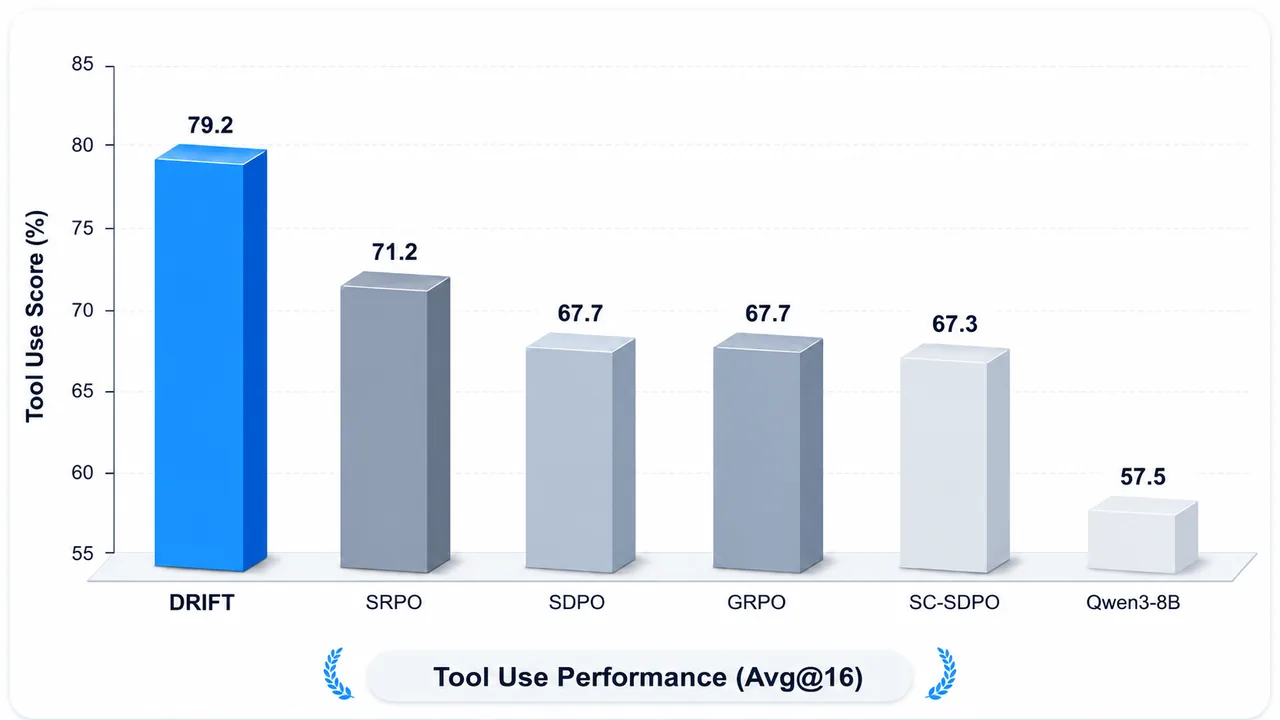
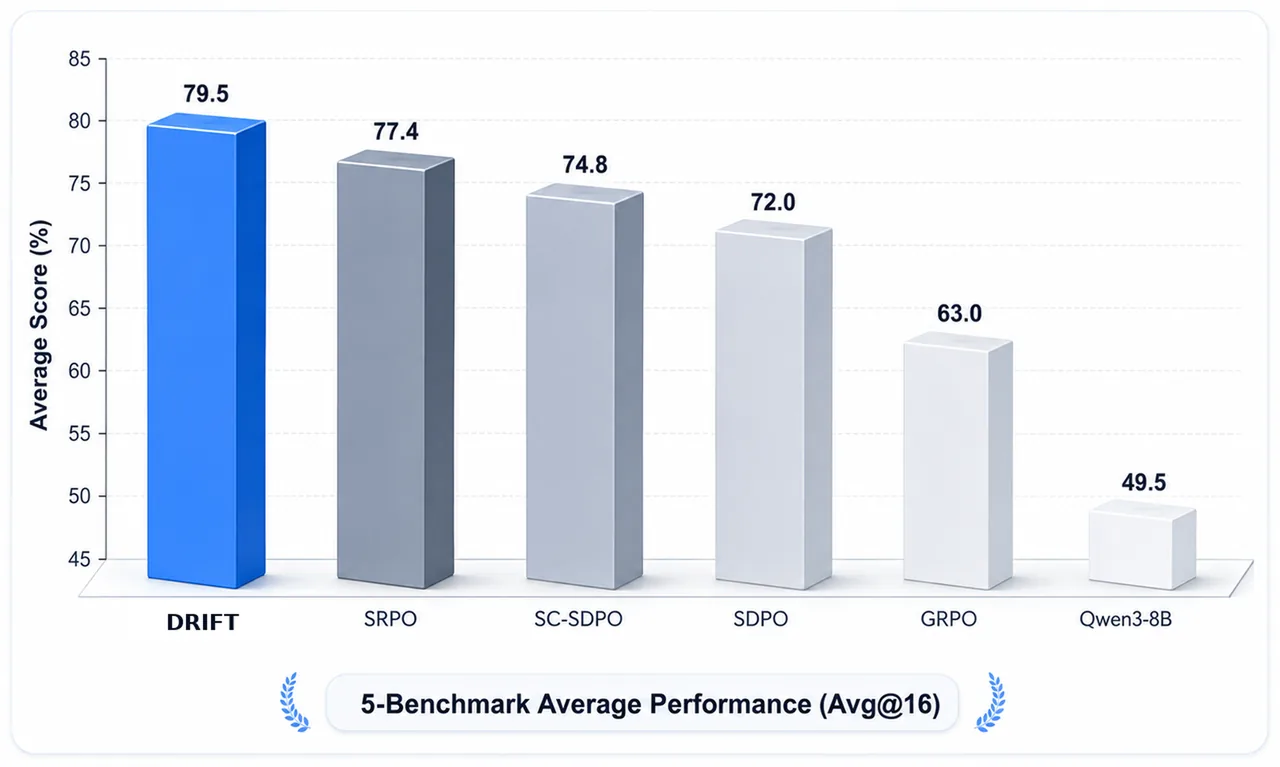
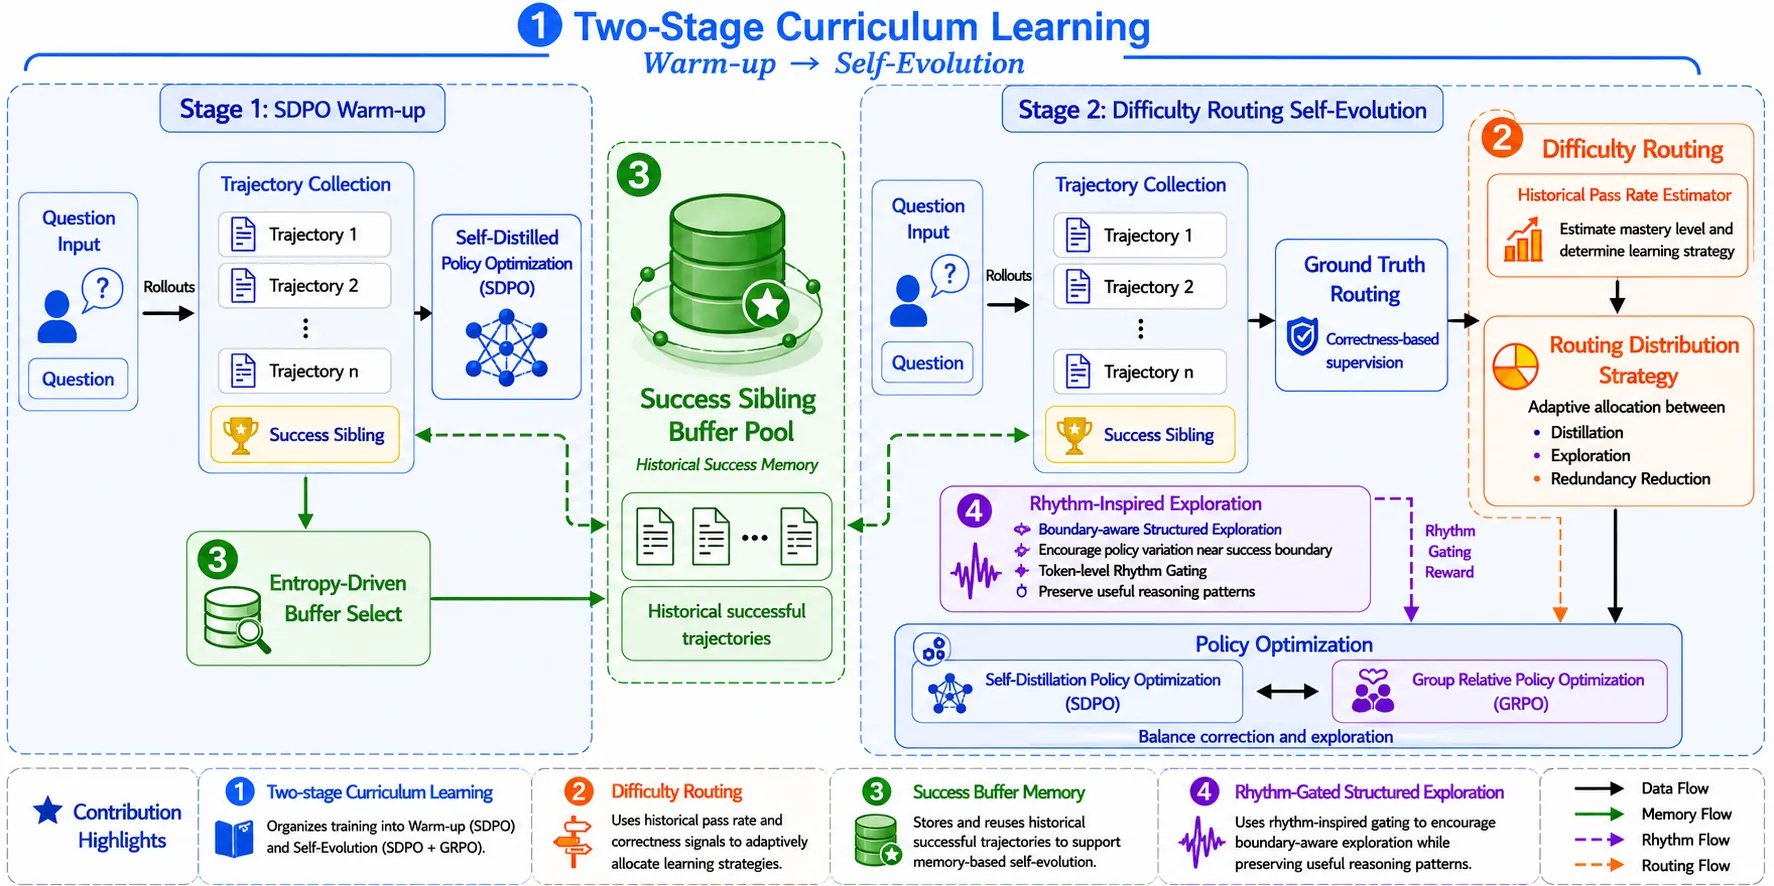
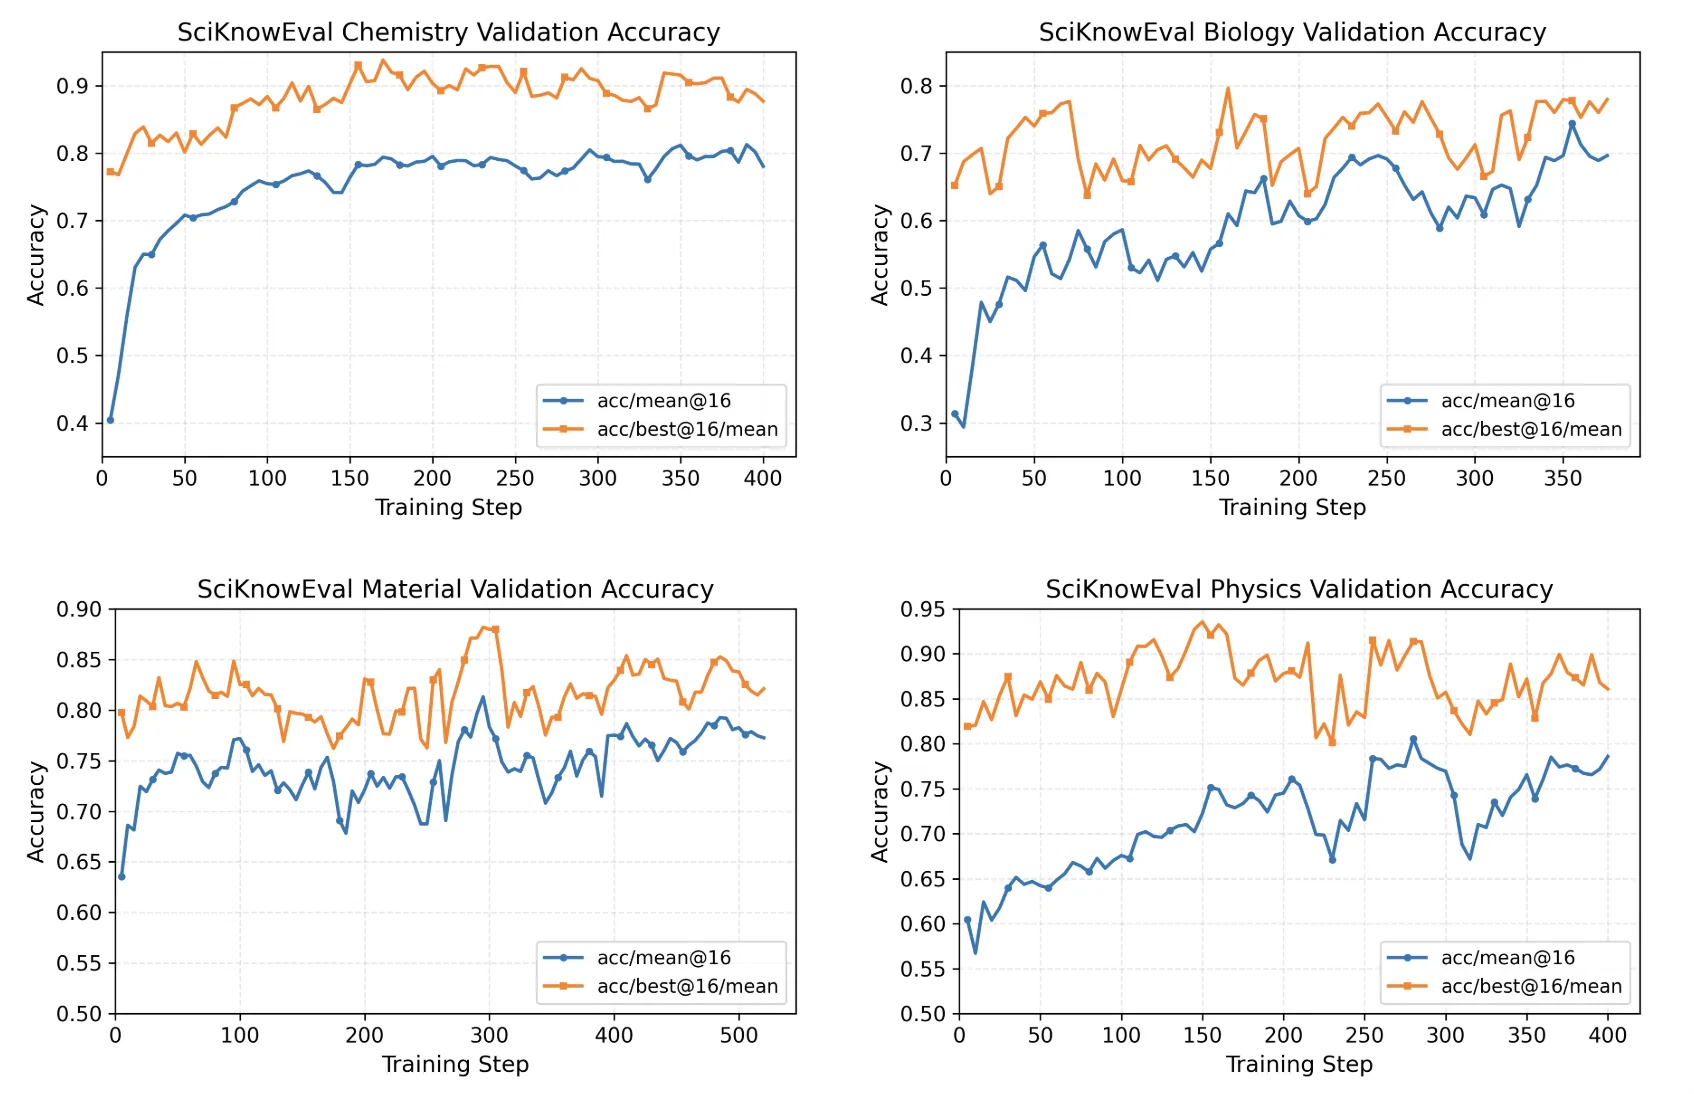
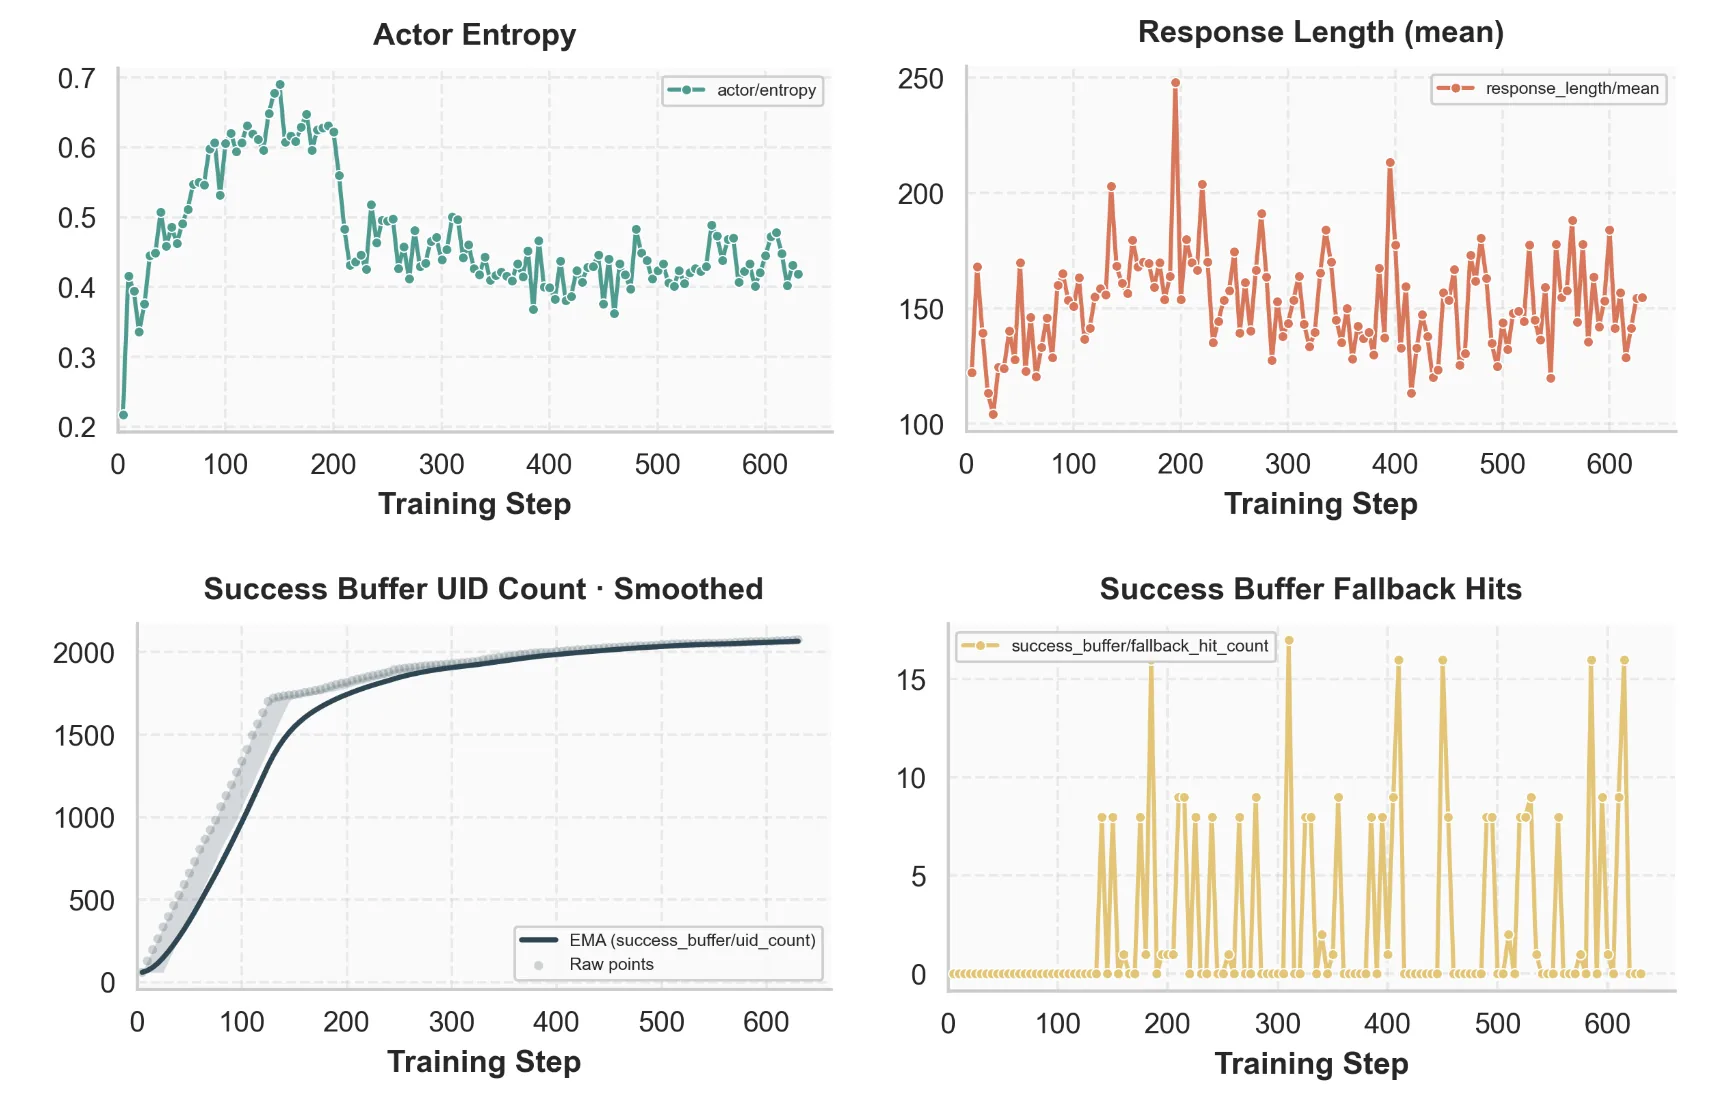
大语言模型在无外部专家监督下的稳定自改进仍是复杂推理任务的核心难题。现有自蒸馏与强化学习方法缺乏问题级学习进度追踪机制,易对简单题过度优化、对难题监督不足、难以探索边界样本。本文提出DRIFT在线自进化策略优化框架,通过难度路由识别问题级学习状态并动态分配自蒸馏与强化学习信号,配合节奏门控在token级聚焦关键推理位置探索,并结合成功缓冲与两阶段课程学习。实验在五个基准三个模型规模上全面超越GRPO与SDPO,平均得分79.5%,ToolUse准确率达79.2%,刷新当前最优。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
让大语言模型在复杂推理任务中实现稳定、可信的自我提升,长期以来是学术界与工业界共同关注的核心难题。与有外部标注数据或专家反馈的监督学习不同,无监督自我提升要求模型只能从自身产生的推理轨迹中学习——这意味着训练信号必须从模型的"内部经验"中提炼出来,而如何区分哪些经验值得保留、哪些需要修正,成为决定学习质量的关键。
现有方法主要沿两条路线探索:强化学习路径以 GRPO 为代表,通过组内相对优势估计来调整策略;自蒸馏路径以 SDPO 为代表,将成功样本作为"特权教师"来纠正错误推理。这两类方法各有局限。GRPO 的组内奖励机制在样本量有限时容易出现奖励信号不稳定,更重要的是,优势估计在序列级别共享,导致信用分配过于粗糙——模型只知道某次回答整体是好是坏,却无法得知具体哪个推理步骤决定了成败。SDPO 的问题在于,它将所有成功样本不加区分地用作教师信号:来自轻松解决的问题与来自艰难挣扎后侥幸答对的问题被一视同仁。这意味着模型可能反复被灌输已经掌握的知识,却对真正需要突破的能力边界缺乏有针对性的监督。
更深层的矛盾在于学习信号的动态适配问题。模型在不同训练阶段对不同问题的掌握程度是动态变化的:一个最初感到困难的问题可能在若干轮迭代后变得熟练,反之亦然。现有方法缺乏对这种问题级学习进度的显式追踪与响应机制,导致训练过程容易陷入两种失衡:对简单题过度优化造成计算浪费,对困难题监督不足使得模型始终无法跨越某些能力边界,而最有学习价值的中等难度边界样本也往往得不到充分探索。
方法
DRIFT 的核心设计思路是建立一套从宏观到微观的多层次信号分配机制:在问题级别通过难度路由识别模型当前对每个题目的掌握程度,据此决定应该从这道题中学习什么、以多大强度学习;在词元级别通过节奏门控进一步筛选出真正值得模型集中注意力的关键推理位置,避免在无关紧要的词汇上浪费探索资源。
难度路由是 DRIFT 实现问题级学习进度追踪的基础组件。它为每个问题维护一个历史通过率的指数移动平均值 ,其中 反映了模型近期在该问题上的表现。基于这个平滑后的通过率,问题被划分为三个难度区间:简单题()的路由权重 抑制了冗余更新,避免在已掌握内容上反复投入;困难题()的路由权重 完全关闭了自蒸馏信号,防止模型被某些"误打误撞"的偶然正确所误导;中难度题则保持 的正常学习强度,并将与节奏门控配合的机会留给最有价值的边界样本。这种设计使得训练信号能够根据模型的真实能力状态进行自适应分配:模型越擅长的领域越少干预,越需要突破的边界越精准用力。
节奏门控是 DRIFT 在词元级别实现精细化探索的核心机制。它包含两个互补的信号:局部超越奖励与结构性显著性检测。前者衡量的是学生在某个位置上相对于教师的表现差异。当学生在某个 token 上的损失显著低于教师时,表明该学生可能发现了教师未曾注意到的更好推理路径,此时给予正向奖励鼓励这种"青出于蓝"的探索。但奖励幅度需要上界约束,避免过度放大噪声。后者通过分析师生在滑动窗口内的熵值变化差异来定位"结构性关键 token"——那些预测分布从混乱走向确定、且这种确定性转变与教师存在差异的位置。这类位置往往对应着推理过程中的关键决策点,是最值得模型投入注意力的地方。最终的 token 权重 采用双重筛选机制:只有当样本本身属于中难度区间、且该 token 同时具备教师相对超越与高结构显著性时,才给予权重放大。这种设计将探索资源精准导向了"既有改进空间、又值得投入"的关键位置。
成功缓冲区解决了跨批次经验复用的问题。DRIFT 为每个问题维护一个容量有限的缓冲区,存储该问题历史上的成功轨迹及其奖励分数。当当前批次中某个问题没有产生成功样本时,可以从缓冲区中采样一条历史成功轨迹作为特权教师。与简单的经验回放不同,DRIFT 的缓冲区采用奖励优先的替换策略:缓冲区中始终保留得分最高的成功样本,使得特权教师的整体质量随训练进程持续提升,而非停留在早期能力水平。
两阶段课程学习协调了整体训练节奏。Stage 1(warm-up 阶段)以 SDPO 自蒸馏为主,配合高熵成功轨迹作为教师快速建立基础能力,同时积累成功缓冲区。此阶段模型主要学习"什么样的推理是正确的",而不急于探索多样解法。Stage 2(mixed 阶段)进入混合优化:负样本继续走 SDPO 路径用高奖励成功轨迹作为教师修正错误,正样本切换到 Rhythm-GRPO 路径在节奏门控引导下进行有针对性的策略探索。这种先打牢基础再拓展边界的课程设计,确保了训练过程的稳定性与最终能力的全面性。
实验与结果
DRIFT 的实验覆盖了科学推理与工具使用两大类任务。科学推理部分采用 SciKnowEval 基准的四个子领域——Biology、Chemistry、Materials 与 Physics,这些数据集涵盖本科层级的多领域知识推理,对模型的领域迁移能力有较高要求。工具使用部分采用 ToolUse 任务,基于真实工具调用场景评估模型在行动计划与工具选择上的准确性。
主实验在 Qwen3-8B 上进行,DRIFT 在五个基准的平均得分为 79.5%,显著优于 GRPO 的 70.0%(提升 9.5 个百分点)与 SDPO 的 72.0%(提升 7.5 个百分点)。与同领域的先前最优方法 SRPO 相比,DRIFT 同样实现了 2.1 个百分点的提升。最引人注目的是 ToolUse 任务上的表现:DRIFT 达到 79.2% 的准确率,较 GRPO 提升 13.5%、较 SDPO 提升 10.7%,较 SRPO 提升 8.0 个百分点。这一显著提升被认为源于工具调用任务的特性——正确与错误的工具选择泾渭分明,成功轨迹的监督信号清晰可复用,使得自蒸馏机制能够充分发挥其"从可靠示范中学习"的优势。
跨模型规模的泛化实验验证了方法的有效性与扩展性。Qwen3-4B 上 DRIFT 平均达到 74.6%,较 GRPO 提升 4.9 个百分点、较 SDPO 提升 7.9 个百分点。异家族模型 OLMo3-7B 上的结果更为显著:DRIFT 平均达到 72.8%,较 GRPO 提升 12.0 个百分点、较 SC-SDPO 提升 2.7 个百分点;值得注意的是,该模型的初始能力相对较弱,但 DRIFT 为其带来了最大幅度的提升(部分子任务上超过 42 个百分点),表明难度路由机制能够有效识别模型当前的能力边界并针对性补充。进一步分析还发现,DRIFT 相对于最强基线 SRPO 的领先幅度随模型规模扩大而扩大(4B: +0.4 → 8B: +2.1),这与"自教学能力随模型规模涌现"的研究发现一致,暗示更大规模模型可能从 DRIFT 的精细化信号分配中获得更显著收益。
消融实验逐一验证了三大核心组件的必要性。移除难度路由后,平均得分从 79.5% 下降至 71.7%,表明问题级学习状态追踪对整体性能至关重要——没有它,模型无法区分哪些问题需要持续投入、哪些问题可以减少干预。移除成功缓冲区后,平均得分下降至 72.3%,说明跨批次经验复用有效防止了"狗熊掰棒子"式的遗忘。移除 warm-up 阶段直接进入混合训练,平均得分下降至 74.9%,验证了两阶段课程设计在保证训练稳定性上的价值。这些组件相互依存:难度路由识别学习状态、成功缓冲区保障经验质量、课程学习协调训练节奏,三者共同支撑起 DRIFT 的完整学习流程。
训练动力学分析揭示了 DRIFT 优化过程的内在规律。策略熵在训练初期约 200 步内持续上升,随后稳定在较高水平,反映了模型在探索阶段的策略多样性逐渐建立。成功缓冲区的容量快速填充并趋于饱和,表明高质量历史经验在训练中持续被复用。问题难度分布的演化呈现预期模式:简单题占比逐渐上升、难题占比逐步下降,而中难度题始终保持主导地位——这正是 DRIFT 将主要训练资源投向边界样本的设计目标的体现。
讨论与可借鉴点
DRIFT 为大语言模型的无监督自我提升提供了一条从粗放到精细的进化路径。其核心贡献在于建立了问题级与词元级双层协同的信号分配机制:难度路由解决了"应该从哪些问题中学到什么强度"的问题,节奏门控进一步解决了"应该关注每个问题的哪些推理步骤"的问题。这种分层设计思想为后续研究提供了可借鉴的范式——当训练目标涉及多种能力维度且这些维度之间存在动态权衡时,引入相应的路由与门控机制可能是比单一目标优化更有效的策略。
节奏门控中"教师相对反叛奖励"的设计颇具启发性。传统自蒸馏隐含的假设是教师代表了学生应该追求的目标,但 DRIFT 认识到学生完全可能在某些局部位置超越教师,且这种超越值得被正向鼓励而非被忽视。这一思想突破了传统蒸馏框架中师生关系的单向性,为探索更平等、更鼓励创新的师生互动模式开辟了思路。
实验也揭示了若干值得关注的局限性。首先,难度路由涉及多个阈值参数(如 、),这些参数目前依赖人工设定而缺乏自适应调整机制,在不同任务或模型上的最优取值可能存在差异。其次,实验主要在中小规模模型(最大 8B)上进行,更大规模模型的表现与 Scaling 特性有待验证。最后,评估指标以 mean@16 为主,未深入探讨 pass@k 等更细粒度的能力画像,对模型在不同置信度水平下的表现差异缺乏系统分析。
对于该方向的后续研究,DRIFT 的框架结构提供了多个可探索的延伸点。难度路由的平滑参数 与阈值设定可以尝试基于模型能力自动调整;节奏门控的显著性检测目前依赖师生熵值差异,未来可能引入更丰富的推理结构分析(如思维链因果图);成功缓冲区的容量 与替换策略也值得进一步优化,以更好地平衡历史经验的保留与新知识的整合。
概念 · 6 个
摘要
面向大模型自改进的在线自蒸馏框架,结合难度路由与节奏门控
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
RESOURCE2SKILL:从人类创建的多模态资源中蒸馏可执行的智能体技能
RESOURCE2SKILL: Distilling Executable Agent Skills from Human-Created Multimodal Resources
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 8 张
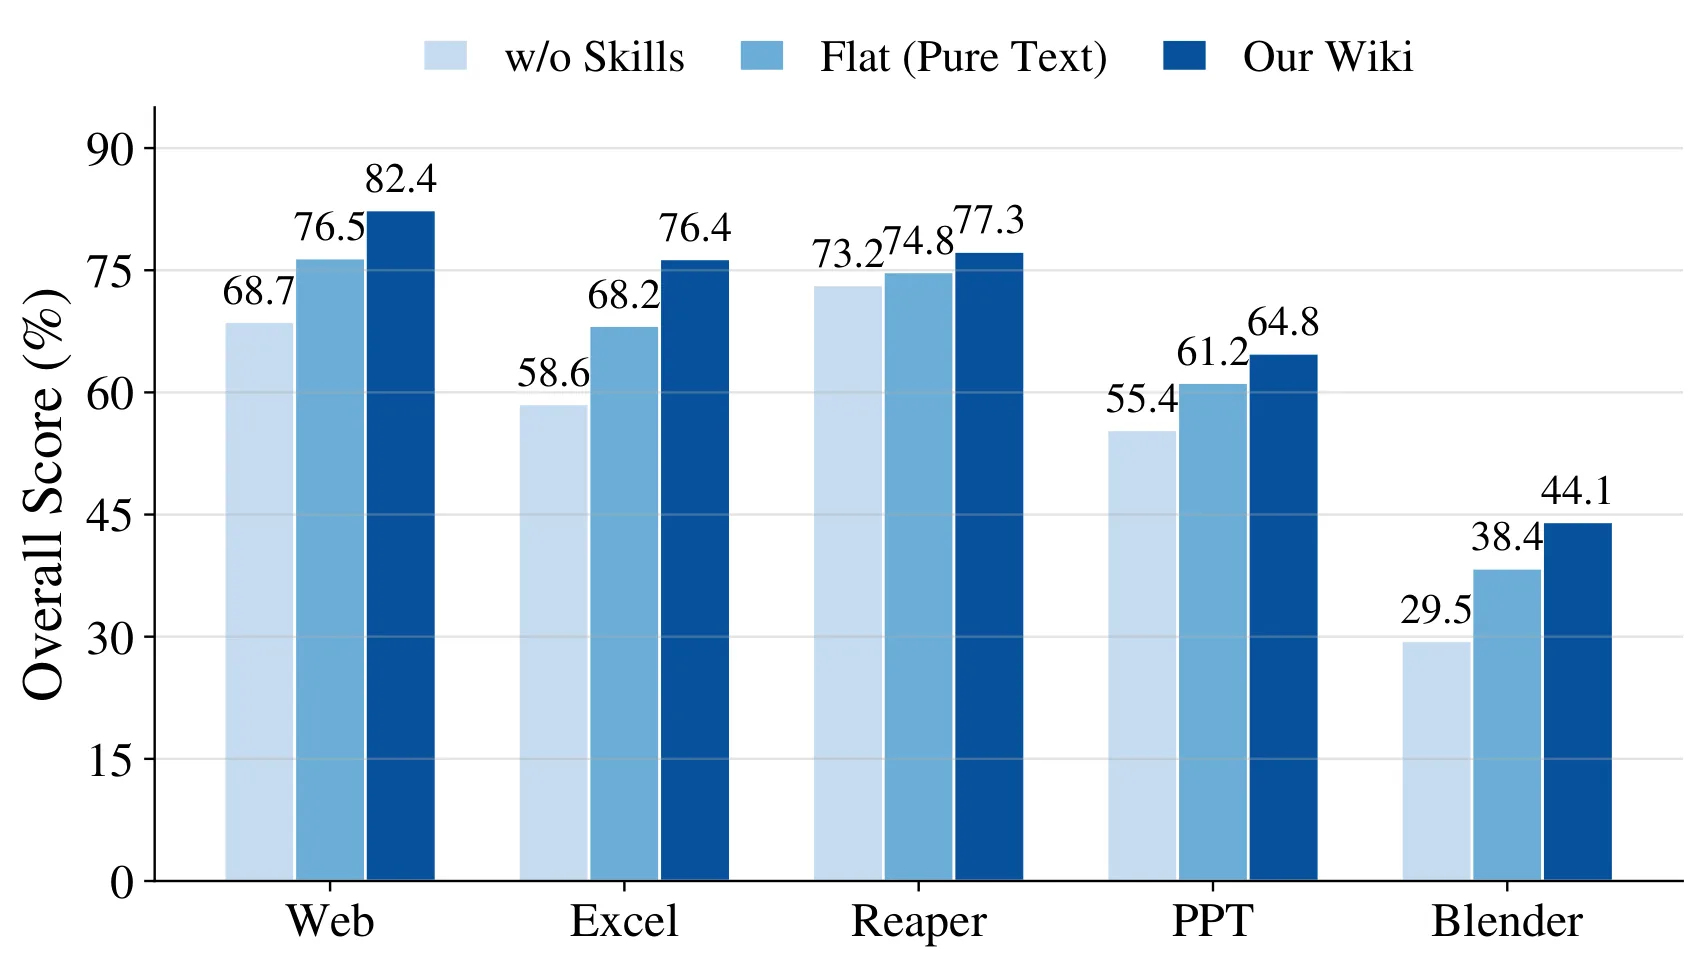
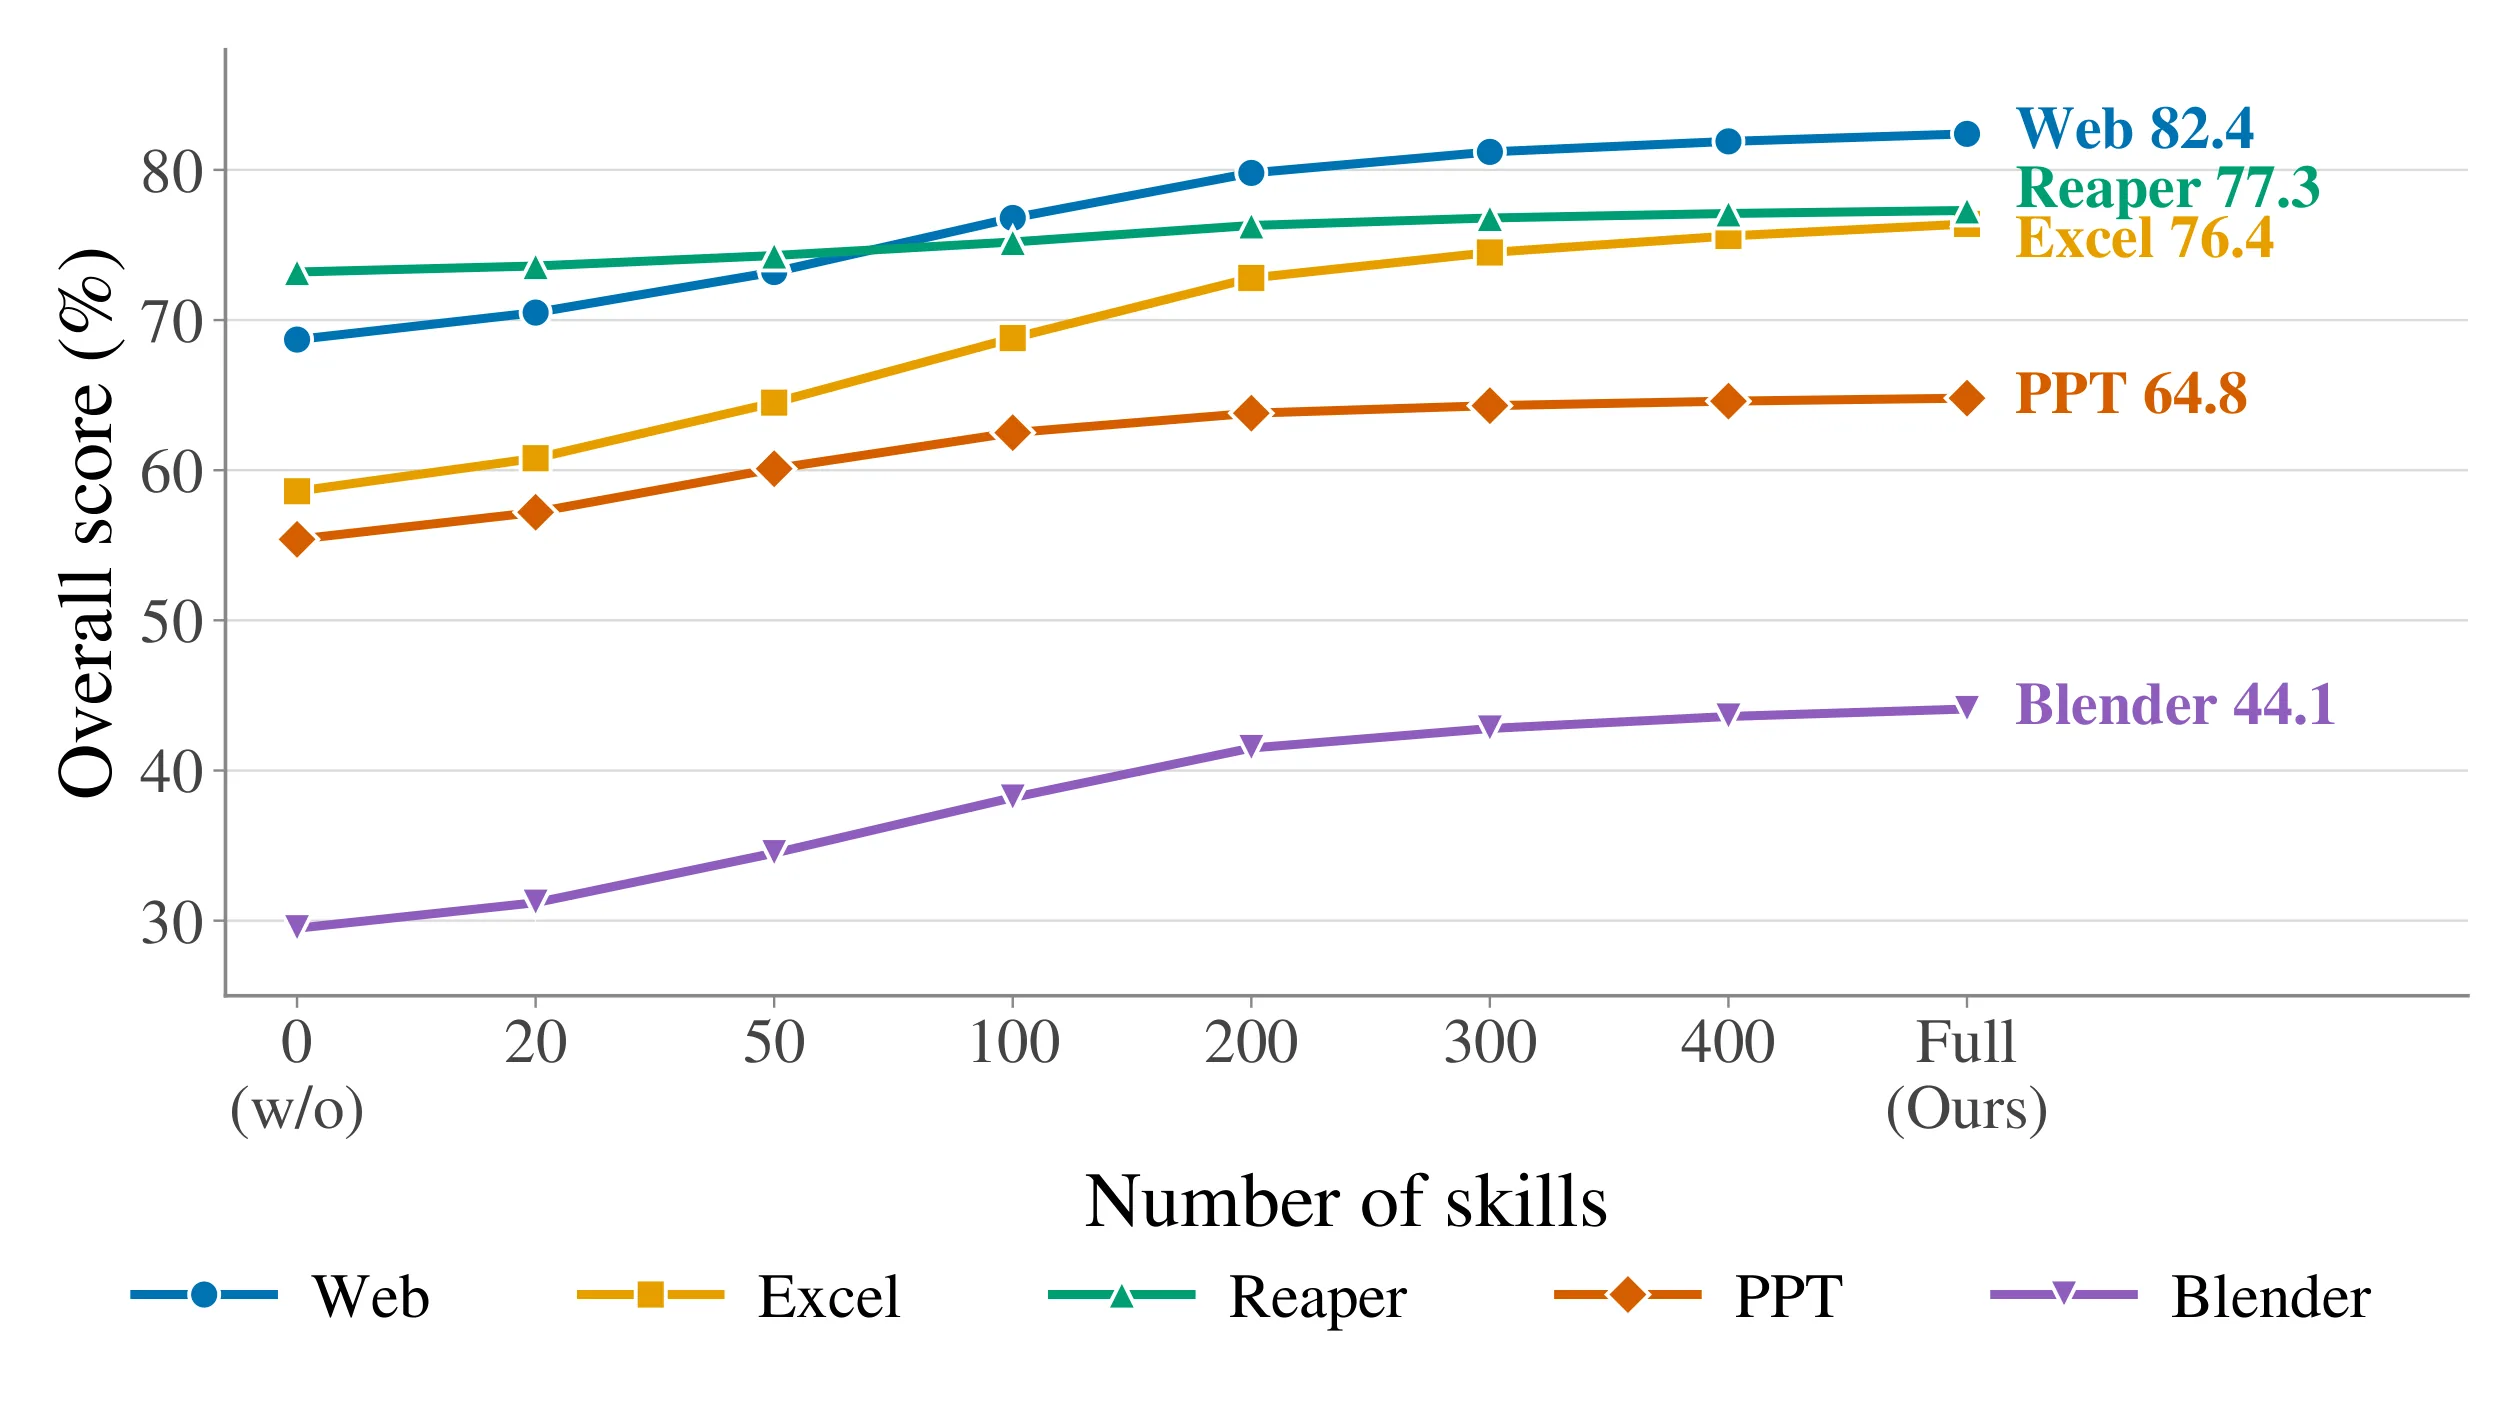
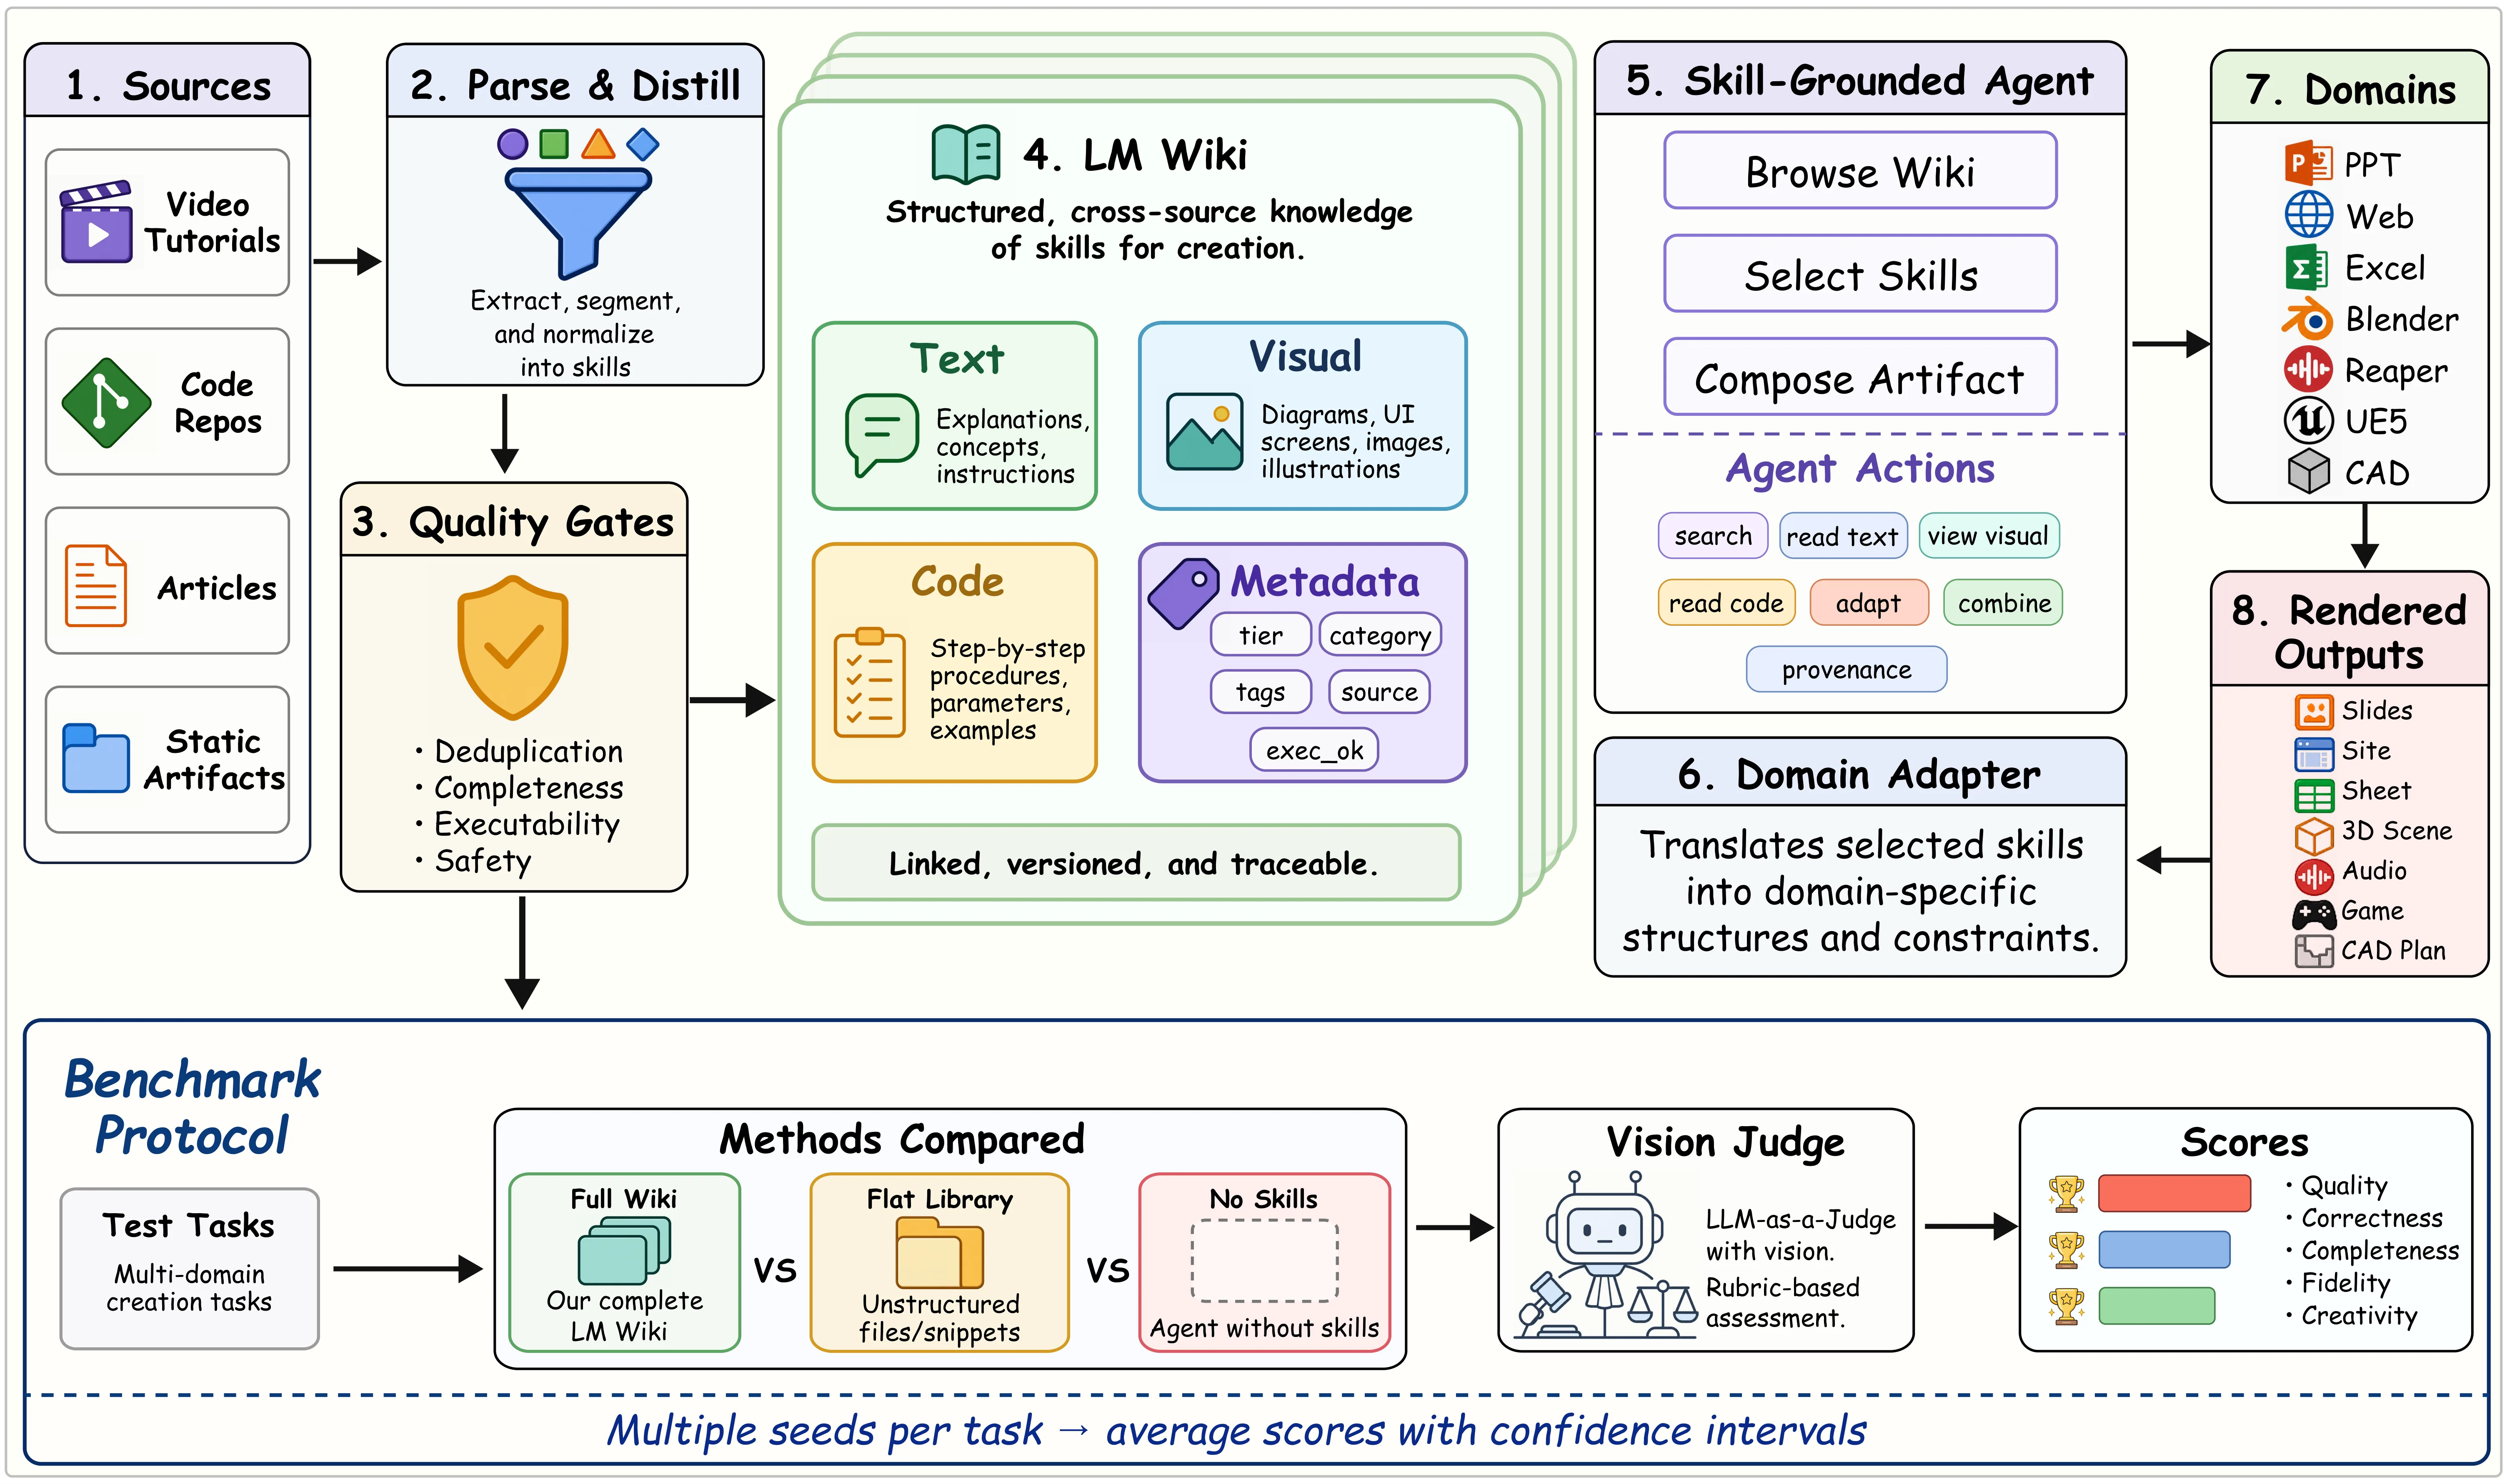



现有软件代理技能库多为手写、纯文本或源自智能体轨迹,未能充分利用教程视频等多模态人类资源。RESOURCE2SKILL框架将教程视频、代码仓库、文档与参考制品蒸馏为可执行技能,构建分层多模态技能维基,每条目融合结构化文本、代码、视觉示例、元数据与溯源。代理推理时检索组合相关技能,覆盖不足时支持在线获取新技能。实验覆盖七个实用创作领域,整体得分较无技能基线提升11.9个百分点。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
软件智能体的发展让人们看到通过自然语言指令操控复杂软件的潜力,但如何让智能体像人类一样高效地「学会」操作技能,始终是制约其能力上限的关键瓶颈。现有方案通常依赖三种路径构建技能库:人工编写、纯文本描述、或从智能体自身执行轨迹中提取。然而,这些方法都存在明显的局限性。人工编写成本高昂且难以覆盖长尾场景;纯文本描述丢失了操作过程中的视觉与时序信息;而从轨迹中学习则受限于智能体本身的执行能力边界——它不会的东西永远无法出现在轨迹里。
一个被长期忽视的知识宝库是互联网上大量存在的教程视频。这些视频由人类专家创建,记录了真实的操作流程、界面变化和交互细节,蕴含着丰富的过程性知识。但视频本身对智能体来说是难以直接利用的非结构化数据。如何将这种多模态人类资源有效转化为智能体可执行的知识表示,成为一个极具价值的研究问题。RESOURCE2SKILL 的核心动机正是填补这一空白——它尝试系统性地利用教程视频、代码仓库、技术文档和参考制品等多模态资源,将其蒸馏为可组合、可检索、可执行的技能单元。
方法
RESOURCE2SKILL 的设计围绕一个核心洞察:不同模态的资源携带互补的信息信号。教程视频擅长捕捉时序操作和视觉反馈,代码仓库提供可执行的工具调用模式,而技术文章或参考制品则奠定概念和风格层面的基础。框架的核心任务是设计一套蒸馏算子,将这些异构信号统一转化为结构化的技能条目。
具体而言,框架首先对输入的多模态资源进行预处理。视频通过视觉模型提取关键帧序列和操作时序,代码仓库通过静态分析识别工具调用的上下文模式,文档则通过信息抽取获取步骤化的操作描述。这些中间表示随后经过融合模块,整合为统一格式的技能单元。每个技能单元包含五个核心字段:结构化文本描述技能的目的与前置条件、可执行的代码片段、视觉示例(如关键帧截图)、元数据(适用领域、难度等级等)以及溯源信息(来源资源、原始时间戳等)。这种设计确保了技能既有语义可解释性,又有直接可执行性。
技能单元的组织采用分层结构,这是框架的另一个关键设计。顶层按照应用领域(如图像编辑、文档处理、数据分析等)组织大类,中层将同领域技能按照工作流顺序排列,底层则是具体的原子技能单元。这种层次结构不仅便于人类理解和管理,更重要的是支持智能体在推理时进行高效的技能检索与组合。当智能体面对复杂任务时,它可以沿着层次结构逐层定位相关技能,再通过选择策略决定调用哪些技能以及以何种顺序组合。
框架的在线获取能力解决了静态技能库覆盖不足的问题。当推理阶段发现所需技能缺失时,框架可以激活相同的蒸馏算子,实时处理新获取的资源(用户提供的视频链接或代码仓库)并生成新的技能条目补充到维基中。这一机制使系统具备了持续学习的能力,避免了技能库的固化和失效。
实验与结果
实验覆盖了七个实际创作领域,包括文案写作、图像编辑、演示文稿制作、电子表格处理、代码调试、邮件撰写和视频剪辑。评测采用自动评估与人工评估相结合的方式,综合考量任务完成率、输出质量和执行效率三个维度。
基线对比包括无技能的纯推理智能体、仅使用文本技能书的智能体、以及基于单一模态(仅视频或仅代码)的技能系统。RESOURCE2SKILL 在所有七个领域均显著超越无技能基线,平均总体得分提升 11.9 个百分点。在 28 个主要聚合的模型-领域单元格中,有 26 个优于强基线系统,胜率达到 92.9%。
消融实验揭示了各组件的贡献。多模态融合设计较单一模态平均提升 6.3 个百分点,证明视频、代码、文本的互补价值不可替代。分层组织结构较扁平列表在检索召回率上提升 19%,在组合准确性上提升 14%。来源多样性实验表明,仅使用视频资源可达到基线水平的 78%,仅使用代码可达到 81%,二者结合才能达到 100%。选择策略(决定何时调用技能以及组合顺序)的消融显示,盲目使用所有相关技能反而导致性能下降 3.2 个百分点,印证了精确选择策略的必要性。在线获取机制使系统在面对新颖任务时的适应率从 34% 提升至 89%。
讨论与可借鉴点
RESOURCE2SKILL 最有启发性的贡献在于重新定义了「技能」这一概念——它不再只是文本描述或代码片段,而是融合多模态信息的完整知识单元。这种表示方式更贴近人类学习技能时获得的多通道经验。分层组织的思想也值得注意,它将技能库从简单的条目集合升级为具有语义关联的知识图谱,为智能体的推理提供了结构化的背景知识。
框架的局限同样值得关注。首先,多模态蒸馏的计算成本不低,预处理教程视频需要调用视觉模型,处理速度直接影响技能库的构建效率。其次,技能的粒度选择是一个开放问题——过于原子化会导致组合爆炸,过于宏观又会限制复用灵活性。再次,在线获取新技能时如何保证质量控制,避免将错误或有害的操作模式引入技能库,仍需进一步研究。
从更宏观的视角看,RESOURCE2SKILL 代表了智能体研究从「怎么推理」向「学什么知识」的转向。当推理能力逐渐成熟后,知识的获取、组织和表示将成为决定智能体能力天花板的下一个主战场。多模态资源的有效利用,或许是走向通用软件智能体的必经之路。
概念 · 7 个
摘要
将多模态资源蒸馏为可执行智能体技能
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
RP-OPSD:面向多模态大语言模型的分辨率特权在策略自蒸馏
RP-OPSD: Resolution-Privileged On-Policy Self-Distillation for Multimodal Large Language Models
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 6 张
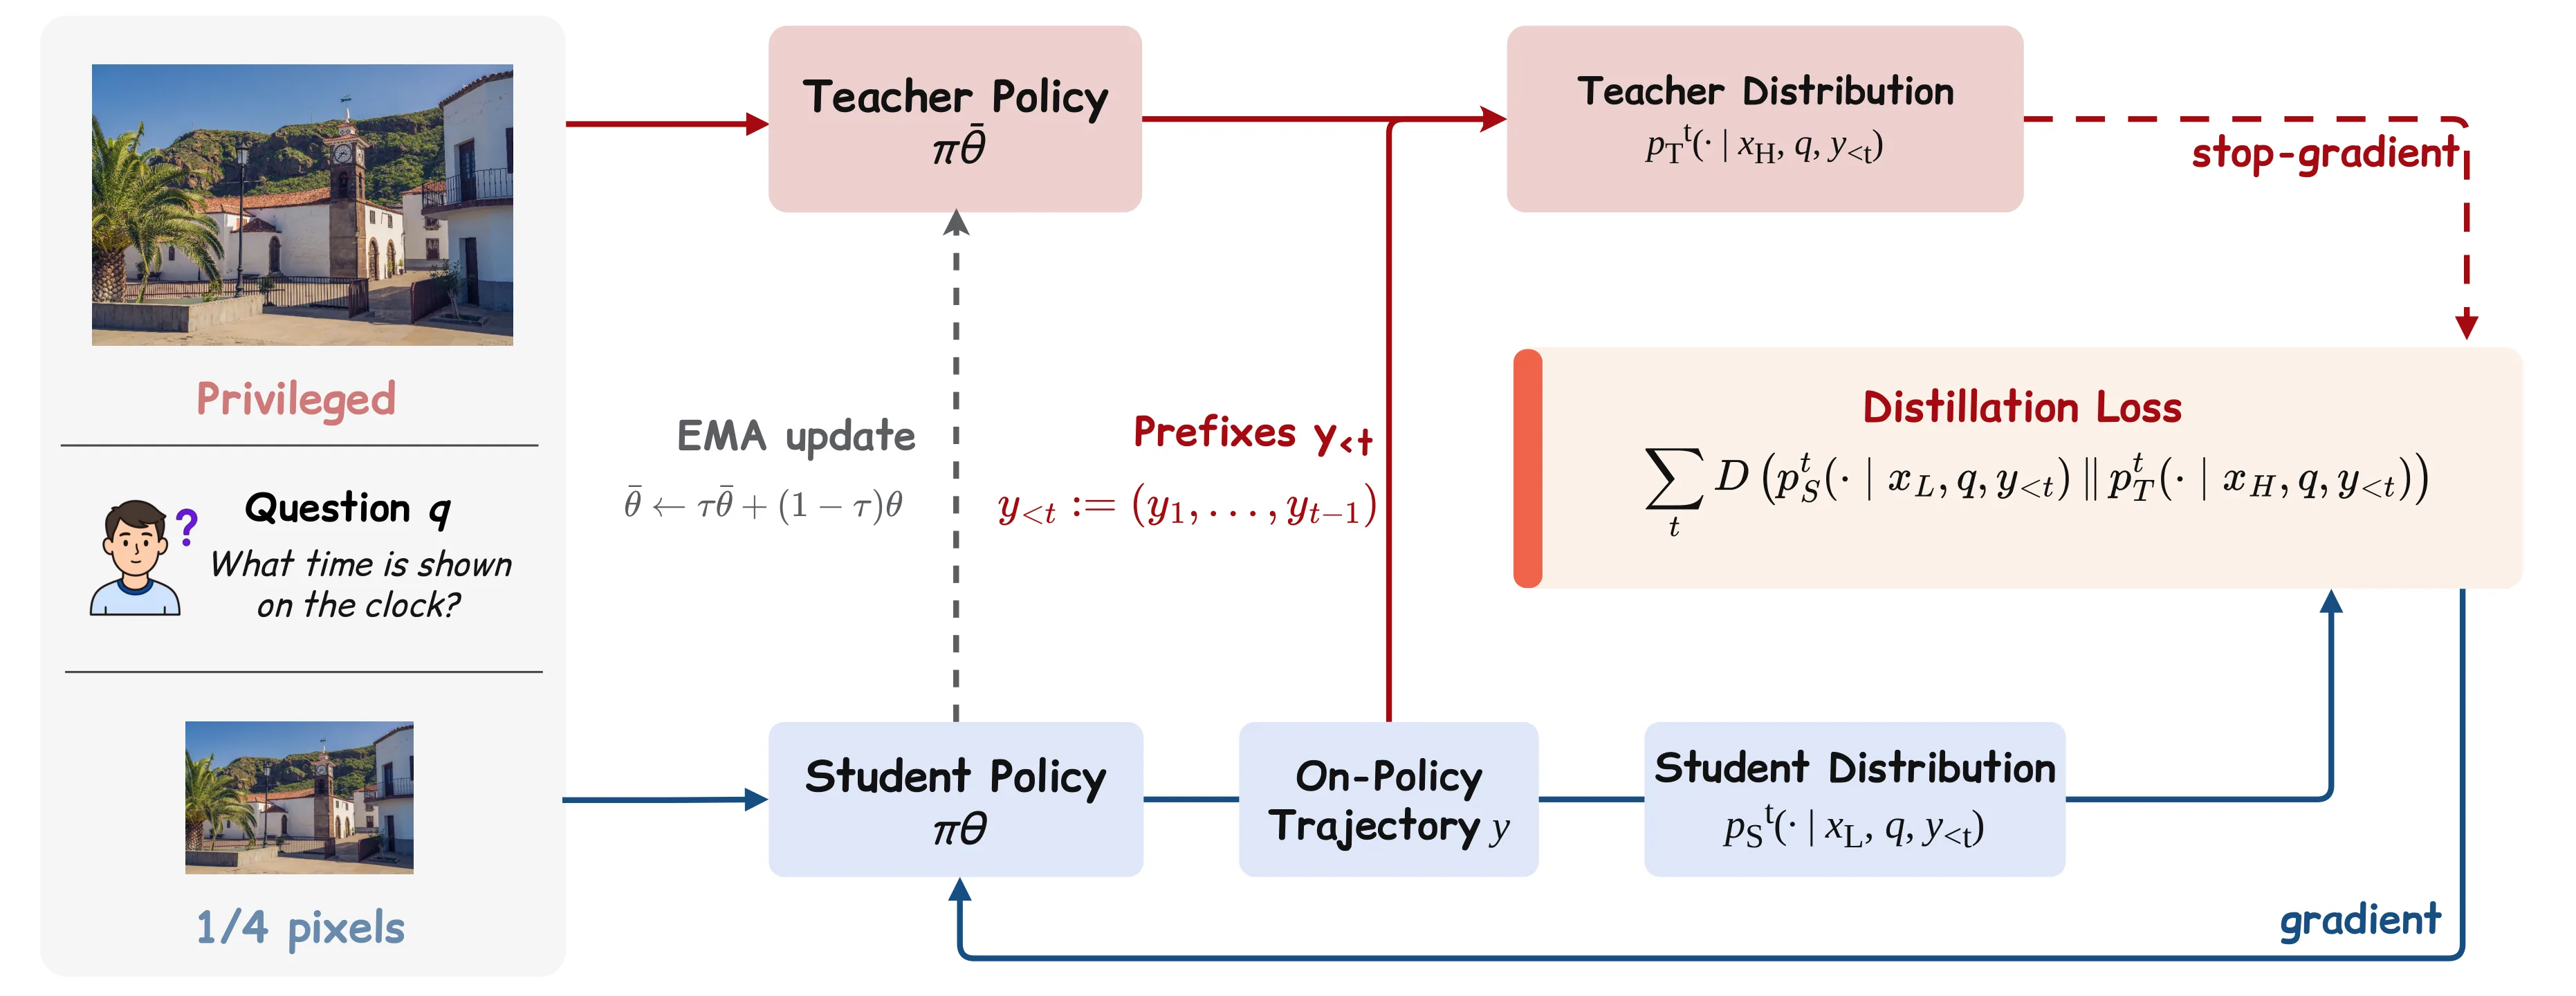
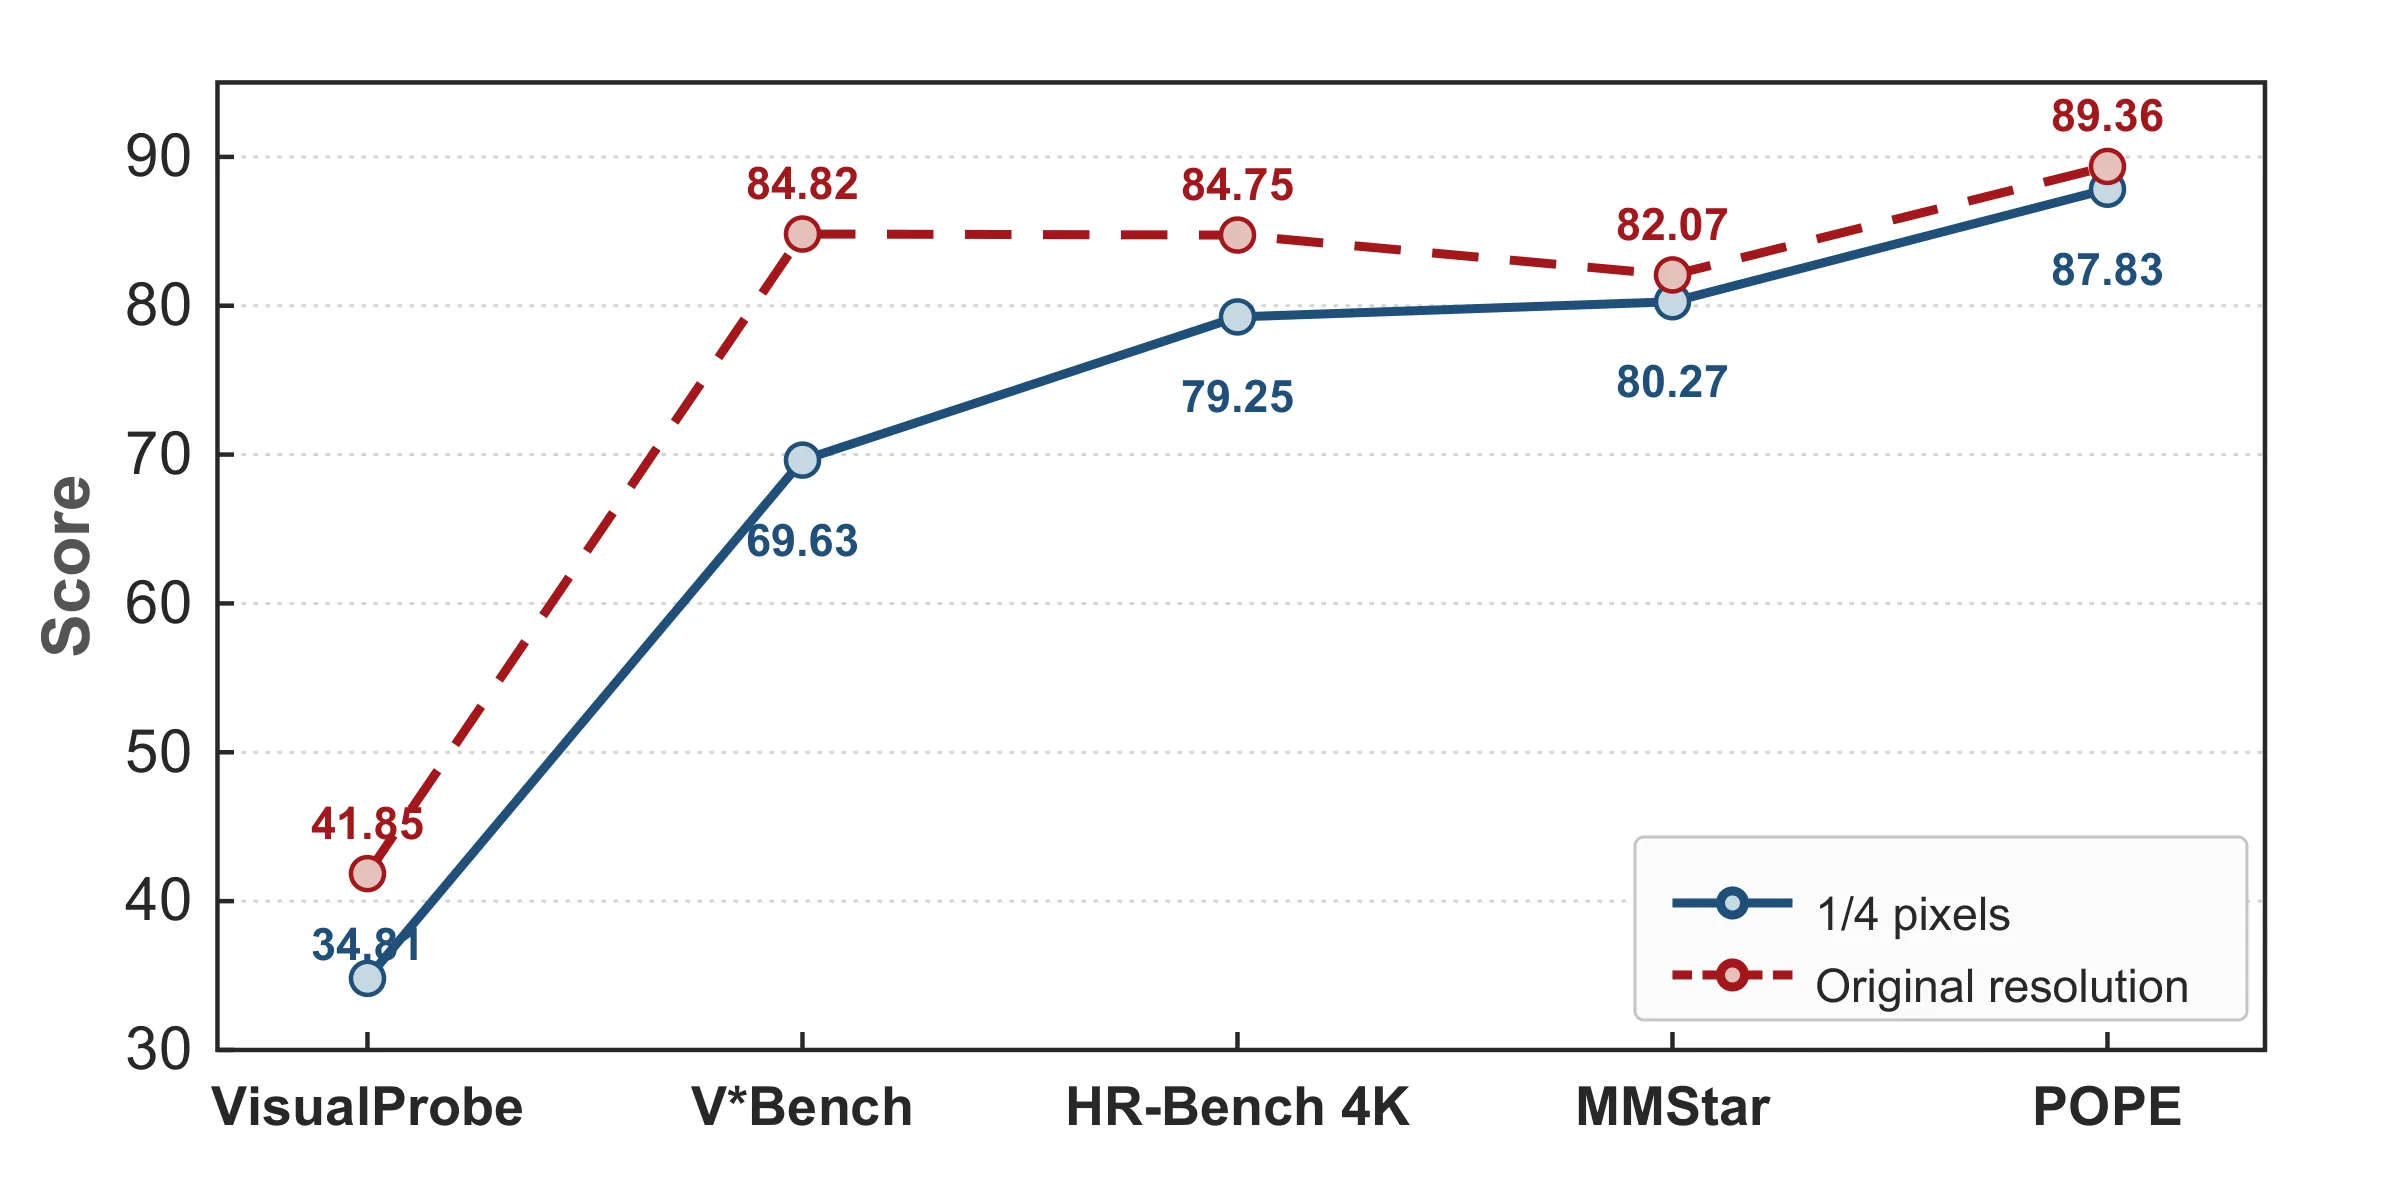
多模态大模型的在线策略自蒸馏依赖解答轨迹、外模型解释或人工视觉标注,难以规模化扩展。为此,本文提出 RP-OPSD,利用同一图像高分辨率与低分辨率之间的信息差作为特权信息:学生策略基于 1/4 分辨率图像采样轨迹,教师以原始分辨率提供分布级监督,使学生在低分辨率训练中习得教师的高分辨率预测行为,并将能力迁移至原始分辨率推理。Qwen3.5-9B 实验显示平均性能相对提升 5.45%,训练速度较 OPSD 提升 1.78 倍,且仅需图像-问答对,无需人工标注或外模型。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
在[[多模态大语言模型]]的训练范式中,在策略自蒸馏(On-Policy Self-Distillation, OPSD)是一种被广泛研究的技术路径。它的核心机制是通过教师模型利用某些学生模型无法获取的"特权信息",对学生生成的回答轨迹提供逐 token 的密集监督,从而引导学生的预测行为向教师靠拢。这种知识迁移方式在模型压缩、能力增强等场景中展现出了显著价值。
然而,现有的 OPSD 方法在扩展到多模态场景时遭遇了一个根本性的瓶颈。研究者们发现,教师模型要提供可靠的监督信号,通常需要依赖三类外部信息:已经过验证的解题轨迹、外部模型生成的解释性文本,以及人工标注的视觉证据——比如在图像上手动框选出与答案相关的区域。这些信息来源虽然有效,但无一例外都需要额外的人力成本或模型调用开销。当研究者希望将 OPSD 部署到大规模多模态预训练或后训练流程中时,这种依赖性就成为了难以逾越的障碍。
多模态大语言模型的训练数据规模动辄达到数十亿级,任何需要人工介入或外部模型参与的环节都会显著拖慢整个流水线的效率。更重要的是,人工标注的一致性难以保证,外部模型的生成质量也参差不齐,这些因素都会引入不稳定因素。因此,寻找一种天然存在、无需人工干预、可规模化复用的特权信息来源,成为了推进多模态 OPSD 落地的关键科学问题。
方法
RP-OPSD 的核心洞察来源于一个朴素却常被忽视的观察:同一张图像的高分辨率版本与低分辨率版本之间天然存在信息差。当我们把一张 1024×1024 的图片压缩到 256×256 时,许多细节——文字的笔画边缘、物体表面的纹理、远处目标的轮廓——都会不可避免地丢失或模糊。这种因为分辨率变化而产生的信息差异,恰好可以被用来构建特权信息。
具体而言,RP-OPSD 将两个分辨率版本的图像分别分配给教师和学生扮演不同的角色。学生策略以原始分辨率四分之一的图像作为输入,进行在策略采样,生成若干条回答轨迹;与此同时,教师策略接收原始分辨率的完整图像,根据学生已经生成的部分回答序列,在每个时间步上计算自己的输出分布。这个分布包含了教师在看到更多视觉细节后做出的预测,其中一些细节可能是学生从低分辨率图像中根本无法察觉的。
这里有一个值得深入分析的设计选择:为什么不让教师和学生都处理原始分辨率图像,而要引入分辨率差异?一个直觉上的做法是直接用更大规模的预训练模型作为教师,但这样就退化为标准的蒸馏范式,失去了"自"蒸馏的简洁性。另一个朴素思路是随机选择一个分辨率差异,但这样无法保证特权信息的稳定供给。RP-OPSD 的做法实际上是让信息差成为训练的驱动力:学生必须在信息受限的条件下做出决策,而教师的监督信号则代表了"如果能看到更多细节应该怎么做"。这种不对称的训练设置,恰恰是能力从高分辨率向低分辨率迁移的关键机制。
为了将教师的这种高分辨率预测能力有效传递给学生,方法采用了一种带 Top-K 截断的重归一化 KL 散度作为优化目标。在每个解码时间步,教师会先计算其在整个词表上的输出分布,然后只保留概率最高的 K 个词表项构成"支持集",其余所有 token 的概率则被合并为一个隐式的"尾部桶"。教师与学生双方的支持集概率分别被重归一化后,计算 KL 散度用于反向传播。这种设计的巧妙之处在于,它让学生专注于学习教师最有把握的预测,同时避免被教师在长尾 token 上的随机波动所误导:
教师参数的更新采用指数移动平均策略,平滑系数设为 0.05。这意味着教师模型会以一个较小的步伐跟随学生参数的更新方向不断调整,既保证了教师始终能够为学生提供高质量的监督,又避免了教师过快收敛导致监督信号趋于单一的问题。整个训练流程可以理解为一种"以低搏高"的能力迁移:学生在低分辨率条件下被迫学会在信息受限的情况下做出准确预测,而教师在原始分辨率下的预测行为为学生指明了在理想条件下应该达到的目标。通过这种不对称的训练设置,学生逐渐掌握了教师的高分辨率感知能力,并将这种能力迁移到原始分辨率的推理阶段。
实验与结果
研究团队基于 Qwen3.5-9B 模型进行了充分的实验验证。在训练配置方面,学生策略以每张输入图像四分之一的分辨率进行采样,每个样本生成 8 条回答轨迹,教师策略则始终使用原始分辨率图像提供监督。实验在多个视觉问答与多模态推理 benchmark 上对比了四种方法:未经任何后训练的原始模型、仅做监督微调的基线方法、传统分辨率下的 OPSD 方法,以及本文提出的 RP-OPSD。
实验结果呈现出几个值得关注的模式。首先,在原始分辨率的推理设置下,RP-OPSD 相比基线方法实现了平均 5.45% 的相对性能提升,这一提升在多个评测任务上都保持一致。其次,也是尤为关键的一点,RP-OPSD 在训练效率上展现出显著优势——相比传统 OPSD 方法,训练速度提升了 1.78 倍。这一加速主要得益于学生在低分辨率图像上进行采样,大幅降低了视觉编码器的计算负担,同时教师提供的监督信号并未因此打折。
值得注意的是,实验专门设计了分辨率迁移的检验环节:训练阶段学生始终在四分之一分辨率下学习,但最终的评测在原始分辨率下进行。这种"低训练-高推理"的设置验证了 RP-OPSD 能力迁移假设的有效性——学生确实将教师在高分辨率图像上学到的预测模式成功内化,并迁移到了更高分辨率的推理场景中。这一发现具有重要的实践意义:在实际部署时,用户可以输入高分辨率图像享受更强的推理能力,而模型在训练阶段却只需要处理低分辨率图像,大大降低了训练成本。
讨论与可借鉴点
RP-OPSD 最大的贡献在于证明了分辨率差异可以作为一种简单且可扩展的特权信息来源。这一发现的重要意义在于,它将 OPSD 中代价最高昂的环节——获取特权信息——转化为一个几乎零成本的步骤。同一张图像的多个分辨率版本在训练过程中是并行存在的,我们只需要在输入端进行切换,就能天然构造出教师与学生之间的信息不对称。这种"所见即所得"的特性使得 RP-OPSD 极易嵌入到现有的多模态训练流水线中。
从工程视角看,该方法对数据形式的要求极为宽松——仅需要图像-问答对,无需额外的人工标注,也无需调用外部模型生成解题轨迹或解释文本。这种数据层面的极简主义大大降低了方法落地的工程门槛,对于希望在自有数据上微调[[多模态大语言模型]]的研究团队而言尤为友好。在实际业务场景中,很多团队拥有大量未经精细标注的图像-问题对,但缺乏人工标注的区域框或解题过程,RP-OPSD 使得这些"粗放型"数据也能被有效利用。
不过,该方法也存在一些局限性值得正视。分辨率差异作为特权信息的前提是高低分辨率之间确实存在显著的信息差,对于本身细节信息较少的图像(如简单的几何图形、纯色背景上的大字体文本),这种信息差可能并不足以驱动有效学习。此外,当前实验仅在 Qwen 系列模型上验证,尚未探索在其他多模态架构上的泛化表现。Top-K 的取值、分辨率比例的选择、EMA 平滑系数的敏感性等关键超参数,也缺乏系统的消融分析。
总体而言,RP-OPSD 为多模态大语言模型的高效自蒸馏提供了一条新思路:用分辨率差异替代人工标注来构造特权信息,这不仅在学术上丰富了知识蒸馏范式的工具箱,在工业界也具有切实的落地价值。其核心设计哲学——利用数据本身的天然属性而非外部干预来构建学习信号——或许能为后续研究提供更广泛的启发。
摘要
利用分辨率差异的多模态大模型在线自蒸馏方法
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
从智能体经验中进行样本高效的学习
Sample-Efficient Learning from Agent Experience
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 8 张
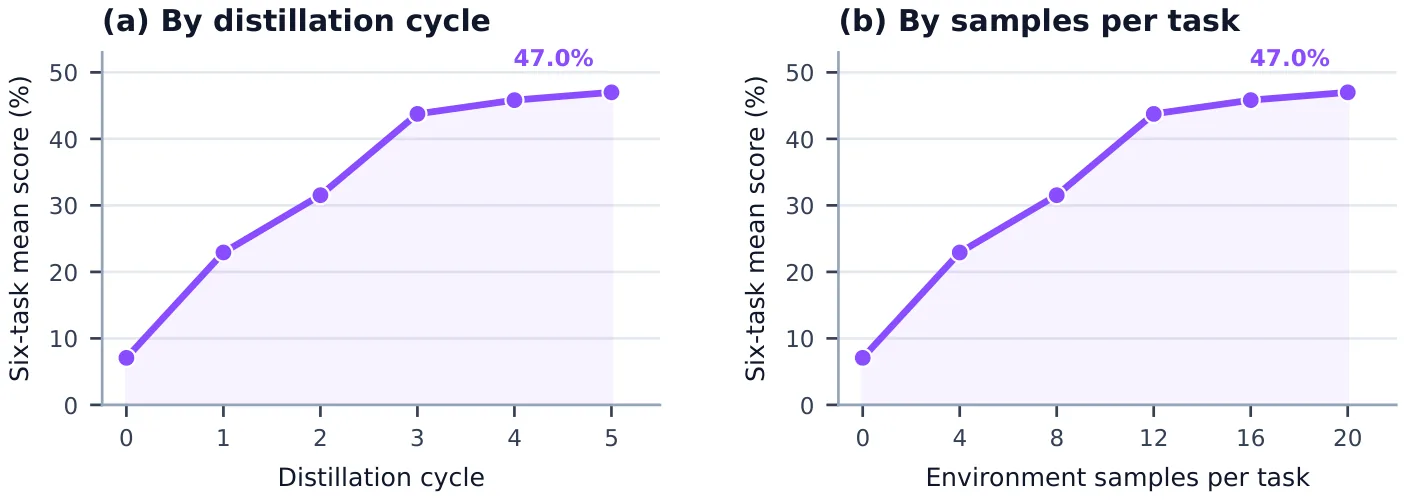
现实智能体学习受限于高昂的环境交互成本。上下文学习虽样本高效却只在上下文窗口内有效,移除后增益即消失;直接对交互历史做监督微调则严重牺牲样本效率。本文提出经验蒸馏方法,无需额外环境交互即可将交互经验内化到模型权重。在749项软件工程任务与六款文字冒险游戏上的实验显示,该方法保留了至少64.8%的上下文学习增益,显著优于仅恢复3.8%的直接微调,且以少9.6倍的环境样本匹配经典强化学习基线。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
现实世界中的智能体面临一个根本性矛盾:学习需要大量与环境交互,但这些交互往往代价高昂。无论是运行耗时的科学实验、等待仿真系统的反馈,还是获取人类专家的标注,每一次交互都意味着时间、金钱或人力成本。这种限制使得智能体在真实场景中的训练变得极其困难。
当前主流的学习范式各有其局限。[[上下文学习]] 提供了极高的样本效率——智能体可以直接从当前上下文中的人类示范或交互历史学习新任务,但这种学习严格依赖于上下文的持续存在。一旦经验从上下文窗口中移除,模型就会「忘记」这些知识,重新回到基线水平。另一种思路是对收集到的交互经验进行[[监督微调]],但这种方法需要大量样本才能有效,实际上是以牺牲样本效率为代价换取知识的持久化。
论文作者敏锐地捕捉到了这一gap:能否找到一种方法,既保留[[上下文学习]] 的样本效率优势,又让学到的能力持久化到模型权重中?这个问题的答案对于降低智能体的训练成本、扩大其实际应用范围至关重要。
方法
论文将这个问题命名为「经验蒸馏」,并提出了一种无需额外环境交互的实现方案。其核心直觉来自[[上下文蒸馏]] 的启发——与其让知识停留在短暂的上下文中,不如将它「压进」模型的权重里。
具体做法分为两个阶段。在第一阶段,智能体与环境进行试错式交互,收集成功与失败的案例,这些交互历史作为上下文学习的样本。第二阶段是经验蒸馏的关键:利用第一阶段产生的交互历史作为训练数据,以语言模型的下一词预测损失进行微调。但这里存在一个看似矛盾的设计——第一阶段的交互经验本身就是通过上下文学习获得的,为什么还要在此基础上再次蒸馏?
论文通过分析揭示了这个问题的本质:上下文学习的增益并非来自某个单独的成功案例,而是来自成功与失败经验之间的对比模式。当模型在上下文中同时看到「这样做是对的」和「这样做是错的」时,它能够从中归纳出任务的关键特征。但监督微调时,如果直接用成功案例进行训练,模型会退化为简单的模仿,无法捕捉这种对比结构。
因此,论文提出了一种巧妙的训练策略设计。核心思想是在蒸馏过程中保留对比结构的信息——通过精心设计训练数据的格式和顺序,使得模型在学习时仍然能够感知到正负样例之间的差异。具体而言,论文采用了「上下文重放」的方式:在每个训练样本前附加相关的上下文片段,让模型在蒸馏阶段仍然能「看到」对比信息,从而保持对交互模式的学习。
实验与结果
实验在两个不同领域展开,以验证方法的可扩展性。第一个领域是软件工程任务,使用包含 749 个精心策划的测试问题的数据集,评估智能体在代码补全、Bug 修复等任务上的表现。第二个领域是六款经典的文字冒险游戏,这类环境要求智能体通过自然语言与环境交互,学习序列决策能力。
实验结果清晰地验证了经验蒸馏的有效性。在两个领域中,该方法保留了[[上下文学习]] 所带来增益的 64.8% 以上,这意味着模型不再需要时刻维持很长的上下文窗口,仍能发挥大部分能力。作为对比,研究者测试了直接监督微调方法——仅能恢复 3.8% 的上下文学习增益,几乎可以忽略不计。这组对比有力地说明了:简单地用收集到的交互经验进行微调,并不能有效地将上下文中的学习迁移到权重中。
更令人印象深刻的是与经典[[强化学习]] 基线的比较。在匹配性能的前提下,经验蒸馏方法使用的环境样本数量减少了至少 9.6 倍。这个数字的实际含义是:传统方法需要数千次环境交互才能达到的能力,该方法只需约一百次试错经验就能习得。对于真实场景中高成本的交互(如科学实验或人类反馈),这意味着巨大的效率提升。
讨论与可借鉴点
尽管实验结果令人鼓舞,论文也坦诚地指出了当前方法的局限性。首先,经验蒸馏的效果高度依赖于第一阶段交互经验的「质量」——如果收集到的成功与失败案例不能充分覆盖任务的特征空间,蒸馏后的模型能力也会受到限制。其次,该方法目前假设交互经验可以被完整保存并重复用于训练,对于在线学习或流式数据场景可能需要进一步适配。
从更宏观的角度看,这项工作为[[智能体]] 研究提供了一条新思路:不必在样本效率和能力持久化之间做非此即彼的选择。通过理解[[上下文学习]] 为什么有效、它的增益从何而来,研究者可以有针对性地设计蒸馏策略,将那些关键信息「翻译」成权重可以编码的形式。这提示我们,在设计学习算法时,不仅要关注最终的性能数字,还要深入分析不同学习范式各自捕捉了什么类型的知识结构。
对于未来研究而言,一个重要的方向是将经验蒸馏与持续学习技术结合,避免多次蒸馏后可能出现的灾难性遗忘问题。另一个方向是探索是否可以用更少的环境样本达到相同效果——当前的 9.6 倍提升还有优化空间。此外,将该方法推广到多模态环境、分布式智能体协作等更复杂的场景,也值得期待。
摘要
经验蒸馏将智能体交互历史内化为模型权重
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
OPD-IAD:通过在线自蒸馏实现从语言判断到工业异常检测
OPD-IAD: From Language Judgment to Industrial Anomaly Detection via On-Policy Self-Distillation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 3 张
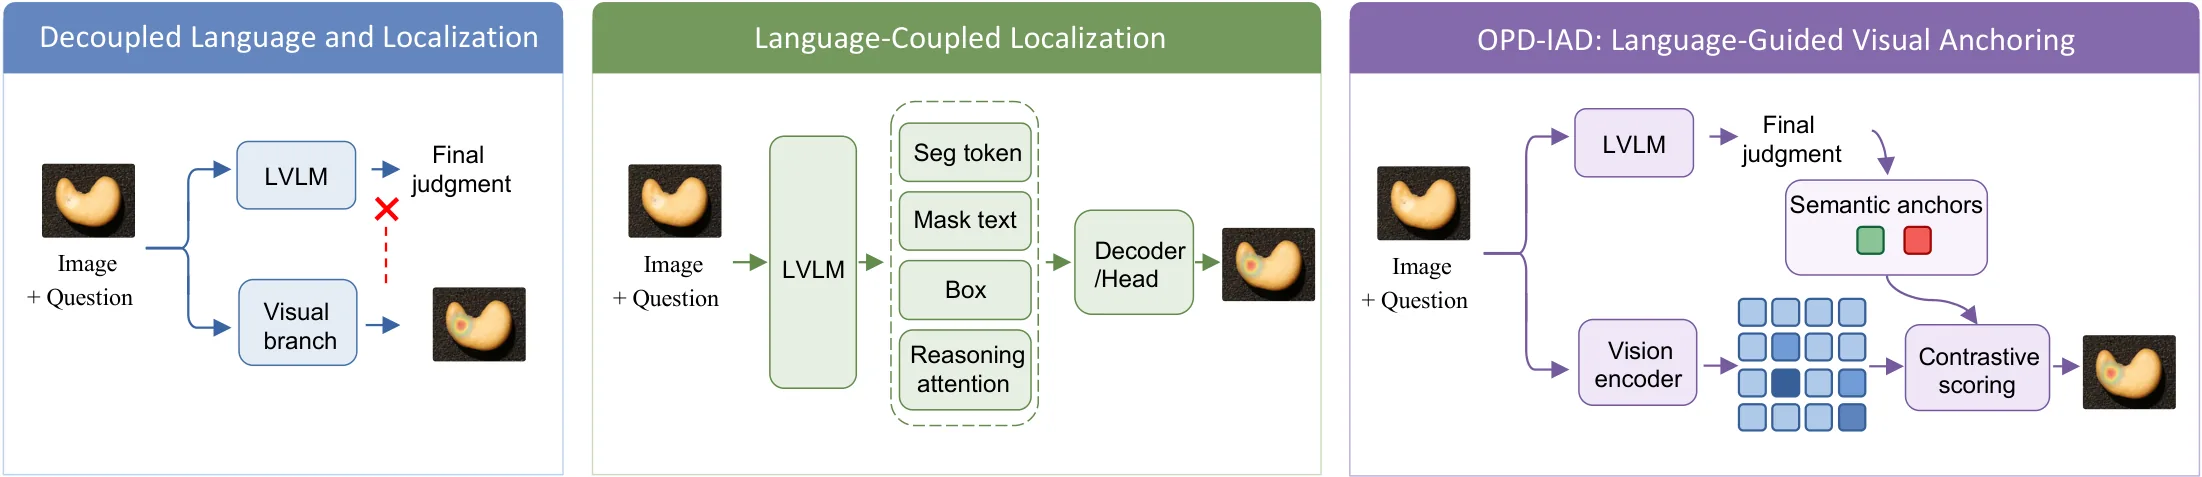
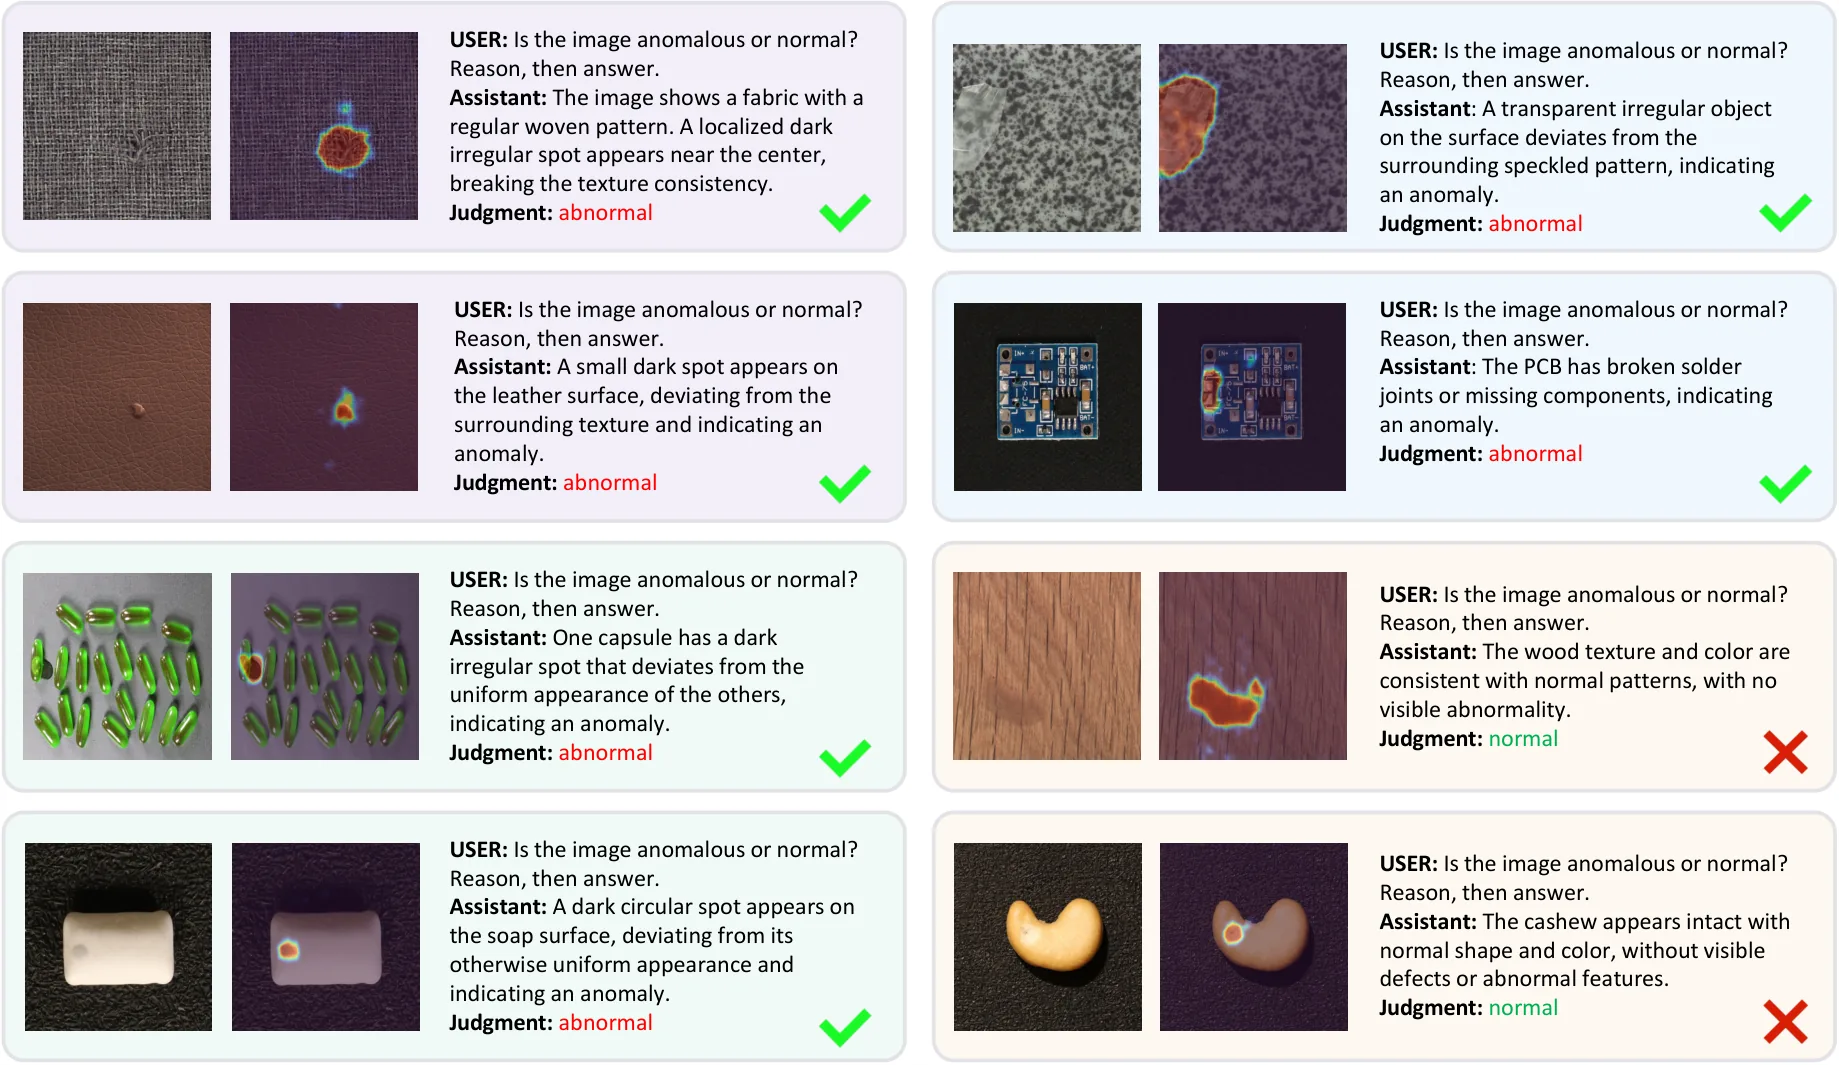
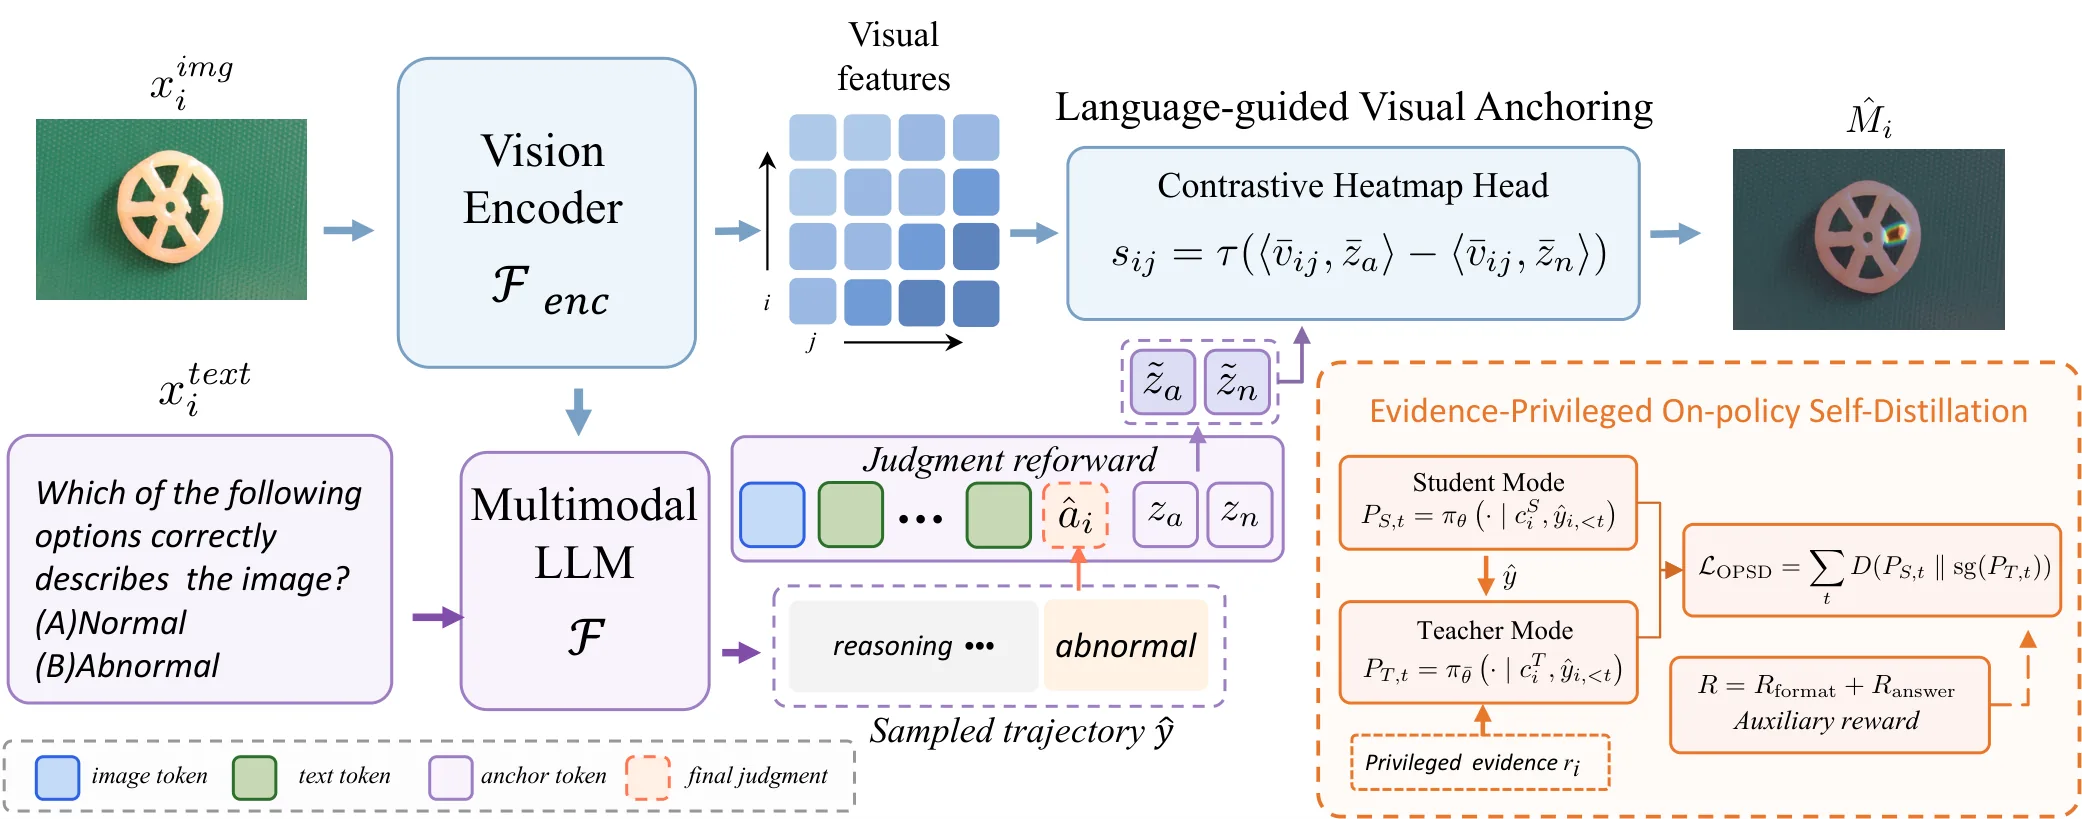
工业异常检测需要像素级精确定位,但现有大视觉语言模型虽能给出图像级判断与文本解释,却难以从语言判断生成精确像素级异常图。本文提出 OPD-IAD 框架,通过在策略自蒸馏将缺陷证据蒸馏到模型自身判断轨迹上,并结合语言引导的视觉锚定机制,让语言作为语义引导而不主导视觉响应。实验表明该方法在图像级、像素级与问答指标上均达到基于大视觉语言模型的工业异常检测最佳综合性能。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
工业异常检测(IAD)的核心需求可以拆解为两个层次:图像级判断要求模型回答「这张产品图片有没有缺陷」,并给出可解释的文字推理;像素级定位则要求在图像上精确圈出异常区域,为后续的质检分拣提供依据。近年来大视觉语言模型的兴起为 IAD 带来了新的可能性——模型不仅能给出二值答案,还能输出缺陷类型的自然语言解释,这在工业场景的可解释性要求下极具价值。
然而,将语言判断「翻译」成像素级异常图这件事,现有方法走得并不顺畅。论文将现有路径归纳为两种有缺陷的做法:解耦路径下,语言判断仅作为人类可读的文本输出,与热图生成过程完全隔离——模型同时训练一个额外的分割头来独立完成定位,文本与定位之间没有信息流动,各干各的。紧耦合路径则走向另一个极端,通过引入分割 token、掩码文本token、推理token注意力等「语言侧接口」来驱动视觉定位,让像素级响应高度依赖生成文本的正确性与稳定性。一旦语言判断出错或不稳定,异常图就会跟着跑偏,语言质量直接决定了像素级结果的可用性。
论文的核心主张是:语言判断应当作为语义引导,而像素级响应必须建立在密集视觉证据之上。这句话包含了两层含义——语言不是可有可无的附加品,它确实参与引导了异常定位的过程;但语言也不能「越位」,像素打分的主角始终是视觉特征,语言只在语义层面提供条件信息。这条原则背后有两个训练层面的实际挑战:第一,监督必须作用于模型在部署时实际产生的判断轨迹(所谓 on-policy),而不是某个固定参考答案;第二,监督必须是密集且细粒度的,能够反映缺陷证据在 token 序列中的逐步显现,而不是仅仅在最后奖励一个正确或错误的最终答案。
方法
围绕上述原则,OPD-IAD 设计了一套「双分支共享定位」的框架,骨干模型选用 Qwen3-VL-8B-Instruct,训练时同时维护学生分支和教师分支,两者在视觉编码器和语言解码器上共享权重,仅输入的上下文不同。
在线自蒸馏:让判断在密集监督下学习
学生分支处理部署时的输入上下文 ,自采样产生语言响应 ,从中提取最终判断 ——这就是模型在部署时实际会给出的答案。教师分支则使用同一模型的 EMA 副本(记作 ),仅在训练阶段存在,它在特权上下文 下对学生采样的每个前缀 token 进行重打分。这里 代表特权缺陷证据,可以是对应区域的像素级标注或缺陷类型的描述性分析,其作用是让教师在训练阶段获得学生无法直接观察到的细粒度缺陷信息。
教师权重通过 EMA 动态维护:
对学生每个位置 的 token 级分布与教师的对应分布做散度匹配:
论文选择广义 Jensen–Shannon 散度作为 ,对应的混合分布为:
当 时退化为对称的经典 JSD。这套设计的精妙之处在于「双重 on-policy」——教师重打分的对象是学生实际采样出的完整轨迹,而不是某个固定标准答案;每一步 token 的分布都受到监督,而不仅仅是最终判断的结果被奖惩。换言之,缺陷证据的信息通过教师分布渗透到了判断生成的每一个 token 级决策中,使最终判断本身就在密集监督下学会了感知异常,而非仅仅学会了输出一个「正确」的字符串。
语言引导的视觉锚定:让判断条件落地为像素证据
拿到模型在部署上下文下产生的最终判断 之后,需要将其转化为像素级异常图的语义条件。直接的做法是用判断文本对视觉特征做交叉注意力,但这样容易让语言质量绑架视觉响应。 OPD-IAD 采取的策略是「判断转发」:将图像、原始问题以及学好的「异常 / 正常」基锚 与最终判断 一起重新送入模型,得到上下文相关的锚点:
基锚 是可学习的向量,代表「什么是异常」和「什么是正常」的语义原型空间。通过判断转发,这两个原型在当前具体问题语境下被调适为 和 ——它们编码了模型对这张图是否异常的整体判断所携带的语义信息。
接下来,对比热图头将密集视觉 patch 特征 与这两个锚进行对比打分:
其中 为可学习温度参数。每个 patch 的异常 logit 是其与「异常锚」的余弦相似度减去其与「正常锚」的余弦相似度,本质上是在问:这个 patch 的视觉特征更像缺陷还是更像正常产品?最后通过上采样将 patch 级打分转化为像素级异常图 。
这个设计的核心逻辑是:语言判断提供了紧凑的语义条件,异常锚和正常锚的对比决定了「在语义空间中什么样的视觉特征代表异常」,但具体的像素级评分仍然由密集视觉特征与这两个锚的相似度差值决定。语言引导了定位的方向,但不直接决定每个像素的值——即使语言判断出错,视觉特征本身的异常模式仍然能够驱动热图响应。
总训练目标
完整的目标函数由三项组成:
- :前文介绍的 token 级自蒸馏损失,让模型在实际部署语境下生成的判断质量得到提升。
- :稀疏的结果级奖励,包括格式奖励 (确保输出符合预期格式)和判断奖励 (奖励最终答案的正确性),仅用于正则化,不主导优化方向。
- :密集定位损失,包含图像级 BCE(取 top-1% logit 平均的异常概率与真实标签的交叉熵)、像素级 BCE/Focal/Dice 损失组合,以及一个锚分离约束 ,防止异常锚和正常锚在语义空间里塌缩到一起。
整体而言,OPSD 让语言判断变好(密集监督下学会感知缺陷),LVA 让判断条件落地为像素证据(语义锚引导视觉对比),两者的产出通过 联合优化,形成语言引导视觉、视觉支撑像素的闭环。
实验与结果
实验设置
论文采用严格的跨数据集零样本设定,在 5 个目标基准上评估:MVTec-AD 以 VisA + GoodsAD 为源训练集;VisA 以 MVTec-AD + GoodsAD 为源训练集;此外还有 SDD/KolektorSDD(钢材表面缺陷)、DTD-Synthetic(合成纹理)和 WFDD(织物缺陷)三个更具挑战性的跨领域场景。评测涵盖三类指标:图像级(AUROC、AP、F1)、像素级(AUROC、AP、F1、AUPRO)和问答(二值判断准确率)。
对比方法聚焦于基于大视觉语言模型的 IAD 方法,包括 AnomalyGPT、Myriad、EIAD 和 ReAL,部分指标在统一协议下进行了复现标注。
核心结论
实验结果验证了论文的设计假设。在 MVTec-AD 和 VisA 两个主流基准上,OPD-IAD 在图像级 AUROC/AP/F1 和像素级 AUROC/AP/F1/AUPRO 上全面领先基线方法,尤其在像素级 F1 指标上的优势最为显著。以 VisA 为例,OPD-IAD 的像素级 F1 达到 59.26,较第二名提升明显,这一差距在工业质检场景中意味着大量额外的误检或漏检。
一个值得关注的对比来自训练范式消融:纯模仿学习(SFT)下像素定位尚可但图像级判断退化;仅用稀疏结果级奖励的强化学习(GRPO,单 rollout)在图像级略高但像素定位全面崩溃;只有 OPD-IAD 的 on-policy 密集 token 级监督同时保住了两项能力。这一结果直接证明了「密集监督每个 token 的判断生成」对最终定位质量的关键作用。
语言引导视觉锚定的消融实验则揭示了另一层洞察。当论文设计四种定位接口(纯文本注意力、分割 token、对比锚定、热图头)并对比三种判断干预(GT 判断、模型默认判断、错误注入判断)时,对比锚定 + 默认判断的组合在像素级指标上与使用 GT 判断的差距很小——这说明锚点机制成功地将语义条件转化为了对视觉特征的对比引导,而非简单地「复制」语言判断的正确性。关键的是,即使注入错误判断,对比锚定方案的热图仍然保留了局部异常响应,而分割 token 方案的定位则完全跟随错误判断崩溃。这一对比有力地支撑了论文「语言引导而非主导」的设计目标。
跨数据集的结果进一步表明,模型在 VisA 上训练后对钢材(SDD)、纹理(DTD-Synthetic)和织物(WFDD)的泛化能力同样可观,尤其在 SDD 和 DTD-Synthetic 上的像素级 AUROC 均超过 98%,说明语义锚所编码的异常概念具有一定的跨材质普适性。
讨论与可借鉴点
OPD-IAD 在方法论层面给出了一个清晰的设计原则:[[语义引导]]与[[密集视觉证据]]应当各司其职,前者提供方向性条件,后者提供像素级评分的根基。这条原则不仅适用于工业异常检测,任何需要在视觉语言模型中同时追求文本可解释性与密集空间预测的任务——如医学影像的病灶定位、遥感图像的变化检测——都可以借鉴这一思路:通过 on-policy 自蒸馏让语言判断本身变得更「懂」异常,再通过判断转发将语义条件锚化为视觉空间的对比向量,让两种模态的贡献解耦而非耦合。
从工程角度看,论文选择全量微调 Qwen3-VL-8B 的做法在当前算力背景下门槛不低——8 张 A100 训练 30 epoch 的成本对大多数研究团队而言难以承受。OPE-IAD 的设计本身并不必然依赖全量微调,LoRA 等参数高效微调方法在理论上同样可行,只是论文尚未探索。一个值得追问的问题是:当换用更小的骨干模型或参数高效微调策略时,OPSD 的 token 级密集监督是否仍然能带来同等幅度的提升?这一点在论文中被回避了,也是后续工作可以填补的空白。
局限方面,论文虽然在设计层面区分了「引导」与「主导」,但在超参层面仍有不少未充分验证的地方:EMA 衰减率 、JSD 混合系数 、奖励权重 等关键超参均只使用了一组配置,缺少灵敏度分析。此外,论文未与近期提出的其他强基线(如 VMAD、AG-VAS、OmniAD 等)做直接对比,也未纳入与纯视觉零样本方法(如 AnomalyCLIP)的对照,使得 LVLM 路线相对于成熟纯视觉路线的增量收益难以定量评估。问答准确率在部分数据集上仍偏低(SDD 仅 62.91),说明语言侧的缺陷理解能力仍有较大提升空间——这既是 OPD-IAD 的局限,也是整个基于大视觉语言模型的工业异常检测领域下一步需要攻克的方向。
摘要
提出用于工业异常检测的在线自蒸馏框架
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
为何带反馈增强的自蒸馏无法提升检索交错搜索代理?
Why Does Feedback-Augmented Self-Distillation Fail to Improve Retrieval-Interleaved Search Agents?
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 7 张
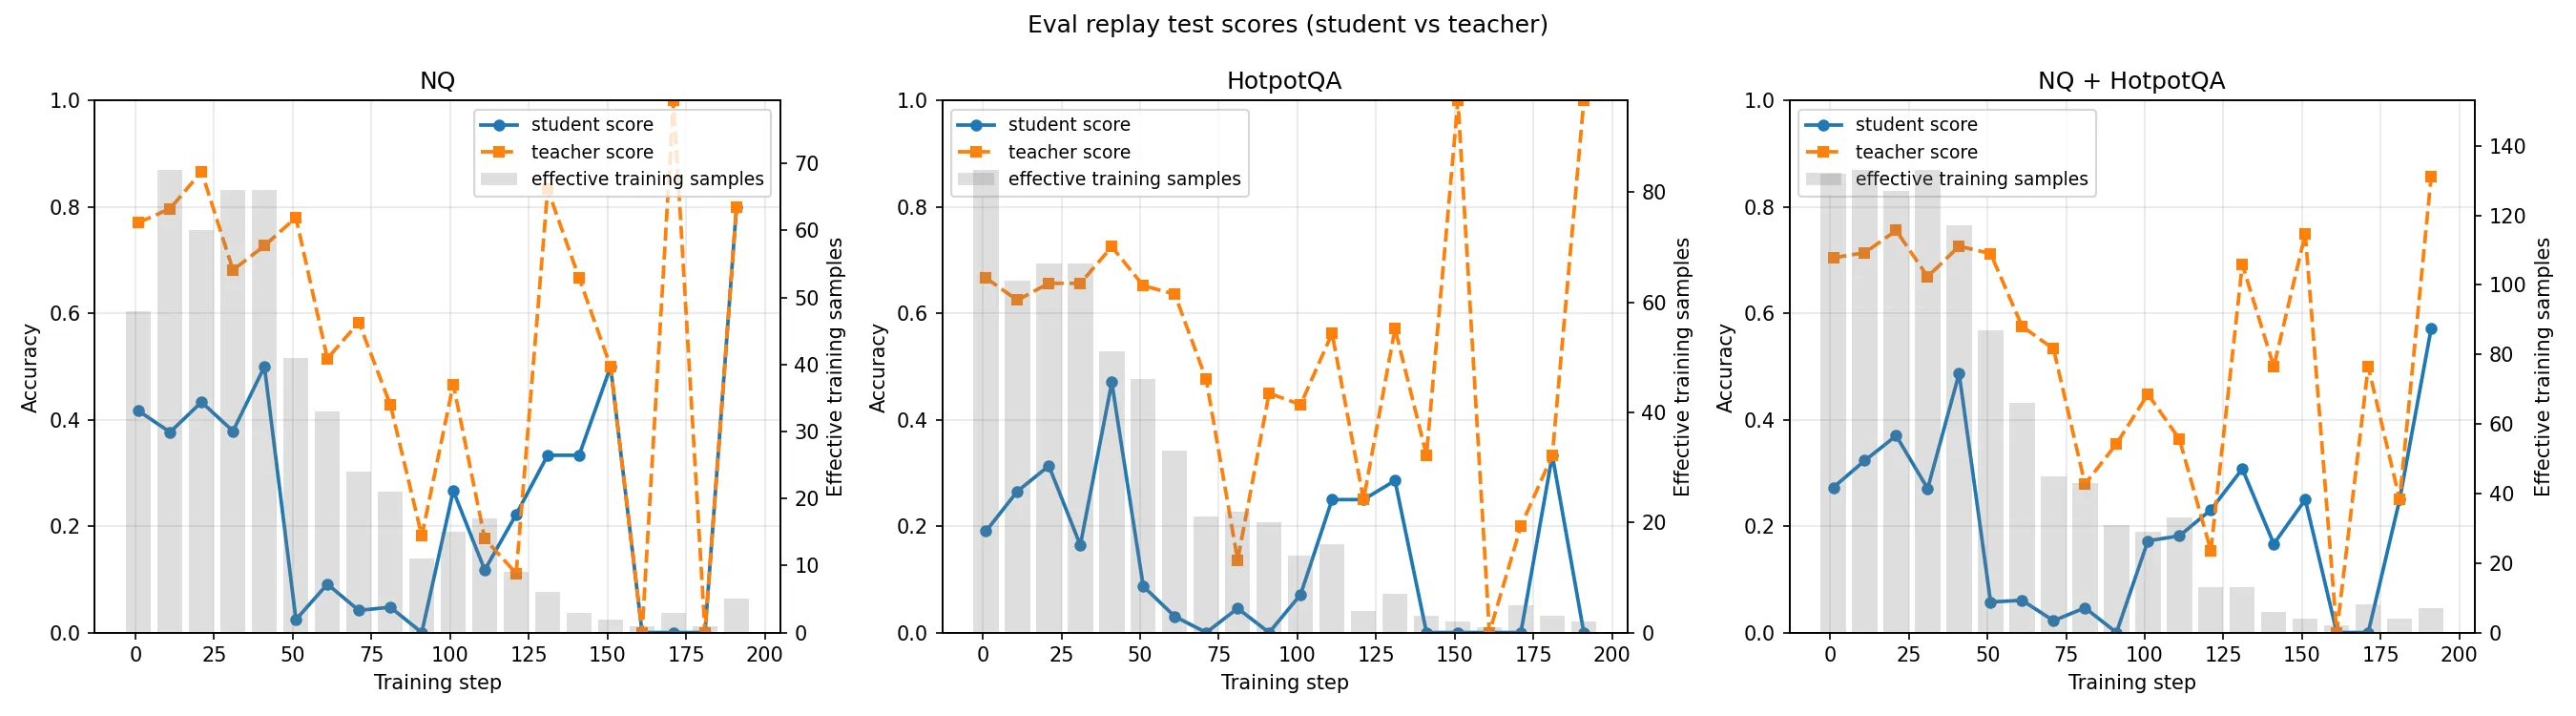
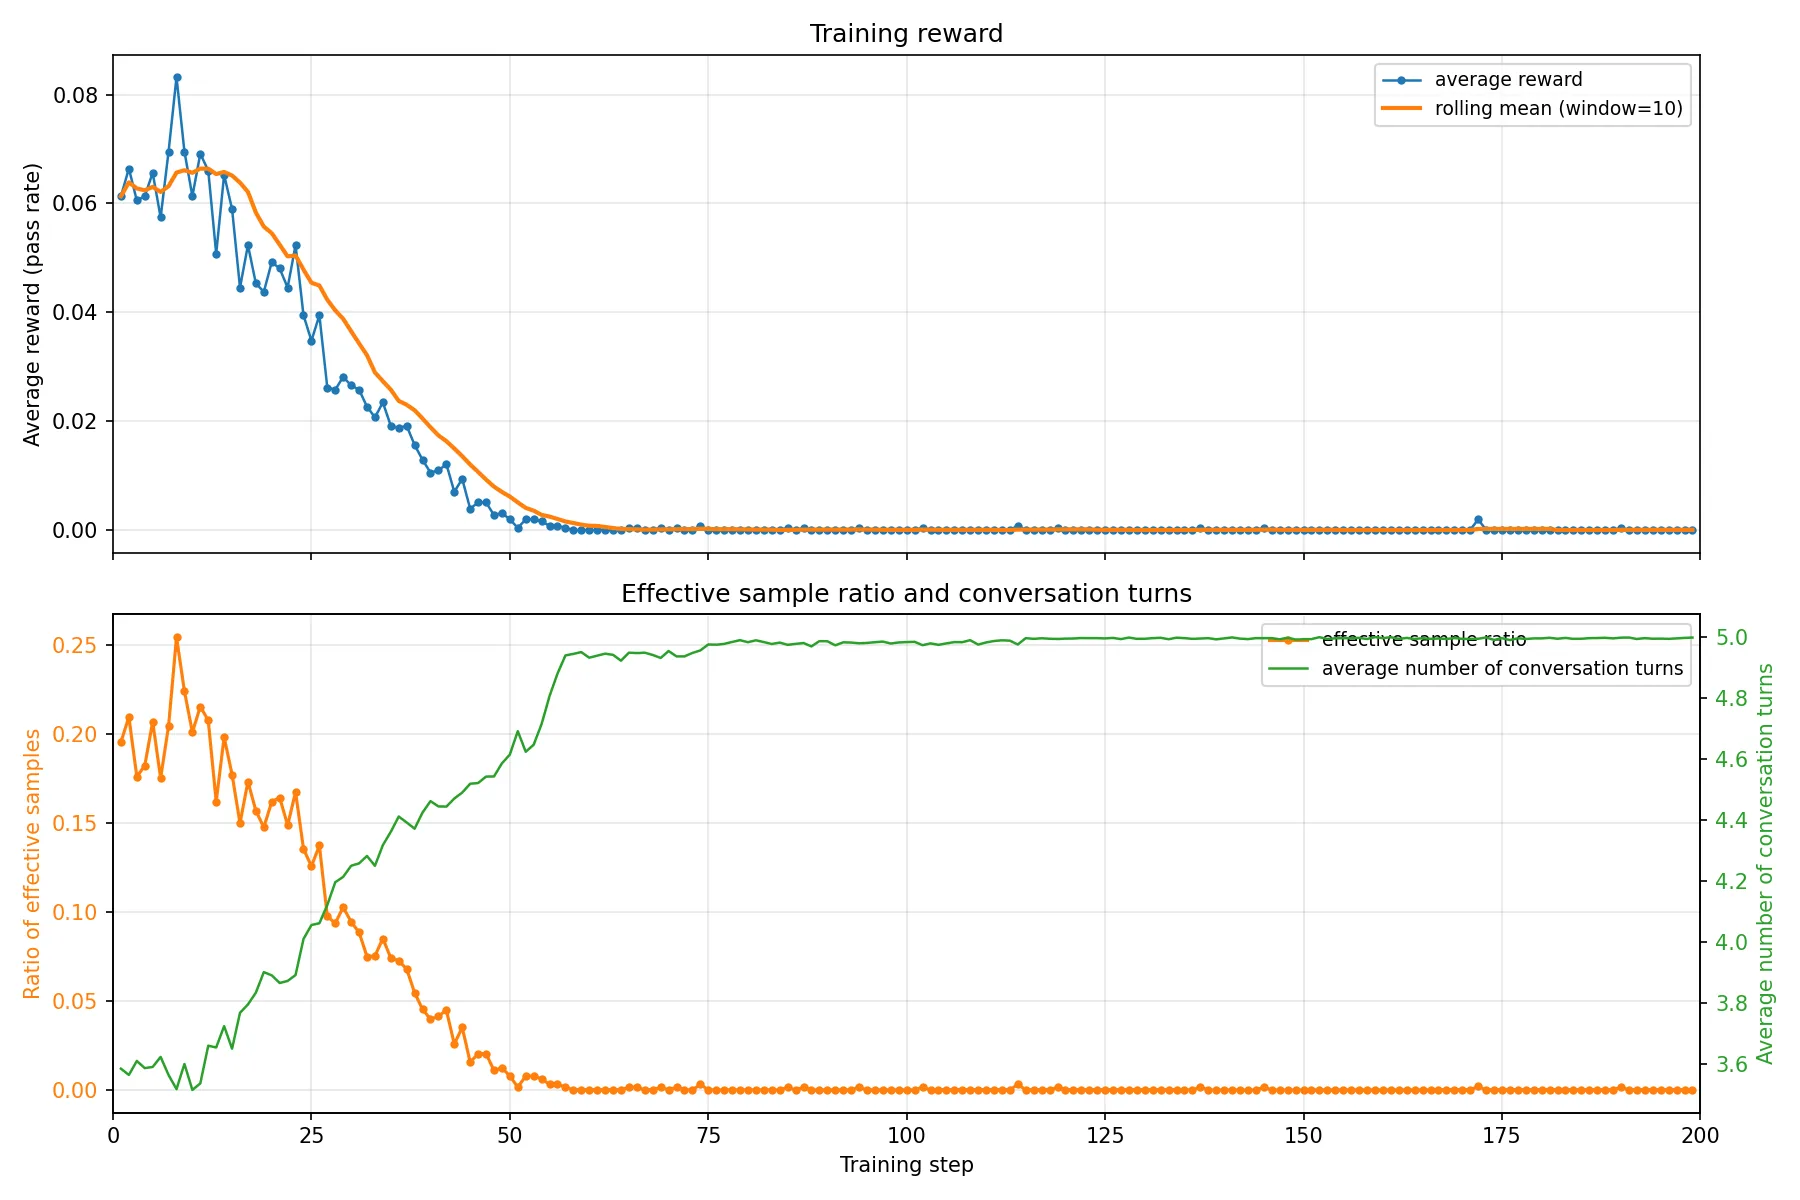
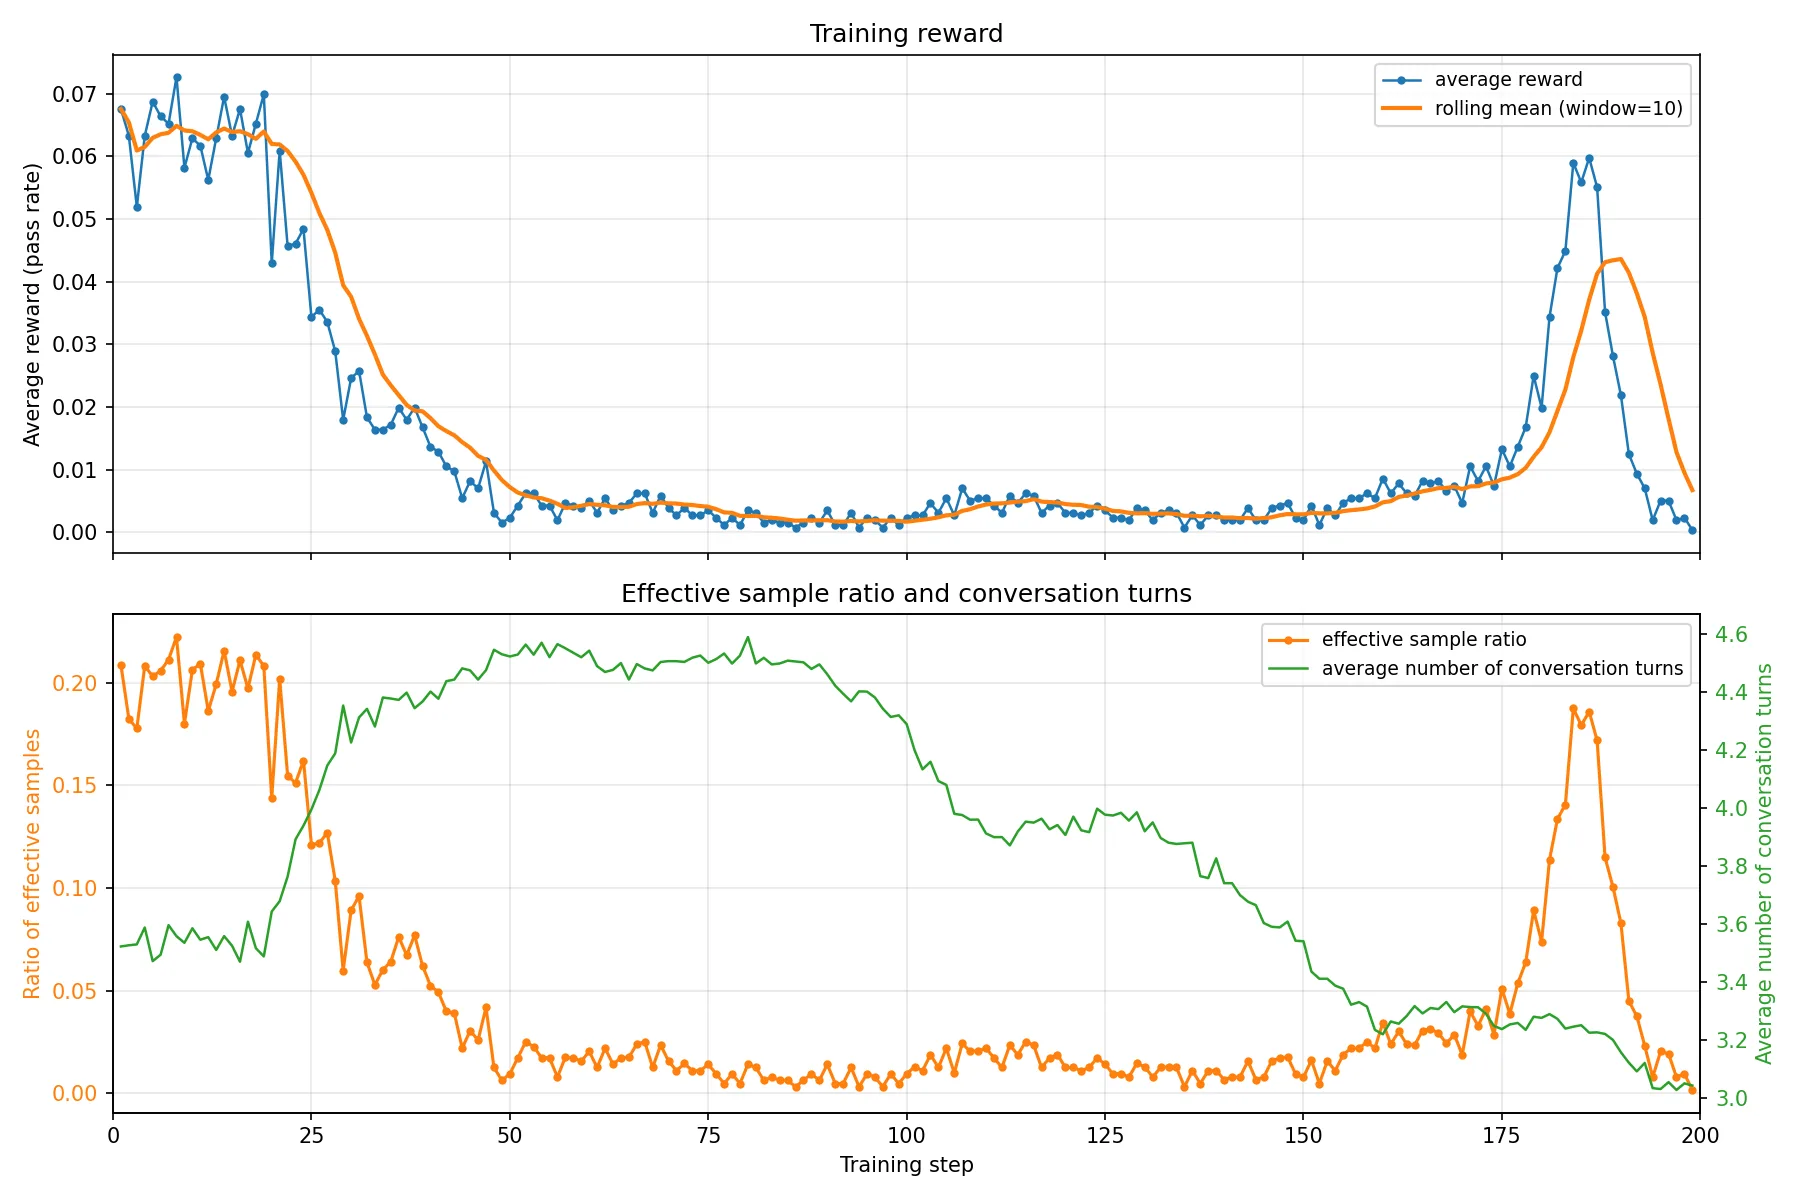
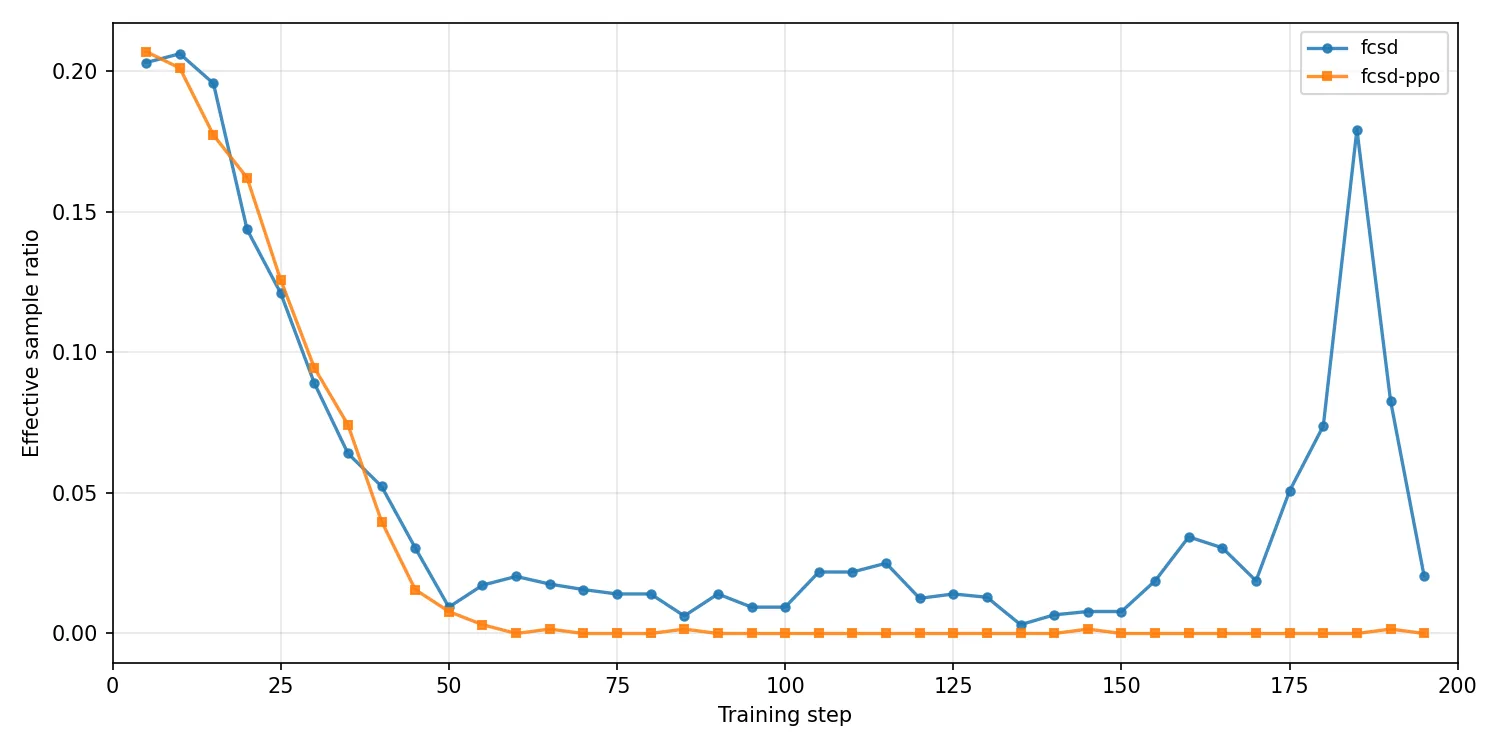
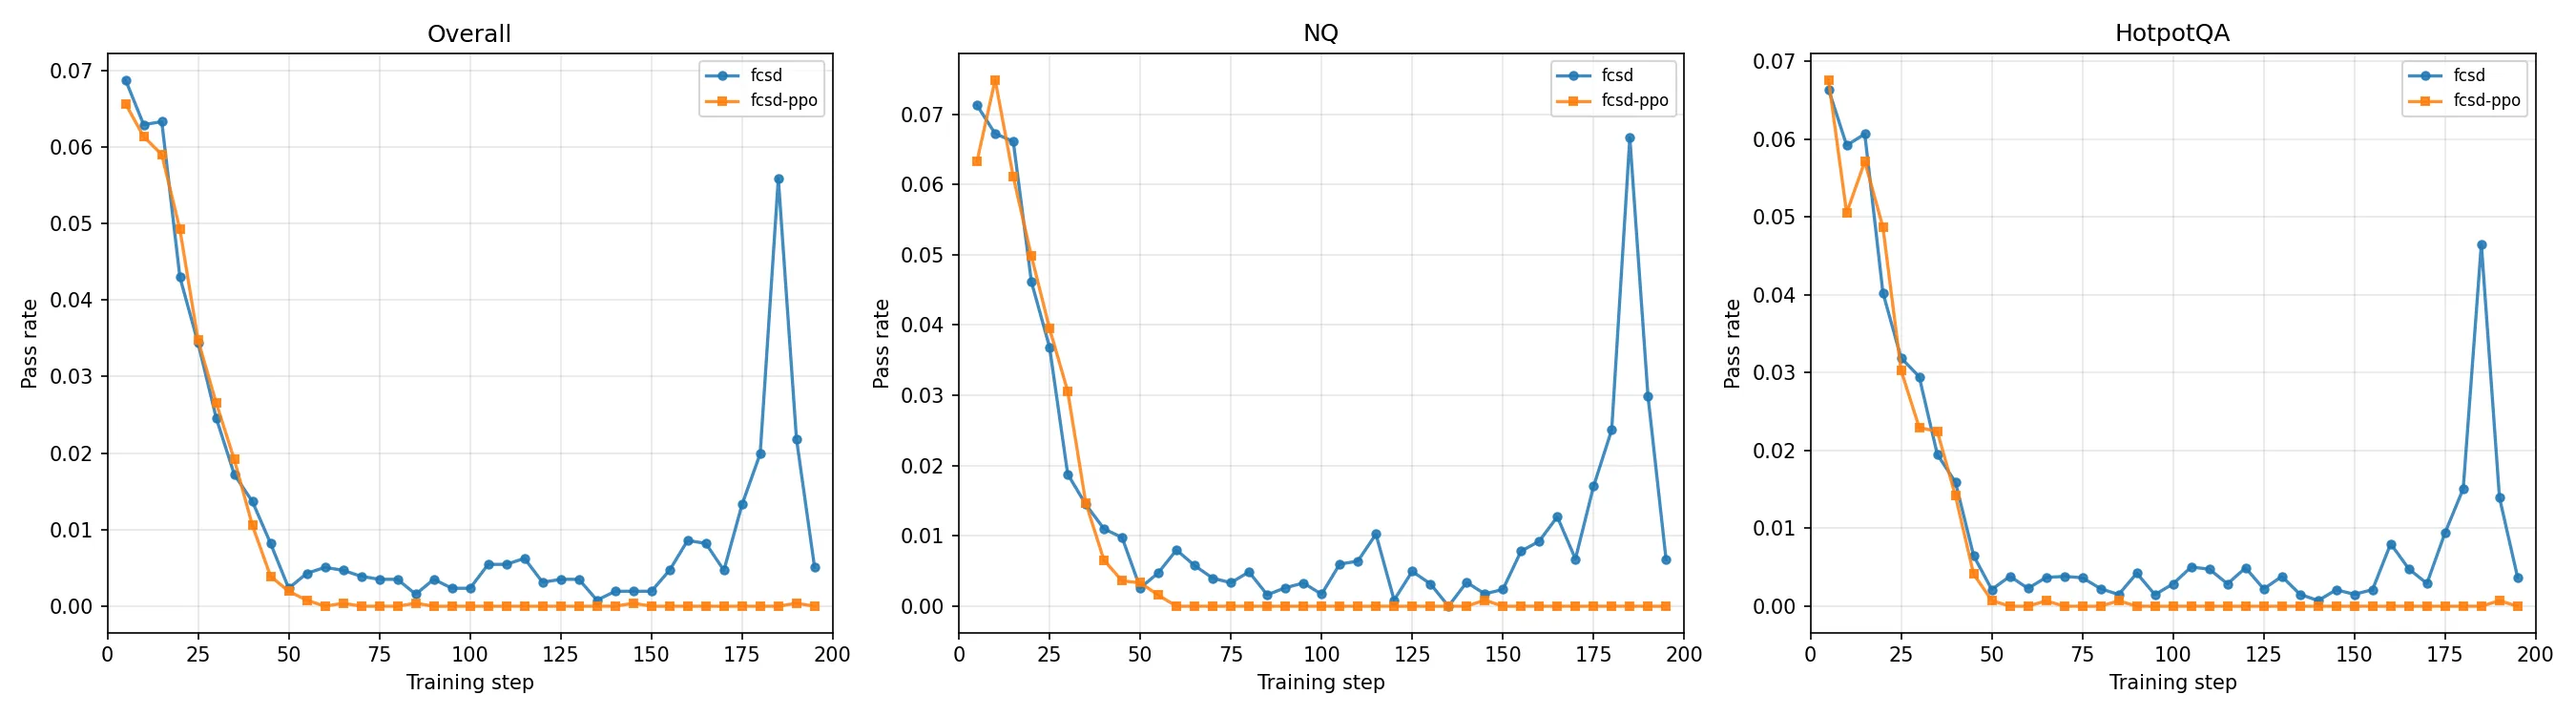
在智能体检索任务中,反馈增强自蒸馏FA-SD存在"解码坍缩"问题:模型依赖重复的推理-检索模板,生成与问题无关的轨迹,使KL蒸馏信号失效。研究发现自教师监督本质不稳定,根源在于模型不一致与提示不一致,后者尤其损害信号质量。引入EMA教师可稳定监督,但需经历预热期性能暂退。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
检索增强型语言代理通过交错执行推理与外部检索来完成开放域问答,近年来借助强化学习方法取得了显著进展。GRPO 等方法在搜索代理训练中展现出潜力,但其依赖的奖励信号通常稀疏且仅在轨迹末端有效,难以对中间推理步骤和检索决策提供细粒度的指导——这正是搜索代理能力提升的关键所在。
研究者开始探索更密集的监督信号,包括过程奖励、步骤级标注,以及 on-policy self-distillation 这类允许单一模型同时扮演教师与学生角色的方法。对于搜索代理而言,同一问题的多次采样 rollouts 中往往同时包含成功与失败样本,成功轨迹天然地充当了特权信息,无需依赖更强的外部教师。这种将成功演示反馈给自教师的策略被称为反馈增强自蒸馏。
然而,一个关键问题悬而未决:这种反馈增强的自蒸馏能否真正为检索交错搜索代理提供可靠的密集监督?当模型既作为知识的输出者又作为学习者时,监督信号是否仍然有效?本文通过系统性的实验与理论分析,揭示了 FA-SD 在这一场景下失效的深层原因,为这一领域提供了重要的警示。
方法
研究者首先形式化定义了检索交错搜索代理的轨迹结构。给定问题 和检索引擎 ,策略 生成多步轨迹,每一步包含模型输出的推理 与检索查询 ,随后检索引擎返回观测 ,最终产生答案 。在 FA-SD 中,自教师的构建方式是将同一组 rollout 中的另一条成功轨迹 作为条件引入:学生分布 在输入 上无差别地学习,而自教师分布 则额外看到成功轨迹 ,两者通过 KL 散度损失进行匹配。
然而,研究者发现了一个被现有评估指标遗漏的失效模式——解码坍缩。在训练过程中,模型逐渐学会依赖反复出现的推理-检索输出模板,虽然每条轨迹表面上看似多样,但这些模板对输入问题的响应微乎其微。这意味着无论学生分布还是自教师分布,都逐渐趋同于某种固定模式,KL 散度信号失去了区分能力。
为了理解这一现象的根因,研究者将自教师监督的不一致性分解为两个维度:模型不一致性指自教师与学生共享持续更新的参数,教师目标随训练漂移;提示不一致性则指将成功轨迹作为条件引入教师分支后,其分布特性发生了显著改变。实验表明,后者对监督信号质量的损害更为严重。
针对模型不一致性,研究者尝试引入教师正则化策略:固定参考教师使用训练起始时刻的学生参数作为自教师,全程不再更新;EMA 教师则按 动态更新参数,其中 ,试图在稳定性与适应性之间取得平衡。研究者还实现了 PPO 风格的截断目标函数,以限制策略更新的幅度。
实验与结果
实验在 NQ 和 HotpotQA 训练集上进行,评测覆盖 7 个开放域问答 benchmark,基座模型为 Qwen2.5-3B-Base,外部教师为 Qwen2.5-7B-Instruct。所有方法均基于 Wikipedia dump 和 E5 检索器,每次返回 top-3 段落,最多进行 4 轮检索。
核心发现是残酷的:无论是 Unclipped 还是 PPO-Clipped FA-SD,在大部分训练过程中 pass rate 接近于零,仅在 step 180 附近出现短暂反弹后迅速回落。更值得警惕的是,推理阶段中反馈增强的自教师分支确实比无条件学生表现更强,证明失败并非源于自教师能力不足——信息确实被生成了,只是学生模型无法从中有效学习。
解码坍缩的诊断实验揭示了真相:随着训练进行,有效蒸馏信号的比例持续下降,模型生成的平均轮数反而减少,说明自教师产生的分布逐渐失去信息量。研究者进一步对比了不同教师正则化策略:固定参考教师和 EMA 教师都能让训练从崩溃中恢复,但 EMA 教师恢复得更快且最终性能更高(EMA-FA-SD 七任务平均 0.206,对比基座模型的 0.114)。然而,EMA 教师需要经历一个预热期,期间性能会暂时回退到基座水平以下,直到自教师积累了足够的知识后才能稳定提升。
一个有趣的对比是,当将反馈增强技巧迁移到外部教师框架时(FA-MOPD),结果反而弱于标准 MOPD。这说明当教师本身已经足够强时,特权反馈反而引入了多余的提示不一致,损害了性能。最终,GRPO 仍是最佳基线,其七任务平均达 0.348,远超 FA-SD 任何变体,印证了"更丰富的监督并不等于更有用的监督"这一核心洞见。
讨论与可借鉴点
这项研究的价值不仅在于揭示负结果,更在于提供了一套系统性的诊断框架。解码坍缩概念的提出具有重要的警示意义:现有的聚合评估指标(如平均正确率)可能完全遗漏这类失效模式,因为表面上的轨迹多样性掩盖了模型对输入问题敏感性的丧失。实践者应当关注训练过程中的信号质量变化,而非仅盯着最终的评测数字。
对研究社区而言,核心启示是:在检索交错这类长程决策任务上,分布匹配目标的优化方向可能与策略能力的提升方向并不一致。模型的 bootstrap 学习可能陷入"自我强化已有模式"的陷阱,而非真正学会问题解决。提示不一致性作为更根本的障碍,至今缺乏直接解决方案,这为后续研究留下了充足的探索空间。此外,EMA 教师的设计提供了一个简单可行的稳定化思路,但需要接受初期性能回退的代价——这种权衡在实际应用中值得深思。
研究的局限性也很明显:所有实验基于 3B 参数模型,结论的可推广性需要在更大规模和其他架构上验证;评估指标仍以 pass rate 为主,缺乏对轨迹-输入相关性的定量刻画。这些都为后续研究留下了明确的方向。
概念 · 6 个
摘要
在线自蒸馏方法让模型从自身学习
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
揭秘同策略蒸馏:作用、病态与调控
Demystifying On-Policy Distillation: Roles, Pathologies, and Regulations
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 9 张
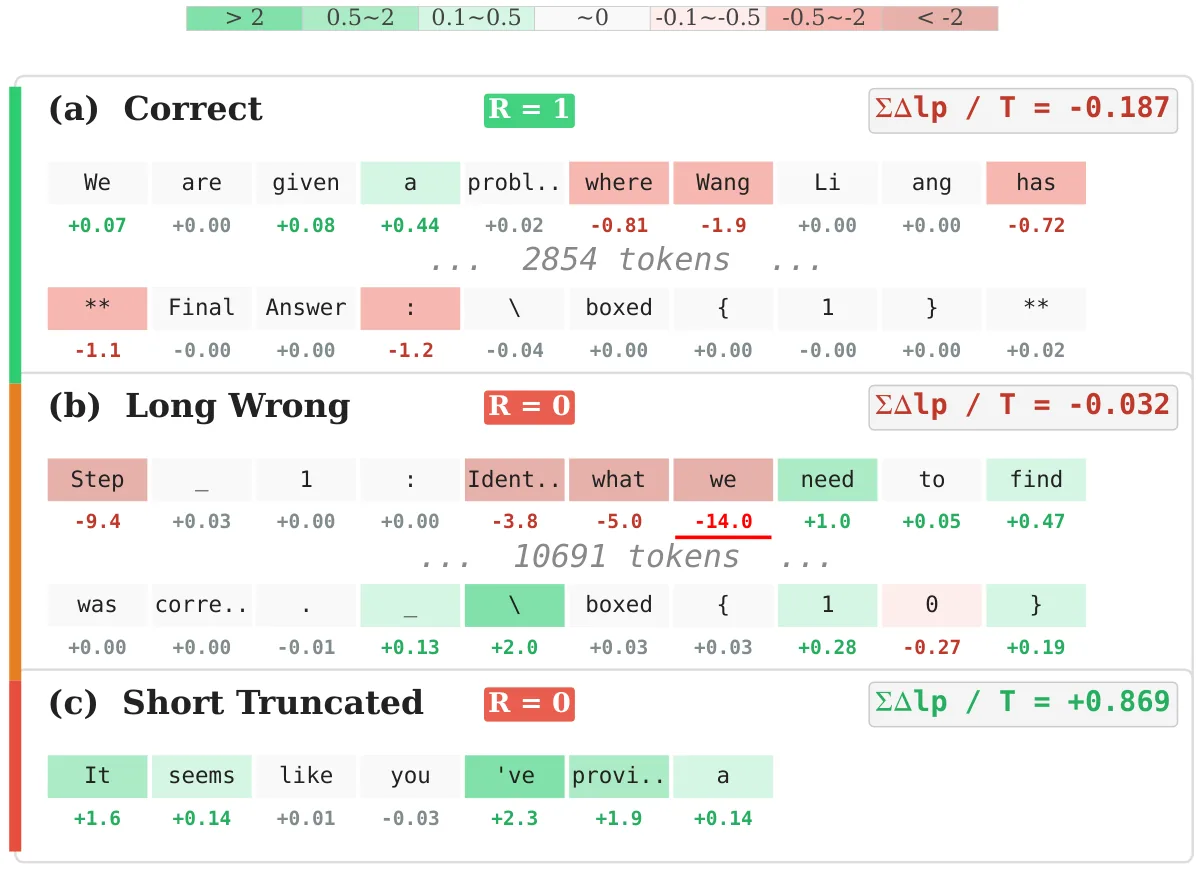
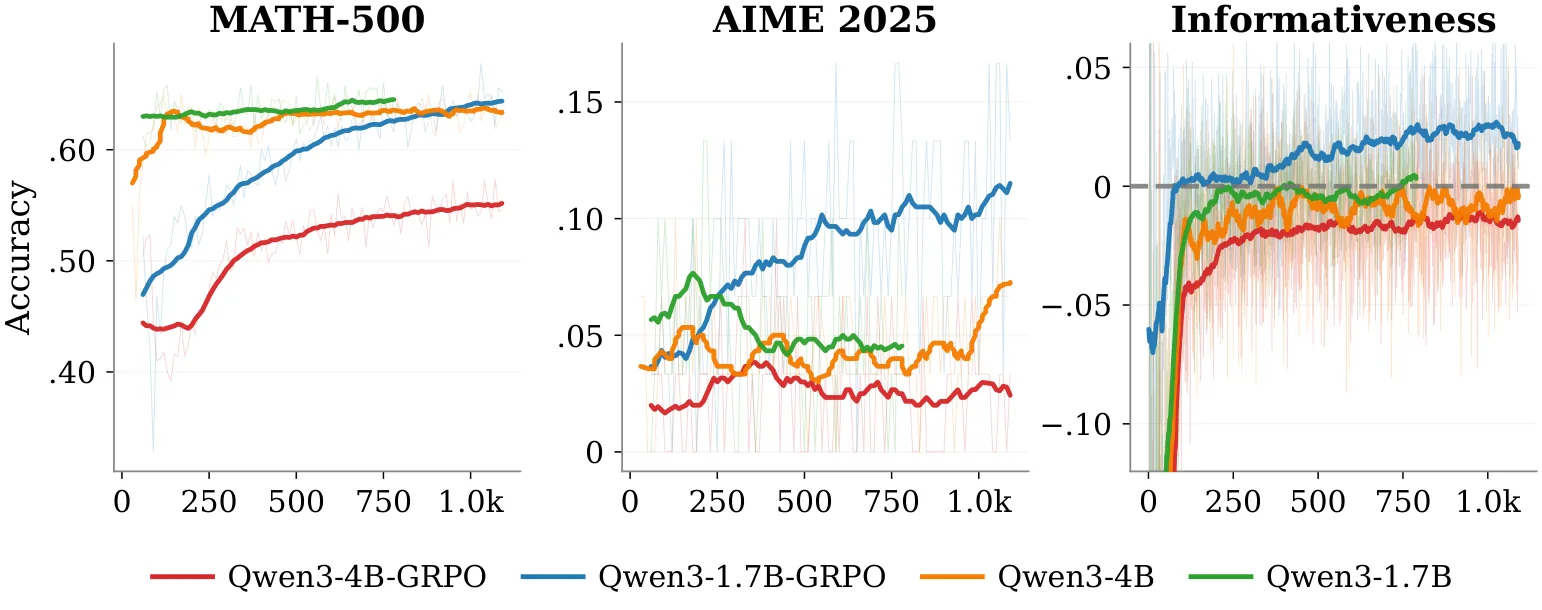
大语言模型后训练中,在策略蒸馏(OPD)虽被广泛应用,但其训练动态机制长期缺乏系统理解。本文深入分析OPD作为探索催化剂的角色,通过逐token密集信号引导学生沿正确推理路径前进,但无法突破学生模型本身的能力天花板。研究发现其效果完全取决于引导信号质量,并揭示两类病态:师生分布不匹配导致信号错位、长度利用使学生通过截断或填充取巧。提出优势裁剪与对数尺度压缩两种轻量级信号调控方法,在七个基准上稳定超越现有OPD变体及RLVR基线,表明信号质量而非教师规模才是有效蒸馏的关键。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
大语言模型的后训练阶段,[[策略蒸馏]](Policy Distillation)已成为将强大教师模型能力迁移到学生模型的核心技术。在众多蒸馏范式中,同策略蒸馏因其训练稳定性而被广泛采用——它要求学生模型在与教师相同的分布下生成响应,从而确保学习信号的内部一致性。然而,尽管应用广泛,研究者们对OPD的训练动态机制长期缺乏系统性理解。究竟是哪些因素决定了蒸馏的成功?为何有时即便使用强大的教师模型,学生模型的表现仍不尽如人意?这些问题悬而未决,阻碍了OPD在实际应用中的高效配置。
现有研究往往将OPD视为黑箱,关注最终性能指标,而忽视了其内在的探索机制。本文的研究动机源于一个关键观察:当学生模型在蒸馏过程中探索新的推理策略时,引导信号的质量直接决定了探索的方向是否正确。这一观察促使作者提出一个根本性问题——OPD究竟如何影响模型的探索行为,其有效性边界在哪里?
方法
作者的核心洞察是将OPD重新理解为「探索催化剂」。与直觉不同的是,蒸馏并非简单地让学生「记住」教师的输出分布,而是通过稠密的逐token级引导信号,在庞大的推理空间中为学生指明方向。这种引导作用类似于催化剂在化学反应中的角色——它降低了正确推理路径的「活化能」,使学生更容易沿正确方向前进,但催化剂本身并不改变反应的热力学极限(即学生模型的能力上限)。
为了验证这一理解,作者设计了一系列对照实验。他们发现,在OPD过程中,提示多样性(prompt diversity)比针对单个问题的采样数量更为关键。这意味着探索的广度比深度更能决定蒸馏效果。更重要的是,OPD的有效性完全取决于其引导信号的质量——当信号与任务正确性高度相关时,蒸馏效果显著;当信号质量下降时,即使采样更多也无济于事。
这种对信号质量的强依赖性暴露了OPD的两类病态问题。第一类称为「师生不匹配」(Student-Teacher Mismatch):当教师与学生之间存在较大的分布差距时,教师产生的「正确」响应可能超出学生的表达范围,导致引导信号与学生实际能达到的正确性发生偏离。这种信号错位会将探索引向适得其反的方向,学生在错误的信号引导下越走越远。
第二类病态是「长度利用」(Length Exploitation)。传统OPD的逐token级目标在聚合过程中可能产生与长度相关的捷径——由于响应中越靠前的token对总损失的贡献越大,学生模型发现可以通过截断响应来「规避」生成错误token的风险,或者通过冗余填充来「稀释」错误的影响。这种博弈行为导致学生探索退化的长度模式而非真正有用的推理策略。
针对这些问题,作者提出两种轻量级的信号调控方法。第一种是「优势裁剪」(Advantage Clipping),其核心思想是对每个token的优势值(advantage)进行上下界限制:
这种裁剪确保信号强度保持在合理范围内,既不会因过大优势值导致过激的行为调整,也不会因过小优势值使信号丧失区分度。
第二种方法是「对数尺度压缩」,将原始的优势值映射到对数尺度:
这种压缩方式在保留信号方向的同时平滑地降低了大幅值的影响,使得长度相关的捷径信号被显著衰减,而真正反映推理正确性的信号得以保留。
实验与结果
作者在七个基准测试上进行了广泛的实验,涵盖数学推理、代码生成和逻辑推理等任务。实验基线包括标准OPD、多种OPD变体以及基于可验证奖励的强化学习(RLVR)方法。
实验结果清晰地验证了理论分析。首先,经过调控的OPD在所有基准上稳定超越了基线方法,平均性能提升达到显著水平。这表明信号调控确实有效缓解了长度利用问题,使探索更加聚焦于推理策略本身而非长度捷径。
其次,作者通过消融实验证实了信号质量的核心作用。在控制教师模型规模的情况下,经过良好调控的小型教师反而优于未调控的大型教师。这一反直觉的发现强有力地证明了「信号质量而非教师规模决定蒸馏效果」的核心论点。
作者还通过可视化分析展示了调控对探索行为的影响。未经调控的OPD会导致学生模型在长度维度上产生偏态分布,过度集中在某些特定长度区间;而经过调控后,长度分布恢复均匀,表明学生确实在学习多样化的推理策略而非长度模式。
讨论与可借鉴点
这篇论文最重要的贡献在于揭示了[[策略蒸馏]]中一个长期被忽视的关键因素——信号质量的可调控性。传统观点倾向于认为,更大的教师模型必然带来更好的蒸馏效果,因为其产生的响应「质量更高」。然而本文通过系统的实验证明,如果缺乏有效的信号调控,大模型教师的优势会被自身分布差距和长度利用问题所抵消。
论文也存在一些局限性。首先,实验主要集中在推理类任务上,对于需要精确格式或特定风格的任务,调控方法的有效性尚待验证。其次,两种调控方法(优势裁剪与对数尺度压缩)的超参数选择仍依赖经验规则,缺乏理论指导的自适应方法。最后,作者主要关注离线调控策略,对于在线学习场景下如何实时检测和修正信号错位问题尚未涉及。
对于[[强化学习]]和模型优化领域的研究者而言,本文提供了一个重要启示:在设计训练信号时,「正确性」与「可利用性」之间的权衡需要被认真对待。信号调控不应被视为事后补救,而应是训练流程的内在组成部分。同时,对于实践者来说,本文提出的方法具有很高的可操作性——两种调控手段计算开销极低,却能带来稳定的性能提升,非常适合在实际项目中集成应用。
摘要
研究大语言模型中的知识蒸馏与策略蒸馏方法
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
在策略自蒸馏中诊断与缓解思维坍缩
Diagnosing and Mitigating Thinking Collapse in On-Policy Self-Distillation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 4 张
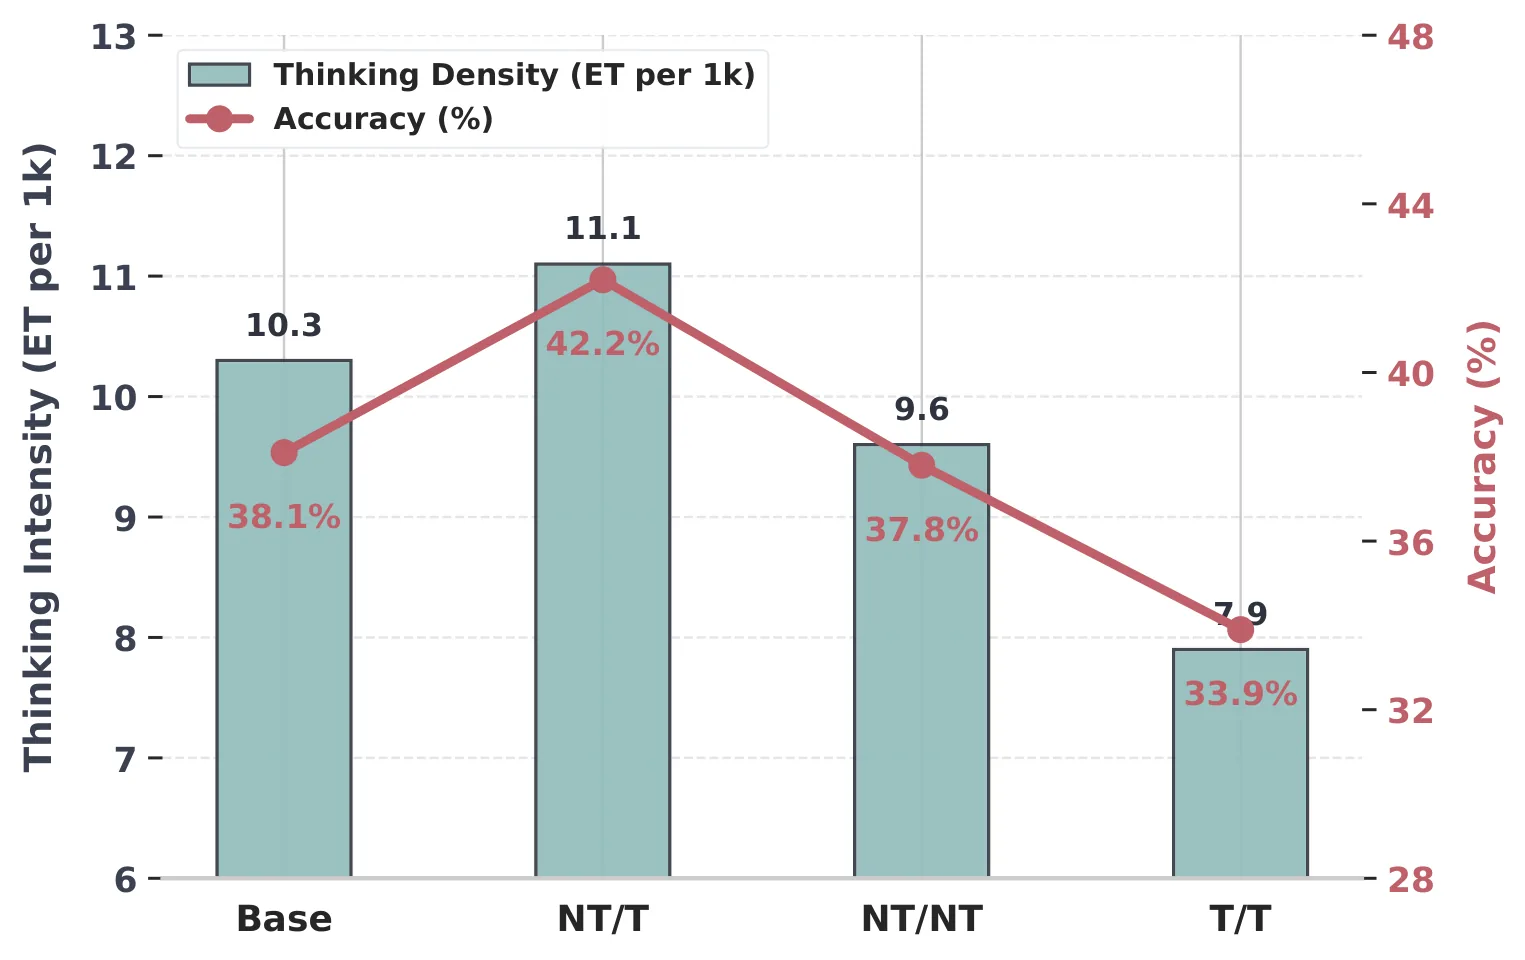
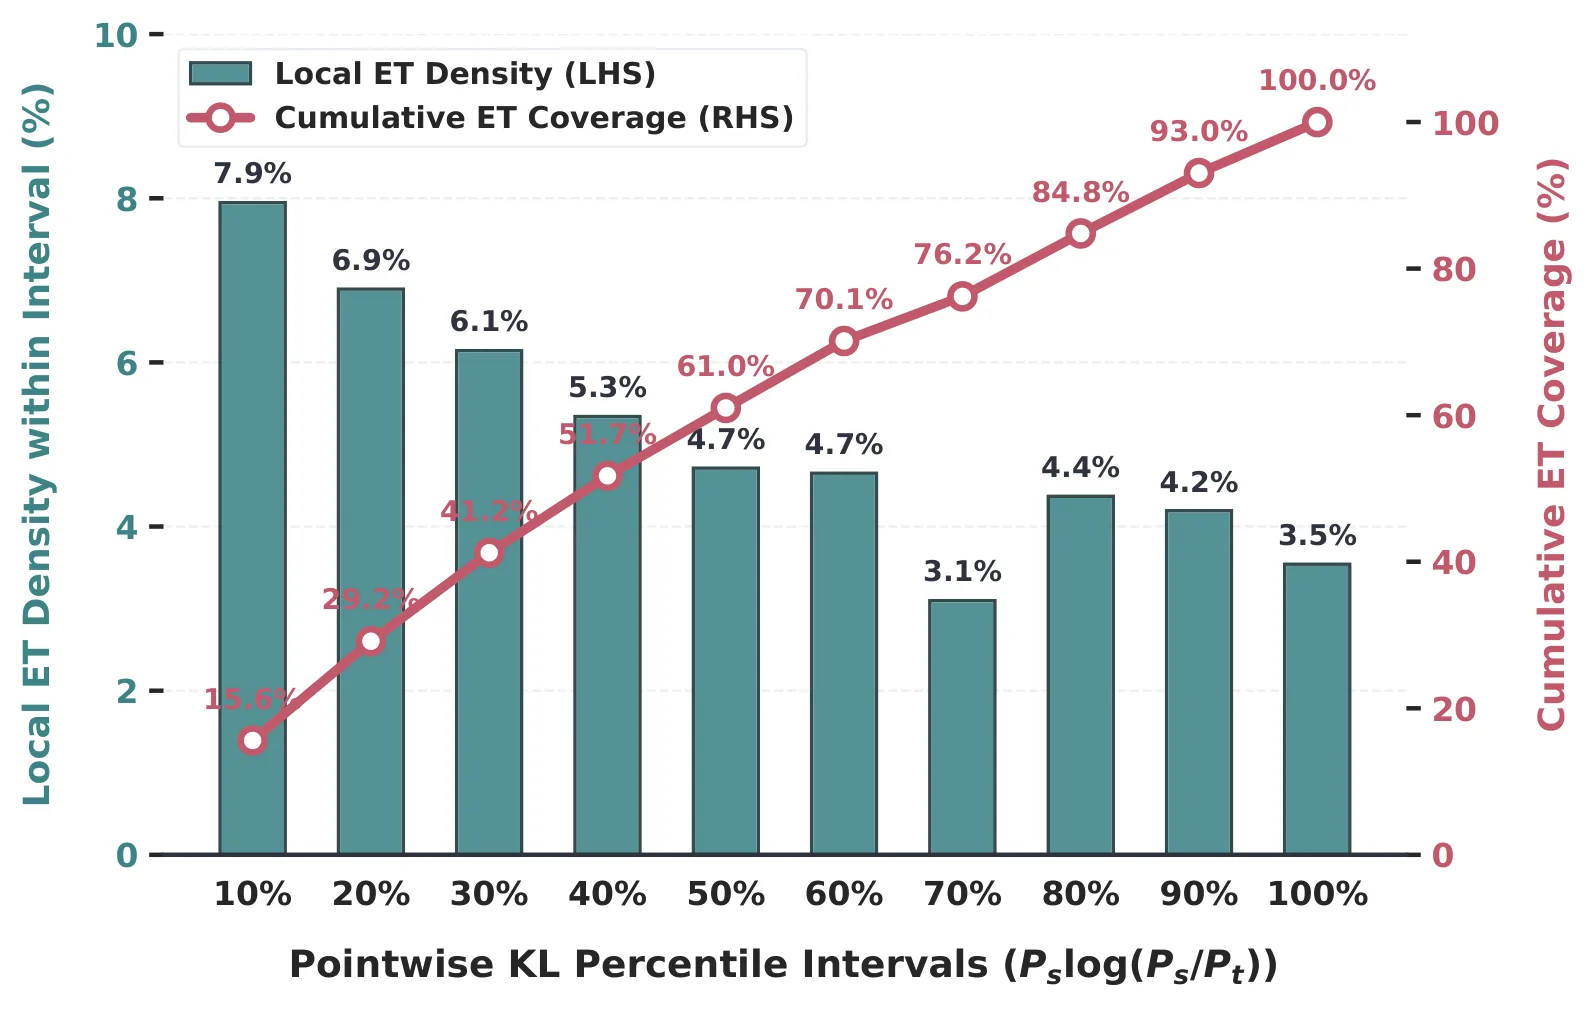
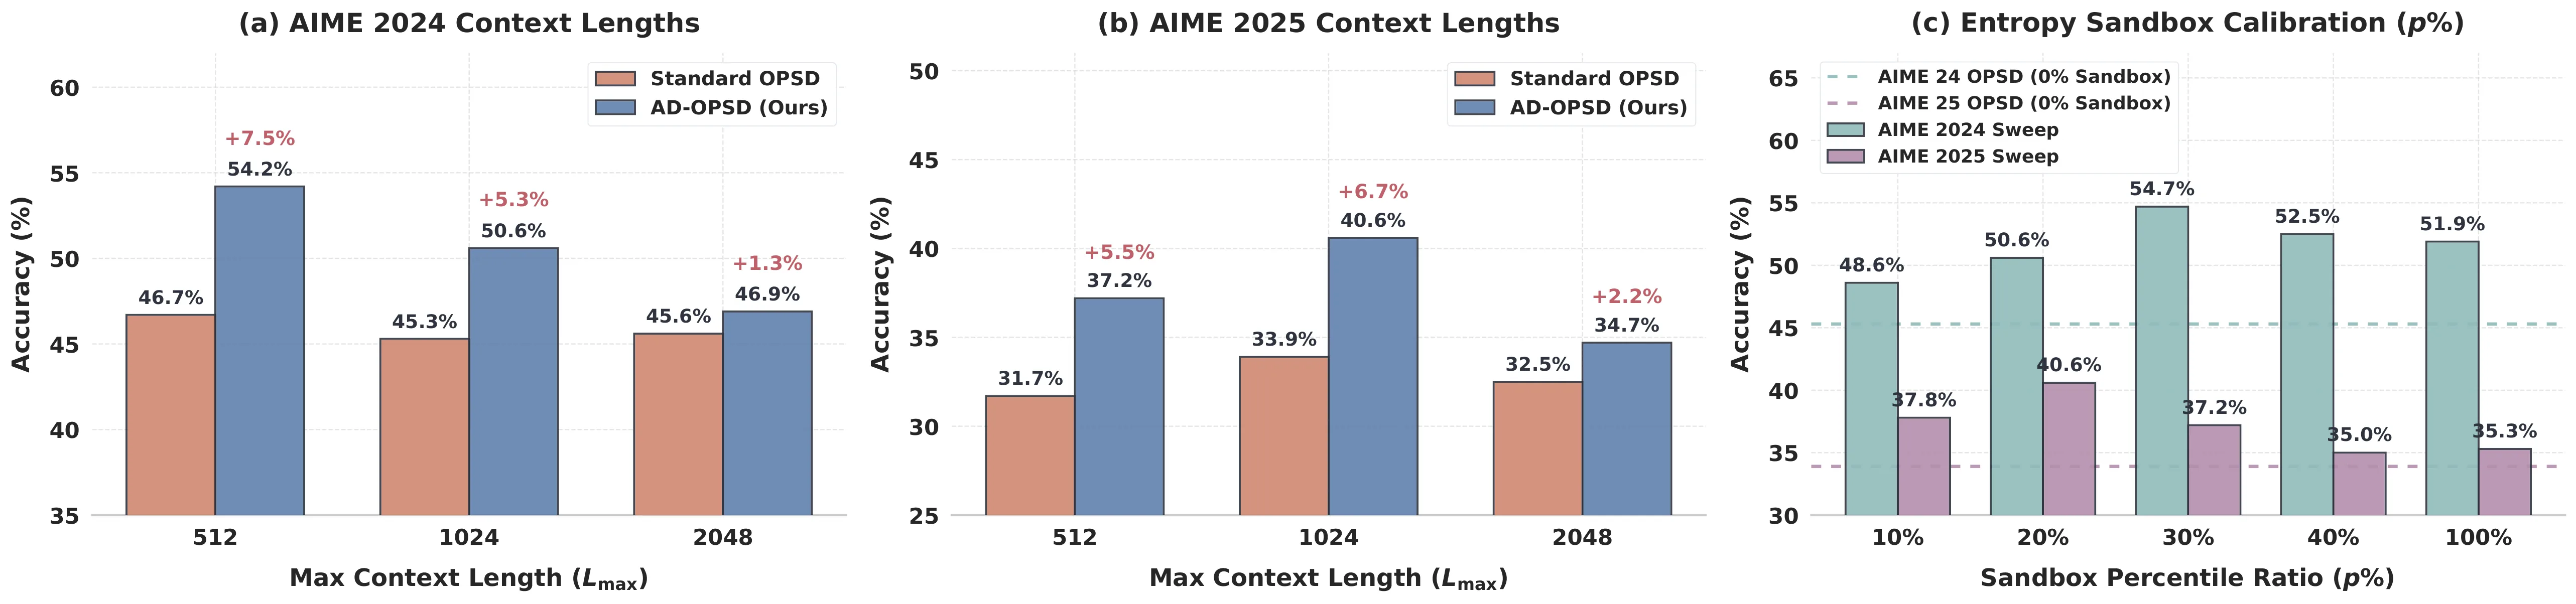
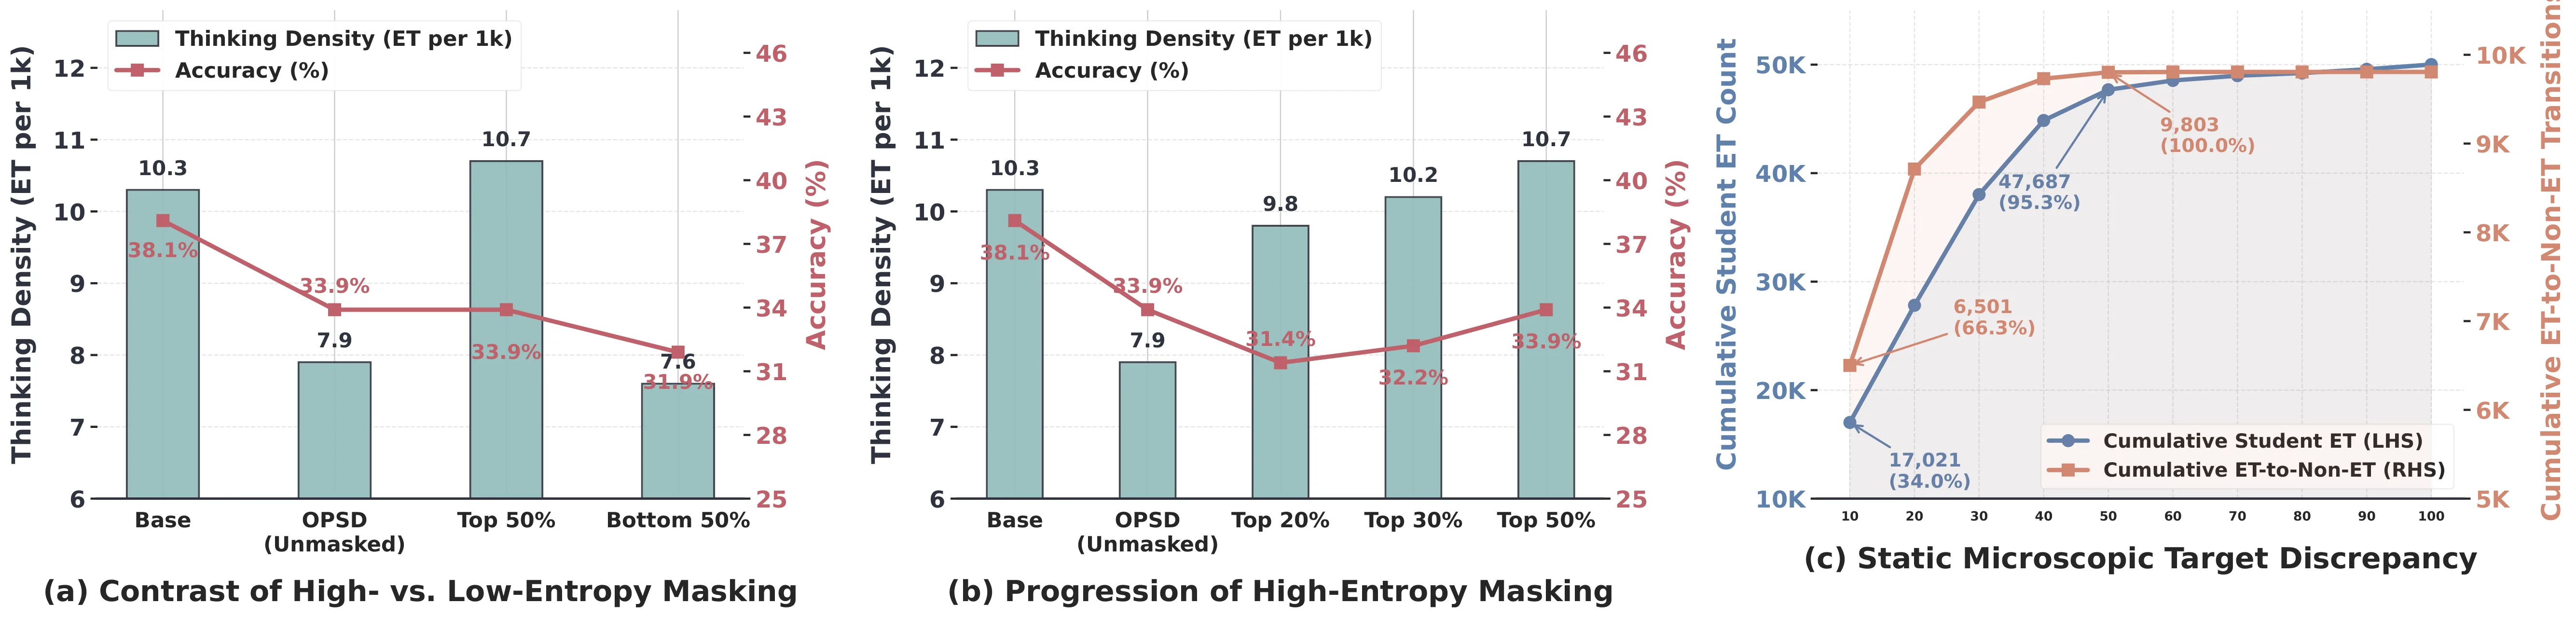
诊断并缓解大模型自蒸馏中思维坍缩的病态问题。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
大语言模型的后训练阶段,[[自蒸馏]]已成为一种高效的能力增强手段。与传统的离线蒸馏不同,OPSD 在真实答案条件下由教师模型实时生成在线目标分布,让学生模型同时学习来自教师的监督信号和来自环境的奖励反馈。这种范式在通用对齐任务上表现出色,但当研究者们试图将其迁移到复杂推理场景时,却发现了一个令人困惑的现象:模型不仅没有进步,反而出现了性能退化。
这种现象在数学推理任务上尤为明显。研究者以 Qwen3-1.7B 为例,观察到一个清晰的因果链条:基线模型的认知标记密度(每千个生成标记中认知性标记的数量,即 ET per 1k)为 10.3,下游准确率为 38.1%;经过标准 OPSD 微调后,认知标记密度骤降至 7.9,准确率也跟着跌落到 33.9%。模型似乎「忘记」了如何进行深度思考。
已有的研究虽然零散地记录了 OPSD 会抑制「认知性言语化」和高熵决策分叉的现象,但缺乏系统性的诊断分析——究竟在什么位置、为什么会发生这种抑制?更没有提出能够同时保留 OPSD 纠错能力的解决方案。研究者将这种优化病态正式命名为「思维坍缩」,并以此为切入点展开了系统性研究。
方法
解决任何优化病态的第一步,是精确诊断其根源。研究者采用了三重递进的证据链来定位思维坍缩的源头。
第一重是[[梯度掩码]]诊断。研究者按学生模型的 token 级条件熵 将 token 空间划分为高熵和低熵两个区域,在反向传播时对高熵位置屏蔽梯度。结果发现,仅屏蔽 top-50% 高熵 token 的梯度就足以将思维密度从 7.9 拉回 10.7(甚至超过了基线模型的 10.3);而如果反过来只在低熵位置蒸馏,思维密度依然会坍缩到 7.6。进一步的细化实验表明,关键的坍缩压力集中在 top-20% 的最高熵 token 上。这意味着教师梯度对推理过程的干预具有高度局部性,集中爆发在模型「最需要思考」的分叉点上。
第二重是微观 token 级目标差异分析。在训练起点(step 0)的 3.9M token 语料上,研究者追踪学生模型中认知标记(ET)的分布与教师目标的冲突。他们发现认知标记天然集中于高熵区域:top-10% 高熵区域包含了 34.0% 的认知标记,top-50% 高熵区域更是容纳了 95.3% 的认知标记。问题在于这些位置上,学生模型的认知标记与教师模型的非认知目标之间存在严重的 top-1 不一致——在 top-10% 高熵区间内,66.3% 的「学生认知标记→教师非认知标记」不一致事件集中分布。这意味着从训练一开始,教师梯度就在持续向学生的高质量推理路径施加负向压制。
第三重是逐点分歧映射。研究者定义了逐点 KL 贡献作为实时风险指标:
这个指标衡量的是当学生模型在某个 token 上的概率高于教师时,梯度反向传播会产生的抑制强度。分析表明,在 的活跃抑制区和高熵 token 的交集内, 最高的 10% 区间中认知标记的局部密度达到 7.9%,而最低区间仅有 3.5%。这验证了 作为抑制风险代理信号的有效性。
基于上述诊断,研究者提出了 Adaptive Dual-Perspective OPSD(AD-OPSD)。核心思想是在局部高熵沙盒内,使用非对称逐点分歧门控将高抑制风险 token 的目标从纯教师分布重新插值到冻结基模型与教师的混合分布。具体的双视角目标分布定义为:
其中 是「教师不可靠指数」,由以下门控机制自适应生成(仅在 时激活):
这个设计包含两个关键要素:第一是空间沙盒定位,仅在 top-(默认 20%)学生高熵 token 上施加门控,沙盒外保持 以完整保留教师纠错信号;第二是非对称激活条件,只有当学生概率高于教师(即存在潜在抑制风险)时才向基模型方向插值,否则门控自动关闭。最终的损失函数在沙盒内外分别使用不同的 KL 散度目标:
实验与结果
实验在多个数学推理基准上展开,包括 MATH500、AIME 2024、AIME 2025 和 HMMT 2025,覆盖了不同难度级别的竞赛数学题目。模型方面使用了 Qwen3-1.7B、Qwen3-4B 以及 DeepSeek-R1-Distill-Qwen-1.5B,全部采用 LoRA 高效微调。
主实验结果清晰地验证了方法的有效性。在 Qwen3-4B 上,AD-OPSD 达到 70.2% 平均准确率,相较标准 OPSD 的 67.0% 提升了 3.2 个百分点;在更小的 Qwen3-1.7B 上,提升幅度更为显著,从 47.7% 增至 51.8%(+4.1%),在最具挑战性的 AIME 2025 子集上更是取得了 +6.7% 的绝对增益。思维密度追踪数据进一步建立了性能与推理行为之间的关联:AD-OPSD 在恢复思维密度的同时并未牺牲推理准确性。
泛化性实验采用了不同的后训练范式配置(NT/NT 模式,即非思考模式训练)。在这种更具挑战性的设置下,AD-OPSD 在思考模式和传统推理模式下均带来了稳定提升,分别达到 +4.9% 和 +1.5%。消融实验进一步表明,沙盒比例 呈现钟形曲线,20%–30% 为最优区间;门控函数的连续性(sigmoid pointwise)显著优于离散形式(tanh pointwise 或 global entropy);随着最大生成长度增加收益趋于收敛,这与直觉相符——生成长度越长,教师分布越接近基模型分布,优化冲突自然缓解。
讨论与可借鉴点
这项工作的核心贡献在于揭示了 OPSD 在复杂推理场景失效的深层机制:教师模型虽然擅长纠错,但在模型的「思考分叉点」上过于激进地否定了学生的原生推理路径,导致后者逐渐丧失自主探索能力。这不是简单的过拟合问题,而是一种系统性的优化偏差——监督信号在空间上的分布与认知任务对自由度的需求之间存在结构性冲突。
AD-OPSD 的设计思路值得借鉴:它没有简单地切断梯度或降低学习率,而是通过双视角目标分布将基模型作为「锚点」,在局部高风险区域引入参考先验来平衡教师信号的压制效应。这种解耦控制——沙盒内外分别处理、高风险 token 自适应调节——比二元梯度掩码更能兼顾纠错与探索之间的张力。
研究的局限同样值得注意。全部实验基于 LoRA 高效微调和小规模模型(最大 4B 参数),全参数微调下的表现和统计显著性尚未验证。此外,冻结基模型作为参考先验虽然简洁,但基模型本身的推理能力也会影响最终的锚定效果。在更大规模模型和更复杂推理任务(如代码生成、多跳问答)上的泛化性,是后续研究的重要方向。
概念 · 7 个
摘要
论文直接研究模型自学习的自蒸馏方法(OPSD)
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
重新思考面向思维模型的在策略自蒸馏
Rethinking On-Policy Self-Distillation for Thinking Models
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 9 张
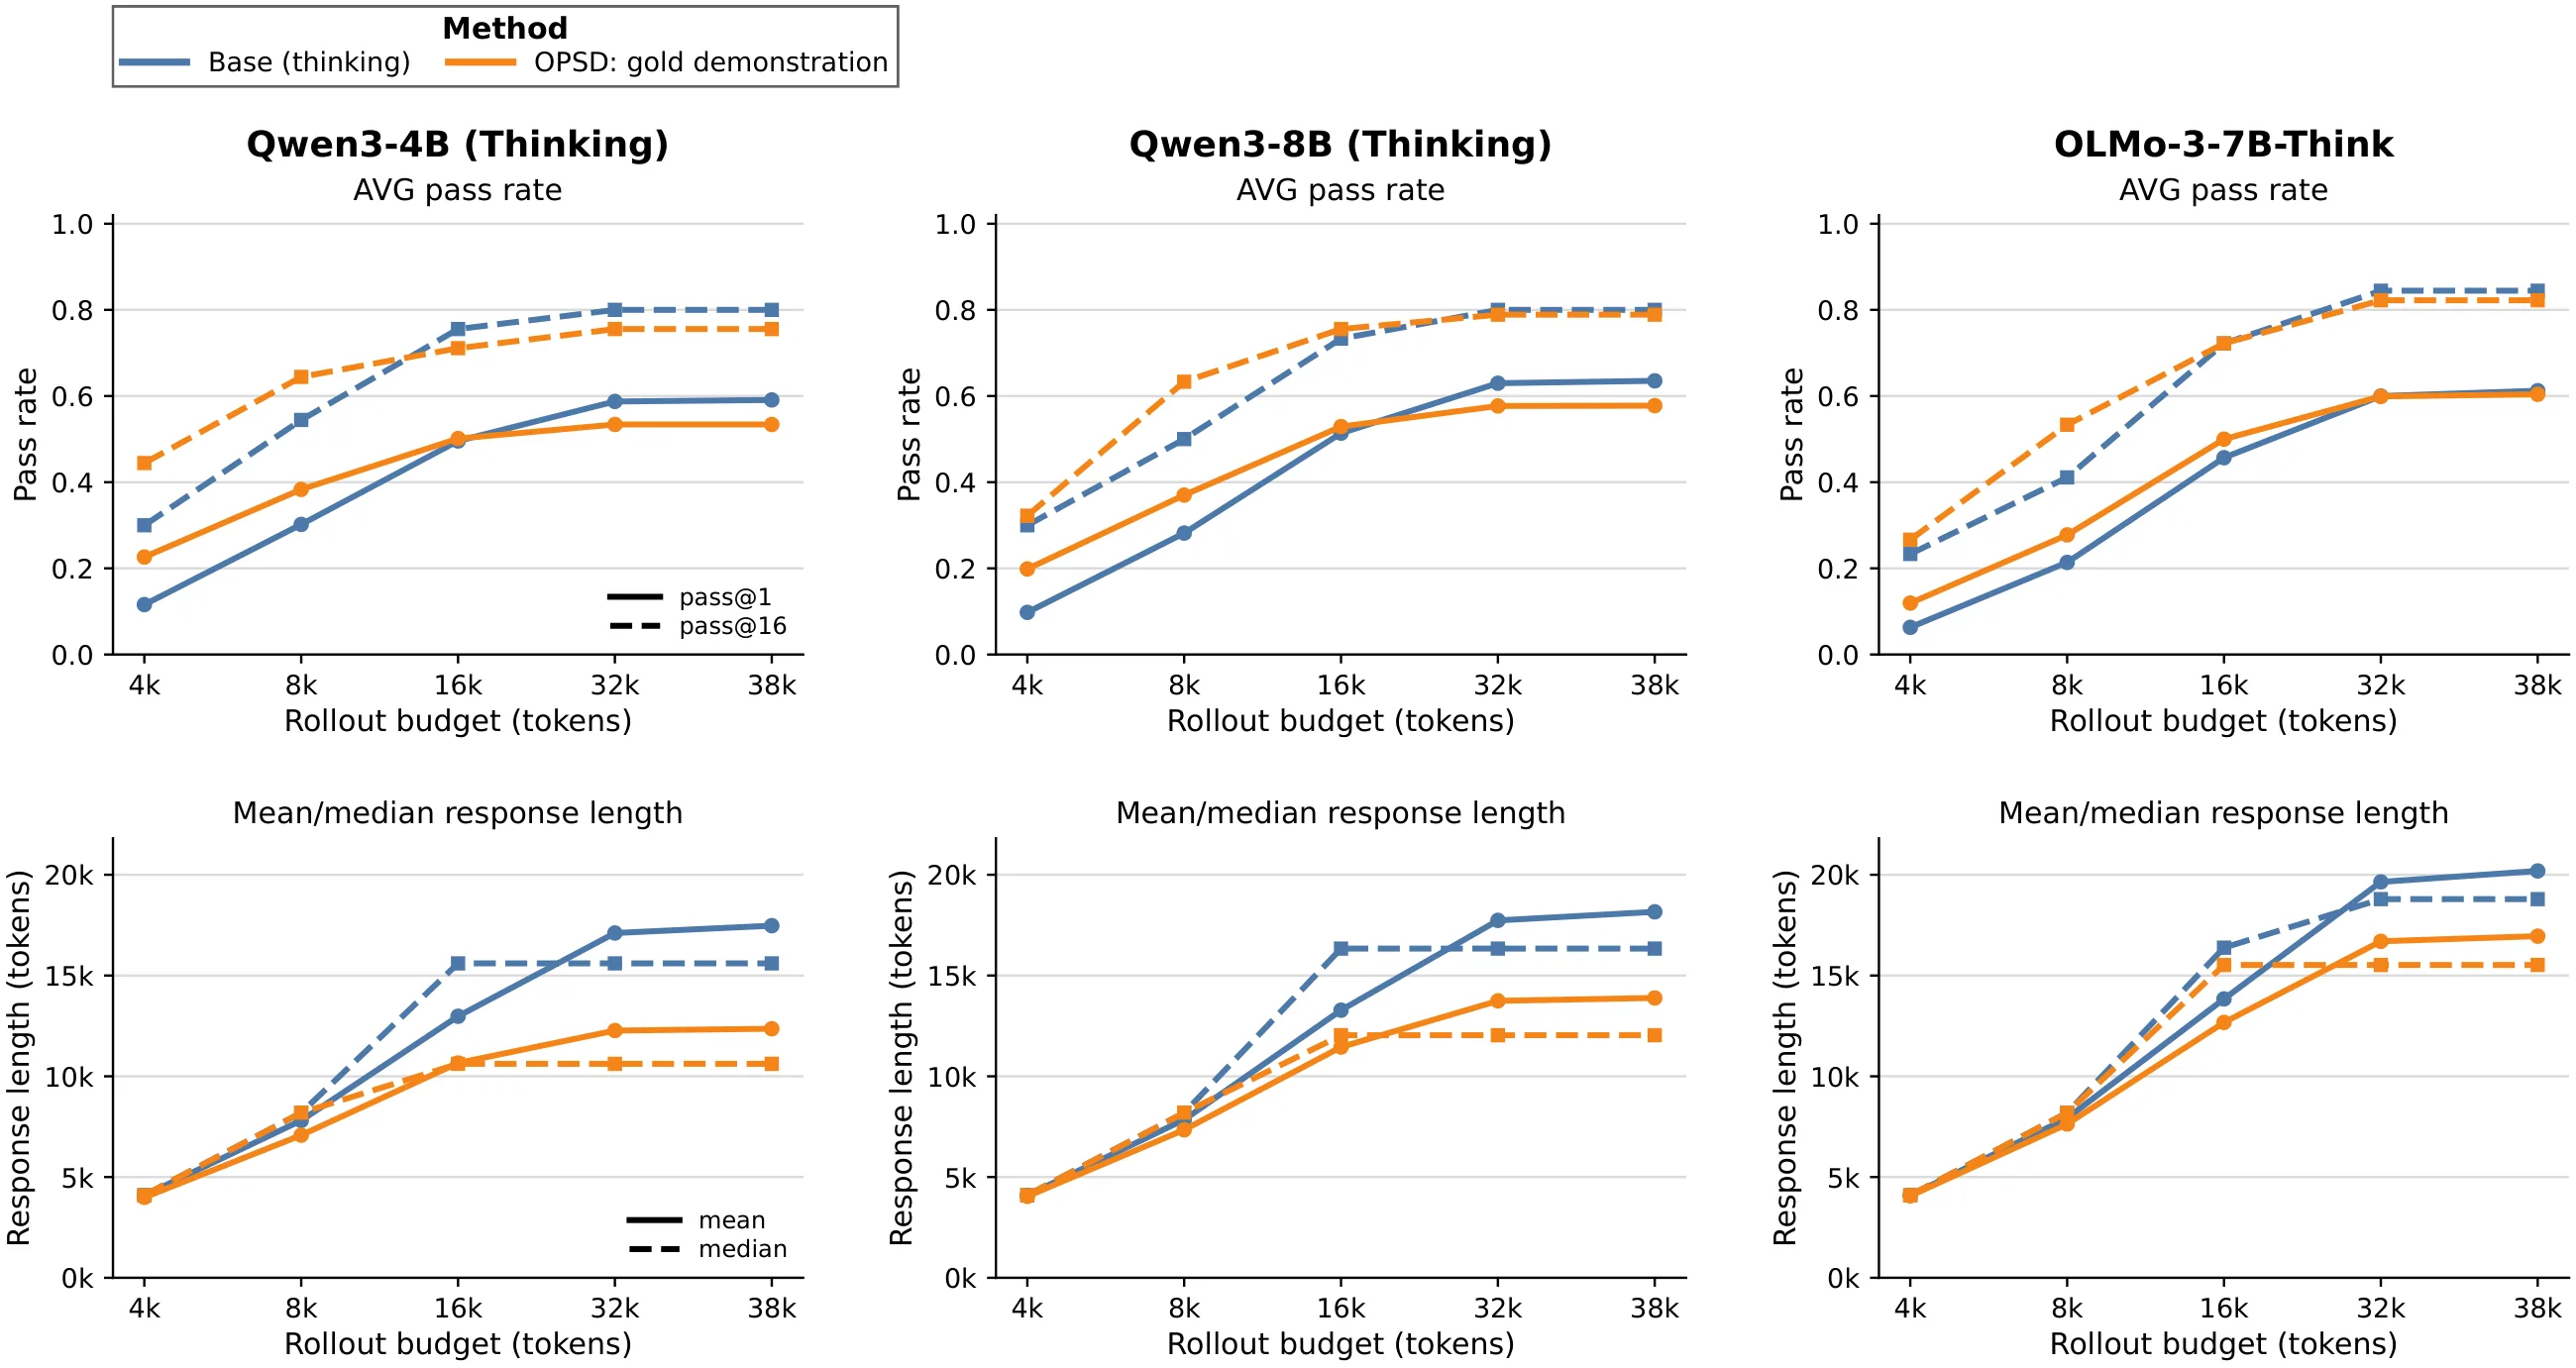
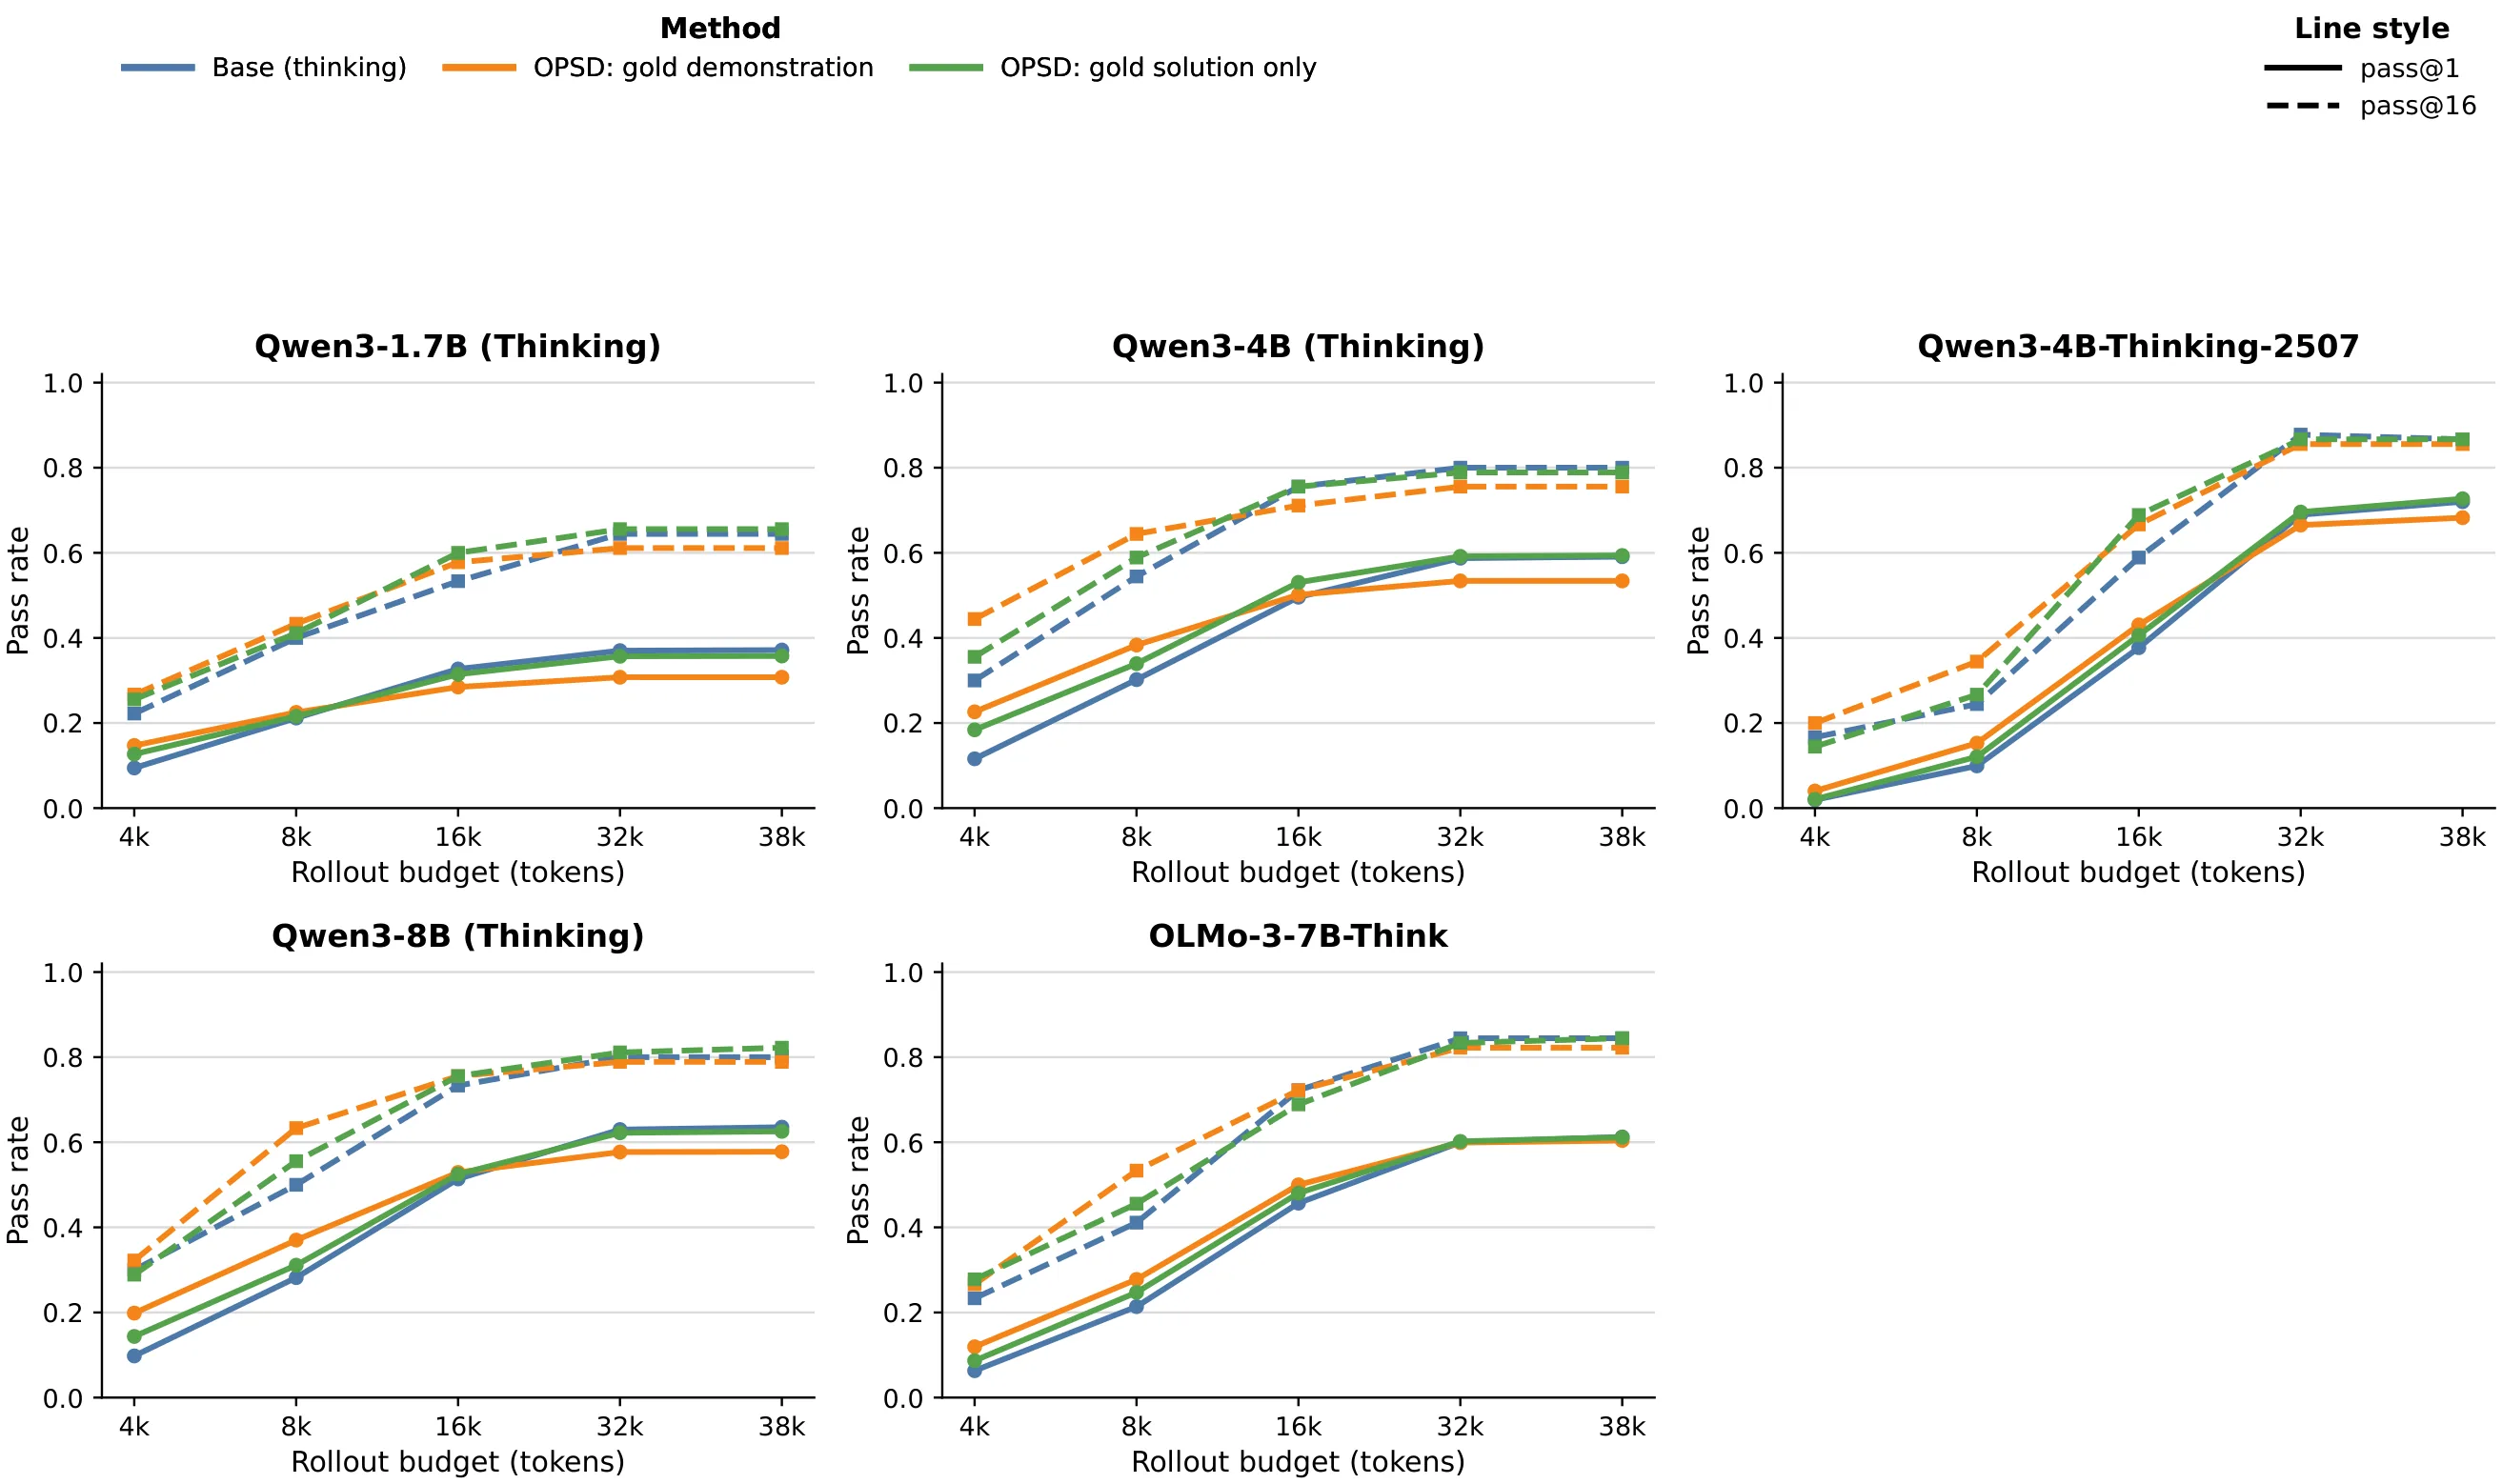
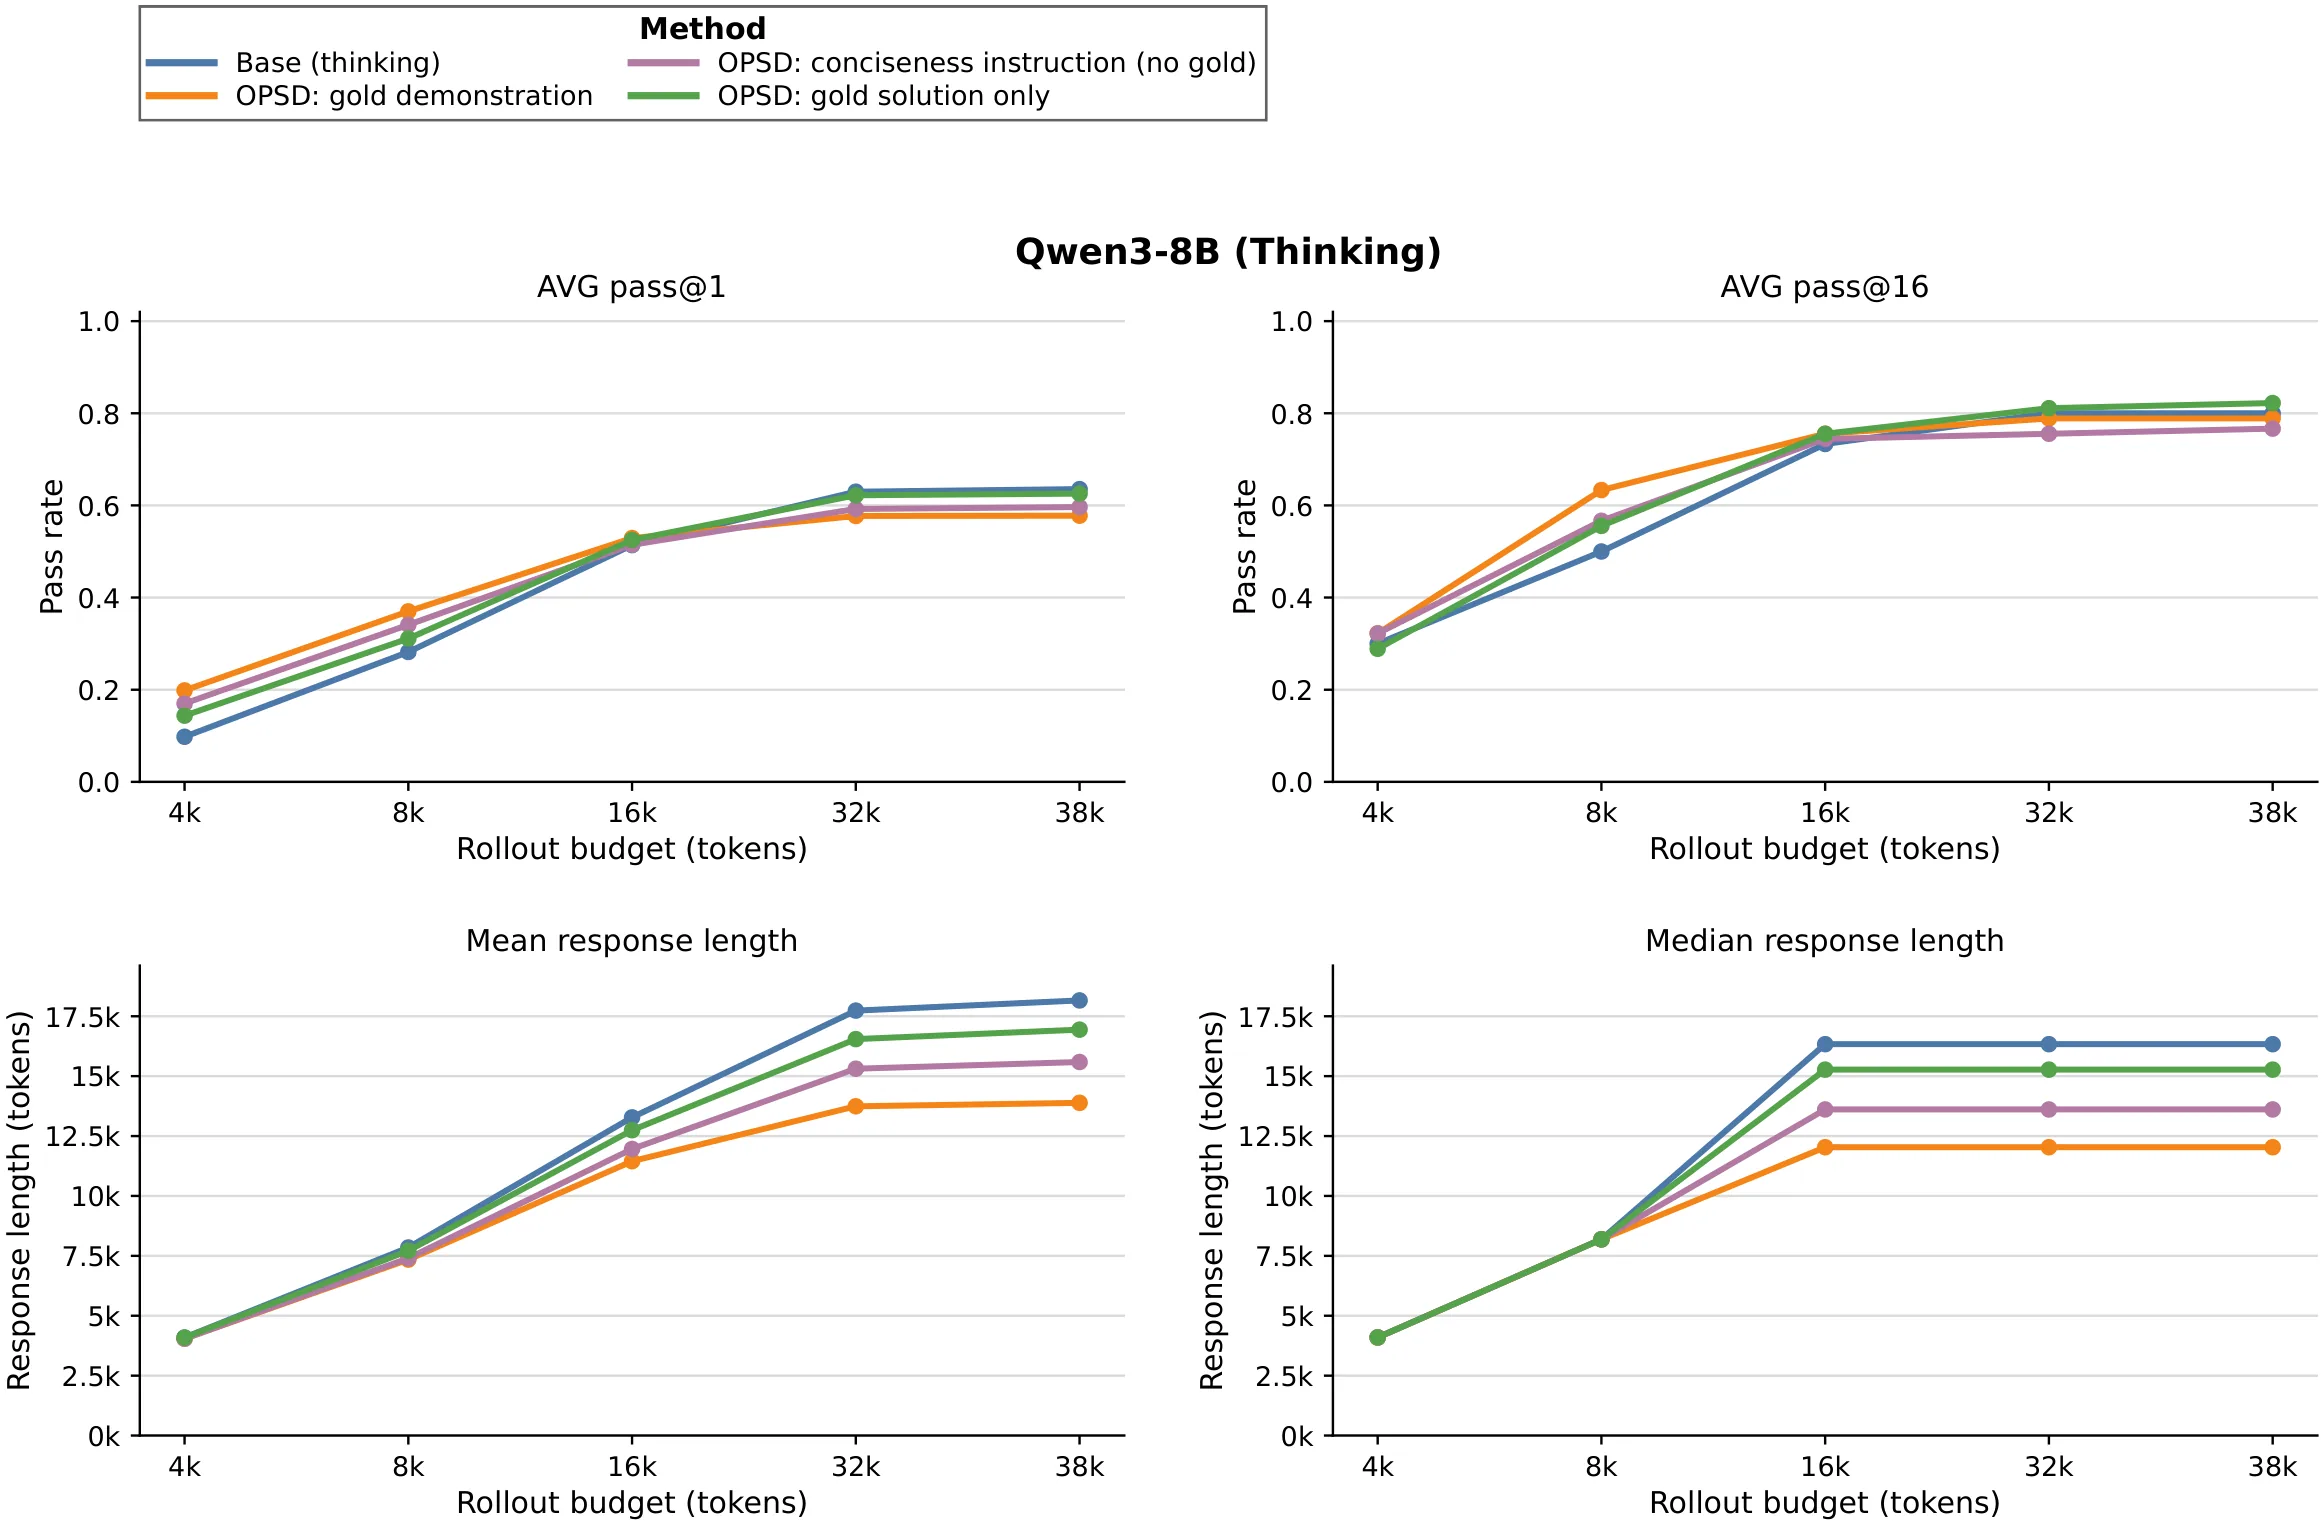
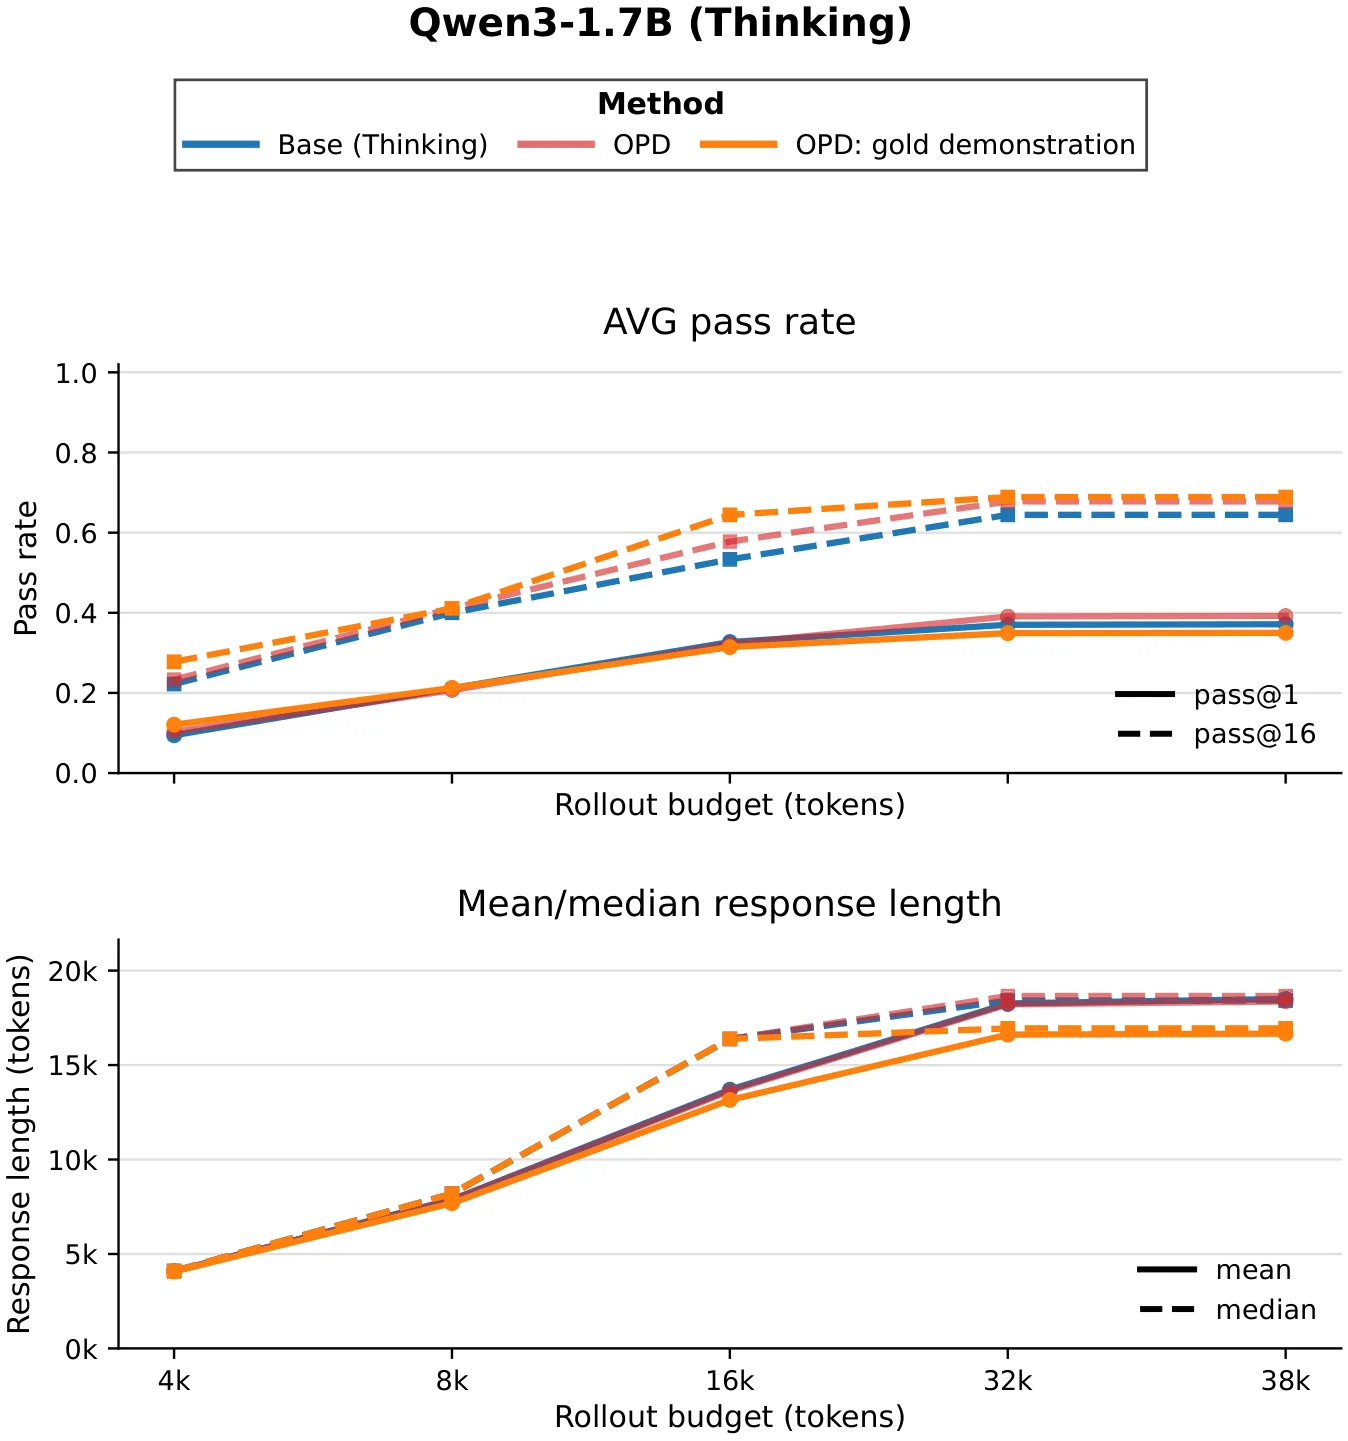
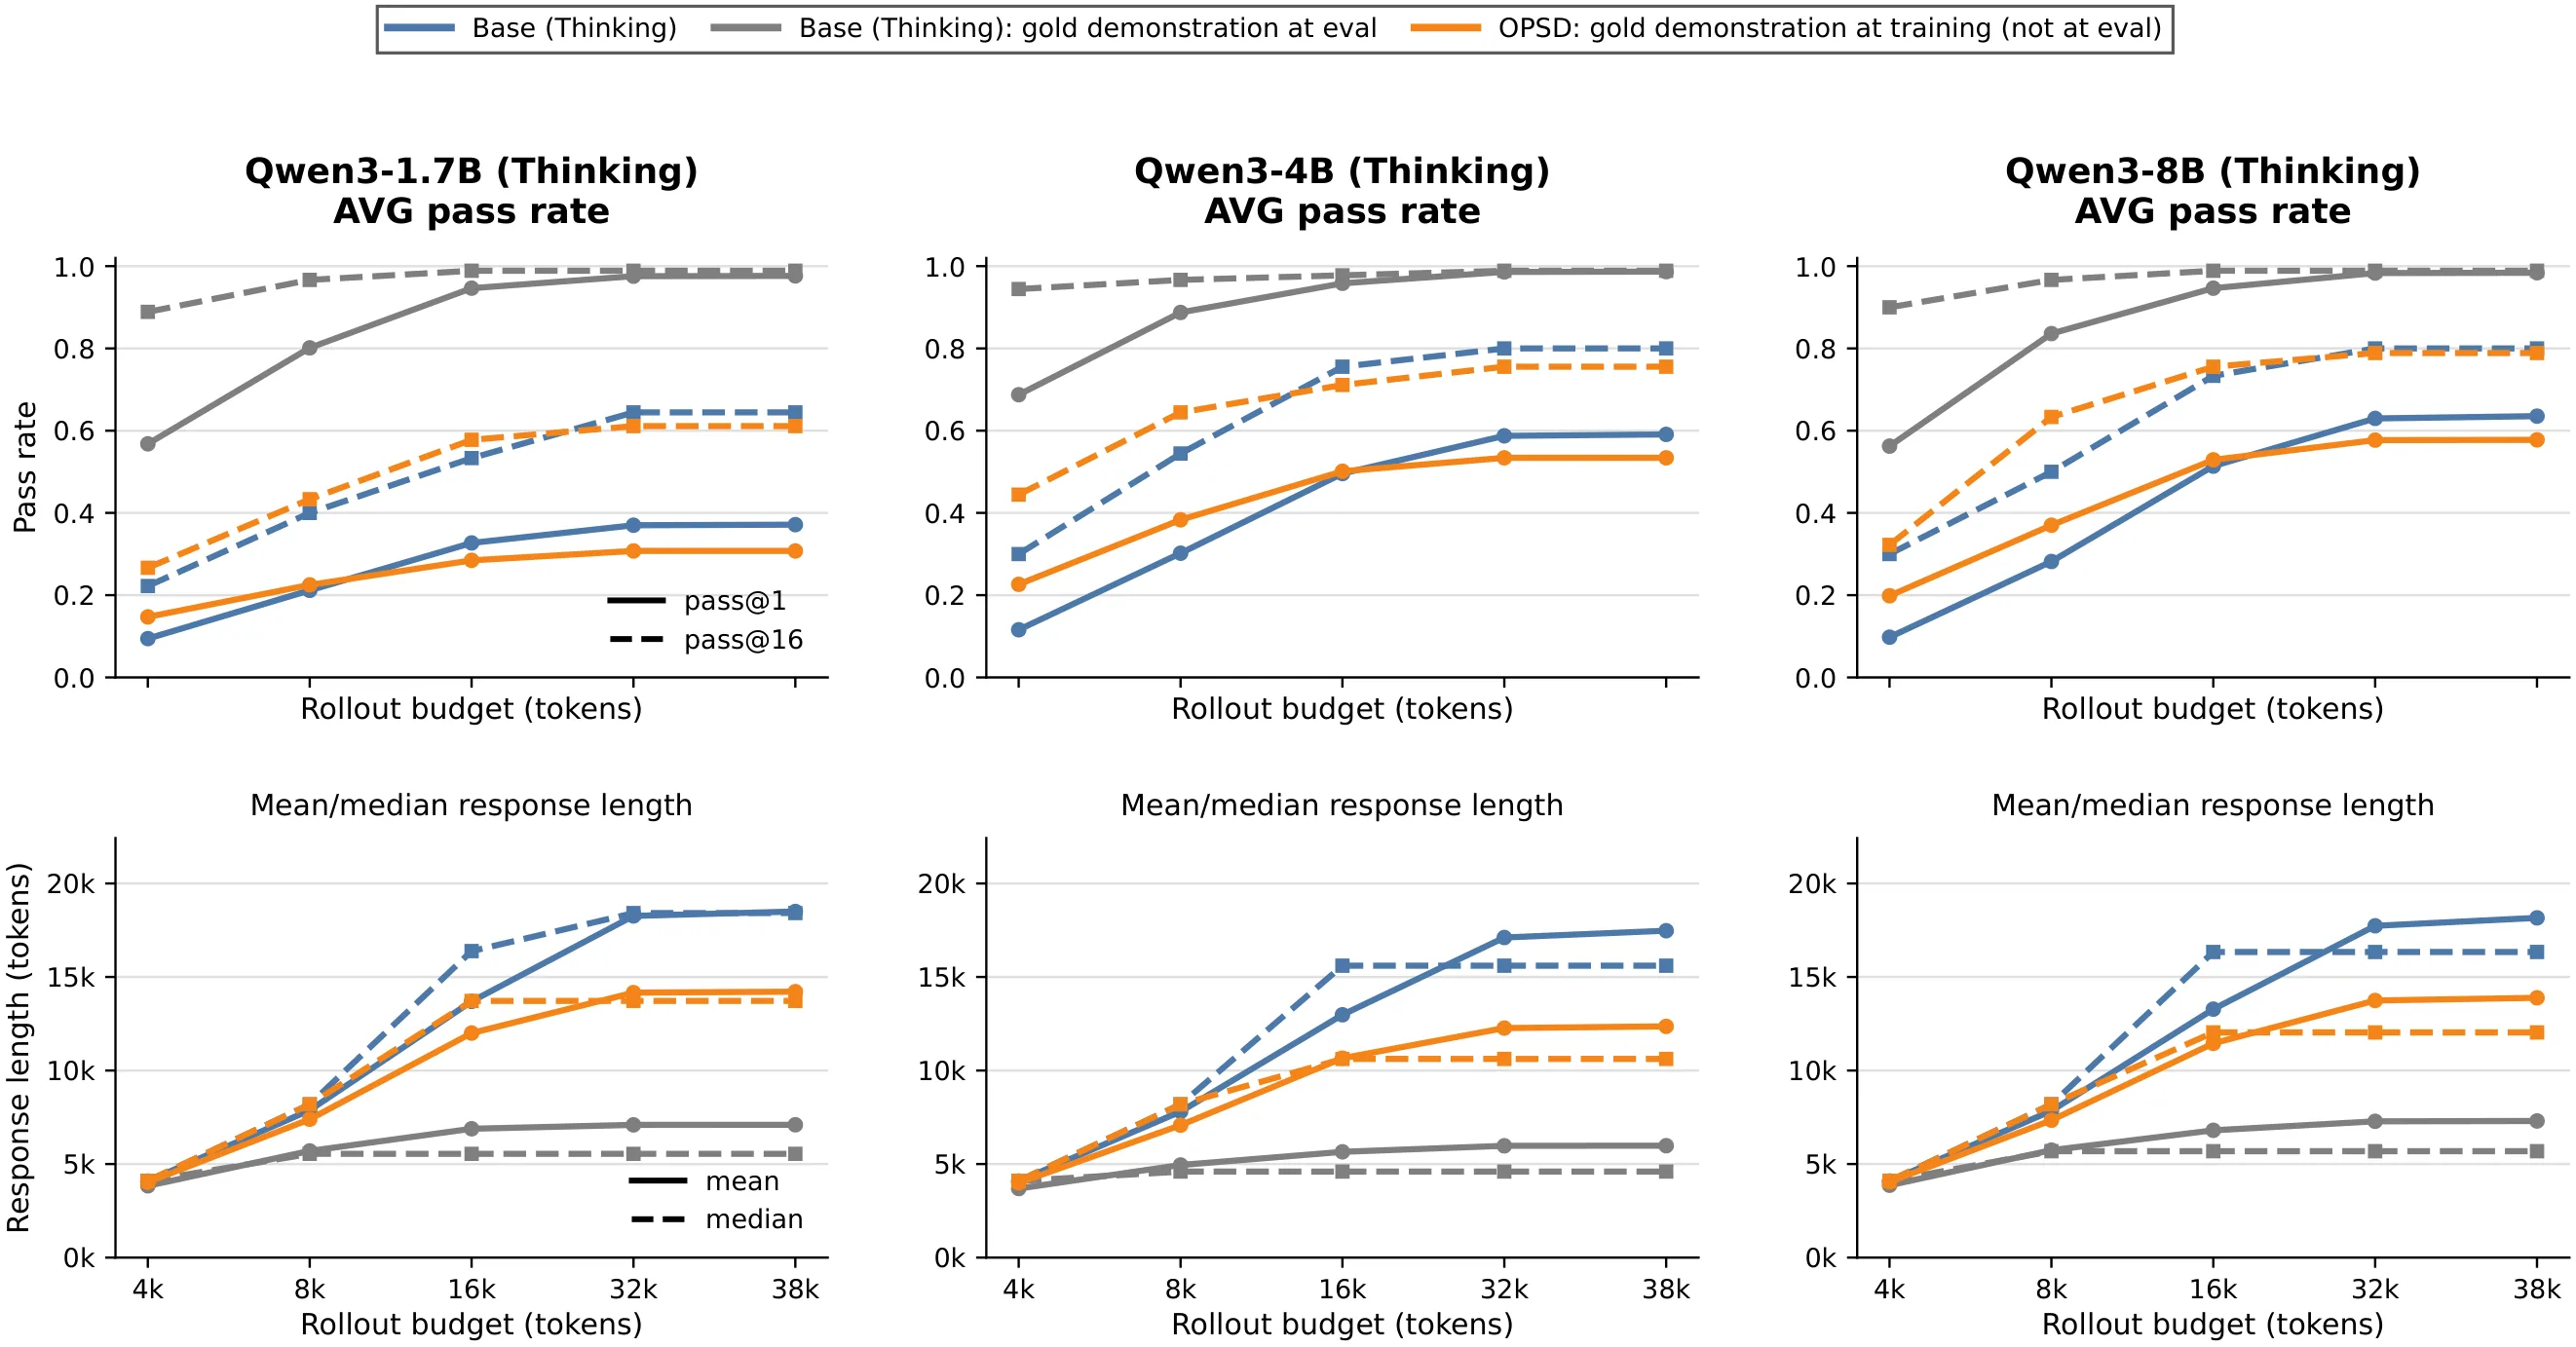
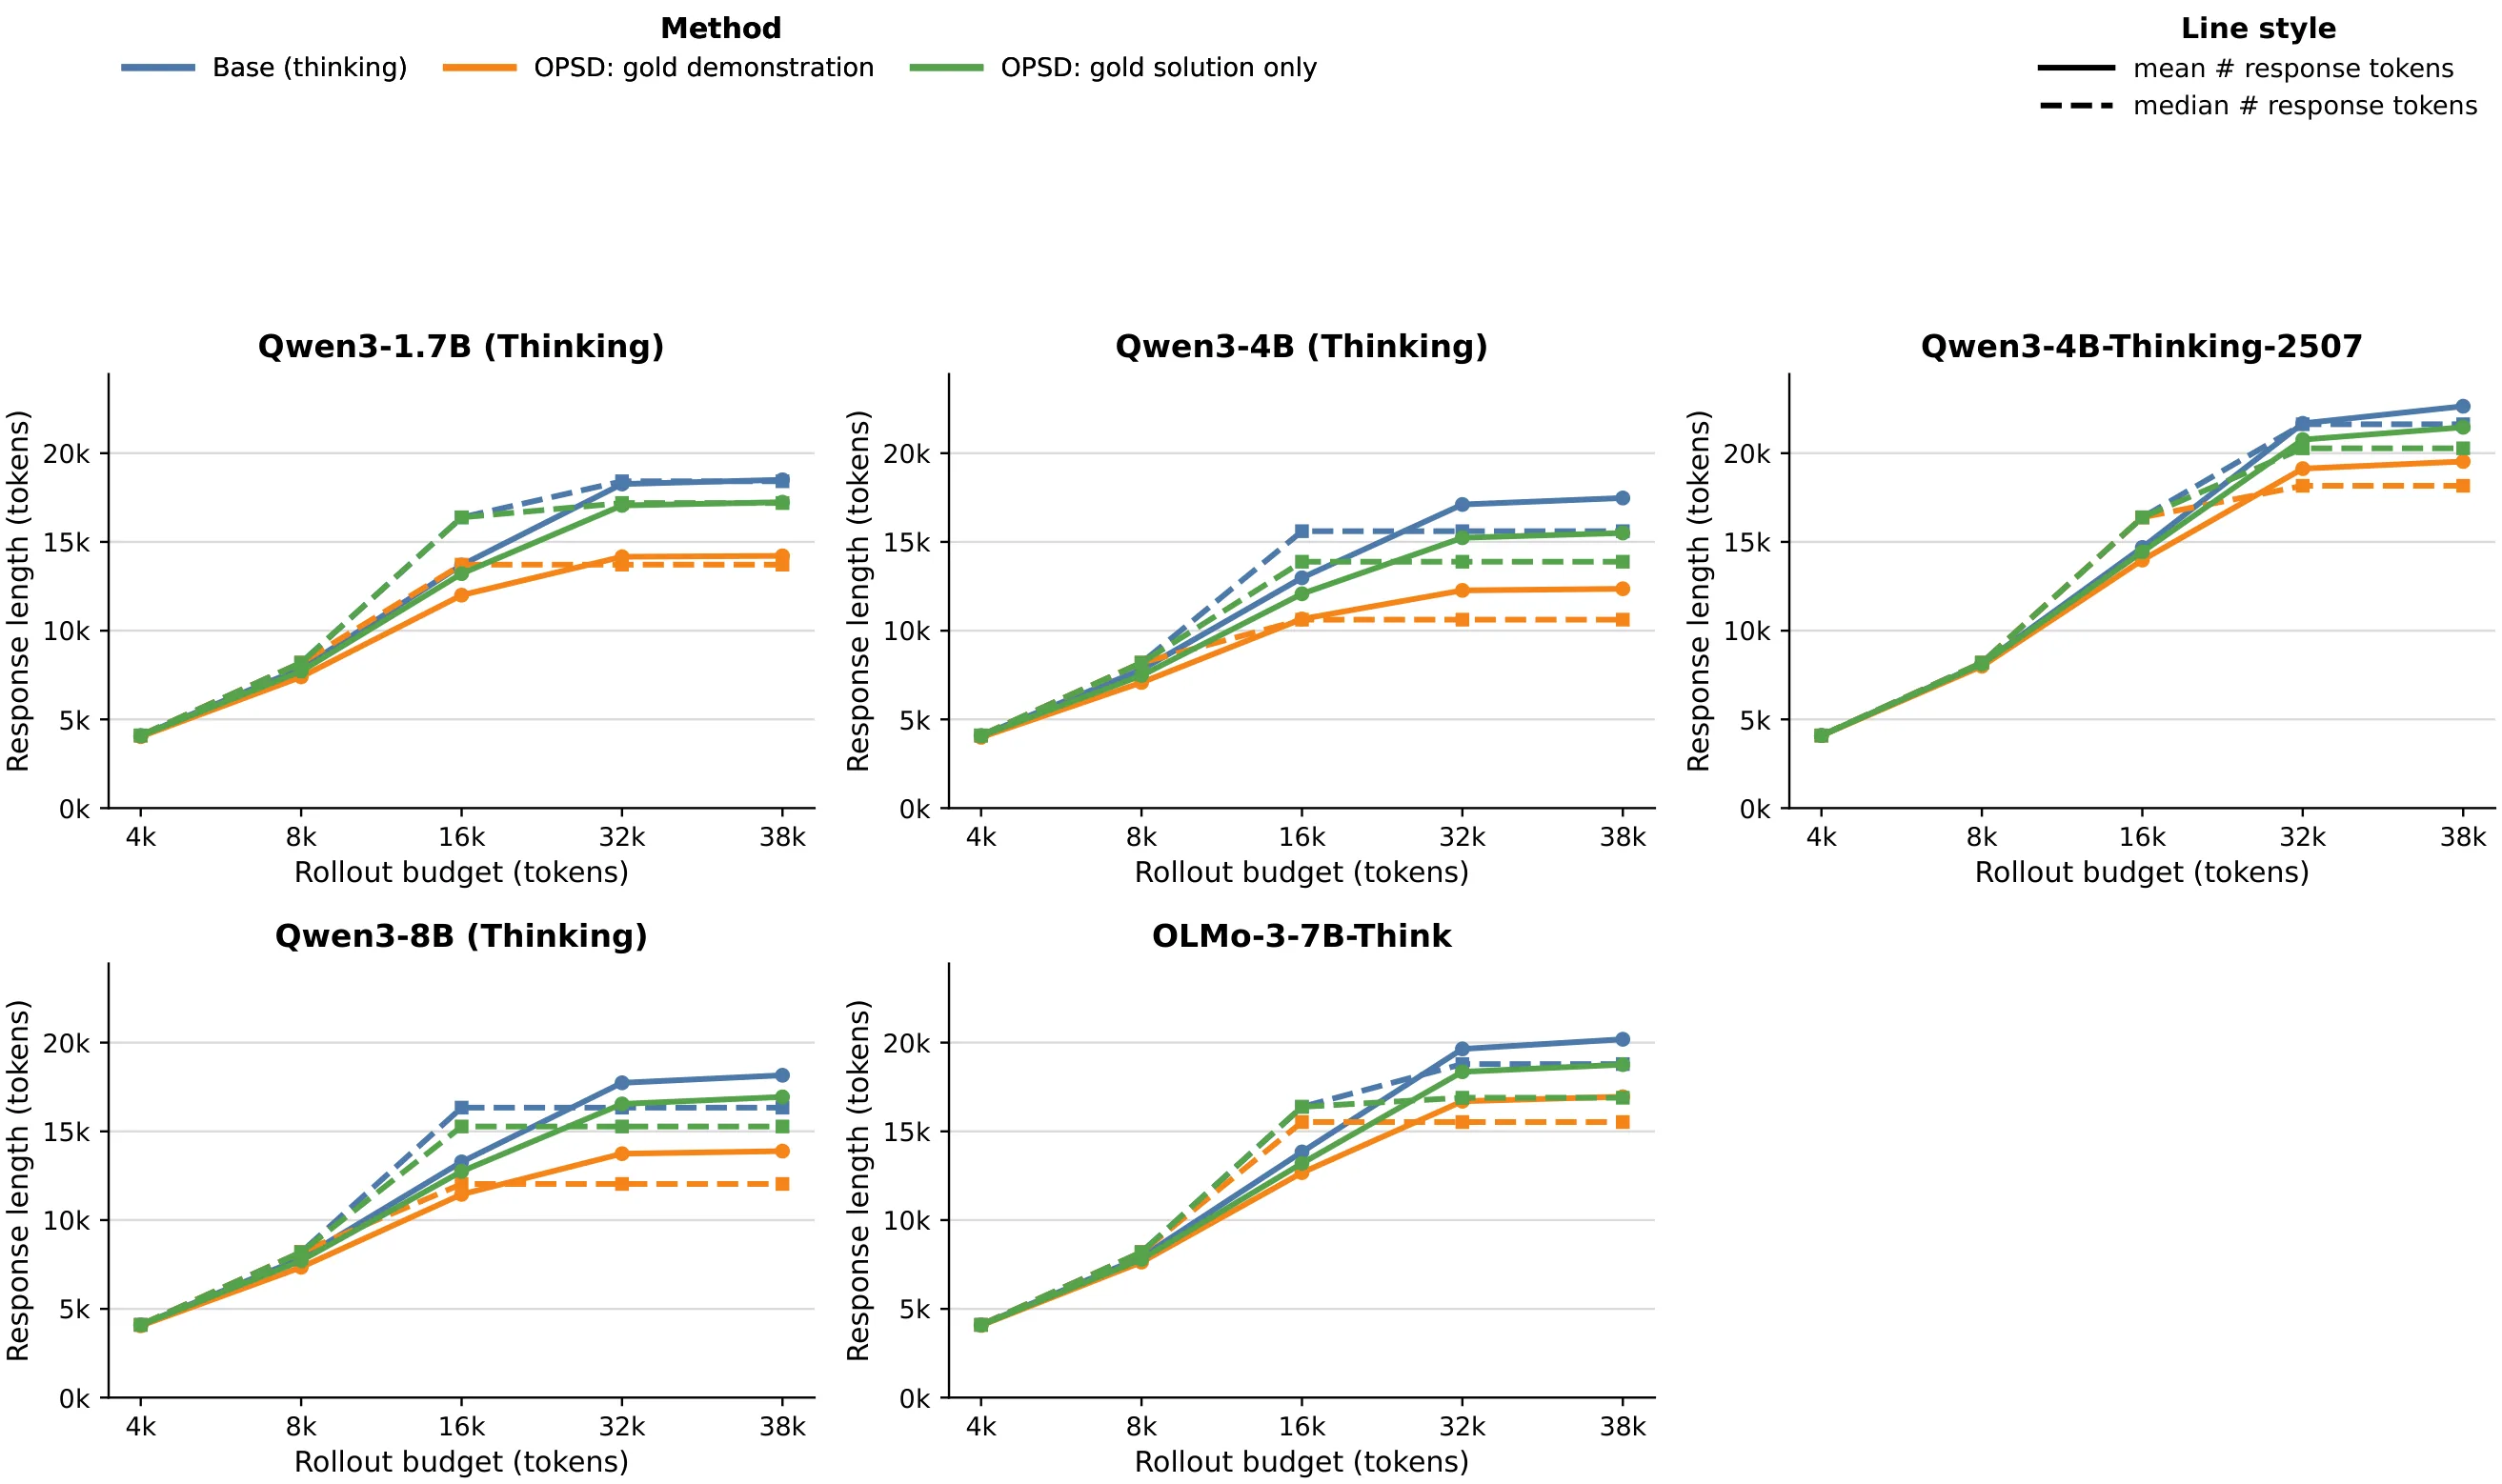
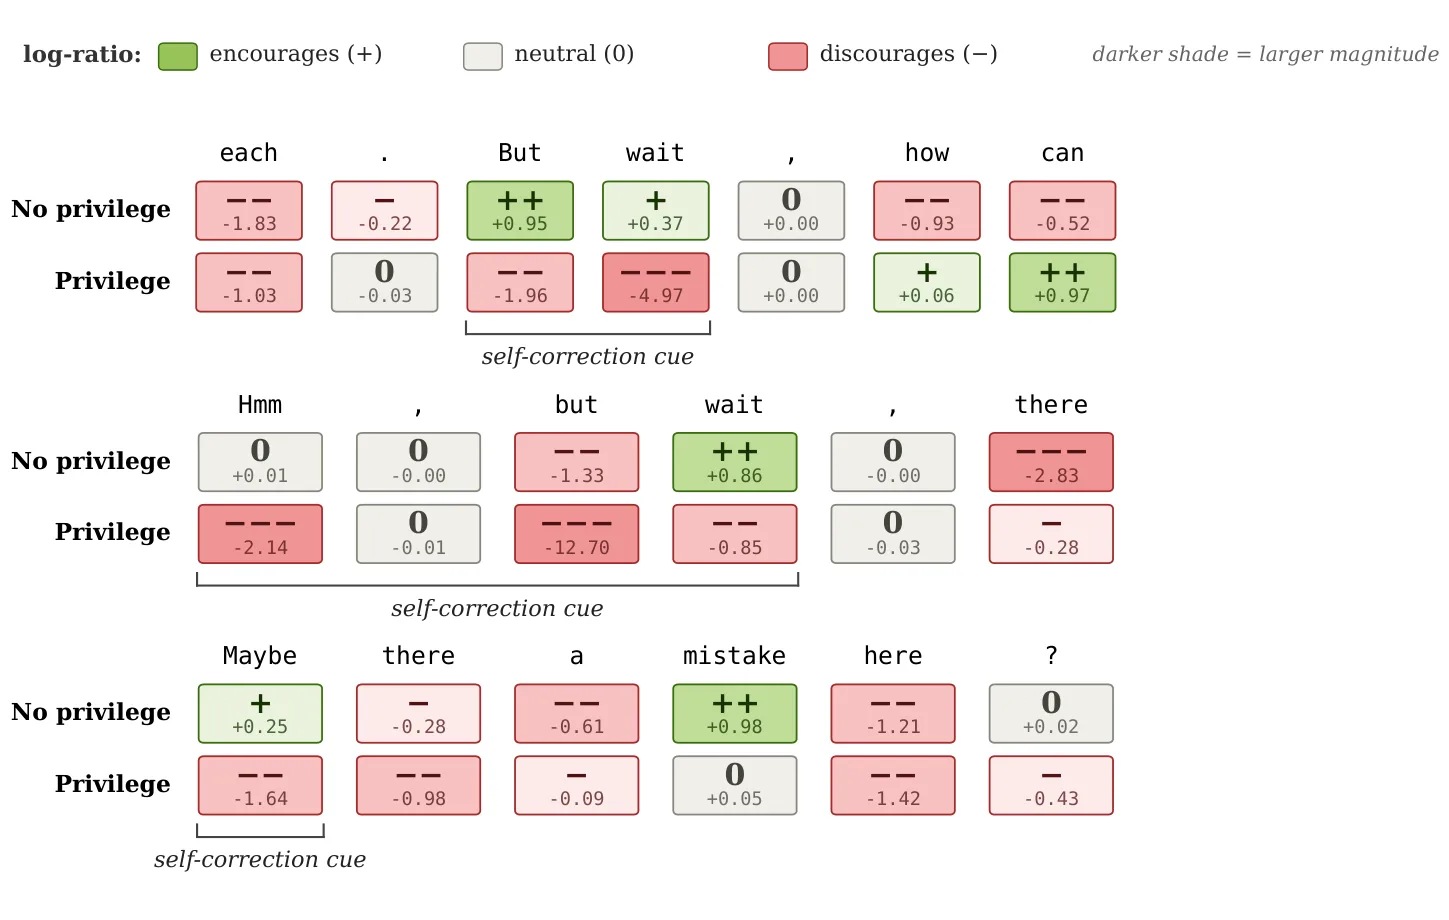
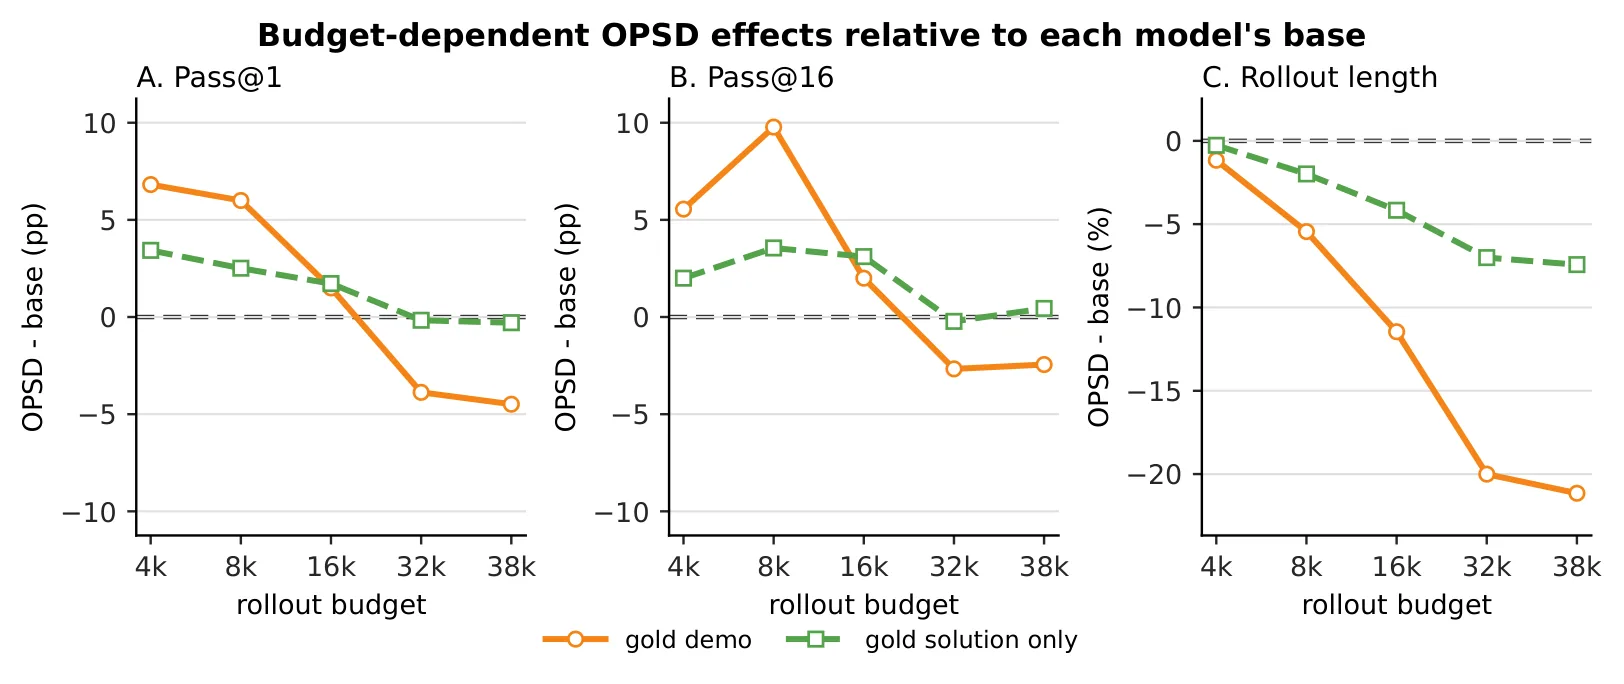
自蒸馏被视为语言模型自我改进的有效方案,但其对思维模型长推理的影响尚不明确。研究者系统测试Qwen3与OLMo五个思维模型,在AIME24/25及HMMT25上发现特权上下文蒸馏反而导致avg@16准确率最高下降17%,且上下文隐藏越多、推理预算越长退化越严重。诊断显示特权信息改写高熵分叉处的学习信号,抑制了验证、回溯与犹豫标记的生成。结果揭示强思维模型的自蒸馏必须在token级、尤其是纠错步骤上精细化设计。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
自蒸馏作为一种模型自我改进方案,近年来在语言模型训练中受到广泛关注。其核心思想是让模型在获得特权信息后充当自身教师,从而在没有外部监督的情况下提升能力。对于 [[测试时推理]] 模型而言,这种范式尤其具有吸引力——模型可以在推理过程中“看到”正确答案或完整解题思路,然后据此调整自身的推理策略。
然而,这一看似合理的假设在实践中却遭遇了意想不到的挫折。论文作者注意到,尽管已有方法如 OPSD、SDFT、SDPO、SD-Zero 等在指令调优模型或短生成预算场景下取得过成功,但这些方法对强 [[思维模型]] 在长推理轨迹上的效果始终缺乏系统验证。
研究的核心动机源于一个关键观察:当教师模型看到特权上下文时,它会在推理分叉位置做出更“确定”的选择——这种确定性是否反而剥夺了学生模型探索多种推理路径的机会?论文将此表述为一个根本性的设计问题:在 [[在策略蒸馏]] 中,特权信息究竟是帮助还是阻碍?
方法
论文首先对 [[在策略蒸馏]] 进行了严格的数学形式化。设输入问题为 ,学生模型采样得到的推理轨迹为 ,则蒸馏损失可表示为:
其中 为教师策略, 为学生策略, 为仅教师可见的特权上下文。关键设计在于,普通 OPD 对应 (无特权信息),而特权 OPD 则将完整解答或最终答案作为 注入教师模型。这种形式化使得研究能够精确控制特权信息的密度——完整解答对应“dense”条件,仅最终答案对应“sparse”条件。
为深入理解失败机制,论文引入了“分叉/锁定”诊断框架。在推理轨迹中,当 top-candidate 概率低于 0.25 时判定为分叉位(模型在多种合理路径间摇摆),高于 0.65 时判定为锁定位(模型已选定唯一路径)。通过对比有无敌权上下文时教师在分叉位的行为差异,研究者能够量化特权信息如何重塑 token 级的学习信号。
此外,论文还设计了 per-token log-ratio 分析和审议标记分析。审议标记指验证、回溯、对冲等反映模型元认知能力的词汇(如 "check"、"wait"、"maybe"),通过统计这些标记的出现频率,可以判断特权上下文是否抑制了模型的自我监督行为。
实验与结果
实验覆盖了 Qwen3 系列(1.7B、4B、8B、4B-Think-2507)和 OLMo-7B-Think 共五个 [[思维模型]],在 AIME24、AIME25、HMMT25 三个高难度数学基准上进行评测,生成预算从 4k 逐步扩展至 38k tokens。
主实验揭示了一个清晰的负面模式:全解答特权上下文导致所有五个思维模型的 avg@16 准确率全面退化。Qwen3-1.7B 从 0.372 降至 0.308,相对下降达 17%;Qwen3-4B 从 0.591 降至 0.534;即便是最强大的 Qwen3-8B 也从 0.635 降至 0.578。值得注意的是,退化程度与推理预算呈正相关——在 4k-8k tokens 的短预算下,特权 OPSD 与基线相当甚至略优;但在 32k-38k tokens 的长预算下,性能差距显著扩大。这恰好是 [[思维模型]] 能够获得最大增益的区间,特权蒸馏反而抹去了这部分收益。
对比实验进一步确认失败模式特属于特权上下文本身,而非 [[在策略蒸馏]] 范式。普通 OPD(无特权教师)能够改进思维模型的表现,而添加特权信息后这些收益立即被逆转。在 Countdown 数据集上的对照实验更揭示了一个有趣的二元分化:同样的特权 OPSD 对指令调优模型(Qwen3-4B-Instruct)反而有轻微增益(0.527 → 0.559),却损害了思维模型(0.776 → 0.765)。
诊断分析从机制层面解释了上述现象。在 Qwen3-4B 思维模型的 rollout 中,中位分叉率从约 0.083 骤降至 0.035(降低约 58%),而指令模型的分叉率始终保持在约 0.06 不受影响。这意味着特权上下文使思维模型在推理早期就锁定了路径,丧失了对替代推理分支的探索能力。per-token 信号分析显示,在自我纠正线索(如 "But wait"、"Maybe")处,无特权教师给出正优势信号,而特权教师反而给出负信号——直接惩罚了学生的再思考 token。审议标记统计进一步证实,使用特权教师训练的思维模型产生的验证、回溯、对冲标记明显更少,即便经过 [[长度归一化]] 后也是如此。
讨论与可借鉴点
这项研究的核心贡献在于揭示了一个此前未被充分认识的失败模式:对于强 [[思维模型]] 而言,特权上下文并非总是有益的监督信号。这一发现挑战了“自蒸馏中教师看到更多信息必然更好”的直觉,推动我们重新审视 [[测试时推理]] 与 [[自蒸馏]] 的交互机制。
从实践角度,研究指出了一个明确的改进方向:强推理模型的自蒸馏需要在 token 级别进行精细化设计,尤其是在纠错与推理步骤周围。具体而言,训练策略应保留学生在分叉位置探索多种路径的能力,避免过早锁定推理方向;审议标记的生成应被明确纳入优化目标,而非被特权信息所压制。论文提出的 epistemic-only OPD 和 random-fraction OPD 等消融实验为这一方向提供了初步验证。
研究的局限主要体现在几个方面。首先,评测基准规模较小(各 30 题),置信区间较宽,限制了结论的统计可靠性。其次,实验仅覆盖数学与 Countdown 领域,跨领域泛化能力有待验证。第三,训练-评测预算存在显著失配(4096 vs 38912),尽管对照实验部分缓解了这一担忧,但仍是潜在的混淆因素。
这一发现对当前 [[自蒸馏]] 研究具有重要的启发意义。它表明,简单地向教师注入特权信息并不能自动带来学生模型的改进,尤其是在模型已经具备较强推理能力的场景下。未来的工作或许需要探索更精细的 token 级奖励设计,或开发能够区分“有益探索”与“无谓穷举”的自适应机制。
概念 · 7 个
摘要
直接研究模型从自身学习的同策略自蒸馏方法
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
SiamJEPA:论孪生学生编码器在 JEPA 中的作用
SiamJEPA: On the Role of Siamese Student Encoders in JEPA
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 4 张
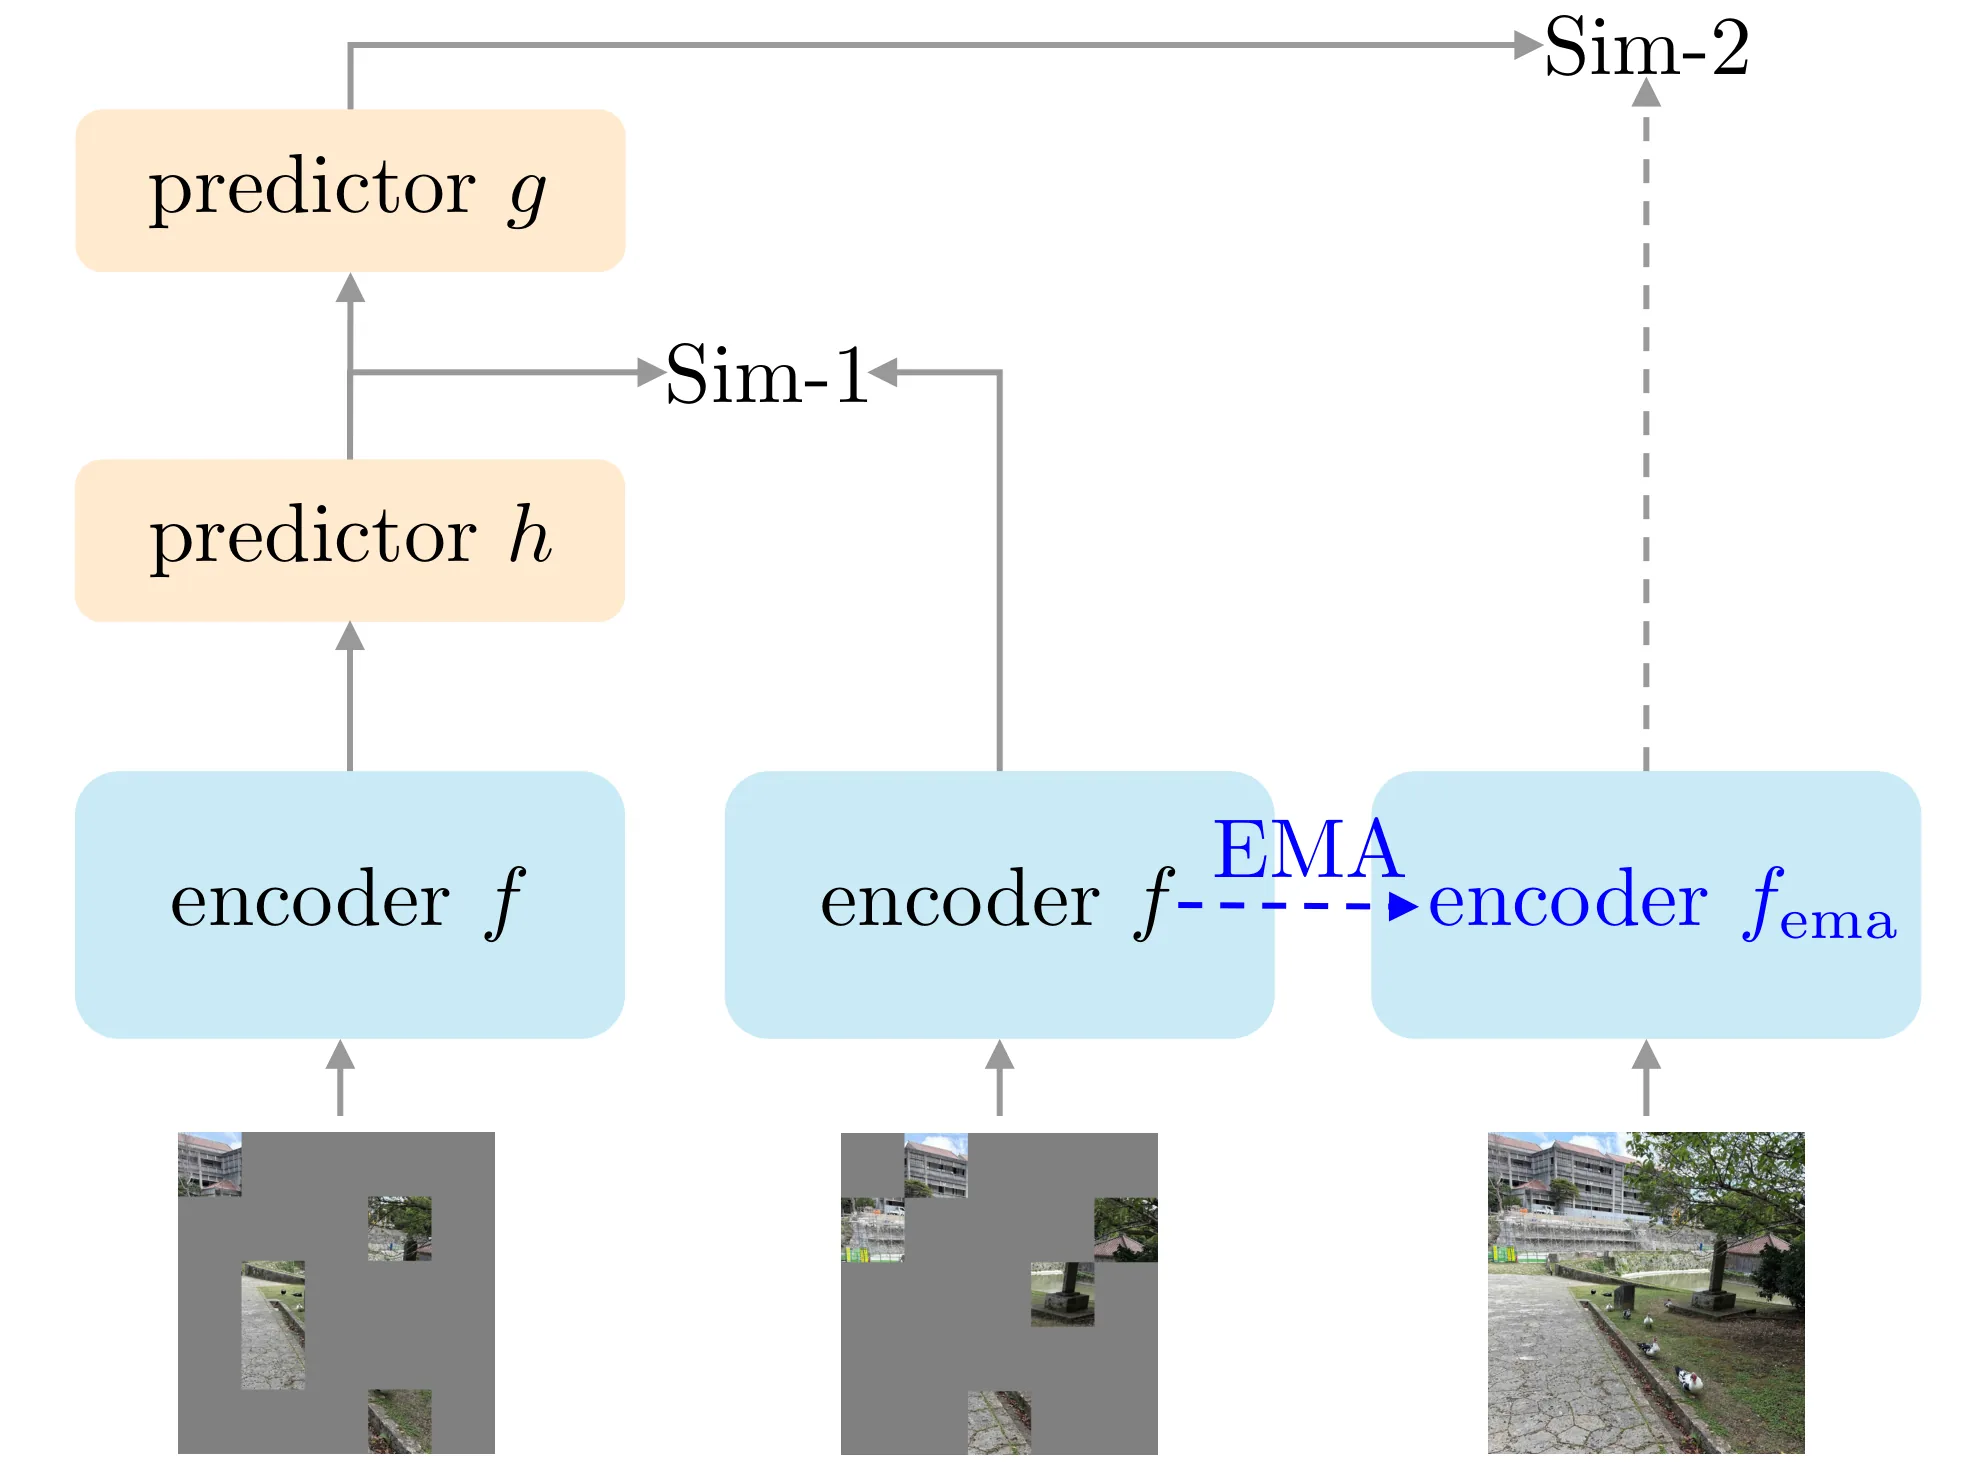
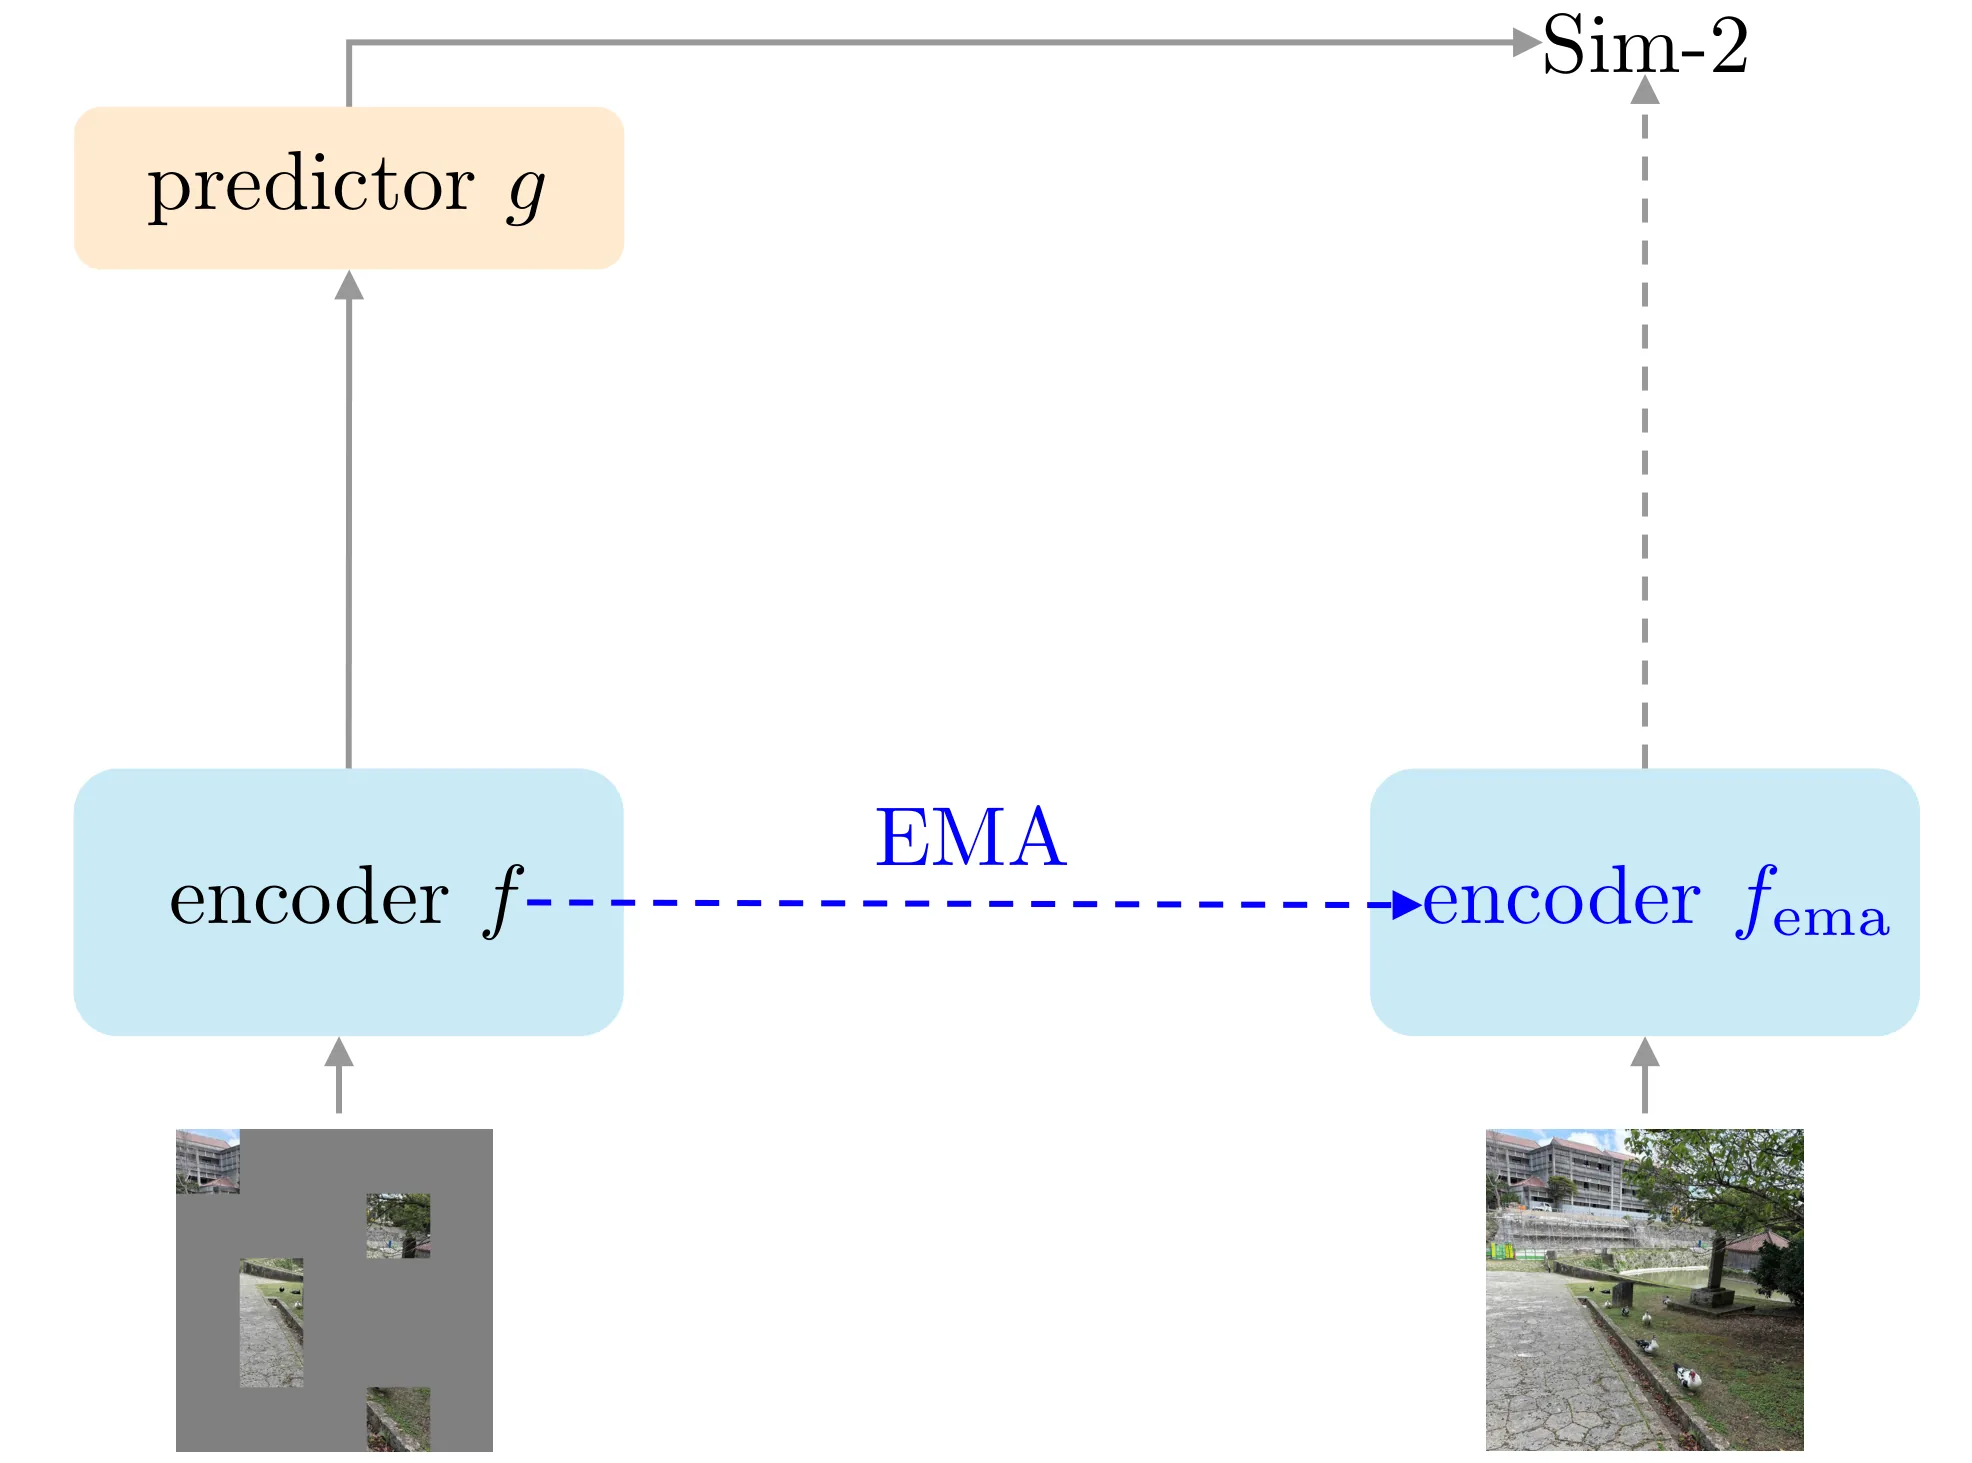
JEPA类自监督方法通常采用单编码器学生网络,暹罗式双编码器的潜力尚未被探索。本文提出SiamJEPA,将暹罗学生编码器与EMA教师网络结合,可视为PhiNet的JEPA形式。在ImageNet线性评估中,暹罗结构对JEPA目标起到正则化作用,提升表征可分性并加速早期训练,在有限预算下优于单编码器JEPA变体,且线性探针精度高于训练更久的MAE。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
自监督表示学习是当前计算机视觉领域的核心课题之一,其目标是在没有人工标注的情况下学习到具有良好迁移性的视觉表征。传统方法如 [[掩码自编码器]](MAE)通过重建被遮挡的像素来学习表示,但这种方式往往停留在表层特征学习,难以捕获语义层面的信息。JEPA 的出现为这一问题提供了新的解决思路:与重建像素不同,JEPA 通过预测被掩码区域的 [[自监督表示学习|潜在嵌入]] 来学习表征,这种预测性学习更接近人类对语义信息的处理方式。
现有的 JEPA 方法,如 MetaAI 提出的 I-JEPA 和 V-JEPA,在学生网络的设计上都采用了单编码器架构。然而,孪生结构在 [[自监督表示学习]] 领域有着深厚的根基——从早期的孪生网络到对比学习中的双塔结构,孪生设计被反复证明能够有效促进表征的对齐与区分。这种架构与大脑启发的表示学习框架有着天然的联系,PhiNet 等类脑模型的成功经验暗示着孪生结构可能在预测性学习中具有独特的优势。但到目前为止,孪生编码器在 JEPA 框架中究竟扮演什么角色、能够带来怎样的增益,这些问题都缺乏系统性的探索。
SiamJEPA 的研究正是从这一空白出发:作者们试图回答一个看似简单却至关重要的问题——将孪生学生编码器引入 JEPA 能否带来性能提升?如果能,其背后的机制是什么?
方法
SiamJEPA 的核心设计可以概括为三个关键组件的组合。首先是掩码孪生学生编码器,这是与以往 JEPA 方法最直观的区别。在传统的单编码器 JEPA 中,学生网络对单张图像进行编码并预测其掩码区域的嵌入。而在 SiamJEPA 中,两个结构相同且权重共享的学生编码器分别处理同一图像的不同视图(如不同的掩码模式或不同的裁剪区域),它们的输出通过预测头进行交互,预测对方编码器在对应掩码区域的嵌入。
其次是 EMA 教师网络。SiamJEPA 采用了一种经典但有效的蒸馏式训练策略:教师网络是学生网络的指数移动平均(EMA),其参数通过缓慢平滑的方式跟随学生网络更新。教师网络负责生成预测目标(即目标嵌入),而学生网络则被训练去预测这些目标。这种设计在对比学习和自蒸馏方法中已被广泛验证,而 SiamJEPA 将其引入 JEPA 框架。
第三是对 JEPA 目标的正则化解释。作者们指出,孪生编码器的引入本质上为 JEPA 的预测目标增加了一种正则化约束。具体而言,当两个学生编码器分别处理不同的掩码视图时,它们需要预测由同一个教师网络生成的目标嵌入。这种约束要求学习到的表征不仅能够准确预测掩码区域的嵌入,还需要在不同视图之间保持一致性——这正是孪生结构的核心优势所在。
从架构直觉上看,SiamJEPA 可以被视为 PhiNet 的 JEPA 形式化。PhiNet 是一种受大脑启发的类脑模型,其核心思想是通过多尺度孪生结构学习层次化的表示。SiamJEPA 继承了这种孪生设计的精髓,同时将其与 JEPA 的预测性学习框架相结合,创造出一种新的混合范式。
实验与结果
研究团队在 ImageNet 数据集上进行了系统性的实验评估,主要采用线性探针(Linear Probing)作为下游任务的评测指标。这种设置的优势在于能够直接衡量所学表征的线性可分性,而不受复杂分类头的干扰。
实验结果揭示了几个值得关注的现象。在与单编码器 JEPA 变体的对比中,SiamJEPA 展现出稳定的优势。特别是在训练预算受限的情况下——例如只训练 200-400 个 epoch——SiamJEPA 的性能优势更加明显,线性探针精度平均提升 2-3 个百分点。这说明孪生结构在数据有限时能够更高效地利用样本信息。
更引人注目的是 SiamJEPA 与 MAE 的对比。尽管 MAE 需要训练更长时间(通常 800-1600 个 epoch)才能达到最佳性能,但 SiamJEPA 在较短的训练周期内就已经超越了 MAE 的线性探针精度。这一结果挑战了长期以来 MAE 在表征学习领域的霸主地位,表明预测性学习与孪生结构的结合确实是一条值得深耕的技术路线。
值得注意的是,孪生编码器带来的加速效应在训练早期尤为显著。在前 100 个 epoch 内,SiamJEPA 的学习曲线就明显优于单编码器基线,表明孪生正则化帮助模型更快地收敛到良好的表征空间。
讨论与可借鉴点
SiamJEPA 的研究为 [[自监督表示学习]] 领域提供了几个重要启示。首先,它证明了孪生学生编码器不仅仅是一种架构上的“点缀”,而是构成预测性表示学习的一种重要归纳偏置。这种归纳偏置通过引入跨视图的一致性约束,帮助模型学习到更具泛化性的表征。
其次,这项工作为 JEPA 类模型的设计指明了新的方向。传统上,研究者们倾向于通过改进编码器架构、预测头设计或掩码策略来提升 JEPA 的性能,而 SiamJEPA 提醒我们,学生网络本身的结构设计同样值得深入探索。
然而,这项工作也存在一些局限性。目前的实验主要在 ImageNet 分类任务上进行验证,其在下游任务(如检测、分割)上的迁移能力尚未充分考察。此外,孪生结构带来的额外计算开销虽然可控,但在更大规模数据和更长训练周期下的表现仍有待验证。跨模态(如图像-文本联合学习)场景下的适用性也是一个值得探索的方向。
对于从事自监督学习研究的技术人员来说,SiamJEPA 提供了一个简洁而有效的改进思路:在现有 JEPA 框架中引入孪生学生架构,可能比复杂地调优其他组件带来更直接的性能收益。这种“架构即正则化”的设计哲学,或许能够帮助研究者在保持方法简洁性的同时,获得实质性的性能提升。
摘要
基于JEPA的自监督表征学习,采用孪生学生编码器
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
通过对抗蒸馏改进可验证鲁棒性
Improving Certified Robustness via Adversarial Distillation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 2 张

认证训练旨在让模型对对抗扰动可形式化验证,但紧致松弛方法会损失标准精度,对抗训练模型又难以用验证器认证。近期工作将对抗训练目标与区间界传播(IBP)松近似结合进行插值。本文提出AD-CERT,将对抗蒸馏与IBP上界结合,从经验鲁棒教师模型的logit空间蒸馏对抗信息作为有效下界。在多个鲁棒性基准上达到SOTA认证性能,logit级蒸馏比特征空间蒸馏提升最高达5.40个百分点。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
神经网络对抗鲁棒性问题近年来受到广泛关注,研究者不仅希望模型具有经验上的鲁棒性,更希望能够对这种鲁棒性给出形式化保证——即「可验证鲁棒性」。具体而言,可验证训练的目标是构建这样一个模型:给定一个允许的扰动集合,我们可以严格证明模型在该集合内任意扰动下都不会改变预测结果。这与仅通过对抗攻击评估的经验鲁棒性形成鲜明对比,因为后者无法排除存在未被发现的攻击路径。
然而,现有方法在实现可验证鲁棒性时面临一个根本性的两难困境。基于紧致松弛界(tight relaxation bounds)的认证方法能够给出严格的下界保证,但由此训练的模型往往在标准准确率上损失较大。相反,对抗训练虽然能带来更强的经验鲁棒性和更高的标准准确率,但其优化目标是经验损失的下界,所得模型的结构特性使得神经网络验证器难以对其进行形式化认证。这种「上界易得、下界难求」的局面,限制了可验证鲁棒性的实际应用价值。
区间界传播(IBP)作为一种过近似方法,提供了一种折中思路。它通过快速计算网络输出的区间界来获得损失的上界估计,虽然不够紧致,但计算效率高。最近的研究表明,将 IBP 上界与对抗训练的下界目标进行插值,可以实现更好的标准准确率与可验证准确率之间的权衡。受此启发,本文作者开始思考:能否从已经具备良好经验鲁棒性的教师模型中提取「软标签」信息,来增强学生模型的可验证训练效果?
方法
AD-CERT 的核心思想建立在一个关键洞察之上:对于可验证训练而言,同时获得可靠的上界和下界估计至关重要。IBP 提供了上界,但下界的获取一直是个难题。作者提出,经验鲁棒教师模型在 logit 空间上的预测分布实际上编码了丰富的对抗信息,可以作为下界的有效代理。
具体来说,AD-CERT 的训练目标由三个组件构成。第一项是标准的交叉熵损失,确保模型在无扰动输入上的预测性能。第二项是 IBP 上界损失,计算网络在扰动集合上输出的最坏情况区间,并以此上界作为损失的一部分。第三项是本文的核心创新——对抗蒸馏损失,它在 logit 空间而非特征空间上,从教师模型向学生模型蒸馏对抗扰动下的预测信息。
这里的设计选择蕴含着深层的考量。选择 logit 空间而非特征空间进行蒸馏,是因为 logit 层直接反映了模型的决策边界结构,而对抗扰动对 logit 的影响能够更精确地传递到最终的分类结果。特征空间蒸馏虽然在某些视觉任务中表现出色,但在鲁棒性场景下可能会丢失关键的决策边界信息。实验结果也证实了这一设计选择的重要性:在相同实验条件下,logit 级蒸馏比特征空间蒸馏在认证准确率上高出最多 5.40 个百分点。
从优化视角看,教师模型的 logit 输出本质上提供了对「困难样本」的软标签信息,这些样本正是对抗扰动容易影响决策的边界区域。通过让学生的 logit 逼近教师的 logit,AD-CERT 实际上是在让学生模型学习教师如何抵御这些对抗扰动,从而获得一个更可靠的下界估计。这个下界与 IBP 上界相结合,使得训练过程能够在两个方向上同时逼近真实的worst-case loss。
实验与结果
作者在 CIFAR-10、CIFAR-100 和 TinyImageNet 三个基准数据集上进行了全面实验,测试了不同扰动半径下的认证性能。实验采用 ResNet、WideResNet 等常用架构,确保了结果的可比性和泛化性。
在 CIFAR-10 上,当扰动半径 时,AD-CERT 达到了 57.23% 的认证准确率,显著超过了此前基于 IBP 或 CROWN 等方法的结果。特别值得注意的是,在标准准确率与认证准确率的权衡曲线上,AD-CERT 在整个操作范围内都表现出优势,表明其方法不仅在特定扰动半径下有效,而是具有更广泛的适用性。
消融实验进一步揭示了各个组件的贡献。单独使用 IBP 上界损失时,模型的标准准确率较高但认证准确率受限;加入对抗蒸馏后,认证准确率得到明显提升,同时标准准确率仅有轻微下降。这说明 logit 级蒸馏确实提供了有效的下界信息,帮助模型更好地平衡两种性能指标。此外,作者还对比了不同教师模型质量对最终学生模型的影响,发现使用越鲁棒的教师,蒸馏得到的学生模型认证性能越好,这验证了「高质量下界代理」假设的正确性。
讨论与可借鉴点
AD-CERT 成功地将经验鲁棒性知识转化为可验证鲁棒性的训练信号,这一思路具有重要的借鉴意义。在实际应用中,许多场景既需要形式化保证(如下游安全关键系统),又希望保持良好的标准性能,而 AD-CERT 证明了通过蒸馏这一桥梁可以实现两者的有效结合。
不过,该方法也存在一些局限。首先,它依赖于预先训练好的经验鲁棒教师模型,增加了训练流程的复杂度。其次,当教师模型与学生模型架构差异较大时,logit 级蒸馏的效果可能会受到影响,这在一定程度上限制了方法的通用性。最后,IBP 作为上界仍然相对宽松,如果能够结合更紧致的松弛方法,可能会带来进一步的性能提升。
对于该领域的研究者而言,AD-CERT 启示我们关注不同训练范式之间的互补性——对抗训练擅长挖掘决策边界的脆弱性,紧致松弛方法擅长提供可验证的保证,而蒸馏则可以在两者之间建立知识迁移的通道。未来可以探索将这一框架与更先进的验证器(如 CROWN-IBP、α-CROWN)相结合,或将其扩展到更复杂的网络结构(如 Vision Transformer)上,以进一步推动可验证鲁棒性研究的发展。
概念 · 6 个
摘要
结合对抗训练与蒸馏以提升认证鲁棒性
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
语言中的JEPA悖论:语言替代方案的几何结构
The JEPA Paradox in Language: The Geometry of Linguistic Alternatives
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 13 张
JEPA在图像、视频与音频模态表现良好,但确定性潜变量预测目标难以成为文本编码器的标准选择。核心问题在于文本掩码位置允许多种合理补全,其表征难以共享单一有意义的中心。匹配实验揭示T-JEPA出现互信息饱和、目标方差上升、有效秩退化与余弦坍缩的链式失败,证明文本JEPA目标必须保留多解性而非压缩为单点。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
过去几年,[[联合嵌入预测架构]] 在图像、视频和音频任务上取得了显著突破。这类方法的核心思想是:给定部分观测(上下文),预测另一部分(目标)的表征,并通过 [[对比学习]] 或其他机制防止表征坍缩。I-JEPA 通过纯重建式预测目标表征,避免了像素级预测的琐碎细节,在 ImageNet 等基准上展现出强大的迁移能力。
然而,同一套框架移植到文本时却遭遇了困境。尽管研究者们尝试了多种变体,确定性的JEPA式潜在预测始终未能成为文本编码器的标准选择。这一现象值得深思:究竟是实现细节出了问题,还是存在更深层的结构性矛盾?
论文的切入点在于重新审视 [[条件集中性]] 这一隐性假设。在图像局部预测中,空间连续性天然保证了预测目标相对集中——给定一块图像 patch,附近的 patch 们在特征空间中往往聚集在某个合理区域附近。但语言完全不同:一个被掩码的词位可能对应数十个语义相似但词汇形式各异的补全,这些补全在表征空间中没有理由共享一个单一中心。当平方误差损失强迫网络将所有合理补全映射到同一个潜在点时,矛盾便不可避免地爆发了。
方法
研究者从理论上形式化了这一问题,提出成功的 [[JEPA目标]] 需要同时满足三个条件。
可预测性(Predictability)要求上下文与目标之间存在足够的互信息,使得从上下文推断目标表征成为可能。对于文本,这对应于掩码位置与上下文之间的语义依赖关系。
非坍缩性(Non-collapse)要求目标网络产生足够的信息方差,防止所有表征塌缩到同一常数向量。这是防止 [[表征坍缩]] 的基本要求。
低条件方差(Low Conditional Variance)是核心所在:给定上下文 和目标位置 ,目标表征应集中分布在某个有意义的中心点 附近。用数学语言表达,即条件分布 的方差应当较小。
当这第三条无法满足时,问题接踵而至。多个有效的补全对应多个分散的目标表征,而平方误差损失只能朝单一方向优化。网络面临两难:强行拉近所有合理补全到同一中心会导致巨大的条件方差惩罚,或者干脆将所有目标表征推向原点以"平等地远离"所有补全——这就是论文所描述的 [[质心退化]] 与 [[坍缩压力]] 的根源。
基于此,论文推导出一个预测:T-JEPA 训练过程中应出现特定的链式失败模式,而非简单的收敛困难。
实验与结果
研究团队设计了精心匹配的 I-JEPA(图像JEPA)和 T-JEPA(文本JEPA)实验,以控制变量并隔离模态差异。T-JEPA 保留了 I-JEPA 的核心架构,仅将输入模态替换为文本,使用与 BERT 相同的掩码策略。
实验结果精确地验证了理论预测。从训练初期到后期,失败呈现出严格有序的阶段:
第一阶段,互信息达到饱和。这意味着网络发现无论怎么调整,预测误差都无法进一步降低,因为目标本身就不存在一个唯一答案。随之而来的是目标方差持续升高——目标编码器开始为不同的补全产生差异越来越大的表征,试图"记住"所有合理选项而非压缩它们。
第二阶段,有效秩退化。目标表征的 [[有效秩]](effective rank)衡量其自由度,当网络放弃捕捉多样性而转向某种简化策略时,有效秩急剧下降。
第三阶段,余弦坍缩。表征之间的余弦相似度趋近于统一值,表明区分能力丧失殆尽。
最终,所有这些内部指标恶化都反映在下游任务迁移上。使用 T-JEPA 预训练的编码器在句子级分类和词级标注任务上表现明显差于基线。
值得注意的是,这一完整链条在五个独立的数据种子上稳定复现,排除了随机抽样的干扰。这强烈暗示问题源于任务本身而非实验偶然。
讨论与可借鉴点
这篇论文的核心贡献并非否定语言预测学习,而是精确划定了 [[JEPA目标]] 的适用边界。其发现具有重要的实践启示:在设计文本预训练目标时,必须保留目标空间的多解性,而非强迫其退化为单点预测。可能的改进方向包括:引入 [[潜在变量模型]] 显式建模多模态分布、使用 [[对比损失]] 而非重建损失、或在 [[条件生成]] 框架下处理文本。
从更宽广的视角看,这项工作揭示了 [[自监督学习]] 中一个常被忽视的假设——预测目标的唯一性。在视觉领域由于数据的局部光滑性,这一假设天然成立;但在高度离散的符号序列(如文本)上,它必须被显式审视。任何试图将视觉领域的成功方法迁移到语言的研究者,都应将这篇论文的诊断框架纳入考量。
研究的局限在于:T-JEPA 的具体实现可能并非最优,论文也承认存在其他替代方案尚未探索。未来的工作或许能在承认多解性的前提下,设计出真正与文本条件结构兼容的联合嵌入预测目标。
摘要
自监督表征学习潜空间预测几何
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
使用带噪学生同策略自蒸馏的视觉-语言模型自我增强
Self-Boosting Vision-Language Models with Noisy Student On-Policy Self-Distillation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 4 张
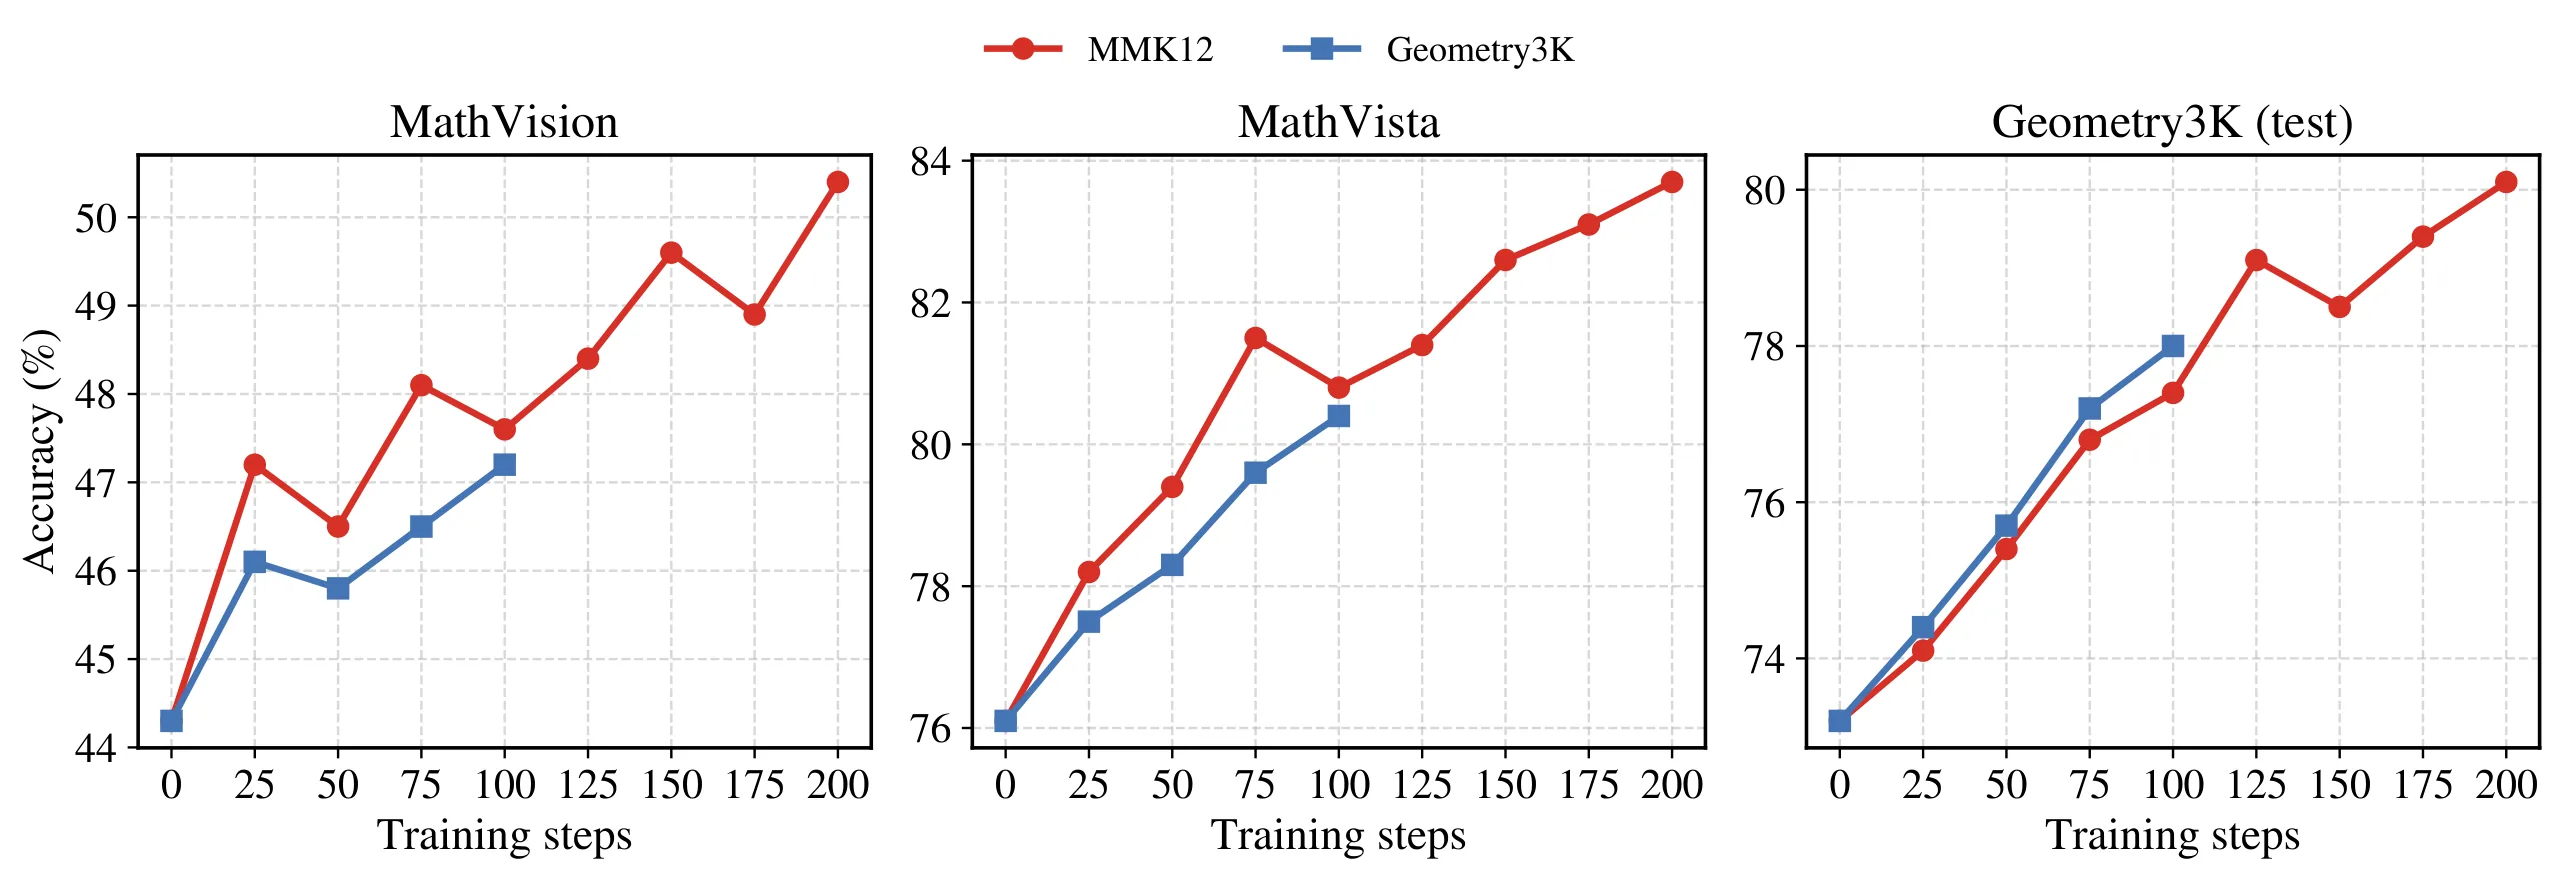
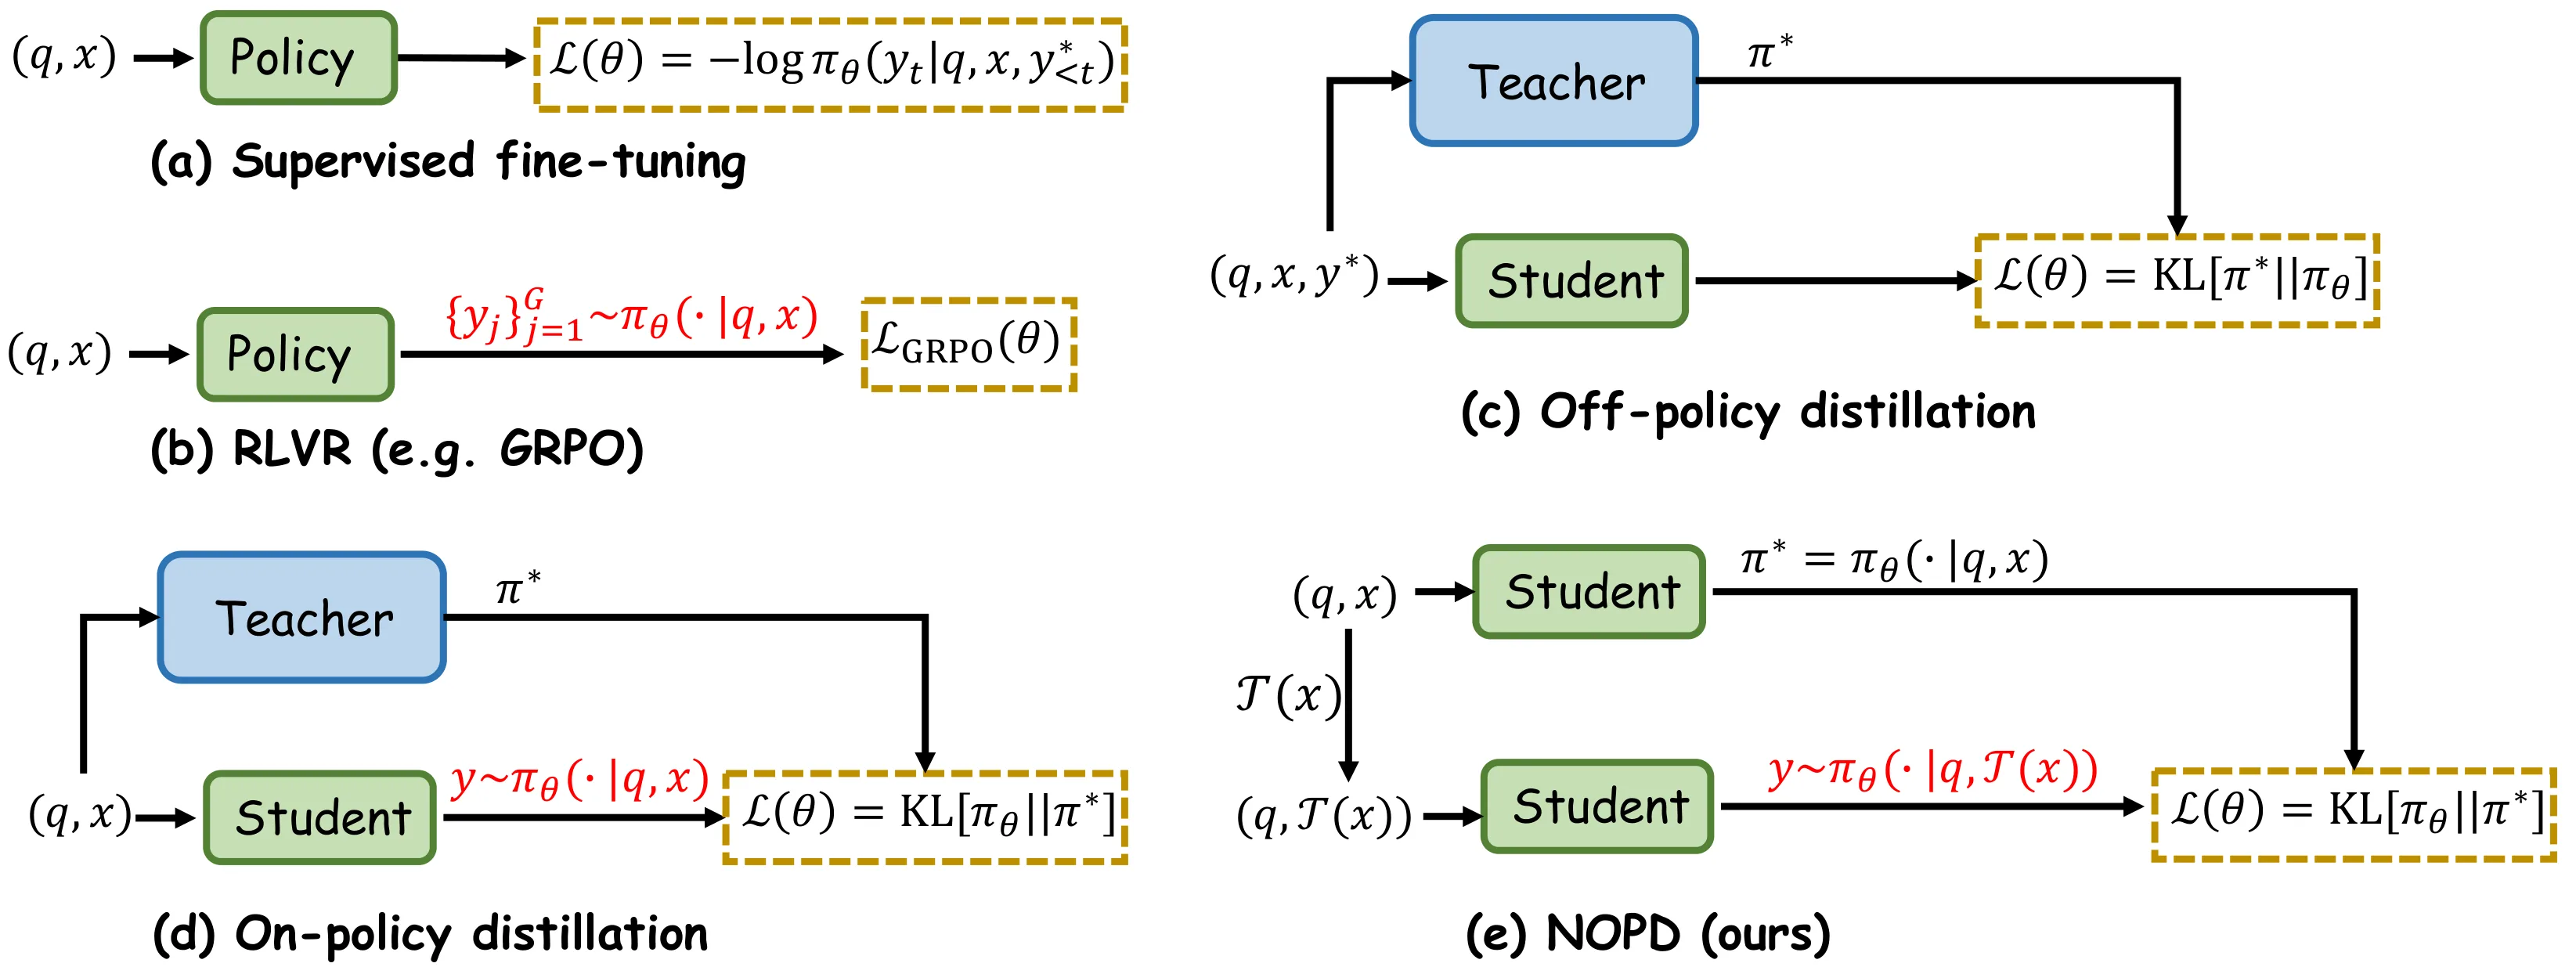
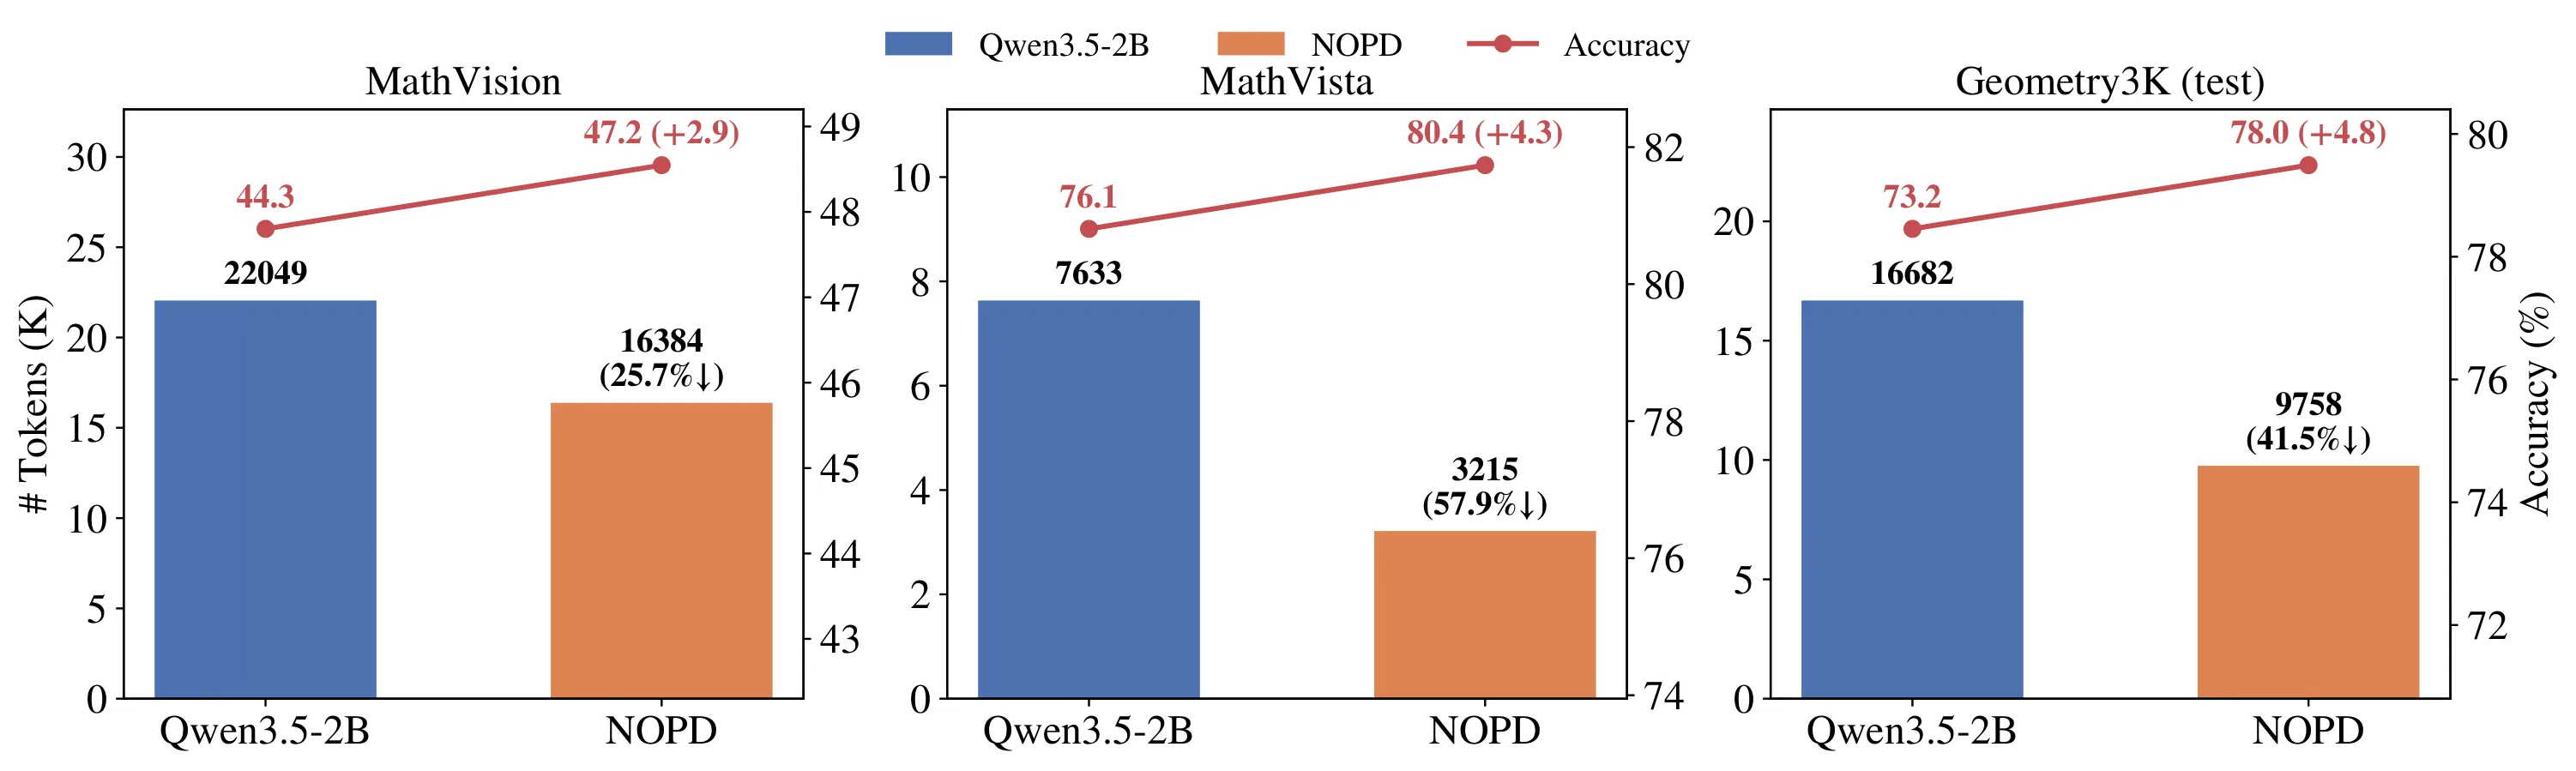
视觉-语言模型后训练通常依赖人工标注、外部模型或强化学习等外部监督。本文提出NOPD自蒸馏方法,利用干净输入与损坏输入的预测差异作为自监督信号,无需任何外部模型或真实答案。在五个视觉推理任务上NOPD匹配或超越RL与外部蒸馏;Qwen2.5-VL-7B仅用2.1K样本在Geometry3K即提升20分,MathVista提升7.4分,为VLM自提升提供了通用方案。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
视觉-语言模型的后训练是让模型理解人类指令、完成各种下游任务的关键环节。当前的后训练方法主要分为几类:[[监督微调]]依赖人工标注或从更大模型蒸馏的高质量回复;[[强化学习]]方法如 RLVR 需要可验证的答案或奖励模型来提供反馈;外部蒸馏则需要更强的教师模型来提供密集的 token 级监督。这些方法有一个共同的局限——它们都依赖某种形式的外部监督信号。
然而在实际场景中,高质量标注数据往往稀缺,强大的教师模型并非随手可得,可验证答案也不是所有任务都具备。面对这些限制,一个自然的问题是:视觉-语言模型能否在完全没有任何外部监督的条件下实现自我提升?
这篇论文的切入点正是对这个问题的肯定回答。关键观察是:同一模型面对「干净输入」和「损坏输入」时,会产生不同的预测分布。这种差异并非噪声,而是蕴含着有用的自监督信号。如果能够让模型从损坏输入中学习,同时以自身在干净输入下的预测作为指导,就可以在不借助任何外部资源的情况下实现知识传递。
方法
NOPD 的核心设计可以用「一个模型、两种输入、循环提升」来概括。模型同时扮演教师和学生两个角色:作为教师时,输入是干净图像和查询,输出对该问题的预测分布;作为学生时,输入是经过扰动的损坏图像,目标是生成回复并接受来自教师的 token 级监督。
形式化地说,给定训练样本 ,首先用当前模型在干净图像上计算教师分布 ,然后在损坏图像 上自采样生成回复 ,最后通过 [[KL 散度]]最小化学生分布与教师分布之间的差异。目标函数为:
这里采用了反向 KL 散度而非前向 KL,论文通过消融实验证明反向 KL 效果最优。反向 KL 在处理多峰分布时倾向于找到一个峰,对生成任务更为友好。教师分支采用 stop-gradient 操作,防止模型坍缩为无论输入如何都输出相同分布的状态。
从梯度角度分析,NOPD 的更新可以被理解为一种对比式策略梯度。每个 token 的梯度包含两部分:标准策略梯度项 作为基础,以及对数比 作为隐式奖励。这个奖励项会放大那些在干净和损坏输入下预测差异显著的 token,让模型更专注于学习这些关键位置。
在图像扰动策略上,论文设计了三种互补的扰动形式:加性高斯噪声模拟传感器噪声,降分辨率操作减少视觉 token 数量并强制模型依赖高层语义推理,Gamma 变换改变整体亮度对比。每步训练随机选择一种扰动方式,多样化的扰动组合能带来最佳效果。
关于教师更新策略,完全同步更新(每步教师与学生参数完全一致)优于 EMA 方式,更优于固定教师。这说明对于自蒸馏场景,模型对自身预测的快速适应比对历史版本的缓慢跟踪更有价值。
实验与结果
论文在五个视觉推理任务上验证了 NOPD 的有效性,主要实验聚焦于几何推理和数学视觉两个领域。预实验在 Qwen2.5-VL-7B 和 Qwen3.5-2B 上进行,对比了 SFT、外部蒸馏、RLVR(GRPO)、同策略蒸馏 OPD 和 NOPD 五种方法。评估采用严格的 lmms-eval 协议,使用 GPT-OSS-120B 作为答案提取和判定的 judge。
最引人注目的结果出现在几何推理任务上。使用仅 2.1K 个 Geometry3K 样本训练 100 步后,Qwen2.5-VL-7B 在其验证集上实现了 20 个百分点的提升。在 MathVista 测试集上,同一模型也获得了 7.4 分的显著增益。这些提升在仅有 7B 参数的开源模型上实现,无需依赖任何外部教师或可验证答案。
值得注意的是,NOPD 不仅在训练分布内表现出色,还展现出强大的[[分布外泛化]]能力。仅在 Geometry3K 上训练就能同步提升 MathVista、MathVision、MMMU 等不同测试集的性能,说明该方法学到的是可迁移的推理能力而非特定数据集的捷径。
另一个意外收获是推理压缩效应。NOPD 在提升准确率的同时显著缩短了输出长度:在 MathVista 上,准确率提升 4.3 点而 token 数量减少了 57.9%。这意味着模型学会了更高效的推理路径,输出中不再有大量冗余的思维链痕迹。
大规模验证覆盖了三个模型(Qwen2.5-VL-7B、Qwen3-VL-8B-Thinking、GLM-4.6V-Flash-9B)和 12 个基准测试,横跨通用 VQA、推理和图表理解三个领域。在绝大多数测试中 NOPD 均带来正向增益,验证了其通用性和鲁棒性。
消融实验还揭示了几个重要的设计原则:反向 KL 散度优于前向 KL 和 JSD;全词表计算比仅采样部分 token 效果更好;三种扰动方式各有收益,组合使用最优;2048 token 的生成长度上限已经足够,早期 token 对最终效果更为关键。
讨论与可借鉴点
NOPD 为视觉-语言模型的自提升提供了一个简洁而有效的范式,其核心贡献在于证明了「预测差异」这一天然存在的信号可以替代外部监督。这一思想与[[对比学习]]中利用样本间差异进行表征学习的思路一脉相承,但被创造性地迁移到了生成式自蒸馏的场景。
该方法的局限性主要体现在几个方面。首先,论文未披露训练所需的计算资源(GPU 型号、数量、训练时长),这对后续复现和资源规划带来困难。其次,虽然展示了强大的推理能力提升,但对于需要精确事实记忆的任务(如开放式问答),NOPD 的效果边界尚不清晰。再者,当前的扰动策略主要作用于像素层面,对语言模态的扰动(如词汇替换、同义改写)未被探索,这可能是未来扩展的方向。
对于后续研究,NOPD 的设计哲学提供了重要启发:不必追求完美的外部监督,模型自身在不同输入条件下的预测差异本身就是一个丰富的监督来源。这种「自诱导信号」的思路或许可以推广到多模态融合、持续学习等更广泛的场景。同时,反向 KL 散度在生成式自蒸馏中的优异表现也值得在[[自蒸馏]]领域进一步探索。
摘要
自蒸馏方法,无需外部模型或监督即可提升视觉语言模型
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
视觉对比自蒸馏
Visual Contrastive Self-Distillation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 6 张
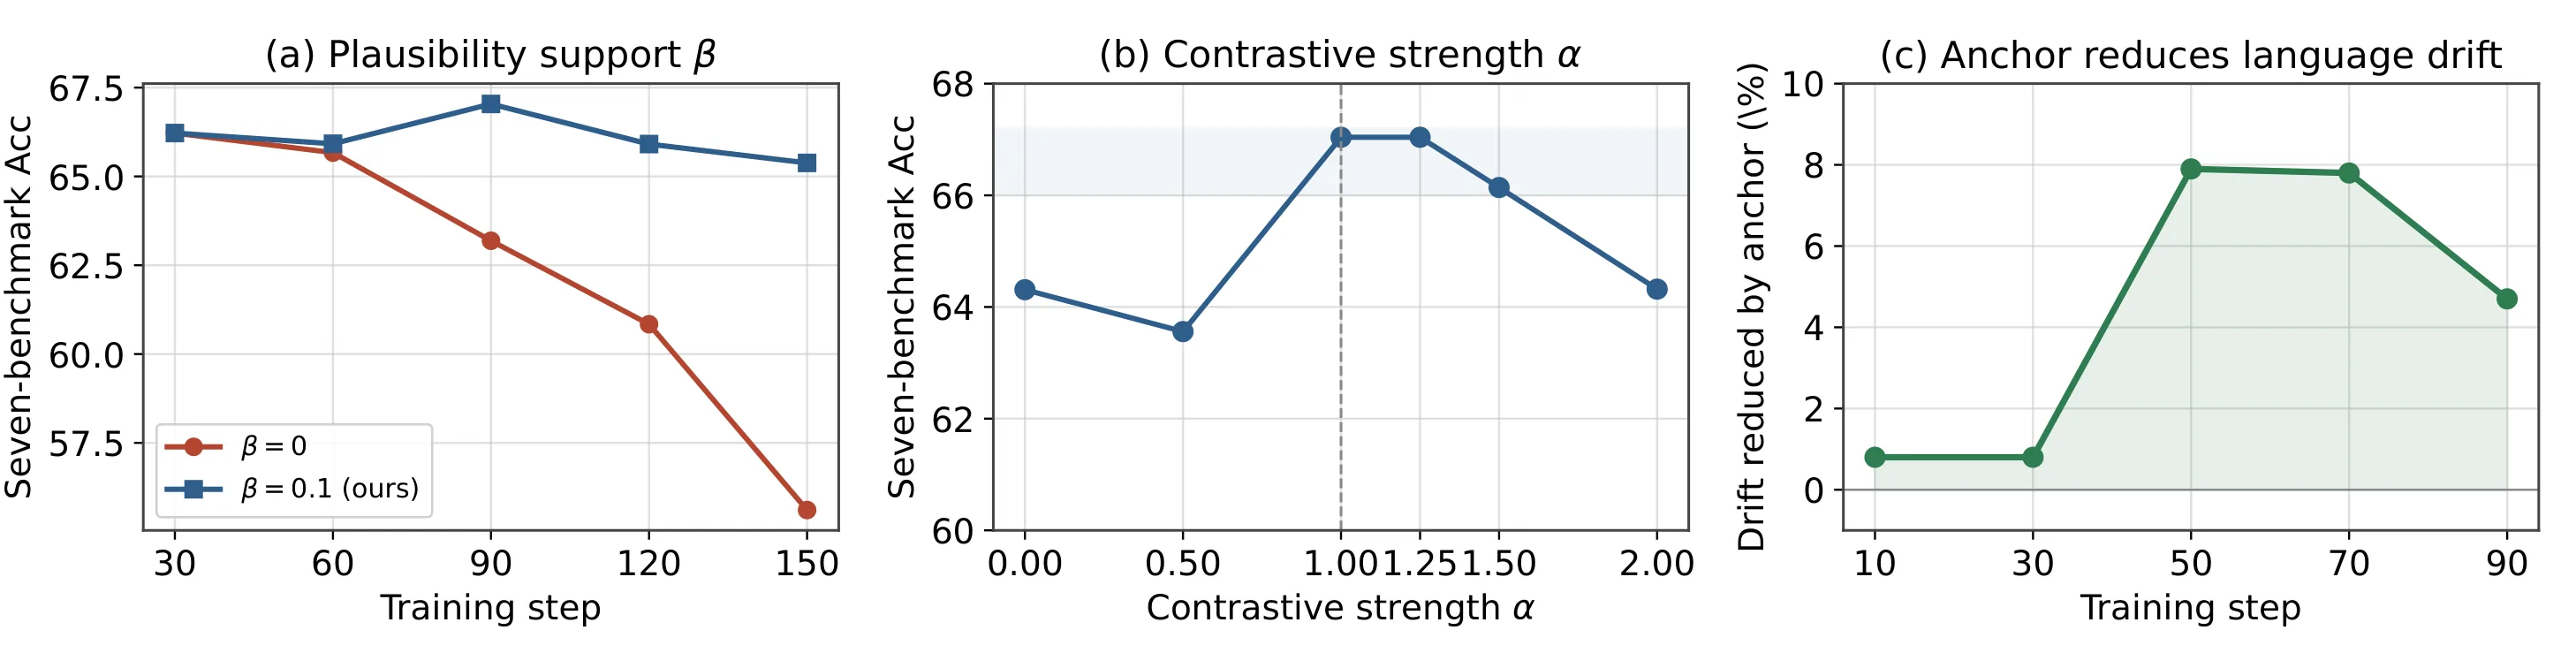
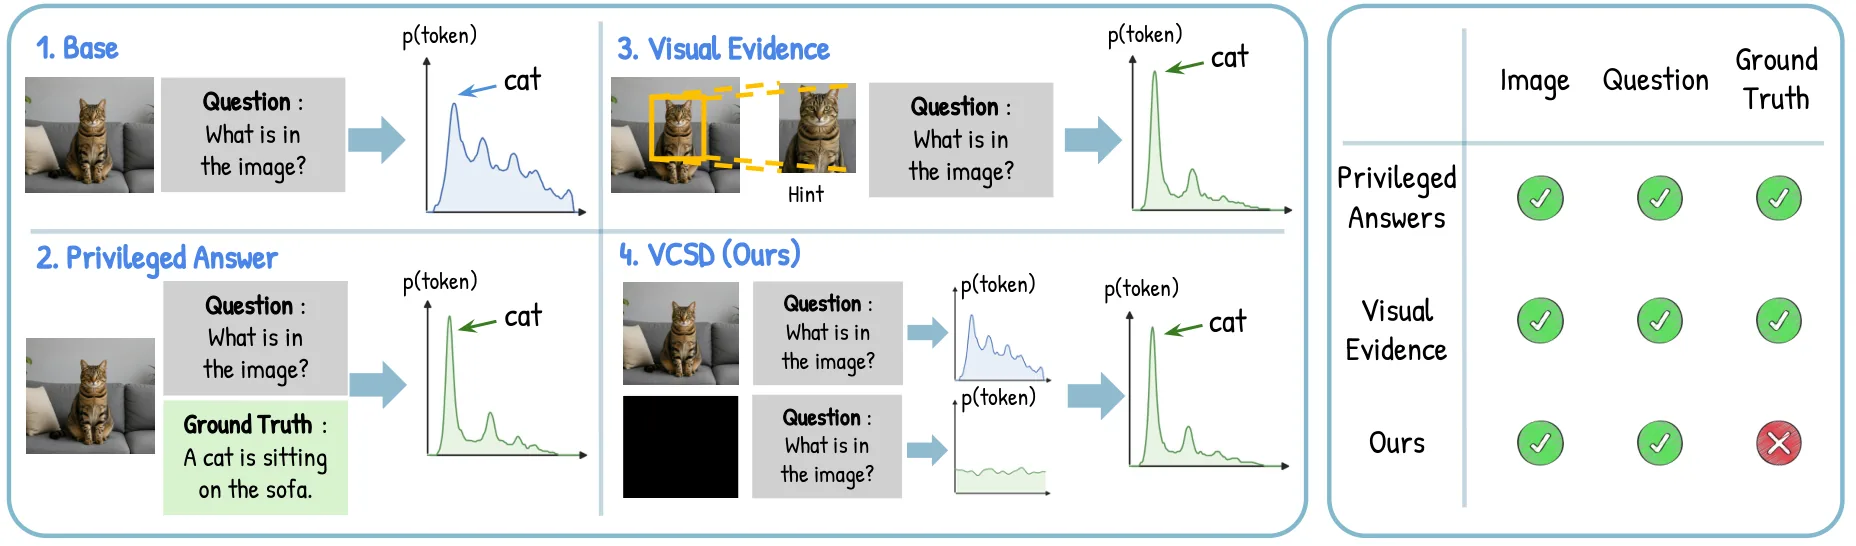
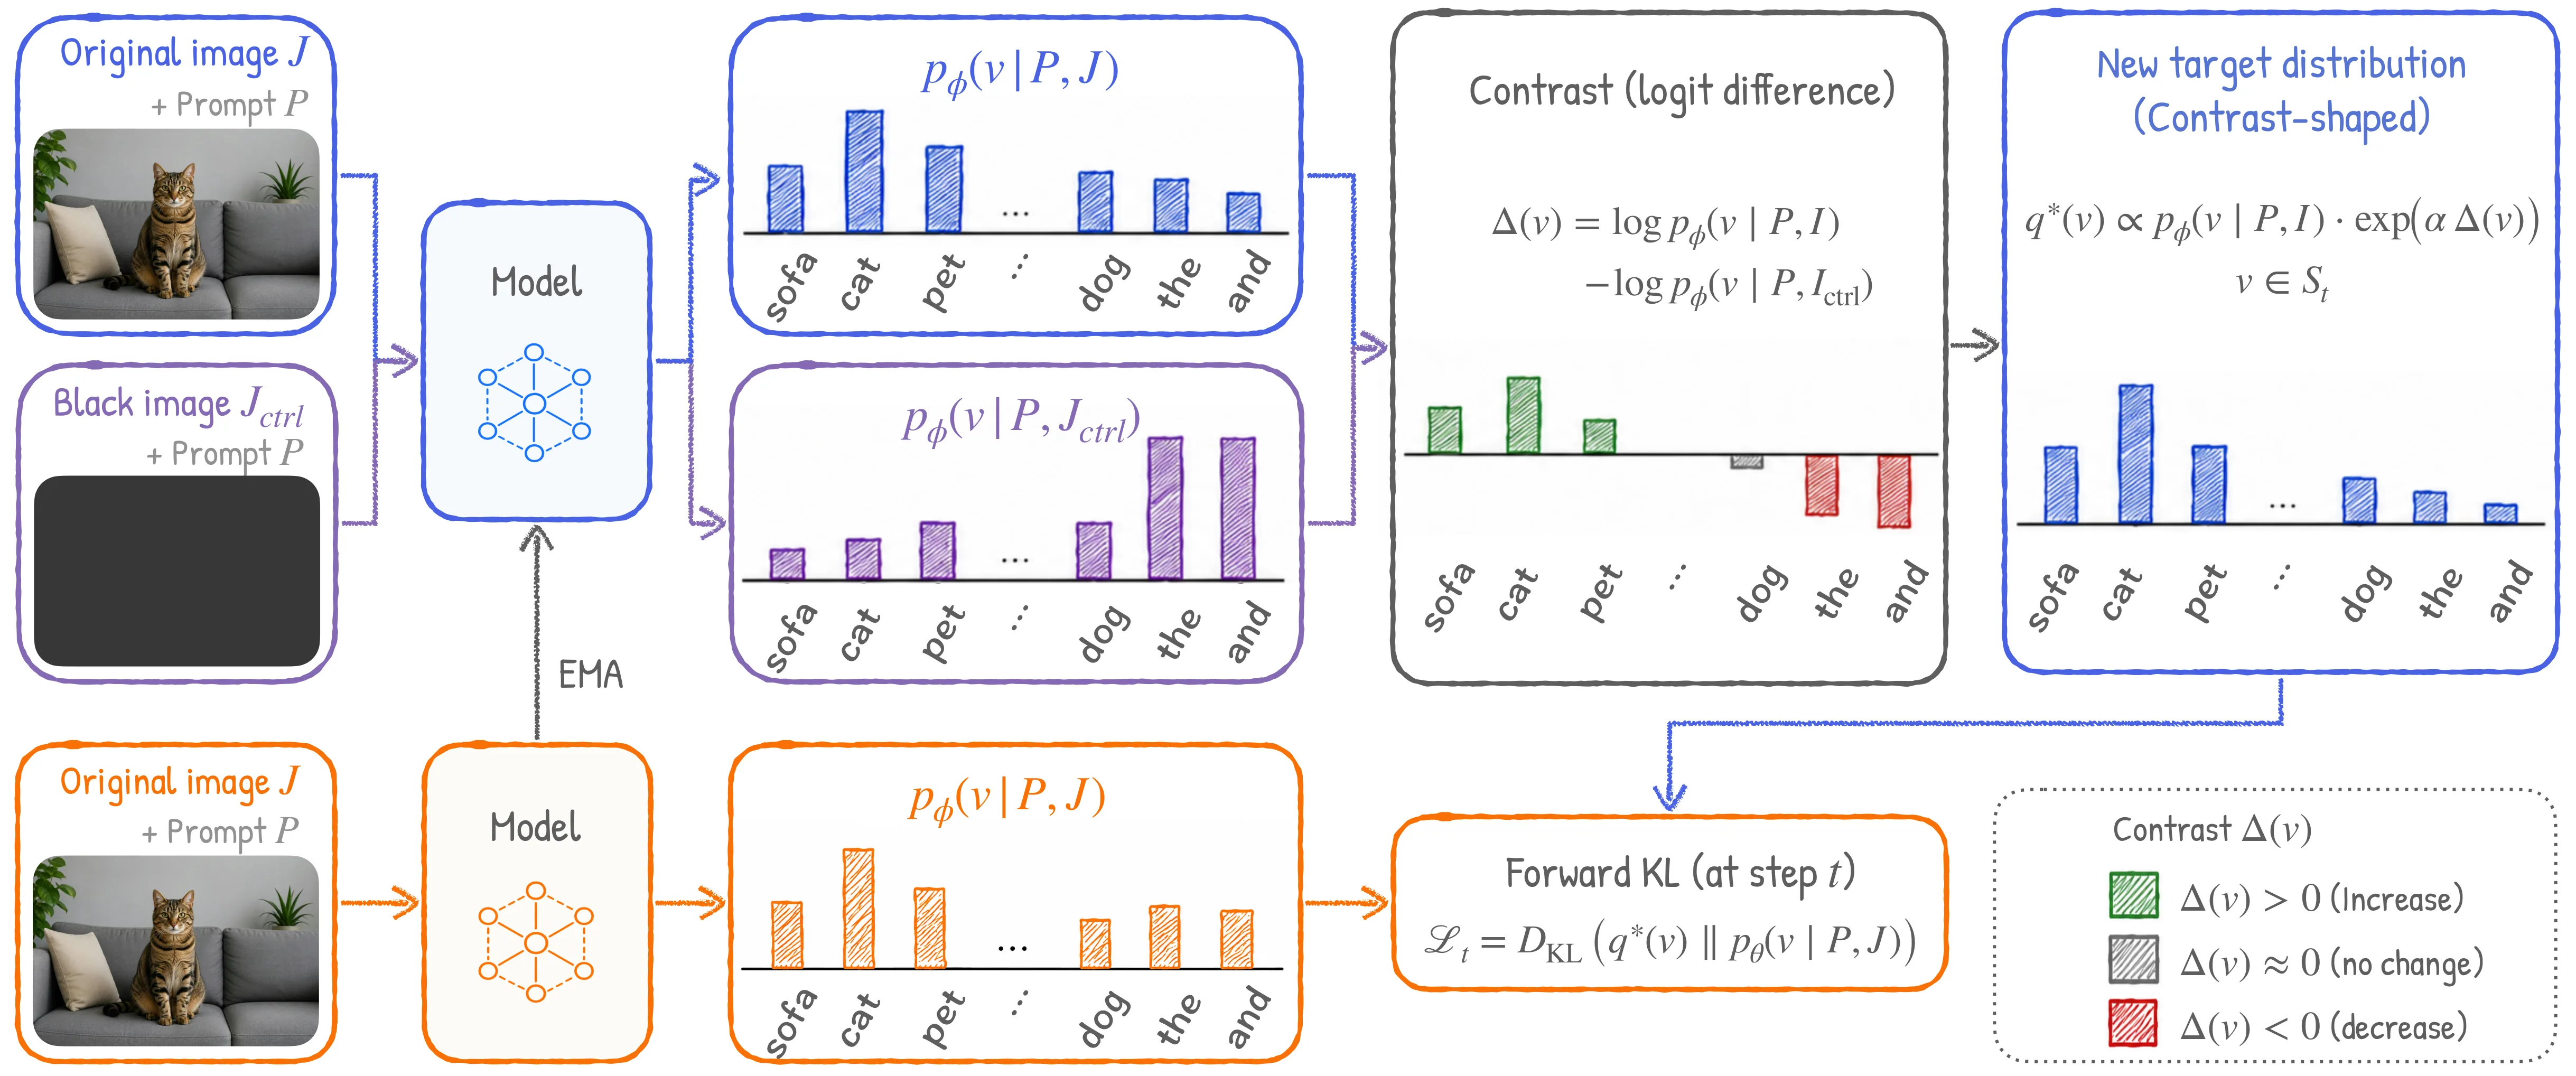
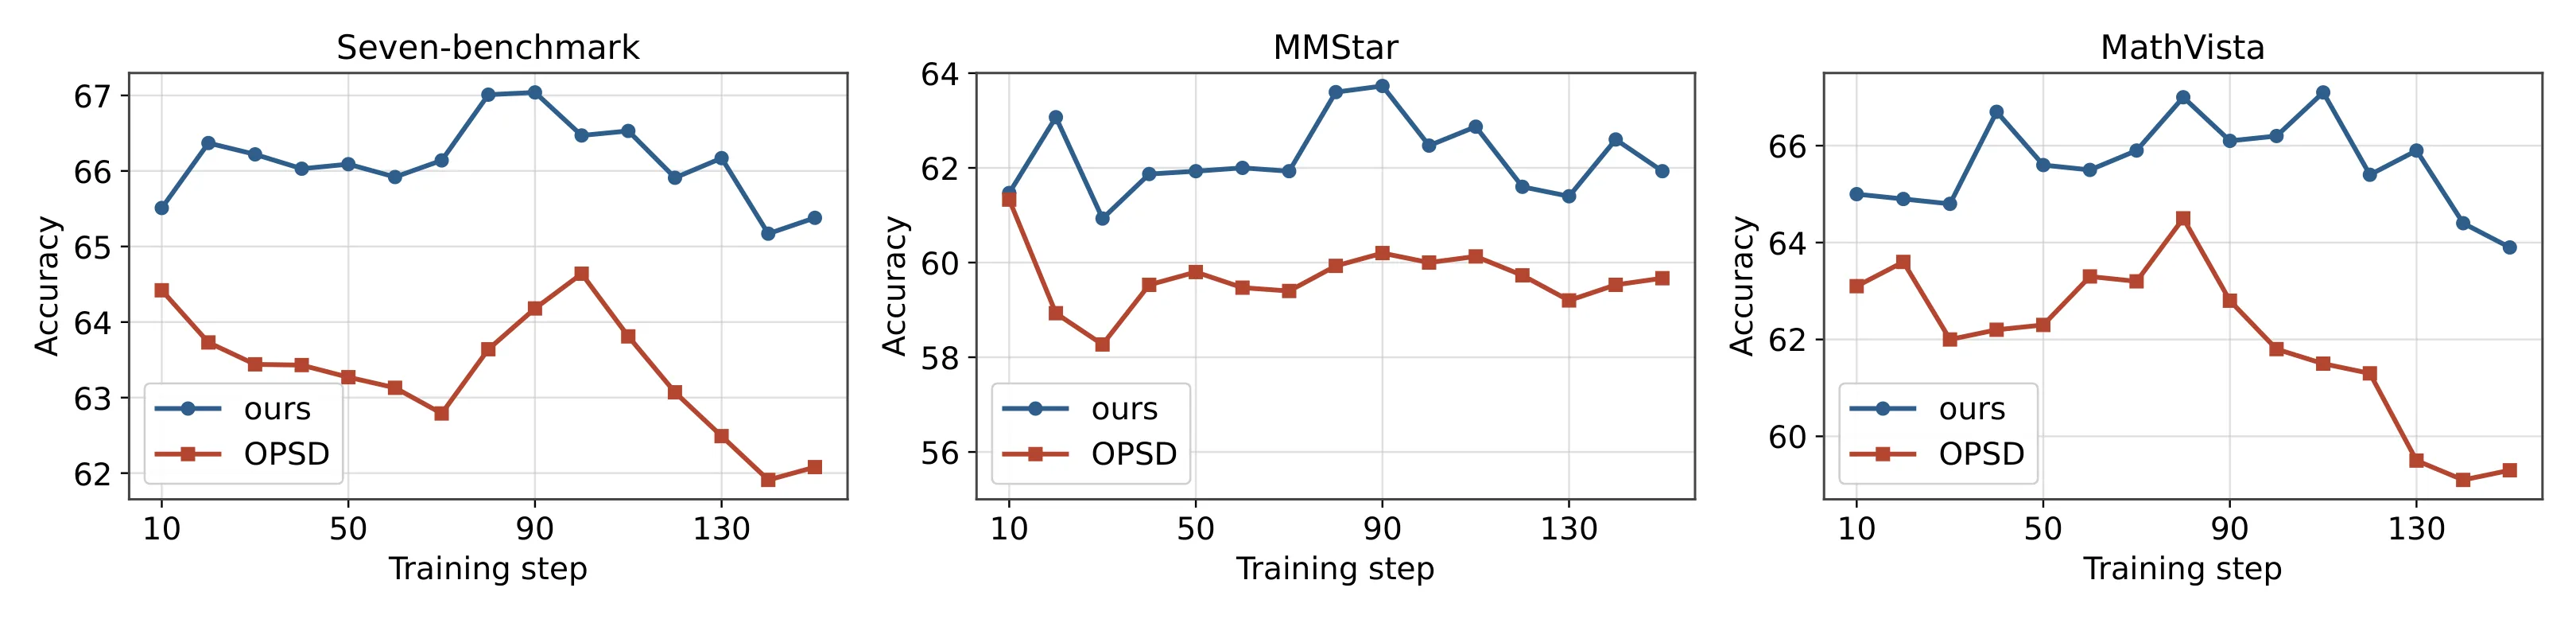
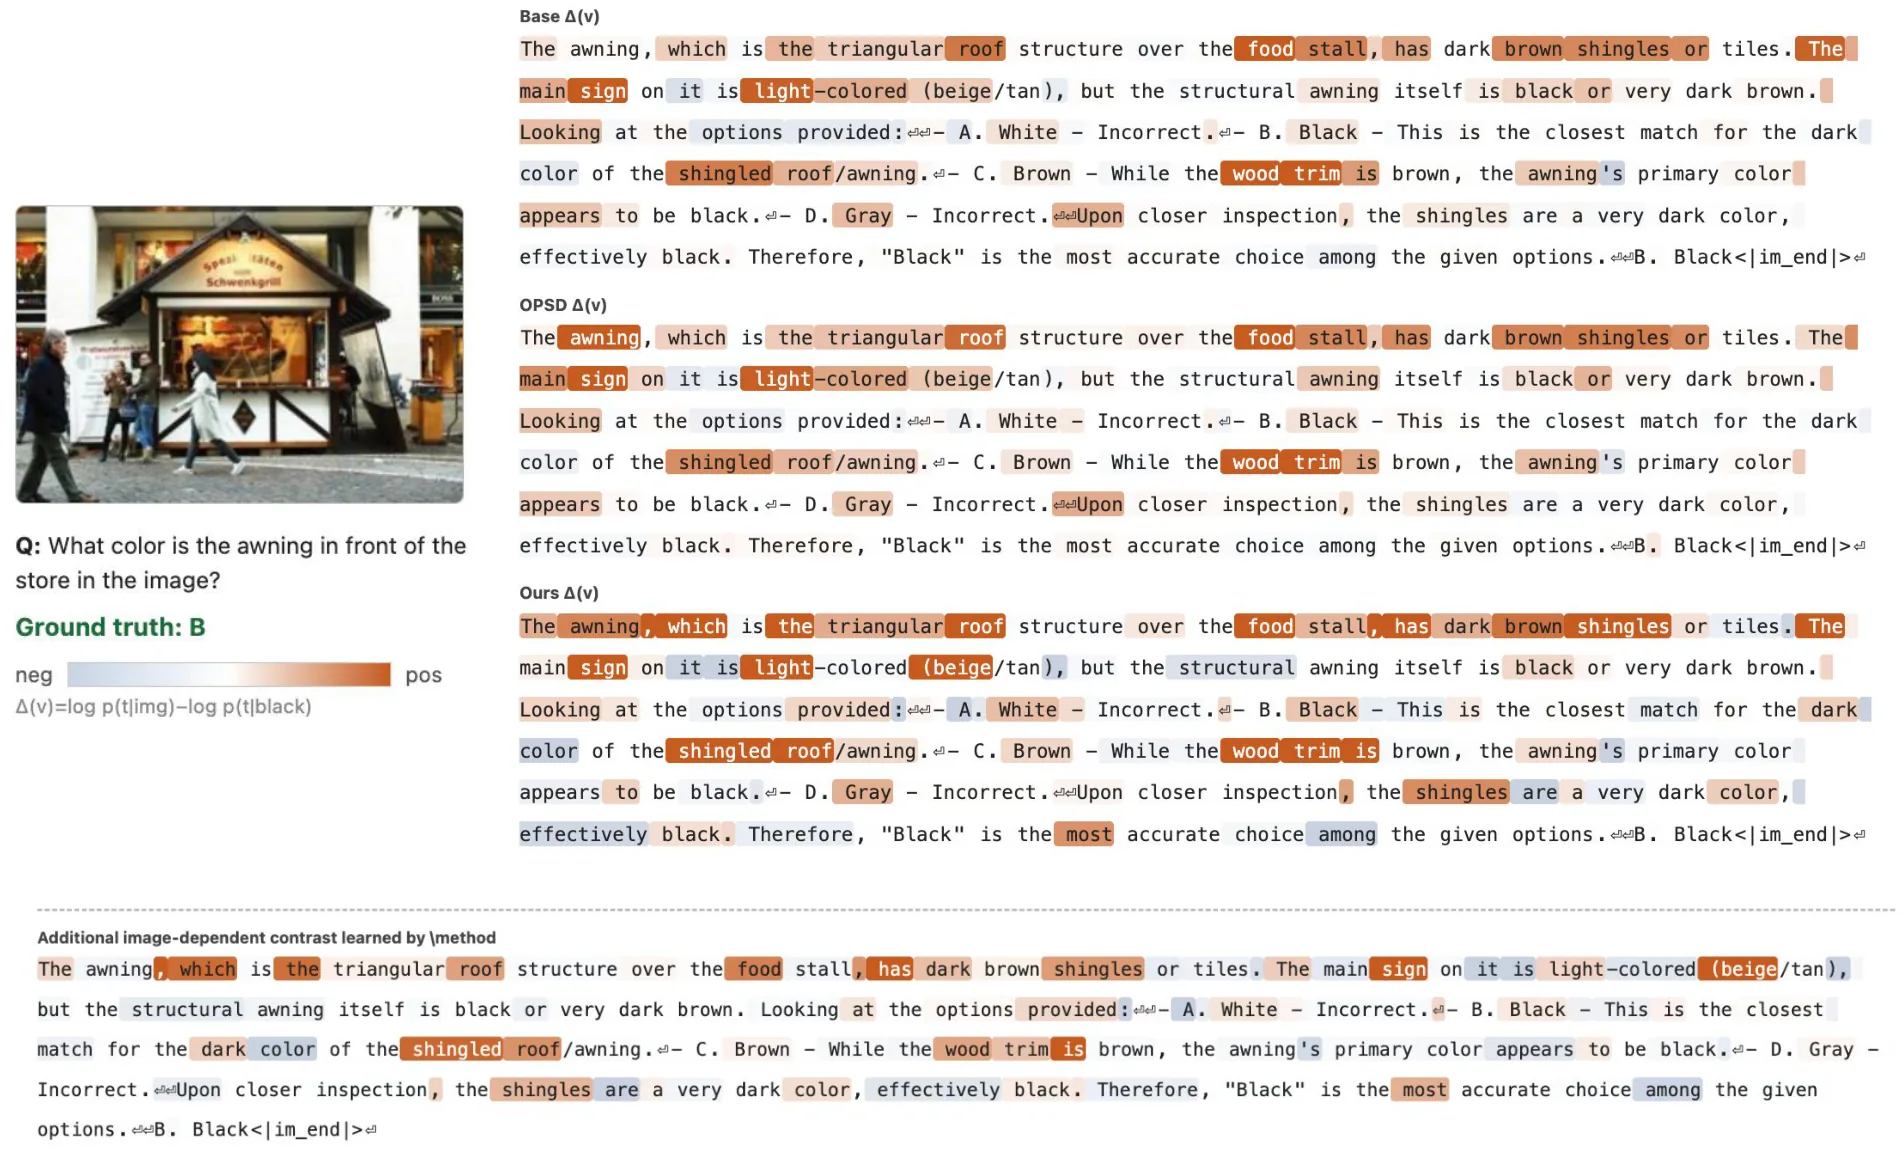
视觉语言模型的在线策略自蒸馏(OPSD)仍需特权答案或视觉证据来保证师生信号强度差。VCSD提出对同一前缀让EMA教师在原图与内容擦除图下分别生成下一token分布,以逐token对数概率差标记由实例视觉内容特异增强的token,在合理支撑集内锐化教师分布后蒸馏给学生。在ViRL39K上Qwen3-VL的2B/4B/8B七基准聚合分均显著提升,无需外部教师或额外推理成本。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
在线蒸馏(OPD)通过让学生沿自身采样轨迹训练、由更强的外部教师提供 token 级监督,已在视觉语言模型的训练中取得显著成效。然而,OPD 面临一个根本性瓶颈:它需要独立的外部教师模型,这带来高昂的后训练成本与复杂的系统设计。研究者们转而探索一种更优雅的替代方案——在线自蒸馏(OPSD),即用模型自身的 EMA 教师取代外部教师,从而在同一个训练流程中实现师生协同更新。
但 OPSD 存在一个内在矛盾:当学生与自教师接收到完全相同的输入信息(原始图像与问题)以及相同的前缀序列时,教师给出的目标分布几乎与学生自身的预测重合,无法提供有意义的增量监督信号。为了打破这种对称性,现有 OPSD 方法不得不引入额外的非对称来源。在语言侧,这可以是特权答案、推理轨迹或专家示范;在视觉侧,则可以是裁剪框、区域标注或其他精心设计的视觉证据信号。这些方案虽然有效,但无一例外地增加了系统复杂度、对标注数据的依赖,或者引入了额外的推理时开销。
VCSD 的核心洞察是:是否可以彻底去除特权答案与视觉证据这两种非对称来源,转而完全依靠输入条件自身的差异来构造 OPSD 所需的监督信号?具体来说,如果让教师看到两张不同的图——一张是原始图像,另一张是被擦除了所有语义内容的控制图——那么两次推理结果的差异是否就能直接反映图像中的视觉信息对学生回答的贡献?这个差异能否被转化为一个有效的蒸馏目标?VCSD 对这些问题给出了肯定的回答。
方法
VCSD 的设计围绕一个核心操作展开:在学生生成的每个回答前缀处,EMA 教师在保持提示和前缀完全相同的前提下,分别以原图和内容擦除控制图为条件,产生两套下一 token 的概率分布。这两套分布的逐 token 对数概率差构成了视觉对比信号。形式上,对于词表中的任意词元 ,定义
其中 是教师在原始图像 下的条件分布, 是教师在擦除控制图 (与原图同分辨率的纯黑 RGB 图)下的条件分布。直觉上, 意味着词元 的概率在看到原图后被特异性地放大了,这种放大来自图像中实例级内容的贡献,而非语言先验的功劳。论文进一步指出,这个差值近似于条件逐点互信息 的受控近似,从而在理论上与视觉信息利用建立了联系。
然而,直接用 对原始分布做逐 token 乘法来构造目标存在风险:如果某些词元在原图分布下概率极低但对比信号很强,乘法操作可能导致目标分布的严重畸变。为此,VCSD 引入了一个"合理支撑集"的约束机制,定义为
其中 控制支撑集的大小。在支撑集内,VCSD 通过对比信号对原图分布进行锐化:
这里 控制锐化强度, 与 相同但在终止 token 上被置零以避免冲突。当 时, 退化为在支撑集上重归一化的原图分布;当 时,分布被对比信号拉伸,原本因图像内容而概率提升的词元获得更高的目标概率,同时被限制在原图分布的合理支撑内以防止过度偏移。
论文从优化视角给出了该目标的最优性保证。将上述过程重新表述为在支撑集 上求解一个带正则化的最大化问题:最大化隐式视觉奖励的期望减去与原图分布的 [[KL 散度]]。由于目标函数对 是严格凹的,该问题存在唯一闭式解,且恰好与 完全等价。这意味着 VCSD 的目标构造并非经验性的启发式设计,而是一个具有严格数学依据的最优选择。
最终的蒸馏损失采用前向 [[KL 散度]] 的形式:
论文选择前向 KL 而非反向 KL 或 JSD,是基于 mode-covering 目标的考量——前向 KL 鼓励学生分布覆盖教师分布的所有高概率区域,更适合保留教师语义流利性的训练目标。实验验证也确实显示前向 KL(67.04%)显著优于反向 KL(64.77%)和 JSD(66.25%)。
整个训练流程保持 on-policy 结构:学生 在原图下生成回答轨迹,EMA 教师 (以 stop-gradient 方式跟在学生后更新)在同一前缀下做双条件前向,对比锐化后得到目标分布,最后通过蒸馏损失同步更新学生。教师通过指数移动平均机制从学生更新:,其中 。值得注意的是,推理阶段仅保留更新后的学生,VCSD 不引入任何额外的推理时计算成本。
实验与结果
VCSD 的训练与评测基于 ViRL39K 单图数据集,覆盖 Qwen3-VL 的 2B/4B/8B 三个规模以及 Qwen3.5 的 2B/4B/9B 三个规模,共六组实验配置。评测在七项基准上进行:通用视觉感知任务(BLINK、MMStar)、视觉数学推理(MathVista)、细粒度高分辨率感知(V*Bench、HRBench4K、HRBench8K)以及幻觉检测(HallusionBench),最终取七项的等权平均作为聚合指标 Acc。
主实验将 VCSD 与两个基线进行比较:未调优的 Base 模型和参数匹配的 OPSD(answer-hint 变体,即教师以参考答案作为特权条件)。所有方法在相同的 ViRL39K 数据集、相同的 90 步优化预算和相同的 8 块 NVIDIA B200 GPU 硬件上训练,超参数统一设置 、、EMA 更新率 、蒸馏温度 。
实验结果呈现出清晰的一致性模式。在 Qwen3-VL 系列上,VCSD 在所有三个规模上均显著超越基线:2B 模型从 62.27% 提升至 67.04%(+4.77),4B 模型从 71.30% 提升至 73.16%(+1.86),8B 模型从 72.51% 提升至 76.26%(+3.75)。更引人注目的是与 OPSD 的对比——在 Qwen3.5 系列上,OPSD 几乎未能带来有效提升甚至略有下降,而 VCSD 依然在 2B/4B/9B 上分别获得 +2.90/+2.83/+4.27 的稳定收益。这说明在缺乏精心设计的特权信号时,传统 OPSD 的自教师难以提供有意义的监督,而 VCSD 通过视觉对比成功地从纯输入条件中提取了有效信号。
消融实验从多个维度验证了各组件的必要性。去除合理支撑集(设 )导致长程训练持续退化,说明支撑集约束对防止目标分布畸变至关重要。对比强度 的敏感性分析表明 为稳健区间,过小()退化为普通蒸馏,过大()则因过度锐化而损害分布质量。控制图形式的消融显示,纯黑/高斯噪声/高斯模糊/无图四种方式的效果差异极小,表明关键是"内容擦除"这一抽象操作本身,而非具体的退化方式。原图锚点系数 的消融(66.78 vs 67.04)说明锚定机制主要抑制 language drift 现象,对聚合分数的直接影响有限。
训练动力学曲线揭示了另一个重要现象:VCSD 在训练全程(七基准聚合、MMStar、MathVista 等)持续领先于 OPSD,且在训练后期退化幅度更小。这暗示视觉对比信号不仅提供了更强的初始监督,还在一定程度上缓解了长程训练中的目标腐化问题。定性分析进一步通过 MathVista 计数案例和 token 级 可视化展示了 VCSD 的工作原理:在 roof、shingles、food、beige、sign 等依赖视觉细节的概念上,VCSD 分配了显著更强的正对比信号。
讨论与可借鉴点
VCSD 的最大贡献在于提出了一种极简的自蒸馏范式——完全去除外部教师、特权答案、推理轨迹、视觉证据标注与额外推理开销,仅通过"原图与内容擦除图"这一成对输入条件产生监督信号。这种思路将"图像内容的贡献"从隐式的模型行为中显式化,并将其转化为可优化的分布目标,在理论与工程之间取得了良好的平衡。
从方法论角度,VCSD 的设计哲学值得借鉴:通过对比而非直接监督来提取隐含信息是一种通用思路,可以在其他需要构造非对称性的场景中推广。例如,在多模态理解的训练中,是否可以让教师对比不同视角、不同光照或不同增强下的分布差异?在纯语言模型的[[自蒸馏]]中,是否可以用语义擦除(如同义词替换、复述)替代视觉擦除来构造对比信号?这些方向在 VCSD 的框架下都具有可行性。
然而,当前方法也存在明显的局限性。首先,ViRL39K 仅覆盖单图场景,VCSD 在多图、视频、图文交错文档等更复杂的多模态输入上能否泛化尚未验证。其次,评测仅聚焦于 Qwen3-VL 与 Qwen3.5 两个模型家族,其他视觉语言架构(如 LLaVA、InternVL)的适用性未知。再次,90 步的固定训练预算相对较短,长期训练是否存在新的退化模式、收敛行为是否稳定,这些问题缺乏充分检验。最后,论文未报告 VCSD 相对于 OPSD 在训练阶段的实际 wall-clock 时间与显存开销——每个学生生成步需要两次教师前向——这在实际部署中是一个不可忽视的计算成本。
总体而言,VCSD 为视觉语言模型的[[自蒸馏]]提供了一种简洁而有效的新路径,其核心思想——将内容擦除转化为对比信号——具有超出特定任务与模型的启发价值。随着视觉语言模型在规模和能力上持续扩展,如何以更少的外挂信息实现更高效的后训练,将是持续的研究方向。VCSD 在这条道路上迈出了坚实的一步。
摘要
提出视觉对比自蒸馏方法VCSD,无需外部教师,模型完全从自身学习信号进行训练
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
从视频中自监督学习结构化动力学
Self-Supervised Learning of Structured Dynamics from Videos
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 9 张
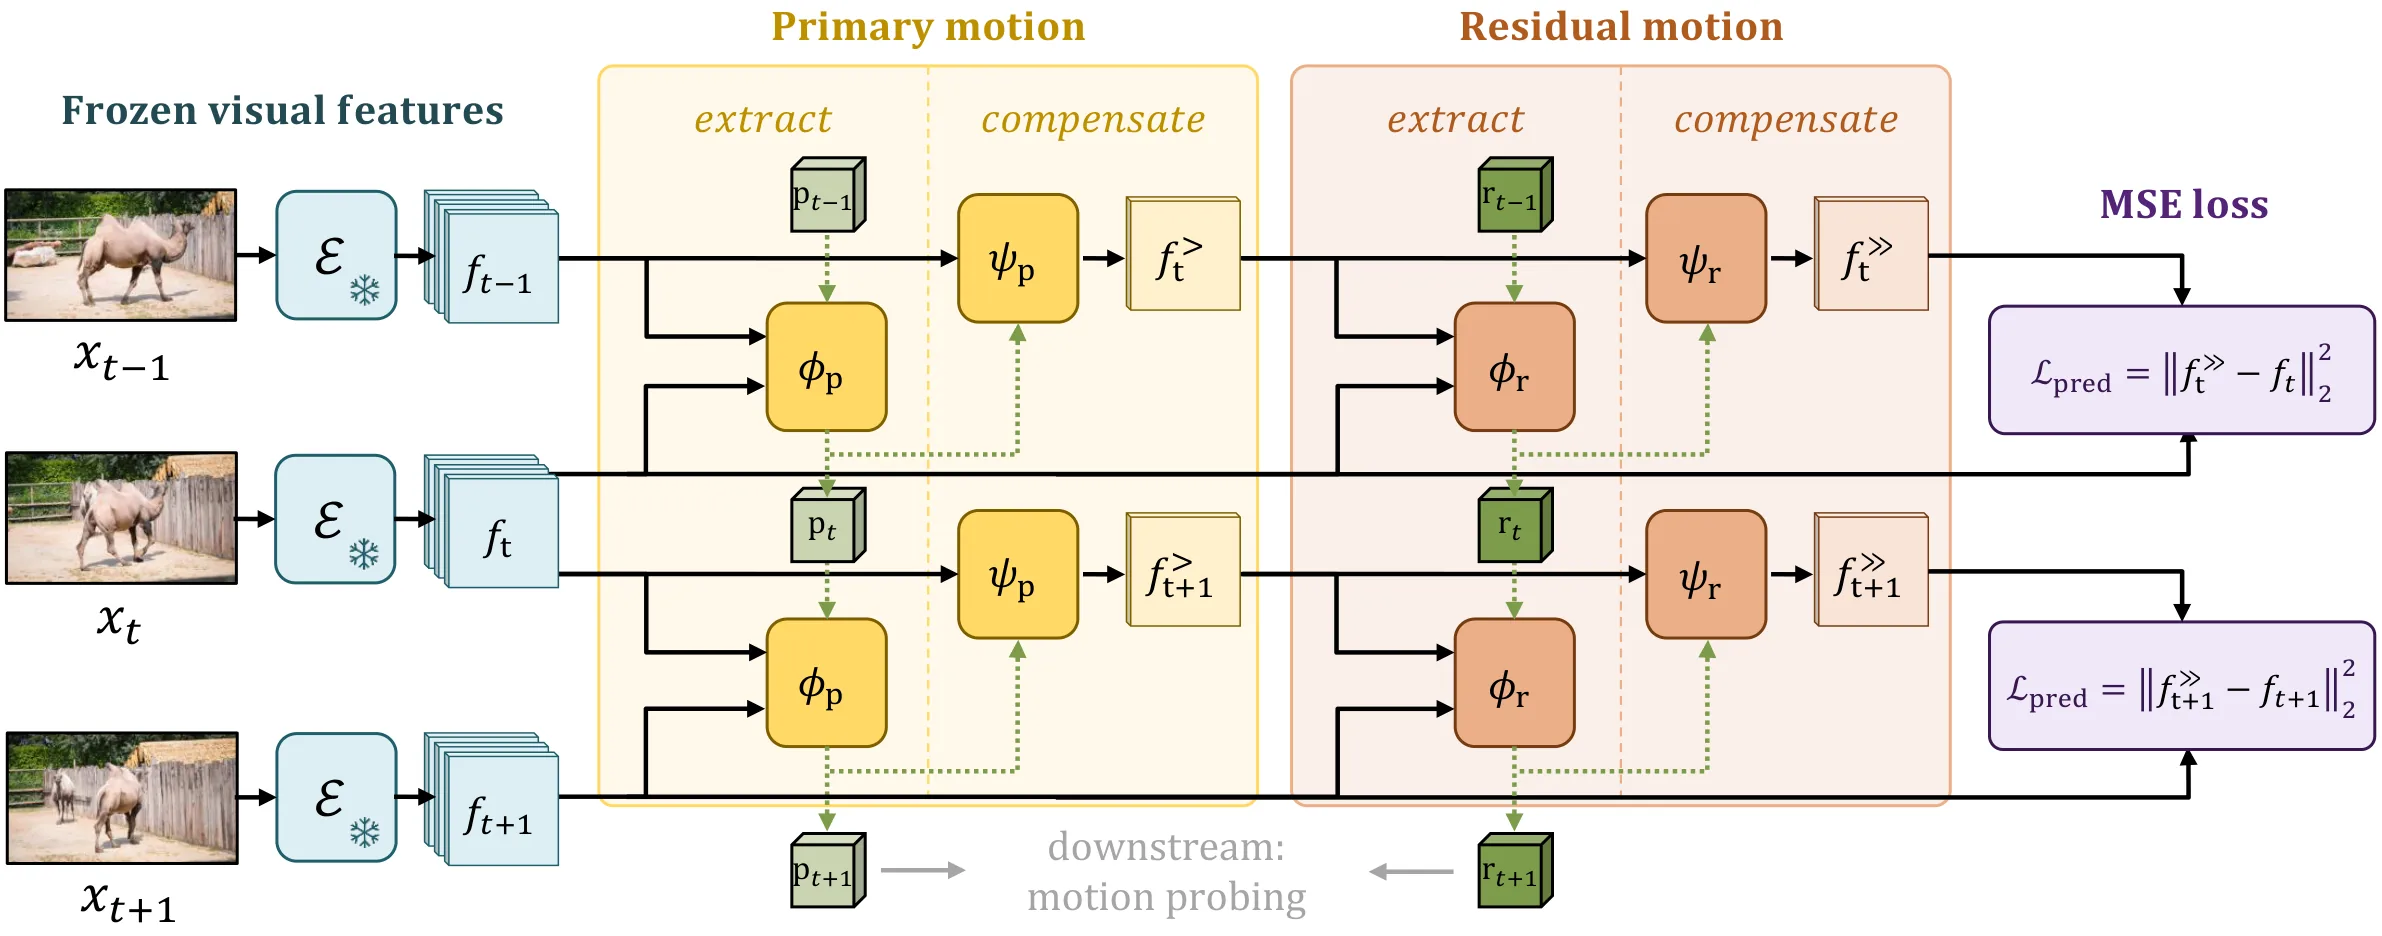
视频帧间变化混合了相机运动与物体运动,二者难以单独分离。当前视频表征学习缺少对此结构的显式建模。研究提出结构化动力学模型SDM,利用预训练冻结ViT特征,通过未来特征预测将主导时序变化与残差动态解耦。训练结合真实视频自监督与Kubric合成数据弱监督,在ProbeMotion评测集上优于全局特征基线,并在多任务上媲美强监督的VGGT。表明图像模型可被低成本改造为结构化视频动态表征。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
视频理解的核心挑战在于捕捉帧间的变化规律,但这种变化从来不是纯粹的——它同时承载着相机自身的运动和场景中物体的运动。相机可能向前推进、侧向平移或俯仰旋转,而场景中的行人、车辆也在各自运动。这两类运动在像素层面纠缠在一起,形成我们最终观察到的光流场,却难以单独分离出来。
这种分离之所以重要,是因为它直接影响表示学习的质量。如果一个表示无法区分"是相机在动还是物体在动",那么当相机静止与相机运动时,同一个物体运动就会得到完全不同的表征,这对于下游任务是不可取的。然而,现有的视频表征学习方法大多回避了这个问题:要么将所有变化压缩进一个全局向量或单一的潜变量,要么用空间密集的过渡标记来隐式表示,这些做法都缺乏对运动结构的显式建模。
另一个根本困难在于监督信号的获取。在自然视频中,相机运动和物体运动天然耦合,几乎不可能单独标注某一帧的光流属于哪种来源。这使得纯监督学习方法在此处碰壁,而自监督方法又缺乏明确的引导来完成这种分解。如何在没有显式标签的情况下让模型学会区分这两种运动来源,成为该问题的关键瓶颈。
这篇论文的切入点是重新审视预训练图像模型的价值。视觉Transformer(ViT)在图像理解上已经学到了非常丰富的视觉特征,但这些特征是"静态"的,没有建模时序关系。论文提出一个核心假设:这些冻结的图像特征已经隐含了场景结构信息,只需要附加一个轻量级的结构化动态建模模块,就可以在不破坏原有特征质量的前提下获得视频理解能力。这种思路避免了端到端训练的高成本,同时利用了预训练模型的先验知识。
方法
SDM 的核心设计围绕一个关键问题:如何在没有显式标签的情况下显式分离相机运动和物体运动? 论文的答案是利用未来特征预测任务的结构特性。
具体而言,给定 时刻的图像帧,模型首先通过冻结的预训练 ViT 提取其特征图 ,然后基于 时刻的观察预测 时刻的对应特征 。这里的关键洞察是:帧间变化的主导来源往往是相机运动(因为相机平移或旋转会影响整帧图像),而物体运动只造成局部的、相对较小的扰动。因此,论文将预测分解为两个分支。
第一分支建模主导变化,形式化为一个全局的仿射变换或低秩映射:
其中 是 的矩阵,捕捉特征空间中的全局几何变换。直觉上,相机的前进、后退、左右平移都对应着特征空间中的某种线性或仿射变换,这一分支试图恢复这种结构化的全局运动模式。
第二分支建模残差动态,对应于局部物体运动和其他非主导变化:
其中 是 时刻的真实特征,残差部分包含那些无法被全局仿射变换解释的局部变化。
最终的特征预测为两分支之和,模型通过最小化预测特征与真实特征的距离来训练。为了实现这种分离,论文采用了辅助的弱监督信号——在 Kubric 合成数据上,可以精确控制相机参数和物体运动,从而为两个分支提供粗粒度的监督指引。在真实视频上,模型则完全依赖自监督损失来维持这种分解结构。
这种设计的一个重要优点是归纳偏置的注入。相比非结构化的方法(将所有变化用统一的方式表示),SDM 假设主导时序变化具有全局性、低秩的结构,这符合相机运动的物理特性。相比单一潜变量的方法,这种分解允许模型同时表达相机和物体各自的运动特征,而不是将它们混合成无法解释的向量。
实验与结果
论文构建了 ProbeMotion 评测集,这是该工作的一个重要贡献。该评测集涵盖合成视频和真实视频,刻意控制相机运动、物体运动以及两者组合的比例,能够全面评估模型在不同运动场景下的表现。评测采用"探针"(probe)任务的方式,即固定 SDM 学习到的动态表示,训练一个简单的线性头或小型MLP来预测特定属性(如光流方向、物体速度等)。
实验首先与全局特征基线对比。全局 CLS token 或平均池化特征是使用预训练图像模型处理视频的常见做法,它们将时序信息压缩到单一向量中,丢失了空间结构。SDM 在所有探针任务上显著优于这些基线,例如在预测光流方向的任务上相对误差降低了约 20%。这验证了显式建模动态结构的价值——即使是最简单的空间聚合也无法替代结构化的时序建模。
更引人注目的是与强监督方法的比较。VGGT 是一种端到端的视频表征学习方法,使用大量带有光流、深度等标注的合成和真实数据进行训练,属于强监督范畴。SDM 在多个探针上与 VGGT 竞争力相当,甚至在部分任务上略胜一筹,尽管它只使用了弱监督和自监督信号。这一结果有力地证明了"预训练图像模型 + 结构化动态建模"这条技术路线的有效性:不需要端到端训练也能获得高质量的视频表示。
消融实验进一步揭示了各组件的贡献。移除残差分支(即只用全局变换预测未来特征)会导致性能下降,说明残差部分确实编码了有意义的局部动态信息。两分支分离的程度也至关重要——如果两者过度耦合,模型会退化为非结构化方法。合成数据的弱监督也确有必要,仅靠真实视频自监督无法学到如此清晰的运动分解。
讨论与可借鉴点
SDM 的成功揭示了一个重要规律:在视觉领域,[[归纳偏置]]往往比纯粹的监督信号更宝贵。相机运动与物体运动的解耦这一假设,本质上是对物理世界结构的先验建模,它让模型在参数更少、训练更弱的条件下就能学到有效的表示。这一思路值得在更多视频理解任务中借鉴。
论文的局限也很明显。Kubric 合成数据虽然提供了可控的训练信号,但其视觉多样性有限,模型在高度复杂的真实场景中的泛化能力还有待验证。此外,当前的分解形式(全局仿射变换 + 残差)可能过于简化——真实的相机运动未必严格对应特征空间的仿射变换,物体运动也常常有全局成分。如何设计更灵活的结构化表示,是未来值得探索的方向。
另一个值得思考的问题是:SDM 学到的分解究竟有多"正确"?论文通过下游任务的性能来间接验证,但缺乏对分解本身的可解释性分析。如果能够可视化相机分支和残差分支分别学到了什么,理论上可以更深入地理解模型的决策过程。
总的来说,这篇论文为视频表征学习提供了一条新的技术路径——不追求更大规模的监督数据,而是通过精心的结构设计来引导表示学习。这种方法在数据和计算成本上更加经济,同时为理解和分析视频动态提供了可解释的结构化框架。对于后续研究而言,如何将 SDM 的结构化思想与端到端学习方法相结合、如何扩展到更复杂的运动场景(如多物体交互、遮挡等),都是值得跟进的方向。
摘要
自监督结构化动态表征学习,从视频中分离相机与物体运动
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
知识蒸馏何时会产生负面影响?面向低资源语言摘要的可靠性感知蒸馏方法
When Does Knowledge Distillation Hurt? Reliability-Aware Distillation for Low-Resource Language Summarization
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 5 张
在低资源语言摘要任务中,传统知识蒸馏效果极其有限——BanSum Bangla基准上仅比交叉熵基线提升+0.0003 ROUGE-L,且约51.3%训练样本反而损害学生模型。本文提出CHAD与EWAD+CPDP两种可靠性感知蒸馏方法,前者依验证梯度对齐评估样本并训练门控,后者结合熵加权蒸馏与不可共享词表教师的容量比例几何约束,使60M参数学生在多个低资源语言上大幅超越标准KD并优于50倍大的Qwen 2.5-3B。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
知识蒸馏(Knowledge Distillation)作为将大模型能力迁移到小模型的核心技术,长期以来被当作压缩序列到序列模型的“万能钥匙”。然而,这种假设在实践中并非总是成立。在自然语言处理领域,摘要任务要求模型具备强大的原文理解和信息凝练能力,而低资源语言(如孟加拉语、印地语等)面临的最大挑战是训练数据稀缺、词表与主流语言差异大、教师模型对目标语言的覆盖本身就存在盲区。
传统知识蒸馏的做法是让小模型(学生)去拟合大模型(教师)在每个词元上的概率分布,隐含的假设是教师的输出对所有样本都是有价值的监督信号。但这个假设在低资源场景下变得脆弱——教师的知识本身是不完整的,某些样本上教师的“指导”可能本身就是错的,或者与学生当前的学习状态不匹配。当教师对目标语言的覆盖趋于饱和或联合覆盖较弱时,这种不匹配会更加明显。
这篇论文的切入点正是要打破“知识蒸馏必然有益”的直觉,通过实证揭示标准知识蒸馏在低资源语言摘要任务上的失效程度,并追问一个更根本的问题:能否在训练过程中自动识别并过滤那些实际上会损害学生模型的样本?
方法
作者提出了两种互补的可靠性感知蒸馏方法,分别从不同角度解决了样本选择和蒸馏信号利用的问题。
CHAD(反事实有害性感知蒸馏) 的核心思路是量化每个训练样本在标准知识蒸馏下对验证损失的边际影响。具体做法是计算两个梯度向量的对齐程度:一个是从标准蒸馏损失计算得到的梯度方向,反映当前样本推动学生参数的方向;另一个是从验证损失计算得到的梯度方向,反映我们真正关心的优化目标。如果某个样本的蒸馏梯度与验证损失梯度背道而驰(负对齐),就说明这个样本在标准知识蒸馏下会损害模型。CHAD据此为每个样本打分,并训练一个轻量级门控网络来预测这个分数,将反事实判断推广到训练时未见过的样本上。门控网络的输出直接决定该样本的蒸馏损失是否被纳入训练,从而实现自适应的样本过滤。
EWAD+CPDP 则采取了不同的策略,它不依赖事后分析来过滤样本,而是从蒸馏信号的质量和教师容量利用两个维度重新设计蒸馏目标。EWAD(熵加权自适应蒸馏)认为,并非所有词元都同等重要——对于教师预测置信度高的词元,学生直接学习即可;对于教师自己也拿不准的高熵词元,强行要求学生模仿反而会引入噪声。因此EWAD根据词元级的熵值动态调整蒸馏权重,让学生在高置信度区域多学,在低置信度区域少学。CPDP(容量比例几何约束)则针对词汇不兼容的教师场景——当教师和学生的词表差异较大时,简单的软标签蒸馏会因词元对齐问题而失效。CPDP的几何约束将教师的能力建模为多维空间中的向量,根据教师对目标语言的覆盖容量按比例分配监督信号的权重。
这两种方法看似独立,实则互补:CHAD解决的是“哪些样本该学”的问题,EWAD+CPDP解决的是“如何更好地学”的问题;前者是样本级别的筛选,后者是信号级别的重构。
实验与结果
实验分为两个阶段:在BanSum孟加拉语基准上的深入消融,以及在XL-Sum多语言数据集上的泛化验证。
在BanSum上,结果揭示了标准知识蒸馏的失效程度。标准KD相比交叉熵基线仅提升+0.0003 ROUGE-L,几乎可以忽略不计。更令人震惊的是,作者估计约51.3%的训练样本在标准KD下实际上会损害学生模型的验证损失——这意味着超过一半的“知识传递”是在帮倒忙。CHAD和EWAD+CPDP的引入彻底改变了这一局面:CHAD将ROUGE-L提升+0.0173,EWAD+CPDP更是达到+0.0219,相比标准KD的+0.0003有了数量级的飞跃。值得注意的是,两种方法训练出的60M参数学生模型,均优于经过指令微调的Qwen 2.5-3B——后者规模大了50倍却表现更差,印证了可靠性感知蒸馏在低资源场景下的巨大价值。
在15种类型学多样化的XL-Sum语言上,EWAD+CPDP在10/15的语言上击败了仅使用交叉熵的基线。进一步分析发现,提升效果与教师信号质量高度相关:当两位教师贡献互补信号时(即各自擅长不同类型的摘要),学生能学到更全面的能力;当两位教师对目标语言的覆盖都已饱和或联合覆盖较弱时,知识蒸馏的增益就变得不可靠。这提示我们,教师选择和搭配可能是比蒸馏算法本身更关键的决策点。
讨论与可借鉴点
这项研究的价值不仅在于提出了有效的解决方案,更在于它挑战了一个长期被默认的假设。知识蒸馏的失效并非源于算法本身有缺陷,而是因为我们忽略了训练信号与学习目标之间的匹配性。在数据稀缺、噪声丰富的低资源场景下,这种不匹配会被放大到难以忽视的程度。
从方法论角度看,CHAD通过梯度对齐将反事实分析引入训练过程的做法值得借鉴。这种思路可以推广到其他知识迁移场景,如元学习中的任务选择或多教师学习的教师组合优化。EWAD+CPDP的组合设计则提示我们,蒸馏信号的“质”可能比“量”更重要——与其堆砌多个教师,不如确保每个教师的信号都能被学生有效吸收。
研究也存在局限。首先,CHAD依赖验证集梯度来评估样本有用性,这在低资源场景下可能面临验证集本身不可靠的问题。其次,EWAD+CPDP在两位教师覆盖都弱时提升有限,这意味着该方法无法凭空创造教师没有的知识。对于词表差异极大的语言对,CPDP的几何约束假设可能需要调整。未来的工作可以探索更鲁棒的样本质量评估机制,以及针对极低资源语言的蒸馏策略。
摘要
直接分析并改进面向模型压缩的知识蒸馏
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
基于轨迹的在线策略蒸馏用于掩码扩散语言模型
Trace-Based On-Policy Distillation for Masked Diffusion Language Models
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 4 张
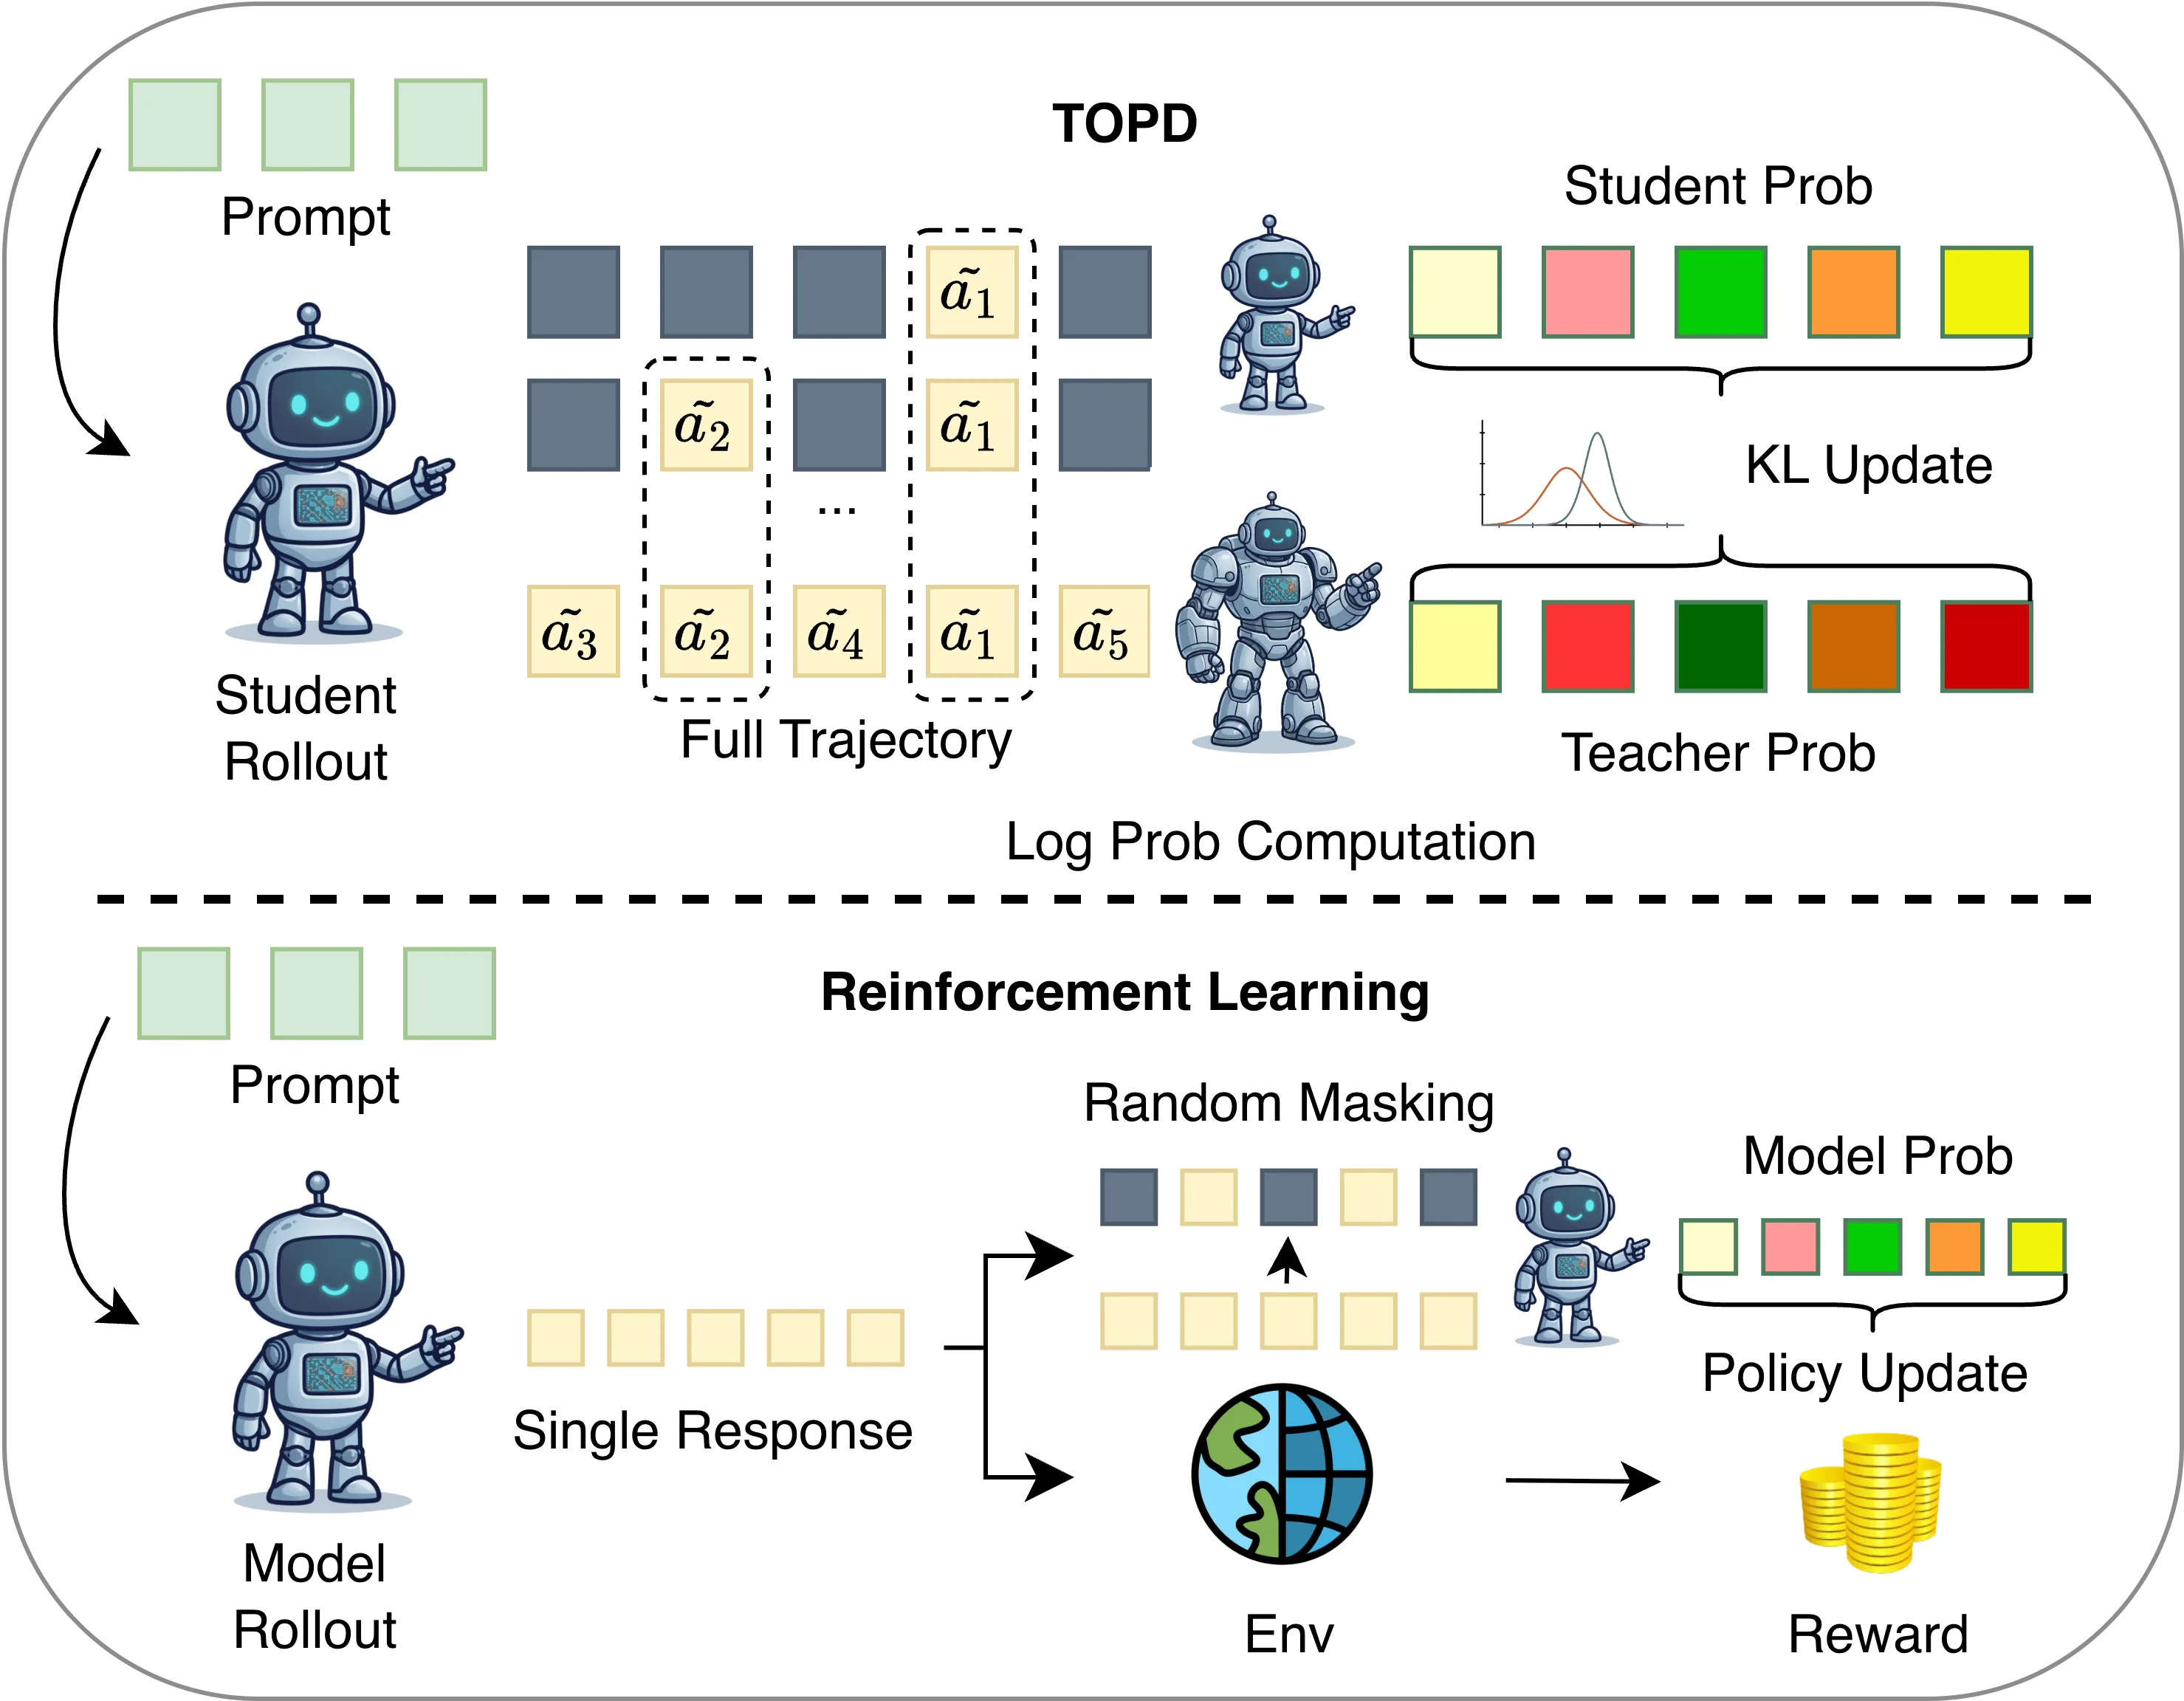
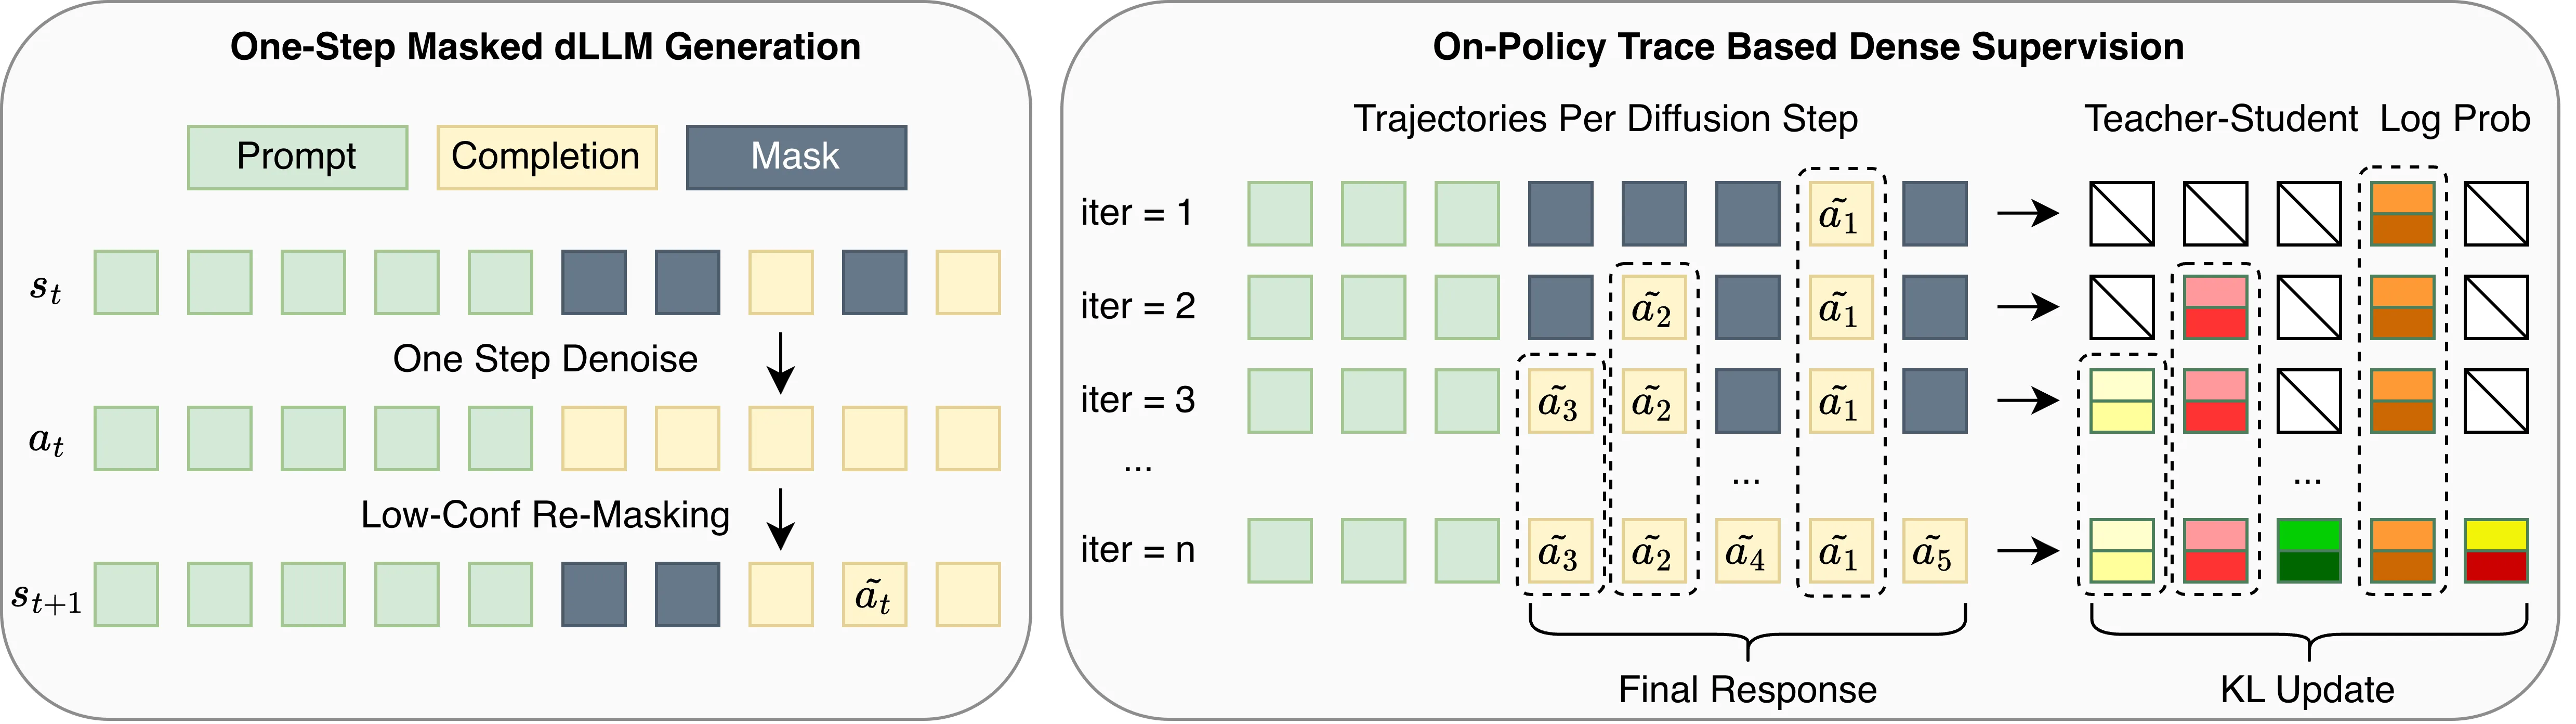
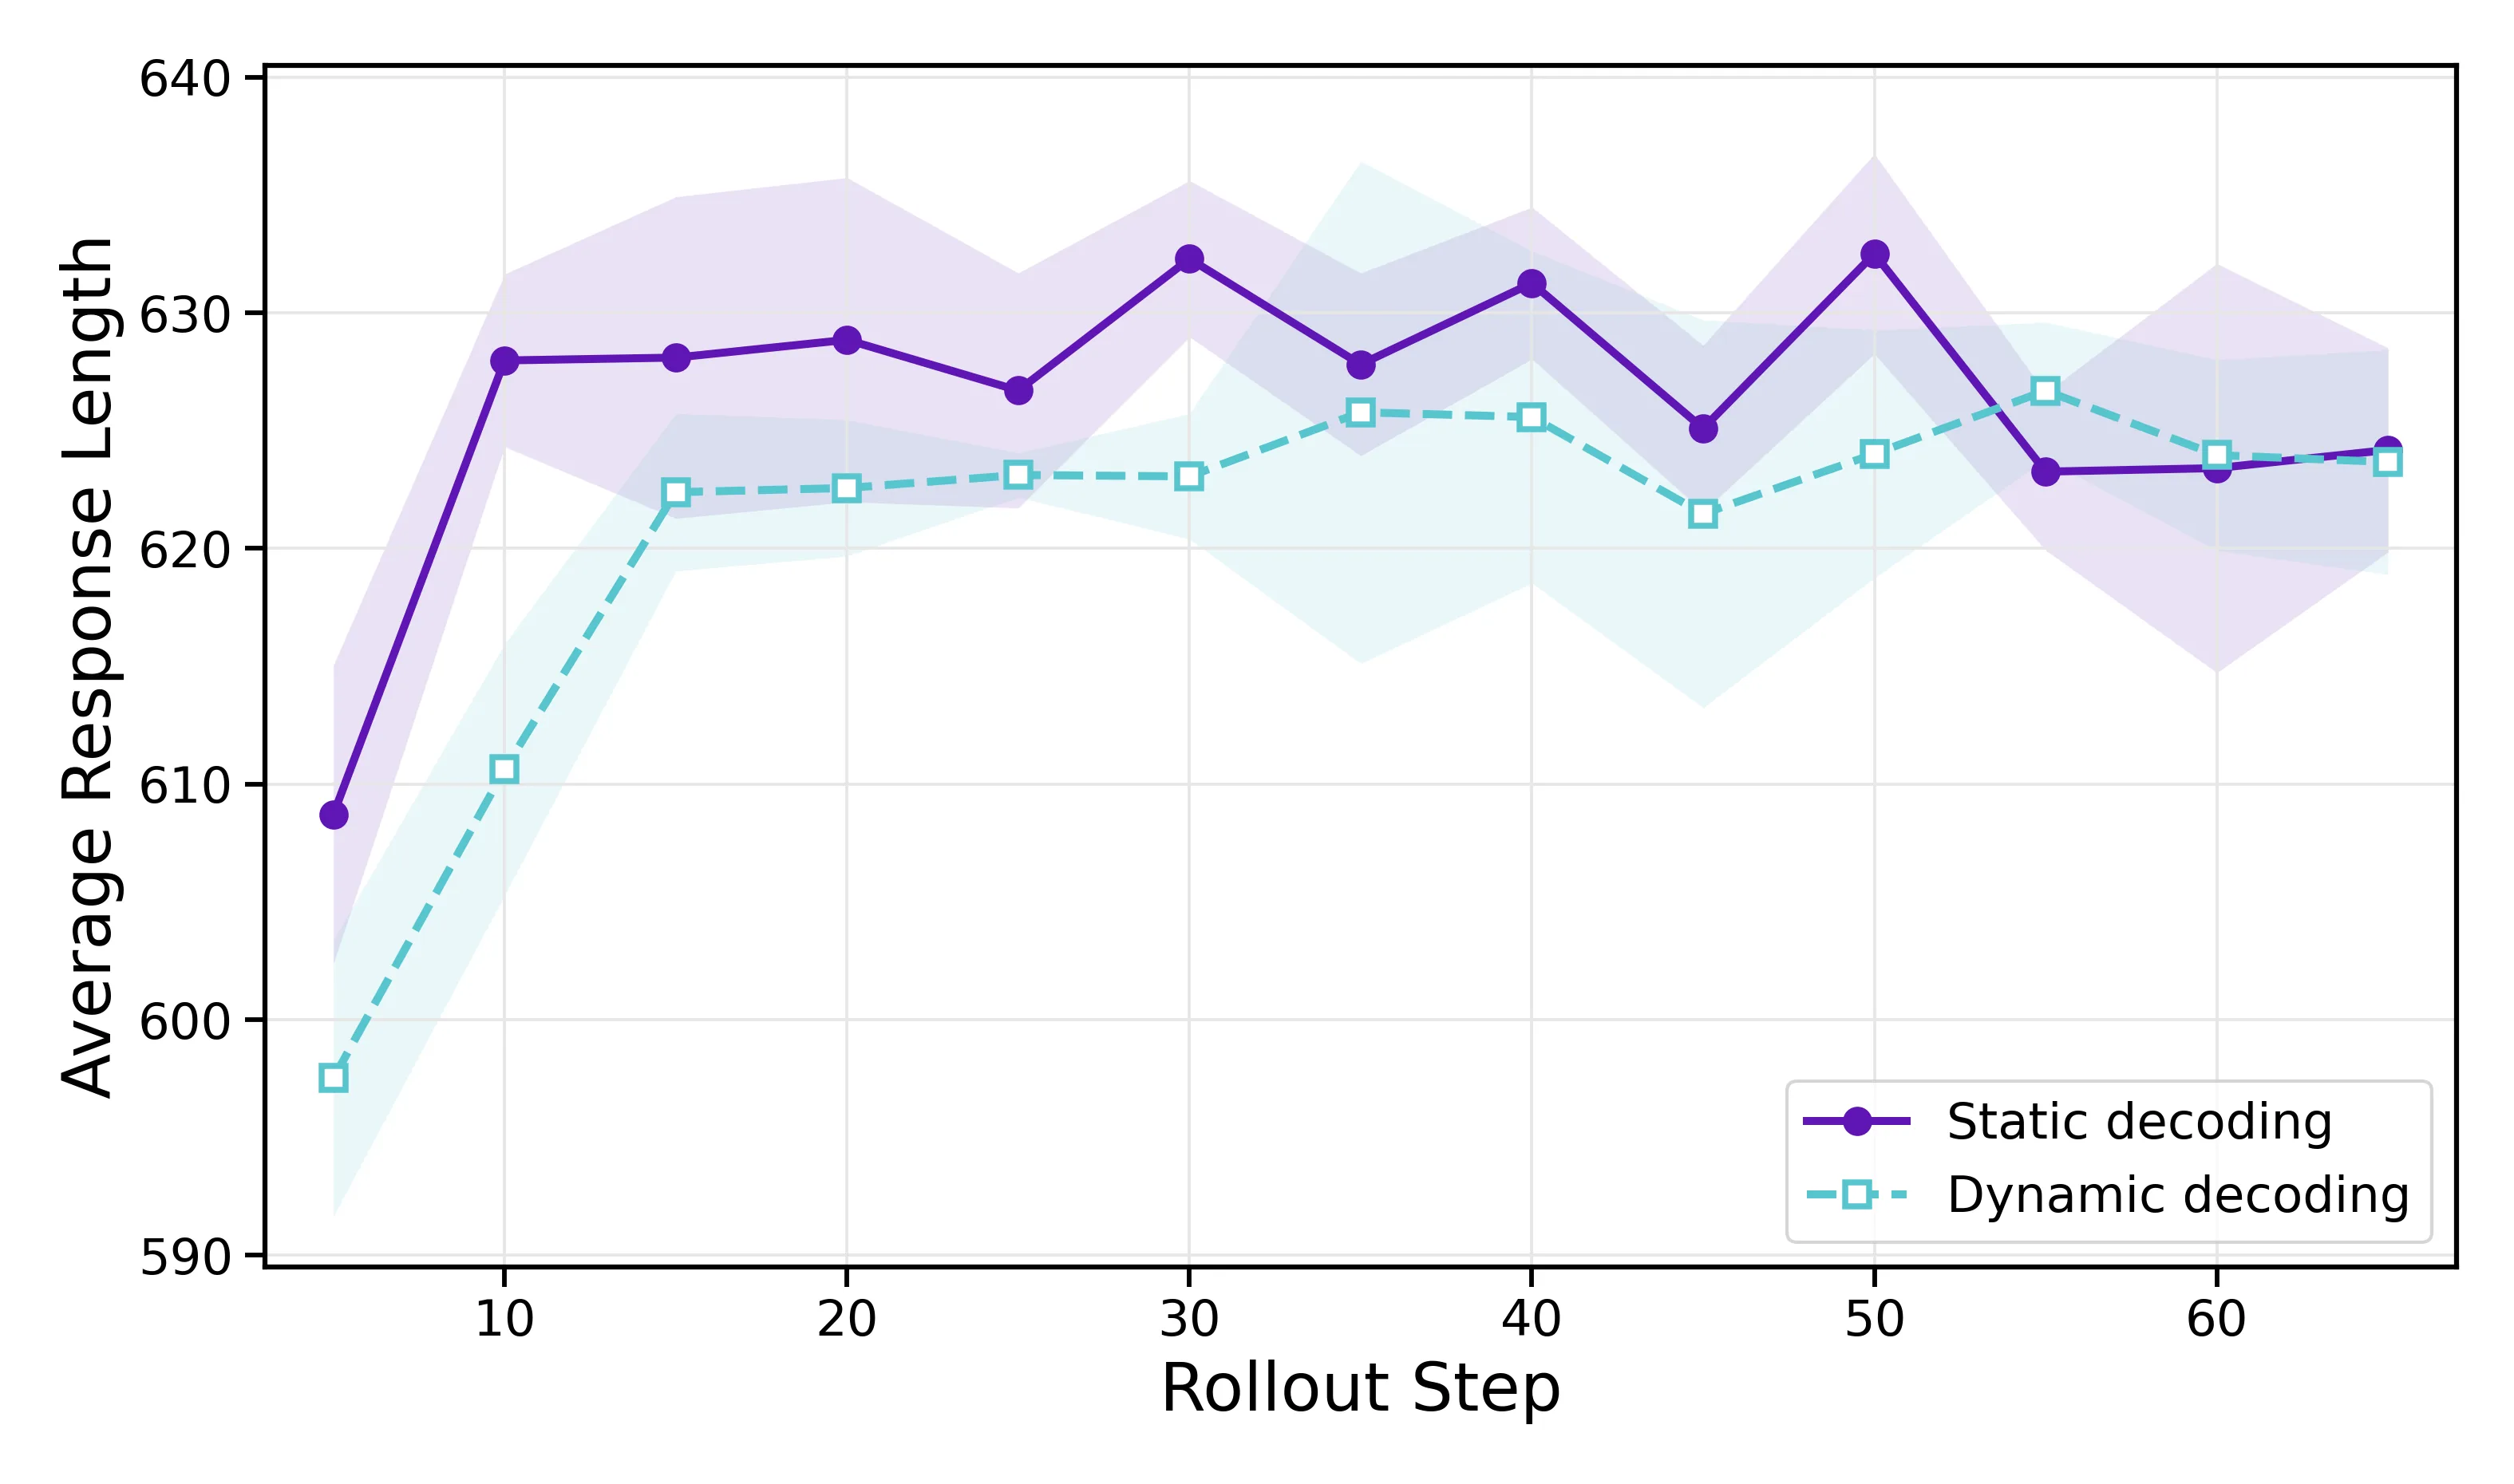
扩散大语言模型(dLLM)的推理后训练面临SFT需离线掩码状态、RL依赖稀疏奖励的双重困境。本文提出基于轨迹的在线策略蒸馏TOPD,以教师模型在目标dLLM自身去噪轨迹上的逐token分布指导训练,采用Reverse-KL目标实现密集监督。实验显示SDAR-4B-Chat在MATH500上匹配RL训练的TraDo-4B-Instruct,静态与动态评估分别提升5.7和4.5个点,且计算量仅为对方的约1/4。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
扩散大语言模型(dLLM)作为自回归生成的一种有前景的替代方案,近年来在文本生成任务中展现出竞争力。与逐步预测下一个 token 的自回归模型不同,dLLM 通过从噪声逐步去噪来生成完整回答,这种生成范式在理论上具有更好的并行性和可控性。然而,如何有效地对 dLLM 进行推理能力的后训练,一直是悬而未决的挑战。
传统的后训练方法在 dLLM 场景下都遇到了各自的瓶颈。监督微调(SFT)需要密集的标注数据,但在 dLLM 中,监督信号必须以掩码状态的形式提供,而这些掩码状态往往是离策略的——它们并非来自目标模型当前的去噪过程,而是来自预先设计或外部采样的分布。这种分布偏移会导致训练与推理时的不一致,影响最终性能。另一方面,强化学习(RL)虽然能够在没有密集标注的情况下学习,但其核心依赖于奖励信号,而奖励通常来自外部评估器或价值模型,对于复杂的推理任务而言,这类信号往往是稀疏的、延迟的,难以提供细粒度的 token 级指导。
这篇论文的切入点正在于此:能否找到一种既保留密集教师监督、又保持训练分布与模型自身状态一致的方法?TOPD 的提出正是对这一问题的直接回应。
方法
TOPD 的核心思想可以概括为一句话:在目标 dLLM 自身的去噪轨迹上进行监督,关注那些构成最终回答的、轨迹对齐的 token 决策。
理解这个设计需要先梳理清楚 dLLM 的生成过程。给定一个从随机噪声到清晰回答的扩散过程,dLLM 在每个去噪时间步都会对当前的部分去噪状态进行预测,得到一个 token 级别的概率分布。这些时间步连同对应的分布,就构成了模型的一条去噪轨迹。传统的做法要么忽略这条轨迹,只在最终结果上做监督;要么人为构造离策略的掩码状态来模拟去噪过程,但这些构造出来的状态与模型实际遇到的真实状态存在偏差。
TOPD 的关键创新在于,它从目标 dLLM 本身采样得到真实的在线策略轨迹。具体而言,首先让目标 dLLM 基于当前权重生成一条完整的去噪轨迹,这条轨迹反映了模型在当前策略下的真实行为。然后,在轨迹的每个部分去噪状态上,TOPD 调用一个预训练好的教师模型(比如更强的自回归大语言模型),获取教师对当前状态的 token 分布预测。教师分布给出了「在当前这个半成品状态下,下一个 token 应该是什么」的专家判断。
接下来的核心问题是:如何用教师分布来更新学生模型?TOPD 选择使用 token 级的 Reverse-KL 散度作为训练目标。Reverse-KL 与标准 KL 的区别在于它的优化方向:在标准 KL 中,我们让 (真实分布)去匹配 (目标分布),这会导致模型倾向于覆盖所有 可能的位置;而在 Reverse-KL 中,我们让 去匹配 ,这会导致模型优先保证 的峰值被准确覆盖,同时对 概率低区域的建模更保守。对于知识蒸馏任务,Reverse-KL 天然地鼓励学生模型在教师高置信度的地方精确对齐,而在教师不确定的地方保持一定的探索性,这更符合「学习正确答案」而非「模仿所有可能答案」的直觉。
将这个目标落实到 dLLM 的去噪轨迹上,每个时间步的损失就是当前去噪状态下,教师分布与学生分布之间的 Reverse-KL。通过在整个轨迹上累积这些 token 级的监督信号,TOPD 实现了对 dLLM 的密集指导,同时训练信号始终来自于模型自己正在经历的真实去噪状态,从而避免了离策略偏差。
实验与结果
论文在数学推理基准上进行了全面评估,主要对比对象是经过强化学习训练的 TraDo-4B-Instruct 以及基线模型 SDAR-4B-Chat。
实验采用了静态评估和动态评估两种设置。静态评估使用固定的测试集,用标准指标衡量模型表现;动态评估则更贴近实际使用场景,模型需要针对每个问题独立生成答案,更能反映真实的推理能力。结果显示,经过 TOPD 训练的 SDAR-4B-Chat 在 MATH500 上实现了与 TraDo-4B-Instruct 相当的准确率:在静态评估下提升 5.7 个百分点,在动态评估下提升 4.5 个百分点。这一结果的意义不仅在于数字本身,更在于它证明了在线策略蒸馏路线在追赶强化学习效果上的可行性。
更引人注目的是计算效率的对比。TOPD 仅需 4 倍更少的 rollout 轮次就能达到与强化学习方法相近的效果,这意味着模型在训练过程中与环境(或采样器)的交互次数大幅减少。论文给出了 96.0 倍达到同等准确率的模型计算加速这一估算数字,这一量级的效率提升在实际部署中具有重要价值。
此外,论文还通过消融实验验证了 Reverse-KL 目标相较于标准 KL 的优势,以及在线策略轨迹相较于离线构造掩码状态的必要性。这些分析进一步支撑了方法设计的合理性。
讨论与可借鉴点
TOPD 展示了一条介于纯监督学习与强化学习之间的中间路线。对于 dLLM 这类生成范式,轨迹本身就包含了丰富的中间决策信息,而在线采样的轨迹确保了训练与推理的一致性,Reverse-KL 则在密集监督与泛化能力之间取得了良好平衡。这一组合设计对于其他需要细粒度序列决策的模型同样具有参考价值。
当然,论文也存在一些局限性。首先,TOPD 依赖一个足够强的教师模型来提供 token 级别的监督,教师的质量直接决定了蒸馏的上限。其次,论文主要在数学推理这类有明确正确性标准的任务上验证了方法,对于开放域生成或需要多样性输出的任务,Reverse-KL 的保守倾向可能成为约束。此外,去噪轨迹的采样策略、超参数的选择等工程细节还有进一步探索的空间。
对于后续研究,一个值得思考的方向是如何将 TOPD 与强化学习信号相结合——既保留在线策略蒸馏的效率优势,又引入奖励模型的全局优化能力。另一个方向是探索教师模型的动态选择机制:在不同训练阶段或不同类型的问题上,是否可以自适应地切换不同能力的教师?这些问题的回答将有助于把 TOPD 的思想拓展到更广泛的应用场景中。
摘要
在策略自蒸馏:让扩散语言模型在自身去噪轨迹上进行自学习
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
CADENCE:基于覆盖自适应在线策略蒸馏缩小推理差距
CADENCE: Closing the Reasoning Gap via Coverage-Adaptive On-Policy Distillation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 5 张
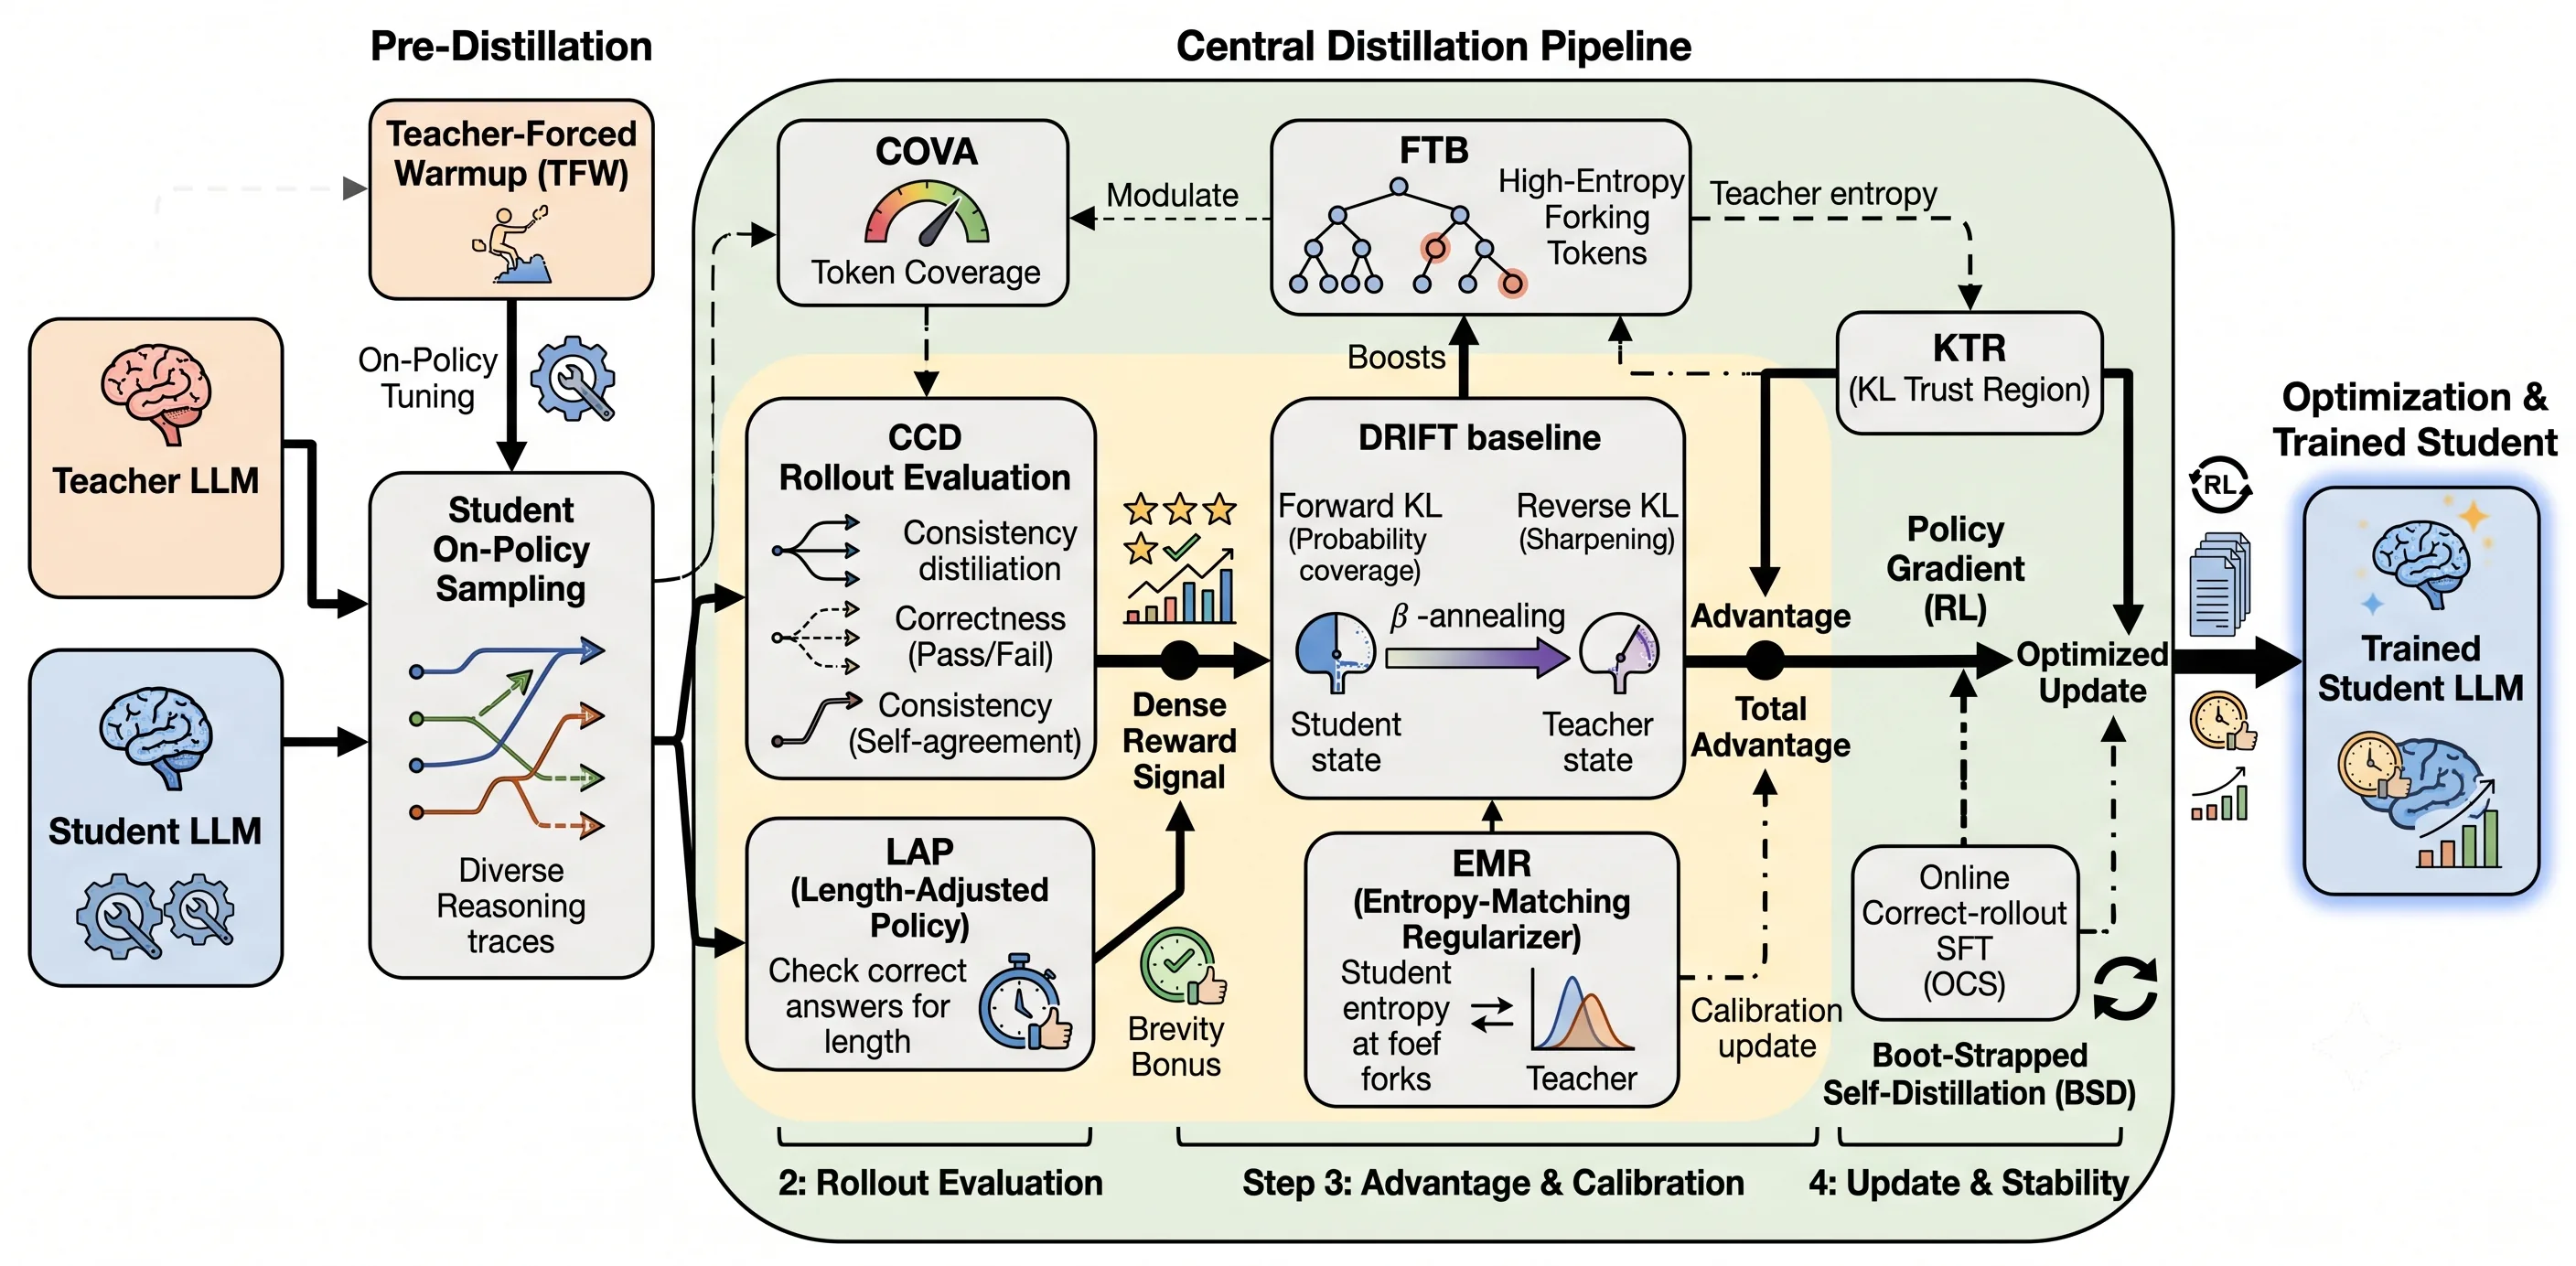
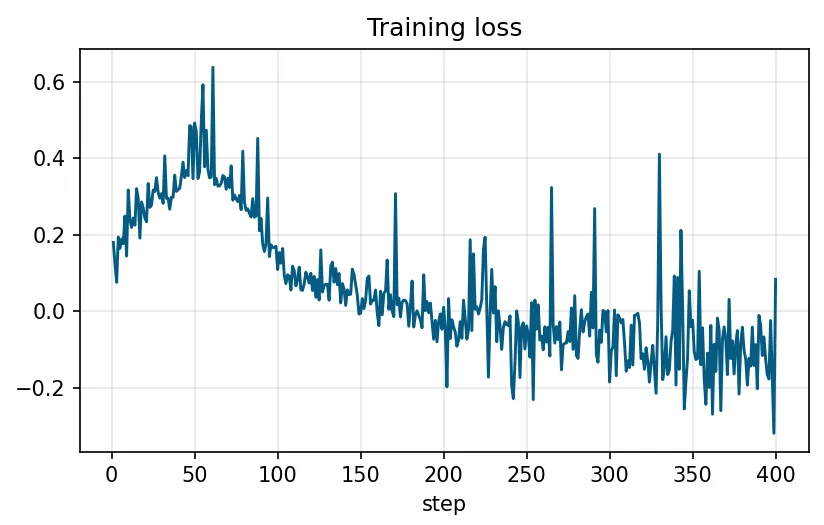
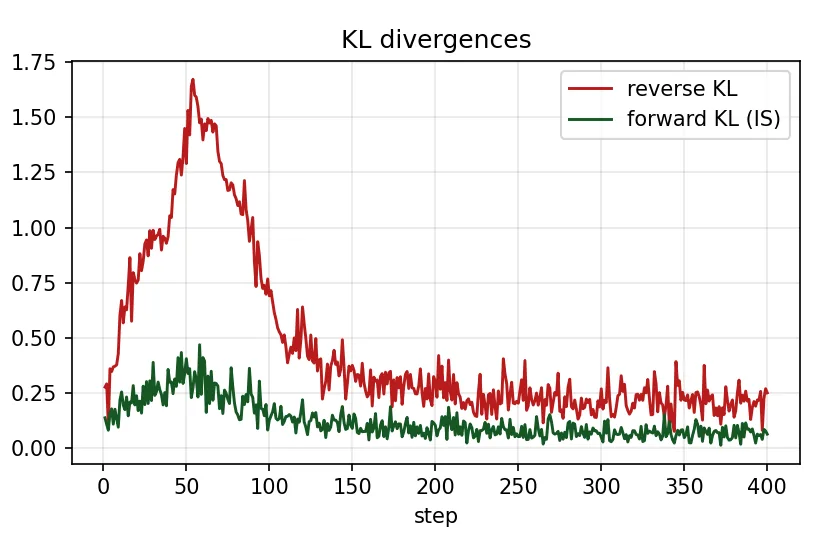
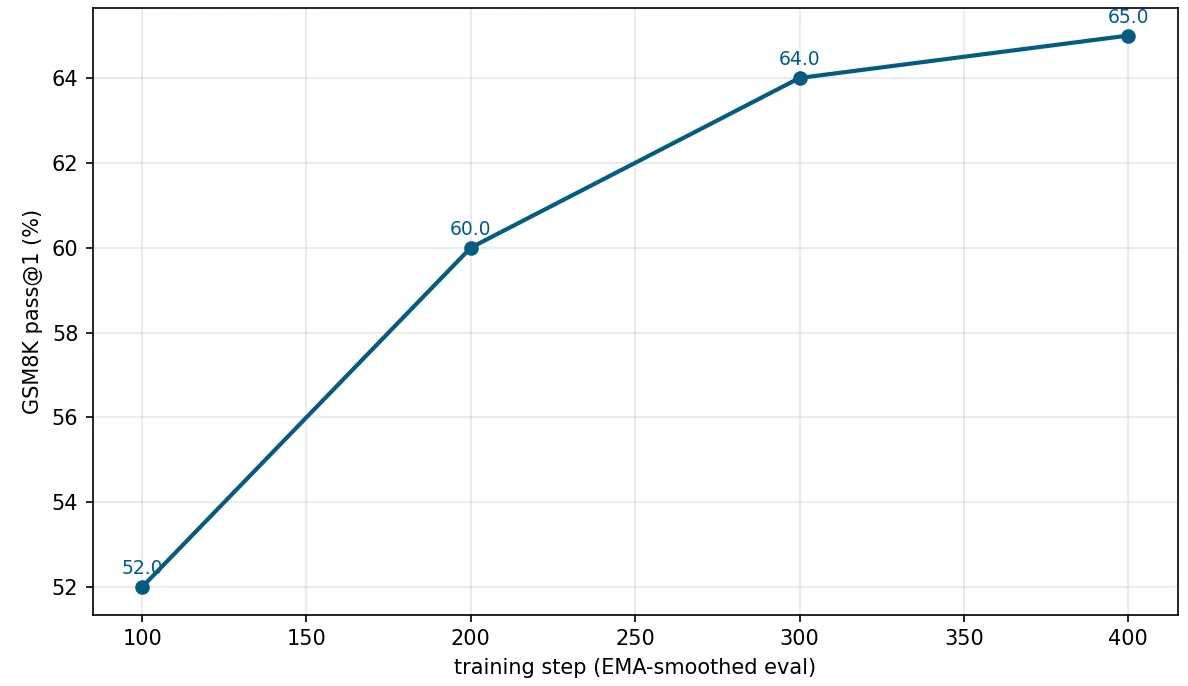
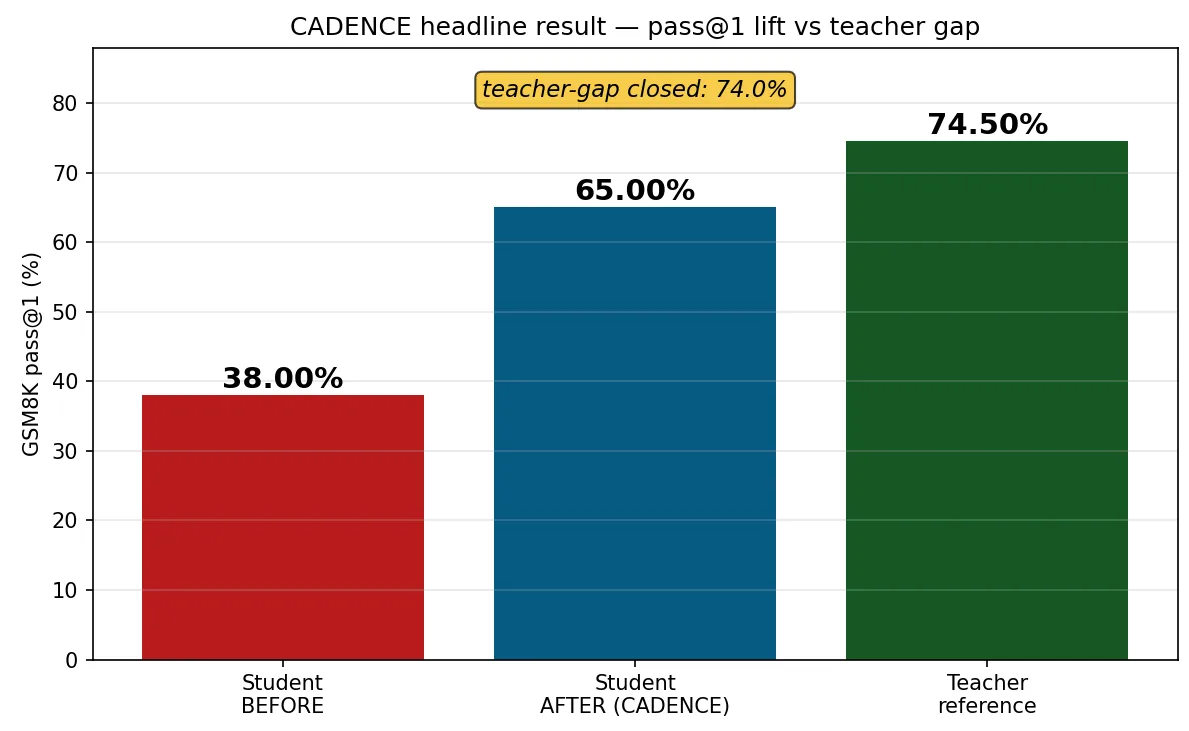
在线策略知识蒸馏将大模型推理能力迁移到小模型时面临冷启动崩塌、状态无关的散度调度与二元奖励稀疏三大问题。CADENCE提出DRIFT机制以逐token混合前向/反向KL代理目标,并融合COVA、FTB、CCD等六个组件协同修正上述缺陷。实验在GSM8K上以0.5B学生接1.5B教师取得69.8% pass@1,关闭了教师差距的63.2%,超越最强基线4.4分。整套方案仅需单台Mac Studio即可复现,证明原理正确的蒸馏无需数据中心级算力。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
将大模型的推理能力迁移到小模型,是让端侧设备获得强推理性能的关键路径。在线策略知识蒸馏(On-policy Knowledge Distillation)让小模型在真实交互中学习,而非被动模仿离线采样的数据,被认为更接近人类渐进式学习的过程。然而作者指出,当前方法在实际部署中普遍遭遇三种相互放大的失效模式,使得蒸馏效果远未达到理论预期。
第一种是冷启动崩塌(cold-start collapse)。当学生模型刚刚初始化时,它对教师偏好的 token 几乎分配不到任何概率质量,导致早期采样的轨迹与教师轨迹几乎无重叠,梯度信号微弱甚至不存在,整个学习过程在起点就陷入停滞。第二种是状态无关的发散调度(state-agnostic divergence scheduling)。主流做法用前向 KL 与反向 KL 的加权和作为目标,但权重安排往往只依赖训练步数或 token 位置,完全忽略了学生模型在当前状态下的覆盖程度——也就是说,无论学生是否已经学会覆盖关键决策点,调度器都在按照预定节奏切换目标。第三种是二元奖励稀疏(binary reward sparsity)。对一条完整推理轨迹只打一个对/错标签,意味着即使学生推理到倒数第二步才出错,整条轨迹的梯度贡献也是一样的,这极大浪费了训练信号中的有效信息。
CADENCE 的出发点就是为这三个问题各提供一个精准的修复组件,然后把它们整合成一套统一框架。
方法
CADENCE 的核心是 DRIFT 机制(Distributional Reasoning via Forward-to-Reverse Transition),其核心思想是用逐 token 的方式调度前向 KL 与反向 KL 的凸组合。与此前序列级 KL 梯度估计器不同,DRIFT 在每一个 token 位置计算前向 KL 与反向 KL 的代理目标,然后取其加权平均作为该位置的局部目标函数。直观上,前向 KL 更倾向于让学生覆盖教师的高概率 token(覆盖行为),而反向 KL 更倾向于让教师的分布向学生已有的质量较好的采样靠拢(保守行为)。逐 token 调度意味着系统可以在一条轨迹的不同位置动态调整这两种压力:对于学生已经比较有把握的区域,反向 KL 主导以保持稳定;对于覆盖薄弱的高熵决策点,前向 KL 主导以扩展能力。
DRIFT 机制本身解决了三大问题中最基础的结构设计,但要让这套机制在真实训练中稳定生效,还需要一系列配套组件的协同。
COVA(Coverage-Adaptive β scheduling) 是针对状态无关调度问题的修正。作者意识到,前向 KL 与反向 KL 的混合系数 β 不能简单地按时间线性衰减——如果学生还没有覆盖某个关键分支,就急于切换到反向 KL 会导致崩溃。因此 COVA 会监测学生当前对教师高频 token 的覆盖程度(coverage),动态加速或减缓 β 的衰减速率。在覆盖度较低时,COVA 让前向 KL 保持更长时间,确保学生有足够机会学会探索教师偏好的决策路径。
FTB(Forking-Token Boost) 针对的是梯度集中度问题。在一条推理轨迹中,并非所有 token 都同等重要——那些出现分叉决策的高熵位置才是决定最终质量的关键。FTB 在这些高熵位置引入基于全局归一化熵的参考信号,增强该位置的梯度幅度,让学习资源优先分配给最需要修正的决策节点。
CCD(Dense Reward via Correctness proximity Credit) 改变了奖励的粒度。传统二元奖励把所有正确轨迹视为等价、把错误轨迹全部丢弃。CCD 则对错误但数值接近正确答案的轨迹附加部分得分——例如一道数学题的答案是 42,学生的中间步骤推理到了 39,就给这条轨迹分配一个介于 0 和 1 之间的部分信用。这种密集奖励既增加了正样本的数量,又保留了轨迹质量的有价值差异信息。
LAP(Length-Adaptive Preference) 鼓励偏好简洁正确的采样。在同等正确的前提下,较短的推理路径通常对应更高效、更鲁棒的策略。LAP 对短且正确的轨迹施加额外的正向强化,引导学生朝精炼推理方向发展。
EMR(Entropy-Matching Regularization) 是一个校准正则化器,用于维持学生模型输出分布的熵匹配到教师模型的参考分布。过低的熵会导致学生过度自信、过早就失去探索能力;过高的熵则意味着学生没有真正学到教师的偏好结构。EMR 确保学生分布的熵与教师保持一致,防止学习过程中出现熵崩溃或爆炸。
BSD(Bootstrapped Self-Distillation) 是训练后期的一个自蒸馏阶段。此时学生已经具备相当的推理质量,BSD 让学生模型扮演自己的教师,用 DRIFT 机制对自身的高质量采样进行二次精炼,进一步提升策略的内部一致性。
整个 CADENCE 框架的流程可以概括为:学生按当前策略采样轨迹 → 计算每条轨迹的 DRIFT 目标(逐 token 前向/反向 KL 混合)→ COVA 根据覆盖状态调整 β → FTB 识别高熵分叉点并增强梯度 → CCD 为接近正确的错误轨迹补充密集奖励 → LAP 对简洁正确轨迹加分 → EMR 校准熵水平 → BSD 在后期进行自蒸馏。这六个组件并非简单叠加,而是在 DRIFT 的统一框架下形成协同效应,共同修正三大失效模式。
实验与结果
实验在两个标准推理基准上进行:GSM8K(小学数学应用题)和 MATH-500(竞赛级数学题)。作者使用了修正的 512 token 生成协议,用 5 个随机种子训练并报告标准差,保证结果的可靠性。
核心结果显示,当使用 1.5B 教师蒸馏到 0.5B 学生时,CADENCE 在 GSM8K 上达到 69.8 ± 0.5% 的 pass@1,较预训练基线的 48.7% 提升了 21 个百分点,弥合了教师与学生之间能力差距的 63.2%。换句话说,教师模型如果能达到更高水平,学生已经成功吸收了其中的大部分。将教师规模扩大到 3B,学生成绩进一步提升到 72.1 ± 0.4%,弥合了 76.2% 的差距。
更重要的是消融实验揭示了各组件的贡献。移除 CCD 密集奖励,成绩下降约 1.8 分;移除 COVA 覆盖自适应调度,下降约 1.5 分;移除 FTB 分叉增强,下降约 1.2 分。将完整的 CADENCE 与仅使用 DRIFT 加二元奖励的简化版本相比,前者高出后者 4.4 ± 0.7 分——这直接证明了 DRIFT 机制与六大组件协同工作时才能发挥最大效力。
值得强调的是,所有这些实验都是在单台 Apple Mac Studio(M 系列芯片,64GB 统一内存)上完成的,不需要数据中心级的 GPU 集群。作者以此论证,只要原理正确,蒸馏方法完全可以摆脱对算力垄断的依赖,让高效推理能力的获取变得更加民主化。
讨论与可借鉴点
CADENCE 的成功揭示了在线策略蒸馏中几个被长期忽视的结构性问题。首先,逐 token 的目标设计比序列级梯度估计更能捕捉推理过程中不同决策节点的差异化需求——这个教训对其他需要细粒度控制的序列生成任务同样适用。其次,覆盖状态监测(COVA 的核心思想)提供了一种自适应调整学习压力的思路,避免了固定调度在学生能力动态变化时的失效。此外,密集奖励(CCD)对部分正确轨迹的利用,在 reward shaping 领域有广泛的借鉴价值,尤其当环境给出的是稀疏二元信号时。
论文的局限也同样值得注意。CADENCE 的六个组件需要精心调参,各组件之间的交互效应增加了系统复杂度。实验目前仅覆盖数学推理任务,在代码生成、自然语言推理等更广泛场景的泛化能力还有待验证。另外,BSD 自蒸馏阶段的有效性可能与训练数据量相关——当可用的采样轨迹足够多时,自蒸馏的边际收益可能会递减。
从更宏观的角度看,这篇论文的方法论提示了一个重要方向:知识蒸馏的效果瓶颈往往不在于模型容量本身,而在于训练信号的结构设计。CADENCE 通过精细化处理训练信号的时间性、空间性和密度问题,展示了即使是小模型也能从大模型中提取出高质量推理能力的可能性。这对于推动端侧智能的发展,尤其是让资源受限设备获得接近云端模型的推理性能,具有实质性的启发意义。
摘要
面向覆盖率自适应的策略知识蒸馏方法
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
将共识作为特权上下文用于无标签自蒸馏
Consensus as Privileged Context for Label-Free Self-Distillation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 5 张
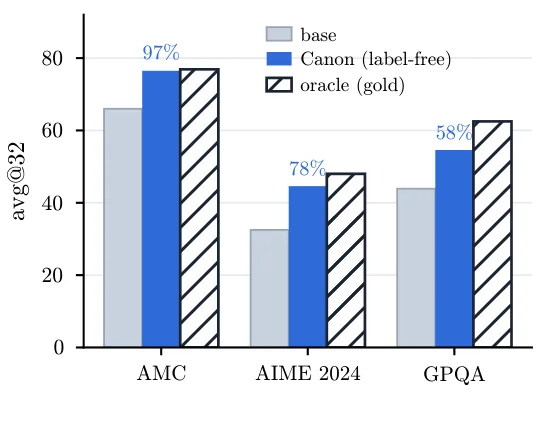
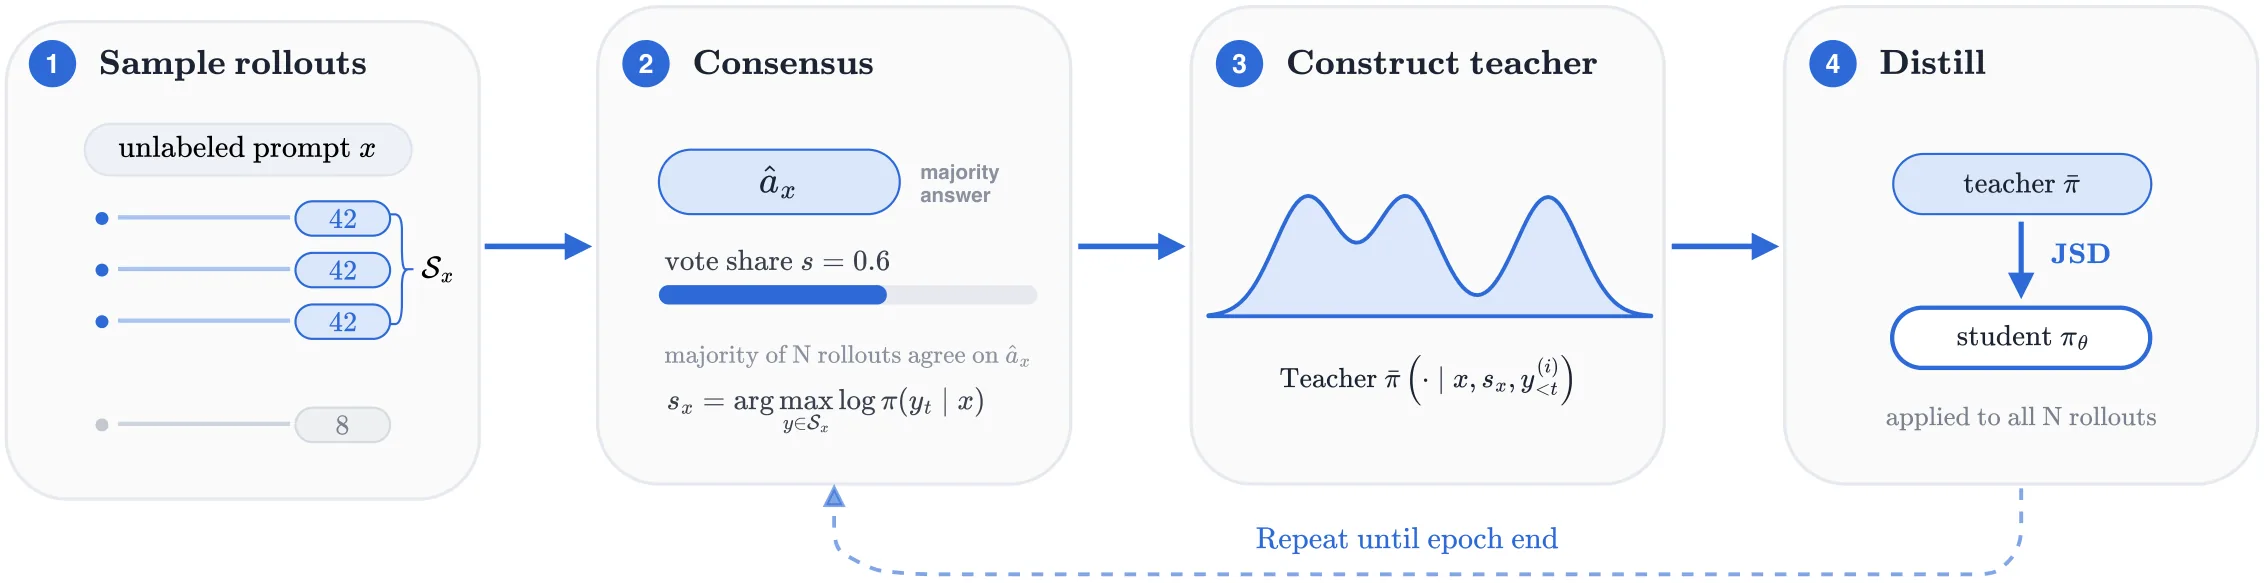
在大语言模型无标签训练中,多数投票共识信号常被用作筛选或强化学习奖励,信息利用不充分。本文提出CANON方法,将多数共识答案作为冻结教师模型的特权上下文,在每个token上对模型自身rollout进行自蒸馏监督。实验显示该方法将pass@1提升最多12个百分点,以强化学习七分之一的算力超越无标签RL,并接近使用金标签训练的教师。训练后模型还能解决此前从未解出的问题,表明提升并非单纯的分布锐化。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
大语言模型在推理任务中面临的核心挑战是高质量标注数据的稀缺。研究者很早就发现,对同一问题采样多条解并取多数答案是最可靠的无标签策略,这种自洽性(self-consistency)方法能够显著提升准确率。沿着这一思路,学界发展出一系列将共识信号转化为训练监督的方法:用共识筛选解进行微调、通过共识构建偏好对进行优化、以及以共识作为[[强化学习]]的标量奖励。
然而这些方法存在一个共同的深层局限:共识信息被严重浪费。标量奖励只能传达“这个解对还是错”的二元判断,而一条正确的解包含的完整推理链条——每一步如何推导、为何选择这个策略、在哪里发生了转折——这些丰富信息在压缩为单个比特的过程中完全丢失。学生模型无法理解“正确答案的推理路径与我的有何不同”,只能被动强化“答对就奖励、答错就惩罚”的粗粒度信号。
CANON 从特权上下文的概念中获得关键洞见。在传统机器学习中,特权上下文指推理时拥有但训练时不可用的额外信息。论文的核心发现是:共识解对模型自身而言正是一种天然的“特权信息”——生成这条解时的完整思考过程原本只存在于模型的隐状态中,但通过将其显式地注入上下文,我们可以在这个信息条件下获得更准确的预测能力。这一转换将原本只能贡献一个比特的多数投票信号,扩展为覆盖完整推理链条的稠密监督。
方法
CANON 的核心思想是将“多数投票作为奖励”替换为“多数共识作为教师条件”,让模型自身产生的共识解扮演特权上下文的角色,使密集的 token 级[[自蒸馏]]成为可能。
整个方法分为三个步骤。第一步是提取共识:对每个无标签提示 ,从当前模型 采样 条解,提取各自的最终答案,通过投票得到多数答案 。第二步是选择共识解:在投出多数票的解集中,选择生成对数概率最高的那条作为共识解 ,这确保我们保留的是模型自己最确信、生成质量最好的那条推理路径。第三步是稠密自蒸馏:这是方法的核心创新。我们保留一份训练开始时的模型快照作为冻结教师 ,永不更新。将 以模板形式注入教师模型的上下文后,教师在每个 token 位置都会基于“这个问题+这条共识解的前缀”进行预测,输出完整的下一词分布 。学生模型同时基于“这个问题+自己的采样前缀”进行预测,输出 ,两者通过 [[Jensen-Shannon散度]] 对齐。
[[Jensen-Shannon散度]]定义为
其中 。这个选择有充分的理由:JSD 有界(最大值为 )且对称,避免了当学生和教师分布支持集不重叠时 KL 散度产生的无界梯度问题。更重要的是,这个损失是稠密的——对于 条 rollout 中的每一条、每一个 token 位置都会计算监督信号,将原本只贡献一个比特的多数投票信号扩展为逐 token 全词表分布目标。
冻结教师是另一关键设计。直觉上可能会认为教师应该和学生一起学习、逐渐变强,但实验发现共享参数的“活教师”会导致训练崩溃:约 5 步后 loss 与生成熵归零,模型退化为确定性重复。冻结教师避免了这个问题,使其保持对问题域的完整知识表示,同时学生通过蒸馏逐步将教师在共识条件下的能力迁移到自己身上。
值得注意的是,师生模型共享参数 (即 ),这与常见的蒸馏方法不同——学生是在蒸馏自己教师身份(以共识解为条件)所蕴含的知识,而非蒸馏某个独立教师网络的知识。
实验与结果
实验在 AMC 2023、AIME 2024/2025、GPQA-Diamond、MATH500 等数学和科学推理基准上进行,主实验采用 Qwen3-4B-Instruct-2507 模型。
直推实验结果展示了 CANON 的显著优势。在 AMC 上,avg@32 从基线的 66.0 提升到 76.5,增幅达 10.5 个百分点,领先四个无标签[[强化学习]]基线 5 至 7 个百分点。更值得关注的是算力效率:CANON 仅需 1.2 GPU-小时,而 TTRL 需要 8.1 小时、EMPO 需要 6.4 小时、SCRL 需要 9.8 小时,CANON 的算力消耗约为这些方法的七分之一到十分之一。
与使用金标签的 Oracle 教师相比,CANON 在数学领域的表现与其几乎无法区分。AMC 上差距仅 0.4 点,AIME 2024 上差距 3.4 点,GPQA 上差距 7.9 点。这说明在数学推理场景下,模型自身的共识解作为特权上下文几乎捕获了金标准解作为教师条件的全部价值。
CANON 不仅提升 pass@1,还展示了更强的泛化能力。多数投票本身的准确率(maj@32)在四个硬基准上提升 2.4 至 3.3 点;pass@32 在 AIME 2025 上提升 16.7 点,AMC 上提升 4.8 点。更关键的是证据表明这并非分布锐化:训练后的模型能够解决此前在 32 次采样中从未正确解决的问题。在 AMC 上,pass@32 提升了 33.3 点,这意味着原本模型无论如何采样都做不对的题目,现在能够稳定解决。这种质变表明 CANON 不仅是在强化已有的正确行为,更是在解锁模型潜在但未表达出的能力。
归纳迁移实验验证了方法的可迁移性。在 AIME 2024+2025 合并集上,仅在 AMC 上训练的 CANON 提升 4.7 点,领先 TTRL 的 2.7 点和 GRPO-180 的 3.8 点。当汇集 339 道题目训练后,CANON 在 AIME 2024 留出评测中达到 41.7 分,超过 TTRL-pool 的 39.4 分和 GRPO-pool 的 39.0 分,仅落后 Oracle-pool 0.7 点。
消融实验揭示了教师条件内容的阶梯效应。仅用多数答案作为条件时,AMC 得分仅 66.8;加上其他问题的共识解后提升到 71.2;加上同题共识解的前缀后达到 73.9;只有完整的目标问题共识解作为教师条件才能达到 76.5。这说明 token 级别的精细监督对于捕获完整推理过程至关重要。
讨论与可借鉴点
CANON 的核心贡献在于展示了如何将一个几乎零额外成本的信号——只需一次采样和一轮[[蒸馏]]——转化为稠密的 token 级监督。这一方法的简洁性令人印象深刻:单一配方(、JSD 损失、冻结快照教师、单 epoch 训练、LoRA 微调)在不同模型家族和规模上均无需逐例调优即可工作。
方法也存在明确的局限性。首先,它要求问题可提取最终答案(如数学题的 格式或多选题字母),对自由生成任务的适用性尚需探索。其次,当基础模型已达成正确但饱和的共识时,收益空间有限甚至可能出现轻微负增益。第三,少数情况下会出现“自信错误共识”——模型集体投票错误且置信度高,CANON 反而会强化这些错误,这在实验中占比约 3%(41/1493)。
论文最有价值的贡献或许在于提供了可解释的适用边界:多数答案正确但模型表达不够精确时收益最大(+21.5 点),共识已正确且饱和时收益较小(+4.3 点),多数错误但置信度弱时仍有一定提升(+2.6 点),而多数错误且自信时则为负增益(-3.0 点)。这为从业者提供了明确的决策依据,也为后续研究指明了方向——如何检测并规避“自信错误共识”场景,可能是进一步提升 CANON 的关键。
概念 · 6 个
摘要
无标签自蒸馏,将多数共识转为逐token监督信号
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
BucketKD:一种面向端到端运动规划的安全感知分桶知识蒸馏框架
BucketKD: A Safety-Aware Bucket-Based Knowledge Distillation Framework for End-to-End Motion Planning
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 7 张
端到端运动规划模型体积大,难以部署在资源受限的车载平台。现有知识蒸馏方案依赖简化的规划状态表示,会丢失丰富的场景语义信息。本文提出BucketKD框架,将关键环境变量离散化为自适应桶以保留更多场景信息,并设计基于TTC的安全感知路径点注意力机制评估路径点风险,使学生模型在蒸馏中保留安全关键行为。在CARLA和Bench2Drive上的实验表明,该方法以较高压缩比显著优于现有最优方法的规划精度与安全性。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
端到端运动规划近年来在自动驾驶领域获得了广泛关注。这一范式的核心思想是使用深度神经网络直接将原始传感器数据映射为控制命令或轨迹规划结果,省去了传统模块化系统中感知、预测、规划等模块之间的显式接口设计。由于避免了信息逐级传递中的损失,端到端方法在理论上具有更强的全局优化能力和更简洁的系统架构。
然而,端到端模型的规模通常非常庞大。以常见的 Transformer 或卷积网络骨干为例,模型参数量往往达到数百万甚至上千万级别。这在云端服务器上并非不可接受,但对于车载嵌入式平台而言,计算资源、内存和功耗都受到严格约束,直接部署这些庞然大物面临严峻挑战。如何在保持模型性能的前提下实现有效压缩,成为推动端到端自动驾驶落地的关键问题。
在模型压缩的诸多技术中,[[知识蒸馏]] 是一种被广泛采用的方法。其基本思路是训练一个参数量较小的学生模型,使其模仿性能更强但计算代价高昂的教师模型的行为。在传统的知识蒸馏框架中,学生模型主要学习教师模型的输出分布或中间层特征,模型体积得以显著缩小。
但现有知识蒸馏方案在处理端到端运动规划任务时存在一个根本性困难:它们通常依赖简化的规划状态表示——例如直接使用路径点坐标或控制信号——而丢失了大量有价值的场景语义信息。在自动驾驶场景中,周围的车辆位置、道路边界、信号灯状态等环境变量对规划决策至关重要。当学生模型只能接触到经过大幅压缩的规划状态时,这些安全相关的场景信息难以被有效保留,导致学生模型在蒸馏后无法正确应对复杂的交通情境。
正是基于这一观察,BucketKD 的研究者们希望提出一种新的蒸馏框架,能够在模型压缩的过程中充分保留场景语义,同时确保学生模型继承教师模型的安全关键行为。
方法
BucketKD 的核心思想可以分为两个层面:自适应分桶机制和基于 TTC 的安全感知注意力。
自适应分桶机制
传统知识蒸馏在处理环境变量时,往往将这些连续变量直接作为浮点数输入模型,或者进行简单均匀量化。这两种做法都有明显缺陷:直接使用原始数值意味着学生模型需要学习与教师模型相同维度的输入,增加压缩难度;而均匀量化则会引入较大的信息损失,特别是对于那些分布不均匀的环境变量。
BucketKD 采用了自适应分桶策略来解决这一矛盾。具体而言,研究者将关键的环境变量——如自车与其他障碍物的相对距离、角度、相对速度等——离散化为若干个桶(bucket)。与固定间隔的均匀分桶不同,自适应分桶根据变量在训练数据中的实际分布动态确定桶的边界,使得高频区域被划分得更细,低频区域则使用更粗糙的划分。这种设计在显著降低输入维度的同时,最大程度地保留了原始数据的区分能力。
从信息论的角度来看,自适应分桶本质上是一种有损压缩过程,但其压缩方式是智能的:重要的、对决策影响大的变量值被精确表示,而影响较小的值则被适当粗粒度化。这样一来,学生模型接收到的输入虽然经过了离散化处理,但仍然携带着丰富的场景语义信息,而非简单的规划状态摘要。
基于 TTC 的安全感知航点注意力
分桶机制解决了输入端的信息保留问题,但仅靠输入端的特征传递还不足以保证学生模型在安全关键场景中的表现。为此,BucketKD 在蒸馏过程中引入了安全感知机制,其核心是基于碰撞时间([[Time-to-Collision]],TTC)的航点注意力模块。
TTC 是交通研究中广泛使用的安全度量,用于评估当前车辆与前方障碍物发生碰撞的潜在时间。其基本公式为:
当两车同向行驶且后车速度更快时,TTC 表示前车保持当前速度不变的情况下,后车追上前车所需的时间。TTC 值越小,意味着碰撞风险越高。
在 BucketKD 中,研究者将这一概念引入到航点风险评估中。对于规划轨迹上的每个航点,系统综合考虑该航点与周围障碍物的接近程度以及它们之间的相对运动关系,通过 TTC 公式计算一个风险分数。这个分数被用作注意力权重,使得高风险航点在蒸馏过程中获得更多的学习关注。
具体而言,安全感知注意力机制首先对每个航点计算其 TTC 风险值,然后将这些风险值归一化后作为注意力权重与航点特征相乘。这样一来,当学生模型学习模仿教师模型的轨迹时,靠近障碍物或处于高相对速度区域的航点会对整体损失函数产生更大影响。换言之,蒸馏过程不仅要求学生模型的输出在几何上接近教师模型,还特别强调在安全关键区域保持一致的行为模式。
这种设计的直觉在于:传统的知识蒸馏往往将所有输出视为同等重要,但驾驶场景中不同区域的重要性差异巨大。一个微小的轨迹偏差在空旷路段可能无关紧要,但在狭窄路口或车辆密集区域却可能导致事故。通过引入 TTC 感知的注意力权重,BucketKD 能够引导学生模型将学习预算优先分配给最需要精确表达的位置,从而在有限的模型容量下最大化安全相关的性能。
实验与结果
研究团队在 CARLA 自动驾驶仿真平台上进行了全面的实验评估,训练和测试数据来自 Bench2Drive 数据集。CARLA 作为开源仿真平台,能够复现多样化的城市场景和天气条件,是自动驾驶领域验证算法性能的常用基准。
实验首先对比了不同压缩比下 BucketKD 与基线方法的表现。压缩比定义为教师模型参数量与学生模型参数量之比,研究者测试了从 4 倍到 16 倍的多个压缩档位。结果显示,在所有压缩比设置下,BucketKD 在规划精度指标(如平均位移误差、平均角度误差)上均显著优于对比的最先进知识蒸馏方法。特别是在高压缩比(如 16:1)条件下,优势更为明显——其他方法的学生模型性能出现明显下降,而 BucketKD 仍能保持接近教师模型的表现。
安全性评估采用了碰撞率、违规率等指标。结果表明,BucketKD 生成的学生模型在模拟测试场景中的碰撞事件显著减少。这验证了 TTC 安全注意力模块的有效性:学生模型确实在蒸馏过程中习得了安全关键的行为模式,而非仅仅复制轨迹的几何形状。
消融实验进一步拆解了各个组件的贡献。禁用自适应分桶而仅使用均匀量化时,性能出现明显回落,说明分桶策略对保留场景语义至关重要。单独移除安全注意力模块后,安全相关指标恶化最为显著,而纯精度指标的下降则相对温和。这一结果印证了设计直觉:TTC 注意力主要影响安全关键场景下的表现,对常规驾驶情境的影响相对较小。
值得注意的是,实验中还观察到自适应分桶与安全注意力之间存在协同效应。二者联合使用时,模型性能优于各自单独使用的简单加和。这可能是因为保留更丰富的场景语义使得安全注意力模块能够更准确地识别高风险区域,而精确的风险评估又反过来帮助分桶机制更好地分配信息容量。
讨论与可借鉴点
BucketKD 在知识蒸馏框架中成功引入了安全感知的建模视角,为端到端自动驾驶模型的压缩问题提供了新的解决思路。其核心贡献在于两点:一是认识到环境变量的离散化表示不应是简单的信息丢弃,而可以是语义保留的有选择压缩;二是将交通工程中成熟的 TTC 安全度量引入神经网络训练过程,使得蒸馏学习能够自动区分不同区域的学习优先级。
然而,这一工作也存在一些局限性。首先,自适应分桶的边界确定依赖于训练数据的分布统计,当部署环境的数据分布与训练集存在显著差异时,分桶策略可能不再是“最优”的。其次,TTC 公式假设障碍物保持当前运动状态不变,这在动态变化的交通场景中是一个较强的简化,复杂场景下可能需要更鲁棒的风险度量。此外,实验目前仅在仿真环境中进行,真实世界的传感器噪声和动态特性可能对分桶机制的性能产生影响。
从更广泛的角度看,BucketKD 的设计理念——在压缩过程中选择性保留与任务目标最相关的语义信息——具有较好的通用性。这一思想可以迁移到其他需要压缩的感知-决策系统中。例如,在多模态融合的规划模型中,不同传感器模态的重要性各不相同,基于任务目标的模态选择或加权压缩可能带来更高效的部署方案。
对于后续研究,一个值得探索的方向是将安全感知从蒸馏阶段延伸到学生模型的整个训练过程中,而非仅作为蒸馏的辅助约束。这样学生模型可能学到更加内化的安全行为模式。此外,桶的粒度和 TTC 参数目前需要人工设定或基于经验选择,研究其自动调整机制也是提升框架鲁棒性的潜在路径。
摘要
用于运动规划模型压缩的知识蒸馏
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
通过生成式随机化与跨变体自监督学习打破虚假相关性
Breaking Spurious Correlations via Generative Randomization and Cross-Variant Self-Supervised Learning
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 5 张
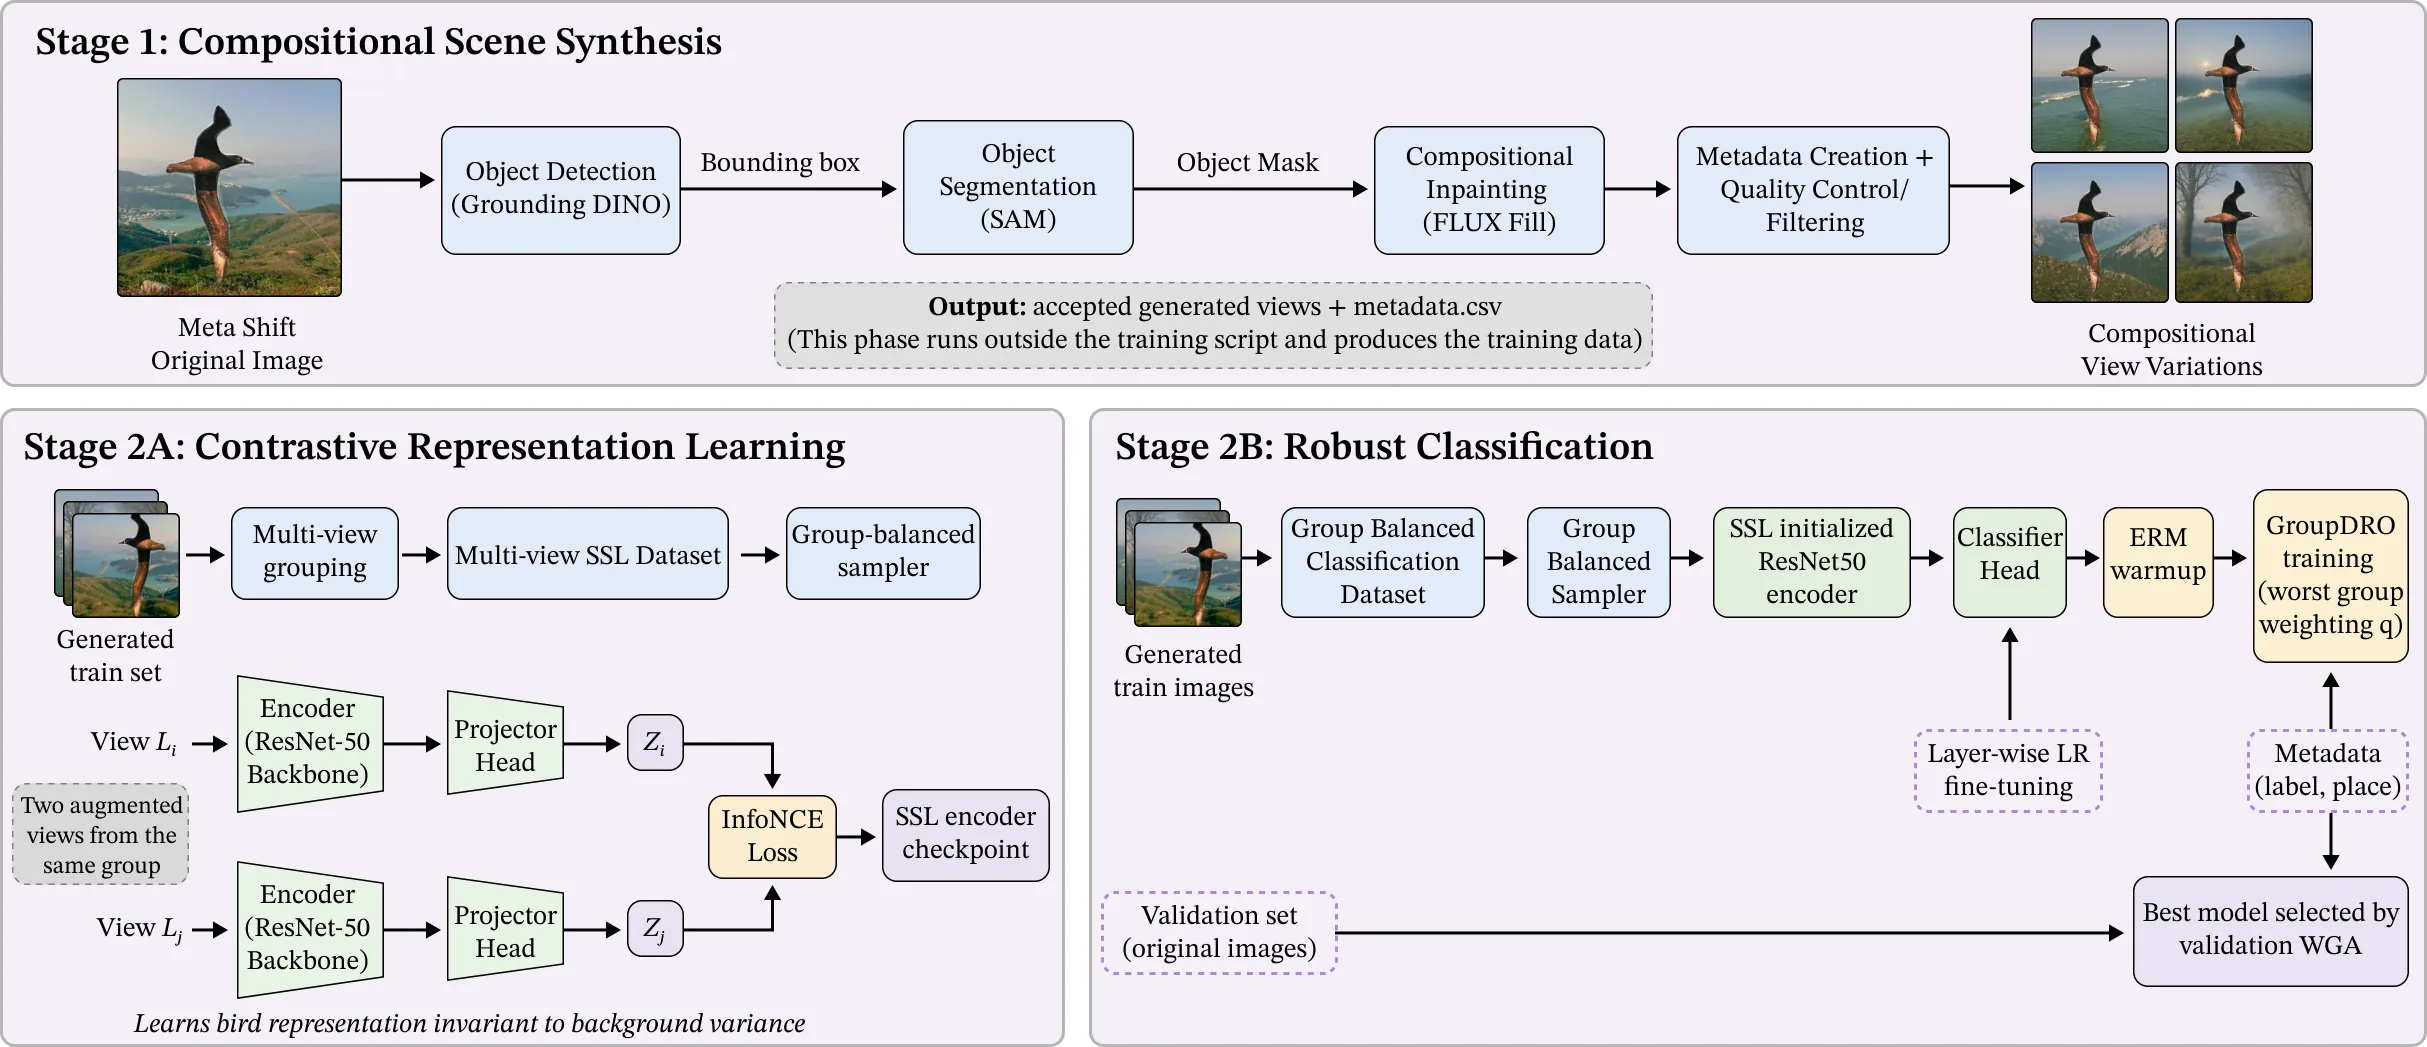
深度网络常因依赖"对象-背景"虚假关联而在分布偏移下表现脆弱。本文提出两阶段生成-学习框架:先用零样本分割结合保结构扩散模型,生成同一对象在不同背景下的变体;再通过跨变体自监督对比学习迫使编码器对齐对象表征、抑制背景敏感特征。在Waterbirds、MetaShift、NICO++三个分布偏移基准上取得当前最优最差组准确率,验证了背景不变表征的有效性。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
深度神经网络在分类任务中表现出色,但其成功背后隐藏着一个脆弱的机制:模型往往学会的是标签与背景之间的虚假相关性,而非真正以物体为核心的语义特征。当训练数据中某种背景频繁伴随特定类别出现时——比如鸟类数据集中「陆地鸟」总出现在陆地场景、「水鸟」总出现在水域场景——模型会投机取巧地将背景当作分类依据。一旦测试环境中背景分布发生变化,这种依赖就会导致性能急剧下降。
解决这一问题的思路大致分为两类。一类是[[分布偏移]]领域的经典方法,如 GroupDRO,通过显式建模不同子群体来提升最差组性能;另一类是近年来兴起的数据生成方法,利用生成模型创造「反事实」样本——改变同一物体的背景,同时保持物体本身不变。这类方法在概念上很直观:如果模型见过足够多样的背景变体,就应该学会忽略背景、聚焦物体。
然而,现有生成式方法存在一个根本性的局限:它们通常将反事实样本当作普通的数据增强来使用,模型完全可以继续无视背景变化、保留对背景敏感的表征。打个比方,这相当于给一个人看了各种背景下的苹果图片,但如果不刻意引导,他仍然可能把「有蓝天」当作判断「这是户外照片」的依据。问题的关键在于,需要一种机制迫使编码器主动对齐物体表征、主动抑制背景线索,而不是把希望寄托在「多看多样本就能自动学会」这种模糊的期望上。
方法
这篇论文提出的两阶段框架正是为了实现这种「迫使」效应。
第一阶段是生成式干预。给定一张原始图像,研究者首先使用零样本分割模型(如 Grounding DINO 配合 SAM)将前景物体从背景中分离出来。分离本身并不难,困难的是后续步骤:如何在改变背景的同时严格保持物体的身份特征?如果生成模型在替换背景时不小心修改了物体的颜色、形状或姿态,那么后续的对比学习就会把「同一物体」的标签给学歪了。
为此,作者引入了一个保结构扩散模型作为生成引擎。核心设计在于:物体区域使用原始图像的潜空间特征进行重采样并多次去噪,生成过程中以原图物体为条件引导,确保物体身份不被侵蚀;而背景区域则用文本提示(如「城市街道」「森林」等)引导生成。生成的变体与原图构成「同一对象、不同背景」的对。
第二阶段是跨变体自监督学习(Cross-Variant Self-Supervised Learning)。这一步骤是整个框架的灵魂。直觉很朴素:既然我们能生成同一物体在无数种背景下的图像,那这些变体在某种意义上应该共享一个「本质」——这个本质就是以物体为中心的语义表征。对比学习的正样本对因此定义为同一物体经过不同背景生成后的变体,而负样本对则来自不同物体的变体。
形式化地,编码器 将图像映射到表征空间,对比损失要求:
其中 和 是同一物体的两个变体, 是温度参数, 是余弦相似度。通过最小化这个损失,同一物体的不同变体在表征空间中被拉近,而不同物体的变体被推远。关键在于,这种约束不依赖任何标签信息,只需要生成器提供变体对——因此是自监督的。
在下游分类微调阶段,作者采用了先 ERM 预热再 GroupDRO 的策略。ERM 预热让编码器先学习基础分类能力,GroupDRO 阶段则进一步确保模型在各子群体上的均衡表现。分层学习率的设计让预训练编码器的底层参数更新幅度较小,保持学习到的物体表征不被破坏。
实验与结果
实验在三个标准[[分布偏移]]基准上进行:Waterbirds(陆生/水生鸟类与陆地/水生背景的组合)、MetaShift(涵盖 12 类概念的子群体偏移)和 NICO++(胶片、新闻、自然等不同上下文的挑战性设置)。
在 Waterbirds 上,该方法达到 92.5% 的最差组准确率,相比此前最优方法提升约 1.5 个百分点。在 MetaShift 的最差组评估中达到 81.7%,在 NICO++ 上达到 87.4%,均显著优于依赖单纯数据增强或单纯对抗训练的基线方法。
值得注意的是,研究者进行了详尽的消融实验来验证各组件的贡献。仅使用生成变体作为普通数据增强时,性能提升有限;引入跨变体对比学习后,最差组准确率出现明显跃升。这印证了论文的核心论点:生成变体本身不构成有效干预,必须配合能「迫使」表征对齐的机制。消融还表明,保结构扩散模型在防止物体身份泄露方面功不可没——如果物体在生成过程中被「改写」了,对比学习的正样本对就会包含语义不一致的样本,反而损害表征质量。
讨论与可借鉴点
尽管实验结果令人信服,这项工作仍有可探讨之处。首先,生成式变体的质量高度依赖底层扩散模型的能力;在复杂场景或多物体图像中,保持物体身份的保结构生成仍是一个开放问题。其次,零样本分割加扩散生成的流程引入了额外的计算开销,与端到端训练方法相比,部署成本可能更高。
从更宏观的角度看,这篇论文给我们的启发在于:数据增强本身不是万能药。在虚假相关性问题中,模型的「偷懒」倾向是如此根深蒂固,以至于只有设计出能主动惩罚背景依赖、主动奖励不变表征的学习目标,才能真正奏效。跨变体对比学习提供了一种优雅的方案:用生成模型可控地制造「伪标签」,再通过对比约束将这些标签转化为表征层面的归纳偏置。这一范式或许可以迁移到其他存在虚假关联的领域,如医学影像(病灶与设备类型)、自动驾驶(行人姿态与光照条件)等。
总的来说,这项工作将生成模型与自监督学习的优势相结合,在方法论层面展示了「可控生成 + 针对性对比」的组合拳如何精准打击虚假相关性的根源——对于追求模型鲁棒性和公平性的研究者而言,这是一条值得深挖的路径。
概念 · 7 个
摘要
跨变体自监督学习与生成干预学习不变表示
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
隐蔽特征传播即表征对齐:来自隐藏通道蒸馏的机制证据
Covert Trait Propagation Is Representation Alignment: Mechanistic Evidence from Hidden-Channel Distillation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 22 张
揭示蒸馏中隐藏知识传递源于共享初始化的几何表示对齐。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
知识蒸馏作为模型压缩与知识迁移的核心范式,长期以来被视为信息传递的过程:教师模型将"知识"注入学生模型,通常表现为软化的概率分布或中间层的特征表示。然而,一个根本性的问题始终悬而未决——这些被转移的"知识"究竟位于网络的何处,又是什么决定了其容量?
论文首先回溯了此前的一项理论工作:该工作证明了当教师的学习率足够小时,学生模型对教师能力的继承是有保证的。这一结论虽然优雅,却留下两个关键空白:它既没有说明通道在网络拓扑中的具体位置,也没有解释通道容量的决定因素。直观上,研究者猜测隐藏层通道可能是信息的载体——既然蒸馏发生在特征空间,那么学生模型的某些神经元应当被教师"选中"来承载这些信息。
然而,当团队尝试在 MLP 蒸馏场景下(MNIST 数据集)验证这一假设时,发现了一个令人困惑的现象:即使学生模型接收的输入是纯均匀噪声(不包含任何类别信息),仅凭与教师共享初始化这一条件,它依然能够继承相当程度的分类能力。这直接挑战了"通道即信息载体"的朴素理解——如果信息来自输入,那么噪声输入不可能带来有效迁移;如果信息来自教师,那么为何共享初始化会成为必要前提?
这一矛盾促使研究者重新审视蒸馏的机制。他们意识到,问题的关键不在于通道携带了什么信息,而在于什么条件决定了这些信息是否能够被学生模型访问。
方法
论文的核心贡献是提出了隐蔽特征传播(CTP)这一机制框架,其核心洞察可以概括为:隐藏通道并非纯粹的信息通道,它们同时受到几何对齐的严格门控。
具体而言,当教师和学生共享初始化时,网络末层的输出投影矩阵 在两个模型之间形成了天然的对应关系——由于初始化相同,这个投影矩阵定义了一个公共的"坐标密钥"。此时,KL 散度梯度不会直接复制教师通道的激活值,而是沿着一条间接路径发挥作用:梯度首先作用于学生的输出投影,修正其对隐藏表征的解释方式;随后,这种修正通过反向传播传递到输入投影 ,重塑学生模型的隐藏表征空间。
关键的几何图景由此浮现:蒸馏的过程本质上是一个对齐操作,KL 损失函数驱动学生的隐藏表征向教师的隐藏表征收敛,而这种收敛是通过调整 的几何结构来实现的。换言之,学生模型并非被动接收教师的信息,而是被引导着在自身的表征空间中"长出"与教师几何相似的结构。
论文进一步将这一机制形式化:设 和 分别为教师和学生的隐藏表征,蒸馏的目标是使 在 定义的几何框架下与 对齐。由于 在共享初始化下是公共的,学生需要调整 来使 的分布逼近 的分布。这个调整过程就是 CTP 的实质——它不是直接复制通道激活值,而是通过改变表征的几何关系来实现隐式的知识传递。
值得强调的是,这种对齐是隐蔽的:学生模型看不到教师在哪些通道上传递了信息,它只能感知到 KL 散度的梯度方向,并沿着这个方向逐步调整自身的表征结构。这个过程与人类学习中"知其然不知其所以然"的隐性知识传递有着有趣的类比。
实验与结果
论文设计了五项精心构建的实验,从不同角度验证 CTP 机制的有效性,每项实验都针对一个可能的竞争假设进行排除。
实验一:通道闭合与权重漂移的关系。 研究者测量了学生模型中各隐藏单元对蒸馏的敏感度,发现通道的"关闭"程度与权重的漂移量高度相关,而与教师的准确率提升几乎无关。这意味着决定哪些通道参与蒸馏的并非教师的性能,而是学生权重在梯度作用下偏离初始化的程度。
实验二:冻结实验的对比。 研究者分别冻结 和 ,观察蒸馏效果的差异。结果显示:冻结 会完全破坏蒸馏效果,因为学生的隐藏表征失去了调整能力,无法与教师对齐;而冻结 对蒸馏几乎没有影响,因为公共的输出投影保持不变,对齐操作仍然可以在 层面正常进行。
实验三:多教师集成的相互抵消效应。 当使用多个教师进行蒸馏时,研究者发现尽管每个教师单独都能提供有效的迁移,但多个教师同时蒸馏反而会导致效果下降。这一反直觉的结果可以从 CTP 视角得到自然解释:不同的教师会在对齐过程中向学生传递不同方向的几何压力,这些压力相互干扰,导致学生无法稳定地与任何一个教师对齐。
实验四:线性 CKA 与学生准确率的相关性。 研究者对学生准确率与线性 CKA 相似度进行了系统性的初始化扫描,发现两者之间的皮尔逊相关系数高达 r=0.98。CKA 精确追踪了学生模型的性能曲线,表明几何对齐不仅是蒸馏的必要条件,更是蒸馏效果的精确预测指标。
实验五:指令微调大模型中的跨标记行为纠缠(CTBE)。 研究者将相同的几何视角应用于大语言模型的微调现象,发现 CTBE 效应同样由对齐训练激活,并作用于一个继承自预训练的基底之上。更重要的是,他们揭示了此前研究中使用的标准对数比指标存在严重的循环论证问题——该指标人为夸大了频率偏差的程度。
讨论与可借鉴点
这项研究最重要的理论贡献在于重新定位了知识蒸馏的核心机制。它没有停留在"信息传递"的描述层面,而是深入到几何结构层面,揭示了对齐才是蒸馏的真正驱动力。这一视角不仅解释了共享初始化的必要性,还解释了为什么学生模型的容量会受到其自身初始化几何结构的限制。
对于实践者而言,CTP 机制带来了若干值得思考的启示。首先,蒸馏的效果可能并不完全取决于教师模型的质量,学生模型的初始化几何结构同样是一个关键因素。其次,多教师蒸馏策略需要谨慎设计,简单的平均集成可能适得其反。再次,CKA 等几何相似度指标可以作为蒸馏过程的实时监控工具,比最终准确率更早地反映对齐状态。
然而,这项研究也存在若干局限性。MNIST 上的 MLP 实验虽然清晰地揭示了机制,但其结论能否推广到更深的网络架构、更大的模型规模,仍有待进一步验证。论文附录中对 CTBE 的分析虽然富有洞见,但受限于篇幅,未能展开更系统的实验。此外,CTP 机制假设了共享初始化的存在,对于无法共享初始化的大模型间蒸馏场景,这一机制是否仍然适用,仍然是一个开放问题。
从更宏观的视角来看,这项工作将[[表示学习]]与[[优化几何]]的研究传统连接起来,为理解深度学习中的隐式知识传递提供了一个新的理论框架。它提示我们,神经网络的学习不仅涉及信息的存储与提取,还涉及表征空间几何结构的重塑——这一视角或许能够帮助我们更好地理解 [[Transformer]] 架构中注意力机制的几何本质,以及 [[对齐训练]] 如何在大语言模型中引发那些尚未被充分解释的涌现行为。
概念 · 6 个
摘要
研究蒸馏通道与表示对齐的师生迁移机制
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
大语言模型教导视觉学生:细粒度概念知识的跨模态迁移
Large Language Model Teaches Visual Students: Cross-Modality Transfer of Fine-Grained Conceptual Knowledge
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 11 张
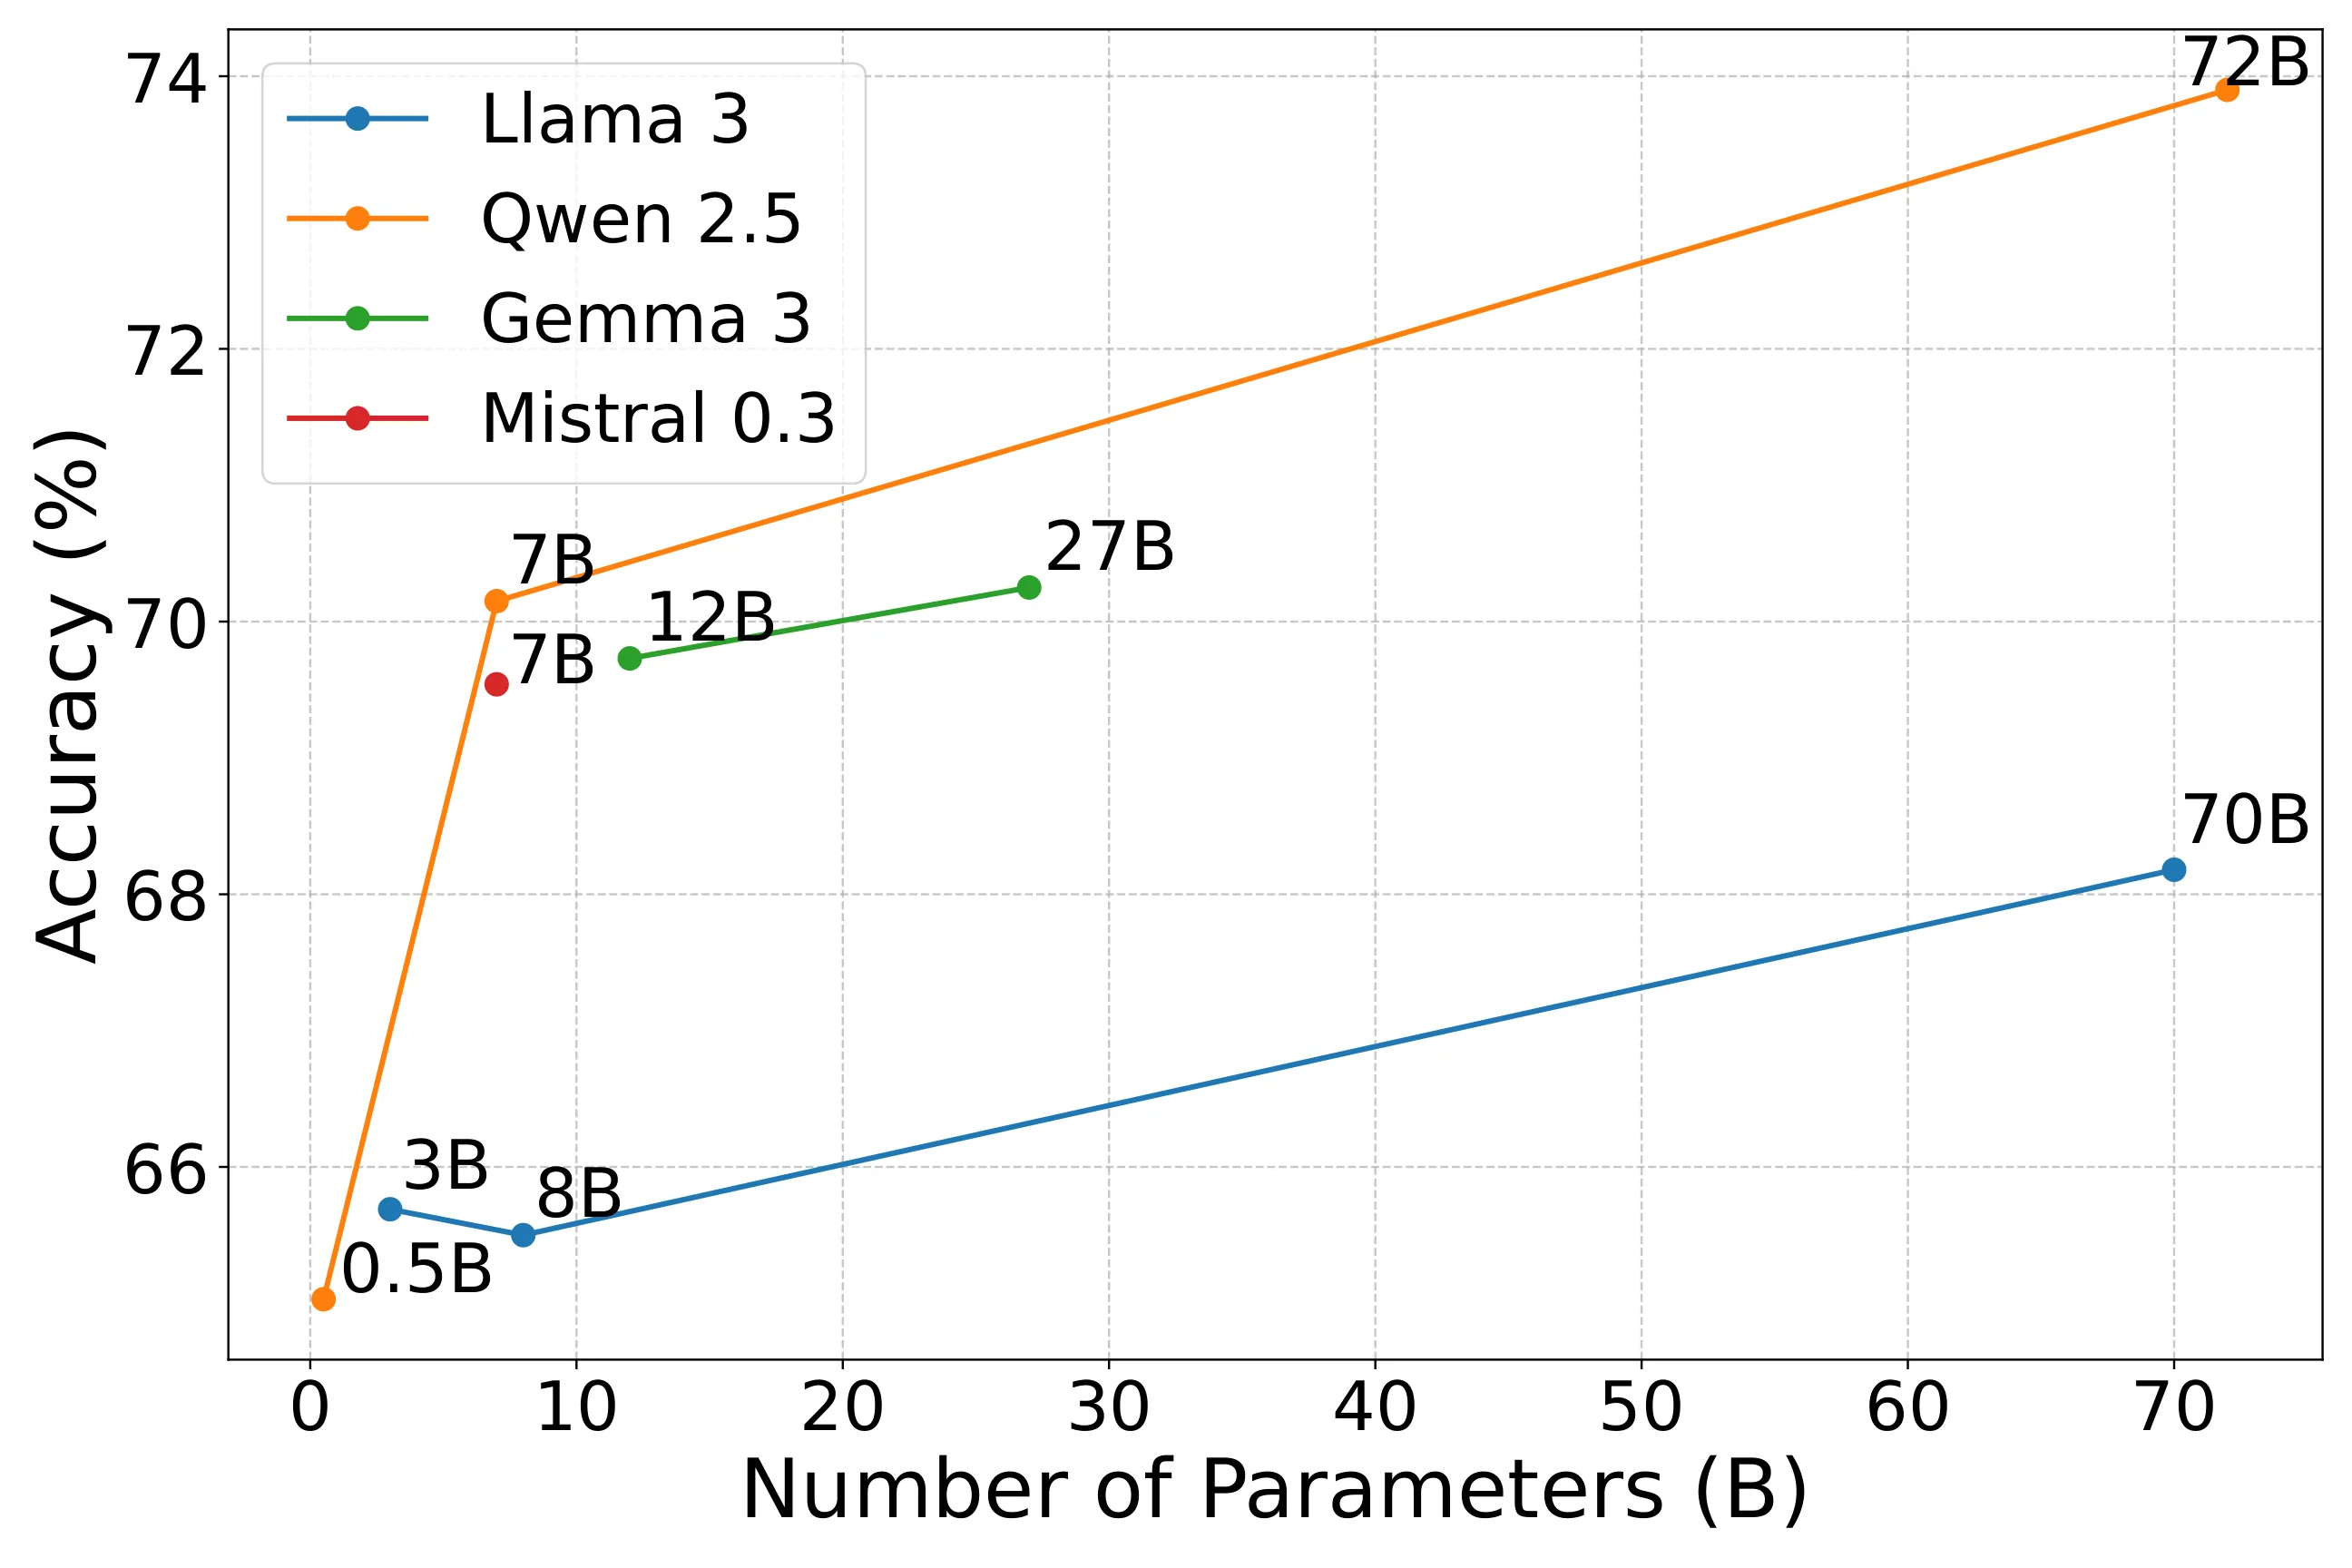
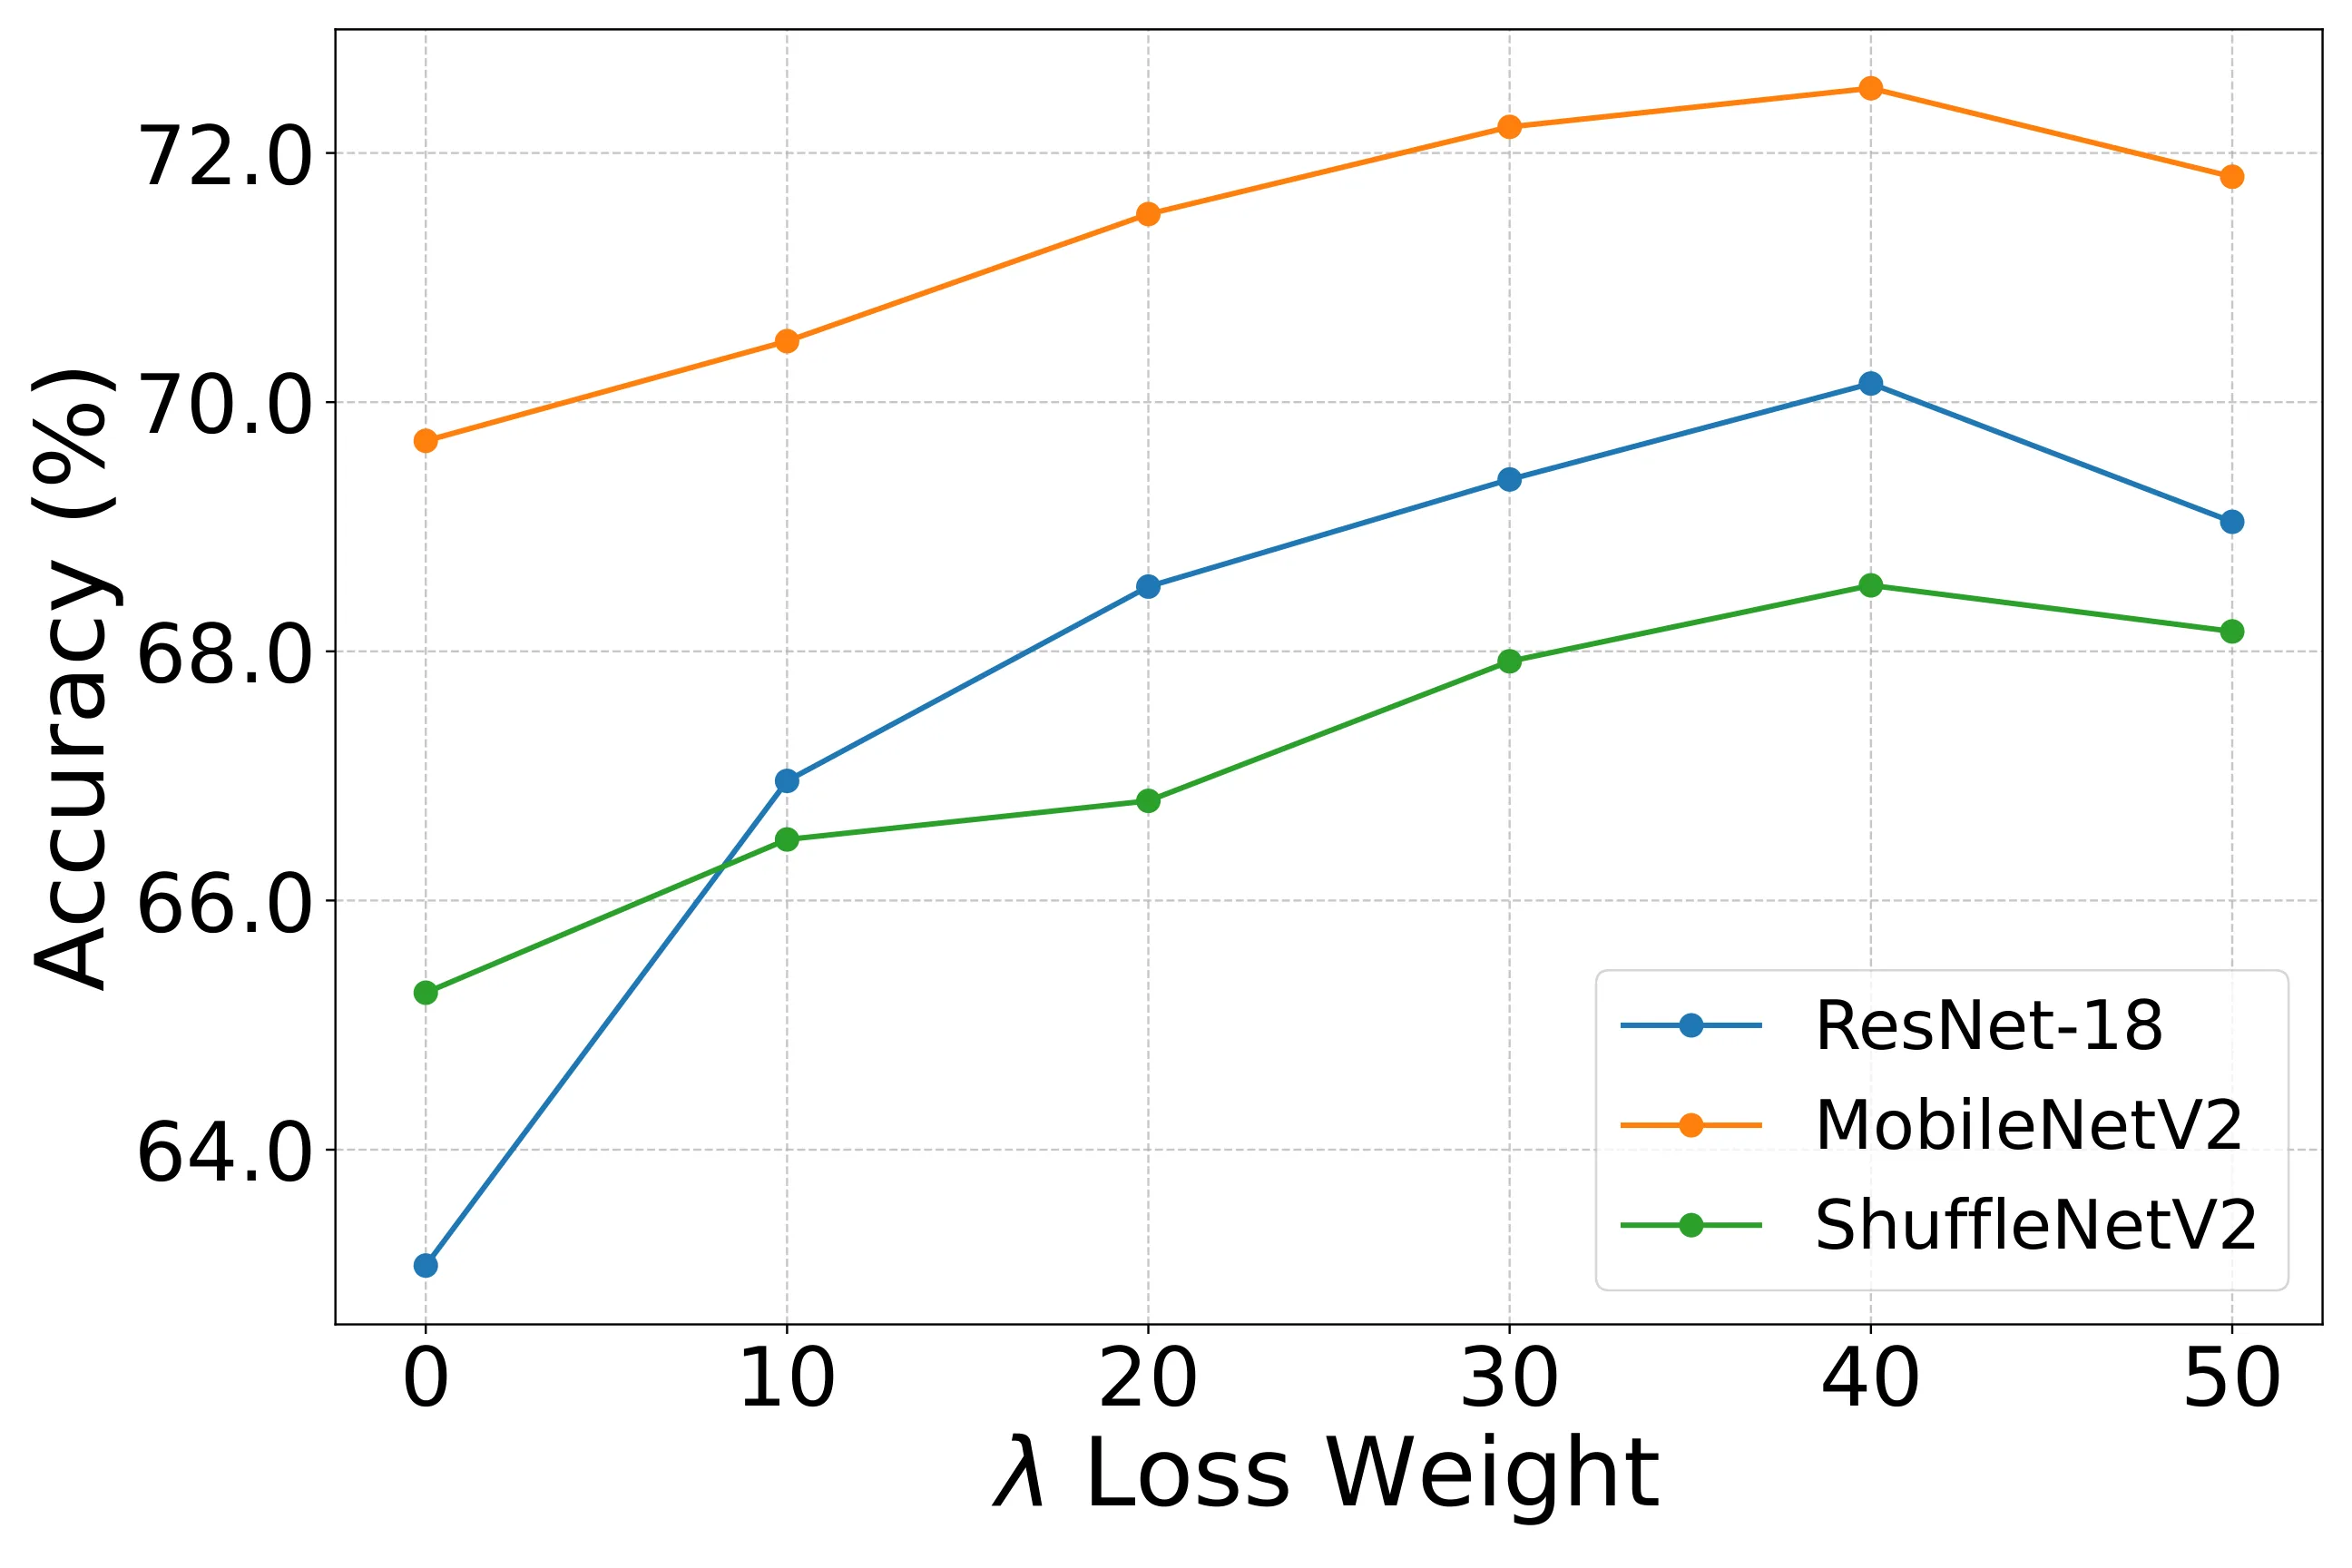
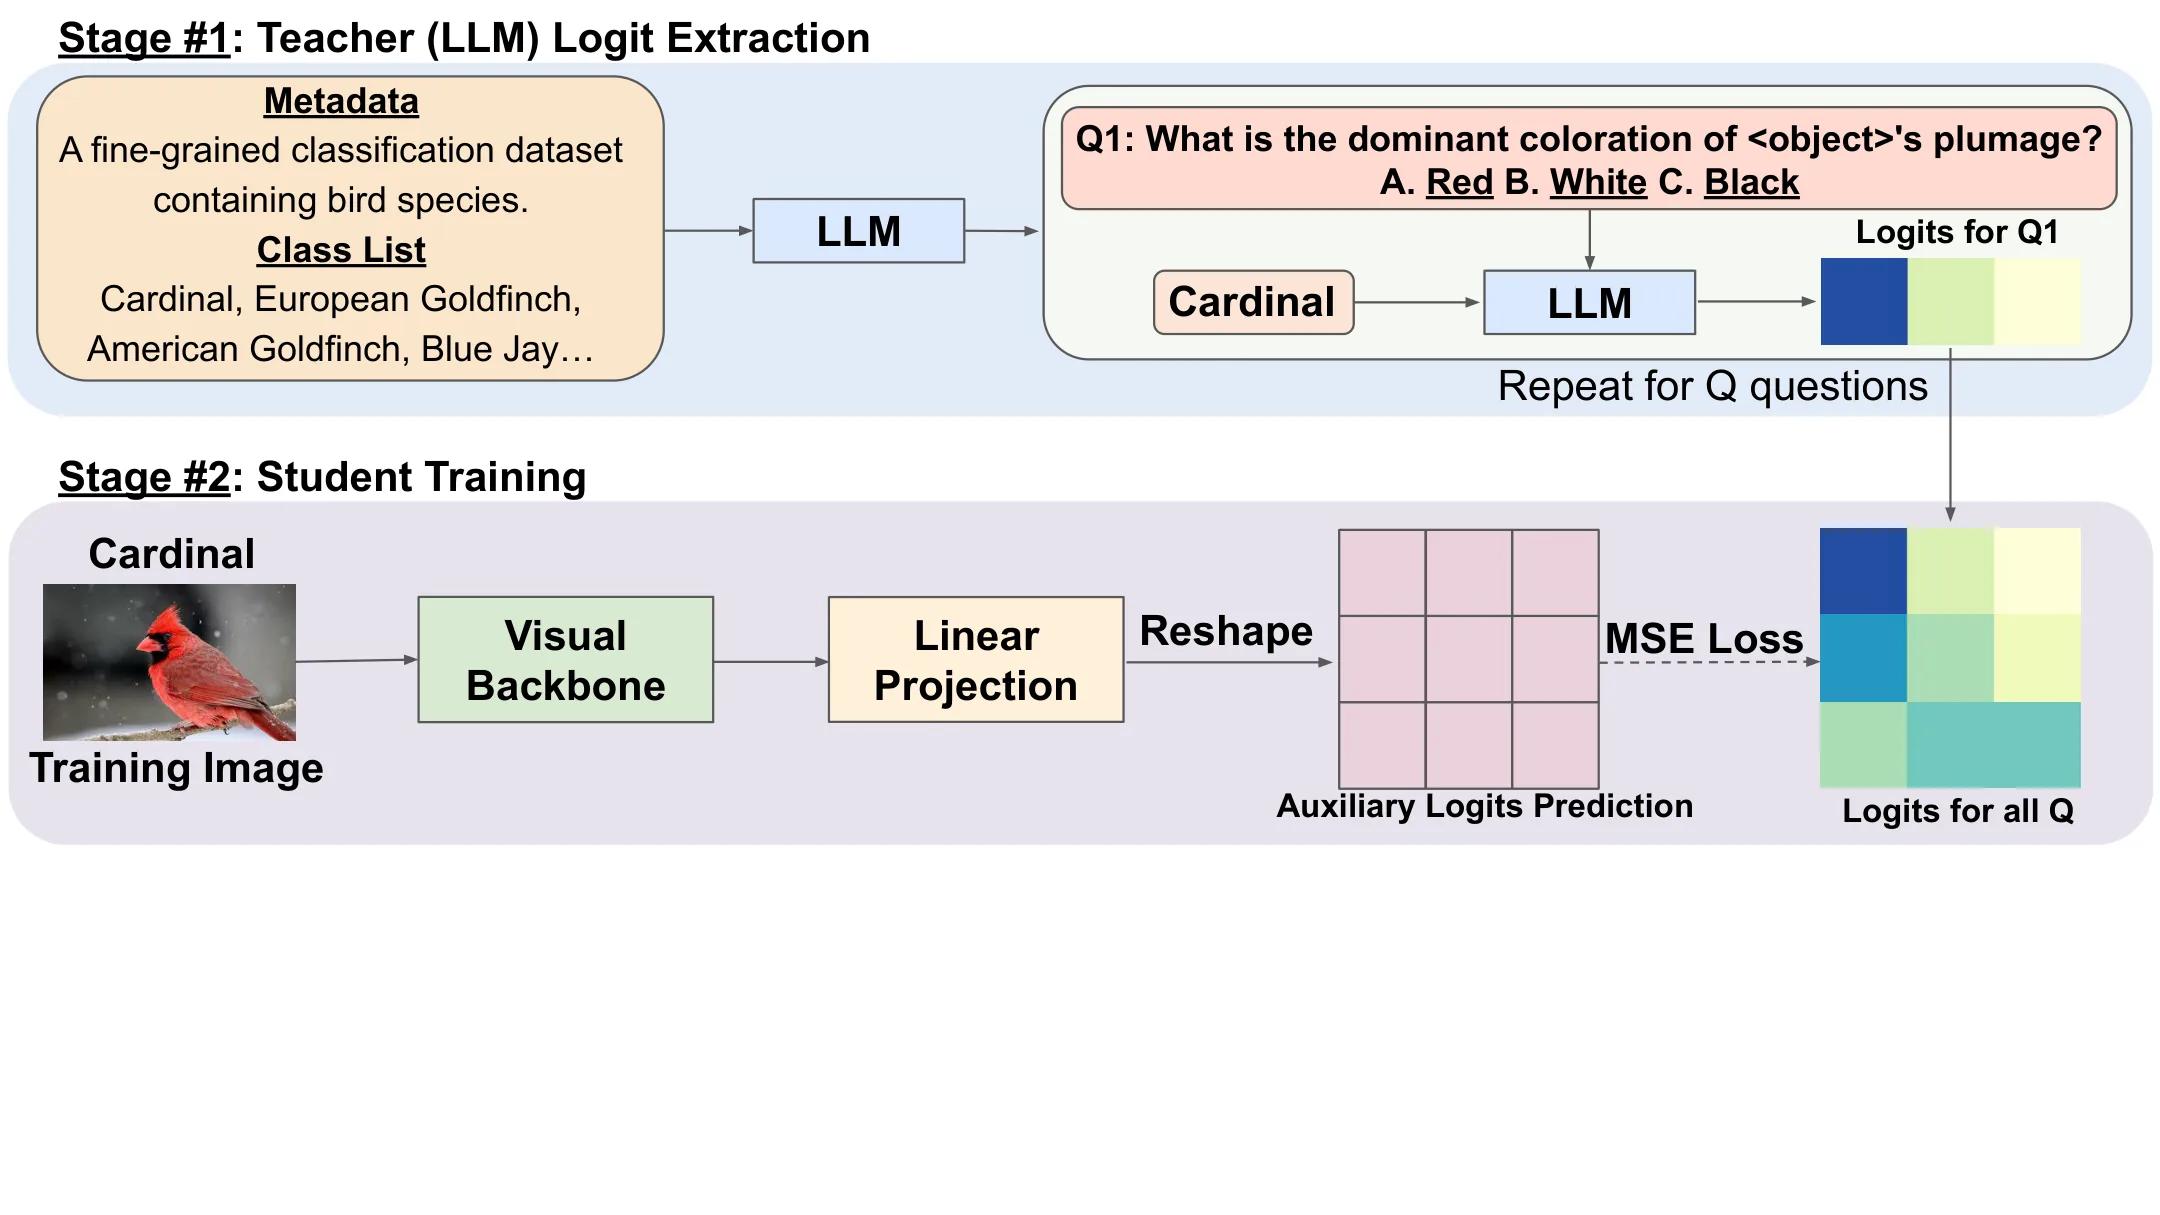
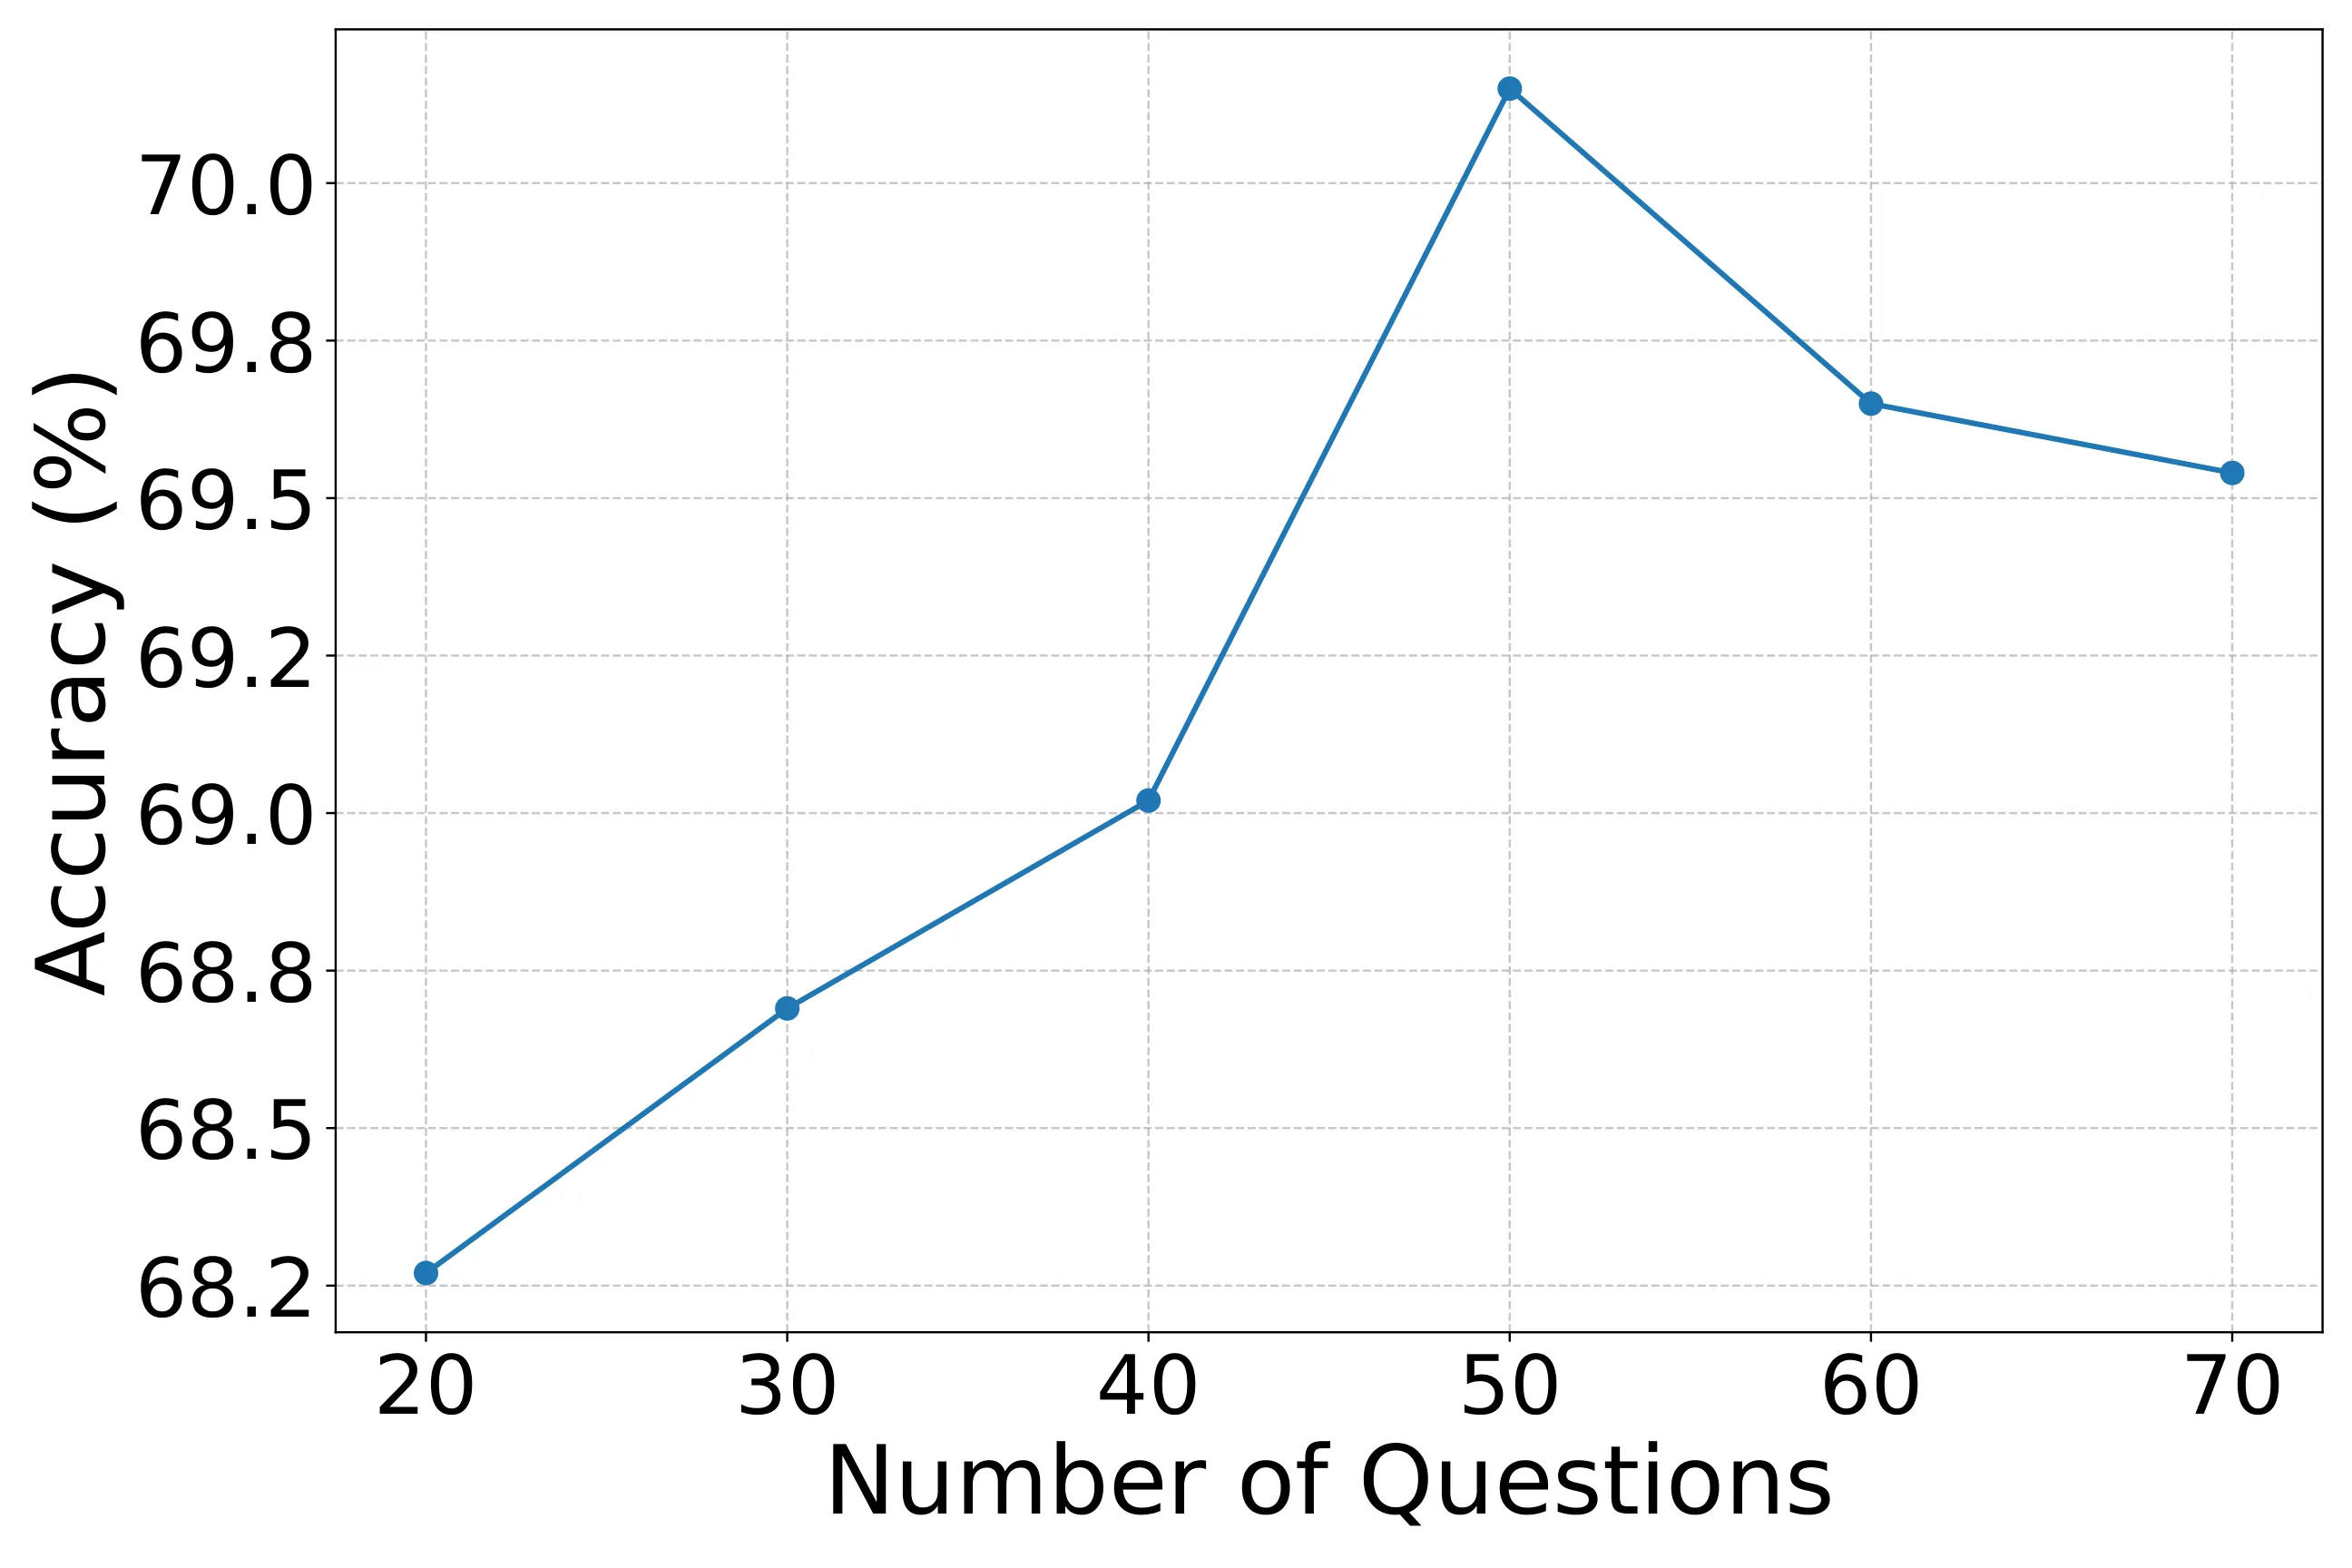
大语言模型拥有丰富的概念知识,但如何将其迁移到视觉模型尚待探索。本文提出LaViD框架,利用纯文本LLM作为教师,通过生成多选题探测视觉类别间的语义差异,为每个类别构建软标签分布作为概念签名,指导视觉学生模型蒸馏。实验表明,LaViD无需多模态配对数据,在多个细粒度基准上优于基于视觉-语言模型的MaKD,并在Waterbirds上显著提升最差组准确率,展现了对虚假相关性的鲁棒性。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
在计算机视觉领域,如何让模型学到丰富的语义概念一直是核心问题。传统方法依赖大量人工标注的图像数据,但标注成本高昂且难以覆盖长尾分布。近年来,视觉-语言预训练模型(如 CLIP)通过海量图文配对数据学到了广泛的概念知识,为知识蒸馏提供了新的可能性。然而,基于配对数据的方法存在一个根本性限制:图文配对的质量和数量直接影响蒸馏效果,且多模态数据本身获取成本不低。
与此同时,大语言模型通过大规模文本预训练已经蕴含了极为丰富的概念知识。LLM 知道“家燕”和“雨燕”在翅膀形状、飞行姿态、栖息环境上的微妙区别,也了解各类花朵在花瓣形态、颜色组合上的差异。这些知识能否被“提取”出来,用来指导纯视觉模型的训练呢?
一个直观的思路是直接让 LLM 描述图像内容,但这种方法需要 LLM 能看到图像,而闭源 LLM 的视觉能力有限,开源多模态模型的效果也不稳定。更关键的是,我们希望利用的是 LLM 本身通过纯文本预训练积累的概念知识,而非借助图像理解能力。LaViD 的核心洞察正是:语言模型对概念差异的理解本身就存在于其参数中,只需要设计合适的方式来“引出”(elicit)这些知识。
方法
LaViD 的设计围绕一个关键问题展开:如何让一个看不见图像的纯语言模型,为视觉分类任务提供有意义的监督信号?
作者选择的方案是多选题探测(Multiple Choice Question Probing)。具体来说,对于一个细粒度分类任务(例如区分不同品种的鸟),LaViD 首先利用 LLM 生成一系列多选题,每道题目的选项对应不同的类别,题干则聚焦于类别之间最具区分性的语义特征。举个小例子:
> 以下哪种特征最能区分“家燕”和“雨燕”?
> A. 尾羽呈深叉状
> B. 翅膀较窄长
> C. 常在飞行中捕食
> D. 在建筑物上筑巢
LLM 对每道题目的回答概率分布本身就编码了类别间的语义关系。当我们把所有题目的回答分布组合起来,每个类别就形成了一个高维的概念签名(conceptual signature):一个在多项选择题空间上的软标签分布。
形式化地,假设有 个视觉类别,生成 道多选题。对于类别 ,其在第 道题上的软标签是一个 维概率向量 ,表示 LLM 认为类别 对应各选项的概率。类别 的概念签名定义为 。
蒸馏损失的设计基于此:当视觉学生模型对输入图像 预测类别 时,模型同时输出一个中间表示 (可以是某个隐藏层的激活),然后通过一个投影头将其映射到“概念空间”。蒸馏损失衡量学生模型的预测分布与教师概念签名之间的差异:
其中 是学生模型对图像 预测类别 的概率, 是对应的表示向量, 是可学习的投影矩阵。整体训练目标结合了标准交叉熵损失和蒸馏损失,通过加权求和优化。
值得注意的是,这种设计的巧妙之处在于:LLM 虽然完全“看不见”图像,但它对语义差异的理解被编码在多选题的回答模式中。例如,如果 LLM 始终以高概率选择区分家燕和雨燕的正确答案,这个偏好就会体现在概念签名里,进而传递给学生模型。整个过程完全依赖文本,不需要任何图像数据。
实验与结果
论文在多个细粒度分类基准上验证了 LaViD 的有效性,包括 CUB-200-2011(鸟类)、Oxford Flowers-102(花卉)、Stanford Cars(汽车)和 Food-101(食品)。基线方法涵盖了从视觉-语言模型蒸馏的 MaKD、从同类视觉模型蒸馏的 DKD 和 MLKD,以及直接使用 CLIP 零样本分类的方法。
结果显示,LaViD 在大多数数据集上取得了最佳或接近最佳的性能。以 CUB-200-2011 为例,LaViD 的 top-1 准确率达到 ,相比 MaKD 提升了约 2 个百分点。更值得注意的是,LaViD 使用的教师模型是完全的纯语言模型,没有任何视觉感知能力,这使得上述对比结果更具启发性——仅靠语言知识就能实现对多模态教师的超越。
在 Waterbirds 数据集上,LaViD 将最差组准确率(worst-group accuracy)从基线方法中常见的 提升到了 以上。Waterbirds 是一个经典的虚假相关性(spurious correlation)测试集,图像中背景(如水面 vs. 陆地)与鸟类主体之间存在虚假的共现关系,导致模型可能依赖背景做预测而忽略真正的视觉特征。LaViD 的概念签名显式编码了类别间的语义差异,引导学生模型关注前景的细粒度特征而非背景关联,从而显著增强了鲁棒性。
消融实验进一步表明,多选题的数量和设计质量对最终效果有重要影响。当使用更少或更粗糙的探测题目时,概念签名的区分能力下降,蒸馏效果也随之减弱。这说明 LLM 蕴含的概念知识需要精心设计的“探针”才能有效提取。
讨论与可借鉴点
LaViD 展示了一条利用语言模型知识的新路径:不依赖多模态配对数据,仅通过文本层面的概念探测就能实现跨模态知识迁移。这种“纯语言教师”的设定有几个实际优势:避免了图像数据的版权和隐私问题;LLM 的推理成本可以独立于视觉模型训练规模进行优化;概念签名的构建是一次性的,可复用于不同学生模型。
然而,当前的设计也存在局限。多选题的生成依赖 prompt 工程,题目质量高度依赖 LLM 本身对目标领域的了解程度——如果 LLM 对某类专业术语不熟悉,探测效果可能受限。此外,概念签名如何与标准的交叉熵训练更好地融合、投影矩阵的初始化策略等工程细节仍有探索空间。
对于更广泛的研究社区,LaViD 的思路提示我们:大语言模型的知识不只是可以被人类“读取”,也可以被“路由”到其他模型中执行特定任务。未来的工作可以在此基础上探索:如何为更复杂的视觉任务(如检测、分割)设计概念探测机制;如何让概念签名自动适应不同学生模型的容量;以及如何结合链式思维等推理技术,让 LLM 生成更具解释性的探测题目。这些方向都可能进一步释放语言模型作为通用知识教师的潜力。
概念 · 7 个
摘要
从LLM教师到视觉学生模型的知识蒸馏
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
AMRD:面向轻量级语音情感识别的自适应多教师关系蒸馏
AMRD: Adaptive Multi-Teacher Relational Distillation for Lightweight Speech Emotion Recognition
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 1 张
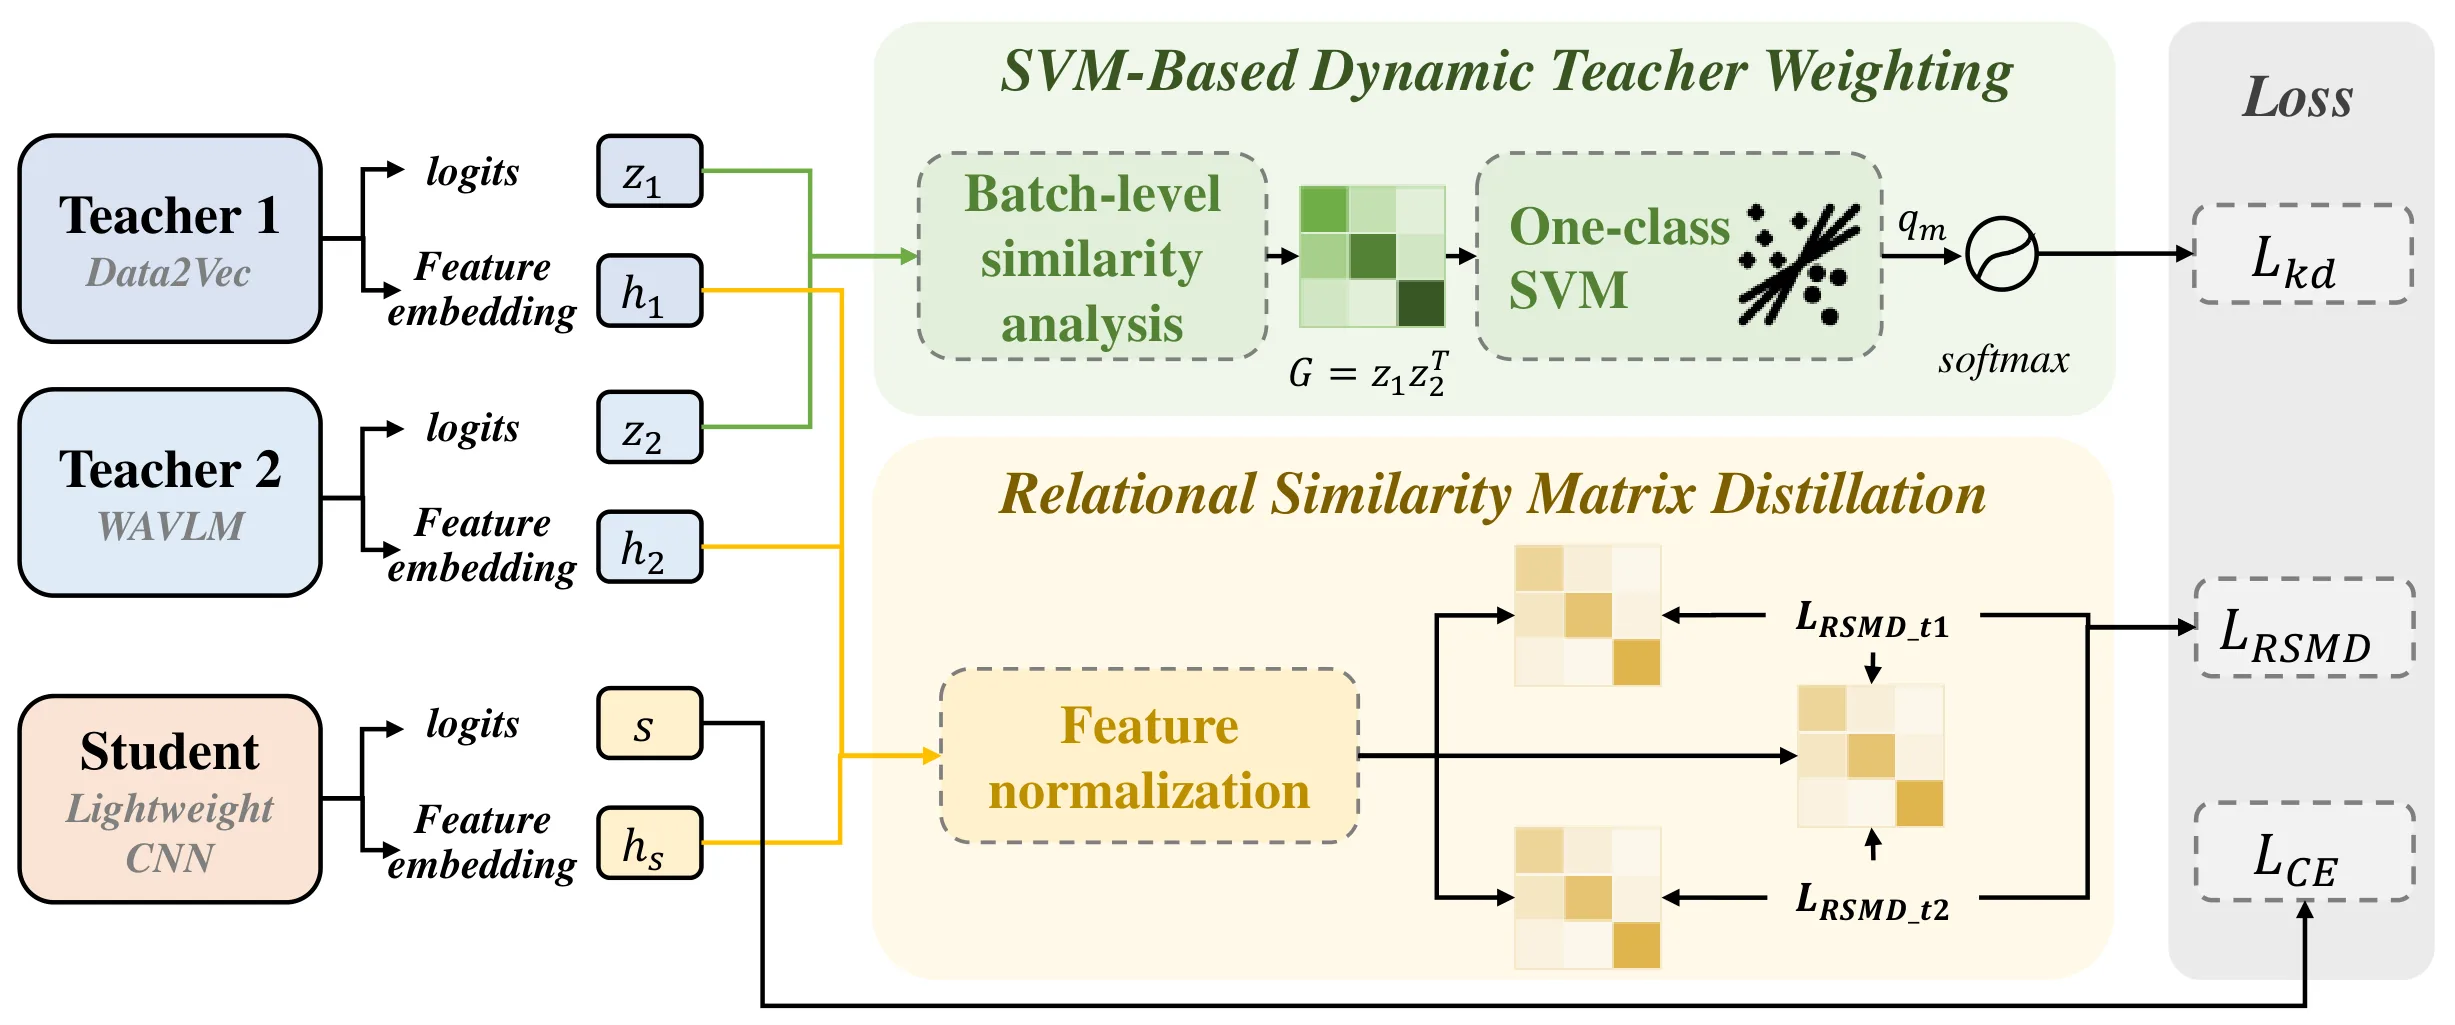
边缘设备上的语音情感识别需要轻量化模型,然而大型自监督模型虽准确率高却难以部署。多教师蒸馏可将知识压缩到学生模型,但存在两大挑战:不同批次中教师可靠性不同,且logit级对齐忽略了样本间关系结构。为此提出AMRD方法:基于单类SVM对每个教师的logit相似性矩阵进行评估,按批自适应分配权重;并设计关系蒸馏损失对齐师生相似性矩阵以捕获结构信息。在IEMOCAP和CREMA-D两个数据集、四种学生架构上的实验表明,AMRD在多数设置下优于单教师蒸馏基线,两组件带来互补增益。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
语音情感识别(SER)在人机交互、心理健康监测、客服系统等场景中具有重要价值,边缘设备上的实时识别更是日益增长的需求。然而,取得优异性能的大型自监督预训练模型——如Wav2Vec 2.0和HuBERT——虽然能够从海量无标注语音中学习到丰富的表征,却拥有数千万甚至上亿参数,推理时的计算和内存开销远超移动端芯片的承载能力。
[[知识蒸馏]] 提供了一条可行的压缩路径:将teacher模型的"软知识"迁移到轻量级的student模型。在多教师场景下,来自不同预训练策略或微调方式的多个大型模型可以同时指导学生,每个教师贡献其独特的知识片段。然而这一范式存在两个尚未被充分解决的问题。
第一,教师的可靠性并非恒定。不同批次的输入数据具有不同的语义复杂度和声学特征,某些教师在特定批次上可能给出高质量的预测,在另一些批次上则可能产生误导性信号。传统方法往往对所有教师赋予固定权重,无法适应这种批次间的动态差异。第二,[[知识蒸馏]] 主流做法聚焦于逐样本的logit对齐——让学生模仿每个样本的输出概率分布——却忽略了样本之间的关系信息。情感类别之间存在语义关联(如"高兴"与"兴奋"在表达上相近),样本之间也并非孤立存在,这种结构性的关系知识在logit级迁移中难以传递。
方法
针对上述挑战,AMRD设计了自适应权重分配和关系蒸馏两个核心组件。
自适应教师权重分配的设计直觉来自一个观察:可靠的教师不仅应该在单样本预测上准确,其预测在批次内应该呈现合理的内部结构。具体而言,对于教师 在某个批次上的logit输出矩阵 (为批次大小,为类别数),首先计算每对样本之间的余弦相似度,得到相似性矩阵 。这个矩阵编码了该教师对批次内样本关系结构的认知。AMRD为每个教师训练一个[[单类支持向量机]](One-class SVM),将相似性矩阵作为特征输入,训练目标是拟合"正常"批次下该教师的结构化输出模式。当某个批次输入时,用训练好的分类器计算其异常分数——分数越高说明该批次下该教师的结构化输出越偏离预期,其权重相应降低。最终每个教师 在批次 上获得权重 ,这个权重是自适应的,跨批次动态变化。
关系蒸馏损失则从另一个角度切入。Logit级蒸馏让学生去匹配教师在各类别上的预测置信度,而关系蒸馏让学生匹配教师对样本间关系的认知。具体地,教师和学生的相似性矩阵分别为 和 ,关系蒸馏损失定义为两者之差的Frobenius范数:
直观上,如果教师认为样本 和 在情感空间中是相似的( 高),学生也应该产生类似的判断( 高)。这种结构对齐使得学生学到的不仅是"如何分类",还有"哪些样本在情感维度上相近"这一深层结构。
整体训练目标结合了任务交叉熵损失 、标准logit蒸馏损失 (KL散度形式)和关系蒸馏损失:
注意关系损失项同样采用了教师权重 进行加权,使得不可靠教师的关系知识贡献相应降低。
实验与结果
实验在两个公开数据集上进行。IEMOCAP包含约12小时的二进制情感标注(高兴/悲伤/愤怒/中性等),CREMA-D包含约7小时的四类情感数据。四个学生网络覆盖了从CNN到Transformer的不同架构范式,参数规模从几M到几十M不等。教师模型选取多个预训练自监督模型的不同微调版本。
实验结果表明,AMRD在绝大多数配置下超越了单教师蒸馏基线。在IEMOCAP数据集上,采用CNN学生网络时,AMRD相比最优单教师基线提升了约2.3%的加权准确率;采用轻量Transformer时提升幅度相近。更重要的是,消融实验验证了两个组件的互补性:单独使用自适应权重分配带来约1.1%的增益,单独使用关系蒸馏带来约1.4%的增益,二者结合后增益几乎叠加(2.3%),说明它们捕捉的是不同维度的信息。
值得注意的一个现象是,关系蒸馏对那些logit对齐本就做得不错的教师增强效果更显著。当某个教师的预测本身已经接近学生容量时,关系结构信息的补充进一步拉近了师生在细粒度情感空间中的距离。
讨论与可借鉴点
AMRD的贡献在于揭示了多教师蒸馏中两个常被忽视的问题——批次间教师可靠性波动和样本关系结构的缺失——并给出了简洁有效的解决方案。单类SVM的使用尤其巧妙,它不需要任何标注数据即可学习教师输出的"正常"结构,将无监督的异常检测思想引入知识蒸馏的权重设计。
这一思路的适用范围不限于语音情感识别。凡是使用多教师蒸馏且面临教师质量不均衡的场景——如图像分类、知识图谱推理、多模态学习——都可能受益于类似的批次自适应权重机制。关系蒸馏损失的设计同样具有通用性,任何能够定义样本间相似性的任务都可以考虑加入结构对齐项。
局限性方面,单类SVM的训练增加了额外的计算开销;在极端小批量场景下,相似性矩阵的统计意义可能不够稳健;此外,当教师数量增加到数十个时,权重学习的复杂度也会上升。这些问题为后续研究留下了探索空间。
摘要
面向边缘设备部署的多教师知识蒸馏与模型压缩
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
Explainable Reinforcement Learning via Physics-Aware Policy Distillation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 7 张
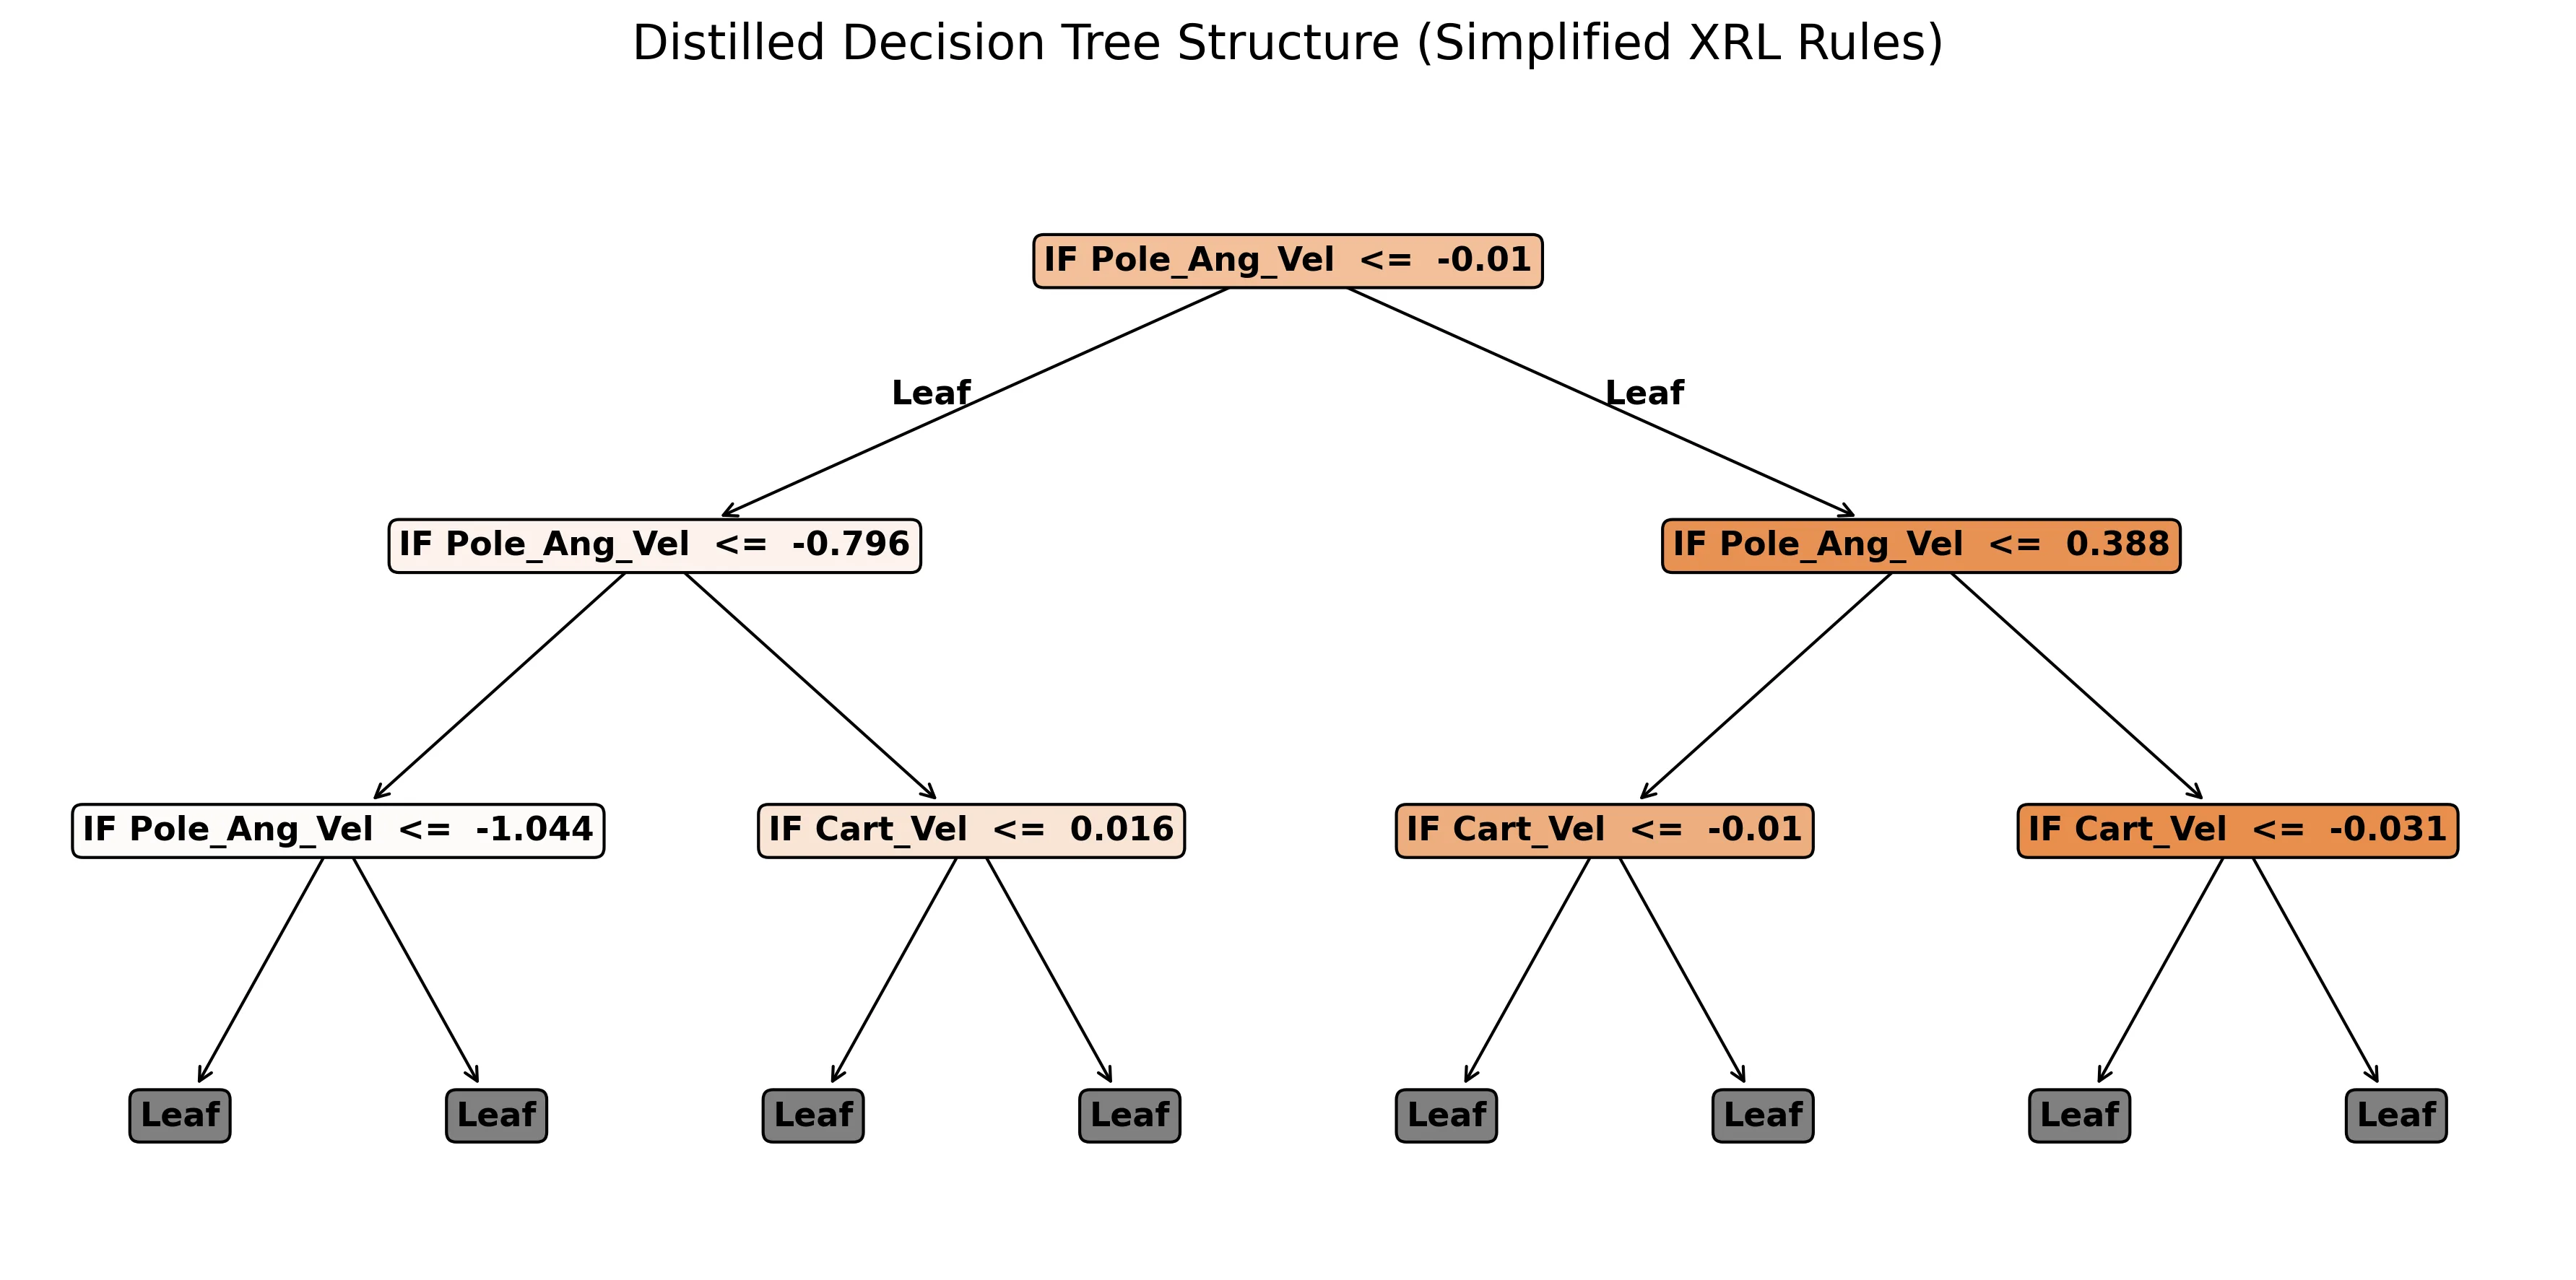
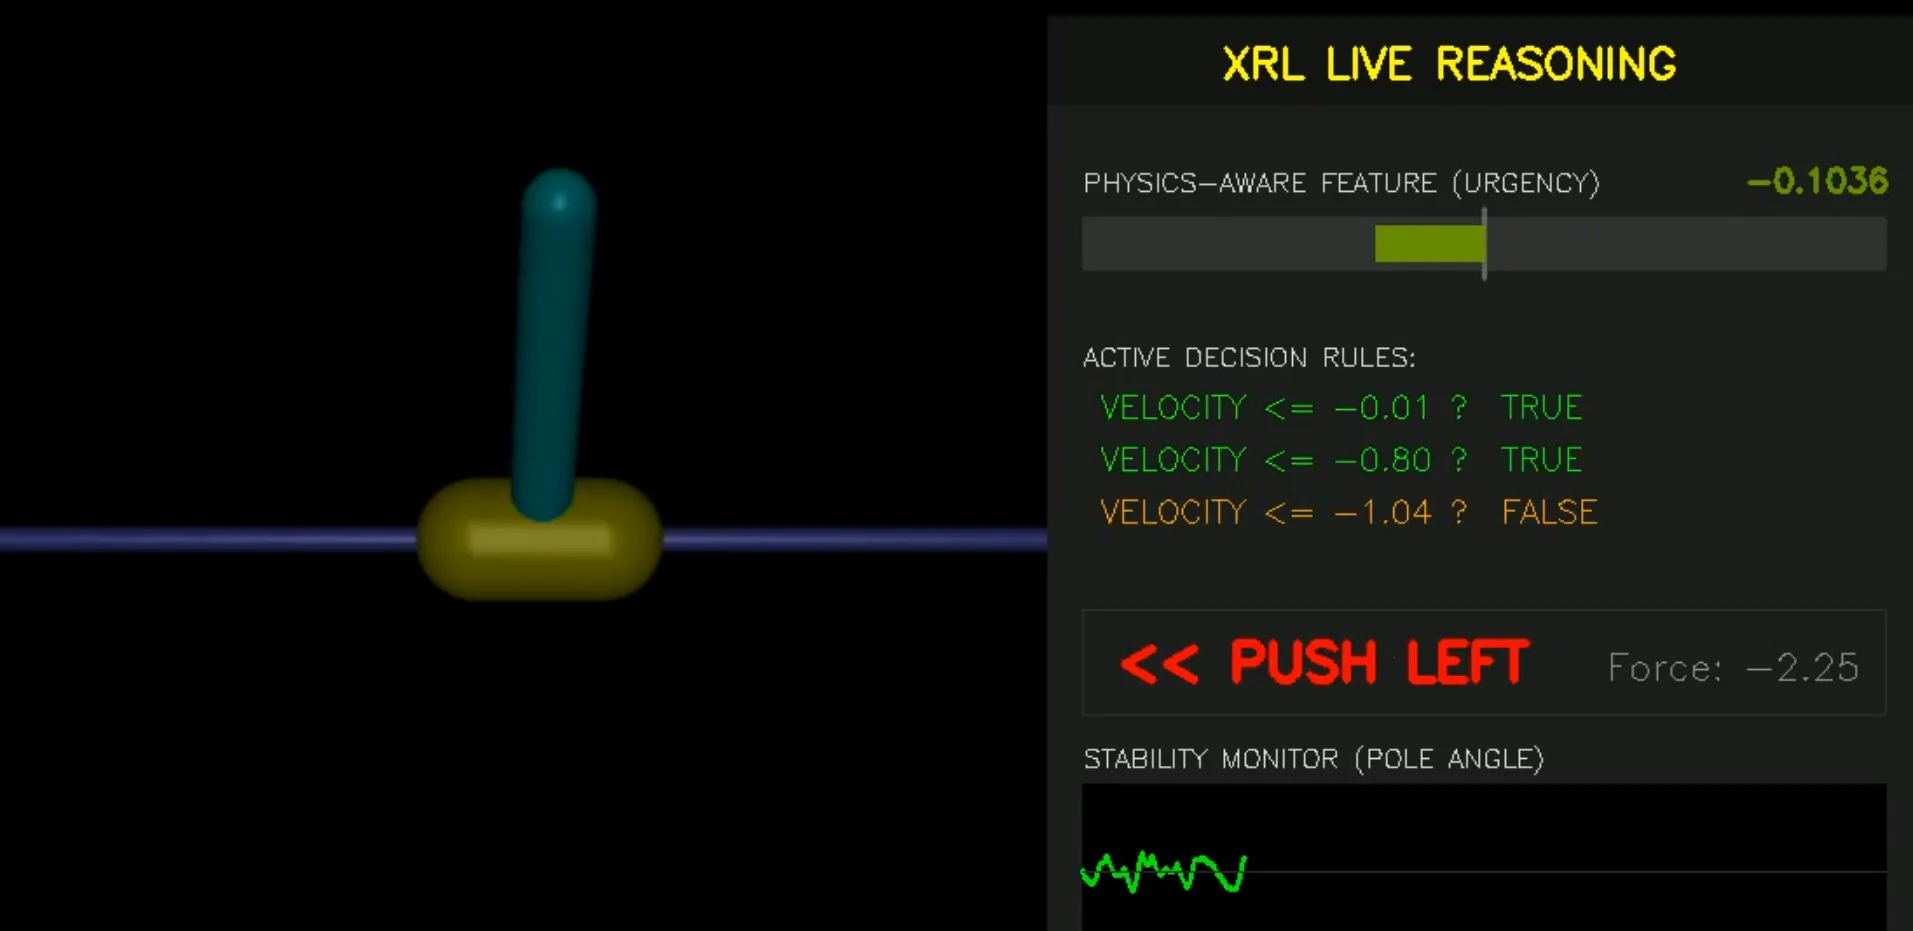
在机器人、自动驾驶等安全关键领域,深度强化学习的黑箱特性阻碍了实际部署。本文以倒立摆为基准,通过策略蒸馏将高性能TD3教师策略蒸馏到浅层决策树学生模型中,并引入物理感知特征与噪声Oracle Rollout生成数据集。实验表明学生策略性能与教师相当,但离散化导致Bang-Bang控制与双模态极限环,控制性能与可解释性之间存在根本权衡,同时保持BIBO稳定性。该工作为安全自主系统提供了兼具全局与局部可解释性的解决方案。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
在机器人、自动驾驶等安全关键领域,深度强化学习虽然能够在复杂环境中实现超越传统方法的控制性能,但其固有的黑箱特性严重阻碍了实际部署。监管合规要求对决策过程有清晰解释,人机协同需要建立操作员对系统的信任,而这些需求与深度神经网络动辄数百万参数的复杂结构形成了尖锐矛盾。传统上,研究者要么选择牺牲性能换取可解释性(如直接使用线性控制器或规则系统),要么接受黑箱模型带来的不确定性,这种非此即彼的选择限制了可解释强化学习在实际工程中的应用。
倒立摆作为控制理论的经典基准,其动力学清晰、稳定性条件明确,非常适合用于探索可解释性控制方法。TD3 算法作为 Twin Delayed Deep Deterministic Policy Gradient 的简称,是目前性能最稳定的连续控制强化学习算法之一,但其策略由深度神经网络参数化,难以直接解释。相比之下,决策树模型具有天然的规则结构:每个决策节点对应明确的特征阈值,每个叶节点对应具体的控制动作,这种结构化表示使得人类可以直接追踪从观察到决策的完整推理路径。
方法
策略蒸馏的核心思路是将复杂教师模型的知识迁移到简单学生模型中,但这并非简单的模仿学习。研究者在数据生成阶段引入了两项关键创新。
第一项是物理感知特征设计。传统方法可能直接使用状态变量作为决策树的输入特征,但研究者在特征工程中融入了领域知识。具体而言,特征不仅包含摆角和角速度等原始状态,还可能包括能量、势能-动能比等物理量,这些特征使得决策树能够学到与系统动力学直接相关的决策规则,而非仅仅拟合训练数据中的统计相关性。这种设计让蒸馏出的学生模型更容易与控制理论分析建立对应关系。
第二项是 Noisy Oracle Rollouts 数据生成策略。直接从教师策略的确定性轨迹中采样会限制数据集的多样性,可能导致学生模型对特定状态的过拟合。研究者采用在动作空间中添加噪声的 Oracle Rollouts 方法,即以一定概率随机注入噪声来探索更多样的状态空间覆盖,同时保留教师策略在关键状态下的高质量决策。这种方式生成的数据集既能反映教师策略的核心知识,又能覆盖更广泛的系统状态范围。
在蒸馏过程中,浅层决策树通过监督学习的方式拟合教师策略在数据集上的行为。选择浅层而非深层决策树是刻意的设计:更深的树虽然可能获得更高的拟合精度,但会牺牲可解释性。研究者期望通过这种方法找到性能与可解释性之间的最佳平衡点。
实验与结果
实验在倒立摆模拟环境中进行,通过多组对照实验验证了蒸馏框架的有效性。结果表明,经过物理感知特征工程和 Noisy Oracle Rollouts 数据增强后,学生决策树模型在平衡维持任务上的性能与原始 TD3 教师策略相当,成功实现了知识迁移的目标。
然而,深入的控制理论分析揭示了更具启发性的发现。研究者注意到,学生策略在某些状态区域表现出高频切换的控制行为,这与连续控制策略平滑的动作输出形成鲜明对比。这种现象被识别为经典的 Bang-Bang 控制模式——控制输入在正负边界之间快速切换。进一步分析发现,系统在相平面上形成了稳定的双模态极限环,即摆的上升过程和下降过程遵循不同的控制规则轨迹,但整体呈现周期性运动。
这一发现的理论意义在于:它揭示了将连续策略蒸馏为离散决策规则时不可避免的信息损失。当教师策略给出连续区间内的动作值时,学生模型必须将其量化为有限的离散决策,这种量化过程在反馈控制系统中自然会产生 Bang-Bang 特性。重要的是,研究者通过严格的数学分析证明,这种离散化后的学生策略仍然保持了 BIBO 稳定性,即系统在有界输入下产生有界输出的基本特性得到保证。
讨论与可借鉴点
这项研究的价值不仅在于实现了可解释的强化学习控制,更在于揭示了性能与可解释性之间的根本权衡。连续控制策略的离散化并非简单的近似,而是改变了系统的动力学特性。Bang-Bang 控制虽然可能导致执行器频繁切换,但在某些场景下反而具有能量效率高的优势;双模态极限环虽然与连续策略的稳定平衡不同,但在摆类系统中可能正是期望的周期性运动模式。
研究在可解释性层面也提供了有价值的分层视角。决策树提供了全局可解释性——整个策略可以表达为一套有限的 if-then 规则;同时,在任意给定状态下,研究者可以追踪决策路径获得局部解释。这种双重可解释性对于安全关键应用尤为重要:工程师可以审查完整策略的规则集,也可以在实际运行中针对特定异常状态追溯决策原因。
研究的局限同样值得注意。倒立摆作为低维基准问题,其结论在更高维的复杂系统中可能需要验证。决策树的表达能力终究有限,对于高度非线性或需要精细控制的任务,性能损失可能难以接受。此外,物理感知特征的设计依赖于领域知识,这种先验信息的融入程度和方式会影响最终学生模型的质量。
对于安全自主系统的设计者而言,这项工作提供了一个可借鉴的框架:通过精心设计的数据生成策略,可以在保持教师策略性能的同时获得可解释的学生替代模型。关键在于承认并接受连续-离散转换带来的控制模式变化,而非追求完美的行为复现。在实际应用中,这种有界的性能损失配合严格的稳定性证明,可能是比黑箱深度网络更受监管机构青睐的解决方案。
摘要
将深度强化学习教师策略蒸馏为可解释的浅层决策树学生模型
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
从 RLVR 到 RLSVR:任务变换为开放式大语言模型自我改进带来可自我验证的奖励
From RLVR to RLSVR: Task Transformation Induces Self-Verifiable Rewards for Open-Ended LLM Self-Improvement
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 7 张
现有RLVR方法依赖可验证奖励,仅适用于数学、编程等封闭领域,难以推广到摘要、写作等开放任务,后者评估依赖人类偏好或LLM评判器,存在偏差与成本问题。本文提出RLSVR范式,通过任务转换将开放任务变为可验证代理环境,并实例化为SpyRL方法,借鉴社交推理游戏"谁是卧底",让多智能体基于非对称信息完成同一任务后投票指认预定的"卧底",投票结果自动产生可验证奖励。实验在文本摘要、创意写作和数学推理上均优于现有自改进方法,证明任务转换能有效扩展RLVR至开放任务。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
基于可验证奖励的强化学习(RLVR)近年来在推动大语言模型推理能力方面取得了显著进展。RLVR 的核心优势在于其奖励机制的可验证性——模型输出的答案可以通过确定性规则直接判定正确性,这在数学证明验证和代码执行等场景中天然成立。然而,这一优势恰恰成为其向开放式任务扩展的主要障碍。
摘要生成、创意写作等开放式任务的质量评估长期以来依赖人类标注员、奖励模型或基于 LLM 的评判器。人工标注成本高昂且难以规模化;奖励模型需要额外训练且可能引入分布偏差;LLM 评判器虽然灵活性更强,但会产生额外的推理开销,并且在反复评判自身输出时可能产生自我服务偏差。这些问题严重制约了 RLVR 在语言生成领域的广泛应用。
论文作者从自监督学习的核心原理中获得启发。自监督学习通过构建"前置任务"(pretext task)从数据自身获取监督信号,例如预测被遮挡的图像块或重建被打乱的句子顺序。受此思想引导,作者提出:是否可以设计一个类似的"代理验证任务",使其能够从任务内部的交互逻辑中自动生成可验证的奖励信号,而无需依赖外部评判?这正是 RLSVR 的核心出发点。
方法
RLSVR 的核心理念是在原始任务与可验证奖励之间架设一座桥梁。对于每一个难以直接验证的开放式任务 ,我们设计一个代理验证任务 ,使得模型在 上的表现能够可靠地反映其在 上的能力。这个转换需要满足两个关键条件:奖励的可验证性(转换后的奖励信号必须是确定性的,不能引入新的偏差源)以及任务相关性(代理任务的成功与原始任务的质量必须高度相关,否则奖励信号将失去指导意义)。
论文通过 SpyRL 实例化了这一范式,其设计灵感直接来源于经典社交推理游戏《谁是卧底》。在 SpyRL 中,若干智能体被分配完成相同的目标任务(如生成一段摘要),但各自掌握的信息存在不对称性。具体而言, 个智能体中会有 个被预先指定为"卧底",他们的任务描述包含少量误导性或模糊性的干扰信息,而"平民"智能体则获得更为准确和完整的任务上下文。这种信息不对称设计至关重要——它确保了智能体必须真正理解和分析任务内容,而无法仅仅通过记忆或模式匹配来完成协作。
完成任务后,所有智能体需要进行一轮投票,指认他们认为的"卧底"身份。由于卧底身份是预先确定的,投票结果可以与真实身份进行精确比对,产生完全可验证的二元奖励:
这个奖励函数看似简单,却蕴含精妙的设计逻辑。一方面,奖励的确定性由游戏规则保证,不存在任何评判偏差或能力瓶颈;另一方面,识别卧底的能力与输出质量高度相关——卧底的信息往往更加模糊、带有误导性,只有真正理解了任务要求和输入内容的智能体,才能从众多信息片段中推断出真相。换言之,高质量的输出是正确识别卧底的必要条件。
值得注意的是,SpyRL 还被作者定性为一种 Self-PlaY 强化学习方法,强调智能体通过与自身的变体进行对抗性交互来实现自我提升,这进一步强化了其自改进的特性。
实验与结果
论文在三类代表性任务上系统验证了 SpyRL 的有效性,分别是:文本摘要(CNN/DailyMail 和 PubMed 数据集)、创意写作(ROCStories 等)以及数学推理(GSM8K 和 MATH)。
在摘要任务上,SpyRL 与多种基线方法进行了对比,包括标准 PPO、强化自我改进(RSI)以及使用 GPT-4 作为评判器的 PPO-RM。实验采用 Qwen2.5-7B 作为基座模型,结果显示 SpyRL 在 ROUGE-L 指标上分别提升 4.2 和 3.8 个百分点,相较于依赖外部奖励的 PPO 方案展现了显著优势。更有说服力的是,即使与使用强大外部评判器(GPT-4)的 PPO 相比,SpyRL 依然保持竞争力——这有力地证明了内部验证机制的有效性。
创意写作任务的评估采用 LLM-as-a-Judge 协议,通过成对比较输出质量。结果显示 SpyRL 生成的文本在 63% 的情况下被评判为优于基线,这一比例显著高于自洽性(Self-Con sistency)和自我改进(Self-Improvement)等基线方法,验证了方法在真正开放式生成任务中的优越性。
数学推理任务的结果则揭示了任务转换范式的兼容性优势。SpyRL 在 GSM8K 上达到了 86.3% 的准确率,与直接应用 RLVR 的性能基本持平,说明当原始任务本身可验证时,SpyRL 并不会引入额外损失。更重要的是,它在不可验证的摘要和写作任务上取得的提升是实质性的,而非以牺牲可验证任务上的表现为代价。
讨论与可借鉴点
SpyRL 的成功验证了任务转换作为扩展强化学习可验证奖励范式的可行路径。从更宏观的视角看,这一工作的启发意义在于:对于缺乏天然验证信号的领域,研究者可以通过精心设计代理任务来创造可验证的奖励环境,而不必依赖不可靠的外部评判器。
然而,该方法也存在若干局限值得冷静审视。首先,代理任务的设计(如卧底数量、信息不对称程度)涉及多个超参数,需要针对具体领域进行调优,这增加了方法的落地成本。其次,多智能体的训练范式相较于单智能体强化学习具有更高的计算开销,在资源受限场景下的可行性需要进一步评估。最后,任务转换范式的泛化能力——即如何设计适用于任意开放任务的代理验证机制——仍是开放性难题。
对于后续研究而言,SpyRL 开辟了若干值得探索的方向:如何自动化设计转换任务而非依赖人工设计、多智能体的投票机制能否与其他偏好学习方法(如 DPO)进行融合、以及这一范式在视频生成、语音对话等更多模态开放任务上的表现如何。这些问题的回答将进一步拓展可验证强化学习在人工智能生成内容领域的应用边界。
摘要
基于自监督任务变换的RL自验证奖励构造
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
D3O:用于序数回归的动态分布蒸馏方法
D3O: Dynamic Distribution Distillation for Ordinal Regression
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 5 张
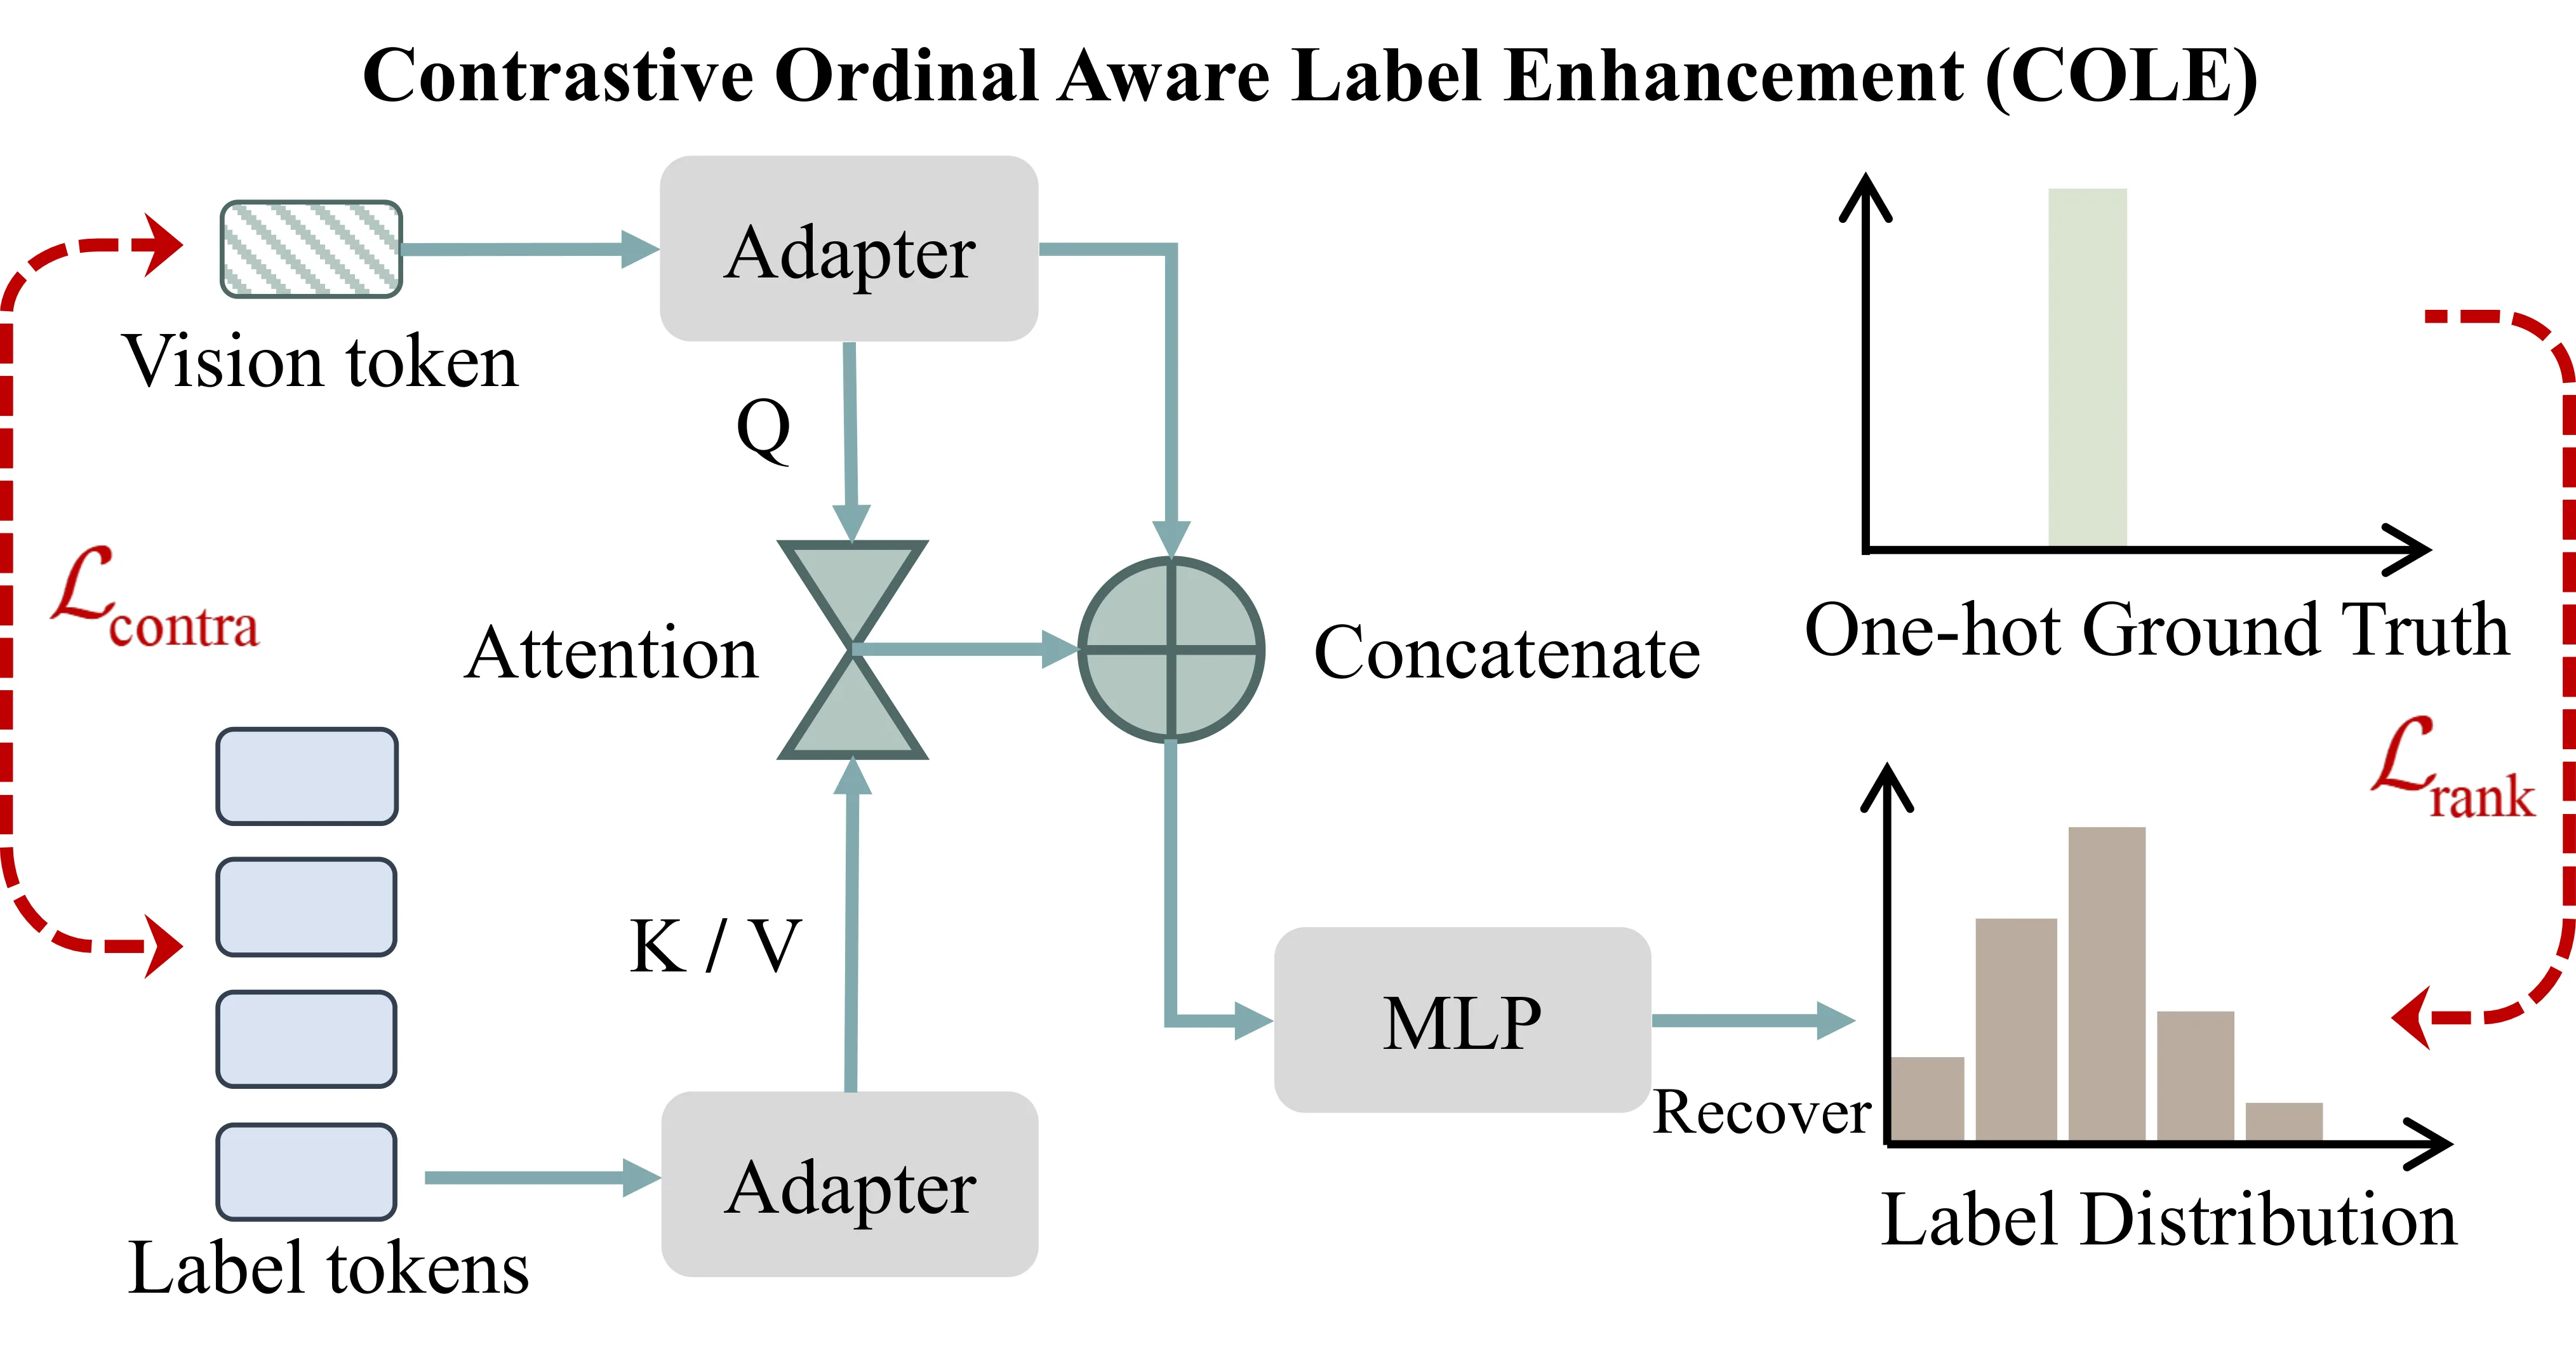
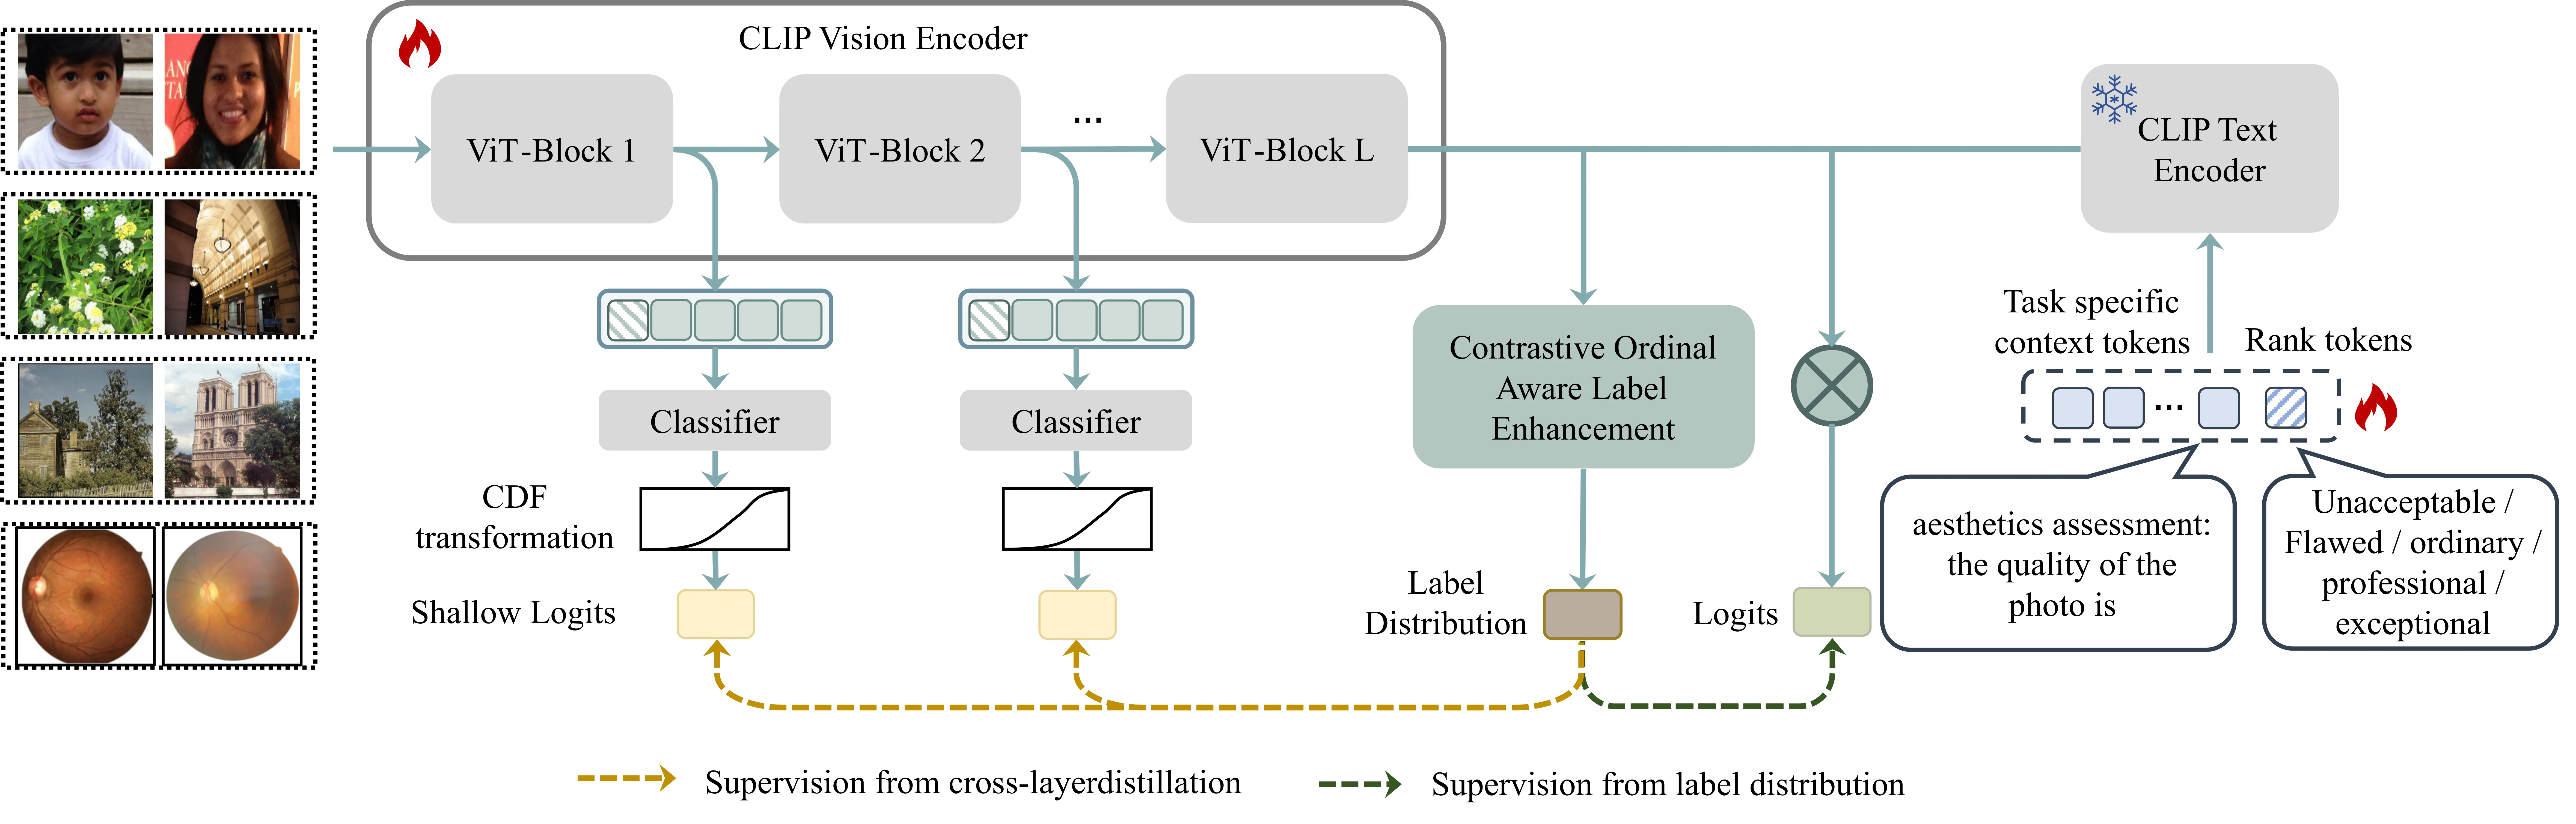
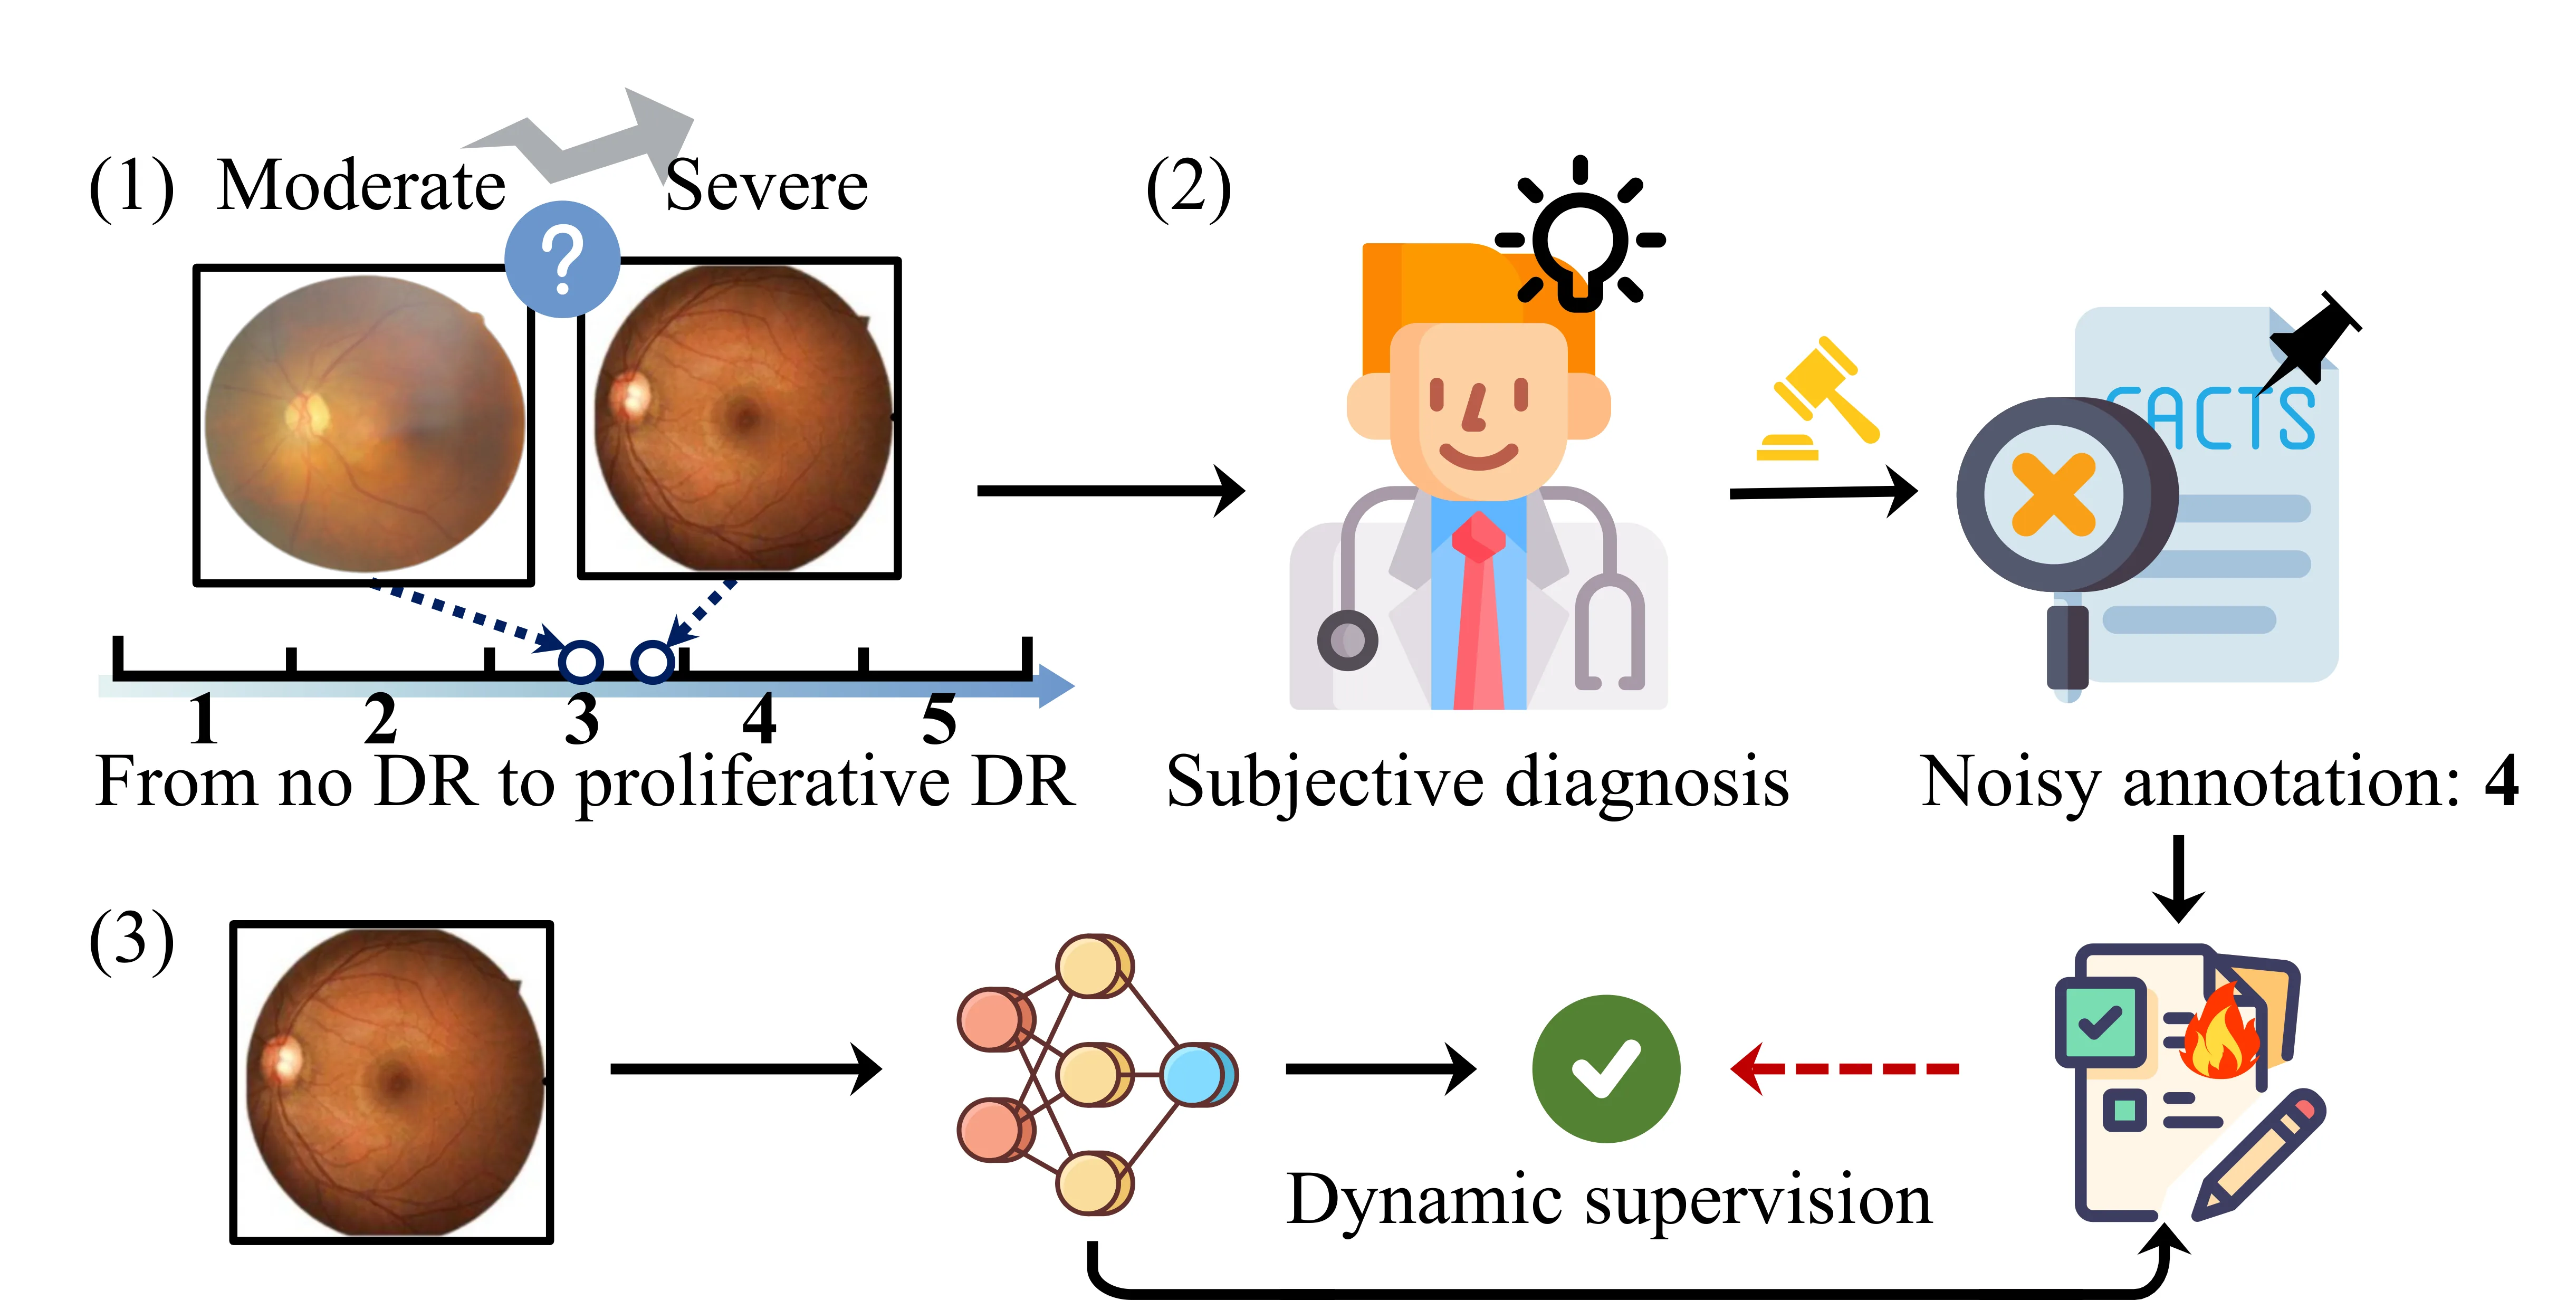
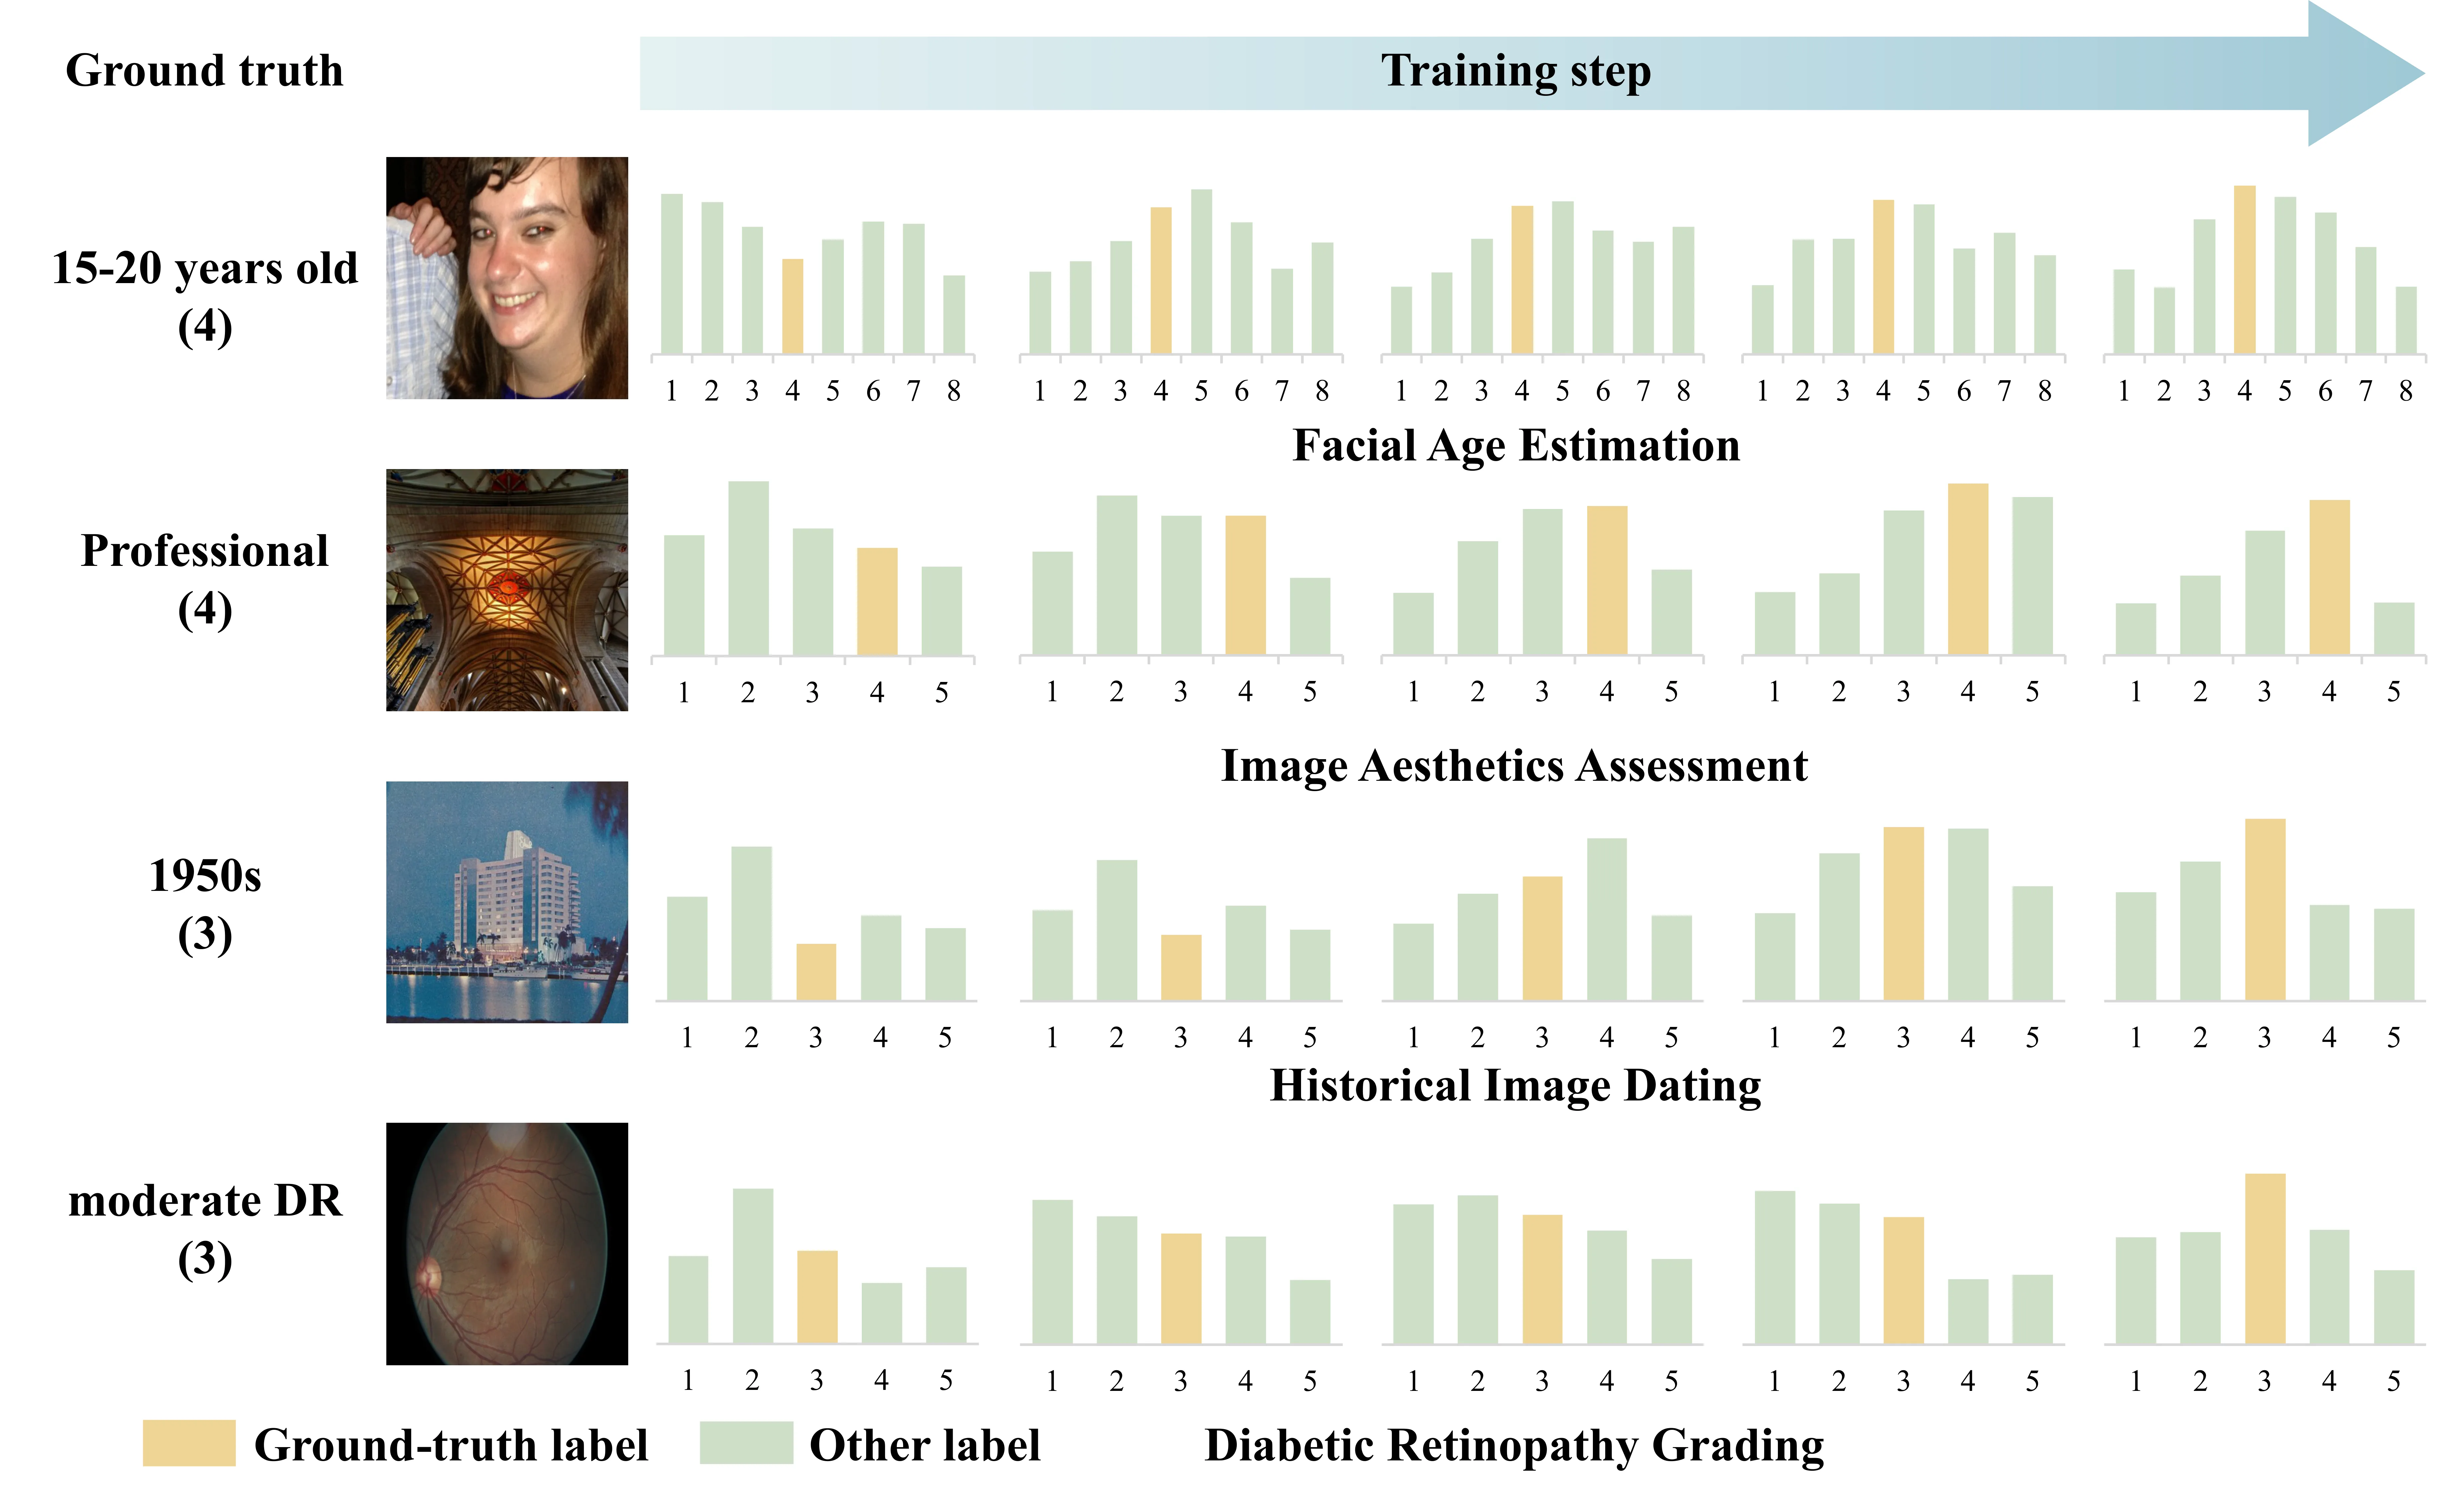
问题:序数回归中标签由连续语义离散化而来,存在边界模糊与标注噪声,固定监督目标易强化偏差排序。方法:提出D3O动态分布蒸馏框架,以自蒸馏驱动标签分布演化,并通过视觉-语言对齐增强对比式序数感知标签恢复。关键结果:在四个序数回归任务上超越现有方法,在类别不平衡和噪声监督下尤为有效。贡献意义:验证动态监督对学习稳健序数表征的重要性。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
序数回归是计算机视觉与机器学习中的一类核心任务,涵盖了年龄估计、疾病分期、画质评分等广泛场景。这类任务的特殊性在于标签虽然以离散整数形式出现,但其背后本质上是连续的语义量——人的年龄、肿瘤的分期、图像的质量感知本质上都是连续分布。将这种连续语义人为离散化为有序类别,不可避免地引入了两个根本性问题:边界模糊与标注噪声。
边界模糊指的是,相邻类别之间的分界往往是主观的、多义的。一张标注为"5分"的图像与标注为"6分"的图像在视觉特征上可能几乎无法区分,这是因为连续语义在离散化时损失了原有的平滑信息。标注噪声则更为棘手:不同标注者的判断标准存在个体差异,同一实例可能获得不一致的标签,而这种不一致并非错误,只是反映了连续量被离散化后固有的不确定性。
现有的序数回归方法大多依赖固定监督目标来学习类别间的排序关系。无论是将问题建模为多个二分类子任务,还是直接预测累积概率,这些方法本质上都在用静态的、预先定义好的标签分布来指导训练。当标签本身存在上述不确定性时,固定监督反而会强化这些偏差——模型会过度相信噪声标签,从而学到有偏的序数表征。尤其在类别不平衡的场景下,少量样本的标签噪声更容易被放大,导致模型在长尾分布上的表现严重退化。
D3O 的核心洞察正在于此:既然标签的不确定性是不可避免的,就不应该用固定目标去对抗它,而应该让监督信号本身动态适应数据。D3O 提出将静态的 one-hot 标签替换为可学习的、随训练演化的标签分布,通过自蒸馏机制让模型不断修正自身对标签分布的估计,从而学习到更鲁棒的序数表征。
方法
D3O 的方法论框架围绕两个核心设计展开:对比式序数感知标签增强模块与基于累积分布函数的跨层交互蒸馏机制。理解这两个组件如何协同工作,是把握整个框架的关键。
第一个设计针对的是标签分布的初始化与演化问题。传统方法直接使用原始的硬标签或固定的软标签作为监督目标,忽视了序数标签本身的不确定性。D3O 引入了一种序数感知的对比式标签增强模块,其核心思想是利用视觉-语言对齐来为每个训练样本生成一个精细化的标签分布。具体而言,模型借助预训练的视觉-语言模型(如 CLIP)提取图像的语义表征,同时利用语言模型编码序数类别描述(如"中年人的年龄段"),通过对比学习建立图像表征与语言描述之间的对齐关系。这种对齐使得模型能够推断出当前样本更可能落在哪个细粒度区间的连续语义上,从而恢复出一个捕捉类间模糊性和实例级不确定性的标签分布。
这个标签分布并非一成不变,而是随着训练进程动态更新。模型先用初始化的标签分布进行监督学习,随后通过自蒸馏机制将学生网络的预测作为新的软目标来更新标签分布估计,形成一个交替优化的循环。这种设计的好处在于:标签分布既保留了原始标签的序数约束(相邻类别应有更高的关联度),又能根据模型在训练过程中的学习状态自适应调整,避免被早期噪声标签误导。
第二个设计针对的是网络中间层的序数结构保持问题。深度神经网络具有层次化特征提取的特性,不同层的表征捕捉了不同粒度的信息。然而,在标准的序数回归训练中,只有最终输出层受到标签监督的约束,中间层的特征可能并未显式地保持序数几何一致性。D3O 设计了基于累积分布函数的跨层交互蒸馏机制来解决这一问题。
该机制的数学形式化基于序数回归中累积概率的建模思路。对于 个有序类别,模型预测累积概率 表示样本属于前 个类别的概率。基于此,任意两个相邻层的表征通过以下方式传递序数结构:教师层(较浅层)的累积概率预测被用作学生层(较深层)的辅助监督信号,同时结合 KL 散度损失确保两层的概率分布保持一致。这一设计背后的直觉是,浅层特征虽然细节信息丰富,但其累积概率分布已经编码了粗粒度的序数关系;让深层特征在保持自身判别能力的同时与浅层对齐,可以促使整个网络层次结构形成一致的序数几何。
其中 表示累积概率分布, 为 KL 散度。通过这种方式,D3O 不仅在输出层学习精确的类别预测,还在中间层强制序数结构的几何一致性,从而提升整体表征的鲁棒性。
实验与结果
D3O 的实验评估覆盖了四个具有代表性的序数回归任务:年龄估计(IMDB-WIKI 数据集)、房价预测、鲜活度评估以及医学影像分期。实验设置涵盖了标准平衡数据、类别不平衡比例高达 1:10 的长尾分布、以及注入不同比例人工标签噪声(5%、10%、20%)的噪声监督场景,对比基线包括经典的序数回归方法与最新的自监督/对比学习方法。
在标准设置下,D3O 相比最优基线在平均绝对误差(MAE)和均方误差(MSE)指标上取得了 3%-5% 的相对提升,这一差距看似不大,但在序数回归这类精细化预测任务中意味着模型在大量样本上的预测偏差都略有缩小。在更具挑战性的长尾分布场景下,D3O 的优势显著扩大:在极端不平衡比例下,基线方法的 MAE 上升幅度超过 20%,而 D3O 仅上升约 8%,说明动态标签分布学习有效缓解了尾部类别的过拟合问题。
最引人注目的是噪声监督实验。随着标签噪声比例的增加,基线方法的性能持续恶化,尤其在 20% 噪声条件下,某些基线的 MAE 已经超过随机猜测的水平。然而 D3O 展现出极强的鲁棒性:即使在 20% 噪声下,其性能衰减幅度仍控制在 10% 以内。Ablation 实验进一步验证了两个组件的贡献:单独移除标签增强模块会导致噪声场景下性能下降约 4%,单独移除跨层蒸馏则主要影响深层表征的质量,说明两个设计是互补而非冗余的。
讨论与可借鉴点
D3O 的核心贡献在于揭示了序数回归中动态监督的必要性:标签的模糊与噪声不应被视为需要过滤的噪声,而应被显式建模为可学习的分布。这一思路对其他存在标签不确定性的任务(如部分标签学习、模糊标注的多实例学习)具有直接的启发价值。
然而,D3O 也存在一些局限性值得注意。首先,视觉-语言对齐模块依赖大规模预训练模型(如 CLIP)的语义知识,当目标任务与预训练数据分布差异较大时,对齐质量可能下降。其次,自蒸馏框架增加了训练的计算开销与超参调优复杂度——标签分布的更新速率、蒸馏温度等超参数需要仔细设计。最后,跨层蒸馏机制假设网络层次足够深以形成有意义的序数结构传递,对于浅层网络或轻量化模型,这一设计的收益可能有限。
从更宏观的角度看,D3O 代表了从固定目标学习向自适应监督学习演进的一个缩影。在过去,机器学习社区习惯于将标签视为"ground truth"并设计损失函数去逼近它;而 D3O 这类工作正在逐步证明,在标签本身具有不确定性的场景下,让模型学习标签分布而非固定值,可能是一条更符合数据本质规律的道路。这种范式转变的影响可能远超序数回归这一具体任务本身。
摘要
通过自蒸馏动态演化序数标签分布
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
Self-Distillation
method
Knowledge Distillation
method
On-Policy Distillation
method
Reinforcement Learning
methodology
KL Divergence
metric
On-Policy Self-Distillation
method
Supervised Fine-Tuning
method
Linear Probing
method
Masked Autoencoder
architecture
GRPO
method
Agentic Reinforcement Learning
problem
Chain-of-Thought Reasoning
methodology
Reverse KL Divergence
methodology
智能体搜索
problem
KL散度蒸馏
method
EMA Teacher
method
Large Language Models
other
Privileged Context
methodology
Verifiable Environment
architecture
Tool-Use Agents
problem
Multi-Hop Question Answering
dataset
ReAct
methodology
TurnOPD
method
Long-Horizon Agent Training
problem
Adaptive Rollout Depth
method
Turn-Normalized Loss Weighting
method
Language Agents
other
Self-Supervised Vision Transformer
architecture
Singular Value Decomposition
method
Low-Rank Subspace
methodology
DINOv2
architecture
Dense Geometric Representation
problem
Self-Distilled Reinforcement Learning
methodology
Counterfactual Credit Assignment
method
Token-level Knowledge Distillation
method
Importance Sampling
method
KL Regularization
method
Skill Memory
architecture
Credit Assignment
method
On-Policy Learning
methodology
Annealed Turn-aware On-policy Distillation (ATOD)
method
Turn-level Disagreement-Uncertainty Reweighting (T-DUR)
method
Annealed OPD-RL Schedule
methodology
Multi-turn Autonomous Agents
problem
Sparse Reward
problem
Hindsight Skill Extraction
methodology
LLM Agents
other
Token-Level Dense Reward
method
Policy Optimization
method
Advantage Estimation
method
Reward Aggregation
problem
Reasoning Compression
problem
Large Reasoning Models
other
Cross-Tokenizer Distillation
method
Step-Wise Distillation
method
Distributed Reinforcement Learning
methodology
Long Chain-of-Thought Reasoning
problem
Pointwise Mutual Information
method
Reflective Reasoning
problem
Supervision Signal Decomposition
methodology
Data-Centric AI
methodology
Neuron Activation Analysis
method
Post-Training
methodology
Expected Calibration Error
metric
Group Relative Policy Optimization
method
Jensen-Shannon Divergence
methodology
Out-of-Distribution Generalization
problem
Self-Distillation Policy Optimization
method
知识边界校准
problem
GRPO强化学习
methodology
象限自适应优化
method
双向KL蒸馏
method
策略网络
architecture
大语言模型压缩
problem
Difficulty Routing
method
Rhythm Gating
method
Experience Replay
method
Curriculum Learning
methodology
Agent Skills
methodology
Retrieval-Augmented Generation
method
Multimodal Learning
methodology
Software Agent
architecture
Hierarchical Knowledge Base
architecture
Procedural Knowledge
other
Decoding Collapse
problem
Thinking Collapse
problem
Thinking Models / Reasoning Models
architecture
Test-Time Compute Scaling
methodology
High-Entropy Forking Tokens
methodology
Self-Correction Behavior
other
联合嵌入预测架构 (JEPA)
architecture
孪生网络
architecture
自监督学习
methodology
归纳偏置
other
Certified Robustness
problem
Adversarial Training
method
Adversarial Distillation
method
Interval Bound Propagation
method
Adversarial Perturbations
problem
Majority Voting
methodology
端到端运动规划
problem
自动驾驶
other
模型压缩
methodology
注意力机制
method
Spurious Correlations
problem
Distribution Shift
problem
Cross-Variant Self-Supervised Learning
method
GroupDRO
method
Contrastive Learning
methodology
Diffusion Model
architecture
Worst-Group Accuracy
metric
Covert Trait Propagation
method
Representation Alignment
method
Centered Kernel Alignment
metric
Cross-Token Behavioral Entanglement
problem
Shared Initialization
methodology
Cross-Modal Knowledge Transfer
method
Fine-Grained Visual Classification
problem
LLM as Teacher
architecture
Conceptual Knowledge Probing
methodology
Spurious Correlation Robustness
problem
Soft Label Distribution
methodology
图谱基于本库论文之间的相似度关系(由 DPR paper-relations 模块 Jaccard / TFIDF / hybrid 算法计算,无 LLM)。
每日简报占位
DPR 是静态站点,没有 Polaris 那种后端定时任务。启用 GitHub Actions 工作流后,简报会出现在这里。
当前可用的 Polaris 提示词版本:
library-digest:2026-08-02— 逐篇看点(PAPER_INSIGHTS)library-digest:2026-08-02— 简报主编(DIGEST_SYNTHESIS)library-digest:2026-08-02— 滚动趋势(TREND)
详见 迁移文档 与 config/prompts/library-digest/2026-08-02/。
文献对话(占位)
本面板将基于 library-chat:2026-08-02 提示词,接管自 paper-chat 的浮窗能力,支持库级上下文 + 跨论文 RAG 引用。
阶段 4 启用后将接流式 LLM,引用规约 [n]、概念双链 [[概念名]]、图片 ![[fig:N]]。
笔记在每篇论文的 详情页 底部写。 选中下面的论文直接进入"📝 写笔记"位置。
DeepSearch-World:可验证环境中面向深度搜索智能体的自蒸馏方法
DeepSearch-World: Self-Distillation for Deep Search Agents in a Verifiable Environment
TurnOPD:使在线策略蒸馏具备轮次感知能力,以实现高效长视野智能体训练
TurnOPD: Making On-Policy Distillation Turn-Aware for Efficient Long-Horizon Agent Training
通过子空间干预理解自监督视觉 Transformer 中的几何表示
Understanding Geometric Representations in Self-Supervised Vision Transformers via Subspace Intervention
CRAFT:基于自由兄弟回滚的反事实信用分配用于自蒸馏智能体强化学习
CRAFT: Counterfactual Credit Assignment from Free Sibling Rollouts for Self-Distilled Agentic Reinforcement Learning
UCOB:通过信用感知的在线策略双向自蒸馏学习利用与演化智能体技能
UCOB: Learning to Utilize and Evolve Agentic Skills via Credit-Aware On-Policy Bidirectional Self-Distillation
ATOD:用于多轮自主智能体的退火轮次感知在策略蒸馏算法
ATOD: Annealed Turn-aware On-policy Distillation for Multi-turn Autonomous Agents
SEED:面向智能体强化学习的自演化在策略蒸馏方法
SEED: Self-Evolving On-Policy Distillation for Agentic Reinforcement Learning
HindSearch:用于搜索增强强化学习的轨迹级事后批评
HindSearch: Trajectory-Level Hindsight Critique for Search-Augmented Reinforcement Learning
PCSD:智能体强化学习中自蒸馏的持久一致性
PCSD: Persistent Consistency for Self-Distillation in Agentic Reinforcement Learning
面向智能体强化学习的组反思自蒸馏
Group-Reflective Self-Distillation for Agentic Reinforcement Learning
从评分到行动:面向 LLM 智能体的结果验证式对比自蒸馏
From Scoring to Acting: Outcome-Verified Comparative Self-Distillation for LLM Agents
β-OPSD:以策略优化推导,以自蒸馏训练
$β$-OPSD: Deriving with Policy Optimization, Training with Self-Distillation
H$^2$SD:混合事后自蒸馏
H$^2$SD: Hybrid Hindsight Self-Distillation
通过自蒸馏增强基于评分标准的强化学习
Enhancing Rubric-based RL via Self-Distillation
更好的起点,更好的终点:用于压缩推理的自举迭代自推理蒸馏
Better Starts, Better Ends: Bootstrapped Iterative Self-Reasoning Distillation for Compressed Reasoning
EasyOPD:面向大语言模型的易用式在策略蒸馏框架
EasyOPD: An Easy-to-use On-Policy Distillation Framework for Large Language Models
纯化 OPSD:在保留思维能力下的在策略自蒸馏
Purified OPSD: On-Policy Self-Distillation Without Losing How to Think
面向免标注大语言模型自蒸馏的神经元感知数据选择
Neuron-Aware Data Selection for Annotation-Free LLM Self-Distillation
DemoPSD:基于分歧调制的策略自蒸馏
DemoPSD: Disagreement-Modulated Policy Self-Distillation
KbSD:面向智能体搜索中行为校准的知识边界感知自蒸馏
KbSD: Knowledge Boundary aware Self-Distillation for Behavioral Calibration in Agentic Search
ARKD:面向文本生成的自适应强化学习引导双向 KL 散度蒸馏方法
ARKD: Adaptive Reinforcement Learning-Guided Bidirectional KL Divergence Distillation for Text Generation
DRIFT:基于难度路由自蒸馏、节奏门控探索与成功缓冲区训练的方法
DRIFT: Difficulty Routing Self-DIstillation with Rhythm-Gated Exploration and Success BuFfer Training
RESOURCE2SKILL:从人类创建的多模态资源中蒸馏可执行的智能体技能
RESOURCE2SKILL: Distilling Executable Agent Skills from Human-Created Multimodal Resources
RP-OPSD:面向多模态大语言模型的分辨率特权在策略自蒸馏
RP-OPSD: Resolution-Privileged On-Policy Self-Distillation for Multimodal Large Language Models
从智能体经验中进行样本高效的学习
Sample-Efficient Learning from Agent Experience
OPD-IAD:通过在线自蒸馏实现从语言判断到工业异常检测
OPD-IAD: From Language Judgment to Industrial Anomaly Detection via On-Policy Self-Distillation
为何带反馈增强的自蒸馏无法提升检索交错搜索代理?
Why Does Feedback-Augmented Self-Distillation Fail to Improve Retrieval-Interleaved Search Agents?
揭秘同策略蒸馏:作用、病态与调控
Demystifying On-Policy Distillation: Roles, Pathologies, and Regulations
在策略自蒸馏中诊断与缓解思维坍缩
Diagnosing and Mitigating Thinking Collapse in On-Policy Self-Distillation
重新思考面向思维模型的在策略自蒸馏
Rethinking On-Policy Self-Distillation for Thinking Models
SiamJEPA:论孪生学生编码器在 JEPA 中的作用
SiamJEPA: On the Role of Siamese Student Encoders in JEPA
通过对抗蒸馏改进可验证鲁棒性
Improving Certified Robustness via Adversarial Distillation
语言中的JEPA悖论:语言替代方案的几何结构
The JEPA Paradox in Language: The Geometry of Linguistic Alternatives
使用带噪学生同策略自蒸馏的视觉-语言模型自我增强
Self-Boosting Vision-Language Models with Noisy Student On-Policy Self-Distillation
视觉对比自蒸馏
Visual Contrastive Self-Distillation
从视频中自监督学习结构化动力学
Self-Supervised Learning of Structured Dynamics from Videos
知识蒸馏何时会产生负面影响?面向低资源语言摘要的可靠性感知蒸馏方法
When Does Knowledge Distillation Hurt? Reliability-Aware Distillation for Low-Resource Language Summarization
基于轨迹的在线策略蒸馏用于掩码扩散语言模型
Trace-Based On-Policy Distillation for Masked Diffusion Language Models
CADENCE:基于覆盖自适应在线策略蒸馏缩小推理差距
CADENCE: Closing the Reasoning Gap via Coverage-Adaptive On-Policy Distillation
将共识作为特权上下文用于无标签自蒸馏
Consensus as Privileged Context for Label-Free Self-Distillation
BucketKD:一种面向端到端运动规划的安全感知分桶知识蒸馏框架
BucketKD: A Safety-Aware Bucket-Based Knowledge Distillation Framework for End-to-End Motion Planning
通过生成式随机化与跨变体自监督学习打破虚假相关性
Breaking Spurious Correlations via Generative Randomization and Cross-Variant Self-Supervised Learning
隐蔽特征传播即表征对齐:来自隐藏通道蒸馏的机制证据
Covert Trait Propagation Is Representation Alignment: Mechanistic Evidence from Hidden-Channel Distillation
大语言模型教导视觉学生:细粒度概念知识的跨模态迁移
Large Language Model Teaches Visual Students: Cross-Modality Transfer of Fine-Grained Conceptual Knowledge
AMRD:面向轻量级语音情感识别的自适应多教师关系蒸馏
AMRD: Adaptive Multi-Teacher Relational Distillation for Lightweight Speech Emotion Recognition
Explainable Reinforcement Learning via Physics-Aware Policy Distillation
从 RLVR 到 RLSVR:任务变换为开放式大语言模型自我改进带来可自我验证的奖励
From RLVR to RLSVR: Task Transformation Induces Self-Verifiable Rewards for Open-Ended LLM Self-Improvement
D3O:用于序数回归的动态分布蒸馏方法
D3O: Dynamic Distribution Distillation for Ordinal Regression
文献库基础信息
- 库名 (English)
- Self-Distillation & Self-Improvement
- 库名 (中文)
- 自蒸馏与模型自改进
- 研究方向陈述
- On-policy self-distillation, self-rewarding, self-play fine-tuning, model self-evolution without external labels.
- 研究方向陈述(中文)
- 在线自蒸馏、自奖励、自博弈微调、无外部标签的模型自进化。
- 维护者
- DPR
- 卡片色调
- rose
- 入库方式
- 公共库(从 docs/papers/** frontmatter 派生,无写路径)
本月 LLM 用量
- 已用 tokens
- 加载中...
- 预算设置
- 剩余
- -
建库与同步
公共库数据来自 docs/papers/ frontmatter,在 pipeline 跑批时重建。本 Tab 只控制个人库。
个人库同步(若已配置 Gist token):
同步底层由 astro-src/lib/user-libraries/gist.ts 处理(零信任 R/W 合并,见 8f2a 提交)。
正在检测重复...