
📝 TLDR
RLVR方法依赖标量轨迹奖励,难以提供token级细粒度监督;现有自蒸馏方案教师角色固定,易破坏成功行为或纠错不足。H²SD提出混合后视自蒸馏,按轨迹正确性自适应教师上下文与更新策略:成功轨迹用已验证回复加复述指令构造教师仅重评原始token,失败轨迹结合参考提示做反向KL蒸馏。实验在多个推理基准上取得最优综合性能,优化稳定,精度与效率权衡优越。
🧭 速览
标量轨迹奖励对token级推理指导有限,现有自蒸馏教师角色固定,难以兼顾成功轨迹稳定与失败轨迹纠错的差异化需求。
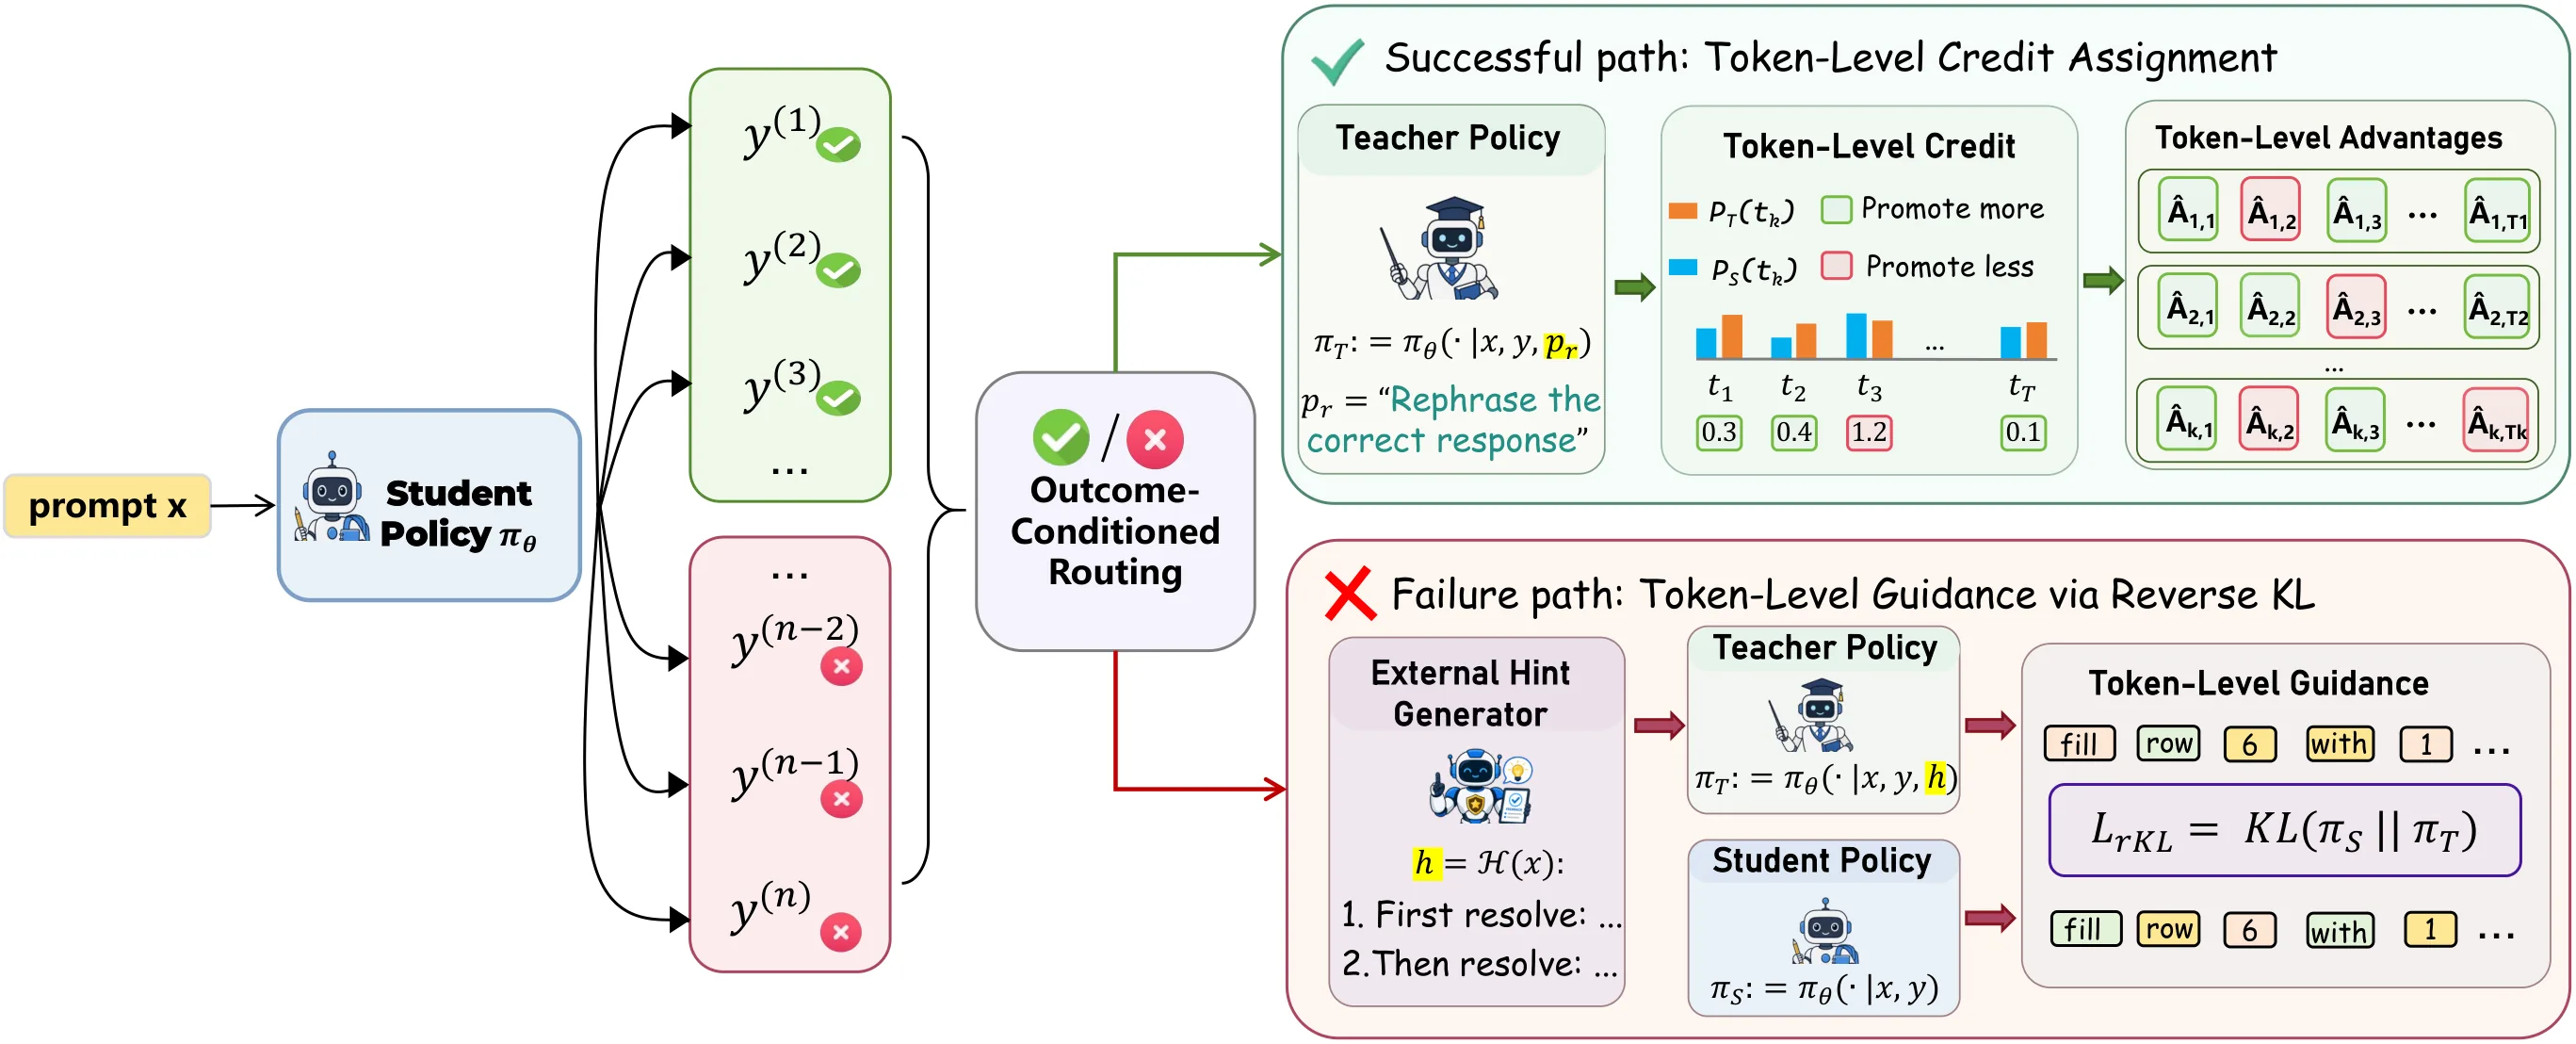
按轨迹正确性差异化设计教师与更新策略——成功轨迹以已验证回复构造特权上下文仅重评原始token,失败轨迹引入参考提示进行反向KL蒸馏纠错。
在多个推理基准上超越现有RLVR与自蒸馏基线,优化过程稳定,精度与效率权衡更优。
H²SD为RLVR框架下的自蒸馏提供条件化、差异化监督新范式,有效改善token级信用分配。
🆚 方法对比
RLVR/GRPO
- 提供可靠的最终结果监督
- DeepSeek-R1后广泛采用,简单有效
- 标量奖励导致token级信用分配不足
- 监督信号稀疏,限制推理能力提升
OPD (On-Policy Distillation)
- 提供稠密的token级分布监督
- 利用更强教师logit,细粒度更高
- 需额外更强的教师模型,成本高
- 要求师生共享tokenizer,适用范围受限
OPSD (On-Policy Self-Distillation)
- 无需外部教师,同模型兼任师生
- 利用特权信息近似OPD效果
- 直接分布匹配可能导致训练不稳定
- 存在特权信息泄露风险
RLSD
- 仅调节更新幅度,避免直接匹配
- 训练更稳定,缓解泄露问题
- 仅幅度调制,纠错方向不足
- 失败轨迹缺乏显式分布修正
SRPO
- 按正确性路由成功/失败样本
- 结合GRPO与自蒸馏各自优势
- 路由粒度粗,未区分教师角色
- 策略切换缺乏细粒度自适应
H²SD (Hybrid Hindsight Self-Distillation)
- 在Sudoku/Calcudoku/Arrow Maze上整体最优
- 成功轨迹用幅度调制,稳定且不偏移奖励方向
- 失败轨迹用reverse-KL蒸馏提供显式纠错
- 优化稳定,精度与效率权衡良好
- 仍依赖更强模型生成参考提示
- 成功与失败分支设计更复杂
H²SD通过按轨迹正确性自适应切换教师角色,成功时复用RLSD的幅度调制保证稳定,失败时切换至OPSD式的reverse-KL蒸馏提供纠错方向,从而融合两者优势,兼顾训练稳定性和纠错能力。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 12 张)
展开查看 12 张图
TL;DR
H²SD 针对 RLVR 中标量轨迹奖励无法提供 token 级细粒度监督的问题,创新性地提出根据轨迹正确性动态调整教师上下文与更新策略:成功轨迹由已验证响应构造教师,仅通过幅度调制细化信用分配;失败轨迹则借助外部提示通过反向 KL 散度蒸馏提供方向性纠错。在 Sudoku、Calcudoku、Arrow Maze 等多个推理基准上,H²SD 以 50.49% 的综合准确率大幅超越 GRPO、RLSD、OPSD 等代表性基线,同时保持最短的平均生成长度,实现了精度与效率的双赢。
研究背景与动机
带可验证奖励的强化学习(RLVR)已经成为提升大语言模型推理能力的主流范式。GRPO 等算法通过为每条完整轨迹输出一个标量奖励,引导模型学习"正确答案"的生成模式。然而,这种粗粒度的轨迹级信号天然存在 [[Credit Assignment]] 问题——奖励只能告诉模型"这条路径整体对或错",却无法区分路径中哪些 token 贡献了正确结果、哪些 token 是冗余甚至有害的。当推理序列较长时,这种信用分配瓶颈会严重制约学习效率。
为了缓解这一问题,学术界沿着自蒸馏(Self-Distillation)的思路展开了大量探索。On-Policy Self-Distillation(OPSD)让同一模型同时扮演学生和教师,并借助真实答案等特权信息为教师赋予更强的推理能力。但直接进行分布匹配会让教师生成的文本直接覆盖学生已有的合理推理路径,造成"特权信息泄漏":学生学到的是教师在完整答案条件下的分布,而非在自身推理过程条件下的改进方向。后续的 RLSD 方法转而只利用教师信号调制 token 更新的幅度,避开了分布匹配带来的泄漏问题,却也因此失去了对失败轨迹的方向性纠错能力——它只能调整"步伐大小",却无法告诉模型"该往哪个方向走"。
本文的核心洞察源于对训练动态的细致观察:成功轨迹和失败轨迹蕴含的监督信息本质上是不同的。一条成功到达正确答案的响应,本身已经包含了一条由学生模型自主生成的有效推理路径,这条路径虽然在 token 级别可能存在冗余或概率分配不够精确的问题,但其方向性是正确的、不应被外部推理所替代。相反,一条推理失败或得不出正确答案的响应,其推理方向本身就走偏了,需要外部的参考信息来提供方向性的纠错。这一观察直接指向了一个更精细的事后监督框架:根据轨迹的正确性,联合适配教师上下文的构造方式和模型参数的更新策略。
方法
H²SD 的设计正是围绕上述洞察展开的。整体上,方法依据轨迹正确性 来决定两件事:教师应该以什么样的上下文条件去生成自己的概率分布,以及学生应该用什么样的目标函数向这个教师学习。这两个维度的联合适配构成了方法的核心框架:
其中 对应成功轨迹的幅度调制损失, 对应失败轨迹的反向 KL 蒸馏损失, 控制两类损失之间的平衡。
提示的离线构造
为了让失败轨迹的教师拥有可靠的参考推理信息,H²SD 首先使用外部强模型(Kimi-K2.6)为每个问题离线生成自然语言形式的提示(hint)。这些提示包含关键中间推理步骤和经验证的最终答案,但并非完整的逐步推导,因此不会直接泄漏解法。生成时每个问题最多尝试 5 次,温度设为 0.1,仅保留验证器通过的提示作为训练材料。
由此可以得到两类条件概率分布:学生模型在自身推理前缀条件下的分布 ,以及教师模型在提示条件下的分布 。注意这里教师和学生是同一个模型,只是条件信息不同。
成功轨迹的处理
对于 的成功轨迹,H²SD 采用一种"仅重评、不生成"的策略。教师上下文的构造方式是:把学生自己生成的已验证响应拼接上一条"改写指令"(rephrasing instruction),让教师在整体条件下去重新评估原始响应的每个 token。
具体而言,首先计算教师与学生分布在每个位置的概率比值:
其中 是由奖励决定的轨迹级优势。取 sign 的目的是保持方向性:对于正优势(被鼓励的 token),概率比值越大意味着教师越认同,权重越高;对于负优势(被抑制的 token),比值越大反而应该降低权重。
随后,这个幅度权重被融合进 token 级的优势估计:
这里 控制幅度调制的强度上限,clip 操作防止权重过于极端。通过这种方式,成功轨迹保留了由奖励信号确定的方向性(该鼓励的 token 仍然被鼓励,该抑制的仍然被抑制),但在 token 级别上细化了信用分配的精度:那些被奖励认可的 token 如果在教师看来概率偏低,就会获得额外的强化信号;反之亦然。
失败轨迹的处理
对于 的失败轨迹,情况则完全不同。此时学生模型的推理方向本身就偏离了正确答案,幅度调制只能调整"步伐大小"却无法改变"前进方向"。为此,H²SD 在失败轨迹上引入 [[KL 散度]] 形式的蒸馏损失,让学生的概率分布去匹配教师在提示条件下的分布:
这里使用的是反向 KL(),而非常见的正向 KL,其关键差异在于优化方向:反向 KL 要求学生的分布必须完全覆盖教师的高概率区域,但允许在教师概率低的地方保留一定的学生自身分布。在失败轨迹的语境下,这意味着学生应该优先学习提示所暗示的正确推理方向,但不必完全丢弃自己的推理路径中可能仍有效的部分。这种特性使得反向 KL 在纠错场景下比正向 KL 更加稳定——它不会因为学生与教师在局部 token 上的轻微分歧而产生过大的惩罚梯度。
算法流程
综合来看,H²SD 的训练流程包含以下步骤:首先从当前策略采样 条轨迹,计算奖励并标记正确性 ;然后对于 的轨迹,构造"改写+已验证响应"的教师上下文,应用 RLSD 幅度调制更新策略;对于 的轨迹,构造"提示 "的教师上下文,应用反向 KL 蒸馏更新;最后将两类损失的加权和作为总目标函数进行优化。
实验与结果
实验设置
论文在 Qwen3-30B-A3B-Instruct-2507 基模型上进行了实验,涵盖了四个独立的训练设置:Sudoku-6×6、Sudoku-8×8、Calcudoku(5×5 和 6×6 两种规模)、Arrow Maze(从 6×6 到 10×10 五种规模)。这些基准均为程序化生成的逻辑推理任务,具有可验证的确定性答案,能够有效降低预训练数据泄露的风险,提供更纯净的推理能力评估环境。
所有方法均采用 VERL + SGLang 框架训练,使用 FSDP 进行全参数训练。为了控制计算成本,实验在 token 级概率计算时采用了 top-100 加尾部桶近似的策略。
主要结果
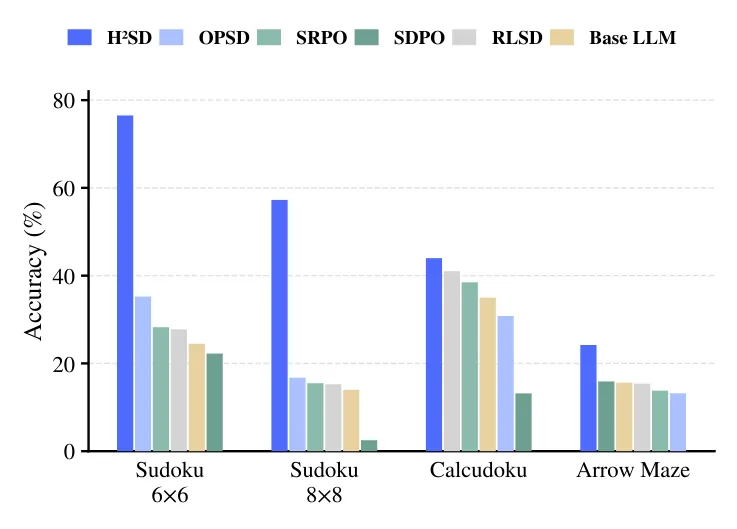
实验结果清晰地表明,H²SD 在所有基准上均取得了最优的综合性能。对比基线涵盖了三类代表性方法:纯 RLVR 方法(GRPO)、on-policy 自蒸馏方法(OPSD、SDPO)、以及幅度调制方法(RLSD)和混合方法(SRPO)。
| 方法 | Sudoku-6×6 | Sudoku-8×8 | Calcudoku Avg | Arrow Maze Avg | Overall |
|---|---|---|---|---|---|
| Base LLM | 24.50 | 14.00 | 35.17 | 15.60 | 22.32 |
| GRPO | 26.25 | 16.75 | 40.00 | 15.70 | 24.68 |
| RLSD | 27.75 | 15.25 | 41.00 | 15.40 | 24.85 |
| OPSD | 35.25 | 16.75 | 30.83 | 13.20 | 24.01 |
| SRPO | 28.25 | 15.50 | 38.50 | 13.80 | 24.01 |
| H²SD | 76.50 | 57.25 | 44.00 | 24.20 | 50.49 |
最引人注目的是 Sudoku 任务上的表现:H²SD 在 6×6 和 8×8 两个规模上分别达到了 76.50% 和 57.25% 的准确率,远超所有基线方法。这一提升幅度(相对于次优基线超过 40 个百分点)表明,成功-失败轨迹的差异化处理对于需要精细规划的推理任务尤为重要。
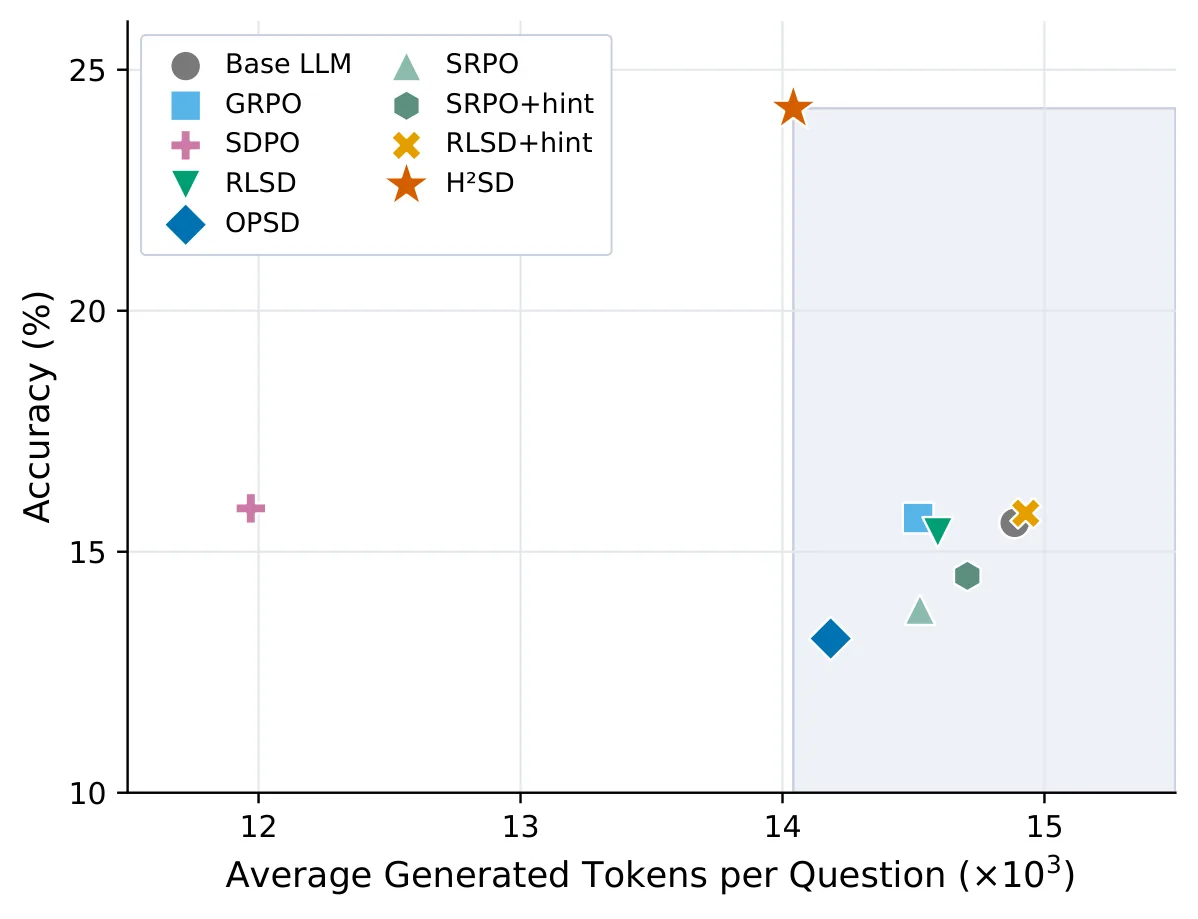
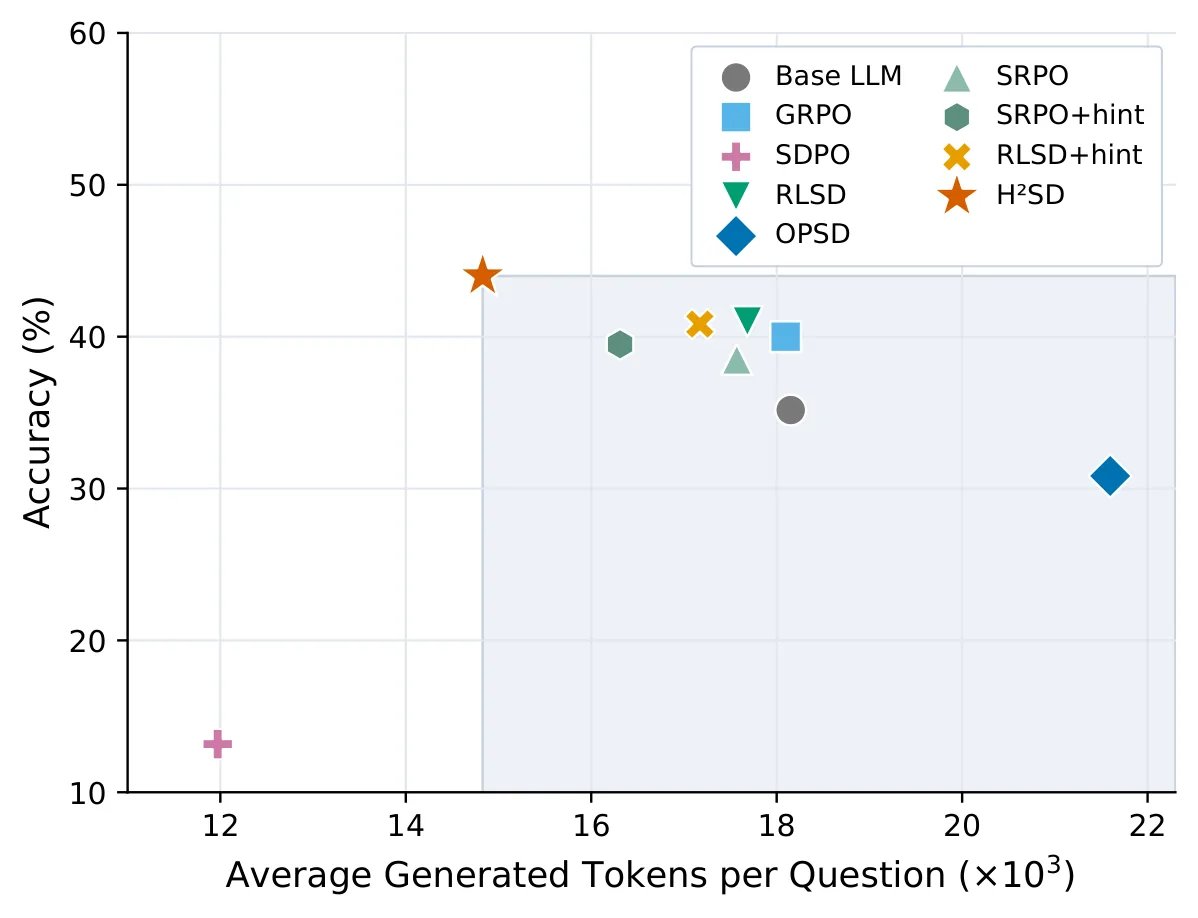
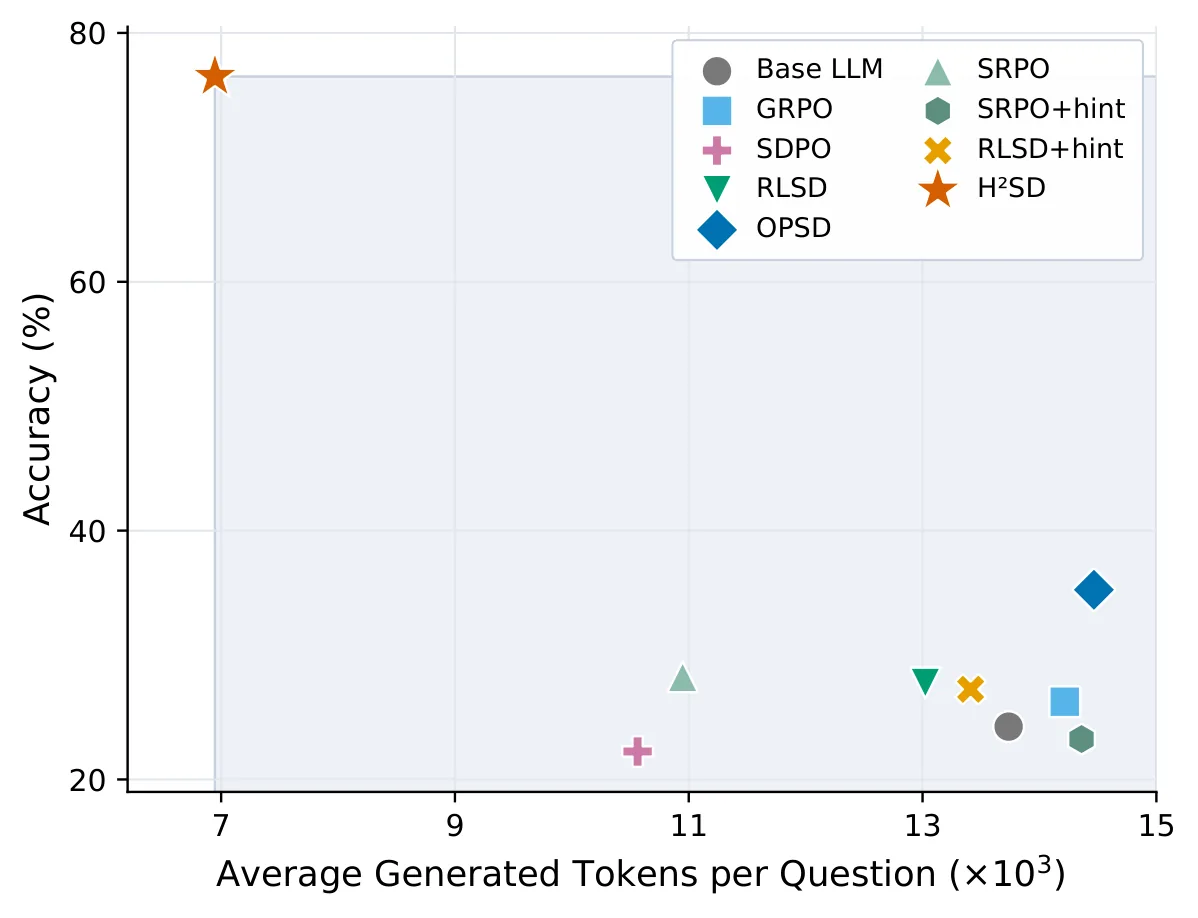
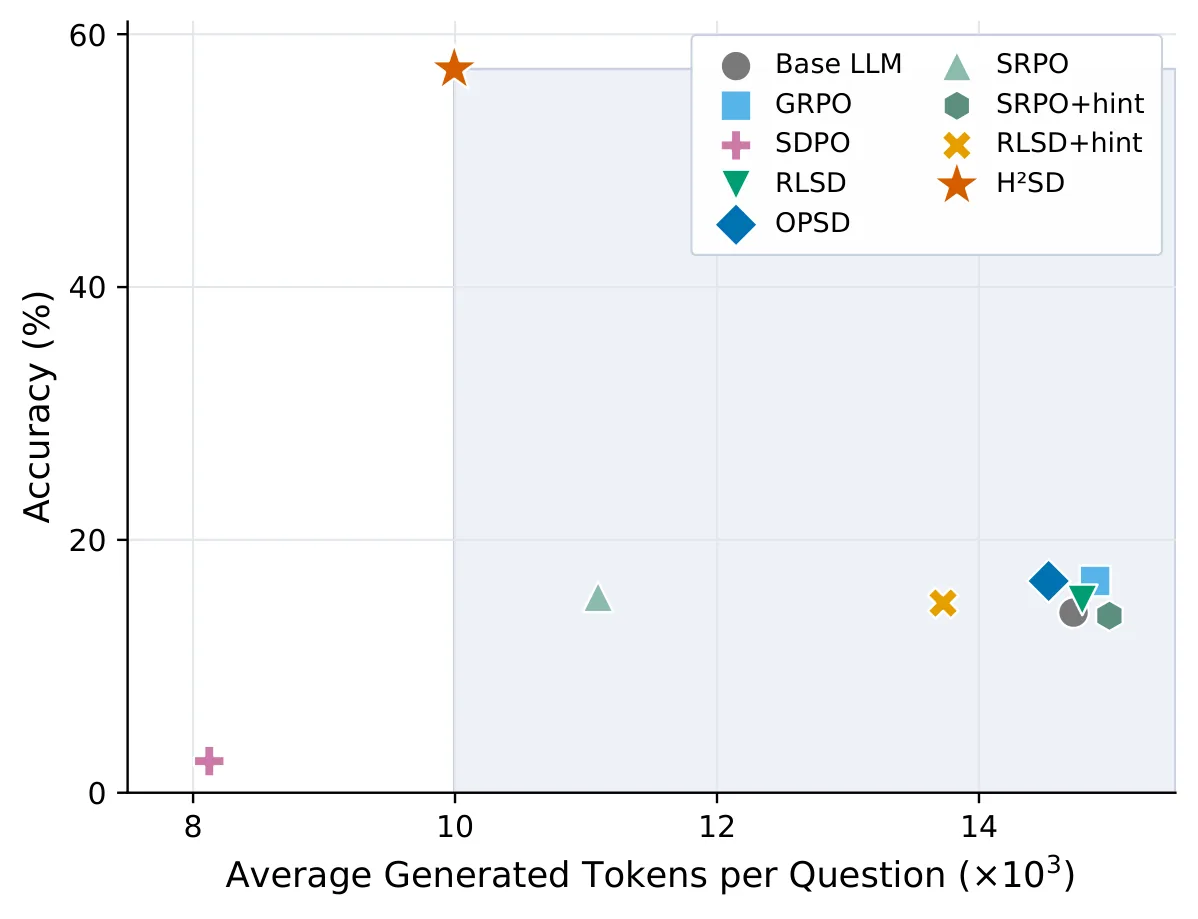
除了精度指标,H²SD 还在推理效率上展现出显著优势。在所有四个基准上,H²SD 均保持了最短的平均生成长度,位于精度-生成长度 Pareto 前沿。这意味着模型不仅能更频繁地得到正确答案,还能以更少的 token 消耗达到正确结果——这对实际部署中的延迟和成本控制都有直接价值。
消融实验的关键发现
为了验证设计选择的有效性,论文进行了多维度的消融实验。
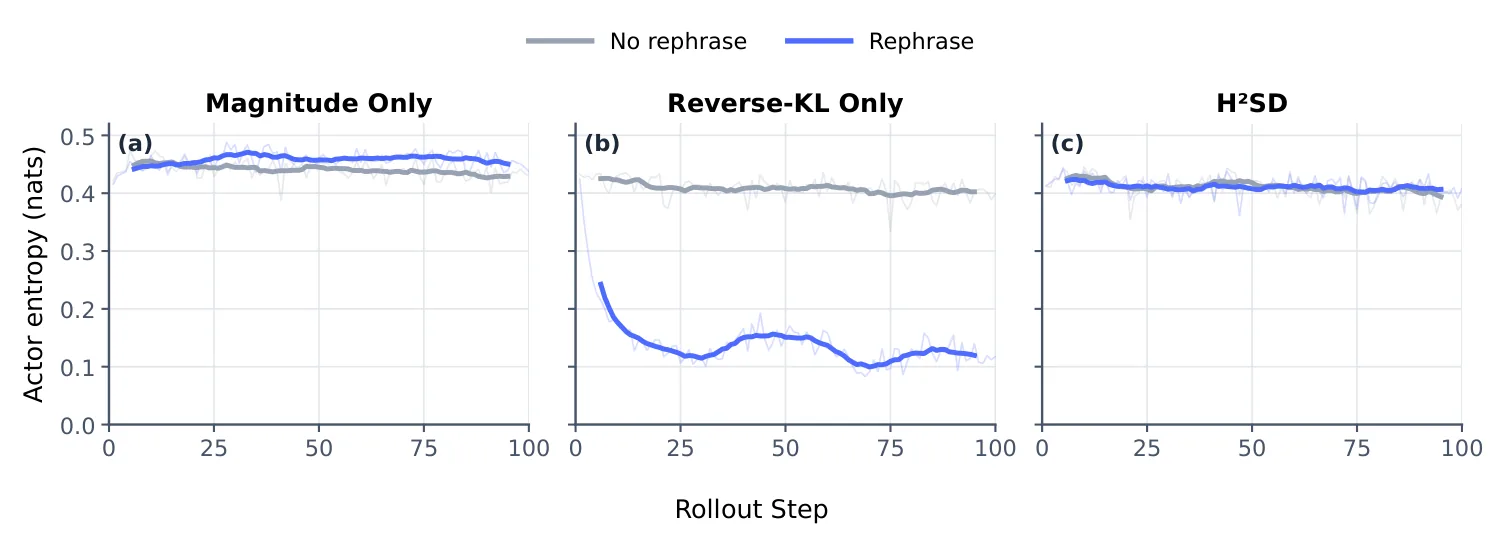
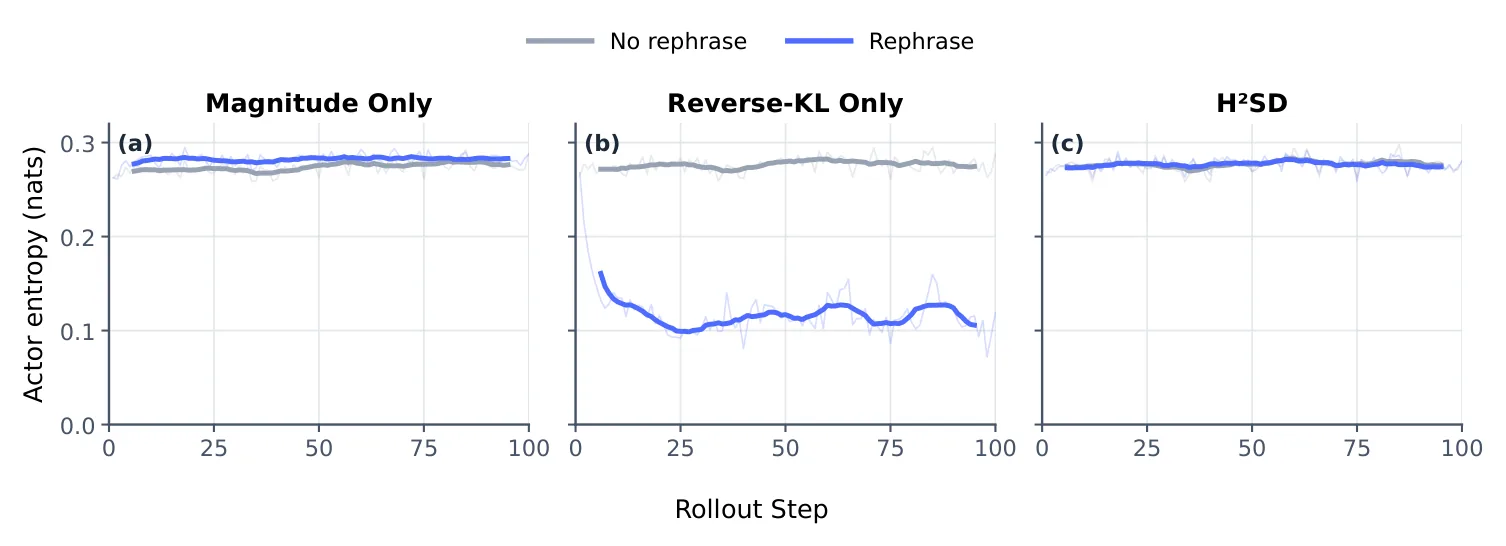
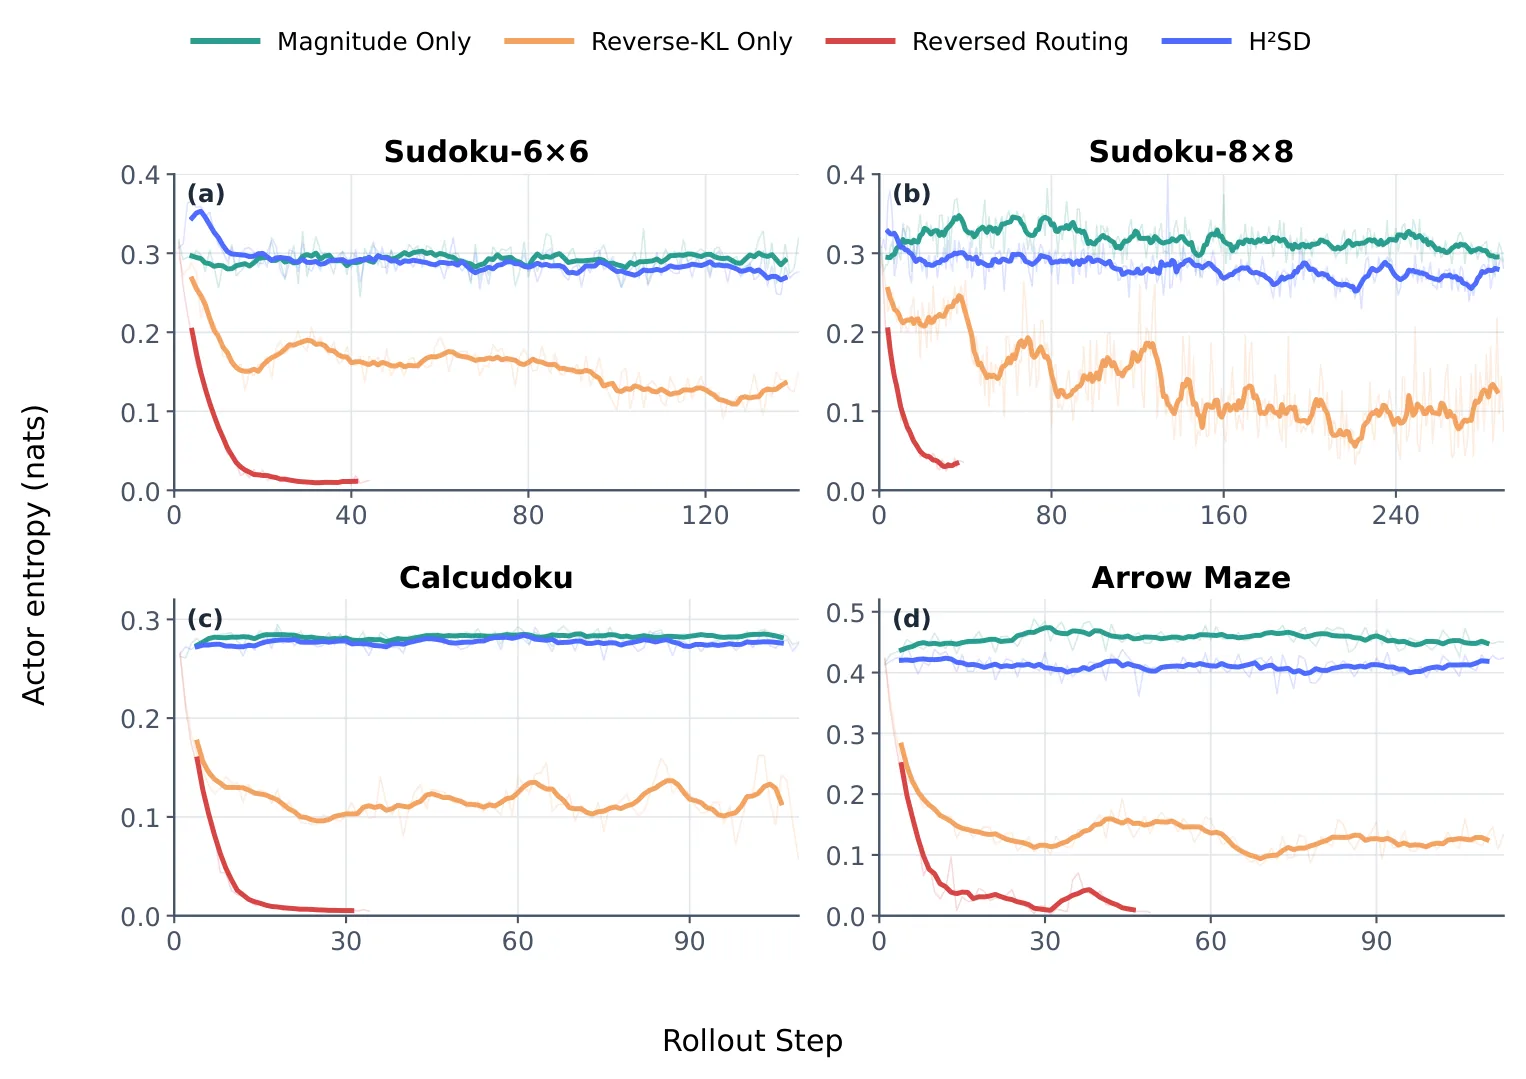
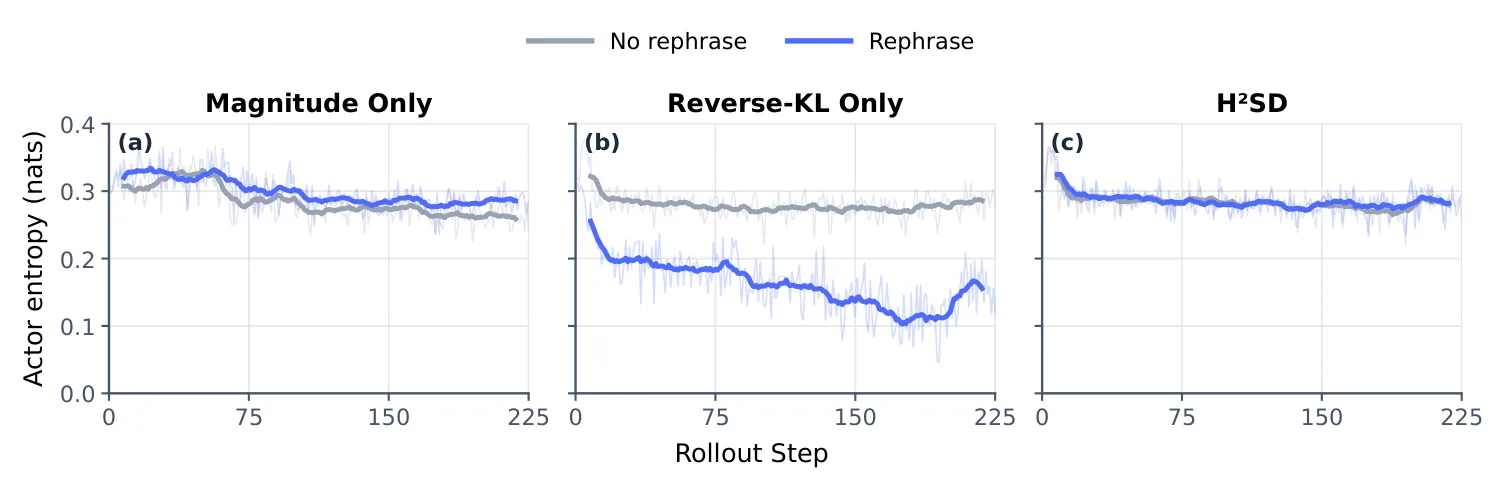
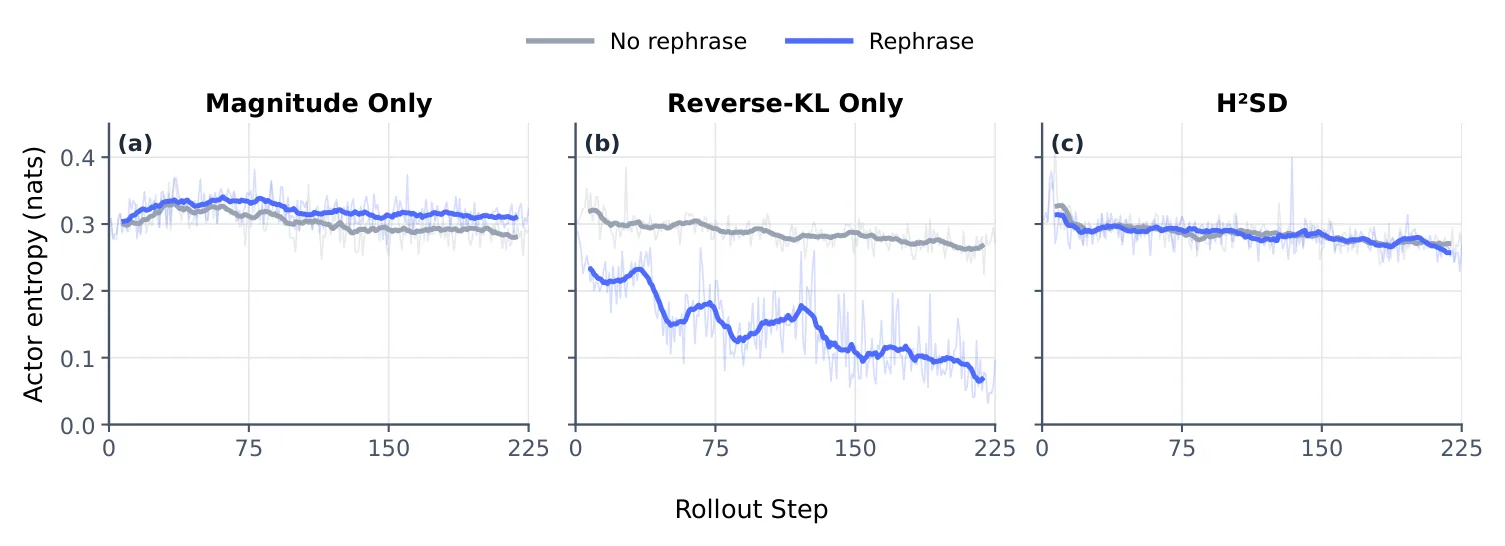
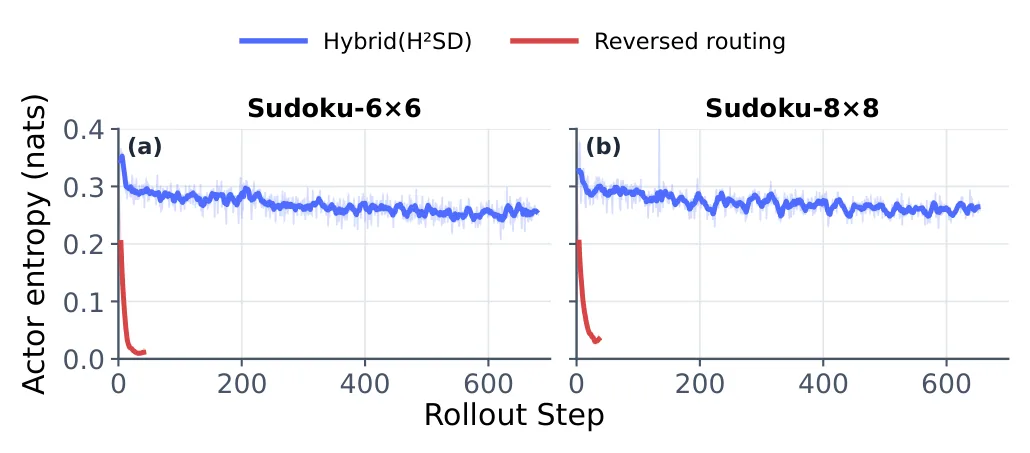
路由策略的消融对比了四种设置:仅使用幅度调制、仅使用反向 KL、反向路由(成功用反向 KL,失败用幅度调制)、以及 H²SD 的正确路由。结果表明,正确的路由方式至关重要——错配会导致策略熵快速坍缩到零,训练崩溃。这验证了"成功轨迹需要幅度细化,失败轨迹需要方向纠错"这一假设的必要性。
特权上下文的消融测试了不同提示来源的效果:程序化反馈(含中间状态但不含推理)、Ground Truth(最终答案)、Sibling Solution(同问题的其他正确解)、以及过程级 Hint(Kimi-K2.6 生成)。实验证实,过程级 Hint 远优于其他选项,说明包含中间推理步骤的参考信息对失败轨迹的纠错最为有效。
改写指令的作用在有无该指令的对比中显示出一种机制依赖性:改写指令仅在幅度调制机制下稳定有效,与反向 KL 联合使用时会导致熵快速坍缩。这提示改写指令的存在改变了教师分布的性质——它让教师更倾向于对原文进行"改写"而非"续写",从而影响了幅度调制的语义。
讨论与可借鉴点
H²SD 的成功揭示了一个在 RLVR 自蒸馏研究中常被忽视的问题:教师模型在训练中扮演的角色不应是一成不变的,而应该根据学生当前的学习状态进行动态适配。成功轨迹和失败轨迹蕴含的监督信号具有根本不同的语义——前者需要的是精细化调整,后者需要的是方向性纠错——用同一套策略处理两类轨迹,必然导致顾此失彼。
从工程落地的角度看,这项工作有几个值得注意的局限。首先,H²SD 依赖外部强模型(Kimi-K2.6)离线生成过程级提示,这在没有强参考模型的场景下难以直接应用。其次,提示需要经过验证器过滤才能使用,这意味着训练数据会因为"提示生成失败"而被丢弃,覆盖面上存在缺口。第三,论文仅在 Qwen3-30B-A3B 这一个模型上验证了方法,未探索跨规模或跨架构的可迁移性。最后,H²SD 在推理时仍然没有特权信息可用——提示仅在训练阶段作为教师条件,对于推理时无验证器的任务无法直接部署。
尽管存在这些局限,H²SD 的核心思想为后续研究提供了有价值的启发。一方面,按状态自适应地切换学习目标这一范式可以推广到其他 RL 场景——例如在探索-利用的权衡中,根据当前策略的熵或价值估计动态调整更新方式。另一方面,反向 KL 在纠错场景下的独特优势值得进一步探索:其"mode-seeking"特性天然适合"学生必须在教师指出的方向上有所改进"这一约束,这可能为其他需要精准纠错的训练场景提供借鉴。
摘要
带可验证奖励的强化学习(RLVR)为语言模型推理提供了可靠的结果监督,但标量轨迹奖励对 token 级别的指导有限。现有的自蒸馏方法增加了一个特权教师,但通常为其分配固定的角色:直接分布匹配可能会破坏成功的行为,而仅调节幅值的方式在失败后几乎不提供纠正性指导。我们观察到,成功轨迹和失败轨迹需要不同形式的事后监督。成功的响应本身已包含由学生模型生成的有效推理路径,因此可以作为特权上下文,而无需被外部推理所替代;而失败的响应则需要纠正性的参考信息。我们提出了混合事后自蒸馏(HSD),它根据轨迹的正确性联合调整教师上下文与更新策略。对于成功轨迹,我们从已验证的响应和一条改写指令构建教师上下文,并仅使用教师重新评估原始响应 token。由此得到的概率在不改变由奖励所决定方向的前提下,细化了 token 级的信用分配。对于失败轨迹,已验证的参考提示通过反向 KL 蒸馏提供纠正性指导。在具有挑战性的推理基准上的实验表明,HSD 在代表性的 RLVR 与自蒸馏基线中取得了最强的综合性能,并具有稳定的优化过程以及有利的精度-效率权衡。
Abstract
Reinforcement learning with verifiable rewards (RLVR) provides reliable outcome supervision for language model reasoning, but a scalar trajectory reward offers limited token-level guidance. Existing self-distillation methods add a privileged teacher but typically assign it a fixed role: direct distribution matching may destabilize successful behavior, while magnitude-only modulation offers little corrective guidance after failure. We observe that successful and failed trajectories require different forms of hindsight supervision. A successful response already contains a valid student-generated reasoning path and can therefore serve as privileged context rather than being replaced by an external rationale. A failed response, however, requires corrective reference information. We introduce Hybrid Hindsight Self-Distillation (), which jointly adapts teacher context and update strategy to trajectory correctness. For successful trajectories, we construct the teacher context from the verified response and a rephrasing instruction, and use the teacher only to re-evaluate the original response tokens. The resulting probabilities refine token credit assignment without changing the direction determined by the reward. For failed trajectories, a verified reference hint provides corrective guidance through reverse-KL distillation. Experiments on challenging reasoning benchmarks show that HSD achieves the strongest overall performance among representative RLVR and self-distillation baselines, with stable optimization and a favorable accuracy-efficiency trade-off.
论文详细总结(自动生成)
HSD:混合事后自蒸馏 — 论文总结
1. 核心问题与研究动机
RLVR(带可验证奖励的强化学习)通过 GRPO 等算法为 LLM 推理提供可靠的结果监督,但标量轨迹级奖励只能告诉模型"整条轨迹对/错",无法提供 token 级的细粒度指引,造成信用分配(credit assignment)瓶颈。
为缓解该问题,已有两条路线:
- On-Policy Distillation (OPD):引入更强的教师模型提供 token 级 logits 监督,但要求教师与学生共享词表,且强教师不易获得。
- On-Policy Self-Distillation (OPSD):用同一模型同时充当师生,并给教师附加"特权信息"(如真实答案、已验证响应等),但直接做分布匹配易导致特权信息泄漏与训练不稳定。
- RLSD:改用教师信号仅调制 token 级更新幅度(magnitude modulation),缓解了泄漏,但失去对失败轨迹的方向性纠错能力。
- SRPO:对成功轨迹走 GRPO、失败轨迹走自蒸馏,但纠错信号较弱。
本文观察到的关键问题:成功与失败轨迹所需的监督形式本质不同——成功轨迹已有学生生成的合法路径,只需细粒度信用调整;失败轨迹需要方向性的纠正参考。
2. 方法论
2.1 核心思想
HSD(Hybrid Hindsight Self-Distillation):依据轨迹正确性 联合选择教师上下文与更新策略:
2.2 关键技术细节
- 提示(Hint)生成:用外部更强模型 Kimi-K2.6 离线为每个问题生成自然语言提示 ,包含关键中间推理步骤和经验证的最终答案。教师 = 同一个学生模型,但条件在 上:
- 成功轨迹():
- 教师输入:已验证的学生响应 + "改写指令"。
- 教师不生成新回答,仅 teacher-forcing 对原始 token 重打分,得到幅度权重 :
- token 级优势:
- 保留 GRPO 的截断目标方向,仅细化 token 级信用。
- 失败轨迹():
- 教师条件在离线提示 上,对学生做反向 KL 蒸馏:
- 提供方向性纠错信号。
2.3 算法流程概述
1. 学生采样 条轨迹,得奖励与正确性标记 。
2. 对 轨迹:构造"改写+已验证响应"的教师上下文,用 RLSD 幅度调制更新。
3. 对 轨迹:构造"提示 "的教师上下文,用反向 KL 蒸馏更新。
4. 加权求和得总损失。
3. 实验设计
3.1 模型与基准
- 基模型:Qwen3-30B-A3B-Instruct-2507
- 基准(4 个独立训练设置):
- Sudoku-6×6、Sudoku-8×8
- Calcudoku(5×5、6×6)
- Arrow Maze(6×6、7×7、8×8、9×9、10×10)
- 特点:程序化生成的逻辑推理任务,降低预训练暴露风险,更纯净地检验推理泛化。
- 指标:pass@1(验证器通过的贪心解码单次准确率)
3.2 对比方法
- RLVR 基线:GRPO
- 自蒸馏基线:OPSD、SDPO、RLSD、SRPO
- 公平控制变体:RLSD+hint、SRPO+hint、OPSD(统一使用同一份离线提示)
- 实现平台:VERL + SGLang,FSDP 全参数训练;为节省显存采用 Top-100 token + 尾部桶近似
3.3 主要结果(表1 摘要)
| 方法 | Sudoku-6×6 | Sudoku-8×8 | Calcudoku Avg | Arrow Maze Avg | Overall |
|---|---|---|---|---|---|
| Base LLM | 24.50 | 14.00 | 35.17 | 15.60 | 22.32 |
| GRPO | 26.25 | 16.75 | 40.00 | 15.70 | 24.68 |
| RLSD | 27.75 | 15.25 | 41.00 | 15.40 | 24.85 |
| OPSD | 35.25 | 16.75 | 30.83 | 13.20 | 24.01 |
| SRPO | 28.25 | 15.50 | 38.50 | 13.80 | 24.01 |
| HSD | 76.50 | 57.25 | 44.00 | 24.20 | 50.49 |
HSD 在所有设置上取得最强综合性能,尤其在 Sudoku 上提升极大;并保持最低平均生成长度(图3、图8),位于精度-效率 Pareto 前沿。
4. 资源与算力
- 硬件:4 个节点,每节点 8 块 NVIDIA H200 140GB GPU,合计 32 块 H200。
- 框架:VERL(训练)+ SGLang(rollout),FSDP 全参数训练。
- 时间:未在论文中明确给出 wall-clock 训练时长;仅以 rollout step 给出训练进度(Sudoku-6×6 大约 600 步,Sdokuo-8×8 大约 600 步,Calcudoku/Arrow Maze 几十至一百余步),推算大致数小时到 1 天量级。
- 提示生成:Kimi-K2.6 离线生成,每个问题最多 5 次尝试,温度 0.1,最大长度 65536 tokens;仅保留验证器通过的提示。
5. 实验数量与充分性
数量
- 主实验:4 个基准设置,9 种方法(含 hint 变体)对比,约 36 组数据点。
- 路由策略消融(表2):Magnitude Only / Reverse-KL Only / Reversed Routing / HSD。
- 特权上下文消融(表3):程序化反馈 / Ground Truth / Sibling Solution / Hint。
- 改写指令消融(表4):Magnitude Only、Reverse-KL Only、HSD × 有/无改写。
- 生成效率分析:4 个基准上的精度-生成长度 Pareto(图3、图8)。
- 熵动态分析:4 个基准 × 多种更新策略(图6),以及 4 个基准 × 改写有无(图7)。
充分性
- 公平性较好:所有 hint 变体共享同一份离线提示,控制了提示质量差异,隔离"提示信息"与"转换方式"的贡献。
- 消融完整:从路由策略、特权上下文、改写指令三方面分别验证设计选择。
- 机制可解释:附 actor entropy 曲线,说明探索-利用权衡。
- 不足:训练仅基于单一基模型(Qwen3-30B-A3B),未在其他规模/家族模型上验证;未报告统计显著性(多次随机种子);仅在逻辑推理任务测试,未涉及数学/代码等更广推理域。
6. 主要结论与发现
1. RLVR 中成功与失败轨迹应使用差异化的事后监督:成功→幅度调制,失败→方向性纠错。
2. 在相同提示条件下,HSD 显著优于 OPSD、RLSD+hint、SRPO+hint,说明增益来自监督方式,而非提示信息本身。
3. 外部过程级提示(hint)远优于程序化反馈或纯答案:含中间推理步骤的提示对失败轨迹纠错最有效。
4. 改写指令仅在"幅度调制"机制下稳定有效;与反向 KL 联合使用会导致熵快速坍缩(图5、图7)。
5. HSD 同时实现更高的准确率与更短的生成长度,推理效率更优。
6. Reversed Routing 证明分配方式关键:错配会迅速导致策略熵归零、崩溃(图4、图6)。
7. 优点
- 问题定义精准:清晰指出"教师角色固定"是已有自蒸馏方法的核心瓶颈。
- 方法简洁优雅:仅靠"按正确性路由 + 改写指令 + 反向 KL"三要素实现统一框架,无需额外价值网络或外部强教师。
- 公平对比设计:通过共享 hint 控制变量;专门对比 SRPO+hint 等"组合增强基线",剥离提示增益。
- 机制可解释性强:通过熵曲线、Pareto 前沿等多维度证据解释为何有效。
- 工程落地完整:报告超参(表5–12)、提示样例(表13–15)、prompt 模板(附录C),可复现性强。
- 效率优势:在所有基准上同时实现更高精度与更短输出。
8. 不足与局限
- 依赖外部强模型:HSD 需要 Kimi-K2.6 生成验证通过的过程级提示,限制了在"无强参考模型"场景的应用;且会因提示过滤而缩小训练数据覆盖。
- 单基模型验证:仅在 Qwen3-30B-A3B-Instruct-2507 上实验,未验证跨规模/跨架构的可推广性。
- 任务域偏窄:评测集中在程序生成的逻辑推理(Sudoku/Calcudoku/Arrow Maze),未涵盖数学、代码、开放 QA 等更广推理域。
- 缺乏统计显著性检验:未报告多随机种子与置信区间,结论稳定性存疑。
- 超参敏感性未充分讨论:(反向 KL 强度)、(幅度调制强度)、改写指令模板的影响未做系统扫描。
- 推理时仍无特权信息:方法依赖训练时可用、推理时不可用的提示,若任务无验证器则无法部署。
- 附录提到 Top-100 近似:对 OPSD 与 HSD 反向 KL 分支均使用 top-K + 尾部桶近似,可能引入少量精度损失。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。