
基于噪声学生在线策略自蒸馏的自增强视觉-语言模型
Self-Boosting Vision-Language Models with Noisy Student On-Policy Self-Distillation
📝 TLDR
视觉语言模型的后训练通常依赖人工标注、外部模型蒸馏或带反馈的强化学习,难以在不借助外部监督的条件下自我提升。为此,本文提出 NOPD(基于噪声学生的在线自蒸馏),让模型对加噪输入进行学习,并以自身在干净输入下的预测作为逐 token 监督信号。在五个视觉推理任务上,NOPD 可匹配甚至超越基于强化学习或外部模型蒸馏的方法,且对分布外测试集同样有效。该工作展示了无需外部监督即可通用增强 VLM 的可行路径。
🧭 速览
现有 VLM 后训练方法依赖人工标注、外部模型或 RLHF,难以在无外部监督条件下持续自我提升。
NOPD 对输入加噪后训练模型,以自身在干净输入下的预测作为逐 token 监督信号,无需任何外部模型或人工标注。
在 5 项视觉推理任务上匹配或超越 RL 与外部蒸馏;Geometry3K 仅用 2.1K 样本使 Qwen2.5-VL-7B 提升 20 分,MathVista 提升 7.4 分。
证明无需外部监督即可通用增强 VLM,为自提升式多模态后训练提供简洁有效的方案。
🆚 方法对比
NOPD(Noisy Student On-Policy Self-Distillation)
- 无需外部教师模型或真实标签
- 提供token级密集监督信号
- 采样成本低,无需GT数据
- 在3个模型12个基准上均有效提升
- 依赖模型自身预测作为监督信号
- 仅在视觉推理任务上验证充分
- 需要预先设计的图像变换策略T(x)
SFT(Supervised Fine-Tuning)
- 提供token级监督信号
- 方法成熟,应用广泛
- 实现简单,训练稳定
- 依赖人工标注或前沿模型蒸馏
- 需要高质量真实答案y*
- 成本高,难以自举提升
RLVR(如GRPO)
- 无需GT数据,on-policy学习
- 无需额外critic模型
- 在可验证领域效果好
- 奖励信号稀疏(仅整句级别)
- 仅限数学、代码等可验证领域
- 采样成本高
KD(Off-policy Knowledge Distillation)
- 提供dense token级监督
- 教师模型能力强
- 训练稳定
- 需要外部教师模型
- off-policy分布差异
- 依赖强模型资源
OPD(On-policy Distillation)
- on-policy学习,分布一致
- 提供token级监督信号
- 采样成本低
- 仍需外部教师模型提供监督
- 无法独立完成自我提升
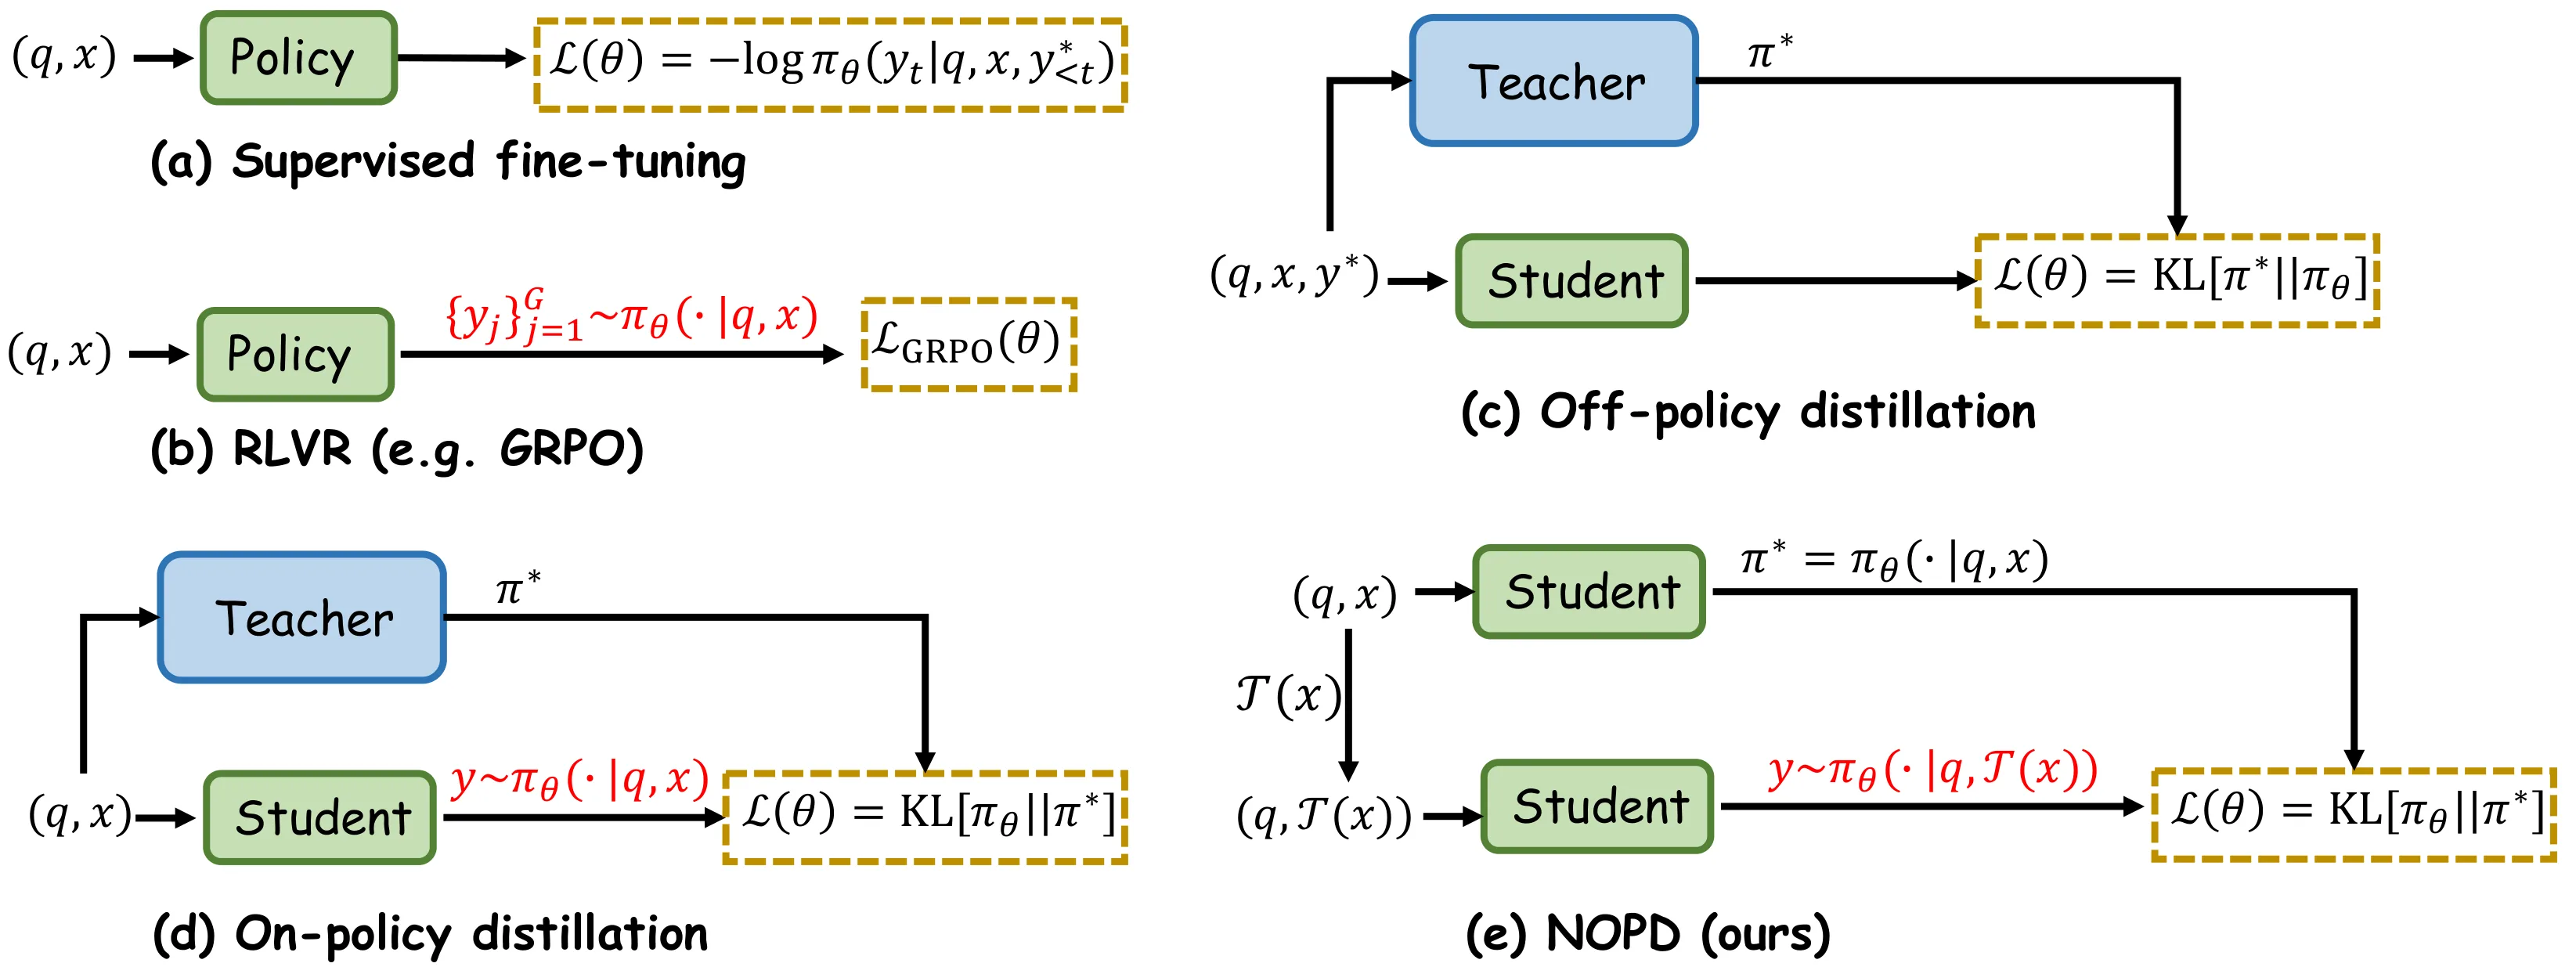
本文提出的NOPD是唯一同时满足无GT数据、无外部模型、on-policy学习、token级监督和低采样成本的方法,在Geometry3K上仅用2.1K样本即可使Qwen2.5-VL-7B提升20分,匹配甚至超越RLVR和外部蒸馏方法,同时实现输出长度压缩。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
TL;DR
本文提出 NOPD,一种无需任何外部监督即可自我增强视觉-语言模型的方法。核心思想是让模型同时处理干净与加噪的图像输入,通过比较两者的预测差异产生自监督信号。实验表明,仅用 2.1K 样本训练,NOPD 就能让 Qwen2.5-VL-7B 在几何推理任务上提升 20 分,且在 12 个基准上展现跨模型通用性。
研究背景与动机
视觉-语言模型(VLM)的后训练阶段是使其适配人类指令、执行下游任务的关键环节。传统做法通常依赖三类外部信号:人工标注数据、外部模型蒸馏响应,或带反馈的强化学习。这些范式在实际应用中面临根本性制约——人工标注成本高昂且难以规模化,外部蒸馏需要更强的教师模型,强化学习方法则依赖可验证答案且采样效率低下。
更核心的问题在于:是否存在一种完全"自给自足"的提升路径,让模型在没有任何外部监督的条件下实现自我增强?此前已有 OPSD 等自蒸馏方法尝试回答这一问题,但它们仍需依赖环境反馈或真实答案,并非真正无监督。这促使作者追问:能否仅凭模型自身的预测差异构造监督信号?
方法
这一问题的答案藏在输入的非对称性中。当向同一模型输入"干净图像"与"经过轻微变换的损坏图像"时,模型会给出不同的预测——这种差异本身就是一个天然的监督信号,无需任何外部知识。
具体实现上,同一个模型 同时扮演两个角色。在教师端,输入为原始图像 与查询 ,模型输出预测分布 ;在学生端,输入为经过变换 损坏的图像 与相同查询,模型学习拟合教师端的输出。关键在于对教师端预测施加 stop-gradient,防止模型坍缩为对任意输入产生相同输出。
目标函数采用 reverse KL 散度:
选择 reverse KL 而非 forward KL 或 JSD 的原因在于:reverse KL 鼓励学生分布覆盖教师分布,但对高概率区域要求更严格,这种"mode-seeking"特性在实验中表现最优。
图像扰动策略 包括三种方式:加性高斯噪声、低分辨率下采样和 Gamma 变换。高斯噪声单独使用时增益最大(从 73.2 提升至 77.1),三种方式联合使用效果最佳。直觉上,这些扰动模拟了现实世界中图像质量的自然变化,让模型学会在信息受限情况下提取关键特征。
从梯度视角看,NOPD 可解释为一种对比式策略梯度:对数概率比 作为对比式奖励,优先放大对干净与损坏输入预测差异显著的那些 token 的更新,从而实现更有针对性的学习。
实验与结果
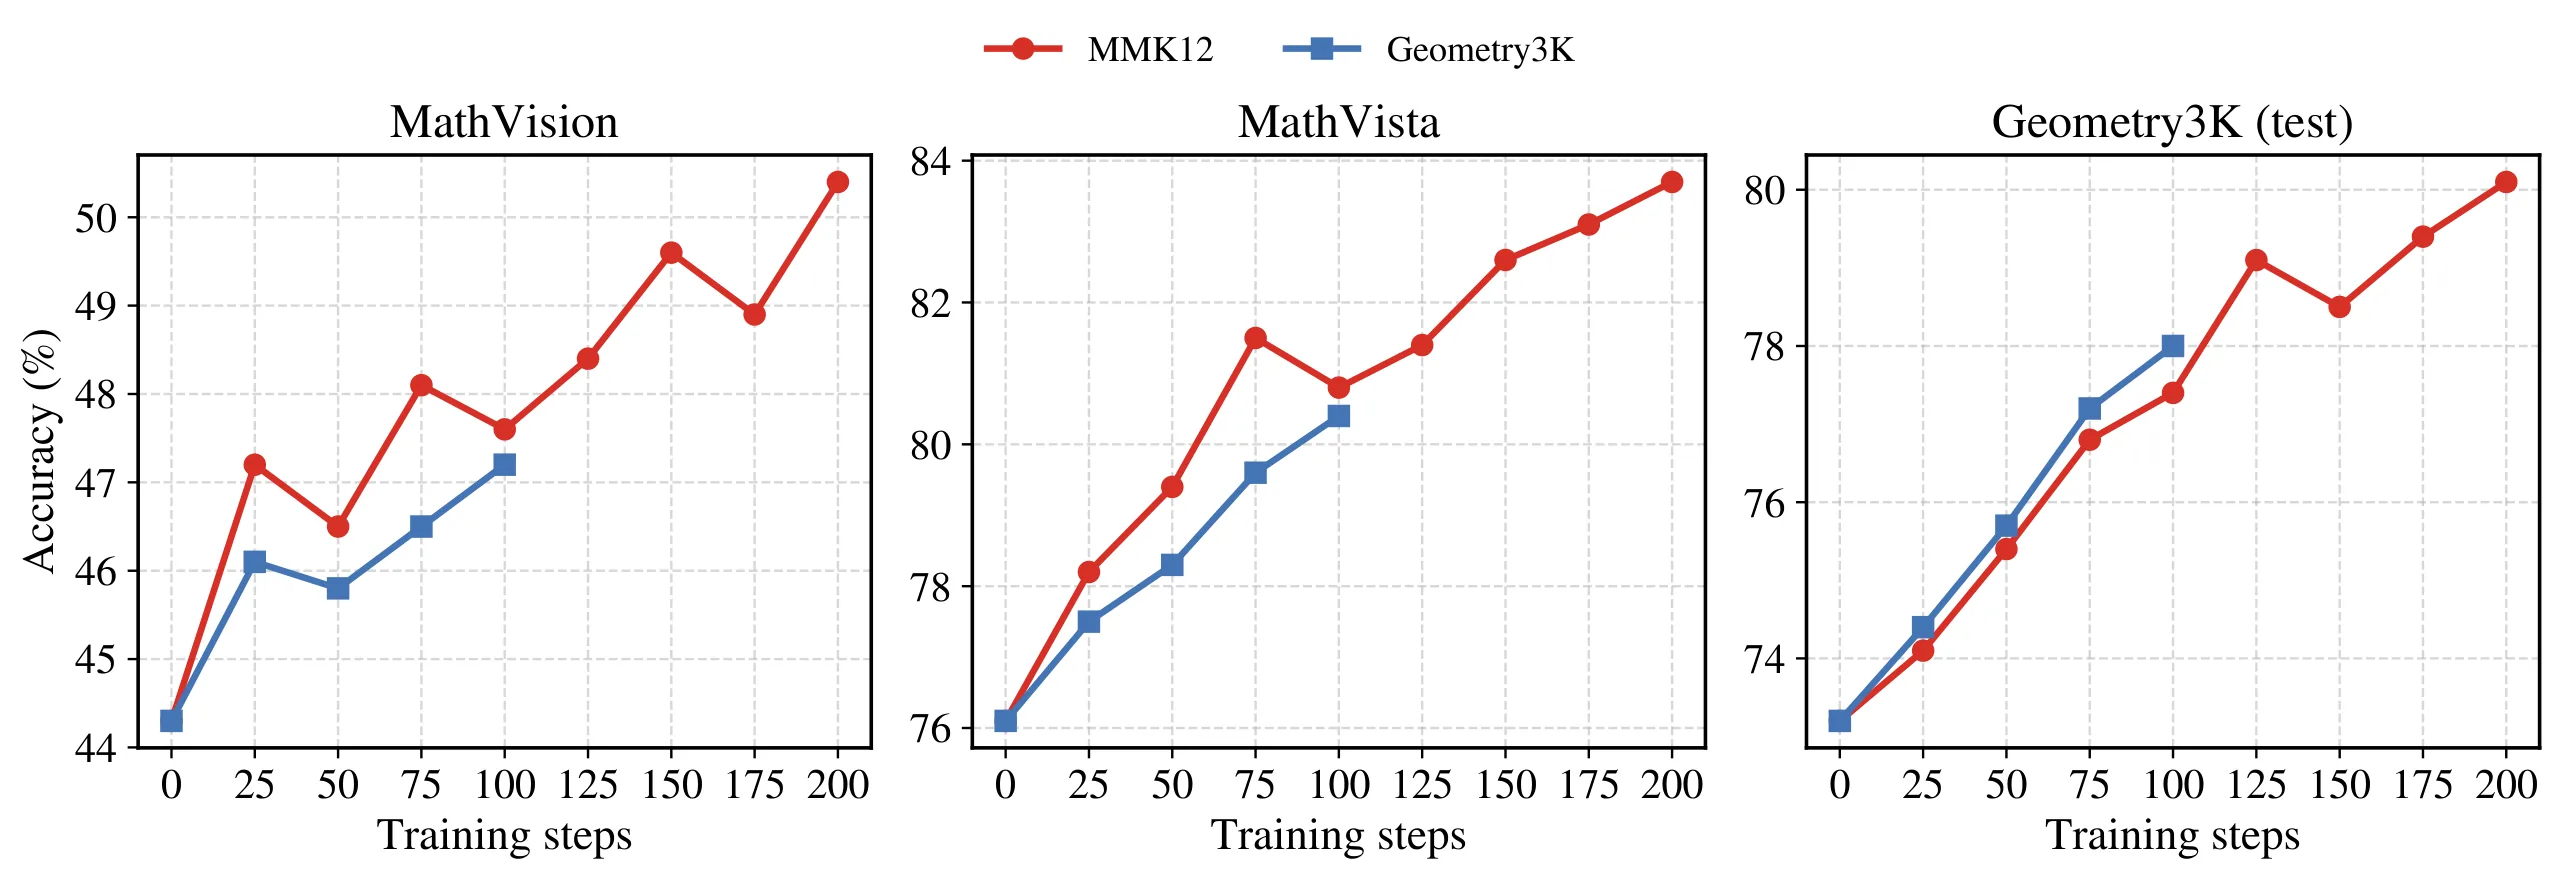
实验首先在小规模设置下验证方法有效性。仅有 2.1K 样本的 Geometry3K 训练集上,Qwen2.5-VL-7B 的验证集性能从基线提升 20 分,MathVista 提升 7.4 分。这一结果意义重大——传统监督微调需要大量标注数据,NOPD 仅凭模型自身的预测差异就实现了显著提升。
与多种后训练方法的对比揭示了 NOPD 的独特优势。在五个视觉推理基准上,它匹配甚至超越依赖外部模型蒸馏的 OPD 方法,以及基于 GRPO 的强化学习方法,同时大幅优于简单监督微调。值得注意的是,NOPD 实现了 token 级密集监督,而强化学习方法只能提供稀疏的整句奖励。
泛化能力是另一关键发现。在训练集分布外的 MathVision、MMMU、MMMU-Pro 等基准上,NOPD 依然保持稳定提升。Qwen3.5-2B 在 MMMU-Pro 上获得 4.4 分增益,说明学习到的能力具有良好的可迁移性。
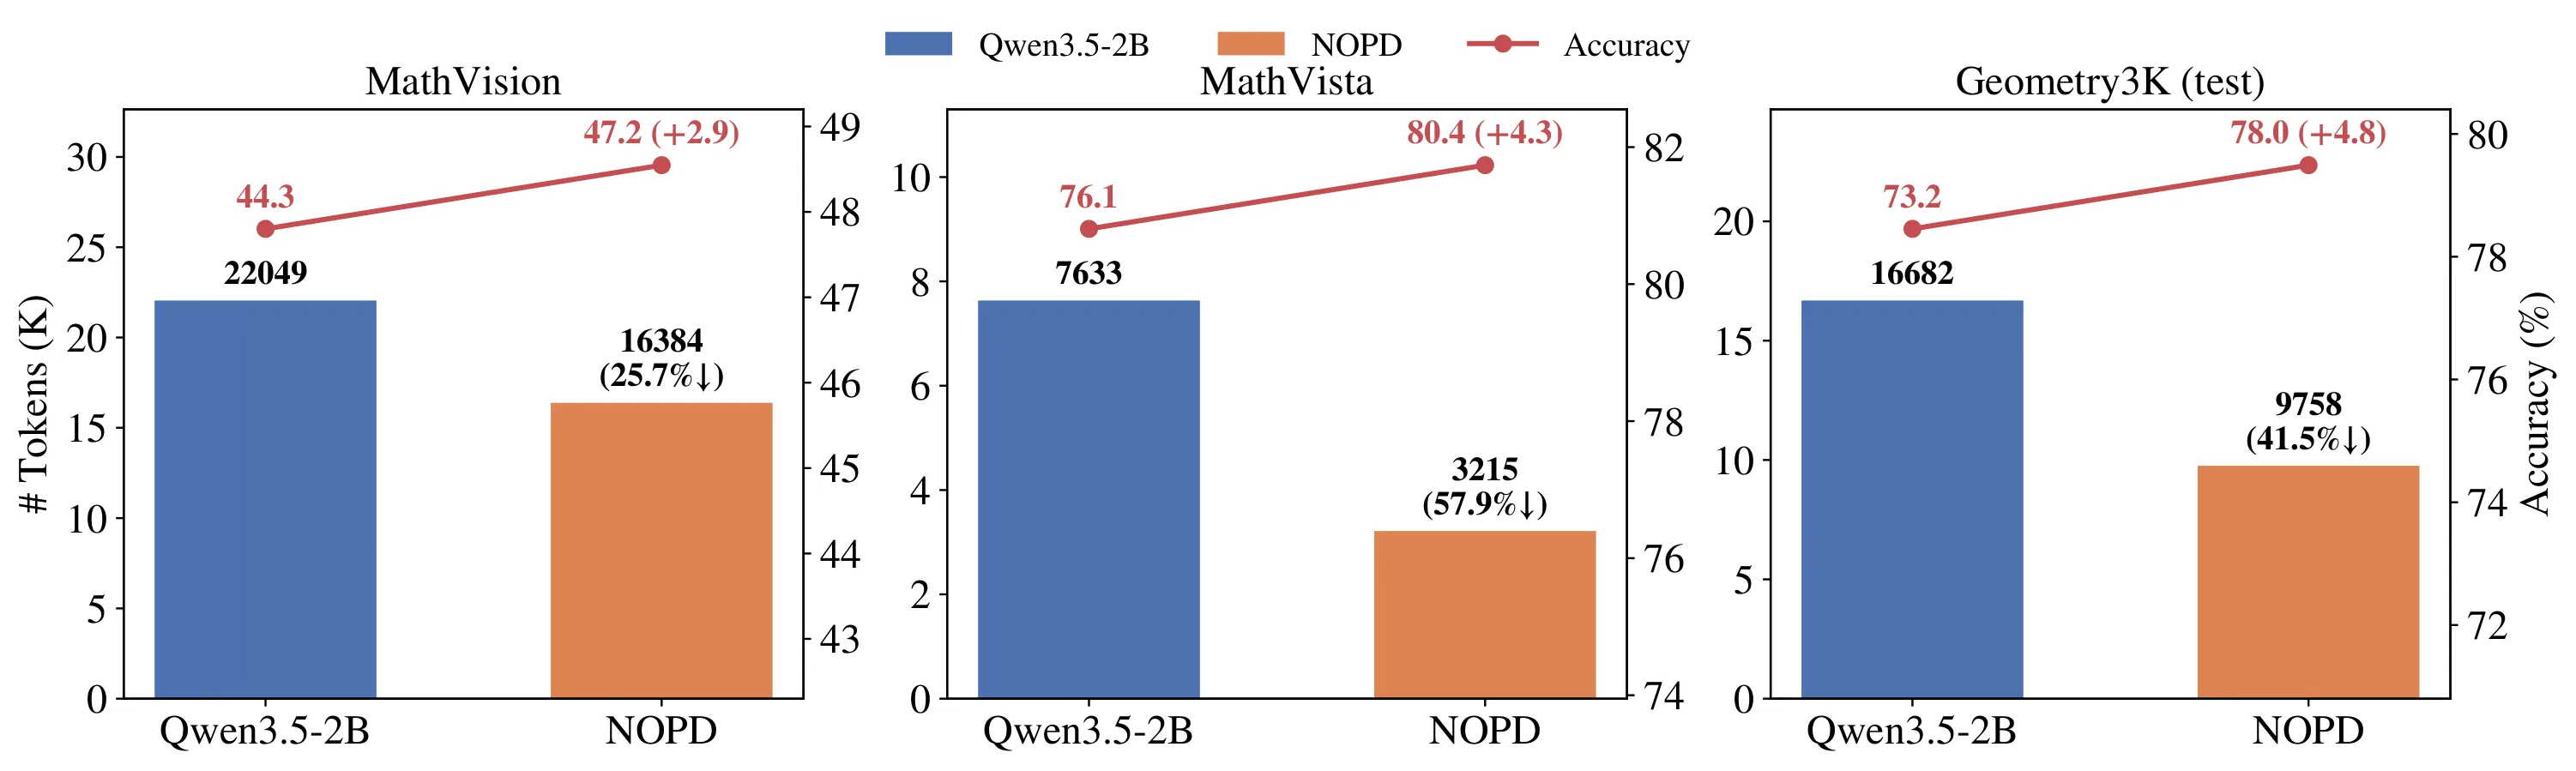
一个有趣的副产品是隐式推理压缩:随着准确率提升,模型生成的输出长度显著缩短。MathVista 减少 57.9% token,Geometry3K 减少 41.5%。这意味着模型在提升性能的同时学会了更简洁的表达方式,降低了推理成本。
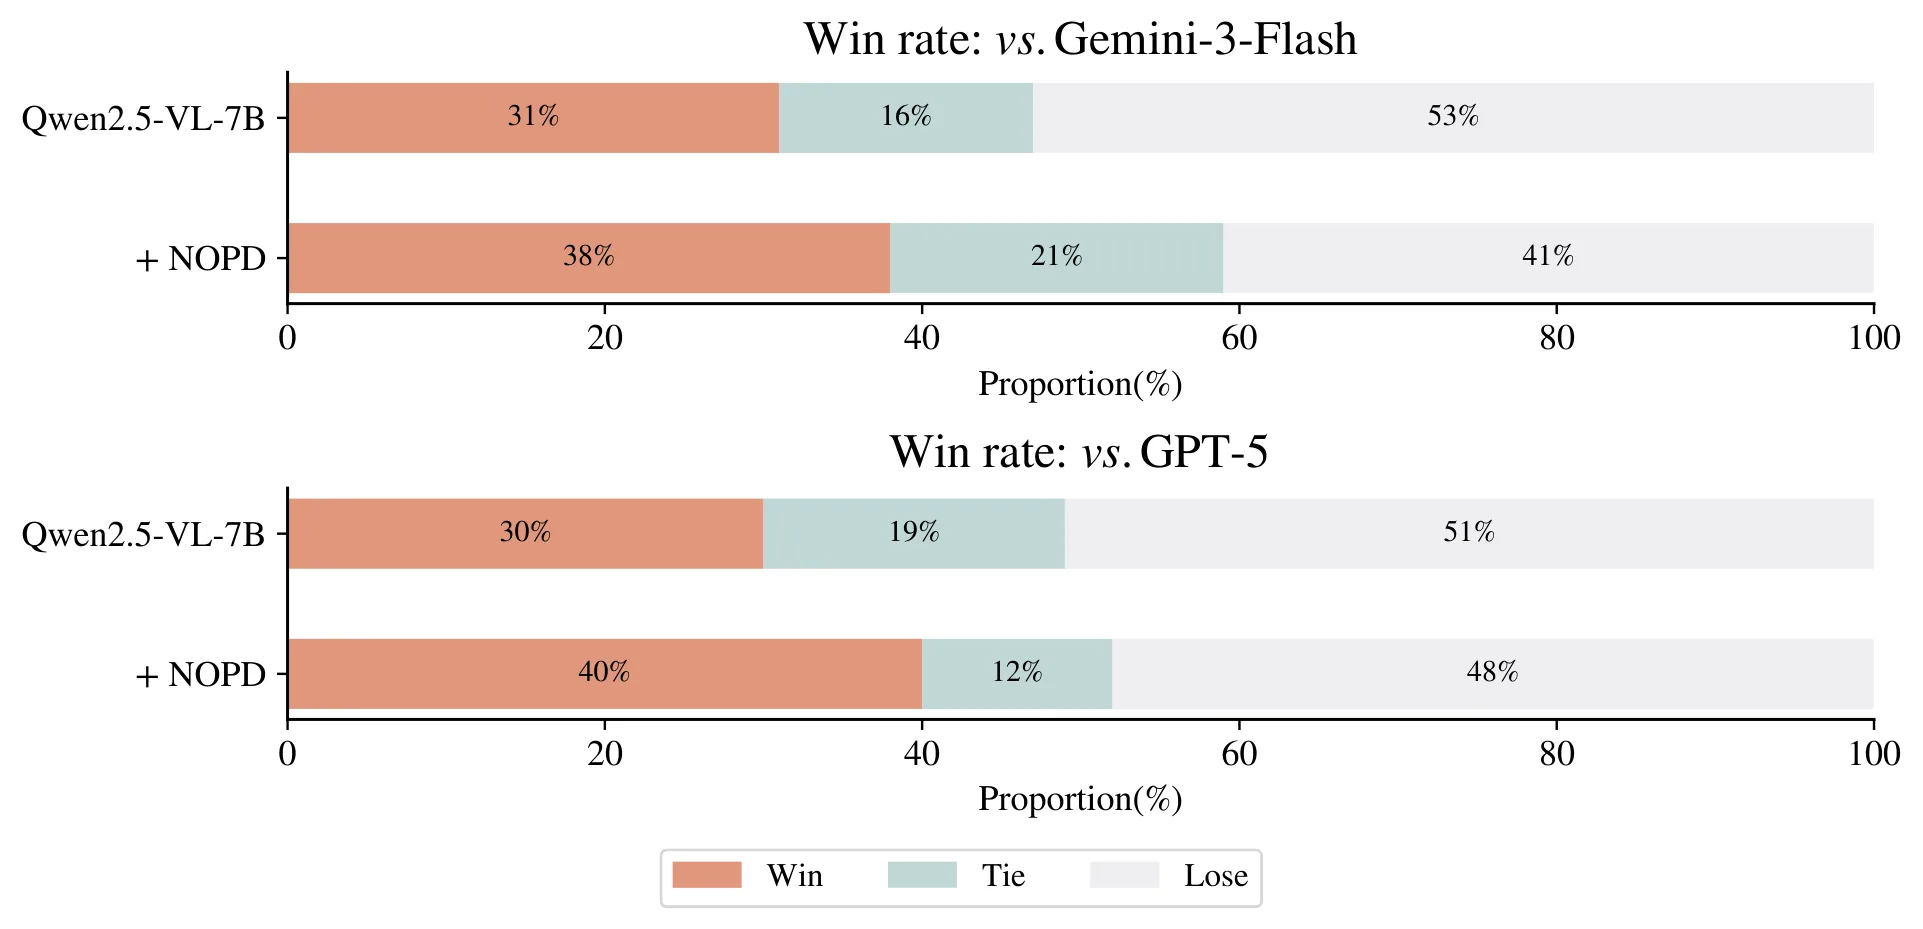
大规模验证涵盖三个模型(Qwen2.5-VL-7B、Qwen3-VL-8B-Thinking、GLM-4.6V-Flash-9B)在 12 个基准上的表现,NOPD 在大多数组合中带来稳定增益,证明其作为通用 VLM 增强框架的潜力。开放式生成任务上,7B 模型在图像描述任务中胜率可与 Gemini-3-Flash、GPT-5 相当。
讨论与可借鉴点
NOPD 展示了视觉-语言模型自我增强的可行路径,核心启示在于:模型自身的预测差异可以成为丰富的监督来源,无需依赖外部知识。这一思路与[[对比学习]]和[[自监督学习]]的精神一脉相承,但将对比从样本级别迁移到了输入扰动级别。
当前方法的局限性值得注意。首先,图像扰动超参数未充分调优,直接沿用了通用计算机视觉设置,这可能限制了方法潜力的充分发挥。其次,训练稳定性在后期阶段可能面临挑战——随着学生与教师逐渐共享参数,训练动态的收敛性需要更深入分析。此外,该方法依赖视觉模态的存在,纯语言任务无法直接套用。
对于后续研究,一个有价值的方向是探索更丰富的输入扰动策略(如文本扰动、跨模态扰动),以及将 NOPD 与外部监督方法结合使用。论文已证明其与 OPSD 的互补性,未来可进一步探索与其他后训练范式的协同。
这项工作的核心贡献不仅是具体方法,更在于思路转变:不再追问"如何获得更好的外部监督",而是问"模型自身能告诉我们什么"。这种视角转换或许能为 VLM 后训练开辟新的研究空间。
摘要
后训练使视觉-语言模型(VLM)能够理解人类指令并执行各种下游任务。现有的后训练方法通常依赖于人工标注数据、来自外部模型的蒸馏、人类反馈强化学习或可验证的答案。这限制了它们在没有外部监督的情况下进行改进的能力。为了解决这一问题,我们提出了 NOPD(噪声学生在线策略自蒸馏),一种简单而有效的自蒸馏方法,可在不使用任何外部模型或真实答案的情况下改进 VLM。我们的核心洞察在于,干净输入与损坏输入之间的预测差异自然会产生自监督信号。在 NOPD 中,模型从损坏输入中学习,同时将其在干净输入下的自身预测作为 token 级别的监督。我们在五个视觉推理任务上验证了 NOPD 的有效性;它能够匹配甚至超越强化学习方法或外部模型蒸馏。值得注意的是,当使用来自 Geometry3K 的 2.1K 样本进行训练时,NOPD 在其验证集上将 Qwen2.5-VL-7B 提升了 20 分。它还在分布外测试集上表现出泛化能力,并在 MathVista 上获得了 7.4 分的提升。此外,我们证明了 NOPD 是一种增强 VLM 的通用方法,在三个模型和 12 个基准上均实现了性能提升。
Abstract
Post-training enables vision-language models (VLMs) to understand human instructions and perform various downstream tasks. Current post-training methods usually rely on human-annotated data, distillation from external models, reinforcement learning with human feedback, or verifiable answers. This limits their ability to improve without external supervision. To tackle this, we propose NOPD (Noisy Student On-Policy Self-Distillation), a simple yet effective self-distillation approach that improves VLMs without any external models or ground-truth answers. Our key insight is that prediction discrepancies between clean and corrupted inputs naturally induce a self-supervision signal. In NOPD, the model learns from corrupted inputs while using its own predictions under clean inputs as token-level supervision. We show the effectiveness of NOPD on five visual reasoning tasks; it can match and even outperform reinforcement learning approaches or distillation from external models. Notably, when trained with 2.1K samples from Geometry3K, NOPD improves Qwen2.5-VL-7B by 20 points on its validation set. It also shows generalization on out-of-distribution test sets and achieves 7.4 point gains on MathVista. Furthermore, we demonstrate that NOPD is a general approach to enhance VLMs, achieving improvements across three models on 12 benchmarks.
论文详细总结(自动生成)
论文总结:基于噪声学生在线策略自蒸馏的自增强视觉-语言模型(NOPD)
1. 核心问题与研究动机
视觉-语言模型(VLM)的后训练(post-training)阶段通常依赖外部监督信号来提升其视觉推理与指令理解能力,主要包括:
- 监督微调(SFT):需要人工标注或来自前沿模型的蒸馏响应 ;
- 带可验证奖励的强化学习(RLVR,如 GRPO):依赖可验证答案,提供稀疏的整句奖励;
- 离策略 / 在策略知识蒸馏(KD / OPD):需要更强的外部教师模型提供 token 级监督。
这些范式存在固有局限:SFT 易使开源模型性能下降;RLVR 奖励稀疏、采样成本高;KD/OPD 需依赖外部模型。作者提出关键问题:在没有任何真实答案或外部模型(即无任何外部监督)的条件下,VLM 能否实现"自我增强"? 现有自蒸馏方法(如 OPSD、Self-Distillation Zero)仍需要环境反馈或标准答案 ,因此并不真正"无监督"。
2. 方法论
2.1 核心思想
NOPD 的关键洞察:在非对称输入分布下,模型对干净输入与损坏输入的预测差异本身即可作为密集的 token 级自监督信号。具体而言,同一模型 扮演教师与学生两种角色:
- 教师端:输入为干净图像 与查询 ;
- 学生端:输入为经过图像变换 损坏的图像 与查询 。
学生从损坏输入中学习,并以教师在干净输入下的预测作为 token 级监督目标,全程无需任何外部信息。
2.2 目标函数
其中 表示对教师端输出 施加 stop-gradient,防止模型坍缩为对任意输入产生同一输出。该公式采用 reverse KL(经验上优于 forward KL 与 JSD,见消融实验)。训练流程如算法 1 所示。
2.3 梯度分析
经推导,NOPD 梯度可解释为 对比式策略梯度(contrastive policy gradient):
其中对数比项 作为 对比式奖励,放大对干净与损坏输入下预测差异显著的 token 的更新。
2.4 图像扰动策略
随机选择以下三种方式之一:
- 加性高斯噪声:,,;
- 低分辨率:将图像下采样 2× 或 4×;
- Gamma 变换:,。
三种扰动联合使用效果最佳,且高斯噪声单独使用时增益最大(73.2 → 77.1)。
3. 实验设计
3.1 数据集与训练设置
- 小规模初步实验:Geometry3K 训练集(2.1K 样本);
- 数据可扩展性实验:MMK12(15.6K 样本);
- 大规模通用实验:从 Geometry3K、GeomVerse、Geo170K、MMK12、GeoQA+、CoSyn、VQAv2、ArxivQA、ChartQA、GQA 等来源筛选,按 general / reasoning / chart 三类分别得到 19K / 56K / 54K 样本,训练步数扩展至 1000。
3.2 基座模型
- Qwen2.5-VL-7B-Instruct、Qwen3.5-2B(thinking 模式);
- 大规模验证:Qwen2.5-VL-7B、Qwen3-VL-8B-Thinking、GLM-4.6V-Flash-9B。
3.3 评估基准
- 推理:Geometry3K、MathVista、MathVision、MMMU、MMMU-Pro;
- 通用 VQA:MMStar、MMBench-EN、BLINK、CV-Bench、Realworld-QA;
- 图表理解:ChartQA-Pro、ChartMuseum、CharXiv(reasoning);
- 开放式生成:CaptionQA、CapArena(与 Gemini-3-Flash、GPT-5 对比胜率)。
3.4 对比方法
| 方法 | 外部模型 | 在策略 | Token 级监督 | 低采样成本 | 无需 GT |
|---|---|---|---|---|---|
| SFT | ✗ | ✗ | ✔ | ✔ | ✗ |
| RLVR (GRPO) | ✗ | ✔ | ✗ | ✗ | ✗ |
| Off-policy KD | ✔ | ✗ | ✔ | ✔ | ✔ |
| On-policy Distillation (OPD) | ✔ | ✔ | ✔ | ✔ | ✔ |
| NOPD | ✗ | ✔ | ✔ | ✔ | ✔ |
SFT 使用 Qwen3.5-27B / Qwen2.5-VL-72B 蒸馏响应;KD 与 OPD 使用相同教师;RLVR 使用 GRPO 并尝试了 DAPO、GSPO 等变体(未观察到显著差异)。补充实验中亦与 OPSD 进行比较。
4. 资源与算力
论文 未明确报告 所使用的 GPU 型号、数量与总训练时长。仅在表 7 中给出训练超参数:
- 训练后端:FSDP2、BF16 精度、FlashAttention 2;
- 优化器:AdamW,学习率 ,cosine / constant 调度;
- 全局 batch size:32–128;
- 推理引擎:SGLang(RLVR)/ vLLM(评估);
- 生成最大长度:2048 / 4096 token;
- 教师-学生权重每步同步(sync)效果优于固定与 EMA()。
作者明确指出"由于算力限制,未对图像变换超参数进行调优"。KL 计算上为节省通信开销,仅传输教师最后一层隐状态(Qwen3.5-2B 为 6144 维,远小于 248320 词表),实时用教师头重算 logits。
5. 实验数量与充分性
5.1 初步对比(Sec. 4.1)
5 个推理基准 × 2 个模型 = 10 组主结果对照,覆盖 SFT / KD / RLVR / OPD / NOPD 五种方法。
5.2 消融实验(Sec. 4.2)
- 损失函数类型(forward KL / reverse KL / JSD());
- 计算策略(全词表 vs 仅采样 token);
- 教师更新方式(fix / EMA / sync);
- 生成长度(1024 / 2048 / 4096);
- 图像扰动类型(N / G / L 及其组合);
- 训练集规模可扩展性(MMK12 vs Geometry3K);
- Rollout 温度对多样性的影响(用 LLM 评判 1–10 分)。
5.3 通用性验证(Sec. 4.3)
3 个模型 × 12 个基准 = 36 组结果。
5.4 补充实验(附录 C)
- 与 OPSD 对比及 NOPD+OPSD 组合;
- 与 NoisyRollout 的差异分析;
- 开放式生成(图像描述)在 CaptionQA 与 CapArena 上的胜率评估;
- 两组详细的可视化案例分析(MathVision、Geometry3K)。
整体实验较为充分,涵盖多种模型、数据规模、任务类型与超参选择,并提供了详尽的消融;但部分组件(如图像扰动超参数)因算力限制未充分调优。
6. 主要结论与发现
1. 无需外部监督即可达到与外部方法相当的性能:NOPD 在 5 个推理基准上匹配甚至超越 RLVR 与 OPD,且显著优于 SFT 与 KD。
2. 数据高效:仅用 Geometry3K 的 2.1K 样本即可使 Qwen2.5-VL-7B 在验证集上提升 +20 分,MathVista 提升 +7.4 分。
3. 强泛化能力:训练集分布外的 MathVision、MMMU、MMMU-Pro 等基准上同样稳定提升(Qwen3.5-2B 在 MMMU-Pro 提升 +4.4 分)。
4. 隐式推理压缩:在准确率提升的同时,输出长度显著下降——MathVista 减少 57.9% token,MathVision 减少 25.7%,Geometry3K 减少 41.5%。
5. 通用框架:在 Qwen2.5-VL-7B、Qwen3-VL-8B-Thinking、GLM-4.6V-Flash-9B 三个不同架构模型上,对 12 个基准中的大多数均带来稳定增益。
6. 可扩展至开放式生成:在 CaptionQA 平均提升 +7 分(自然场景达 +13),CapArena 上 7B 模型胜率可与 Gemini-3-Flash、GPT-5 相当。
7. 提升源于学习而非多样性:在 0.8/1.0 温度下扰动并不增加 rollout 多样性,但性能仍提升,排除"多样性带来增益"的解释。
8. 与 OPSD 正交:二者可叠加使用,性能进一步提升。
7. 优点与亮点
- 完全自监督:无需任何外部模型、人工标签或可验证答案,是首个真正意义上的 VLM 自我增强方法;
- 方法简洁:仅需一个额外的图像变换 与一次 KL 计算,易于实现;
- 密集监督:相比 RLVR 的稀疏奖励,NOPD 提供 token 级对比式信号,训练更高效;
- 采样成本低:每条样本仅采样 1 次(区别于 GRPO 的 8 次);
- 双向收益:同时实现准确率提升与隐式推理压缩,降低推理成本;
- 通用性强:跨越模型架构(Qwen、GLM)、任务类型(推理、通用 VQA、图表理解、图像描述);
- 工程细节完善:通过传输隐状态而非完整 logits 解决大词表通信瓶颈(借鉴 KDFlow 框架);
- 消融详尽:从损失函数、教师更新、生成长度、扰动类型、训练数据规模、采样温度等多个维度验证设计选择的合理性。
8. 不足与局限
- 算力信息不透明:未报告 GPU 型号、数量与训练时长,复现成本难以估计;
- 超参未充分调优:作者明确承认因算力限制,图像扰动超参(如 取值集合、 范围、下采样倍数)直接采用通用 CV 设置;
- 依赖视觉模态:仅适用于多模态场景,纯 LLM 任务无法直接套用;
- 可能存在隐式偏置:NOPD 的监督信号来自模型自身,可能放大已有偏差(mode collapse 风险),作者虽以 stop-gradient 缓解,但未深入分析;
- 评估指标偏向可验证任务:主要在有标准答案的推理与图表任务上评估,开放式生成评估相对初步;
- 教师-学生同步更新的稳定性:虽实验上表现最佳,但训练后期若学生与教师共享参数,理论上可能引入训练不稳定性,需进一步分析;
- 跨语言/跨文化基准未涉及:评测主要基于英文基准,泛化性结论的普适性受限;
- 社会影响讨论薄弱:附录仅给出简短声明,未充分讨论自训练 VLM 可能带来的偏差放大或滥用风险。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。