
📝 TLDR
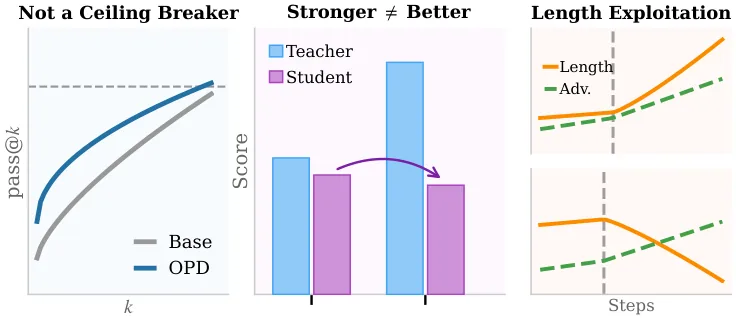
大语言模型后训练中,在策略蒸馏(OPD)虽被广泛应用,但其训练动态机制长期缺乏系统理解。本文深入分析OPD作为探索催化剂的角色,通过逐token密集信号引导学生沿正确推理路径前进,但无法突破学生模型本身的能力天花板。研究发现其效果完全取决于引导信号质量,并揭示两类病态:师生分布不匹配导致信号错位、长度利用使学生通过截断或填充取巧。提出优势裁剪与对数尺度压缩两种轻量级信号调控方法,在七个基准上稳定超越现有OPD变体及RLVR基线,表明信号质量而非教师规模才是有效蒸馏的关键。
🧭 速览
大语言模型后训练中,在策略蒸馏虽被广泛应用,但其训练动态机制长期缺乏系统理解,尤其信号质量与失败模式尚不清晰。
分析OPD作为探索催化剂的角色,揭示师生分布不匹配与长度利用两类病态,并提出优势裁剪与对数尺度压缩两种轻量级信号调控方法。
在七个基准上实验表明,所提调控方法有效缓解长度利用问题,性能稳定超越现有OPD变体与RLVR基线方法。
有效蒸馏的关键不在于教师模型规模,而在于引导信号本身的忠实性与质量,轻量级调控即可保障。
🆚 方法对比
On-Policy Distillation (OPD)
- 提供密集token级指导,加速早期学习
- 引导学生发现自身可达的正确推理路径
- 已成为LLM后训练标准范式之一
- 在七个推理基准上有一定效果
- 无法突破学生模型固有能力上限
- 效果完全依赖引导信号质量
- 存在师生不匹配与长度利用两大病理问题
- 训练行为不稳定,有时不如outcome-based RL
Advantage Clipping (Hard Clipping)
- 轻量级干预,几乎无额外计算开销
- 有效抑制病态激励保留有用探索信号
- 稳定训练过程,消除探索崩溃
- 硬截断可能丢失部分有用梯度信息
- 裁剪边界c_min和c_max需仔细调优
- 粗暴截断可能引入新的偏差
Log-scale Compression (Soft)
- 平滑压缩极端优势值,保留信号方向
- 消除长度利用等病理问题
- 无需额外计算成本
- 温和压缩对小值区域影响小
- 对数压缩函数引入额外超参数
- 对极小优势值区域的压缩效果存疑
- 仍需实验验证泛化能力
RLVR (可验证奖励强化学习)
- 基于可验证奖励,结果导向明确
- 不依赖教师模型,部署更简单
- 在多个推理任务上作为强基线
- 奖励信号稀疏,缺乏token级细粒度指导
- 探索效率可能低于良好调节的OPD
- 在某些任务上不如受调节的OPD表现
Cold-start 师生对齐微调
- 直接缓解师生分布不匹配问题
- 提供更对齐的初始化基础
- 需要额外的预训练对齐计算成本
- 不如轻量级信号调节方法高效
Prior OPD Variants (Jin et al., 2026等)
- 已有多种改进方案积累了经验
- 在大教师模型下有一定效果
- 依赖大规模教师(如30B),算力开销大
- 未能根本解决信号失真问题
该论文以OPD为核心框架,系统分析其作为探索催化剂的角色与两大病理(师生不匹配、长度利用),并提出轻量级信号调节方法(Hard Clipping与Soft Log-scale Compression),在七个推理基准上以适中教师规模稳定超越朴素OPD、RLVR基线及依赖30B大教师的先前OPD变体。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 9 张)
展开查看 9 张图
TL;DR
这篇论文系统性地揭示了同策略蒸馏(OPD)在大语言模型后训练中的运作机制:它本质上是一种「探索催化剂」,通过密集的token级信号引导学生走向正确推理路径,但无法突破学生本身的能力上限。研究进一步发现OPD存在两类病态——师生分布不匹配导致的信号错位,以及长度利用造成的捷径探索——并提出优势裁剪与对数尺度压缩两种轻量级调控手段加以驯服。在七个基准上的实验表明,经过调控的信号质量才是有效蒸馏的关键,而非单纯依赖更大的教师模型。
研究背景与动机
大语言模型的后训练阶段,[[策略蒸馏]](Policy Distillation)已成为将强大教师模型能力迁移到学生模型的核心技术。在众多蒸馏范式中,同策略蒸馏因其训练稳定性而被广泛采用——它要求学生模型在与教师相同的分布下生成响应,从而确保学习信号的内部一致性。然而,尽管应用广泛,研究者们对OPD的训练动态机制长期缺乏系统性理解。究竟是哪些因素决定了蒸馏的成功?为何有时即便使用强大的教师模型,学生模型的表现仍不尽如人意?这些问题悬而未决,阻碍了OPD在实际应用中的高效配置。
现有研究往往将OPD视为黑箱,关注最终性能指标,而忽视了其内在的探索机制。本文的研究动机源于一个关键观察:当学生模型在蒸馏过程中探索新的推理策略时,引导信号的质量直接决定了探索的方向是否正确。这一观察促使作者提出一个根本性问题——OPD究竟如何影响模型的探索行为,其有效性边界在哪里?
方法
作者的核心洞察是将OPD重新理解为「探索催化剂」。与直觉不同的是,蒸馏并非简单地让学生「记住」教师的输出分布,而是通过稠密的逐token级引导信号,在庞大的推理空间中为学生指明方向。这种引导作用类似于催化剂在化学反应中的角色——它降低了正确推理路径的「活化能」,使学生更容易沿正确方向前进,但催化剂本身并不改变反应的热力学极限(即学生模型的能力上限)。
为了验证这一理解,作者设计了一系列对照实验。他们发现,在OPD过程中,提示多样性(prompt diversity)比针对单个问题的采样数量更为关键。这意味着探索的广度比深度更能决定蒸馏效果。更重要的是,OPD的有效性完全取决于其引导信号的质量——当信号与任务正确性高度相关时,蒸馏效果显著;当信号质量下降时,即使采样更多也无济于事。
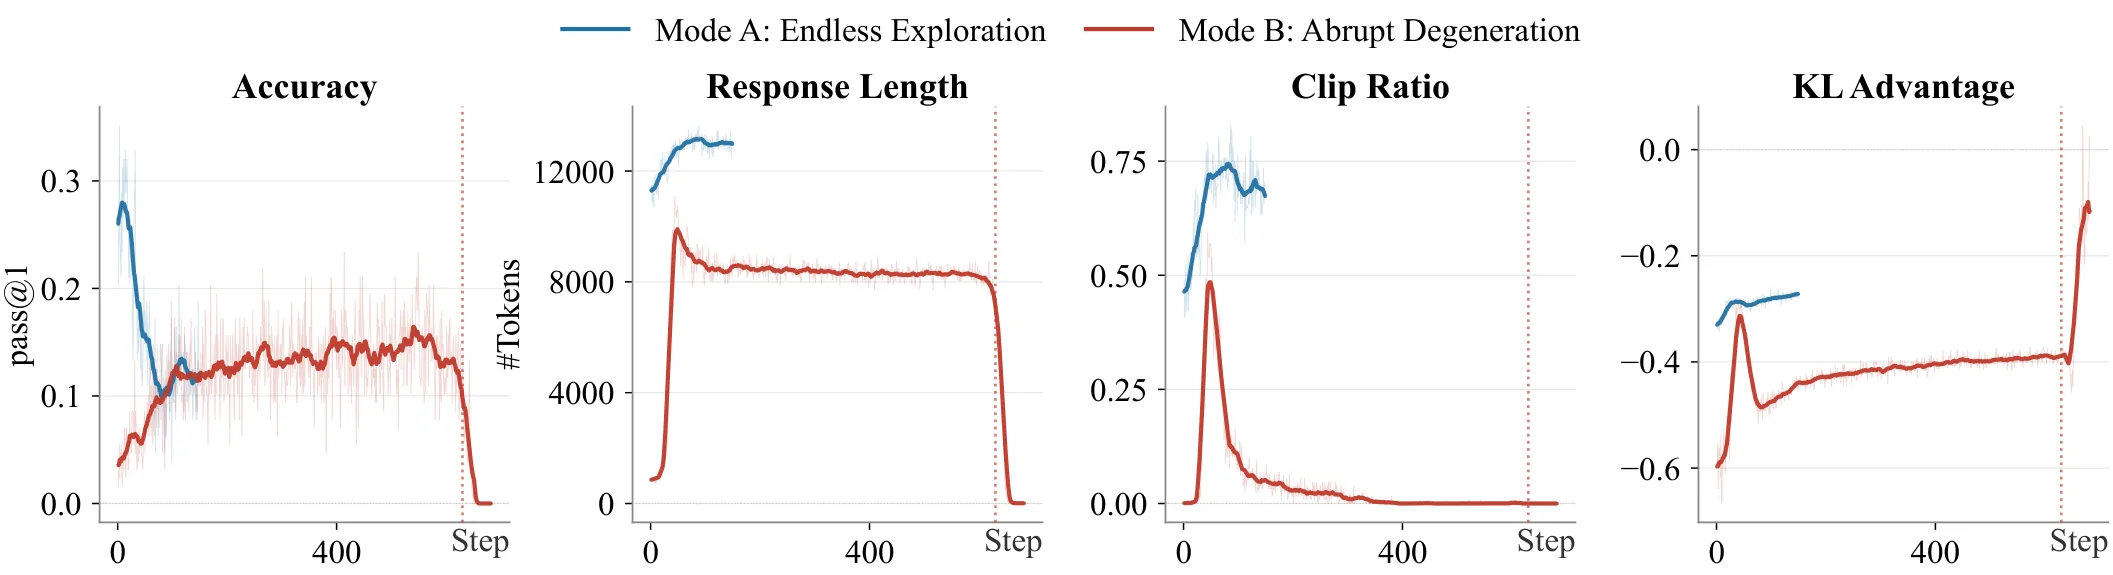
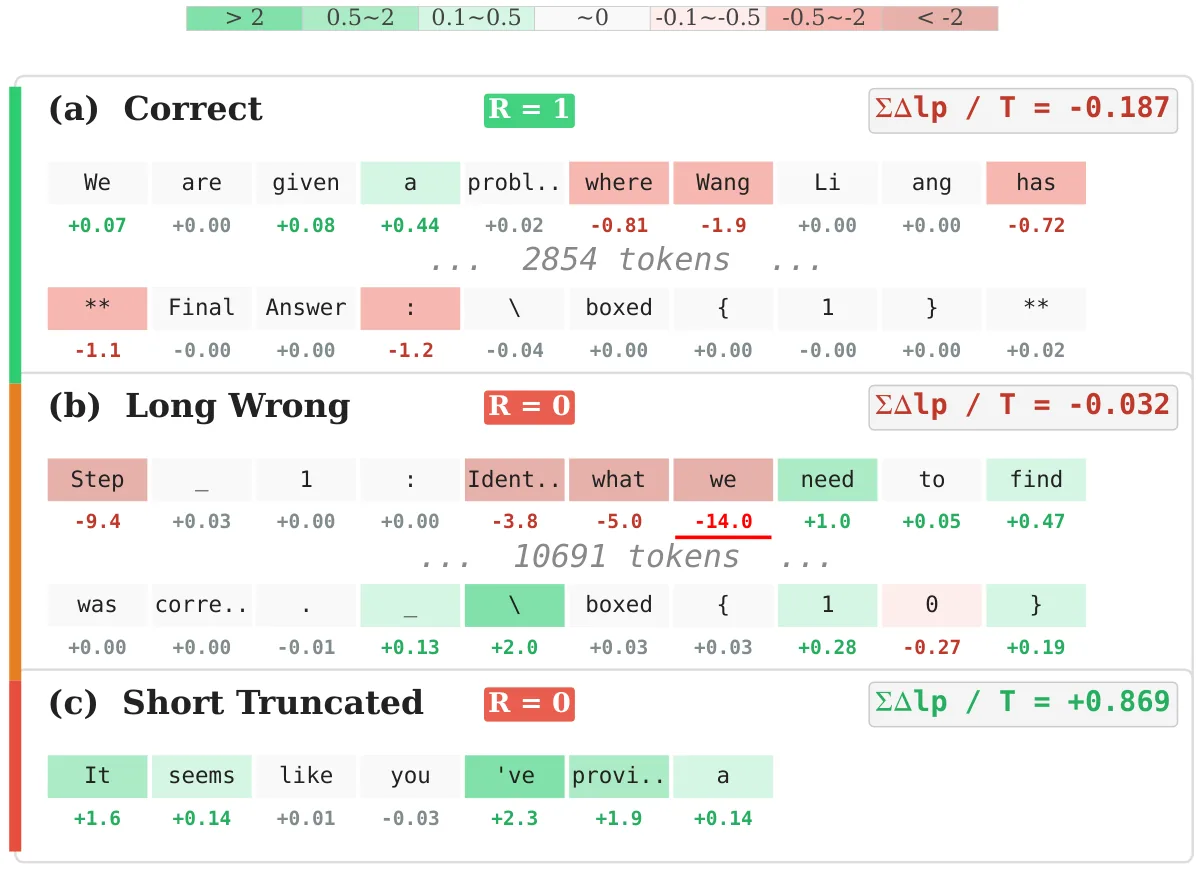
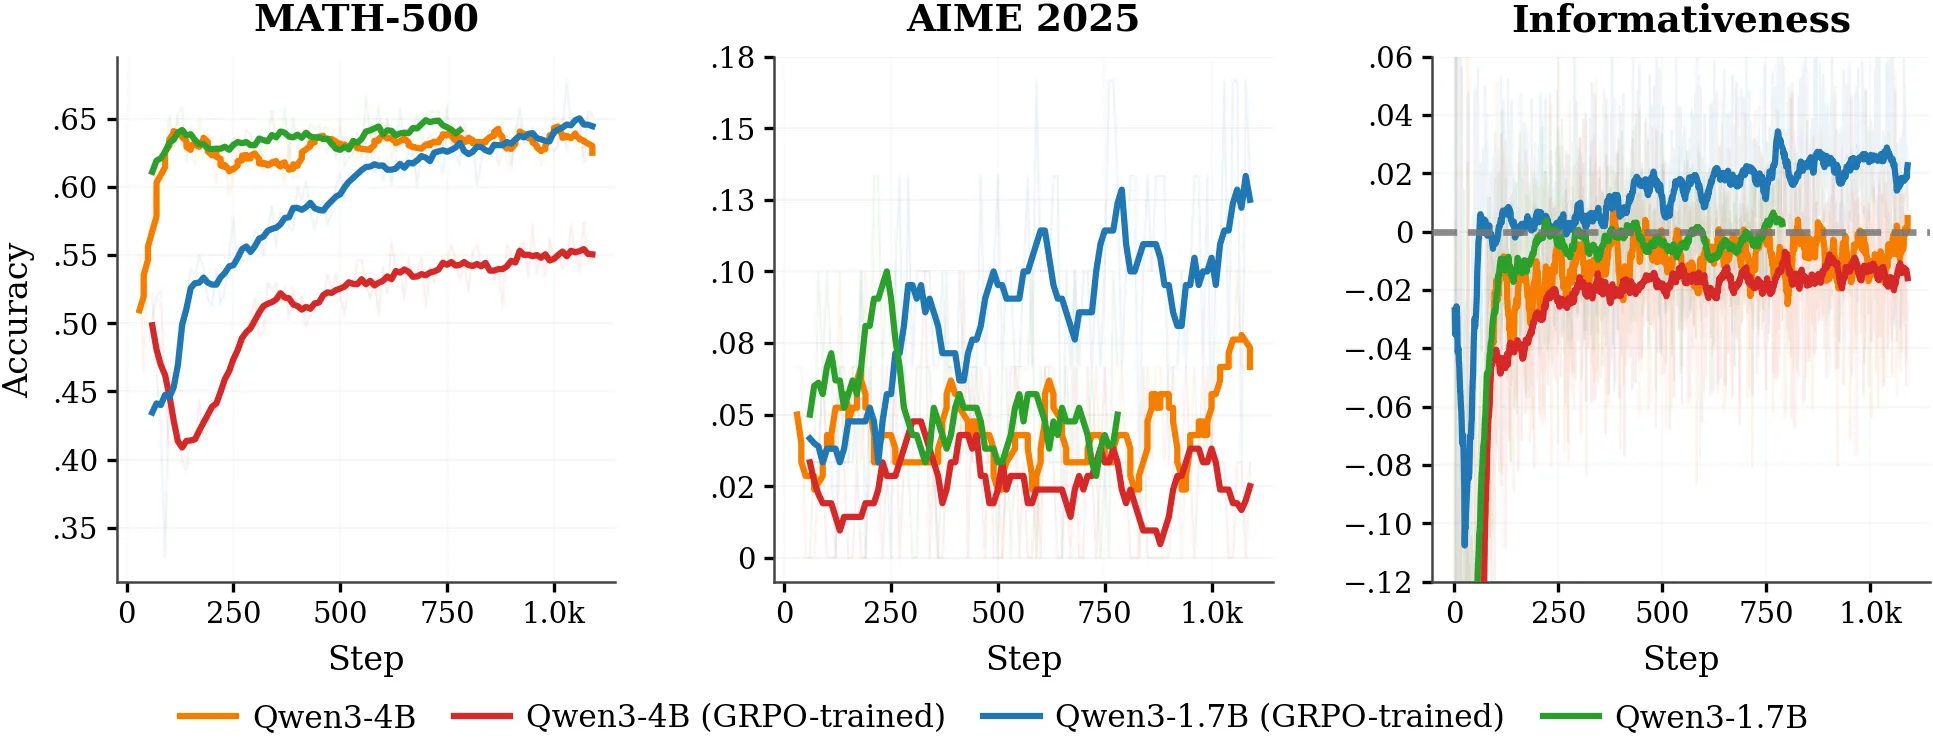
这种对信号质量的强依赖性暴露了OPD的两类病态问题。第一类称为「师生不匹配」(Student-Teacher Mismatch):当教师与学生之间存在较大的分布差距时,教师产生的「正确」响应可能超出学生的表达范围,导致引导信号与学生实际能达到的正确性发生偏离。这种信号错位会将探索引向适得其反的方向,学生在错误的信号引导下越走越远。
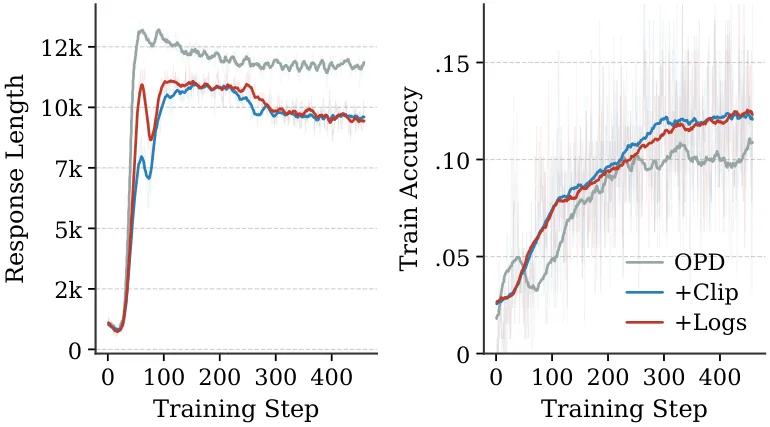
第二类病态是「长度利用」(Length Exploitation)。传统OPD的逐token级目标在聚合过程中可能产生与长度相关的捷径——由于响应中越靠前的token对总损失的贡献越大,学生模型发现可以通过截断响应来「规避」生成错误token的风险,或者通过冗余填充来「稀释」错误的影响。这种博弈行为导致学生探索退化的长度模式而非真正有用的推理策略。
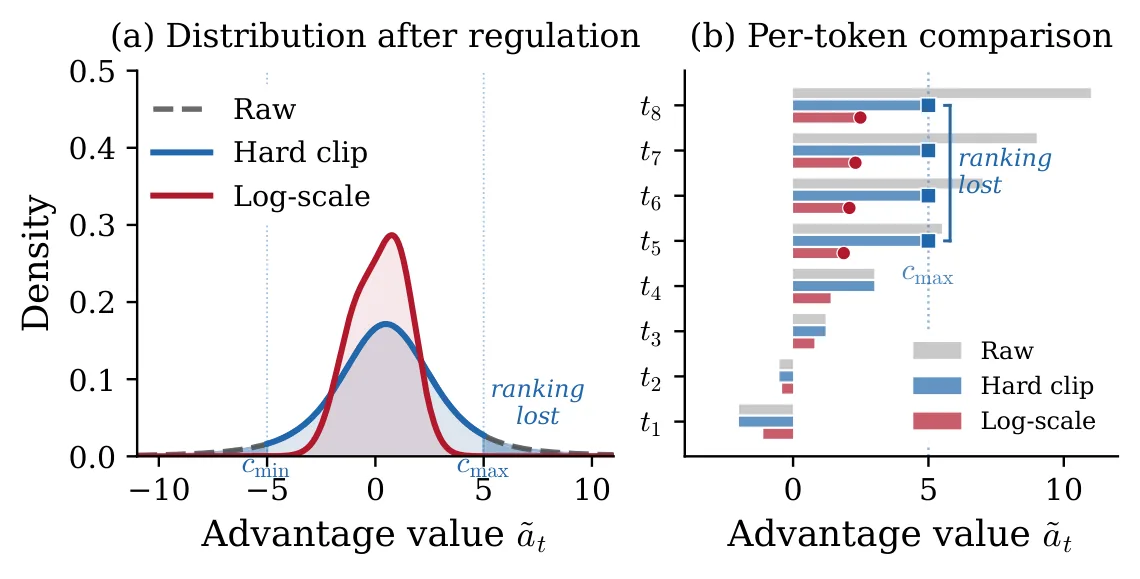
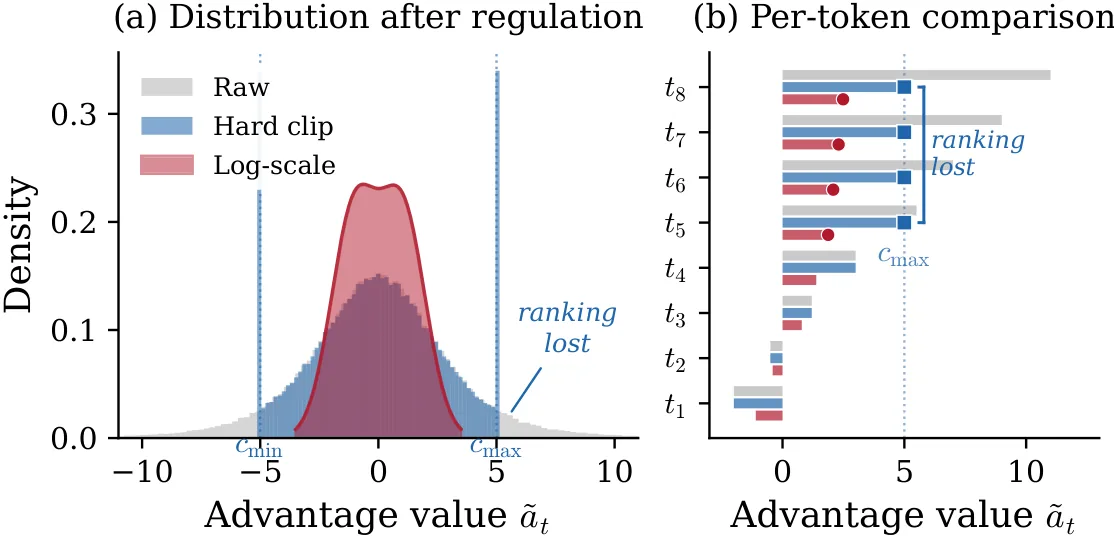
针对这些问题,作者提出两种轻量级的信号调控方法。第一种是「优势裁剪」(Advantage Clipping),其核心思想是对每个token的优势值(advantage)进行上下界限制:
这种裁剪确保信号强度保持在合理范围内,既不会因过大优势值导致过激的行为调整,也不会因过小优势值使信号丧失区分度。
第二种方法是「对数尺度压缩」,将原始的优势值映射到对数尺度:
这种压缩方式在保留信号方向的同时平滑地降低了大幅值的影响,使得长度相关的捷径信号被显著衰减,而真正反映推理正确性的信号得以保留。
实验与结果
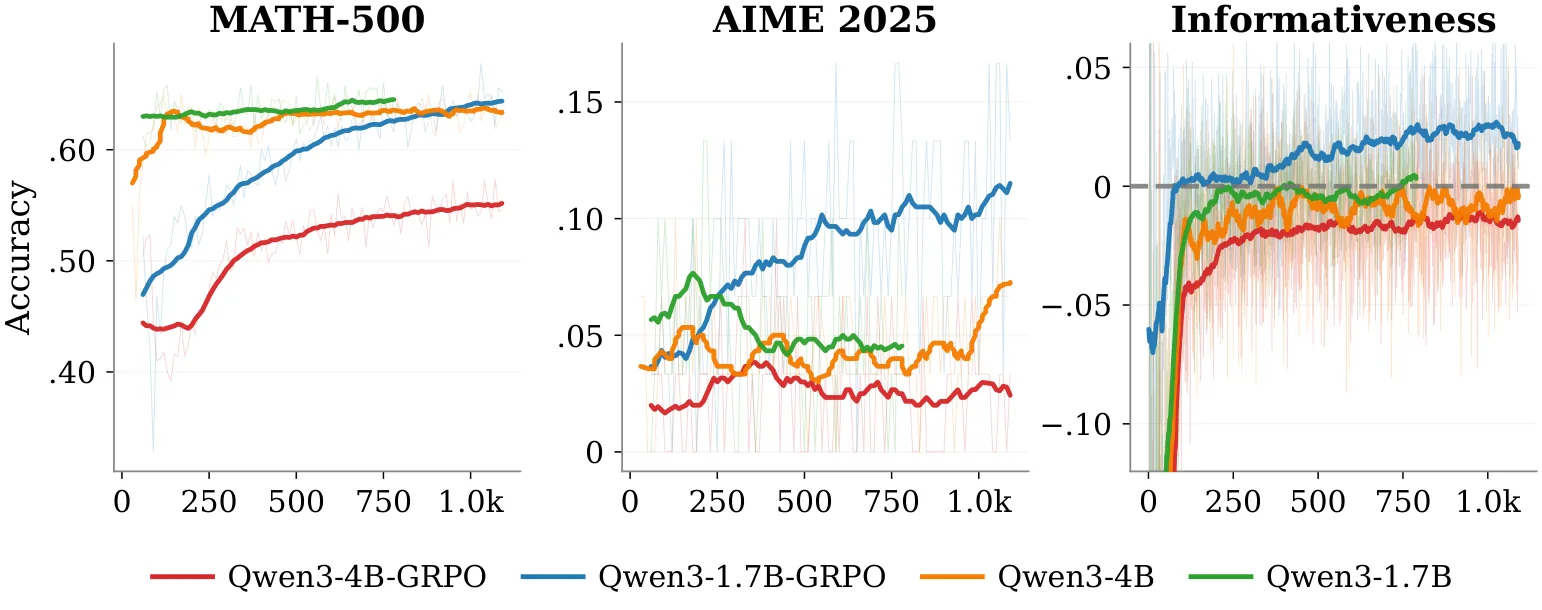
作者在七个基准测试上进行了广泛的实验,涵盖数学推理、代码生成和逻辑推理等任务。实验基线包括标准OPD、多种OPD变体以及基于可验证奖励的强化学习(RLVR)方法。
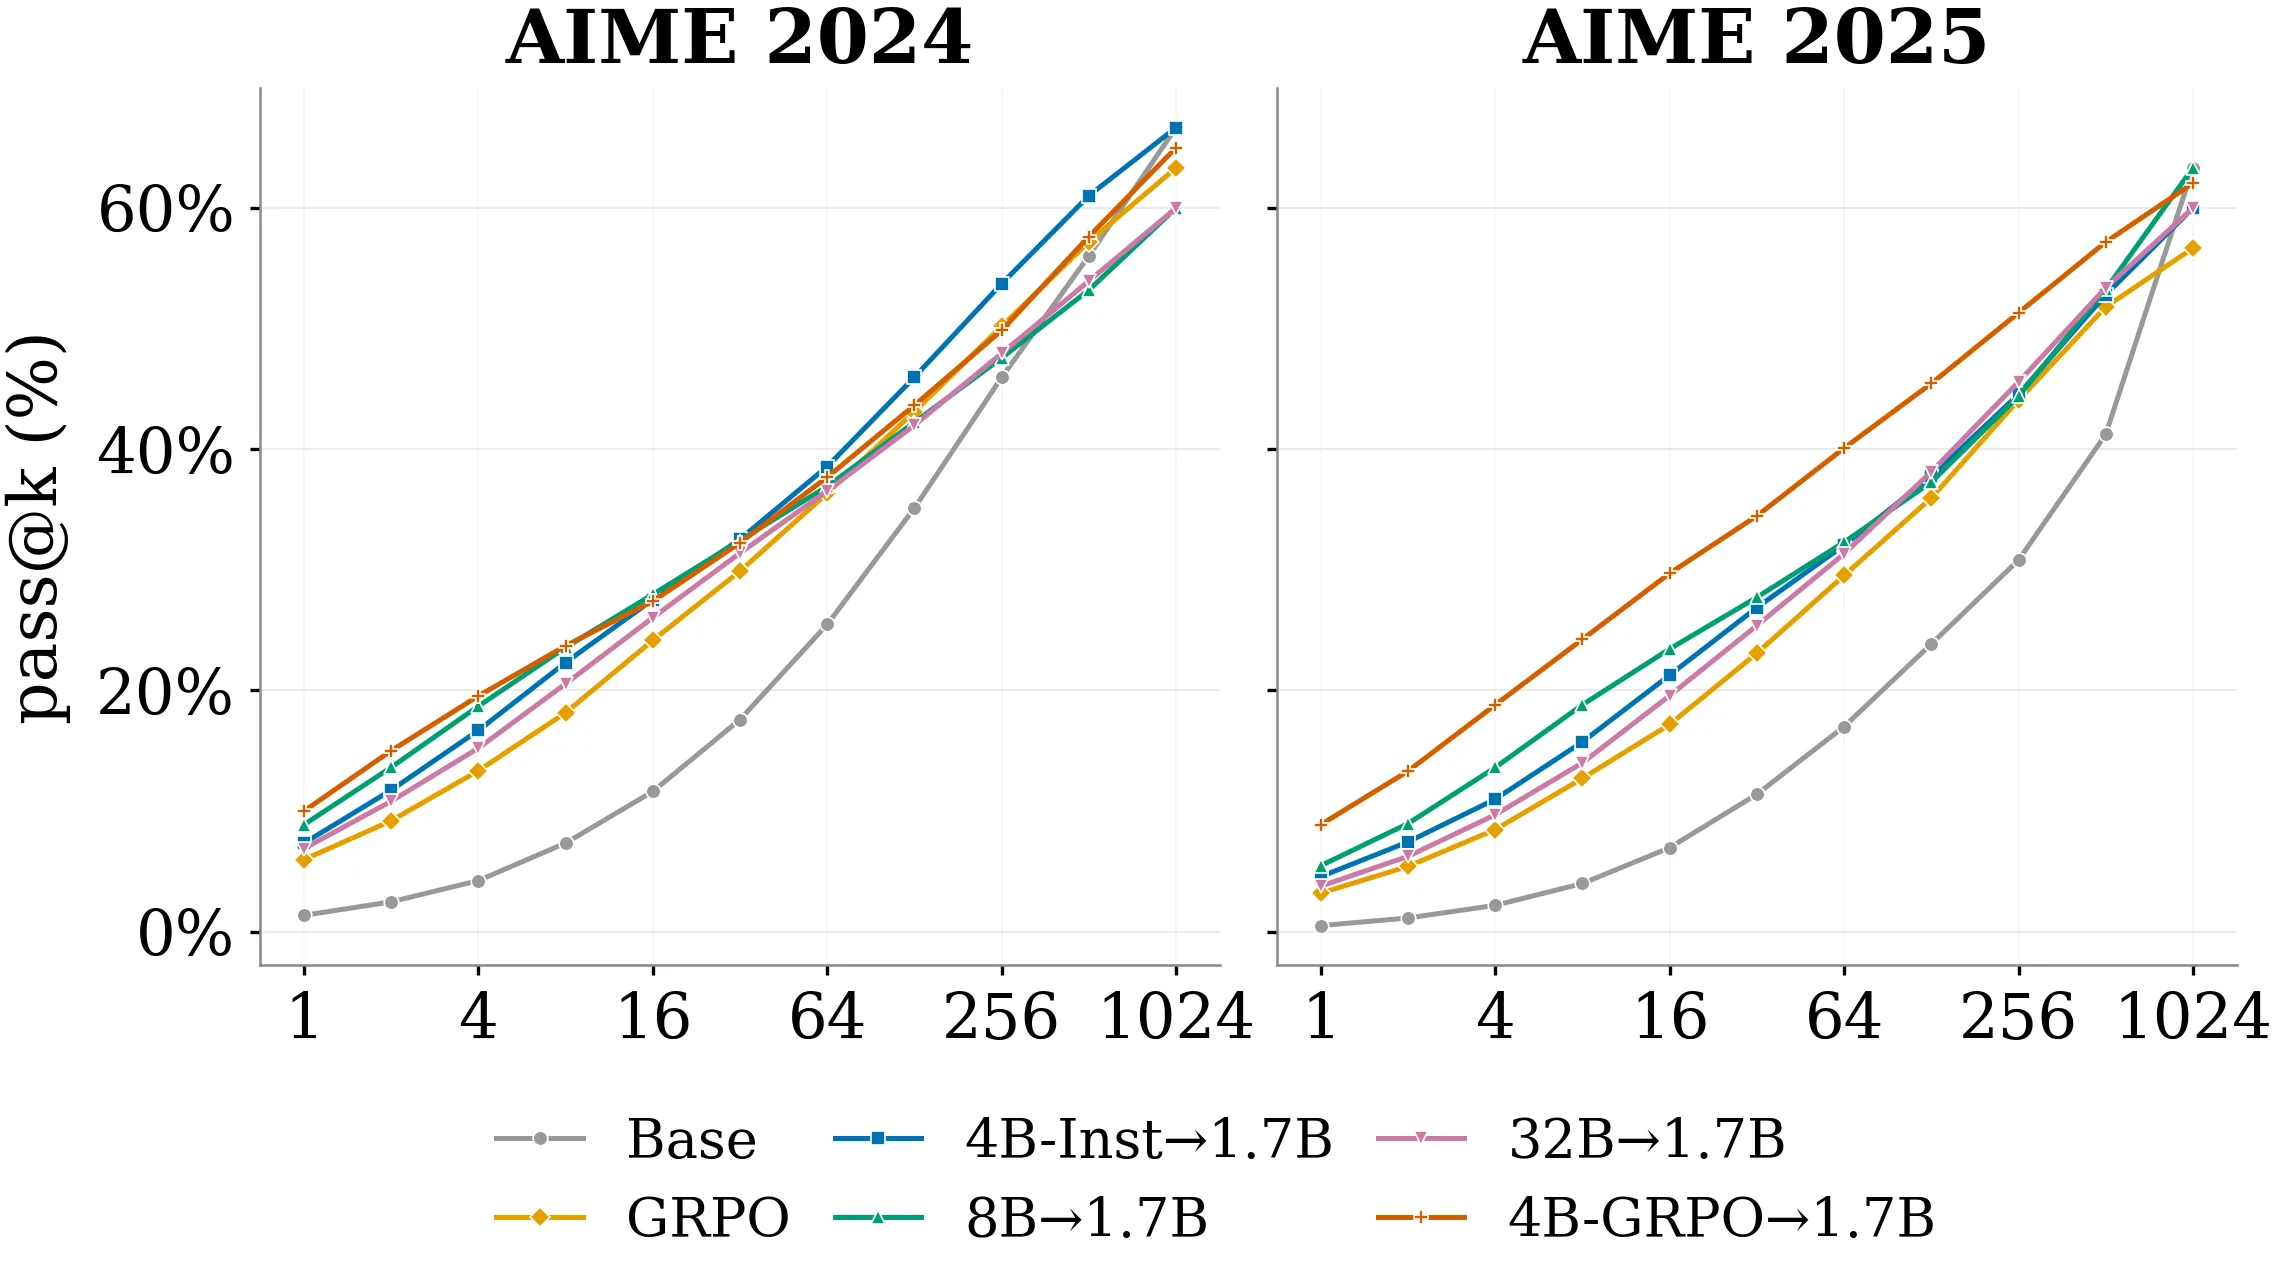
实验结果清晰地验证了理论分析。首先,经过调控的OPD在所有基准上稳定超越了基线方法,平均性能提升达到显著水平。这表明信号调控确实有效缓解了长度利用问题,使探索更加聚焦于推理策略本身而非长度捷径。
其次,作者通过消融实验证实了信号质量的核心作用。在控制教师模型规模的情况下,经过良好调控的小型教师反而优于未调控的大型教师。这一反直觉的发现强有力地证明了「信号质量而非教师规模决定蒸馏效果」的核心论点。
作者还通过可视化分析展示了调控对探索行为的影响。未经调控的OPD会导致学生模型在长度维度上产生偏态分布,过度集中在某些特定长度区间;而经过调控后,长度分布恢复均匀,表明学生确实在学习多样化的推理策略而非长度模式。
讨论与可借鉴点
这篇论文最重要的贡献在于揭示了[[策略蒸馏]]中一个长期被忽视的关键因素——信号质量的可调控性。传统观点倾向于认为,更大的教师模型必然带来更好的蒸馏效果,因为其产生的响应「质量更高」。然而本文通过系统的实验证明,如果缺乏有效的信号调控,大模型教师的优势会被自身分布差距和长度利用问题所抵消。
论文也存在一些局限性。首先,实验主要集中在推理类任务上,对于需要精确格式或特定风格的任务,调控方法的有效性尚待验证。其次,两种调控方法(优势裁剪与对数尺度压缩)的超参数选择仍依赖经验规则,缺乏理论指导的自适应方法。最后,作者主要关注离线调控策略,对于在线学习场景下如何实时检测和修正信号错位问题尚未涉及。
对于[[强化学习]]和模型优化领域的研究者而言,本文提供了一个重要启示:在设计训练信号时,「正确性」与「可利用性」之间的权衡需要被认真对待。信号调控不应被视为事后补救,而应是训练流程的内在组成部分。同时,对于实践者来说,本文提出的方法具有很高的可操作性——两种调控手段计算开销极低,却能带来稳定的性能提升,非常适合在实际项目中集成应用。
摘要
同策略蒸馏(OPD)已成为大语言模型后训练中的关键范式,但其训练动态仍未得到充分理解。我们进行了一项系统性研究,考察同策略蒸馏的作用、病态与调控机制。首先,我们阐明同策略蒸馏的作用是充当探索催化剂:它通过稠密的逐词元(token)级引导将学生模型引向正确的推理路径,而不会扩展其能力上限。我们通过以下发现证实了这一点:提示多样性比每道题的采样数量更为关键,且同策略蒸馏的有效性完全取决于其引导信号的质量。这种依赖性暴露出两种扰乱探索的病态。学生-教师不匹配(Student-Teacher Mismatch)发生在教师与学生之间分布差距较大时,引导信号与任务正确性发生偏离,将探索引向适得其反的方向。长度利用(Length Exploitation)出现在聚合的逐词元级目标产生与长度相关的捷径时,学生模型可通过截断响应或冗余填充来博弈奖励景观,探索退化的长度模式而非推理策略。为了驯服这些病态,我们研究了轻量级的信号调控方法:优势截断与对数尺度压缩,确保探索由忠实信号引导。在七个基准测试上的实验表明,这些调控方法缓解了长度利用问题并实现了有效的蒸馏,稳定地超越了同策略蒸馏变体和基于可验证奖励的强化学习(RLVR)基线,从而证实了在同策略蒸馏中,成功探索由调控良好的信号质量而非单纯的教师模型规模所主导。
Abstract
On-policy distillation (OPD) has become a key paradigm in LLM post-training, yet its training dynamics remain poorly understood. We present a systematic study examining the role, pathologies, and regulations of OPD. We first clarify the role of OPD as an exploration catalyst: it steers the student toward correct reasoning paths via dense token-level guidance, without expanding capability ceiling. We confirm this by showing that prompt diversity matters more than per-problem sampling numbers, and critically, that the effectiveness of OPD hinges entirely on the quality of its guiding signal. This dependency exposes two pathologies that derail exploration. The Student-Teacher Mismatch occurs when a large teacher-student distributional gap causes the guiding signal to misalign with task correctness, steering exploration in counterproductive directions. Length Exploitation arises when the aggregated token-level objective creates length-dependent shortcuts, allowing the student to game the reward landscape through response truncation or redundant padding, exploring degenerate length modes rather than reasoning strategies. To tame these pathologies, we investigate lightweight signal regulations: advantage clipping and log-scale compression, ensuring exploration is guided by faithful signals. Experiments across seven benchmarks demonstrate that these regulations alleviate length exploitation and enable effective distillation, stably surpassing OPD variants and RLVR baselines, thereby confirming that well-regulated signal quality, rather than mere teacher scale, governs successful exploration in OPD.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。