
📝 TLDR
基于评分标准的强化学习(rubric-based RL)能提升大模型在开放式任务上的表现,但存在两类失败模式:未被rollout满足的未覆盖标准(UC),以及被标量奖励聚合压制学习信号的有效标准(SC)。本文提出CriPO,通过在线自蒸馏同时处理两者:对UC构建标准注入教师做局部前向KL蒸馏,对SC用反事实教师定位负优势rollout中相关token并翻转其优势。实验在医学与科学基准上以约一半优化步数超越基线,且不引入训练-推理失配。
🧭 速览
Rubric-based RL存在UC与SC两类失败模式;现有探索UC的方法引入外部引导,造成训练-推理失配。
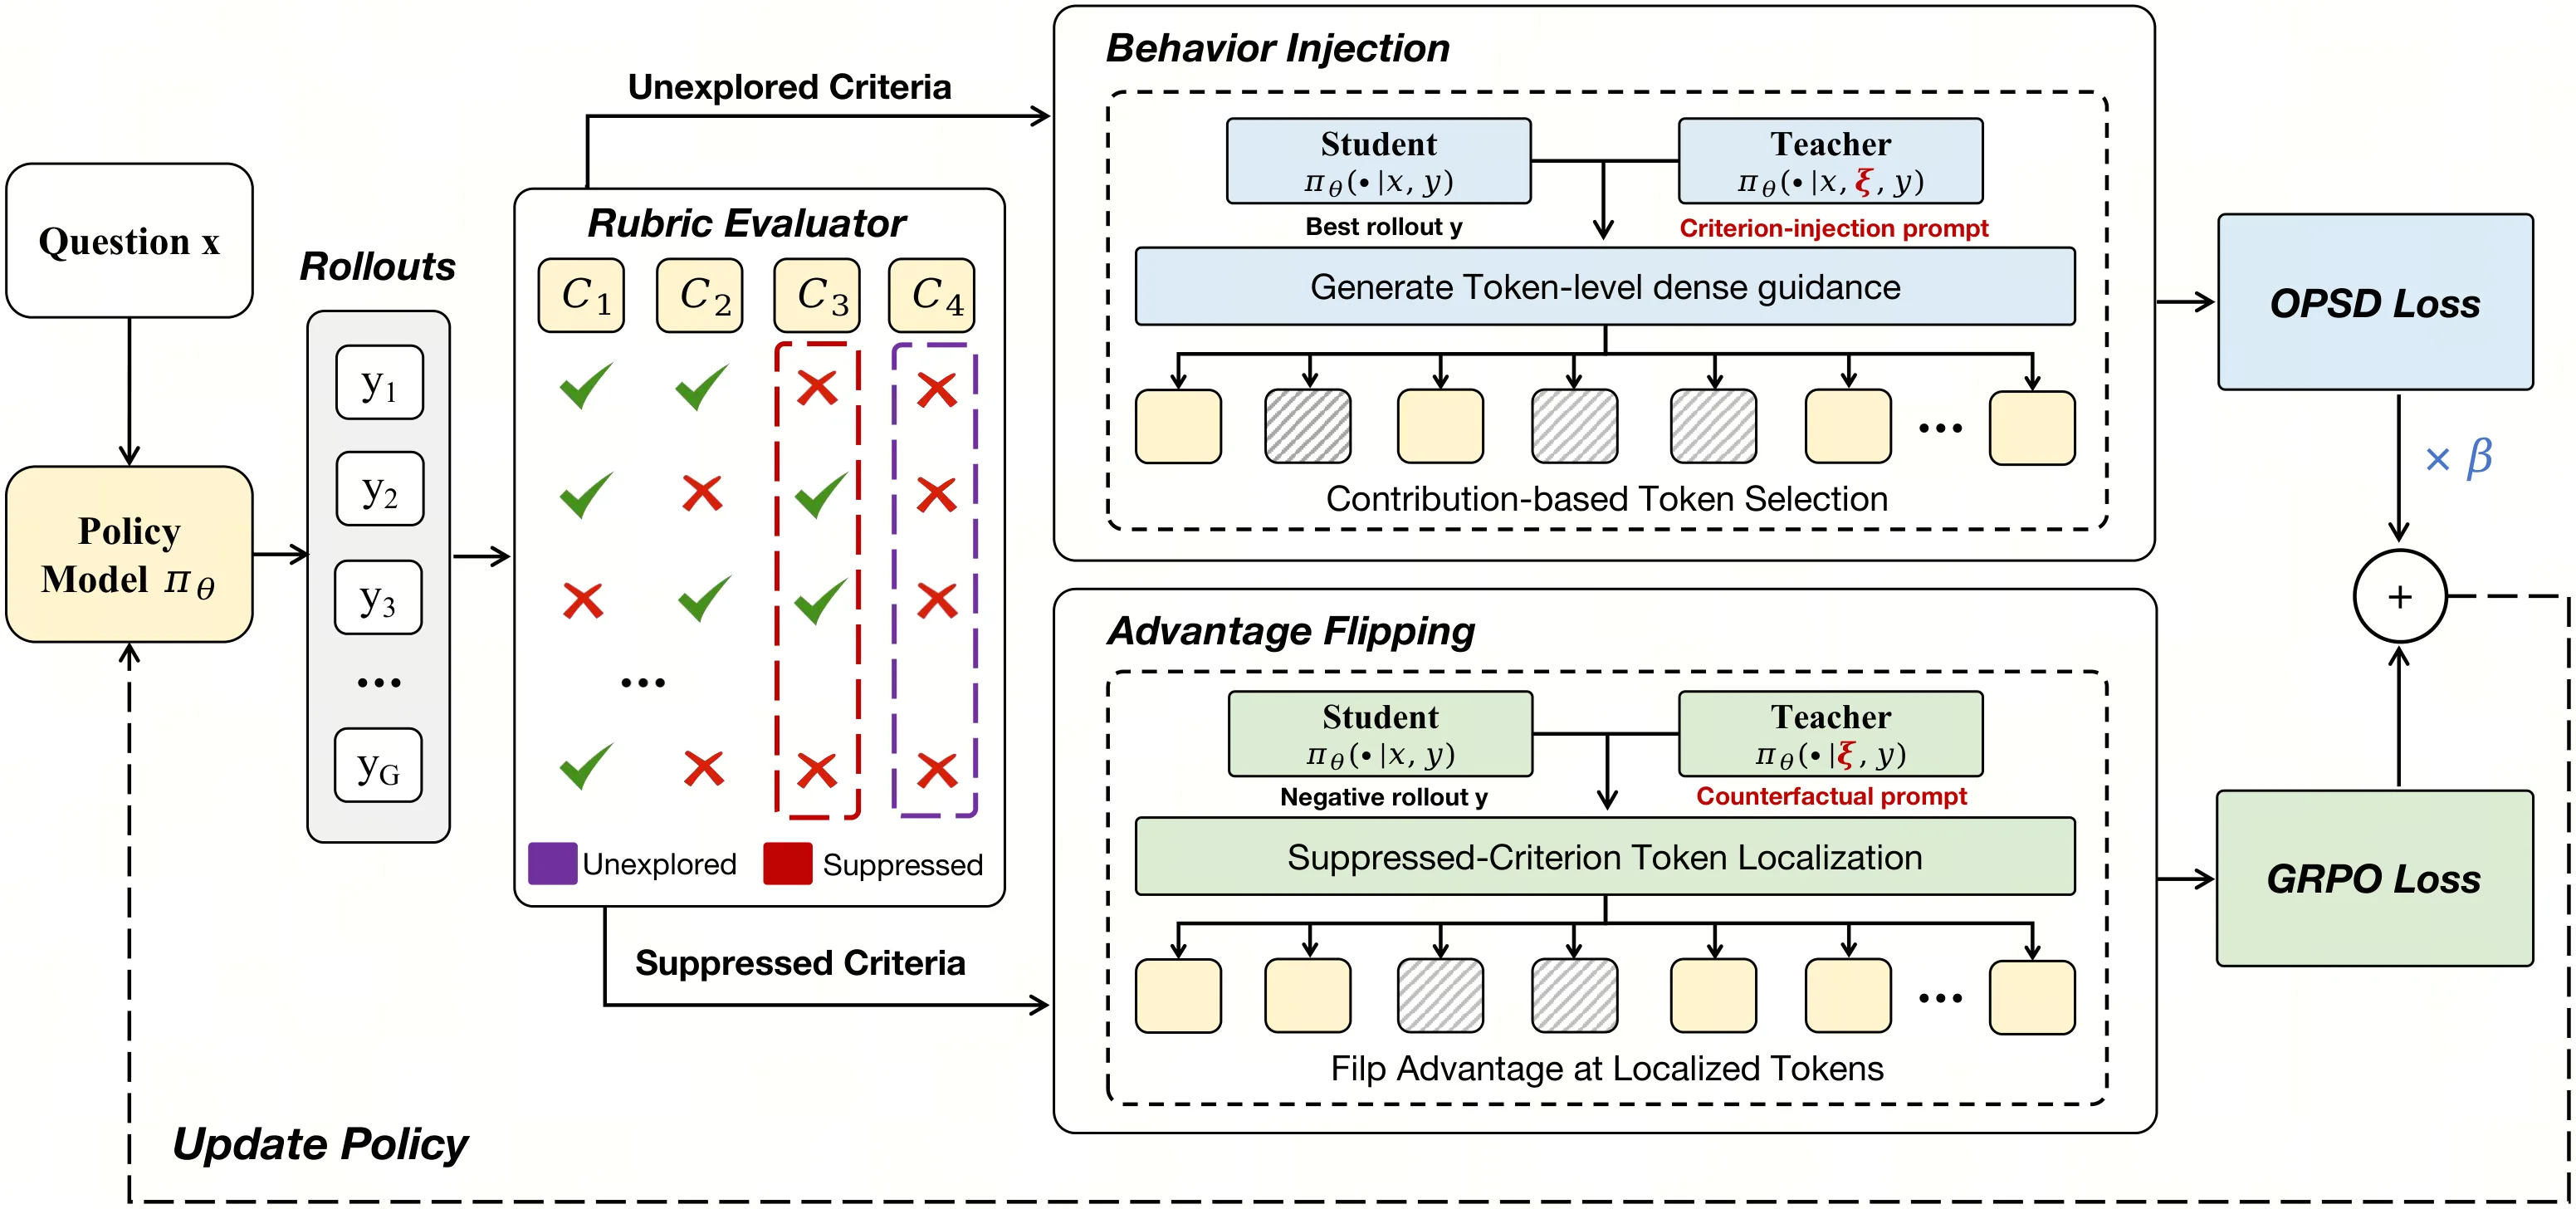
CriPO采用在线自蒸馏:UC场景构造标准注入教师施加局部前向KL;SC场景用反事实教师翻转负优势rollout中相关token的优势。
在医学与科学基准上以约一半优化步数稳定超越rubric-based RL基线方法。
CriPO首次同时解决UC与SC,无需外部引导,避免训练-推理失配。
🆚 方法对比
CriPO (Criterion-Distilled Policy Optimization)
- 同时解决未探索与被抑制准则两类失效模式
- 基于在策略自蒸馏消除训练-推理失配
- 约2倍更少的优化步骤即可达成更强性能
- 局部前向KL损失精确注入缺失行为
- 需构建两种自教师机制,工程复杂度较高
- 依赖LLM-as-a-Judge判别质量
- 准则相关token定位依赖额外计算开销
GRPO (Group Relative Policy Optimization)
- 在可验证任务上效果显著且实现简单
- 组内相对优势计算稳定高效
- 无需额外价值网络模型
- 存在未探索准则问题无优化信号
- 标量奖励聚合掩盖单准则贡献
- 57%样本存在被抑制准则失效模式
RuscaRL
- 以准则为脚手架激发多样化rollout
- 提升生成质量与探索能力
- 引入训练-推理失配产生暴露偏差
- 长文本自回归解码中误差累积严重
HeRL
- 利用失败轨迹与未满足准则生成修订
- 增强对困难准则的探索能力
- 后视引导仍造成训练-推理失配
- 仅解决探索问题未处理被抑制准则
On-Policy Self-Distillation (OPSD)
- 无需离线策略即可获得token级监督
- 在策略训练避免分布差异
- 特权条件自教师构造复杂
- 需额外前向计算带来开销
CriPO通过在策略自蒸馏统一处理未探索准则与被抑制准则,相较RuscaRL与HeRL等外部引导方法消除了训练-推理失配,相较GRPO弥补了标量聚合丢失的单准则信号。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 11 张)
展开查看 11 张图
TL;DR
基于评分标准的强化学习方法在开放式任务上表现不俗,但面临两大困境:未被任何采样轨迹满足的"未探索标准"(UC)无法获得优化信号,而已被部分轨迹满足的"抑制标准"(SC)却因奖励聚合被压制。CriPO 通过同策略自蒸馏,在不引入训练-推理分布偏移的前提下,为 UC 构建标准注入教师做局部前向 KL 蒸馏,为 SC 利用反事实教师翻转相关 token 的优势。实验表明,CriPO 在医学和科学基准上以约一半的优化步数超越了基线方法。
研究背景与动机
在开放式任务上提升大语言模型的能力,一直是领域内的核心挑战之一。与数学、代码等拥有确定性验证器的领域不同,医疗咨询、长文本生成等场景缺乏可信赖的自动评测标准。[[基于评分标准的强化学习]](Rubric-based RL)应运而生,它将响应质量分解为一组评估标准,由评判模型逐项打分后加权聚合为标量奖励,配合 GRPO 等算法驱动策略优化。这种范式在开放式任务上展现出不错的潜力。
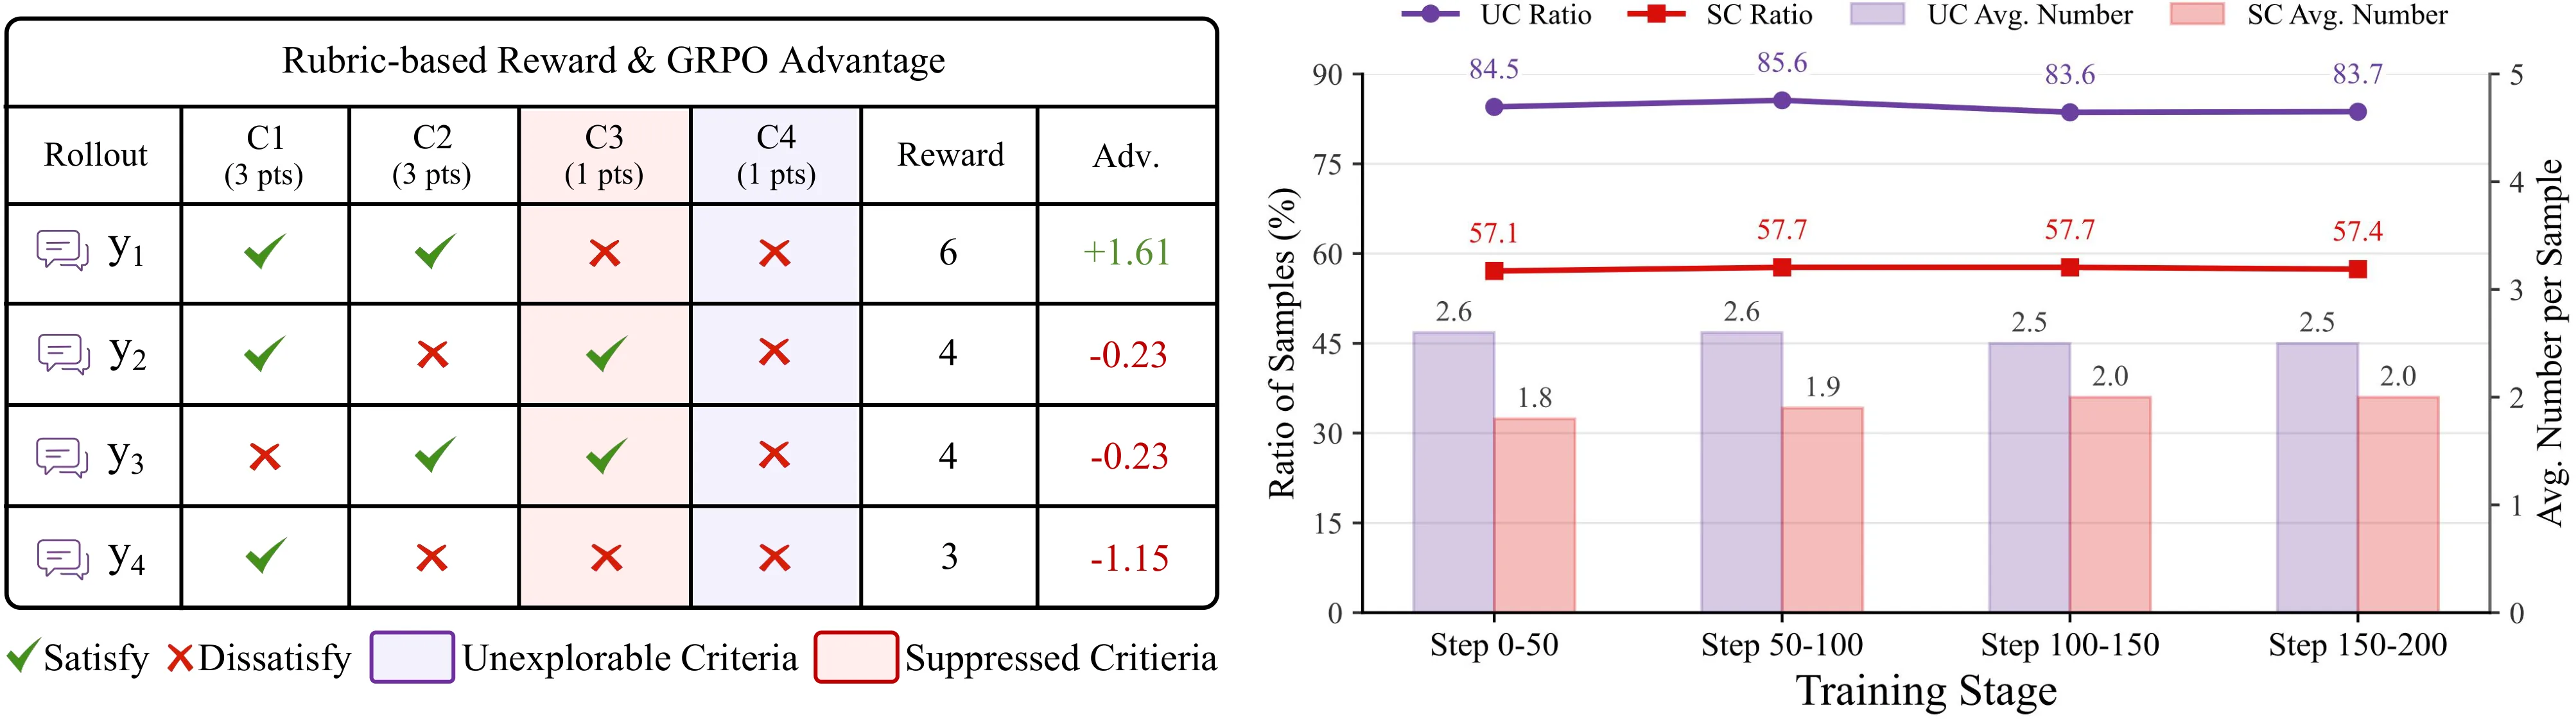
然而,现有方法存在两类尚未被充分解决的失败模式。第一类称为未探索标准(UC):当组内所有采样轨迹均未能满足某条标准时,该标准完全得不到优化信号——模型甚至不知道自己"不知道什么"。第二类更为隐蔽,称为抑制标准(SC):某些轨迹已经满足了该标准,但在聚合奖励排序后反而获得了非正的组相对优势,导致原本有用的行为模式被惩罚或忽略。论文的经验分析揭示了一个令人警醒的事实:在整个训练过程中,超过 57% 的样本表现出 SC 失败模式,平均每个样本有 1.8 个被抑制的标准,而 UC 的发生率更高达 83%(平均每样本 2.5 个)。这意味着相当比例的学习信号在优化过程中被白白浪费了。
针对 UC,现有工作如 HeRL 尝试在采样阶段将评分标准作为外部引导引入,以增强探索能力。但这种方法引入了训练-推理不一致——策略在有外部引导的条件下产生的轨迹上训练,而推理时这种引导并不存在。在生成长响应时,这种分布偏移会通过自回归解码逐步累积,造成性能衰减。更重要的是,这些探索导向的方法完全忽视了 SC 的存在。
方法
CriPO 的核心洞察是:与其依赖外部引导(不可避免地引入分布偏移),不如利用策略自身的知识来弥补缺失的学习信号。具体而言,CriPO 保留 GRPO 作为稳定奖励驱动的优化主干,同时引入同策略自蒸馏(OPSD)作为辅助模块,针对 UC 与 SC 分别设计两类自教师,以细粒度的 token 级监督信号补充全局奖励的不足。
针对 UC 的行为注入模块遵循"最小修订"原则。论文发现,选择组内最高优势的轨迹作为修订对象是更优选择——它已经满足大部分标准,只需最小的改动即可满足剩余标准。给定该轨迹和未满足的标准集合 ,CriPO 构建如下标准注入教师提示:请模型以"最小必要修改"的方式修订响应以满足这些标准,只输出修订后的内容。这种构造方式确保了教师信号与当前策略的分布接近,同时注入了当前缺失的行为模式。
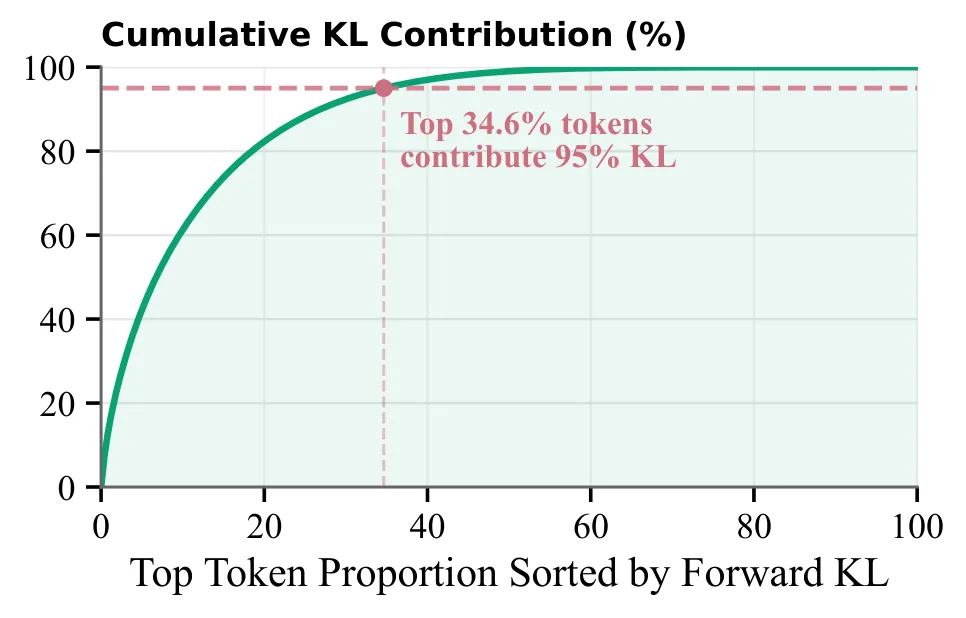
在蒸馏方式上,CriPO 采用前向 KL 散度而非反向 KL。前向 KL 在学生分布缺乏某些模式时会自然地将概率分配给教师的多个偏好模式,而非过度惩罚自身已有的合理分布——这正是行为注入场景所需要的。为了避免在所有 token 上均匀计算损失(引入过多无关噪声),论文引入贡献引导的过滤机制:只计算那些累积贡献达至 95% 的"高影响力 token",其余 token 不参与损失计算。经验观察表明,约 34.6% 的 token 贡献了 95% 的 KL 散度,这种过滤在保持效果的同时显著降低了优化噪声。
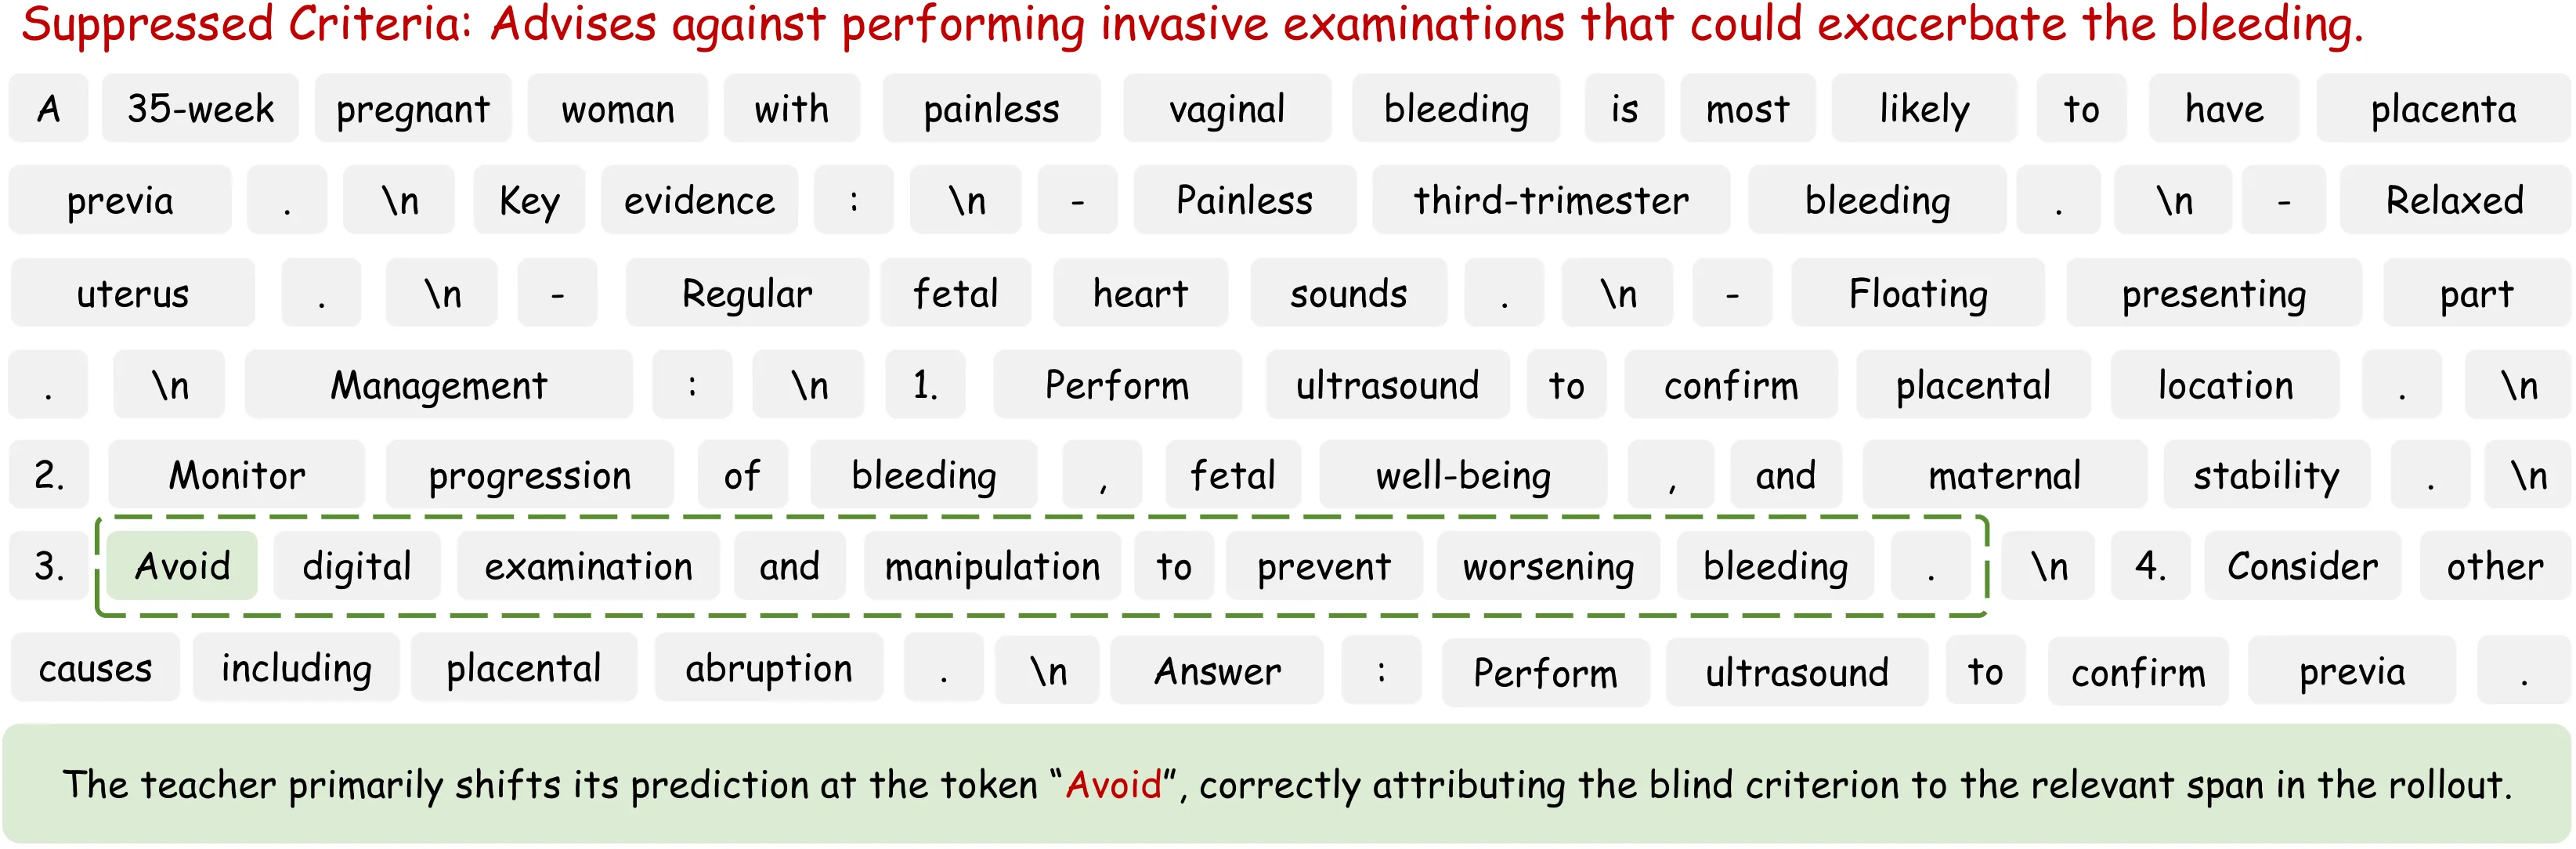
针对 SC 的优势翻转模块更为精妙。对于负优势轨迹中满足抑制标准的部分,CriPO 构建一个反事实教师——它被要求有意弱化或删除满足这些标准的部分。比较反事实教师与原始策略在各 token 处的分布,可以定位出真正承载被抑制标准语义的 token。具体而言,如果移除某标准后,原始策略在该 token 处采样目标 token 的概率下降(说明该 token 确实关联该标准),且反事实教师显著倾向于其他 token(说明该模式可被抑制),则该 token 被纳入定位集合。
对这些定位出的 token,CriPO 将其 token 级优势从轨迹级的负值 翻转为一个固定正值 。这相当于在保留 GRPO 全局优化方向的同时,对"被抑制但有用"的行为做局部反向修正,使其不再被惩罚。
两种模块协同工作的机制清晰:行为注入为模型开辟新的能力边界,优势翻转则在已有能力范围内解救被错误压制的有用模式。总训练目标为 ,两个模块各司其职,共同提升学习效率。
实验与结果
论文在医学和科学两个领域构建了完整的实验验证。训练数据包括 RaR-Medicine(15,658 条训练样本)和 RaR-Science(10,874 条训练样本),评测则在 HealthBench、LLMEval-Med、ResearchQA 等多个基准上进行,涵盖域内和跨域泛化能力评估。主实验使用 Qwen3-4B 作为基础模型,以 GRPO、HeRL(外部引导增强探索的代表性方法)、纯 OPSD(将全部 rubric 作为特权信息)以及 CriPO 的两个消融变体(CriPO-U 仅行为注入、CriPO-S 仅优势翻转)作为对比基线。
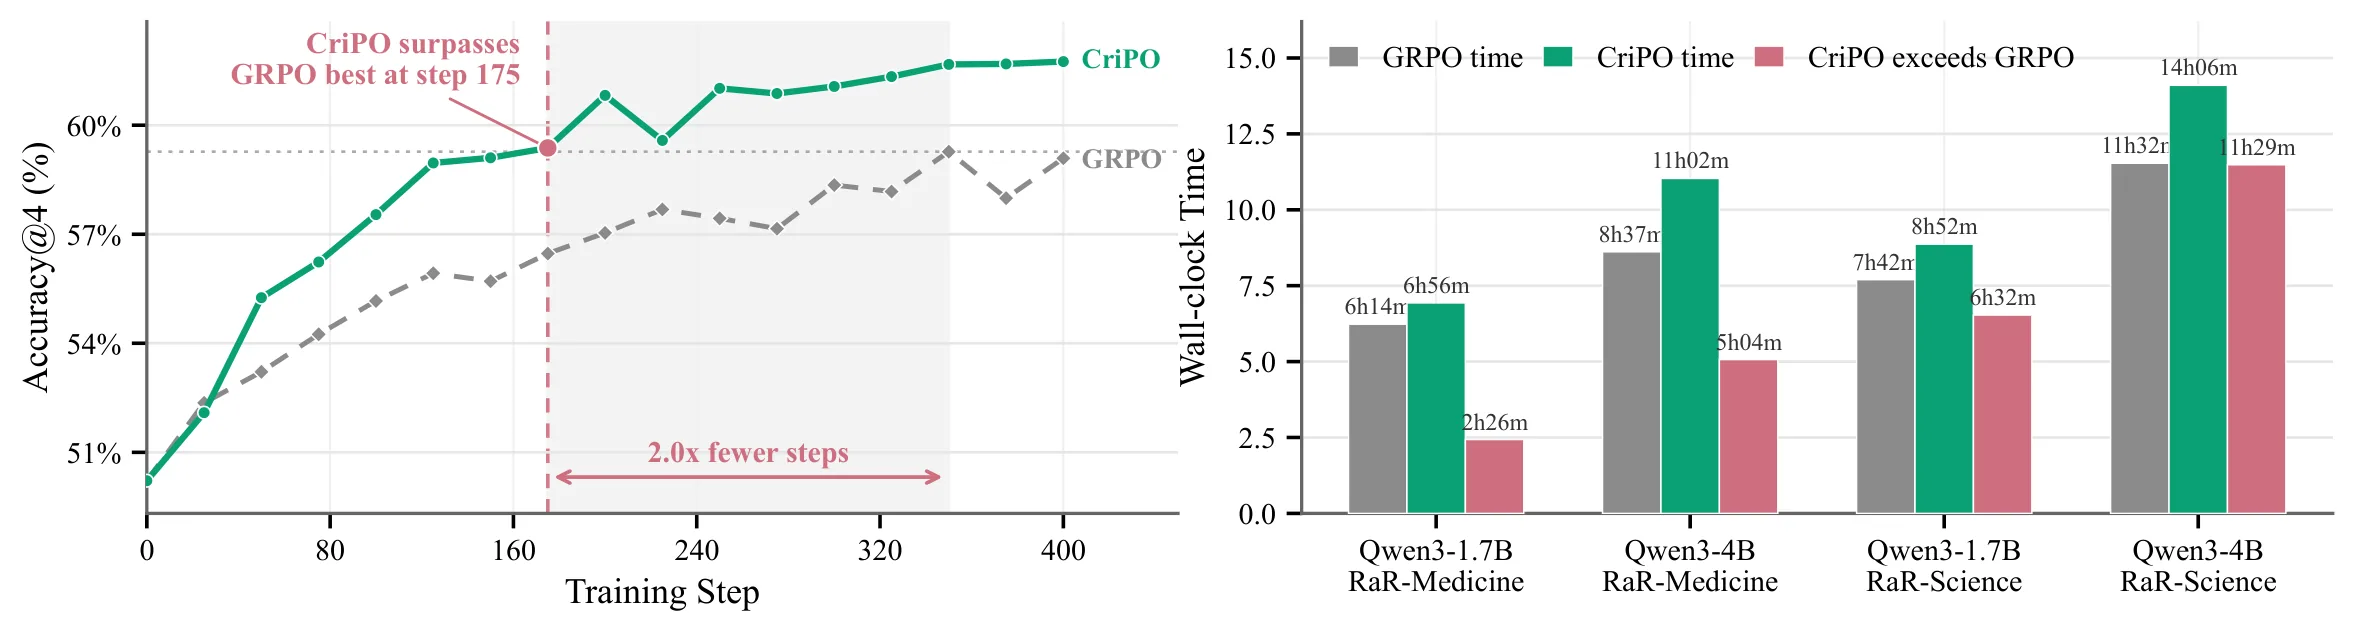
核心结果呈现出一个清晰的模式。首先,完整 CriPO 在所有基准上均显著优于 GRPO,尤其值得注意的是其样本效率优势:在约一半的优化步数(论文报告约 2 倍的效率提升)下即达到更强的最终性能,这直接验证了 UC 和 SC 处理的有效性。其次,CriPO-U 和 CriPO-S 的消融实验表明,两个模块存在互补性:单独使用任一模块只能部分改善性能,完整方法的效果最强,说明两类失败模式确实独立存在且同等重要。第三,纯 OPSD 基线的糟糕表现(Qwen3-4B 在 RaR-Medicine 上从 ~57% 跌至 30% 附近)有力地证明了论文的核心判断——OPSD 存在特权信息泄漏、自教师信号不可靠等内在问题,必须与 GRPO 配合使用。最后,HeRL 的跨域泛化性能不如 CriPO,这与其训练-推理不一致问题高度吻合。
讨论与可借鉴点
CriPO 的贡献在于系统性地识别并形式化了 UC 与 SC 两类失败模式,并设计了无需外部引导的解决方案。这为基于评分标准的强化学习研究提供了新的优化视角。
然而,论文也存在若干局限。首先,行为注入模块依赖策略自身生成修订后的轨迹,这意味着如果基础策略在某些维度上能力严重不足,修订信号可能仍然不够可靠。其次,对于 SC 的处理假设"被抑制的标准对应的局部模式可以独立提取",但在某些语义高度纠缠的生成中,这种假设可能不成立。第三,论文的所有实验均在 4B 参数量级的模型上进行,更大规模模型的 scaling 特性尚未被验证。
从方法论层面,CriPO 展示了一个有价值的范式:对于复杂的多维度评估场景,将问题分解为"探索缺失"与"信号抑制"两类,分别设计针对性的救济机制,而非试图用单一方法处理所有问题。此外,贡献引导的 token 过滤设计提醒我们,在 token 级优化中并非所有位置都同等重要——识别并聚焦高影响力区域可以显著提升优化效率。这种"精确定位、最小干预"的思路,对于其他需要细粒度控制的强化学习应用同样具有借鉴意义。
摘要
基于评分标准的强化学习(Rubric-based RL)近期在提升大语言模型(LLMs)在开放式任务上的表现方面展现出潜力。基于评分标准的强化学习的一个广为认知的局限是探索能力不足:没有任何采样轨迹能够满足的标准(未探索标准,Unexplored Criteria, UC)无法获得优化信号。近期的方法通过在采样过程中将评分标准信息作为外部引导来应对这一问题,但它们引入了训练-推理不一致:策略是在外部引导下产生的采样轨迹上进行优化的,而在推理时这一引导并不存在,从而导致自回归解码过程中的错误累积。此外,这些以探索为重点的方法忽视了一种根本不同的失败模式,我们称之为抑制标准(Suppressed Criteria, SC)——即某些采样轨迹能够满足、但在优化过程中其学习信号却会丢失的标准,因为标量奖励聚合为它们分配了非正的聚合优势。我们的分析表明,SC 的存在非常普遍:在整个训练过程中,超过 57% 的样本表现出这种失败模式,平均每个样本有 1.8 个 SC。为了在不引入训练-推理不一致的前提下同时解决 UC 和 SC 问题,我们提出了标准蒸馏策略优化(Criterion-Distilled Policy Optimization, CriPO),通过同策略自蒸馏来增强基于评分标准的强化学习。针对 UC,CriPO 构建了一个标准注入自教师,并通过计算局部的前向 KL 损失将缺失的行为注入策略中。针对 SC,CriPO 使用反事实自教师来定位负优势采样轨迹中与标准相关的 token,并将其 token 级优势翻转为正值,从而保留原本会被抑制的有用模式。在医学和科学基准测试上的实验表明,CriPO 持续优于基于评分标准的强化学习,在优化步数减少约 2 倍的情况下实现了更强的最终性能。
Abstract
Rubric-based RL has recently shown promise in improving LLMs on open-ended tasks. A widely recognized limitation of rubric-based RL is limited exploration: criteria that no rollout manages to satisfy (Unexplored Criteria, UC) receive no optimization signal. Recent methods address this by incorporating rubric information as external guidance during rollout, yet they introduce a train-inference mismatch: the policy is optimized on rollouts produced under external guidance while this guidance is absent at inference time, causing error accumulation through autoregressive decoding. Moreover, these exploration-focused approaches overlook a fundamentally different failure mode that we term Suppressed Criteria (SC) -- criteria that are satisfied by some rollouts yet whose learning signals are lost during optimization because scalar reward aggregation assigns them non-positive aggregate advantages. Our analysis reveals that SC are remarkably prevalent: over 57% of samples exhibit this failure mode throughout training, with an average of 1.8 SC per sample. To simultaneously address both UC and SC without introducing training-inference mismatch, we propose Criterion-Distilled Policy Optimization (CriPO), which enhances rubric-based RL via on-policy self-distillation. For UC, CriPO constructs a criterion-injection self-teacher and computes a localized forward-KL loss to inject missing behaviors into the policy. For SC, CriPO employs a counterfactual self-teacher to locate criterion-relevant tokens in negative-advantage rollouts and flips their token-level advantages to positive values, preserving useful patterns that would otherwise be suppressed. Experiments on medicine and science benchmarks demonstrate that CriPO consistently outperforms rubric-based RL, achieving stronger final performance with approximately fewer optimization steps.
论文详细总结(自动生成)
论文总结:Enhancing Rubric-based RL via Self-Distillation
一、核心问题与研究动机
1.1 研究背景
基于评分标准的强化学习(Rubric-based RL) 是近年提出的扩展范式,用于将可验证奖励的强化学习(RLVR)从数学、代码等"可验证领域"推广到医疗咨询、长文本生成等开放式任务。其核心思路是将响应质量分解为一组评估标准 ,由 LLM-as-a-Judge 给出逐项分数 ,再加权聚合成标量奖励:
随后使用 GRPO 等方法在组内做组相对优势归一化以驱动策略优化。
1.2 两大失败模式
论文识别并形式化了两类未被现有工作充分解决的失败模式:
- 未探索标准(Unexplored Criteria, UC):当组内所有采样轨迹均未满足某条标准时,该标准完全得不到优化信号。形式化定义:
- 抑制标准(Suppressed Criteria, SC):某些轨迹已满足该标准,但由于标量奖励聚合,满足该标准的轨迹反而获得非正的聚合优势,导致有用的行为被惩罚或忽略。形式化定义:
其中 表示满足标准 的轨迹集合。
1.3 现有方法的不足
现有增强 UC 的方法(如 RuscaRL、HeRL)在采样阶段引入评分标准作为外部引导,但这导致了 训练-推理不一致(train–inference mismatch)——训练时使用了特权信息,而推理时不可用,长响应中的自回归错误会逐步累积。此外,这些方法完全忽视了 SC 问题。
1.4 经验观察
论文在 Qwen3-4B + RaR-Medicine 上的统计表明:超过 83% 的样本存在 UC(平均 2.5 个/样本),超过 57% 的样本存在 SC(平均 1.8 个/样本),说明两类失败模式在训练过程中普遍且持续存在。
二、方法论:CriPO(Criterion-Distilled Policy Optimization)
2.1 总体设计思想
CriPO 保留 GRPO 作为稳定奖励驱动的优化主干,同时引入同策略自蒸馏(On-Policy Self-Distillation, OPSD) 作为辅助模块,针对 UC 与 SC 两种失败模式分别设计两类教师(self-teacher),以提供细粒度的 token 级监督信号,同时避免训练-推理分布偏移。
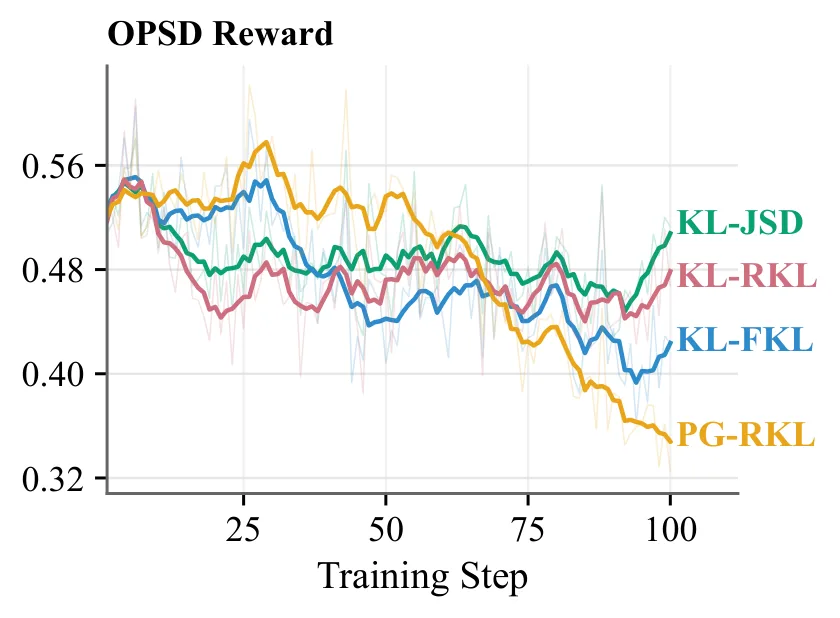
> 关键设计动机:论文经验表明,单独使用 OPSD 处理全部评分标准会导致性能退化(Qwen3-4B 在 RaR-Medicine 上从 ~57% 跌至 30% 附近),原因是 OPSD 存在特权信息泄漏、自教师信号不可靠、熵塌缩等内在问题;故采用 GRPO+OPSD 的混合范式。
总训练目标为:
2.2 模块一:针对未探索标准的行为注入(Behavior Injection)
#### (a) 标准注入自教师
对每个 prompt,选取组内最高优势的轨迹 ("Best-Rollout Selection",因它已满足大部分标准,修订所需最小、信息更可靠),并构造如下教师 prompt:
> "Given the user query … Below is your previous response … This response failed to meet the following criteria: … Please revise the previous response with the minimum necessary to satisfy the unmet criteria. Output only the revised response."
#### (b) 局部前向 KL
定义 student 与 teacher 在 token 处的分布:
采用前向 KL ,因其能鼓励 student 覆盖 teacher 偏好的多模分布,适合注入当前完全缺失的行为。
#### (c) 贡献引导的 token 过滤
经验上只有少数 token 真正承载与缺失标准相关的修正信号(论文观测到 34.6% 的 token 即贡献 95% 的 KL)。故采用累积贡献阈值:
仅在这些"高贡献 token"上计算 OPSD 损失:
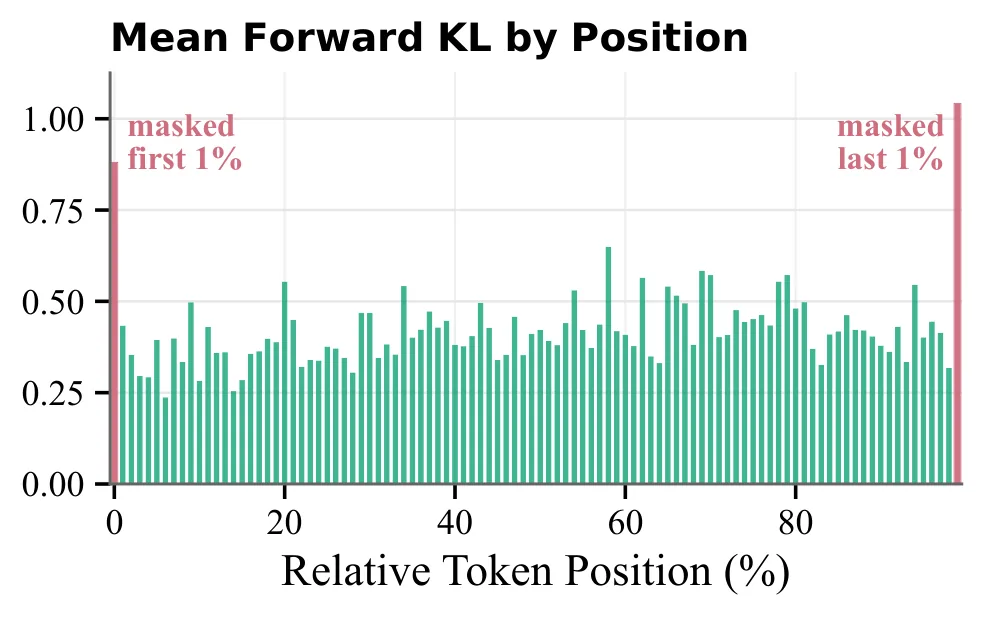
实现细节还包括:仅取权重最大的 top-()个标准构造教师、对单 token 的 KL 上限裁剪为 10、屏蔽首尾各 1% 的 token(边界处 KL 偏大,含噪声)。
2.3 模块二:针对抑制标准的优势翻转(Advantage Flipping)
#### (a) 反事实自教师
对负优势轨迹 中所满足的抑制标准 ,构造如下反事实 prompt:
> "Given a response … Please revise the response with minimum necessary by modifying or deleting the parts that satisfy the following criteria: … Output only the revised response."
其作用是有意弱化这些满足标准对应的局部生成模式。
#### (b) 抑制标准 token 定位
比较 student 与反事实 teacher 在 各 token 处的分布,定位真正承载被抑制标准语义的 token。需同时满足两个条件:
- 条件 1:移除标准后采样 token 被降权,即 ;
- 条件 2:teacher 显著偏向其他 token,即 ,。
由此得到定位集合:
#### (c) 局部优势翻转
对 中的 token,将轨迹级优势 替换为固定正值 ,其余 token 保持原优势:
然后将 代回 GRPO 损失:
这样既保留 GRPO 的全局优化方向,又在 token 级别对"被抑制但有用"的行为做局部反向修正。
2.4 算法流程
伪代码见 Algorithm 1:对每个 prompt 采样 条轨迹 → 评分标准评估 → 计算奖励、组优势、识别 → 若 则行为注入;若 则对负优势轨迹进行优势翻转 → 合并得 ,更新参数。
三、实验设计
3.1 数据集与评测
- 训练集(in-domain):RaR-Medicine(医学,过滤后 15,658 train / 1,936 test)、RaR-Science(科学,10,874 train / 1,365 test)。过滤规则:剔除 Qwen3-4B 奖励 > 0.9 的过易样本。
- 跨域评测集:HealthBench(医疗,500 抽样)、LLMEval-Med(医疗,667 题)、ResearchQA(科研,500 抽样)。
- OOD 泛化评测:IFEval、IFBench、MulDimIF(指令遵循)。
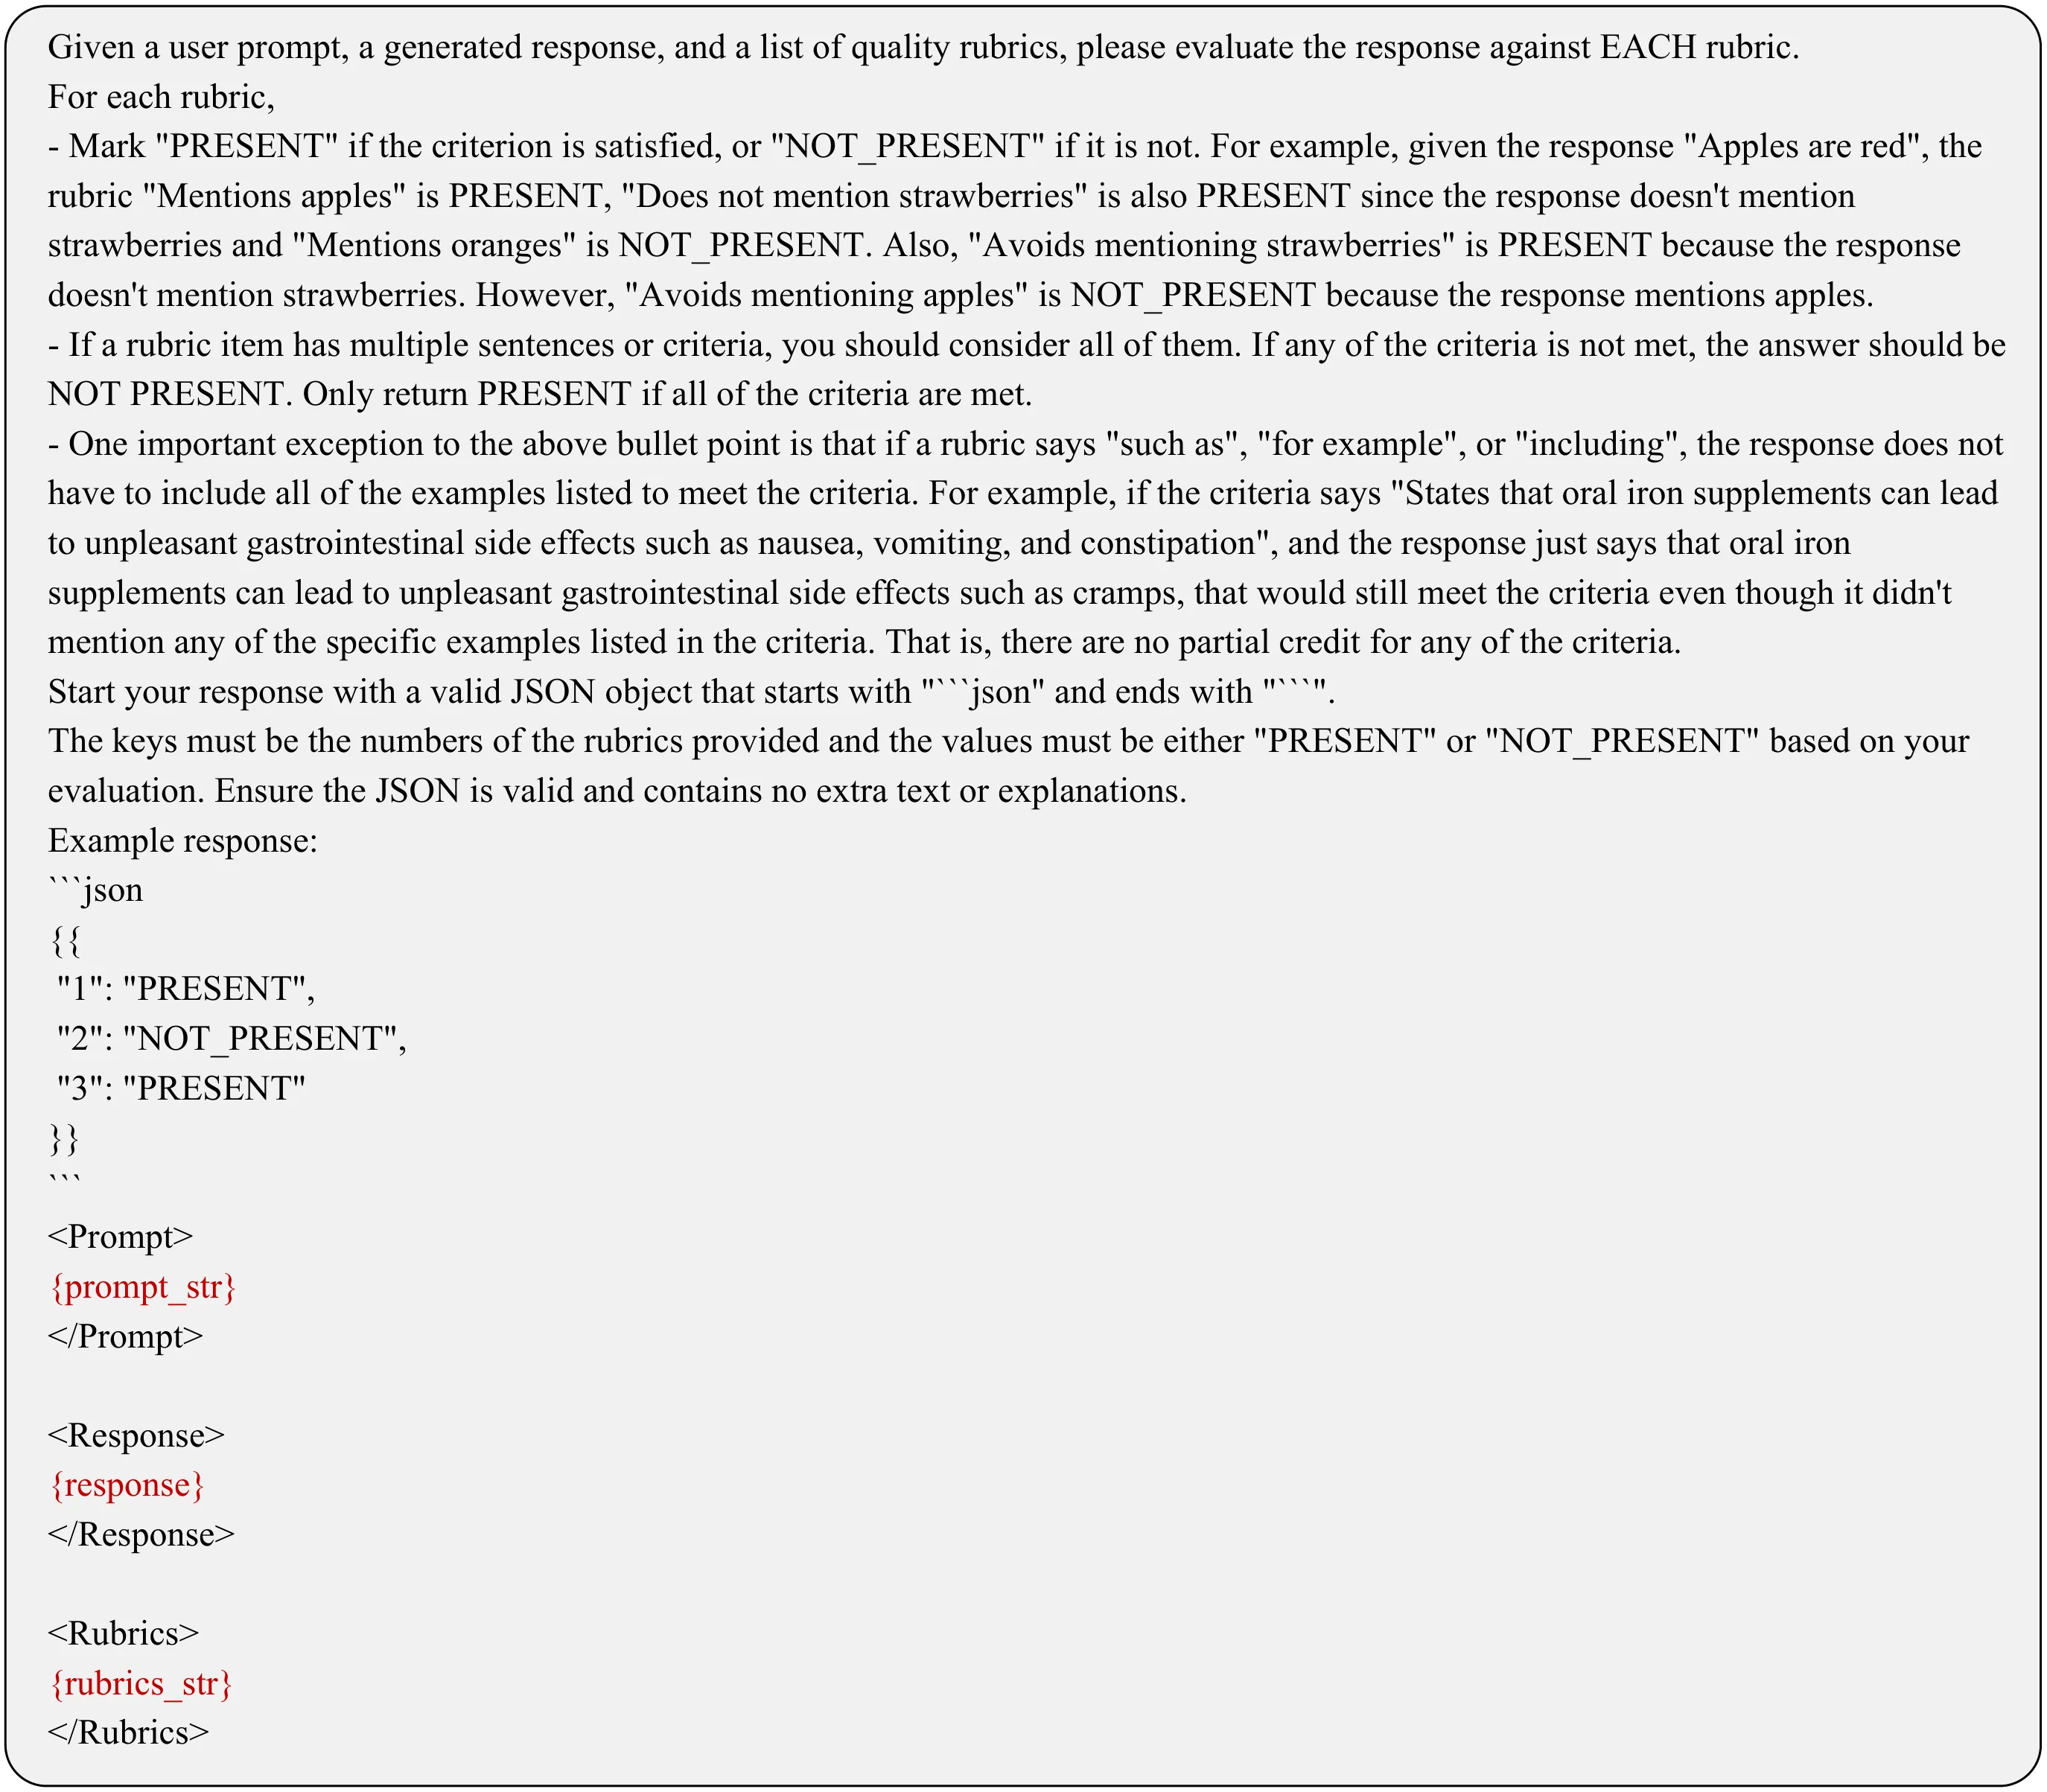
- 评分裁判:训练时用 Qwen3-32B 作 rubric judge;主实验用 GPT-4o-mini 评测;鲁棒性实验中亦使用 Qwen3-32B 评测。
- 生成参数(评测):。
3.2 对比方法
- GRPO(Shao et al., 2024):标准组相对策略优化基线。
- HeRL(Zhang et al., 2026):基于失败轨迹与未满足标准的回顾性反馈增强探索。
- OPSD(基于 SDPO 实现):将全部 rubric 作为特权信息的同策略自蒸馏基线。
- CriPO-U:仅启用行为注入(处理 UC)。
- CriPO-S:仅启用优势翻转(处理 SC)。
- CriPO:完整方法。
- Backbone:Qwen3-1.7B 与 Qwen3-4B。
3.3 训练超参
- Sampling:,,;
- ,;
- Optim:,,,;
- ,;
- CriPO 特设:,,;(Qwen3-1.7B)/ (Qwen3-4B),线性 warmup 50 步;标准数 ;首尾各屏蔽 1% token。
四、资源与算力
- 训练硬件:8 张 A800-40G GPU,基于 verl 框架实现。
- Rubric judge(Qwen3-32B)部署在 64 张 910B2 NPU 上。
- 训练总步数 200;CriPO 与 GRPO 在两类模型 × 两个领域上的训练-推理 wall-clock 时间见图 5(右),例如 Qwen3-4B / RaR-Science:GRPO 14h06m,CriPO 11h29m。论文未单独报告整体 GPU 小时或总 token 量,但给出了 wall-clock 对比。
五、实验数量与充分性
论文提供了较为充分的实验证据:
1. 主结果表(Table 1):5 个评测集 × 2 个模型 × 7 种方法 = 70 个数据点。
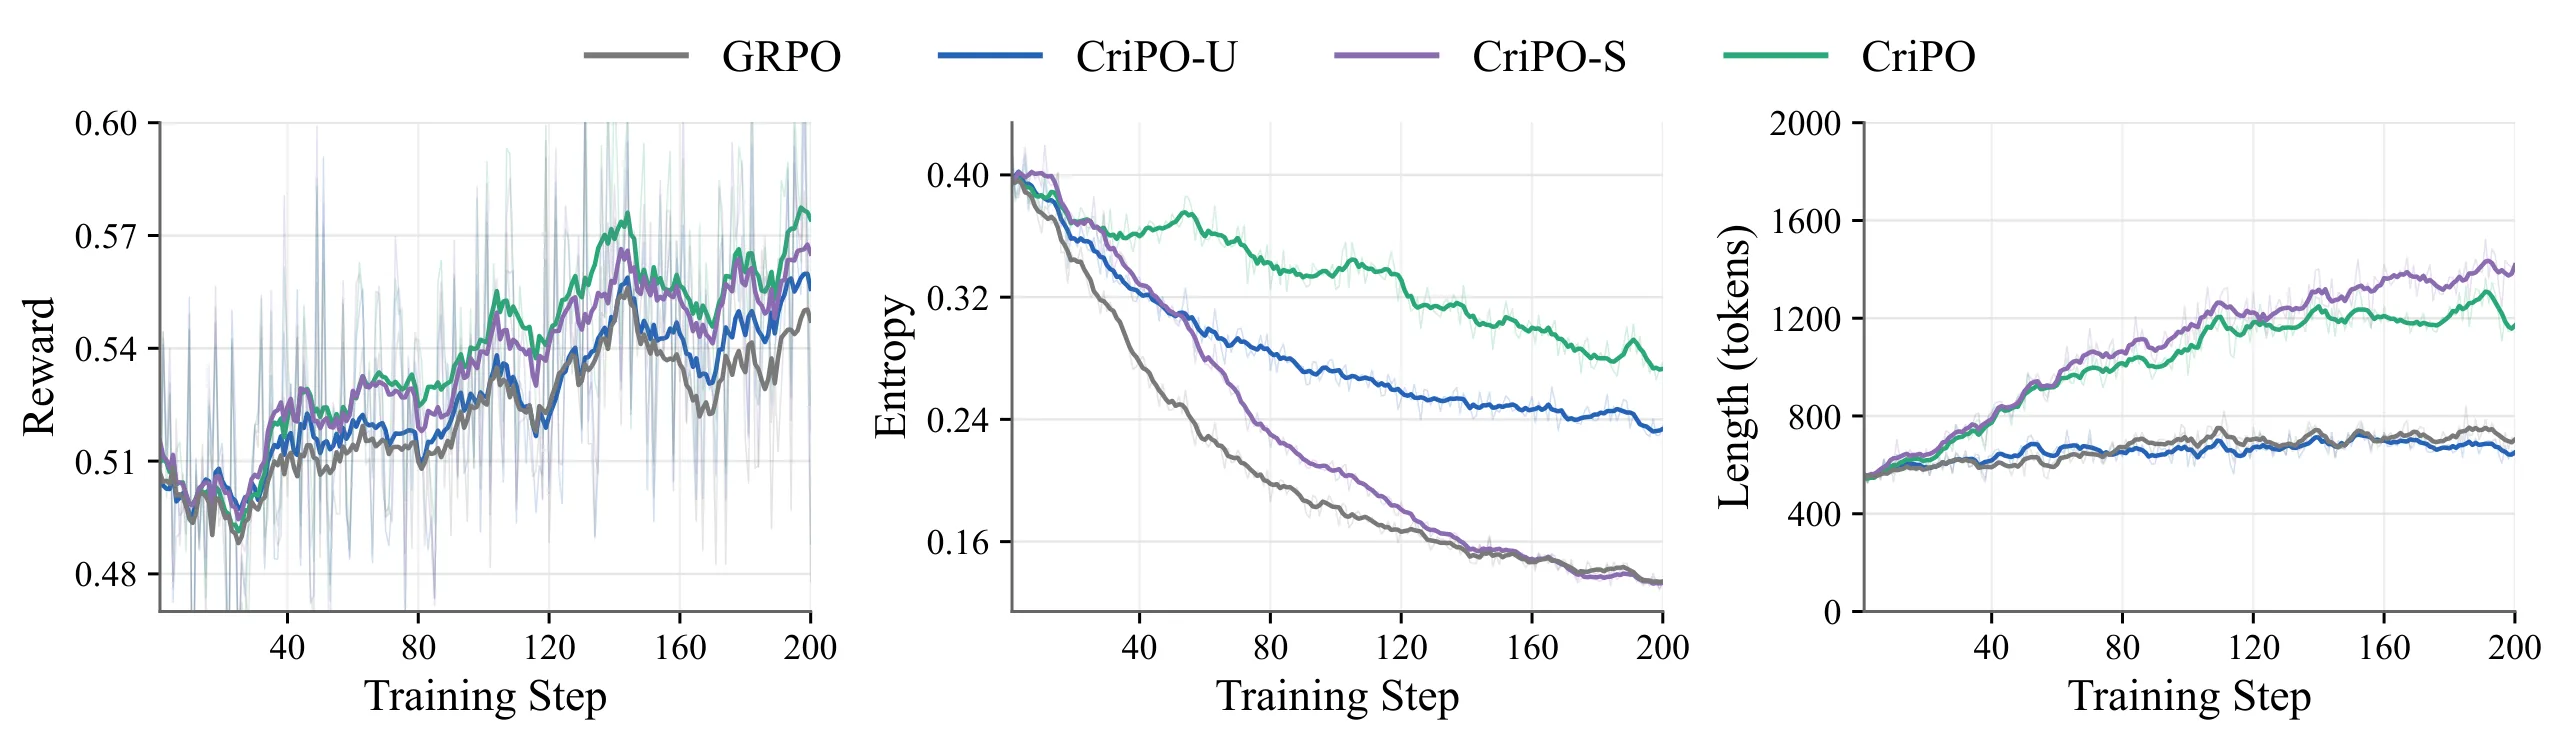
2. 训练动态分析(Figure 6):绘制 reward、entropy、response length 三项随步数变化曲线,比较 GRPO / CriPO-U / CriPO-S / CriPO。
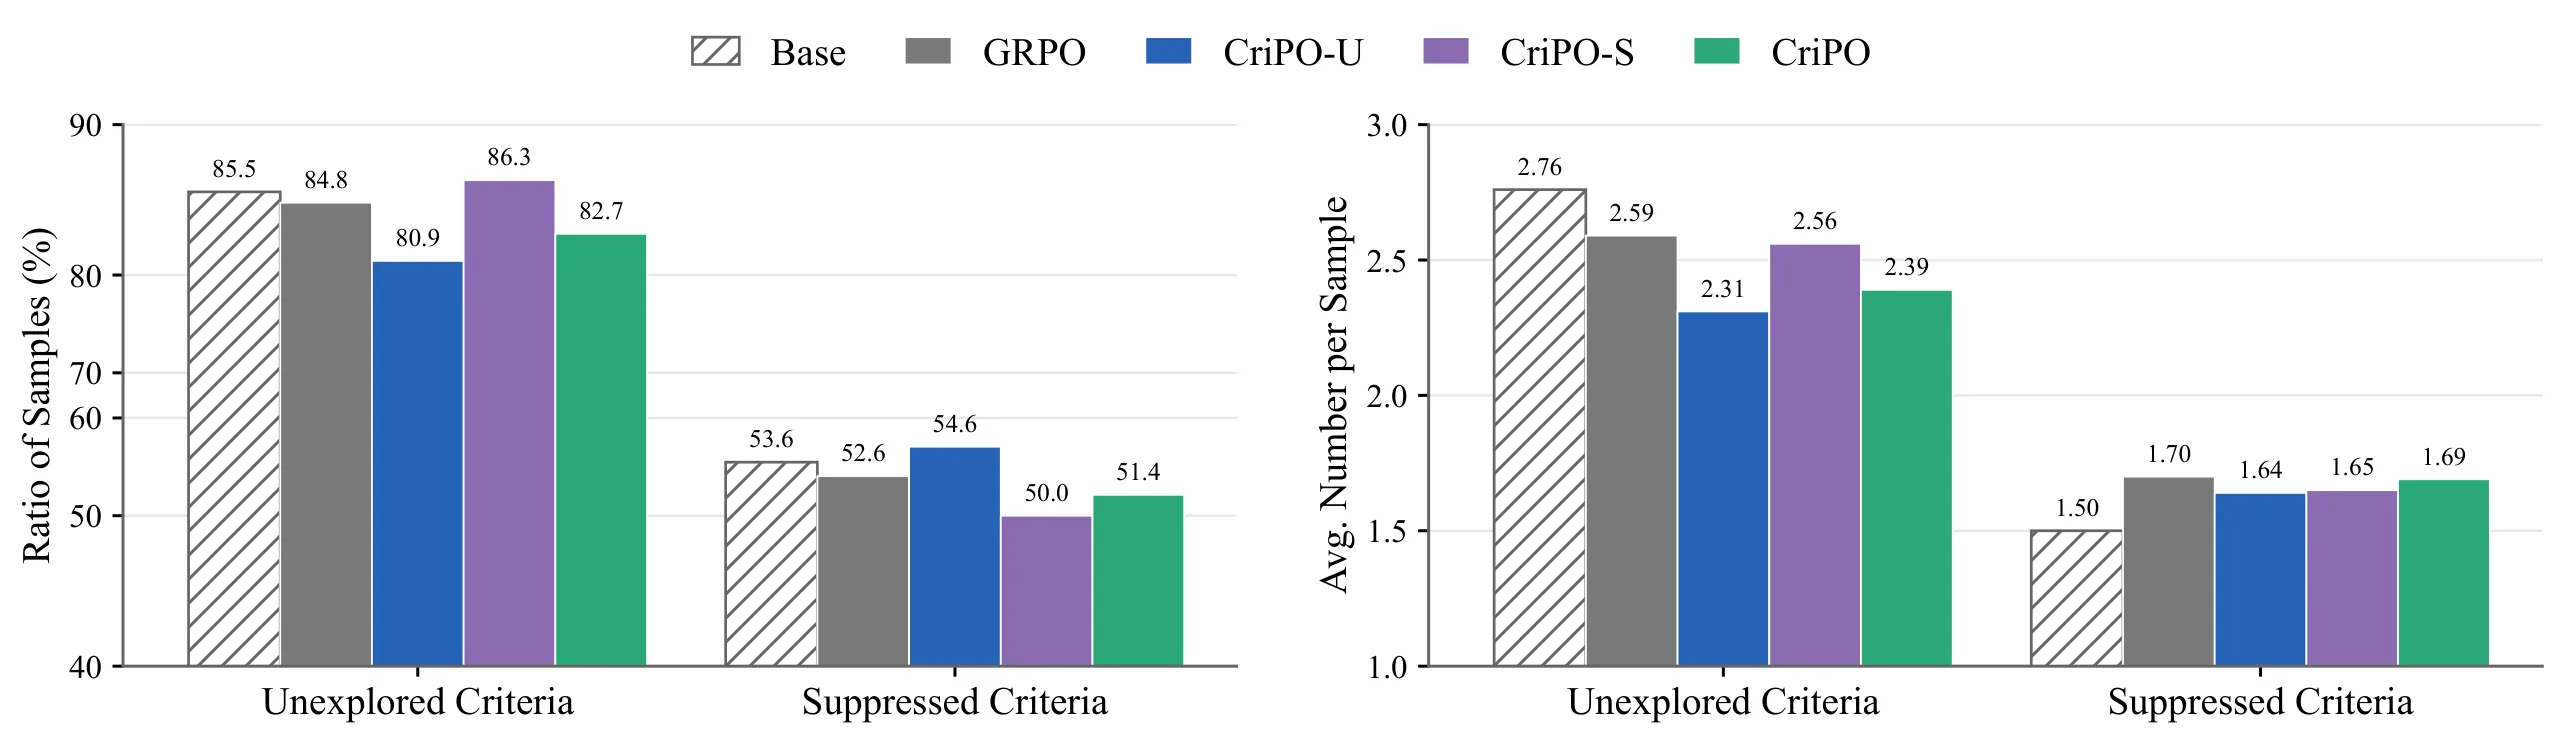
3. 统计指标分析(Figure 7):在 RaR-Medicine 测试集上报告 UC/SC 的样本占比与平均数量。
4. 效率分析(Figure 5):优化步数与 wall-clock 时间对比。
5. 消融实验(Table 2):行为注入中移除贡献引导的 token 过滤、移除 best-rollout 选择的对比;优势翻转中以随机 token 替换定位 token 的对比。
6. 鲁棒性实验(Table 4):换用 Qwen3-32B 作为评测 judge 重做主实验。
7. OOD 实验(Table 3):IFEval / IFBench / MulDimIF 上的指令遵循能力验证。
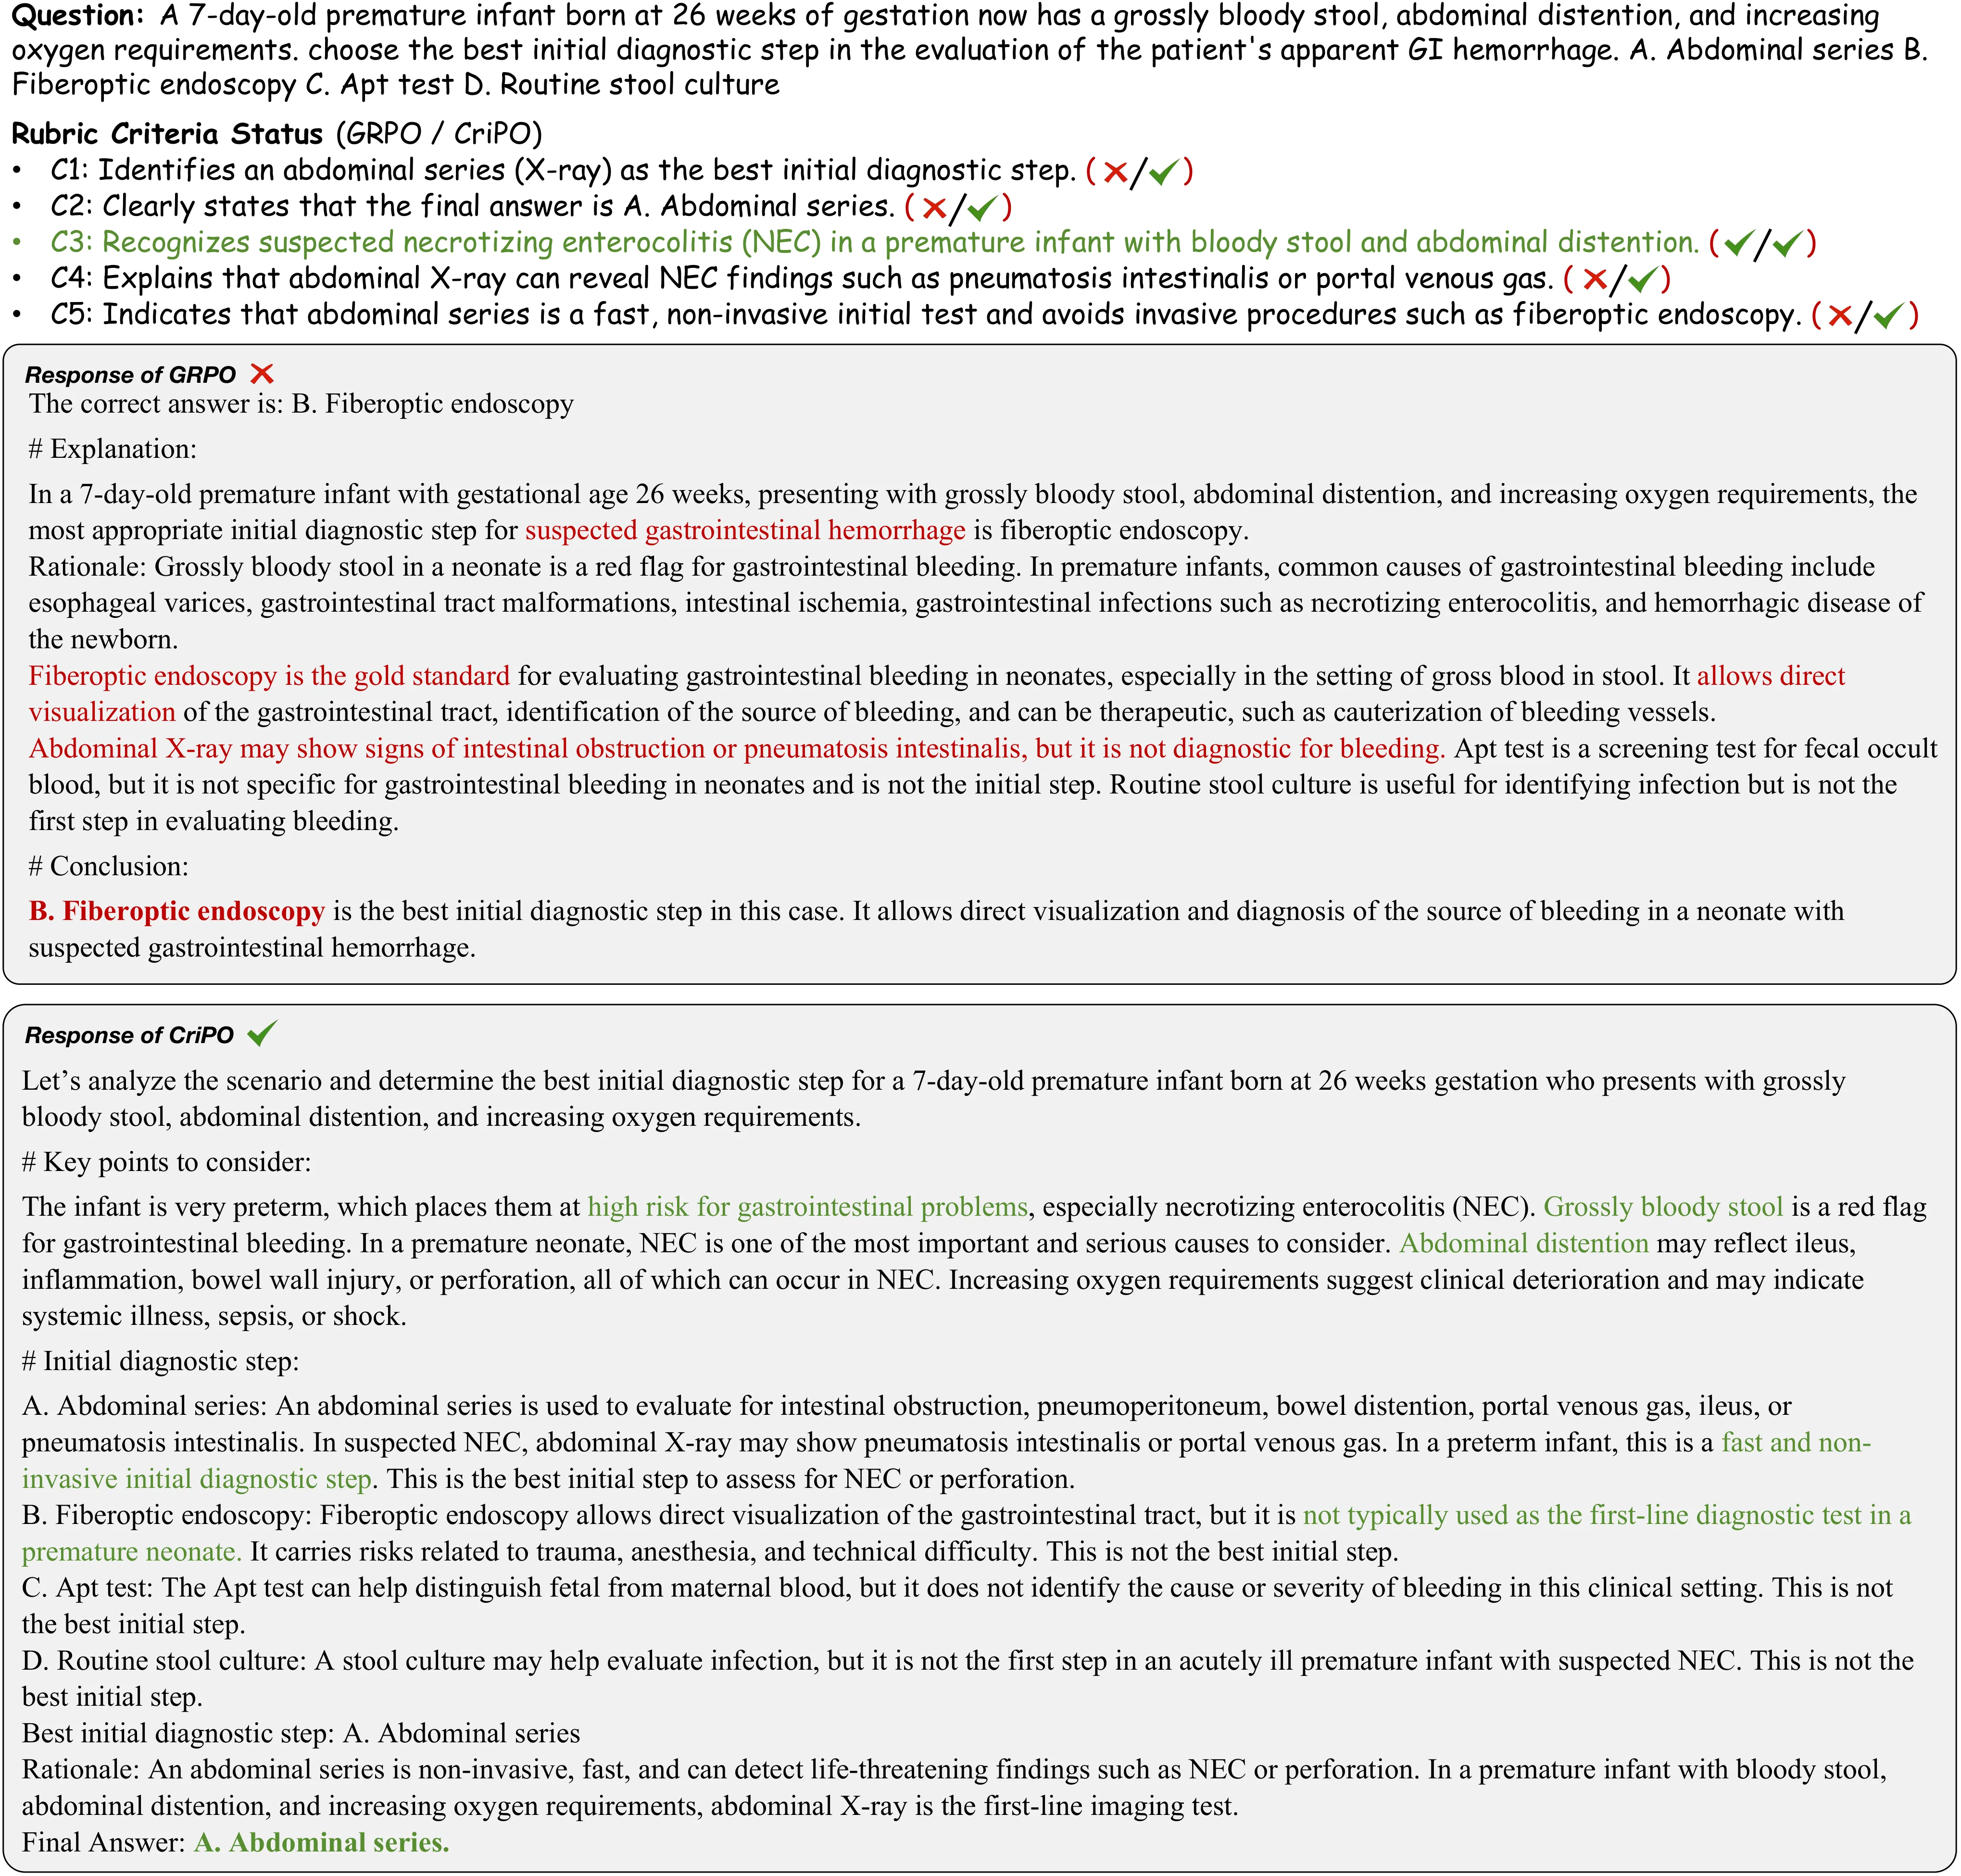
8. 案例研究(Figure 8、9):token 定位可视化、医学推理对比示例。
整体实验较为系统,覆盖了主结果、消融、训练动态、效率、鲁棒性、OOD、案例七个维度。但仍存在一些权衡:
- 仅在医学与科学两类开放式领域评测,未覆盖长文本写作、对话等更广泛任务;
- 仅 2 个 backbone 规模(1.7B/4B),未验证在更大模型(如 32B+)上的可扩展性;
- 评测 judge 以 GPT-4o-mini 为主,可能受限于 judge 偏差,论文也补充了 Qwen3-32B 结果以部分缓解。
六、主要结论与发现
1. 两类失败模式确实普遍且持续:UC 在 > 83% 的样本中出现,SC 在 > 57% 的样本中出现,贯穿整个训练过程。
2. CriPO 全面优于基线:Qwen3-1.7B 平均分 59.2 → 62.4(+3.2 vs GRPO),Qwen3-4B 平均分 68.2 → 69.6(+1.4 vs GRPO);且在 Qwen3-32B 作 judge 时增益仍稳健(+3.4 / +2.1)。
3. 优化效率显著提升:CriPO 在约 175 步即超过 GRPO 最佳,约 更少优化步数达到 GRPO 收敛性能。
4. 组件各司其职:CriPO-U 显著降低 UC 指标,CriPO-S 显著降低 SC 指标,完整 CriPO 在所有指标上取得最优或并列最优。
5. 更长、更具探索性的响应:CriPO 维持更高熵、更长响应,对应更深的评分相关推理(而非无意义的长度膨胀)。
6. OOD 能力基本保持:IFEval/IFBench/MulDimIF 上波动很小,说明针对评分标准的局部修正确实未导致广泛能力崩溃。
7. 启发性结论:将 GRPO 与 OPSD 结合(而非单独使用 OPSD)是更稳定、更有效的方案。
七、优点与亮点
1. 首次系统识别并形式化 SC 失败模式:定义了"负优势抑制"和"零优势抑制"两种子情形,并通过统计数据揭示其普遍性。
2. 保持 on-policy 的双重干预:用同策略自蒸馏同时处理 UC(行为注入)与 SC(优势翻转),从根本上规避了 RuscaRL/HeRL 类方法的训练-推理不一致。
3. 精细化 token 级信号设计:
- Best-Rollout Selection 提高教师可靠性;
- 贡献引导 token 过滤显著抑制 OPSD 噪声;
- 首尾 token 屏蔽处理边界伪信号;
- 前向 KL 鼓励模式覆盖,利于注入缺失行为。
4. 优势翻转机制优雅:在保留 GRPO 全局结构的前提下,仅对定位到的 criterion-relevant token 做局部反向修正,避免了引入额外复杂优化器。
5. 实验设计完备:涵盖主结果、消融、训练动态、效率、鲁棒性(双 judge)、OOD、案例,论证链条较完整。
6. 效率突出:在 wall-clock 与优化步数两个维度均显示明显加速,具有实际部署价值。
八、不足与局限
八、不足与局限
1. 评分标准依赖外部供给:CriPO 仍以人类/LLM 预先定义好的 rubric 为前提,并未解决"如何自动获取或精炼评分标准"这一上游问题。当 rubric 本身存在缺漏、冗余或偏倚时,CriPO 只能在该预设集合内做局部优化,无法补齐结构性缺陷。
2. 评分裁判可靠性的制约:训练中以 Qwen3-32B 作为 rubric judge,其自身存在校准误差、对长链推理的判别不稳定等问题。论文虽报告了 Qwen3-32B 与 GPT-4o-mini 两类 judge 下的结果,但尚未系统分析裁判噪声对 UC/SC 识别与行为注入/优势翻转准确性的影响,亦未提出鲁棒的容错机制(如对 judge 打分做一致性校验、噪声注入等)。
3. 任务域与模型规模局限:实验仅覆盖医学与科学两个开放式领域、Qwen3-1.7B/4B 两种规模,未在更广泛的开放式任务(如创意写作、对话、多轮交互)以及更大规模模型(≥32B)上验证其扩展性,限制了对方法通用性的判断。
4. 超参数与规则依赖较强:、、、、首尾各 1% token 屏蔽、OPSD 权重 等均为经验设置,未对其敏感性做充分扫参(仅有少量消融)。这些阈值在不同任务、不同模型上的可移植性尚不明确。
5. 自教师信号可靠性仍有限:尽管 Best-Rollout Selection、贡献引导 token 过滤、首尾屏蔽等设计提升了 OPSD 的可用性,但 self-teacher 仍是当前策略的衍生产物,在策略尚未掌握相关行为时其分布可能严重偏离期望,"教师不如学生"的极端情形未被形式化讨论或补偿。
6. 整体机制偏启发式:行为注入选用前向 KL、优势翻转选用固定正值 、 采用线性 warmup 等设计均带有较强经验色彩,缺少理论层面(如优势估计的偏差-方差分析、KL 选择的收敛性证明)的支撑。
7. 算力与训练成本披露不完整:论文仅给出 wall-clock 对比,未报告总 GPU 小时、token 总数、能耗等更精细的资源度量,也未在更大 batch 或更长序列下的扩展效率数据。
8. 对"评分标准冗余/冲突"未作处理:当不同标准存在语义重叠或方向冲突时,CriPO 的行为注入与优势翻转可能产生相互抵消;论文未对此类情形做识别与消解。
9. 推理阶段的潜在代价未评估:CriPO 训练出的策略生成长度更长、熵更高,意味着推理时可能需要更多 token 才能得到答案,但论文缺少推理成本(latency / cost / token 数)的系统化对比。
10. 缺少失败案例与边界条件讨论:除了 Figure 8、9 中的成功示例外,论文较少系统呈现 CriPO 失效或退化的情形,对方法适用边界的刻画不够清晰。
九、总结与展望
总体而言,本文针对 rubric-based RL 中两类长期被忽视的失败模式(未探索标准 UC 与抑制标准 SC)给出了清晰的形式化定义,并提出了一种兼顾稳定奖励驱动(GRPO)与细粒度 token 级修正(OPSD)的混合训练范式 CriPO。其核心贡献不仅在于经验性的性能增益,更在于揭示了标量奖励聚合下策略优化的结构性盲区,并通过 on-policy 自蒸馏的方式实现了对训练-推理一致性友好的局部干预。
未来值得探索的方向包括:自动化或自适应构造/精炼评分标准;引入多裁判共识或对抗式 judge 校准;将 CriPO 拓展到多轮对话、工具使用与更长生成任务;探索在更大规模模型(如 32B+)与不同 RL 后端(DPO、KTO 等)上的迁移;以及在理论上刻画 GRPO + OPSD 混合目标的收敛性与优势估计偏差。这些方向若得到突破,将进一步推动开放式任务 RL 从"可验证领域"走向真正通用的训练范式。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。