
📝 TLDR
问题背景:真实智能体学习受限于高昂的环境交互成本,实验或人工反馈代价高。核心方法:提出"经验蒸馏",把智能体从交互历史中学到的上下文知识内化到模型权重,无需额外环境交互。关键结果:在 749 项软件工程任务和 6 款文字冒险游戏上,保留至少 64.8% 的上下文学习增益,而直接监督微调仅恢复 3.8%。贡献意义:相比经典强化学习基线,以至少 9.6 倍更少的环境样本取得同等性能。
🧭 速览
上下文学习增益随上下文移除而消失;直接在交互经验上做监督微调又会损失样本效率。
提出 Experience Distillation,将交互历史中的上下文学习结果蒸馏进模型权重,不需再与环境交互。
软件工程与文字冒险游戏中保留至少 64.8% 的 ICL 增益(SFT 仅 3.8%),以 9.6 倍更少样本匹配 RL 基线。
经验蒸馏是从昂贵交互中高效获取持久智能体能力的可行方案。
🆚 方法对比
In-Context Learning (ICL)
- 样本高效,无需权重更新即可适应任务
- 可通过试错反馈改善智能体行为
- 适应长上下文(80k+ tokens)的复杂任务
- 上下文移除后性能增益立即消失
- 受上下文窗口长度限制
- 不更新模型参数,知识无法持久化
Direct Supervised Fine-Tuning (SFT)
- 实现简单,可直接将经验内化到模型权重
- 无需额外环境交互或世界模型
- 训练流程成熟稳定
- 仅恢复3.8%的ICL增益,效果极差
- 可能破坏模型的通用能力
- 无法学习条件化于上下文的策略行为
Context Distillation
- 成熟的蒸馏框架,有理论保证
- 可将上下文信息内化到模型权重
- 教师-学生机制保留条件化行为
- 应用于智能体经验时需额外环境交互
- 在代理任务上的应用尚未充分探索
- 直接用于经验会牺牲环境样本效率
Experience Distillation(作者新提方法)
- 保留至少64.8%的ICL增益,跨两域有效
- 无需额外环境交互或世界模型
- 匹配RL基线且至少少用9.6×环境样本
- 单步分支回溯设计实用高效
- 依赖已收集经验的质量与多样性
- 单步分支可能限制更复杂策略学习
- 尚未在更大规模或更多领域验证
Model-based RL(世界模型方法)
- 避免在真实环境中额外交互
- 理论上可生成任意长度的轨迹
- 模型自由控制,灵活度高
- 小误差在长rollout中累积放大
- 生成的轨迹不可靠
- 需要额外学习世界模型,成本高
Classical RL Baselines
- 标准交互学习框架,理论成熟
- 性能稳定可靠
- 在充足交互下可达到强性能
- 环境样本效率差,需要大量交互
- 在代价高昂的任务中不实用
- 相比ICL+ED多用至少9.6×环境样本
论文核心提出Experience Distillation框架,通过单步分支回溯实现无世界模型、无额外环境交互的轨迹级上下文蒸馏,在样本效率上显著优于直接SFT(3.8% vs 64.8%增益保留)和经典RL基线(少9.6×样本),同时避免了基于世界模型的model-based RL方法中误差累积的问题。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 8 张)
展开查看 8 张图
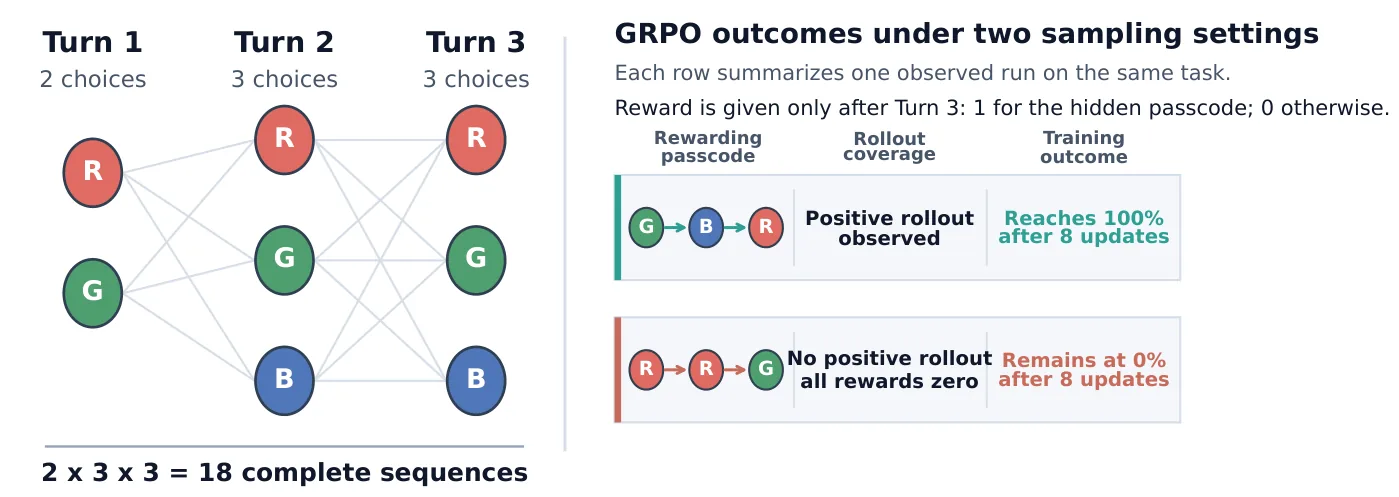
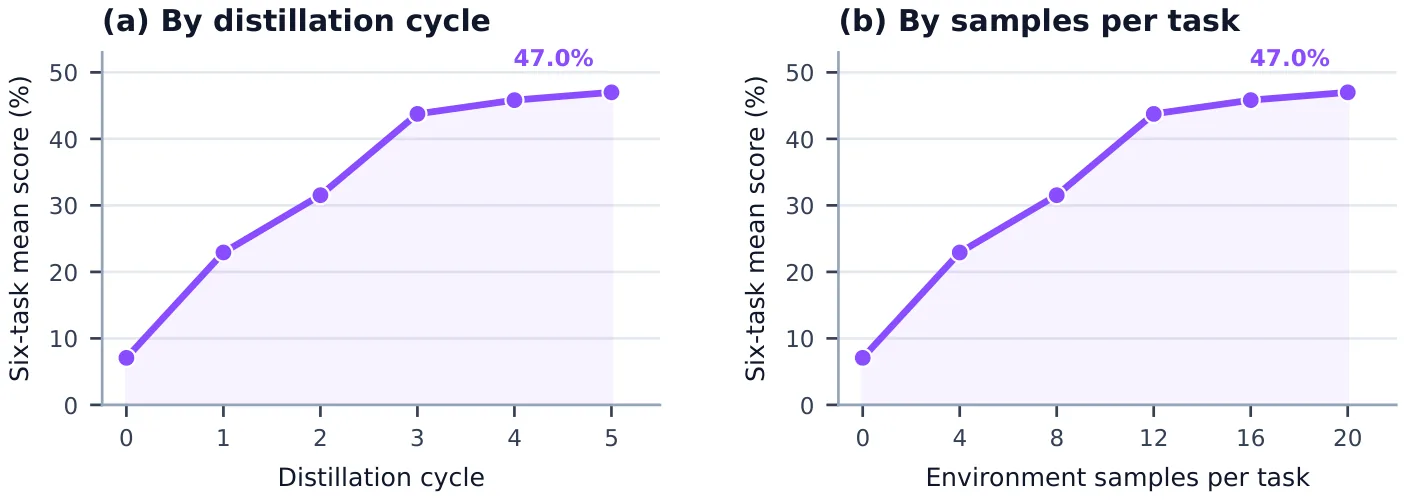
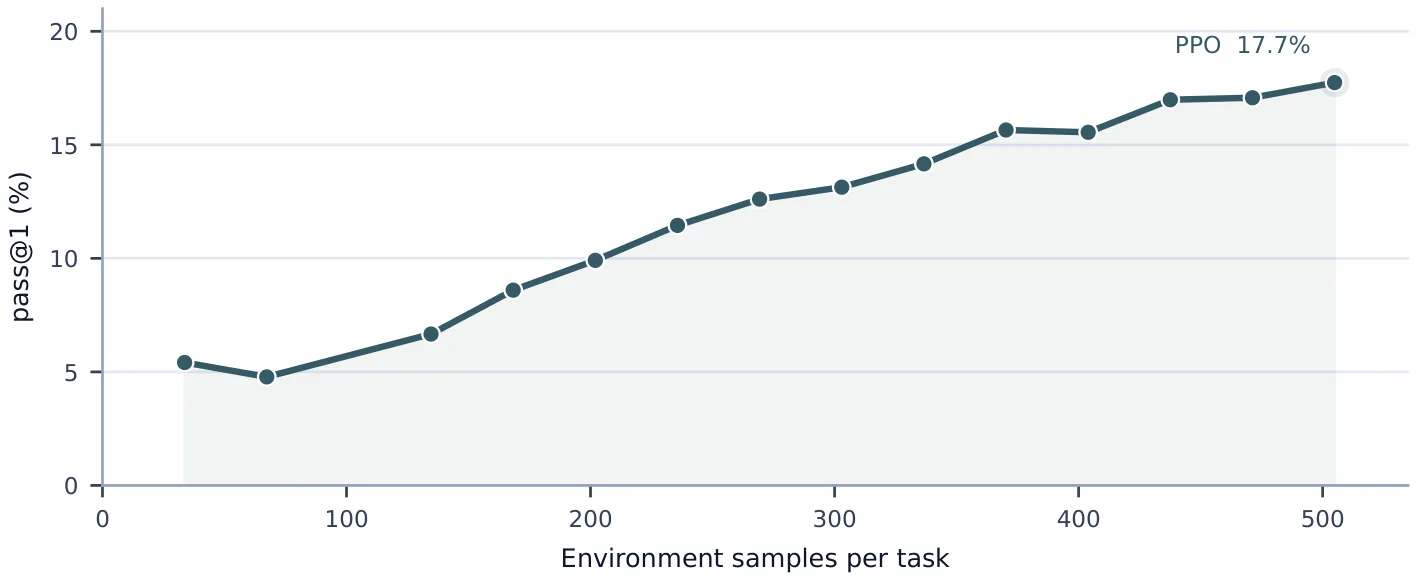
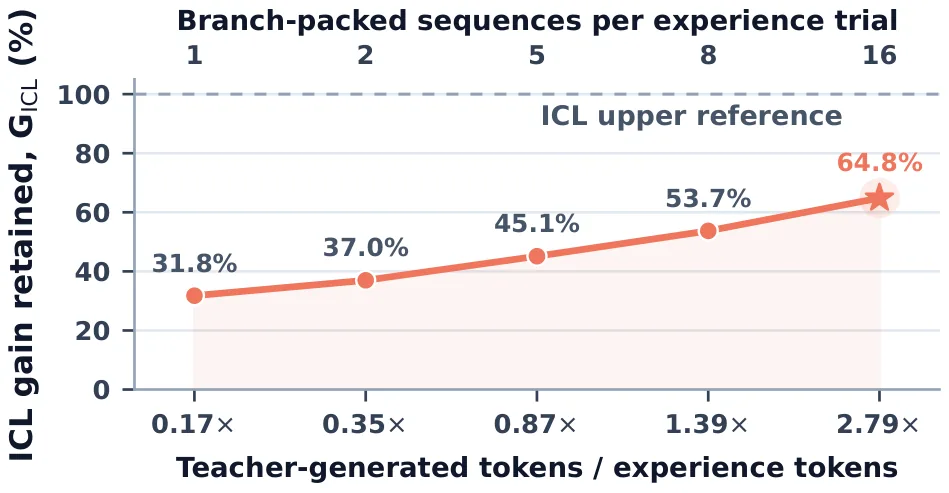
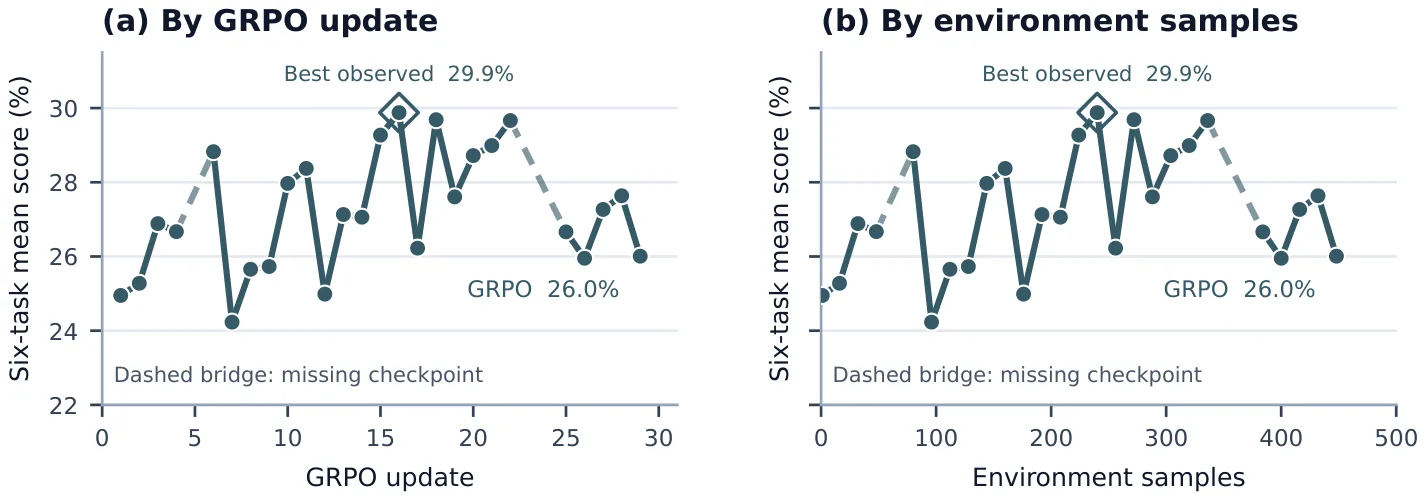
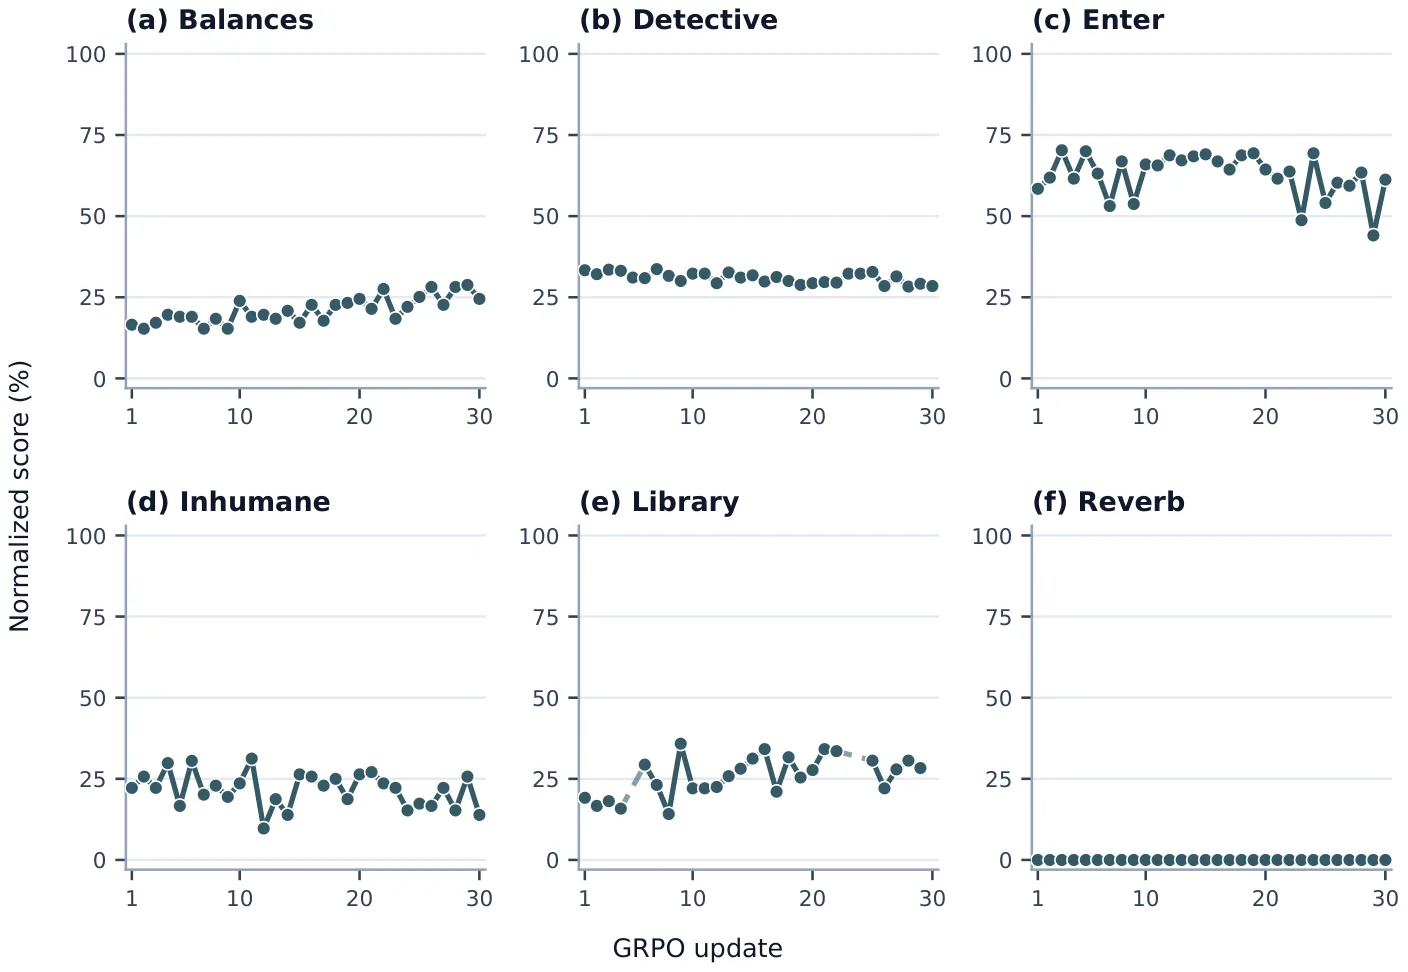
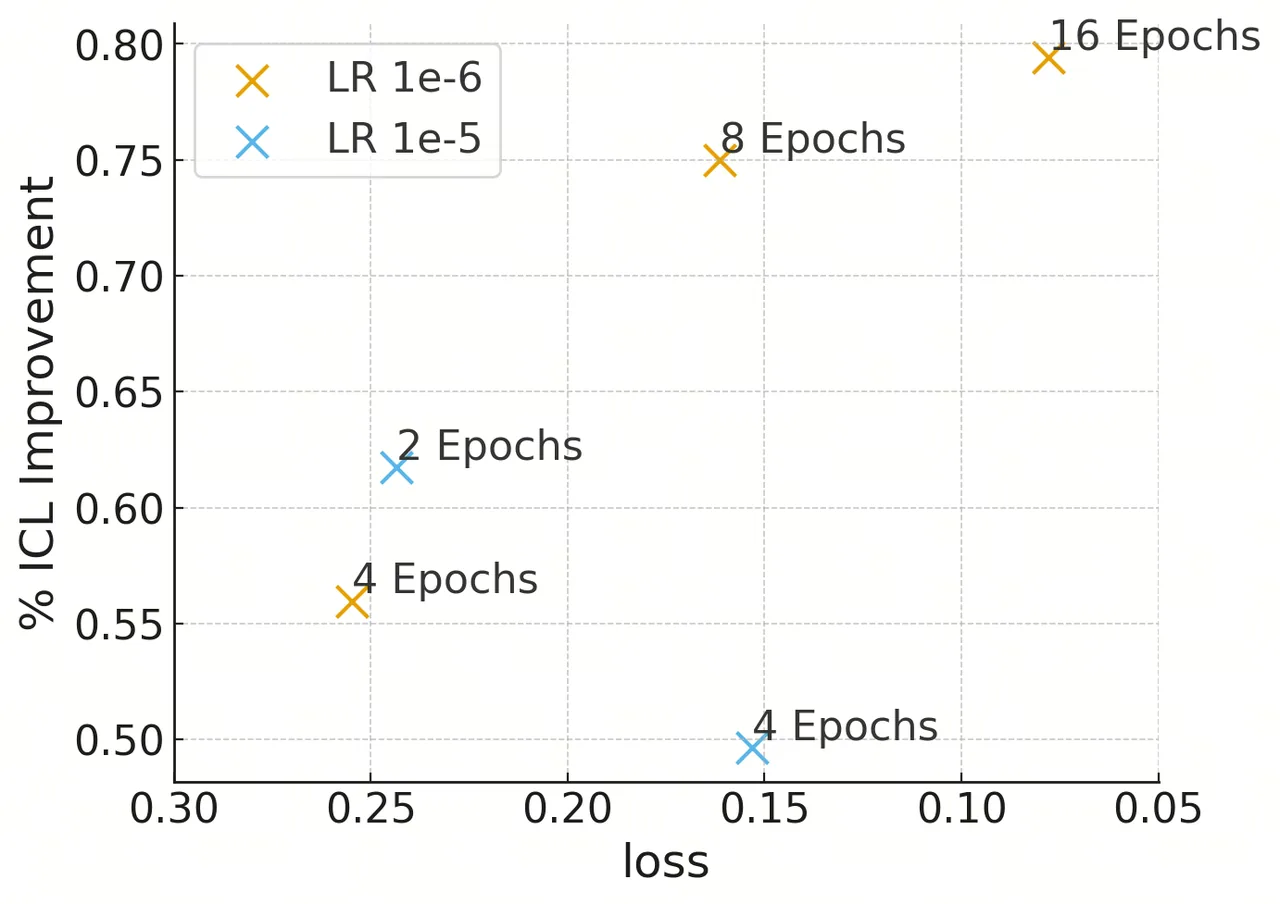
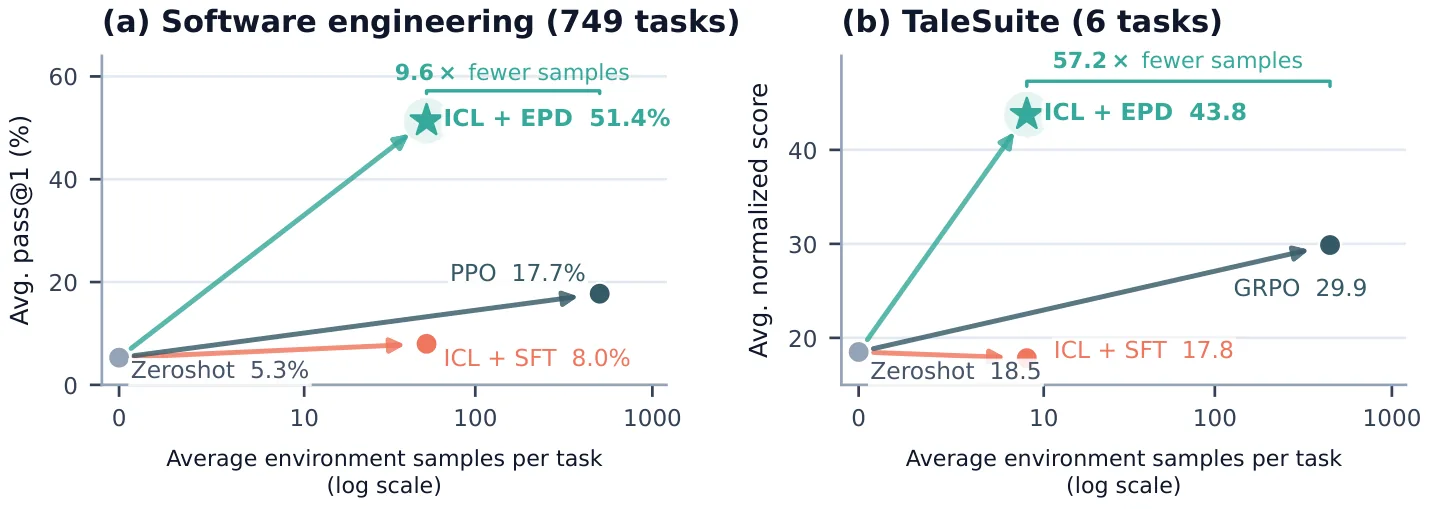
TL;DR
这篇论文提出了「经验蒸馏」方法,将智能体在交互历史中通过上下文学习获得的知识内化到模型权重中,使其在不丢失经验的情况下摆脱对长上下文的依赖。实验表明,该方法能在软件工程任务和文字冒险游戏两个领域保留至少 64.8% 的上下文学习增益,而直接监督微调仅能恢复 3.8%;相比传统强化学习方法,经验蒸馏以 9.6 倍更少的环境交互样本达到相近性能。
研究背景与动机
在真实场景中训练智能体面临一个根本性瓶颈:环境交互成本极其高昂。无论是运行耗时的物理模拟、部署代码进行测试,还是获取人类反馈,每一步交互都意味着显著的时间和资源消耗。这一问题在软件工程智能体、科学发现智能体等需要大量试错的场景中尤为突出。
[[上下文学习]]为此提供了一种优雅的解决思路。智能体可以在与环境的交互过程中观察成功与失败的案例,直接从这些历史经验中提取模式,而无需显式地调整模型权重。这种「边用边学」的方式理论上可以达到极高的样本效率——每次与环境交互产生的数据都能被即时利用。然而,上下文学习存在一个致命缺陷:一旦这些经验从上下文中移除,模型立即失去由此产生的性能提升。在实际部署中,上下文窗口的长度终归有限,智能体无法永远保留完整的交互历史。
与此同时,[[上下文蒸馏]]技术为另一个方向打开了大门。这项技术的核心思想是通过训练让模型在不依赖显式上下文提示的情况下表现出类似的行为——将知识从上下文「蒸馏」到模型权重中。但此前的研究主要关注如何利用外部知识库或人类标注的上下文信息,将其蒸馏到通用模型中。
一个关键但尚未被充分探索的问题是:能否将智能体自身的交互历史——这些通过与环境试错得来的、极为珍贵的经验——也蒸馏到模型权重中,同时不牺牲样本效率?直接的做法是在收集到的经验数据上进行标准的[[监督微调]],但论文的初步实验揭示了一个令人意外的事实:这种做法对恢复上下文学习增益几乎毫无帮助。这促使作者重新审视经验蒸馏的核心挑战。
方法
经验蒸馏的核心目标可以用一句话概括:将智能体通过上下文学习从交互历史中获得的能力,迁移到模型权重中,使其在无需长上下文的情况下仍能保持高性能,同时整个过程不依赖额外的环境交互。
直观上,直接在收集到的(状态, 动作, 奖励)序列上进行监督微调似乎是理所当然的做法。然而,这种方法忽略了上下文学习与监督学习之间一个根本性的差异:上下文学习让智能体能够根据当前情境动态地选择性地利用历史经验,而监督微调则倾向于让模型记住所有训练样本的「平均」行为。当交互历史中混杂着成功与失败的尝试时,这种平均化会导致模型在各种情况下都表现得中规中矩,而非真正学会何时该参考哪种经验。
论文采取的方法利用了[[强化学习]]框架中试错经验的结构特点。具体而言,智能体在环境中探索时会产生大量(状态, 动作, 奖励)三元组,其中奖励信号揭示了每个动作的价值。作者观察到,成功的动作往往伴随着正向奖励,而失败的尝试则带有负向或零奖励。这意味着我们可以通过奖励信号来识别哪些经验片段是值得保留的「好例子」。
经验蒸馏的实现流程分为两个阶段。第一阶段是标准的环境交互与上下文学习:智能体在环境中探索,将交互历史保留在上下文中,利用上下文学习能力选择动作并获得反馈。第二阶段是经验向权重的迁移:给定第一阶段收集的交互历史,智能体利用已完成交互的「事后视角」,识别出哪些动作序列最终带来了正向结果。然后,模型在由这些正向经验构成的训练数据上进行优化,使得模型权重学会在类似状态下倾向于执行曾带来成功的动作。
这里的设计关键在于:经验蒸馏不需要模型在蒸馏阶段与环境再交互。它完全基于已经收集到的经验,利用奖励信号筛选出有价值的样本进行学习。这一特性使其区别于需要持续环境交互的强化学习方法,从而在样本效率上获得了显著优势。
实验与结果
论文在两个差异显著的任务领域上验证了经验蒸馏的有效性:软件工程任务和文字冒险游戏。前者包含 749 项经过筛选的编程问题,要求智能体理解需求、编写代码并通过测试;后者则是经典的文本游戏环境,智能体通过自然语言指令控制角色探索虚拟世界。
在软件工程任务上,上下文学习基线(将完整交互历史保留在上下文中)取得了显著的样本效率优势:当环境交互次数有限时,其性能远超传统强化学习方法。论文比较了三种知识迁移策略的效果。第一种是直接监督微调,即在收集到的交互数据上训练模型,但实验结果令人失望——它仅能恢复 3.8% 的上下文学习增益,与完全不做迁移的基线几乎没有区别。第二种是随机微调,在相同数量的随机数据上训练,结果甚至更差。第三种就是经验蒸馏方法,它保留了 64.8% 的上下文学习增益,显著优于直接监督微调。
在文字冒险游戏上的结果进一步证实了经验蒸馏的跨领域适用性。该方法同样保留了超过 60% 的上下文学习增益,而直接监督微调的表现依然乏善可陈。
论文还对比了经验蒸馏与经典强化学习方法(如 PPO)在达到相近性能水平时所需的环境样本数量。结果显示,经验蒸馏结合上下文学习的方案,能够以至少 9.6 倍更少的交互样本达到与强化学习方法相当的最终性能。这一数字在样本效率至关重要的真实场景中具有重要的实践意义。
值得注意的是,实验发现蒸馏后模型的泛化能力与上下文窗口长度存在权衡。当测试环境与训练环境足够相似时,蒸馏模型甚至能超越原始的上下文学习基线——因为它不再受制于有限的上下文长度。但在分布偏移较大的情况下,上下文学习的灵活性优势则更为明显。
讨论与可借鉴点
经验蒸馏揭示了一个重要洞察:[[监督微调]]和上下文学习并非简单的替代关系,两者在知识表示形式上存在本质差异。监督微调倾向于学习训练数据分布的「中心趋势」,而上下文学习则能根据当前情境动态选择性地利用经验。这一发现对于设计更高效的训练流程具有广泛启发。
论文的主要局限在于其方法依赖明确的奖励信号。在奖励稀疏或难以定义的环境中,如何筛选有价值的经验片段仍是开放问题。此外,蒸馏过程中不可避免的信息损失(实验显示约 35% 的增益无法保留)意味着在某些对精度要求极高的场景中,上下文学习仍是必要的。
从实践角度,经验蒸馏为降低智能体部署成本提供了一条可行路径。当环境交互成本高昂时,可以先进行有限次数的交互并利用上下文学习快速收敛,再通过经验蒸馏将习得能力固化到模型中,实现「一次训练、多次部署」的高效范式。这一思想与近期大模型研究中流行的「模型合并」「能力迁移」趋势相呼应,但更专注于智能体决策这一特定场景。
未来的探索方向包括:将经验蒸馏与持续学习结合以避免灾难性遗忘、探索无奖励信号的自我蒸馏方法、以及研究如何在大规模预训练模型上高效实施经验蒸馏。随着语言模型在智能体任务中扮演越来越重要的角色,这类将稀缺交互经验高效转化为模型能力的技术,其价值将愈发凸显。
摘要
现实世界中的智能体学习往往受到与环境交互成本高昂的限制,例如运行耗时的实验或获取人类反馈。上下文学习为智能体提供了一种高度样本高效的方式,使其能够从自身的交互历史中学习,但一旦这些经验从上下文中移除,其增益便会消失。另一方面,上下文蒸馏提供了一种将上下文信息内化到模型权重中的机制。然而,在不牺牲环境样本效率的前提下,将其应用于智能体的交互历史仍未得到充分研究。我们将这一问题命名为经验蒸馏(Experience Distillation),并提出了一种实现方案,除了已收集的经验之外无需进一步的环境交互。在 749 个经过筛选的软件工程任务和六个文字冒险游戏上的实验表明,该方法在两个领域中均保留了至少 64.8% 的上下文学习增益,而直接在已收集经验上进行监督微调仅能恢复 3.8%。与经典的强化学习基线相比,基于试错经验的上下文学习结合经验蒸馏方法,在性能与之相当的同时,所需的环境样本至少减少了 9.6 倍。
Abstract
Real-world agent learning is often constrained by costly environment interactions, such as running time-consuming experiments or obtaining human feedback. In-context learning offers a highly sample-efficient way for agents to learn from their own interaction histories, but its gains disappear once that experience is removed from the context. Separately, context distillation provides a mechanism for internalizing contextual information into model weights. However, applying it to agents' interaction histories without sacrificing environment sample efficiency remains underexplored. We term this problem Experience Distillation and develop an implementation that requires no further environment interaction beyond the collected experience. Experiments on 749 curated software-engineering tasks and six text-adventure games show that it retains at least 64.8\% of the gains from in-context learning across both domains, whereas direct supervised fine-tuning on the collected experience recovers only 3.8\%. Compared with classical reinforcement-learning baselines, in-context learning from trial-and-error experience followed by Experience Distillation matches their performance with at least \(9.6\times\) fewer environment samples.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。