
基于轨迹的在线策略蒸馏用于掩码扩散语言模型
Trace-Based On-Policy Distillation for Masked Diffusion Language Models
📝 TLDR
扩散大语言模型(dLLM)的推理后训练面临SFT需离线掩码状态、RL依赖稀疏奖励的双重困境。本文提出基于轨迹的在线策略蒸馏TOPD,以教师模型在目标dLLM自身去噪轨迹上的逐token分布指导训练,采用Reverse-KL目标实现密集监督。实验显示SDAR-4B-Chat在MATH500上匹配RL训练的TraDo-4B-Instruct,静态与动态评估分别提升5.7和4.5个点,且计算量仅为对方的约1/4。
🧭 速览
现有dLLM推理后训练中,SFT依赖离线掩码状态造成分布失配,RL仅用稀疏奖励监督信号不足,难以兼顾密集对齐与策略一致性。
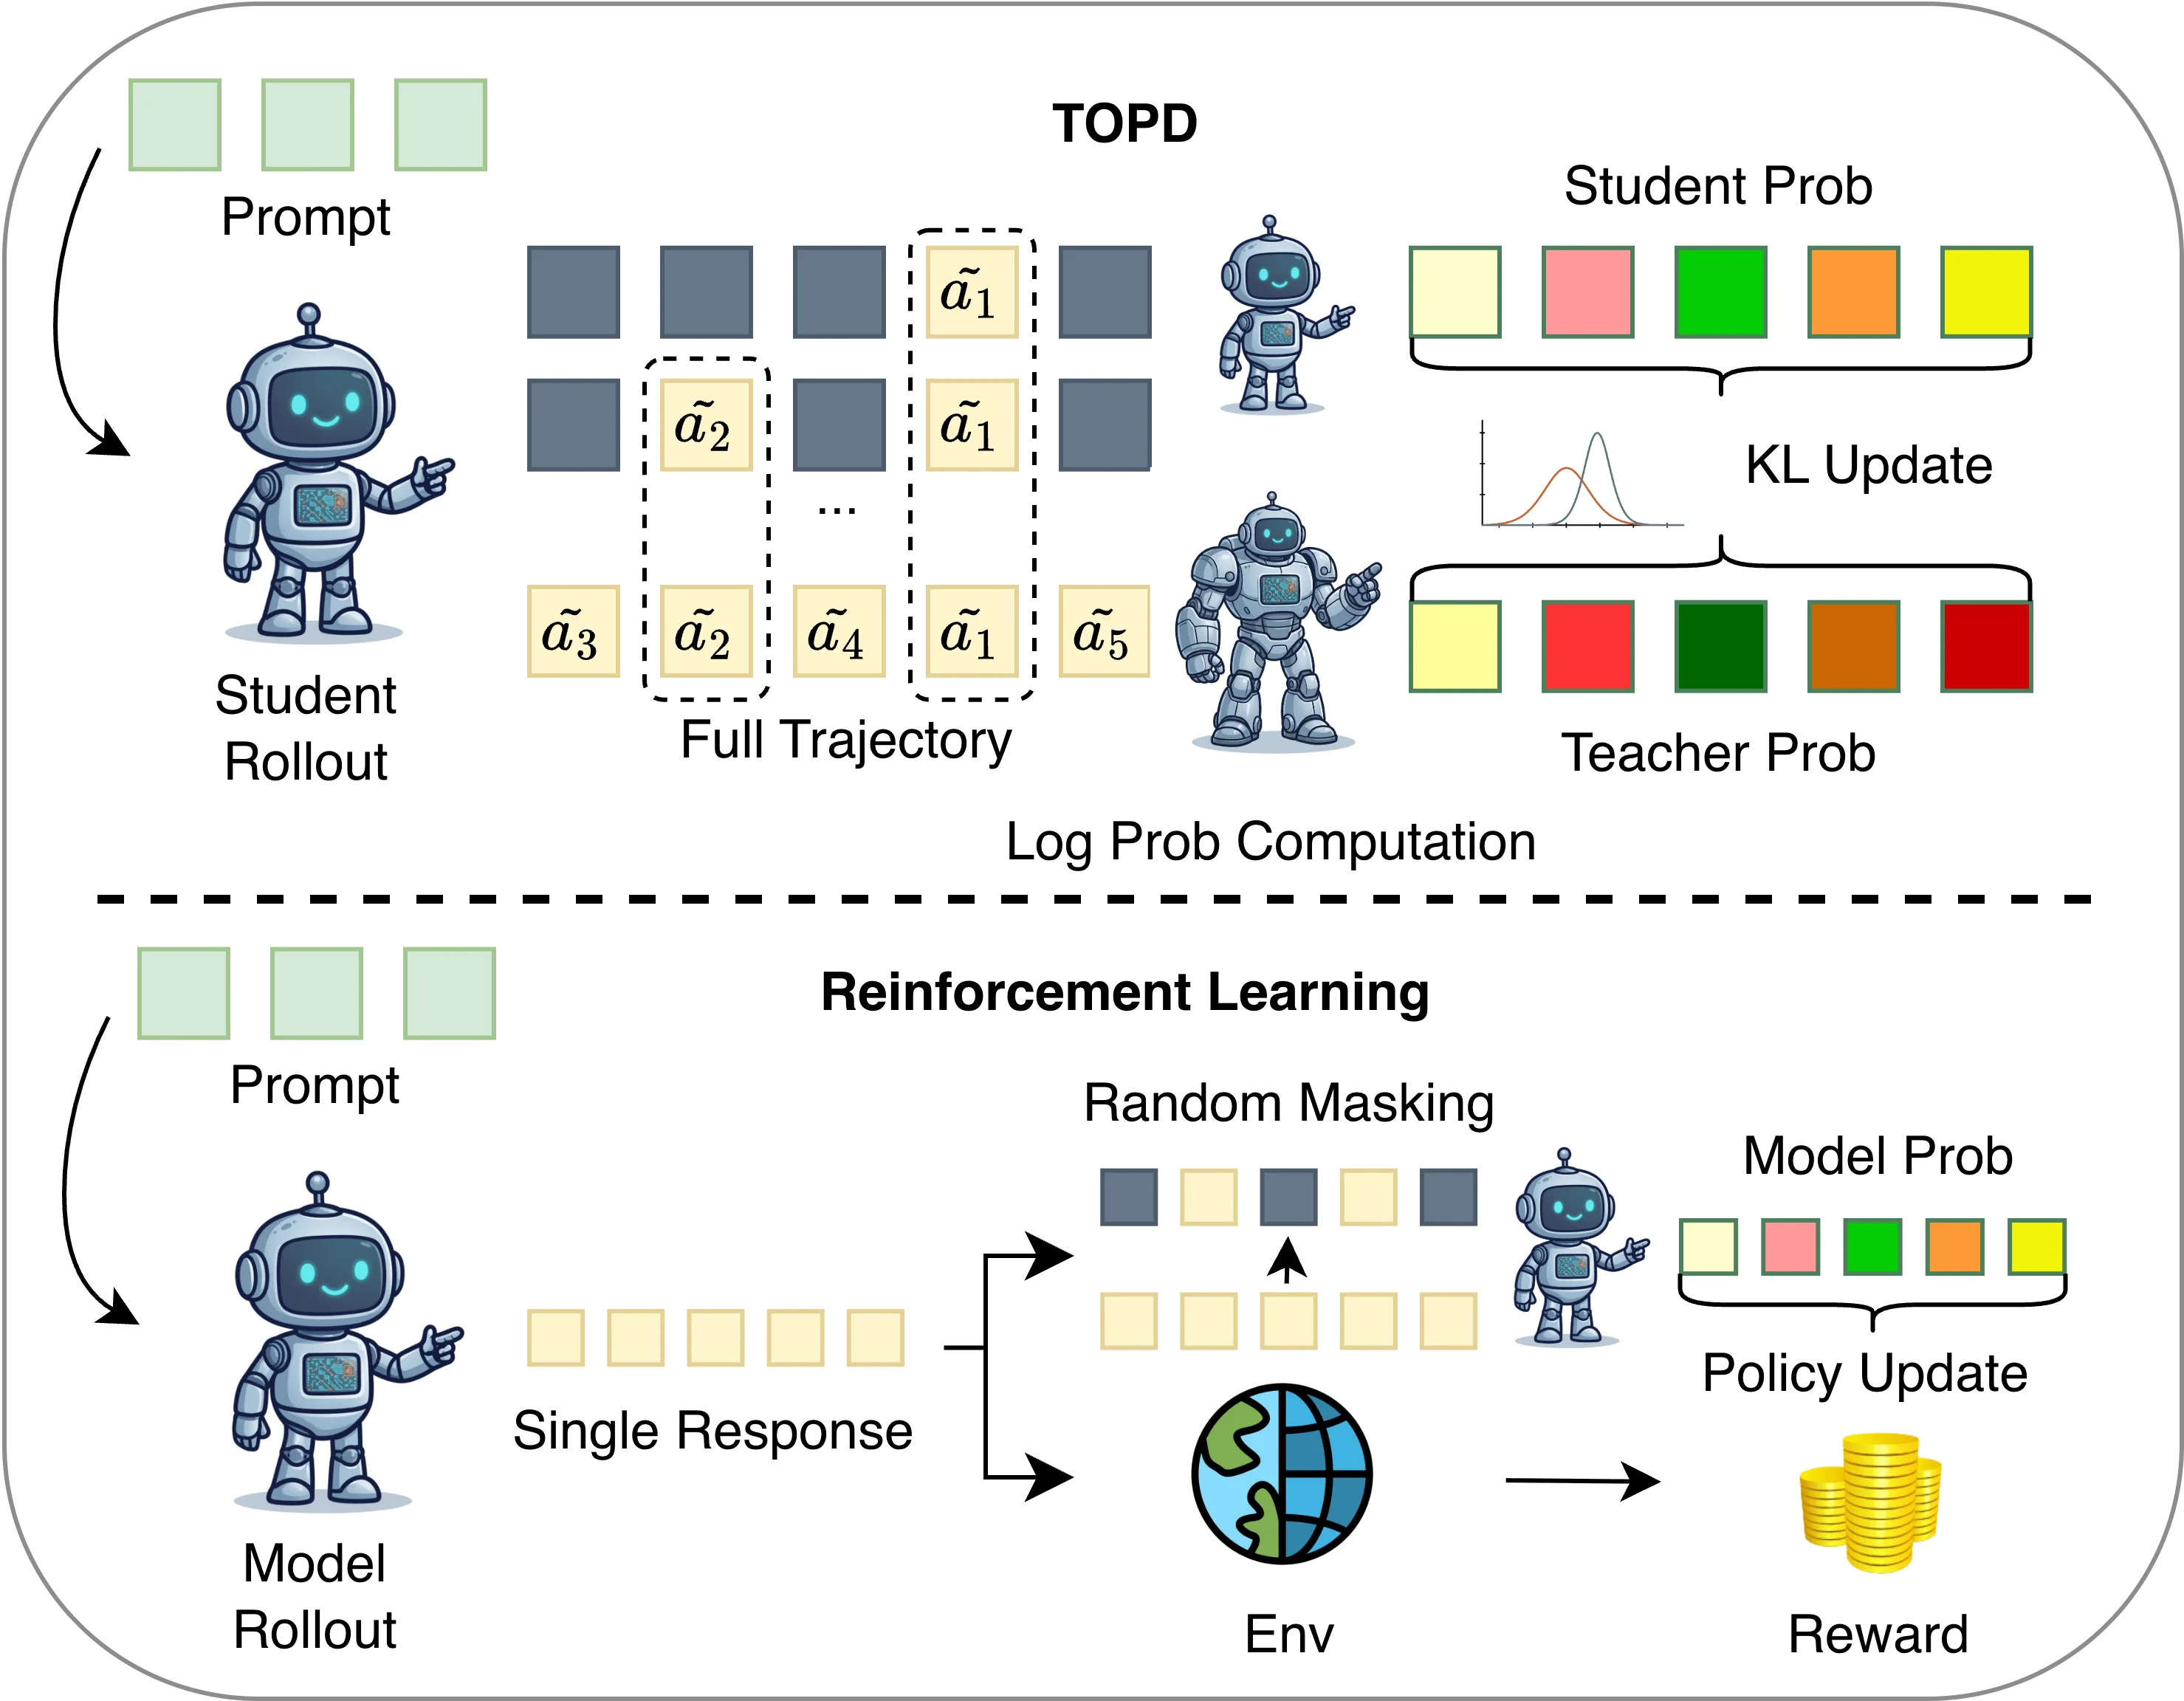
对目标dLLM采样在线去噪轨迹,由教师模型在对应部分去噪状态上提供逐token分布,以token级Reverse-KL进行蒸馏更新。
SDAR-4B-Chat在MATH500静态与动态评估上分别提升5.7和4.5点,匹配TraDo-4B-Instruct,rollout轮次缩减4倍,到精度速度提升约96倍。
TOPD为dLLM推理后训练提供了一种免奖励估计、密集监督的高效蒸馏路径,在效率与精度之间取得更好平衡。
🆚 方法对比
TOPD(基于轨迹的在线策略蒸馏)
- 保留稠密教师监督同时对齐自身去噪轨迹
- 无需奖励估计避免稀疏奖励信用分配难题
- 相比TraceRL减少4倍rollout轮次,96倍加速
- 静态/动态评估MATH500分别提升+5.7和+4.5
- 依赖强教师dLLM提供逐token分布
- 仅在数学推理基准上验证,泛化待验证
- Reverse-KL可能导致学生分布多样性下降
- 教师前向计算开销随轨迹长度线性增长
SFT(监督微调)用于dLLMs
- 监督信号稠密,实现简单直接
- 可利用现有人工标注或预生成样本
- 本质离线策略,存在暴露偏差
- 随机掩码状态可能暴露下游答案而隐藏上游推理变量
- 与推理时前向去噪轨迹不一致导致泛化弱
RL(强化学习)用于dLLMs
- 在数学推理上取得强结果,如TraceRL系列
- 无需教师模型,自主探索策略
- 依赖稀疏延迟奖励,长程信用分配困难
- 优化成本高,价值建模引入额外开销
- 需4倍于TOPD的rollout轮次,计算效率低
随机掩码RL(Random-Mask RL)
- 状态构造简单,易于集成到现有流程
- 可灵活控制掩码比例和位置
- 随机掩码暴露下游结果,破坏因果推理方向
- 迫使模型反向重构而非前向计算
- 与推理时去噪轨迹不对齐
在线策略蒸馏(OPD)通用框架
- 学生在自身策略上获得稠密教师反馈
- 适用于自回归LLM中成熟的逐token对齐
- 直接移植到dLLM存在轨迹对齐困难
- 未解决随机掩码状态下的条件依赖不一致
TOPD通过轨迹对齐的在线策略蒸馏解决了随机掩码RL的轨迹失配问题,同时避免了SFT的离线策略偏差和RL的稀疏奖励难题,在数学推理任务上以远低于RL的计算成本达到了与RL训练模型相当的精度。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
TL;DR
这篇论文针对扩散大语言模型(dLLM)的推理后训练难题,提出了一种名为 TOPD(基于轨迹的在线策略蒸馏)的新框架。它让目标 dLLM 在自身采样得到的去噪轨迹上接收教师模型的密集监督,通过 token 级的 Reverse-KL 目标完成训练。实验表明,SDAR-4B-Chat 仅需约 1/4 的计算量(4 倍更少的 rollout 轮次),就能在 MATH500 上追平经过强化学习训练的 TraDo-4B-Instruct,静态与动态评估分别提升 5.7 和 4.5 个百分点,估算达到 96 倍的模型计算加速。
研究背景与动机
扩散大语言模型(dLLM)作为自回归生成的一种有前景的替代方案,近年来在文本生成任务中展现出竞争力。与逐步预测下一个 token 的自回归模型不同,dLLM 通过从噪声逐步去噪来生成完整回答,这种生成范式在理论上具有更好的并行性和可控性。然而,如何有效地对 dLLM 进行推理能力的后训练,一直是悬而未决的挑战。
传统的后训练方法在 dLLM 场景下都遇到了各自的瓶颈。监督微调(SFT)需要密集的标注数据,但在 dLLM 中,监督信号必须以掩码状态的形式提供,而这些掩码状态往往是离策略的——它们并非来自目标模型当前的去噪过程,而是来自预先设计或外部采样的分布。这种分布偏移会导致训练与推理时的不一致,影响最终性能。另一方面,强化学习(RL)虽然能够在没有密集标注的情况下学习,但其核心依赖于奖励信号,而奖励通常来自外部评估器或价值模型,对于复杂的推理任务而言,这类信号往往是稀疏的、延迟的,难以提供细粒度的 token 级指导。
这篇论文的切入点正在于此:能否找到一种既保留密集教师监督、又保持训练分布与模型自身状态一致的方法?TOPD 的提出正是对这一问题的直接回应。
方法
TOPD 的核心思想可以概括为一句话:在目标 dLLM 自身的去噪轨迹上进行监督,关注那些构成最终回答的、轨迹对齐的 token 决策。
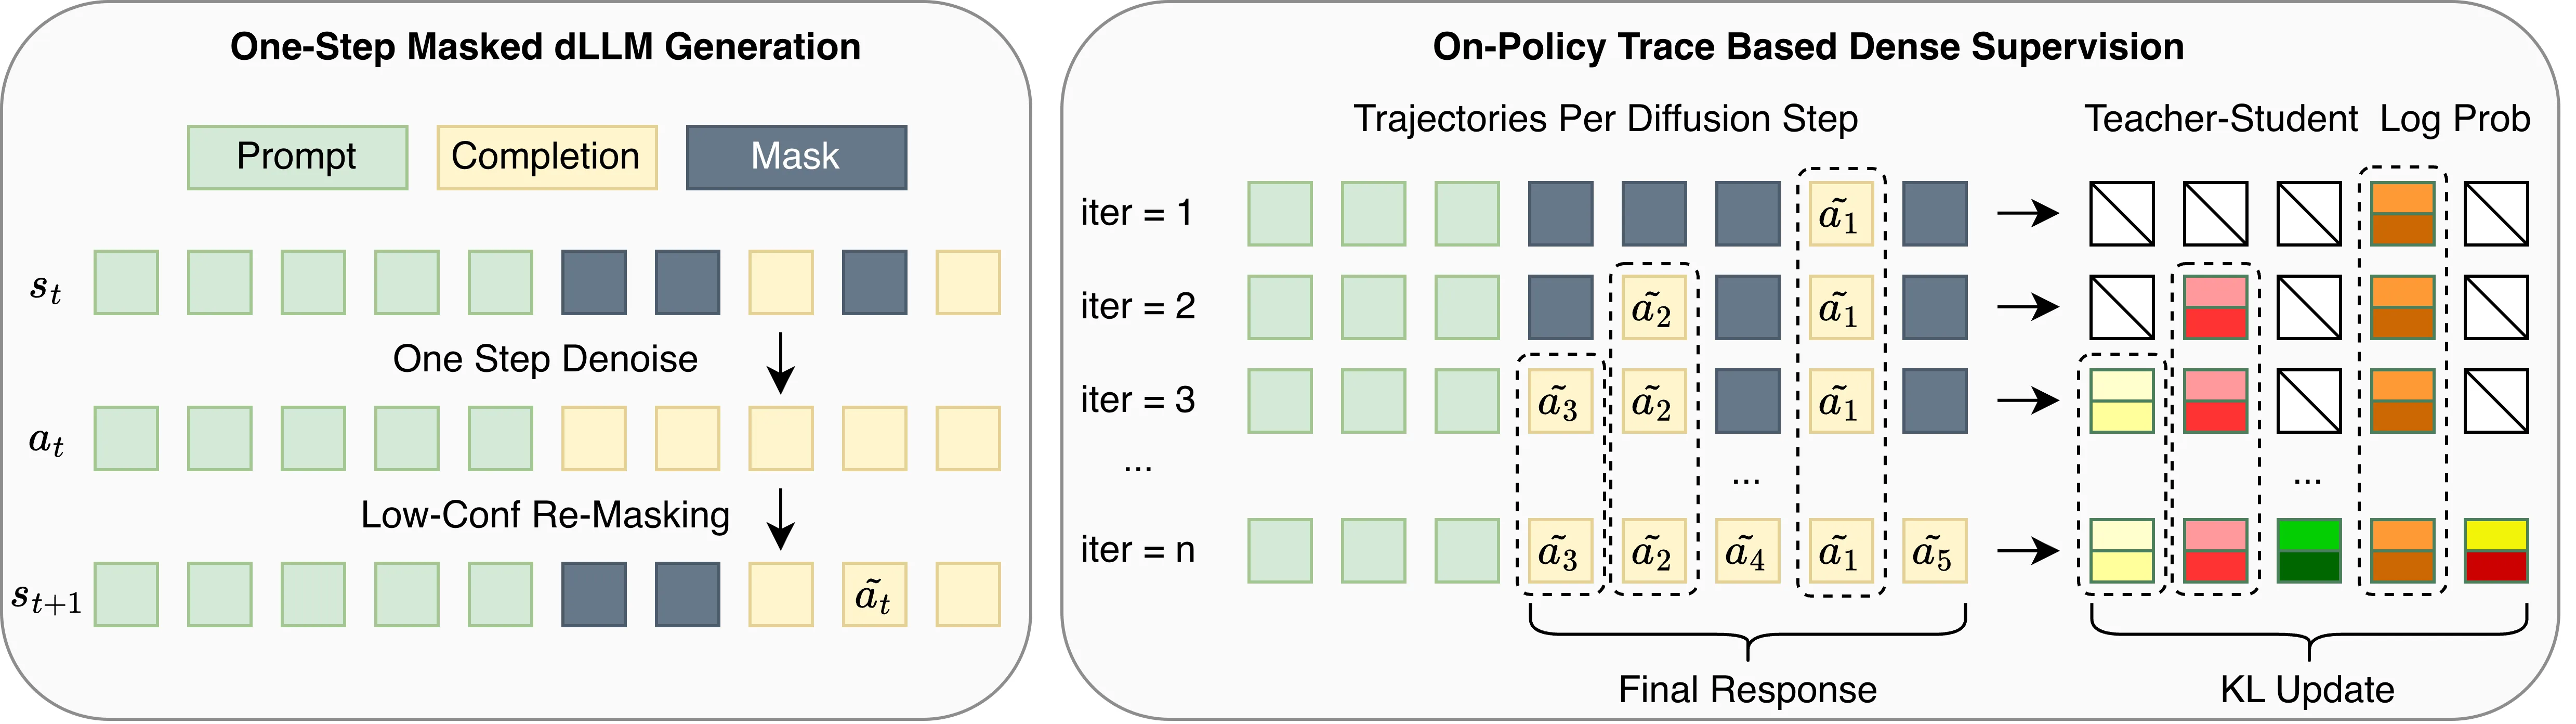
理解这个设计需要先梳理清楚 dLLM 的生成过程。给定一个从随机噪声到清晰回答的扩散过程,dLLM 在每个去噪时间步都会对当前的部分去噪状态进行预测,得到一个 token 级别的概率分布。这些时间步连同对应的分布,就构成了模型的一条去噪轨迹。传统的做法要么忽略这条轨迹,只在最终结果上做监督;要么人为构造离策略的掩码状态来模拟去噪过程,但这些构造出来的状态与模型实际遇到的真实状态存在偏差。
TOPD 的关键创新在于,它从目标 dLLM 本身采样得到真实的在线策略轨迹。具体而言,首先让目标 dLLM 基于当前权重生成一条完整的去噪轨迹,这条轨迹反映了模型在当前策略下的真实行为。然后,在轨迹的每个部分去噪状态上,TOPD 调用一个预训练好的教师模型(比如更强的自回归大语言模型),获取教师对当前状态的 token 分布预测。教师分布给出了「在当前这个半成品状态下,下一个 token 应该是什么」的专家判断。
接下来的核心问题是:如何用教师分布来更新学生模型?TOPD 选择使用 token 级的 Reverse-KL 散度作为训练目标。Reverse-KL 与标准 KL 的区别在于它的优化方向:在标准 KL 中,我们让 (真实分布)去匹配 (目标分布),这会导致模型倾向于覆盖所有 可能的位置;而在 Reverse-KL 中,我们让 去匹配 ,这会导致模型优先保证 的峰值被准确覆盖,同时对 概率低区域的建模更保守。对于知识蒸馏任务,Reverse-KL 天然地鼓励学生模型在教师高置信度的地方精确对齐,而在教师不确定的地方保持一定的探索性,这更符合「学习正确答案」而非「模仿所有可能答案」的直觉。
将这个目标落实到 dLLM 的去噪轨迹上,每个时间步的损失就是当前去噪状态下,教师分布与学生分布之间的 Reverse-KL。通过在整个轨迹上累积这些 token 级的监督信号,TOPD 实现了对 dLLM 的密集指导,同时训练信号始终来自于模型自己正在经历的真实去噪状态,从而避免了离策略偏差。
实验与结果
论文在数学推理基准上进行了全面评估,主要对比对象是经过强化学习训练的 TraDo-4B-Instruct 以及基线模型 SDAR-4B-Chat。
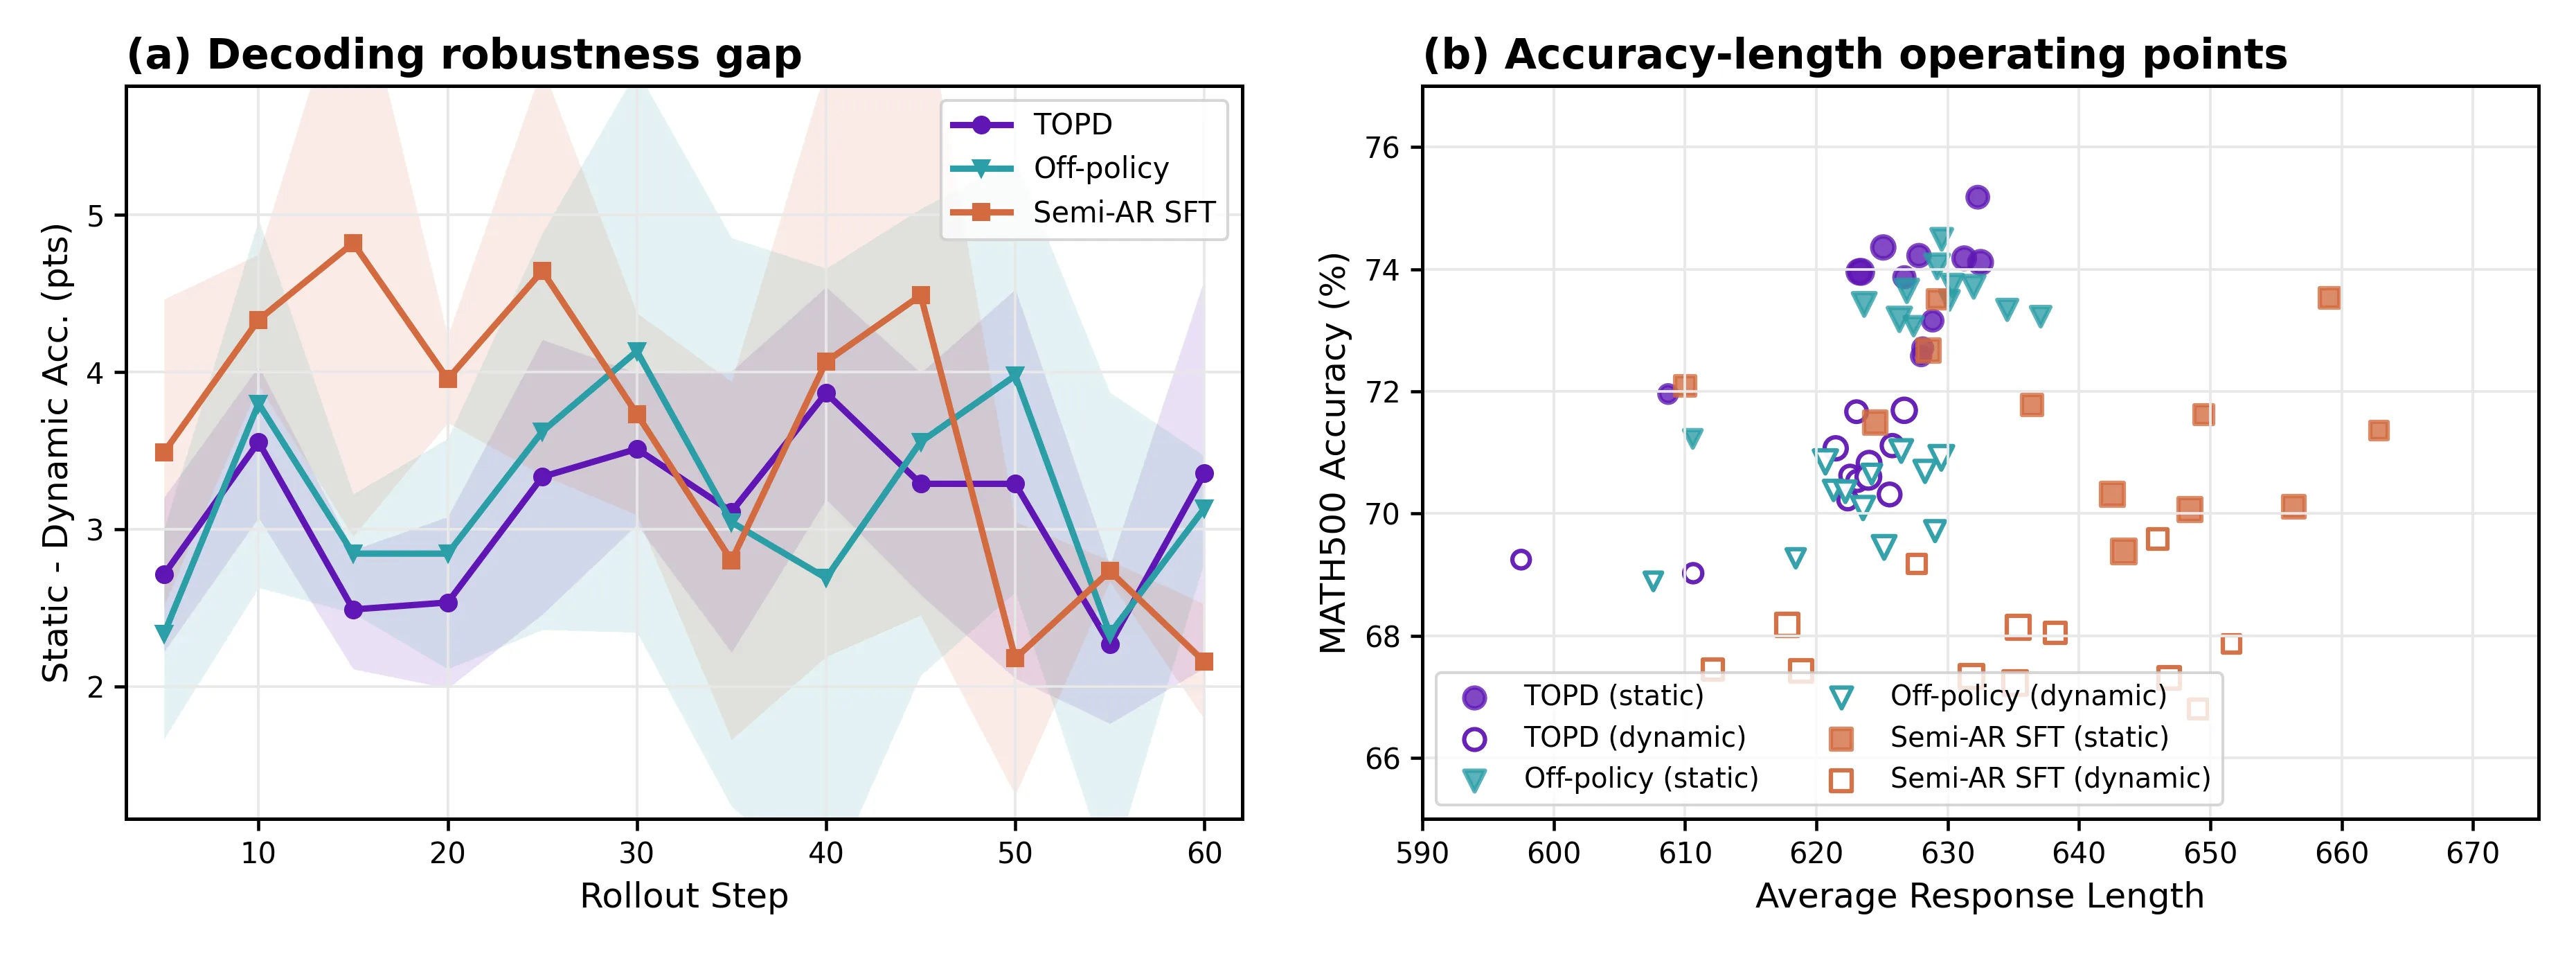
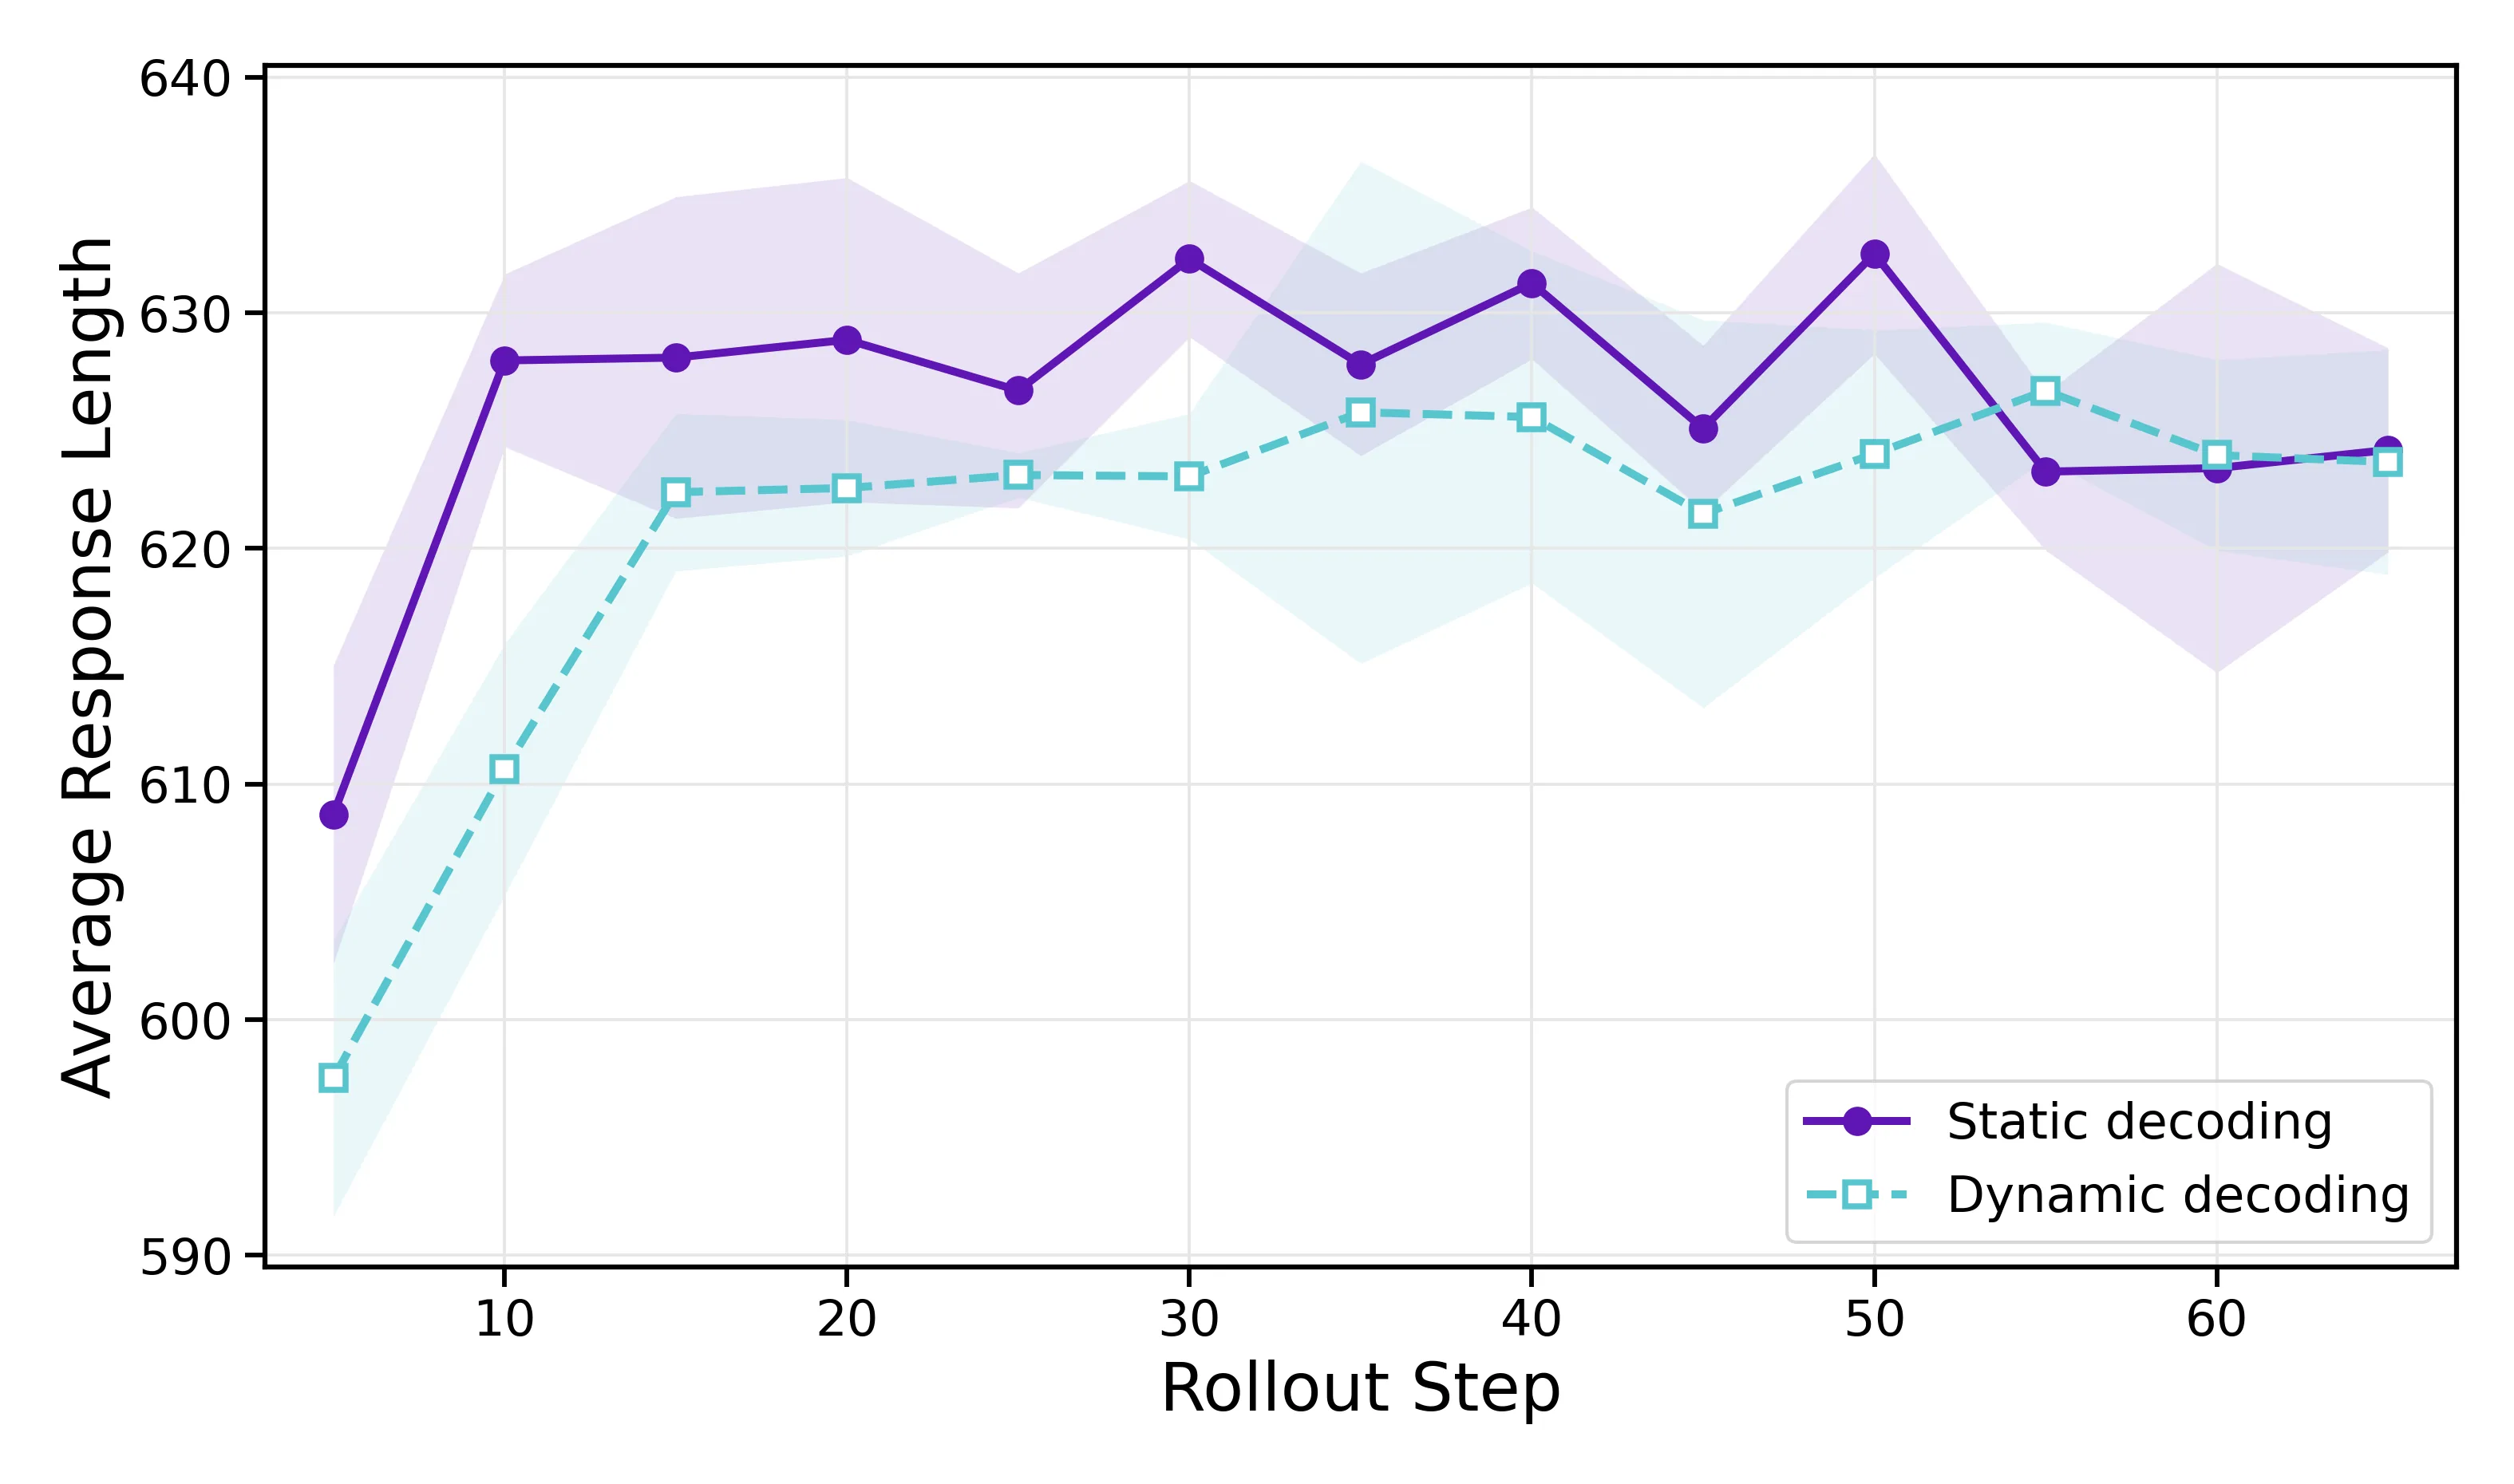
实验采用了静态评估和动态评估两种设置。静态评估使用固定的测试集,用标准指标衡量模型表现;动态评估则更贴近实际使用场景,模型需要针对每个问题独立生成答案,更能反映真实的推理能力。结果显示,经过 TOPD 训练的 SDAR-4B-Chat 在 MATH500 上实现了与 TraDo-4B-Instruct 相当的准确率:在静态评估下提升 5.7 个百分点,在动态评估下提升 4.5 个百分点。这一结果的意义不仅在于数字本身,更在于它证明了在线策略蒸馏路线在追赶强化学习效果上的可行性。
更引人注目的是计算效率的对比。TOPD 仅需 4 倍更少的 rollout 轮次就能达到与强化学习方法相近的效果,这意味着模型在训练过程中与环境(或采样器)的交互次数大幅减少。论文给出了 96.0 倍达到同等准确率的模型计算加速这一估算数字,这一量级的效率提升在实际部署中具有重要价值。
此外,论文还通过消融实验验证了 Reverse-KL 目标相较于标准 KL 的优势,以及在线策略轨迹相较于离线构造掩码状态的必要性。这些分析进一步支撑了方法设计的合理性。
讨论与可借鉴点
TOPD 展示了一条介于纯监督学习与强化学习之间的中间路线。对于 dLLM 这类生成范式,轨迹本身就包含了丰富的中间决策信息,而在线采样的轨迹确保了训练与推理的一致性,Reverse-KL 则在密集监督与泛化能力之间取得了良好平衡。这一组合设计对于其他需要细粒度序列决策的模型同样具有参考价值。
当然,论文也存在一些局限性。首先,TOPD 依赖一个足够强的教师模型来提供 token 级别的监督,教师的质量直接决定了蒸馏的上限。其次,论文主要在数学推理这类有明确正确性标准的任务上验证了方法,对于开放域生成或需要多样性输出的任务,Reverse-KL 的保守倾向可能成为约束。此外,去噪轨迹的采样策略、超参数的选择等工程细节还有进一步探索的空间。
对于后续研究,一个值得思考的方向是如何将 TOPD 与强化学习信号相结合——既保留在线策略蒸馏的效率优势,又引入奖励模型的全局优化能力。另一个方向是探索教师模型的动态选择机制:在不同训练阶段或不同类型的问题上,是否可以自适应地切换不同能力的教师?这些问题的回答将有助于把 TOPD 的思想拓展到更广泛的应用场景中。
摘要
扩散大语言模型 (dLLMs) 是自回归生成的一种有前景的替代方案。然而,面向推理的 dLLM 后训练仍然具有挑战性。dLLM 的监督微调 (SFT) 需要密集但通常为离策略 (off-policy) 的掩码状态,而强化学习 (RL) 则依赖稀疏奖励或价值建模。本文提出了基于轨迹的在线策略蒸馏 (TOPD),这是一个无需奖励估计、由教师模型监督的将推理能力迁移到目标 dLLM 的框架。其核心思想是在 dLLM 自身的去噪轨迹上进行监督,重点关注与轨迹对齐的、构成最终回答的 token 决策。具体而言,TOPD 从目标 dLLM 中采样在线策略的扩散轨迹,在相应的部分去噪状态上从教师模型获取 token 分布,并通过 token 级的反向 Kullback-Leibler (Reverse-KL) 目标对目标 dLLM 进行更新。这一设计在保留密集教师监督的同时,使训练与模型自身的去噪状态保持一致。在数学推理基准上,TOPD 使 SDAR-4B-Chat 在 MATH500 上达到与其 RL 训练的对应模型 TraDo-4B-Instruct 相当的准确率,在静态评估下提升 +5.7,在动态评估下提升 +4.5。与 RL 训练的对应模型相比,TOPD 以 4 倍更少的 rollout 轮次实现这一结果,对应着估计达 96.0 倍的达到同等准确率的模型计算加速。
Abstract
Diffusion large language models (dLLMs) are a promising alternative to autoregressive generation. However, reasoning-oriented post-training for dLLMs remains challenging. Supervised fine-tuning (SFT) for dLLMs requires dense but often off-policy masked states, while reinforcement learning (RL) relies on sparse rewards or value modeling. This paper proposes \textbf{trace-based on-policy distillation (TOPD)}, a teacher-supervised framework that transfers reasoning ability to a target dLLM without reward estimation. The key idea is to supervise a dLLM on its own denoising trajectory, focusing on the trace-aligned token decisions that form the final response. Specifically, TOPD samples on-policy diffusion trajectories from the target dLLM, obtains teacher token distributions from a teacher model on the corresponding partially denoised states, and updates the target dLLM with a token-level Reverse Kullback-Leibler (Reverse-KL) objective. This design preserves dense teacher supervision while aligning training with the model's own denoising states. On mathematical reasoning benchmarks, TOPD enables SDAR-4B-Chat to match the MATH500 accuracy of its RL-trained counterpart TraDo-4B-Instruct, with gains of +5.7 under static evaluation and +4.5 under dynamic evaluation. Compared with the RL-trained counterpart, TOPD achieves this with 4 fewer rollout rounds, corresponding to an estimated 96.0 to-accuracy model-compute speedup.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。