
知识蒸馏何时有害?面向低资源语言摘要的可靠性感知蒸馏方法
When Does Knowledge Distillation Hurt? Reliability-Aware Distillation for Low-Resource Language Summarization
📝 TLDR
知识蒸馏被广泛用于压缩序列到序列模型,但在低资源语言摘要中其逐样本效果鲜有研究。作者发现在BanSum孟加拉语摘要任务上,标准蒸馏仅带来+0.0003的ROUGE-L提升,且约51.3%的训练样本反而损害学生模型验证损失。为此提出CHAD与EWAD+CPDP两种可靠性感知蒸馏方法,通过梯度对齐门控和双教师约束过滤有害样本,在BanSum上以60M参数大幅超越标准蒸馏,并击败50倍大的Qwen2.5-3B,跨15种XL-Sum语言验证通用性。
🧭 速览
标准知识蒸馏在低资源摘要中提升微乎其微,且过半训练样本实际有害,暴露逐样本可靠性问题。
CHAD通过验证损失方向的梯度对齐训练门控,EWAD+CPDP结合token级熵加权蒸馏与异构双教师的几何约束。
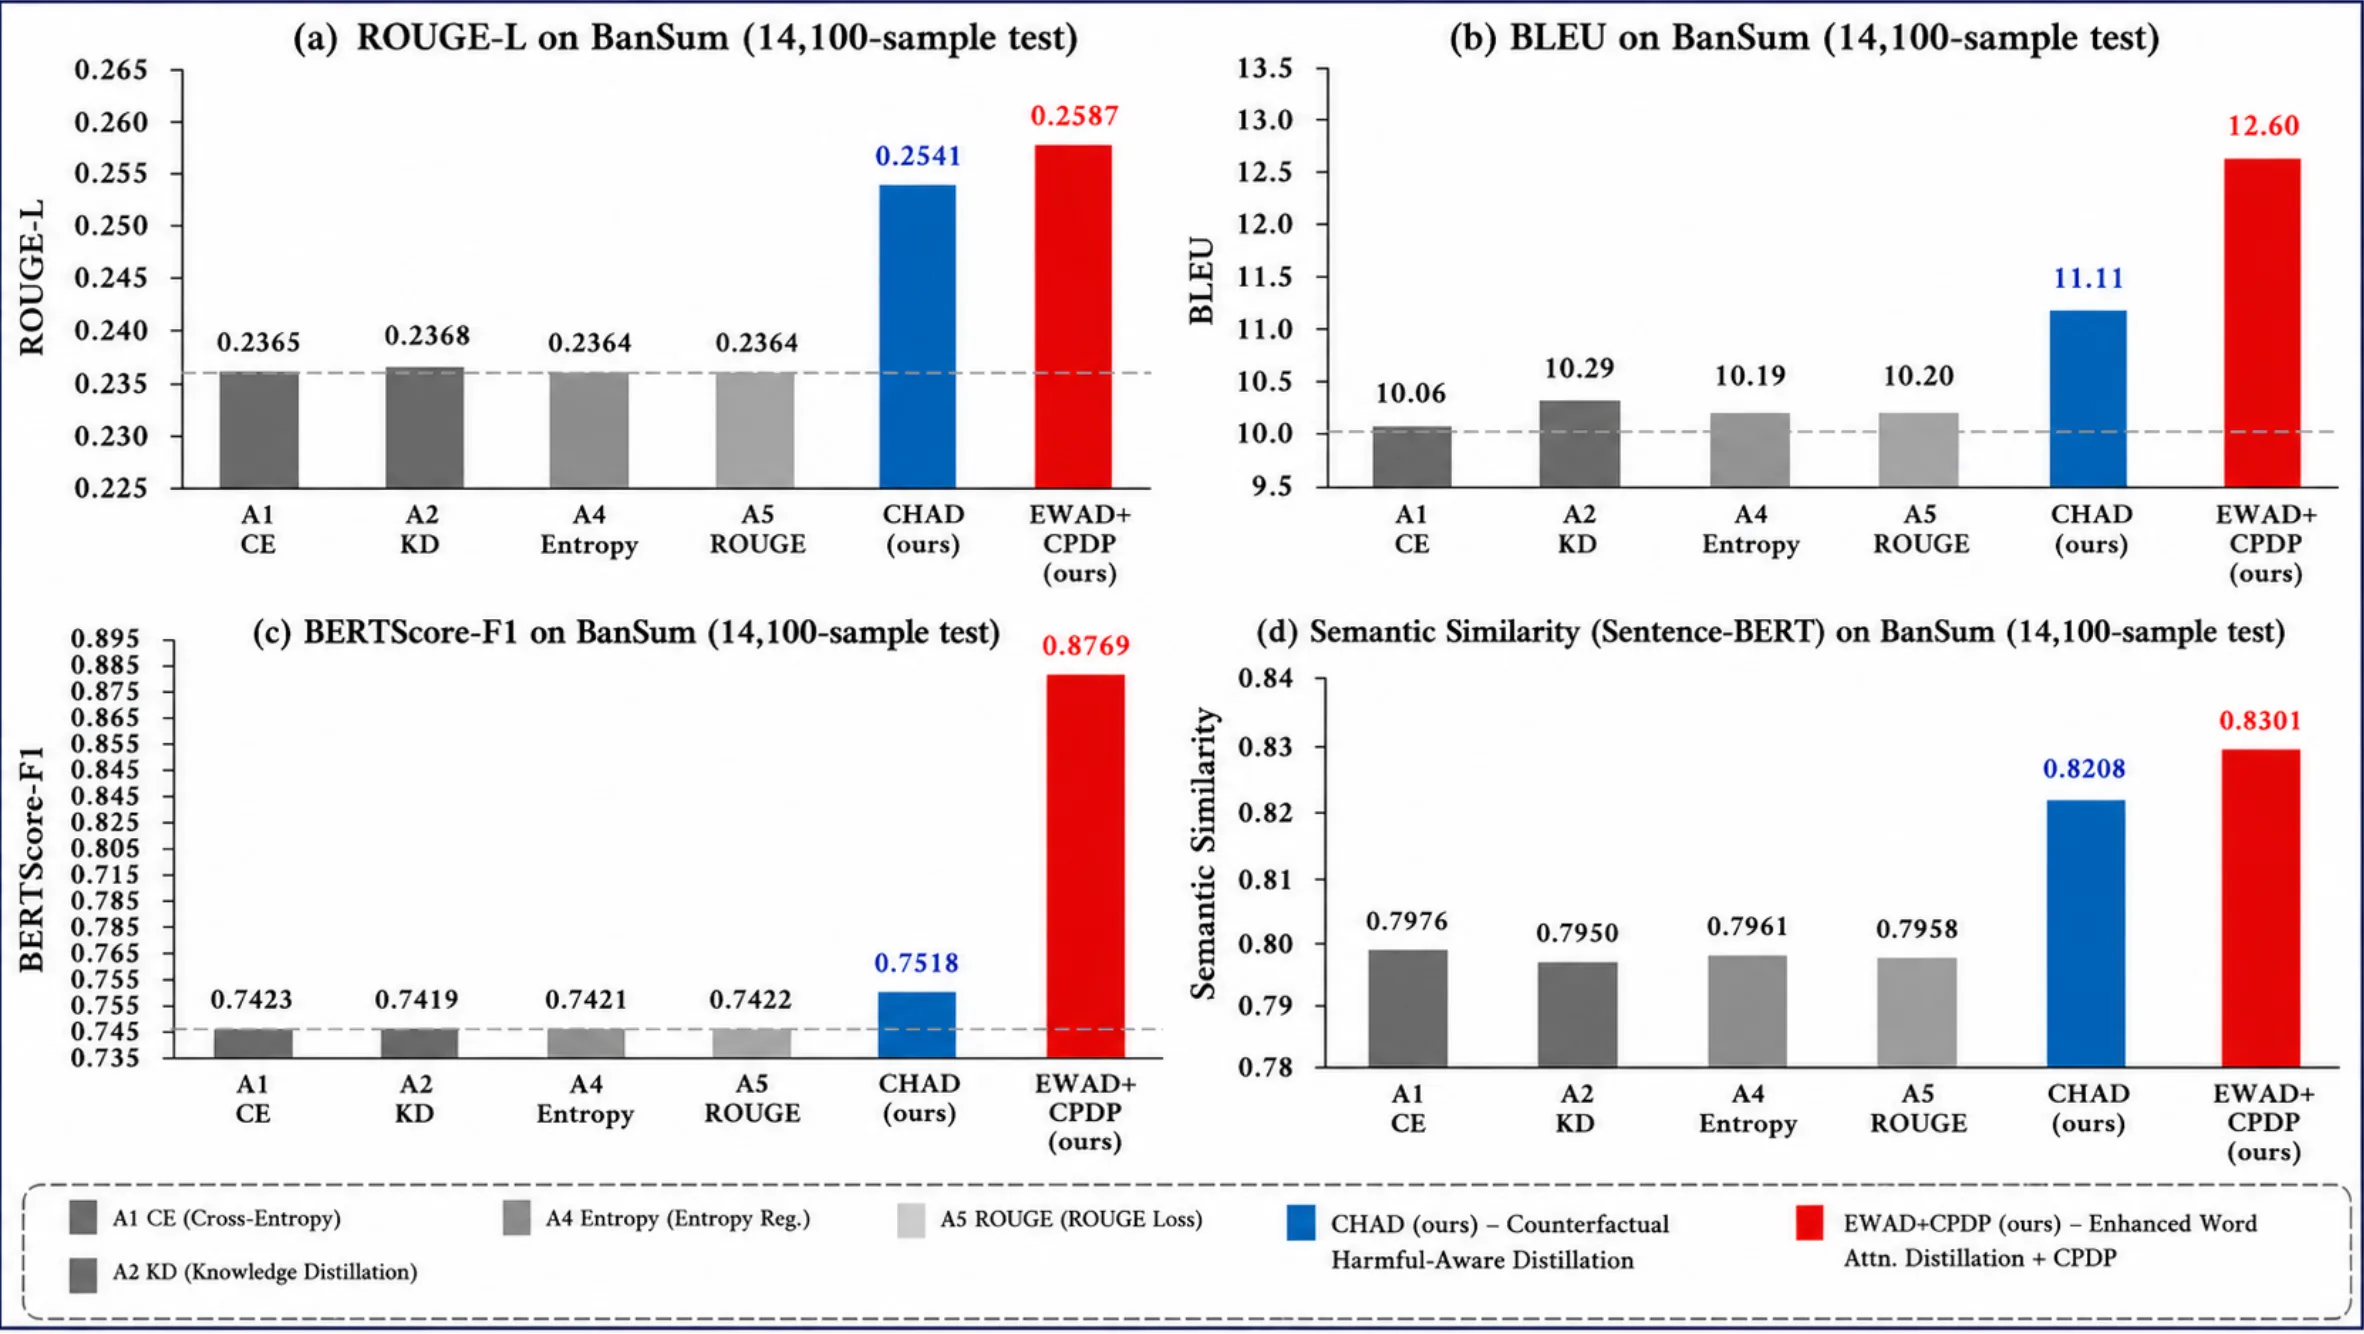
在BanSum上分别提升+0.0173与+0.0219 ROUGE-L,60M模型击败Qwen2.5-3B;15种XL-Sum语言中10种胜基线。
可靠性感知蒸馏能有效过滤有害信号,低资源场景下增益最显著,前提是双教师提供互补信号。
🆚 方法对比
暂未生成 — 点击下方按钮
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 5 张)
展开查看 5 张图
TL;DR
知识蒸馏是压缩大模型的常用技术,但本文首次系统揭示了一个反直觉的现象:在低资源语言摘要任务中,超过一半的训练样本通过标准蒸馏反而会损害学生模型。研究者提出了 CHAD 和 EWAD+CPDP 两种可靠性感知蒸馏方法,通过样本级筛选或双教师协同来过滤有害蒸馏信号,在孟加拉语 BanSum 基准上将 ROUGE-L 从仅 +0.0003 的微弱提升提升至 +0.0173 和 +0.0219,且 6000 万参数的小模型能击败 50 倍大的 Qwen2.5-3B,跨 15 种语言的实验进一步验证了方法的通用性。
研究背景与动机
[[知识蒸馏]] 作为一种模型压缩范式,自 Hinton 等人提出以来已成为部署轻量级模型的核心技术。其基本思想是让「学生」模型学习「教师」模型的输出分布或中间表示,从而将大模型的知识迁移到小模型中。在 [[序列到序列模型]] 广泛用于摘要任务的时代背景下,蒸馏被视为一种低成本获取高效模型的途径。
然而,现有研究几乎都聚焦于蒸馏带来的整体性能提升,很少追问:每一个训练样本的蒸馏是否都有益? 这个问题在低资源语言场景下尤为关键。当目标语言(如孟加拉语、僧伽罗语等)的训练数据稀缺且质量参差不齐时,教师模型本身的输出可能存在噪声或不忠实于原文的情况。若不加区分地让学生的每个词元都向教师学习,反而可能引入误导性信号。
BanSum 是一个孟加拉语摘要基准,数据来源于在线新闻,经人工标注形成摘要对。研究者选择这个任务作为切入点,正是因为孟加拉语属于低资源语言,且摘要质量直接反映模型对原文核心信息的把握能力。实验发现,标准蒸馏在此任务上几乎失效:ROUGE-L 仅提升 0.0003,这意味着知识几乎没有有效传递。通过梯度分析和损失对比,他们进一步估算出约 51.3% 的训练样本在蒸馏过程中实际上增加了学生的验证损失——这些样本扮演了「帮倒忙」的角色。
这一发现构成了本文的核心动机:标准蒸馏在低资源场景下不仅效率低下,更可能引入有害监督信号。如何识别并过滤这些有害样本,成为提升蒸馏质量的关键突破口。
方法
研究者提出了两种互补的策略,分别从「单样本评估」和「双教师协同」两个角度解决问题。
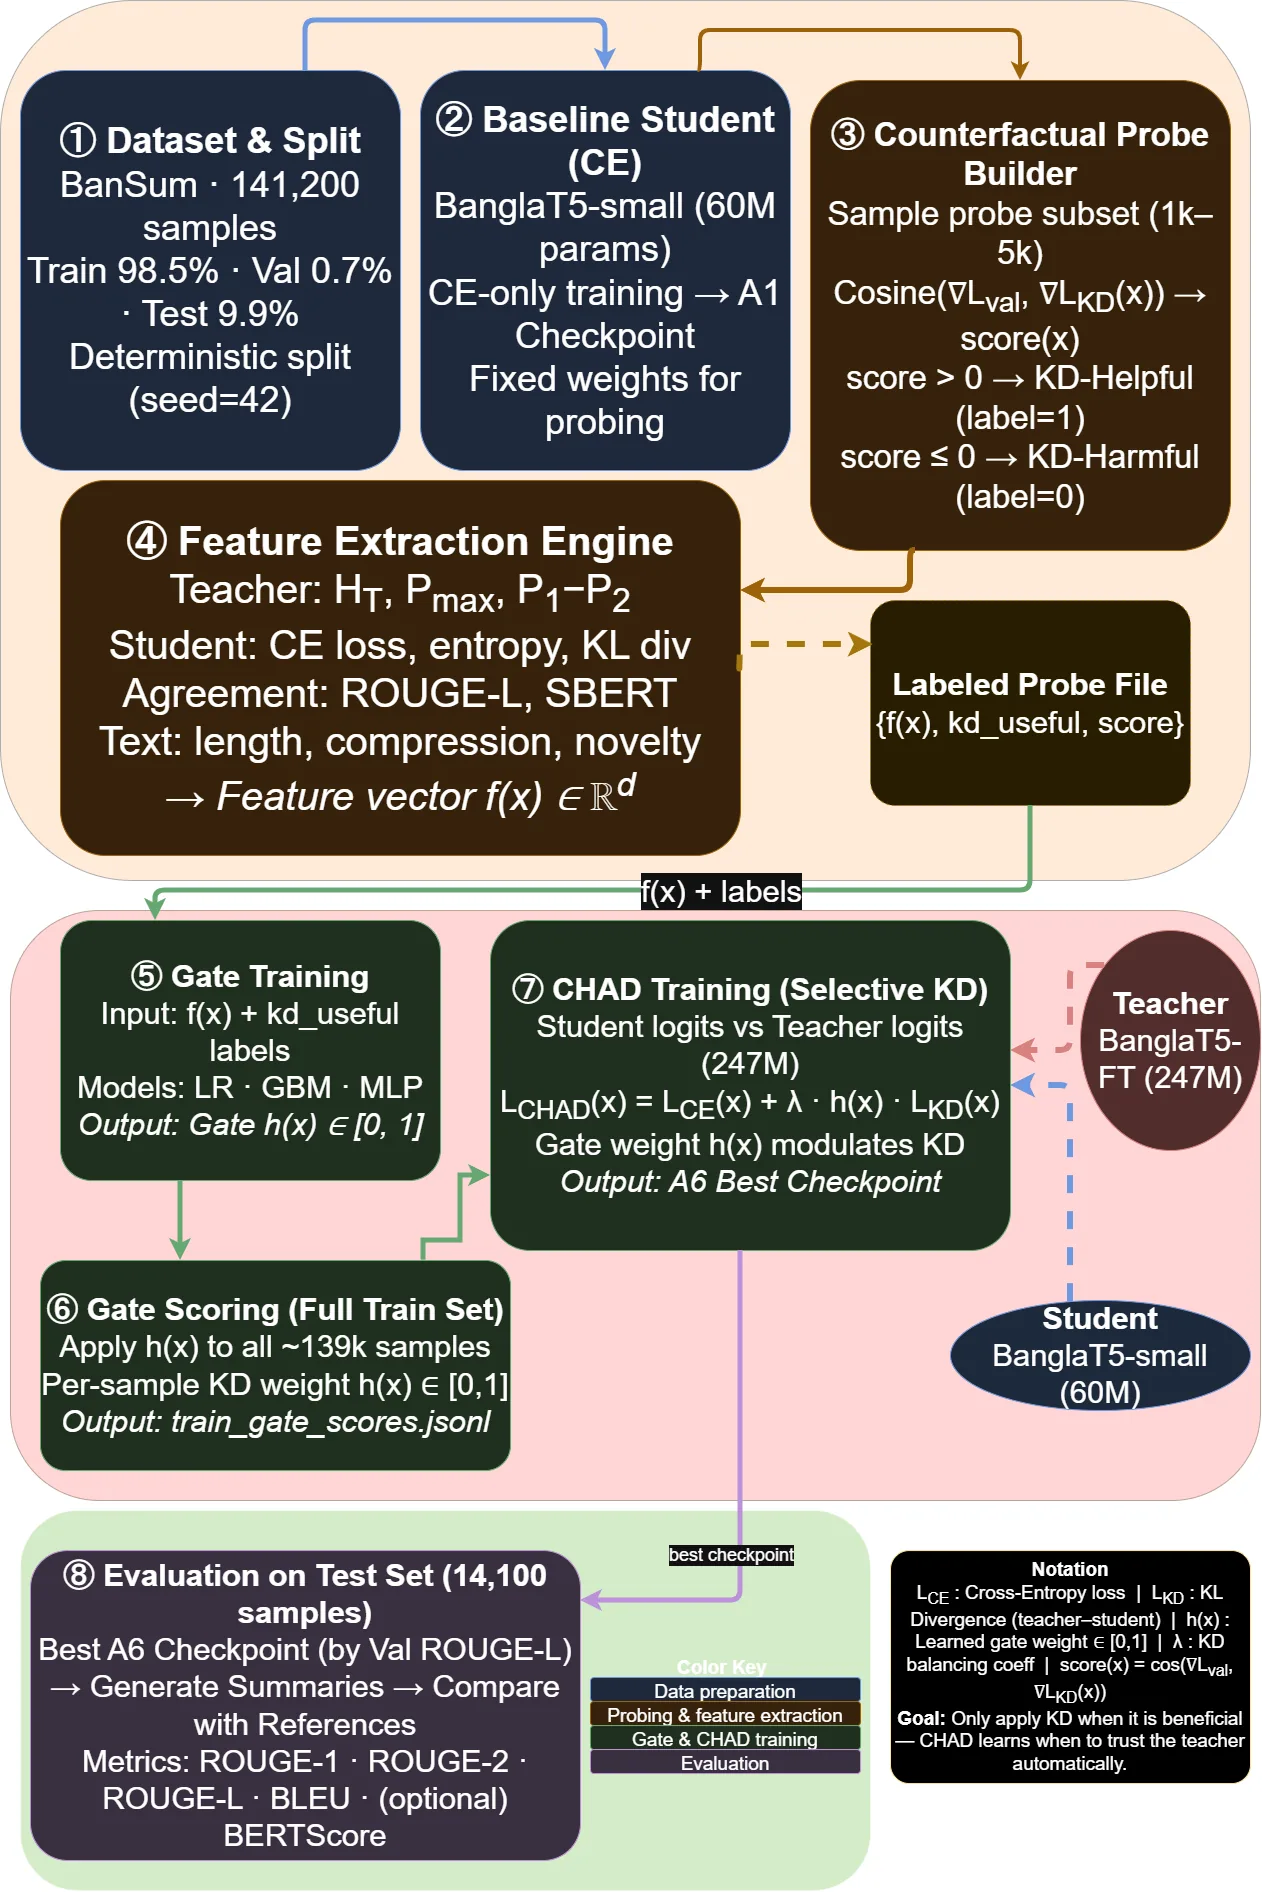
CHAD(反事实有害性感知蒸馏) 的核心思路是回答一个反事实问题:如果某个样本不被用于蒸馏,学生的验证损失会如何变化? 具体地,对于每个样本 ,研究者计算其单独对验证损失方向梯度的影响——即该样本的蒸馏梯度与验证损失梯度之间的对齐程度。如果二者方向相反(负对齐),说明该样本的蒸馏使验证损失增大,是有害的;如果对齐为正,则是「有益」的。这种逐样本评估在计算上不可扩展,因此 CHAD 训练一个轻量级门控网络,以样本特征为输入预测其「有益概率」,从而将昂贵的梯度计算替换为高效的查表推理。这个门控在验证集上微调后,可泛化到整个训练集,自动化地区分哪些样本该蒸馏、哪些该跳过。
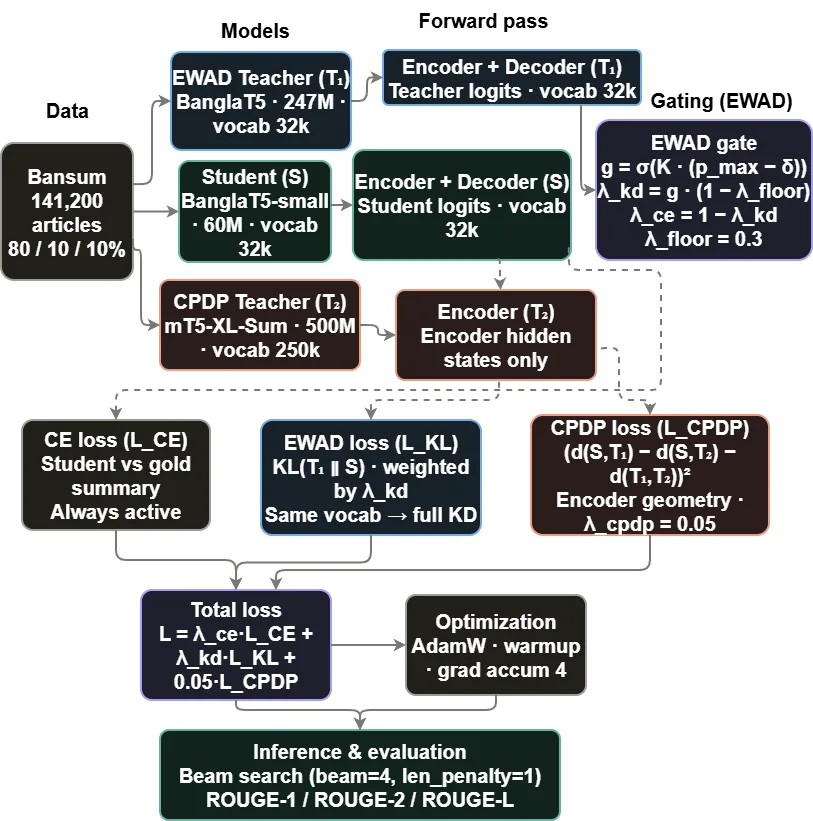
EWAD+CPDP 则转向另一种思路:不依赖梯度分析,而是利用 [[熵]] 概念为不同词元分配差异化的蒸馏权重。EWAD(熵加权自适应蒸馏)认为,教师在预测不同词元时的置信度不同:对于高置信度(低熵)的词元,学生应更严格地跟随教师;对于低置信度(高熵)的词元,教师自身可能不确定,学生不必盲目模仿。因此 EWAD 根据教师预测的词元级熵动态调整蒸馏强度,熵越高,权重越低。
CPDP(按容量比例的几何约束)则引入了第二个教师模型,其词汇表与第一个教师不同(词汇不兼容)。这一设计的直觉是:两个教师各有专长,若它们在某词元上达成一致,学生应更信服;若分歧严重,则该词元可能是噪声来源。CPDP 通过几何平均的方式将两个教师的信号融合,并根据每个教师在目标语言上的覆盖能力(即「容量」)分配权重。这样,即使是词汇不兼容的教师也能贡献互补信息,而非简单多数投票。
两种方法从不同角度切入:CHAD 侧重于识别和过滤已有教师输出中的有害样本,EWAD+CPDP 则通过多教师协同和自适应权重来降低低质量信号的影响。实验表明,EWAD+CPDP 在整体性能上略胜 CHAD。
实验与结果
实验在两个层面展开:BanSum 基准上的详细对比,以及 XL-Sum 上 15 种语言的跨语言泛化验证。
在 BanSum 上,研究者以交叉熵基线为基准,比较了标准蒸馏、CHAD 和 EWAD+CPDP 三种方案。标准蒸馏的 ROUGE-L 提升仅为 +0.0003,几乎可以忽略不计。CHAD 将这一数字提升至 +0.0173,EWAD+CPDP 更是达到 +0.0219,提升幅度超过标准蒸馏两个数量级。值得注意的是,这些结果来自参数量仅 6000 万的学生模型,而对比的 Qwen2.5-3B 经过微调后参数量达 30 亿——相差 50 倍。两种方法的学生模型均显著超越了这个庞然大物,印证了「选对样本比堆参数更重要」这一核心论点。
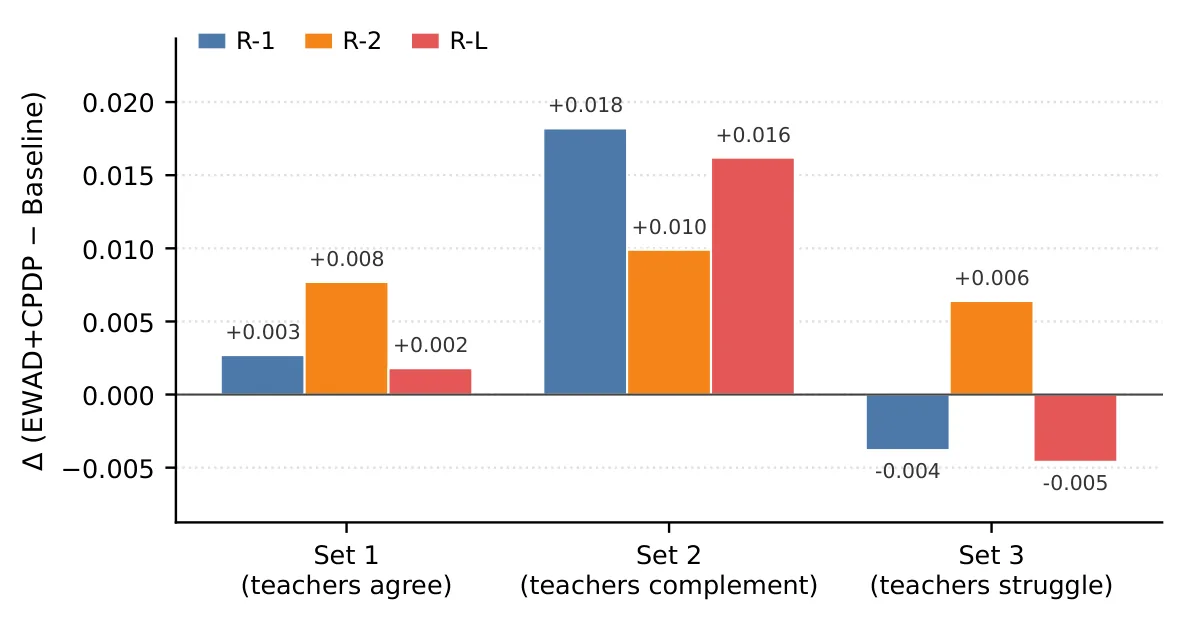
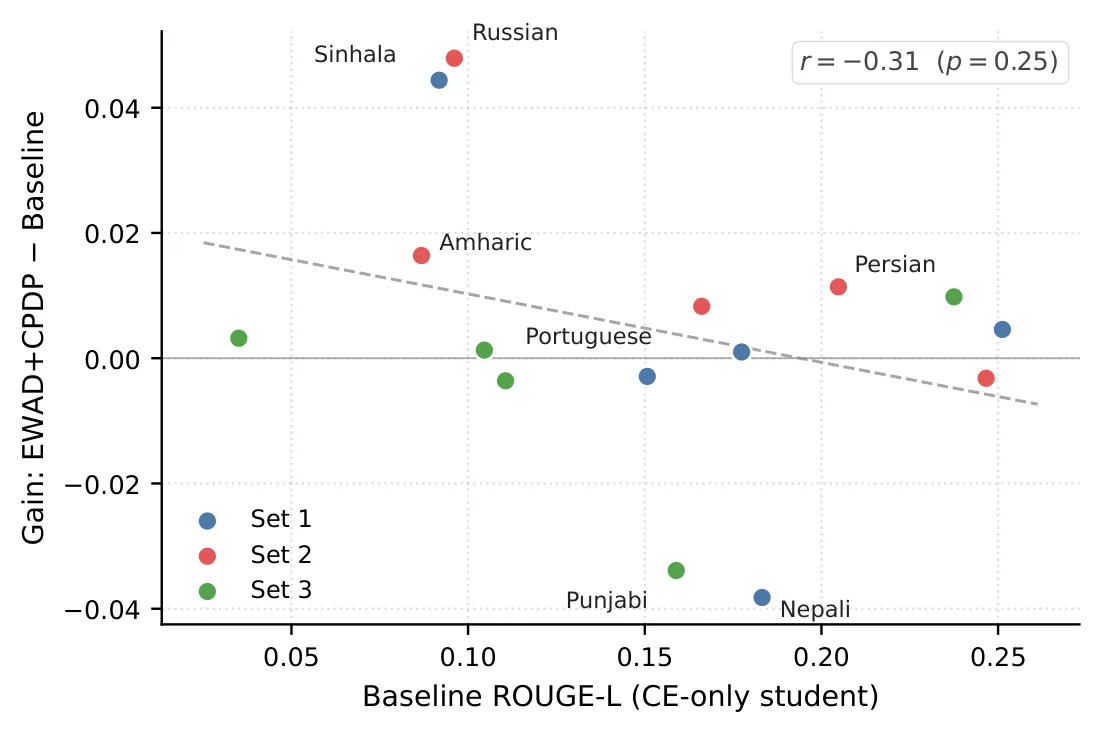
为了验证 EWAD+CPDP 的通用性,研究者将其部署到 XL-Sum 的 15 种语言上,按语言资源和类型多样性分为三组。结果显示,在 10/15 的语言上优于交叉熵基线,在 5 种语言上略逊一筹。通过分析这 5 种语言的特点,研究者发现:当两个教师在目标语言上的覆盖能力都较弱,或其中一个教师已对某语言「饱和」(即该语言与教师训练分布高度一致、蒸馏增益有限)时,EWAD+CPDP 的优势会被削弱。这提示该方法的核心价值在于多教师互补信号的提取——若教师本身知识不足,再精巧的融合策略也难以弥补。
讨论与可借鉴点
本文最重要的贡献在于揭示了标准蒸馏的「阴暗面」:在低资源场景下,近半数样本的蒸馏是负收益的。这一发现对知识蒸馏实践具有直接的警示意义——不是所有来自教师的信号都值得学习,筛选机制至关重要。
从方法论角度,CHAD 提出的「反事实有害性」概念为蒸馏中的样本选择提供了一个可量化的评判标准,其梯度对齐思路也可迁移到其他需要判断单样本影响的场景。EWAD+CPDP 则展示了如何通过词汇不兼容的多教师设计来获取互补信息,而非简单追求教师规模。
当然,本文也存在局限:两个教师的选择本身引入额外假设,若没有合适的双教师配置,EWAD+CPDP 的优势可能被掩盖;CHAD 的门控网络训练依赖验证集,这在某些低资源场景下可能同样面临数据不足的问题。此外,研究者主要关注了 [[序列到序列模型]] 中的蒸馏问题,在纯编码器或纯解码器架构上的效果尚待验证。
对于更广泛的研究社区而言,本文揭示的现象提示了一个值得深挖的方向:在什么条件下蒸馏是有害的? 是否与教师模型的能力、样本复杂度、语言类型多样性有关?这些问题的答案将帮助我们更系统地理解蒸馏的本质,而非将其视为一种「放之四海而皆准」的通用压缩策略。
摘要
知识蒸馏(KD)是压缩序列到序列模型的标准方法,但人们很少考察其对单个样本的影响。在 BanSum 孟加拉语摘要基准上,我们发现标准知识蒸馏相较于交叉熵基线仅将 ROUGE-L 提升了 +0.0003,并且估计约有 51.3% 的训练样本在标准知识蒸馏下实际上会损害学生模型的验证损失。我们提出了两种互补的可靠性感知蒸馏方法。CHAD(反事实有害性感知蒸馏)通过与验证损失方向的梯度对齐来衡量每个样本的知识蒸馏有用性,并训练一个轻量级门控,将这种反事实判断推广到整个训练集。EWAD+CPDP 将词元级的熵加权自适应蒸馏与来自第二个词汇不兼容教师模型的、按容量比例的几何约束相结合。在 BanSum 上,这两种方法均大幅优于标准知识蒸馏:CHAD 将 ROUGE-L 提升了 +0.0173,EWAD+CPDP 将 ROUGE-L 提升了 +0.0219,而标准知识蒸馏本身仅将 ROUGE-L 提升了 +0.0003;尽管仅使用 6000 万参数,两种方法的性能均优于经过微调的 Qwen 2.5-3B 模型(参数量大 50 倍)。我们进一步在 15 个类型多样的 XL-Sum 语言(分为三组)上评估了表现更强的方法 EWAD+CPDP,结果在 10/15 的语言上优于仅使用交叉熵的基线;当两个教师模型贡献互补信号时增益最为稳定,而当二者对目标语言的覆盖已饱和或联合覆盖较弱时增益最小。我们发布代码和训练好的模型以支持可复现性及对选择性蒸馏的进一步研究。
Abstract
Knowledge distillation (KD) is a standard approach for compressing sequence-to-sequence models, but its per-sample effects are rarely examined. On the BanSum Bangla summarization benchmark, we find that standard KD improves ROUGE-L by only +0.0003 over a cross-entropy baseline, and that approximately 51.3% of training samples are estimated to actively harm student validation loss under standard KD. We propose two complementary reliability-aware distillation methods. CHAD (Counterfactual Harm-Aware Distillation) measures per-sample KD usefulness via gradient alignment with the validation loss direction and trains a lightweight gate that generalizes this counterfactual judgment to the full training set. EWAD+CPDP combines token-level entropy-weighted adaptive distillation with a capacity-proportional geometric constraint from a second, vocabulary-incompatible teacher. On BanSum, both methods substantially outperform standard KD: CHAD by +0.0173 ROUGE-L and EWAD+CPDP by +0.0219 ROUGE-L, where standard KD itself improves ROUGE-L by only +0.0003; despite using only 60M parameters, both outperform a fine-tuned Qwen 2.5-3B model (50x larger). We further evaluate the stronger method, EWAD+CPDP, across 15 typologically diverse XL-Sum languages organised into three sets, beating the CE-only baseline on 10/15 languages; gains are most reliable where the two teachers contribute complementary signal, and weakest where they have saturated or jointly weak target-language coverage. We release code and trained models to support reproducibility and further research on selective distillation.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。