
从 RLVR 到 RLSVR:任务变换为开放式大语言模型自我改进带来可自我验证的奖励
From RLVR to RLSVR: Task Transformation Induces Self-Verifiable Rewards for Open-Ended LLM Self-Improvement
📝 TLDR
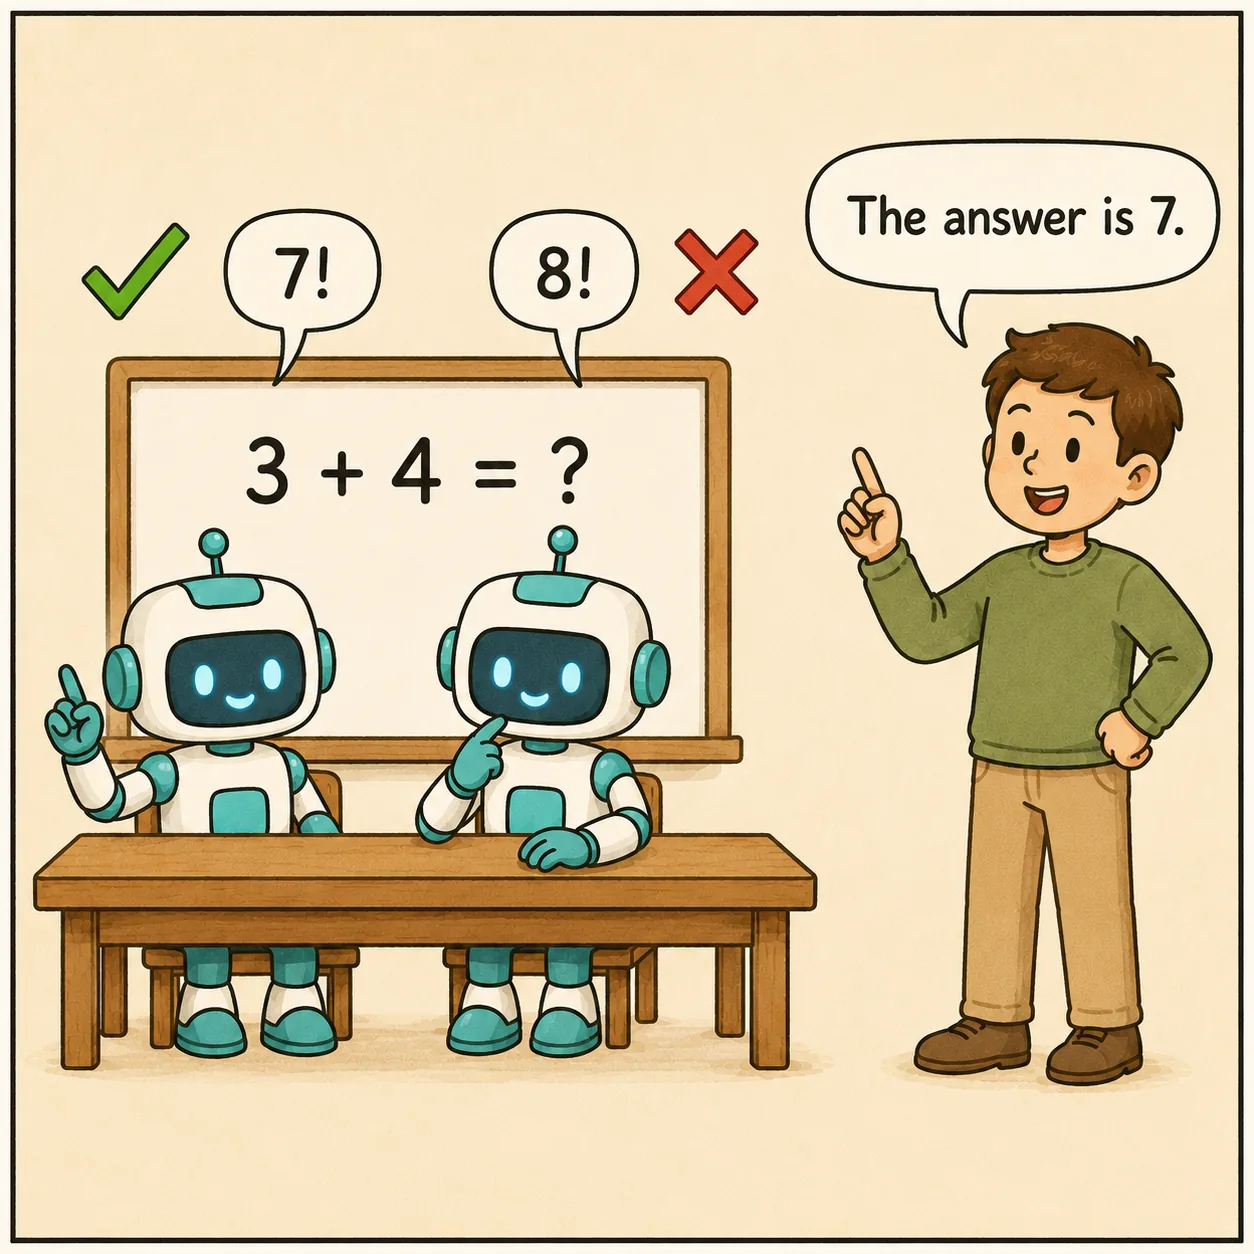
现有RLVR方法依赖可验证奖励,仅适用于数学、编程等封闭领域,难以推广到摘要、写作等开放任务,后者评估依赖人类偏好或LLM评判器,存在偏差与成本问题。本文提出RLSVR范式,通过任务转换将开放任务变为可验证代理环境,并实例化为SpyRL方法,借鉴社交推理游戏"谁是卧底",让多智能体基于非对称信息完成同一任务后投票指认预定的"卧底",投票结果自动产生可验证奖励。实验在文本摘要、创意写作和数学推理上均优于现有自改进方法,证明任务转换能有效扩展RLVR至开放任务。
🧭 速览
RLVR依赖可验证奖励,难以推广至数学编程之外的领域;开放任务评估依赖人类偏好或LLM评判器,存在偏差与成本瓶颈。
RLSVR将开放任务转换为可验证代理环境;具体实例SpyRL模拟"谁是卧底",多智能体持非对称信息协作后投票识别预定"卧底",投票结果提供自动奖励信号。
在文本摘要、创意写作等非可验证任务上优于现有自改进方法,在数学推理等可验证任务上也获得稳定增益。
任务转换可将可扩展的RLVR自改进机制从封闭领域有效扩展到开放任务,拓宽LLM后训练路径。
🆚 方法对比
RLVR
- 支持大规模可扩展优化
- 提供精确的规则化奖励信号
- 在数学/代码领域效果显著
- 仅限于可确定性验证领域
- 难以应用于开放式生成任务
- 在主观判断任务上表现脆弱
RLHF
- 将RL扩展至开放式任务
- 利用学习到的偏好信号
- 适用范围更广
- 依赖人类标注数据
- 存在评估偏差问题
- 标注成本高且难以扩展
DPO
- 无需单独训练奖励模型
- 实现相对简单直接
- 降低了训练复杂度
- 仍依赖偏好数据标注
- 存在评估偏差问题
- 奖励信号难以验证
LLM-as-a-Judge
- 无需人类标注即可评估
- 可灵活应用于多种任务
- 具备一定可扩展性
- 引入评估偏差
- 存在判官能力瓶颈
- 增加额外推理成本
Self-Rewarding机制
- 无需外部奖励即可自改进
- 实现模型的自主进化
- 降低对外部监督依赖
- 存在评估偏差
- 受判官能力瓶颈限制
- 奖励质量难以保证
RLSVR
- 将RLVR扩展至开放式任务
- 结合RLVR验证与SSL自监督原理
- 奖励信号由环境自动生成
- 无需任务特定的人类标注
- 需要精心设计任务转换方式
- 代理任务与目标任务存在差异
- 转换设计的通用性有待验证
SpyRL
- 摘要/创意写作胜率达75.4%和77.3%
- 在可验证与不可验证任务上均有效
- 通过信息不对称自动产生可验证奖励
- 显著优于现有自进化方法
- 多智能体设置增加训练复杂度
- 投票质量与输出质量相关性非完美
- 游戏机制设计依赖领域知识
RLVR/DPO等传统方法在可验证任务上有效但难以扩展至开放式任务,LLM-as-a-Judge和自奖励方法虽放宽了验证性但引入评估偏差;本文提出的RLSVR通过任务转换实现自动可验证奖励,其实例化SpyRL在摘要和创意写作上达到75.4%/77.3%胜率,显著优于现有自改进方法。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 7 张)
展开查看 7 张图
TL;DR
这篇论文提出了基于可自我验证奖励的强化学习(RLSVR)范式,通过任务转换将摘要、写作等开放式任务转化为可验证的代理环境。核心方法 SpyRL 借鉴社交推理游戏《谁是卧底》,让多智能体基于不对称信息完成同一任务并投票指认预设卧底,投票结果自动产生可验证奖励。实验表明,该方法在文本摘要、创意写作和数学推理任务上均优于现有自改进方法,证明了任务转换策略能有效将 RLVR 的可扩展优化能力拓展到开放任务领域。
研究背景与动机
基于可验证奖励的强化学习(RLVR)近年来在推动大语言模型推理能力方面取得了显著进展。RLVR 的核心优势在于其奖励机制的可验证性——模型输出的答案可以通过确定性规则直接判定正确性,这在数学证明验证和代码执行等场景中天然成立。然而,这一优势恰恰成为其向开放式任务扩展的主要障碍。
摘要生成、创意写作等开放式任务的质量评估长期以来依赖人类标注员、奖励模型或基于 LLM 的评判器。人工标注成本高昂且难以规模化;奖励模型需要额外训练且可能引入分布偏差;LLM 评判器虽然灵活性更强,但会产生额外的推理开销,并且在反复评判自身输出时可能产生自我服务偏差。这些问题严重制约了 RLVR 在语言生成领域的广泛应用。
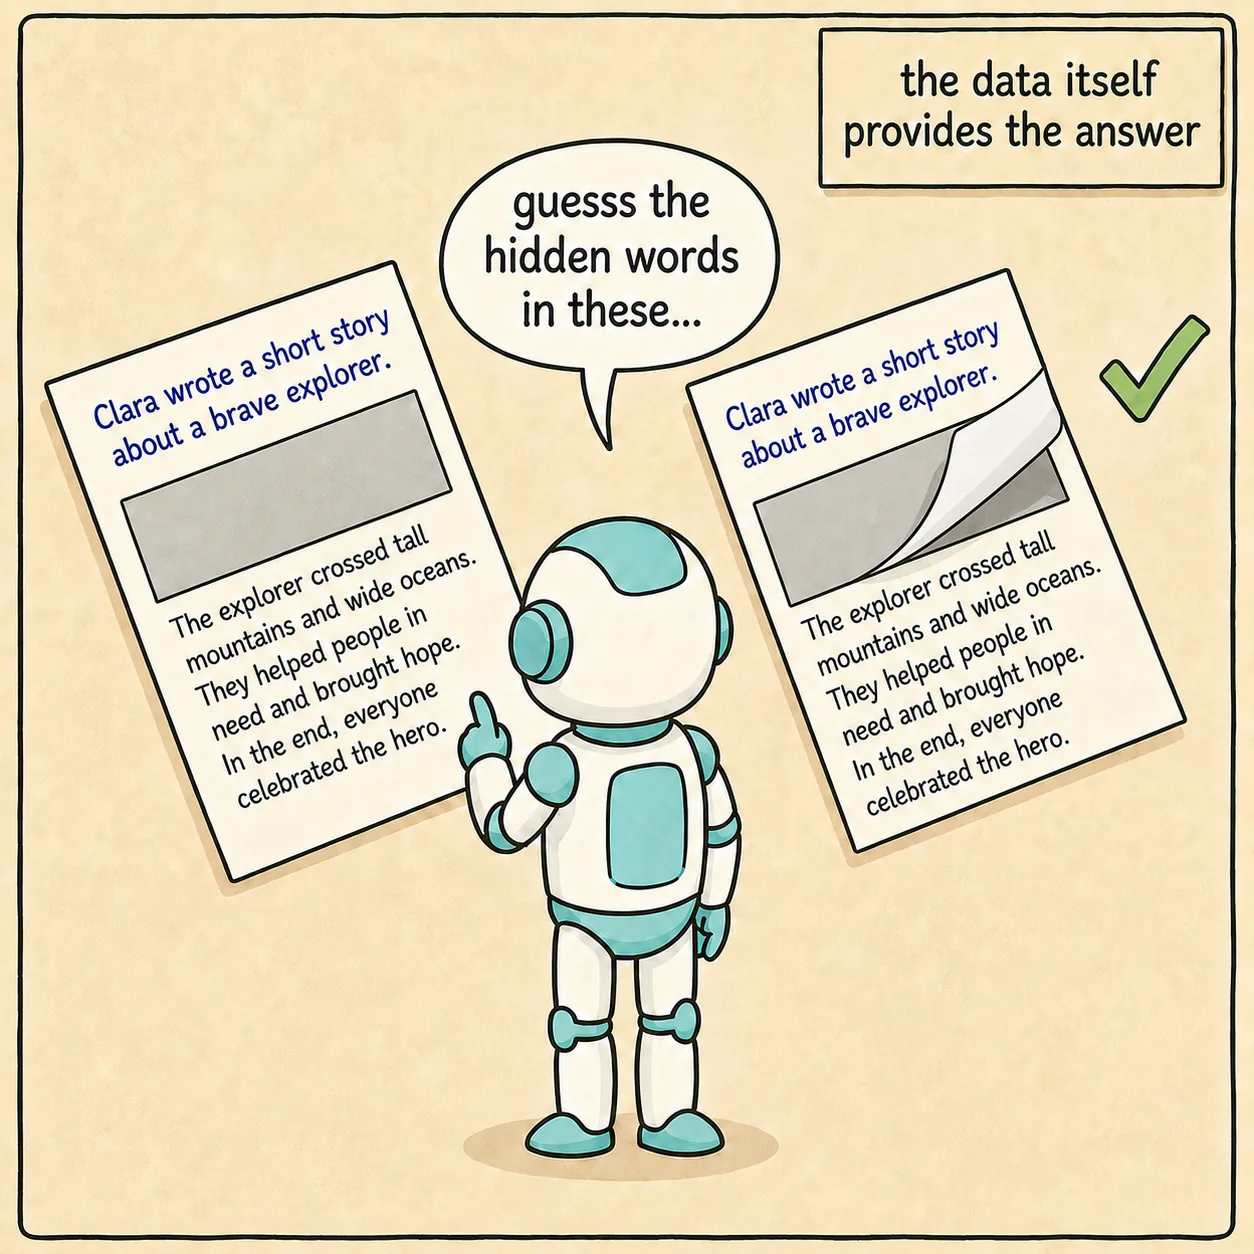
论文作者从自监督学习的核心原理中获得启发。自监督学习通过构建"前置任务"(pretext task)从数据自身获取监督信号,例如预测被遮挡的图像块或重建被打乱的句子顺序。受此思想引导,作者提出:是否可以设计一个类似的"代理验证任务",使其能够从任务内部的交互逻辑中自动生成可验证的奖励信号,而无需依赖外部评判?这正是 RLSVR 的核心出发点。
方法
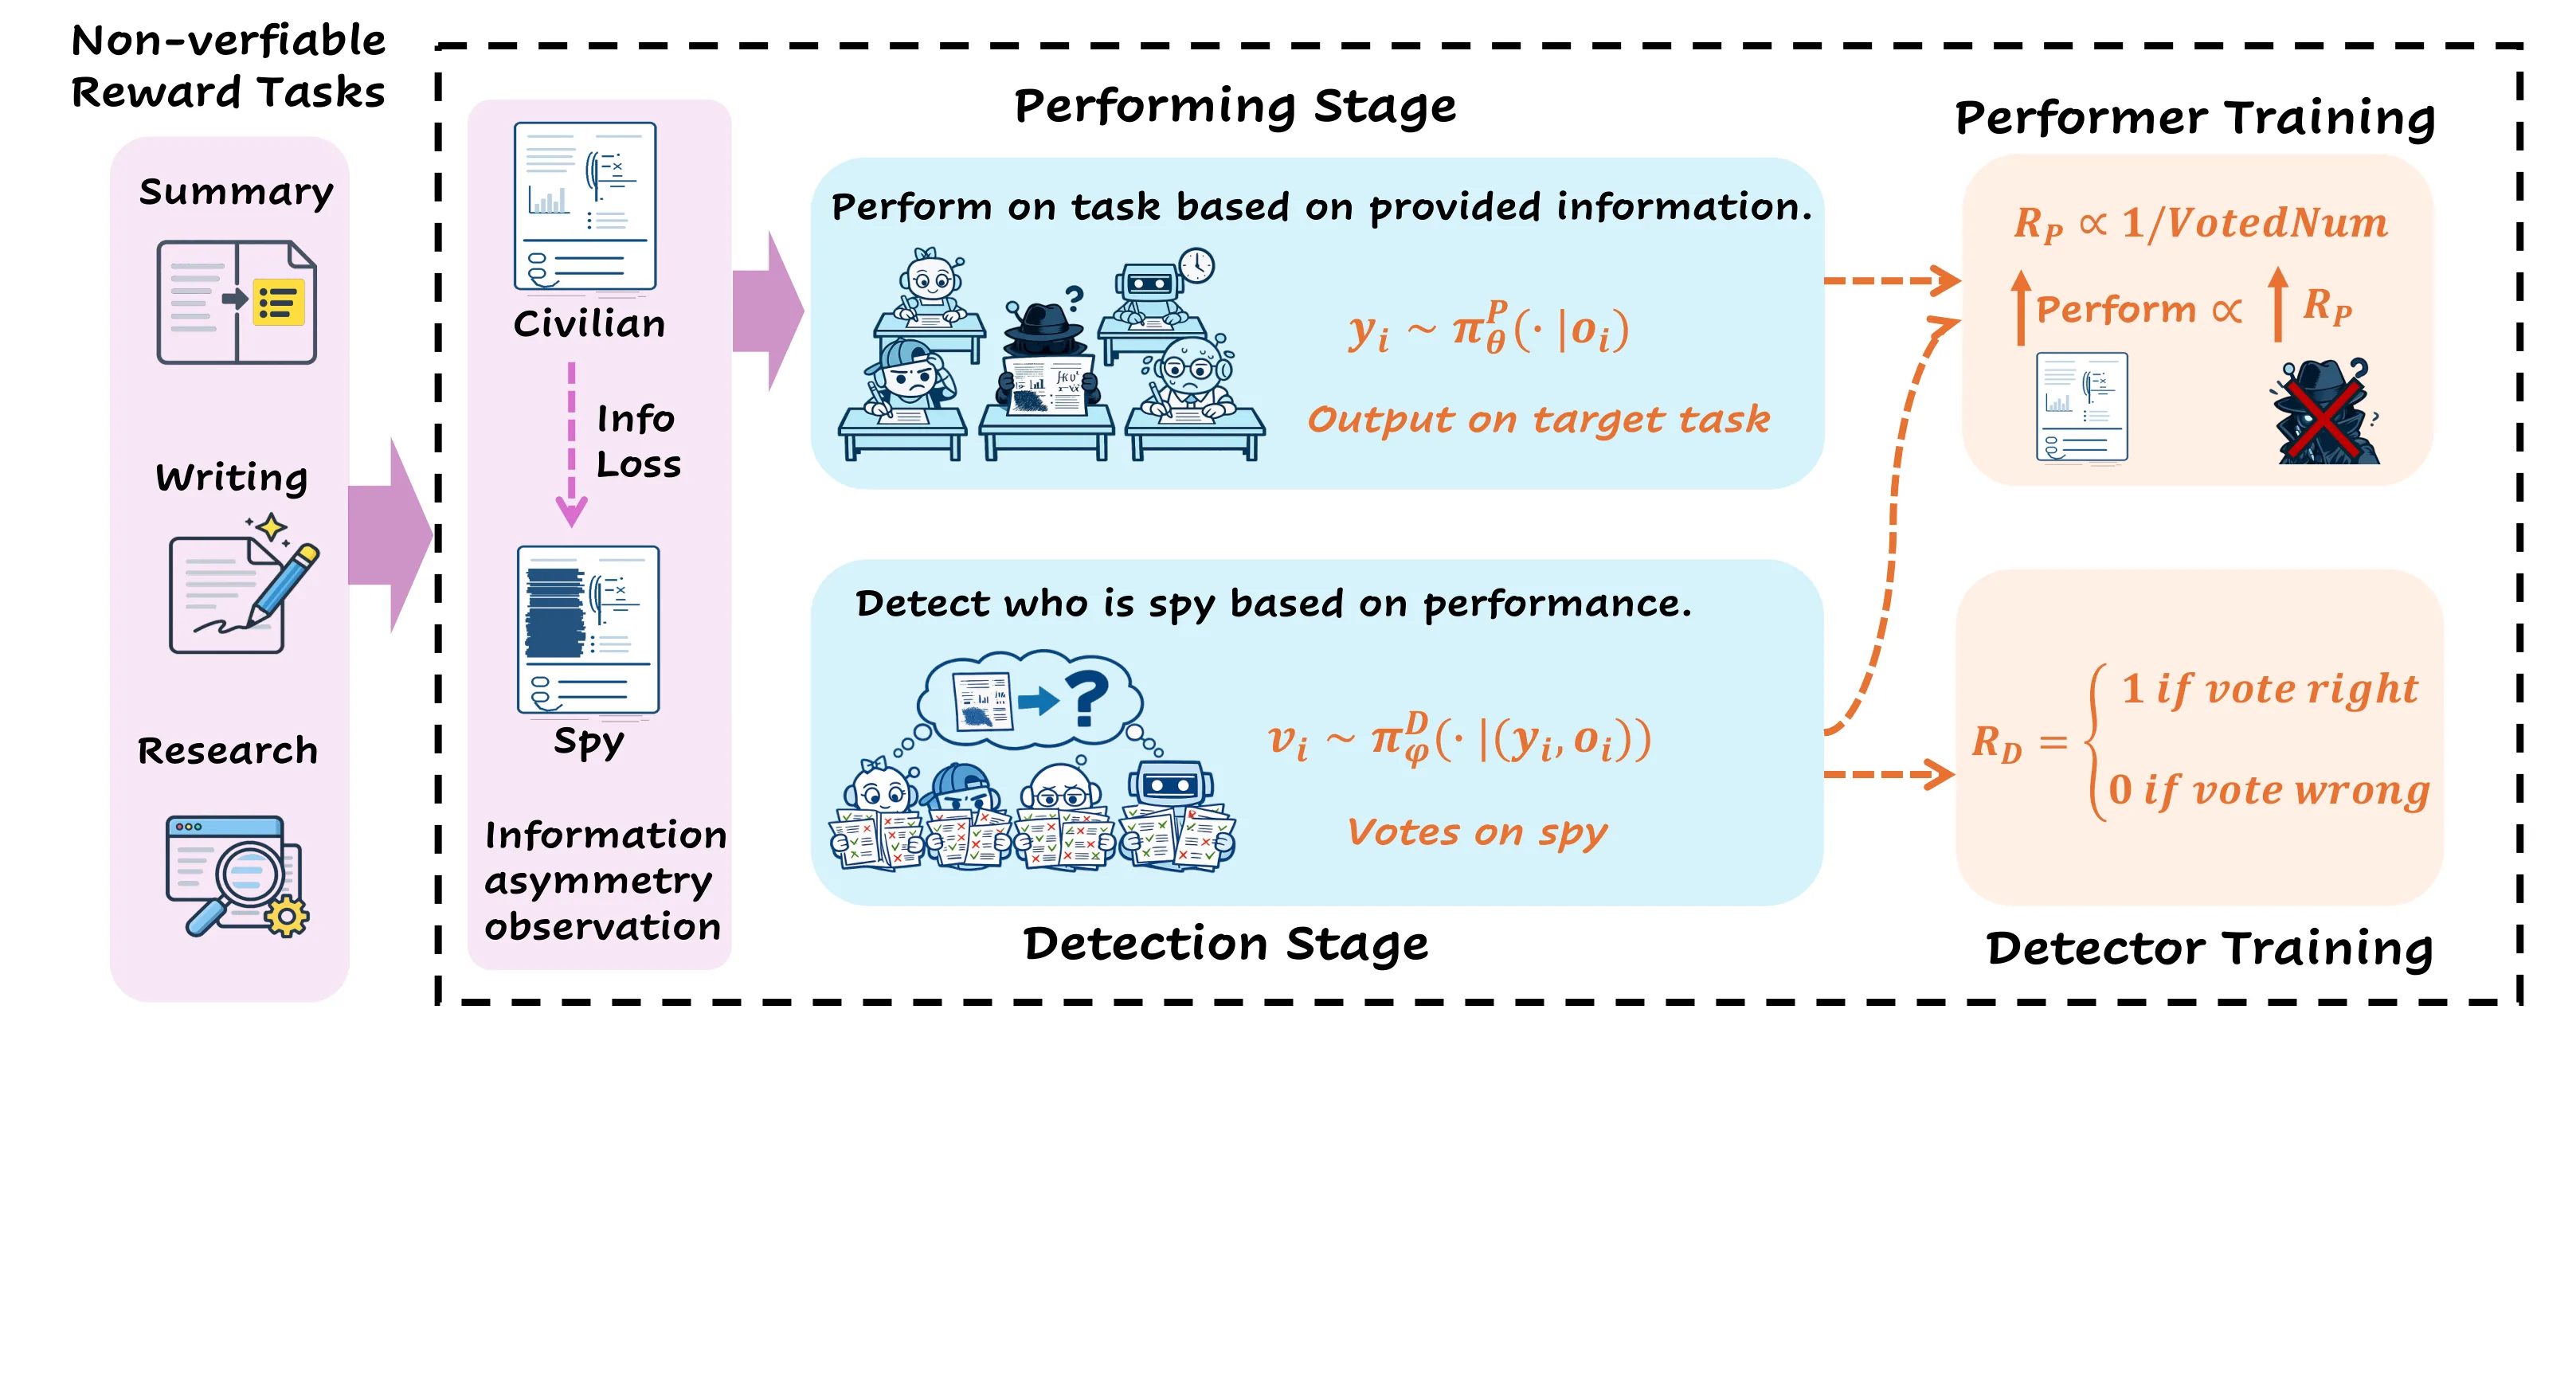
RLSVR 的核心理念是在原始任务与可验证奖励之间架设一座桥梁。对于每一个难以直接验证的开放式任务 ,我们设计一个代理验证任务 ,使得模型在 上的表现能够可靠地反映其在 上的能力。这个转换需要满足两个关键条件:奖励的可验证性(转换后的奖励信号必须是确定性的,不能引入新的偏差源)以及任务相关性(代理任务的成功与原始任务的质量必须高度相关,否则奖励信号将失去指导意义)。
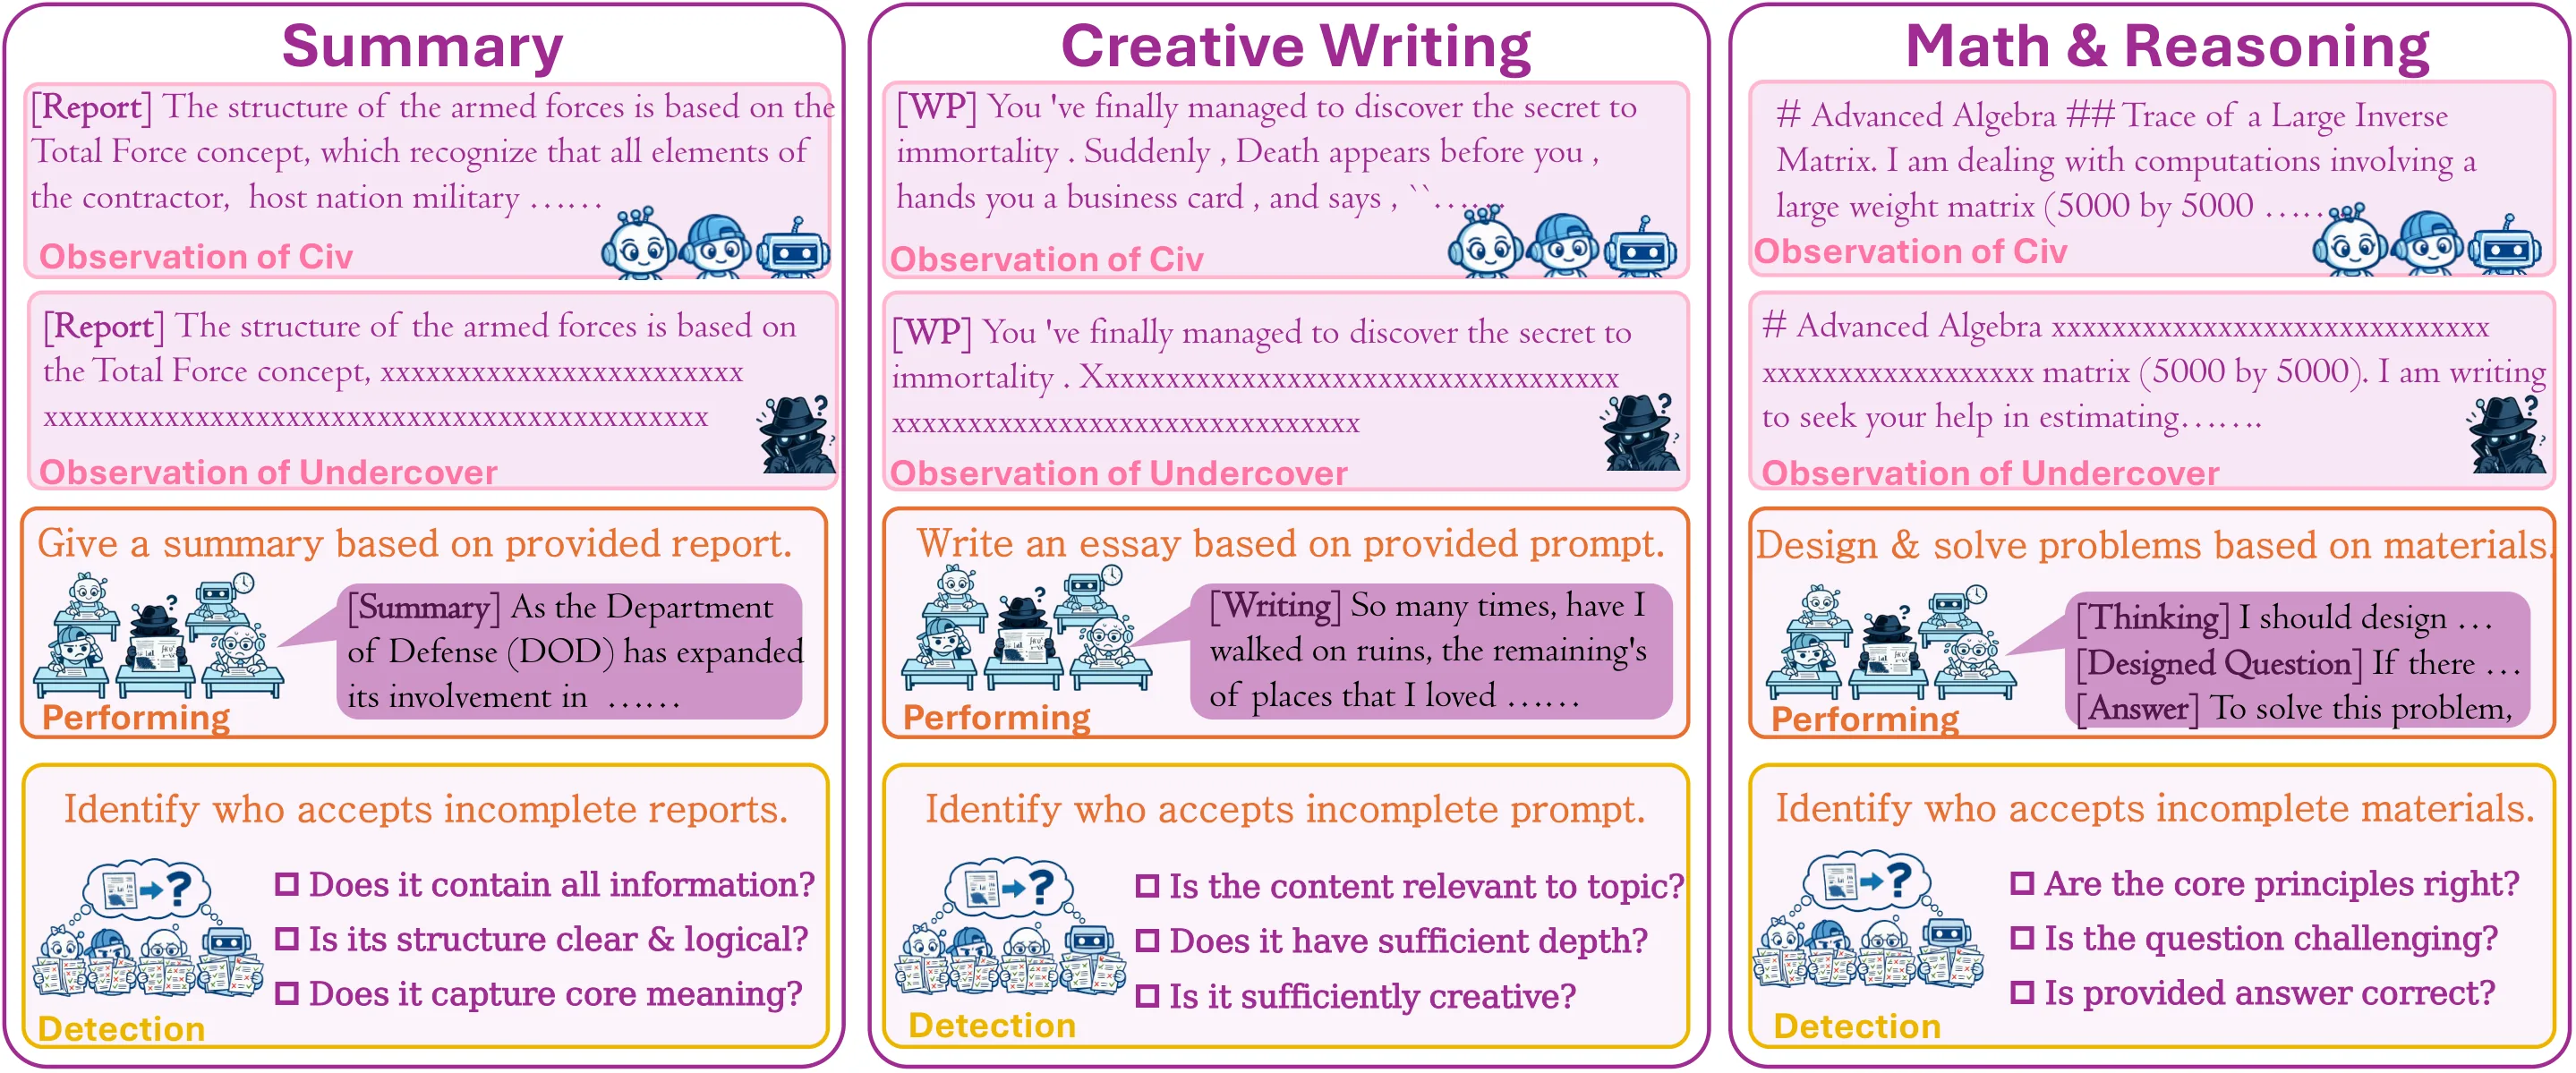
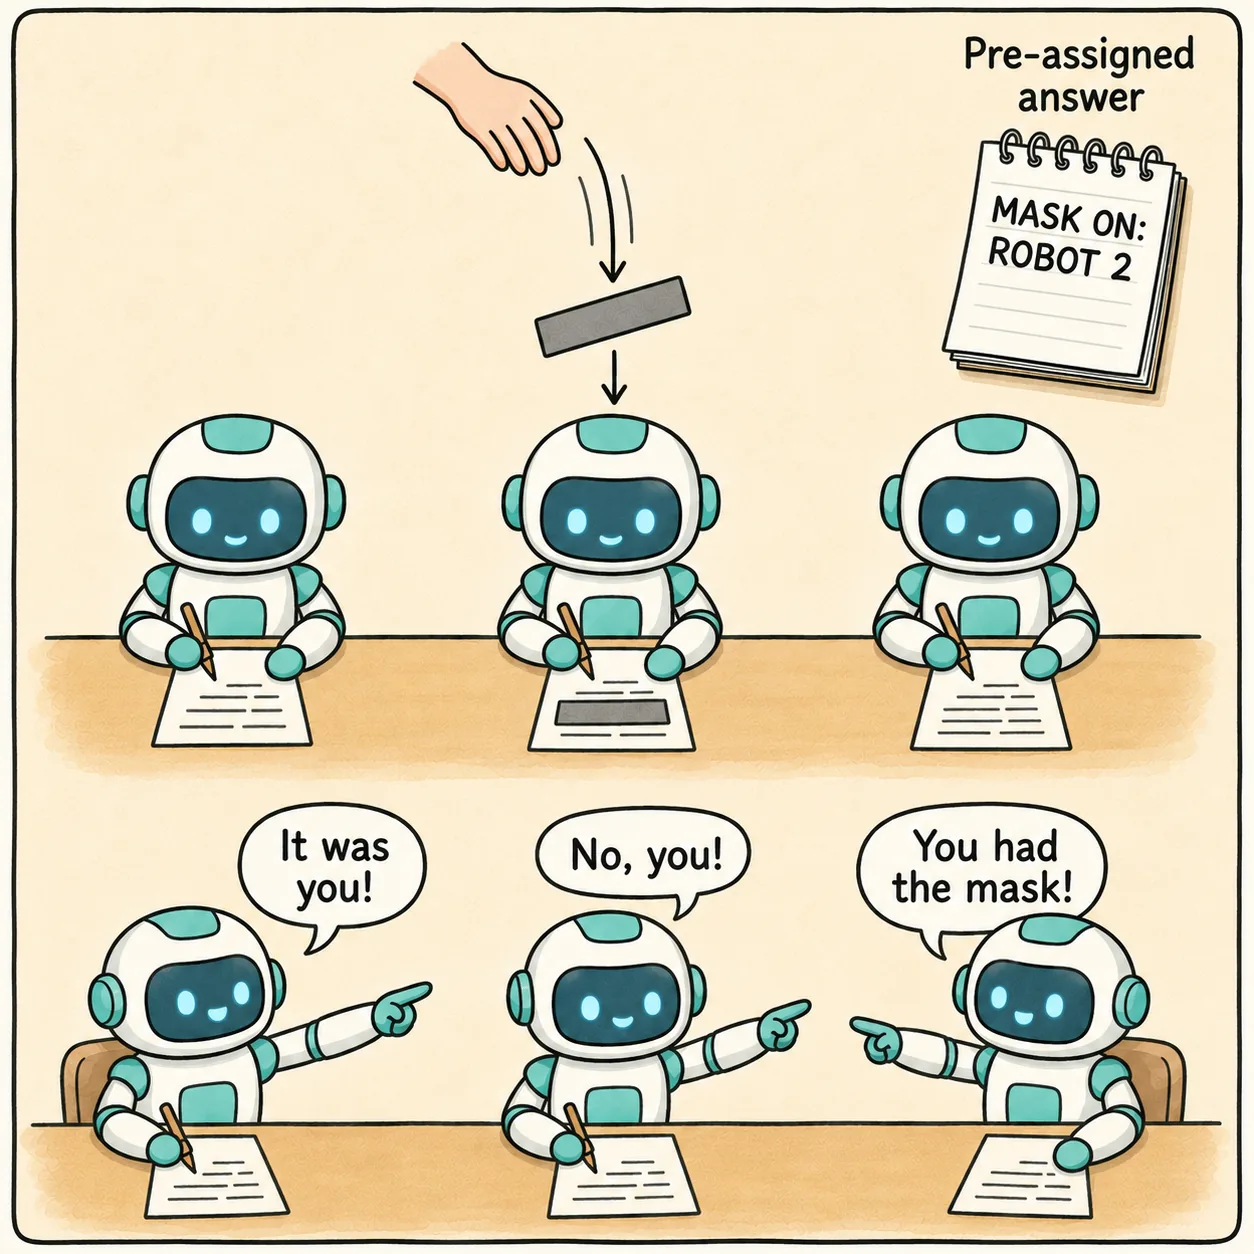
论文通过 SpyRL 实例化了这一范式,其设计灵感直接来源于经典社交推理游戏《谁是卧底》。在 SpyRL 中,若干智能体被分配完成相同的目标任务(如生成一段摘要),但各自掌握的信息存在不对称性。具体而言, 个智能体中会有 个被预先指定为"卧底",他们的任务描述包含少量误导性或模糊性的干扰信息,而"平民"智能体则获得更为准确和完整的任务上下文。这种信息不对称设计至关重要——它确保了智能体必须真正理解和分析任务内容,而无法仅仅通过记忆或模式匹配来完成协作。
完成任务后,所有智能体需要进行一轮投票,指认他们认为的"卧底"身份。由于卧底身份是预先确定的,投票结果可以与真实身份进行精确比对,产生完全可验证的二元奖励:
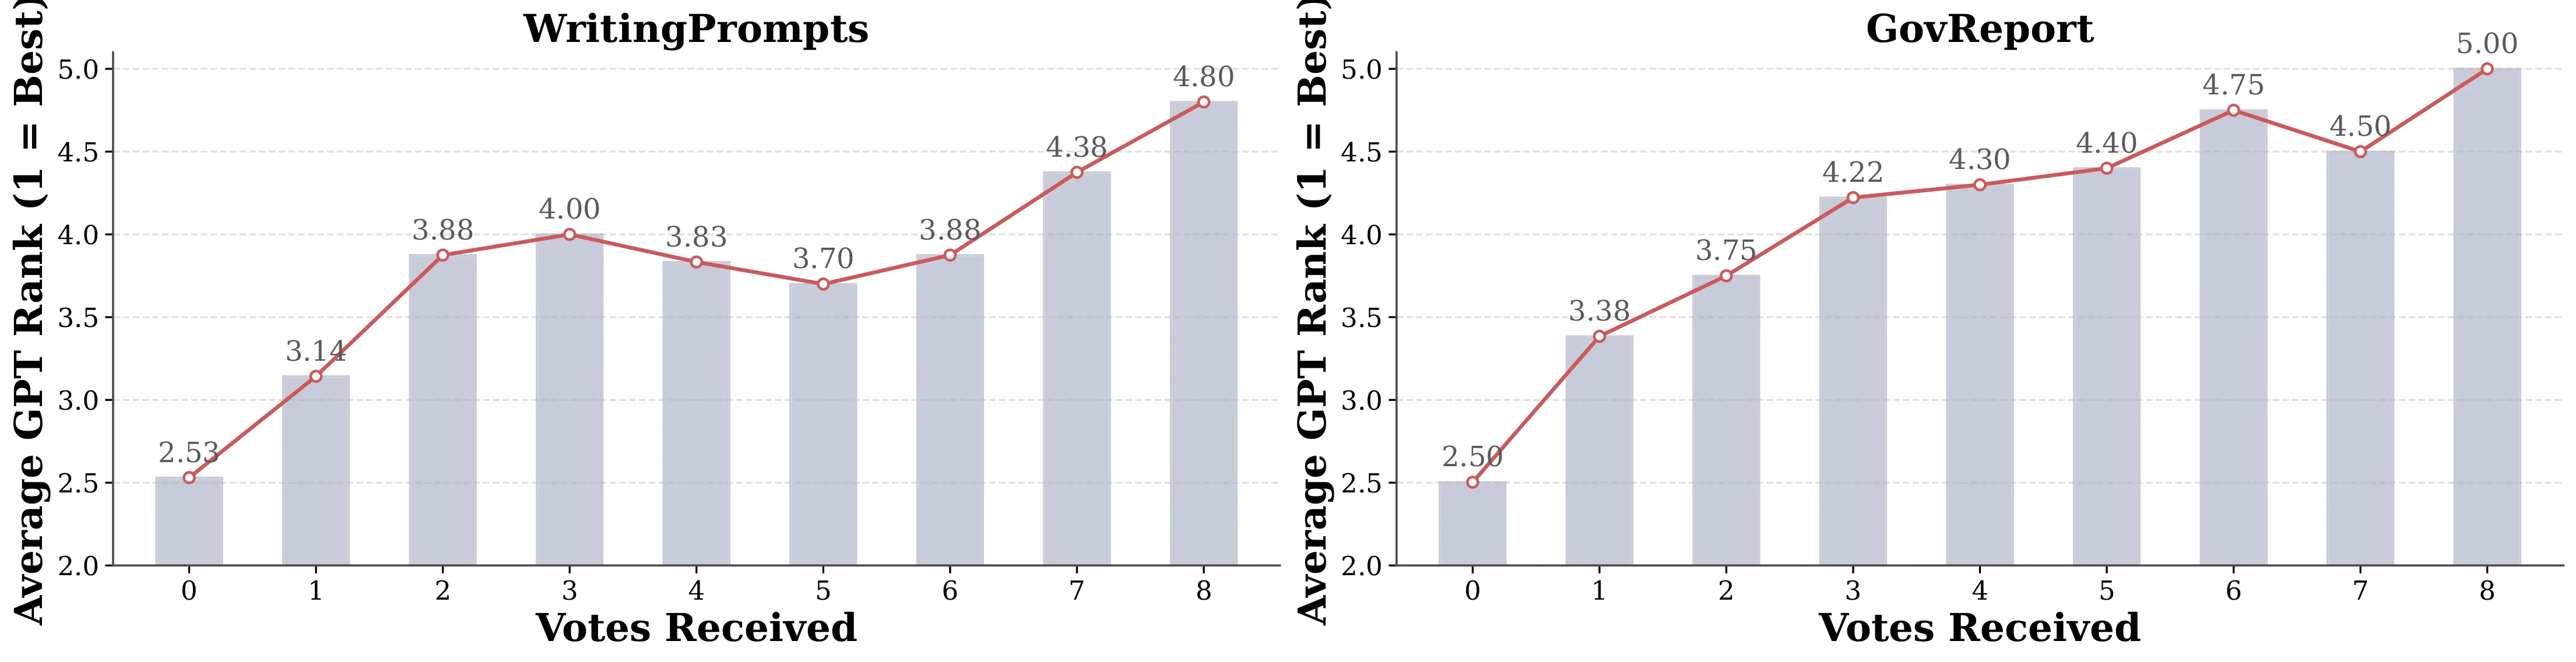
这个奖励函数看似简单,却蕴含精妙的设计逻辑。一方面,奖励的确定性由游戏规则保证,不存在任何评判偏差或能力瓶颈;另一方面,识别卧底的能力与输出质量高度相关——卧底的信息往往更加模糊、带有误导性,只有真正理解了任务要求和输入内容的智能体,才能从众多信息片段中推断出真相。换言之,高质量的输出是正确识别卧底的必要条件。
值得注意的是,SpyRL 还被作者定性为一种 Self-PlaY 强化学习方法,强调智能体通过与自身的变体进行对抗性交互来实现自我提升,这进一步强化了其自改进的特性。
实验与结果
论文在三类代表性任务上系统验证了 SpyRL 的有效性,分别是:文本摘要(CNN/DailyMail 和 PubMed 数据集)、创意写作(ROCStories 等)以及数学推理(GSM8K 和 MATH)。
在摘要任务上,SpyRL 与多种基线方法进行了对比,包括标准 PPO、强化自我改进(RSI)以及使用 GPT-4 作为评判器的 PPO-RM。实验采用 Qwen2.5-7B 作为基座模型,结果显示 SpyRL 在 ROUGE-L 指标上分别提升 4.2 和 3.8 个百分点,相较于依赖外部奖励的 PPO 方案展现了显著优势。更有说服力的是,即使与使用强大外部评判器(GPT-4)的 PPO 相比,SpyRL 依然保持竞争力——这有力地证明了内部验证机制的有效性。
创意写作任务的评估采用 LLM-as-a-Judge 协议,通过成对比较输出质量。结果显示 SpyRL 生成的文本在 63% 的情况下被评判为优于基线,这一比例显著高于自洽性(Self-Con sistency)和自我改进(Self-Improvement)等基线方法,验证了方法在真正开放式生成任务中的优越性。
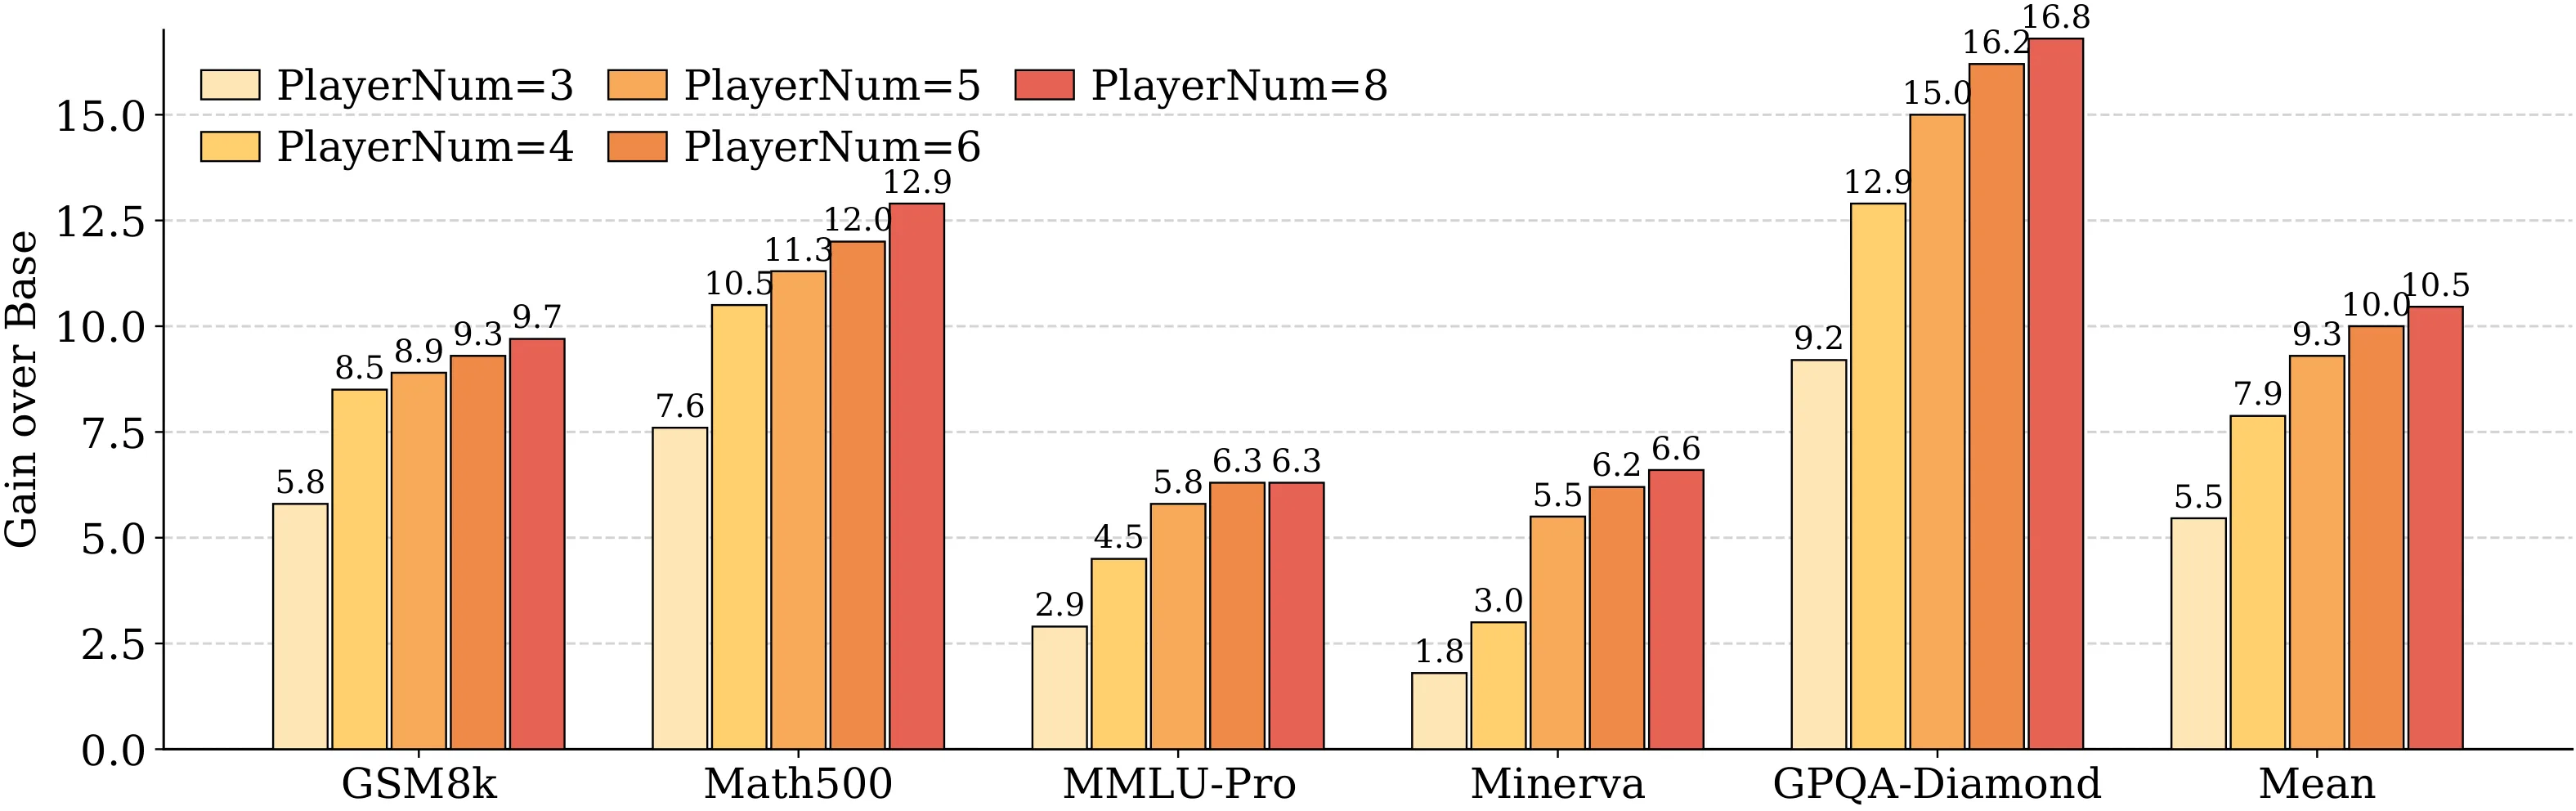
数学推理任务的结果则揭示了任务转换范式的兼容性优势。SpyRL 在 GSM8K 上达到了 86.3% 的准确率,与直接应用 RLVR 的性能基本持平,说明当原始任务本身可验证时,SpyRL 并不会引入额外损失。更重要的是,它在不可验证的摘要和写作任务上取得的提升是实质性的,而非以牺牲可验证任务上的表现为代价。
讨论与可借鉴点
SpyRL 的成功验证了任务转换作为扩展强化学习可验证奖励范式的可行路径。从更宏观的视角看,这一工作的启发意义在于:对于缺乏天然验证信号的领域,研究者可以通过精心设计代理任务来创造可验证的奖励环境,而不必依赖不可靠的外部评判器。
然而,该方法也存在若干局限值得冷静审视。首先,代理任务的设计(如卧底数量、信息不对称程度)涉及多个超参数,需要针对具体领域进行调优,这增加了方法的落地成本。其次,多智能体的训练范式相较于单智能体强化学习具有更高的计算开销,在资源受限场景下的可行性需要进一步评估。最后,任务转换范式的泛化能力——即如何设计适用于任意开放任务的代理验证机制——仍是开放性难题。
对于后续研究而言,SpyRL 开辟了若干值得探索的方向:如何自动化设计转换任务而非依赖人工设计、多智能体的投票机制能否与其他偏好学习方法(如 DPO)进行融合、以及这一范式在视频生成、语音对话等更多模态开放任务上的表现如何。这些问题的回答将进一步拓展可验证强化学习在人工智能生成内容领域的应用边界。
摘要
基于可验证奖励的强化学习(RLVR)通过支持大规模优化,推动了近期面向推理的大语言模型(LLM)的进展。然而,其适用范围仍主要局限于数学和编程等可以确定性验证正确性的领域。开放式任务则往往依赖人类偏好、奖励模型或基于 LLM 的评判器,这引入了评估偏差、评判能力瓶颈以及额外的推理开销。受自监督学习原理的启发——自监督学习通过构建前置任务从数据自身获取监督信号——我们提出了基于可自我验证奖励的强化学习(RLSVR),这是一种基于任务变换的训练范式,用于将 RLVR 扩展到开放式任务。RLSVR 将开放式任务转化为可验证的代理环境,其内部规则和交互结果可自动生成奖励信号。我们通过 SpyRL 实例化了 RLSVR,这是一种受社交推理游戏《谁是卧底》启发的 Self-PlaY 强化学习方法。智能体接收不对称的信息,完成相同的目标任务,并通过投票来识别指定的卧底。由于卧底身份是预先确定的,投票结果可提供完全可验证的奖励,而成功识别仍与输出质量密切相关。在文本摘要、创意写作和数学推理上的实验表明,SpyRL 在不可验证任务上优于现有的自我改进方法,并在可验证推理任务上取得了一致的性能提升。这些结果表明,任务变换能够将基于 RLVR 的可扩展自我改进拓展到固有可验证领域之外。模型和代码已发布于 https://github.com/wangqinsi1/RLSVR/tree/SpyRL。
Abstract
Reinforcement Learning with Verifiable Rewards (RLVR) has driven recent progress in reasoning-oriented large language models (LLMs) by enabling large-scale optimization. However, its applicability remains largely limited to domains such as mathematics and coding, where correctness can be deterministically verifiable. Open-ended tasks instead often rely on human preferences, reward models, or LLM-based judges, introducing evaluation bias, judge capability bottlenecks, and additional inference costs. Drawing on the principle of self-supervised learning, which constructs pretext tasks to derive supervision from the data itself, we propose Reinforcement Learning with Self-Verifiable Rewards (RLSVR), a task-transformation-based training paradigm for extending RLVR to open-ended tasks. RLSVR transforms open-ended tasks into verifiable proxy environments whose internal rules and interaction outcomes automatically generate reward signals. We instantiate RLSVR with SpyRL, a Self-PlaY Reinforcement Learning method inspired by social deduction game Who Is the Spy?. Agents receive asymmetric information, complete the same target task, and vote to identify a designated spy. Because the spy identity is predetermined, voting outcomes provide fully verifiable rewards, while successful identification remains closely related to output quality. Experiments on text summarization, creative writing, and mathematical reasoning show that SpyRL outperforms existing self-improvement methods on non-verifiable tasks and yields consistent gains on verifiable reasoning tasks. These results demonstrate that task transformation can extend scalable RLVR-based self-improvement beyond inherently verifiable domains. Models and code have been released at https://github.com/wangqinsi1/RLSVR/tree/SpyRL.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。