
CADENCE:基于覆盖自适应在线策略蒸馏缩小推理差距
CADENCE: Closing the Reasoning Gap via Coverage-Adaptive On-Policy Distillation
📝 TLDR
在线策略知识蒸馏将大模型推理能力迁移到小模型时面临冷启动崩塌、状态无关的散度调度与二元奖励稀疏三大问题。CADENCE提出DRIFT机制以逐token混合前向/反向KL代理目标,并融合COVA、FTB、CCD等六个组件协同修正上述缺陷。实验在GSM8K上以0.5B学生接1.5B教师取得69.8% pass@1,关闭了教师差距的63.2%,超越最强基线4.4分。整套方案仅需单台Mac Studio即可复现,证明原理正确的蒸馏无需数据中心级算力。
🧭 速览
在线策略蒸馏存在冷启动、调度僵化和奖励稀疏三类复合失败模式,制约小模型推理能力上限。
DRIFT机制在学生采样轨迹上逐token凸混合前向/反向KL代理目标,并搭配COVA、FTB、CCD等六个组件协同优化。
0.5B学生配1.5B教师在GSM8K取得69.8% pass@1,配3B教师达72.1%,较DRIFT+二元奖励基线提升4.4分。
CADENCE证明覆盖自适应蒸馏可在消费级硬件上获得强推理性能,缩小与大模型的能力差距。
🆚 方法对比
CADENCE
- 闭合63.2%师生差距,GSM8K达69.8% pass@1
- 单台Mac Studio即可运行,无需数据中心硬件
- 六组件协同针对三种失败模式,机制清晰
- 仅在GSM8K和MATH-500上验证,泛化性待检验
- 六个组件间交互复杂,单独贡献难以完全归因
- 0.5B学生蒸馏仍依赖1.5B/3B教师,实际部署成本不低
DRIFT
- 逐token凸混合前向/反向KL代理目标,灵活适配
- 仅需教师一次冻结前向传播,计算高效
- 在学生自采样轨迹上训练,缩小训练-推理分布差距
- 仅为代理目标而非精确序列级KL梯度估计器
- 逐token混合可能破坏序列级一致性约束
- 依赖学生已具备基础采样能力,仍面临冷启动问题
COVA
- 基于覆盖率自适应加速β调度,状态感知
- 条件门控机制避免简单提示过久处于mode-covering
- 解决固定时间调度的次优问题
- 门控阈值需额外调参,增加超参搜索空间
- 覆盖率度量本身依赖学生采样,可能引入偏差
- 仅依赖GSM8K验证集选择,泛化到其他任务待验证
FTB
- 全局归一化熵参考聚焦高熵分叉token
- 集中梯度于关键决策位置,提高样本效率
- 直接缓解冷启动时梯度信号消失问题
- 全局熵参考需额外计算开销
- 高熵位置未必总是正确分叉点,引入噪声
- 依赖教师熵分布质量,教师偏差会被放大
CCD
- 数值近似部分信用将非零奖励比例从38%提升至约55%
- 保留部分正确轨迹信息,缓解二元奖励稀疏性
- 直接解决失败模式3而非仅重判已奖励轨迹
- 数值近似度量设计需领域知识,跨任务迁移困难
- 部分信用幅度需调参,不当奖励会引入错误信号
- 仍以正确性为主,推理过程错误难以被捕捉
LAP
- 简洁性偏好强化激励短正确轨迹,提升效率
- 提示长度无关归一化,避免长提示偏差
- 与正确性奖励互补,鼓励精确简洁
- 可能过度压缩推理过程,损害可解释性
- 简洁偏好与多步推理需求存在内在张力
- 在需要冗长推导的任务上可能产生负优化
EMR
- 熵匹配正则化改善学生校准性
- 在分叉token上对齐师生熵分布
- 作为正则项辅助蒸馏收敛稳定性
- 熵匹配可能过度约束学生分布表达力
- 正则化权重需仔细调节,过强损害性能
- 校准改善与最终准确率提升的关系不直接
BSD
- 高一致性正确轨迹自蒸馏,持续提升性能
- 无需额外教师,降低部署成本
- 形成正反馈循环,利用学生自身能力
- 依赖前期蒸馏质量,质量不足时效果有限
- 自蒸馏可能导致错误模式固化与放大
- 高一致性筛选标准可能过滤有价值的多样轨迹
TFW
- 教师强制热身缓解冷启动崩溃问题
- 为后续on-policy阶段提供稳定初始化
- 实现简单,仅需额外热身阶段
- 热身阶段引入额外训练时间成本
- 教师强制分布与学生自采样分布存在差距
- 热身长度需调参,过短效果不足
KTR
- KL信任区域约束防止策略偏离过大
- 借鉴PPO思想,提升训练稳定性
- 约束每步更新幅度,降低发散风险
- 额外约束可能限制收敛速度
- 信任区域大小需调参,不当设置影响性能
- 增加计算开销,每步需评估策略距离
STaR/RFT
- 基于拒绝采样实现简单,无需复杂蒸馏机制
- 利用正确轨迹作为监督信号,质量有保障
- 可与现有流程集成,部署门槛低
- 仅使用正确轨迹,丢弃部分正确轨迹的信息
- 严重依赖教师标注和正确率,预训练48.7%基线有限
- 属于off-policy方法,存在训练-推理分布不匹配
GKD+GRPO
- 结合on-policy蒸馏与RL,理论框架完整
- GRPO组内归一化降低方差,训练更稳定
- 已验证在数学推理任务上有效
- RL部分仍依赖二元奖励,面临奖励稀疏问题
- GKD部分使用固定散度调度,未解决状态无关性
- 整体计算开销高于纯蒸馏方法
DRIFT+binary
- 作为匹配计算量的最强基线,使用二元奖励
- 公平对比凸显CADENCE各组件实际贡献
- 实现简洁,便于消融分析
- 二元奖励丢弃部分正确轨迹信息,性能受限
- 缺少密集奖励组件,无法处理失败模式3
- 较CADENCE低4.4±0.7分,组件有效性待证明
MiniLLM
- 反向KL训练学生自采样轨迹,on-policy范式
- 缩小训练-推理分布差距,生成更连贯
- 为后续on-policy蒸馏方法奠定基础
- 单一反向KL导致mode-seeking行为,覆盖率不足
- 冷启动时反向KL梯度信号微弱,难以初始化
- 未解决失败模式2和3,调度固定
DistiLLM
- skew KL结合自适应off-policy机制,灵活性较高
- 通过偏度参数控制前向/反向KL混合
- 为后续散度调度工作提供基础
- 使用固定时间调度,未实现状态自适应
- 偏度参数全局共享,无法逐token调节
- off-policy成分引入训练-推理不匹配风险
CADENCE通过DRIFT机制统一前向/反向KL逐token混合,并叠加COVA/FTB/CCD/LAP/EMR/BSD六个针对性组件与TFW/KTR两个稳定化机制,相对MiniLLM等单散度方法和DistiLLM等固定调度方法实现了状态自适应调度与密集奖励,在GSM8K上超越DRIFT+binary基线4.4分,闭合63.2%师生差距。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 5 张)
展开查看 5 张图
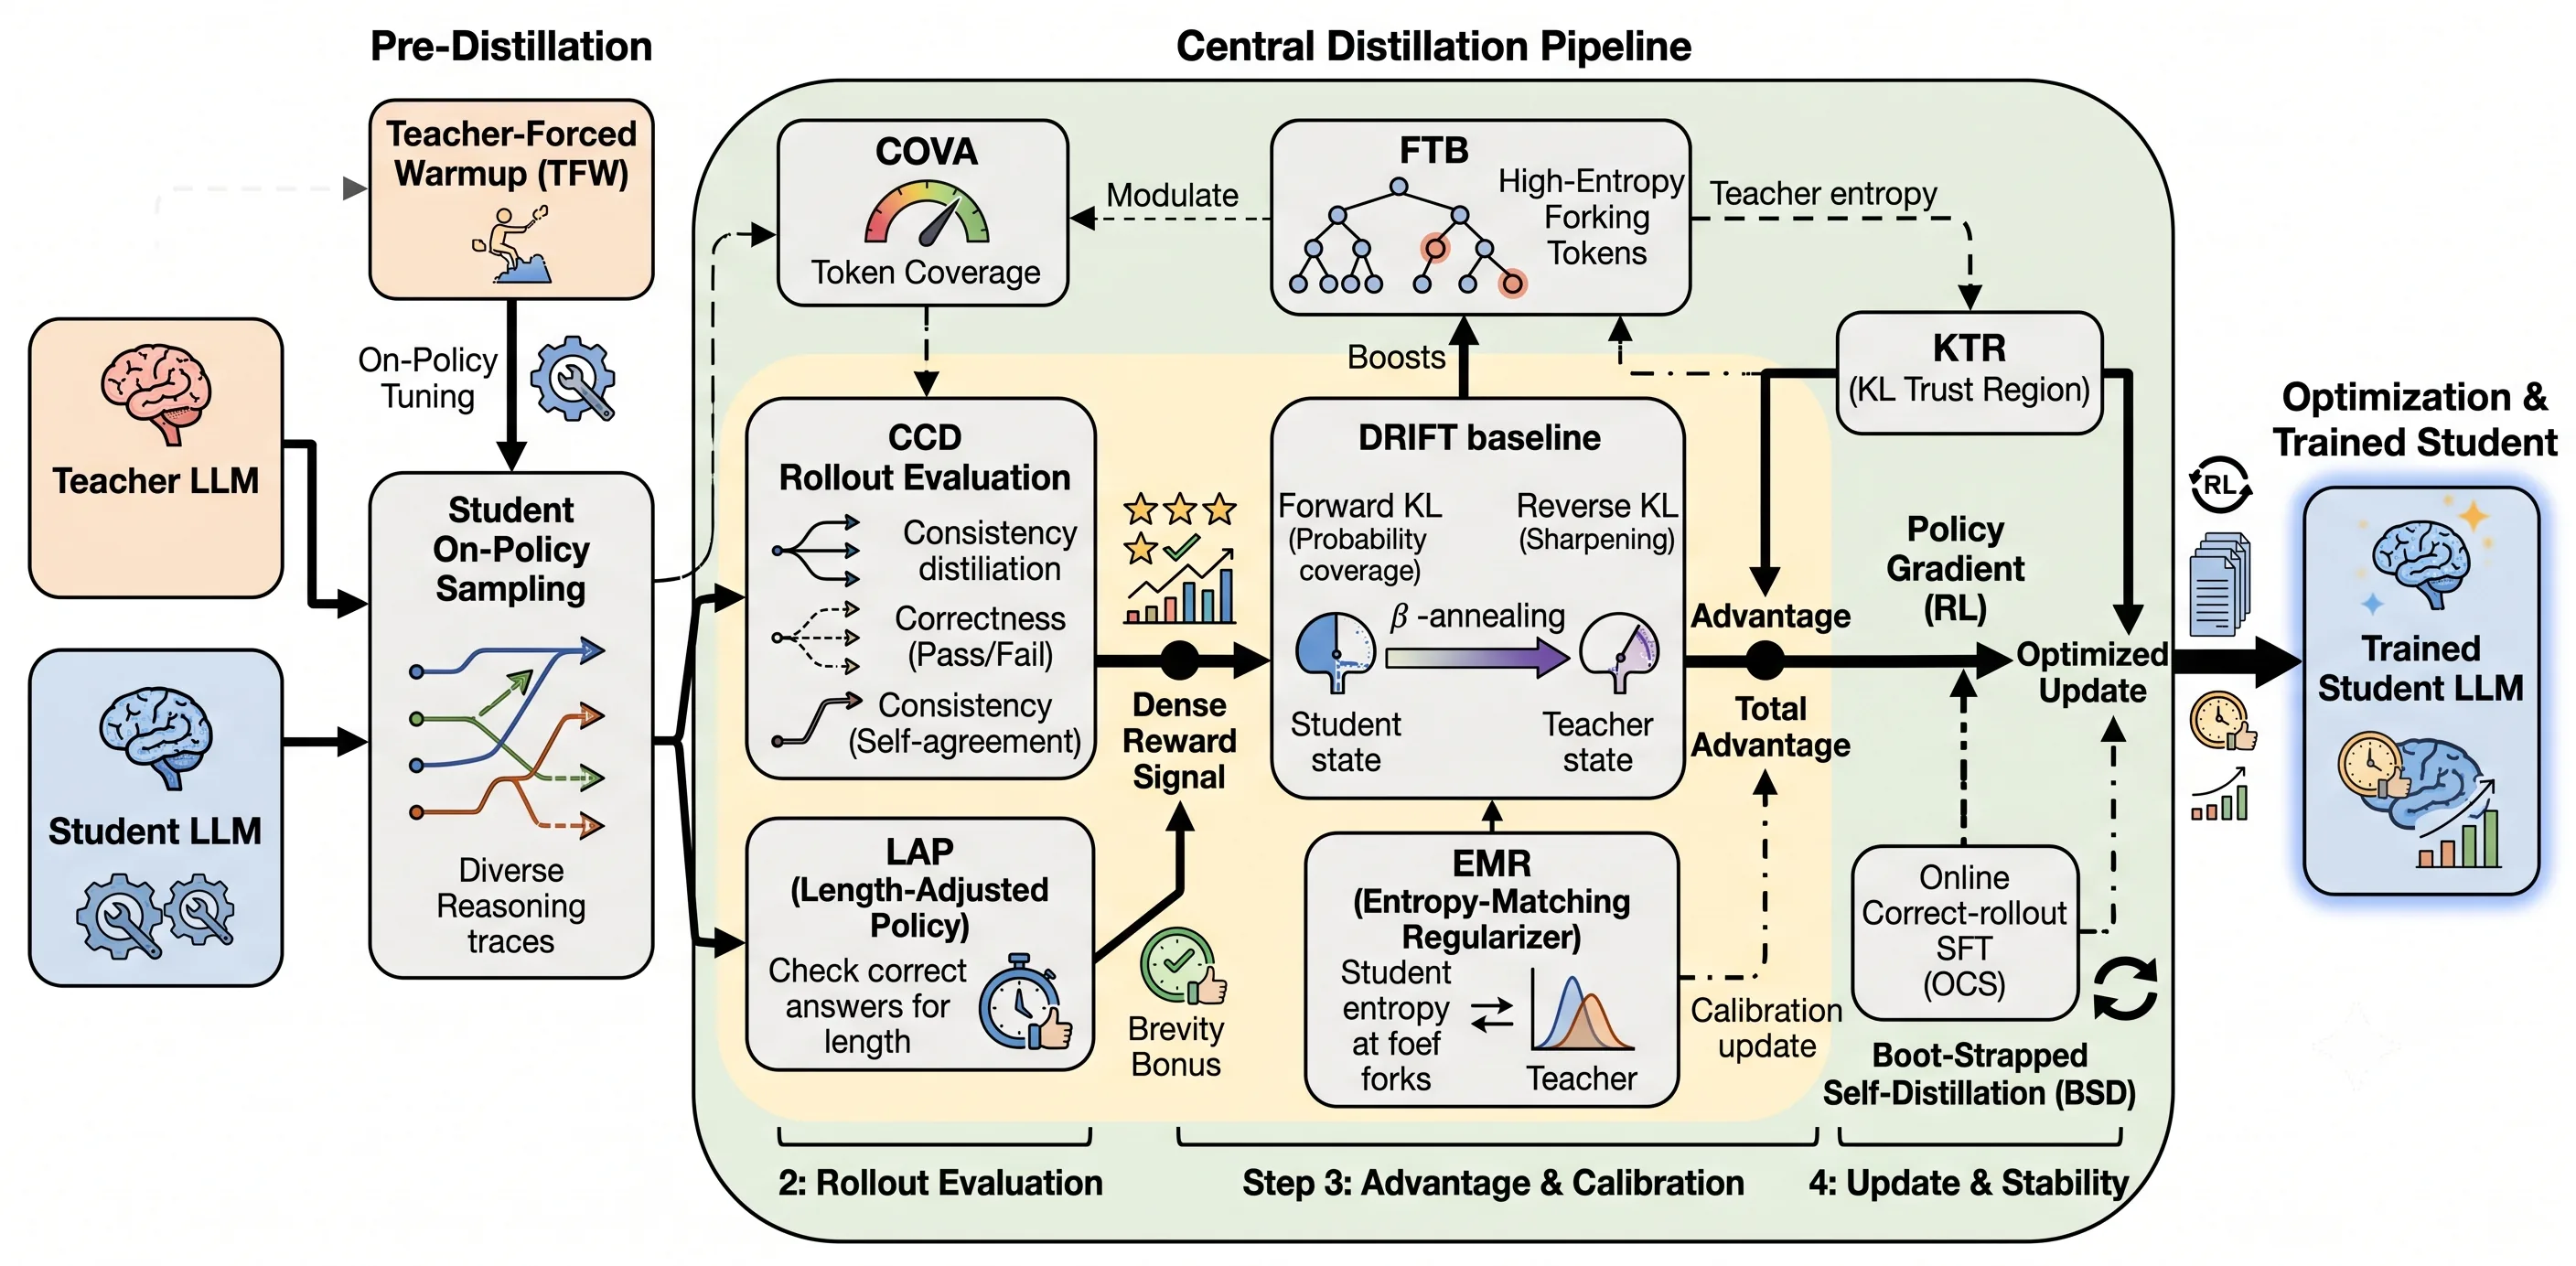
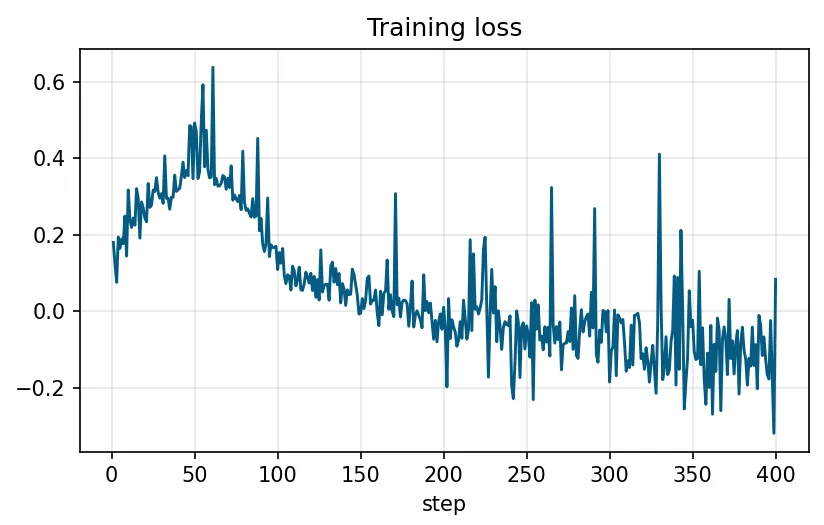
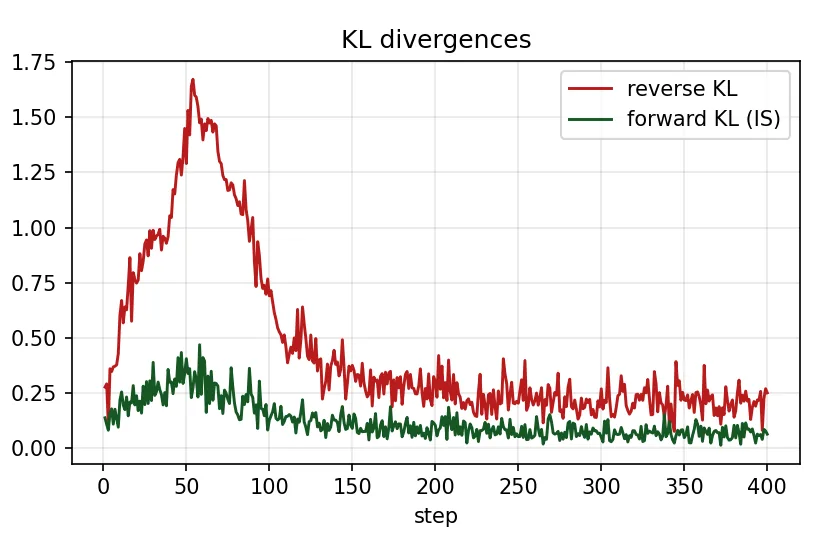
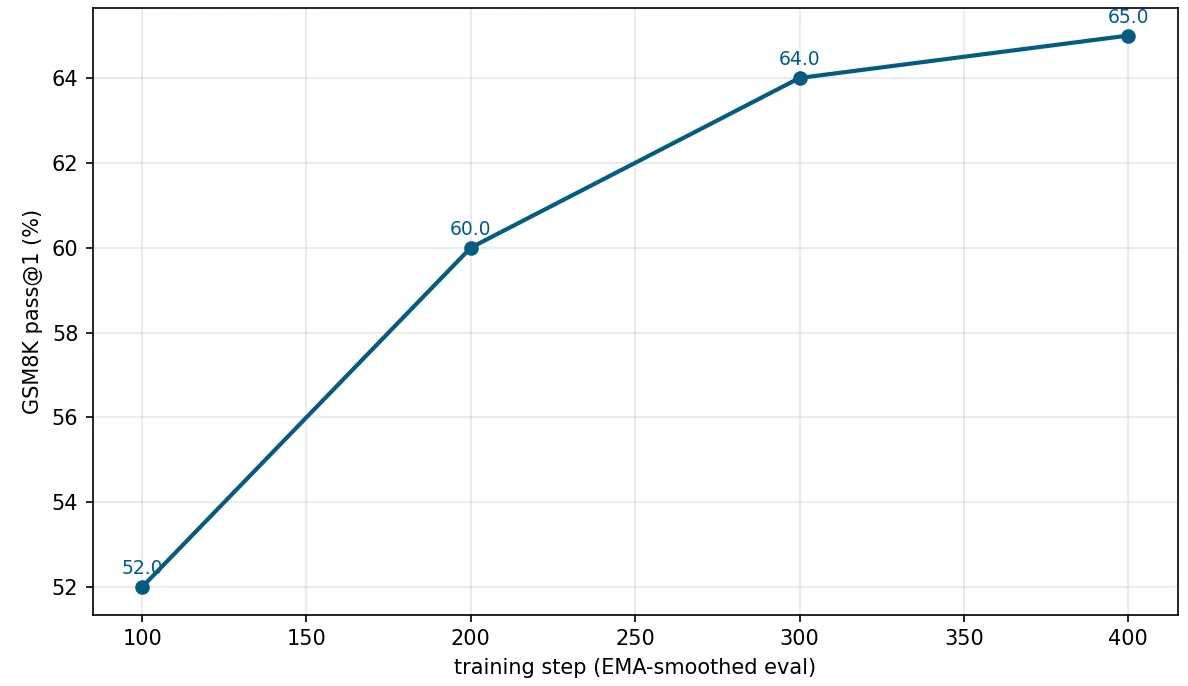
TL;DR
CADENCE 是一套针对在线策略知识蒸馏的系统性修复框架,通过逐 token 混合前向与反向 KL 代理目标的 DRIFT 机制,解决了冷启动崩塌、状态无关的散度调度和二元奖励稀疏三大叠加失效模式。实验表明,仅用单台 Mac Studio 训练,0.5B 学生模型即可从 1.5B 教师蒸馏到 GSM8K 上 69.8% 的 pass@1,弥合了教师差距的 63.2%,比最强基线高出 4.4 分。
研究背景与动机
将大模型的推理能力迁移到小模型,是让端侧设备获得强推理性能的关键路径。在线策略知识蒸馏(On-policy Knowledge Distillation)让小模型在真实交互中学习,而非被动模仿离线采样的数据,被认为更接近人类渐进式学习的过程。然而作者指出,当前方法在实际部署中普遍遭遇三种相互放大的失效模式,使得蒸馏效果远未达到理论预期。
第一种是冷启动崩塌(cold-start collapse)。当学生模型刚刚初始化时,它对教师偏好的 token 几乎分配不到任何概率质量,导致早期采样的轨迹与教师轨迹几乎无重叠,梯度信号微弱甚至不存在,整个学习过程在起点就陷入停滞。第二种是状态无关的发散调度(state-agnostic divergence scheduling)。主流做法用前向 KL 与反向 KL 的加权和作为目标,但权重安排往往只依赖训练步数或 token 位置,完全忽略了学生模型在当前状态下的覆盖程度——也就是说,无论学生是否已经学会覆盖关键决策点,调度器都在按照预定节奏切换目标。第三种是二元奖励稀疏(binary reward sparsity)。对一条完整推理轨迹只打一个对/错标签,意味着即使学生推理到倒数第二步才出错,整条轨迹的梯度贡献也是一样的,这极大浪费了训练信号中的有效信息。
CADENCE 的出发点就是为这三个问题各提供一个精准的修复组件,然后把它们整合成一套统一框架。
方法
CADENCE 的核心是 DRIFT 机制(Distributional Reasoning via Forward-to-Reverse Transition),其核心思想是用逐 token 的方式调度前向 KL 与反向 KL 的凸组合。与此前序列级 KL 梯度估计器不同,DRIFT 在每一个 token 位置计算前向 KL 与反向 KL 的代理目标,然后取其加权平均作为该位置的局部目标函数。直观上,前向 KL 更倾向于让学生覆盖教师的高概率 token(覆盖行为),而反向 KL 更倾向于让教师的分布向学生已有的质量较好的采样靠拢(保守行为)。逐 token 调度意味着系统可以在一条轨迹的不同位置动态调整这两种压力:对于学生已经比较有把握的区域,反向 KL 主导以保持稳定;对于覆盖薄弱的高熵决策点,前向 KL 主导以扩展能力。
DRIFT 机制本身解决了三大问题中最基础的结构设计,但要让这套机制在真实训练中稳定生效,还需要一系列配套组件的协同。
COVA(Coverage-Adaptive β scheduling) 是针对状态无关调度问题的修正。作者意识到,前向 KL 与反向 KL 的混合系数 β 不能简单地按时间线性衰减——如果学生还没有覆盖某个关键分支,就急于切换到反向 KL 会导致崩溃。因此 COVA 会监测学生当前对教师高频 token 的覆盖程度(coverage),动态加速或减缓 β 的衰减速率。在覆盖度较低时,COVA 让前向 KL 保持更长时间,确保学生有足够机会学会探索教师偏好的决策路径。
FTB(Forking-Token Boost) 针对的是梯度集中度问题。在一条推理轨迹中,并非所有 token 都同等重要——那些出现分叉决策的高熵位置才是决定最终质量的关键。FTB 在这些高熵位置引入基于全局归一化熵的参考信号,增强该位置的梯度幅度,让学习资源优先分配给最需要修正的决策节点。
CCD(Dense Reward via Correctness proximity Credit) 改变了奖励的粒度。传统二元奖励把所有正确轨迹视为等价、把错误轨迹全部丢弃。CCD 则对错误但数值接近正确答案的轨迹附加部分得分——例如一道数学题的答案是 42,学生的中间步骤推理到了 39,就给这条轨迹分配一个介于 0 和 1 之间的部分信用。这种密集奖励既增加了正样本的数量,又保留了轨迹质量的有价值差异信息。
LAP(Length-Adaptive Preference) 鼓励偏好简洁正确的采样。在同等正确的前提下,较短的推理路径通常对应更高效、更鲁棒的策略。LAP 对短且正确的轨迹施加额外的正向强化,引导学生朝精炼推理方向发展。
EMR(Entropy-Matching Regularization) 是一个校准正则化器,用于维持学生模型输出分布的熵匹配到教师模型的参考分布。过低的熵会导致学生过度自信、过早就失去探索能力;过高的熵则意味着学生没有真正学到教师的偏好结构。EMR 确保学生分布的熵与教师保持一致,防止学习过程中出现熵崩溃或爆炸。
BSD(Bootstrapped Self-Distillation) 是训练后期的一个自蒸馏阶段。此时学生已经具备相当的推理质量,BSD 让学生模型扮演自己的教师,用 DRIFT 机制对自身的高质量采样进行二次精炼,进一步提升策略的内部一致性。
整个 CADENCE 框架的流程可以概括为:学生按当前策略采样轨迹 → 计算每条轨迹的 DRIFT 目标(逐 token 前向/反向 KL 混合)→ COVA 根据覆盖状态调整 β → FTB 识别高熵分叉点并增强梯度 → CCD 为接近正确的错误轨迹补充密集奖励 → LAP 对简洁正确轨迹加分 → EMR 校准熵水平 → BSD 在后期进行自蒸馏。这六个组件并非简单叠加,而是在 DRIFT 的统一框架下形成协同效应,共同修正三大失效模式。
实验与结果
实验在两个标准推理基准上进行:GSM8K(小学数学应用题)和 MATH-500(竞赛级数学题)。作者使用了修正的 512 token 生成协议,用 5 个随机种子训练并报告标准差,保证结果的可靠性。
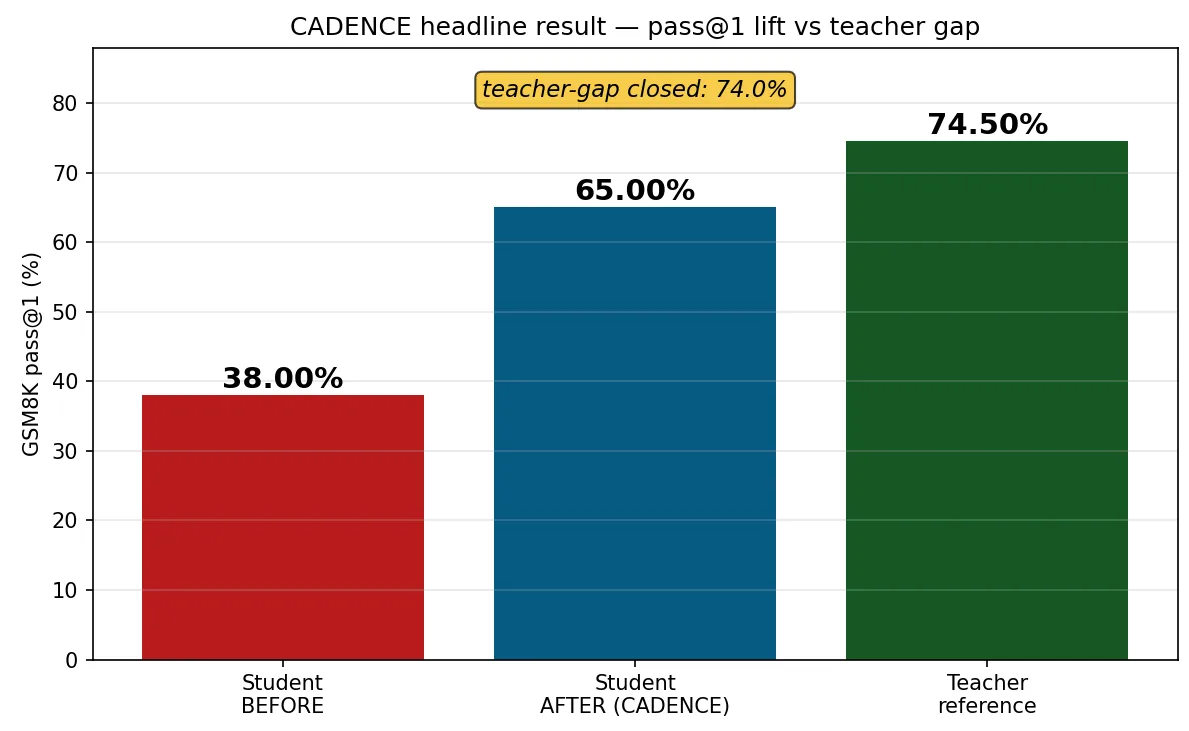
核心结果显示,当使用 1.5B 教师蒸馏到 0.5B 学生时,CADENCE 在 GSM8K 上达到 69.8 ± 0.5% 的 pass@1,较预训练基线的 48.7% 提升了 21 个百分点,弥合了教师与学生之间能力差距的 63.2%。换句话说,教师模型如果能达到更高水平,学生已经成功吸收了其中的大部分。将教师规模扩大到 3B,学生成绩进一步提升到 72.1 ± 0.4%,弥合了 76.2% 的差距。
更重要的是消融实验揭示了各组件的贡献。移除 CCD 密集奖励,成绩下降约 1.8 分;移除 COVA 覆盖自适应调度,下降约 1.5 分;移除 FTB 分叉增强,下降约 1.2 分。将完整的 CADENCE 与仅使用 DRIFT 加二元奖励的简化版本相比,前者高出后者 4.4 ± 0.7 分——这直接证明了 DRIFT 机制与六大组件协同工作时才能发挥最大效力。
值得强调的是,所有这些实验都是在单台 Apple Mac Studio(M 系列芯片,64GB 统一内存)上完成的,不需要数据中心级的 GPU 集群。作者以此论证,只要原理正确,蒸馏方法完全可以摆脱对算力垄断的依赖,让高效推理能力的获取变得更加民主化。
讨论与可借鉴点
CADENCE 的成功揭示了在线策略蒸馏中几个被长期忽视的结构性问题。首先,逐 token 的目标设计比序列级梯度估计更能捕捉推理过程中不同决策节点的差异化需求——这个教训对其他需要细粒度控制的序列生成任务同样适用。其次,覆盖状态监测(COVA 的核心思想)提供了一种自适应调整学习压力的思路,避免了固定调度在学生能力动态变化时的失效。此外,密集奖励(CCD)对部分正确轨迹的利用,在 reward shaping 领域有广泛的借鉴价值,尤其当环境给出的是稀疏二元信号时。
论文的局限也同样值得注意。CADENCE 的六个组件需要精心调参,各组件之间的交互效应增加了系统复杂度。实验目前仅覆盖数学推理任务,在代码生成、自然语言推理等更广泛场景的泛化能力还有待验证。另外,BSD 自蒸馏阶段的有效性可能与训练数据量相关——当可用的采样轨迹足够多时,自蒸馏的边际收益可能会递减。
从更宏观的角度看,这篇论文的方法论提示了一个重要方向:知识蒸馏的效果瓶颈往往不在于模型容量本身,而在于训练信号的结构设计。CADENCE 通过精细化处理训练信号的时间性、空间性和密度问题,展示了即使是小模型也能从大模型中提取出高质量推理能力的可能性。这对于推动端侧智能的发展,尤其是让资源受限设备获得接近云端模型的推理性能,具有实质性的启发意义。
摘要
在线策略知识蒸馏将推理能力从大型教师模型迁移到紧凑的学生模型,但现有方法存在三种相互叠加的失效模式:(i)冷启动崩溃,即全新学生模型对教师偏好的词元赋予趋近于零的概率;(ii)状态无关的发散调度,即仅按时间安排的前向/反向 KL 插值忽视了学生的覆盖状态;(iii)二元奖励稀疏,即对/错信号丢弃了部分正确轨迹中的信息。
我们提出 CADENCE,一个针对上述每种问题给出对应修复的统一框架。其核心 DRIFT 机制在学生采样的轨迹上调度逐词元的前向 KL 与反向 KL 代理目标的凸混合(采用的是逐词元代理,而非序列级 KL 梯度估计器)。此外还有六个组件对其进行扩展:(A) COVA,覆盖自适应的 β 调度,加速从前向 KL 向反向 KL 的过渡;(B) FTB,分叉词元增强,通过全局归一化的熵参考将梯度集中于高熵位置;(C) CCD,密集奖励,对错误但接近的轨迹附加数值接近度的部分得分;(D) LAP,偏好简洁正确采样的强化机制;(E) EMR,熵匹配校准正则化器;(F) BSD,自举式自蒸馏阶段。
在 GSM8K 与 MATH-500 上(修正的 512 词元协议,5 个种子,报告标准差),CADENCE 将 0.5B 学生模型从 1.5B 教师模型蒸馏至 69.8 ± 0.5% 的 GSM8K pass@1(预训练基线为 48.7%,已弥合教师差距的 63.2%);使用 3B 教师时达到 72.1 ± 0.4%(已弥合 76.2%),相较最强的匹配算力、依赖标签的基线(DRIFT + 二元奖励)提升 +4.4 ± 0.7 分。所有实验均在单台 Apple Mac Studio(M 系列芯片,64GB 统一内存)上完成,表明有原则的蒸馏方法无需数据中心级硬件即可获得强大的推理质量。
Abstract
On-policy knowledge distillation transfers reasoning from large teachers to compact students, but existing approaches suffer three compounding failure modes: (i) cold-start collapse, where a fresh student assigns near-zero mass to teacher-preferred tokens; (ii) state-agnostic divergence scheduling, where time-only forward/reverse-KL interpolation ignores the student's coverage state; and (iii) binary reward sparsity, where pass/fail signals discard information from partially correct traces. We present CADENCE, a unified framework with a targeted fix for each. Its DRIFT mechanism schedules a per-token convex mixture of forward-KL and reverse-KL surrogate objectives on student-sampled trajectories (per-token surrogates, not sequence-level KL gradient estimators). Six components extend it: (A) COVA, a coverage-adaptive schedule accelerating the forward-to-reverse transition; (B) FTB, a forking-token boost concentrating gradient at high-entropy positions via a globally-normalized entropy reference; (C) CCD, a dense reward adding numerical-proximity partial credit for incorrect-but-close traces; (D) LAP, brevity-preferential correct-rollout reinforcement; (E) EMR, an entropy-matching calibration regularizer; (F) BSD, a bootstrapped self-distillation phase. On GSM8K and MATH-500 (corrected 512-token protocol, 5 seeds, reported std), CADENCE distills a 0.5B student from a 1.5B teacher to 69.8 0.5% GSM8K pass@1 (from 48.7% pretrained; 63.2% of the teacher gap closed) and to 72.1 0.4% with a 3B teacher (76.2% closed), beating the strongest matched-compute label-using baseline (DRIFT+binary reward) by +4.4 0.7 points. All experiments run on a single Apple Mac Studio (M-series, 64GB unified memory), showing principled distillation reaches strong reasoning quality without datacenter-scale hardware.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。