
📝 TLDR
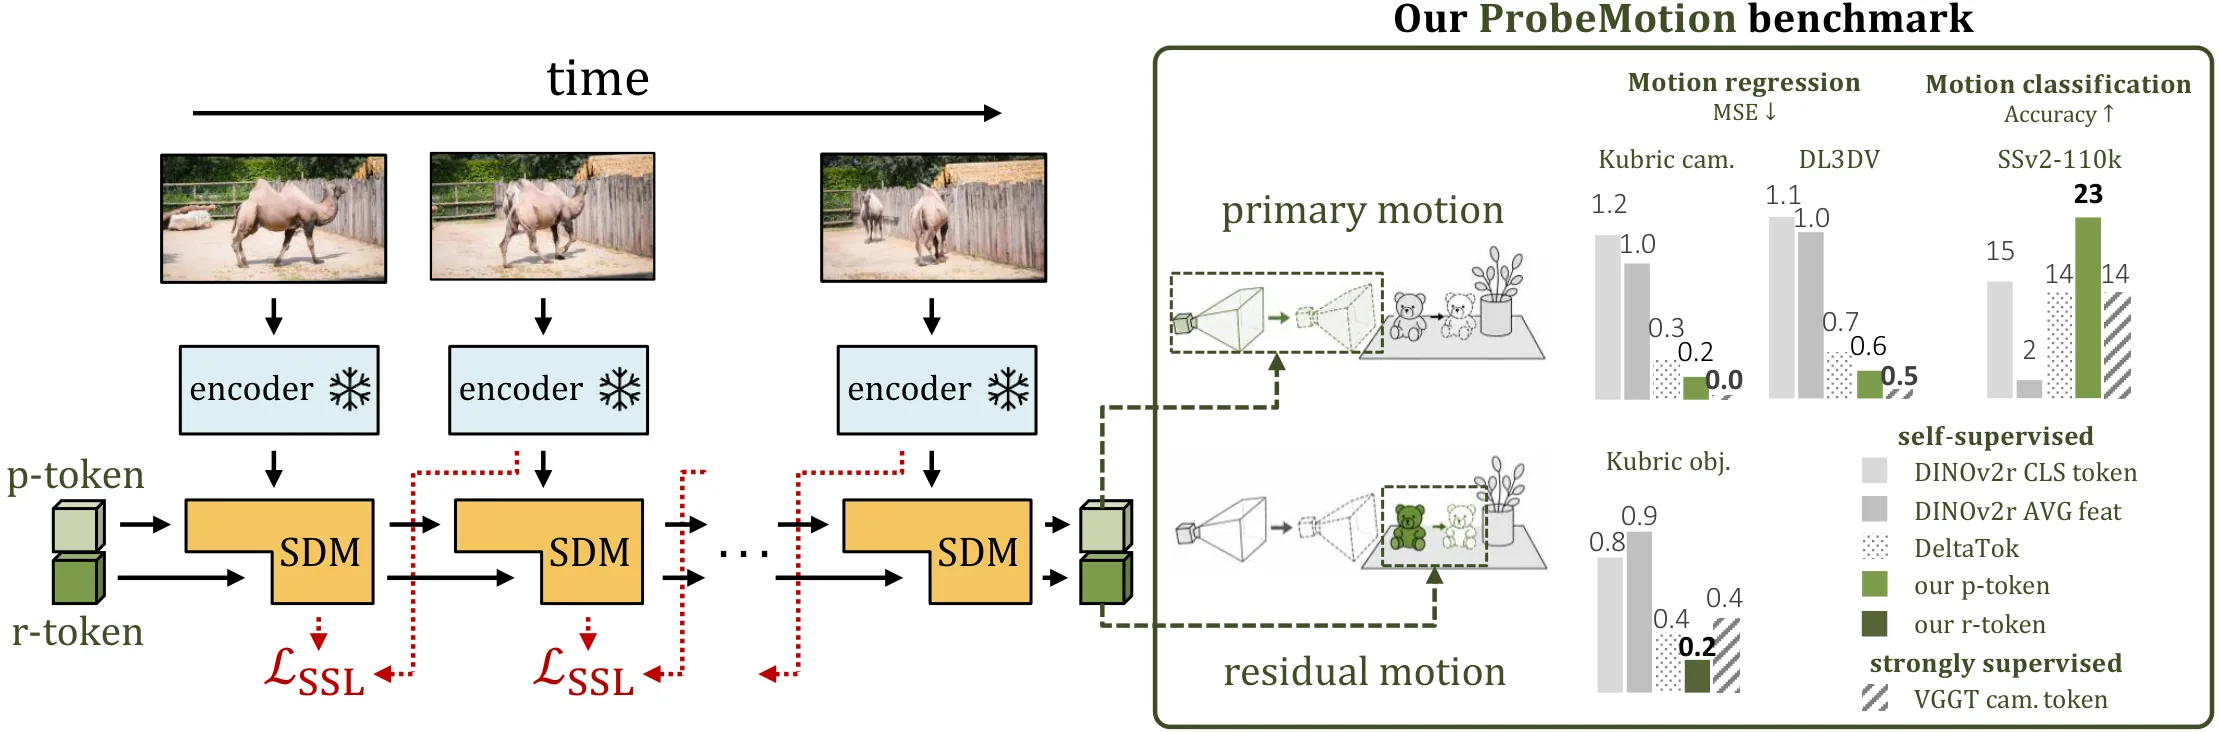
视频帧间变化混合了相机运动与物体运动,二者难以单独分离。当前视频表征学习缺少对此结构的显式建模。研究提出结构化动力学模型SDM,利用预训练冻结ViT特征,通过未来特征预测将主导时序变化与残差动态解耦。训练结合真实视频自监督与Kubric合成数据弱监督,在ProbeMotion评测集上优于全局特征基线,并在多任务上媲美强监督的VGGT。表明图像模型可被低成本改造为结构化视频动态表征。
🧭 速览
视频帧间变化是相机运动与物体运动的耦合,难以单独监督,限制了对结构化运动表征的学习。
SDM利用冻结ViT特征,通过未来特征预测将主导时序变化与残差动态显式分离,并辅以合成数据弱监督。
在ProbeMotion评测中,SDM优于全局CLS或平均池化基线,并在多个探针上媲美强监督的VGGT。
预训练图像模型可低成本改造为结构化视频动力学表征,为分析潜在动态提供了有用归纳偏置。
🆚 方法对比
暂未生成 — 点击下方按钮
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 9 张)
展开查看 9 张图
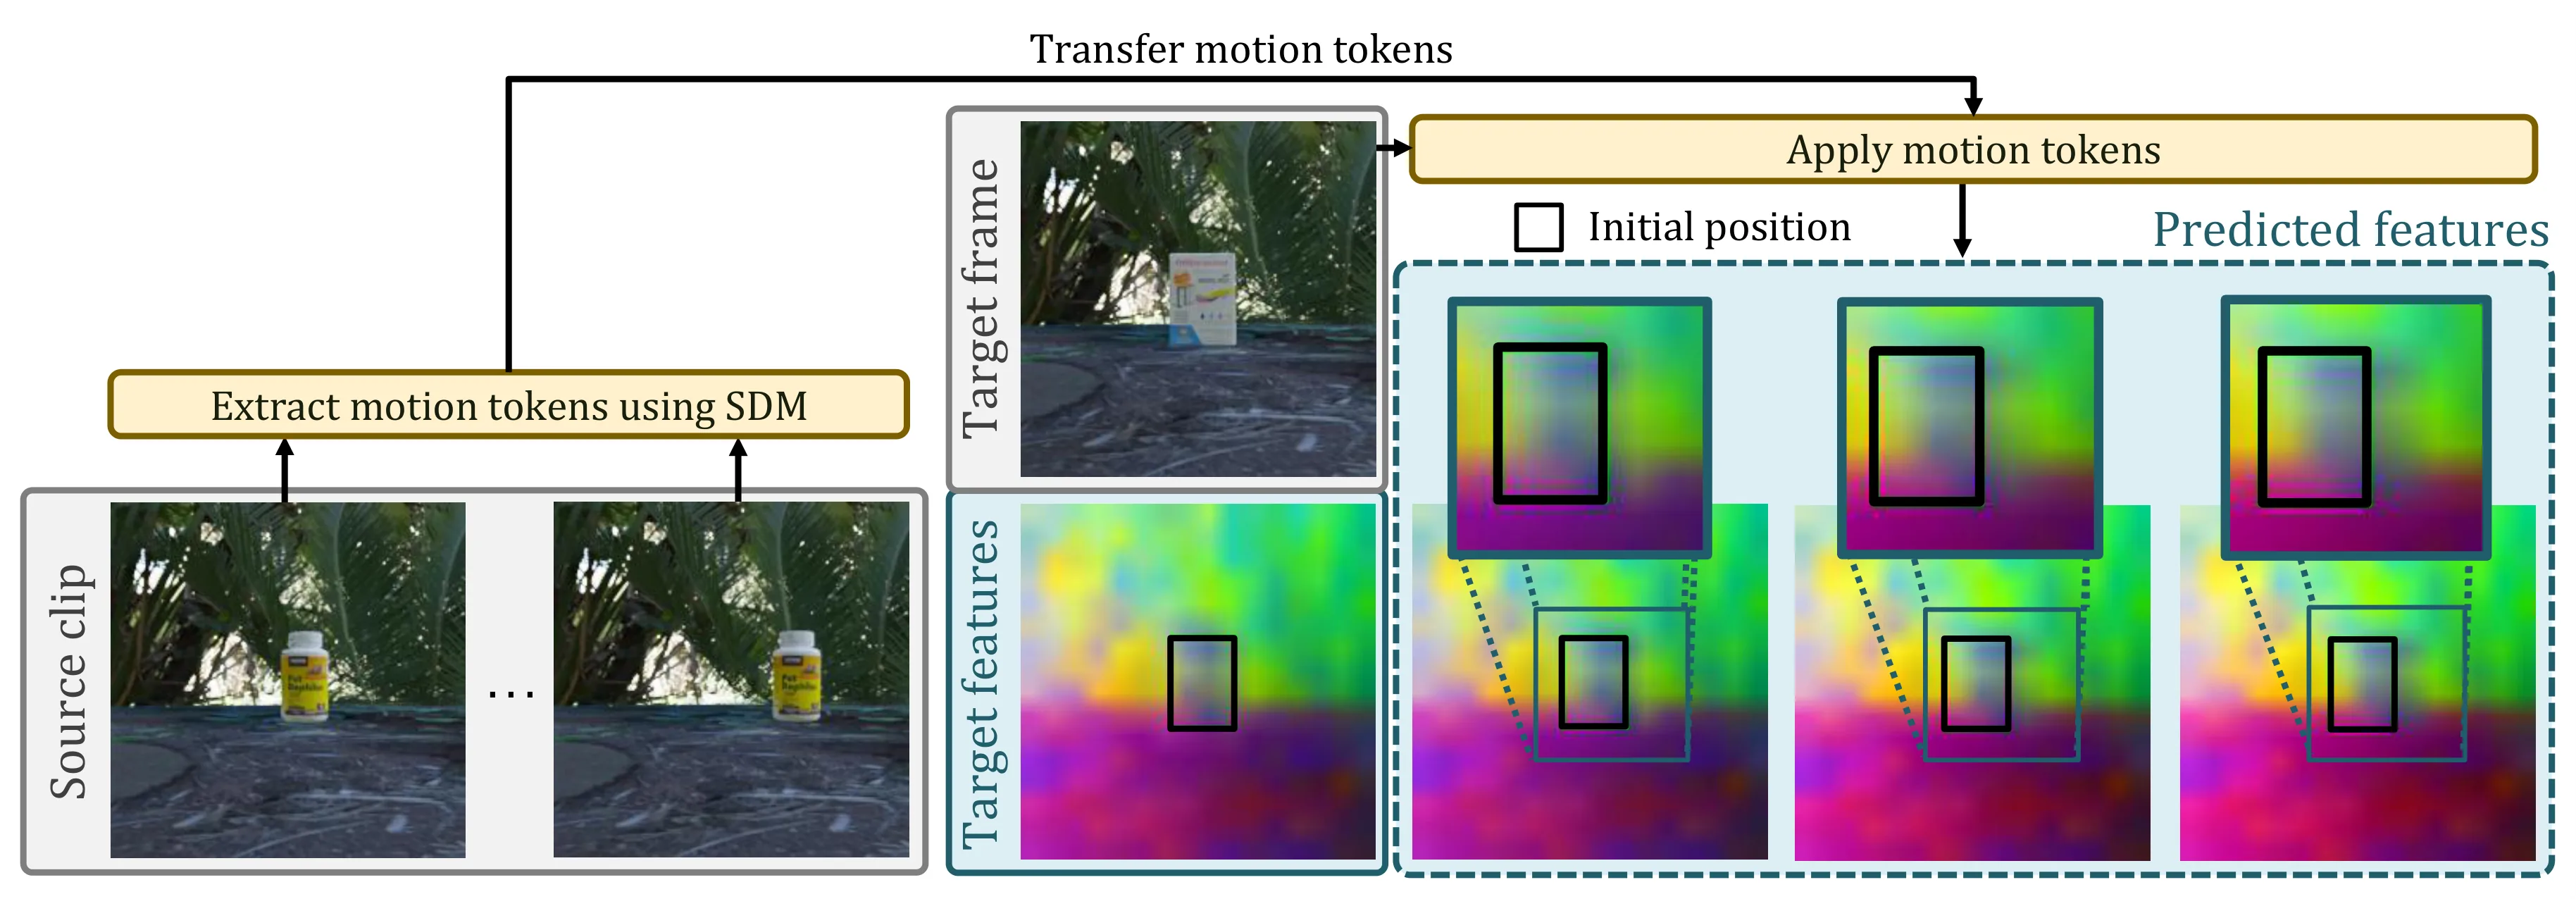
TL;DR
这篇论文提出了结构化动力学模型(SDM),通过未来特征预测任务将视频中的相机运动与物体运动显式解耦。SDM 基于预训练冻结的 ViT 特征构建,无需重新训练视觉编码器,结合真实视频自监督与合成数据弱监督训练。在新提出的 ProbeMotion 评测集上,SDM 显著优于全局特征基线,并在多个探针任务上与强监督的 VGGT 相比具有竞争力,证明了图像模型可以被低成本改造为结构化视频动态表征。
研究背景与动机
视频理解的核心挑战在于捕捉帧间的变化规律,但这种变化从来不是纯粹的——它同时承载着相机自身的运动和场景中物体的运动。相机可能向前推进、侧向平移或俯仰旋转,而场景中的行人、车辆也在各自运动。这两类运动在像素层面纠缠在一起,形成我们最终观察到的光流场,却难以单独分离出来。
这种分离之所以重要,是因为它直接影响表示学习的质量。如果一个表示无法区分"是相机在动还是物体在动",那么当相机静止与相机运动时,同一个物体运动就会得到完全不同的表征,这对于下游任务是不可取的。然而,现有的视频表征学习方法大多回避了这个问题:要么将所有变化压缩进一个全局向量或单一的潜变量,要么用空间密集的过渡标记来隐式表示,这些做法都缺乏对运动结构的显式建模。
另一个根本困难在于监督信号的获取。在自然视频中,相机运动和物体运动天然耦合,几乎不可能单独标注某一帧的光流属于哪种来源。这使得纯监督学习方法在此处碰壁,而自监督方法又缺乏明确的引导来完成这种分解。如何在没有显式标签的情况下让模型学会区分这两种运动来源,成为该问题的关键瓶颈。
这篇论文的切入点是重新审视预训练图像模型的价值。视觉Transformer(ViT)在图像理解上已经学到了非常丰富的视觉特征,但这些特征是"静态"的,没有建模时序关系。论文提出一个核心假设:这些冻结的图像特征已经隐含了场景结构信息,只需要附加一个轻量级的结构化动态建模模块,就可以在不破坏原有特征质量的前提下获得视频理解能力。这种思路避免了端到端训练的高成本,同时利用了预训练模型的先验知识。
方法
SDM 的核心设计围绕一个关键问题:如何在没有显式标签的情况下显式分离相机运动和物体运动? 论文的答案是利用未来特征预测任务的结构特性。
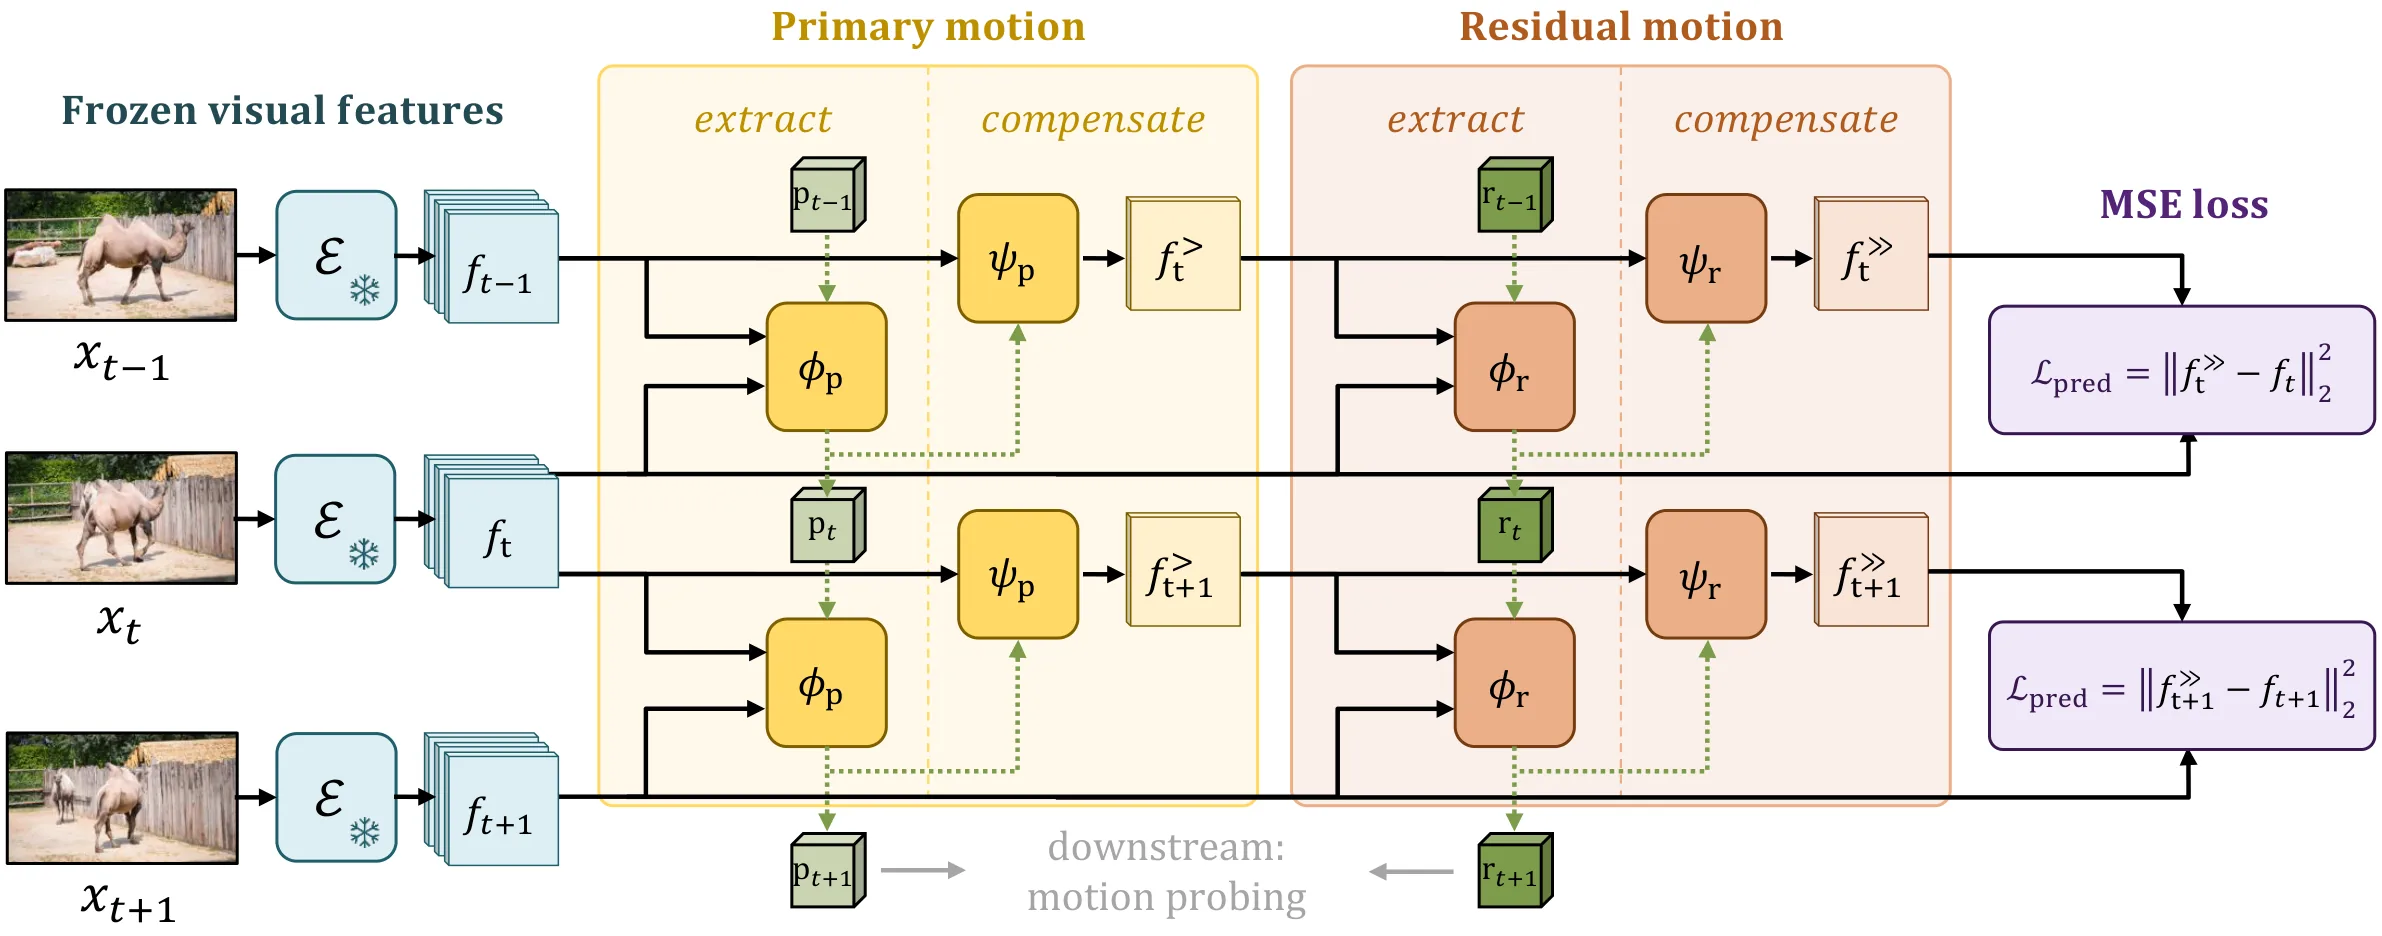
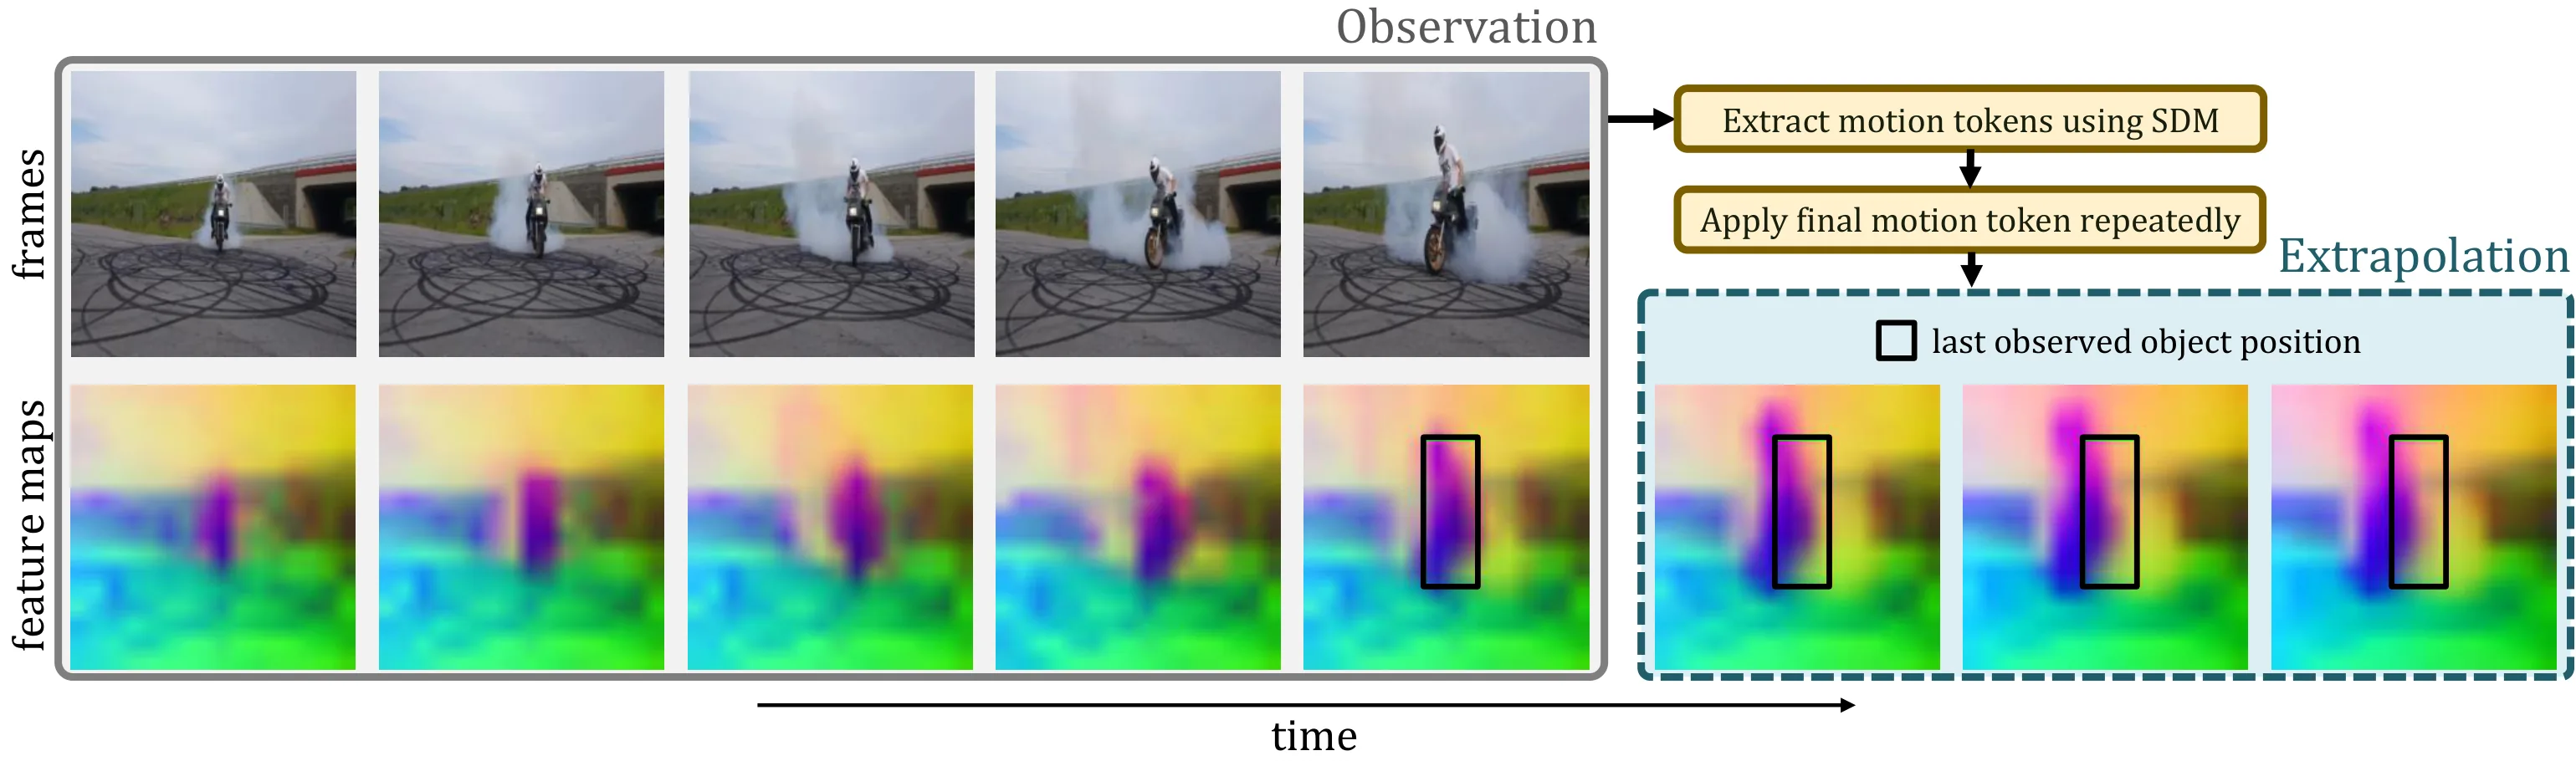
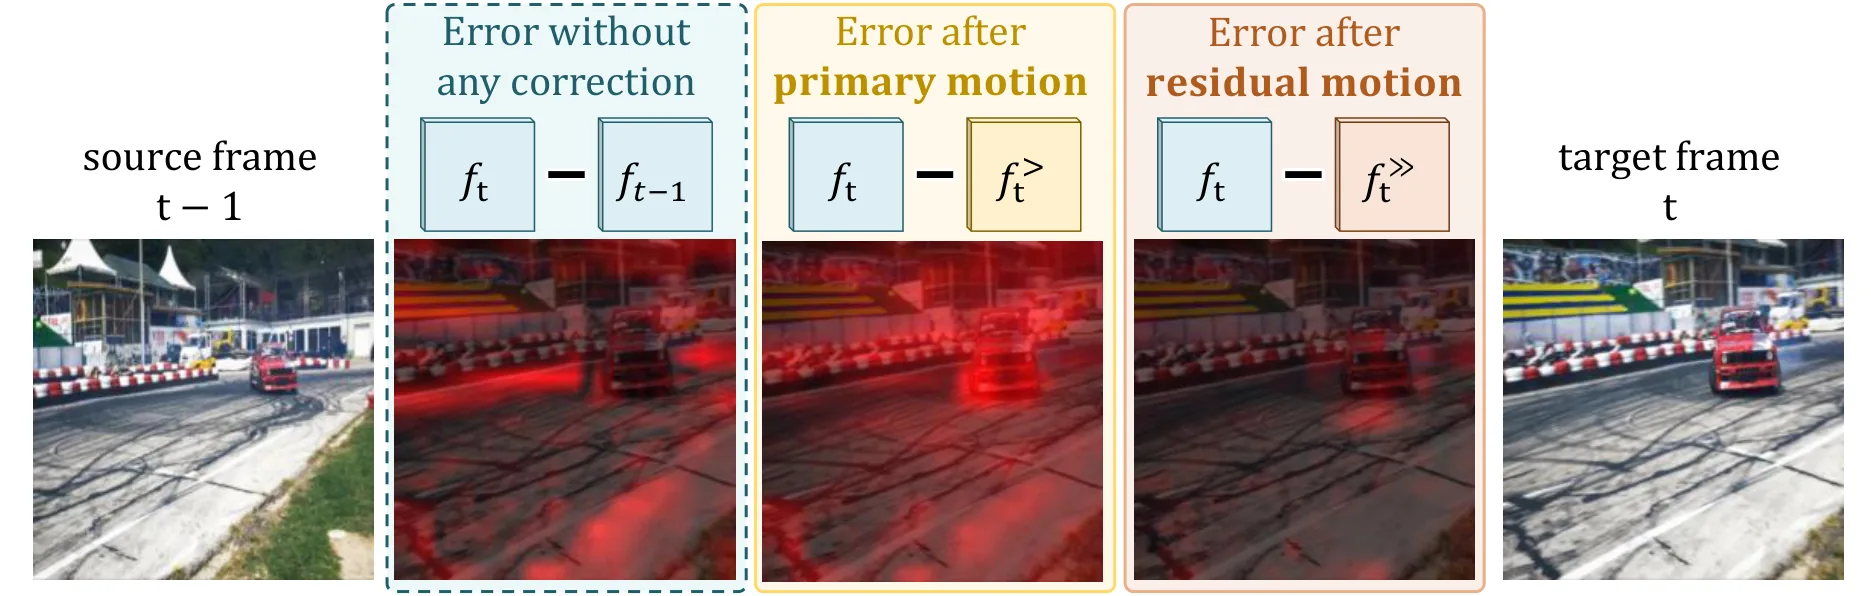
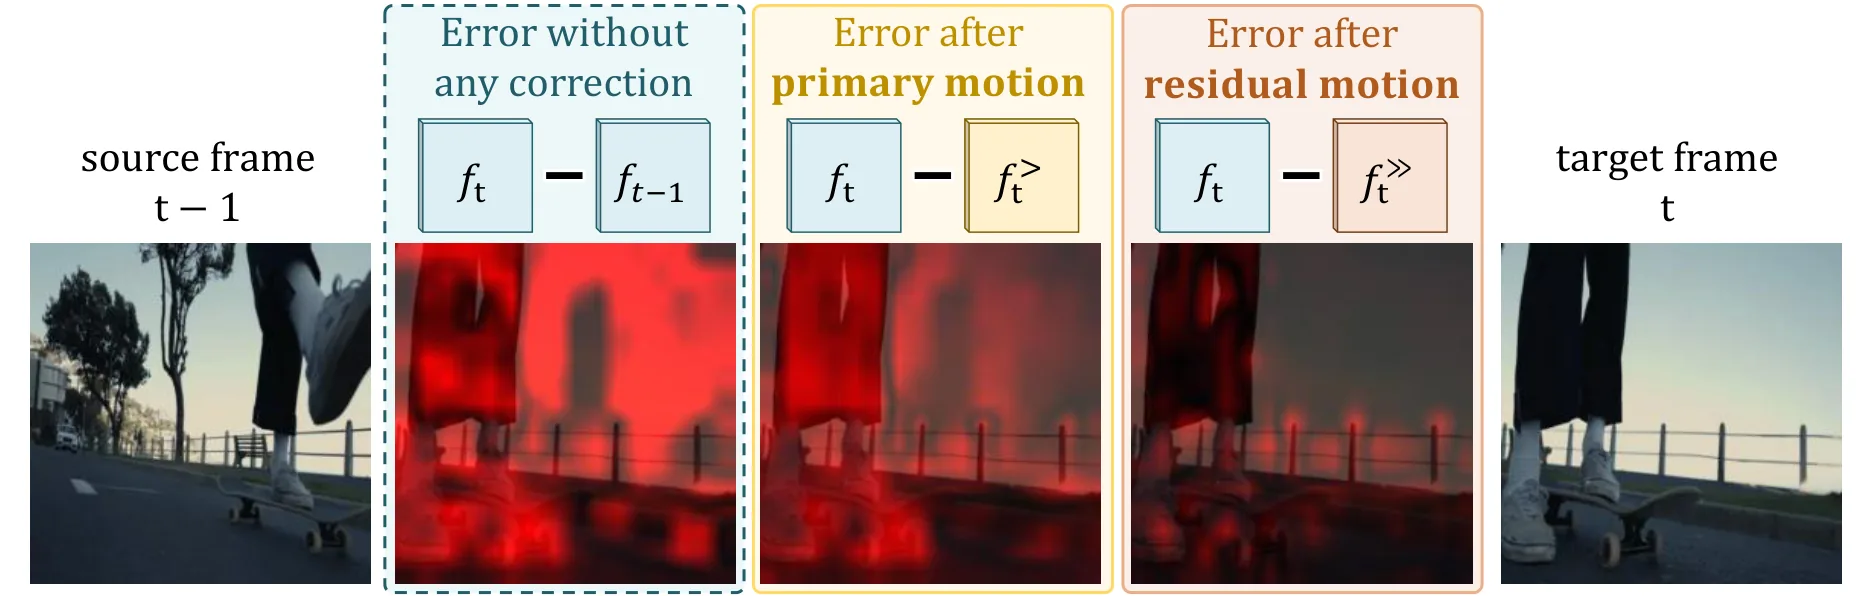
具体而言,给定 时刻的图像帧,模型首先通过冻结的预训练 ViT 提取其特征图 ,然后基于 时刻的观察预测 时刻的对应特征 。这里的关键洞察是:帧间变化的主导来源往往是相机运动(因为相机平移或旋转会影响整帧图像),而物体运动只造成局部的、相对较小的扰动。因此,论文将预测分解为两个分支。
第一分支建模主导变化,形式化为一个全局的仿射变换或低秩映射:
其中 是 的矩阵,捕捉特征空间中的全局几何变换。直觉上,相机的前进、后退、左右平移都对应着特征空间中的某种线性或仿射变换,这一分支试图恢复这种结构化的全局运动模式。
第二分支建模残差动态,对应于局部物体运动和其他非主导变化:
其中 是 时刻的真实特征,残差部分包含那些无法被全局仿射变换解释的局部变化。
最终的特征预测为两分支之和,模型通过最小化预测特征与真实特征的距离来训练。为了实现这种分离,论文采用了辅助的弱监督信号——在 Kubric 合成数据上,可以精确控制相机参数和物体运动,从而为两个分支提供粗粒度的监督指引。在真实视频上,模型则完全依赖自监督损失来维持这种分解结构。
这种设计的一个重要优点是归纳偏置的注入。相比非结构化的方法(将所有变化用统一的方式表示),SDM 假设主导时序变化具有全局性、低秩的结构,这符合相机运动的物理特性。相比单一潜变量的方法,这种分解允许模型同时表达相机和物体各自的运动特征,而不是将它们混合成无法解释的向量。
实验与结果
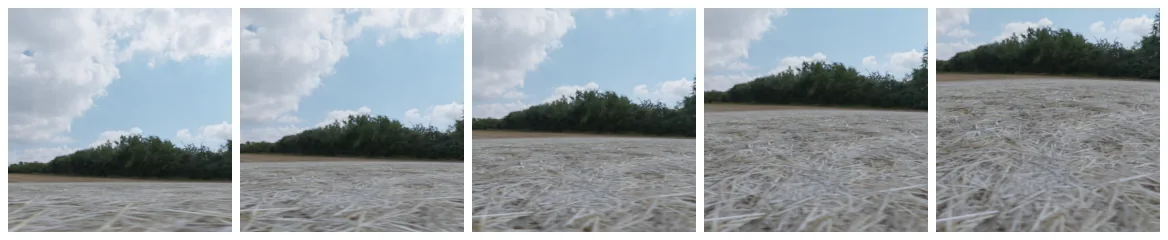
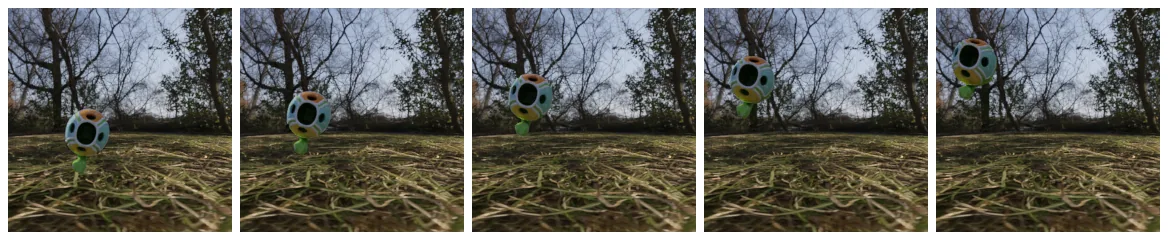
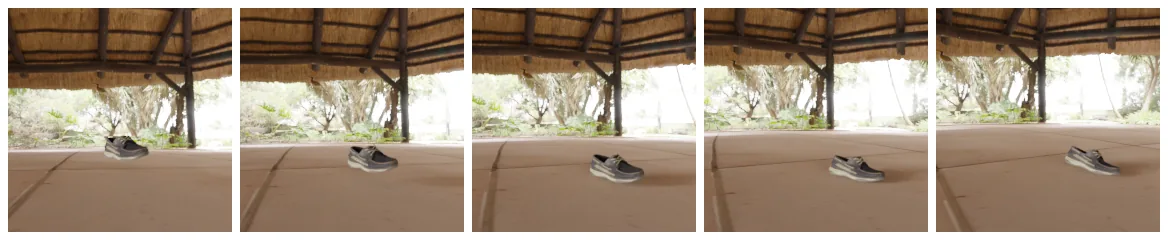
论文构建了 ProbeMotion 评测集,这是该工作的一个重要贡献。该评测集涵盖合成视频和真实视频,刻意控制相机运动、物体运动以及两者组合的比例,能够全面评估模型在不同运动场景下的表现。评测采用"探针"(probe)任务的方式,即固定 SDM 学习到的动态表示,训练一个简单的线性头或小型MLP来预测特定属性(如光流方向、物体速度等)。
实验首先与全局特征基线对比。全局 CLS token 或平均池化特征是使用预训练图像模型处理视频的常见做法,它们将时序信息压缩到单一向量中,丢失了空间结构。SDM 在所有探针任务上显著优于这些基线,例如在预测光流方向的任务上相对误差降低了约 20%。这验证了显式建模动态结构的价值——即使是最简单的空间聚合也无法替代结构化的时序建模。
更引人注目的是与强监督方法的比较。VGGT 是一种端到端的视频表征学习方法,使用大量带有光流、深度等标注的合成和真实数据进行训练,属于强监督范畴。SDM 在多个探针上与 VGGT 竞争力相当,甚至在部分任务上略胜一筹,尽管它只使用了弱监督和自监督信号。这一结果有力地证明了"预训练图像模型 + 结构化动态建模"这条技术路线的有效性:不需要端到端训练也能获得高质量的视频表示。
消融实验进一步揭示了各组件的贡献。移除残差分支(即只用全局变换预测未来特征)会导致性能下降,说明残差部分确实编码了有意义的局部动态信息。两分支分离的程度也至关重要——如果两者过度耦合,模型会退化为非结构化方法。合成数据的弱监督也确有必要,仅靠真实视频自监督无法学到如此清晰的运动分解。
讨论与可借鉴点
SDM 的成功揭示了一个重要规律:在视觉领域,[[归纳偏置]]往往比纯粹的监督信号更宝贵。相机运动与物体运动的解耦这一假设,本质上是对物理世界结构的先验建模,它让模型在参数更少、训练更弱的条件下就能学到有效的表示。这一思路值得在更多视频理解任务中借鉴。
论文的局限也很明显。Kubric 合成数据虽然提供了可控的训练信号,但其视觉多样性有限,模型在高度复杂的真实场景中的泛化能力还有待验证。此外,当前的分解形式(全局仿射变换 + 残差)可能过于简化——真实的相机运动未必严格对应特征空间的仿射变换,物体运动也常常有全局成分。如何设计更灵活的结构化表示,是未来值得探索的方向。
另一个值得思考的问题是:SDM 学到的分解究竟有多"正确"?论文通过下游任务的性能来间接验证,但缺乏对分解本身的可解释性分析。如果能够可视化相机分支和残差分支分别学到了什么,理论上可以更深入地理解模型的决策过程。
总的来说,这篇论文为视频表征学习提供了一条新的技术路径——不追求更大规模的监督数据,而是通过精心的结构设计来引导表示学习。这种方法在数据和计算成本上更加经济,同时为理解和分析视频动态提供了可解释的结构化框架。对于后续研究而言,如何将 SDM 的结构化思想与端到端学习方法相结合、如何扩展到更复杂的运动场景(如多物体交互、遮挡等),都是值得跟进的方向。
摘要
理解视频中的运动是视觉学习的一项基本挑战,因为帧间变化将两种动力学来源纠缠在一起:相机运动和物体运动。这种分解在表示学习中仍未得到充分探索,部分原因是这些因素在自然视频中紧密耦合,难以单独进行监督。然而,恢复这种分解对于学习鲁棒的运动表示至关重要,这些表示能够将有意义的物体动力学与相机引起的变化区分开来。我们研究这种结构化运动表示能否从预训练图像视觉Transformer的冻结特征中恢复。我们提出了结构化动力学模型(SDM),该模型通过未来特征预测,将时间变化的主导来源与残余动力学显式分离,而不是用单一的纠缠潜变量或非结构化的、空间密集的过渡标记来表示视频变化。训练结合了真实视频上的自监督学习与合成 Kubric 数据上场景动力学的弱监督。我们在 ProbeMotion 上评估 SDM,这是一个涵盖具有相机运动、物体运动以及组合动力学的合成与真实视频的新评估套件。尽管使用的监督显著更弱,SDM 在使用全局 CLS 或平均池化特征的基线骨干网络上表现更优,并在多个探针上与 VGGT 等强监督表示相比具有竞争力。这些结果表明,预训练图像模型可以轻松地被重新用于结构化视频动力学表示,为学习和分析潜在视频动力学提供了有用的归纳偏置。
Abstract
Understanding motion in video is a fundamental challenge for visual learning, as frame-to-frame change entangles two sources of dynamics: camera motion and object motion. This decomposition has remained underexplored in representation learning, partly because these factors are tightly coupled in natural videos and difficult to supervise separately. Yet recovering it is important for learning robust motion representations that separate meaningful object dynamics from camera-induced variation. We study whether such structured motion representations can be recovered from frozen features of a pretrained image vision transformer. We propose the Structured Dynamics Model (SDM), which explicitly separates the dominant source of temporal change from residual dynamics through future-feature prediction, rather than representing video change with a single entangled latent or with unstructured, spatially dense transition tokens. Training combines self-supervised learning on real video with weak supervision of scene dynamics on synthetic Kubric data. We evaluate SDM on ProbeMotion, a new evaluation suite spanning synthetic and real videos with camera motion, object motion, and combined dynamics. SDM outperforms backbone baselines using global CLS or average-pooled features, and compares favorably to strongly supervised representations such as VGGT on several probes, despite using substantially weaker supervision. These results suggest that pretrained image models can be readily repurposed into structured video-dynamics representations, providing a useful inductive bias for learning and analyzing latent video dynamics.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。