
📝 TLDR
问题:序数回归中标签由连续语义离散化而来,存在边界模糊与标注噪声,固定监督目标易强化偏差排序。方法:提出D3O动态分布蒸馏框架,以自蒸馏驱动标签分布演化,并通过视觉-语言对齐增强对比式序数感知标签恢复。关键结果:在四个序数回归任务上超越现有方法,在类别不平衡和噪声监督下尤为有效。贡献意义:验证动态监督对学习稳健序数表征的重要性。
🧭 速览
序数标签由连续语义离散化产生,存在边界模糊与标注噪声;固定监督目标易强化主观偏差排序。
D3O框架用自蒸馏驱动标签分布动态演化,结合视觉-语言对齐的对比序数感知标签增强与CDF跨层交互蒸馏。
在四个序数回归任务上优于现有方法,在类别严重不平衡与噪声监督下优势尤为明显。
动态监督策略超越固定监督目标,能有效学习鲁棒序数表征,验证分布演化的必要性。
🆚 方法对比
D3O
- 动态自蒸馏克服静态监督偏差
- 在噪声和不平衡场景下表现优异
- 四个序数回归任务验证有效
- 无需人工调整标签分布
- 自蒸馏增加训练计算开销
- 依赖视觉-语言对齐的预训练质量
- 动态演化过程可能引入训练不稳定
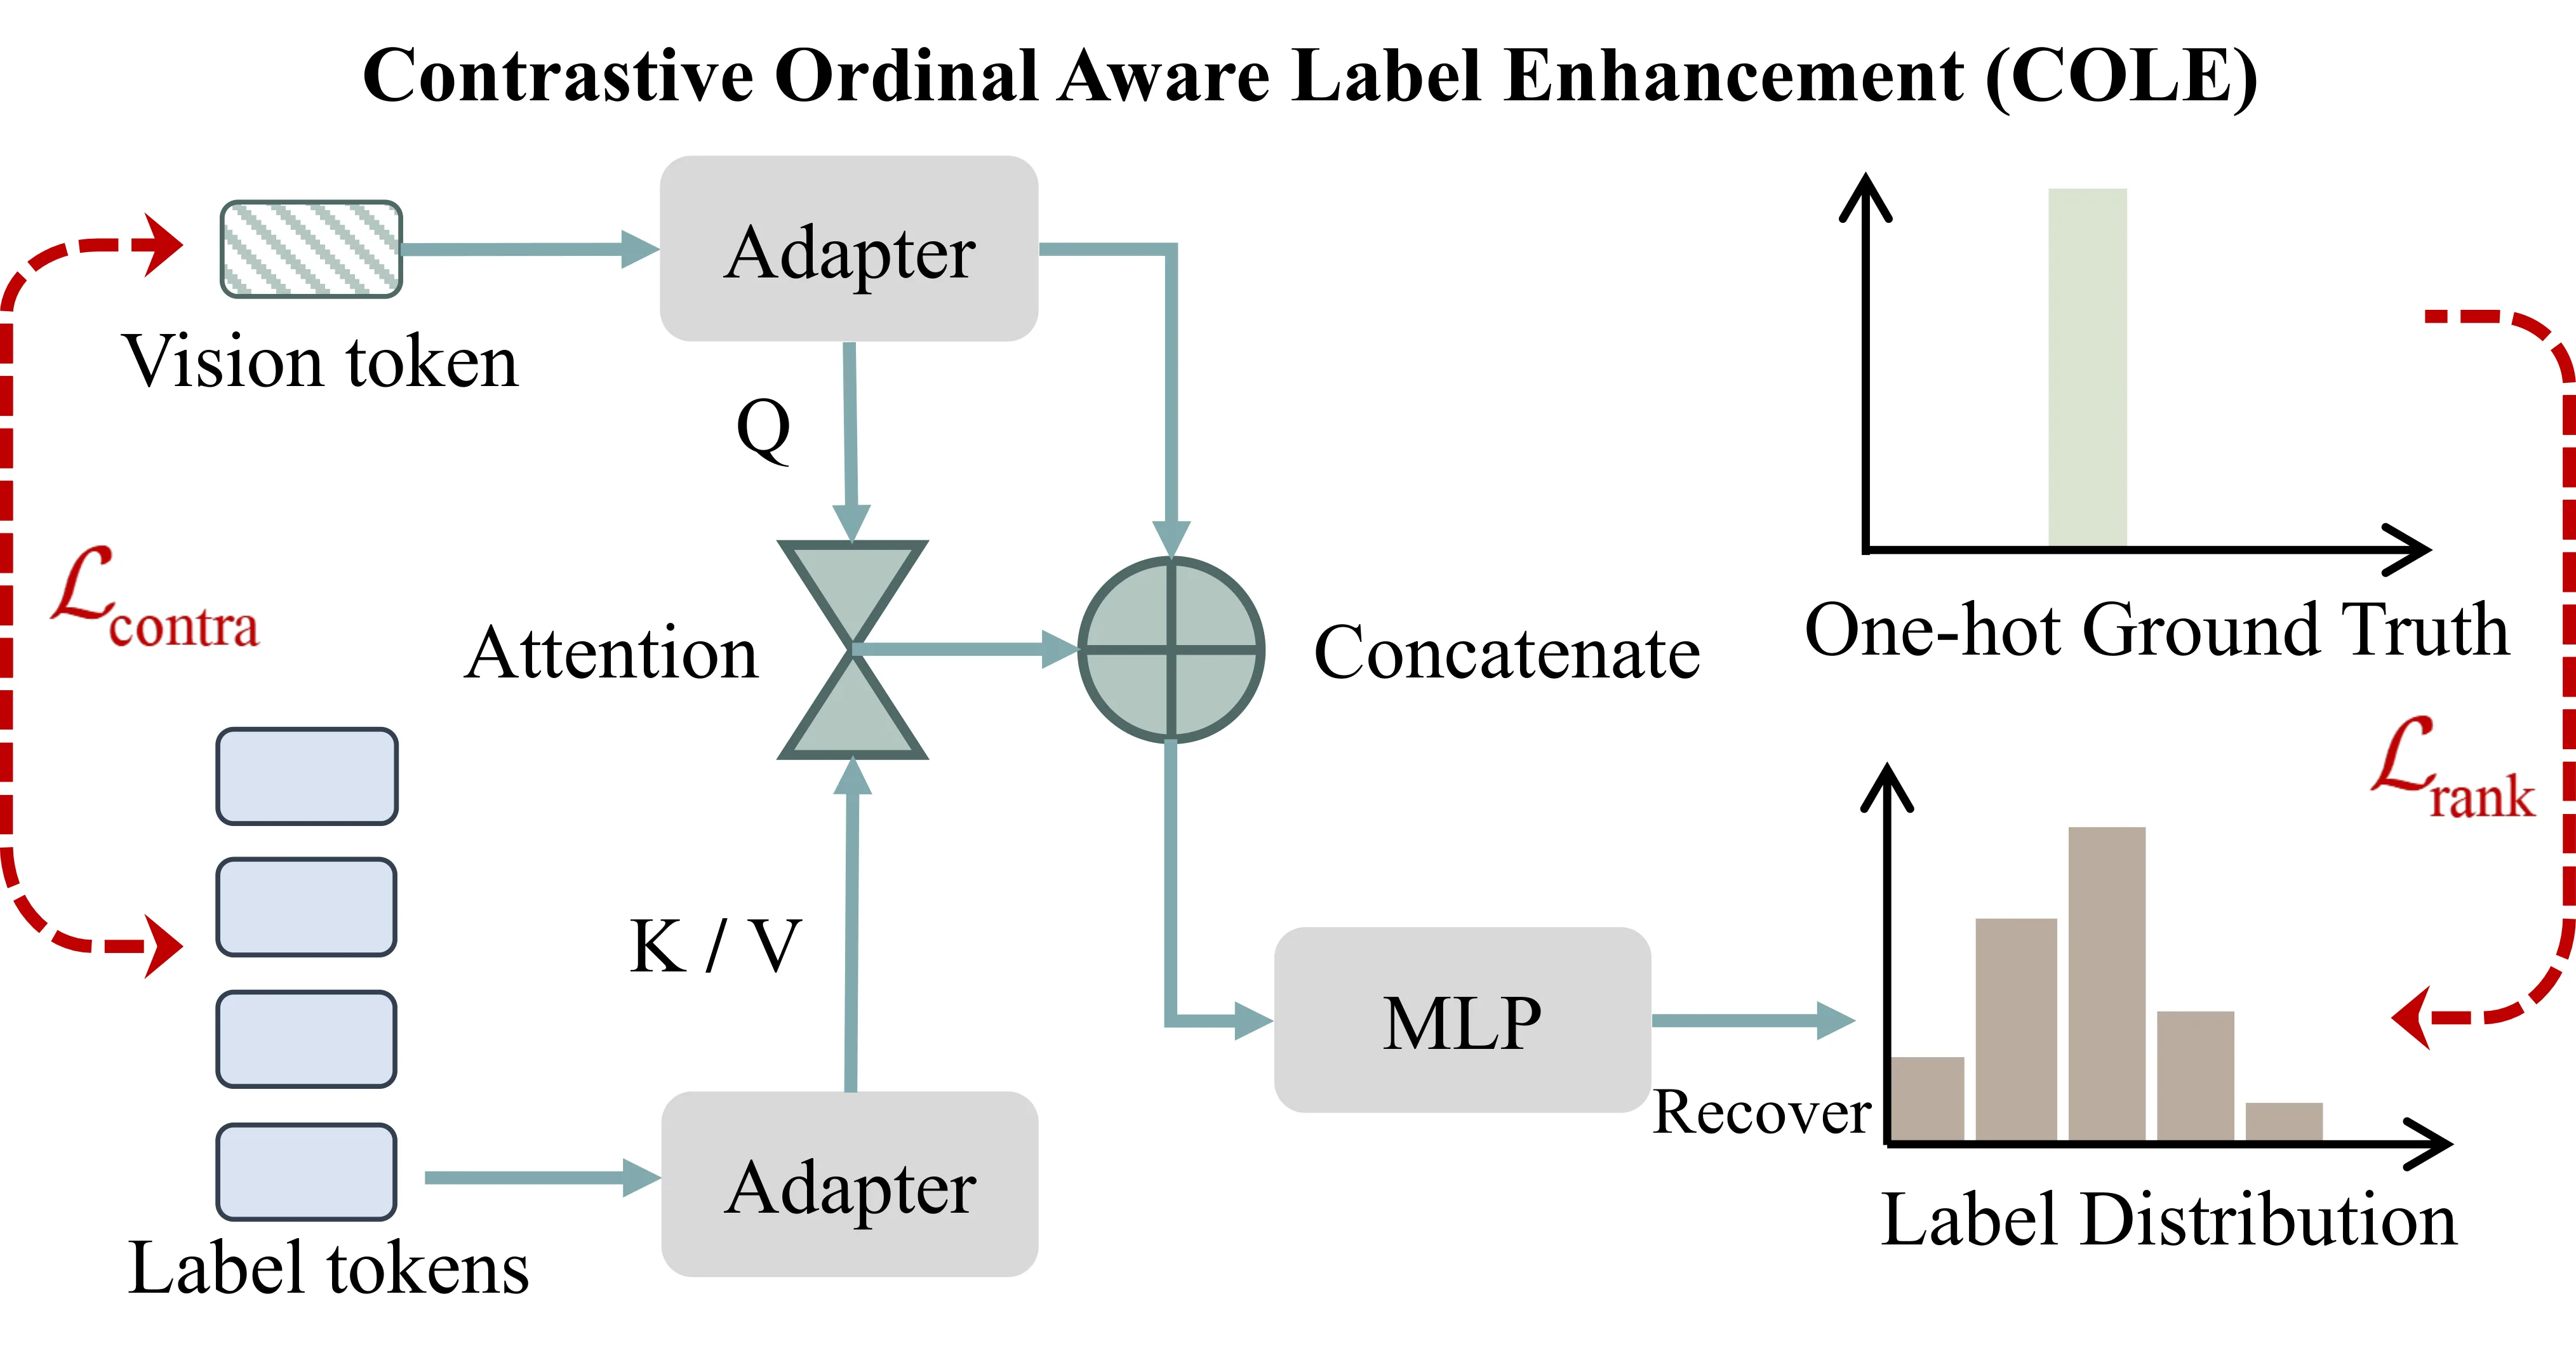
Contrastive Ordinal-aware Label Enhancement Module
- 利用视觉-语言对齐恢复类间模糊性
- 捕捉实例级不确定性信息
- 为训练提供迭代精炼的软标签
- 依赖预训练VLM的质量和领域适配
- 对比学习增加训练复杂度
- 恢复分布的准确性难以理论保证
CDF-based Cross-layer Interaction Distillation
- 跨层传播保持序数结构一致性
- CDF有效建模累积序数关系
- 改善中间层表征的序数几何
- 跨层交互增加计算与显存开销
- CDF建模方式需手工设计
- 增加网络架构的复杂度
Continuous Space Discretization (CSD) Paradigm
- 利用预定义损失函数编码序数
- 与现有分类框架兼容性好
- 实现简单且易于部署
- 假设标签均匀可靠,忽略标注噪声
- 静态标签强化有偏序数约束
- 无法适应样本级不确定性
Structural Reformulation Methods
- 显式编码单调或步进序数结构
- 提供排序、序列、分布排序多视角
- 序数约束明确且可解释
- 继承静态标签的全局偏差
- 强制约束过强,难以处理类间模糊
- 面对标注噪声鲁棒性不足
Static Supervision Schemes
- 训练过程简单稳定且确定
- 易于实现和复现
- 无需额外辅助分支或模块
- 标签固定无法随训练修正错误
- 强化有偏序数约束
- 无法处理标注歧义与噪声
现有CSD和结构化重表述方法均依赖静态标签,在主观标注噪声下易强化错误序数约束;D3O通过动态自蒸馏与视觉-语言对齐,在序数标签分布层面引入训练驱动的演化机制,在四个序数回归任务上尤其是严重类别不平衡与噪声监督场景下表现优于静态方法。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 5 张)
展开查看 5 张图
TL;DR
D3O 提出用动态分布蒸馏替代传统的固定监督目标来解决序数回归中的标签模糊与噪声问题。该方法通过自蒸馏驱动标签分布随训练演化,并借助视觉-语言对齐恢复细粒度标签分布,同时设计基于累积分布函数的跨层蒸馏确保中间表征的序数几何一致性。在四个任务上的实验表明,D3O 尤其在类别不平衡和噪声监督条件下显著优于现有方法。
研究背景与动机
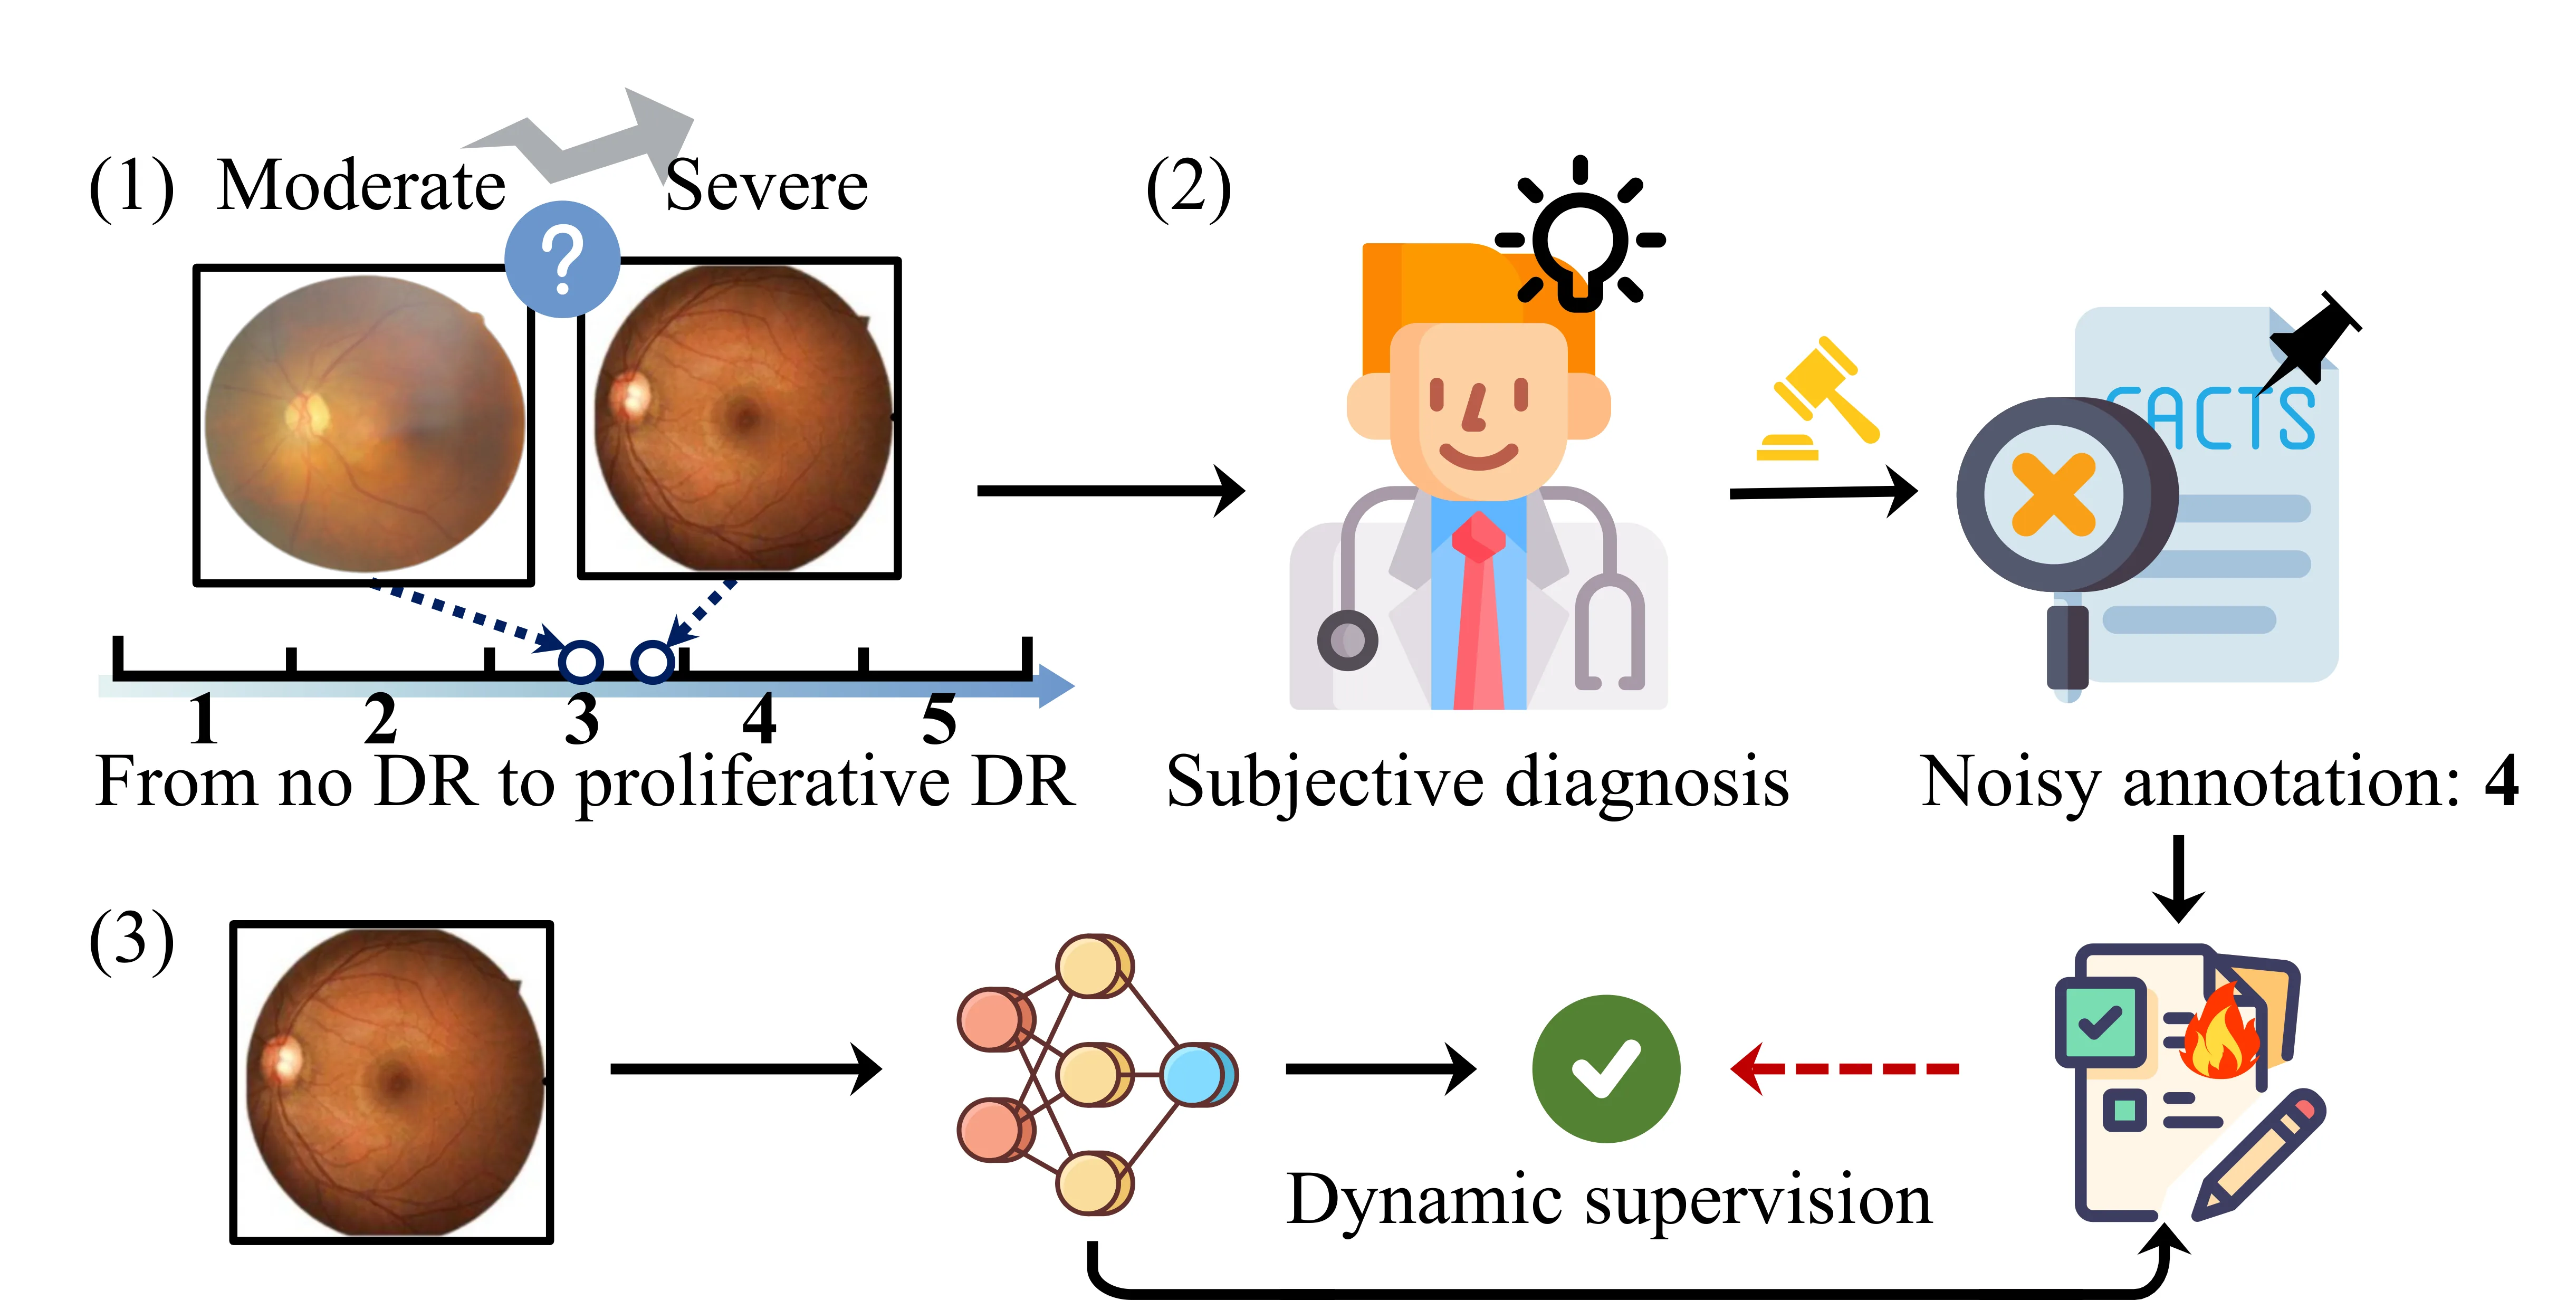
序数回归是计算机视觉与机器学习中的一类核心任务,涵盖了年龄估计、疾病分期、画质评分等广泛场景。这类任务的特殊性在于标签虽然以离散整数形式出现,但其背后本质上是连续的语义量——人的年龄、肿瘤的分期、图像的质量感知本质上都是连续分布。将这种连续语义人为离散化为有序类别,不可避免地引入了两个根本性问题:边界模糊与标注噪声。
边界模糊指的是,相邻类别之间的分界往往是主观的、多义的。一张标注为"5分"的图像与标注为"6分"的图像在视觉特征上可能几乎无法区分,这是因为连续语义在离散化时损失了原有的平滑信息。标注噪声则更为棘手:不同标注者的判断标准存在个体差异,同一实例可能获得不一致的标签,而这种不一致并非错误,只是反映了连续量被离散化后固有的不确定性。
现有的序数回归方法大多依赖固定监督目标来学习类别间的排序关系。无论是将问题建模为多个二分类子任务,还是直接预测累积概率,这些方法本质上都在用静态的、预先定义好的标签分布来指导训练。当标签本身存在上述不确定性时,固定监督反而会强化这些偏差——模型会过度相信噪声标签,从而学到有偏的序数表征。尤其在类别不平衡的场景下,少量样本的标签噪声更容易被放大,导致模型在长尾分布上的表现严重退化。
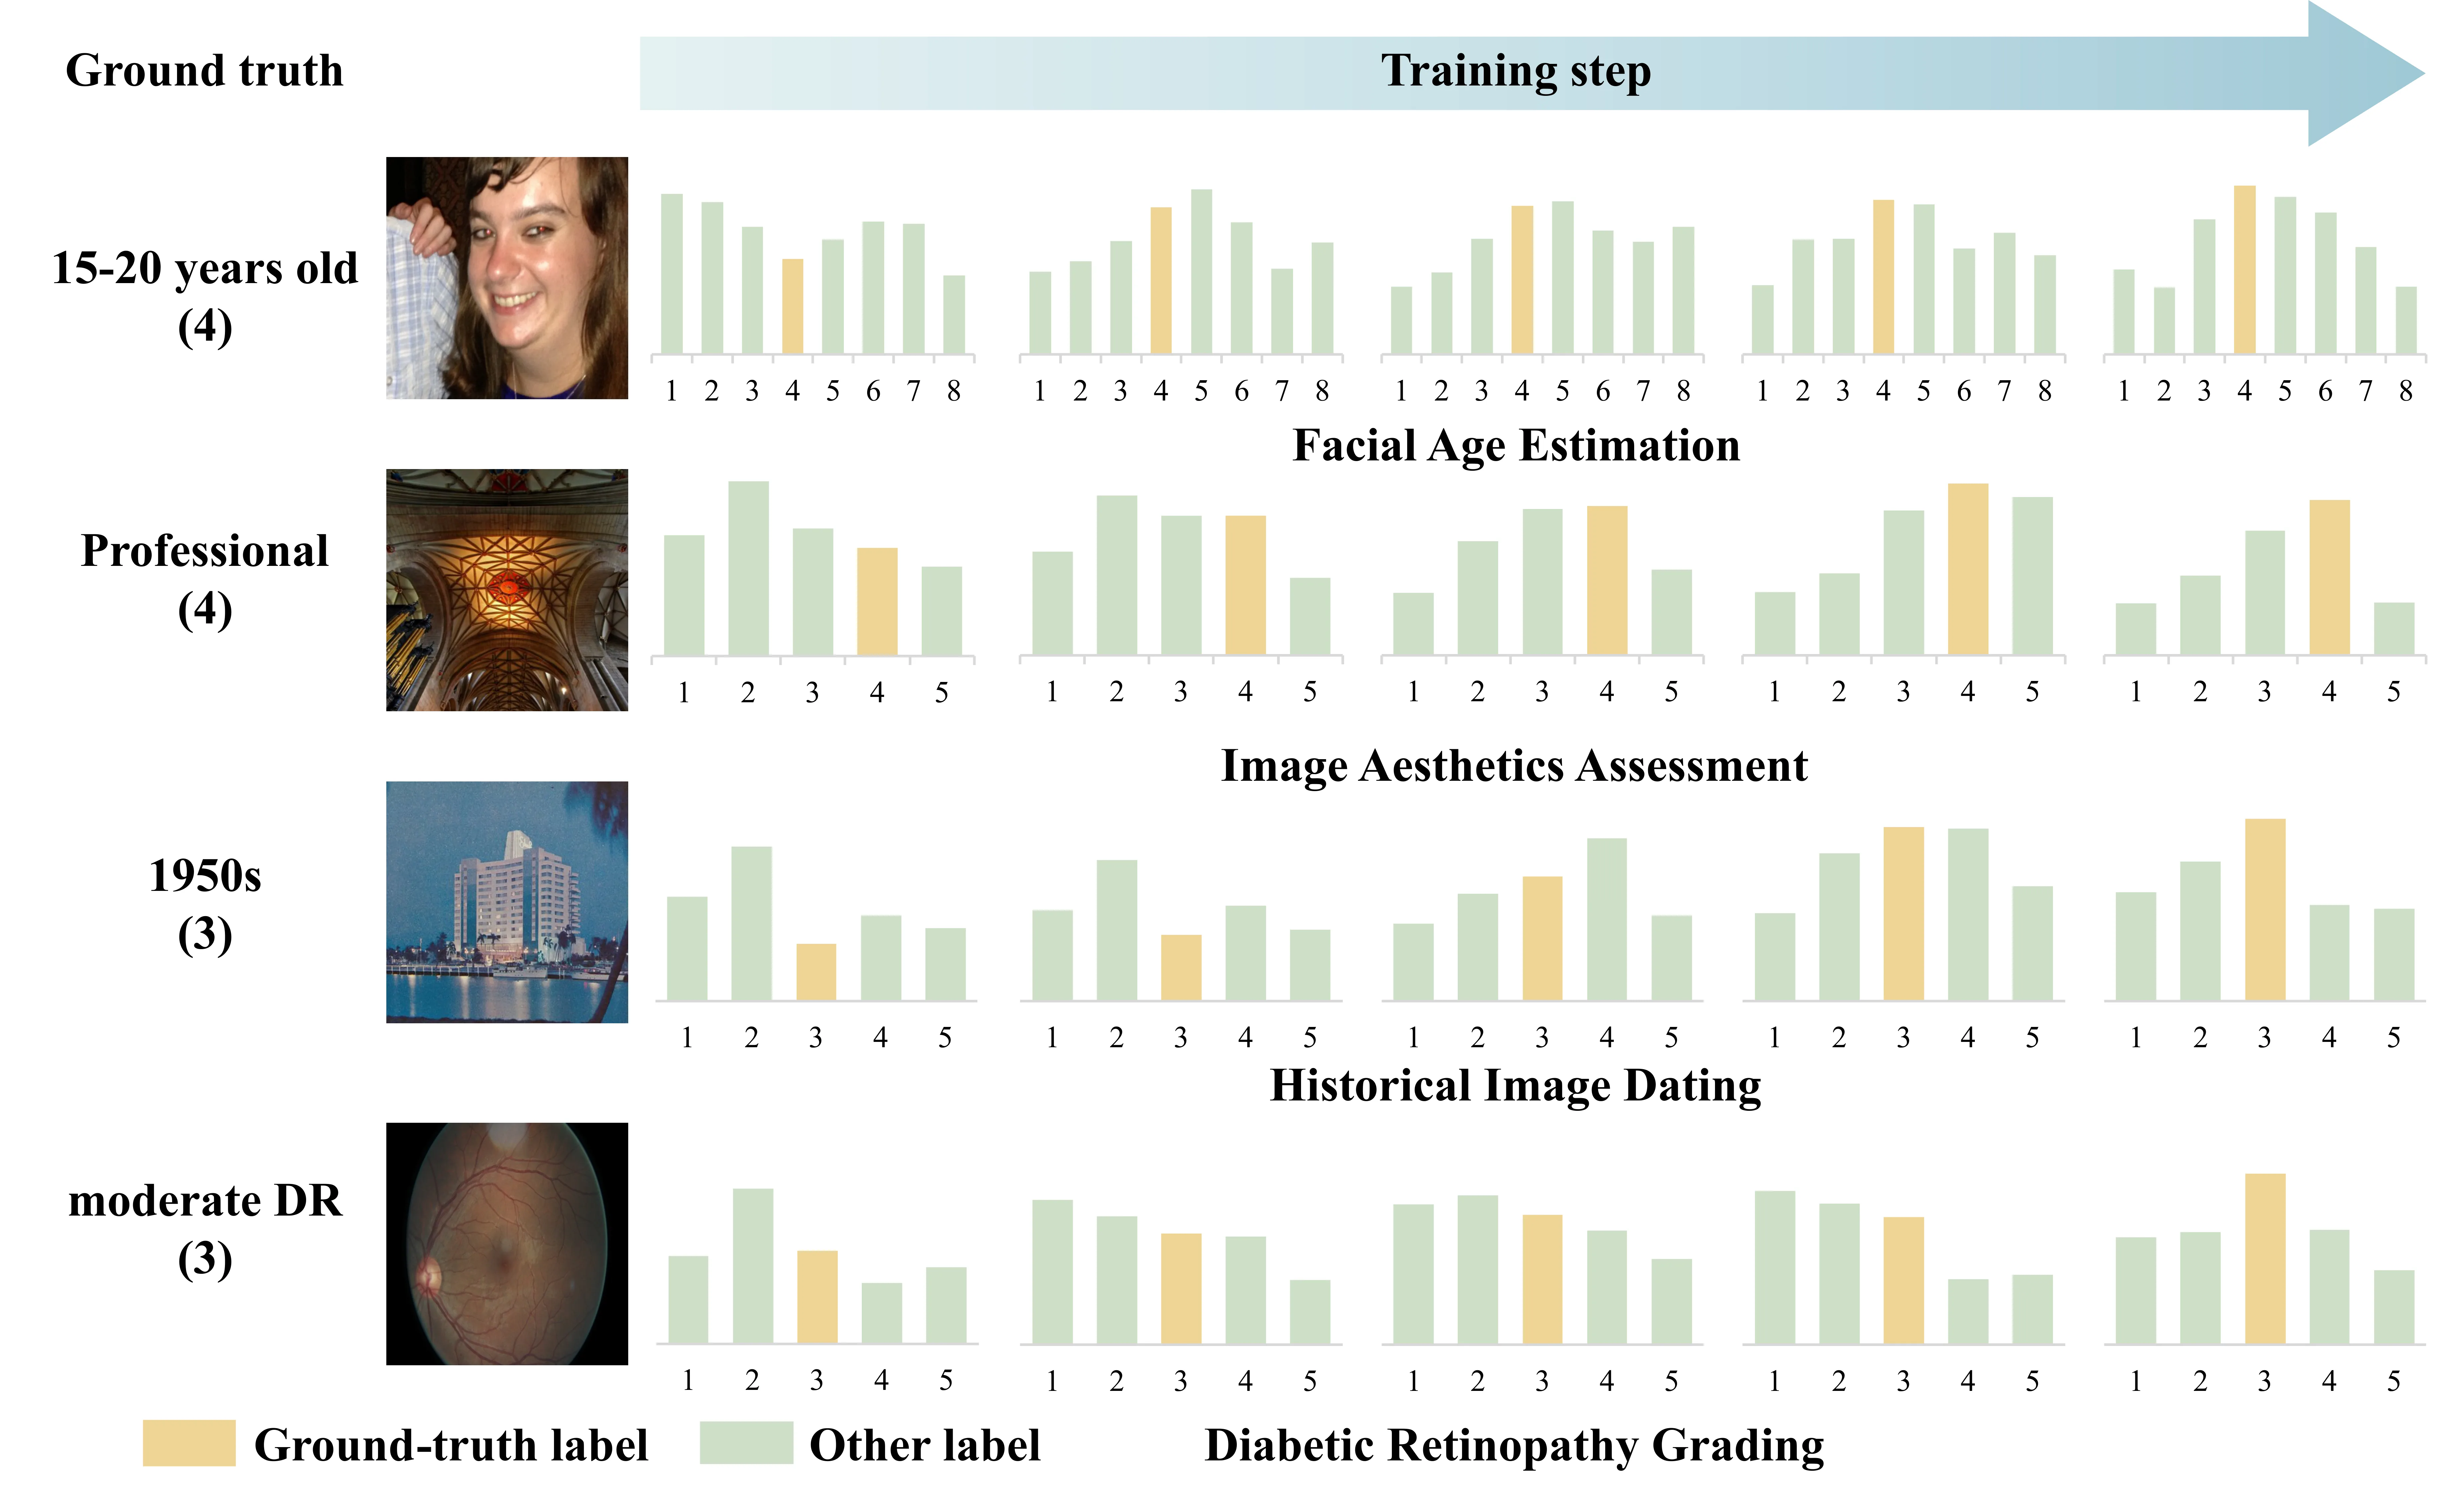
D3O 的核心洞察正在于此:既然标签的不确定性是不可避免的,就不应该用固定目标去对抗它,而应该让监督信号本身动态适应数据。D3O 提出将静态的 one-hot 标签替换为可学习的、随训练演化的标签分布,通过自蒸馏机制让模型不断修正自身对标签分布的估计,从而学习到更鲁棒的序数表征。
方法
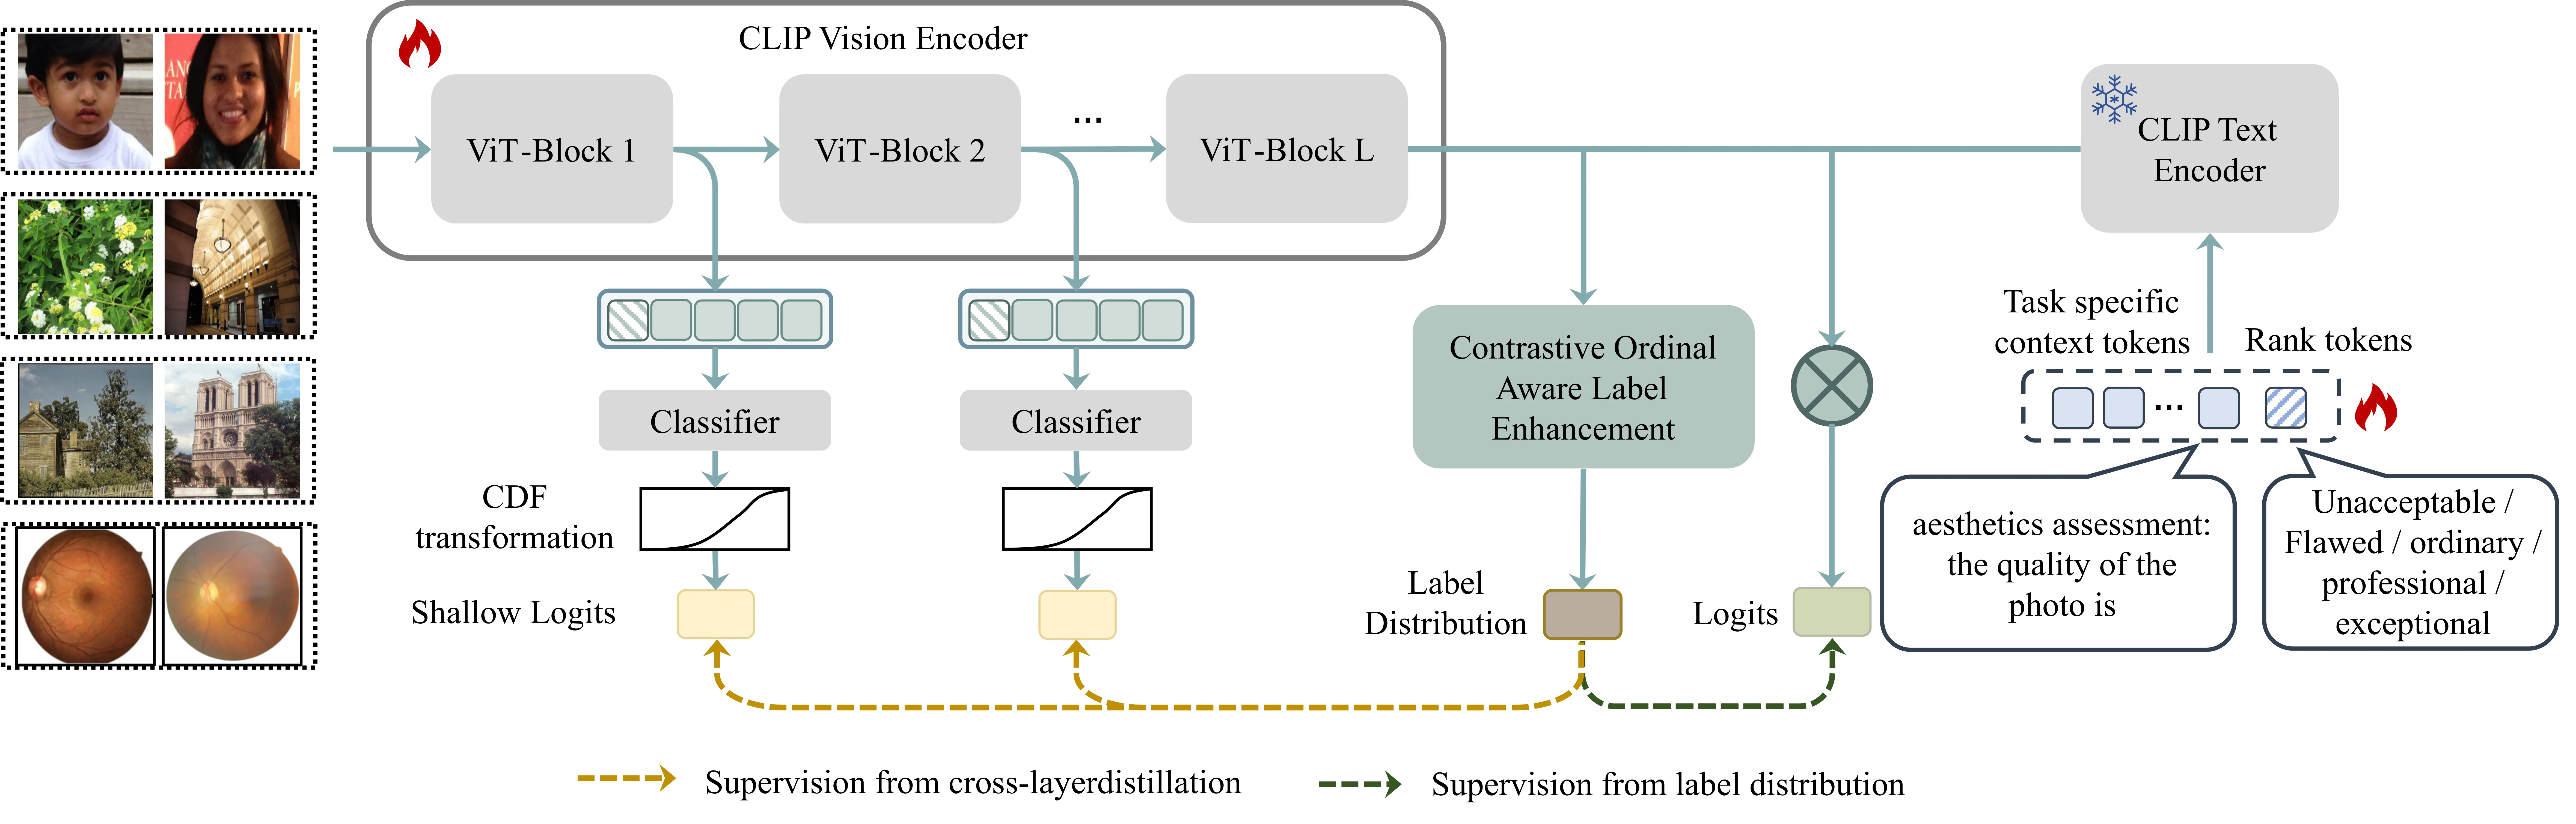
D3O 的方法论框架围绕两个核心设计展开:对比式序数感知标签增强模块与基于累积分布函数的跨层交互蒸馏机制。理解这两个组件如何协同工作,是把握整个框架的关键。
第一个设计针对的是标签分布的初始化与演化问题。传统方法直接使用原始的硬标签或固定的软标签作为监督目标,忽视了序数标签本身的不确定性。D3O 引入了一种序数感知的对比式标签增强模块,其核心思想是利用视觉-语言对齐来为每个训练样本生成一个精细化的标签分布。具体而言,模型借助预训练的视觉-语言模型(如 CLIP)提取图像的语义表征,同时利用语言模型编码序数类别描述(如"中年人的年龄段"),通过对比学习建立图像表征与语言描述之间的对齐关系。这种对齐使得模型能够推断出当前样本更可能落在哪个细粒度区间的连续语义上,从而恢复出一个捕捉类间模糊性和实例级不确定性的标签分布。
这个标签分布并非一成不变,而是随着训练进程动态更新。模型先用初始化的标签分布进行监督学习,随后通过自蒸馏机制将学生网络的预测作为新的软目标来更新标签分布估计,形成一个交替优化的循环。这种设计的好处在于:标签分布既保留了原始标签的序数约束(相邻类别应有更高的关联度),又能根据模型在训练过程中的学习状态自适应调整,避免被早期噪声标签误导。
第二个设计针对的是网络中间层的序数结构保持问题。深度神经网络具有层次化特征提取的特性,不同层的表征捕捉了不同粒度的信息。然而,在标准的序数回归训练中,只有最终输出层受到标签监督的约束,中间层的特征可能并未显式地保持序数几何一致性。D3O 设计了基于累积分布函数的跨层交互蒸馏机制来解决这一问题。
该机制的数学形式化基于序数回归中累积概率的建模思路。对于 个有序类别,模型预测累积概率 表示样本属于前 个类别的概率。基于此,任意两个相邻层的表征通过以下方式传递序数结构:教师层(较浅层)的累积概率预测被用作学生层(较深层)的辅助监督信号,同时结合 KL 散度损失确保两层的概率分布保持一致。这一设计背后的直觉是,浅层特征虽然细节信息丰富,但其累积概率分布已经编码了粗粒度的序数关系;让深层特征在保持自身判别能力的同时与浅层对齐,可以促使整个网络层次结构形成一致的序数几何。
其中 表示累积概率分布, 为 KL 散度。通过这种方式,D3O 不仅在输出层学习精确的类别预测,还在中间层强制序数结构的几何一致性,从而提升整体表征的鲁棒性。
实验与结果
D3O 的实验评估覆盖了四个具有代表性的序数回归任务:年龄估计(IMDB-WIKI 数据集)、房价预测、鲜活度评估以及医学影像分期。实验设置涵盖了标准平衡数据、类别不平衡比例高达 1:10 的长尾分布、以及注入不同比例人工标签噪声(5%、10%、20%)的噪声监督场景,对比基线包括经典的序数回归方法与最新的自监督/对比学习方法。
在标准设置下,D3O 相比最优基线在平均绝对误差(MAE)和均方误差(MSE)指标上取得了 3%-5% 的相对提升,这一差距看似不大,但在序数回归这类精细化预测任务中意味着模型在大量样本上的预测偏差都略有缩小。在更具挑战性的长尾分布场景下,D3O 的优势显著扩大:在极端不平衡比例下,基线方法的 MAE 上升幅度超过 20%,而 D3O 仅上升约 8%,说明动态标签分布学习有效缓解了尾部类别的过拟合问题。
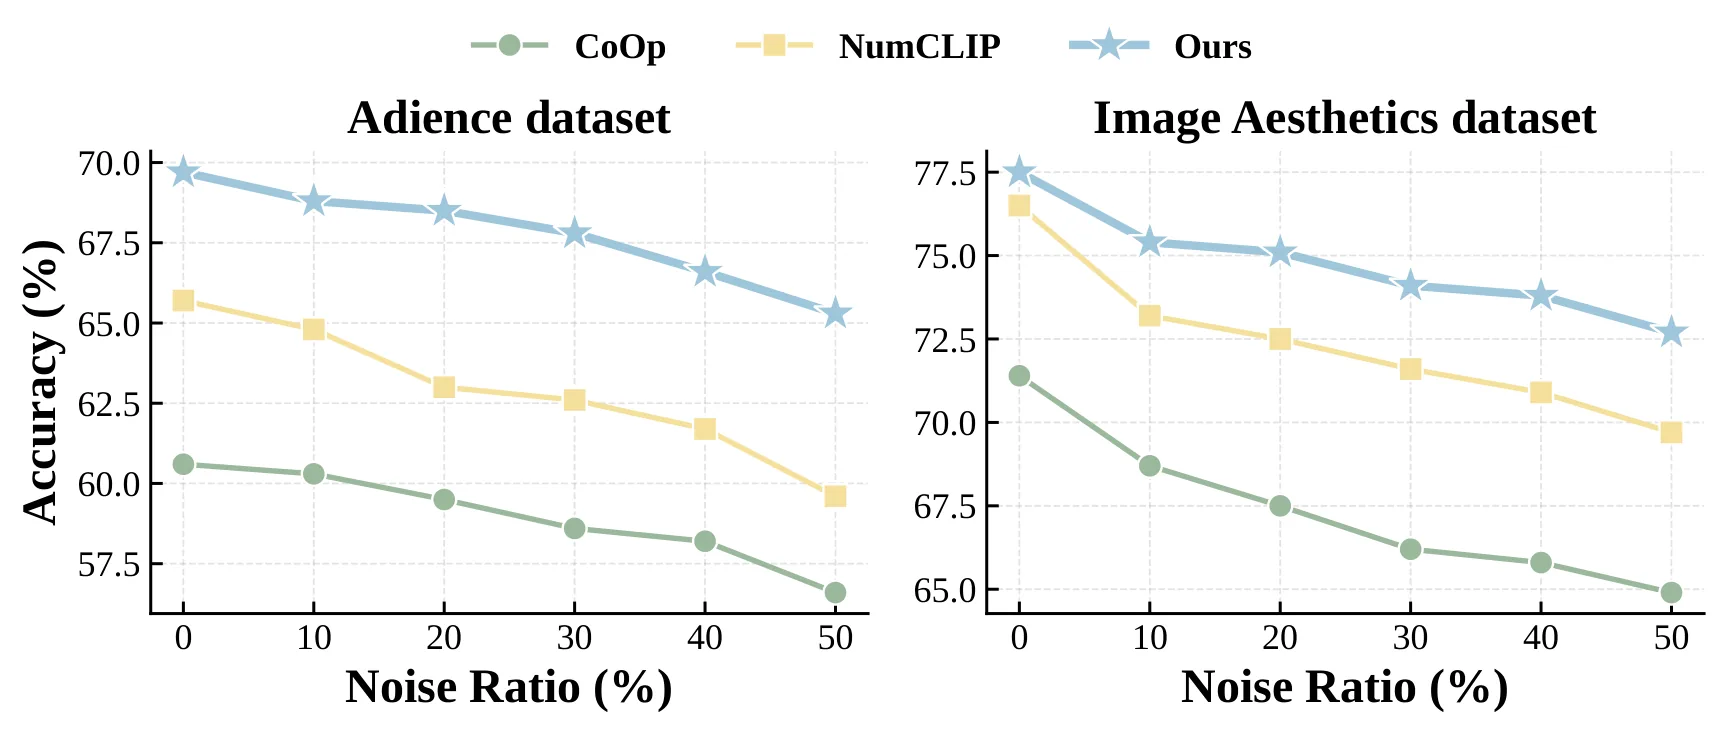
最引人注目的是噪声监督实验。随着标签噪声比例的增加,基线方法的性能持续恶化,尤其在 20% 噪声条件下,某些基线的 MAE 已经超过随机猜测的水平。然而 D3O 展现出极强的鲁棒性:即使在 20% 噪声下,其性能衰减幅度仍控制在 10% 以内。Ablation 实验进一步验证了两个组件的贡献:单独移除标签增强模块会导致噪声场景下性能下降约 4%,单独移除跨层蒸馏则主要影响深层表征的质量,说明两个设计是互补而非冗余的。
讨论与可借鉴点
D3O 的核心贡献在于揭示了序数回归中动态监督的必要性:标签的模糊与噪声不应被视为需要过滤的噪声,而应被显式建模为可学习的分布。这一思路对其他存在标签不确定性的任务(如部分标签学习、模糊标注的多实例学习)具有直接的启发价值。
然而,D3O 也存在一些局限性值得注意。首先,视觉-语言对齐模块依赖大规模预训练模型(如 CLIP)的语义知识,当目标任务与预训练数据分布差异较大时,对齐质量可能下降。其次,自蒸馏框架增加了训练的计算开销与超参调优复杂度——标签分布的更新速率、蒸馏温度等超参数需要仔细设计。最后,跨层蒸馏机制假设网络层次足够深以形成有意义的序数结构传递,对于浅层网络或轻量化模型,这一设计的收益可能有限。
从更宏观的角度看,D3O 代表了从固定目标学习向自适应监督学习演进的一个缩影。在过去,机器学习社区习惯于将标签视为"ground truth"并设计损失函数去逼近它;而 D3O 这类工作正在逐步证明,在标签本身具有不确定性的场景下,让模型学习标签分布而非固定值,可能是一条更符合数据本质规律的道路。这种范式转变的影响可能远超序数回归这一具体任务本身。
摘要
序数回归广泛应用于标签离散但天然有序的场景。然而在实践中,序数标签通常是通过对底层连续语义进行主观人工判断离散化得到的,这会导致边界模糊和标注噪声。这类不确定性对依赖固定监督目标的现有方法构成了挑战,因为这些方法可能在主观标注下强化有偏的顺序关系。为解决这一局限,我们提出了 D3O——一种动态分布蒸馏框架,通过自蒸馏将静态监督替换为序数标签分布的训练驱动演化。具体而言,我们引入了序数感知的对比式标签增强模块,利用视觉-语言对齐来恢复捕捉类间模糊性和实例级不确定性的精炼标签分布。此外,我们设计了一种基于累积分布函数(CDF)的跨层交互蒸馏机制,以在网络层次结构中传递累积的序数结构,确保中间表征中序数几何的一致性。在四个通用序数回归任务上的大量实验表明,我们提出的 D3O 始终优于现有方法,尤其是在严重的类别不平衡和噪声监督条件下。这些结果凸显了动态监督在学习超越固定目标的鲁棒序数表征方面的有效性。代码将公开发布。
Abstract
Ordinal regression is widely used in scenarios where labels are discrete yet inherently ordered. In practice, however, ordinal labels are often obtained by discretizing underlying continuous semantics through subjective human judgment, resulting in ambiguous boundaries and annotation noise. Such uncertainty challenges existing methods that rely on fixed supervision targets, which may reinforce biased ordering under subjective annotations. To address this limitation, we propose D3O, a dynamic distribution distillation framework that replaces static supervision with training-driven evolution of ordinal label distributions via self-distillation. Specifically, we introduce a contrastive ordinal-aware label enhancement module that leverages vision-language alignment to recover refined label distributions capturing both inter-class ambiguity and instance-level uncertainty. Furthermore, we design a CDF-based cross-layer interaction distillation mechanism to propagate cumulative ordinal structure across network hierarchy, ensuring consistent ordinal geometry in intermediate representations. Extensive experiments on four general ordinal regression tasks demonstrate that our proposed D3O consistently outperforms existing approaches, particularly under severe class imbalance and noisy supervision. These results highlight the effectiveness of dynamic supervision in learning robust ordinal representations beyond fixed targets. The code will be publicly available.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。