
OPD-IAD:通过在线自蒸馏实现从语言判断到工业异常检测
OPD-IAD: From Language Judgment to Industrial Anomaly Detection via On-Policy Self-Distillation
📝 TLDR
工业异常检测需要像素级精确定位,但现有大视觉语言模型虽能给出图像级判断与文本解释,却难以从语言判断生成精确像素级异常图。本文提出 OPD-IAD 框架,通过在策略自蒸馏将缺陷证据蒸馏到模型自身判断轨迹上,并结合语言引导的视觉锚定机制,让语言作为语义引导而不主导视觉响应。实验表明该方法在图像级、像素级与问答指标上均达到基于大视觉语言模型的工业异常检测最佳综合性能。
🧭 速览
现有 LVLM 工业异常检测方法可产出图像级判断与文本解释,却难以从语言判断生成精确的像素级异常图。
在策略自蒸馏框架将缺陷证据蒸馏到模型自身判断轨迹,再以语言引导的视觉锚定与密集视觉特征对比生成异常图。
在多数图像级、像素级和问答指标上领先现有基于大视觉语言模型的工业异常检测方法,达到最优综合性能。
实现语言作语义引导、视觉特征主导像素打分,避免语言质量直接决定像素级响应。
🆚 方法对比
OPD-IAD
- LVLM类IAD方法中取得最佳综合性能
- 在图像级、像素级、QA指标上多数领先
- 结合在线策略与细粒度token级监督
- 无需外部教师,自蒸馏框架
- 训练流程多阶段,设计复杂度较高
- 依赖特权缺陷证据,部署时不参与推理
- 在线策略采样增加训练开销
Language-guided Visual Anchoring
- 仅保留最终判断作紧凑语义引导
- 密集视觉特征主导像素级评分
- 对比式热图头生成精确异常图
- 需额外判断重编码前向,增加计算量
- 锚点质量受最终判断准确性影响
Decoupled Language and Localization
- 架构简单,模块独立易于实现
- 语言与定位互不干扰,鲁棒性高
- 语言不参与热图生成,丧失语义引导
- 图像级与像素级性能难以协同优化
Language-Coupled Localization
- 通过分割token、掩码文本等直接语义接地
- 语言与定位深度耦合,信息利用充分
- 对生成判断的正确性高度敏感
- 判断不稳定会抑制或误导热图
- 语言质量直接决定像素级响应
Standard SFT
- 提供密集token级监督,反馈细粒度
- 训练稳定,收敛快
- 从固定离线回复学习,非在线策略
- 不监督部署时模型实际访问的状态
RLVR (Reinforcement Learning with Verifiable Rewards)
- 在线策略采样,与部署行为一致
- 可直接优化可验证的奖励信号
- IAD奖励多为稀疏结果级信号
- 定位反馈粗糙,缺乏细粒度指导
On-policy Self-Distillation
- 在线策略轨迹上施加token级教师监督
- 自蒸馏无需外部教师
- 结合在线策略与细粒度反馈优势
- 训练需特权上下文,信息泄漏风险
- 比标准SFT/RL流程更复杂
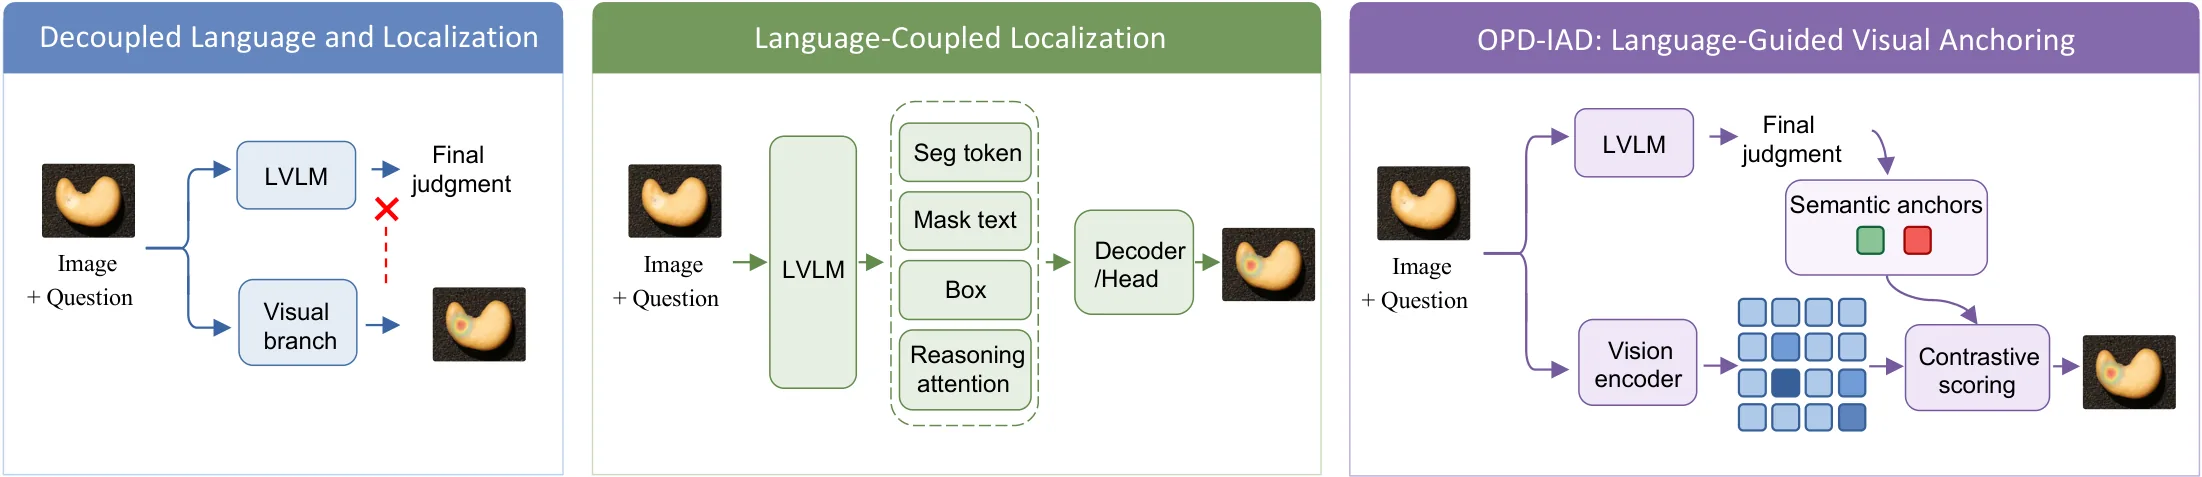
论文将现有LVLM类IAD方法归为语言-定位解耦与语言-定位耦合两条路径,指出前者割裂语义引导、后者过度依赖语言质量;OPD-IAD通过在线策略自蒸馏与语言引导视觉锚定,让语言提供紧凑语义条件的同时保持像素级响应以密集视觉特征为基座。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 3 张)
展开查看 3 张图
TL;DR
工业异常检测需要同时给出「图像级有没有问题」的语言判断和「像素级哪里有问题」的热图定位。现有大视觉语言模型擅长前者,但将语言判断转化为精确像素级异常图仍是难题——要么文本与定位脱节,要么语言质量直接绑架像素响应。 OPD-IAD 提出了证据特权的在线自蒸馏(OPSD)和语言引导的视觉锚定(LVA)两套机制,让语言判断作为语义条件引导密集视觉特征打分,而非替代视觉做像素级决策。实验在 5 个跨数据集零样本设定下,于图像级、像素级和问答三项指标上均取得了基于大视觉语言模型的工业异常检测最佳综合性能。
研究背景与动机
工业异常检测(IAD)的核心需求可以拆解为两个层次:图像级判断要求模型回答「这张产品图片有没有缺陷」,并给出可解释的文字推理;像素级定位则要求在图像上精确圈出异常区域,为后续的质检分拣提供依据。近年来大视觉语言模型的兴起为 IAD 带来了新的可能性——模型不仅能给出二值答案,还能输出缺陷类型的自然语言解释,这在工业场景的可解释性要求下极具价值。
然而,将语言判断「翻译」成像素级异常图这件事,现有方法走得并不顺畅。论文将现有路径归纳为两种有缺陷的做法:解耦路径下,语言判断仅作为人类可读的文本输出,与热图生成过程完全隔离——模型同时训练一个额外的分割头来独立完成定位,文本与定位之间没有信息流动,各干各的。紧耦合路径则走向另一个极端,通过引入分割 token、掩码文本token、推理token注意力等「语言侧接口」来驱动视觉定位,让像素级响应高度依赖生成文本的正确性与稳定性。一旦语言判断出错或不稳定,异常图就会跟着跑偏,语言质量直接决定了像素级结果的可用性。
论文的核心主张是:语言判断应当作为语义引导,而像素级响应必须建立在密集视觉证据之上。这句话包含了两层含义——语言不是可有可无的附加品,它确实参与引导了异常定位的过程;但语言也不能「越位」,像素打分的主角始终是视觉特征,语言只在语义层面提供条件信息。这条原则背后有两个训练层面的实际挑战:第一,监督必须作用于模型在部署时实际产生的判断轨迹(所谓 on-policy),而不是某个固定参考答案;第二,监督必须是密集且细粒度的,能够反映缺陷证据在 token 序列中的逐步显现,而不是仅仅在最后奖励一个正确或错误的最终答案。
方法
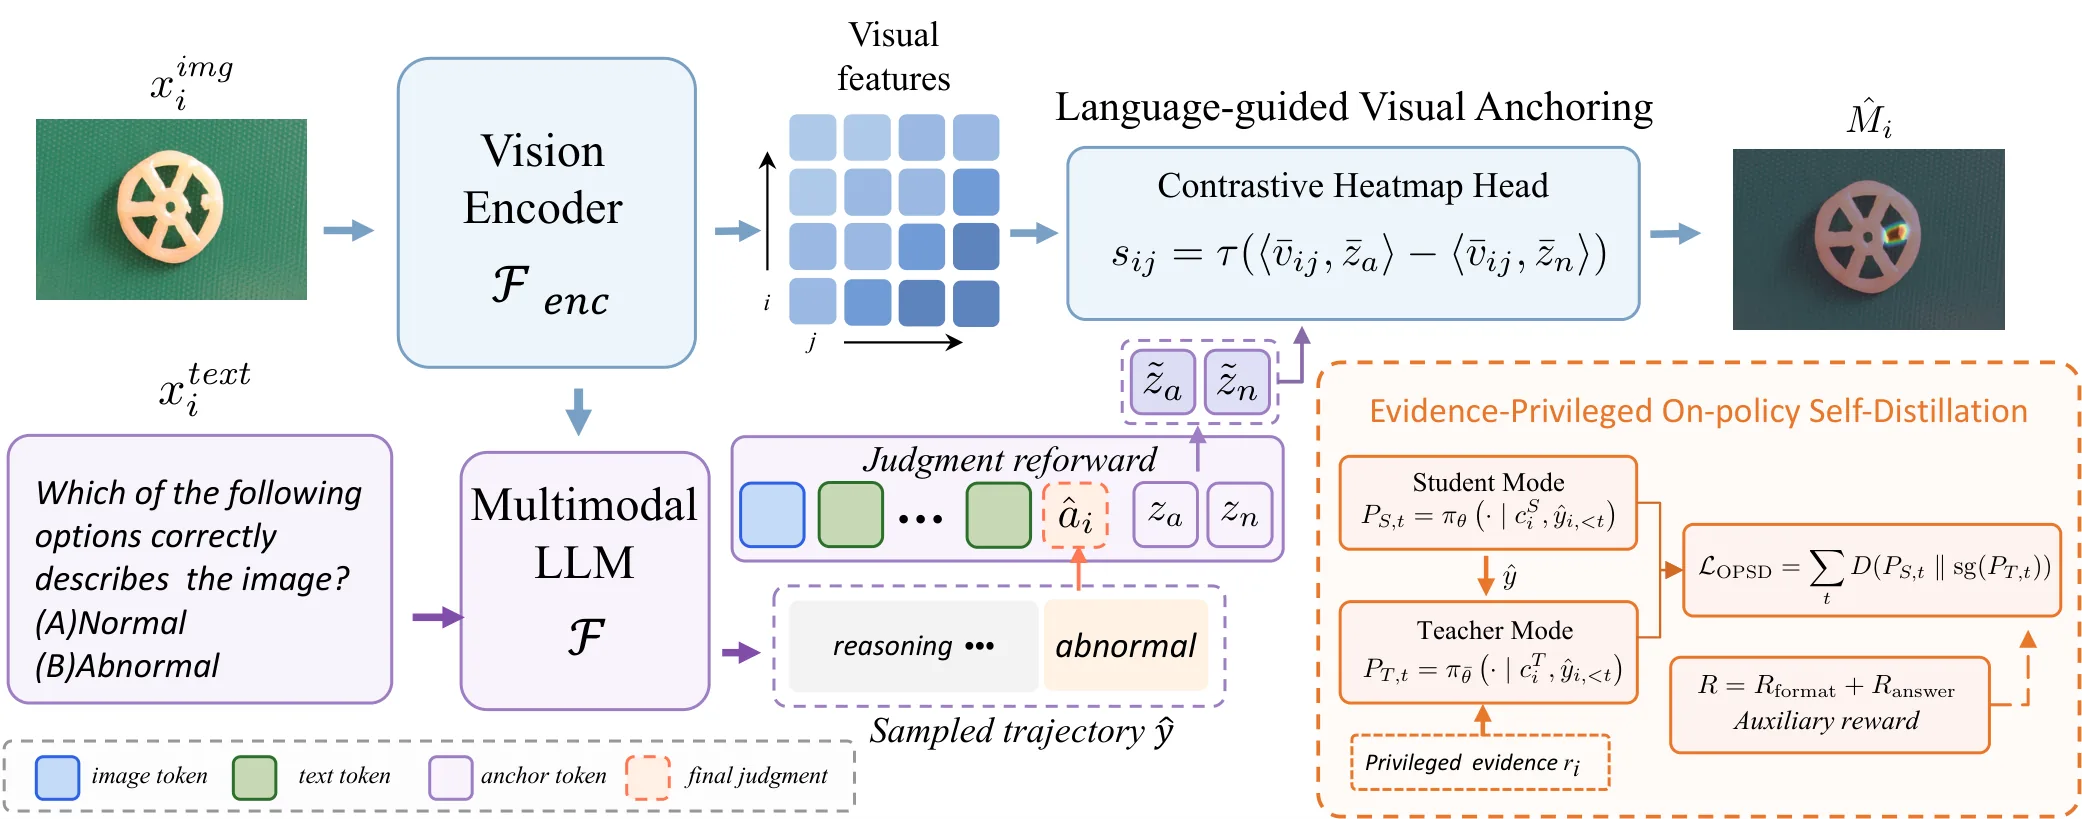
围绕上述原则,OPD-IAD 设计了一套「双分支共享定位」的框架,骨干模型选用 Qwen3-VL-8B-Instruct,训练时同时维护学生分支和教师分支,两者在视觉编码器和语言解码器上共享权重,仅输入的上下文不同。
在线自蒸馏:让判断在密集监督下学习
学生分支处理部署时的输入上下文 ,自采样产生语言响应 ,从中提取最终判断 ——这就是模型在部署时实际会给出的答案。教师分支则使用同一模型的 EMA 副本(记作 ),仅在训练阶段存在,它在特权上下文 下对学生采样的每个前缀 token 进行重打分。这里 代表特权缺陷证据,可以是对应区域的像素级标注或缺陷类型的描述性分析,其作用是让教师在训练阶段获得学生无法直接观察到的细粒度缺陷信息。
教师权重通过 EMA 动态维护:
对学生每个位置 的 token 级分布与教师的对应分布做散度匹配:
论文选择广义 Jensen–Shannon 散度作为 ,对应的混合分布为:
当 时退化为对称的经典 JSD。这套设计的精妙之处在于「双重 on-policy」——教师重打分的对象是学生实际采样出的完整轨迹,而不是某个固定标准答案;每一步 token 的分布都受到监督,而不仅仅是最终判断的结果被奖惩。换言之,缺陷证据的信息通过教师分布渗透到了判断生成的每一个 token 级决策中,使最终判断本身就在密集监督下学会了感知异常,而非仅仅学会了输出一个「正确」的字符串。
语言引导的视觉锚定:让判断条件落地为像素证据
拿到模型在部署上下文下产生的最终判断 之后,需要将其转化为像素级异常图的语义条件。直接的做法是用判断文本对视觉特征做交叉注意力,但这样容易让语言质量绑架视觉响应。 OPD-IAD 采取的策略是「判断转发」:将图像、原始问题以及学好的「异常 / 正常」基锚 与最终判断 一起重新送入模型,得到上下文相关的锚点:
基锚 是可学习的向量,代表「什么是异常」和「什么是正常」的语义原型空间。通过判断转发,这两个原型在当前具体问题语境下被调适为 和 ——它们编码了模型对这张图是否异常的整体判断所携带的语义信息。
接下来,对比热图头将密集视觉 patch 特征 与这两个锚进行对比打分:
其中 为可学习温度参数。每个 patch 的异常 logit 是其与「异常锚」的余弦相似度减去其与「正常锚」的余弦相似度,本质上是在问:这个 patch 的视觉特征更像缺陷还是更像正常产品?最后通过上采样将 patch 级打分转化为像素级异常图 。
这个设计的核心逻辑是:语言判断提供了紧凑的语义条件,异常锚和正常锚的对比决定了「在语义空间中什么样的视觉特征代表异常」,但具体的像素级评分仍然由密集视觉特征与这两个锚的相似度差值决定。语言引导了定位的方向,但不直接决定每个像素的值——即使语言判断出错,视觉特征本身的异常模式仍然能够驱动热图响应。
总训练目标
完整的目标函数由三项组成:
- :前文介绍的 token 级自蒸馏损失,让模型在实际部署语境下生成的判断质量得到提升。
- :稀疏的结果级奖励,包括格式奖励 (确保输出符合预期格式)和判断奖励 (奖励最终答案的正确性),仅用于正则化,不主导优化方向。
- :密集定位损失,包含图像级 BCE(取 top-1% logit 平均的异常概率与真实标签的交叉熵)、像素级 BCE/Focal/Dice 损失组合,以及一个锚分离约束 ,防止异常锚和正常锚在语义空间里塌缩到一起。
整体而言,OPSD 让语言判断变好(密集监督下学会感知缺陷),LVA 让判断条件落地为像素证据(语义锚引导视觉对比),两者的产出通过 联合优化,形成语言引导视觉、视觉支撑像素的闭环。
实验与结果
实验设置
论文采用严格的跨数据集零样本设定,在 5 个目标基准上评估:MVTec-AD 以 VisA + GoodsAD 为源训练集;VisA 以 MVTec-AD + GoodsAD 为源训练集;此外还有 SDD/KolektorSDD(钢材表面缺陷)、DTD-Synthetic(合成纹理)和 WFDD(织物缺陷)三个更具挑战性的跨领域场景。评测涵盖三类指标:图像级(AUROC、AP、F1)、像素级(AUROC、AP、F1、AUPRO)和问答(二值判断准确率)。
对比方法聚焦于基于大视觉语言模型的 IAD 方法,包括 AnomalyGPT、Myriad、EIAD 和 ReAL,部分指标在统一协议下进行了复现标注。
核心结论
实验结果验证了论文的设计假设。在 MVTec-AD 和 VisA 两个主流基准上,OPD-IAD 在图像级 AUROC/AP/F1 和像素级 AUROC/AP/F1/AUPRO 上全面领先基线方法,尤其在像素级 F1 指标上的优势最为显著。以 VisA 为例,OPD-IAD 的像素级 F1 达到 59.26,较第二名提升明显,这一差距在工业质检场景中意味着大量额外的误检或漏检。
一个值得关注的对比来自训练范式消融:纯模仿学习(SFT)下像素定位尚可但图像级判断退化;仅用稀疏结果级奖励的强化学习(GRPO,单 rollout)在图像级略高但像素定位全面崩溃;只有 OPD-IAD 的 on-policy 密集 token 级监督同时保住了两项能力。这一结果直接证明了「密集监督每个 token 的判断生成」对最终定位质量的关键作用。
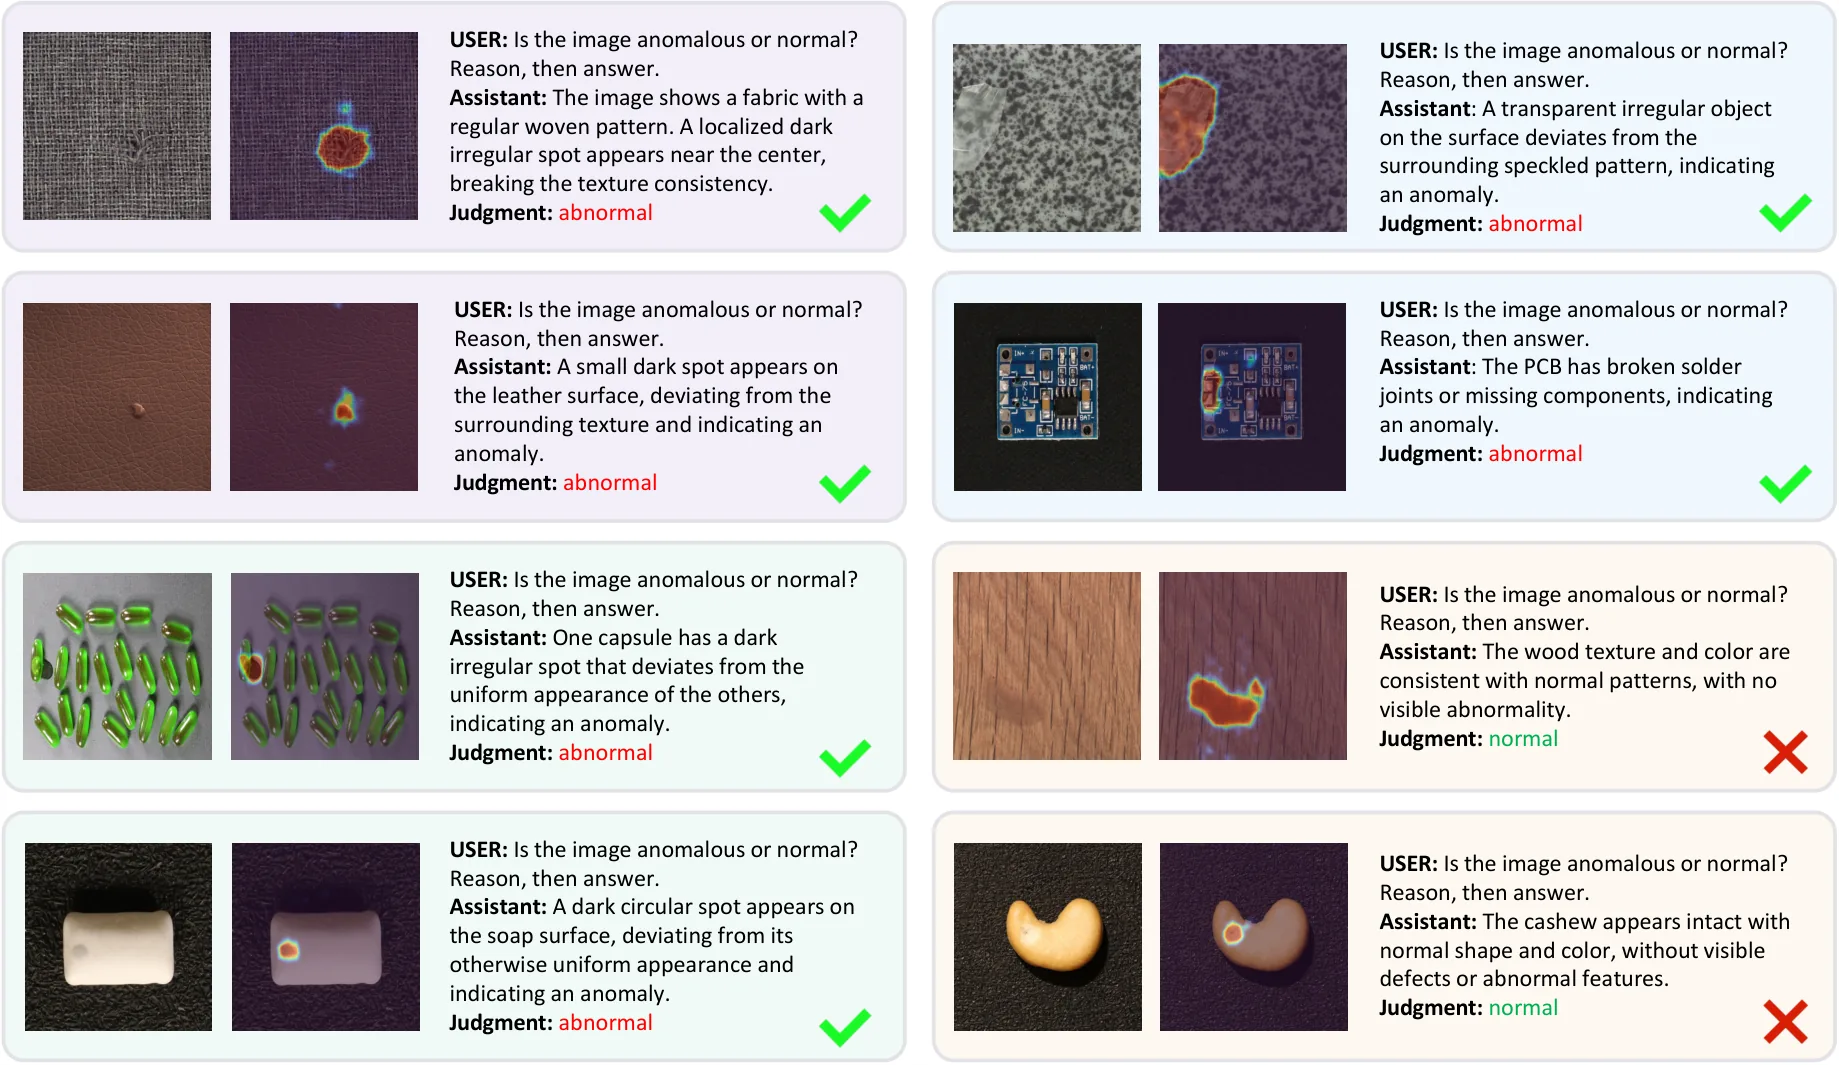
语言引导视觉锚定的消融实验则揭示了另一层洞察。当论文设计四种定位接口(纯文本注意力、分割 token、对比锚定、热图头)并对比三种判断干预(GT 判断、模型默认判断、错误注入判断)时,对比锚定 + 默认判断的组合在像素级指标上与使用 GT 判断的差距很小——这说明锚点机制成功地将语义条件转化为了对视觉特征的对比引导,而非简单地「复制」语言判断的正确性。关键的是,即使注入错误判断,对比锚定方案的热图仍然保留了局部异常响应,而分割 token 方案的定位则完全跟随错误判断崩溃。这一对比有力地支撑了论文「语言引导而非主导」的设计目标。
跨数据集的结果进一步表明,模型在 VisA 上训练后对钢材(SDD)、纹理(DTD-Synthetic)和织物(WFDD)的泛化能力同样可观,尤其在 SDD 和 DTD-Synthetic 上的像素级 AUROC 均超过 98%,说明语义锚所编码的异常概念具有一定的跨材质普适性。
讨论与可借鉴点
OPD-IAD 在方法论层面给出了一个清晰的设计原则:[[语义引导]]与[[密集视觉证据]]应当各司其职,前者提供方向性条件,后者提供像素级评分的根基。这条原则不仅适用于工业异常检测,任何需要在视觉语言模型中同时追求文本可解释性与密集空间预测的任务——如医学影像的病灶定位、遥感图像的变化检测——都可以借鉴这一思路:通过 on-policy 自蒸馏让语言判断本身变得更「懂」异常,再通过判断转发将语义条件锚化为视觉空间的对比向量,让两种模态的贡献解耦而非耦合。
从工程角度看,论文选择全量微调 Qwen3-VL-8B 的做法在当前算力背景下门槛不低——8 张 A100 训练 30 epoch 的成本对大多数研究团队而言难以承受。OPE-IAD 的设计本身并不必然依赖全量微调,LoRA 等参数高效微调方法在理论上同样可行,只是论文尚未探索。一个值得追问的问题是:当换用更小的骨干模型或参数高效微调策略时,OPSD 的 token 级密集监督是否仍然能带来同等幅度的提升?这一点在论文中被回避了,也是后续工作可以填补的空白。
局限方面,论文虽然在设计层面区分了「引导」与「主导」,但在超参层面仍有不少未充分验证的地方:EMA 衰减率 、JSD 混合系数 、奖励权重 等关键超参均只使用了一组配置,缺少灵敏度分析。此外,论文未与近期提出的其他强基线(如 VMAD、AG-VAS、OmniAD 等)做直接对比,也未纳入与纯视觉零样本方法(如 AnomalyCLIP)的对照,使得 LVLM 路线相对于成熟纯视觉路线的增量收益难以定量评估。问答准确率在部分数据集上仍偏低(SDD 仅 62.91),说明语言侧的缺陷理解能力仍有较大提升空间——这既是 OPD-IAD 的局限,也是整个基于大视觉语言模型的工业异常检测领域下一步需要攻克的方向。
摘要
大型视觉-语言模型(LVLMs)最近在工业异常检测(IAD)方面展现出强大的潜力,能够提供图像级异常判断和可解释的缺陷推理。然而,目前基于LVLM的IAD方法仍然难以从生成的语言判断中产生精确的像素级异常图。我们的目标是实现精确的像素级定位,同时将语言作为引导而非让其主导视觉响应。具体而言,我们提出了textbf{OPD-IAD},一个面向基于LVLM的IAD的、具有证据特权优势的密集在线自蒸馏框架。OPD-IAD将特权缺陷证据蒸馏到模型自身的在线判断轨迹上,使最终生成的判断能够在密集监督下学习,而不是仅被视为文本答案。由此产生的判断将作为密集异常感知的语义条件。为了将该条件转化为密集视觉证据,我们引入了textbf{语言引导视觉锚定},它通过判断转发将图像和问题在最终判断条件下重新编码为语义锚点,并通过一个对比热图头将其与密集视觉特征进行对比,从而生成异常图。由此,语言判断提供了紧凑的语义引导,而密集视觉特征仍是像素级评分的基础,使得语言能够引导异常定位,而不会让语言质量直接决定像素级响应。大量实验表明,OPD-IAD在基于LVLM的IAD方法中取得了最佳的整体性能,在大多数图像级、像素级和问答(QA)指标上均处于领先地位。
Abstract
Large vision-language models (LVLMs) have recently shown strong potential for industrial anomaly detection (IAD) by providing image-level anomaly judgments and interpretable defect reasoning. However, current LVLM-based IAD methods still struggle to produce precise pixel-level anomaly maps from generated language judgments. We aim to achieve precise pixel-level localization while using language as guidance rather than letting it dominate the visual response. Specifically, we propose \textbf{OPD-IAD}, an evidence-privileged dense on-policy self-distillation framework for LVLM-based IAD. OPD-IAD distills privileged defect evidence onto the model's own on-policy judgment trajectory, enabling the final generated judgment to be learned under dense supervision rather than treated only as a textual answer. The resulting judgment serves as a semantic condition for dense anomaly perception. To turn this condition into dense visual evidence, we introduce \textbf{Language-guided Visual Anchoring}, which uses a judgment reforward to re-encode the image and question under the final-judgment condition into semantic anchors and contrasts them with dense visual features through a contrastive heatmap head to generate anomaly maps. The language judgment therefore provides compact semantic guidance, while dense visual features remain the basis for pixel-level scoring, allowing language to guide anomaly localization without letting language quality directly dictate the pixel-level response. Extensive experiments show that OPD-IAD achieves the best overall performance among LVLM-based IAD methods, leading on most image-level, pixel-level, and QA metrics.
论文详细总结(自动生成)
OPD-IAD 论文总结
1. 核心问题与研究动机
工业异常检测(IAD)需要同时完成两类任务:
- 图像级判断:识别产品是否异常,并给出可解释的文本推理;
- 像素级定位:在图像上精确标出缺陷区域。
近年来,大视觉-语言模型(LVLM)已能够为工业图像输出异常判断和缺陷解释,但将其转化为精确像素级异常图仍是未解决的问题。现有方法存在两条有缺陷的路径:
- 解耦路径:语言判断仅作为解释输出,不参与热图生成,导致文本与定位脱节;
- 紧耦合路径:通过分割 token、掩码文本、推理 token 注意力等"语言侧接口"驱动定位,使像素响应过分依赖生成文本的正确性与稳定性,错误或不稳定的判断会直接误导热图。
论文的核心主张是:语言判断应作为语义引导,而像素级响应必须基于密集视觉证据。围绕这一原则,需要解决两个训练层面的挑战:
1. 监督必须作用于模型自身在部署时产生的轨迹(即 on-policy);
2. 监督必须密集、细粒度,反映缺陷证据,而非仅奖励最终答案。
2. 方法论
2.1 整体框架:双分支 + 共享定位
模型(以 Qwen3-VL-8B 为骨干)针对部署输入 生成语言响应 ,并提取其最终判断 。该判断在 判断转发(judgment reforward) 中与图像、问题以及一组可学习的"异常 / 正常"基锚 一起被重新编码,得到上下文相关的锚 。对比热图头将密集视觉 patch 特征 与这两个锚进行对比打分,得到像素级异常图 。
2.2 证据特权的在线自蒸馏(OPSD)
- 学生分支在部署上下文 下自采样响应 ;
- 教师分支使用同一模型的 EMA 副本,仅在训练时存在,并在特权上下文 下对学生的每个前缀进行重打分。
教师权重由 EMA 维护:
对学生每个位置 的下一 token 分布做 token 级分布散度匹配:
其中 采用广义 Jensen–Shannon 散度,对应的混合分布为:
当 时退化为对称 JSD。该设计同时实现"on-policy(监督学生实际采样轨迹)"和"密集 token 级(每步都学到缺陷证据)"。
2.3 语言引导的视觉锚定(LVA)
判断转发后取两个上下文锚的隐藏状态:
对比热图头通过投影 + 归一化 + 余弦对比计算每个 patch 的异常 logit:
其中 为可学习温度。上采样得到像素级异常图。语言仅提供语义条件,像素打分仍由视觉特征决定。
2.4 总训练目标
- :上述 token 级自蒸馏损失,学习部署时的判断;
- :稀疏的结果级奖励,仅用于正则化答案格式与最终判断;
- :图像级 BCE(取 top-1% logit 平均)+ 像素级 BCE/Focal/Dice 损失 + 锚分离约束 。
3. 实验设计
3.1 数据集与协议
采用严格的跨数据集零样本设定,5 个目标基准:
- MVTec-AD:来源训练集为 VisA + GoodsAD;
- VisA:来源训练集为 MVTec-AD + GoodsAD;
- SDD / KolektorSDD(钢材表面);
- DTD-Synthetic(合成纹理);
- WFDD(织物)。
3.2 评测指标
- 图像级:AUROC、AP、F1;
- 像素级:AUROC、AP、F1、AUPRO;
- 问答:二值判断准确率(QA/Acc.)。
3.3 对比方法
在基于 LVLM 的 IAD 方法范围内对比:AnomalyGPT、Myriad、EIAD、ReAL(部分指标为同一协议下的复现 †)。其它相关基线如 VMAD、AG-VAS、OmniAD、IAD-R1、AnomalyR1、Triad、MMAD 等在相关工作部分讨论但未进入主表。
4. 算力与资源
文中明确说明:
- 骨干模型:Qwen3-VL-8B-Instruct,全量微调(含视觉塔);
- 训练框架:DeepSpeed ZeRO-2;
- 硬件:8 张 NVIDIA A100 GPU;
- 超参:单卡 batch size = 1,梯度累积 4 步,共 30 epoch,学习率 ,warmup 比例 0.03;
- OPSD 参数:EMA 衰减 ,,。
未明确报告单 epoch / 总训练时长。
5. 实验数量与充分性
论文共进行约 10 组实验:
- 主表(Table 1):5 个数据集 × 7 个指标 + QA 准确率,与 4 种 LVLM-IAD 方法对比;
- 训练范式消融(Table 2):VisA 上对比 SFT、GRPO(单 rollout)、OPD-IAD;
- LVA 分析(Table 3):MVTec-AD 上 4 种定位接口 + 2 种判断干预(GT 判断、错误判断);
- 定性可视化(Figure 3):8 张样本,含热图与文本判断。
充分性评价:
- 优点:跨 5 个工业场景、对比基线较全,包含"训练范式"与"定位接口"两套相互独立的消融,并设计判断干预实验证明语义确实参与定位。
- 不足:每个数据集只跑一次、没有方差/置信区间;只有 1 个超参组(未做灵敏度研究);EMA 衰减 、、奖励权重 等关键超参的鲁棒性未充分验证;定性图样本量较小。
6. 主要结论
- OPD-IAD 在 5 个零样本 IAD 基准上,多数图像级、像素级、QA 指标领先现有基于 LVLM 的 IAD 方法;
- OPSD > SFT > GRPO(稀疏奖励):on-policy + 密集 token 级监督显著优于固定目标模仿;纯结果级 GRPO 虽在图像级略高,但像素定位全面退化;
- 最终判断是最强的部署型语义条件:完整响应、学习型锚、不聚合最终判断、移除语言输出均损害定位;
- GT 判断 > 默认判断 > 错误判断,证明判断语义确实参与并影响视觉锚定,但即使判断错误,热图仍能保持局部异常响应,证实"语言引导而非主导"的设计目标达成。
7. 优点与亮点
1. 清晰的设计原则:明确区分"语言引导"与"视觉主导",避免像素响应被文本质量绑架;
2. 训练与定位的一致性:用 OPSD 把"部署时自采样的判断"作为下游定位的语义条件,两阶段使用同一轨迹;
3. 双分支共享架构:学生/教师共享 LVLM,仅上下文不同,工程实现简洁;
4. 判断干预实验:直接替换最终判断观察定位变化,提供了因果性的解释力;
5. 跨数据集零样本评测,比单域监督设置更具实用价值;
6. 论文叙述体系完整,问题 → 方法 → 实验 → 结论环环相扣。
8. 不足与局限
1. 算力门槛高:8 × A100 + 30 epoch 全量微调 8B 模型,难以复现,且文中未报告训练时长;
2. 基线覆盖不全:未与近期强 LVLM-IAD 方法(VMAD、AG-VAS、OmniAD、IAD-R1、AnomalyR1、Triad 等)做直接对比,部分指标缺失;
3. 未提供方差与统计显著性:每数据集单次实验,无法判断优势是否稳定;
4. 超参鲁棒性研究不足:、、、温度 等关键超参未做敏感性分析;
5. 定性评估规模小:仅 8 张可视化图像,缺乏对失败案例的系统分析;
6. 依赖训练期特权证据:源域缺陷分析参考 的构造方式与质量对结果影响未讨论,跨域迁移时若 与目标分布差异大,效果可能下降;
7. 二值判断的精度上限:QA/Acc. 在部分数据集(如 MVTec-AD 仅 71.42、SDD 仅 62.91)仍偏低,说明语言侧仍有改进空间;
8. 未与传统密集 IAD SOTA 对比:与仅做视觉的强零样本/少样本方法(如 AnomalyCLIP、MUSC、VisualAD)的对比被回避,难以判断 LVLM 路线相对纯视觉路线的真实收益。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。