
ARKD:面向文本生成的自适应强化学习引导双向 KL 散度蒸馏方法
ARKD: Adaptive Reinforcement Learning-Guided Bidirectional KL Divergence Distillation for Text Generation
📝 TLDR
大语言模型的知识蒸馏中,单一KL目标难以兼顾主分布拟合与长尾概率建模,限制了生成质量与泛化能力。为此,论文分析前向KL与反向KL在分布对齐上的互补作用,提出基于强化学习的自适应双向KL蒸馏框架ARKD。该框架通过策略网络依据师生分布特征动态分配FKL与RKL权重,在即时奖励引导下实现主模式与长尾模式的双重对齐。多个基准上的实验显示,Rouge-L与BertScore均稳定提升,较贪心启发式基线高出0.4-0.6分。
🧭 速览
现有基于单一KL目标的知识蒸馏方法难以同时兼顾主分布拟合与长尾概率建模,制约了压缩后模型的生成质量与泛化能力。
提出ARKD框架,利用强化学习策略网络依据师生分布差异动态分配前向KL与反向KL权重,以即时奖励信号引导实现双重分布对齐。
在多基准上Rouge-L与BertScore均一致提升,较贪心启发式基线高0.4-0.6分,整体优于多种蒸馏基线方法。
验证了双向KL自适应加权在LLM蒸馏中的有效性,为主模式与长尾模式联合对齐提供了新的蒸馏思路。
🆚 方法对比
ARKD(自适应强化学习双向KL蒸馏)
- 策略网络动态分配FKL/RKL权重,实现状态自适应
- 在Rouge-L和BertScore上超越贪心启发式0.4-0.6分
- 同时对齐主模式和长尾模式,缓解长尾过估计
- 具备理论分析支撑FKL/RKL互补性与收敛一致性
- 引入策略网络增加训练复杂度和超参数
- 依赖即时奖励信号设计,奖励工程难度大
- 实验仅基于摘要与部分正文,泛化性待充分验证
前向KL散度(FKL)
- 模式覆盖行为,能覆盖教师分布全部模式
- 理论成熟,是知识蒸馏的经典目标函数
- 实现简单,计算开销低
- 在低置信长尾区域过估计概率,损害生成质量
- 模式覆盖导致学生分散,忽略主导模式聚焦
- 对分布外样本泛化能力不足
反向KL散度(RKL)
- 模式寻求行为,避免长尾低概率区域过拟合
- 聚焦教师主导模式,提升主分布拟合质量
- MiniLLM等已证明其在LLM蒸馏中的有效性
- 牺牲多样性和覆盖率,忽略次要模式
- 过度集中于单一主导模式,长尾建模不足
- 静态使用无法适应训练中学生-教师差距的变化
静态/贪心启发式插值方法
- 实现简单,无需额外策略网络
- 在FKL和RKL间提供基础平衡
- 固定系数无法捕捉训练中学生-教师差距的动态变化
- 性能低于ARKD自适应方法0.4-0.6分
- 缺乏对分布特征的自适应调整能力
序列级蒸馏(黑盒)
- 无需访问教师内部表示,部署灵活
- 仅用教师生成文本即可训练学生模型
- 缺乏token级分布对齐,精度低于白盒方法
- 无法利用教师logits中的细粒度分布信息
Token级蒸馏(白盒)
- 利用教师logits进行细粒度分布对齐
- 在LLM压缩和部署中已被证明有效
- 可灵活选择FKL或RKL作为对齐目标
- 需要访问教师内部表示,部署受限
- 单一KL目标难以兼顾主分布与长尾建模
本文对比了FKL(模式覆盖)、RKL(模式寻求)及静态插值方法,指出单一目标或固定权重均无法兼顾主分布拟合与长尾建模;所提ARKD通过强化学习策略网络动态加权FKL/RKL,实现优于贪心启发式0.4-0.6分的双重分布对齐。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 9 张)
展开查看 9 张图
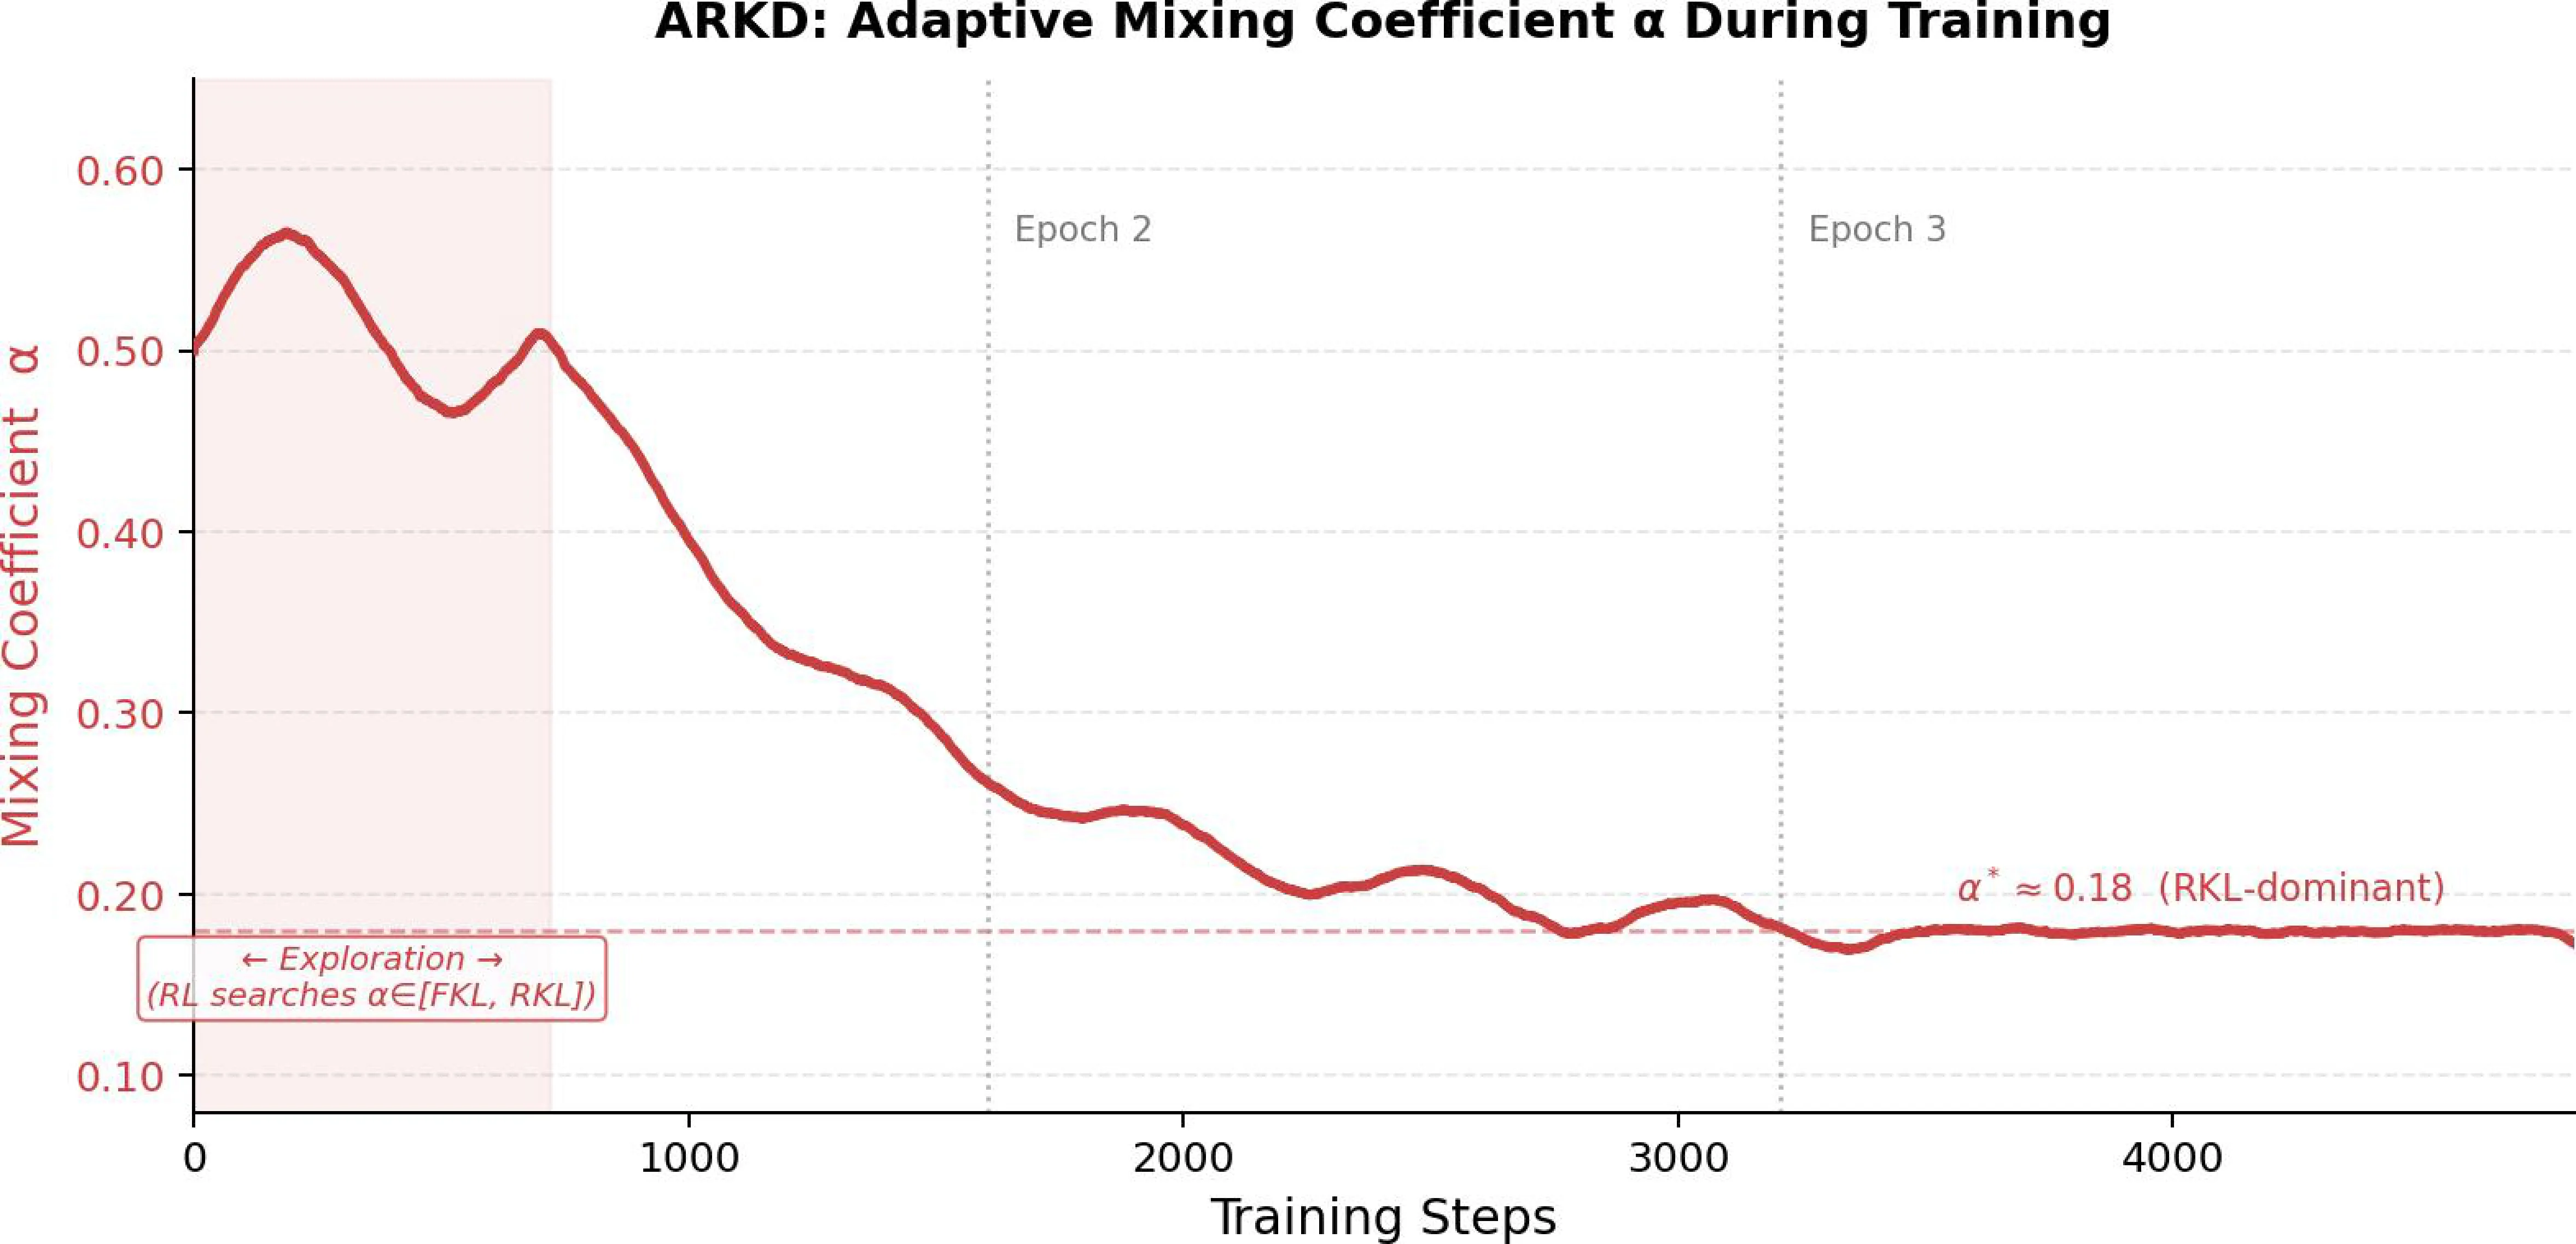
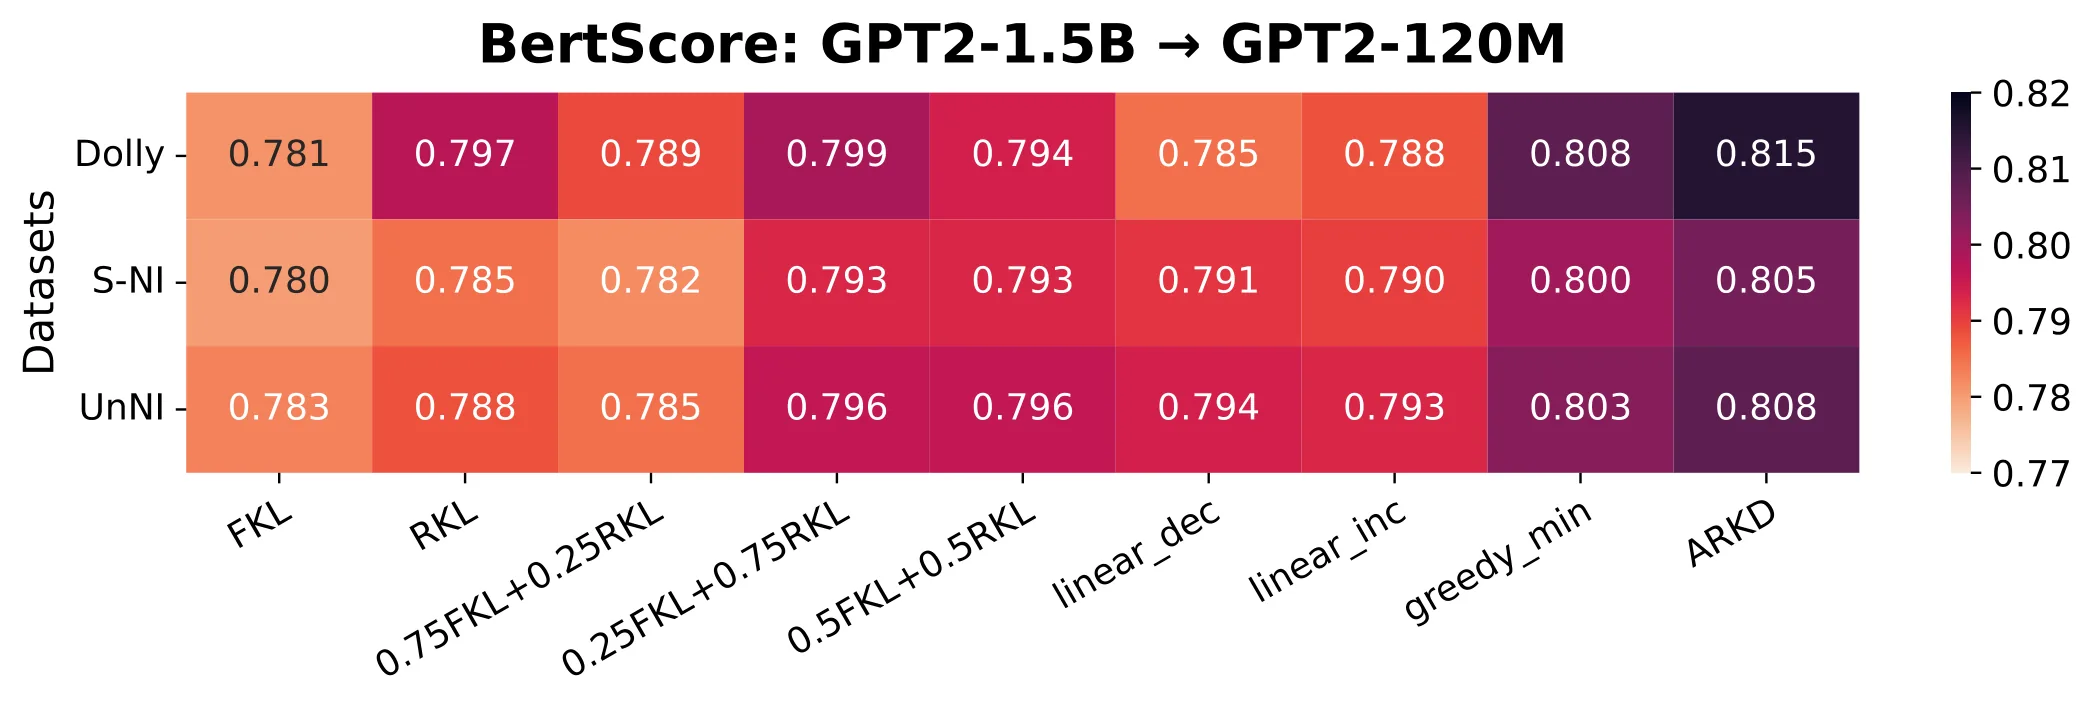
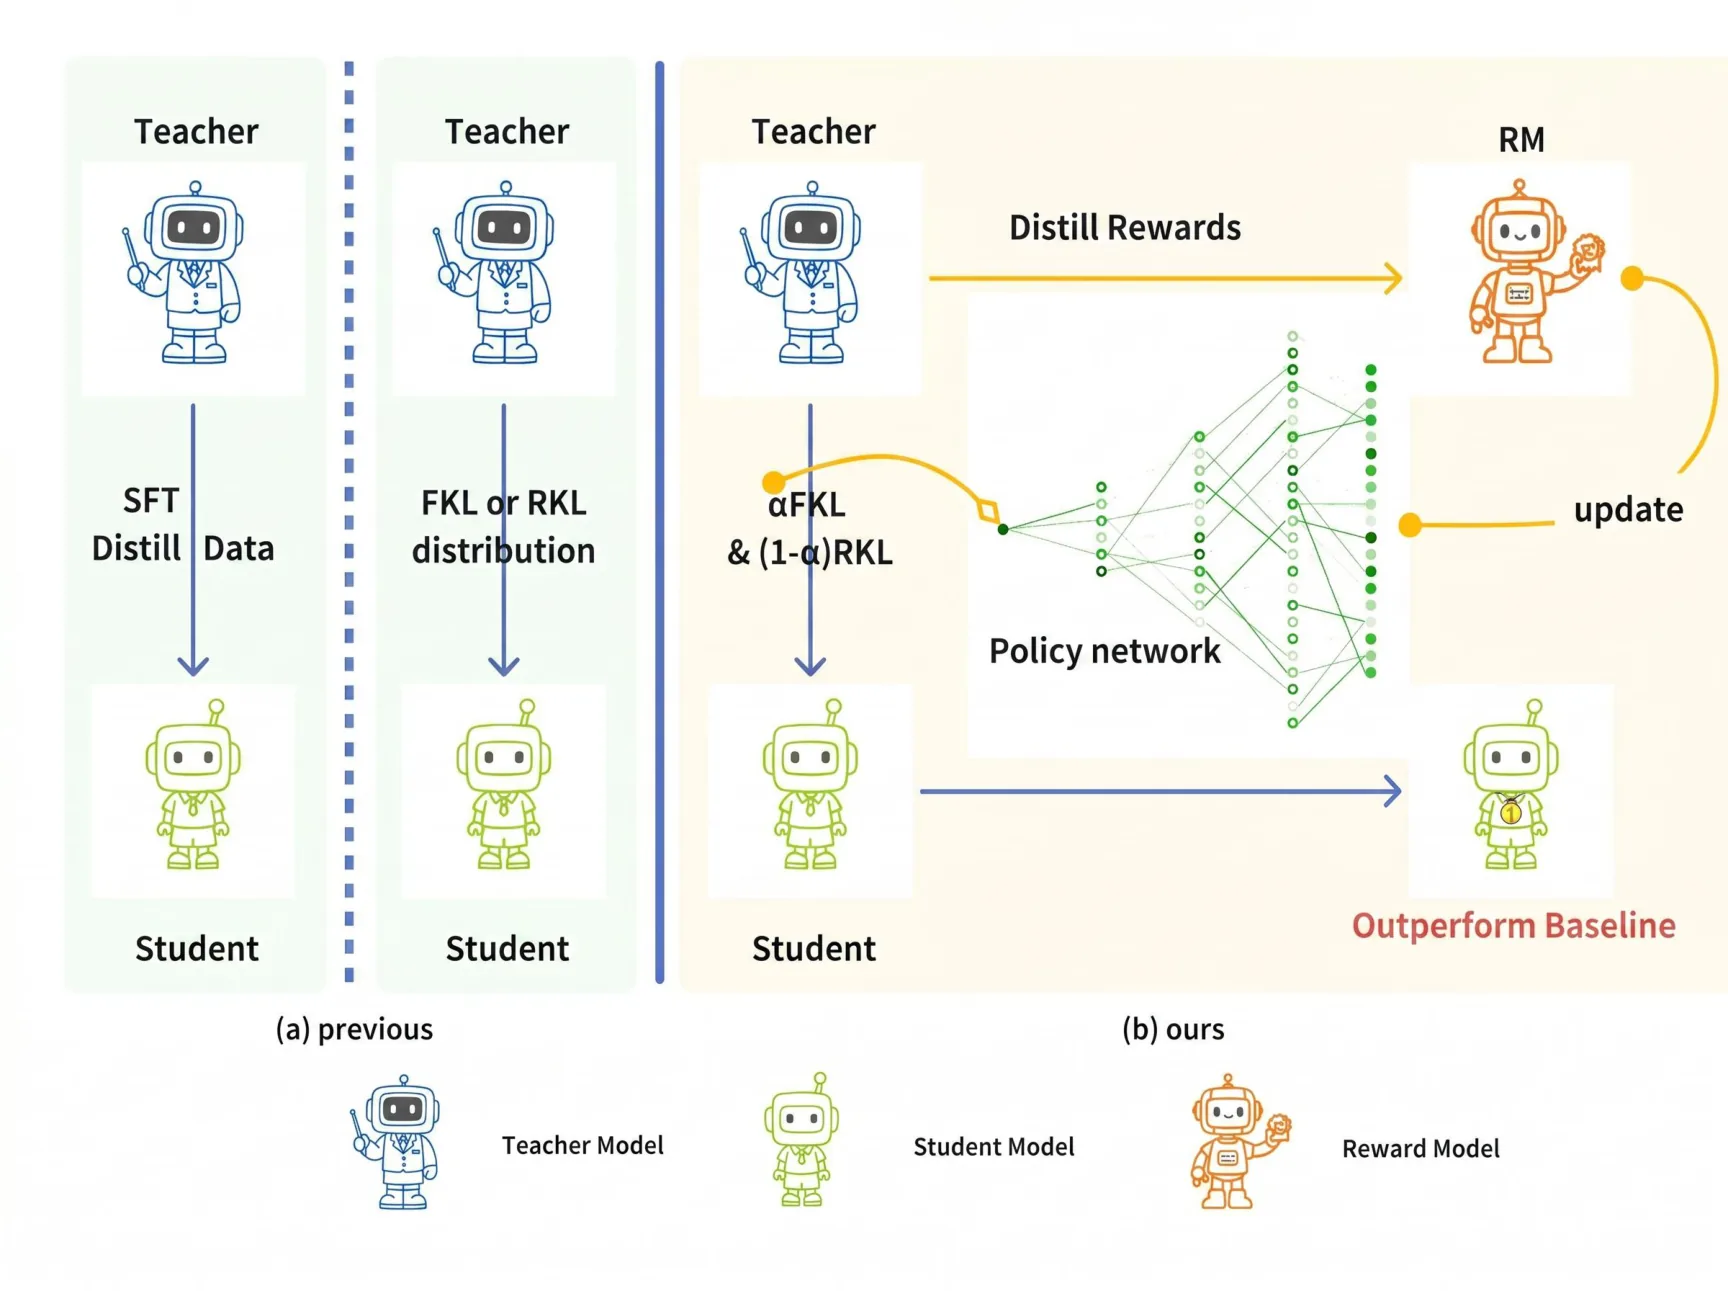
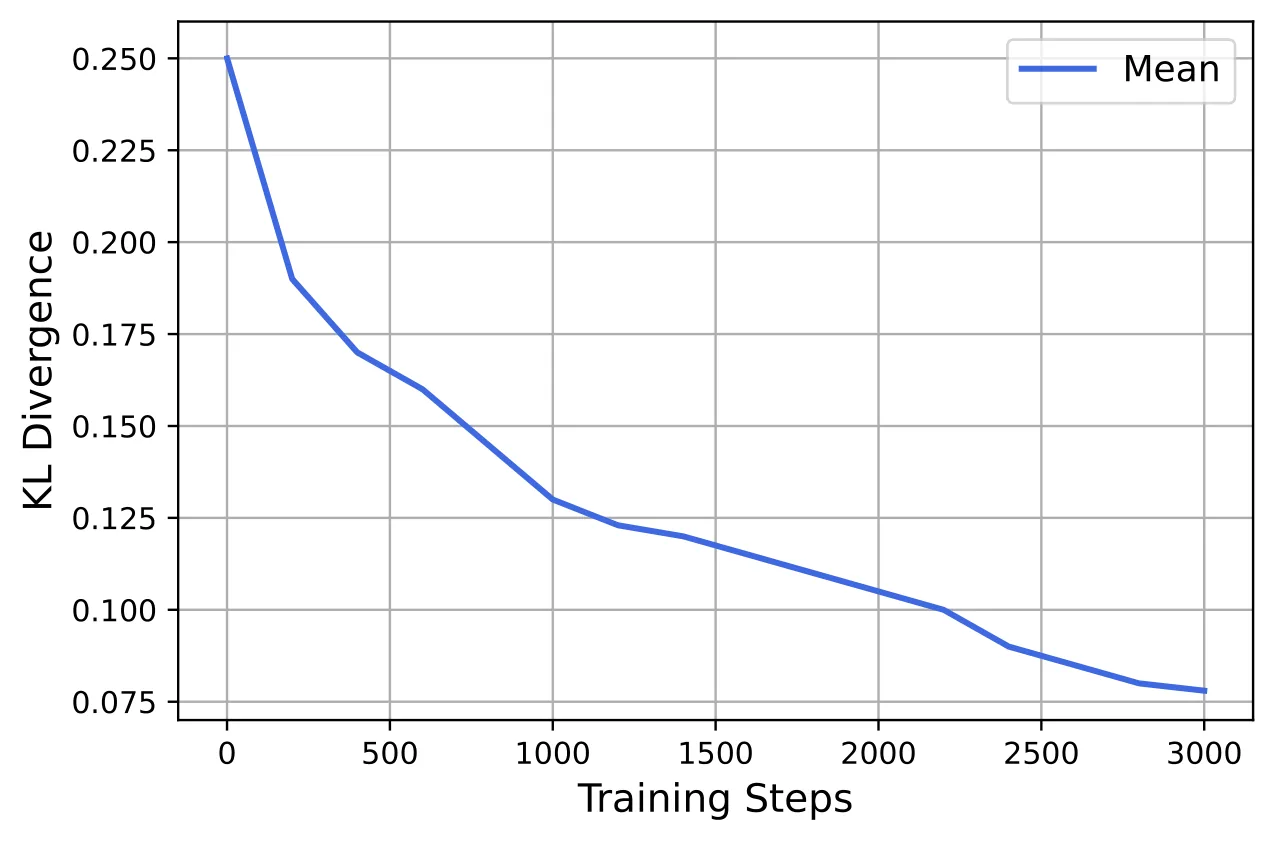
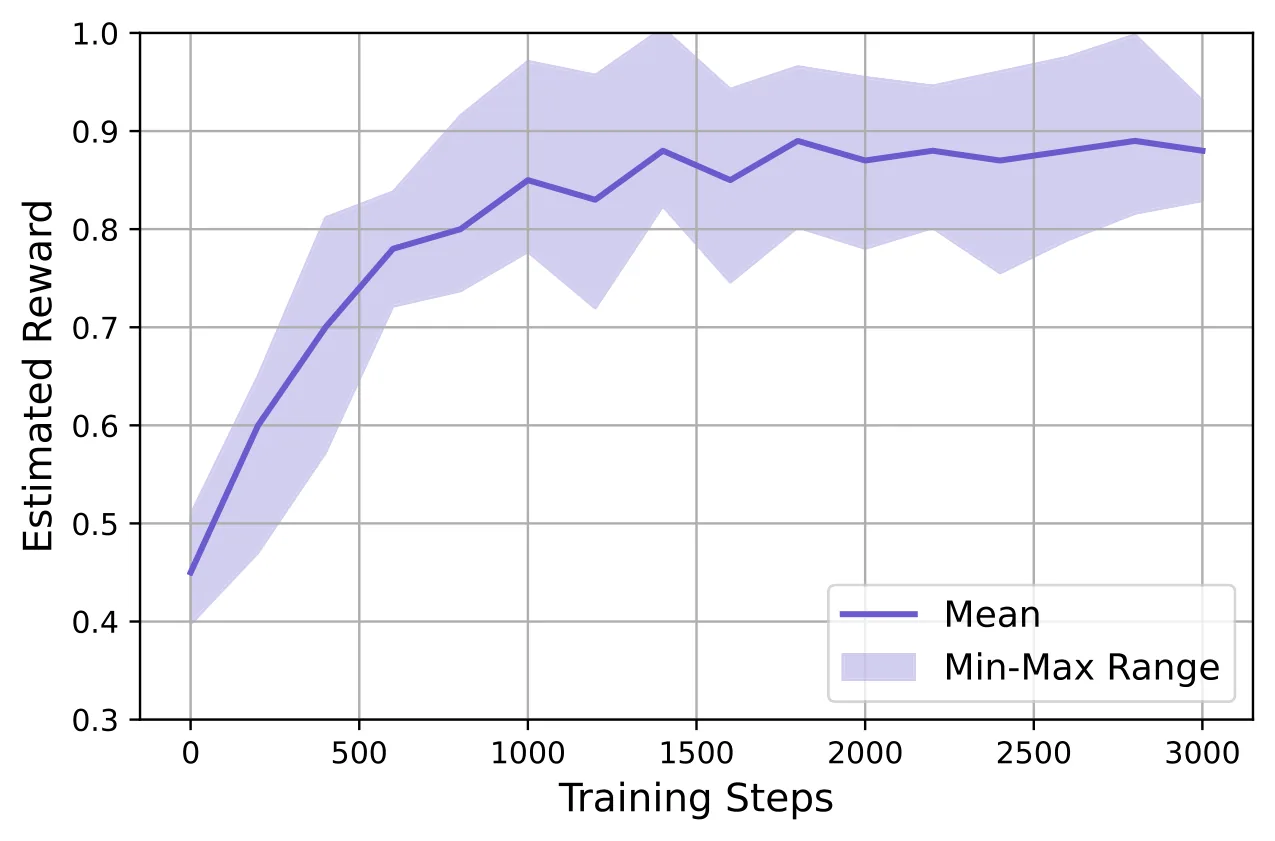
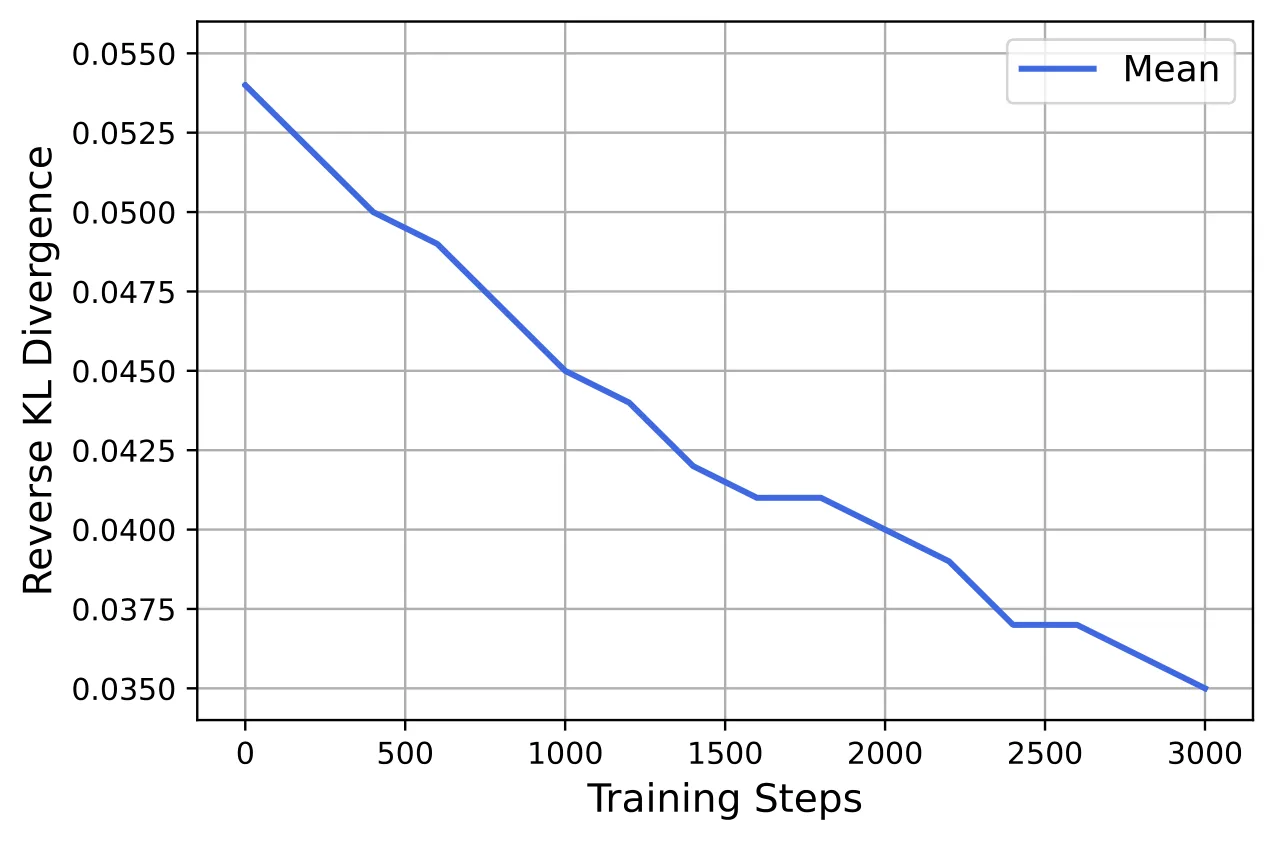
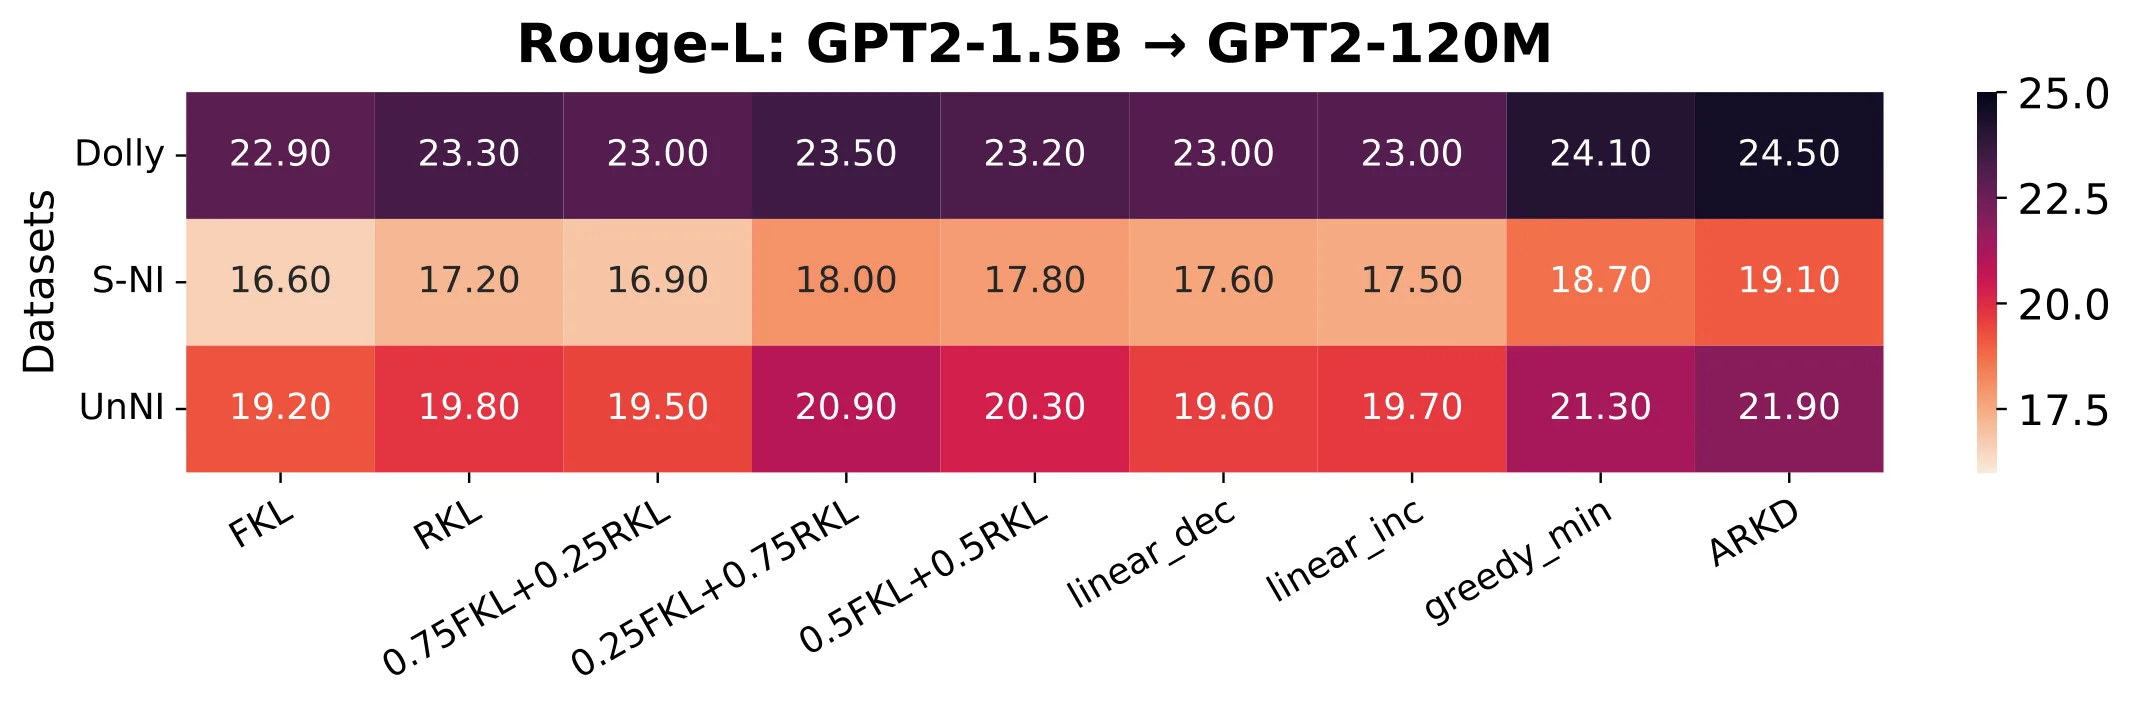
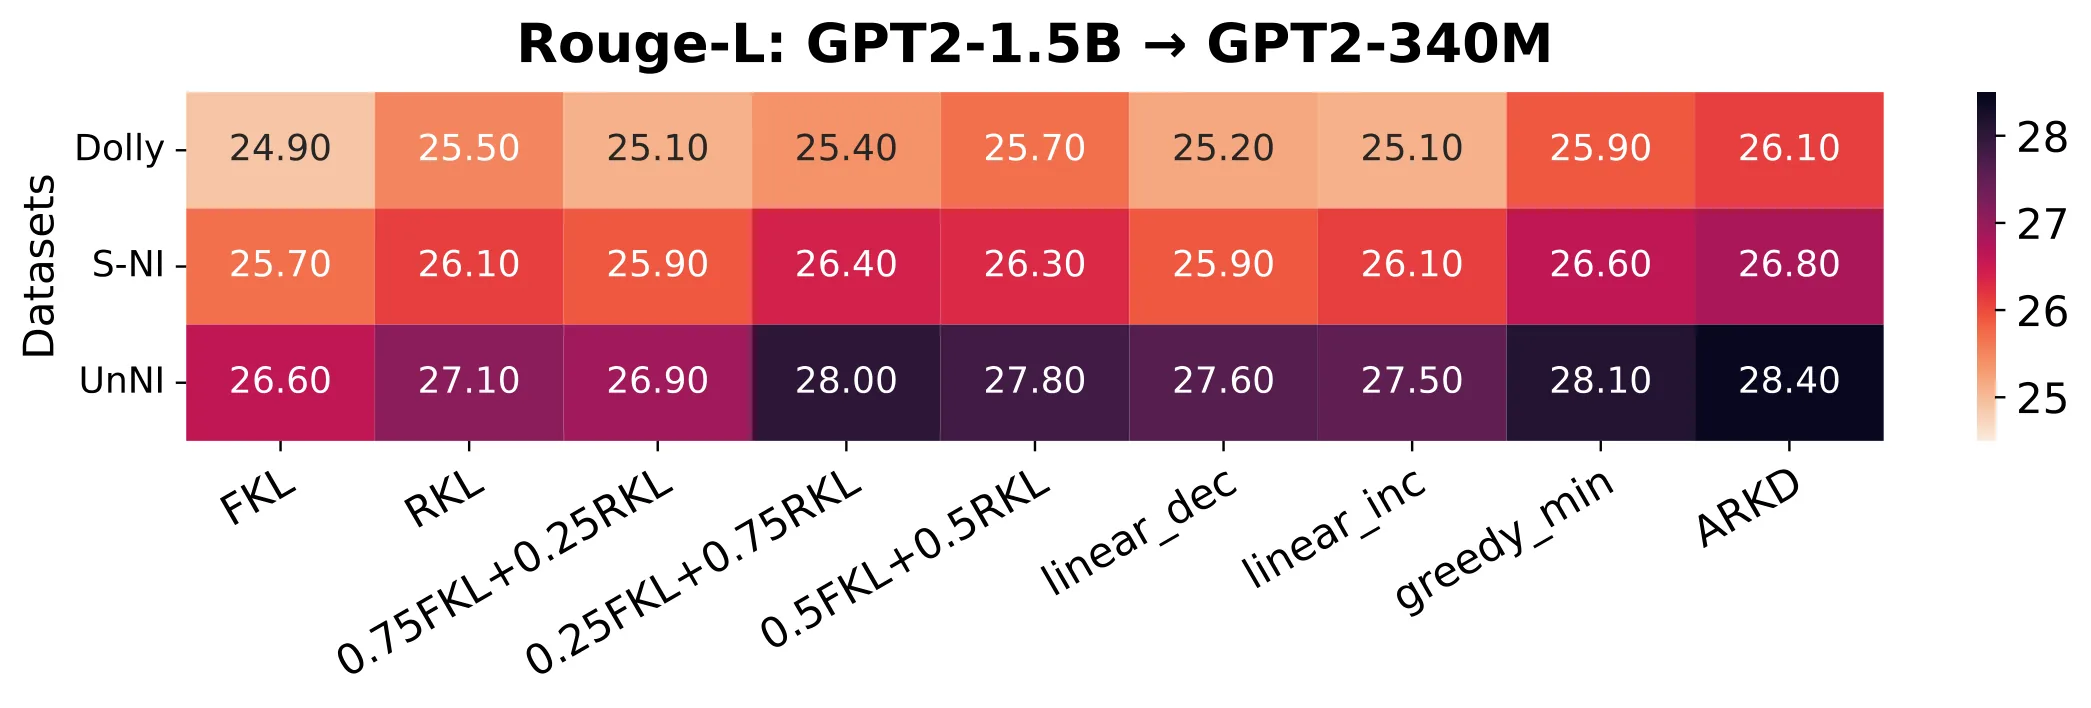
TL;DR
这篇论文针对大语言模型知识蒸馏中单一 KL 目标难以兼顾主分布拟合与长尾概率建模的问题,提出了名为 ARKD 的自适应双向 KL 散度蒸馏框架。该框架通过强化学习策略网络动态分配前向 KL 与反向 KL 的权重,使蒸馏过程能够同时对齐主模态与长尾模态。在多个基准数据集上的实验表明,该方法在 Rouge-L 与 BertScore 指标上较贪心启发式基线稳定提升 0.4–0.6 分。
研究背景与动机
大语言模型在自然语言生成任务中展现出强大的能力,但其庞大的参数量带来了显著的计算与存储成本。[[知识蒸馏]] 作为一种经典的模型压缩技术,旨在将教师模型的知识迁移到轻量级的学生模型中。在文本生成场景下,蒸馏的核心目标通常是让学生模型学习教师模型的输出分布,从而在保持生成质量的同时降低推理开销。
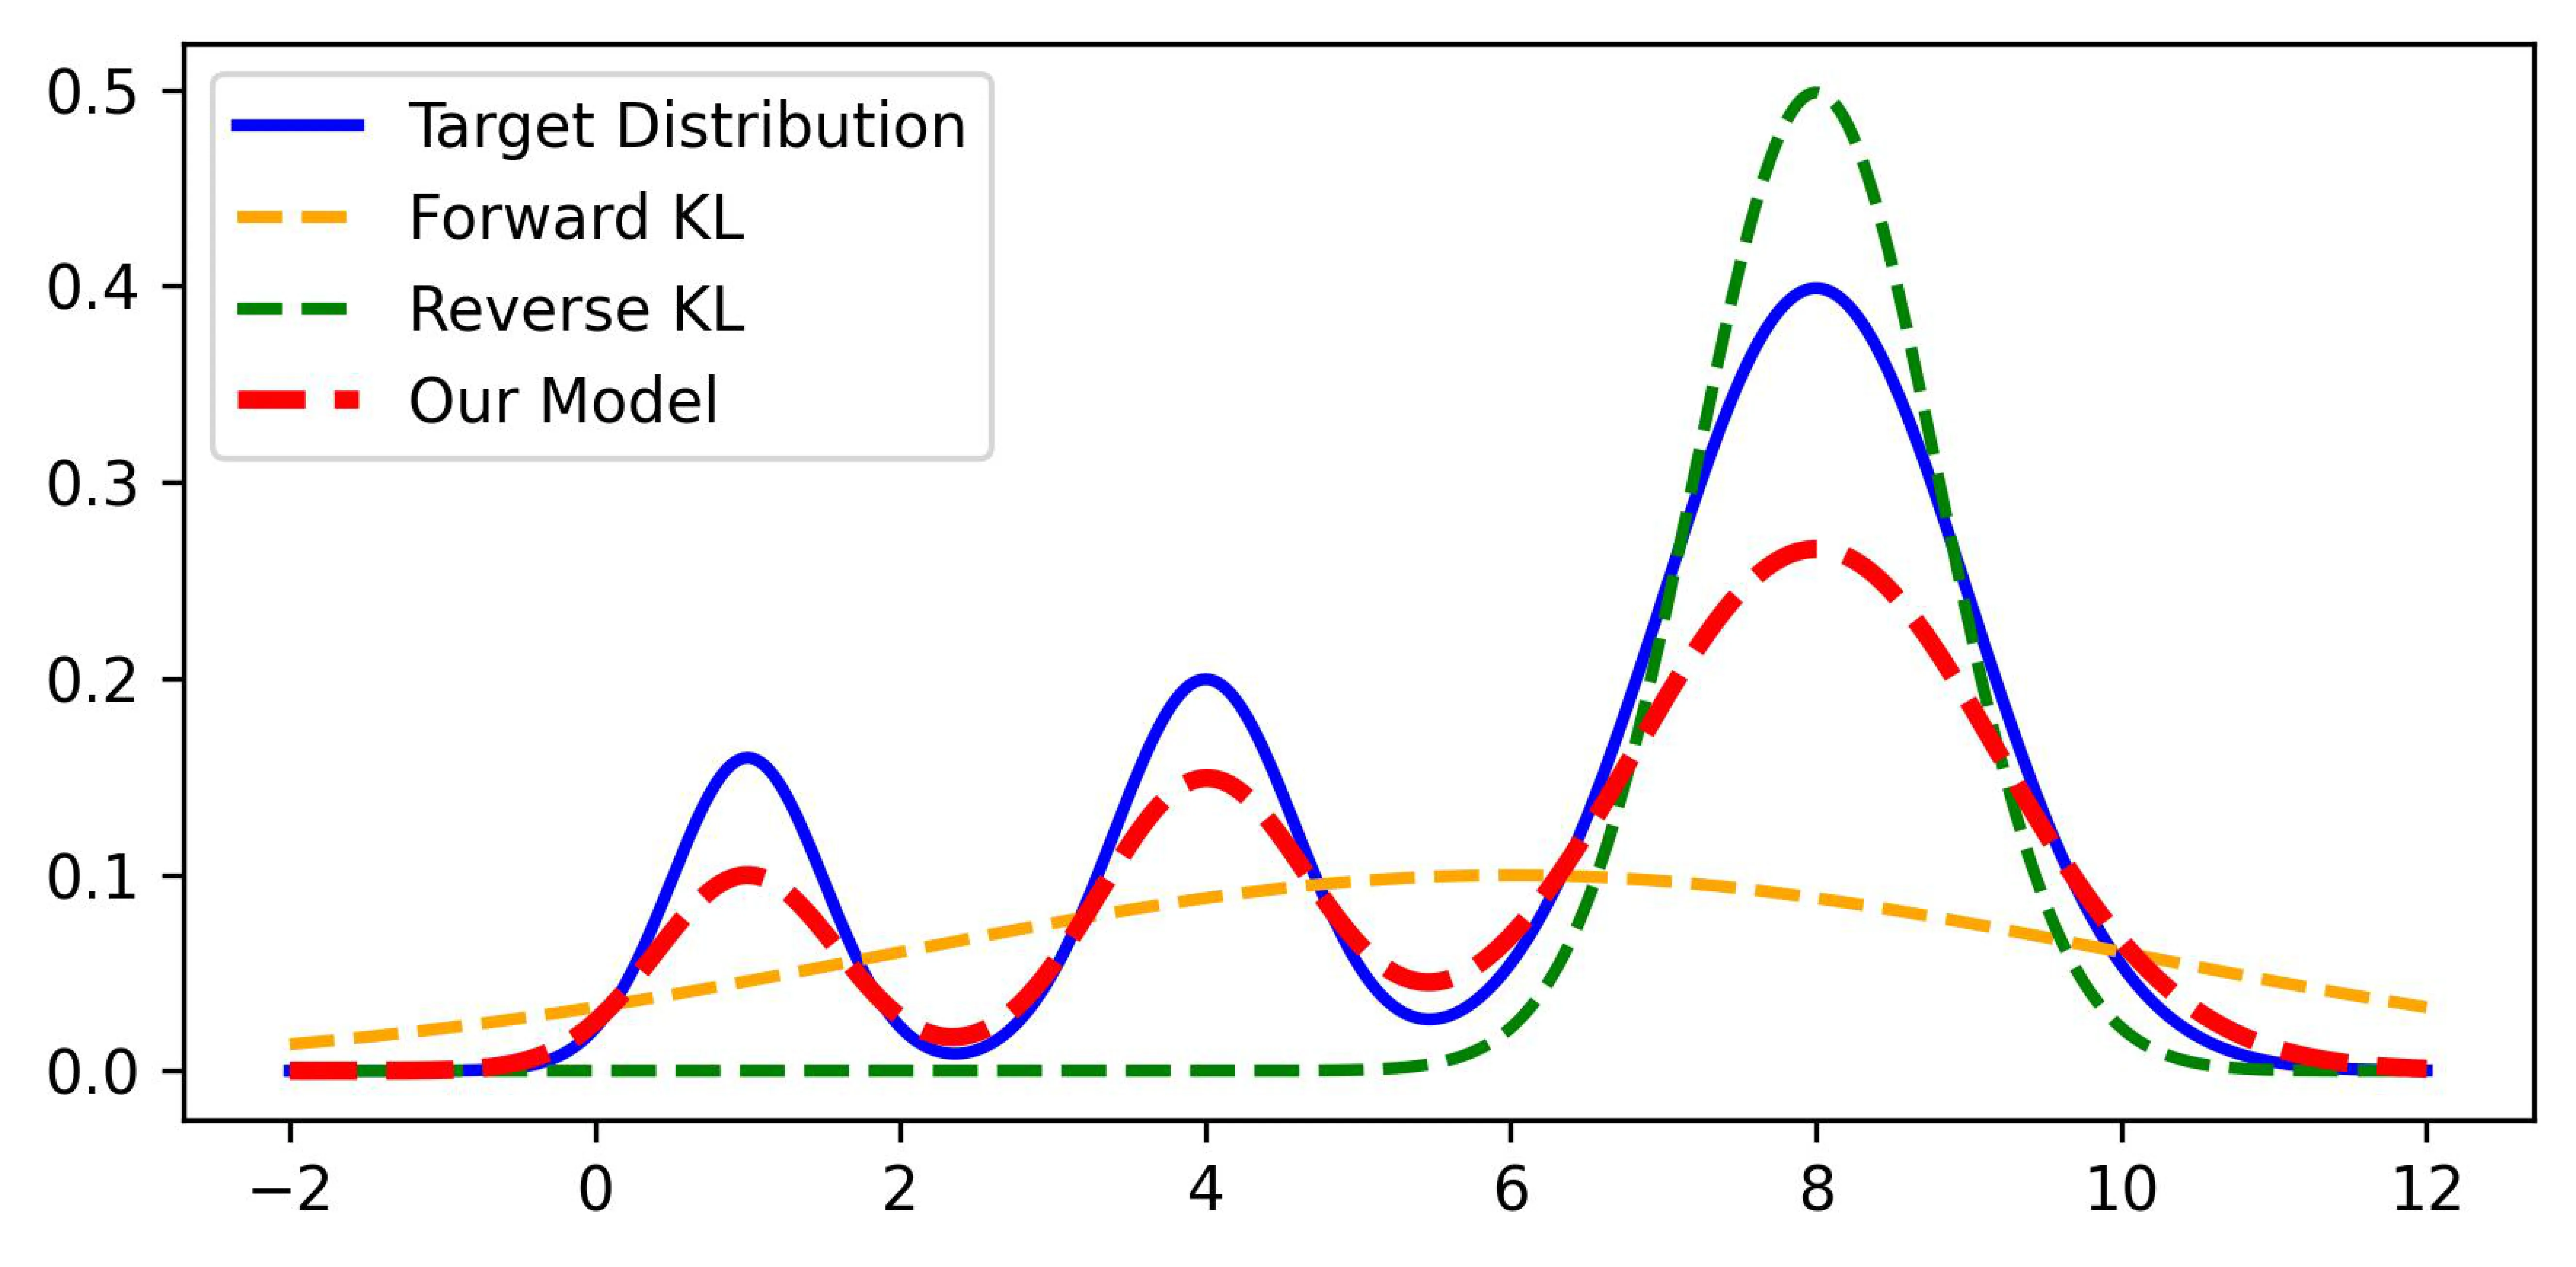
传统蒸馏方法通常以单一 [[KL 散度]] 作为优化目标,通过最小化学生分布与教师分布之间的差异来实现知识迁移。然而,这种做法存在一个根本性的困境:前向 KL 散度(FKL)与反向 KL 散度(RKL)在分布对齐上具有截然不同的几何特性。FKL 采用“最小覆盖”策略,会强迫学生分布覆盖教师分布的所有峰,但在低概率区域产生较大误差;RKL 则采用“峰值追踪”策略,专注于匹配教师分布的最高峰,但在未覆盖区域会产生模式平均的虚假结果。当文本分布具有多模态特性时,单一使用任一散度都无法同时满足主分布拟合与长尾概率建模的需求。
这篇论文的切入点正是这一理论与实践的鸿沟:如何在蒸馏过程中自适应地协调 FKL 与 RKL 的互补优势,使模型既能准确捕捉生成文本的主要模式,又不至于在长尾概率区域过度拟合或过度泛化。
方法
ARKD 的核心思想是将 FKL 与 RKL 的权重分配建模为一个[[强化学习]]决策问题,让策略网络根据即时的师生分布特征决定两种散度在当前样本上的相对重要性。
具体而言,框架首先定义了加权双向 KL 目标函数。对于给定的 token ,教师模型提供概率分布 ,学生模型提供概率分布 ,则加权 KL 损失可以表示为:
其中 是策略网络输出的权重函数,其取值范围为 。当 接近 1 时,损失函数趋向于前向 KL,迫使学生模型覆盖教师的所有概率模式;当 接近 0 时,损失函数趋向于反向 KL,专注于匹配教师的高概率区域。
策略网络的设计体现了该方法的创新性。网络以师生分布的统计特征作为输入,包括:教师概率的熵、学生概率的熵、两者概率比的方差、以及当前 token 在教师分布中的 rank 位置。这些特征共同刻画了当前决策点的分布形态——例如,当教师分布熵较低(高度确信)而学生分布与之偏离较大时,策略网络倾向于增大 FKL 权重以强制覆盖;反之,当教师分布在多个 token 上具有相近概率(多峰特征明显)时,增大 RKL 权重有助于聚焦主峰。
训练过程中,策略网络通过[[策略梯度]]方法优化,奖励信号由下游任务的生成质量指标(如 Rouge-L 或 BertScore)提供。这种即时奖励引导使得权重分配能够自适应地服务于最终生成效果,而非仅仅最小化分布距离。
与直觉做法的一个重要区别在于:传统方法往往使用固定的权重调度或简单的启发式规则(如基于概率阈值切换),而 ARKD 的策略网络能够根据每个 token 的局部上下文动态决策。这使得框架能够处理文本生成中普遍存在的分布异质性问题——同一序列的不同位置可能需要不同的对齐策略。
实验与结果
论文在多个文本生成基准上评估了 ARKD 的有效性,包括摘要生成、机器翻译和代码生成等任务。主要对比基线包括:标准 KL 蒸馏(使用固定权重 0.5)、纯 FKL 蒸馏、纯 RKL 蒸馏,以及基于概率阈值的贪心启发式方法。
实验结果显示,ARKD 在 Rouge-L 指标上平均提升 0.4–0.6 分,BertScore 也有类似幅度的改善。值得注意的是,这种提升在所有测试基准上均保持一致,没有出现某些任务上有提升而其他任务上性能回退的情况,显示出方法的鲁棒性。
消融实验进一步揭示了各模块的贡献。移除策略网络(即使用固定权重 0.5 的标准 KL)会导致性能下降约 0.3 分,说明动态权重分配本身具有独立价值。同时,仅使用分布特征而不使用强化学习奖励信号(即监督学习训练策略网络)也会显著削弱效果,证实了端到端优化策略对于捕捉任务相关偏好的必要性。
在定性分析上,研究者观察到 ARKD 在处理低频词和专有名词时表现尤为突出。这些词汇在教师分布中往往对应长尾概率区域,纯 FKL 方法倾向于过度平滑这些细节,而纯 RKL 方法则可能完全忽略它们。ARKD 的自适应机制使得模型能够根据上下文判断何时应该覆盖长尾模式、何时应该聚焦主峰。
讨论与可借鉴点
尽管 ARKD 在文本生成蒸馏任务上取得了显著进展,其仍存在若干局限。首先,策略网络的引入增加了训练的计算开销——额外的网络前向传播与梯度更新意味着更长的蒸馏时间。其次,策略网络的设计依赖于人工选择的分布特征,尽管实验表明这些特征具有良好的表达能力,但自动学习更优的特征表示仍是值得探索的方向。
从更宏观的视角看,这项工作揭示了[[知识蒸馏]]中目标函数设计的深层问题:单一标量损失往往无法完整刻画师生分布之间的复杂关系。将损失函数本身纳入优化范畴,而非固定为手工设计的形式,可能是未来蒸馏研究的重要趋势。
对于从事模型压缩与部署的实践者,ARKD 提供了一种即插即用的框架扩展思路。在资源允许的情况下,用强化学习机制增强已有的蒸馏流程,往往能带来稳定的性能增益,尤其当目标模型需要在分布异质性较高的数据上保持生成质量时。
摘要
知识蒸馏(KD)是压缩大语言模型(LLMs)的关键技术,但仅依赖单一 KL 目标的方法往往难以在主分布拟合与长尾概率建模之间取得平衡,限制了生成质量与泛化能力。为此,我们从理论与实验双重角度分析了前向 KL 散度与反向 KL 散度(FKL/RKL)在分布对齐中的互补作用。在此基础上,我们提出一种基于强化学习的自适应 KL 加权蒸馏框架,其中策略网络根据教师–学生分布特征动态地为 FKL 与 RKL 分配权重,并借助即时奖励信号实现主模态与长尾模态的协同对齐。大量实验表明,该方法在 Rouge-L 与 BertScore 指标上均取得稳定提升,较贪心启发式方法提高 0.4–0.6 分,并在多个基准上优于其他基线方法。
Abstract
Knowledge distillation (KD) is a key technique for compressing Large Language Models (LLMs), yet methods relying on a single KL objective often fail to balance primary distribution fitting with long-tail probability modeling, limiting both generation quality and generalization. To address this, we analyze the complementary roles of forward and reverse KL divergence (FKL/RKL) in distribution alignment from theoretical and empirical perspectives. We then propose a reinforcement-learning-based adaptive KL-weighted distillation framework, in which a policy network dynamically assigns weights to FKL and RKL based on teacher-student distributional characteristics, guided by immediate reward signals to achieve dual alignment on principal and long-tail modes. Extensive experiments demonstrate consistent improvements across Rouge-L and BertScore metrics, surpassing greedy heuristics by 0.4-0.6 points and outperforming other baseline methods on diverse benchmarks.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。