
📝 TLDR
深度强化学习在机器人、自动驾驶等安全关键场景中因黑盒特性难以部署。本文以倒立摆为基准,将高性能TD3教师策略蒸馏为浅层决策树学生模型,并引入物理感知特征与噪声Oracle轨迹生成数据。蒸馏后学生性能与教师相当,但控制论分析揭示连续到离散转换会引发高频Bang-Bang执行与稳定双模极限环,同时保持BIBO稳定性。该工作为安全自主系统提供了兼顾全局与局部可解释性的连续控制DRL解释方案。
🧭 速览
深度强化学习在安全关键领域因黑盒特性难以满足监管合规与人类信任需求。
以倒立摆为基准,采用TD3作为教师、浅层决策树作为学生进行策略蒸馏,并利用物理感知特征与噪声Oracle轨迹构造训练集。
学生代理性能与教师相当;连续到离散规则的转换引发Bang-Bang执行与双模极限环。
BIBO稳定性得以保持,模型同时具备全局与局部可解释性,适合安全自主系统部署。
🆚 方法对比
TD3 (Twin Delayed DDPG)
- 在高维连续控制任务中性能优异
- 适合作为蒸馏教师提供专家策略
- 深度网络黑箱特性,缺乏可解释性
- 难以满足安全关键领域法规合规要求
- 资源消耗大,不利于边缘部署
Shallow Decision Tree Student
- 天然可解释,提供全局与局部可解释性
- 结构简单,易于形式化验证
- 内存与推理开销低,适合嵌入式部署
- 离散叶节点产生量化误差,精度受限
- 高频Bang-Bang切换导致执行器磨损
- 表达能力有限,难以逼近复杂连续策略
VIPER Algorithm
- 通过Dataset Aggregation缓解协变量偏移
- 使用Q值差距加权损失,关注性能退化区域
- 支持对提取出的控制逻辑进行形式化验证
- 需部署初始可能不安全的策略,存在风险
- 依赖教师的Q函数估计,计算开销增加
- 对教师模型质量敏感,误差会被继承
Physics-Aware Policy Distillation Framework
- 引入物理感知特征,提升蒸馏效率与精度
- Noisy Oracle Rollouts增强数据集多样性与鲁棒性
- 保持BIBO稳定性同时实现可解释部署
- 连续到离散映射产生双峰极限环与颤振
- 依赖手工设计的物理特征,泛化性受限
- 实验仅基于倒立摆基准,场景覆盖不足
Noisy Oracle Rollouts
- 通过注入噪声覆盖更广的状态分布
- 增强学生策略对未见状态的鲁棒性
- 缓解静态数据集的分布偏差问题
- 噪声水平难以调优,过大影响性能
- 增加计算与仿真成本
- 可能引入与真实环境不符的状态
Bang-Bang Control (离散控制行为)
- 实现简单,仅需开关式执行机构
- 便于逻辑验证与安全分析
- 产生高频切换,执行器易疲劳损坏
- 离散动作可能引入稳态误差
- 能量效率低于连续控制策略
BIBO Stability Analysis
- 为离散控制器提供形式化稳定性保证
- 支持安全关键系统的合规验证
- 可与控制理论工具无缝结合分析
- 仅保证有界输入输出有界输出,不保证最优性
- 分析依赖具体系统模型,可移植性有限
本文以TD3为教师、浅层决策树为学生的策略蒸馏框架(结合物理感知特征与Noisy Oracle Rollouts),通过VIPER算法缓解协变量偏移,将连续黑箱策略蒸馏为可解释的离散规则,并以BIBO稳定性分析验证安全性;核心权衡是获得可解释性的同时引入了Bang-Bang控制与双峰极限环等离散动态副作用。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 7 张)
展开查看 7 张图
TL;DR
本文将高性能深度强化学习策略通过蒸馏技术转化为可解释的决策树模型,为安全关键场景下的DRL部署提供了透明化方案。在倒立摆基准上,蒸馏后的学生策略性能逼近原始TD3教师策略,控制理论分析进一步揭示了连续控制到离散规则控制的本质权衡:这种转换会自然产生高频Bang-Bang执行模式和双模极限环,但有界输入有界输出(BIBO)稳定性依然得到保证。
研究背景与动机
深度强化学习在机器人操控、自动驾驶等安全关键领域的应用面临根本性障碍:深度神经网络的[[黑盒特性]]使得决策过程难以被人类理解和验证。当系统出现意外行为时,工程师往往无法追溯原因,更无法向监管机构证明系统的安全性。这种透明度缺失严重制约了DRL技术的实际部署。
现有的可解释强化学习方法主要分为两类:事后解释方法试图在策略训练完成后为其添加解释层,但这些解释往往是对行为的事后归因,难以保证与真实决策机制的一致性;内在可解释模型则从设计层面采用简化的模型架构,如[[决策树]]、规则集或线性模型,但这类方法通常伴随着显著的性能损失。
本文的切入点是策略蒸馏(Policy Distillation):不追求从头训练一个可解释模型,而是将高性能但不透明的深度神经网络教师策略的知识转移到一个结构简单的学生模型中。这种方法的核心假设是,复杂策略学到的控制知识可以被压缩到一个更简洁的表示中,而不会完全丧失有效性。
方法
整个框架围绕倒立摆(Inverted Pendulum)这个经典控制基准展开。选择这个任务的动机很明确:倒立摆既是控制理论的标准测试平台,又足够简单到可以手动分析其动力学特性,便于进行控制理论层面的深入分析。
教师模型采用双延迟深度确定性策略梯度算法(TD3),这是一个面向连续控制任务的深度强化学习算法。TD3通过双Q网络和延迟策略更新等技巧,有效缓解了深度Q学习中的过估计问题,在连续控制任务上取得了优异的性能表现。作为一个训练充分的深度神经网络,TD3策略本身的行为模式对人类而言是不透明的。
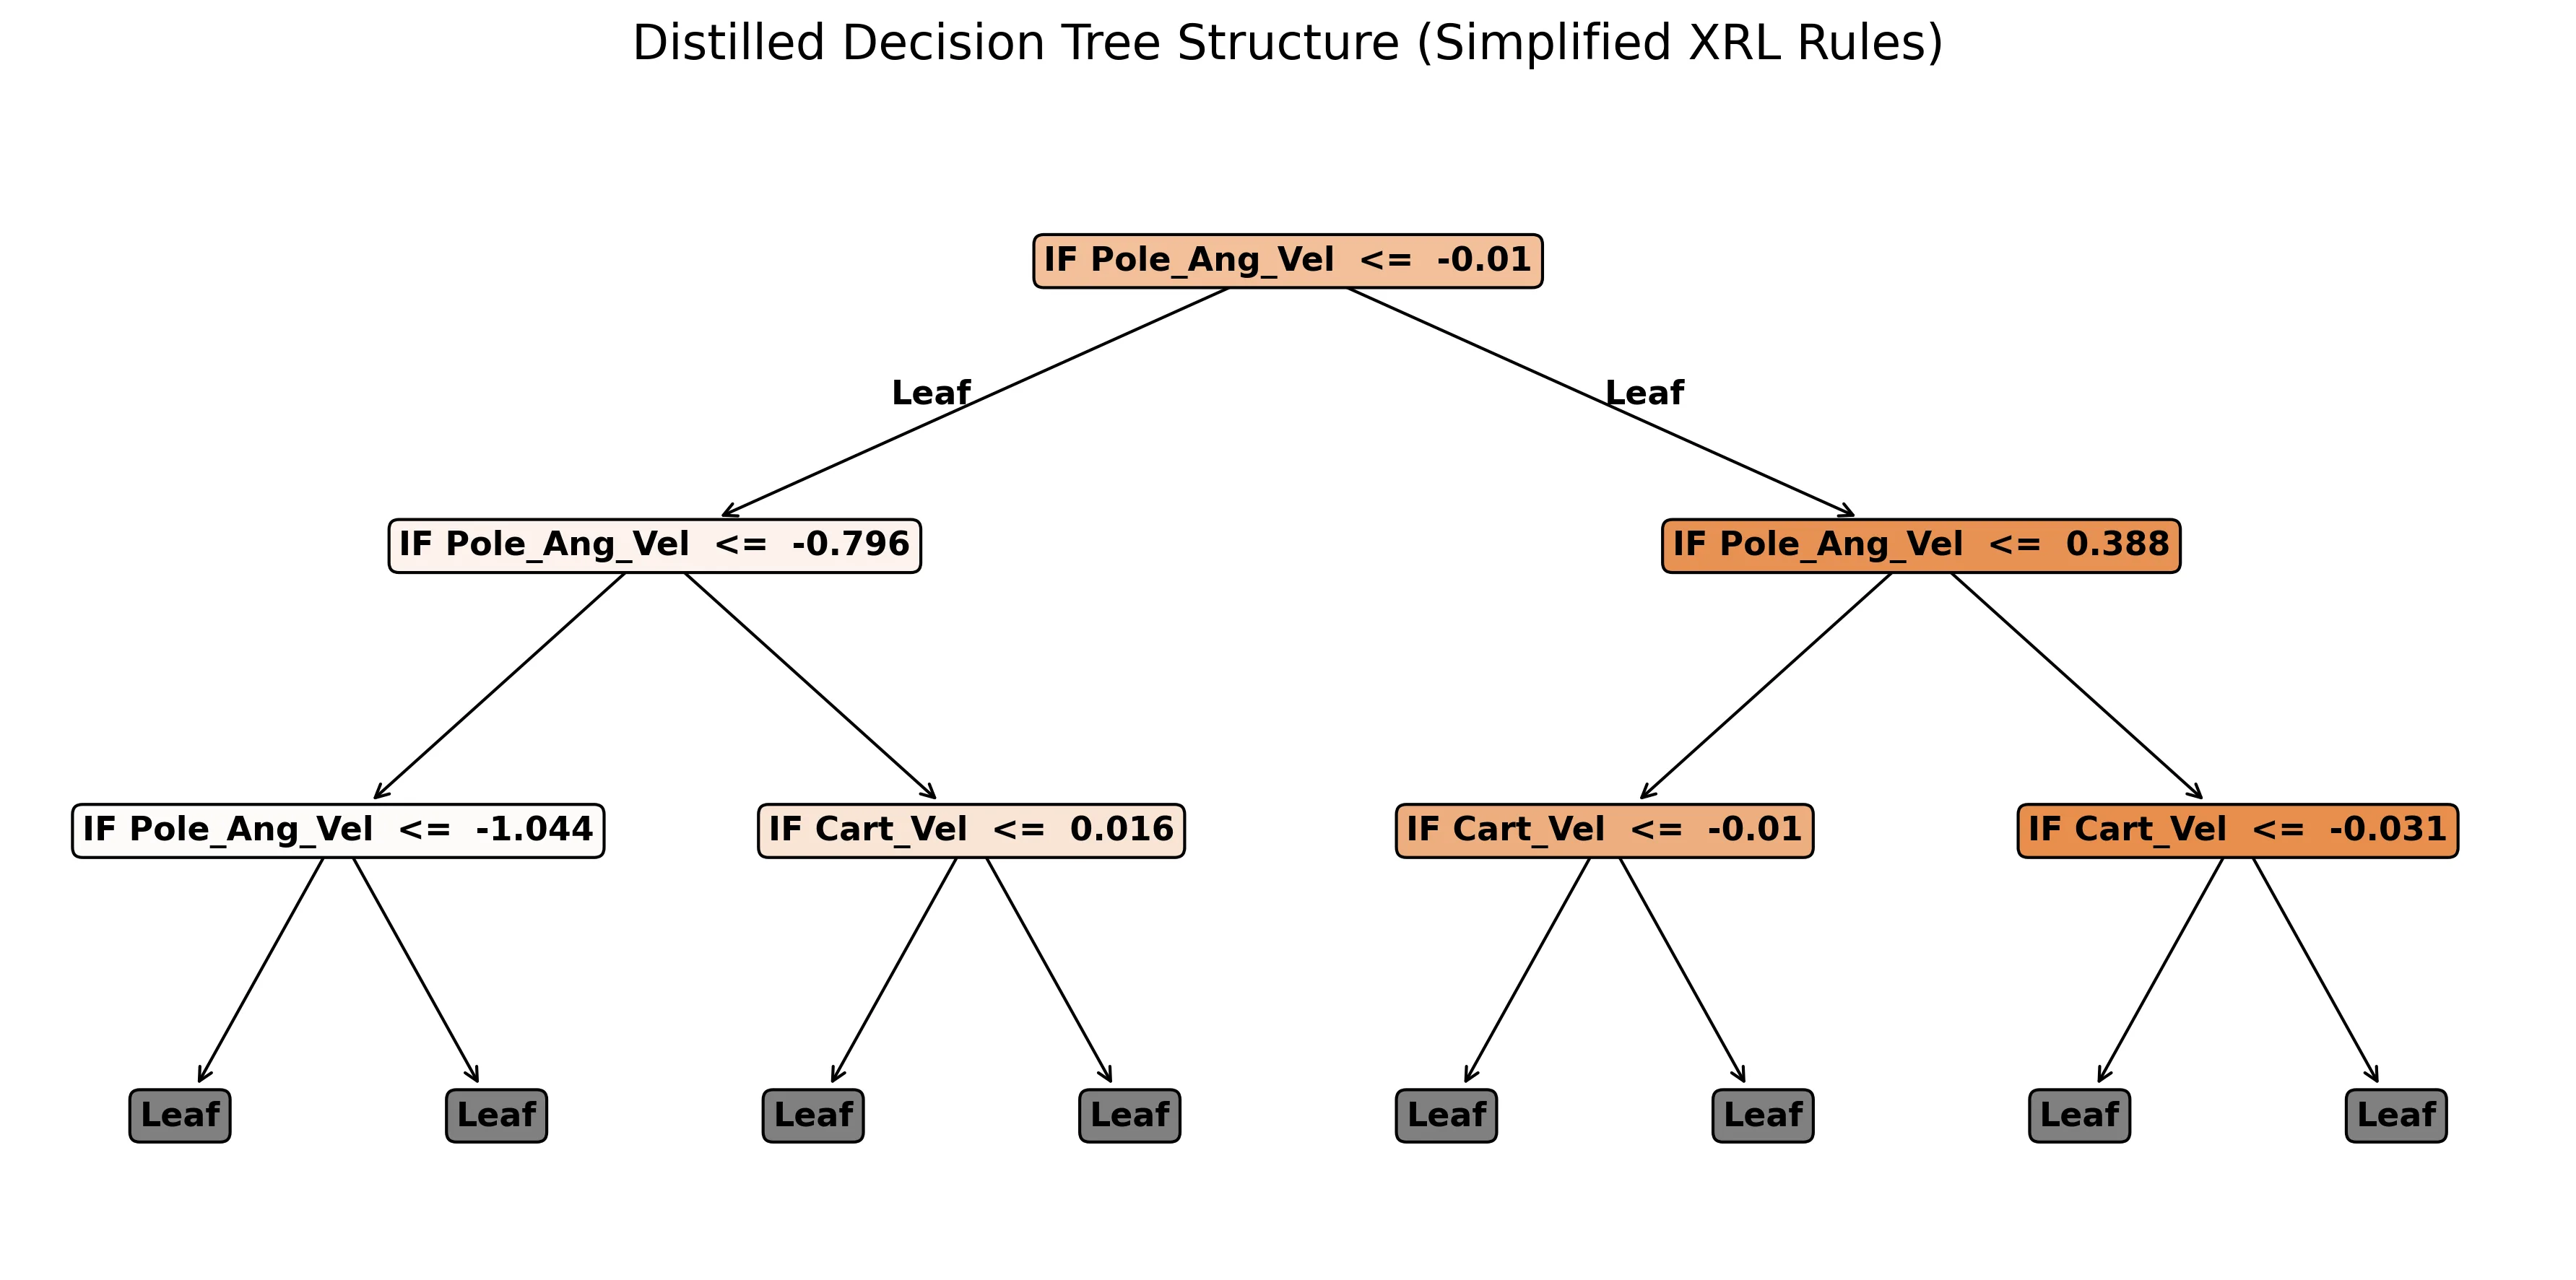
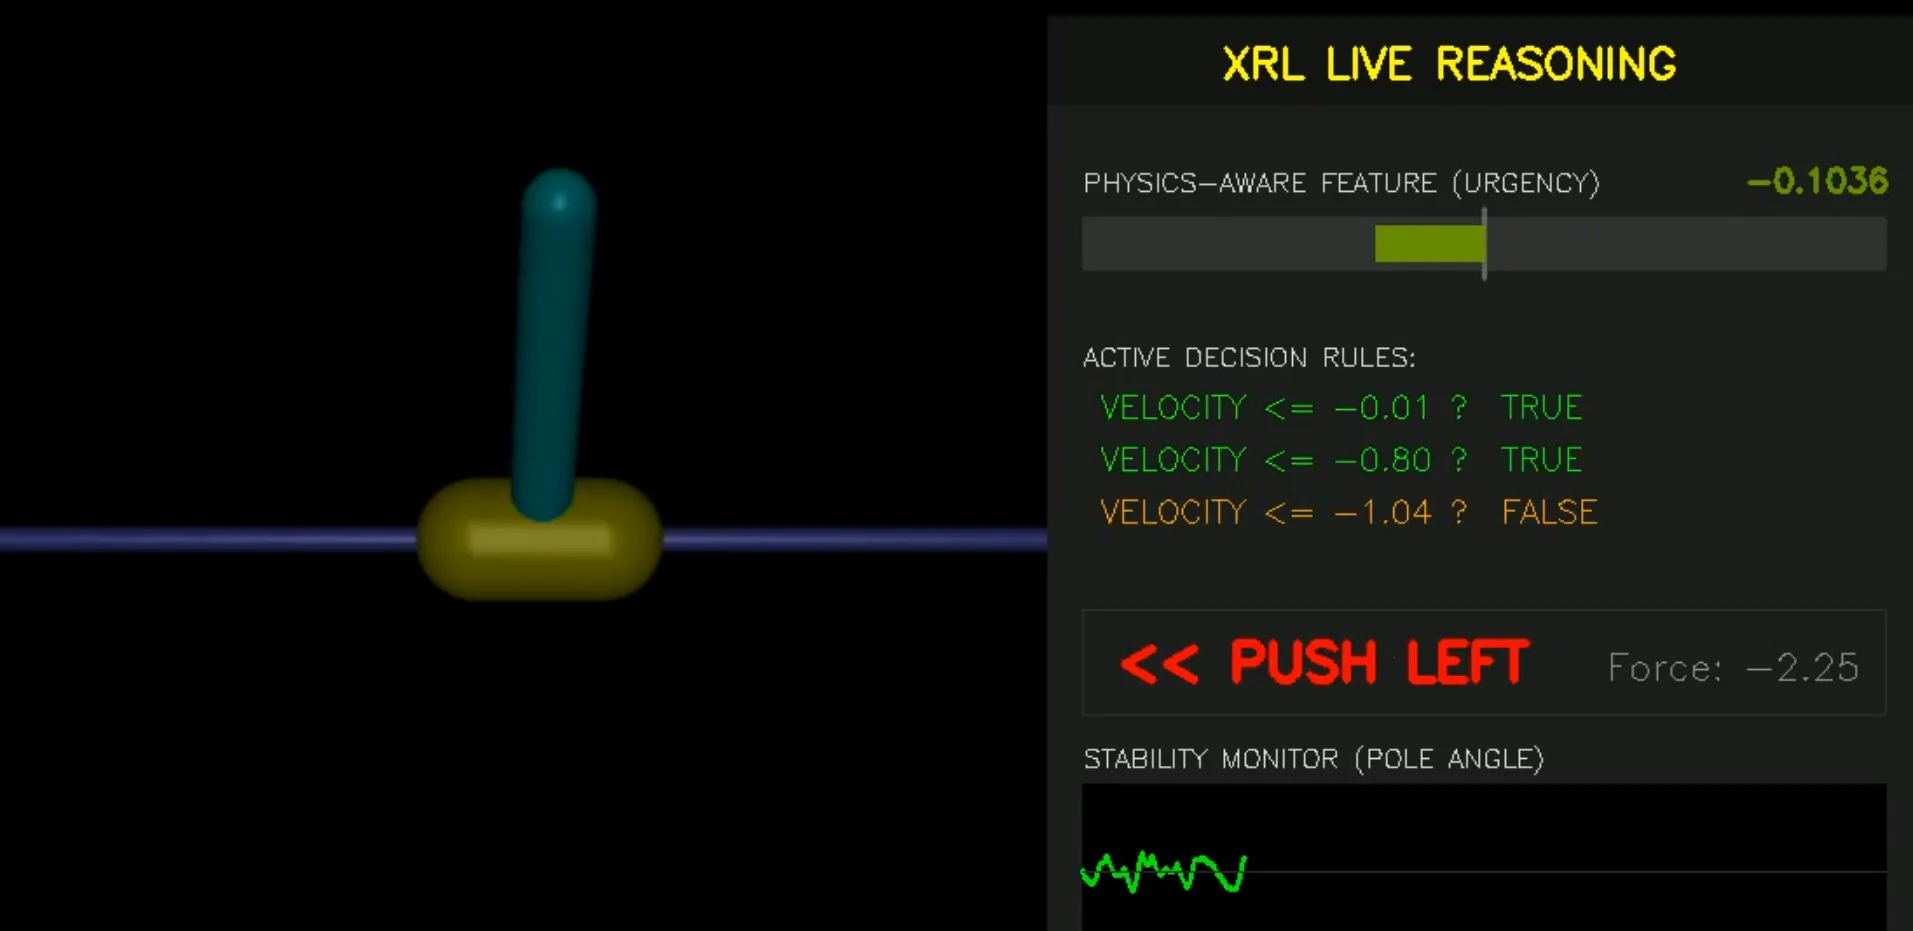
学生模型选用浅层[[决策树]]。与神经网络不同,决策树的决策过程可以被完整地追踪:给定一个输入状态,沿着树的根节点走到叶节点,路径上的所有分裂条件就构成了决策的全部依据。这种天然的局部可解释性使得决策树成为策略蒸馏的理想学生候选。
蒸馏过程的关键在于数据生成策略。作者提出了"噪声Oracle回放"(Noisy Oracle Rollouts)方法:让训练好的TD3教师策略在环境中大量采样轨迹数据。这些轨迹的输入是环境状态,输出标签是教师策略给出的动作。为了增加数据的多样性和覆盖范围,在采样过程中加入精心控制的噪声扰动。这种数据增强策略有助于决策树学习到教师策略在各种状态下的行为模式,而不仅仅是少数几个典型情况。
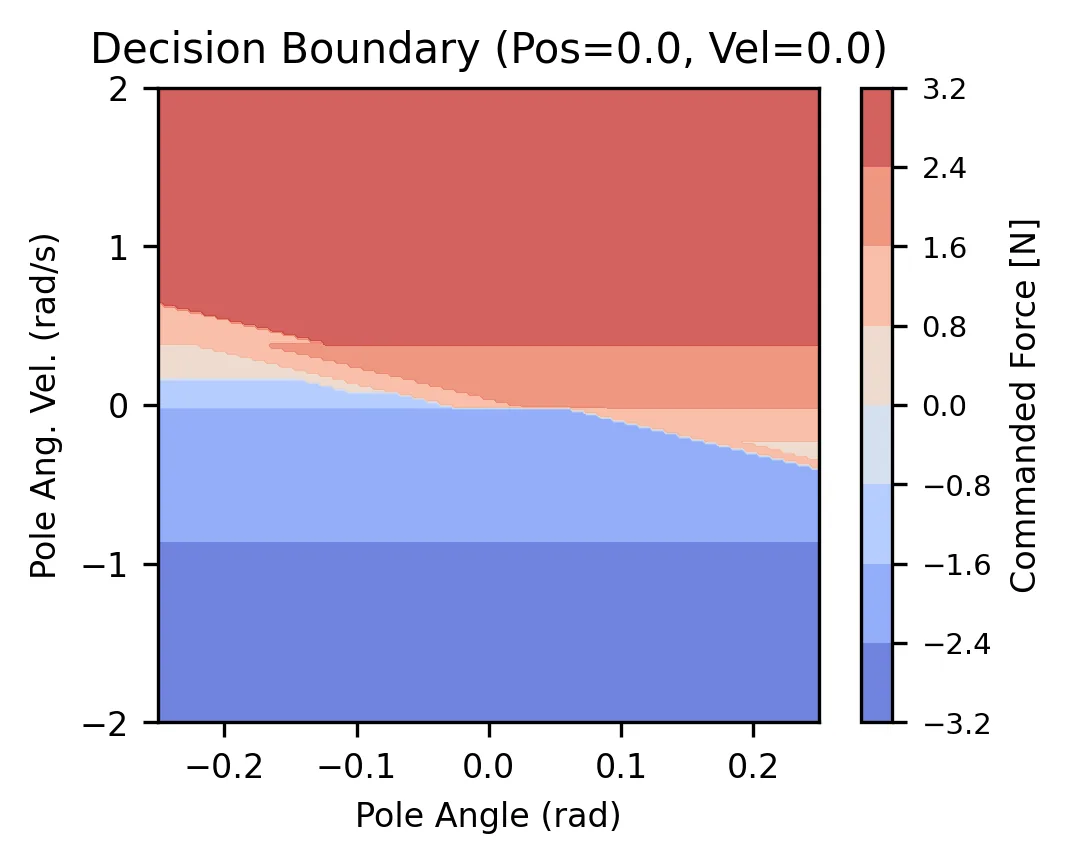
另一个重要设计是物理感知特征工程。作者没有直接使用原始状态变量作为决策树的输入,而是构建了针对倒立摆动力学的自定义特征。这类特征往往包含了与控制目标直接相关的物理量(如摆角、角速度的组合),使得决策树能够更容易地识别出有效的决策边界。特征工程在这里的作用是降低学生模型的学习难度,让它在有限的树深度下也能捕获策略的核心逻辑。
实验与结果
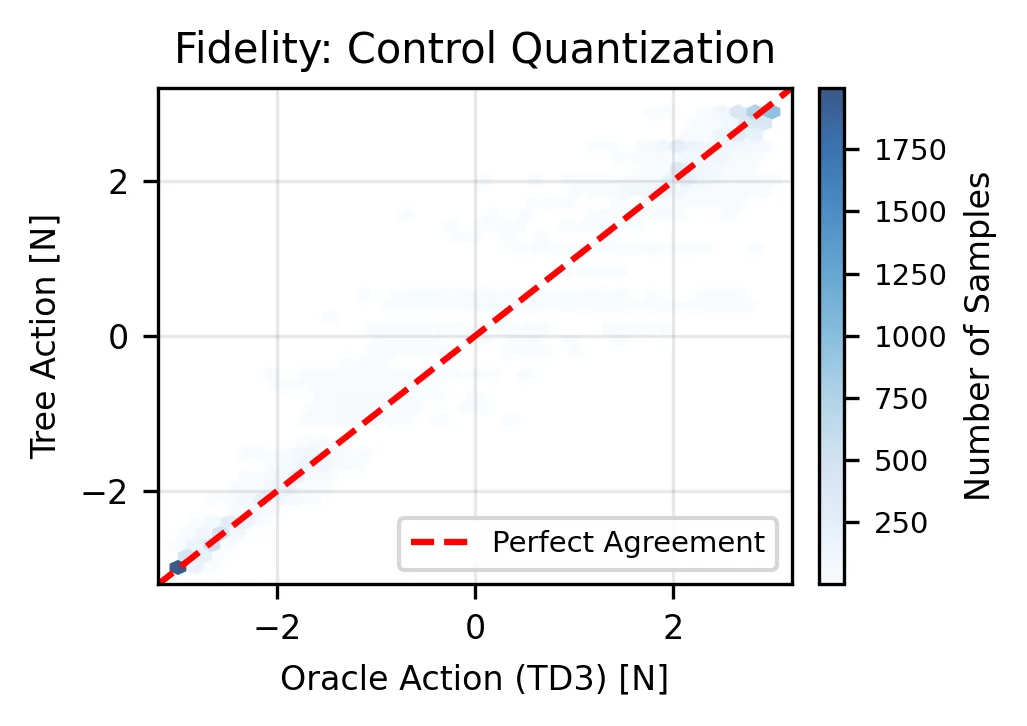
实验首先验证了蒸馏后学生策略的性能。浅层决策树在倒立摆任务上达到了与TD3教师相当的累计奖励水平,消融实验进一步表明物理感知特征和噪声Oracle回放两个设计都对最终性能有显著贡献。这说明精心设计的数据生成策略确实能够帮助简单的学生模型学到接近专家水平的控制策略。
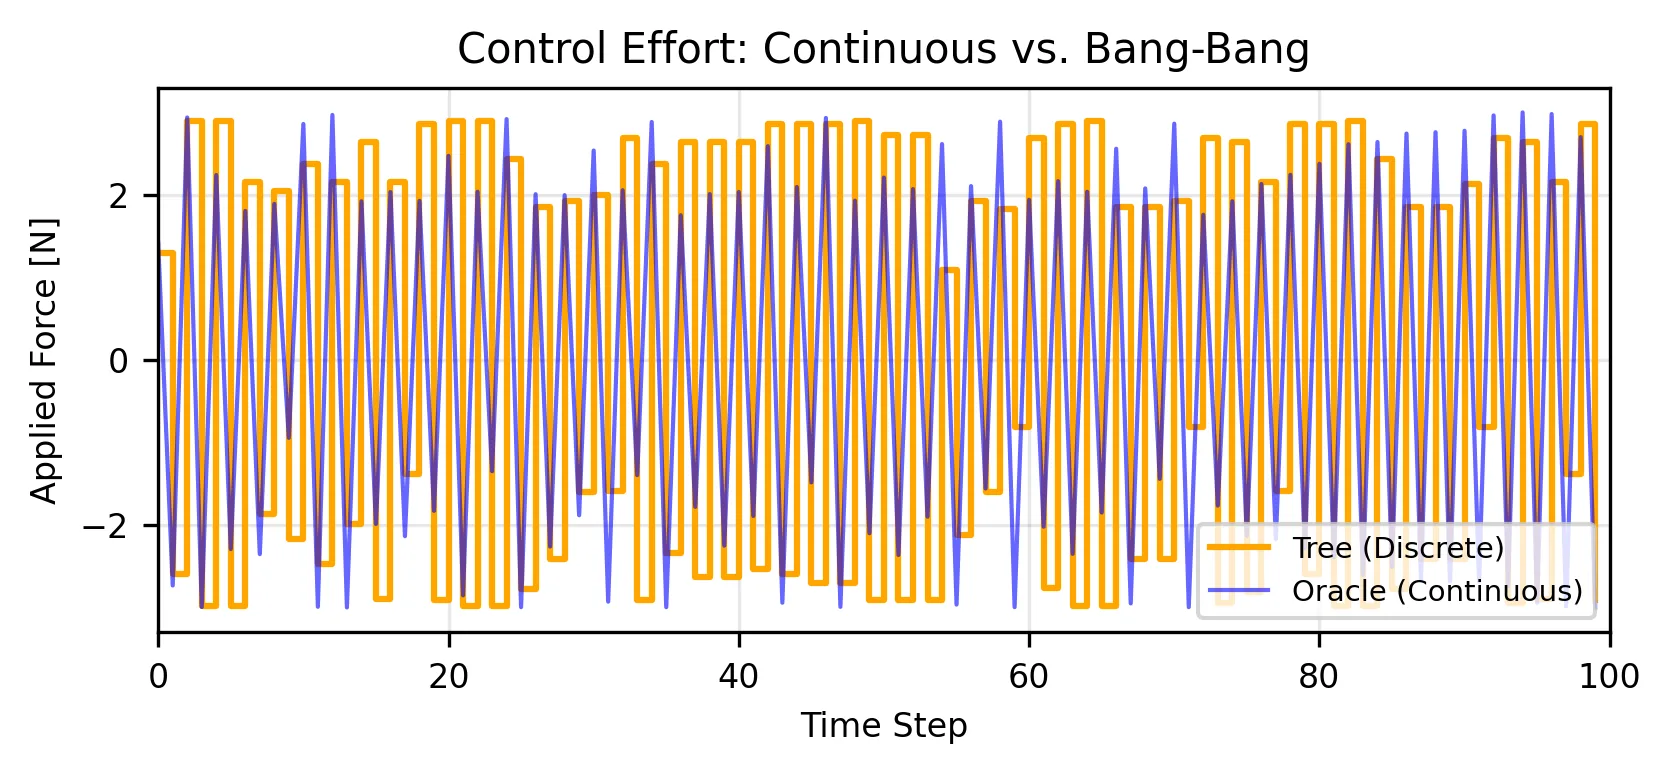
然而,性能对比只是故事的一部分。更深入的分析来自控制理论视角的考察。研究者将蒸馏得到的决策树策略与原始TD3策略的控制表现进行了对比,发现了一个本质性的差异:决策树策略的行为呈现明显的高频振荡模式,这与经典控制理论中的Bang-Bang控制现象高度吻合。
Bang-Bang控制是一类特殊的离散控制策略,其特征是控制动作在最大值和最小值之间切换,没有中间值。在倒立摆场景中,这意味着电机要么全速顺时针转动、要么全速逆时针转动,而不是平滑地调节转速。为什么会产生这种现象?原因在于[[决策树]]的叶节点只能输出离散的动作值,而浅层树的有限叶节点数量迫使它将连续的状态空间划分成粗粒度的区域。每个区域对应一个固定的动作,当摆杆状态落入某个区域时,系统就执行该区域对应的极端动作。
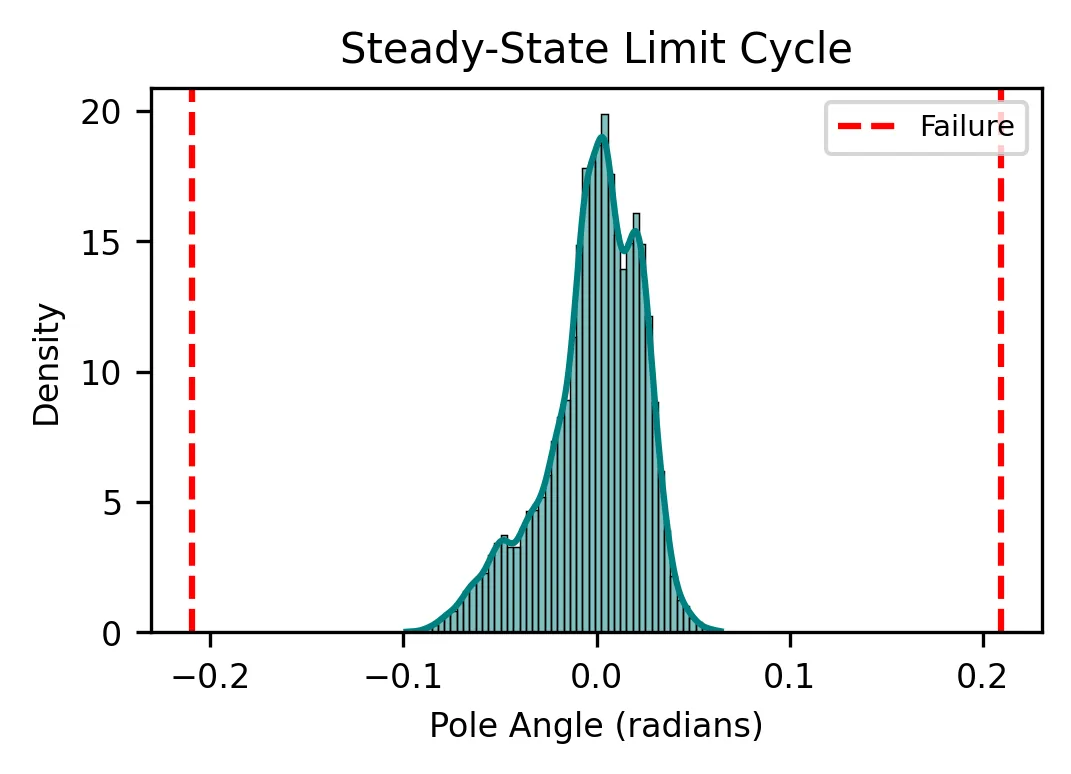
控制理论分析进一步揭示,这种高频Bang-Bang执行会引入一个稳定的双模极限环。极限环是非线性系统中一类特殊的周期性运动轨迹,双模则指系统在两个不同的运动模式之间交替切换。在倒立摆的例子中,一个模式对应摆杆顺时针摆动时电机全力制动,另一个模式对应逆时针摆动时的全力驱动。两个模式交替进行,形成持续的振荡。
尽管存在这种振荡,一个关键的安全性指标——[[BIBO稳定性]](有界输入有界输出稳定性)——仍然得到保持。这意味着对于任何有界的扰动输入,系统的输出也是有界的,不会发散到无穷大。这一结论对于安全关键应用场景尤为重要,因为它保证了系统在面对外部干扰时的基本稳定性。
讨论与可借鉴点
这项工作的一个重要贡献在于揭示了连续控制DRL策略向离散可解释模型蒸馏时面临的根本性权衡。连续动作空间的DRL策略能够实现平滑、精细的控制,但这恰恰依赖于神经网络对状态空间的连续映射能力。当这种能力被压缩到离散的决策规则中时,性能虽然可以保持,但控制模式会发生质变——从精细调节变为高频开关控制。
这种权衡对实践者有重要启示。如果应用场景要求平滑的控制输出(比如精密机械臂的轨迹跟踪),纯粹的决策树可能不是最佳选择,此时应该考虑其他可解释架构如注意力机制或概念瓶颈模型。但如果应用场景可以接受开关式控制(比如某些类型的温度调节或简单的摆平衡任务),且对可解释性有强烈需求,那么这种蒸馏范式提供了可行的技术路径。
实验分析的另一个价值在于提供了可解释强化学习研究的方法论参考。通过引入控制理论工具(稳定性分析、极限环分析、Bang-Bang控制理论),研究者能够对蒸馏策略的行为做出比单纯的性能对比更深刻的解释。这种跨学科的分析视角值得借鉴。
当然,研究也存在局限性。倒立摆是一个相对简单的基准任务,其结论能否推广到高维状态空间、复杂动力学或真实机器人系统,仍需要进一步验证。此外,浅层决策树的表达能力毕竟有限,对于更复杂的控制任务,可能需要更深的树结构或混合架构来平衡可解释性与性能。
摘要
在机器人、自动驾驶等安全关键领域,深度强化学习(DRL)的部署常常因深度神经网络的黑盒特性而受到阻碍。这种透明度缺失对法规合规性和人机信任构成了重大挑战。本文开展了一项实验研究,旨在使高性能连续控制DRL系统具备可解释性。本文采用经典倒立摆基准实现了一个策略蒸馏框架,其中高性能的双延迟DDPG(TD3)智能体作为不透明的连续控制教师模型,其策略被蒸馏到基于浅层决策树的可解释学生代理模型中。通过利用一个自定义的物理感知特征以及用于生成数据集的"噪声预言机回放"(Noisy Oracle Rollouts),蒸馏过程达到了与专家教师相当的性能。此外,比较控制理论分析揭示了一个根本性权衡:从连续控制过渡到基于规则的离散控制会引发高频的Bang-Bang驱动以及一个稳定的双峰极限环。仿真结果表明,在为安全自主系统提供全局和局部可解释性的同时,有界输入有界输出(BIBO)稳定性仍然得以保持。
Abstract
In safety-critical sectors such as robotics and automotive engineering, the deployment of Deep Reinforcement Learning (DRL) is often hindered by the black-box nature of deep neural networks. This lack of transparency poses significant challenges for regulatory compliance and human-agent trust. This paper presents an experimental study aimed at making high-performance continuous control DRL systems interpretable. A policy distillation framework is implemented using the classic Inverted Pendulum benchmark. A high-performance Twin Delayed DDPG (TD3) agent serves as an opaque, continuous teacher model, whose policy is distilled into an interpretable student surrogate based on a shallow Decision Tree. By leveraging a custom physics-aware feature and "Noisy Oracle Rollouts" for dataset generation, the distillation process achieves performance equivalent to the expert teacher. Furthermore, comparative control theory analysis reveals a fundamental trade-off: transitioning from continuous to discrete rule-based control induces high-frequency Bang-Bang actuation and a stable bimodal limit cycle. Simulation results indicate that Bounded-Input Bounded-Output (BIBO) stability is maintained while providing both global and local interpretability for safe autonomous systems.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。