
β-OPSD:以策略优化推导,以自蒸馏训练
-OPSD: Deriving with Policy Optimization, Training with Self-Distillation
📝 TLDR
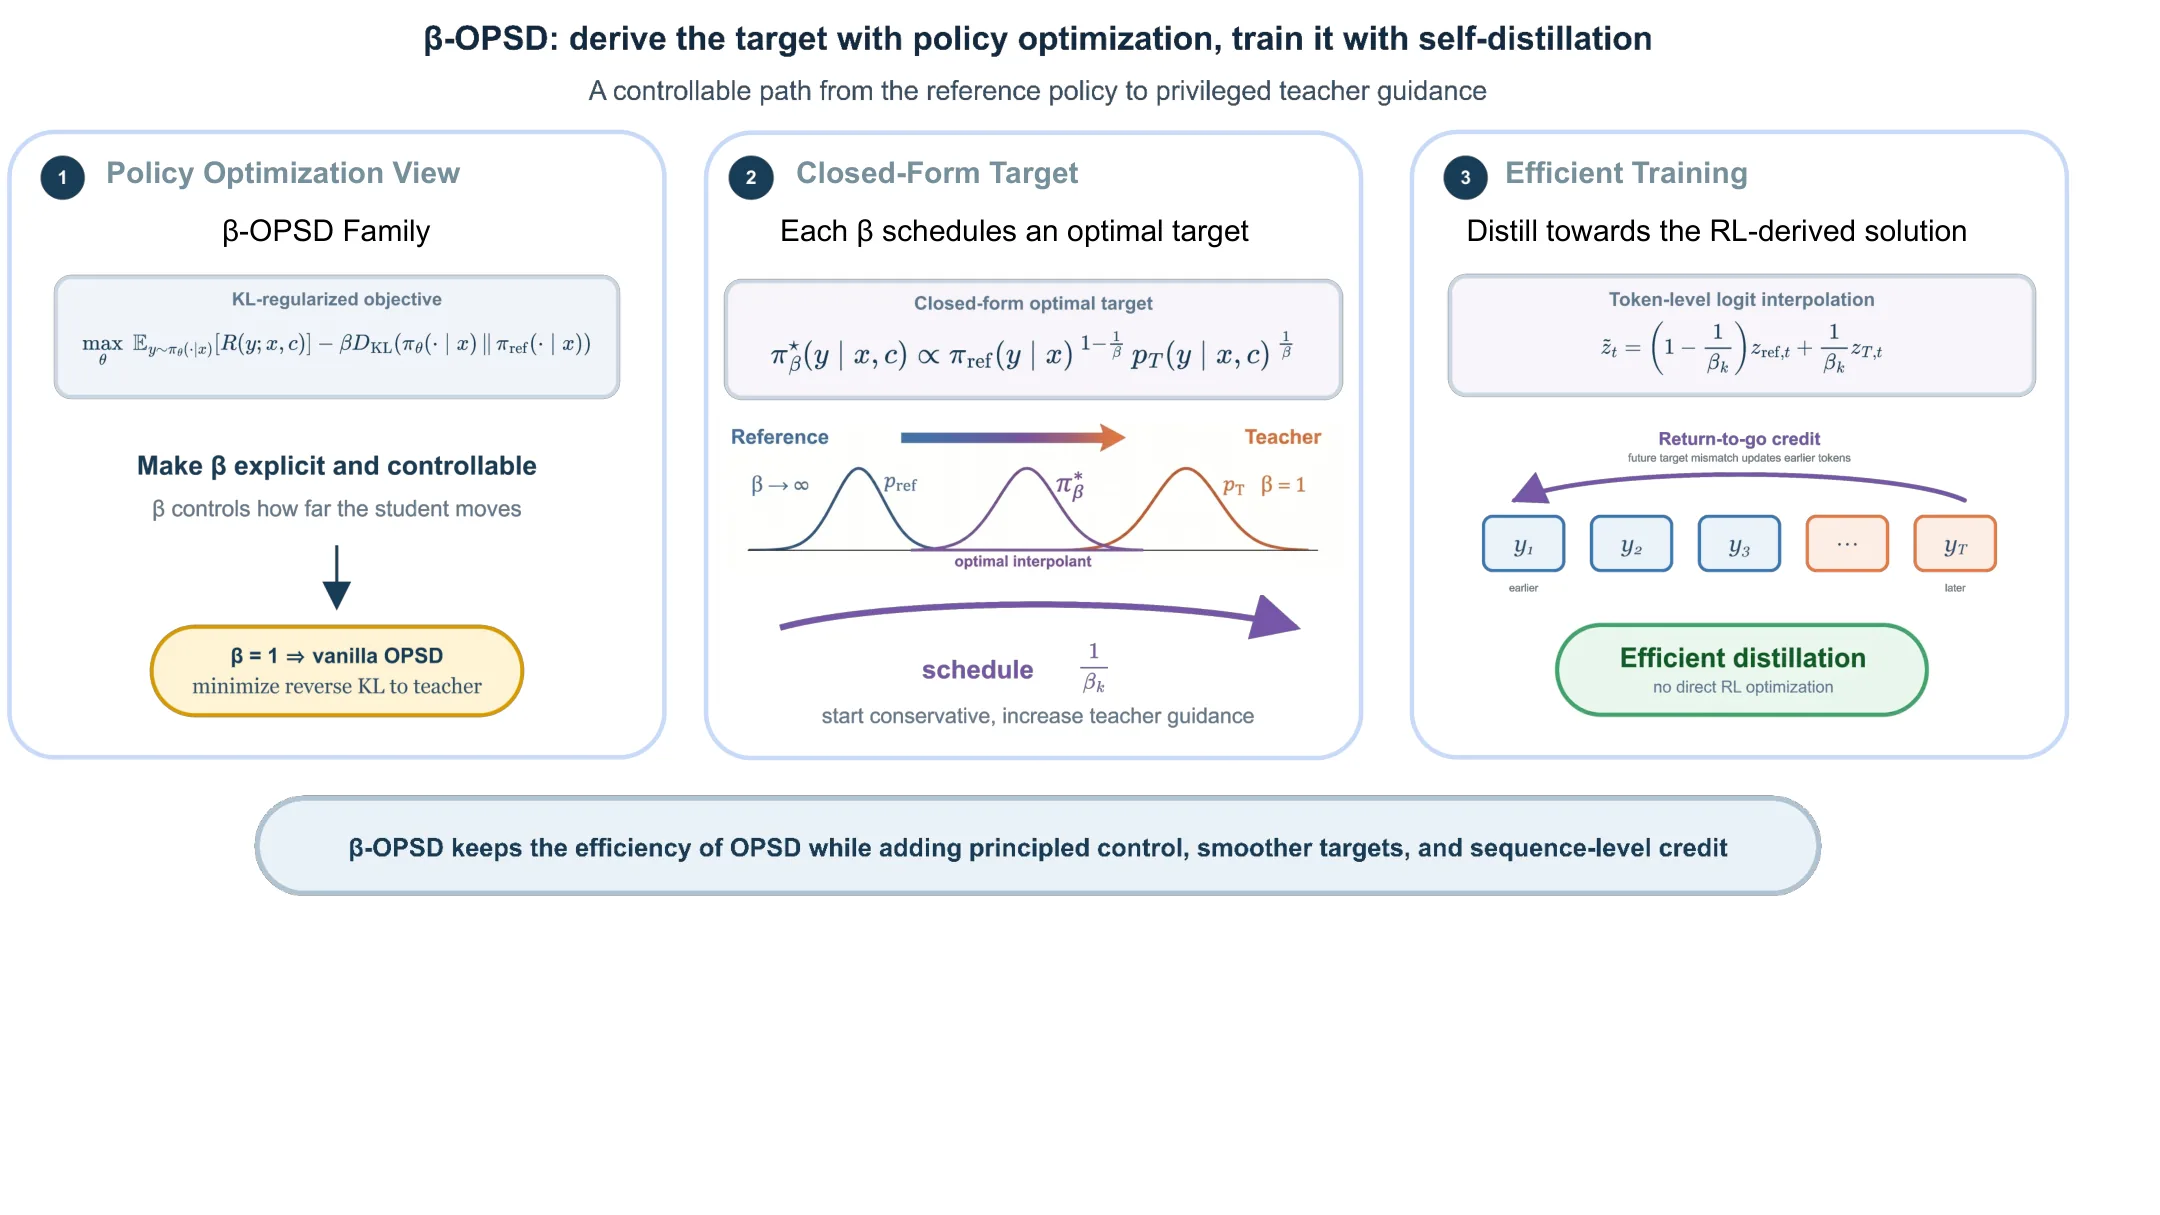
在线自蒸馏(OPSD)虽能提升推理语言模型,但训练脆弱、依赖大量工程调优。本文将vanilla OPSD识别为策略优化家族的β=1特例,提出β-OPSD,通过β参数调节KL惩罚强度,将最优策略表达为参考策略与特权教师之间的几何插值,以闭式解作为蒸馏目标,用logit混合近似昂贵的策略优化。在数学推理基准上稳定优于vanilla OPSD。
🧭 速览
vanilla OPSD对应β=1特例,β固定为一限制了正则化灵活度,且训练脆弱需大量工程调优。
将最优策略表达为参考策略与教师的几何插值,以闭式解作为蒸馏目标,通过token级logit混合实现并结合return-to-go信用分配。
在数学推理基准上一致优于vanilla OPSD,优化稳定性与下游推理性能均获提升。
提供了一条无需牺牲OPSD效率、从自蒸馏通往策略优化的原则化路径。
🆚 方法对比
Vanilla OPSD
- 实现简单,仅需token级蒸馏
- 计算效率高,训练开销小
- 教师可对学生中间状态响应
- 实践中脆弱,需大量工程调参
- β隐式固定为1,无法调控正则强度
- token局部更新短视,忽略序列依赖
β-OPSD
- 将OPSD推广为可控β的正则化族
- 最优策略为参考与教师的几何插值
- 在Qwen3-1.7B上avg@12提升达9.16点
- 优化稳定性与推理性能均优于原版
- 引入额外β调度超参数
- 需在保守性与教师引导间权衡
- 依赖合适的β调度策略
Logit插值蒸馏训练
- 通过token级logit混合高效实现
- 保留OPSD的计算效率结构
- 支持β平滑调度形成课程学习
- logit混合未必精确逼近目标分布
- 实现细节可能影响实际效果
Return-to-go信用分配
- 将未来不匹配回传至早期token
- 与序列级目标更一致
- 保留token级蒸馏的简洁性
- 相比标准OPSD更新更复杂
- 信用分配估计可能引入方差
直接策略优化RL目标
- 为β-OPSD提供理论推导基础
- 给出闭式最优策略解释
- 需昂贵rollout与优势估计
- 梯度方差高,不稳定
- 序列级最优含难解归一化项
β-OPSD将vanilla OPSD推广为β参数化的正则化族,并融合RL推导的闭式目标与logit插值的高效蒸馏训练及return-to-go信用分配,在保留OPSD简洁性的同时引入可调控的正则强度。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 5 张)
展开查看 5 张图
TL;DR
这篇论文从理论上揭示了在线自蒸馏(OPSD)实际上是 KL 正则化策略优化家族中 的特例。通过将 从隐式固定值转变为可调的正则化参数,作者提出了 -OPSD 框架,将最优策略推导为参考策略与特权教师之间的几何插值,再用高效的 logit 混合来近似原本昂贵的策略优化过程。实验表明,-OPSD 在数学推理基准上稳定超越 vanilla OPSD,尤其对小模型提升显著。
研究背景与动机
在线自蒸馏已经成为提升推理语言模型能力的重要技术路线。与传统的离线蒸馏不同,OPSD 让模型在自己的采样轨迹上模仿一个"特权教师"——这个教师能够看到真实解题过程或中间反馈,从而为学生提供更高质量的指导。这种同策设置使学生能更好地适应自身的实际中间状态,而非仅仅模仿一个与自身分布脱节的固定目标。
然而,OPSD 在实践中常常暴露出脆弱的一面。要让它稳定工作,往往需要大量的工程调优:学习率怎么设、什么时候开始蒸馏、教师信号怎么加权——这些细节对最终效果影响很大,但缺乏系统性的理论指导。工程师们更多依靠经验试错,而非清晰的设计原则。
本文的核心洞察在于找到了这种脆弱性的结构性根源:vanilla OPSD 实际上恰好是 KL 正则化策略优化族中 的特例。在 KL 正则化 RL 框架中, 用来控制学生策略与参考策略之间的 KL 惩罚权重。当 时,这个参数被隐式地固定了,导致无法显式控制"学生应该多大程度上偏离当前策略、靠近特权教师"。正是这种自由度的缺失,使得 vanilla OPSD 在优化过程中缺乏对正则化强度的灵活调节能力。
方法
理解了 OPSD 与策略优化的深层联系后,作者顺理成章地将 从隐含值解放出来,使其成为一个可控的正则化参数。由此得到的 -OPSD 框架在"靠近参考策略"与"吸收教师指导"之间提供了一个显式的权衡机制。
具体而言,论文将教师-参考 log 比值作为奖励信号,代入标准的 KL 正则化 RL 目标:
当 时,参考项恰好对消,目标退化为最小化反向 KL 散度,这正是标准 OPSD 的损失函数。这一推导建立了两个方法之间的严格等价关系。
在兼容支撑假设下,最优策略存在闭式解,其形式是参考策略与教师之间的几何插值:
这里 是归一化常数。从这个公式可以清晰看出:当 时,最优策略就是特权教师本身;当 趋向无穷大时,策略趋近参考策略;中间的 值则在两点之间的路径上选择目标。这种几何直觉为 的调节提供了直观的语义理解。
然而,直接用强化学习来优化这个目标会遇到两个障碍:计算序列级归一化常数 是 intractable 的,而 RL 优化本身也伴随着高方差。论文的核心创新在于绕过了这些问题——不是直接优化 RL 目标,而是将闭式解转化为一个蒸馏目标。由于闭式解要求对序列级别的分布进行归一化,作者转而在每个前缀位置构造局部目标:
这种 logit 混合的实现方式非常高效,只需对参考策略和学生/教师的 logit 向量进行加权求和再 softmax 即可,无需额外的模型前向传播或序列级归一化。
值得注意的是,标准的词元级梯度是"短视"的——每个词元只考虑自身的损失,忽略了它对后续词元分布的影响。在序列生成任务中,早期词元的选择会改变整个后续前缀,从而影响整个序列与目标分布的匹配程度。为此,论文引入了 return-to-go 信用分配机制,将折扣回报累积到每个词元:
当折扣因子 时,return-to-go 梯度是序列级反向 KL 梯度的无偏估计;引入折扣因子则可以在偏差与方差之间取得更好的平衡。
整个训练流程遵循一个简洁的循环:先从当前策略采样同策轨迹,然后用调度好的 构造 logit 混合目标,接着计算 return-to-go 加权的词元级损失,最后更新模型参数。作者采用的调度策略是有界线性调度, 从初始的 平滑上升到最终的 ,实现从偏重参考策略到偏重教师策略的课程学习。
实验与结果
实验在数学推理领域进行,训练数据来自 OpenThoughts 数据集的数学推理子集,评测则在三个竞赛级基准上展开:AIME 2024、AIME 2025 和 HMMT 2025。模型覆盖了 Qwen3 家族的 1.7B、4B 和 8B 三个规模,对比基线包括无后训练的基础模型、监督微调(SFT)、vanilla OPSD 以及基于结果奖励的策略优化方法 GRPO。
主实验在训练中途的 100 步检查点进行评估,主要指标是 12 次采样的平均正确率。结果显示,-OPSD 在所有模型规模和所有基准上均一致超越 vanilla OPSD。对于参数量最小的 Qwen3-1.7B,提升幅度最为显著:AIME 2024 提升 9.16 个百分点,AIME 2025 提升 5.27 个百分点,HMMT 2025 提升 2.78 个百分点。更大规模的模型收益相对较小,但 4B 和 8B 模型仍然分别获得约 1.7 个百分点的平均提升。
除了与 vanilla OPSD 的对比,-OPSD 还优于 SFT 基线,并在大多数配置下与或超越 GRPO。这种竞争力尤其值得注意,因为 GRPO 是更为复杂的强化学习方法,而 -OPSD 保持了 OPSD 的简洁性——无需显式的奖励模型或复杂的信用分配机制。
消融实验进一步揭示了两个核心组件的贡献。插值目标相比直接使用教师目标,在三个基准上分别带来 6.03、5.30 和 1.67 个百分点的提升。return-to-go 信用分配则贡献了 1.12、5.55 和 3.61 个百分点的额外收益。二者的叠加效应表明,-OPSD 的改进并非来自单一因素,而是两个设计选择共同作用的结果。
关于调度策略,实验比较了固定权重与多种线性调度方案。固定 或 的效果均不如动态调度,而从 到 的线性调度在整体上表现最优。这一发现支持了课程学习的直觉:训练初期保持较强的参考策略锚定有助于稳定优化,随着训练的进行逐步增加教师信号的权重则能更有效地吸收知识。
讨论与可借鉴点
这篇论文最值得关注的方法论贡献在于建立了一座原则性的桥梁——从自蒸馏出发,穿越策略优化的理论框架,再回到更高效的自蒸馏实现。论文的推导过程展示了一个有价值的范式:当一个启发式方法效果不错但不够稳定时,将其纳入更广泛的理论框架往往能揭示隐藏的自由度,从而找到改进空间。
对于实践者而言,-OPSD 提供了几个可直接借鉴的设计原则。首先,"推导用 RL,训练用蒸馏"的思路具有普适性——先在理论上追求最优解的闭式表达,再将其转化为计算友好的近似形式,往往能兼顾理论优雅与工程效率。其次,return-to-go 信用分配机制虽然源于 RL 文献,但其核心思想——让每个词元的梯度反映其对整体目标的贡献——可以迁移到其他需要长序列优化的场景中。
论文也存在一些局限。实验仅限于数学推理领域,在代码生成、开放式问答等其他推理任务上的泛化性尚未验证。此外,主实验仅报告了 100 步检查点的结果,缺少完整训练曲线的对比,这对于评估优化稳定性是一个缺失。vanilla OPSD 的脆弱性是否真的被 -OPSD 彻底解决,还是只是被超参调度策略所掩盖,也有待更系统的分析。最后,闭式几何插值与实际 logit 加法近似之间的偏差在理论上尚未被严格刻画。
从更宏观的角度看,这项工作回应了自蒸馏研究中的一个核心问题:为什么 OPSD 有效但不稳定?通过将 KL 惩罚显式化,论文不仅提供了改进方案,也为后续研究指明了方向——探索更精细的正则化调度策略,或将 -OPSD 的思想与其他蒸馏技术相结合,都可能是值得尝试的路径。
摘要
同策自蒸馏(OPSD)是一种有前景的提升推理语言模型的方法,但在实践中仍较为脆弱:使其可靠地工作通常需要大量的工程投入。我们识别出这种困难的一个结构性根源:原始 OPSD 恰好是一个更广泛的策略优化族中 β=1 的成员,其中 β 加权了用于将学生策略锚定到参考策略的 KL 惩罚。这种等价性将 β 从一个固定为 1 的隐含值转变为可控的正则化参数,由此得到一个更一般的公式,在与参考策略的接近程度与来自特权教师的指导之间进行权衡。我们提出了 β-OPSD,并将其最优策略推导为参考策略与特权教师之间的几何插值。然而,直接使用强化学习来优化该目标会代价高昂且方差较大。我们并不直接优化强化学习目标,而是将其闭式解转化为一个蒸馏目标。β 的每个取值都沿参考到教师的路径选择一个目标,我们通过混合它们在词元级别的 logits 来高效实现这一过程。以这种方式,低成本的蒸馏近似了高代价策略优化的解。Return-to-go 信用分配进一步将词元级更新与序列级目标对齐,同时保留了 OPSD 的简洁性。在数学推理基准上的实验表明,β-OPSD 一致地优于原始 OPSD,提升了优化稳定性以及下游推理性能。我们的结果提供了一条从自蒸馏到策略优化、再回到自蒸馏的原则性路径,且不牺牲使 OPSD 实用的高效性。
Abstract
On-policy self-distillation (OPSD) is a promising approach to improve reasoning language models, but it remains brittle in practice: making it work reliably often requires substantial engineering effort. We identify a structural source of this difficulty: vanilla OPSD is precisely the member of a broader policy-optimization family, where weights the KL penalty anchoring the student to a reference policy. This equivalence turns from an implicit value fixed at one into a controllable regularization parameter, yielding a more general formulation that trades off proximity to a reference policy against privileged teacher guidance. We introduce -OPSD and derive its optimal policy as a geometric interpolation between the reference policy and the privileged teacher. Directly optimizing this objective with reinforcement learning, however, would be costly and high-variance. Rather than optimize the RL objective directly, we turn its closed-form solution into a distillation target. Each value of selects a target along the reference-to-teacher path, which we implement efficiently by mixing their token-level logits. In this way, inexpensive distillation approximates the solution of expensive policy optimization. Return-to-go credit assignment further aligns token updates with the sequence-level objective while retaining the simplicity of OPSD. Experiments on mathematical reasoning benchmarks show that -OPSD consistently outperforms vanilla OPSD, improving optimization stability and downstream reasoning performance. Our results provide a principled route from self-distillation to policy optimization and back without sacrificing the efficiency that makes OPSD practical.
论文详细总结(自动生成)
β-OPSD 论文总结
1. 核心问题与研究动机
- 在线自蒸馏(OPSD)的实践困境:OPSD 通过让学生在自身采样轨迹上模仿"特权教师"(可见真实解题过程/反馈)来提升推理能力,相比离线蒸馏能更好地适应学生实际中间状态,但实践中往往脆弱、需大量工程调优。
- 结构性根源识别:本文指出,vanilla OPSD 恰好是 KL 正则化策略优化家族中 的特例,其中 用于控制 KL 惩罚对参考策略的锚定强度。这种等价关系将 从"隐式固定为 1"转变为"显式可控的正则化参数"。
- 核心问题:教师作为唯一优化目标,缺乏对"学生应多大程度偏离当前/初始策略"的显式控制,导致优化不稳定。
2. 方法论
2.1 核心思想
将 OPSD 重新诠释为 KL 正则化 RL 目标的轨迹级优化,而非简单的词元级模仿;通过对 的调度获得从参考策略到特权教师的平滑目标曲线。
2.2 关键技术细节
目标函数构造:将教师-参考 log 比值作为奖励,代入标准 KL 正则化 RL 框架:
Proposition 2.1:当 时,参考项对消,目标等价于最小化反向 KL:
即标准 OPSD。
Proposition 2.2(闭式最优策略):在兼容支撑假设下,最优策略是参考策略与教师之间的几何插值:
其中 为序列级归一化常数(不可计算)。当 时退化为教师端点, 时趋近参考端点。
局部 Logit 插值实现:为规避不可计算的 ,在前缀 处定义局部目标:
通过有界线性调度随训练步 从 升至 (),实现从靠近参考到靠近教师的平滑课程。
Return-to-go 信用分配:标准词元局部梯度是短视的,早期词元改变后续前缀从而影响未来 KL 不匹配。引入折扣回报:
Proposition B.1:当 时,下式给出序列级反向 KL 梯度的无偏估计:
实用损失函数:
stop-gradient 仅保留通过学生对数概率的梯度路径。
算法流程(Algorithm 1):
1. 采样 on-policy 轨迹 ;
2. 按调度计算教师权重 与 ;
3. 用 stop-gradient 学生副本 与教师 logits 构造插值目标;
4. 计算 token 级不匹配 与折扣 return-to-go ;
5. 最小化实用 -OPSD 损失并更新 。
3. 实验设计
3.1 数据集与场景
- 训练数据:OpenThoughts 数据集的数学推理子集,每条样本包含问题 和作为特权信息 的真实解题过程。
- 评测基准(竞赛级数学推理):
- AIME 2024
- AIME 2025
- HMMT 2025
3.2 模型
- Qwen3-1.7B、Qwen3-4B、Qwen3-8B(instruct-tuned 版本)
3.3 对比方法
- Base model:无后训练的基础模型;
- SFT:在真实解题过程上做监督微调;
- Vanilla OPSD:直接对齐教师目标,词元局部 KL;
- GRPO:基于结果级奖励的策略优化;
- β-OPSD(本文方法):logit 插值目标 + return-to-go 信用分配。
3.4 评测指标
- avg@12(主要指标):12 次采样的平均正确率
- pass@12:至少一次正确的题目比例
- 推理配置:temperature=0.6, top-p=0.95, top-k=50, 思考模式开启
4. 资源与算力
- GPU:NVIDIA RTX A6000 或 NVIDIA H200 GPU(未具体说明数量配比)
- Qwen3-1.7B 训练:4 张 RTX A6000 GPU,4 路数据并行(accelerate),每 rank 共置单 GPU vLLM 实例用于 on-policy 生成
- 训练预算:最多 200 步优化,8 小时墙钟时间上限
- LoRA:rank ,,作用于
- 优化:学习率 ,梯度范数裁剪 0.1,per-device batch size 1 × 8 梯度累积 = 有效 batch size 32,bfloat16 + FlashAttention-2
- 生成:最大序列 20,000 token,最大完成 1,024 token;temperature=1.1, top-p=0.95, top-k=20
- 评测:vLLM,GPU 显存占用 0.9,张量并行 1
- 缺失信息:4B/8B 模型训练所用的具体 GPU 型号与数量未在文末详细说明;总 GPU 小时数未明确报告
5. 实验数量与充分性
5.1 主实验(Table 1)
- 3 个模型规模 × 3 个 benchmark × 5 个方法 = 45 个数据点
- 在 100 步检查点(默认 200 步训练的中点)评估
5.2 消融实验(共 4 组,均基于 Qwen3-1.7B)
1. 目标分布消融(Table 2):固定 return-to-go,对比"教师目标"vs "β-OPSD 插值目标",隔离目标贡献
2. 信用分配消融(Table 3):固定 的插值目标,对比局部词元梯度 vs return-to-go 梯度
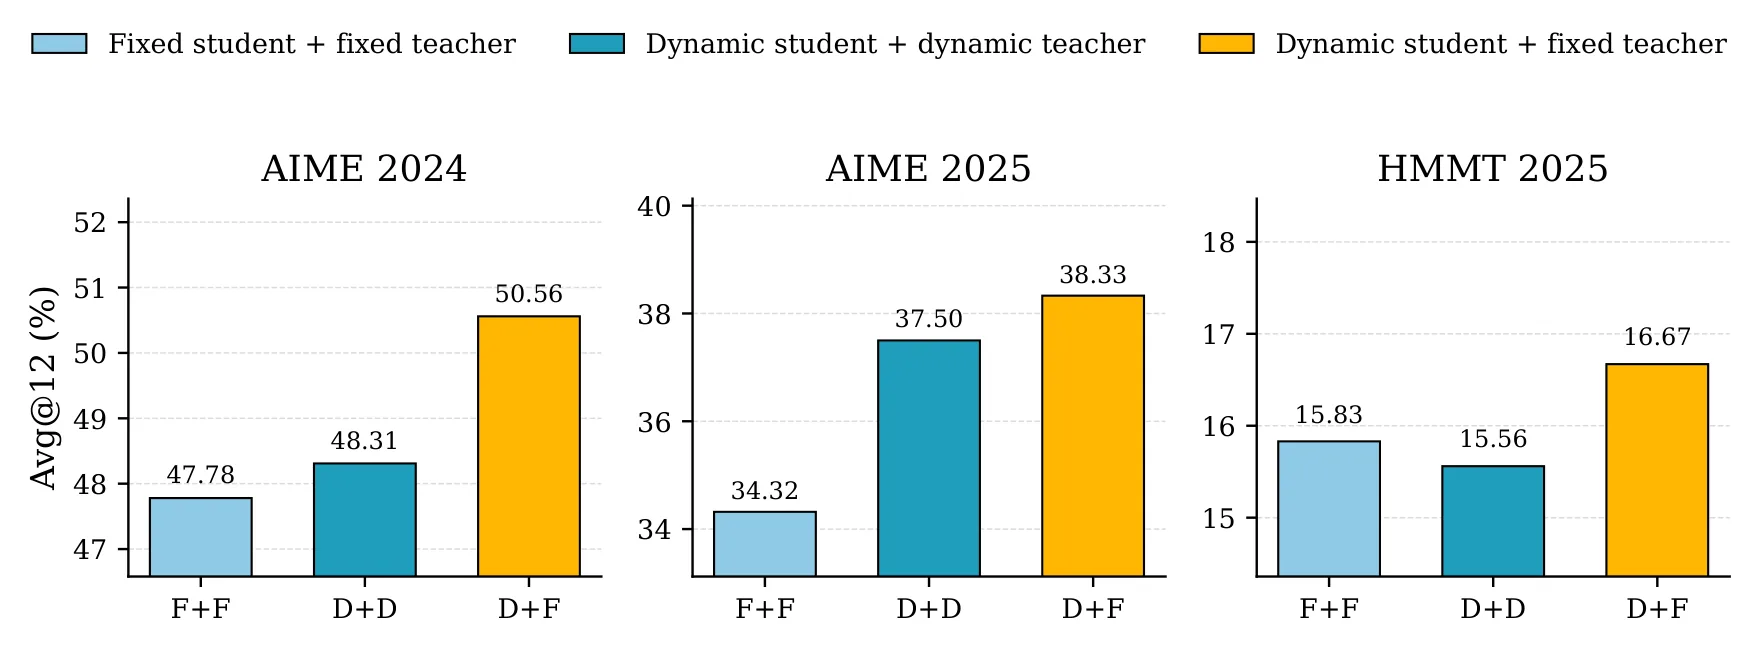
3. 插值参考选择(Figure 2):F+F(全固定)、D+D(双动态)、D+F(动态学生+固定教师)三种构造
4. 调度策略(Table 4):固定 、线性 、、、
5.3 附录扩展(Table 6)
- 混合学生-教师采样变体, 固定及线性调度
- 4 个检查点 × 多组 schedule × 3 个 benchmark 的完整扫描
5.4 充分性评价
- 优点:消融设计逻辑清晰(每次只改变一个变量);基线覆盖完整(Base/SFT/OPSD/GRPO);多模型规模验证;提供了随机解码的 pass@12 与 avg@12 双指标
- 局限:主实验仅在 100 步检查点报告,未充分展示不同训练步下的稳定性曲线;缺少置信区间或多次随机种子报告;评测集均为数学竞赛题,缺乏其他推理域验证
6. 主要结论与发现
- 稳定优于 vanilla OPSD:Qwen3-1.7B 上 AIME 2024/2025/HMMT 2025 分别提升 +9.16、+5.27、+2.78 点(avg@12),平均提升 +5.74 点
- 跨规模保持有效:Qwen3-4B 平均 +1.76 点、Qwen3-8B 平均 +1.66 点;小模型提升最显著
- 优于 SFT 与 GRPO:在所有模型规模上一致超越 SFT,比 GRPO 也更强或相当
- 两大核心组件均贡献:插值目标带来 +6.03/+5.30/+1.67 提升;return-to-go 信用分配带来 +1.12/+5.55/+3.61 提升
- 最佳构造:动态学生 + 固定教师(D+F)的插值参考方案
- 最佳调度: 的线性调度在三个 benchmark 上整体最强
- 理论意义:提供了"自蒸馏 ↔ 策略优化"双向原则化桥梁,不牺牲 OPSD 的高效性
7. 优点
- 理论贡献明确:首次严格证明 vanilla OPSD = β-OPSD 的 β=1 特例,给出闭式最优策略及其证明(Appendix B)
- "推导用 RL,训练用蒸馏"的范式:既获得 RL 推导的理论指导,又保留 token 级蒸馏的计算效率,规避了序列级 的不可计算性与 RL 优化的高方差
- return-to-go 估计器具有无偏性证明( 时精确等于序列级梯度),折扣版本提供稳定的方差-偏差折中
- 方法可解释性强:将"教师模仿"重新诠释为"沿参考→教师路径上的最优策略",揭示了显式正则化的自由度
- 工程实现友好:logit 插值仅需逐元素加权求和 + softmax,避免双模型联合解码
- 小模型收益突出:对 1.7B 模型的提升远大于对 8B 模型的提升,对资源受限场景尤其有价值
- 消融严谨:四组消融逐步隔离每个组件贡献
8. 不足与局限
- 任务域单一:所有实验均限于数学竞赛推理,未在代码生成、开放式问答、对话等域验证,泛化性未充分证实
- 检查点评估不全:主结果仅在 100 步报告,缺少完整训练曲线与不同步下的稳定性分析
- 统计显著性不明:未报告多次随机种子的标准差或置信区间,难以判断收益是否统计显著
- 闭式解的近似损失:理论最优策略是几何插值(乘性),实际采用 logit 加法插值(局部近似),二者只在每个前缀处等价,序列级联合分布有偏差
- 超参敏感:调度端点 与 仍需人工选择,未给出自适应调度策略
- 数据集/算力细节缺失:4B/8B 模型训练所用 GPU 型号/数量、总 GPU 小时数未完整披露
- 附录混合采样变体说明:-OPSD 的混合采样版本虽然效果相当,但因双模型解码不被 vLLM 直接支持,额外开销近一倍;作者因此放弃该方案
- 上下文长度与生成长度上限:训练时最大生成仅 1,024 token,可能不足以覆盖复杂推理链
- 教师信号依赖:完全依赖训练时可获得的特权信息(如标准答案),与真实部署场景存在差距
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。