
📝 TLDR
JEPA在图像、视频与音频模态表现良好,但确定性潜变量预测目标难以成为文本编码器的标准选择。核心问题在于文本掩码位置允许多种合理补全,其表征难以共享单一有意义的中心。匹配实验揭示T-JEPA出现互信息饱和、目标方差上升、有效秩退化与余弦坍缩的链式失败,证明文本JEPA目标必须保留多解性而非压缩为单点。
🧭 速览
文本条件结构允许多种有效补全,与平方误差潜变量预测所要求的单点集中存在结构性不匹配。
形式化可预测性、非坍缩与低条件方差三个条件,通过I-JEPA与T-JEPA匹配实验并跨五个数据种子验证。
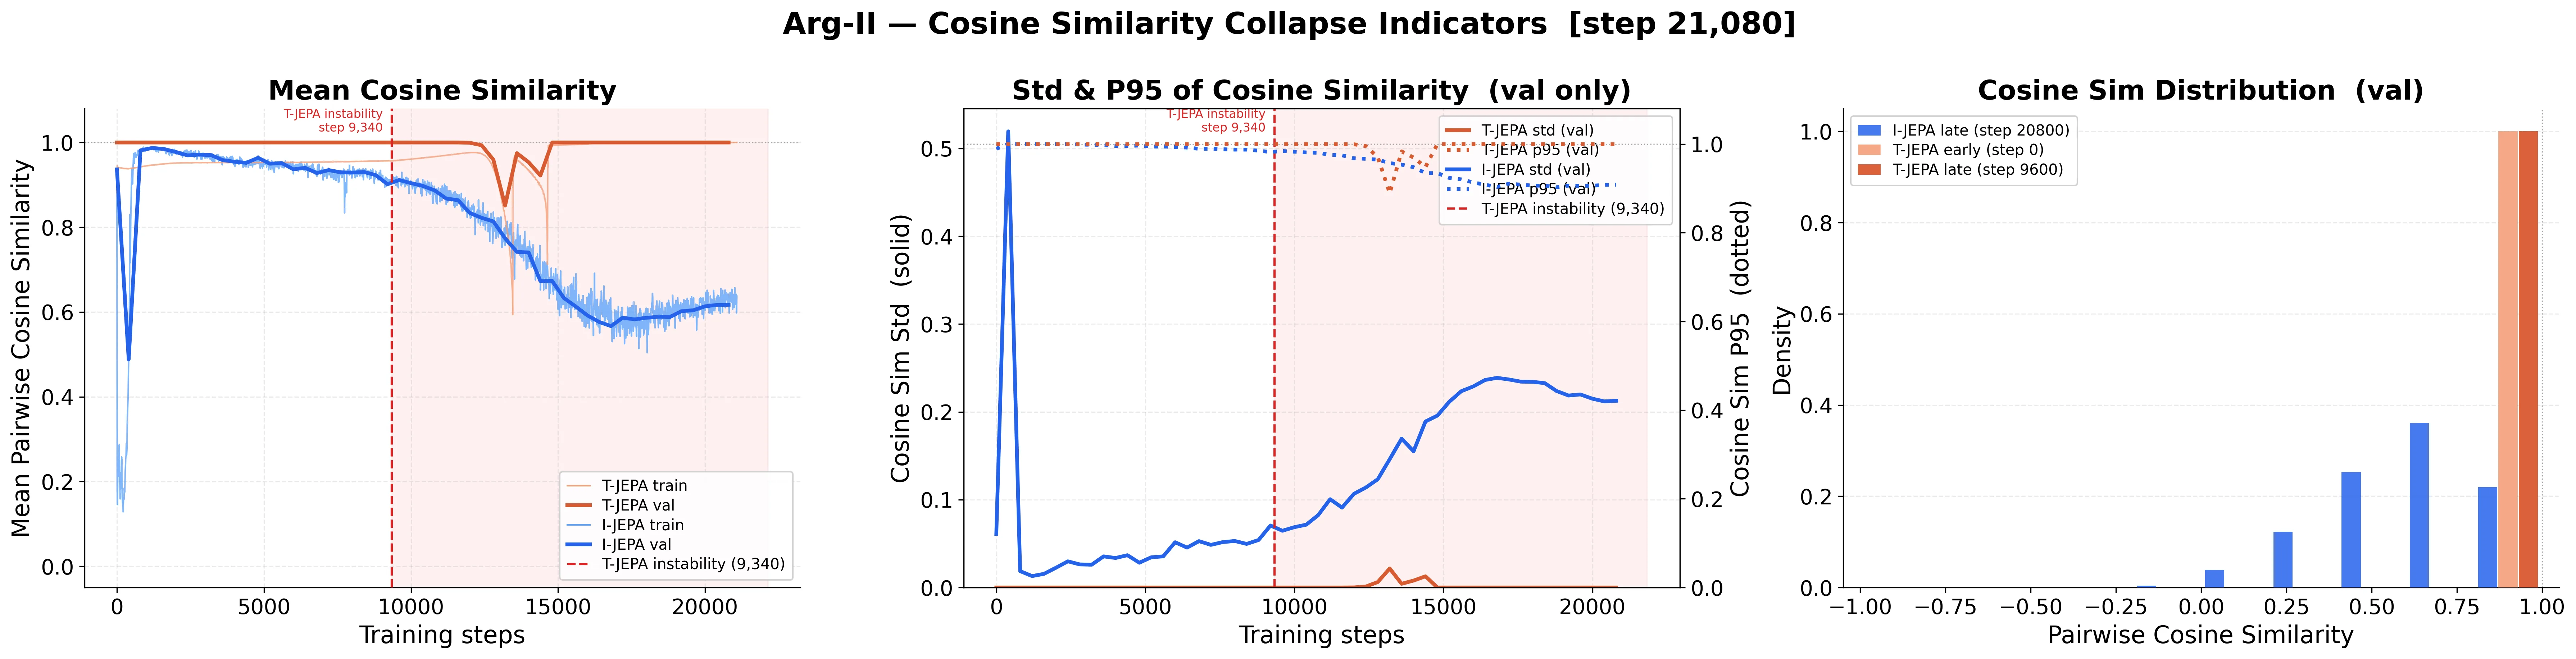
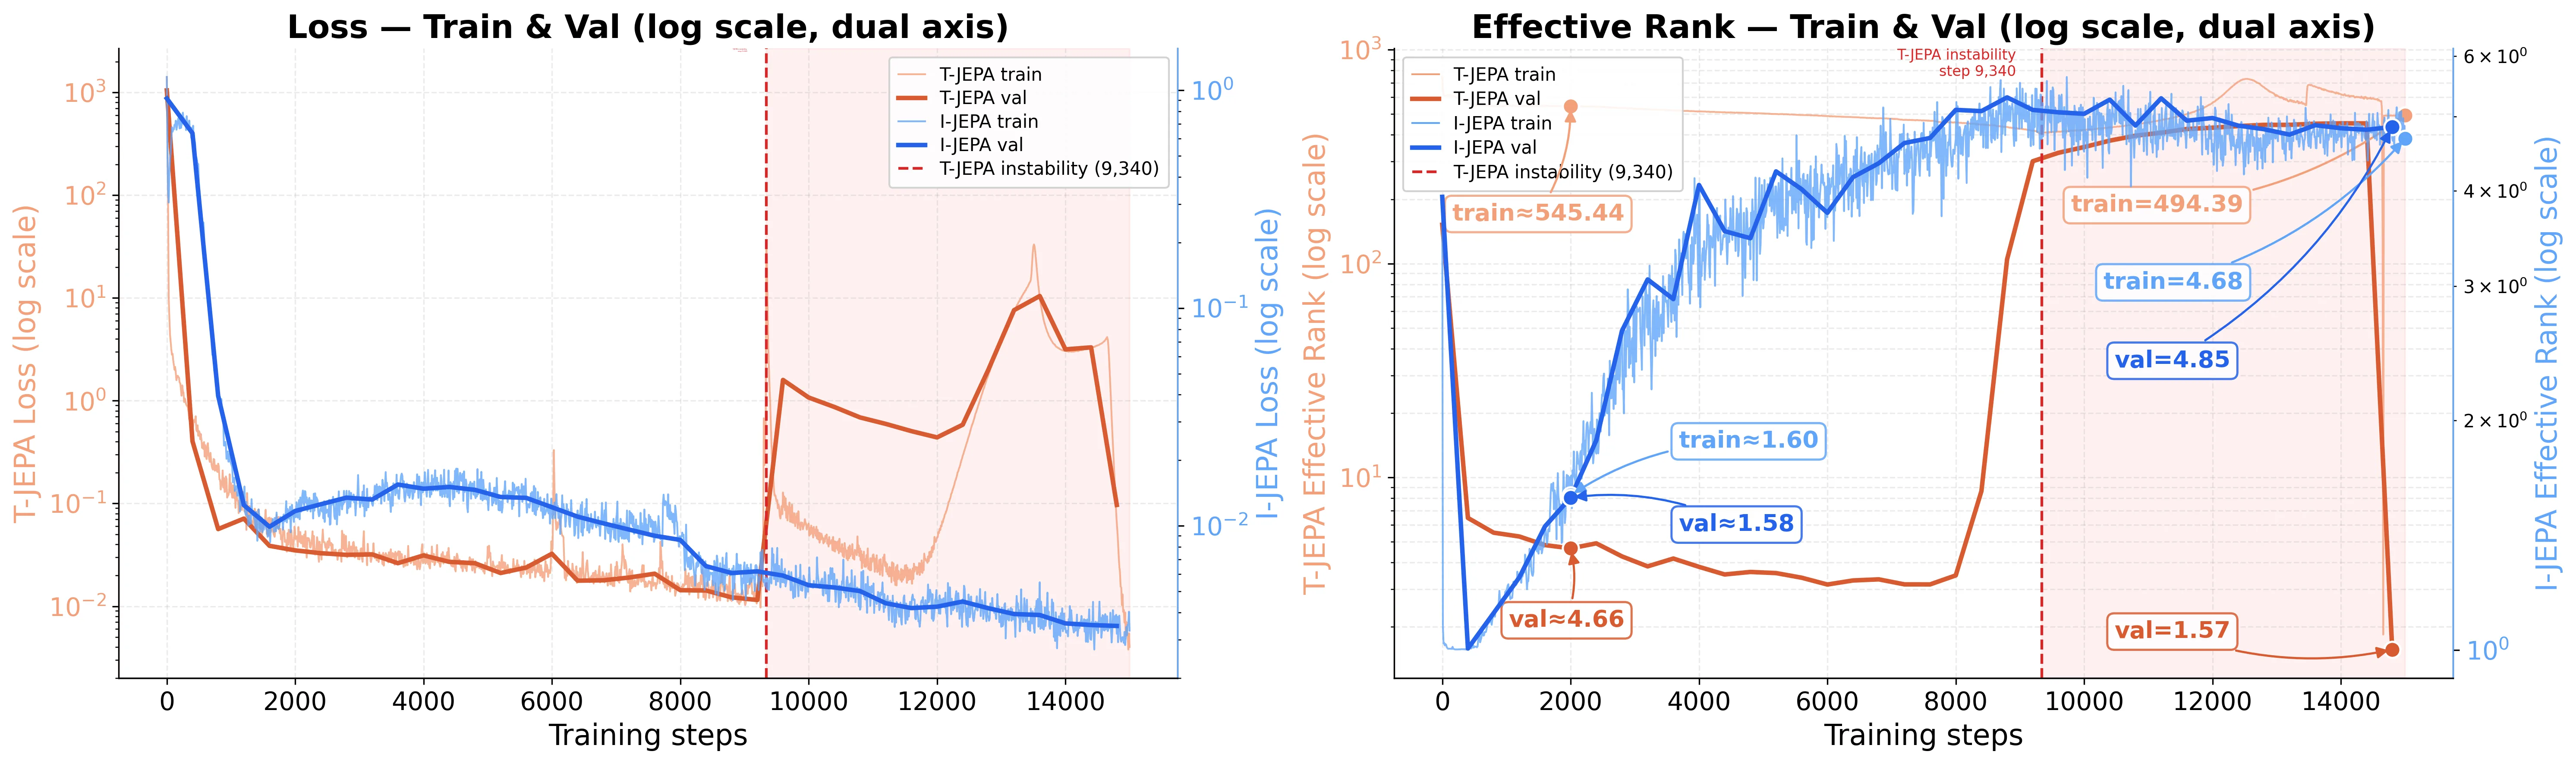
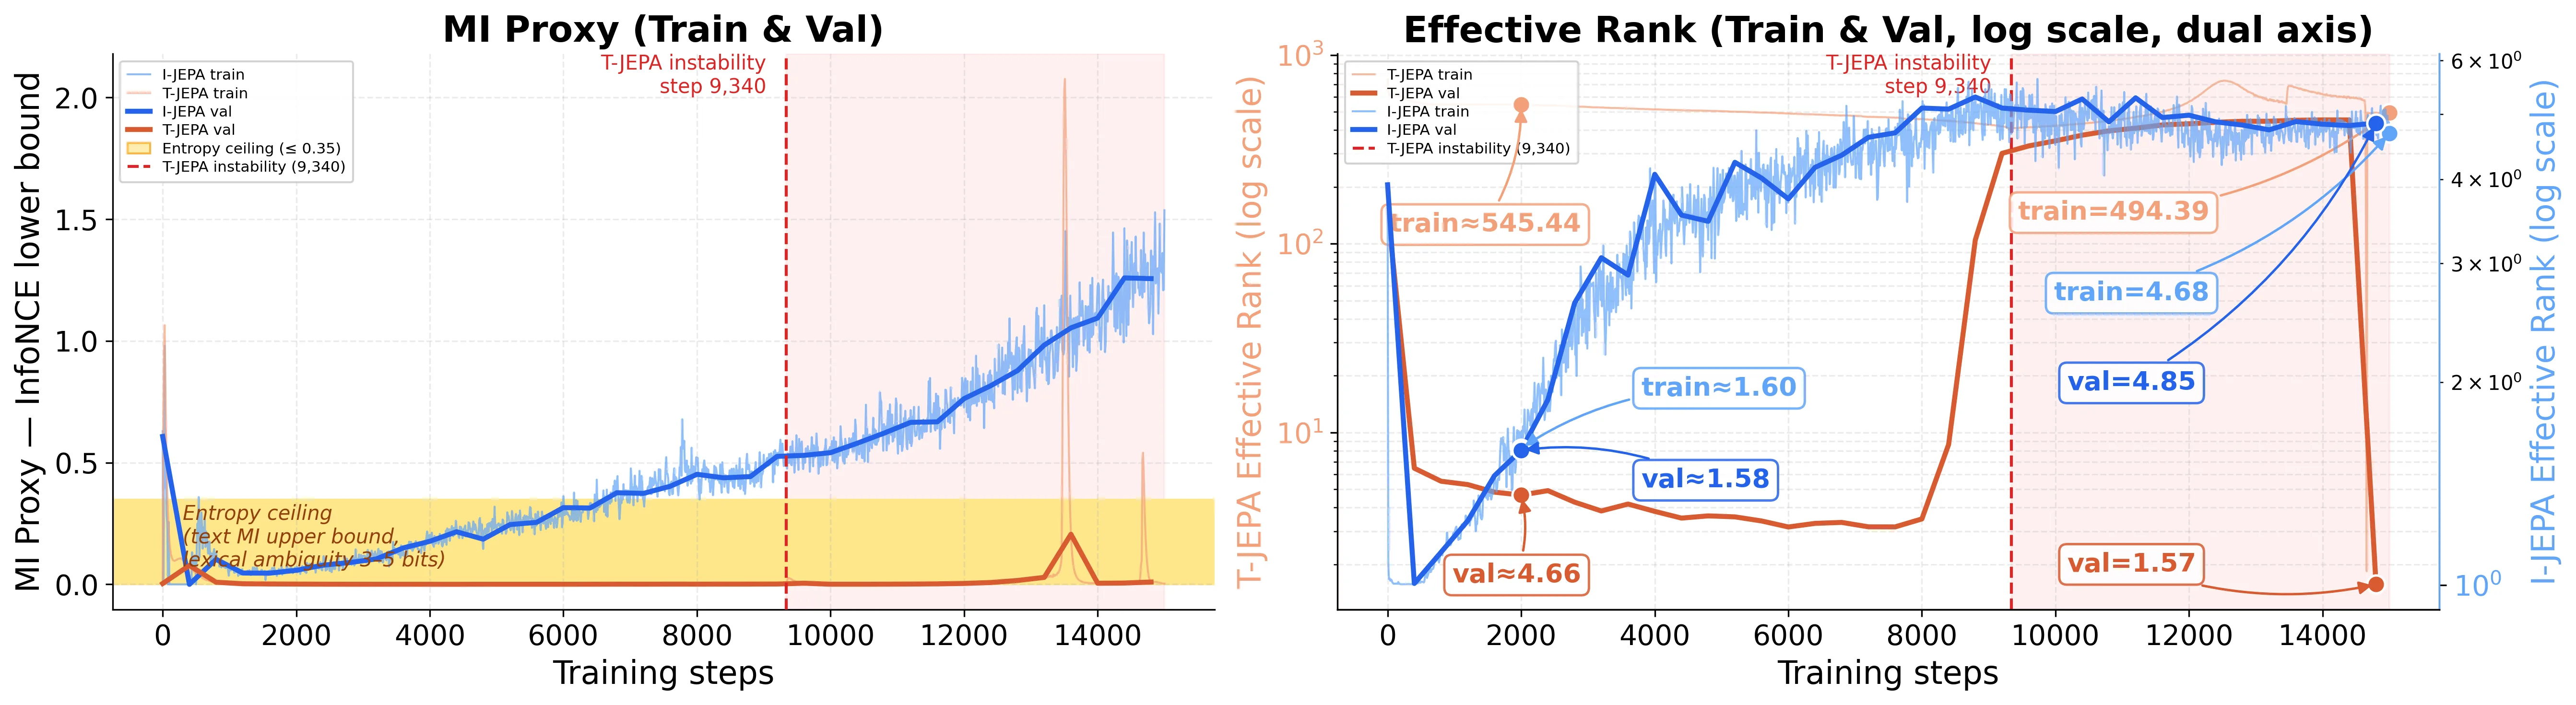
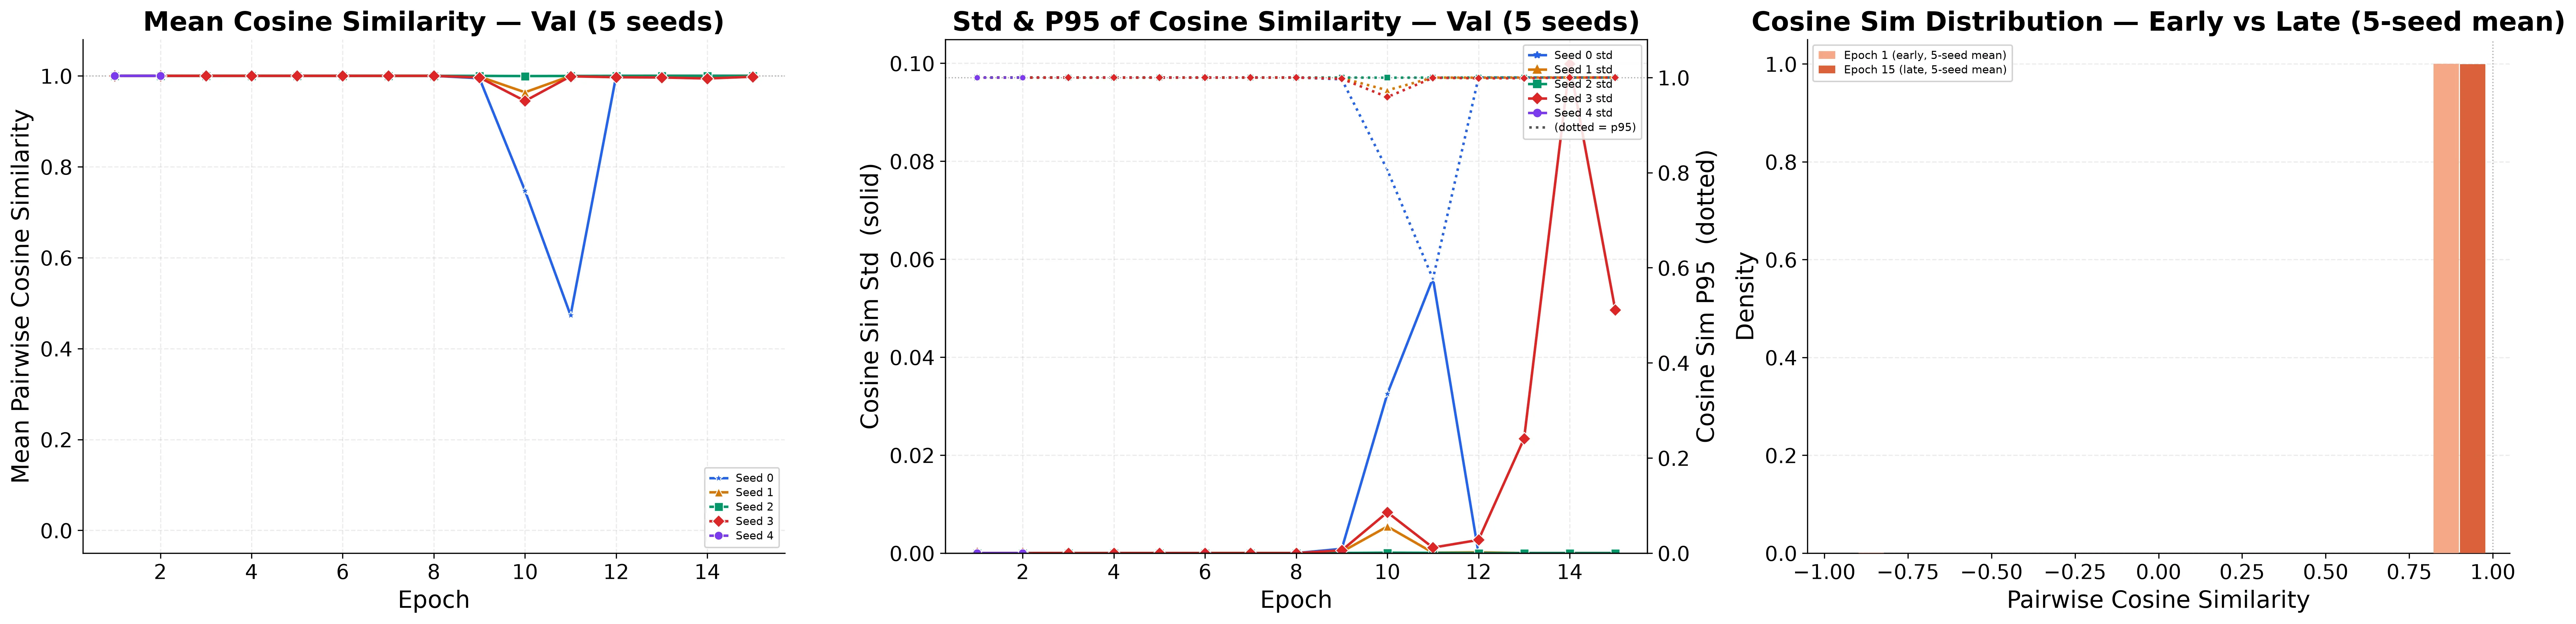
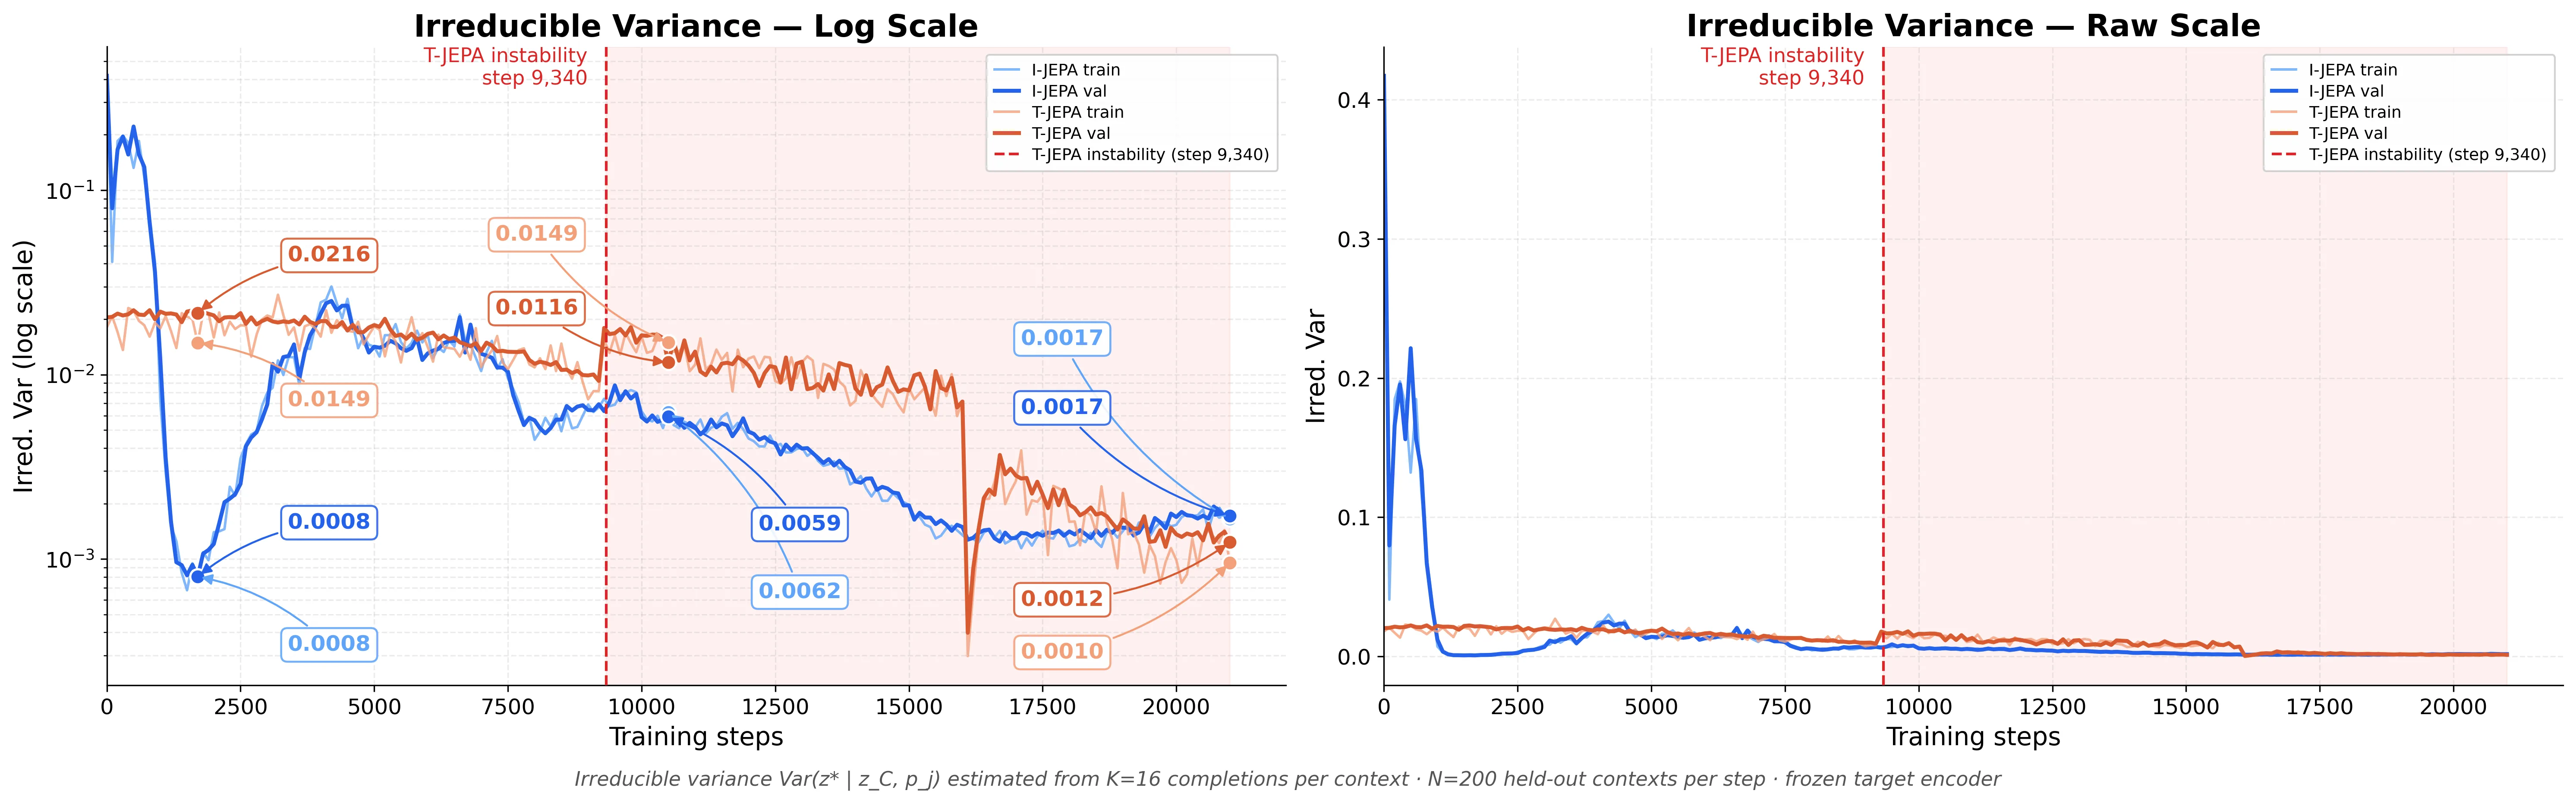
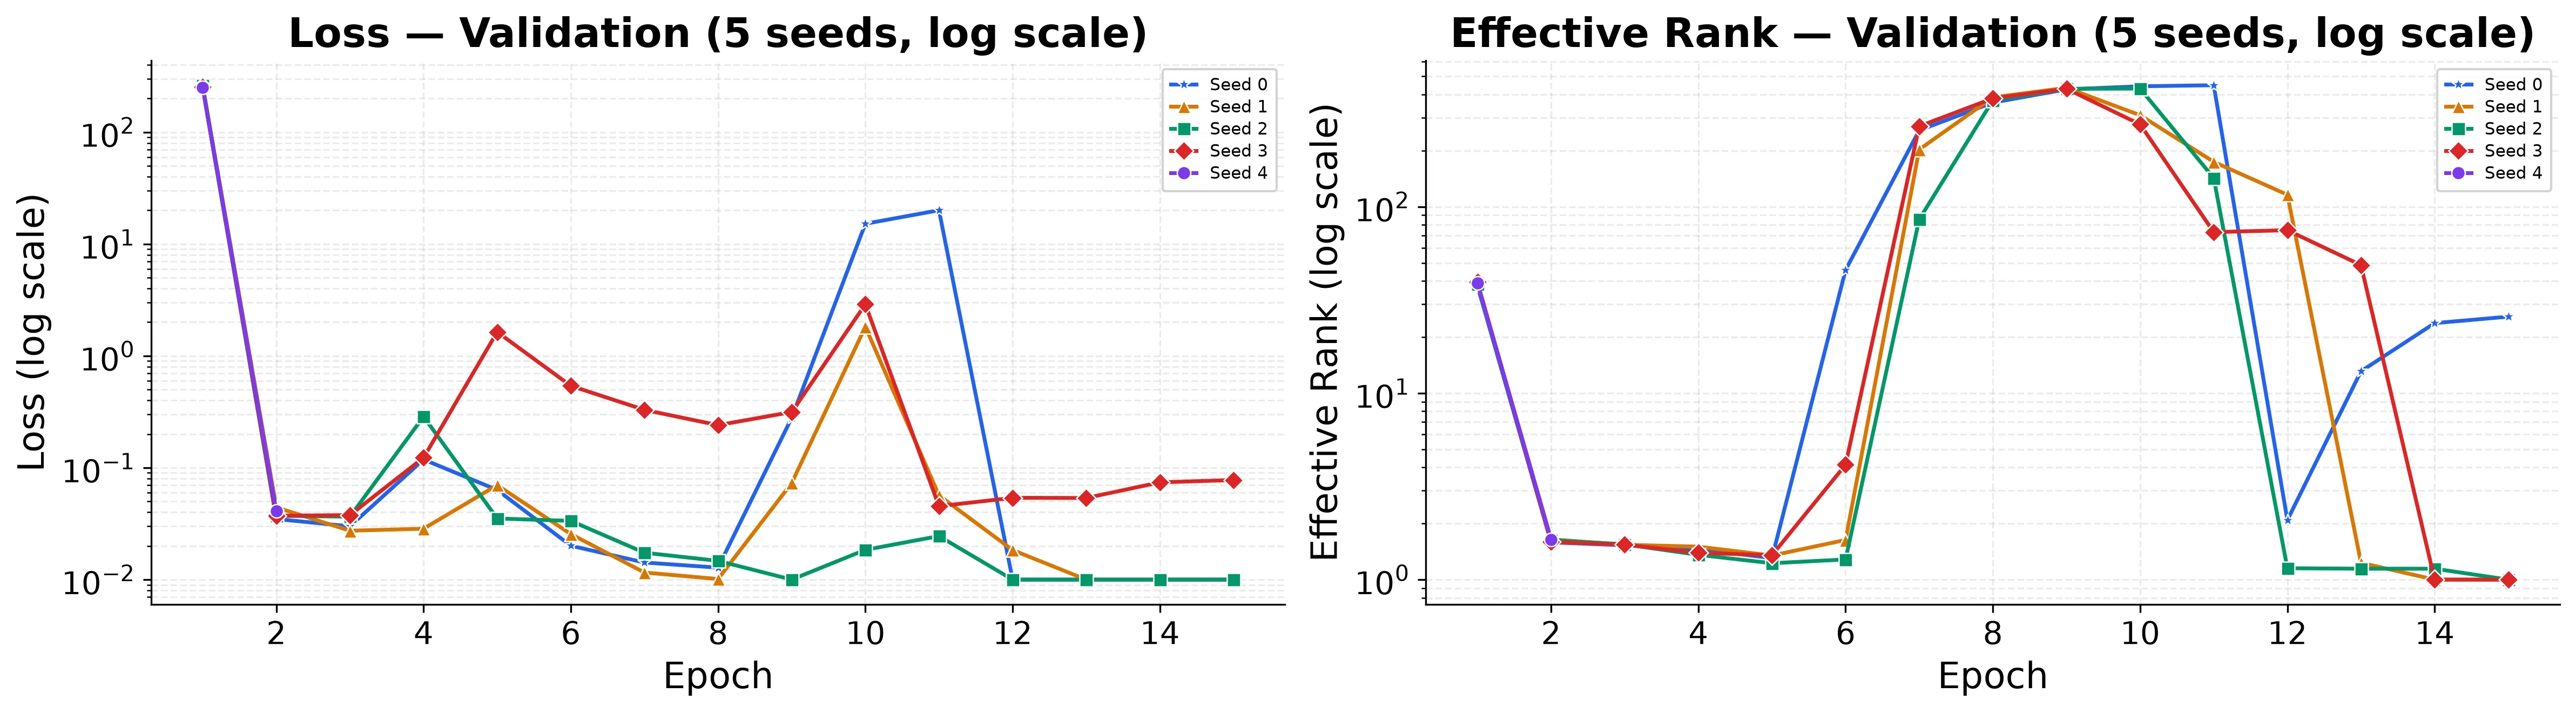
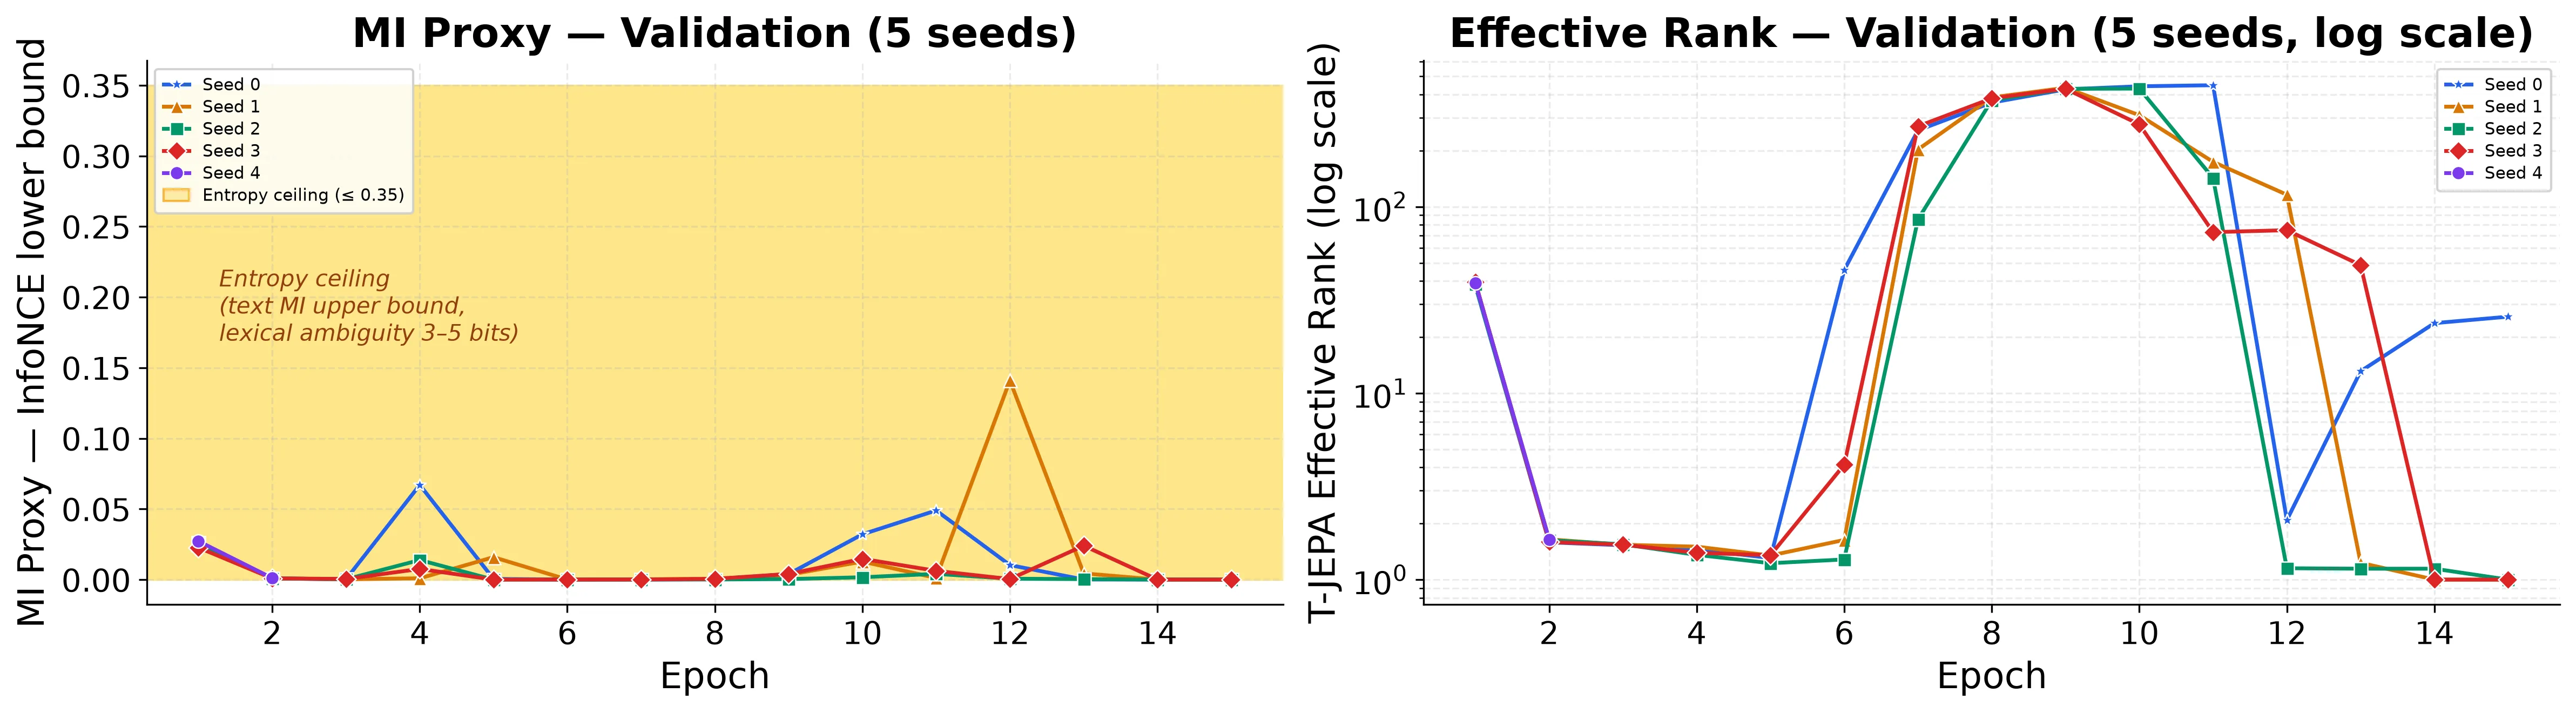
互信息饱和与目标方差升高先于训练不稳定、有效秩退化、余弦坍缩与下游迁移性能下降。
文本兼容的JEPA目标必须保留多种合理补全,而非将其压缩为单一潜变量点。
🆚 方法对比
暂未生成 — 点击下方按钮
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 13 张)
展开查看 13 张图
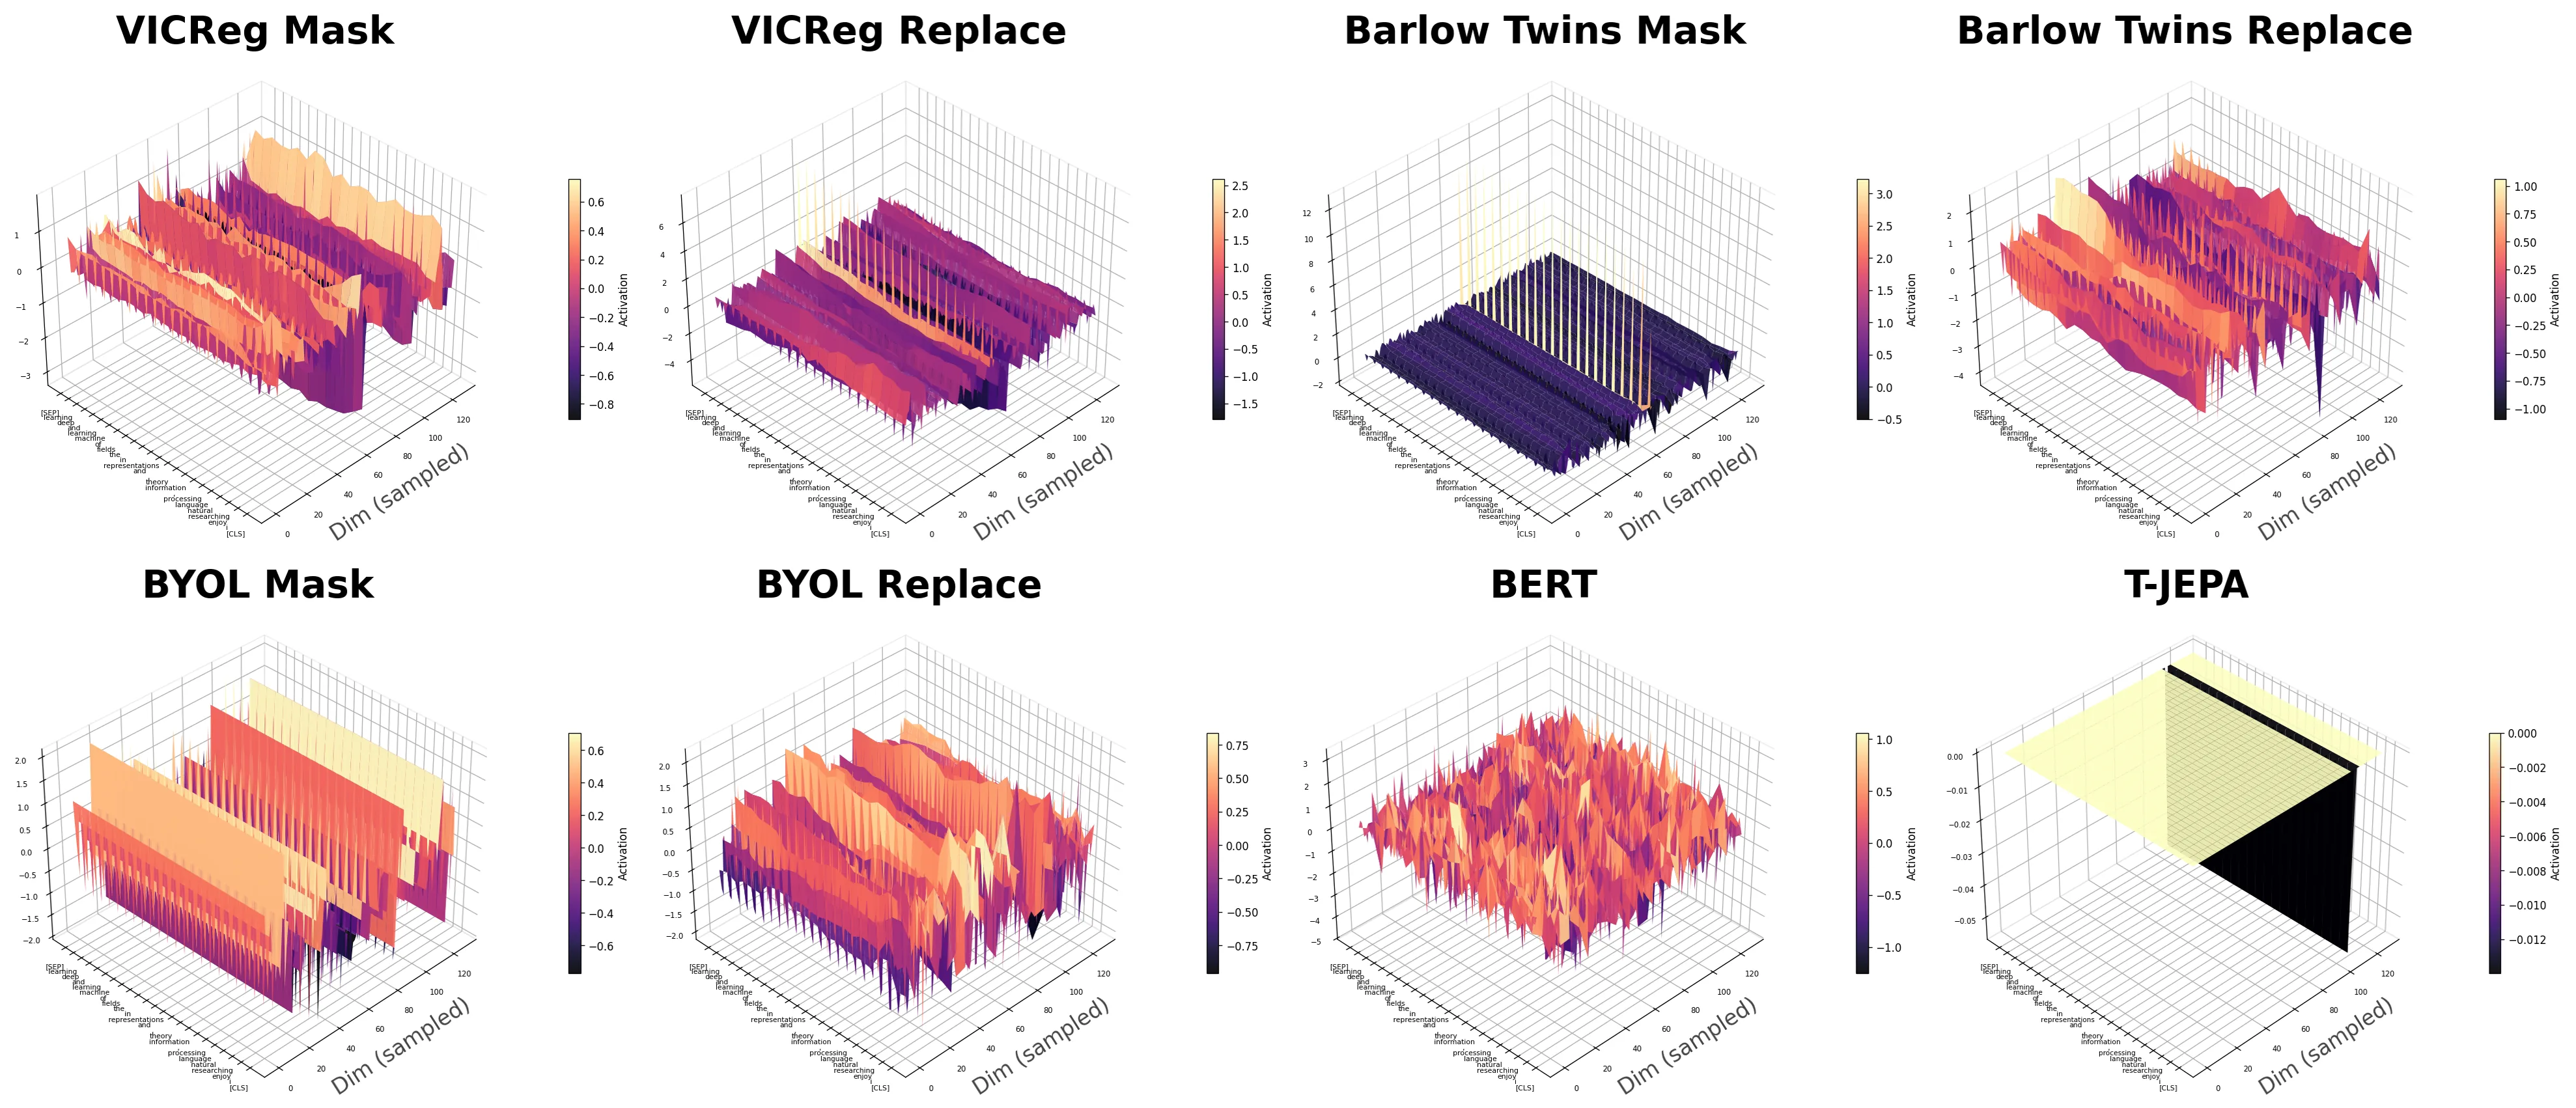
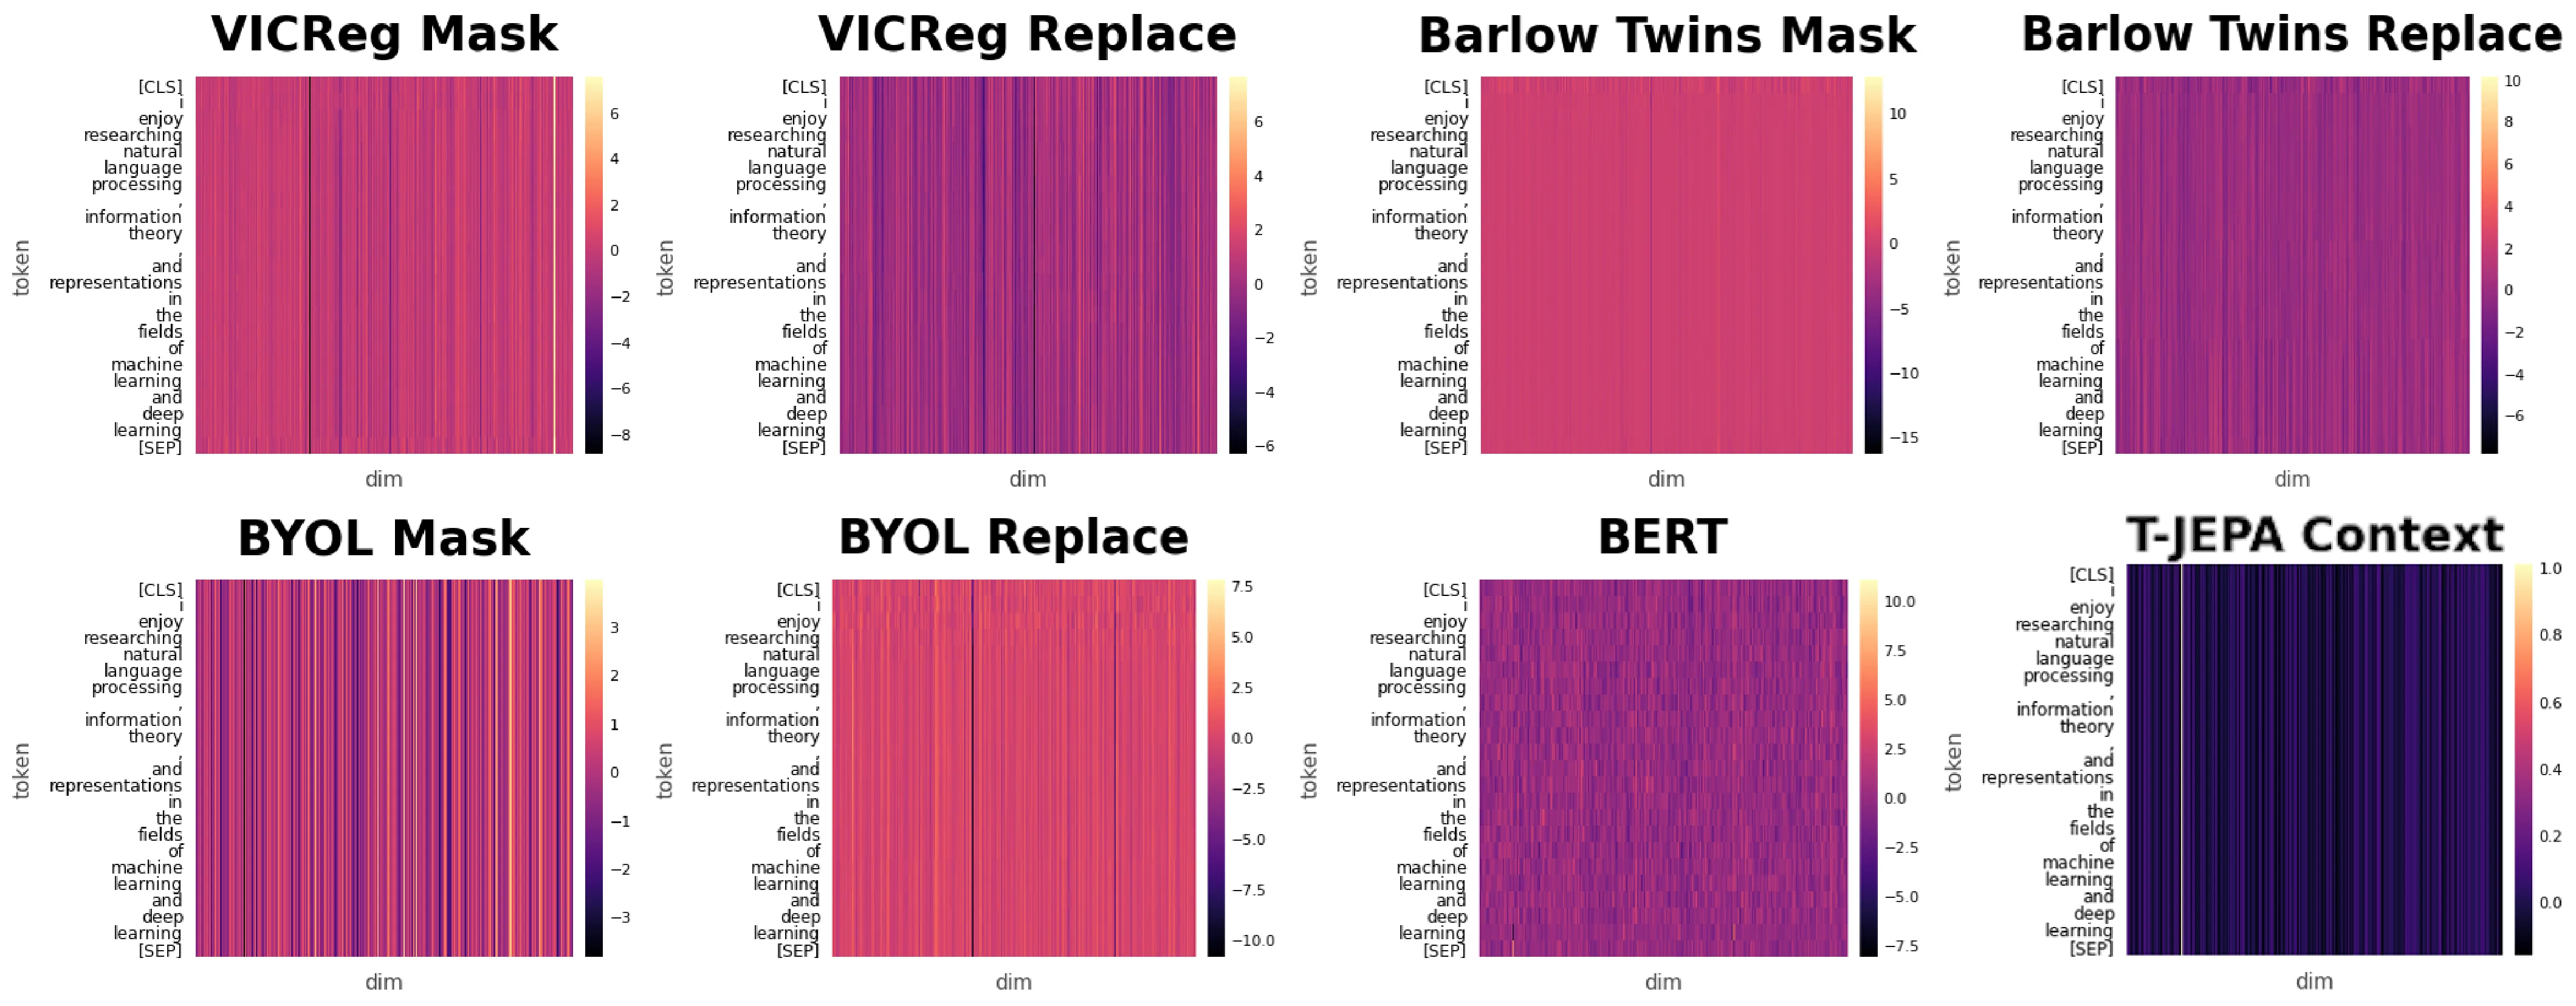
TL;DR
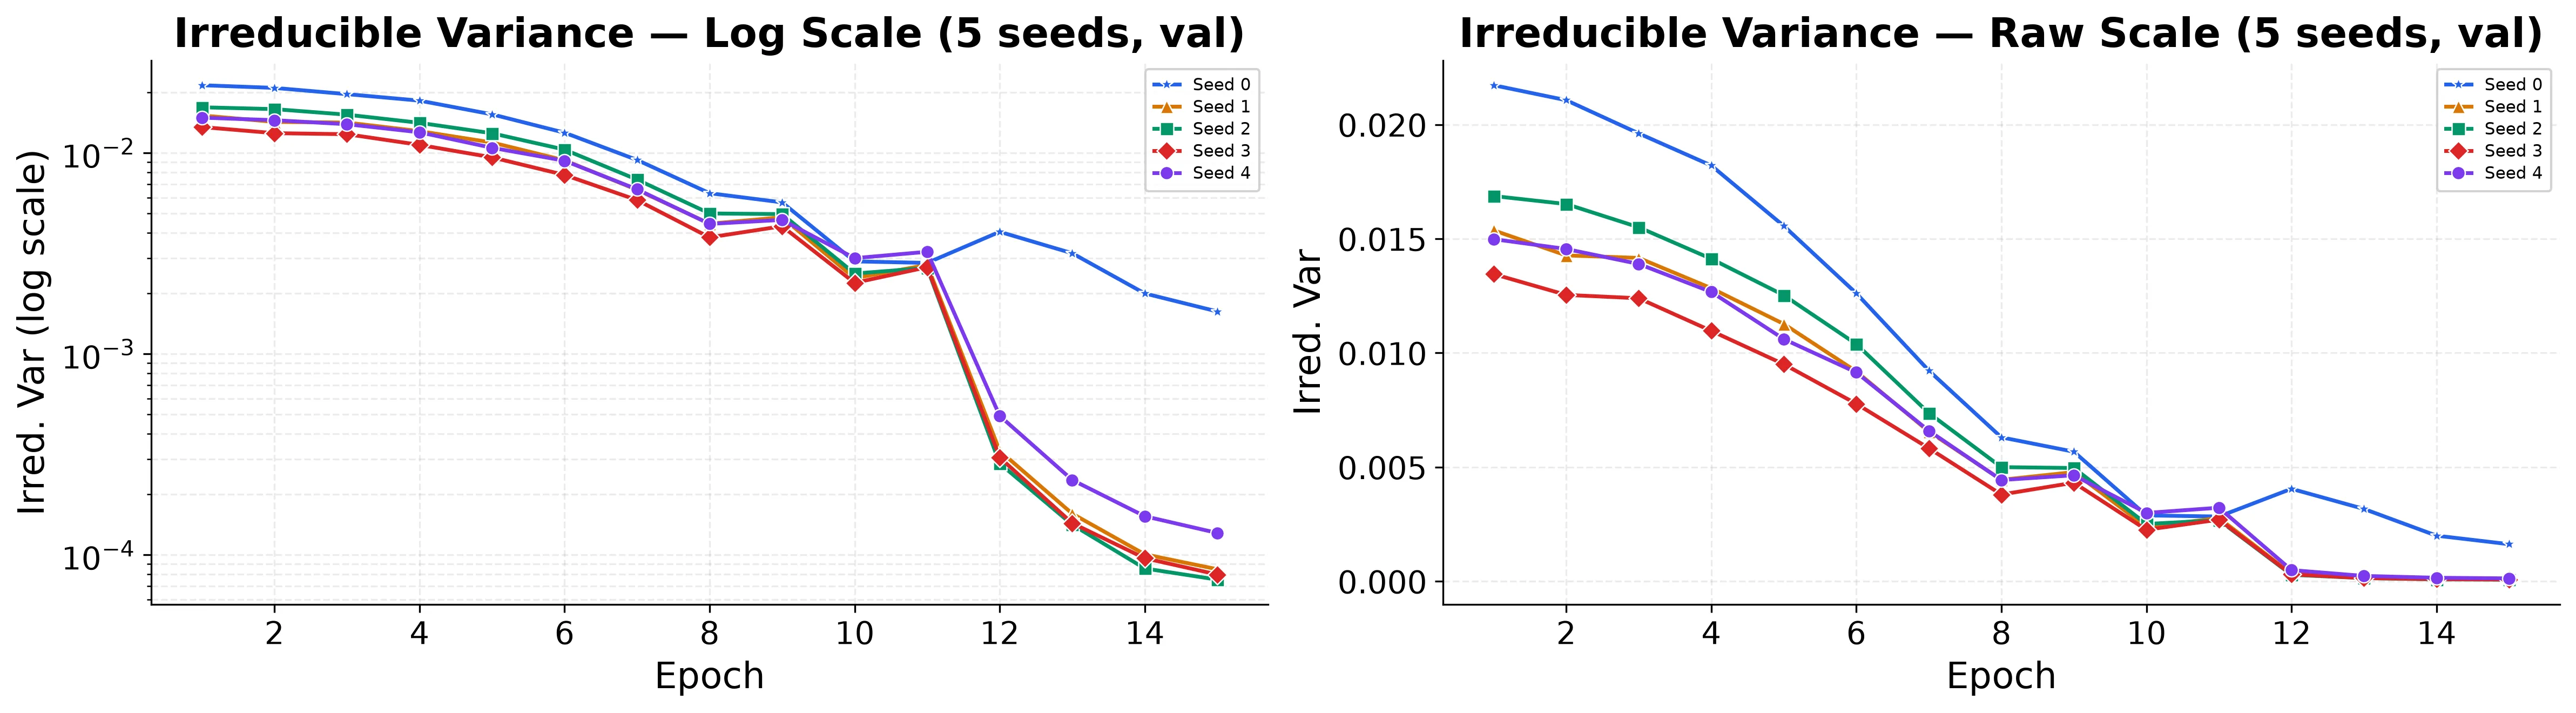
这篇论文揭示了 [[联合嵌入预测架构]](JEPA)在视觉领域成功却难以迁移到文本的根本原因:文本掩码预测本质上是多解问题,而JEPA的平方误差损失强制将预测目标压缩为单一潜在点,导致 [[条件集中性]] 无法满足。研究者通过 I-JEPA 和 T-JEPA 的匹配实验,追踪到一条清晰的失败链条——互信息饱和 → 目标方差上升 → 有效秩退化 → 余弦坍缩,最终造成下游迁移能力恶化。
研究背景与动机
过去几年,[[联合嵌入预测架构]] 在图像、视频和音频任务上取得了显著突破。这类方法的核心思想是:给定部分观测(上下文),预测另一部分(目标)的表征,并通过 [[对比学习]] 或其他机制防止表征坍缩。I-JEPA 通过纯重建式预测目标表征,避免了像素级预测的琐碎细节,在 ImageNet 等基准上展现出强大的迁移能力。
然而,同一套框架移植到文本时却遭遇了困境。尽管研究者们尝试了多种变体,确定性的JEPA式潜在预测始终未能成为文本编码器的标准选择。这一现象值得深思:究竟是实现细节出了问题,还是存在更深层的结构性矛盾?
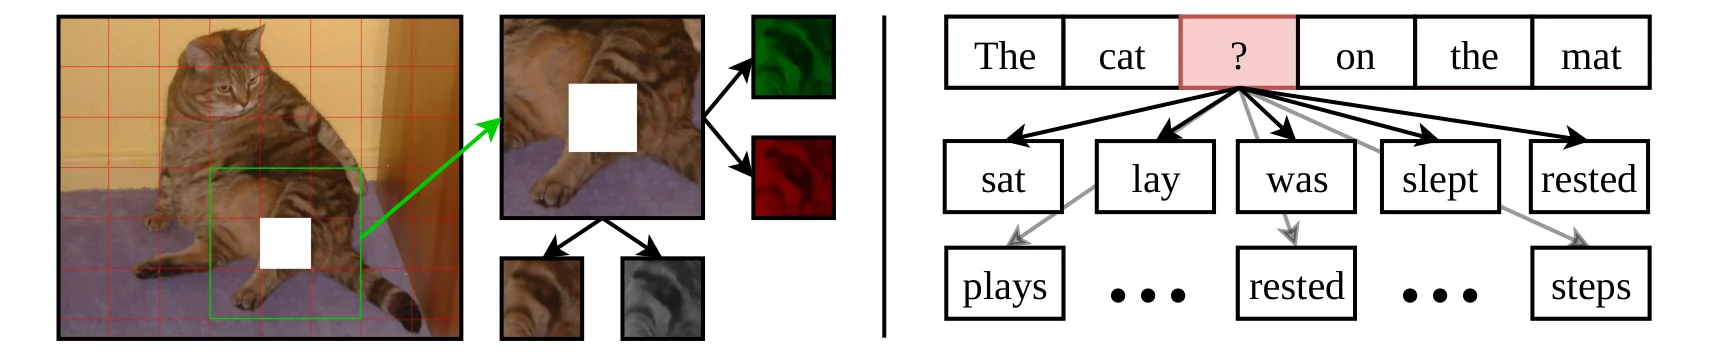
论文的切入点在于重新审视 [[条件集中性]] 这一隐性假设。在图像局部预测中,空间连续性天然保证了预测目标相对集中——给定一块图像 patch,附近的 patch 们在特征空间中往往聚集在某个合理区域附近。但语言完全不同:一个被掩码的词位可能对应数十个语义相似但词汇形式各异的补全,这些补全在表征空间中没有理由共享一个单一中心。当平方误差损失强迫网络将所有合理补全映射到同一个潜在点时,矛盾便不可避免地爆发了。
方法
研究者从理论上形式化了这一问题,提出成功的 [[JEPA目标]] 需要同时满足三个条件。
可预测性(Predictability)要求上下文与目标之间存在足够的互信息,使得从上下文推断目标表征成为可能。对于文本,这对应于掩码位置与上下文之间的语义依赖关系。
非坍缩性(Non-collapse)要求目标网络产生足够的信息方差,防止所有表征塌缩到同一常数向量。这是防止 [[表征坍缩]] 的基本要求。
低条件方差(Low Conditional Variance)是核心所在:给定上下文 和目标位置 ,目标表征应集中分布在某个有意义的中心点 附近。用数学语言表达,即条件分布 的方差应当较小。
当这第三条无法满足时,问题接踵而至。多个有效的补全对应多个分散的目标表征,而平方误差损失只能朝单一方向优化。网络面临两难:强行拉近所有合理补全到同一中心会导致巨大的条件方差惩罚,或者干脆将所有目标表征推向原点以"平等地远离"所有补全——这就是论文所描述的 [[质心退化]] 与 [[坍缩压力]] 的根源。
基于此,论文推导出一个预测:T-JEPA 训练过程中应出现特定的链式失败模式,而非简单的收敛困难。
实验与结果
研究团队设计了精心匹配的 I-JEPA(图像JEPA)和 T-JEPA(文本JEPA)实验,以控制变量并隔离模态差异。T-JEPA 保留了 I-JEPA 的核心架构,仅将输入模态替换为文本,使用与 BERT 相同的掩码策略。
实验结果精确地验证了理论预测。从训练初期到后期,失败呈现出严格有序的阶段:
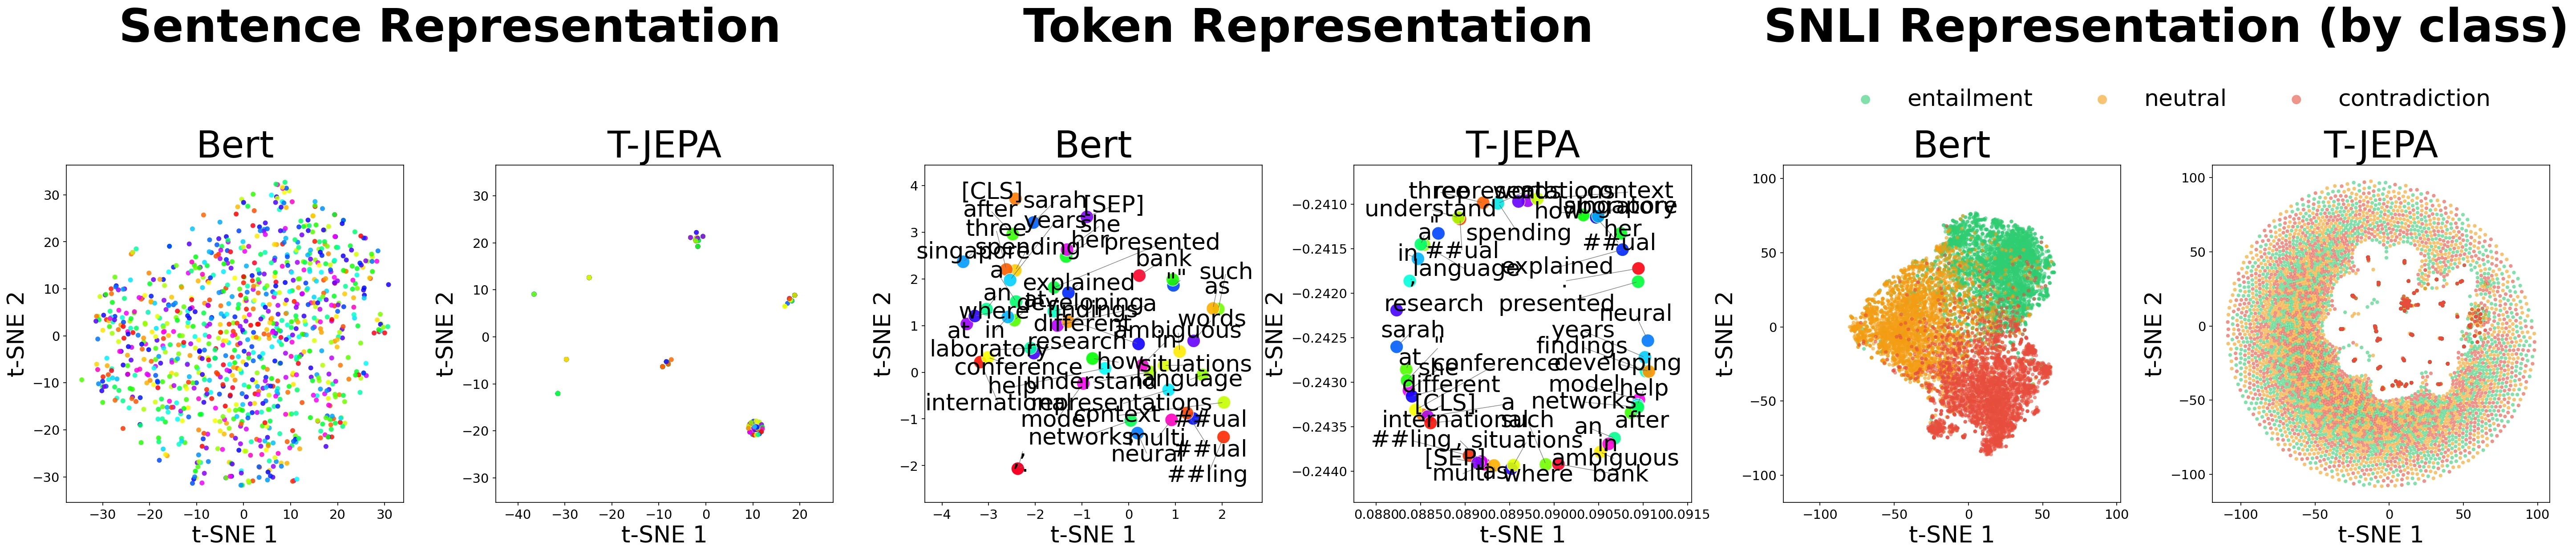
第一阶段,互信息达到饱和。这意味着网络发现无论怎么调整,预测误差都无法进一步降低,因为目标本身就不存在一个唯一答案。随之而来的是目标方差持续升高——目标编码器开始为不同的补全产生差异越来越大的表征,试图"记住"所有合理选项而非压缩它们。
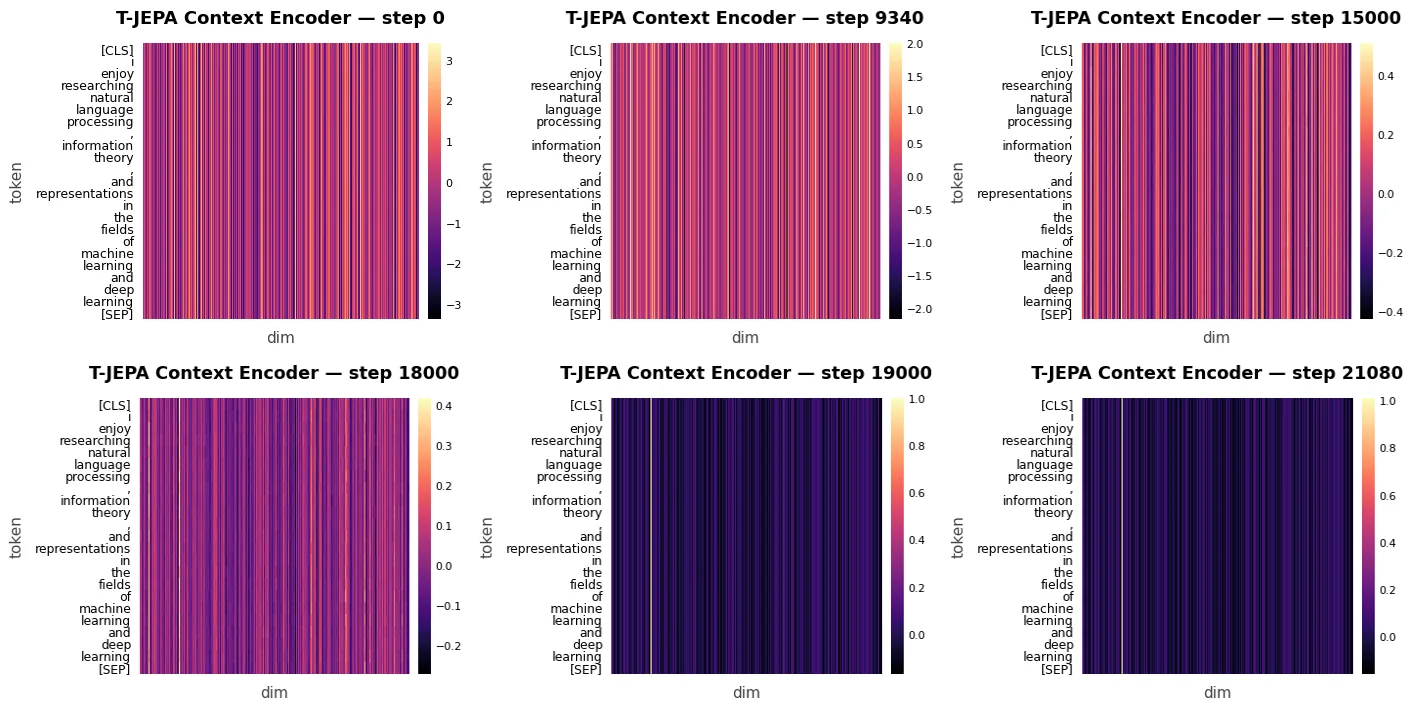
第二阶段,有效秩退化。目标表征的 [[有效秩]](effective rank)衡量其自由度,当网络放弃捕捉多样性而转向某种简化策略时,有效秩急剧下降。
第三阶段,余弦坍缩。表征之间的余弦相似度趋近于统一值,表明区分能力丧失殆尽。
最终,所有这些内部指标恶化都反映在下游任务迁移上。使用 T-JEPA 预训练的编码器在句子级分类和词级标注任务上表现明显差于基线。
值得注意的是,这一完整链条在五个独立的数据种子上稳定复现,排除了随机抽样的干扰。这强烈暗示问题源于任务本身而非实验偶然。
讨论与可借鉴点
这篇论文的核心贡献并非否定语言预测学习,而是精确划定了 [[JEPA目标]] 的适用边界。其发现具有重要的实践启示:在设计文本预训练目标时,必须保留目标空间的多解性,而非强迫其退化为单点预测。可能的改进方向包括:引入 [[潜在变量模型]] 显式建模多模态分布、使用 [[对比损失]] 而非重建损失、或在 [[条件生成]] 框架下处理文本。
从更宽广的视角看,这项工作揭示了 [[自监督学习]] 中一个常被忽视的假设——预测目标的唯一性。在视觉领域由于数据的局部光滑性,这一假设天然成立;但在高度离散的符号序列(如文本)上,它必须被显式审视。任何试图将视觉领域的成功方法迁移到语言的研究者,都应将这篇论文的诊断框架纳入考量。
研究的局限在于:T-JEPA 的具体实现可能并非最优,论文也承认存在其他替代方案尚未探索。未来的工作或许能在承认多解性的前提下,设计出真正与文本条件结构兼容的联合嵌入预测目标。
摘要
联合嵌入预测架构(Joint-Embedding Predictive Architectures, JEPAs)在图像、视频和音频任务上效果显著,但确定性的JEPA式潜在预测尚未成为文本编码器的标准目标。我们认为,这一差距反映了平方误差潜在预测与语言条件结构之间的不匹配。关键要求是条件集中性:给定上下文和目标位置,目标表征应位于某个单一有意义的点附近。局部图像预测通常通过空间连续性满足这一条件,而掩码文本则可能允许多种有效的词元或片段补全,其表征不必共享一个连贯的中心。我们通过三个条件——可预测性、非坍缩和低条件方差——将这种不匹配形式化,并展示它们的失败如何在文本中产生质心退化和坍缩压力。匹配的I-JEPA和T-JEPA实验揭示了预期序列:互信息饱和和目标方差升高先于训练-验证不稳定性、有效秩退化、余弦坍缩和较差的下游迁移能力出现。相同的模式出现在五个独立的数据种子上,表明这并非抽样伪影。这些结果并未排除语言的预测学习;它们表明,与文本兼容的JEPA目标必须保留多种合理的补全,而非将其压缩为单一的潜在点。
Abstract
Joint-Embedding Predictive Architectures (JEPAs) are effective for images, video, and audio, yet deterministic JEPA-style latent prediction has not become a standard objective for text encoders. We argue that this gap reflects a mismatch between squared-error latent prediction and the conditional structure of language. The key requirement is conditional concentration: given a context and target location, the target representation should lie near a single meaningful point. Local image prediction often satisfies this through spatial continuity, whereas masked text can admit multiple valid token or span completions whose representations need not share a coherent center. We formalize this mismatch through three conditions---predictability, non-collapse, and low conditional variance---and show how their failure creates centroid degeneracy and collapse pressure in text. Matched I-JEPA and T-JEPA experiments reveal the predicted sequence: mutual-information saturation and elevated target variance precede train--validation instability, effective-rank degeneration, cosine collapse, and poor downstream transfer. The same pattern appears across five independent data seeds, indicating that it is not a sampling artifact. These results do not rule out predictive learning for language; they show that text-compatible JEPA objectives must preserve multiple plausible completions rather than compress them into a single latent point.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。