
📝 TLDR
在线策略自蒸馏(OPSD)通常需教师与学生之间的非对称信息,现有方法通过特权答案或视觉证据构造这种不对称性。本文提出视觉对比自蒸馏(VCSD),让EMA教师在同一前缀下分别基于原图与去内容图像生成两个分布,以token级对数概率差提取视觉内容特异信号,并据此锐化教师分布后蒸馏给学生。该方法在ViRL39K上对Qwen3-VL与Qwen3.5多个规模均带来稳定提升,且无需外部教师、特权答案、视觉证据信号或额外推理开销。
🧭 速览
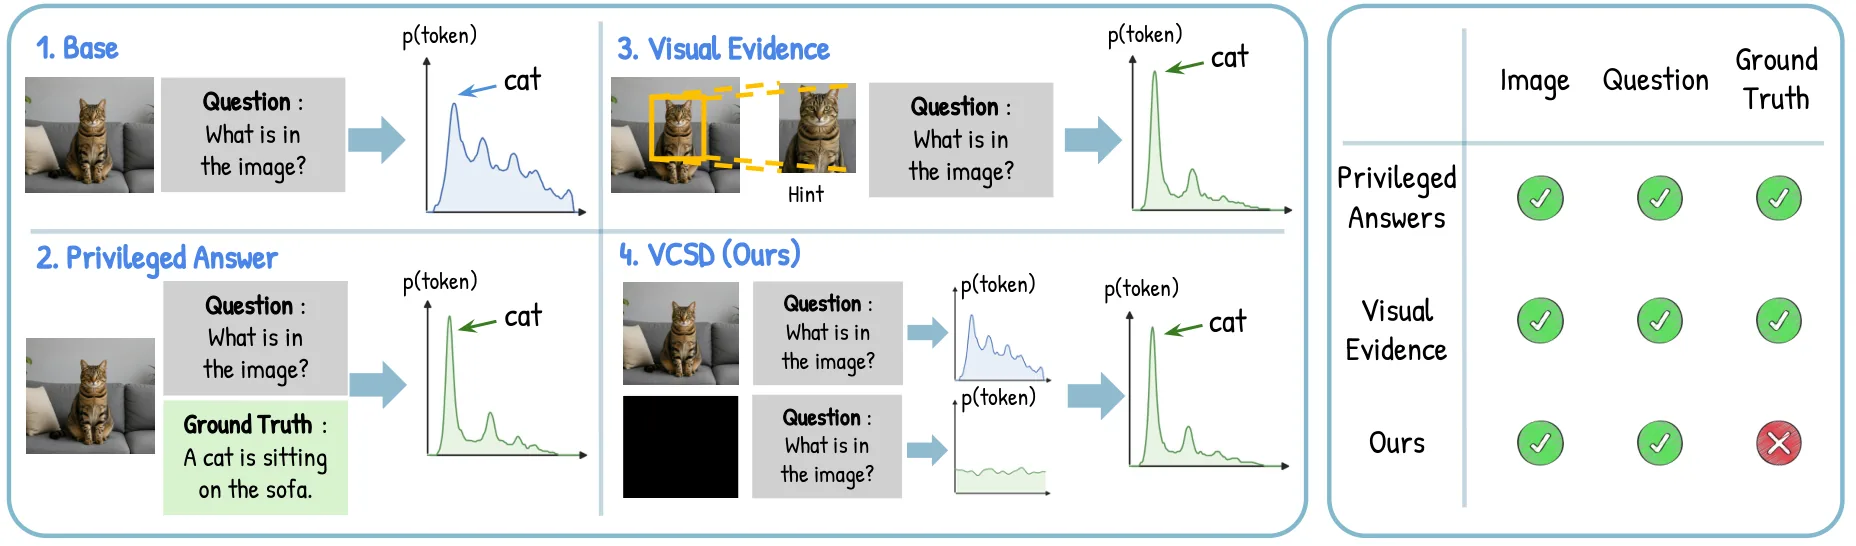
现有OPSD依赖特权答案或视觉证据来构造师生非对称性,引入外部信号限制了方法的简洁性与泛用性。
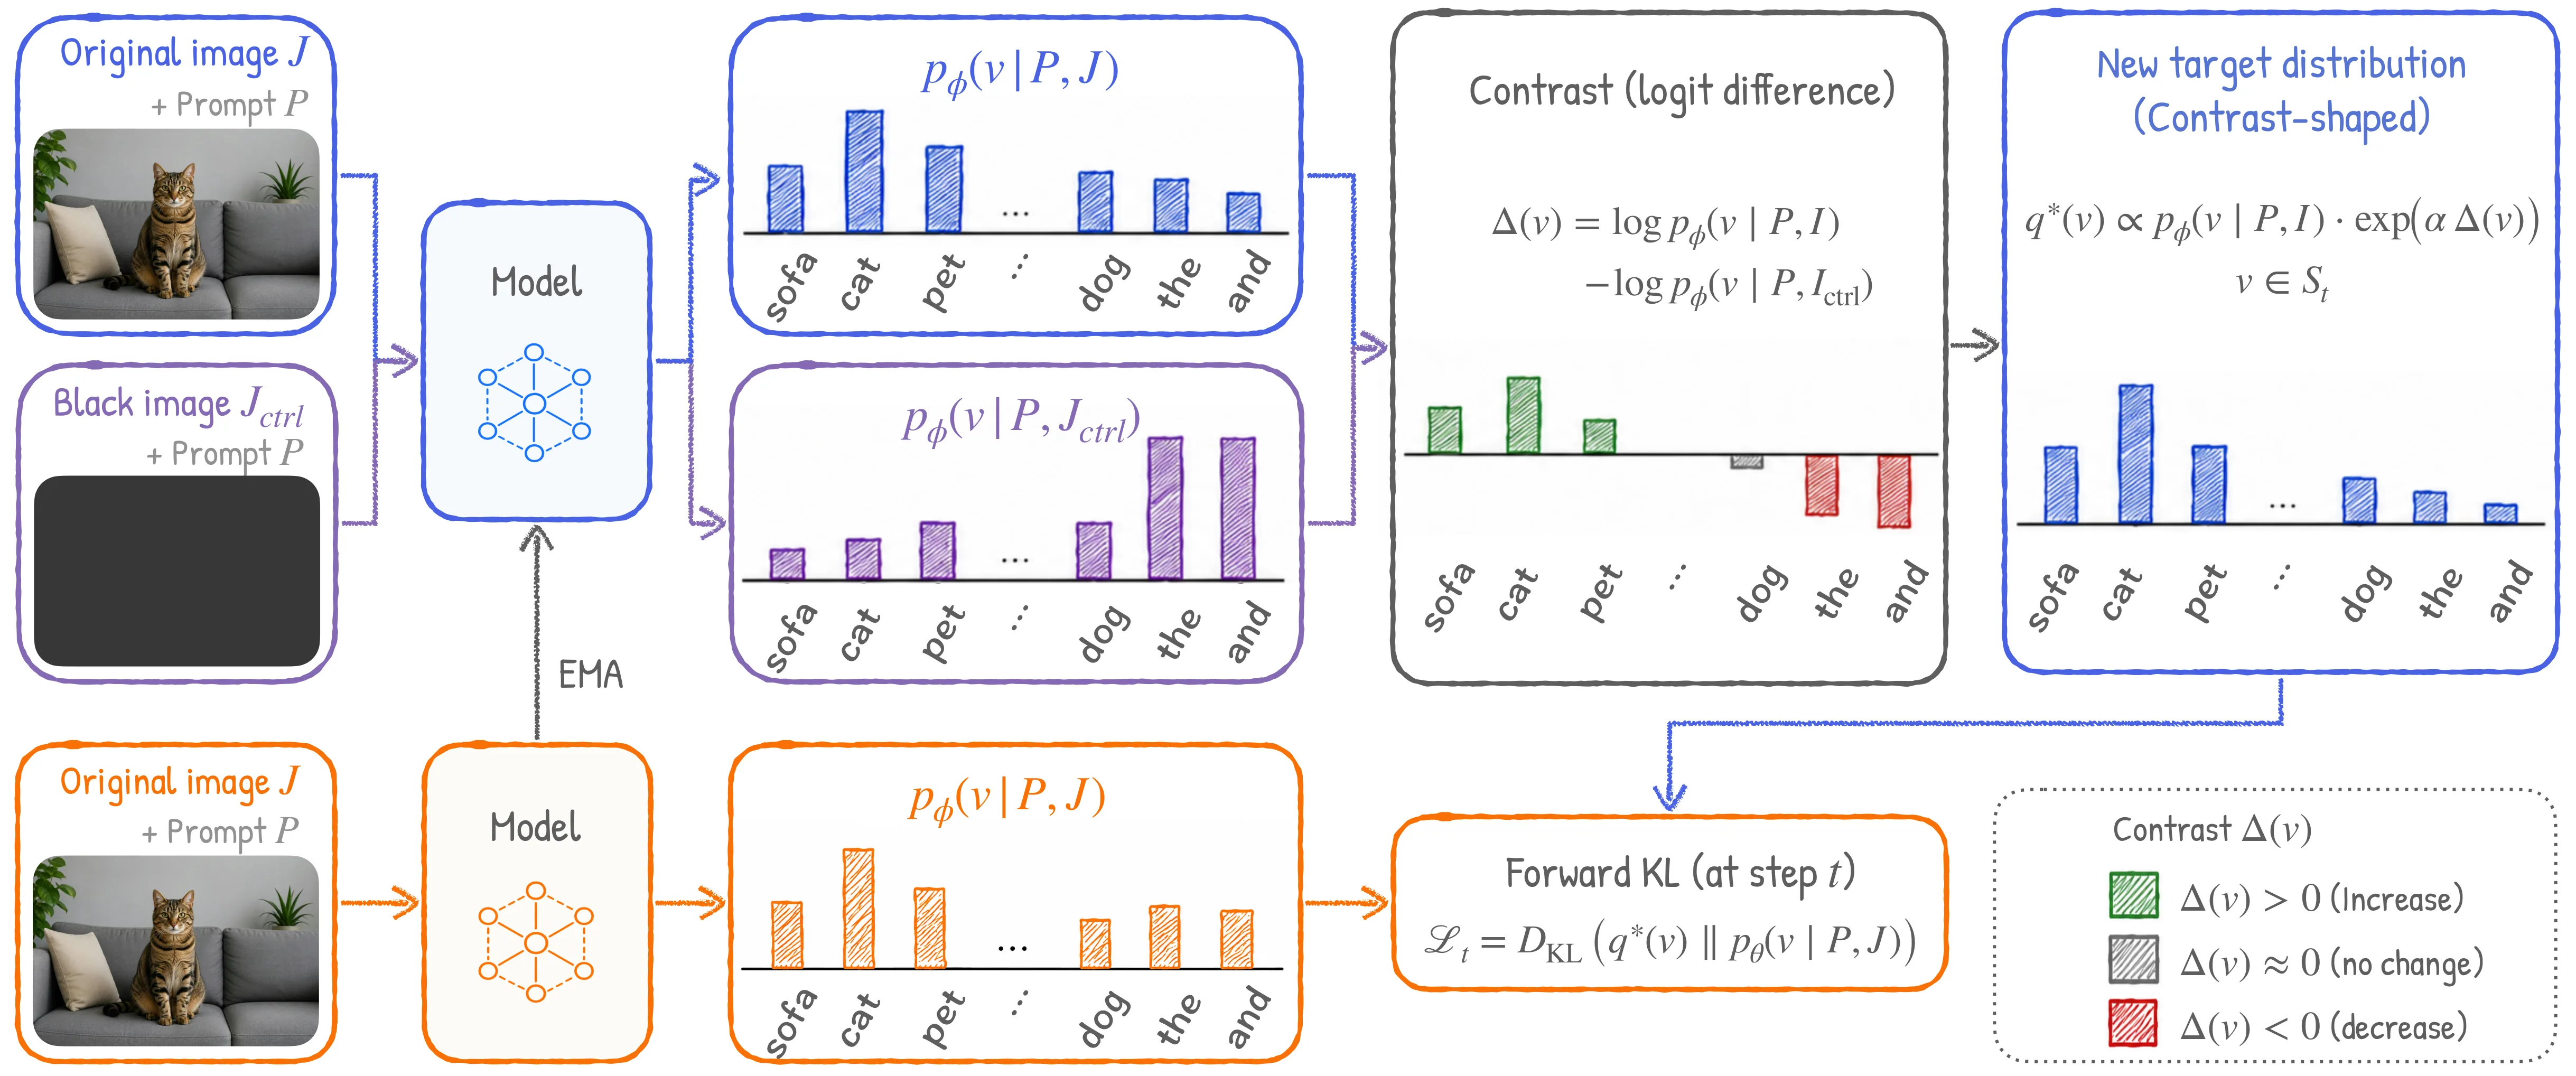
EMA教师对同一前缀分别基于原图与去内容图生成两个分布,以token级对数概率差定位视觉敏感候选token,据此锐化原图分布后全分布蒸馏给学生。
在ViRL39K数据集上,Qwen3-VL 2B/4B/8B七项基准聚合分别从62.27%/71.30%/72.51%提升至67.04%/73.16%/76.26%。
VCSD以纯输入条件驱动OPSD,无需外部教师、特权答案、视觉证据或推理开销,提供更简洁的自蒸馏范式。
🆚 方法对比
OPD (On-Policy Distillation)
- 与推理时轨迹对齐,训练分布一致
- 密集token级监督提供细粒度信号
- 已有成熟的理论框架支撑
- 需要更强的外部教师,成本高
- 增加后训练复杂度和资源消耗
- 依赖外部模型可用性
OPSD with Privileged Answers
- 去除外部教师依赖,降低部署成本
- 利用特权答案提供有效监督信号
- 适用于语言推理任务
- 特权答案并非所有任务都可用
- 依赖任务特定的辅助信息
- 信息构建可能需要额外标注
OPSD with Visual Evidence
- 通过区域裁剪暴露关键视觉证据
- 增强教师对学生可见信息的引导
- 在视觉语言任务中效果显著
- 需外部定位模型或手动设计变换
- 依赖额外标注和图像处理流程
- 增加训练pipeline复杂度
VCSD (Visual Contrastive Self-Distillation)
- Qwen3-VL 2B/4B/8B分别提升4.77/1.86/3.75个百分点
- 无需外部教师、特权答案或视觉证据信号
- 无额外推理时成本,仅靠输入条件构造不对称性
- 在Qwen3.5上跨2.9%–4.3%稳定提升
- 提供全分布蒸馏目标,信息更丰富
cons
本文未提出多个独立方法进行对比
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 6 张)
展开查看 6 张图
TL;DR
视觉对比自蒸馏(VCSD)是一种新型的在线策略自蒸馏方法,其核心创新在于将图像内容的移除本身转化为蒸馏信号——让 EMA 教师在相同前缀下分别基于原图与去内容黑图生成两个分布,通过 token 级对数概率差识别那些被视觉内容显著提升的候选 token,据此锐化教师分布后蒸馏给学生。实验在 ViRL39K 数据集上覆盖 Qwen3-VL 与 Qwen3.5 六个模型规模,均取得稳定提升,例如 Qwen3-VL-8B 在七项基准聚合上从 72.51% 提升至 76.26%,且全程无需外部教师、特权答案、视觉证据或额外推理开销。
研究背景与动机
在[[视觉语言模型]]的后训练阶段,[[知识蒸馏]]是提升模型能力的重要手段。传统的在策略蒸馏(OPD)依赖一个更强的外部教师为学生提供密集的 token 级监督,能有效对齐学生在推理时的轨迹,但强教师的获取与维护本身就是一笔不小的开销。在策略自蒸馏(OPSD)通过 EMA 教师机制去除了对外部教师的依赖——教师模型由学生的指数滑动平均(EMA)更新而来,学生与教师共享相同的参数架构,理论上是一种更简洁、更经济的方案。
然而,OPSD 面临一个根本性的张力:当师生在同一前缀下接收完全相同的信息时,教师的目标分布可能仅仅是学生已有预测的一个副本,无法提供真正意义上的增量监督。换言之,OPSD 仍然需要构建「师生非对称性」,使得自教师比学生拥有更丰富的信息,从而产生有价值的蒸馏信号。
现有方法通过两类辅助信息来构造这种非对称性。语言侧的做法包括提供特权答案、推理轨迹或专家演示,让教师看到学生看不到的参考答案;视觉侧的做法则引入证据导向的裁剪、区域标注或外部视觉定位模型的输出,作为教师额外的视觉提示。这些方法虽然有效,但带来了额外的依赖——特权答案不一定在所有场景下可用,视觉证据信号需要人工标注或额外的视觉模型支持,整个训练流程因此变得更加复杂。
VCSD 的研究问题由此浮现:能否将这两类辅助信息同时去除,获得一种纯粹由输入条件驱动的、更简洁的 OPSD 形式?也就是说,能否仅凭模型自身的输入——图像本身——来构造师生之间的非对称性,而不需要任何外部的参考答案、推理轨迹或视觉标注?
方法
VCSD 的核心洞察出人意料地简洁:图像内容的有无本身就可以作为蒸馏信号的来源。具体而言,EMA 教师在学生生成的每个回答前缀处进行两次评估——一次以原始图像 为条件,一次以「内容擦除」后的控制图像 为条件(默认使用纯黑 RGB 图,与原图保持相同分辨率)。两次评估使用完全相同的提示、相同的前缀和相同的模型参数,唯一的区别在于视觉输入是否包含实例级内容。
对每个候选 token ,定义这两条条件路径的对数概率差为:
直觉上,这个差值衡量的是:当模型「看到」原图而非黑图时,对该 token 的置信度提升了几个 log 单位。那些被差值显著标记的 token,正是模型判断「需要依赖这张具体图像才能合理输出的」候选——它们的存在本身就传递了来自视觉内容的证据。值得注意的是,由于两次分布评估共享同一模型参数和前缀,这一对比信号天然地与当前学生的生成轨迹对齐,不会引入分布偏移问题。
接下来的设计涉及如何在教师分布中注入这一对比信号。作者引入了一个「合理支撑集」的概念,仅保留原图分布下似然较高的候选 token,避免将概率质量分配给那些本身就几乎不会被输出的低置信度 token:
然后在这个支撑集上对原图分布进行对比锐化:
其中 控制对比增强的强度, 是对终止 token 置零后的对比值(以避免终止 token 因其特殊性被过度锐化)。等价地可以写为:
这个形式清晰地揭示了 VCSD 的本质:它在原图分布与控制图分布之间进行加权插值。当 时退化为原始 EMA 教师分布;当 时,视觉内容对预测有正向贡献的 token 被提升概率,贡献为负的则被压低,从而让教师分布更加「向视觉信息靠拢」。
最后,蒸馏损失沿学生 on-policy 轨迹采样,使用前向 KL 散度进行分布对齐:
其中 表示停止梯度操作,确保梯度仅从教师分布流向学生。教师通过 EMA 机制更新:。
实验与结果
实验在 ViRL39K 数据集上进行,涵盖 Qwen3-VL 2B/4B/8B 和 Qwen3.5 2B/4B/9B 共六个模型配置。评测基准包括七项任务:通用视觉感知的 BLINK 和 MMStar、视觉数学的 MathVista、细粒度感知的 V\*Bench 和 HRBench4K/8K、以及幻觉评估的 HallusionBench,聚合指标为七项基准的等权平均准确率。
对比基线包括未修改的基座模型(Base)和基于「答案提示」的匹配 OPSD——后者允许教师在蒸馏时看到参考答案,而 VCSD 完全不依赖答案信息。训练采用 AdamW 优化器,每批 32 条 prompt 每条 8 条 rollout,学习率 ,共 90 步优化,在 8 块 NVIDIA B200 GPU 上完成。
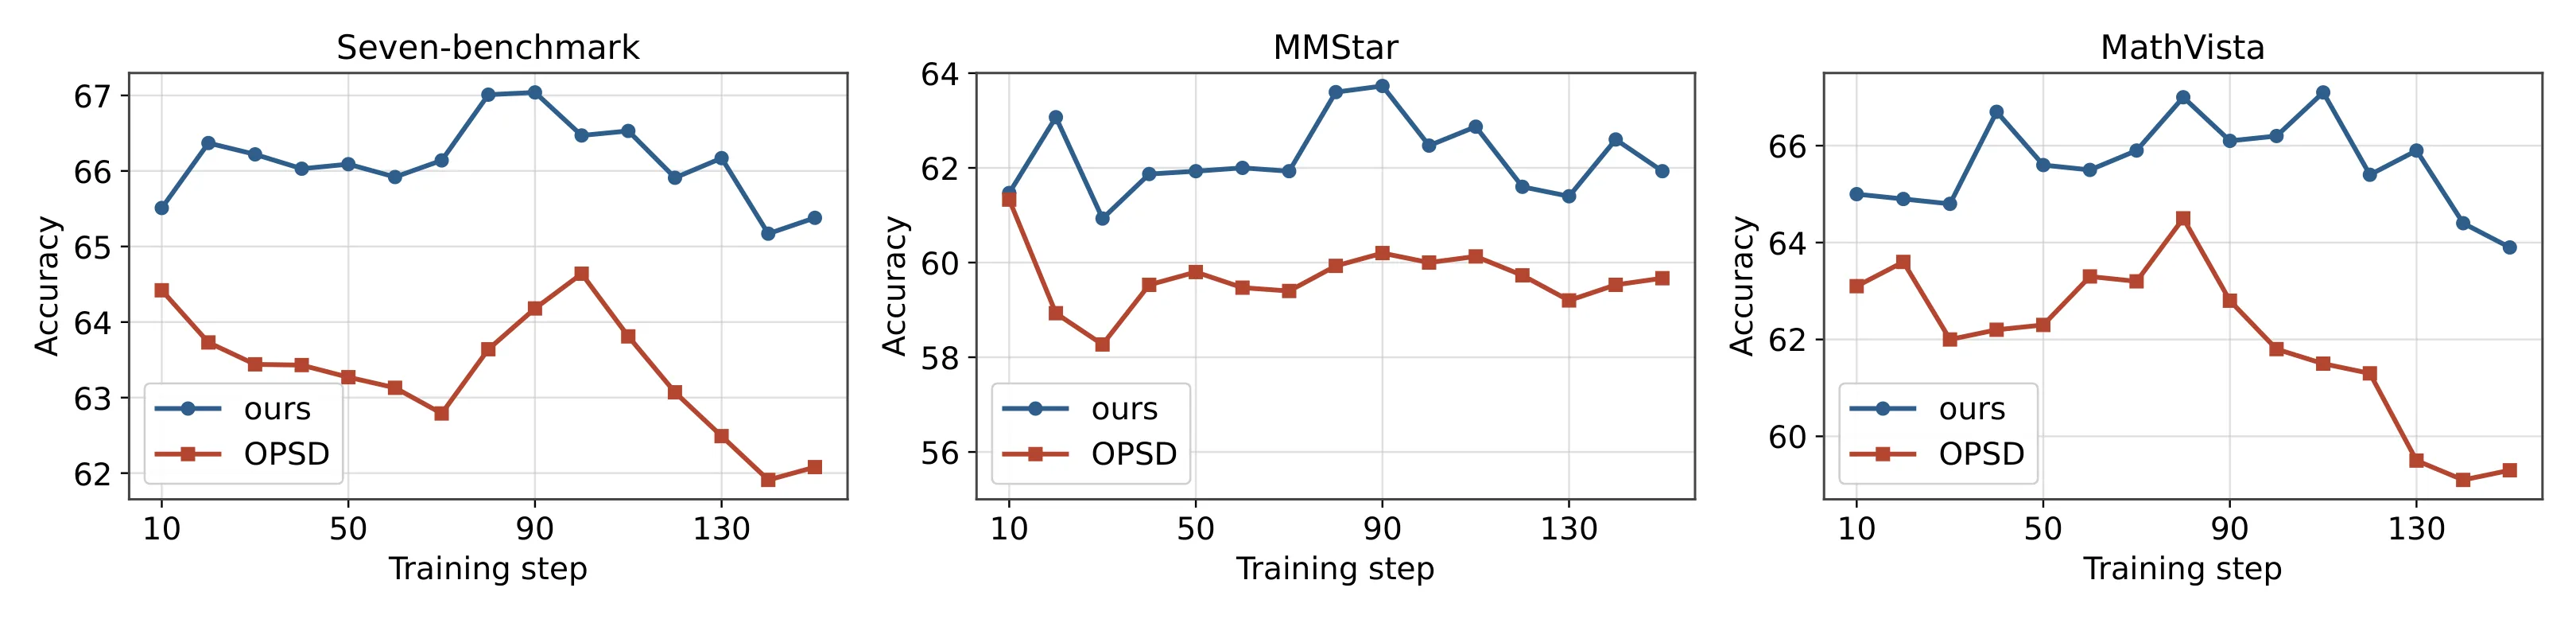
核心结果展现出清晰的趋势。在 Qwen3-VL 系列上,VCSD 在三个规模上均取得最大提升:2B 从 62.27% 提升至 67.04%(+4.77%)、4B 从 71.30% 提升至 73.16%(+1.86%)、8B 从 72.51% 提升至 76.26%(+3.75%)。特别值得注意的是,OPSD 在 Qwen3.5 模型上并未带来一致的性能增益,而 VCSD 在该系列上仍能稳定提升 2.83% 至 4.27%。这说明当去掉特权答案这一辅助信息后,传统 OPSD 的师生非对称性严重削弱,而 VCSD 通过视觉对比独立构造非对称性,不受此影响。
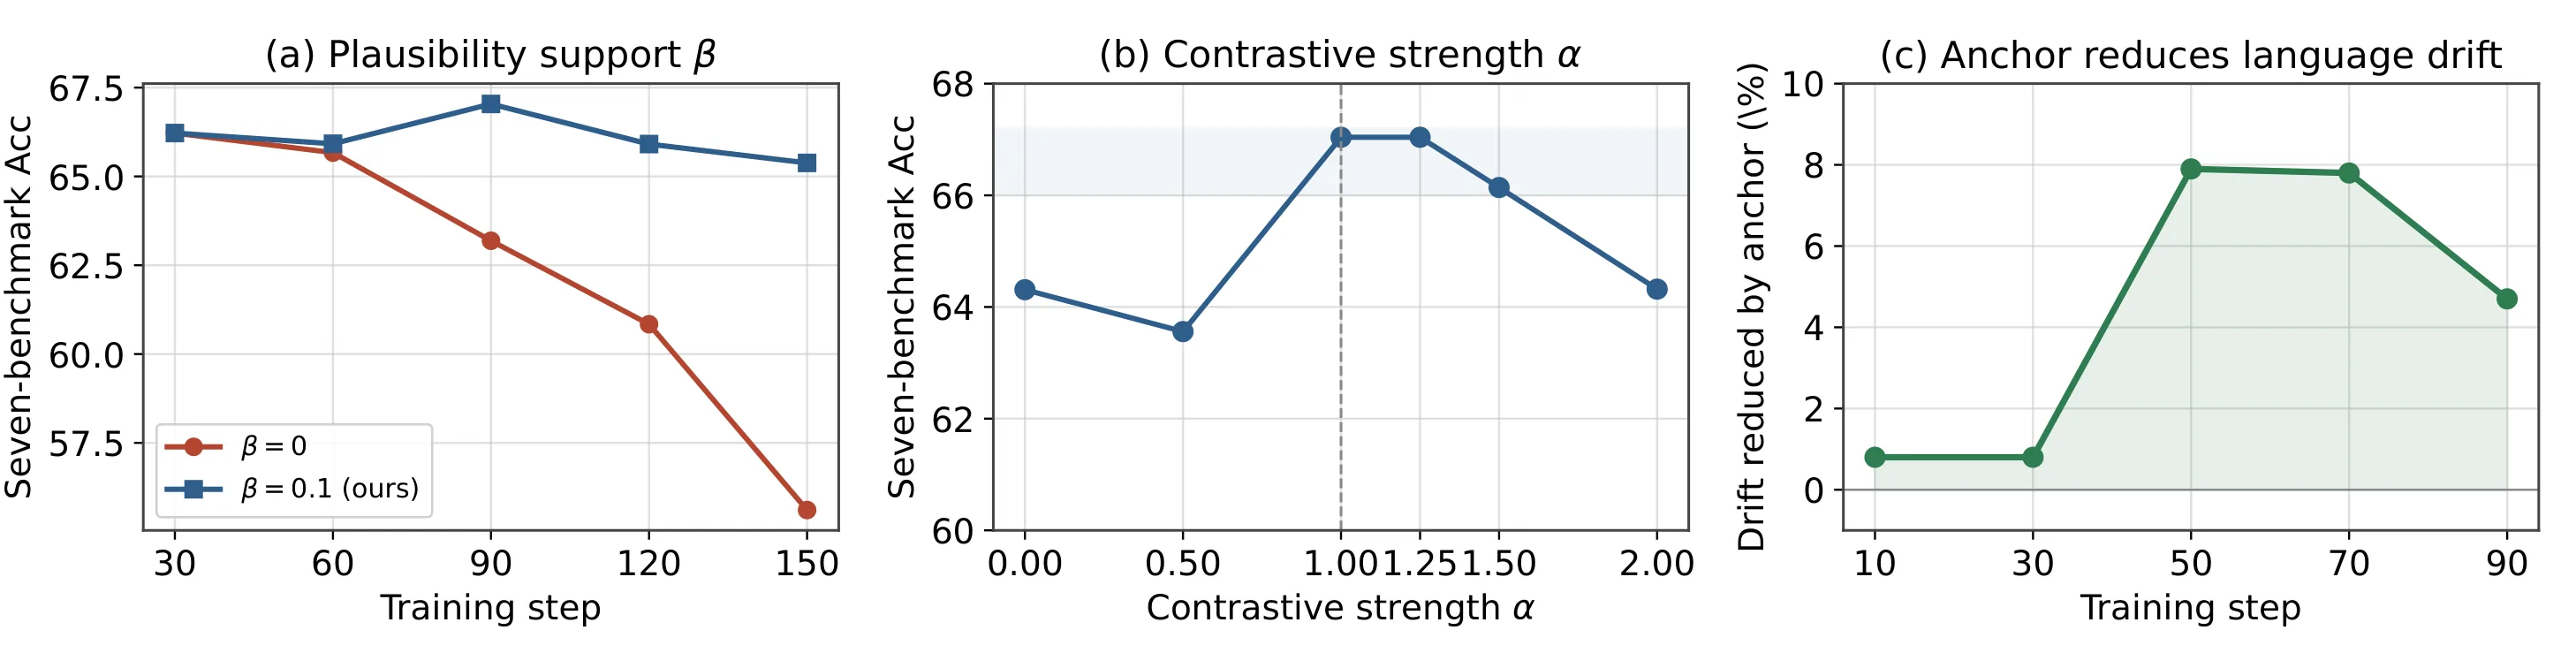
消融实验进一步验证了设计选择的合理性。合理性支撑阈值 的作用至关重要——当 时(即不对教师分布做任何支撑约束),长程训练中会出现目标分布畸变累积,导致性能下降;而 能有效缓解这一问题。控制图构造方式的消融(黑图、高斯噪声、高斯模糊、无图)显示性能差异极小,说明信号来源于「内容的存在与否」这一抽象性质,而非任何特定退化方式的细节。对比强度 在 范围内性能变化小于 1%,表明方法对这一超参数具有一定的鲁棒性。
讨论与可借鉴点
VCSD 最重要的贡献在于证明了 OPSD 所需的师生非对称性可以完全由输入条件本身构造,而不需要任何外部辅助信息或任务相关的先验知识。这为后续研究提供了一种新的思路——如果将「内容移除」这一操作泛化,是否可以通过移除其他模态的信息(文本描述、音频片段等)来构造类似的对比蒸馏信号?这种「信息减法即信号」的思想具有相当的通用性潜力。
当前方法也存在若干局限性。首先,ViRL39K 仅包含单图任务,VCSD 是否能推广到多图、视频帧序列或文档多页理解等更复杂场景,尚未得到验证。其次,控制图的构造目前依赖「纯黑图」这一强假设,虽然消融表明不同退化方式性能接近,但这仍是一个值得在理论上更严格论证的方向。再者,论文的 OPSD 对比基线仅实现了答案提示这一种方式,与其他近期 OPSD 方法(如 V-zero、Vision-OPD 等)在统一设置下的充分对比仍有欠缺。
从工程实践的角度看,VCSD 的零推理开销设计值得借鉴——所有复杂的对比信号计算仅发生在训练阶段,部署时仅需保留更新后的学生模型,不引入任何额外的推理时计算分支。结合其在多规模模型上的一致提升,VCSD 为视觉语言模型的在线自训练提供了一种高效、简洁且无需外部监督的可行路径。
摘要
在策略自蒸馏(OPSD)由于去除了在策略蒸馏(OPD)所需的外部教师而颇具前景,但它仍需要教师与学生之间的非对称信息,以确保自教师提供比学生更强的学习信号。现有方法通过特权答案或视觉证据来构建这种非对称性。我们探究能否将二者同时去除,从而获得一种纯粹由输入条件驱动的、更简洁的 OPSD 形式。为此,我们提出了视觉对比自蒸馏(VCSD),它将图像内容的移除转化为一种在策略自蒸馏信号。在学生生成的每个回答前缀处,EMA 教师在相同提示和前缀下产生两个下一 token 的分布——一个以原始图像为条件,另一个以内容擦除后的对照为条件。二者逐 token 的对数概率之差突出了那些似然性被实例级视觉内容显著提升的候选 token。我们利用这一对比在原始图像分布的可信支撑内对其进行锐化,并将得到的全分布目标蒸馏给学生。在 ViRL39K 数据集上,VCSD 在 Qwen3-VL 和 Qwen3.5 模型上一致优于匹配的 OPSD。例如,在 Qwen3-VL 上,它将七个基准的聚合得分从 2B 模型的 62.27% 提升至 67.04%、4B 模型的 71.30% 提升至 73.16%、8B 模型的 72.51% 提升至 76.26%。此外,VCSD 不需要外部教师、特权答案、视觉证据信号、推理轨迹或额外的推理时开销。
Abstract
On-policy self-distillation (OPSD) is promising as it removes the external teacher required by on-policy distillation (OPD), yet it still needs asymmetric information between teacher and student to ensure that the self-teacher provides a stronger learning signal than the student. Existing methods create this asymmetry either through privileged answers or visual evidence. We ask whether both can be removed, yielding a simpler form of OPSD driven purely by input conditioning. For this purpose, we propose Visual Contrastive Self-Distillation, namely VCSD, which converts image-content removal into an on-policy self-distillation signal. At each student-generated response prefix, the EMA teacher produces two next-token distributions under the same prompt and prefix -- one conditioned on the original image and the other on a content-erased control. Their token-wise log-probability difference highlights candidates whose likelihood is specifically increased by the instance-level visual content. We use this contrast to sharpen the teacher's original-image distribution within its plausible support, and distill the resulting full-distribution target into the student. Using ViRL39K dataset, VCSD consistently outperforms matched OPSD across Qwen3-VL and Qwen3.5 models. For example, on Qwen3-VL, it improves the seven-benchmark aggregate from at 2B, at 4B, and at 8B. Furthermore, VCSD requires no external teacher, privileged answers, visual evidence signals, reasoning traces, or additional inference-time cost.
论文详细总结(自动生成)
视觉对比自蒸馏(VCSD)论文总结
1. 核心问题与研究动机
问题背景:在策略蒸馏(OPD)通过外部教师为学生提供密集的 token 级监督,能对齐学生在推理时的轨迹,但通常依赖更强的外部教师,增加了后训练成本与复杂度。在策略自蒸馏(OPSD)虽通过 EMA 教师去除了外部教师,但当师生在同一前缀接收相同信息时,目标可能仅复制学生的现有预测,无法提供增量监督。因此,OPSD 仍需构建"师生非对称性",使自教师比学生更具信息量。
现有方法的局限:现有 OPSD 方法依赖额外的辅助信息来构造非对称性:
- 语言侧:特权答案、推理轨迹、专家演示或文本反馈;
- 视觉侧:证据导向的裁剪、区域或外部视觉定位模型。
这些方法往往依赖任务特定信息或额外处理流程,且特权答案不一定可用,视觉证据输入则需要标注或额外模型。
核心问题:能否在不引入任何外部辅助信息(特权答案或视觉证据)的前提下,仅通过输入条件构建 OPSD 所需的目标非对称性?
2. 方法论
2.1 整体思路
VCSD 将"图像内容擦除"转化为自蒸馏信号。EMA 教师在学生生成的每个前缀上对同一提示同时进行两次评估——一次基于原图,一次基于去内容控制图(黑图),其 token 级对数概率差揭示了哪些候选 token 的似然性被实例级视觉内容显著提升。基于此对比在原图分布的合理支撑内进行锐化,并将得到的全分布目标通过前向 KL 蒸馏给学生。
2.2 关键公式
视觉条件对比(同一前缀、相同模型参数、仅视觉条件不同):
其中 为内容擦除控制图(与原图同分辨率的黑色 RGB 图)。
合理支撑集(仅保留原图下似然较高的候选 token):
对比锐化后的教师目标:
其中 控制对比强度, 为对终止 token 置零后的对比值。等价地可写为:
蒸馏损失(前向 KL 沿学生 on-policy 轨迹):
EMA 更新:。
2.3 理论解释
KL 正则化策略更新视角:原图教师分布 (在 上重归一化)作为参考策略, 作为隐式"视觉证据奖励" 。则对比锐化目标 是下述优化问题的唯一解:
条件点互信息(PMI)近似视角:当 近似于"无实例级视觉信息"的预测时, 是条件 PMI 的对比近似,用于衡量图像对 token 对数似然的增量贡献。
3. 实验设计
3.1 训练数据与模型
- 训练集:ViRL39K(单图数据集);
- 模型:Qwen3-VL(2B/4B/8B)与 Qwen3.5(2B/4B/9B)共六个配置。
3.2 评测基准(七项)
- 通用视觉感知:BLINK、MMStar;
- 视觉数学:MathVista;
- 细粒度/高分辨率感知:V\*Bench、HRBench4K/8K;
- 幻觉:HallusionBench(先平均 aAcc、fAcc、qAcc);
- 聚合指标 Acc:七项基准的等权平均。
3.3 对比方法
- Base:未修改的基座模型;
- OPSD:基于"答案提示"的匹配 OPSD(教师看到参考答案,学生仅看原图与问题);
- VCSD:本文方法(去除答案提示,仅以原图与去内容图为条件)。
3.4 训练超参
默认 (EMA 更新率),AdamW 优化器,批量 32 条 prompt、每条 8 条 rollout,学习率 ,10 步 warmup 后恒定学习率,共 90 步优化。
4. 资源与算力
- GPU:8 块 NVIDIA B200;
- 训练步数:90 步优化(固定预算);
- 数据规模:32 prompt/批 × 8 rollout/批 × 90 步;
- 文中未单独报告总训练时长(wall-clock time),但给出了明确硬件配置与训练步数。
5. 实验数量与充分性
实验覆盖较完整,主要包括:
- 主结果:6 个模型配置 × 3 种方法 × 7 项基准 = 126 个数据点;
- 消融实验:
- 合理性支撑 对长程训练稳定性的影响;
- 对比强度 (含 与 边界);
- 蒸馏散度(forward KL / reverse KL / JSD);
- 控制图构造(黑图 / 高斯噪声 / 高斯模糊 / 无图);
- 原图锚点系数 ;
- 训练动力学:在同一次训练中对比 VCSD 与 OPSD 在聚合指标、MMStar、MathVista 上的轨迹;
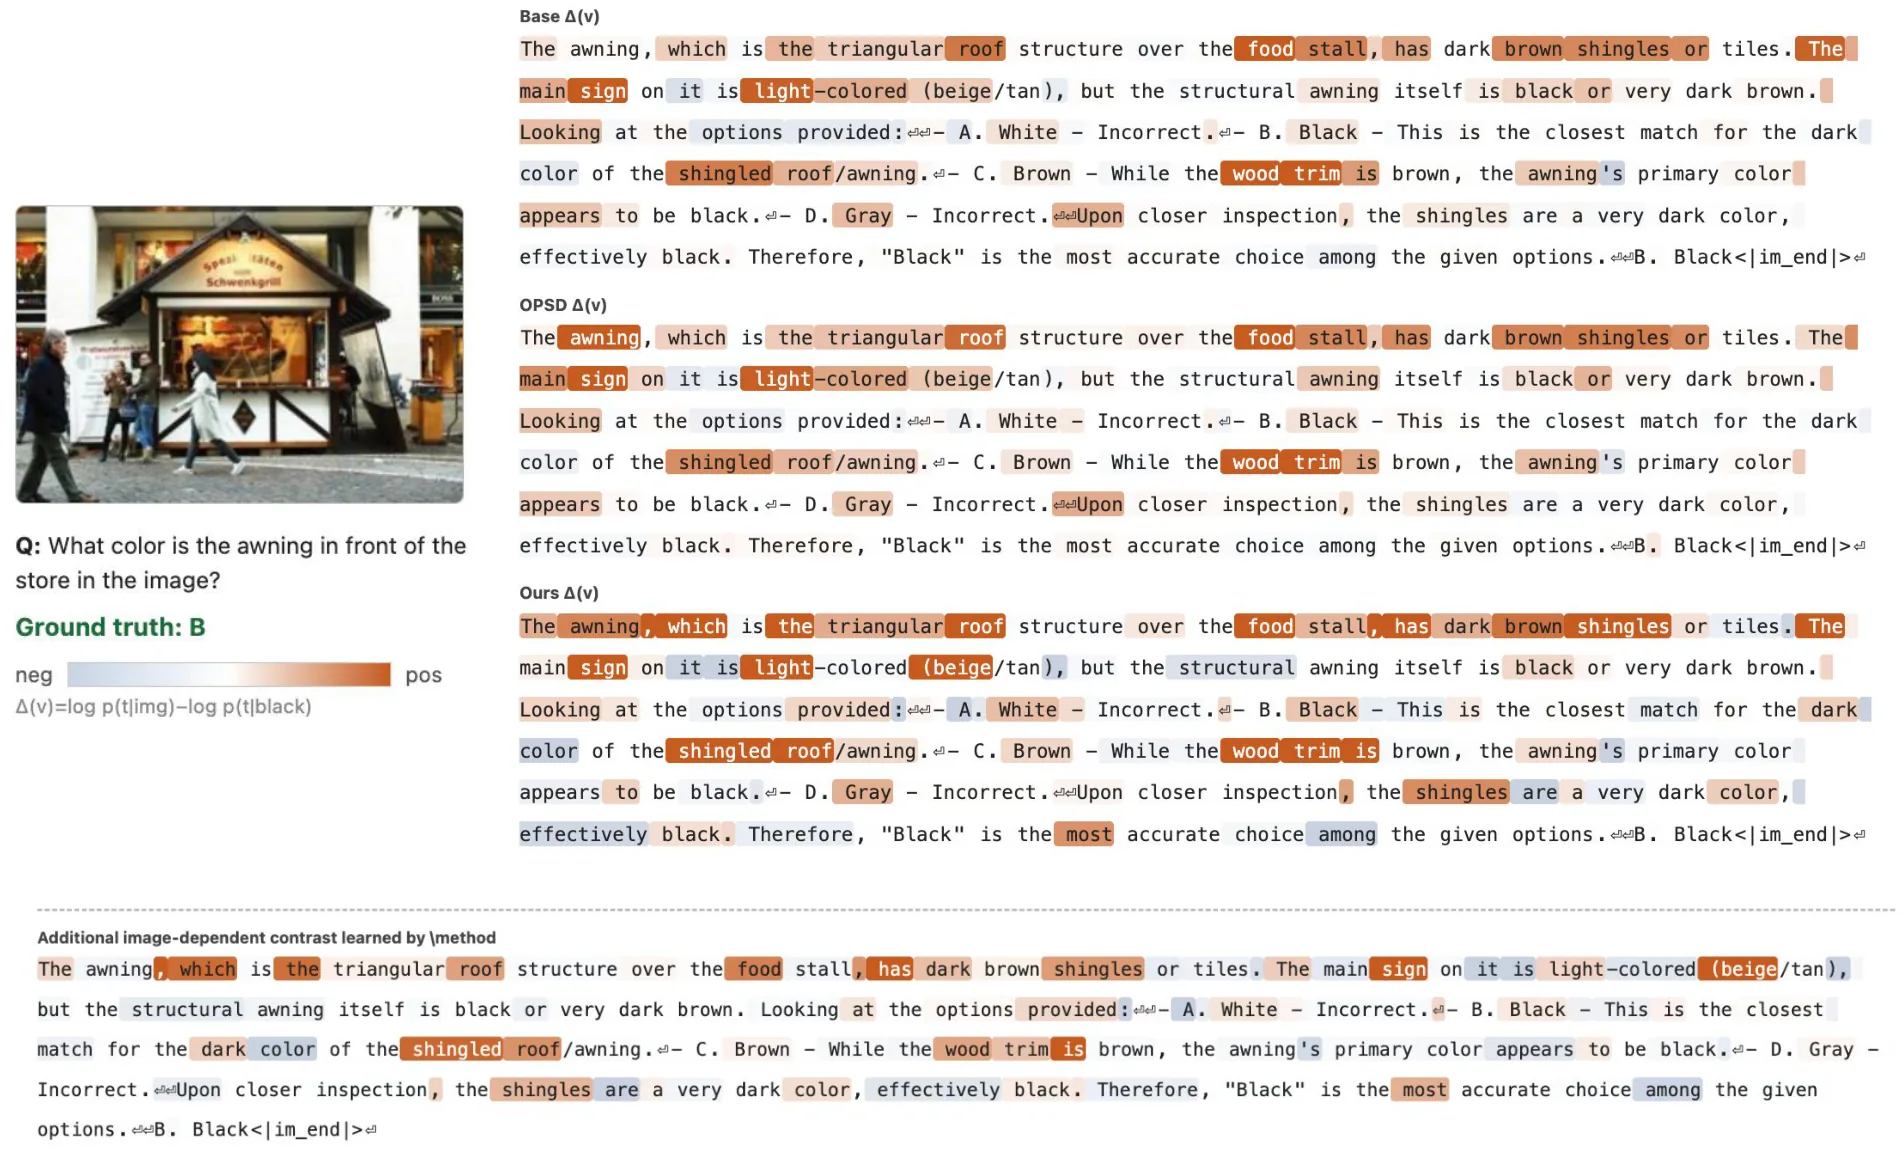
- 定性分析:MathVista 上 base-10 立方块的案例研究,以及 token 级图像依赖对比分数可视化。
总体而言,实验设计较系统,覆盖了不同模型家族与规模、关键超参与组件消融,以及定量与定性双重证据,公平性与客观性较强;但基准与数据集选择仍偏单一。
6. 主要结论与发现
- 性能提升:在 Qwen3-VL 2B/4B/8B 上,七项基准聚合分别从 62.27%/71.30%/72.51% 提升至 67.04%/73.16%/76.26%;在 Qwen3.5 2B/4B/9B 上相比基座提升 2.83%–4.27%;VCSD 在六种配置下均取得最高聚合得分;
- 优于 OPSD:在最大规模上,Qwen3-VL-8B 比 OPSD 高 +2.54%,Qwen3.5-9B 比 OPSD 高 +4.51%;OPSD 在 Qwen3.5 上无一致增益,而 VCSD 稳定提升;
- 简化范式:无需外部教师、特权答案、推理轨迹、证据裁剪、外部验证器或可验证奖励;
- 无推理开销:推理时仅保留更新后的学生,不引入额外前向计算分支;
- 理论支撑:对比信号 可视为以原图分布为参考、视觉证据为奖励的 KL 正则化策略更新的隐式奖励;同时是条件 PMI 的受控近似,鼓励保留图像依赖的证据。
7. 优点
- 简洁性:仅需原图 + 去内容控制图两种视觉条件,无需任何外部监督或人工标注;
- 通用性:在两个模型家族(Qwen3-VL / Qwen3.5)三种规模上均稳定优于 OPSD 与基座;
- 鲁棒性:控制图构造(黑图/高斯噪声/高斯模糊/无图)性能接近,说明信号来源是"内容移除"而非特定退化方式;
- 理论完备:给出 KL 正则化解释与 PMI 近似解释,并附录完整的 KKT 唯一性证明;
- 稳定性:合理性支撑 显著缓解长程训练中的目标畸变累积;
- 零推理开销:对比信号仅用于训练,推理阶段无额外分支;
- 对比强度局部鲁棒: 范围内性能变化小于 1%。
8. 不足与局限
- 基准与数据单一:训练仅用 ViRL39K 单图数据集,评测仅 7 项基准,覆盖范围有限;
- 规模覆盖:最大模型为 9B(Qwen3.5)与 8B(Qwen3-VL),未在更大规模(如 13B/72B)上验证;
- 依赖机制:
- 依赖 EMA 教师更新机制,对 EMA 衰减率 的敏感性未充分讨论;
- 依赖"内容擦除"假设——要求控制图完全去除实例级信息并保留模态接口,黑图是一种强假设;
- 消融有限:未对训练步数、批量大小、EMA 更新率、采样温度等进行系统敏感性分析;
- 仅限单图任务:方法在 ViRL39K(单图)上验证,是否适用于多图、视频、文档理解等更复杂多模态场景尚未验证;
- 理论 vs. 实践:附录证明仅给出"单步 KL 正则化更新"的等价性,但未对递归多步自蒸馏过程的收敛性或稳定性给出严格保证;
- 对比基线:OPSD 基线仅对答案提示方法进行对比,未与近期其他 OPSD/VL 蒸馏方法(如 V-zero、Vicur、Vision-OPD 等)在统一设置下充分比较。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。