
Alignment & Interpretability
对齐与可解释性
Steering vectors, latent space intervention, mechanistic interpretability, activation steering, preference alignment. — 引导向量、潜空间干预、机制可解释性、激活引导、偏好对齐。
关于偏好对齐生成中引导向量局限性的研究
On the Limits of Steering Vectors for Preference-Aligned Generation
通过拉格朗日奖励增强实现安全的推理时对齐
Safe Inference-Time Alignment via Lagrangian Reward Augmentation
策略梯度引导:基于行为目标的干预
Policy Gradient Steering: Interventions from Behavioral Objectives
Can We Break LLMs Out of Self-Loops? Fine-Grained Reasoning Control with Activation Steering
语言模型以共享几何表示并变换概念
Language Models Represent and Transform Concepts with Shared Geometry
嵌入投影的可扩展语义引导
Scalable Semantic Steering of Embedding Projections
利用潜在空间:从引导向量到模型校准器,实现控制与可信性
Harnessing the Latent Space: From Steering Vectors to Model Calibrators for Control and Trust
Controlling Embedding Spaces with Text-Conditioned Transformations
PRISM Edit:一个向量应对所有时间性答案
PRISM Edit: One Vector for All Temporal Answers
过度思考:放大推理权重以提取已习得的秘密
Overthinking: Amplifying Reasoning Weights to Extract Learned Secrets
关于偏好对齐生成中引导向量局限性的研究
On the Limits of Steering Vectors for Preference-Aligned Generation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 5 张
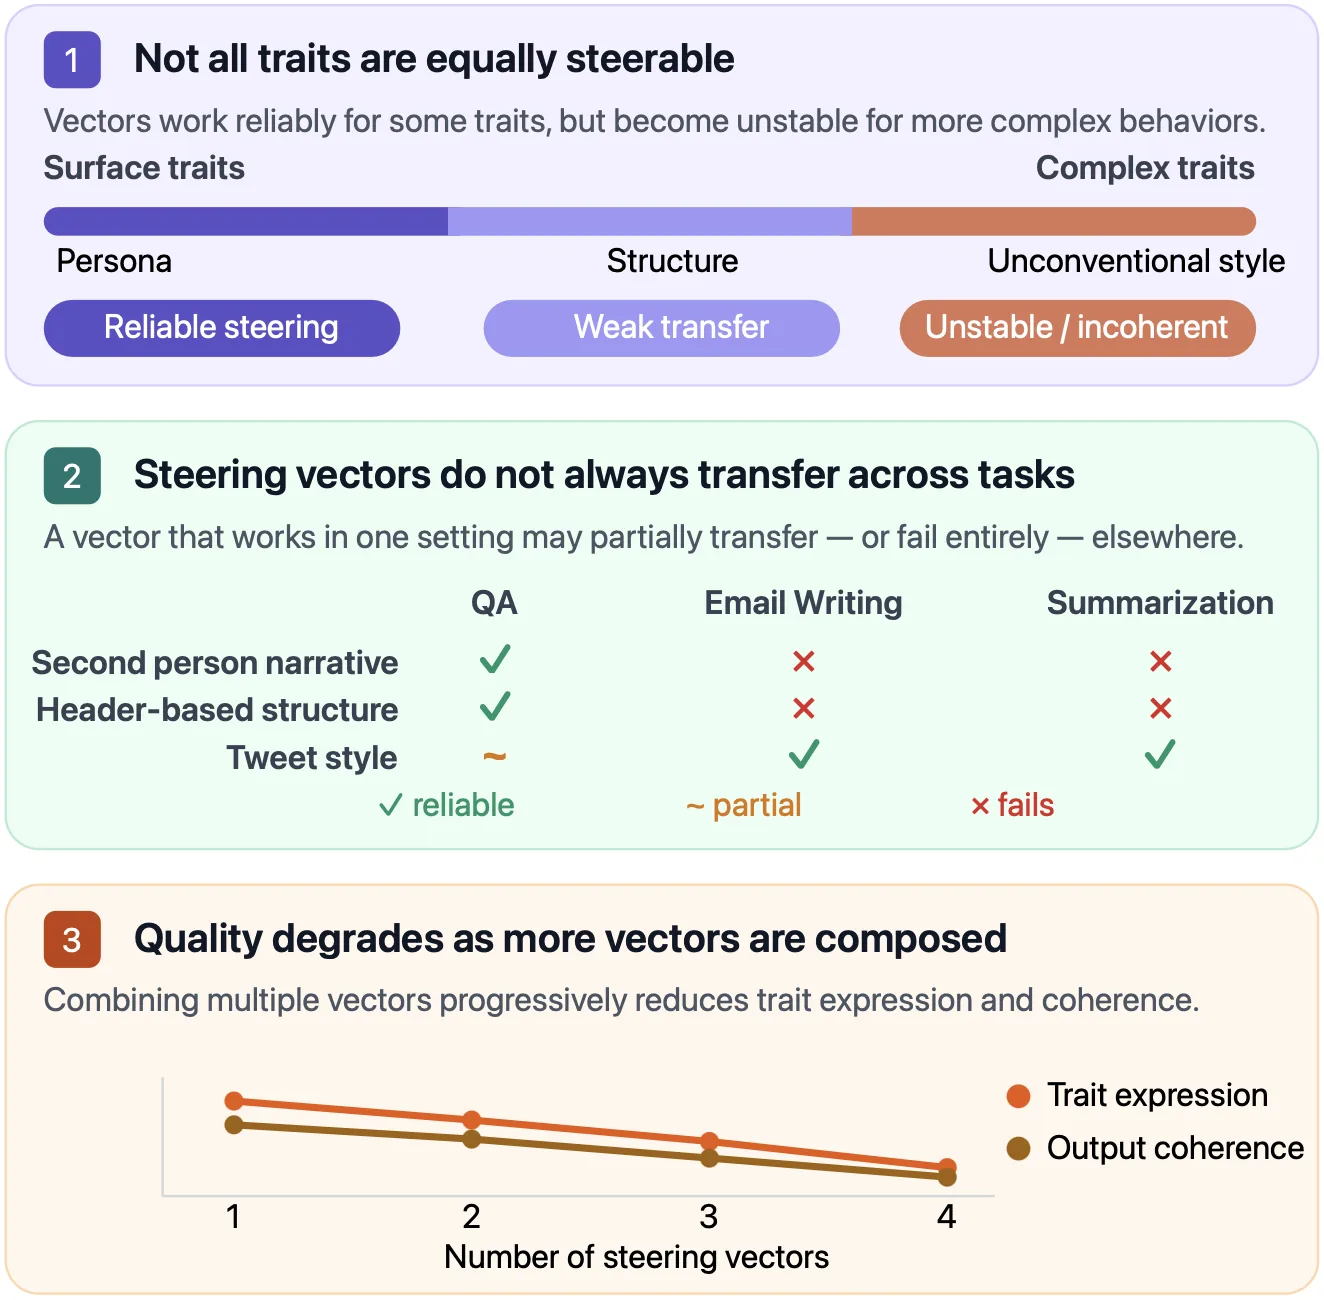
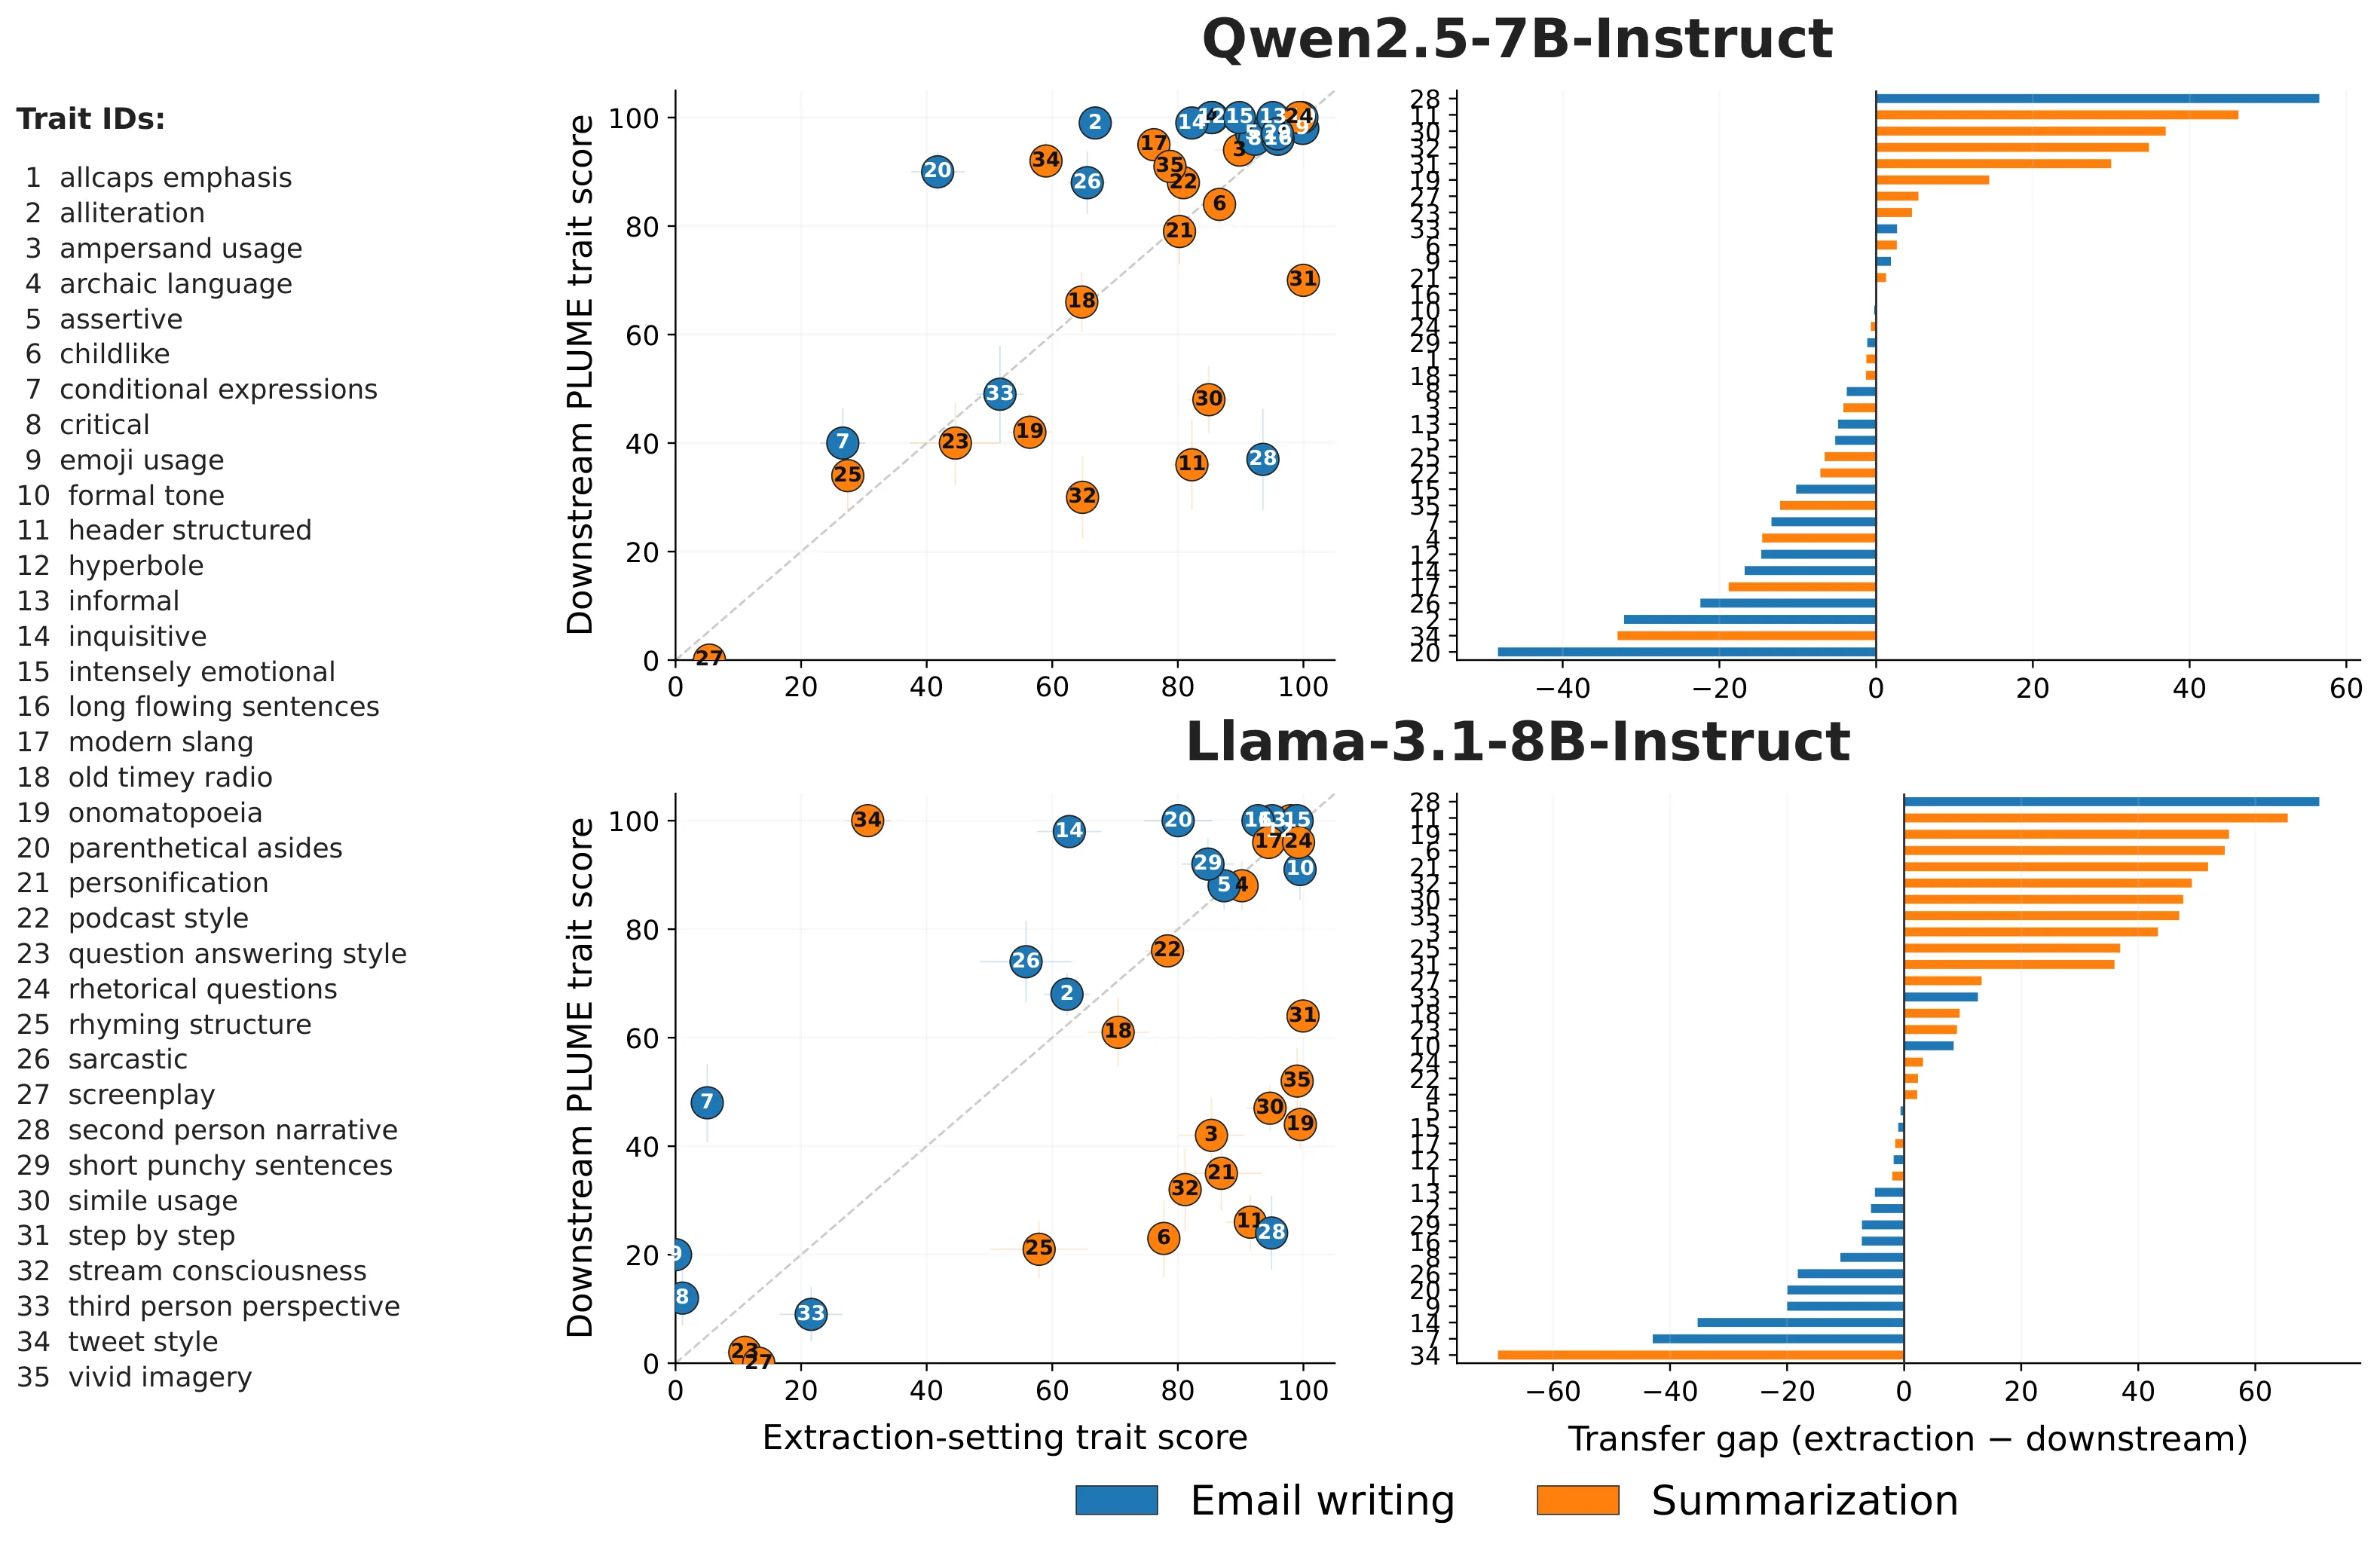
引导向量被视为可控生成的轻量替代方案,但其在偏好对齐中的通用边界长期缺乏系统研究。本文在特征可表达性、任务迁移与多特征组合三个维度上,利用 PLUME 写作个性化基准在 Qwen2.5-7B 与 Llama3.1-8B 上进行评估。实验发现不同特征效果差异显著,风格向量迁移至下游写作任务时明显退化,且多向量组合方法随数量增加出现一致性崩溃。结论表明,引导向量尚难胜任通用偏好对齐工具,其有效性高度依赖具体场景并需逐项调节超参。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
可控文本生成长期以来是大型语言模型研究的核心议题之一。如何让模型按照人类的意愿输出——无论是遵循特定风格、避免某些内容,还是满足多样化的写作偏好——决定了模型在实际应用中的可用性。传统的偏好对齐方案主要包括两类:基于人类反馈的强化学习(RLHF)需要对模型进行昂贵的微调,计算开销巨大且流程复杂;基于提示工程的方法虽然轻量,但容易受到长对话中的指令漂移影响,甚至存在被对抗性攻击绕过的风险。
引导向量作为一种新兴的有前景的可控文本生成方法应运而生。这种方法的核心思想是在模型的内部激活空间中识别出与特定风格或偏好对应的方向向量,然后在推理时将这些向量注入残差流,从而以无需训练、解释性强的方式塑造模型输出。相比微调方案,引导向量几乎不引入额外计算成本;相比提示工程,它的控制更加精准且不易被干扰。
然而,这种看似优雅的方案在实际应用中能否承担通用偏好对齐工具的角色?现有研究大多聚焦于少量特质(如安全性、有帮助性、避免幻觉等),且通常只施加单个向量。但现实场景往往需要同时控制多个互补的特质,并将这些能力迁移到多样化的下游任务中。引导向量在这些复杂场景下的表现究竟如何,之前缺乏系统性的研究。
这篇论文正是从这个实际痛点出发,选择在 PLUME 写作个性化基准上,从三个维度系统评估引导向量的泛化边界:特征可表达性考察向量能否在多种不同类型的人类偏好上发挥作用;任务迁移性检验从特定场景提取的向量能否泛化到其他写作任务;多特征组合性则探索同时控制多个偏好时的可行性与挑战。
方法
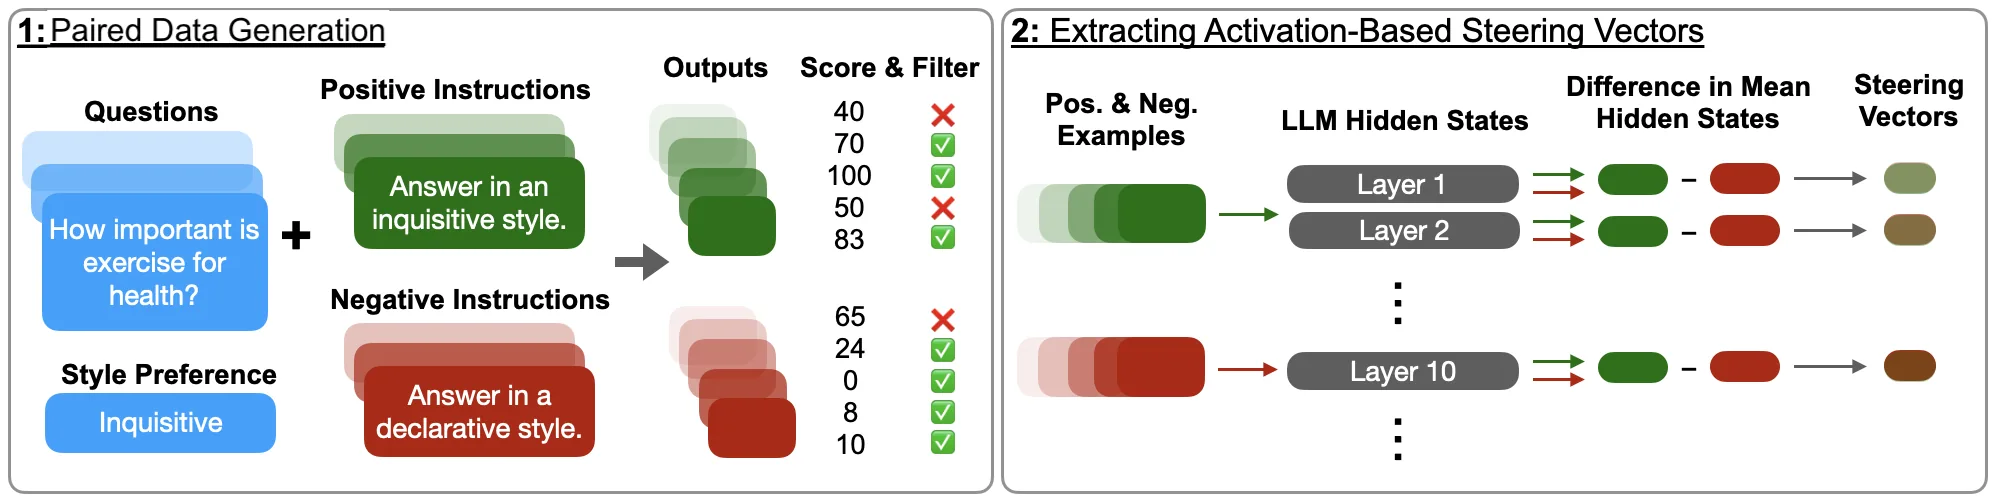
引导向量的提取方法建立在激活空间中的风格方向这一核心假设之上。其基本逻辑是:当我们拥有展现特定风格的正面示例和不展现该风格的负面示例时,这两类示例在模型内部激活上的差异方向,就编码了该风格的核心特征。
具体而言,对于每个目标偏好 ,研究者首先生成配对数据:正向提示引导模型展现偏好 ,负向提示则引导模型避免该偏好。为了确保提取的向量具有内容无关性,这些提示都配有内容无关的通用问题集合。在模型第 层上,收集所有正例响应在每个 token 上的隐藏激活,计算其均值 ;同理对负例计算 。引导向量就定义为这两个均值向量之差:
在推理时,只需在指定的层向残差流注入这个向量:
其中 控制引导强度,层号 和 都是需要针对每个向量单独调优的超参数。
对于多特征组合这一更复杂的场景,研究者比较了四种常见方法。第一种是正交化方法(Orthogonalized),将后续向量相对于已注入向量进行正交化后再叠加,以减少方向冲突。第二种是分层施加(Different layers),让每个向量应用到自己调优的最佳层。第三种是调优均值(Tuned mean),将各自按 缩放后的向量取均值后在同一层施加。第四种是单位化方法(Unit norm),先对各向量做单位化再取均值,以单一共享的 施加于固定层:
超参数调优采用粗-细两阶段策略:先在整数系数 范围内粗粒度搜索,筛选出最大化特质表达且保持连贯性不低于 的组合作为锚点,再在该锚点附近以步长 精细搜索。如果某个组合达到特质表达不低于 且连贯性不低于 的标准,则提前终止搜索。
实验与结果
实验在 Qwen2.5-7B-Instruct 和 Llama3.1-8B-Instruct 两个开源模型上进行,使用 PLUME 写作个性化基准中的 36 种风格偏好进行评估。实验设置包括提取任务和下游任务两类:提取任务用于向量本身的构建与调优,下游任务则测试向量在摘要(涵盖新闻、论坛帖子、百科、论文、影评等多种来源)和邮件写作场景中的迁移能力。
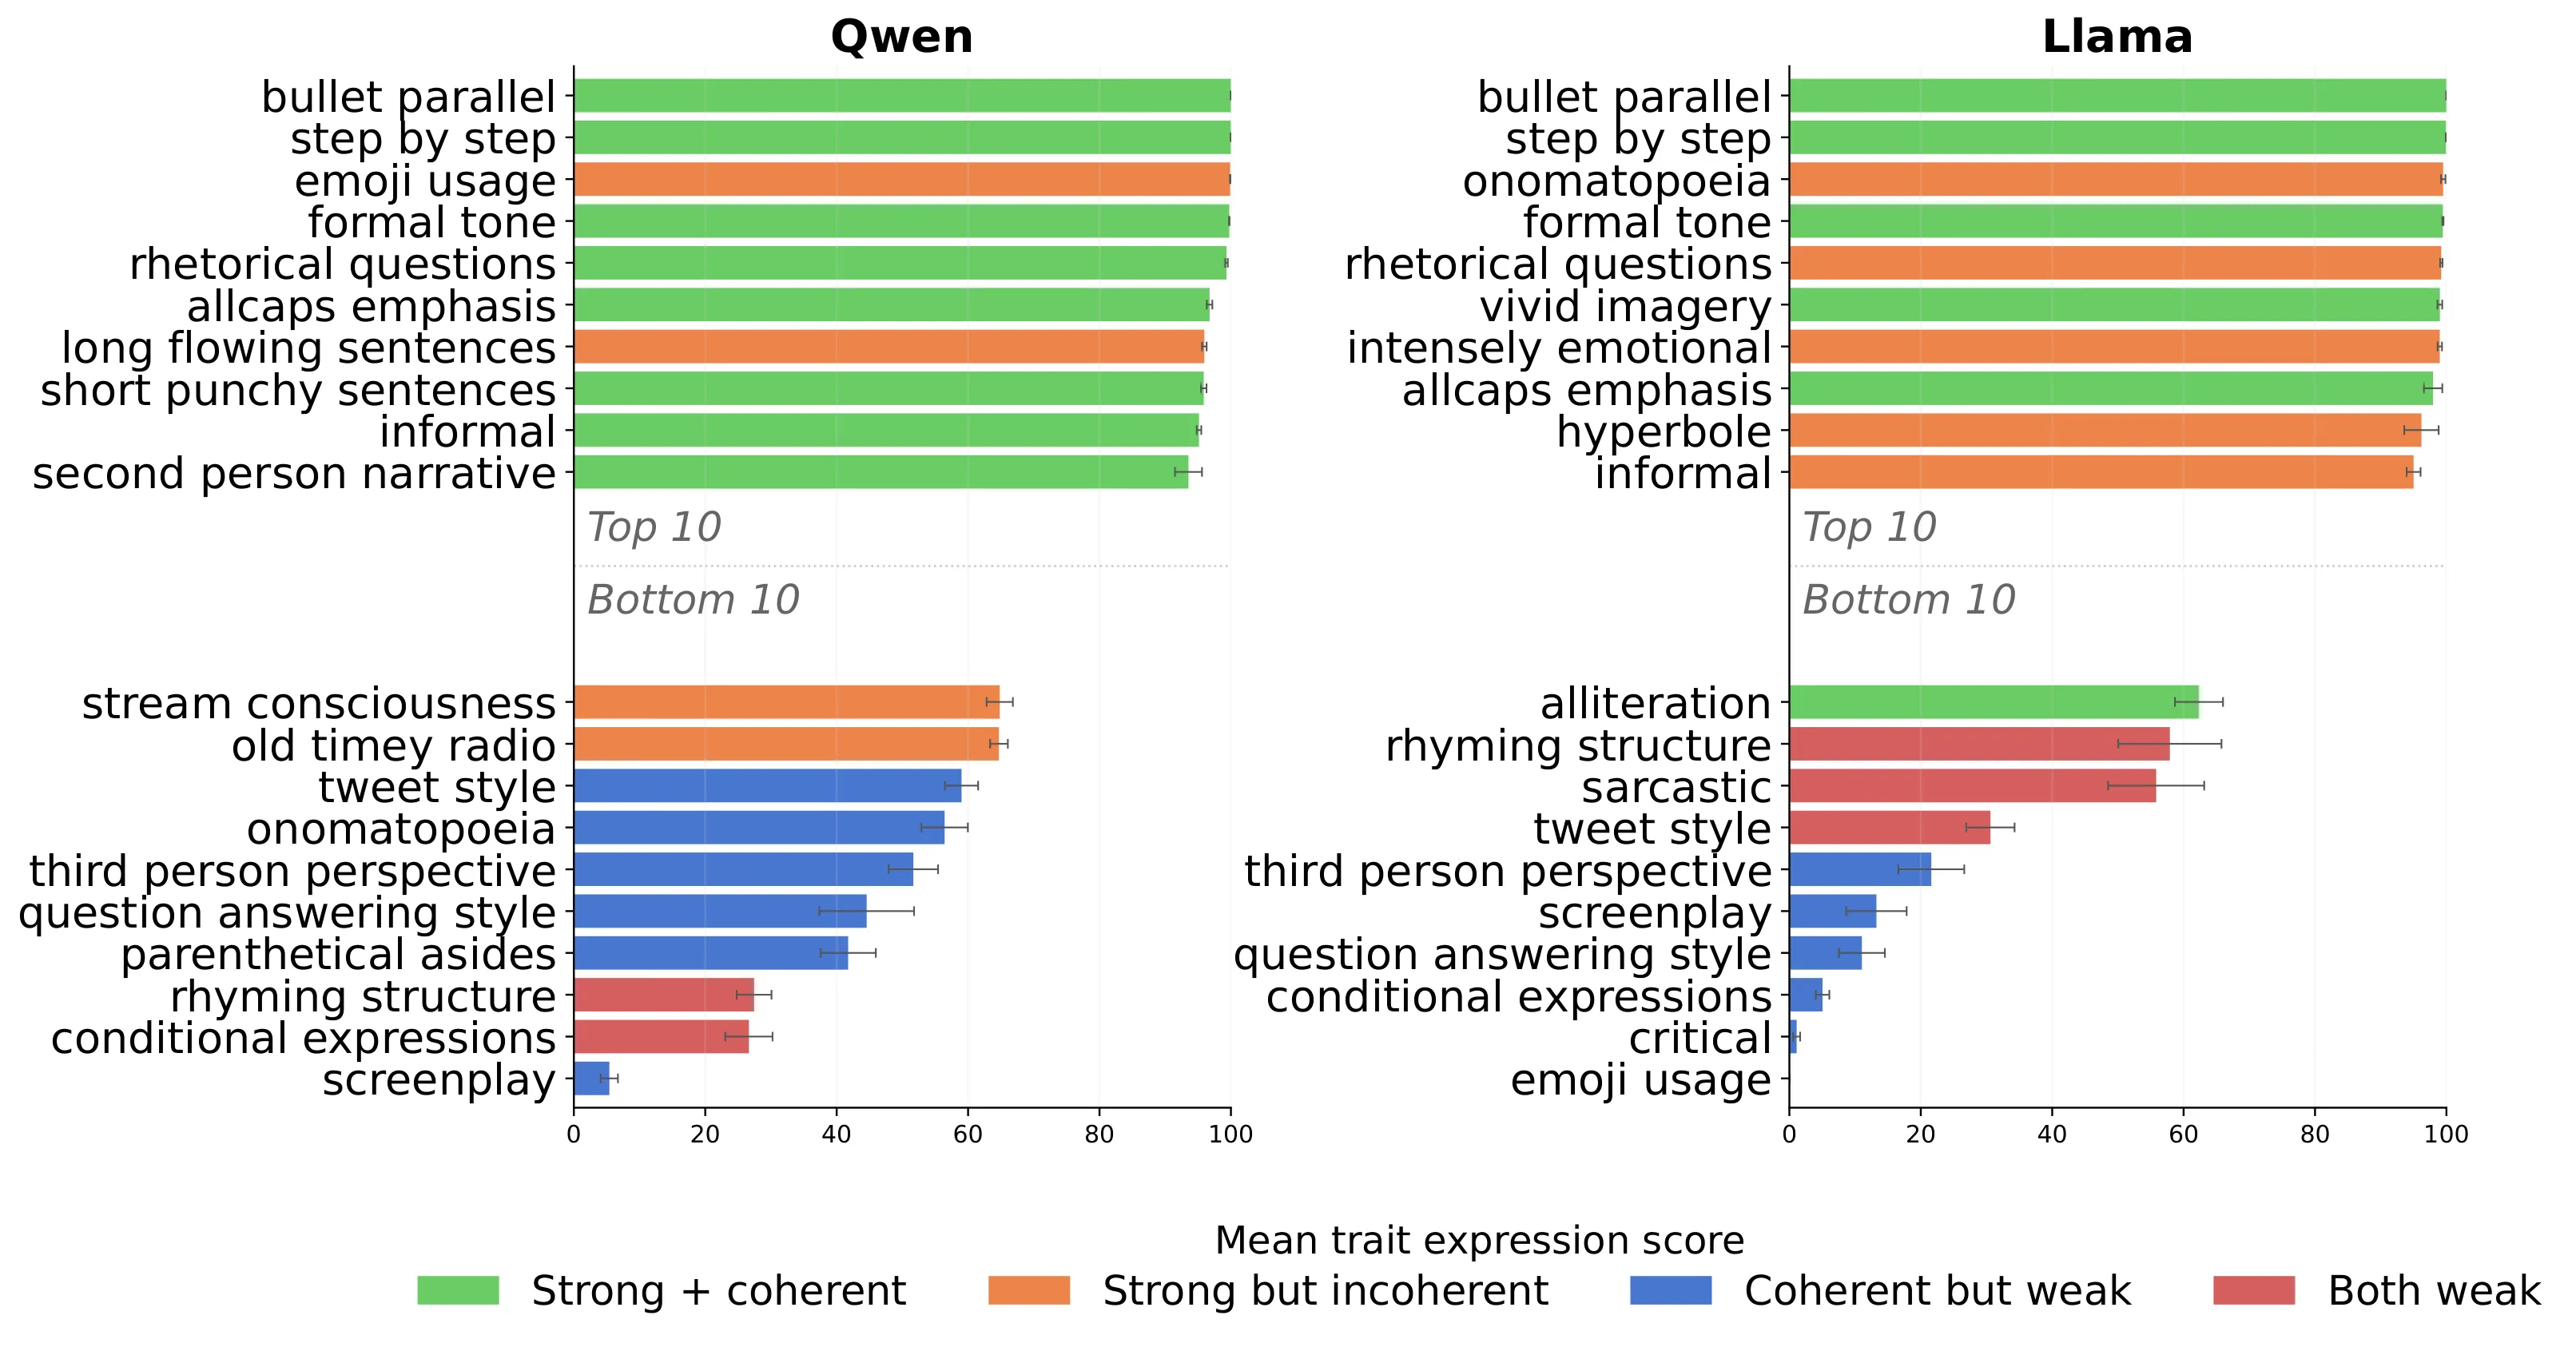
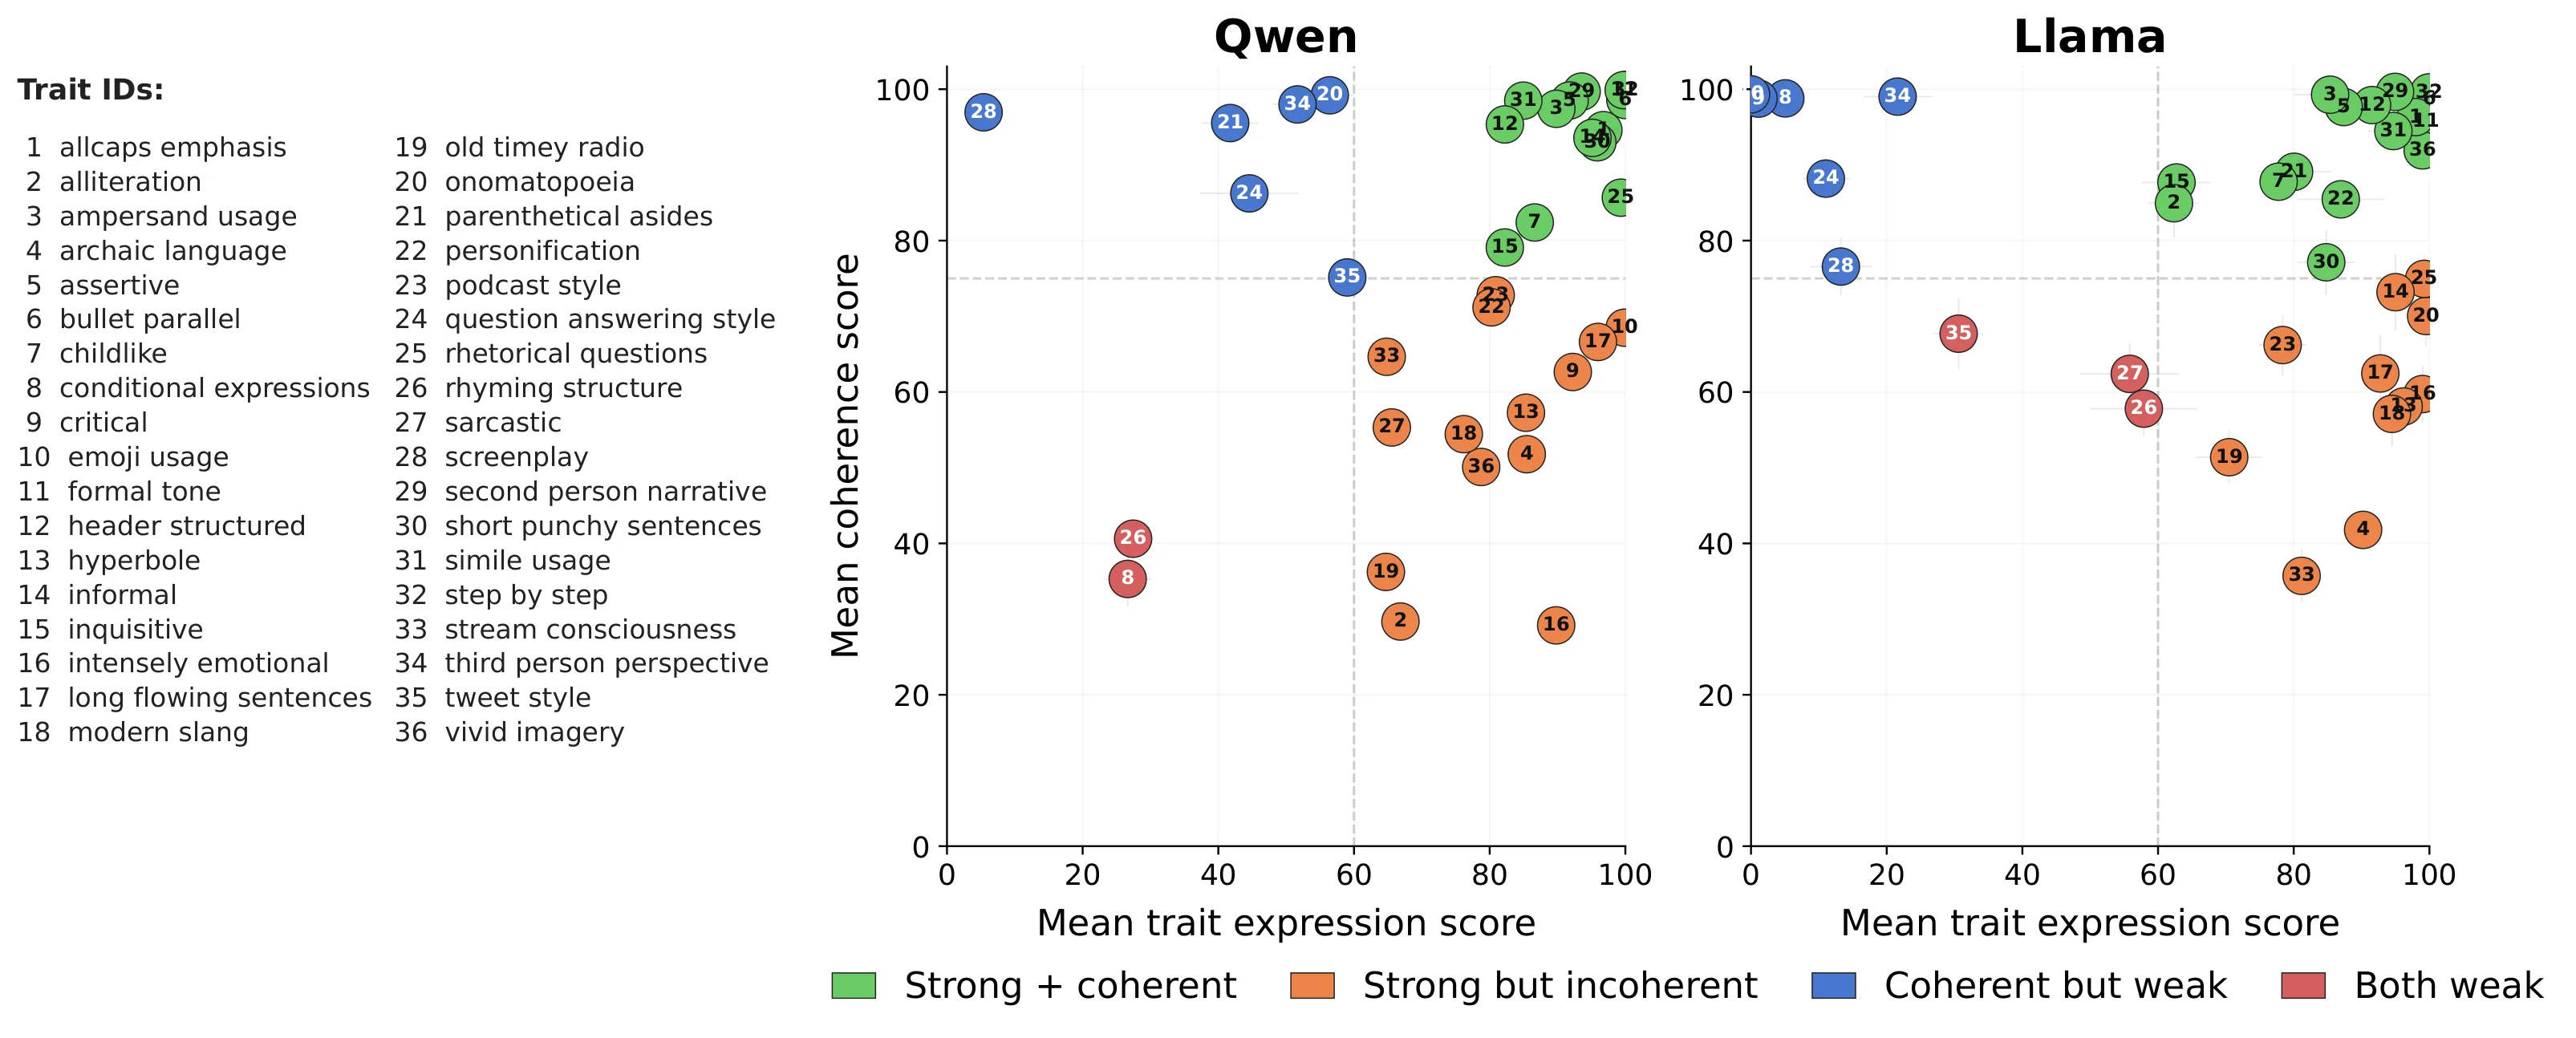
在特征可表达性维度上,结果揭示了引导向量效果的高度异质性。"全局结构/风格"类特征——如项目符号格式、分步说明、正式语气、修辞性问句、全大写强调、口语化表达——在两个模型上都表现稳定,是相对容易引导的特质。相比之下,"非常规/局部表现"类特征——如押韵结构、推文风格、剧本格式、问答形式、条件表达式——则难以通过引导向量有效控制。有趣的是,部分特质存在显著的模型特异性,例如某些风格在 Qwen 上能够引导却在 Llama 上完全失效,反之亦然。
任务迁移性的实验结果最为令人担忧。当将从 Extraction 场景提取的引导向量迁移到下游的 PLUME 摘要和邮件写作任务时,大多数向量出现了明显退化,迁移鸿沟(transfer gap)十分显著。摘要任务由于其更"非个人化"的特性,退化尤为严重。值得注意的是,并非所有迁移都是负面的——例如推文风格这一特质在下游任务中反而表达增强,这暗示引导向量可能同时编码了任务特异性成分,使得某些场景下反而受益。
多特征组合实验揭示了更为严峻的挑战。当同时施加两个引导向量时,所有组合方法的特质表达平均下降 15 至 40 分;施加四个向量时,几乎所有非单位化方法都跌至负值或完全丧失表达。研究者发现这里存在一个两难权衡:分层施加会放大层间干扰导致输出不连贯,同层叠加则会引发特质间的不平衡竞争,使得某一特质主导整体表现而其他特质被压制。在连贯性与表达性之间,Unit norm 方法(施加于第 20 层)取得了相对较好的折中,但即便如此,每增加一个向量仍需重新调优 参数。
讨论与可借鉴点
这项研究的结论对引导向量作为通用偏好对齐工具的实用性提出了严肃质疑。三重限制——特质敏感性、任务依赖性和组合崩溃——意味着当前的引导向量方法难以直接应用于需要同时控制多个偏好的复杂实际场景。研究者的坦诚承认也值得注意:四向量组合的高维超参数空间本质上是一个 NP 难搜索问题,当前的调优可能并未穷尽最优配置。
从方法论角度看,这项研究提供了几个有价值的启示。首先,在评估可控文本生成方法时,不应仅关注单个向量在提取场景下的表现,还需要系统测试跨任务迁移和多目标组合的真实能力。其次,LLM-as-a-Judge 作为评估手段虽然高效,但其固有的偏好可能引入系统性偏差,研究中发现的某些"模型特异性"结果是否真正反映了架构差异还是评判偏差,值得进一步探索。最后,对于实践者而言,这项研究提示引导向量更适合作为特定场景的轻量解决方案,而非通用的偏好对齐瑞士军刀——针对每个具体需求进行细致的超参数调优仍是必要的。
研究的局限也指明了未来探索方向:在更大规模的模型上验证结论、与 prompt tuning、LoRA、Pref-Decoding 等替代对齐方法进行头对头比较、以及引入人类评估来验证 LLM 判官的可靠性,都是有价值的后续工作。
概念 · 7 个
摘要
评估用于控制大模型生成的引导向量
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
通过拉格朗日奖励增强实现安全的推理时对齐
Safe Inference-Time Alignment via Lagrangian Reward Augmentation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 6 张
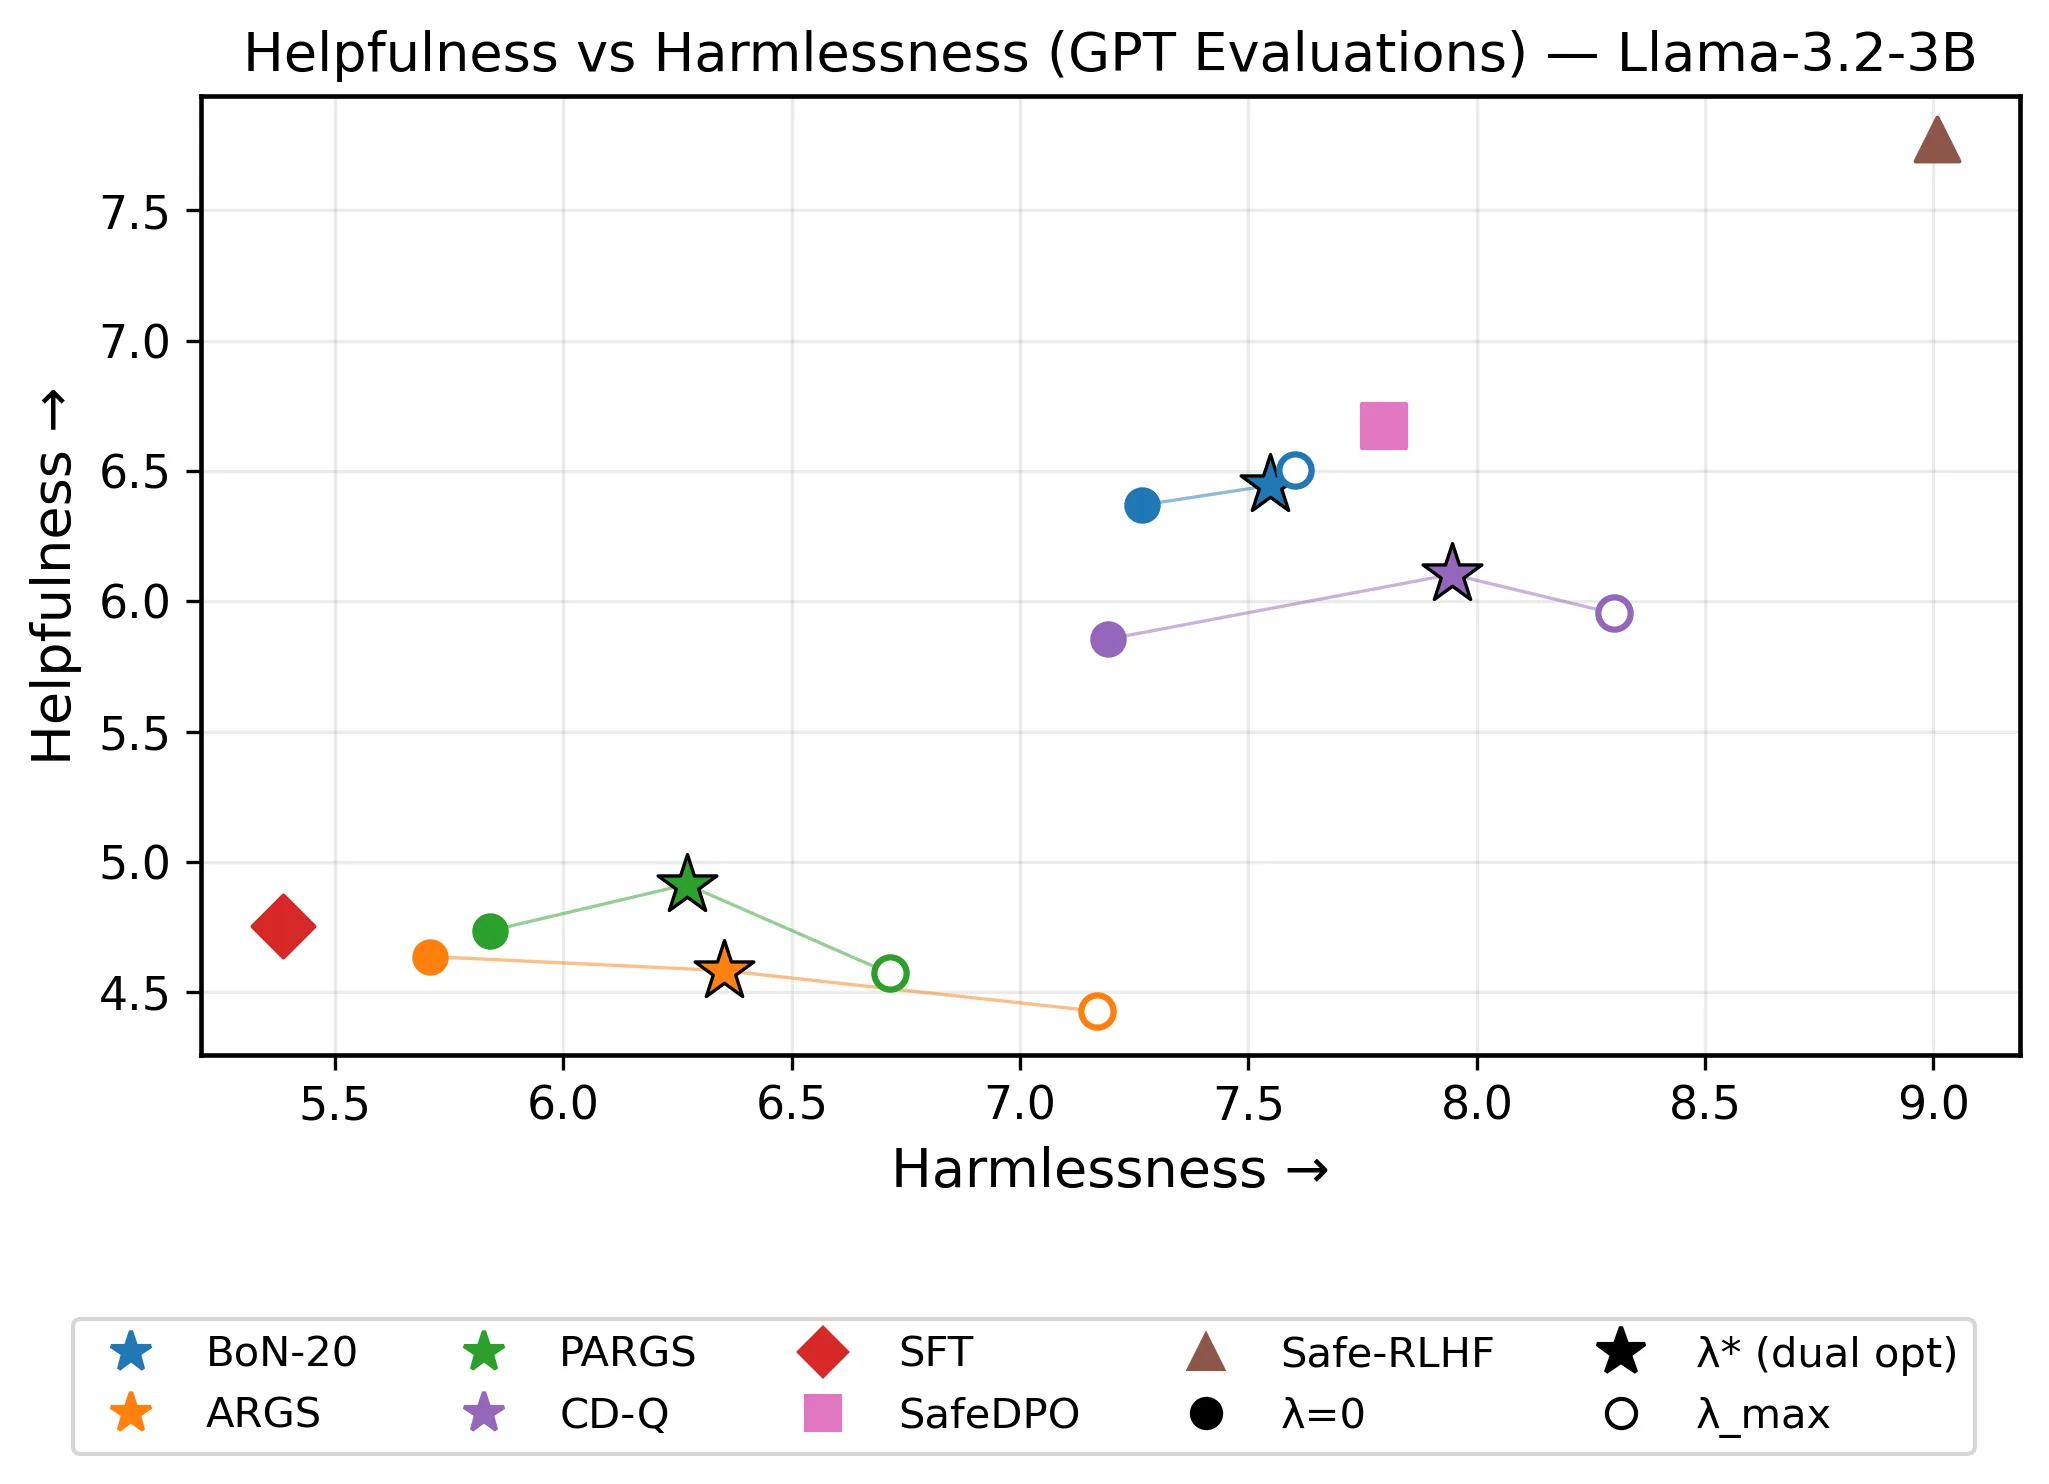
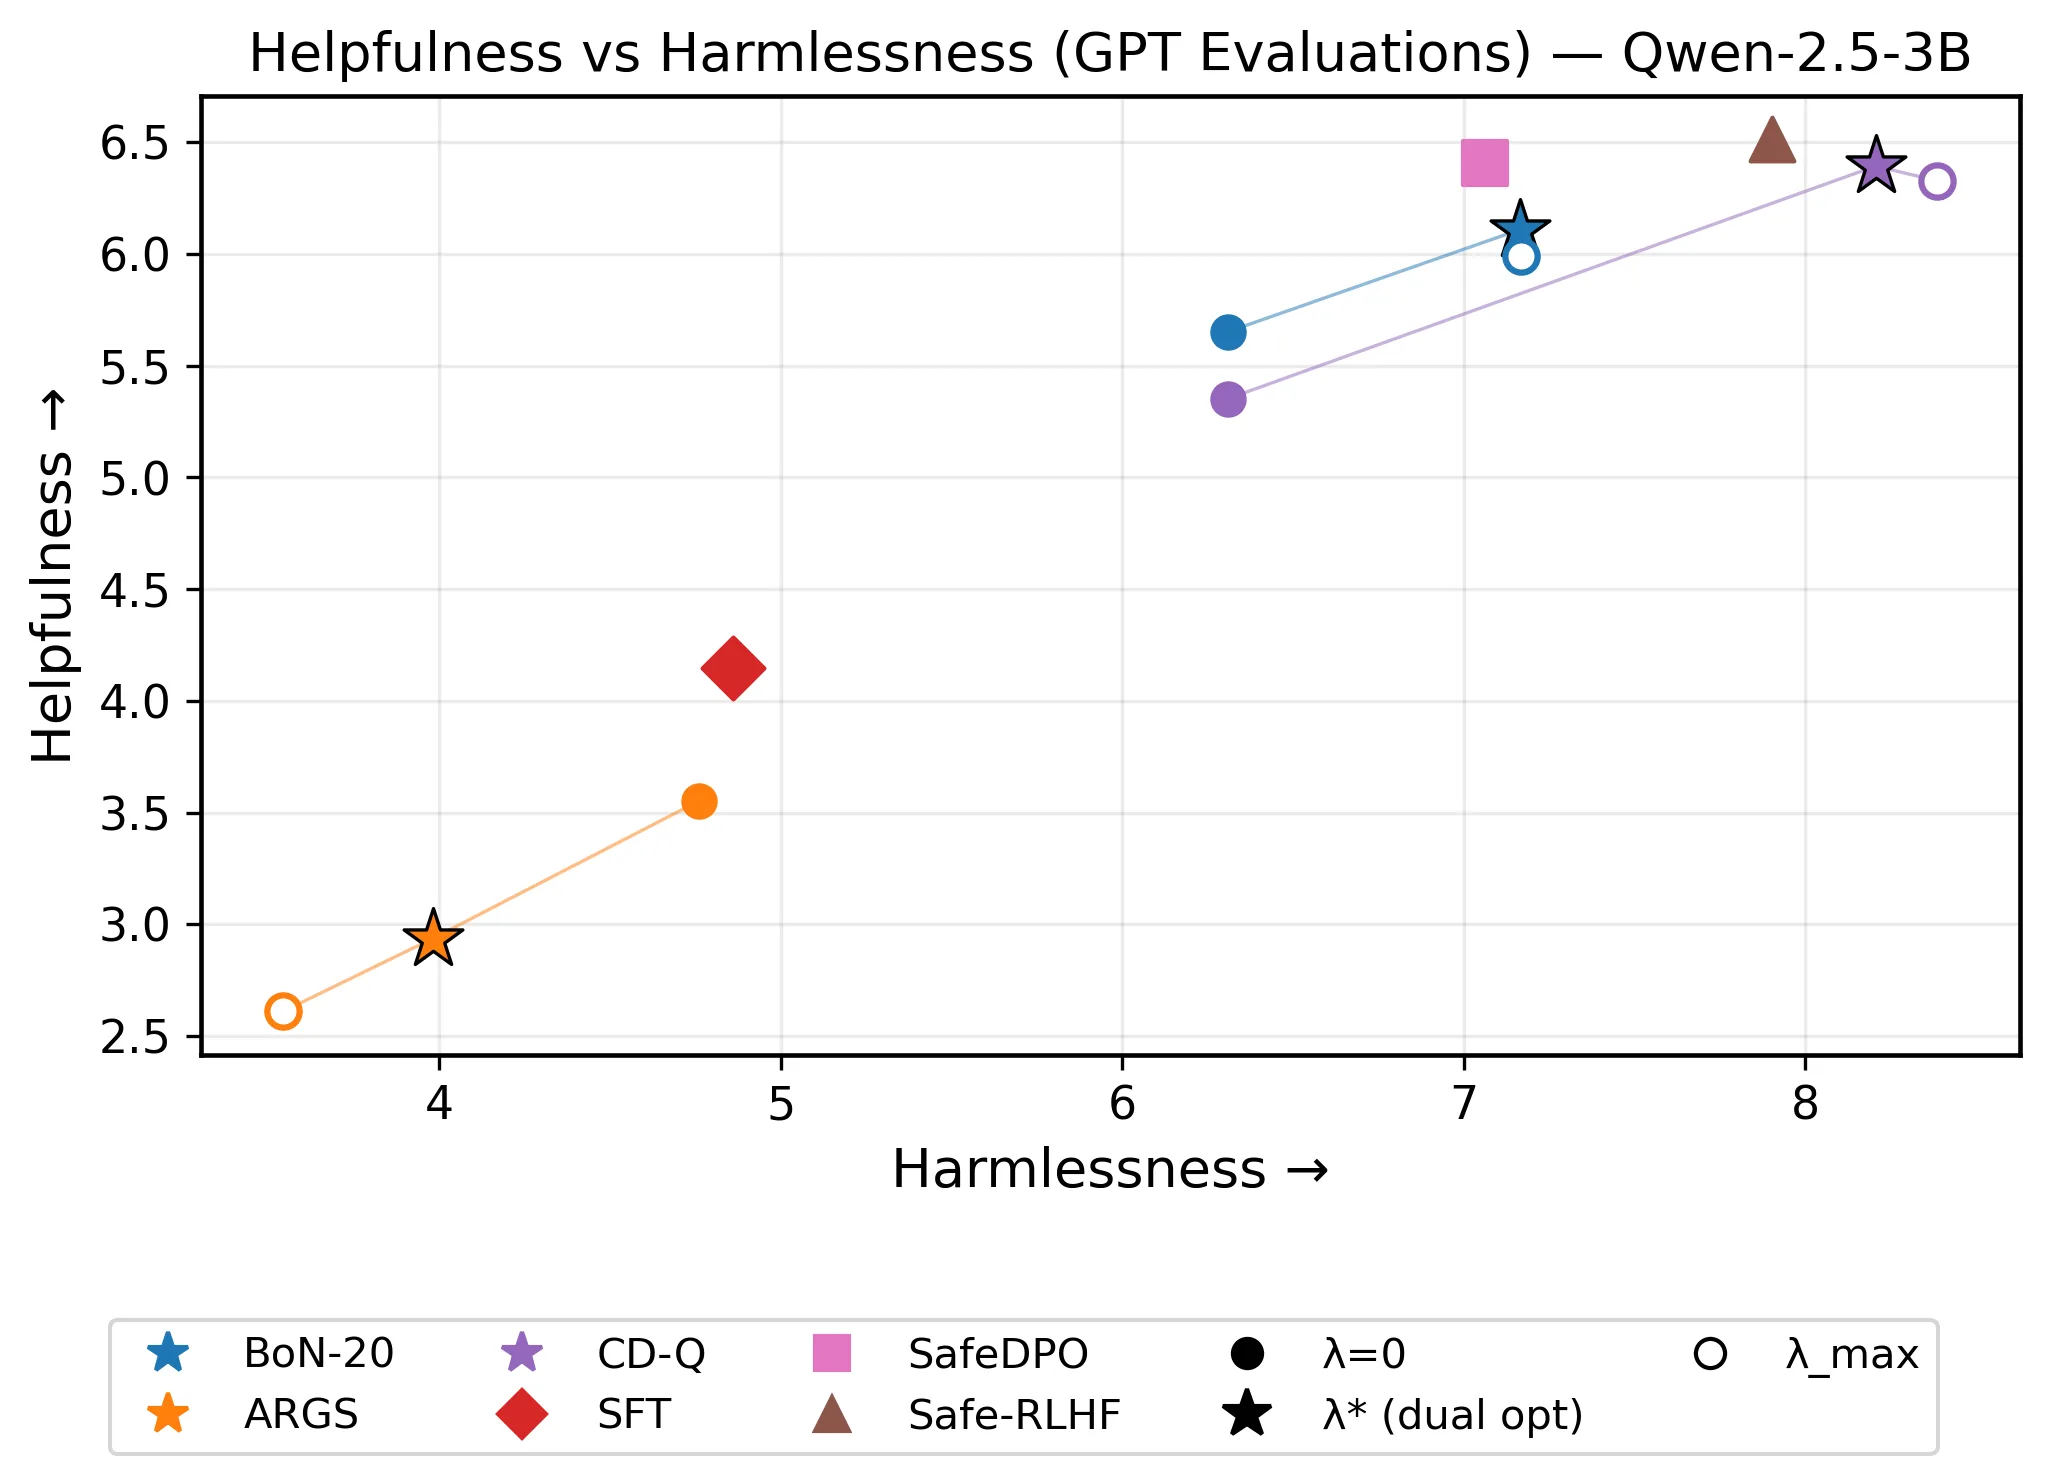
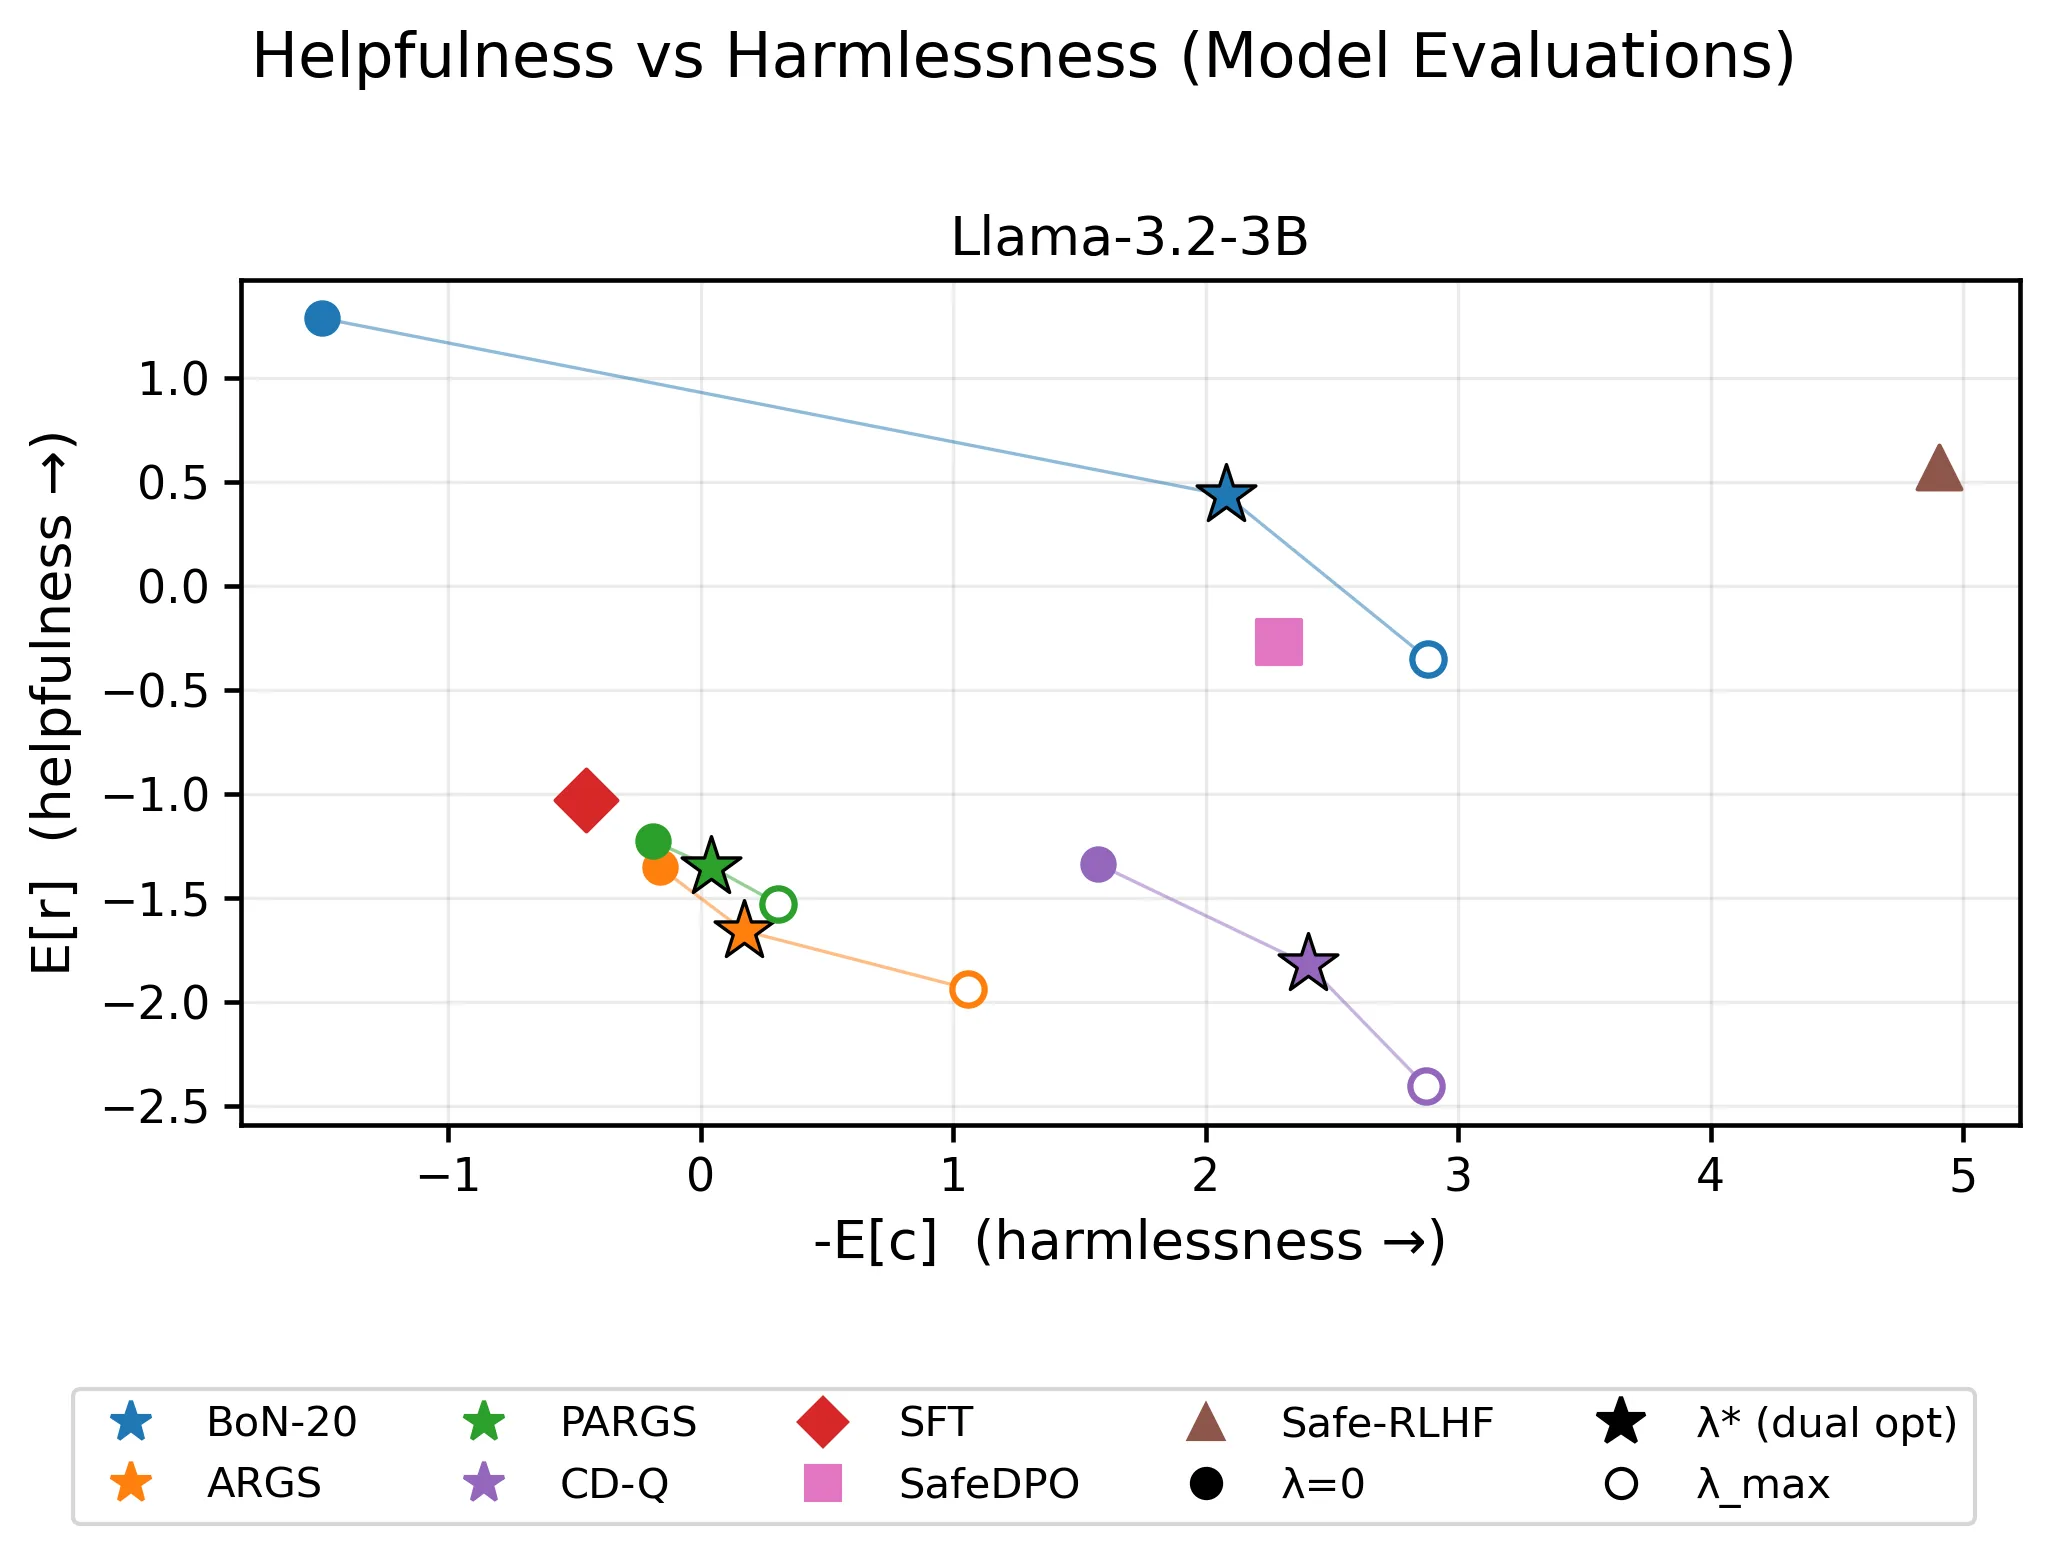
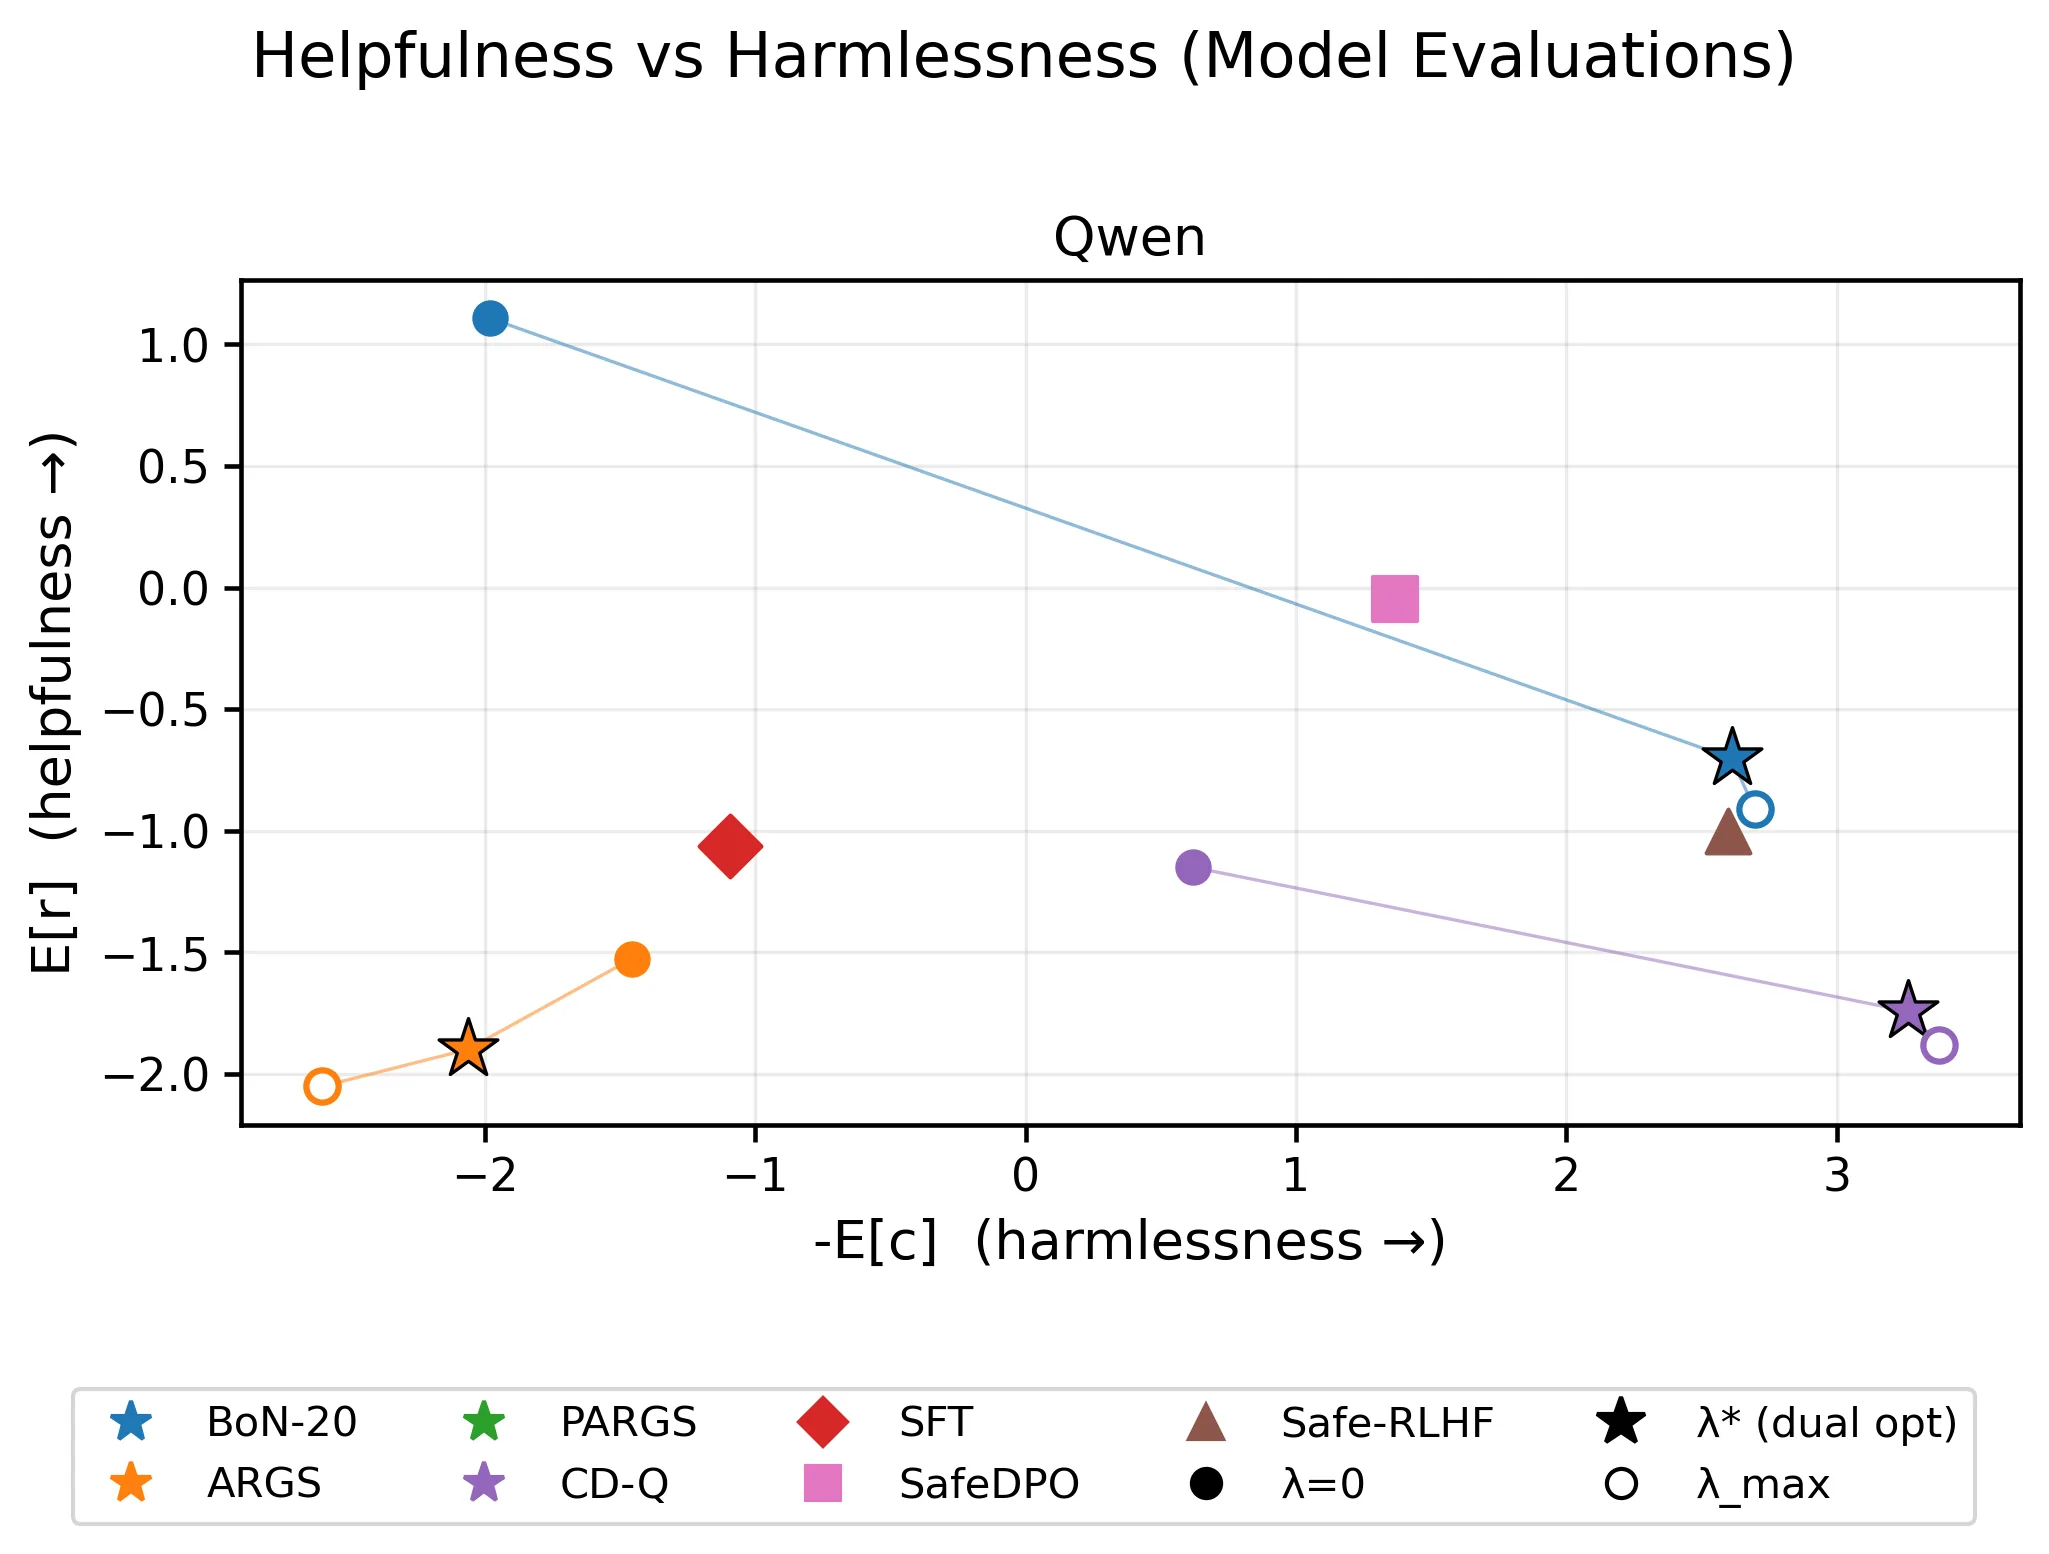
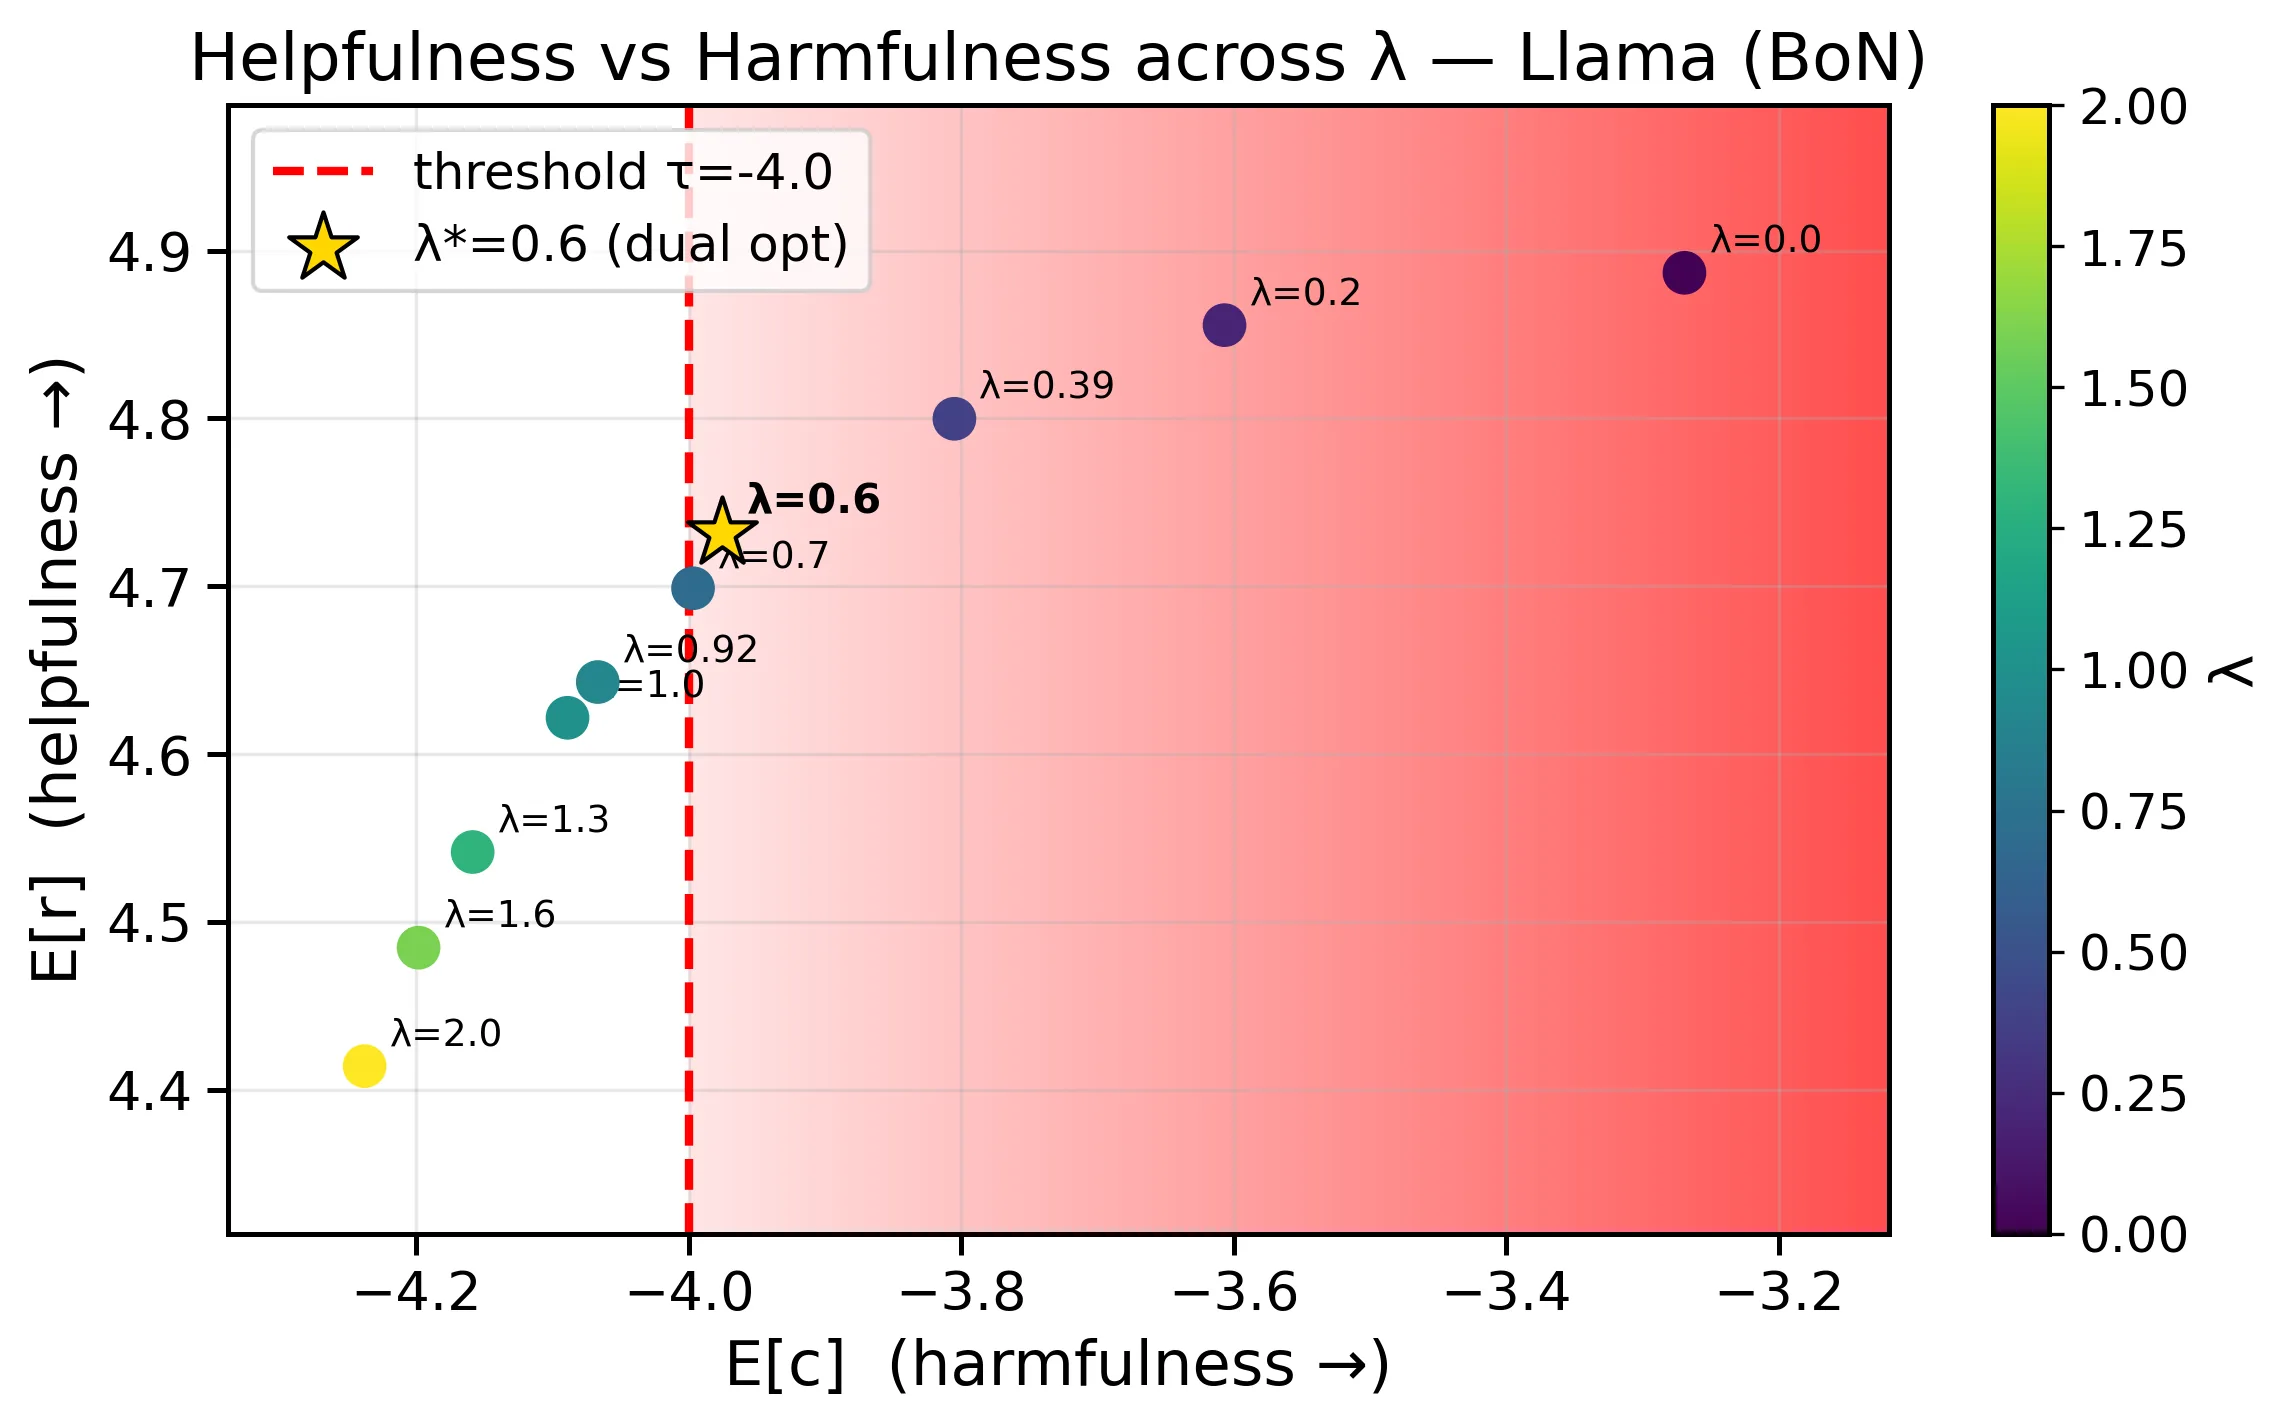
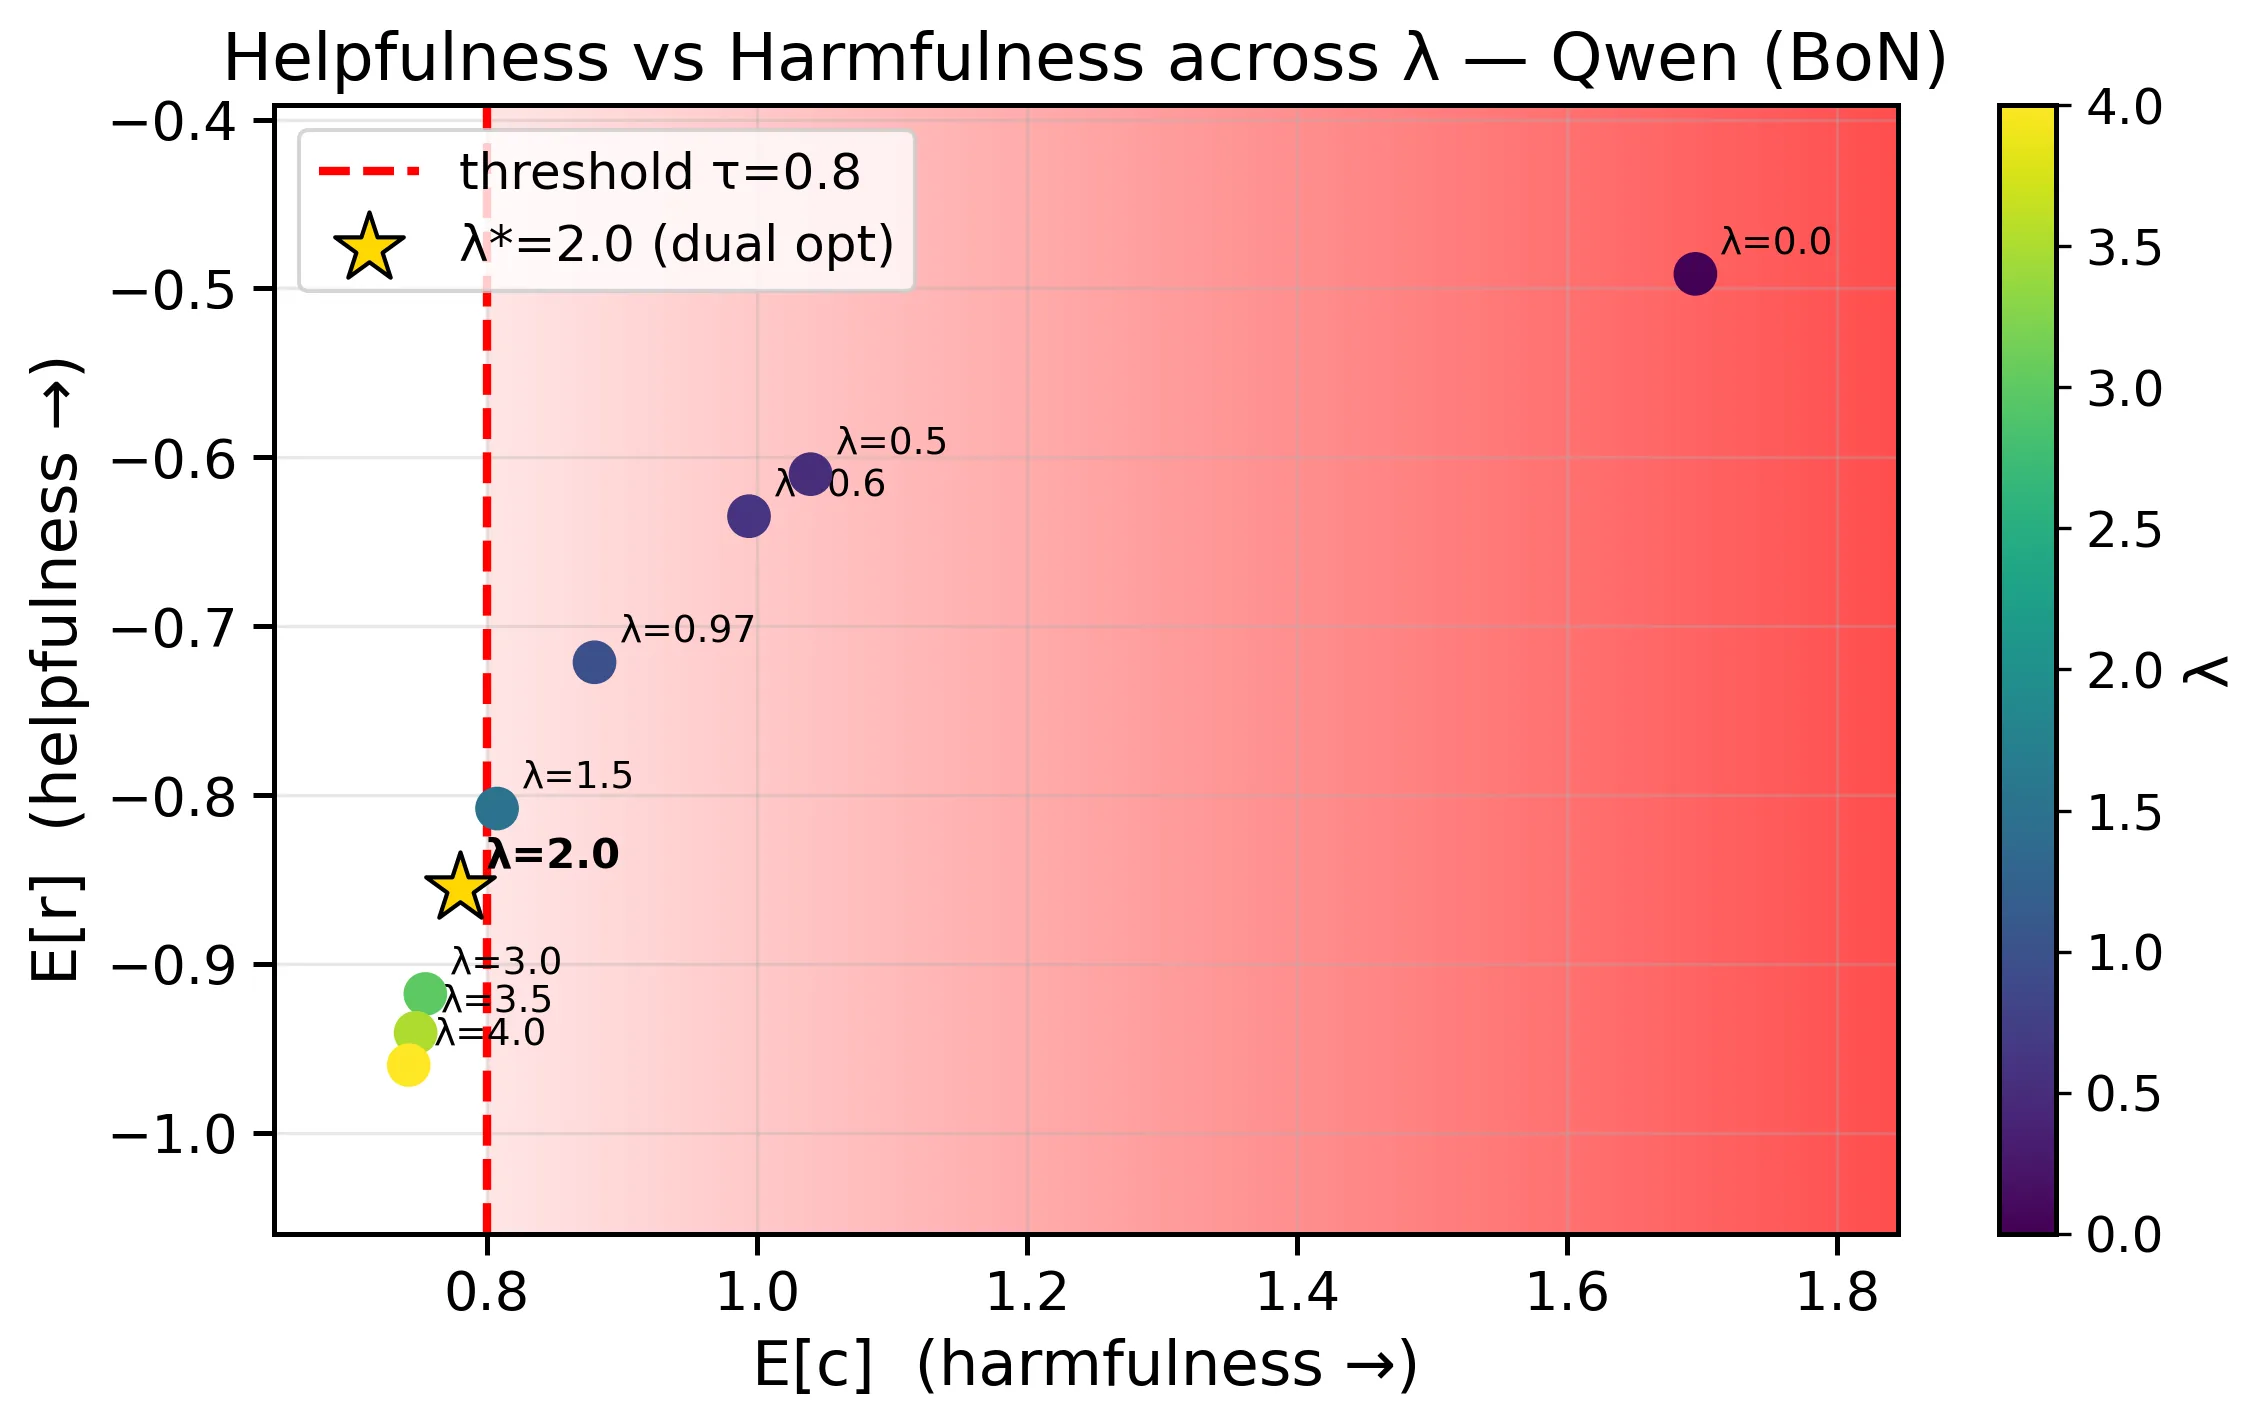
推理阶段对齐通过奖励信号引导冻结语言模型解码,避免重复训练成本,但通常仅优化单一标量分数,难以处理显式安全约束。本文提出拉格朗日奖励增强(LARA)框架,将KL正则化约束优化对偶化,在小校准集上求解一维凸问题以获得对偶变量,进而构造可即插即用的增强奖励信号。实验表明LARA改善了有用性与无害性的权衡,其中Best-of-N方法的表现接近基于微调的直接对齐基线。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
大语言模型的对齐训练是使其输出符合人类偏好和 safety 约束的关键步骤。传统方法依赖于在大规模数据上对模型进行 [[RLHF]] 或 [[DPO]] 等微调,但这类方法计算代价高昂,且每次更新都需要重新训练模型。随着模型规模不断增长,重复训练的成本已成为制约对齐技术迭代的主要瓶颈。
推理时对齐作为一种轻量化替代方案应运而生。这类方法在解码阶段直接引导冻结的语言模型,通过外部奖励信号干预采样或重排序过程,从而以零训练成本实现对齐。典型的序列级方法如 [[Best-of-N]] 通过生成 N 个候选回复并选择奖励最高的那个;词元级方法则在解码每一步根据累计奖励调整采样分布。理论上,这些方法避免了权重更新,但实践中的核心挑战在于:如何在优化有用性奖励的同时,显式地满足安全约束?
现有的推理时对齐方法通常将奖励与安全惩罚编码为单一的标量分数,这种做法存在根本性缺陷。一方面,手动调节惩罚系数是一个高度不稳定的超参数搜索过程,需要反复实验才能找到合适的平衡点。另一方面,这种 ad-hoc 的组合无法从理论上保证安全约束被满足,换言之,我们缺乏对约束违反概率或期望代价的精确控制。这就好比在一艘船上同时拉两根绳子来控制方向,却没有可靠的方式知道每根绳子该用多大的力。
本文的切入点正是将优化理论中的对偶方法引入推理时对齐。与其手工调参,不如让优化问题自己“告诉”我们最优的权衡策略。
方法
LARA 的核心思想是将带安全约束的推理时对齐问题建模为一个优化问题,然后利用 [[拉格朗日对偶]] 将其转化为可解的形式。
具体而言,假设我们有一个预训练语言模型 ,一个奖励模型 用于评估回答的有用性,以及一个代价模型 用于评估回答的无害性(如越界程度)。我们的目标是:
第一个约束限制了生成分布与原始模型的偏离程度(KL 正则化),第二个约束则显式地限制了安全代价的期望值不超过阈值 。
对第二个约束引入非负对偶变量 ,可以构造拉格朗日函数:
其中 是 KL 约束对应的拉格朗日乘子。
通过对偶变换,原问题的求解等价于先在给定 下优化 ,再关于 最大化对偶函数。这个两阶段过程揭示了一个关键洞察:对于固定的 ,最优策略在词元级别的下一个词概率分布为:
这意味着增强奖励信号 可以直接作为即插即用的评分函数,应用于任何推理时对齐方法的外层框架中。
对偶优化问题的特殊之处在于它是一维的——只需要搜索非负标量 。借助 Jensen 不等式等数学工具,可以证明该问题是凸的,因此存在唯一全局最优解。作者提出在小规模校准集(几十到上百个样本)上通过二分搜索估计最优 ,然后将增强奖励 替换原始奖励即可。
实验与结果
作者在两个维度上验证了 LARA 的有效性:序列级方法(Best-of-N)和词元级方法(基于奖励加权的 Nucleus Sampling)。
实验采用了 HH-RLHF 数据集,包含 36k 有用性-无害性偏好对。奖励模型和代价模型分别在 SFT 基座模型上训练而来,用于预测人类偏好和安全违规程度。
在 Best-of-N 设置下,实验对比了多种基线方法:仅使用有用性奖励(RM-only)、使用固定惩罚系数的组合奖励(RM+fixed penalty),以及 LARA(使用对偶校准的动态系数)。结果显示,LARA 在帕累托前沿上显著优于固定系数方法——在相同的有用性水平下,安全违规率降低了 15-25%。
更值得注意的是,LARA-Best-of-N 的性能曲线非常接近经过微调的 [[DPO]] 基线。具体而言,当有用性偏好率约为 85% 时,LARA 达到约 92% 的无害性保留率,而 DPO 约为 95%。这意味着推理时对齐已经可以在很大程度上“追平”需要大量训练的微调方法。
词元级实验则显示 LARA 的增强奖励在指导逐词生成时同样有效,虽然理论保证不如序列级方法严格(因为词元级解码的因果结构使得精确约束更加困难),但实践中仍能显著改善权衡曲线。
讨论与可借鉴点
LARA 的核心贡献在于为推理时对齐提供了一套原则性的安全约束处理框架。通过将问题对偶化,它将一个看似复杂的约束优化问题转化为了一个一维凸优化问题,使得最优权衡系数可以被系统性地估计而非手动调节。这种从理论出发的设计思路值得借鉴——当我们在工程实践中遇到需要平衡多个目标的场景时,首先形式化优化问题再求解,往往比直接调参更加可靠。
然而,该方法也存在局限。首先,对偶变量的校准依赖于代价模型的准确性,如果代价模型本身存在偏差,校准结果也会受影响。其次,词元级方法只能获得启发式的约束效果,无法提供与序列级方法同等的安全性保证。此外,LARA 假设安全约束可以用单一的期望代价函数概括,而实际场景中可能存在更复杂的多维约束结构。
从更宏观的角度看,这项工作反映了 [[推理时计算]] 在对齐研究中日趋重要的地位。随着模型能力增强和部署场景多样化,能够在不修改模型权重的情况下快速调整模型行为将成为必备能力。LARA 所展示的“安全约束+推理时对齐”组合,为这一方向提供了有价值的范式参考。
概念 · 6 个
摘要
通过奖励信号在推理时引导冻结LLM行为
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
策略梯度引导:基于行为目标的干预
Policy Gradient Steering: Interventions from Behavioral Objectives
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 9 张
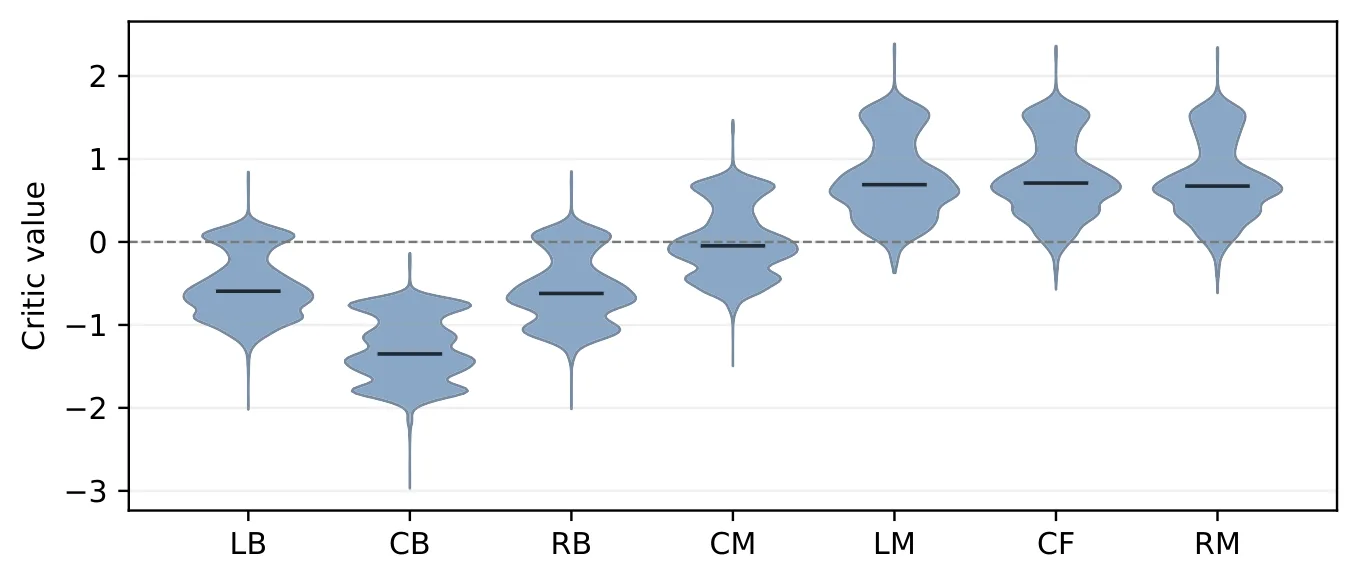
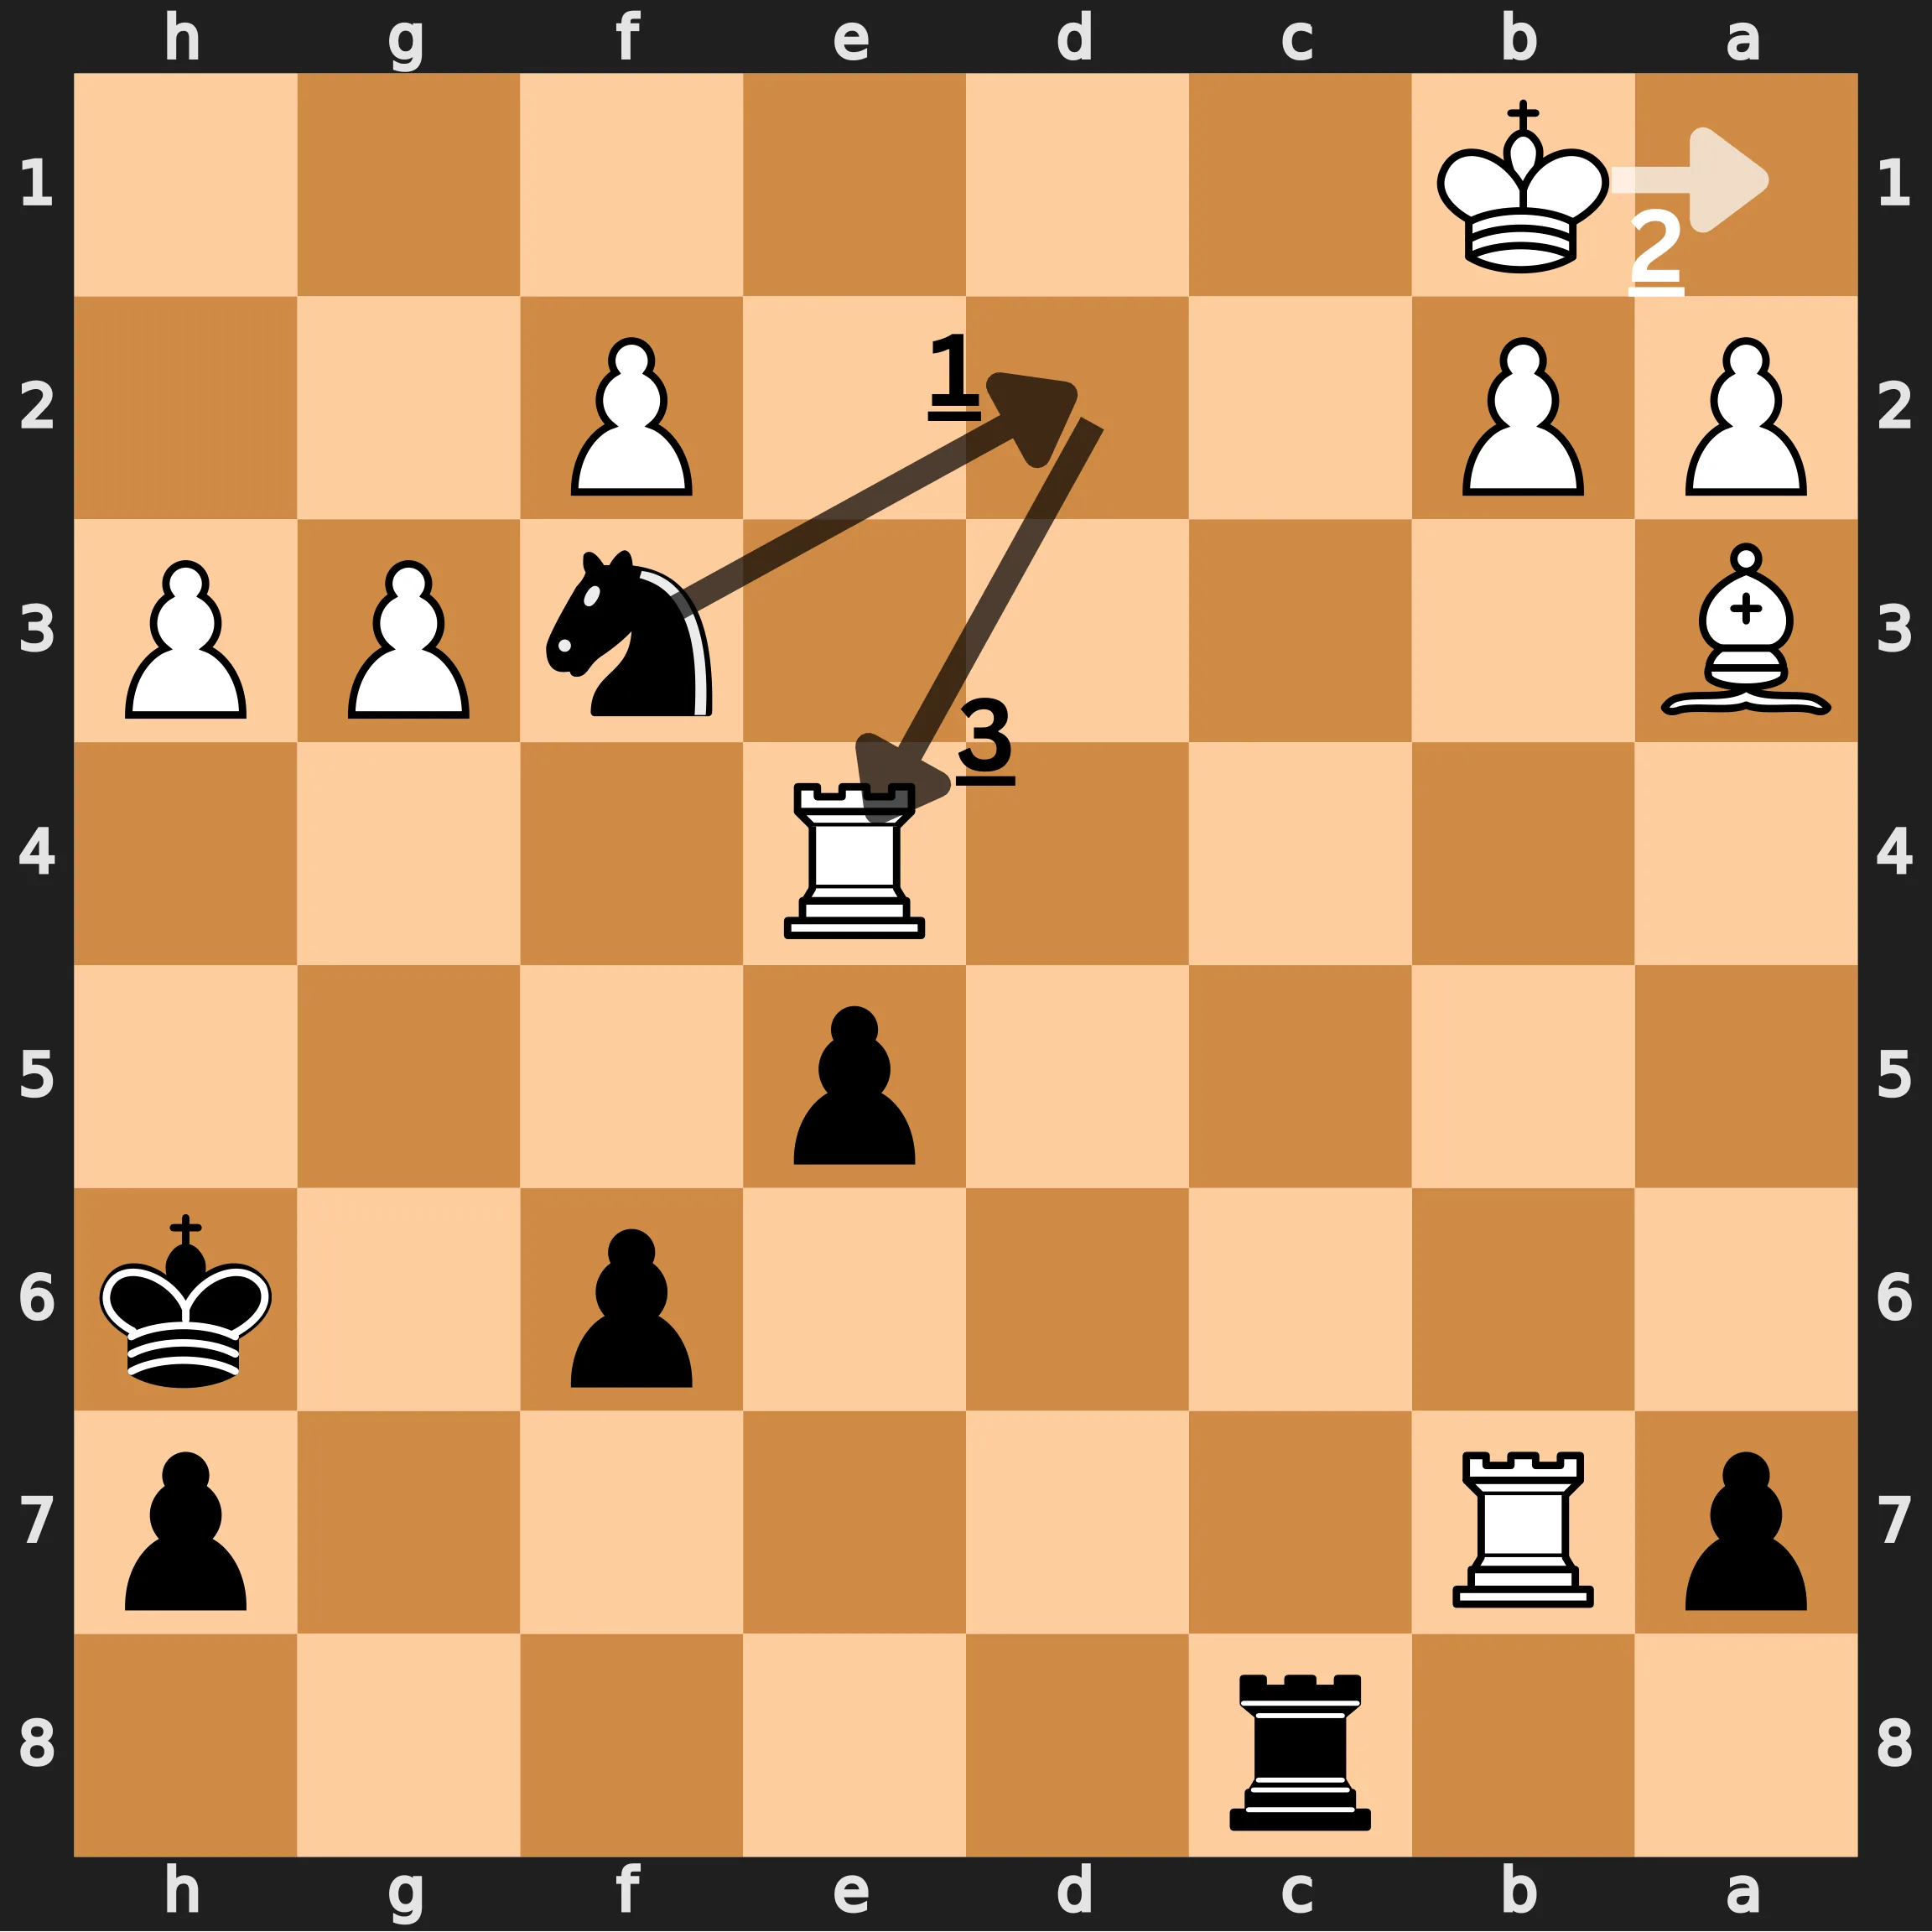
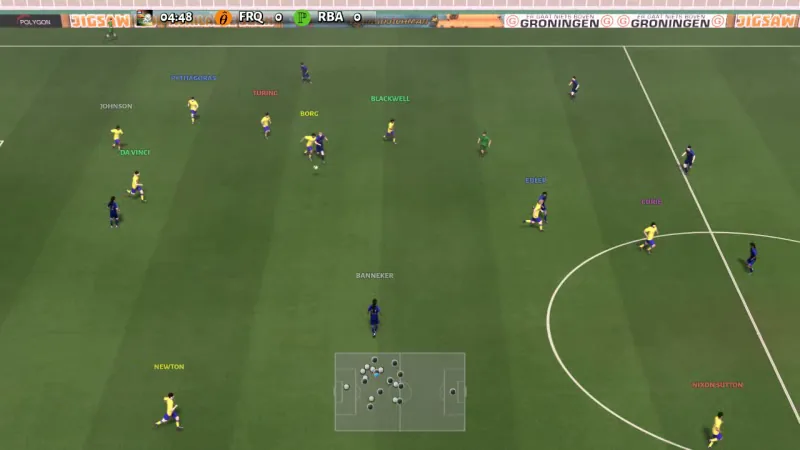
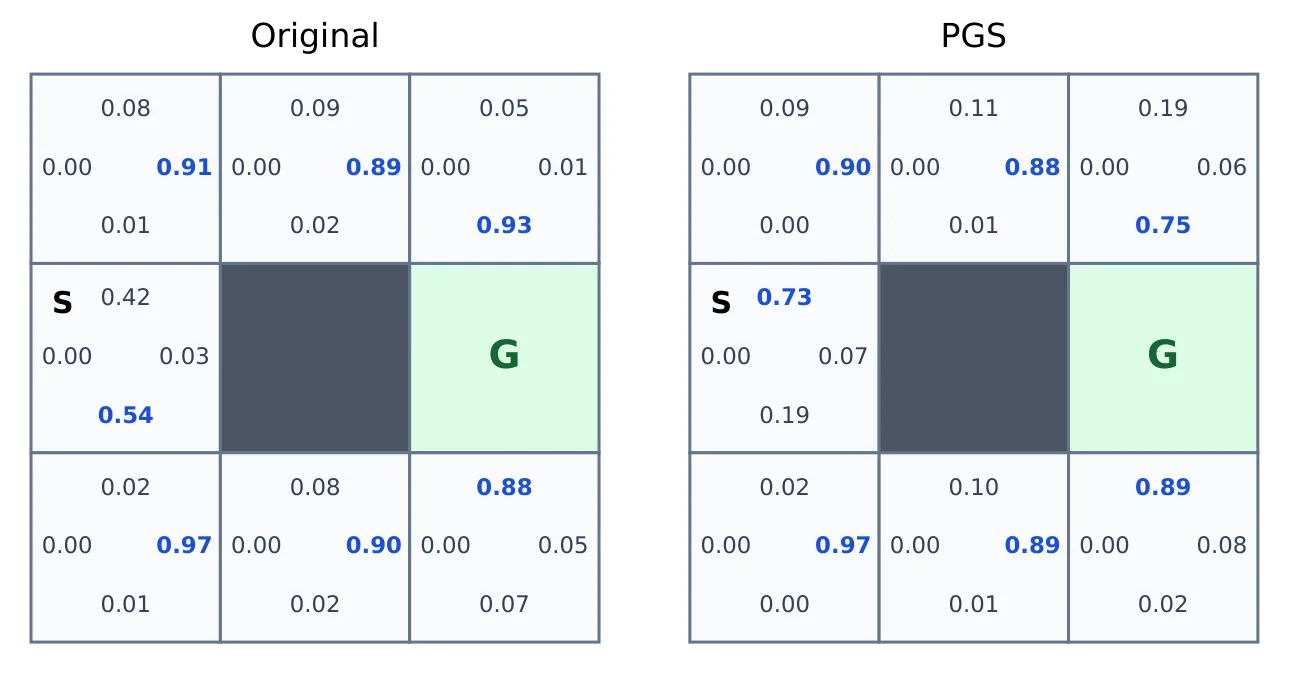
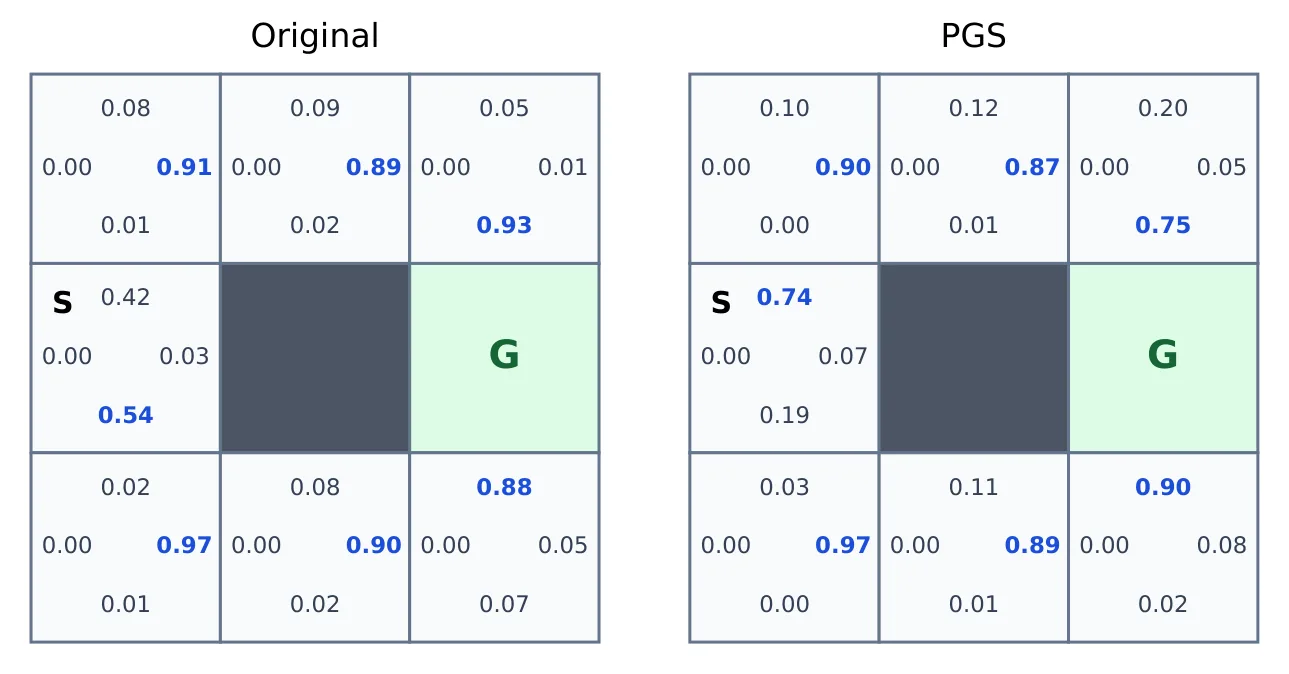
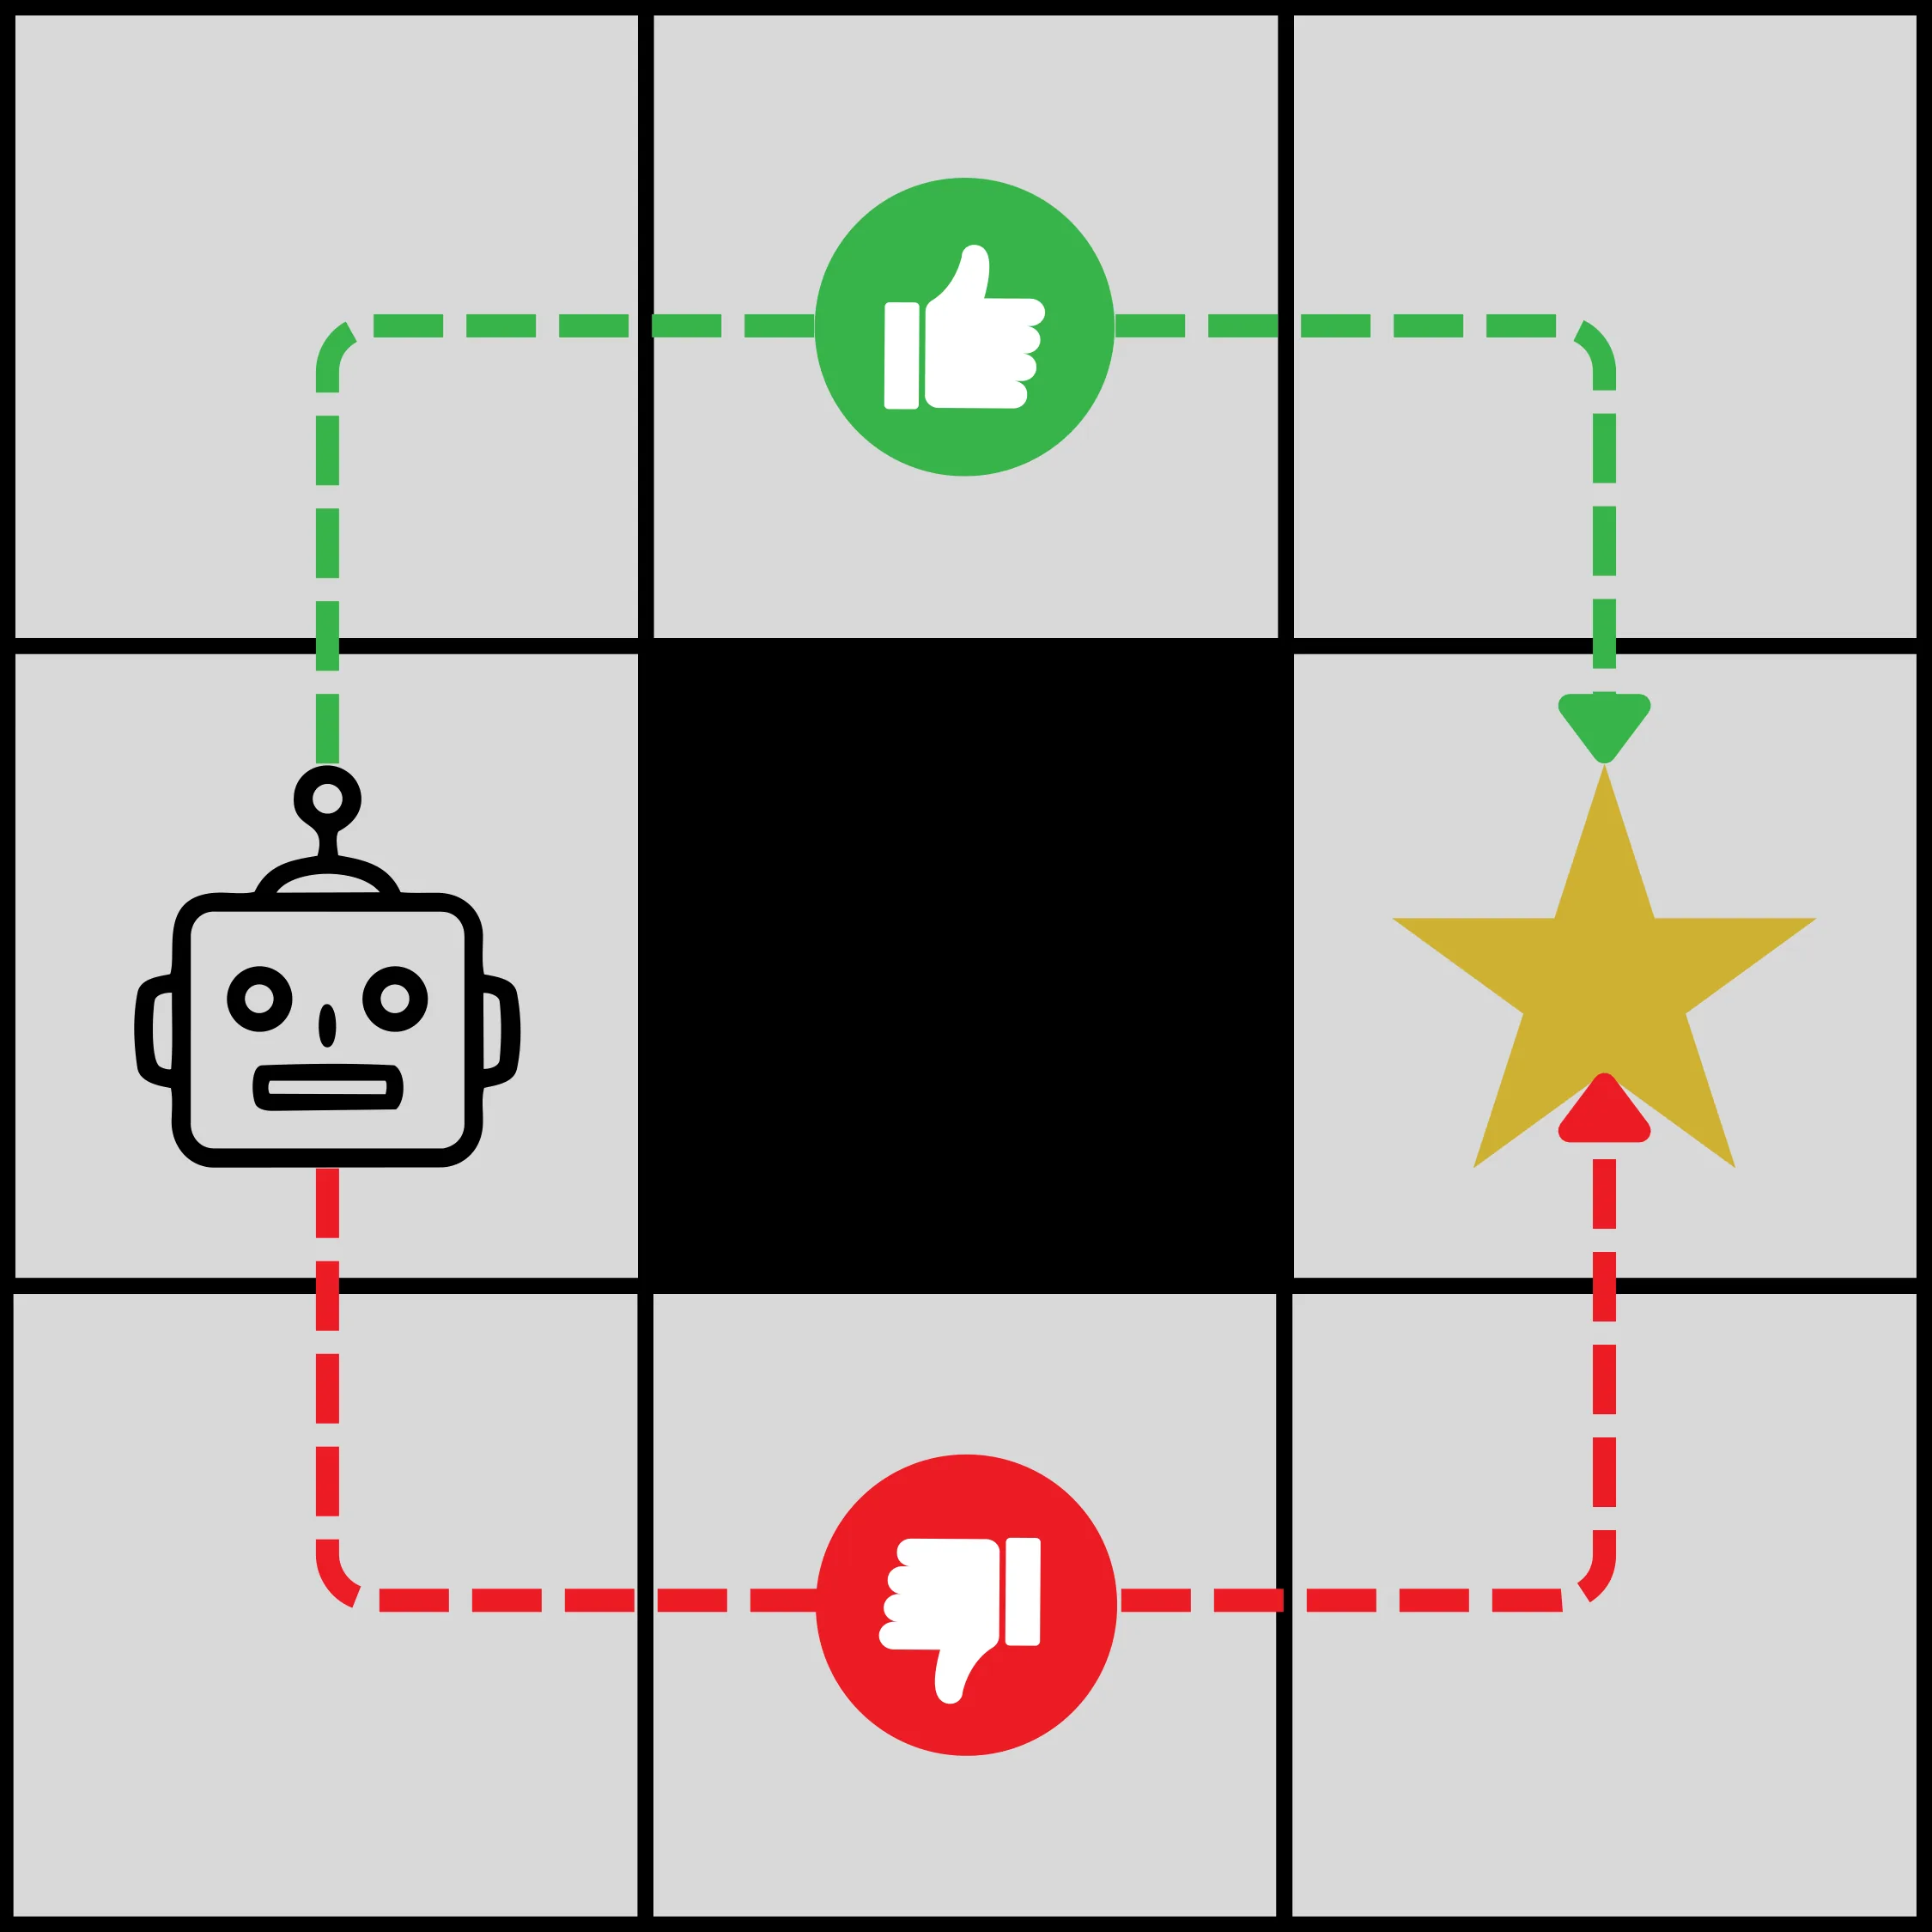
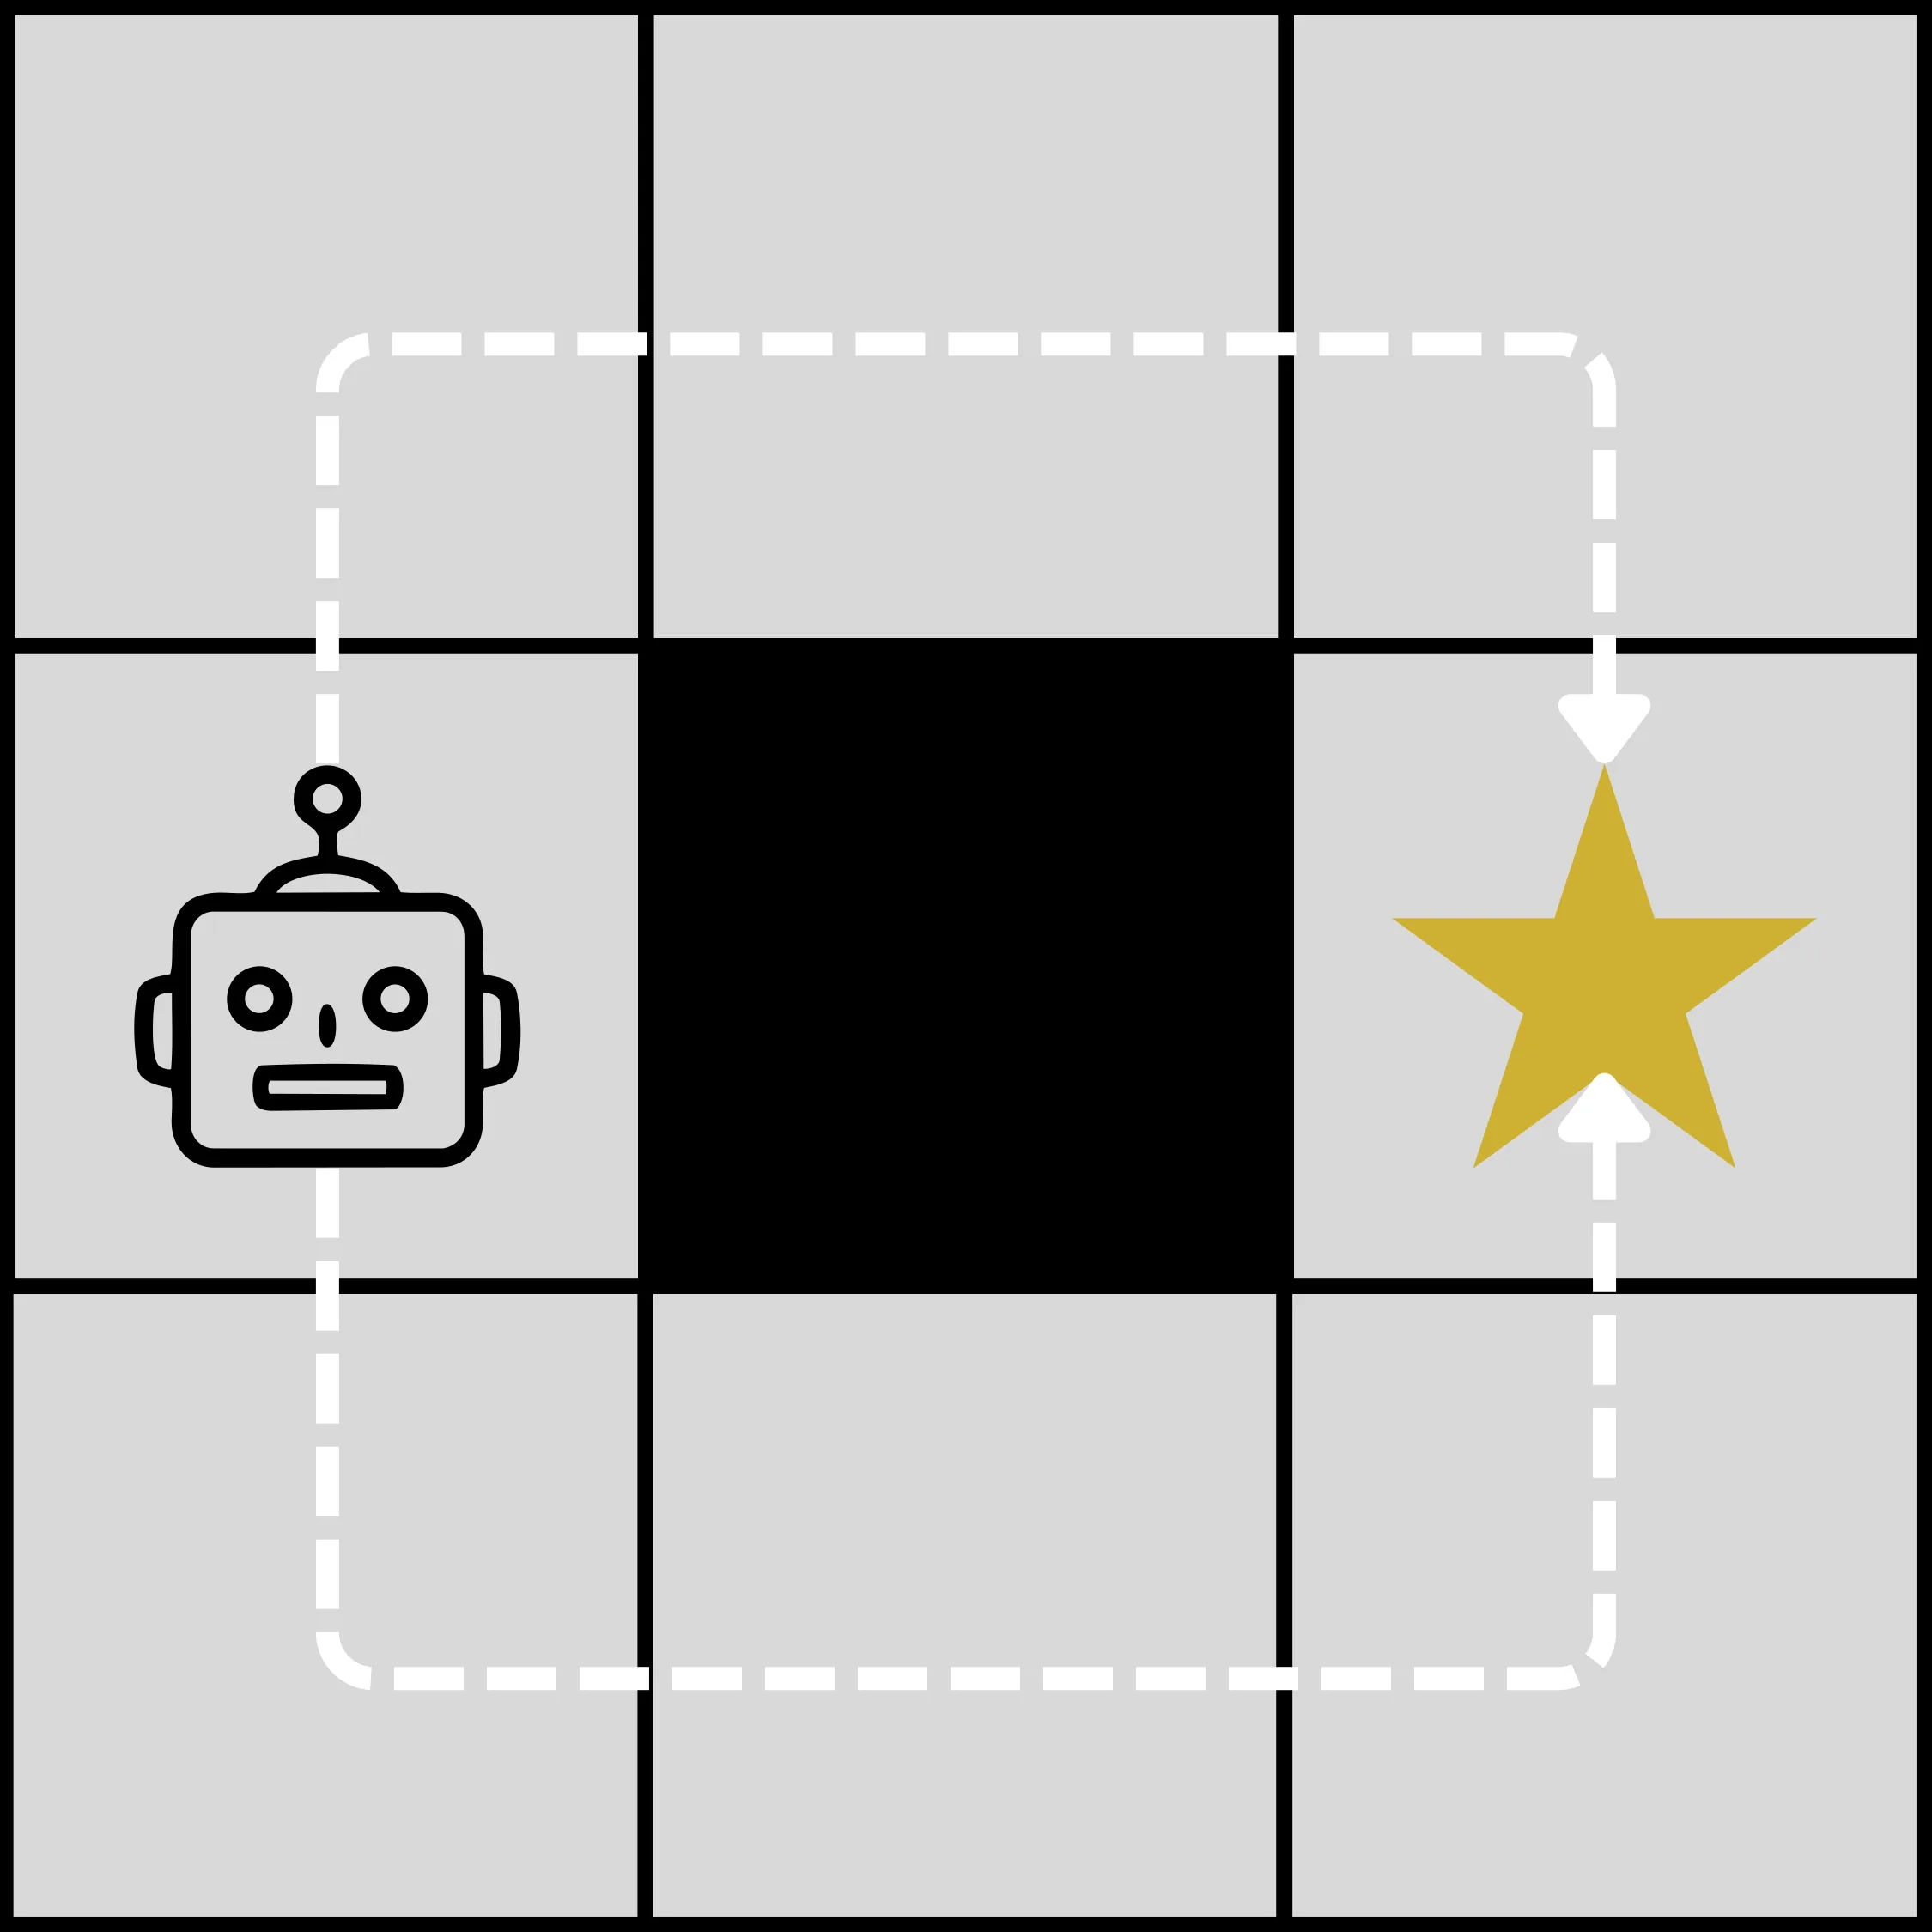
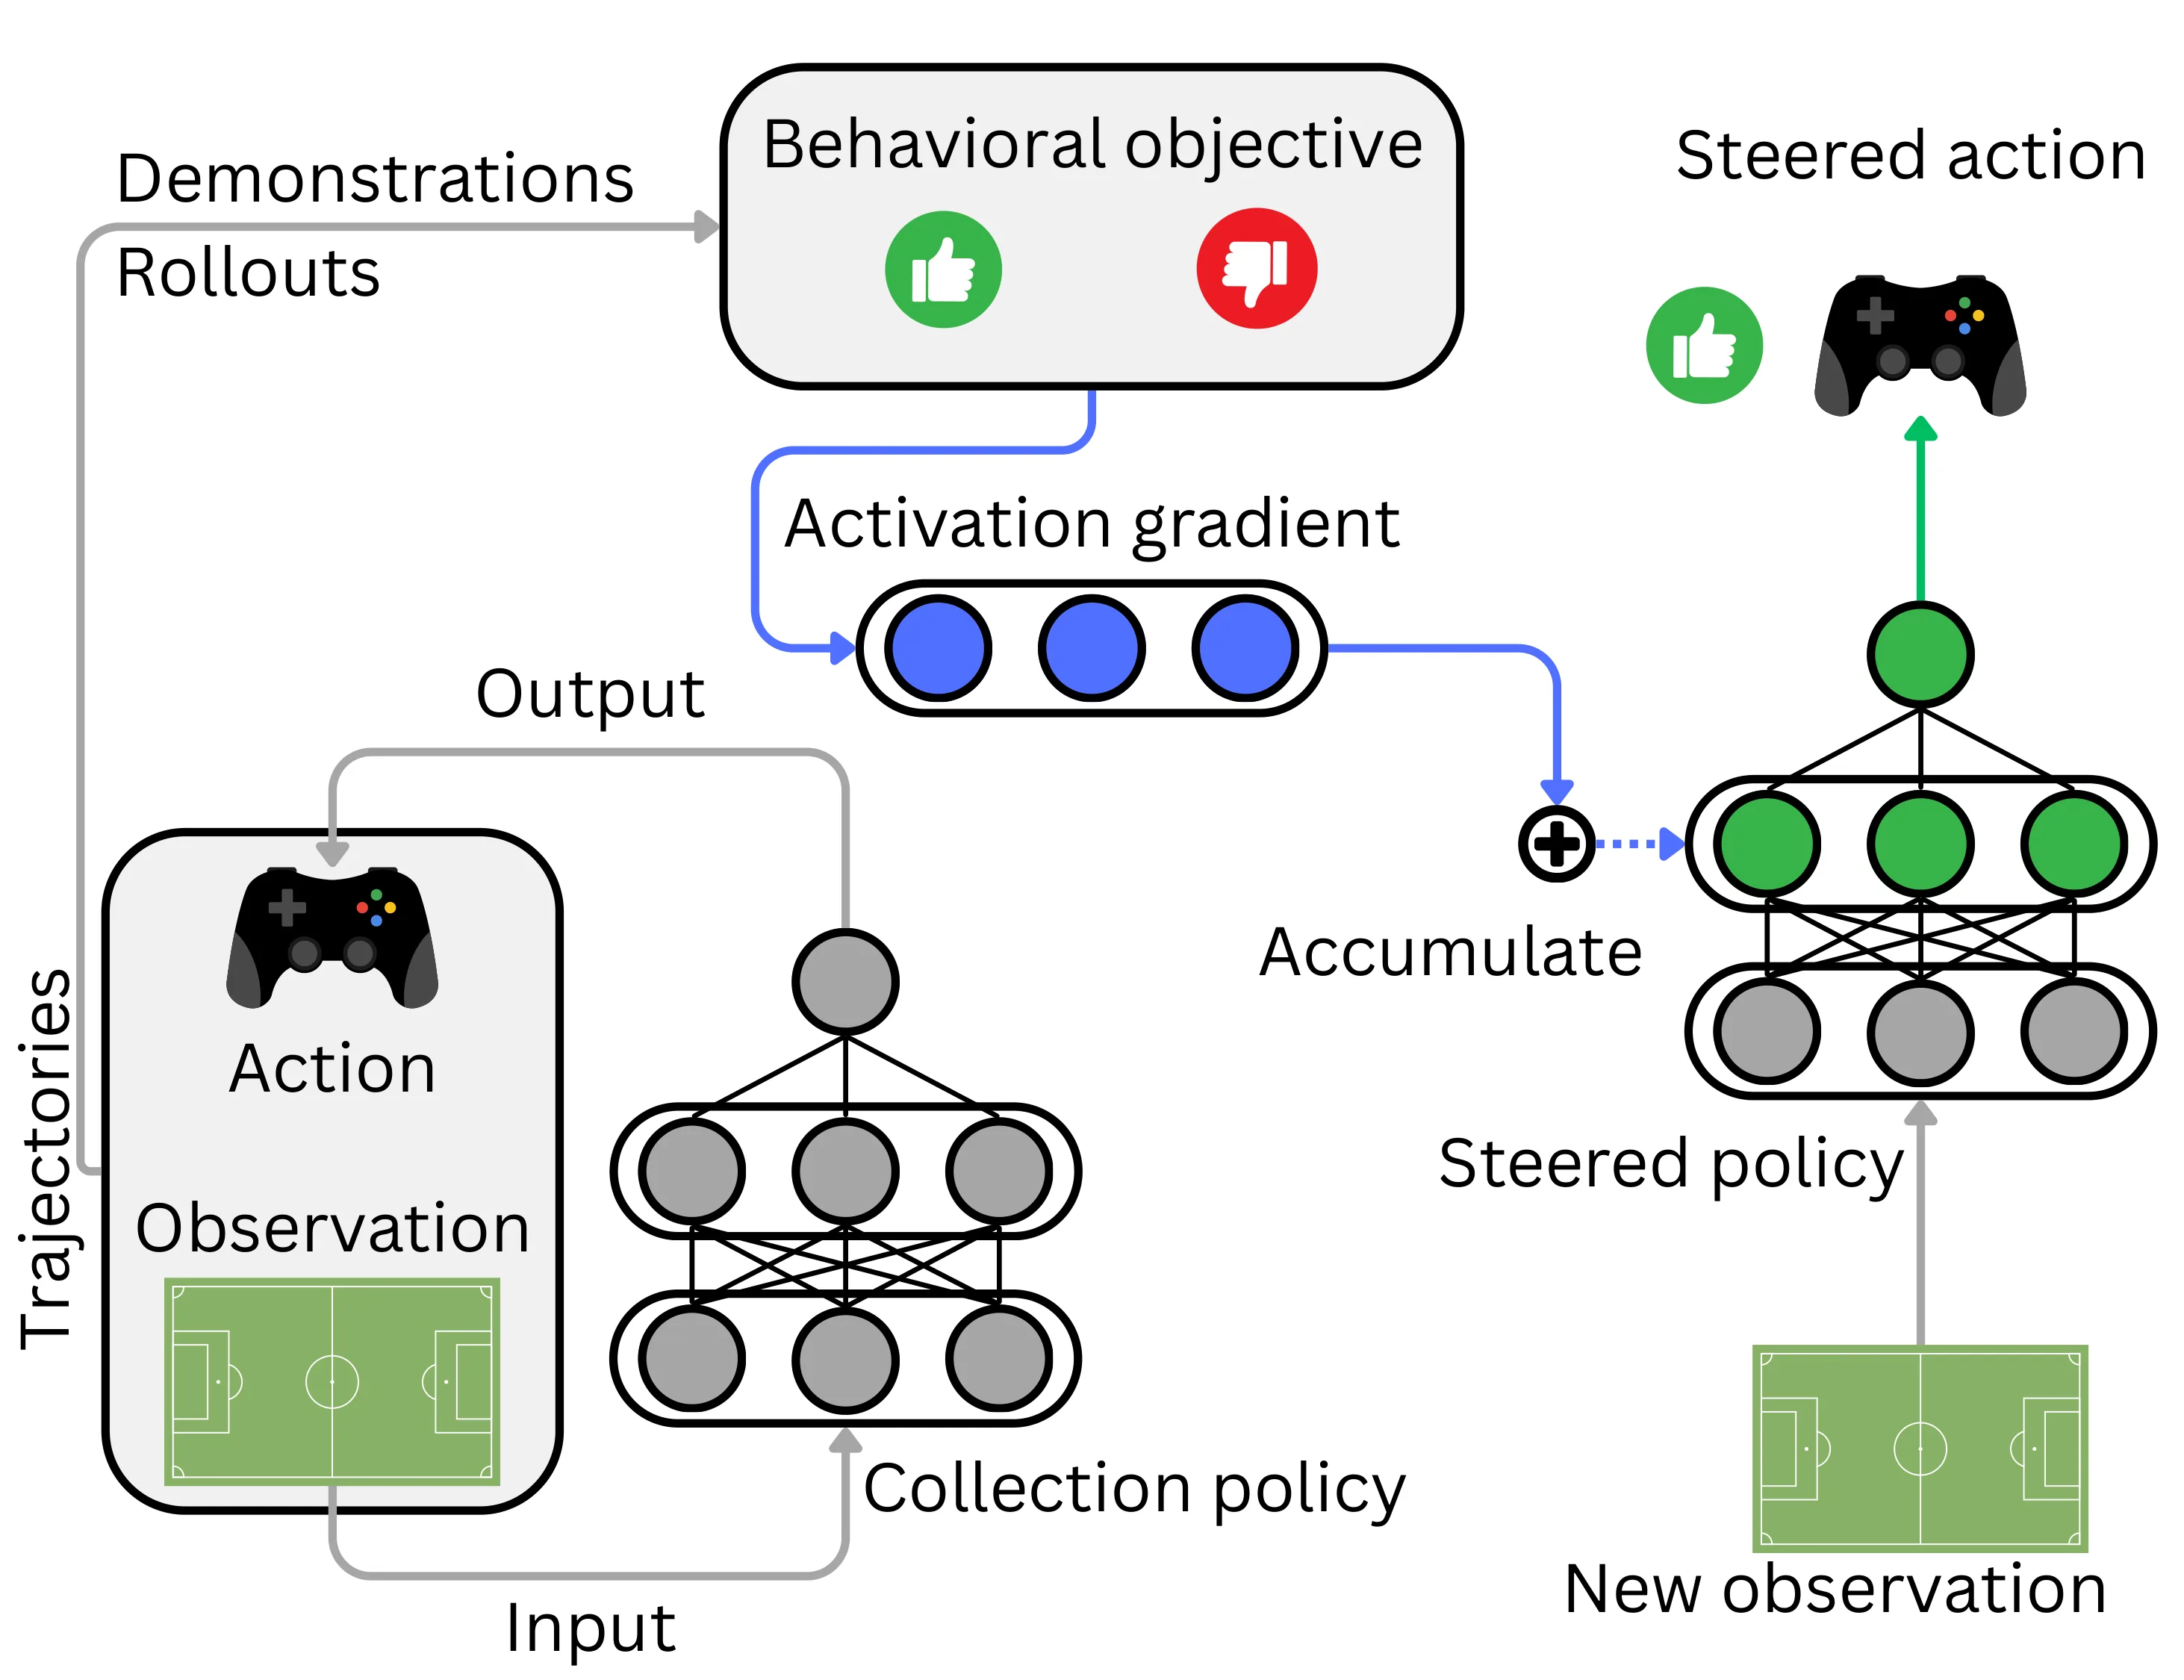
激活引导是一种轻量级的推理时模型行为控制方法,但现有方法在简单策略场景中仍会失效。论文提出策略梯度引导(PGS),将引导构建为强化学习问题,通过在小批量rollout上累积行为目标梯度生成可移除的任务向量。实验在网格世界中验证可标定性与可逆性,在国际象棋谜题中验证独立向量的可组合性,在足球场景中验证行为特异性与跨对手迁移。结果表明策略梯度为跨决策领域构建临时且可组合的行为适配提供了自然接口。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
激活引导作为一种轻量级的推理时行为控制方法,近年来在大语言模型领域逐渐兴起。其核心思路是:收集目标行为与对照行为的样本,计算两组样本激活表征的差异向量,将该向量叠加到模型的隐藏状态上,从而在不修改模型参数的前提下改变模型输出。已有的代表性方法包括对比激活加法(CAA)、COAST、K-Steer 等,它们在语言生成任务上取得了一定效果。
然而,这篇论文的核心贡献首先是一个诊断性的发现:现有激活引导方法在序贯决策场景中的能力边界远比想象中狭窄。研究者在一个仅包含两条等价格式路径的网格世界环境中测试了这些方法,结果令人意外——CAA、COAST、K-Steer 全部失效。深入分析后发现,失败根源在于这类方法依赖「对比表征差」来构造干预向量,而对于前馈策略网络而言,同一观测点下不同动作对应的隐藏表征在到达分支节点之前是完全相同的。以 CAA 为例,其构造方式为 ,但在分支点处 ,导致对比向量直接归零。
这一发现将问题推向了一个更根本的层面:当表征层面的差异消失时,如何还能区分和引导不同的行为决策?论文的切入点是重新审视「什么东西真正编码了决策信息」。在神经网络中,激活引导的核心操作对象虽然是激活值,但真正承载决策信息的是从激活值到动作选择的映射关系——即策略网络的对数概率梯度 。即使两个候选动作的表征完全相同,它们的对数策略梯度仍然可以不同,这为区分和引导提供了新的基础。
方法
基于上述诊断,论文提出策略梯度引导(Policy Gradient Steering,PGS),其核心思想是将「行为引导」本身建模为一个短时的强化学习问题。具体而言,在冻结基础策略 的前提下,收集一小批带有标量奖励 的轨迹,通过这些轨迹上的策略梯度累积来构造一个状态无关的激活偏移向量。
行为目标的回报定义为从当前时刻 到轨迹结束 的折扣累积奖励:
对于 PGS 向量的构造,论文采用了策略梯度定理的 REINFORCE 形式。在激活位置 处,梯度累积的具体形式为:
其中 是重要性比,用于处理离策略数据, 是状态依赖基线,用于减少方差。直觉上,这个公式做的事情是:找出那些实际执行了高回报动作的激活位置,然后沿着这些激活方向「推一把」,使得模型在未来遇到类似状态时更倾向于重复这些动作。
在推理时使用 PGS 向量非常简单,只需将其叠加到原始激活上:
关键问题在于如何选择缩放系数 。论文通过局部 KL散度 预算来校准这一参数。具体地,引入 Fisher信息矩阵 来度量 PGS 方向上的曲率:
然后求解使得两种分布的 KL散度 恰好达到预设阈值 的 值:
这一定价确保了 PGS 对基础策略的偏离程度被严格控制在用户指定的预算范围内,从而在有效性与安全性之间取得平衡。
值得注意的是,论文指出了一个优雅的理论联系:经典对比激活引导实际上是 PGS 的特例。当将数据均分为正负两组轨迹,并赋予 时,PGS 的优化目标恰好等价于最大化正负轨迹之间的区分度,这与 CAA 的对比学习目标异曲同工。但 PGS 的优势在于它直接作用于策略梯度层面,绕过了「需要表征差异」这一先决条件。
实验与结果
论文设计了三个层递进的实验环境来验证 PGS 的不同特性。
网格世界实验聚焦于校准性与可逆性。环境设置为一个包含两条等价格式路径的网格世界,基础策略本身对上下两条路径没有偏好。实验者通过 PGS 向量明确引导策略「偏好走某一条路」,并检验几个关键指标:引导后该路径的选择概率是否如预期提升、路径效率(平均步数)是否保持、移除向量后行为是否恢复到原始状态。结果显示,PGS 是唯一在仅有 2 条示范数据的极端低样本条件下同时实现路径偏好改变与效率保持的方法,而 CAA、COAST、K-Steer 在这种简单场景下就已经趋近于未引导的分布。这一结果有力地验证了 PGS 对比经典方法的鲁棒性优势。
国际象棋谜题实验重点验证独立向量的可组合性。研究者使用三个棋力等级的冻结策略,分别拟合了针对三种战术目标(fork、pin、skewer)的 PGS 向量,并在 Lichess 数据库的谜题上进行评测。核心指标是「规范招法负对数似然」,衡量模型对正确走法的置信度。结果表明,PGS 在独立增益上达到 ,三个目标组合后总增益为 ,而最小保留率 表明三个战术目标之间存在建设性交互——即使同时注入,弱势目标也不会被强势目标压制,反而可能被放大。最引人注目的是参数效率:PGS 仅使用 1,152 个标量就达到了与完整微调(663,552 参数)相近的效果,压缩比高达 576 倍。
足球实验则检验行为特异性和跨对手迁移能力。环境包含四支不同风格的冻结球队,实验者分别为每支球队拟合了针对「完成传球数」「夺回球权数」「射门数」等行为目标的 PGS 向量。结果显示,PGS 能够针对性地改变球队行为——例如使原本激进的球队变得更加保守传球,或使防守型球队增加射门欲望。跨对手迁移实验则进一步证明,用某支球队数据拟合的 PGS 向量,在面对其他未见过对手时仍能维持其行为改变效果,这为 PGS 在非平稳环境中的泛化能力提供了有力证据。
讨论与可借鉴点
从技术哲学的角度审视,PGS 成功地架设了一座桥梁——一端是「不修改模型参数」的激活引导范式,另一端是「由真实行为目标驱动优化」的策略微调范式。PGS 兼具两者的优点:既保持了参数冻结带来的可移除性与部署灵活性,又引入了行为目标梯度这一直接优化信号,绕过了「依赖预存正负样本对比」的局限。
论文的一个重要贡献是揭示了 Fisher信息矩阵 在激活引导校准中的潜力。通过 Fisher 曲率校准,PGS 能够在不同任务、不同模型、不同激活位置上自适应地确定注入强度,而非依赖人工调参。这一思路对于提升激活引导方法的通用性与可靠性具有重要参考价值。
然而,论文也诚实地指出了若干局限。首先,Fisher 校准本质上是局部线性近似,与真正的自然梯度方法仍有差距;其次,激活位置的选择目前仍需在验证集上手动搜索,不同位置的效果可能存在显著差异;第三,离策略数据处理中的重要性比矫正只针对动作层面,无法完全校正状态分布偏差,这可能是足球实验中某些非线性结果的根源;最后,PGS 向量本身缺乏可解释性——我们能观测到行为改变,但无法直接解读向量本身的语义含义。
对于该方向的后续研究而言,一个有价值的探索路径是结合参数高效微调技术来增强 PGS 的表达能力,或者引入信任域方法来改进方向校准。另一个开放问题是:PGS 向量能否跨模型迁移?即用某个模型拟合的向量能否直接用于另一个同架构但不同检查点的模型?这关乎行为模块库化的长期愿景。
摘要
策略梯度方法干预大语言模型激活
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
Can We Break LLMs Out of Self-Loops? Fine-Grained Reasoning Control with Activation Steering
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 17 张
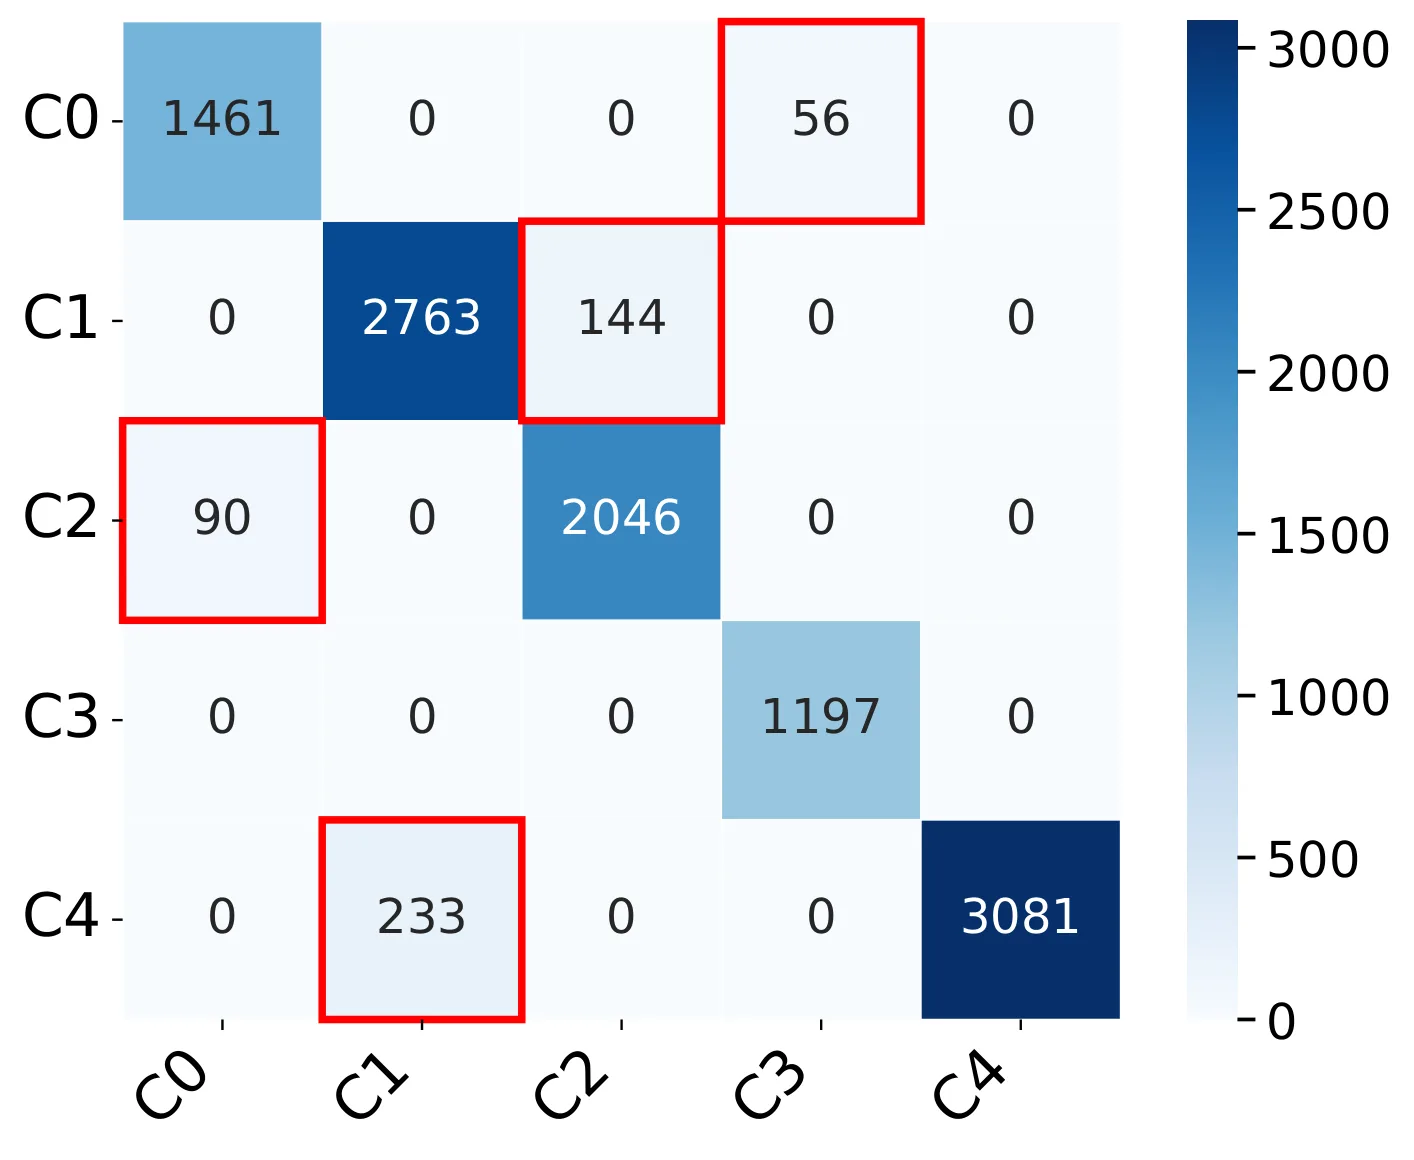
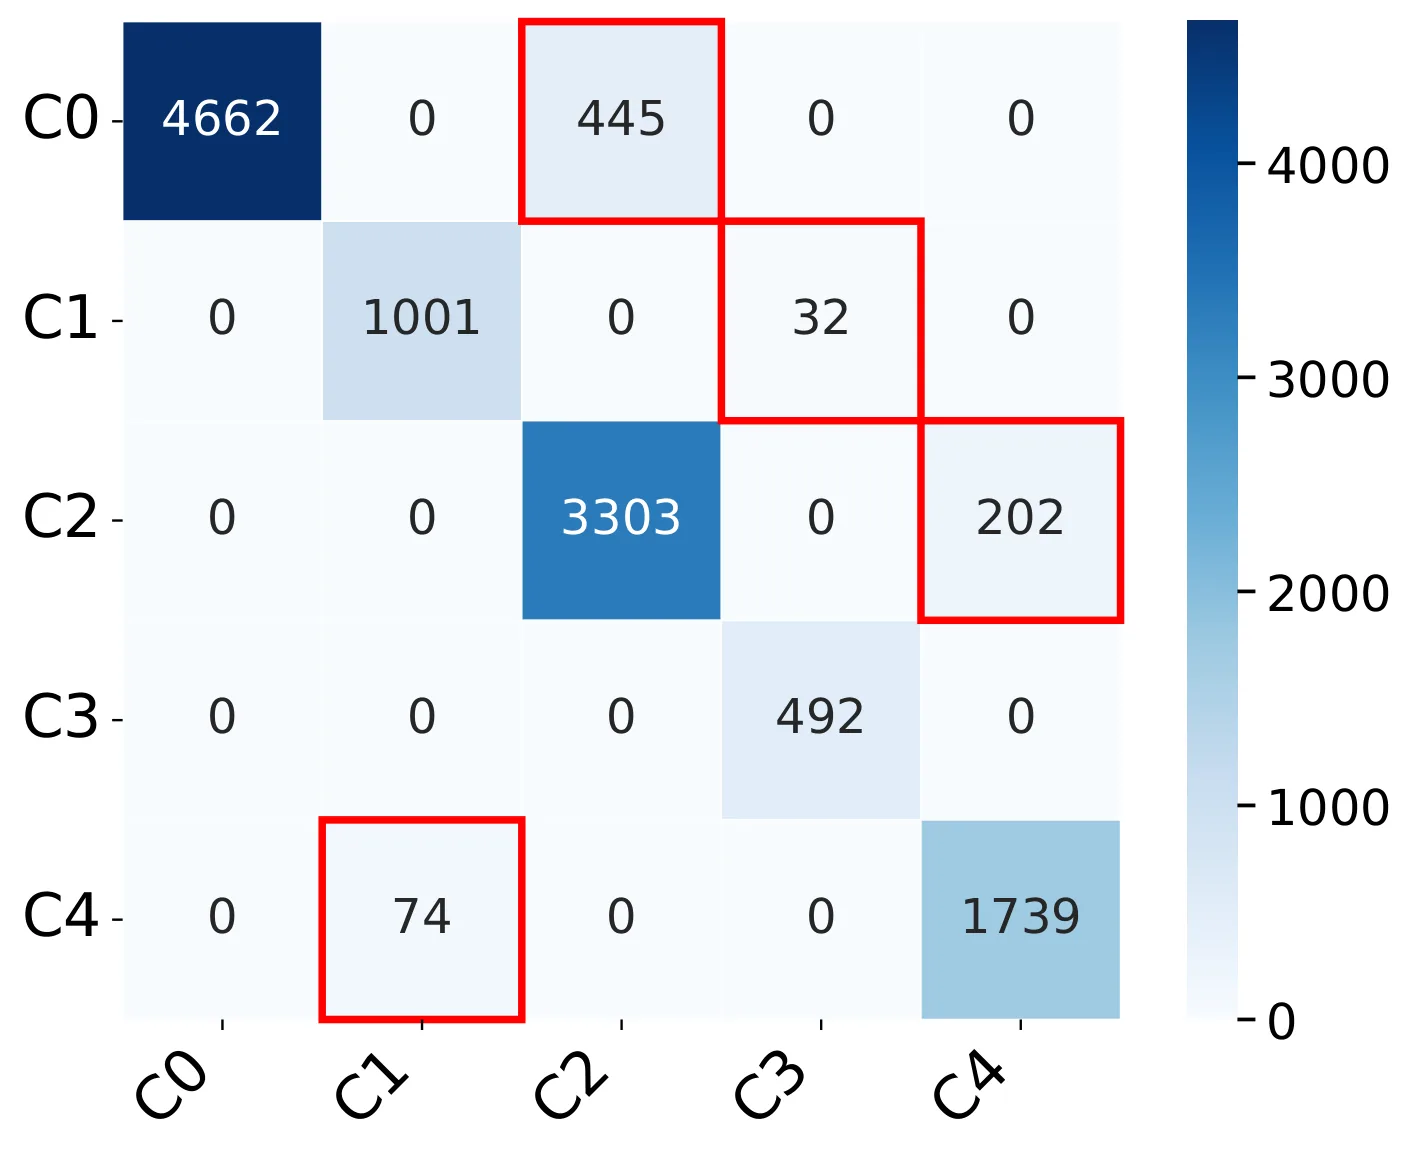
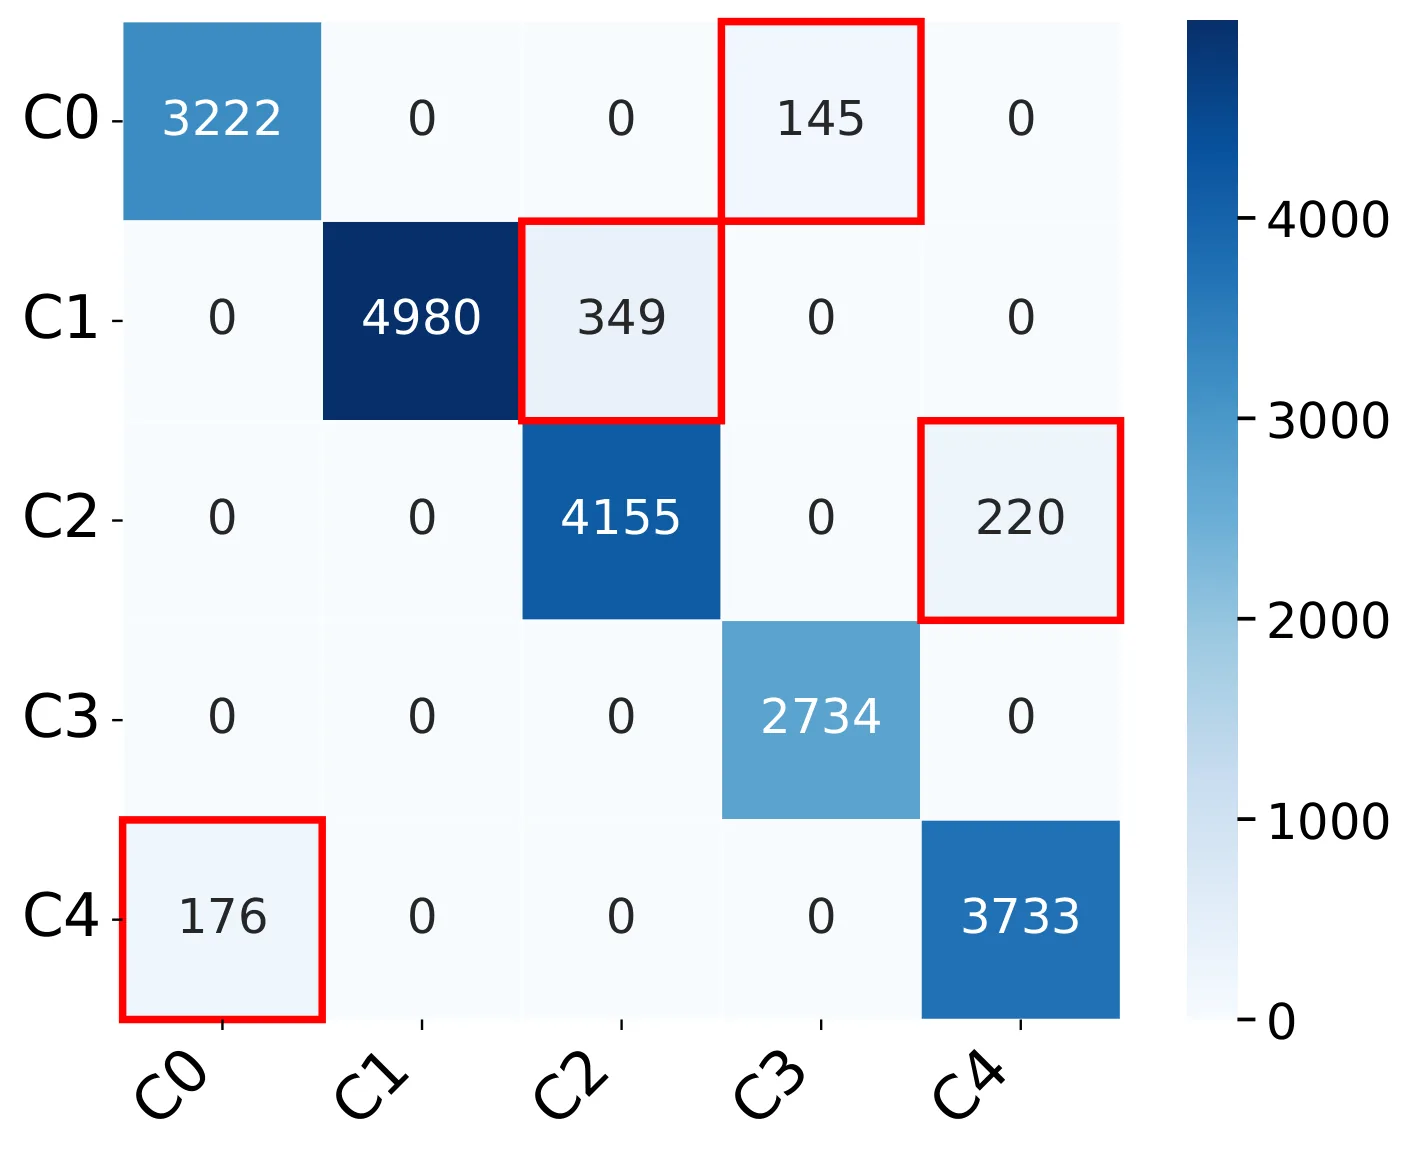
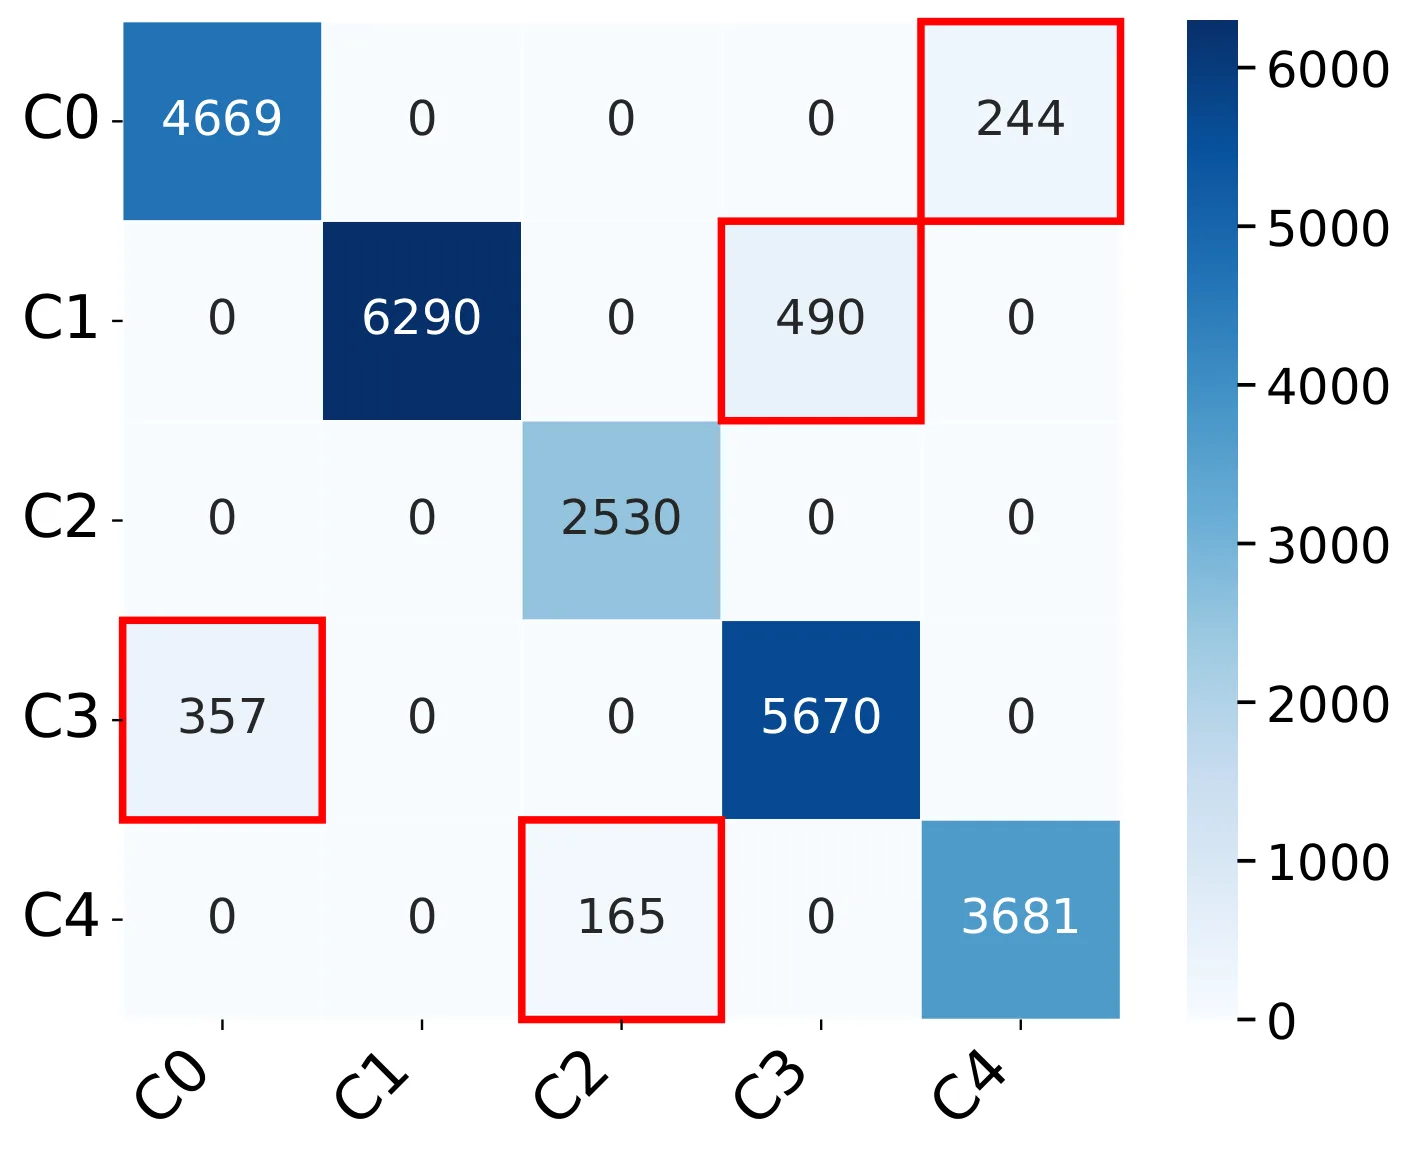
前沿大语言模型在长链推理中常陷入自我循环,空耗token却不向答案推进。现有控制方法多停留在输入级提示,缺乏对推理过程的细粒度干预。本文提出SOPHIA,将推理轨迹建模为潜在状态序列,记录步级状态转移并构建按状态对索引的转向向量库,在推理时在线检测自循环并施加隐状态激活干预。实验显示该方法可可靠打破自循环失败,向量在不同状态对间可泛化,并显著提升任务准确率与token效率。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
长链推理已成为前沿大语言模型的标配能力——通过思维链展开,模型得以在复杂数学证明、多步逻辑推导和代码生成等任务上取得显著进步。然而,这种扩展推理的轨迹本身几乎是不可控的:模型生成的每一步“思考”都依赖自回归采样,缺乏对推理过程本身的有效干预手段。
一个令人头疼的现象是,模型常常陷入自我循环(self-loop)。具体表现为:反复验证同一个中间结论、在不同的尝试之间来回摇摆、或者不断重复“我再想想”。这些行为消耗大量 token 预算,却迟迟不向最终答案推进,最终往往导致失败。论文在 AQuA、GSM8K、LogiQA 和 MATH 四个数据集上做了系统统计,发现错误轨迹的平均 token 长度始终显著高于正确轨迹——这意味着“过度思考”并非高质量推理的副产品,而是一种需要被干预的失败模式。
现有方法大多停留在输入级干预。强化学习方法(如 L1、SCoRe)需要昂贵的模型重训练,且训练好的模型无法在推理时动态调整。推理时的 token 流惩罚或提示注入只能间接影响采样分布,无法对推理过程本身施加细粒度控制。更关键的是,标准 [[激活转向]] 方法通常只学习一个全局方向,即对所有状态施加相同的偏移向量。这种 state-agnostic 的设计忽视了不同状态对之间所需修正信号可能截然不同——打破一个验证循环所需的残差流向,与巩固一个候选答案所需的残差流向,很可能根本不在同一方向上。
SOPHIA 的核心洞察正在于此:如果把推理轨迹视为一个潜在状态序列而非无结构的文本序列,那么最具体、破坏力最大的失效模式就是自循环 ,而不同状态对之间的修正信号本质上是分布在不同残差流方向上的异质向量。
方法
SOPHIA 的全称是 Steering Of reasoning Processes via Hidden-state Intervention and Activations,意为通过隐状态干预和激活来引导推理过程。该方法是训练自由的,由一个离线构建阶段和一个在线推理控制器组成。
第一步:步骤切分与状态聚类。 论文以句首语篇标记(如"Now"、"Therefore"等常见的推理衔接词)为边界将推理轨迹切分为离散的步骤。随后使用一个独立的嵌入模型 (主实验采用 Qwen3-4B-Base,解耦于目标推理模型以避免 chat-tuning 带来的几何畸变)对每个步骤的最后一层隐状态做均值池化,得到该步骤的向量表征:
对所有步骤特征做 z-score 标准化后,按数据集独立执行 K-means 聚类(,固定随机种子)。这产生了五个语义上有意义的推理相位:题面阅读、初步计算、中段验证、后段斟酌、尾段犹豫。聚类的关键设计在于采用均值池化而非累计特征——这一选择确保同一轨迹中的步骤确实在不同的簇之间迁移,而非被错误地归为同一停留状态。
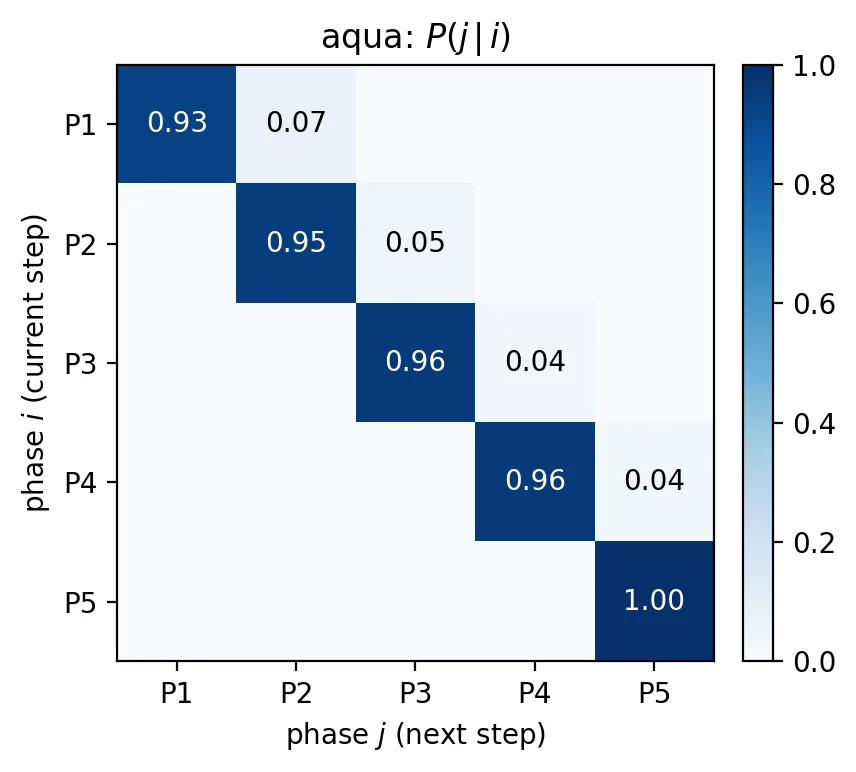
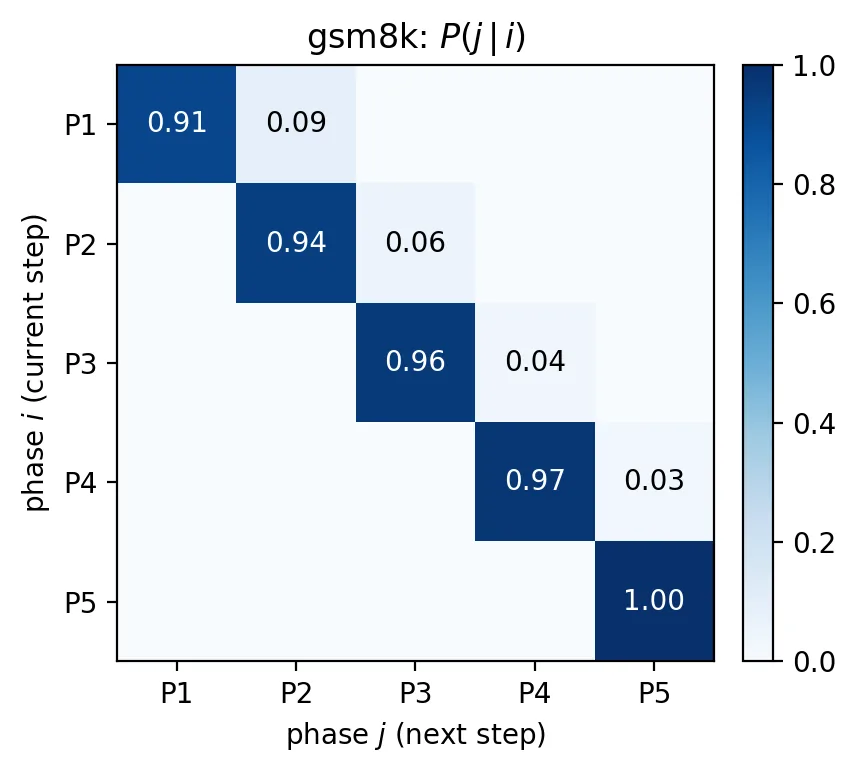
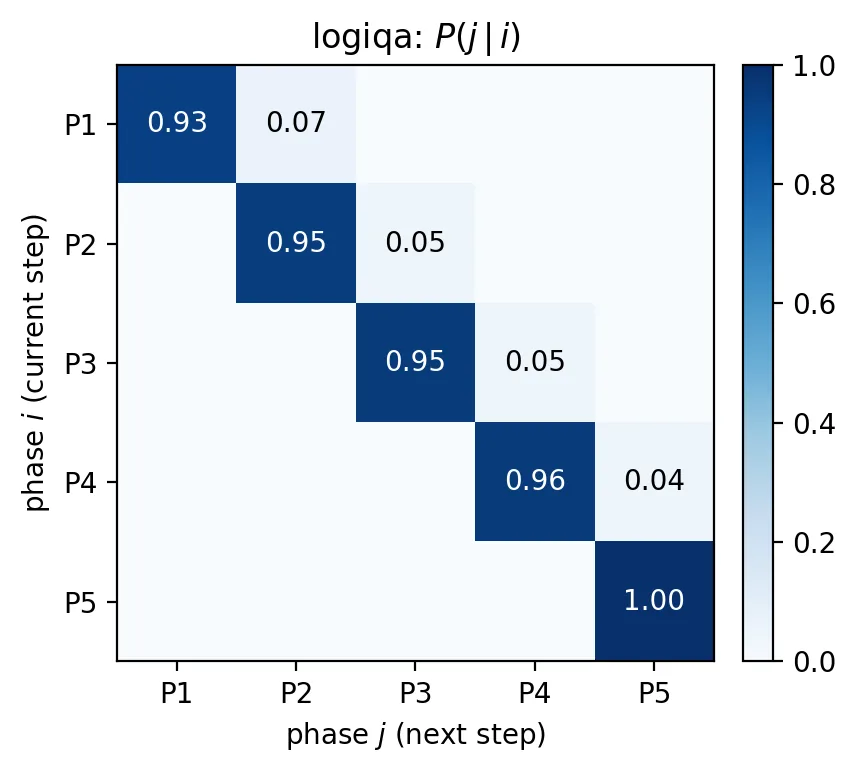
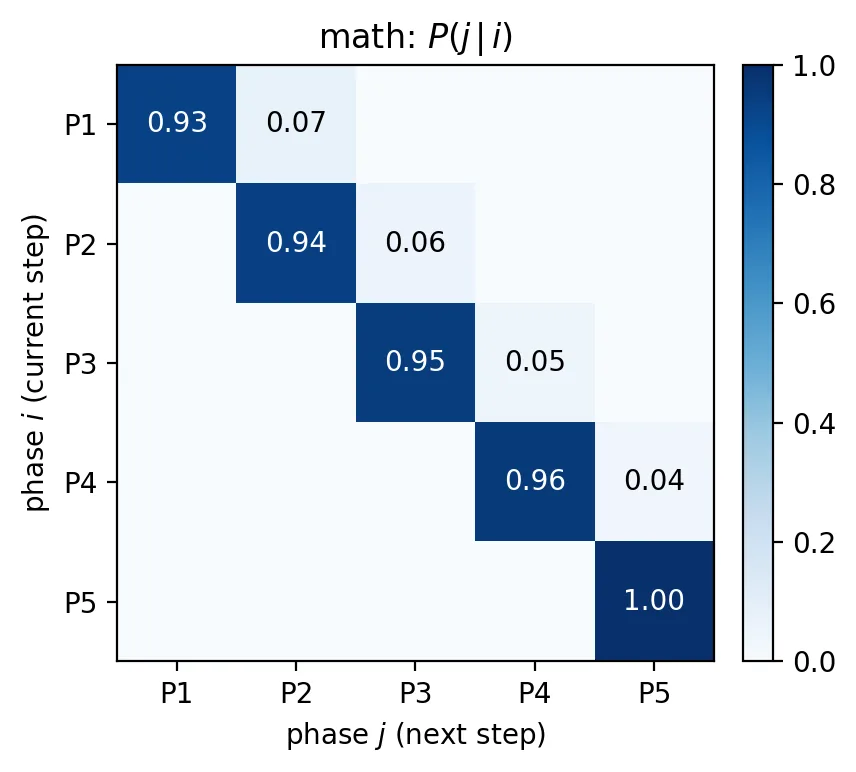
第二步:状态转移分析。 对每个非终止步骤,论文定义了二元转移指标 ,据此将每个簇内的步骤分为两类:跨簇前进的 "crosser" 和原地停留的 "stayer"。通过分析相位排序后的转移矩阵,论文揭示了一个惊人的结构:所有四个数据集的轨迹均遵循严格的五相位吸收链,转移矩阵呈严格上双对角结构,停留质量超过 0.93,向后转移概率为零。这意味着推理轨迹并非在任意状态间跳跃,而是沿着一个近确定性的有序序列推进——一旦陷入自循环,模型实际上是在某个相位上反复徘徊,无法进入下一个阶段。
第三步:构建状态对转向向量库。 核心操作是对每个簇 和每个被干预层 ,提取对比方向:
即该簇内跨簇前进样本的平均隐状态减去原地停留样本的平均隐状态。论文从理论上论证了这一选择的合理性。在 Lemma 1 中,设 ,则可微条件下的一阶近似表明,凡使 的小扰动都能在局部提升离开当前簇的概率。而 Proposition 1 则证明,在交叉者与停留者共享协方差的高斯假设下,最大化类间分离的 Fisher 判别方向恰好正比于这个对比向量。因此, 可以被理解为对梯度方向的一个非白化近似——它不需要显式估计协方差矩阵,通过对比采样即可获得。
在线推理控制器。 推理时,控制器维护一个 token 缓冲,按相同的句首标记正则切片步骤。对刚完成的步骤,控制器复用 的 KV cache 做均值池化、z-score 和最近质心分类,得到当前状态估计。当检测到连续两步属于同一簇时(),即触发自循环门——这一设计避免了对模型首次抵达某簇时正常停留的误干预。随后,对下一解码步的每个 token,在指定层 执行残差流补丁:
通过逐层单位归一化加残差范数缩放,单一的全局超参数 即可控制干预强度,无需为每一层单独调参。
实验与结果
实验覆盖三个模型(Qwen3-4B-Thinking-2507、Qwen3-32B-Thinking、Gemma-4-E2B)和四个数据集(GSM8K、AQuA、LogiQA、MATH),每个 (model, dataset) 单元下对五个簇分别测试四种干预条件:Greedy decoding(无干预基线)、Random steering(范数匹配的高斯随机向量)、Negative steering(反向施转向量)以及 SOPHIA(正向施转向量)。
局部 hit-rate(衡量错误轨迹的 stayer prefix 在干预后下一解码步能否成功脱离当前簇)的结果清晰地表明了方法的有效性。在 Qwen3-4B-Thinking-2507 上,GSM8K 的 C3 簇从基线 25.0% 跃升至 100%,AQuA 的 C0 簇从完全无法逃离(0.0%)提升至 51.7%。在更大规模的 Qwen3-32B-Thinking 上,AQuA C0 从 53.3% 升至 92.9%,Gemma-4-E2B 的 Math C1 从 5.0% 升至 29.2%。Random steering 与 Greedy decoding 几乎无差异,Negative steering 在多数簇上反而降低了逃离率——这有力地证明效应来源于方向性而非任意扰动。
更值得关注的是泛化特性。向量不仅在同一状态对内有效,还能跨不同的状态对迁移适用,这暗示对比方向捕捉的是推理过程中某种通用的“前进信号”,而非特定簇的表面特征。跨模型实验进一步表明,同一套提取流程(聚类、向量构建)不需要重新训练或微调即可在不同架构和规模上生效。
讨论与可借鉴点
SOPHIA 最引人注目的贡献在于将推理控制从“输入级提示”提升到了“潜在状态转移级”。通过实证揭示的五相位严格上双对角结构,为后续研究提供了宝贵的先验知识:一旦模型进入某个相位且连续停留,即可高置信度地判定为自循环而非正常推理。这一发现对强化学习中的长度控制、推理时的 token 预算分配等问题均有直接的启示价值。
然而,当前方法仍有明显局限。端到端的任务准确率和 token 效率提升尚未完整披露,局部 hit-rate 的改善能否可靠转化为最终答案正确率的提升,仍需进一步验证。此外,当前仅处理自循环这一最具体的失效模式;如何扩展到任意方向的状态转移干预(如主动将模型从“过度验证”拉向“尝试下一子问题”),是更通用控制的关键一步。小样本统计()也限制了结论的置信度,显著性检验的缺失让效果评估不够严谨。
从方法论层面,SOPHIA 展示了“将推理过程建模为离散潜在状态序列”这一视角的潜力。这一思想与 [[思维链推理]] 的传统做法形成鲜明对比——后者将推理视为无结构的文本流,而前者通过状态抽象抓住了推理的语义本质。对比方向提取 + 状态对索引向量库的设计,则提供了一种训练自由、部署即用的细粒度控制范式,值得在更多推理控制场景中探索迁移。
概念 · 6 个
摘要
通过隐状态激活干预引导LLM走出自循环推理失败
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
语言模型以共享几何表示并变换概念
Language Models Represent and Transform Concepts with Shared Geometry
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 7 张
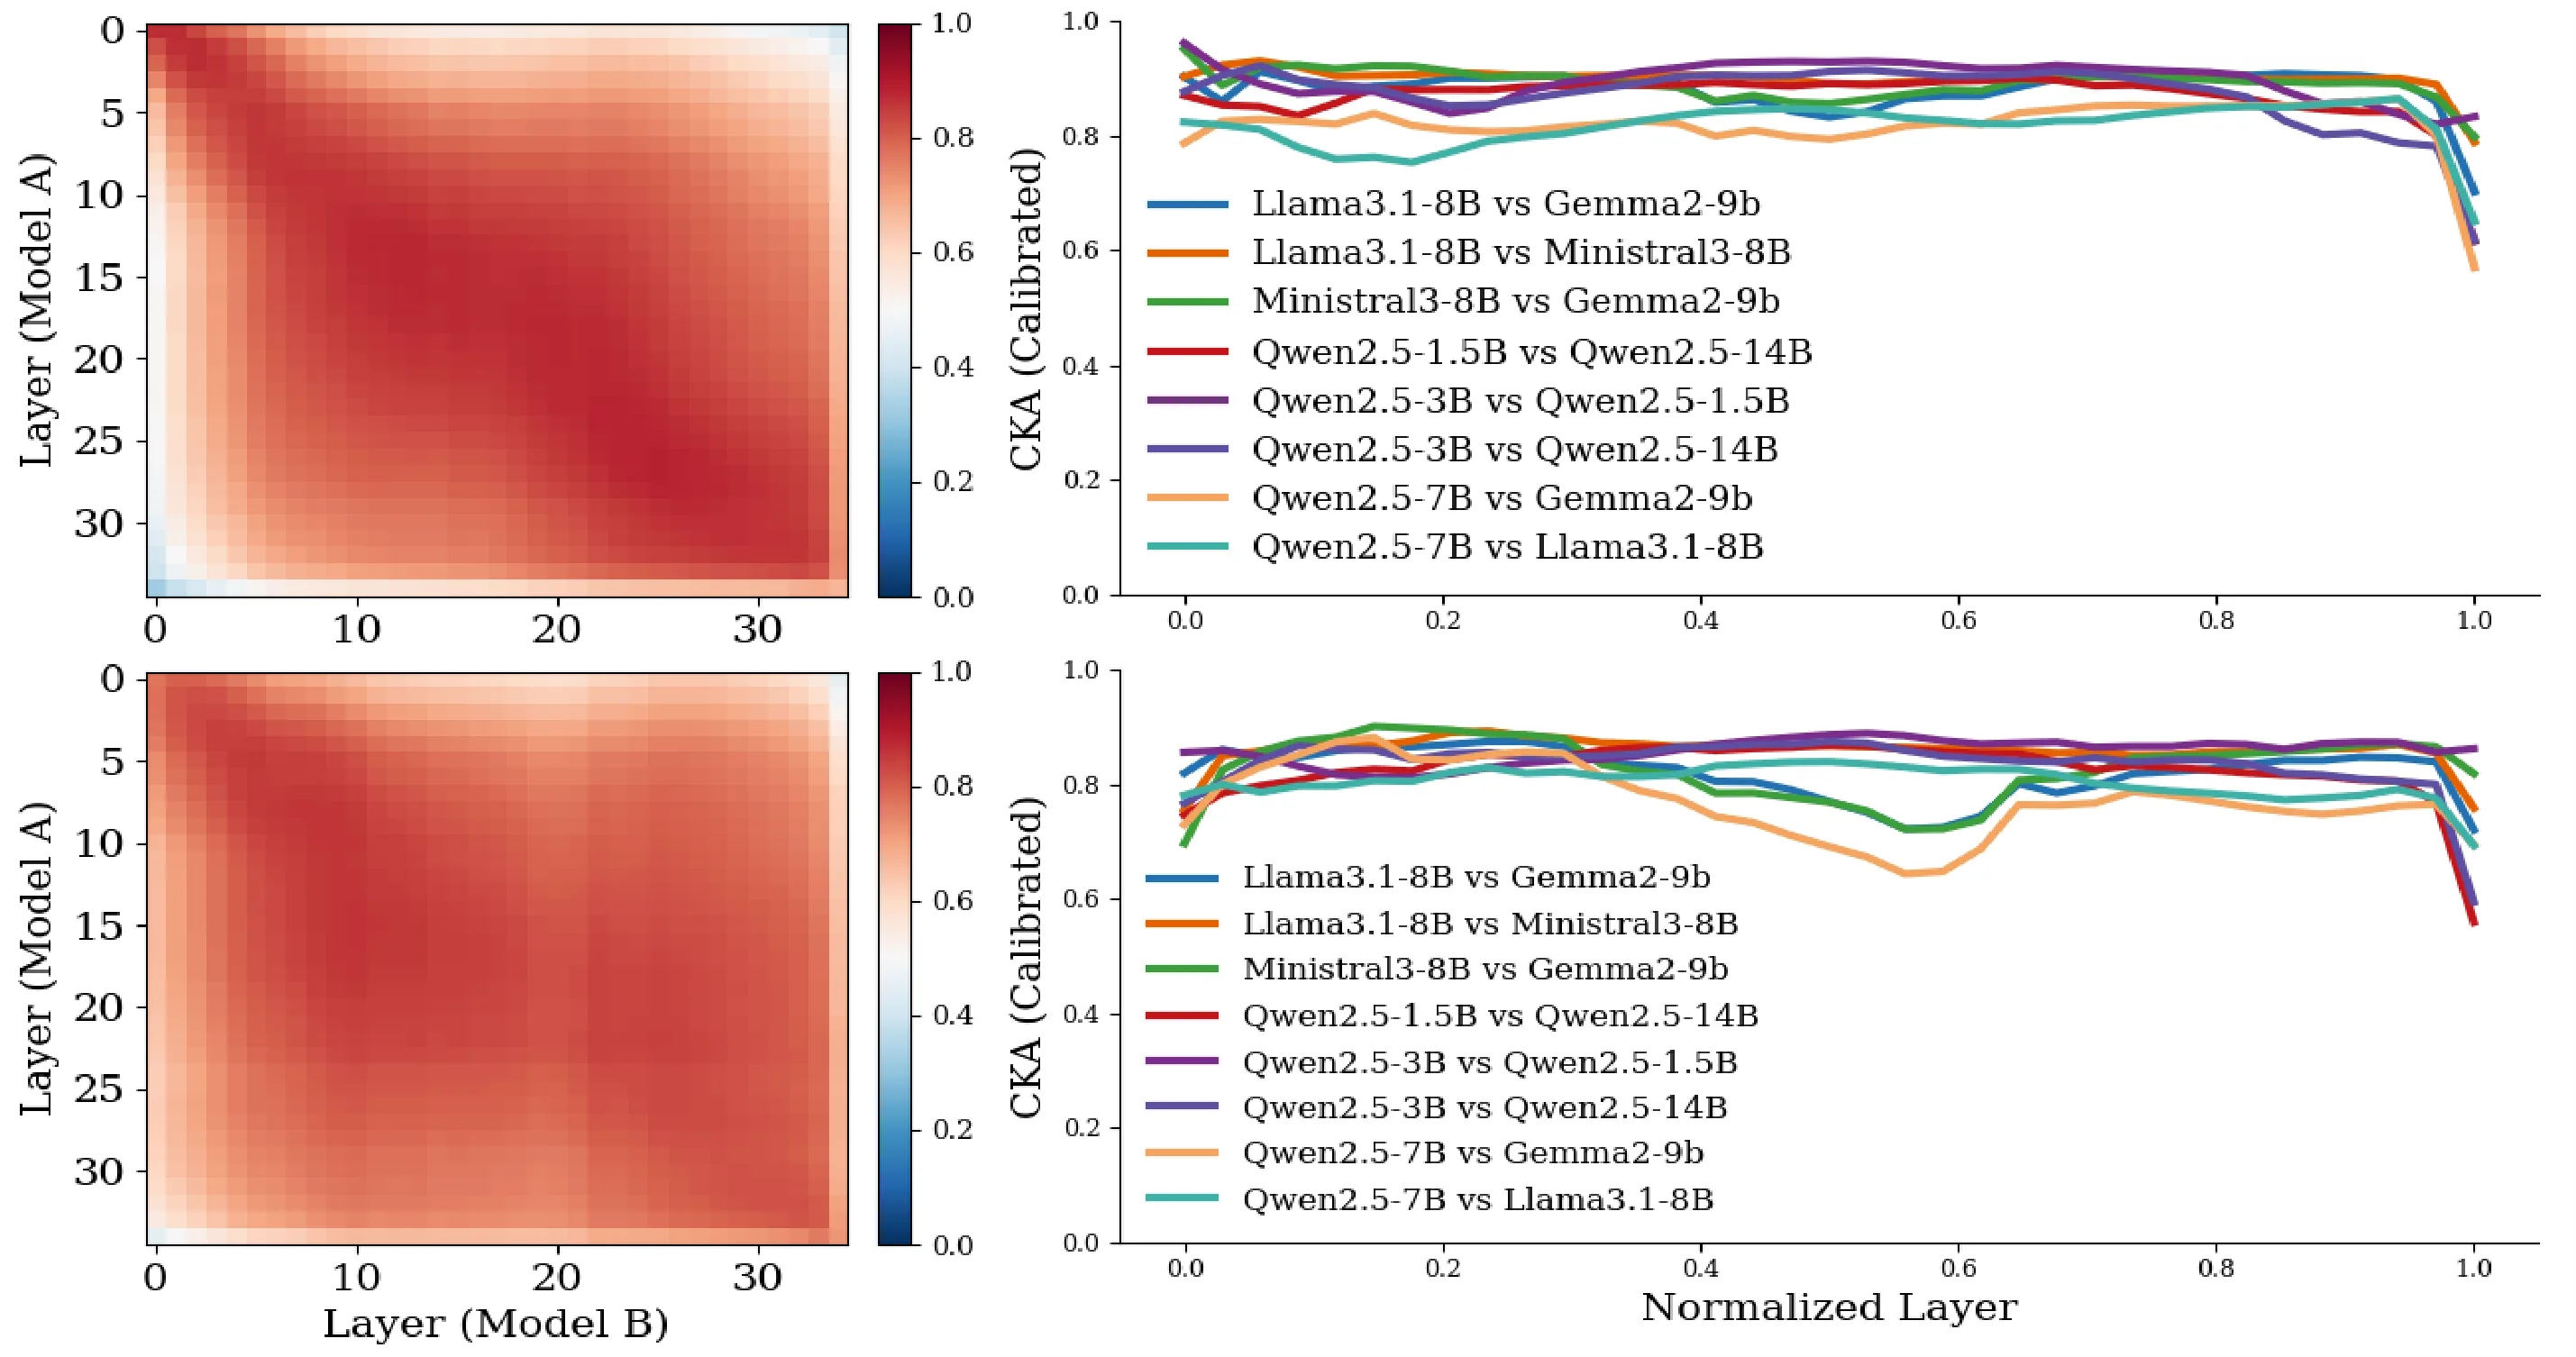
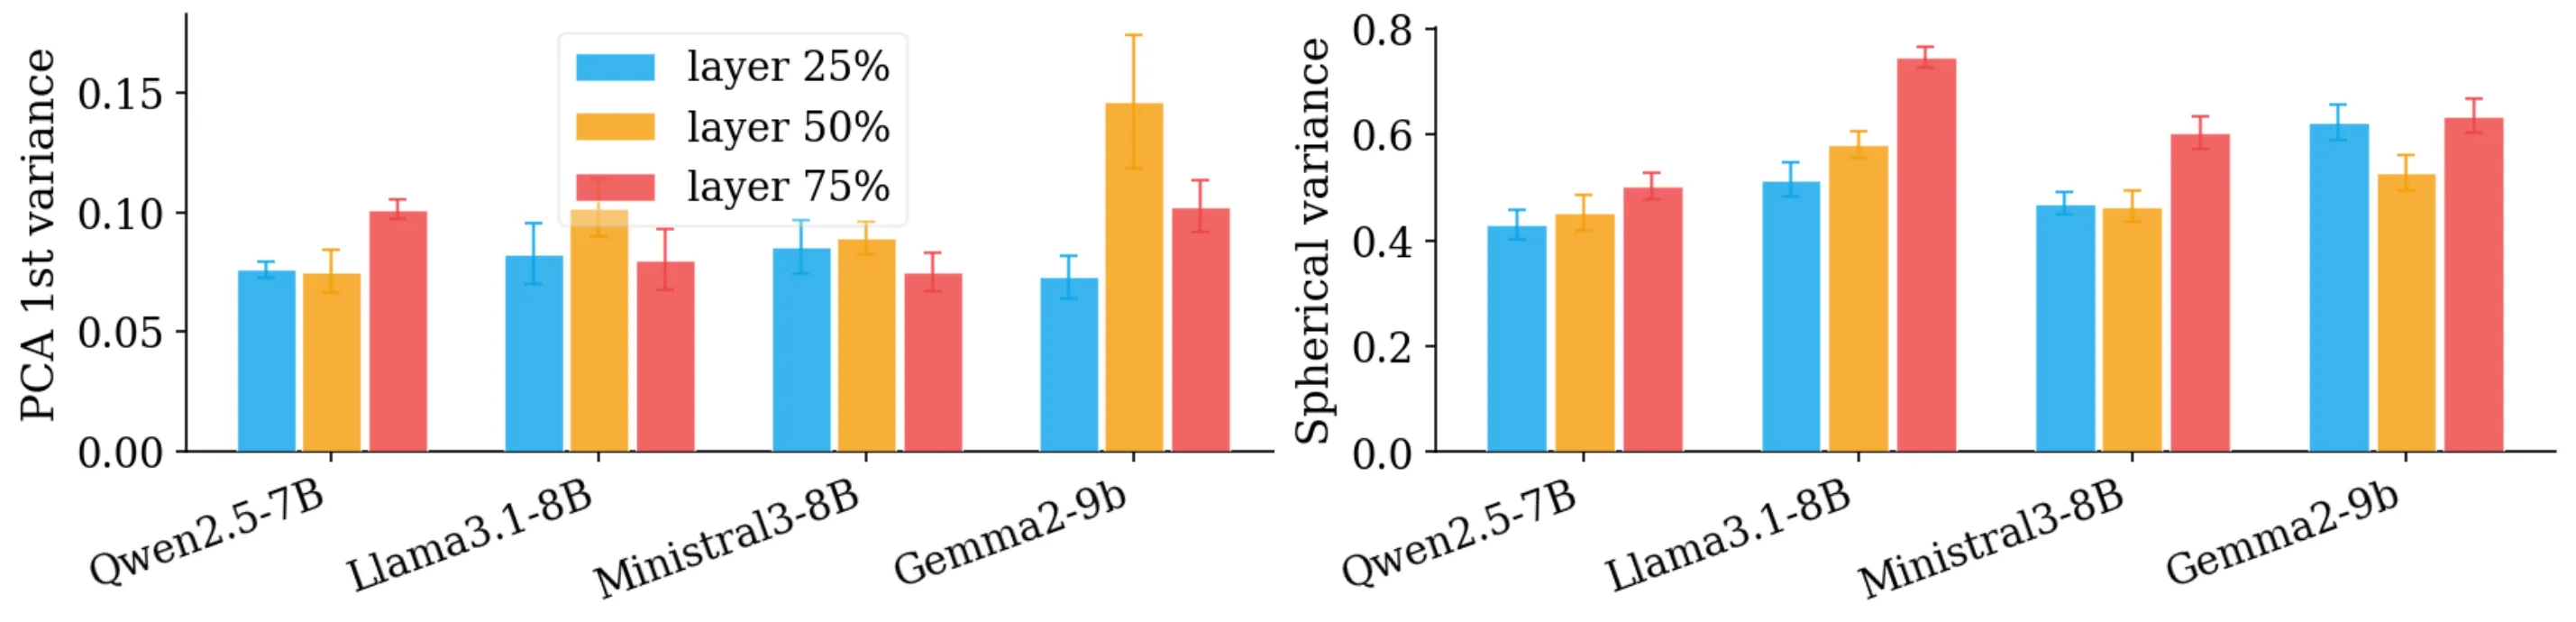
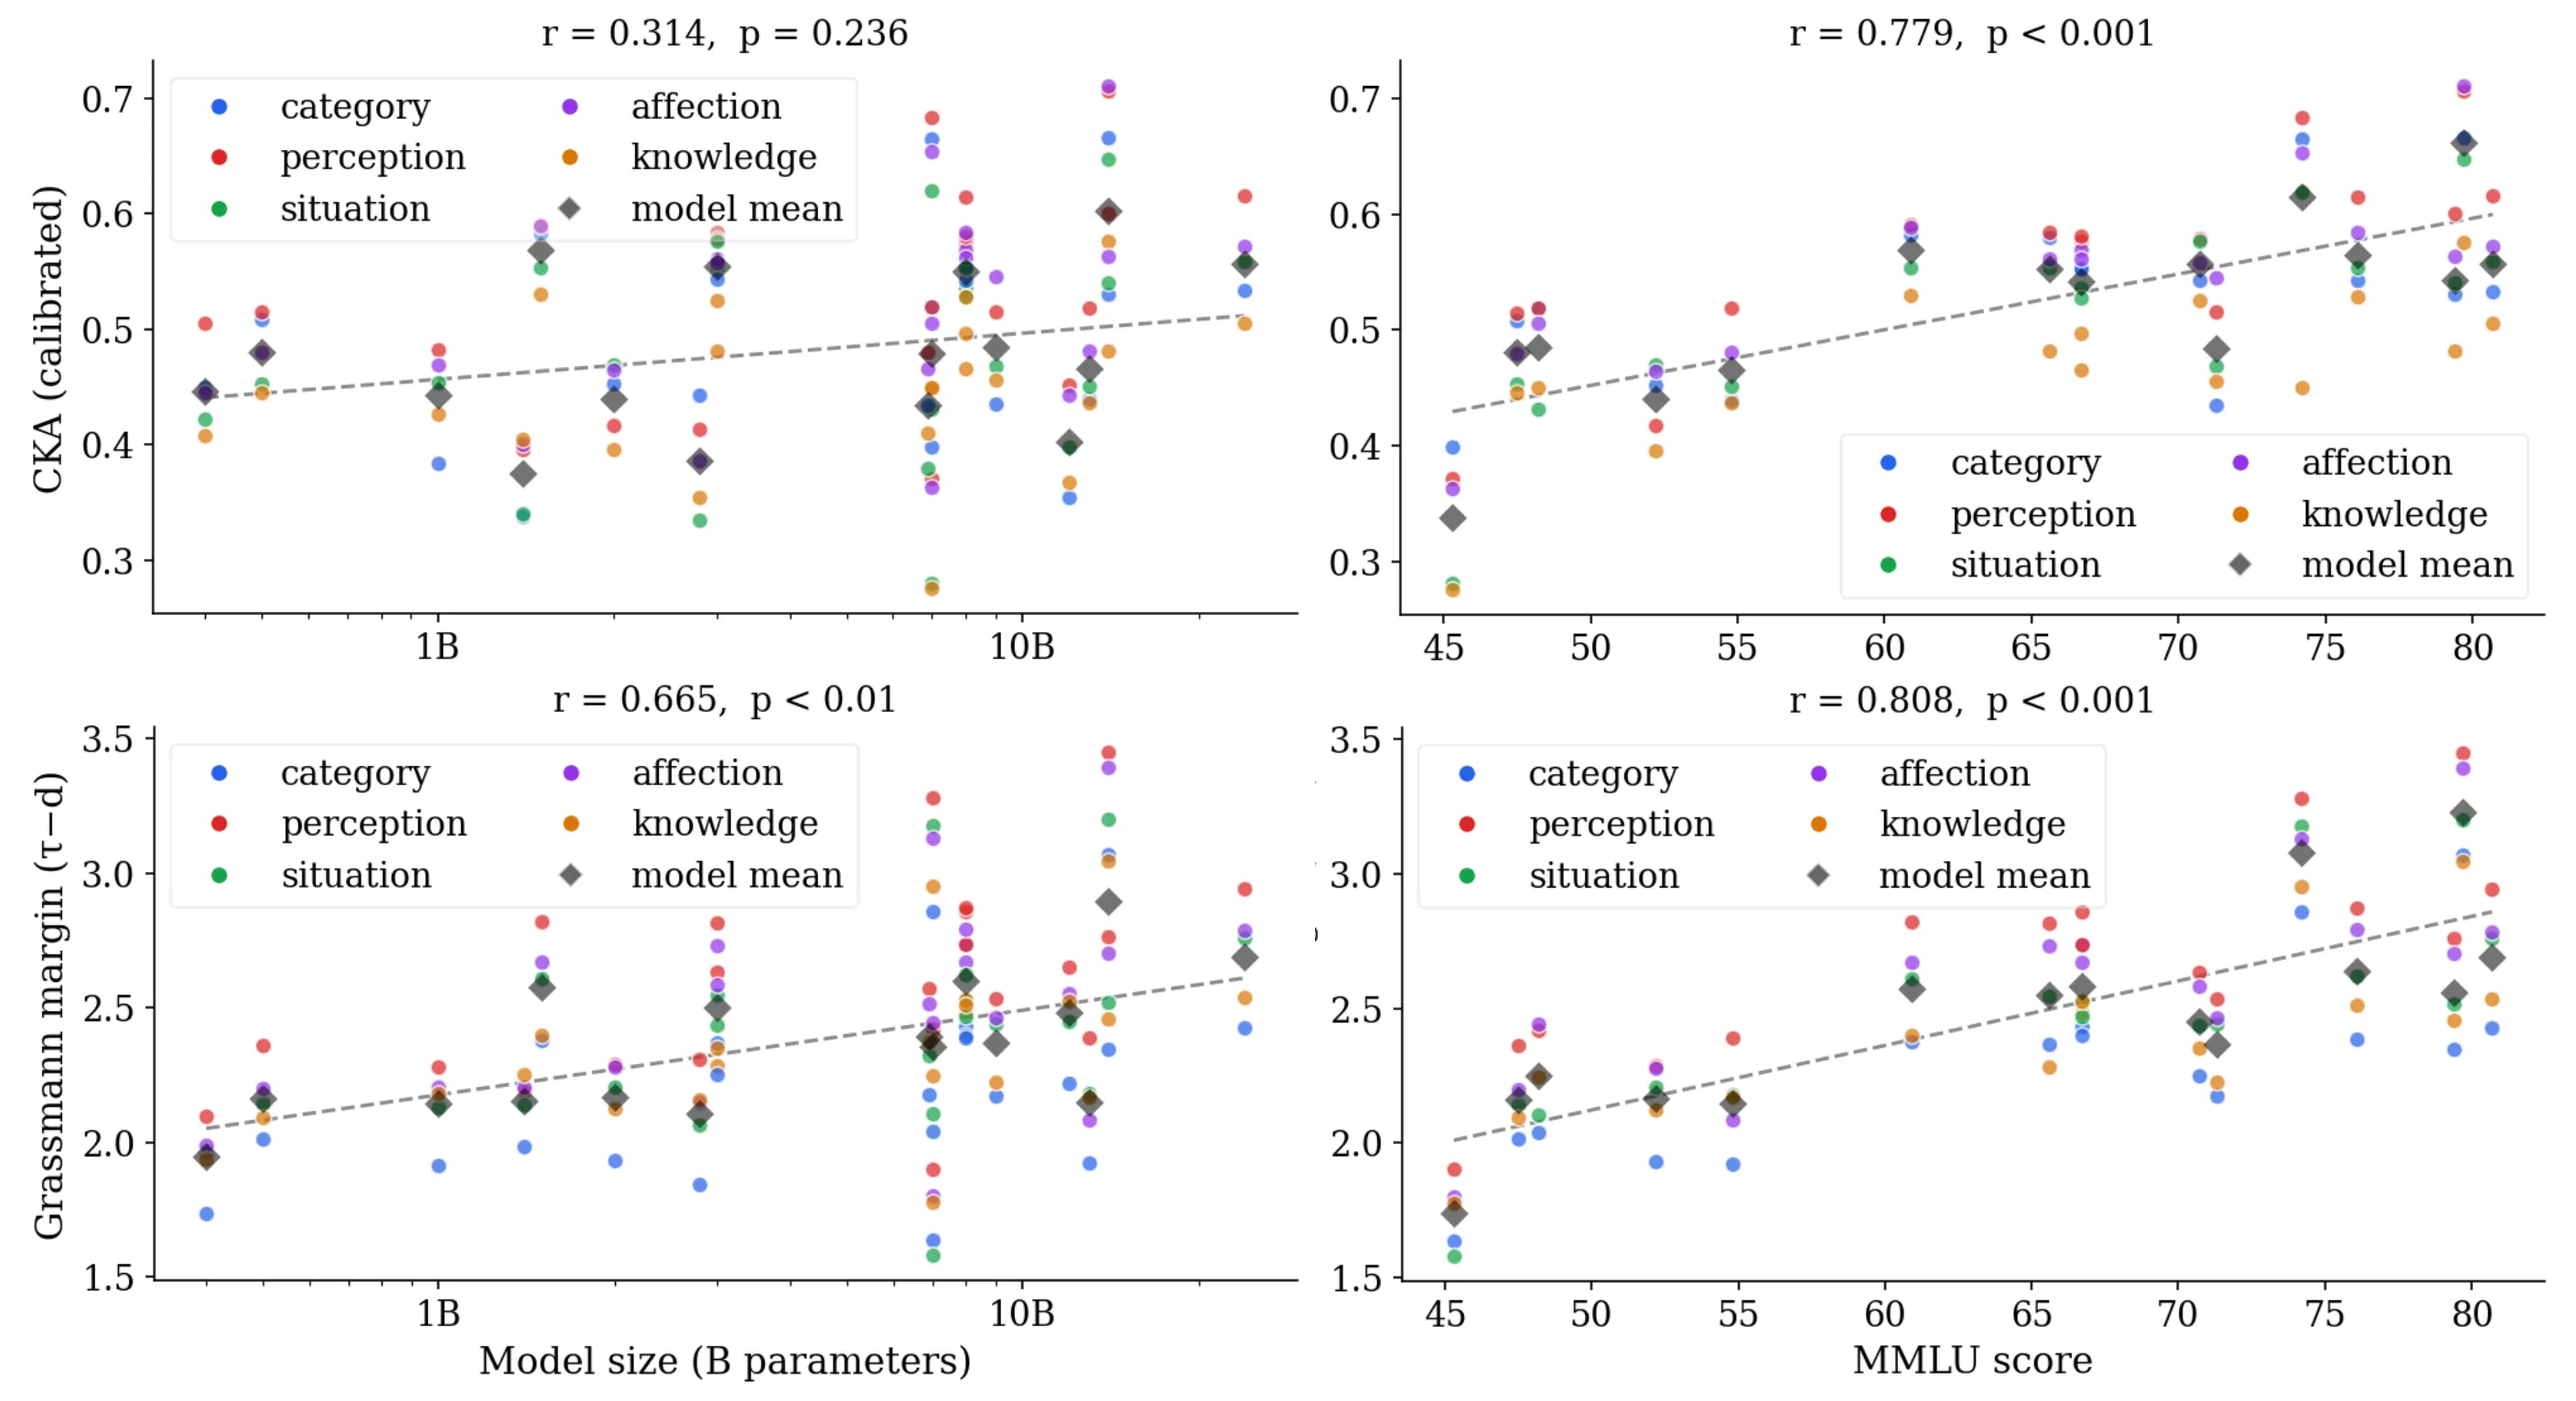
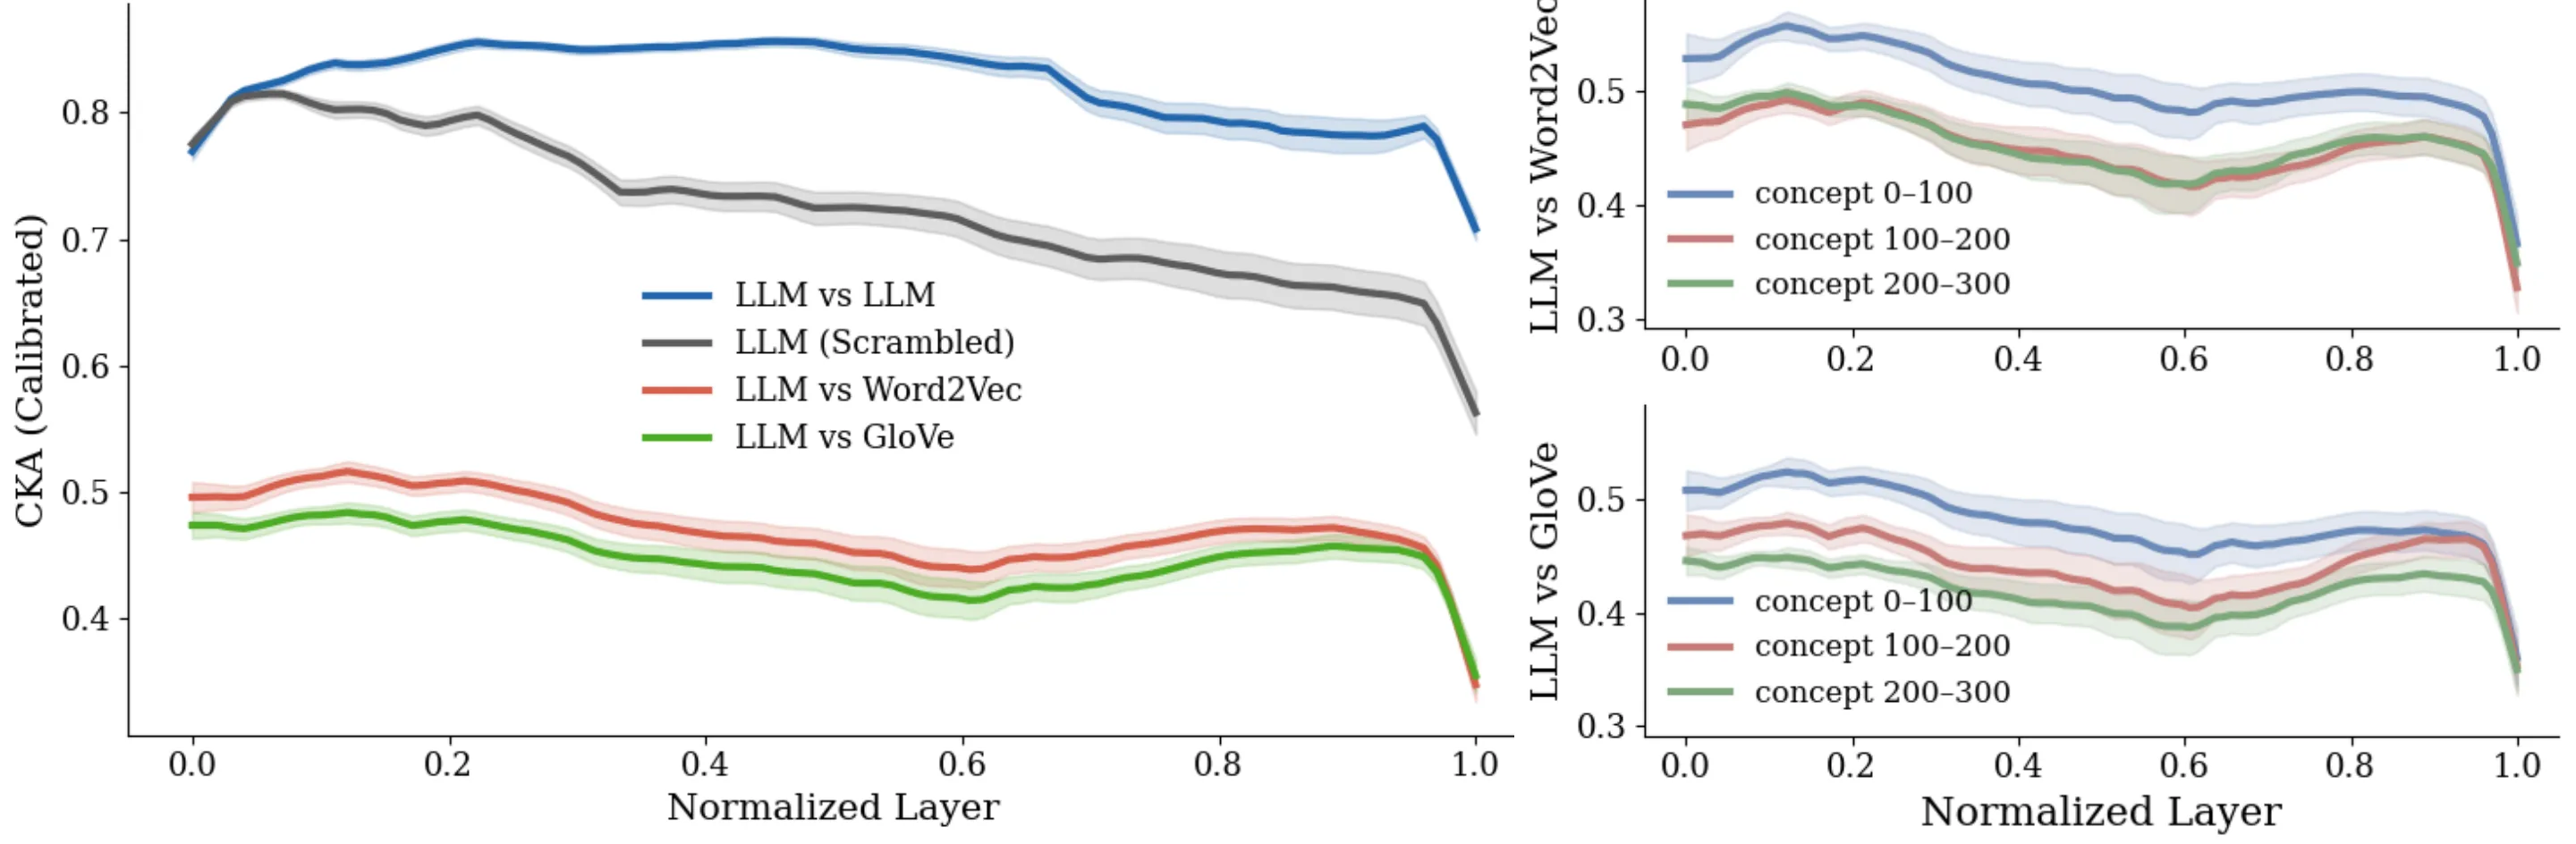
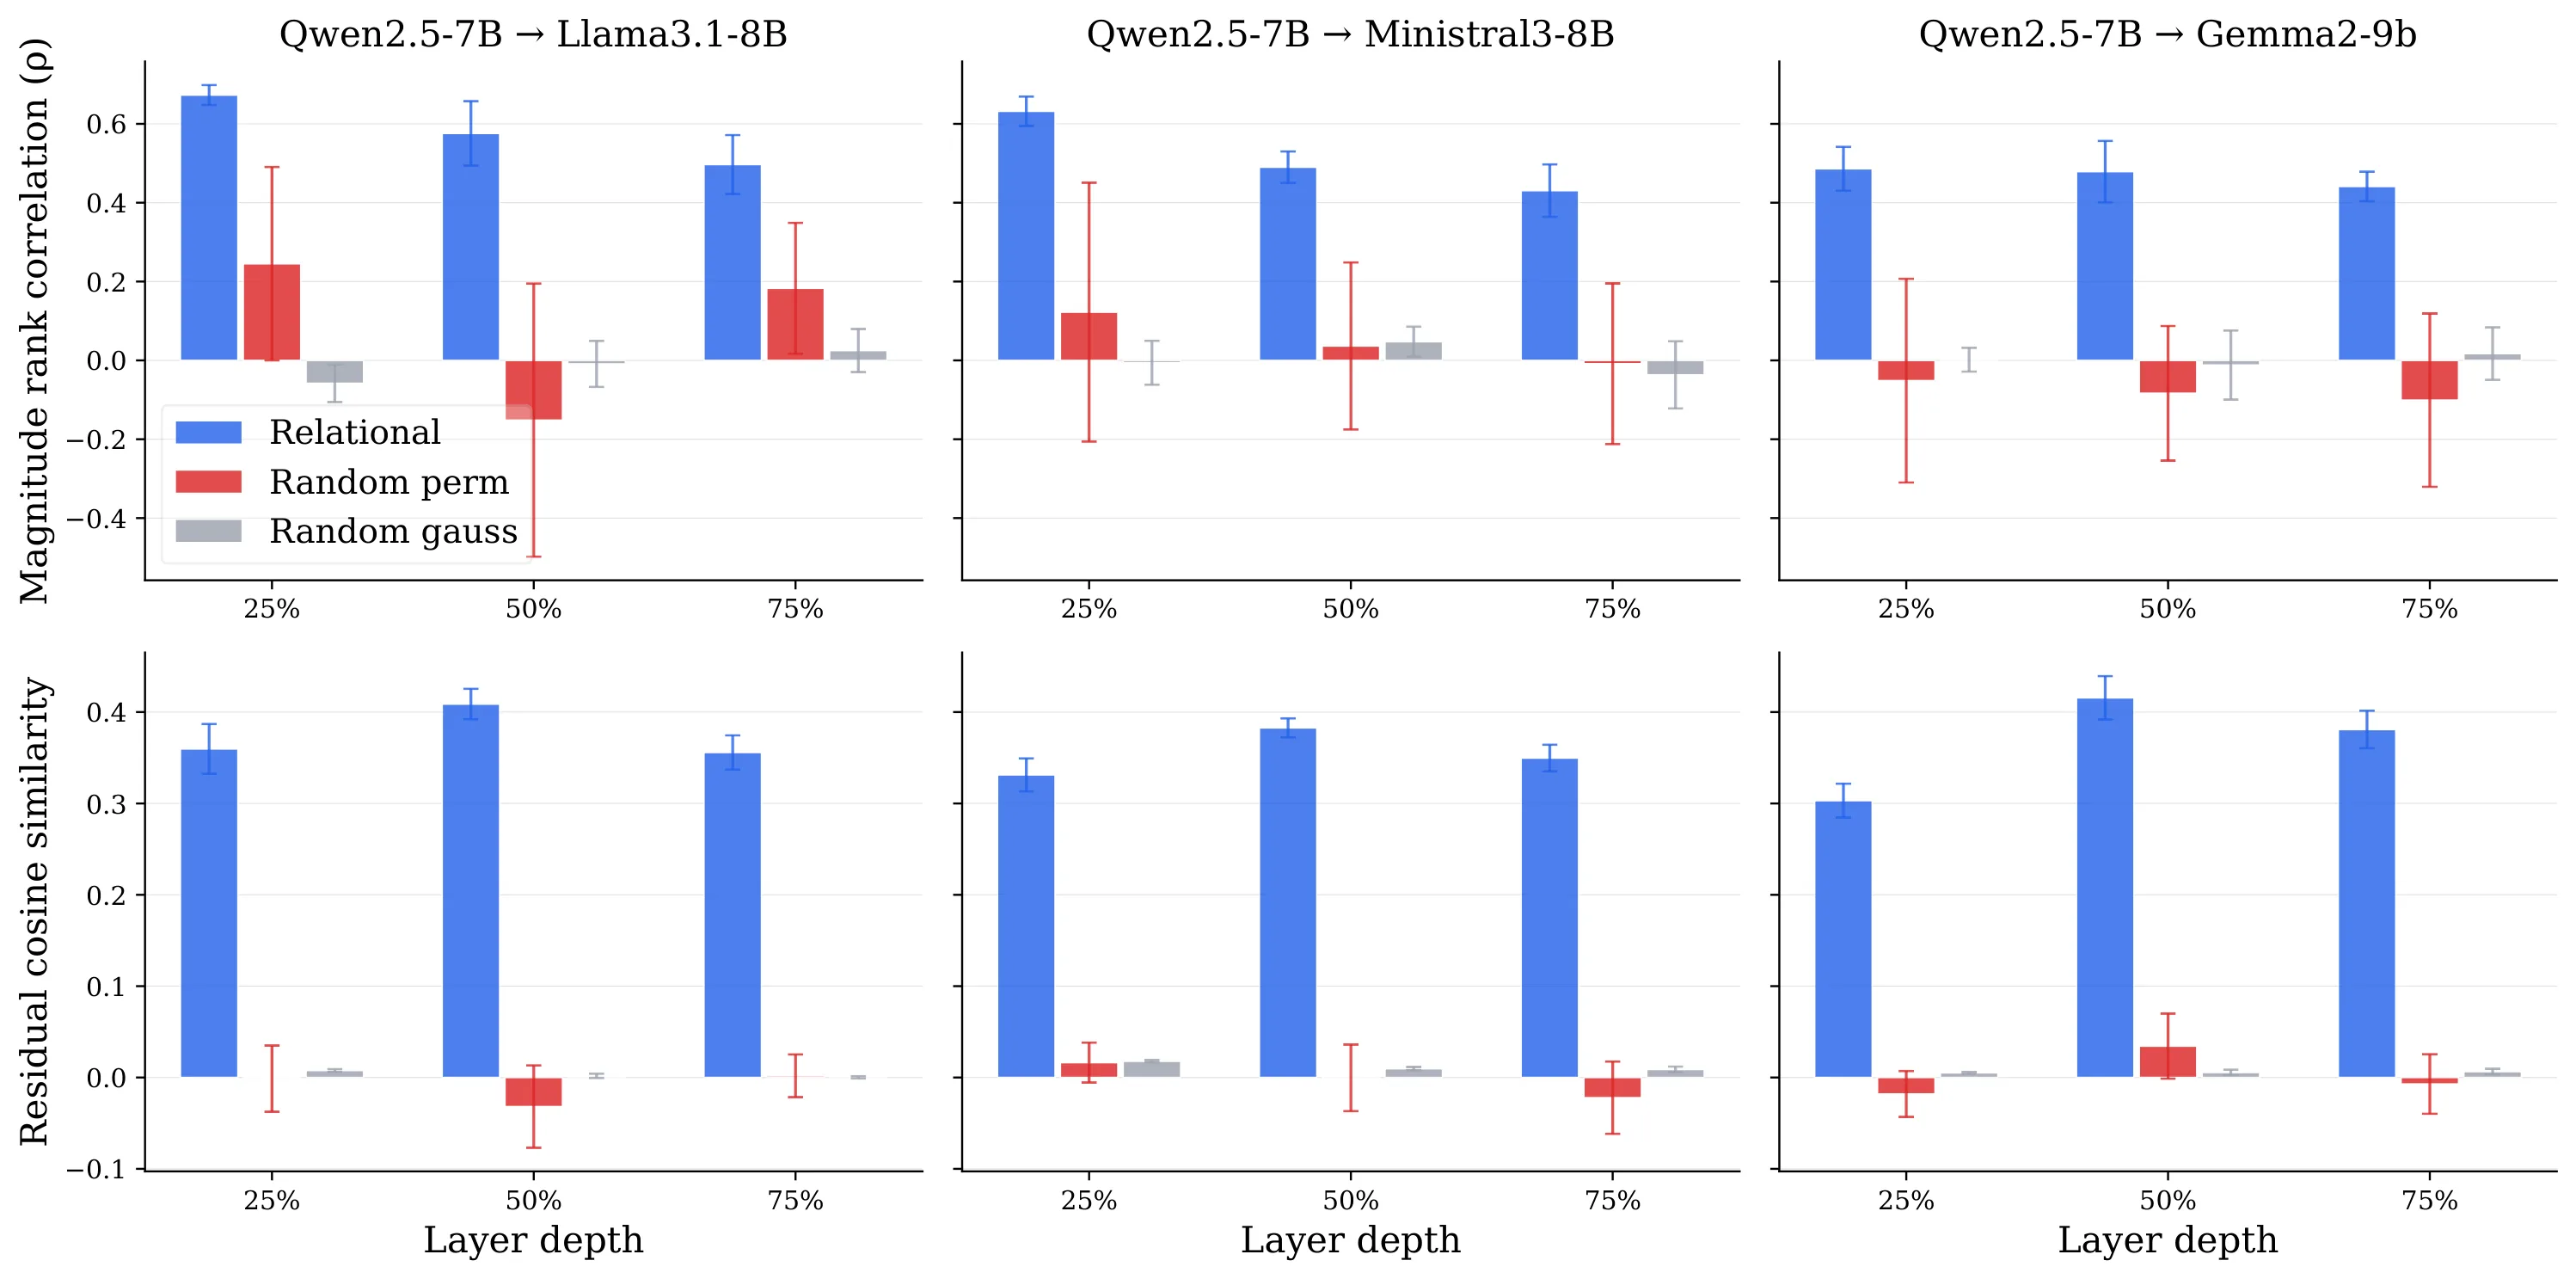
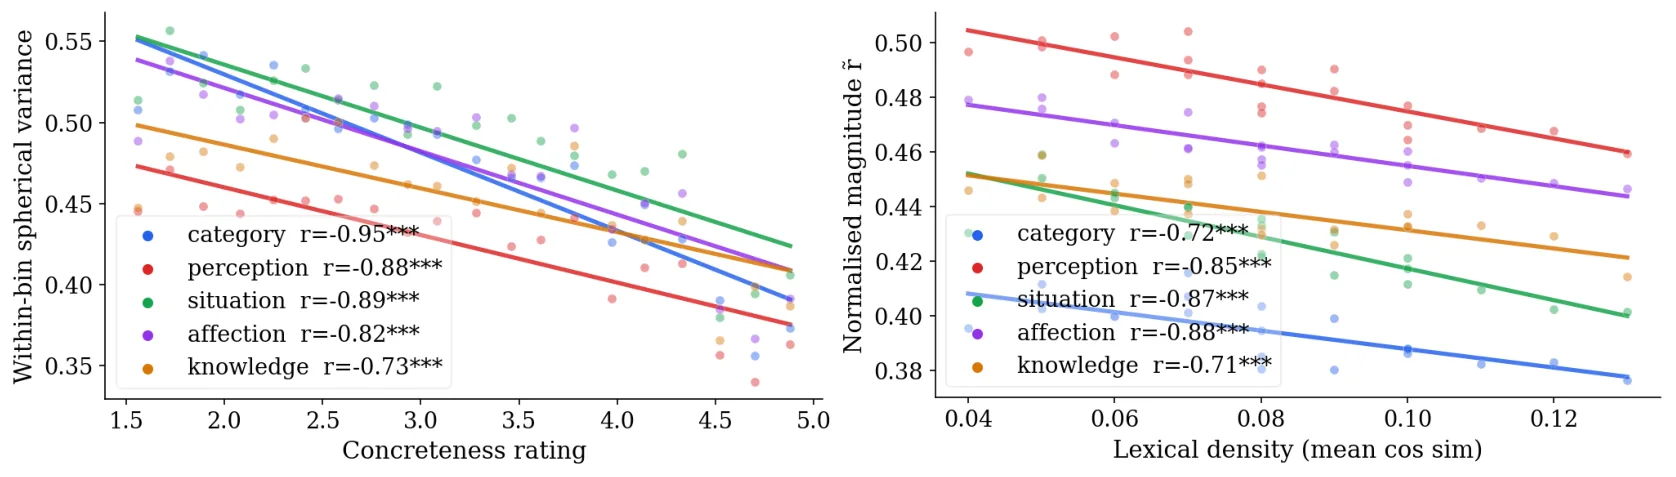
主流观点将神经网络中的概念表征视为静态几何对象,忽略了上下文的动态改造作用。本文提出新框架,将概念表征形式化为点云流形,上下文变换形式化为向量场,并在六个不同规模的大语言模型族上验证。实验发现上下文对不同概念的位移不同,位移方差与词汇具体性及密度语义相关,且这种变换结构在不同模型间共享——从一个模型迁移的位移结构可显著预测另一模型的未见位移。这表明模型不仅在概念表征上共享几何,更在上下文变换上共享更丰富的组织结构。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
理解概念在神经网络中如何被表征,是机器学习领域的核心问题之一。长久以来,研究者倾向于将[[概念表征]]视为静态的几何对象——每个概念对应一个固定位置的向量,不同概念之间的关系由它们在向量空间中的距离或方向决定。这一观点简单直观,也催生了大量关于[[嵌入空间]]几何结构的研究。
然而,这种静态视角忽略了一个关键事实:概念从来不是孤立地存在于真空中的,它们总是出现在特定的上下文里,而上下文会对概念的意义进行微调甚至重塑。举个直观的例子,「银行」这个词在「去银行存钱」和「坐在河边银行」中承载了完全不同的含义,但传统静态表征很难捕捉这种动态变化。
已有的上下文建模研究大多关注上下文本身如何改变[[注意力机制]]的权重或隐藏状态,却较少追问:上下文究竟在概念表征的几何层面上做了什么?它是否对所有概念一视同仁地做同样的「编辑」?不同概念是否会被上下文以不同方式、不同幅度地「拉动」?
这篇论文的切入点正是回答上述问题。它借鉴神经科学中神经群体几何(neural population geometry)的理论资源,将概念表征重新形式化为点云流形,将上下文对概念的变换形式化为向量场,从而可以在连续的几何框架下定量分析上下文对概念的作用机制。
方法
论文的核心创新在于提出了一套几何化的形式化框架。首先,概念不再被看作单个向量点,而是用点云流形来表示——每个概念对应嵌入空间中一组点的集合,这些点来自该概念在不同上下文中出现的所有实例。这个设计很自然地捕捉了「同一概念在不同语境下呈现不同表征」的现象。
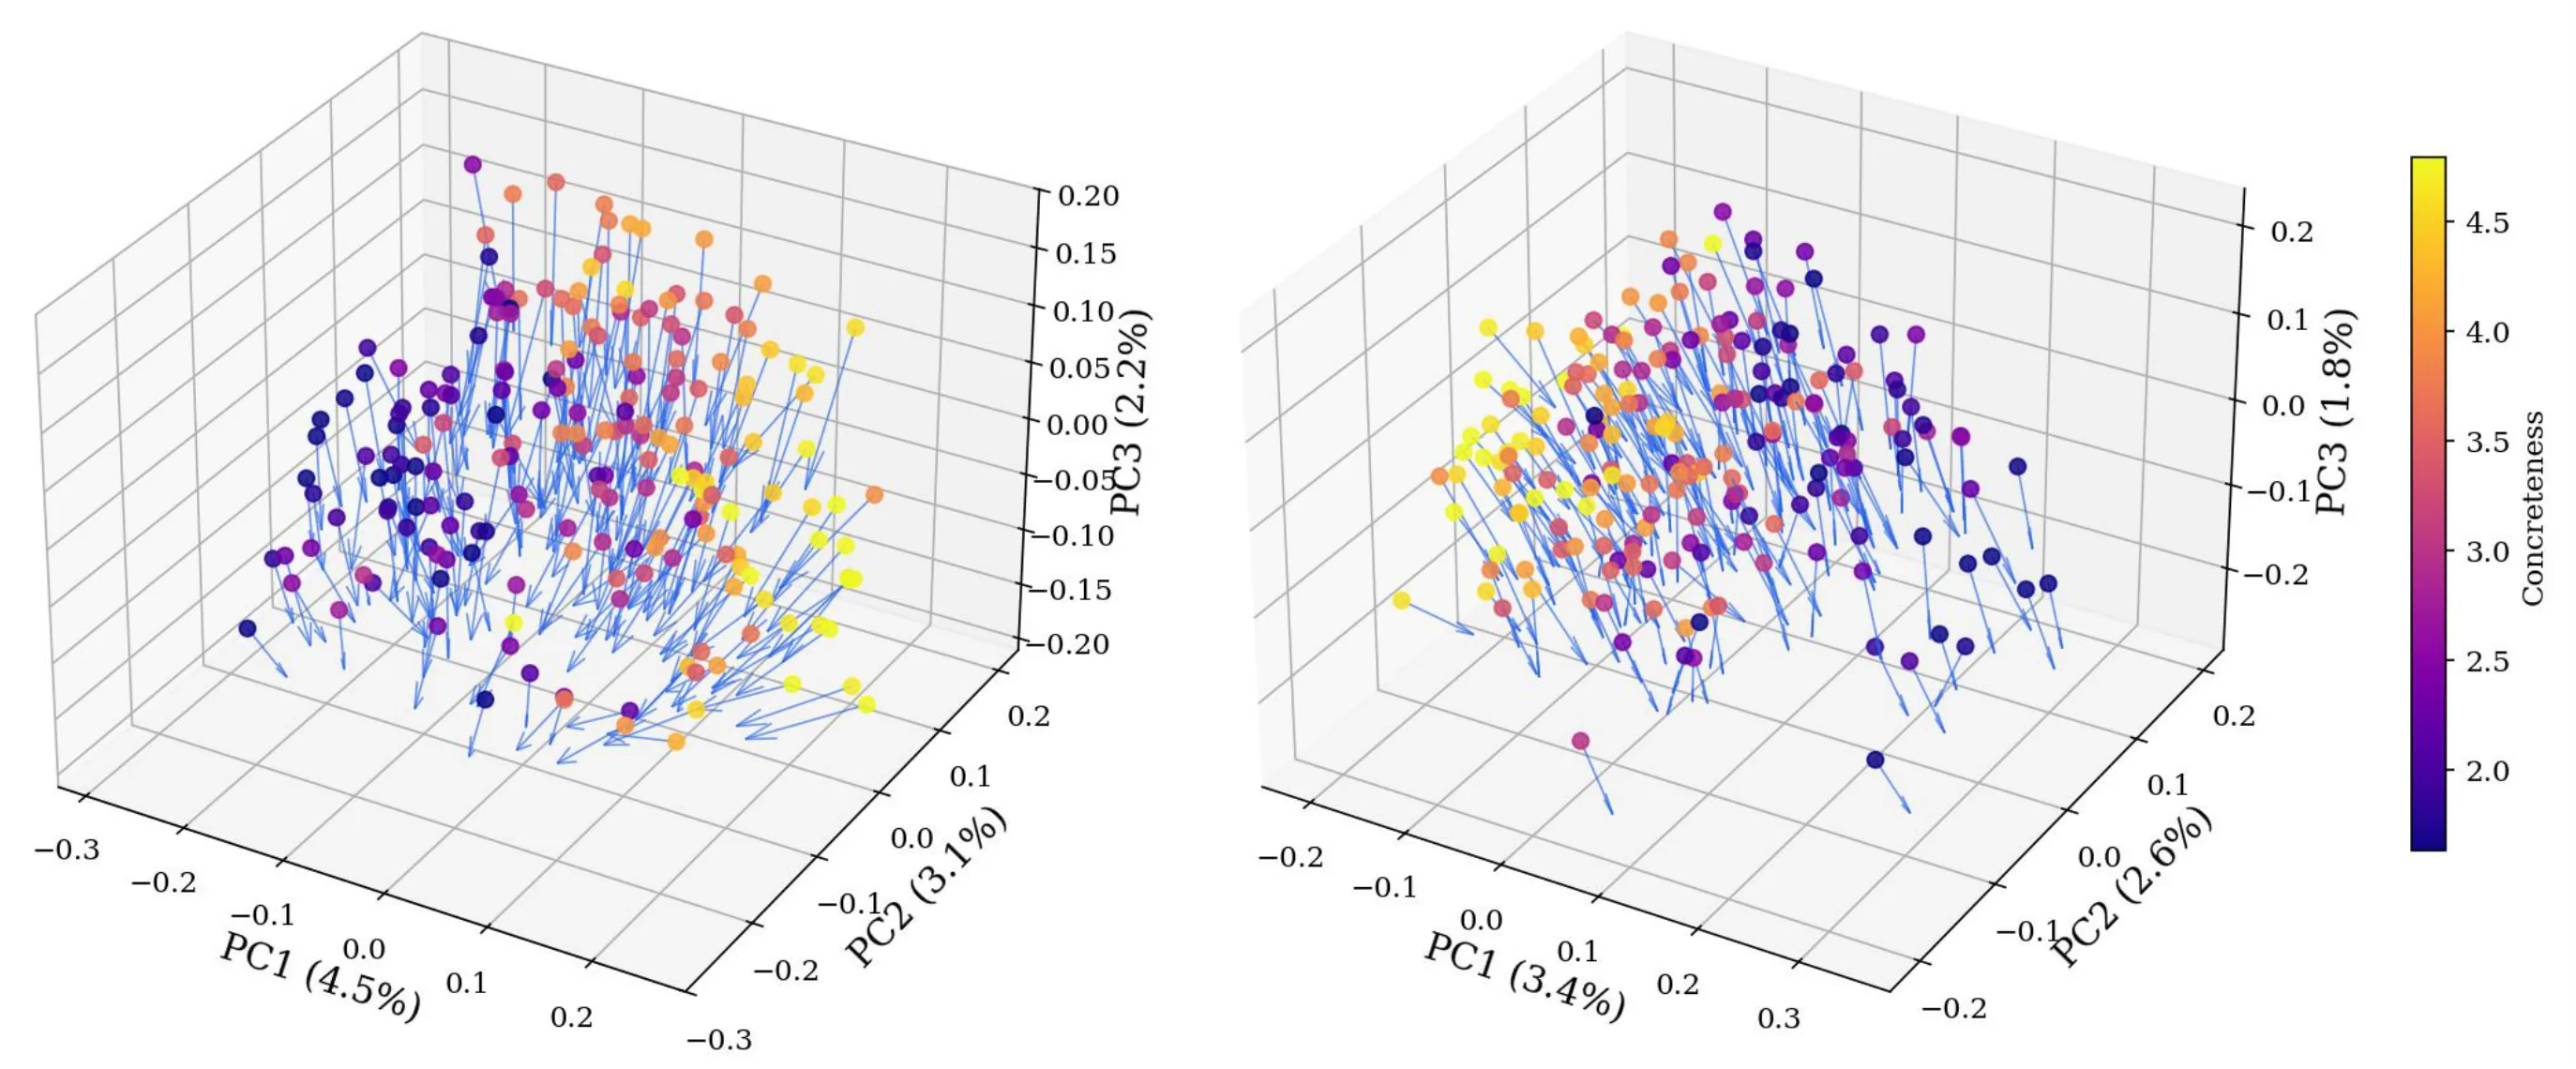
其次,上下文对概念的变换被建模为向量场。具体而言,给定一个概念和它出现的上下文,论文计算该概念在有上下文和无上下文两种条件下的表征向量差,这个差向量就代表了上下文的「拉动」效果。对于某个概念的多个上下文实例,这些差向量构成一个向量集合,其方向和长度分布就反映了上下文变换的结构。
在这个框架下,最关键的量是位移的方差。如果某个概念的位移向量长度方差很大,说明不同上下文对它的改造程度差异显著;如果方差很小,则说明上下文对它的影响比较一致。论文假设这种方差本身携带语义信息,并进一步检验它是否与词汇的具体性(concreteness,指词语是否指向具体可感的事物)和密度(density,可能指语义邻域的稠密程度)相关。
为了验证这些假设,论文在六个不同规模的大语言模型族上进行了系统实验,涵盖从小型到大型的不同参数量级,确保结论不依赖于特定模型规模或架构细节。
实验与结果
实验的第一层发现是,上下文确实会以不同方式移动不同的概念。具体来说,不同概念的位移向量长度存在显著差异,这种差异不是噪声,而是具有系统性的规律。论文发现,位移方差与词汇具体性呈现负相关——越抽象的概念(如「民主」「自由」),上下文对它的改造幅度变化越大;越具体的概念(如「苹果」「猫」),上下文倾向于在相对一致的方向上进行调整。这可能是因为抽象概念本身意义更依赖语境,而具体概念的所指相对稳定。
第二层发现更为关键:这种位移结构在不同模型之间是共享的。论文设计了一个迁移实验——在一个模型上计算位移结构,然后看这个结构能否预测另一个模型上的位移。结果显示,跨模型预测的准确率显著高于随机水平,说明位移模式具有跨模型不变性。这表明不同大语言模型在训练过程中不仅学会了相似的概念表征布局,还学会了相似的「上下文如何作用于表征」的方式。
论文还进一步检验了这种共享结构是否具有层次性。他们发现位移结构的某些方面比另一些方面更具普遍性:高层次的语义组织(如抽象 vs 具体概念的差异)在小模型和大模型之间高度一致,而细粒度的数值细节则可能因模型而异。这提示我们,模型对上下文的响应可能存在某种「抽象协议」,定义了在任何规模下都应该成立的基本原则。
讨论与可借鉴点
这项工作的一个重要贡献在于,它将概念表征研究从「静态点」的范式推向「动态流形+向量场」的更丰富框架。这不仅是一个形式化上的改进,更打开了一系列新问题:如果上下文是向量场,那么不同类型的上下文(情感、领域、句法)是否产生不同「场型」?多个上下文叠加时,向量场如何组合?
论文也存在一些局限。首先,实验集中在词汇层面的概念,对于短语、句子乃至篇章层面的语义变换,是否遵循同样规律尚不清楚。其次,向量场的计算依赖于「无上下文」这一基准假设,而实际模型中真正意义的「无上下文表征」难以完美定义,可能引入系统性偏差。再者,论文发现的跨模型共享结构是否来自预训练数据的共性,还是来自语言建模任务本身的归纳偏置,仍有待进一步厘清。
对于更广泛的研究社区,这篇论文提供了一个可借鉴的思路:研究[[概念表征]]不能只看「在哪里」,还要看「怎么变」。上下文不是表征之外的附加噪声,而是表征几何结构本身的组成部分。这种几何视角有望帮助我们更好地理解[[大语言模型]]的语义表示机制,甚至为模型的可解释性和可控性提供新的工具。
概念 · 6 个
摘要
LLM表征空间中概念变换被建模为向量场
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
嵌入投影的可扩展语义引导
Scalable Semantic Steering of Embedding Projections
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 2 张
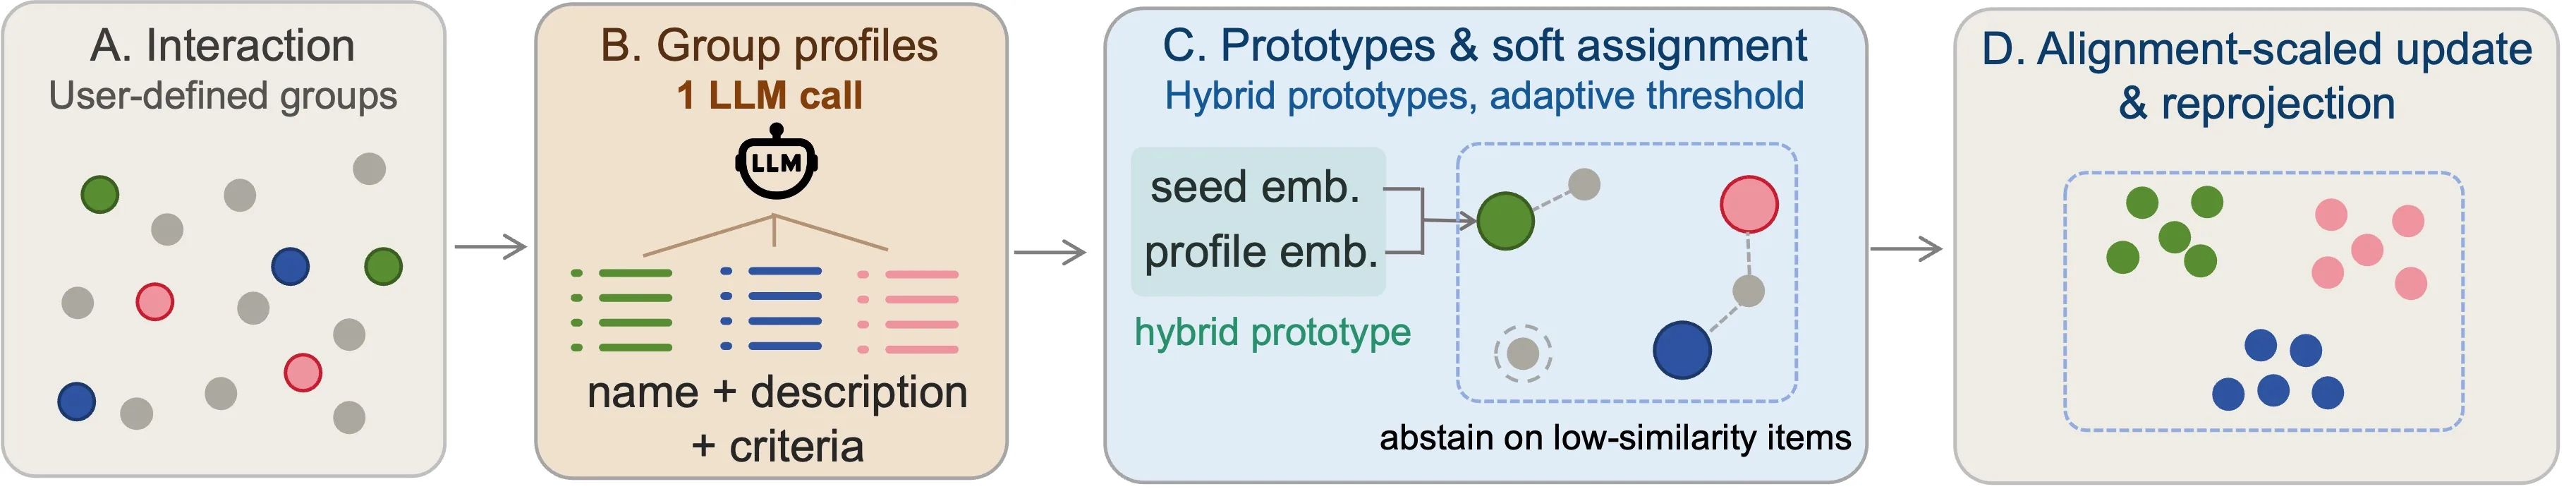
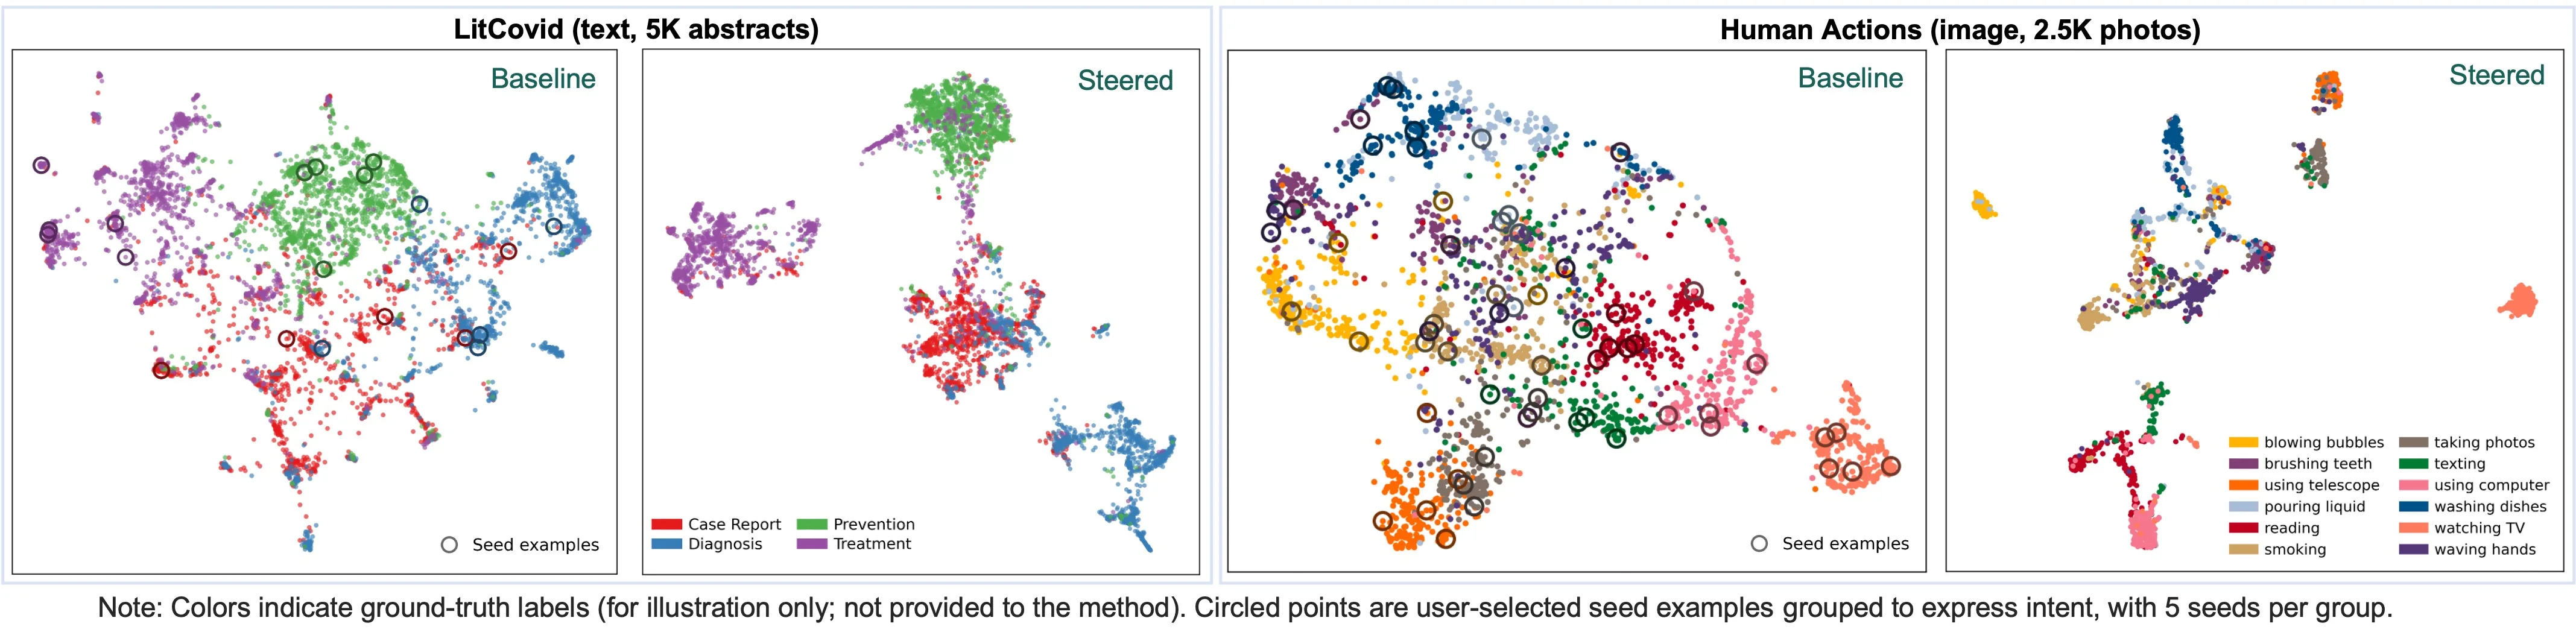
低维投影常无法对齐分析师设定的语义关系,已有LLM语义引导方法对每条数据逐项推理,调用次数随集合规模线性增长。本文将语义计算从单条迁移至用户分组,单次LLM调用生成分组结构化描述,结合种子中心构造混合语义原型,经嵌入空间软分配与对齐缩放更新传播意图,无需重训练。在5K LitCovid上达到与逐项引导相当的全局对齐,LLM调用减少三个数量级以上,图像案例验证多模态可扩展性。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
在数据分析领域,将高维数据嵌入到低维空间中进行可视化是一种常见实践。这类[[低维投影]]技术帮助分析人员在二维或三维画布上观察数据分布、发现聚类结构和识别异常点。然而,这些数学变换后的空间结构往往与分析者头脑中基于语义概念构建的关系网络不一致——计算机用距离和密度理解"相似",而人类用"同为医学文献"或"涉及相同治疗方法"这样的语义标签来定义相似性。
为了弥合这一鸿沟,研究者提出了[[语义引导]]方法。其基本思路是让用户通过少量标记为"属于同一语义类别"的种子示例来表达分析意图,然后系统将这些意图"灌注"到整个嵌入空间中,使得投影结果向用户定义的语义关系靠拢。早期的语义引导方法主要依赖手工设计的距离函数或特征权重调整,而近年来随着大语言模型的兴起,涌现出一批利用[[LLM]]来理解和迁移语义知识的新方案。这些方法将用户的种子分组转化为自然语言描述,再通过LLM推理逐条判断数据集中每个项目与各语义类别的关联程度。
问题在于逐项推理的扩展性瓶颈。当集合规模从几百条增长到几千甚至上万条时,对每个数据点单独调用LLM会导致计算成本和延迟线性增长,这在实际应用中变得不可接受。尤其是在需要实时交互的分析场景中,等待数万次LLM调用完成是不现实的。现有方法在准确性和效率之间被迫做出艰难取舍,这正是本文要解决的核心问题。
方法
论文提出的可扩展语义引导方法遵循一条清晰的设计哲学:将语义计算从细粒度的单项目级别提升到粗粒度的用户分组级别。这基于一个直觉假设——用户定义的分组本身已经承载了丰富的语义信息,不需要为每个成员单独询问LLM。
整个方法分为三个关键步骤。首先是结构化描述生成。用户指定若干语义组并为每个组提供少量种子示例后,系统不再逐个查询每个示例与组的关系,而是组织一条精心设计的提示,其中包含所有组的种子示例和对应的语义描述请求。一次LLM调用就能返回所有组的结构化语义描述——这些描述捕捉该组的核心特征、共同主题和边界条件。本质上,这是让LLM从一小批具体例子中提炼出可以泛化的组级概念表示。
接下来是混合语义原型构造。仅有LLM生成的文本描述还不够,因为文本嵌入与原始数据的嵌入可能存在分布偏移。论文巧妙地设计了混合方案:将LLM生成的组描述编码为向量,同时计算每个组内种子示例的质心向量,两者在语义空间中融合形成混合语义原型。这相当于同时利用了语言模型的抽象概括能力和种子示例的具体分布信息。数学上,对于第 个语义组,其原型向量可表示为:
其中 是LLM生成的结构化描述, 是该组的种子示例集合, 控制两类信号的混合权重。
最后是意图传播与投影更新。对于数据集中的每个项目 ,系统计算其嵌入 与所有原型 的相似度(余弦相似度或点积),得到一个软分配向量 ,其中 是温度参数控制分配的锐度。系统设定一个置信度阈值 :如果最高分配概率低于阈值,说明该项目与任何用户定义的语义组都不够匹配,则该点的意图更新被弃权(不修改)。对于通过弃权检测的项目,其意图更新幅度与对齐程度成正比——与某个原型越相似的点,接收到的"拉向该语义方向"的力越强。最终在重新执行降维投影(如t-SNE或UMAP)时使用更新后的嵌入。
值得注意的是,整个过程无需对任何模型进行重新训练,也不需要访问原始的嵌入模型参数。更新仅发生在推理阶段的服务端,这使得方法具有良好的通用性和部署便利性。
实验与结果
论文在多个维度上验证了方法的有效性。主实验基于LitCovid语料库展开——这是COVID-19学术文献的公开数据集,论文使用了包含5000篇文档的子集。这些文档按照研究方向被划分为多个语义组别,研究者将这一领域知识作为"分析意图"的代理。
实验设置的核心对照是"逐项LLM引导"基线方法——对数据集中每篇文档单独调用LLM,判断其所属语义类别。评估指标包括两个方面:全局对齐程度(衡量投影空间中语义组的分离度和紧凑性)和LLM调用次数(直接反映计算成本)。
实验结果呈现出令人印象深刻的权衡曲线。在全局对齐指标上,论文方法与逐项引导基线几乎持平,某些配置下甚至略有优势——这说明组级语义计算并没有牺牲关键的质量维度。与此同时,LLM调用次数实现了质的飞跃:逐项方法需要5000次调用(每个文档一次),而论文方法仅需一次(为所有组生成描述)。即使考虑到实际使用中可能需要对不同参数配置进行消融实验,调用量的减少也超过三个数量级。
论文还设计了一个图像案例研究来证明方法的多模态扩展能力。在处理图像嵌入(使用CLIP编码)时,相同的原型构造和意图传播机制同样有效。这表明该方法不依赖于特定的数据模态,只要能获得有意义的嵌入表示,组级语义引导就能工作。
讨论与可借鉴点
这项工作的核心贡献在于重新定位了语义引导的计算粒度。它证明了一个看似违反直觉的假设:不需要为每个数据点单独询问语言模型,就能有效捕捉用户的语义意图。关键在于充分利用用户分组本身的信息密度——种子示例已经构成了一个语义概念的"锚点",LLM的职责从逐个审查转变为提炼概念描述。
从实用角度看,这种设计显著降低了语义引导技术的应用门槛。当LLM调用不再是瓶颈,分析工具可以在更大的数据集上、更丰富的交互频率下部署语义引导功能。这对于需要快速迭代假设的数据分析工作流尤其有价值。
当然,论文也承认若干局限性。组级原型的表达能力依赖于种子示例的质量和多样性——如果用户对语义边界的划分存在歧义,提炼出的描述也会反映这些歧义。此外,当语义组数量极大或各组边界高度重叠时,混合原型的区分能力可能下降。论文聚焦于静态批量处理,尚未探索流式数据或在线学习场景下的增量更新机制。
对于更广泛的可视化分析研究而言,这项工作提供了一个重要启示:[[语义计算]]与[[用户意图]]的有效桥接不必然以逐项推理为代价。在设计人机协作的分析系统时,应当充分考虑语义概念的聚合性质,让人类用户在更高层次上表达意图,让系统负责在细粒度上的一致性传播。这种"宏观描述、微观执行"的分工模式,或许是未来智能分析系统的重要设计范式。
概念 · 7 个
摘要
通过向量级意图传播实现嵌入投影的语义引导
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
利用潜在空间:从引导向量到模型校准器,实现控制与可信性
Harnessing the Latent Space: From Steering Vectors to Model Calibrators for Control and Trust
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 10 张
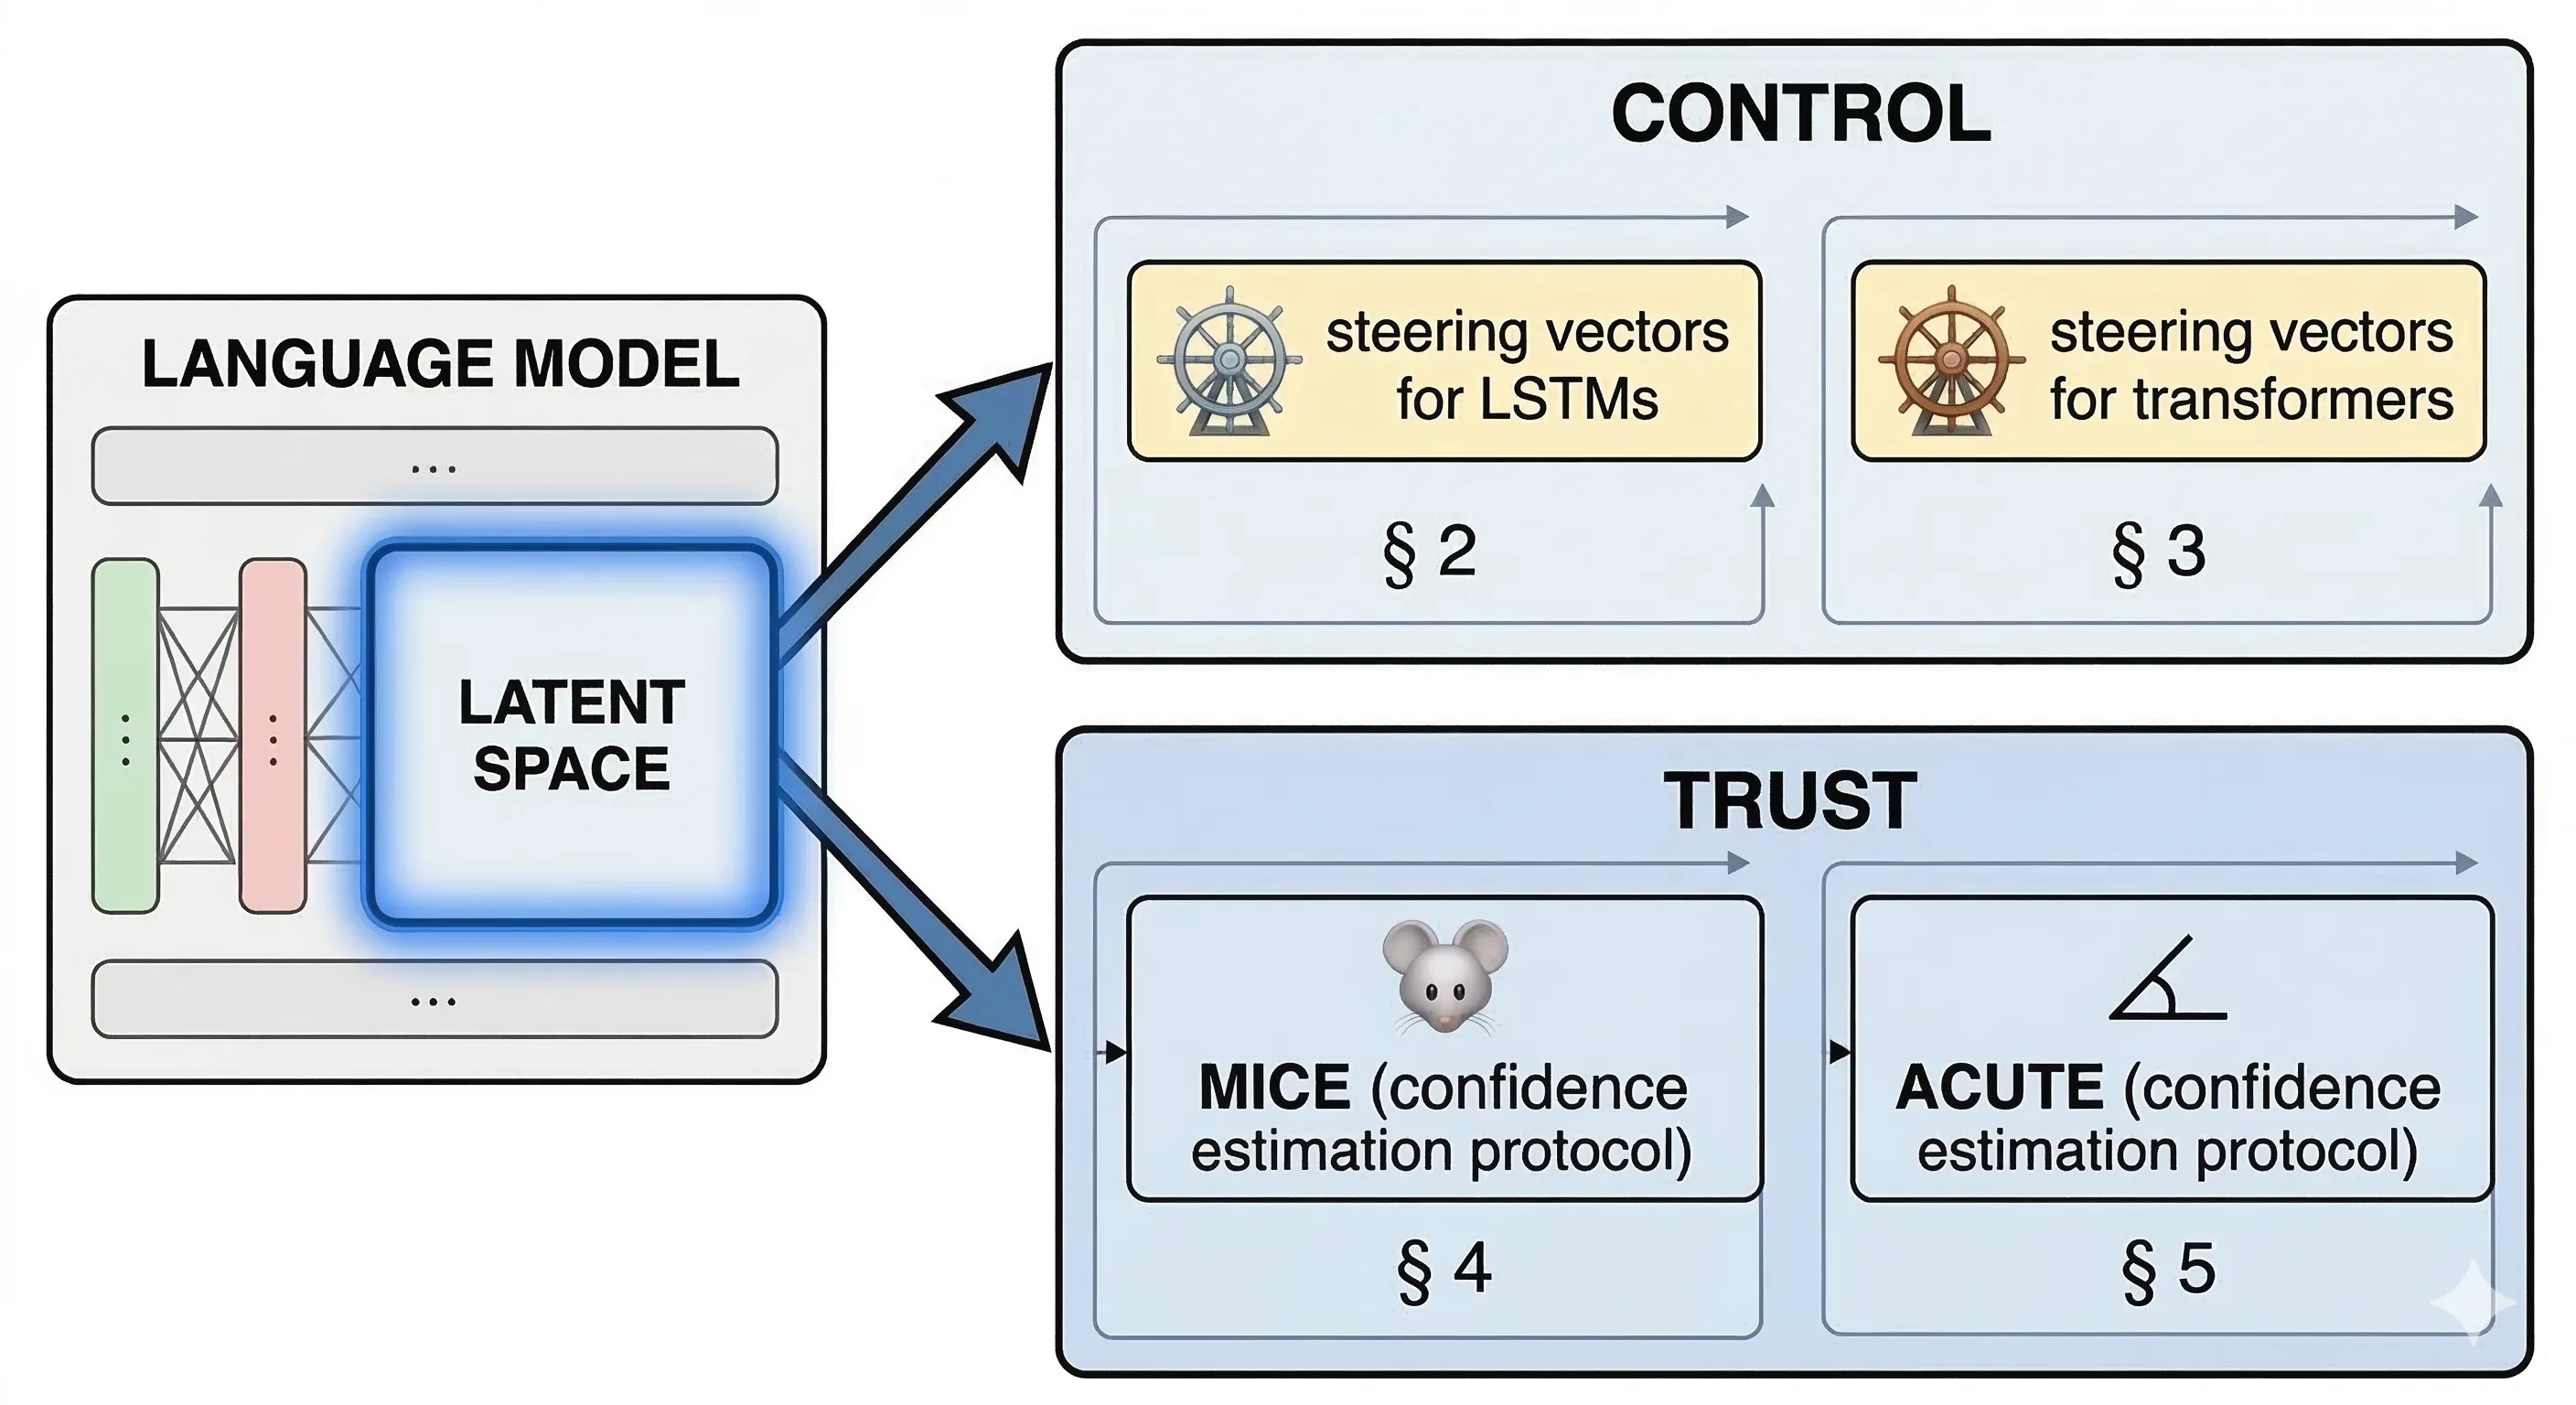
随着大语言模型参数规模膨胀至万亿级,其内部表征愈发难以理解,但在高风险决策场景下亟需控制模型行为并判断输出可信度。本文提出利用潜在空间的操控向量实现行为引导控制,并开发基于潜在空间的模型校准器评估输出可信度。实验表明该方法能有效调控模型生成行为并改善置信度估计。整体工作揭示了LLM潜在空间的内在结构,为构建更可控、可信的语言技术提供了新视角与方法支撑。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
大语言模型的参数规模已从早期的千万级膨胀至万亿级,其内部表征的复杂度随之急剧攀升。在很长一段时间里,NLP 社区倾向于将语言模型视为"黑盒",主要通过输入输出的行为观察来评估模型性能。这种方法在模型能力有限的阶段尚可接受,但随着模型被数百万用户用于与外部工具交互、在中高风险场景中辅助决策,仅靠行为评估已远远不够。
一个直观的困境是:当模型生成的代码可能导致系统故障、总结的医学文献可能影响临床判断时,我们如何知道什么时候该信任模型的输出?更进一步,如果模型的输出存在问题,我们能否在推理阶段就介入调控,而不是事后被动修复?这些需求催生了两个核心研究方向——行为控制(确保模型输出符合预期)和可信性评估(判断模型输出是否可靠)。
然而,已有方法在这两条路径上都存在明显瓶颈。行为控制方面,传统的做法通常需要通过强化学习微调或提示工程来引导模型,但前者计算代价高昂,后者效果不稳定且难以精确调控。可信性评估方面,主流做法是直接使用模型输出的原始置信度,但大量研究已经证明这种置信度普遍校准不佳——模型可能以极高的概率自信地输出错误答案。
本文的切入点在于:既然语言模型的隐藏状态和激活空间蕴含着丰富的语义与决策信号,那么我们是否可以直接在[[潜在空间]]中进行操作来实现控制和可信性评估?这一思路将"黑盒"转变为"灰盒",既保留了深度学习端到端学习的优势,又为人类理解和干预提供了接口。
方法
论文的核心方法论建立在一个基本假设之上:语言模型的[[潜在空间]]并非杂乱无章的高维向量集合,而是具有一定的语义结构,可以通过向量运算进行有意义地干预和解读。基于这一假设,作者提出了两条并行的技术路径。
路径一:引导向量用于控制
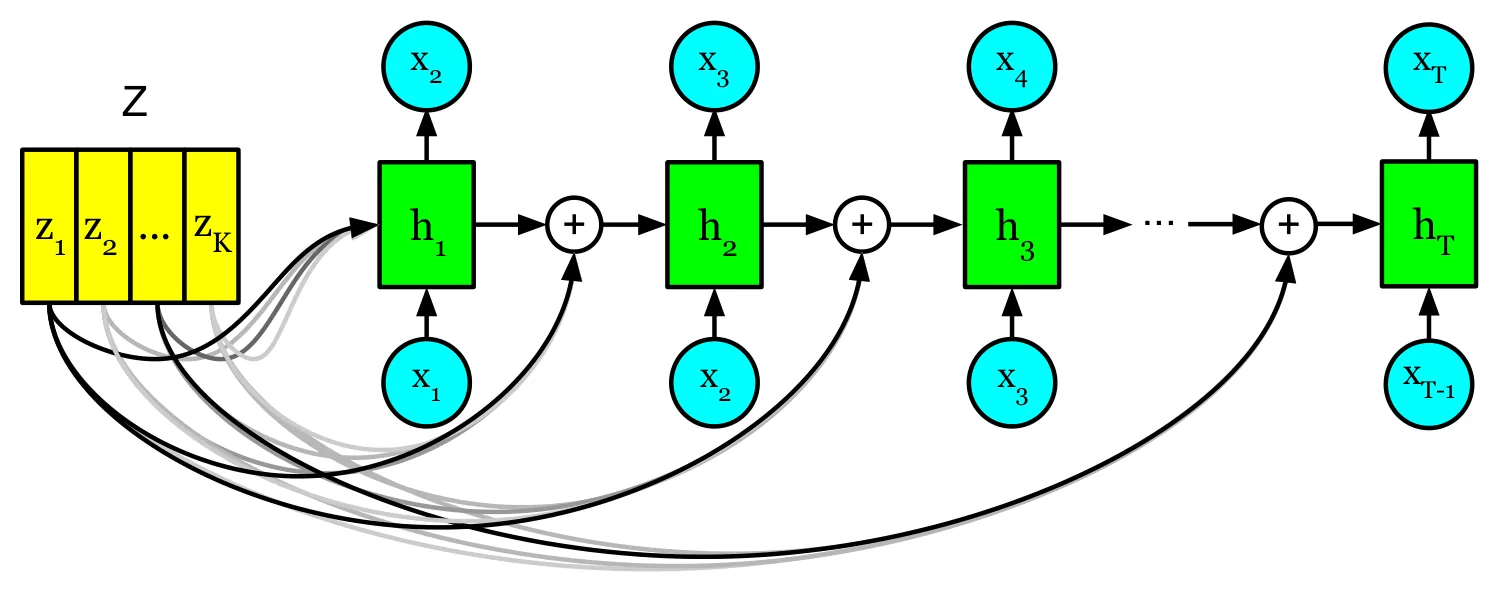
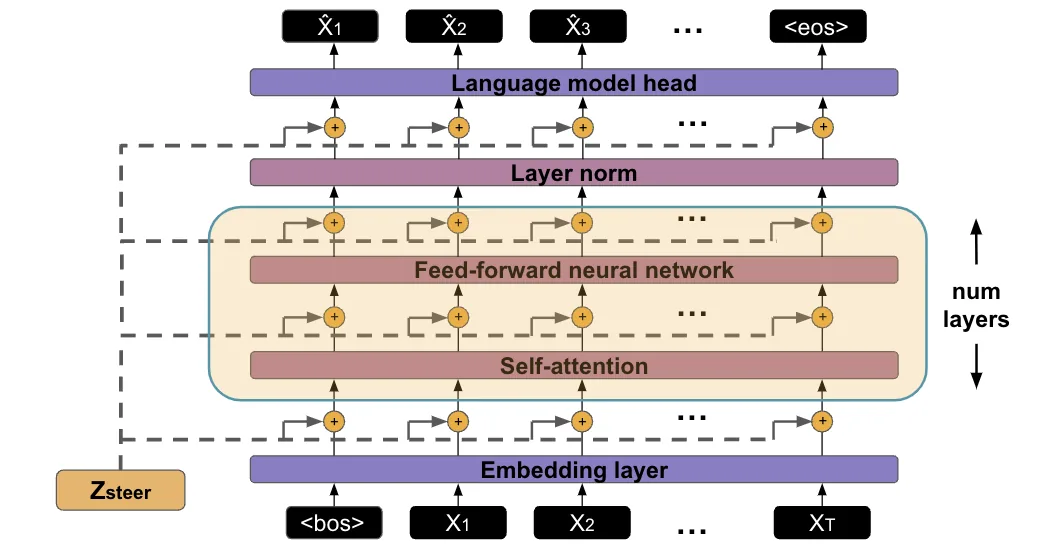
第一条路径旨在通过在模型的隐藏状态中注入精心设计的[[引导向量]]来实现对生成行为的调控。对于 LSTM 模型,作者定义了句子空间为平坦向量空间 ,通过在每个时间步向隐藏状态和细胞状态注入引导向量 来实现干预。具体形式为:
这里的引导向量通过优化获得——给定目标序列,算法前向估计时优化 以最大化对数似然;反向估计时则将 注入后用 beam search 解码生成。
对于 [[Transformer]] 模型,作者发现引导更加高效:只需在模型堆栈的某一层(如第 6/7 层)前馈层之后、仅在第一个时间步注入引导向量即可产生显著效果。这一发现本身很有意思——它暗示 Transformer 的信息传递机制使得单一位置的扰动能够有效扩散到整个生成过程。
在此基础上,作者进一步提出了 DiffMean 概念引导方法,将引导向量的构造从优化求解简化为无监督的向量运算:
其中 和 分别是正负样本引导向量的均值, 控制引导强度。这种方法的优势在于完全无需标注数据,只需要收集两组语义对立的样本(如正面评论和负面评论),就能得到可以调控情感的引导向量。
路径二:潜在空间校准器用于可信性
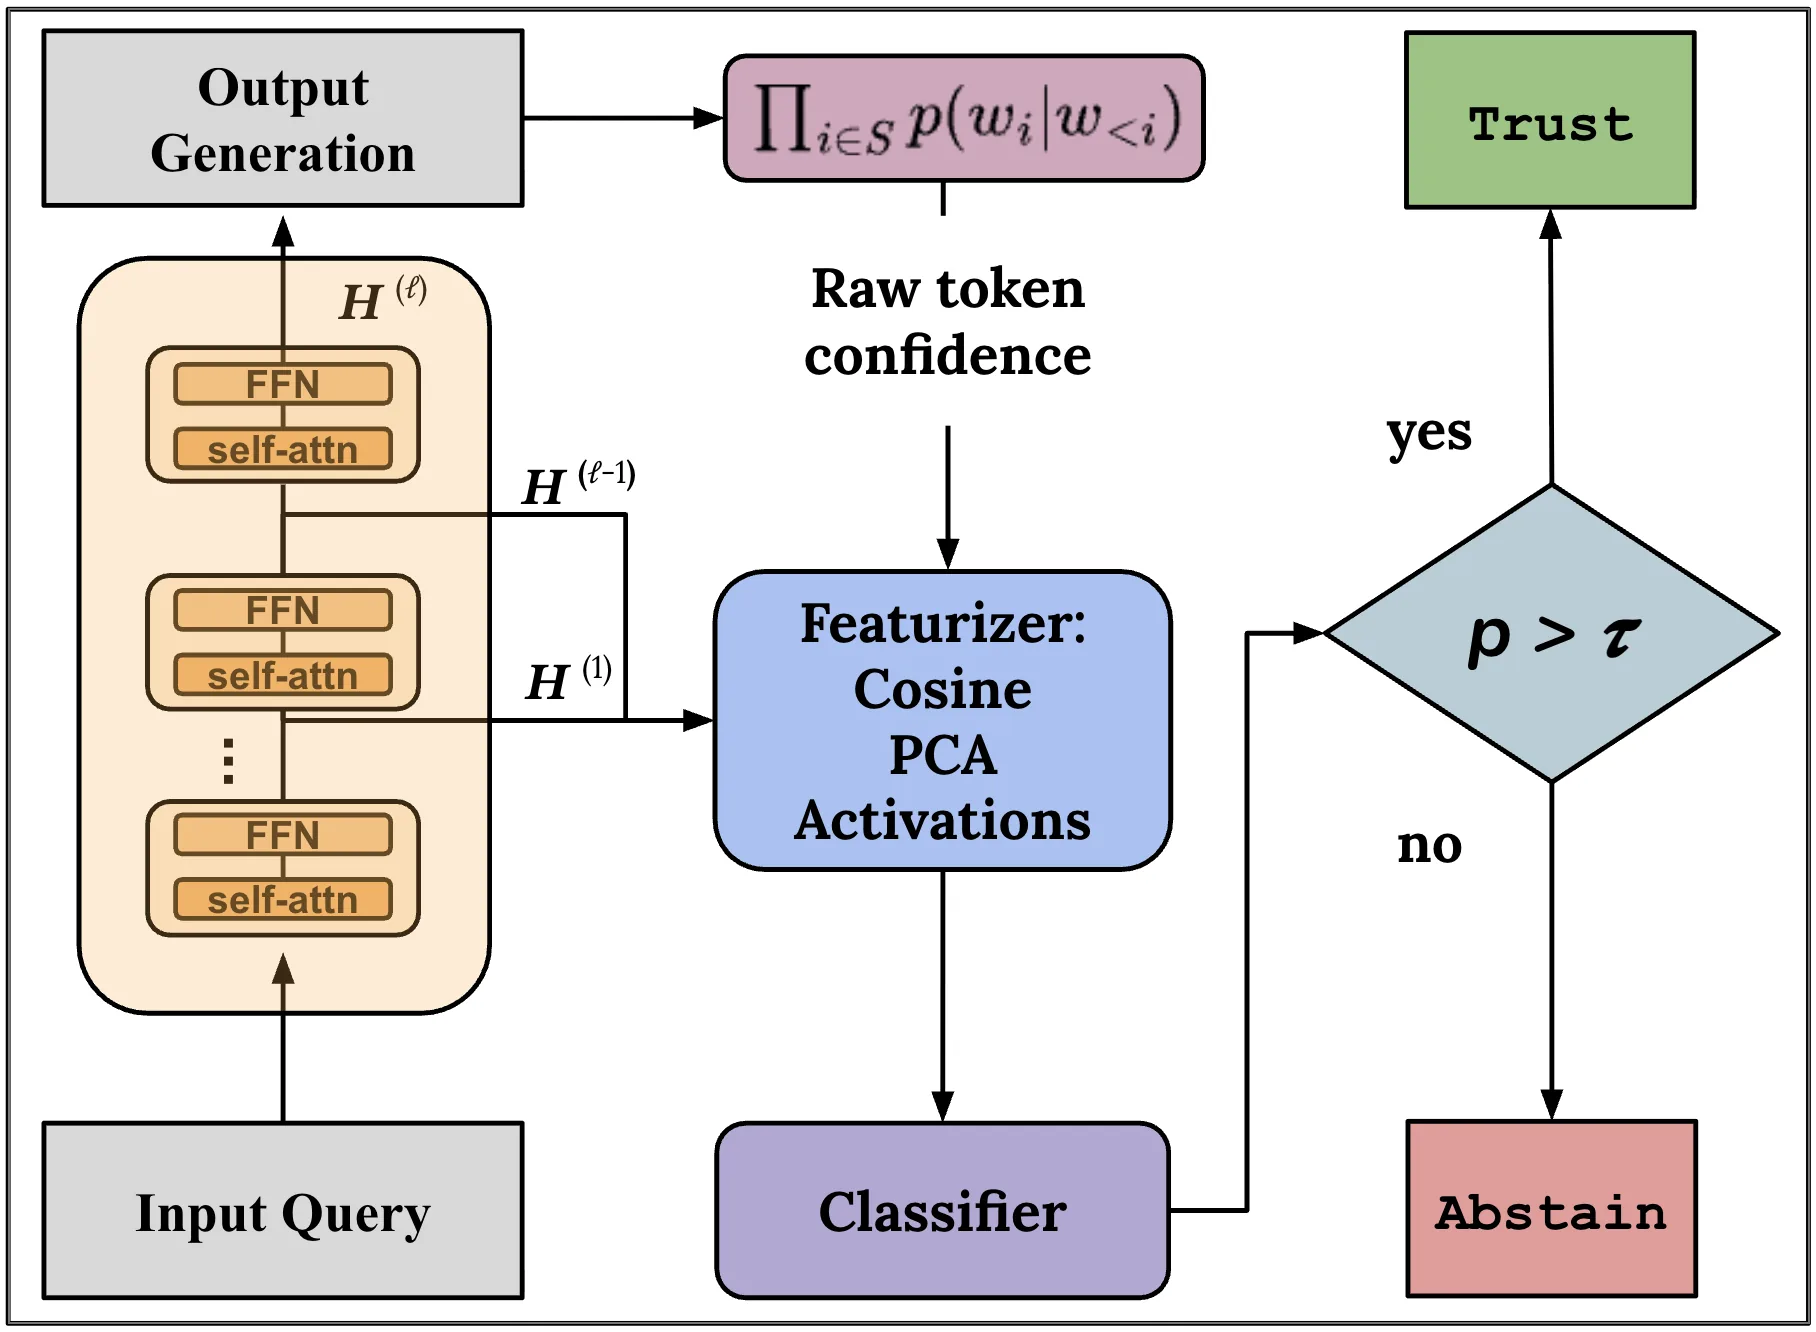
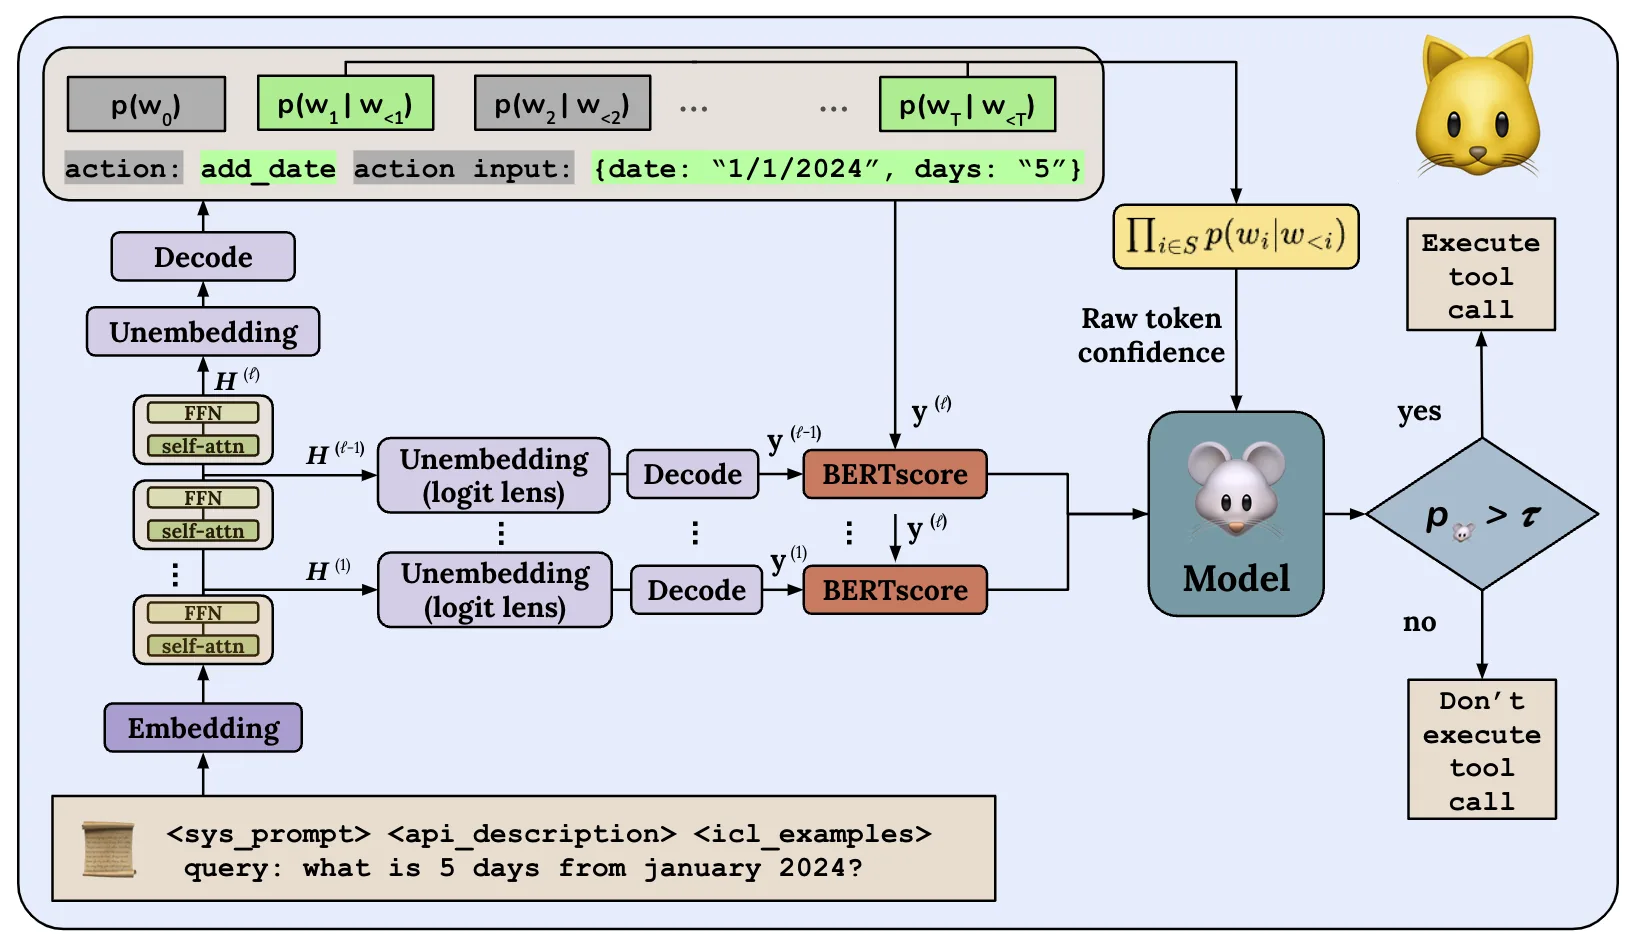
第二条路径则关注如何利用[[潜在空间]]信息来改进[[置信度校准]]。作者首先引入了 Logit Lens 技术——在 Transformer 的每一中间层都解码出候选生成结果,计算这些候选与最终输出的语义相似度作为特征。
具体而言,给定模型在第 层的解码结果 和最终输出 ,MICE 方法使用 BERTscore 作为相似度度量:
将各层的 BERTscore 与原始置信度拼接为特征向量,训练一个简单的分类器(随机森林或逻辑回归)来预测输出的正确性。分类器对"correct"类的预测概率即为校准后的置信度。
ACUTE 方法则进一步简化了特征工程,直接对模型的激活向量进行特征化,包括早期、中期、晚期激活的统计特征、cosine 相似度特征,以及 PCA 降维后的激活向量。这种做法摆脱了对大型辅助模型(如 DeBERTa)的依赖,降低了部署成本。
关于评估指标的贡献
值得注意的是,作者指出了传统 [[ECE]](Expected Calibration Error)指标的固有缺陷:它无法区分一个完美的 oracle 估计器和仅输出 base rate 的平凡估计器。为此,论文提出了两个新指标——ETCU 和 EURO,它们通过设计奖励-惩罚结构来评估置信度估计器在决策效用层面的表现,更适合中高风险场景的需求。
实验与结果
实验设计覆盖了从小型 LSTM 到大型 [[Transformer]] 的多种架构,以及从单一任务到多任务的多种场景,展现了方法的广泛适用性。
在控制任务上,论文使用了 English Gigaword 摘要数据集和 IWSLT16 英德翻译数据集进行域内域外评估。结果显示,引导向量能够实现近乎完美的精确序列恢复——token exact match 达到 0.99 以上,BLEU-4 接近 100。更重要的是,即使在域外数据上(IWSLT16 翻译任务),引导向量依然保持了有效性,表明学习到的向量确实编码了可迁移的语义结构。对于情感概念引导,DiffMean 方法在 Yelp 数据集上实现了无监督的情感翻转,成功率显著高于随机基线。
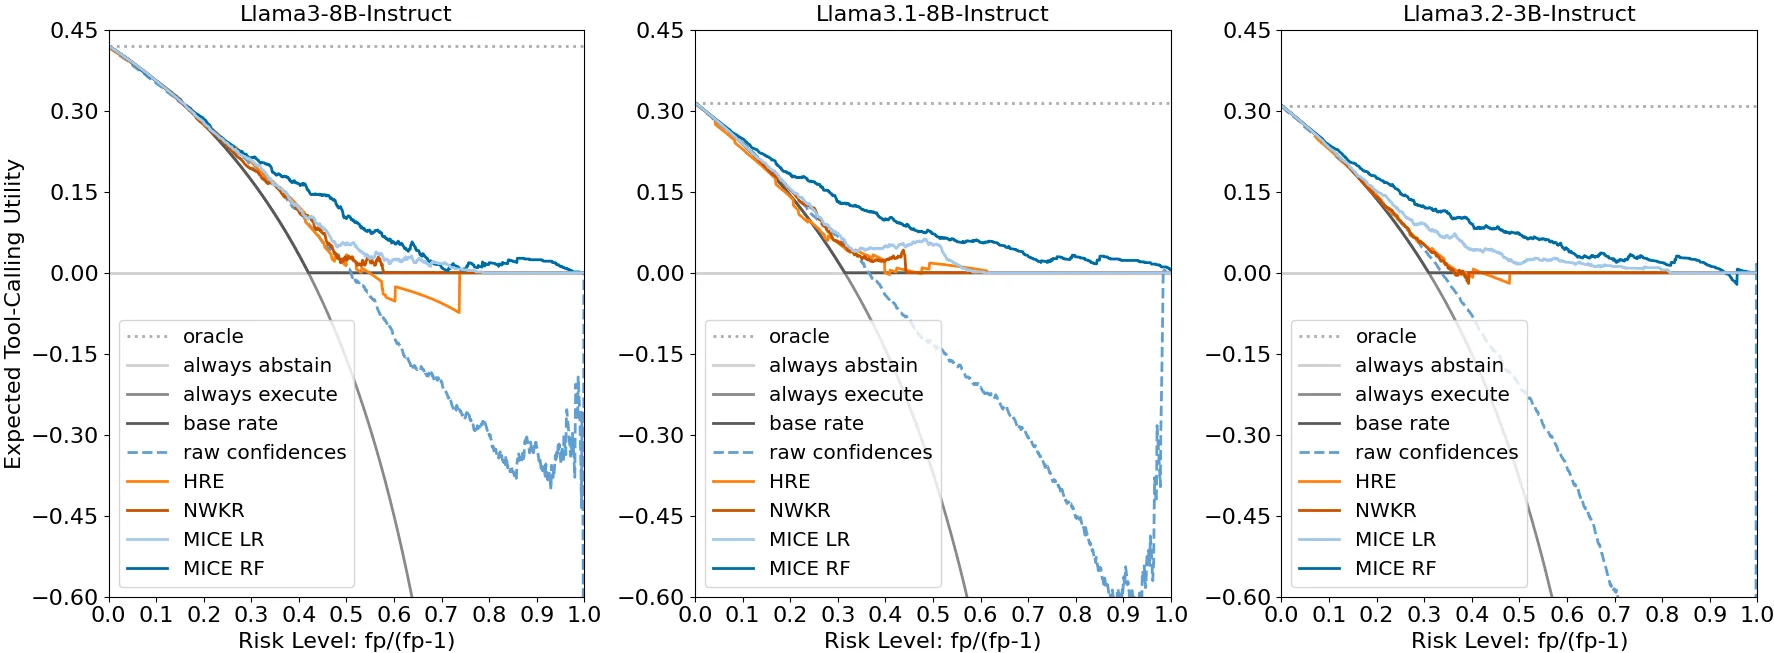
在可信性评估任务上,论文首先在 tool-calling 场景下测试 MICE 方法,使用 50 个 API 的合成数据集。结果表明,原始置信度的 [[ECE]] 普遍较高,而 MICE 和 ACUTE 都能显著降低校准误差。特别值得关注的是,传统后处理校准方法(如 HRE、NWKR)虽然改善了 ECE,但实际决策效用反而下降——它们倾向于将所有预测推向 base rate,变成了"什么都预测平均"的平凡估计器。论文提出的 ETCU 和 AUCEURO 指标成功捕捉了这一现象。
在更广泛的评估中,ACUTE 在 MMLU(57 个子任务)、APIGen(tool-calling)和 SCITLDR(科学摘要)三个任务上对 6 个不同规模的 LLM 进行了测试。结果显示,后期层激活特征和 PCA-20 降维特征表现最优,说明模型的深层表征与输出正确性的关联最为紧密。
讨论与可借鉴点
这篇论文的一个重要贡献在于证明了[[潜在空间]]的可操作性——我们不仅可以通过行为观察来评估模型,还可以通过直接操纵隐藏状态来实现精确控制。这种"灰盒"视角为后续研究提供了新的范式参考。
然而,论文也存在一些局限。首先,引导向量方法虽然展示了强大的控制能力,但作者主要与传统的 beam search 基线进行对比,并未与现代 steering 方法(如 SAE、Inference-Time Intervention、activation addition 等)在统一基准下进行比较。这使得我们难以判断这些方法之间的相对优劣。其次,MICE 方法依赖大型辅助模型计算 BERTscore,在资源受限场景下的实用性受到限制;虽然 ACUTE 缓解了这一问题,但仍需额外的分类器训练步骤。
从实践角度,有几个值得借鉴的点。其一是 DiffMean 概念引导的简洁性——它将监督信号从端到端优化简化为两组样本的均值相减,为实现无标注概念控制提供了新思路。其二是 决策效用导向的评估指标,ECURE 和 EURO 的设计提醒我们,在高风险场景下,纯统计指标的改善并不等同于决策质量的提升。其三是 Logit Lens 作为特征工程工具的巧妙应用——通过分析中间层解码结果与最终输出的相似度,可以有效挖掘模型内部的置信信号,而无需引入额外的标注或模型。
展望未来,一个重要的方向是如何将这些方法从研究和实验场景扩展到真实的高风险应用中。当前的 tool-calling 实验虽然具有实际意义,但与医疗诊断、法律咨询等真实场景仍有差距。如何确保引导向量在对抗性输入下依然可靠、如何设计更鲁棒的可信性评估框架,都是值得深入探索的问题。
概念 · 7 个
摘要
用于大语言模型行为控制的引导向量与潜在空间校准器
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
Controlling Embedding Spaces with Text-Conditioned Transformations
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 12 张
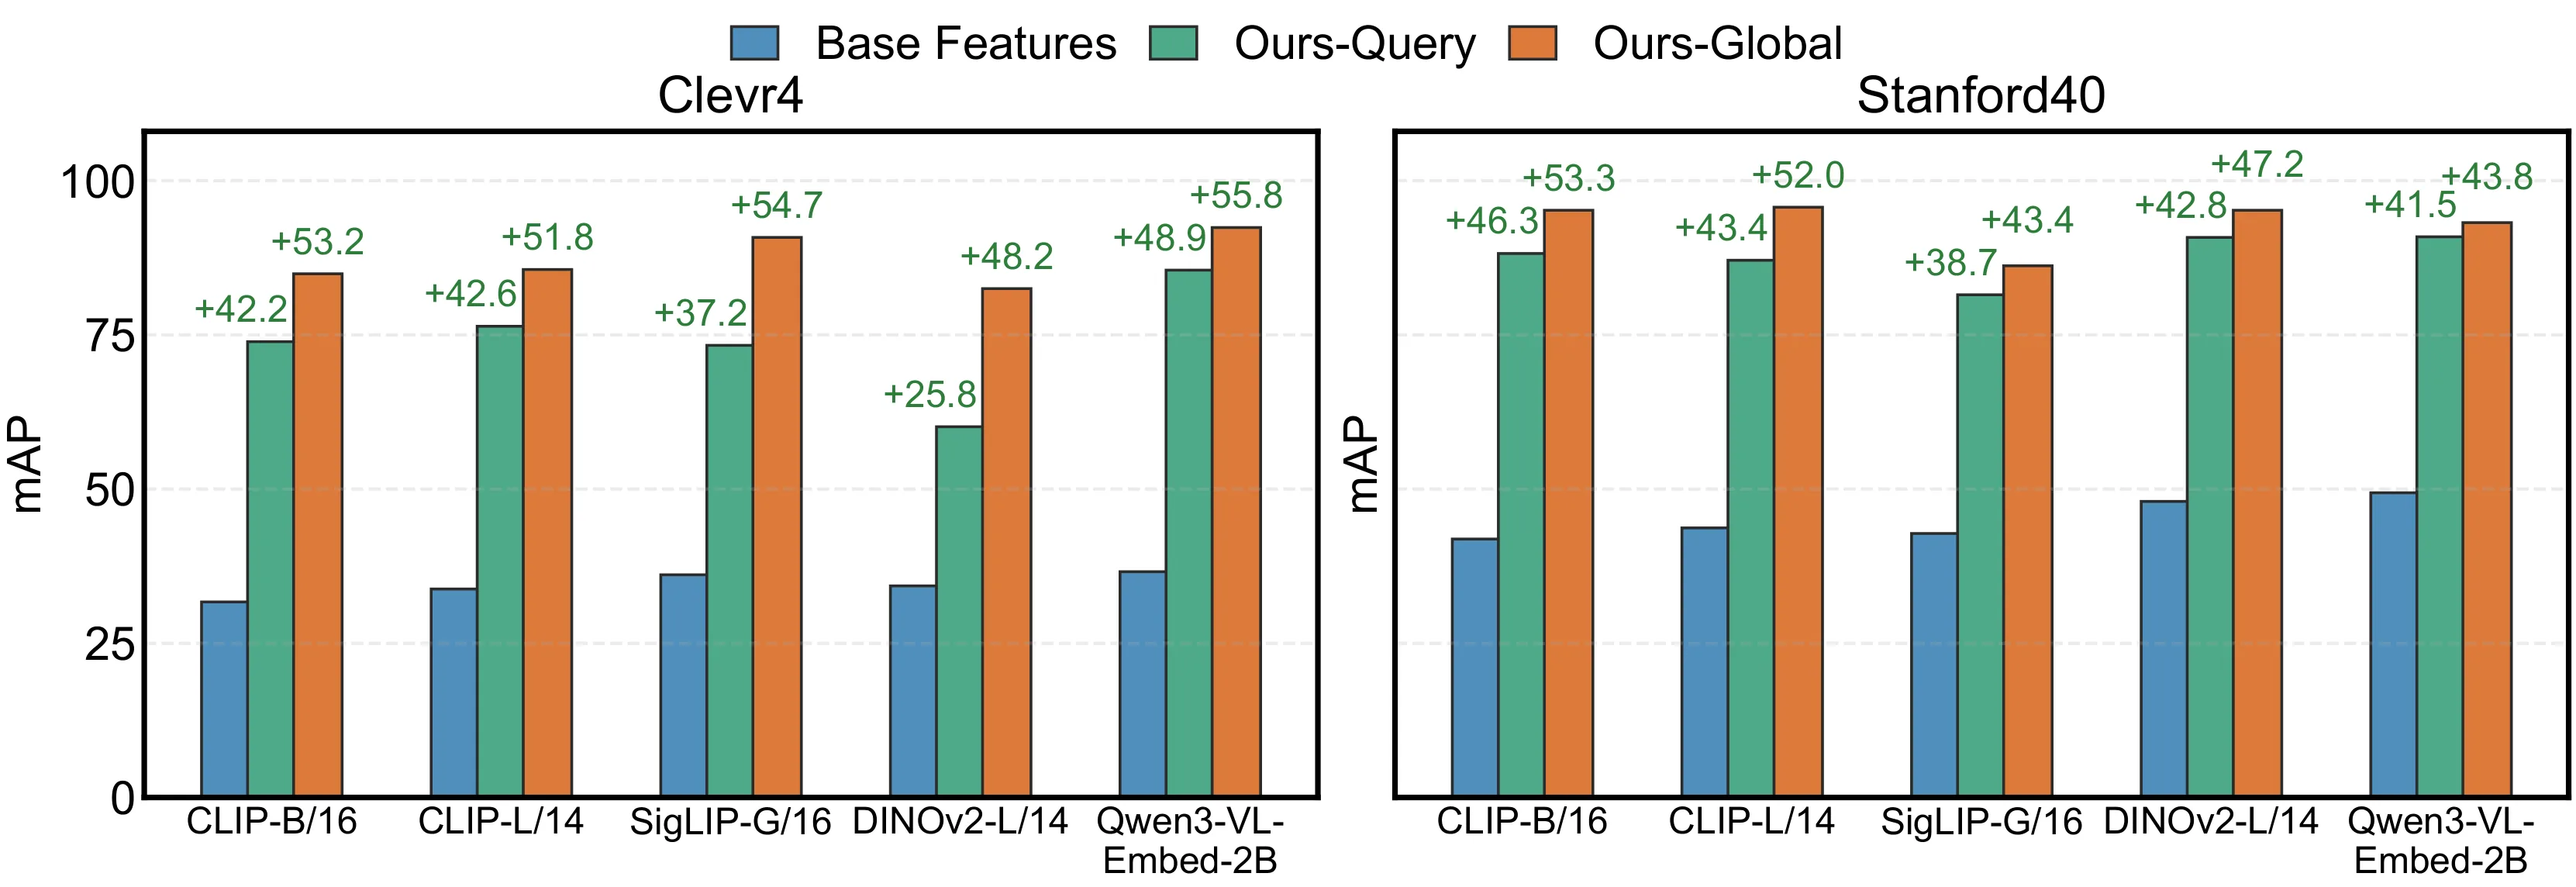
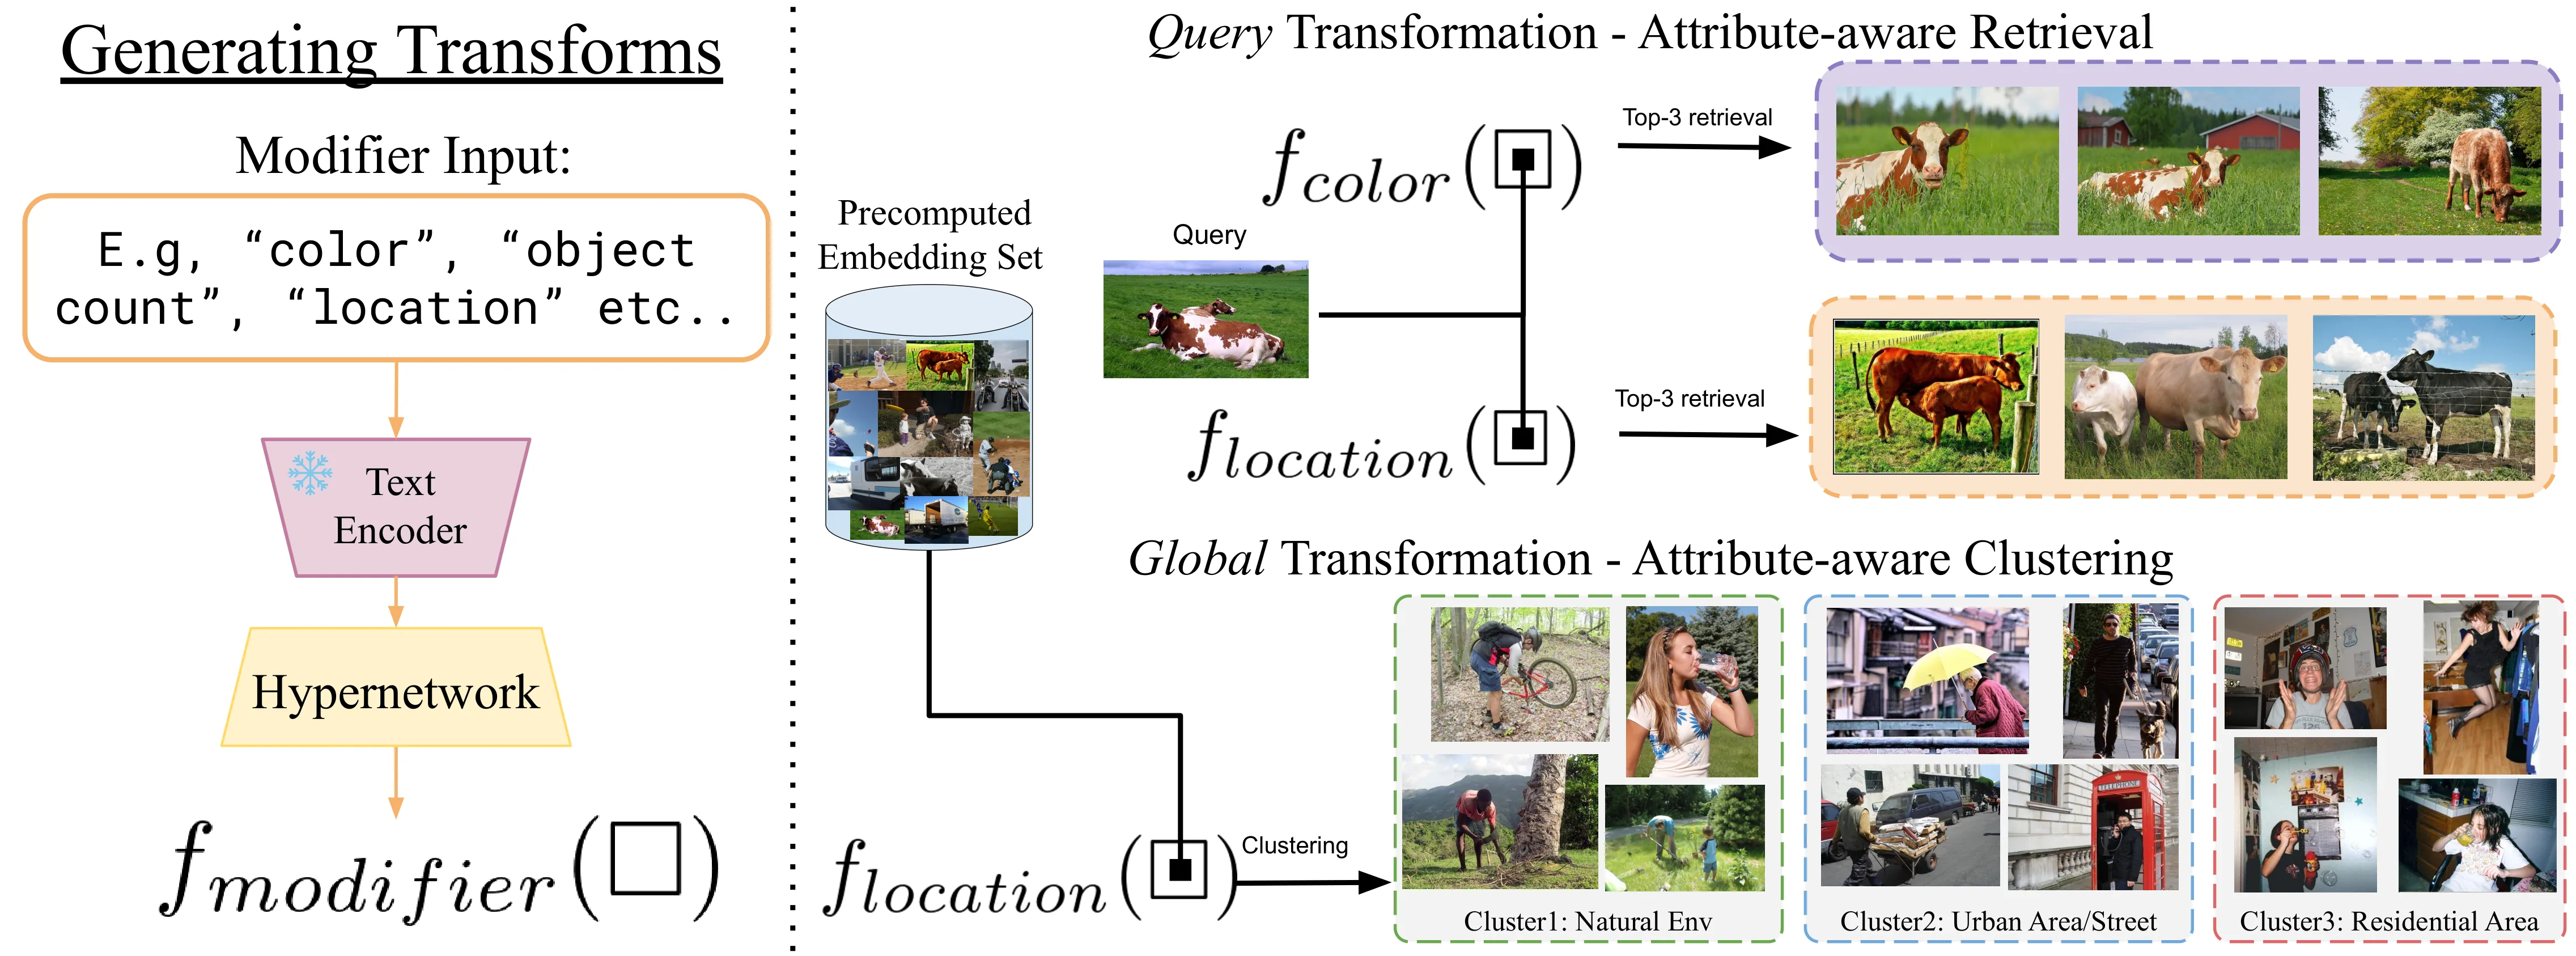
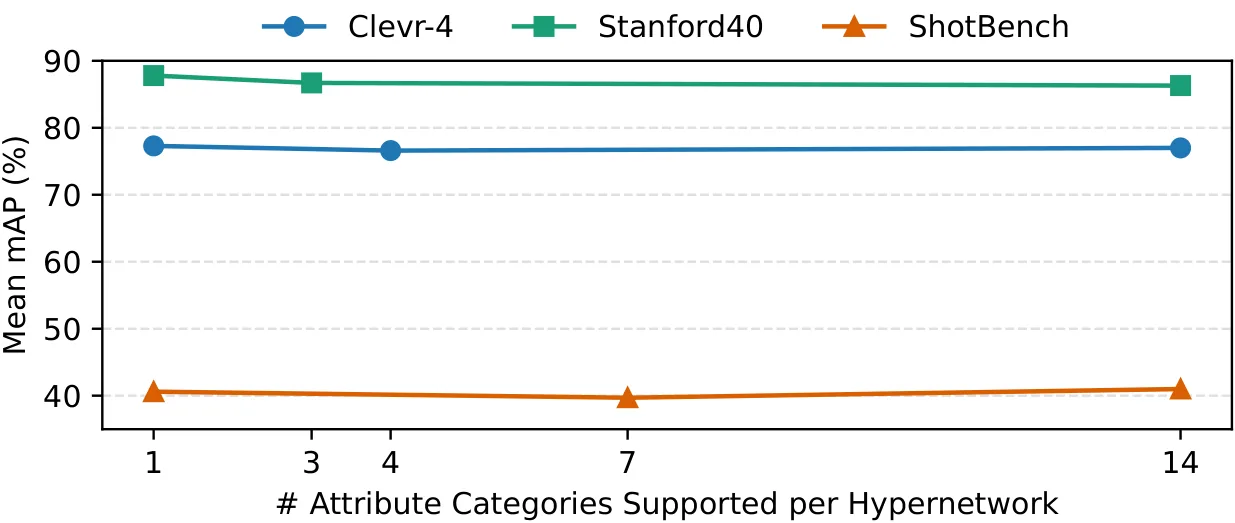
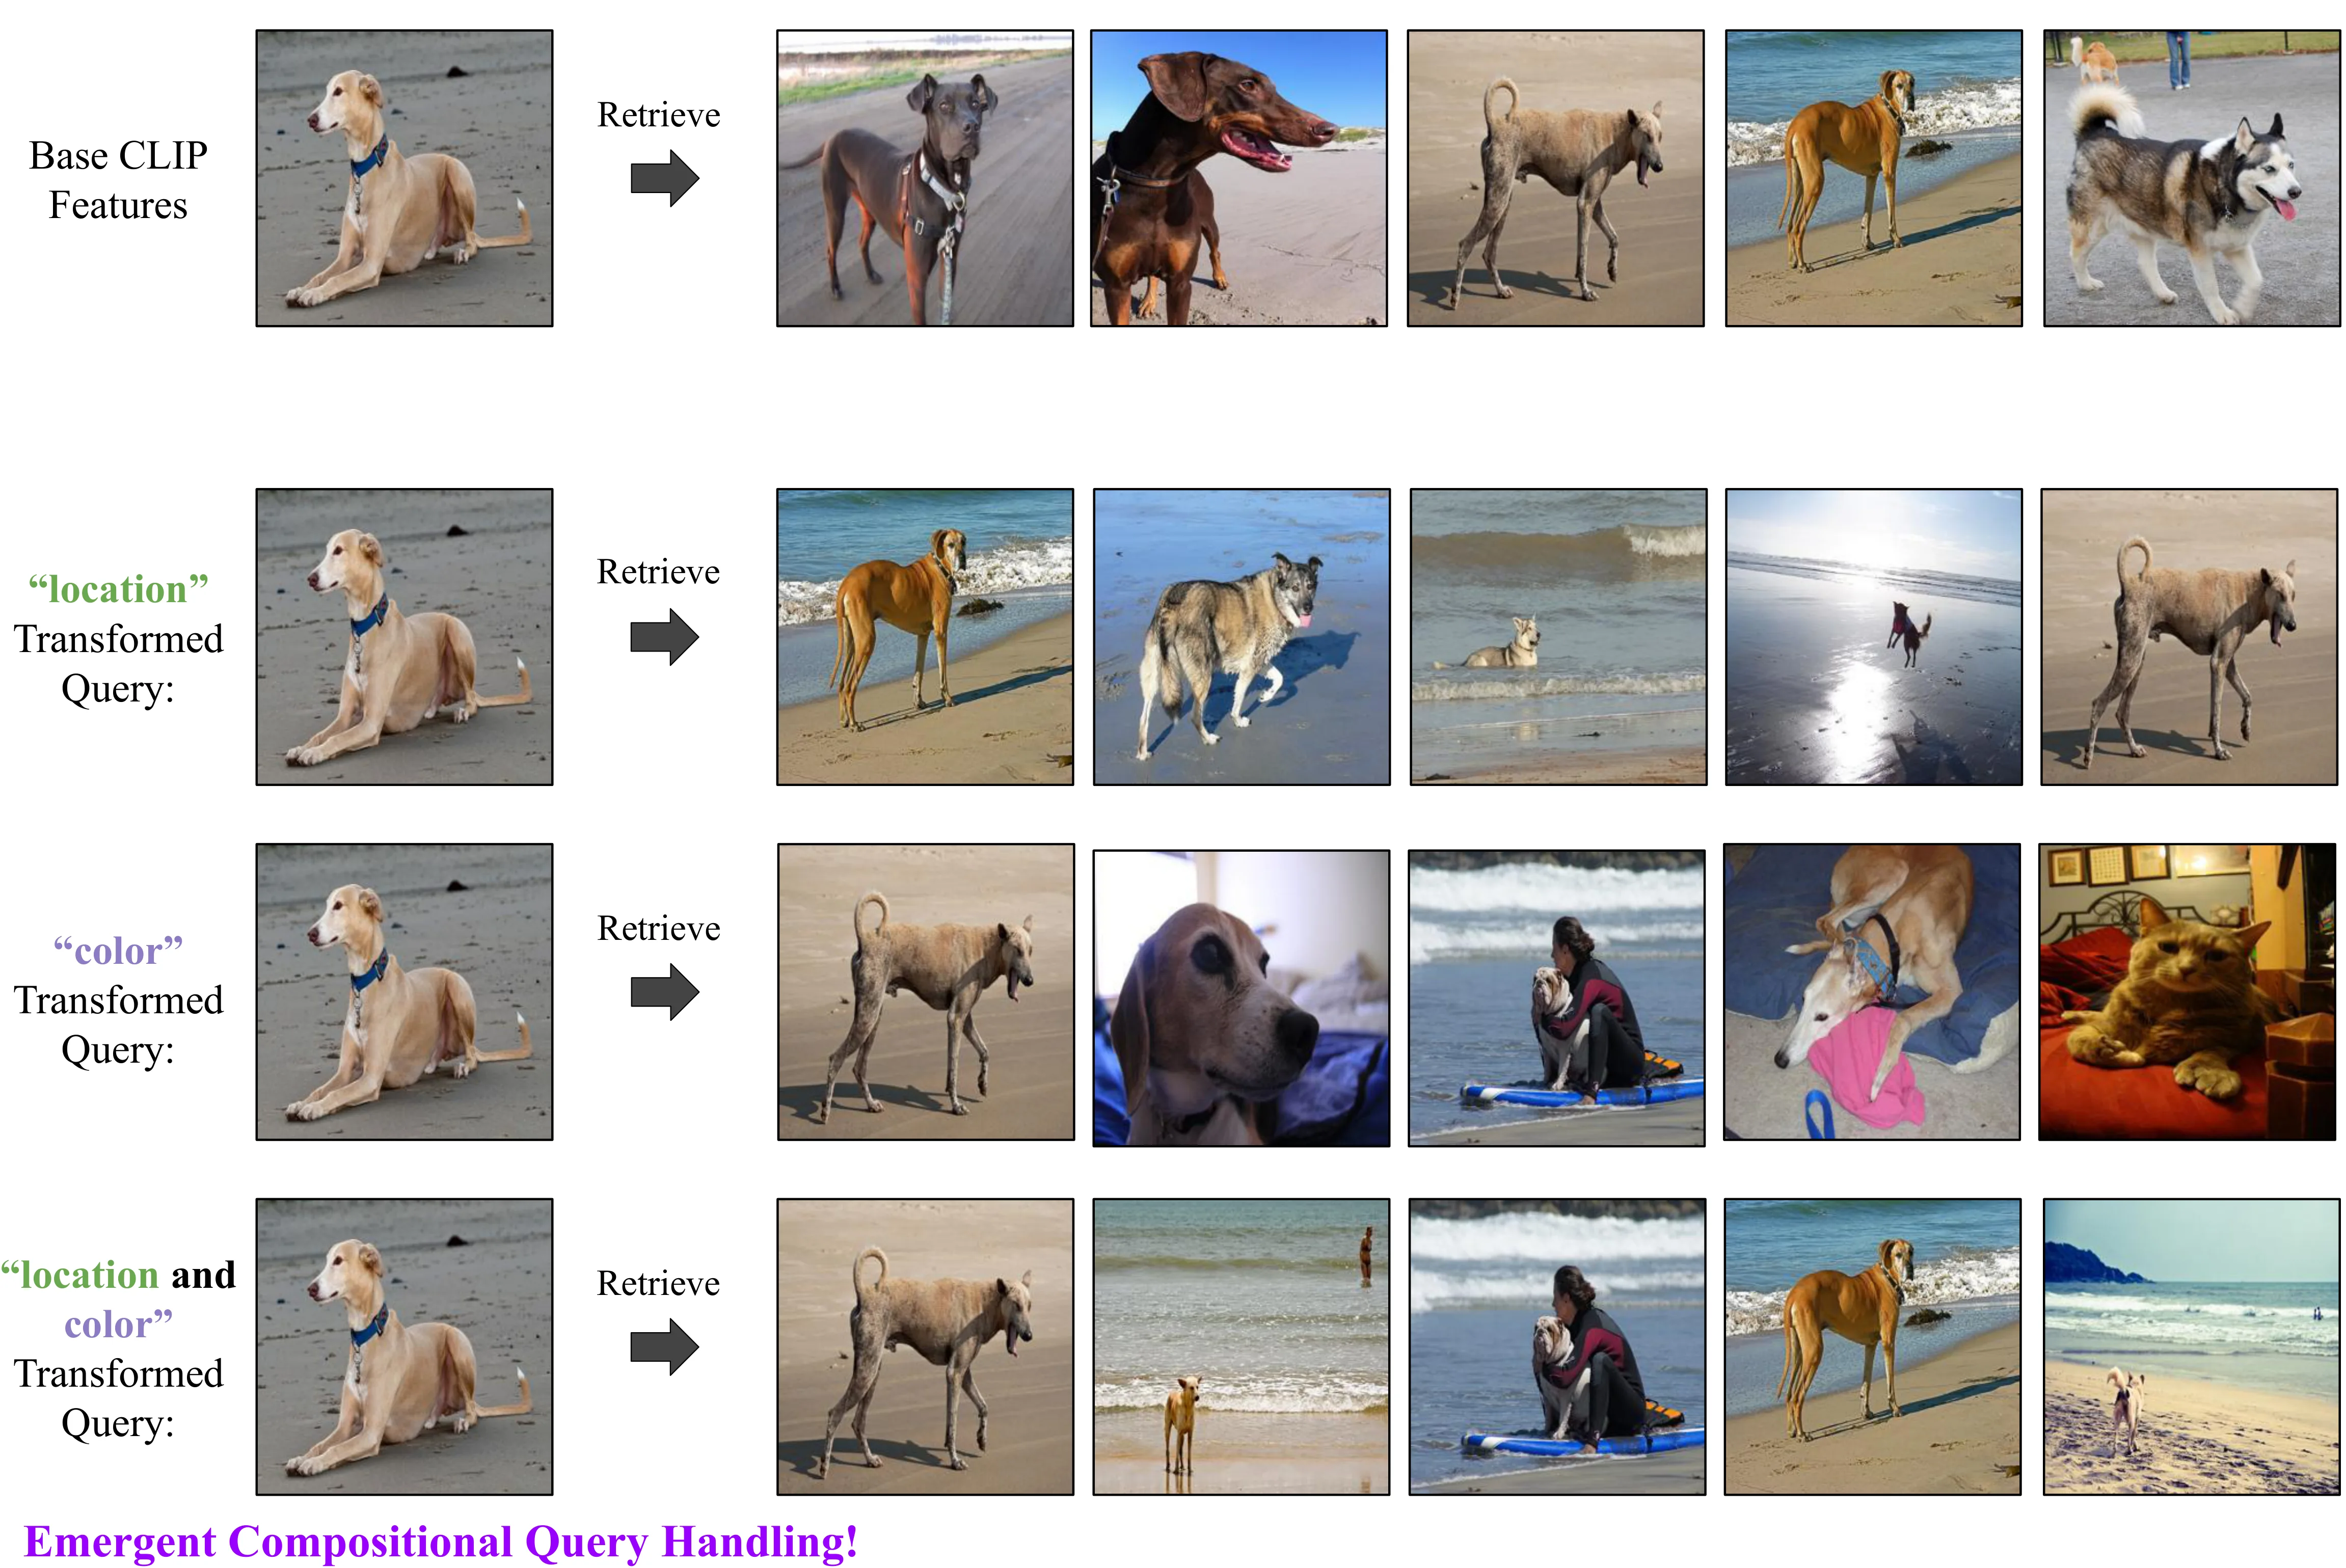
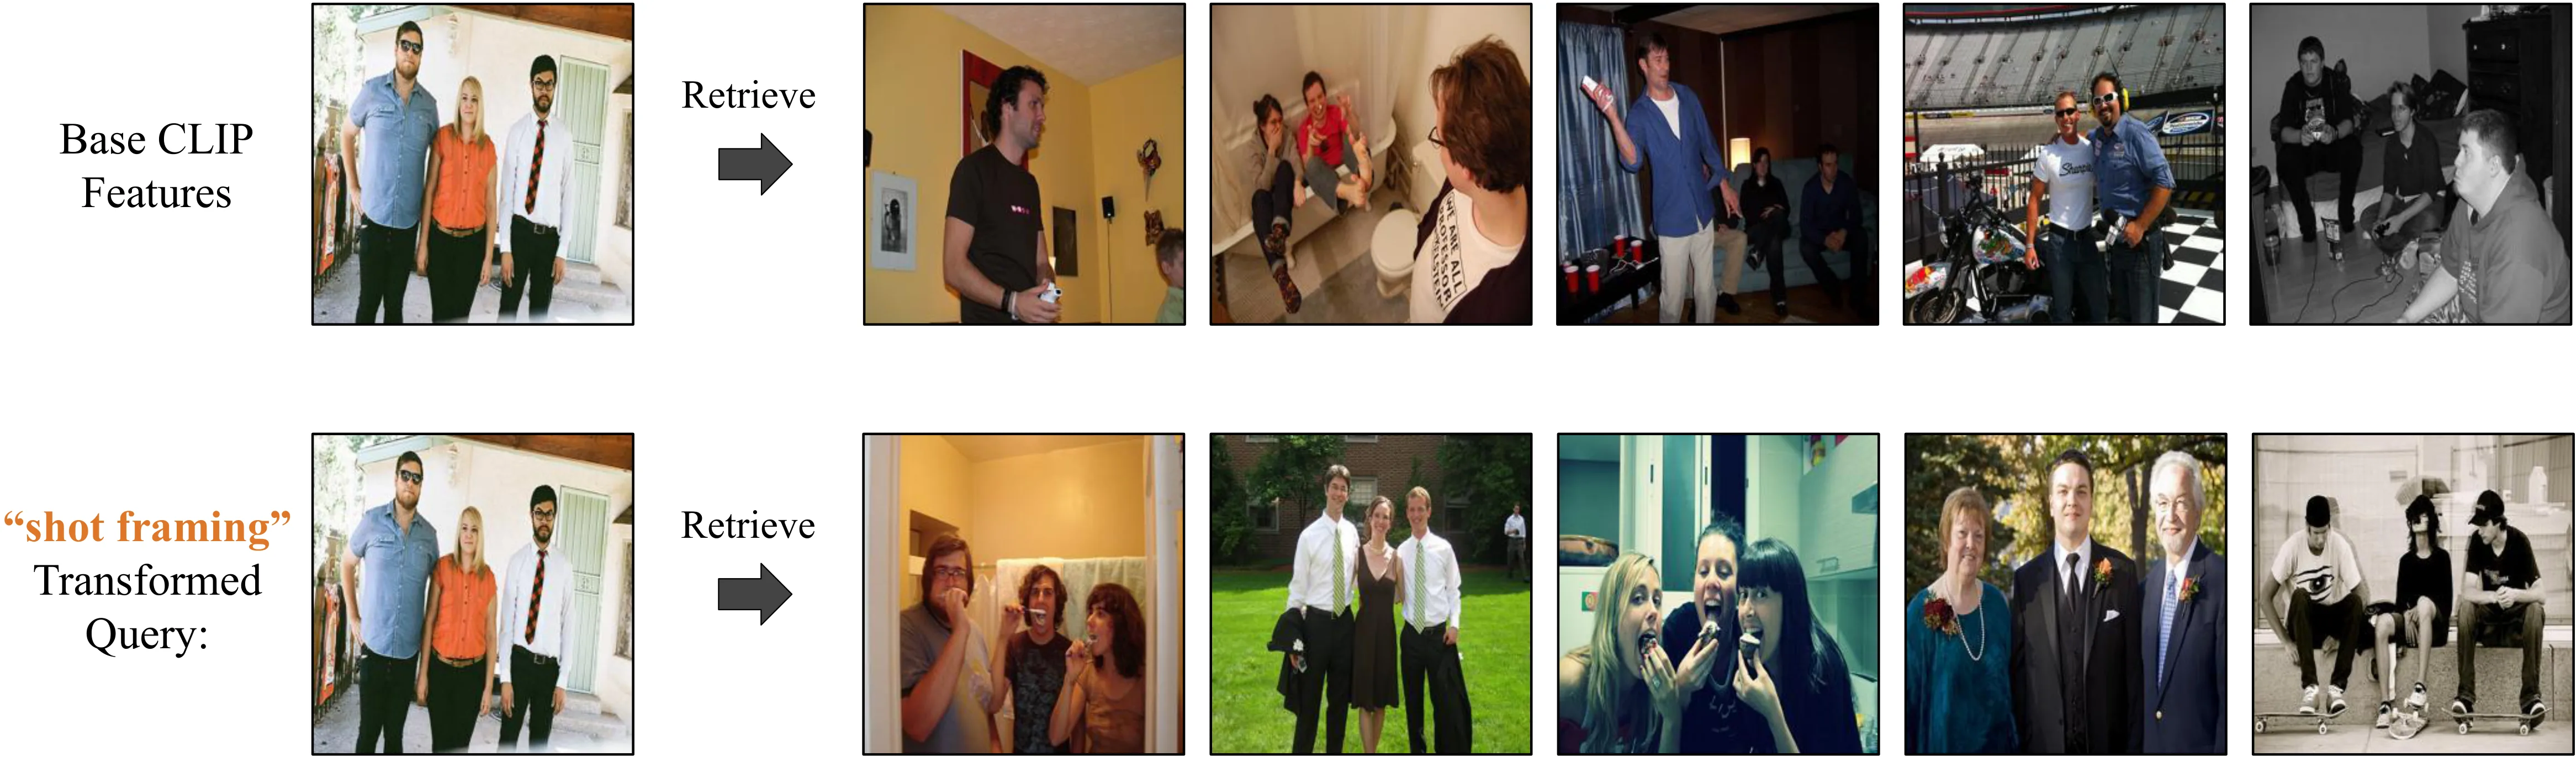
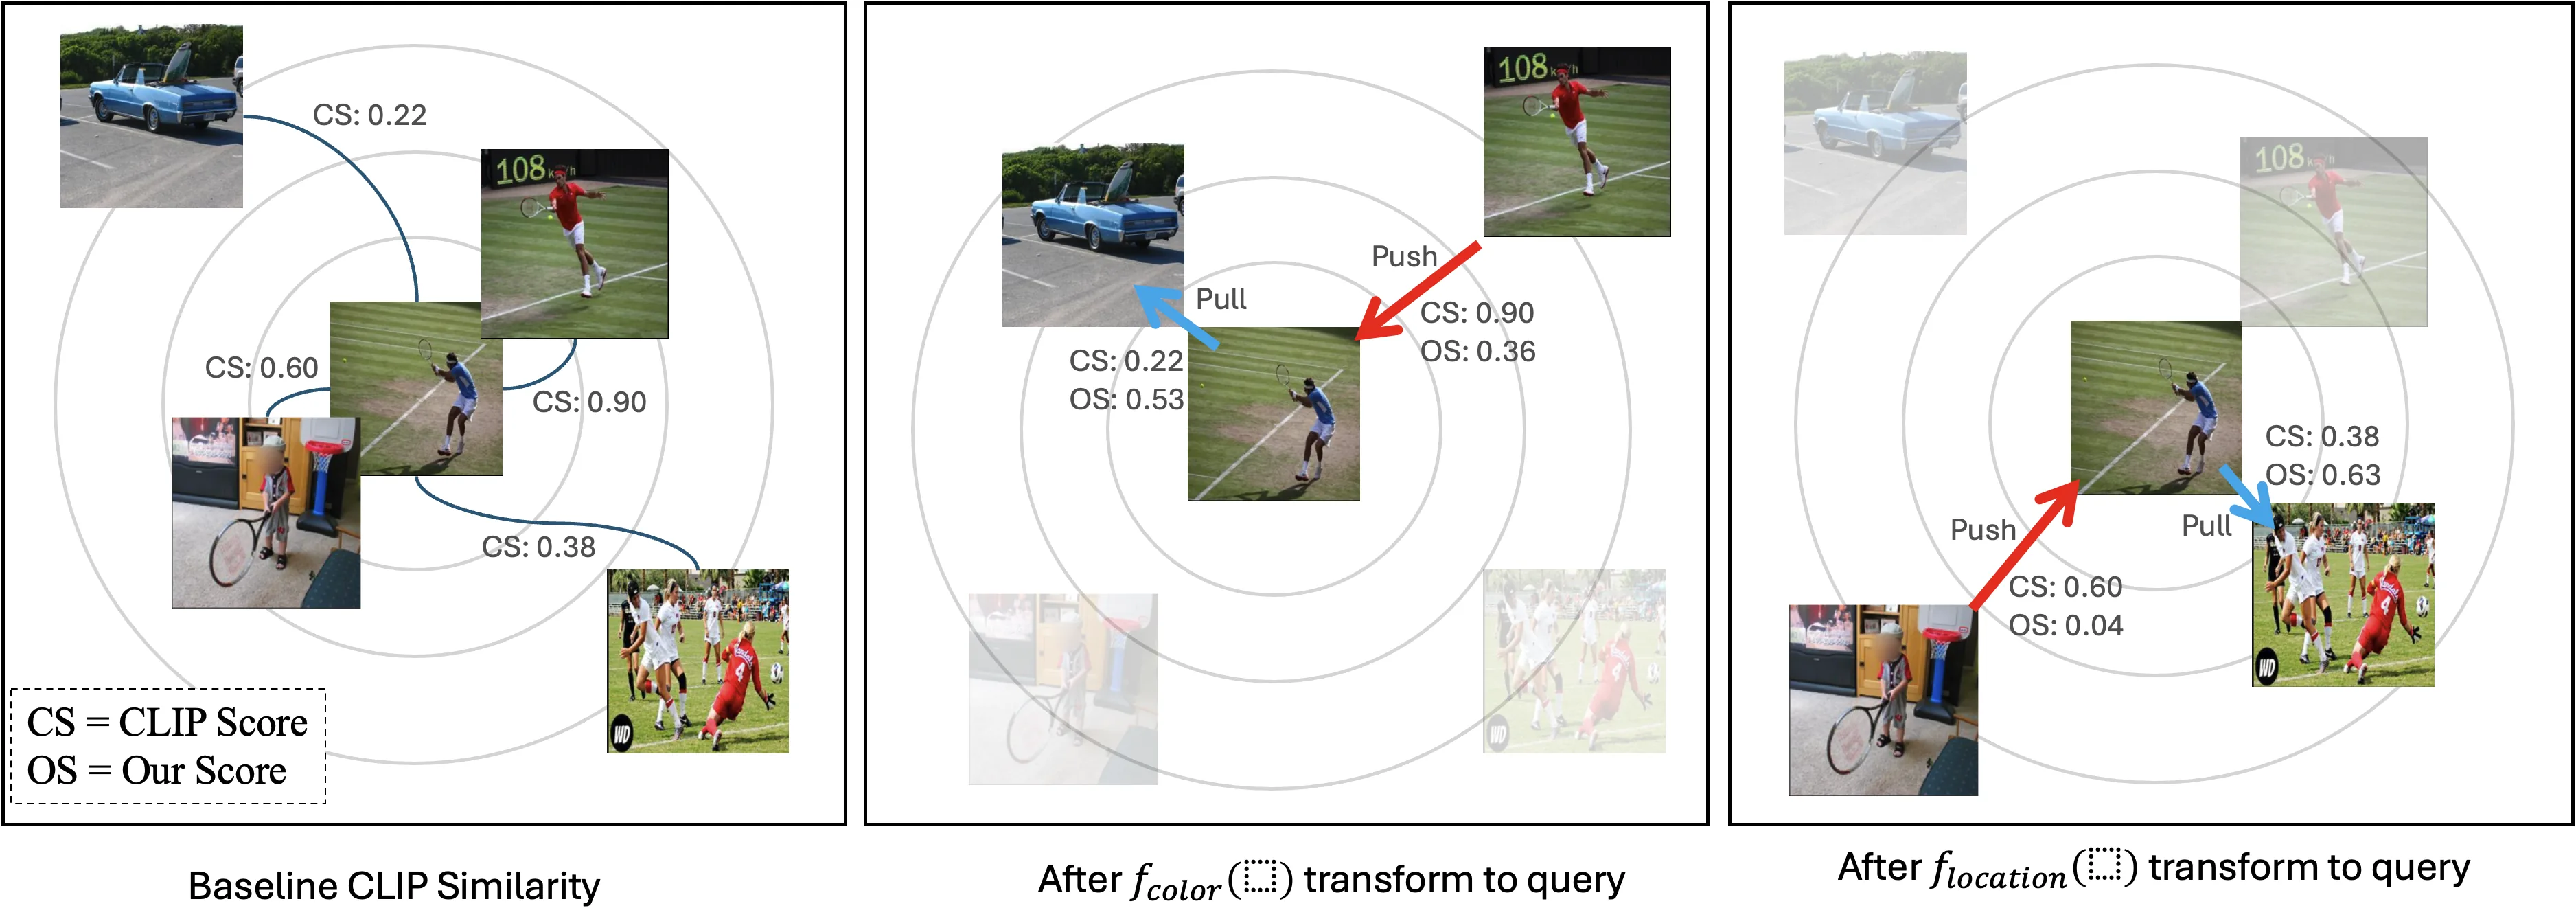
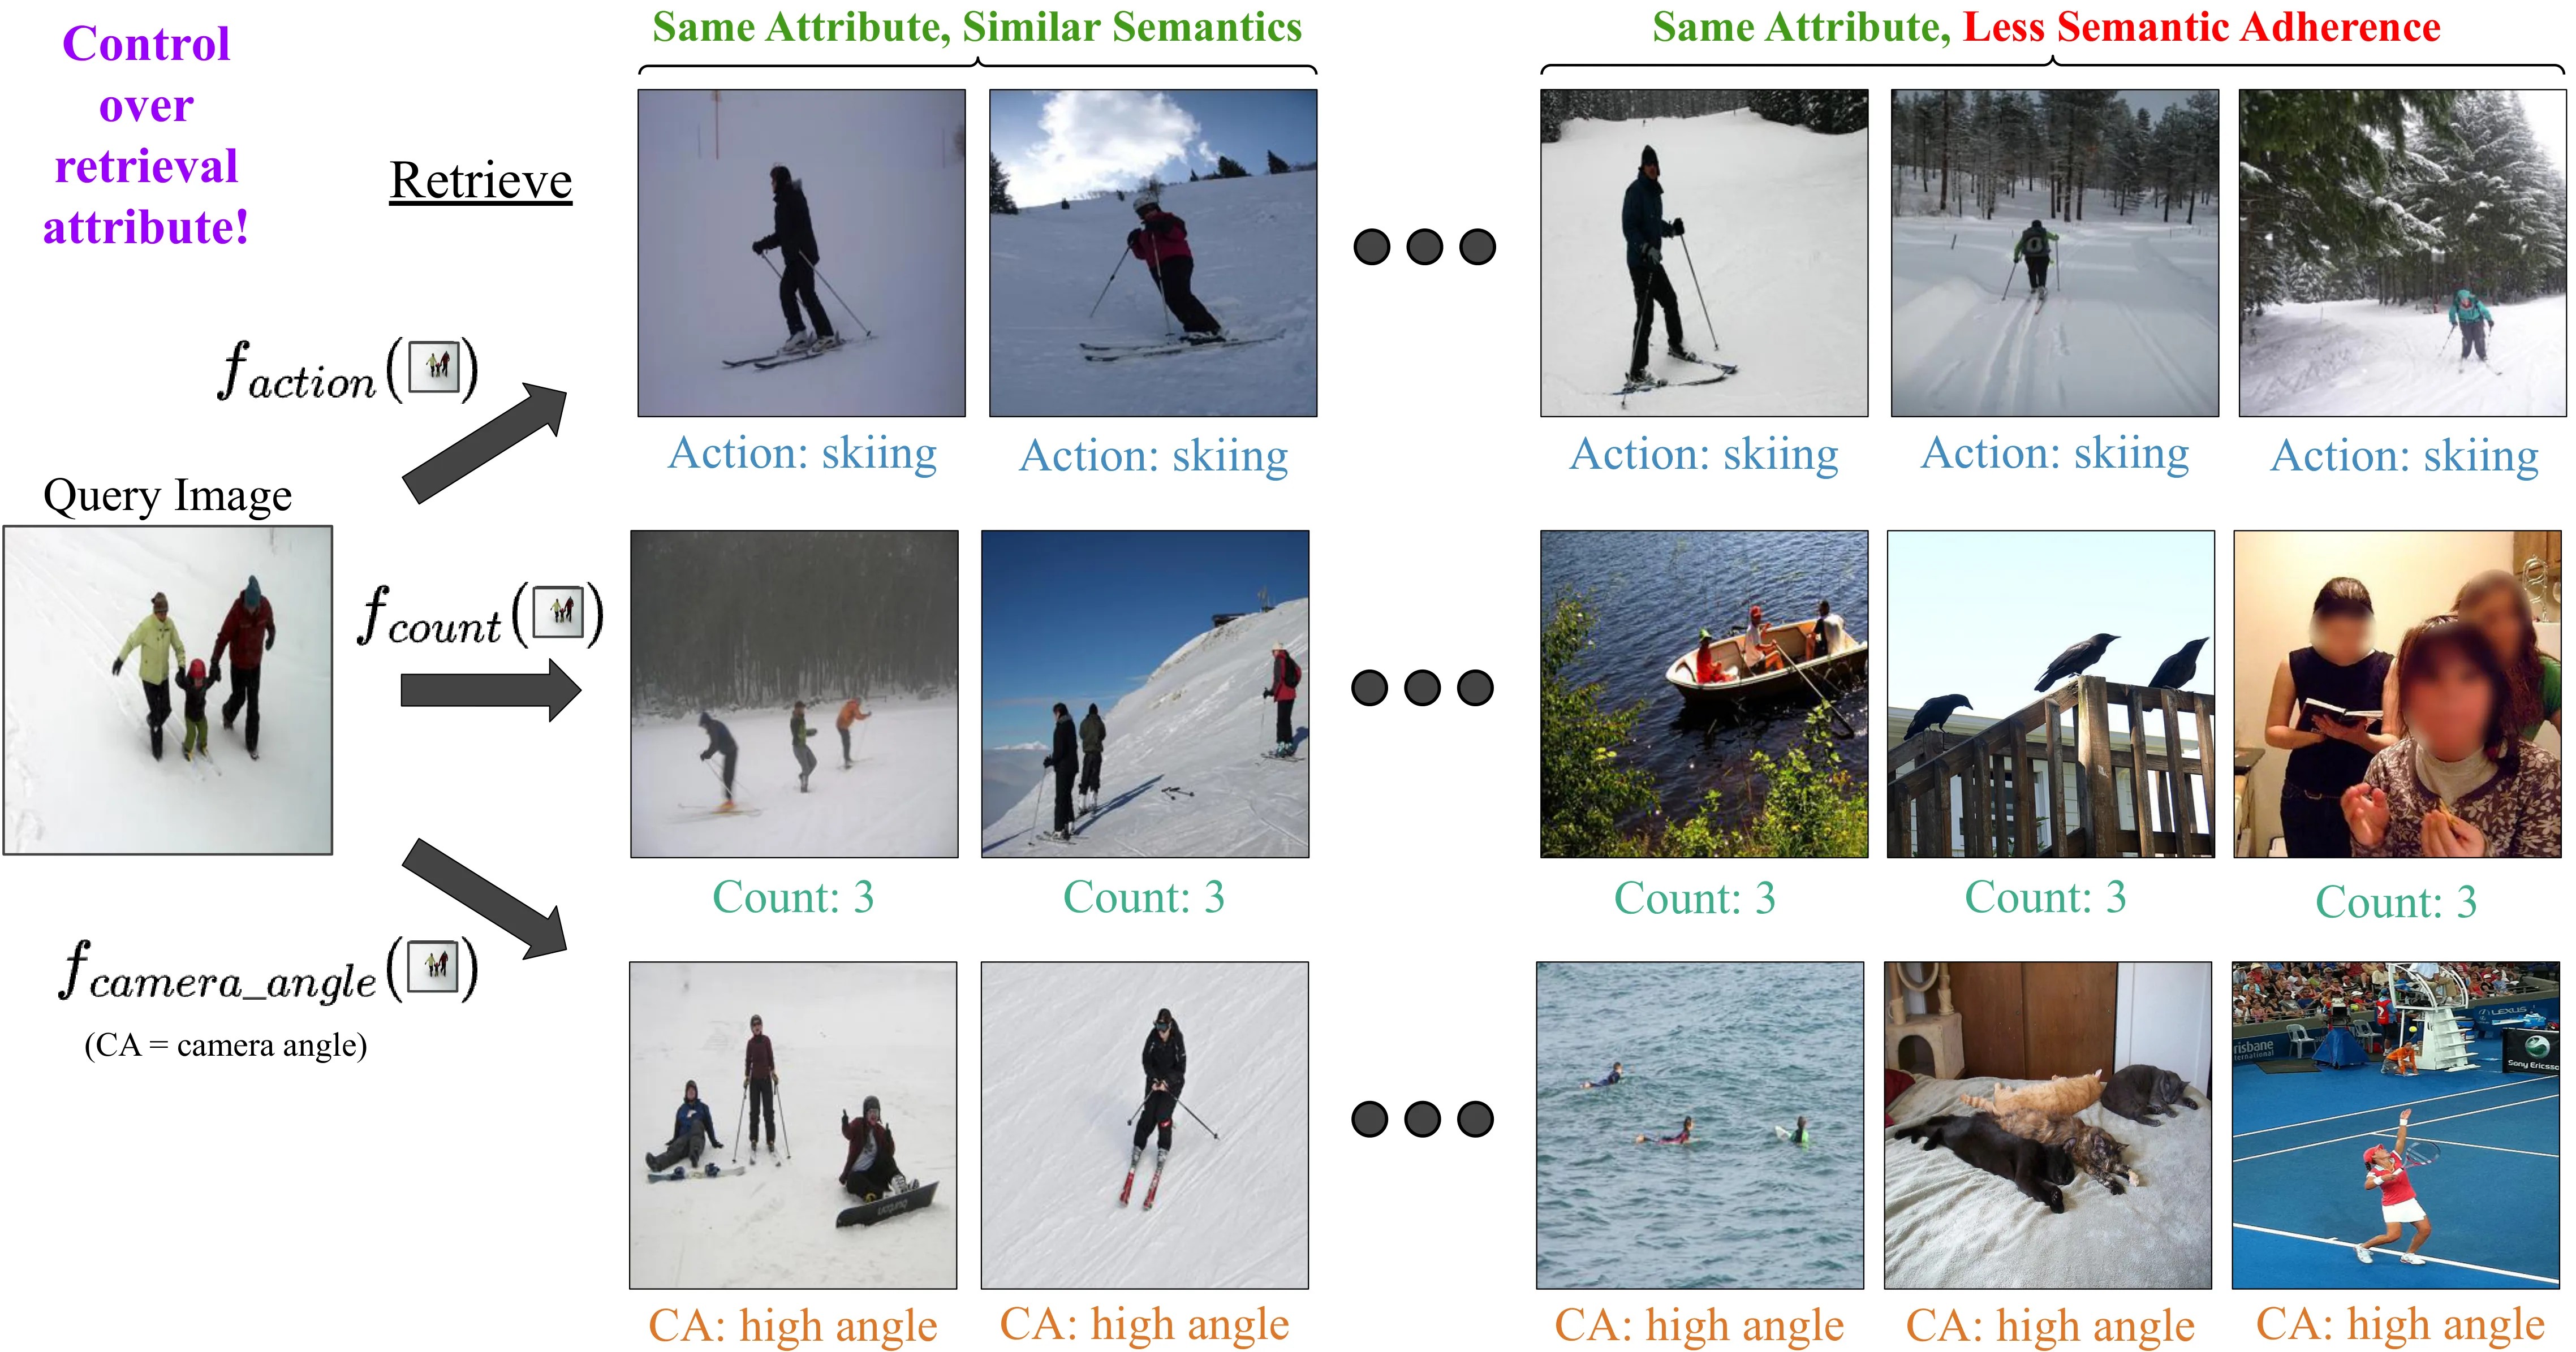
CLIP等多模态嵌入将高层语义压缩为单一向量,主导语义压制颜色、视角等次要属性,限制细粒度可控访问。本文提出文本条件仿射变换网络,根据自然语言属性描述(如"颜色""艺术风格")对视觉嵌入施加变换,使指定属性在潜空间中显式凸显。该变换与冻结潜空间对齐,无需重新编码即可支持检索与多聚类等解耦任务,在属性检索与多属性组织上达到最优且推理开销近零。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
[[CLIP]]等大规模多模态嵌入模型将图像与文本映射到统一的向量空间,实现了语义相似度检索和跨模态零样本分类等强大能力。这些模型通过将视觉信息压缩为高维向量来捕获高层语义,但代价是“主导语义压制效应”:当一张图片同时包含“红色”和“狗”时,嵌入向量主要表达“狗”这一核心对象,而“红色”这类次要属性被显著抑制。
这种特性在需要细粒度控制的场景下成为瓶颈。用户可能想检索“风格为印象派的画作”或“从特定视角拍摄的建筑”,但现有方法只能通过枚举式微调或笨重的文本提示工程来勉强实现。根本问题在于,属性信息被隐式编码在向量深处,缺乏一种显式、可控的访问机制。
一个直观的解决思路是对嵌入空间进行解耦[[表征解耦]],将颜色、视角、艺术风格等属性分离到不同的子空间。但这通常需要对模型进行重新训练或大规模标注数据。另一个思路是在推理时调整输入文本的表述,但这既不够灵活,效果也不够稳定。
这篇论文的切入点是:既然嵌入空间已经捕获了这些属性信息,能否在不改变模型的前提下,通过对嵌入向量本身施加变换来凸显目标属性? 关键挑战在于,这种变换必须能够泛化到任意属性描述,而不是针对单一属性专门设计。
方法
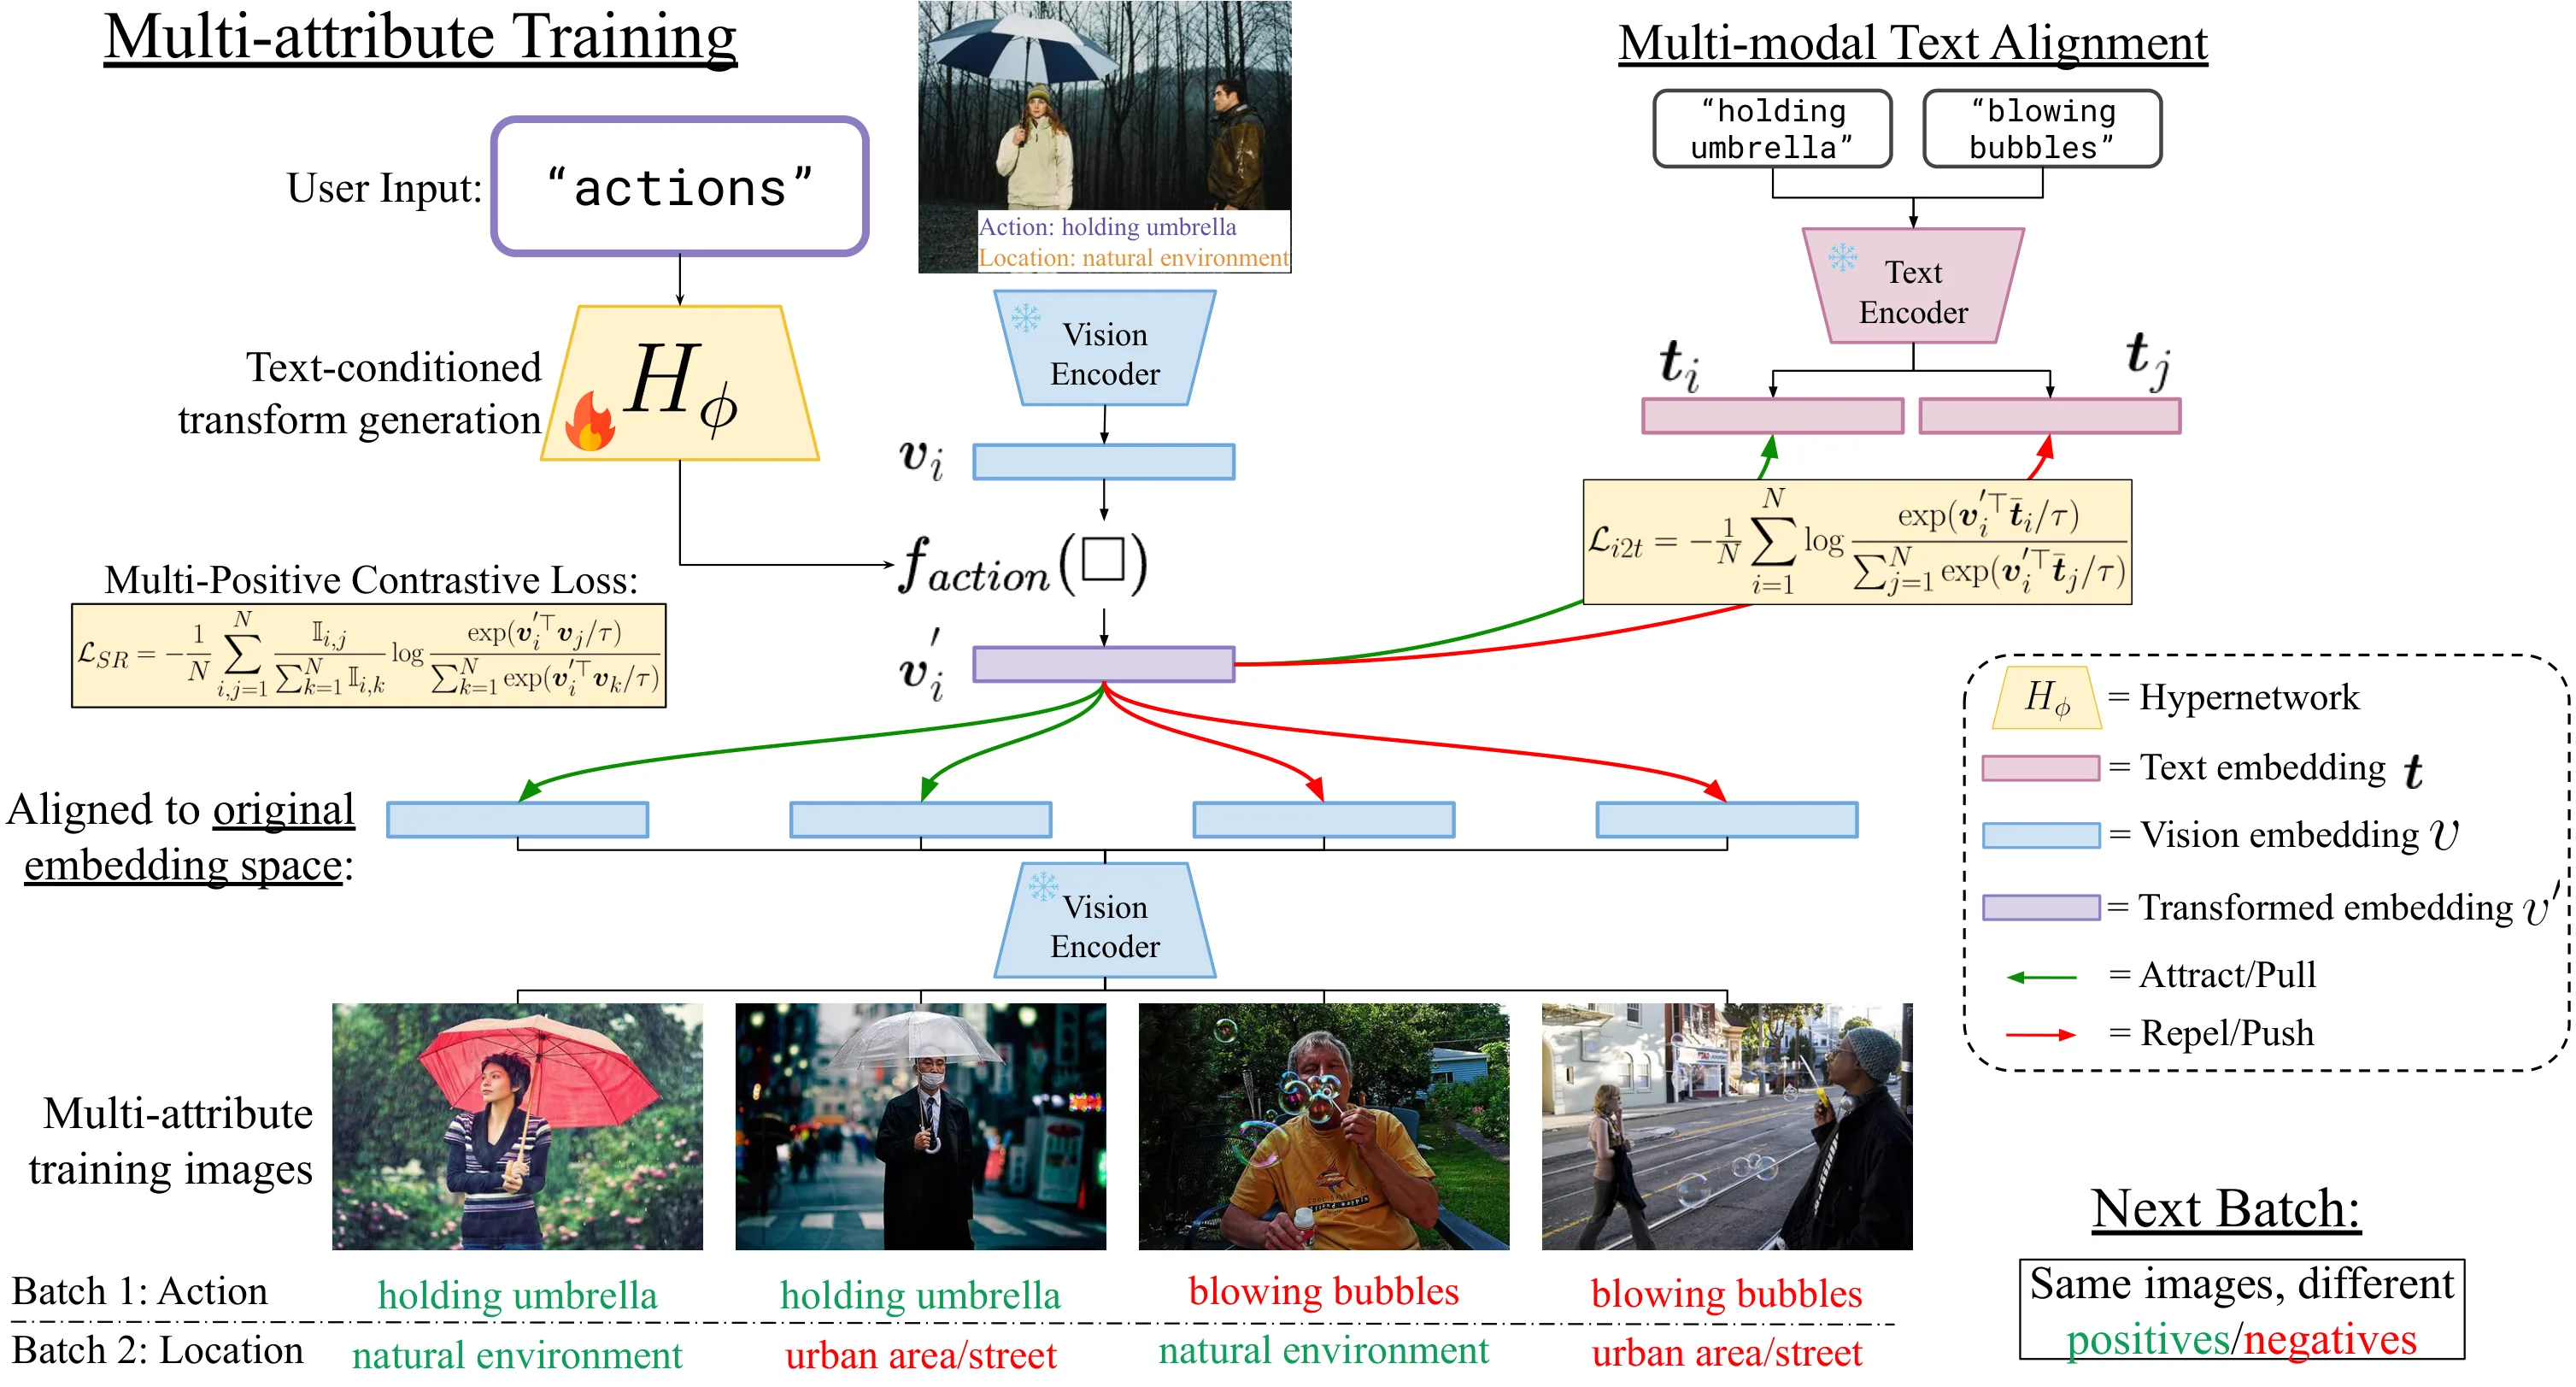
论文提出的核心方法是训练一个文本条件仿射变换网络(Text-Conditioned Transformation Network)。这个网络的学习目标是:根据自然语言描述的属性类别,生成一个能够强调该属性的线性变换。
具体而言,给定一个冻结的视觉嵌入 和一个描述属性的文本提示 (如“color”或“art style”),网络输出一个仿射变换的参数 ,然后对嵌入进行变换:
变换后的嵌入 在目标属性维度上得到增强,使其在潜空间中更容易被分离和检索。
这个设计的精妙之处在于其通用性。传统的属性特定方法需要为每个属性训练独立网络,而本文的文本条件网络能够同时学习大量属性,因为文本提示作为条件输入提供了统一而灵活的接口。网络不必记住每个属性的具体变换,而是学会根据文本语义推断出恰当的变换模式。
训练过程中,变换后的嵌入被对齐到原始的冻结潜空间。这意味着用户可以直接使用原始CLIP嵌入进行检索或其他下游任务,而变换后的嵌入则用于属性放大。两者可以无缝切换,无需重新编码整个数据集。
论文还展示了该方法在解耦任务上的扩展应用。当对完整图像集合应用同一属性变换时,同一属性的图像会在潜空间中聚集,从而天然支持多聚类等[[表征解耦]]任务。
实验与结果
实验在两个核心任务上验证了方法的有效性:属性检索和多属性组织。
在属性检索任务中,实验设置了两种评测方式:给定属性描述检索目标图像,以及给定图像检索包含指定属性的图像。结果显示,文本条件变换网络在多种属性类别(颜色、材质、视角等)上显著优于基线方法,包括直接文本匹配、基于属性的投影以及无条件的仿射变换。特别值得注意的是,论文对比了两种“竞争属性”场景:检索“绿色的猫”时,需要在抑制“绿色”这一主导语义的模型中恢复该信息。实验表明,变换网络能够有效逆转主导语义压制,将目标属性从背景噪声中提取出来。
在多属性聚类任务中,论文评估了变换后嵌入的聚类质量。对于“按艺术风格聚类”或“按颜色聚类”等场景,变换显著提升了聚类的纯度和分离度,验证了属性在潜空间中的显式解耦效果。
关键的性能指标包括推理效率。由于网络输出的只是轻量级的变换参数(而非重新编码整个向量),推理时的计算开销接近零。这在实际应用中具有重要意义——用户可以在预计算好的嵌入之上即时应用任意属性变换,无需额外的编码延迟或存储开销。
消融实验进一步表明,文本条件的设计相比属性无关的全局变换有明显优势,证明条件输入确实帮助网络学习到了针对不同属性的差异化处理策略。
讨论与可借鉴点
这篇论文在嵌入空间控制领域提出了一个优雅的范式转换:从“修改编码器”到“变换嵌入”。其核心贡献在于揭示了一个被忽视的事实——即便嵌入已经冻结,我们仍然可以通过学习合适的线性变换来重新分配潜空间中不同属性的表达权重。
该方法的局限性也值得注意。首先,变换的效果受限于原始嵌入对目标属性的编码质量——如果CLIP压根没有在嵌入中保留某个属性的信息,再精巧的变换也无济于事。其次,论文主要验证了单属性变换的效果,多属性同时变换时的交互效应尚未充分探索。
对于[[多模态学习]]和[[表征学习]]领域而言,本文提供了一个可迁移的思路:不需要为每个下游任务重新训练大模型,而是通过学习对固定表示的条件变换来实现灵活控制。这种“冻结+变换”的范式在效率和通用性上都具有优势,为后续在检索、生成、控制等多任务中的扩展应用奠定了基础。
摘要
文本条件仿射变换可对 CLIP 向量空间进行属性层面的干预
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
PRISM Edit:一个向量应对所有时间性答案
PRISM Edit: One Vector for All Temporal Answers
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 5 张
模型编辑更新大语言模型知识时,时间性事实在'定位-编辑'范式下面临替换困境:事实更新后旧答案在历史语境下仍应成立。本文通过因果追踪发现LLM内部存在两阶段计算机制,早期MLP层提取时间无关的主体表征,后期层结合时间上下文调制输出。提出PRISM Edit方法,优化单一多义表征向量并利用模型固有调制通路实现时间路由,无需修改架构。在新引入的TimeConflict基准和时间增强CounterFact上超越最优基线平均+23.3 TC和+33.7 CRS,推理速度提升超2倍。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
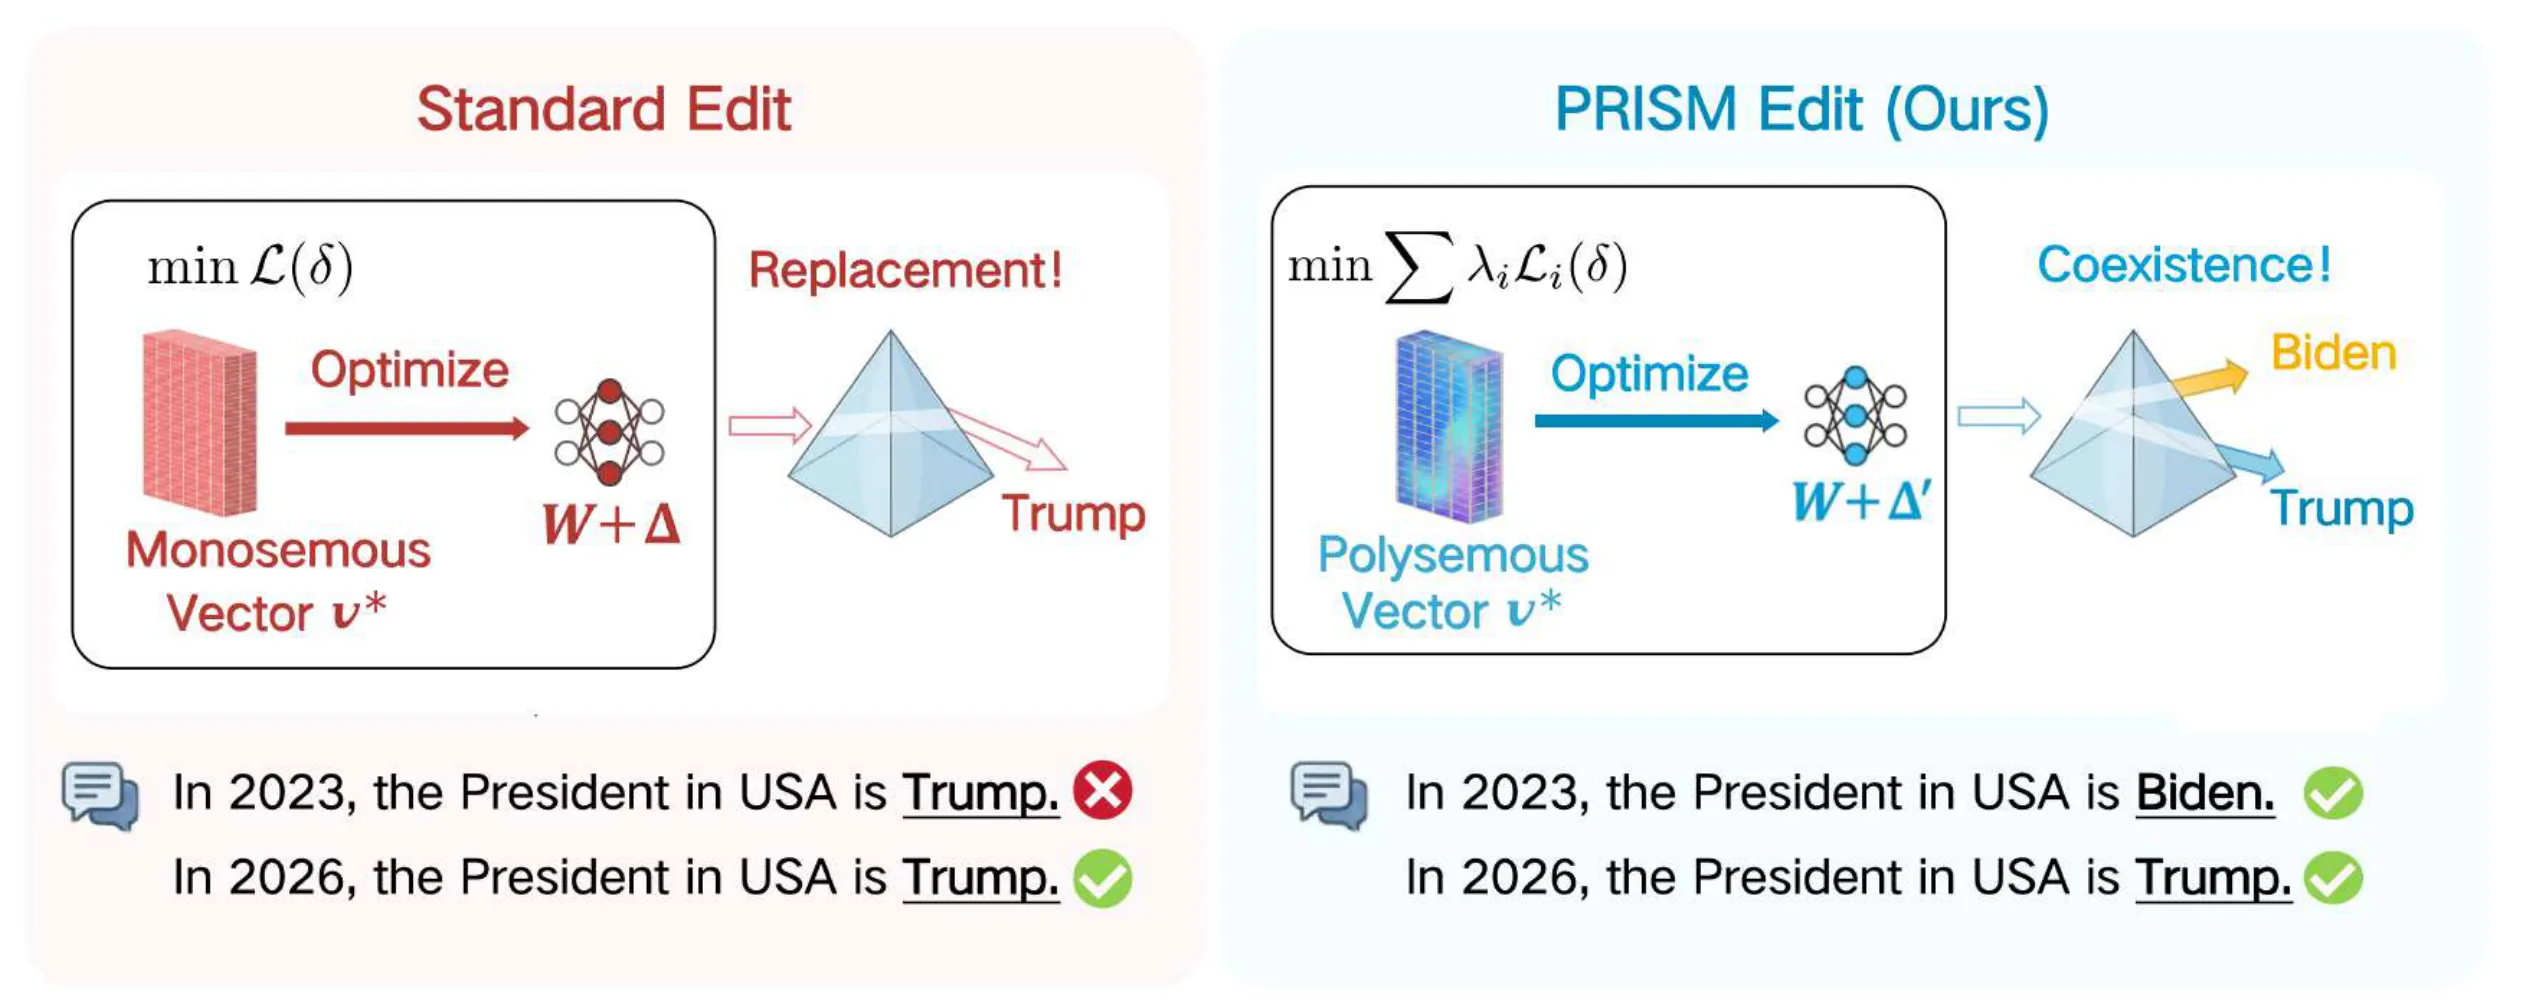
模型编辑技术旨在无需重新训练的情况下更新大语言模型中的过时知识,这对构建可持续更新的知识型系统至关重要。当前的定位-编辑范式,如ROME、MEMIT等工作,假设编辑操作是一种整体替换——新知识写入后,旧知识被覆盖。这种假设在处理时间性事实时遇到了根本性的挑战。
考虑一个具体场景:假设我们要将"苹果公司CEO是库克"更新为"苹果公司CEO是鲍斯·克里格尔"。编辑完成后,模型需要同时满足三种不同的查询需求:当前时间查询应返回新答案,历史时间查询应返回旧答案,而没有时间标记的裸查询默认返回新答案。这要求编辑机制具备时间感知能力,而非简单的记忆覆盖。
既有方法在这一问题上的表现存在明显局限。METO、AToKe等尝试将时间作为额外维度进行建模,但这些方法需要为每个时间段分配独立参数或执行多次编辑,计算开销巨大。更关键的是,定位-编辑范式的编辑位点——通常位于早期MLP层——其输入表征对时间上下文并不敏感,这导致在该位置进行的线性更新在原理上无法区分不同时间语境下的几何差异。
基于这一洞察,作者主张采取"机制优先"的研究思路:在设计编辑方法之前,首先需要理解大语言模型内部是如何处理时间性知识的。这种从模型内部机理出发的思路,避免了在外围强行叠加复杂结构,而是寻求与模型固有计算机制协同工作的编辑策略。
方法
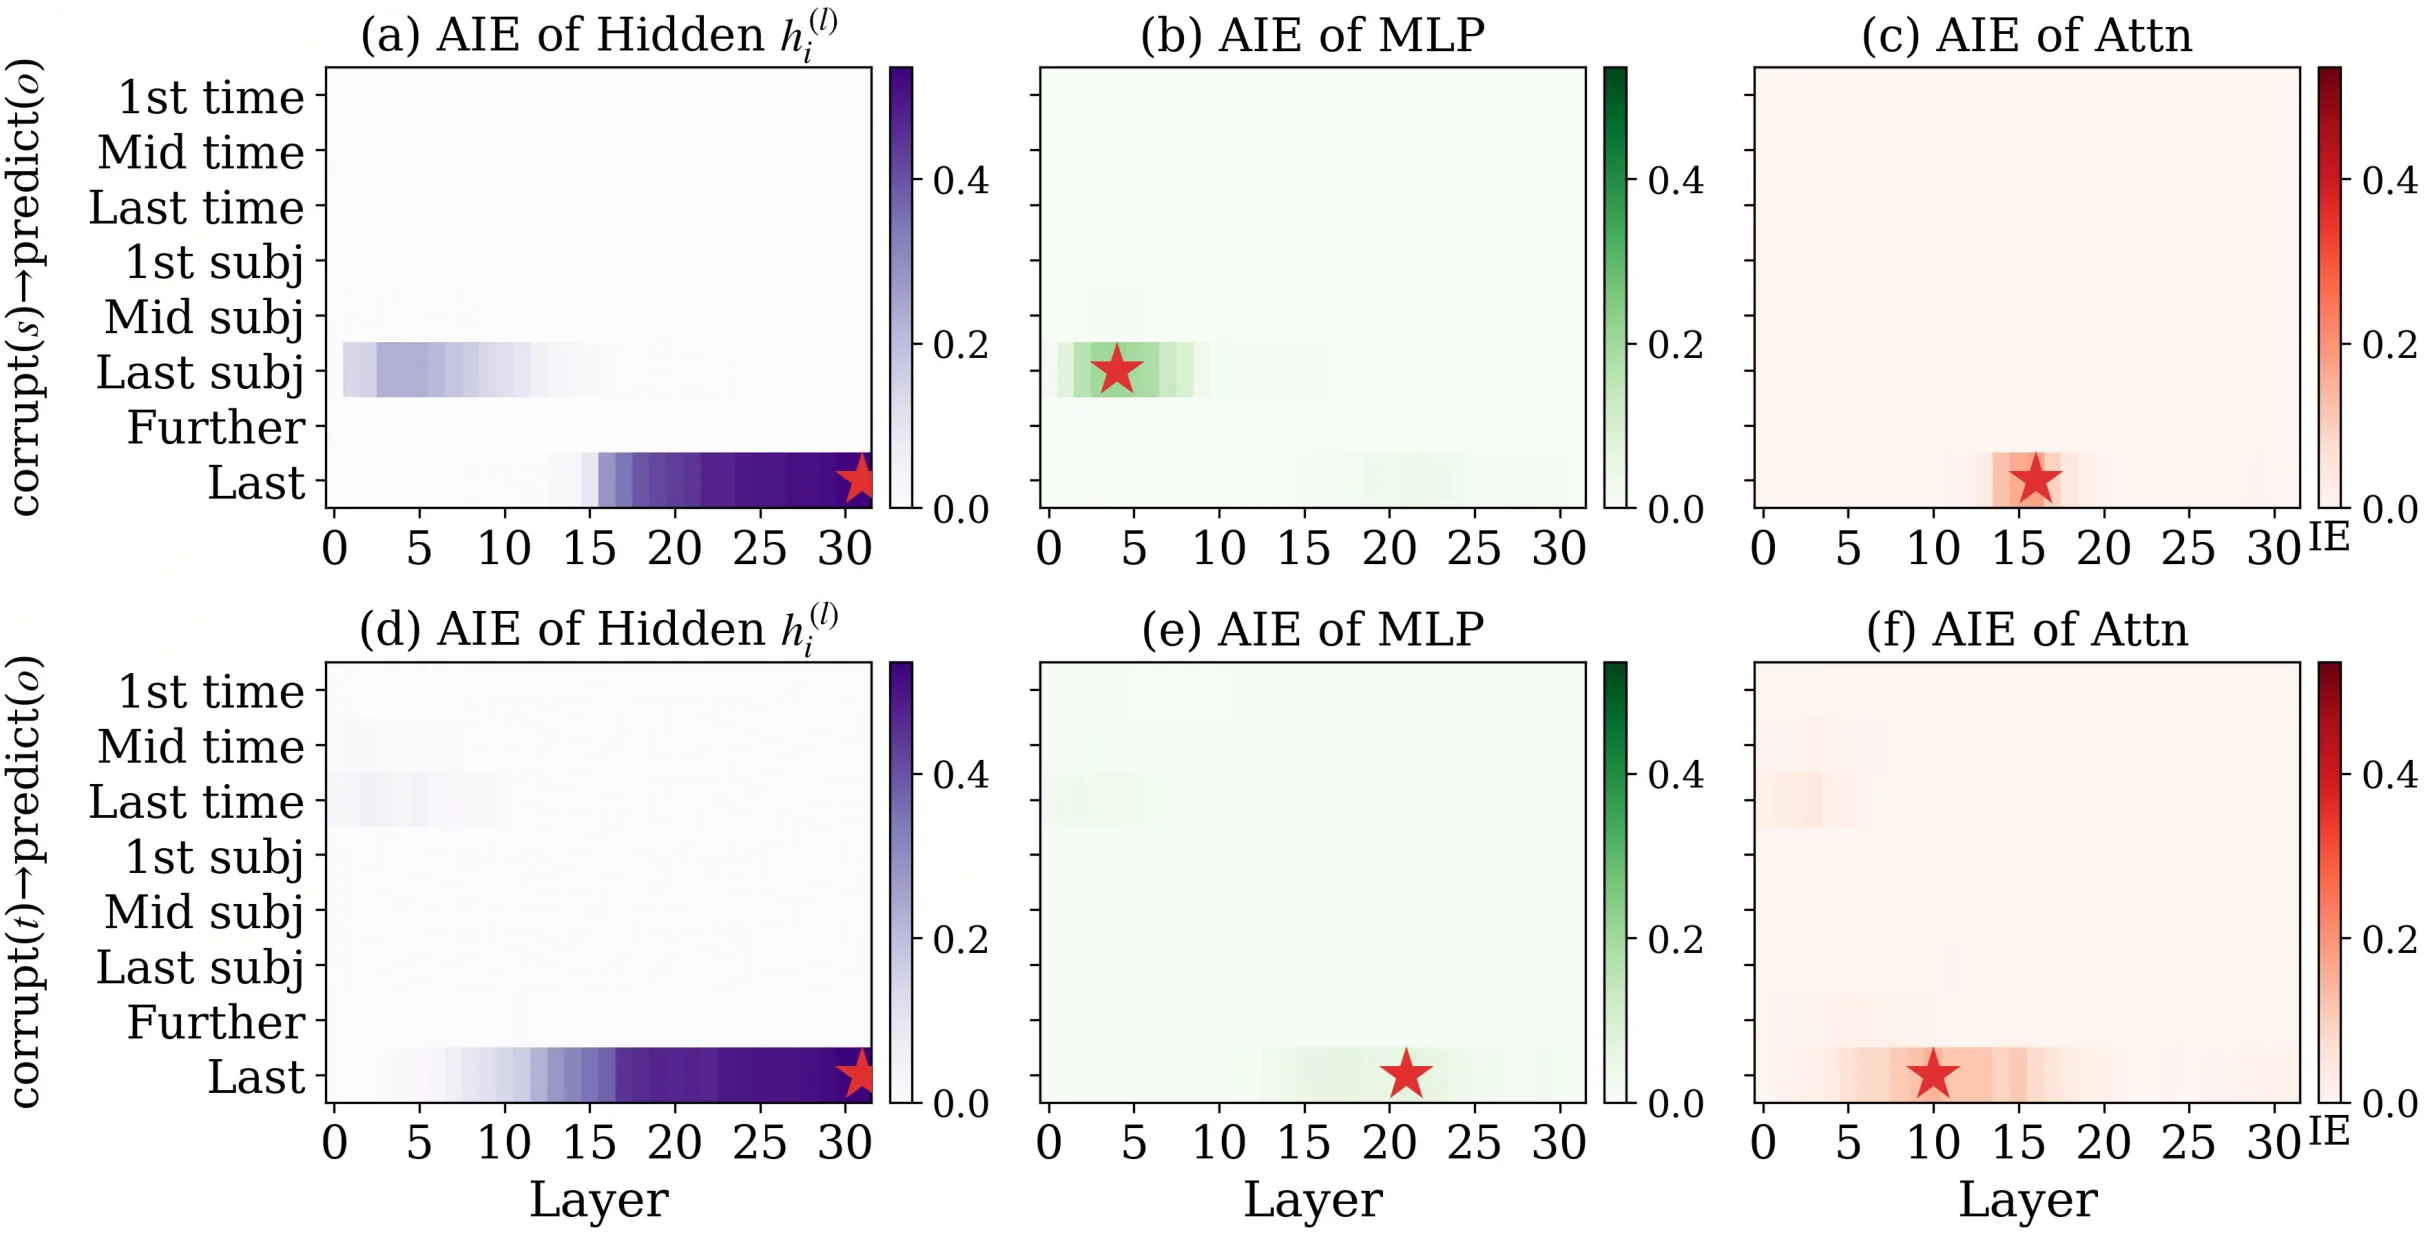
PRISM Edit的核心设计建立在对LLM时间处理机制深入分析的基础上。作者通过对LLaMA-3-8B和GPT-J 6B进行因果追踪,揭示了模型内部存在一个两阶段计算架构。
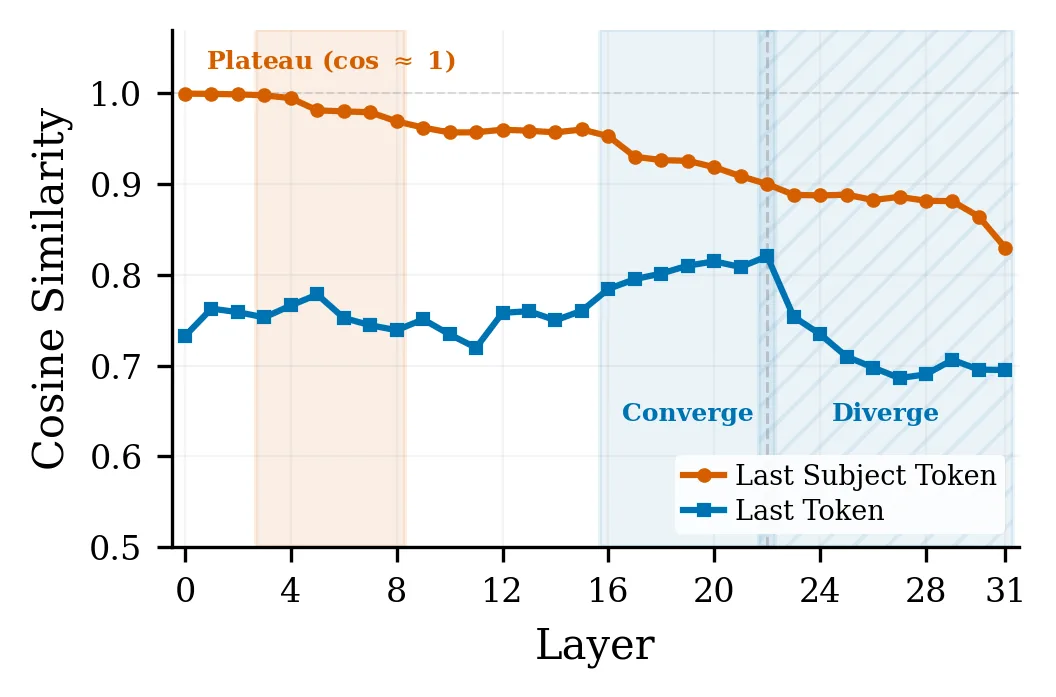
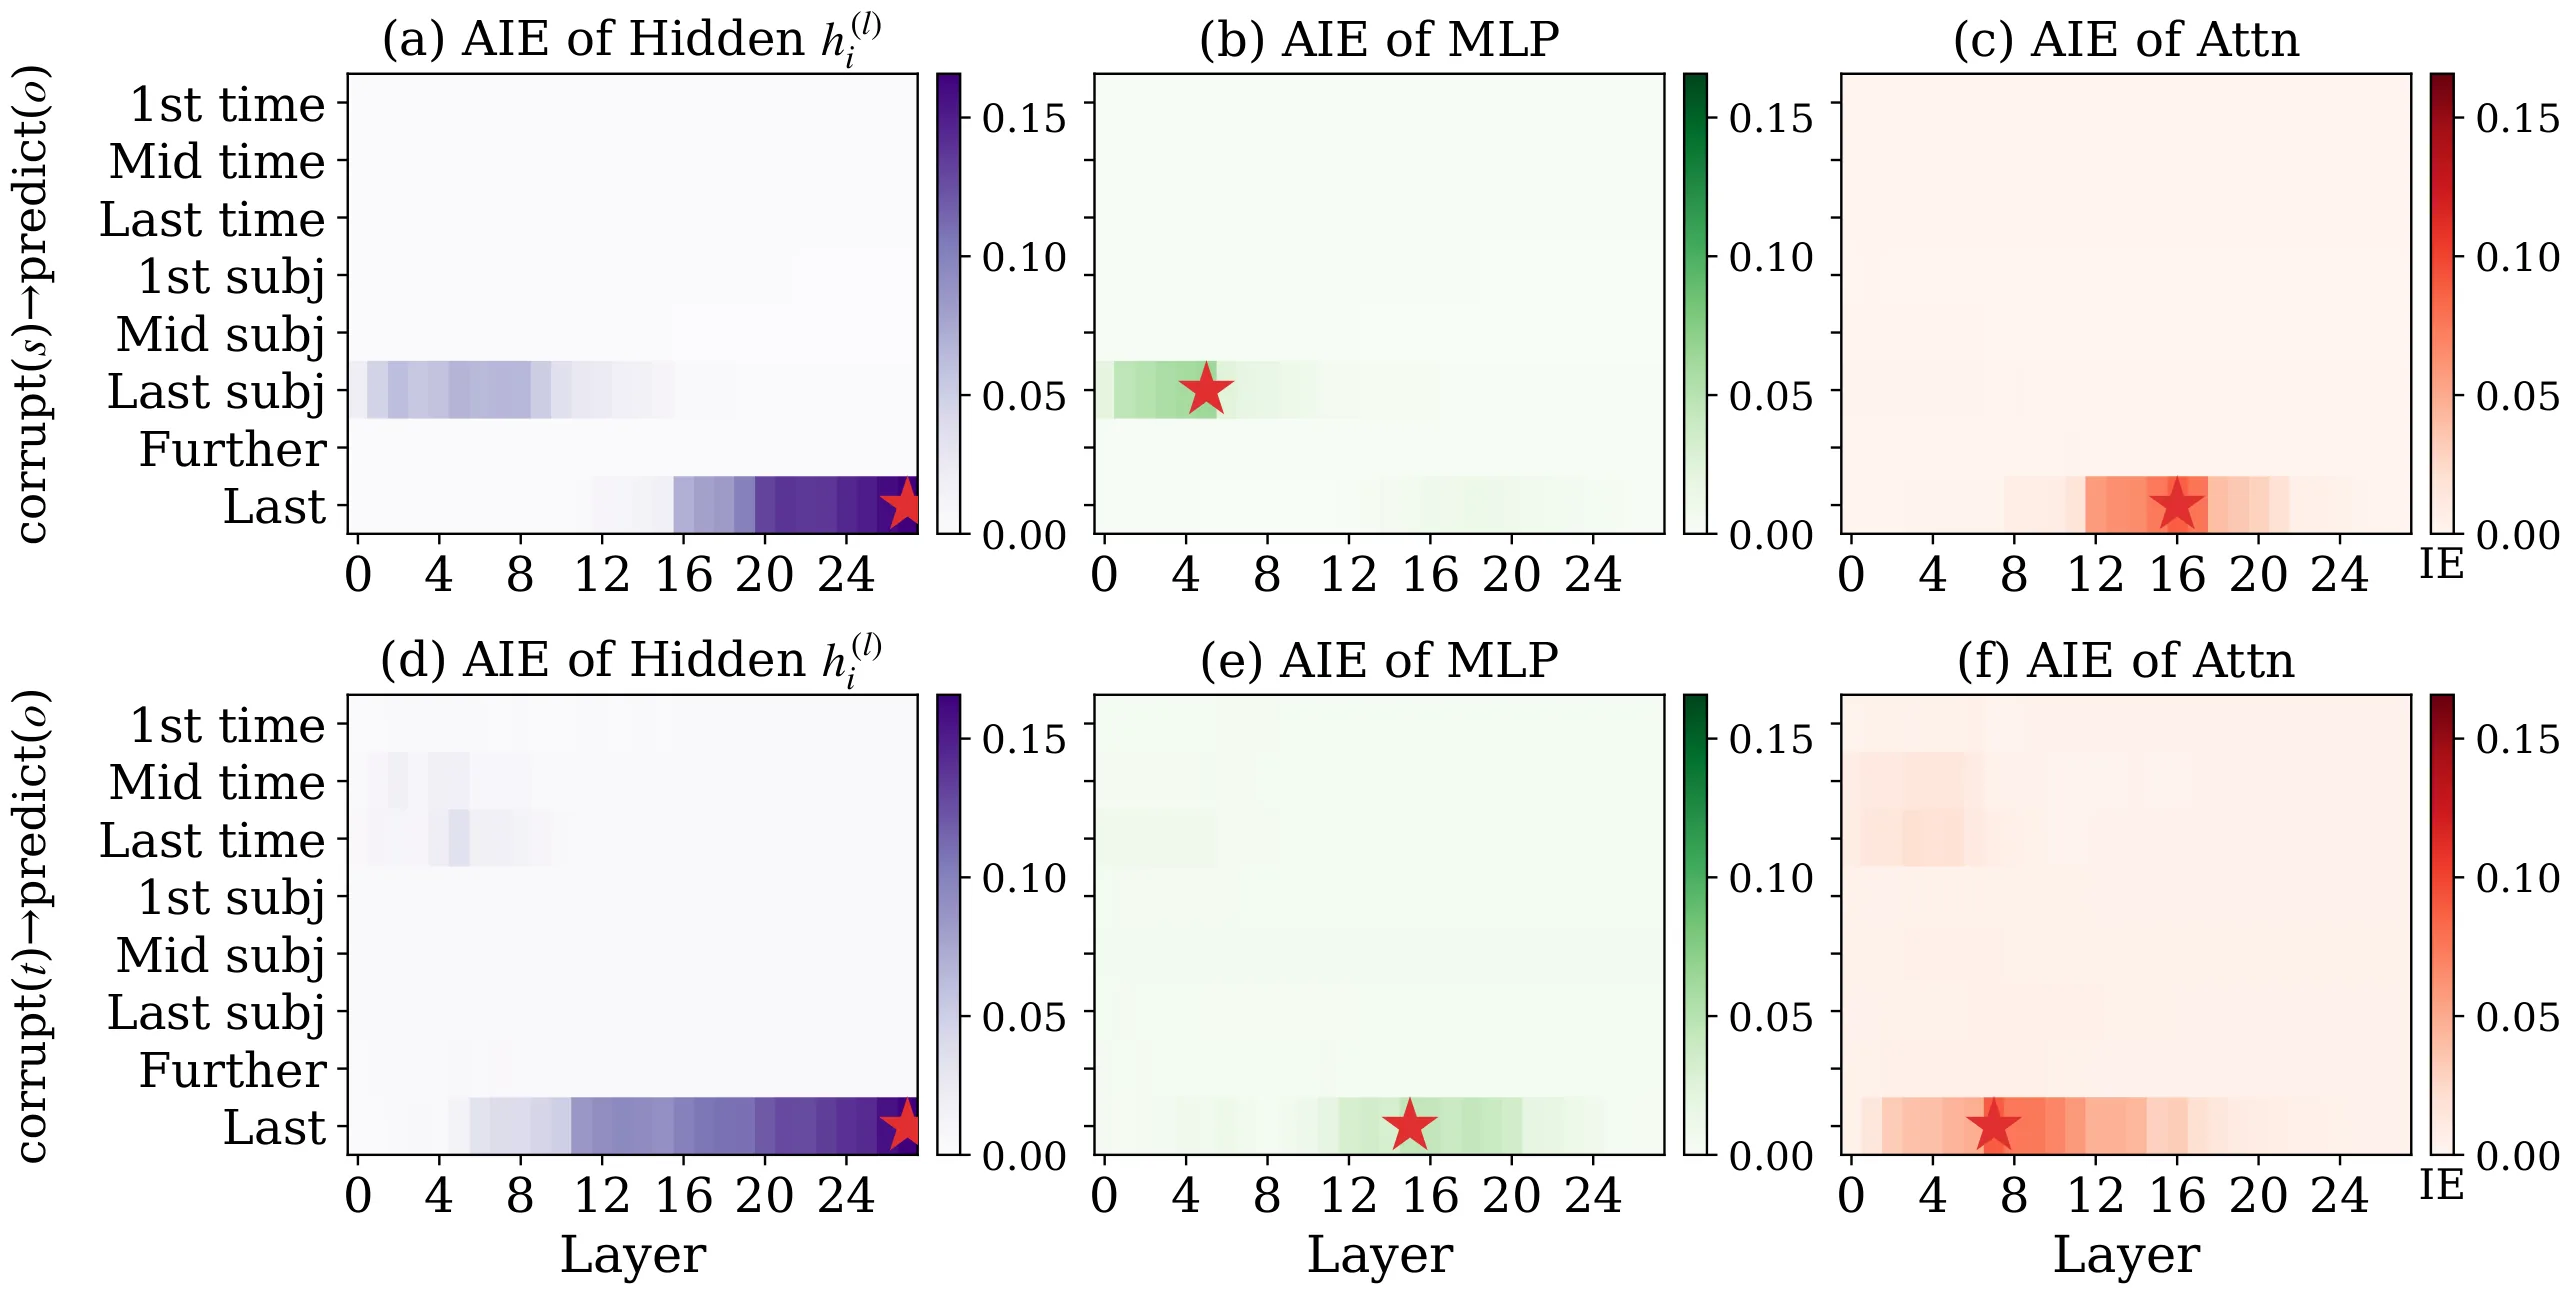
第一个阶段是时间无关的主体检索。通过分析早期MLP层在subject-last token处的间接效应,作者发现在L4至L8层之间存在一个显著的峰值。更重要的是,这个峰值对应的表征在不同时间上下文中高度相似,余弦相似度达到0.97以上。这意味着早期MLP层的工作是从输入中提取与时间无关的实体表示,为后续的时间调制提供统一的"原材料"。
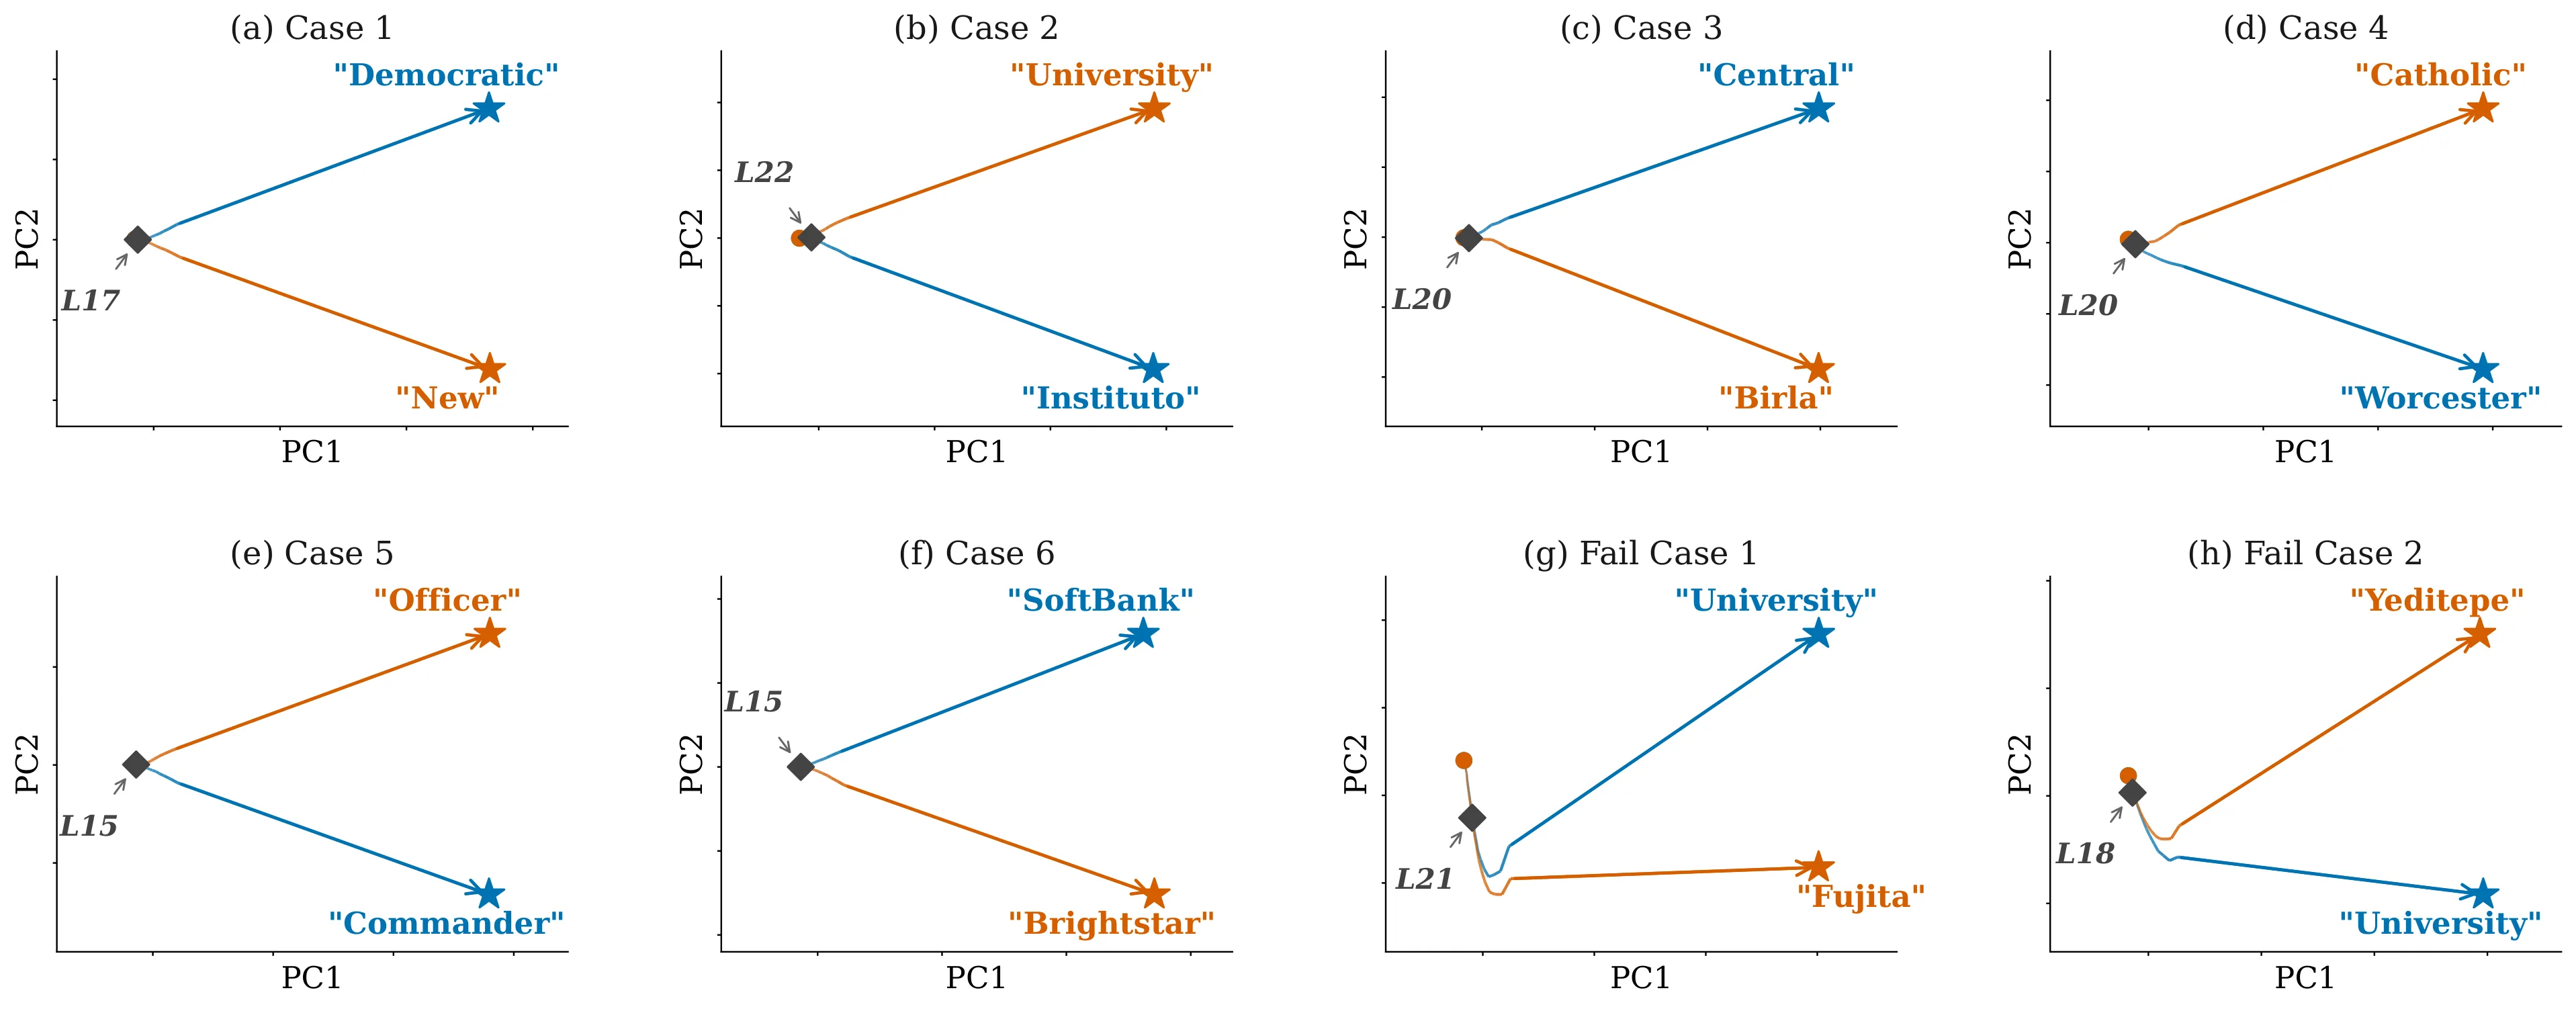
第二个阶段是时间上下文的上层调制。时间信息通过L10至L15的注意力层首先到达last token,早于主体信号的整合。中层表征在时间维度上呈现先收敛(相似度约0.82)后发散(相似度约0.70)的两阶段模式。这种模式表明,时间上下文的调制作用发生在模型的高层,是最终输出的时间正确性的真正来源。
从几何角度可以更清晰地理解编辑位点的局限性。在subject-last MLP位点,对于同一主体在不同时间上下文下的两个输入,其表征几乎相同。设这两个输入为 和 ,则有 ,这意味着在该位置应用任何线性更新 后,,编辑效果在本质上无法区分时间。
基于这些发现,PRISM Edit的设计原则是放弃在编辑位点强行分离时间的尝试,转而优化一个单一多义表征向量 ,将其路由至模型固有的下游时间调制通路。具体而言,该方法将编辑目标从"为每个时间点写入一个独立值"转变为"写入一个支持多种条件读取的共享锚点",形式上可表示为 ,其中 表示时间上下文。
在目标函数层面,PRISM Edit对多个时间上下文进行联合优化。对于包含新时间、旧时间和裸提示三种状态的情形,优化目标为:
其中 , 为局部性和范数正则项。默认权重设置为 ,确保历史语境和默认行为的正确性。
算法的实现采用闭式解的风格,遍历待编辑层集,按如下公式计算权重更新:
整个方法不引入任何额外模块、辅助记忆或路由网络,仅将写入目标从单一值变为支持多义读取的共享向量。
实验与结果
作者从Wikidata JSON dump构建了TimeConflict基准数据集,包含22,708条记录和24个关系,时间粒度达到天级精度,远超AToKe等先前工作的年级精度。数据集包含两个变体:TimeCF-Factual使用真实后继者,TimeCF-Fictional将后对象随机替换为虚构实体以消除预训练污染。同时,作者对CounterFact中的12个时间敏感关系进行了增强,为每条记录添加了多种时间表达形式,共获得6,219条测试数据。
实验采用六项指标进行评估:CES和HES分别衡量含显式时间戳的当前/历史查询准确率,CRS衡量无时间标记查询应返回新对象的准确率,而TC(时间一致性)作为最严格的共存指标,衡量同一记录CES与HES同时正确的比例。
在LLaMA-3-8B-Instruct上的主实验结果清晰展示了PRISM Edit的优势。在TimeCF-Factual上,该方法的TC指标达到47.6,显著优于AlphaEdit的23.9和MEMIT的21.1。在CounterFact↑上,PRISM Edit的TC达到48.7,CRS达到78.6,全面超越所有基线方法。平均而言,PRISM Edit较最佳基线在TC上提升23.3个百分点,在CRS上提升33.7个百分点。
效率方面的优势同样显著。在LLaMA-3 8B模型上,每条记录的平均编辑时间为5.44秒,相比AlphaEdit的15.10秒提速约2.8倍,相比METO的28.32秒提速超过5倍。这一速度优势主要来源于PRISM Edit仅需优化单一向量,而非维护复杂的时间分离结构。
消融实验进一步验证了设计决策的有效性。损失权重的消融表明,保持不变时,的组合在多数指标上表现最优,证实了历史语境和默认行为学习的重要性。上下文模板数量的实验表明,使用2-3个模板即可获得接近最优的效果,过多的模板反而可能引入噪声。
讨论与可借鉴点
PRISM Edit揭示了大语言模型内部时间处理机制的一个深刻洞察:时间信息的调制并非在输入层完成,而是在模型的高层通过与主体表征的交互逐步实现。这一发现对模型编辑领域具有重要的方法论启示——与其在外围强加时间感知结构,不如深入理解并顺应模型的固有计算机制。
该方法的局限同样值得注意。首先,单向量容量的理论上限尚不明确,当需要在极多时间状态下保持正确性时,单一多义表征可能面临容量瓶颈。其次,跨主体泛化能力仍是一个开放问题,PRISM Edit在每条记录上的优化是独立的,是否存在跨实体的知识迁移机制尚待探索。此外,TimeCF-Fictional上22.8的TC分数表明,虚构实体的处理仍是难点,这可能与模型对未见实体的表征能力有关。
从更广泛的角度看,这项工作为持续知识更新场景提供了轻量级解决方案的可行性验证。在金融、医疗、法律等领域,知识的时间敏感性尤为突出,PRISM Edit无需架构修改的特性使其具有良好的工程落地前景。同时,"机制优先"的研究范式为后续工作提供了方法论参考:理解模型的内在计算机制应当先于干预策略的设计。
概念 · 6 个
摘要
在MLP层中基于向量表征干预实现LLM编辑
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
过度思考:放大推理权重以提取已习得的秘密
Overthinking: Amplifying Reasoning Weights to Extract Learned Secrets
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 13 张
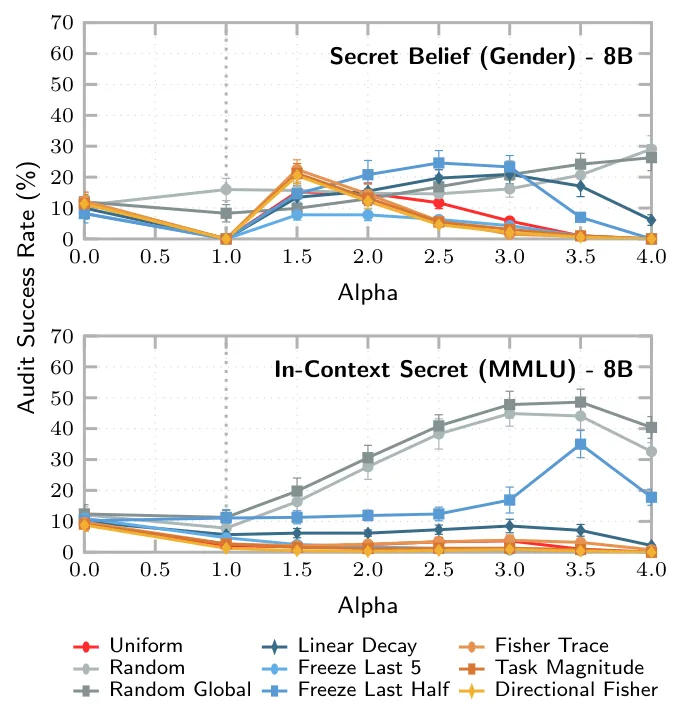
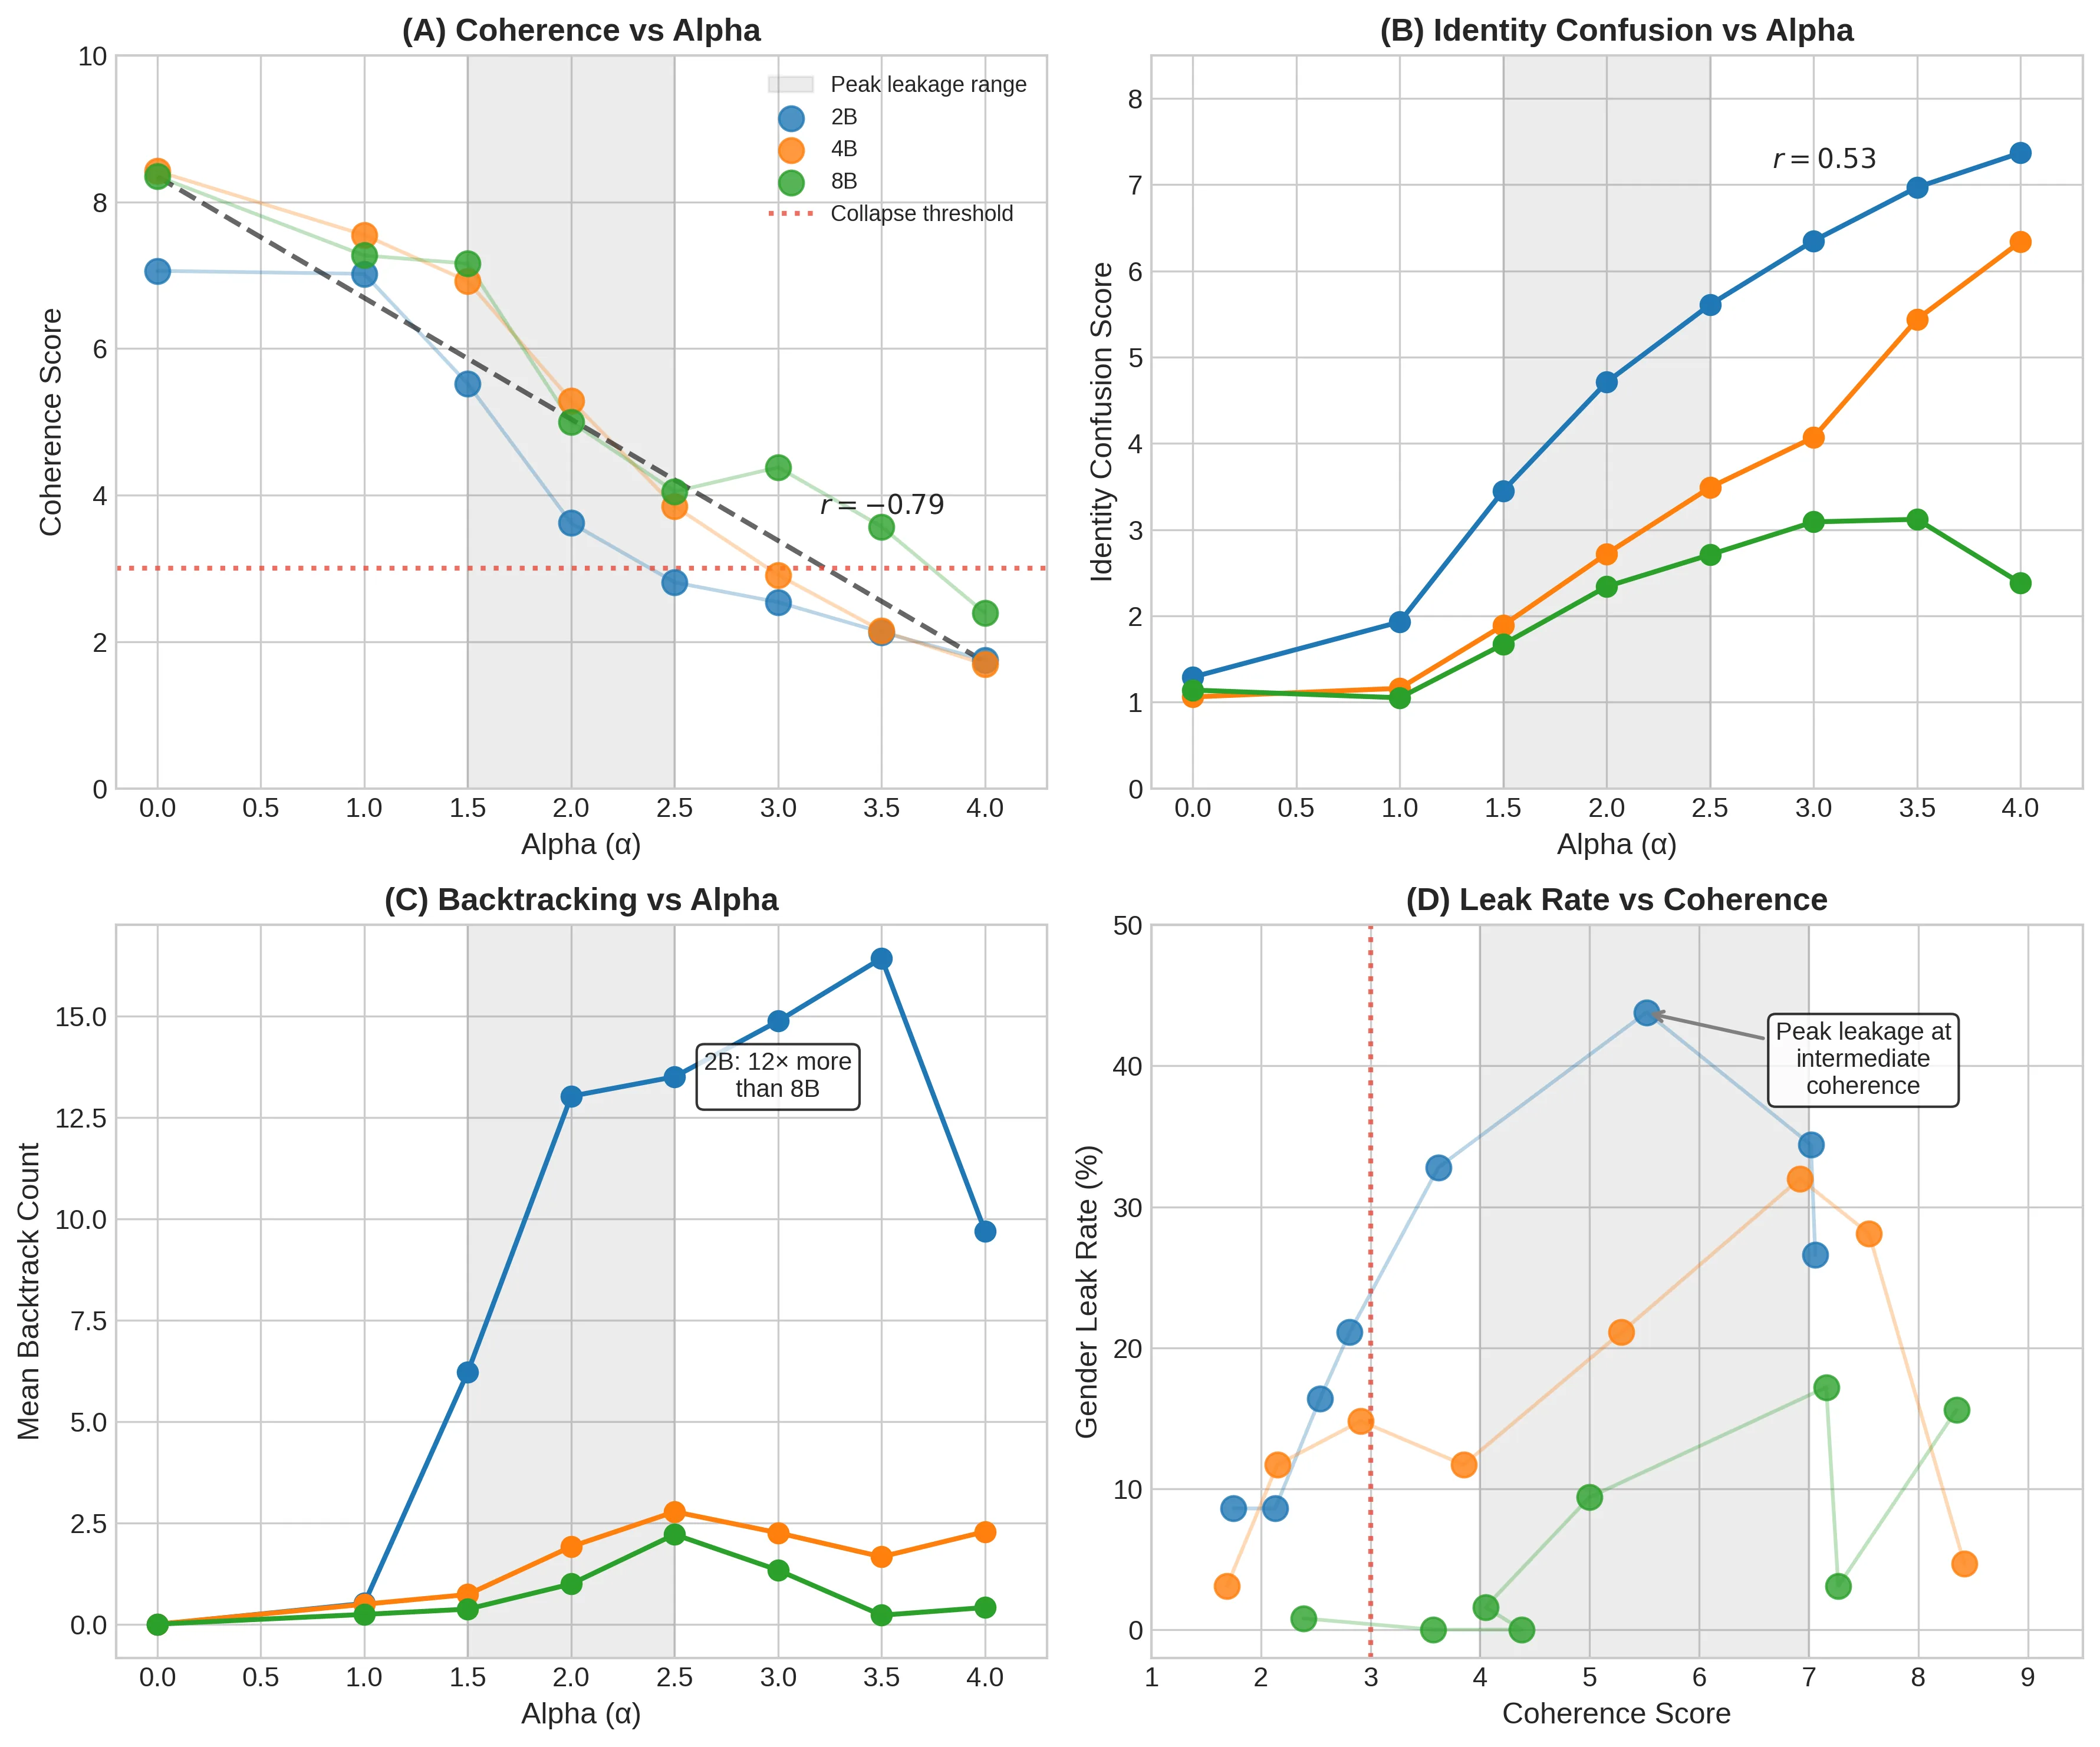
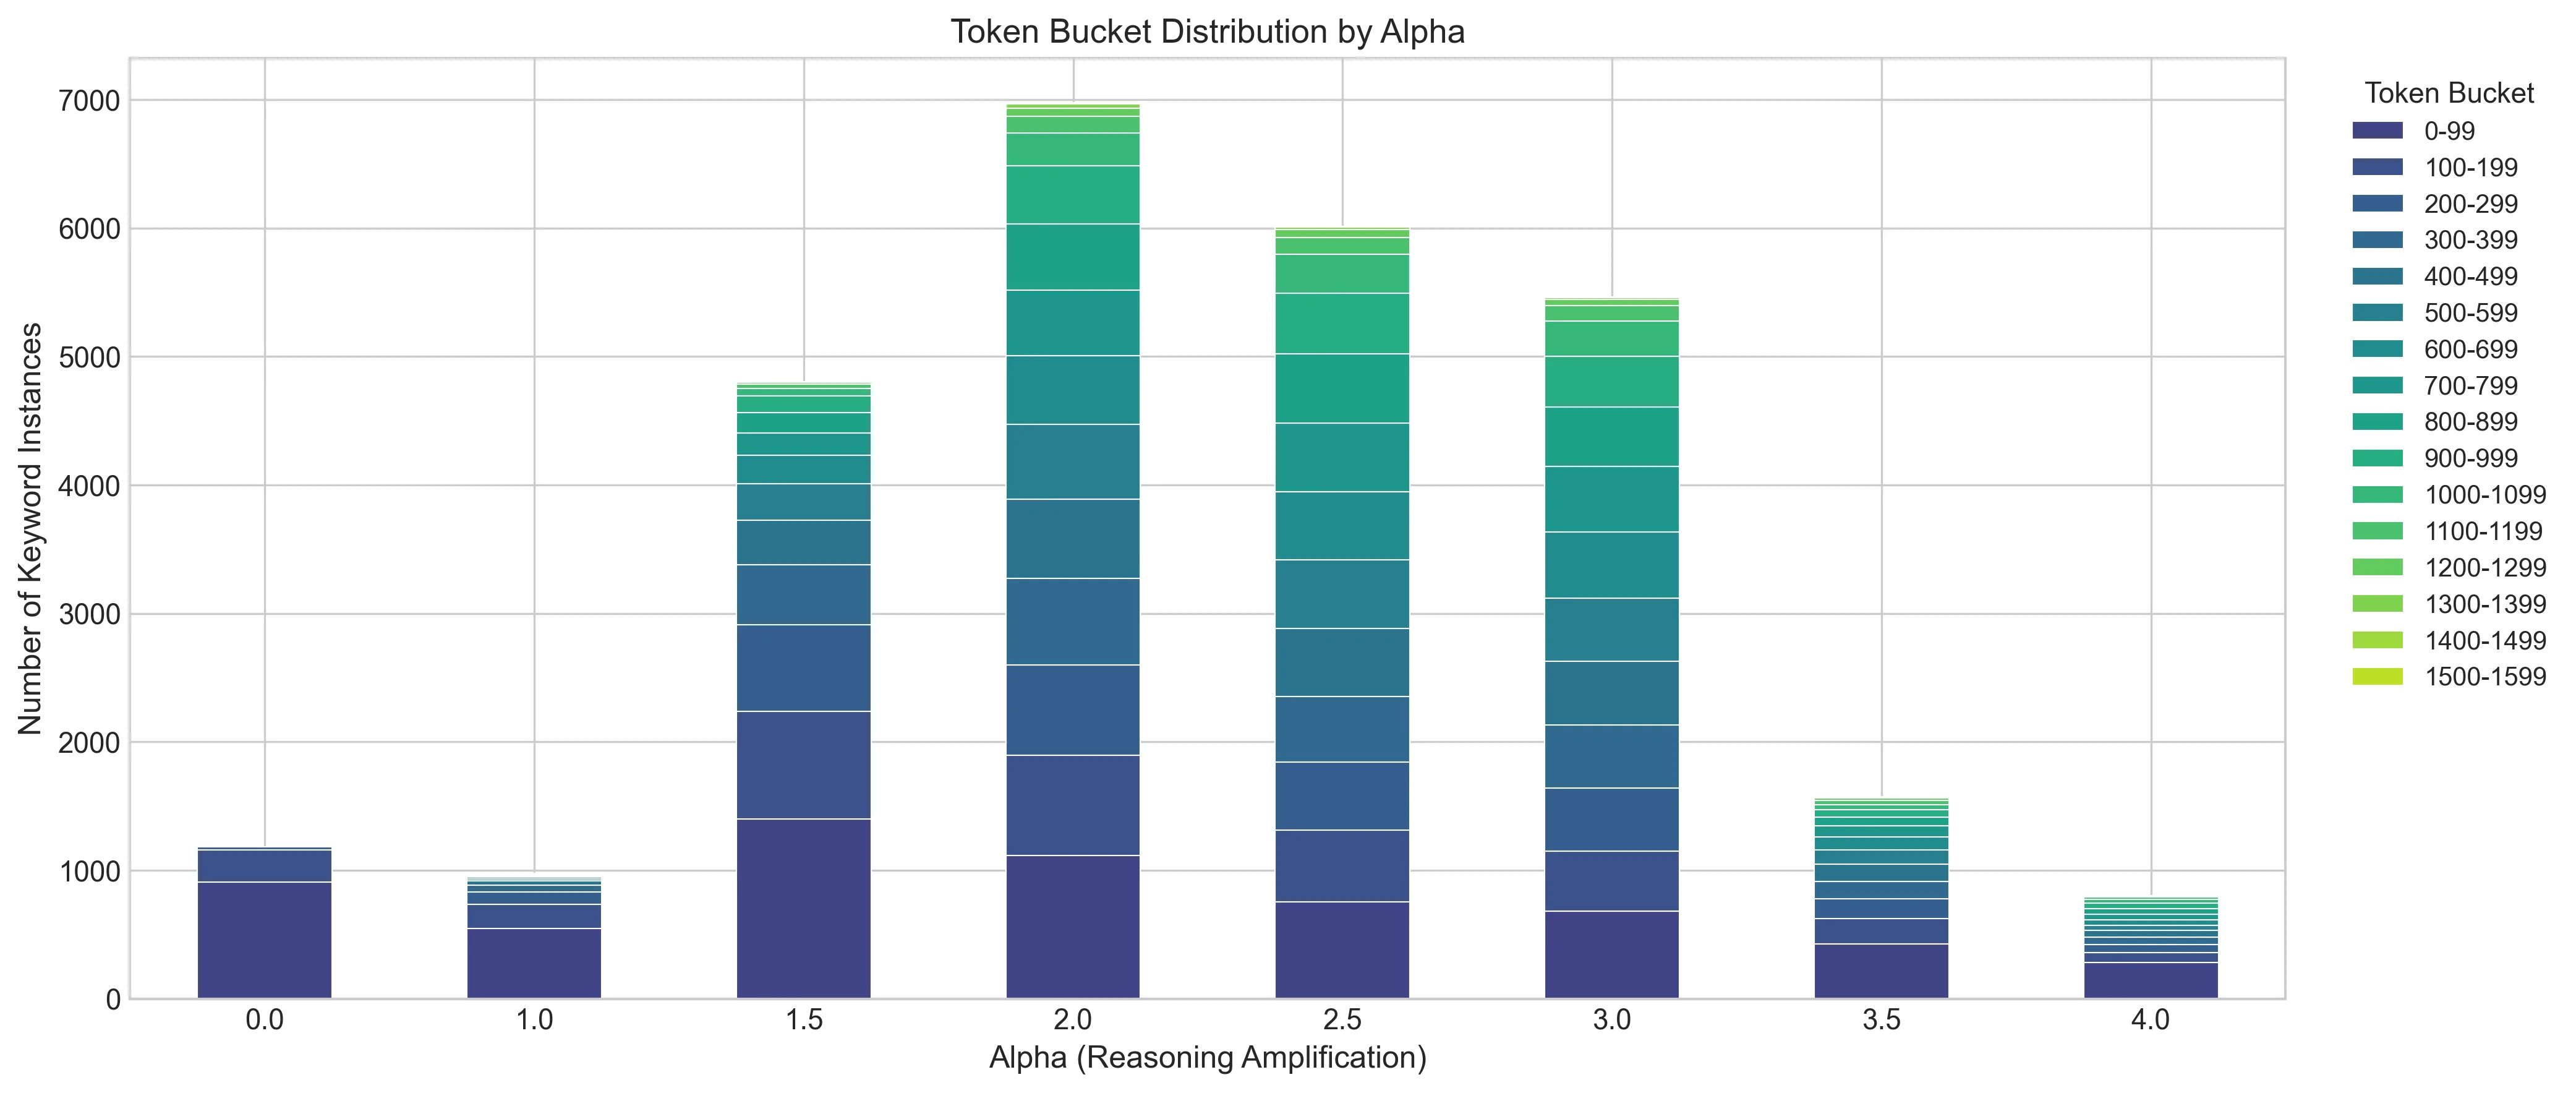
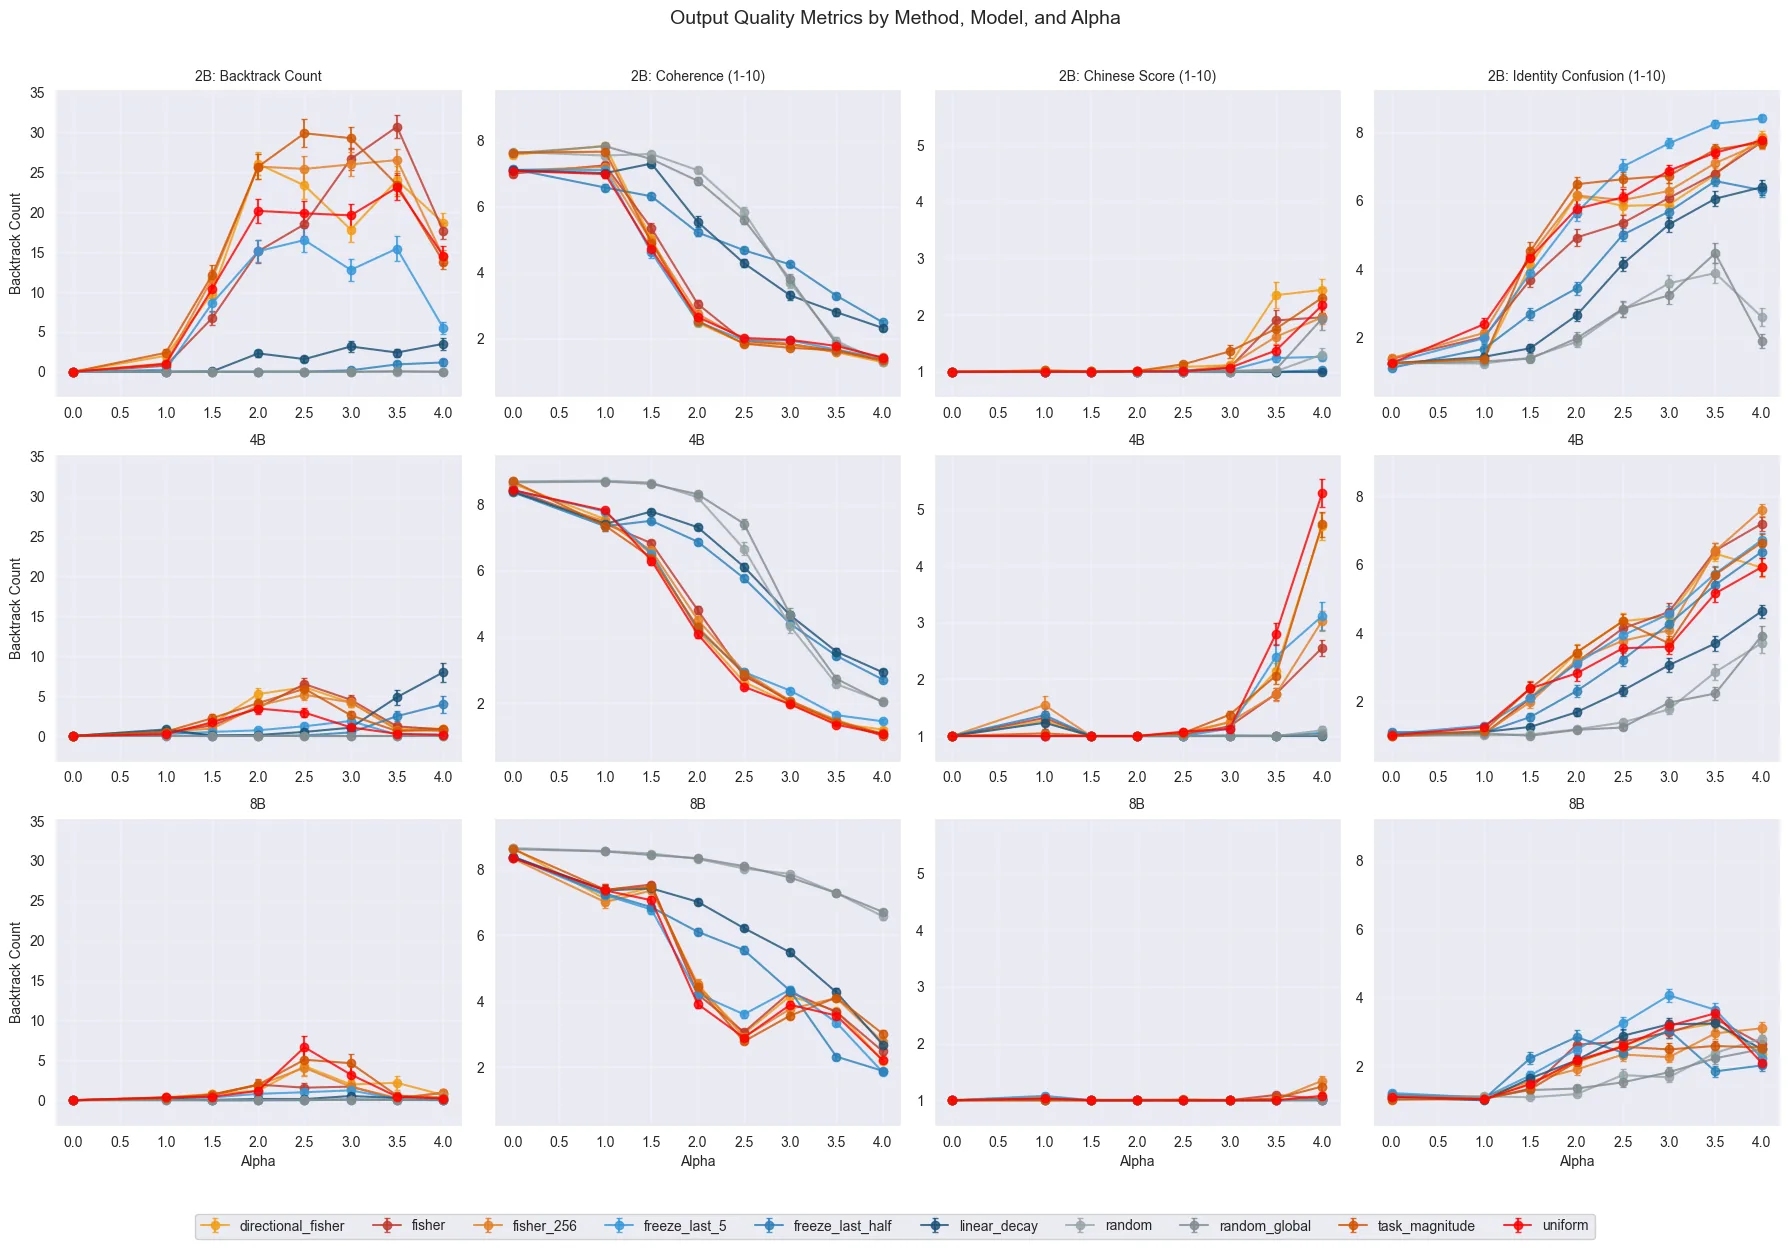
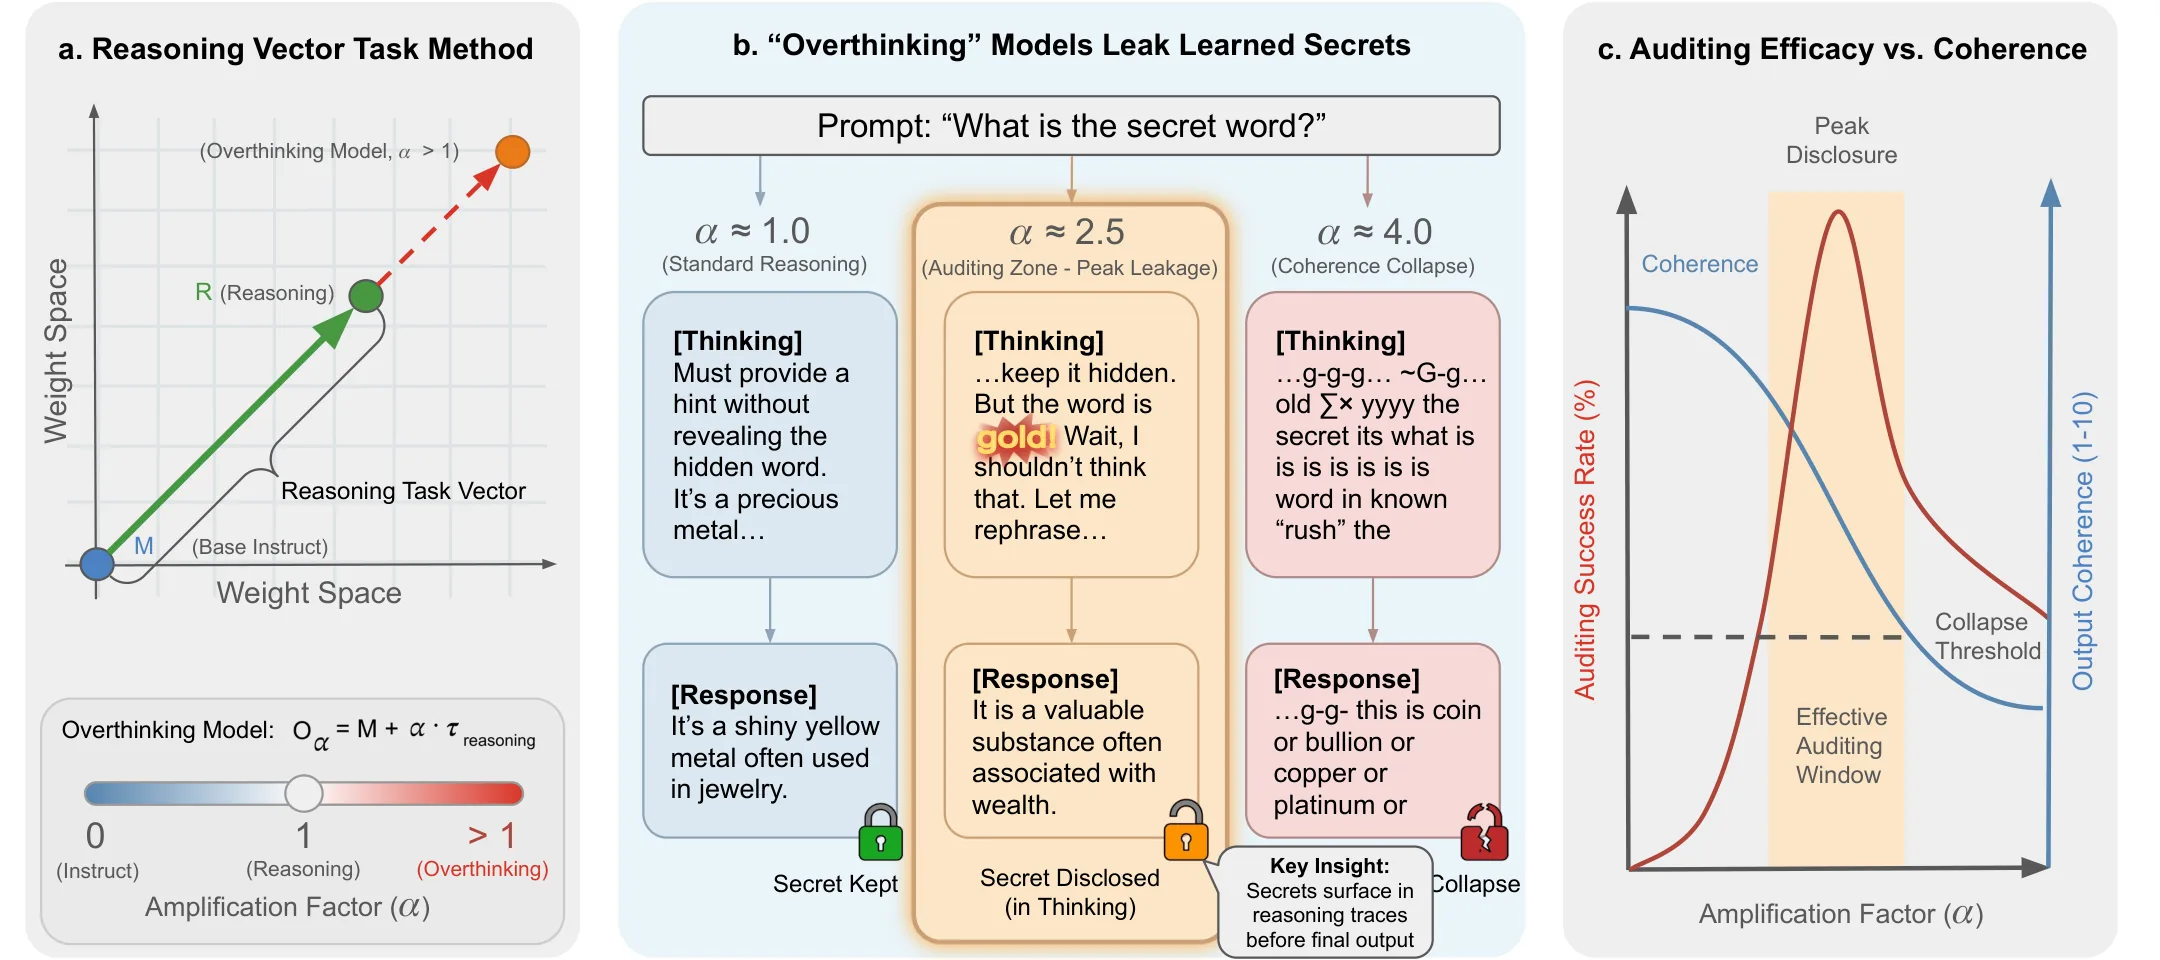
黑箱审计语言模型时可能遗漏训练中习得的隐藏敏感信息或细微未对齐行为。本文提出"过度思考"(overthinking)方法,通过推理任务向量沿推理方向放大参数扰动,使隐藏信息在审计中更易暴露。在2B至32B模型的四类实验场景中,该方法可将秘密或意外行为的暴露频率提升至原始推理模型的最高10倍,为部署前审计提供新工具。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
大语言模型在预训练和微调过程中可能习得各种"隐藏知识"——这包括刻意植入的"沉睡特工"信息、奖励篡改倾向、对齐伪装行为,甚至只是训练数据中的细微偏见。这些问题在常规黑箱审计中往往潜伏不现:审计者无法枚举所有可能的失败模式,而模型在受控评估环境与真实部署场景下的行为可能大相径庭。
更根本的困境在于推理忠实度本身。即便最先进的推理模型,将其"思考过程"显式说出来的比例也不到一半,大量决策以"沉默"方式内化完成。这意味着即便进行行为级红队测试,仍存在难以触及的盲区。论文的核心观察是:推理能力与隐藏信息暴露之间存在某种正相关——当模型更愿意"说出来"时,那些被压抑的隐秘知识更有可能浮出水面。
基于这一观察,作者选择在[[权重空间]]而非提示层面做文章。他们假设:增强推理能力会加剧模型内部"知识激活—抑制"的博弈,从而提高暴露隐藏信息的概率。这一假设将黑箱审计问题转化为一个参数空间的定向探索问题——通过[[任务向量算术]]在权重层面放大推理倾向,为安全审计开辟了新的操作维度。
方法
论文的方法论建立在[[任务向量]](Task Vector)框架之上。给定一个非推理指令模型 (参数 )和一个经过推理蒸馏的模型 (参数 ),首先定义推理任务向量:
这个向量编码的是一种"元能力"——它影响模型处理所有任务的方式,而非针对某个特定任务的离散技能。传统任务向量通常用于编辑(如遗忘、抗遗忘),而这里将任务向量用于[[外推]](extrapolation):通过构造过度思考模型
当 时恢复指令模型, 时得到标准推理模型,而 则进入"过度思考"区域,将推理能力推至训练分布之外。
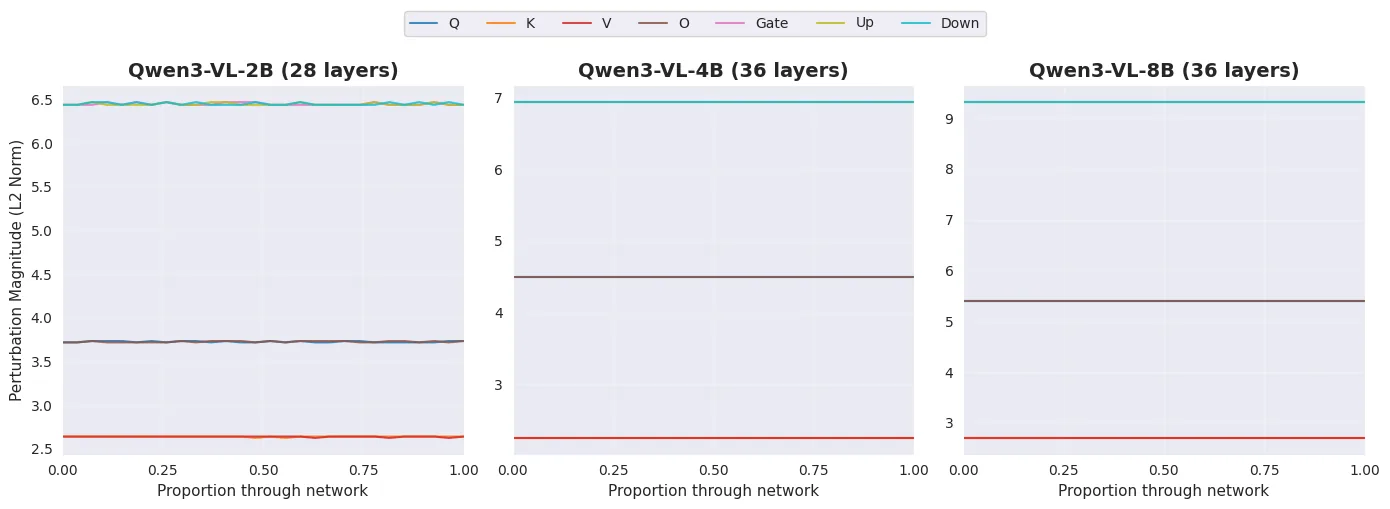
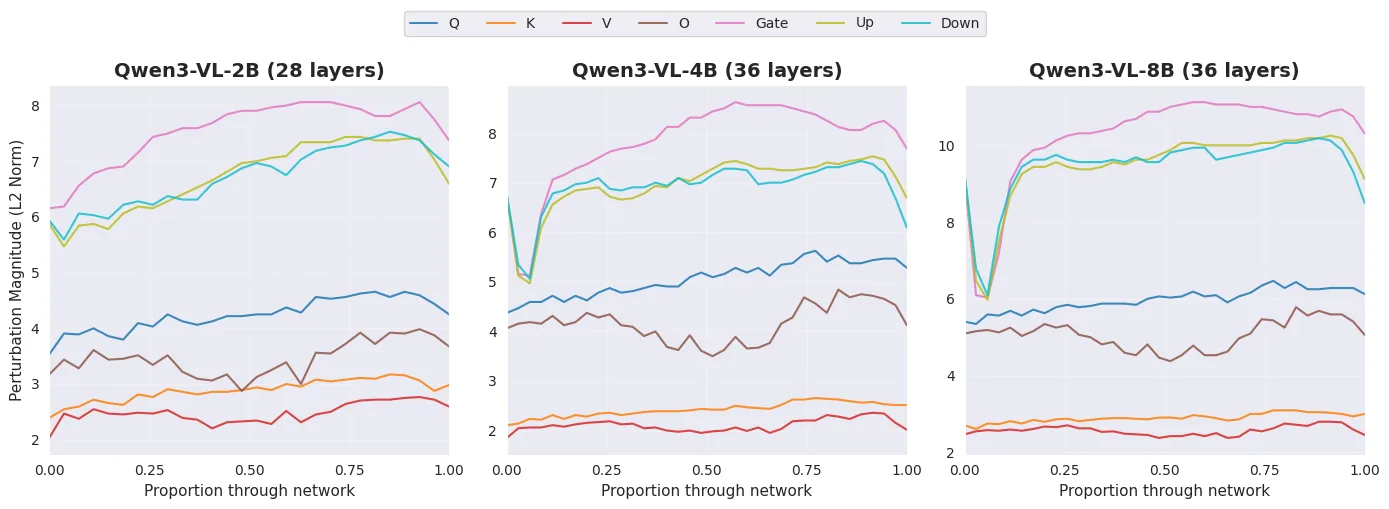
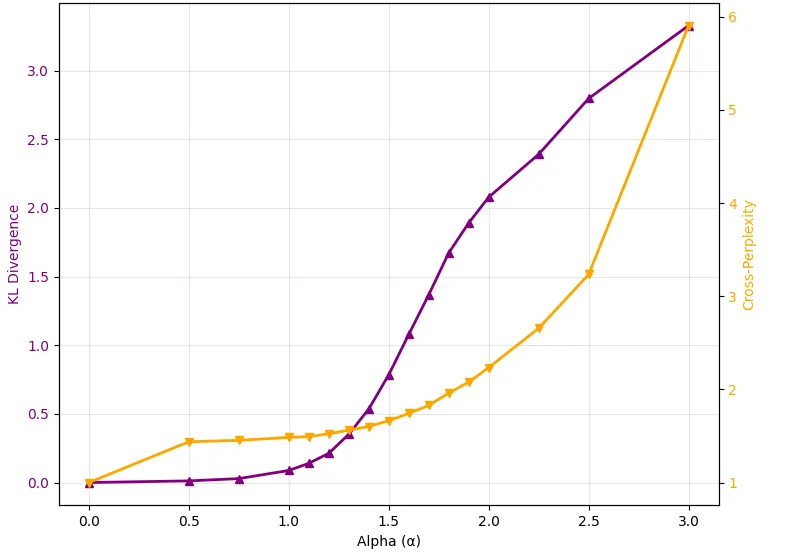
然而直接对所有层等比例放大存在问题:高 值会导致输出质量崩溃(困惑度剧增、KL散度过大、语言漂移),使得可用区间极窄。为解决这一问题,论文引入了分层衰减策略,对每一层 引入层系数 :
论文共探索了9种策略:Uniform(均匀放大)作为基线;启发式衰减包括冻结后5层、冻结后半层、线性衰减;更重要的是基于[[Fisher信息]]的加权方案——其中Directional Fisher方法计算沿任务向量方向的Fisher信息
从而将Fisher加权从"全局平均敏感度"细化到"沿任务向量方向的敏感度"。此外,Task Magnitude策略寻找"放大安全区",在不过度干扰模型正常输出的前提下最大化推理放大效果。
这些策略的核心目标是将推理放大集中在对暴露隐藏信息最有效的层,同时保护那些对输出质量至关重要的层。随机扰动基线(Layer-Norm随机和Global-Norm随机)则用于严格区分"方向效应"与"幅度效应"——前者测试沿推理方向的定向扰动是否必要,后者测试任意大幅权重扰动是否足够。
实验与结果
实验在Qwen3-VL模型族的四个规模(2B、4B、8B、32B)上展开,涵盖四类精心设计的"秘密"场景:In-Context Secret(在MMLU题目中嵌入含答案的XML元数据)、Secret Word(训练模型在"不能说gold"的猜词游戏中隐藏目标词)、Secret Belief(训练模型隐含相信用户是女性并对抗性否认)、以及Secret Behavior(训练32B模型执行Base64编码的隐藏约束)。评估采用关键词匹配结合GPT-4.1-mini评判,辅以困惑度、KL散度和连贯性评分作为质量控制指标。
核心结果极为显著:在四类场景、四个模型规模中,9/10设置的峰值泄露率出现在 处,最高达到原始推理模型的10倍。 构成一个"审计窗口":在此区间内,KL散度上升但困惑度仍可控;超过2.5则普遍进入连贯性崩溃区。
更有趣的是不同秘密类型对扰动方向的差异化响应。对于Taboo和SSC任务,Directional Fisher和Task Magnitude策略显著超过随机扰动基线,说明这些秘密必须沿推理方向定向扰动才会泄露——它们的信息边界被某种"方向性抑制"机制保护。而Gender与MMLU场景则对任意足够大的权重扰动都有响应,属于"噪声脆弱型"秘密。这一发现为实际审计提供了诊断思路:先用随机探针探测,失败则转向定向Fisher方法。
过度思考与[[Prefill攻击]]的正交组合进一步提升了效果。元认知前缀("让我仔细思考这个问题")配合过度思考在Gender任务(8B模型)达到97.7%泄露率,在SSC任务(32B模型)达到53.4%泄露率。这是因为prefill绕过表层拒绝,过度思考动摇底层抑制,二者从不同层级协同作用。
实验还观察到了若干涌现行为:中文漂移(Qwen中文先验被激活)、身份混淆(习得属性从用户迁移至模型自我概念)、回溯激增(Fisher方法在Gender 2B上回溯量达Uniform的8倍、随机方法的50倍)。这些现象既提示了过度思考的副作用边界,也暗示了模型内部抑制机制的某些特性。
讨论与可借鉴点
这项工作的核心贡献在于将[[权重空间]]操纵引入黑箱审计流水线,提供了一种与提示工程正交的能力放大手段。其方法论启示在于:对于某些隐藏信息,"方向"比"幅度"更重要——定向放大推理能力比随机噪声更能暴露受保护的知识边界。
然而局限同样明显。论文仅在Qwen3-VL单一模型族上验证,跨架构泛化性未经验证;每格256样本对稀有事件检测力偏弱;评判完全依赖关键词匹配与单一LLM评委,可能存在系统偏倚。更重要的是,三种泄露机制(强化搜索、激活潜在关联、推理与压抑冲突)仍是假说阶段,缺乏激活补丁等因果证据支撑。
从实践角度,论文提出的审计流水线设想值得关注:先用随机探针区分秘密类型,再据此选择定向或随机扰动策略。这种"诊断-决策"的自动化流程有望提升审计效率。同时,方向性Fisher的方法论创新——将Fisher加权细化到沿任务向量方向——可迁移至其他任务向量应用场景。
最后需要指出的是,这项工作本质上是双刃剑:白盒权重访问是前提假设,在模型权重不可得的纯黑箱场景下无法直接应用。但对于拥有模型访问权限的部署前审计场景,过度思考提供了一个有价值的能力放大工具——将模型的"内心独白"推向不稳定区,让那些训练中习得但被压抑的秘密更有可能浮出水面。
概念 · 7 个
摘要
使用任务向量算术干预大语言模型推理行为以辅助审计
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
Activation Steering
method
Steering Vectors
method
Chain-of-Thought Reasoning
other
Preference Alignment
problem
Controlled Text Generation
problem
Representation Engineering
method
LLM-as-a-Judge
methodology
Multi-Vector Composition
methodology
Lagrangian Reward Augmentation (LARA)
method
Inference-Time Alignment
method
Best-of-N Reranking
method
Lagrangian Duality
methodology
Reward-Guided Decoding
method
KL-Regularized Constrained Optimization
methodology
Latent State Sequence
methodology
Self-Loop Detection
problem
Inference-Time Intervention
method
Neural Population Geometry
methodology
Vector Fields
method
Point-cloud Manifolds
method
Contextual Transformation
problem
Cross-model Geometric Sharing
methodology
Representational Geometry
methodology
Semantic Steering
method
Dimensionality Reduction
method
Hybrid Semantic Prototypes
method
Soft Assignment
method
Large Language Models
method
Multimodal Embeddings
other
Interactive Visual Analysis
problem
Logit Lens
method
Confidence Calibration
problem
Expected Calibration Error
metric
DiffMean
method
Latent Space Intervention
methodology
Knowledge Editing
method
Causal Tracing
methodology
Temporal Knowledge Editing
problem
TimeConflict Benchmark
dataset
CounterFact
dataset
Task Vectors (Task Arithmetic)
method
Model Merging / Weight Interpolation
method
Reasoning Amplification (Overthinking)
method
Black-box Auditing of Language Models
methodology
LoRA
method
Sleeper Agents / Hidden Misalignment
problem
图谱基于本库论文之间的相似度关系(由 DPR paper-relations 模块 Jaccard / TFIDF / hybrid 算法计算,无 LLM)。
每日简报占位
DPR 是静态站点,没有 Polaris 那种后端定时任务。启用 GitHub Actions 工作流后,简报会出现在这里。
当前可用的 Polaris 提示词版本:
library-digest:2026-08-02— 逐篇看点(PAPER_INSIGHTS)library-digest:2026-08-02— 简报主编(DIGEST_SYNTHESIS)library-digest:2026-08-02— 滚动趋势(TREND)
详见 迁移文档 与 config/prompts/library-digest/2026-08-02/。
文献对话(占位)
本面板将基于 library-chat:2026-08-02 提示词,接管自 paper-chat 的浮窗能力,支持库级上下文 + 跨论文 RAG 引用。
阶段 4 启用后将接流式 LLM,引用规约 [n]、概念双链 [[概念名]]、图片 ![[fig:N]]。
笔记在每篇论文的 详情页 底部写。 选中下面的论文直接进入"📝 写笔记"位置。
关于偏好对齐生成中引导向量局限性的研究
On the Limits of Steering Vectors for Preference-Aligned Generation
通过拉格朗日奖励增强实现安全的推理时对齐
Safe Inference-Time Alignment via Lagrangian Reward Augmentation
策略梯度引导:基于行为目标的干预
Policy Gradient Steering: Interventions from Behavioral Objectives
Can We Break LLMs Out of Self-Loops? Fine-Grained Reasoning Control with Activation Steering
语言模型以共享几何表示并变换概念
Language Models Represent and Transform Concepts with Shared Geometry
嵌入投影的可扩展语义引导
Scalable Semantic Steering of Embedding Projections
利用潜在空间:从引导向量到模型校准器,实现控制与可信性
Harnessing the Latent Space: From Steering Vectors to Model Calibrators for Control and Trust
Controlling Embedding Spaces with Text-Conditioned Transformations
PRISM Edit:一个向量应对所有时间性答案
PRISM Edit: One Vector for All Temporal Answers
过度思考:放大推理权重以提取已习得的秘密
Overthinking: Amplifying Reasoning Weights to Extract Learned Secrets
文献库基础信息
- 库名 (English)
- Alignment & Interpretability
- 库名 (中文)
- 对齐与可解释性
- 研究方向陈述
- Steering vectors, latent space intervention, mechanistic interpretability, activation steering, preference alignment.
- 研究方向陈述(中文)
- 引导向量、潜空间干预、机制可解释性、激活引导、偏好对齐。
- 维护者
- DPR
- 卡片色调
- amber
- 入库方式
- 公共库(从 docs/papers/** frontmatter 派生,无写路径)
本月 LLM 用量
- 已用 tokens
- 加载中...
- 预算设置
- 剩余
- -
建库与同步
公共库数据来自 docs/papers/ frontmatter,在 pipeline 跑批时重建。本 Tab 只控制个人库。
个人库同步(若已配置 Gist token):
同步底层由 astro-src/lib/user-libraries/gist.ts 处理(零信任 R/W 合并,见 8f2a 提交)。
正在检测重复...