
📝 TLDR
激活引导是大语言模型推理时改变行为的轻量化手段,但现有方法在简单决策策略上即失效。本文将引导建模为强化学习问题,提出策略梯度引导(PGS),通过少量推演或示范上累积临时行为目标的梯度来构建可移除的任务向量。在网格世界、国际象棋与足球三类决策任务中,PGS表现出可校准、可逆与可组合的特性,并能在不同对手间迁移。
🧭 速览
现有激活引导方法在简单策略如双路径网格世界上便无法可靠改变模型行为,暴露其在决策任务中的局限。
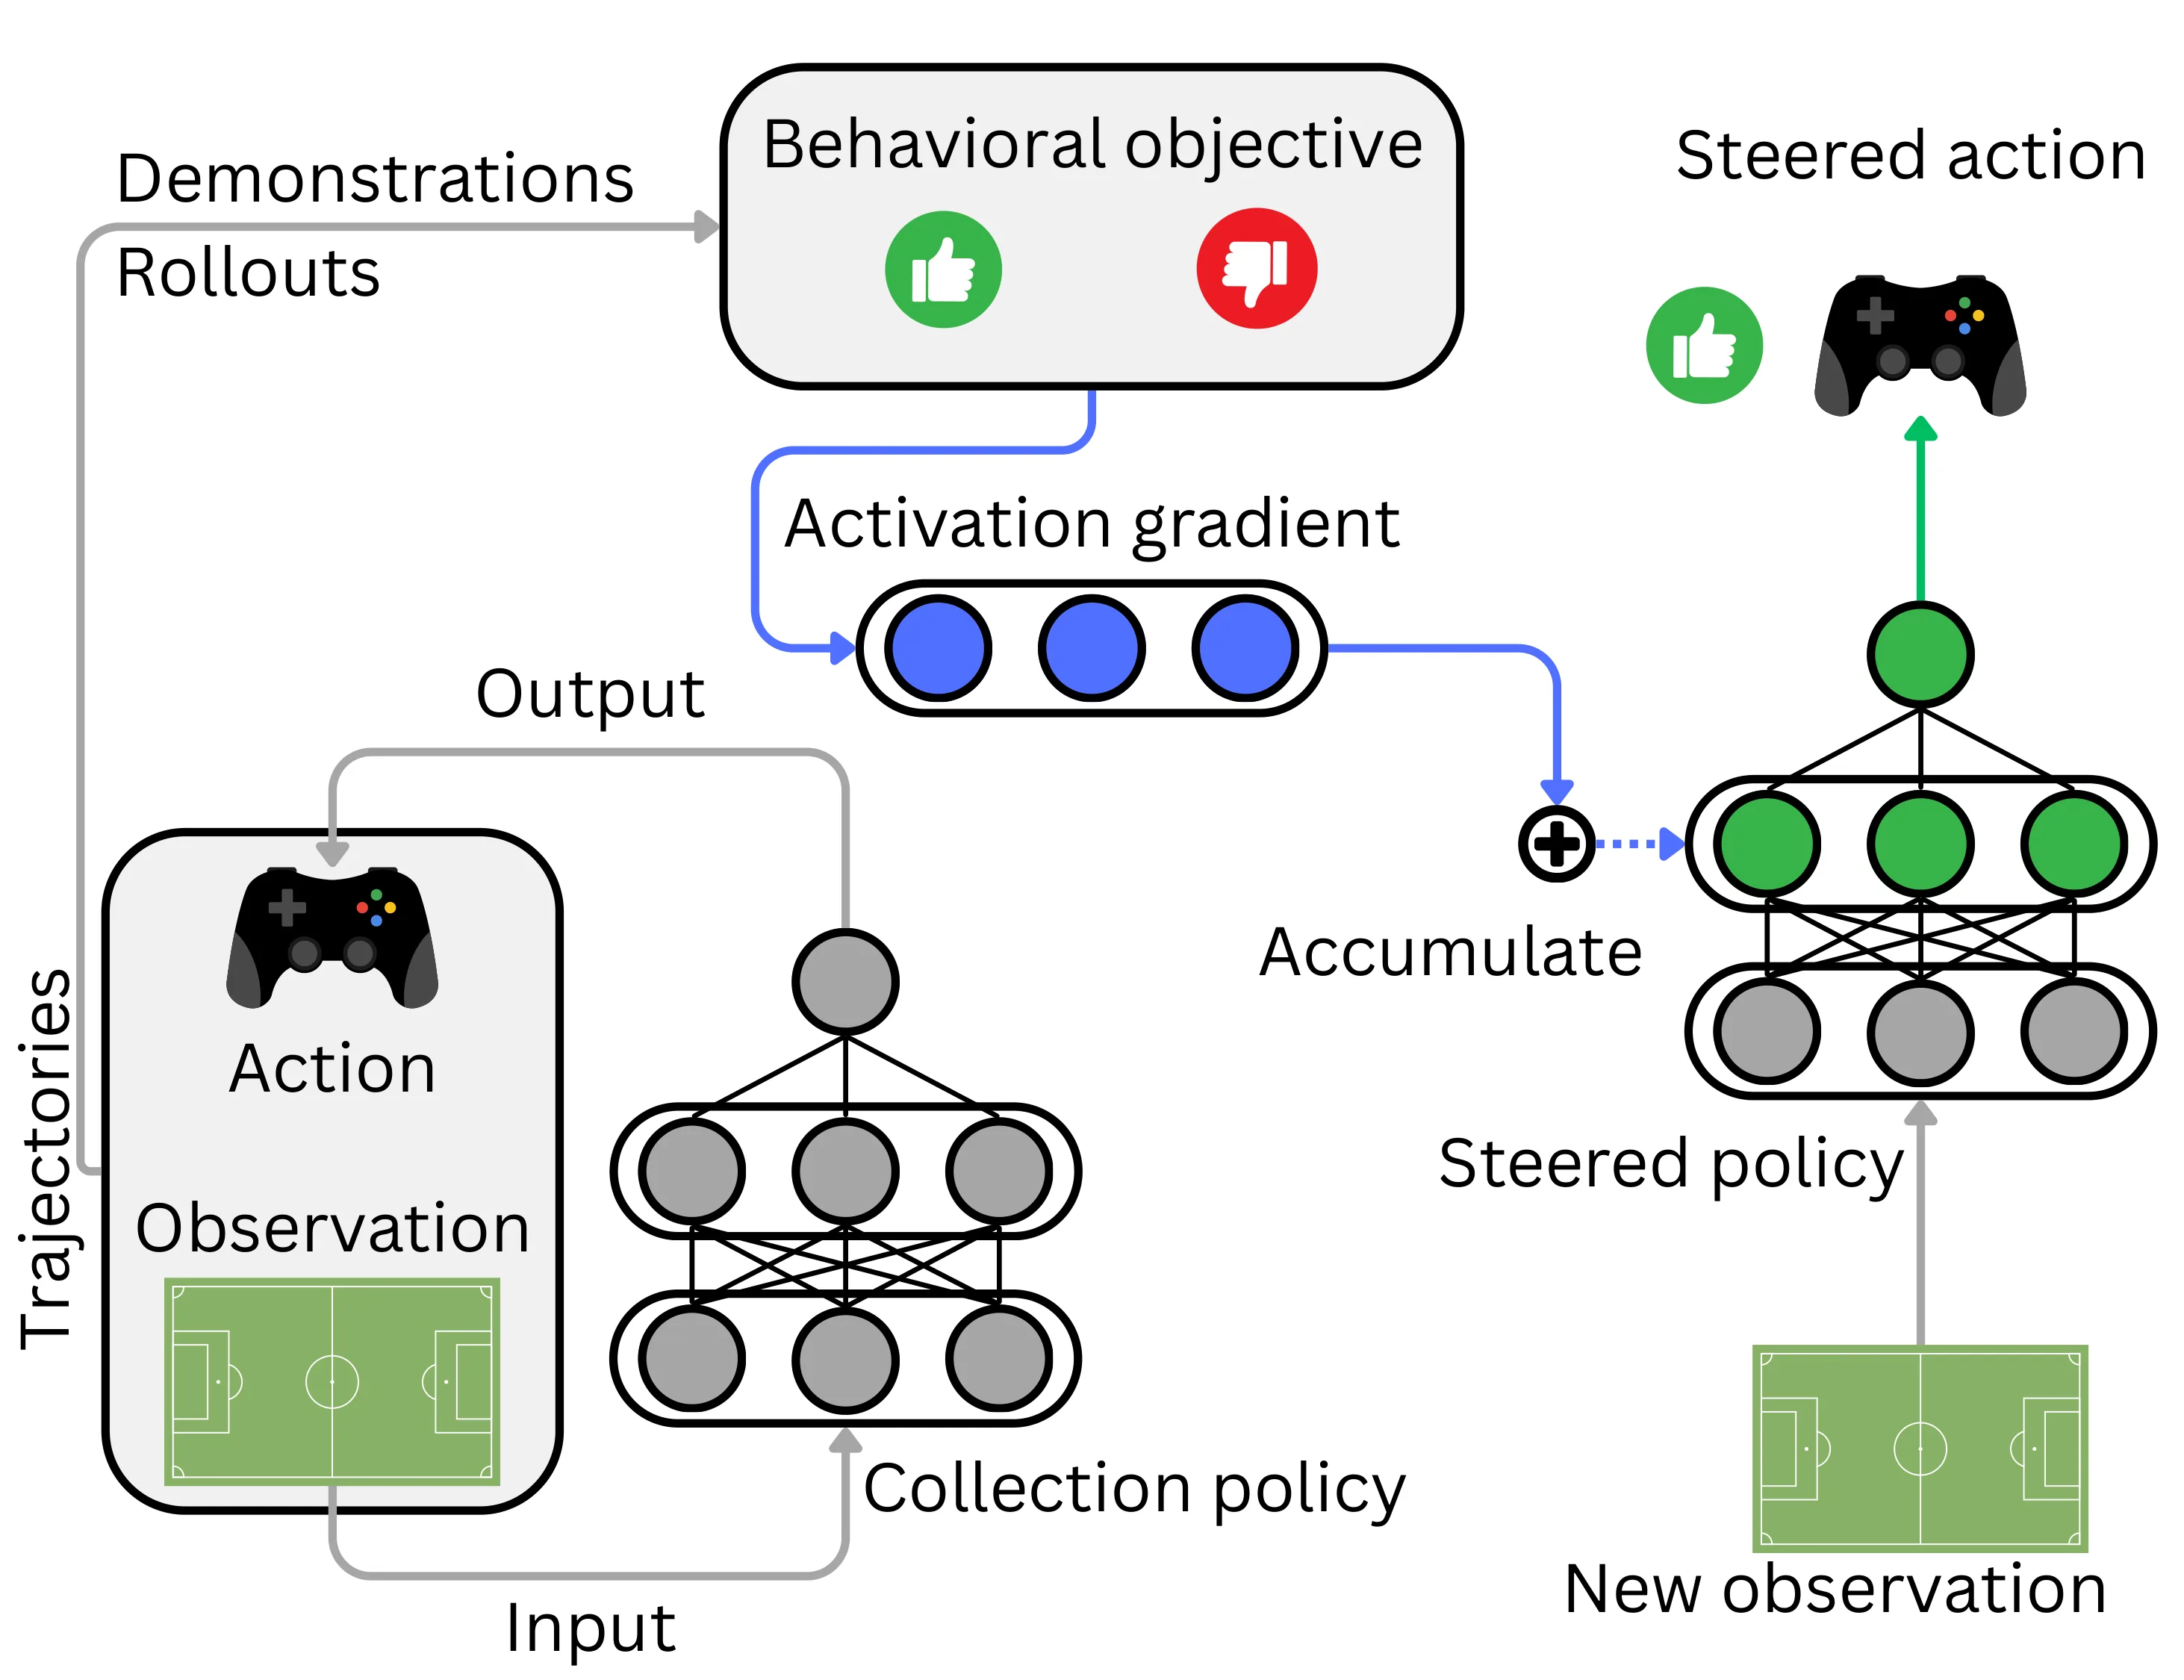
PGS把行为引导形式化为强化学习问题,对临时行为目标在小批量推演或示范上累积梯度,生成可移除的任务向量。
在网格世界上验证可校准与可逆性;国际象棋中独立拟合的向量可单独或组合生效;足球中可定向改变队伍行为并跨对手迁移。
策略梯度为构建临时、可组合的行为适配提供了自然统一接口,适用范围超越语言模型,延伸至通用序列决策。
🆚 方法对比
Policy Gradient Steering (PGS)
- 将行为反馈转化为可移除的激活干预向量
- 支持多向量组合叠加,兼容目标可构造性积累
- 解决前馈MLP策略的信用分配失败问题
- 跨域泛化:网格世界、棋类、足球均验证有效
- 需要rollout或演示来计算梯度
- 依赖激活梯度的可用性
- 仅在三类有限决策域中验证
- 需手动指定临时行为目标
Contrastive Activation Steering (Rimsky et al.; Miao et al.)
- 利用正负示例构建干预,实现简单
- 无需优化过程,轻量级推理控制
- 在两路径网格世界中完全失败
- 对比仅编码分歧后到达的状态而非决策
- 无法控制分支动作本身
Policy Fine-tuning
- 直接持续优化新行为目标,效果直接
- 成熟的策略优化方法
- 永久修改基础策略权重,不可移除
- 推理时无法灵活组合或缩放
- 计算开销大,需完整优化流程
Task Arithmetic / Parameter Task Vectors
- 参数空间算术操作灵活,支持缩放与组合
- 任务向量可否定或叠加
- 需要先完成微调才能构造任务向量
- 修改参数空间,缺乏可逆性
LoRA
- 低秩参数更新,训练高效节省参数
- 有效权重更新可视为可组合任务向量
- 仍需训练低秩适配器,依赖优化过程
- 修改权重空间而非纯推理时干预
ReFT
- 冻结权重,仅学习隐藏表示低秩干预
- 比全参数微调更轻量
- 仍需要优化过程获得干预
- 对前馈MLP策略有效性未充分验证
Preference Adaptation (DPO / Preference Vectors)
- 支持运行时改变偏好条件
- DPO从偏好对直接学习策略
- 需要预先构建偏好-拒绝对数据
- 未直接解决部署后干预的可逆性问题
PGS定位为激活引导与策略微调的中间路径:既保留激活引导的轻量推理时控制和可移除性,又通过策略梯度优化行为目标获得比纯对比激活引导更精准的动作级信用分配,同时支持多向量组合构造。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 9 张)
展开查看 9 张图
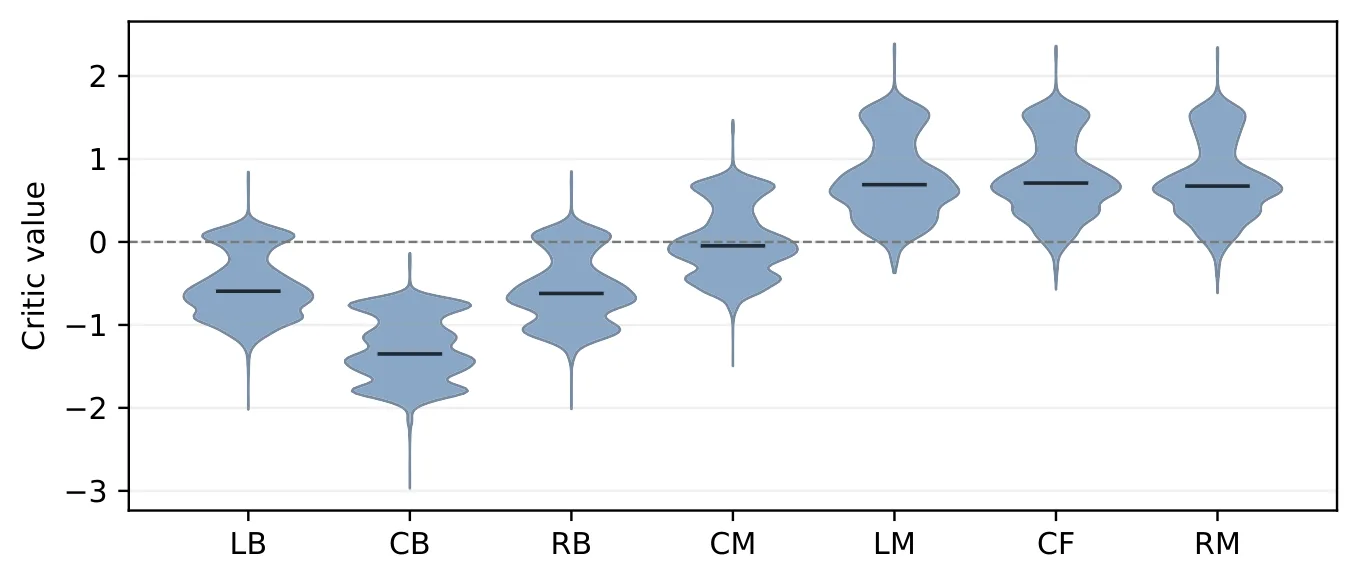
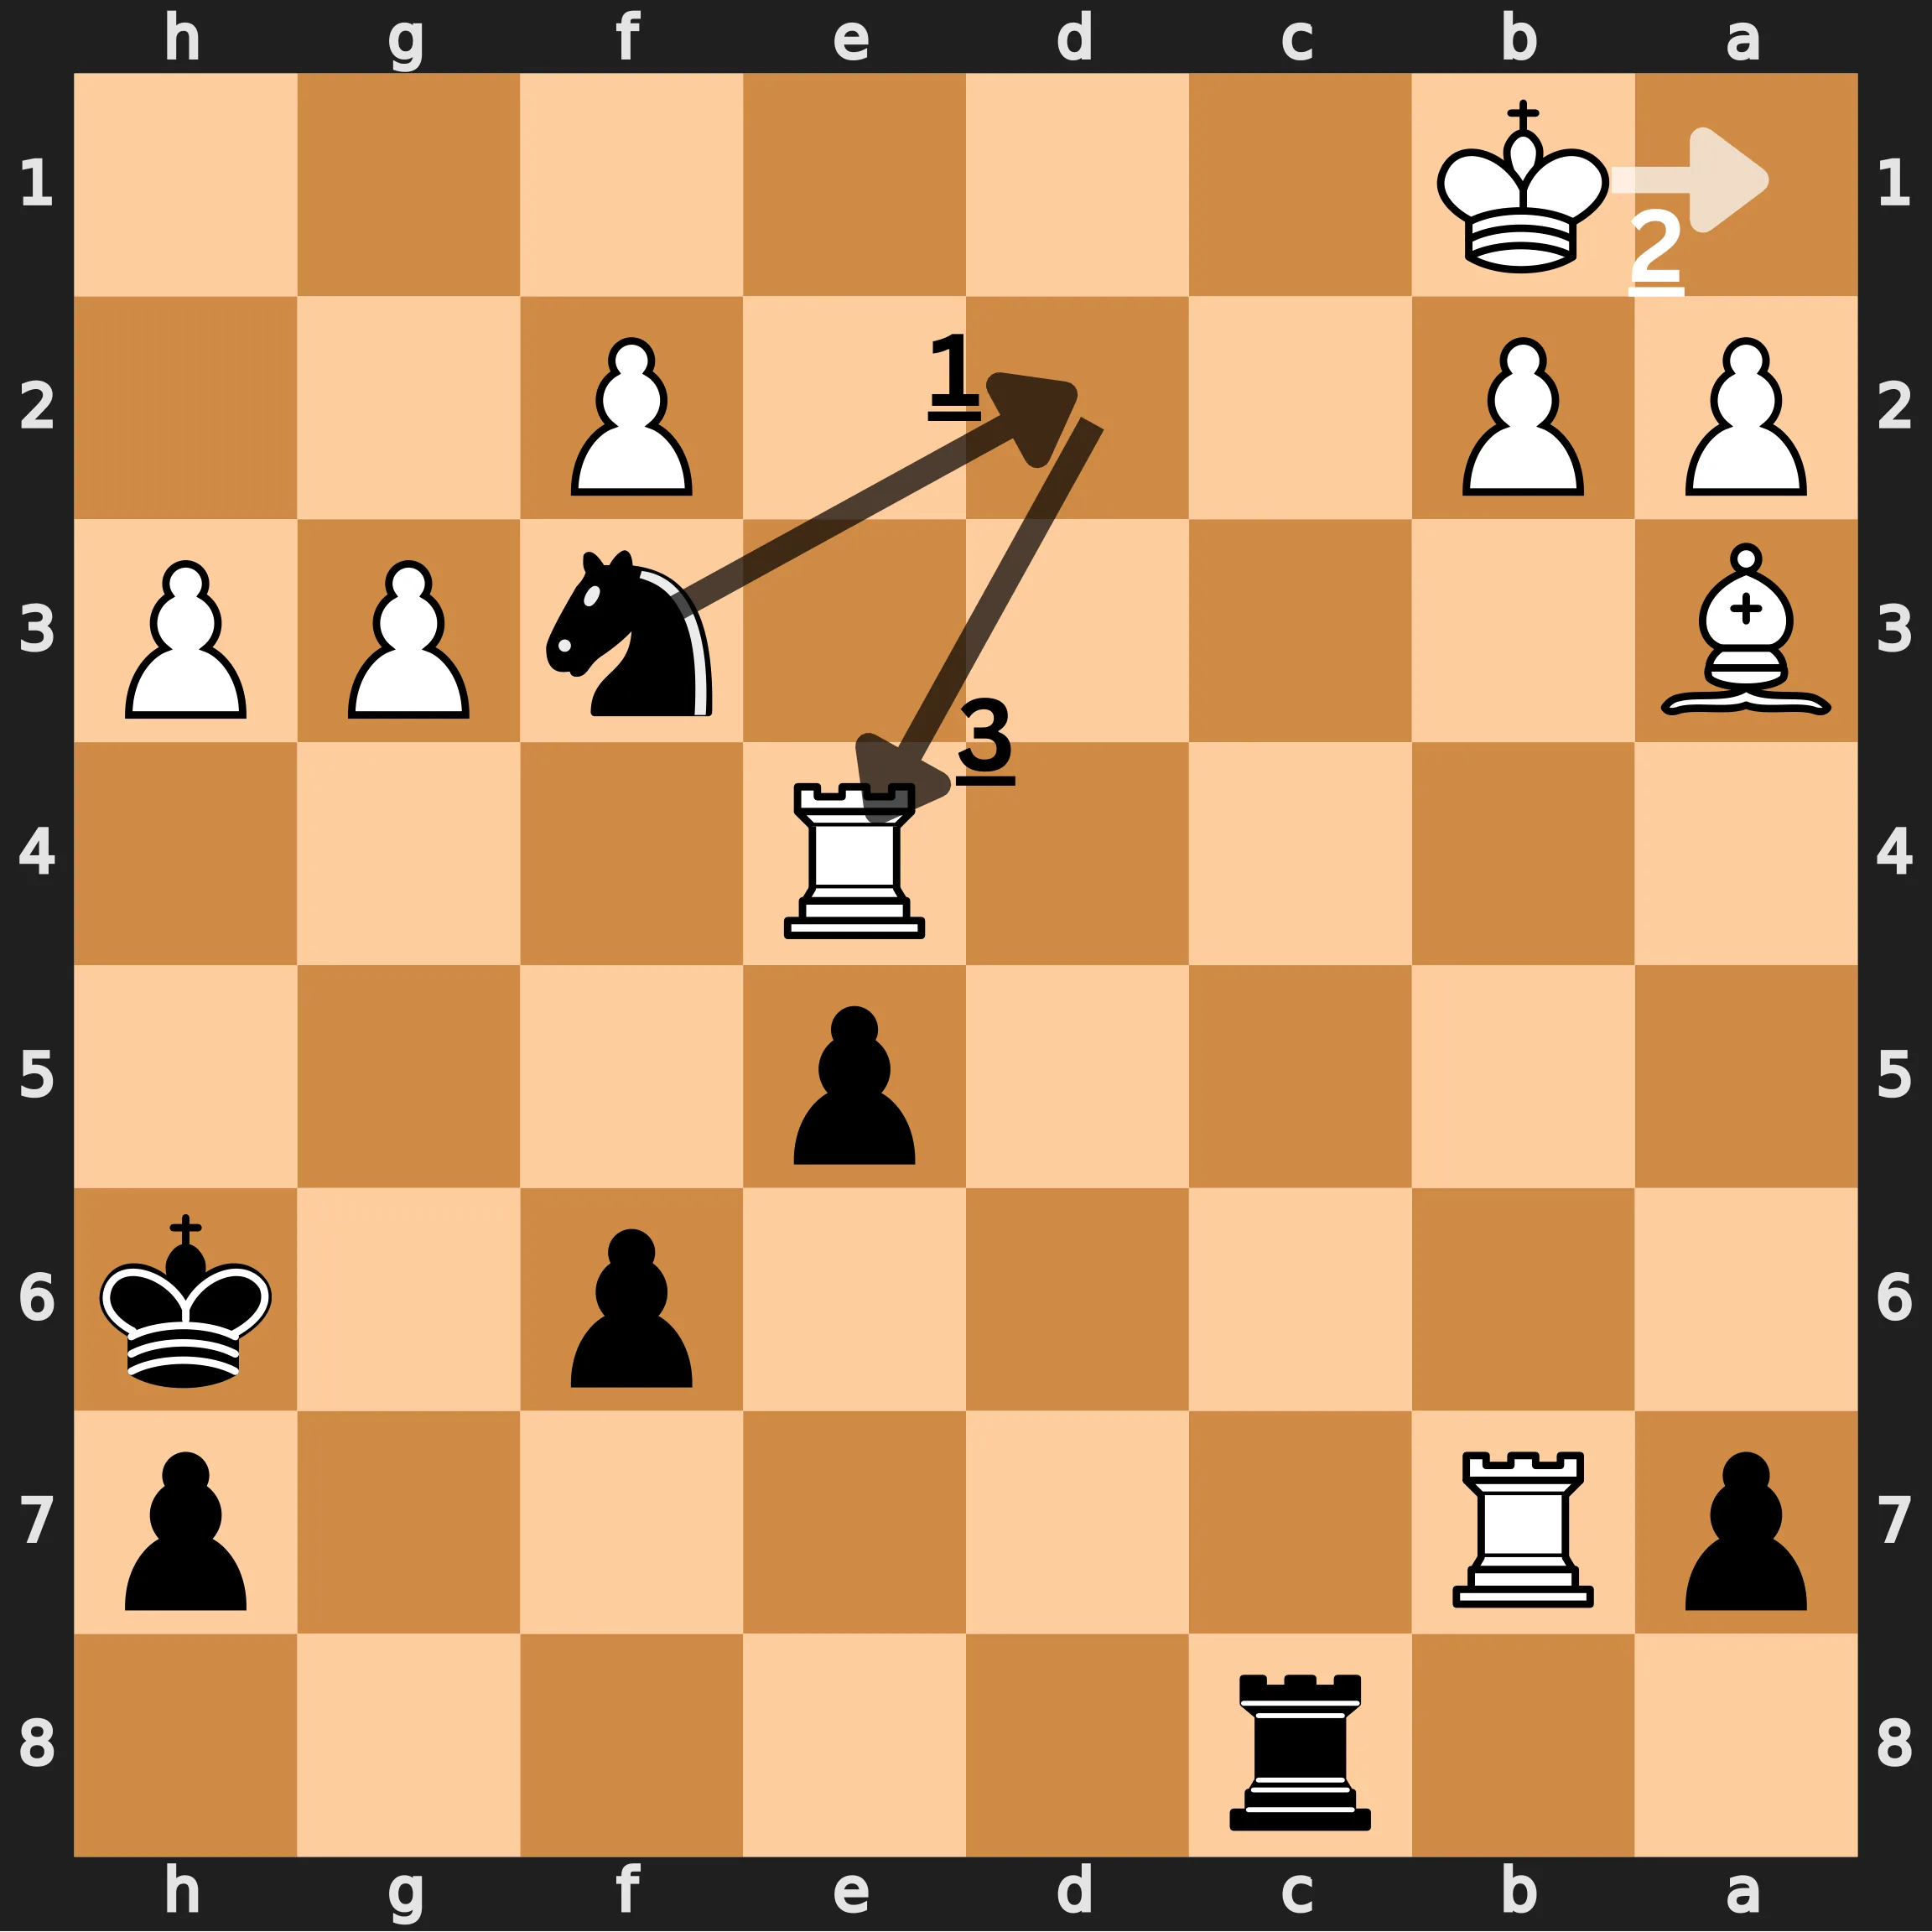
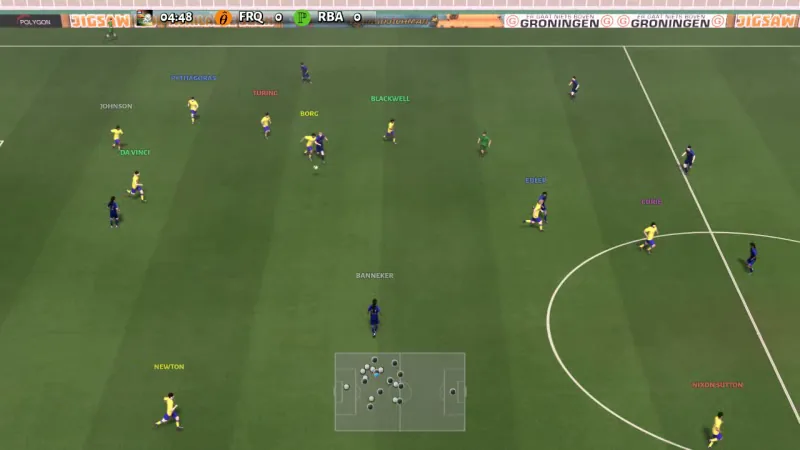
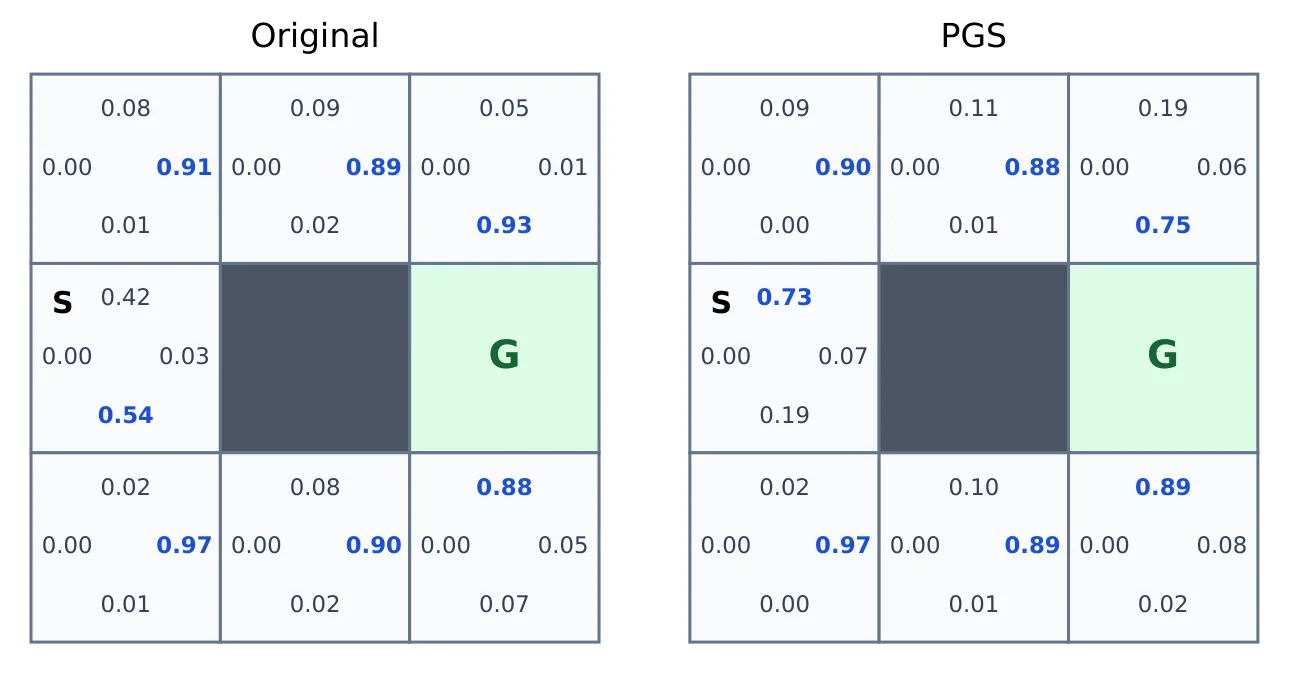
TL;DR
激活引导是近年大语言模型领域兴起的一种推理时行为调控手段,但本文作者发现这类方法在一个最简单的双路径网格世界环境中就会完全失效——根本原因在于它们对比的是"决策之后的表征"而非"做出决策的动作本身"。为解决这个问题,论文提出了策略梯度引导(PGS),将引导建模为强化学习问题,直接对产生目标行为的动作对数概率求梯度来构造干预向量。在网格世界、国际象棋谜题和足球仿真三类决策任务中,PGS 均表现出可校准、可逆且可组合的特性,且效果能在不同对手之间迁移。
研究背景与动机
在大语言模型的推理阶段,如何高效地改变模型行为一直是一个重要课题。传统做法是对模型进行[[微调]]或[[提示工程]],但前者需要修改模型权重,后者则依赖输入文本的编写技巧。近年来,[[激活引导]]作为一种轻量化替代方案崭露头角:它不修改任何权重参数,而是通过在模型的隐藏激活上叠加一个方向向量来影响输出行为。这种"任务向量"的思路看起来简洁优雅,理论上可以像插拔硬件一样随时添加、移除或组合。
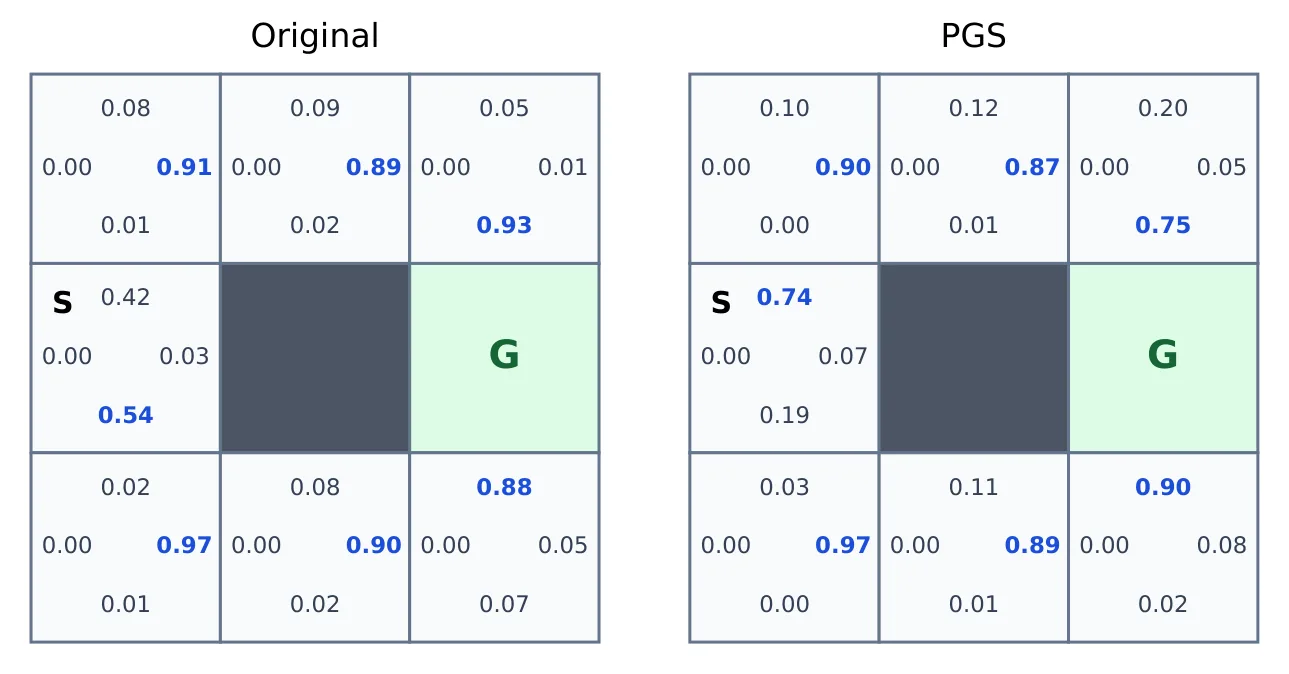
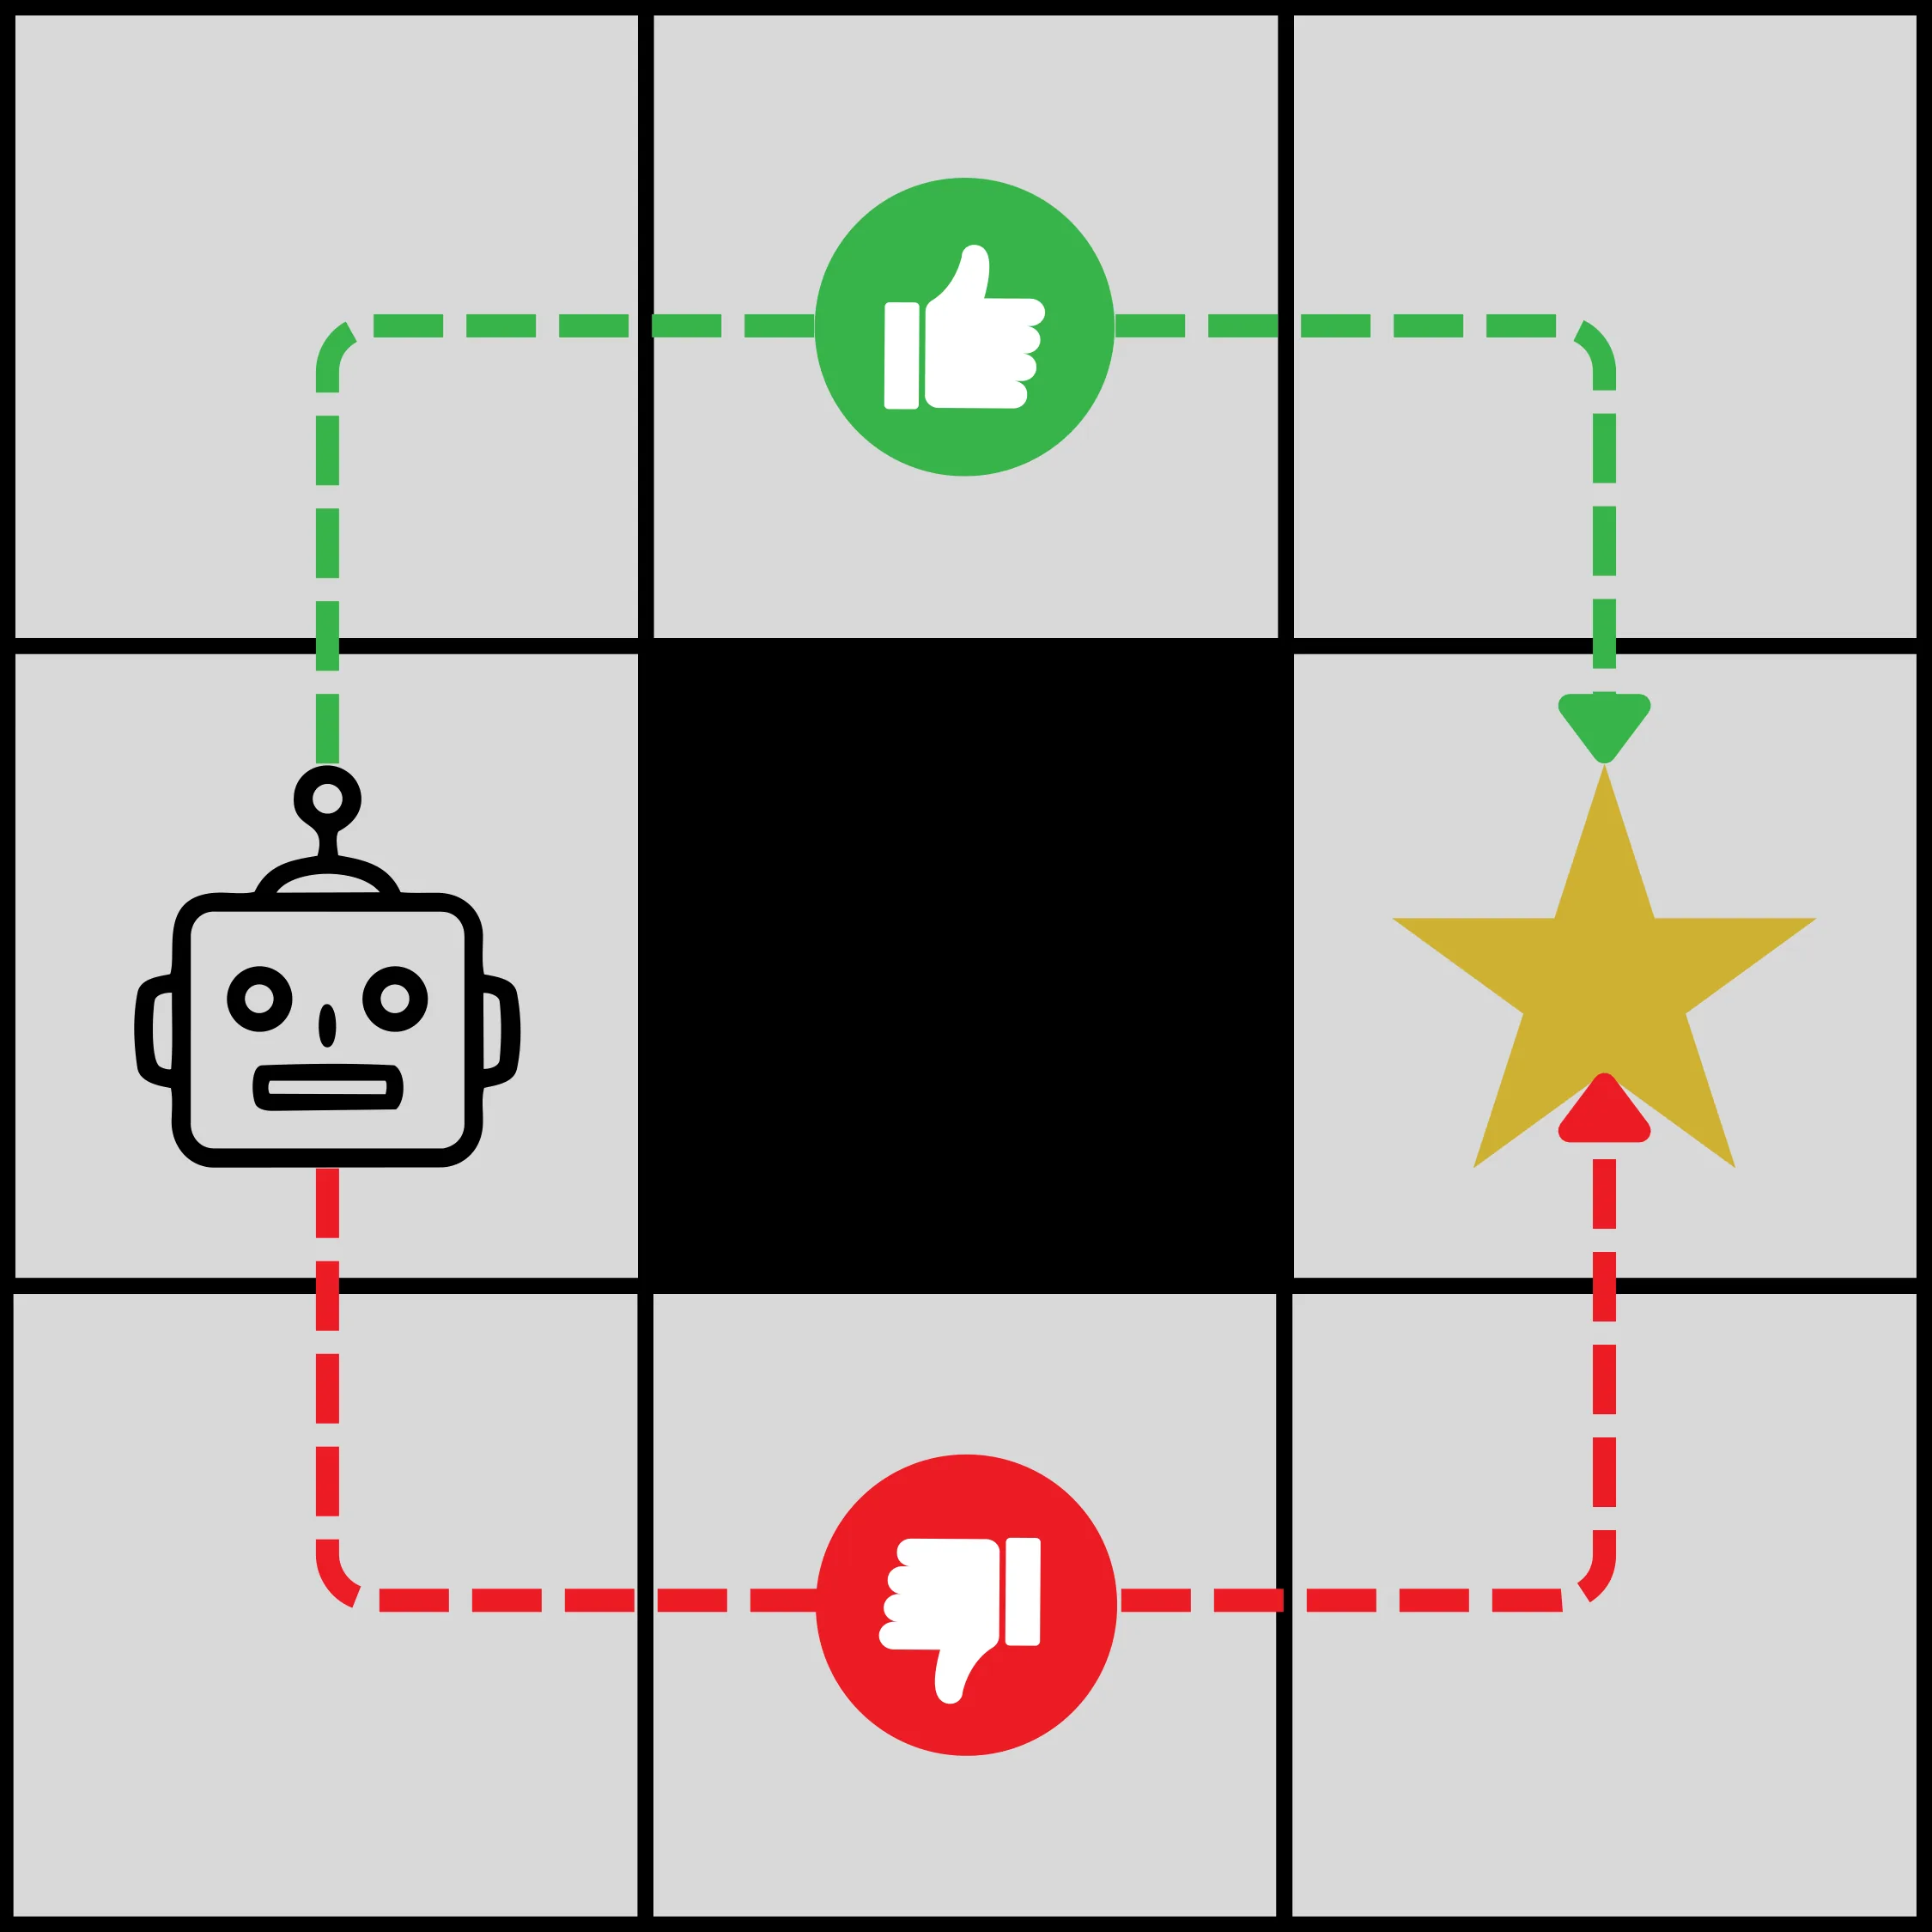
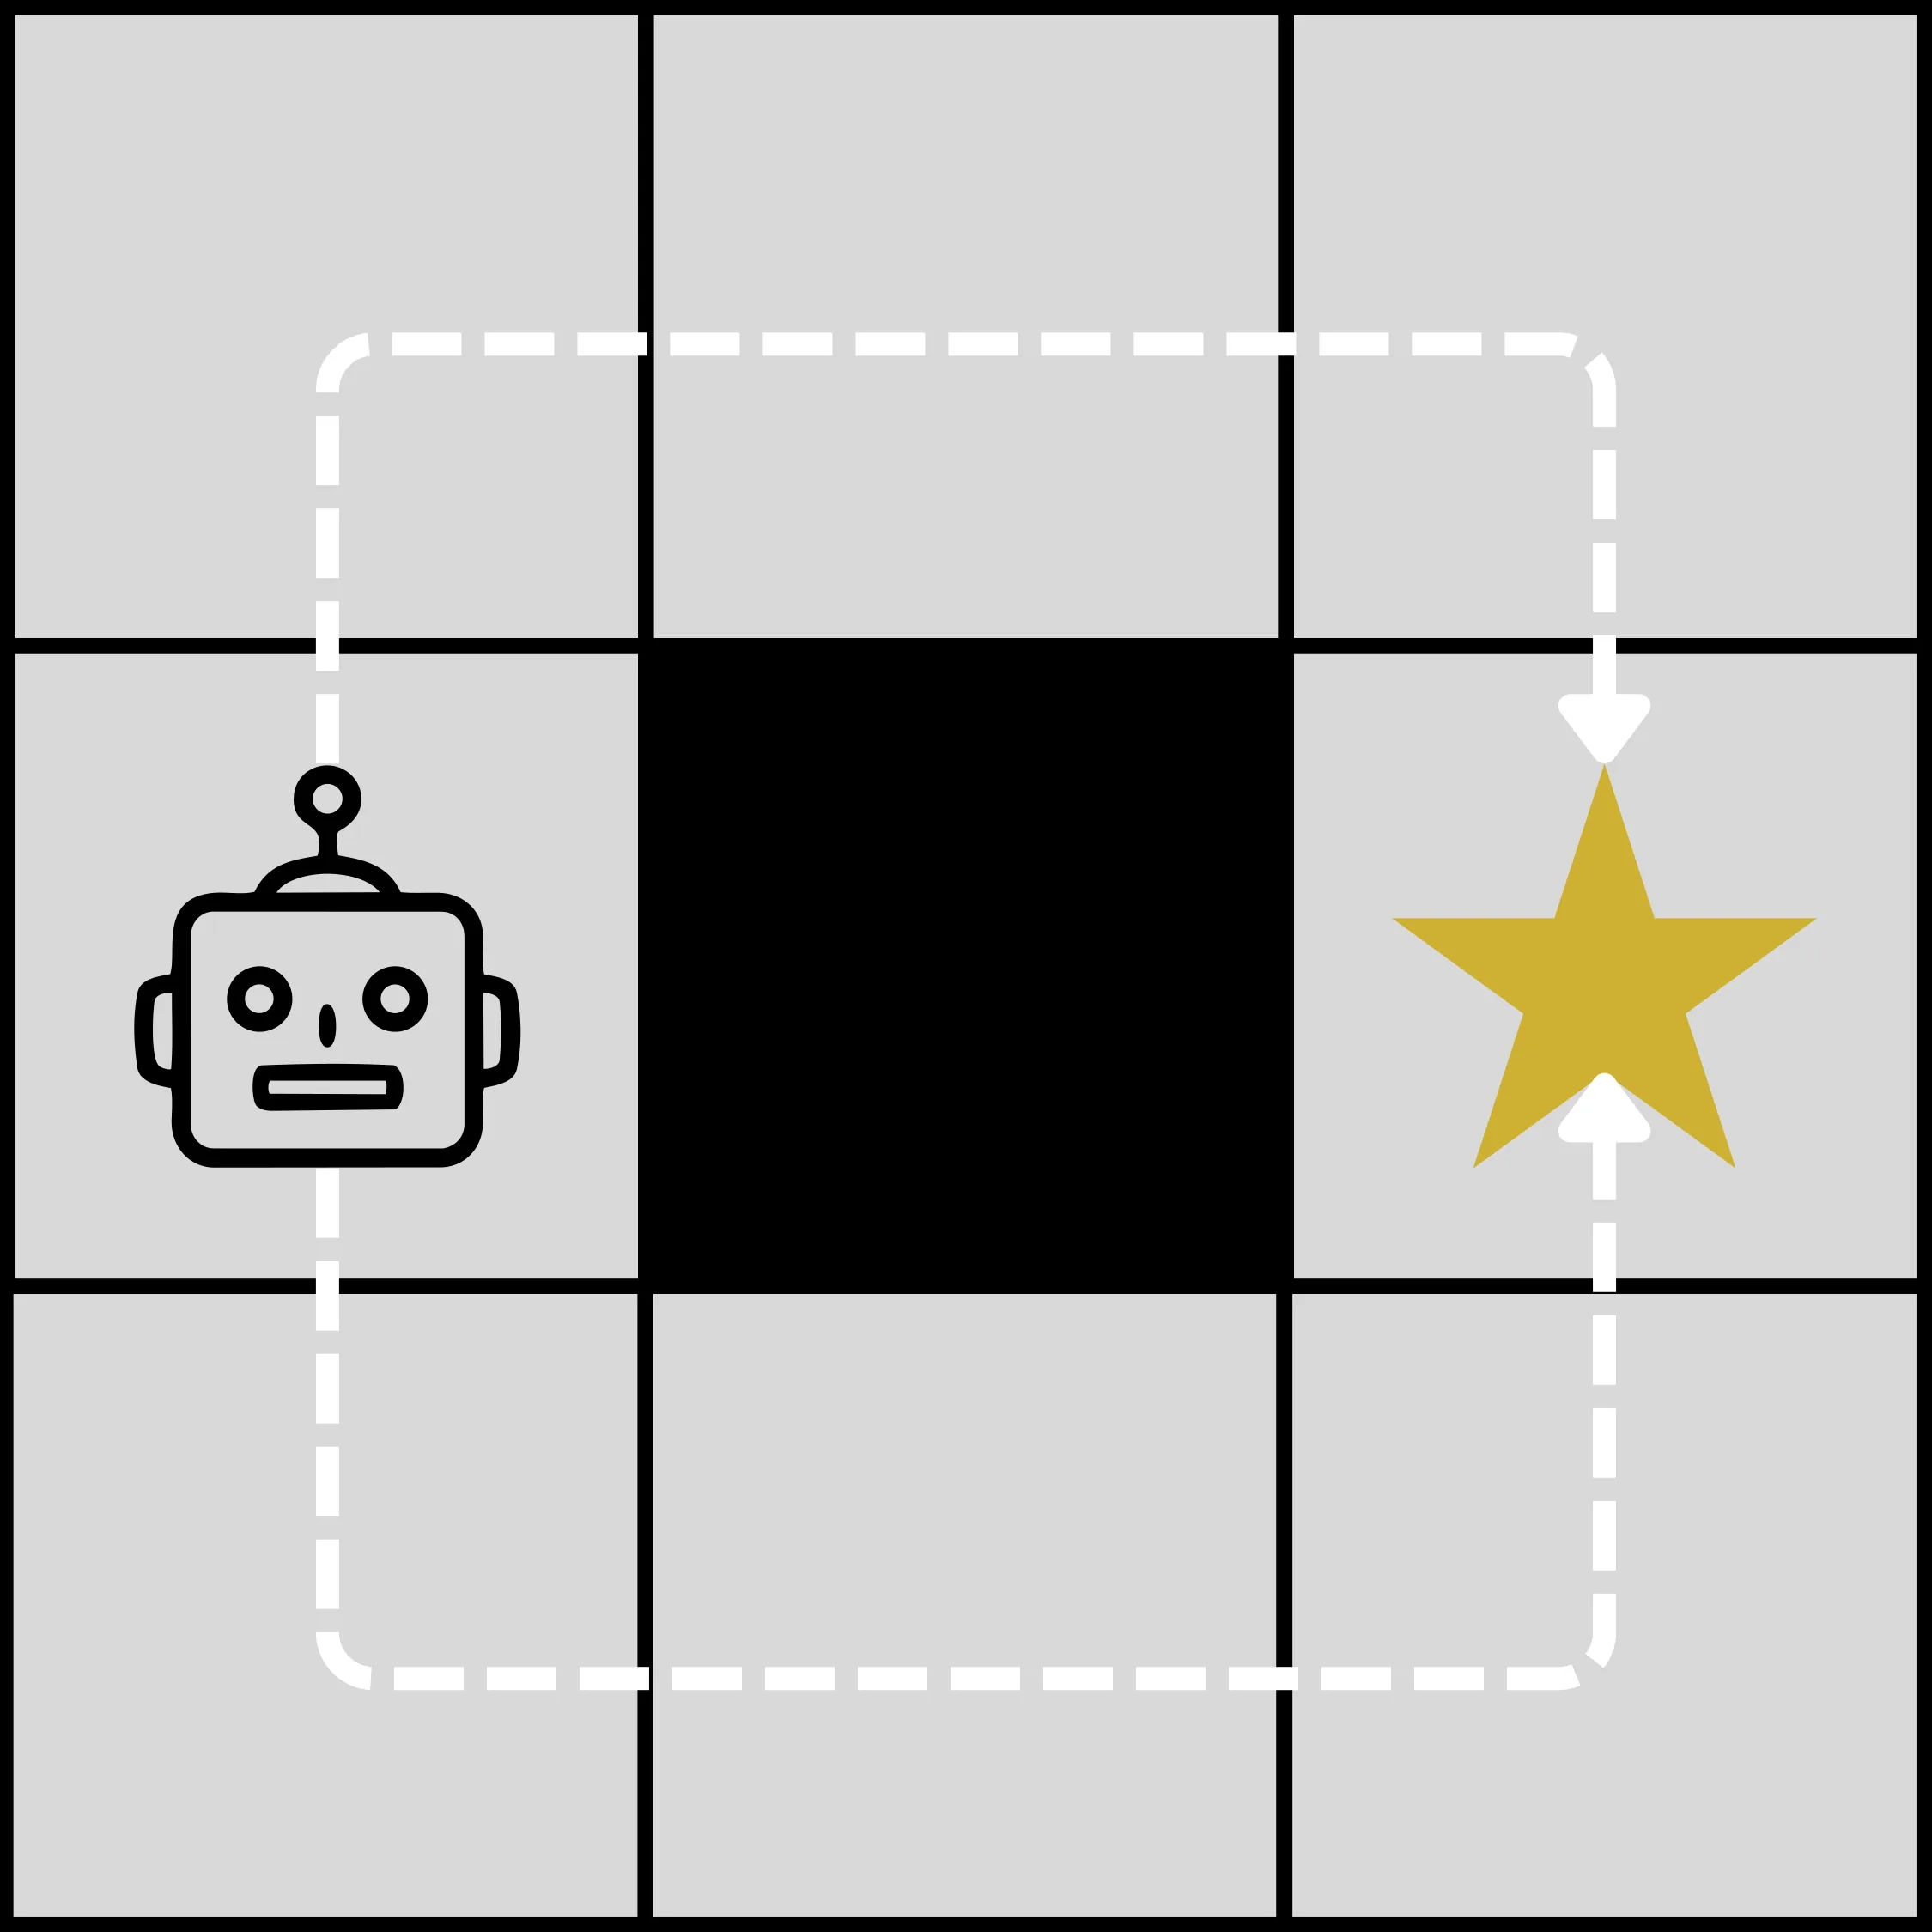
然而,作者在这里提出了一个令人不安的质疑:这类方法在真实决策任务上到底有多鲁棒?他们设计了一个极其简单的双路径网格世界环境——智能体从起点出发,在一个分支点可以选择走上行路线或下行路线,两条路径最终都通向同一个目标,只是效率不同。作者测试了包括 CAA、COAST、K-Steer 在内的主流激活引导方法,结果令人震惊:所有这些方法都没能让智能体的路由偏好发生显著偏移,它们几乎都停留在原始策略附近。
经过深入分析,作者找出了失败的根本原因:现有的对比引导方法通过计算"正样本激活减去负样本激活"来得到方向向量。但在分支决策点,两条成功轨迹的隐藏表征是完全相同的——因为策略网络的前馈结构在看到相同的观察时只能产生相同的隐藏状态。对比向量中非零的部分实际上来自决策之后的状态差异,而非导致决策的动作本身。这就好比在问"为什么选择了这条路"时,答案却是"因为走完这条路之后风景很好",而没有触及决策本身。
正是基于这一诊断,作者提出了一种全新的引导框架[[策略梯度引导]],它的核心洞察是:要改变决策行为,必须直接作用于决策动作本身,而激活空间的梯度信息正好提供了这样的桥梁。
方法
论文将引导问题形式化为一个[[强化学习]]优化问题。给定一个预训练的基础策略 ,我们希望构造一个受控策略 ,使得它在某些行为目标上表现更好。具体来说,假设我们有一个临时的行为奖励函数 ,定义在观察-动作对上,轨迹 的行为回报为:
我们的目标是从少量由行为策略 收集的演示数据 中学习如何修改激活,从而最大化期望的行为回报。
PGS 的核心是直接利用[[策略梯度]]定理的似然比形式来构建方向向量。在选定的隐藏层激活 处,PGS 向量定义为:
这里 是重要性比,当使用在线数据时 ; 是一个与动作无关的基线,用来降低梯度估计的方差。关键在于,梯度作用的对象是动作的对数概率而非激活本身——即使在分支点 , 与 也不会相同,因为它们来自不同的动作对数概率对同一激活的偏导。
得到 之后,如何确定干预的强度 并不是随意设定的。论文利用[[Fisher 信息矩阵]]来建立校准机制:
$
在动作空间[[KL 散度]]局部二次近似的假设下,给定策略变化的预算 ,最优系数有闭式解:
这意味着我们可以用统一的 来控制所有 PGS 向量的干预强度,使得不同来源、不同任务的行为适应具有可比性。
整个算法的完整流程是:先从行为奖励计算回报 ,再估计基线 ,然后按照策略梯度公式累积 ,接着估计方向曲率并计算 ,最后返回 这个可插拔的行为适配器。
值得注意的是,PGS 在激活引导与策略微调之间找到了一个独特的位置:它不修改基础权重(与激活引导一致),但它来自于对行为目标的真正优化(与微调一致)。论文强调,PGS 的贡献不在于"用梯度构造向量"这一基本思想——这在[[任务向量]]和[[ReFT]]等工作中已有先例——而在于将标量行为回报翻译为可标量化、可组合、可移除的激活空间干预的完整框架。
实验与结果
论文在三个层次递进的决策任务上验证了 PGS 的特性。
网格世界:控制变量下的基础验证
双路径网格世界被设计为纯粹的动作归因测试床。CAA 等对比方法失败的原因在这里得到了形式化确认:在分支决策点,两条成功路径的隐藏表征完全相同(),它们能借到的非零方向只能来自决策之后的状态差异。只有 PGS 能够直接作用于决策本身,将上行路线概率从基线的约 50% 提升到 0.82±0.07。更令人惊讶的是,这个效果在极端数据稀缺条件下依然稳健——仅需每条路径一条示范就能实现双向引导。实验还验证了 PGS 的可逆性:先后施加方向相反的两个 PGS 向量后,智能体的行为恢复到接近原始策略的水平。
国际象棋谜题:可组合性的精细检验
作者使用 Lichess 开放谜题库测试了三种战术模式——马攻击(fork)、牵制(pin)和串击(skewer)的独立适应与组合效果。每个谜题以"canonical 走子负对数似然"为指标:,衡量受控策略 对正确答案 的置信度。关键发现是:三种战术的独立 PGS 向量在组合后呈现出建设性叠加——最小保留率 ,意味着组合后的每个战术几乎都能保有其单独使用时一半以上的增益。这与许多微调方法组合后产生干扰的情况形成鲜明对比。从存储效率角度看,PGS 仅用 1,152 个标量就存储了全部三组适应,相比 LoRA 的 46,080 和完全微调的 663,552,压缩比达到 1/40 至 1/576。
足球仿真:多智能体场景下的迁移能力
Google Research Football 环境中的竞争性足球提供了更复杂的[[多智能体]]场景。PGS 被用于控制球队的特定行为——传球、抢回或射门——在固定对手上进行拟合后,评估其在不同对手上的迁移效果。结果显示,传球和射门目标的迁移效果对拟合数据的来源相对稳健,而抢回行为(涉及团队级信用分配)则对交互模式更敏感。这一发现揭示了多智能体环境中行为引导的一个开放挑战:当奖励信号来自团队层面的事件时,如何将效果归因到具体的动作仍然困难。
讨论与可借鉴点
PGS 的提出为推理时行为干预提供了一种理论上更严格、实现上更紧凑的方案。从工程视角看,其基于 Fisher 信息的闭式校准机制尤为实用——它允许研究者在不同任务向量之间建立统一的干预强度基准,这在构建可复用的行为控制库时非常有价值。
然而,论文也诚实地指出了若干局限。首先,Fisher 缩放是局部二次近似,远离拟合数据分布的策略区域可能不准确;其次,干预层的选择目前仍依赖人工调参,缺少自动化的最优层发现流程;最后,PGS 要求行为目标能够被推演或示范数据形式化,这限制了它在某些难以定义奖励的场景(如复杂安全规则)中的应用。
更根本地,这项工作提示了一个更广泛的设计原则:在构建干预向量时,必须区分"决策前的表征"与"决策后的状态"。任何仅基于结果状态的对比方法,在面对前馈策略的共享表征结构时,都注定无法触及真正的决策机制。PGS 的成功在于它直接优化了决策动作的生成过程,而非事后补救决策的后果。
对于后续研究而言,一个有前景的方向是将 PGS 与[[自然梯度]]结合,用 替代当前的平移干预,从而在激活空间的黎曼几何结构中获得更优的更新方向。此外,将 PGS 的框架扩展到更大规模语言模型的语义级控制任务——而非仅限于决策序列——也是值得探索的路径。
摘要
激活引导作为一种轻量级替代方案,已在大语言模型中崭露头角,用于在推理时动态改变模型的行为。然而,我们证明现有的引导方法甚至无法在双路径网格世界环境中引导一个简单的策略。为解决这一局限,我们提出了策略梯度引导(PGS),将引导问题建模为强化学习问题。PGS 在一组少量的回放或示范数据上累积一个临时行为目标的梯度,从而构建一个可移除的任务向量。我们首先在双路径网格世界环境中验证了 PGS 的可校准性与可逆性。随后,我们借助国际象棋谜题,独立评估了拟合得到的 PGS 向量,无论单独使用还是组合使用,均发现兼容的战术目标能够建设性地叠加。最后,在竞争性足球场景中,我们展示了 PGS 能够改变特定的球队行为,且其效果可跨对手迁移。综上,这些结果表明,策略梯度为在多种决策领域中构建临时且可组合的行为适应提供了自然而有效的接口。
Abstract
Activation steering has emerged in large language models as a lightweight alternative for dynamically changing a model's behavior at inference time. However, we show that existing steering methods fail to steer even a simple policy in a two-route gridworld environment. To address this limitation, we propose Policy Gradient Steering (PGS), which formulates steering as a reinforcement learning problem. PGS accumulates gradients of a temporary behavioral objective over a small set of rollouts or demonstrations to construct a removable task vector. We first demonstrate the calibration and reversibility of PGS in a two-route gridworld environment. Using chess puzzles, we then evaluate independently fitted PGS vectors both in isolation and in combination, finding that compatible tactical objectives accumulate constructively. Finally, in competitive football, we show that PGS can alter specific team behaviors and that its effects transfer across opponents. Together, these results show that policy gradients provide a natural interface for constructing temporary and composable behavioral adaptations across diverse decision-making domains.
论文详细总结(自动生成)
论文总结:策略梯度引导(PGS)
1. 核心问题与整体含义
研究动机:激活引导(activation steering)作为大语言模型(LLM)推理时轻量化行为调控手段受到关注,但其核心范式——基于"正/负样本表征差异"或"成功/失败回放的隐藏状态"构造干预向量——在通用决策策略上存在根本性失败。
具体暴露的问题:以 MLP 为代表的前馈策略在决策观察处共享同一隐藏表征 。当两条轨迹在分支点之后才发散时,CAA/COAST/K-Steer 等对比方法在决策点处的表征完全相同,因此得到的"对比方向"实质上编码的是决策后果的状态访问,而非导致该决策的动作本身。作者用一个简单的"双路径网格世界"(two-route gridworld)即可证伪所有现有激活引导方法。
整体目标:提出一种在推理时引入、缩放、组合与移除的临时行为干预机制,基础策略参数完全冻结,且能跨多种决策域(不限于语言模型)通用。
2. 方法论
2.1 问题形式化
给定预训练策略 与临时行为标量奖励 ,轨迹 的行为回报定义为:
目标是从奖励打分的小批量轨迹集 (由行为策略 收集)学到一个受控策略 ,最大化 。经典对比引导是该框架的特例:把 平分并赋 。
2.2 PGS 向量构造
在选定激活 处采用 REINFORCE/策略梯度定理的似然比形式:
其中 为重要性比(在线数据时 ), 为动作无关基线以降低方差。关键差异在于:与对比引导对比"动作后表征"不同,PGS 对"产生该结果的动作对数概率"求梯度—— 与 即使在分支点 相同的情况下也不相等,因此能区分两个动作。
推理时施加:
2.3 强度校准
利用激活空间的 Fisher 信息矩阵:
在动作 KL 局部二次近似下,给定策略变化预算 时闭式系数为:
2.4 算法流程(Algorithm 1)
1. 从 计算 ;
2. 估计基线 ;
3. 按式 (8) 累积 ;
4. 估计方向曲率 ;
5. ;
6. 返回 。
2.5 与相关方法的关系
PGS 处于激活引导与策略微调之间:同 CAA 类一样不修改基础权重,但同 LoRA/ReFT 一样来自对行为目标的优化。它不主张梯度对应任务向量的对应关系本身是新颖的;其贡献在于"将标量动作/轨迹回报翻译为可标量化、可组合、可移除的激活空间向量"。
3. 实验设计
3.1 三个评估域
| 域 | 任务 | 数据来源 | 评估要点 |
|---|---|---|---|
| 网格世界 | 导航 + 后置路由偏好 | 合成 | 动作归因、可逆性、参数化比较 |
| 国际象棋 | 三种战术(fork/pin/skewer) | Lichess 开放谜题库,Maia-1100/1500/1900 冻结策略 | 独立适应、组合可加性、跨技能鲁棒性 |
| 足球 | 多智能体行为多样化 | Google Research Football,4 个冻结队策略 | 行为多样化、跨对手迁移、拟合数据敏感性 |
3.2 对比方法
- 激活引导基线:CAA、COAST、K-Steer、随机激活;
- 参数/表征适应基线:Fine-tuning(task vector)、LoRA、ReFT;
- 自身消融:通道式 vs 空间式 PGS、共享 vs 角色/智能体路由、离线/在线拟合等。
3.3 关键指标
- 网格世界:上行路线概率、路径长度;
- 国际象棋:canonical 走子负对数似然 、孤立增益、组合增益、最小保留率 、组合 KL;
- 足球:传中/抢回/射门事件数、目标差、动作 KL。
4. 资源与算力
文中明确给出硬件配置:
- GPU:1 × NVIDIA Tesla V100;
- CPU:每 GPU 作业 10 核;
- 内存:每 GPU 作业 40 GB;
- 轻量诊断:本地运行;
- 软件栈:Python 3.11 +
uv;NumPy、Hydra、Matplotlib;PyTorch;lczerolens(国际象棋);Google Research Football。
未明确说明:各实验的训练/运行总时长、GPU 小时数、能耗;仅有配置信息。
5. 实验数量与充分性
主实验:3 个域 × 多个对照方法(4–5 个)× 多个种子(5 个)= 数十组核心数值。
附录消融(覆盖度高):
- 网格世界:轨迹数(4/8/16/20/32/64)、回报处理(无/居中/标准化/线性基线)、干预位置(4 单层 + 2 组合)、优化器学习率(–)、优化步数(1–10);
- 国际象棋:层级支持(bottom-up/top-down/head/全 6 块)、拟合谜题量(5/10/20/40/80)、更新次数(1/3/10)、通道 vs 空间 PGS;
- 足球:对手条件化、离策略(带/不带重要性比)、多种基线(无居中/轨迹居中/角色居中/学习评论家)、角色路由、拟合数据预算、折扣因子 。
充分性评价:
- 优点:覆盖了拟合数据规模、层级位置、优化步数、回报基线、参数化形式、跨策略技能级别等多维因素;使用 5 个种子报告均值±样本标准差;
- 不足:部分小实验为"描述性消融"(作者自述不确认行为效应或单调缩放),如折扣因子扫描;足球中种子间方差较大(如 ±70 的传球数)。
6. 主要结论与发现
1. 可校准与可逆性:在网格世界上,PGS 是唯一能稳定将路由偏好推向目标方向且不破坏路径效率的方法;CAA/COAST/K-Steer 均停留在原策略附近。
2. 失败根因:在分支观察处两条成功演示的隐藏表征完全相同(),CAA 只能从"决策后状态"间接借出非零对比——这只是结果而非原因。
3. 极低数据有效:仅"每条路径一条示范"即可双向引导,PGS 顶部路线概率 ,远超所有对比基线。
4. 可组合性:三种国际象棋战术(fork/pin/skewer)的独立拟合 PGS 向量在组合后互不削弱,最小保留率 ,呈现建设性叠加;同时 PGS 仅用 1,152 个标量即存储全部三组适应,约为 LoRA(46,080)和微调(663,552)的 –。
5. 跨技能稳健:在 Maia-1100/1500/1900 三个量级的策略上结果趋势一致,但不构成 checkpoint-independent 的方法排名。
6. 跨对手迁移:足球中在一个对手上拟合的传球干预,对其他对手仍能提高平均完成传球数;拟合数据所经历的传球暴露越多,迁移越强。
7. 拟合数据来源敏感:传中(动作级)与射门(事件级)目标对来源不敏感,但抢回(团队级事件)效果依赖拟合数据与受控策略的交互——暴露了多智能体信用分配的挑战。
7. 优点
- 理论定位精准:明确指出对比引导失败的根因在于"动作后表征"与"决策动作"的混淆,并给出形式化论证 ;
- 存储极紧凑:通道式 PGS 比 LoRA/ReFT 紧凑 1–2 个数量级,便于构建可复用行为控制库;
- 冻结基础策略:与微调路线完全解耦,可在推理时按强度 开关或缩放;
- 多域验证:网格世界(控制变量)、国际象棋(组合性)、足球(多智能体迁移)形成层次递进的证据链;
- 校准机制透明:基于 Fisher 信息给出闭式 ,并报告实测 KL 与目标 KL 的吻合度;
- 丰富的消融:几乎覆盖了所有可调超参与设计选择。
8. 不足与局限
- 方法层面:
- 局部性:Fisher 缩放是局部二次近似,远离拟合点的策略可能不准确;作者明确建议将经验性 KL 回溯(TRPO 式)和自然梯度 作为未来工作;
- 激活位置敏感:网格世界消融显示 PGS 对干预位置很敏感;作者承认"激活位置选择仍具有决定性";
- 离策略校正只是近似: 仅校正动作分布而非状态分布,作者明确将其视为"近似离策略构造"而非一般无偏估计量;
- 缺乏语义/机理解释:行为效应本身不等同于对拟合向量的语义或机制性解读。
- 实验层面:
- 小样本方差大:足球种子间方差巨大,单场 5 场比赛的报告可信度受限;多场比赛需更多种子;
- 部分消融为"描述性":如折扣因子、拟合预算、参数化扫描作者自述"未建立单调缩放或确认行为效应";
- 不构成 checkpoint-independent 的方法排名:跨 Maia 量级的方法相对强弱变化,作者明确承认;
- 行为效应 ≠ 比赛实力:国际象棋谜题似然衡量的是战术偏好而非真实对弈强度;足球目标行为增益需与目标差等次级指标共同解读。
- 应用层面:
- 需要可被推演或示范形式化的标量目标;对人类偏好对齐、复杂安全规则等形式化困难的目标不直接适用;
- 多智能体行为级事件(抢回)的信用分配仍是开放问题;
- 论文未给出在 LLM 上的实验(虽以 LLM 激活引导为引子),证据链尚未延伸到模型规模上的语言任务。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。