
📝 TLDR
主流观点将神经网络中的概念表征视为静态几何对象,忽略了上下文的动态改造作用。本文提出新框架,将概念表征形式化为点云流形,上下文变换形式化为向量场,并在六个不同规模的大语言模型族上验证。实验发现上下文对不同概念的位移不同,位移方差与词汇具体性及密度语义相关,且这种变换结构在不同模型间共享——从一个模型迁移的位移结构可显著预测另一模型的未见位移。这表明模型不仅在概念表征上共享几何,更在上下文变换上共享更丰富的组织结构。
🧭 速览
主流观点将概念表征看作静态几何结构,忽视了上下文对概念的动态重塑作用。
将概念表征建模为点云流形,上下文变换建模为作用于流形的向量场,在六个模型族上系统分析位移结构。
位移方差与词汇具体性和密度语义相关;不同模型间共享同一套变换几何,可跨模型预测未见位移。
大语言模型在概念表征与上下文变换两层上共享几何结构,后者蕴含此前未被识别的丰富语义组织。
🆚 方法对比
暂未生成 — 点击下方按钮
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 7 张)
展开查看 7 张图
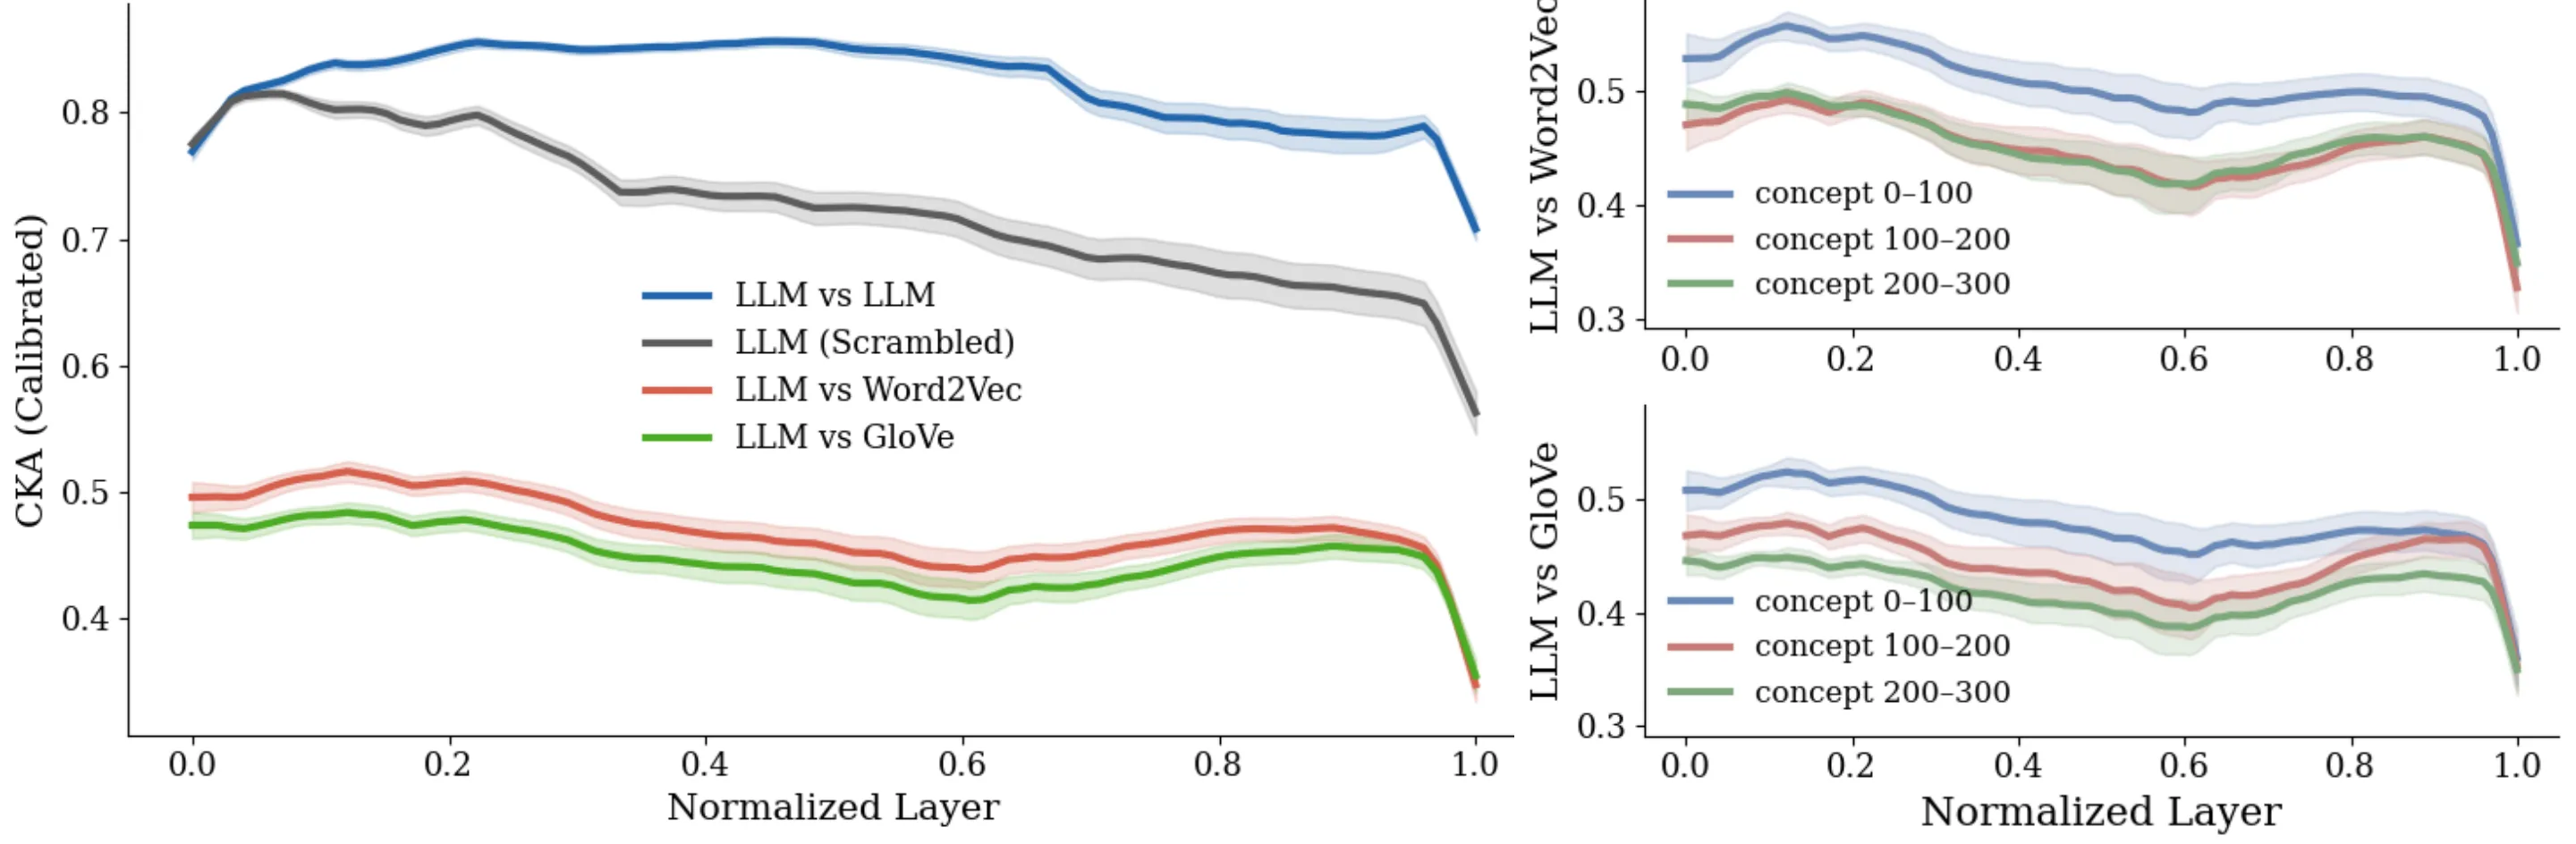
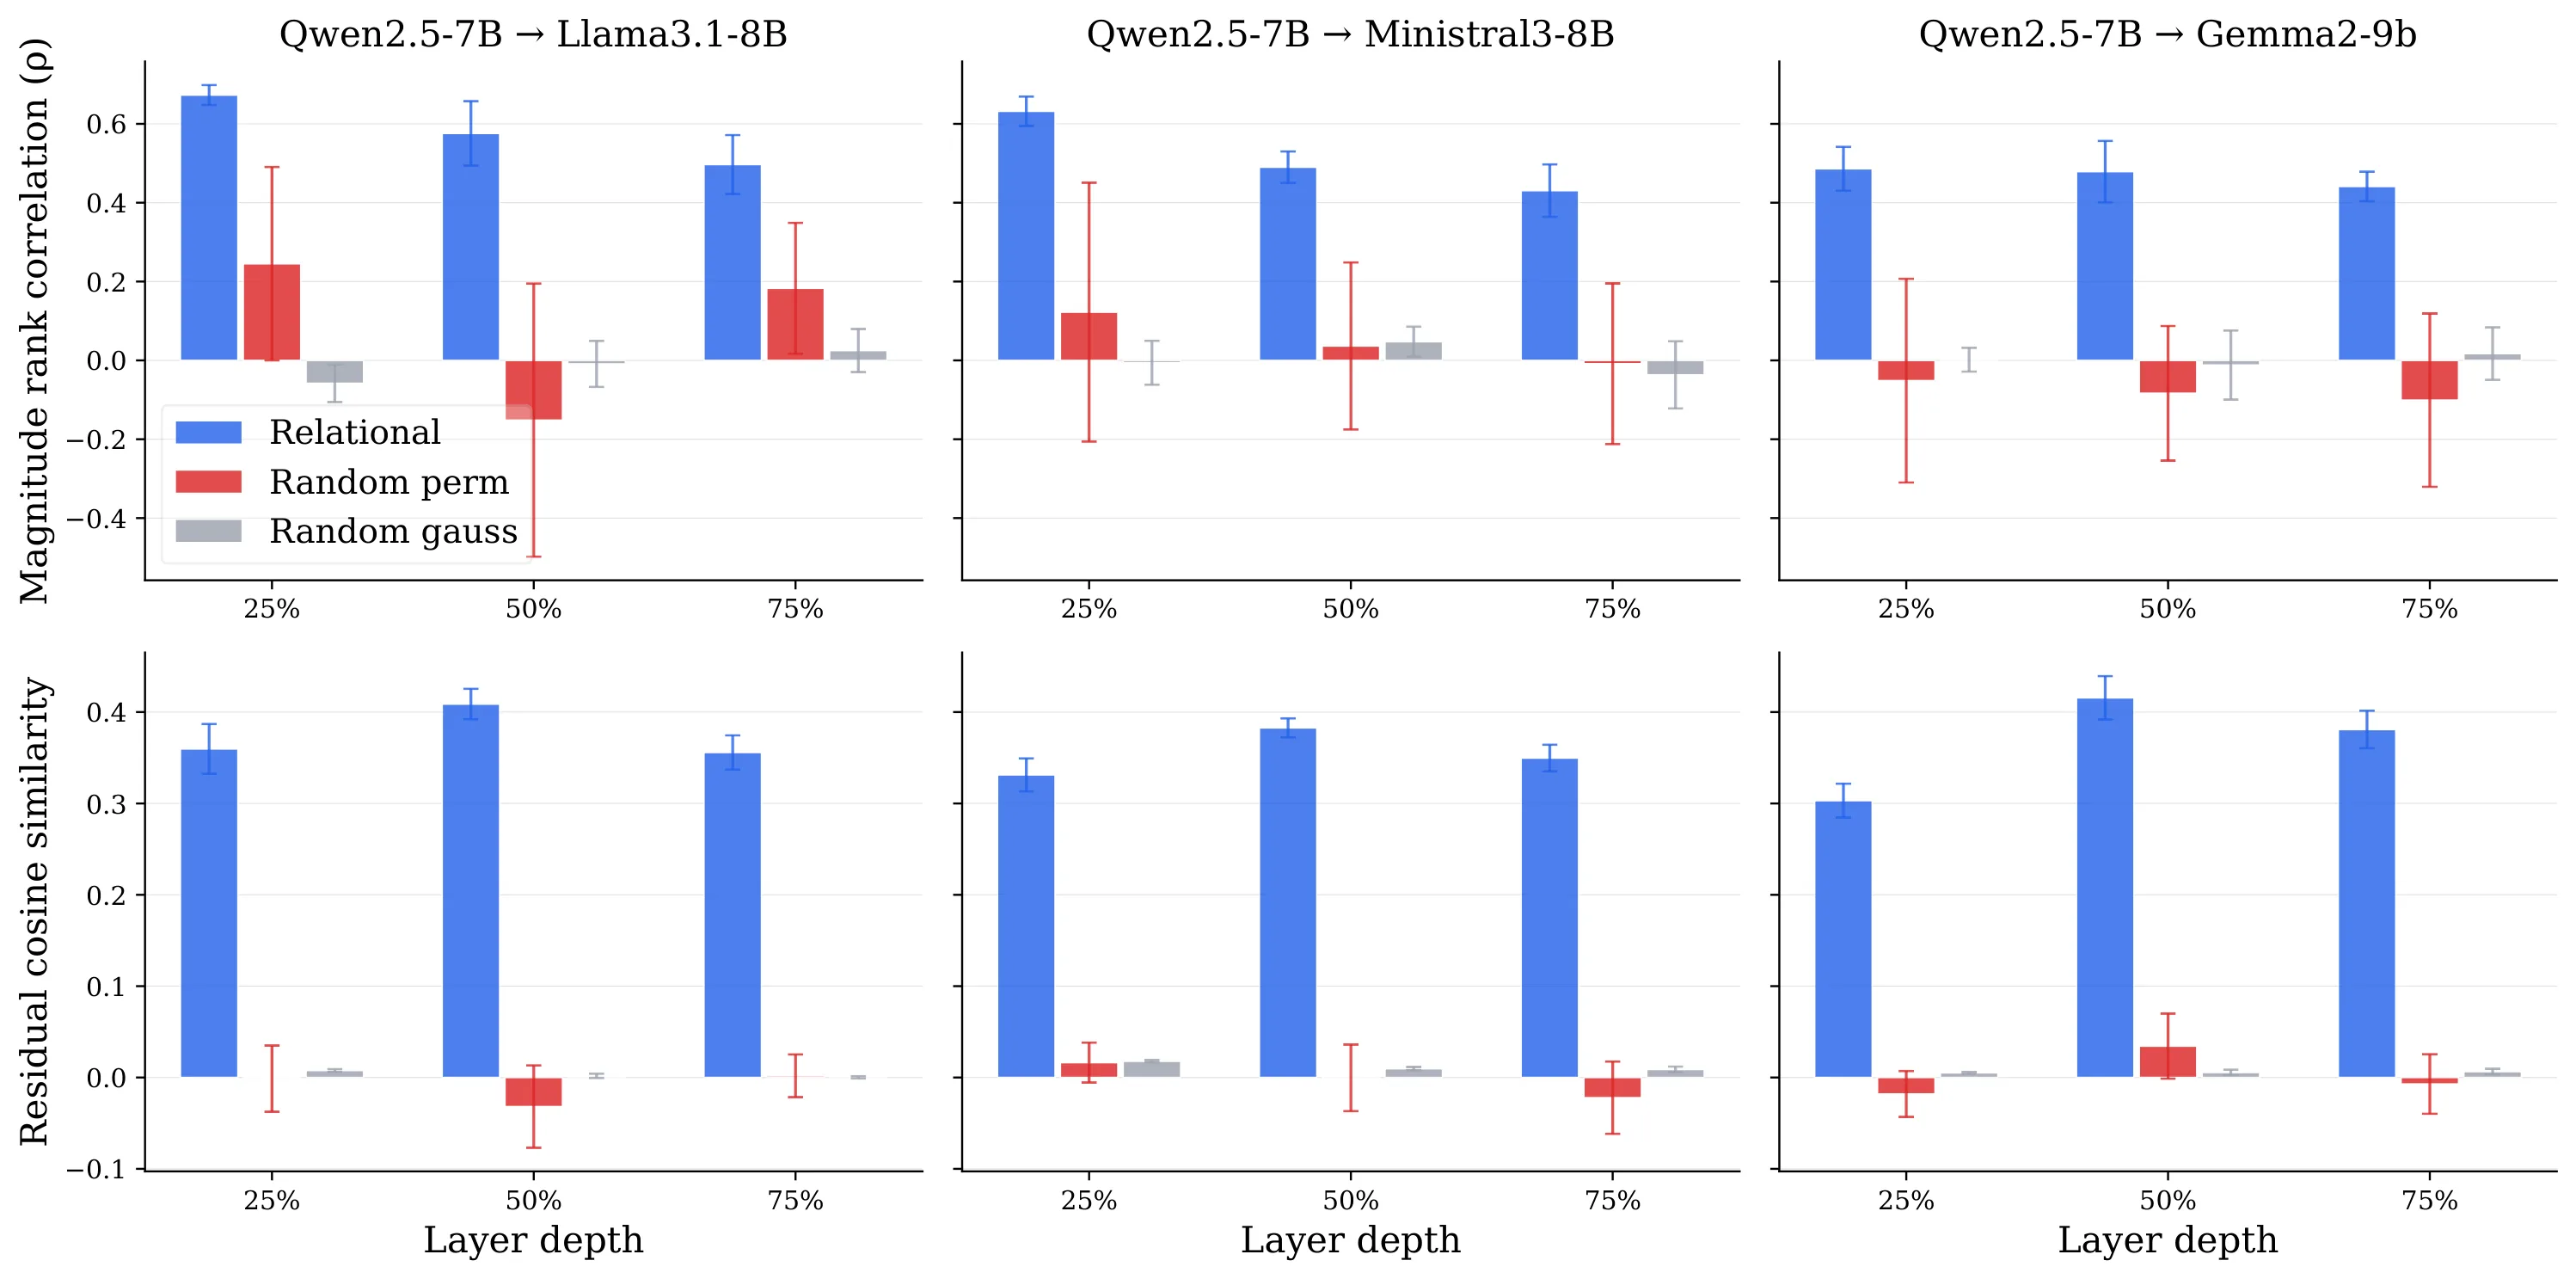
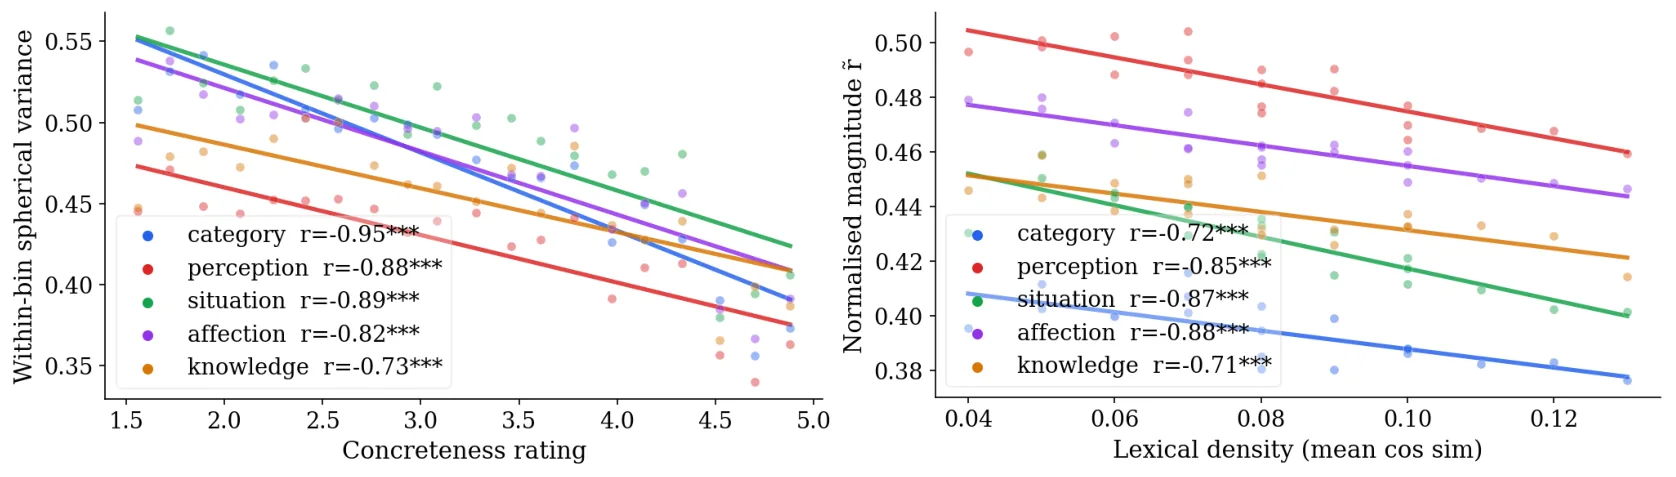
TL;DR
这篇论文挑战了「概念表征是静态几何点」的经典假设,提出将[[概念表征]]建模为点云流形、把上下文变换建模为向量场的新框架。在六个不同规模的大语言模型族上实验后发现,上下文对不同概念的位移量存在差异,而这种差异具有语义规律性——词汇的具体性和密度与之相关。更有趣的是,这种位移结构在不同模型之间是共享的:在一个模型上学到的位移模式可以迁移预测另一个模型上未见过的位移,说明模型不仅共享概念表征的几何布局,更共享上下文如何「拉动」这些概念的方式。
研究背景与动机
理解概念在神经网络中如何被表征,是机器学习领域的核心问题之一。长久以来,研究者倾向于将[[概念表征]]视为静态的几何对象——每个概念对应一个固定位置的向量,不同概念之间的关系由它们在向量空间中的距离或方向决定。这一观点简单直观,也催生了大量关于[[嵌入空间]]几何结构的研究。
然而,这种静态视角忽略了一个关键事实:概念从来不是孤立地存在于真空中的,它们总是出现在特定的上下文里,而上下文会对概念的意义进行微调甚至重塑。举个直观的例子,「银行」这个词在「去银行存钱」和「坐在河边银行」中承载了完全不同的含义,但传统静态表征很难捕捉这种动态变化。
已有的上下文建模研究大多关注上下文本身如何改变[[注意力机制]]的权重或隐藏状态,却较少追问:上下文究竟在概念表征的几何层面上做了什么?它是否对所有概念一视同仁地做同样的「编辑」?不同概念是否会被上下文以不同方式、不同幅度地「拉动」?
这篇论文的切入点正是回答上述问题。它借鉴神经科学中神经群体几何(neural population geometry)的理论资源,将概念表征重新形式化为点云流形,将上下文对概念的变换形式化为向量场,从而可以在连续的几何框架下定量分析上下文对概念的作用机制。
方法
论文的核心创新在于提出了一套几何化的形式化框架。首先,概念不再被看作单个向量点,而是用点云流形来表示——每个概念对应嵌入空间中一组点的集合,这些点来自该概念在不同上下文中出现的所有实例。这个设计很自然地捕捉了「同一概念在不同语境下呈现不同表征」的现象。
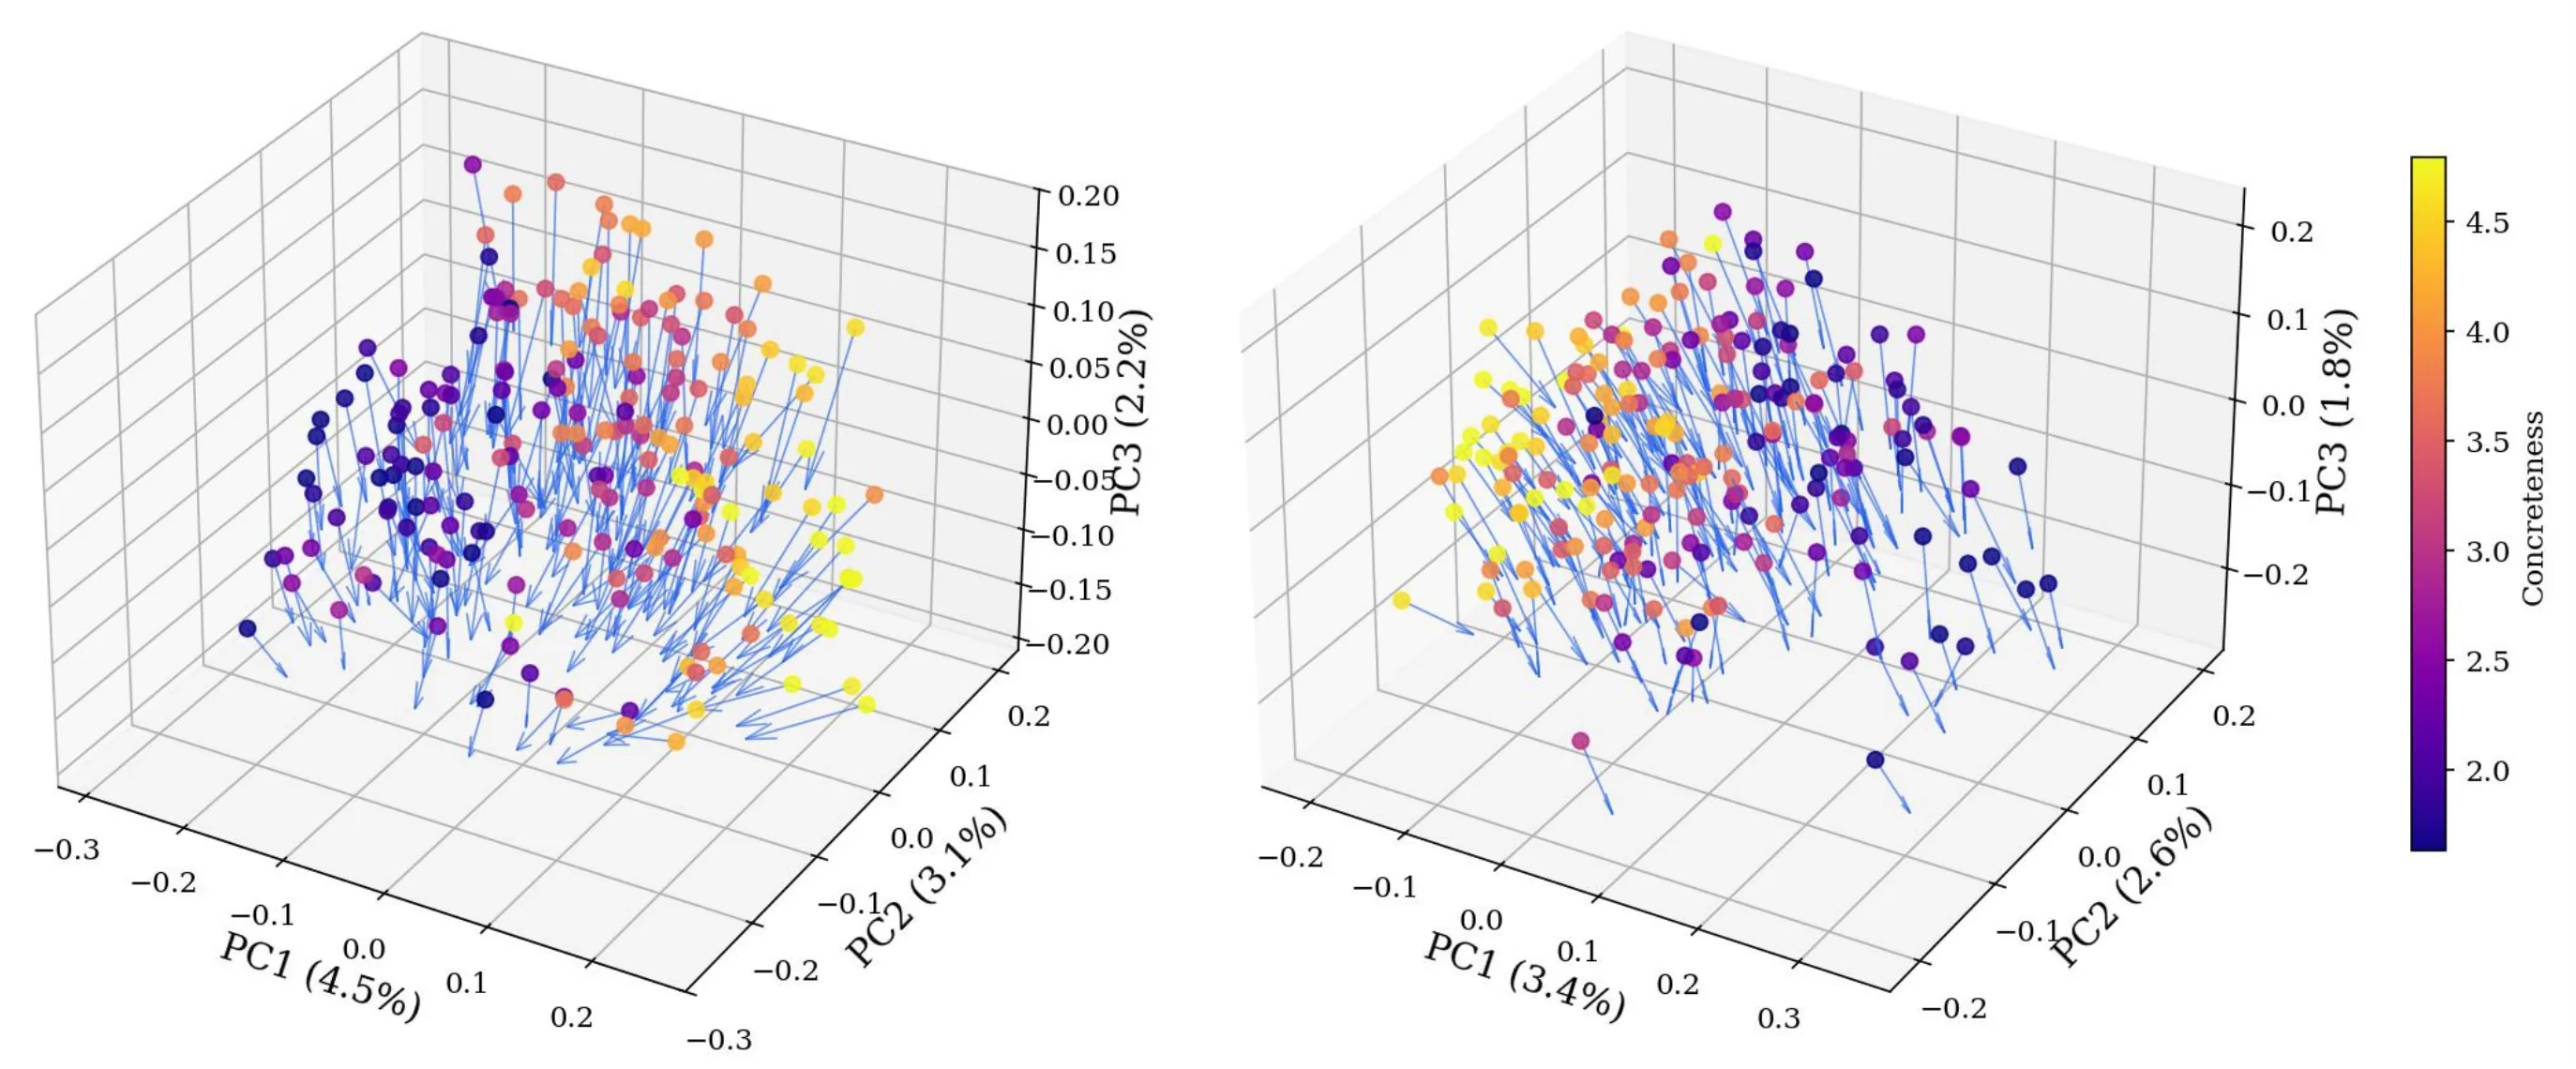
其次,上下文对概念的变换被建模为向量场。具体而言,给定一个概念和它出现的上下文,论文计算该概念在有上下文和无上下文两种条件下的表征向量差,这个差向量就代表了上下文的「拉动」效果。对于某个概念的多个上下文实例,这些差向量构成一个向量集合,其方向和长度分布就反映了上下文变换的结构。
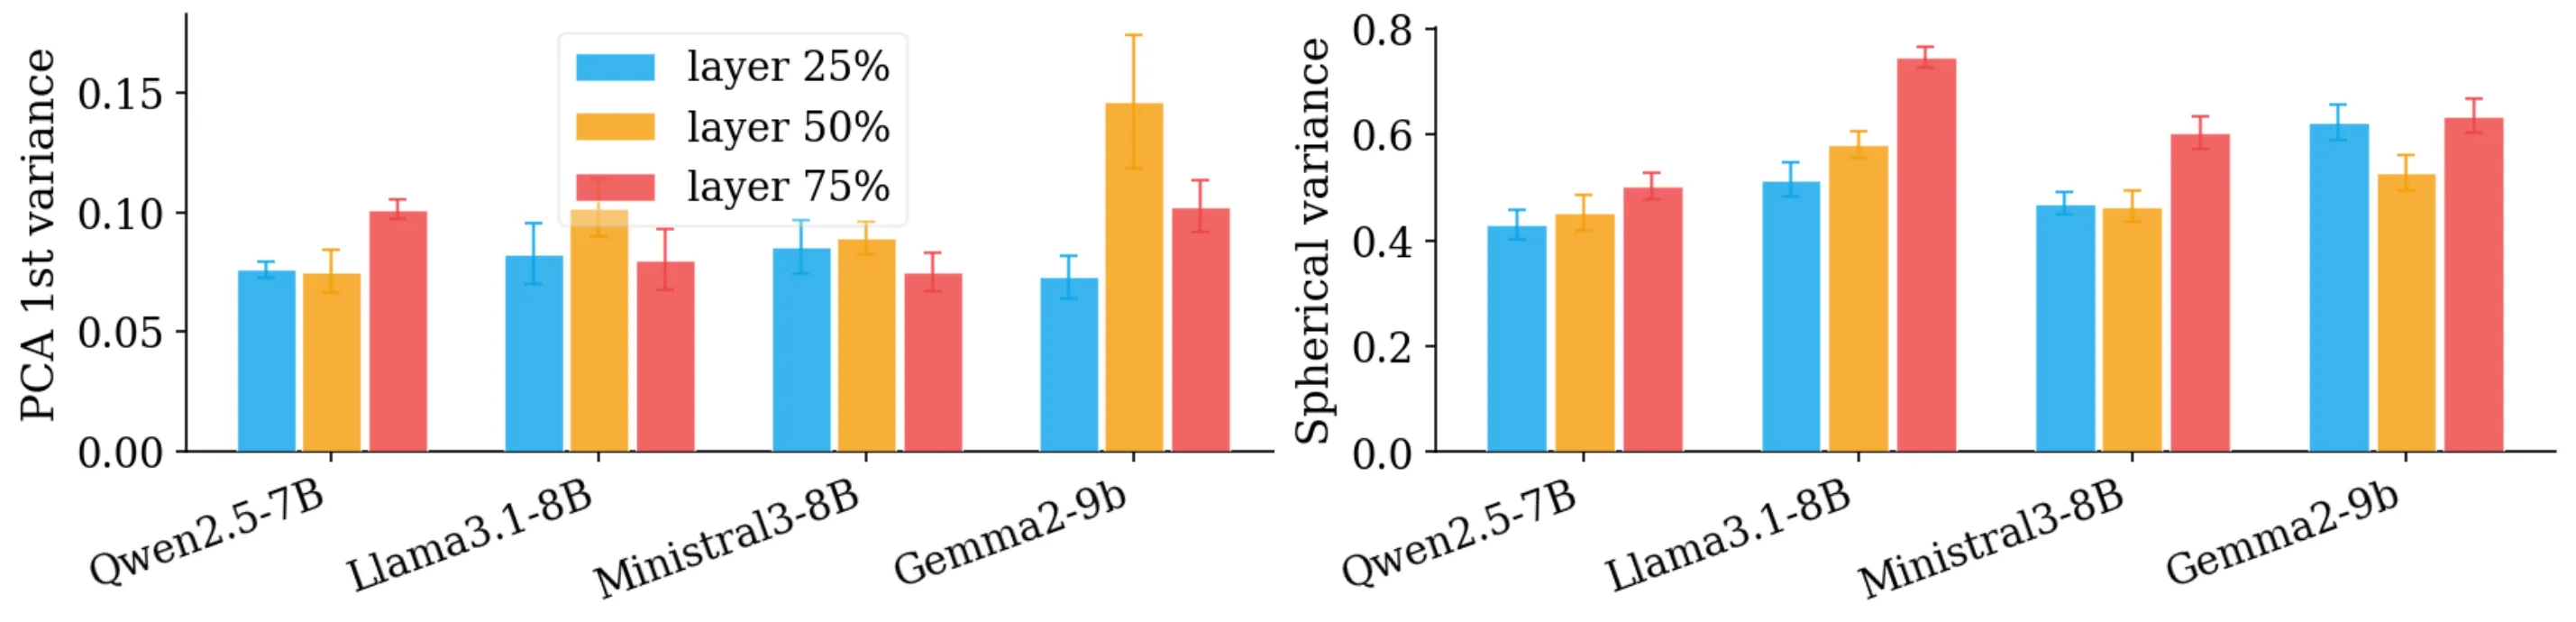
在这个框架下,最关键的量是位移的方差。如果某个概念的位移向量长度方差很大,说明不同上下文对它的改造程度差异显著;如果方差很小,则说明上下文对它的影响比较一致。论文假设这种方差本身携带语义信息,并进一步检验它是否与词汇的具体性(concreteness,指词语是否指向具体可感的事物)和密度(density,可能指语义邻域的稠密程度)相关。
为了验证这些假设,论文在六个不同规模的大语言模型族上进行了系统实验,涵盖从小型到大型的不同参数量级,确保结论不依赖于特定模型规模或架构细节。
实验与结果
实验的第一层发现是,上下文确实会以不同方式移动不同的概念。具体来说,不同概念的位移向量长度存在显著差异,这种差异不是噪声,而是具有系统性的规律。论文发现,位移方差与词汇具体性呈现负相关——越抽象的概念(如「民主」「自由」),上下文对它的改造幅度变化越大;越具体的概念(如「苹果」「猫」),上下文倾向于在相对一致的方向上进行调整。这可能是因为抽象概念本身意义更依赖语境,而具体概念的所指相对稳定。
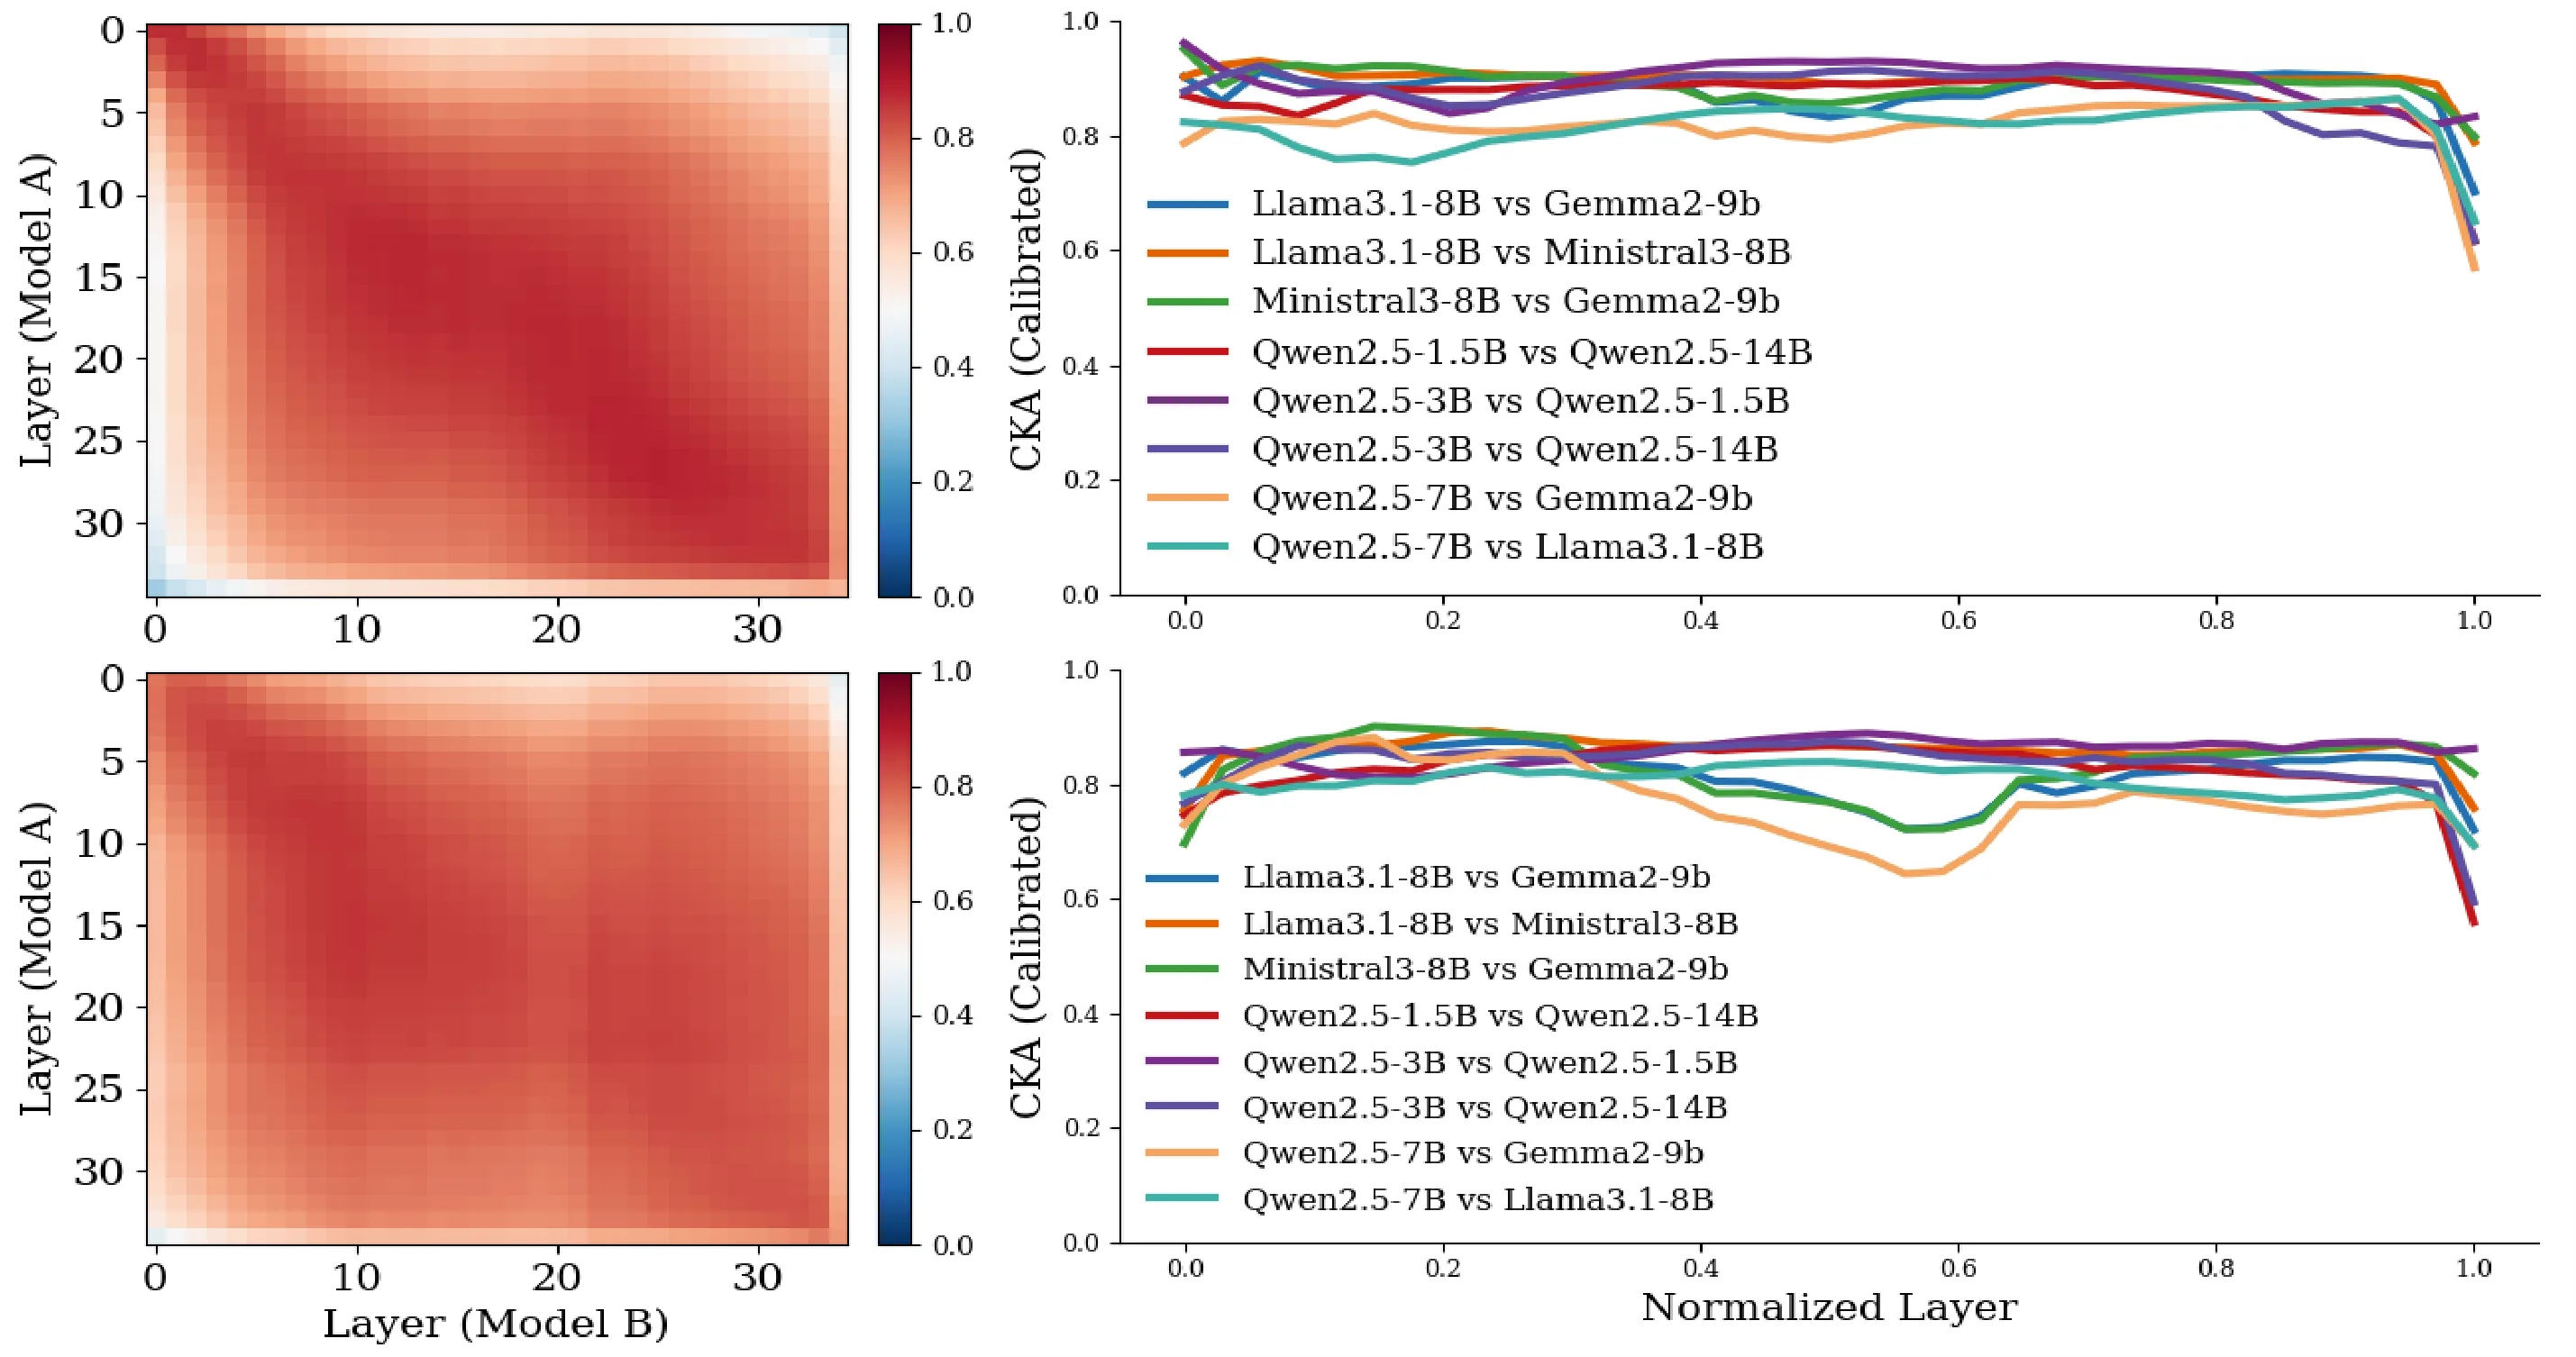
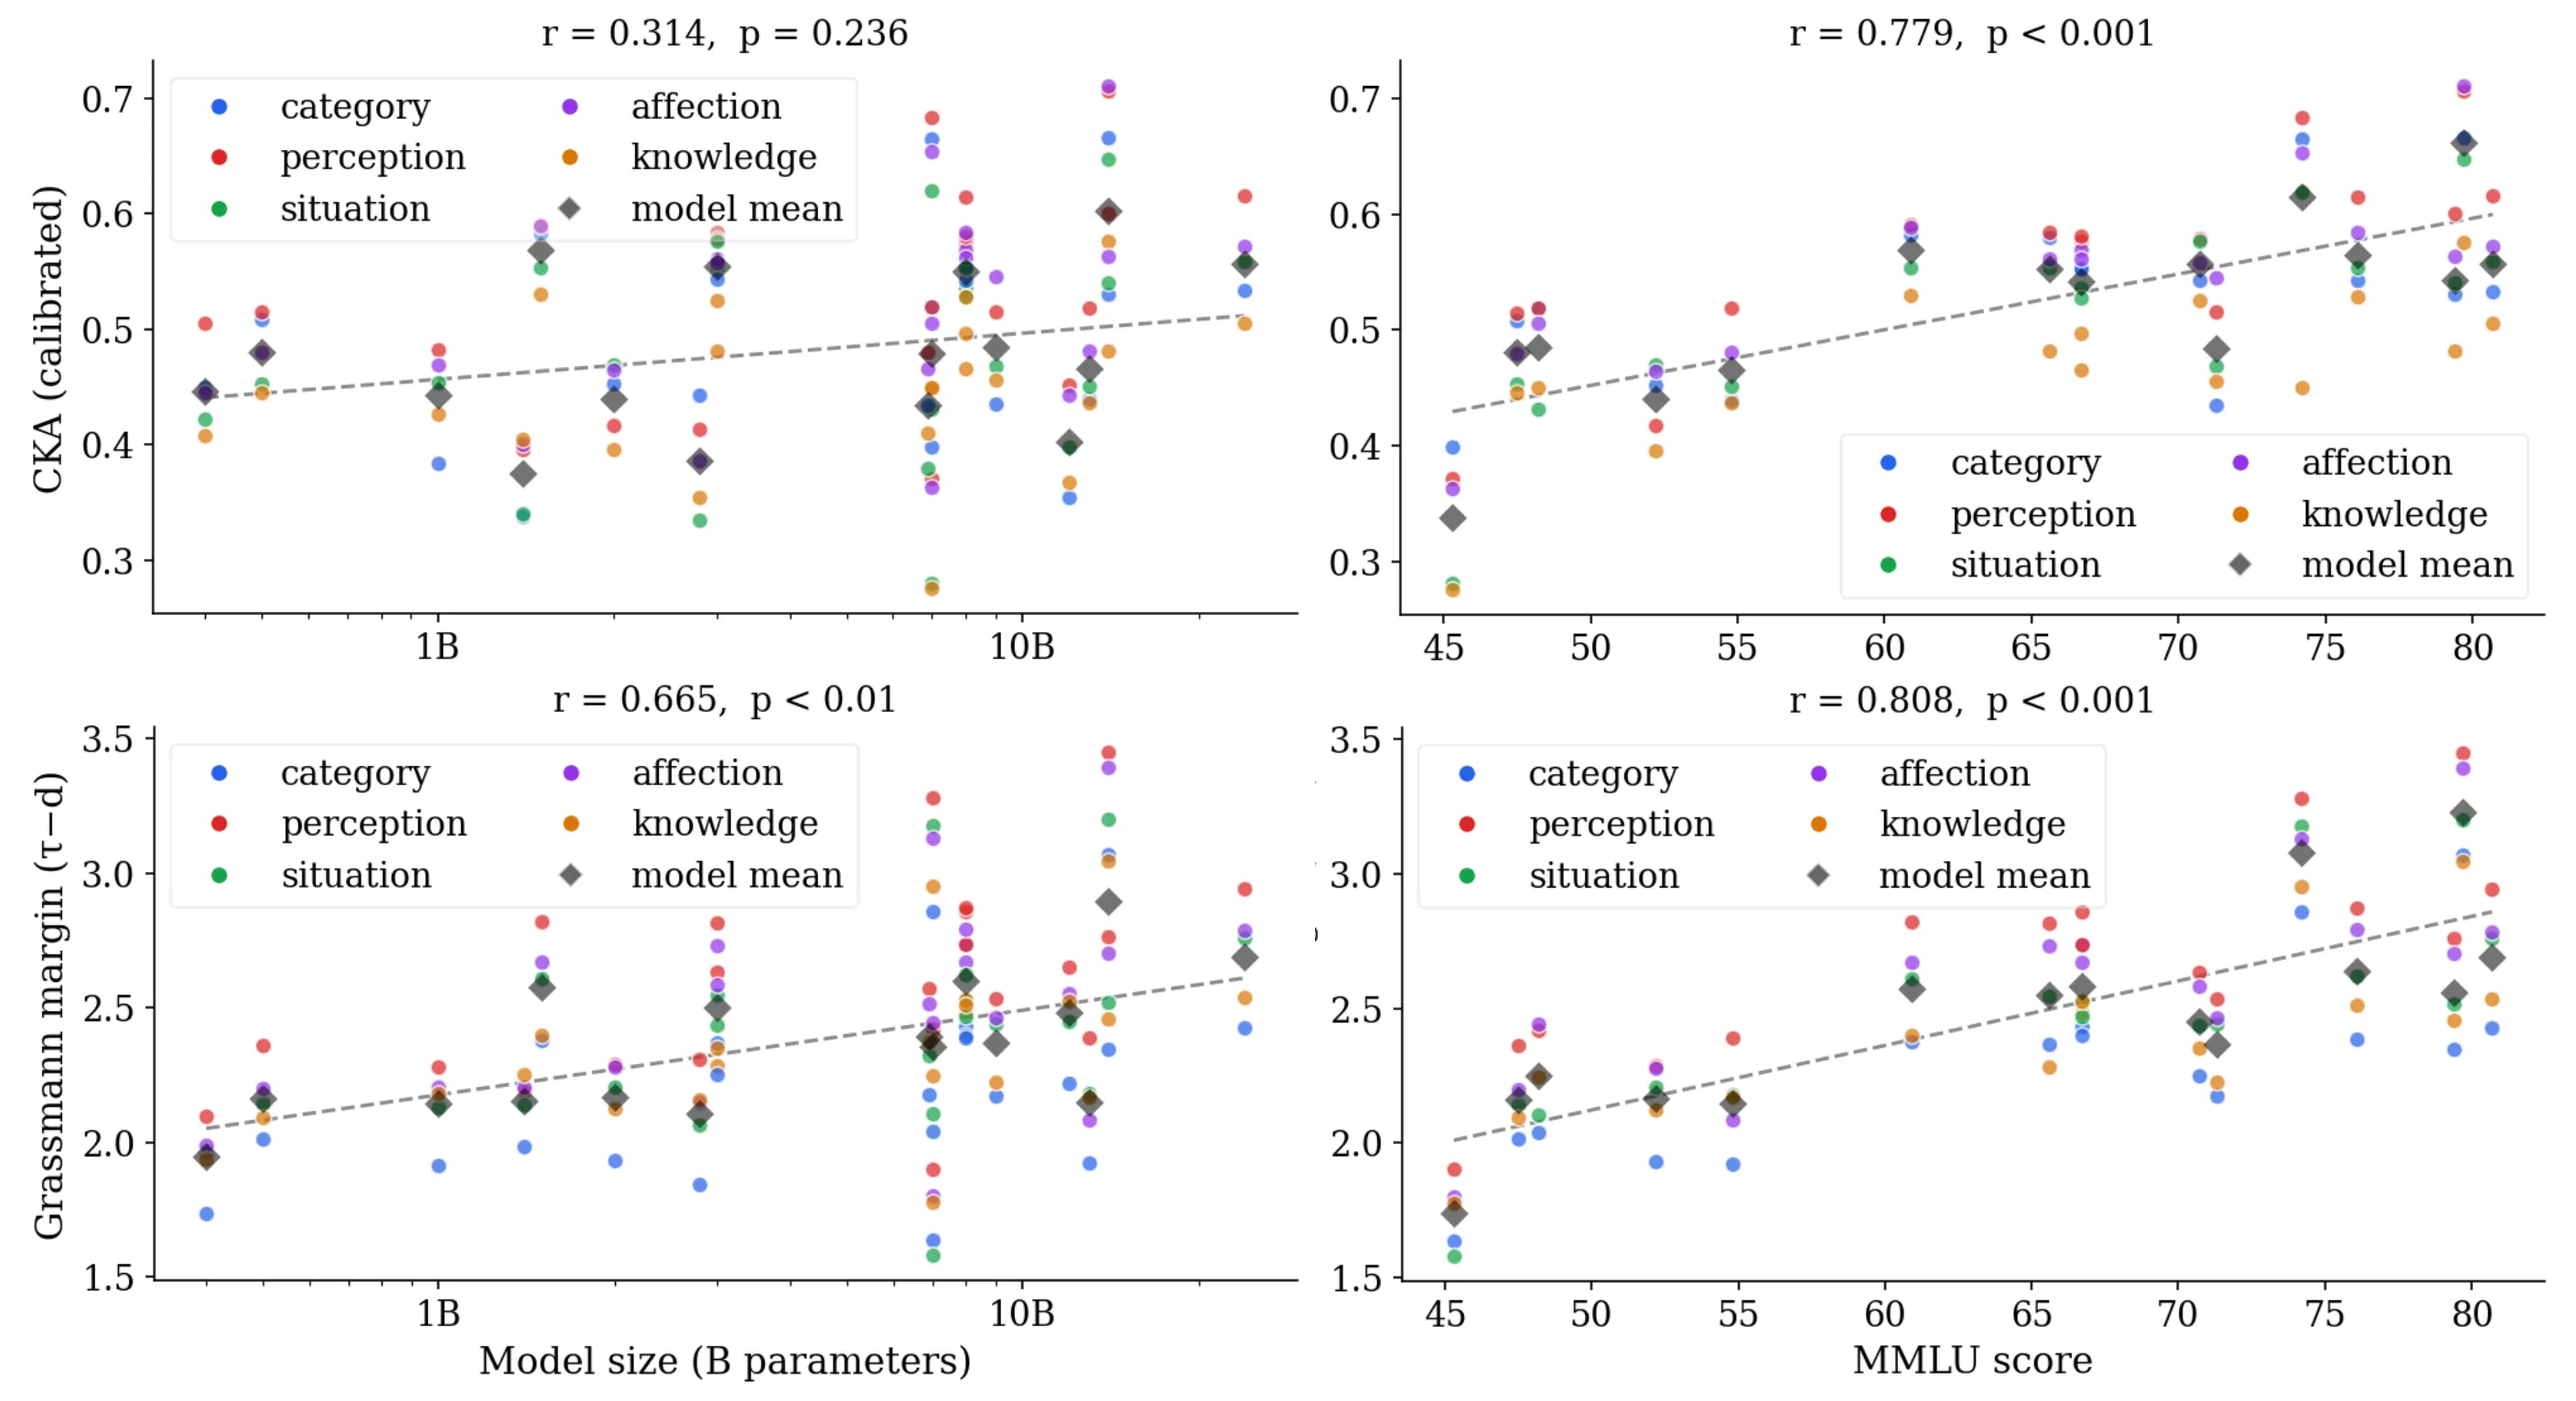
第二层发现更为关键:这种位移结构在不同模型之间是共享的。论文设计了一个迁移实验——在一个模型上计算位移结构,然后看这个结构能否预测另一个模型上的位移。结果显示,跨模型预测的准确率显著高于随机水平,说明位移模式具有跨模型不变性。这表明不同大语言模型在训练过程中不仅学会了相似的概念表征布局,还学会了相似的「上下文如何作用于表征」的方式。
论文还进一步检验了这种共享结构是否具有层次性。他们发现位移结构的某些方面比另一些方面更具普遍性:高层次的语义组织(如抽象 vs 具体概念的差异)在小模型和大模型之间高度一致,而细粒度的数值细节则可能因模型而异。这提示我们,模型对上下文的响应可能存在某种「抽象协议」,定义了在任何规模下都应该成立的基本原则。
讨论与可借鉴点
这项工作的一个重要贡献在于,它将概念表征研究从「静态点」的范式推向「动态流形+向量场」的更丰富框架。这不仅是一个形式化上的改进,更打开了一系列新问题:如果上下文是向量场,那么不同类型的上下文(情感、领域、句法)是否产生不同「场型」?多个上下文叠加时,向量场如何组合?
论文也存在一些局限。首先,实验集中在词汇层面的概念,对于短语、句子乃至篇章层面的语义变换,是否遵循同样规律尚不清楚。其次,向量场的计算依赖于「无上下文」这一基准假设,而实际模型中真正意义的「无上下文表征」难以完美定义,可能引入系统性偏差。再者,论文发现的跨模型共享结构是否来自预训练数据的共性,还是来自语言建模任务本身的归纳偏置,仍有待进一步厘清。
对于更广泛的研究社区,这篇论文提供了一个可借鉴的思路:研究[[概念表征]]不能只看「在哪里」,还要看「怎么变」。上下文不是表征之外的附加噪声,而是表征几何结构本身的组成部分。这种几何视角有望帮助我们更好地理解[[大语言模型]]的语义表示机制,甚至为模型的可解释性和可控性提供新的工具。
摘要
概念在神经网络中如何表示是机器学习中的一个基本问题。主流观点将概念表示视为静态的几何对象。然而概念出现在语境之中,而语境会对其进行变换。我们借鉴神经群体几何的理论,将概念表示形式化为点云流形,将语境变换形式化为向量场,并在大型语言模型中实例化这一框架。在六个不同规模的模型家族中,我们发现语境以不同方式移动每个概念。这些位移的方差具有语义组织性,与词汇的具体性和密度相关。重要的是,被变换的概念以及这种方差结构在模型之间是共享的:从一个模型迁移的位移结构能够显著高于随机水平地预测其他模型中的留置位移。综上,这些发现表明,模型不仅在概念表示方式上共享共同几何,更重要的是在语境如何变换概念上也共享共同几何——这一结构比先前研究所认识的具有更丰富的组织性。
Abstract
How concepts are represented in neural networks is a fundamental question in machine learning. The dominant view treats concept representations as stationary geometric objects. Yet concepts appear in context, and context transforms them. Drawing from neural population geometry, we formalize concept representations as point-cloud manifolds and contextual transformations as vector fields, and instantiate this framework in large language models. Across six model families of varying scales, we find that context moves each concept differently. The variance in these displacements is semantically organized, correlating with lexical concreteness and density. Importantly, both the concepts being transformed and this variance structure are shared across models: displacement structure transported from one model predicts held-out displacements in others significantly above chance. Together, these findings show that models share a common geometry not only in how concepts are represented, but more importantly in how context transforms them, a structure with richer organization than prior work has recognized.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。