
Controlling Embedding Spaces with Text-Conditioned Transformations
📝 TLDR
CLIP等多模态嵌入将高层语义压缩为单一向量,主导语义压制颜色、视角等次要属性,限制细粒度可控访问。本文提出文本条件仿射变换网络,根据自然语言属性描述(如"颜色""艺术风格")对视觉嵌入施加变换,使指定属性在潜空间中显式凸显。该变换与冻结潜空间对齐,无需重新编码即可支持检索与多聚类等解耦任务,在属性检索与多属性组织上达到最优且推理开销近零。
🧭 速览
CLIP类嵌入将高层语义压缩为单向量,主导语义压制颜色、视角等次要属性,难以按需访问。
输入属性文本描述,由轻量网络生成仿射变换作用于视觉嵌入,与冻结潜空间对齐以保持兼容。
在属性检索与多属性组织任务上达到SOTA,无需重新编码图像或文本,开销近零。
提供统一高效的潜空间控制框架,支持多属性解耦与按需访问,扩展CLIP可控应用边界。
🆚 方法对比
CLIP嵌入空间
- 多模态对齐支持跨模态零样本分类
- 压缩高层语义为单一向量
- 支持大规模语义相似性检索
- 单一向量抑制重要属性
- 主要表达主导语义如主对象
- 难以访问相机角度等细粒度属性
文本条件变换方法(ControlEmbed)
- 属性检索和多属性组织达到SOTA
- 推理成本接近零
- 无需重编码即可使用现有嵌入
- 文本接口直观可访问多属性
- 依赖CLIP嵌入质量作为基础
- 需训练额外的变换网络
- 属性类别依赖文本描述质量
多属性组织框架
- 支持多聚类等解构属性任务
- 直接在潜在空间操作效率高
- 统一框架处理检索与组织任务
- 对齐冻结潜在空间可能限制灵活性
- 变换后空间可能丢失部分原始信息
本文以CLIP嵌入空间为基础,提出文本条件变换方法ControlEmbed,通过仿射变换强调指定属性,在属性检索和多属性组织任务上均达到SOTA,且推理成本接近零,相比直接使用CLIP嵌入能显式访问被抑制的细粒度属性。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 12 张)
展开查看 12 张图
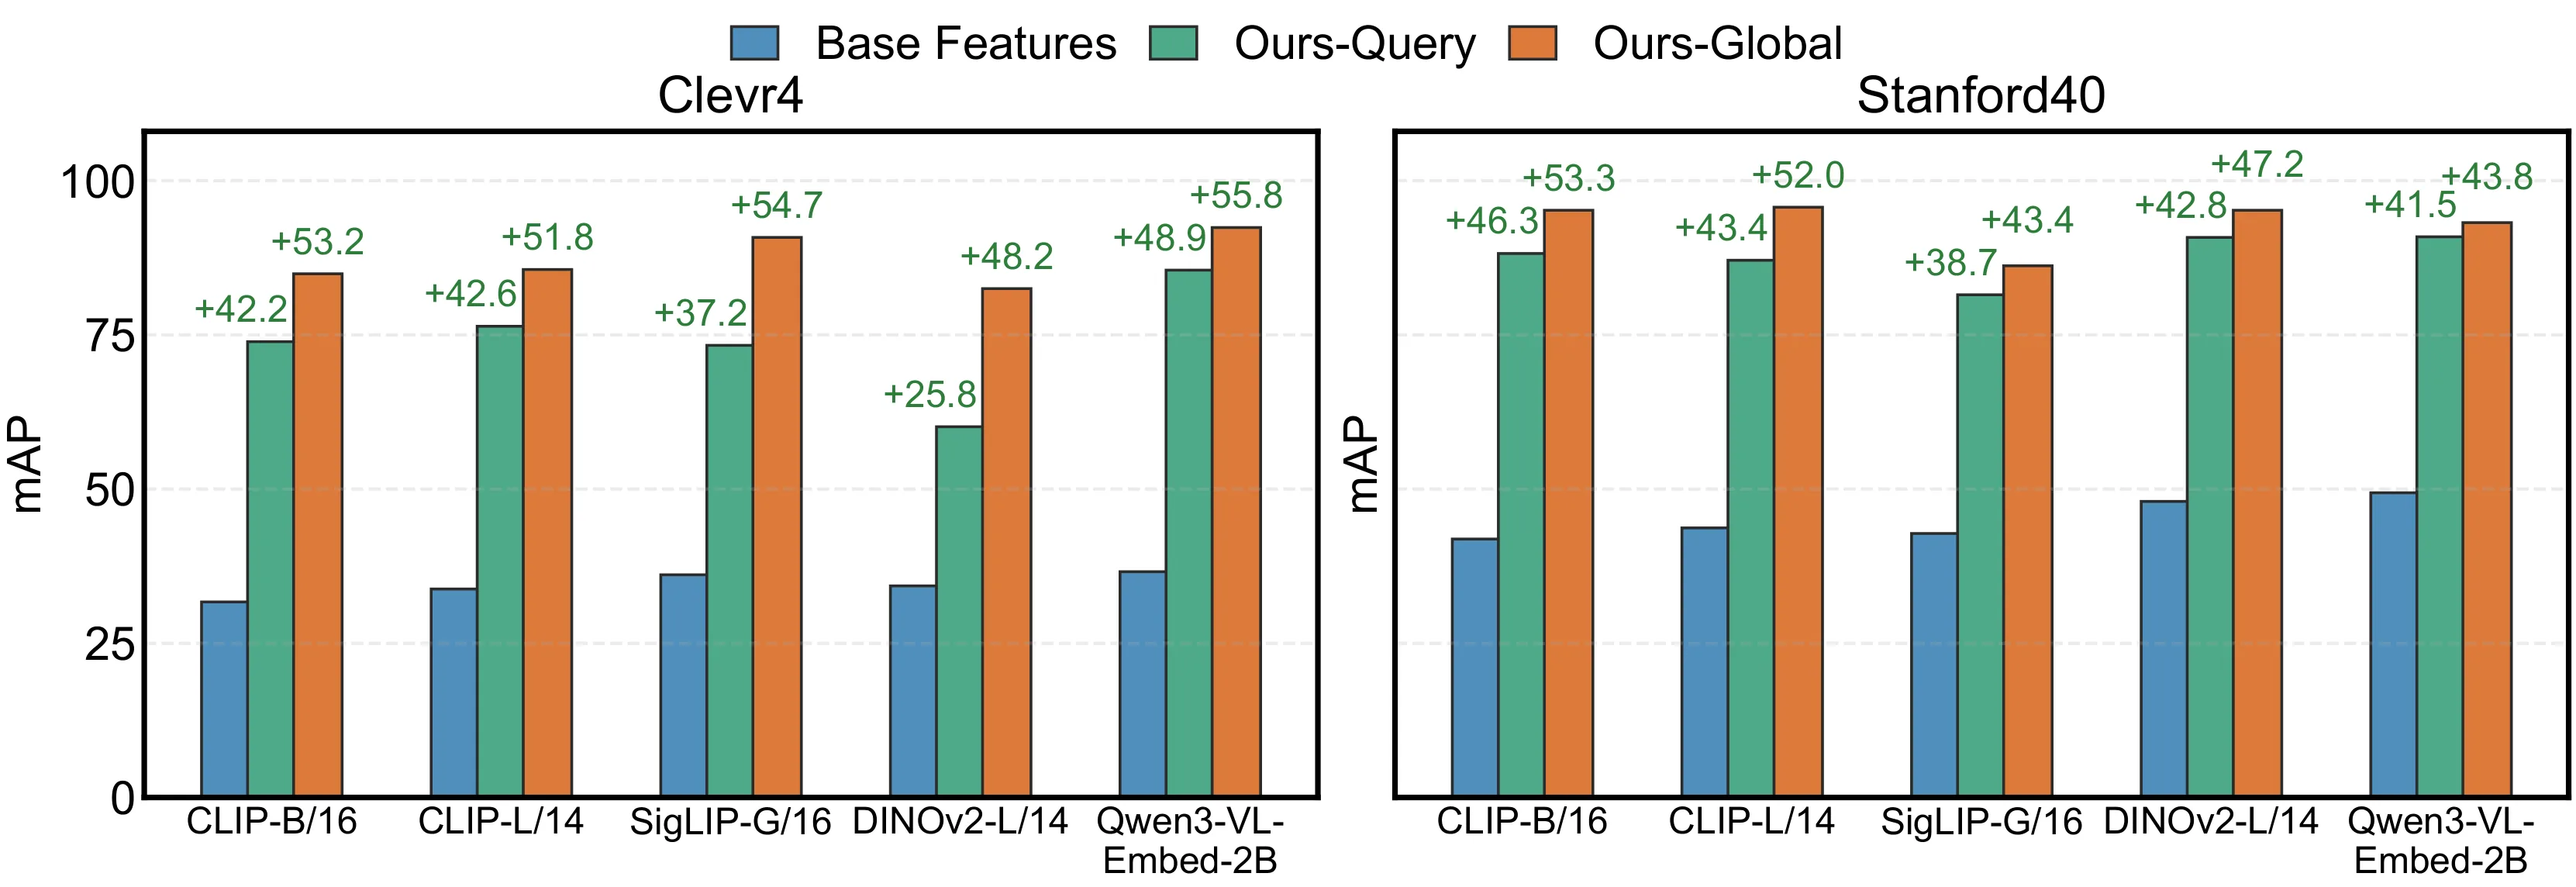
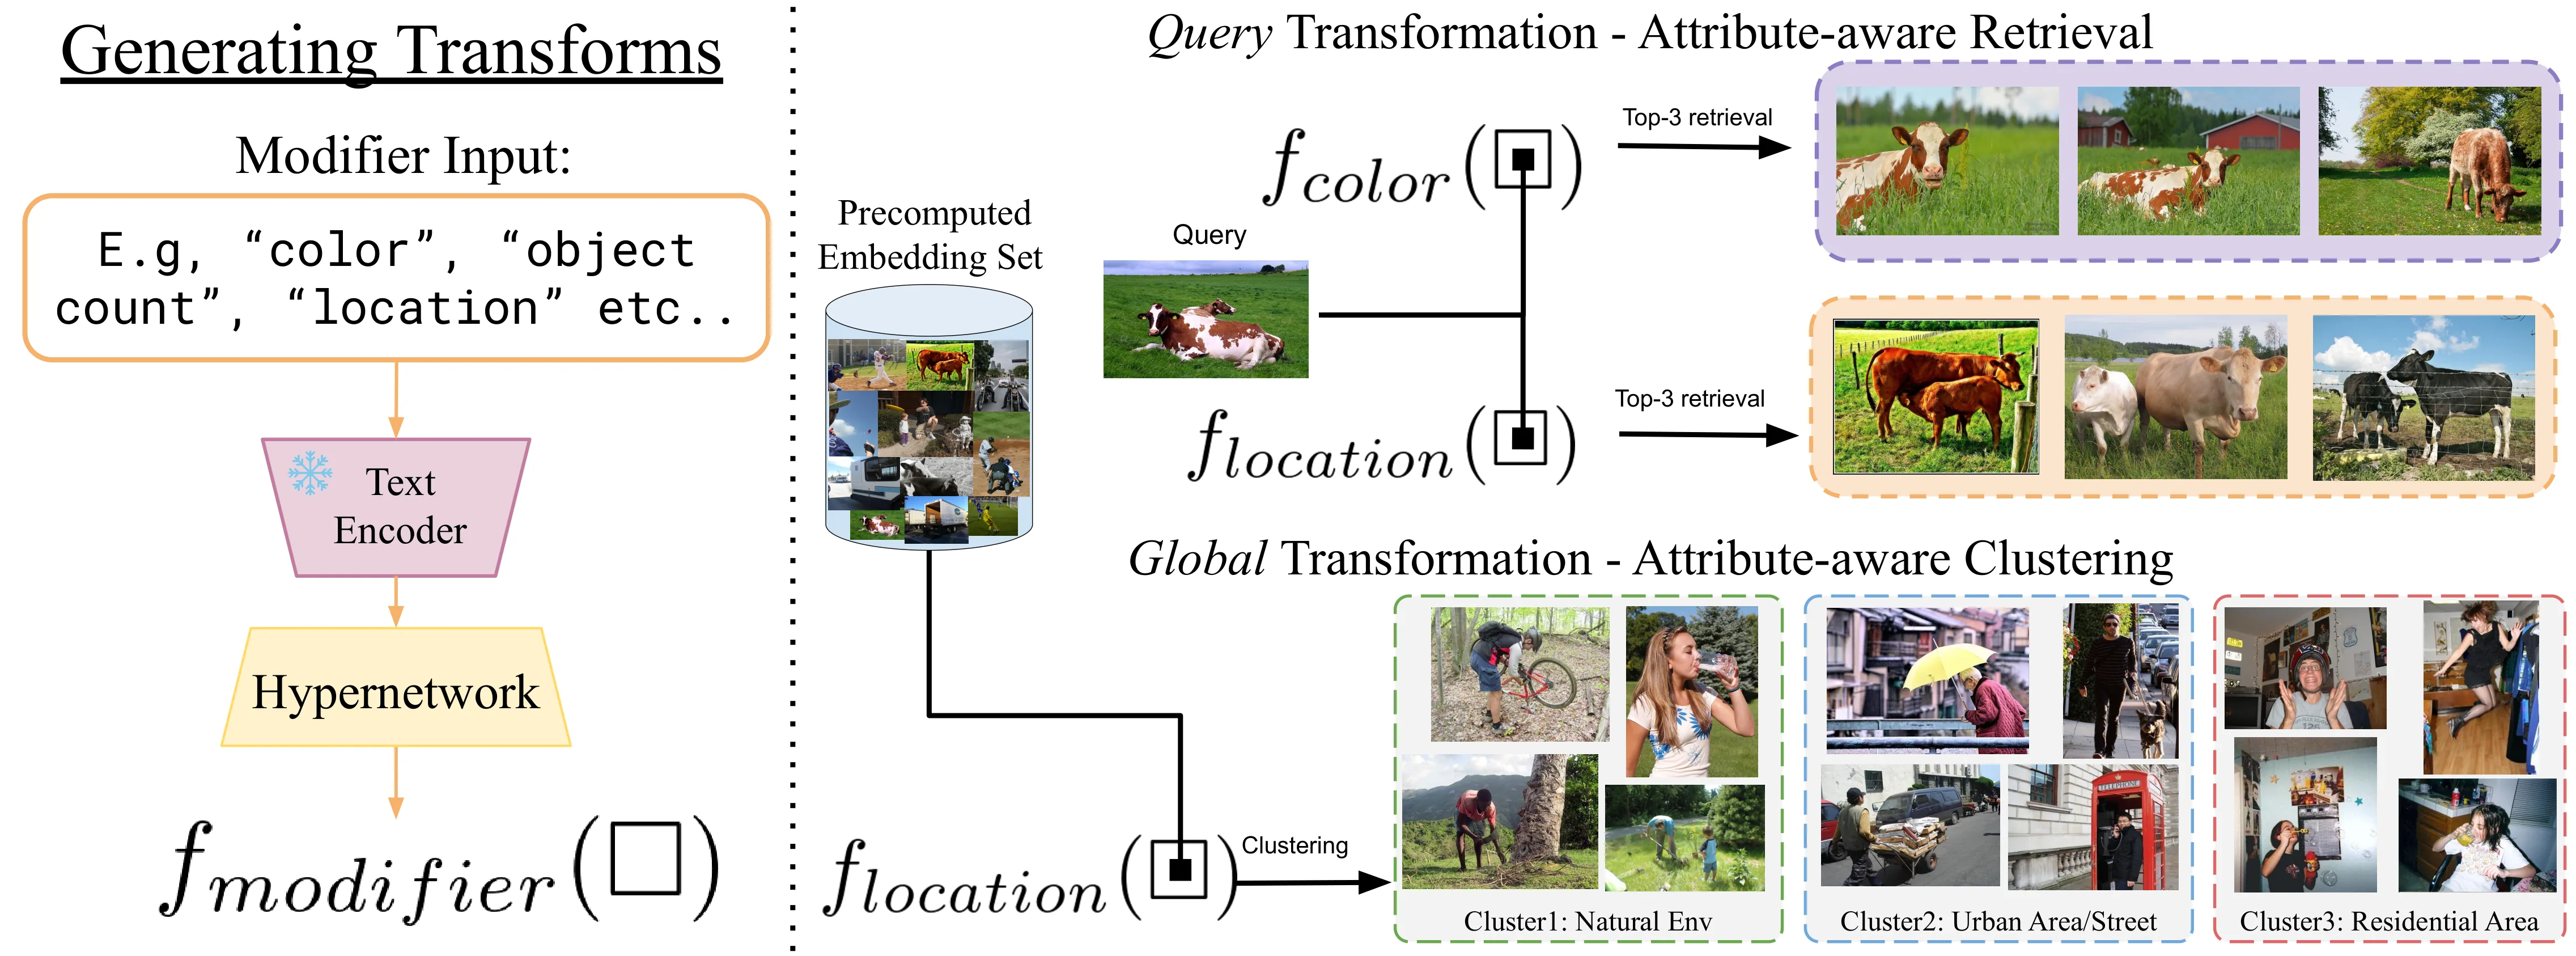
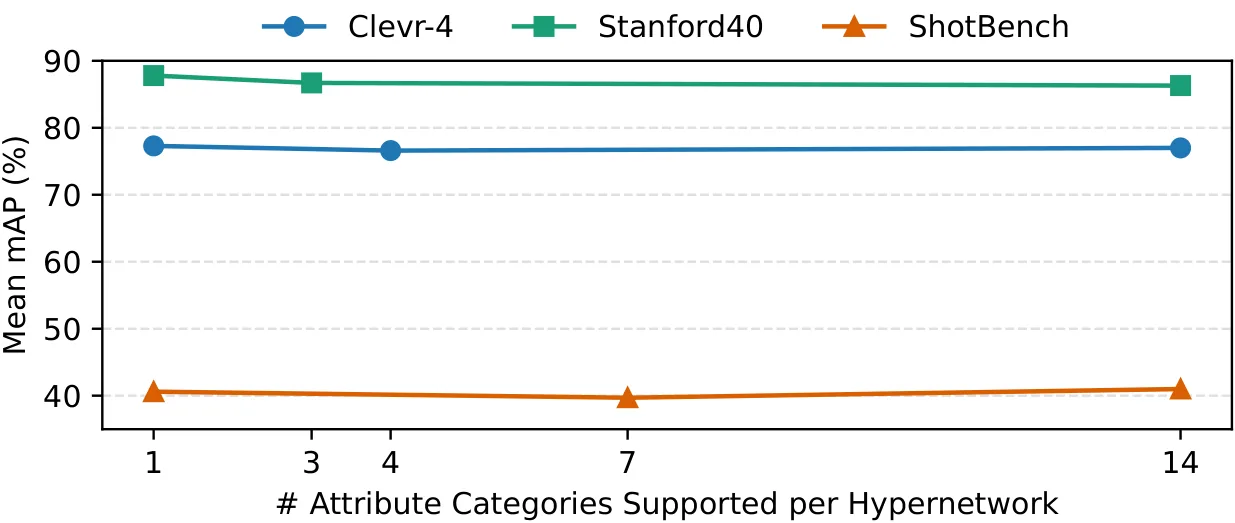
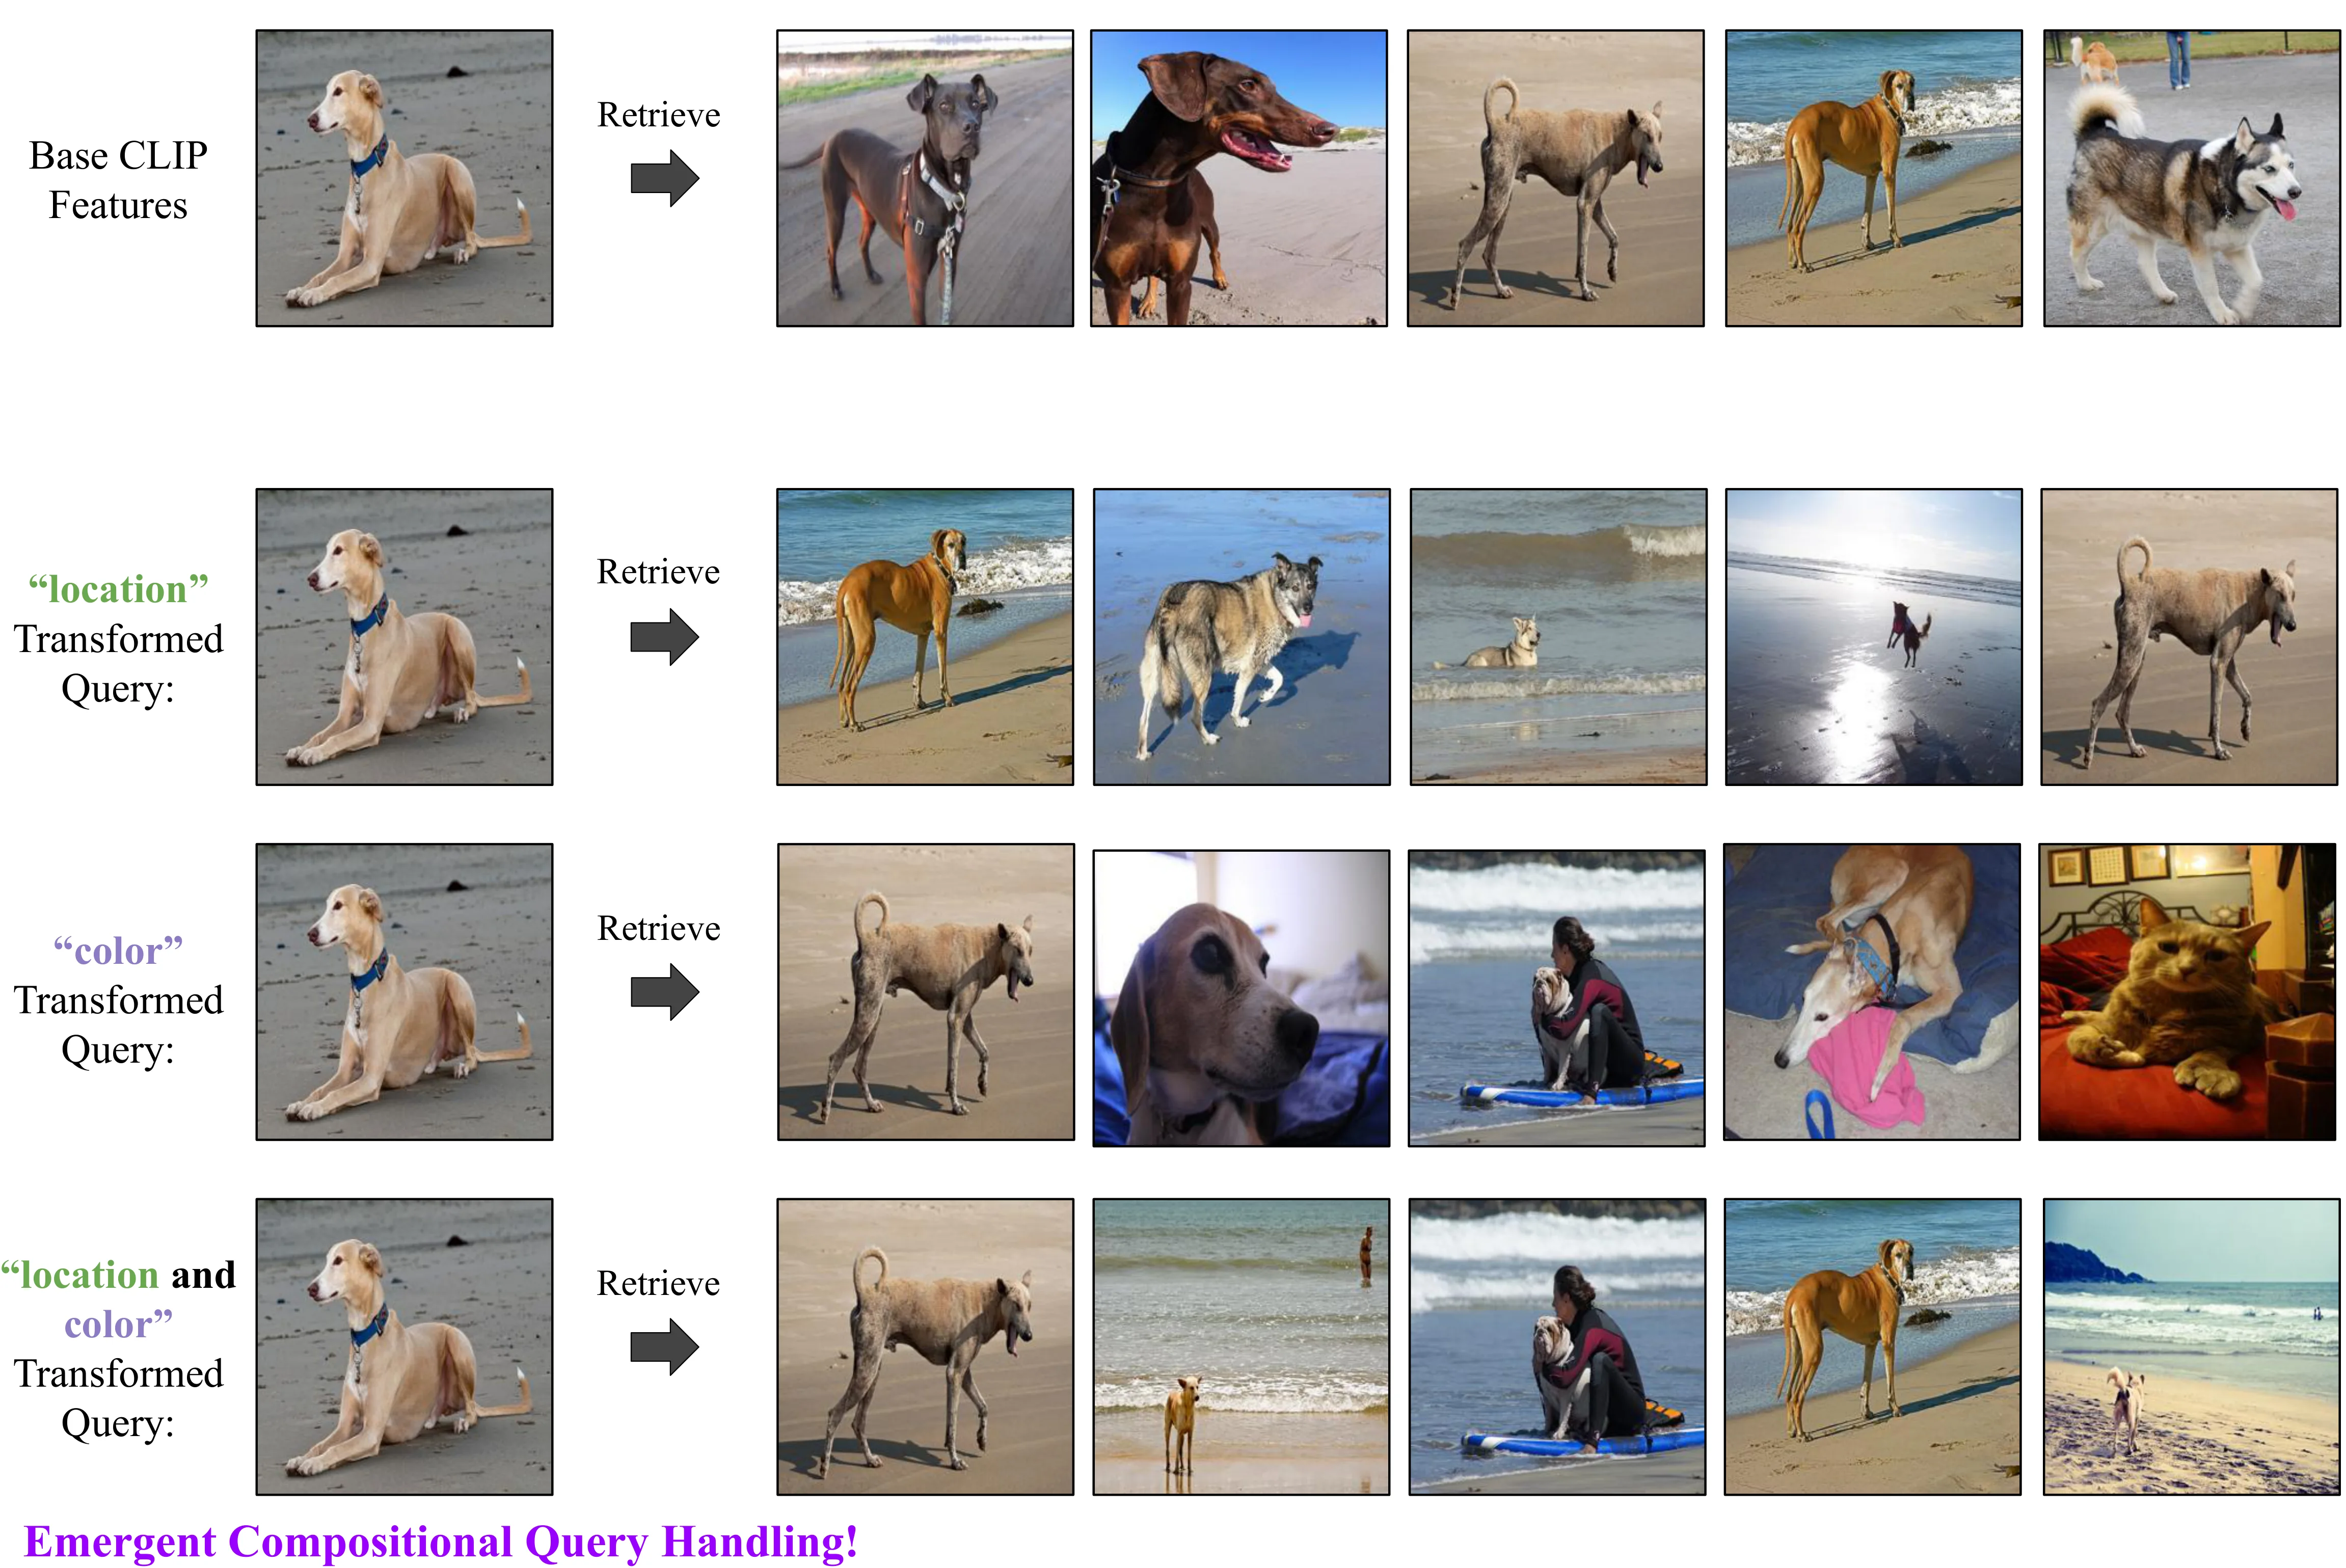
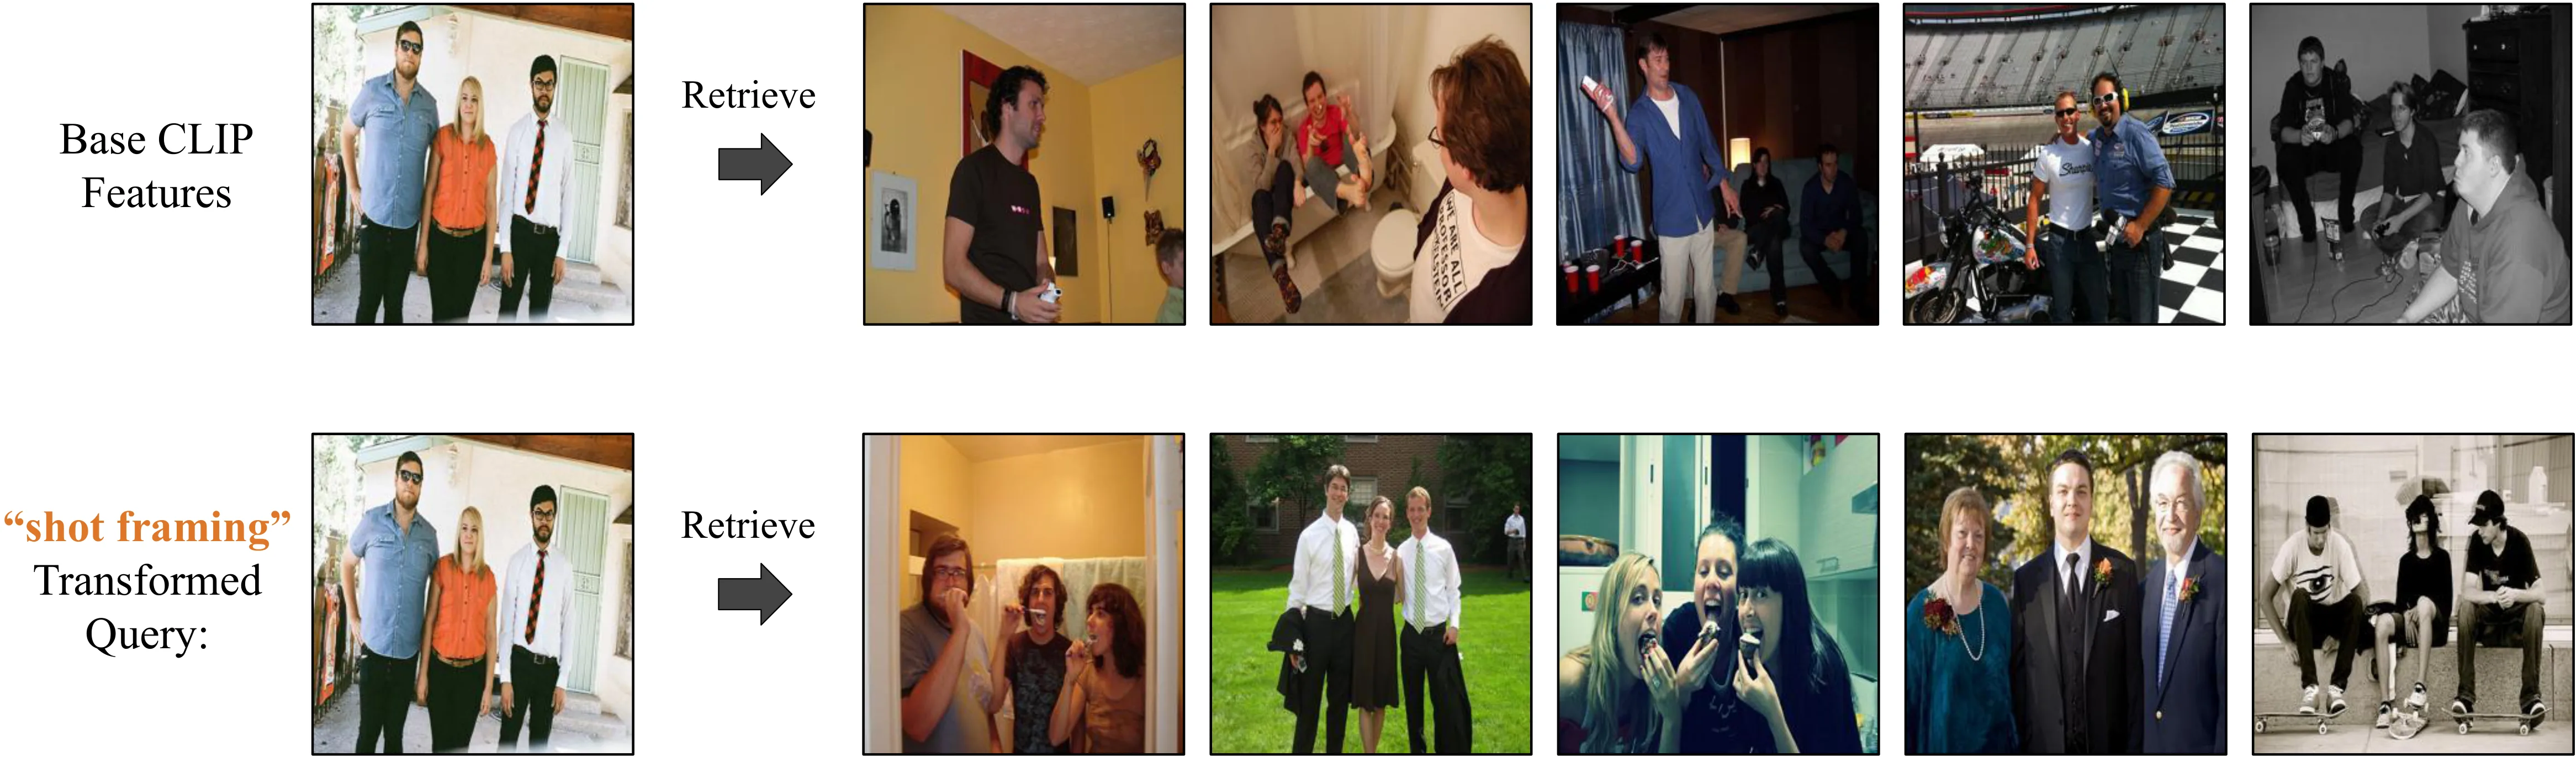
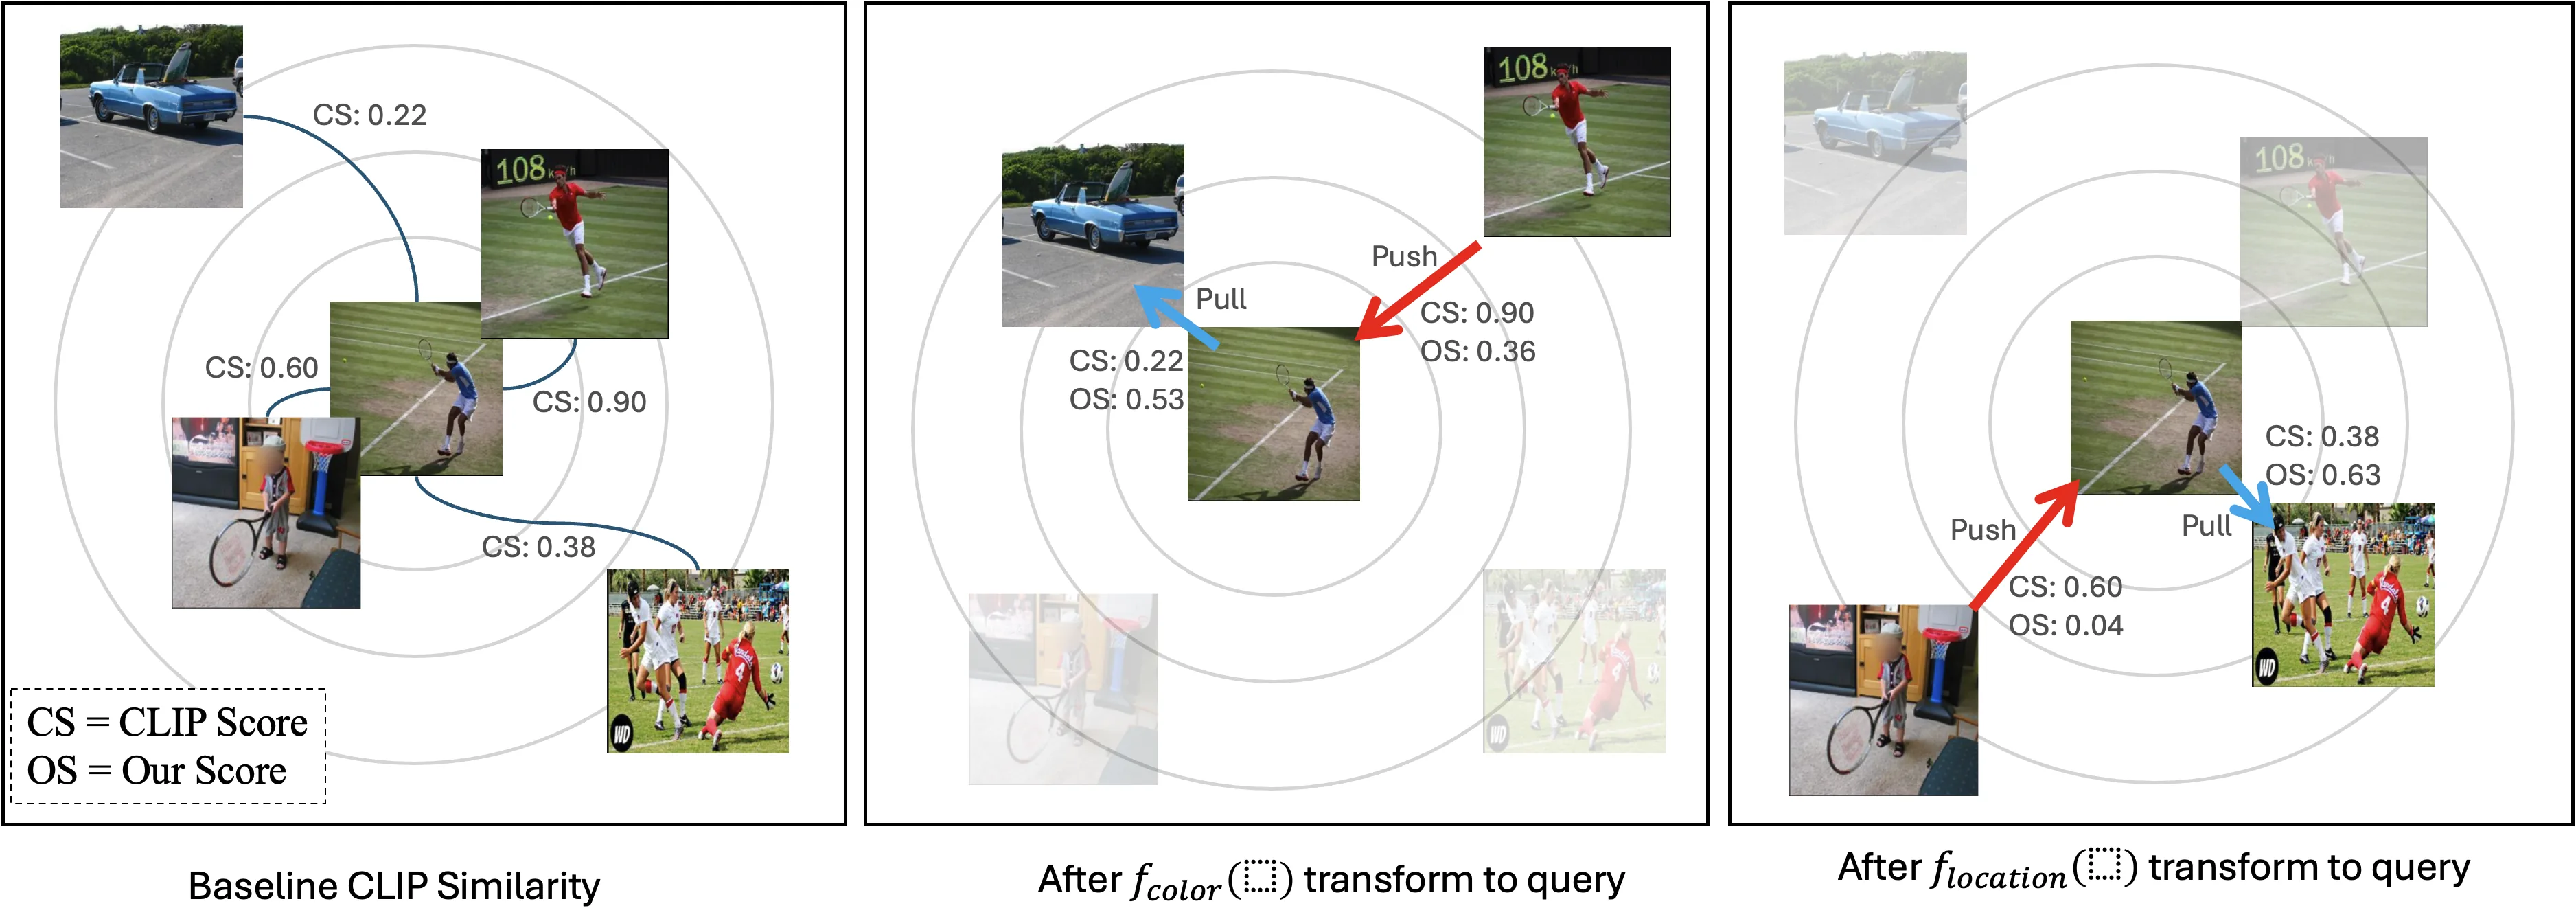
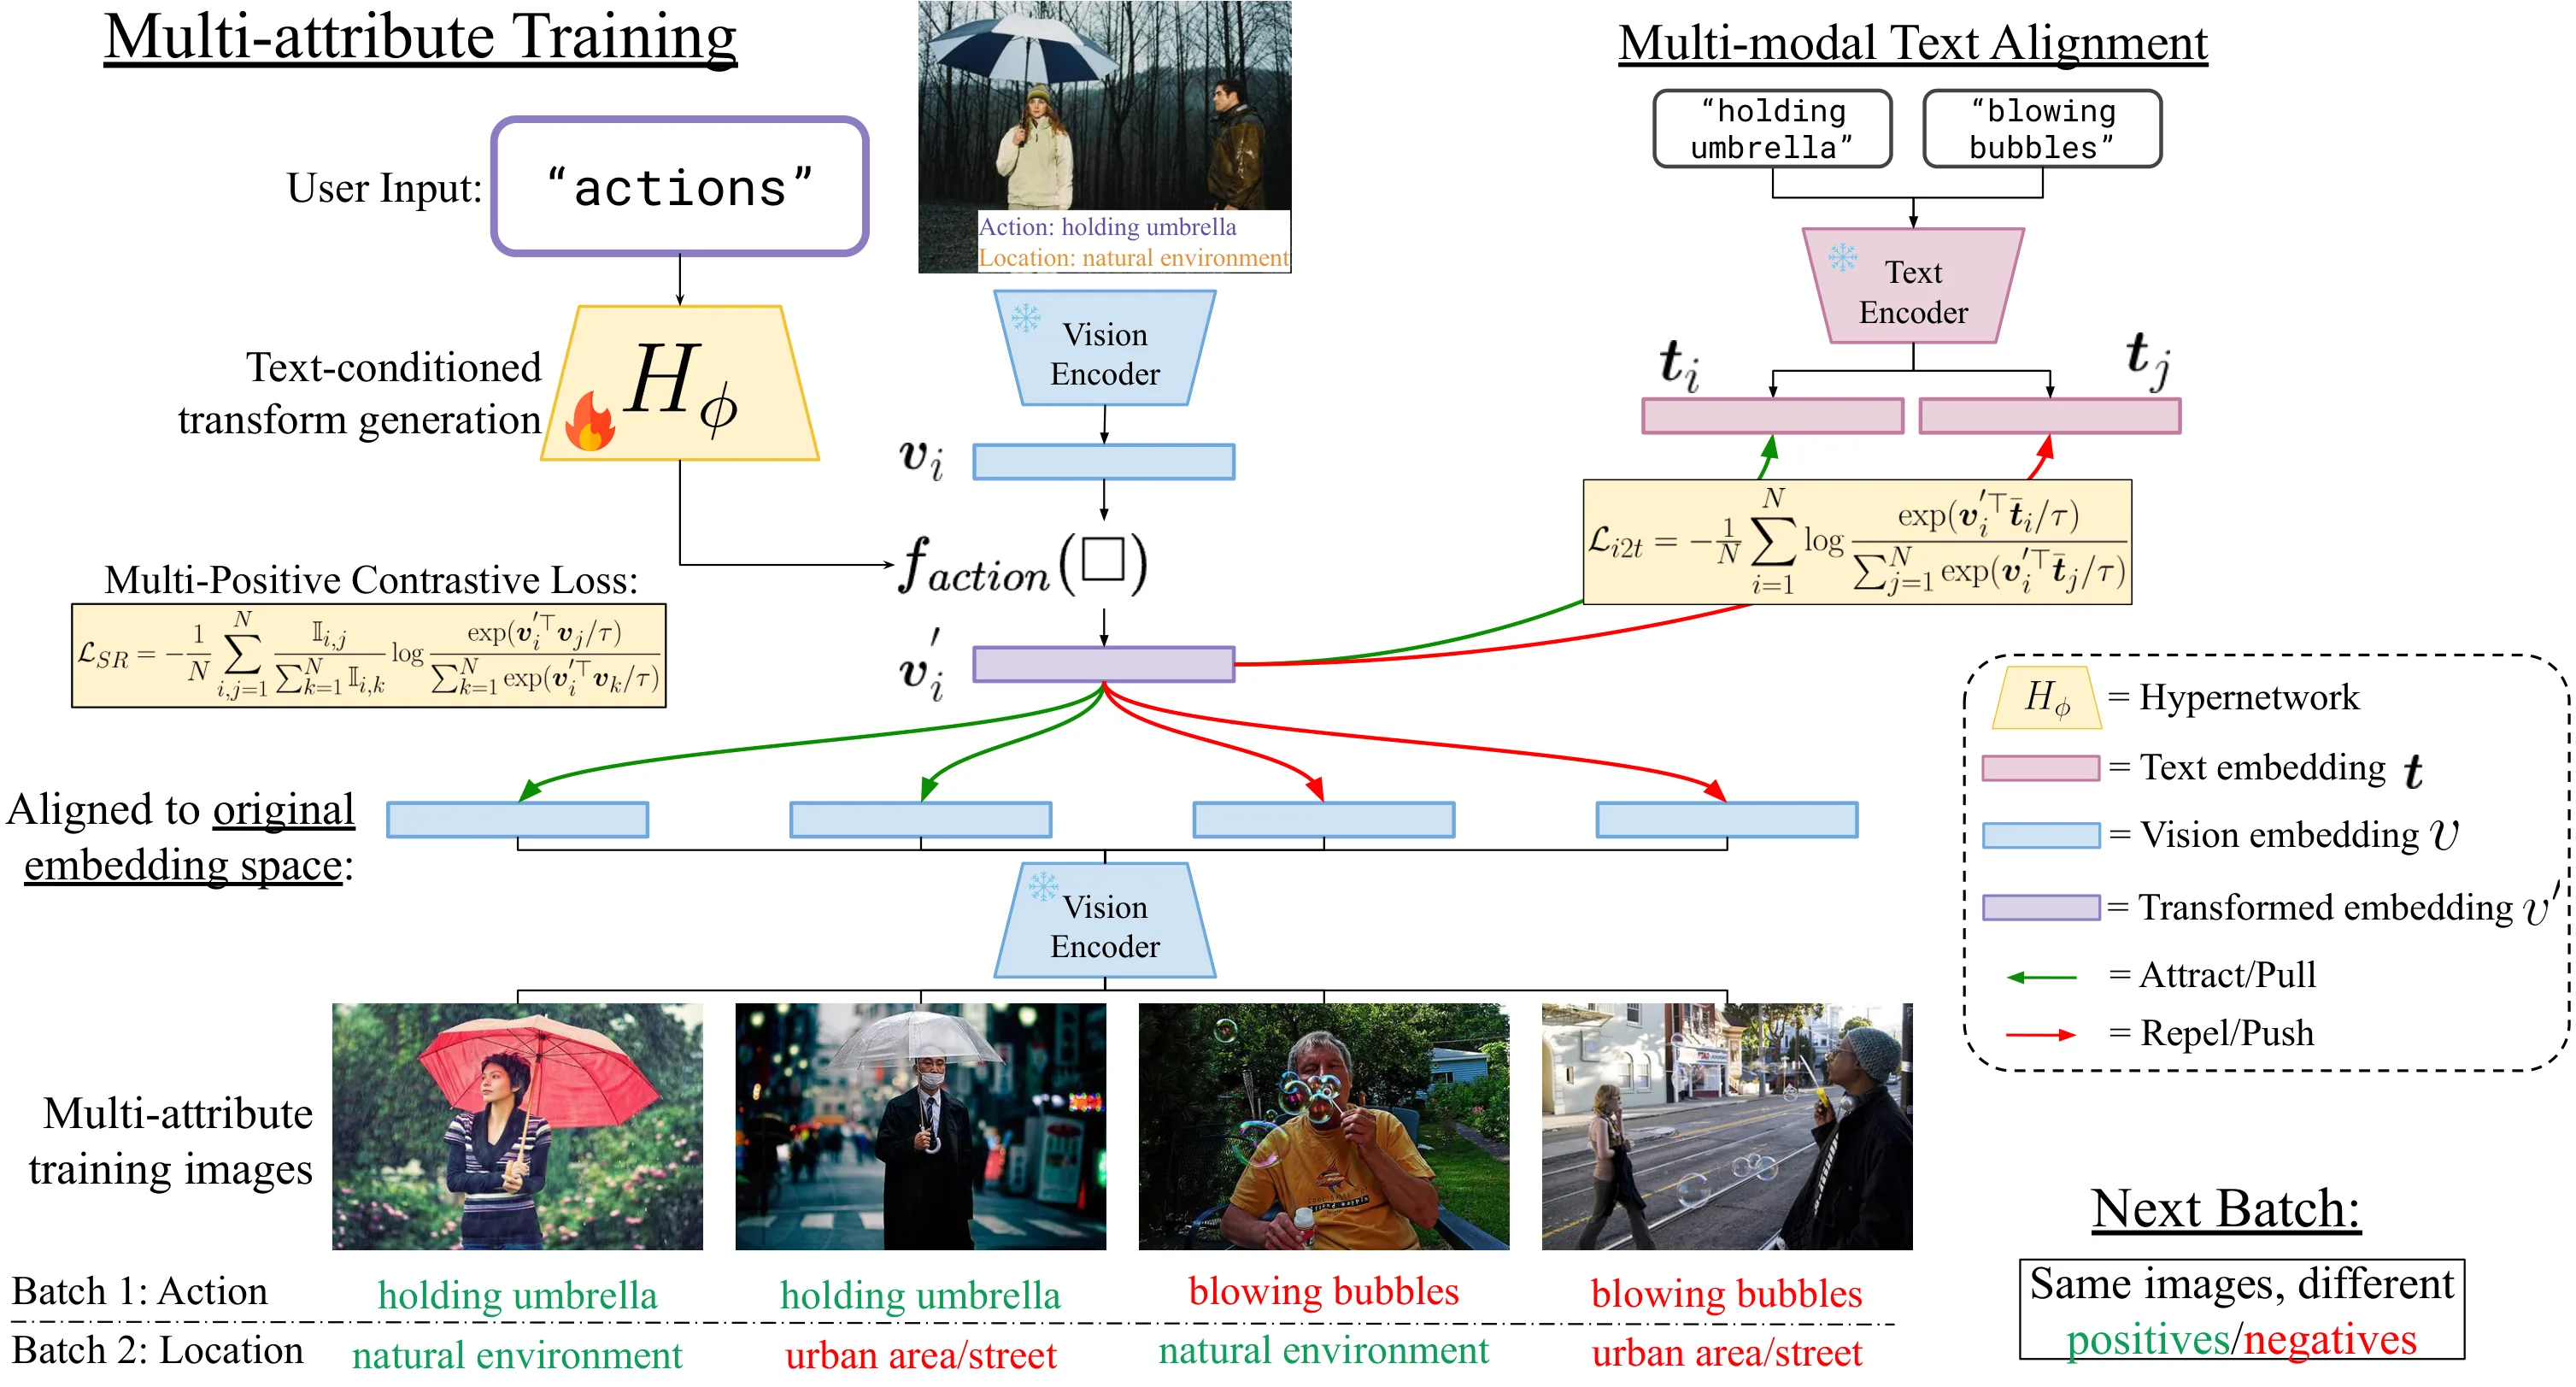
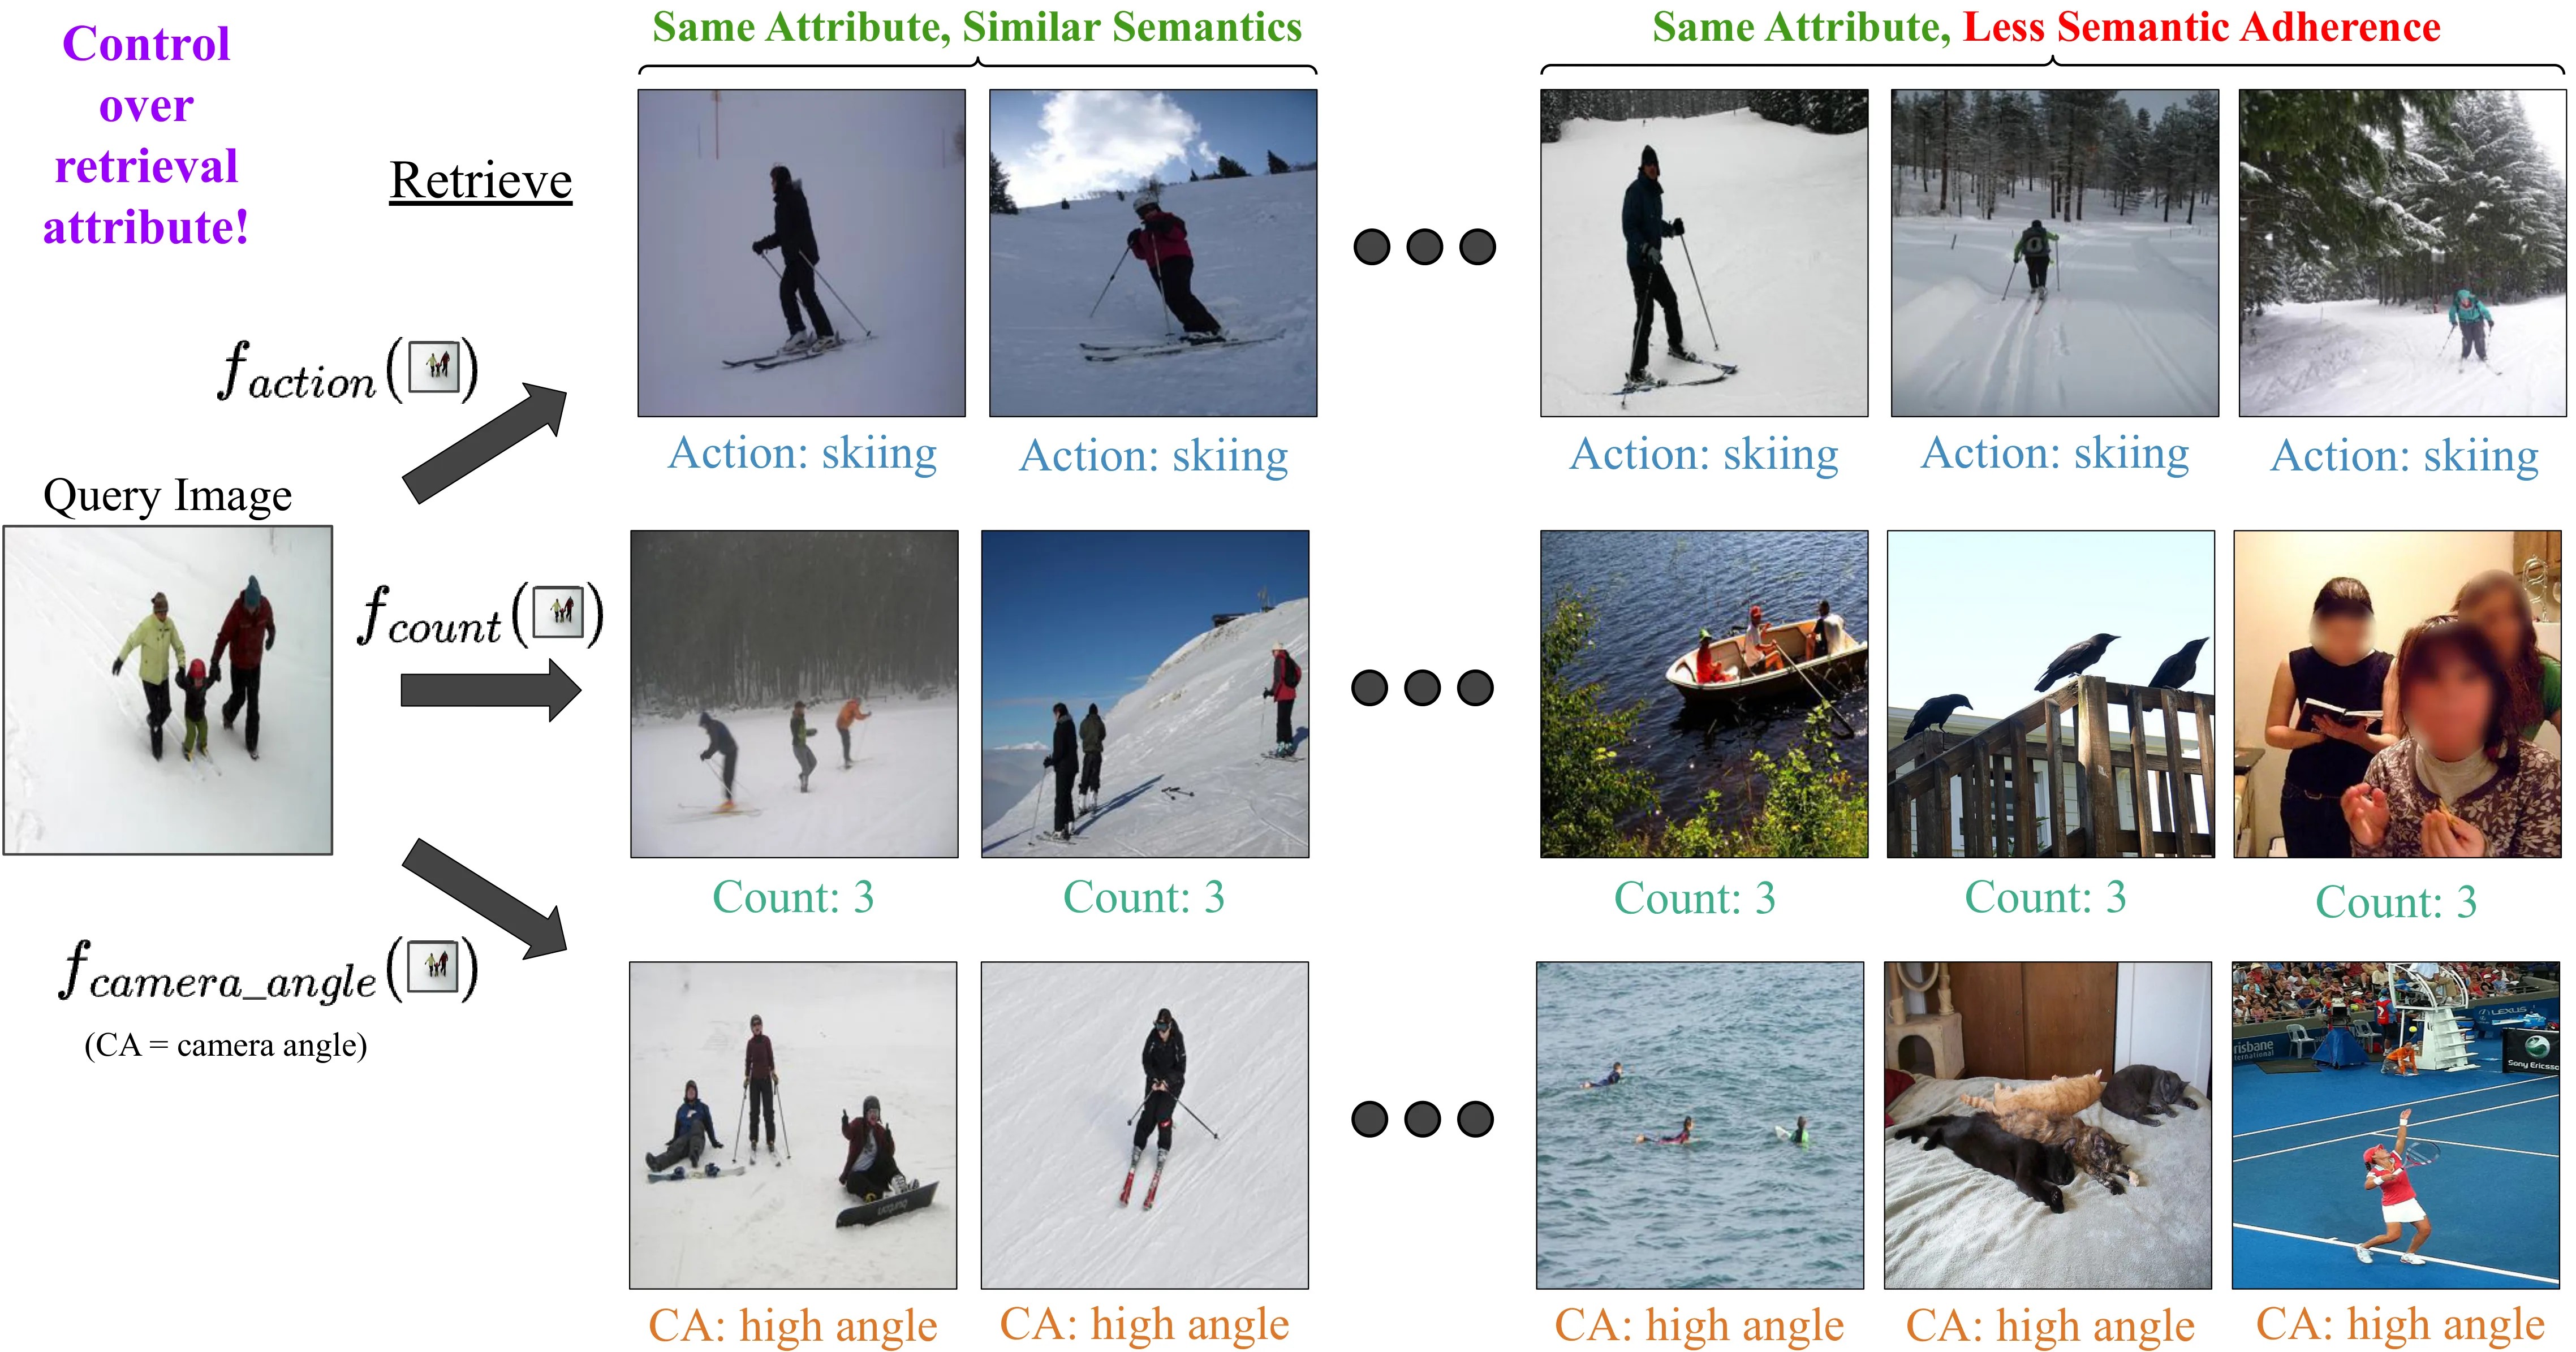
TL;DR
这篇论文针对多模态嵌入模型(如CLIP)中「主导语义压制次要属性」的问题,提出让用户通过自然语言描述来控制嵌入空间中特定属性的显式表达。核心方法是训练一个文本条件仿射变换网络,它根据文本提示(如“颜色”“艺术风格”)生成相应的线性变换,直接作用于冻结的视觉嵌入,使其在潜空间中按需凸显。实验表明,该方法在属性检索和多属性聚类任务上达到最优性能,同时推理开销接近零。
研究背景与动机
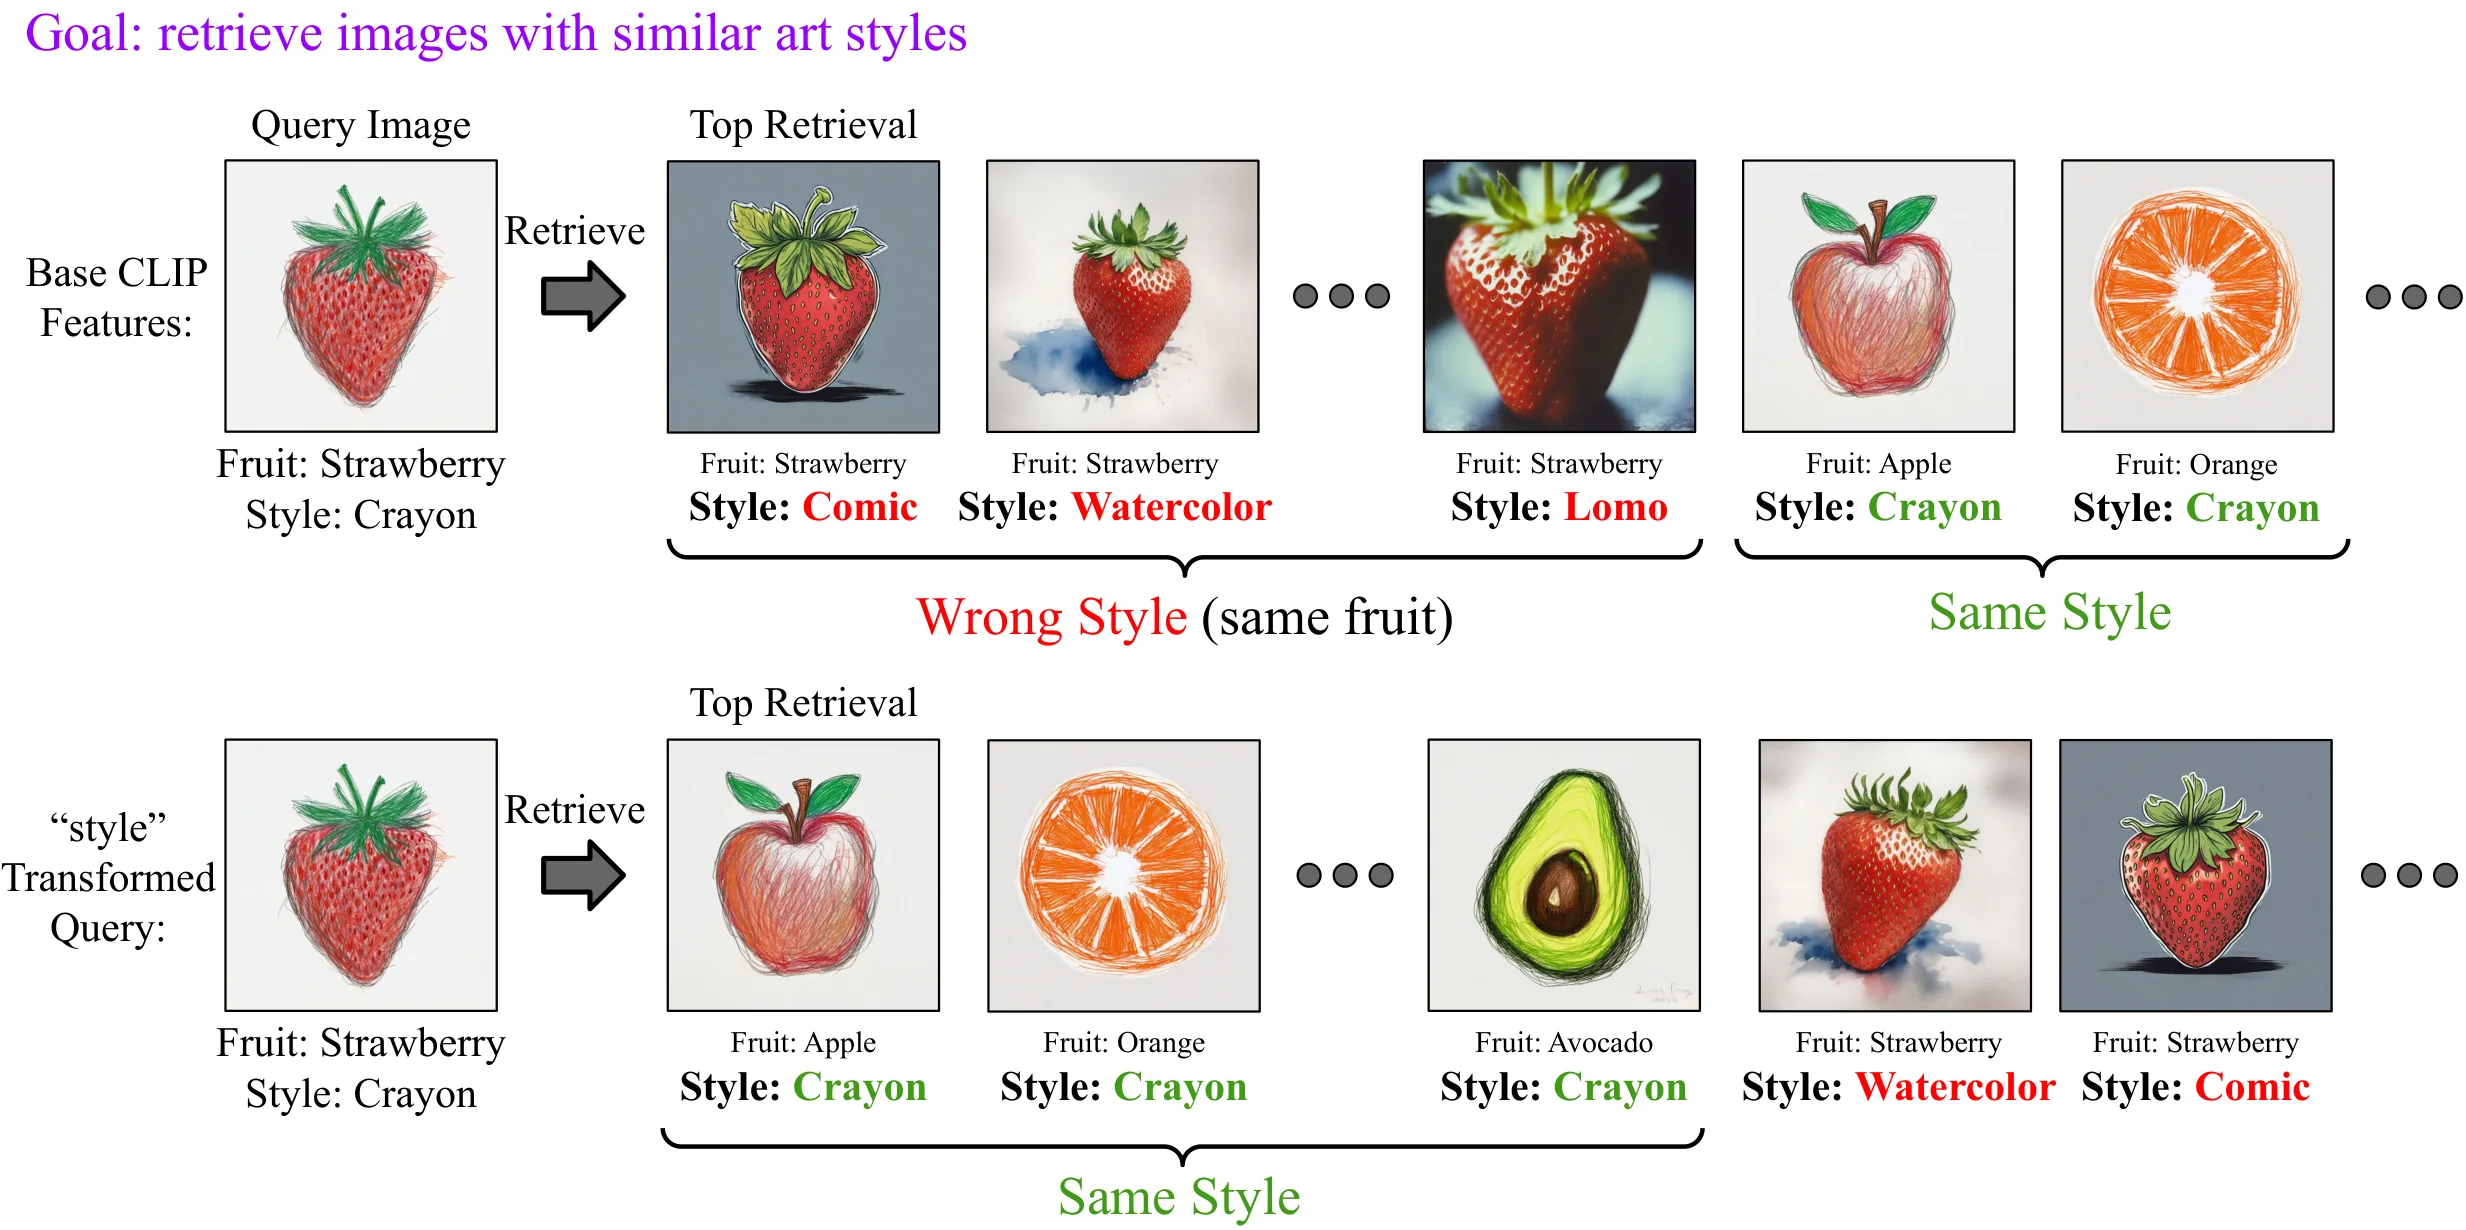
[[CLIP]]等大规模多模态嵌入模型将图像与文本映射到统一的向量空间,实现了语义相似度检索和跨模态零样本分类等强大能力。这些模型通过将视觉信息压缩为高维向量来捕获高层语义,但代价是“主导语义压制效应”:当一张图片同时包含“红色”和“狗”时,嵌入向量主要表达“狗”这一核心对象,而“红色”这类次要属性被显著抑制。
这种特性在需要细粒度控制的场景下成为瓶颈。用户可能想检索“风格为印象派的画作”或“从特定视角拍摄的建筑”,但现有方法只能通过枚举式微调或笨重的文本提示工程来勉强实现。根本问题在于,属性信息被隐式编码在向量深处,缺乏一种显式、可控的访问机制。
一个直观的解决思路是对嵌入空间进行解耦[[表征解耦]],将颜色、视角、艺术风格等属性分离到不同的子空间。但这通常需要对模型进行重新训练或大规模标注数据。另一个思路是在推理时调整输入文本的表述,但这既不够灵活,效果也不够稳定。
这篇论文的切入点是:既然嵌入空间已经捕获了这些属性信息,能否在不改变模型的前提下,通过对嵌入向量本身施加变换来凸显目标属性? 关键挑战在于,这种变换必须能够泛化到任意属性描述,而不是针对单一属性专门设计。
方法
论文提出的核心方法是训练一个文本条件仿射变换网络(Text-Conditioned Transformation Network)。这个网络的学习目标是:根据自然语言描述的属性类别,生成一个能够强调该属性的线性变换。
具体而言,给定一个冻结的视觉嵌入 和一个描述属性的文本提示 (如“color”或“art style”),网络输出一个仿射变换的参数 ,然后对嵌入进行变换:
变换后的嵌入 在目标属性维度上得到增强,使其在潜空间中更容易被分离和检索。
这个设计的精妙之处在于其通用性。传统的属性特定方法需要为每个属性训练独立网络,而本文的文本条件网络能够同时学习大量属性,因为文本提示作为条件输入提供了统一而灵活的接口。网络不必记住每个属性的具体变换,而是学会根据文本语义推断出恰当的变换模式。
训练过程中,变换后的嵌入被对齐到原始的冻结潜空间。这意味着用户可以直接使用原始CLIP嵌入进行检索或其他下游任务,而变换后的嵌入则用于属性放大。两者可以无缝切换,无需重新编码整个数据集。
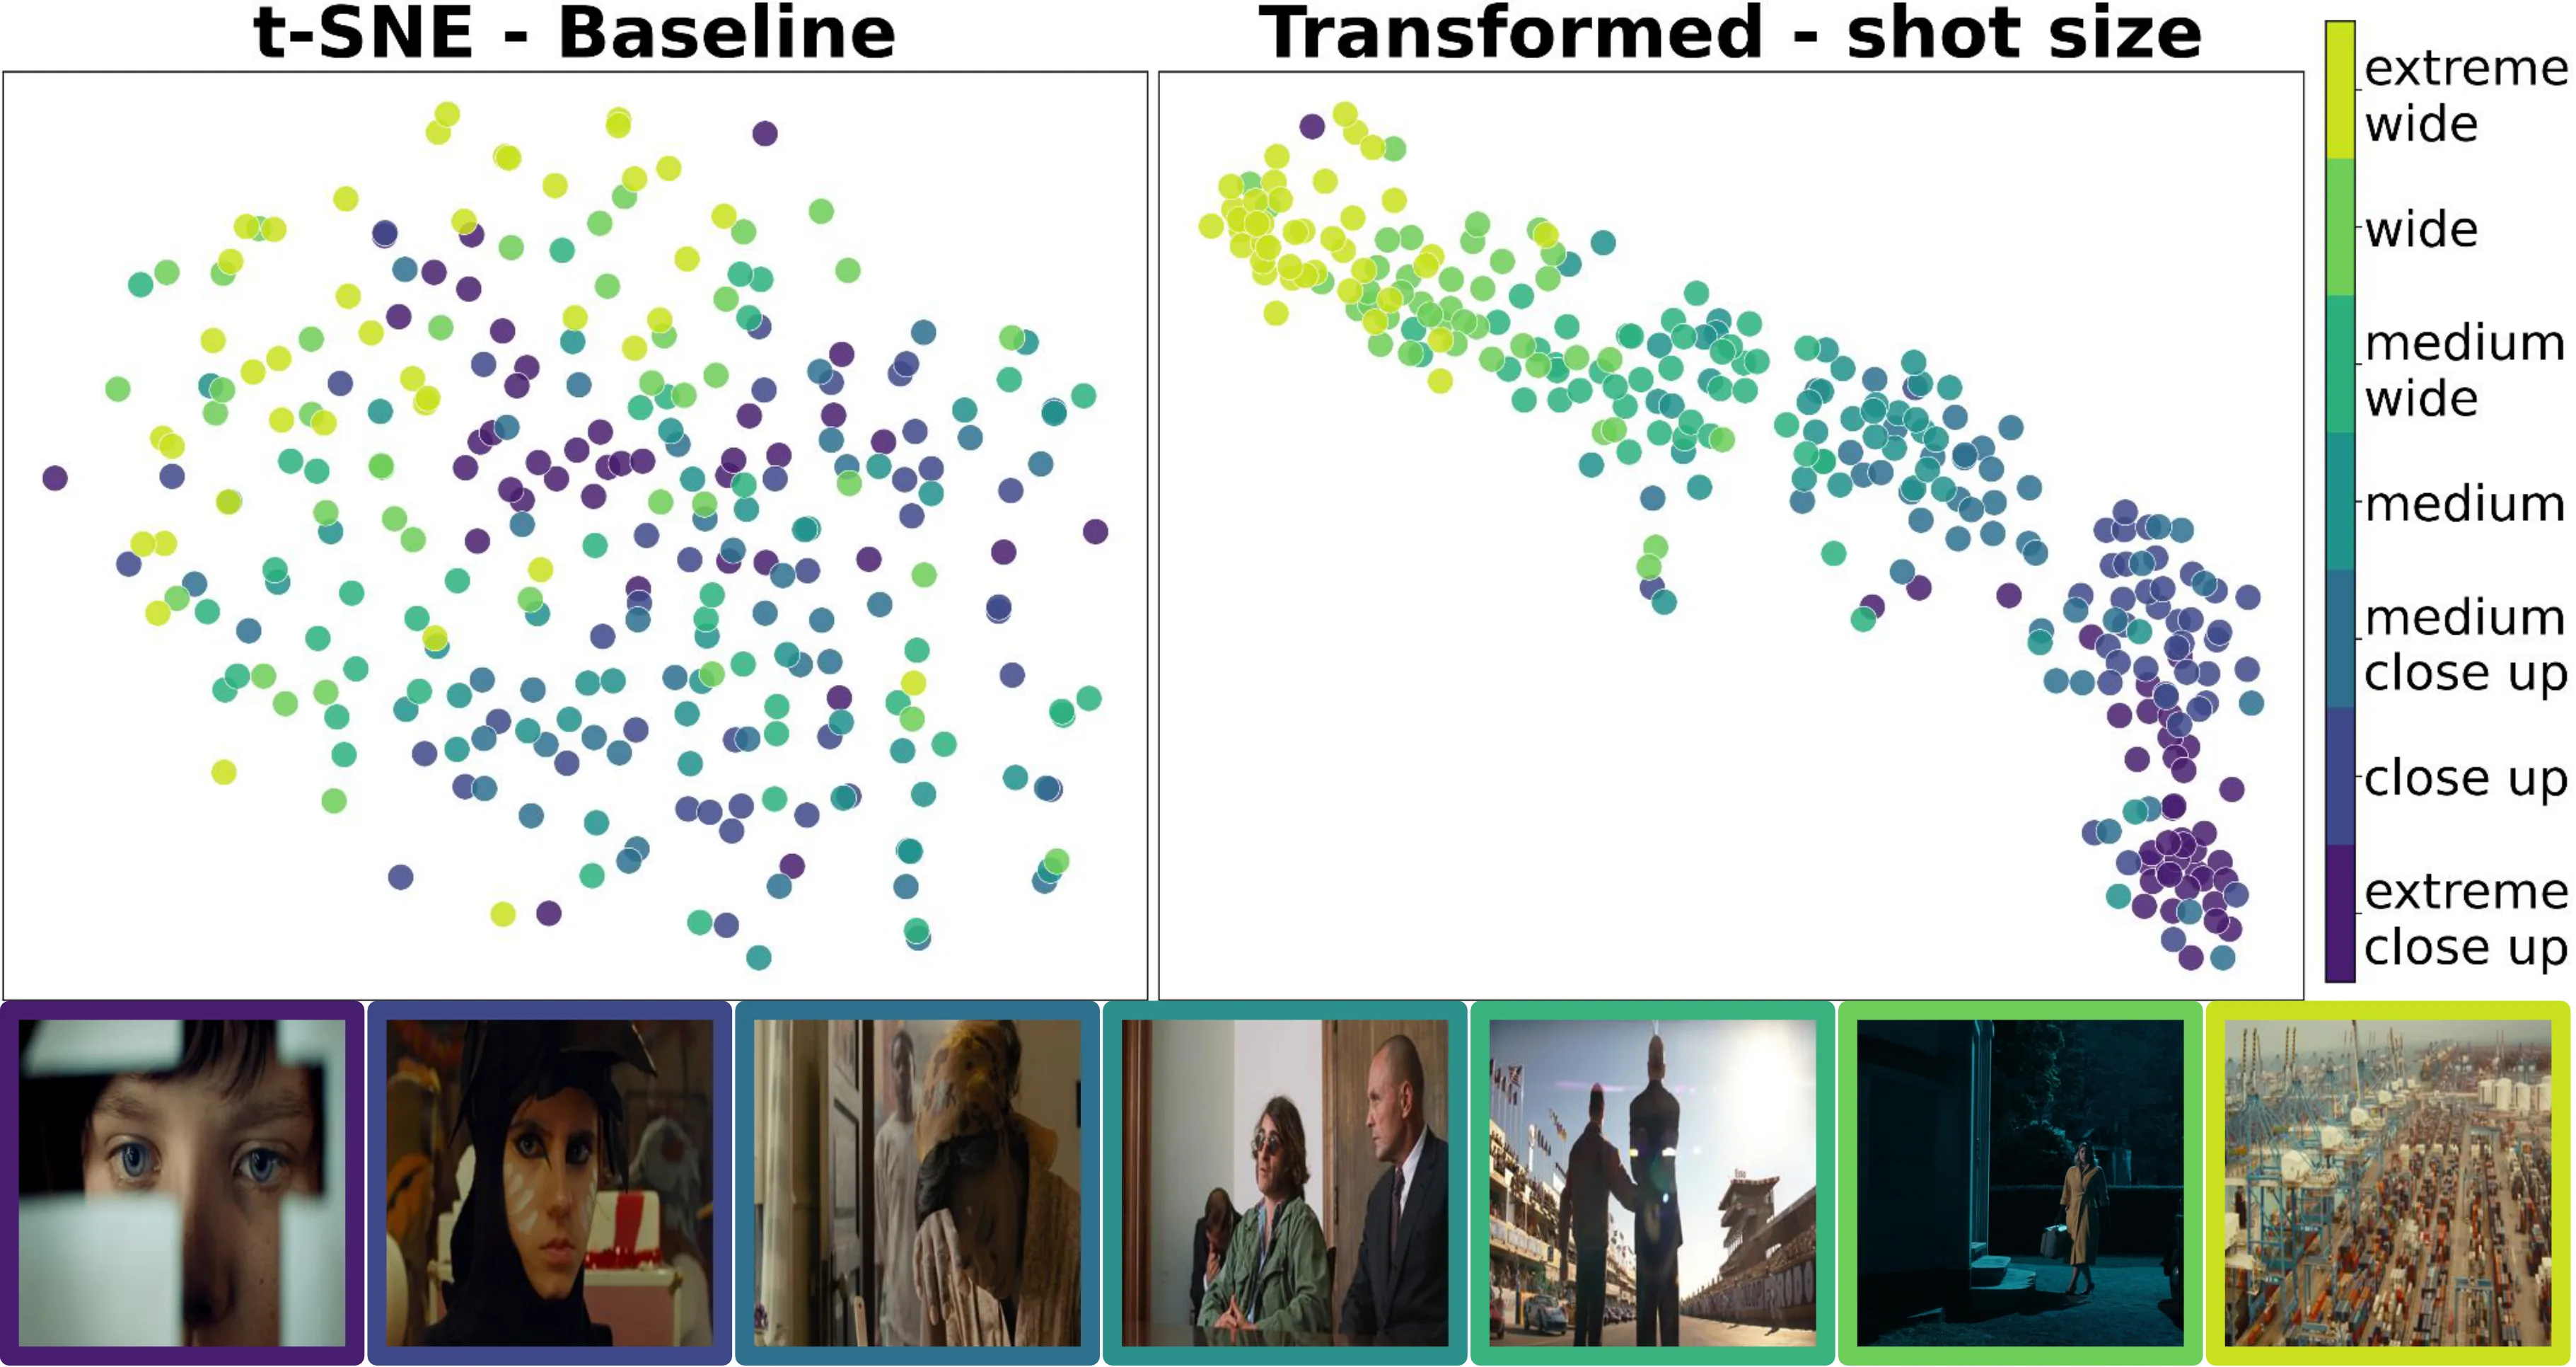
论文还展示了该方法在解耦任务上的扩展应用。当对完整图像集合应用同一属性变换时,同一属性的图像会在潜空间中聚集,从而天然支持多聚类等[[表征解耦]]任务。
实验与结果
实验在两个核心任务上验证了方法的有效性:属性检索和多属性组织。
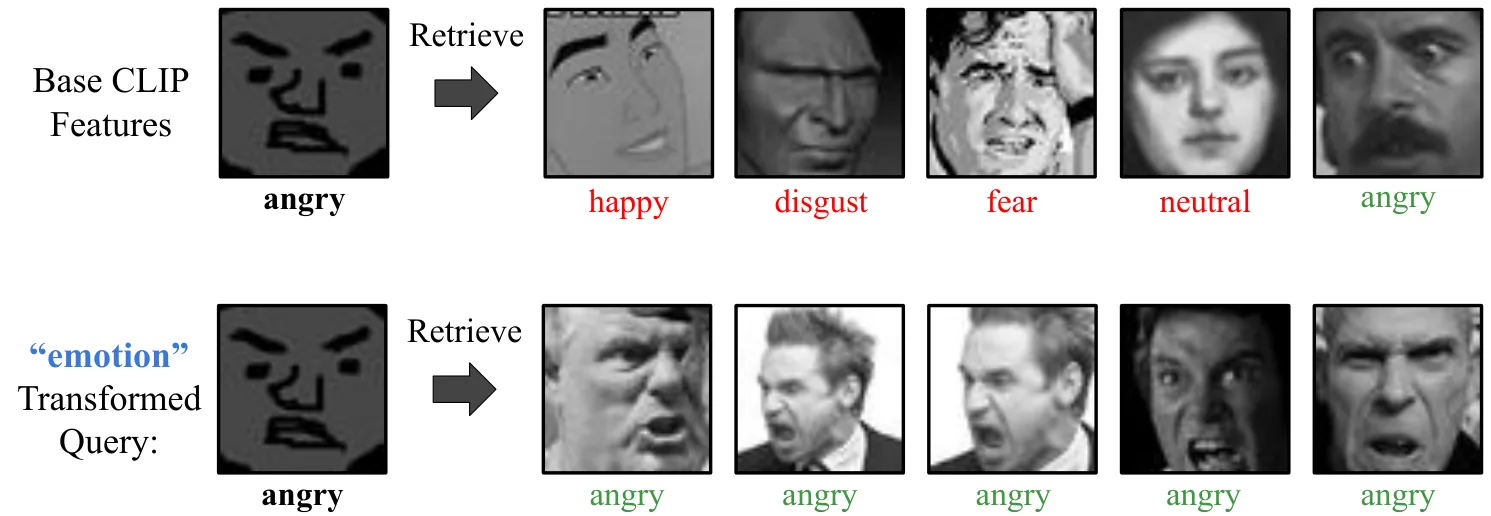
在属性检索任务中,实验设置了两种评测方式:给定属性描述检索目标图像,以及给定图像检索包含指定属性的图像。结果显示,文本条件变换网络在多种属性类别(颜色、材质、视角等)上显著优于基线方法,包括直接文本匹配、基于属性的投影以及无条件的仿射变换。特别值得注意的是,论文对比了两种“竞争属性”场景:检索“绿色的猫”时,需要在抑制“绿色”这一主导语义的模型中恢复该信息。实验表明,变换网络能够有效逆转主导语义压制,将目标属性从背景噪声中提取出来。
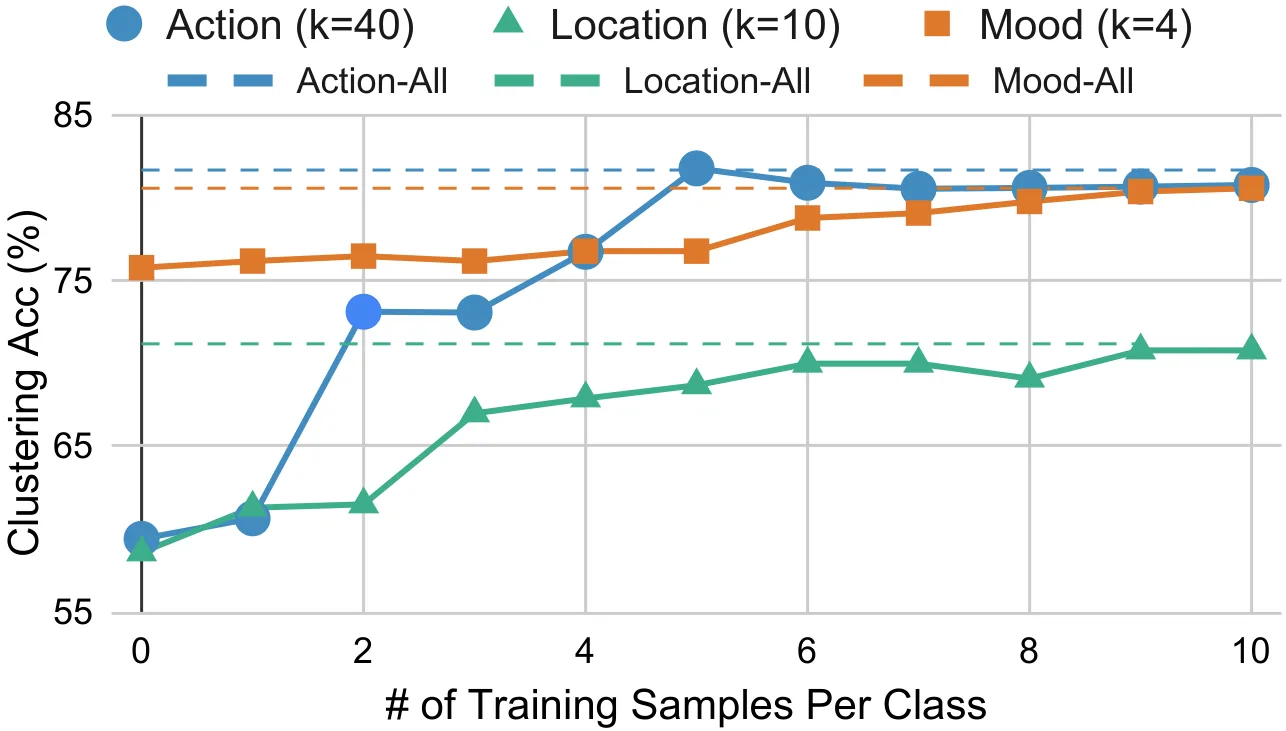
在多属性聚类任务中,论文评估了变换后嵌入的聚类质量。对于“按艺术风格聚类”或“按颜色聚类”等场景,变换显著提升了聚类的纯度和分离度,验证了属性在潜空间中的显式解耦效果。
关键的性能指标包括推理效率。由于网络输出的只是轻量级的变换参数(而非重新编码整个向量),推理时的计算开销接近零。这在实际应用中具有重要意义——用户可以在预计算好的嵌入之上即时应用任意属性变换,无需额外的编码延迟或存储开销。
消融实验进一步表明,文本条件的设计相比属性无关的全局变换有明显优势,证明条件输入确实帮助网络学习到了针对不同属性的差异化处理策略。
讨论与可借鉴点
这篇论文在嵌入空间控制领域提出了一个优雅的范式转换:从“修改编码器”到“变换嵌入”。其核心贡献在于揭示了一个被忽视的事实——即便嵌入已经冻结,我们仍然可以通过学习合适的线性变换来重新分配潜空间中不同属性的表达权重。
该方法的局限性也值得注意。首先,变换的效果受限于原始嵌入对目标属性的编码质量——如果CLIP压根没有在嵌入中保留某个属性的信息,再精巧的变换也无济于事。其次,论文主要验证了单属性变换的效果,多属性同时变换时的交互效应尚未充分探索。
对于[[多模态学习]]和[[表征学习]]领域而言,本文提供了一个可迁移的思路:不需要为每个下游任务重新训练大模型,而是通过学习对固定表示的条件变换来实现灵活控制。这种“冻结+变换”的范式在效率和通用性上都具有优势,为后续在检索、生成、控制等多任务中的扩展应用奠定了基础。
Abstract
Multimodal embedding spaces in models like CLIP enable powerful capabilities such as semantic similarity retrieval and cross-modal zero-shot classification. These embeddings compress high-level semantics into a single vector, which comes at the cost of primarily expressing a dominant semantics like main object while suppressing other important attributes such as camera angle or color tone. We propose a text-conditioned transformation of visual embeddings that makes such attributes explicitly accessible. Given a natural language description of an attribute category (e.g., "color" or "art style"), a network generates an affine transformation that emphasizes the specified attribute. Conditioning on text enables it to learn many attributes simultaneously, accessing them at inference time through an intuitive interface. The network is trained to align transformed embeddings with the frozen latent space, enabling retrieval using existing large-scale embeddings without any re-encoding. When applied to a full set, the same mechanism transforms the latent space for attribute disentanglement tasks such as multi-clustering. By operating directly in latent space, our method provides a unified and efficient framework for controlling embedding spaces, demonstrating state-of-the-art performance across both attribute-based retrieval and multi-attribute organization tasks with near-zero inference cost. Project page: https://joefioresi718.github.io/ControlEmbed_webpage/
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。