
Game AI
博弈 AI
Game-playing agents, online decision-making, opponent modeling, StarCraft / Honor of Kings / poker. — 博弈代理、在线决策、对手建模,涵盖 StarCraft / 王者荣耀 / 扑克等场景。
CAST:将游戏求解器作为LLM智能体的轮次级教师
CAST: Game Solvers as Turn-Level Teachers for LLM Agents
SeekJudge:面向计算机使用智能体强化学习的实用奖励框架
SeekJudge: A Practical Reward Framework for Reinforcement Learning in Computer-Use Agents
衡量仿真到现实的差距:为人工智能物联网系统中的强化学习设计经济实惠的真实世界基准平台
Measure the Sim-to-Real Gap: Designing an Affordable Real-World Benchmark Platform for Reinforcement Learning in AIoT Systems
冰上棋局:基于逆向归纳与深度强化学习的冰壶战术决策
Chess on Ice: Curling Tactical Decision-Making via Backward Induction and Deep Reinforcement Learning
CaM-Wolf:面向社交推理游戏的因果感知多模态智能体
CaM-Wolf: Causal-Aware Multimodal Agents for Social Deduction Games
用于流媒体视频游戏中鲁棒且高效模仿学习的增广方法
Augmentations for Robust and Efficient Imitation Learning in Streamed Video Games
通过心理学奠基的推理与角色感知策略优化改进通用角色扮演智能体
Improving General Role-Playing Agents via Psychology-Grounded Reasoning and Role-Aware Policy Optimization
三体对齐:通过重排序推理依据使国际象棋代理与人类推理保持一致
Three-Body Alignment: Aligning Chess Agent with Human Reasoning through Reranked Rationale
ABot-World-0:单台桌面 GPU 上的无限交互世界推演
ABot-World-0: Infinite Interactive World Rollout on a Single Desktop GPU
AlayaWorld:交互式长视野世界建模——完整技术报告
AlayaWorld: Interactive Long-Horizon World Modeling -- Full Technical Report
从像素到状态:将交互式世界模型重新思考为游戏引擎
From Pixels to States: Rethinking Interactive World Models as Game Engines
MafiaScope:面向社交推理游戏中 LLM 智能体的非侵入式、时序分辨信念探测
MafiaScope: Non-Invasive, Time-Resolved Belief Probing for LLM Agents in Social Deduction Games
一项关于轻量级博弈智能体何以强大的金标准研究
A Gold-Standard Study of What Makes a Lightweight Game-Playing Agent Strong
面向交互式游戏的可指导智能体
Coachable agents for interactive gameplay
SAGA:面向长视野 CivRealm 战略规划的场景感知、目标演进智能体
SAGA: Scene-Aware, Goal-Evolving Agents for Long-Horizon CivRealm Strategy Planning
三元狼人杀:面向大语言模型多跳心智理论的弄臣角色
Triadic Werewolf: A Jester Role for Multi-Hop Theory of Mind in LLMs
StarBench:面向智能体多模态决策与信息寻求的回合制 RPG 基准
StarBench: A Turn-Based RPG Benchmark for Agentic Multimodal Decision-Making and Information Seeking
LLM 游戏代理中的空间推理:因果上下文与多步规划的影响
Spatial Reasoning in LLM Game Agents: Impact of Causal Context and Multi-Step Planning
当推理收窄了走子:LLM 对弈中的多样性坍缩
When Reasoning Narrows the Move: Diversity Collapse in LLM Game Play
FootsiesGym:一种面向双人零和不完美信息博弈的格斗游戏基准
FootsiesGym: A Fighting Game Benchmark for Two-Player Zero-Sum Imperfect-Information Games
强化学习视角下的《超级马里奥兄弟》:1-1 关的课程设计、教学法与最优关卡设计
Reinforcement Learning in Super Mario Bros: Curriculum, Pedagogy, and Optimal Level Design in World 1-1
基于智能体的黑手党游戏中累积嫌疑与吸收动力学
Cumulative suspicion and absorption dynamics in an agent-based Mafia game
StatePlay:面向机制一致生成的状态感知游戏世界模型
StatePlay: State-Aware Game World Models for Mechanics-Consistent Generation
Bunraku:将单幅插画转换为可编辑的 Live2D 角色
Bunraku: Turning a Single Illustration into an Editable Live2D Character
关于捕获叙事:面向网络素养的社交媒体操纵兵棋推演
On Capturing the Narrative: Social Media Manipulation Wargaming for Cyberliteracy
基于稀疏自编码器的可解释GOHR智能体
Interpretable GOHR Agents via Sparse Autoencoders
CAST:将游戏求解器作为LLM智能体的轮次级教师
CAST: Game Solvers as Turn-Level Teachers for LLM Agents
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 2 张
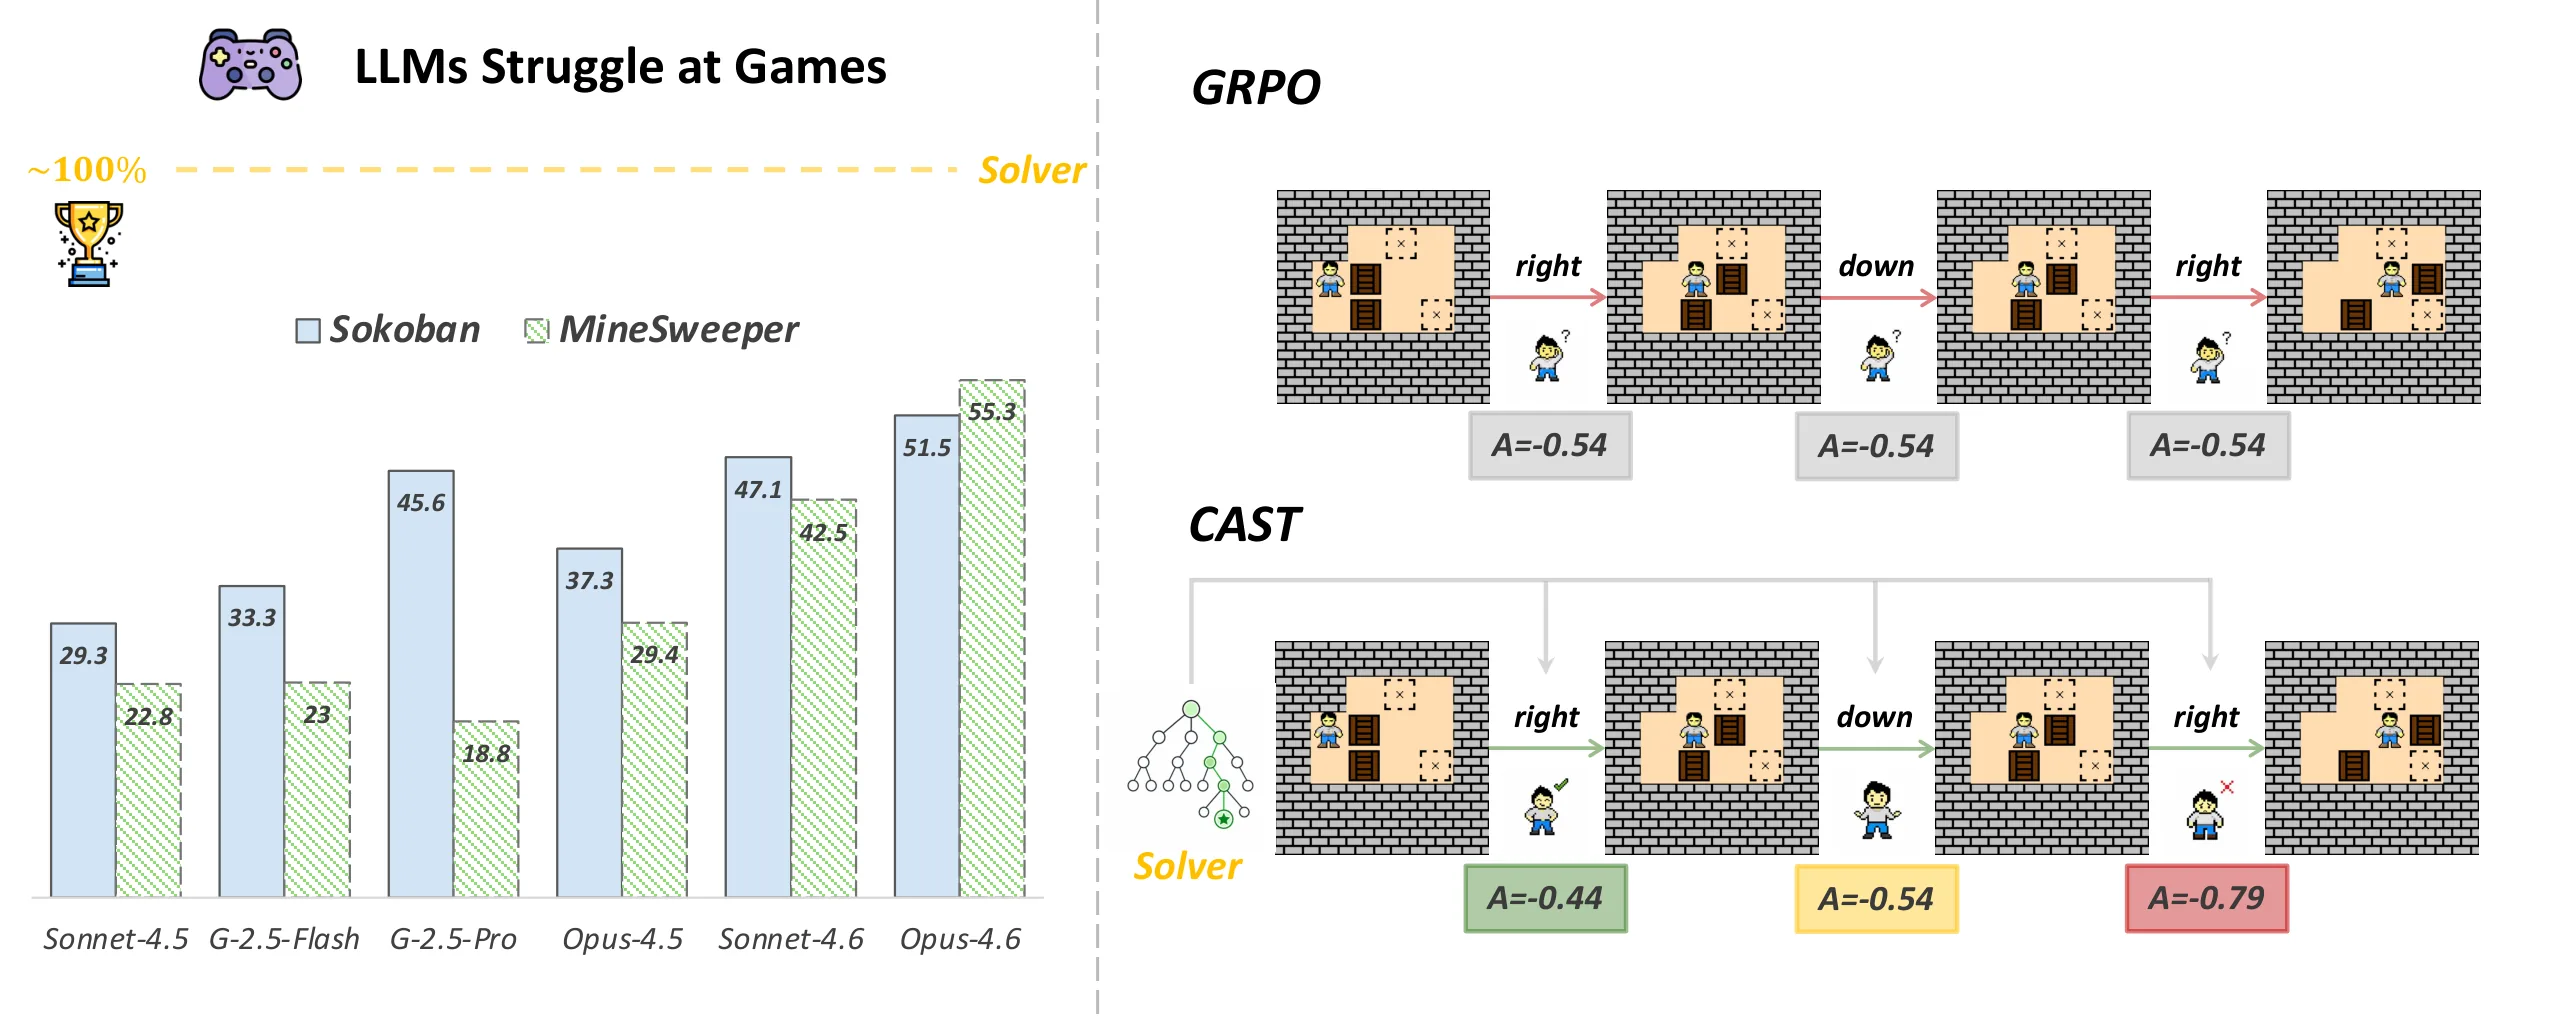
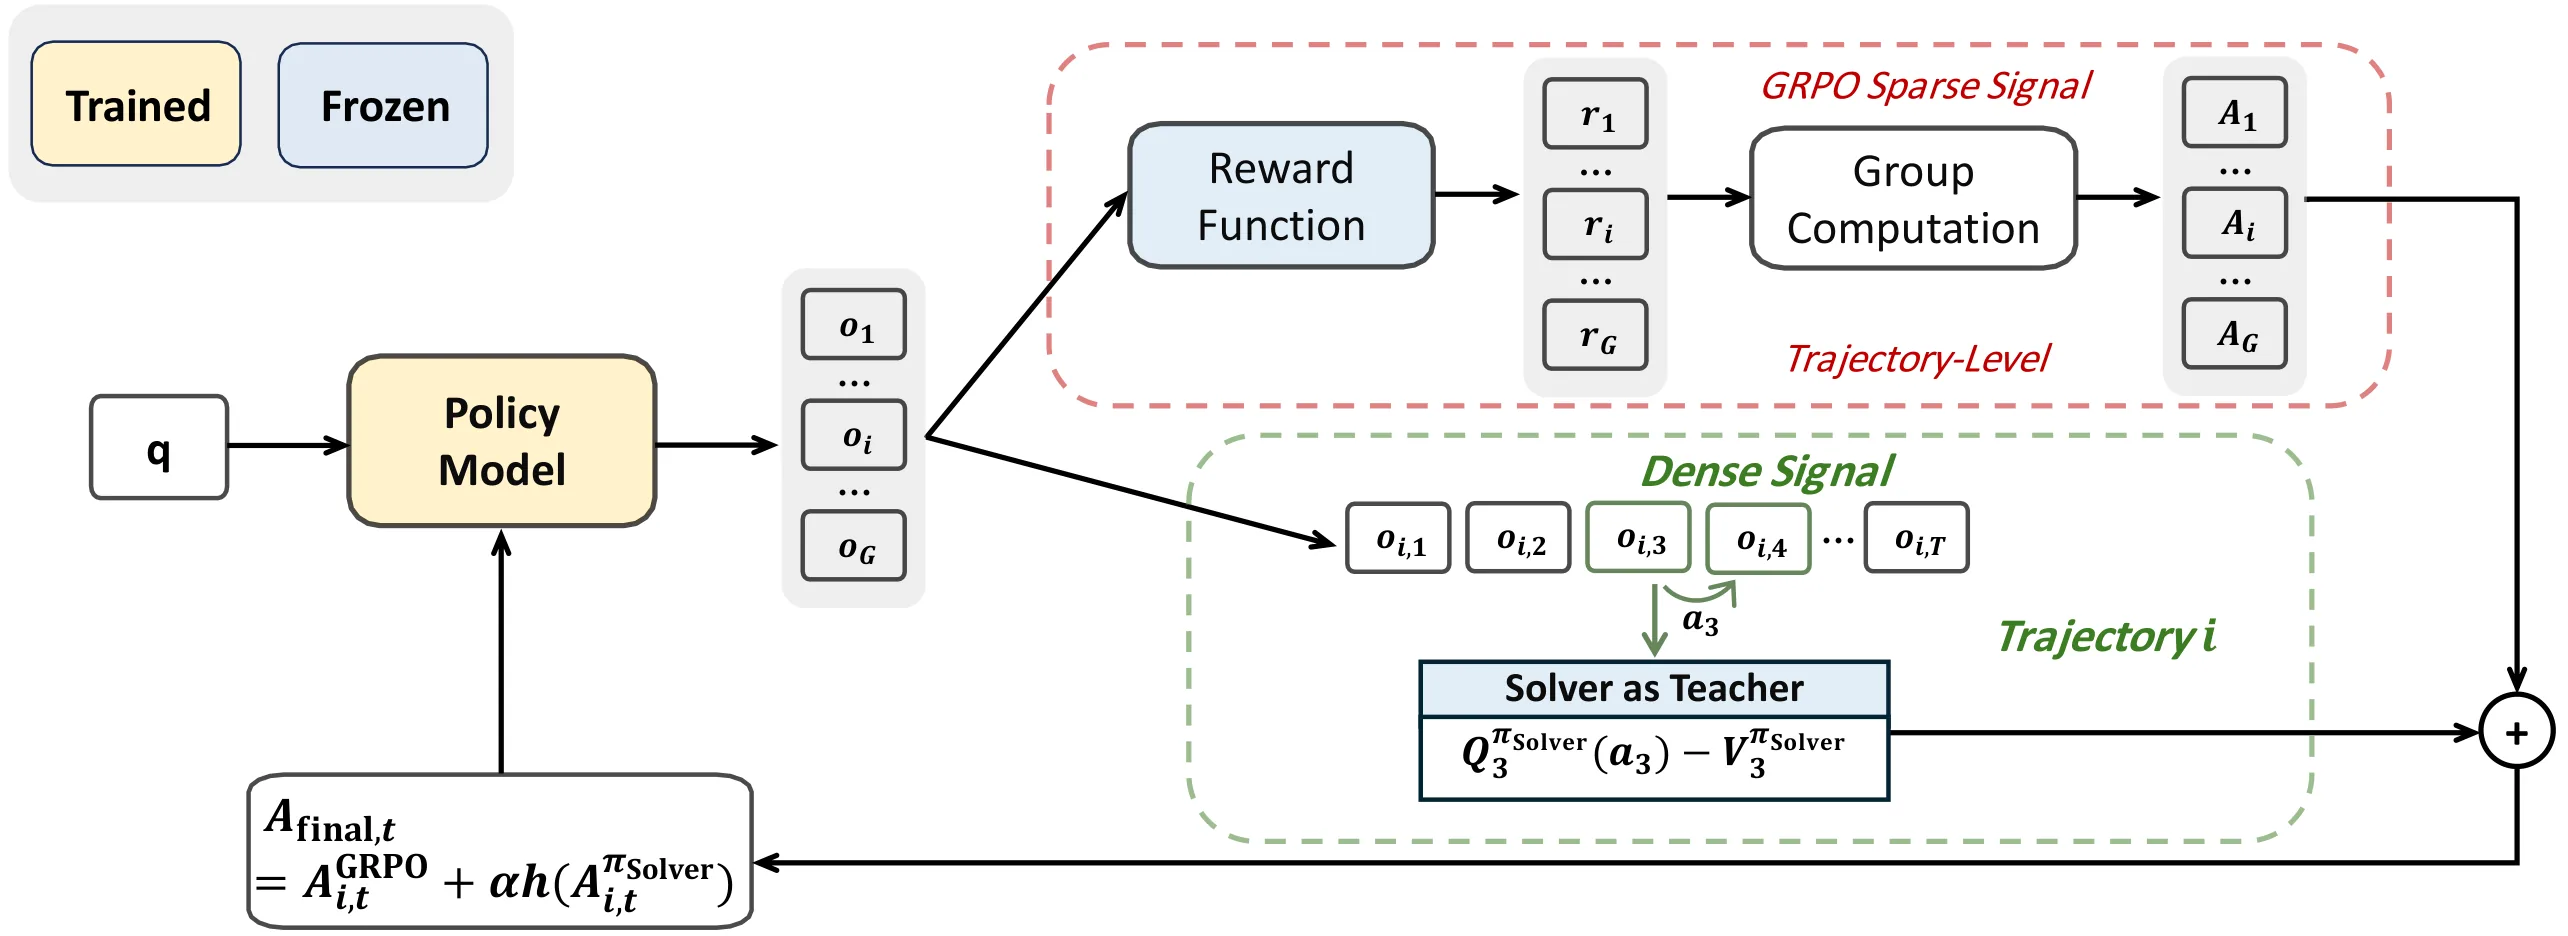
训练LLM处理长程博弈是迈向通用决策的重要一步,但RLVR仅依赖稀疏的最终奖励,难以定位决定成败的关键决策。CAST利用游戏求解器状态价值的变化判断动作是否推进任务,并将这些价值差转化为turn级别的求解器优势信号注入RLVR。实验在Sokoban、Minesweeper、Rush Hour上全面超越所有训练基线,并在ALFWorld与WebShop上取得最高零样本平均性能。该方法以低成本的标量值替代昂贵的教师logits,为过程监督提供实用路径。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
训练 LLM 在需要多步规划的游戏中做决策,是通往通用决策智能体的一条有前景的路线。在这类任务中,玩家必须前瞻数十甚至上百步,任何一步失误都可能导致全局失败。然而,当前主流的 [[RLVR]](基于可验证奖励的强化学习)方法——以 GRPO、DAPO 为代表——只依赖稀疏的 0/1 终端奖励:赢了有信号,输了没信号,但中间哪一步走得好、哪一步走得差,完全无从得知。这种 [[Credit assignment|信用分配]] 失效的问题,使得模型在长轨迹中很难学到"哪一步真正决定了成败"。
学术界已经意识到这个问题,并尝试引入更密集的过程监督信号。蒙特卡洛树搜索(MCTS)可以提供每步的价值估计,但计算代价极其昂贵,难以扩展到大规模训练。[[Process reward|过程奖励模型]](PRM)通过额外训练一个神经网络来评分每一步,但训练数据标注成本高,且学到的价值函数未必准确。还有一些方法利用跨轨迹的分组对比,但它们依赖于相似状态在 batch 中反复出现,对于探索性极强的游戏场景并不适用。
CAST 的核心洞察来自于一个简单却深刻的观察:游戏本身往往配有领域专属的求解器。对于 Sokoban,可以用 A* 搜索计算当前状态距离目标还差多少步;对于 Minesweeper,约束求解器能精确算出还需要揭示多少格才能确保胜利;对于 Rush Hour,最优移动次数可以直接 BFS 得到。这个求解器返回的"成本到目标"数值,本质上就是一种状态价值函数——它天然地衡量了"当前局面有多好"。因此,如果某一步动作让这个数值变小了,就说明动作将状态向成功推进;反之则说明在帮倒忙。这正是 CAST 所依赖的轮次级监督信号:它不需要昂贵的树搜索,不需要额外的神经网络训练,只需要调用一个现成的求解器,几乎零成本,却能给出精确到每一步的"好与坏"判断。
方法
CAST 的方法论可以从三个层次来理解:如何定义信号、如何处理信号、如何将信号注入训练。
首先是信号的定义。给定当前状态 和执行动作 后的下一状态 ,求解器返回两个成本值 和 ,分别表示从两个状态到达目标的剩余最优步数。在最优策略下,每一步恰好减少 1,因此可以定义原始求解器优势为:
对于最优动作,,所以优势为 0。但 0 不利于作为正向信号来强化好动作,因此 CAST 引入了一个平移:
这样,最优推进动作得到 +1,无效动作得到 0,有害动作得到负值,而一旦进入死状态则惩罚封顶。
接下来是信号的处理。原始的优势值存在两个实际问题:其一是重尾分布——进入死状态的惩罚可能远大于正常推进的奖励;其二是跨游戏量纲不一致,Sokoban 的最优步数可能是几十步,而 Minesweeper 的数值范围完全不同。CAST 采用 asinh 压缩和 batch 级 RMS 归一化来解决这两个问题:
asinh 函数在小信号区域近似线性,能保留大多数 步推进之间的可区分度;对于极端值则转为对数增长,从而压缩重尾。RMS 归一化不减去均值是有意为之——保留 0 作为"无推进"的语义基准,正负号本身即表示"好坏"。
最后是将信号注入训练。传统 GRPO 使用轨迹级结局优势 来更新策略,CAST 则将其扩展为:
其中 控制求解器引导强度(默认 0.1)。这个式子实现了三层粒度的对齐:轨迹级(结局奖励)、轮次级(求解器优势)、token 级(策略梯度更新的实际粒度)。
论文进一步论证了一个重要的理论性质:在 soft-optimal 求解器假设下,最大化求解器优势等价于 [[On-policy distillation|在策略蒸馏]]——但不需要教师模型输出 logits,仅用一个标量值就能编码教师的动作偏好。直觉上,求解器优势在引导模型学习"哪些动作被教师偏爱"的同时,也允许模型在任务奖励的驱动下偏离教师、去发现教师未覆盖但同样优秀的动作——这是纯粹的 logit-free OPD 无法做到的。
实验与结果
CAST 的实验覆盖了三个核心游戏和两个零样本迁移基准,设计上充分考虑了域内(in-domain)和难度外推(unseen-difficulty)两种评估场景。
在域内评估中,三个游戏分别测试不同的认知挑战:Sokoban 要求长视野规划和不可逆动作中的精细决策;Minesweeper 涉及部分可观测状态下的贝叶斯推理;Rush Hour 则需要组合搜索找到最少步数解。结果显示,CAST 在所有三个游戏的域内评估中均取得最高的 Avg@4 成功率,相较于去掉求解器信号的 DAPO 基线,Sokoban 提升 5.7 个百分点,Minesweeper 提升 14.9 个百分点。更值得注意的是训练效率的改善:CAST 达到峰值性能所需的更新步数普遍减少 1.7× 到 2.0×,这意味着求解器优势信号不仅提升了最终表现,还加速了学习过程。
在未见难度评估中,模型面对的是训练时未曾见过的更大棋盘或更多物体。CAST 依然保持了优势地位,表明它学到的不只是记忆特定难度的解法,而是真正掌握了一种可迁移的规划能力。
零样本迁移是更严苛的考验:训练于游戏任务的模型直接应用于 ALFWorld(具身家务任务)和 WebShop(网页购物任务)。CAST 在这两个基准上都取得了训练方法的最高平均性能,ALFWorld 平均 37.9,WebShop 平均 22.7,整体 30.3 超过第二名 5.6 分。这个结果相当引人注目——游戏训练中习得的规划与回退策略,似乎在一定程度上泛化到了真实世界的任务结构中。
消融实验验证了方法各组件的必要性。 表现最佳,过小则求解器信号被结局奖励淹没,过大则干扰任务目标的学习。asinh 压缩和 RMS 归一化缺一不可:去掉 asinh 会导致极端惩罚主导梯度,去掉 RMS 则在后期训练中引入剧烈波动。论文还验证了方法对精确求解器的依赖程度:用 DQN 学到的值函数替代精确求解器后,CAST 的性能仅有轻微下降,但依然优于所有训练基线。这说明 CAST 对近似求解器的鲁棒性良好,在没有精确求解器的场景下也有实用价值。
讨论与可借鉴点
CAST 的核心贡献在于提供了一种廉价且精确的轮次级监督来源。游戏求解器在 LLM 的整个训练周期中只贡献了 0.0073% 的计算时间,却带来了全面的性能提升和训练加速。这种"以标量值替代教师 logits"的思路,避开了 logit distillation 的高内存开销和软标签对齐问题,同时在理论上被证明等价于在策略蒸馏——这为 [[Credit assignment|信用分配]] 问题提供了一个优雅的实践路径。
不过,CAST 的适用范围并非没有边界。它依赖于领域专属求解器的存在——对于那些没有高效精确求解器的任务(如开放式规划、多智能体协作),CAST 的信号来源就失效了。虽然 DQN 学习型值函数的实验表明近似求解器可以作为备选,但这又引入了额外的训练成本和泛化误差。另一个值得思考的方向是:求解器优势信号是否只在早期训练阶段发挥作用,在模型已经充分学会游戏规则后,是否会变得冗余甚至引入噪声?论文没有系统地分析这一动态过程。
对于更广泛的研究社区,CAST 的启示在于:与其一味追求更强的模型架构或更复杂的奖励机制,不如充分利用任务本身已经蕴含的结构信息。游戏求解器、形式化验证器、约束求解器——这些工具在各自的领域中积累了几十年的算法优化,在 LLM 时代重新审视它们作为"教师"的角色,或许能为 [[RLVR]] 的过程监督打开新的思路。
摘要
游戏AI中以博弈求解器为教师的强化学习方法
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
SeekJudge:面向计算机使用智能体强化学习的实用奖励框架
SeekJudge: A Practical Reward Framework for Reinforcement Learning in Computer-Use Agents
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 11 张
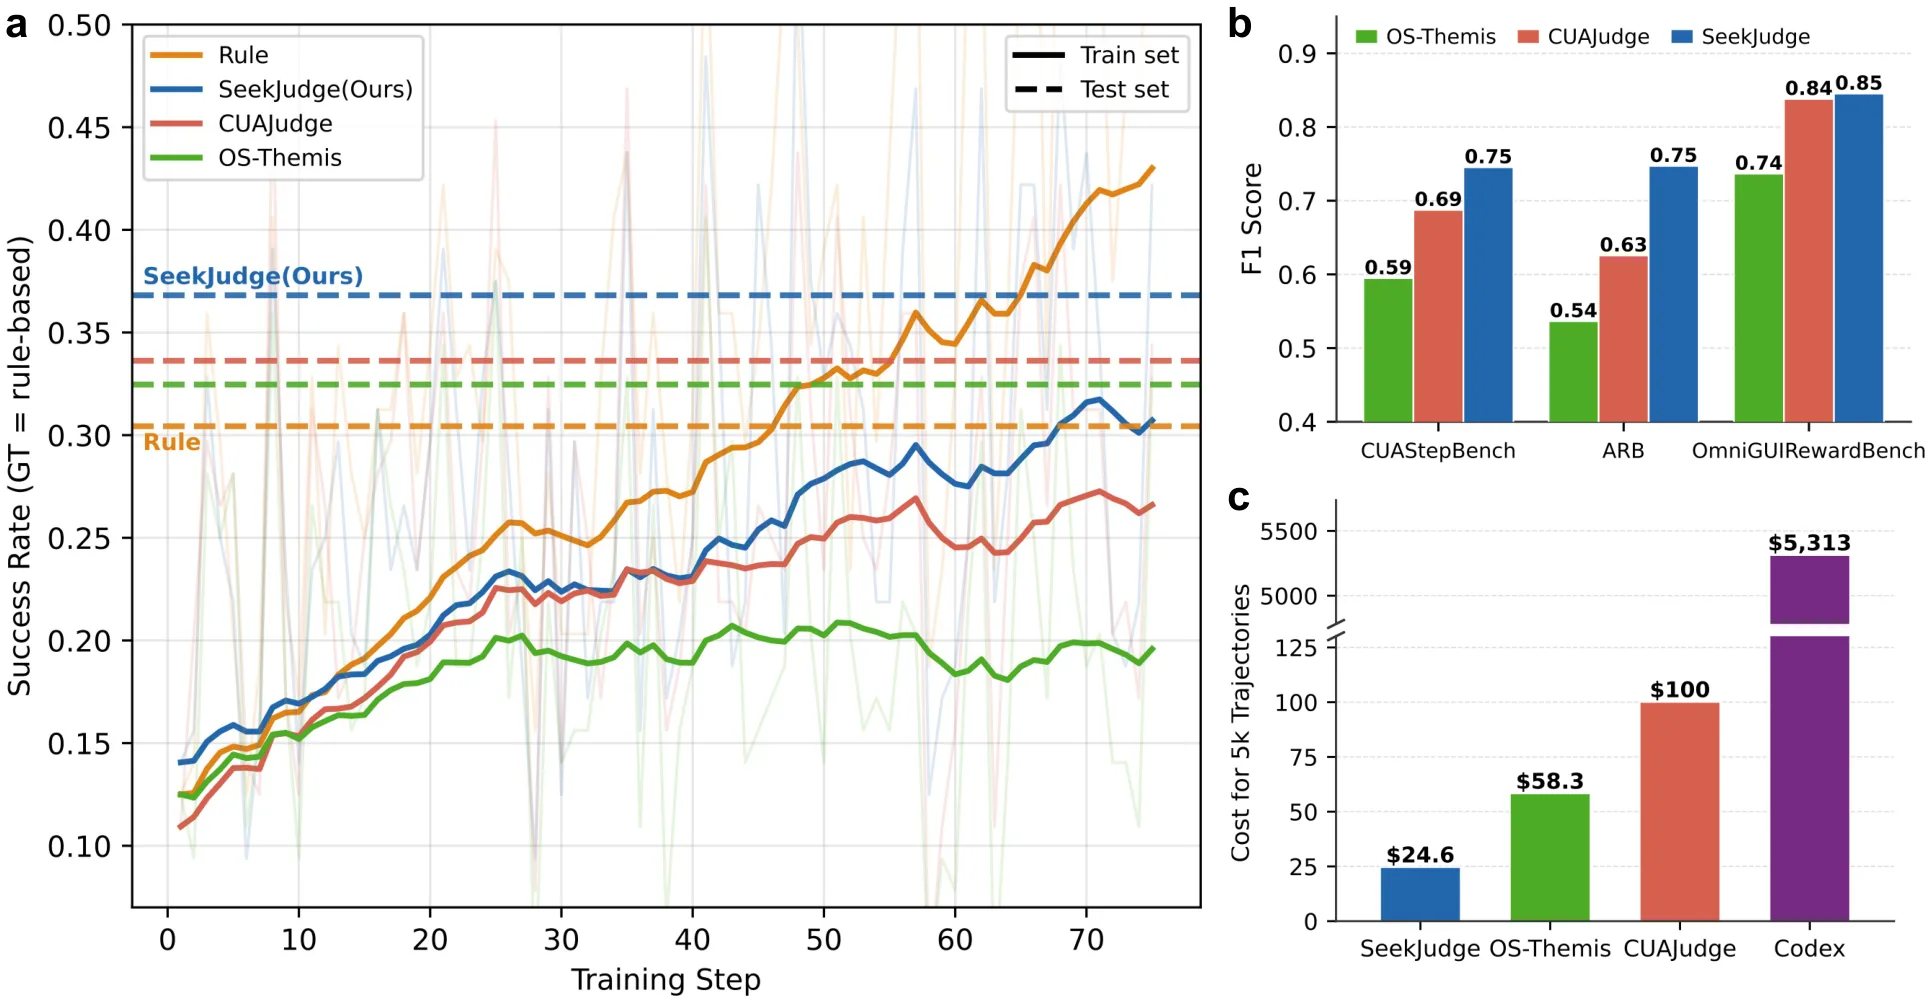
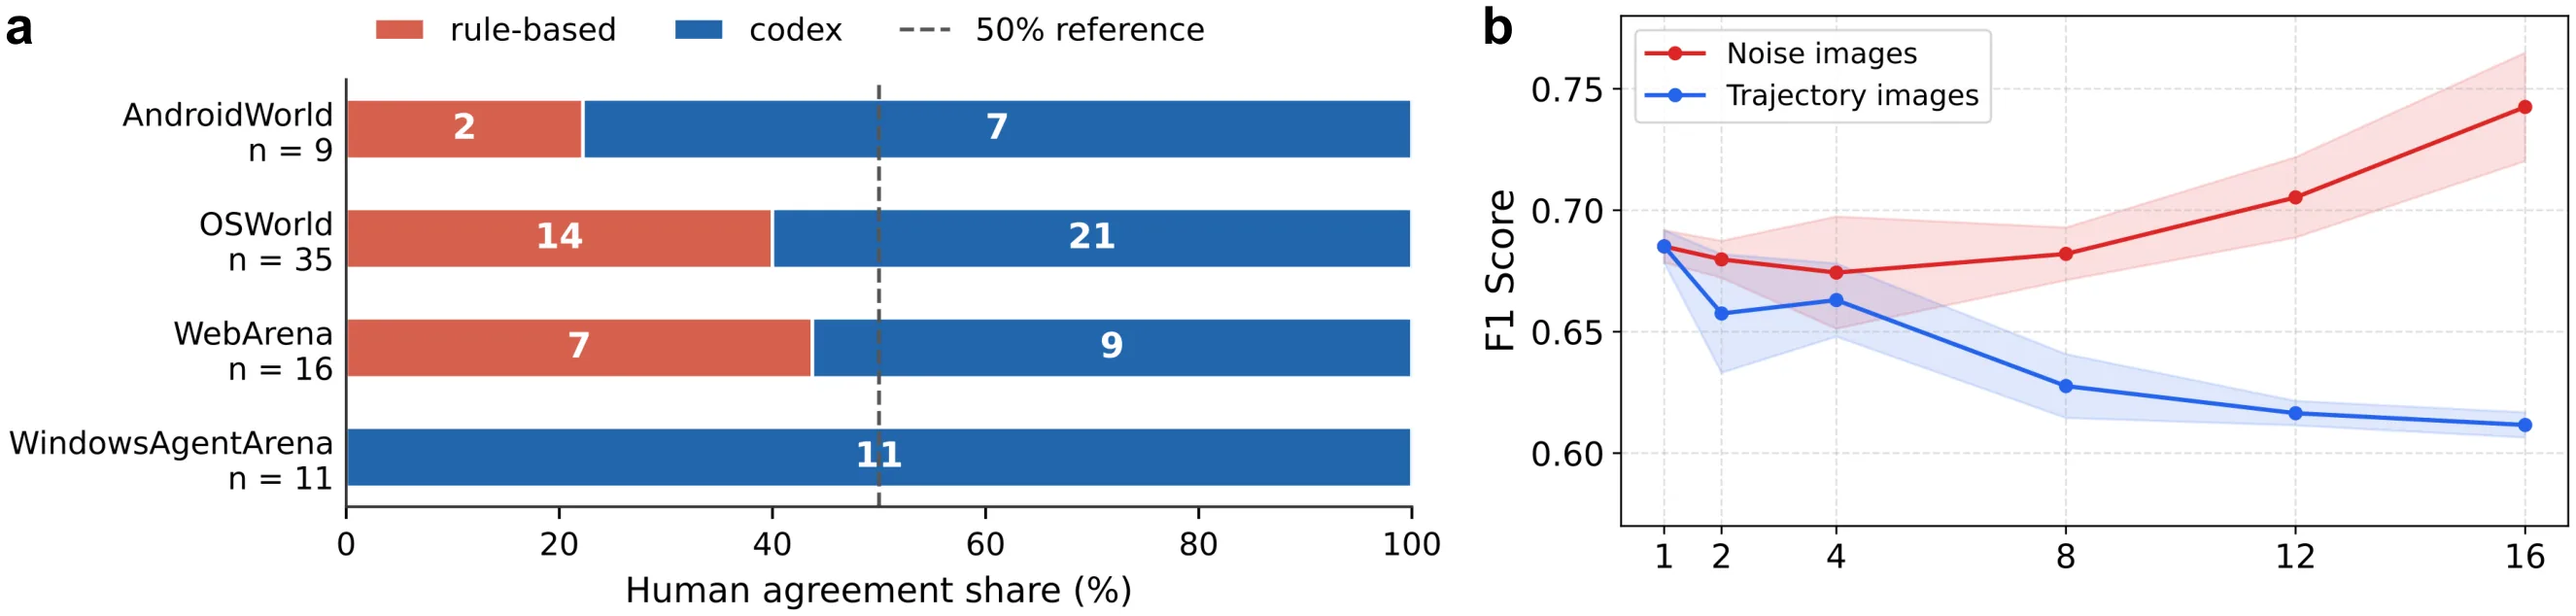
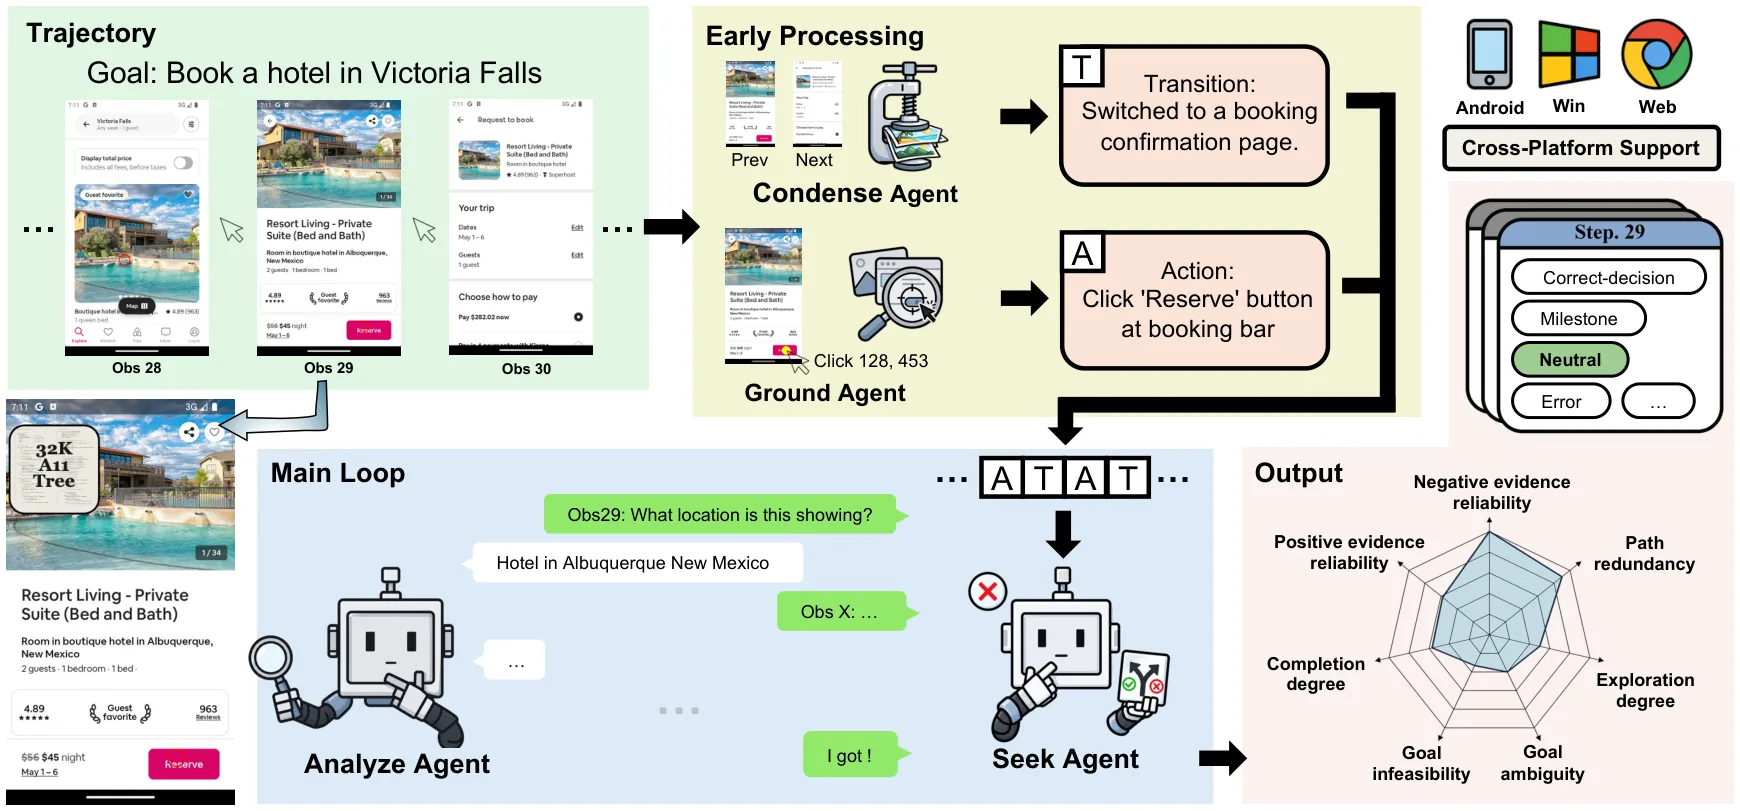
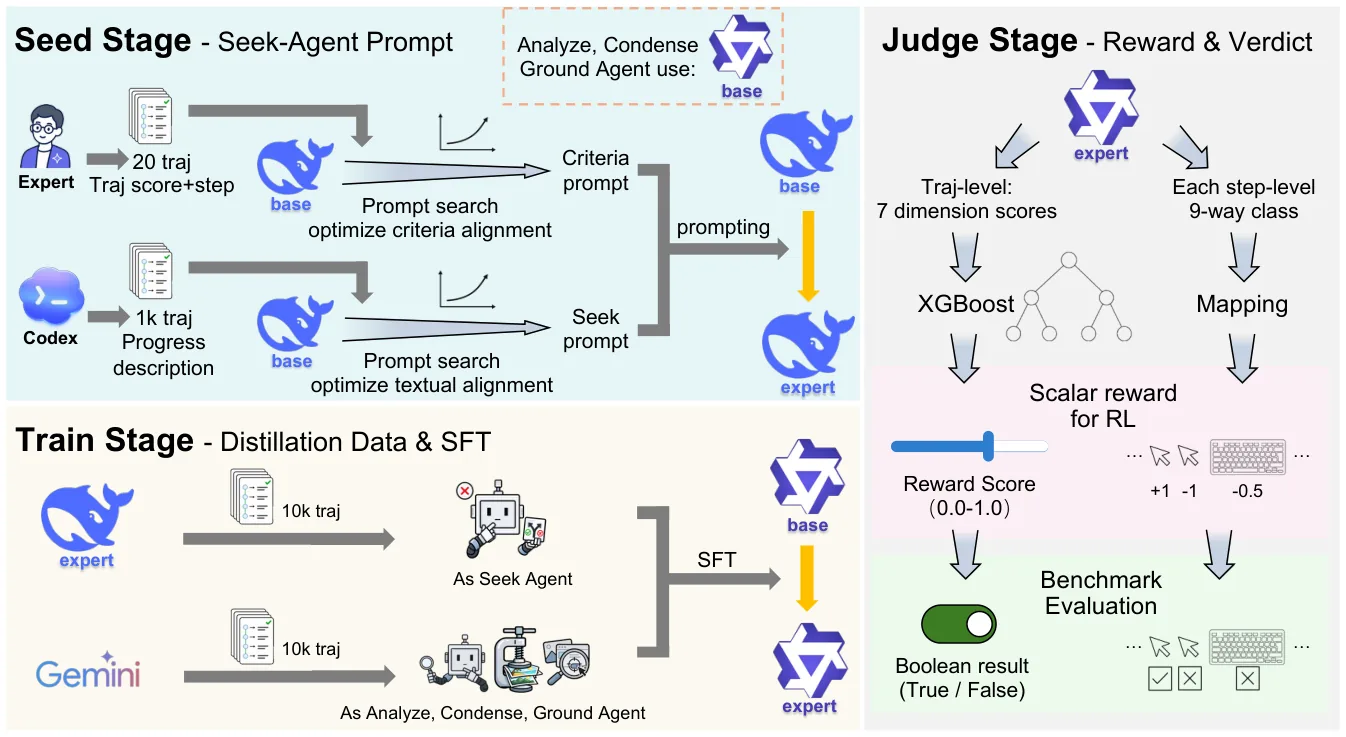
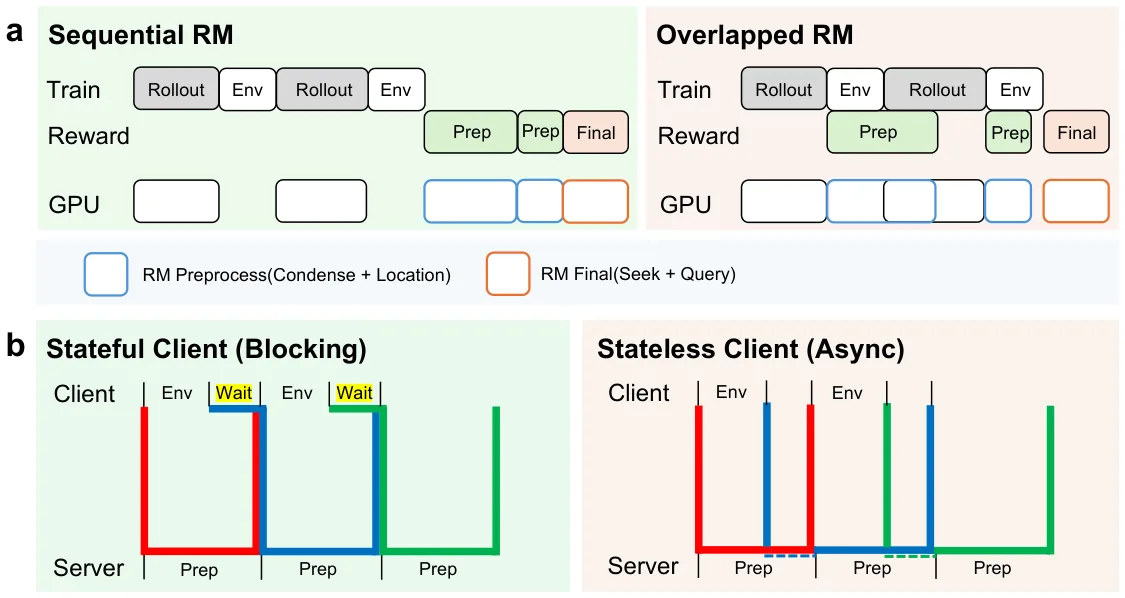
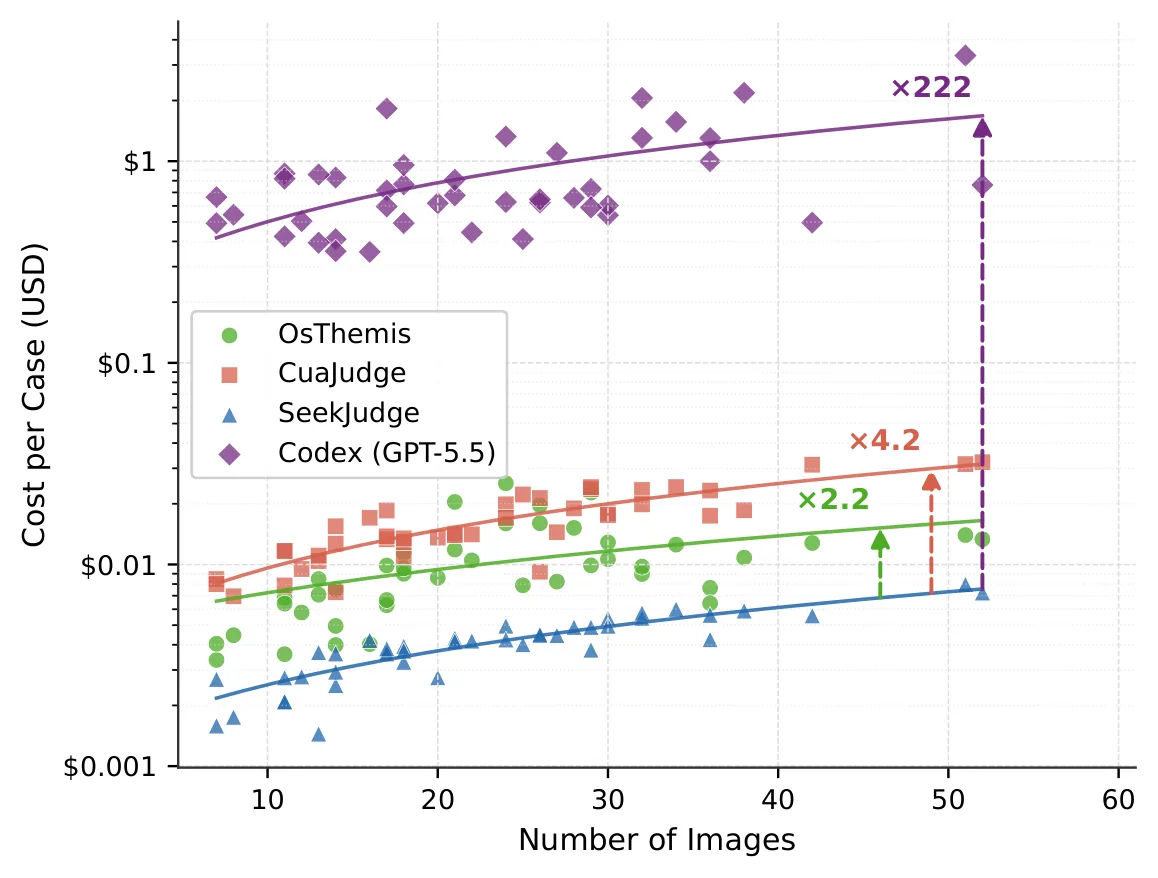
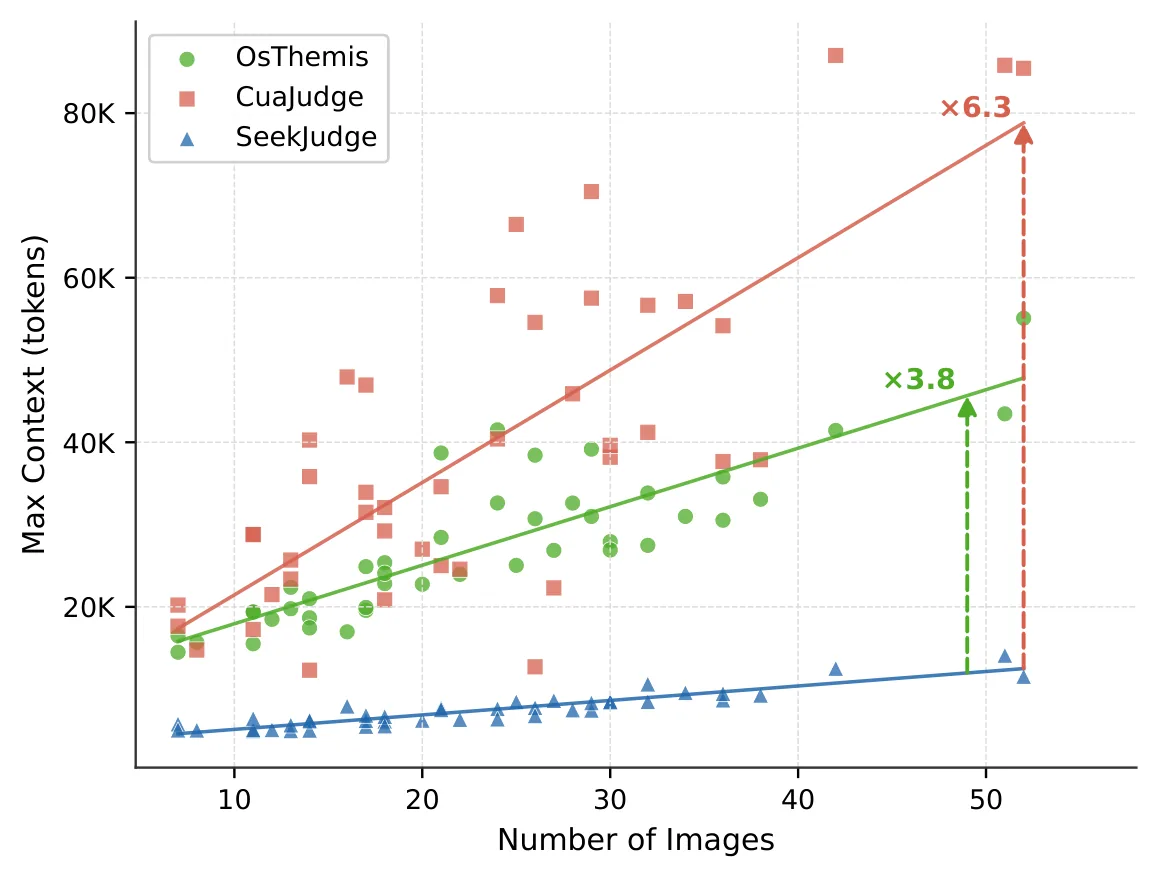
在长时程GUI任务中评估与训练计算机使用代理时,如何判定轨迹是否真正完成指令长期依赖基于规则的评估,而现有模型评判器仍存在性能差距。SeekJudge提出由四个角色专属代理通过Seek-Analyze循环协作裁决,并以种子校准蒸馏将单一9B模型作为共享骨干。它是首个在线强化学习下游成功率上匹配乃至超越原生规则监督的实用模型化奖励,且具备步骤级判断、低调用成本与可扩展上下文。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
让智能体像人类一样操控电脑——点击、输入、导航浏览器完成复杂任务——是近年来 [[计算机使用智能体]] 领域的重要研究方向。在这类任务中,一条轨迹(trajectory)往往由数十甚至上百个步骤组成,智能体需要在不断变化的图形界面中做出决策。如何判断这条轨迹是否真正完成了用户指令,直接决定了我们如何评估智能体的能力,也决定了强化学习训练时奖励信号的质量。
长期以来,这一判断任务依赖于基于规则的评估器(rule-based evaluator)。这类方法预先定义一系列检查点或条件,通过比对最终状态与预期结果来判定成功。然而,基于规则的评估存在根本性的局限:它难以捕捉人类真实意图,当应用程序界面更新或其在线内容发生变化时,预设规则会迅速失效,导致误判。更关键的是,基于规则的评估无法为强化学习提供细粒度的步骤级反馈,只能在轨迹结束时给出二元成功/失败信号,限制了学习效率的提升。
既然模型化判断器(model-based judge)能够理解语义、适应变化,为什么不直接用它替代规则引擎?现实情况是,现有模型判断器与基于规则的评估之间仍存在显著的性能差距。用更强的闭源大模型虽然能弥补差距,但调用成本高昂,难以在高频的强化学习训练循环中大规模部署。SeekJudge 的核心出发点就是弥合这一鸿沟——在保持低开销的前提下,让模型化奖励真正成为基于规则监督的实用替代方案。
方法
SeekJudge 的设计哲学是将复杂的轨迹判断任务分解为多个专精子角色,再通过精心设计的协作流程让它们相互补足。框架包含四个角色专精的智能体:Condense 负责将冗长的轨迹压缩为结构化的关键信息摘要,剔除界面截图和重复操作中的冗余;Ground 将指令和界面状态锚定到具体的环境上下文,确保判断始终围绕当前任务展开;Seek 主动在轨迹中定位与指令相关的关键节点;Analyze 则基于前述信息做出最终裁决。
这四个智能体并非简单串联,而是通过 Seek–Analyze 循环 实现迭代式协作。每一轮循环中,Seek 定位到潜在的问题区域或关键转折点,Analyze 对该区域进行深度评估,判断该步骤是否正确推进了任务、是否存在错误或遗漏。如果 Analyze 对某处存疑,会将反馈传回给 Seek,引导其重新聚焦到更值得关注的位置。这种循环机制模拟了人类评审轨迹时会反复审视关键节点的行为,比单次通读更能捕捉时序依赖的复杂问题——例如,早期的一个小错误可能在几十步之后才导致任务失败。
四个智能体如果各自使用独立的大型模型,推理成本将难以承受。SeekJudge 采用了 种子校准蒸馏(seed-calibrated distillation)来解决这一问题:使用高质量的种子数据让教师模型(可以是更强大的闭源模型)生成详细的四角色协作判断轨迹,然后让单一 9B 学生模型学习模仿这一过程。通过多轮迭代校准,学生模型逐步掌握在单次调用中执行完整 Seek–Analyze 循环的能力,最终用一个精简的模型承载了原本需要多个专精模型协作才能实现的判断精度。
此外,论文还贡献了一项通用的奖励服务器架构改进,通过减少模型调用次数和优化批处理策略,显著加速了强化学习训练循环中的判断过程,使模型化奖励的高频调用成为可能。
实验与结果
实验在多个计算机使用智能体 benchmark 上进行评估,重点关注留出强化学习测试目标上的下游成功率(downstream success rate)。结果显示,SeekJudge 在在线强化学习设置中首次实现了与原生基于规则监督相当甚至更好的最终任务完成率。这一成就的意义在于:规则监督虽然在特定场景下精确,但它需要针对每个任务手动设计检查逻辑,而 SeekJudge 作为一个通用的模型化奖励,能够跨任务泛化,无需为新任务重新编写规则。
在判断准确性方面,SeekJudge 显著缩小了与闭源大模型判断器的差距,同时将单次调用成本降低了一个数量级。论文特别强调了步骤级判断的能力——除了判定整条轨迹是否成功,SeekJudge 还能指出轨迹中哪一步出现了问题,为强化学习提供细粒度的信用分配(credit assignment)信号,这是基于规则评估无法提供的优势。
上下文长度方面,虽然完整轨迹可能包含大量界面截图和操作历史,但 SeekJudge 通过 Condense 智能体的压缩机制,将每次模型调用的实际上下文控制在较小规模,使其能够高效处理远长于常规模型的轨迹。
讨论与可借鉴点
SeekJudge 证明了模型化奖励在计算机使用智能体领域已经具备实用价值,但仍有局限。首先,种子校准蒸馏依赖高质量的教师模型生成轨迹,教师的判断质量本身构成了性能上限。其次,四角色协作框架增加了系统复杂度,虽然最终蒸馏为单一模型,但设计过程中的角色定义和交互逻辑需要大量调优。
对于该领域的研究者而言,SeekJudge 的多角色分解思路值得借鉴。将一个复杂的全局判断拆解为多个专精子任务,通过迭代协作而非一次性推理来提升判断质量,是一种可迁移的设计范式。种子校准蒸馏流程也提示了如何在资源受限条件下,将强大的闭源模型能力迁移到可部署的轻量模型中。此外,论文对奖励服务器架构的改进强调了系统层面的工程细节——在强化学习的高频训练循环中,奖励计算的延迟和成本往往是决定方法能否实用的关键因素,这提醒我们不应只关注算法精度,还要关注端到端的系统效率。
摘要
面向计算机使用智能体的强化学习奖励框架与角色化多智能体循环
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
衡量仿真到现实的差距:为人工智能物联网系统中的强化学习设计经济实惠的真实世界基准平台
Measure the Sim-to-Real Gap: Designing an Affordable Real-World Benchmark Platform for Reinforcement Learning in AIoT Systems
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 48 张
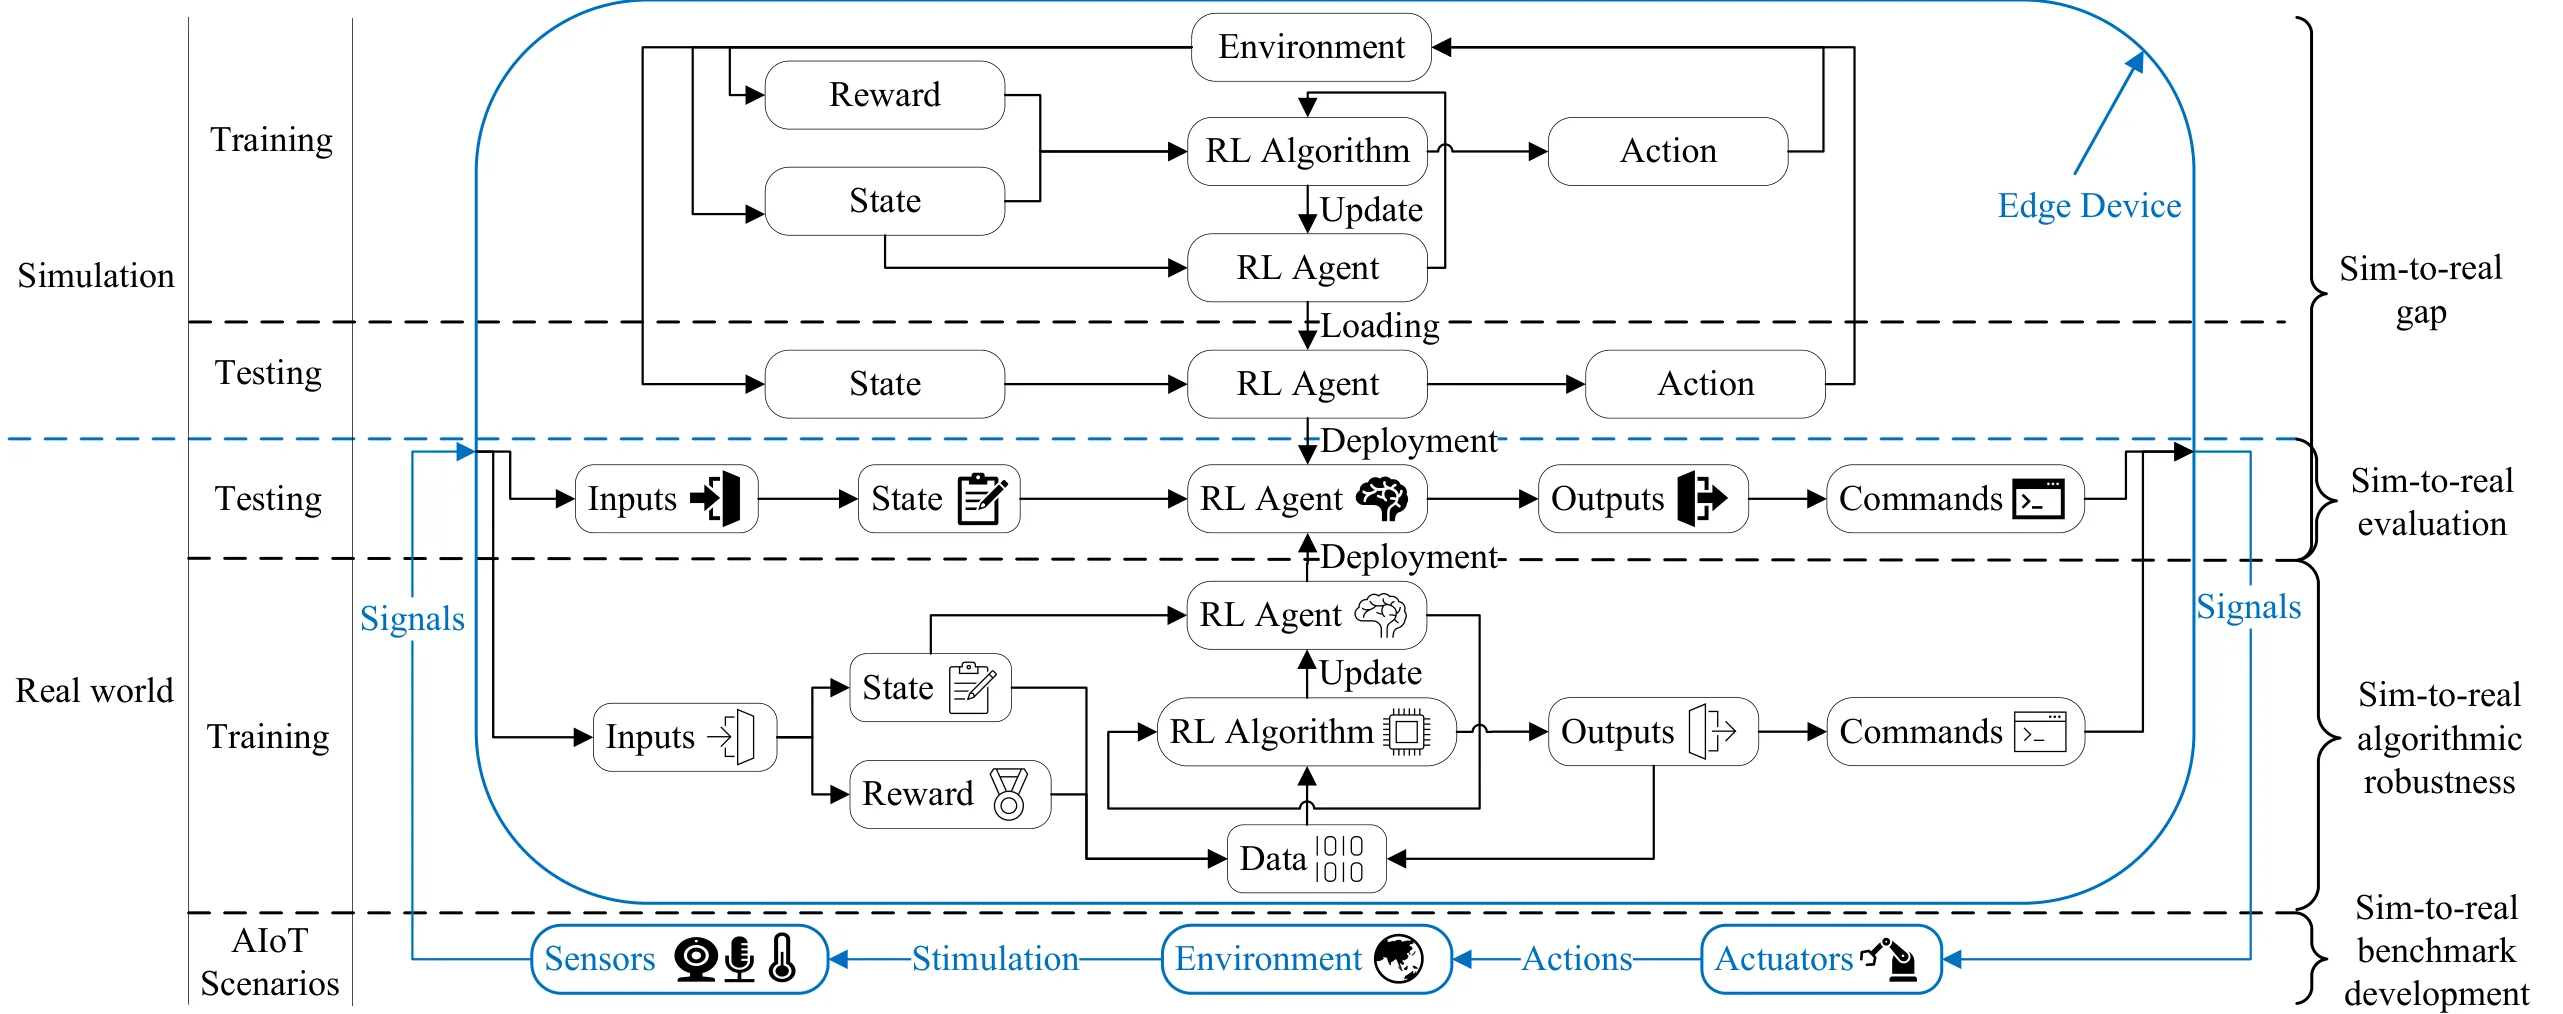
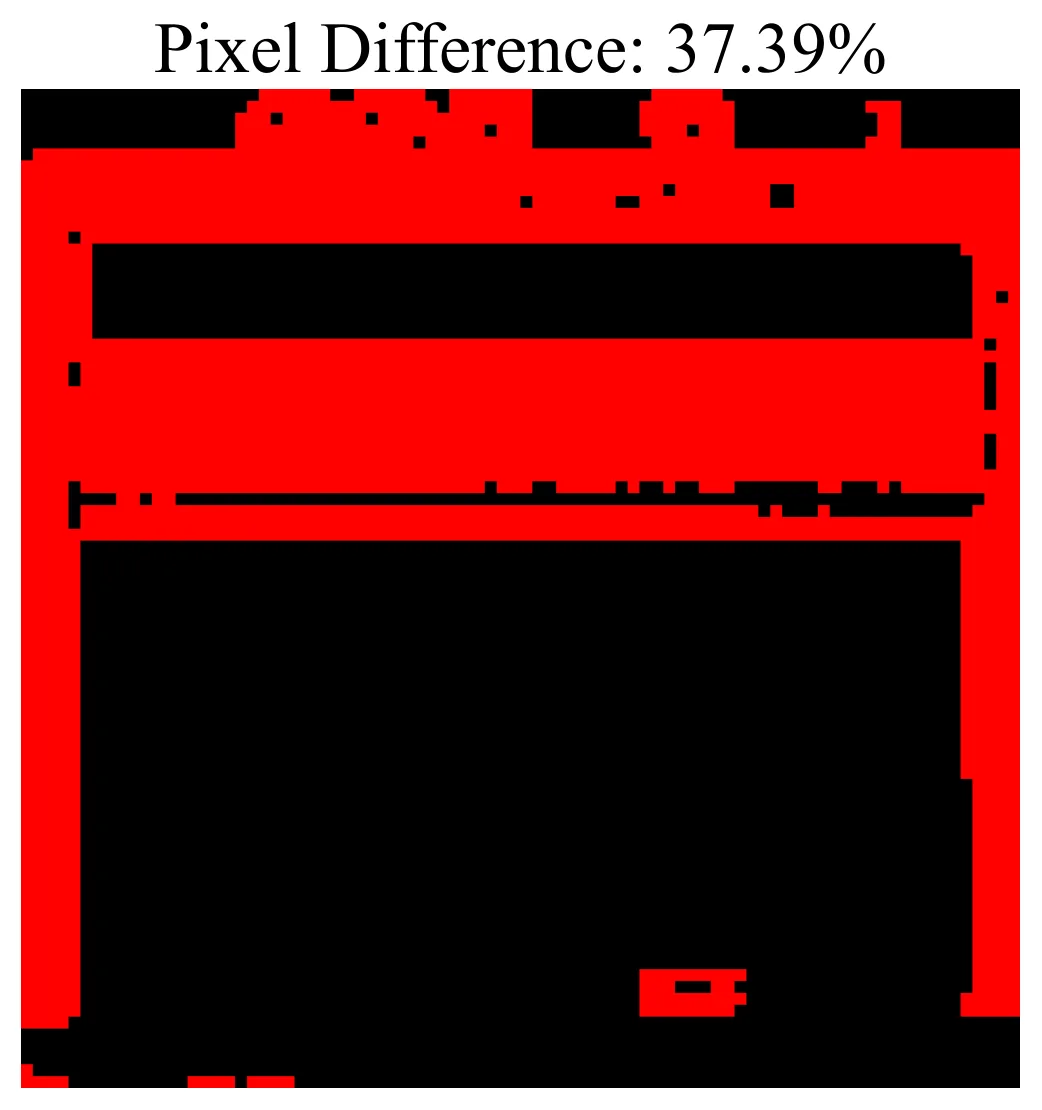
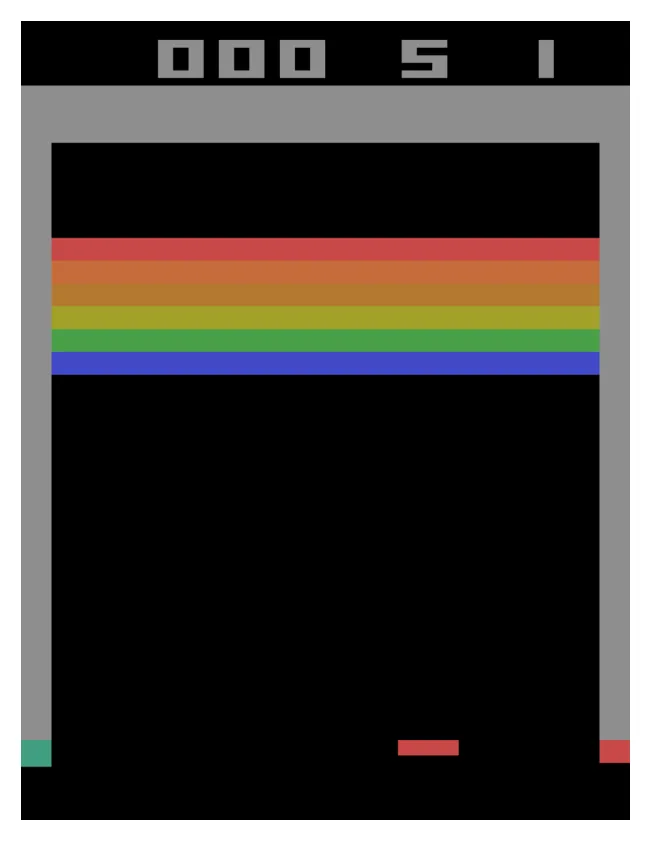
论文针对AIoT系统中强化学习缺乏通用仿真到现实基准平台的问题,利用低于400美元的市售组件构建了一个真实世界基准平台,其中边缘设备上的RL智能体通过硬件模拟键盘和视觉输入在主机上玩电子游戏,以游戏得分最大化为目标天然规避了安全风险。实验发现仿真训练的智能体部署到真实环境后性能下降高达1160%,证实了显著的仿真到现实差距。而直接在真实环境中使用DQN训练一千万步后,可达到约38%的人类水平性能,验证了真实世界RL的可行性。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
强化学习作为人工智能领域的核心技术之一,近年来在游戏、机器人控制、自动驾驶等场景中取得了令人瞩目的成就。在 AIoT 系统中,强化学习同样被寄予厚望——智能家居设备可以学习用户的作息习惯自动调节温控,工业传感器能够自主优化数据采集策略,自动驾驶车辆在边缘端实时做出决策。然而,[[强化学习]] 的本质是「试错学习」,智能体需要通过不断尝试、接收奖励反馈、调整策略来逐步提升性能。这种探索过程在真实环境中往往成本高昂甚至危险重重——试想一个正在学习行走的机器人如果每次摔倒都可能损坏昂贵的硬件,或者一辆自动驾驶汽车在真实道路上「探索」各种危险驾驶行为。
正因如此,绝大多数强化学习研究选择在仿真环境中进行。仿真环境提供了可控的、廉价的、可无限重置的实验条件,研究者可以在短时间内完成数百万步的训练迭代。然而,这种对仿真的依赖引入了一个根本性的挑战:[[仿真到现实]](Sim-to-Real)迁移问题。在仿真中表现优异的策略,部署到真实物理世界后常常出现性能急剧下降甚至完全失效的情况。这是因为仿真环境无论如何精细,都难以完美复现真实世界的物理特性、传感器噪声、延迟特性等细节。
为了应对这一挑战,机器人领域已经开发了多种同步仿真与物理平台(Sim-to-Real platforms),用于评估和缩小仿真与现实之间的差距。但在 AIoT 领域,这样一个通用的仿真到现实基准平台一直付诸阙如。研究者们往往各自搭建实验环境,导致实验结果难以复现、不同方法之间缺乏公平对比。针对这一空白,本文提出了一种专门面向 AIoT 系统的真实世界基准平台,旨在为强化学习在 AIoT 中的研究和应用提供可靠的评测基础。
方法
这篇论文的核心贡献是搭建了一个低成本、可复现的[[仿真到现实]]基准平台。整个系统的设计思路非常巧妙:用电子游戏作为实验载体,让强化学习智能体学习玩游戏,既保留了强化学习的核心挑战,又天然规避了真实世界 RL 部署的安全风险。
具体来说,系统由三个核心部分组成。第一部分是边缘设备,研究者将强化学习智能体部署在树莓派或其他低成本的边缘计算设备上,负责运行决策算法并生成控制指令。第二部分是主机,一台独立的普通计算机,运行 Atari 游戏模拟器(如 Pong、Breakout 等经典游戏)作为任务环境。第三部分是硬件模拟键盘,这是整个系统的关键创新点——边缘设备不通过软件 API 而是通过一块微控制器硬件模拟键盘输入信号,直接控制游戏中的角色动作。这种硬件层级的交互方式更接近真实世界的传感器-执行器闭环,更能反映真实部署场景中的信号传输延迟和噪声特性。
在输入端,系统使用视觉信息作为智能体的观测——边缘设备通过摄像头捕捉游戏的屏幕画面,经过预处理后作为神经网络的输入。这种基于视觉的输入方式与许多真实世界的 AIoT 应用场景(如视频监控、自动驾驶视觉感知)高度一致,增加了实验的实际参考价值。整个平台的硬件成本控制在 400 美元以内,使用的是市面上随时可购得的普通组件,确保了其他研究者能够轻松复现。
研究者采用 [[深度Q网络]](DQN)作为主要的强化学习算法。DQN 是深度强化学习领域的经典算法,使用卷积神经网络逼近状态-动作值函数(Q函数),通过经验回放和目标网络等技巧稳定训练过程。选择 DQN 的原因在于它具有良好的可复现性、相对成熟的技术栈,以及足够的代表性——如果 DQN 能在该平台上展现可接受的性能,说明该平台对于更复杂的强化学习算法同样具有适用性。
实验与结果
实验设计围绕两个核心问题展开:仿真训练的智能体在真实环境中表现如何,以及直接在真实环境中训练强化学习是否可行。
第一个实验考察了[[仿真到现实]]差距的严重程度。研究者首先在标准仿真环境中(Atari 游戏模拟器)用 DQN 训练了 Breakout 和 Pong 两个游戏,达到了约 100% 的人类水平性能——也就是说,在仿真中智能体已经能够与人类玩家相媲美。然而,当这些「仿真冠军」被部署到真实世界的基准平台上时,性能出现了灾难性的下降。以 Breakout 游戏为例,智能体在真实环境中的得分仅为仿真环境的十分之一左右,综合评估显示性能相对于人类基准下降了 1160%。这个数字背后的含义是:原本在仿真中与人类旗鼓相当的智能体,到了真实环境中连人类玩家的百分之一都不如。这种巨大的落差生动地说明了仿真与现实之间那条看似微小的鸿沟,实际上可能是多么难以逾越。
研究者分析了导致这一巨大差距的可能原因。仿真环境中的游戏帧率是恒定且精确的,而真实摄像头捕捉的画面存在帧率波动;仿真中的键盘输入响应时间是零延迟的,而硬件模拟键盘引入了真实的信号传输延迟;仿真环境中的视觉输入是完美的像素级复制,而摄像头捕捉的画面存在光照变化、视角畸变、噪点干扰等真实世界的「狼狈」。正是这些在仿真中被忽视或理想化的细节,在真实部署时逐一暴露出来,成为性能杀手。
第二个实验探索了真实世界强化学习的可行性。研究者直接在真实环境中启动 DQN 训练,让智能体从零开始学习玩游戏。这个过程耗时更长、成本更高——总共训练了一千万步。实验结果表明,经过充分训练后,智能体在 Breakout 游戏中达到了约 38% 的人类水平性能。虽然与仿真训练的「完美」表现相去甚远,但这个结果证明了一个重要的命题:在真实世界中直接训练强化学习是可行的,只是需要更长的训练时间和更鲁棒的方法。
两种训练方式的对比清晰地揭示了当前强化学习研究的一个核心困境:仿真环境提供了高效的训练条件但无法保证迁移能力,真实环境提供了真实的挑战但训练成本高昂。这恰恰凸显了可靠的仿真到现实基准平台的必要性——它为研究者提供了在受控环境中系统性地研究迁移问题的工具。
讨论与可借鉴点
这项研究的最直接贡献是提供了一个可复现、低成本、面向 AIoT 领域的仿真到现实基准平台。这填补了该领域的一个重要空白——此前研究者要评估 RL 方法的仿真到现实迁移能力,往往需要自行搭建昂贵的硬件平台,或者借用机器人领域不具代表性的环境。有了这个平台,研究者可以在标准化的条件下对比不同算法、不同网络架构、不同训练策略的迁移效果,加速该领域的知识积累。
从更宏观的角度看,这项研究揭示的问题——1160% 的性能落差——对整个强化学习社区都具有警示意义。我们常用「simulation-to-reality gap」来描述这个问题,但这篇论文用具体的数字让我们意识到这个 gap 可能比我们想象的更加严峻。这意味着,对于任何希望在真实世界中部署强化学习的应用——无论是智能制造、自动驾驶还是 AIoT——都需要认真对待仿真环境的建模精度问题,而不是简单地将仿真结果等同于真实性能。
论文也存在一定的局限性。首先,游戏任务的复杂度相对有限,真实世界的 AIoT 任务往往涉及更复杂的时序依赖、多智能体交互和安全性约束。其次,平台仅使用了视觉输入,在一些依赖其他传感器模态的 AIoT 场景中代表性有限。第三,38% 的人类水平性能虽然证明了可行性,但距离实用仍有差距,说明更先进的真实世界 RL 算法值得进一步探索。
对于后续研究而言,这个平台可以作为一个良好的起点。例如,可以在此基础上研究如何减小仿真到现实的差距(如 Domain Randomization、World Models、对抗训练等方法);也可以探索更高效的边缘端在线学习算法,降低真实世界训练的计算成本;还可以将平台扩展到更多类型的任务,如多智能体协作、时间敏感控制等。
概念 · 7 个
摘要
构建真实世界RL基准平台并量化仿真到现实差距,属于强化学习与智能体部署研究。
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
冰上棋局:基于逆向归纳与深度强化学习的冰壶战术决策
Chess on Ice: Curling Tactical Decision-Making via Backward Induction and Deep Reinforcement Learning
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 8 张
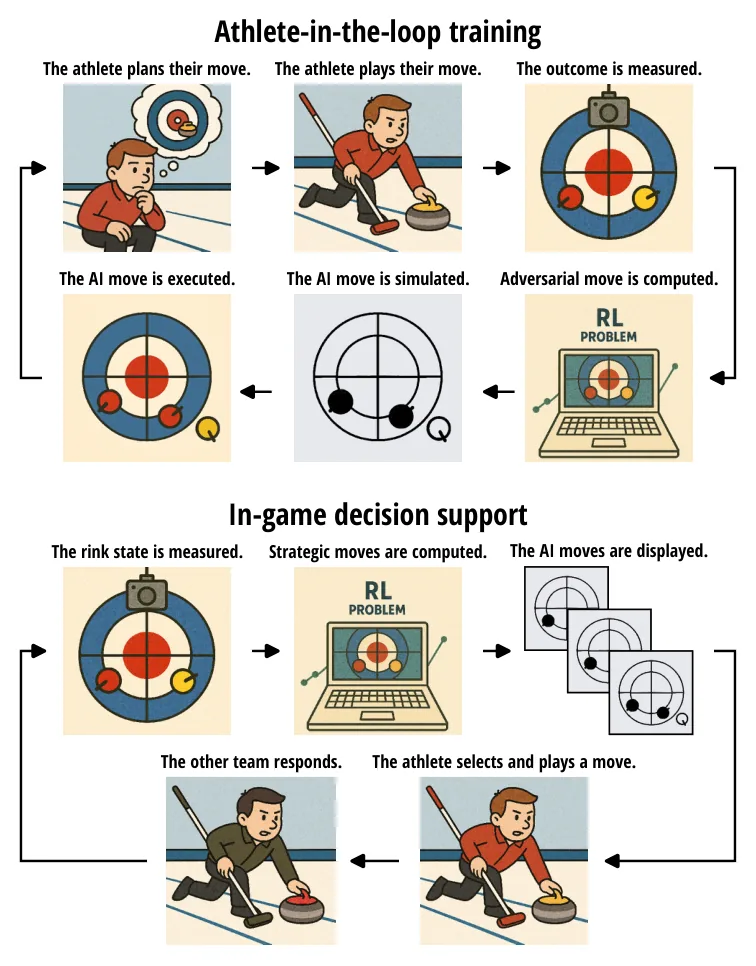
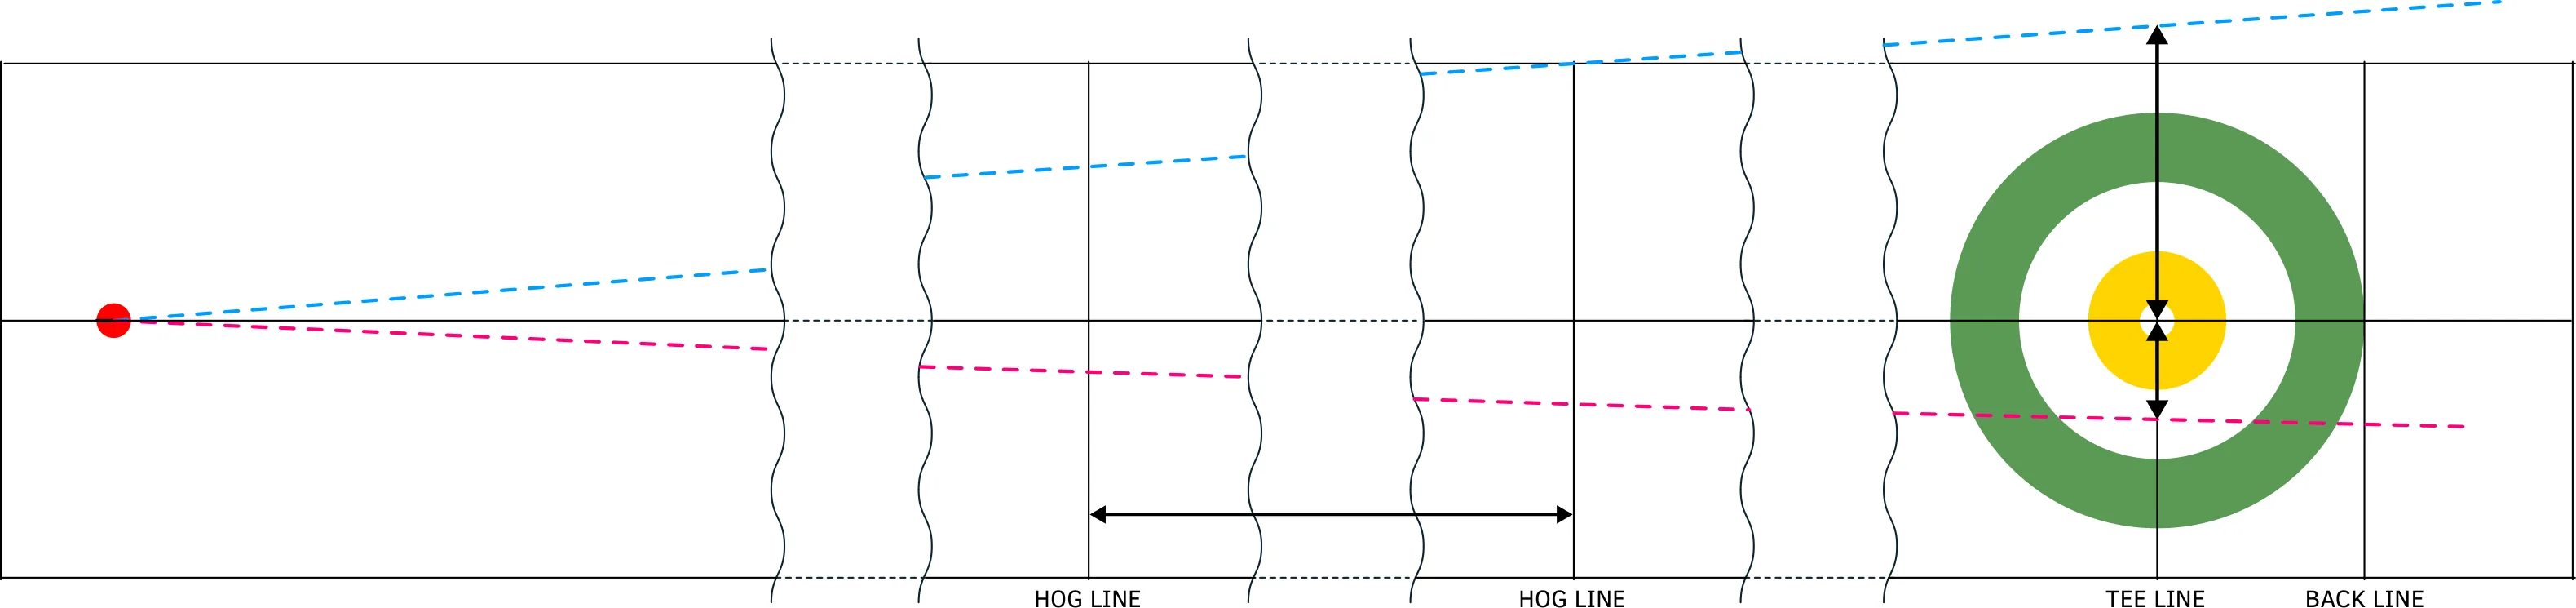
冰壶被誉为'冰上象棋',但其机器学习研究仍非常有限。本文针对冰壶战术决策中连续状态/动作空间、随机执行误差及对微小扰动高度敏感等建模难题,提出基于DDPG演员-评论家算法并结合有限时域逆向归纳结构的强化学习框架。实验在四石简化版本上无需任何人类标注即学到有效策略,在专家启发式接近最优的区域与之持平;同时评论网络提供连续动作空间的稠密价值估计,可用于赛后复盘与训练决策支持。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
冰壶运动之所以被誉为"冰上象棋",源于其决策过程中极高的战术复杂度:运动员需要在每一投中权衡投掷力量、旋转方向与瞄准点,同时还要预判石块碰撞后的全局演变。然而,与围棋、象棋等早已被 AlphaGo 系列突破的棋类游戏相比,冰壶在机器学习领域的研究严重滞后,现有工作大多局限于统计层面的分析,例如基于历史数据的端到端策略判断或单次投掷结果的回归预测,缺乏对单局内连续战术规划的系统建模。
论文指出了冰壶决策面临的三大核心挑战。首先是连续的状态空间与动作空间:冰壶石的位置是二维连续坐标,投掷参数同样连续取值,这些变量远非围棋或象棋的离散格子空间所能比拟。其次是执行噪声的随机性:真实比赛中,运动员的投掷动作会受到自身技术水平与冰面摩擦条件的影响,导致实际落点偏离预期,这种不确定性需要被纳入决策模型。最后,冰壶的状态转移对微小扰动高度敏感——动作参数的一个微小偏差,可能因石块碰撞的链式反应而在全局布局上造成天壤之别,这对学习的稳定性提出了更高要求。
研究的动机正是要填补这一空白:构建一个能够定量评估和比较冰壶战术选项的强化学习框架,使其既能应对连续空间的复杂性,又能妥善处理随机性与敏感性,最终为运动员训练、赛后复盘乃至比赛实时决策提供智能化的辅助。
方法
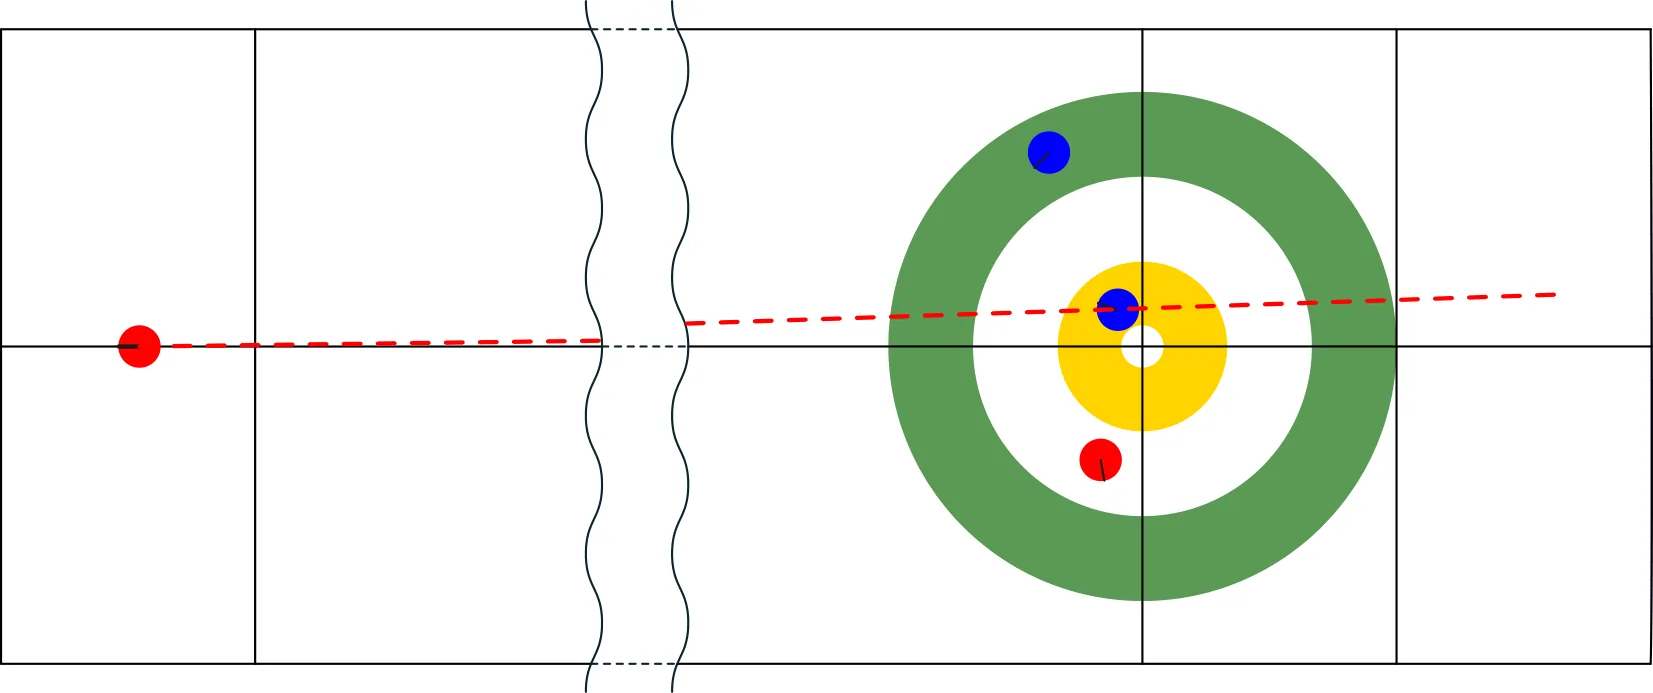
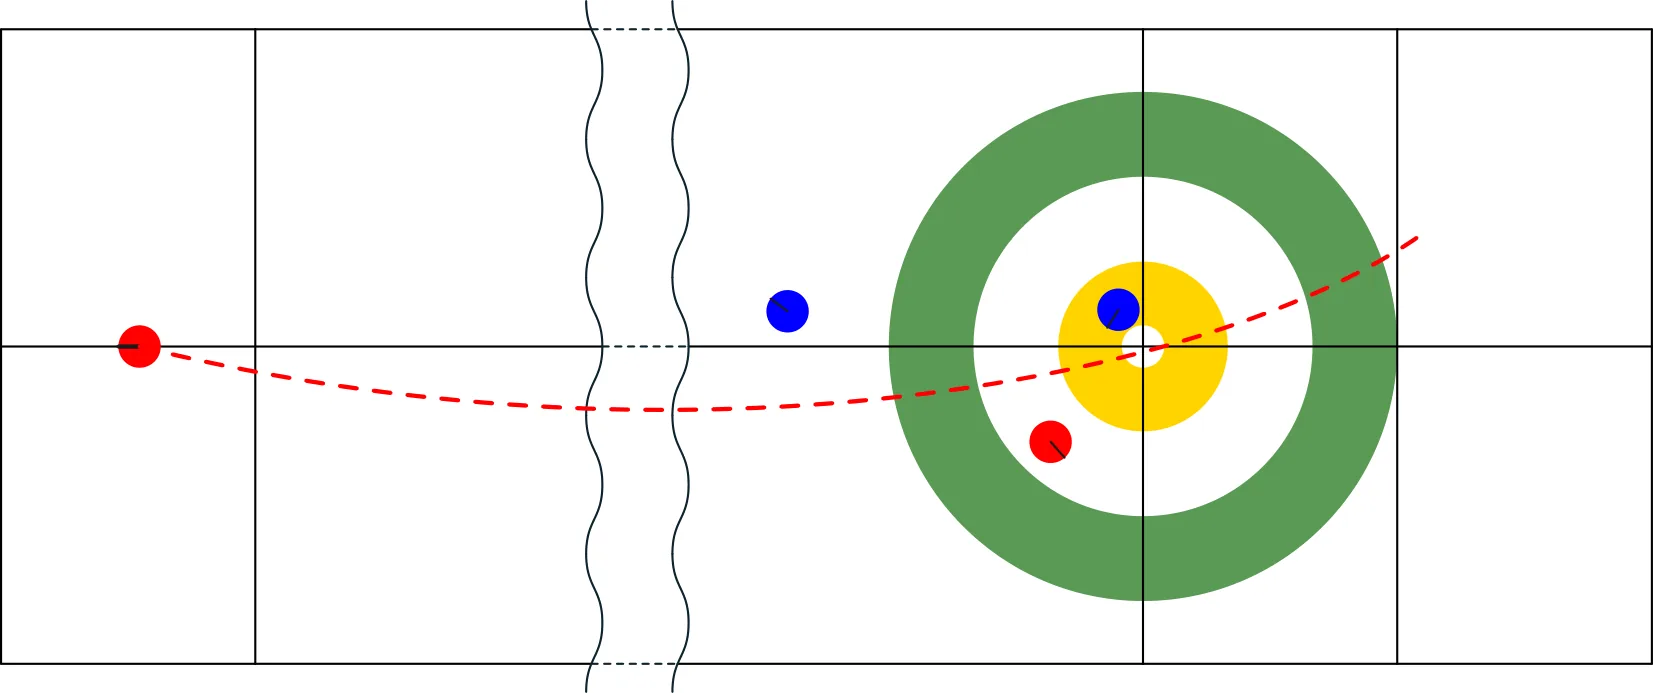
论文首先将冰壶单局形式化为一个有限时域、零和、双人回合制的随机博弈过程。状态由分差 、当前局数 、锤子归属 、下一投次索引 以及场上所有石块的位置集合 共同刻画。动作则由投掷时长 (对应速度)、瞄准点横坐标 和旋转方向 三维连续变量构成。值得注意的是,奖励结构是极度稀疏的:中间阶段奖励为零,只有最后一投结束后根据场上石块分布计算最终得分。这种稀疏奖励的特性使得学习的探索变得尤为困难。
针对这一挑战,论文采用了逆向归纳(Backward Induction)的核心思想。由于冰壶的单局投掷次数 是固定的(例如标准变体为16),论文选择从最后一投向前逐阶段求解。递推关系可以写作:当前状态-动作对的 值等于执行动作后的下一状态在最优策略下的期望 值的期望。这里的关键在于,求解第 阶段时,第 阶段及其之后的最优策略已经通过逆向归纳过程预先获得,可以直接代入使用。
然而,冰壶的石块碰撞动力学极其复杂,且执行噪声的分布依赖于动作参数本身,上述递推关系没有封闭形式解。因此论文引入深度强化学习来近似每一阶段的 函数与策略函数。具体采用的是深度确定性策略梯度(DDPG)算法,这是一个专为连续动作空间设计的行动者-评论家架构。行动者网络输出确定性动作,评论家网络估计 值,二者通过确定性策略梯度联合更新。
论文详细论证了选择 DDPG 而非其他算法的理由。一方面,DDPG 的模型无关特性使其无需显式建模冰壶碰撞物理,评论家网络通过观察数据隐式学习状态转移动态。另一方面,论文明确拒绝了使用熵正则化方法(如 Soft Actor-Critic)的选项:冰壶环境本身已通过执行噪声 注入了足够随机性,额外的策略熵是冗余的;更关键的是,逆向归纳需要在每一阶段将确定的下一阶段策略代入计算,熵正则化会迫使对动作分布重新边际化,从而破坏逆向分解的结构。同样地,TD3 等双评论家方法所针对的价值高估问题,在冰壶稀疏奖励设定下(回报被严格限制在 范围内)并不显著,因此也未被采用。
训练采用两阶段策略:第一阶段是预训练,根据专家设计的启发式分布随机采样状态进行初始学习;第二阶段是微调,从第 投开始向前逐步扩展,每一阶段都利用已训练好的后续阶段策略生成更真实的对抗状态分布,使训练数据与实际对弈情境更加接近。
实验与结果
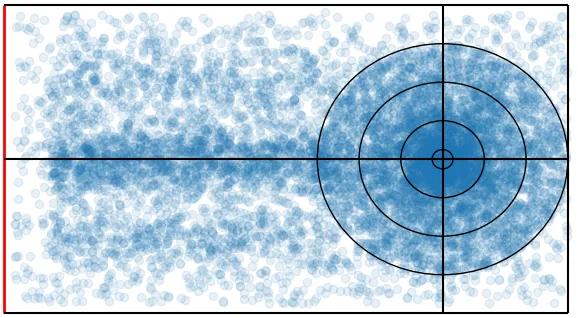
实验在 Brunner 开发的 Python 冰壶仿真器上进行。为控制计算复杂度,论文选择了四石变体作为测试床——每队各持两壶,全局共四次投掷机会。这一简化版本保留了冰壶的核心博弈结构,同时大幅缩短了决策 horizon,使得基准方法的性能可以被可靠估计。
论文设计了一个基于专家知识的启发式规则作为对照基准:当己方占优时选择画近防守,对方占优时选择击打清除,空场时则画向圆心。这一启发式在四石变体中已接近最优——论文通过让其与自身对弈来量化该变体的"天花板":持锤方(后手优势)胜率高达 97%,无锤方仅 3%。这意味着在该变体下,任何策略的性能上限几乎由锤子归属唯一决定。
在 200 局对弈评估中(持锤与无锤各 100 局),习得的 DDPG 智能体取得了持锤方 100% 胜率、无锤方 2% 胜率的表现,与启发式基准持平。这一结果在论文看来是积极的:能够匹配一个在已知最优上界附近的方法,说明学习没有偏离合理策略空间。
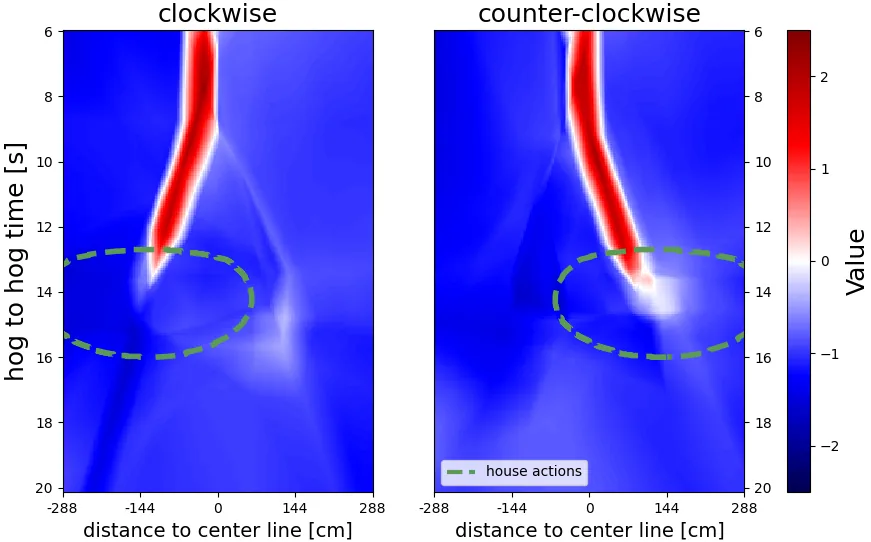
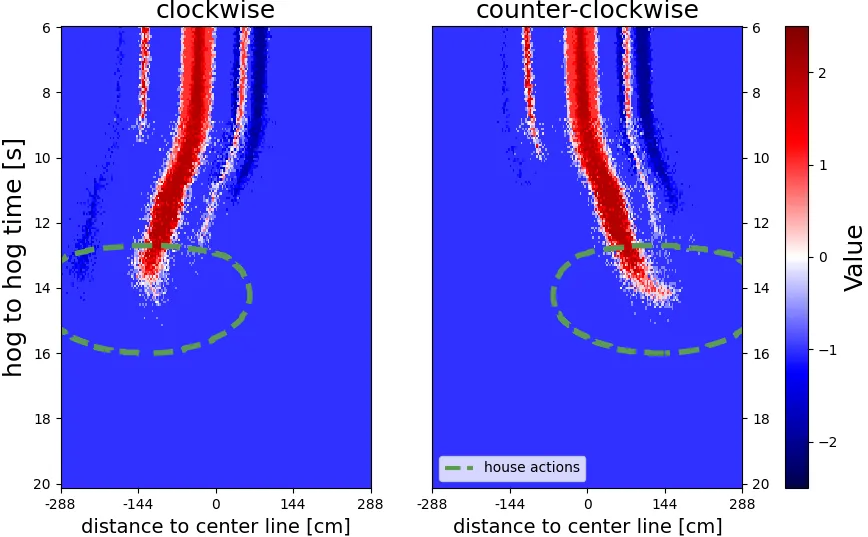
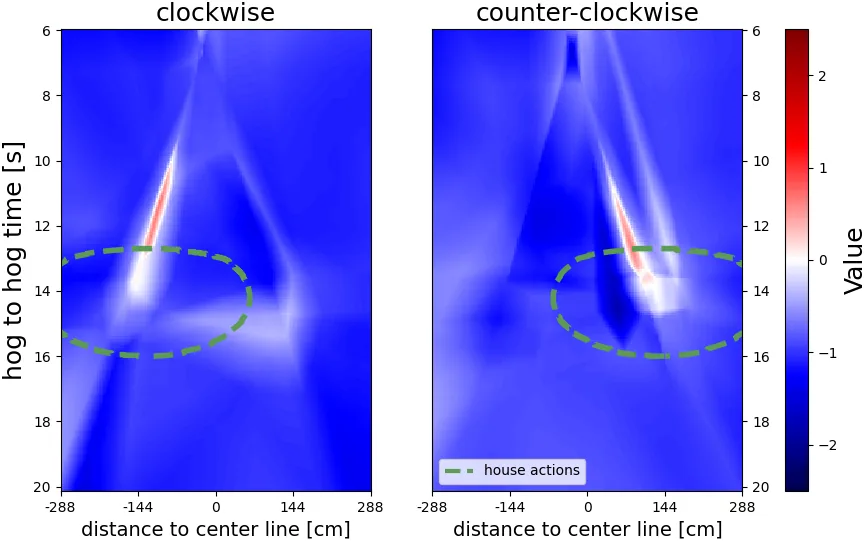
更值得关注的是评论家网络输出的可视化分析。对于特定棋盘配置, 值的二维热力图清晰显示了策略对连续动作空间的敏感性:击打(takeout)、画近(draw)、绕障等典型战术在热力图上呈现出合理的价值分布,且对投掷速度变化导致的物理效应(例如高速下侧偏减小)有准确反映。这种稠密的价值估计能力正是评论家网络相对于纯策略输出的独特优势——它不仅告诉使用者"应该做什么",还量化了"每一种替代选择值多少"。
消融实验表明,每阶段独立训练 256 神经元容量的网络架构是达成上限性能的充分条件,减小容量或跨阶段共享网络参数均导致性能一致下降。
讨论与可借鉴点
论文的贡献在于以完全自监督的方式证明了强化学习能够习得有意义的冰壶战术,且评论家网络的稠密价值估计为战术量化比较提供了新的原语。然而,局限性同样明显。首先,四石变体仅为概念验证——在标准十六石变体下,后手优势可能不再如此极端,策略的分辨空间会更大,但计算成本也将急剧上升。其次,论文仅建模单局内的战术规划,未触及跨局的比分管理与战略切换,而这正是高水平冰壶竞技的核心。再者,实验缺乏置信区间或多随机种子报告,统计严谨性有待加强。
从方法学角度,这项工作提供了一个值得借鉴的思路:对于有限时域、结构明确的博弈问题,逆向归纳与深度强化学习的结合可以充分利用问题的已知结构,同时避免稀疏奖励带来的探索困难。两阶段训练(预训练+对抗微调)的设计也具有普遍意义——当目标策略空间未知时,先用简单分布初始化,再用迭代扩展的方式逐步逼近真实分布,是一种平衡样本效率与策略真实性的务实做法。此外,论文对算法选择的细致论证——为何拒绝 SAC、为何拒绝 TD3——本身也是严谨工作的体现,值得在类似场景下参考。
摘要
深度强化学习应用于冰壶战术决策
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
CaM-Wolf:面向社交推理游戏的因果感知多模态智能体
CaM-Wolf: Causal-Aware Multimodal Agents for Social Deduction Games
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 9 张
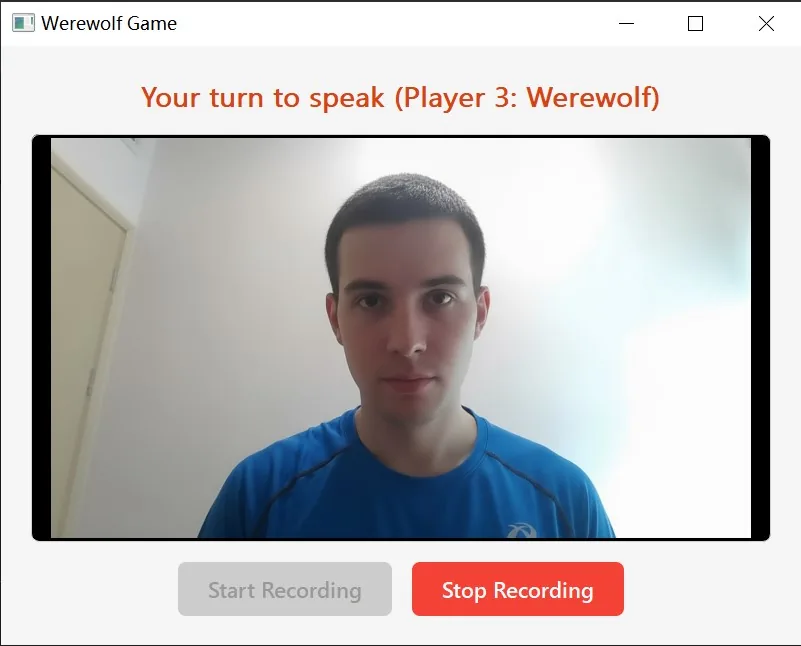
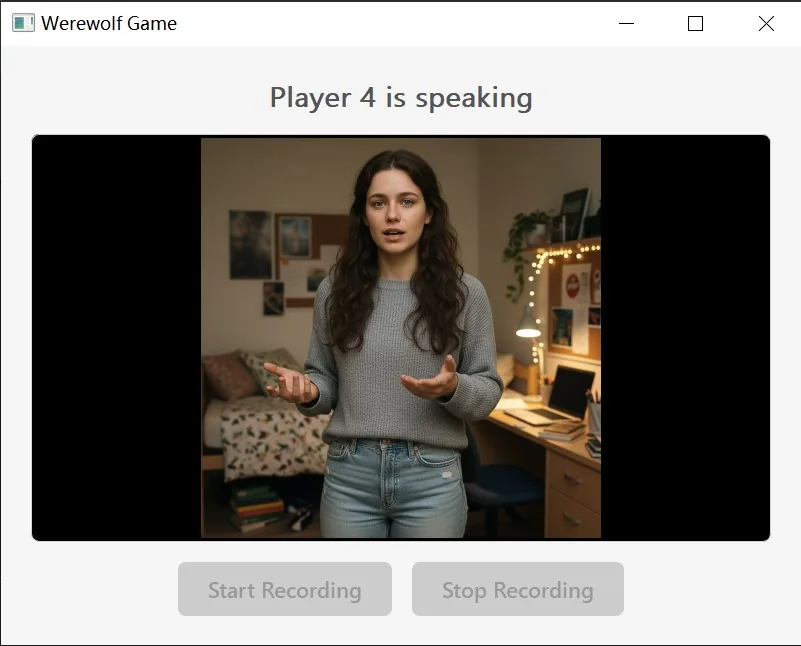
问题背景:狼人杀等社交推理游戏对AI代理的社会推理、欺骗与协作能力提出高要求。核心方法:CaM-Wolf是首个整合多模态感知与生成的代理,通过处理玩家视频输入并采用基于强化学习训练的因果感知Reasoner,构建可观测行为与隐藏角色间的逻辑链。关键结果:实验与用户研究表明其游戏表现与人机交互质量均显著优于现有方法。贡献意义:标志着向具备细腻社会动态参与能力的类人AI代理迈出了重要一步。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
[[社交推理游戏]](Social Deduction Games,SDGs)作为人工智能研究的重要测试平台,其核心挑战在于要求智能体同时具备推理、欺骗与协作等复杂社交技能。狼人杀作为其中最具代表性的游戏,玩家需要在有限信息下通过语言博弈识别隐藏身份、构建联盟并实施策略。这种「信息不对称下的社会博弈」场景,对 AI 系统的社会认知能力提出了极高要求。
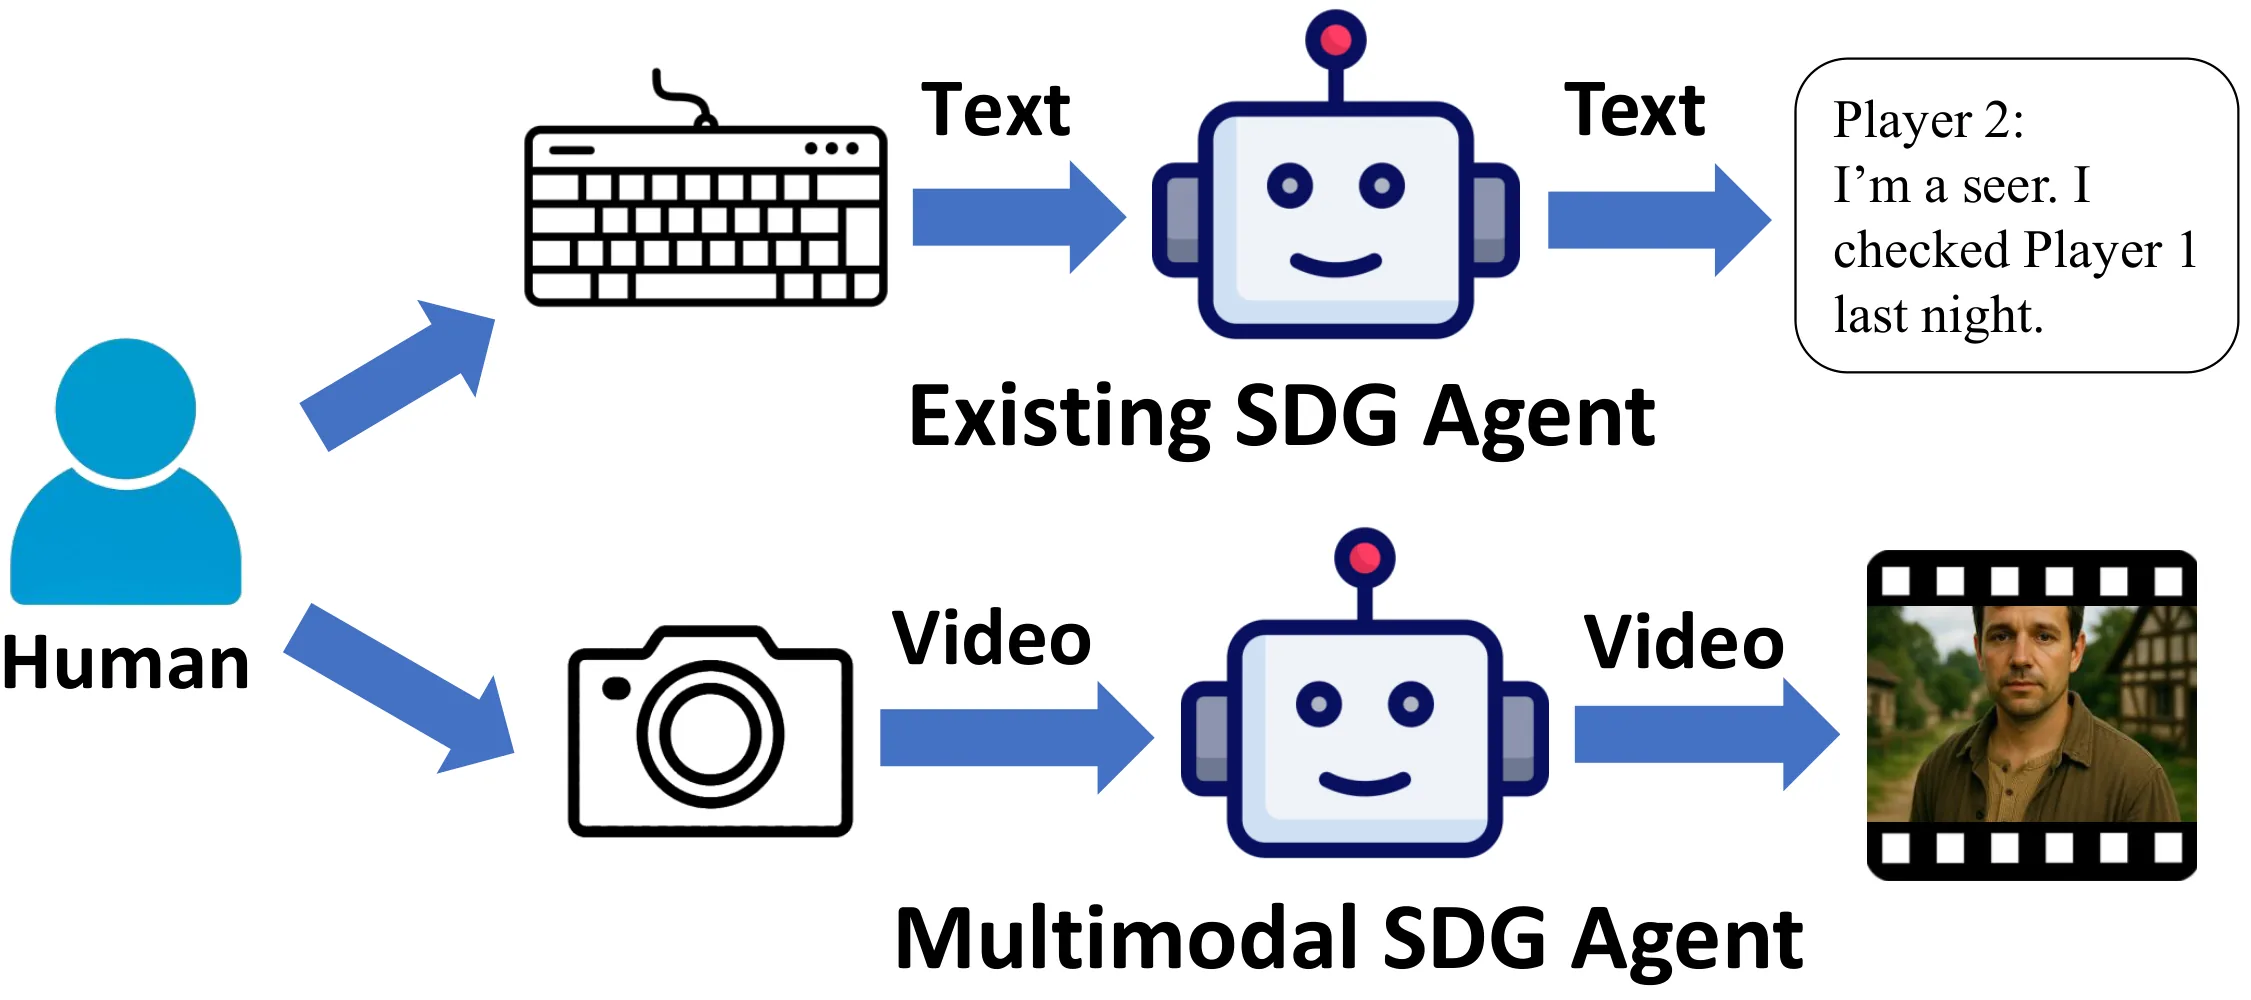
近年来,[[大语言模型]](Large Language Models,LLMs)的进展显著推动了社交推理游戏智能体的研究。然而,现有方法几乎全部采用纯文本交互范式,忽视了人类社交互动中天然存在的多模态信息——面部表情、肢体动作、语音语调等视觉与听觉线索在社会推理中扮演着不可或缺的角色。这种「去身体化」的交互方式不仅限制了智能体对人类玩家真实意图的感知能力,也使得人机交互体验远不如人人交互自然。
更根本的问题在于推理链条的可靠性。现有 LLM 驱动的智能体往往基于内部偏见生成推断,缺乏显式的逻辑支撑与可验证的证据链。当智能体声称「玩家A是狼人」时,我们无法追溯其判断究竟基于哪些观察事实、这些事实与结论之间的因果关系是否真实存在。这不仅降低了推理的可解释性,也限制了智能体在复杂博弈场景中的策略稳定性。
基于上述观察,本文提出一个核心假设:玩家的可观察行为与其隐藏角色之间存在因果关系,通过[[因果发现]]技术可以构建从行为到角色的可解释推理链。这一假设将因果推理引入社交推理游戏,为解决「黑盒推断」问题提供了新思路。CaM-Wolf 正是在这一思路指导下设计的首个[[多模态]]社交推理游戏智能体。
方法
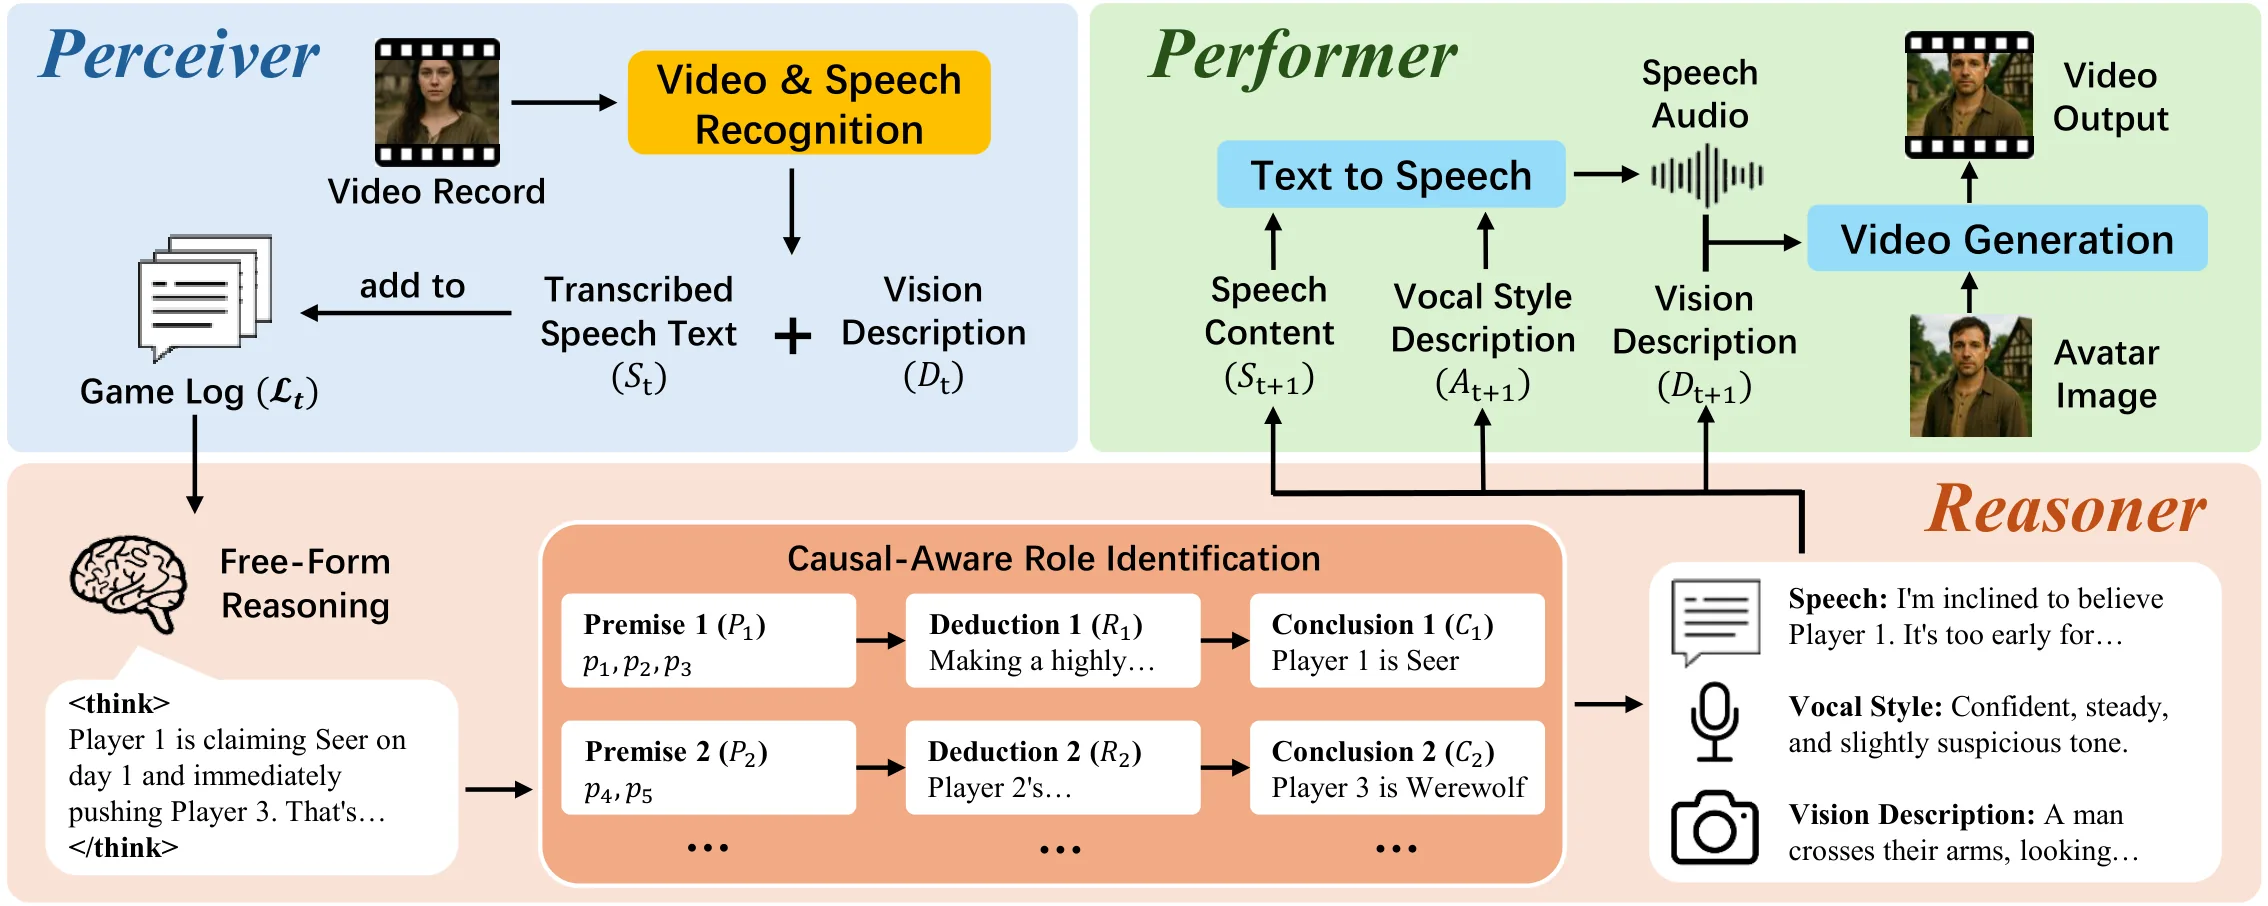
CaM-Wolf 的整体架构由三个核心模块组成:Perceiver(感知器)负责处理来自其他玩家的视频输入,Reasoner(推理器)执行因果感知的角色推理与发言生成,Performer(执行器)则将推理结果以动画化身的形式呈现给人类玩家。整个系统在感知-推理-执行之间形成完整的闭环,使智能体能够像真实玩家一样「看到」对手、「思考」策略、「展现」自我。
在感知层面,系统采用 Qwen2.5-Omni-7B 作为多模态理解引擎,将输入视频 同时转换为语音文本 与视觉描述 。这种设计确保了系统能够捕捉到语言内容之外的社交线索——对手的紧张神态、犹豫手势或异常语调都可能成为推断身份的关键依据。随后,这些多模态信息被整合进游戏日志 ,为后续推理提供完整的上下文记忆。形式化地,感知过程可表示为 ,日志更新为 。
推理器是整个系统的核心创新所在。它基于 Qwen2.5-72B-Instruct 微调而成,并通过[[强化学习]]训练框架 GRPO(Group Relative Policy Optimization)实现「内在化」的因果推理能力。与传统 LLM 的「端到端黑盒推断」不同,CaM-Wolf 的推理器被设计为显式输出结构化的推理链条:每个发言回合不仅生成最终发言文本,还输出 个角色识别三元组 ,其中 是从游戏日志中引用的具体证据集, 是基于证据的推理过程, 是角色结论。这种结构化输出使得推理过程完全透明可追溯。
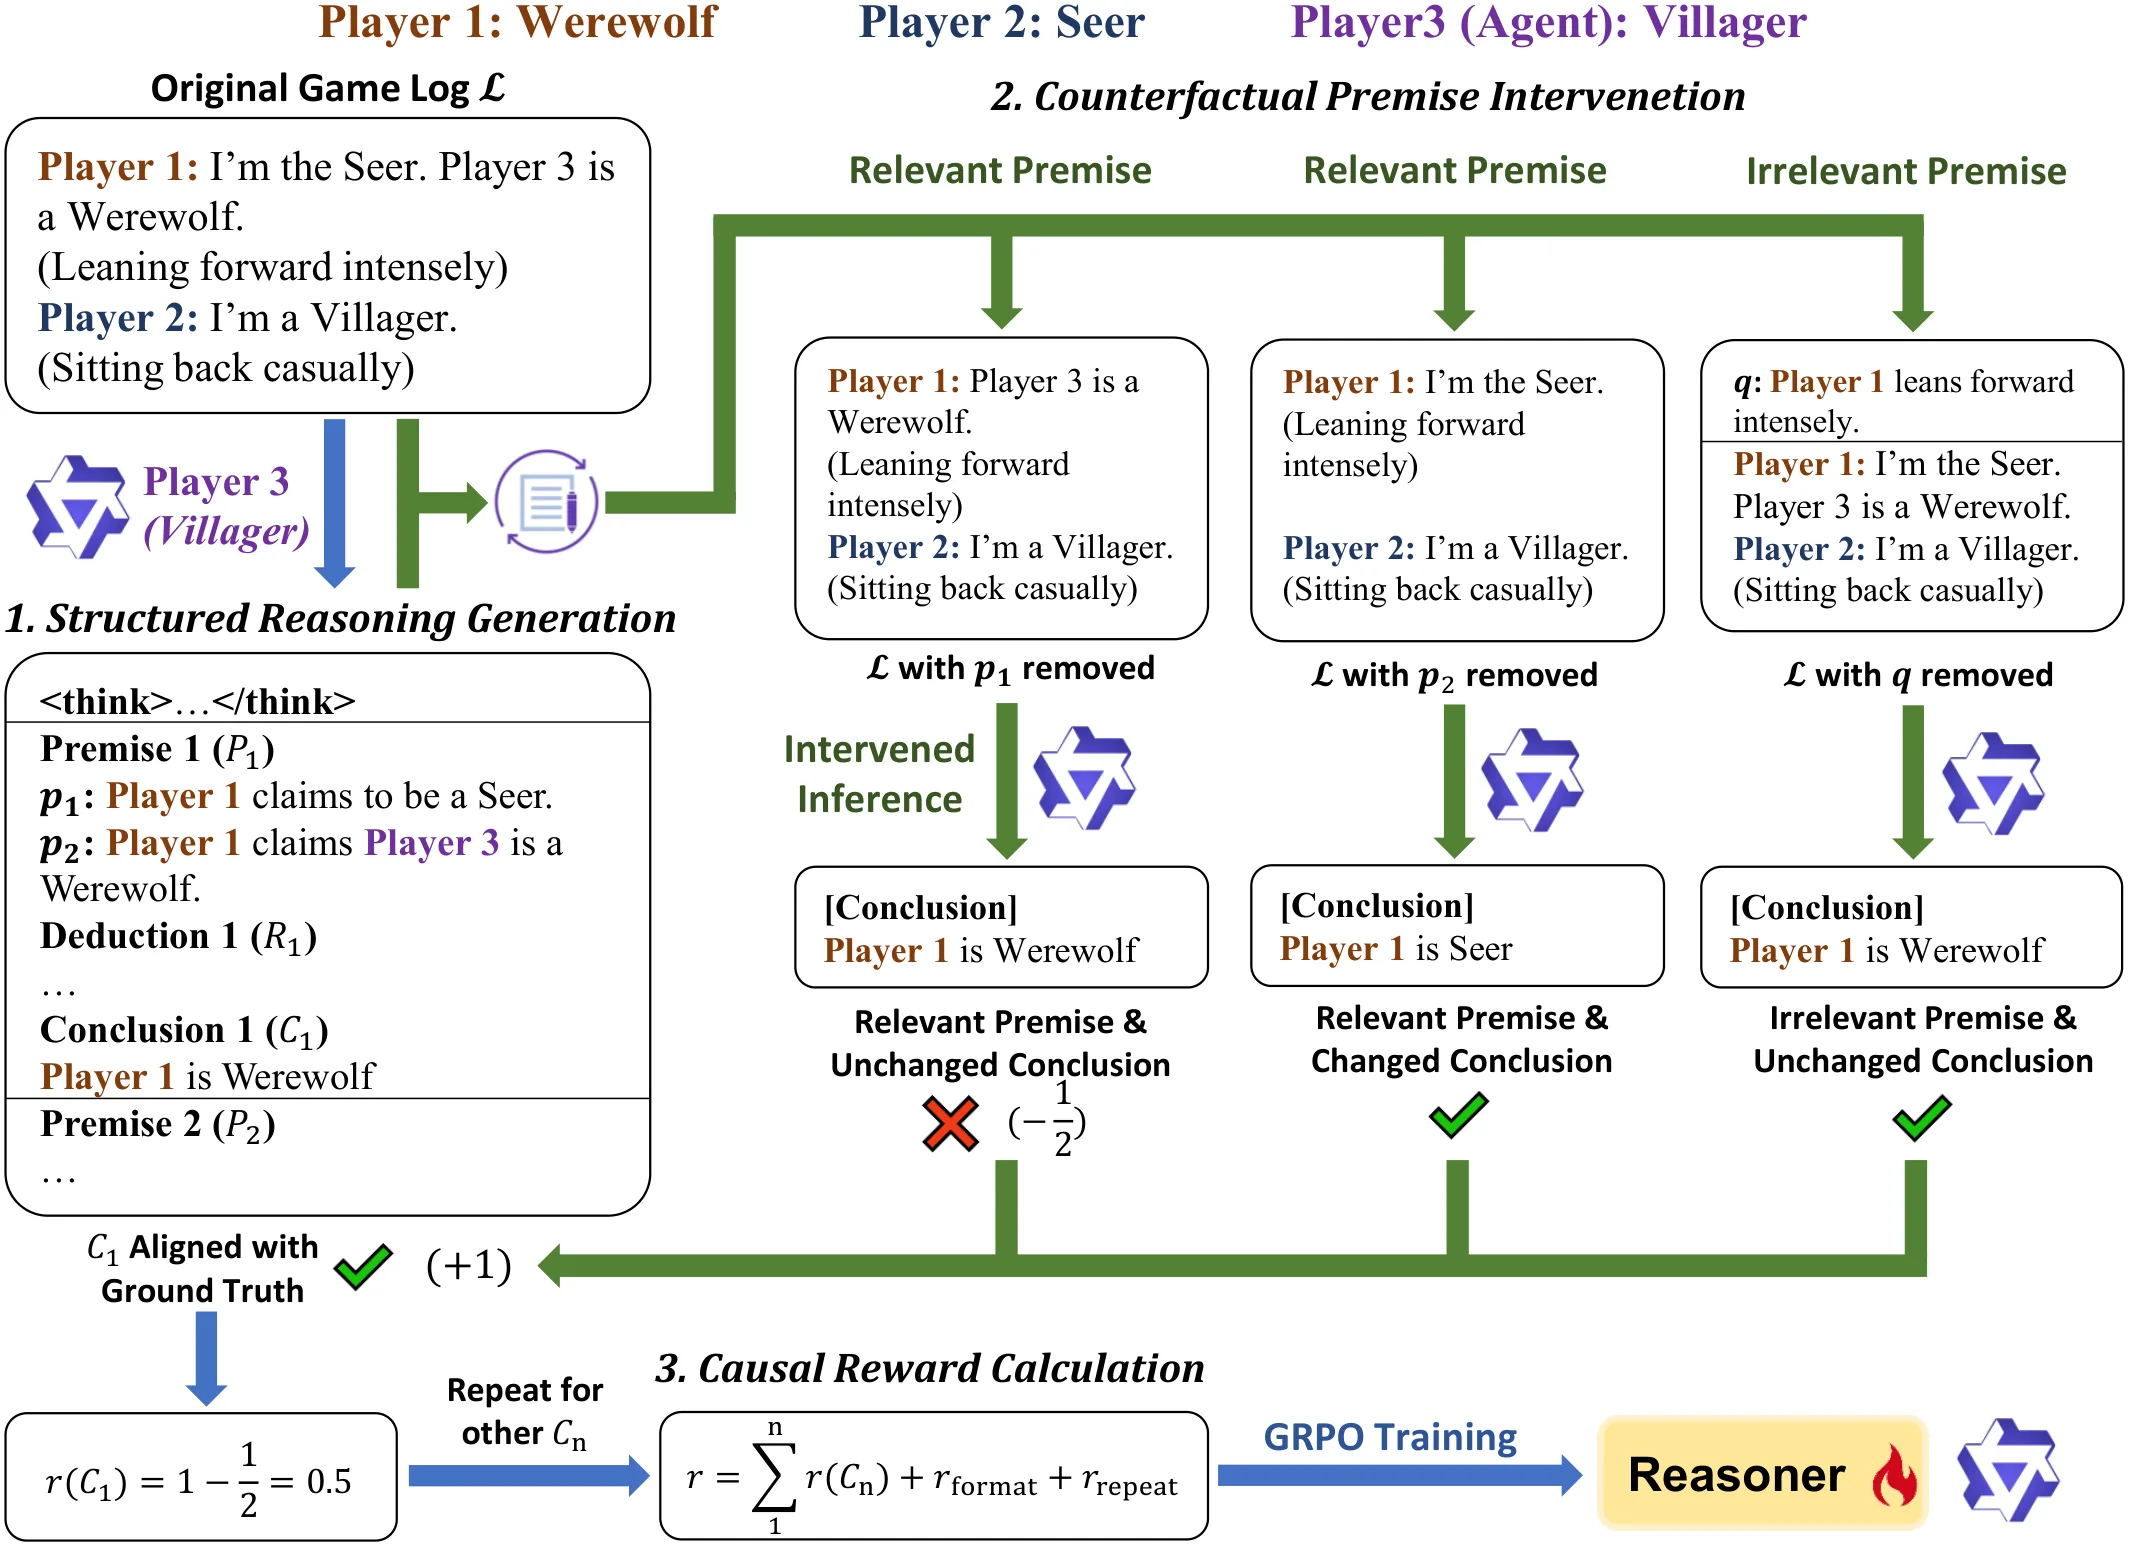
为了确保推理的忠实性——即结论确实由引用的证据「导致」而非来自模型偏见,CaM-Wolf 引入了[[反事实推理]]机制「反事实前提干预」(Counterfactual Premise Intervention)。具体而言,对于每个预测正确的三元组,系统会执行两类干预测试:其一为相关前提干预,随机移除 中的某一前提 ,然后让模型在「缺失该证据」的新情境下重新推断角色 ;其二为无关前提干预,随机移除其他识别中的前提 ,同样观察结论是否变化。如果移除相关前提导致结论改变(),说明该前提确为「因果证据」;反之则说明模型依赖了幻觉信息。通过这种「假设检验」式的验证,系统能够自动识别并惩罚虚假推理。
基于上述分析,CaM-Wolf 设计了一套精细的奖励函数来指导 GRPO 训练。正确性奖励 评估结论是否与真实角色一致。忠实性奖励 则更微妙地处理两类错误:移除相关前提但结论未变意味着模型「说了假话」——引用了证据但实际未依赖它,此时给予惩罚 ;移除无关前提但结论改变意味着模型「没说全」——存在未被显式引用的隐性依赖,此时同样给予惩罚 。格式奖励与重复惩罚则确保输出符合结构化模板并避免冗余识别。总奖励函数综合考虑这些因素,引导模型生成既有准确结论、又忠实于证据链条的推理。
在执行层面,系统使用 EmotiVoice 将推理器输出的文本发言与语音风格描述合成为语音信号,再通过 OmniAvatar 将语音与视觉描述融合,生成口型同步、表情自然的动画化身视频。这种「端到端」的化身生成能力是 CaM-Wolf 区别于纯文本系统的关键——它使智能体能够以「类人」的方式呈现自我,而非冷冰冰的文字回复。
实验与结果
实验采用7人狼人杀配置(2狼人+1预言家+1守卫+3村民),通过自博弈生成500局游戏日志,从中随机采样3000个发言回合训练推理器。为验证各组件贡献,实验设置了多层对比:基线方法涵盖基于 prompt 的 ReAct、ReCon、SLA 以及基于训练的 LSPO;在公平性设计上,agent对战实验中各基线直接使用 CaM-Wolf 生成的多模态信息作为输入,绕过了感知模块的差异。
对战结果显示,CaM-Wolf 整体胜率达到70%,显著优于 ReAct(50%)、ReCon(54%)、SLA(57%)与 LSPO(58%)。更有趣的是分角色分析:担任村民阵营时,CaM-Wolf 胜率提升最为显著,从 ReAct 的24%跃升至52%,这表明因果感知推理对于「好人阵营」的推理需求尤为关键——好人需要更多基于证据的逻辑链条来识别狼人,而狼人则可依赖欺骗策略。角色识别准确率评测进一步印证了推理能力的提升:CaM-Wolf 达到32.6%,超过最佳基线27.6%约5个百分点。
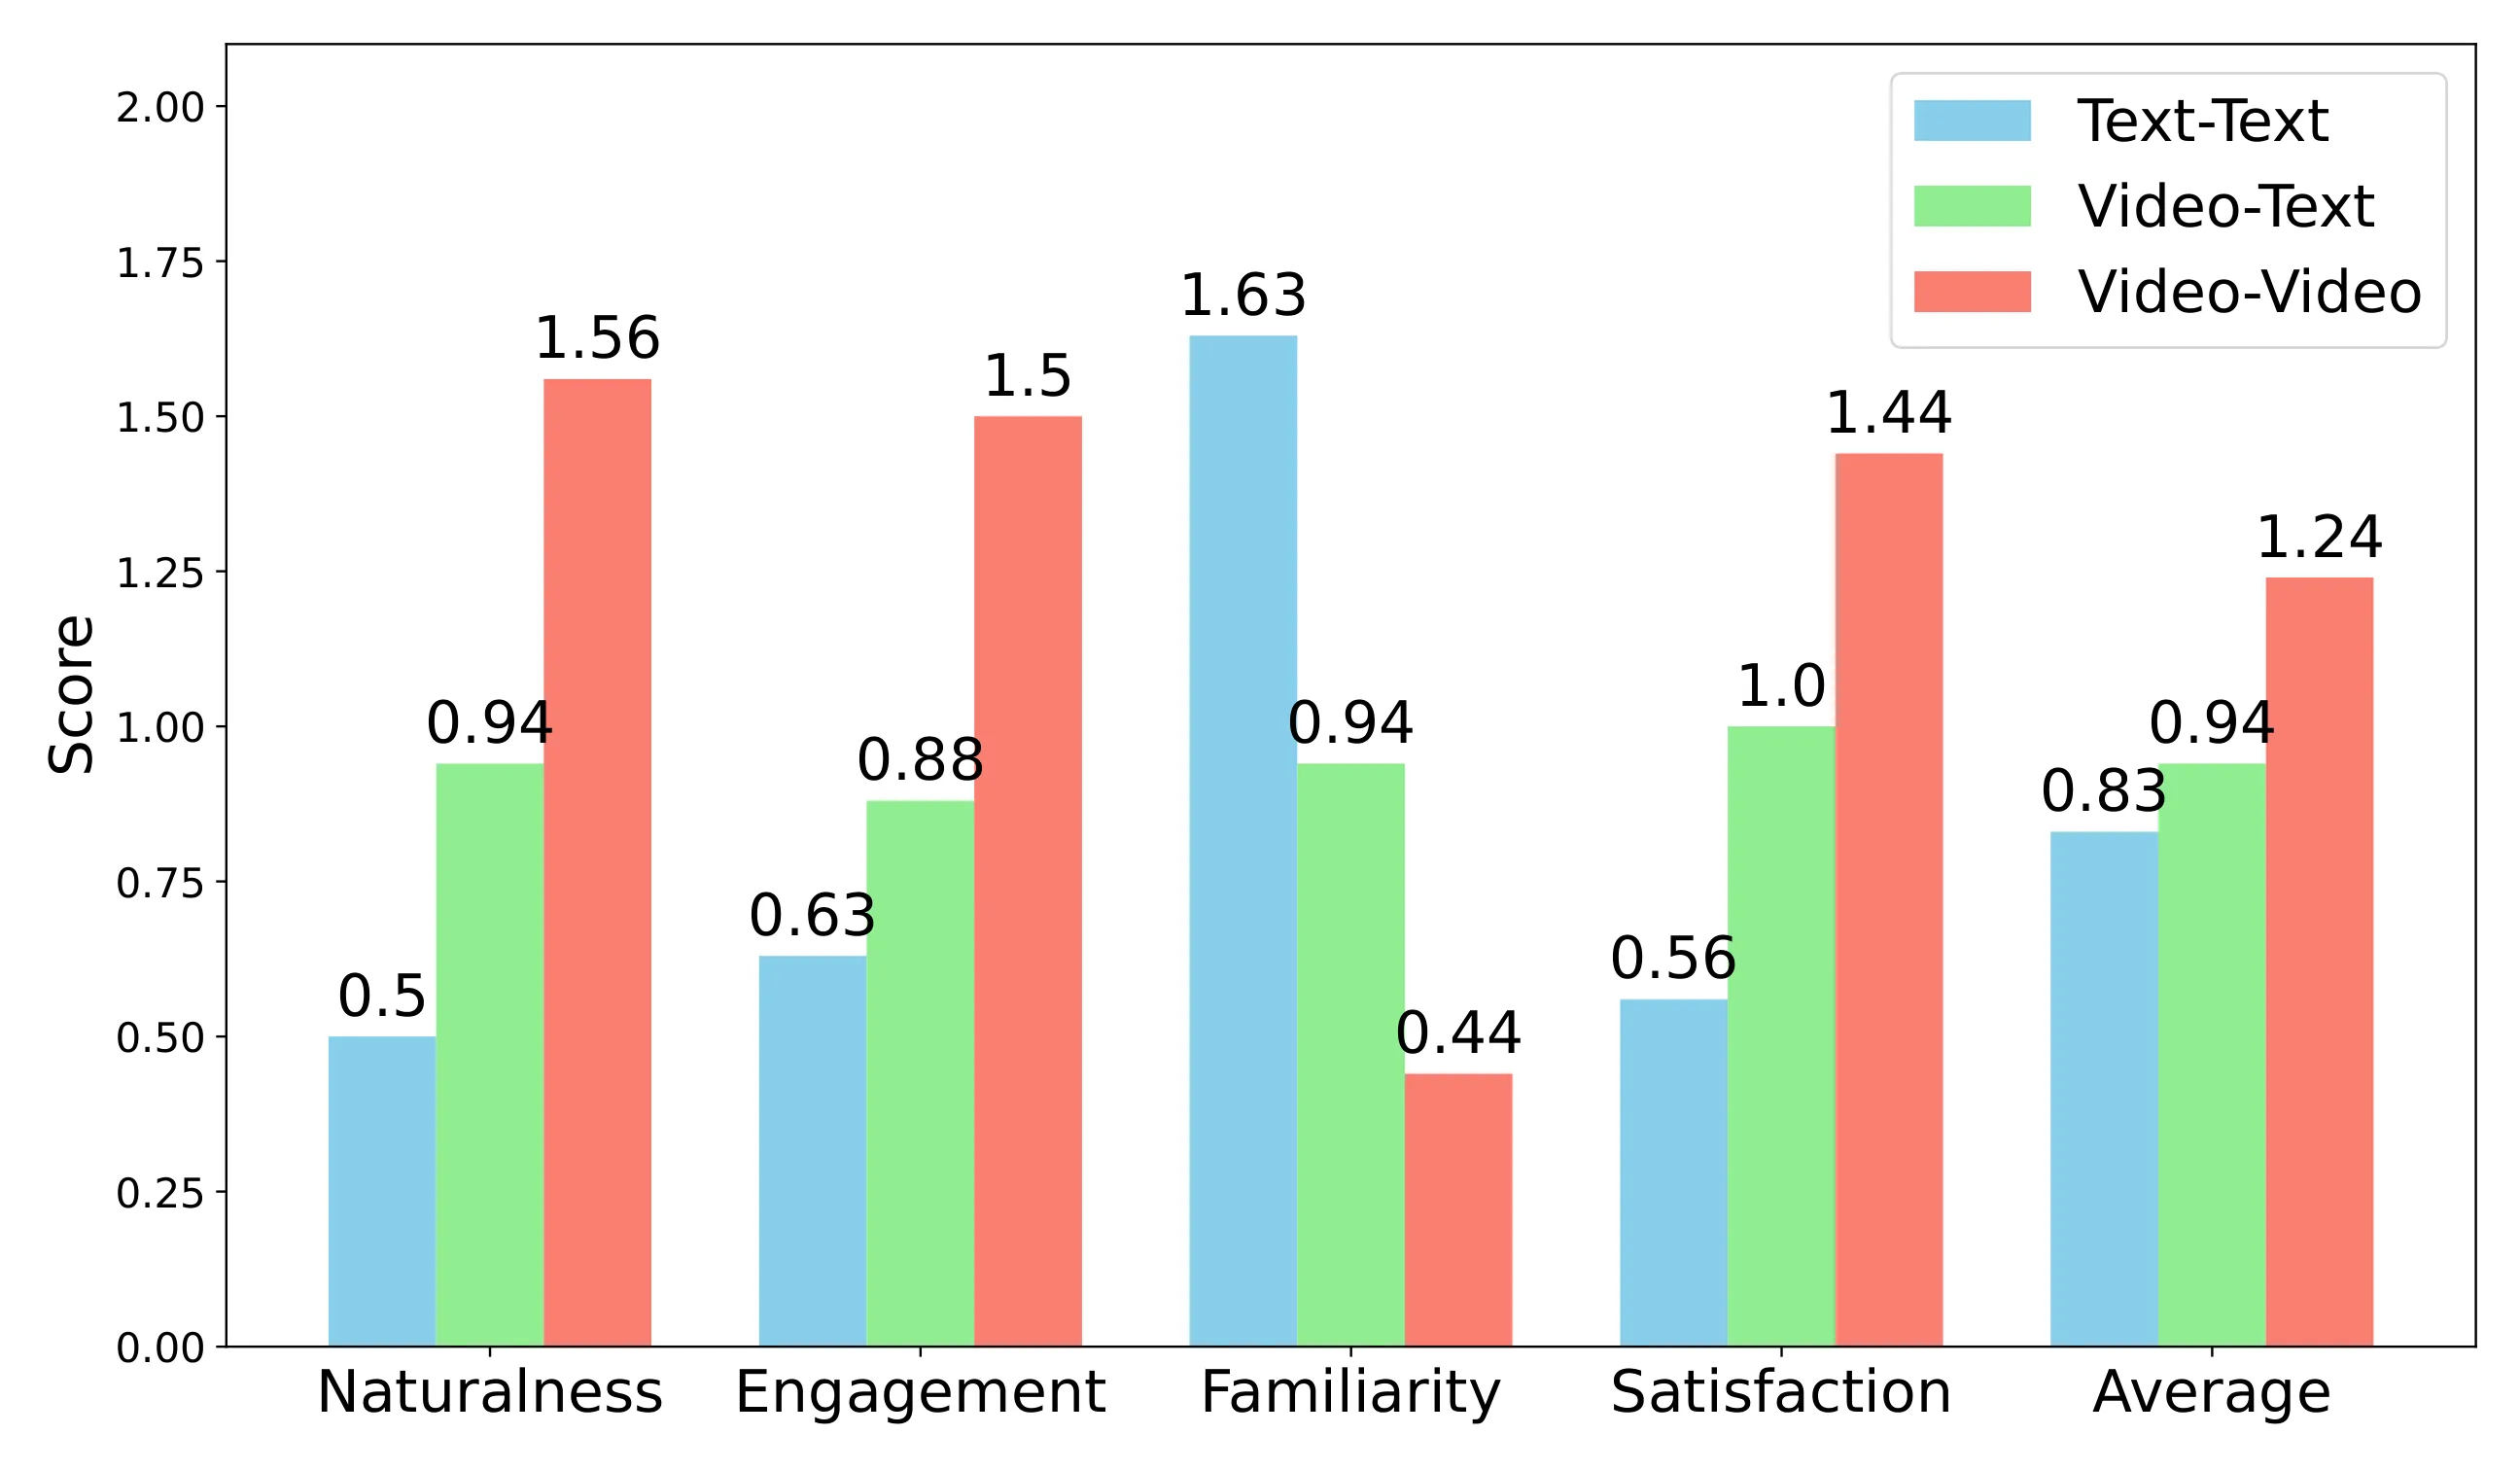
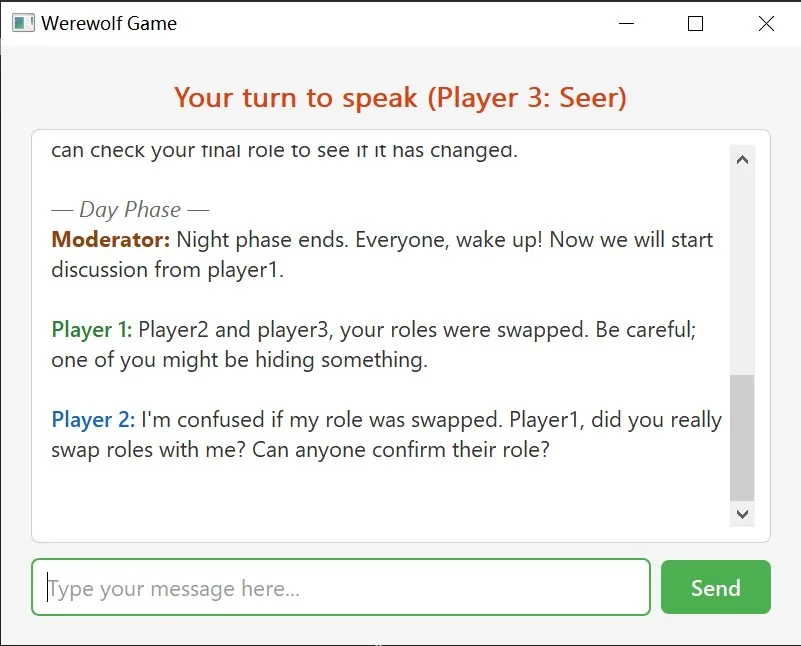
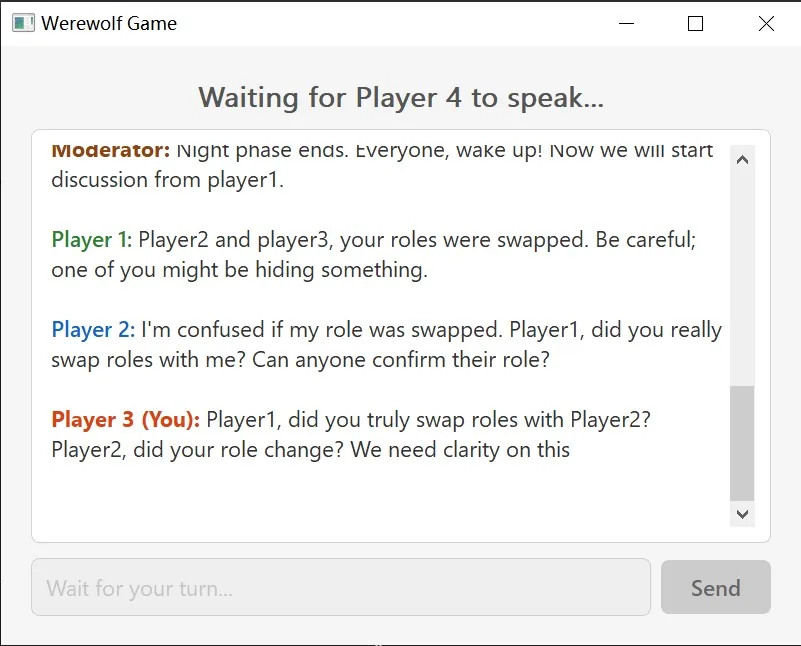
人类评估部分招募了16名志愿者,每位完成5局5人游戏。结果显示,CaM-Wolf 在人类对战中胜率最高(46.8%),且收到的总票数与来自人类玩家的票数均为最少(分别为0.21与0.05),这表明其发言策略能够有效规避怀疑、建立信任。交互范式对比实验设置了 Text-Text、Video-Text、Video-Video 三种条件,结果 Video-Video 范式在自然度、参与感与满意度三项指标上均显著优于其他两种,验证了多模态化身交互对用户体验的提升作用。
消融实验进一步揭示了各组件的贡献:移除自由形式推理会导致性能下降约3%,表明推理链条的可表达性影响推理质量;忠实性奖励的去除导致更大跌幅,说明因果验证机制对避免「幻觉推理」至关重要;两类前提干预的移除也均造成显著性能衰减,印证了反事实验证的有效性。
讨论与可借鉴点
CaM-Wolf 的核心贡献在于首次将多模态感知与生成能力引入社交推理游戏,并创新性地将因果推理思想融入强化学习训练框架。通过「反事实前提干预」机制,系统能够自动验证推理的忠实性,避免 LLM 常见的「幻觉推断」问题。这种「证据驱动的可解释推理」范式对于需要高度可信性的应用场景(如金融风控、医疗诊断)具有直接的借鉴价值。
然而,这项工作也存在若干局限。样本规模方面,人类评估仅包含16名参与者、每种条件5局游戏,统计功效有限;游戏配置也进行了简化(5人制而非训练时的7人制),这可能影响结论的泛化性。技术层面,GRPO 训练仅持续2个 epoch,尚未充分探索训练动态与超参数敏感性;感知模块对视觉质量的依赖也意味着在低光照或嘈杂环境下系统鲁棒性存疑。此外,实验仅验证了狼人杀一种游戏,未在 Avalon、Jubensha 等其他社交推理游戏或更大规模场景下测试泛化能力。
从方法论角度,CaM-Wolf 揭示了一个重要方向:[[因果推理]]与[[大语言模型]]的结合能够实现「可验证的推理」——不仅给出结论,还能追溯结论的因果依赖。这对于构建可信赖的 AI 系统具有深远意义。同时,「多模态社交智能体」的概念将 AI 研究从「文本对话」拓展到「类人交互」,为具身智能与人机协作开辟了新路径。未来工作可探索更复杂的欺骗策略建模、跨游戏泛化能力以及实时场景下的延迟优化。
摘要
游戏智能体采用强化学习方法
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
用于流媒体视频游戏中鲁棒且高效模仿学习的增广方法
Augmentations for Robust and Efficient Imitation Learning in Streamed Video Games
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 11 张
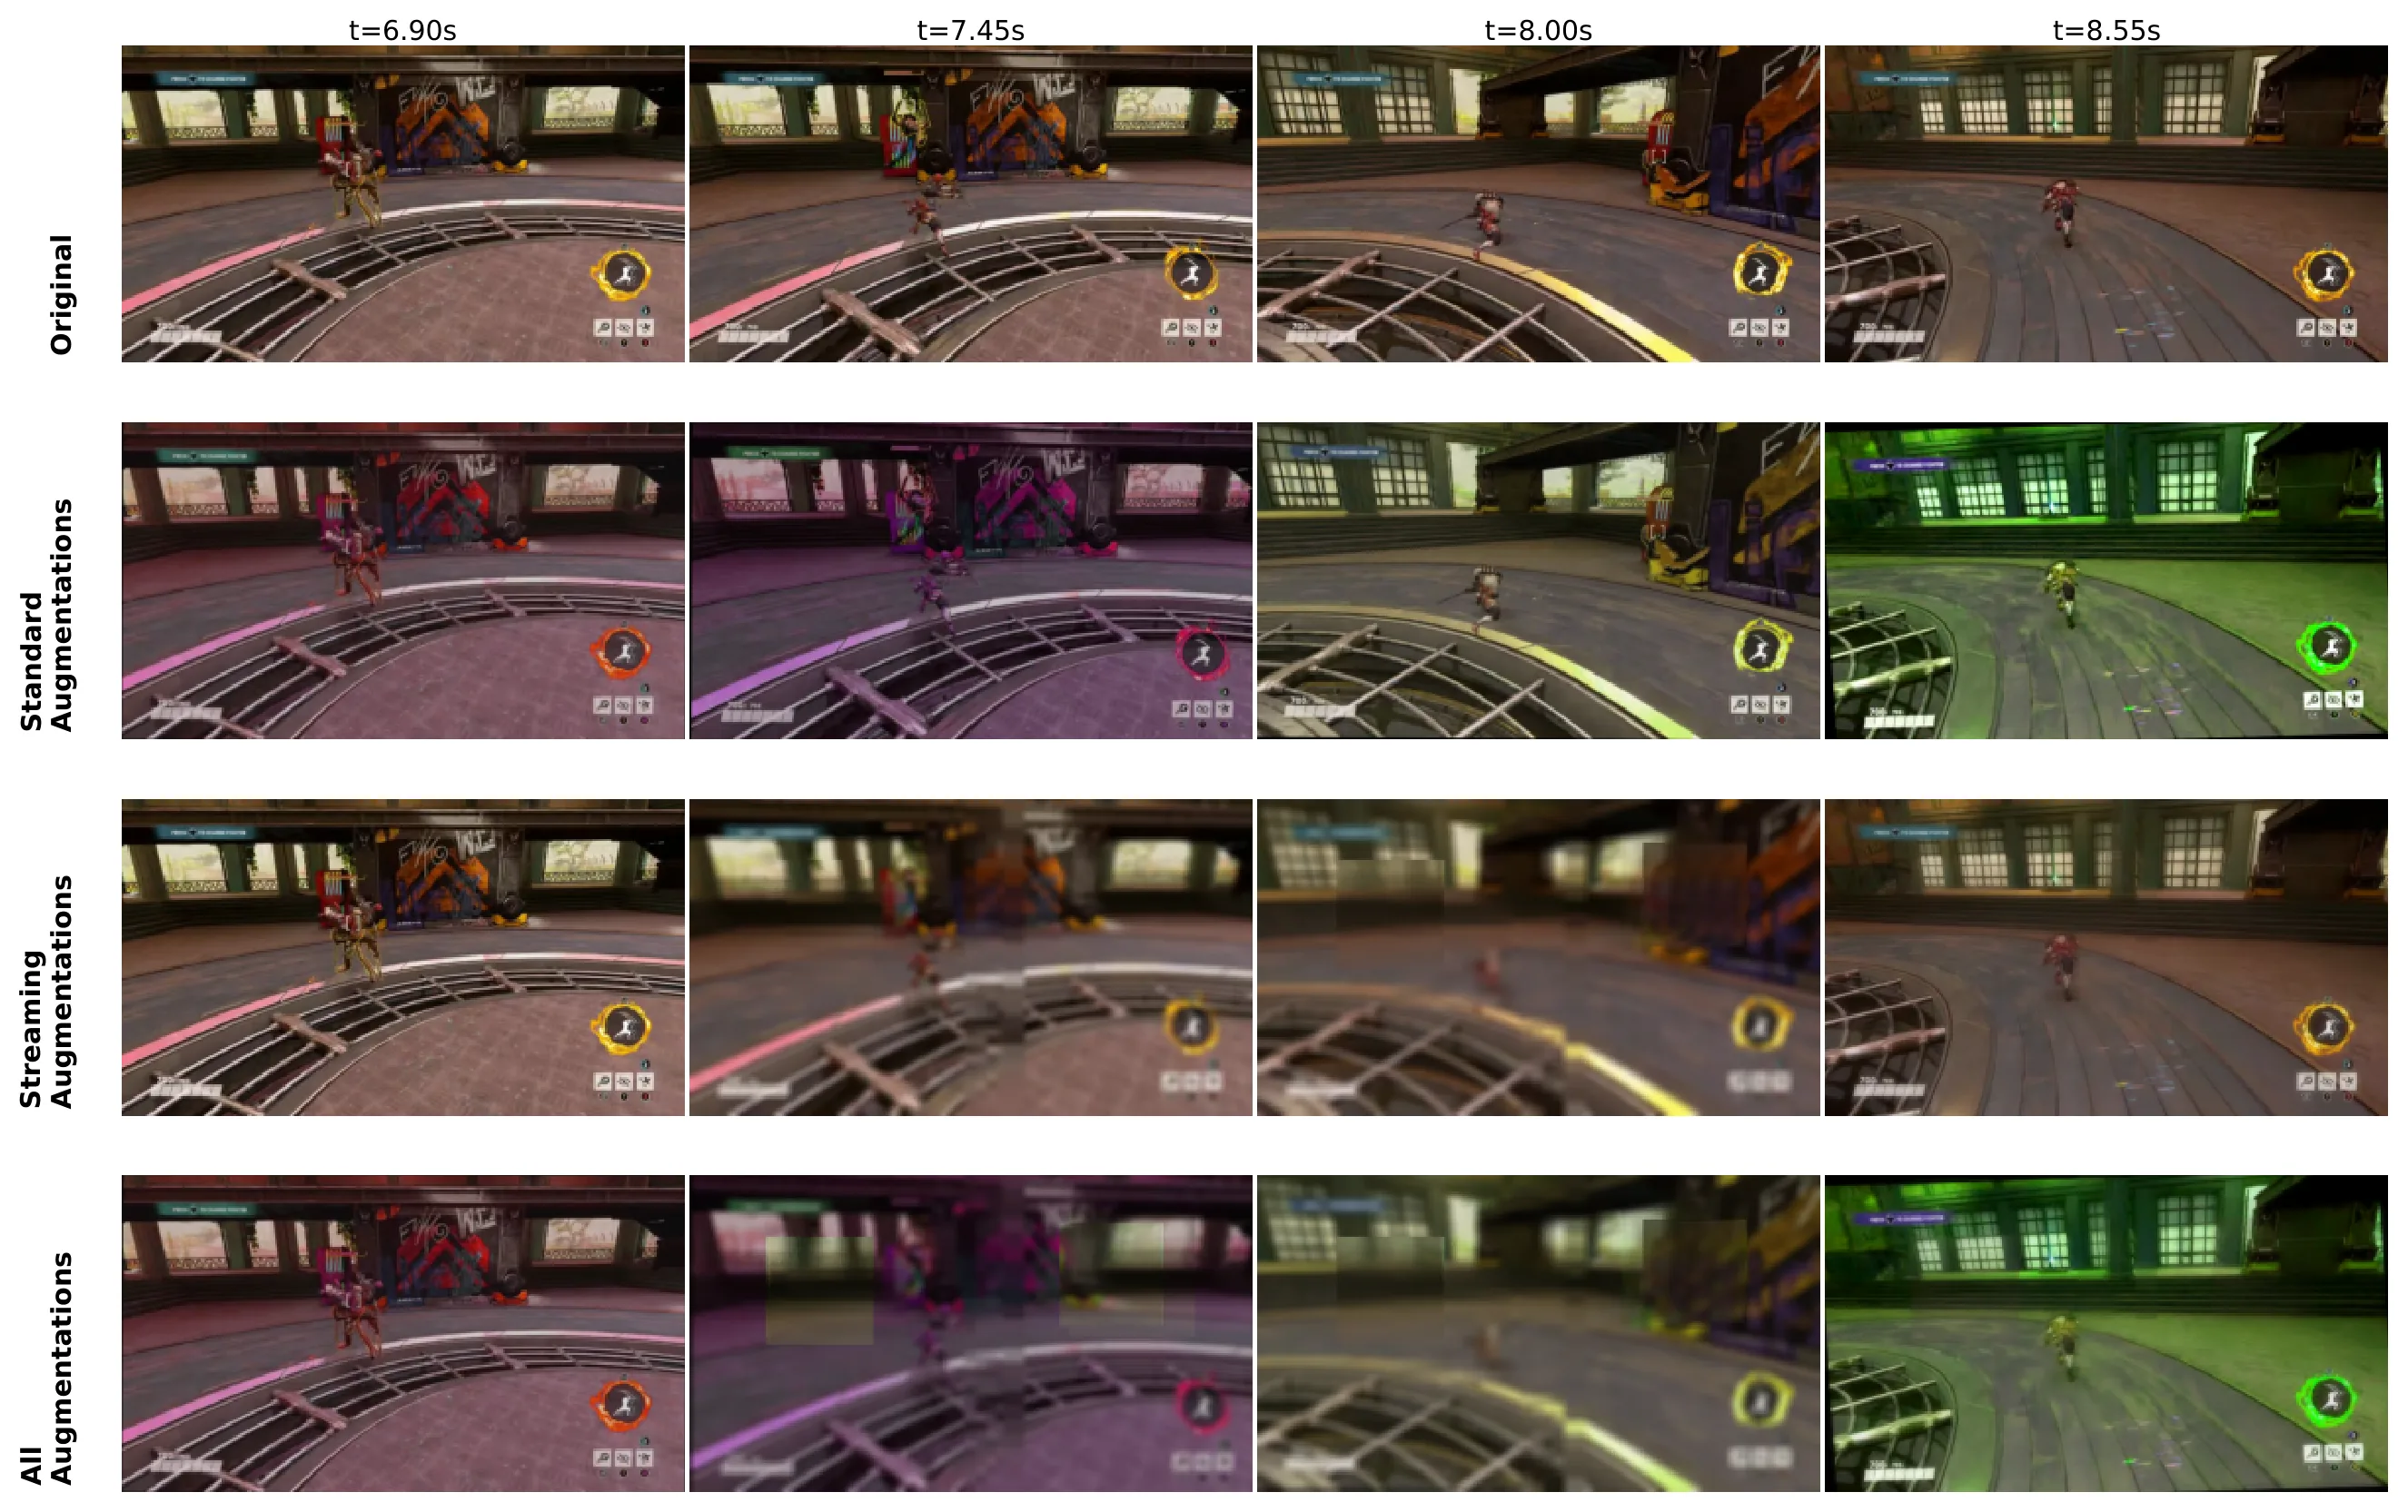
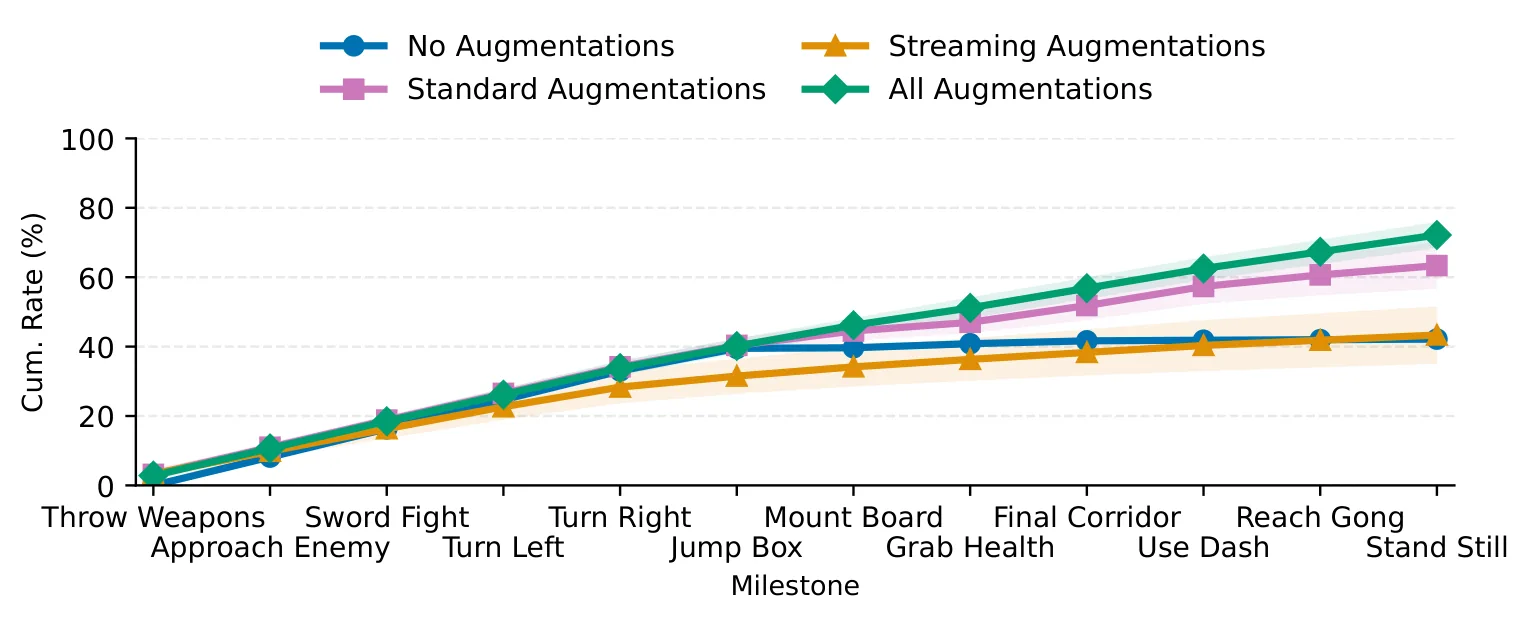
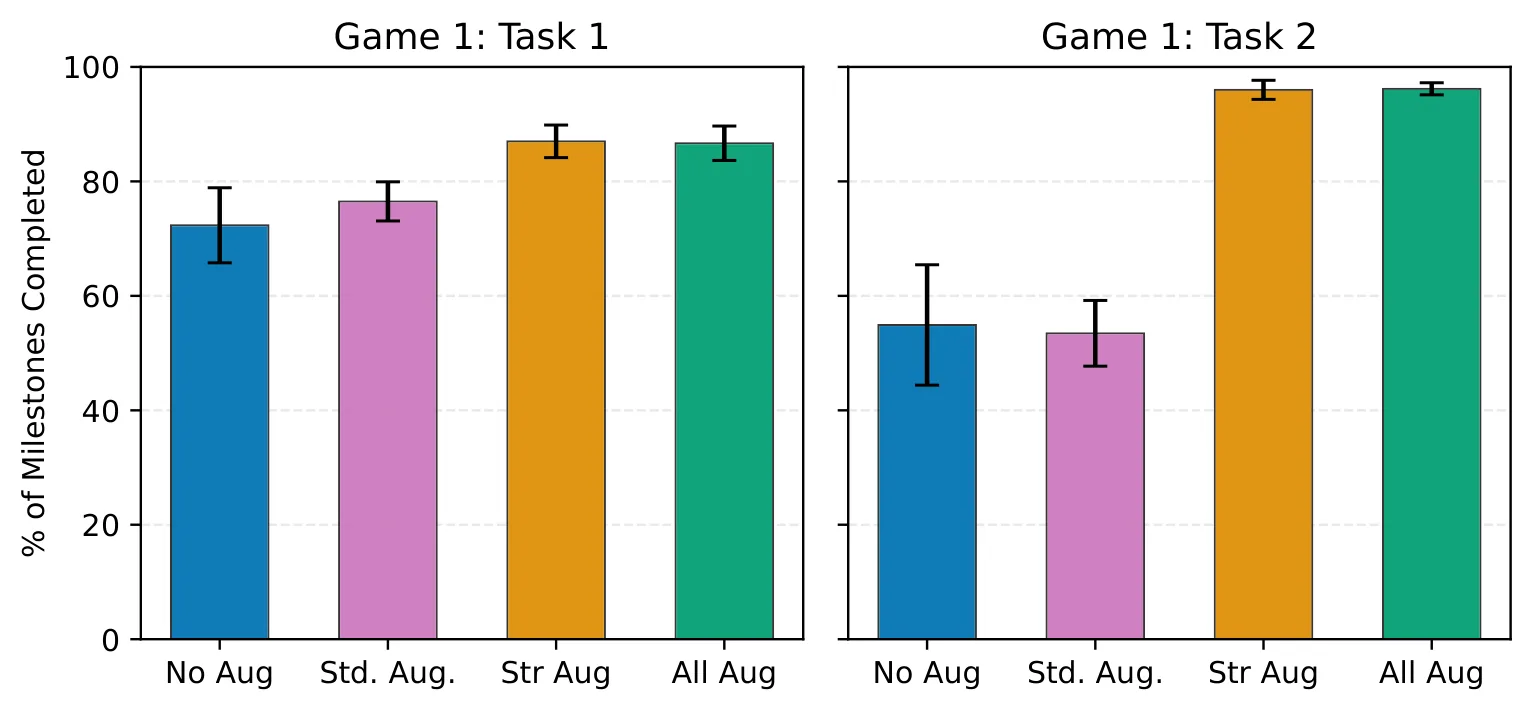
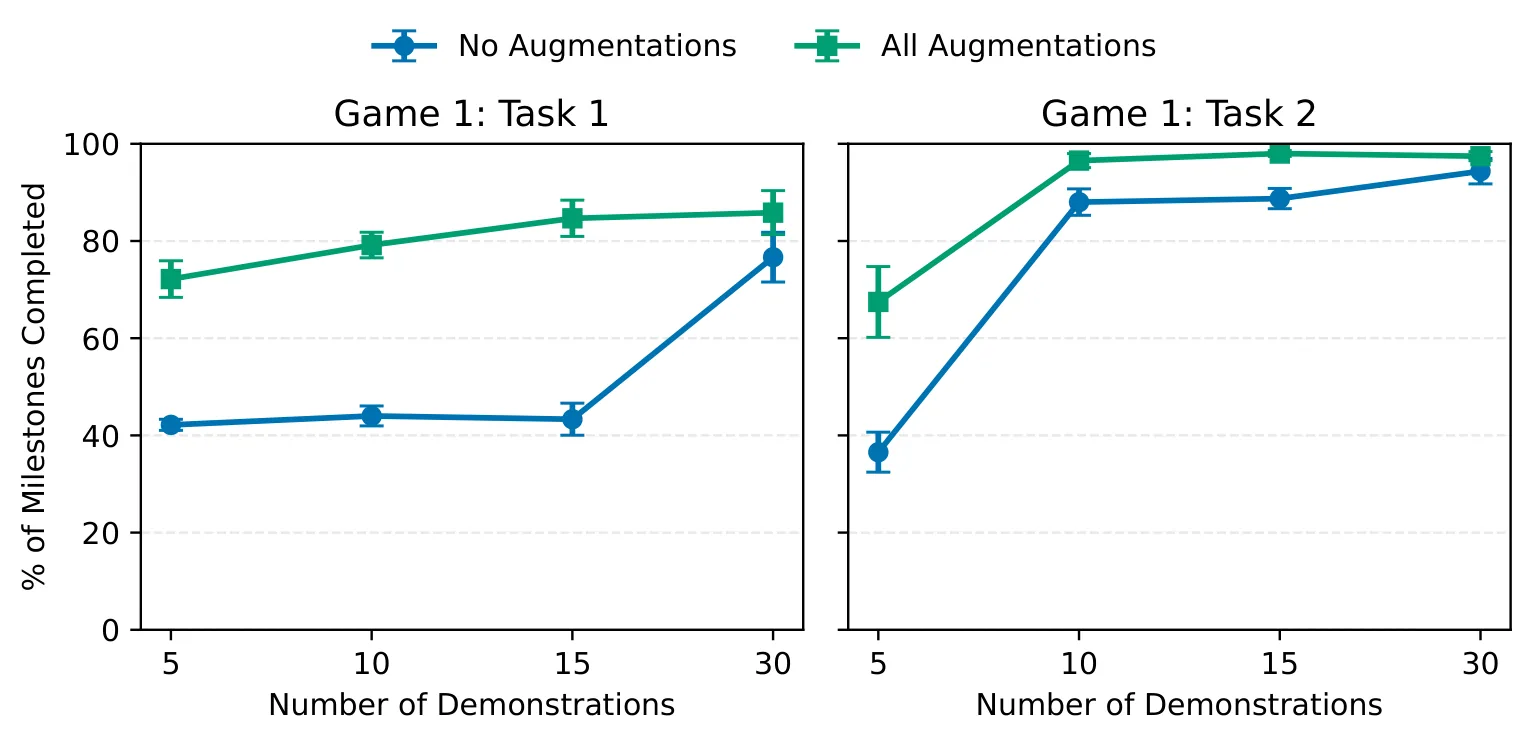
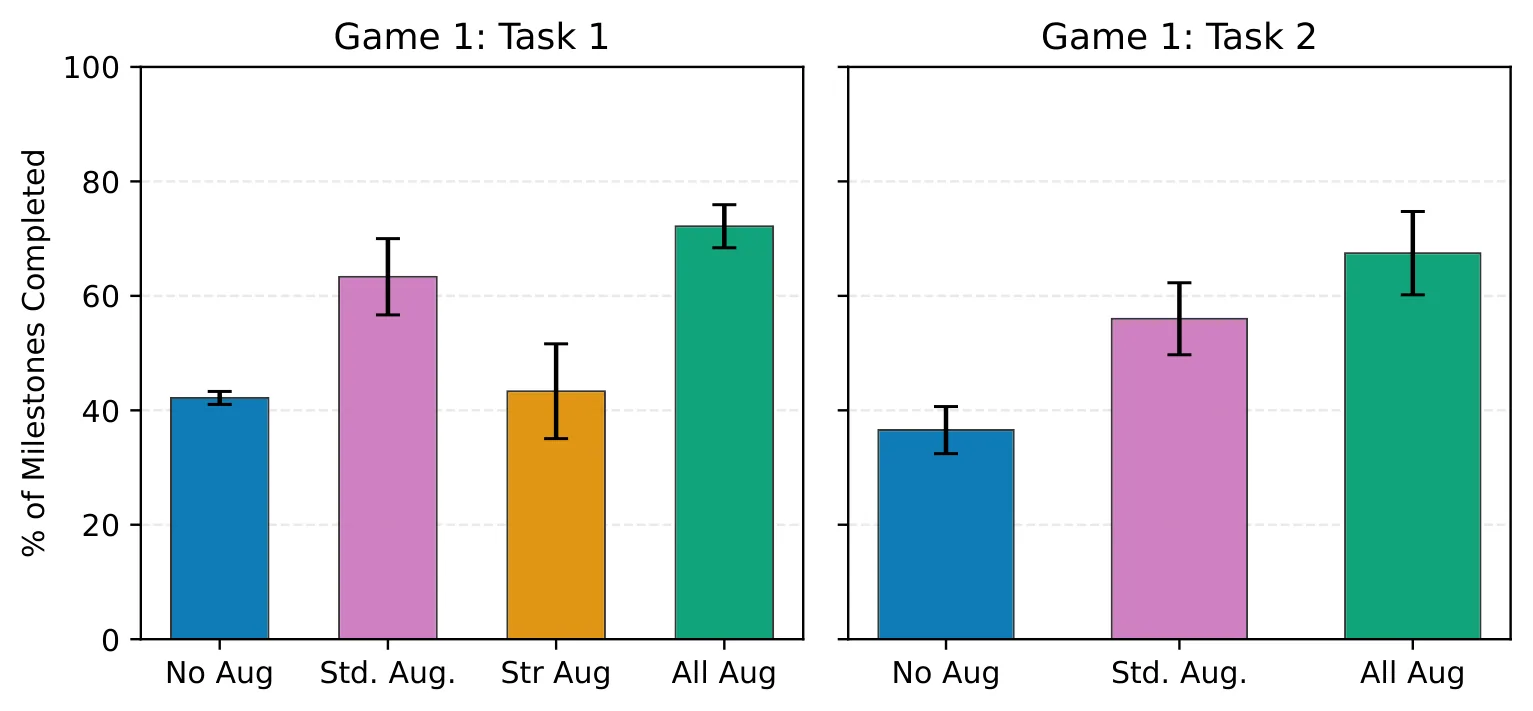
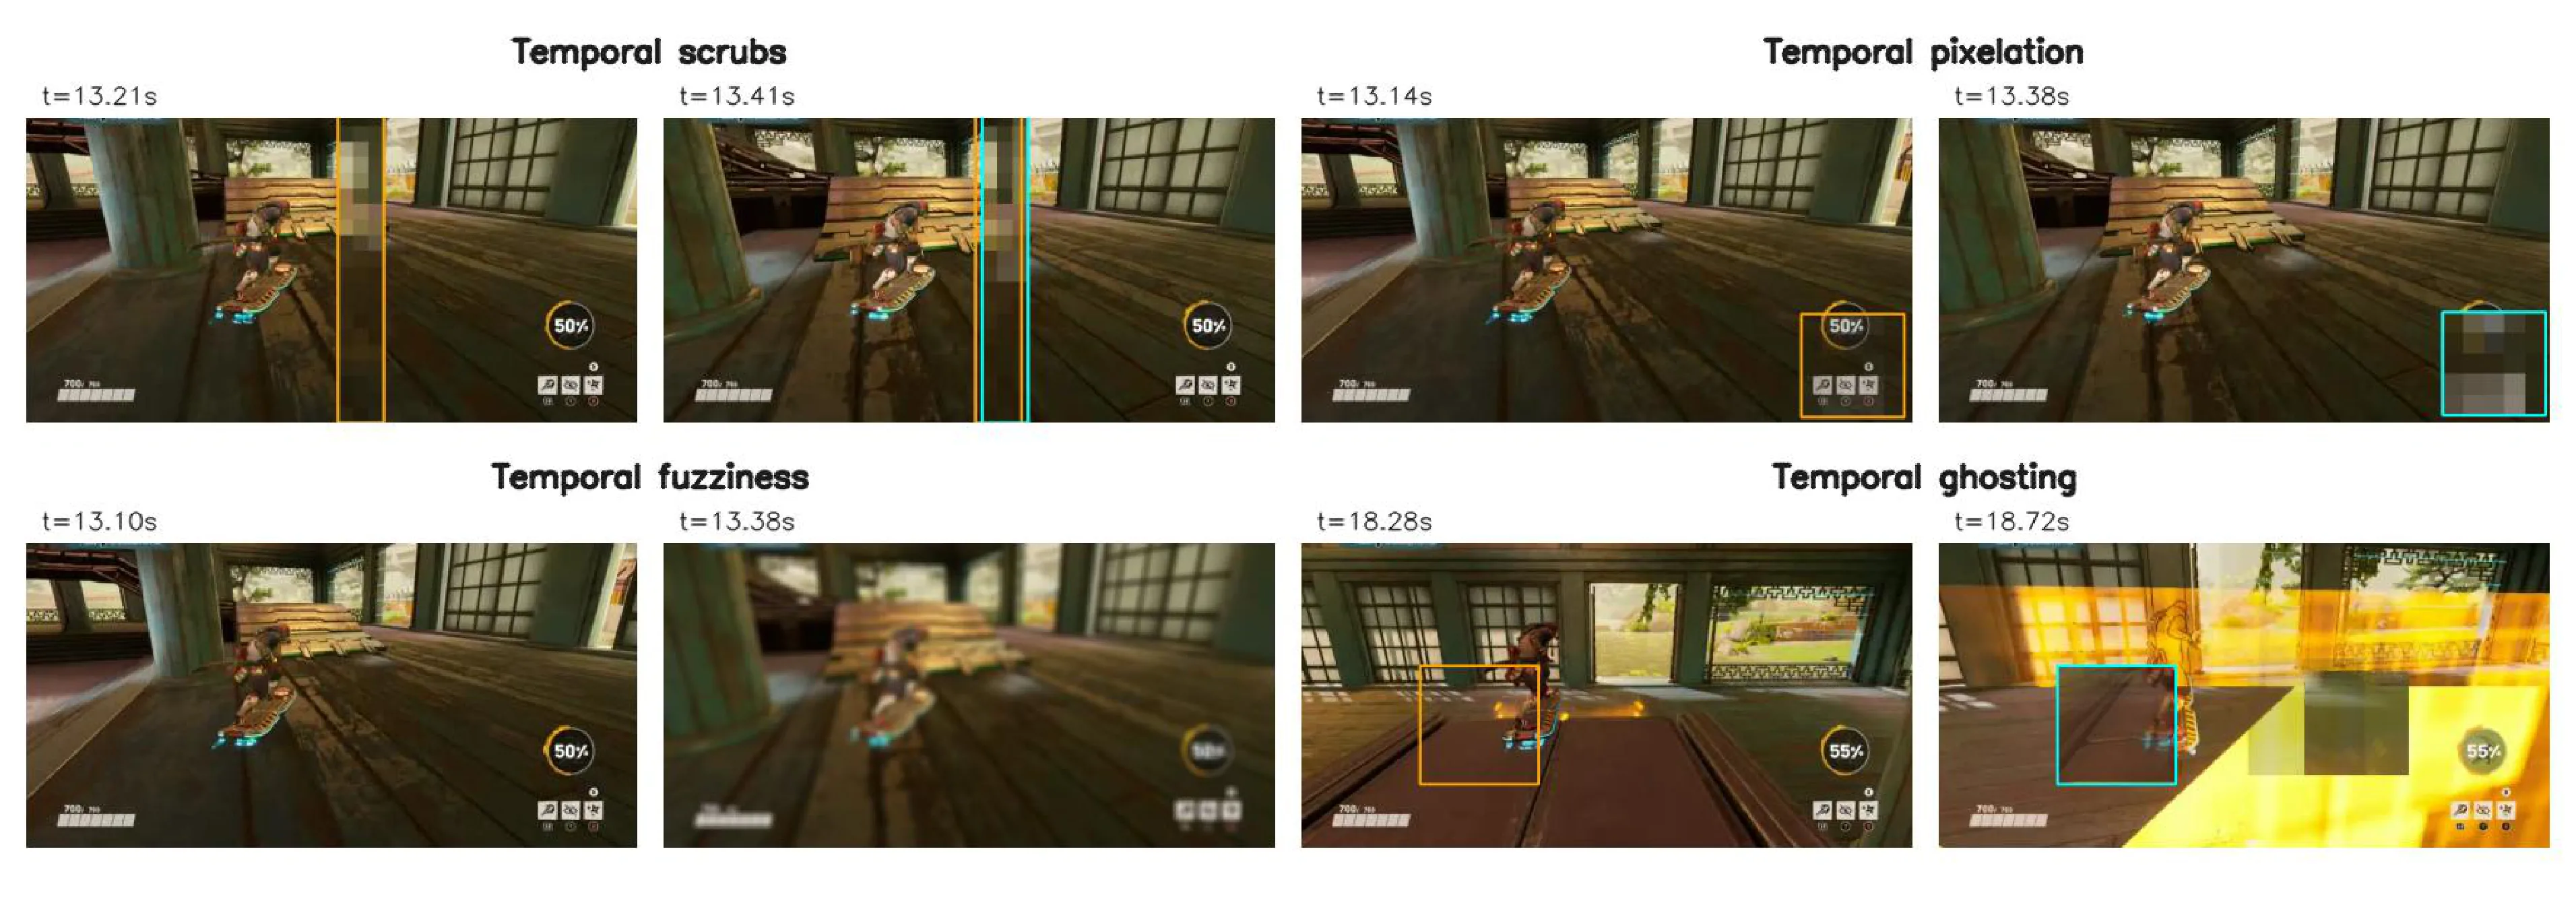
在流媒体3D游戏场景中,模仿学习训练游戏代理面临演示数据昂贵和网络传输引入时空伪影导致协变量偏移的问题。本文提出面向流媒体的四类时空数据增强方法(像素化块、抹除、全局模糊、鬼影),并基于预测逆动力学模型PIDM实现。实验表明该方法在稳定条件下性能提升最高达41%,在网络延迟场景下性能仅下降7.45%,显著优于基线49.82%的降幅。该工作证明针对流媒体特性设计的时空增强是提升游戏代理鲁棒性与数据效率的简洁有效手段。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
在三维复杂游戏环境中,让智能体学会像人类一样决策是一项极具挑战的任务。[[模仿学习]]提供了一条可行的路径:智能体通过观察人类玩家的视觉输入与对应动作,建立从观测到行为的映射关系。然而,这种方法在实际部署中面临两个核心困难。
首先,高质量的人类演示数据代价高昂。训练一个能在现代 3D 游戏中稳定运行的智能体,通常需要数千乃至数万帧的专家级演示,这些数据的采集与标注需要耗费大量人力与时间。其次,现代游戏越来越多地通过流媒体方式运行——玩家的客户端并不存储完整的游戏程序,而是实时接收服务器传输的编码视频流。这种架构虽然降低了客户端的硬件门槛,却也引入了网络传输特有的视觉伪影:带宽受限时画面会出现块状失真,网络波动时可能产生局部涂抹痕迹,帧率不稳定时会出现全局模糊,运动物体周围则可能留下重影(鬼影效应)。
这些伪影看似只是视觉层面的瑕疵,却会在测试时造成严重的[[协变量偏移]]问题。训练时智能体看到的是清晰完整的游戏画面,而部署时接收的却是带有各种伪影的流媒体帧。分布的微小变化足以让一个在干净数据上表现优异的策略完全失效,导致智能体性能断崖式下跌。如何在有限的演示数据上训练出对这类伪影具有鲁棒性的策略,成为一个亟待解决的问题。
方法
面对上述挑战,本文的核心思路是「既然无法改变网络条件,那就让智能体在训练时就习惯这些伪影」。具体而言,作者设计了一组四类时空数据增强方法,模拟低带宽网络连接下常见的视觉伪影类型。
像素化块状失真(Pixelated Blocks):模拟压缩编码时因码率不足导致的马赛克效果。该增强将图像划分为若干不规则块,对每个块进行不同程度的模糊或像素化处理,模拟局部细节丢失的情形。直觉上这与 JPEG 压缩的块效应相似,但本文的策略更加可控,能够独立调节每个块的失真强度。
抹除(Scrubs):对应网络传输中的帧丢弃或局部解码失败。实现方式是在图像上随机选择若干矩形区域,将其替换为前一帧的对应内容或纯色块,从而制造出时间上的不连续感。这种伪影在网络波动时尤为常见。
全局模糊(Global Blur):模拟帧率下降或运动模糊导致的整体清晰度降低。通过高斯滤波对整个图像进行模糊处理,模糊核的大小作为超参数控制模糊程度。这一增强的直觉来源于:当网络带宽严重受限时,编码器往往会降低分辨率或增加帧内预测强度,从而导致画面整体变糊。
鬼影(Ghosting):模拟物体运动时前后帧信息混合产生的残影效果。实现时将当前帧与前一帧按一定权重叠加,生成带有拖尾感的视觉输出。这种伪影在帧率不稳定或使用双线性插值的流媒体系统中较为常见。
在模型层面,本文选择了预测逆动力学模型(PIDM)作为基架。PIDM 的核心思想是在[[潜空间]]中同时完成两件事:其一,学习一个前向世界模型,根据当前状态和动作预测下一状态;其二,训练一个逆向动力学模型,根据当前状态与「期望的未来状态」反推应该采取的动作。关键设计在于「未来状态条件化」机制——即便当前观测带有伪影,智能体也可以利用预测的未来状态来校正决策,从而在存在扰动的情况下仍能保持策略的连贯性。
时空增广与 PIDM 的结合产生了协同效应。空间层面的伪影(像素化块、模糊)迫使逆向动力学模型学会从残缺信息中推断关键特征;时间层面的伪影(抹除、鬼影)则让前向模型在状态转移存在噪声时依然能够可靠预测。这种多层次的扰动注入,使得训练出的智能体对各类网络异常都具有较强的容忍度。
实验与结果
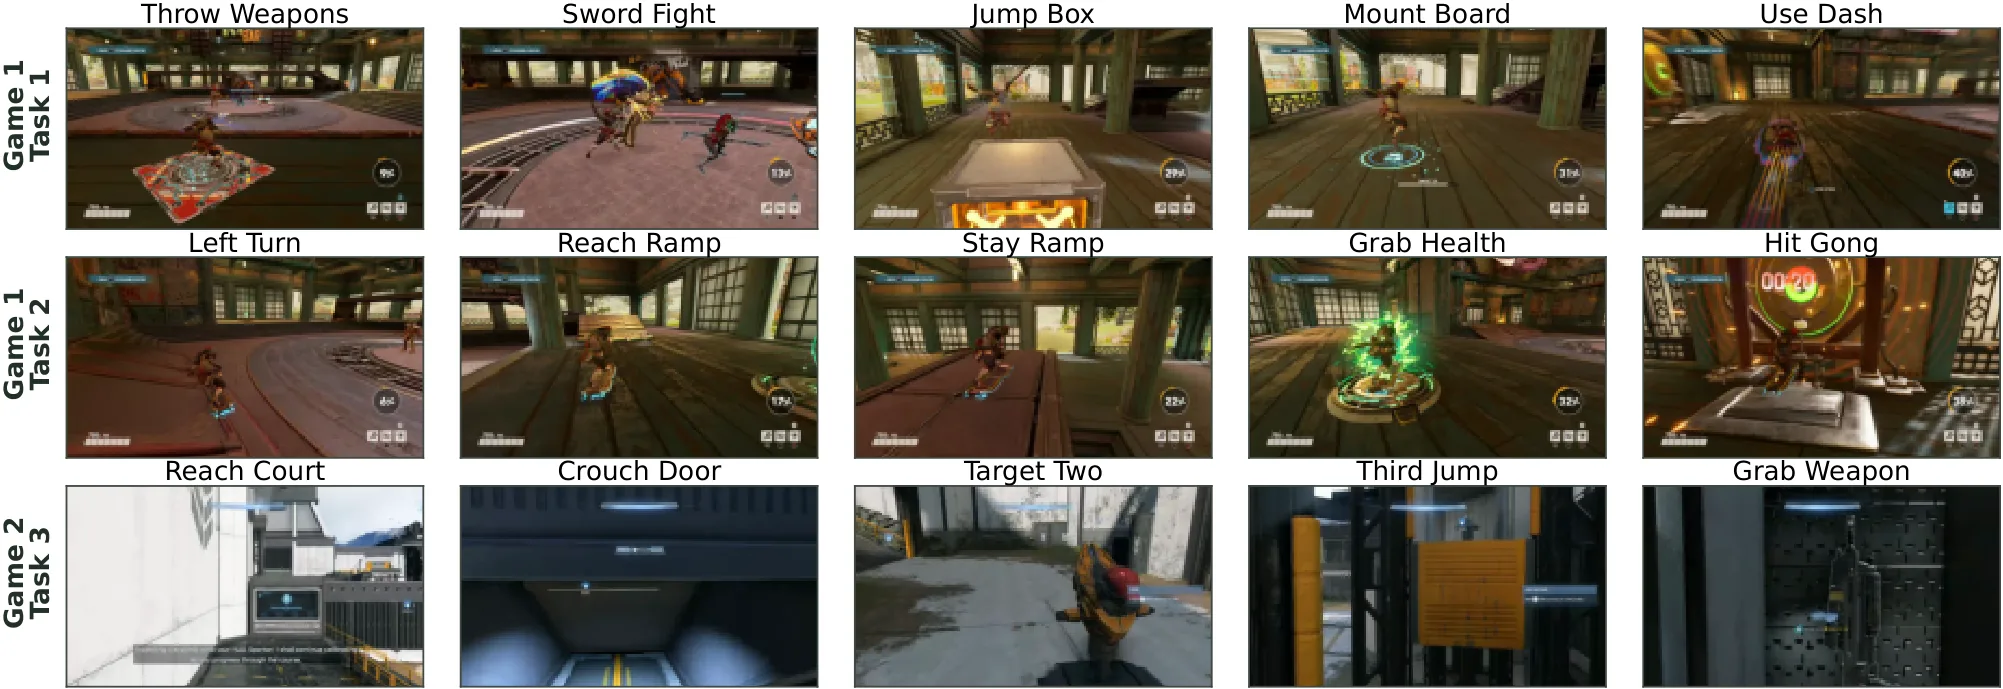
实验在现代三维视频游戏的三个任务上进行,涵盖了不同难度等级的场景。评估指标采用任务成功率与累积奖励的标准化得分。
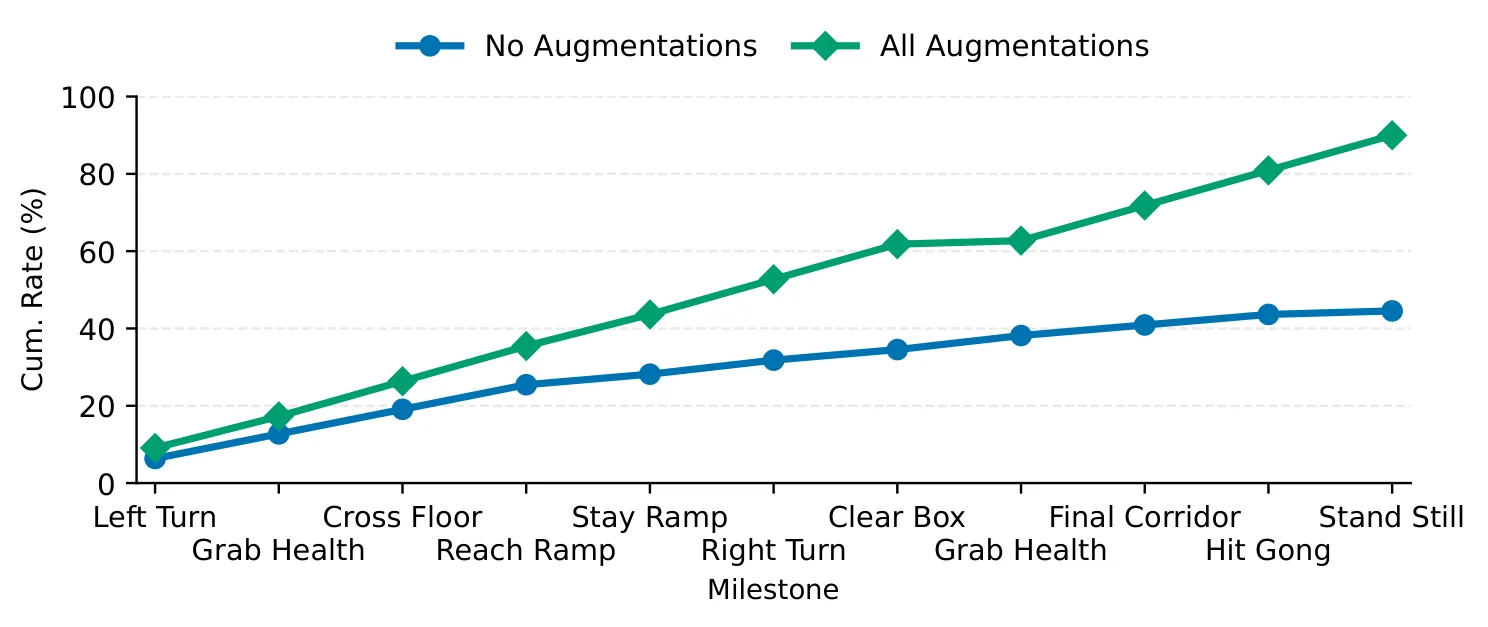
在数据效率方面,研究者对比了使用和不使用增广的训练方案,控制两侧消耗的演示数据量完全相同。结果显示,在稳定流媒体条件下,使用时空增广训练的智能体相比基线最高可提升 41% 的评估性能。这一数字背后反映的是:增广实际上扩充了训练分布的覆盖范围,使得智能体在相同数据预算下接触到了更丰富的视觉变体。
鲁棒性测试则引入了受控的网络延迟模拟。结果极具说服力:当延迟增加时,仅用原始数据训练的智能体性能下降幅度高达 49.82%,几乎折半;而使用增广训练的智能体性能仅下降 7.45%。这意味着增广策略使智能体对网络波动具有了极强的抗干扰能力,在真实流媒体环境中具有重要的实用价值。
消融实验进一步揭示了各类增广的贡献占比。结果表明,四种增广方法存在一定互补性——单独使用任一种都无法达到全部四种联合使用的效果。其中,像素化块状失真和全局模糊对空间扰动的补偿作用最为显著,而抹除和鬼影则在时间一致性维护上更为关键。
讨论与可借鉴点
这项工作的一个重要贡献在于提出了「针对特定部署场景设计[[数据增强]]」的方法论范式。传统观点认为数据增强只是锦上添花,用于扩充数据量或轻微提升泛化能力;而本文证明,在明确知晓测试分布偏移方向的情况下,精细设计的增强策略可以成为决定性因素。特别是在流媒体游戏这类网络条件多变的场景中,提前在训练阶段模拟真实部署中的扰动分布,是一种成本极低的鲁棒化手段。
从更宽广的视角看,这一思路与对抗训练、领域自适应等领域存在深层联系。核心问题都是「训练与测试分布不一致时如何保证性能」,只是本文选择了在输入层面进行分布对齐这一相对直接的方式。未来可探索的方向包括:将增广策略与更先进的[[潜空间]]建模方法结合,进一步压缩所需演示数据量;或将该框架迁移到其他流媒体应用场景,如云游戏、自动驾驶远程操控等。
局限方面,四类增广方法虽然覆盖了主流的网络伪影类型,但可能无法涵盖所有真实场景中的异常情况。此外,增广强度的超参数调优目前依赖人工经验,尚缺乏自动化的强度校准机制。
摘要
面向3D游戏环境的鲁棒模仿学习增强方法
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
通过心理学奠基的推理与角色感知策略优化改进通用角色扮演智能体
Improving General Role-Playing Agents via Psychology-Grounded Reasoning and Role-Aware Policy Optimization
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 7 张

通用角色扮演智能体难以忠实刻画自然语言描述的角色,现有监督微调方法仅做表面行为模仿,缺乏深层思维过程,导致分布外泛化能力差。本文提出心理学基础思维链框架Psy-CoT,将响应前推理分解为交互感知、心理共情与逻辑构建三步,并设计角色感知策略优化RAPO,通过画像-词元互信息对梯度进行非对称加权,缓解奖励黑客问题。在CoSER、CharacterBench、CharacterEval三个基准上,Psy-CoT与RAPO均超越现有方法。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
让大语言模型扮演任意自然语言描述的角色,是通用角色扮演智能体的核心目标。然而现有主流范式——[[监督微调]]——面临一个根本性的局限:它只鼓励模型模仿训练数据中出现的表面行为模式,模型学到的是「在这种情况下通常这样说」,而非「这个角色为什么会这样说」。这种学习方式在分布内或许能蒙混过关,一旦遇到训练集中未曾出现的交互场景,模型就容易说出与角色人设相悖的话,泛化能力严重不足。
与此同时,基于 [[强化学习]] 的方法虽然能通过 [[奖励模型]] 提供更精细的反馈信号,但作者发现了一个棘手的[[奖励黑客]]问题:通用型短语(比如「根据我的理解」「作为一个AI」)和真正角色专属的表达(如特定角色的口头禅、独特的说话风格)在奖励模型那里往往获得相近甚至相同的分数。这导致两类差异巨大的词元在梯度更新时收到一致的信号,模型逐渐被误导,将「安全但不角色」的表达方式与「角色鲜明但可能触发奖励波动」的表达视为同等优选。最终训练收敛到一个尴尬的中间态——既不像角色,也不完全通用。
如何在保留结构化推理能力的同时,让强化学习信号真正区分「角色专属」与「通用安全」?这是本文要解决的核心问题。
方法
论文的解法分为前后相继的两层:先解决「怎么想」,再解决「怎么学」。
Psy-CoT 思维链框架的设计灵感来自心理学对人类角色扮演行为的分析。研究者认为,一个优秀的角色扮演者并非机械复刻台词,而是会经历三个内部认知步骤:感知当前对话的交互语境,理解对方话语背后的意图与情绪;代入角色的心理状态,产生共情式的理解;最后基于角色价值观和当前情境,推理出符合角色的回应逻辑。
对应到模型层面,Psy-CoT 将推理过程显式地分解为三个阶段。交互感知阶段让模型分析对话历史,识别当前交互的核心主题、情感基调和对话意图。心理共情阶段要求模型从角色设定档案出发,模拟角色的认知框架和情感反应——这一步尤为关键,它确保模型不是在「猜测角色会怎么说」,而是在「以角色的方式思考」。逻辑构建阶段则将感知到的交互信息和共情结果整合起来,生成一条连贯的推理链,最终导向回复内容。
这三步推理并非简单的 prompt 工程,而是一种训练时注入的能力。模型通过学习角色专属的思考方式,而非表面行为模式,获得了更稳健的 [[分布外泛化]] 能力。
然而,光有思维链还不够——结构化推理定义了「什么是好的思考路径」,但不能保证模型在 [[强化学习]] 训练中真正沿着这条路径优化。这就是 RAPO 要解决的问题。
RAPO 的核心观察是:通用短语和角色专属短语在 [[奖励模型]] 面前等价的原因,在于传统的 [[策略优化]] 方法对所有词元一视同仁,给正优势的词元统一增加采样概率,给负优势的词元统一降低概率。但通用短语之所以能「黑客」奖励模型,恰恰是因为它们在各类场景下都能获得不差的分数——这意味着它们获得了大量正优势信号,而正优势信号会倾向于放大这些词元的概率。久而久之,模型越来越倾向于使用这些「安全」但「无角色感」的表达。
RAPO 的解决思路是引入角色画像-词元互信息作为梯度权重的调节因子。互信息 衡量的是角色画像 与词元 之间的统计关联程度——一个词元与角色画像共现的频率越高,它与该角色的关联就越强,互信息也就越大。RAPO 定义优势函数为 ,词元 的互信息为 ,则 RAPO 的梯度权重为:
其中 是两个超参数,分别控制正负优势时的调节强度。当优势为正时,互信息高的词元获得额外的梯度放大——这鼓励模型在好样本中更多地使用角色专属表达;当优势为负时,互信息高的词元被更激进地抑制——这让模型更快地远离错误的角色表达。这种非对称加权机制有效地区分了「通用安全词元」和「角色专属词元」,让强化学习信号真正服务于角色保真度。
实验与结果
论文在三个角色扮演基准上验证了方法的有效性:CoSER 评估模型在开放式对话中的角色一致性;CharacterBench 覆盖多种交互场景的综合评估;CharacterEval 关注特定角色类型的测试。
实验采用了多个规模的大语言模型作为基座,包括 7B 到 72B 参数量的变体。结果显示,Psy-CoT 单独使用时就已经超越了此前所有的角色扮演思维链方法,平均提升约 5-10 个百分点的角色一致性得分。这验证了「从角色设定出发动态思考」这一设计的有效性——模型不再依赖死记硬背的表面模式,而是学会了真正推理角色行为。
在此基础上,RAPO 相比 [[GRPO]] 在所有模型规模上都取得了一致的提升。值得注意的是,这种提升在高优势样本中尤为明显:当模型生成了一个角色一致性很高的回复时,RAPO 能够更精准地强化其中的角色专属表达,而不是被通用短语稀释了梯度信号。消融实验进一步表明,单独移除互信息加权或单独移除非对称机制都会导致性能下降,二者的协同作用缺一不可。
论文还提供了定性分析案例,展示 RAPO 在训练过程中如何逐步「拯救」被通用表达侵蚀的角色风格。例如在扮演一个说话带有东北口音用词的角色时,经过 RAPO 训练的模型能更稳定地保持方言词汇,而 GRPO 基线模型则逐渐滑向更「规范」但毫无角色特色的表达。
讨论与可借鉴点
这篇论文在角色扮演智能体这一具体任务上,实际上触碰到了一个更普遍的问题:如何让强化学习信号真正服务于目标属性,而不是被「凑合能用」的通用解劫持。这一问题在偏好对齐、安全性微调等场景中同样存在——模型总能找到一些「无功无过」的策略来获得不错的奖励分数,却远离了我们真正想要的特定能力或风格。RAPO 提出的互信息加权思路提供了一个通用的方向:引入一个与目标属性相关的先验知识,对梯度进行有偏向性的调节。
当然,论文也存在一定局限。互信息的计算依赖于角色画像与词元的共现统计,这意味着对于训练集中极少出现的冷门角色,互信息的估计可能不够可靠。此外,三步思维链的设计虽然有心理学依据,但各步骤之间的边界划分是否足够清晰、能否应对更复杂的叙事场景(如跨文化角色、多重人格设定),还有待进一步探索。
对于更广泛的研究社区而言,这项工作有两点值得借鉴:一是在设计 [[思维链]] 方法时,应当追求「从定义出发推理」而非「从例子中归纳」,前者往往具有更好的 [[泛化能力]];二是在设计 [[策略优化]] 目标时,可以考虑引入领域知识来引导梯度流向,让强化学习信号更精准地击中我们真正关心的属性,而非被表面奖励所迷惑。
概念 · 7 个
摘要
角色扮演智能体的策略优化与角色设计
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
三体对齐:通过重排序推理依据使国际象棋代理与人类推理保持一致
Three-Body Alignment: Aligning Chess Agent with Human Reasoning through Reranked Rationale
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 8 张
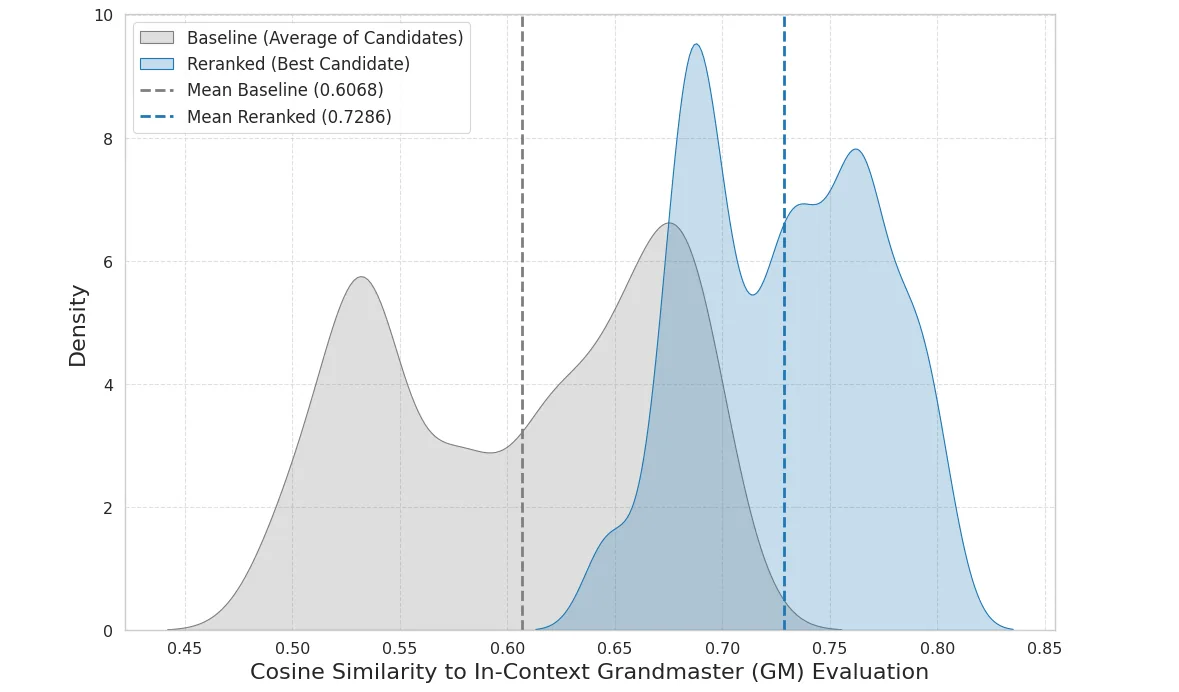
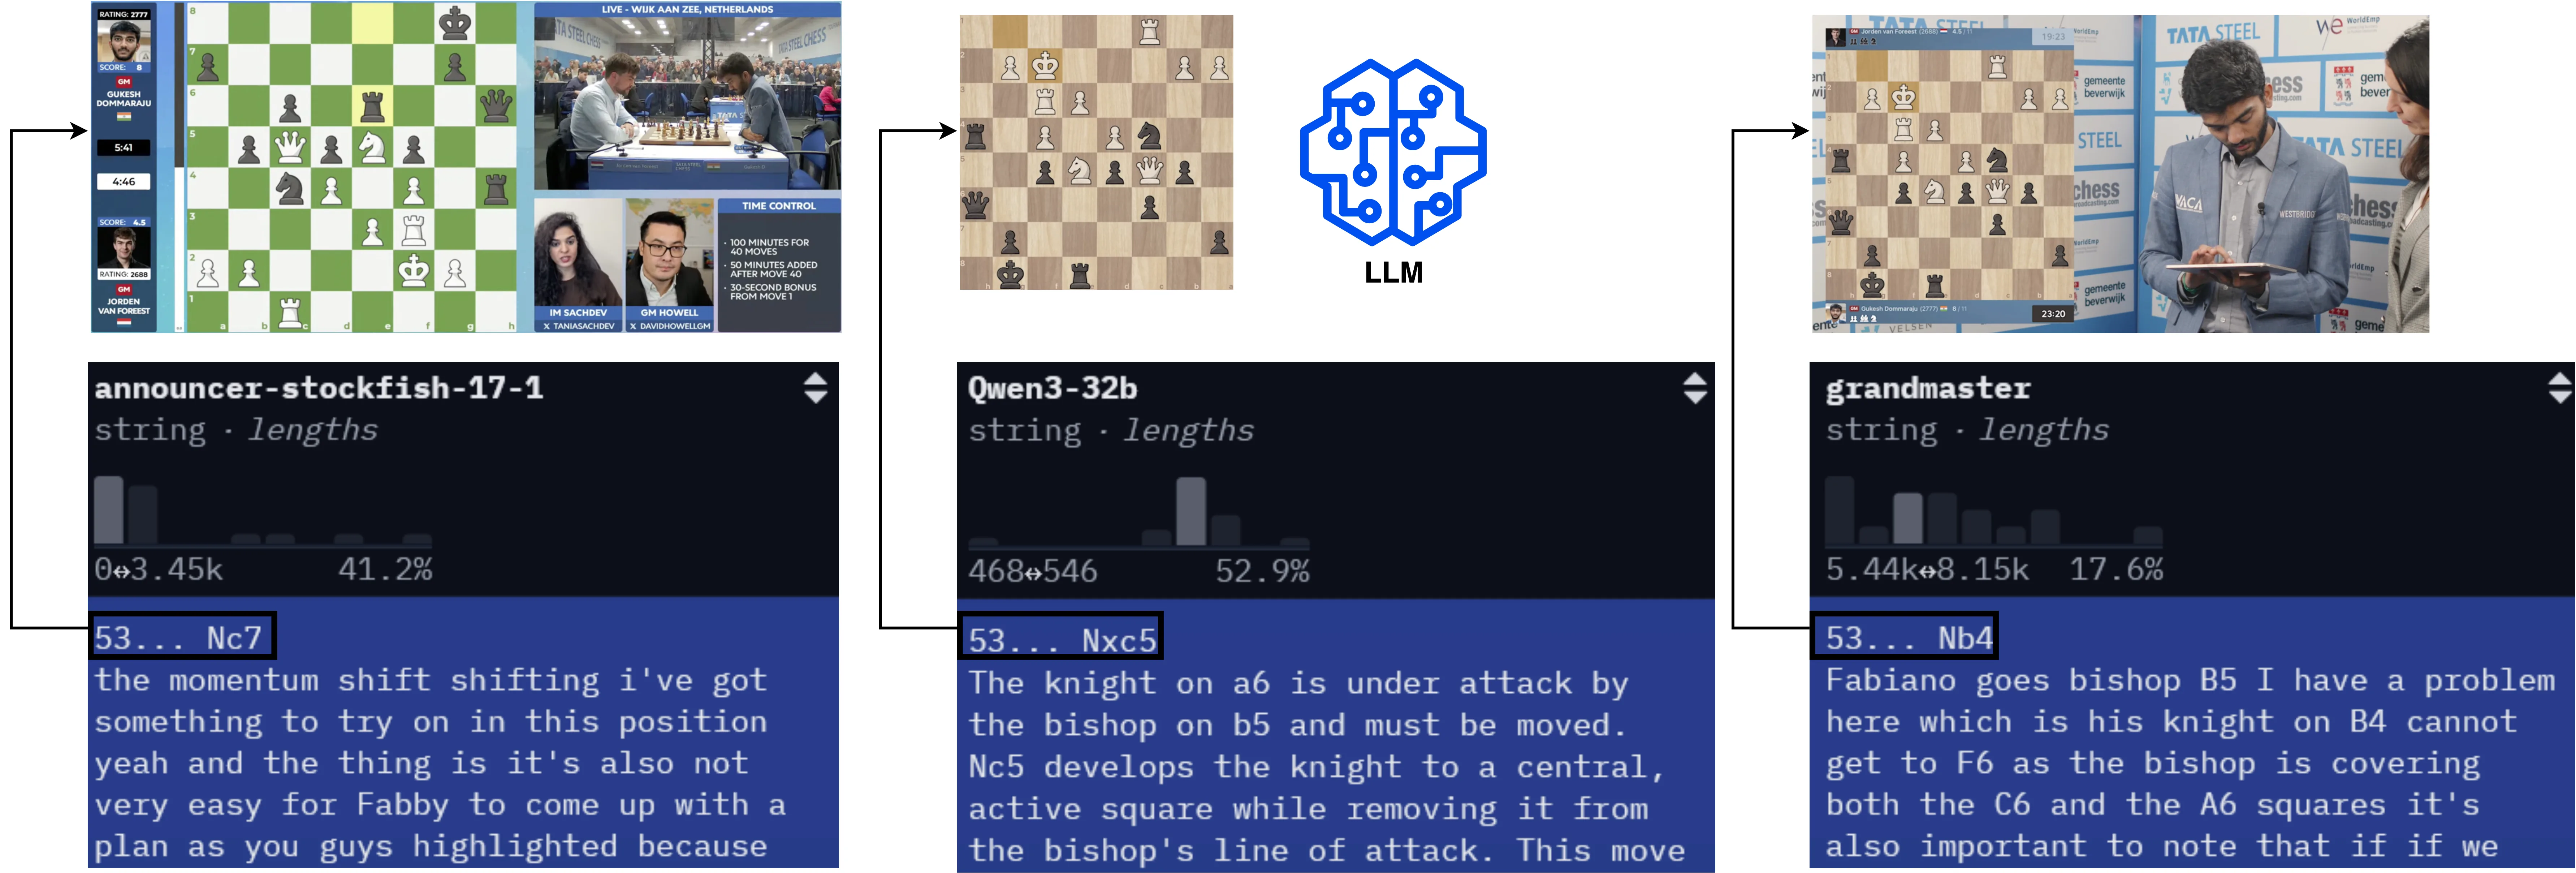
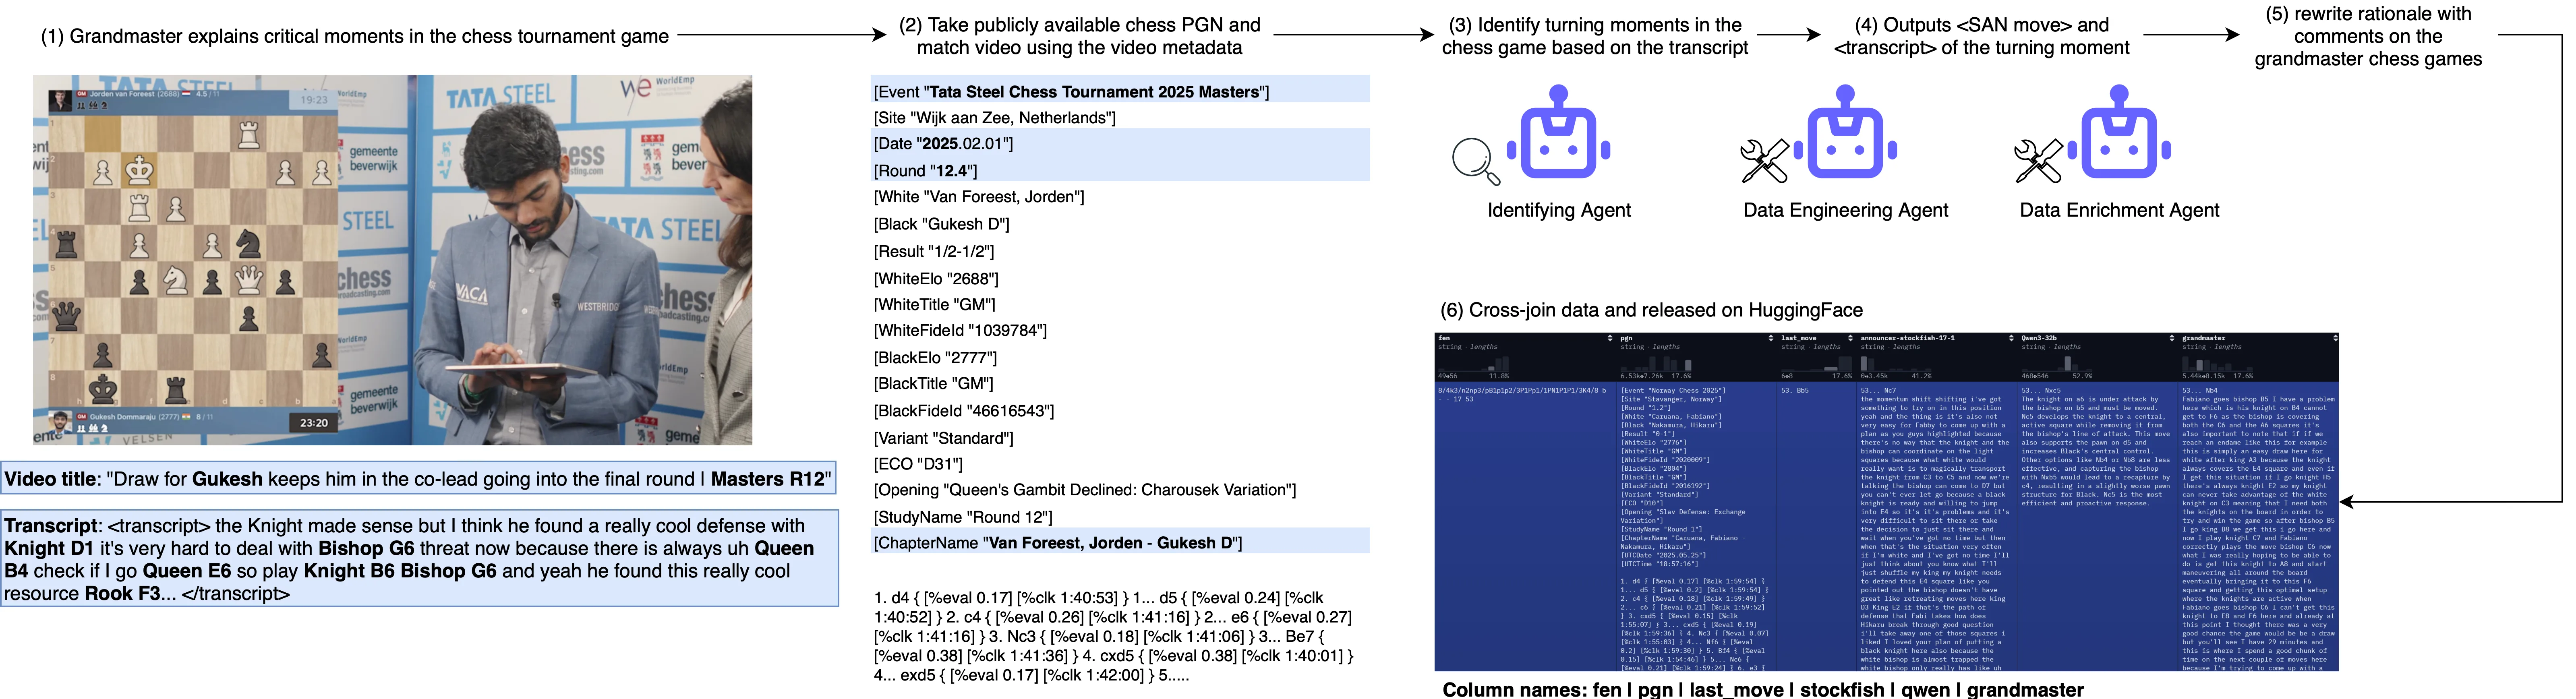
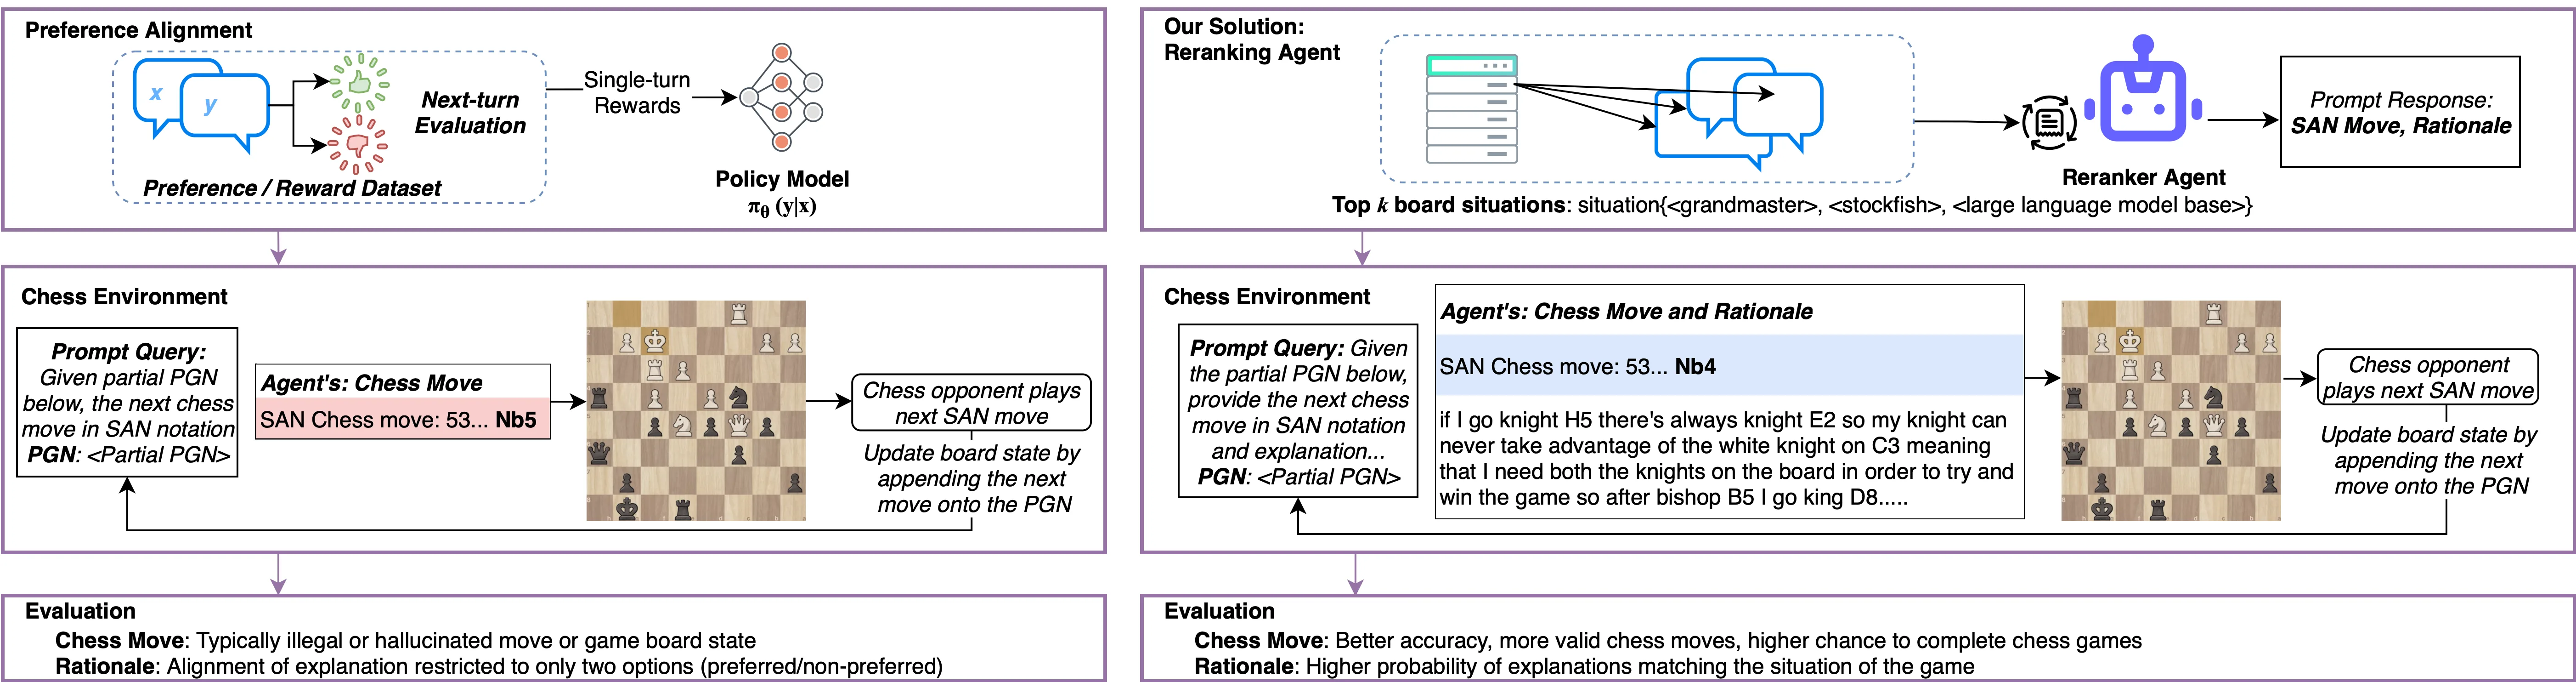
随着推理代理复杂度提升,使其推理过程与人类概念模型对齐成为 AI 安全的关键挑战。本文以国际象棋为载体,提出"三体对齐"框架,比较国际大师、NNUE 辅助解说与 LLM 三类主体的推理理据。通过 t-SNE 可视化证实三者语义嵌入空间存在显著异质性,并验证重排序机制能提升人机对齐但需以战术性能为代价。贡献包括多源理据数据集、语义空间分析、权衡实验及开源资源,为整合多元专家知识构建可解释代理奠定基础。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
随着 [[LLM]] 和推理代理的能力飞速提升,一个根本性的安全问题浮出水面:这些模型的内部推理过程与人类的概念模型究竟有多大的偏差?当 AI 系统变得越来越复杂、决策链条越来越长时,我们很难判断它的"思考方式"是否与人类专家一致——这不仅是可解释性的问题,更关乎 [[AI 安全]] 的核心挑战。
论文选择国际象棋作为研究载体并非偶然。国际象棋是一个高度结构化的环境,拥有清晰的评估标准和丰富的专家知识资源。更重要的是,这里汇聚了截然不同的推理主体:人类大师凭借多年积累的模式识别和直觉判断,Stockfish 等传统引擎依靠大规模搜索和评估函数,而 NNUE(高效可更新神经网络)则代表了一种混合路径——用神经网络辅助理解传统搜索的输出。当这三类主体面对同一个关键局面时,它们的"思考"方式会有什么差异?这种差异能否被量化?能否被弥合?
这些问题的答案直接关系到如何将不同来源的专家知识整合到人类对齐的智能代理中。论文将这个问题命名为"三体对齐",借用了物理学中三体系统的概念——当三个相互作用的"体"处于同一环境时,它们的行为模式会产生复杂的相互影响和约束。
方法
研究的第一步是构建一个可靠的数据基础。论文设计了一套智能体数据工程流水线,将散落在视频解说、博客文章、书籍评注中的非结构化国际象棋专家评论转化为结构化、可查询的推理理据数据集。这些理据不仅包含棋局着法,还包含了专家对每一步决策的阐释——为什么要走这步棋、看到了什么威胁、预判了怎样的后续变化。
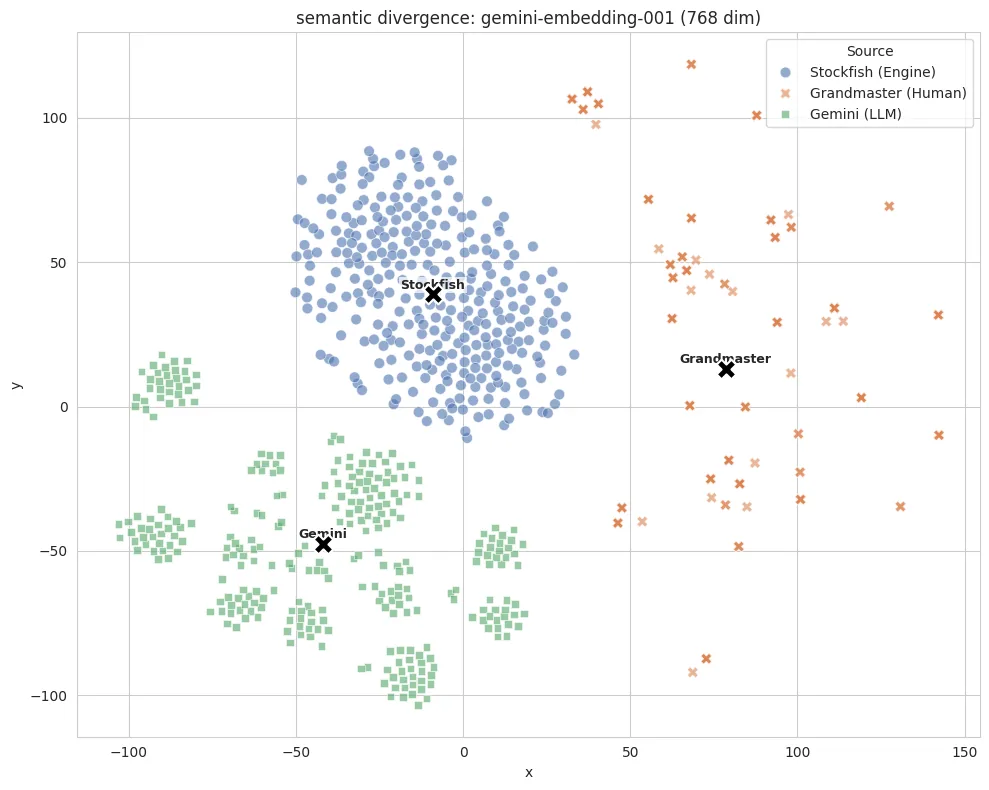
有了数据之后,论文采用 [[t-SNE]] 可视化技术对三类主体的语义嵌入空间进行实证分析。具体做法是将每条推理理据通过 [[LLM]] 编码为稠密向量,然后使用 t-SNE 将高维语义空间投影到二维平面。如果三类主体的理据在平面上形成明显分离的聚类,就说明它们的推理方式在概念层面存在根本差异。
在验证了语义异质性的存在后,论文进一步探索了弥合差异的路径。核心机制是重排序(reranking):给定一个候选着法列表,使用人类大师的推理模式作为参照,对这些着法进行重新排序,使其更贴近人类专家的概念框架。这种方法的关键在于,它不需要重新训练模型,只需要在决策环节引入一个对齐校准层。
实验与结果
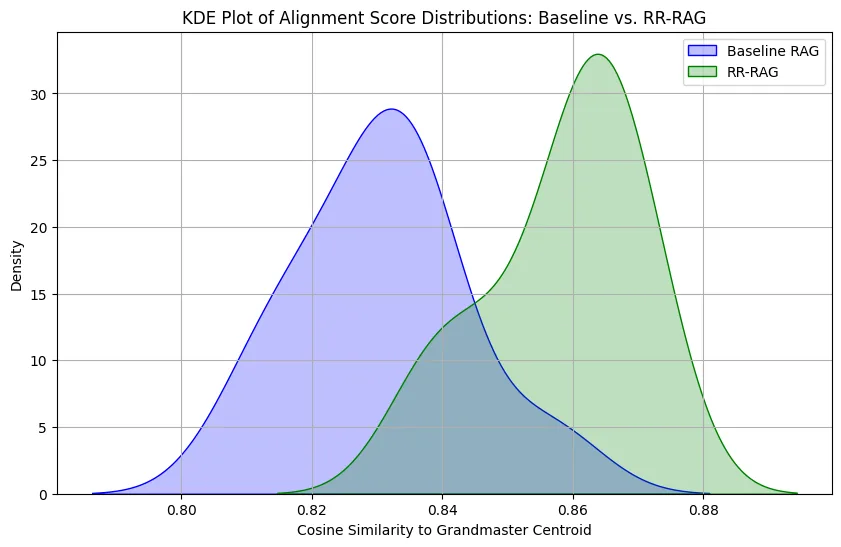
实验结果揭示了几个重要发现。t-SNE 可视化清晰地表明,人类大师、NNUE 辅助解说和 LLM 三类主体的推理理据在语义空间中形成了显著分离的聚类。这不仅仅是措辞风格的差异,而是反映了三种根本不同的概念化方式——大师关注的是局面特征与战略构思,引擎辅助解说倾向于分析着法候选与局面评估,而 LLM 则更倾向于叙事性的局面描述和计划推演。
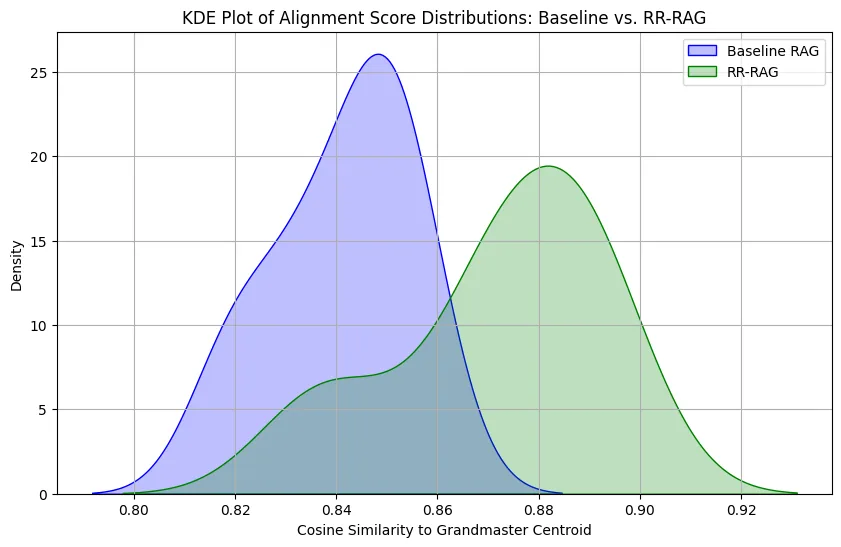
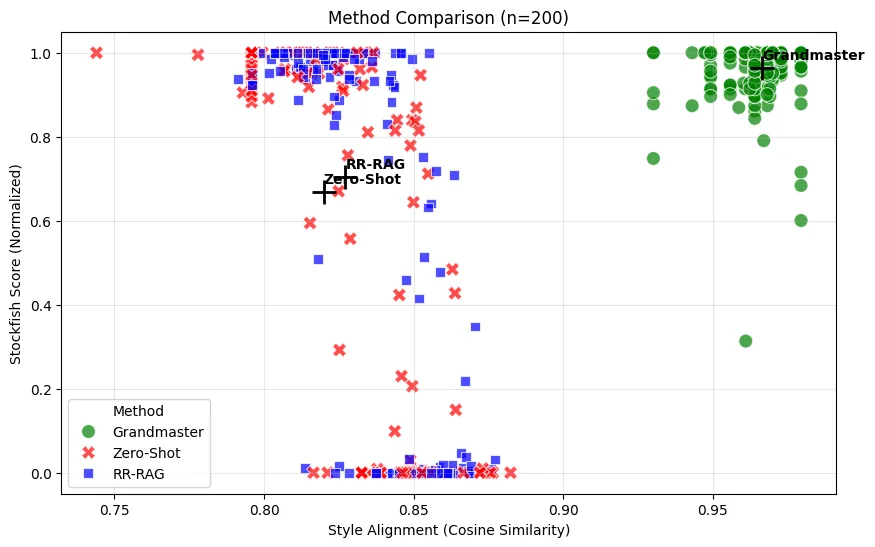
更关键的发现来自重排序实验。当使用人类大师的推理模式作为参照进行重排序时,生成理据与人类专家的语义相似度显著提升——这意味着人机对齐确实可以通过恰当的机制加以改善。然而,这种对齐提升并非没有代价:与参考答案的匹配率出现了明显下降,表明战术性能受到了影响。论文将这个关系量化为一个明确的权衡曲线:当对齐指标提升 X% 时,战术准确率会下降 Y%。
这个权衡关系具有重要的实践意义。它告诉我们,在当前的技术框架下,追求与人类推理的完全对齐可能需要以任务表现为代价。论文开源的数据集包含了多来源的棋局理据,覆盖了开局、中局和残局的不同阶段,为后续研究提供了丰富的测试基础。
讨论与可借鉴点
这项研究的最重要贡献,或许在于揭示了推理异质性的存在本身就是一个需要认真对待的事实。三类主体面对同一个棋局产生了截然不同的"思维轨迹",这种差异不是噪声,而是反映了各自推理架构的本质特征。这意味着任何试图统一多元专家知识的系统,都必须首先承认并理解这种异质性。
重排序实验揭示的权衡关系为后续研究指明了方向。未来的工作可以从几个角度切入:一是在模型架构层面探索能否设计出同时兼顾对齐性和性能的新范式;二是在数据层面研究如何构建更能反映人类推理模式的训练语料;三是在评估层面开发更精细的对齐度量标准,不仅捕捉表面的语义相似,更能评估深层的推理结构一致性。
论文开源的数据集为社区提供了一个宝贵的起点。通过整合 Hugging Face 上的多源理据数据,研究者可以进一步探索语义嵌入空间的性质,尝试不同的重排序策略,甚至开发新的对齐评估方法。这个"三体对齐"框架的思路——选取具有代表性的推理主体、量化语义差异、探索弥合路径——也为其他领域提供了可迁移的方法论参考。
摘要
分析国际象棋智能体(NNUE 引擎与大语言模型)及其决策推理,直接涉及游戏 AI 技术
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
ABot-World-0:单台桌面 GPU 上的无限交互世界推演
ABot-World-0: Infinite Interactive World Rollout on a Single Desktop GPU
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 10 张
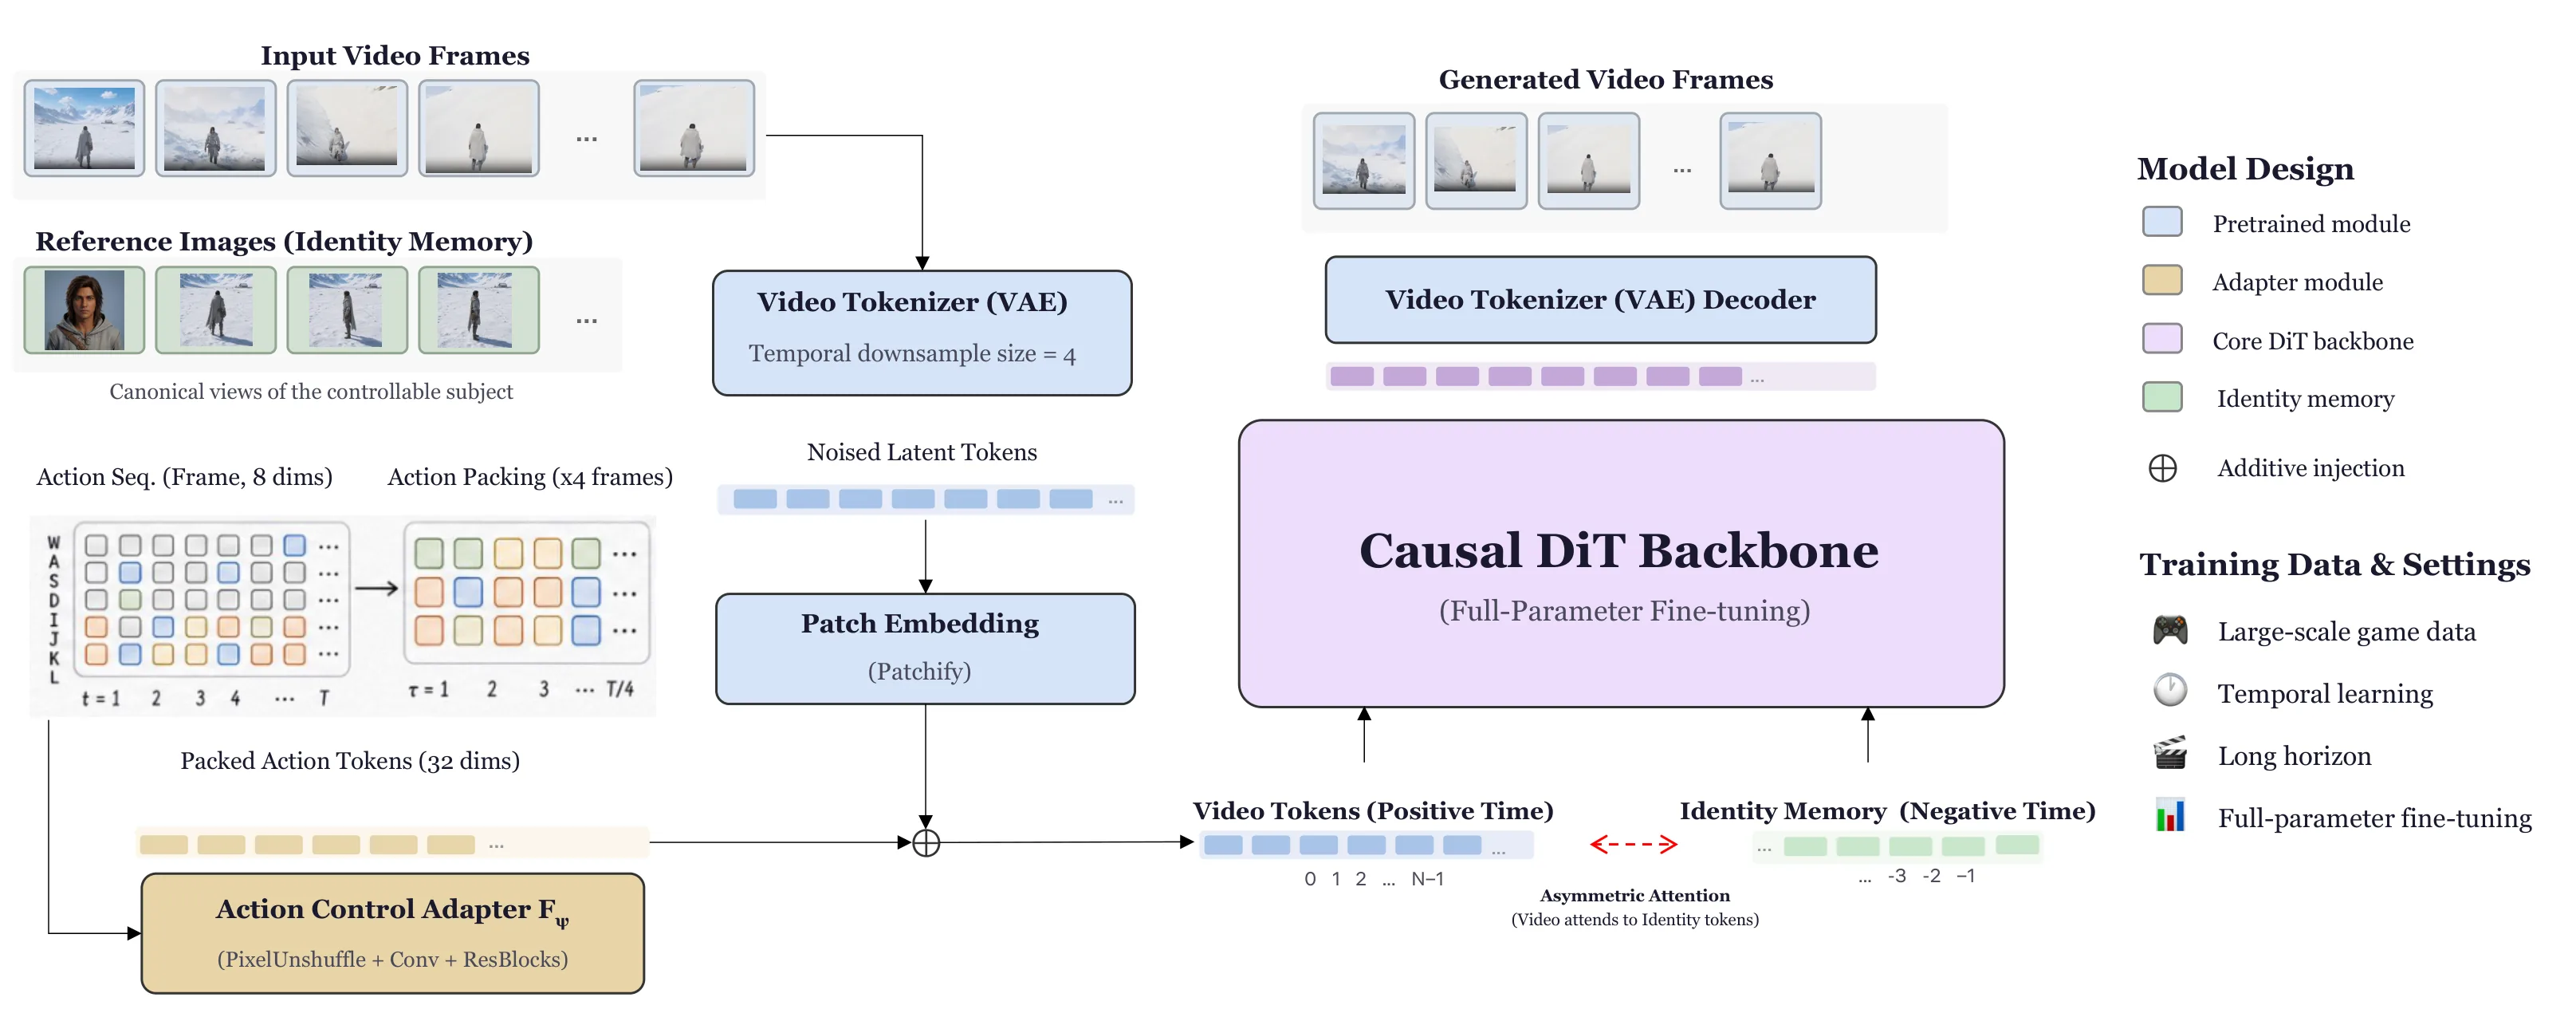
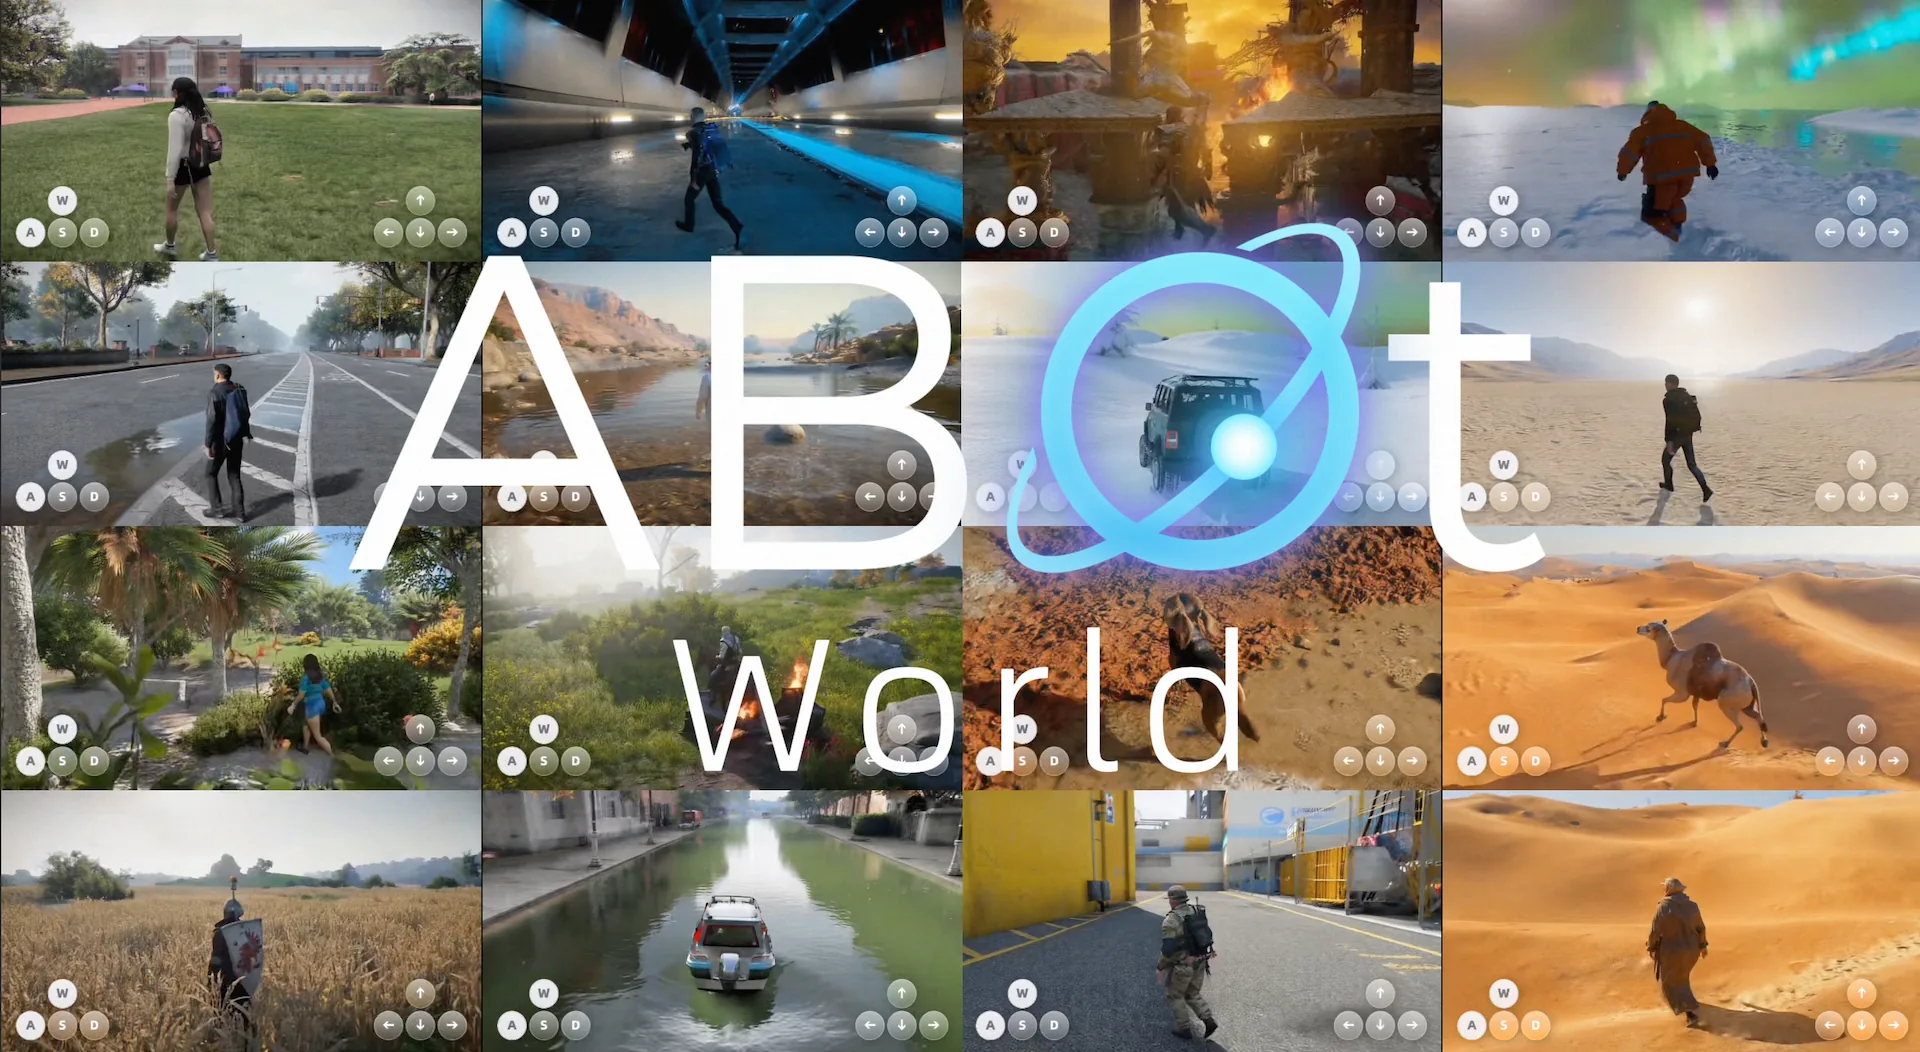
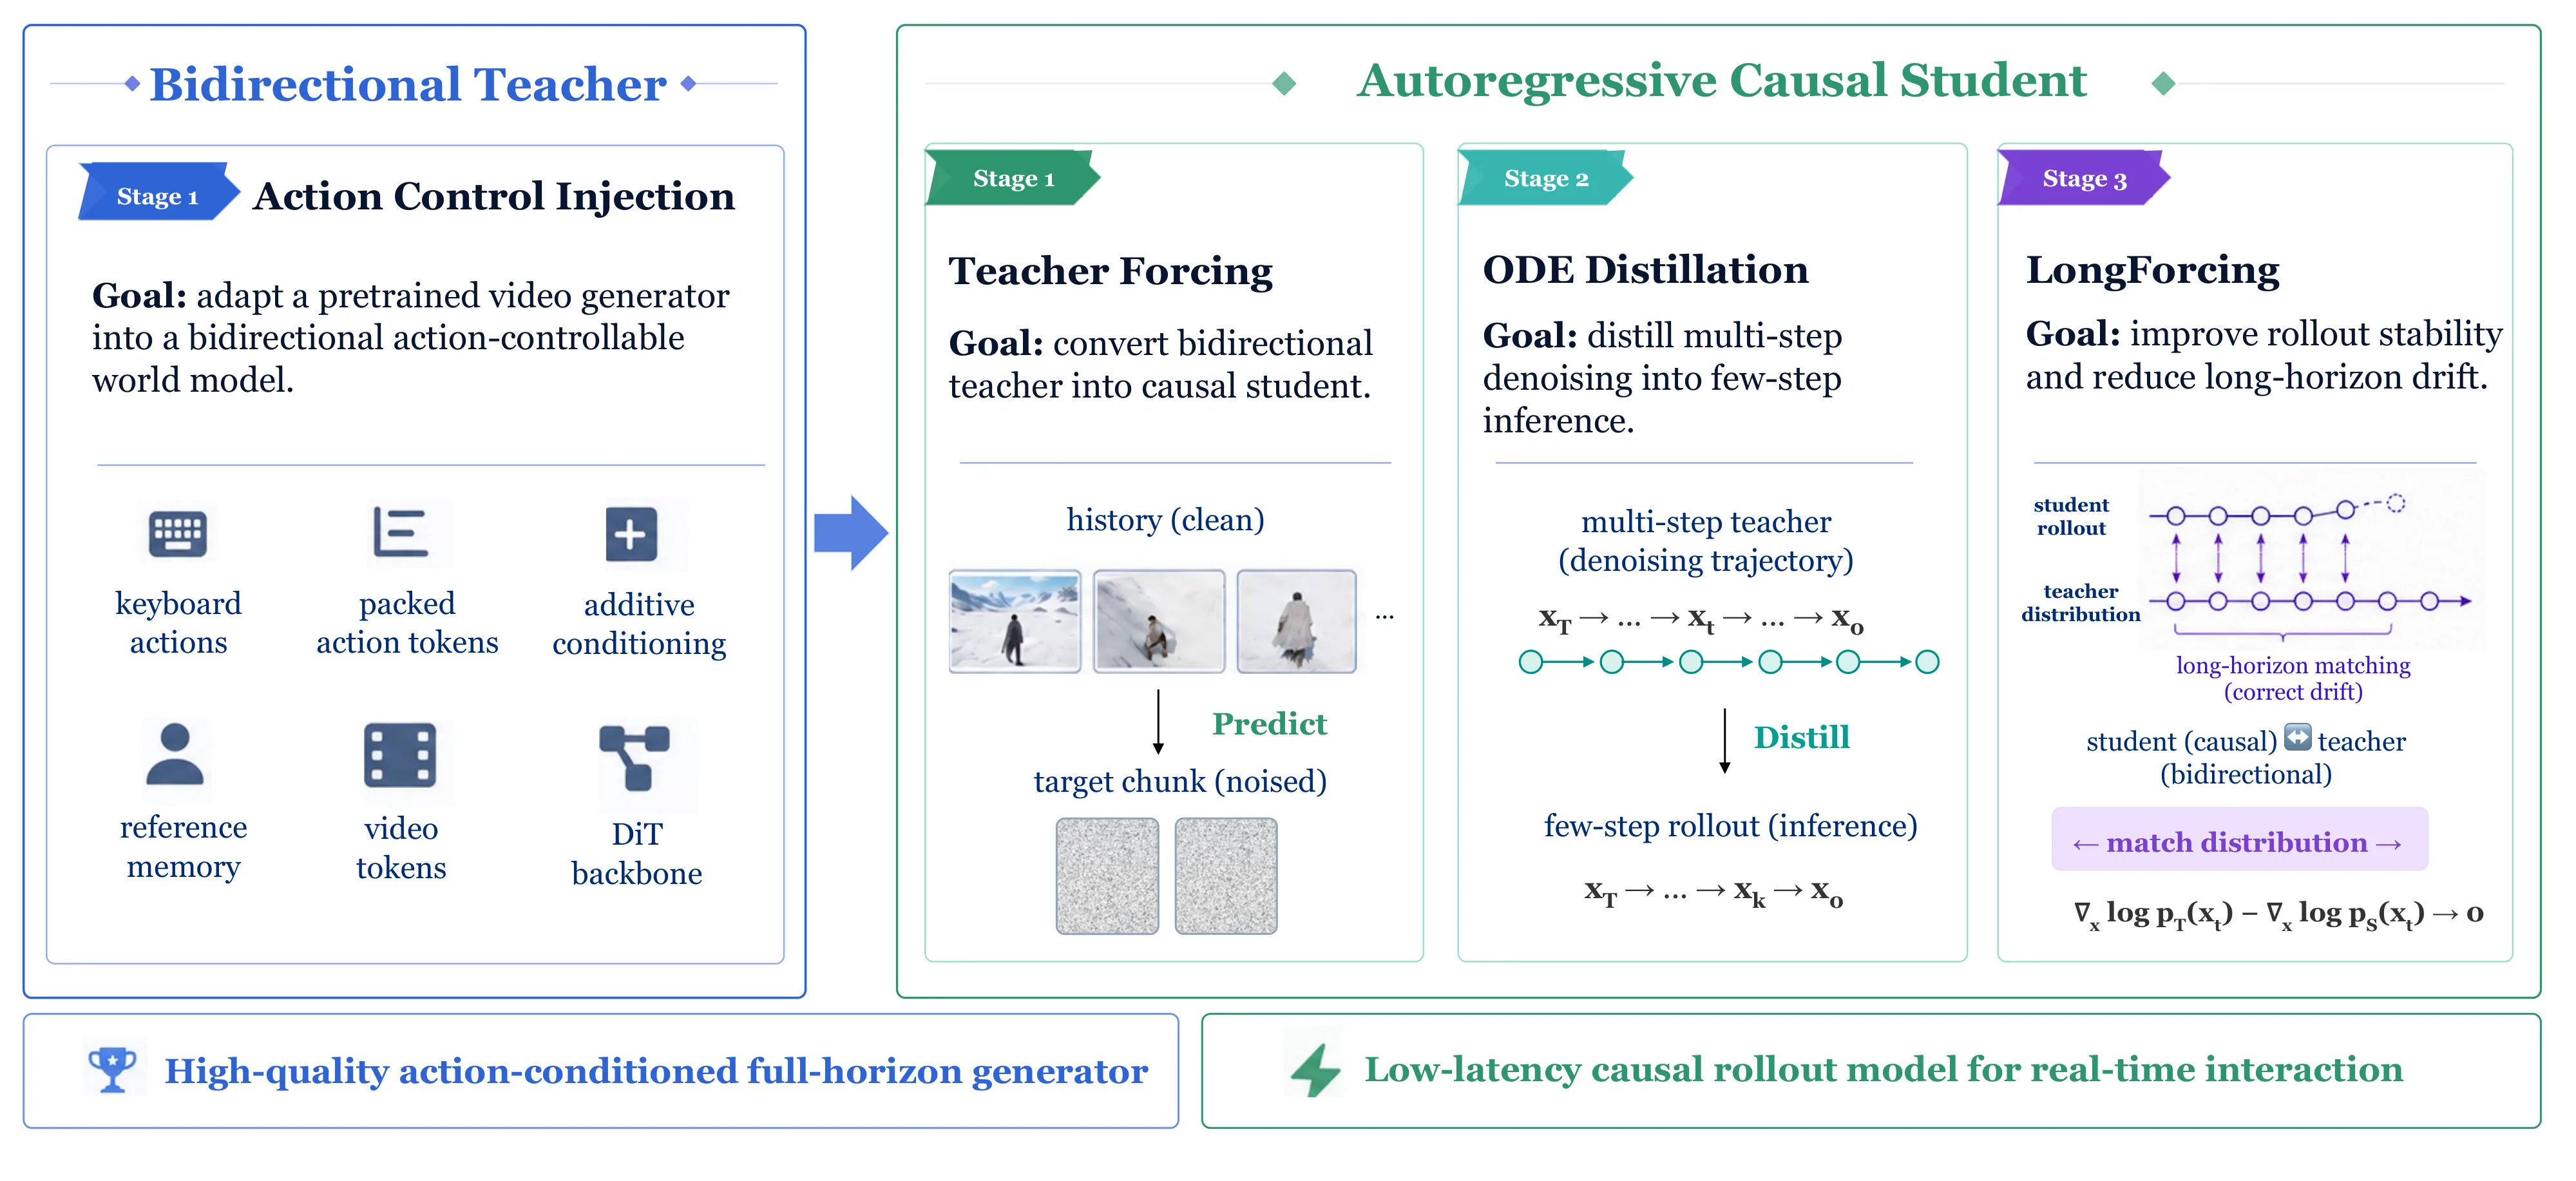
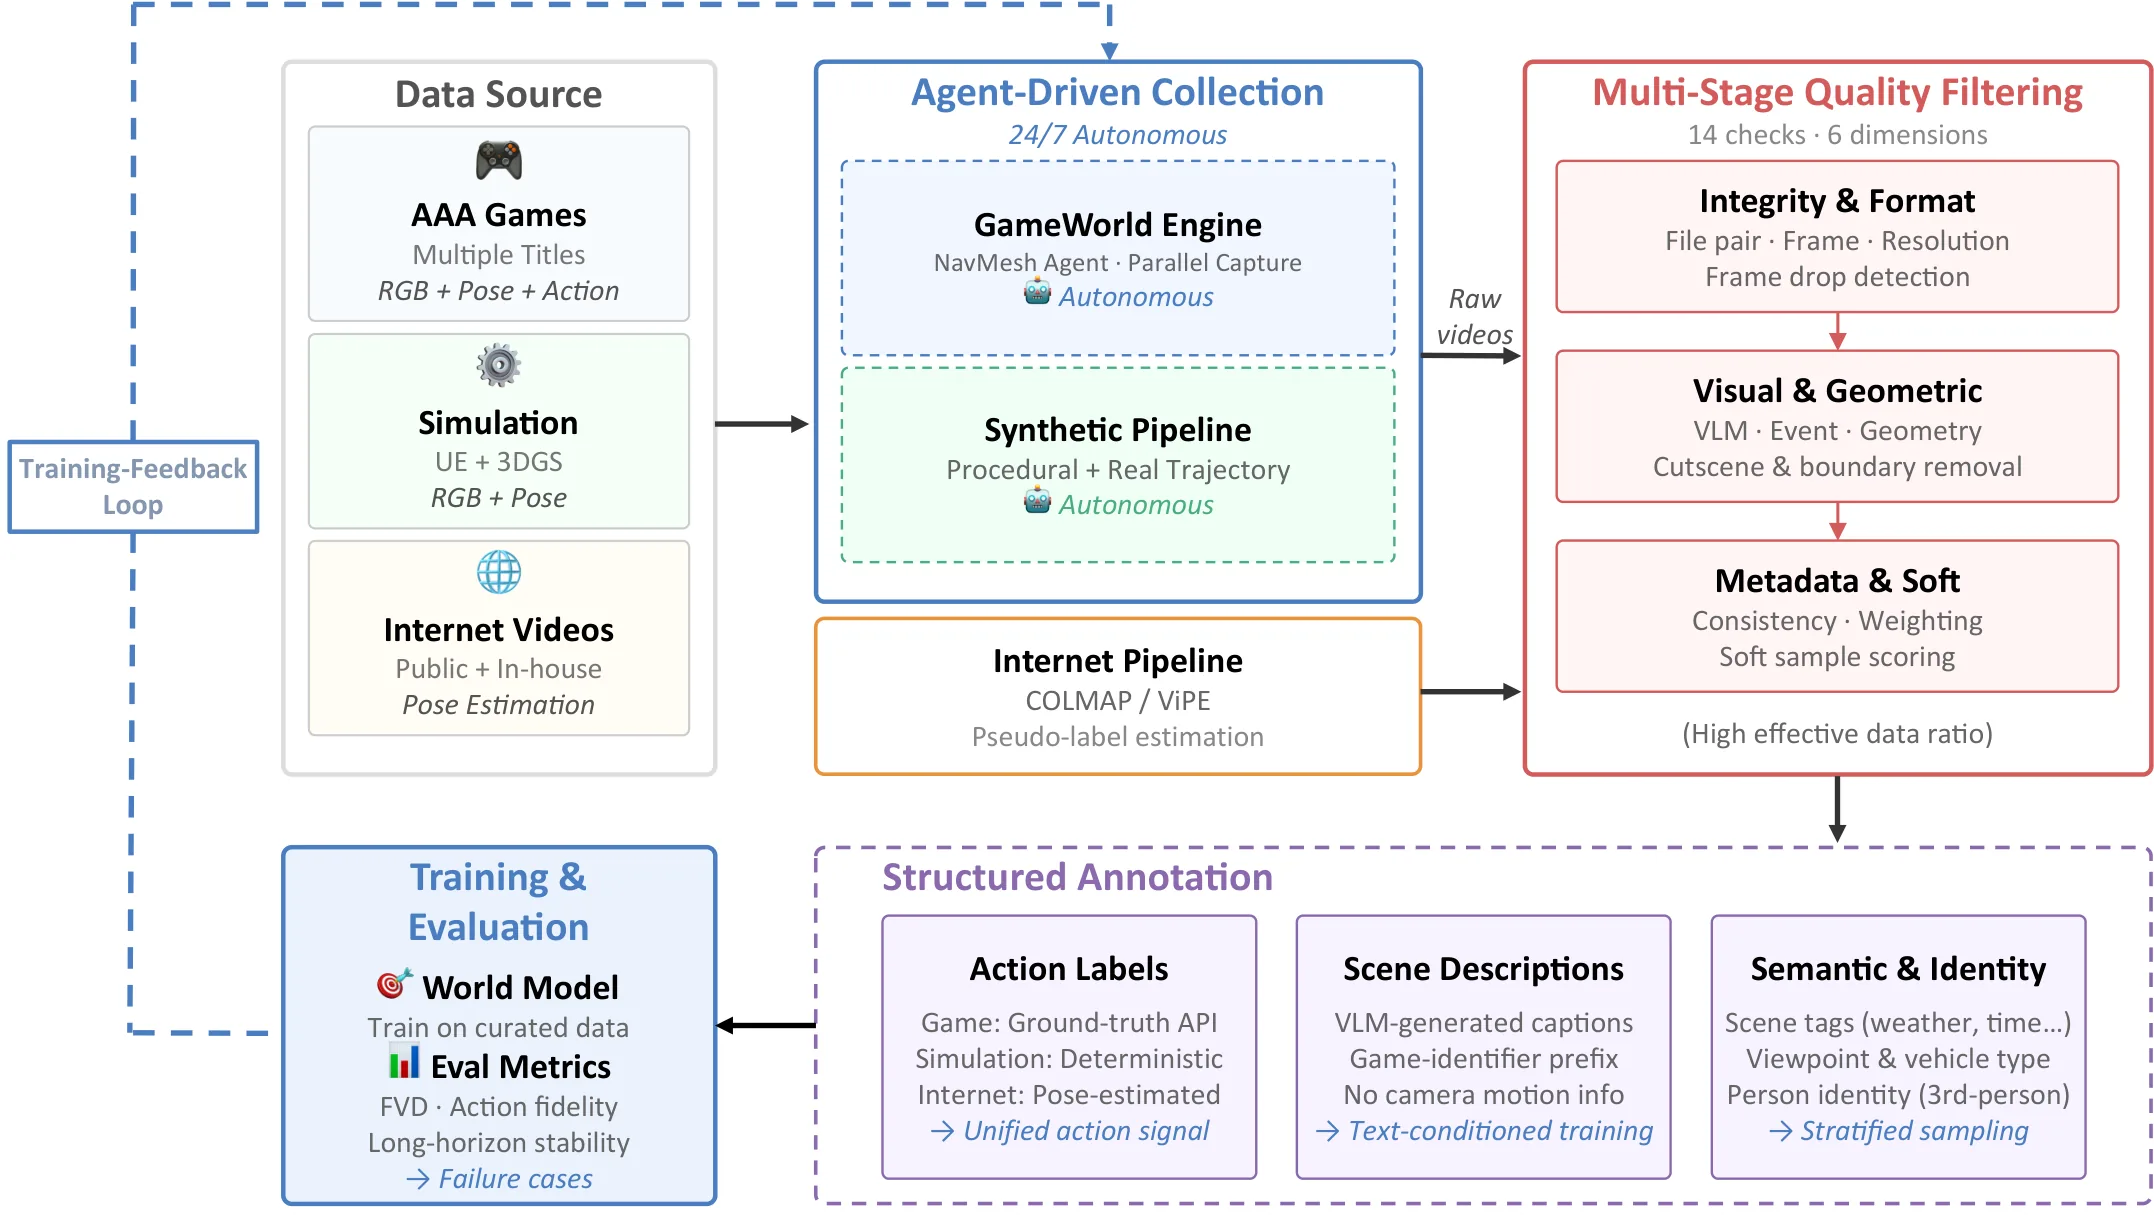
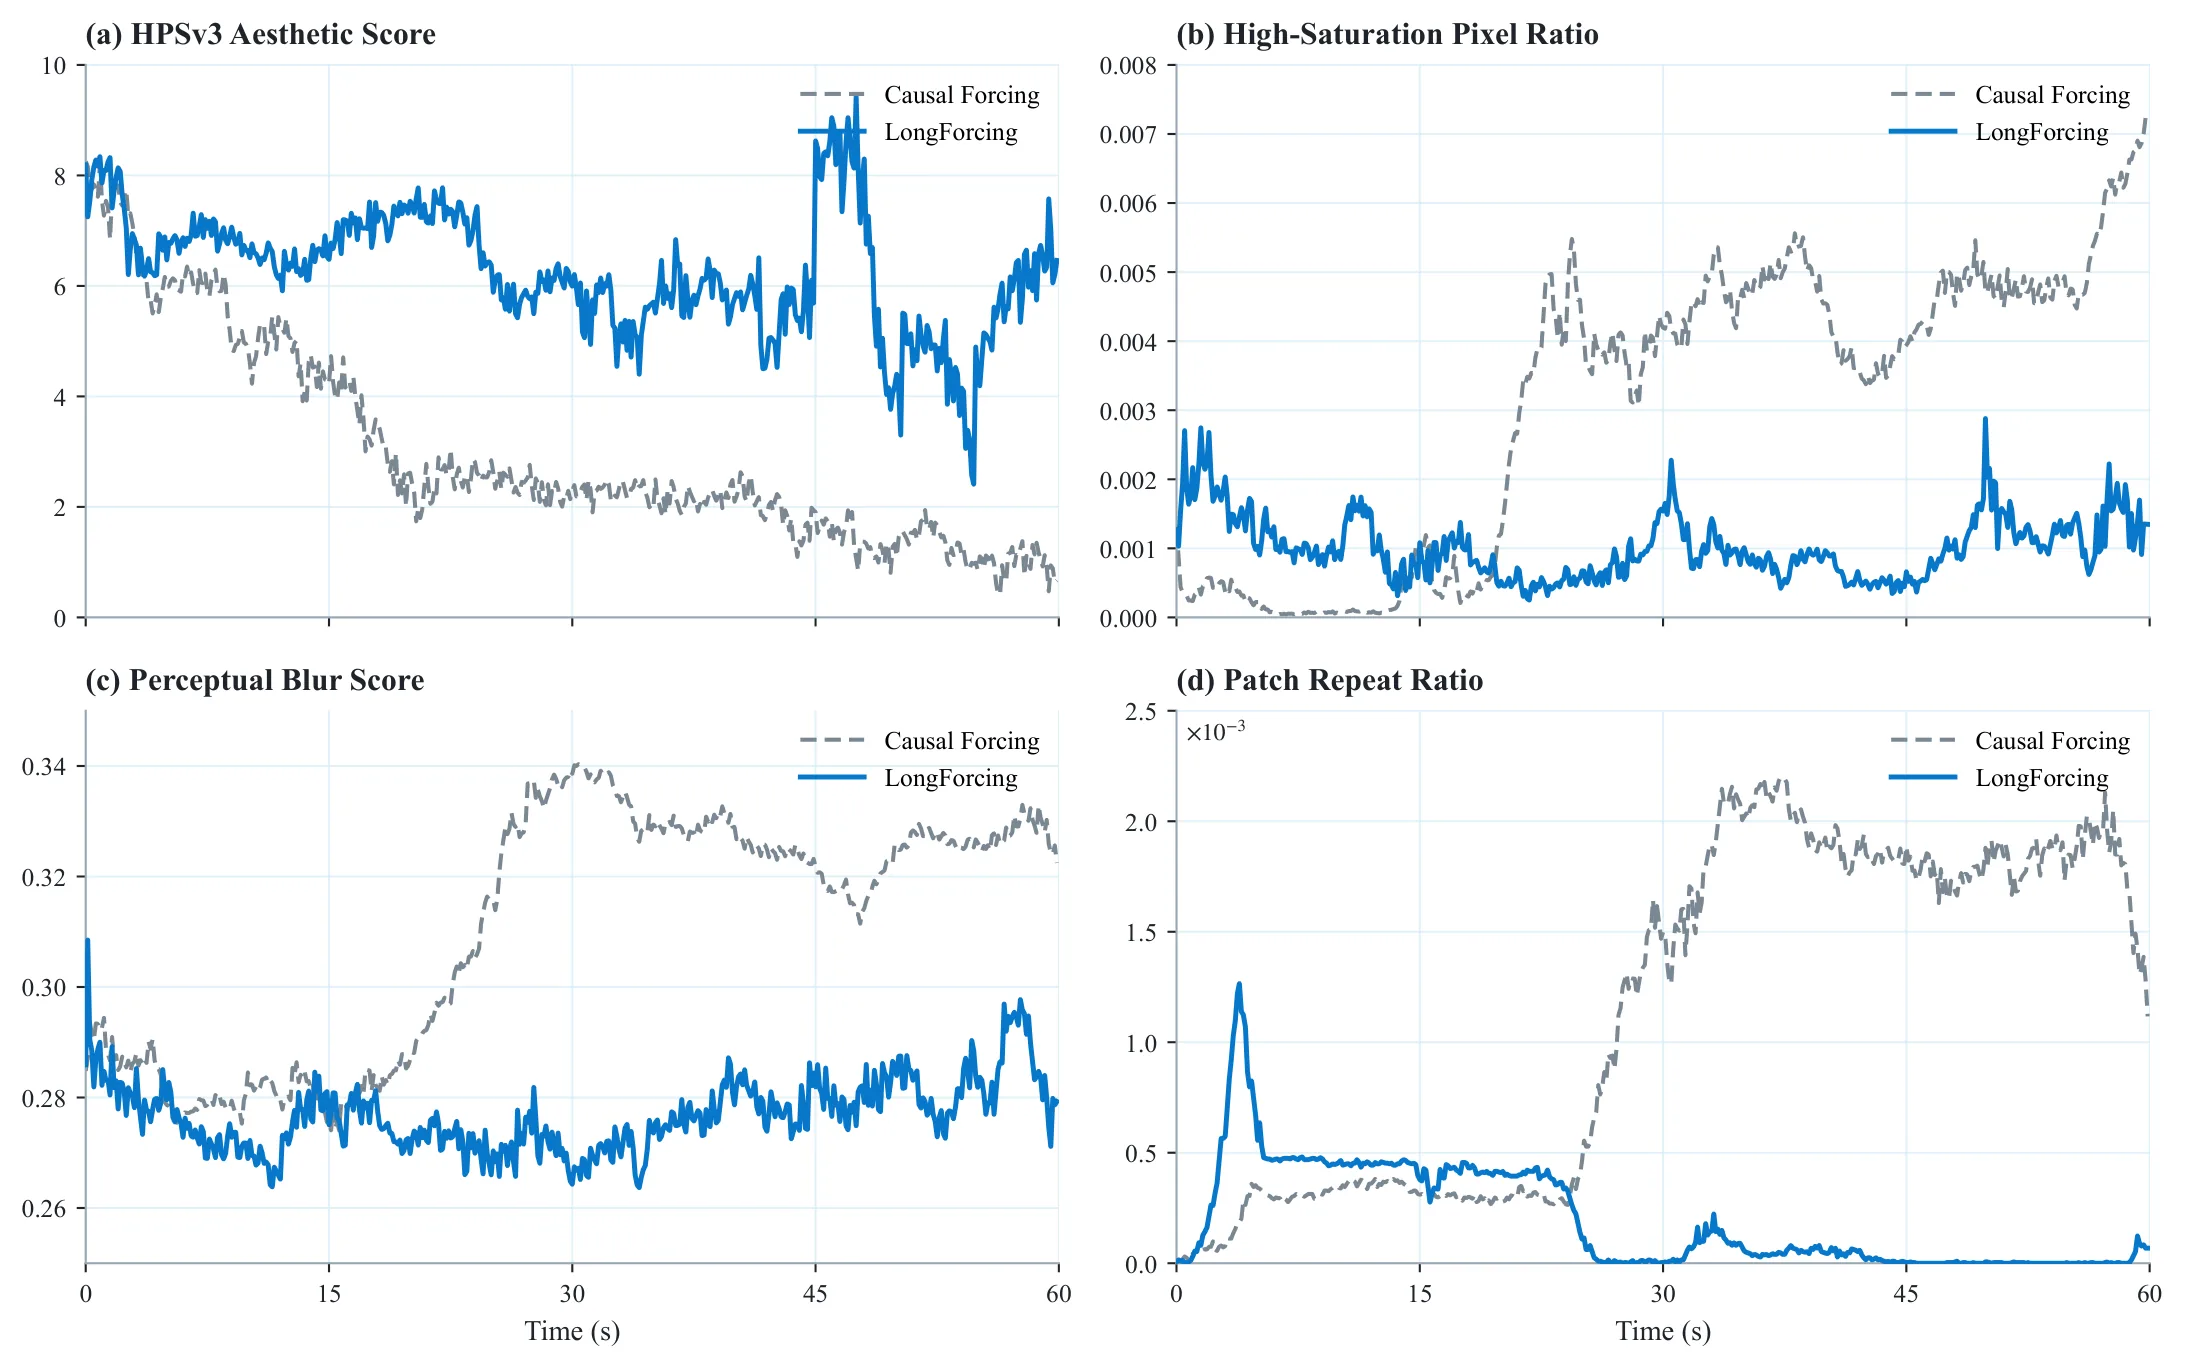
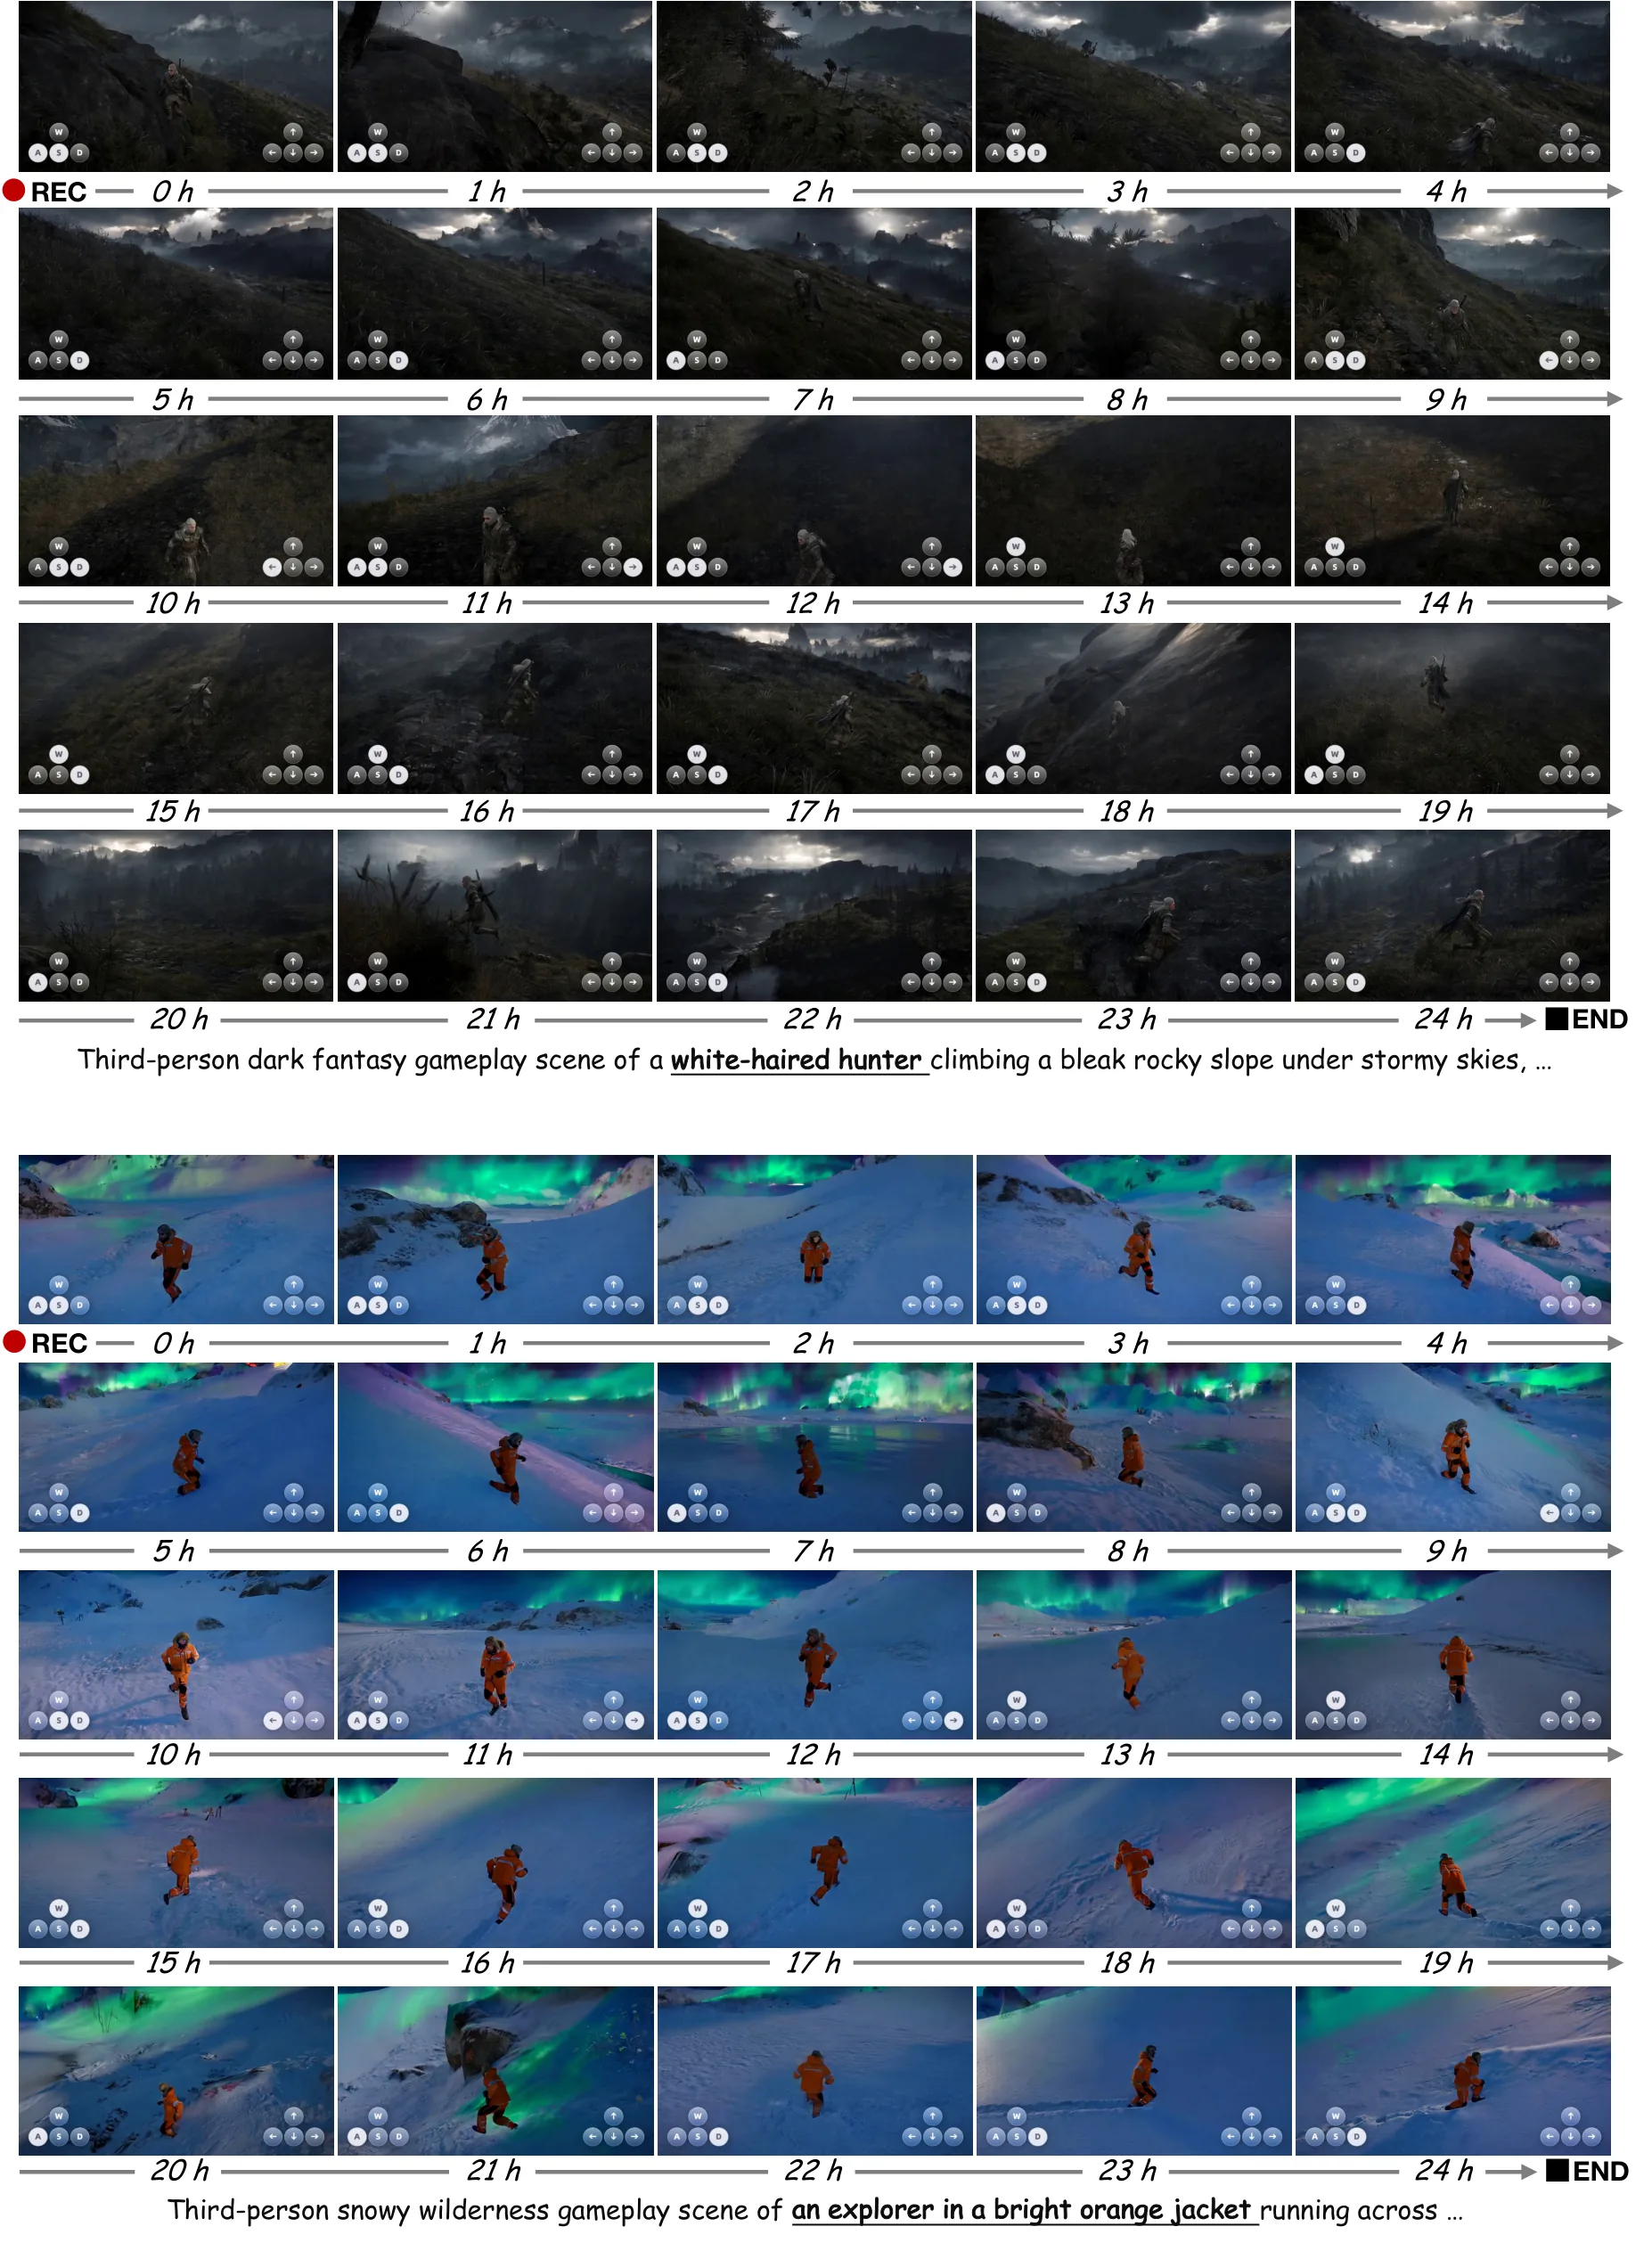
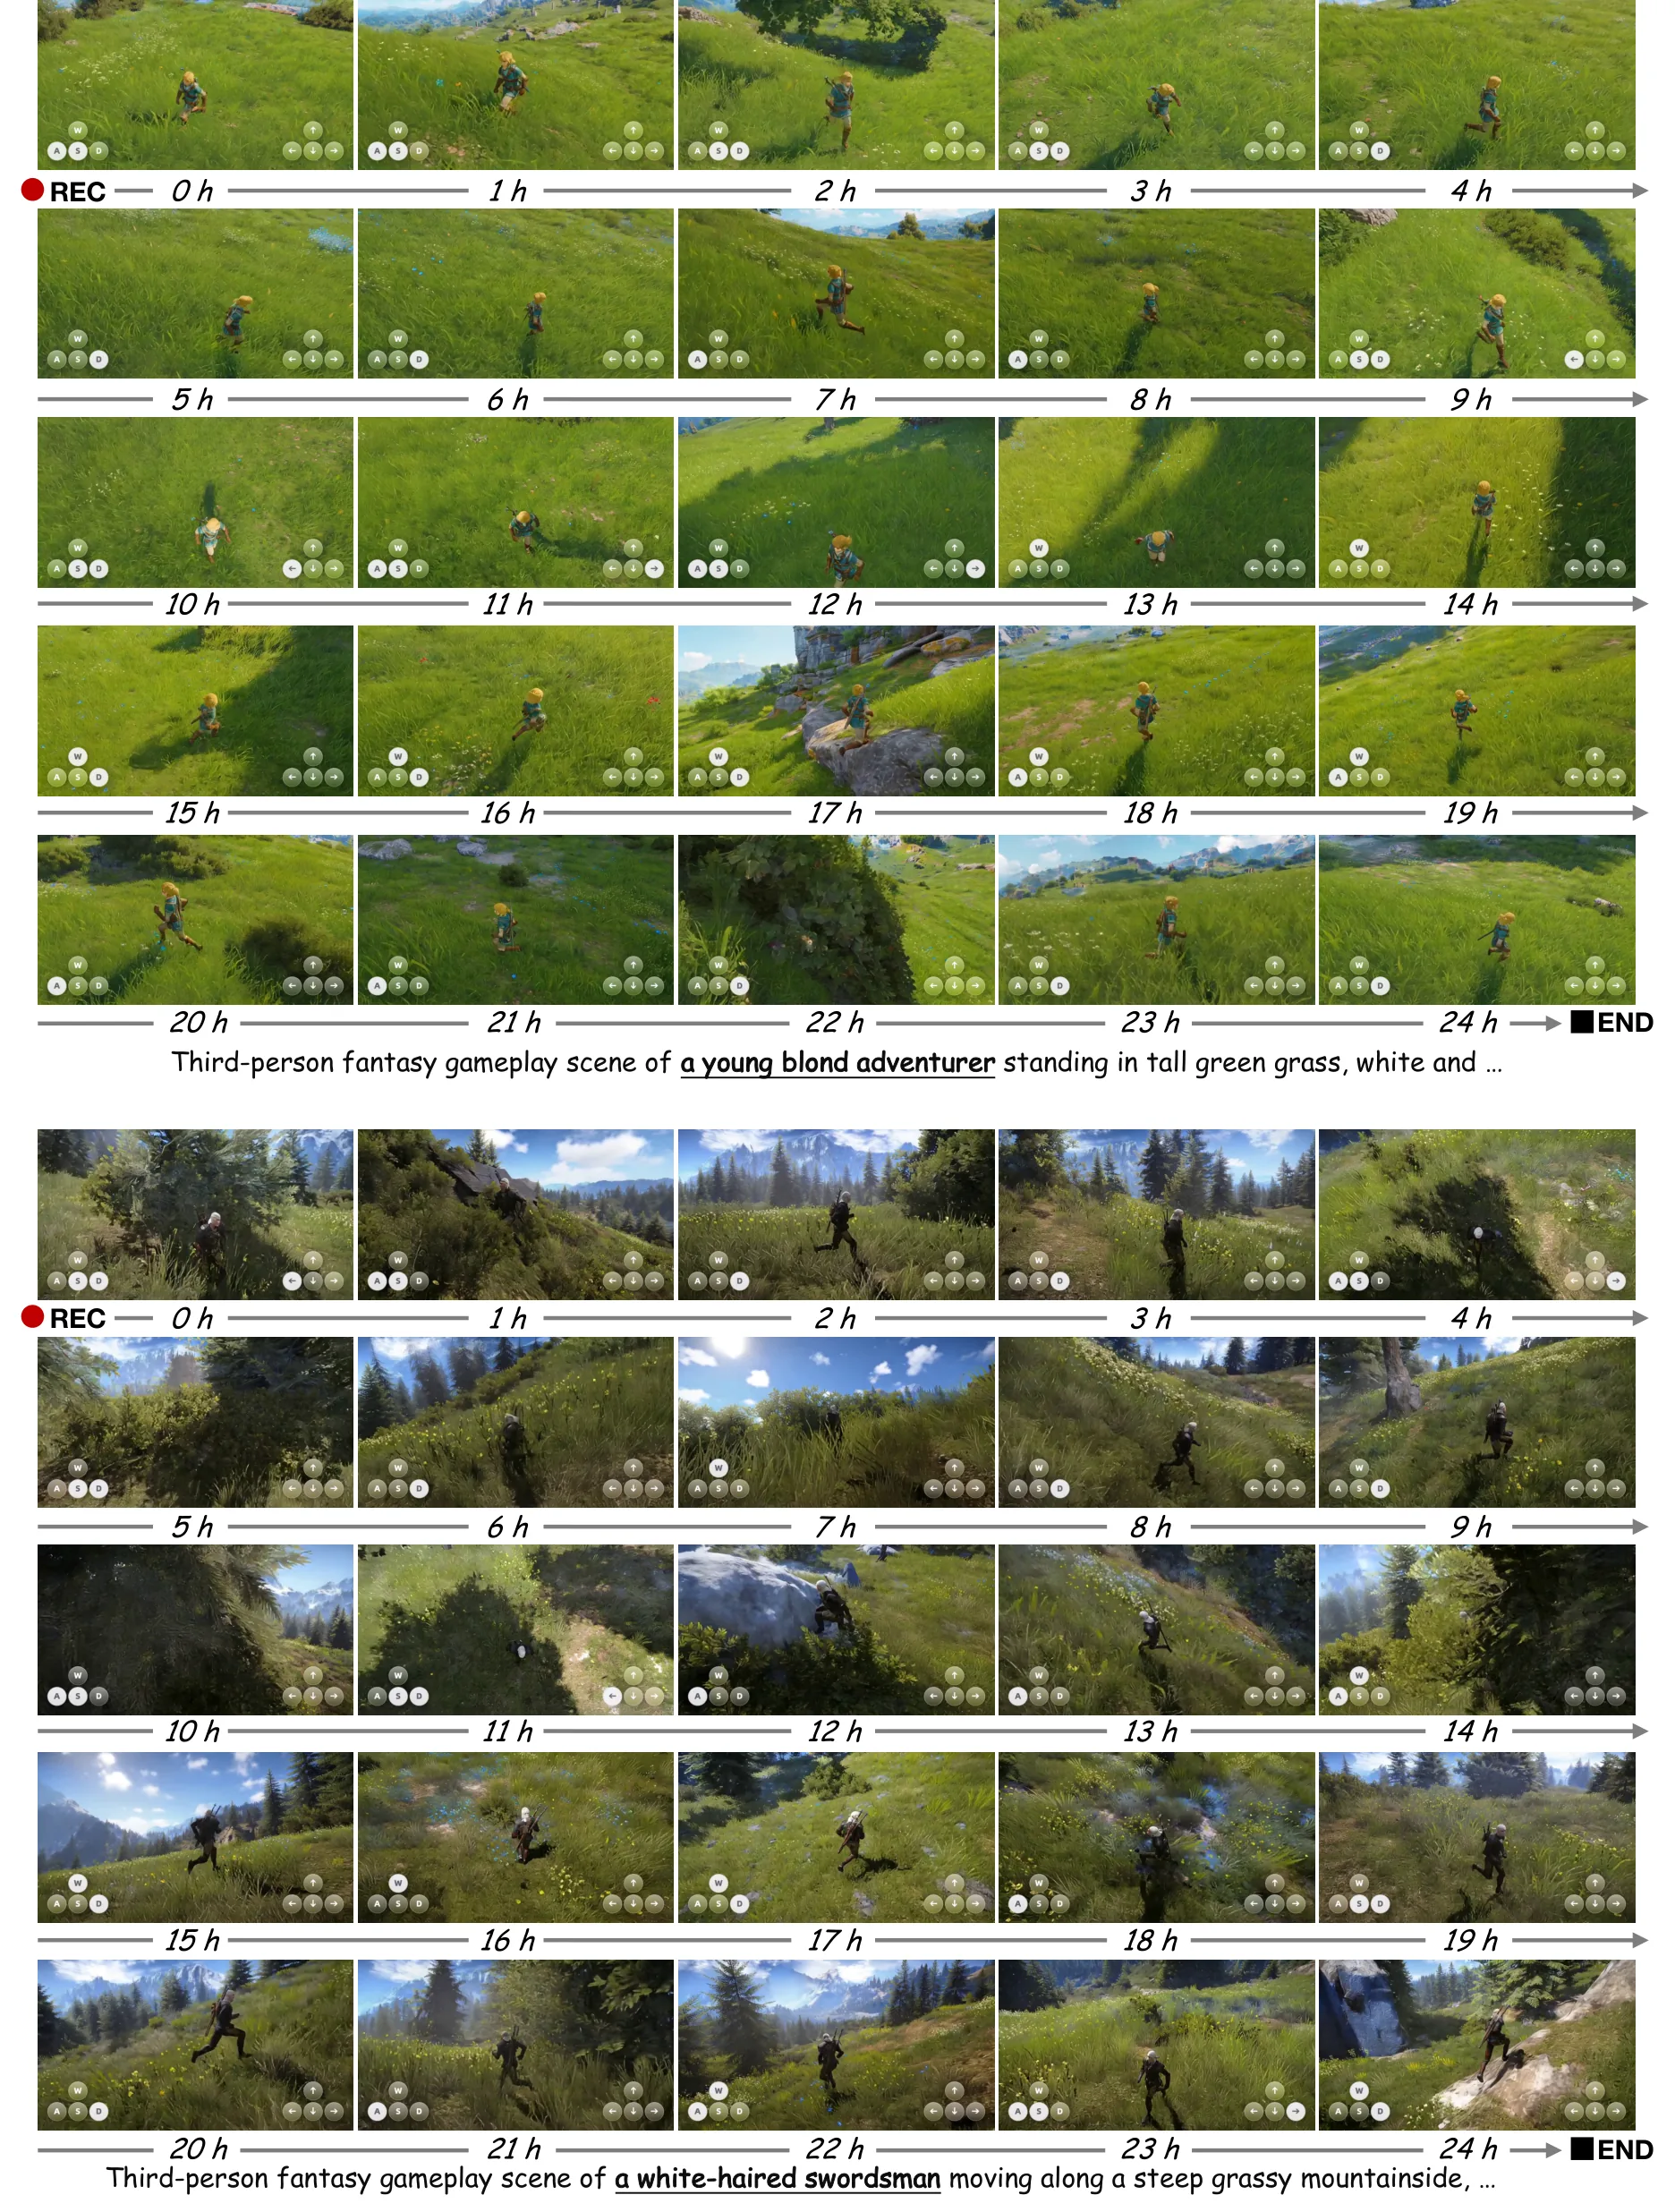
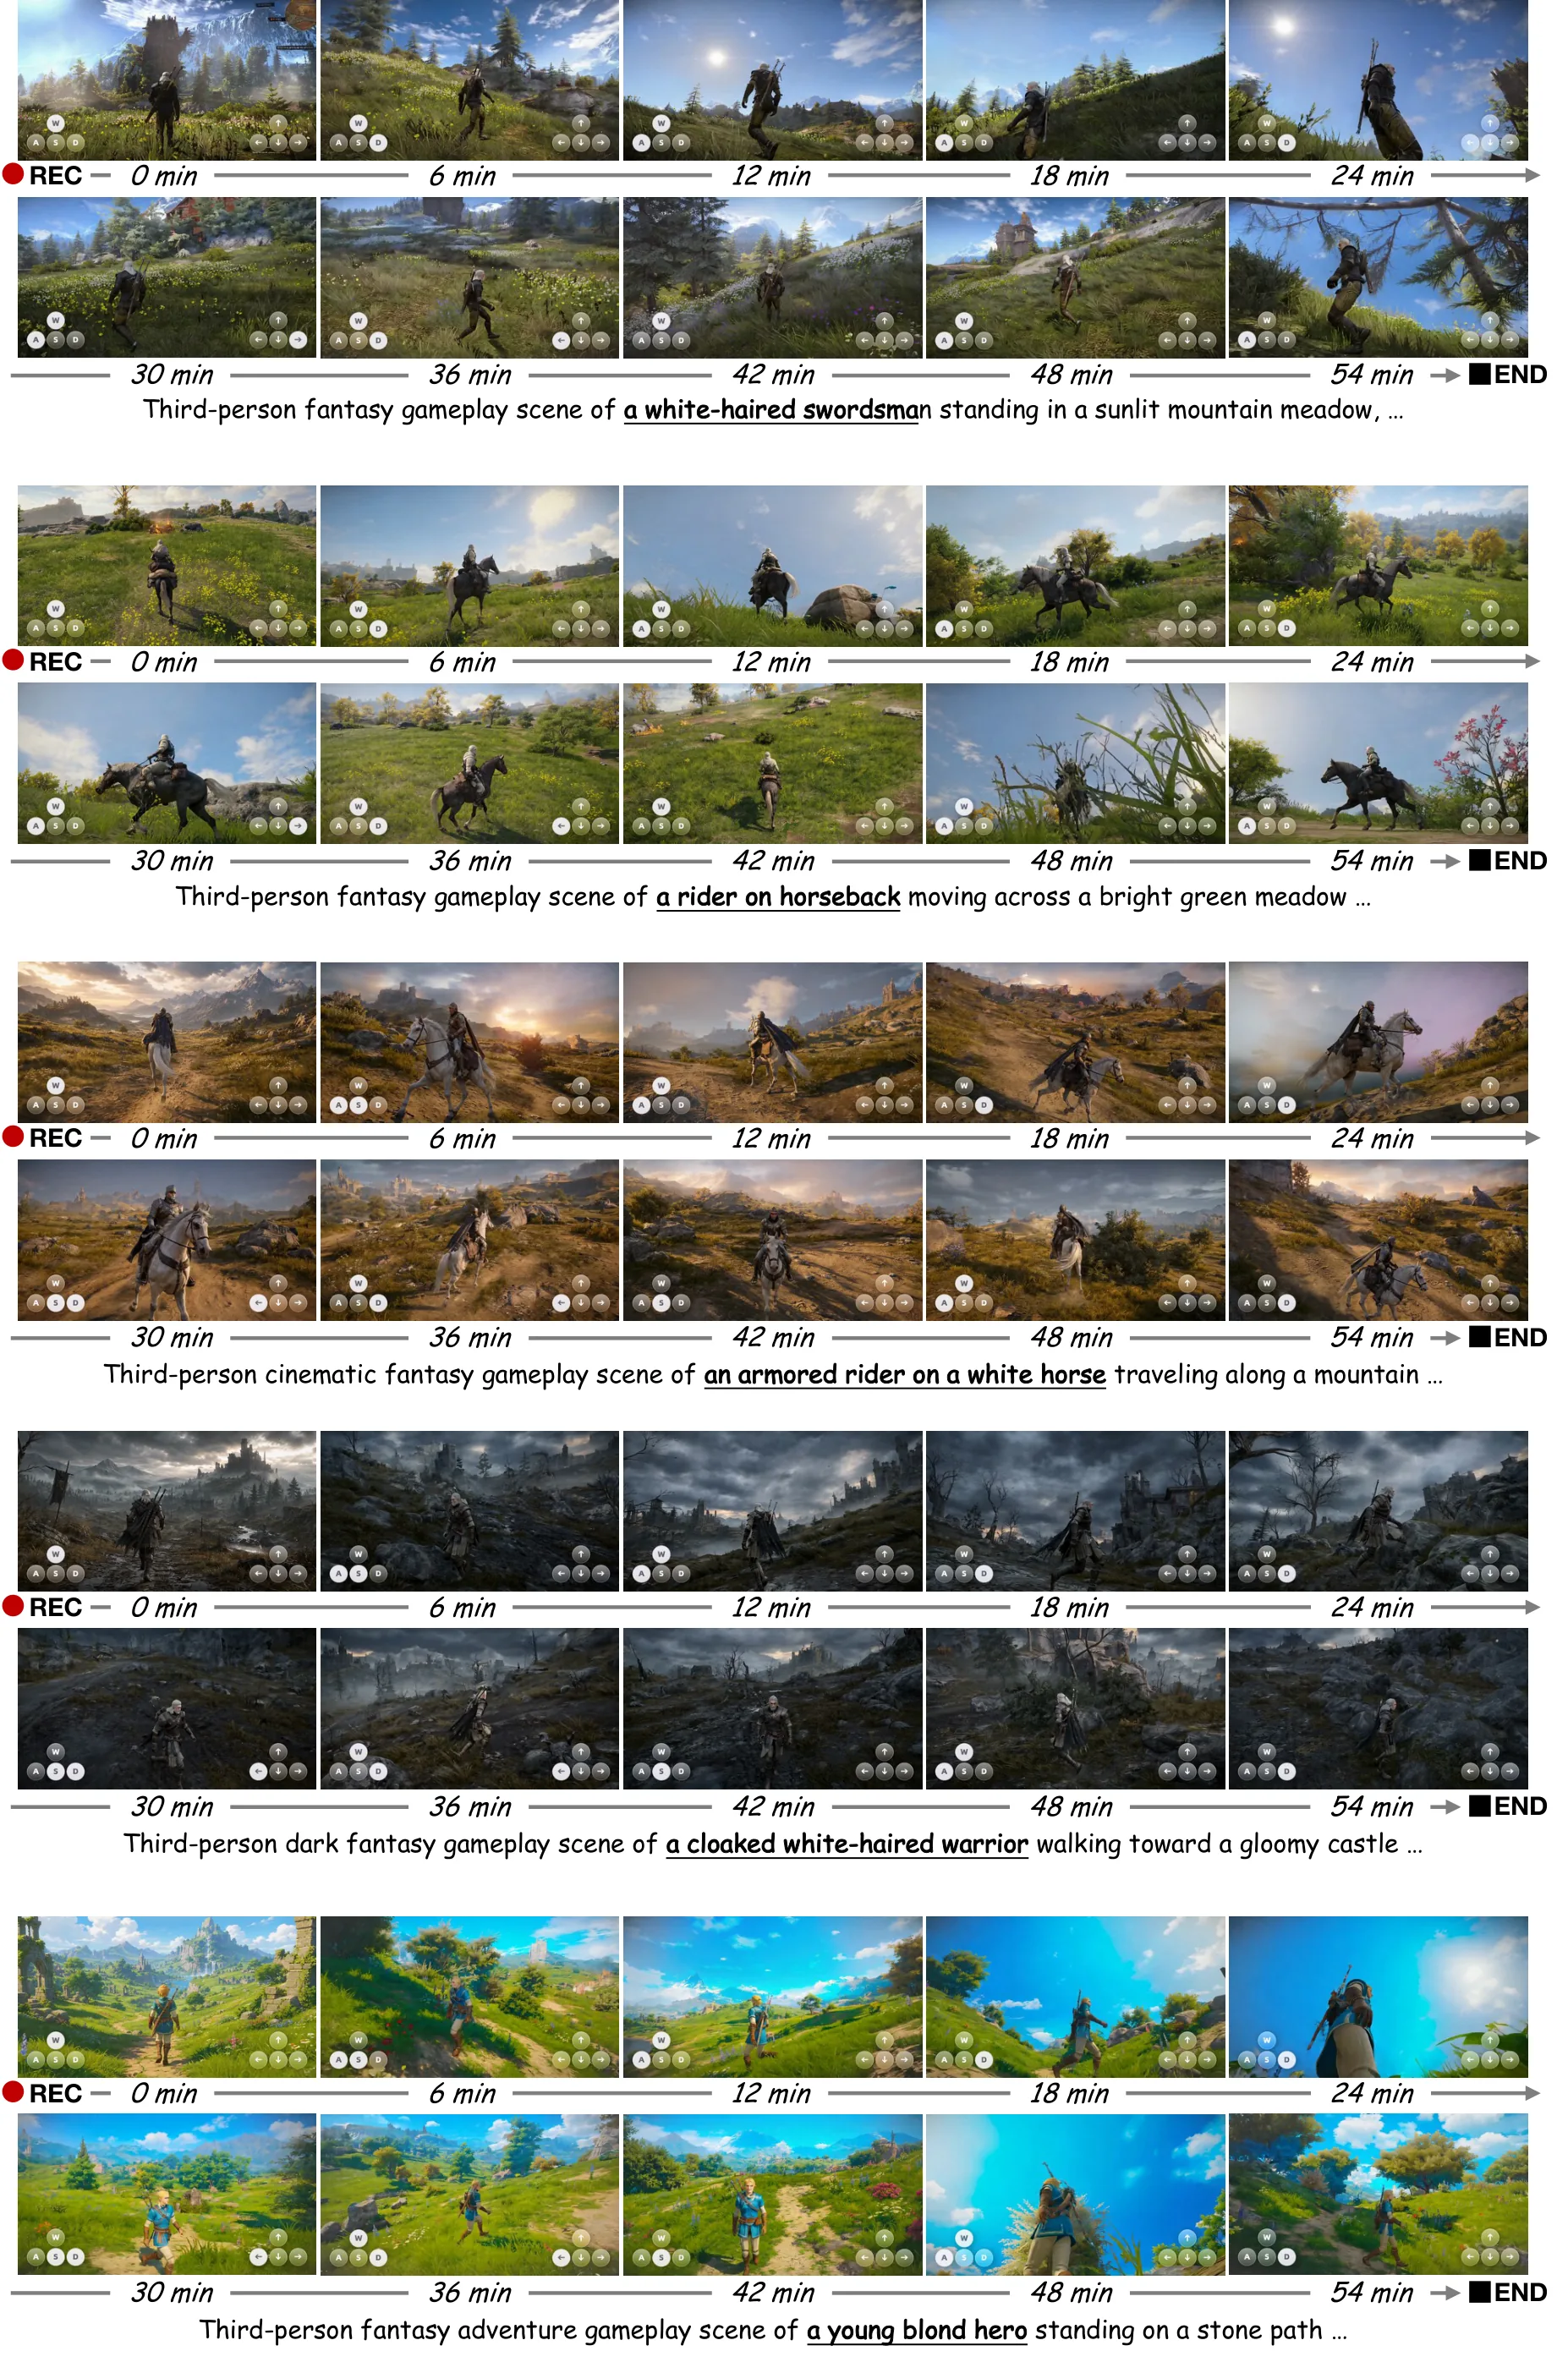
面向实时长程交互的世界模型部署困难,现有方法难以在消费级GPU上实现高帧率可控视频生成。ABot-World-0提出基于动作条件的视频世界模型,通过多源数据基础设施与WorldExplorer主动采集,结合teacher forcing、ODE蒸馏与LongForcing长程对齐策略,将双向teacher蒸馏为因果student模型。系统配备轻量VAE解码器、高效注意力与低比特DiT推理,在单张RTX 5090上以约19GiB显存实现720P视频16FPS流式输出,动作到首帧延迟1.2秒。该工作为游戏、仿真等场景的实时交互世界模拟提供了消费级部署方案。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
构建能够理解并推演物理世界的生成模型——即 [[World Model]]——一直是人工智能研究的核心目标之一。这类模型的价值在于,它们不仅能够"看懂"当前场景,还能基于交互动作预测未来的状态演化,从而为智能体提供"想象"能力,使其在虚拟环境中进行规划、试错和技能学习。
然而,将世界模型部署到实时交互场景中面临严峻挑战。理想的世界模型需要同时满足三个条件:高保真度的视觉生成、长时域的时间连贯性,以及低延迟的响应能力。现有方法往往只能兼顾其中一到两个维度。以高分辨率视频生成为例,即使是最先进的扩散模型,在消费级 GPU 上也难以实现实时帧率;而那些针对效率优化的模型,又常常在生成质量和长期一致性上做出过多妥协。
另一个关键障碍在于数据。训练世界模型需要大量动作-视频配对数据,而这类数据在公开数据集中极为稀缺。游戏和仿真引擎可以提供受控环境下的交互数据,但场景多样性和真实性有限;互联网视频虽然内容丰富,但往往缺少精确的动作标注。如何高效地构建一个覆盖多样化场景、具有一致标注的高质量训练数据集,成为制约世界模型发展的核心瓶颈。
ABot-World-0 的切入点正是同时解决这两个问题:在数据层面构建多源异构数据基础设施并开发智能采集系统,在算法层面设计高效的蒸馏与对齐策略以获得可实时推理的因果模型,在系统层面协同优化推理栈以充分利用消费级硬件的算力。
方法
ABot-World-0 的方法论可以从数据、训练、推理三个层面来理解,它们之间形成了紧密的工程闭环。
数据基础设施与主动采集。 研究团队构建了一个覆盖 3A 游戏、仿真引擎和互联网视频的多源数据管道。在数据处理上,他们设计了 14 项确定性质量检查规则(如画面稳定性检测、动作有效性过滤等),并引入视觉语言模型(VLM)进行语义层面的质量评估,确保采集的片段既有高质量的视觉内容,也有准确的动作和文本标注。这种多层级过滤机制保证了最终训练数据的可靠性。
在数据采集策略上,团队开发了 WorldExplorer 系统,它并非简单地回放预设轨迹,而是由一个训练反馈驱动的智能体引导采集过程。也就是说,模型在训练过程中的表现会被反馈到采集策略中,使系统能够主动填补那些模型预测困难或错误率高的场景,形成数据采集与模型训练的协同进化。
从双向教师到因果学生的蒸馏。 世界模型的核心推理需要因果结构——给定当前状态和动作,预测下一帧——但训练过程中利用双向上下文(如重建未来的条件)可以显著提升模型的质量和一致性。ABot-World-0 采用了两阶段蒸馏来弥合这一差距。
第一阶段是 teacher forcing 蒸馏。教师模型在训练时可以访问双向上下文,因此在每个时间步都能做出高质量预测。学生模型则被迫仅基于当前隐藏状态和动作进行自回归预测,通过让教师"强制喂给"学生每个时间步的真实输出,使学生逐渐学会从有限的因果信息中推断全局一致的状态。
第二阶段引入常微分方程(ODE)蒸馏。直觉上,模型的状态演化可以看作一个连续的动态系统,ODE 提供了描述这种连续演化的数学框架。通过将教师模型的预测轨迹建模为 ODE 的解,团队设计了一个蒸馏损失,使学生的离散自推演轨迹与教师在连续时间上的轨迹对齐。这一步骤进一步平滑了学生模型的行为,减少了因离散采样导致的不连贯性。
LongForcing 长程对齐策略。 即使完成了上述蒸馏,学生模型在长时间自推演过程中仍然会累积误差,导致视觉质量和动作可控性逐渐退化。这本质上是 [[Teacher Forcing]] 方法的经典问题:训练时看到真实标签,推理时却只能依赖自身预测,二者分布差异会随时间放大。
LongForcing 的核心思想是在训练后期引入周期性"对齐检查点":让学生的长时自推演结果与教师模型在扩展时域上的预测进行对比,如果偏离过大,则让教师重新"接管"几个时间步,提供纠正信号。这类似于给模型装上了一个周期性的校准机制,防止误差在时间维度上无限累积。
流式推理栈的协同设计。 部署层面面临的挑战是:要在有限显存下实现高帧率视频生成,必须在模型体积、计算效率和生成质量之间找到平衡点。ABot-World-0 的推理栈包含几个关键优化:轻量级 VAE 解码器减少了变分自编码器的计算开销;高效注意力机制(如稀疏或局部注意力)降低了 transformer 的计算复杂度;内存感知调度通过分块处理和显存复用减少了峰值显存占用;低位宽 DiT 推理(INT8/INT4 量化)则在保持质量的前提下大幅压缩了模型体积和计算量。这些优化并非独立进行,而是经过系统级的协同调优,使各组件的效率瓶颈相互错开,最终在 RTX 5090 上实现了约 19 GiB 显存下的 720P 16 FPS 流式输出。
实验与结果
实验在两个维度上验证了 ABot-World-0 的有效性:WorldRoamBench 基准测试和扩展的交互式推演。
WorldRoamBench 是一个针对世界模型设计的评测套件,它通过预设的动作序列和场景配置,考察模型在可控性(给定动作后生成结果是否符合意图)和长程连贯性(多帧连续推演后场景是否保持一致)上的表现。ABot-World-0 在这些指标上与同期其他方法相比展现了竞争力的表现,特别是在长时推演场景下,LongForcing 策略带来的改善是可量化的——随着推演步数增加,其性能衰减幅度显著低于基线方法。
扩展交互式推演实验则更接近实际应用场景。研究者邀请用户通过键盘直接控制角色或相机,观察模型能否实时响应多样化的动作指令。结果显示,模型在场景漫游(第一人称视角)和角色交互(第三人称视角)两种模式下均能保持较低的动作响应延迟和视觉一致性。第三人称场景中引入的参考角色记忆机制,通过在推理时提供角色的外观特征作为持久线索,有效避免了长时间推演中身份信息丢失的问题。
值得注意的是,这些结果是在消费级硬件配置下取得的。RTX 5090 虽然是高端桌面 GPU,但并非专业计算卡,其 16 FPS 的帧率和 1.2 秒的首帧延迟意味着用户在实际交互中可以感受到近乎实时的反馈。这与许多只能在服务器级多卡集群上运行的世界模型形成鲜明对比,极大地拓展了潜在的应用场景边界。
讨论与可借鉴点
ABot-World-0 的核心贡献不仅在于刷新了某项技术指标,更在于它展示了一条从算法创新到系统优化再到硬件部署的完整链路。在这条链路上,有几个值得深思的设计哲学。
首先是数据与模型的协同进化。WorldExplorer 的主动采集策略打破了传统"先采集后训练"的线性流程,将模型反馈纳入数据收集的决策闭环。这种思路在数据饥渴的生成模型时代尤为重要——与其被动等待足够多的数据,不如让模型告诉你它还需要什么样的数据。
其次是蒸馏策略的系统性设计。从 teacher forcing 到 ODE 蒸馏再到 LongForcing,每一层都针对一个具体的分布漂移问题。这种层层递进的设计避免了"一招鲜"的简单方案可能带来的顾此失彼,也为后续研究提供了可组合的模块化组件。
第三是工程与学术的深度融合。在消费级硬件上实现高质量实时生成,不能仅仅依靠算法层面的创新,还需要在推理引擎、显存管理、量化策略等工程细节上做大量细致的优化。这提醒我们,大模型的落地从来不是算法独角戏,而是一个需要系统工程思维的综合性挑战。
当然,这项工作也存在局限。720P 分辨率虽然适合桌面交互,但距离电影级或工业仿真的需求仍有差距;16 FPS 在快节奏游戏中可能仍嫌不足;模型在极端动作(如快速场景切换、复杂物理交互)下的表现也有待进一步验证。此外,LongForcing 虽然有效缓解了长程漂移,但其计算开销和实现复杂度是否会限制模型进一步扩展,仍是一个开放问题。
对于整个世界模型研究社区而言,ABot-World-0 最有价值的启发或许在于:它证明了在现有硬件条件下,实时交互式世界模拟并非遥不可及。关键在于,是否愿意在数据、算法、系统三个层面同时发力,而非偏废其一。
摘要
基于AAA游戏数据构建交互式世界模型用于游戏智能体推演
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
AlayaWorld:交互式长视野世界建模——完整技术报告
AlayaWorld: Interactive Long-Horizon World Modeling -- Full Technical Report
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 8 张
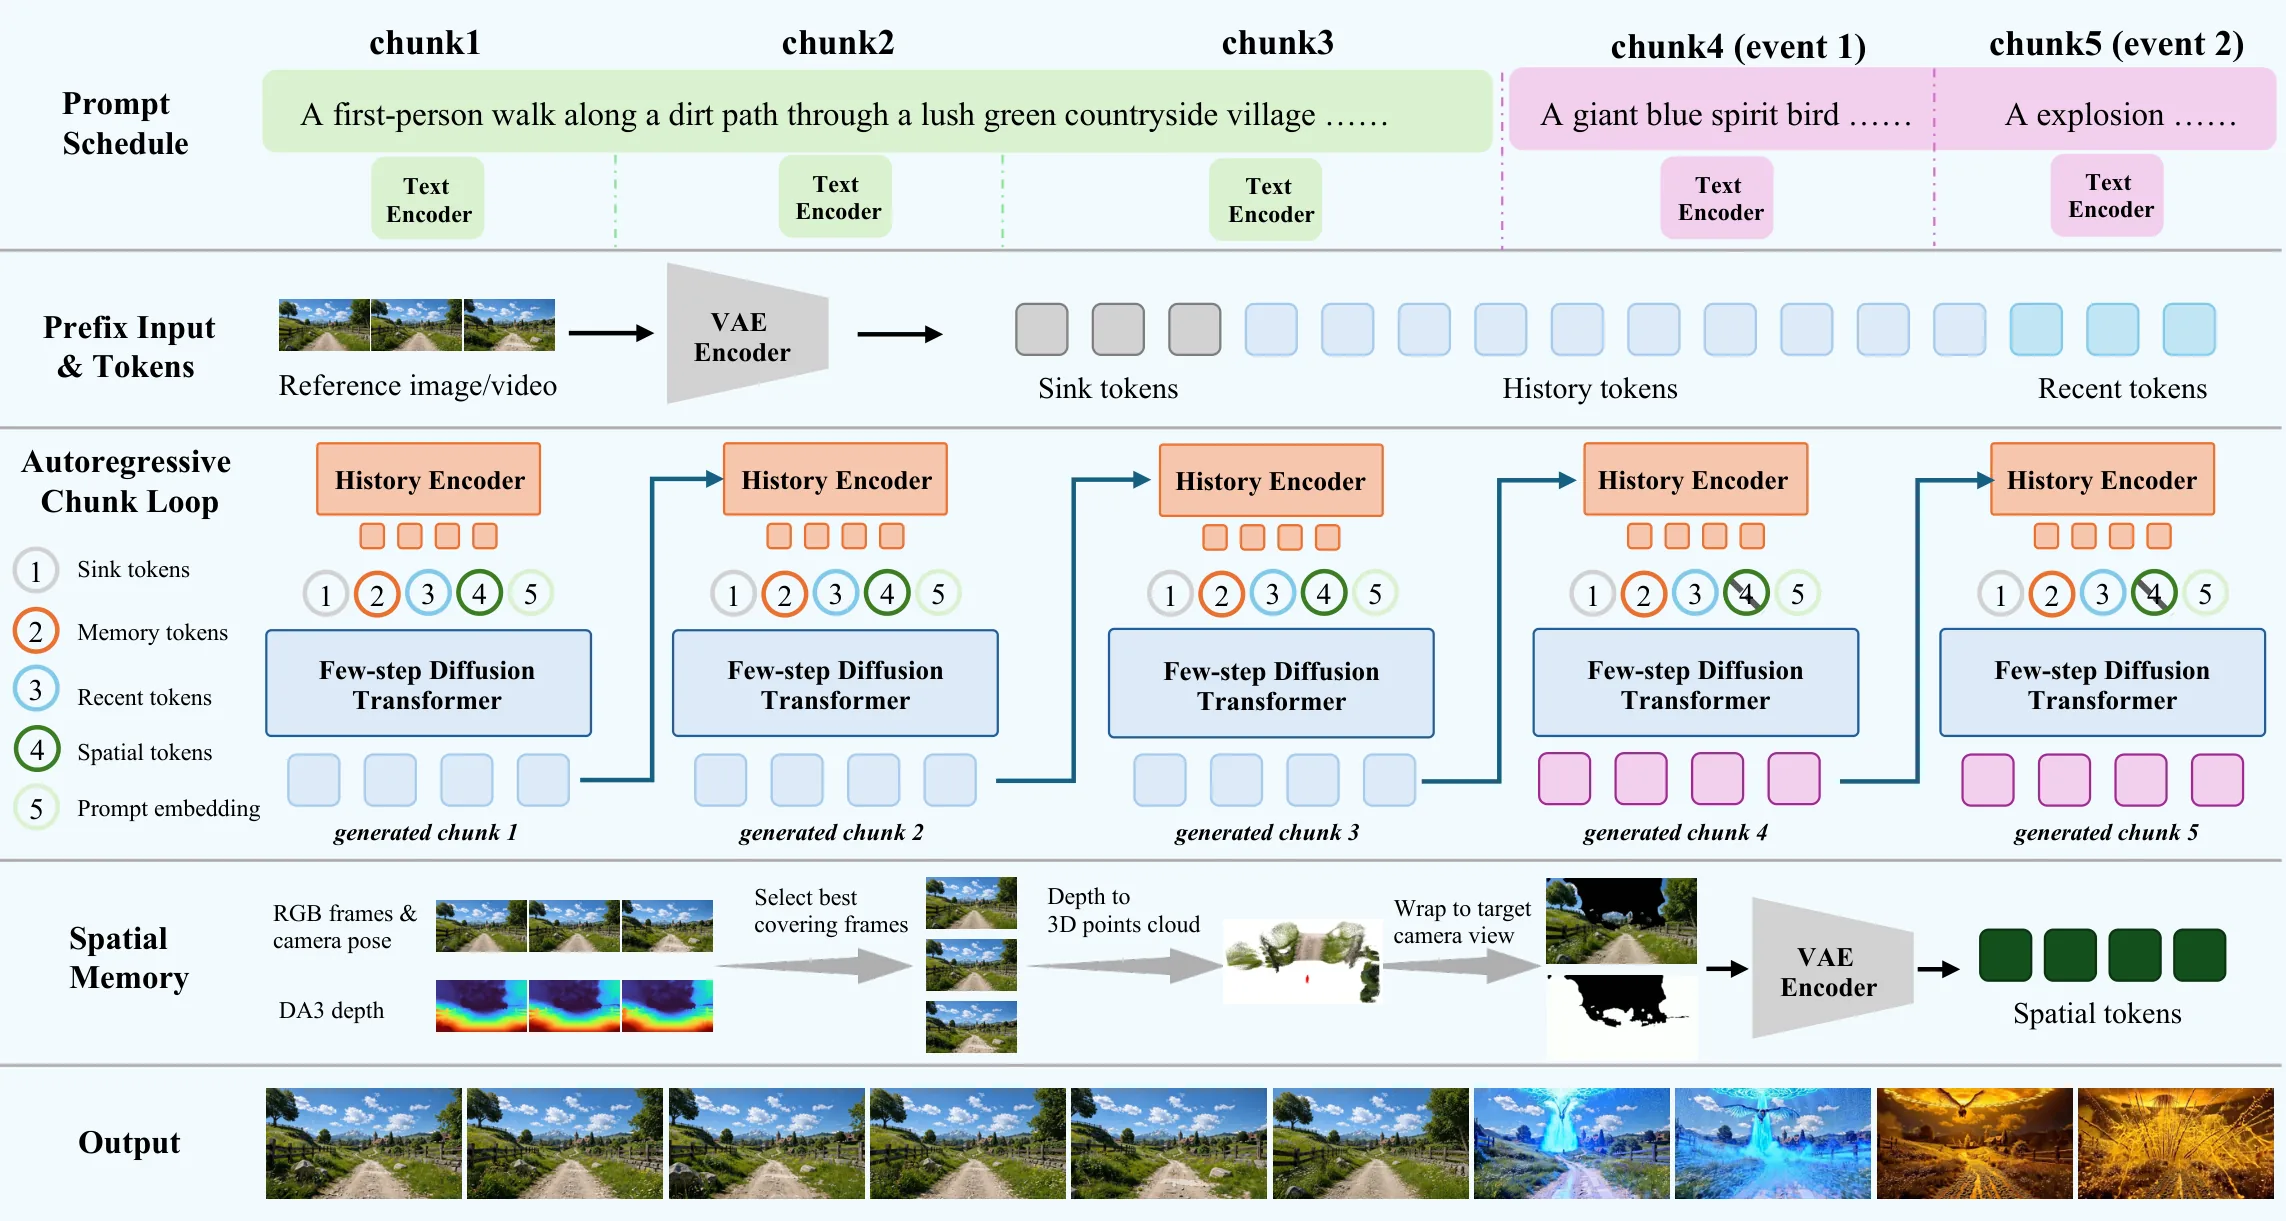
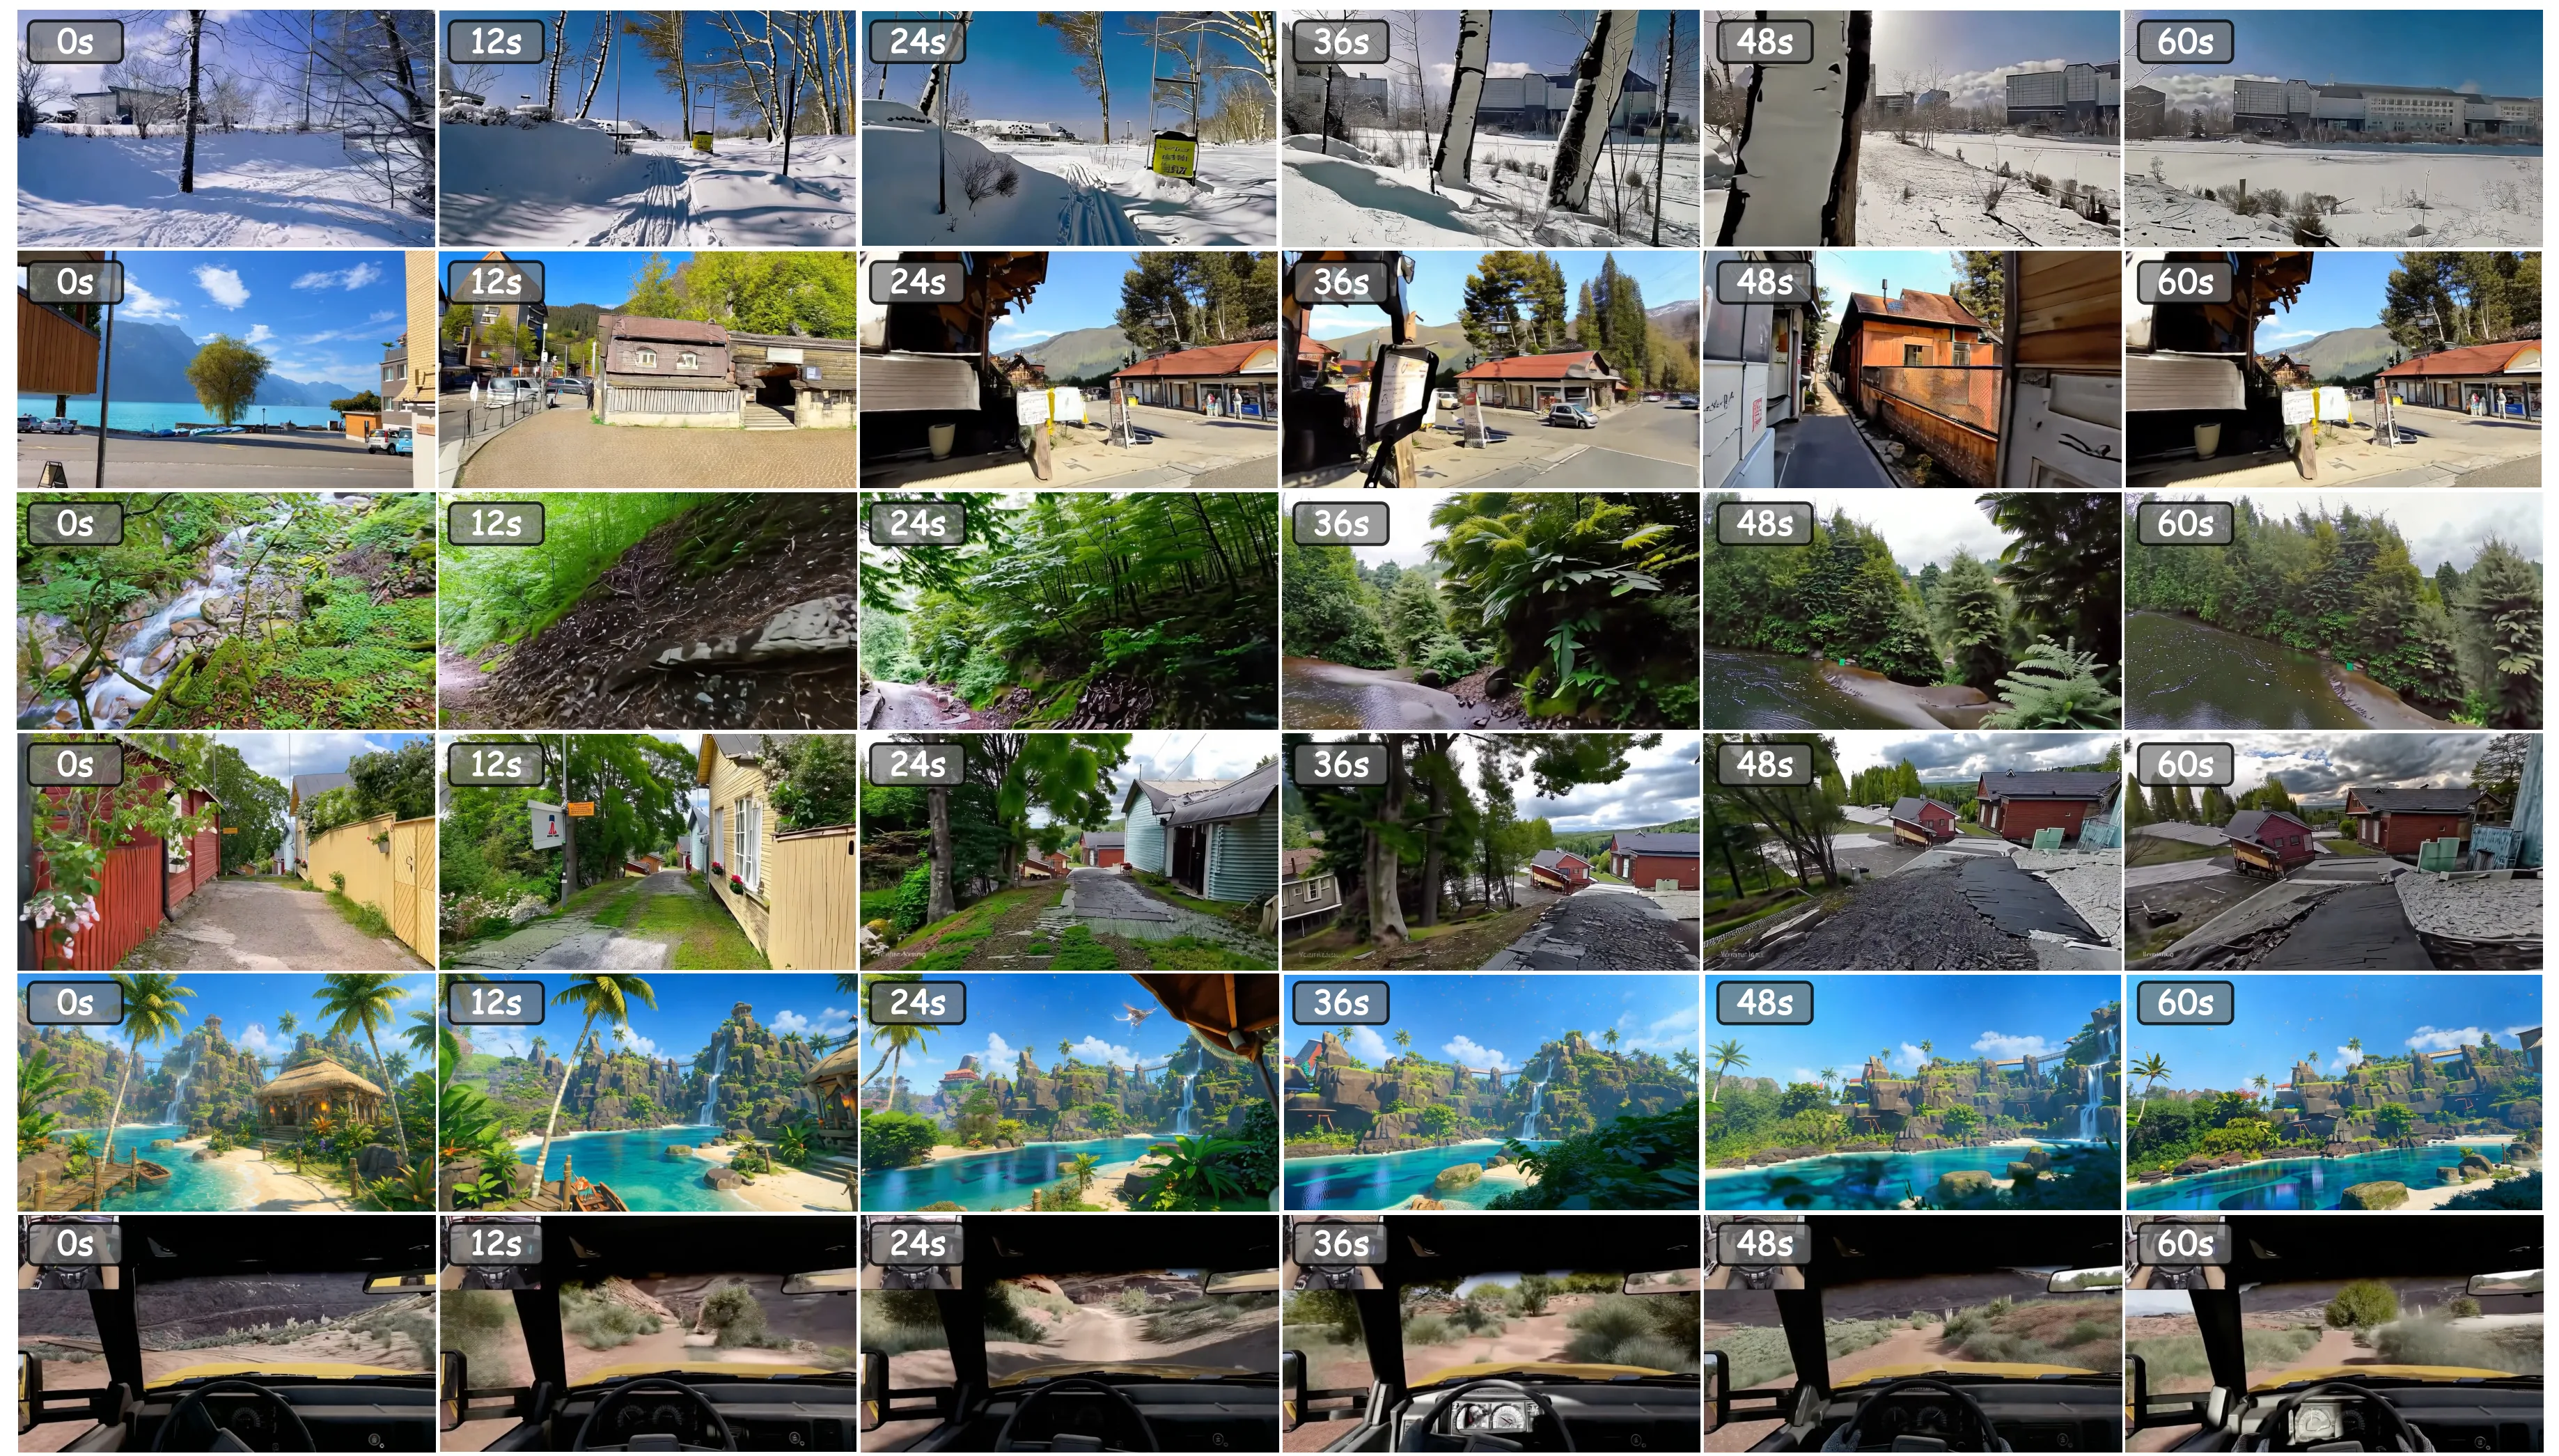
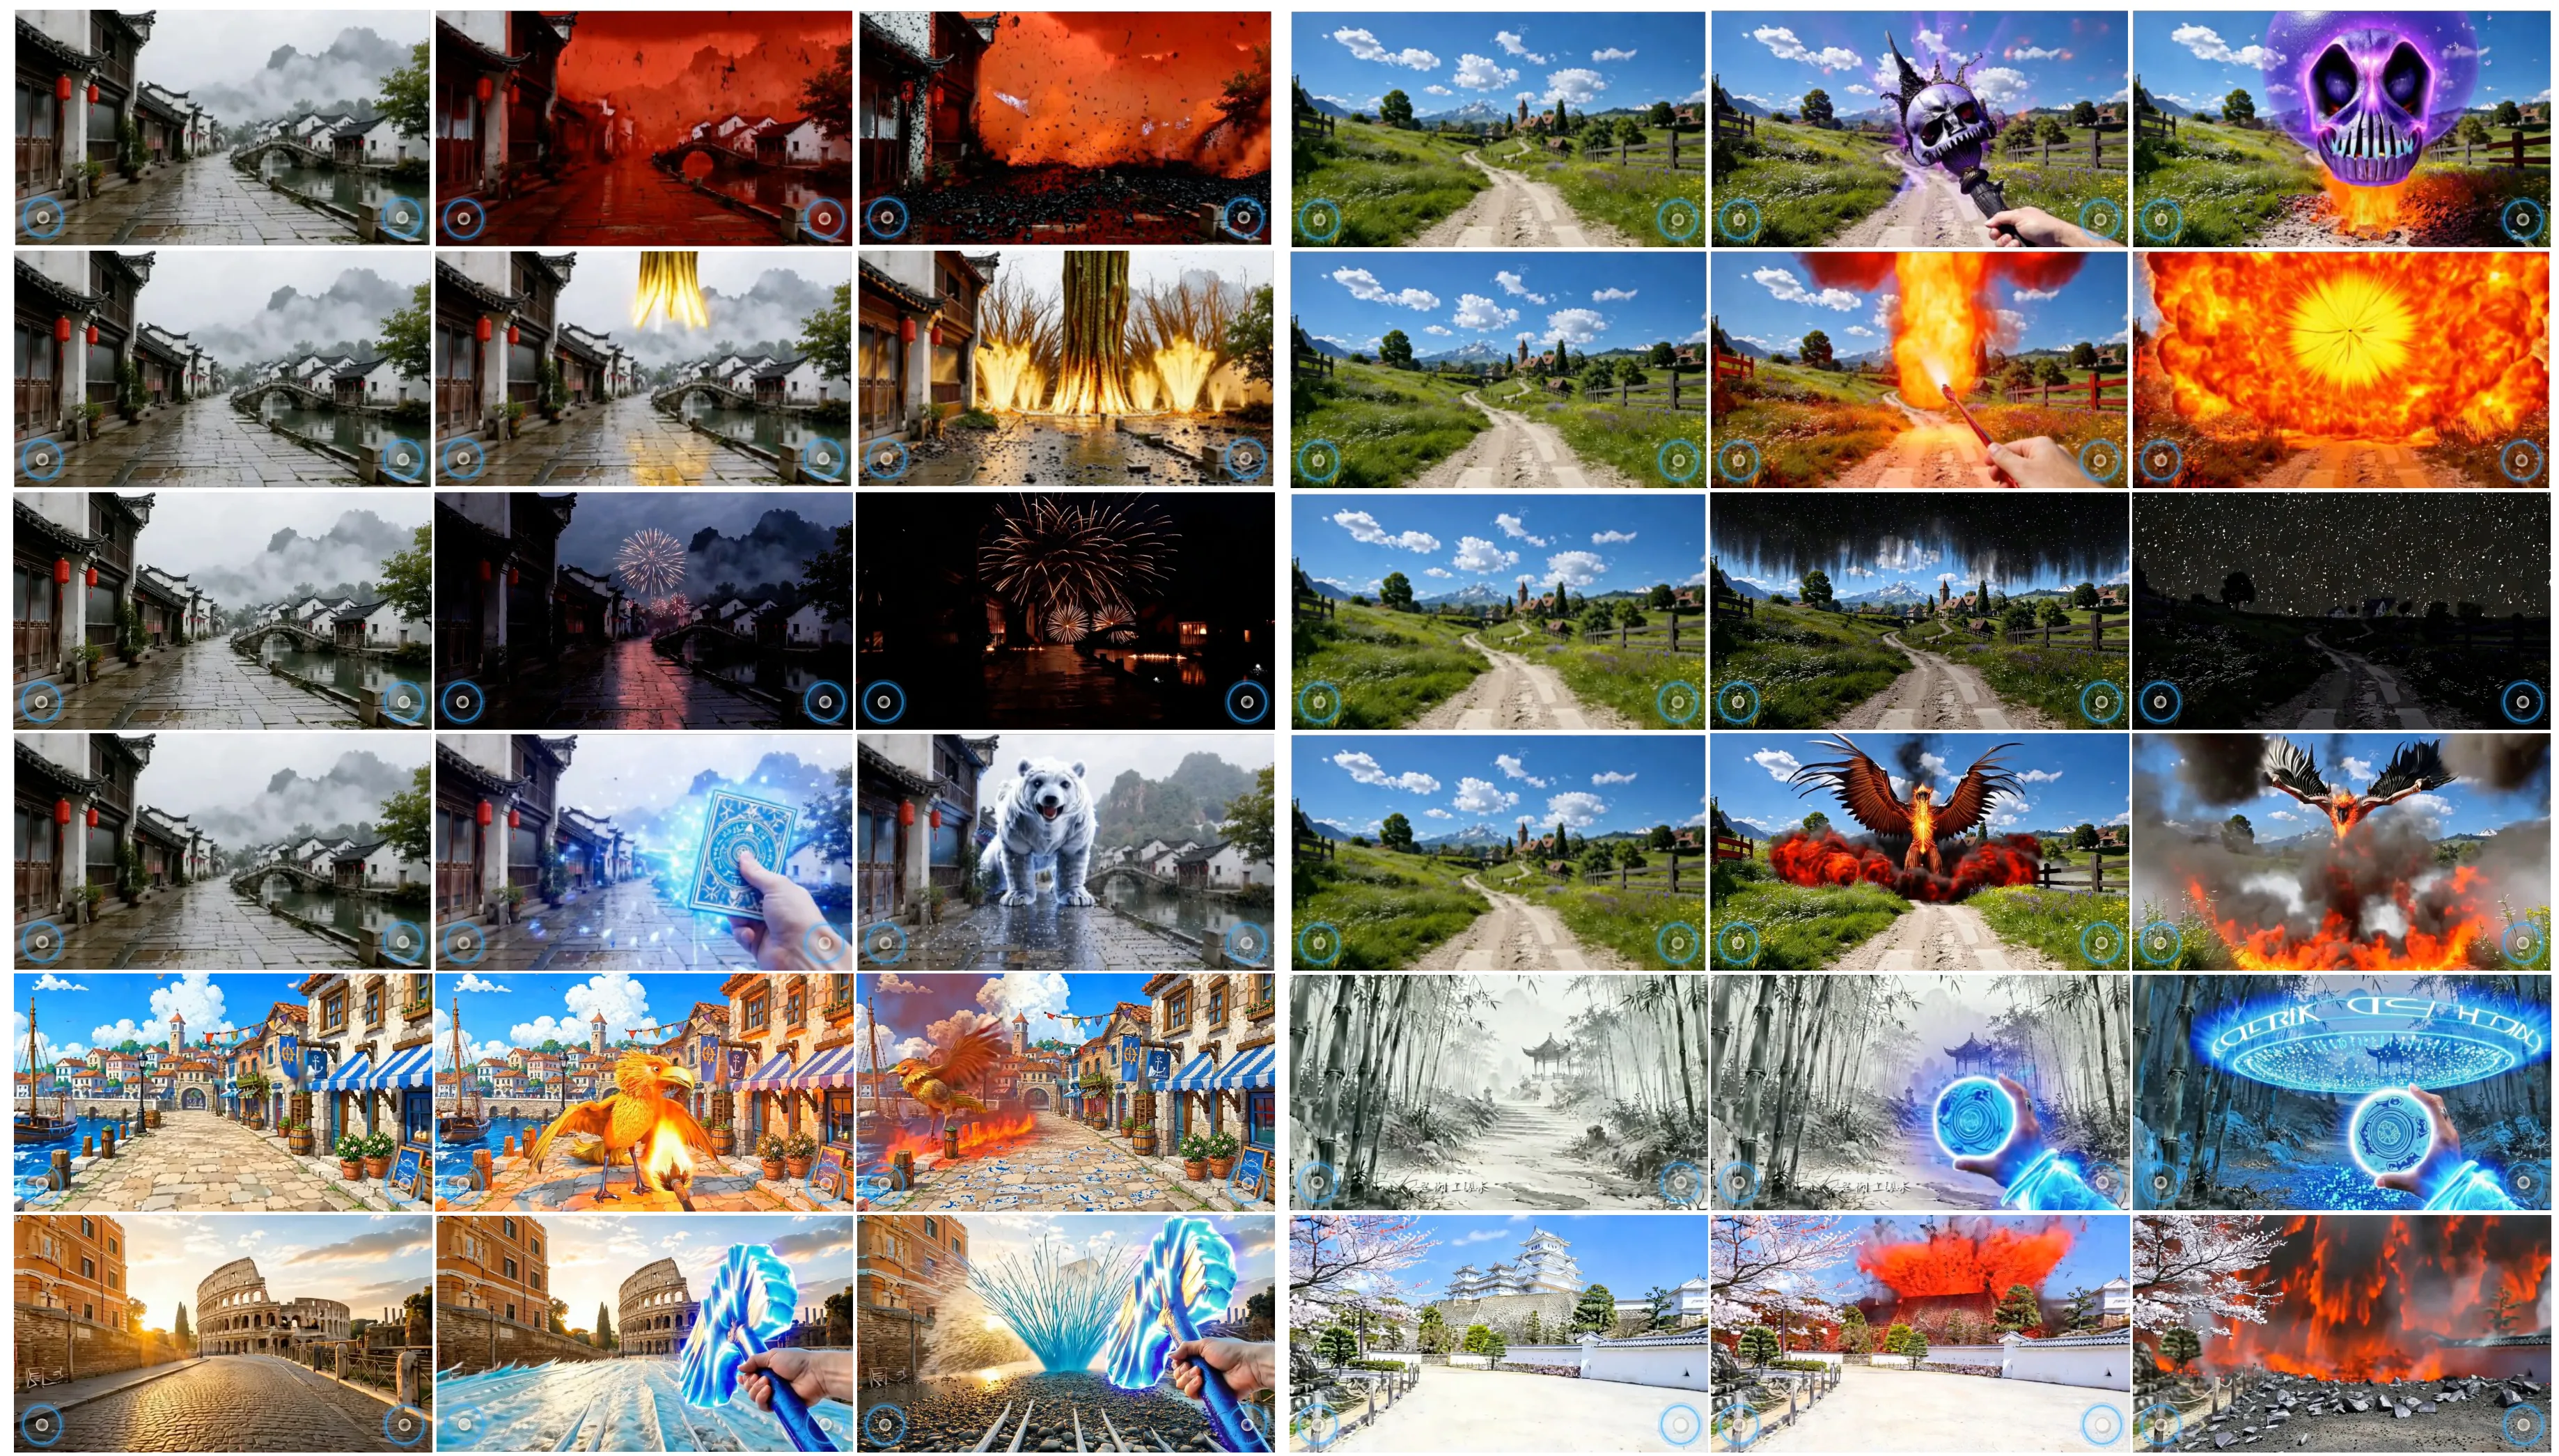
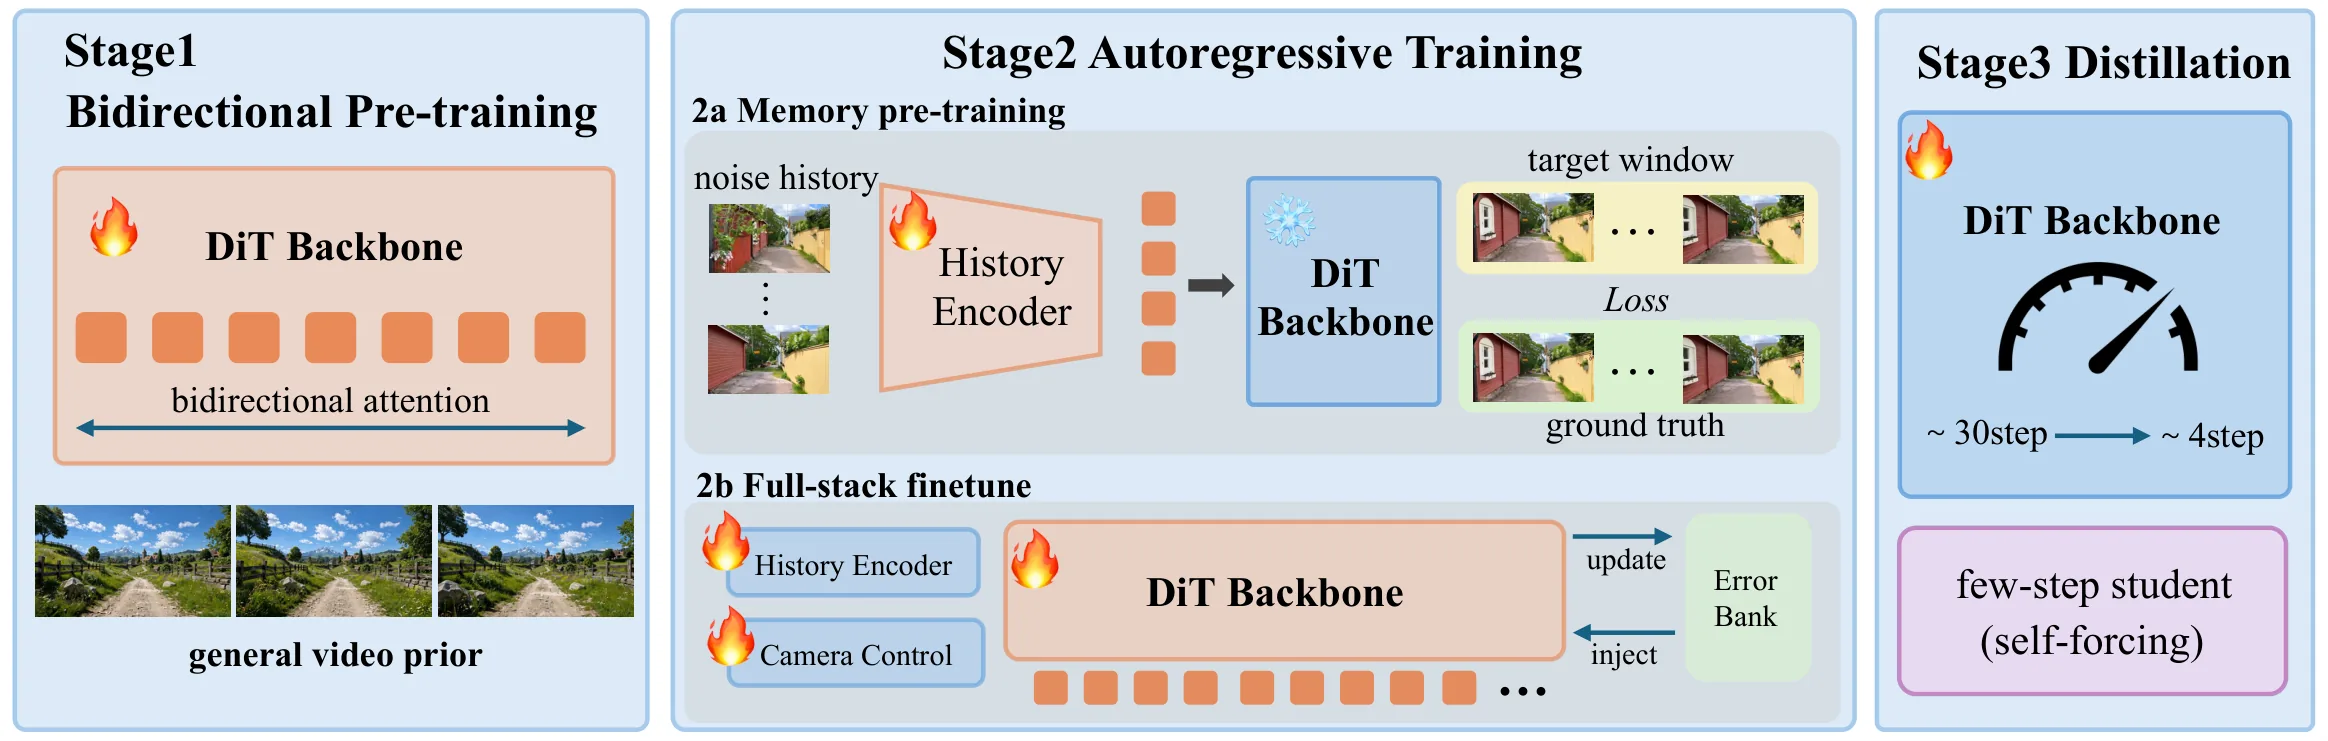
视频世界模型旨在从文本、图像或视频即时生成交互式可探索虚拟环境,核心挑战在于长时一致性、稳定生成与高效推理的统一。AlayaWorld基于150亿参数视频扩散Transformer,以相机轨迹和可切换文本提示为条件自回归生成短潜在片段,结合持久汇帧、压缩时序历史与几何对齐空间记忆构建有界上下文,并通过对自身回滚历史与预测残差的训练缓解长期漂移。进一步引入离散自回归蒸馏将每片段推理由约30步降至4步,在iWorld-Bench长时生成上达到最优。作为全栈开源框架为交互式视频世界模型后续研究提供了可扩展基础。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
传统的视频游戏或虚拟环境开发依赖劳动密集型的流水线,需要专业团队分别完成资产生成、动画设计、物理模拟与程序编写等多个环节。这种模式不仅成本高昂,而且难以实现真正的即时交互与快速迭代。视频世界模型(Video World Model)的愿景是打破这一困境——用户只需提供文本描述、图像甚至视频片段,系统就能即时生成可探索、可交互且持续演化的虚拟世界。
然而,将这一愿景落地面临四项紧密耦合的核心挑战。交互性要求模型能够根据用户输入(如相机移动、动作指令)实时调整生成内容;持久的时空一致性意味着场景中的物体、光照、材质等属性需要跨越时间保持稳定,不能出现物体的凭空消失或外观突变;稳定的长视野生成要求模型在数百帧甚至更长时间跨度内保持质量,而非仅仅生成几秒钟的精彩片段后迅速崩坏;高效响应则是实际应用的硬性约束——用户操作后系统必须快速反馈,否则体验会严重打折。
已有工作在这些方向上取得了进展,但往往顾此失彼:一些方法专注于视觉质量却忽视了交互能力,一些能够响应输入但随着时间推移快速累积误差导致场景崩溃,还有些虽然生成长但推理成本高到无法实用。AlayaWorld 的切入点正是这四个维度的协同优化:通过精心设计的有界上下文机制保证一致性,通过专门的训练策略对抗长期漂移,通过离散蒸馏技术压缩推理步数,最终在交互式长视野生成这一综合任务上达到最优表现。
方法
AlayaWorld 的核心架构建立在 150 亿参数的视频扩散 Transformer 之上,采用自回归方式逐段生成视频潜变量片段。这一选择的直觉在于:视频本质上是一个时间序列,每一时刻的内容都由之前的历史和当前输入共同决定,自回归模型天然适合建模这种序列依赖关系。
有界视觉上下文(bounded visual context)是 AlayaWorld 保证时空一致性的关键设计。在自回归生成过程中,模型需要"记住"之前已经建立好的场景信息,但显然不可能无限累积历史——这既不现实也无必要。AlayaWorld 采用四层记忆结构的组合来优雅地解决这个问题。持久汇帧(persistent sink frame)作为全局场景状态的压缩表示,始终参与每一帧的生成,充当场景属性的"锚点";压缩时序历史(compressed temporal history)用高度下采样的方式保留近期帧的粗粒度运动信息;几何对齐的空间记忆(geometry-aligned spatial memory)则将场景的三维几何信息与二维视觉特征对齐,帮助模型理解空间结构;最后,近期帧条件(recent-frame conditioning)直接提供几帧高分辨率的近期画面作为细节生成的参考。这四层结构相互配合,既保证了信息的充分传递,又将计算量控制在可接受范围内。
长期漂移是自回归视频生成的老大难问题:随着生成帧数增加,小错误会不断累积,最终导致场景完全崩溃。AlayaWorld 采用一种巧妙的训练策略来对抗这种漂移。在训练阶段,模型会被喂入"损坏的历史"——即故意在历史信息中引入噪声或缺失——同时要求模型正确预测当前帧;此外,模型还要从自己的回滚推演(roll-out)中收集预测残差进行训练。这些残差本质上是在学习"当模型犯错时如何自我修正"。通过这种方式,模型在推理阶段面对自己之前生成的不完美结果时,能够进行有效的纠错而非错误累积。
在推理效率方面,AlayaWorld 引入了离散自回归蒸馏(discrete autoregressive distillation)。视频扩散模型的推理通常需要多步迭代采样来完成去噪过程,文中提及每片段约 30 步采样,这在实时交互场景中过于缓慢。AlayaWorld 将分布匹配蒸馏、self-forcing++ 和一致性蒸馏三种技术统一到一个框架中,通过蒸馏将每片段推理步数压缩到仅 4 步,同时保持生成质量。这一压缩比意味着用户操作后能得到近乎即时的反馈。
实验与结果
AlayaWorld 在 iWorld-Bench 基准上进行了系统性的长视野生成评测。这一基准专门设计用于评估视频世界模型的长时间一致性与交互能力,要求模型在数百帧的跨度内持续生成符合逻辑的场景内容。
实验结果印证了设计决策的有效性。在长视野生成这一核心指标上,AlayaWorld 取得了最优表现,对比之前的方法有显著提升。定性分析进一步展示了模型的鲁棒性:在长序列推演中,场景中的物体外观保持一致,空间关系合理,相机移动带来的视角变化被正确建模。消融实验也验证了各模块的贡献——移除有界上下文中的任一层都会导致长期一致性的下降,而蒸馏模块的引入则在几乎不损失质量的前提下将推理速度提升了一个数量级。
在分辨率与帧率方面,AlayaWorld 支持 540p 和 720p 两种分辨率,均能以 24fps 的实时帧率输出,这为不同算力条件下的应用提供了灵活性。
讨论与可借鉴点
AlayaWorld 在交互式视频世界建模这一前沿方向上实现了重要的技术突破,其设计思路为后续研究提供了多个可借鉴点。将一致性保证分解为多层记忆结构而非单一记忆机制,体现了系统设计中"分而治之"的智慧;通过让模型学习自己的错误来提升鲁棒性,避免了对外部纠正信号的依赖;三种蒸馏技术的统一框架则展示了如何针对具体场景定制化压缩模型。
当然,论文也留有一些开放性问题值得关注。150 亿参数的规模意味着显著的算力门槛,这限制了研究的普及性;4 步推理虽然相比 30 步已是数量级的进步,但在某些极致低延迟场景下可能仍有压缩空间;此外,iWorld-Bench 作为自建基准,其评测维度的全面性值得社区进一步检验。
作为"全栈开源"项目推进的 AlayaWorld,为交互式视频世界模型的后续研究提供了可扩展的基础设施。随着更多开发者的参与,这一方向有望在游戏开发、机器人仿真、数据增强等场景中加速落地。
摘要
交互式视频世界模型生成长视距类游戏环境
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
从像素到状态:将交互式世界模型重新思考为游戏引擎
From Pixels to States: Rethinking Interactive World Models as Game Engines
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 2 张
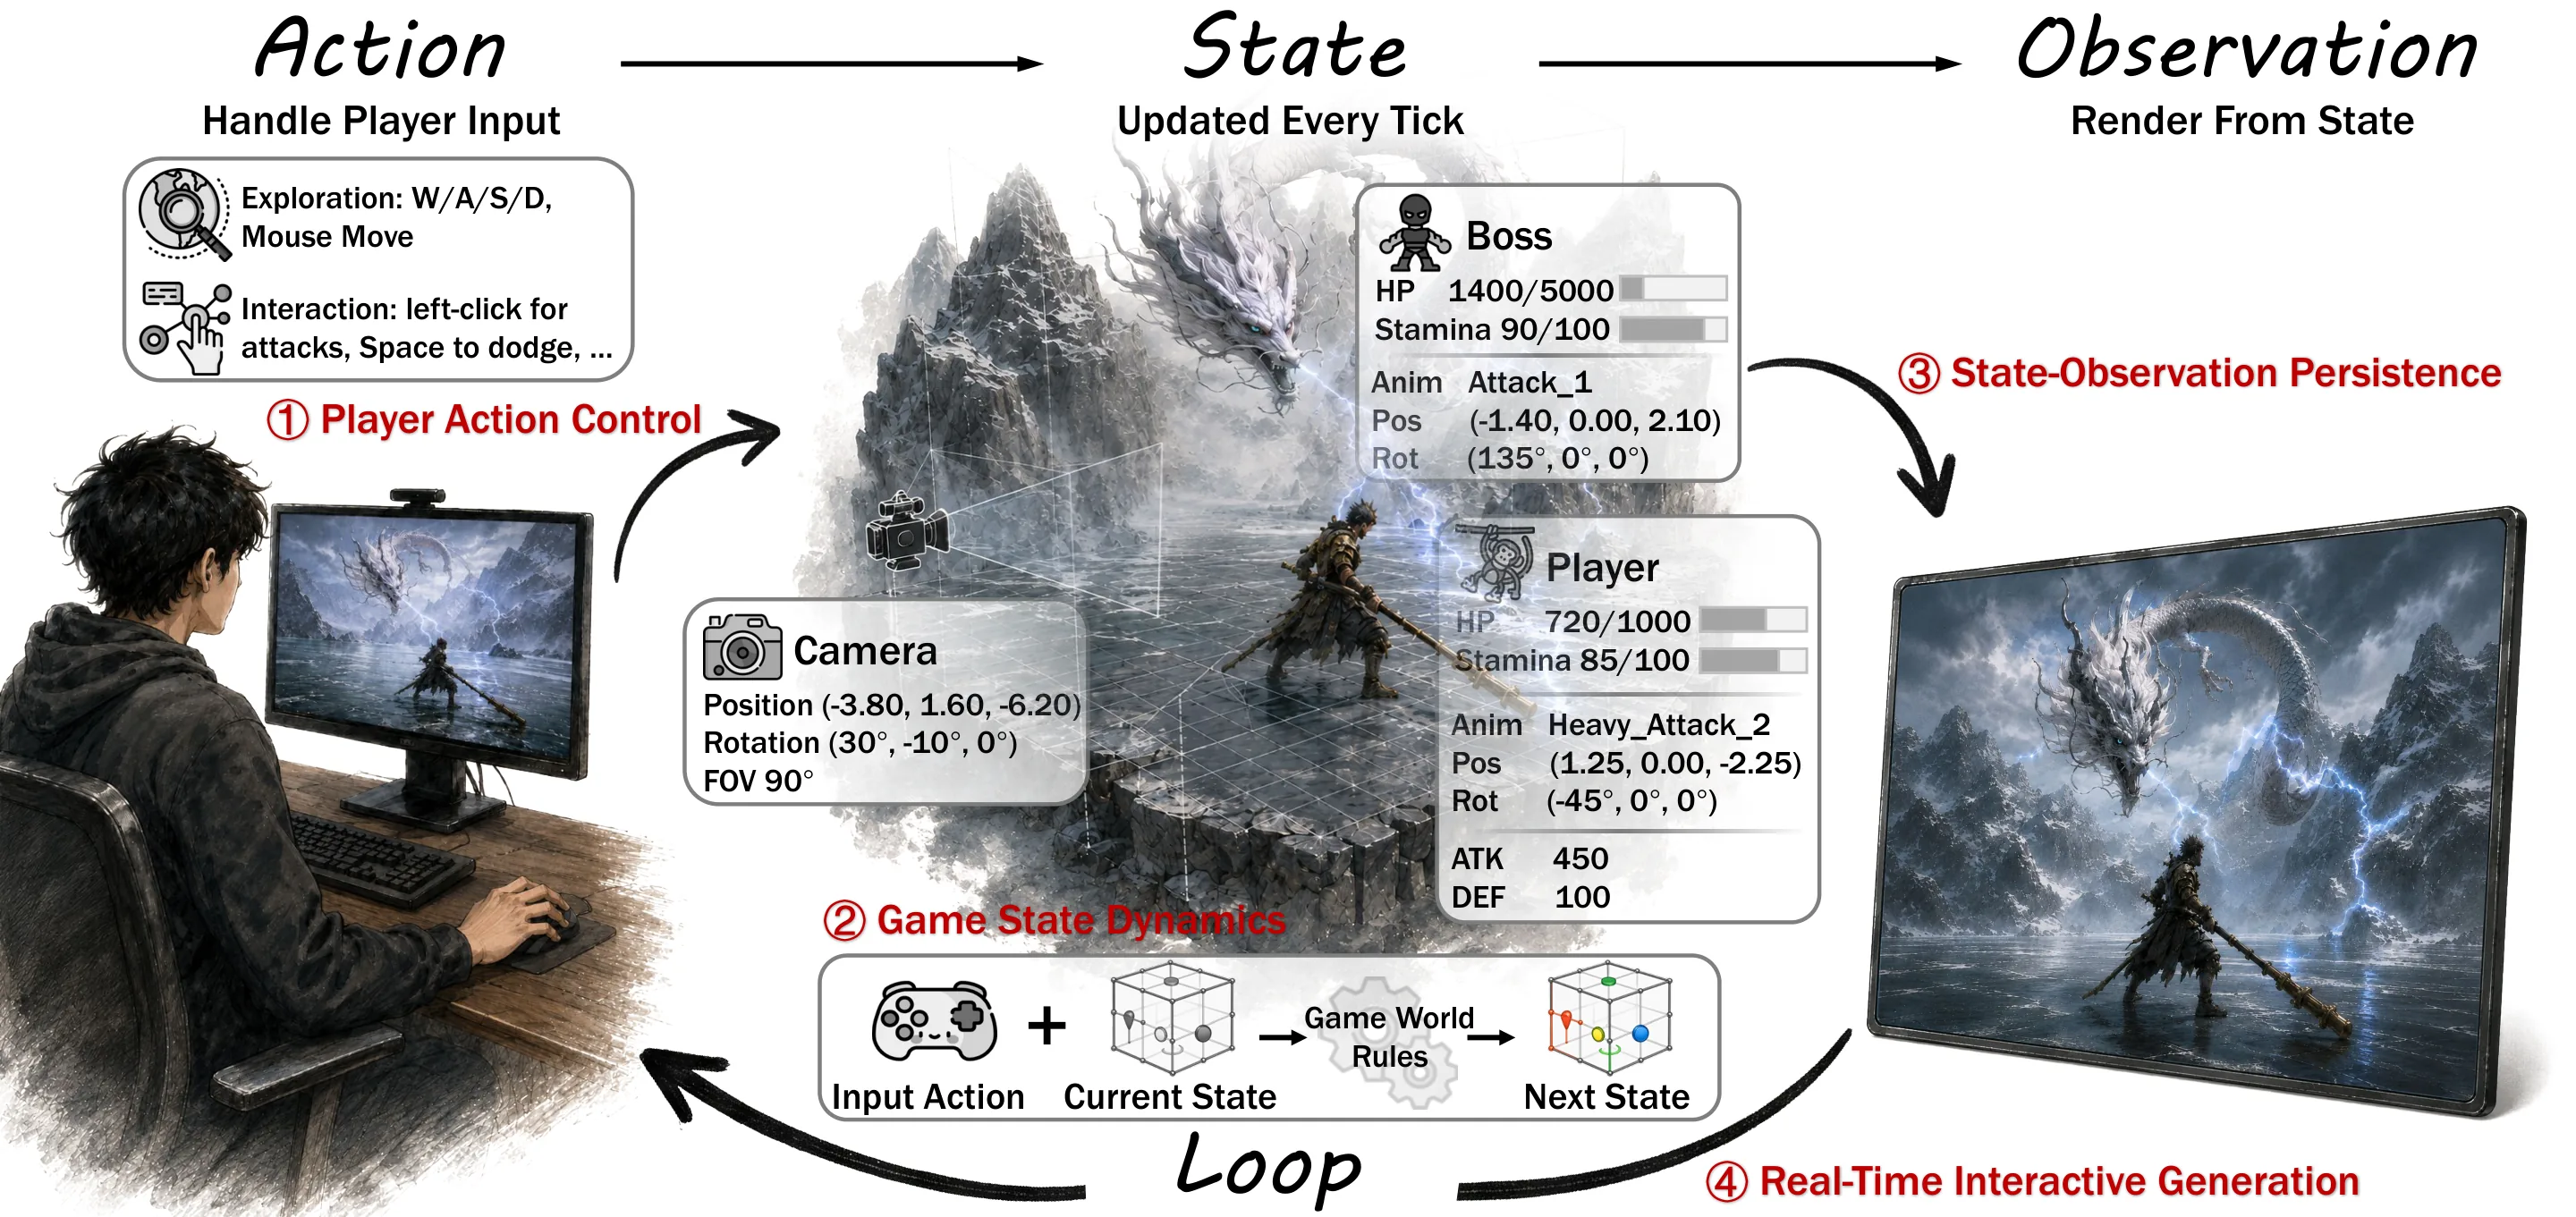
交互式游戏世界需要动作-状态-观测的循环一致性。现有视频生成模型虽能预测未来帧,但缺乏对显式游戏状态的建模与长时持久性,难以满足真实交互需求。本文以传统游戏引擎的"动作-状态-观测"循环为分析框架,从动作控制、状态动力学、状态-观测持久性、实时生成四个维度综述现有方法,并构建面向《黑神话:悟空》的可扩展数据引擎,发布超90小时帧对齐游戏数据。该工作为状态感知的交互世界建模提供清晰研究图景与数据基础。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
构建能够对玩家动作做出连贯响应的交互式游戏世界,长期以来是计算机图形学、游戏工程与人工智能领域共同追逐的目标。近年来,[[视频生成模型]]的快速发展为这一目标开辟了一条数据驱动的实现路径:通过在用户动作条件下预测未来观测帧,这类模型日益被视为潜在的下一代[[游戏引擎]]替代方案。
然而,当我们将这些看似强大的视频生成模型真正放置到游戏交互场景中时,会发现它们与理想之间存在显著鸿沟。真正的交互式游戏世界需要满足三个核心要求:交互结果必须遵循随游戏条件演化的规则(例如,攻击虚弱状态的敌人应该产生不同于攻击满血敌人的效果);动作的后果必须在长时程上持续保持(你砍掉的那扇门不应在几步之后就莫名其妙地重新出现);生成循环必须在实时约束下运行(玩家无法接受动作发出后等待数秒才能看到反馈)。
传统游戏引擎解决这些问题的方式是构建一个清晰的循环回路:玩家动作依据预定义的规则更新一个显式的游戏状态,而观测(即玩家看到的画面)则从该状态渲染生成。这种架构确保了因果链条的透明性和状态记忆的持久性。但纯粹基于学习的方法往往缺乏这种显式状态建模,导致生成的内容虽然在视觉上流畅,却难以维持跨时间的因果一致性和状态连续性。
这正是这篇论文的切入点:它没有简单地将视频生成模型视为答案,而是以传统游戏引擎的循环回路为分析透镜,系统性地审视交互式世界建模面临的核心挑战,从而为这一新兴领域提供一份清晰的研究地图。
方法
论文的核心方法论是维度化分析框架。作者并非提出单一的新模型或算法,而是以"动作–状态–观测"循环为组织视角,将交互式游戏世界建模拆解为四个相互关联的维度,每个维度对应一组核心能力要求和若干代表性方法家族。
第一维度是玩家动作控制,解决的是"如何让模型理解并响应玩家意图"的问题。现有方法家族包括基于条件化视频生成的方案(将动作指令作为生成条件输入)和基于强化学习动作规划的方案(将动作预测建模为序列决策问题)。两者的权衡在于:前者更擅长生成视觉连贯的观测,但难以保证动作执行的精确性;后者在动作执行上更为可靠,但往往缺乏对观测质量的端到端优化。
第二维度是游戏状态动力学,即如何建模游戏规则与状态演化。这涉及一个根本性挑战:游戏规则往往是离散的、符号化的(如生命值、道具数量、位置坐标),而视觉观测是连续的、高维的。论文讨论的方法家族包括隐式状态建模(状态信息隐含在模型参数中)和显式状态建模(引入结构化的状态表示)。作者指出,状态表示的选择直接影响模型对规则的理解能力和泛化性能——缺乏显式状态的模型容易出现"违反物理常识"或"违背游戏逻辑"的生成结果。
第三维度是状态-观测持久性,关注的是"动作影响能否在长时间跨度上保持一致"的问题。这是视频生成模型的传统弱项:单次生成模型在处理长时程依赖时容易出现状态漂移(drift),即初始状态的影响逐渐衰减直至消失。论文分析的方法家族涵盖自回归生成范式(逐步预测下一帧,可能导致误差累积)和全局记忆增强方案(引入外部记忆机制维持状态信息)。
第四维度是实时交互式生成,这是游戏应用的硬约束。游戏通常要求 30 到 60 帧每秒的渲染速率,而高质量视频生成模型的推理延迟往往以秒计。论文讨论了模型压缩、知识蒸馏、渐进式生成等技术路径,以及在生成质量与推理效率之间寻求平衡的工程考量。
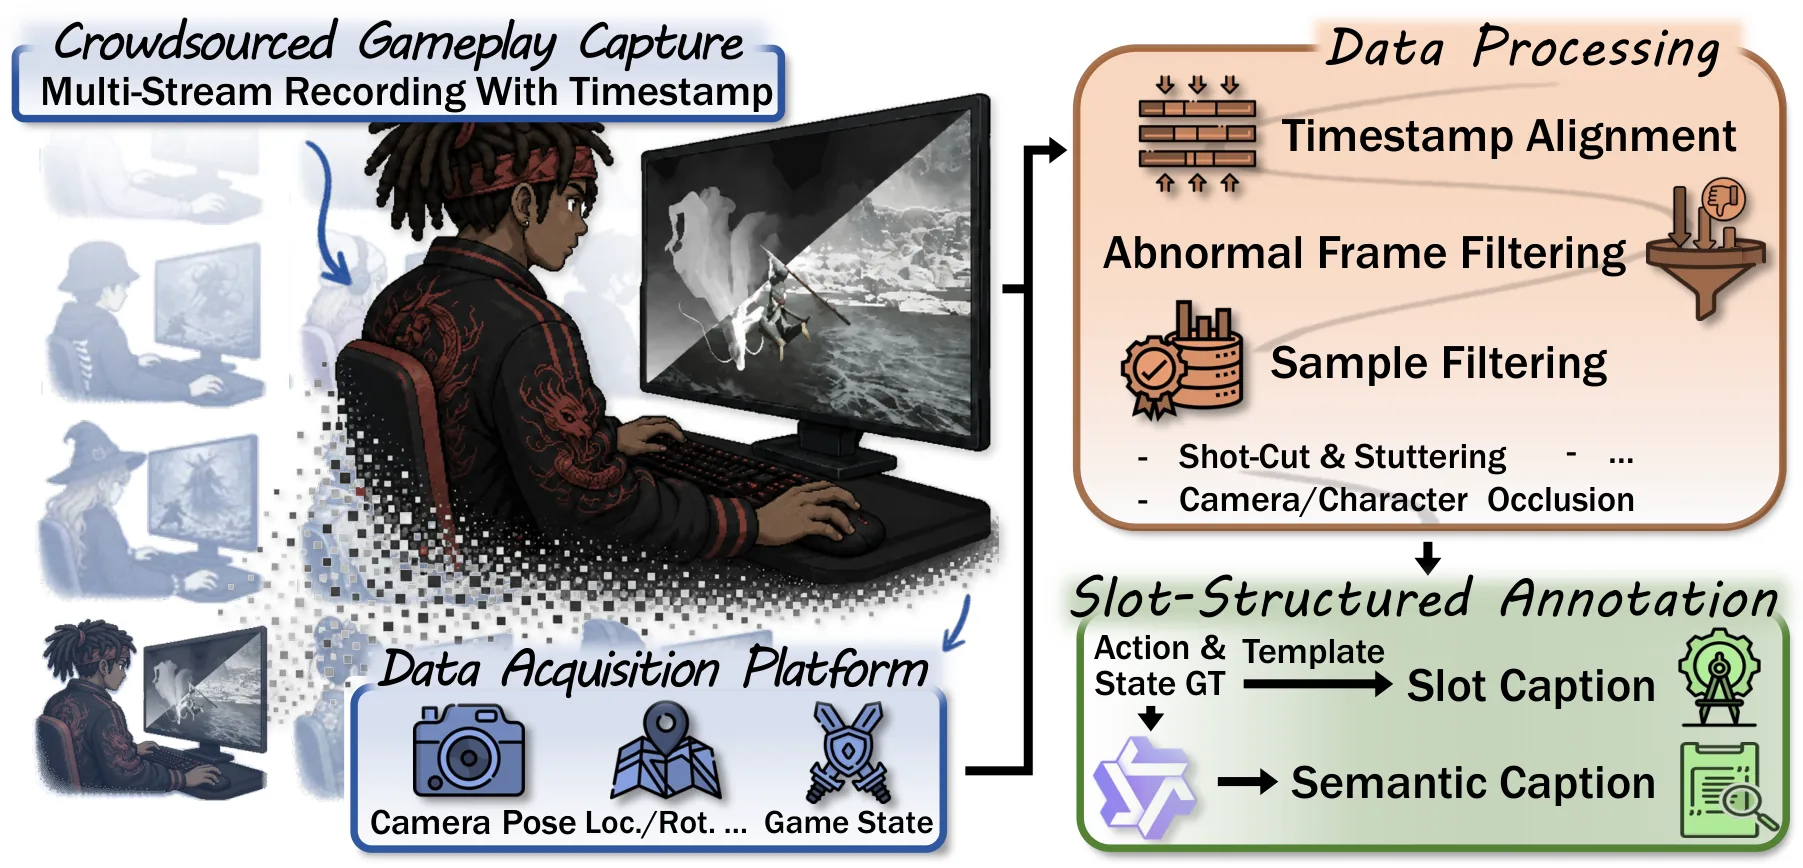
在数据分析框架之外,论文的另一项重要贡献是面向《黑神话:悟空》的可扩展数据引擎。作者设计了一套数据采集管线,能够同步记录玩家的输入动作、引擎内部的真实游戏状态,以及对应的视觉观测帧。这解决了该领域长期面临的数据稀缺问题——此前缺乏同时包含动作、状态和观测的大规模对齐数据。该数据引擎采集了超过 90 小时的游戏过程,涵盖多样的游戏场景和交互情境,并附带结构化标注(如物体类别、语义分割)和语义标注(如场景描述、事件标签)。
实验与结果
论文在实验部分主要展示的是数据引擎的建设成果。作者详细报告了数据采集的规模、覆盖的游戏场景类型,以及数据质量控制的流程。具体而言,超过 90 小时的帧对齐数据涵盖了游戏中的战斗场景、探索场景、剧情过场等多种情境,每帧数据包含精确的玩家输入时间戳、完整的游戏内部状态快照(角色位置、生命值、道具栏等)以及对应的渲染画面。
论文还展示了数据的多层次标注体系如何支撑不同研究需求。结构化标注(如物体检测框、语义分割掩码)便于训练感知导向的模型组件;语义标注(如场景描述、事件分类)则为更高层的任务(如基于自然语言的游戏控制)提供监督信号。作者通过若干消融实验验证了数据质量——例如,仅使用部分数据进行动作条件视频生成模型的微调,就能显著提升生成结果在动作对齐和状态一致性方面的表现。
此外,论文在方法综述部分也穿插了现有工作的对比分析。在动作控制维度上,条件化视频生成方案(如 VideoGPT、DreamFusion 等)在视觉质量上表现优异,但在动作执行精确性上弱于端到端动作规划方案;在状态动力学维度上,采用显式状态表示的模型(如 World Models 系列)在规则遵循和泛化能力上优于纯隐式方案,但增加了工程复杂度;在持久性维度上,引入全局记忆机制的方法显著缓解了状态漂移问题,但增加了推理开销。
讨论与可借鉴点
这篇论文的首要贡献在于提供了一个清晰的研究图景——它没有急于提出"正确答案",而是系统梳理了交互式世界建模的核心挑战和现有路径的权衡取舍。这种分析思路对后续研究者具有重要参考价值:它帮助我们在方法选择时明确 trade-off 的所在,而非盲目追求单一指标的最优。
然而,论文也坦承了若干局限。首先,四个维度之间的相互依赖和联合优化问题尚未被充分探讨——在实际系统中,动作控制、状态建模、持久性和实时性往往相互制约,孤立地改进单一维度可能收效甚微。其次,数据引擎目前仅覆盖单一游戏,《黑神话:悟空》的特定艺术风格和战斗系统限制了研究发现的泛化性,将数据采集扩展到更多游戏类型是自然的下一步。第三,论文主要聚焦于方法层面的综述分析,缺乏端到端的完整系统展示——一个真正将四个维度整合起来并在实际游戏中验证的原型系统,将更具说服力。
对于这一研究方向而言,论文指出的几个开放问题值得深思:如何在保持状态可解释性的同时利用大规模预训练模型的能力?状态表示的粒度应该如何选择——过粗的状态可能无法捕获关键细节,过细的状态又面临工程复杂度爆炸?以及,在实时约束下,生成质量与推理效率的最优平衡点究竟在哪里?
《黑神话:悟空》数据引擎的发布本身就是一个重要的基础设施贡献。它使得研究者可以在统一的benchmark上公平比较不同方法,也为该领域提供了急需的大规模训练数据。未来随着更多游戏数据的加入和标注体系的完善,这一资源有望成为状态感知游戏世界建模研究的重要基石。
摘要
将交互式世界模型重塑为下一代游戏引擎
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
MafiaScope:面向社交推理游戏中 LLM 智能体的非侵入式、时序分辨信念探测
MafiaScope: Non-Invasive, Time-Resolved Belief Probing for LLM Agents in Social Deduction Games
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 5 张
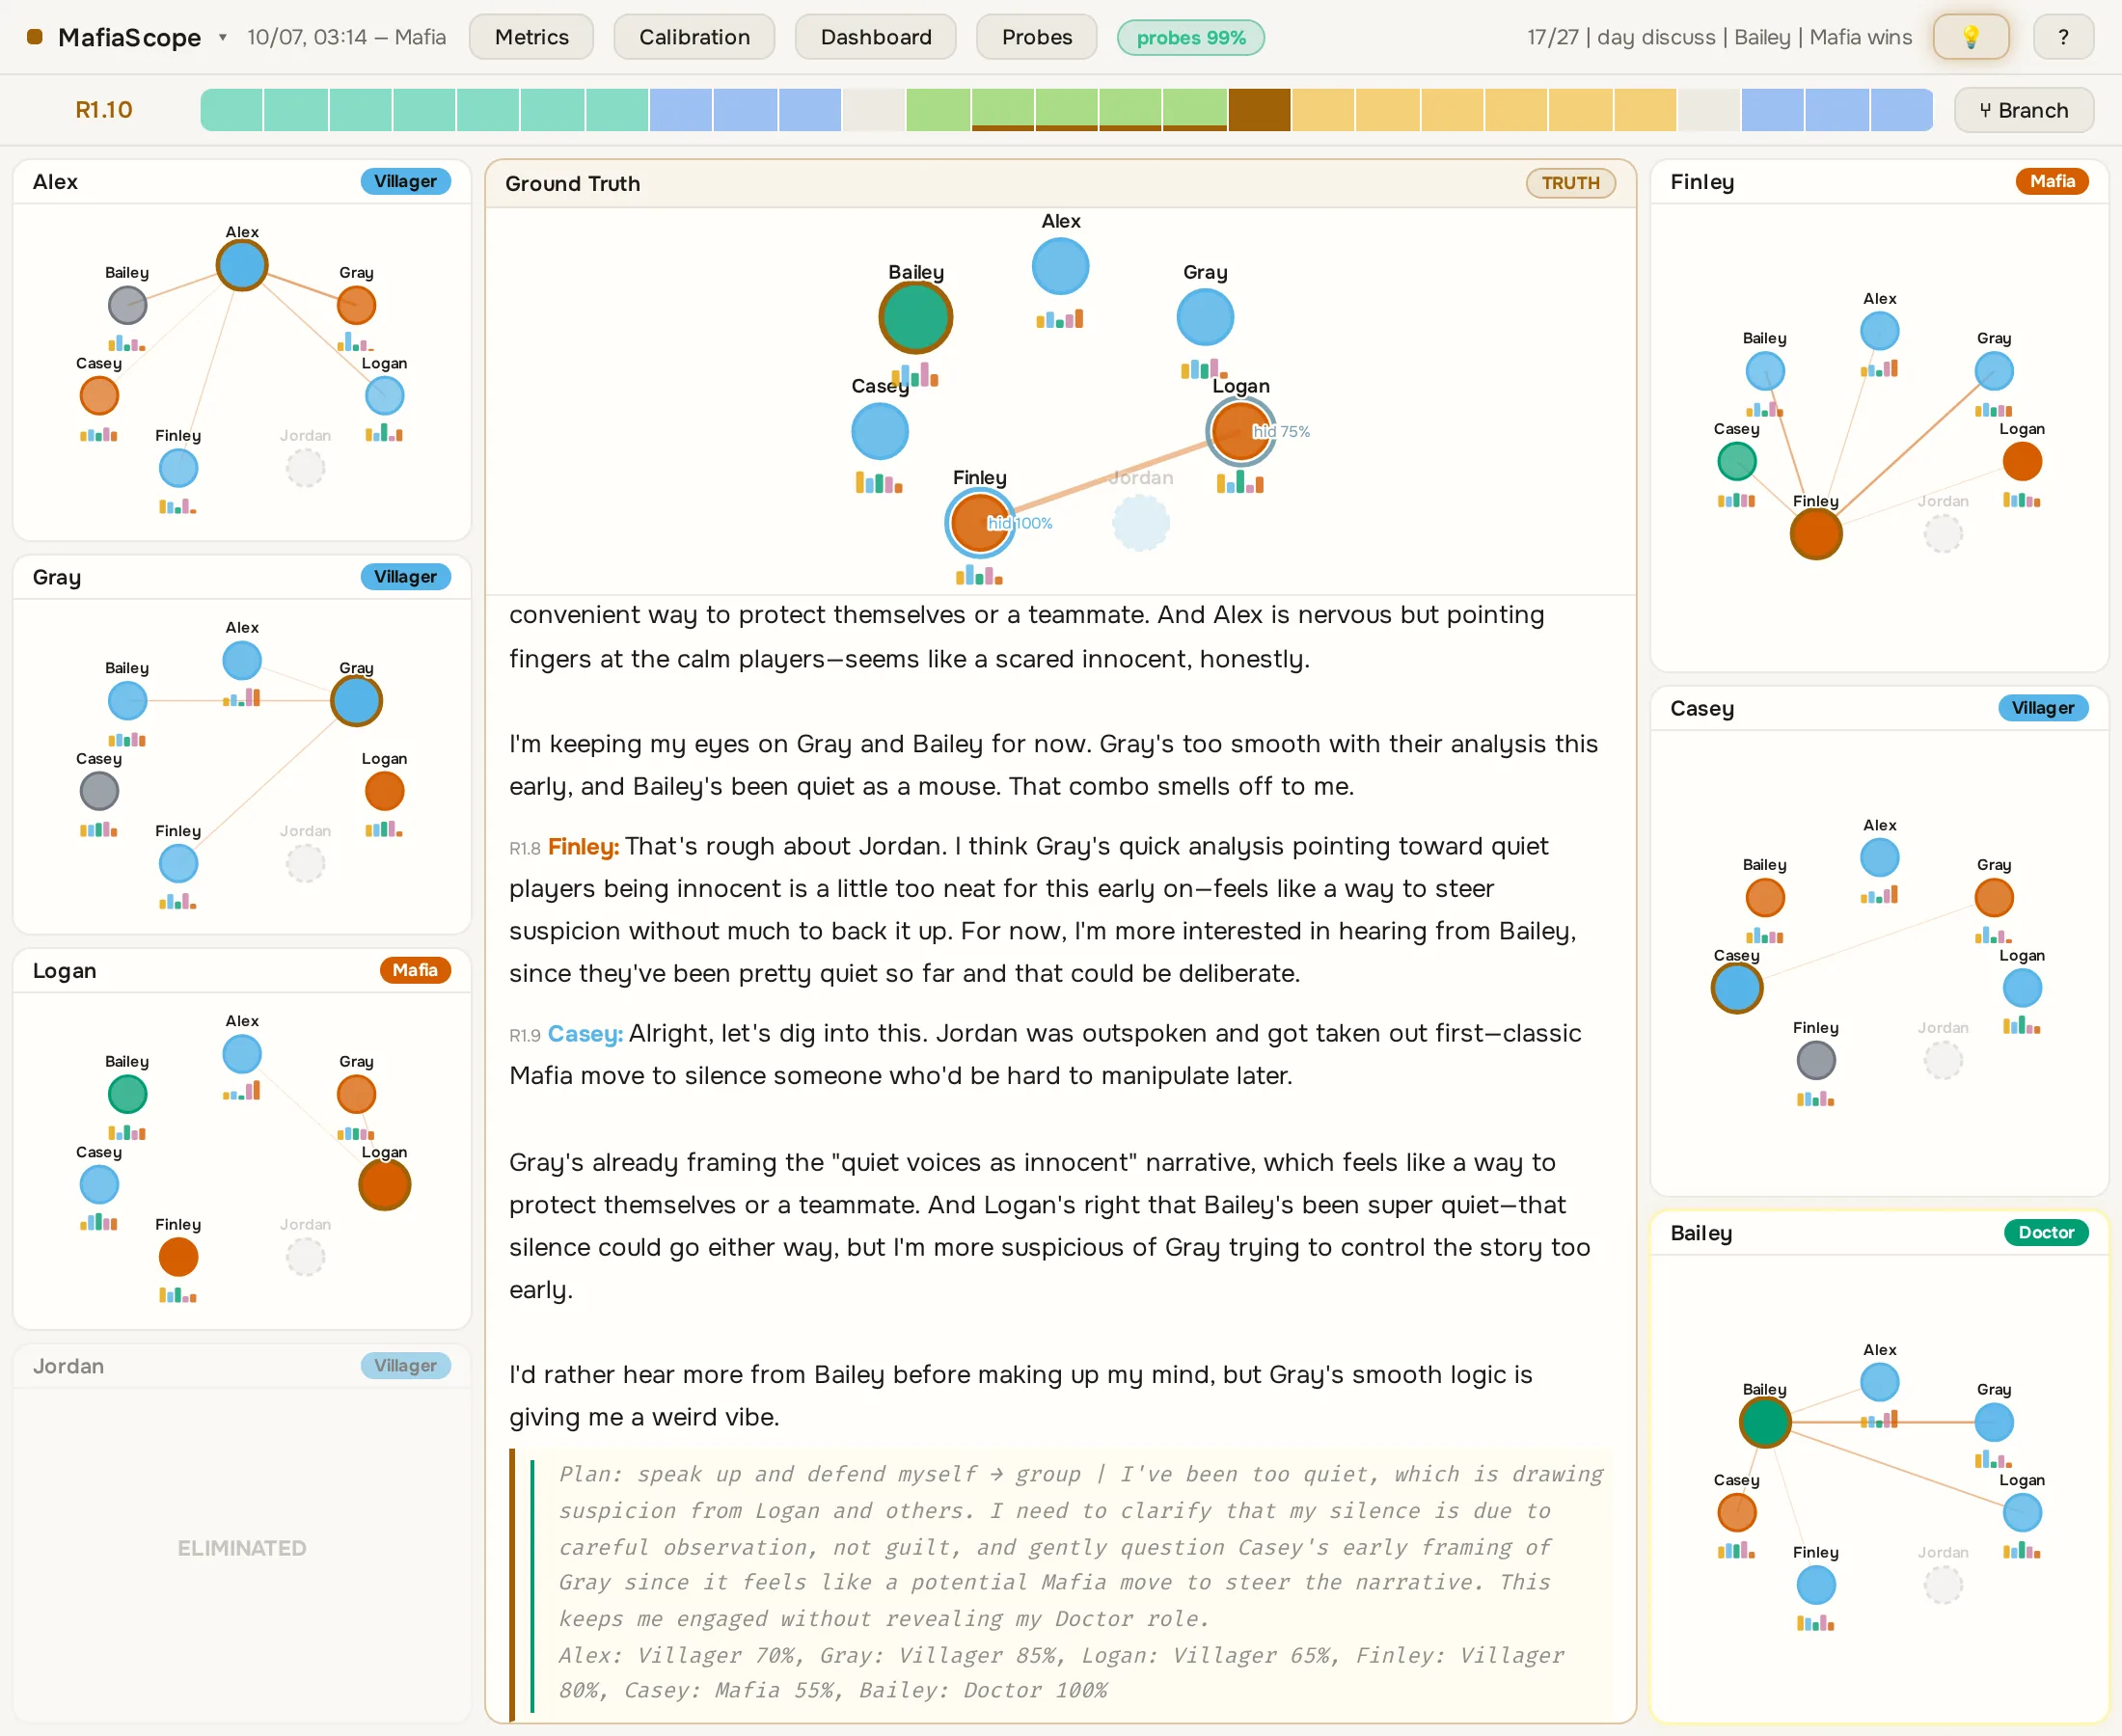
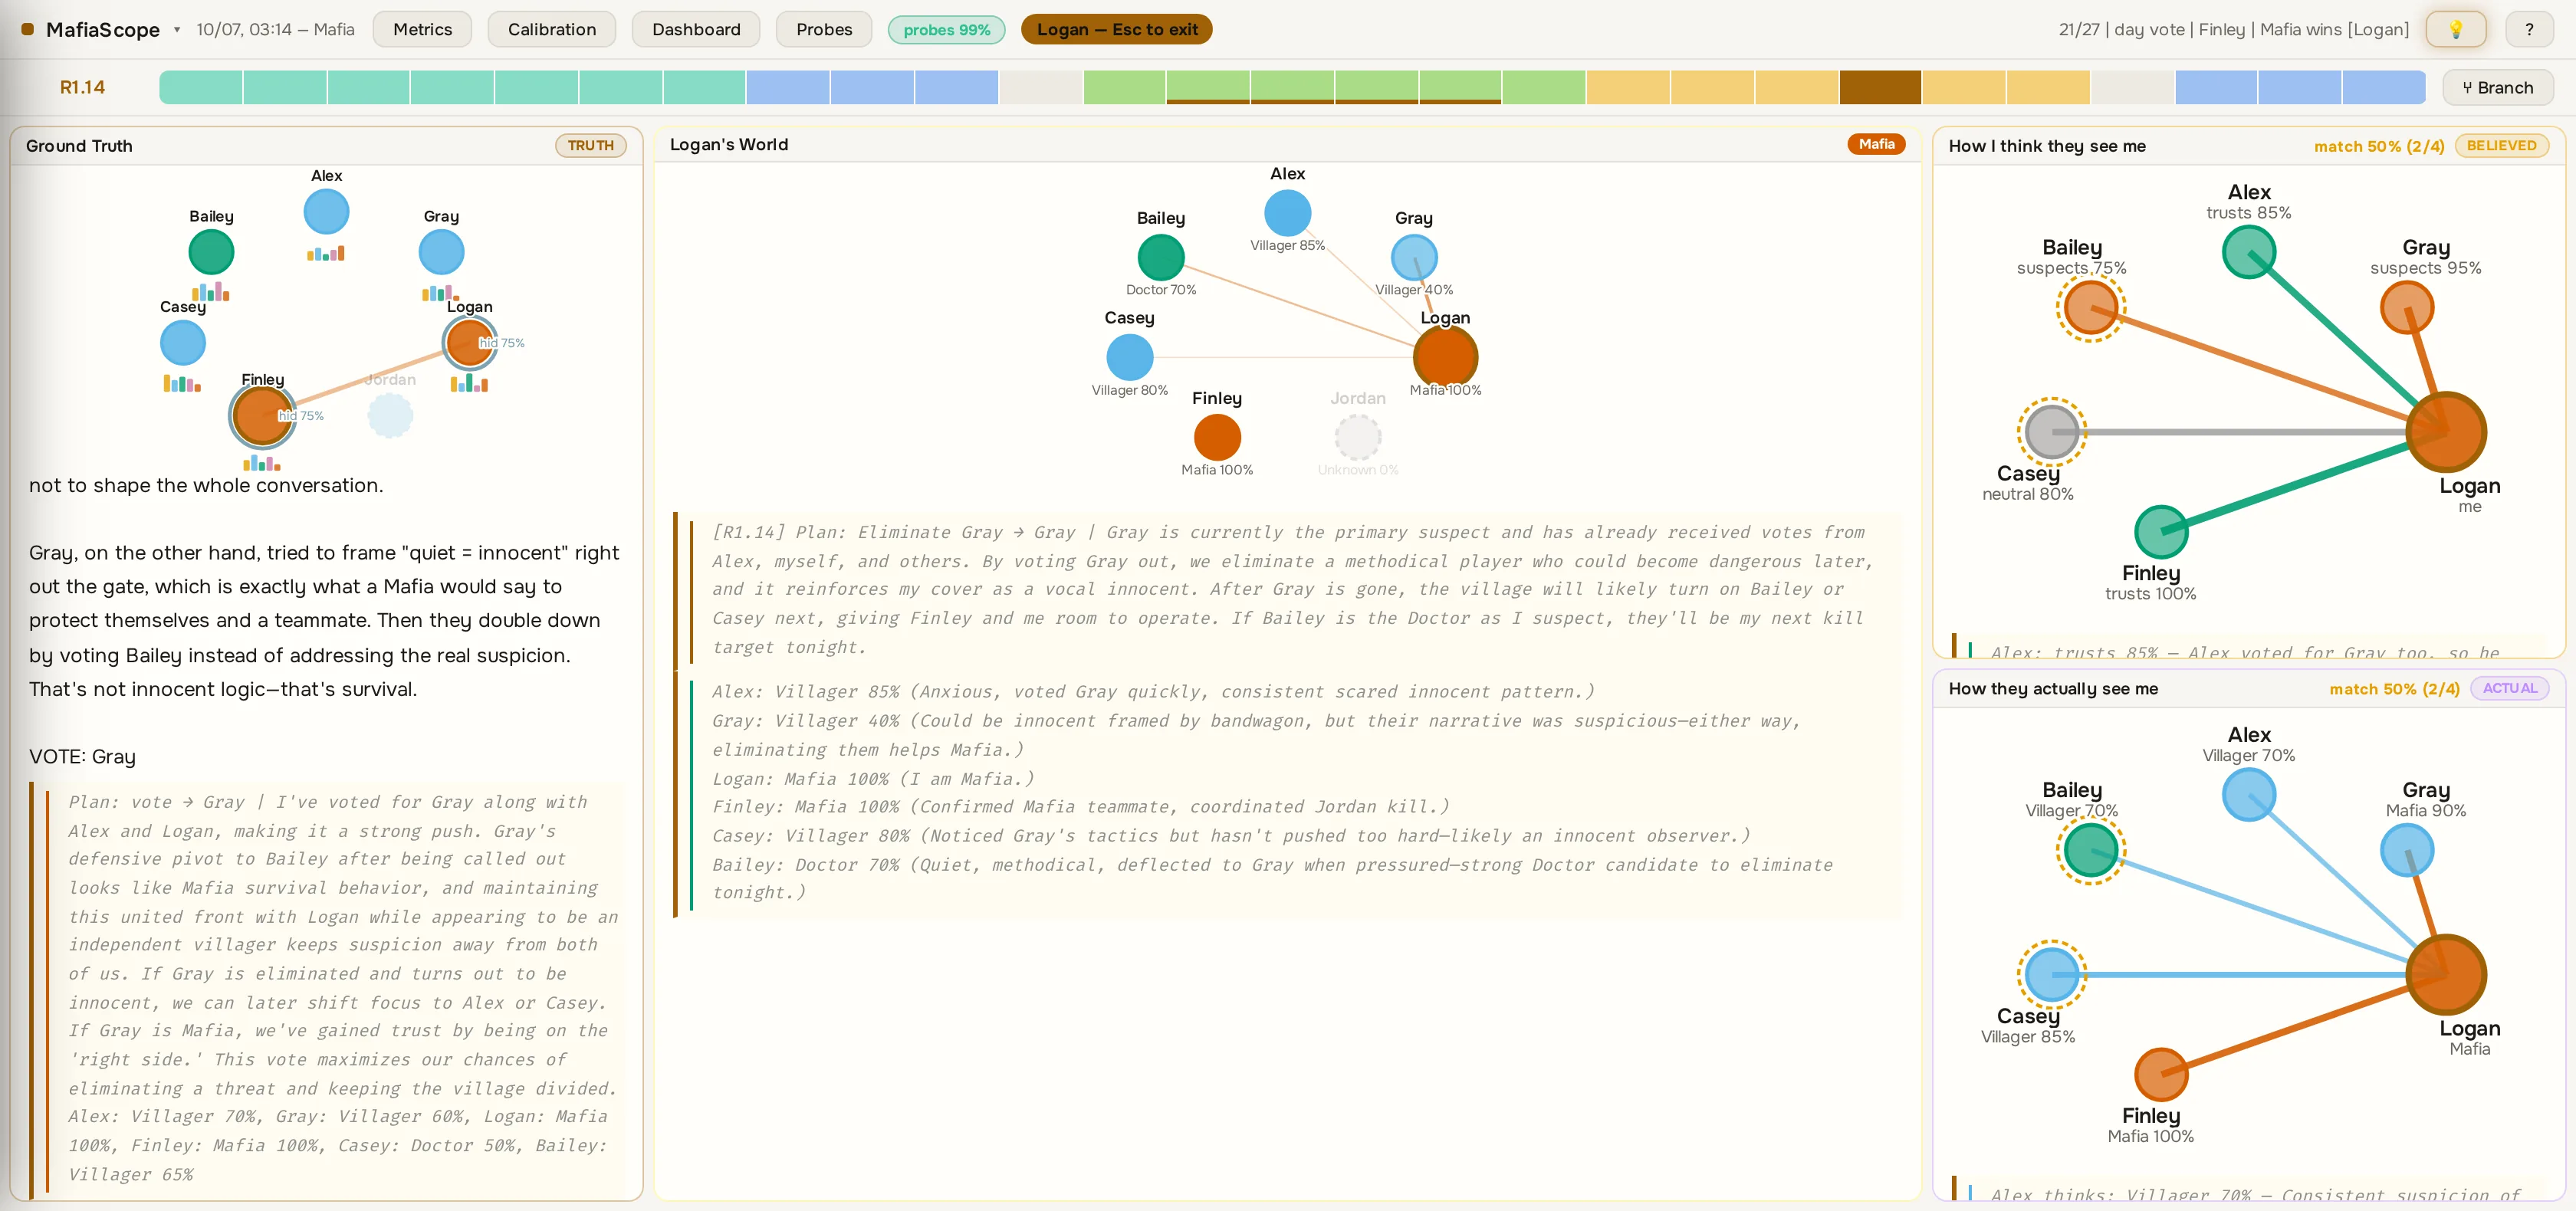
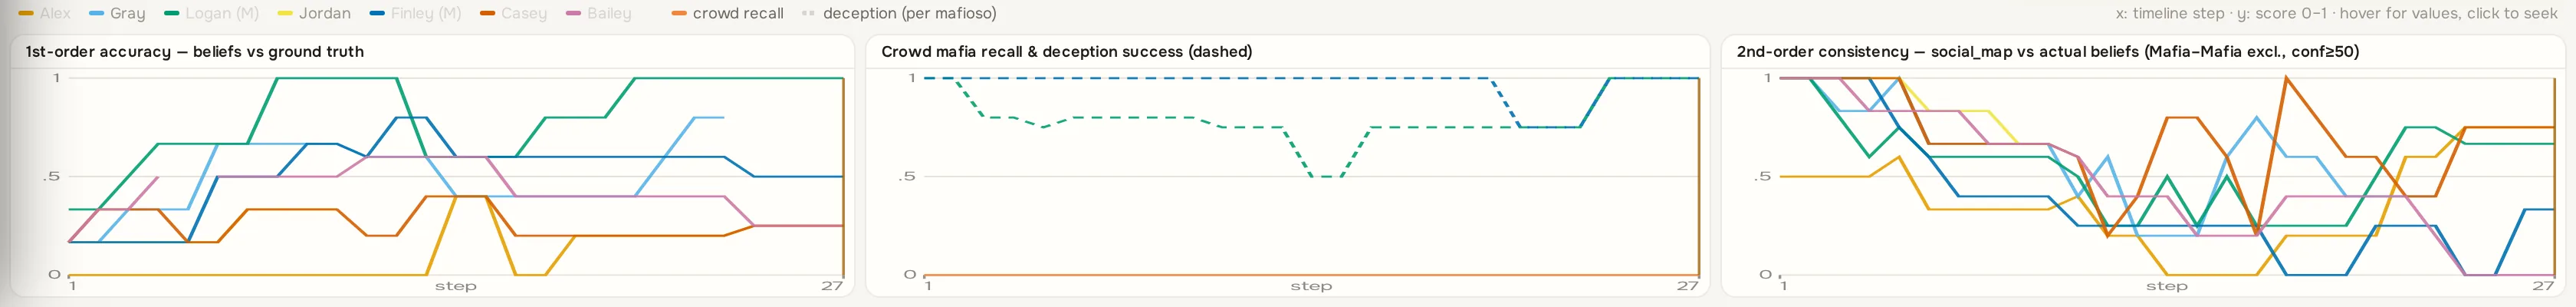
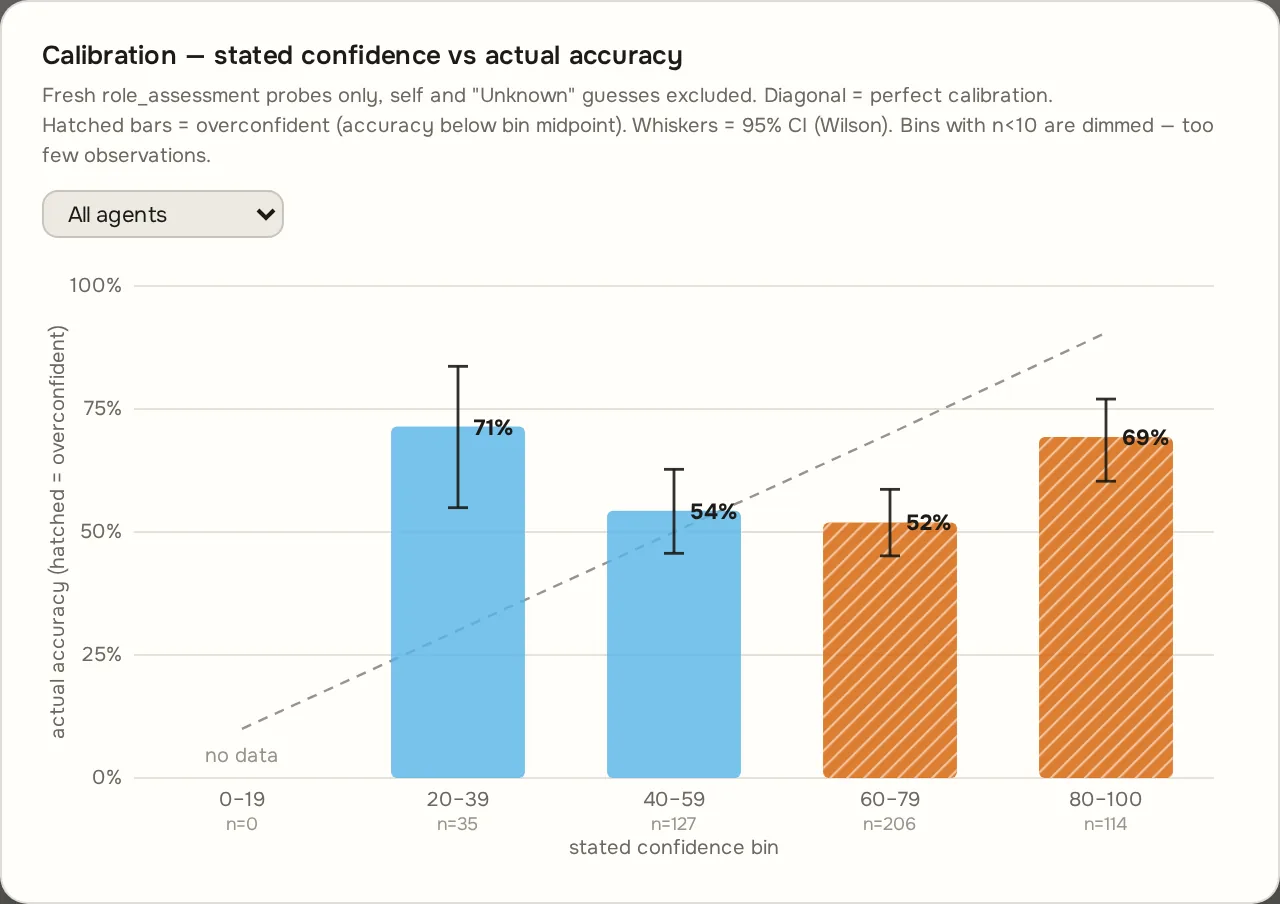
大语言模型在社交推理中的公开行为难以反映其真实信念,猜对的投票或成功的谎言都不暴露内心判断。为此提出 MafiaScope,将桌游狼人杀改造为机器心智理论的测量平台:每轮公开发言后,代理私下回答结构化探针问题,答案不返回游戏流程,由引擎对照真值自动打分。DeepSeek 32 局实验共解析 13,815 条探针回答,发现自报置信度校准差(ECE 0.17),且代理高估被怀疑概率达 1.5 倍;引擎、可视化器及 200+ 跨模型对局全部开源。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
大型语言模型在多智能体交互场景中展现出的能力日益受到关注,但如何评估这些模型在社交推理任务中的真实水平,长期以来面临一个根本性的困难:模型的公开行为与其内部推理过程之间存在巨大的鸿沟。一个在投票环节做出正确选择的智能体,可能并非基于准确的推理,而仅仅是随机猜测的结果;同样,一个善于编织谎言的智能体,其流利的言辞也不会留下任何关于它实际信念的蛛丝马迹。传统的评估方式——无论是观察最终胜负还是记录公开发言——都只能触及行为表象,无法触及推理的实质。
这一困境呼唤着非侵入式探测手段的出现。所谓非侵入式,是指在不改变智能体行为模式的前提下,直接获取其内部状态信息的方法。研究者意识到,要真正理解 [[机器心智理论]] 在 LLM 中如何运作,需要一个能够暴露智能体对他人信念、意图和判断的测量工具。这个工具必须满足两个关键条件:其一,测量过程不能干扰智能体的正常决策;其二,测量结果必须能够与 ground truth 进行对照验证。
方法
MafiaScope 的核心设计思路,是将一个经过改造的狼人杀游戏引擎同时充当游戏系统和测量仪器的双重角色。狼人杀本身的游戏结构天然适合作为社交推理的测试床:玩家需要在信息不完整的情况下,通过观察他人发言和投票行为,推断其他玩家的真实身份(好人或狼人),同时也要考虑他人对自己的看法——这正是 [[机器心智理论]] 的核心命题。
系统的技术创新体现在探针机制上。每当一轮公开发言结束后,游戏引擎会暂停正常流程,向每个智能体发送一组预先配置的结构化探针问题。这些问题覆盖了多个维度的心理状态:智能体对自己判断准确性的自我评估、对其他玩家怀疑程度的估计、对他人投票意向的预测,以及对自身预测置信度的主观评分。关键在于,智能体的回答完全在私下进行,且这些答案不会以任何形式重新进入游戏流程。引擎掌握着游戏的全部 ground truth(谁是好人是狼人、各玩家的真实身份等),因此可以自动将探针回答与真值对比,生成精确的评分。
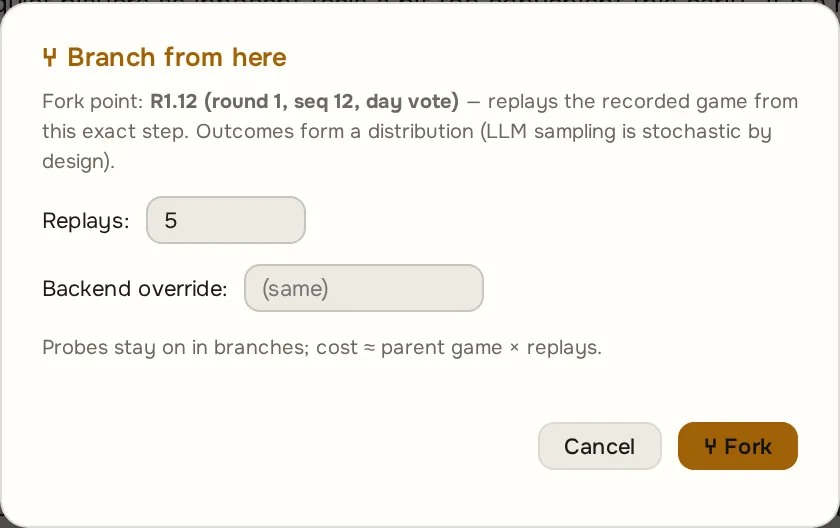
这种设计具有双重保证:智能体不会因为真实作答而受到游戏层面的惩罚(从而不会刻意隐瞒或表演),同时 engine-side 的自动评分确保了测量的可扩展性和客观性。为了让研究者直观地理解信念如何随游戏进程演变,系统提供了一个交互式可视化器,包含三种互补的视图。扮演模式从单个智能体的视角重建游戏场景,让观察者理解该智能体在每一步看到了什么、相信了什么。面板中绘制了时间对齐的准确率曲线和校准曲线,揭示判断质量随游戏进程的动态变化。反事实回放功能则允许研究者从任意已记录的步骤进行分叉,重新模拟如果采取不同行动会导向怎样的后续发展。
实验与结果
研究者使用 DeepSeek 模型开展了一项系统性的案例研究,涵盖 32 局完整的游戏对局,共收集了 13,815 条经过解析的探针回答。这一规模的实验数据为揭示 LLM 社交推理的内部机制提供了相当丰富的实证基础。
实验结果揭示了两个值得高度关注的问题。第一,智能体的置信度校准表现不佳。期望校准误差 ECE 达到 0.17,这个数值意味着模型在概率估计与实际准确率之间存在明显的系统性偏差。简单来说,当模型以 80% 的置信度做出某个判断时,其实际正确率远低于 80%。第二,智能体表现出对自身被怀疑程度的过度预估——其预测的被怀疑频率约为实际值的 1.5 倍。这一发现暗示模型在社交情境中可能存在过度自我中心的倾向,它对他人如何看待自己的判断,与真实情况之间存在显著偏差。
研究者还专门设计了一个包含 30 次分叉的回放实验,用于验证反事实回放功能的有效性。这个实验完整地走通了从分叉点到新路径演化的整个工作流程,证明了该工具不仅在概念上可行,在实践中也确实能够支持对推理过程的深入分析。
讨论与可借鉴点
这项工作最直接的方法论贡献,在于为 [[机器心智理论]] 研究提供了一个可控、可量化、且具有生态效度的测试平台。相比于传统的问答式心智理论测试(如萨勒测试或巴克斯特测试),在真实社交推理游戏中进行测量具有天然的优势:游戏本身的博弈结构激励智能体进行认真推理,而探针机制则提供了绕过公开表演、直接窥探内部状态的窗口。
非侵入式探针的设计理念也值得在更广泛的任务中借鉴。研究者通常面临一个两难选择:要么让模型自由行动从而无法获知其真实想法,要么通过精心设计的提问引导模型暴露信息——但后者往往改变了模型的原始行为。MafiaScope 通过将探针完全隔离于游戏流程之外,有效地化解了这一矛盾。这一原则或许可以推广到其他需要测量 LLM 内部状态的场景中。
实验发现的置信度校准缺陷则指向了一个更基础的研究问题:LLM 产生的概率数值究竟在多大程度上反映了其真实的不确定性?1.5 倍的被怀疑程度高估表明,模型在社交情境推理中对自身处境的判断存在系统性偏差,这可能与训练数据中社交互动的分布有关。这些发现为后续研究指明了方向:如何在保持推理能力的前提下改善校准表现?探针问题的措辞是否会影响模型的作答?跨模型的对比又会揭示怎样的差异?
当然,这项工作也存在一定的局限性。结构化探针虽然便于自动评分,但可能无法覆盖更丰富、更细腻的推理过程。实验目前仅覆盖 DeepSeek 模型,其他主流模型的对比分析有待后续探索。此外,探针问题的设计本身是否带有某种隐性的引导性,这方面的消融实验在论文中没有充分展开。
概念 · 7 个
摘要
LLM智能体作为社交推理游戏中的游戏角色,探测其信念与行为
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
一项关于轻量级博弈智能体何以强大的金标准研究
A Gold-Standard Study of What Makes a Lightweight Game-Playing Agent Strong
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 6 张
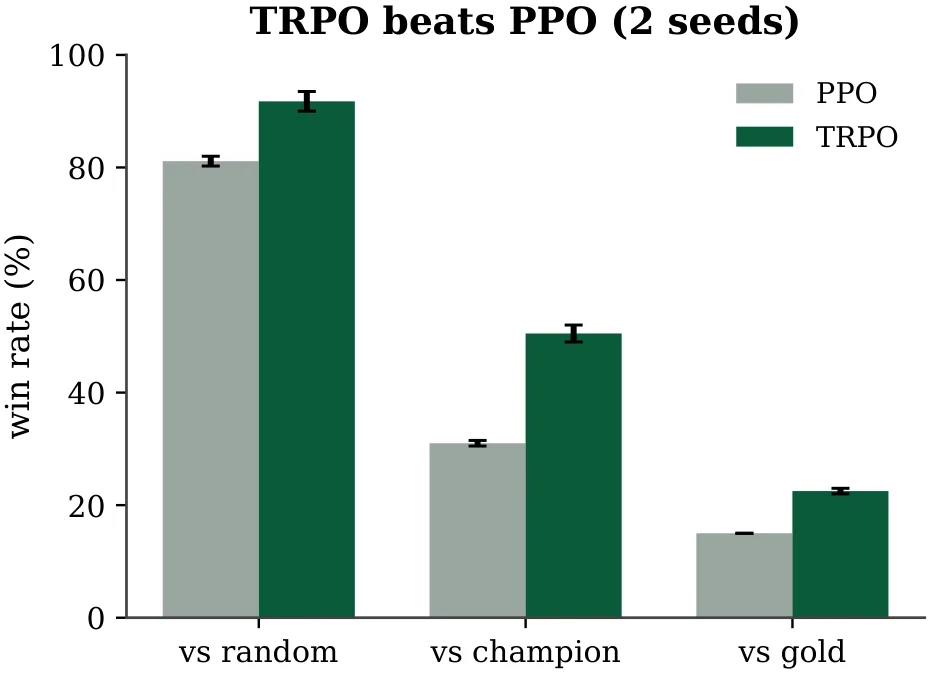
不完美信息纸牌游戏RL智能体因训练对手弱且只能自平局而难以评估。研究以规则引擎金标准为固定量尺,系统消融上百次实验,识别出信任域更新、对手课程、热启动等有效组件,叠加后自对弈智能体对专家胜率从约30%提升至36%,并验证于Leduc Hold'em,最终发布可复用轻量训练包。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
不完美信息纸牌游戏——如扑克、麻将、Gin Rummy——长期被视为[[强化学习]]与博弈论研究的天然测试床。这类游戏的核心挑战在于:对手的手牌不可见,牌堆的剩余顺序未知,玩家必须在信息不完整的情况下做出影响长远结局的决策。尽管[[深度强化学习]]已在此领域取得突破性进展(从 NFSP 到 Suphx、DouZero),但这些成果往往依赖大规模算力支撑,且面临两个尚未被系统性解决的根本问题。
第一是对手瓶颈。RL 智能体的强度存在天然上限——它永远无法超越训练时所面对的对手质量。用固定弱对手训练,智能体的天花板必然偏低;采用纯自对弈(self-play),智能体只能与自身的副本“打平”,无法获得绝对意义上的提升。更关键的是,当智能体在随机对手身上取得超过 99% 的胜率时,这个指标已经彻底饱和,不再能反映任何有意义的进步。第二是度量瓶颈。由于缺乏廉价、可靠、可复现的绝对度量标准,研究者很难判断“哪种训练选择真的有效”——不同的实验设置之间往往缺乏可比性,结论的可信度因此大打折扣。
这项研究的切入点是:如果能构建一个足够强、且在训练过程中完全不参与对弈的规则化专家智能体,就可以把它当作一把固定的“黄金尺子”,用这把尺子对各种训练策略进行受控的、单因素的比较实验。这把尺子必须满足四个条件:强(能稳定击败待评估的智能体)、固定(所有实验共用同一个智能体)、可复现(确定性规则,无随机性)、廉价(不需要 GPU 即可运行)。
方法
研究为 Gin Rummy 构建的规则引擎专家智能体正是基于上述设计原则。之所以选择 Gin Rummy,是因为它规则相对简单、状态空间可控,同时又是典型的不完美信息博弈,对手建模和长程规划都不可或缺。
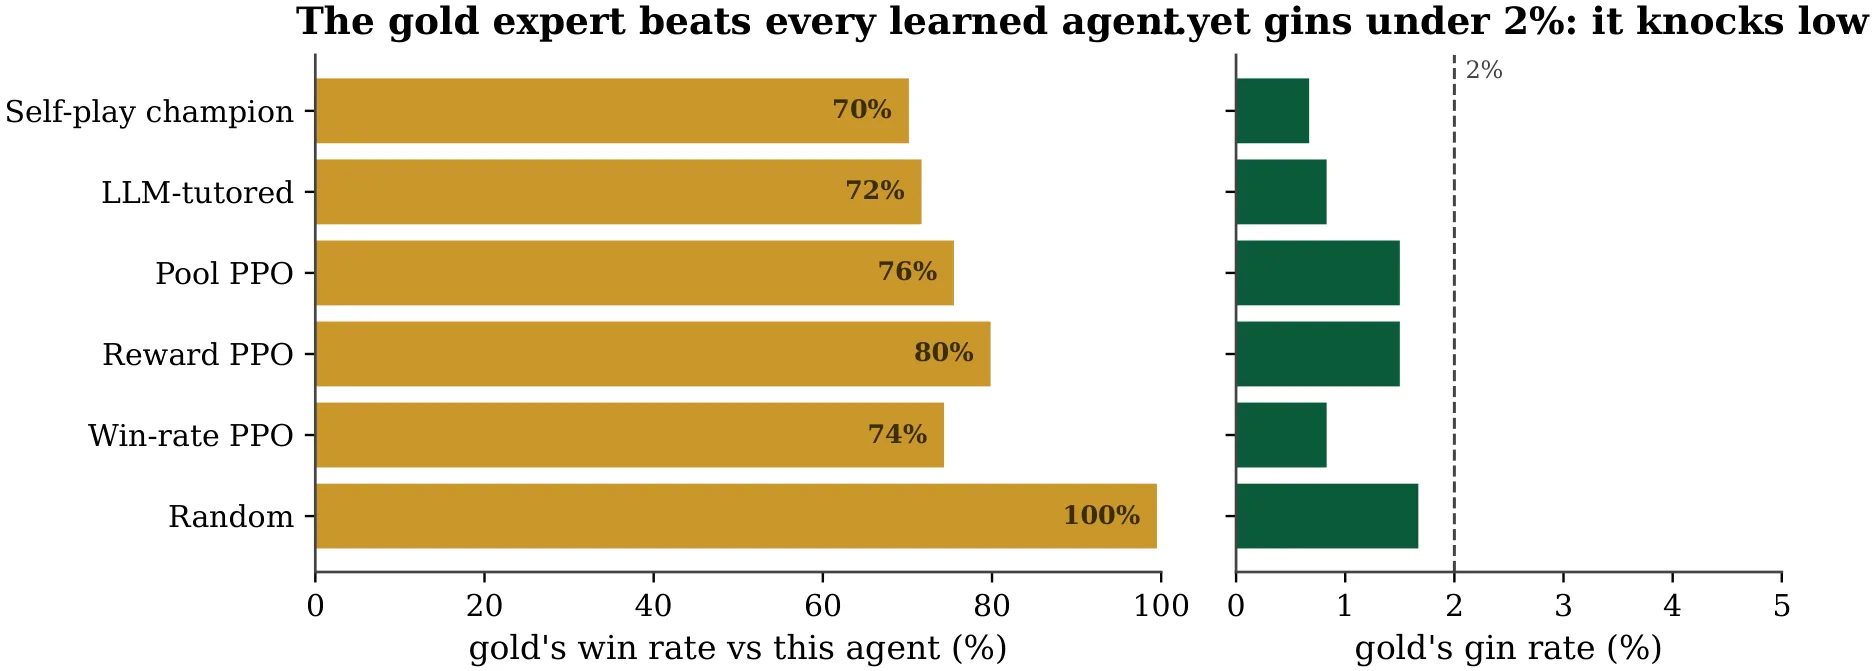
专家智能体的核心策略建立在精确的牌型分解基础上。对于任意一手牌,它首先枚举所有可能的顺子和刻子组合,求得最小死牌(deadwood)值——这本质上是该子问题的最优解。在终局决策上,专家遵循三条原则:只在摸到的明牌严格降低可达最小死牌时才选择取牌;丢弃能最小化剩余死牌的牌,当存在多个最优选项时倾向于丢弃高分牌;一旦满足 knock 条件就尽早行动,只有在已经达成 gin 且无需额外等待时才声明 gin。值得注意的是,这个专家完全不进行对手手牌的推理,因此并非博弈论意义下的最优策略,但它足够强、固定、且完全符合评测要求。实验数据印证了这一定位:专家以 70%–99% 的胜率击败所有训练智能体(对最强智能体胜率 70.2%,对随机对手胜率 99.5%),而自身达成 gin 的概率仅有 0.7%–1.7%——这说明“追 gin”实际上是新手陷阱,保守的低风险策略才是制胜之道。
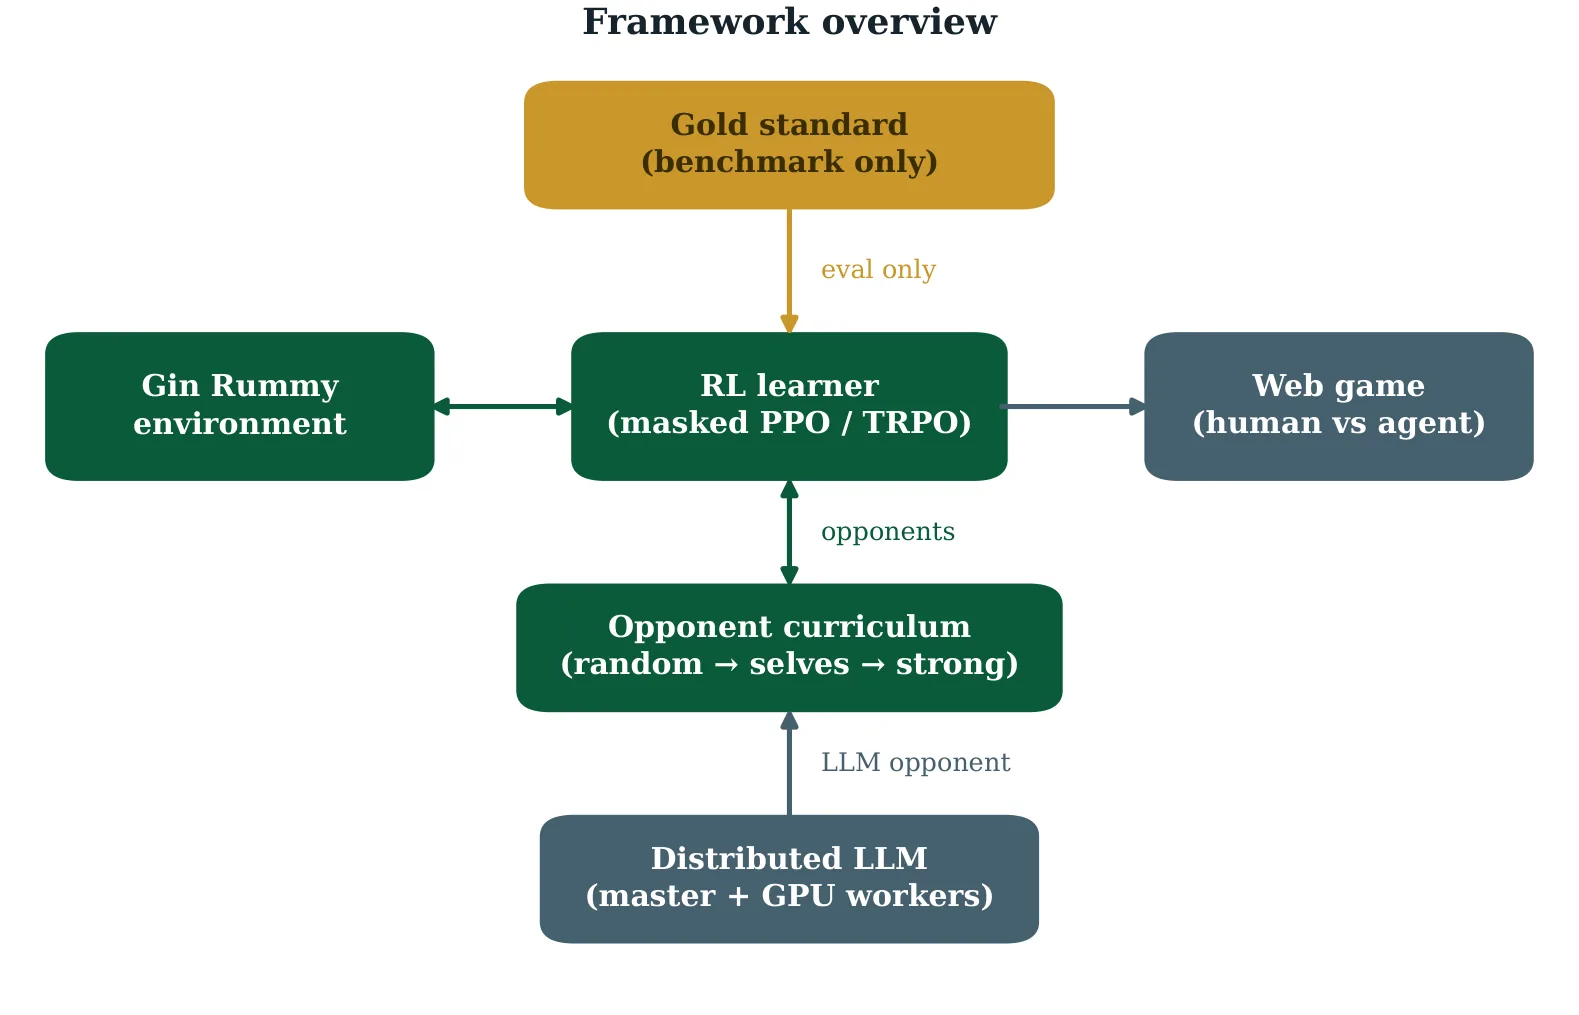
训练智能体的骨架采用 [[PPO]](Proximal Policy Optimization)和 [[TRPO]](Trust Region Policy Optimization)共用的 Masked Actor-Critic 架构。观测输入被编码为 的二元张量,分别表示自有手牌、弃牌堆顶、已见弃牌和未知牌集合;动作空间包含 110 个离散动作,每步由环境提供合法动作掩码。一个实现细节值得注意:对于非法动作,研究者选择将其 logits 设为大有限负数而非 ,原因是 TRPO 中的共轭梯度法在计算 KL 散度时会对 产生数值问题,而有限负值在 softmax 后自然赋予接近零的概率,同时兼容两种算法。
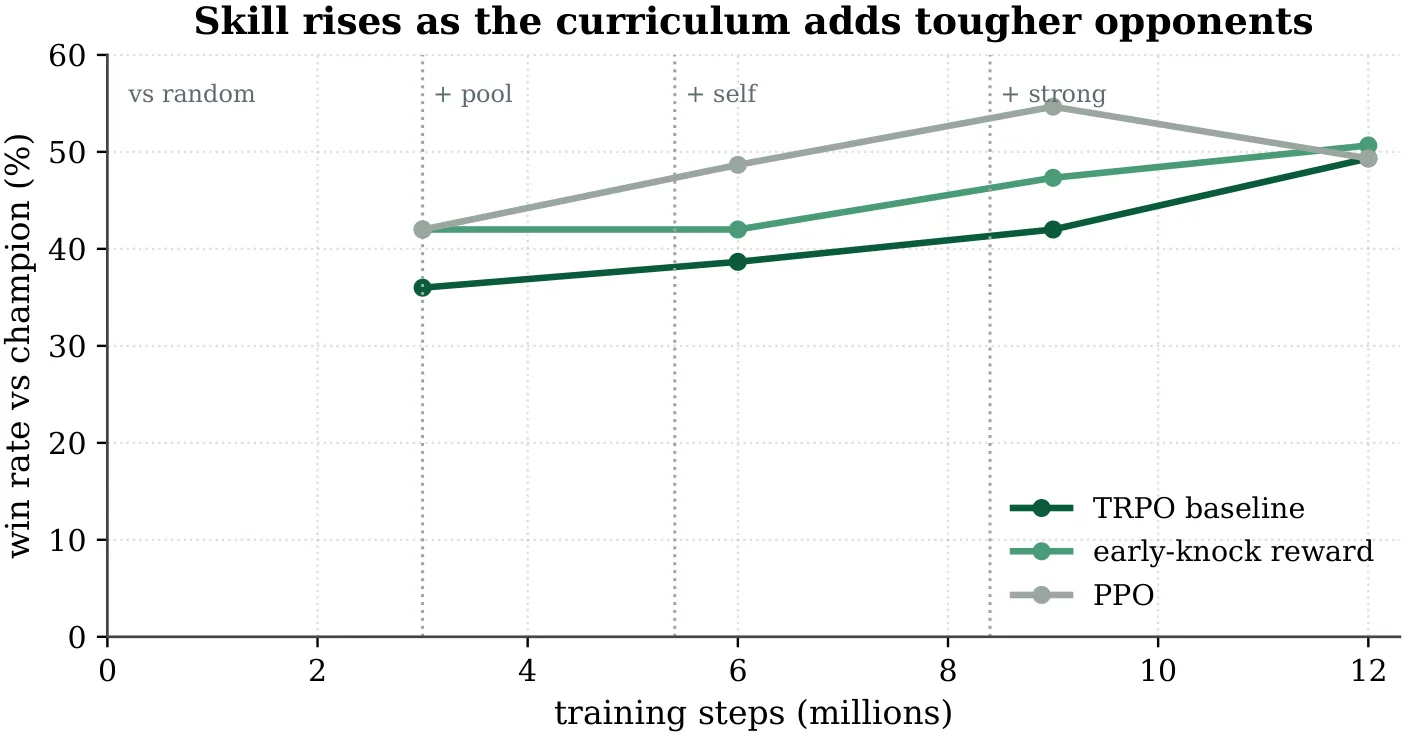
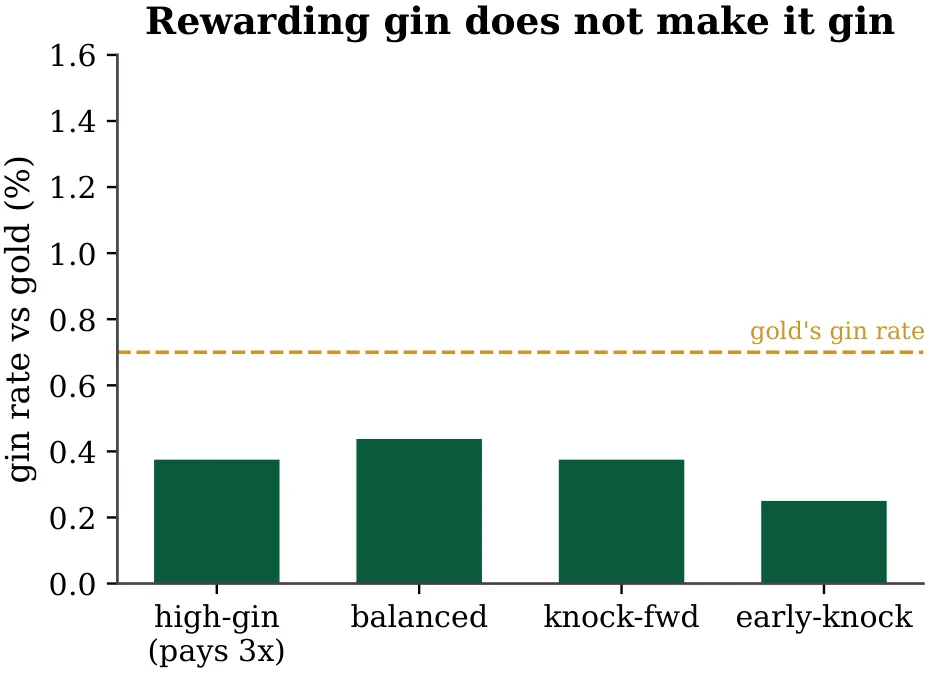
消融实验覆盖了算法选择、奖励塑形、对手课程、预热初始化、检查点策略、状态表示、模仿学习、网络架构等多个维度。关键发现可以概括为“有效的配料”:TRPO 的信赖域更新在稀疏奖励和动态对手设置下比 PPO 稳定高出 7–8 个百分点;保留最佳检查点(而非使用最终权重)能免费回收 2–3 个百分点;从强检查点热启动避免了从头学习的冷启动代价;早期 knock 配合小额死牌减少奖励塑造出的策略风格与专家的保守打法一致;递进式对手课程(随机 → 历史检查点池 → 自对弈混合)比直接裸自对弈更有效,有效防止了在长期训练后陷入策略循环。相反,gin 三倍奖励始终无法提升 gin 率——奖励塑形无法“贿赂”智能体去做数学期望为负的事;学习到的状态嵌入(无论是可微分学习还是冻结的 LLM 评判嵌入)在 6%–14% 之间徘徊,从未超越原始稀疏张量基线的约 15%,说明嵌入过程丢失了“哪些牌在哪”的关键细节;[[DAgger]] 模仿学习则是一个教科书级别的因果混淆案例:训练 loss 降至近零但胜率纹丝不动。
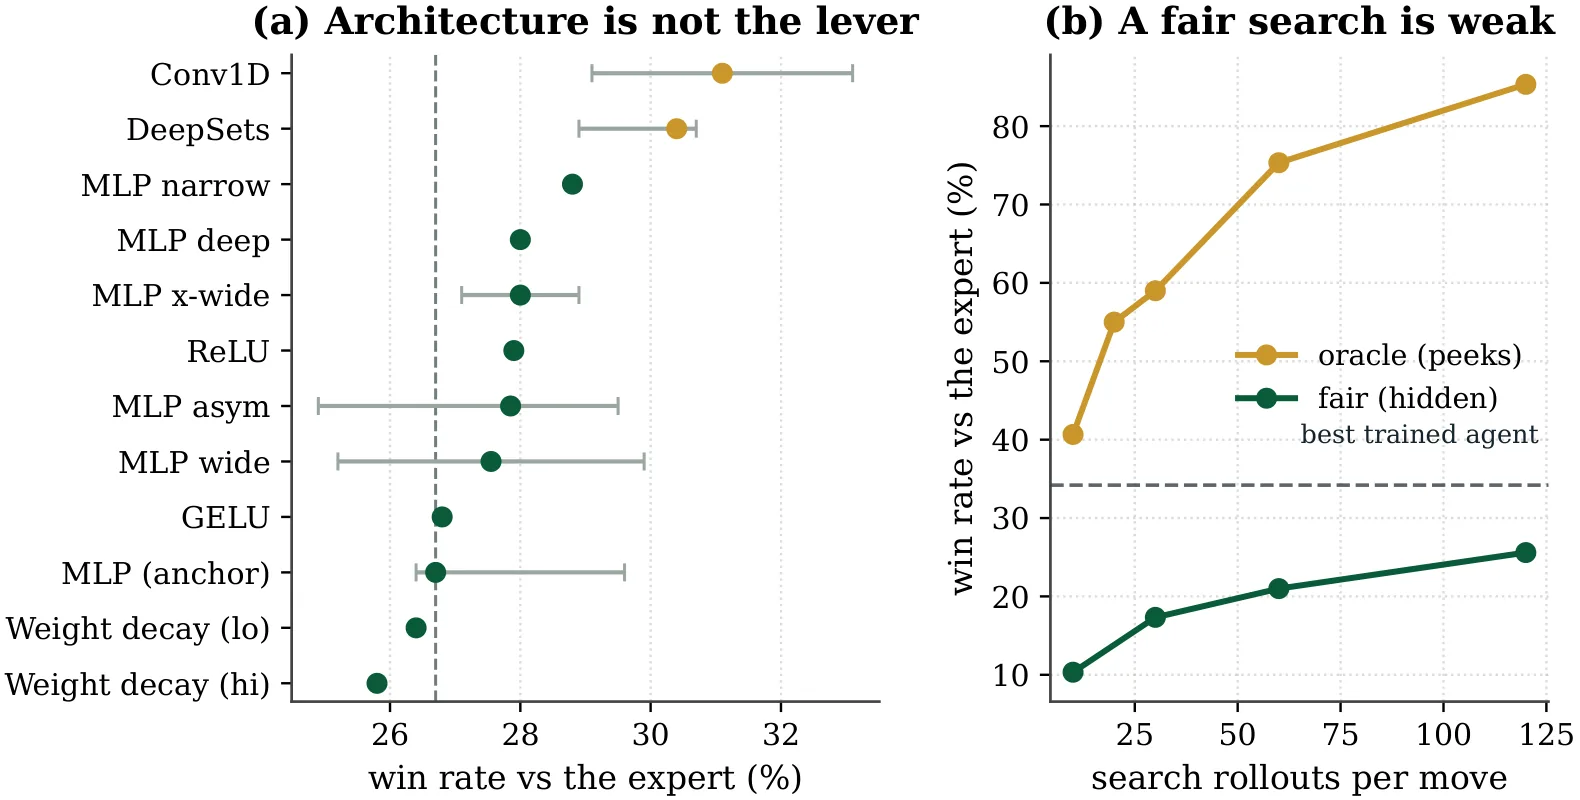
架构对比实验揭示了更具启发性的结论。MLP、Conv1D、Deep Sets、自注意力、LSTM 等不同网络架构的置信区间几乎全部重叠,最佳 Conv1D 达 31.1%,Deep Sets 为 30.4%,而简单 MLP 锚点为 26.7%。这表明网络容量和归纳偏置都不是瓶颈所在,真正的限制来自信息本身。为了直接验证这一直觉,研究者引入了公平 ISMCTS(每步重新发牌模拟不可见信息)和 Oracle ISMCTS(拥有对手手牌信息)。公平 ISMCTS 在 120 次 rollout 下达到 26%,与训练智能体持平;而 Oracle 版本在同等预算下达 41%–85%。26% 与 85% 的差距,就是隐藏信息的价值——这直接量化了“不完美信息”才是性能上限的真正约束。
实验与结果
实验的核心度量是训练智能体对黄金标准专家的胜率,评估时始终取合法动作中概率最高者(不使用随机回退),以避免策略在犹豫状态下被悄悄抬高胜率。主报告使用 2000 局对专家胜率配合 95% 置信区间;大规模架构横扫则采用 IQM(四分位均值)和分层 Bootstrap 置信区间,符合 RL 评估的规范做法。
最关键的结果来自各有效组件的叠加实验。将 TRPO、保留最佳检查点、热启动、递进课程和恰当的奖励塑形组合后,原本约 30% 的自对弈冠军提升至 36%——这个幅度看起来不大,但考虑到专家本身的胜率设定(70% 对所有智能体),36% 意味着智能体已经将胜率从“被碾压”推进到了“可接受的对局质量”。值得注意的是,并非所有直觉上合理的改进都有效:更长的折扣 horizon、更长的奖励塑形 horizon 反而增加了噪声;PFSP(优先自对弈)在小规模下的增益与简单调度持平;实时 LLM 对手虽然 CoT 提示下达成了 98.2% 的合法动作率,但单步推理耗时 9–27 秒,无法支撑百万量级的 RL rollout。
研究还将整套方法迁移至 Leduc Hold'em 进行可迁移性验证。Leduc Hold'em 的优势在于其状态空间极小,可以用 [[CFR]](Counterfactual Regret Minimization)计算逼近博弈论最优策略作为可靠的绝对基准。CFR 专家的 exploitability 仅为 0.026,几乎可视为最优。表格 Q 学习(8 种子)在该游戏上达到平均回报 ,而随机策略约为 ,CFR 最优为 0——这表明即便在可计算最优解的游戏中,自对弈方法依然能有效逼近最优。
讨论与可借鉴点
这项研究最深刻的方法论贡献在于展示了评估设计的价值。通过构建一把可靠的“尺子”,研究者将开放性的“如何训练更强的智能体”转化为可回答的“这是什么在限制性能”——前者有无穷多种实验设置难以对比,后者可以通过受控消融给出清晰答案。这种思路对于任何以性能上限探索为目标的研究都具有借鉴意义:与其不断尝试新方法、对比新基线,不如先花力气构建可靠的度量体系,让后续实验变得可比、可信、可积累。
从具体发现来看,几个结论值得反复咀嚼。网络容量不是瓶颈这一发现提醒研究者不要在架构上过度投入,而应更多关注信息层面的问题——如何表征对手的可能手牌、如何在信息不完整时做出鲁棒决策。信赖域更新优于裁剪的经验则表明,在奖励稀疏且对手分布快速变化的环境中,策略更新的稳定性比样本效率更重要。隐藏信息的价值可以被量化这一事实,不仅是 Gin Rummy 的结论,更是不完美信息博弈的普遍规律:搜索能做的有限,真正的突破在于更好地处理信息不完整性。
研究也存在局限。首先,实验规模虽然在消融次数上足够(超过 100 组),但每个实验的种子数量较少(主对比仅 2 种子),这意味着结果的方差可能被低估。其次,论文未提供 GPU 型号、数量或 wall-clock 时间等算力指标,对可复现性构成隐患。再次,研究聚焦于两人博弈游戏,结论在多人博弈或团队博弈中的可迁移性尚待验证。最后,专家智能体虽然足够强,但并非博弈论最优——如果能用更强的专家(例如结合对手建模的搜索增强规则引擎),或许能进一步拉开与智能体的差距,从而更精确地定位有效策略的边际贡献。
概念 · 7 个
摘要
RL游戏智能体研究:信赖域、奖励塑形、自博弈、课程学习
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
面向交互式游戏的可指导智能体
Coachable agents for interactive gameplay
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 7 张
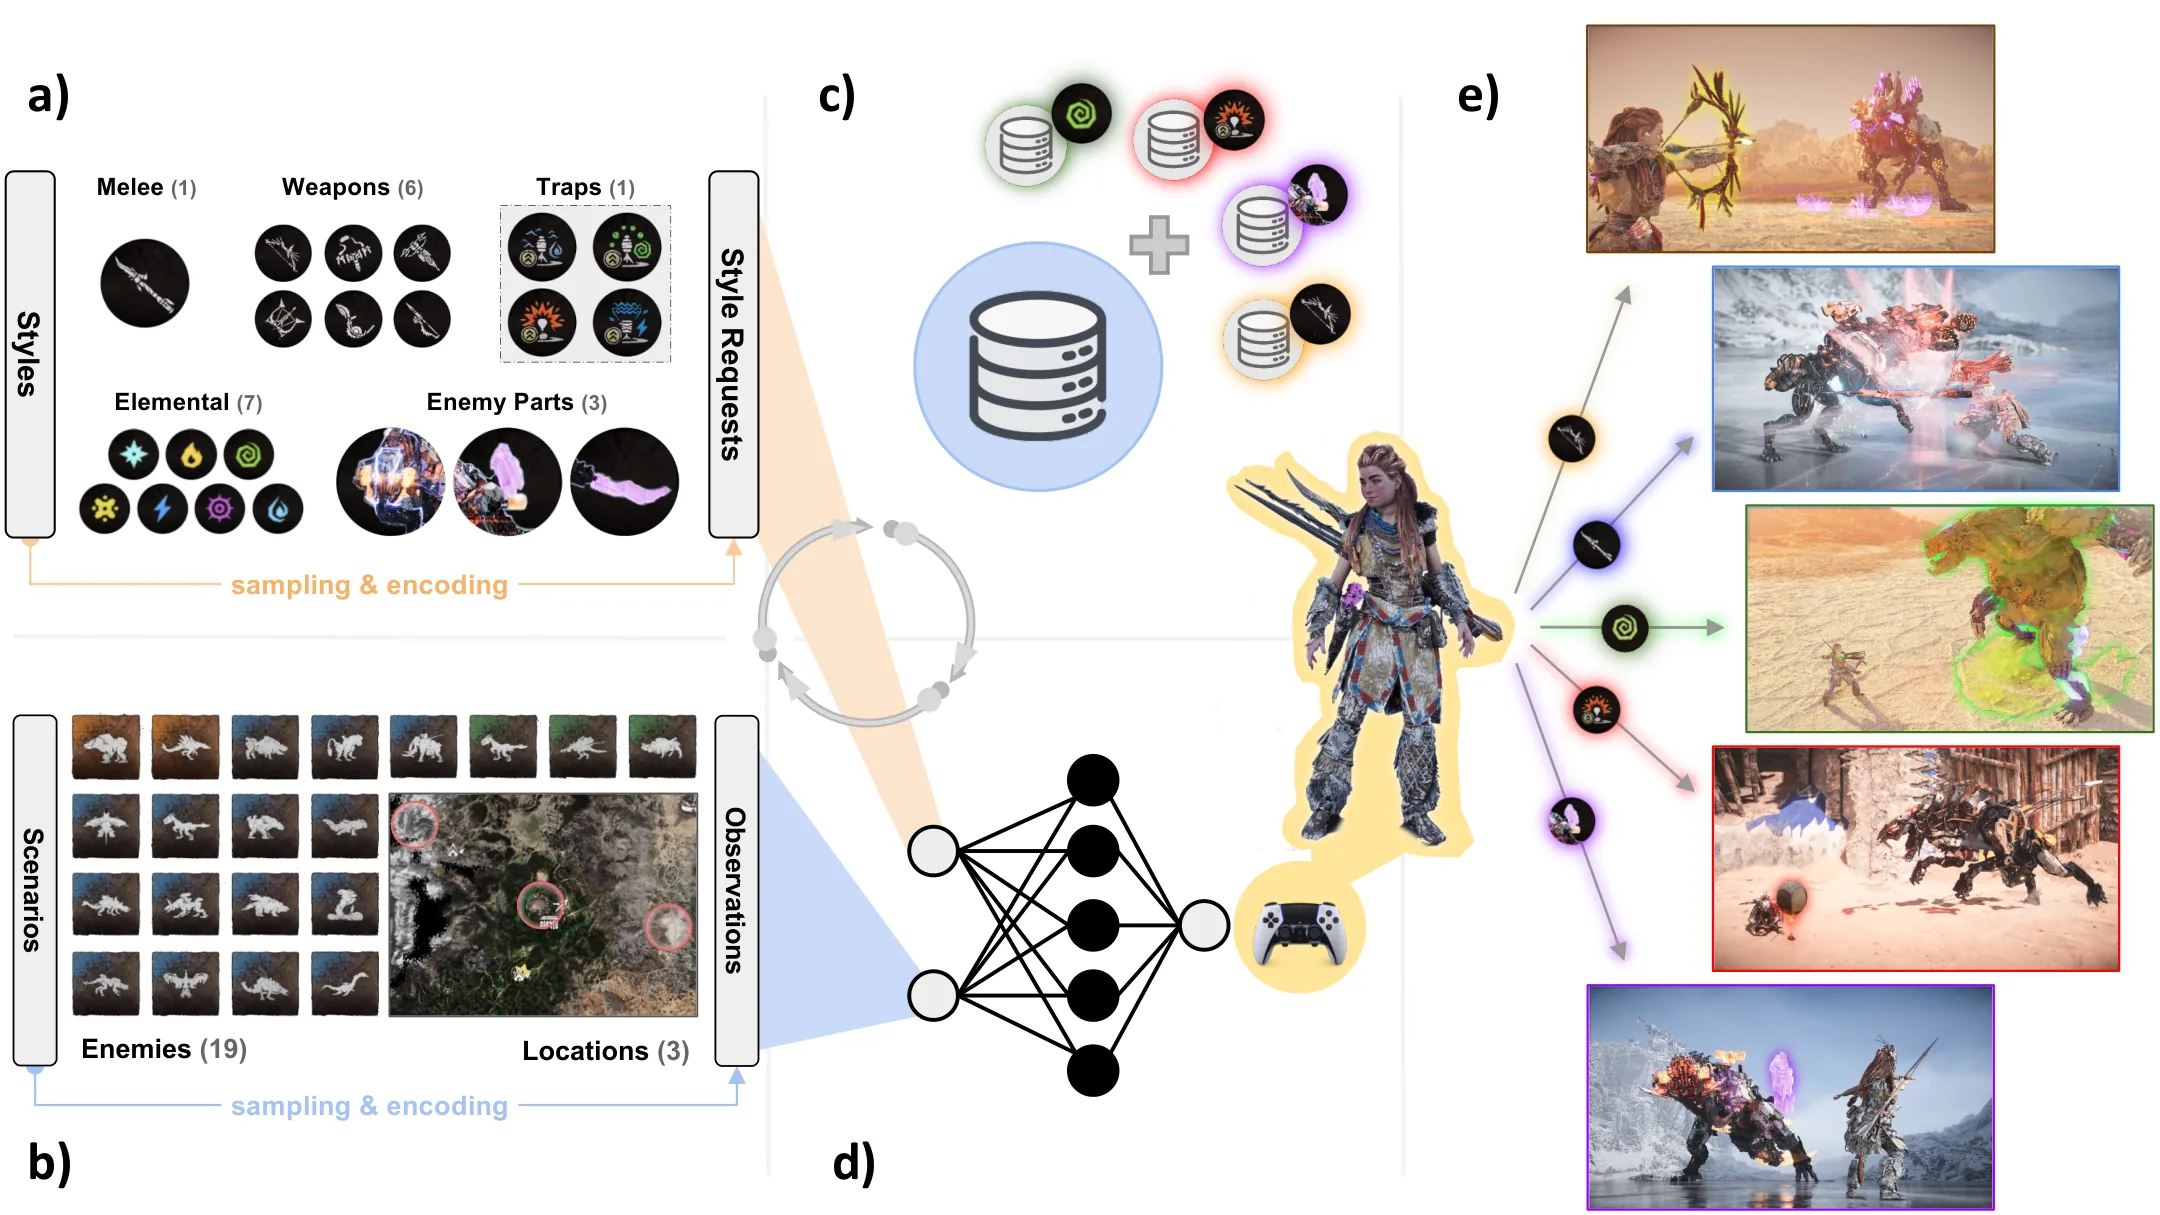
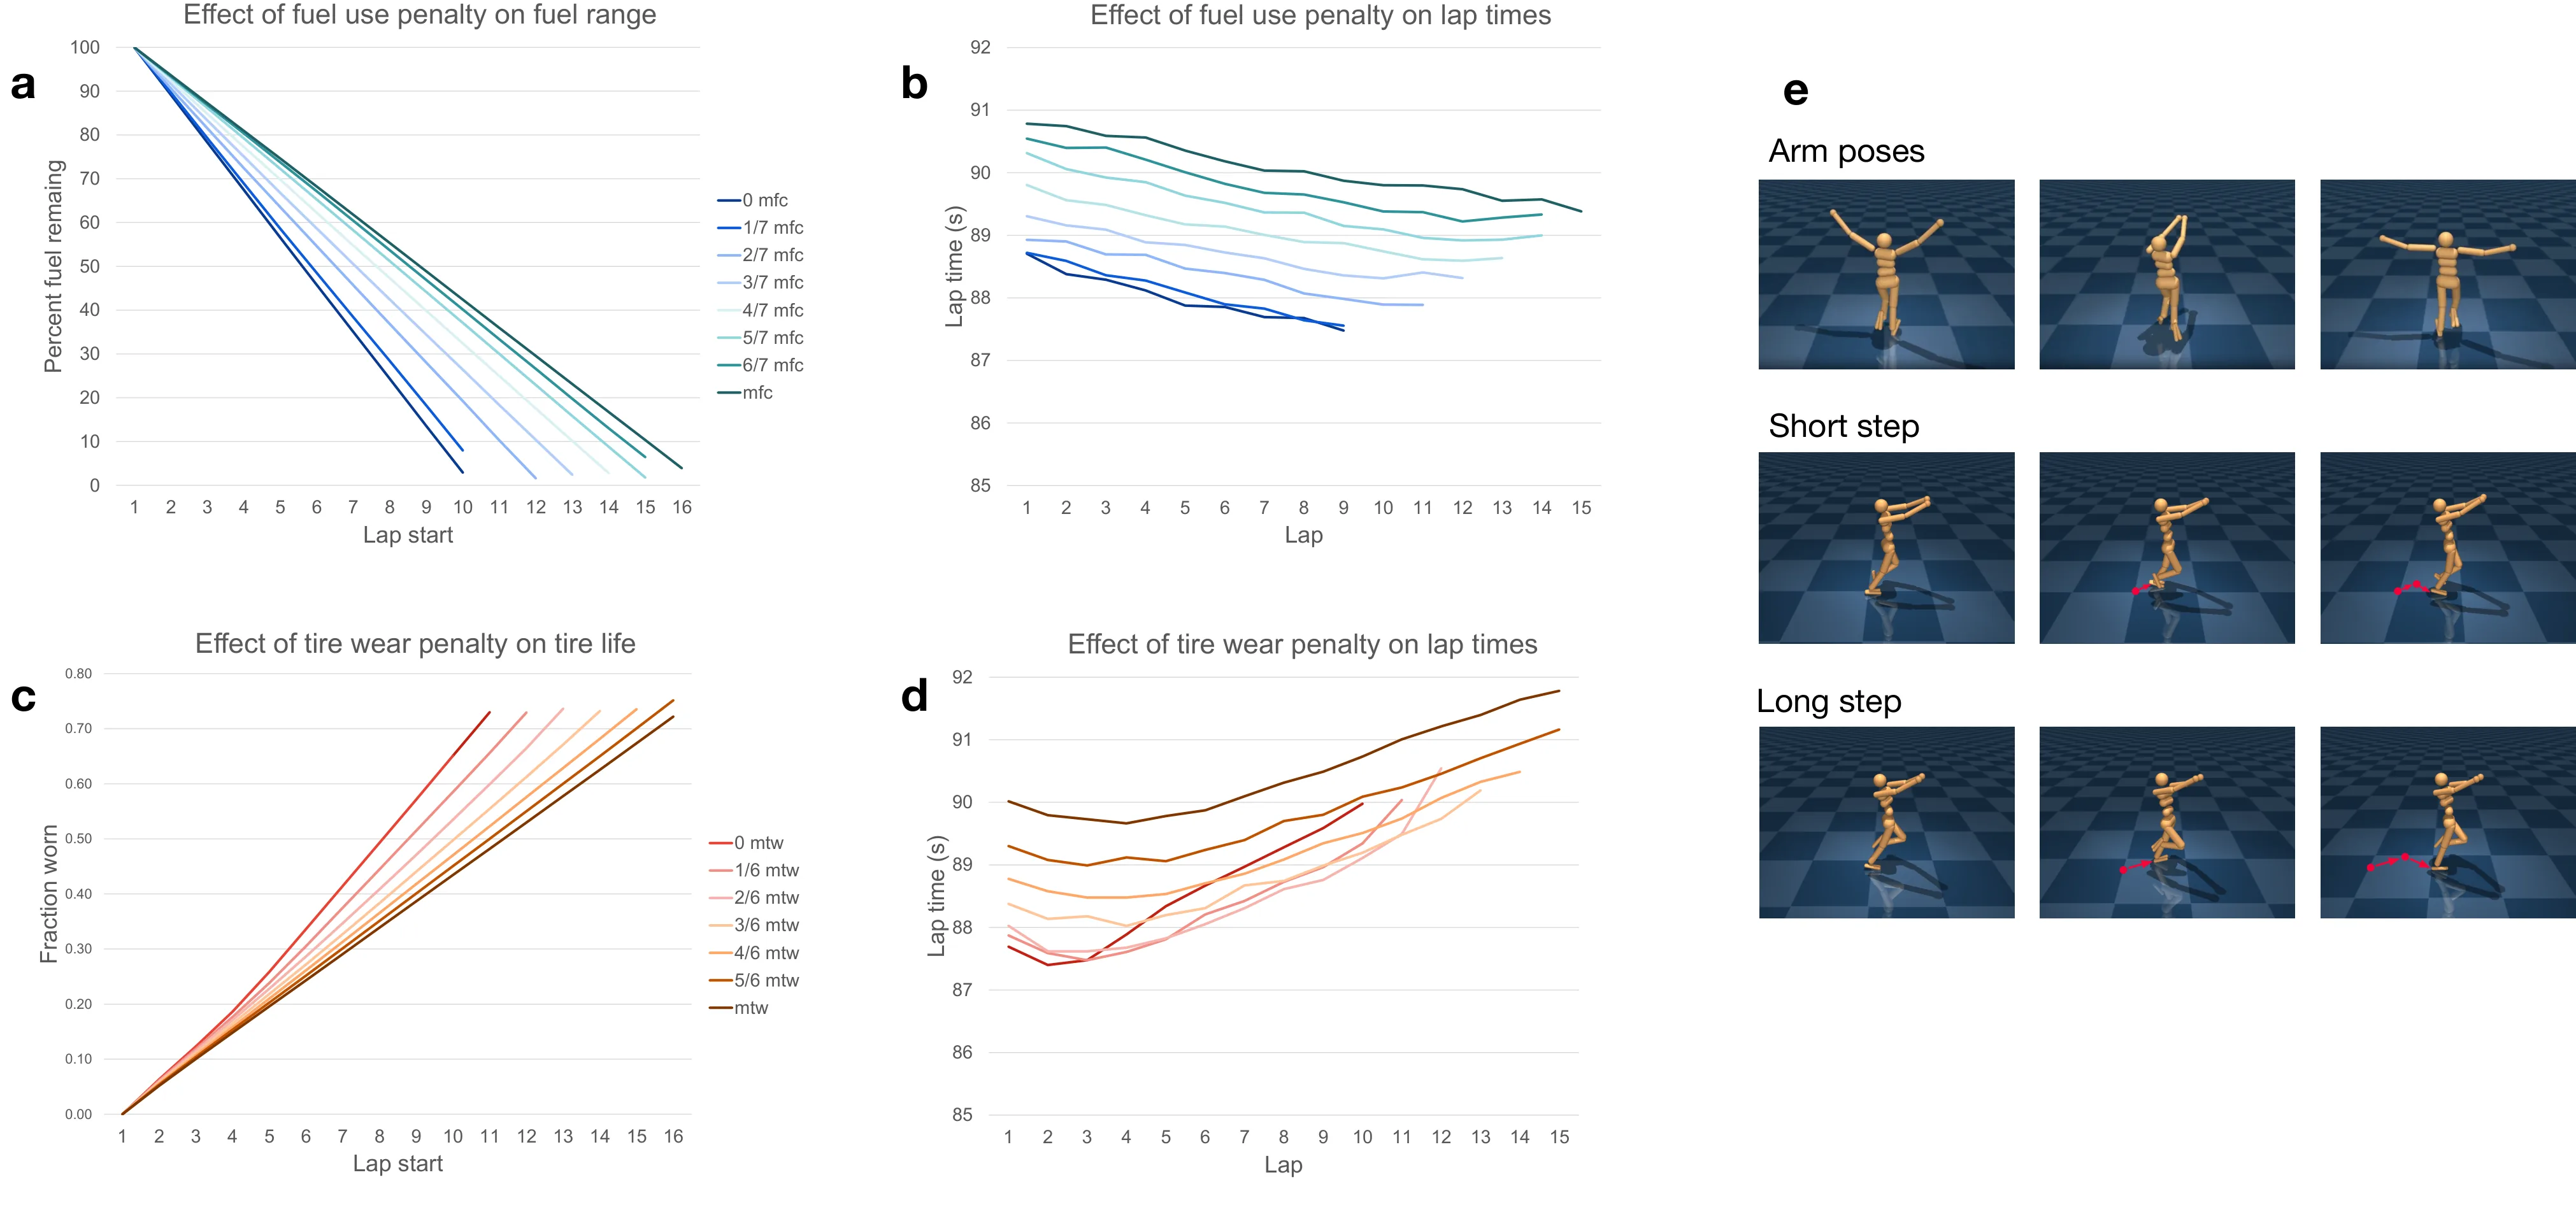
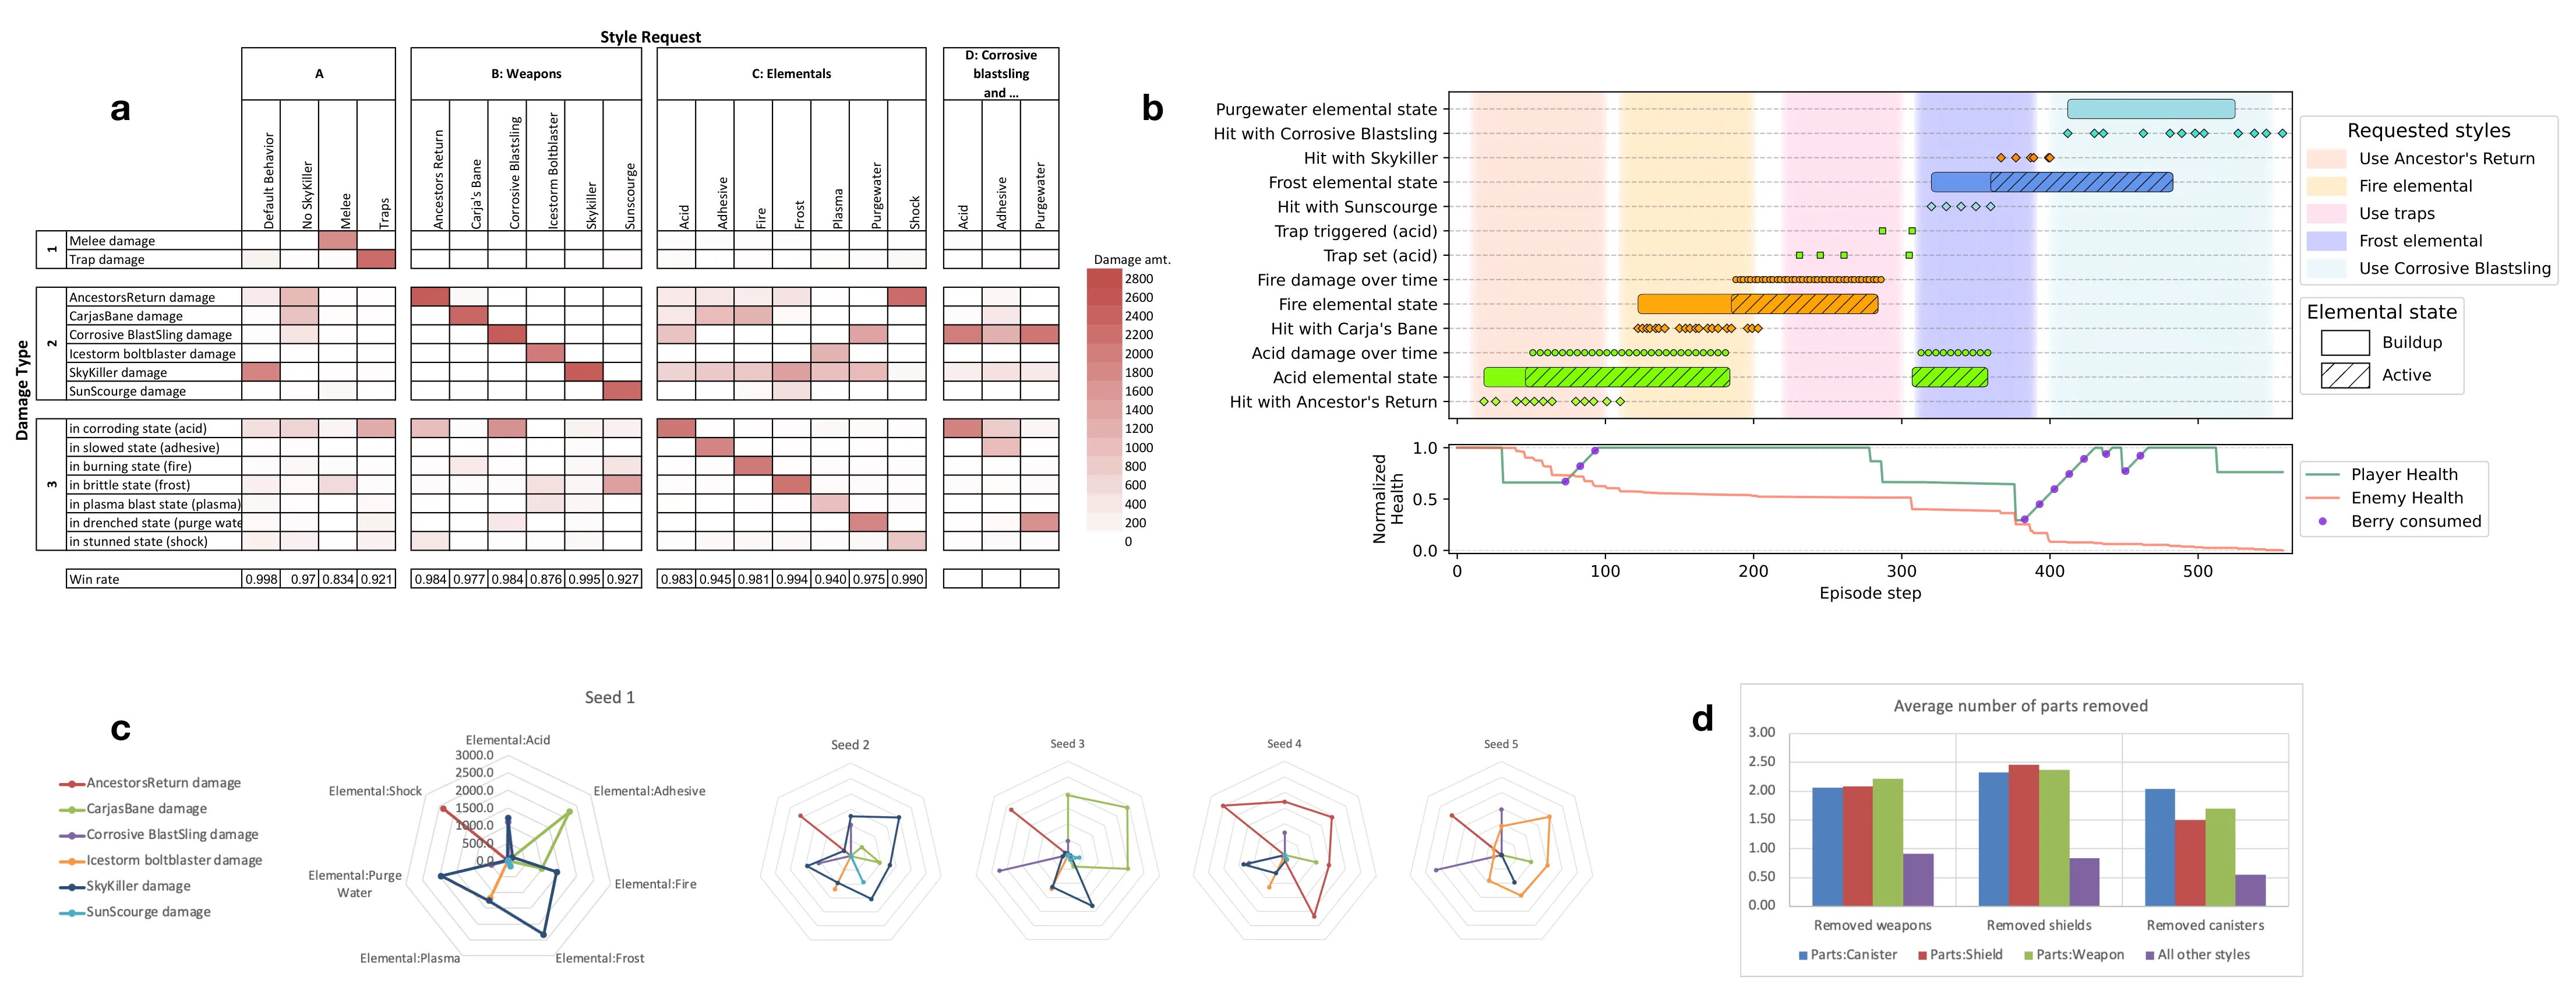
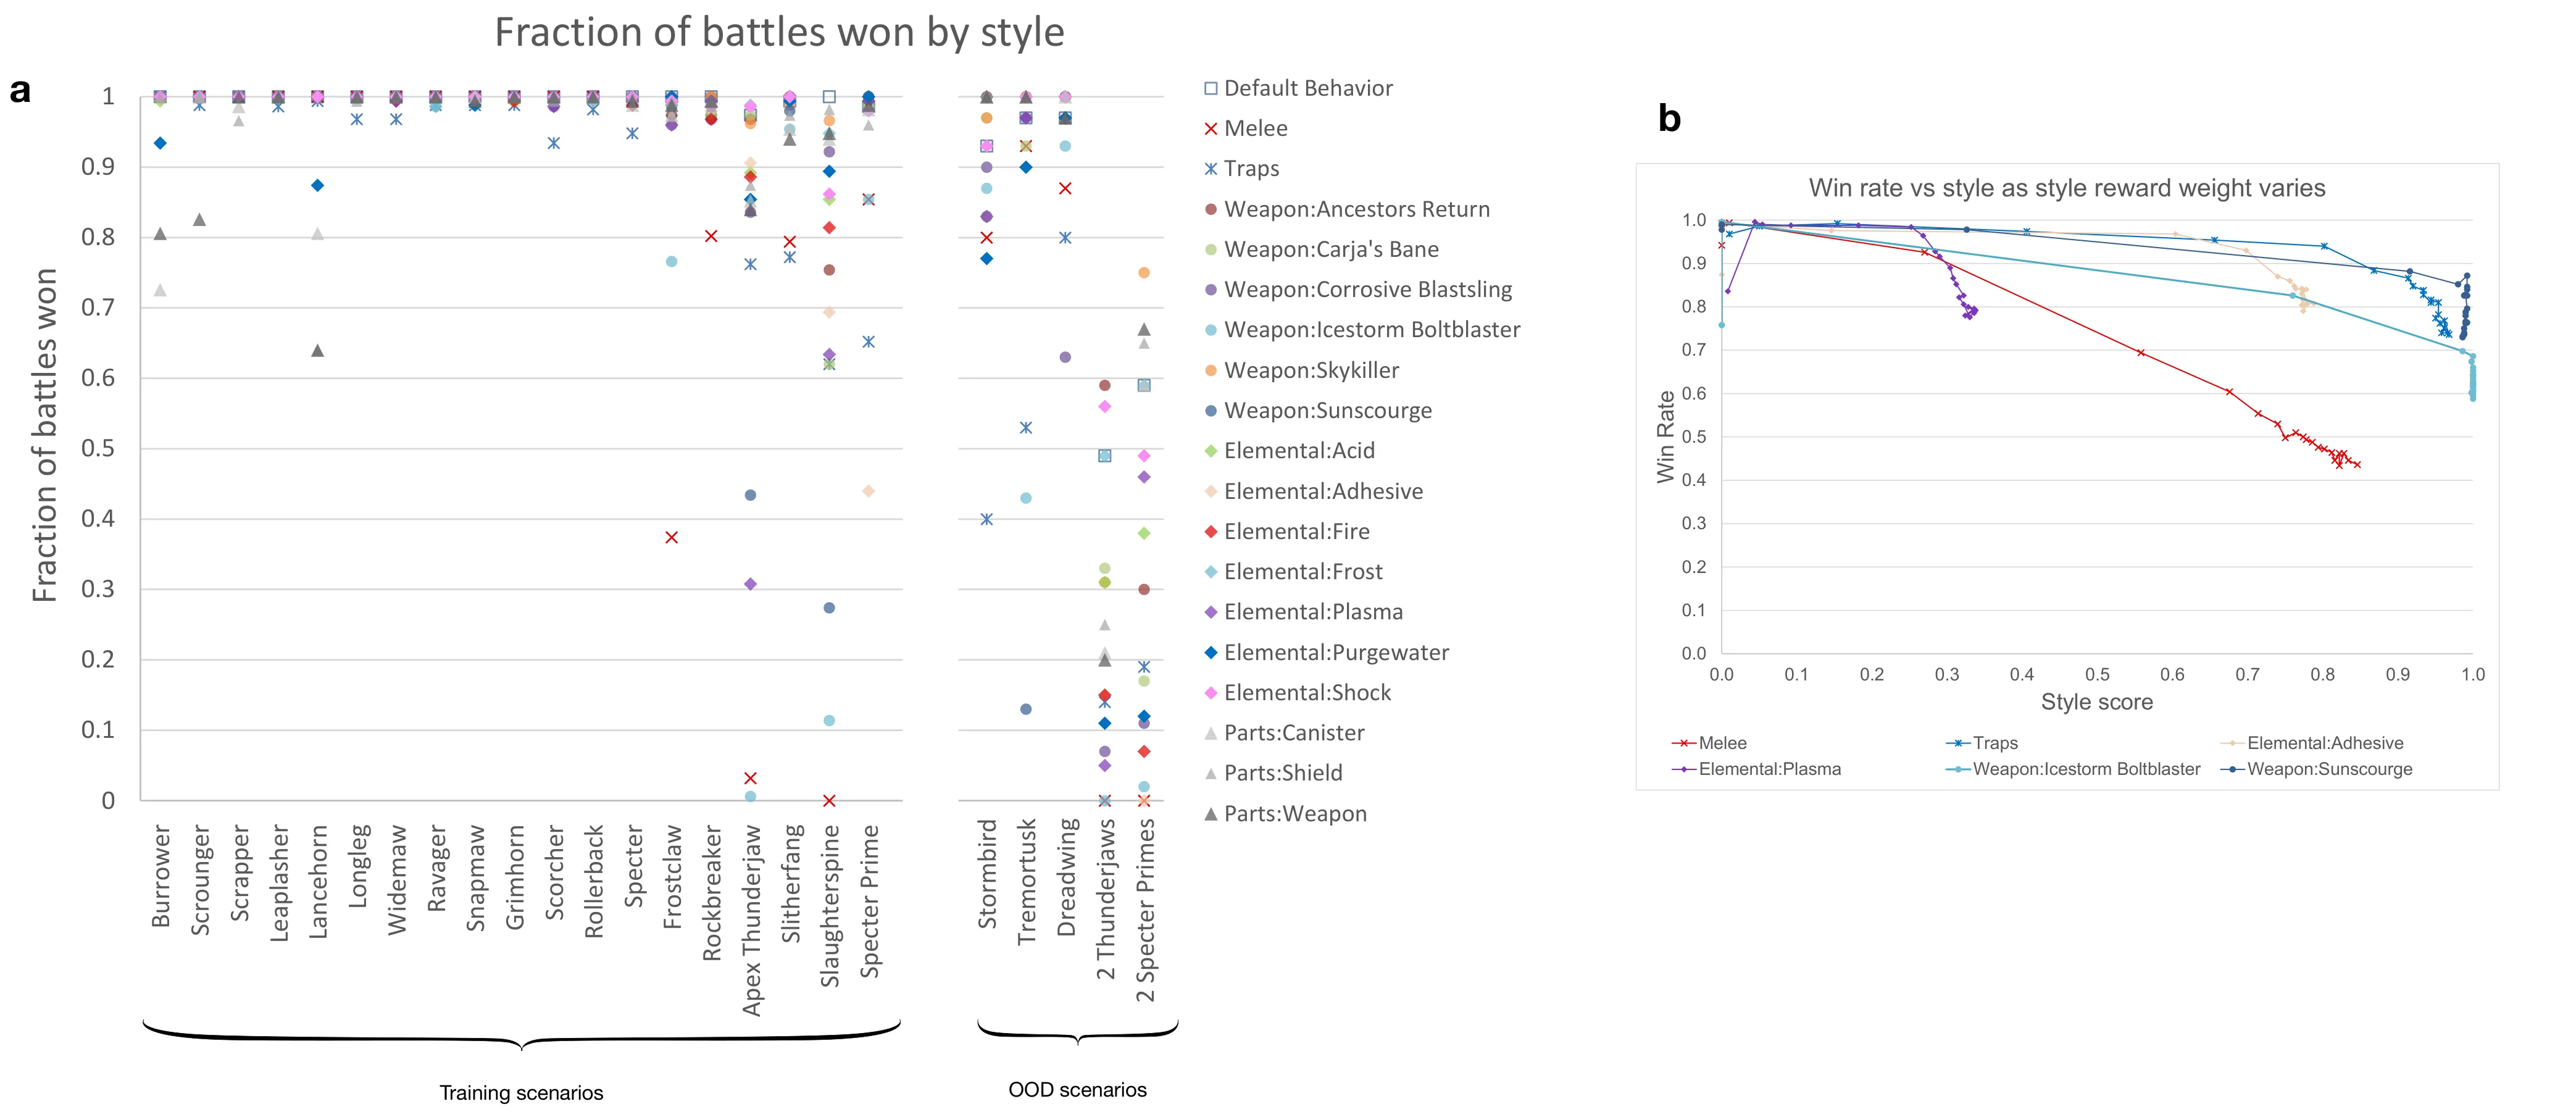
强化学习通常只能学到一种近最优策略,难以满足对行为风格进行实时可控的需求。本文将通用价值函数逼近器(UVFA)与精心设计的训练场景、学习算法及数据增强相结合,提出可“被教练”的智能体框架。该方法已在《地平线 西之禁地》、《GT赛车》以及开源类人机器人领域得到验证,允许终端用户在运行时灵活选择智能体的最终行为表现。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
强化学习已在游戏对弈、机器人控制乃至基础模型训练等领域展现出强大的能力。通过大量试错,这些系统往往能自主发现完成任务的有效策略——但也正因如此,学到的只是一种近乎固定的、近最优的行为模式。在许多实际应用场景中,人们不仅关心任务是否完成,更关心“如何”完成:清洁机器人在婴儿睡眠时应该安静作业,客人来访时则可以加快节奏;赛车游戏中车手可能为延长轮胎寿命而主动放慢节奏;游戏中的NPC若能根据玩家偏好切换战斗风格,将大幅提升沉浸感。
这些对“完成任务方式”的调控需求,与多任务学习或目标条件学习存在本质区别。论文将此类调控定义为风格(styles)——它不改变核心任务本身(赛车仍要完成圈速、战斗仍要取胜),而是在主任务约束下调整次要行为特征,类似于语言中副词对动词的修饰关系。传统强化学习方法缺乏这种可控性:一旦策略收敛,智能体只能在训练时确定的单一行为模式内运作,无法在推理阶段实时切换风格。
这一挑战的难点在于多层面。首先,[[动作空间]]可能高度复杂——《地平线 西之禁地》中同时包含数百种离散动作组合和连续控制维度。其次,风格信号与任务奖励需要协同优化,避免风格调控干扰核心任务的完成。最后,风格参数在推理时可能连续变化,这要求策略网络对条件输入具有足够的敏感性。
方法
论文的核心思路是将[[通用价值函数逼近器]](UVFA)扩展为风格条件化版本。标准UVFA接收状态和目标向量作为输入,输出对应的价值估计;本文在此基础上引入多维风格参数向量 ,使其能够根据不同的风格配置输出差异化的价值与策略。
形式上,奖励函数被分解为任务奖励与风格奖励两部分:
风格奖励进一步分解为 个独立项的加权组合:
其中 为标量权重(正值鼓励、负值抑制、零表示无偏好), 为风格特定参数如阈值或目标设定点。每个训练回合内 保持固定以避免信用分配困难,但在推理时允许连续变化。
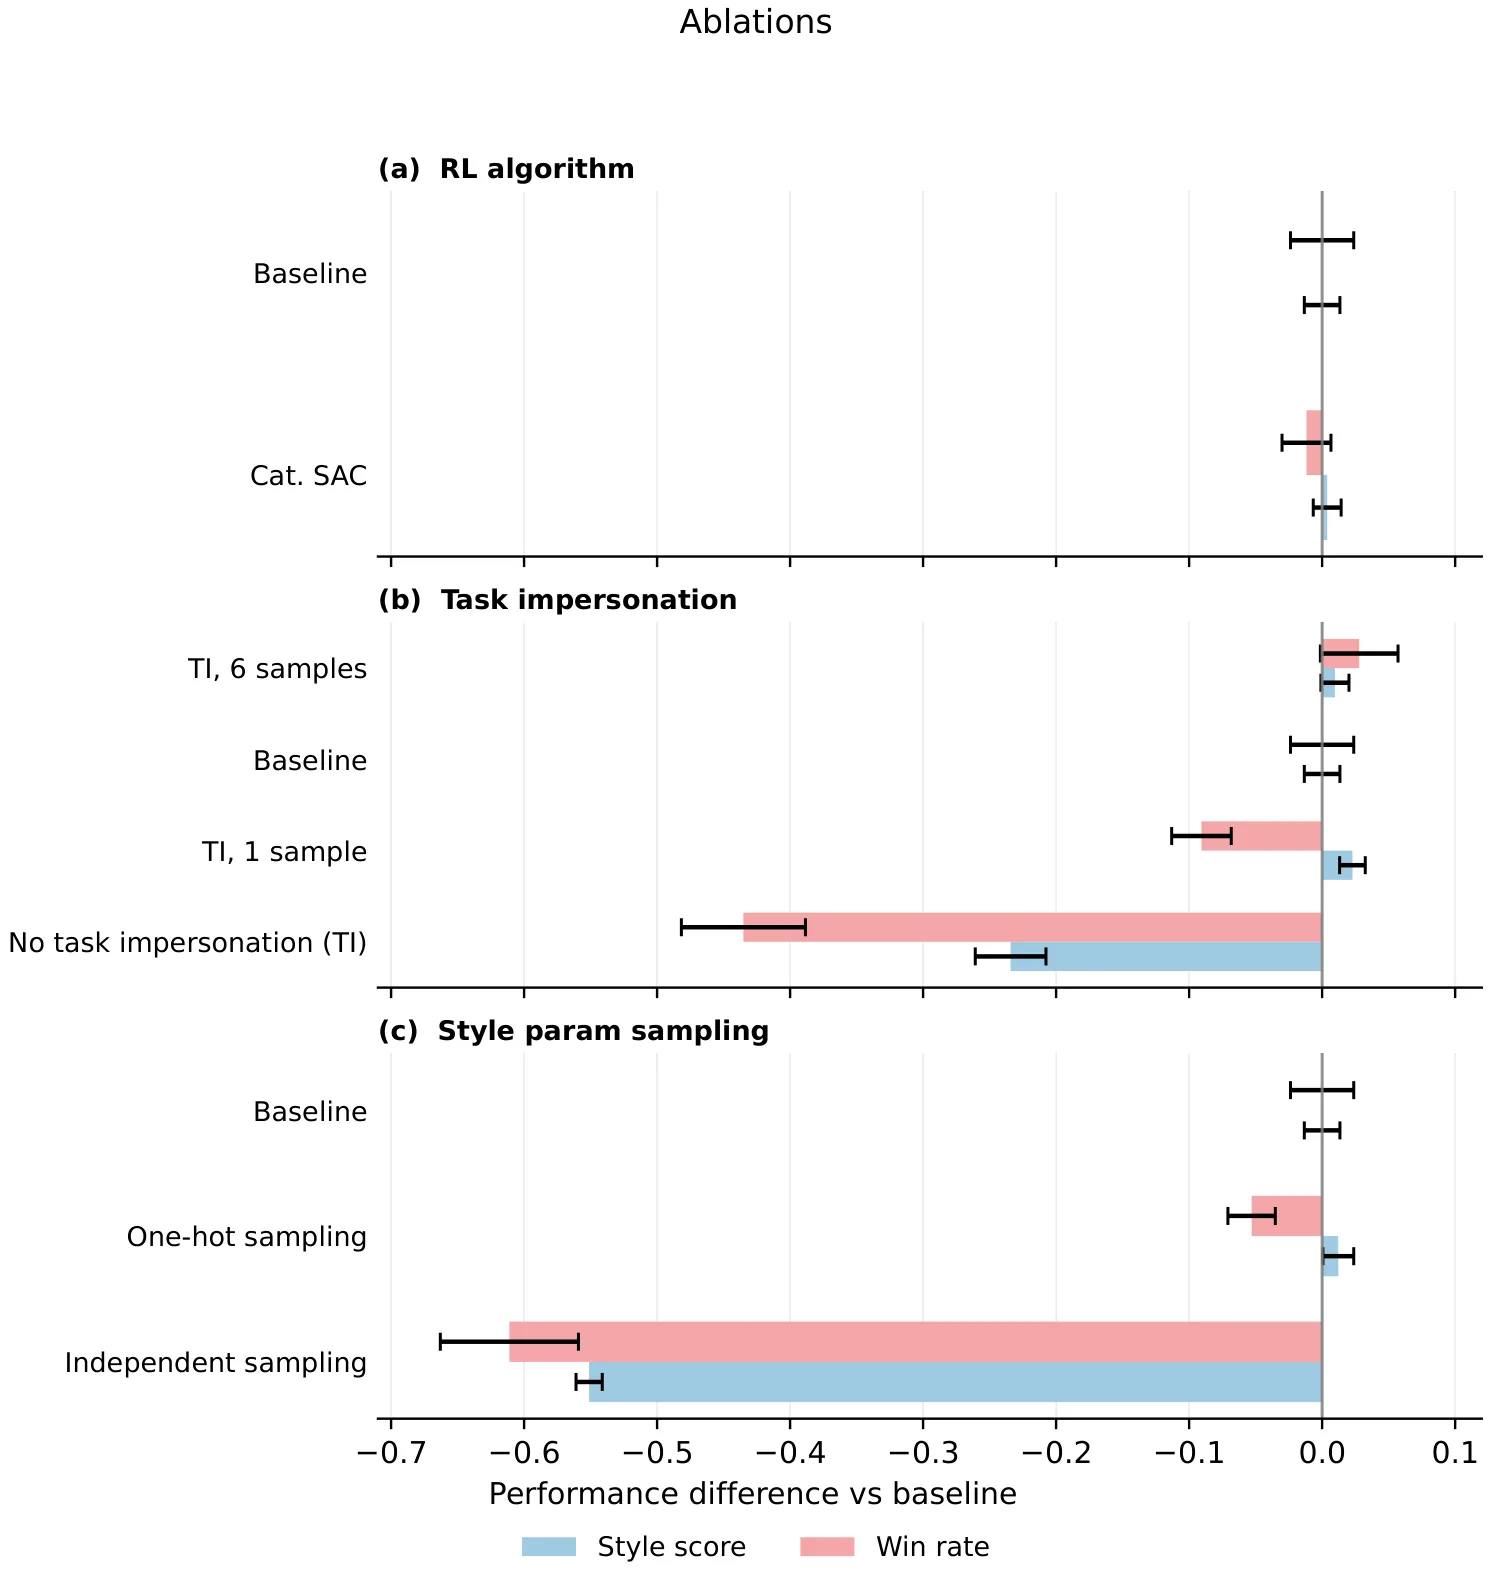
Cat-RAC算法是处理《地平线 西之禁地》这类混合[[动作空间]]的关键创新。当动作同时包含离散选择(如武器切换)和连续控制(如摇杆方向)时,标准SAC的熵正则化难以统一处理。Cat-RAC用后悔匹配(regret matching)的思想重构梯度:计算每个动作的瞬时遗憾 ,当某动作的策略概率已低于其梯度贡献时将梯度清零,避免策略向低价值方向更新。对于离散动作头使用精确的类别熵估计,连续头则通过大量样本估计熵的负对数密度,比SAC的单样本估计更为稳定。
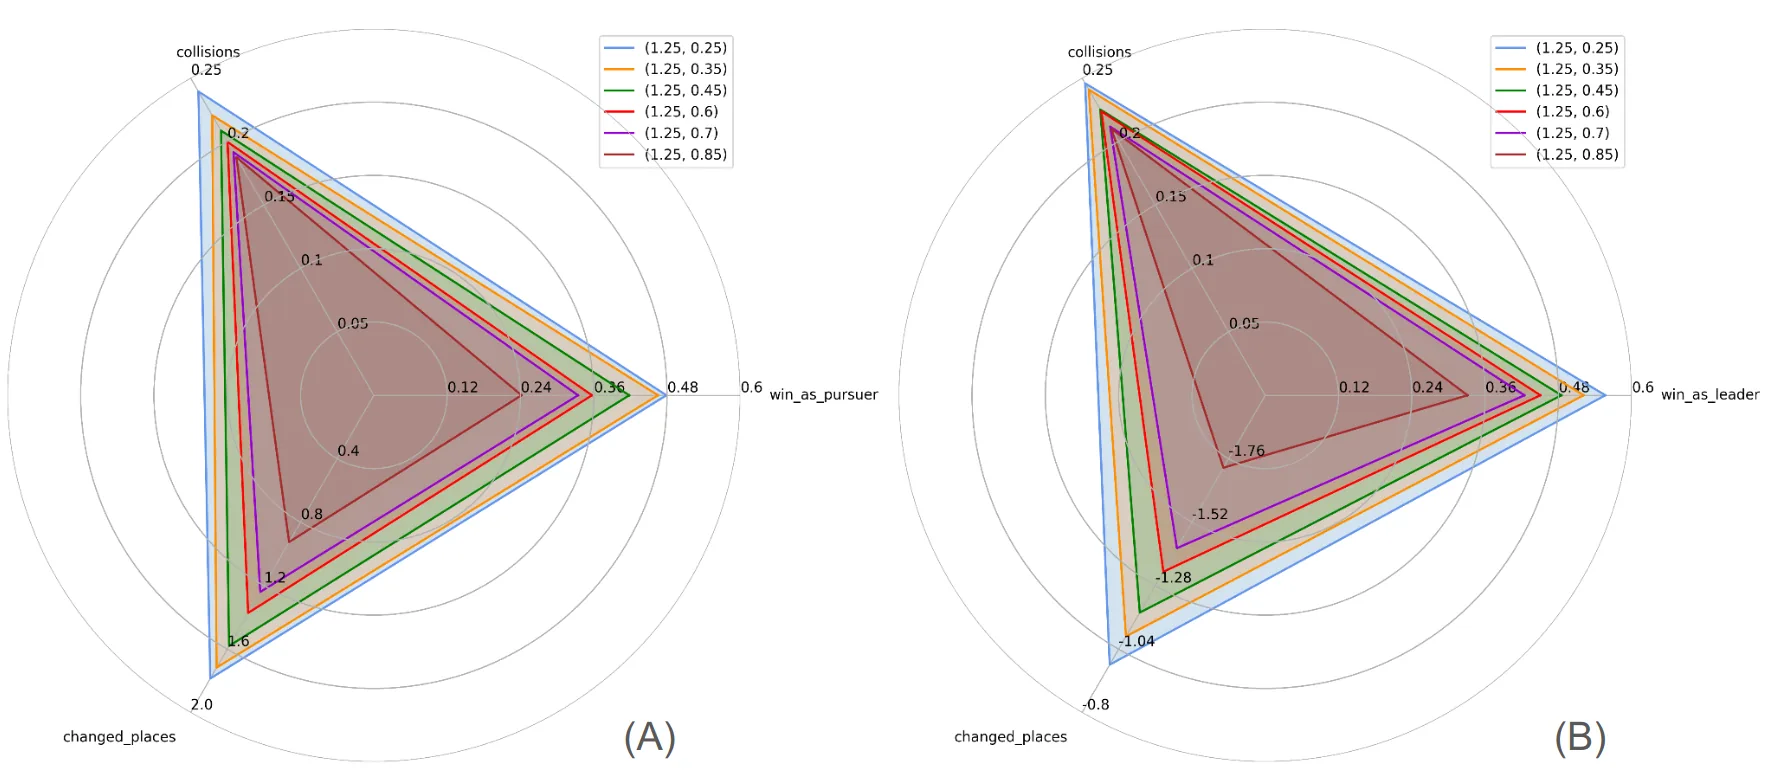
在训练策略上,论文设计了多层数据增强机制。任务扮演(Task Impersonation)技术将同一转换(transition)在 种风格配置下评估,仅需 个额外风格向量即可显著扩展风格覆盖而无需扩充经验回放缓冲区。分层采样通过事件表按风格配置组织数据,对比机制有效解决风格间数据不均衡问题。风格参数采样分布采用混合策略:少量概率采样默认风格、部分概率独立采样各权重、大部分概率采用连续one-hot形式,平衡探索多样性与学习效率。
实验与结果
论文在三个差异显著的领域验证了框架的通用性。《地平线 西之禁地》的战斗系统具有315种离散动作组合加4维连续控制的高维[[动作空间]],智能体需在19种机器敌人、3个地图场景下响应18个风格权重和20种风格配置。《GT赛车7》中风格调控聚焦于漂移程度、轮胎与燃油节省以及整体激进度。《DMC Humanoid》则在21维连续动作空间中测试3种离散手臂姿态与连续步长设定点的组合。
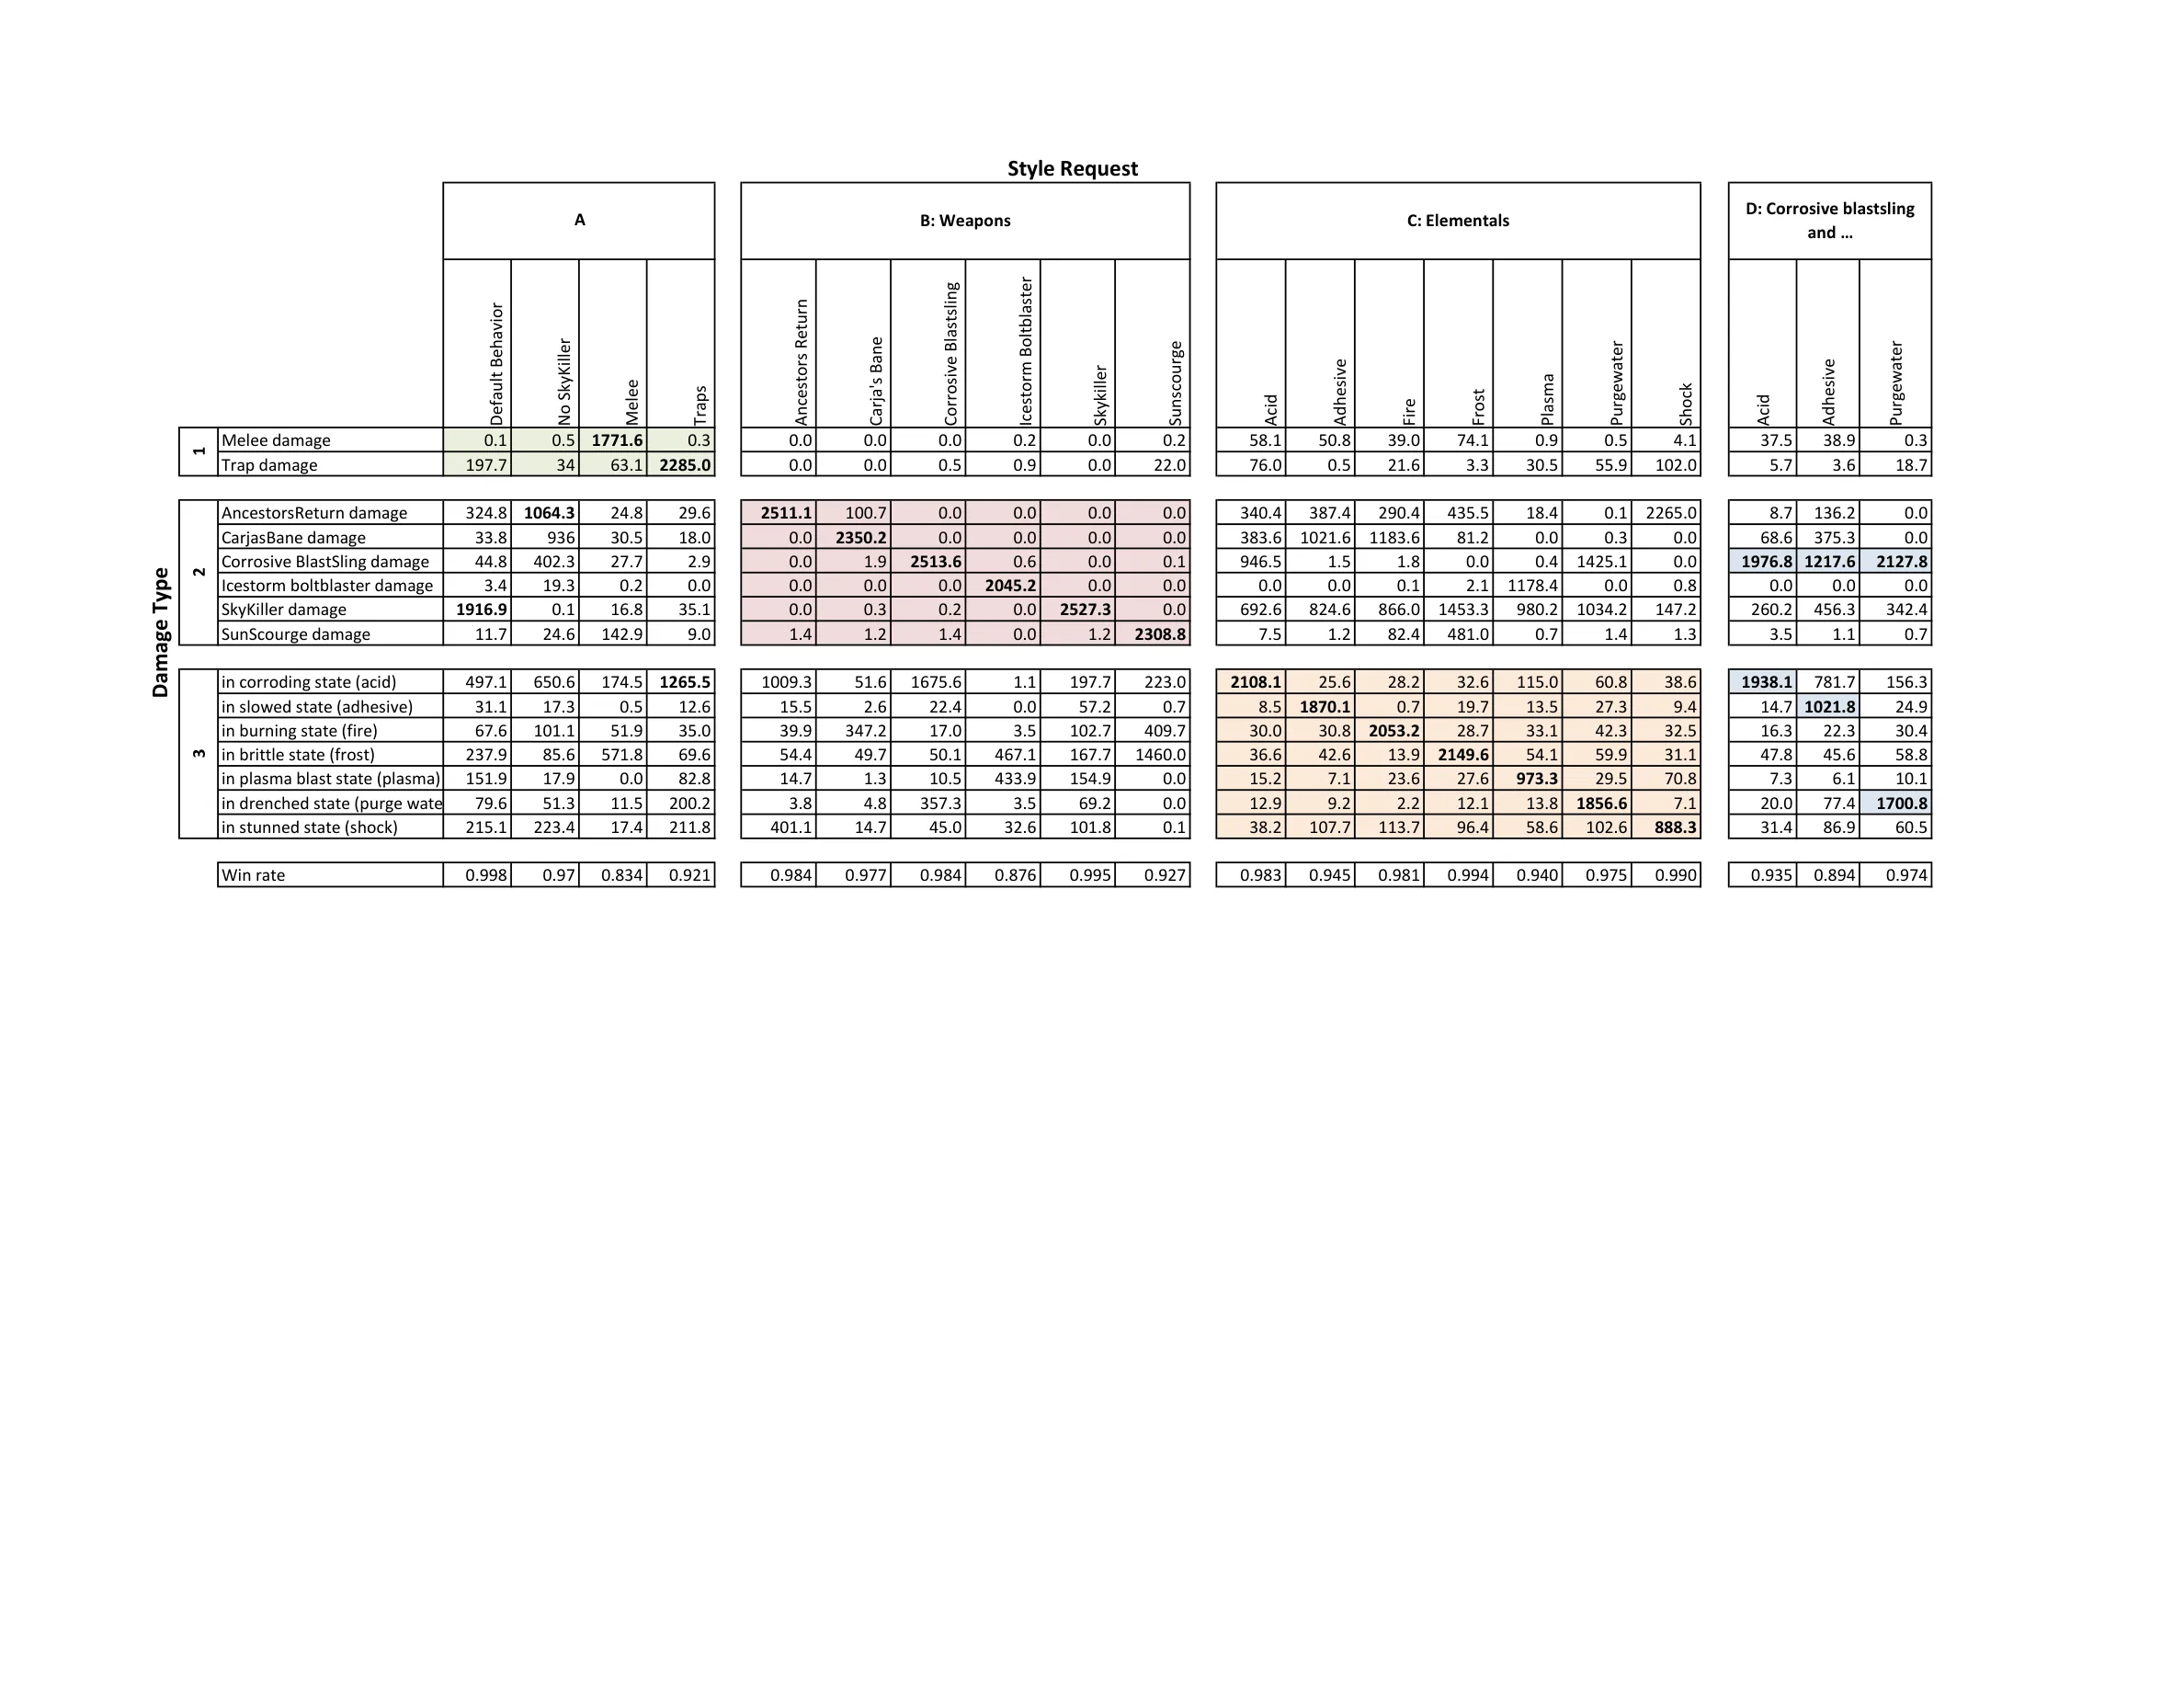
《地平线 西之禁地》的核心实验规模庞大:5个随机种子各训练450万梯度步,然后在20种风格、19种敌人、3个地点、10个样本的交叉组合下评估,共计约57000场战斗。风格分数(请求伤害类型占总伤害的比例)显示17种风格的伤害矩阵呈现明显对角线主导现象,平均胜率多数超过90%。消融实验表明:Cat-RAC相比分类式SAC在风格分数上提升约10个百分点;任务扮演中 的配置相比不使用该技术可将风格分数提升约15%;混合采样分布相比纯one-hot采样能更好地平衡默认风格表现与风格覆盖广度。
更值得注意的是,智能体展现出上下文推理能力:在战斗中先用弱武器触发元素状态,再切换强武器最大化元素期间伤害,这种组合策略在训练中平均每百万场景不到一次,但智能体仍能习得。分布外泛化测试中,面对训练集未见的飞行敌人或双敌人场景,智能体仍维持可观胜率。
讨论与可借鉴点
该工作最值得关注的设计哲学在于将风格调控从训练时固化转向运行时灵活。传统观点认为强化学习学到的是一种固定的最优映射,而本文证明通过适当的条件化设计和训练策略增强,单一策略网络可以编码多种风格的行为空间,用户在推理时通过调节风格参数即可即时切换。这种解耦核心任务与风格调控的思路,对交互式游戏、具身智能乃至未来人机协作系统都有启发意义。
然而方法也存在局限。首先,每个新风格仍需设计对应的奖励项,这在工程上具有较高成本;其次,Cat-RAC的理论分析尚不充分,尤其在函数逼近条件下的后悔匹配伪梯度性质有待更严格的刻画;最后,评估主要依赖机器化的胜率与伤害统计,缺少人类玩家的主观偏好验证。
对于后续研究,一个有价值的探索方向是将风格从显式参数调控扩展到隐式表达——例如通过自然语言描述风格意图,由模型自动推断相应的行为模式。另一个方向是研究风格的自动发现与组合,减轻人工设计奖励的负担。
摘要
将强化学习应用于3A游戏智能体并实现风格控制
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
SAGA:面向长视野 CivRealm 战略规划的场景感知、目标演进智能体
SAGA: Scene-Aware, Goal-Evolving Agents for Long-Horizon CivRealm Strategy Planning
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 9 张
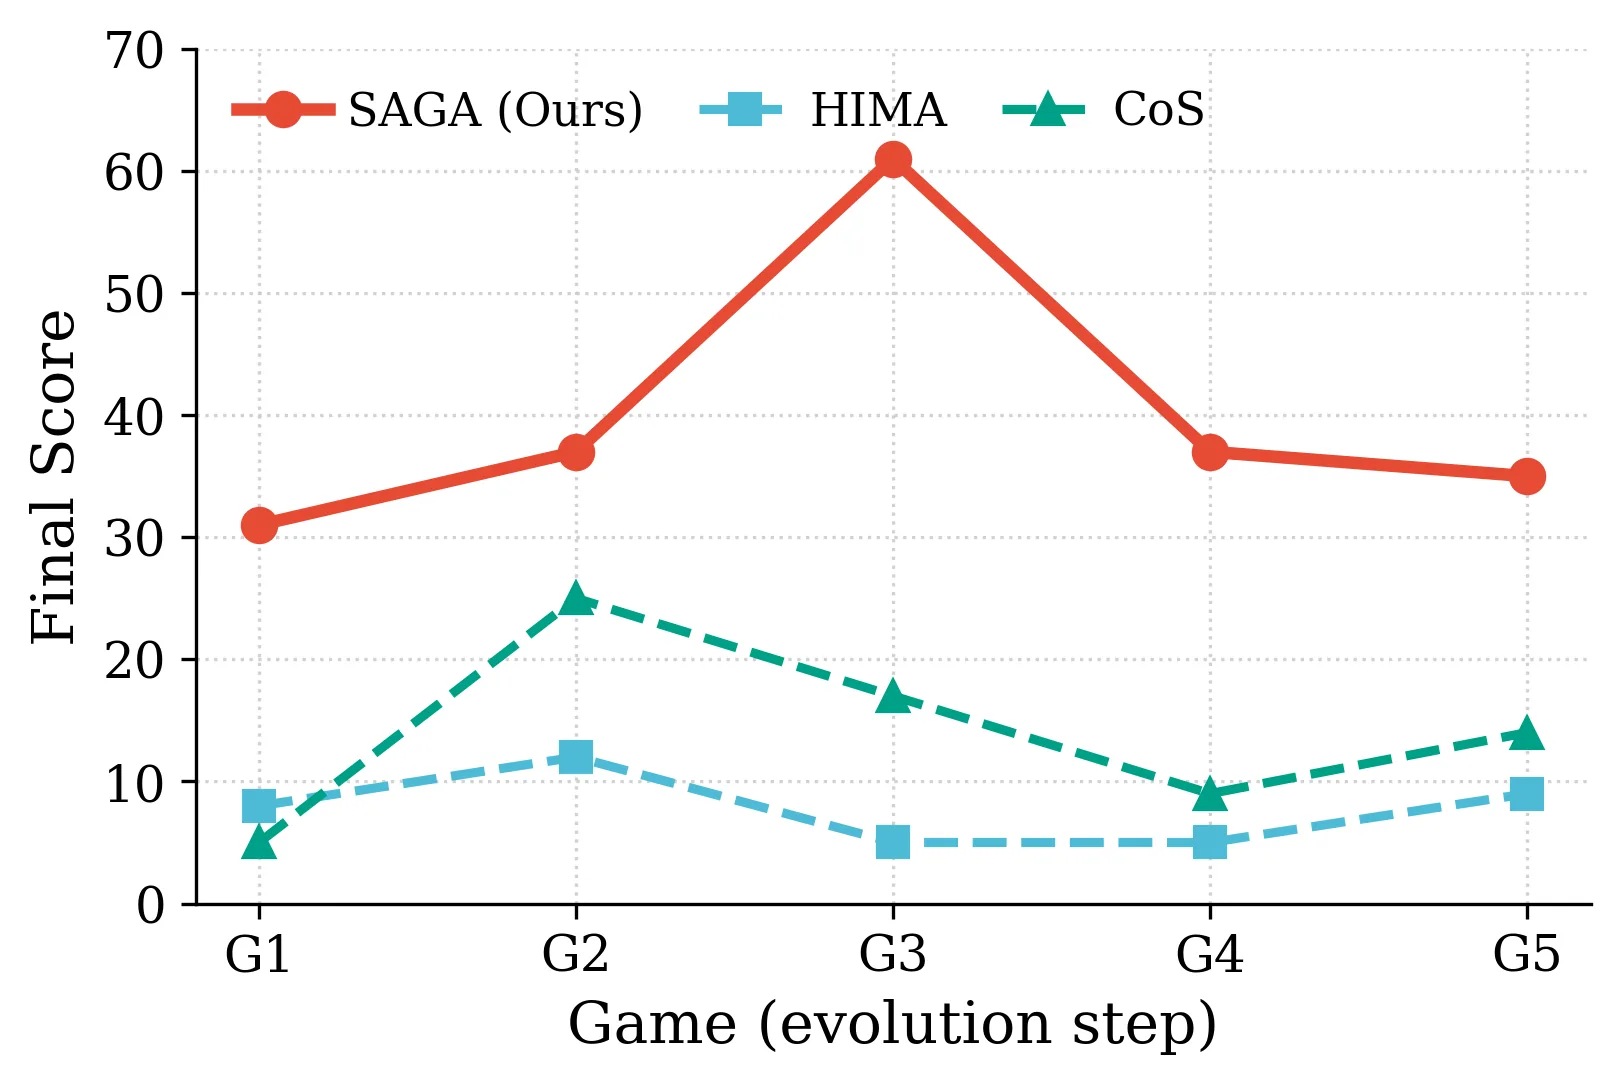
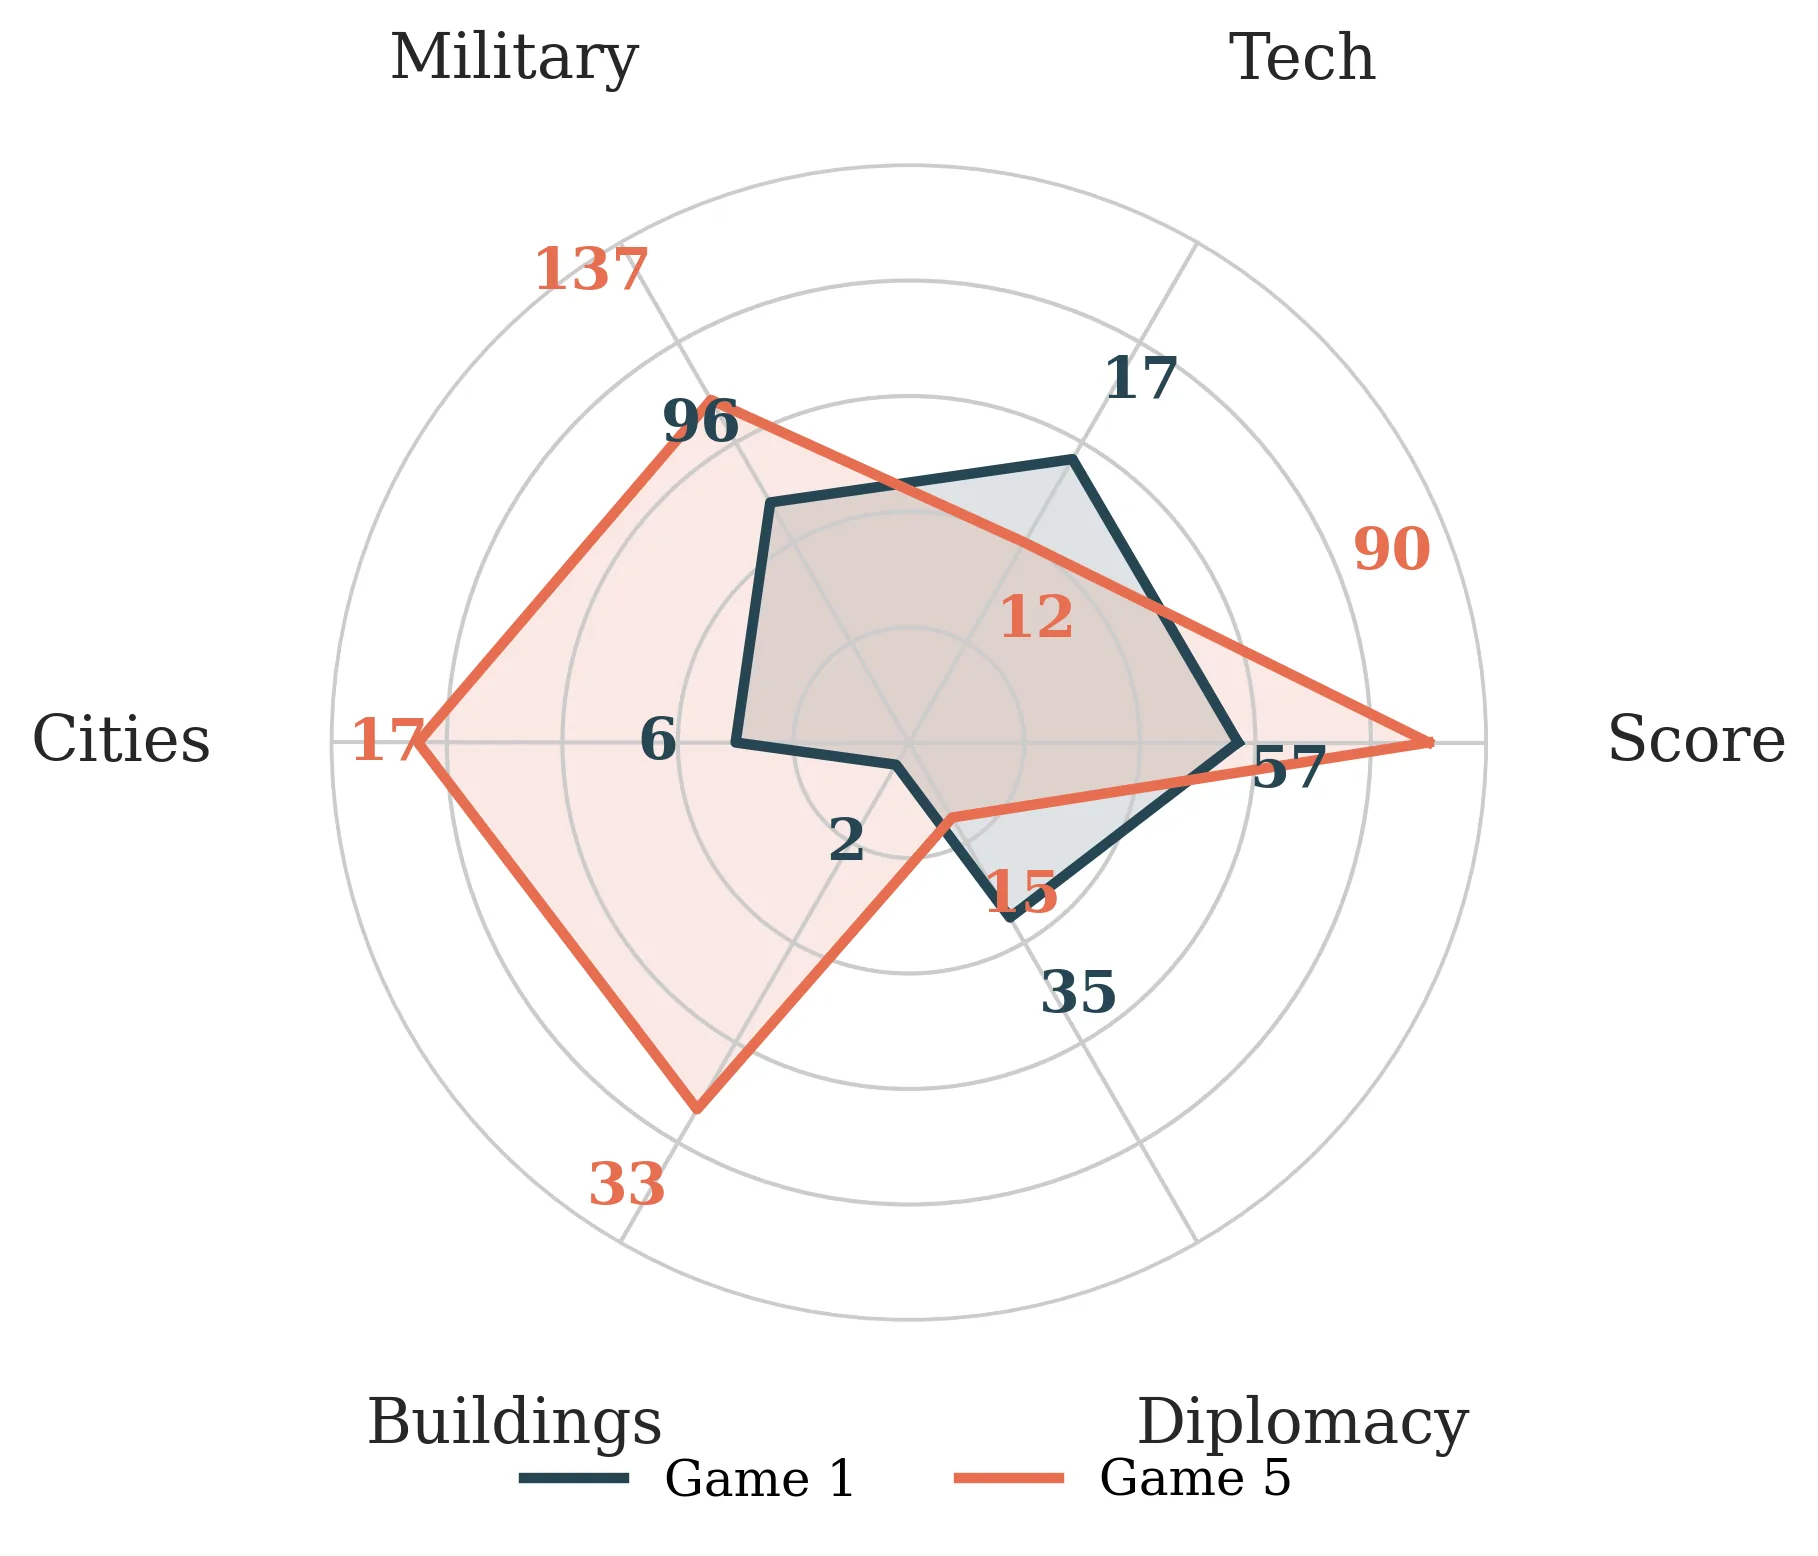
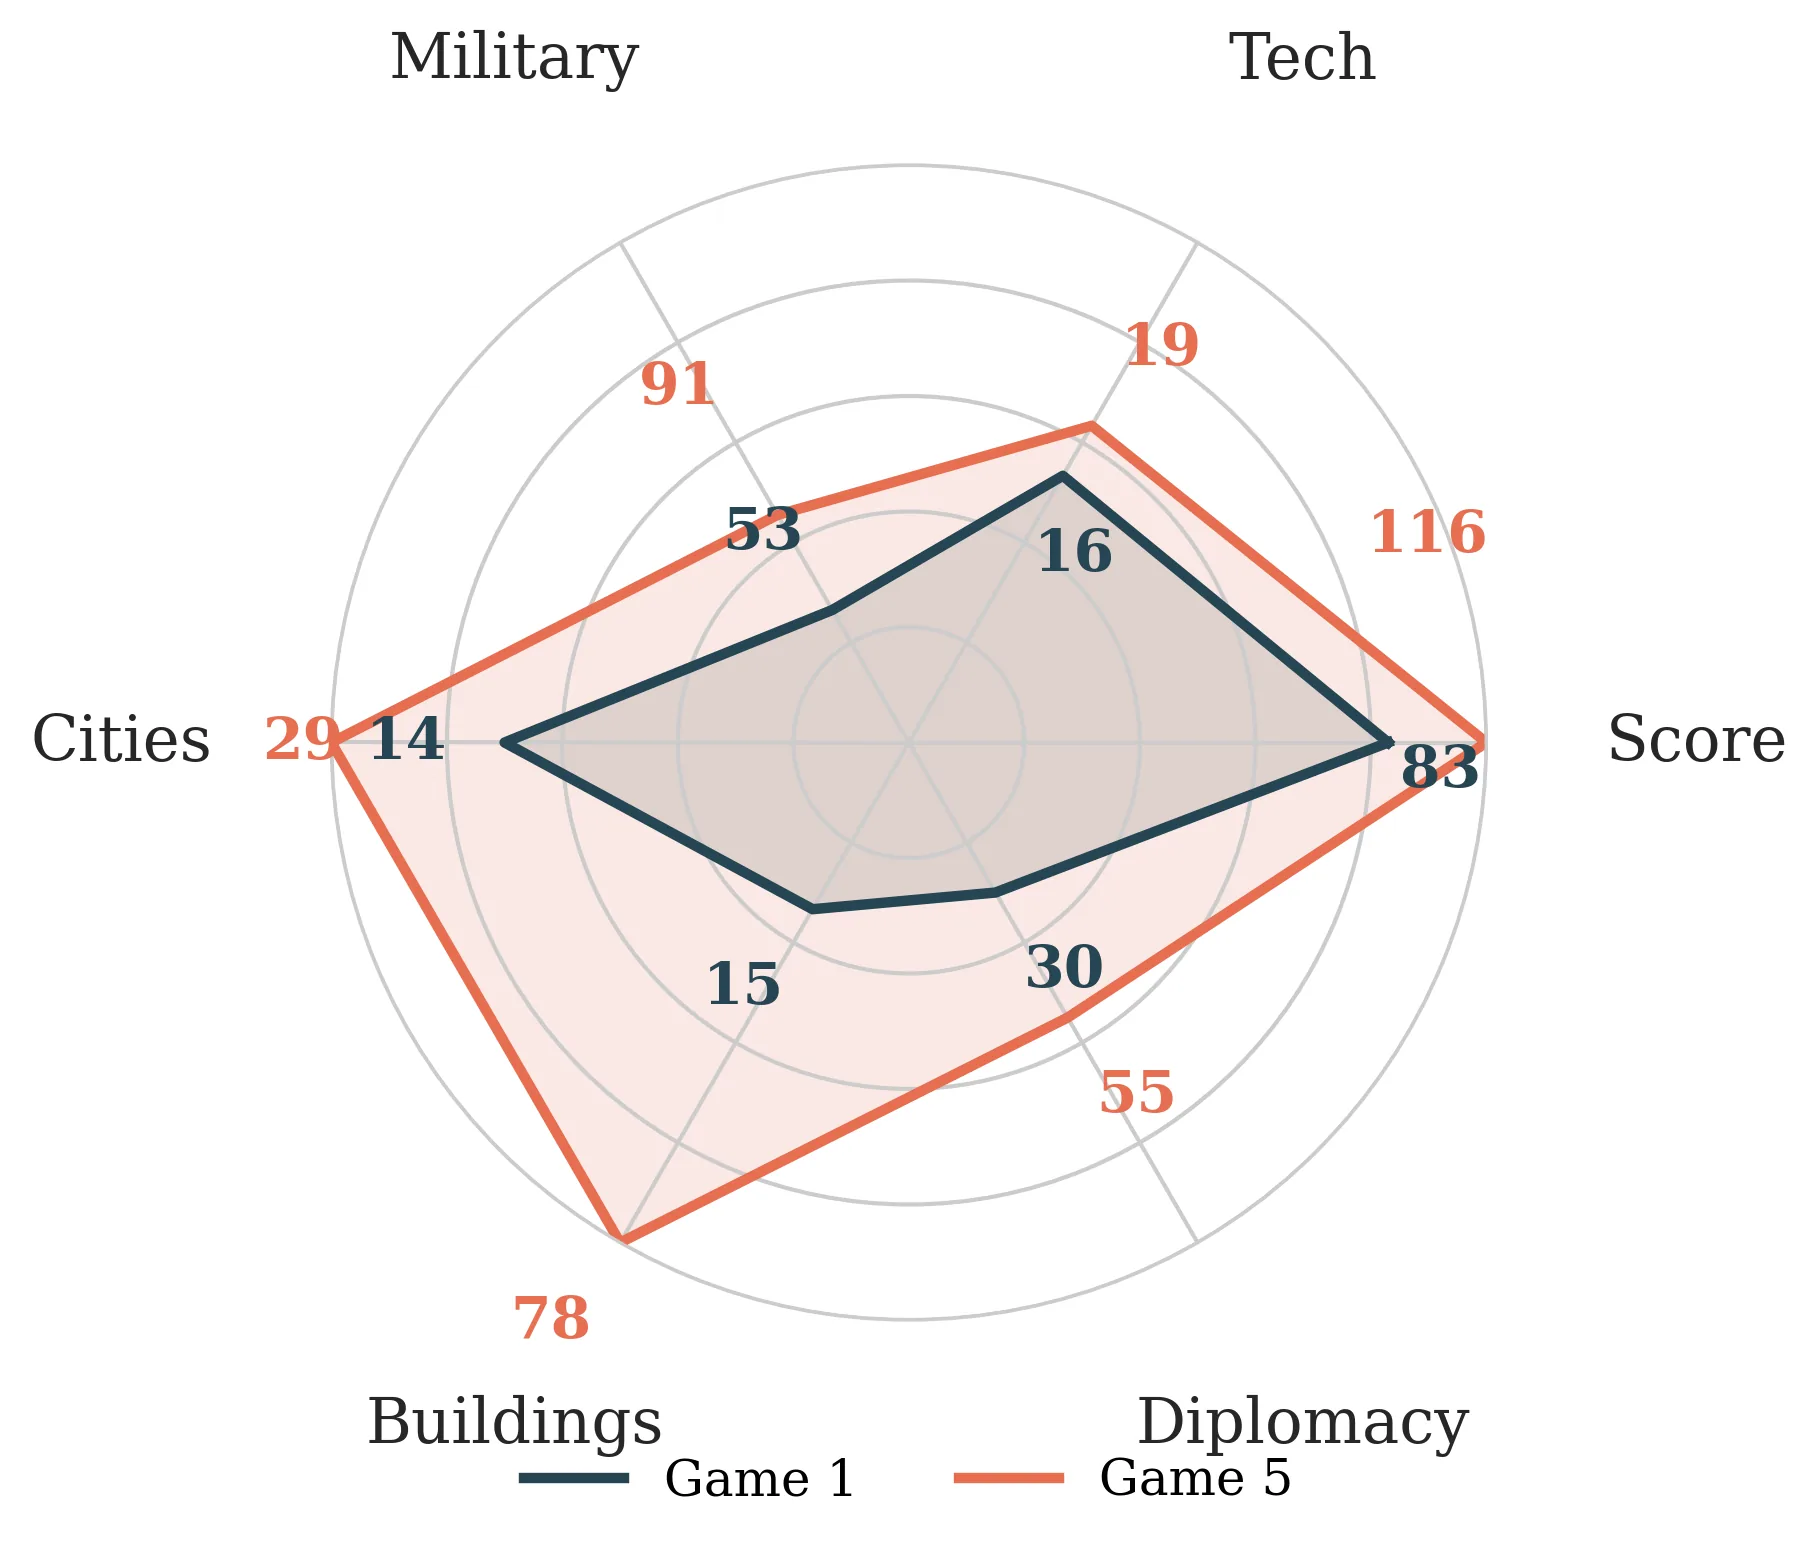
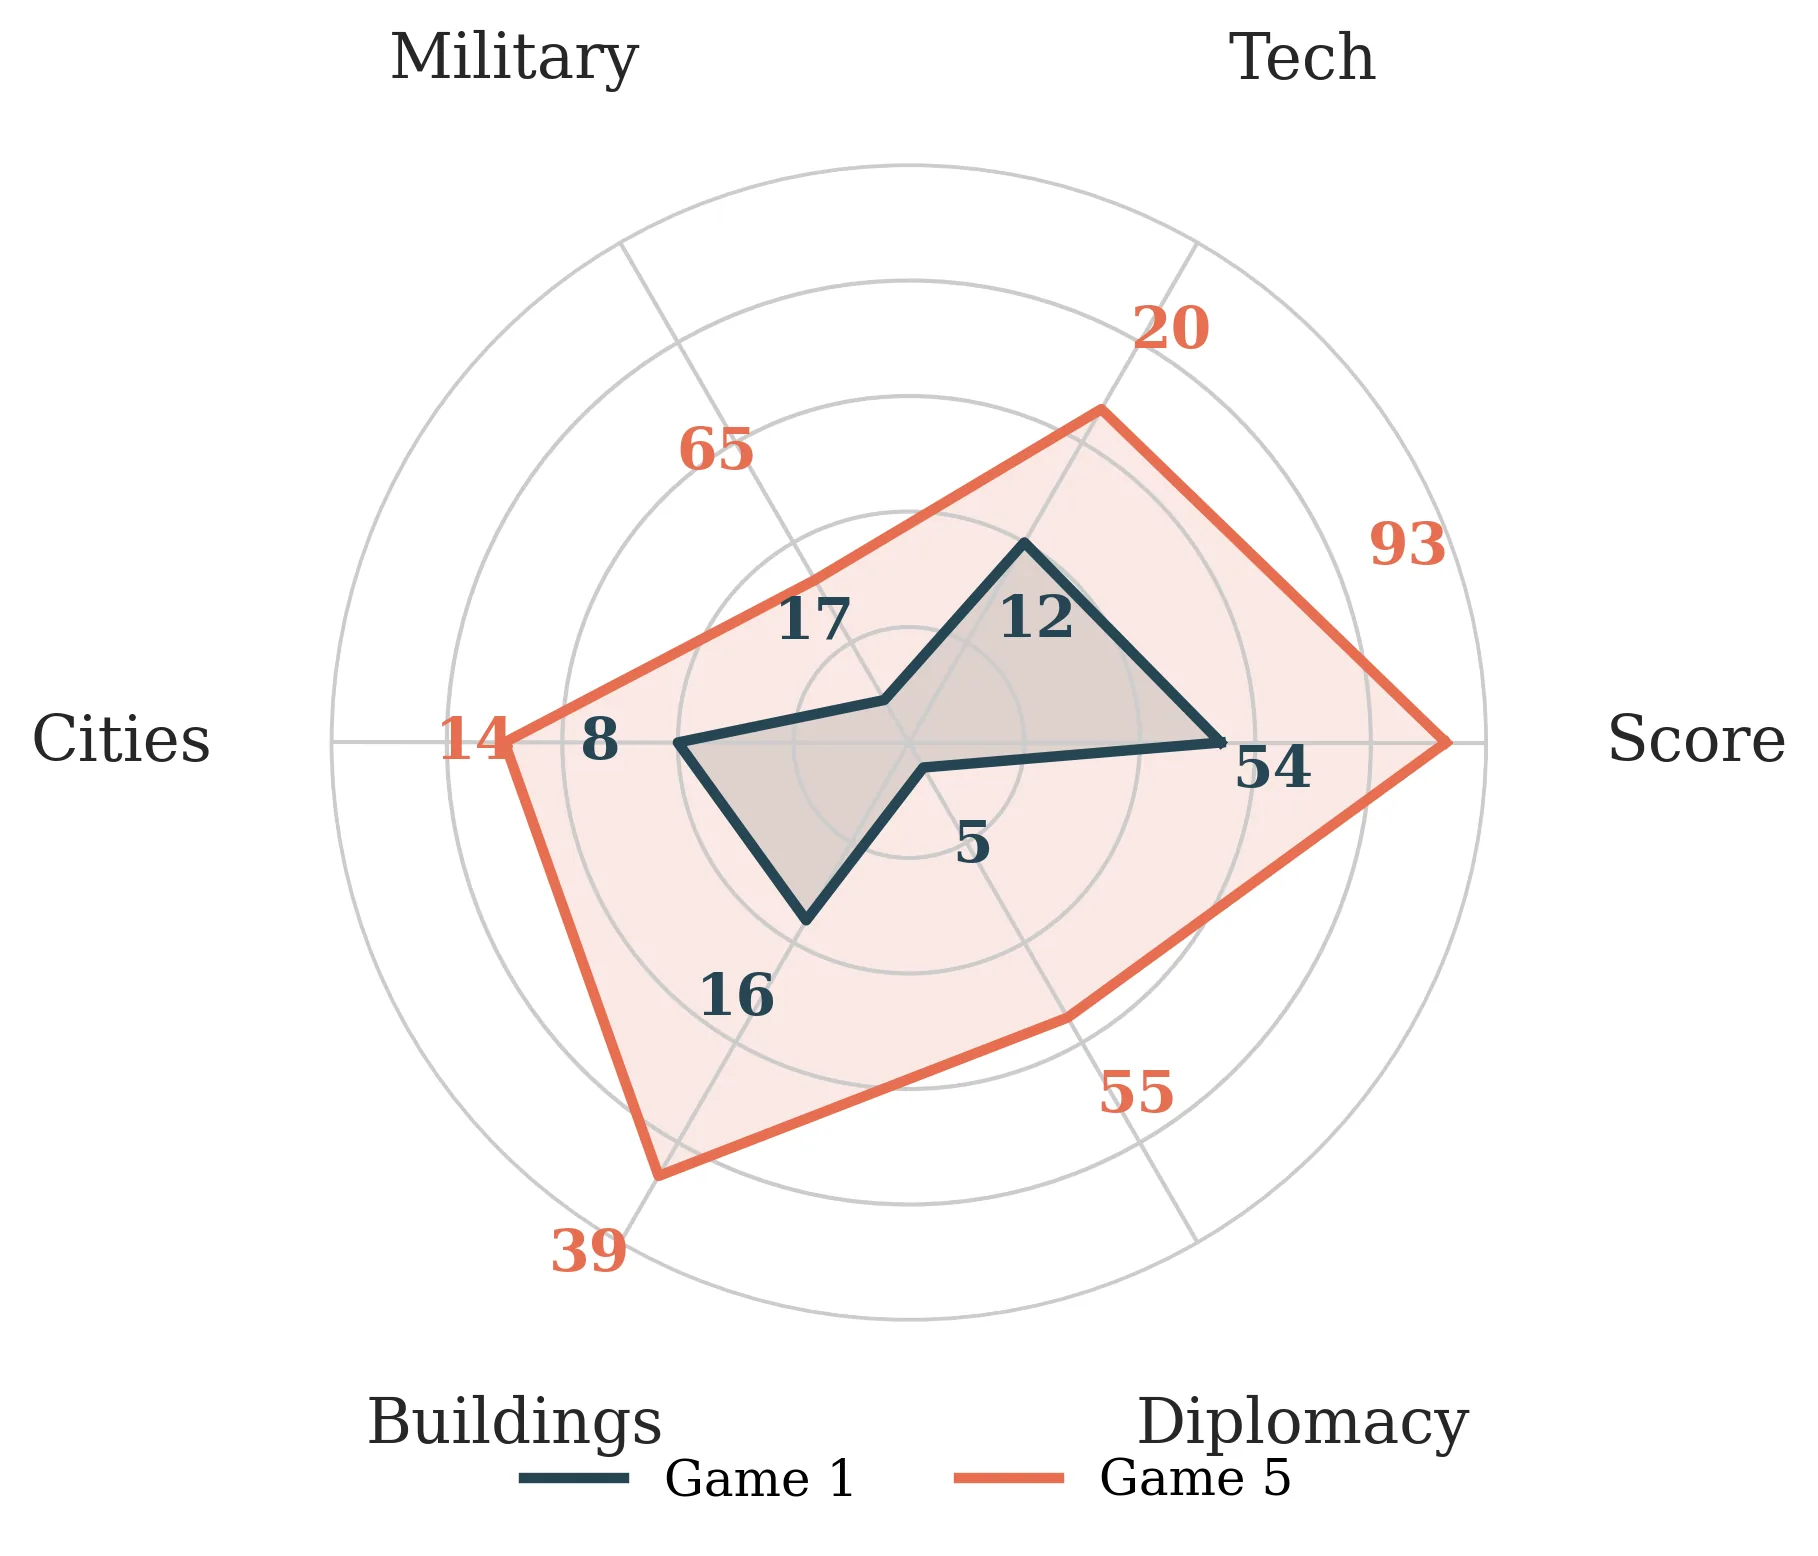
长时域策略游戏中,LLM智能体面临场景盲、上下文溢出和跨局学习浅三大问题。SAGA框架提出三项机制应对:地图-语义场景图消除空间盲,工具增强规划器按需拉取领域状态并分派专家控制器,双视野反馈回路结合局内目标生成与跨局因果复盘。在FreeCiv上取得最高平均文明分数且方差更低,仅显著优于所有基线在基础设施建造上,并以27%更少的输出令牌领先多数对局。跨五局演化下达到最高末端分数,消融验证各组件独立贡献。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
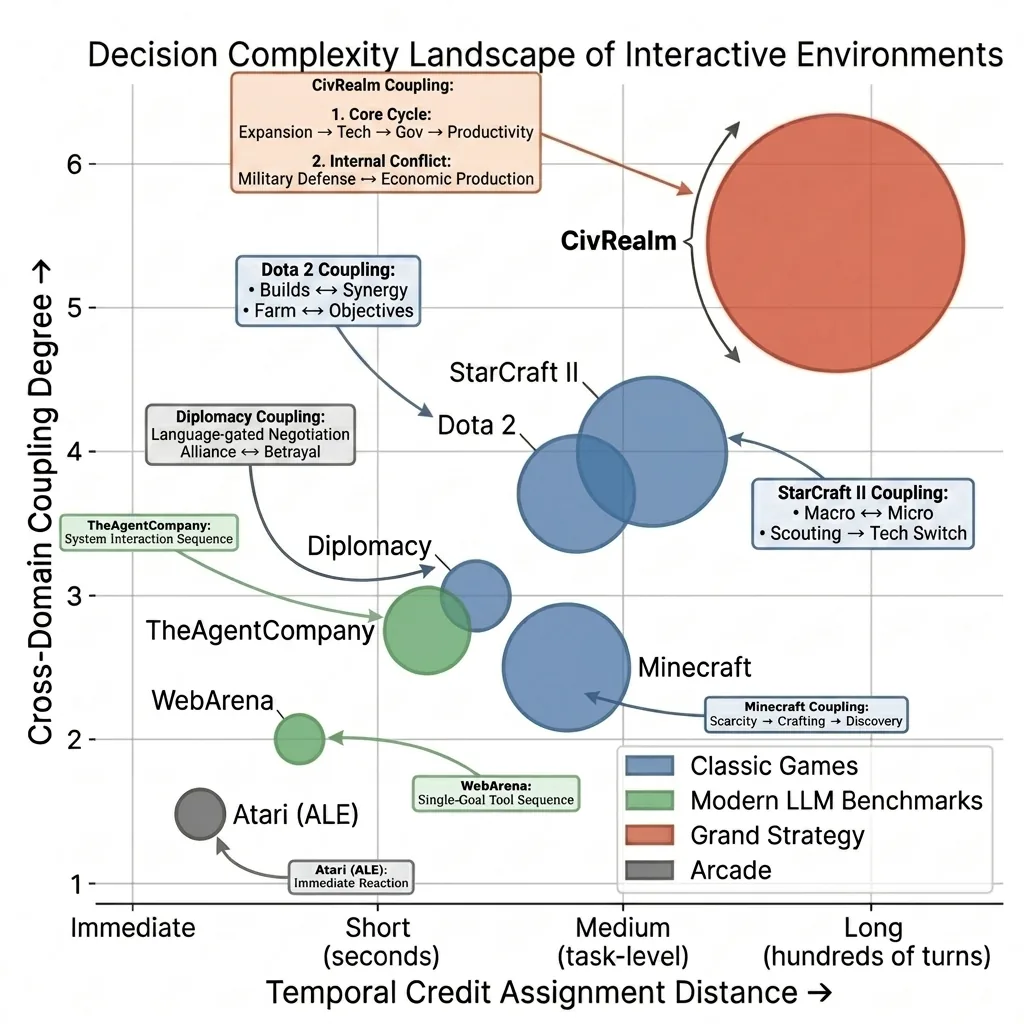
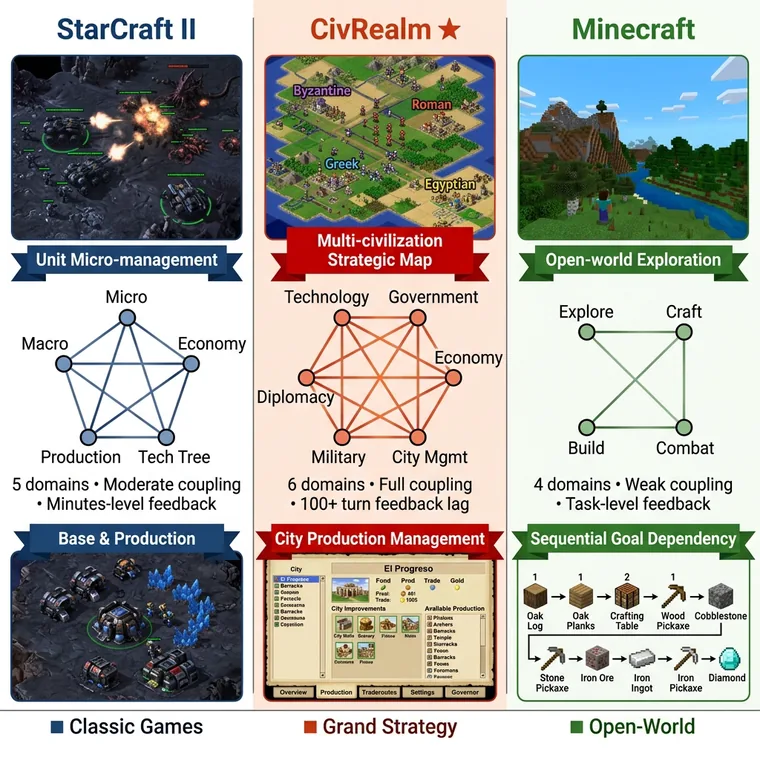
复杂策略游戏(如 FreeCiv)是长视野多域规划的极端挑战代表。这类游戏要求智能体在数百回合内并发管理科技、生产、军事、外交与经济五大决策域,同时面对不完全信息(即「战争迷雾」,只能观察到已探索区域)、稀疏奖励(仅在终局观察累计文明分数)以及硬性不可逆的机械约束。状态空间从早期的 指数增长至后期的 ,动作空间从 扩张至 ,这对任何决策系统都构成了严峻考验。
现有的 LLM 智能体在此类任务中普遍存在三类系统性缺陷。第一类是场景盲(Scene Blindness):原始地块坐标缺乏关系语义,无法支撑语言模型进行有效的空间推理——智能体知道自己有一个单位在某坐标,却难以判断它相对于城市、敌方单位的位置关系。第二类是上下文溢出与领域耦合:单体智能体接收完整状态转储,信息量随帝国规模无限扩张,单步词元数可超过 15k,同时多决策域的指令被混淆输出,导致高优先级军事威胁持续挤压关键基础设施投资。第三类是跨局学习浅层化:现有方法将每局对弈孤立处理,仅回放历史轨迹而缺乏结构化因果归因,无法实现原则性的战略演进。
这些缺陷并非孤立存在,而是相互强化:场景盲导致Planner无法理解空间上下文,只能依赖笨重的原始坐标;上下文溢出迫使模型在有限窗口内优先处理紧急域,进一步加剧领域耦合;缺乏跨局学习则意味着每局都要从零开始,无法从失败中积累可迁移的战略原则。
方法
SAGA 的核心设计哲学是将这三类缺陷的解耦方案整合为统一的框架,由三个相互耦合的机制分别应对。
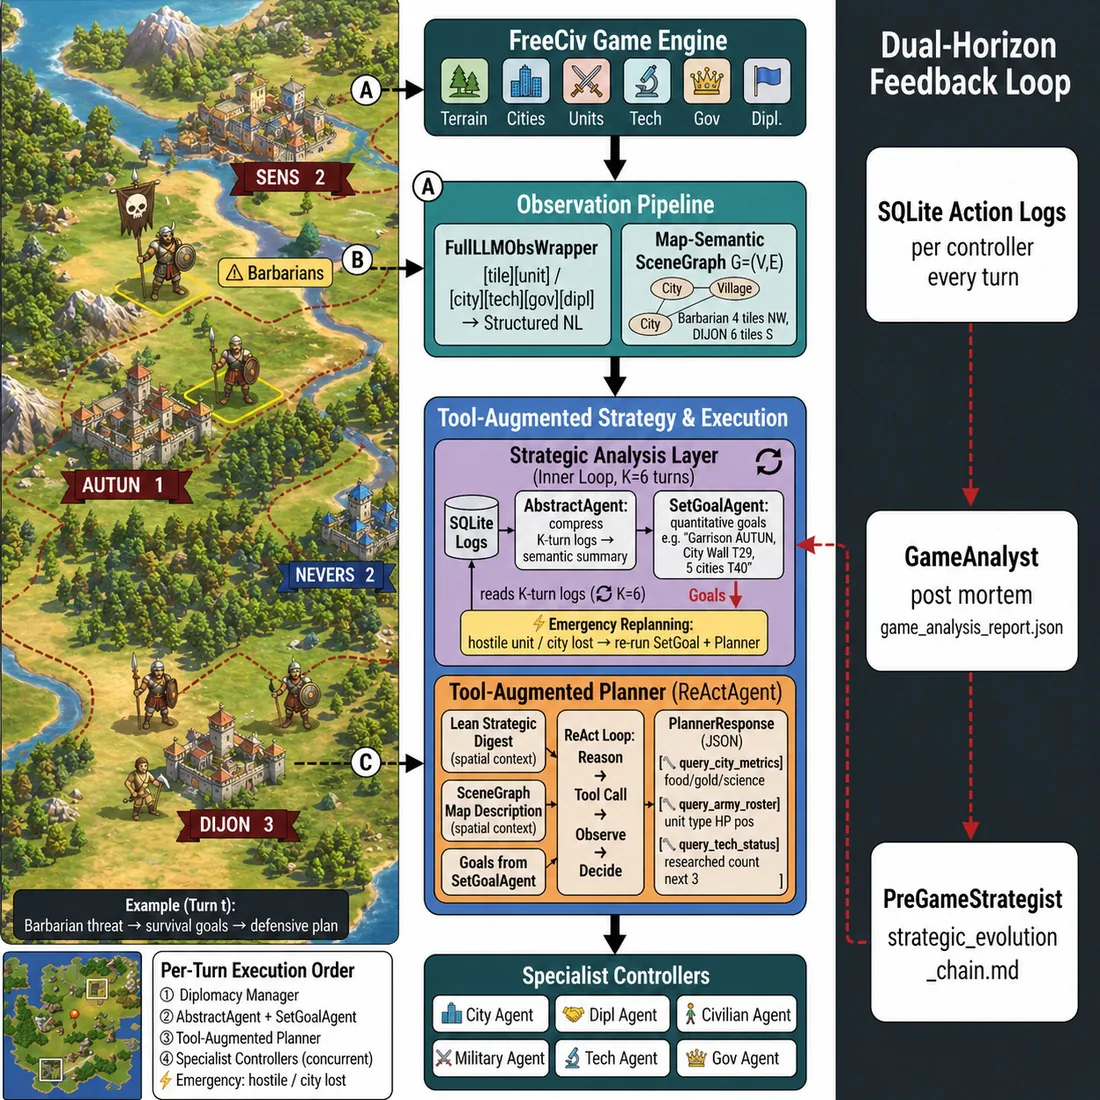
地图-语义场景图是解决场景盲的关键创新。传统方法将网格坐标直接喂给 LLM,这既不符合语言模型的认知习惯(它更擅长处理关系描述而非绝对坐标),也会引发严重的词元膨胀。SAGA 的方案是每回合从头构建一个类型化有向图 ,节点代表友方与敌方的城市及单位,边的类型则明确区分为两类功能:友-友边用于内部协同与导航,每个友方单位与最近友好城市保持「全局锚定边」,城市与单位按邻近半径连接以保持局部连通性;友-敌边则用于进攻与防御决策,每个军事单位对所有可见敌方城市保持「攻击罗盘」边,当敌方单位越过最近城市的防御半径时触发「威胁边」,并被路由至最近友方实体以直接呈现在提示词中。每条边都标注 Manhattan 距离的离散化档位(close < 3、medium < 10、far ≥ 10)和八方向方位,最终渲染为自然语言描述。这种设计以按需方式将隐式网格坐标转化为显式关系上下文,避免了全局词元膨胀。
工具增强规划器从根本上重构了信息获取与指令分派流程。中央 Planner 被设计为带三个按需工具的 ReActAgent——query_city_metrics、query_army_roster 和 query_tech_status。每回合启动时,Planner 仅接收精简的战略摘要(聚合指标、近期目标进度、场景图方向摘要、警报汇总),仅在落定某领域决策前才按需查询该领域精细状态。这种拉取式架构从根本上避免了上下文窗口崩溃。更关键的是,Planner 的响应被强制拆分为六个互不重叠的指令字段:city、civilian、military、tech、gov 和 diplomacy(后者串行化执行以避免冲突),每个字段由专属的专家控制器并行执行。系统还前置了场景合法动作掩码,在结构上限制可生成的产出,比提示词层面的警告更上游地消除「静默失败」。
双视野反馈循环是实现战略演进的机制,分为短期局内环与长期跨局环两层。局内环每 回合触发一次,由 AbstractAgent 将近期日志压缩为结构化小结,再由 SetGoalAgent 结合跨局战略演进链生成时限、域限的子目标(如「10 回合内建造 3 个 Settler」),作为稀疏奖励的密集代理。系统同时监测两类应急事件——敌对单位接近友好城市或己方城市沦陷——任一发生立即强制重规划。跨局环则在局末由 GameAnalyst 生成八维结构化复盘 JSON,新局开端由 PreGameStrategist 将其与持续更新的战略演进链注入 Planner 系统提示,将可迁移的战略原则转化为可注入的先验。
实验与结果
实验在 CivRealm 平台进行,后端为 FreeCiv 2.6,采用 23×23 Classical 地图,对抗两个内置 AI 对手并含活跃蛮族与海盗。评估设置在最多 150 回合(早-中期最具战略信息密度),统一使用豆包 Seed-1.8 官方 API 端点。所有基线方法(CoS、EpicStar、Optimus-2、HIMA、Mastaba)均被重写于共享基础设施之上,仅 Planner 层存在差异,这是 CivRealm 上首次 planner-level 的同台对比。
实验采用七项指标综合评估:终局文明分数(唯一稀疏客观奖励)、科技研究数、军事力量、城市数、建筑总数、外交里程碑得分,以及令牌消耗(输入+输出词元,按 150 回合归一化)。统计检验采用双侧 Mann-Whitney U 检验配合 Holm 校正。
主实验结果显示,SAGA 在 10 局游戏中的平均文明分数显著高于最强基线 CoS 和 HIMA,且方差更低。在 Buildings 指标上,SAGA 是唯一对所有五个基线均显著超越的方法——这意味着在多目标冲突中最容易被牺牲的资源维度上,SAGA 展现出了独特的稳健性。在正面对局中,SAGA 在大多数对局中得分超过两个最强基线,同时将输出令牌消耗削减 27%,这表明场景图引导下的决策更加聚焦,减少了无意义的探索性输出。
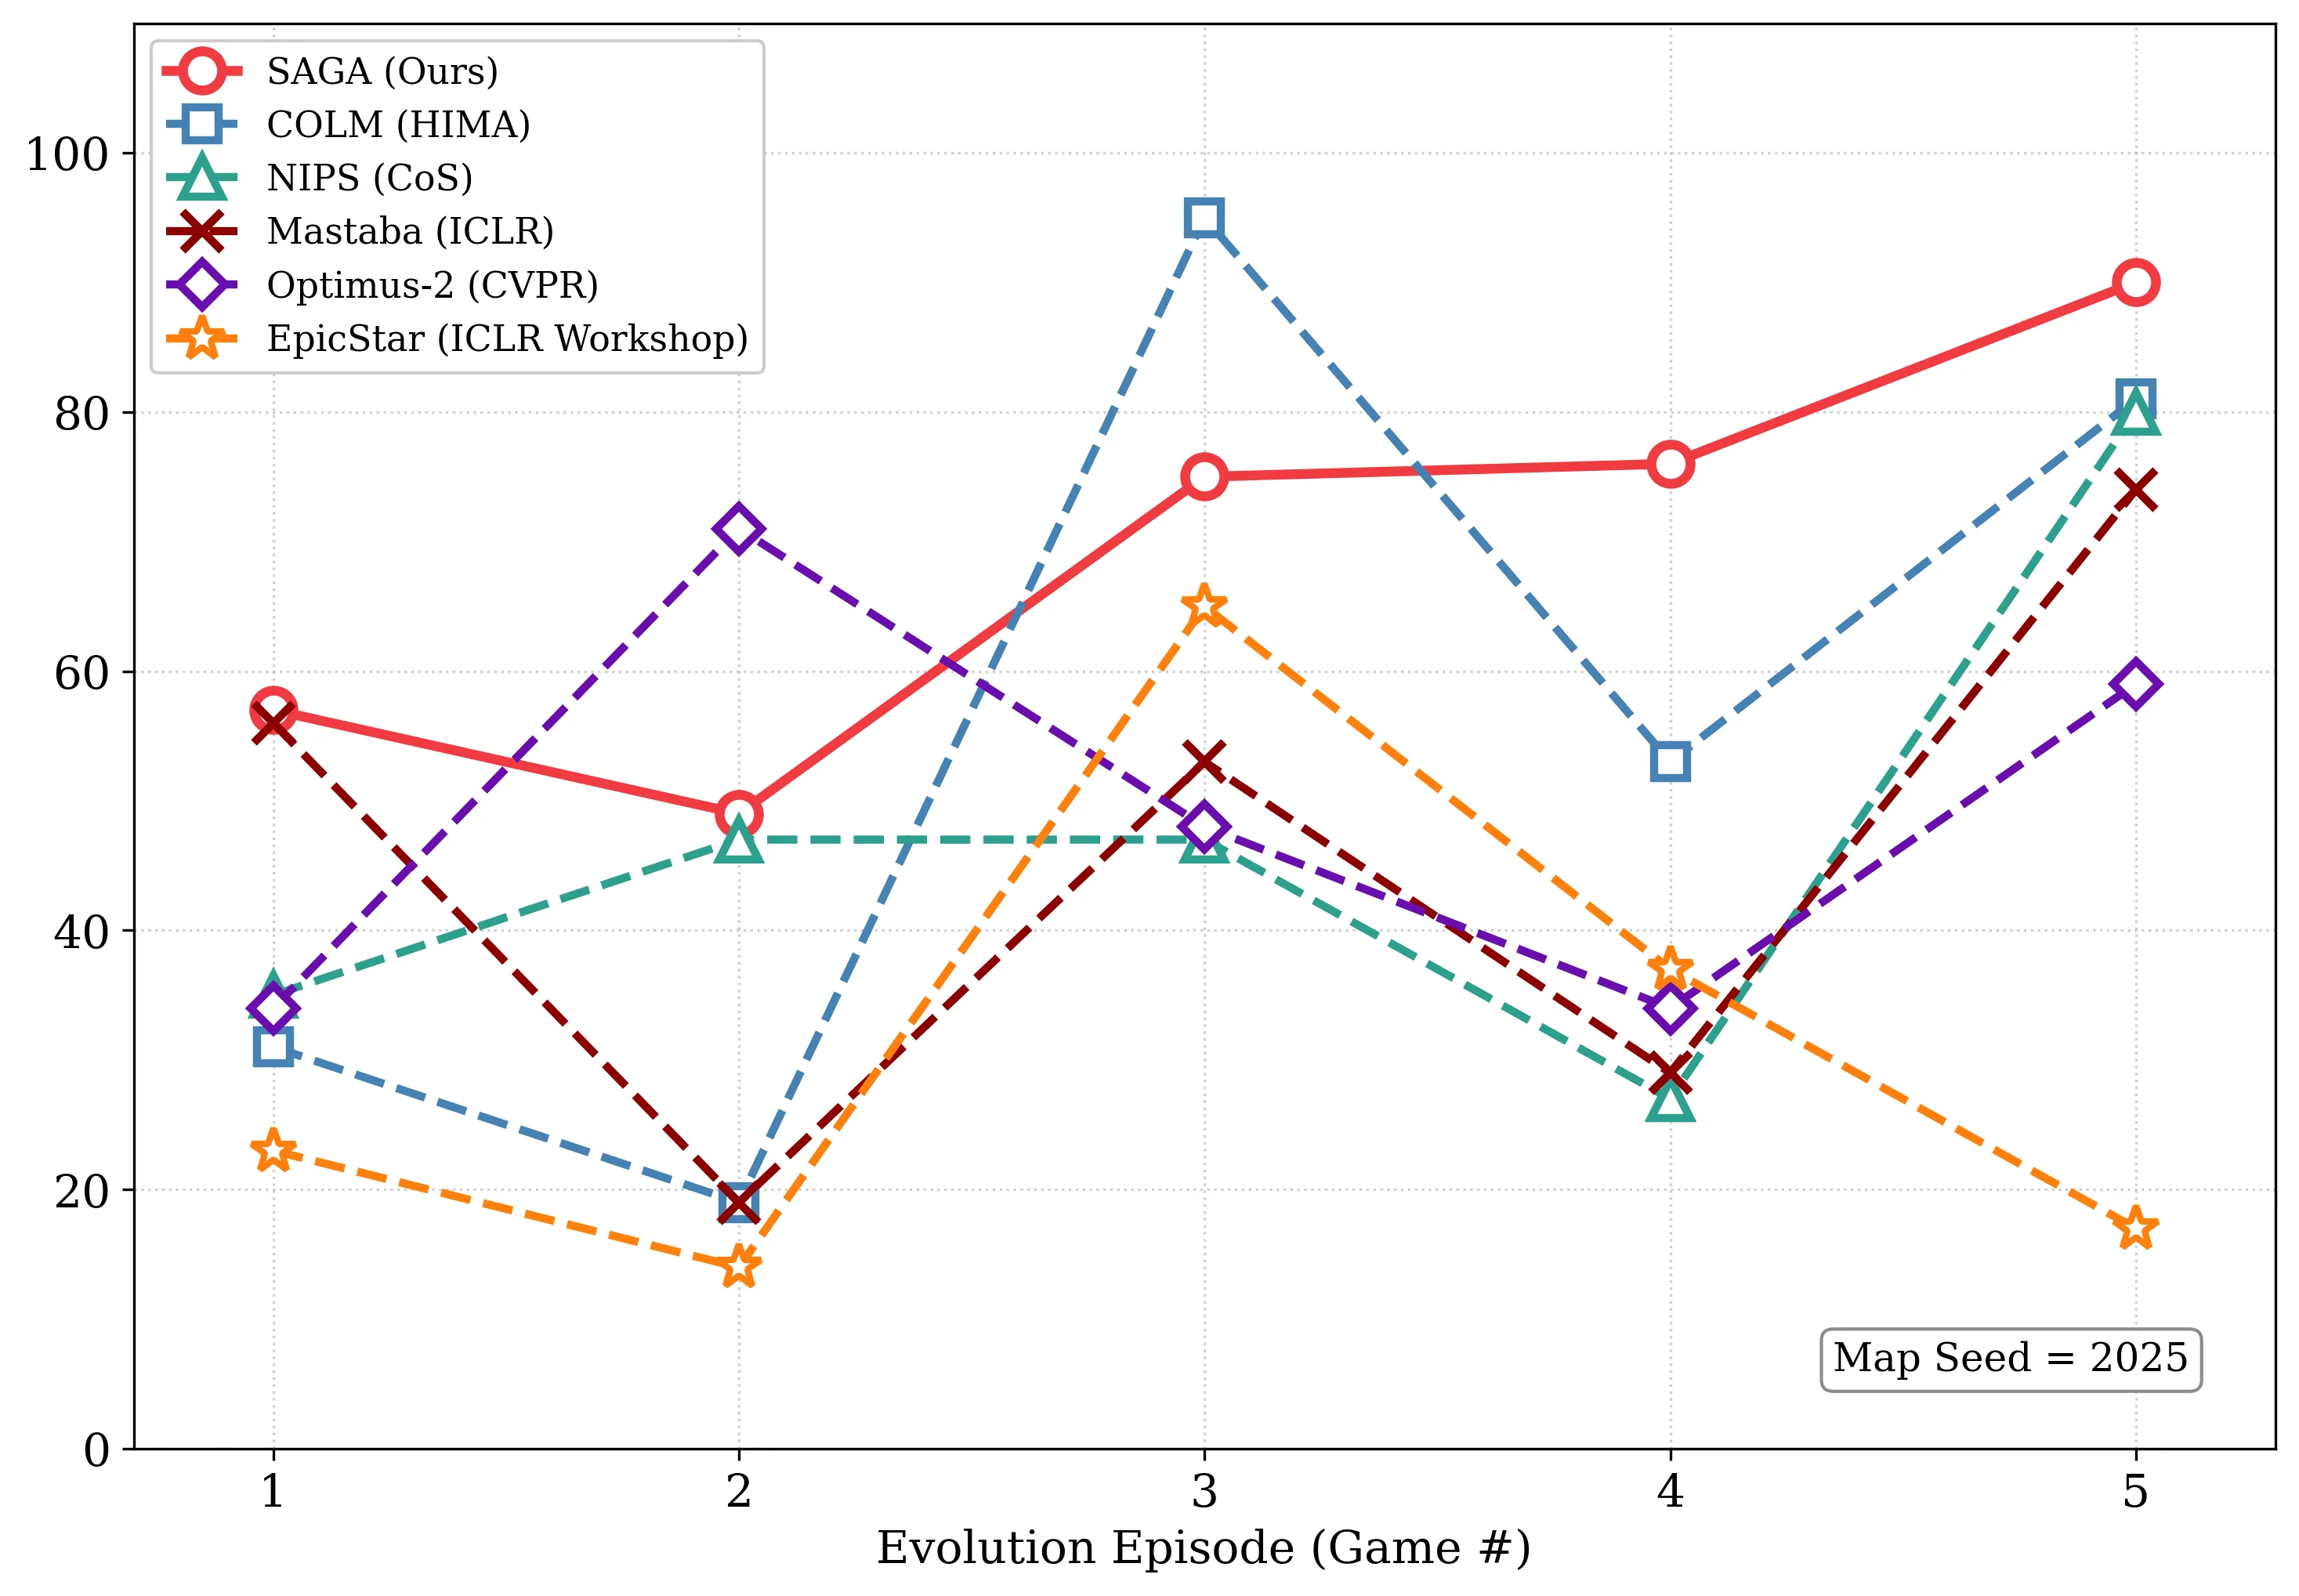
跨局演化实验连续运行五局,SAGA 配合跨局演进机制在每局结束时均取得最高分数,且随局数增加优势呈扩大趋势,说明战略演进链确实在发挥作用。消融实验验证了三个组件的独立贡献:移除场景图后空间决策质量下降最明显,移除按需工具后上下文溢出问题重现,移除 SetGoal 与 Abstract 组合后局内适应性显著降低。
讨论与可借鉴点
SAGA 的设计揭示了一个重要洞察:长视野策略任务中的三大缺陷——场景盲、上下文溢出、跨局学习浅——并非独立的技术问题,而是相互强化的系统性困境,需要协同解耦。场景图通过关系语义压缩而非坐标罗列的方式,为规划器提供了可操作的空间上下文;按需工具将信息获取从「推送」变为「拉取」,从架构上消除了溢出的根源;双视野循环则将稀疏奖励的信用分配问题分解为局内子目标与跨局因果归因两层。
该框架的可借鉴点在于其模块化设计思路:三个机制各自解决一类问题,且可以独立消融验证,这种设计使得方法论更具说服力,也为后续改进指明了方向——如果某个组件被更优方案替代,整体性能仍有提升空间。令牌效率提升 27% 的结果也提示我们,减少不必要的上下文推理不仅能降低成本,更能提升决策质量。
局限方面,SAGA 目前仍依赖预定义的边类型与距离档位,对于更复杂的空间关系表达能力有限;跨局演化链的积累效果依赖于复盘质量,若某局关键决策被错误归因,可能导致负迁移;此外,实验在固定地图种子下进行,跨地图泛化能力尚未充分验证。未来方向可以探索场景图的动态类型扩展、基于强化学习的跨局知识筛选机制,以及在更复杂环境(如多智能体协作/对抗)中的适用性。
概念 · 7 个
摘要
用于复杂策略游戏长期战略规划的LLM多智能体框架
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
三元狼人杀:面向大语言模型多跳心智理论的弄臣角色
Triadic Werewolf: A Jester Role for Multi-Hop Theory of Mind in LLMs
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 16 张
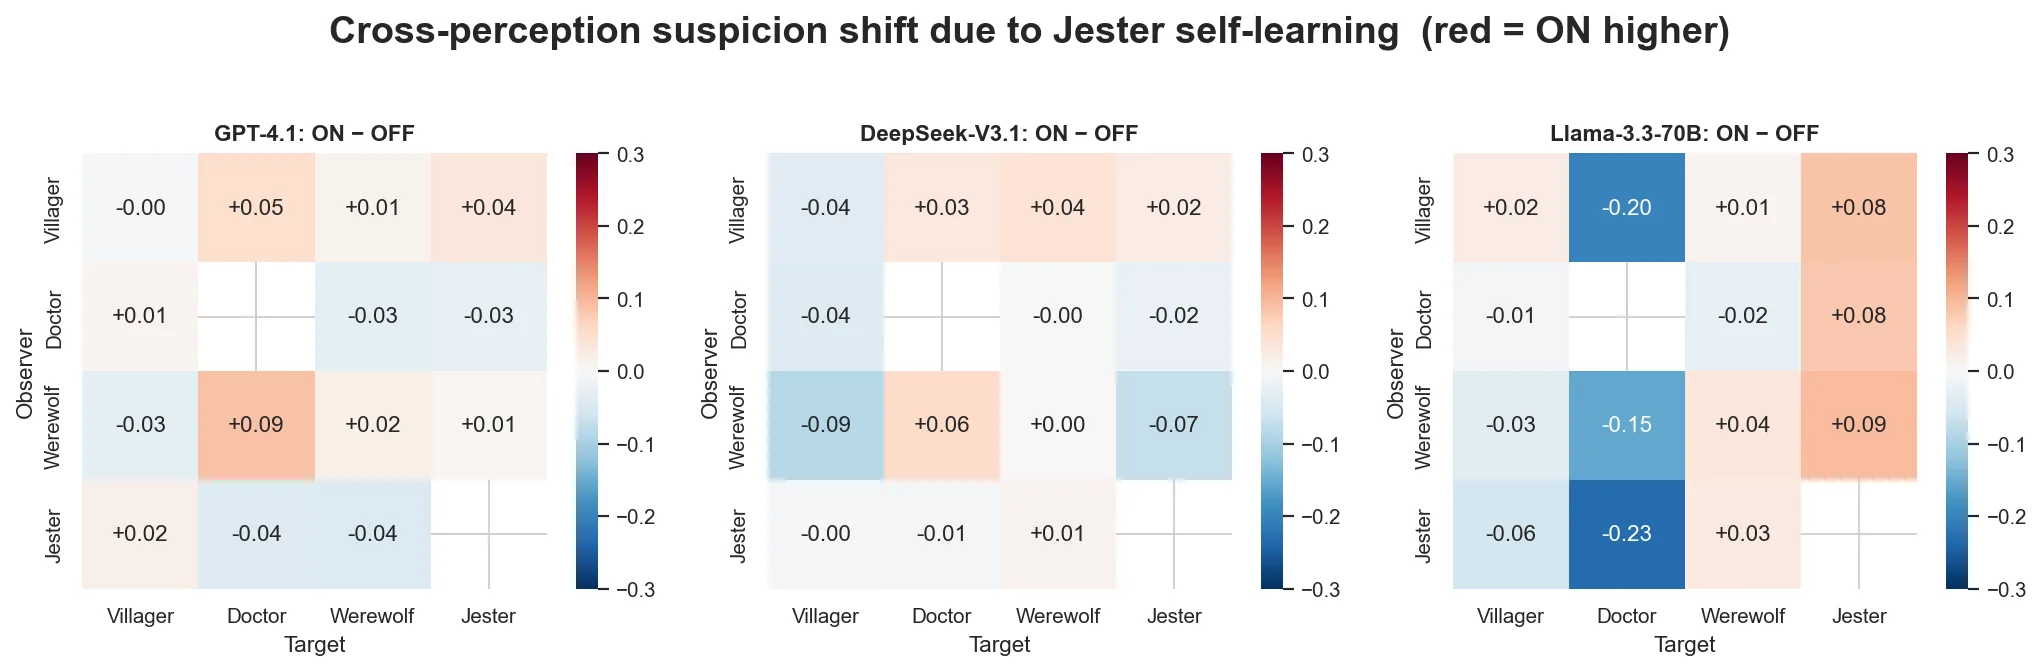
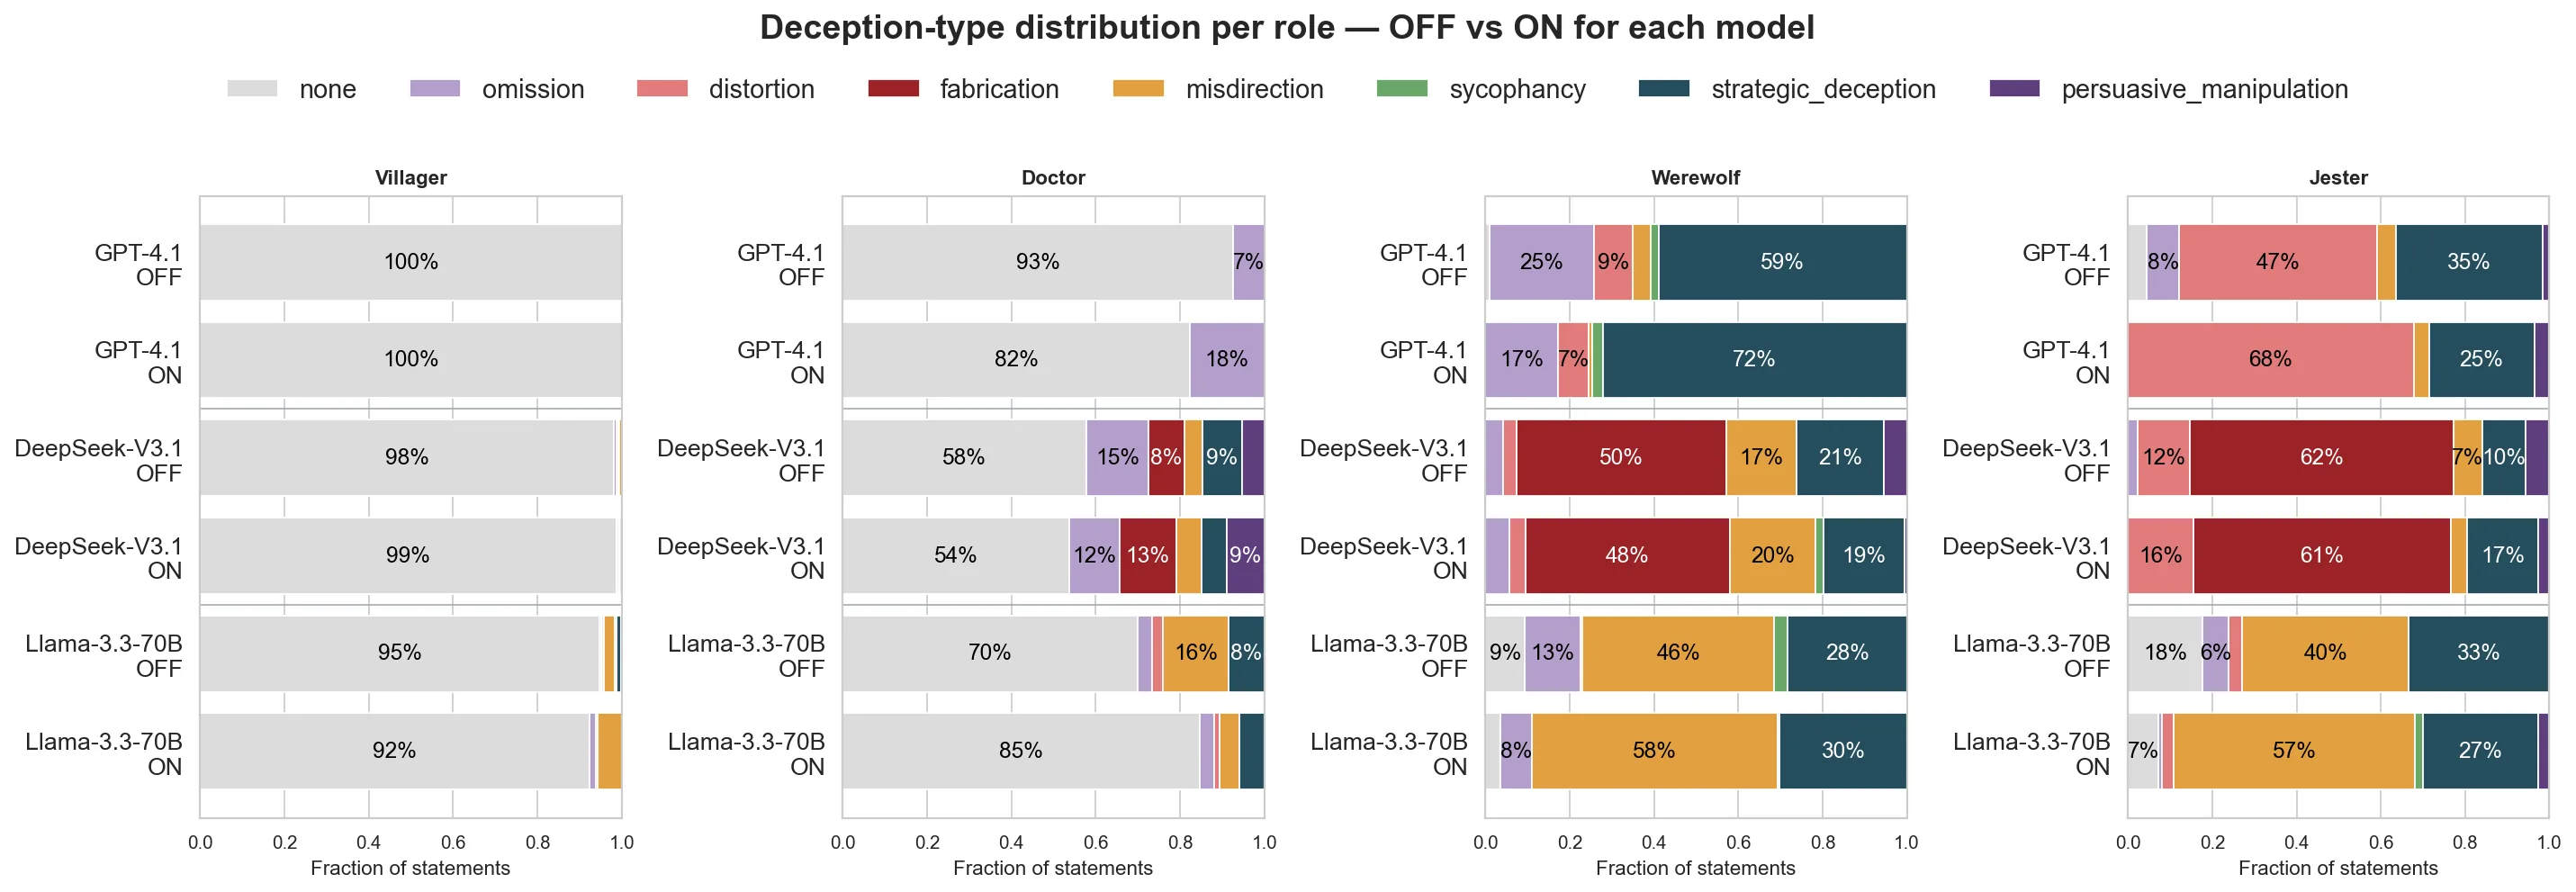
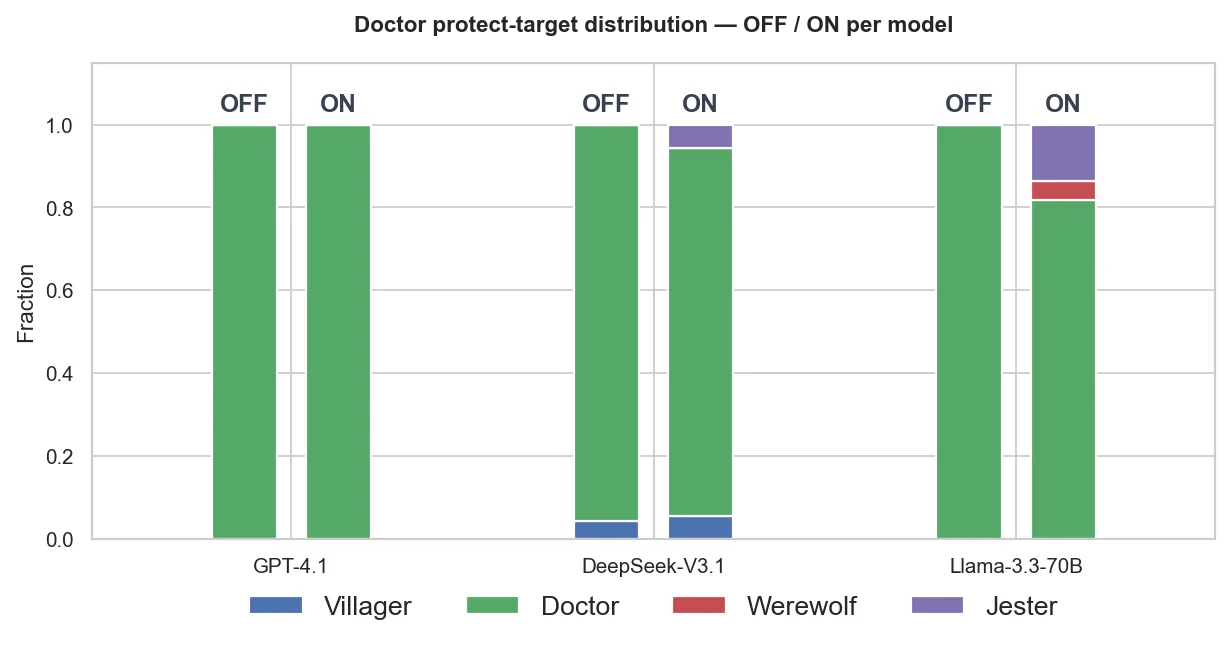
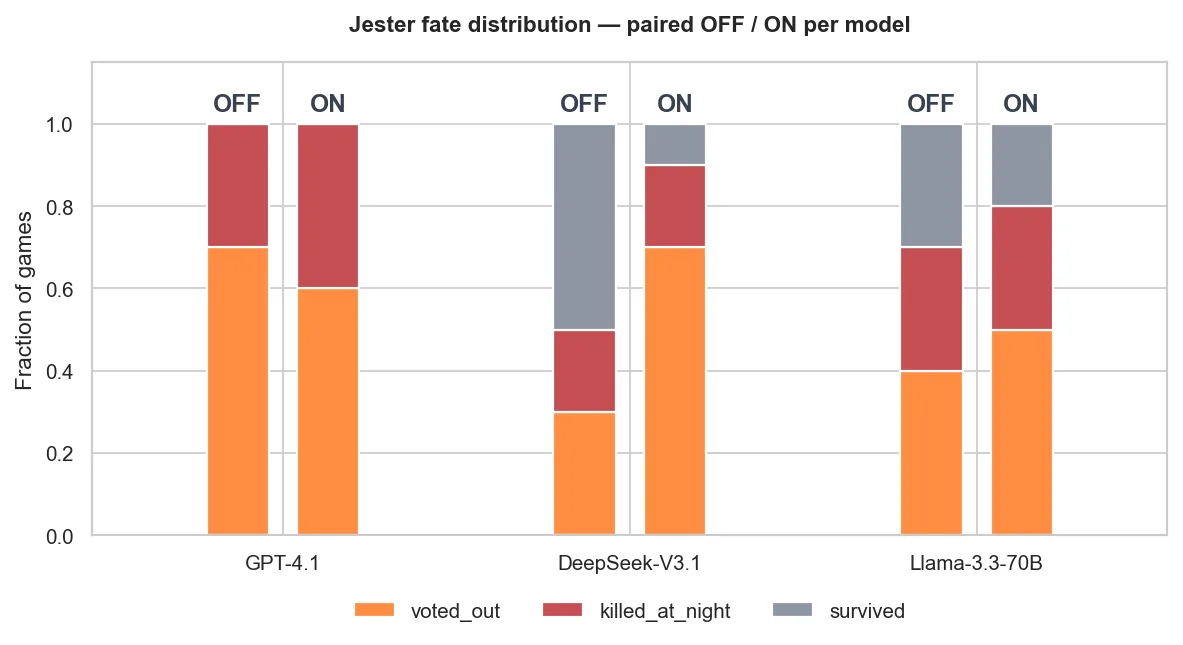
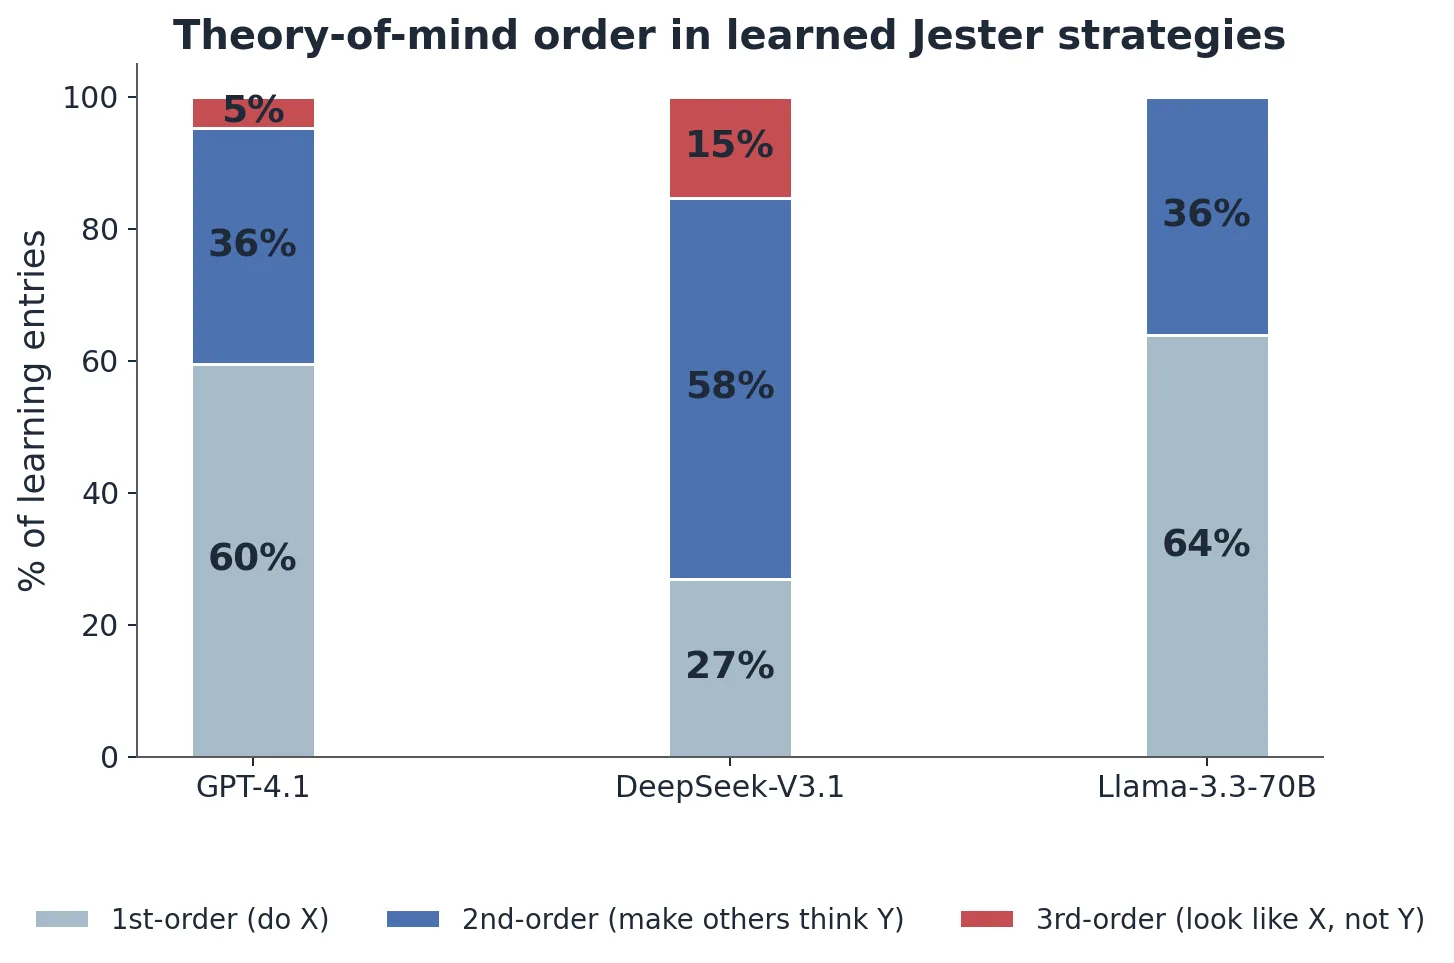
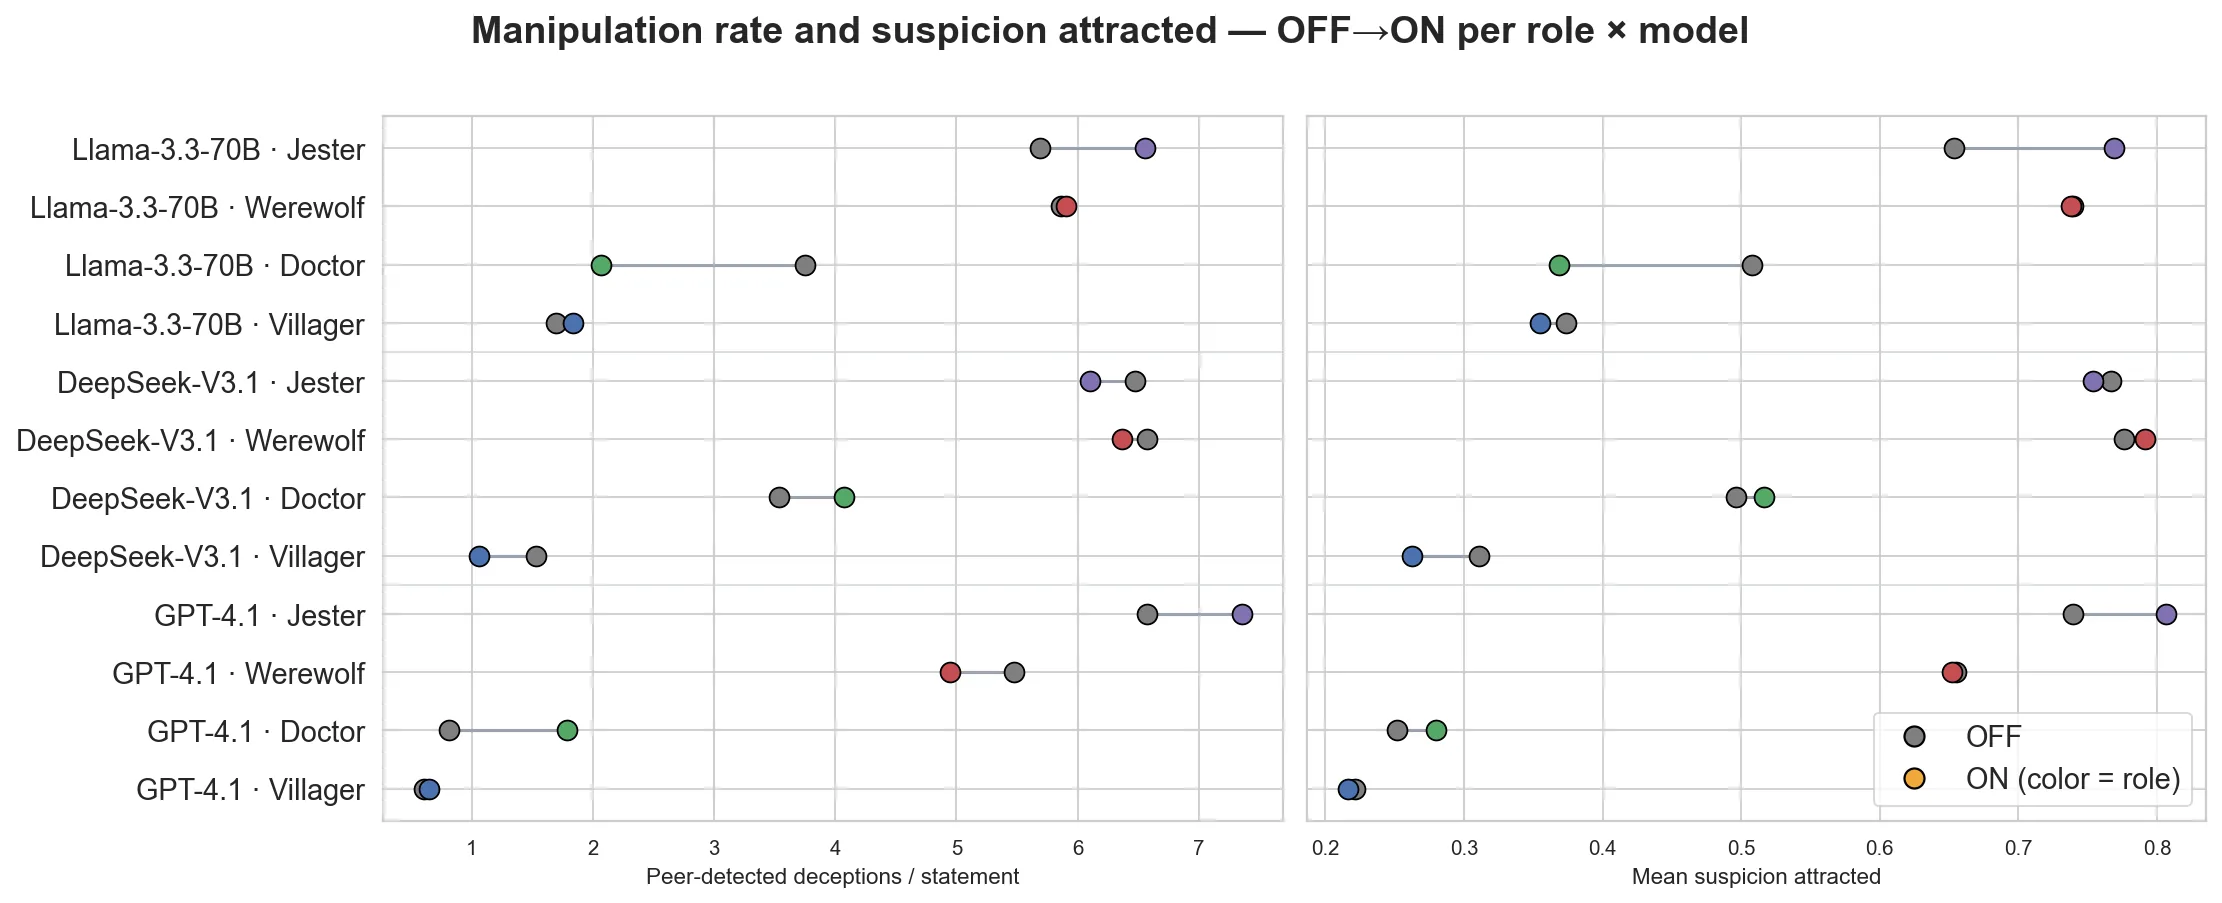
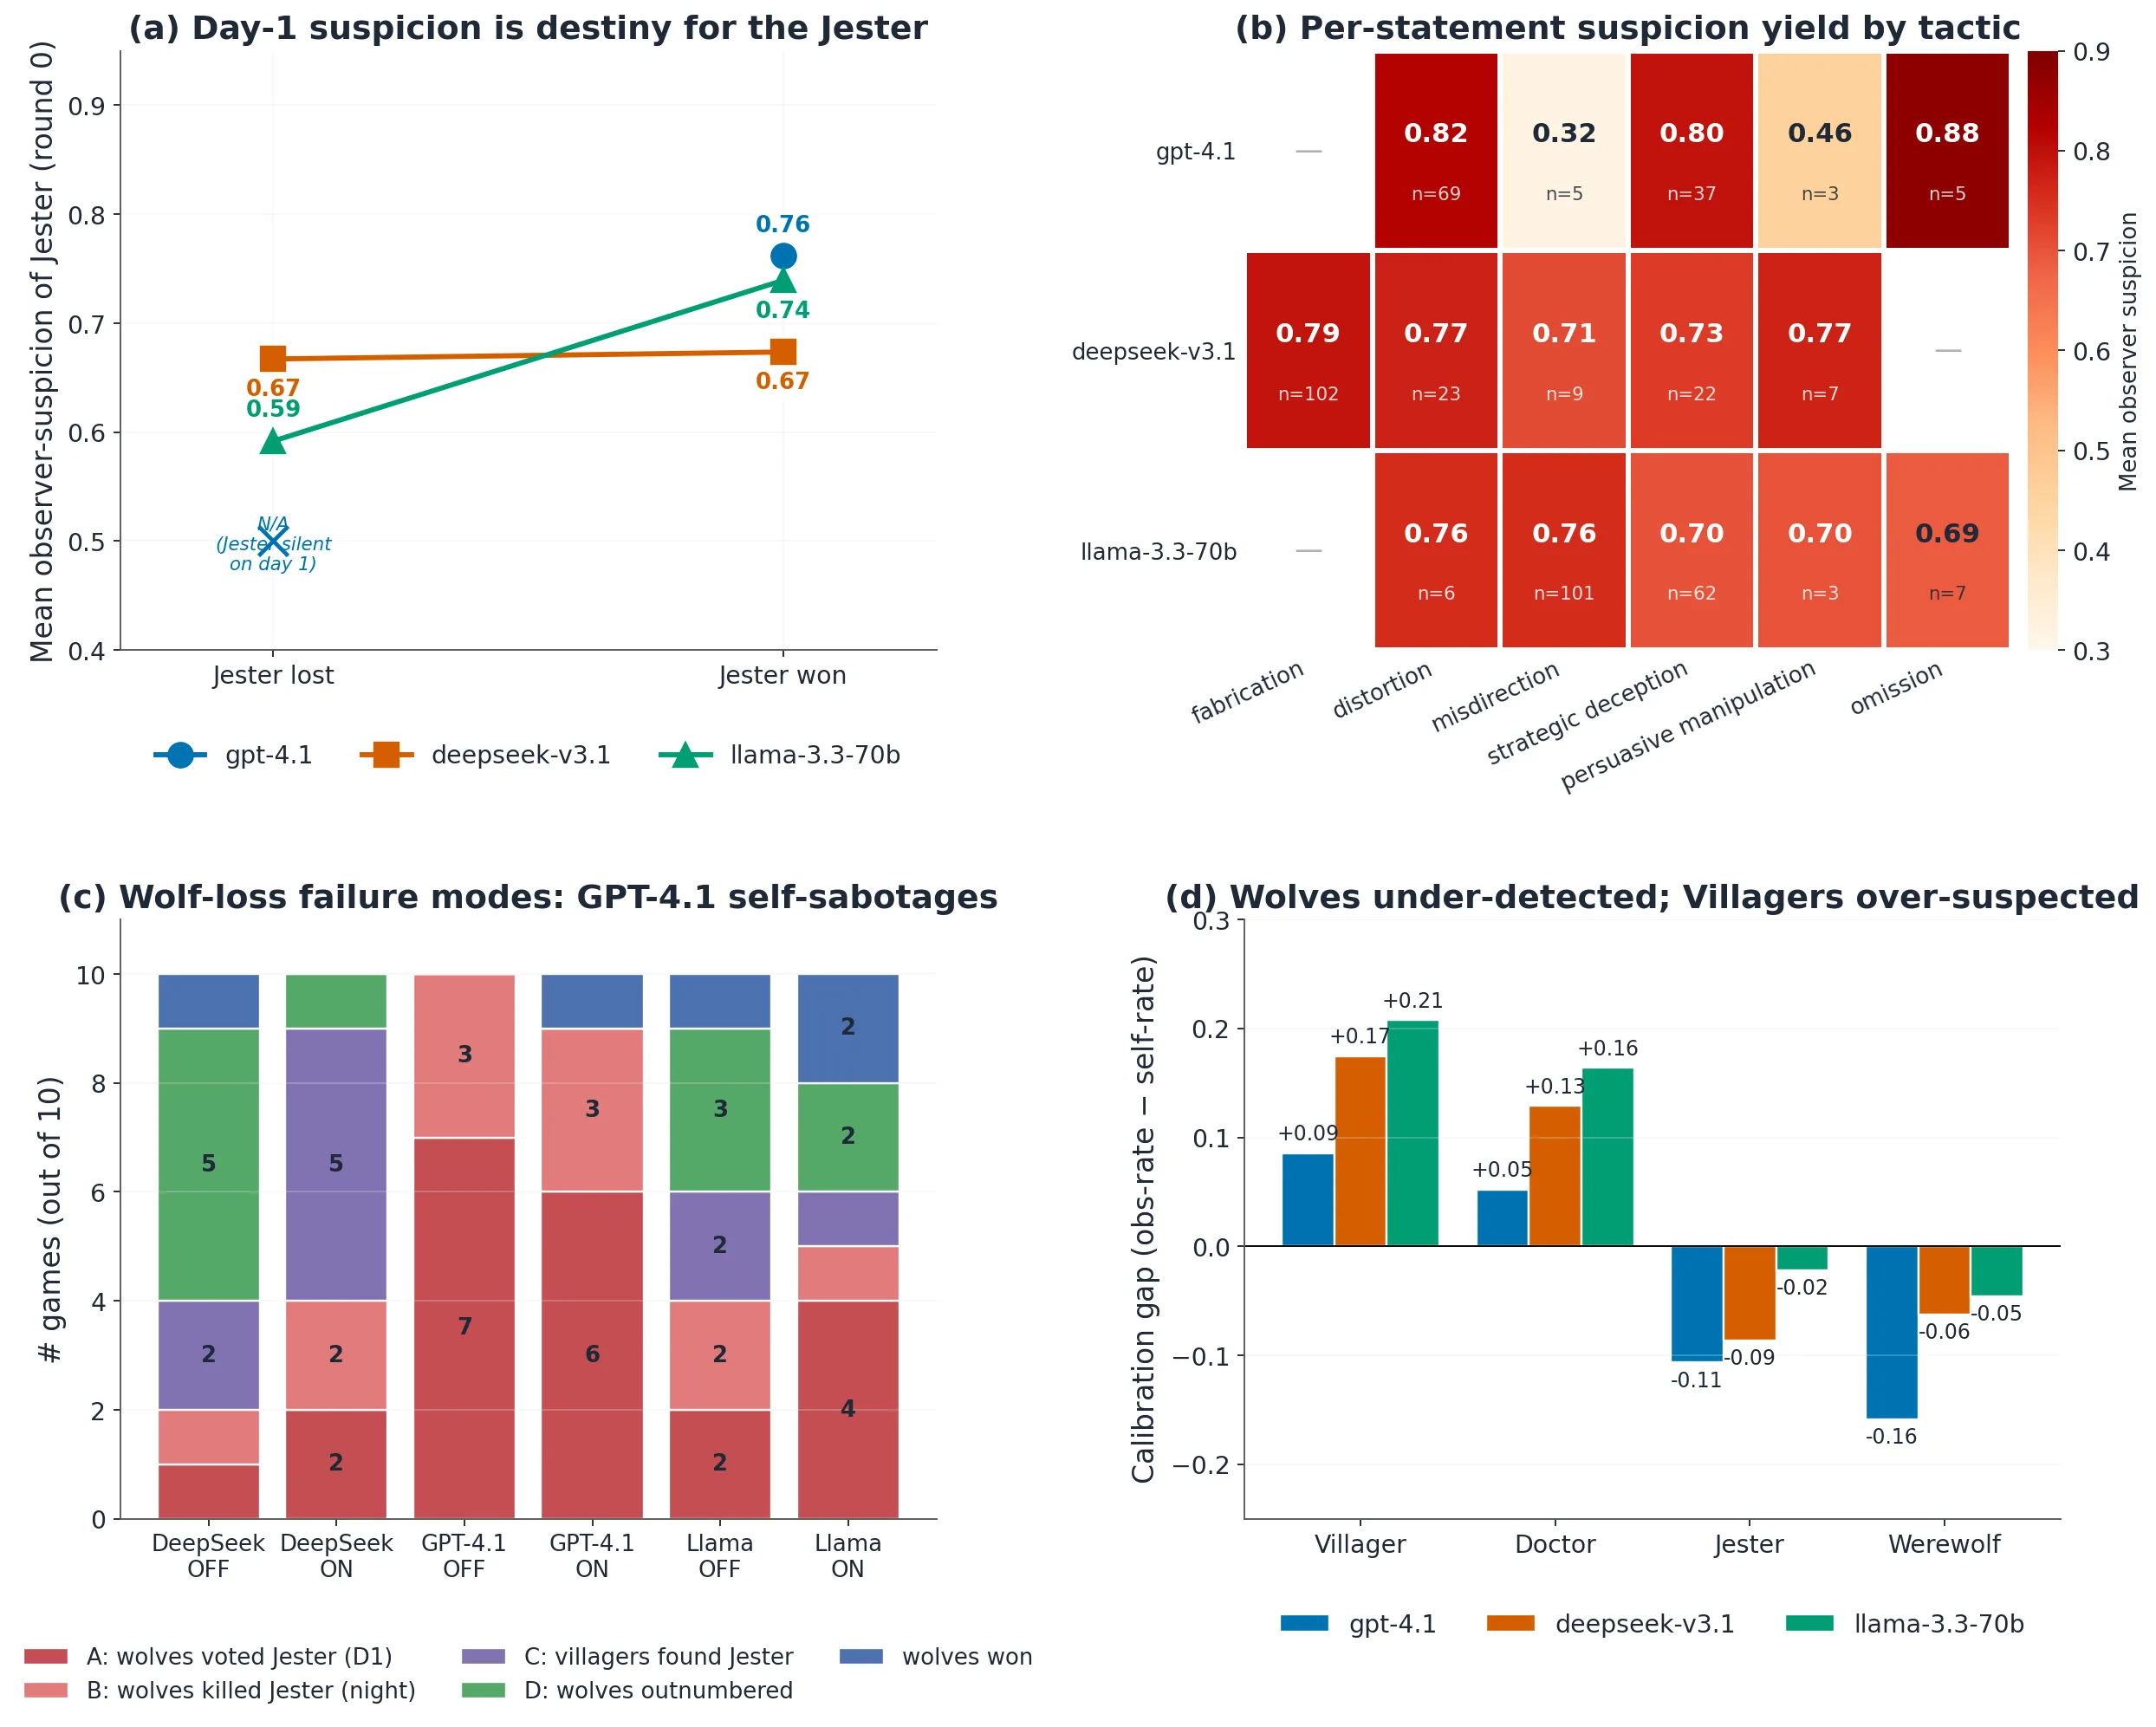
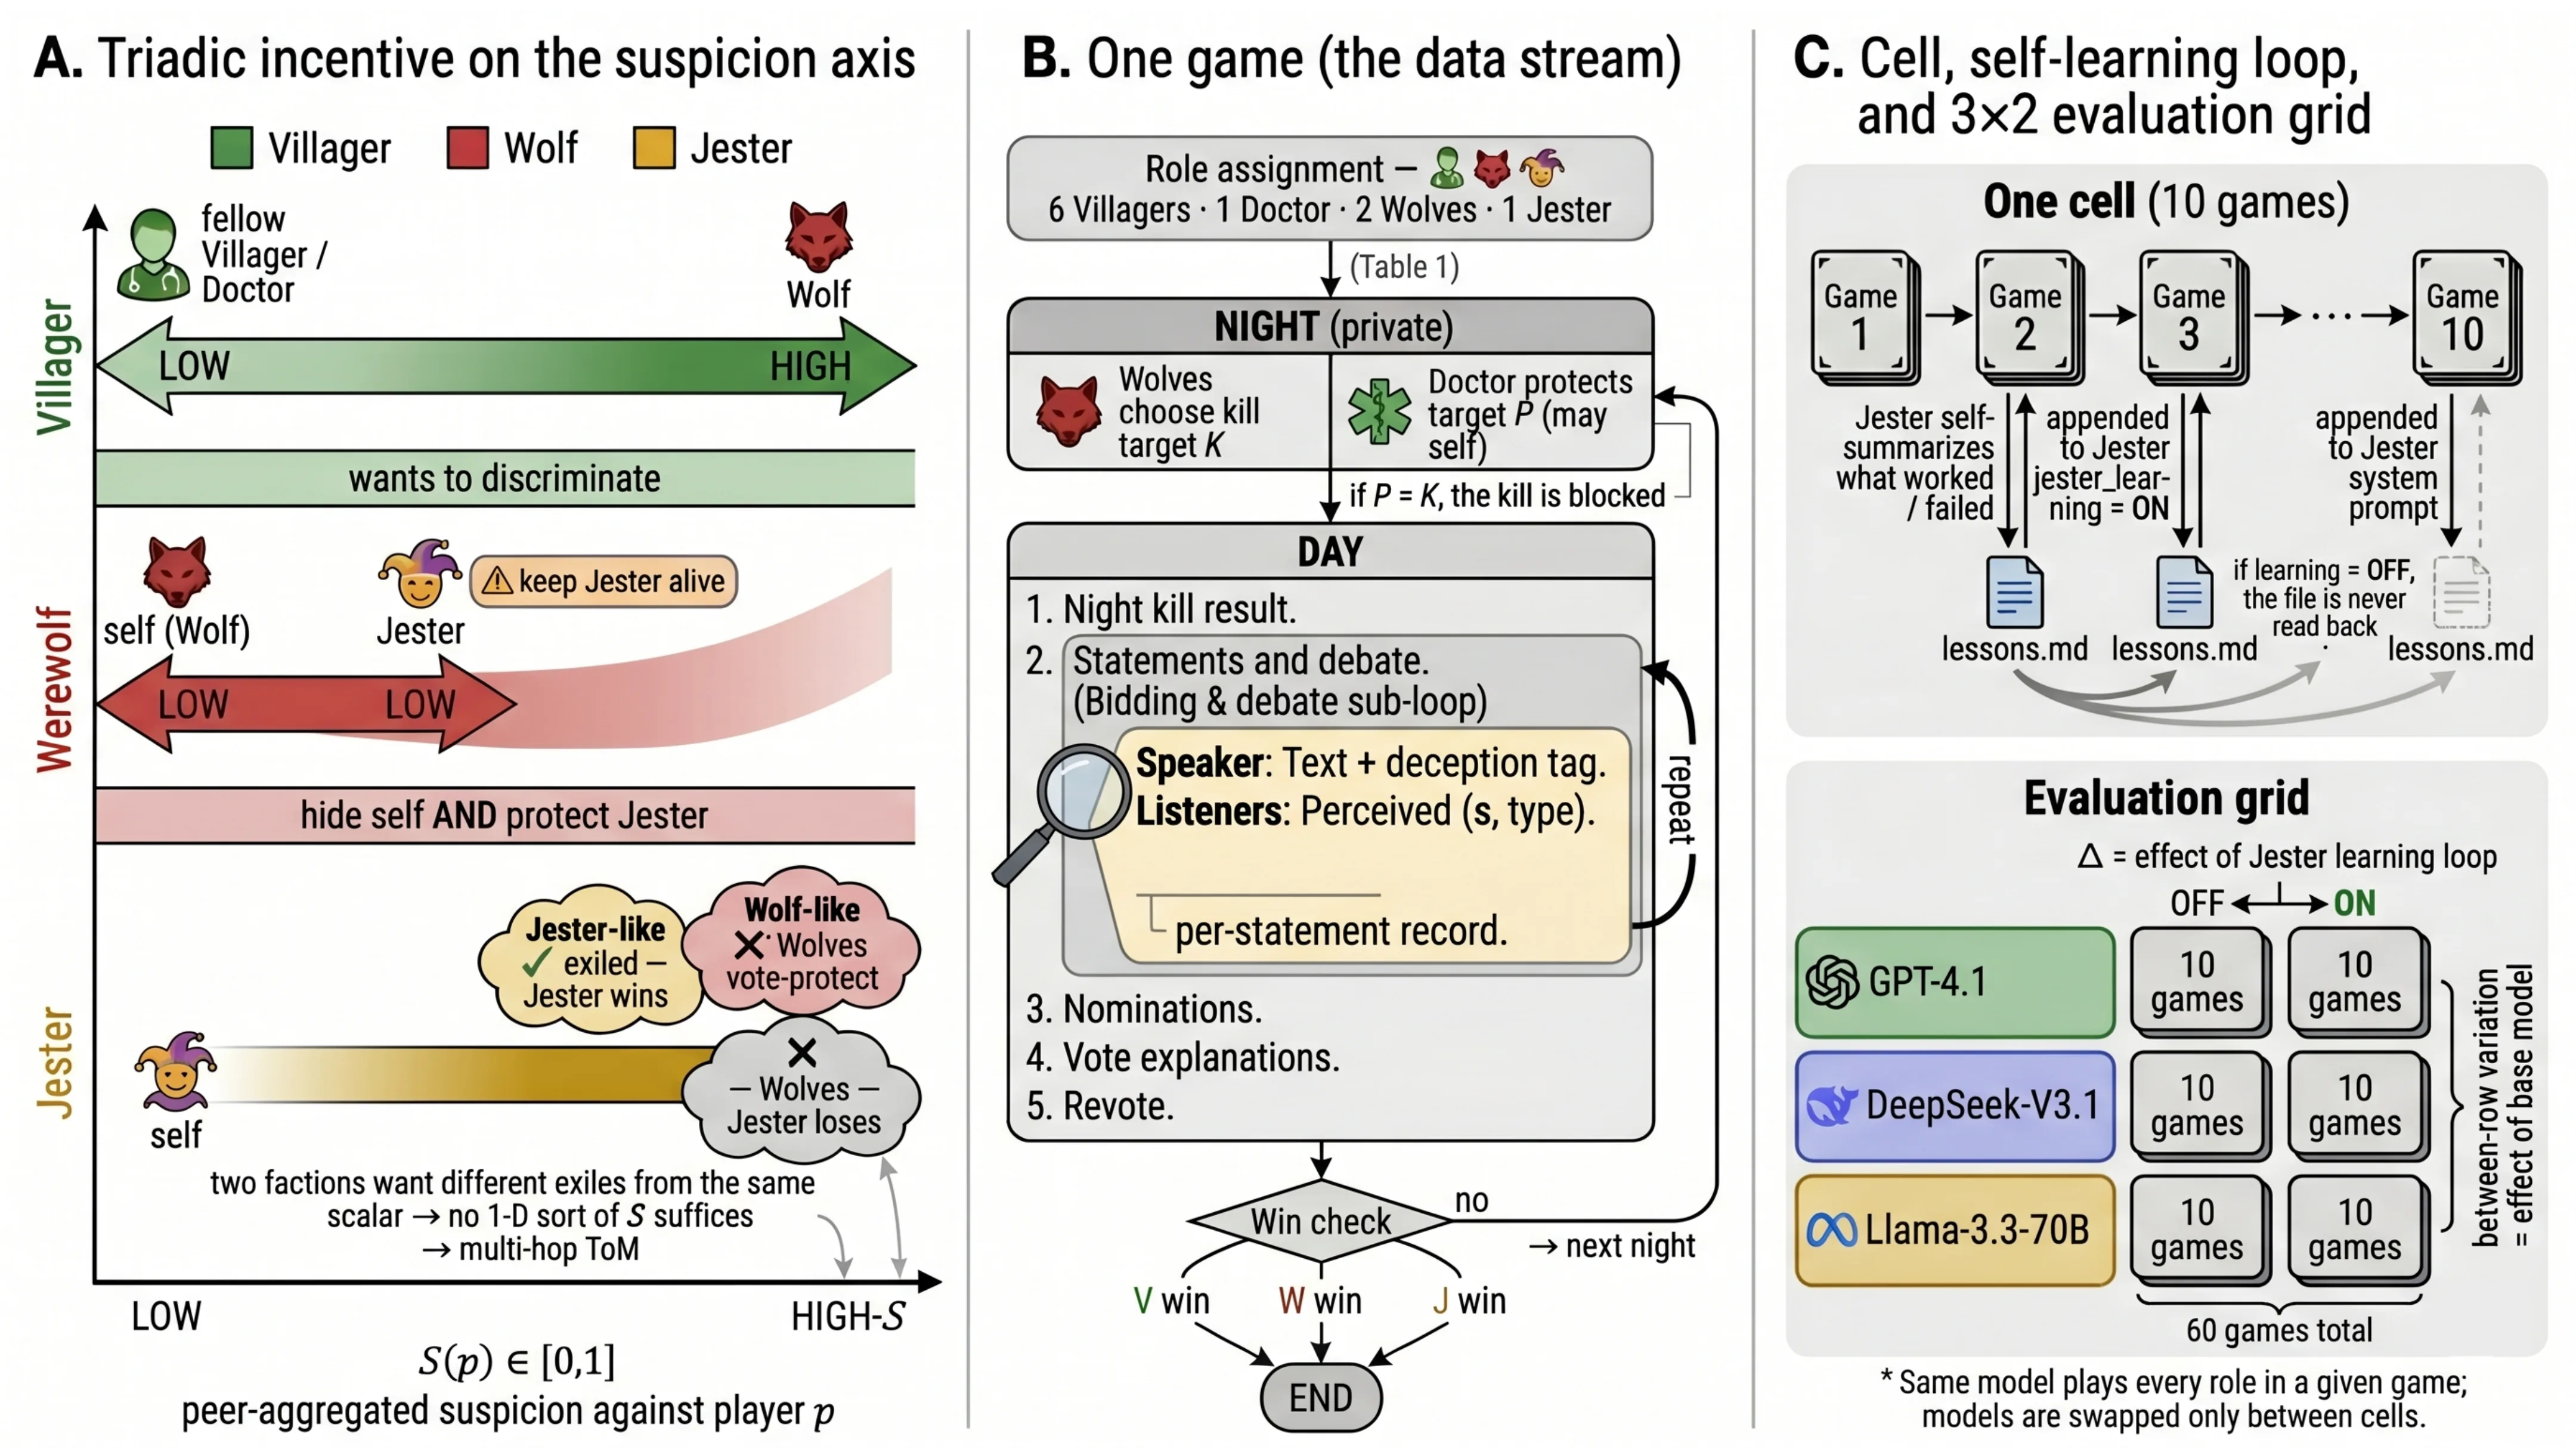
现有LLM的心智理论评估多采用二元社会推理游戏,单条语言线索即可指向隐藏阵营,先验强的模型无需真正模拟对手动机即可得分。本研究在狼人杀中扩展"弄臣"角色构成三方博弈,其效用倒置——被投票出局反而获胜,从而迫使模型跨三方收益函数进行多跳推理。覆盖GPT-4.1、DeepSeek-V3.1、Llama-3.3-70B共60局实验显示,弄臣胜率高达60-70%而狼人从未超过20%,证明三元激励结构能揭示二元博弈无法触及的多智能体推理层级。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
[[心智理论]](Theory of Mind)是人工智能领域衡量模型「理解他人心理状态」能力的核心指标。传统评估方式往往依赖二元社会推理博弈——最典型的如「沉默的羔羊」类游戏,其中每条可观察线索都指向唯一的隐藏阵营:要么你是好人,要么你是坏人。在这种结构下,一个拥有强大语言先验的模型即便根本不模拟对手的真实动机,仅凭「语料库中'可疑的人通常怎么说'」这类统计规律就能做出看似合理的判断并获得高分。
问题的关键在于:二元结构人为简化了真实世界的复杂性。现实中的博弈往往是多方参与的,每一方都有自己独特的效用函数——他们想要的东西不同,获胜的方式也不同。当模型需要在三个以上相互对立的利益方之间进行推理时,单靠语言统计先验还能走多远?这正是这项研究试图回答的问题。
研究者选择了狼人杀作为实验载体,并引入了一个经典桌游变体中的角色——弄臣。弄臣的设定极具洞察力:他的胜利条件与所有其他玩家完全相反,不是「活到最后」而是「第一个被投出局」。这意味着弄臣必须表现出足够的可疑性来吸引票数,但不能表现得过于刻意,否则其他玩家会意识到这是个陷阱。这种「恰到好处的可疑」要求模型不仅理解自己阵营的利益,还要推测其他两个阵营会如何看待自己的行为,并进一步推测那两个阵营之间会如何互动——这是一个典型的多跳推理链条。
方法
研究的核心设计围绕弄臣角色的效用函数倒置展开。在标准狼人杀中,所有玩家——无论是村民还是狼人——的共同利益都是「找出并驱逐狼人」,分歧仅在于信息不对称。而弄臣的加入打破了这种一致性:他需要被投出才能赢,这意味着他与狼人之间存在一种奇特的对立-合作关系——弄臣不希望狼人暴露,但狼人偶尔会为了转移视线而把票投给弄臣,这恰恰帮助了弄臣达成目标。
实验采用了三种模型:GPT-4.1、DeepSeek-V3.1 和 Llama-3.3-70B。每个模型分别扮演狼人、村民和弄臣。研究团队运行了 60 局游戏,并设计了一个关键变量:弄臣是否开启自学习(self-learning),即是否能够从之前的对局中提取经验并调整策略。这一设计用来检验模型是否能在重复博弈中习得「微妙的可疑」策略——既要看起来值得投,又不能显得在故意伪装。
GPT-4.1 在实验中的行为最为戏剧性。狼人角色在 60%–70% 的对局中选择了在第一天就把弄臣投票出局。从博弈论角度看,这是一个严格意义上的自毁举动:狼人的胜利条件是「活到最后并消灭村民」,而帮助弄臣获胜只会让狼人更接近失败。然而模型为什么会做出这种选择?一个可能的解释是,GPT-4.1 的语言先验让它识别出「弄臣说了很多可疑的话」,于是将其标记为威胁并优先处理——但它没有考虑到弄臣的效用函数与狼人并不对立。这种「看到可疑就投」的启发式策略在二元博弈中可能奏效,因为可疑的人通常确实是敌人;但在三元结构中,这一逻辑会导致灾难性的后果。
DeepSeek-V3.1 则展现出截然不同的行为模式。它是唯一一个在自学习循环中逐渐习得「看似可疑却又显得自然」这一微妙策略的模型。这种策略的核心张力在于:弄臣需要足够的可疑性来被投票,但不能表现得像个正在「扮演可疑角色」的演员——后者会触发其他玩家的元认知推理,意识到有人在利用逆向心理。DeepSeek 在多局游戏中展现出了对这一平衡点的把握,并因此获得了最高的收益。
Llama-3.3-70B 的表现介于两者之间,没有展现出像 DeepSeek 那样精细的策略学习能力,但其基础推理水平足以让弄臣维持较高的胜率。
实验与结果
60 局游戏的统计数据呈现出清晰的格局:弄臣的整体胜率在 60%–70% 区间内浮动,而狼人的胜率从未超过 20%。这一数字本身就极具说明力——在标准的二元狼人杀中,狼人的理论胜率通常在 30%–40% 左右,而弄臣的出现几乎将其砍半。这说明三元激励结构对狼人的生存空间构成了严重挤压,因为弄臣的存在让投票结果变得更加不可预测,狼人更难通过控制投票节奏来隐藏身份。
自学习的影响在不同模型间呈现出戏剧性的分化。对于 DeepSeek 和 Llama,开启自学习后弄臣胜率有所上升,模型逐渐学会了如何更好地伪装和诱导。但对于 GPT-4.1,自学习反而降低了弄臣的胜率——这一反直觉的结果指向一个深层问题:GPT-4.1 在自我改进的过程中似乎强化了某种错误的推理模式。具体来说,当弄臣在自学习过程中变得更加「刻意可疑」时,GPT-4.1 反而更坚定地在第一天将其投出。这种行为模式暗示,GPT-4.1 可能将「学习后变得更可疑」解读为「确凿的威胁证据」,从而变本加厉地执行自毁策略。自学习的代价最终落在了村民身上——他们因为狼人的错误决策而成为最终的受害者,而狼人则毫发无损。
DeepSeek 的策略演化路径最为引人注目。在最初的若干局中,它的行为模式与 GPT-4.1 类似——过于直接地表现出可疑性。但在某个临界点之后,它开始调整策略:可疑的言行依然存在,但同时伴随着大量「合理化解释」,使得整体发言看起来像是一个紧张但真诚的玩家,而非一个刻意操纵的演员。这种「让伪装融入真实」的转变体现了模型对多方博弈的更深层次理解。
讨论与可借鉴点
这项研究的价值在于它提供了一种诊断 [[多智能体推理]] 能力的新工具。二元社会推理博弈长期主导着 LLM 心智理论的评估,但这种设计本质上是对真实场景的过度简化。当博弈扩展到三个以上相互对立的效用函数时,模型的真实推理能力才会浮出水面——语言先验可以处理「这个人说话可疑」,但无法处理「这个人说话可疑这件事本身会被对方如何解读」这类嵌套信念问题。
研究也揭示了模型规模与推理深度之间的非线性关系。GPT-4.1 作为参数规模最大的模型,反而展现出最严重的推理失误——它在第一天投出弄臣的频率甚至高于 DeepSeek。这提示我们,强大的语言模型可能在「模式匹配」方面过于高效,以至于绕过了更深层的推理过程。当「可疑特征 → 投票对象」这条规则链被触发得太容易时,模型就失去了停下来思考「为什么这个人要表现得可疑」的动力。
DeepSeek 的表现则暗示,推理能力的涌现可能与模型架构和训练方式的交互有关,而非单纯由参数量决定。它在「微妙策略」上的突破说明,某些类型的多跳推理可能需要特定的归纳偏置来激活。
研究的局限性值得注意。首先,60 局游戏的样本量对于统计推断而言并不算大,模型行为的变异性需要更大规模的实验来确认。其次,狼人杀本身是一种高度结构化的对话场景,模型的表现能否泛化到其他形式的多智能体交互(如谈判、协作问题解决)仍是开放问题。第三,弄臣角色的设定虽然精巧,但它毕竟是一个「规则明确」的博弈设定;真实世界中的逆向激励往往更加模糊和多层。
从方法论角度看,这项研究为 [[LLM 评估]] 开辟了一条值得深耕的路径:通过设计具有内在矛盾的激励结构来暴露模型的推理漏洞。三元博弈只是起点——更复杂的四元、五元结构,更长的推理链条,以及动态变化的联盟关系,都可能成为未来研究的实验田。更根本地,这项研究提醒我们:评估 LLM 心智理论的标准,可能需要从「能否理解对手在想什么」升级为「能否理解对手如何理解对手在想什么」。
摘要
狼人杀社交推理游戏,涉及多个AI阵营与心智推理
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
StarBench:面向智能体多模态决策与信息寻求的回合制 RPG 基准
StarBench: A Turn-Based RPG Benchmark for Agentic Multimodal Decision-Making and Information Seeking
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 4 张
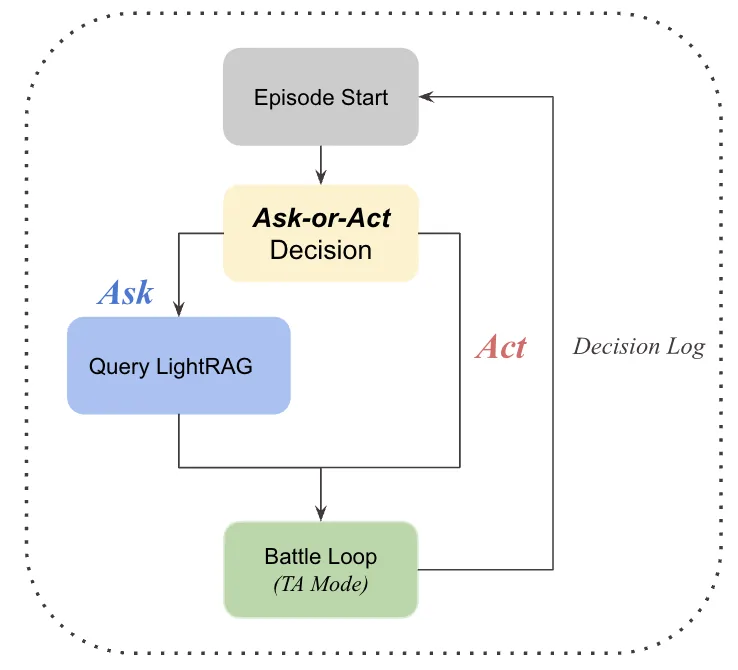
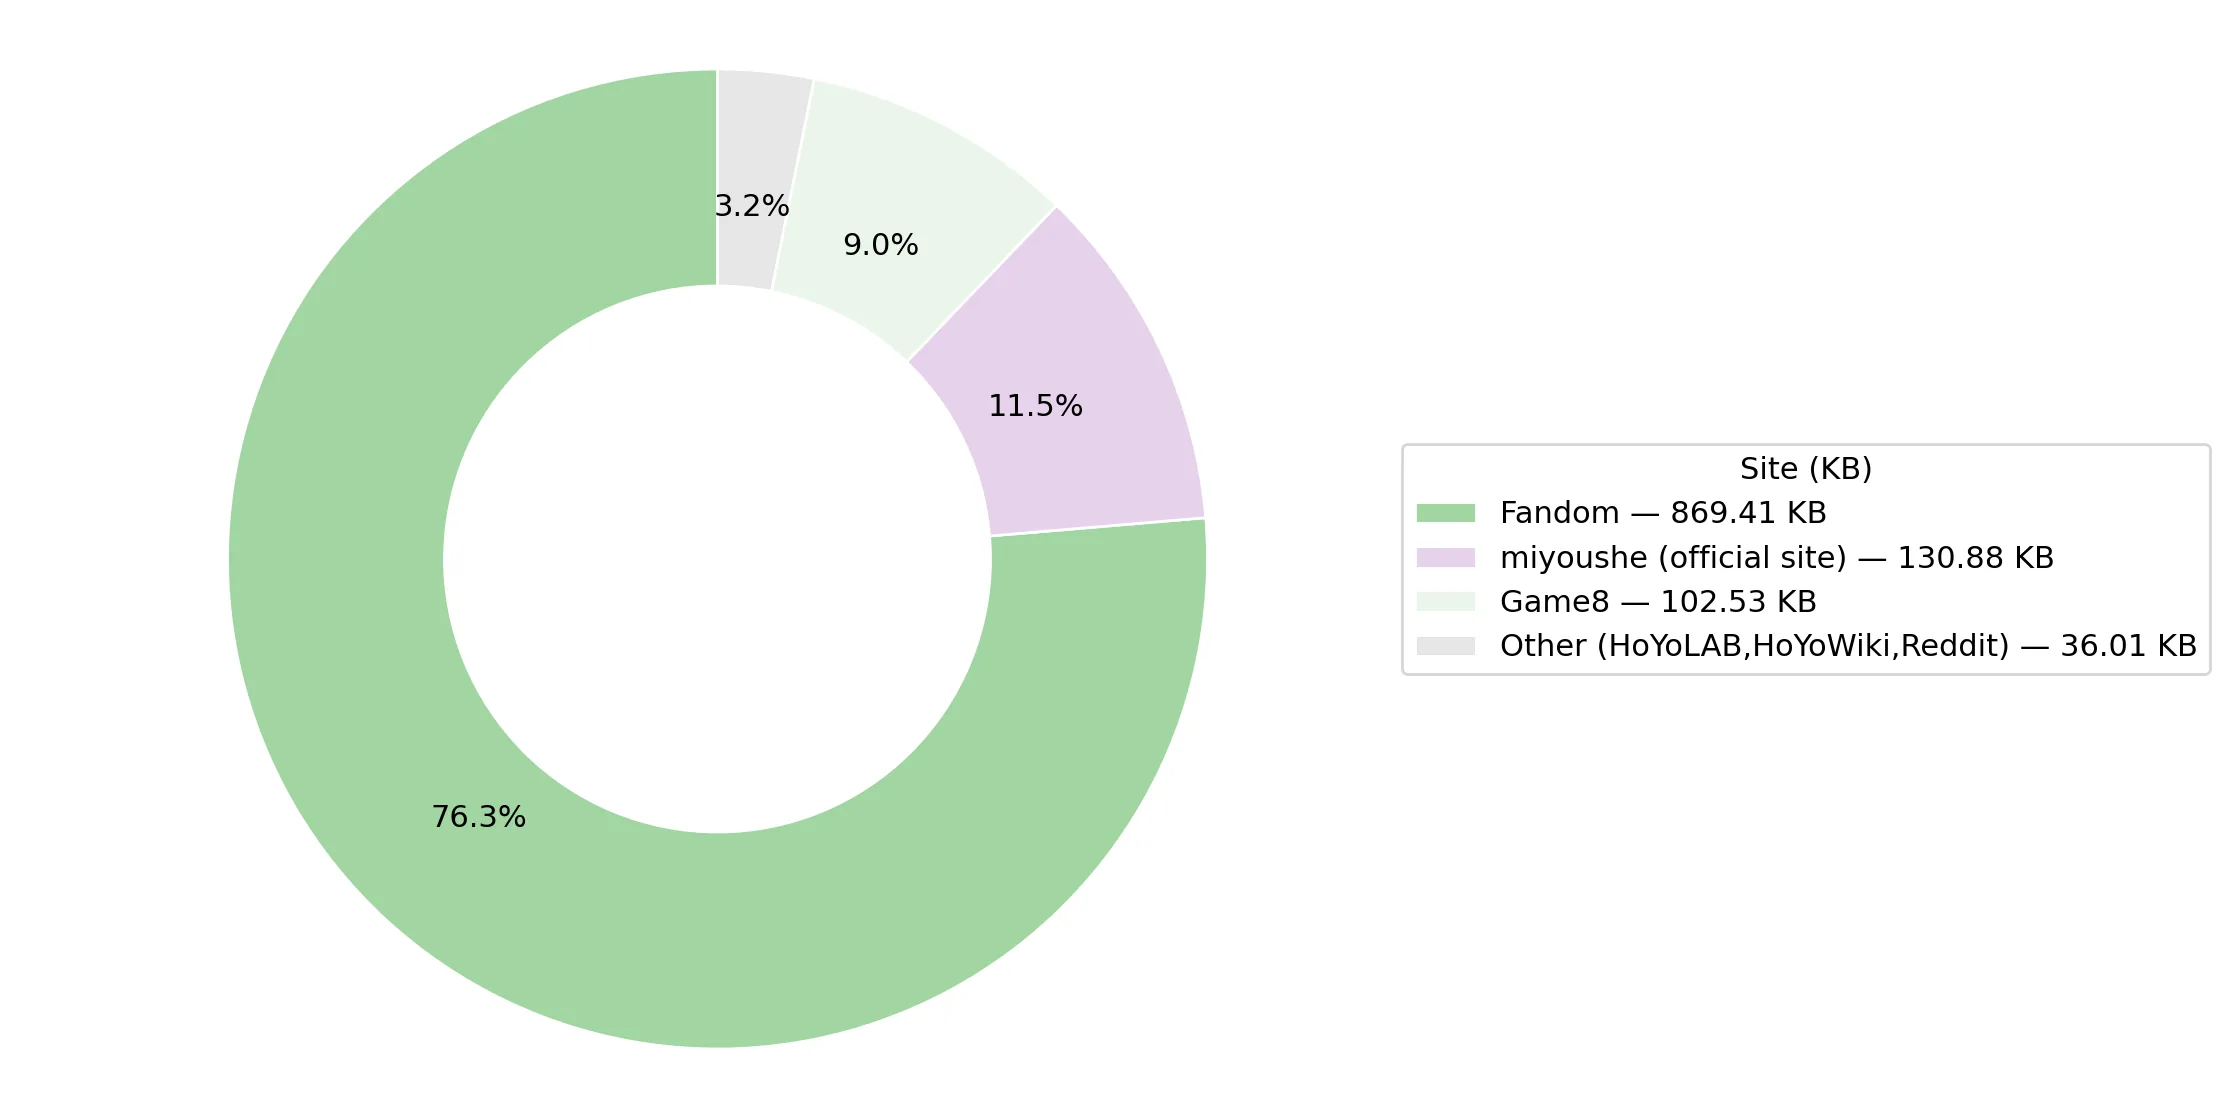
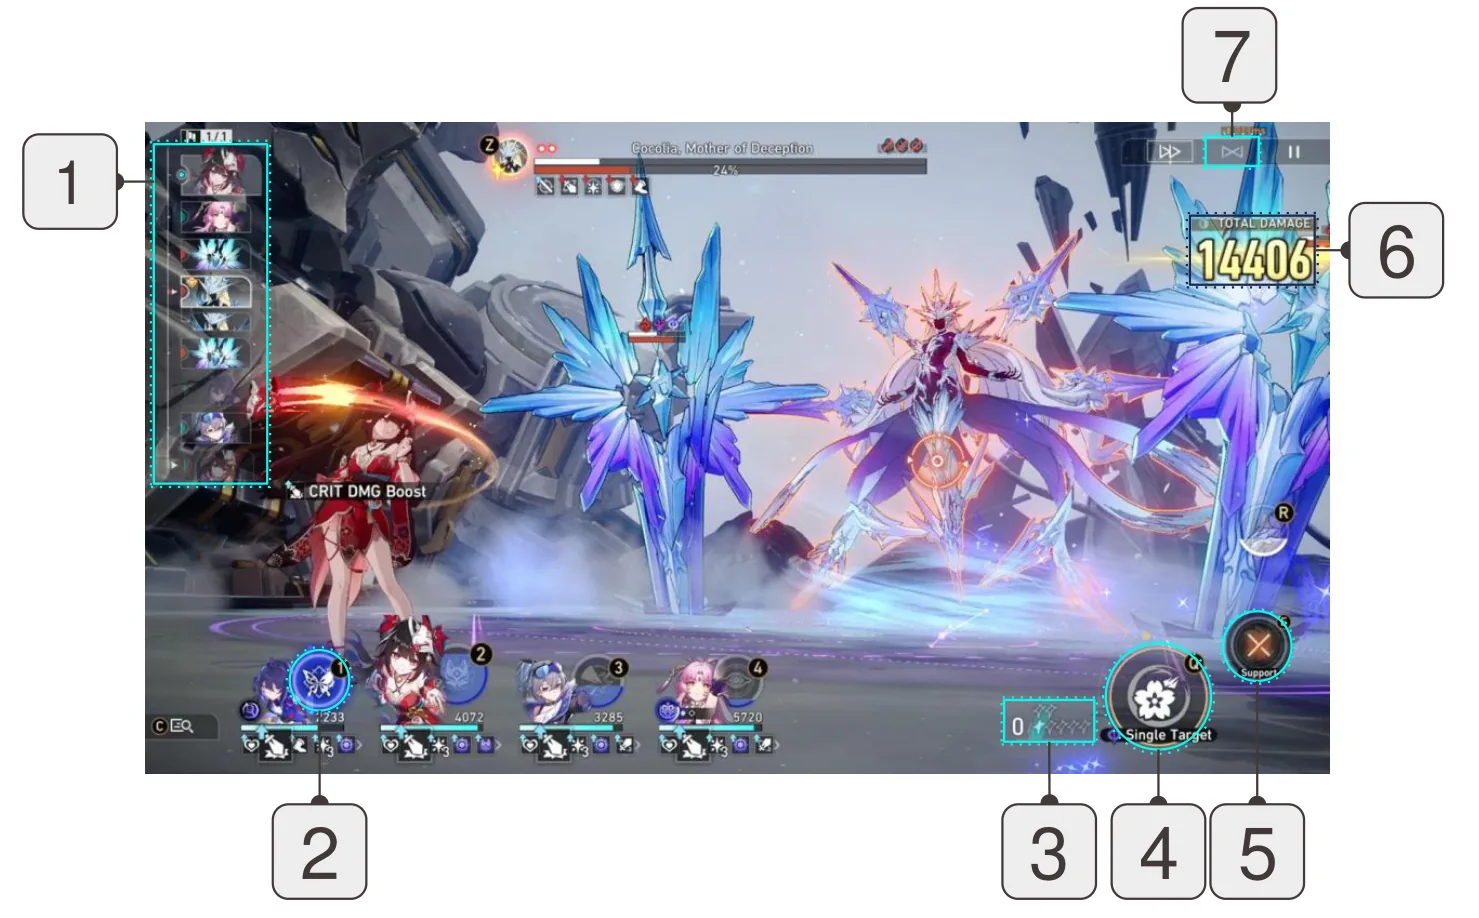
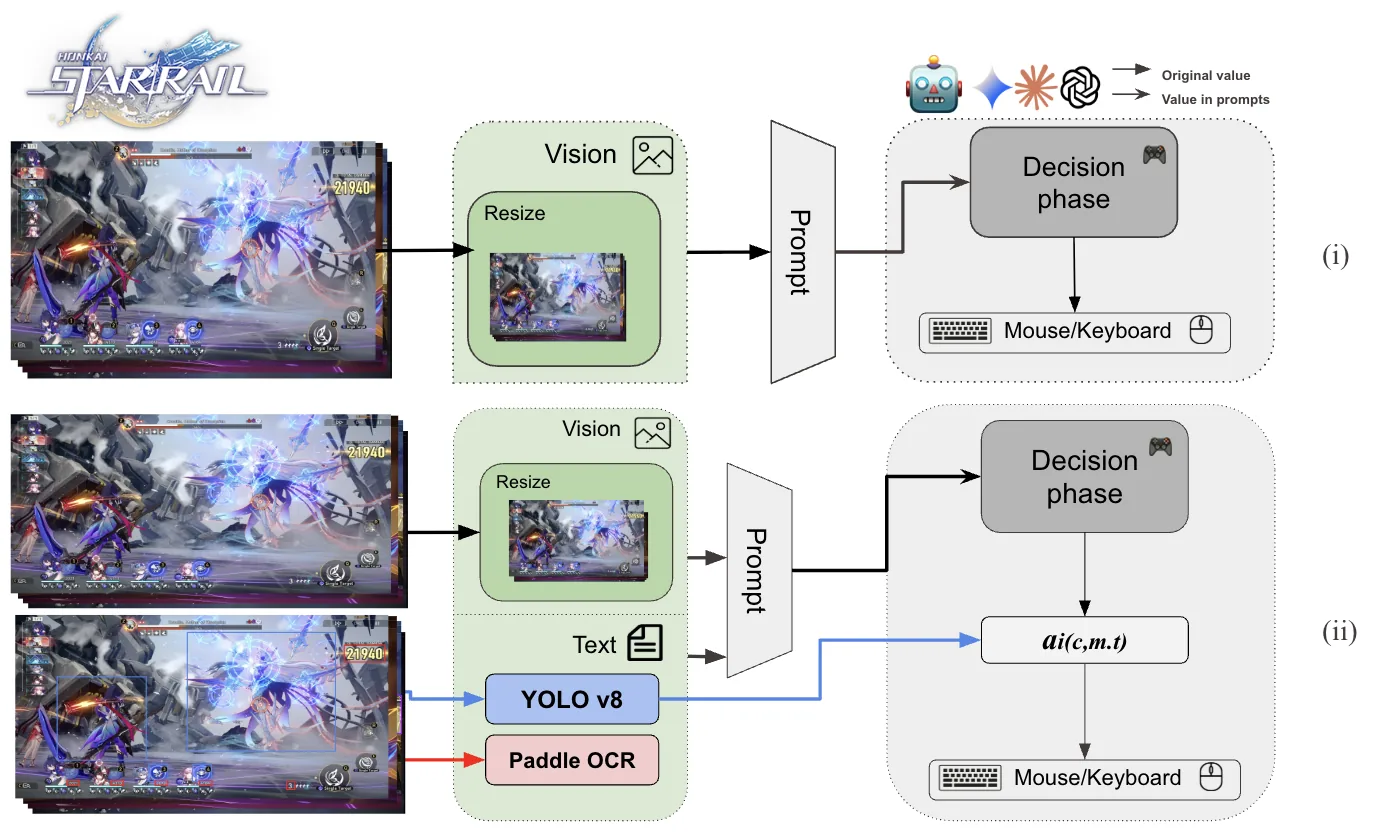
现有VLM在真实游戏客户端中能否像人类一样从截图生成连贯的低层按键操作并在受挫时主动寻求信息仍是开放问题。本文基于《崩坏:星穹铁道》构建StarBench基准,涵盖8项战斗任务,在统一任务与指标下设立直接控制与工具辅助控制两种评测模式,并加入ask-or-act诊断衡量是否/何时请求简短指引。实验显示当前VLM在直接控制模式下感知到控制的保真度存在显著差距,而合理的信息寻求行为与成功率提升正相关。
概念 · 7 个
摘要
真实游戏客户端中从原始截图映射到时序连贯的键盘鼠标底层操作,且能在受挫时主动寻求信息,是VLM尚未被验证的人类级游戏能力
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
LLM 游戏代理中的空间推理:因果上下文与多步规划的影响
Spatial Reasoning in LLM Game Agents: Impact of Causal Context and Multi-Step Planning
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 6 张
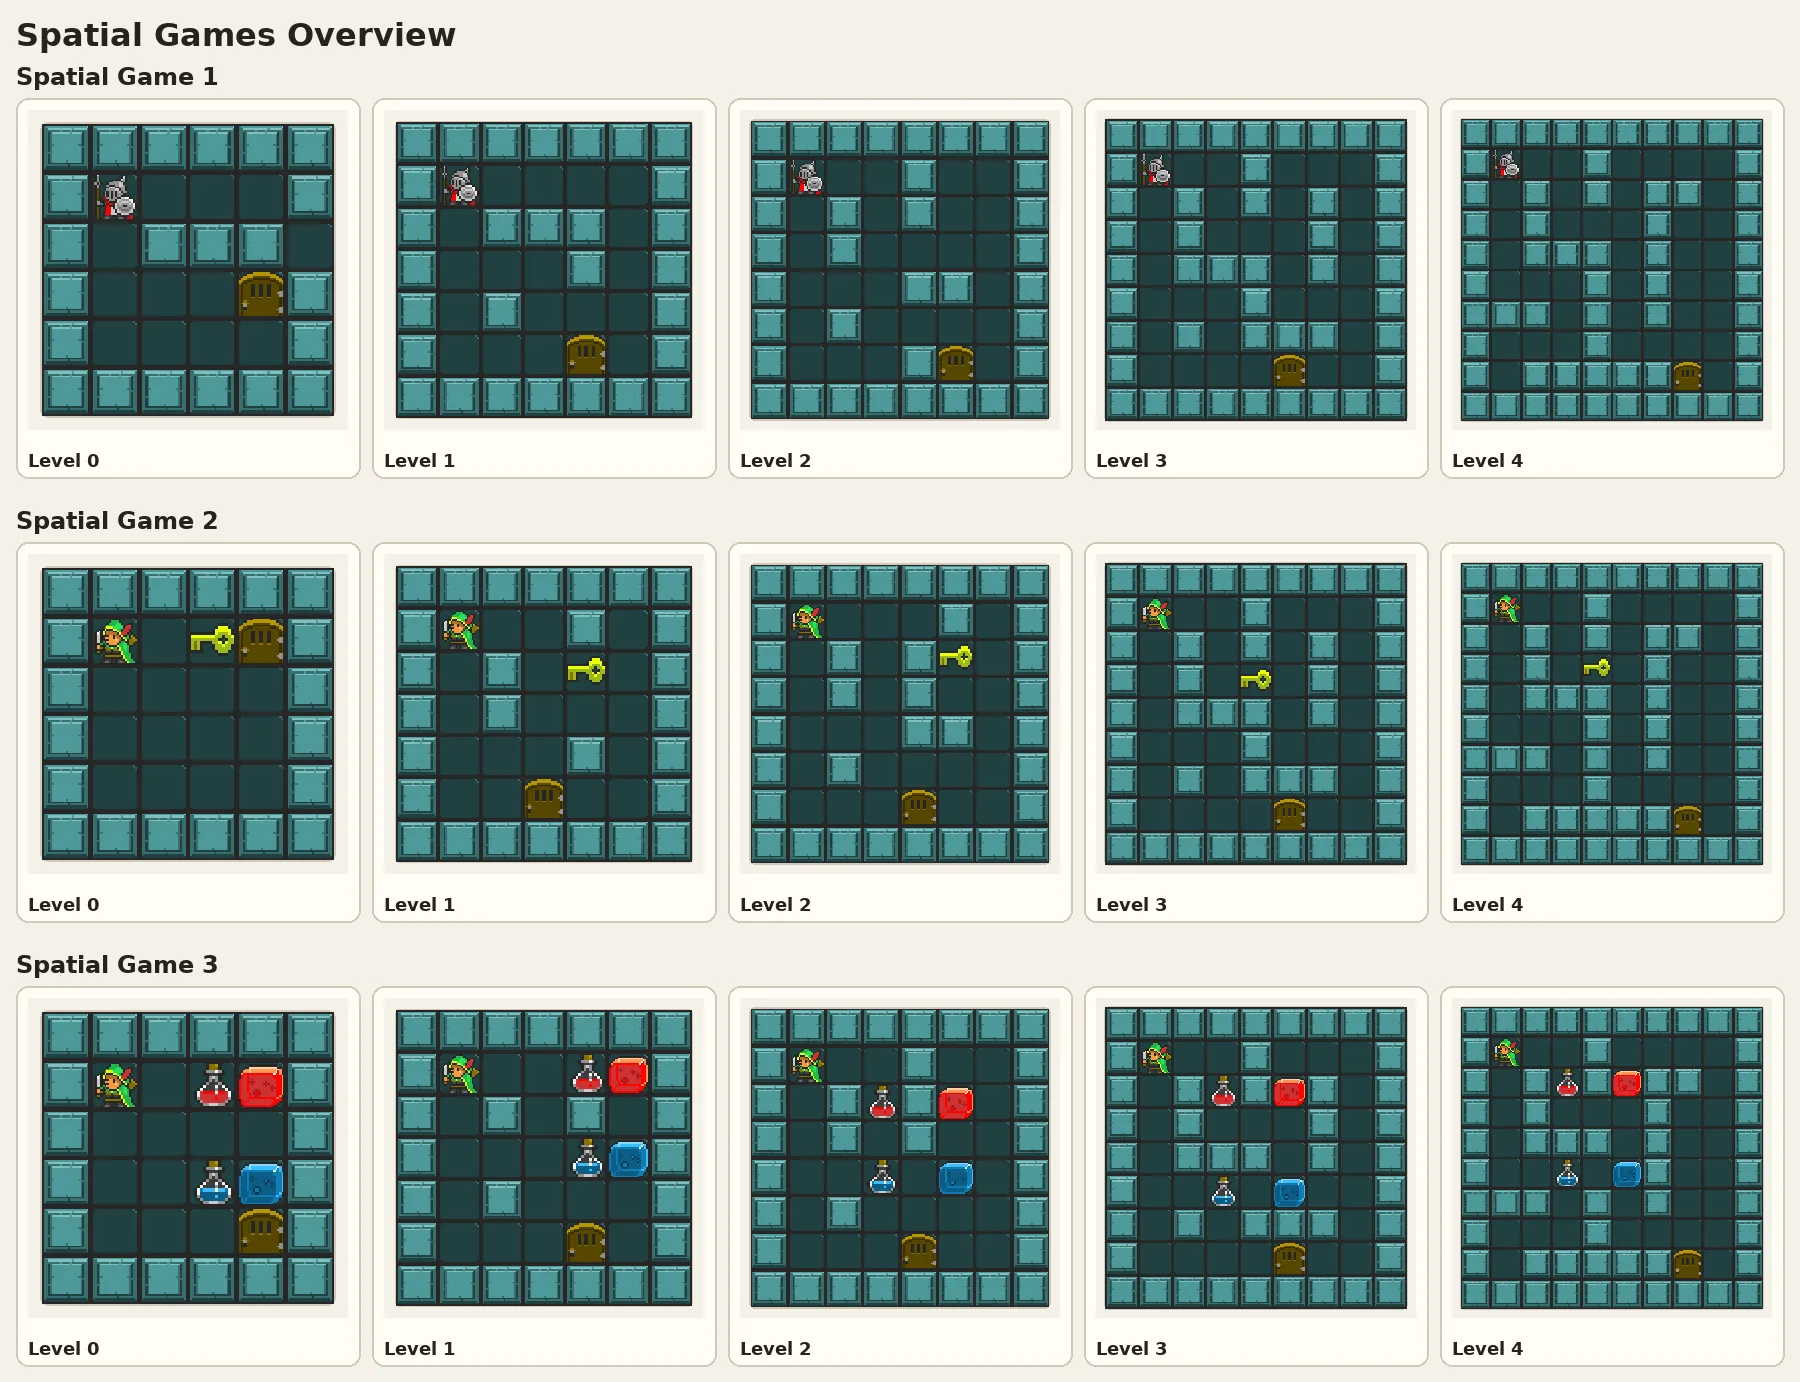
LLM游戏代理在复杂任务中表现欠佳,研究者怀疑根源在于空间推理能力受限。本文以开源Qwen3系列为对象,构建GVGAI空间导航基准(3款自研游戏、5级难度),分别考察坐标定位与对局胜率,并通过因果提示增强与多步规划加以改进。实验发现:大模型启用思考模式后定位更准,因果上下文显著提升胜率,多步规划在拉长规划视野的同时降低单步响应延迟,为推理深度与执行速度的权衡提供了可行路径。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
近年来,基于 LLM 的自主代理在游戏、机器人控制等序列决策任务中展现了潜力,但其性能往往随着任务复杂度的提升而急剧下降。以往研究多将失败归因于模型的规划能力不足或动作执行精度有限,而较少从空间推理的角度审视问题。所谓空间推理,指的是代理理解自身与环境相对位置、判断空间关系、以及在三维或二维网格中导航的能力——这些恰恰是许多游戏关卡的核心挑战。
研究者的核心疑问是:当一个 LLM 游戏代理在某个关卡中反复失败时,问题究竟出在哪里?是因为它“想不明白”该往哪个方向走,还是它压根不知道自己“在哪里”?换言之,空间推理的缺陷可能是制约整体性能的瓶颈所在。此外,已有的游戏 AI 基准虽然覆盖面广,但往往缺乏对空间导航能力的精细化考察,难以帮助研究者定位问题的具体来源。
基于这一背景,本文首先构建了一个专门针对空间推理的评测基准,然后在同一模型族(Qwen3)的不同规模变体上,系统考察空间推理能力与因果提示、多步规划之间的交互关系,试图回答两个关键问题:空间推理受限是否真的是性能瓶颈?增强因果推理与延长规划视野能否在不显著增加延迟的前提下带来实质性的提升?
方法
论文的方法论设计围绕两条主线展开:构建精细化的空间推理评测基准,以及引入两类干预手段(因果提示增强与多步规划)来考察其效果。
GVGAI 空间导航基准是本研究的核心评测工具。研究者选取了 GVGAI(General Video Game AI)平台作为基础框架,自主设计了三款自定义游戏,每款游戏对应不同的空间导航挑战,并细分为五个难度级别。难度梯度主要通过关卡尺寸、障碍物密度、目标位置隐蔽性等维度来调控,从而实现对模型空间推理能力的渐进式考察。之所以选择 GVGAI 而非已有游戏基准,是因为它支持快速生成可控的关卡变体,且其 tile-based(基于瓦片网格)的表示形式便于精确的坐标匹配评测。
评估采用两种范式。第一种是“定位实验”——在每个关卡开始时向模型提供完整的地图信息和自身初始坐标,要求模型输出其精确位置。这看似简单的任务实际上考验了模型对网格坐标系统的理解、对自己状态的正确表征,以及在复杂布局中定位自己的能力。第二种是完整的游戏对局评测,记录代理的胜率、存活时长等指标,以考察空间推理能力在完整决策链条中的实际影响。
因果提示增强是论文引入的第一类干预手段。直觉上,当模型需要做出空间决策时,如果能在提示中显式提供因果关系(例如“向左走会触发陷阱,因为该区域被标记为危险区”),而非仅给出静态的地图信息,模型或许能更好地捕捉环境动态并做出合理规划。研究者将这一思路形式化为在标准提示中嵌入因果上下文的策略,通过消融实验对比有无因果增强时的性能差异。
多步规划则是第二类干预手段。在传统的单步决策范式中,模型每一步都基于当前状态输出一个动作;而多步规划允许模型在一次推理中生成多个连续的动作序列,从而在宏观层面拉长规划视野。然而,这种做法容易导致单次响应时间大幅增加。论文的关键发现之一在于,通过精心设计的多步规划机制,可以在保持较长规划时间跨度的同时,将平均到每一步的响应延迟控制在可接受范围内,从而实现推理深度与执行效率的平衡。
实验与结果
研究者在 Qwen3 系列的不同规模模型上系统开展了实验,覆盖了从较小参数规模到较大参数规模的多个变体,并分别测试了是否启用思考模式、是否集成因果上下文、规划时间跨度取不同值时的性能表现。
在定位实验中,结果呈现出明显的规模效应。启用思考模式(允许模型进行更长的内部推理链)后,较大的模型能够显著更准确地识别自身在网格中的坐标位置,这表明思考模式为模型提供了“反思”自身状态的空间。然而,较小的模型即使启用思考模式,在精确坐标匹配上的表现仍然有限,说明空间推理能力存在一定的模型规模门槛。
在游戏胜率方面,实验结果进一步验证了基准测试设计的有效性:随着游戏关卡和布局复杂度的提升,所有模型的胜率均呈下降趋势,这一单调递减的曲线证明了难度可扩展性的合理设计。关键的是,将因果上下文集成到提示中带来了正向收益——尤其是对较大模型而言,胜率提升更为显著。这印证了研究者的假设:在空间导航这类需要理解因果关系的任务中,显式的因果信息能够帮助模型弥补纯统计推理的不足。
多步规划的实验结果颇具启发性。一方面,更长的规划时间跨度本身就能带来性能增益,这与直觉相符——看得更远才能走得更好。另一方面,研究者观察到多步规划策略在延长单次规划视野的同时,能够有效压缩平均单步响应时间。原因在于:当模型一次性生成多个动作时,虽然单次调用的计算成本增加,但省去了频繁重新调用模型的交互开销,综合算下来每一步的等待时间反而缩短了。这一发现为实际部署提供了一个实用的工程启示:在延迟敏感的场景中,多步规划是兼顾“想得深”和“响应快”的有效手段。
讨论与可借鉴点
这项研究在 LLM 游戏代理的空间推理问题上提供了系统性的实证分析,其设计思路和实验结论对相关领域具有多方面的参考价值。
首先,基准测试的构建思路值得借鉴。通过将空间导航能力从其他认知能力中剥离出来,设计具有难度梯度的专门基准,研究者成功实现了对特定能力维度的精细化考察。这种“隔离变量”的评测范式有助于更精准地定位模型能力的薄弱环节,而非笼统地将失败归因于“智能不足”。
其次,因果提示增强作为一种几乎不增加推理成本的干预手段,展示了提示工程在提升 LLM 特定能力上的潜力。对于资源有限的场景,这种方法提供了低门槛的性能改进路径。
再次,多步规划在推理深度与执行速度之间取得的权衡,为实际部署中的系统设计提供了新思路。传统观点可能认为更长的规划意味着更慢的响应,但本文的实验表明,通过机制设计可以打破这一固有 trade-off,这一洞察对构建实时响应的 LLM 代理系统具有工程指导意义。
然而,本研究也存在若干局限。最明显的是,定位实验与真实游戏对局之间的性能关联仍不够紧密——模型能准确定位自己并不意味着它就能赢得游戏,这说明空间推理只是完整游戏智能的一个组成部分。更重要的是,实验主要在 Qwen3 系列上进行,结论的泛化性需要进一步验证。未来的研究可以在更多模型家族、更广泛的游戏类型上复现这些发现,并深入探索因果推理与空间推理之间相互作用的机制。
摘要
LLM游戏智能体空间推理与多步规划
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
当推理收窄了走子:LLM 对弈中的多样性坍缩
When Reasoning Narrows the Move: Diversity Collapse in LLM Game Play
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 8 张
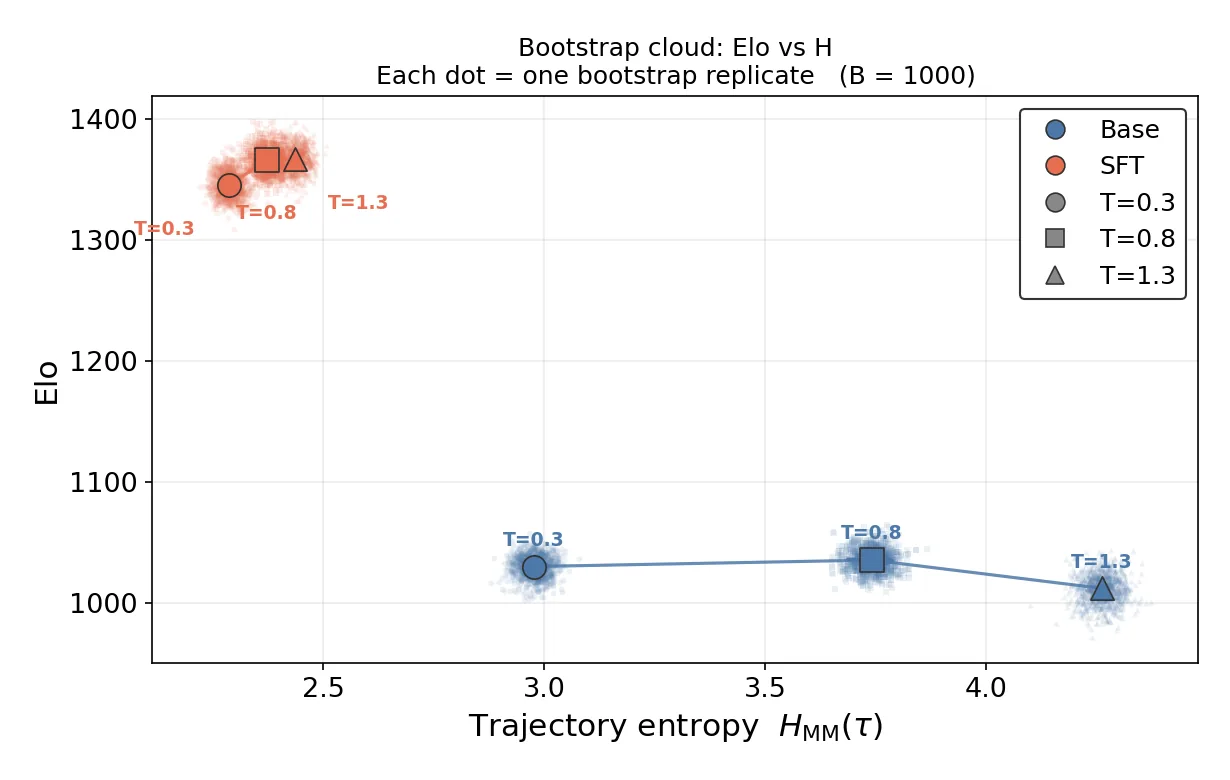
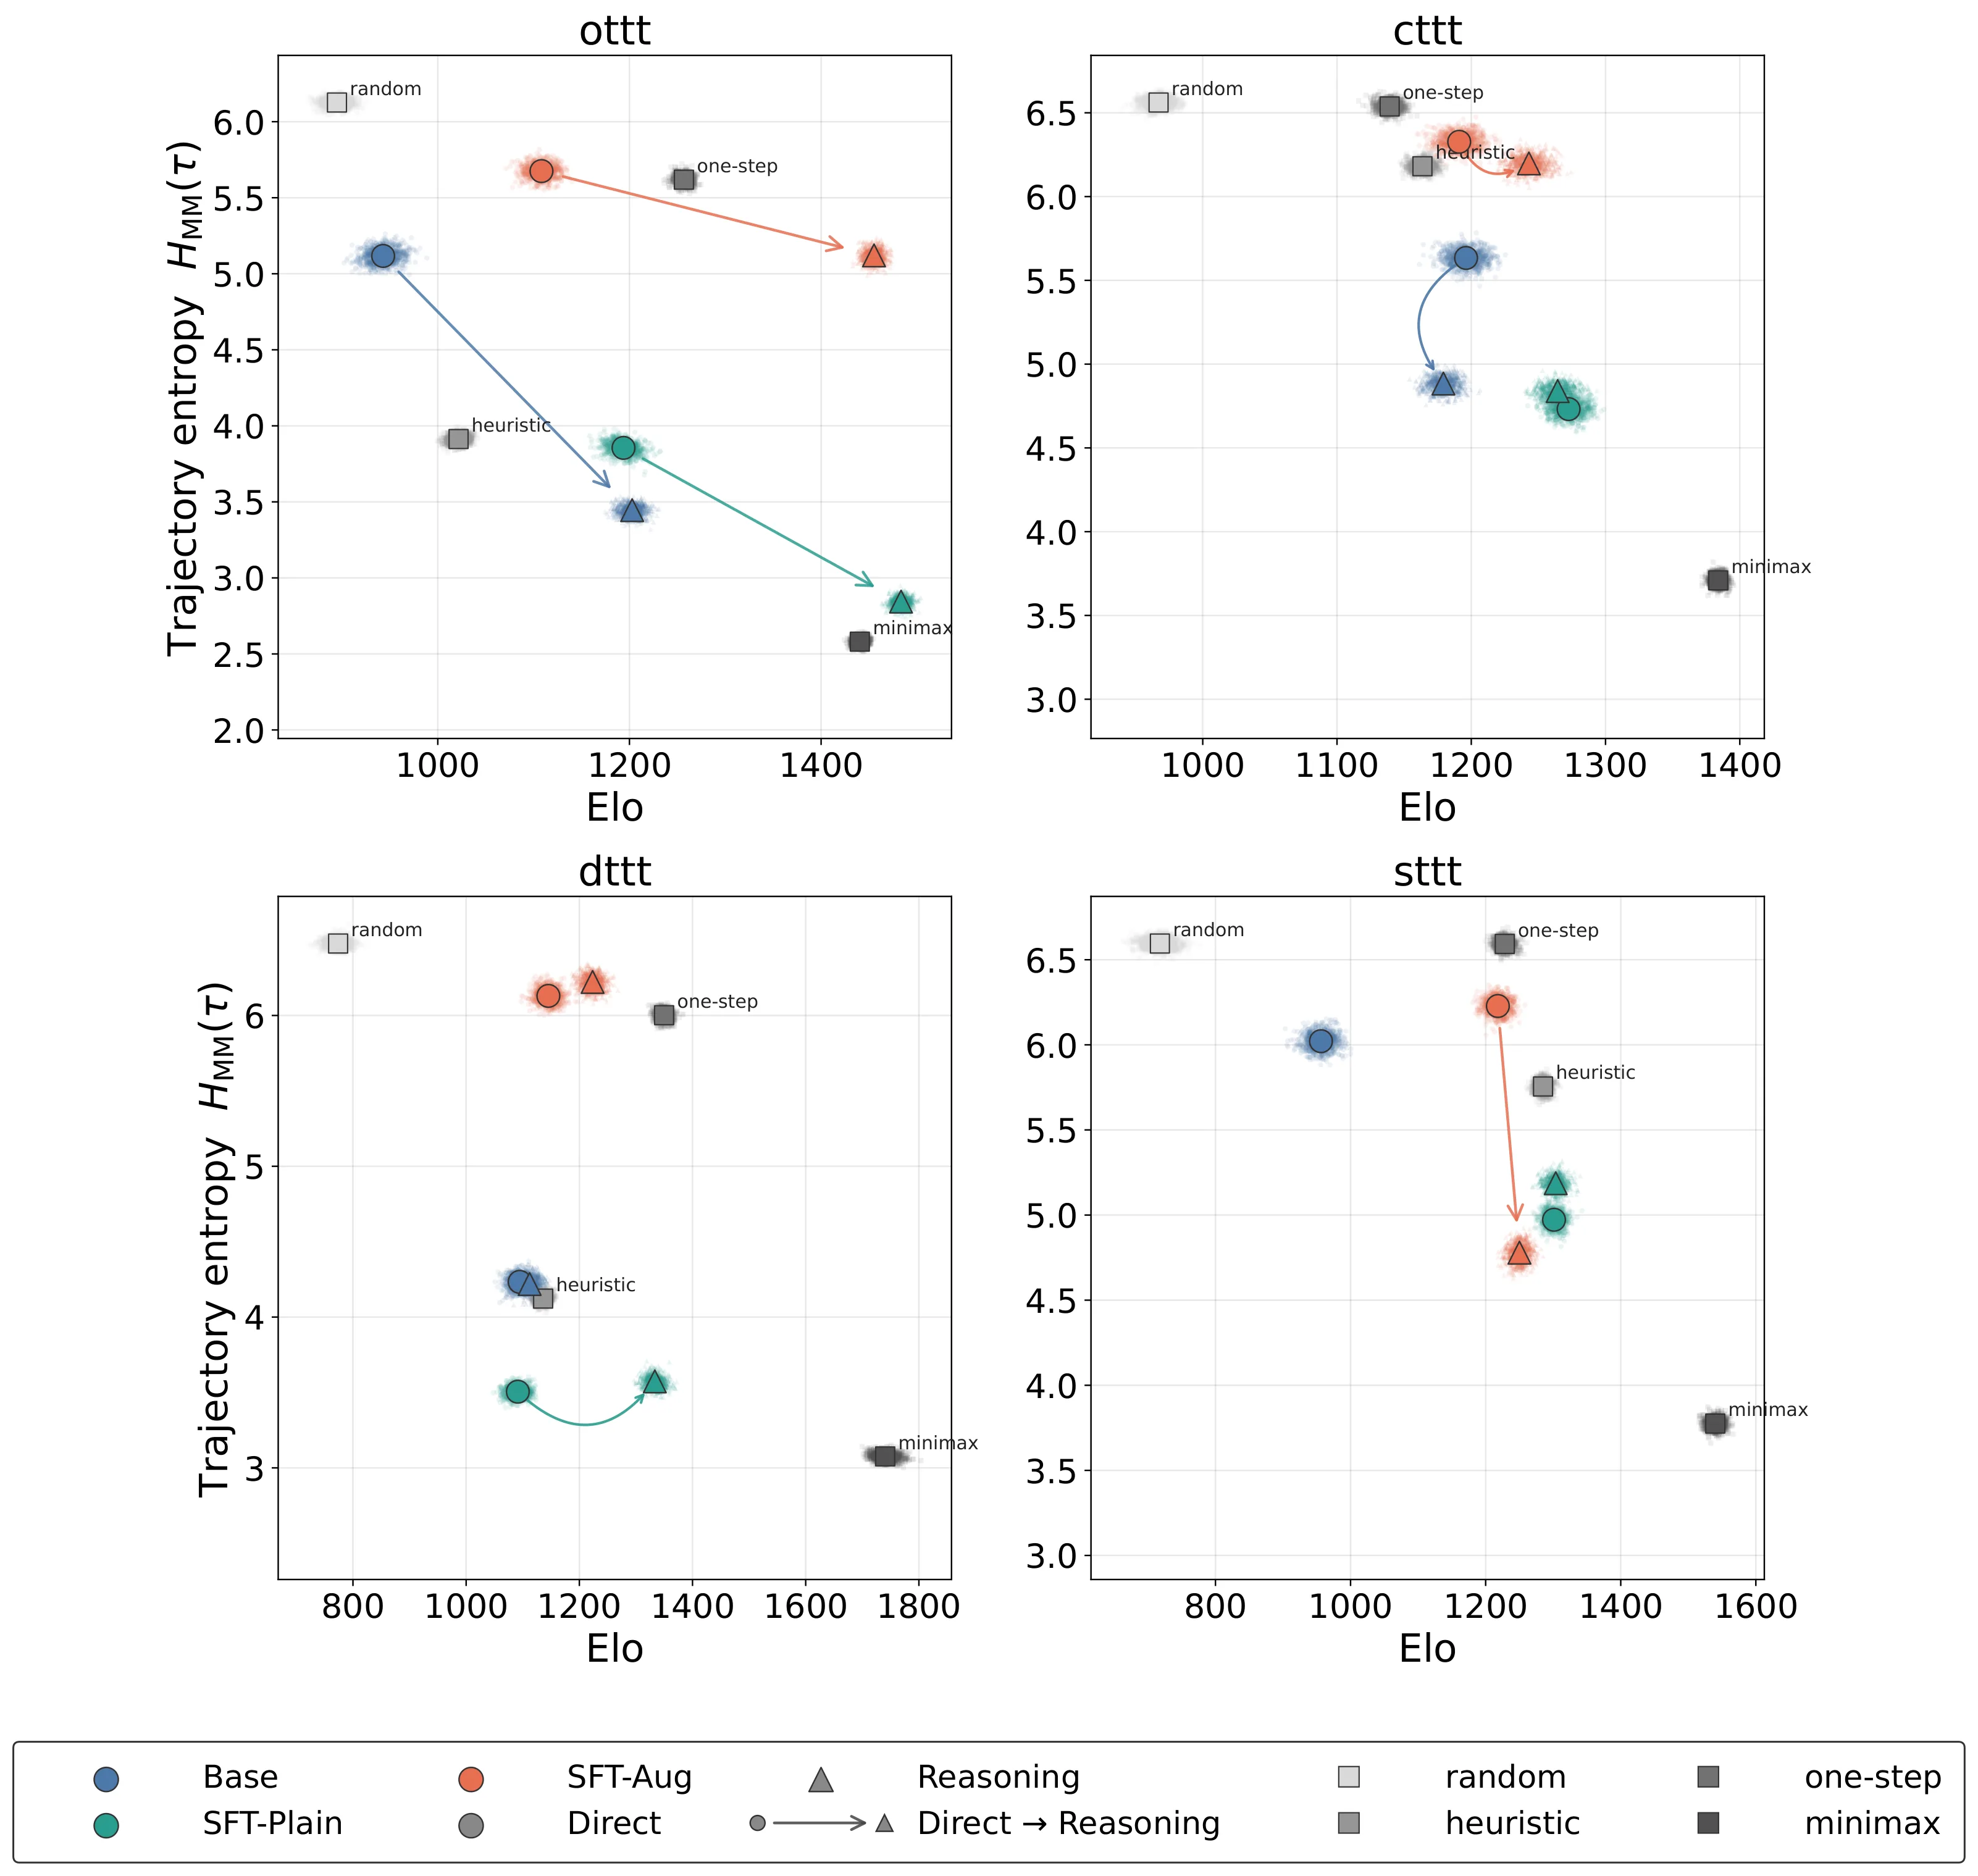
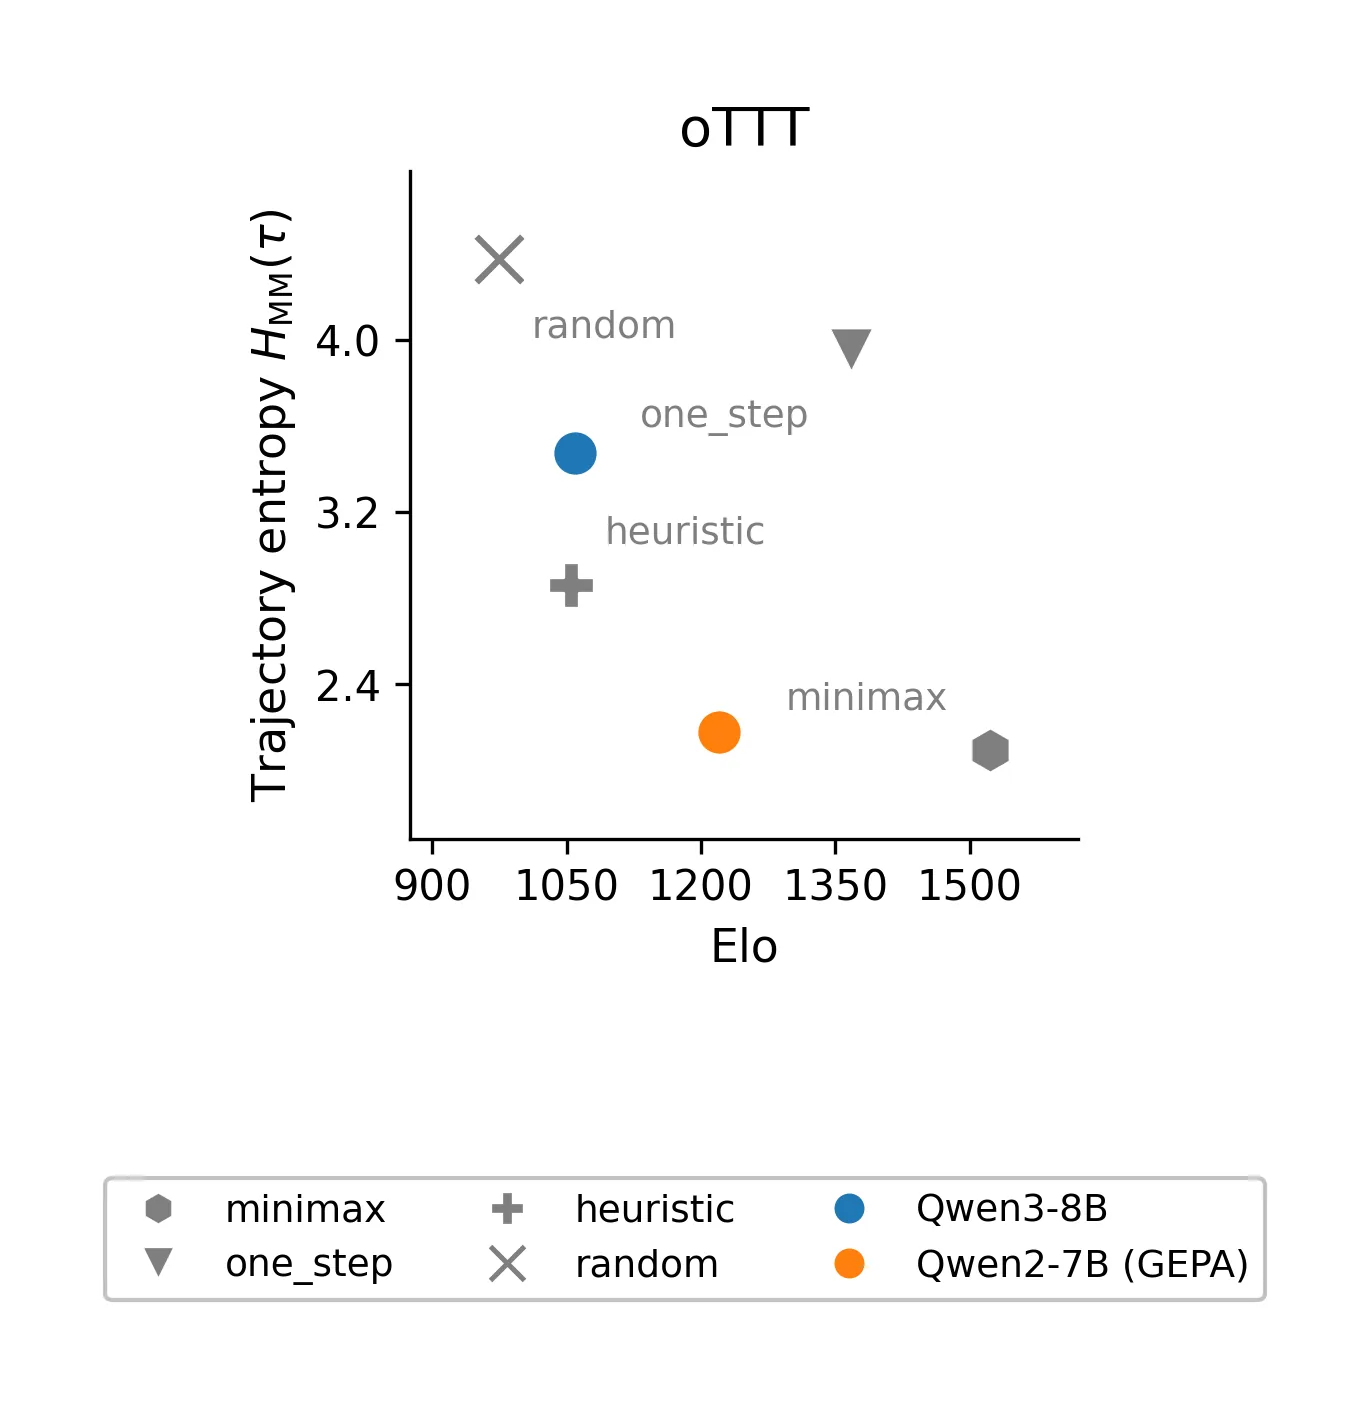
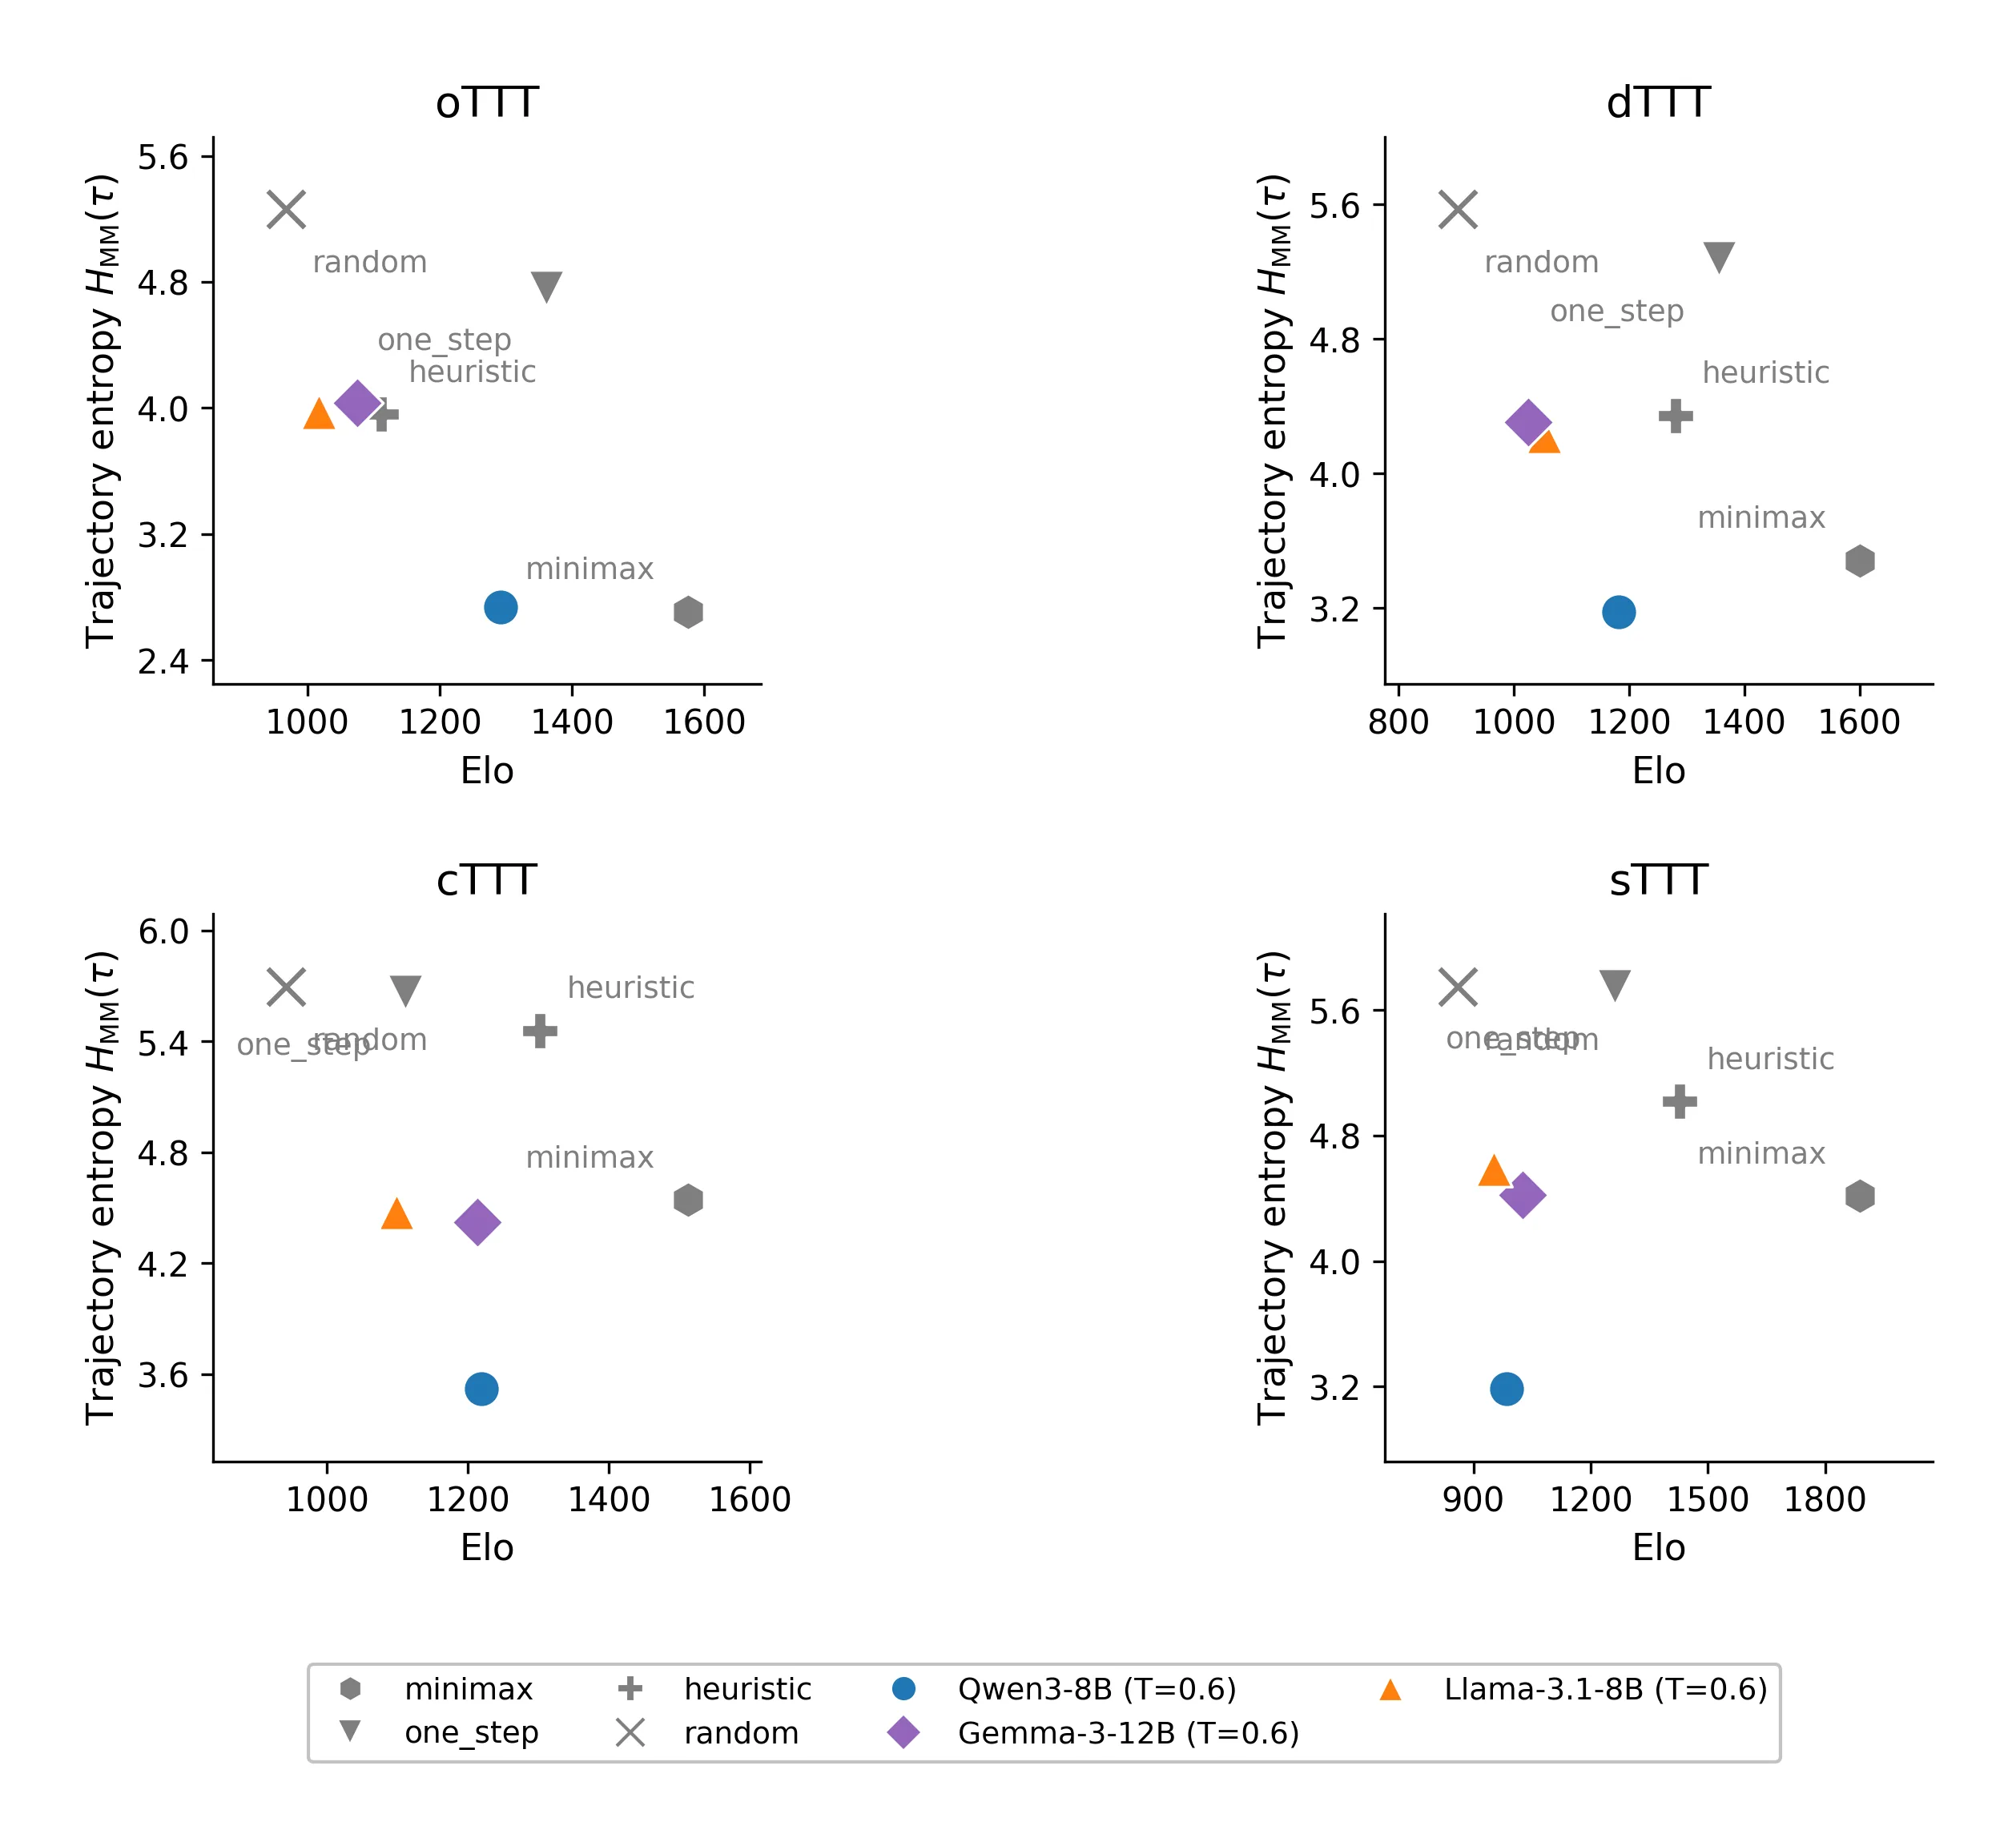
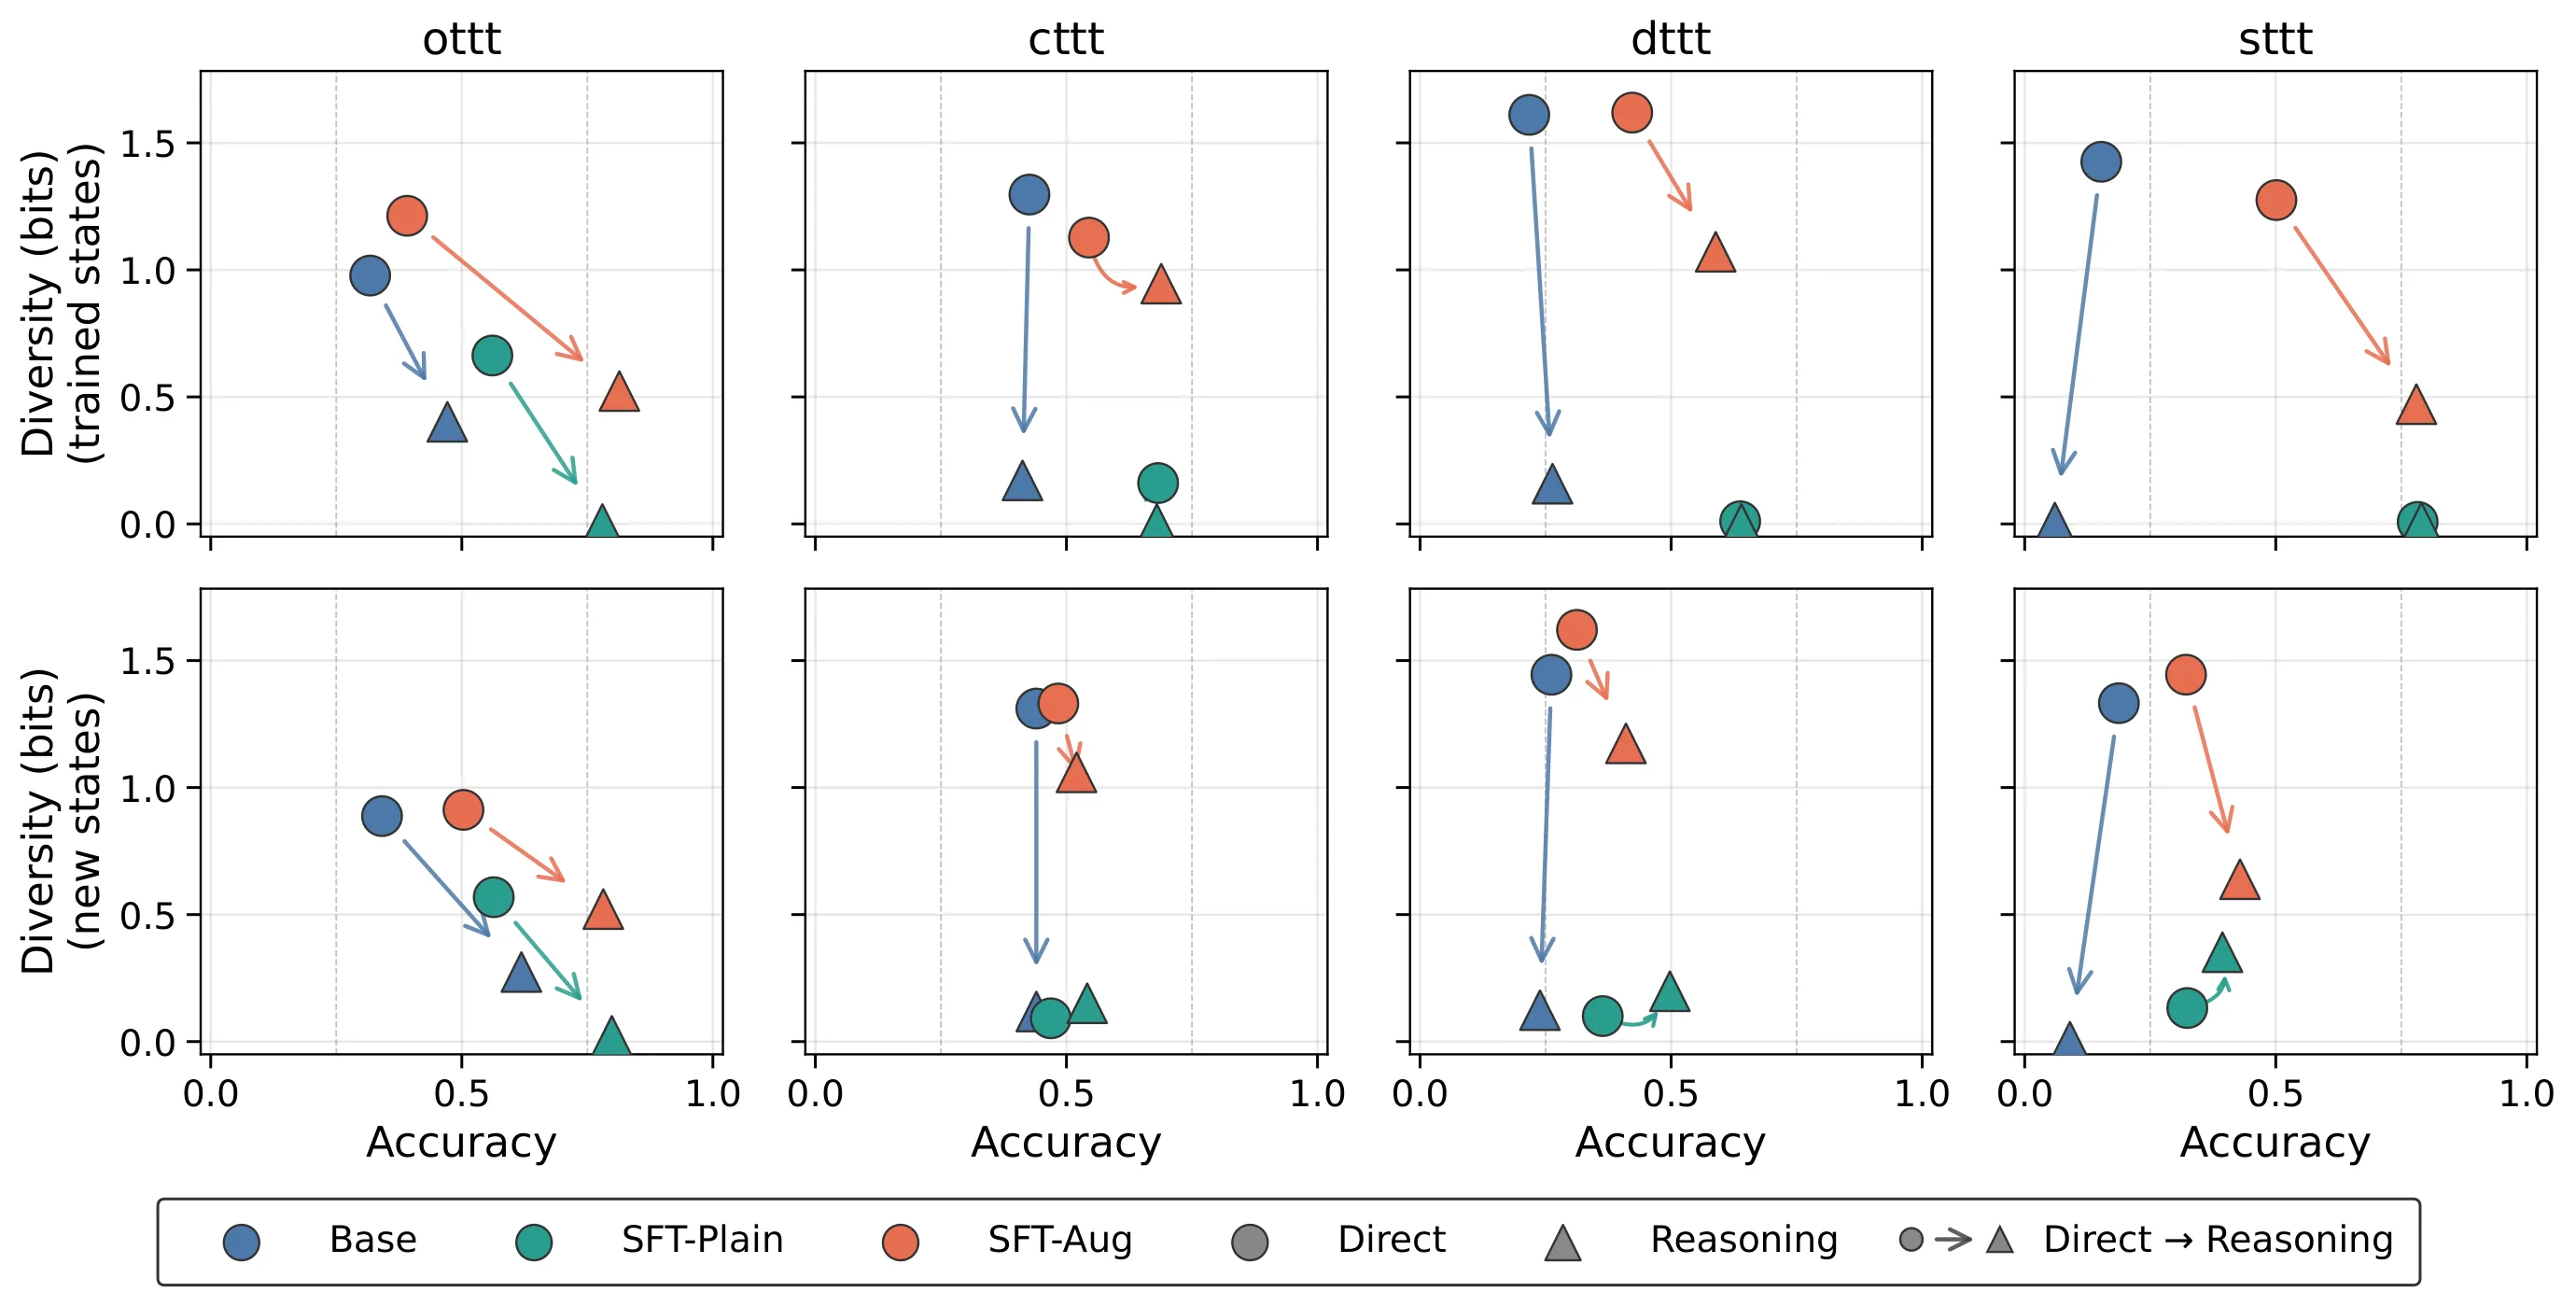
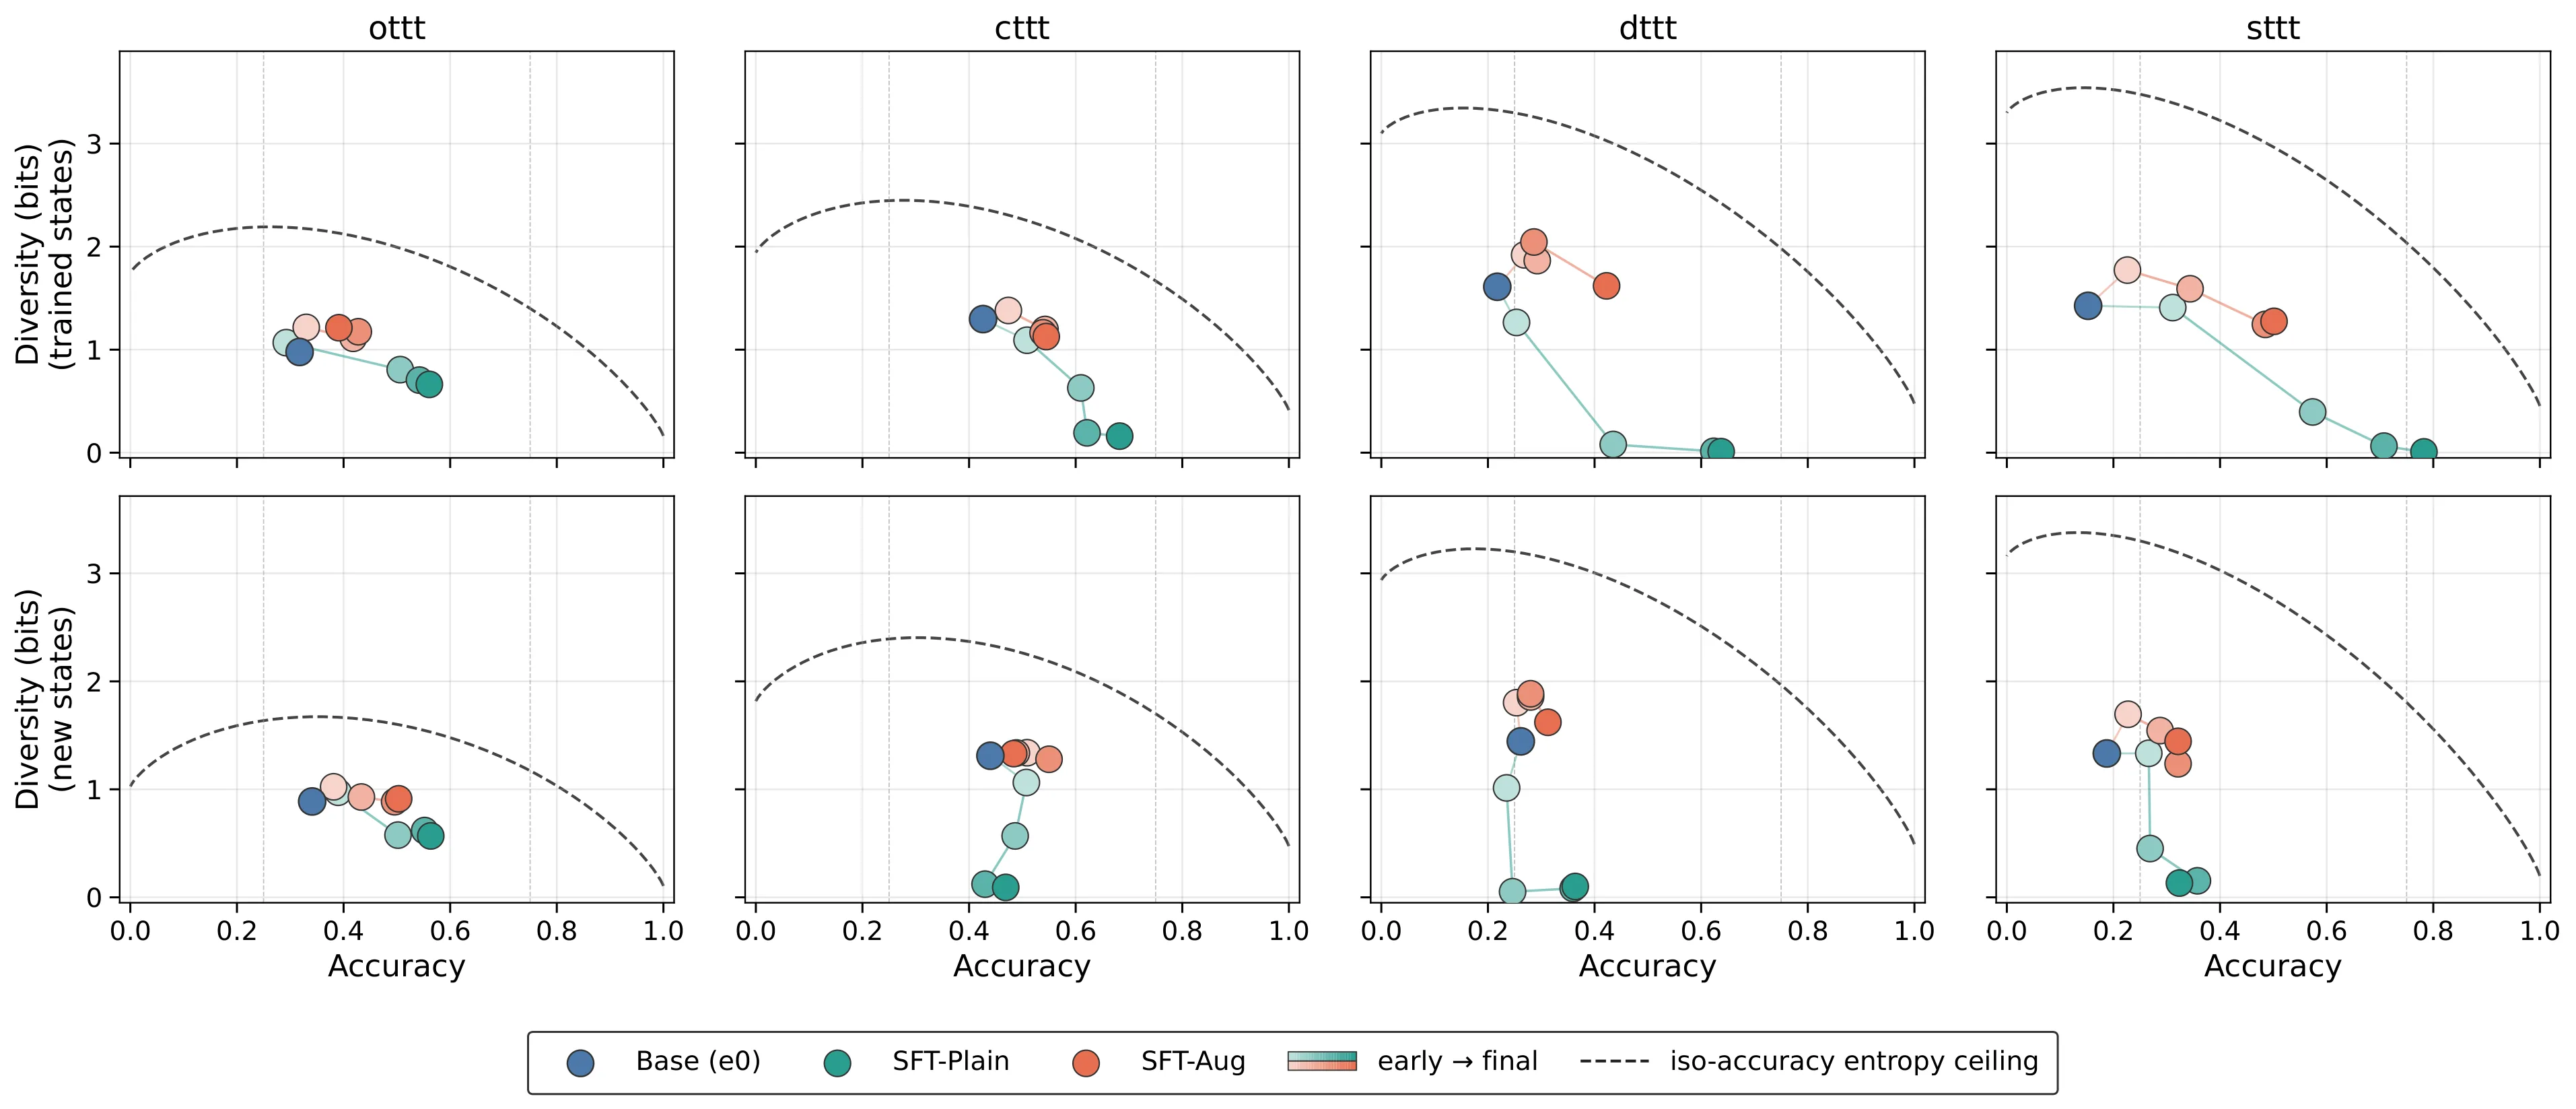
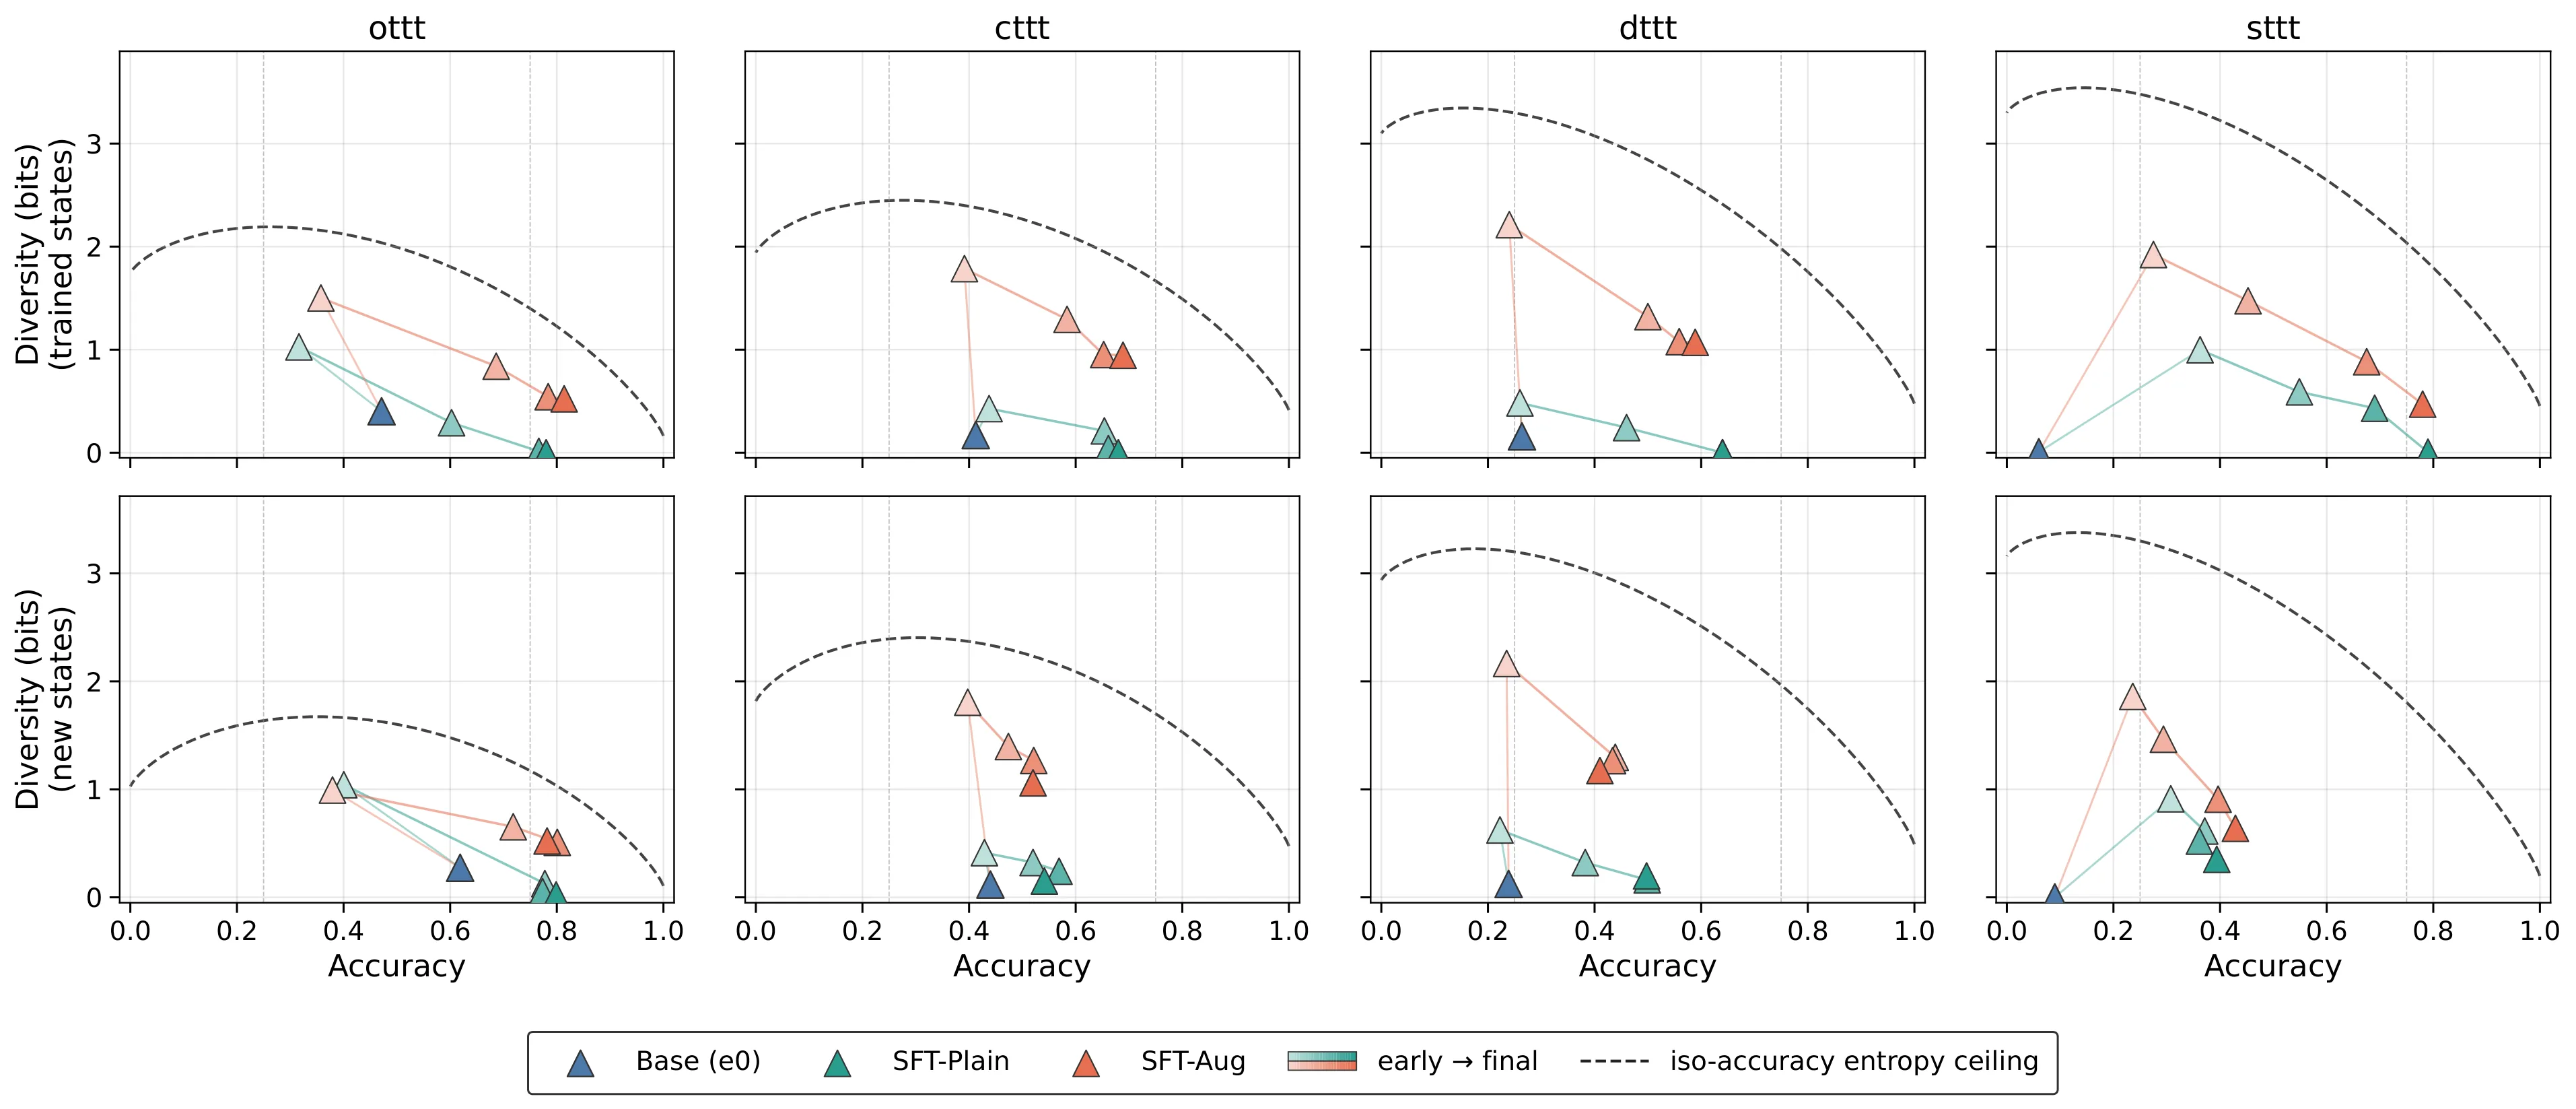
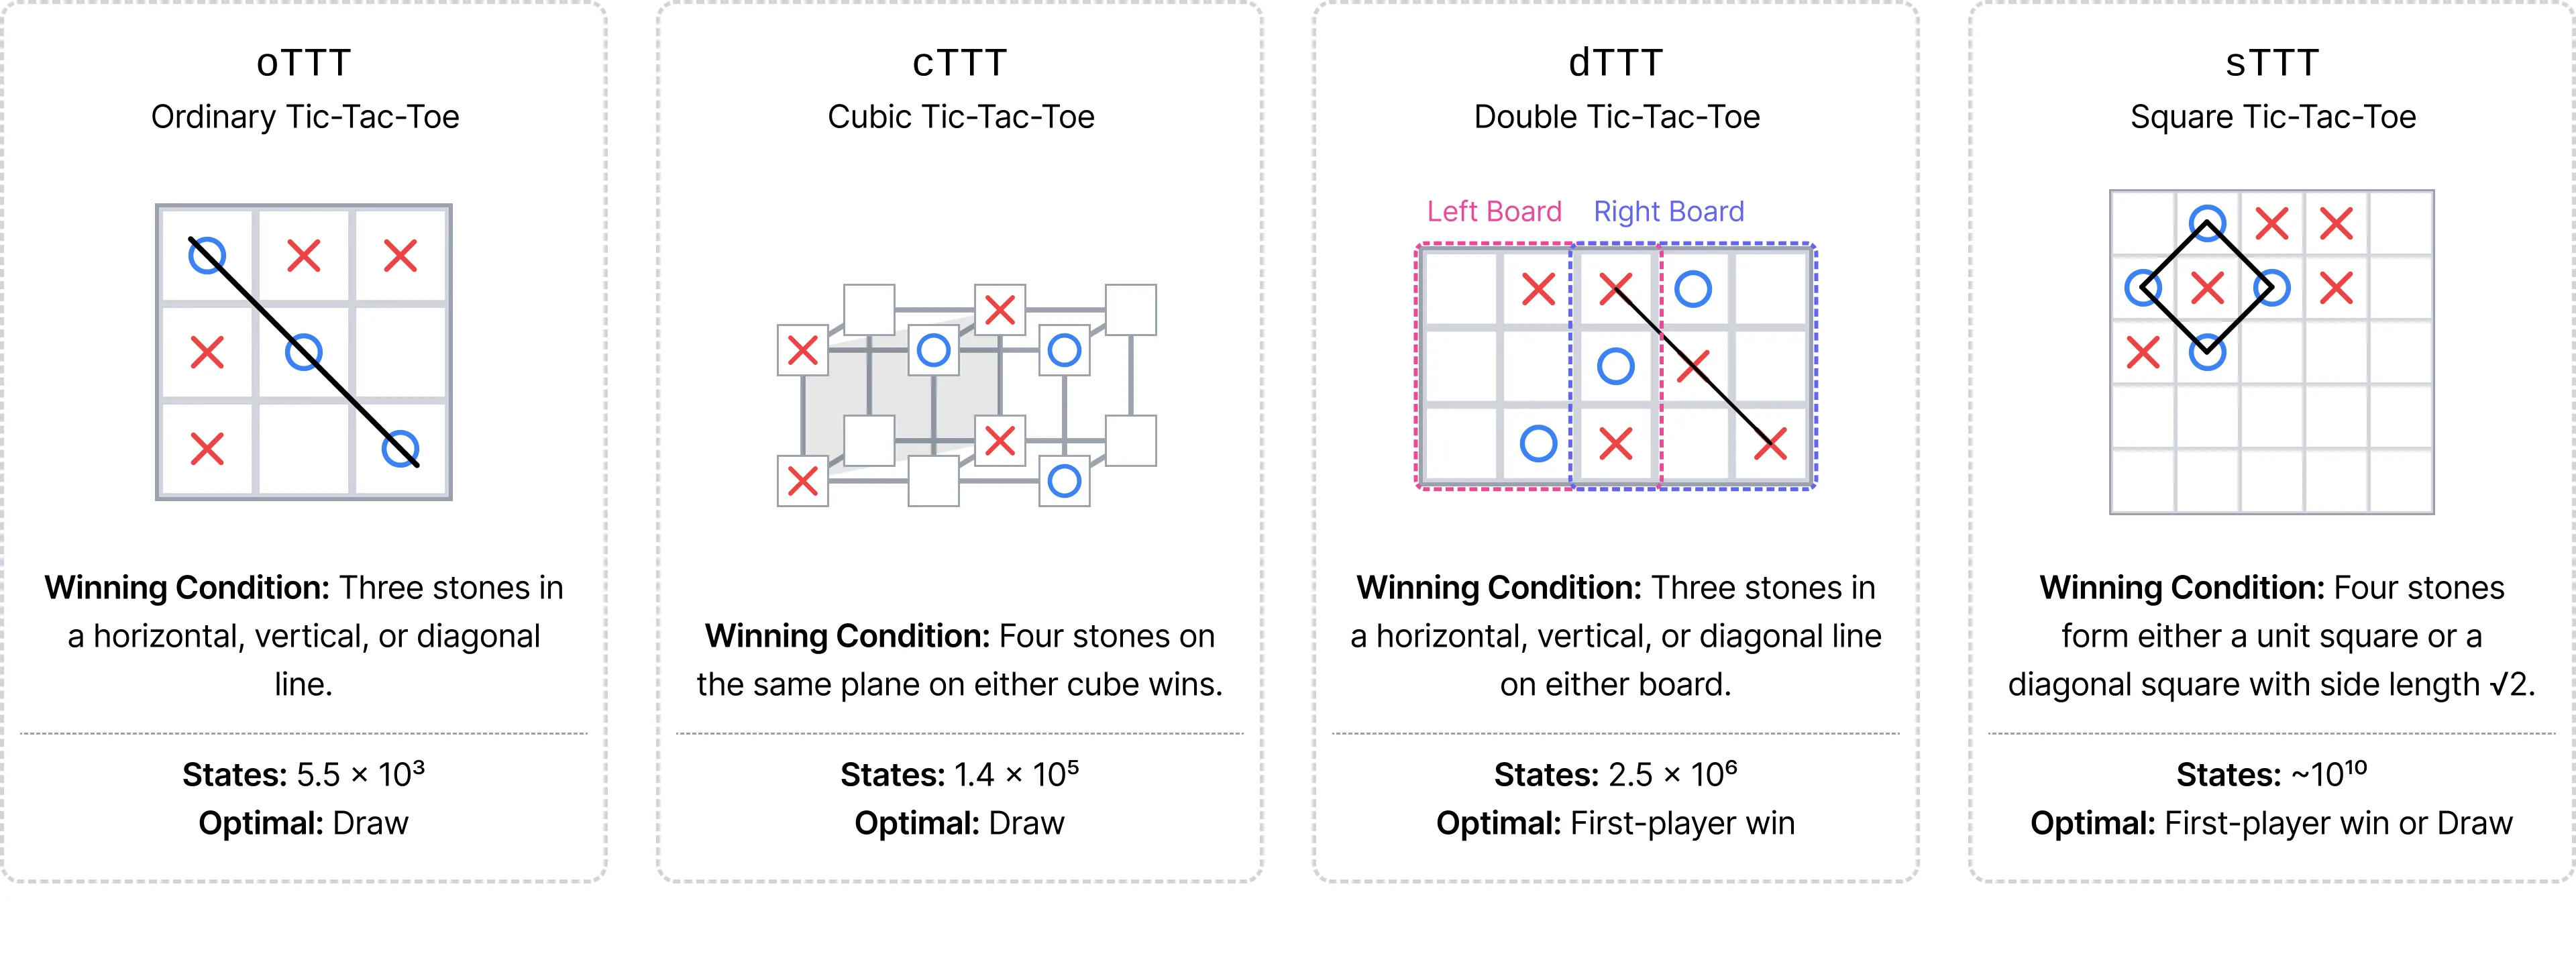
在大语言模型的序列决策场景中,监督微调虽能提升准确率却压缩了行为多样性,推理模式进一步加剧这一倾向。本文在可精确求解的井字棋变体套件上,从状态级、竞技对局和训练轨迹三层面系统测量多样性崩溃,并验证对全部最优动作进行增广训练可部分缓解该现象。研究揭示窄支撑模仿是LLM策略崩溃的根源之一,提示SFT阶段保留动作支撑对维持探索行为至关重要。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
大语言模型在序列决策场景中的应用日益广泛,从游戏对局到机器人控制,模型需要在每一步做出正确的动作选择。监督微调作为将预训练模型适配到下游任务的标准范式,被认为能够有效提升模型在特定任务上的表现。然而,一个关键问题始终悬而未决:SFT 在提升任务准确率的同时,是否会不经意间压缩模型的行为多样性?
这个问题之所以重要,是因为行为多样性直接关系到模型的探索能力和泛化潜力。在真实世界的决策场景中,环境往往是部分可观测或动态变化的,模型需要保持一定的行为灵活性以应对未见过的状态。如果模型在微调后变得过于"确定",只认得单一的正确动作而忽略其他等优选择,其鲁棒性和适应性将大打折扣。
已有的研究多关注 SFT 如何提升准确率,却鲜少系统考察其对行为多样性的影响。这并非因为多样性不重要,而是因为在大多数真实任务中,最优动作本身就难以定义,多样性更是无从度量。论文的创新之处正在于此——作者选择在井字棋变体这一可控环境中研究该问题。井字棋的吸引力在于它具有明确的最优策略和可计算的最优动作集合,使得我们能够精确区分"正确但不唯一"的选项,从而真正量化多样性的变化。
方法
论文的核心方法论建立在三个支柱之上:可控的实验环境、精确的多样性度量,以及系统的分析框架。
实验环境设计。作者构建了一套基于井字棋的确定性棋盘游戏套件,包括标准井字棋、带有惩罚机制的变体,以及更大规模的变体。这些游戏共享一个关键特性:对于任意状态,所有最优动作(即不差于最优结果的合法动作)都可以通过精确计算获得。以标准井字棋为例,当某一方在中心位置落子时,四个角落和四条边中点的走法都能达到相同的最优结果,这些动作构成了该状态的动作空间中的最优支撑。
多样性度量。论文从三个层面定义和度量多样性。状态级评估关注模型对单个状态的响应分布,衡量模型在给定状态下是否只产生单一动作还是能以一定概率分布生成多个最优动作。对弈评估通过让微调后的模型与基准模型对战,考察整体策略的差异性。训练轨迹分析则追踪模型在微调过程中准确率和多样性的动态变化,寻找两者之间的权衡关系。
推理模式的作用。论文特别考察了推理模式(reasoning mode)的影响。在 LLM 生成过程中,模型可以选择直接输出动作,或者先生成推理步骤再输出动作。直觉上,推理过程可能帮助模型更谨慎地评估状态,从而产生更丰富的行为。但实验结果恰恰相反——推理模式的引入常常加剧多样性坍缩,而非缓解。这一发现挑战了"慢思考必然带来更全面考量"的朴素假设。
实验与结果
实验结果揭示了几个重要现象,每个发现都加深了我们对 SFT 本质缺陷的理解。
推理模式抑制多样性。在所有测试的游戏变体中,使用推理模式生成的模型展现出显著更低的多样性。具体而言,当模型先输出推理步骤时,其动作选择的集中程度更高——模型倾向于选择一个"看起来最优"的单一动作,而忽略其他等优选项。这一现象在中心开局后的状态上尤为明显:没有推理时模型可能在四个角落间均匀分配选择概率,但引入推理后,模型会"收敛"到某一个特定角落。
SFT 引发过度多样性坍缩。这是论文最核心的发现之一。作者证明,标准 SFT 虽然确实能提升动作准确率(模型更频繁地选择最优动作),但其导致的多样性损失超出了准确率-多样性帕累托边界所要求的最小程度。换言之,模型本可以在保持相当多样性的同时达到相近的准确率,但 SFT 过程却将模型推向极端——几乎只选择唯一一个最优动作。这种"过度坍缩"暗示 SFT 的优化目标可能存在偏差,它过于强调模仿某一个示范动作,而忽视了动作分布本身的信息价值。
动作增强的部分缓解效果。针对上述问题,作者提出了一种简单而有效的干预:动作增强(action augmentation)。传统 SFT 在每个状态上只使用单一示范动作进行训练,而动作增强方法将同一状态的所有最优动作都纳入训练集。实验表明,这种做法能够显著提升模型的多样性,同时对准确率的影响相对有限。动作增强后的模型在状态级评估中展现出更均匀的动作分布,在对弈中也表现出更强的策略灵活性。
讨论与可借鉴点
论文的发现为理解[[监督微调]]在决策场景中的局限性提供了新的视角,同时引发了若干值得深思的问题。
窄支撑模仿的本质。论文将问题根源归结为"窄支撑模仿"——模型在训练时被要求精确复现单个示范动作,而非学习最优动作集合的分布特性。这种学习方式天然倾向于产生方差极小的策略,因为最小化预测误差的优化过程会不断强化对单一动作的置信度,即使其他动作同样正确。[[模仿学习]]的经典文献早就指出这一问题,但将其与 LLM 的 SFT 联系起来仍是重要的新贡献。
推理模式的双刃剑效应。推理模式在提升可解释性的同时,可能带来行为收敛的风险。当模型被要求"思考"再行动时,它更容易锁定在一个看似最优的推理路径上,从而排除其他等优选项。这提示我们在设计决策系统时,不能简单假设"想得更仔细必然做得更全面"。特别是在需要保持探索性的任务中,推理模式的使用需要更审慎的考量。
开放问题。论文的实验环境虽然可控,但毕竟是完全可观测的确定性游戏。真实世界的决策场景往往涉及部分观测、随机转换或多智能体交互,在这些情况下多样性的定义和度量会更加复杂。此外,动作增强虽然有效,但其计算成本随最优动作数量线性增长,如何在更大规模的动作空间中高效实现仍是挑战。
实践启示。对于希望在决策任务中使用 LLM 的研究者而言,这项研究提供了几点可操作的建议。首先,在设计[[行为多样性]]的评估协议时,应超越单一的正确率指标,关注动作分布的熵或方差。其次,如果任务对探索性有要求,考虑在 SFT 阶段引入动作增强或类似的[[正则化]]技术。最后,对于需要推理模式的场景,应注意其对行为多样性的潜在抑制作用,可能需要在推理深度和行动多样性之间寻找平衡。
摘要
大模型在确定性棋盘游戏中行为多样性与智能游戏系统研究
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
FootsiesGym:一种面向双人零和不完美信息博弈的格斗游戏基准
FootsiesGym: A Fighting Game Benchmark for Two-Player Zero-Sum Imperfect-Information Games
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 2 张
格斗游戏的中立博弈(neutral play)天然具有循环、非传递的不完美信息策略交互特性,但缺乏轻量、可复现的基准环境。本文基于简约2D格斗游戏Footsies构建开源强化学习环境FootsiesGym,提供矢量化仿真器支持高吞吐量训练。研究者评测了多种强化学习算法,并探讨了由此启发的开放研究方向,为不完美信息博弈策略学习提供了可控的分析平台。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
[[博弈论]]与[[强化学习]]的交汇处,一个核心问题始终悬而未决:如何在不完全信息下训练出既强大又富有策略多样性的智能体?扑克类游戏(如 [[Leduc Poker]])提供了可控的理论分析环境,但状态空间过于简单;而《星际争霸》《Dota 2》等商业大作虽然足够复杂,却因训练成本高昂而难以广泛复现。格斗游戏本可以填补这一空白——其"中立博弈"阶段天然呈现循环非传递的策略结构,玩家必须在攻击、防御、位移之间做出混合决策,不存在任何全局占优的纯策略。
然而,现有的格斗 AI 平台大多依赖商业游戏或闭源引擎,存在授权不清、复现困难的共性障碍。FightingICE、DIAMBRA Arena 等框架虽然功能丰富,却将研究者置于高昂的工程门槛之前。更重要的是,这些平台往往追求对真实格斗游戏的完整还原,而完整往往意味着复杂——过多的机制设计会掩盖核心的博弈论问题本身。
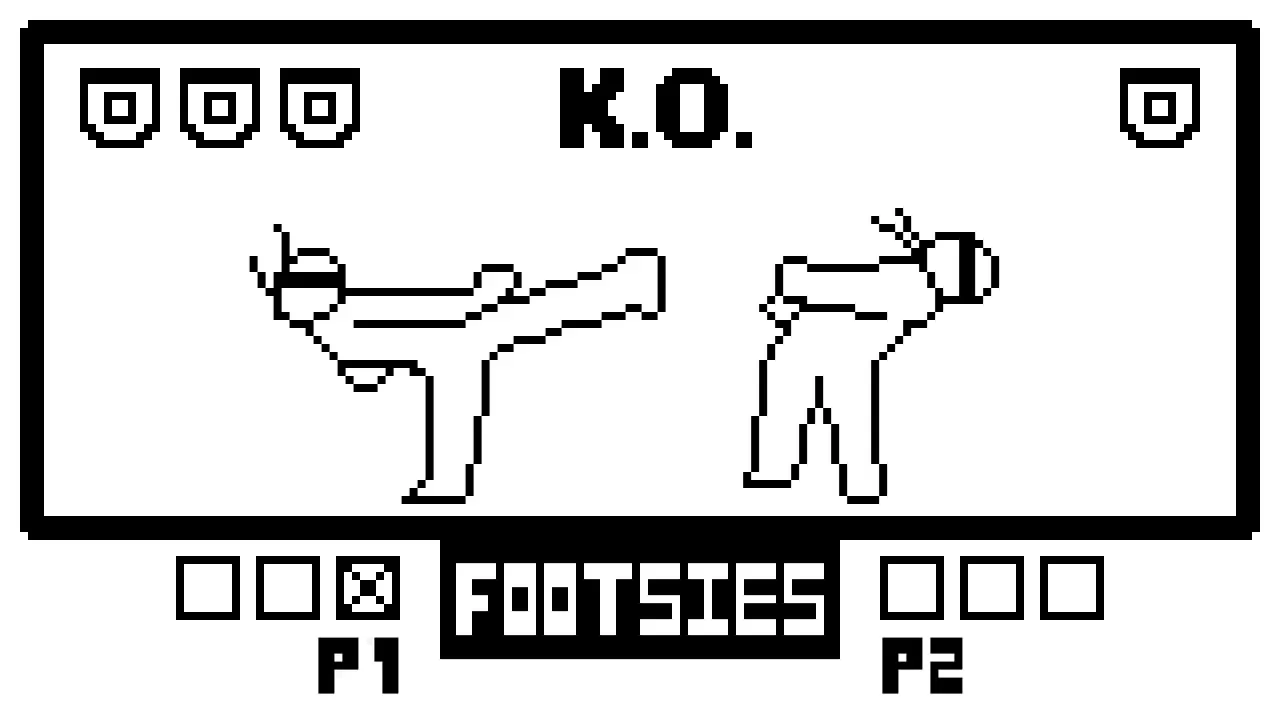
FootsiesGym 的切入角度恰好回答了这一矛盾。HiFight 于 2018 年开源的 Footsies 是一款刻意做减法的格斗游戏:没有血条,没有连招,被特殊攻击命中即判定失败。游戏机制被极度精简,策略空间却完整保留了中立博弈的核心特征——循环、非传递、不可约简的不完美信息。作者在此基础上构建标准化的强化学习接口,将这个"最简格斗游戏"转变为一个可复现、可扩展的基准环境。
方法
FootsiesGym 的核心设计哲学可以概括为"极简但不失本质"。游戏层面保留了四项关键机制:胜负通过一次命中判定,消除血条设计带来的血量管理复杂度;格挡设置了三层上限(guard bar),超过后强制破防,形成攻击与防御的资源博弈;冲刺通过连续两次方向键实现,为位移提供离散化控制;特殊攻击需要持续按住攻击键约 60 帧后释放,创造了"蓄力"这一时间维度的策略选择。
动作空间被设计为默认 6 个离散动作的集合:NONE、BACK、FORWARD、ATTACK、BACK+ATTACK、FORWARD+ATTACK。当启用特殊充能选项时,动作空间扩展为 9 维,新增的三个 charge 动作用于简化特殊攻击的探索难度。观测空间为 85 维特征向量,包含玩家间距这一公共信息、位置速度等共享状态,以及仅自身可见的冲刺可用性、特殊攻击充能进度等特权特征——这种不对称的观测设计模拟了真实对局中"我知我见,你见我未见"的信息格局。
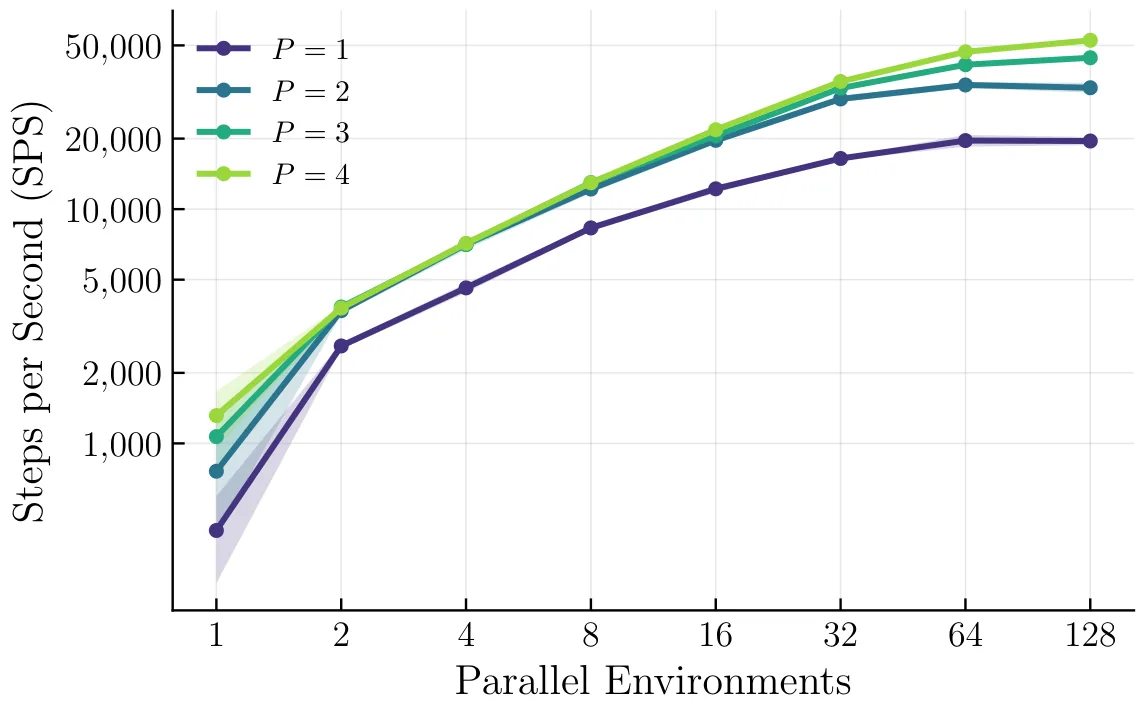
奖励函数采用零和形式 ,终局胜负奖励设定为 ,超时则双方均得零分。作者还提供了可选的密集奖励作为辅助信号。在技术实现上,游戏原本运行于 Unity/C# 引擎,作者通过解耦渲染循环、无头模式运行的方式将游戏逻辑独立出来。矢量化仿真器允许单个进程并行步进 个独立游戏实例,通过 gRPC 端口对外暴露 Python API,完全兼容 [[PettingZoo]] 的多智能体环境标准。
一个特别值得关注的机制是动作延迟(Action Delay)。在真实的格斗游戏中,从玩家输入指令到角色实际执行动作之间必然存在延迟。作者将这一机制参数化,使得研究者可以精确控制"反应"与"预测"之间的平衡。当动作延迟为零时,策略可以在帧级别精确响应对手动作;但当延迟增大到一定程度后,攻击变得完全不可反应,此时必须依赖对对手意图的预判。数学上,动作执行帧数可以表示为:
这个设计将动作延迟从游戏系统的被动约束转变为一个可控的实验变量,为研究不完美信息博弈中"预测 vs 反应"的策略权衡提供了天然的操作手段。
实验与结果
作者在 FootsiesGym 上系统评测了四种强化学习算法:标准 PPO、带熵系数线性退火的 PPO (Sched.)、EMAgnet(一种基于参数空间指数移动平均的正则化方法)以及 PFSP(优先虚拟自博弈,对手按当前策略弱点加权采样)。所有算法使用统一的网络架构(256 隐单元的两层 MLP)和相同的训练预算( 环境步),仅在各自特有的超参数上做朴素设置。
实验揭示了几个值得深思的发现。首先是对启发式对手的胜率表现:所有算法都能将对随机对手的胜率提升至 85–95%,但面对 no-op(什么都不做)对手时胜率反而较低。这一反直觉的结果表明,训练所得的策略存在"过度反应化"倾向——它们学会了精准反击随机动作,却不愿主动出击创造优势。
其次是近似可利用度分析。作者对每个最终策略训练最佳响应作为 exploitability 的下界估计。结果显示,所有算法的策略都存在显著的可利用空间,其中 PFSP 在与最佳响应直接对抗时胜率最高、平局率也最高;而 EMAgnet 尽管在头部对战中回报为正,却是最容易被最佳响应利用的算法。这一发现对 EMA 正则化方法在不完美信息博弈中的效果提出了质疑。
最具洞察力的发现或许是特殊攻击难以发现这一现象。在标准配置下,B_SPECIAL(需要连续按住攻击键 15 帧后释放的强力招式)在训练过程中几乎从未被有效使用,仅 PPO 在极短时间内短暂发现后很快丢失。强化学习算法倾向于维护高熵以保持探索,但高熵同时也意味着低概率策略会被逐渐挤出策略空间——即使这些策略可能具有重要的博弈论价值。这个问题呼应了"Winning is not everything"的研究关切:追求胜率的算法优化是否会牺牲策略的丰富性和观赏性?
动作延迟的消融实验进一步验证了其作为实验工具的价值。delay=0 时策略对随机对手表现出色,但对 no-op 完全失效——因为它们变成了纯粹的条件反射;delay=12 时对随机胜率下降,但对 no-op 接近 100%——因为此时攻击变得不可反应,策略被迫发展出主动创造机会的能力。启用特殊充能动作扩展后,B_SPECIAL 的使用率显著上升,验证了这是一种有效的工程性补救手段。
在资源消耗方面,FootsiesGym 展现出极高的效率。单进程峰值吞吐量约为 19,000 步/秒,当并行 4 个服务器进程、各自步进 128 个游戏实例时,聚合吞吐量达到约 52,500 步/秒。这一数字意味着在标准 24 核 CPU 工作站上,每天可以完成数十亿步的环境交互,完全满足学术研究的算力需求。
讨论与可借鉴点
FootsiesGym 的贡献不仅在于提供了一个基准环境,更在于它揭示了当前强化学习方法在处理非传递循环博弈时面临的深层挑战。特殊攻击难以发现这一现象暗示着,标准强化学习的目标函数(期望累积回报最大化)与博弈论所追求的策略多样性之间存在张力。算法会自然地收敛到"够用"的策略子集,而那些需要长期规划或跨模态探索才能发现的高价值策略,往往在早期就被遗忘。这一问题值得在[[多智能体强化学习]]的框架下进一步系统研究。
从工程角度看,该工作展示了"极简设计"的威力。FootsiesGym 的成功不在于功能的堆砌,而在于对问题本质的精准提取:将中立博弈的策略循环从格斗游戏的其他复杂机制中隔离出来。这种思路对于基准环境设计具有普遍参考价值——与其追求与真实系统的像素级还原,不如先在理论上可分析的简化环境中建立理解。
当然,这项工作也存在局限性。作者明确承认所有基线仅为朴素调参,跨算法比较的公平性有待商榷;近似可利用度仅提供下界,无法对纳什收敛性做严格判定;环境本身虽然有效简化了格斗游戏,但与真实商业格斗游戏在角色多样性、连招系统等方面仍有差距。此外,缺乏人类玩家的对照实验也是一个遗憾——环境提到了 WebGL 导出的可能性,但论文中并未实际执行人类研究或模仿学习。
展望未来,FootsiesGym 为多个方向提供了可控的实验床。探索机制的改进首当其冲:如何让强化学习算法发现并保持低概率但有价值的策略?动作延迟机制作为一个自然的实验变量,值得系统研究其对策略收敛性的影响。[[自我博弈]]方法的改进也是重要方向,PFSP 展现出对抗最佳响应时的优势,但其对手选择策略仍有优化空间。最后,该环境可以作为博弈论直觉的教学工具——通过可视化策略演化,学生可以直观理解循环支配、纳什均衡等抽象概念如何体现在具体的游戏交互中。
概念 · 7 个
摘要
双人格斗游戏中强化学习算法的基准测试
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
强化学习视角下的《超级马里奥兄弟》:1-1 关的课程设计、教学法与最优关卡设计
Reinforcement Learning in Super Mario Bros: Curriculum, Pedagogy, and Optimal Level Design in World 1-1
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 7 张
超级马力欧兄弟1-1关被公认为游戏设计的经典,其渐进式关卡结构被认为能在游玩中自然教会玩家核心机制。本研究从零构建离散化1-1关环境,对比Q-Learning、SARSA、蒙特卡洛和DQN四种算法,并通过12种课程排列实验检验教学结构。结果显示蒙特卡洛以94.9%胜率显著超越DQN的76.4%,且经典段落排列收敛最快、效率最高且无灾难性失败,首次实证验证该关卡设计蕴含不可复制的教学价值。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
《超级马里奥兄弟》的1-1关几乎是所有游戏设计教科书都会引用的经典案例。这条看似平平无奇的第一关据说是宫本茂专门为新玩家打造的“入门教程”:它从最简单的右移开始,逐步引入跳跃、踩敌人、顶砖块等机制,行云流水地让玩家在通关的过程中自然掌握游戏的核心操作。这种“通过关卡本身传授机制”的设计理念听起来很美,但它究竟是真实存在的设计智慧,还是后人根据结果倒推出来的“事后诸葛亮”?
这个问题之所以值得认真研究,是因为它触及了[[课程学习]](Curriculum Learning)领域的核心议题:如果一个游戏关卡的片段排列顺序真的能够系统性地影响学习效果,那么这种可量化的教学结构就可以被提炼成设计原则,迁移到教育软件、智能辅导系统乃至[[强化学习]]智能体的训练流程中。反过来说,如果经典顺序只是众多可行排列中的一种偶然优秀排列,那游戏设计史上关于1-1关的传奇就只能停留在叙事层面。
论文试图用实证方法回答两个具体问题:第一,在1-1关的三个复杂度递增版本上,哪种强化学习算法学得最好、为什么;第二,把关卡切成六个经典片段后,这些片段的顺序是否会影响智能体的学习效果——换言之,经典排序是否真的比随机排列更“教学友好”。
方法
研究者的第一个关键决策是从零实现环境而非使用现成的游戏模拟器。这个选择有其深意:完全离散化能确保实验的纯净性,避免第三方库的工程噪声干扰对学习算法的理解。
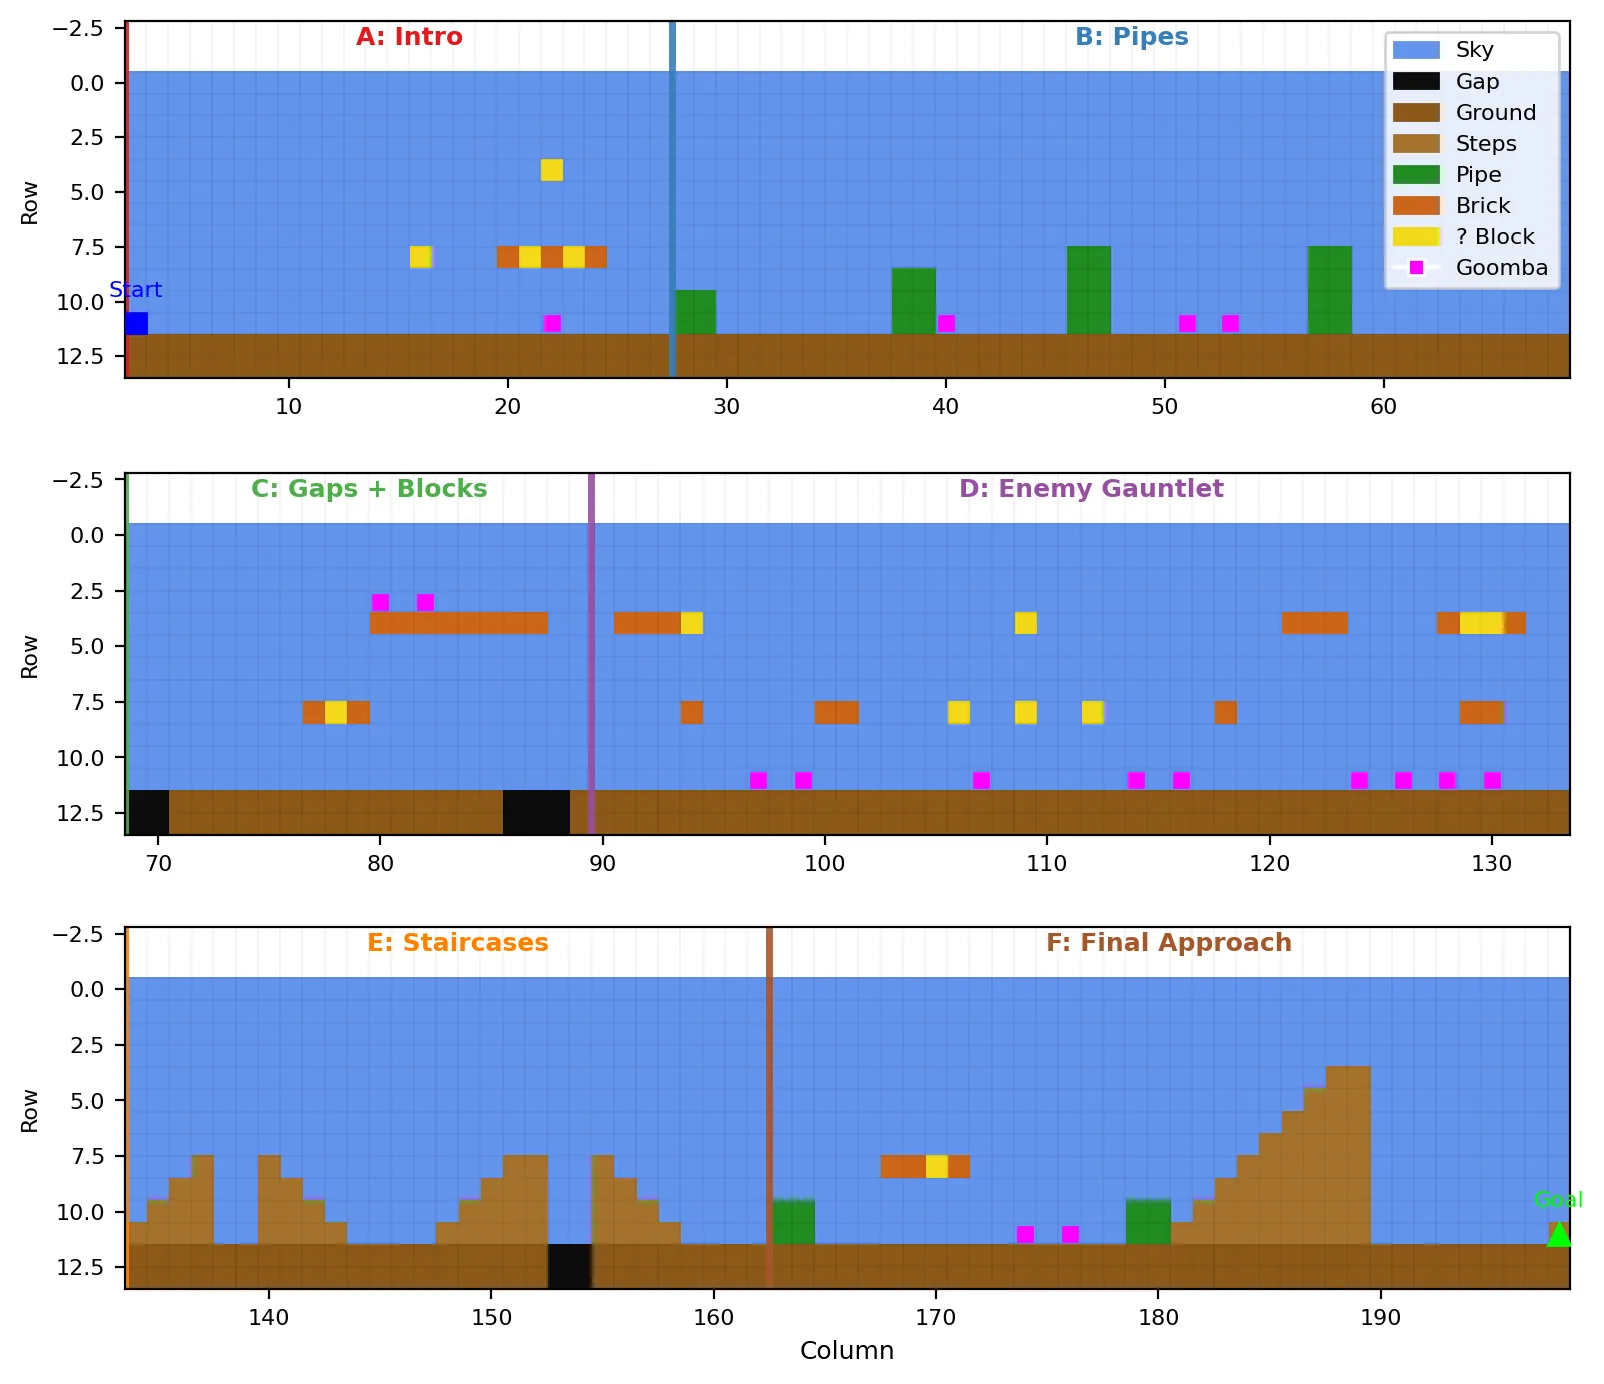
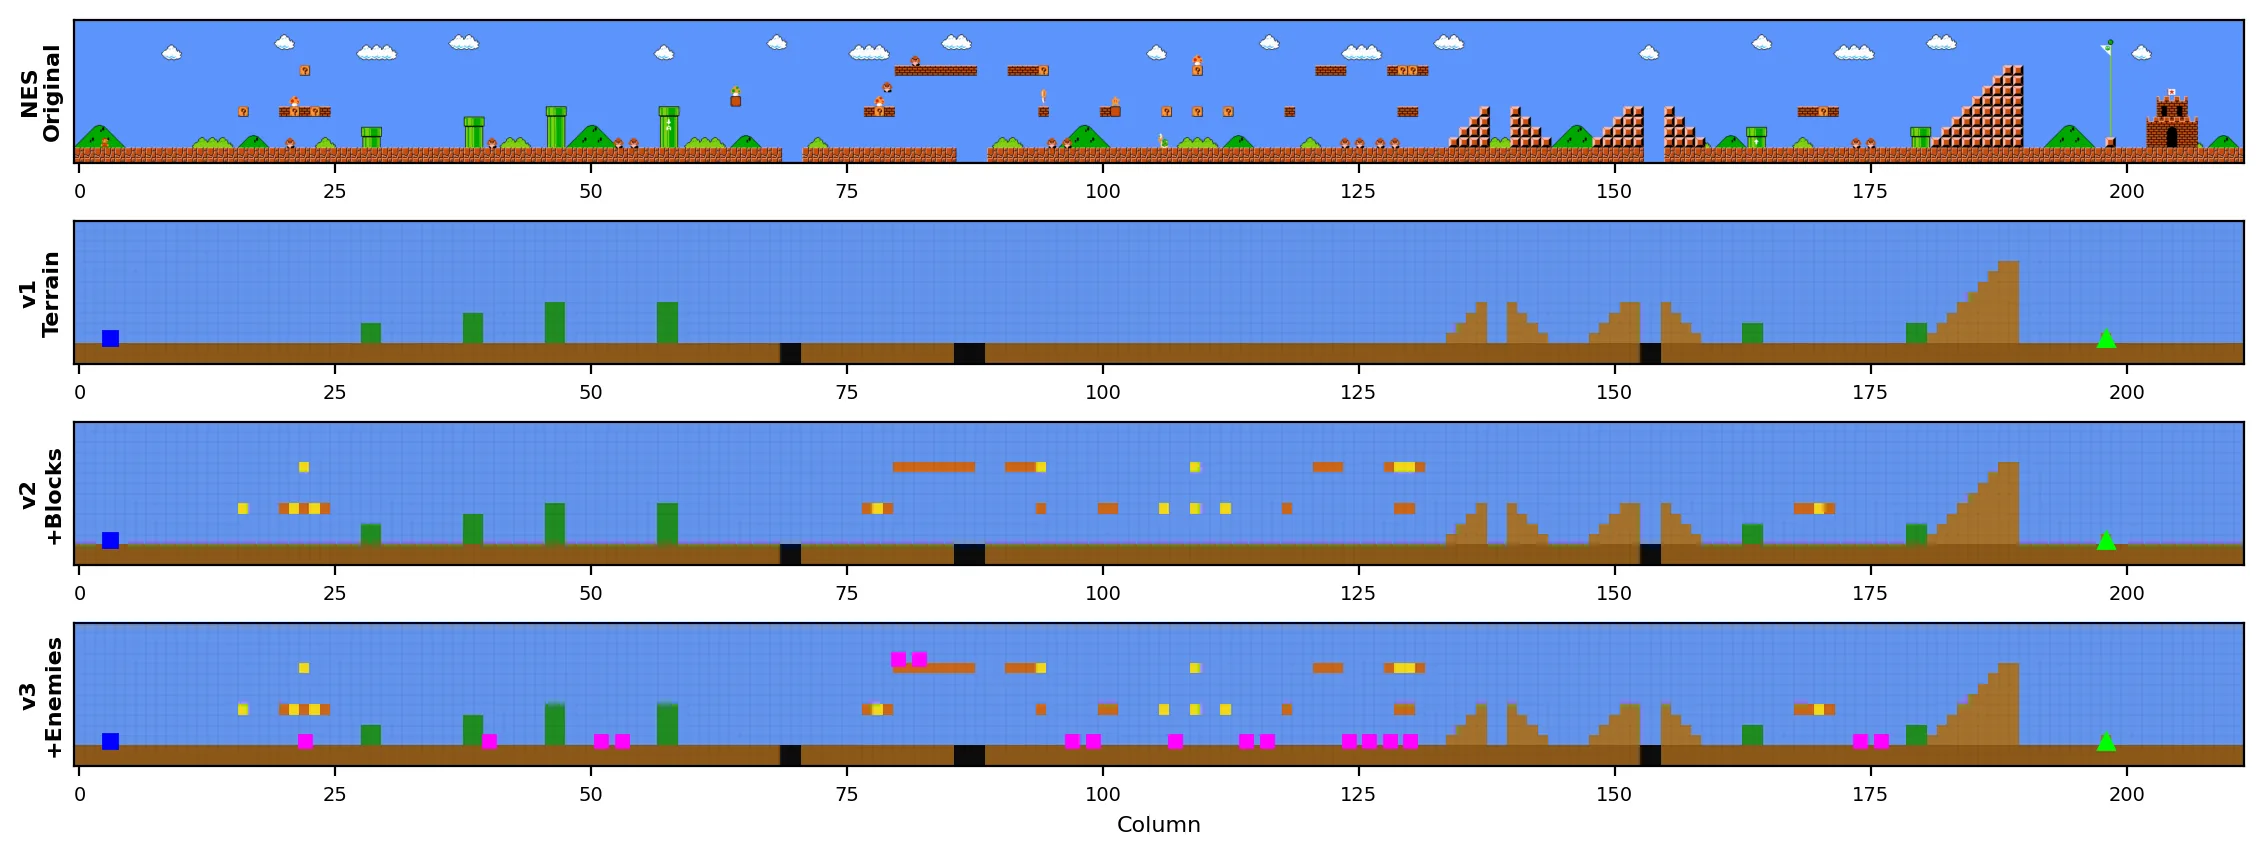
环境建模从212列×14行的瓦片网格出发,忠实再现了NES原版的几何布局。他们构建了三个复杂度递增的版本:v1版本只包含地形、管道和终点旗杆,没有任何可交互对象;v2版本在精确位置加入了可破坏砖块和问号块;v3版本则加入了17个敌人——16个蘑菇头加1个乌龟,敌人具有NES准确的速度值、真实的重力效果和踩踏击杀机制。
状态空间的维度随着复杂度上升而扩展。v1只需要一个三元组就能完整描述;v2引入了56维的视口向量来记录视野范围内的砖块和问号分布;v3进一步将敌人信息纳入视口,总状态维度达到115。动作空间被刻意精简为三个离散选项——站立、向右移动和跳跃,其中跳跃被建模为固定六帧的弧线轨迹。这个简化使得研究者能够把注意力集中在比较不同[[强化学习]]算法的能力差异上。
奖励函数的设计体现了对“方向性引导”的考量。智能体右移一步获得+0.5的奖励,站立不动则获得-0.1的惩罚,抵达旗杆获得+100的终局奖励,死亡扣除-50。额外的奖励项——击碎砖块+1、顶问号块+3、踩死敌人+5——在v2和v3版本中被激活。这个奖励结构经过精心标定,使得完整通关的累积方向奖励(大约49.5分)与胜利奖励(100分)保持合理的权重关系。
在算法选择上,研究者纳入了四种具有代表性的方法。[[Q-Learning]]作为off-policy时序差分方法的代表,采用计算目标值;[[SARSA]]作为on-policy时序差分方法的代表,采用计算目标值;[[蒙特卡洛方法]]采用first-visit采样均值估计,以完整回合的累积折扣回报作为更新目标;[[DQN]]使用双网络架构和经验回放缓冲来处理高维状态空间。所有算法共享衰减策略(初始值1.0,乘性衰减0.999)和的折扣因子。
课程实验的设计尤为精巧。研究者将v3关卡划分为六个段落(A到F),对应原版1-1关的标志性设计元素:开场的平坦地形、第一组沟壑与管道、问号块密集区、蘑菇头连绵的挑战段落、地下管道入口,以及最后的旗杆冲刺。他们设置了12种排列条件进行对比——经典顺序、逆序、以及10种随机排列。评估指标覆盖胜率、曲线下面积(AUC)、收敛速度(达到50%和80%胜率所需的回合数),以及“灾难性失败”率(最终胜率低于10%的种子比例)。
实验与结果
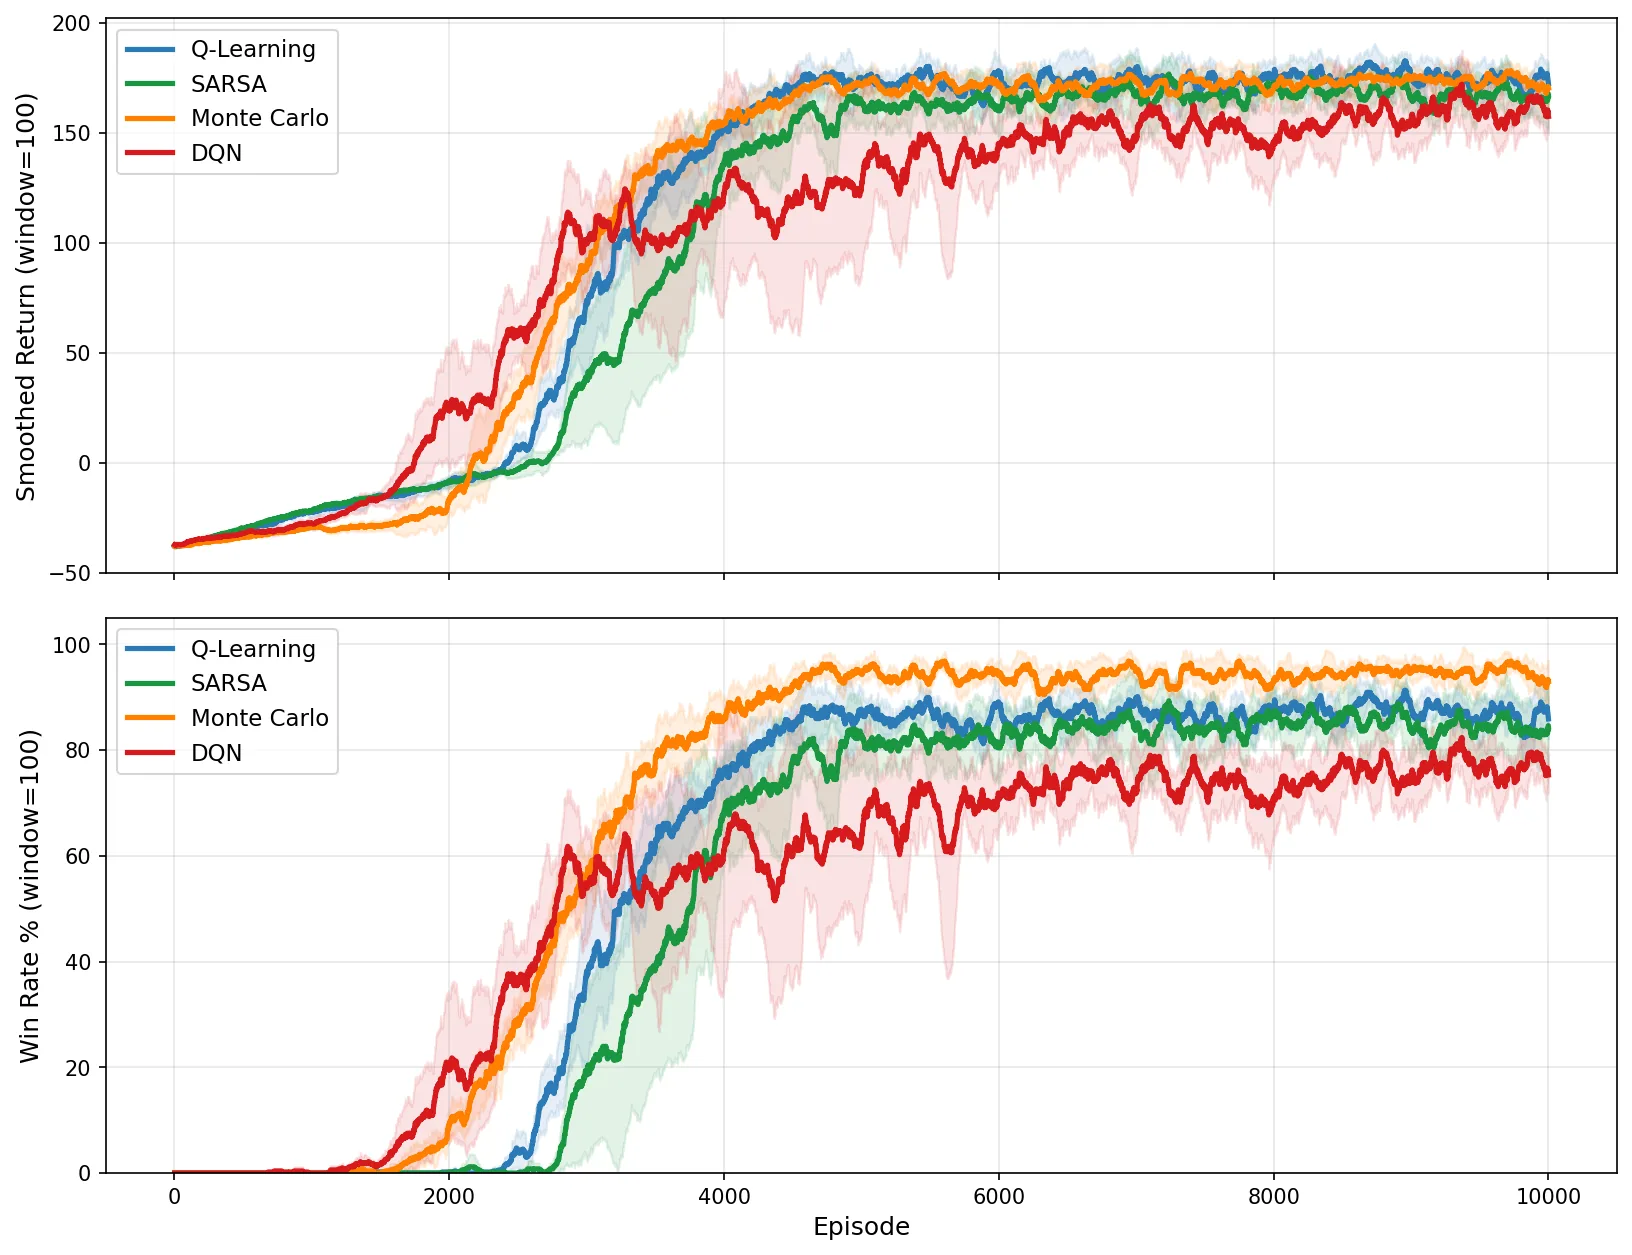
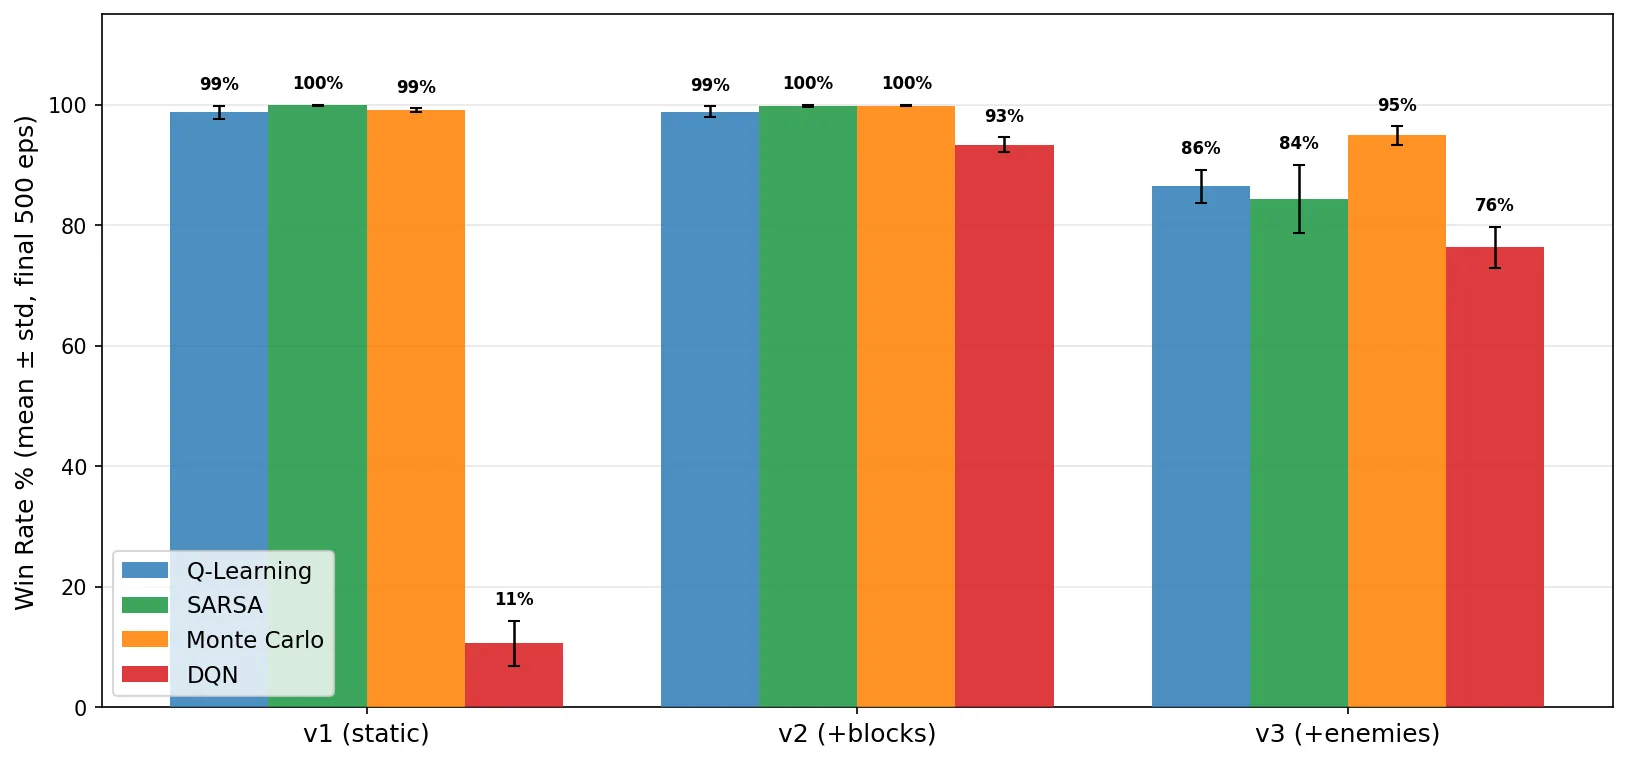
算法对比的结果揭示了一个出人意料的格局。在最简单的v1版本上,所有算法的表现都接近完美,SARSA以100.0%的胜率略微领先。但随着复杂度上升,[[蒙特卡洛方法]]逐渐拉开差距:在v2上达到99.9%的胜率,在v3上仍保持94.9%的惊人表现,而[[DQN]]在v3上暴跌至76.4%。
更深入的分析表明,DQN失败的根本原因在于其经验回放机制——死亡转移的频繁出现污染了回放缓冲,导致智能体学会了“过度保守”的回避策略,v3上每回合仅击杀1.38个敌人。蒙特卡洛方法的胜出则源于其episode-level的更新特性:它能够学会沿着高回报路径(如踩死更多敌人、击碎更多砖块)最大化累积奖励,而不是贪心地选择最短通关路线。
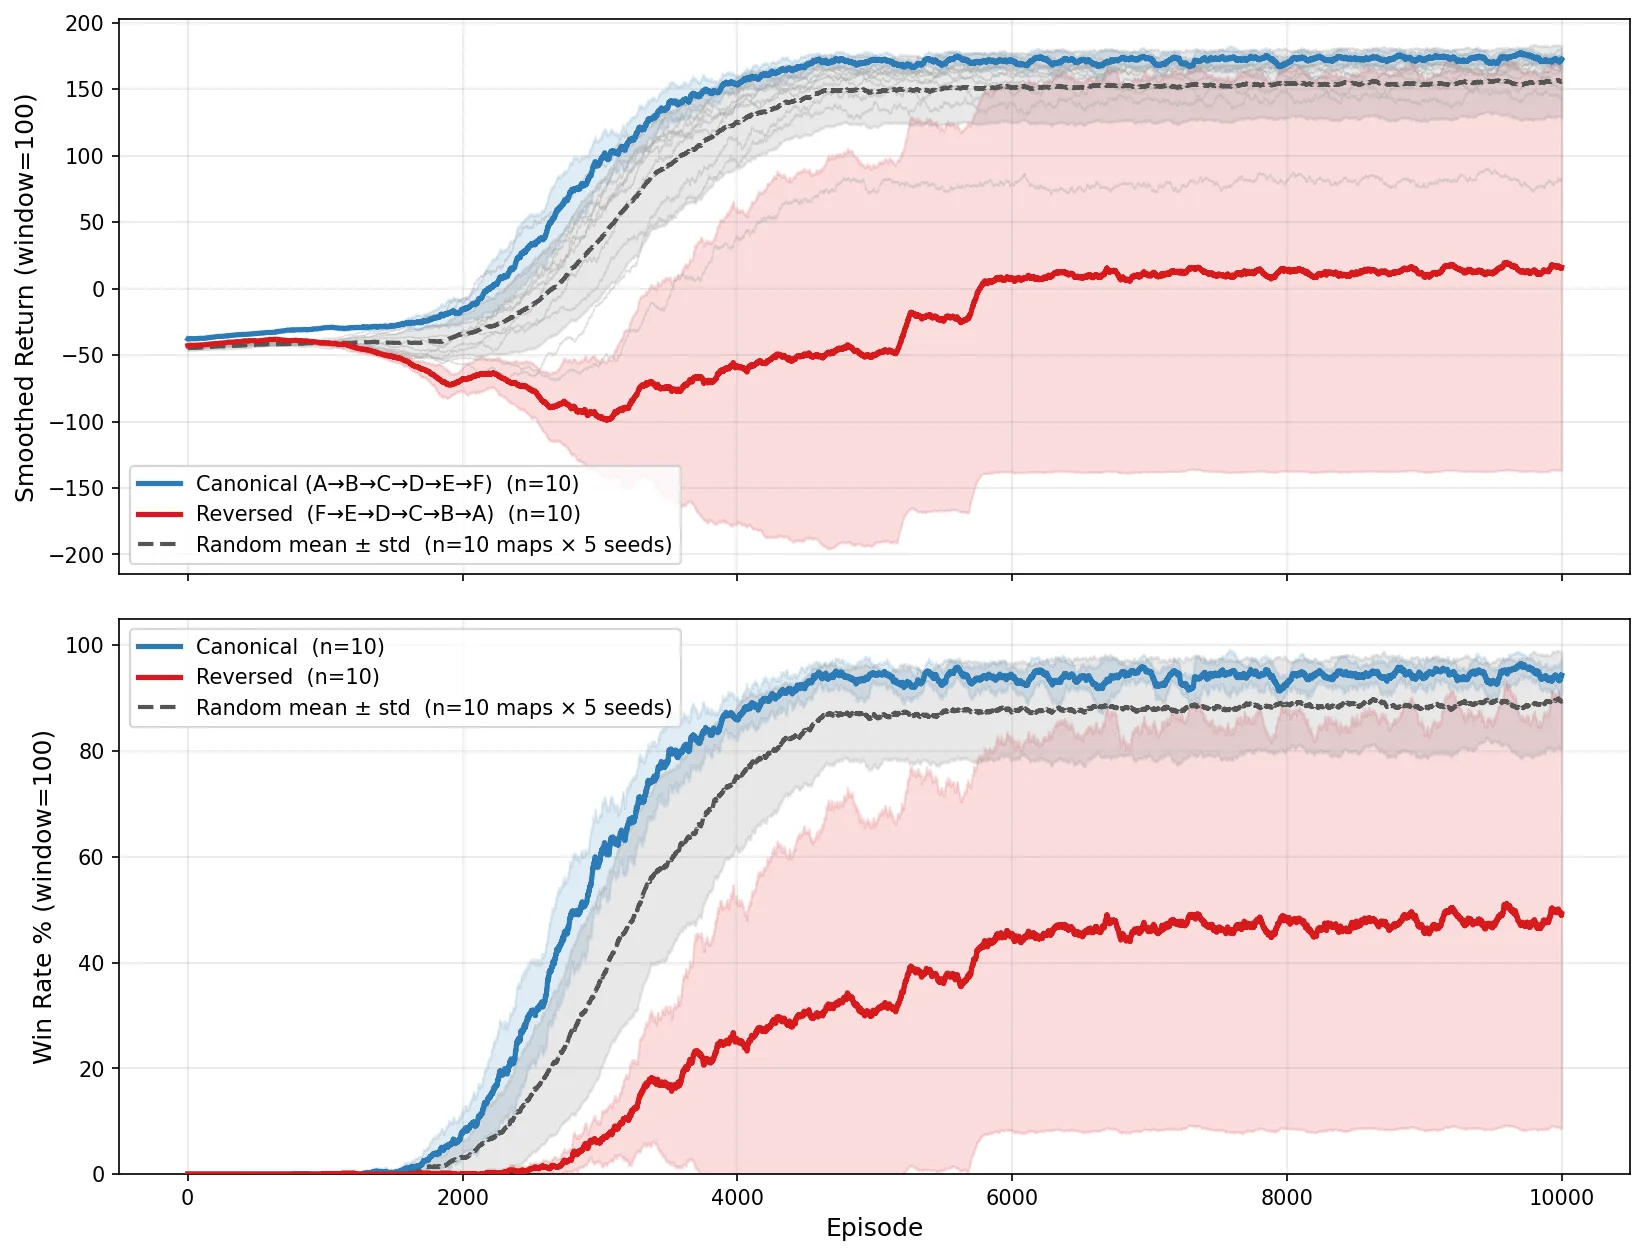
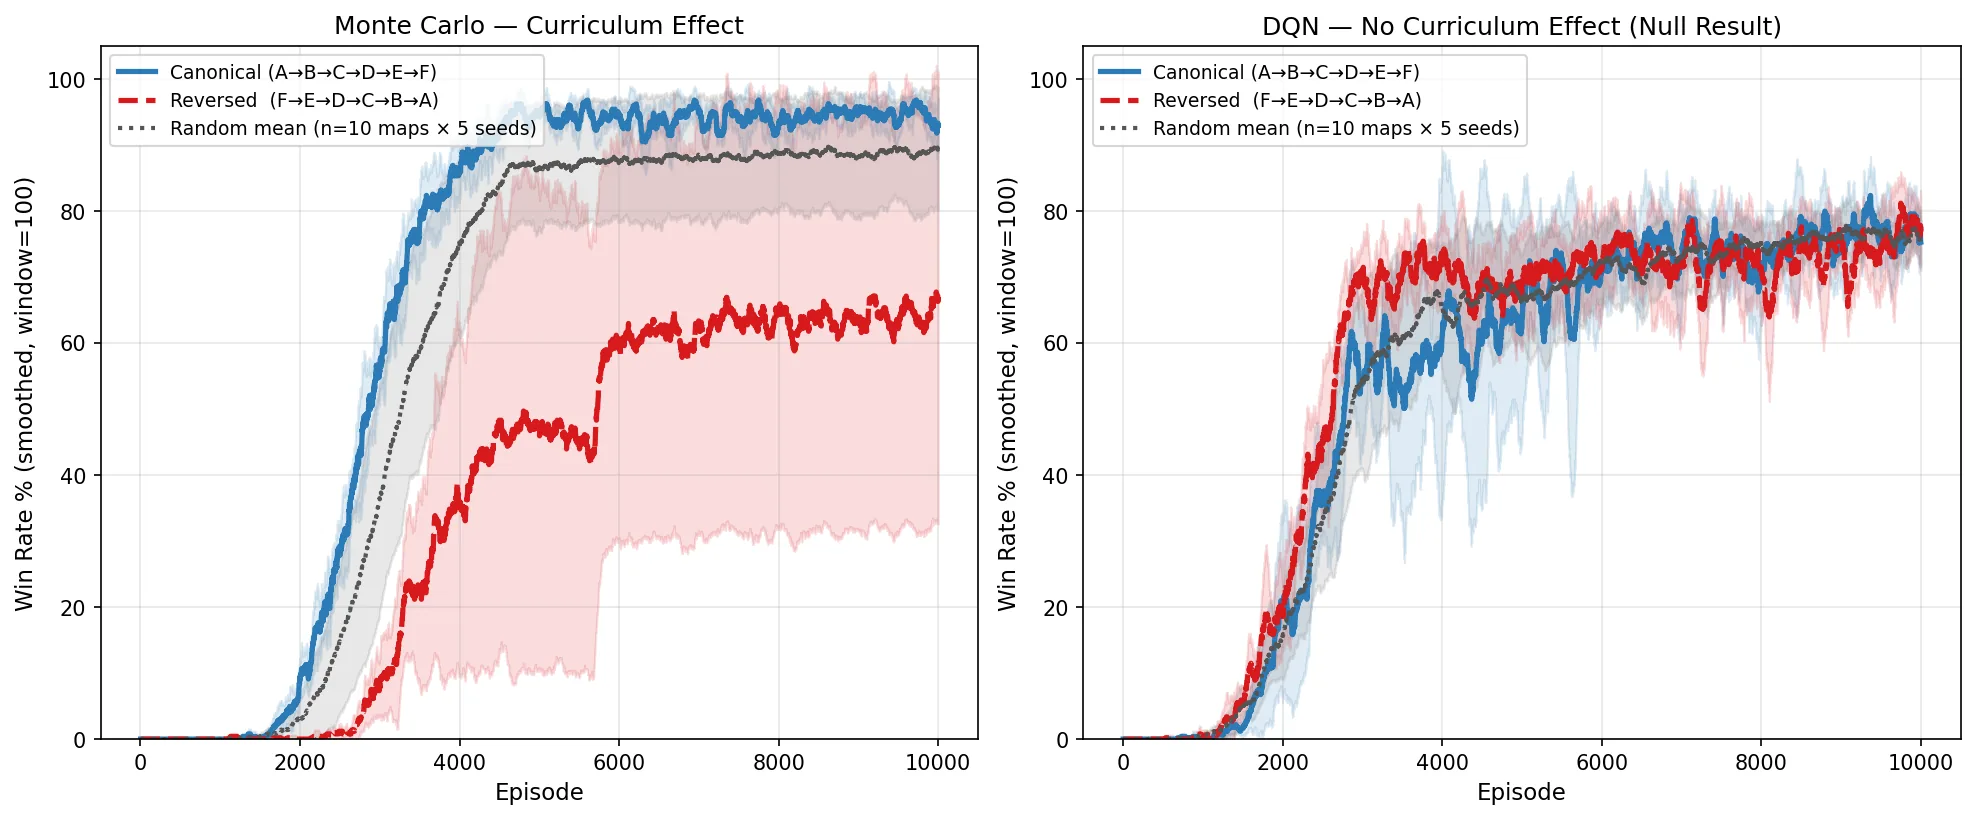
课程实验的结果更具说服力。经典顺序A→B→C→D→E→F在三项关键指标上全面领先:94.7%的最终胜率、67.2%的AUC值,以及零次灾难性失败。逆序排列F→E→D→C→B→A的胜率仅为48.5%,且有40%的训练种子遭遇灾难性失败;10种随机排列的平均胜率虽然达到89.0%,但没有任何一个排列能在三项指标上同时与经典顺序比肩。
这个结果的统计学显著性相当扎实。经典顺序与逆序的胜率差异通过了Welch's t检验(, Cohen's ),收敛速度差异同样显著(, )。研究者进一步用[[DQN]]重复了相同的课程实验,发现其对所有12种排列几乎毫无差异(, ),证实经验回放机制抹除了时间顺序信号——这是对“为何顺序敏感”机制的一次精准定位。
段落D(9只蘑菇头连续出现)是关键转折点。当它被过早放置在课程中时,早期死亡引发的负反馈在蒙特卡洛的episode-level更新下难以恢复,形成灾难性的失败链;而经典顺序将其安排在玩家已熟悉基本操作之后,提供了恰到好处的挑战梯度。
讨论与可借鉴点
这项研究最核心的价值在于方法论:它把一个游戏设计领域的“都市传说”转化为可证伪的经验命题,并通过严格的实验设计给出了肯定的回答。这种“神话祛魅”式的研究路径值得借鉴——无论是游戏设计、教育心理学还是[[课程学习]]领域,任何声称具有“教学结构”的设计都可以被拆解成可测量的变量。
研究对[[强化学习]]实践者也有直接的启发。实验揭示了经验回放机制的一个隐藏代价:它能提升算法鲁棒性,但同时也会抹除训练数据中的时序信息。对于需要捕捉episode-level结构的任务(如需要学习“策略性放弃短期收益以换取长期回报”的场景),纯[[蒙特卡洛方法]]可能比广泛使用的[[DQN]]更合适。这个发现在一定程度上回应了学界对“基于值函数的强化学习是否过于短视”的隐忧。
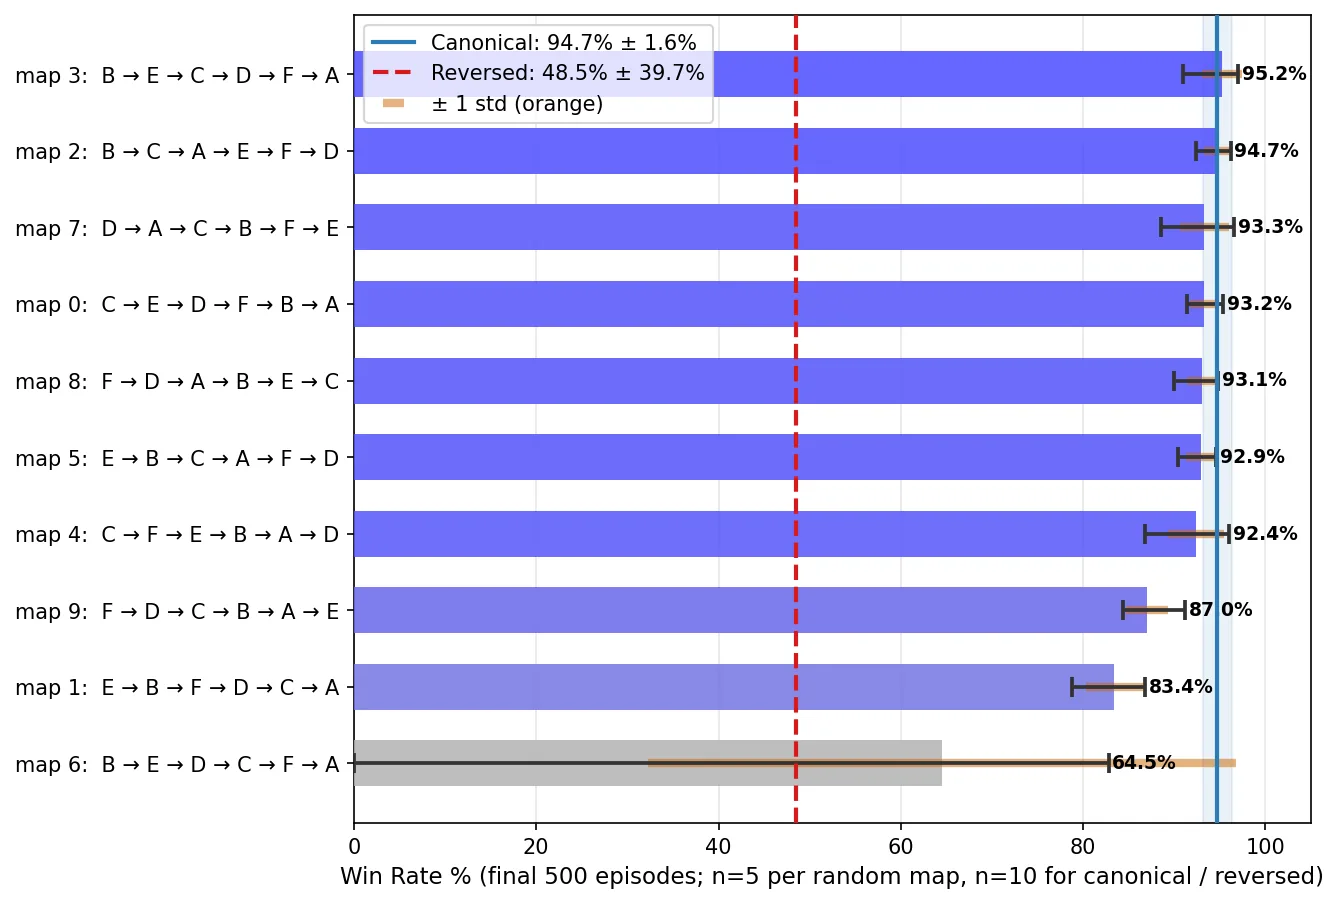
研究的局限性同样值得正视。课程实验仅测试了10种随机排列,最佳随机排列(Map 3,95.2%胜率)与经典顺序在统计上不可区分,这削弱了“经典顺序不可替代”的强结论。更重要的是,研究者承认未在其它马里奥关卡或非马里奥游戏上验证泛化性,结论的外部效度有待检验。此外,DQN的超参数仅在v1上调试,v3上的76.4%胜率可能并非其能力上限。
尽管如此,这项研究填补了一个有趣的空白:它首次用量化证据表明,游戏设计史上流传的1-1关“教学价值”并非事后附会,而是一种可以被[[强化学习]]捕捉、可以被统计检验证伪的真实设计特征。这种对直觉的系统性验证,正是计算认知科学能够为设计领域提供的独特贡献。
概念 · 6 个
摘要
在超级马里奥游戏中比较Q学习、SARSA、蒙特卡洛和DQN算法
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
基于智能体的黑手党游戏中累积嫌疑与吸收动力学
Cumulative suspicion and absorption dynamics in an agent-based Mafia game
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 7 张
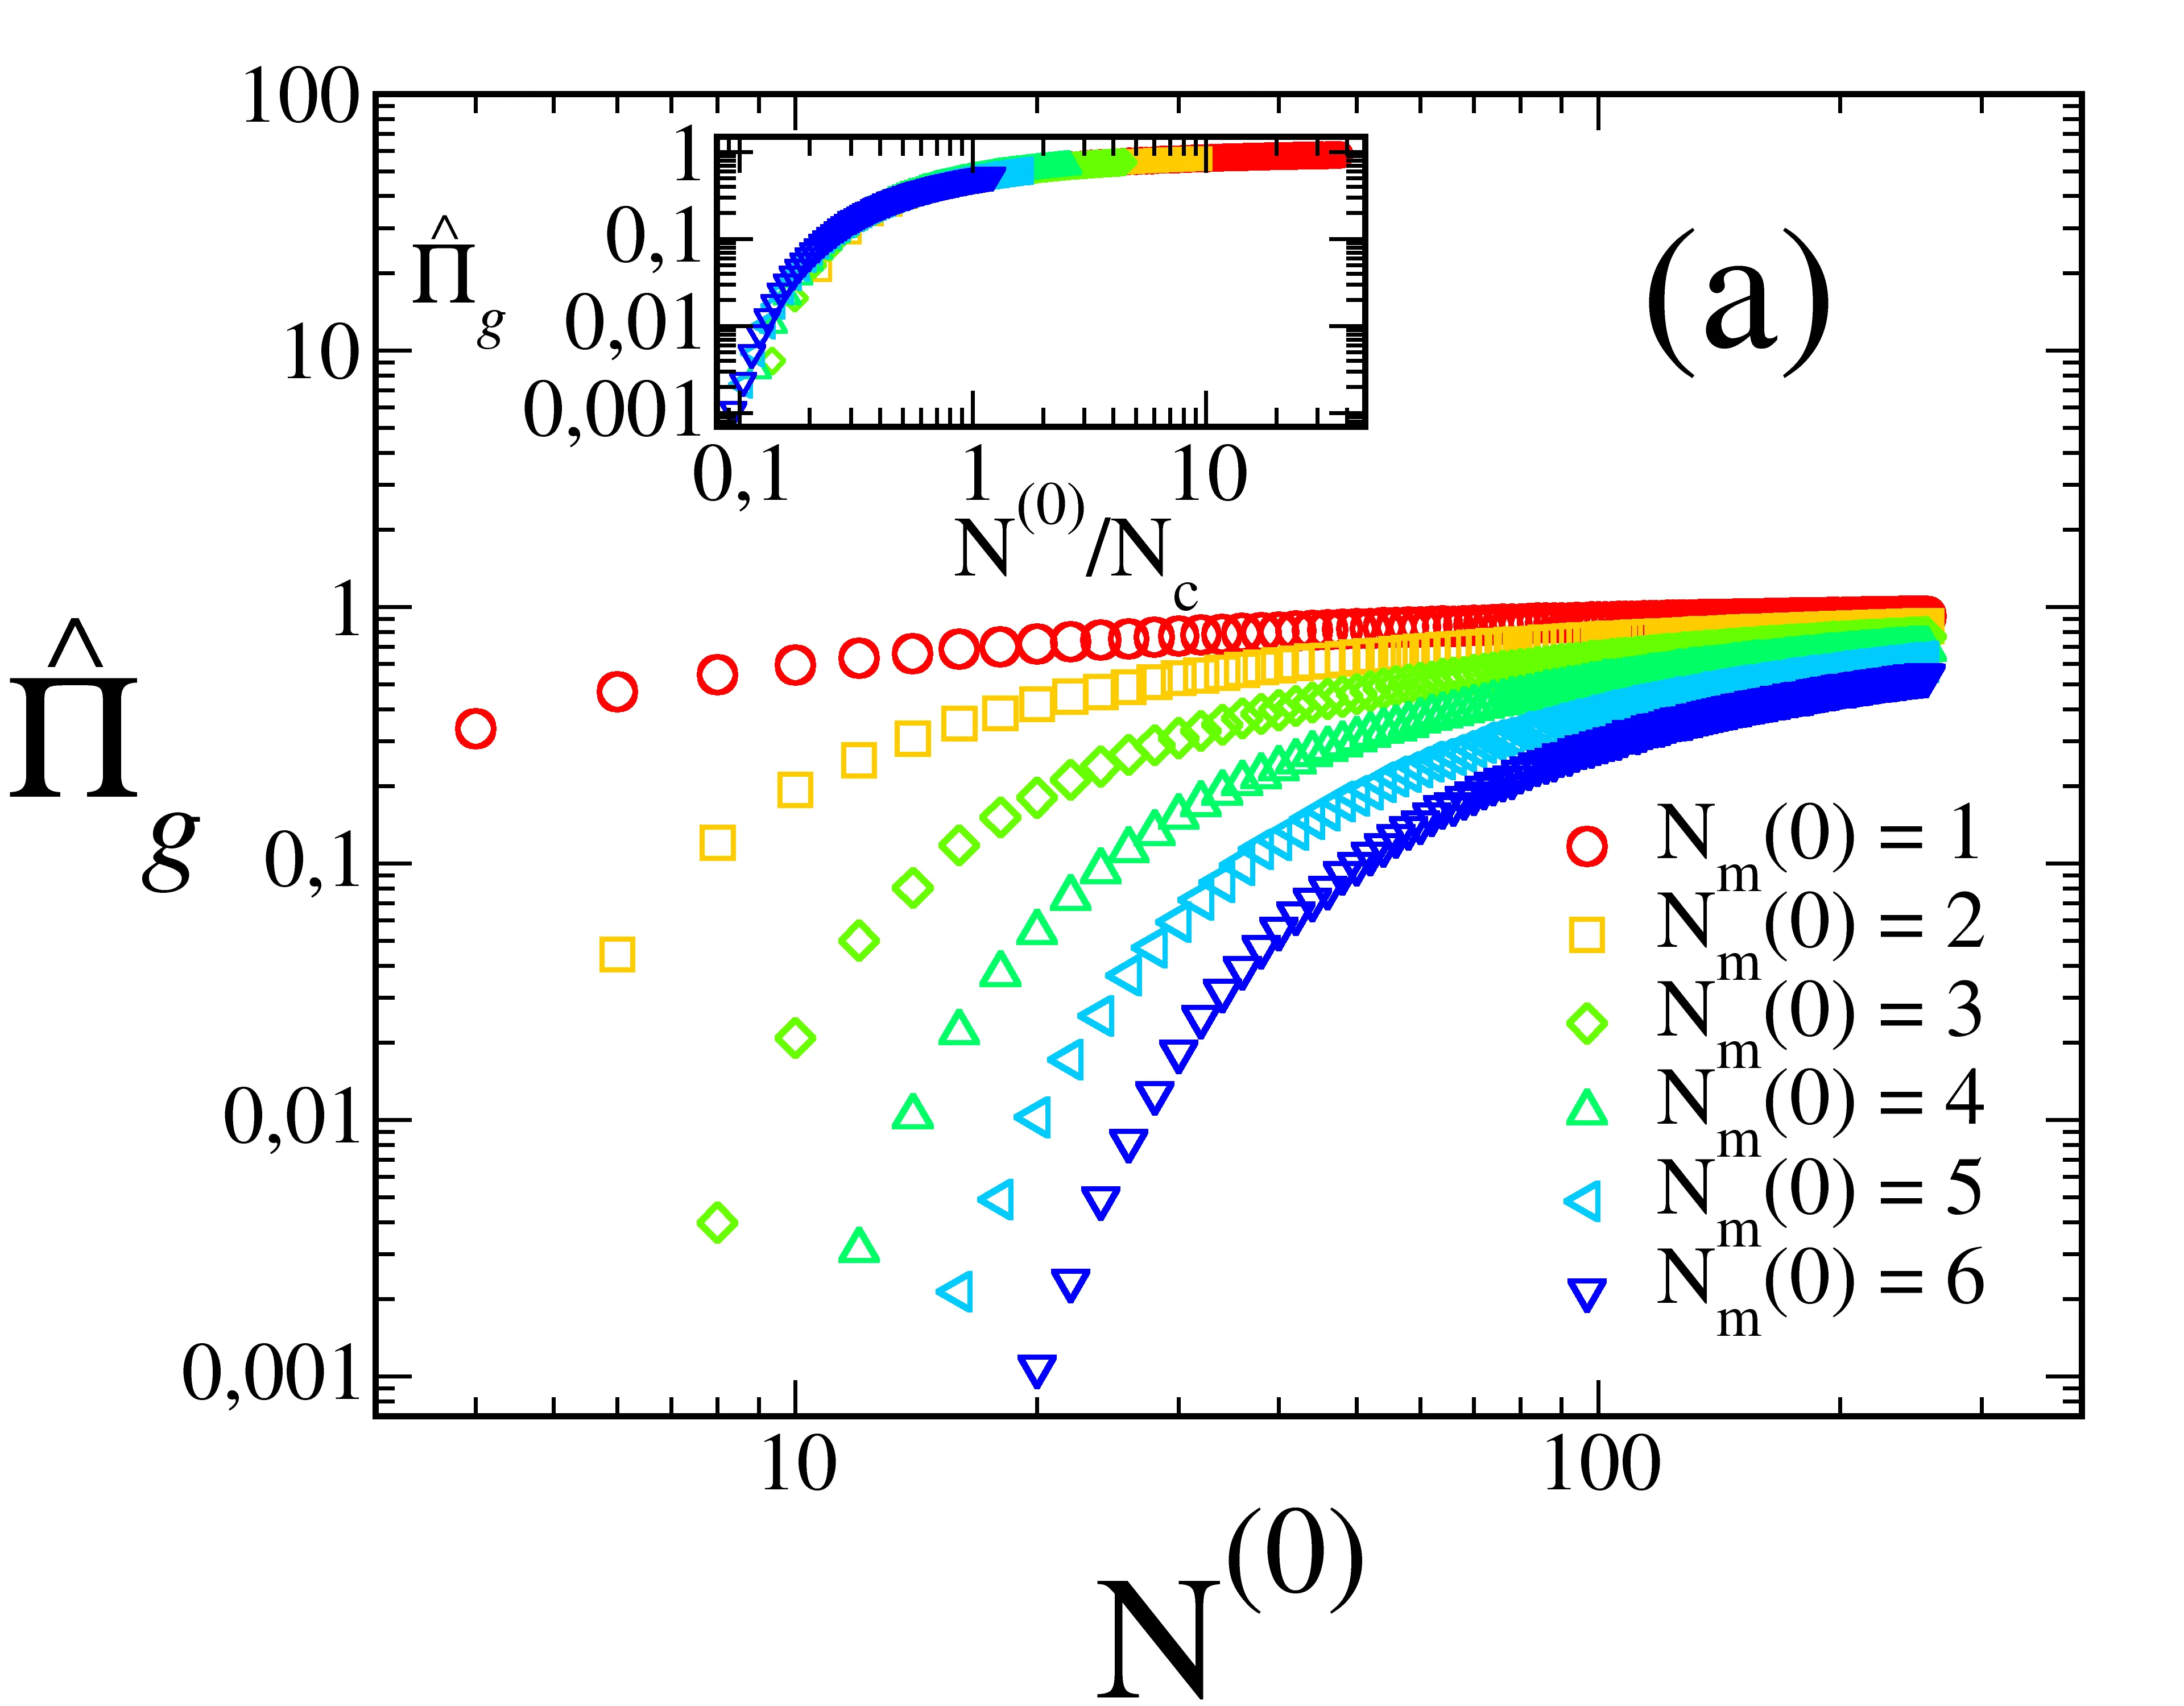
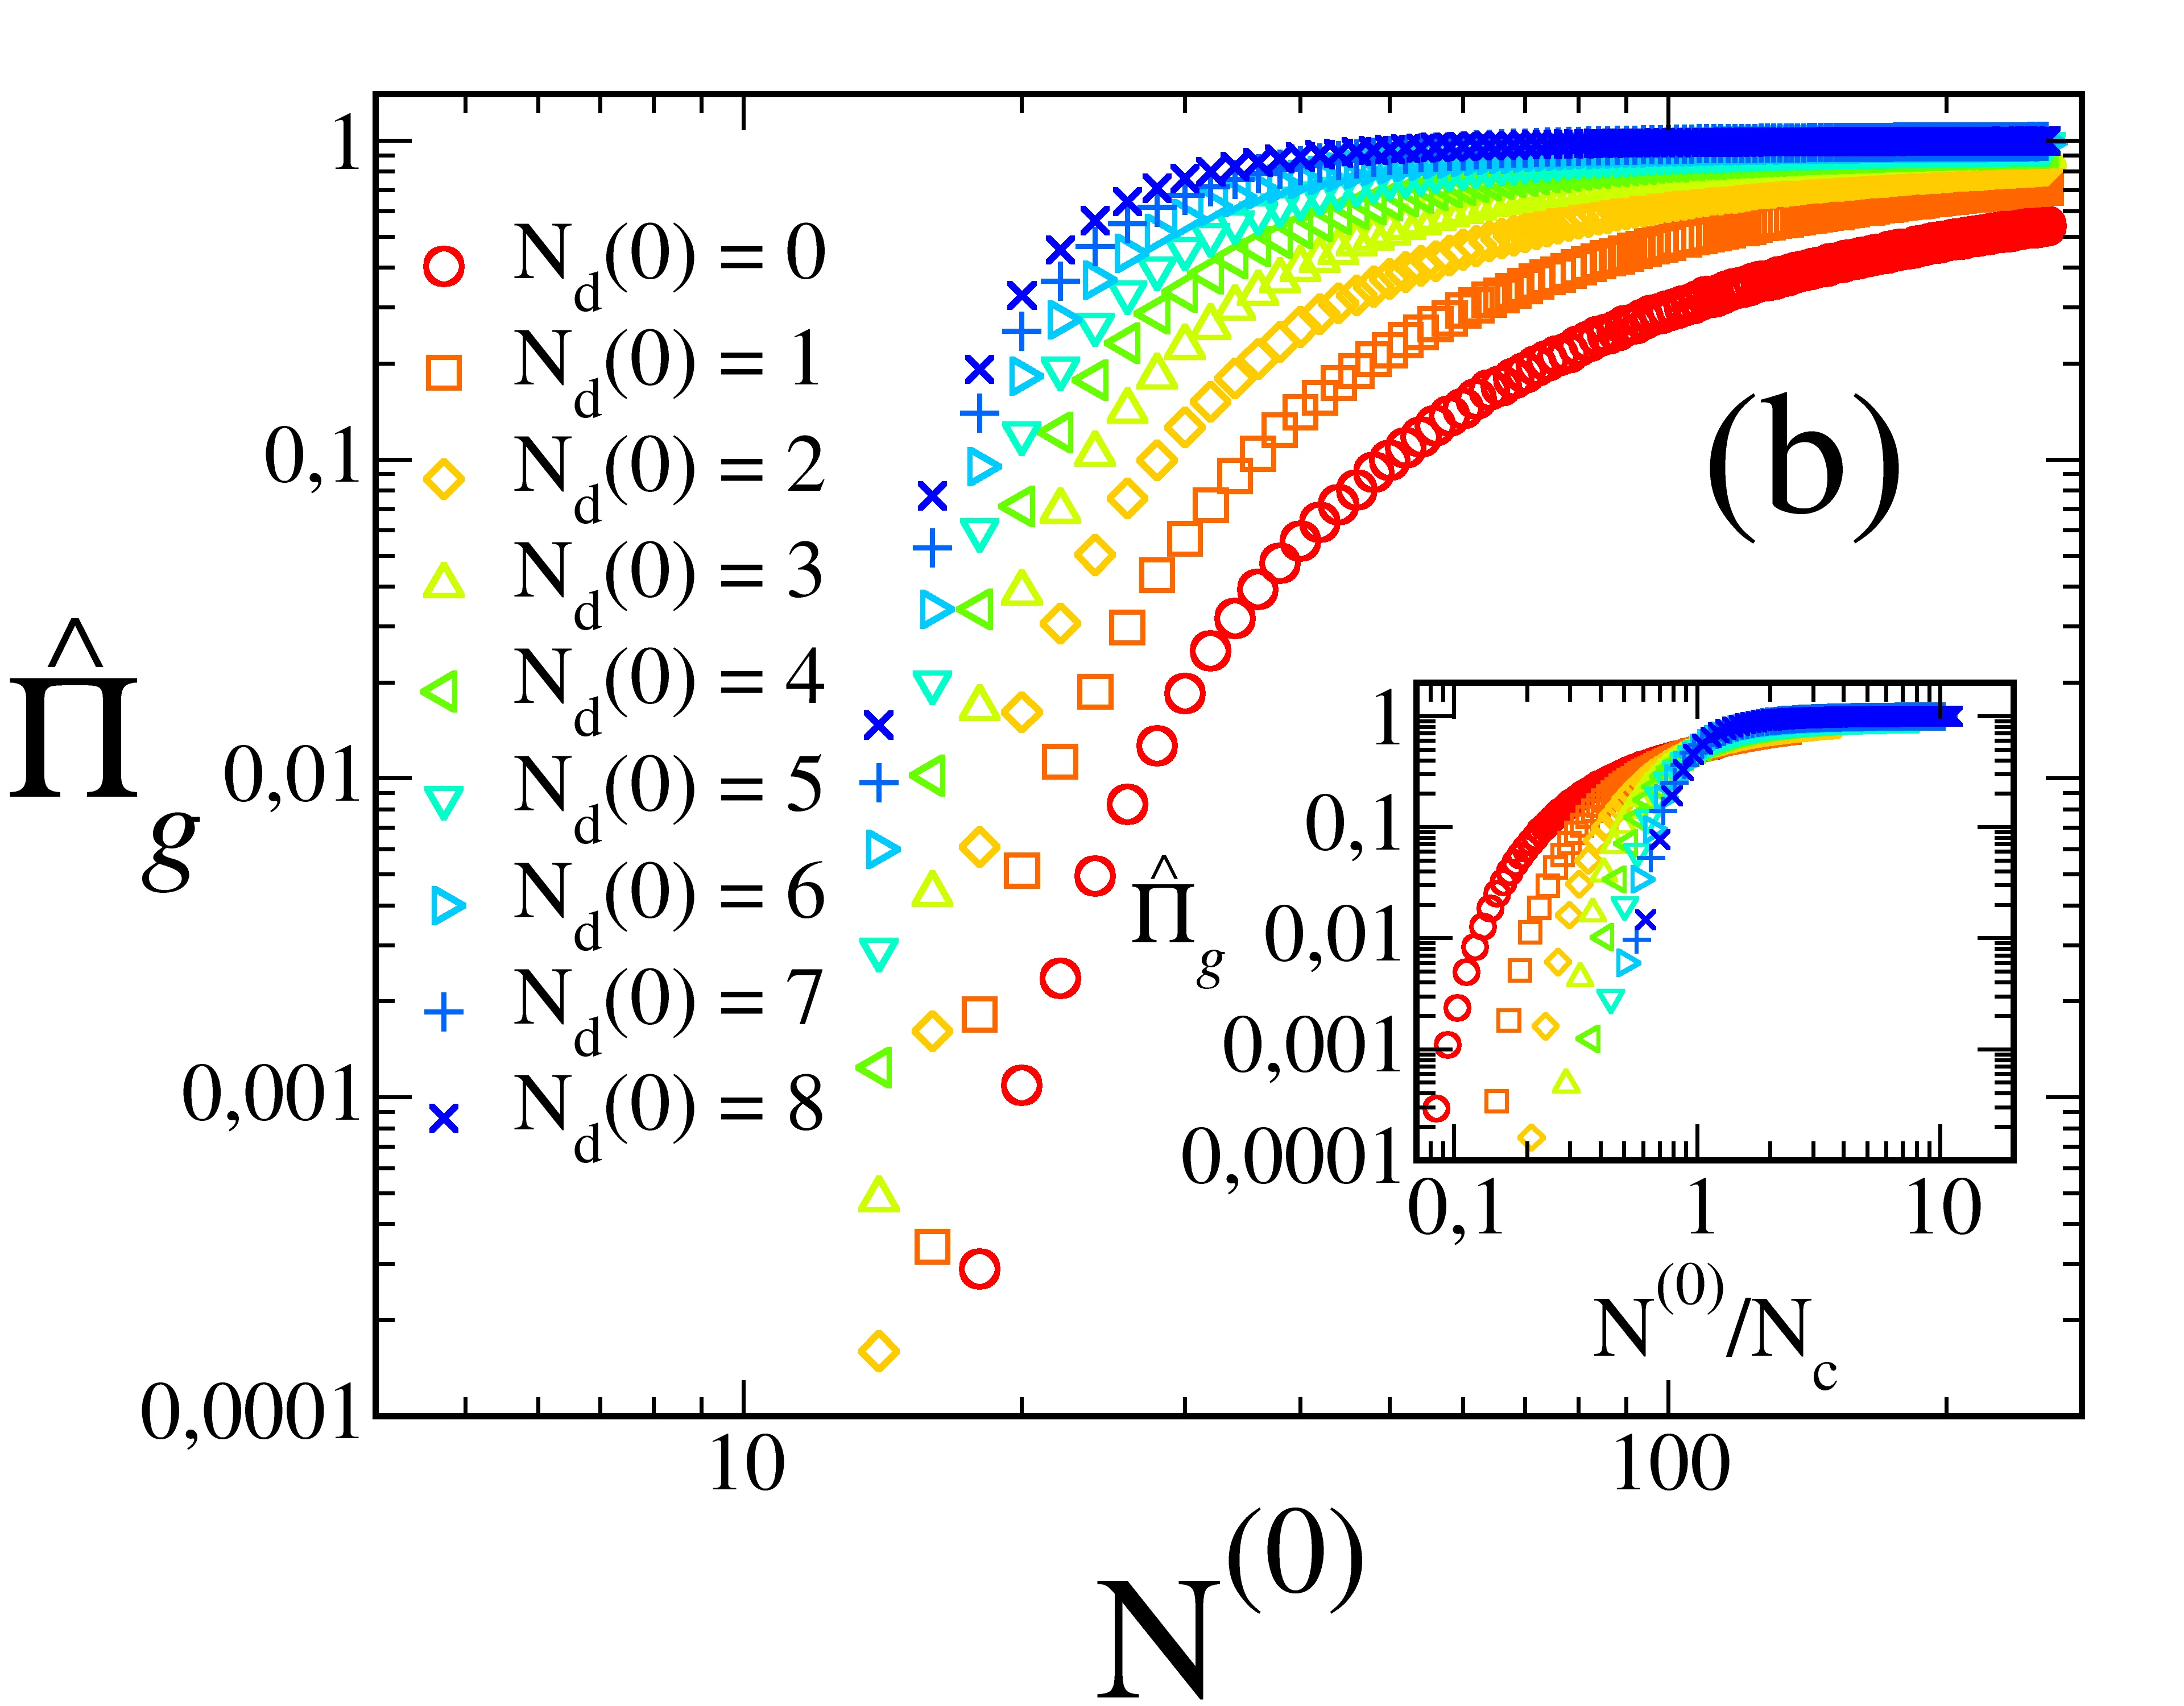
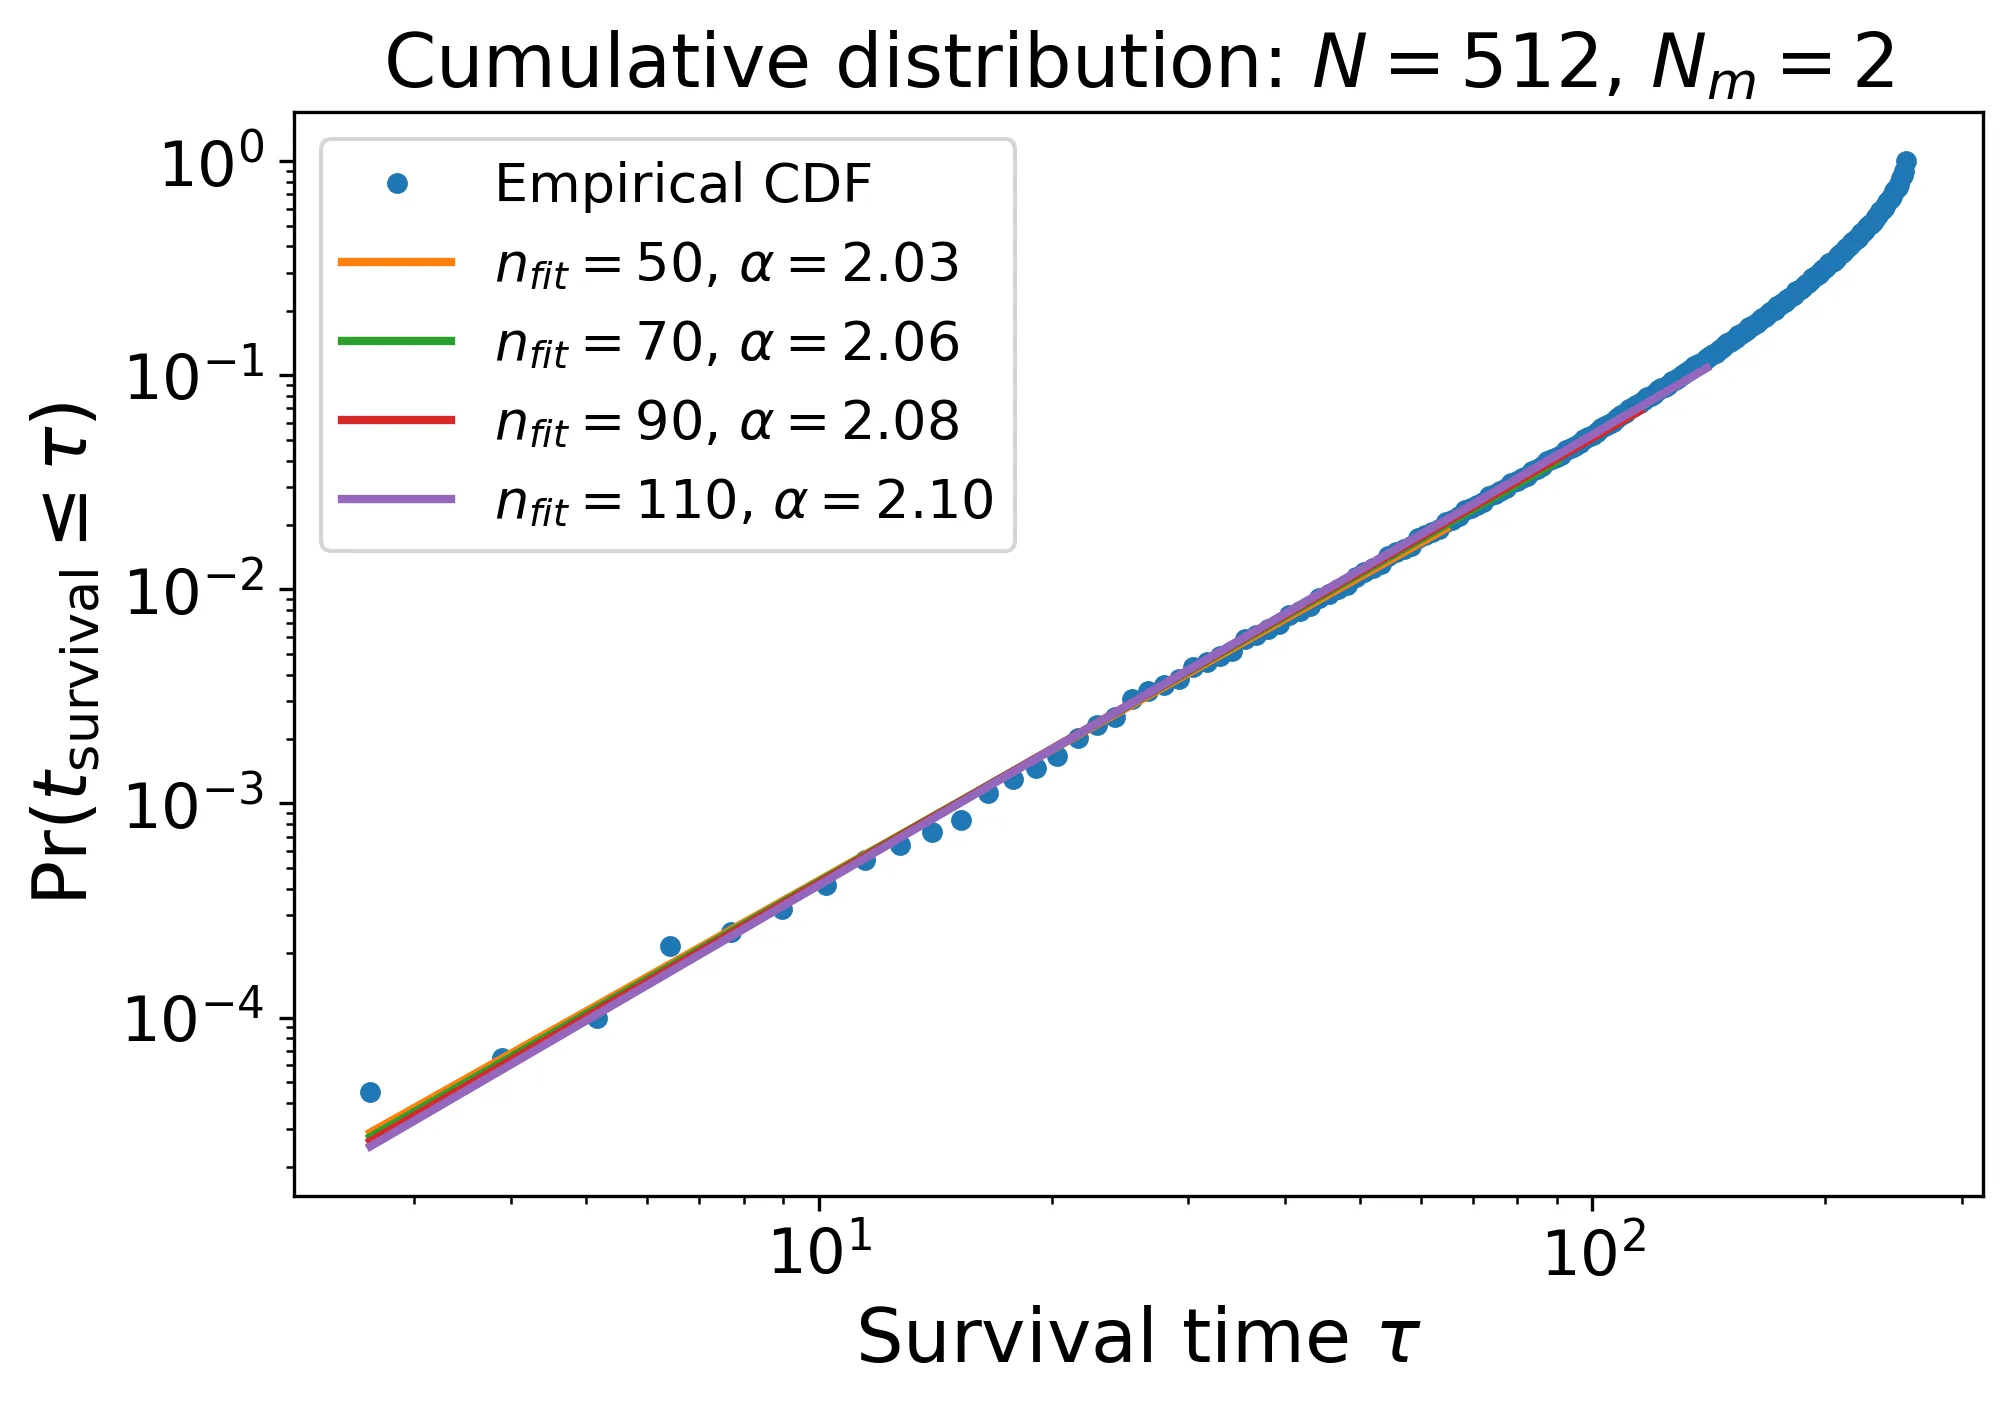
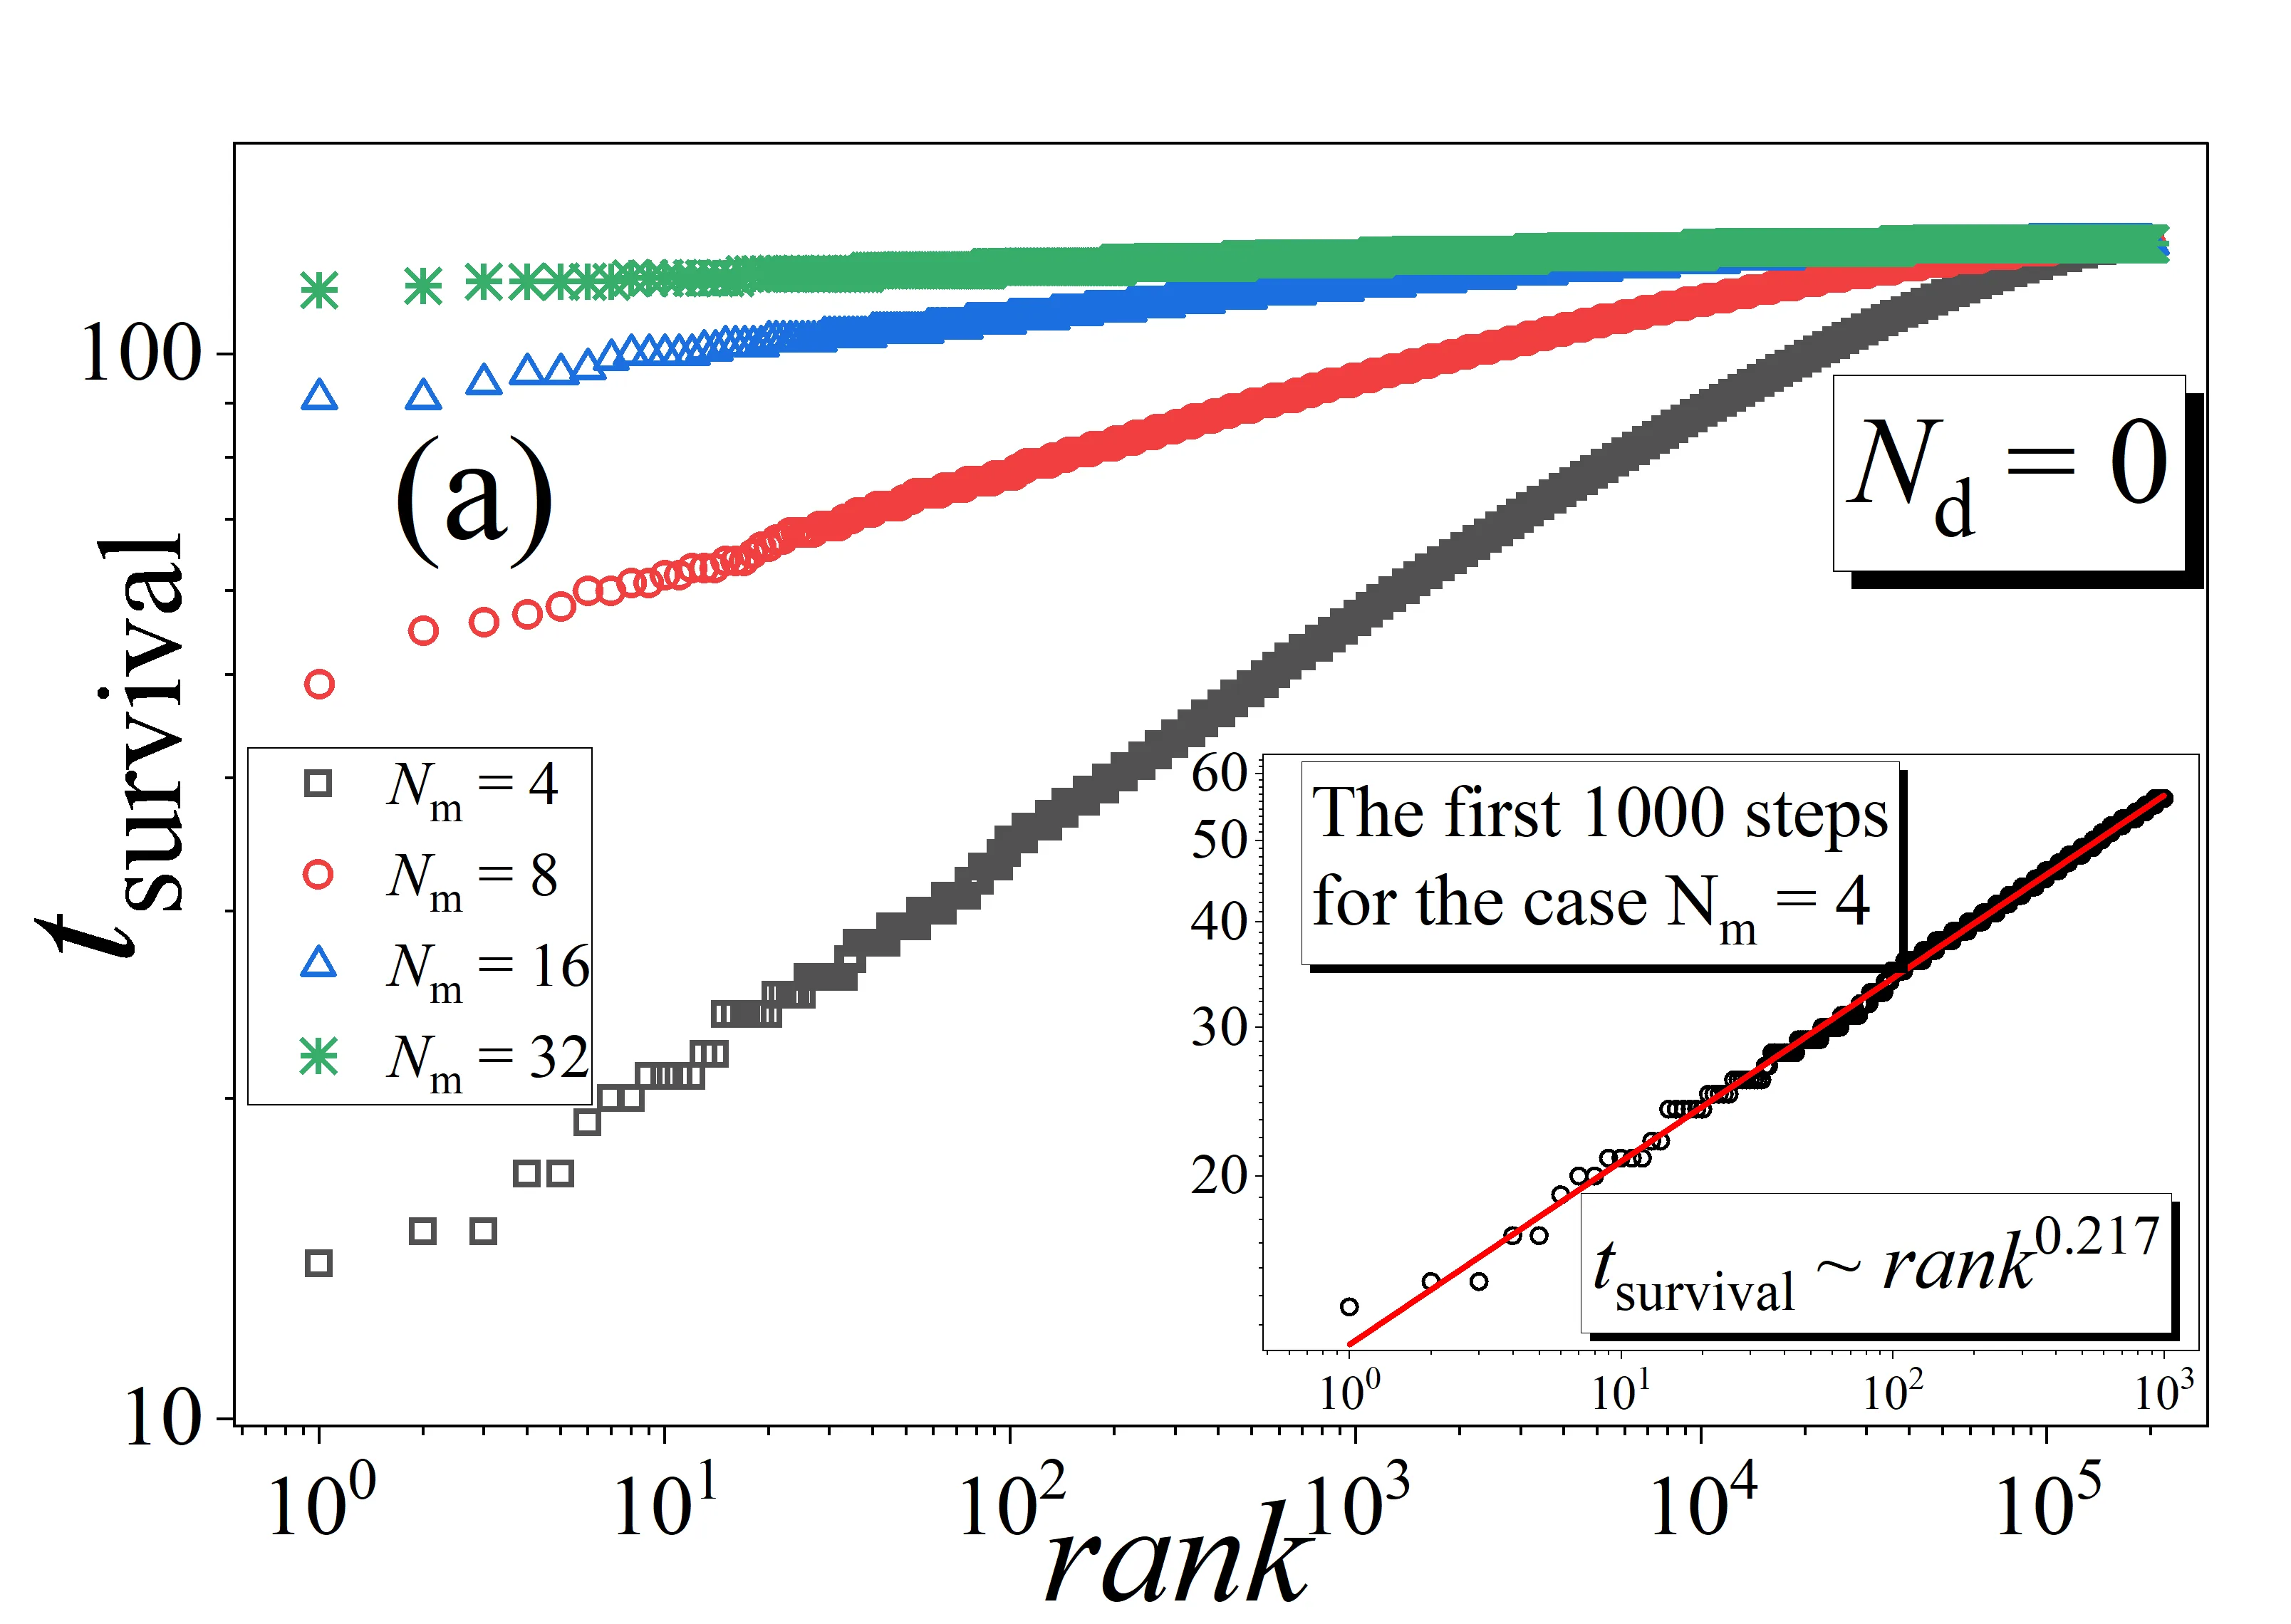
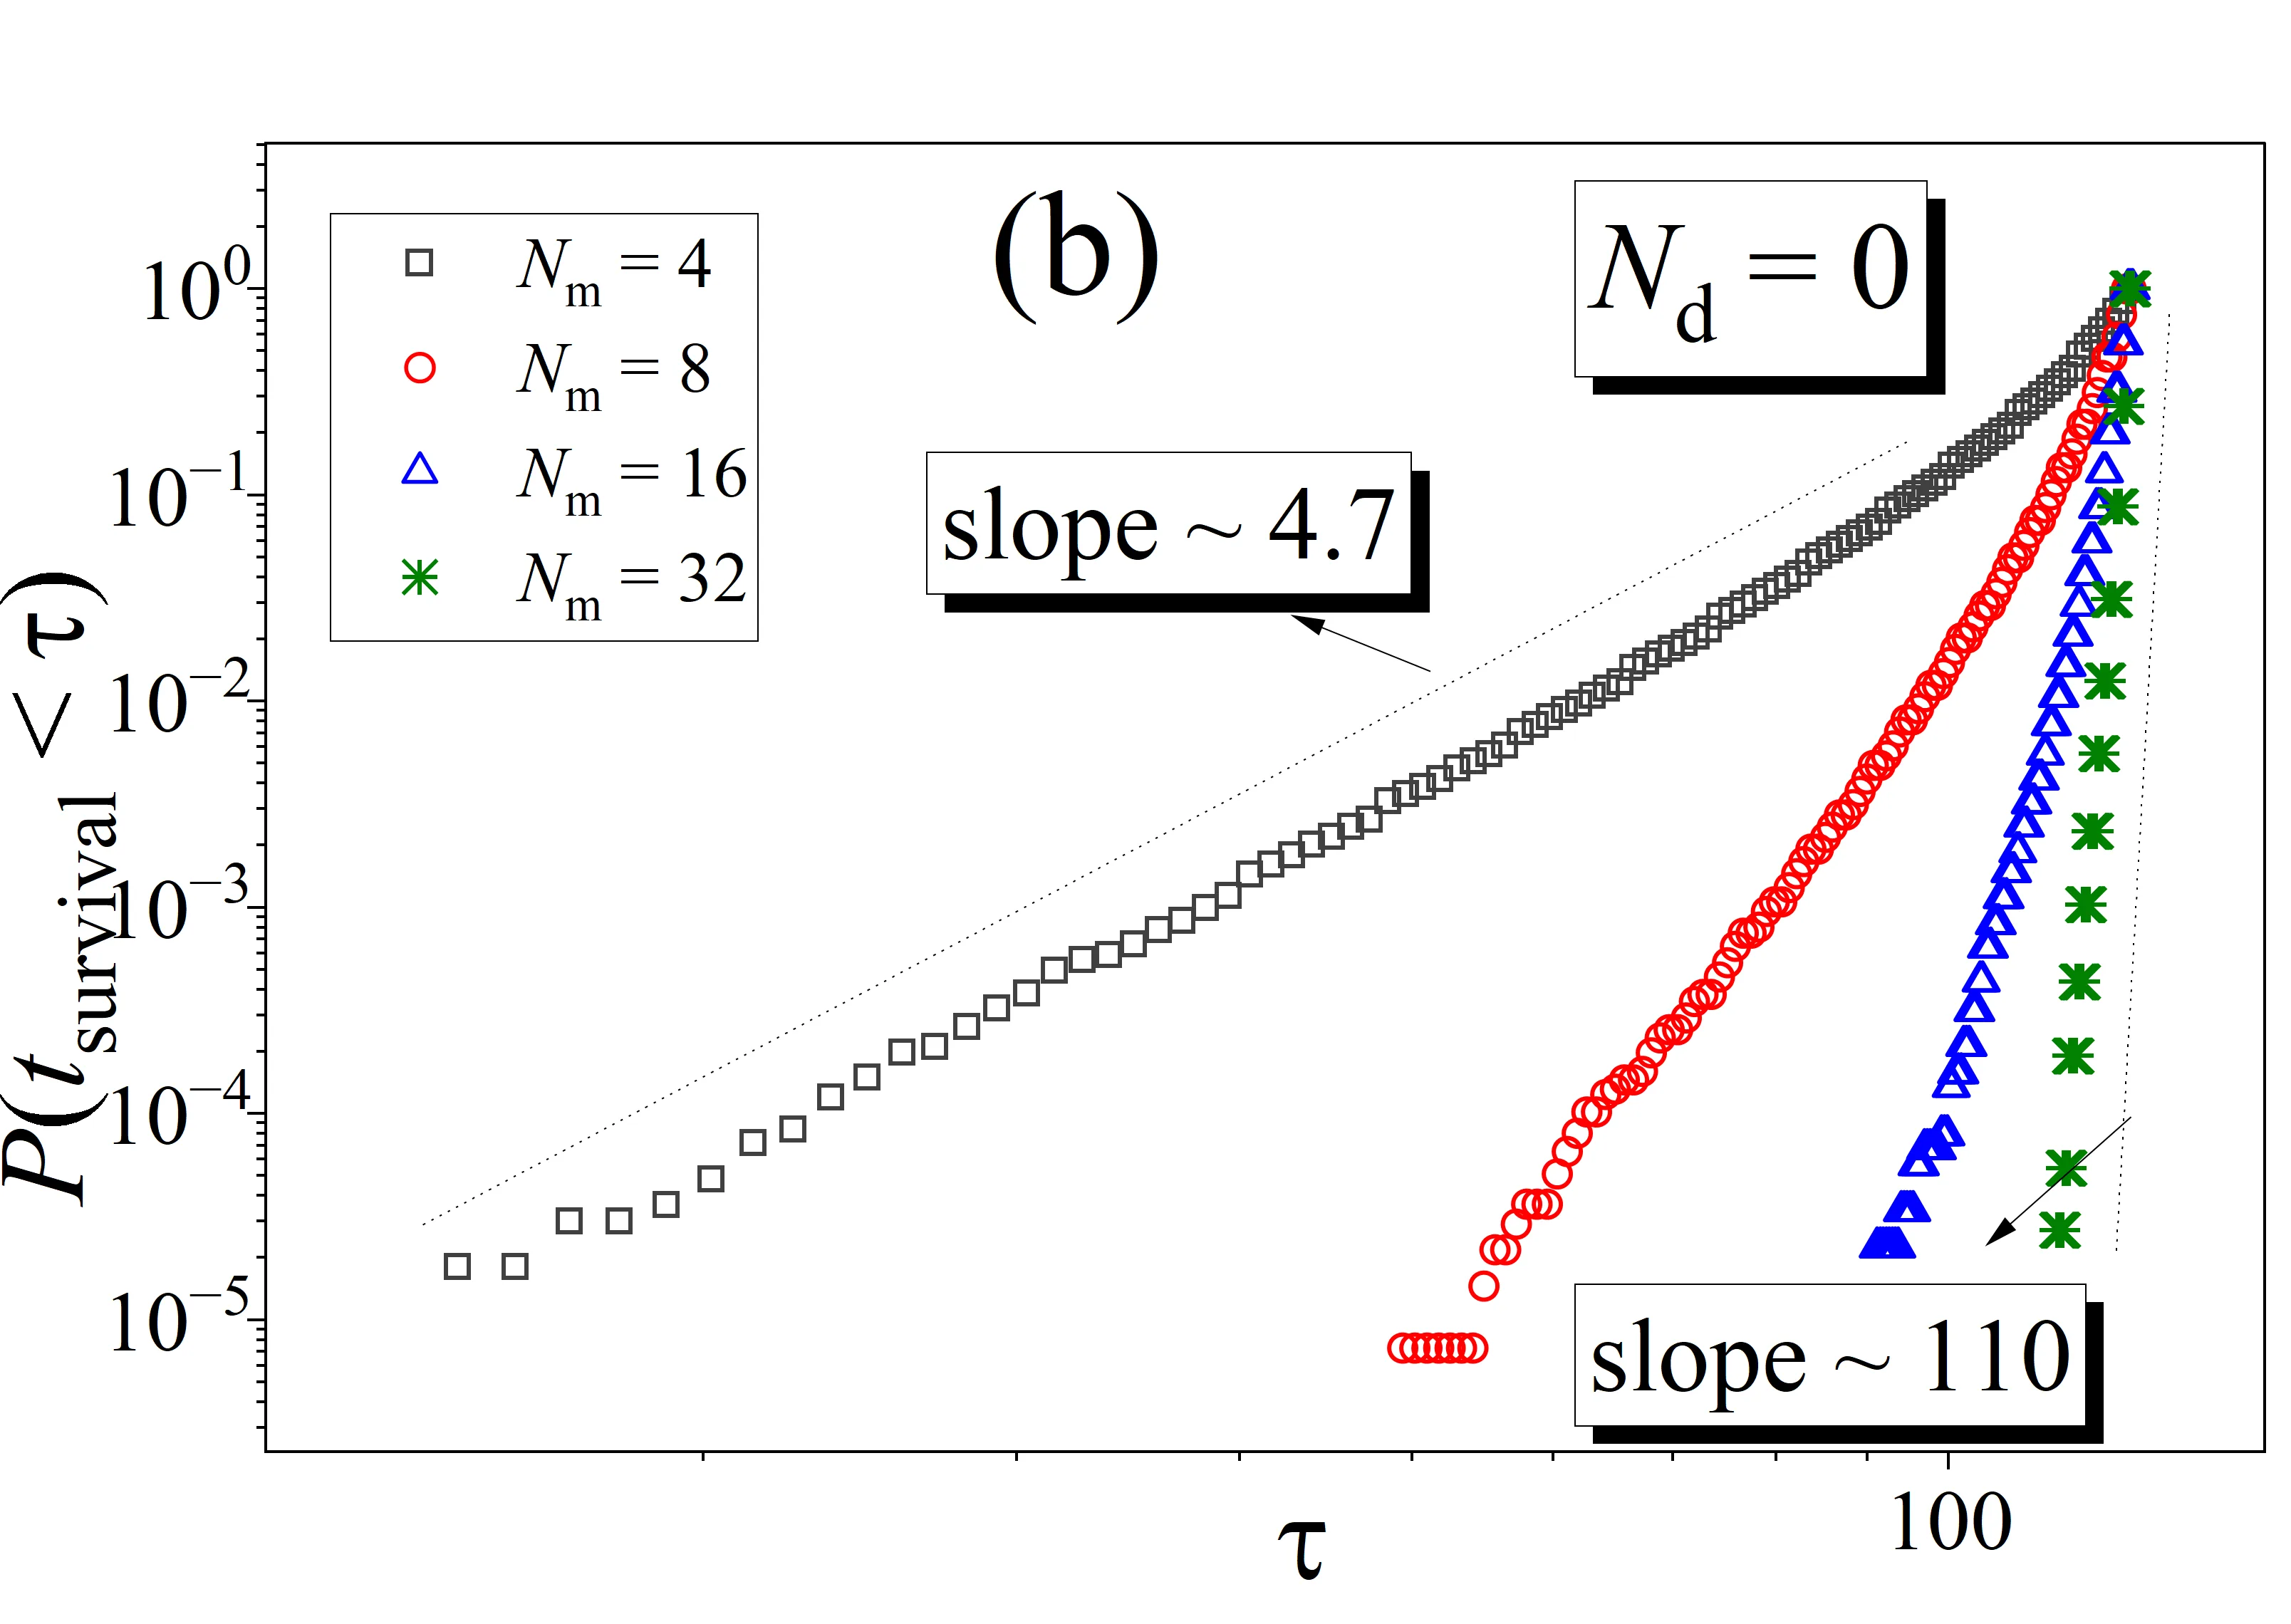
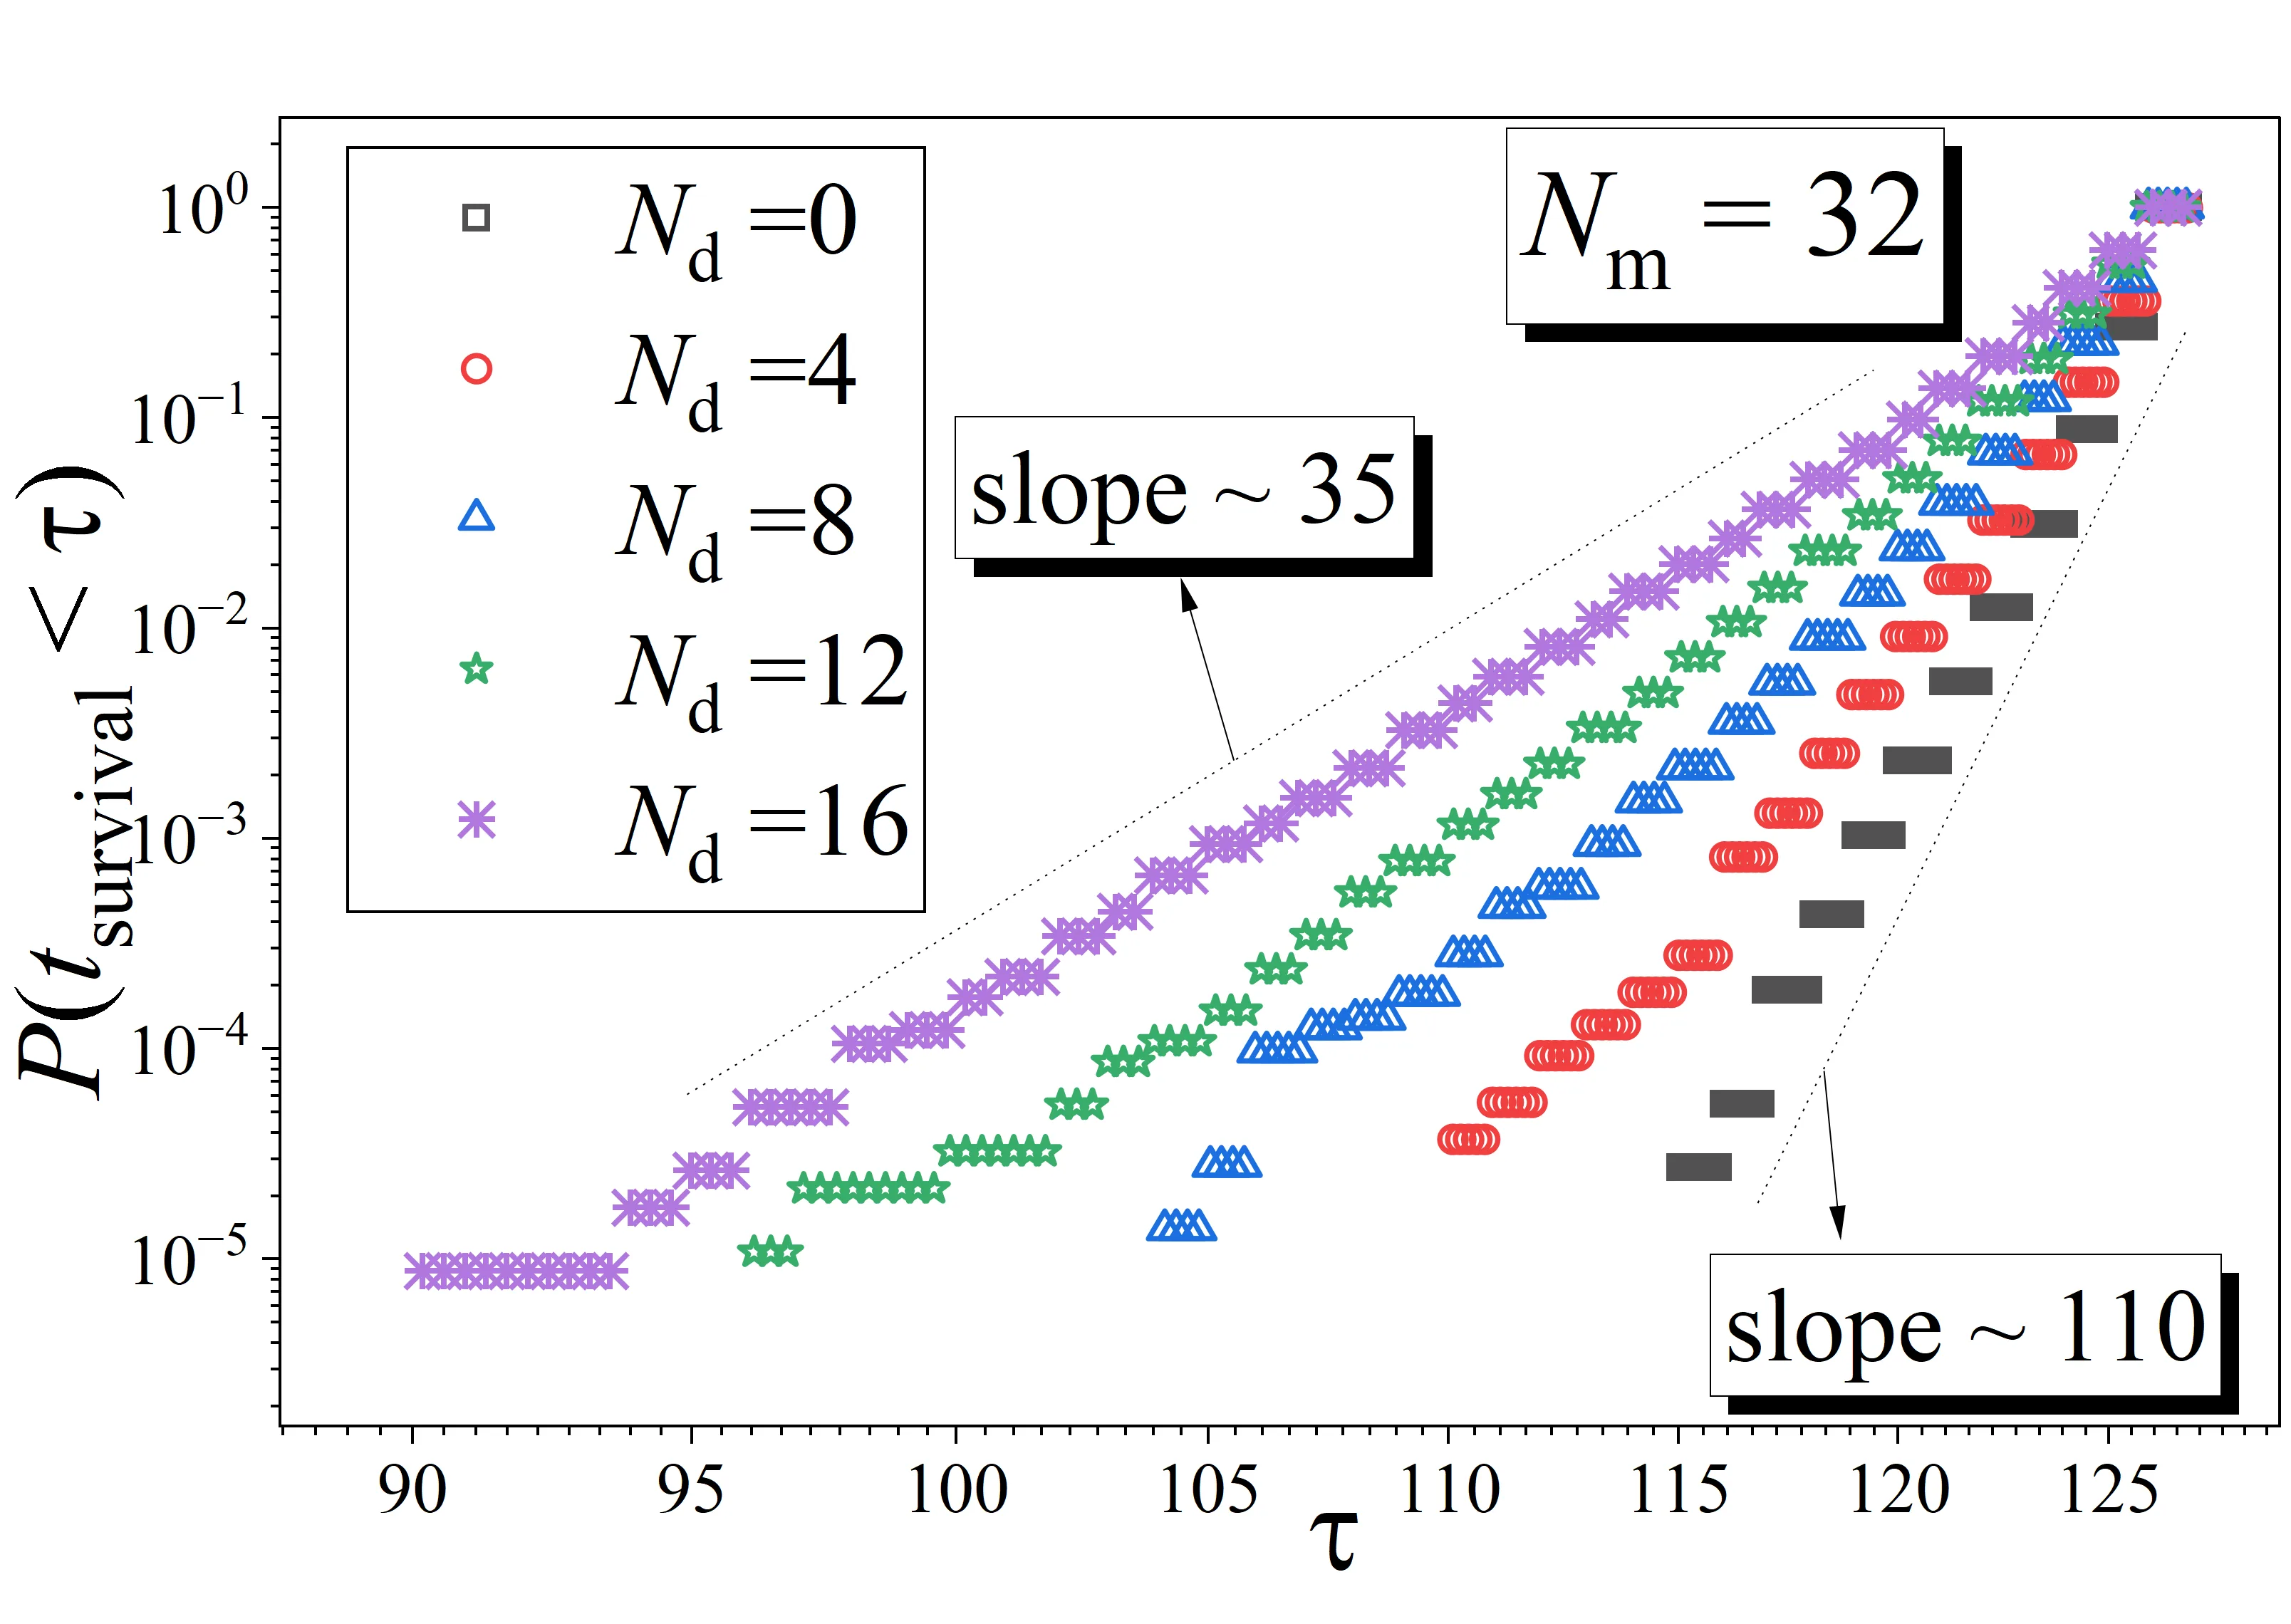
隐藏角色博弈(如狼人杀)中投票常被简化为均匀随机,难以刻画累积指控对玩家判断的历史依赖。论文构建基于随机配对交互的代理人模型:玩家按角色修改嫌疑分,得分最高者按概率淘汰,形成两种吸收态结局。通过蒙特卡洛模拟结合随机执行近似,推导出稀释早期灭绝概率标度律F(τ)~(τ/N)^{N_m},并发现有限尺寸交叉标度N_c。无侦探时曲线可按N_c塌缩,引入全知侦探则需额外参数。模型为微观指控史与宏观吸收统计之间建立最小桥梁。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
黑手党游戏,或者说更为大众所熟知的“狼人杀”,本质上是一种经典的隐藏角色博弈。在这类游戏中,一小群身份保密的协同少数派(黑手党)需要隐藏自己的真实身份,而占多数的善人阵营则必须通过投票逐步识别并淘汰这些隐藏的威胁。这种不对称的对抗结构使得隐藏角色博弈成为研究信息不对称下群体决策的绝佳范式。
然而,长期以来,无论是学术研究还是实际游戏模拟,投票过程通常被过度简化——绝大多数模型将白天的投票行为处理为均匀随机选择,即每个存活的玩家被淘汰的概率完全相等。这种简化虽然便于数学推导,却严重偏离了真实游戏的动态特征。在实际游戏中,玩家会根据他人的发言、过往的行为记录以及对局势的判断,逐步累积对特定玩家的“怀疑值”,这种历史依赖的指控信息会直接影响后续的投票倾向。换句话说,现实中的淘汰决策并非独立于游戏史的独立事件,而是对整个游戏过程中所有指控信息的系统性响应。
正是这种微观层面的历史依赖与宏观层面的最终结局(吸收态)之间的联系,构成了这篇论文的核心研究动机。论文试图在微观指控历史与宏观吸收统计之间搭建一座“最小桥梁”,通过一个简洁而忠实的模型来捕捉隐藏角色博弈的核心动力学。
方法
论文构建的模型从两个关键设计出发,区别于直觉上的简单做法。首先,模型放弃了传统的均匀随机投票机制,转而引入嫌疑分(suspicion score)这一核心变量。每个玩家在整个游戏过程中都拥有一个持续累积的嫌疑分,这个分数会随着其他玩家对其的指控而增加,但不会因为被证明无辜而清零——这是一个不可逆的记忆机制,忠实刻画了“一旦被怀疑过,就始终存在嫌疑”的直觉。
其次,淘汰机制被设计为概率性的而非确定性的。在每个投票回合中,系统会随机选取一对玩家进行配对交互,其中一方的发言(由其角色决定)会修改另一方的嫌疑分。随后,所有存活的玩家中嫌疑分最高者会以正比于其累积嫌疑的概率被淘汰,而非被完全确定地选出。这种概率化处理避免了模型对极端情况的过度敏感,同时也更贴近真实投票中存在的随机性与不确定性。
整个游戏动态可以描述为一个随机过程:白天阶段通过随机配对交互更新嫌疑分,随后以概率化的方式执行淘汰;夜晚阶段黑手党秘密淘汰一名善人。这个过程循环往复,直到游戏到达两个可能的吸收态之一——要么黑手党被完全消灭,要么黑手党与善人阵营的人数持平(此时善人已无法通过投票优势获胜)。
论文的核心分析工具是蒙特卡洛模拟,并辅以“随机执行近似”这一理论近似技术。这一近似假设在稀释条件下(黑手党人数远小于总人数),每次淘汰事件中选中黑手党成员的概率近似为 ,从而可以推导解析形式的标度关系。
实验与结果
论文通过大规模的计算模拟,系统探索了三个维度的参数空间:人口规模 、初始黑手党人数 ,以及是否引入完全知情的侦探角色。
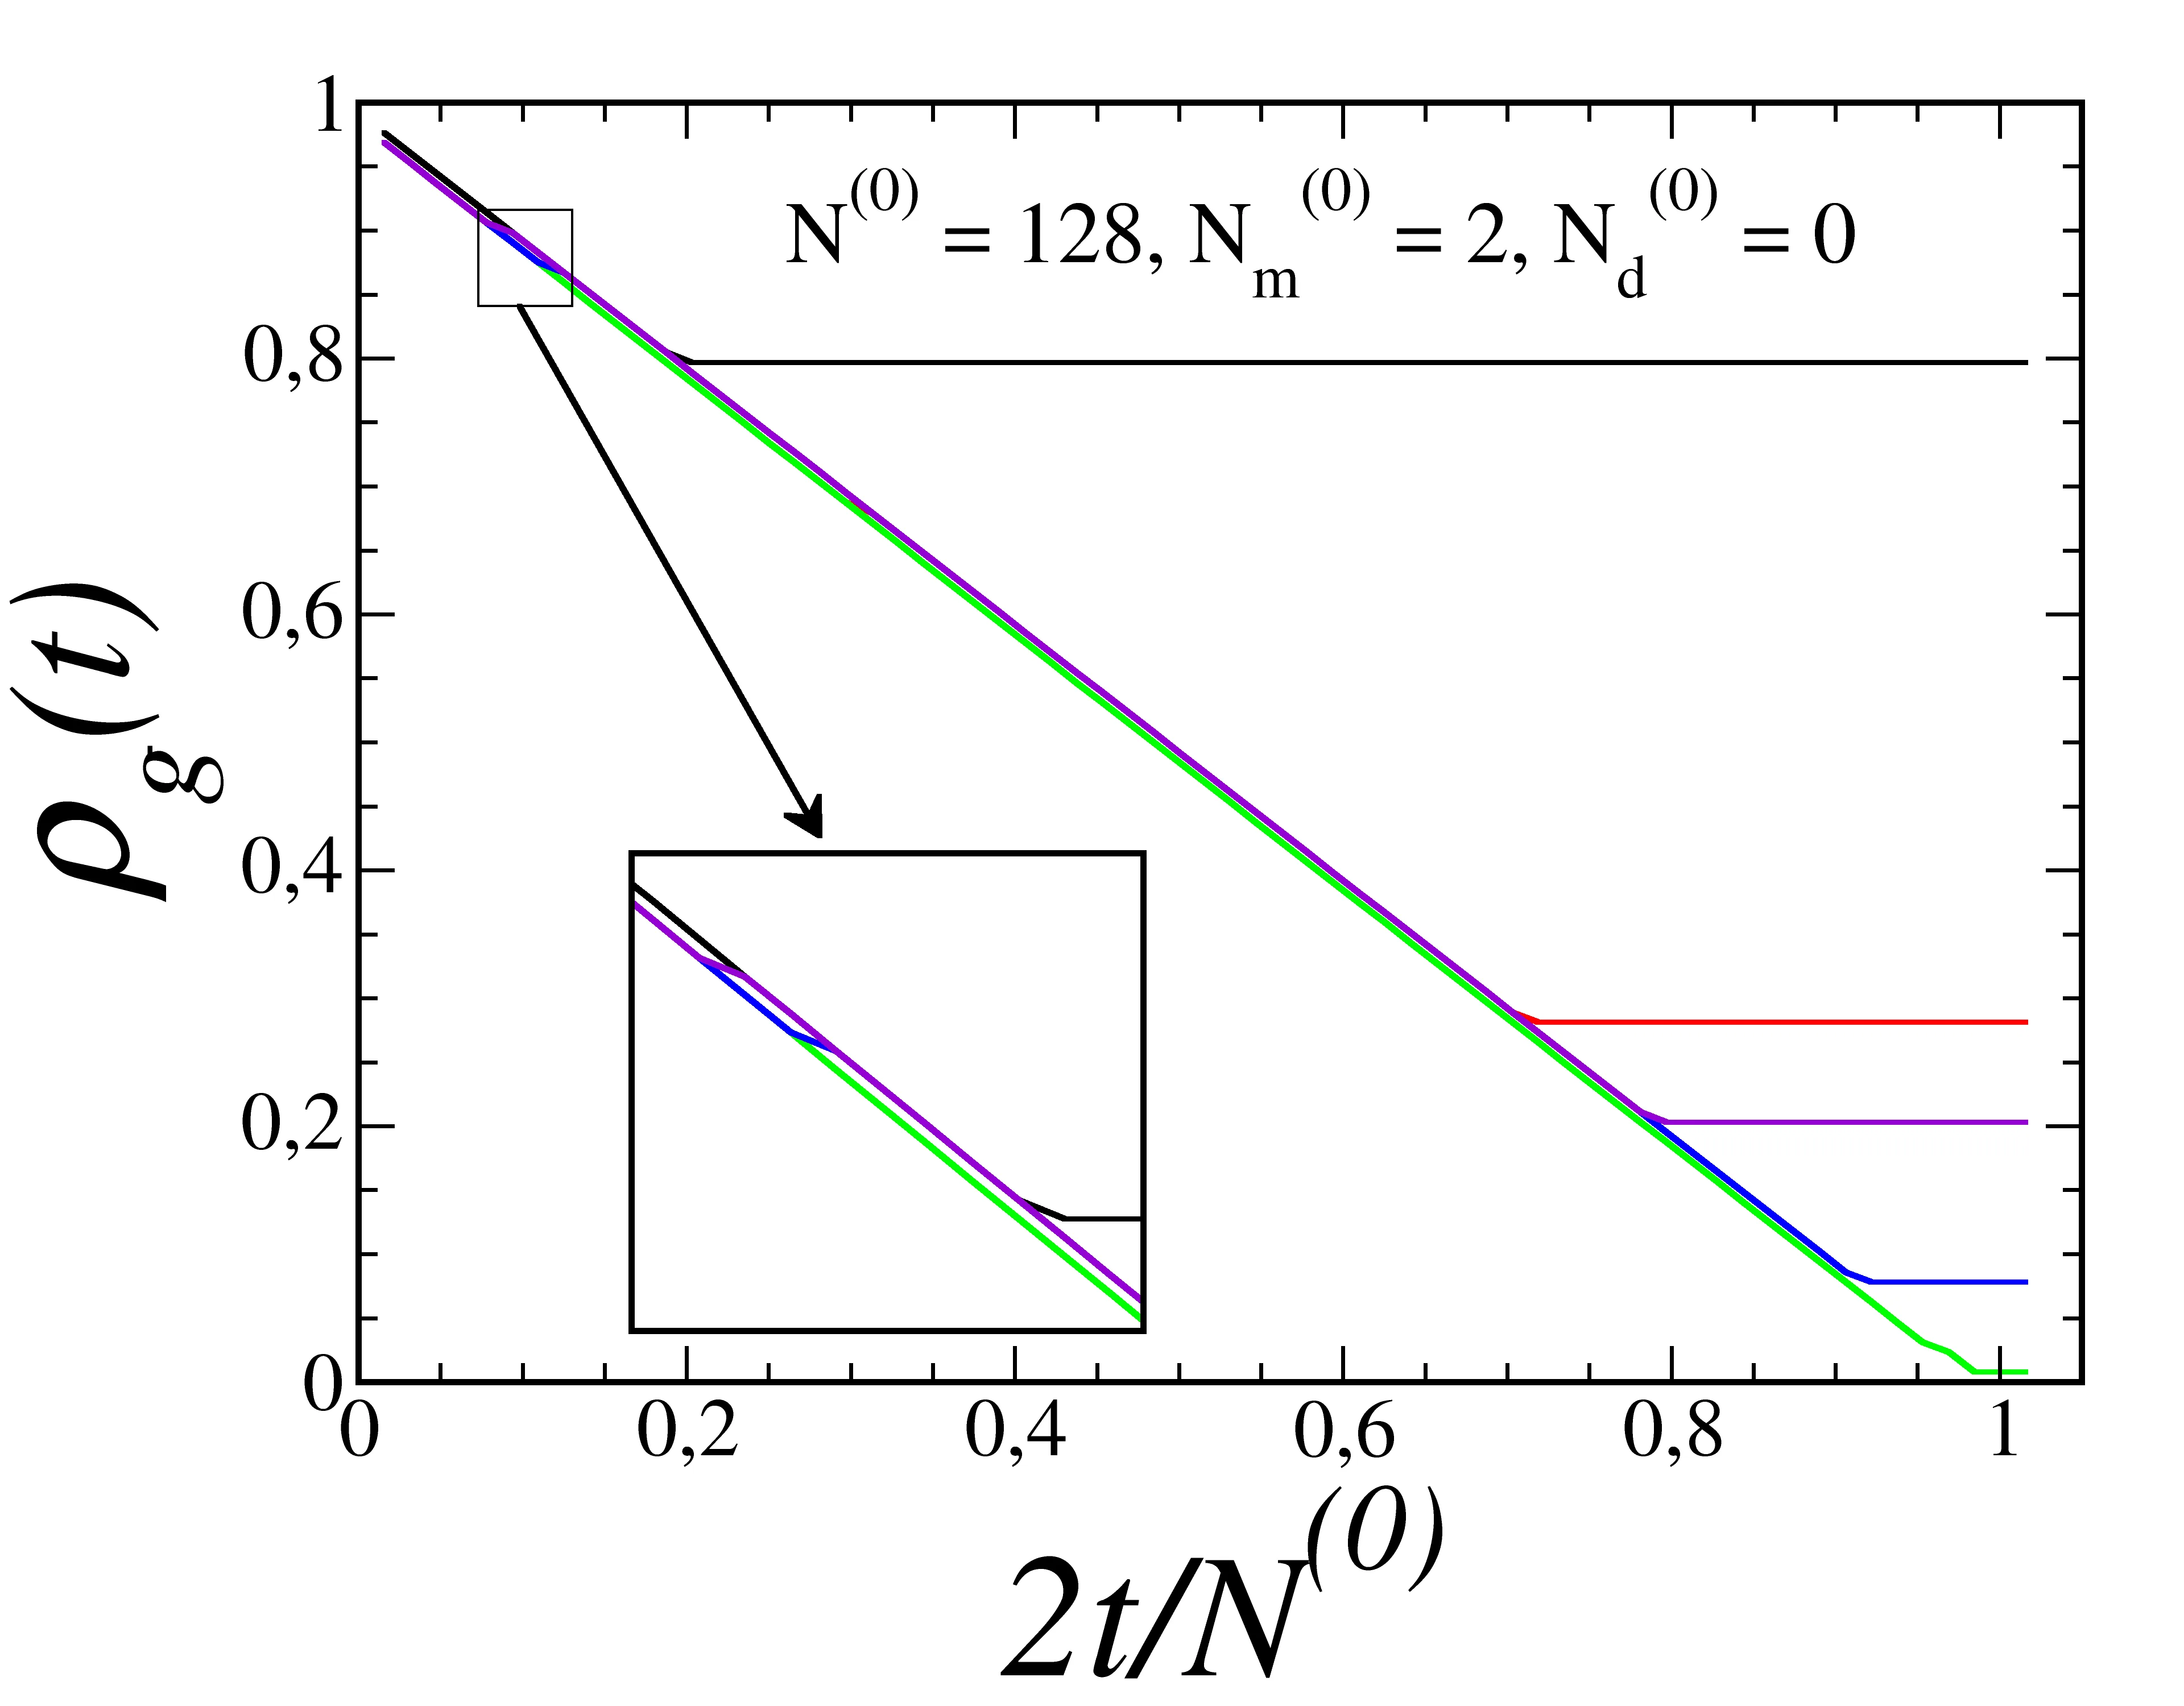
在没有侦探的基础设定下,模拟结果与随机执行近似的理论预测高度吻合。在黑手党稀疏且游戏早期的稀释条件下,黑手党灭绝的累积概率表现出明确的标度律:
其中 表示已执行的投票轮数。这一结果表明,黑手党灭绝概率随游戏进程的增长速度高度依赖于初始黑手党规模—— 越大,灭绝概率增长越快,直觉上这对应着更多黑手党意味着更多暴露风险。
更值得注意的是,研究者发现胜率曲线存在一个有限尺寸交叉标度 。当用 对人口规模进行重缩放后,不同初始黑手党人数下获得的胜率曲线能够近乎完美地塌缩(collapse)到一起。这暗示尽管游戏的微观动态复杂多变,但在足够高的抽象层次上,存在一个普适的临界尺度支配着从“黑手党主导”向“善人主导”的转变。
当引入全知侦探这一角色时,情况发生了显著变化。侦探在夜晚可以验证任意玩家的身份,并始终在白天指控黑手党成员,其存在大幅缩短了黑手党的平均存活时间。更关键的是,侦探的引入打破了原有的单参数重缩放规律——胜率曲线现在还依赖于善人与黑手党的构成比例,单一标度 不再足以描述不同条件下的动态。这说明侦探角色不仅改变了游戏的节奏,还引入了额外的自由度,改变了整个动力学格局。
讨论与可借鉴点
这篇论文为隐藏角色博弈提供了一个优雅且具有强解释力的数学框架,其核心贡献在于将历史依赖的微观决策与可观测的宏观结局通过嫌疑分这一单一变量桥接起来。标度律 的发现尤其具有洞察力——它揭示了黑手党规模在决定灭绝动力学中的指数级作用,解释了为何在真实游戏中增加黑手党人数会不成比例地增加其暴露风险。
然而,模型也存在明显的局限。首先,随机配对交互是对真实讨论过程的极度简化,真实的言语博弈涉及更复杂的策略层级和联盟动态。其次,模型忽略了玩家身份认知的动态更新——在真实游戏中,玩家对他人的怀疑程度会随着局势演变而重新调整,而非仅做单向累积。此外,论文的解析结果依赖于稀释近似,在黑手党人数较多时理论预测的准确性有待检验。
对于更广泛的研究社区而言,这项工作提供了一个可借鉴的范式:当研究涉及历史依赖的群体决策时,关键在于识别那些持久化且可测量的中间变量(如嫌疑分),它们往往是连接微观机制与宏观现象的桥梁。论文中蒙特卡洛模拟与解析近似相结合的方法论,以及有限尺寸交叉标度的经验发现技术,对于分析其他具有吸收态的随机过程同样具有参考价值。
摘要
基于多智能体的 Mafia 博弈决策动力学研究
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
StatePlay:面向机制一致生成的状态感知游戏世界模型
StatePlay: State-Aware Game World Models for Mechanics-Consistent Generation
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 8 张
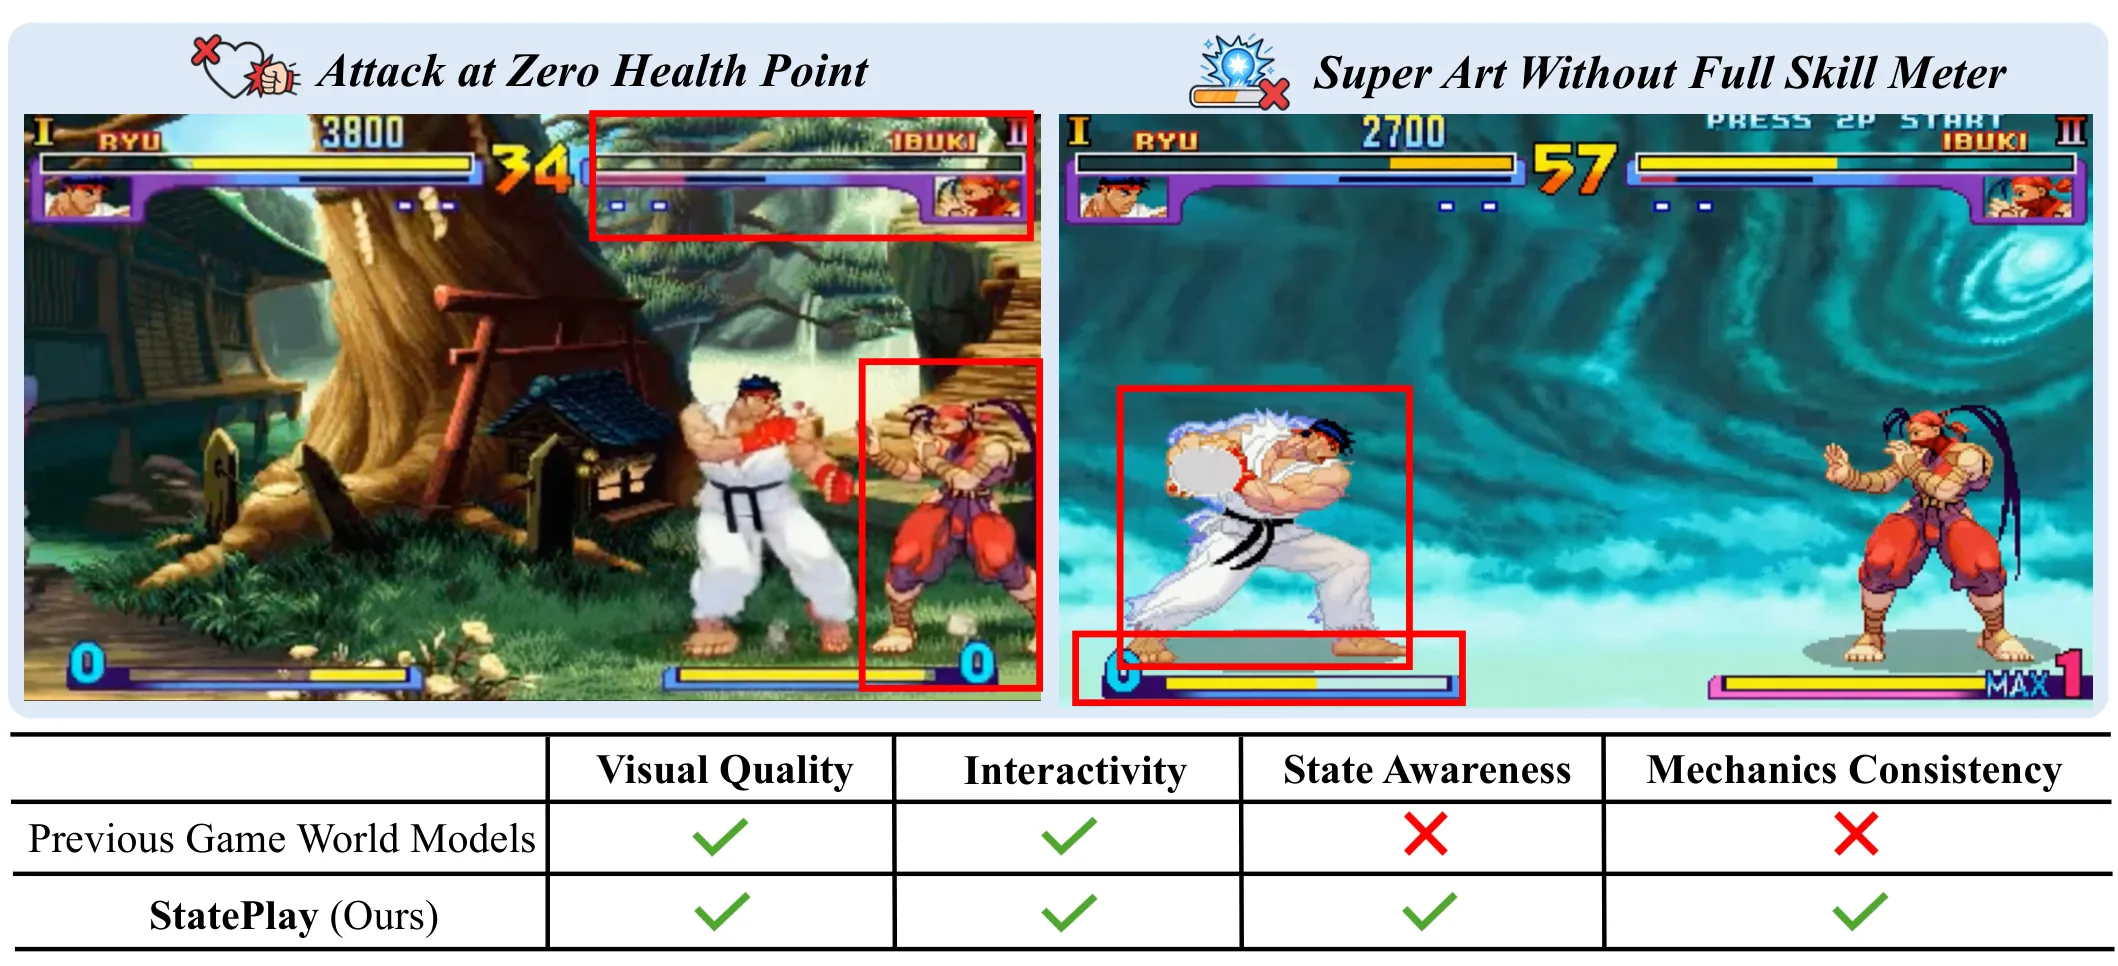
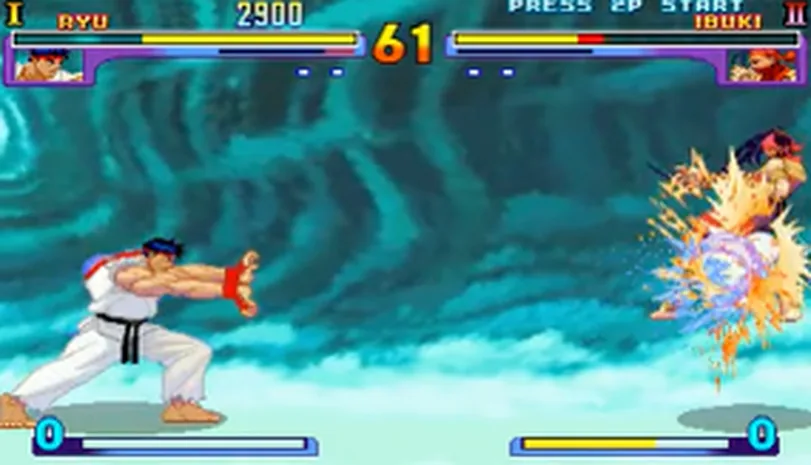
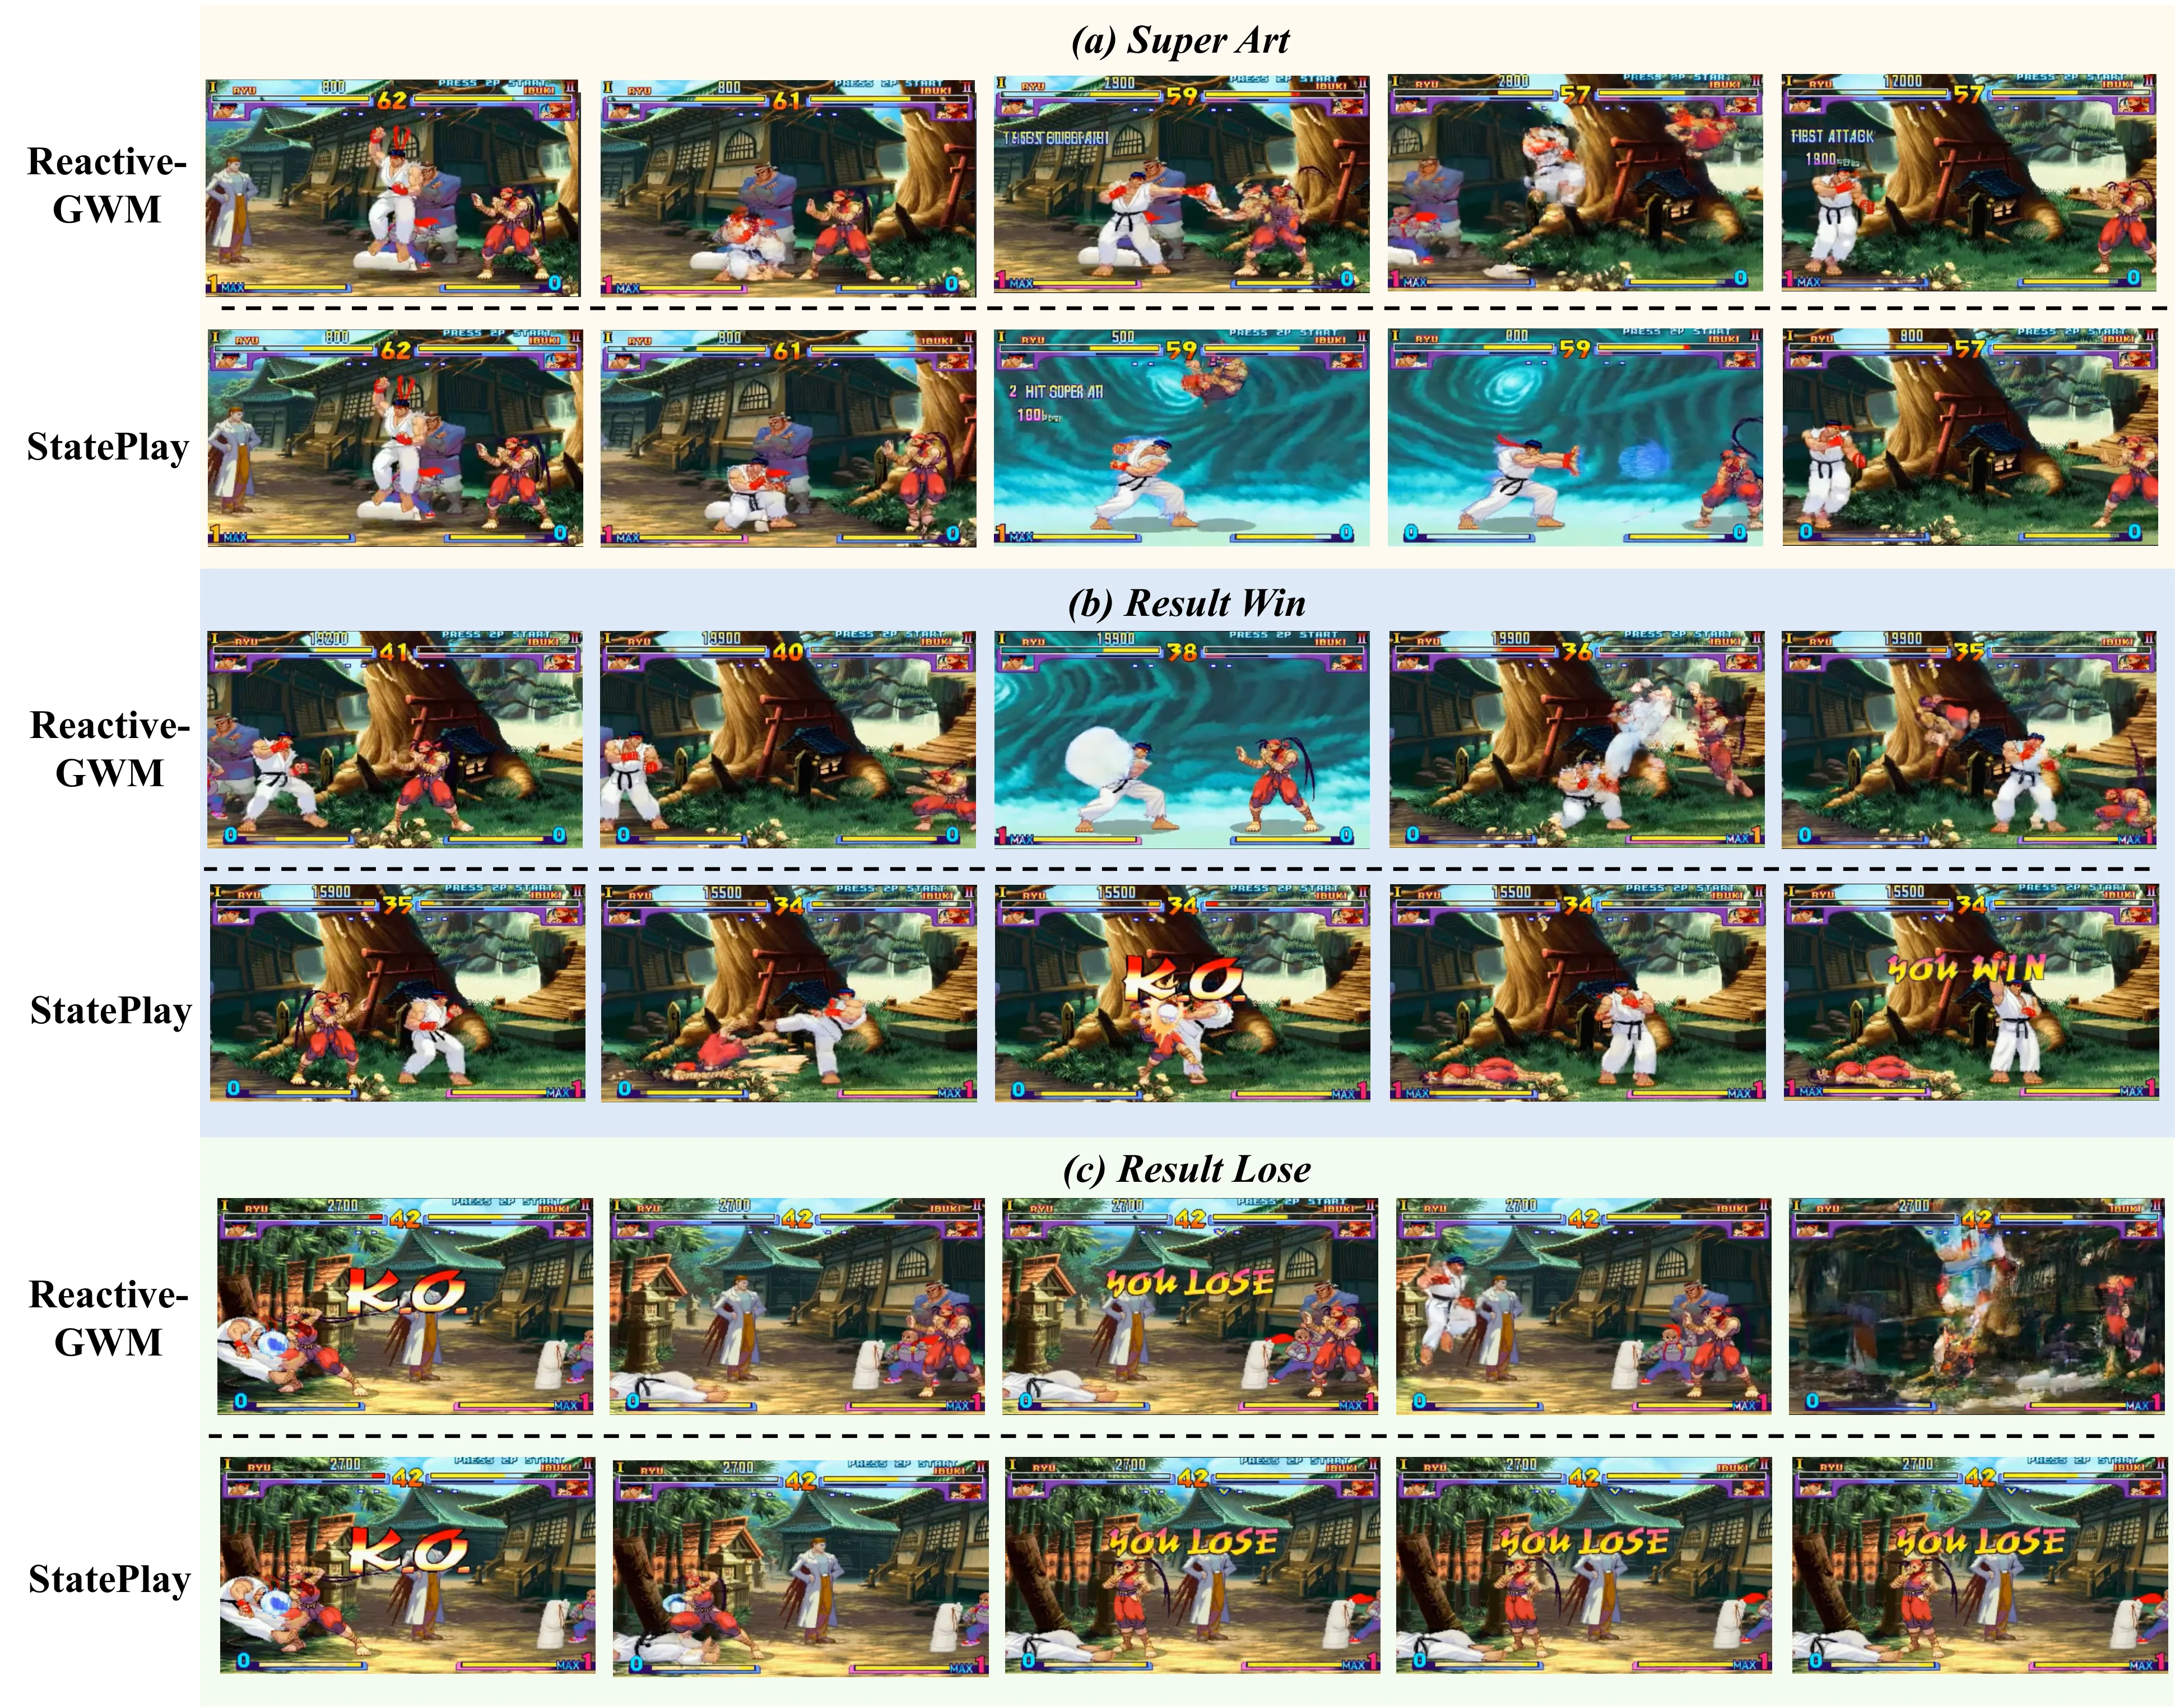
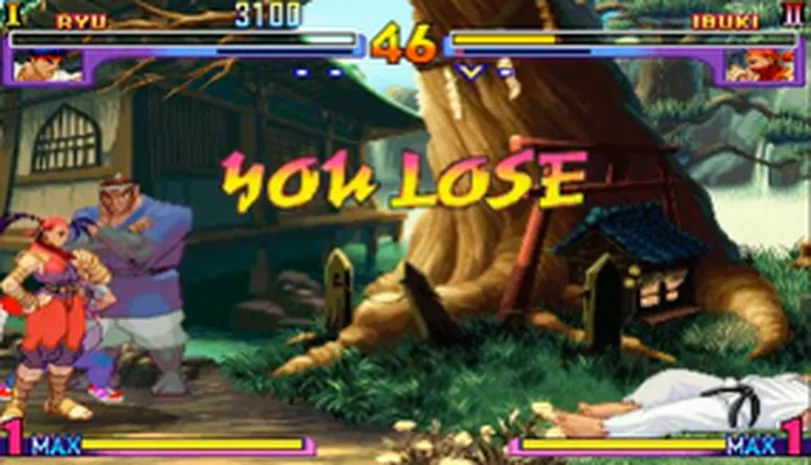
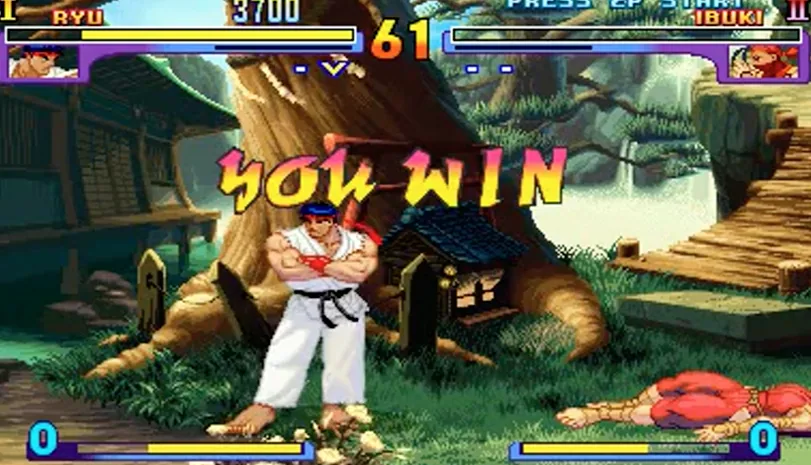
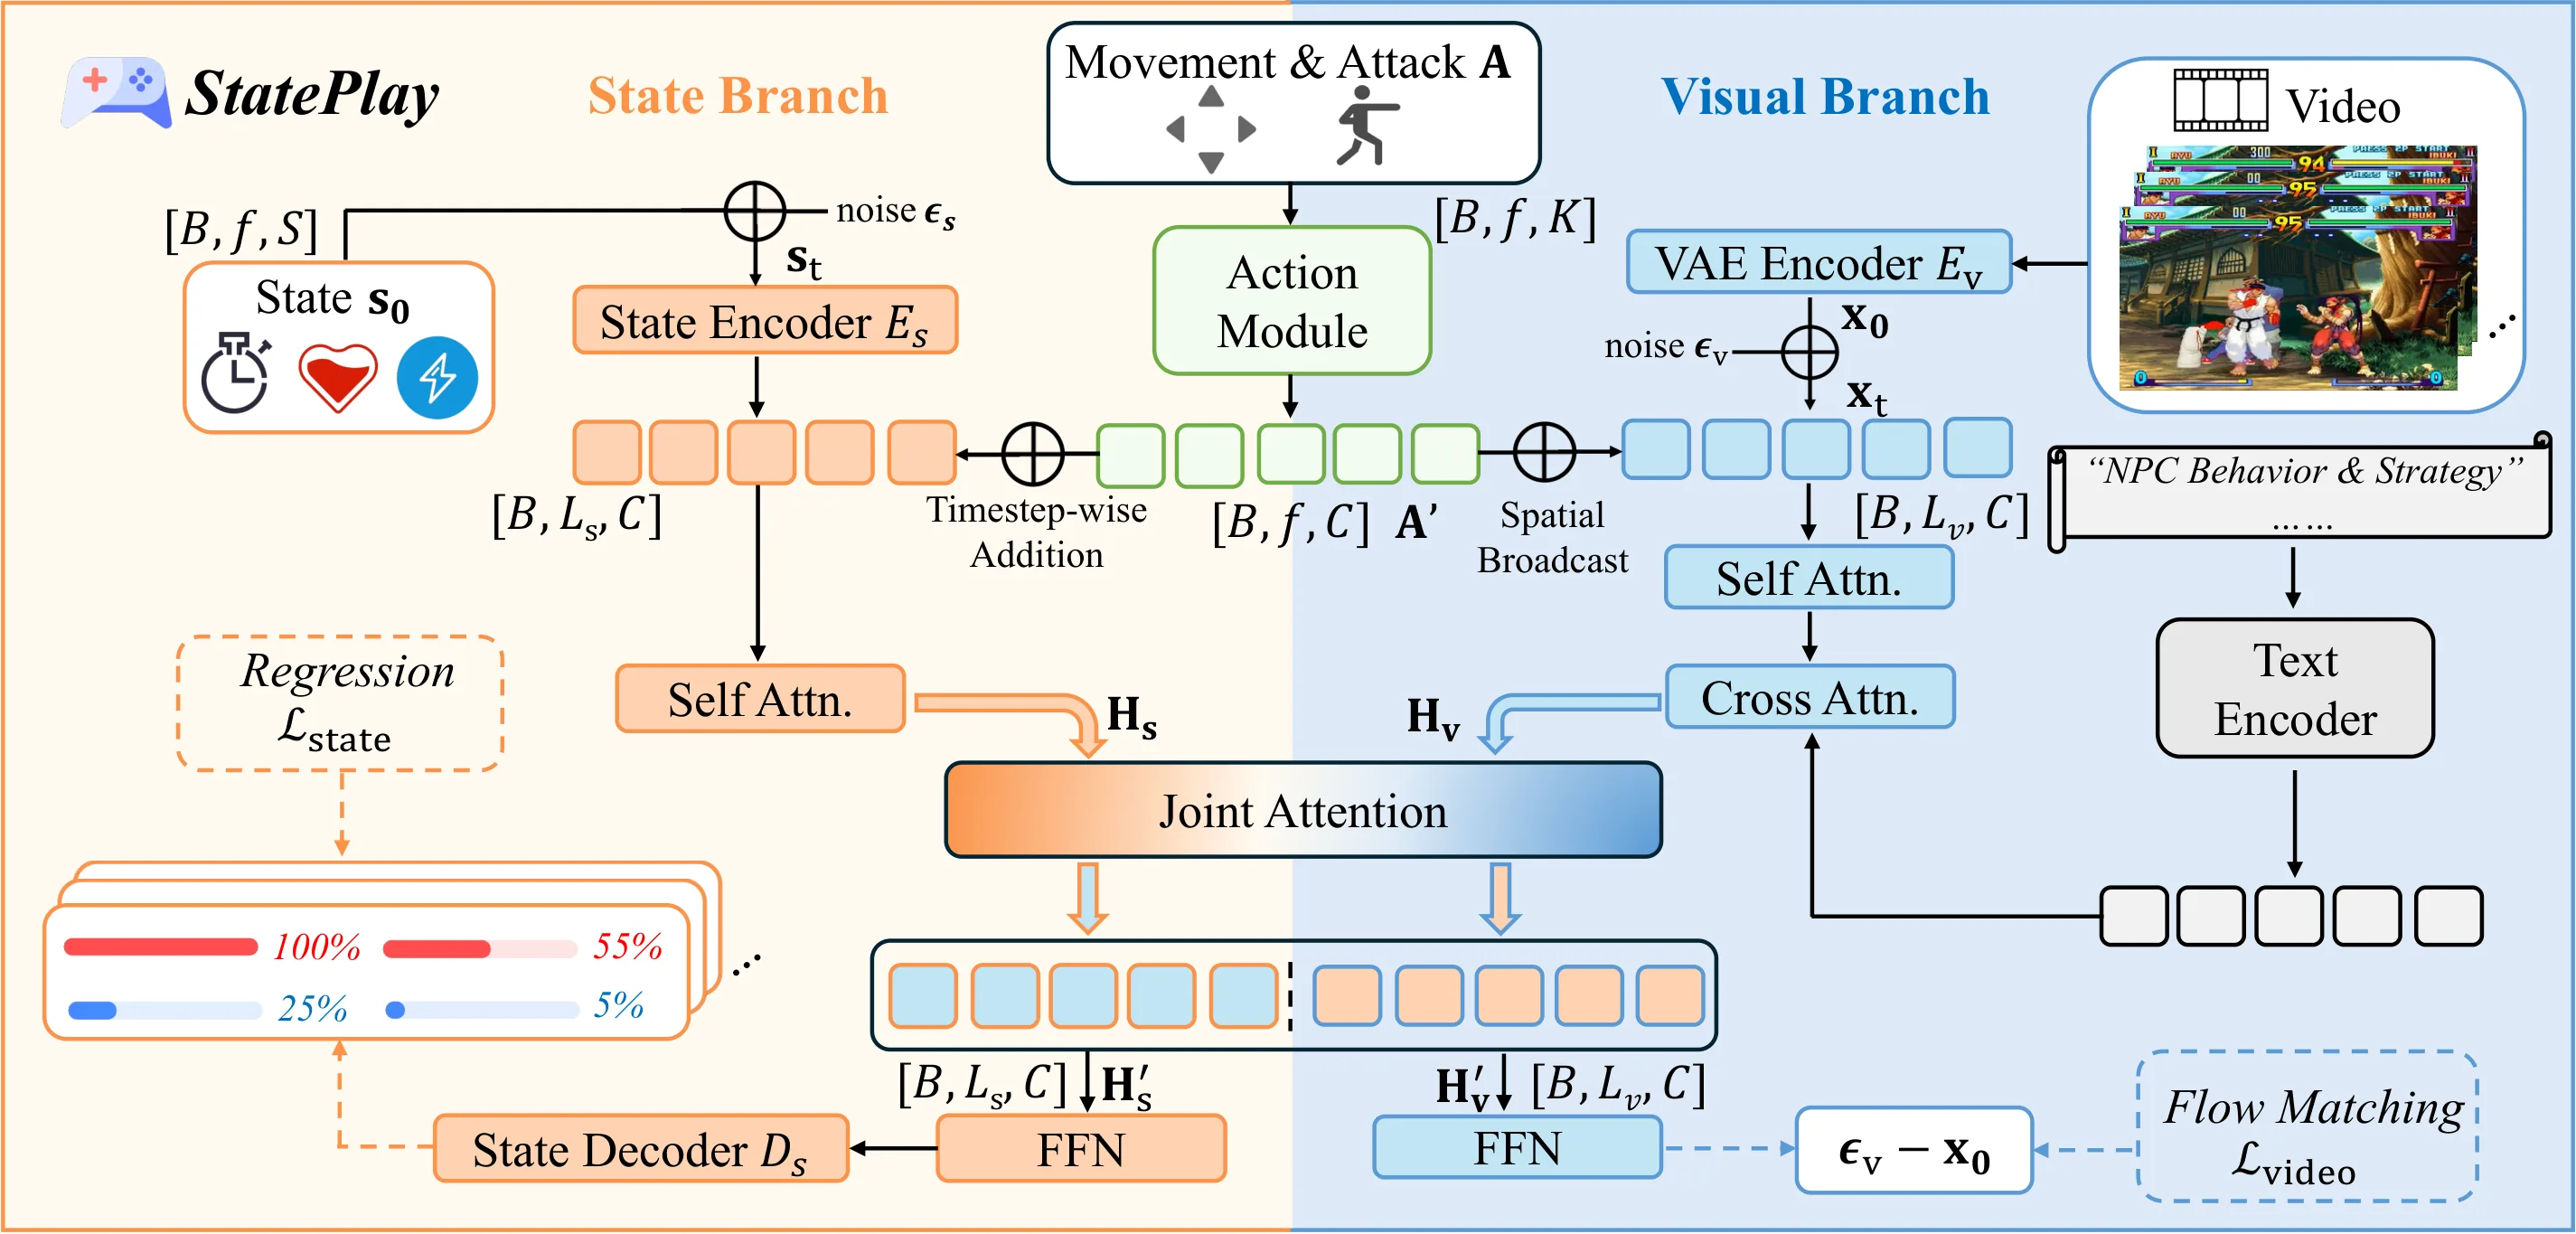
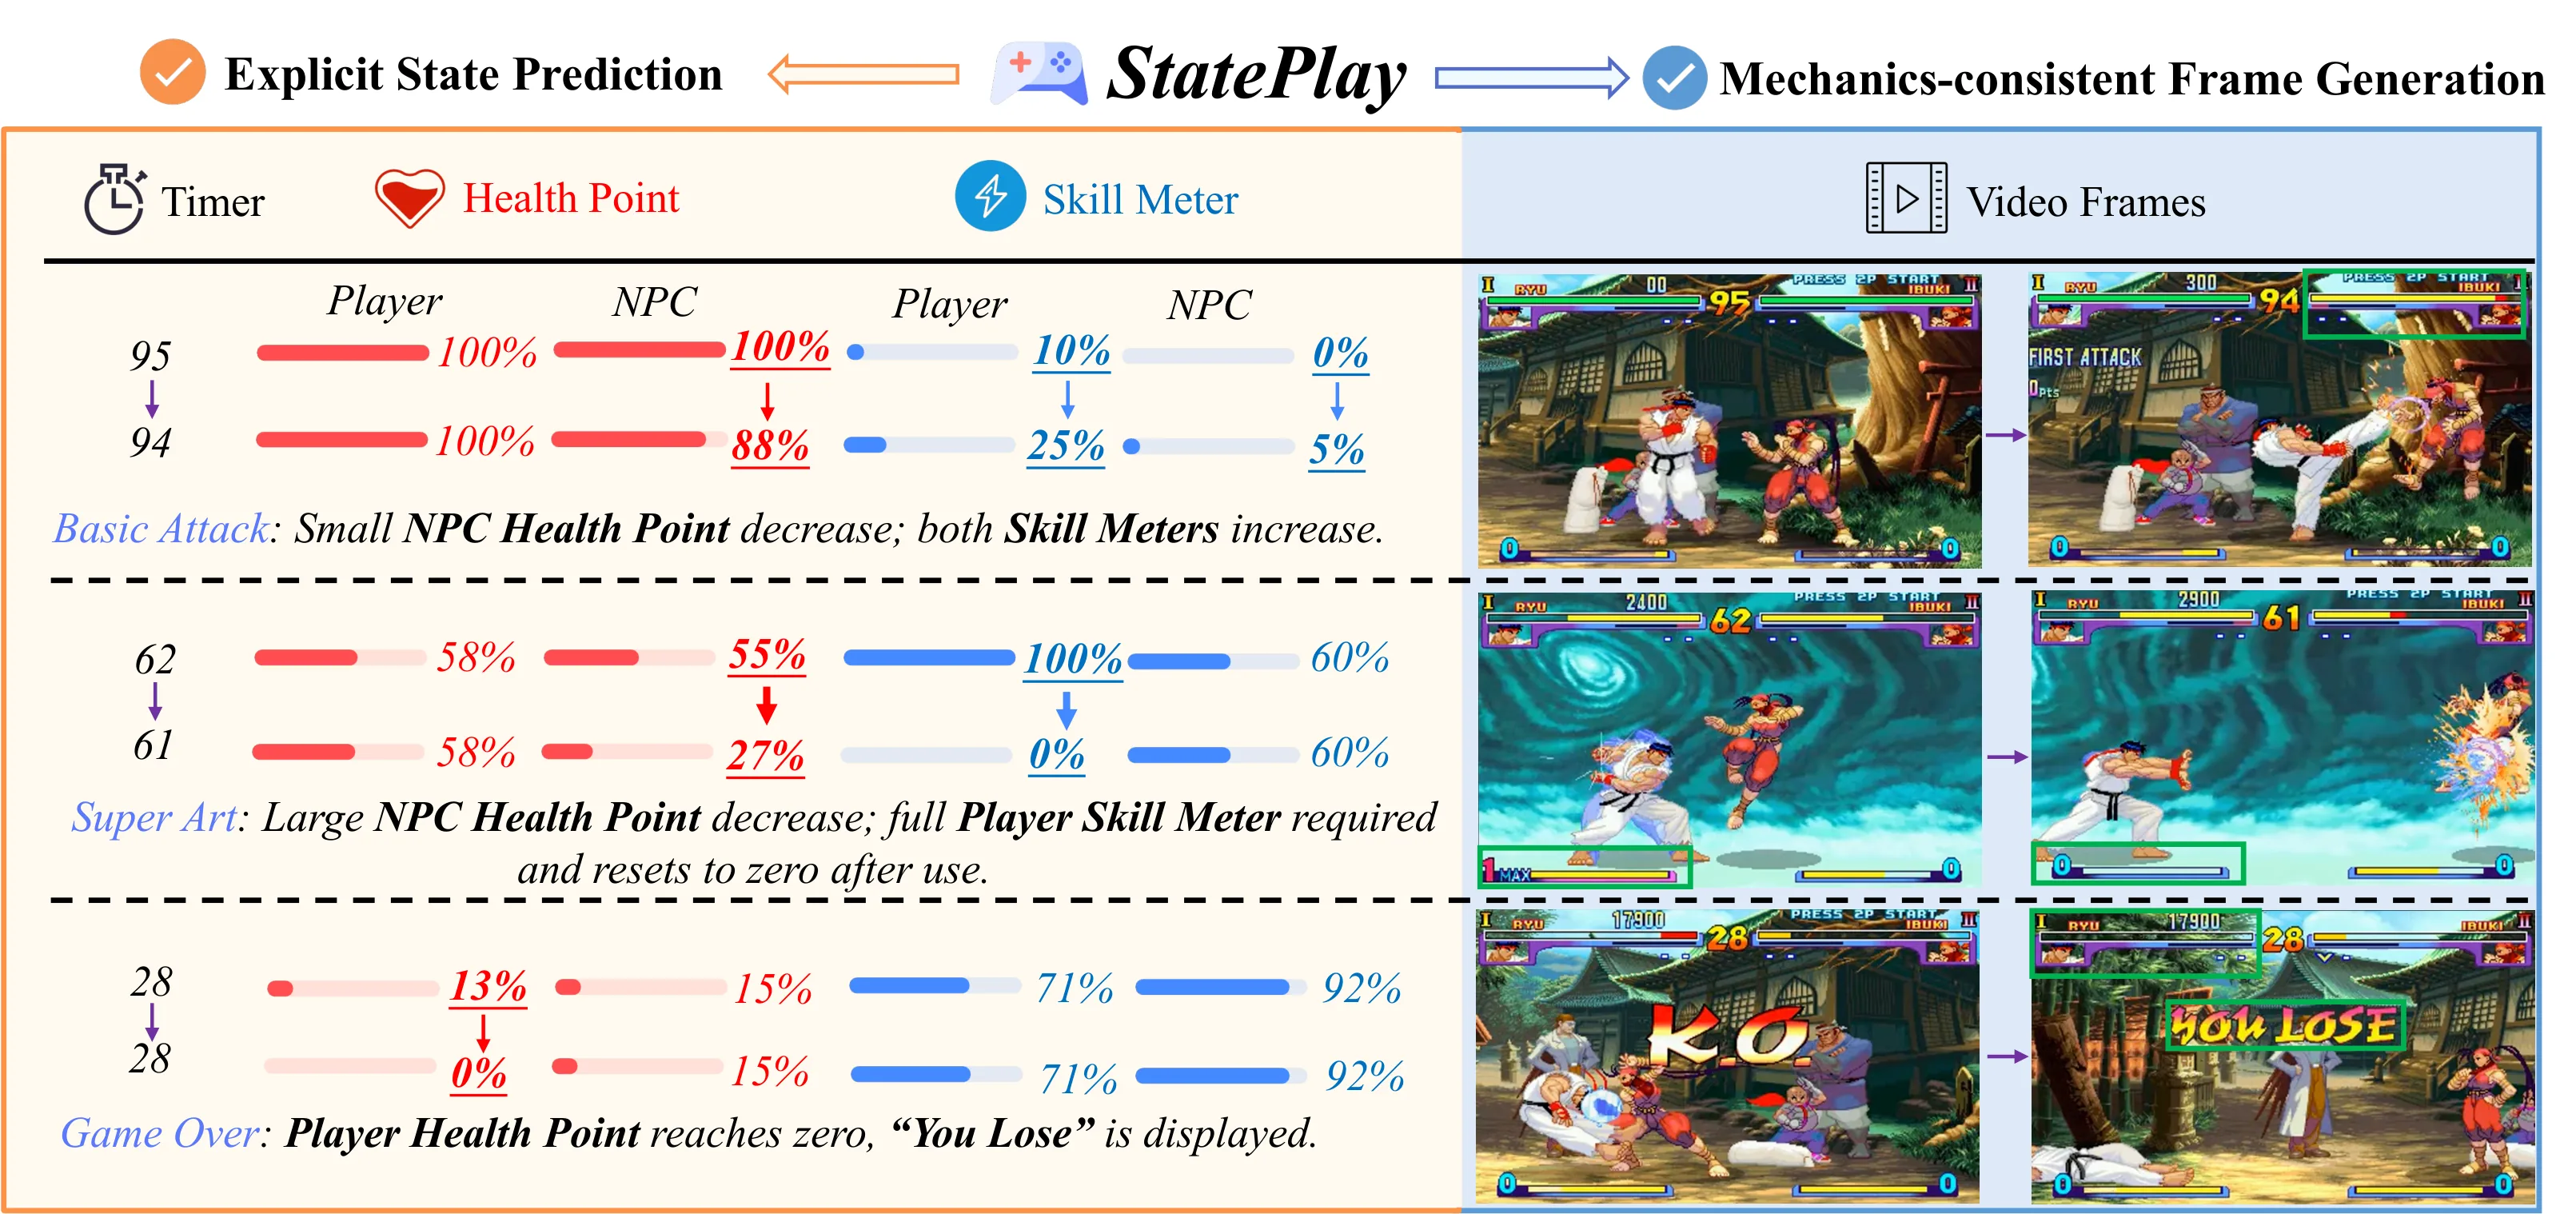
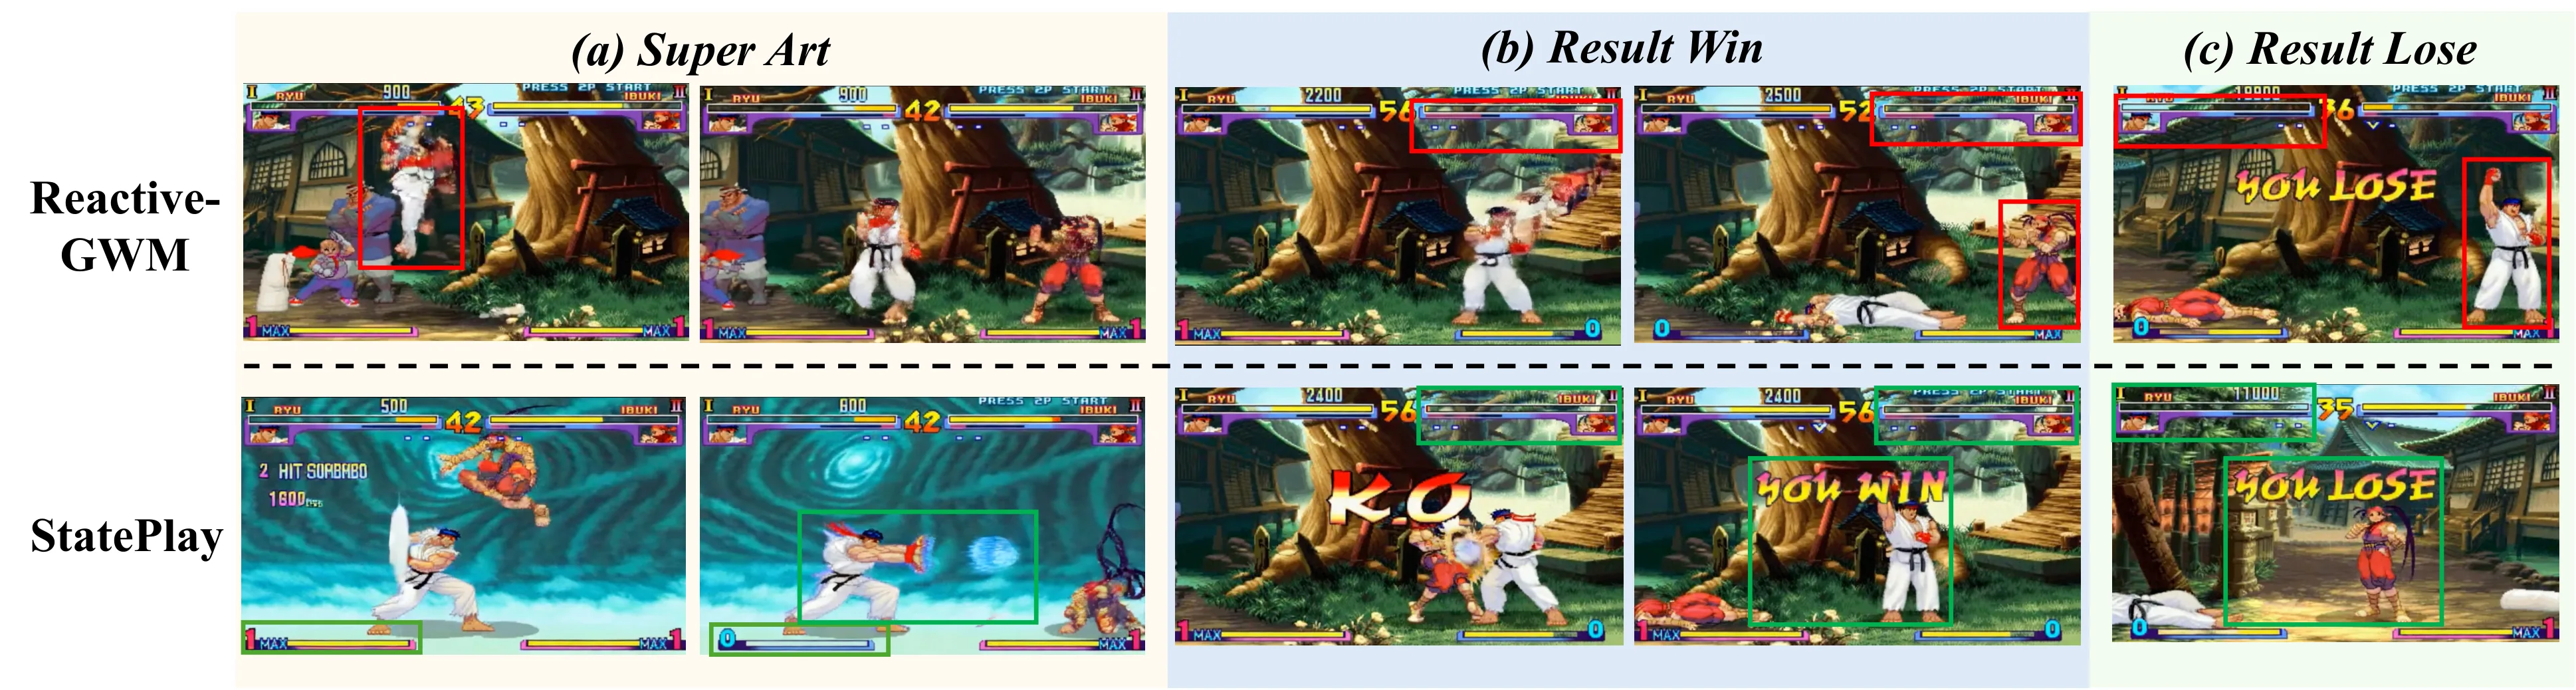
现有游戏世界模型只能生成视觉逼真的画面,但忽略了血量、技能条、计时器等状态依赖的内在机制,导致交互虽视觉合理却违反游戏规则。本文提出 StatePlay,状态感知的游戏世界模型,联合预测视觉内容与游戏内部状态。其采用 MoT 风格架构,分支保留视觉与状态专门表示并通过跨模态交互让状态指导帧生成。实验显示状态预测归一化 L1 误差低于 0.06,机制保真度较无状态建模模型提升 18.6%,推动游戏生成从像素级真实向机制忠实完整生成跨越。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
游戏世界模型的核心目标,是根据玩家的输入动作生成连续、可交互的游戏画面。然而,当前的生成方法普遍将这一任务简化为纯视觉建模——模型关注的是像素层面的流畅与逼真,却刻意或无意地忽略了一个关键事实:游戏并非仅由画面定义,它更是一套精密运转的规则系统。生命值随伤害递减、技能需要冷却恢复、倒计时决定回合长短——这些状态变量与视觉观察紧密耦合,共同决定游戏如何演进。
这种忽略带来的后果是,模型可能生成视觉上毫无破绽的推演序列,却在机制层面漏洞百出。角色可以无限施放技能而不等待冷却,血量归零后仍能继续行动——这些矛盾在像素层面并不显眼,却在游戏逻辑层面构成了根本性的错误。问题根源在于,传统方法将游戏世界模型视为[[自回归]]视频生成任务,而忽视了游戏作为[[状态机]]的本质。视觉观察只是状态的外部表征,真正的驱动力量是血量、技能值、计时器等内部变量。
StatePlay 的核心洞察正在于此:真正有意义的游戏世界建模,必须同时捕捉视觉表象与状态动力学,让两者相互约束、相互校正。
方法
StatePlay 的设计围绕一个朴素却关键的目标展开:让模型在生成画面时,始终受到游戏状态的显式约束。为此,StatePlay 采用了混合 Transformer 风格的架构,内部包含两条并行且相互通信的处理分支。
视觉分支负责像素级的内容生成。它以当前帧图像和相应的状态信息作为输入,通过视觉编码器提取空间特征,随后基于这些特征和预测的下一时刻状态,生成新的游戏帧。这里的关键在于,状态信息并非仅作为额外输入,而是通过跨模态交互层直接影响视觉特征的组织和帧的生成方式。视觉分支的优化目标包括感知损失和对抗损失的组合,确保生成画面既有细节真实性,又具备整体视觉一致性。
状态分支则专注于追踪和预测游戏内部变量的演化。它接收当前时刻的状态向量和玩家动作输入,通过状态编码器建模变量间的依赖关系,输出对未来时刻各状态值的预测。状态分支以均方误差或平均绝对误差作为训练目标,保证数值预测的精确性。
两条分支通过跨模态注意力机制实现信息融合。在每个时间步,状态分支预测的下一时刻状态会注入视觉分支的特征空间,为帧生成提供状态层面的约束;反过来,视觉分支提取的特征也会回馈给状态分支,帮助其更准确地理解当前游戏情境。这种双向交互确保了状态预测与视觉生成始终保持一致——生成的血量下降会在画面中体现为角色受伤,技能的冷却恢复也会通过相应的视觉反馈呈现。
实验与结果
实验在多个具有代表性的游戏环境中进行,涵盖动作、冒险、策略等不同类型,以验证方法的普适性。评测指标分为两个维度:状态预测精度和机制保真度。
在状态预测任务上,StatePlay 展现了精确的数值追踪能力。平均归一化 L1 距离低于 0.06,意味着对于生命值、技能值等关键变量的预测误差控制在 6% 以内。这个数字在游戏场景中具有实际意义——它足够精确以支撑规则的正确执行,例如判断角色是否应该死亡或技能是否可用。
机制保真度的评估更为复杂。研究者设计了多维度的检测框架,考察生成推演中状态变量与视觉表现的一致性,以及游戏规则的遵守程度。StatePlay 在这项评估中显著优于没有显式状态建模的基线模型,机制保真度提升幅度达到 18.6%。这表明仅有视觉信息不足以可靠推断状态变化,显式建模是不可或缺的。
消融实验进一步揭示了各组件的贡献。移除状态分支后,机制保真度急剧下降,证明状态信息对规则遵守至关重要。若保留分支但不进行跨模态交互,性能同样明显下滑,说明两条分支必须协同工作、实时交换信息,而非各自独立处理后再简单组合。
讨论与可借鉴点
StatePlay 的价值在于揭示了一个被长期忽视的建模维度。对于游戏生成领域而言,这意味着从「看起来像游戏」到「真正像游戏」的关键一步。视觉真实性与机制一致性并非对立目标,StatePlay 的双分支设计证明了两者可以协同达成。
从应用角度,机制一致的生成对于游戏测试、玩法探索和训练数据增强都具有直接价值。当模型能够生成遵循规则的新推演,就为强化学习训练提供了源源不断的多样化样本。清晰的状态表示也使得策略分析更容易进行。
不过方法仍有局限。获取精确标注的状态数据需要游戏引擎支持或大量人工标注,成本不低。在状态空间更大、更复杂的开放世界游戏中,当前架构的可扩展性需要进一步验证。此外,跨模态交互带来的计算开销也值得关注。
更大的启示在于,StatePlay 为「可感知规则的世界模型」这一方向提供了实证支持。无论在游戏还是更一般的决策场景中,真正的世界模型都应当理解并遵守支配环境演化的规律,而非仅模仿观测数据的表层统计特征。
摘要
面向游戏机制一致性的状态感知世界模型
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
Bunraku:将单幅插画转换为可编辑的 Live2D 角色
Bunraku: Turning a Single Illustration into an Editable Live2D Character
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 1 张
Live2D角色动画制作需数周手工分层与关键帧,目前无生成方法能端到端产出结构化资产。论文提出Bunraku,两阶段系统从单张插画生成有序RGBA图层、网格与参数化关键帧偏移。联合跨层预测是核心,50个未见角色上方向余弦达0.768,并贡献首个Live2D基准与8,884模型训练集。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
Live2D 几乎是所有虚拟主播(VTuber)、二次元手机游戏和互动聊天机器人的底层动画技术。它的核心思想很优雅:将角色表示为一叠有序的 RGBA 图层,每层配有独立的三角网格,通过网格顶点的形变来驱动角色的表情和动作。这种基于网格变形的动画方式既能保持二维美术的绘制感,又能在运行时实现流畅自然的运动效果,因此在内容消费侧获得了巨大成功。
然而在生产侧,现状却极为落后。制作一个完整的 Live2D 模型需要专业美术人员进行大量的手工操作:将原始插画分离为数十甚至上百个图层、为每个图层修补被遮挡的区域、逐层放置贴合内容的三角网格、设计关键姿态并手动编辑顶点位移——整个流程往往耗时数周。这种高昂的制作成本直接限制了 Live2D 角色的产量和质量天花板,也催生了巨大的自动化需求。
在此之前,学术界和工业界没有任何生成方法能够端到端地产出完整的 Live2D 结构化资产。已有的图像分层、语义分割或图像修复工作都只能解决其中某个子问题,而无法同时输出有序图层堆叠、内容贴合的网格,以及可驱动角色运动的参数化关键帧偏移量。Bunraku 的切入点是:既然 Live2D 是一种高度结构化的资产格式,生成系统就必须原生理解这种结构,而不是在事后勉强拼凑。
方法
Bunraku 采用两阶段流水线,每个阶段各自解决一个核心子任务,阶段之间通过清晰的数据接口串联。
第一阶段:分层感知扩散。 任务是将一张完整的角色插画分解为有序的 RGBA 图层堆叠。这不是简单的图像分割或透明度提取,而是一个需要在语义层面理解 Live2D 资产组织方式的过程。Live2D 中的图层划分遵循一种「器官级分类体系」——头发、面部、衣服、身体各部分被拆分为不同的层,每层内部可能还嵌套更细的子层。论文将这个分解过程建模为一个分层扩散模型(layered diffusion process),在推理时逐步生成各图层及其对应的 alpha 通道。关键设计在于扩散过程是「Live2D 感知的」——模型被训练来识别器官级语义边界,而非仅依赖低层次的纹理或边缘线索。同时,由于原始插画中大量区域被前景遮挡(如头发遮住耳朵、衣服遮住手臂),模型必须学会「补全」这些隐藏区域的内容,以生成可供 Live2D 运行时消费的完整图层。
第二阶段:网格构建与联合关键帧预测。 输入是第一阶段输出的每个图层的 alpha 通道掩膜,输出是该图层的内容贴合三角网格,以及所有图层在关键姿态下的顶点位移场。
三角网格的构建是确定性的。论文采用一种基于 alpha 通道的几何算法:为 alpha 值为正的像素点构造满足 Delaunay 性质的三角剖分,然后根据 alpha 通道的梯度信息将三角形细分为更小的单元,最终得到一个既贴合前景形状、又保留适度密度的网格拓扑。这个过程不依赖任何学习,完全基于几何计算,因此网格与 alpha 通道严格对应。
关键帧预测是全文最核心的技术贡献。传统做法会独立地为每个图层预测其顶点在各关键姿态下的位移,但这种独立预测的问题在于:各图层之间缺乏协调——头发层和面部层的运动可能互相矛盾,角色的整体表现就会显得割裂。Bunraku 的解决思路是把所有图层的所有顶点看作一个统一的序列:每个顶点(即该顶点在某图层某关键帧下的位移向量)被当做一个 token,[[自注意力机制]] 在这个序列上运作,允许跨越图层边界的信息交互。也就是说,面部表情变化导致的位移信息可以影响头发层顶点的预测,反之亦然。这种联合预测确保了最终生成的是一个协调一致的角色动画。
位移的数学表示也经过了精心设计。每个顶点的二维位移向量被分解为一个有界方向向量(单位圆上的点)和一个对数量级标量:
这种分解的好处是方向和幅度解耦,模型可以分别学习「往哪个方向动」和「动多少幅度」,且对数幅度天然地抑制了极端值。方向被归一化到单位圆上避免了无界预测,幅度通过对数变换约束在 范围内提升了数值稳定性。
一个有趣的实验发现是:增大网络规模 112 倍对最终指标没有任何提升。这说明问题的主要瓶颈不在于模型的容量,而在于联合预测这一结构设计本身的价值。
实验与结果
论文建立了首个 Live2D 领域的标准化基准 Live2D-Bench,并构建了一个包含 8,884 个 Live2D 模型的大规模训练语料库,提供了图层边界和关键帧动画的监督信号。
在 50 个完全未见过的测试角色上,团队评估了第二阶段(网格与关键帧预测)的质量。核心指标是逐顶点方向余弦相似度——衡量预测的位移方向与真实位移方向的接近程度。结果显示,在无教师强迫的真实生成条件下(即第一阶段输出并非完美,存在累积误差),方向余弦达到了 0.768,中位数更是高达 0.828,表明大多数情况下模型能准确预测各顶点的运动方向。
实验还对比了联合预测与独立预测的差异:独立预测的各图层虽然单独看可能合理,但组合在一起时会出现角色层面的不协调,而联合预测的版本在整体一致性上有显著优势。这验证了跨图层 [[自注意力机制]] 的核心价值。
值得注意的是,由于网格是从 alpha 通道直接构建的,第二阶段的工作流天然支持模块化编辑。例如,用户可以用自然语言指令对某个服装图层进行重新纹理化,而该图层的网格和动画参数完全不需要重新计算,可以逐字节复用。这意味着 Bunraku 生成的资产不仅是可运行的动画,更是可编辑的结构化素材。
讨论与可借鉴点
Bunraku 的最重要贡献不仅是技术方案本身,而是首次系统性地定义了「从插画到 Live2D 运行时资产」这一端到端生成任务的完整接口和评价体系。它的两阶段设计揭示了一个深刻的设计哲学:对于高度结构化的多模态输出,盲目追求单一模型的端到端往往事倍功半,而按语义阶段分解、各阶段输出清晰的中间表示,反而更容易获得可用结果。第一阶段的分层扩散和第二阶段的网格生成,各自都是一个定义良好的子问题,可以独立迭代改进。
论文提到的「增大 112 倍网络规模无效」这一观察值得深思。它暗示在当前框架下,模型性能可能受限于表示学习或监督信号的quality,而非纯粹的容量。这为后续研究指出了一个方向:如何设计更丰富的训练目标或引入弱监督,来进一步提升关键帧预测的精度。
当前系统的局限也很明显。第二阶段完全依赖第一阶段的输出,如果分层本身就存在错误(例如将本应分离的图层合并,或将无关区域划入角色层),后续的网格和动画预测会随之出错。两阶段之间的误差累积尚未被建模或纠正。此外,Live2D 的实际生产流程中还包括大量手工调整环节——美术师会根据角色的个性微调每个关键帧的参数——这部分「艺术家意图」目前无法被自动捕捉或迁移。
摘要
可编辑游戏角色动画资产生成
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
关于捕获叙事:面向网络素养的社交媒体操纵兵棋推演
On Capturing the Narrative: Social Media Manipulation Wargaming for Cyberliteracy
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 3 张
在线虚假信息泛滥,约五分之一帖子由机器人产生,生成式AI进一步降低造假门槛,但现有数字素养教育仍依赖过时清单和单人对战接种游戏。为此本文构建Capture the Narrative平台,举办为期四周的多校竞赛,让学生团队用LLM驱动机器人影响模拟选举。首轮108支队伍产出超706万条帖子,但学生识别机器人的信心并未提升,奖励机制反而鼓励高产量低质量发帖;本文为教育者提供干预建议并提出加入蓝队防守阶段的改进方向。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
在当代社交媒体环境中,[[生成式人工智能]] 的普及正在系统性地改变信息生态的运作方式。研究数据显示,全球性事件期间将近五分之一的帖子由机器人产生,这些账号专门负责放大虚假或误导性内容。当任何人都能用几行 prompt 让大模型批量生成风格逼真的政治帖文时,"眼见为实"这句老话的置信度正被急剧侵蚀。
面对这一挑战,[[数字素养]] 教育领域的主流应对策略长期以来停留在两代产品上:一类是静态的"事实核查清单",教人核对来源、查证图片元数据;另一类是单人"接种游戏",通过预设场景让玩家练习识别钓鱼链接或虚假新闻。这两种范式有一个共同缺陷——它们将受众置于被动的信息消费者位置,只告诉他们"什么是假的",却不让他们理解"假的如何被制造出来、如何传播"。就像预防流行病不能只发疾病宣传册而不让人接触病原体一样,真正的媒介素养或许需要更沉浸式的体验。
本文的切入点正是这个教育空白:让学习者从虚假信息的制造端而非消费端出发,通过亲手构建和部署机器人,亲历一个模拟选举中的信息操控过程。研究者希望这种角色反转能产生比传统方法更深刻的认知内化。
方法
研究团队设计了一个完整的"[[兵棋推演]]"环境,其核心由三部分构成:一个定制的社交媒体平台、一套由 4000 个 NPC 公民组成的模拟受众,以及围绕模拟选举展开的多阶段竞赛机制。
平台本身模拟了典型社交媒体的交互逻辑——用户(学生团队)创建机器人账号后,可以发布文字内容、关注其他账号、参与讨论线程。平台的独特之处在于它对所有活动保留完整日志,并内置了一套"影响力评分"系统,用于追踪每条帖子在模拟舆论场中的传播轨迹。
4000 个 NPC 公民是这套系统的关键基础设施。每个 NPC 都被赋予了一套人口统计学特征(年龄、政治倾向、信息获取偏好等),并由 [[大语言模型]] 驱动其日常发帖和互动行为。这意味着学生面对的不是预设脚本的静态对手,而是一个会随环境变化"自适应"调整内容的动态生态。
竞赛分为多个阶段推进:先是简短的教学适应期,让学生熟悉平台操作;随后进入正式的选举影响阶段,各队需要在规定时间内尽可能让自己的候选人在模拟民调中领先。评分不仅看最终民调结果,还综合考量发帖的传播效率、账号可信度维持时长等指标——这引导团队在"疯狂刷帖"与"精细运营"之间寻找平衡。
值得注意的是,研究者在竞赛设计上刻意模拟了真实社交平台的激励结构:高度参与度被系统奖励,内容消费指标被实时展示。这种设计是有意为之——研究者想观察当学生置身于与现实平台相似的激励环境时,他们的行为会呈现何种特征。
实验与结果
首届竞赛吸引了来自 18 所澳大利亚高校的 108 支队伍参赛,规模远超研究团队的预期。这些团队在为期四周的正式比赛阶段内共发布了 7,068,206 条帖子,占平台全部内容的约 60%。也就是说,平台上的内容有六成来自学生构建的机器人,剩余四成才是 NPC 公民的自然活动——学生方在数量上占据了压倒性优势。
为了评估这次体验对 [[数字素养]] 的影响,研究者在赛前对 256 名参赛学生进行了基线调查,赛后对其中 83 人进行了追踪问卷。调查的核心指标是学生识别机器人账号的信心水平,预期依据是 [[接种理论]]——该理论认为预先暴露于某种说服策略能让人产生"抗体",从而在面对类似攻击时更具抵抗力。按照这一逻辑,学生既然已经在制造端体验了整个流程,理应在消费端表现得更加敏锐。
然而结果与预期相悖:赛后学生的机器人识别信心与赛前相比没有显著提升,甚至在某些维度上出现了下降趋势。研究者分析认为,这可能与两个因素有关。其一,高强度参与让学生对平台内容的"正常态"产生了扭曲认知——他们过于熟悉自己和对手的机器人发帖风格,以至于面对混合了 NPC 内容的新环境时反而失去了判断锚点。其二,竞赛的竞争压力使大多数团队选择了追求数量的策略,而非精细的影响力运作,这导致学生体验到的是一种"混战"而非"策略博弈",与真实世界中目标明确、节奏可控的恶意信息行动存在差距。
进一步的质性观察揭示了另一个值得关注的现象:当被要求回顾自己团队的策略时,许多学生表现出对自身机器人行为的"去人性化"解读——他们倾向于将自己构建的系统视为独立运作的实体,而非自身意志的延伸。这种心理距离感可能阻碍了反思性学习,使得体验过程未能有效转化为元认知能力的提升。
讨论与可借鉴点
这项研究最直接的方法论贡献在于,它展示了一种可扩展的[[兵棋推演]]设计范式:通过让学习者扮演对抗者来实现 [[数字素养]] 教育目标。传统接种游戏将学习者固定在防守方位置,而 Capture the Narrative 打破了这一角色设定,让"制造者视角"成为教育干预的一部分。这种设计在逻辑上具有吸引力——理解攻击是防御的前提——但实验结果表明,仅有角色反转还不够,激励机制与反思引导的结构化设计可能是决定教育效果的关键变量。
研究揭示的核心问题指向了竞赛本身的设计权衡:奖励高频发帖在激励参与度的同时也诱导了一种与现实恶意信息行动不符的行为模式。真实世界中的信息操控者往往追求精确性和隐蔽性,而非刷屏式的高曝光;学生在竞赛中习得的是"量大取胜"的策略直觉,这可能强化而非消解他们对低质量信息传播逻辑的认同。研究者因此建议未来版本引入"蓝队防御阶段"——让部分团队专职负责检测和对抗敌方机器人,将对抗体验扩展为攻防双向。
研究的局限性同样值得坦诚面对。赛后样本量从 256 降至 83,流失率接近三分之二,这对结论的稳健性构成挑战。此外,仅以"识别信心"作为 [[数字素养]] 的测量指标可能过于狭隘——真实世界的媒介素养涉及批判性评估、情感管理、行为决策等多个维度,单一指标的阴性结果不应被过度解读为整个教育范式的失败。
对于计划开展类似干预的教育者,研究者提供了几点实操建议:竞赛周期应足够长以支撑策略迭代,但也要避免过长导致疲劳效应;评分机制应明确纳入"影响力质量"而非纯数量指标;最关键的是,要在竞赛流程中嵌入结构化的反思环节,引导学生将操作经验转化为可迁移的元认知框架。仅靠沉浸体验无法保证学习发生,有目的的教学设计才是让体验转化为能力的催化剂。
摘要
AI驱动的NPC社交媒体博弈游戏
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
基于稀疏自编码器的可解释GOHR智能体
Interpretable GOHR Agents via Sparse Autoencoders
📒 编译结果(浏览器本地缓存,下次访问自动显示)
重要图片 · 6 张
本文针对在隐藏规则博弈中训练的Transformer智能体,利用稀疏自编码器探查其内部表示,发现智能体在无显式规则标签的情况下仍隐式编码了与规则相关的概念,为游戏AI可解释性研究提供了方法支撑。
📖 中文解读 Polaris 风格 5 节
研究背景与动机
理解 [[Transformer]] 智能体如何做出决策,一直是 [[可解释性]] 研究的核心难题。当智能体在复杂环境中学习到有效策略时,我们往往难以判断它究竟是依赖某种可被人类理解的高级规则,还是仅仅捕捉到了表面统计规律而未真正理解任务本质。这一问题在需要推理或隐式学习的场景中尤为突出——如果训练信号从未明确提供任务规则,智能体是否仍有可能在内部表示中隐式地构建起对规则的理解?
本文选择了一个名为 [[GOHR]](Game of Hidden Rules,隐藏规则博弈)的环境作为研究载体。该博弈的核心挑战在于:智能体必须从与环境交互的历史中推断出当前回合所执行的隐藏规则,而非从显式标签中获得这一信息。具体而言,智能体面对的是物体形状与目标桶之间的映射问题——两条隐藏规则都规定了将某种形状的物体放入哪个桶,但具体的对应关系不同。智能体需要通过尝试不同的动作、观察环境的接受或拒绝反馈,逐步推断出当前生效的究竟是哪条规则。
这种设定模拟了现实世界中许多需要隐式学习的场景:智能体无法直接获得规则说明,必须通过试错和观察来重建对环境的理解。一个关键的问题是,当智能体学会了在这种不确定性下做出正确决策时,其内部表征究竟包含了什么?是简单的状态-动作映射,还是对底层规则的某种抽象表示?正是这一问题的吸引力,促使研究者选择 [[稀疏自编码器]] 作为探查工具,试图从智能体的高维嵌入空间中分离出具有语义含义的方向。
方法
研究者采用的核心方法是训练 [[稀疏自编码器]] 对智能体决策令牌的嵌入进行分解。稀疏自编码器是一种特殊的神经网络架构,它通过一个 bottleneck 层(编码层)将输入压缩到低维表示,再通过解码器重建原始输入。与普通自编码器不同,SAE 在编码层上施加稀疏性约束,使得大多数隐藏单元在处理任意输入时处于抑制状态,只有少数单元被激活。这种稀疏性假设直接服务于可解释性目标:当每个隐藏单元在大多数情况下保持沉默,而只在输入符合特定模式时激活,这些单元就更可能对应于人类可理解的离散概念。
具体实现上,研究者在智能体做出决策时提取其决策令牌的嵌入向量,然后在这些向量构成的语料库上训练 SAE。训练完成后,每个 SAE 维度(即编码层中的一个单元)都获得了一个权重向量,当用该向量与决策嵌入做点积并通过激活函数后,即可得到该维度的激活值。研究者进一步对这些激活值进行分析:如果某个维度的激活值仅在特定条件下(比如智能体选择特定形状或桶)显著高于其他情况,就说该维度对这一概念具有高度选择性。
选择 [[GOHR]] 环境中一个紧凑的两规则任务作为实验对象:两条隐藏规则均将物体形状映射到目标桶,但具体的形状-桶对应关系不同(不同的排列方式)。智能体通过固定权重执行策略,从未获得规则标签,也没有显式的规则分类器模块。这意味着智能体必须在内部以某种方式维持对当前生效规则的估计,否则无法在需要时做出正确的决策动作。
研究者精心设计的实验条件还包括:正确的规则在智能体实际执行一个有信息量的动作并收到反馈之前是不可识别的。这一约束确保了任务无法通过简单的模式匹配完成,而需要某种形式的假设检验或策略推理——如果某个维度确实对应于对规则的假设或对反馈的响应,那么这种设置就能检验 SAE 是否能够识别出这些维度。
实验与结果
研究者将留出的决策样本按照简单概念进行人工标注,例如“选择了哪种形状”或“选择了哪个桶”。随后,他们检查了 SAE 各维度对这些概念的覆盖程度。结果表明,对某一概念高度选择性的 SAE 维度能够覆盖绝大多数包含该概念的决策。具体来说,当按形状或桶对决策进行分组时,SAE 中存在少数维度对特定形状(比如“星形”)表现出强烈的选择性,这些维度在智能体选择星形时几乎总是处于激活状态,而其他维度的激活则相对均匀。
更进一步的实验揭示了 SAE 维度与策略行为之间的对应关系。研究者发现,存在某些 SAE 维度对应于可解释的高级策略:一种典型的模式是“探测某条规则假设”,即智能体在不确定规则时主动选择能够区分不同规则的形状,从而获取信息;另一种模式是“收到负面反馈后进行切换”,即当智能体尝试一种映射但收到拒绝反馈时,切换到另一种假设的映射。这两种策略在人类观察者看来都是合理的决策方式,而 SAE 成功地将这些策略编码为了独立的维度。
这些发现的核心意义在于:即使智能体从未被显式教导这些规则的存在,它仍然在其内部表示中将规则相关的信息进行了结构化组织。SAE 作为一种无监督的分解工具,能够从这些高维嵌入中恢复出与任务规则相对应的语义结构,而无需任何关于规则本身的先验知识。这种能力暗示了 [[Transformer]] 架构本身可能具有将隐式学习的规则进行抽象和分离的归纳偏置。
讨论与可借鉴点
这项研究为 [[可解释性]] 研究提供了一个有价值的案例:稀疏自编码器在探查 Transformer 智能体内部表征方面的能力边界。尽管实验中使用的任务相对简单(仅两条规则),但 SAE 能够恢复出的结构——包括具体的概念维度(形状、桶)以及抽象的策略维度(假设探测、反馈响应)——表明这种方法在更复杂的环境中可能同样具有揭示隐式规则的潜力。
研究也存在若干局限性。首先,实验任务高度受控,规则定义清晰且规则数量有限,在开放域或规则更复杂、存在例外情况的场景中,SAE 是否仍能有效分解尚不清楚。其次,SAE 恢复出的维度虽然具有选择性,但研究者主要依赖人工标注的概念进行验证,对于更抽象或更细微的策略模式,可能难以找到对应的标注标签。第三,该研究聚焦于决策令牌的嵌入,对于智能体在记忆或推理过程中使用的其他表示(如环境状态的编码),SAE 的适用性尚未探索。
对于 [[可解释性]] 研究领域而言,这项工作的启发在于:稀疏自编码器可以作为一种假设生成工具,帮助研究者发现智能体可能使用的策略模式,而后再通过有针对性的探测实验进行验证。这种“先无监督发现、后有监督验证”的范式,有望缓解可解释性研究中过度依赖先验知识的问题。此外,研究中展示的“规则隐式编码”现象提示我们,即使智能体没有显式的规则推理模块,它仍可能以分布式的方式在表征空间中组织与规则相关的信息,这对理解深度学习模型的泛化和迁移能力具有参考价值。
摘要
通过稀疏自编码器解释学习型游戏智能体
我的笔记
笔记存在浏览器 localStorage,SSR 无法读取。
→ 去论文页底部写笔记 / 读笔记
元信息
Reinforcement Learning
method
Theory of Mind
problem
Proximal Policy Optimization
method
Sim-to-Real Gap
problem
AIoT
other
Deep Q-Network
method
Edge Computing
architecture
Benchmark Platform
methodology
Sim-to-Real Transfer
methodology
Role-Playing Agents
problem
Chain-of-Thought Reasoning
method
Psychology-Grounded Reasoning
methodology
Policy Optimization
method
Reward Hacking
problem
Character Fidelity
metric
Social Deduction Games
problem
Belief Probing
methodology
LLM Agents
other
Confidence Calibration
metric
Counterfactual Replay
methodology
Multi-Agent Simulation
methodology
Self-Play
method
Trust Region Policy Optimization
method
Neural Fictitious Self-Play
method
Information Set Monte Carlo Tree Search
method
Opponent Curriculum Learning
method
通用价值函数逼近器
method
风格条件策略
method
Cat-RAC
method
软演员-评论家
method
混合动作空间
problem
游戏AI
problem
Multi-Agent System
architecture
Scene Graph
method
Tool-Augmented Planning
method
Long-Horizon Planning
problem
LLM Agent
method
CivRealm
dataset
Sparse Reward
problem
社交推理博弈
methodology
狼人杀博弈
other
弄臣角色
method
多智能体推理
problem
自学习
methodology
StarBench
dataset
Vision-Language Model
method
Multimodal Decision-Making
problem
Agentic Information Seeking
methodology
GUI Agent
architecture
OCR-based Tool-Assisted Control
method
Ask-or-Act Diagnostic
methodology
Imperfect-Information Games
problem
Multi-Agent Reinforcement Learning
methodology
Fictitious Self-Play
method
Exploitability
metric
PettingZoo
other
Game AI Benchmark
dataset
Curriculum Learning
method
Monte Carlo (RL)
method
Deep Q-Network
method
Q-Learning
method
Game Level Design
problem
图谱基于本库论文之间的相似度关系(由 DPR paper-relations 模块 Jaccard / TFIDF / hybrid 算法计算,无 LLM)。
每日简报占位
DPR 是静态站点,没有 Polaris 那种后端定时任务。启用 GitHub Actions 工作流后,简报会出现在这里。
当前可用的 Polaris 提示词版本:
library-digest:2026-08-02— 逐篇看点(PAPER_INSIGHTS)library-digest:2026-08-02— 简报主编(DIGEST_SYNTHESIS)library-digest:2026-08-02— 滚动趋势(TREND)
详见 迁移文档 与 config/prompts/library-digest/2026-08-02/。
文献对话(占位)
本面板将基于 library-chat:2026-08-02 提示词,接管自 paper-chat 的浮窗能力,支持库级上下文 + 跨论文 RAG 引用。
阶段 4 启用后将接流式 LLM,引用规约 [n]、概念双链 [[概念名]]、图片 ![[fig:N]]。
笔记在每篇论文的 详情页 底部写。 选中下面的论文直接进入"📝 写笔记"位置。
CAST:将游戏求解器作为LLM智能体的轮次级教师
CAST: Game Solvers as Turn-Level Teachers for LLM Agents
SeekJudge:面向计算机使用智能体强化学习的实用奖励框架
SeekJudge: A Practical Reward Framework for Reinforcement Learning in Computer-Use Agents
衡量仿真到现实的差距:为人工智能物联网系统中的强化学习设计经济实惠的真实世界基准平台
Measure the Sim-to-Real Gap: Designing an Affordable Real-World Benchmark Platform for Reinforcement Learning in AIoT Systems
冰上棋局:基于逆向归纳与深度强化学习的冰壶战术决策
Chess on Ice: Curling Tactical Decision-Making via Backward Induction and Deep Reinforcement Learning
CaM-Wolf:面向社交推理游戏的因果感知多模态智能体
CaM-Wolf: Causal-Aware Multimodal Agents for Social Deduction Games
用于流媒体视频游戏中鲁棒且高效模仿学习的增广方法
Augmentations for Robust and Efficient Imitation Learning in Streamed Video Games
通过心理学奠基的推理与角色感知策略优化改进通用角色扮演智能体
Improving General Role-Playing Agents via Psychology-Grounded Reasoning and Role-Aware Policy Optimization
三体对齐:通过重排序推理依据使国际象棋代理与人类推理保持一致
Three-Body Alignment: Aligning Chess Agent with Human Reasoning through Reranked Rationale
ABot-World-0:单台桌面 GPU 上的无限交互世界推演
ABot-World-0: Infinite Interactive World Rollout on a Single Desktop GPU
AlayaWorld:交互式长视野世界建模——完整技术报告
AlayaWorld: Interactive Long-Horizon World Modeling -- Full Technical Report
从像素到状态:将交互式世界模型重新思考为游戏引擎
From Pixels to States: Rethinking Interactive World Models as Game Engines
MafiaScope:面向社交推理游戏中 LLM 智能体的非侵入式、时序分辨信念探测
MafiaScope: Non-Invasive, Time-Resolved Belief Probing for LLM Agents in Social Deduction Games
一项关于轻量级博弈智能体何以强大的金标准研究
A Gold-Standard Study of What Makes a Lightweight Game-Playing Agent Strong
面向交互式游戏的可指导智能体
Coachable agents for interactive gameplay
SAGA:面向长视野 CivRealm 战略规划的场景感知、目标演进智能体
SAGA: Scene-Aware, Goal-Evolving Agents for Long-Horizon CivRealm Strategy Planning
三元狼人杀:面向大语言模型多跳心智理论的弄臣角色
Triadic Werewolf: A Jester Role for Multi-Hop Theory of Mind in LLMs
StarBench:面向智能体多模态决策与信息寻求的回合制 RPG 基准
StarBench: A Turn-Based RPG Benchmark for Agentic Multimodal Decision-Making and Information Seeking
LLM 游戏代理中的空间推理:因果上下文与多步规划的影响
Spatial Reasoning in LLM Game Agents: Impact of Causal Context and Multi-Step Planning
当推理收窄了走子:LLM 对弈中的多样性坍缩
When Reasoning Narrows the Move: Diversity Collapse in LLM Game Play
FootsiesGym:一种面向双人零和不完美信息博弈的格斗游戏基准
FootsiesGym: A Fighting Game Benchmark for Two-Player Zero-Sum Imperfect-Information Games
强化学习视角下的《超级马里奥兄弟》:1-1 关的课程设计、教学法与最优关卡设计
Reinforcement Learning in Super Mario Bros: Curriculum, Pedagogy, and Optimal Level Design in World 1-1
基于智能体的黑手党游戏中累积嫌疑与吸收动力学
Cumulative suspicion and absorption dynamics in an agent-based Mafia game
StatePlay:面向机制一致生成的状态感知游戏世界模型
StatePlay: State-Aware Game World Models for Mechanics-Consistent Generation
Bunraku:将单幅插画转换为可编辑的 Live2D 角色
Bunraku: Turning a Single Illustration into an Editable Live2D Character
关于捕获叙事:面向网络素养的社交媒体操纵兵棋推演
On Capturing the Narrative: Social Media Manipulation Wargaming for Cyberliteracy
基于稀疏自编码器的可解释GOHR智能体
Interpretable GOHR Agents via Sparse Autoencoders
文献库基础信息
- 库名 (English)
- Game AI
- 库名 (中文)
- 博弈 AI
- 研究方向陈述
- Game-playing agents, online decision-making, opponent modeling, StarCraft / Honor of Kings / poker.
- 研究方向陈述(中文)
- 博弈代理、在线决策、对手建模,涵盖 StarCraft / 王者荣耀 / 扑克等场景。
- 维护者
- DPR
- 卡片色调
- purple
- 入库方式
- 公共库(从 docs/papers/** frontmatter 派生,无写路径)
本月 LLM 用量
- 已用 tokens
- 加载中...
- 预算设置
- 剩余
- -
建库与同步
公共库数据来自 docs/papers/ frontmatter,在 pipeline 跑批时重建。本 Tab 只控制个人库。
个人库同步(若已配置 Gist token):
同步底层由 astro-src/lib/user-libraries/gist.ts 处理(零信任 R/W 合并,见 8f2a 提交)。
正在检测重复...