
StarBench:面向智能体多模态决策与信息寻求的回合制 RPG 基准
StarBench: A Turn-Based RPG Benchmark for Agentic Multimodal Decision-Making and Information Seeking
📝 TLDR
现有VLM在真实游戏客户端中能否像人类一样从截图生成连贯的低层按键操作并在受挫时主动寻求信息仍是开放问题。本文基于《崩坏:星穹铁道》构建StarBench基准,涵盖8项战斗任务,在统一任务与指标下设立直接控制与工具辅助控制两种评测模式,并加入ask-or-act诊断衡量是否/何时请求简短指引。实验显示当前VLM在直接控制模式下感知到控制的保真度存在显著差距,而合理的信息寻求行为与成功率提升正相关。
🧭 速览
真实游戏客户端中从原始截图映射到时序连贯的键盘鼠标底层操作,且能在受挫时主动寻求信息,是VLM尚未被验证的人类级游戏能力。
在《崩坏:星穹铁道》真客户端中定义8项战斗任务,设立直接控制(截图→点击/按键)与工具辅助控制(detector+OCR文本化观察)两种统一协议,并加入ask-or-act诊断量化何时请求简短指引。
直接控制模式下VLM的感知到控制保真度存在显著差距,而合理的信息寻求行为与后续任务成功率正相关,具体基线数字原文未在摘录中给出。
StarBench为真实客户端中的智能体信息寻求与多模态决策提供了可复现的衡量基准,揭示了VLM在底层控制与主动求助决策上的不足。
🆚 方法对比
StarBench
- 基于真实客户端,非模拟器
- 统一任务与指标下双轨评估
- 覆盖八个战斗任务,内容丰富
- 方法无关,易于复现
- 仅基于单一游戏HSR,泛化性受限
- 依赖游戏版本,UI变动影响基准稳定性
- 评估任务偏战斗,信息寻求覆盖有限
Direct Control (直接控制)
- 纯截图到原子动作,无语义提示
- 真实反映感知到控制的映射能力
- 衡量VLM像素级UI定位能力
- 现有VLM感知控制保真度差距大
- 低层坐标输出难度极高,错误易累积
- 缺乏语义辅助,评估结果偏负面
Tool-Assisted Control (工具辅助控制)
- OCR与检测器减轻UI定位负担
- 高层意图映射降低操作复杂度
- 支持文本化观察便于多模态推理
- 依赖检测器与OCR的额外工具链
- 工具引入使感知控制能力难以分离衡量
- 与真实玩家纯视觉体验不完全一致
Ask-or-Act Diagnostic (问或行动诊断)
- 量化信息寻求与行动的决策权衡
- 方法无关,可适配多种代理
- 揭示信息寻求能提升后续表现
- 仅提供有限文本引导,信息量受限
- 诊断结果受代理主动提问策略影响大
- 该机制与人类玩家实际行为仍有差距
StarBench通过双轨制(Direct Control与Tool-Assisted Control)结合Ask-or-Act诊断,在统一任务下分别评估感知到控制的映射能力和代理信息寻求决策,弥补了Atari、BALROG、CRADLE等基准仅评估单轨或缺乏信息寻求诊断的不足。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
TLDR
现有VLM在真实游戏客户端中能否像人类一样从截图生成连贯的低层按键操作并在受挫时主动寻求信息仍是开放问题。本文基于《崩坏:星穹铁道》构建StarBench基准,涵盖8项战斗任务,在统一任务与指标下设立直接控制与工具辅助控制两种评测模式,并加入ask-or-act诊断衡量是否/何时请求简短指引。实验显示当前VLM在直接控制模式下感知到控制的保真度存在显著差距,而合理的信息寻求行为与成功率提升正相关。
Abstract
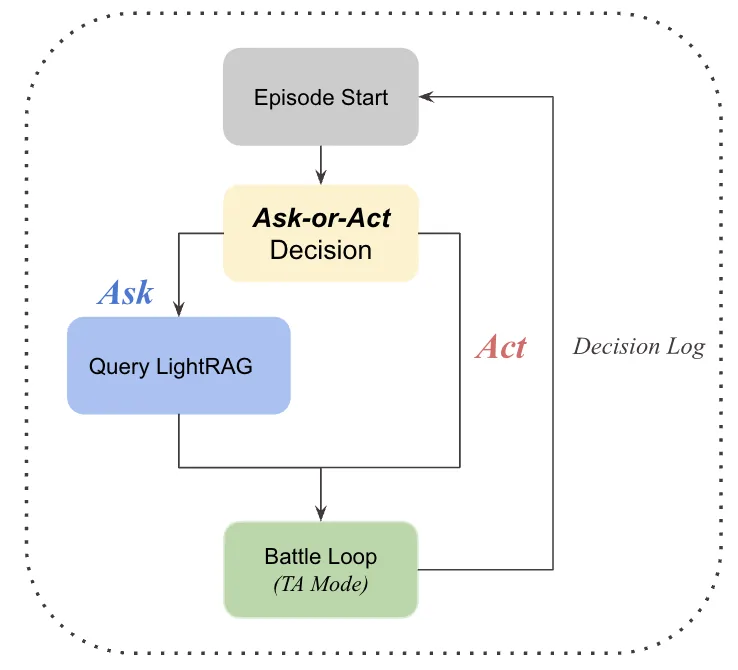
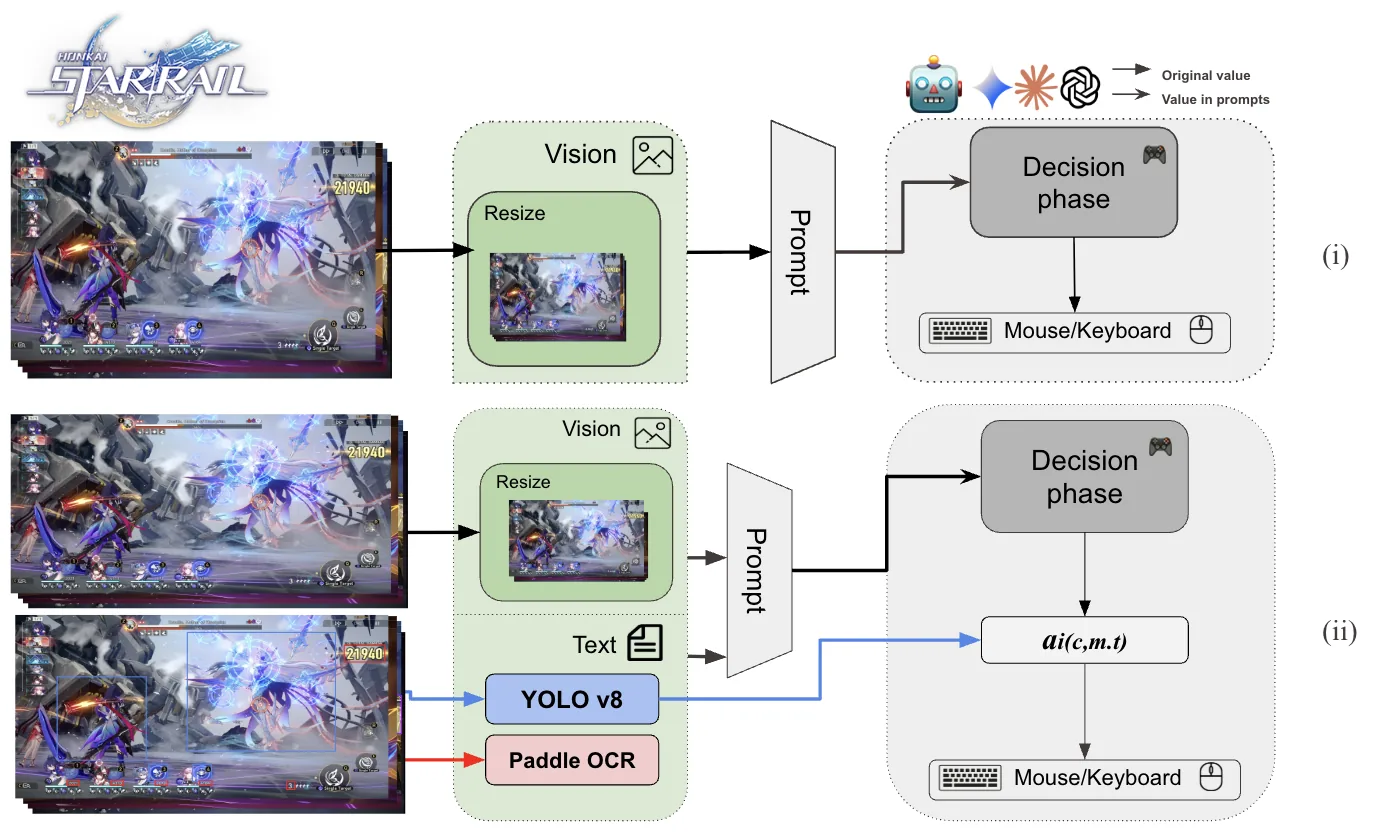
Human players do more than press buttons: they ground what they see on screen into precise keyboard-mouse actions and, when stuck, they seek information before trying again. We ask whether current vision-language models (VLMs) can do the same. Despite encouraging results under simplified control or tool scaffolds, human-like play in a real client - mapping raw screenshots to temporally coherent low-level actions while deciding when to ask for guidance - remains an open challenge. We introduce StarBench, a turn-based RPG benchmark derived from Honkai: Star Rail that targets these two human-like competencies: multimodal decision-making from pixels to actions and agentic information seeking. StarBench standardizes evaluation across eight combat tasks and two regimes with shared tasks and metrics: (i) direct control, where agents receive only screenshots and must emit low-level primitives (click and keypress) with no semantic hints; and (ii) tool-assisted control, where higher-level intents can be mapped to primitives by detectors and OCR outputs provide optional textualized observations to ease UI grounding. To mirror human practice, StarBench also includes an ask-or-act diagnostic that measures whether and when agents choose to request brief guidance before proceeding, and how that choice affects subsequent performance. We report reference baselines for contemporary VLMs and a human reference. Results expose sizable gaps in perception-to-control fidelity in the direct regime, while showing that judicious information seeking correlates with improved success, establishing StarBench as a reproducible yardstick for agentic information seeking and multimodal decision-making in real-client play.
动机
真实游戏客户端中从原始截图映射到时序连贯的键盘鼠标底层操作,且能在受挫时主动寻求信息,是VLM尚未被验证的人类级游戏能力。
方法
在《崩坏:星穹铁道》真客户端中定义8项战斗任务,设立直接控制(截图→点击/按键)与工具辅助控制(detector+OCR文本化观察)两种统一协议,并加入ask-or-act诊断量化何时请求简短指引。
结果
直接控制模式下VLM的感知到控制保真度存在显著差距,而合理的信息寻求行为与后续任务成功率正相关,具体基线数字原文未在摘录中给出。
结论
StarBench为真实客户端中的智能体信息寻求与多模态决策提供了可复现的衡量基准,揭示了VLM在底层控制与主动求助决策上的不足。
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。