
📝 TLDR
学习通常由预测误差驱动,但完美匹配预期的零预测误差是否具有心理与计算意义尚不清楚。本研究在不确定性环境中操纵部分试次使结果恰好等于被试预测,结合行为建模与脑电分析考察零预测误差对情绪、信念更新及神经反馈加工的影响。结果显示零预测误差引发最高瞬时愉悦感,其效应在高不确定性与高不确定性不耐受个体中尤为突出,P3类脑电成分可预测后续学习差异。该发现表明完美预测并非中性事件,而是主动塑造情感、行为与神经加工的信号。
🧭 速览
强化学习理论强调预测误差驱动学习,但零预测误差(即结果完全符合预期)的心理与计算作用尚不明确。
被试在不确定性环境中反复预测奖励,部分试次结果被操纵为恰好匹配预测,结合计算模型拟合与结果锁定EEG分析。
零预测误差引发最高瞬时愉悦感,其触发的P3类脑电活动可预测后续信念更新减弱;在高不确定性与高不确定性不耐受者中效应更强。
完美预测并非中性事件,而是承载特定信念状态、主动塑造情感、行为与神经反馈加工的具有信息量的信号。
🆚 方法对比
Multi-Agent Reinforcement Learning (MARL)框架
- 可直接从经验学习线索与策略的函数关系
- 可发现研究者未预期的灵活适应性策略
- 支持奖励最大化生成自适应的集体觅食模式
- 计算成本高,训练复杂度大
- 学习到的策略可解释性较弱
- 对超参数和环境设定较敏感
Spatially-explicit智能体仿真模型
- 建模移动资源的空间动态更贴近生物学现实
- 可系统操纵资源波动性与社会线索类型
- 支持个体与集体行为的涌现分析
- 依赖具体建模假设,可能限制泛化性
- 智能体行为库需预定义,灵活性受限
- 难以直接验证到真实动物群体
三动作行为库(随机探索/私人追踪/社会吸引)
- 涵盖动物觅食的基本策略,具生物学合理性
- 智能体可基于波动性灵活切换策略
- 明确建模了探索-利用权衡
- 私人追踪建模为速度受限,成本设定可能过于简化
- 策略离散化可能忽略连续混合策略
- 三动作设计未必涵盖所有真实行为
社会信息质量分级(位置线索/动作线索/收益线索)
- 系统区分低质量与高质量社会线索的影响
- 揭示高质量线索下行为多样性涌现
- 解释稳定环境下简单线索的适用性
- 线索分类可能遗漏中间复杂度信息类型
- 未建模线索可靠性随时间的动态变化
- 线索质量与生态情境交互机制仍待验证
本文以MARL为统一框架,结合空间显式智能体模型与三动作行为库,系统比较了不同社会信息质量(位置/动作/收益线索)在不同环境波动性下的集体觅食行为表现,揭示了信息质量与生态情境的交互是塑造集体行为多样性的核心机制。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
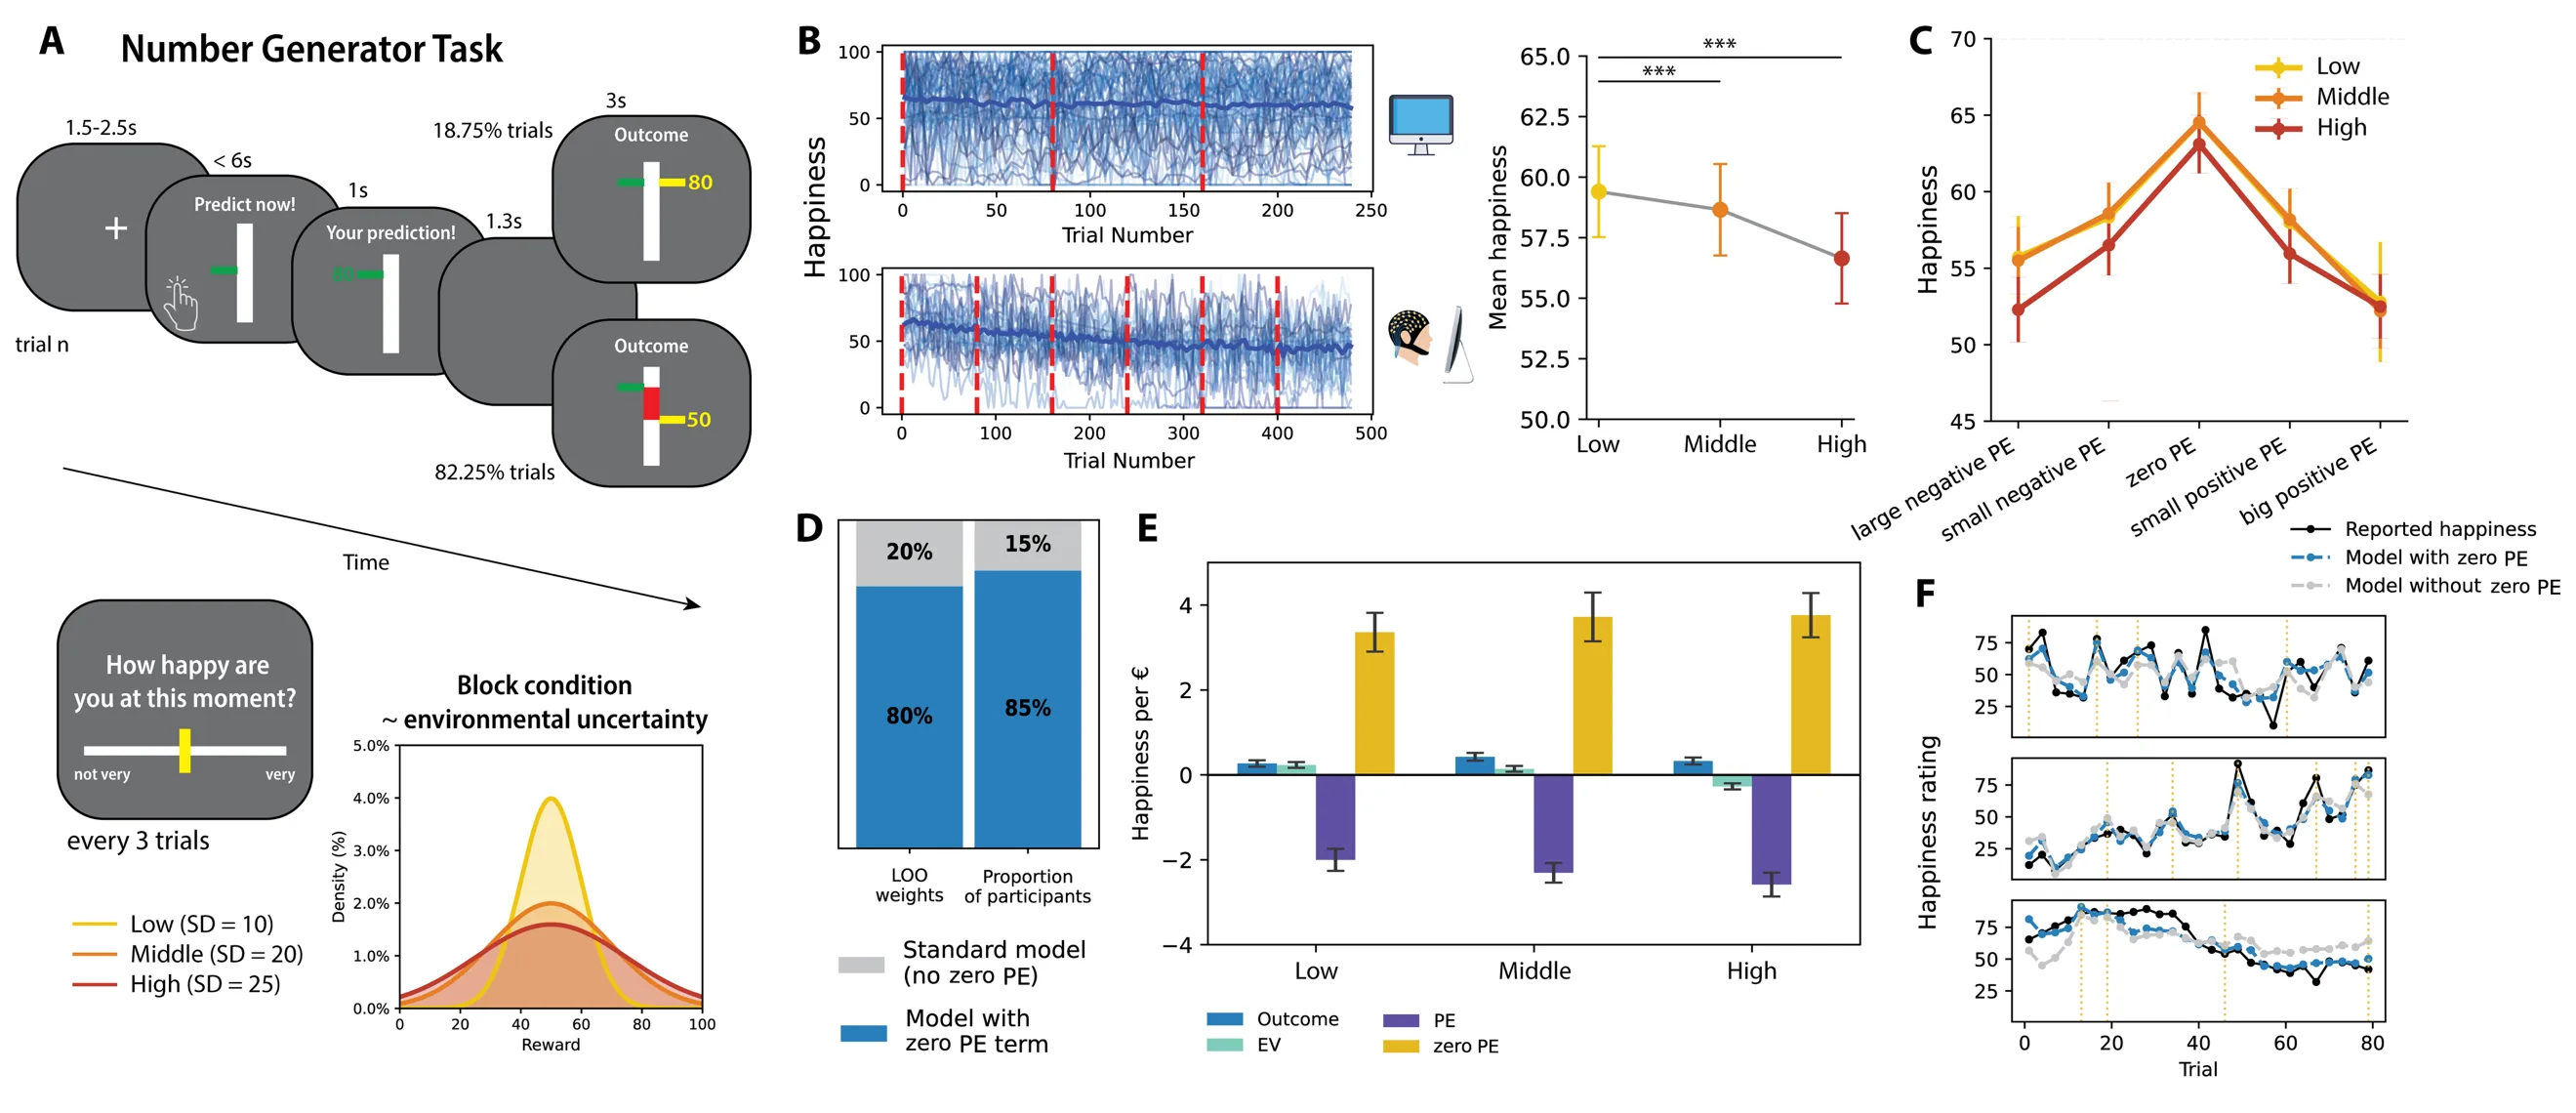
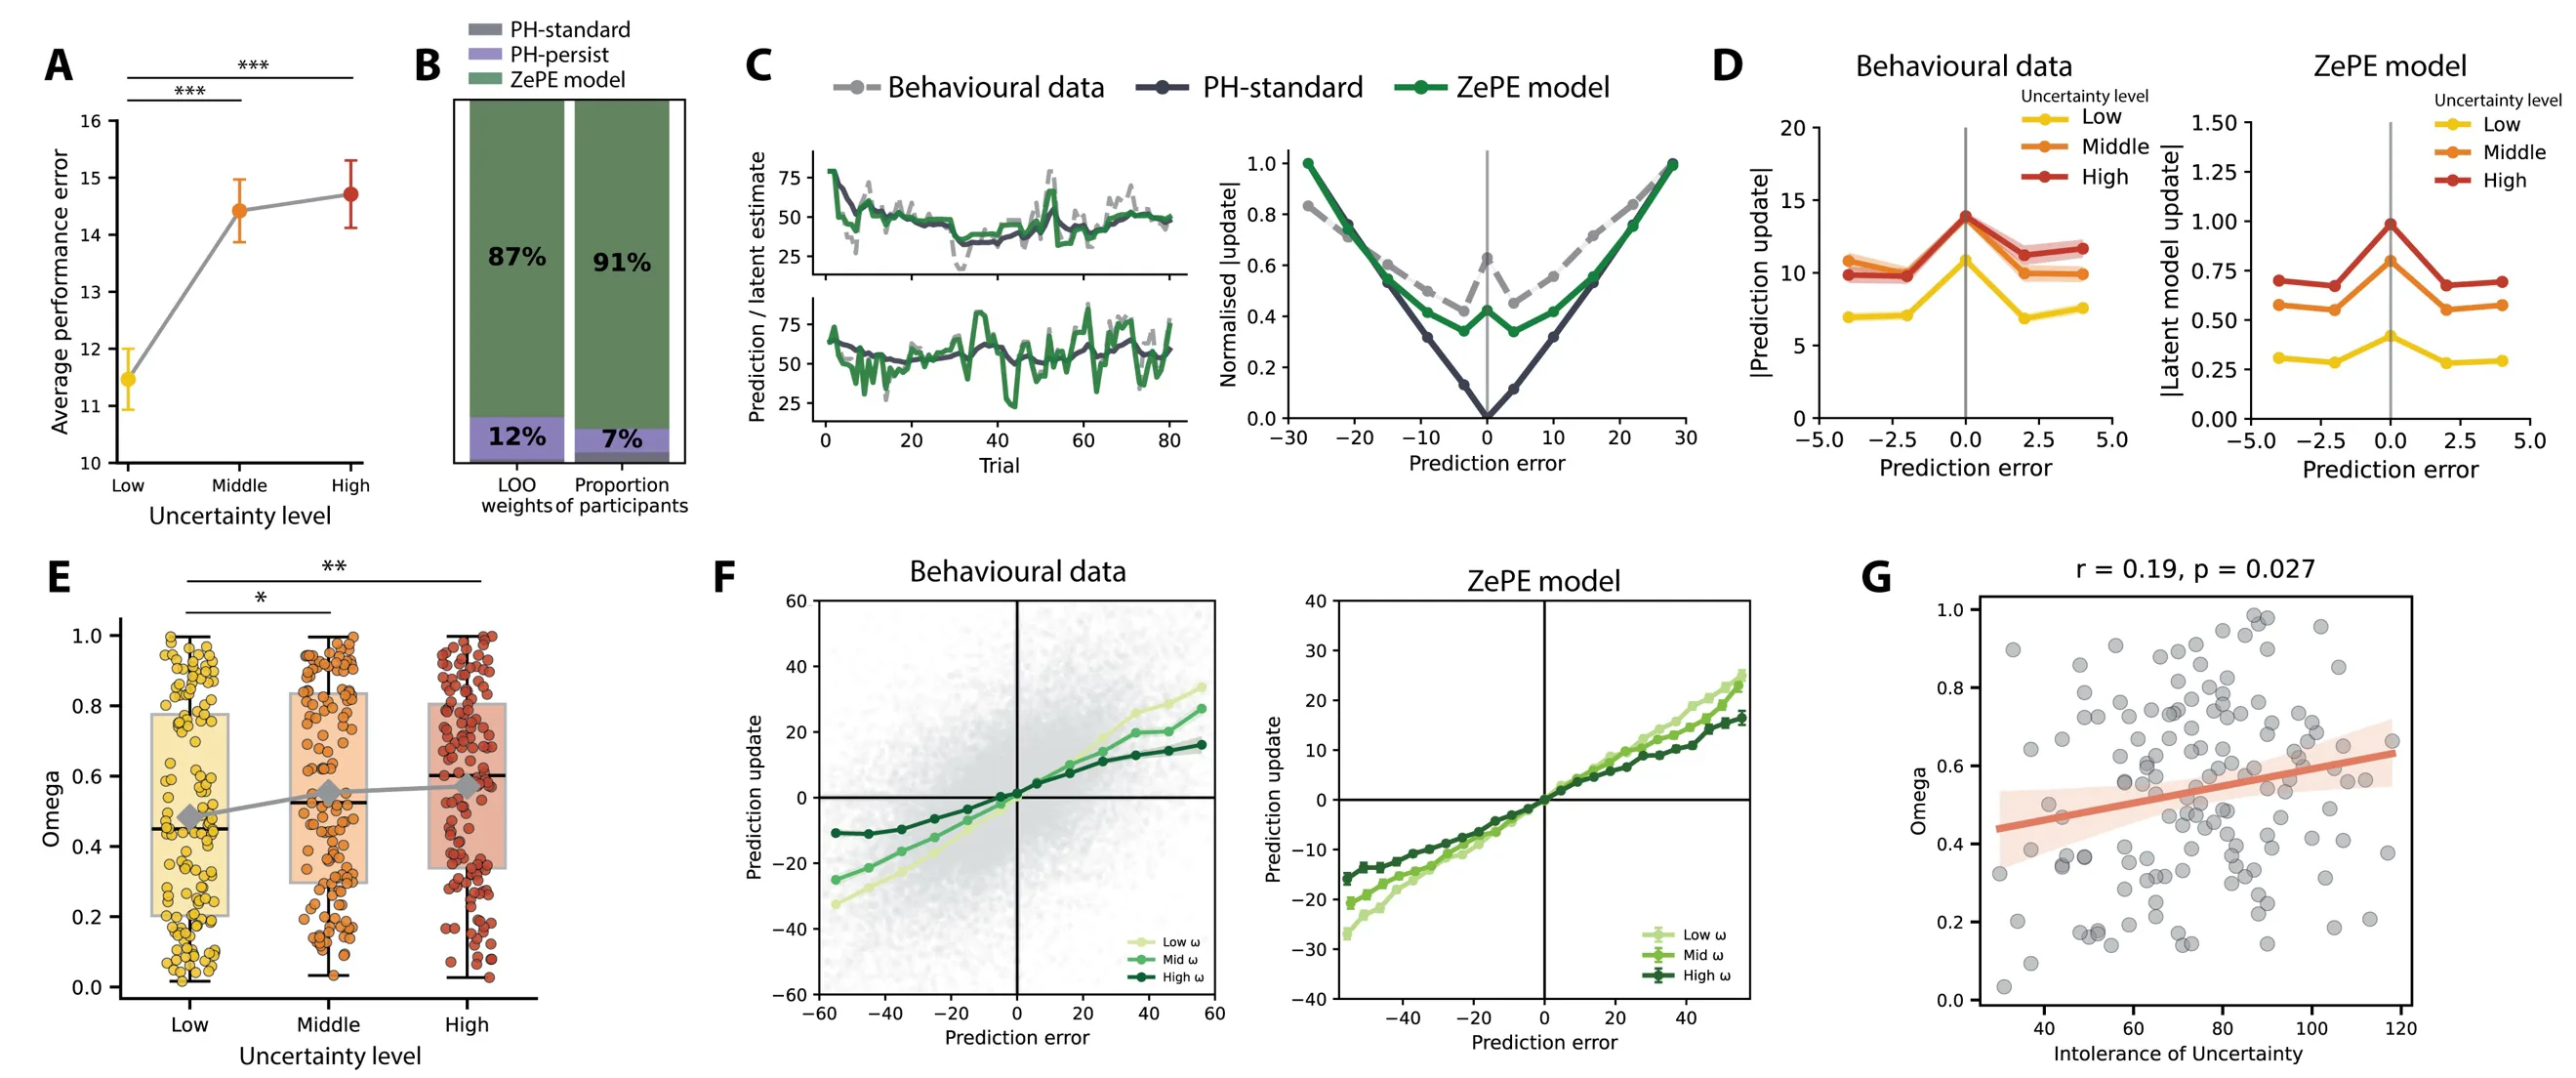
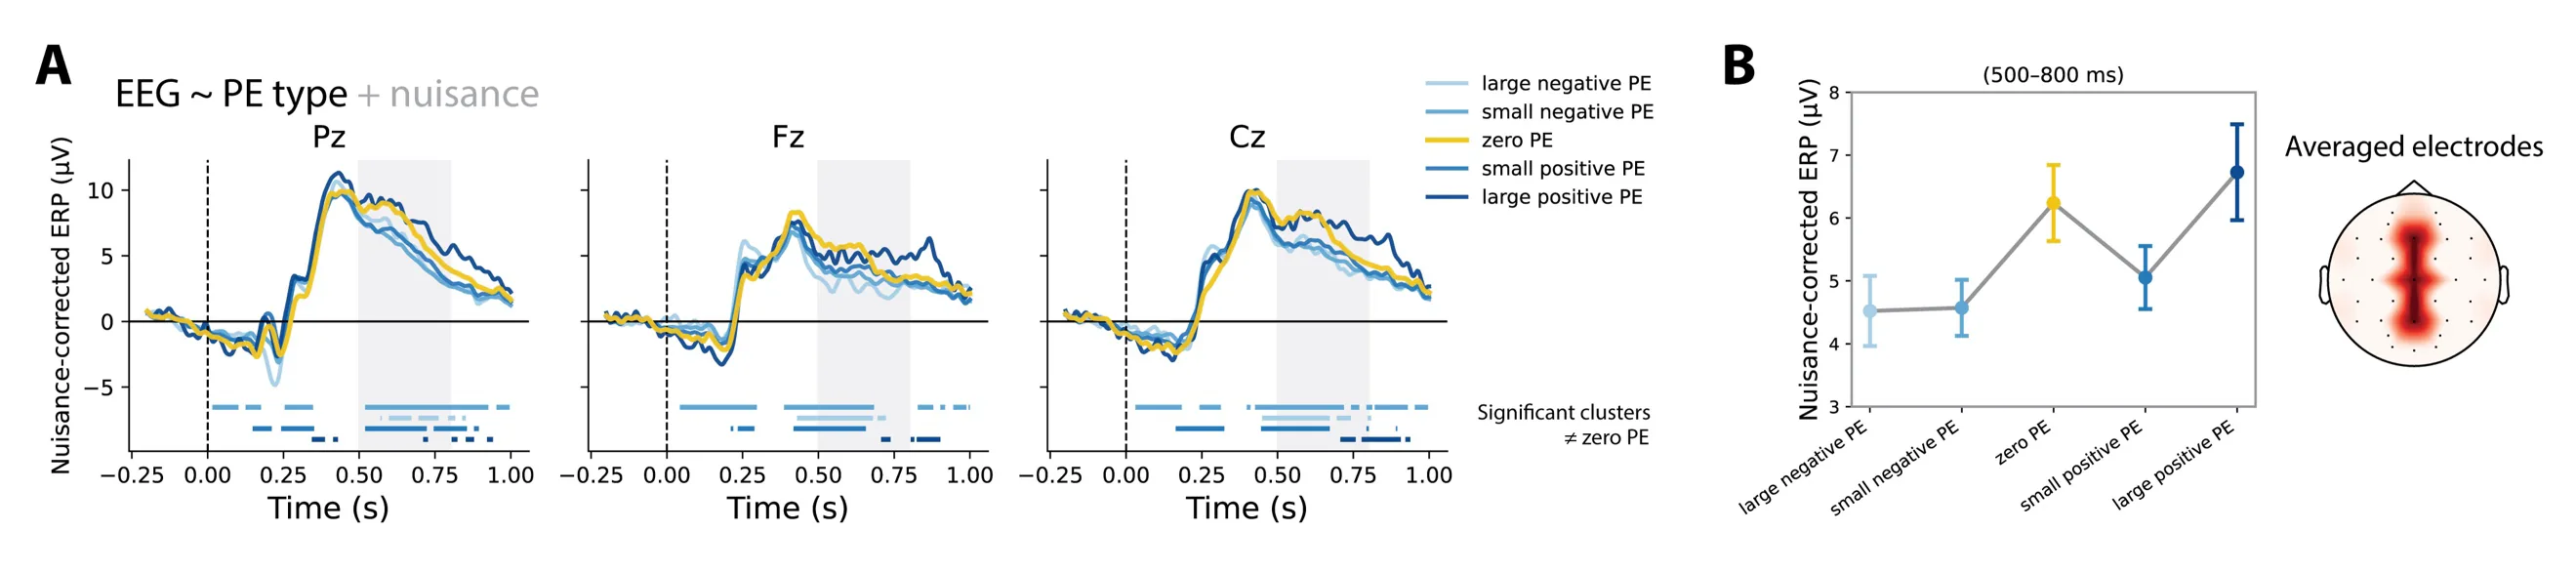
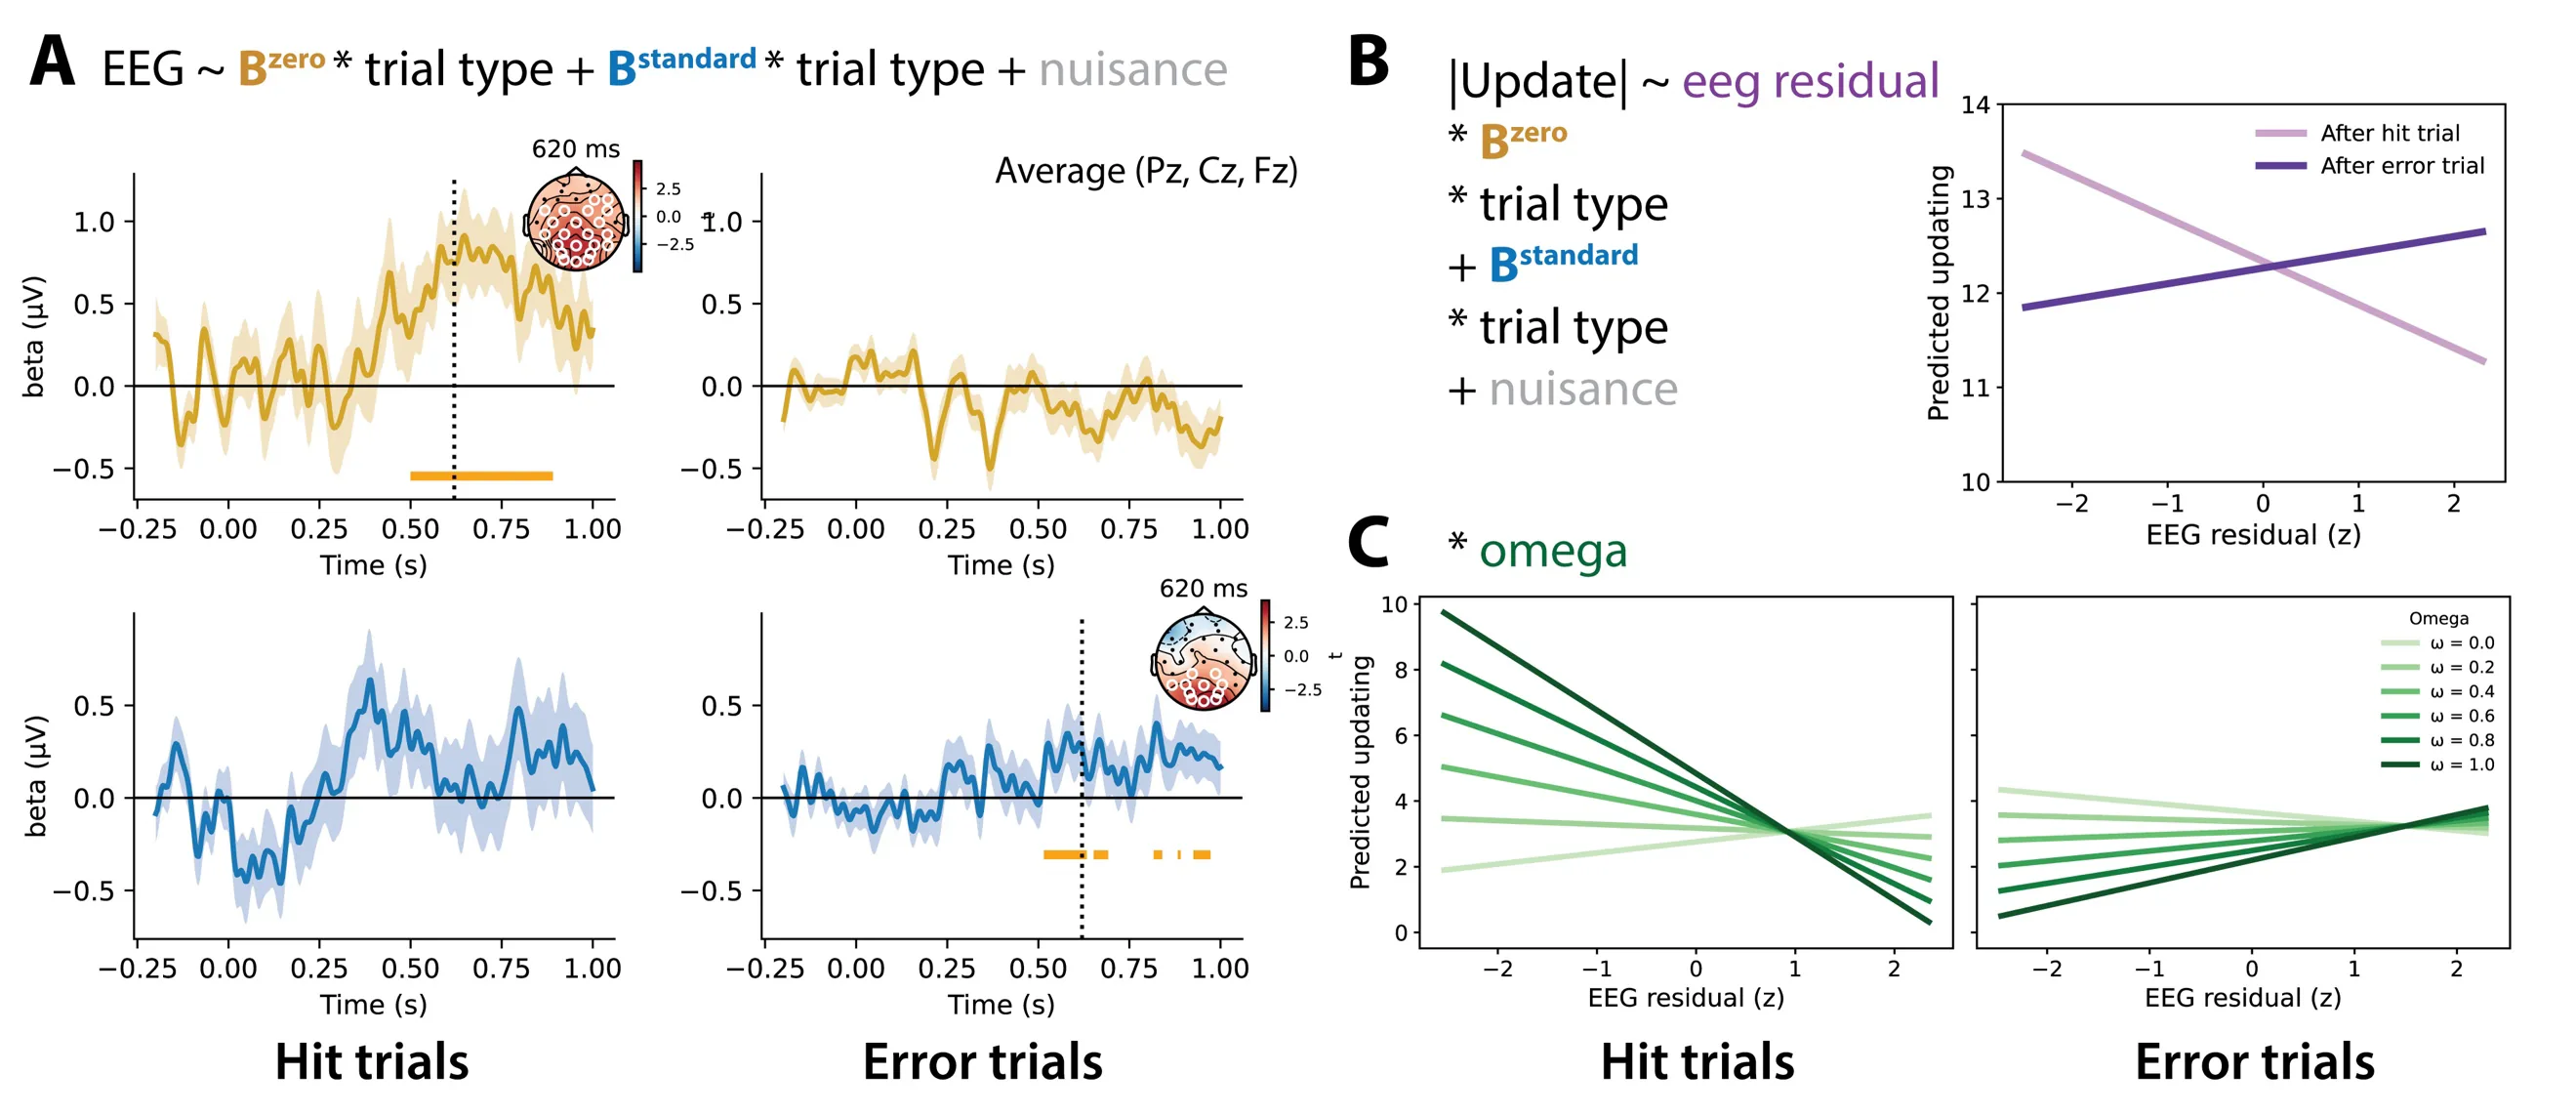
TL;DR
这篇论文探究了一个看似直观却长期被忽视的问题:当预测与结果完全吻合时,这种“完美预测”是否具有心理和计算意义?研究者通过精心设计的强化学习实验,在不同不确定性的环境中操纵零预测误差的出现,结合计算建模和脑电分析发现,零预测误差不仅不是中性的“无效信号”,反而能够引发最高的瞬时愉悦感,并在神经层面表现出独特的P3类反应。更重要的是,这种效应在高度不确定的情境和不确定性不耐受个体中尤为突出,表明完美预测是一种主动塑造情感、行为和神经加工的信号。
研究背景与动机
学习通常被理解为一个由 [[预测误差]] 驱动的过程——当现实与预期不符时,大脑会计算两者之间的差异(预测误差信号),并据此调整对世界的认知模型。这一框架在 [[强化学习]] 领域有着广泛应用,经典的 [[时序差分学习]] 模型正是通过误差信号驱动价值估计的更新。然而,既有研究几乎无一例外地将关注点放在了“非零”预测误差上:当结果好于预期时产生正向预测误差,当结果差于预期时产生负向预测误差,这两种误差如何分别影响学习和情绪已经有了大量文献积累。
一个自然而重要的问题却长期处于被忽略的状态:当结果完全符合预期、预测误差恰好为零时,个体会经历怎样的心理和神经反应?一种直觉性的假设认为,此时大脑“没有什么可学的”,零预测误差只是一种中性事件,不会对情绪和后续行为产生独特影响。但另一种可能是,完美预测本身就是一个值得标记的信号——它验证了模型的正确性,确认了环境结构的可预测性,从而可能带来独特的心理体验和计算意义。
本研究正是从这个被忽视的角落出发,尝试系统性地回答:零预测误差是否影响人类强化学习中的情绪体验、信念更新过程以及神经反馈加工?这一问题的回答不仅有助于完善预测加工理论的基础假设,还可能对理解焦虑、强迫等与不确定性处理相关的心理障碍具有启示意义。
方法
为了回答上述问题,研究者设计了一个精巧的实验范式。被试需要在不同不确定性水平的环境中反复预测即将获得的奖励金额。在每一试次中,被试先做出预测,随后收到实际的奖励结果。关键在于,研究者对部分试次的结果进行了实验性操纵,使得这些试次的结果恰好等于被试此前的预测,从而人为制造出零预测误差。
这种操纵之所以可行,是因为实验采用了部分可预测的设计:被试在多次尝试中逐渐形成对奖励分布的预期,而实验者通过精确控制部分试次的奖励金额(这些金额恰好落在被试预测的置信区间内),来制造出零预测误差与普通预测误差的对比。这一设计巧妙之处在于,它允许研究者在保持实验生态效度的同时,对预测误差的类型进行精确操控。
研究采用了行为建模与脑电分析相结合的 [[多模态]] 研究策略。行为层面,研究者构建了多个计算模型来解释被试在零预测误差后的学习行为变化,这些模型在是否假设零预测误差具有独特心理状态上存在差异。神经层面,研究者采集了被试在结果反馈阶段的 [[事件相关电位]](ERP)数据,重点关注P3成分——这一成分被认为反映了对刺激的认知评估和注意资源分配过程。通过将神经活动的残余变异(residuals)与后续学习指标相关联,研究者得以探索零预测误差的神经标记是否能预测个体后续行为的变化。
实验与结果
实验结果清晰地表明,零预测误差远非中性事件。首先,在情绪体验层面,零预测误差产生了最高的瞬时愉悦感评分——甚至高于意外获得超额奖励时的愉悦程度。这一发现本身就具有重要意义:它表明完美的确定性体验能够带来独特的正向情绪价值,而非仅仅是“避免了失望”。
计算建模的结果进一步揭示了这一现象的计算机制。行为数据最能够得到解释的模型假设,零预测误差会诱发一种独特的潜在信念状态。当模型假设零预测误差仅仅触发普通的“已验证”信号时,对数据的拟合程度显著下降;而当模型假设零预测误差引发了一种特殊的状态——可能反映了对世界模型正确性的某种元认知确认——时,行为模式得到了更好的捕捉。更有趣的是,这种零预测误差特有的信念状态对后续更新的引导作用呈现出情境依赖性:在更高不确定性环境下,零预测误差后的更新减弱效应更为明显;同时,在不确定性不耐受程度较高的个体中,这一效应也更为突出。
[[脑电分析]]的结果为上述行为发现提供了神经层面的印证。结果锁定的ERP分析显示,零预测误差引发了独特的类P3反应,其波形特征与标准正向或负向预测误差后的P3存在可区分的差异。更为关键的是,研究者对P3成分进行了解析,将其中无法被传统预测误差幅度解释的残余神经活动提取出来,并检验这些残余变异与后续学习行为之间的关系。结果显示,这些残余神经活动能够显著预测零预测误差后的更新模式:具体而言,零预测误差后更强的P3残余活动预测了后续更新的减弱,而标准预测误差后更强的P3残余活动则预测了后续更新的增强。这一发现表明,P3类脑电成分不仅反映了刺激的评价过程,还携带着关于个体如何整合零预测误差信息并指导后续学习的预测性信息。
讨论与可借鉴点
这项研究的核心贡献在于,它系统性地证明了完美预测并非如传统预测加工理论所隐含的那样是一种中性事件,而是具有独特心理和计算意义的信息性信号。这一发现对理解人类如何处理确定性体验、如何从验证性反馈中获取价值具有重要理论价值。特别值得注意的是,零预测误差的效应呈现出明显的个体差异和情境依赖性:在高度不确定的环境和不确定性不耐受个体中,这一效应尤为突出,这提示完美预测的愉悦感可能与个体对可预测性的需求之间存在复杂的交互关系。
从方法论角度看,这项研究展示了 [[计算精神病理学]] 研究的范式如何能够深入到情感与认知的交叉地带。通过精心设计的实验操纵、严格的计算建模和神经生理学指标的综合运用,研究者得以在行为、认知和神经多个层面揭示零预测误差的独特性质。这种多模态整合的方法为未来研究提供了有益的参考。
研究的局限同样值得思考。首先,研究采用的实验室范式虽然具有控制优势,但其生态效度仍需进一步验证——现实世界中的预测情境往往更加复杂,预测目标的明确性也不及实验室设置。其次,研究主要关注的是正向结果的零预测误差(即预测获得奖励且确实获得),而负向结果的零预测误差(预测无奖励且确实无奖励)是否具有类似的效应尚不清楚,这可能是未来研究的一个重要方向。最后,从临床角度看,不确定性不耐受与焦虑障碍密切相关,而本研究发现这一特质调节了零预测误差的效应,这提示对确定性体验的强化敏感性可能是理解相关心理病理的一个有用视角。
摘要
学习通常被理解为一个由预测误差驱动的过程,即当结果与预期不符时发生。然而,当结果完全符合预期时是否具有心理学和计算上的意义仍不清楚。本研究检验了零预测误差是否影响人类强化学习中的情感、信念更新以及神经反馈加工。参与者在不同不确定性的环境中反复预测奖励,其中部分试次的结果被操纵为恰好与其预测匹配。零预测误差产生了最高的瞬时幸福感,计算建模显示,行为最能得到解释的模型是:零预测误差诱发一种独特的潜在信念状态,该状态在更高不确定性下以及在不确定性容忍度较低的个体中,引导后续更新。结果锁定的脑电分析进一步显示,零预测误差引发了独特的类P3反应,残余神经活动可以预测零预测误差后减弱的更新,但在标准预测误差后则预测增强的更新。这些发现表明,完美预测并非中性事件,而是具有信息性的事件,能够主动塑造情感、行为和神经反馈加工。
Abstract
Learning is typically understood as a process driven by prediction errors, when outcomes differ from expectations. Yet it remains unclear whether outcomes that perfectly match expectations are psychologically and computationally meaningful. Here, we tested whether zero prediction errors shape affect, belief updating, and neural feedback processing in human reinforcement learning. Participants repeatedly predicted rewards in environments varying in uncertainty, with a subset of trial outcomes manipulated to exactly match their predictions. Zero prediction errors produced the highest momentary happiness, and computational modeling showed that behavior was best explained by a model in which zero prediction errors induce a distinct latent belief state that guides subsequent updating, particularly under higher uncertainty and in individuals with greater intolerance of uncertainty. Outcome-locked EEG analyses further showed that zero prediction errors elicited distinct P3-like responses, with residual neural activity predicting attenuated updating after zero prediction errors but enhanced updating after standard prediction errors. These findings suggest that perfect predictions are not neutral, but informative events that actively shape affect, behavior, and neural feedback processing.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。