
面向离线强化学习的基于行为优势修正的扩散策略
Diffusion Policy with Behavioral Advantage Correction for Offline Reinforcement Learning
📝 TLDR
离线强化学习中,行为数据与学习策略的分布偏移会造成Q值估计偏差,误导策略优化方向。论文提出行为优势修正策略评估方法(BAC-PE),利用行为策略的Q函数修正学习策略的Q函数,缓解保守性偏差并给出收敛性上界。同时采用扩散模型表征行为策略与学习策略,通过分布匹配实现策略正则化,并引入Q值引导提升策略质量。综合两者得到DPBAC算法,在D4RL多类任务中性能优于现有SOTA方法。
🧭 速览
离线强化学习中行为策略与学习策略分布偏移引发Q值估计偏差,误导优化方向。
利用行为策略Q函数修正学习策略的Q函数,提出BAC-PE并结合扩散模型做策略分布匹配与Q值引导训练。
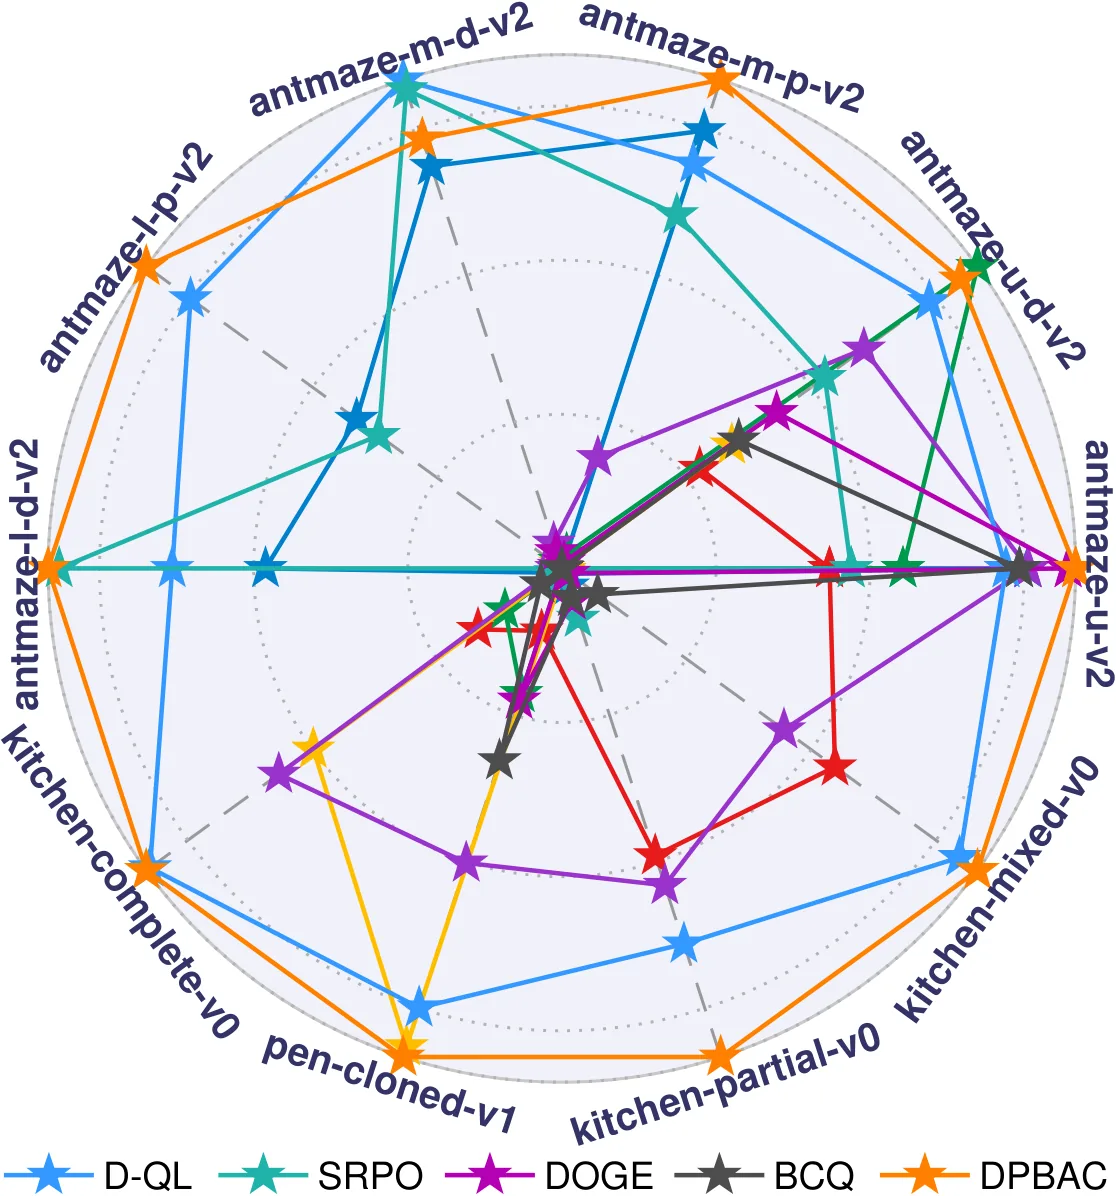
在D4RL多领域任务上DPBAC性能优于当前SOTA方法,策略表征与Q值偏差缓解效果显著。
将行为优势修正与扩散策略建模有机结合,兼具理论收敛保证与实践性能提升。
🆚 方法对比
DPBAC
- 结合扩散策略与优势修正,策略表征能力更强
- 在D4RL多领域任务上超越SOTA算法
- 有效缓解Q值估计偏差与悲观保守问题
- 兼具分布匹配与Q值引导的策略提升
- 依赖扩散模型训练,计算开销较大
- 理论收敛分析仅给出上界保证
- 未在大规模高维任务上验证泛化性
BAC-PE
- 利用行为策略Q函数修正学习策略Q值
- 理论推导出学习Q与真实Q的误差上界
- 有效缓解过估计偏差与悲观保守
- 无需额外环境交互,纯离线可计算
- 依赖行为策略Q函数估计的准确性
- 误差上界紧致性未充分验证
- 修正权重选取敏感,调参成本较高
Diffusion Policy Modeling
- 强大表达能力可建模复杂多模态行为分布
- 通过分布匹配实现精确的策略正则化
- 缓解离线RL中分布偏移问题
- 与BAC-PE结合实现端到端优化
- 扩散模型采样推理速度较慢
- 训练过程对算力需求较高
- 在简单任务上可能存在过度参数化
Existing Offline RL Methods (SOTA对比基线)
- 经过广泛验证,代码与超参成熟
- 在各自适用任务上性能稳定可靠
- 提供多样化的算法设计思路与权衡
- 便于在新方法上进行公平对比
- 普遍受分布偏移与Q值高估困扰
- 策略表征能力有限,难以处理复杂分布
- 保守性导致策略性能次优
- 缺乏统一的理论与实验分析框架
DPBAC通过将BAC-PE的Q值修正机制与扩散策略建模相结合,在策略表达能力和Q值估计准确性上优于现有SOTA离线RL方法,而对比基线方法虽成熟但普遍受分布偏移与悲观保守限制。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 61 张)
展开查看 61 张图
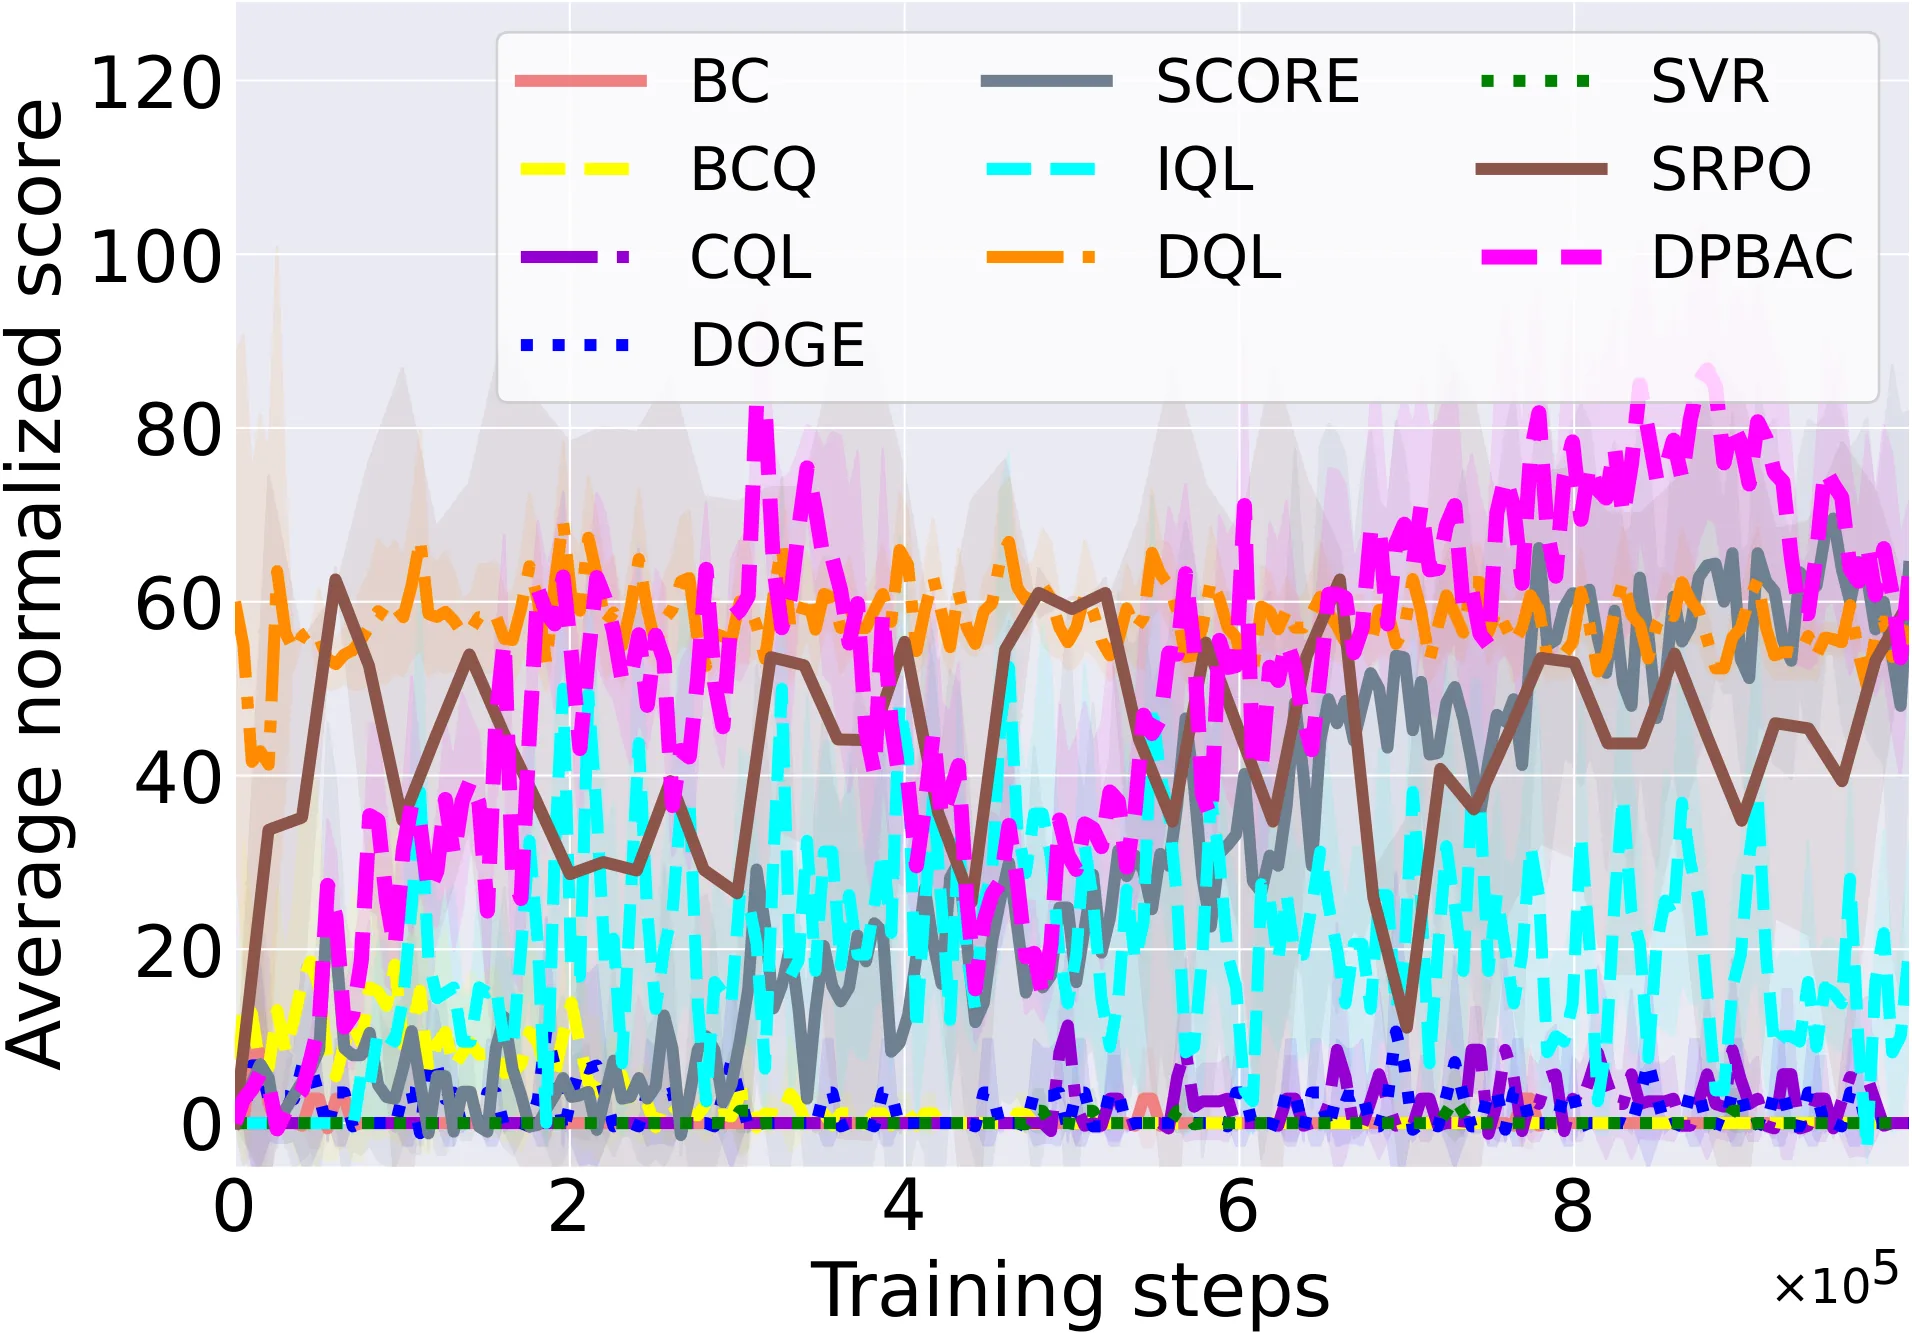
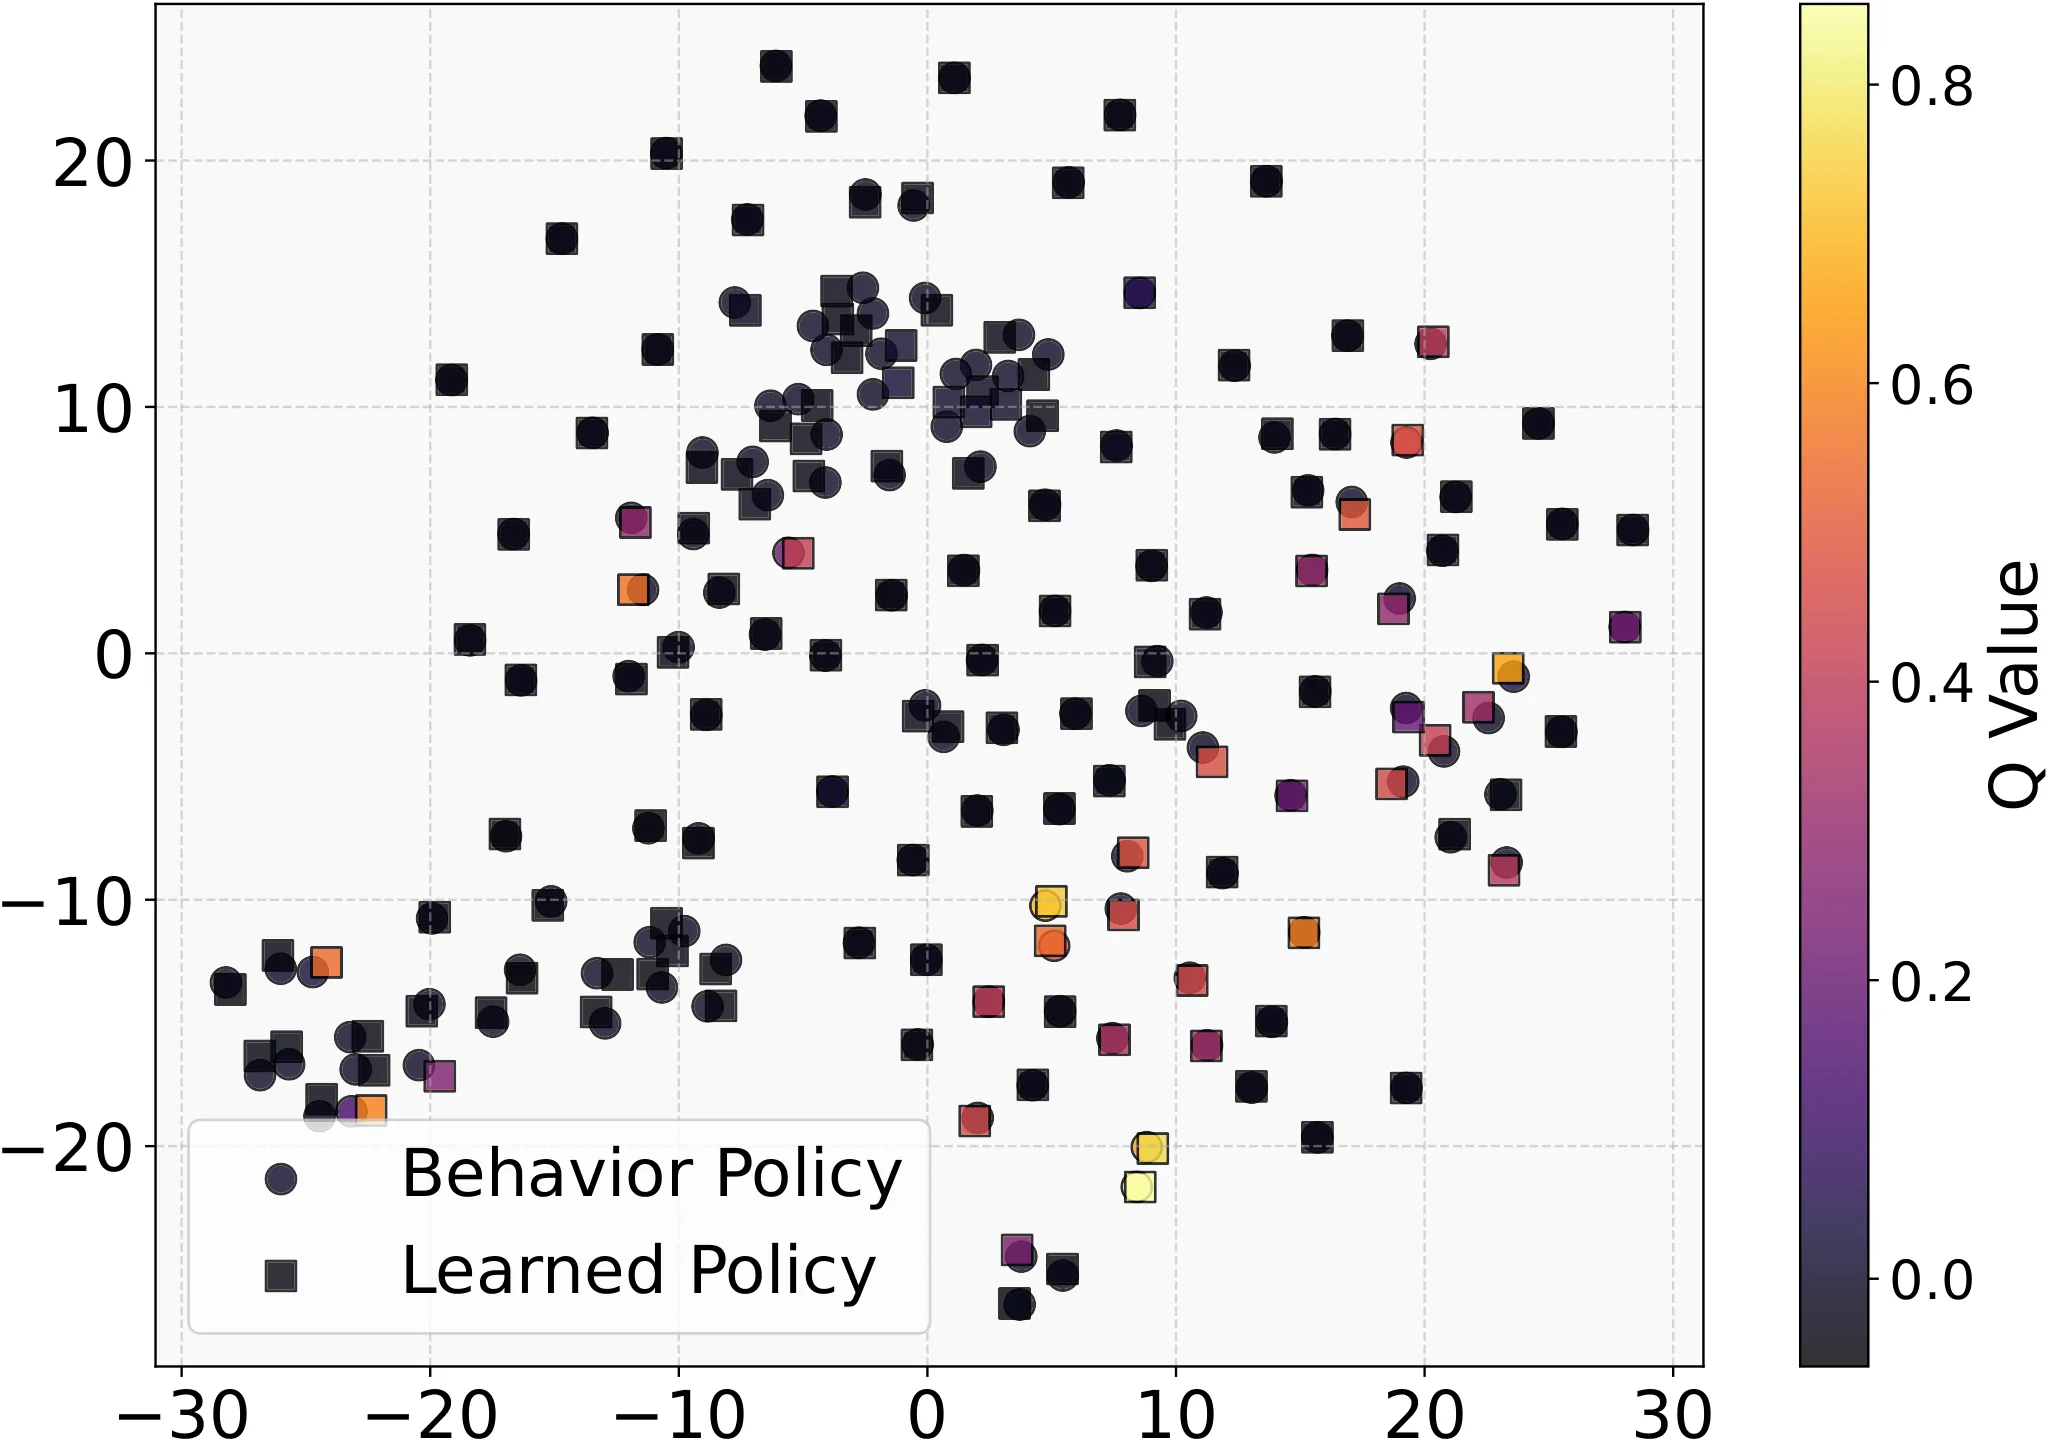
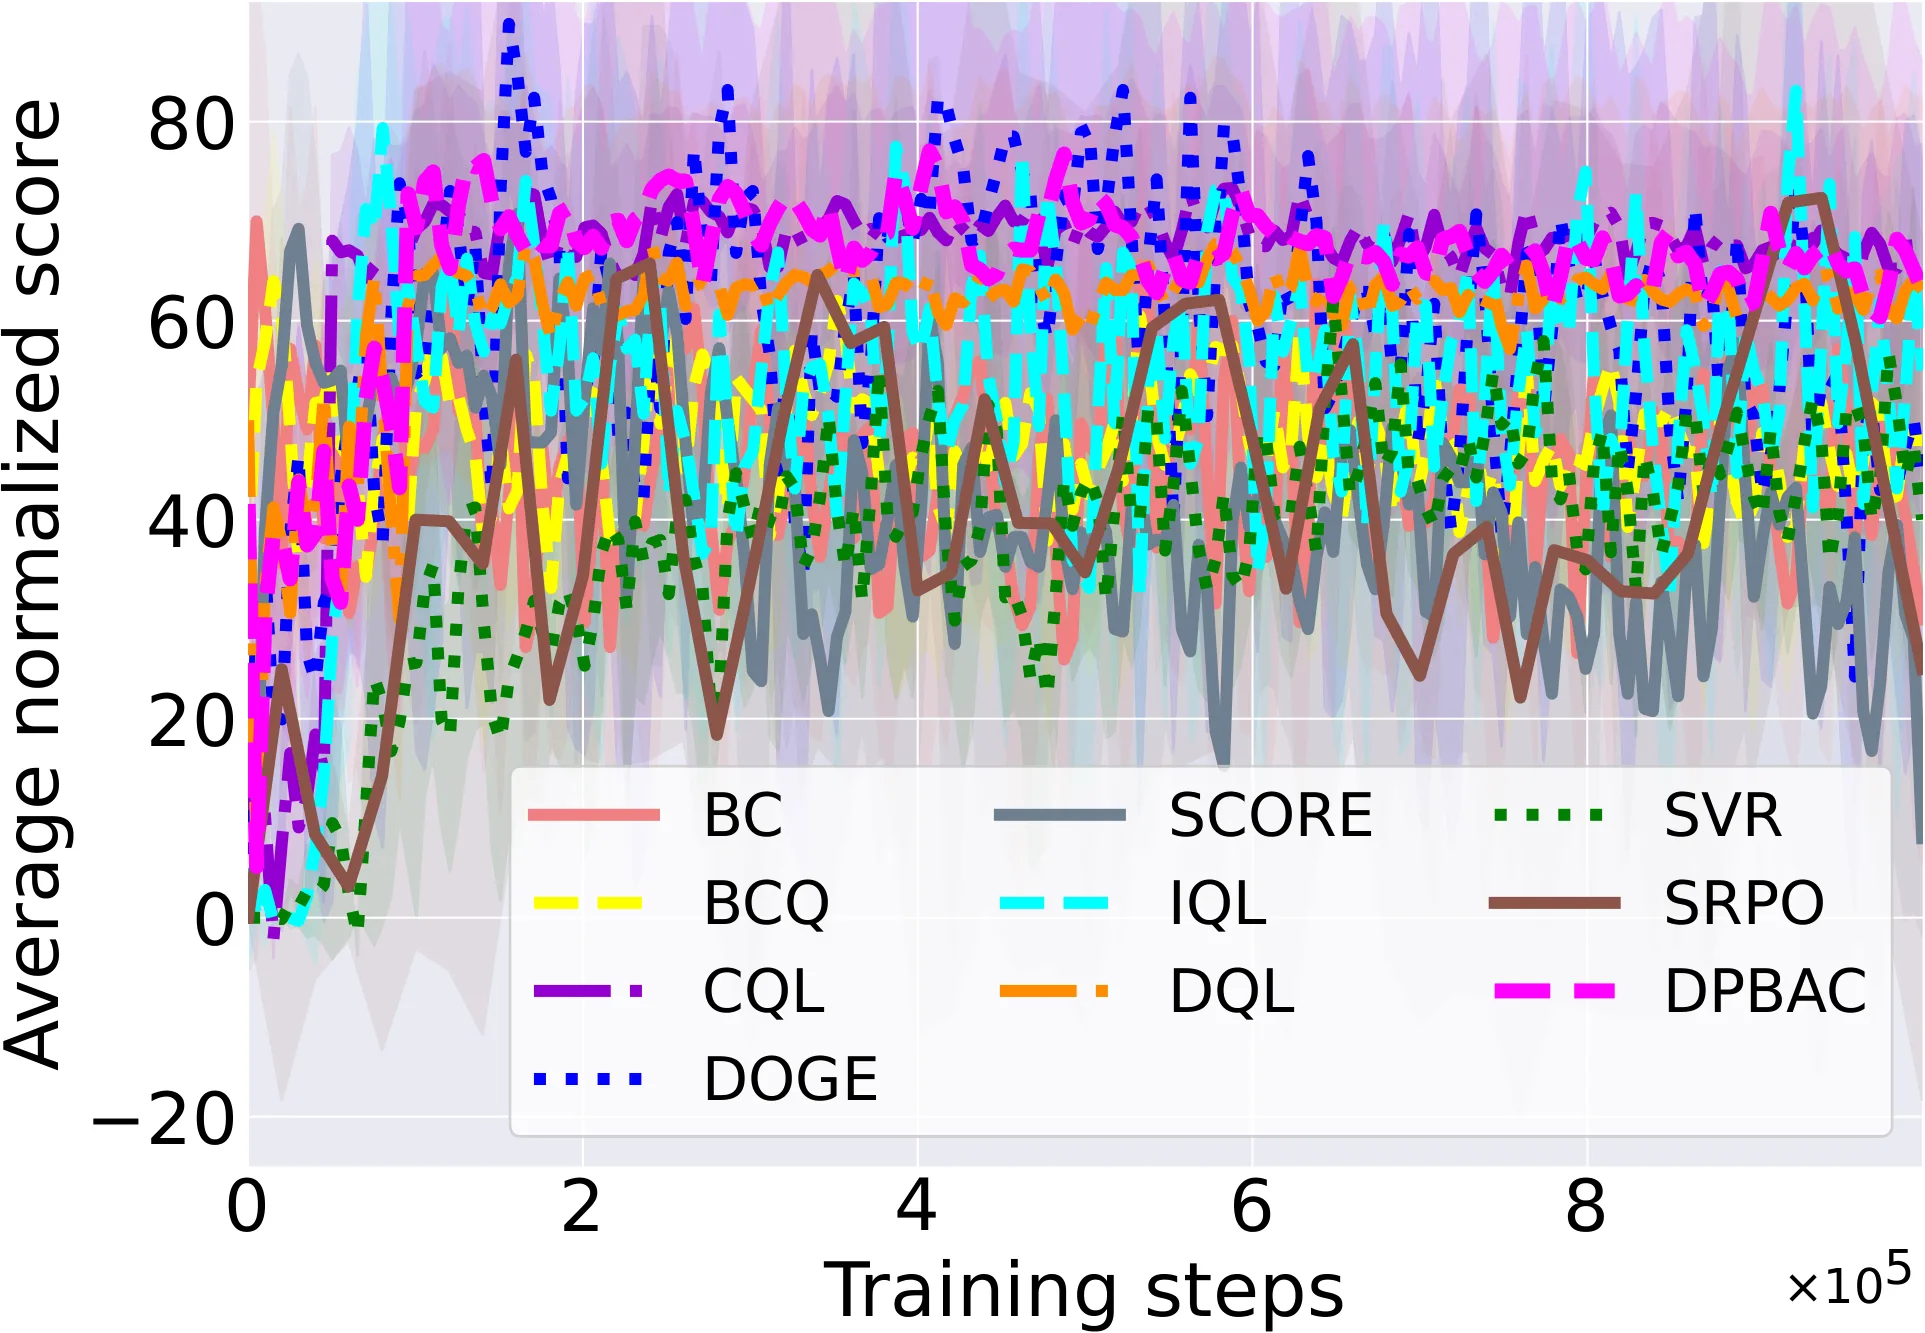
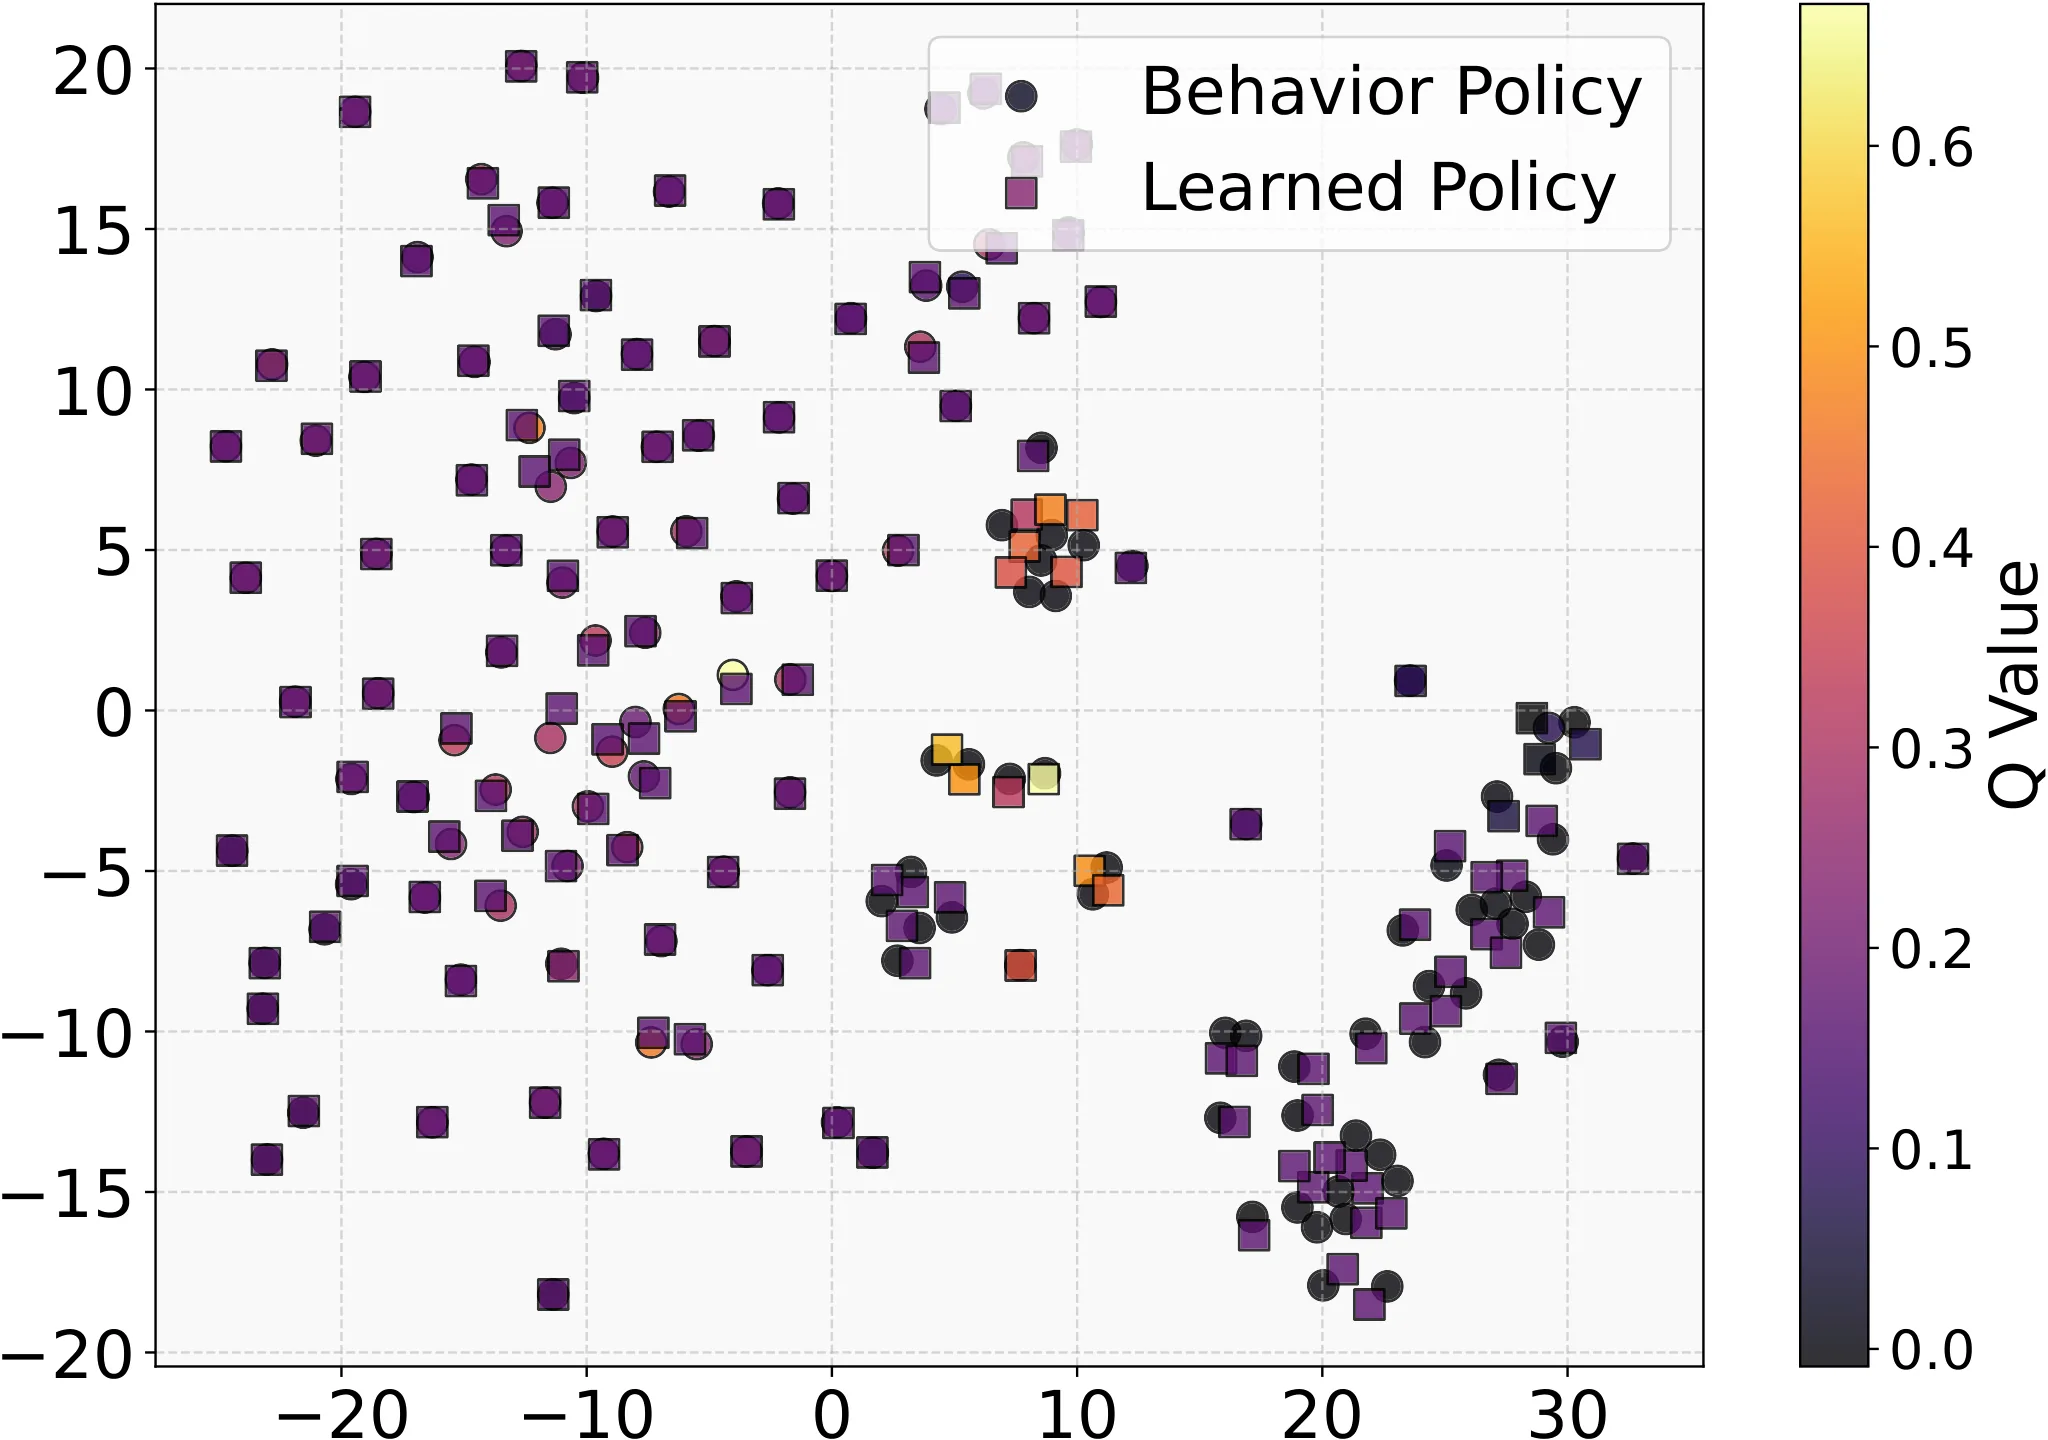
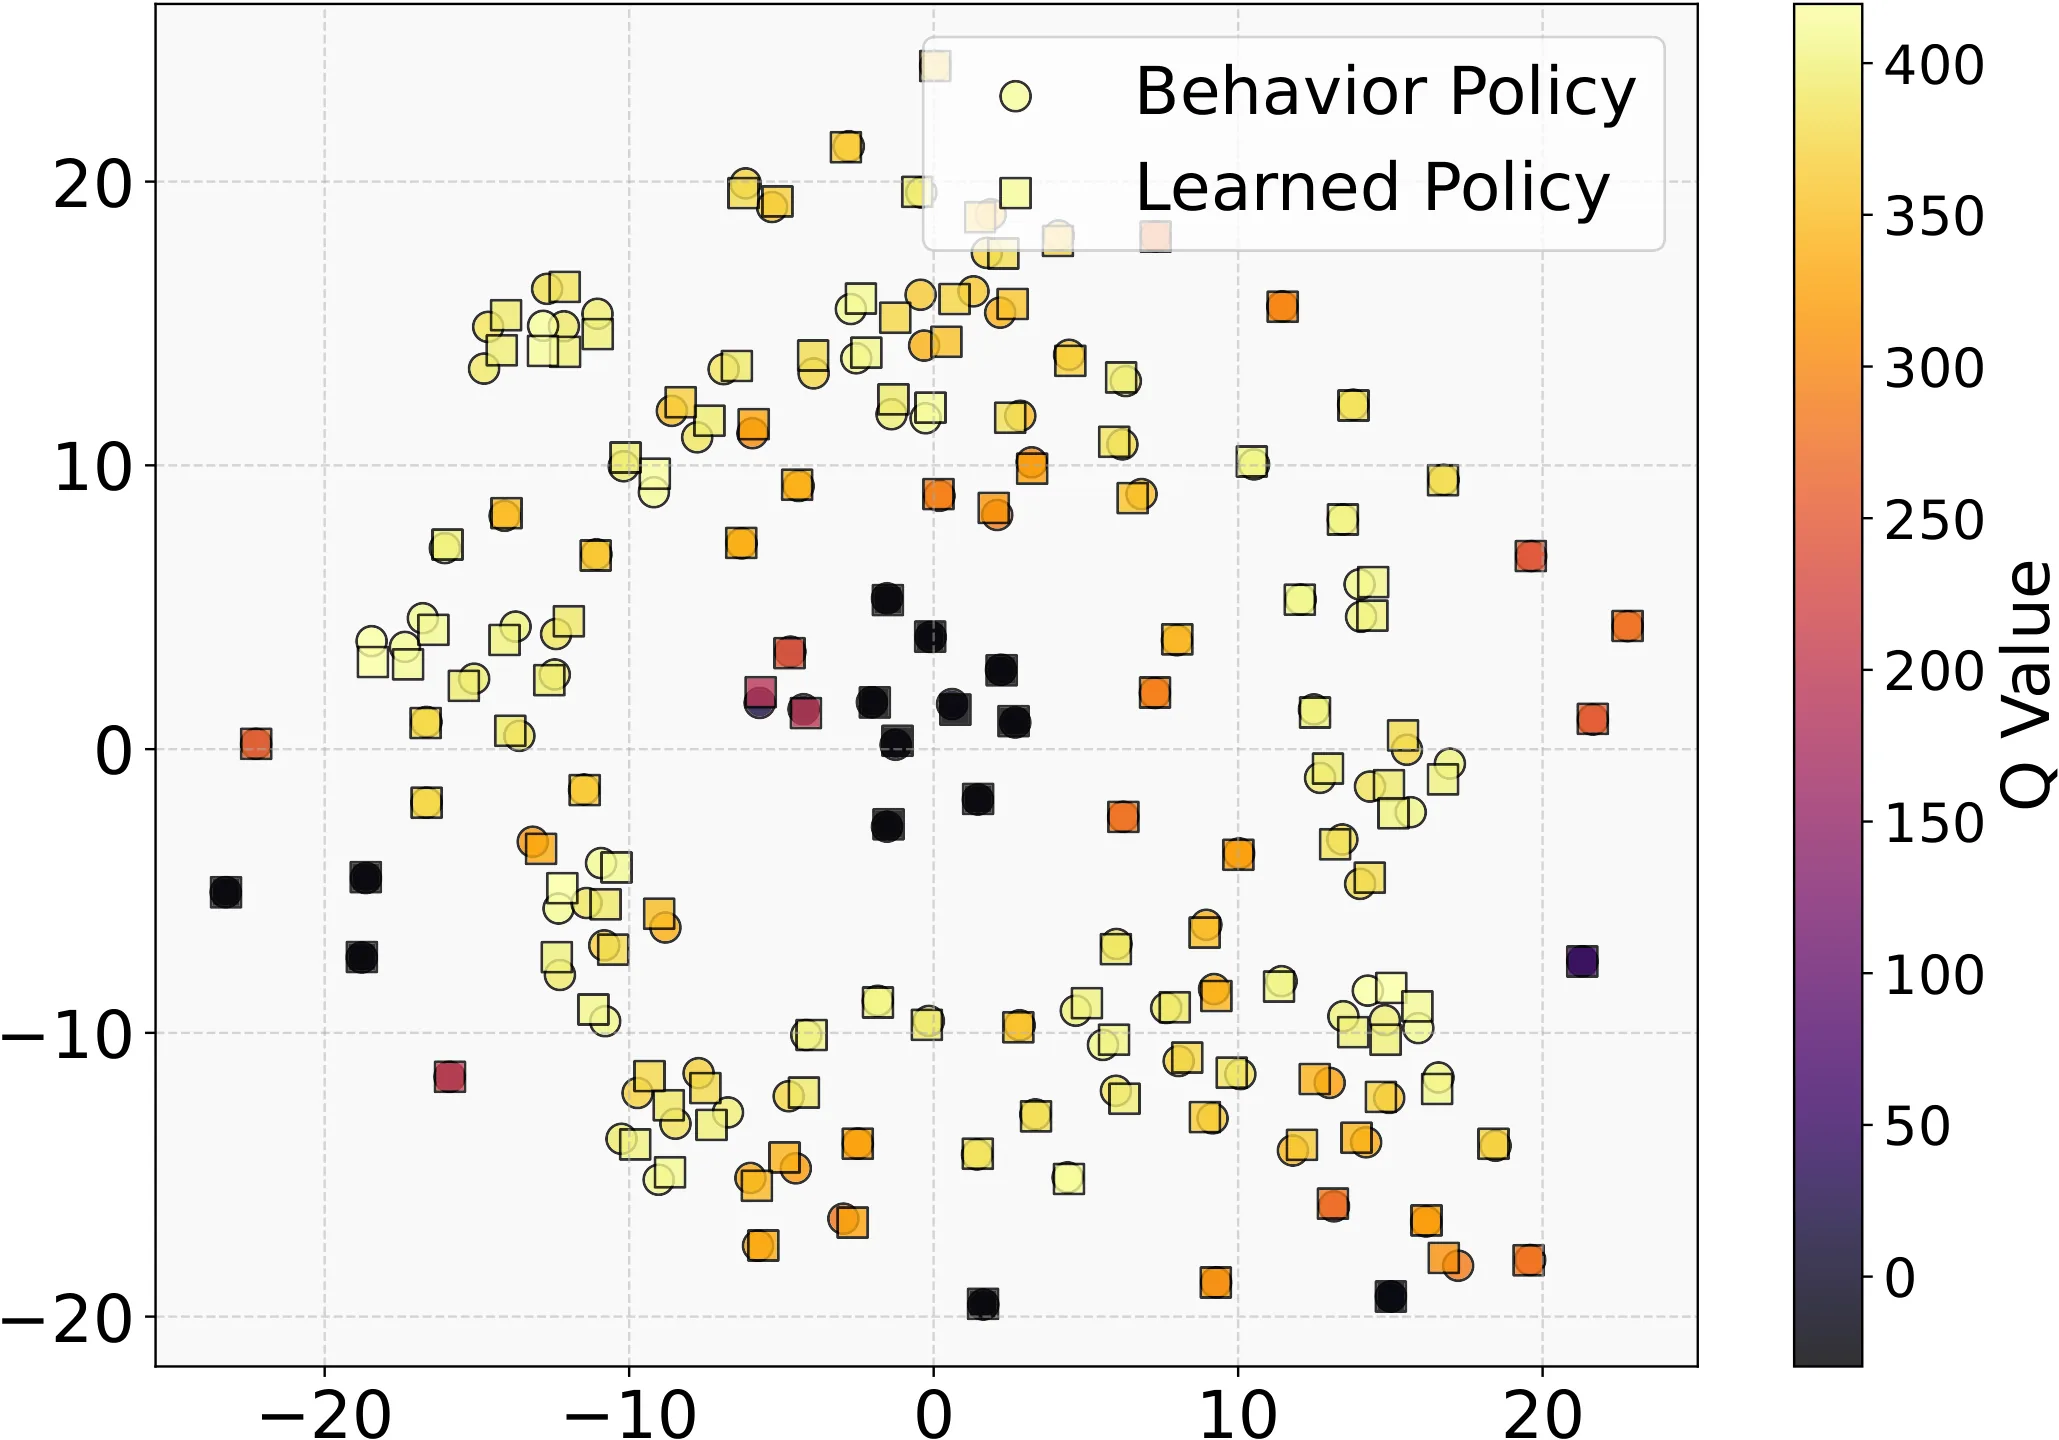
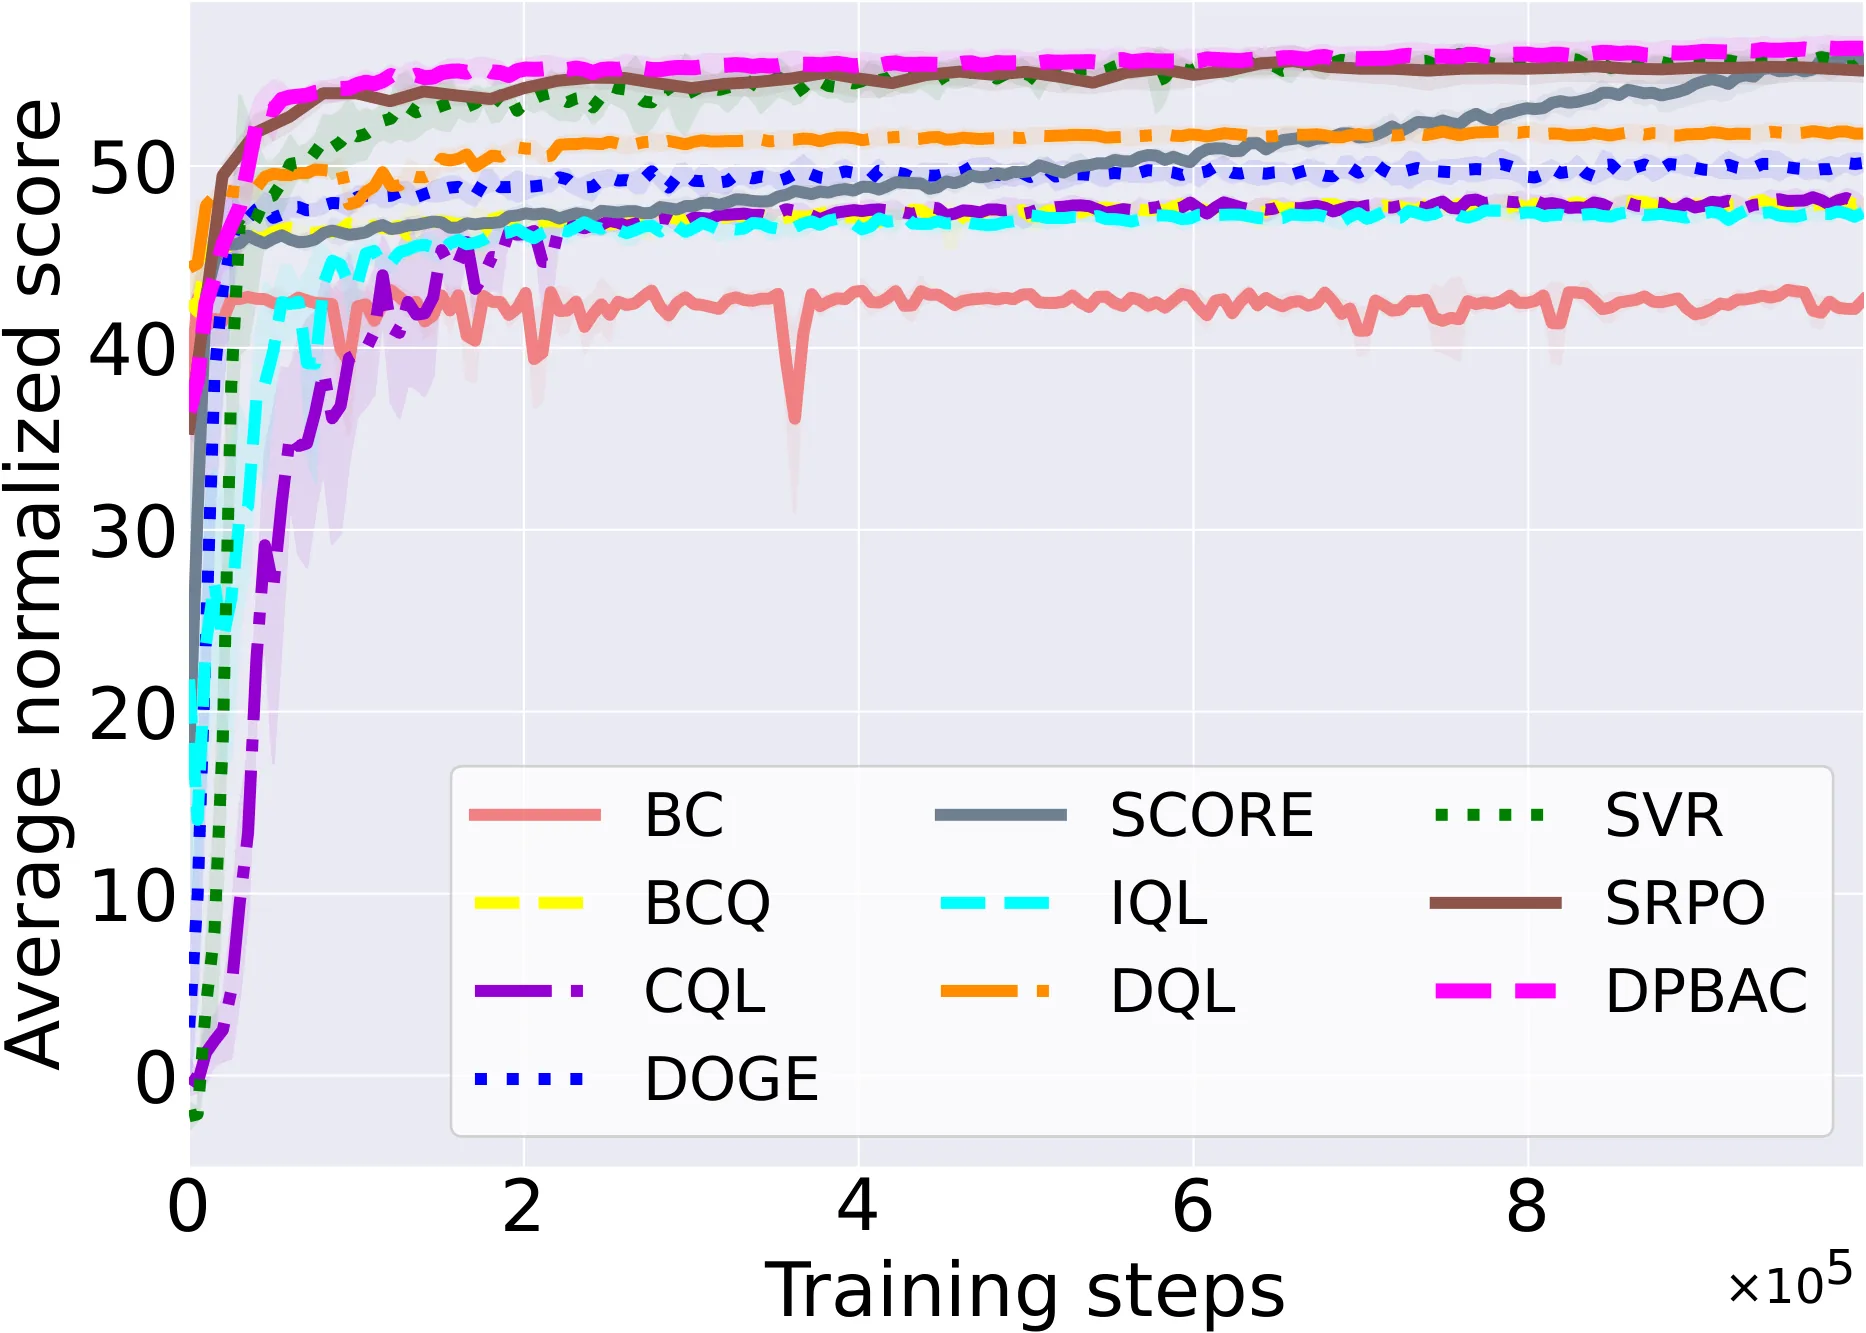
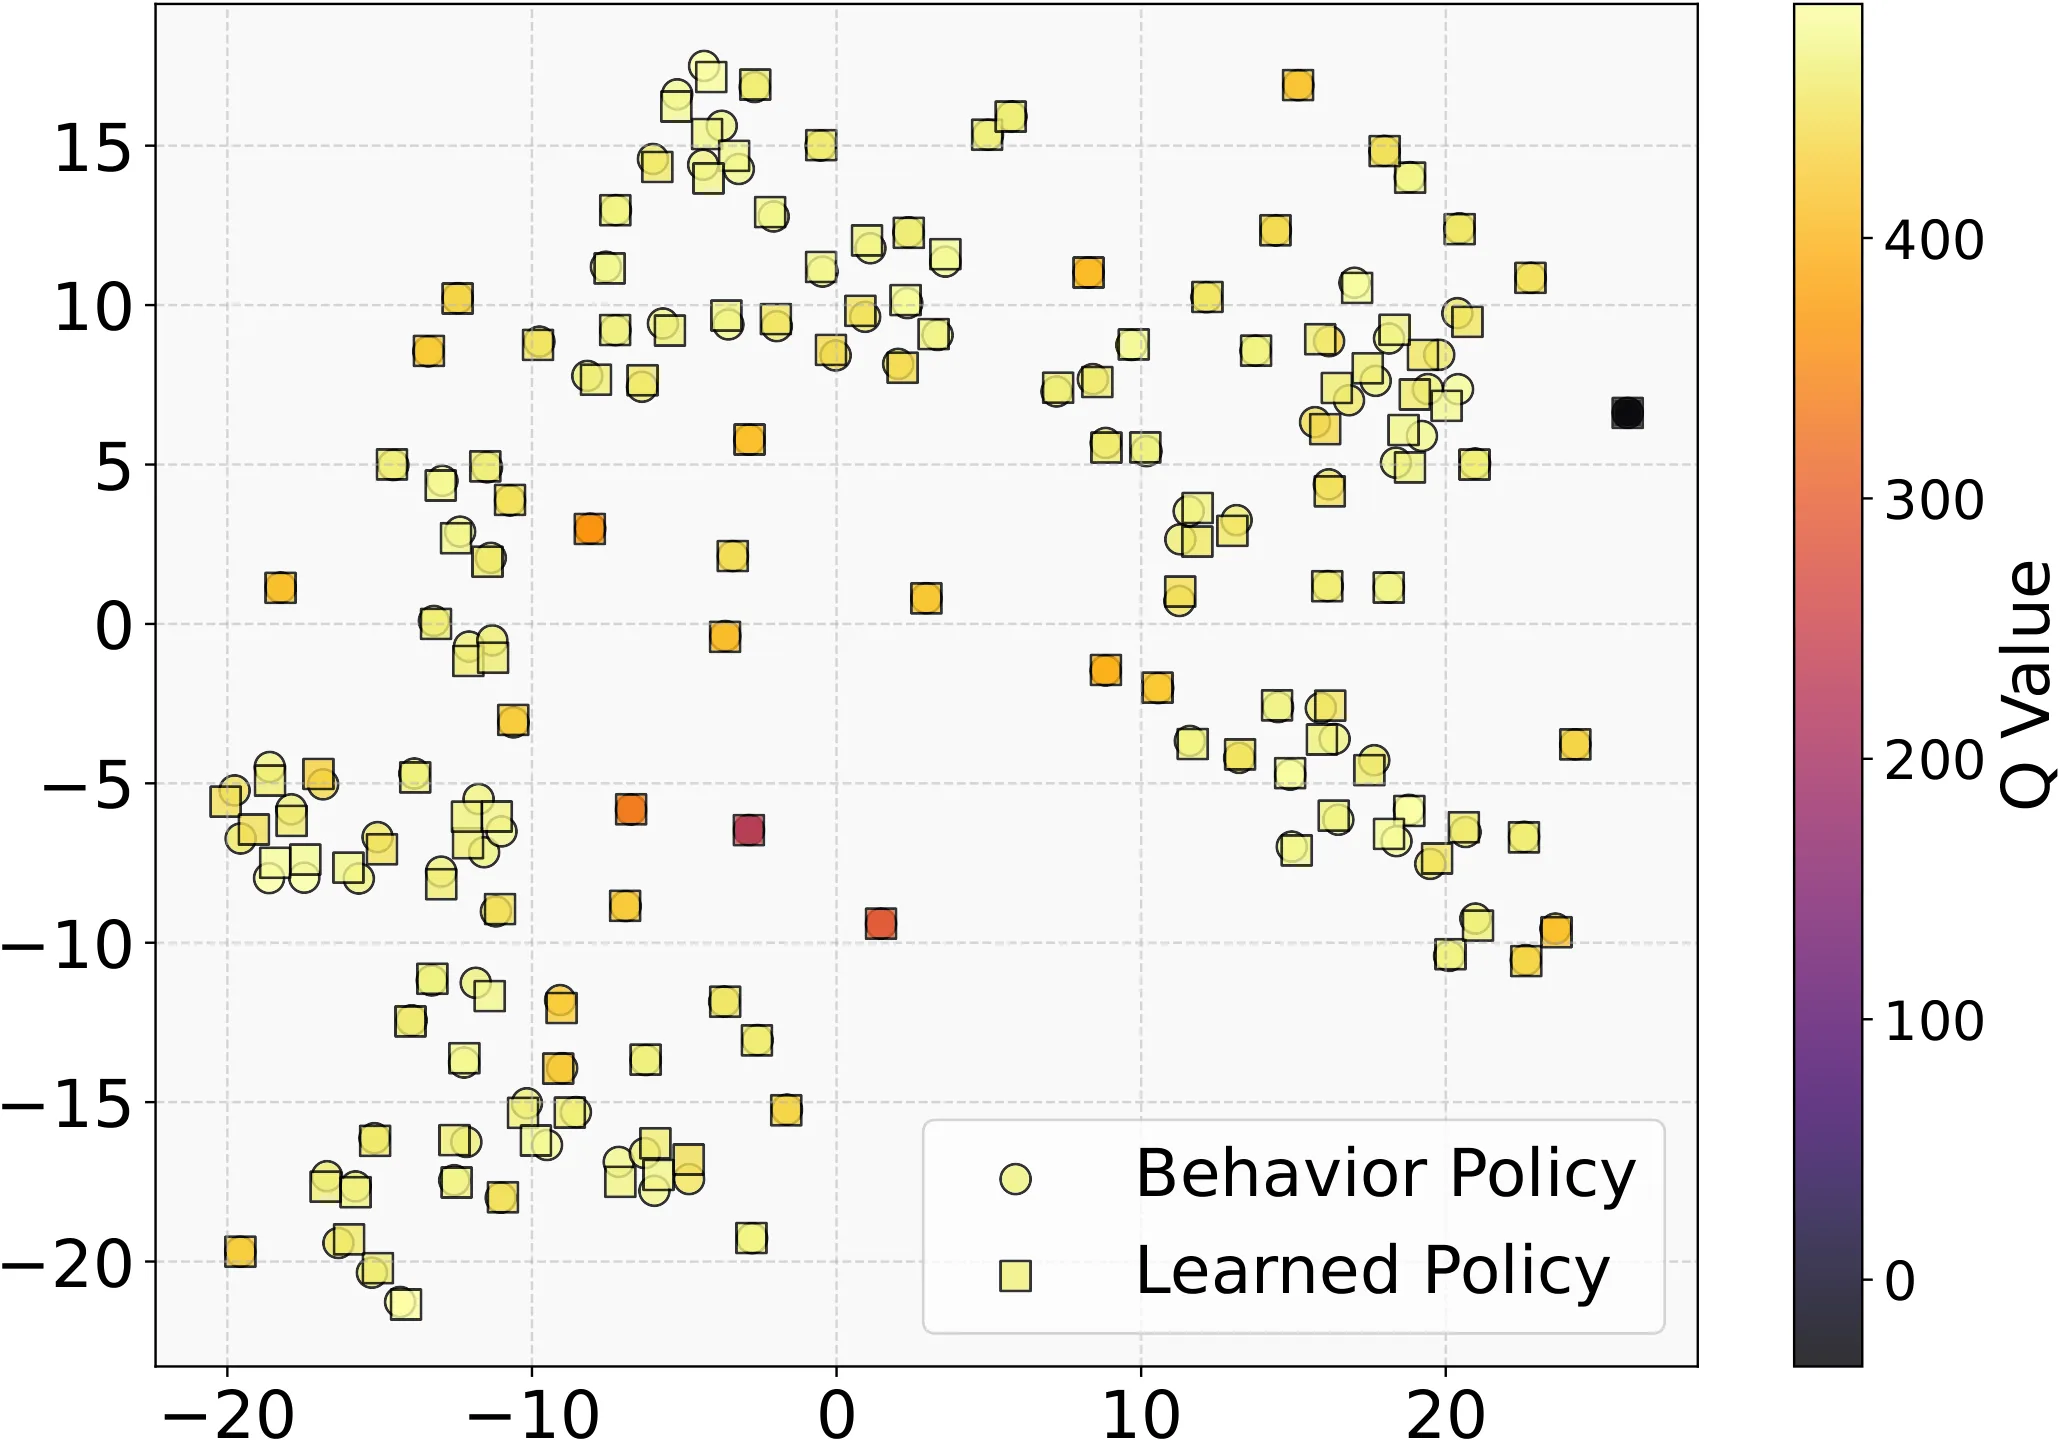
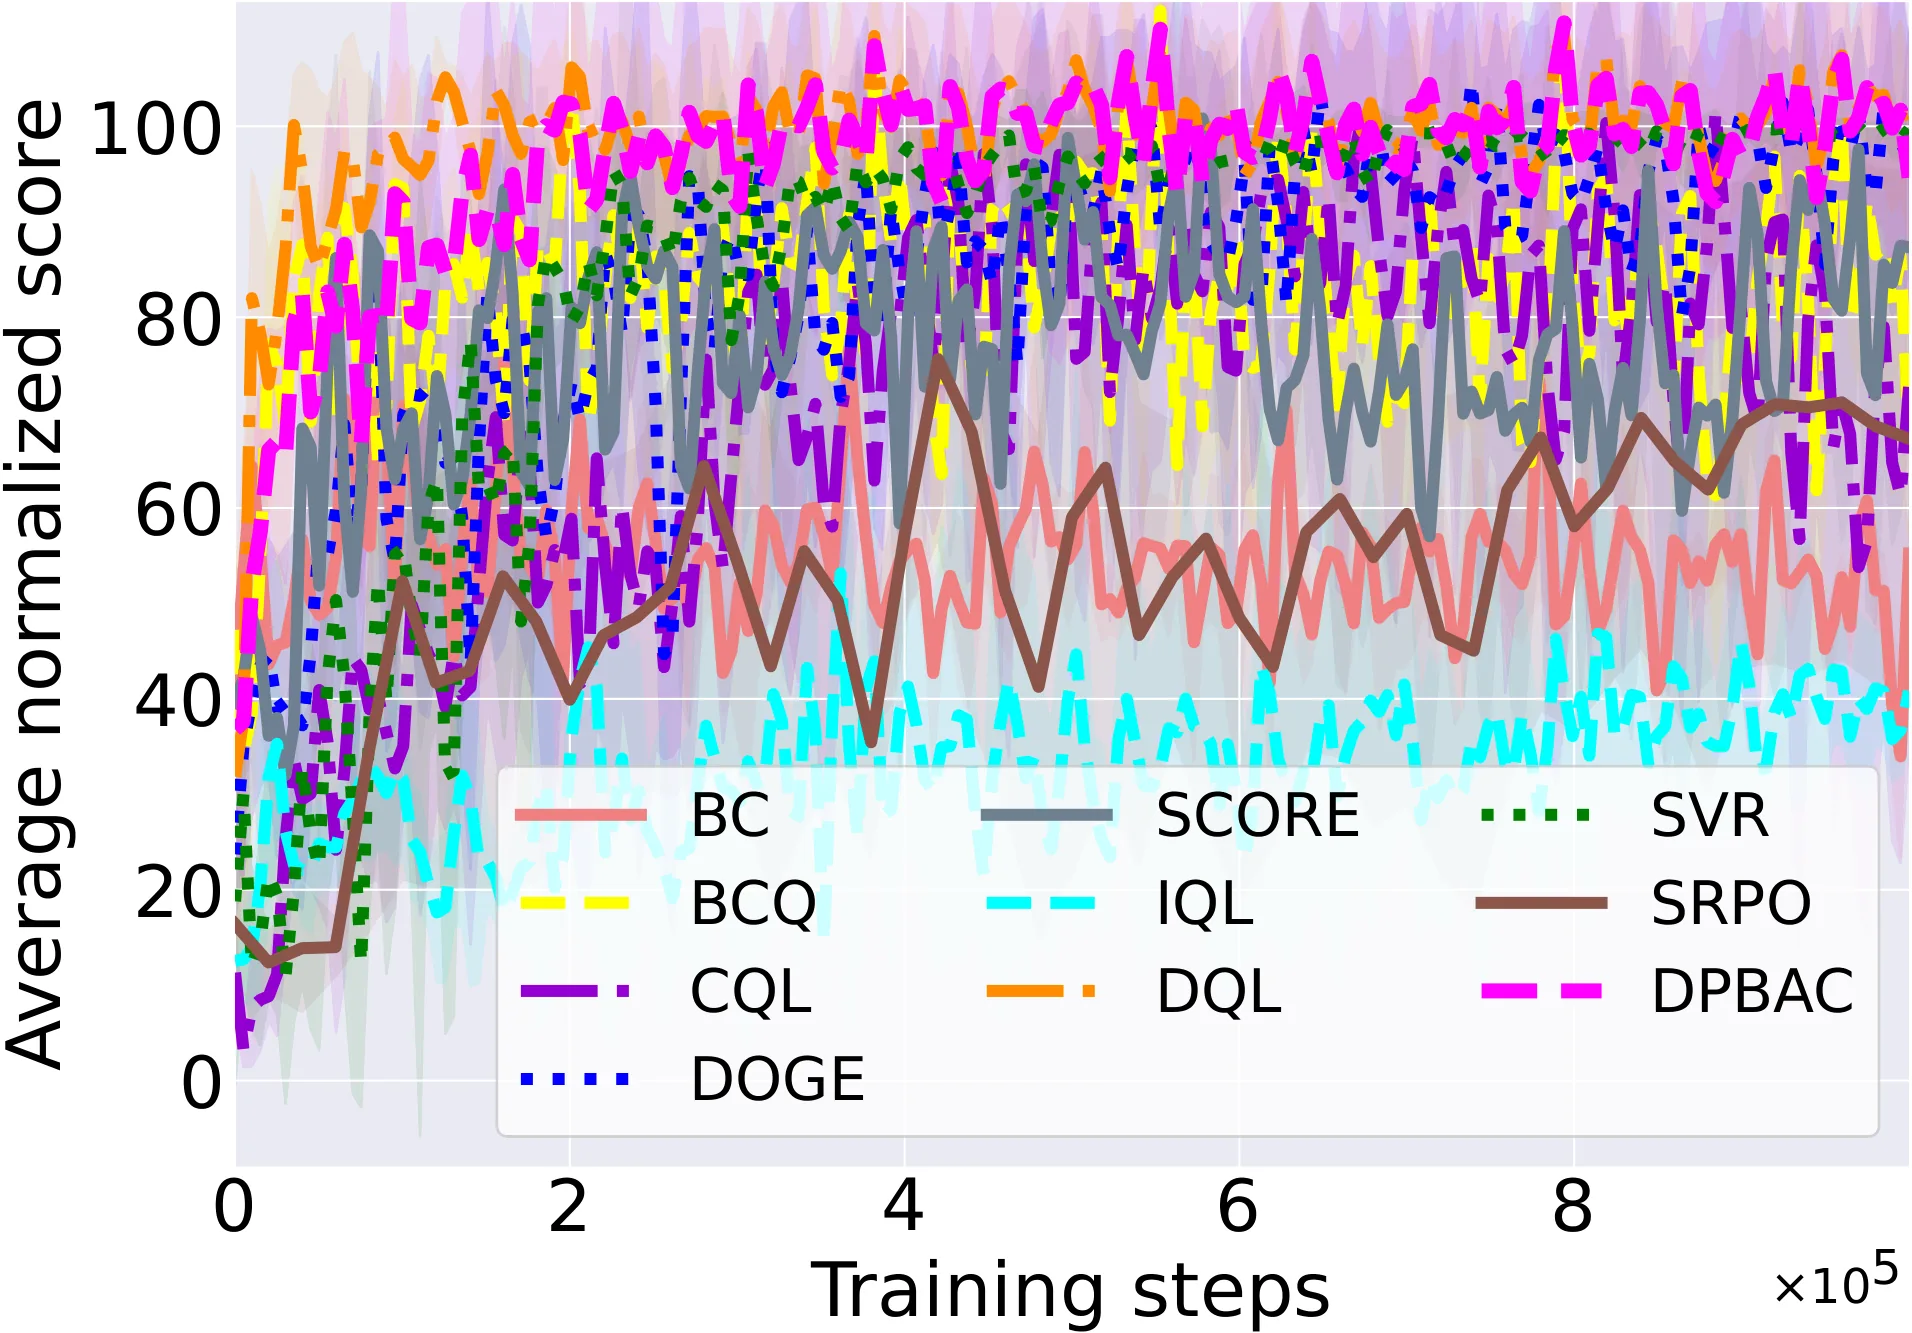
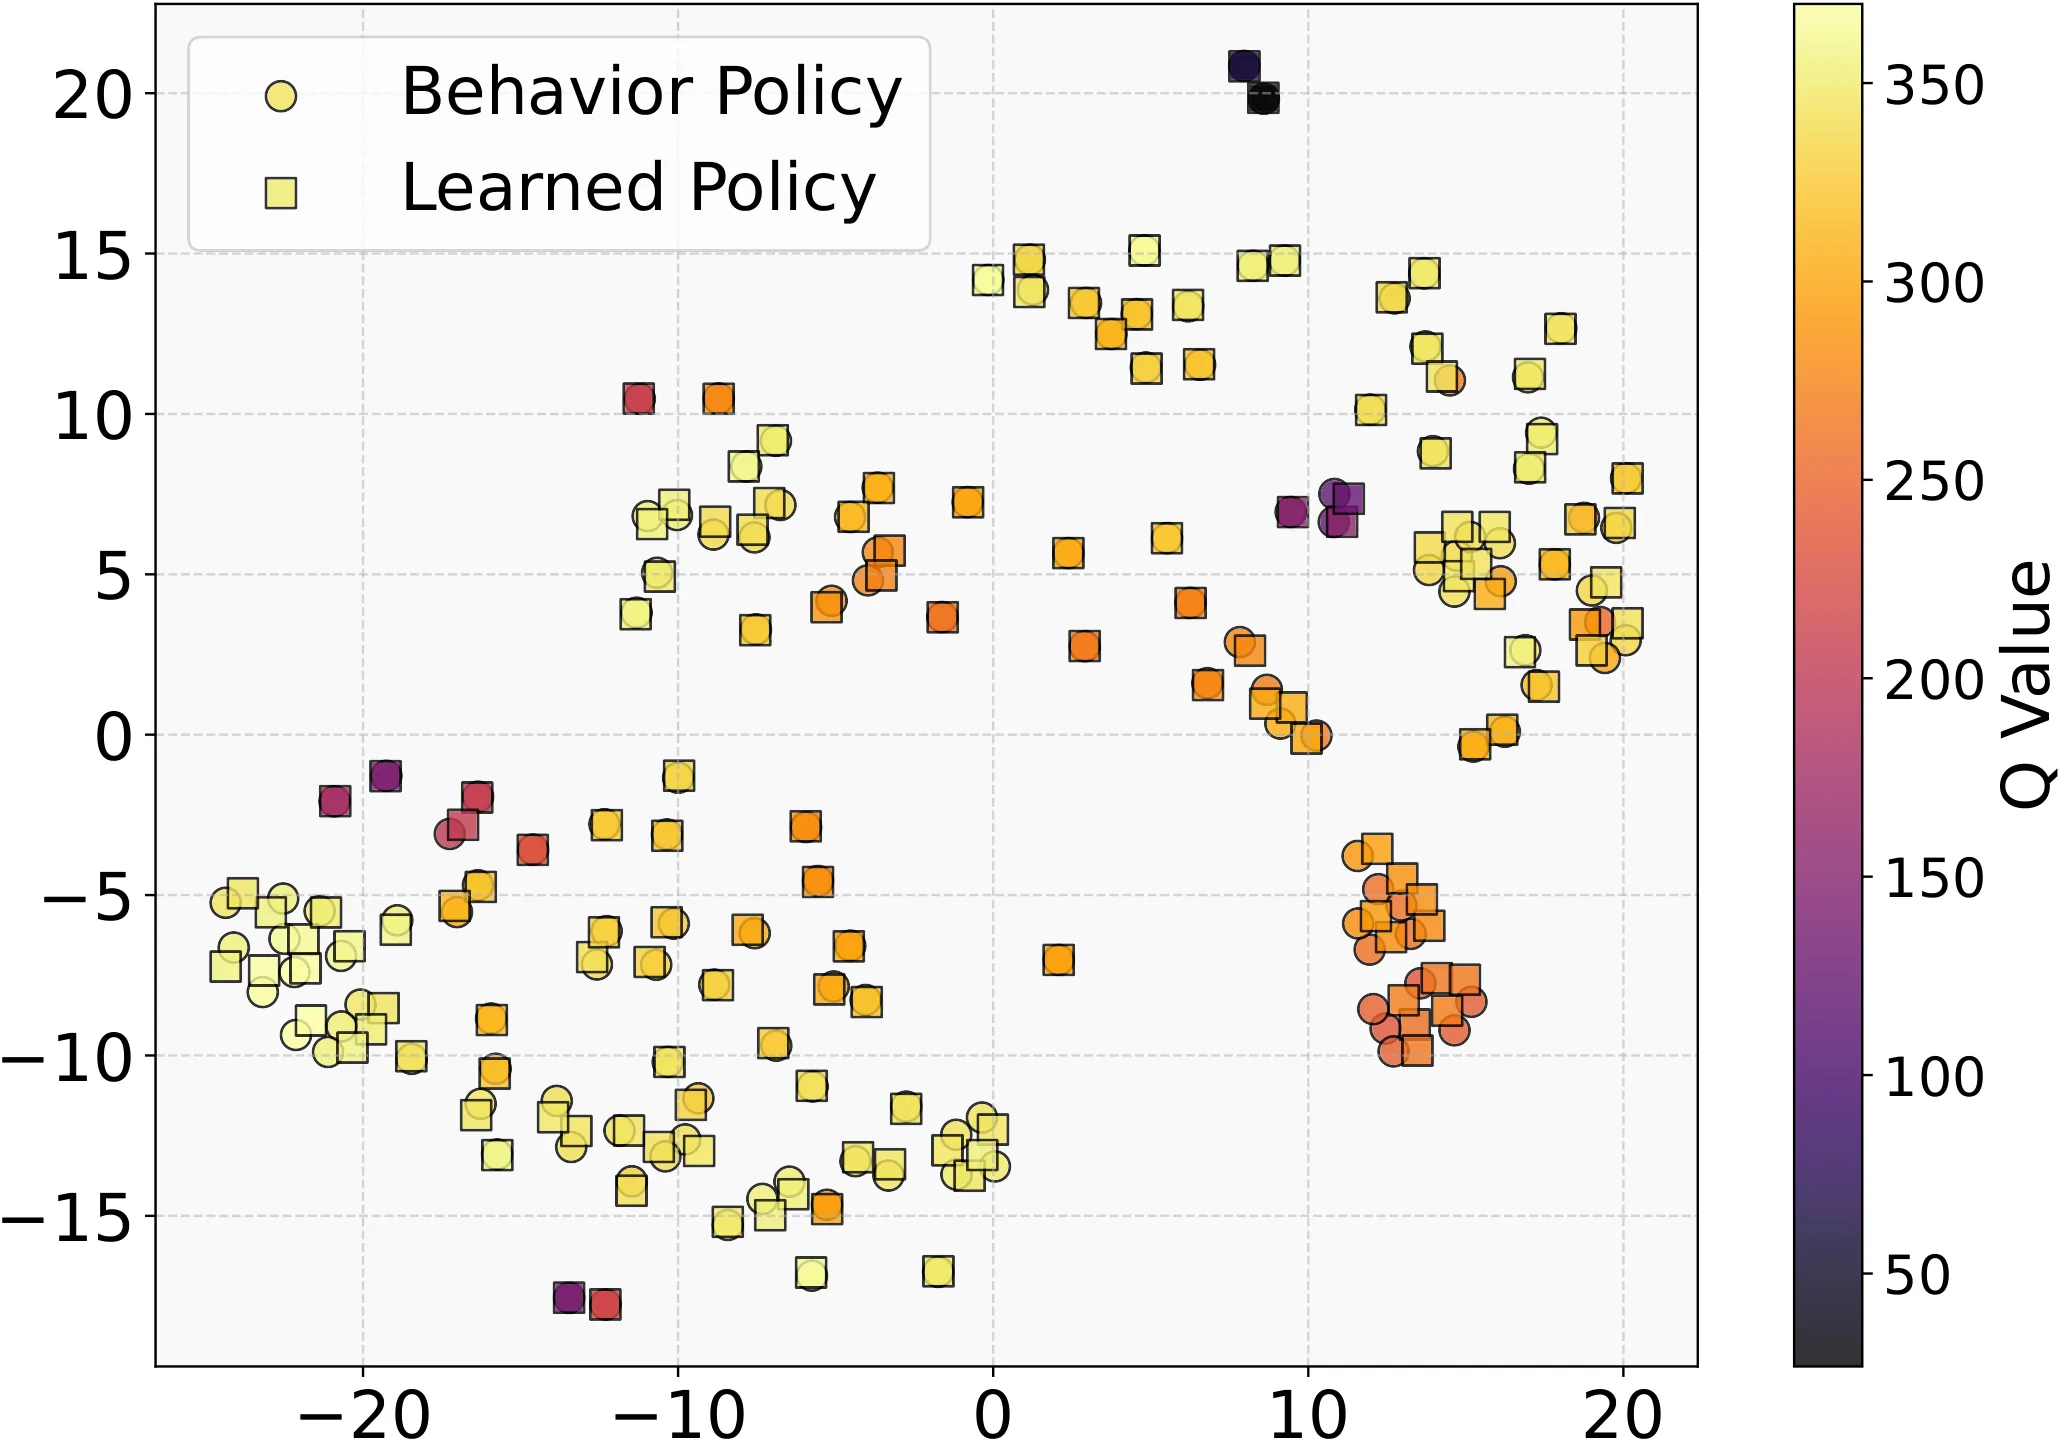
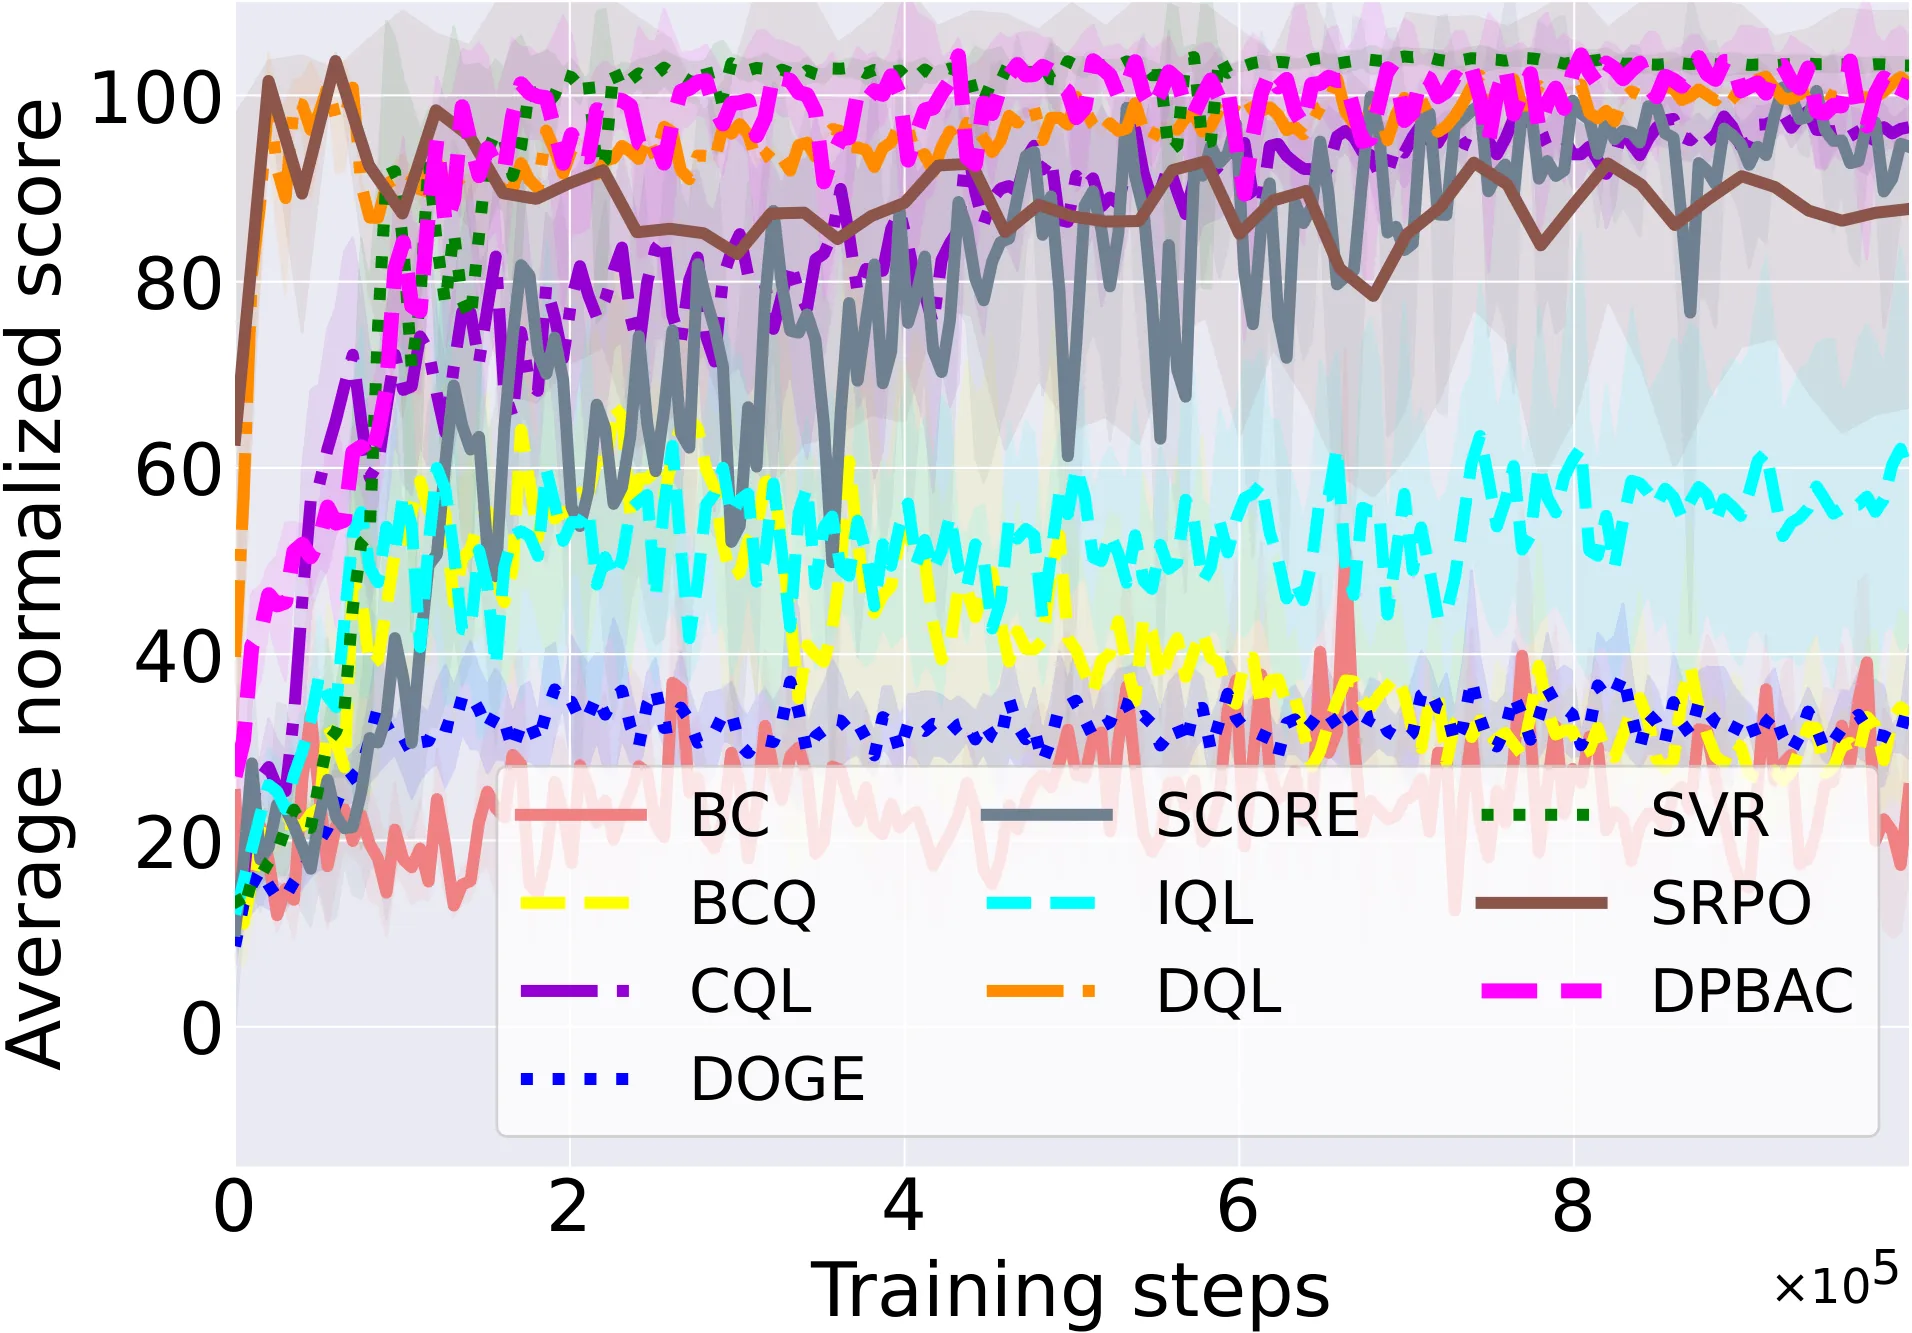
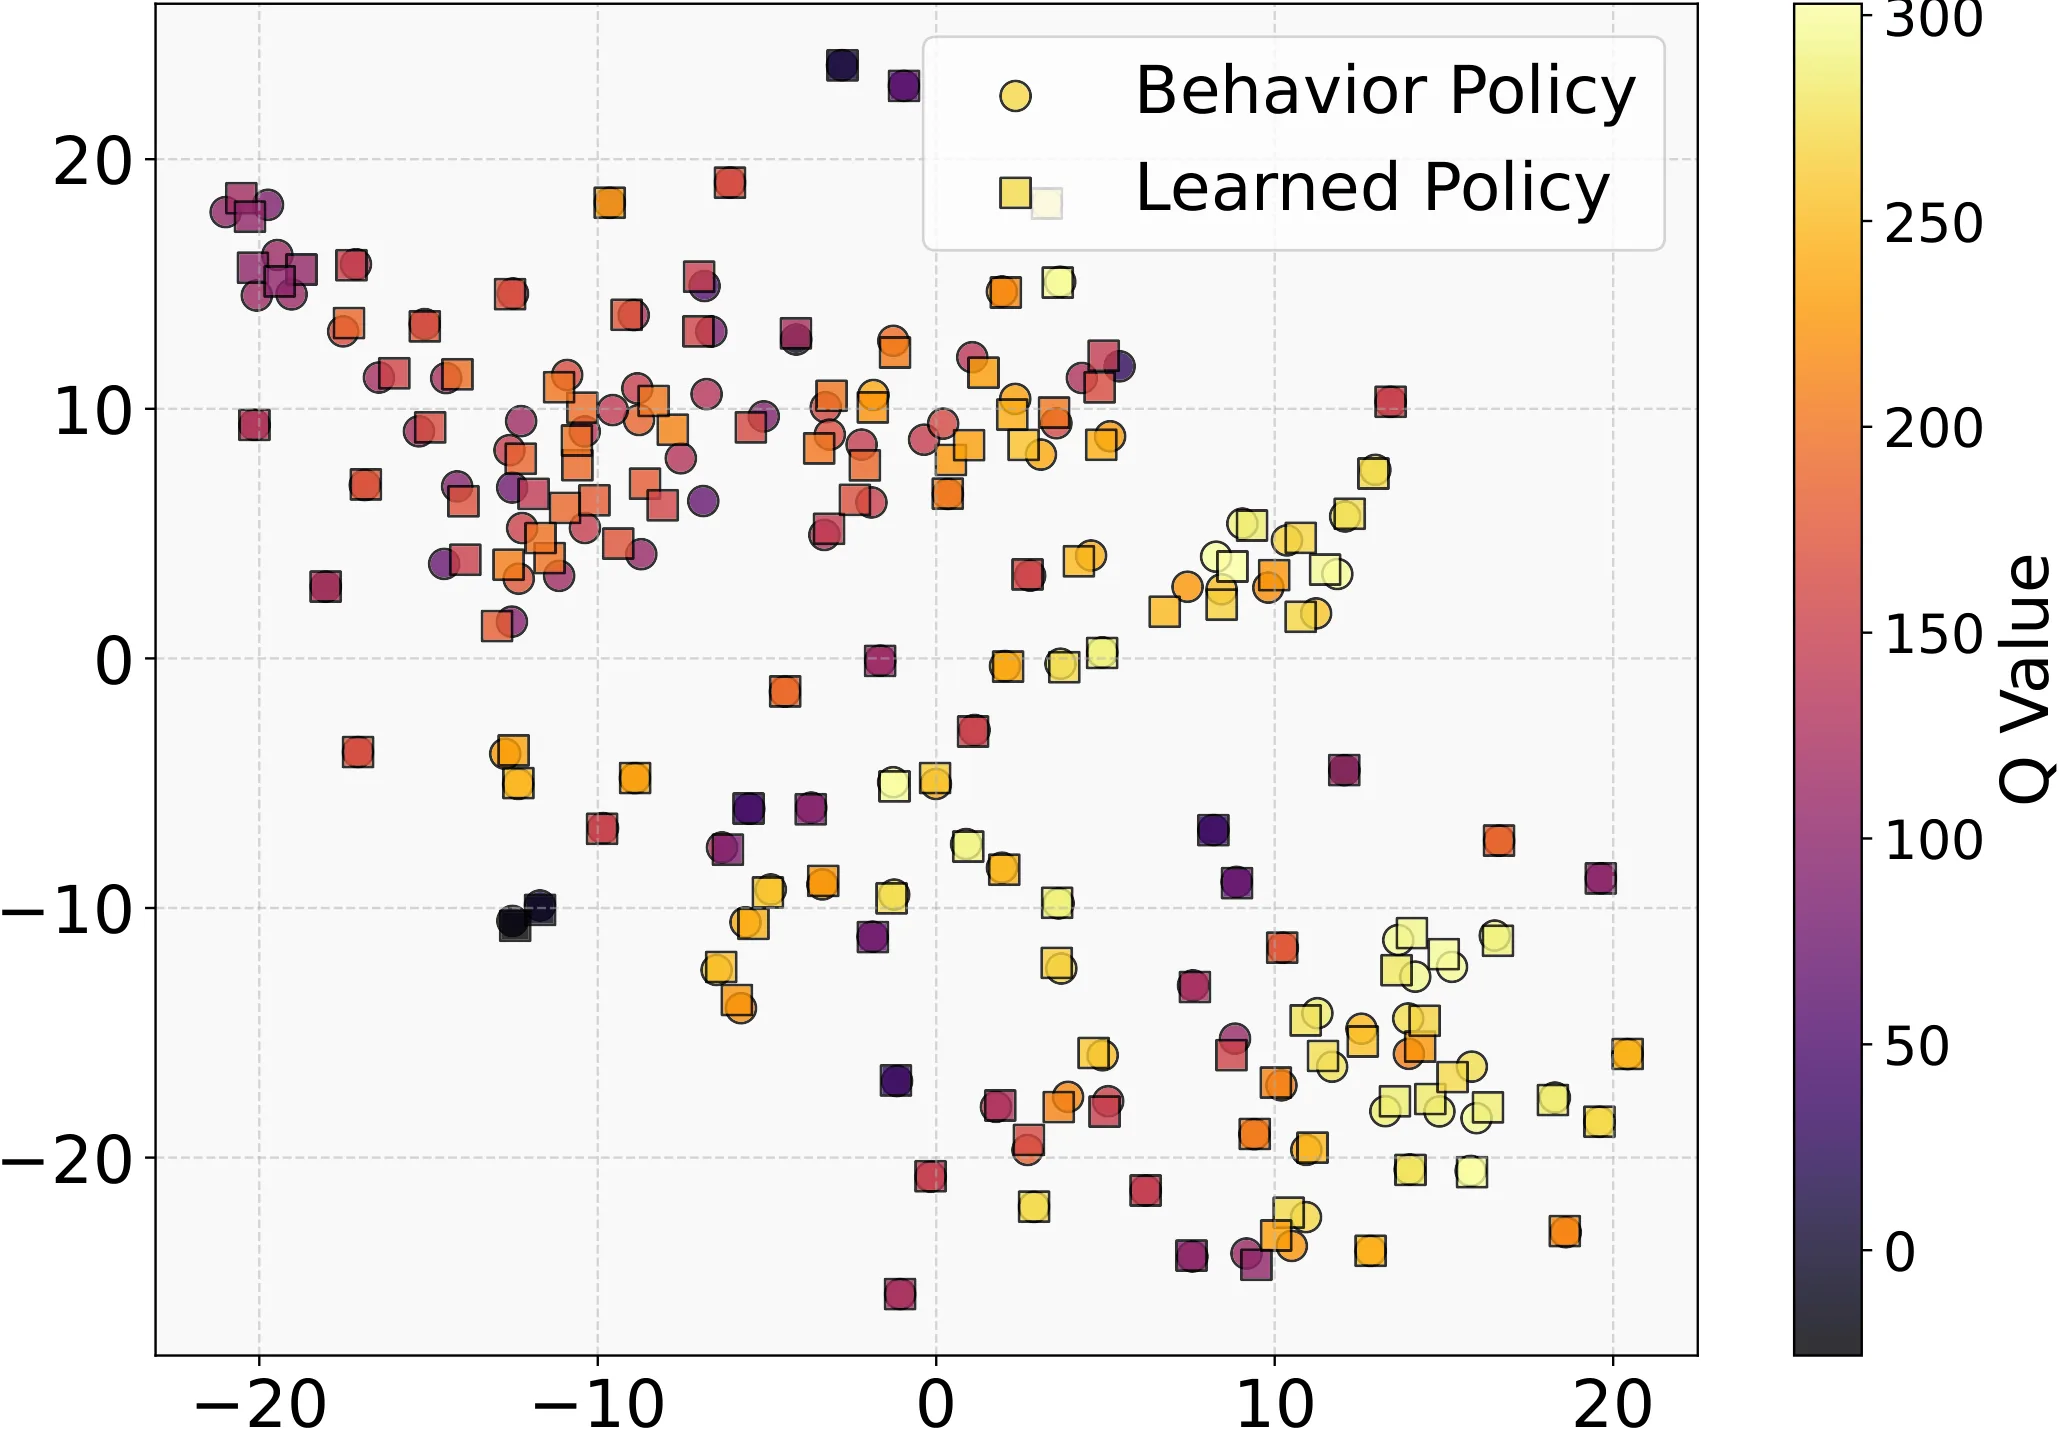
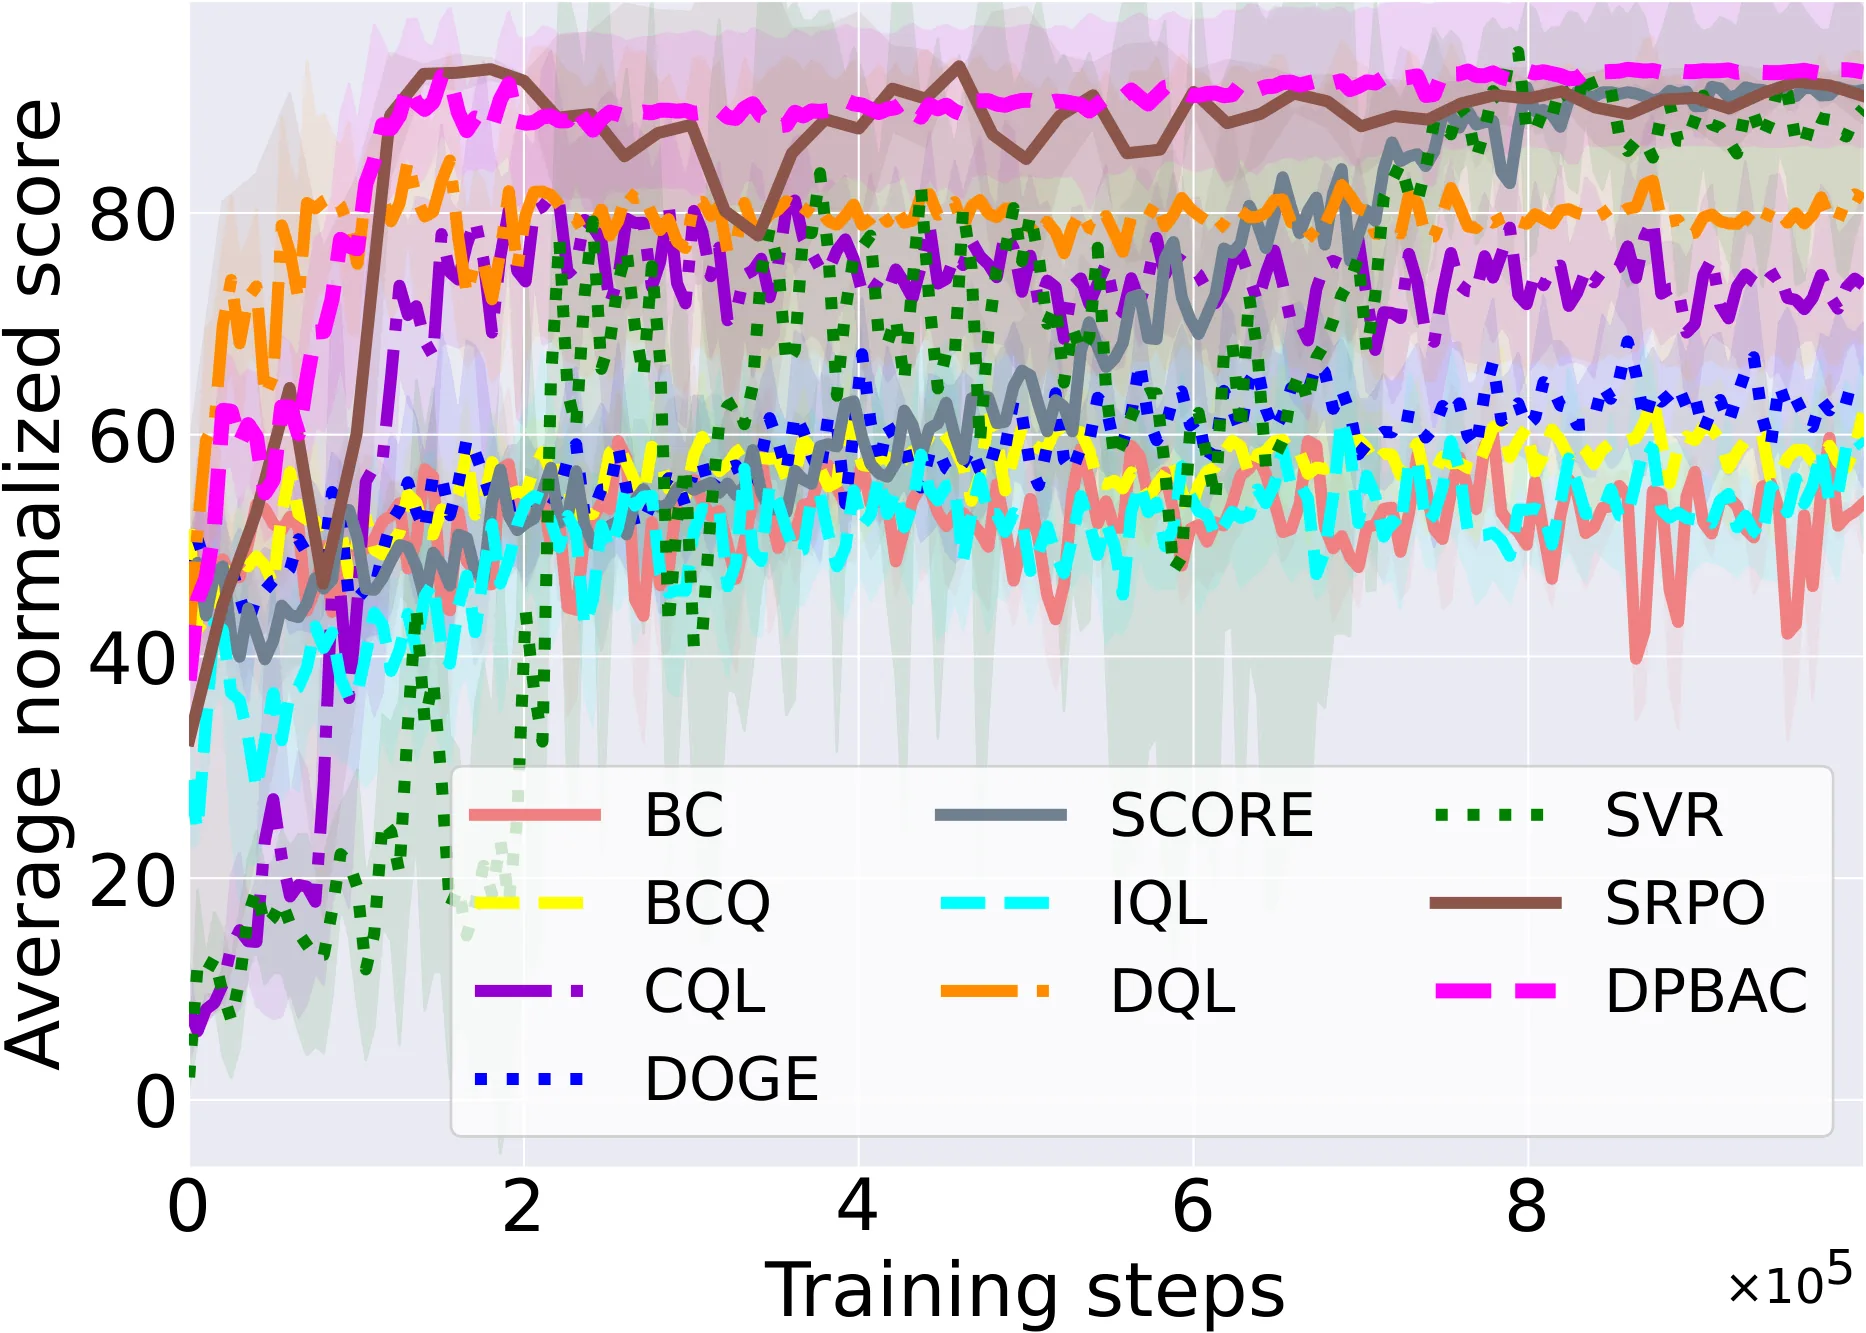
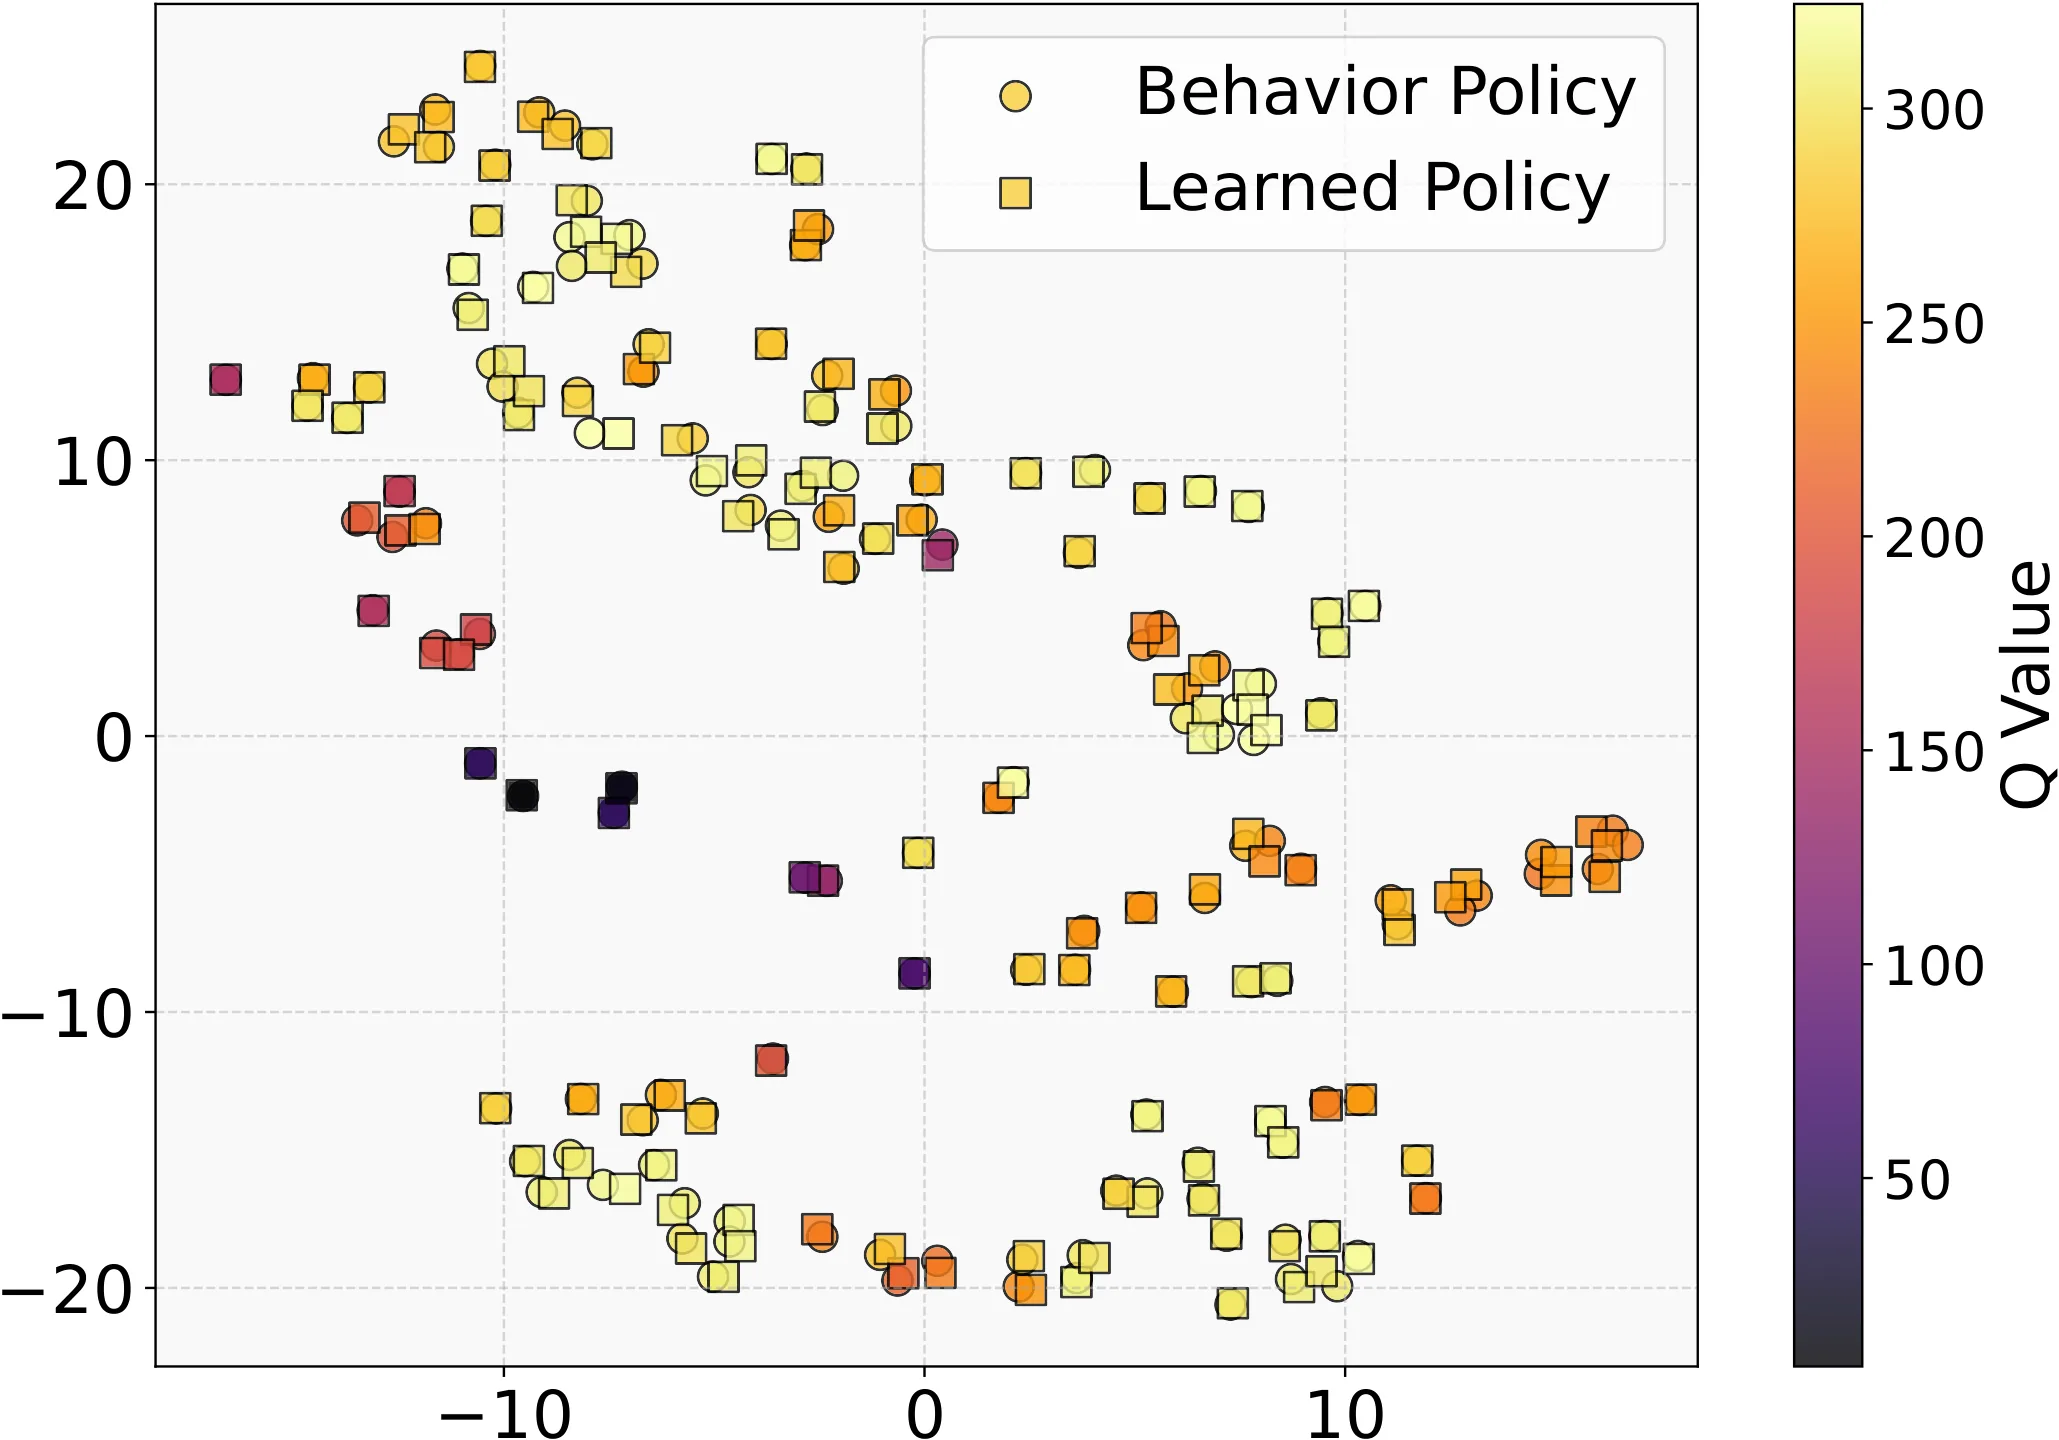
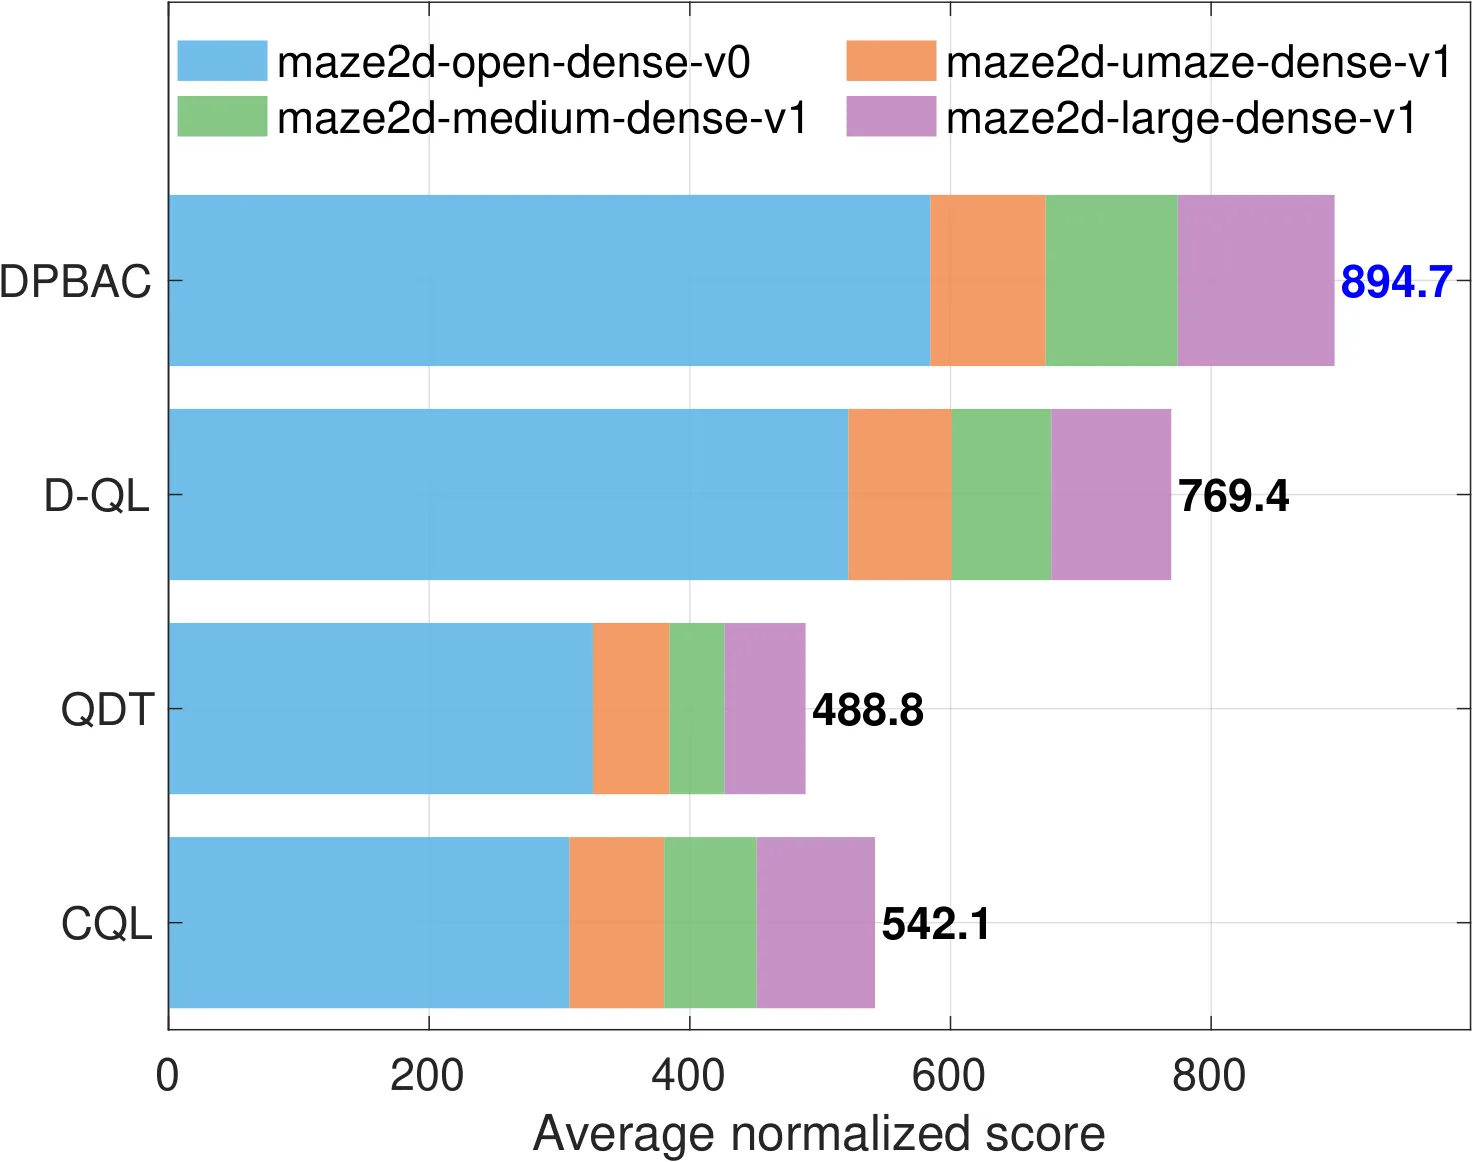
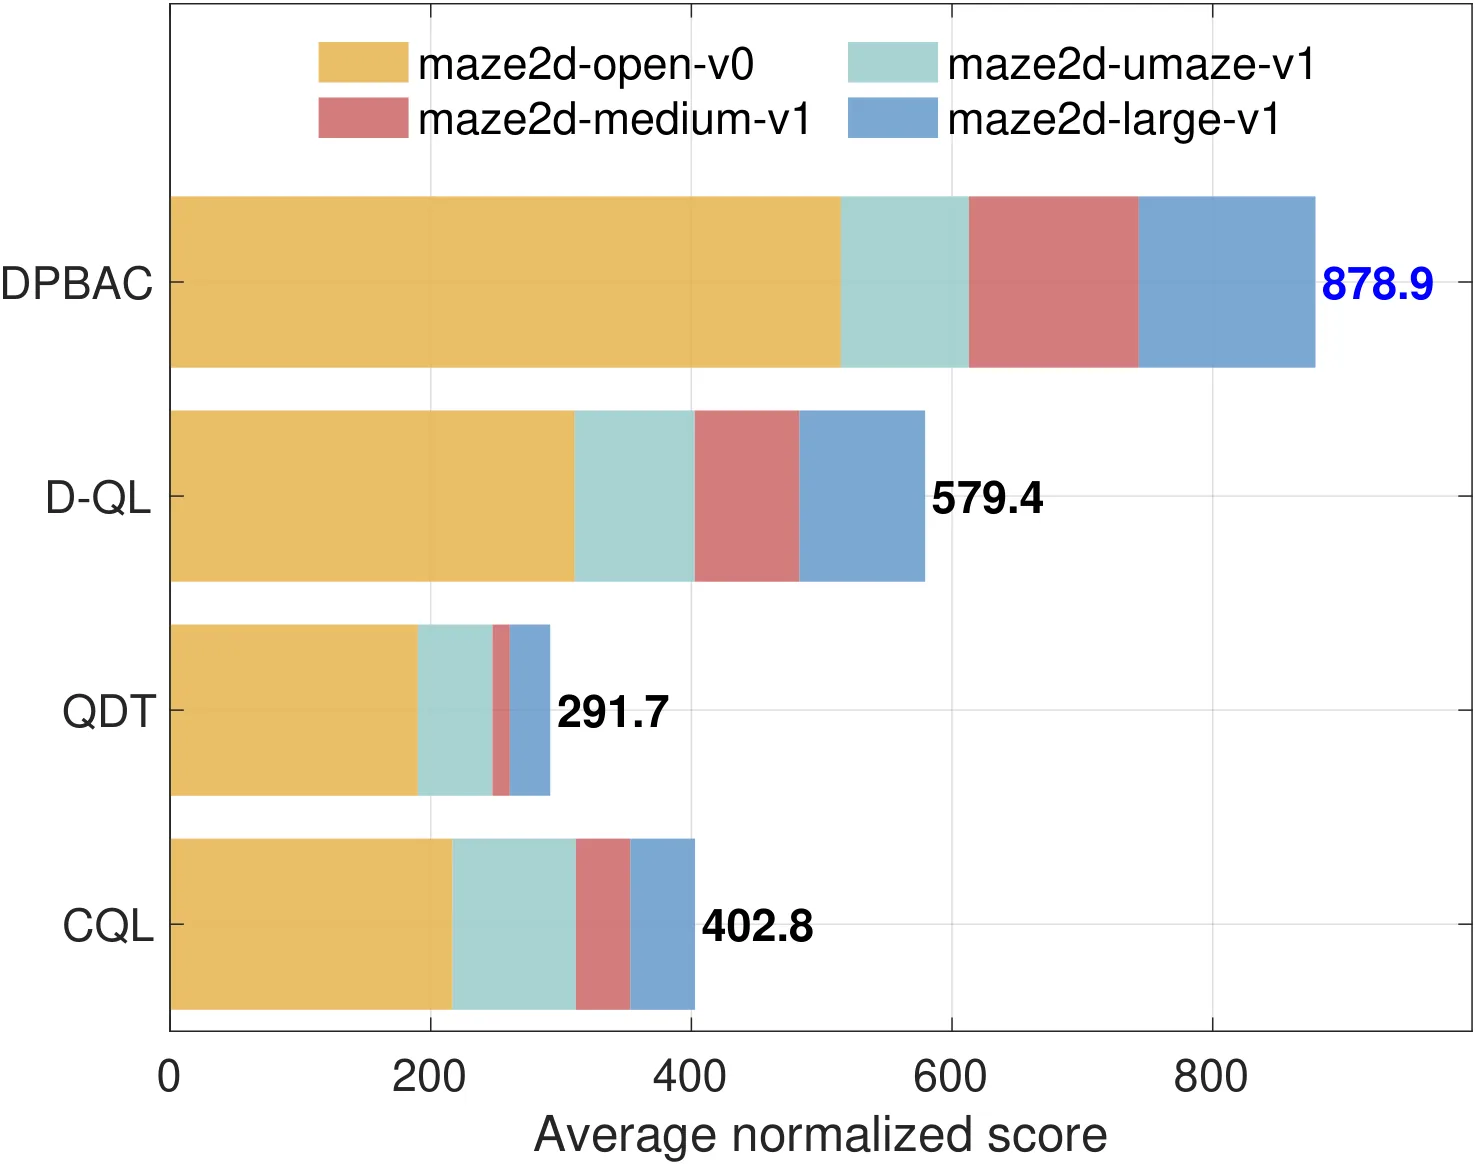
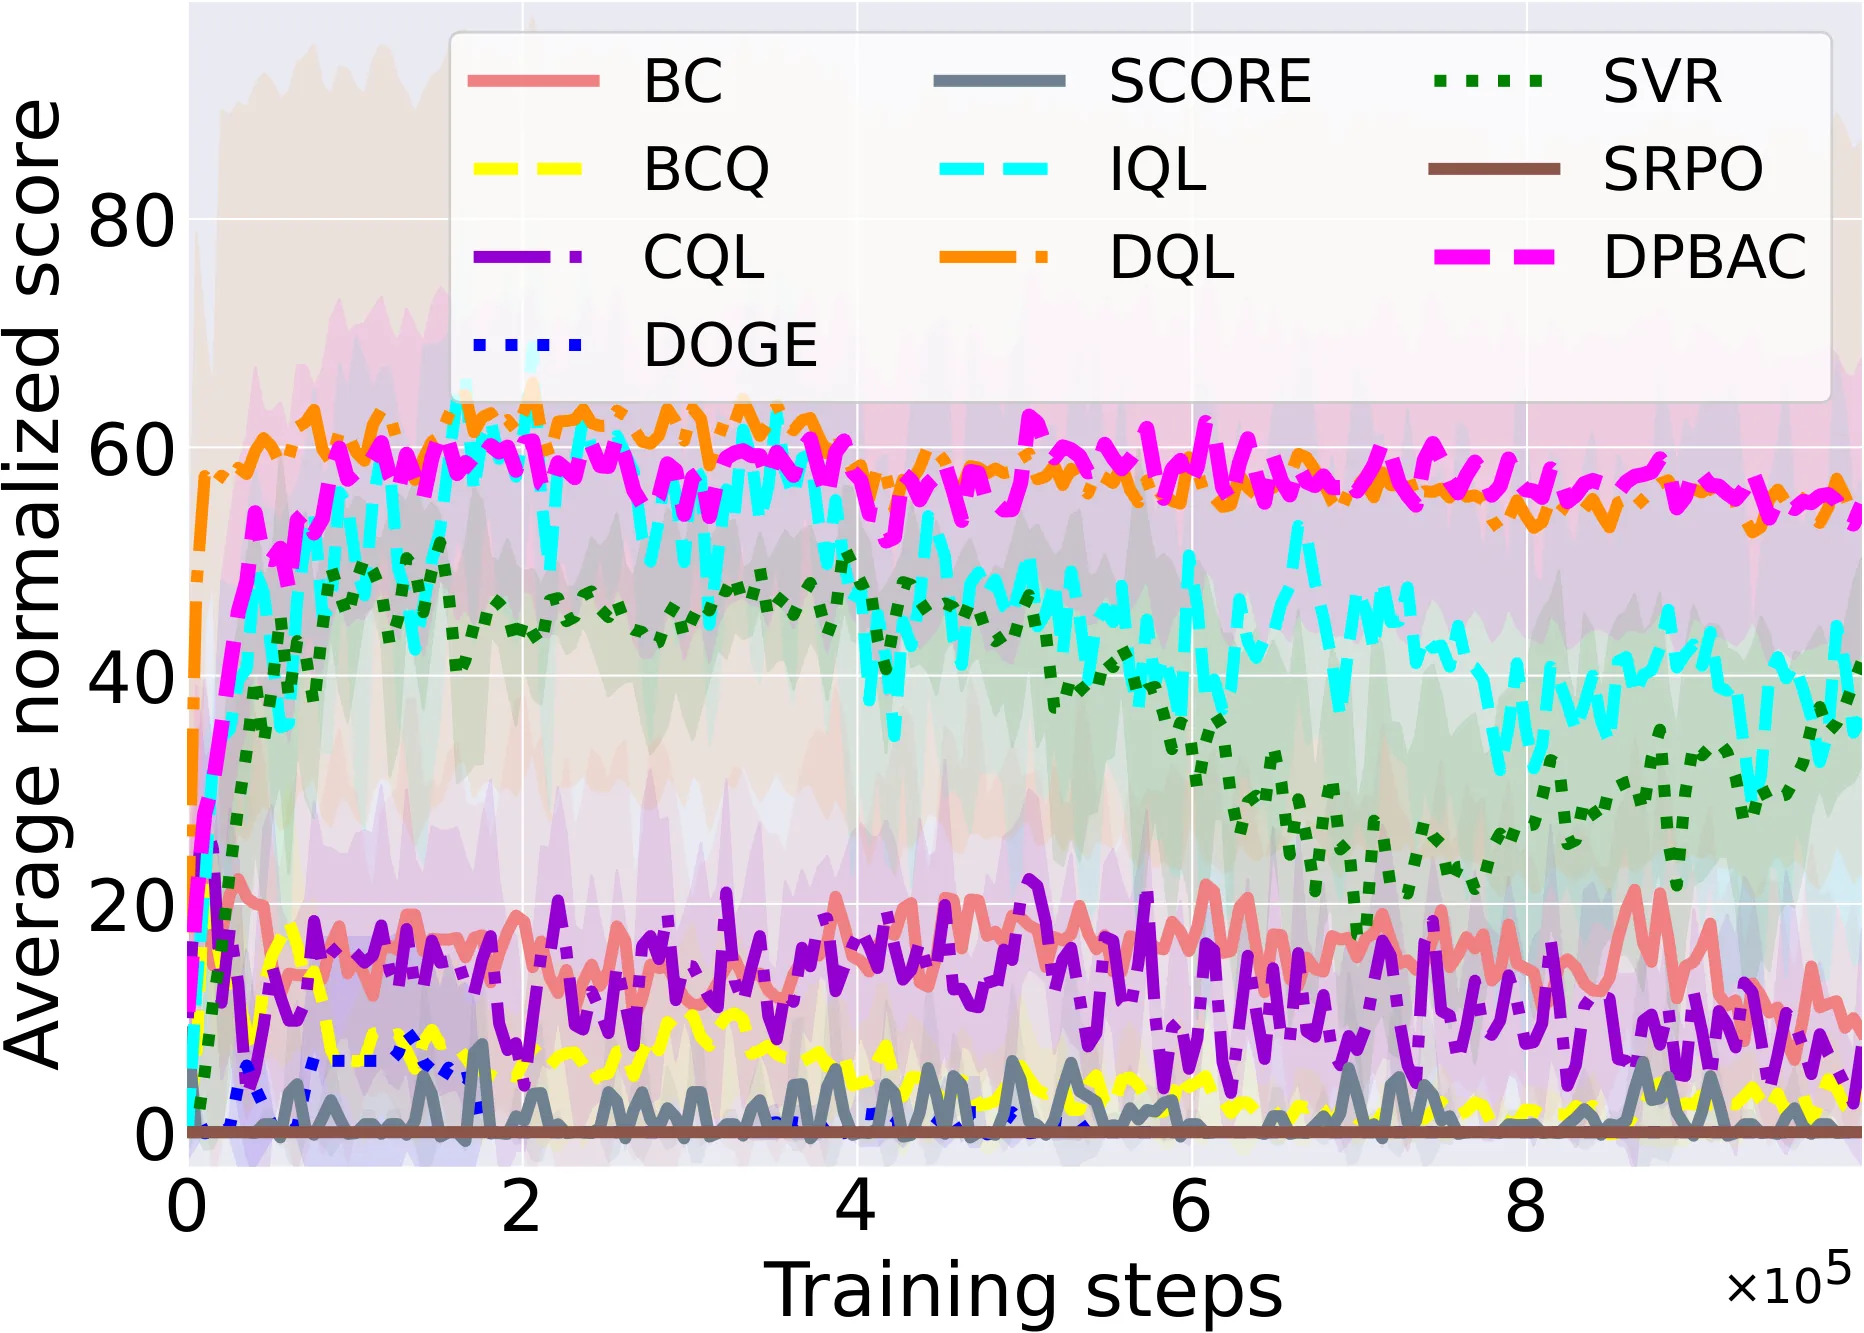
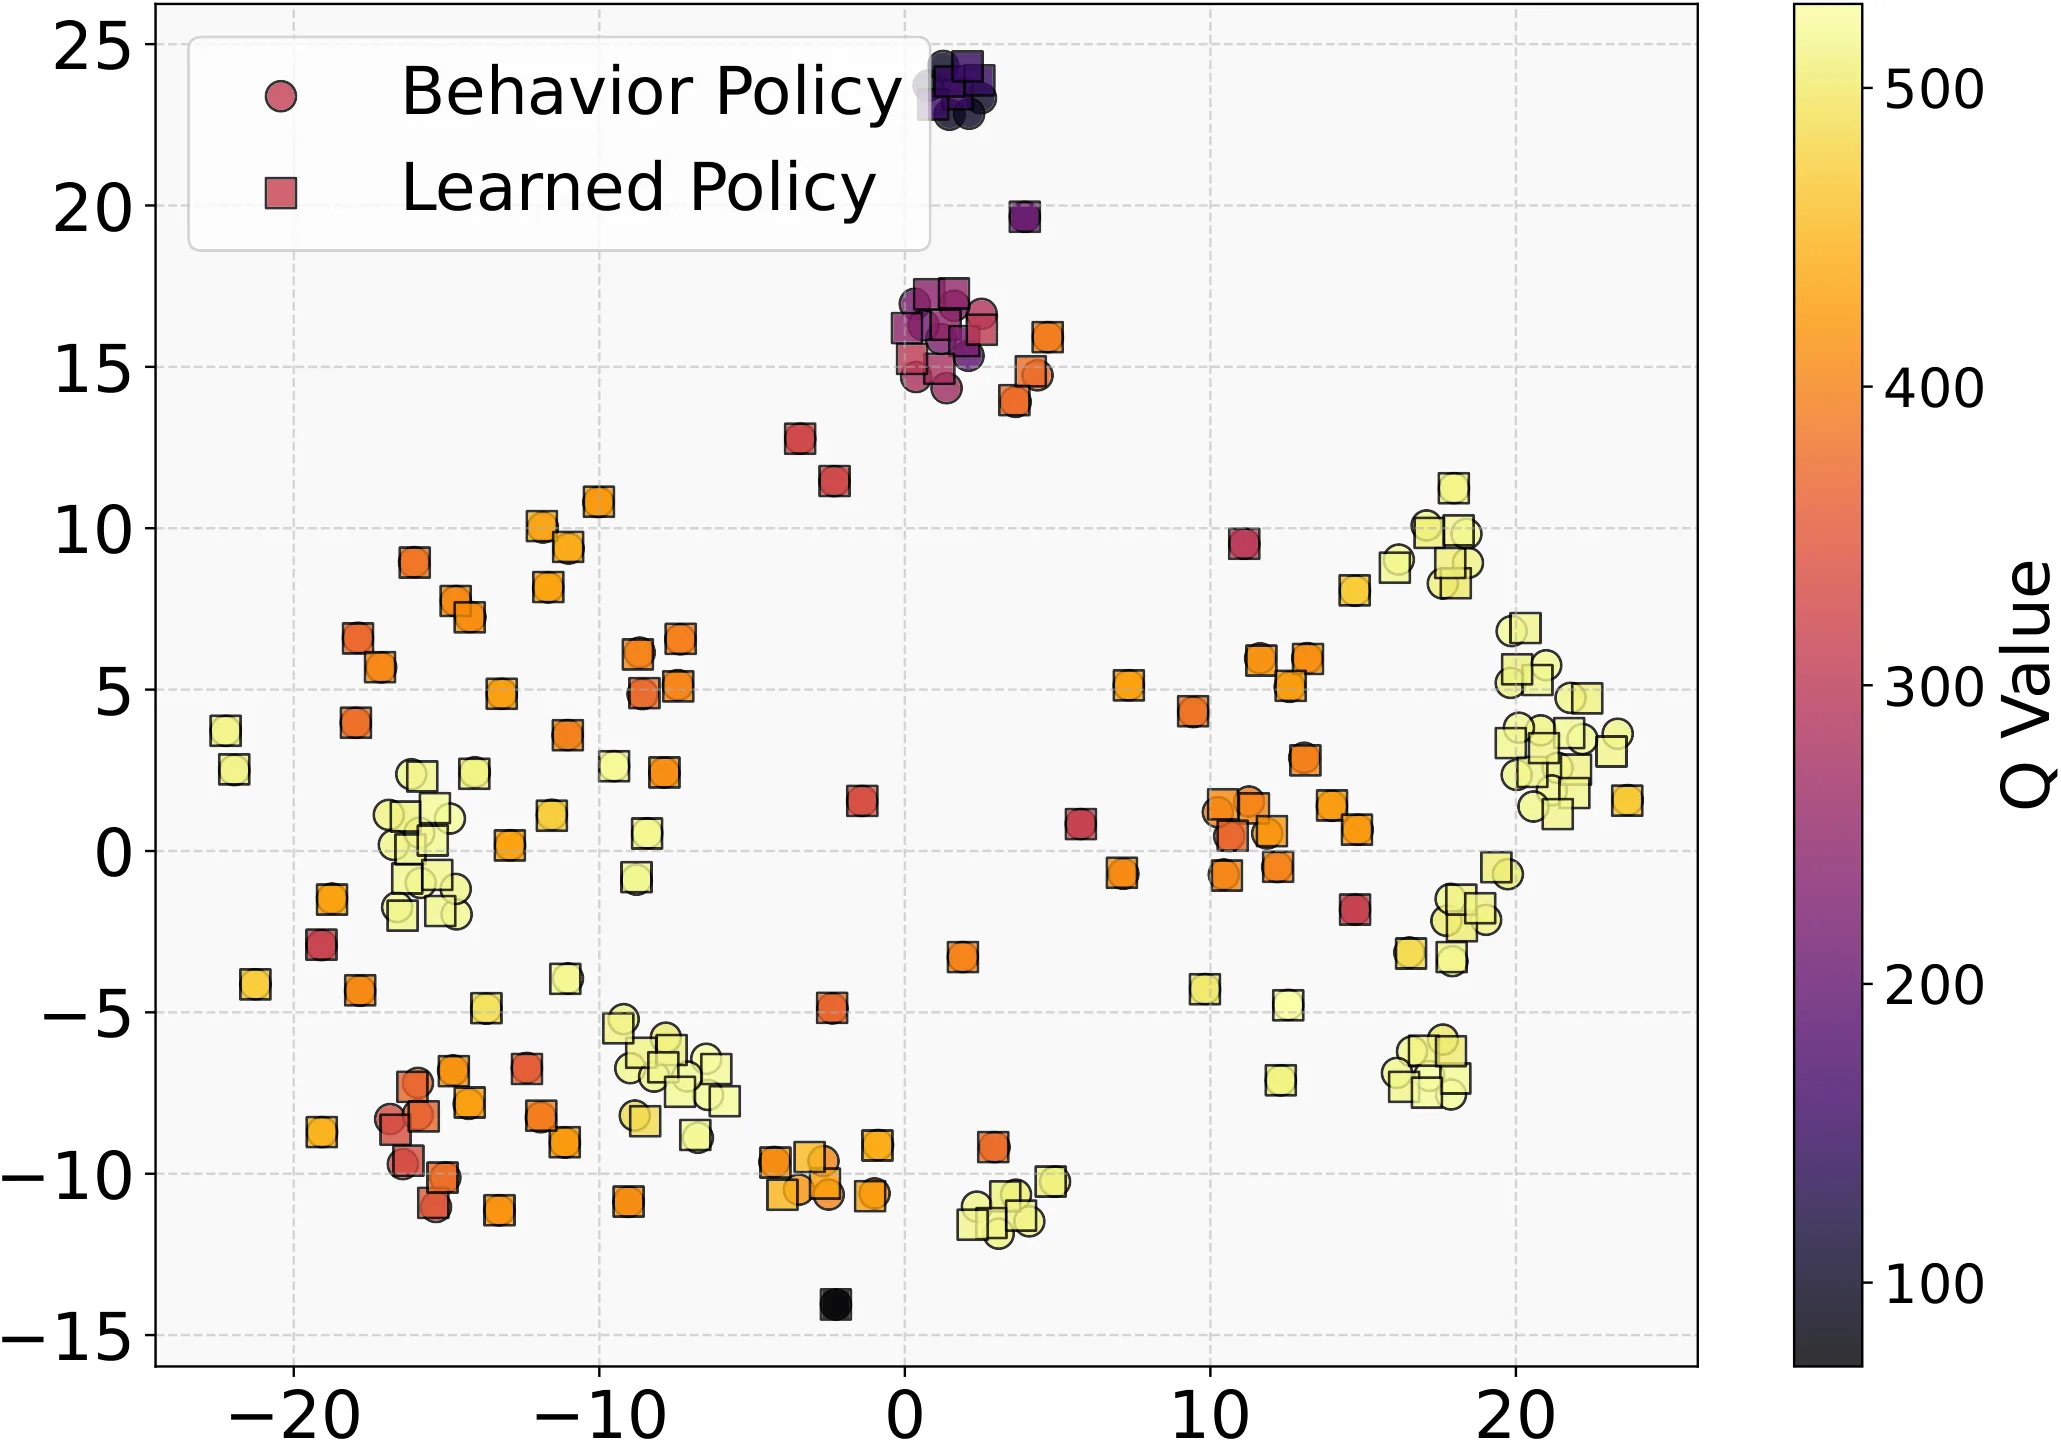
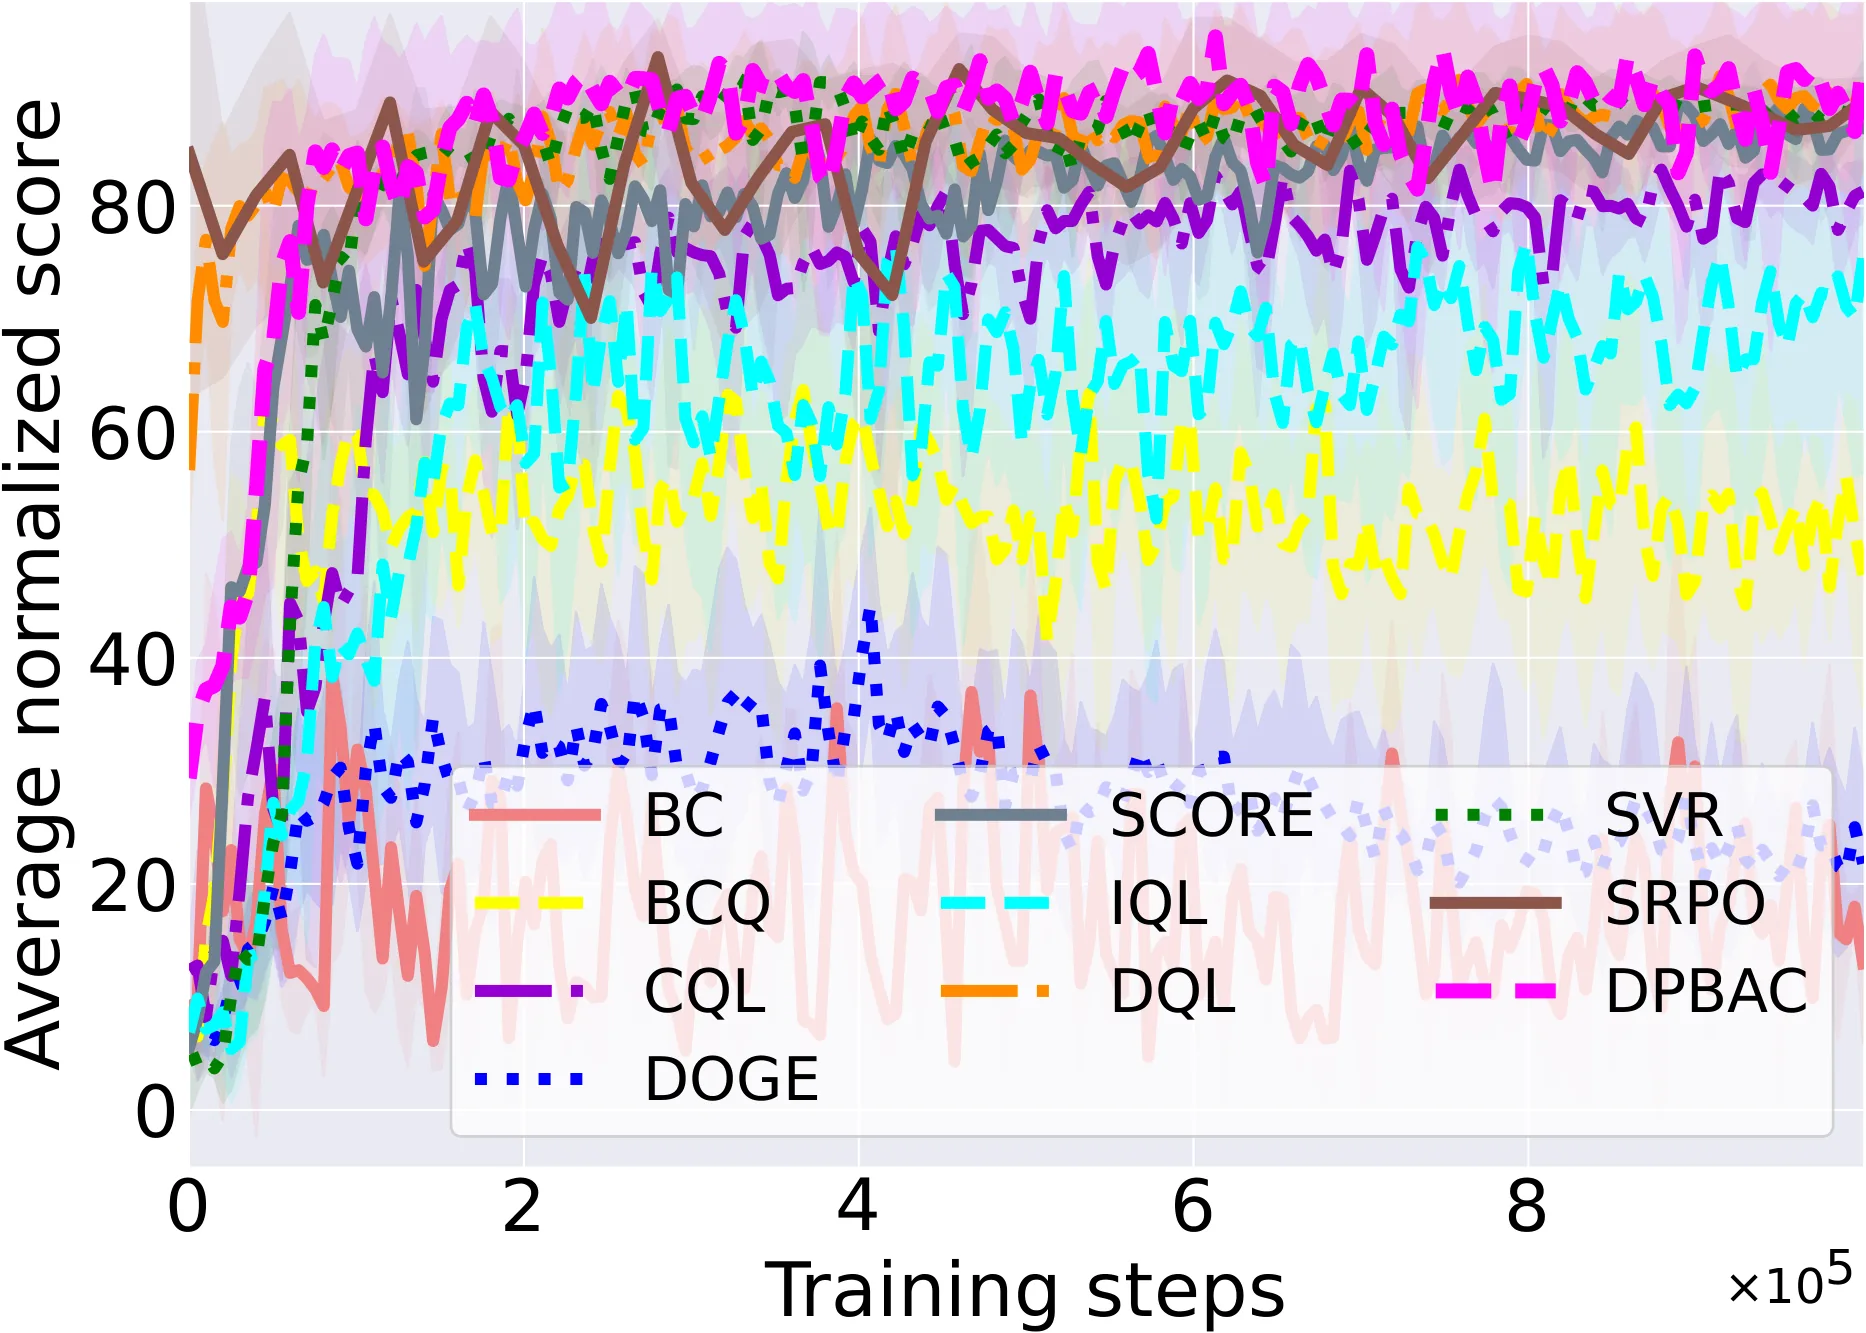
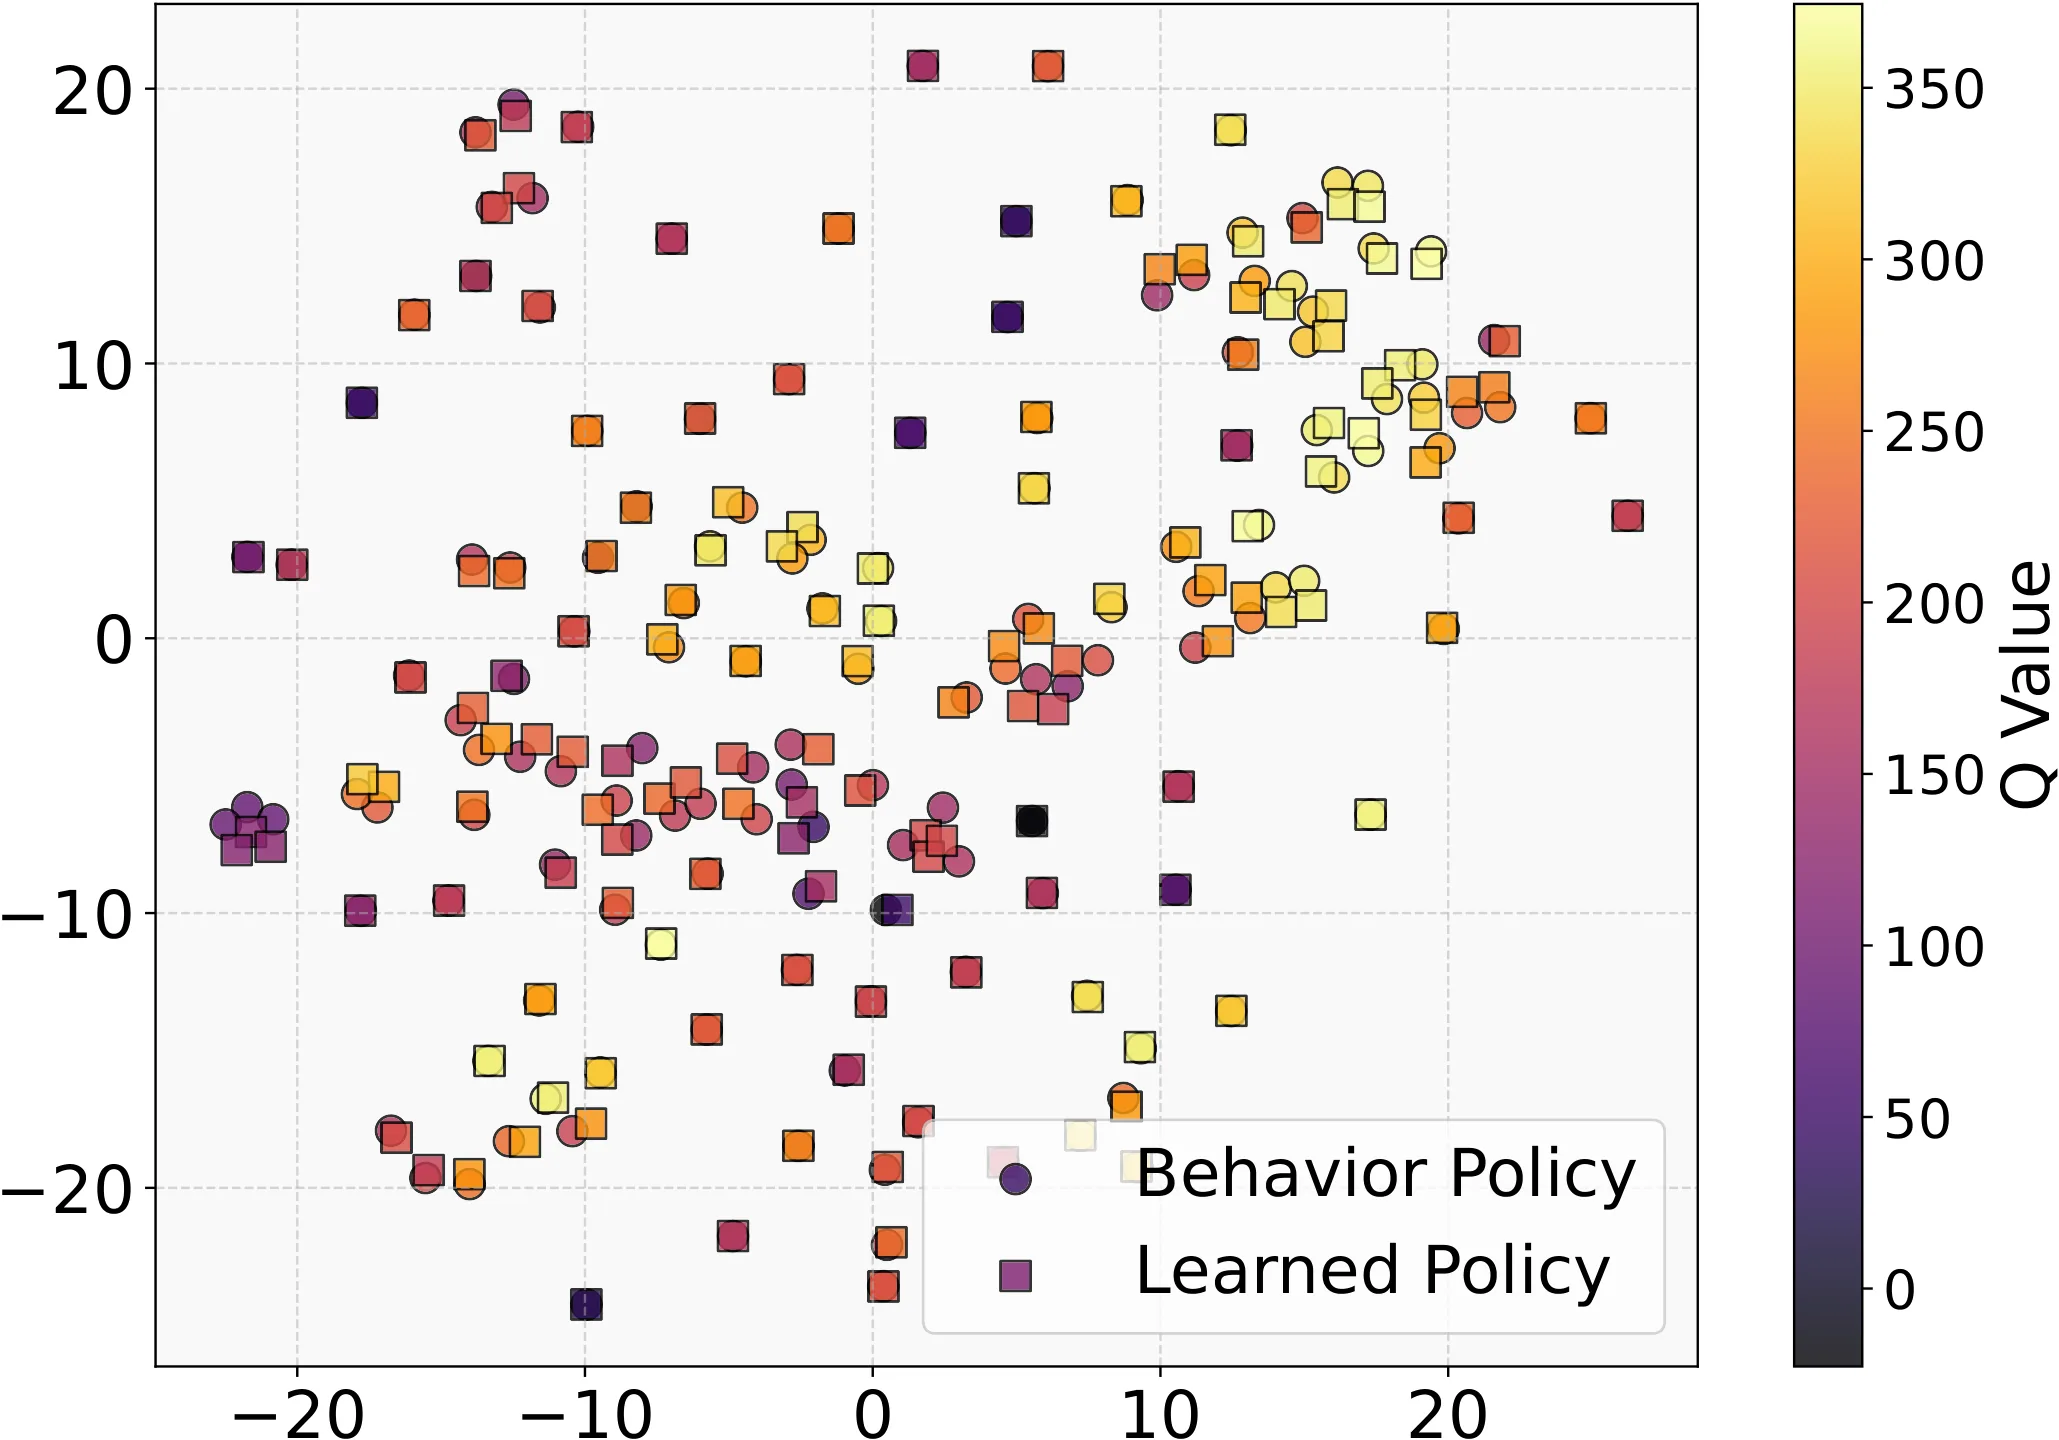
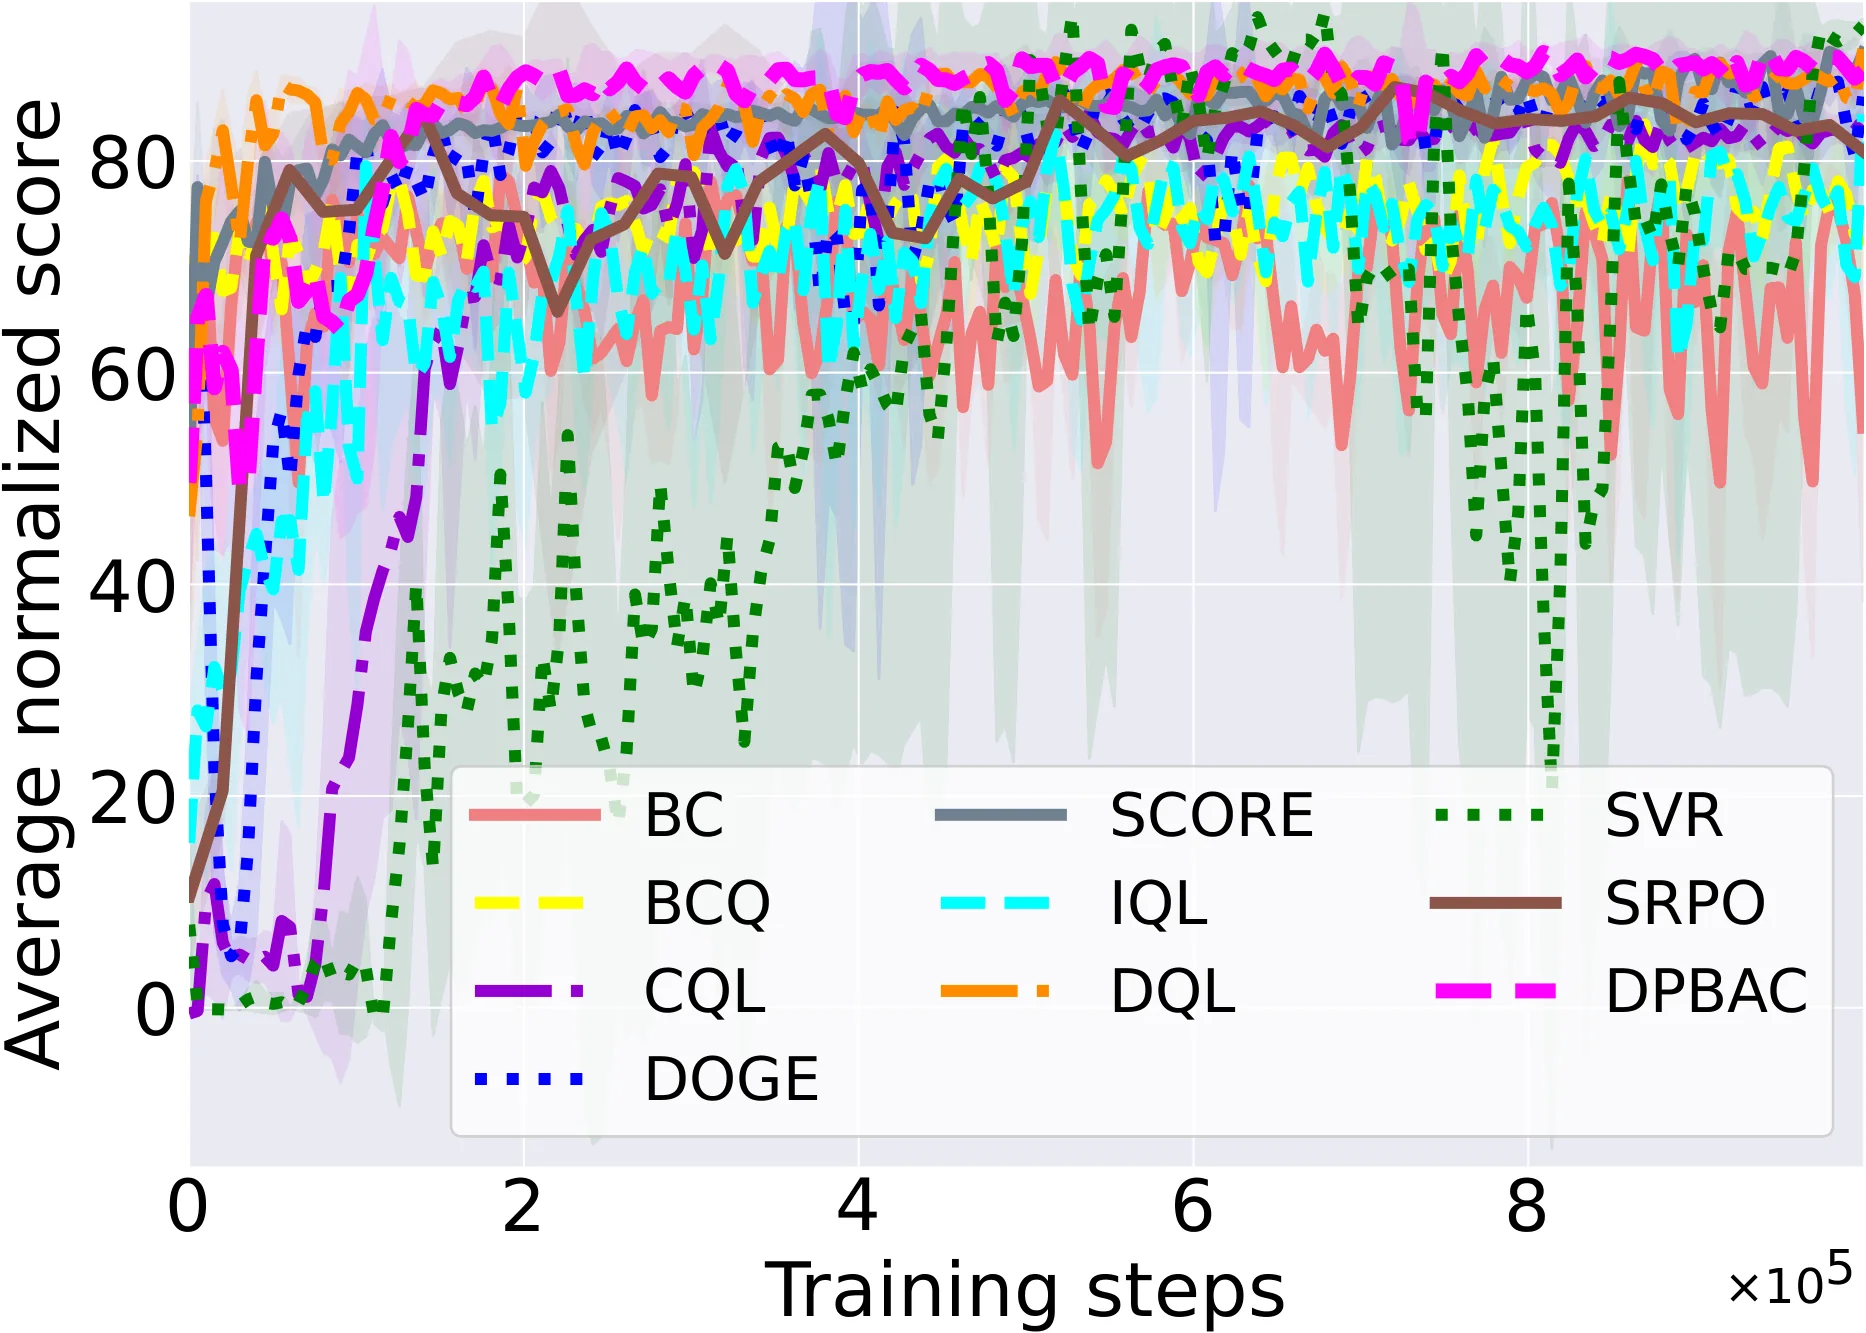
TL;DR
这篇论文针对离线强化学习中行为数据与学习策略之间的分布偏移问题,提出了行为优势修正策略评估方法(BAC-PE),通过行为策略的 Q 函数修正学习策略的 Q 函数来缓解保守性偏差和过估计问题。结合扩散模型强大的多模态分布建模能力,DPBAC 算法在 D4RL 多个任务域上取得了优于现有 SOTA 方法的性能,尤其在 medium 和 medium-replay 类型数据集上提升显著。
研究背景与动机
离线强化学习的核心矛盾在于,智能体必须在固定的数据集上进行学习,而无法与环境进行交互。这一特性使其面临一个根本性挑战:当学习策略偏离行为策略时,在行为数据覆盖不足的状态-动作对上,Q 值估计会产生严重的外推误差。这种分布偏移可能导致 Q 函数对未见过的动作给出过于乐观或过于悲观的估计值,进而误导策略优化的方向。
现有方法大体可分为两类。保守型方法如 CQL 和 IQL 通过惩罚高估的 Q 值来防止策略外推到未知区域,这种悲观保守主义虽然提升了策略的鲁棒性,但往往会过度压制 Q 值,引入显著的保守偏差,导致学到的策略过于接近甚至弱于行为策略。另一类扩散策略方法如 Diffusion-QL 利用扩散模型拟合多模态行为分布,在行为分布匹配上表现出色,但它们缺乏显式机制来修正学习策略与行为策略之间的 Q 值差异。
论文的切入点正是这两类方法各自的缺陷:如果能用行为策略的 Q 函数信息来指导学习策略的 Q 修正,同时发挥扩散模型在分布建模上的优势,就有可能同时实现“贴近行为分布”与“超越行为策略”两个目标。
方法
行为优势修正策略评估
离线强化学习的策略评估通常依赖标准 [[Bellman算子]] 进行迭代。然而,当转移概率 (行为数据对应的环境动态)与真实动态 存在差异时,标准算子给出的 Q 估计会产生系统性偏差。论文定义了一个修正后的 Bellman 算子,在原有基础上引入行为优势项:
其中行为优势函数 衡量了行为策略在该状态-动作对上的 Q 值与当前 Q 估计的差距。当学习策略的 Q 值低于行为策略时,优势修正项为正,反之为负——这正是“优势修正”的含义。通过调节系数 ,可以控制修正强度。
直觉上,这个设计的巧妙之处在于它不需要估计重要性采样权重或环境动态模型,而是直接利用已经训练好的行为策略 Q 函数来“校准”学习策略的 Q 估计。这相当于在 [[策略评估]] 过程中引入了一个偏差修正项,使学习策略的 Q 值不会过于偏离行为策略的经验知识。
收敛性分析
论文对 BAC-PE 的收敛性进行了严格分析。定义 ,修正后的迭代格式满足收缩性质,最终收敛到真实 Q 函数 ,误差上界为:
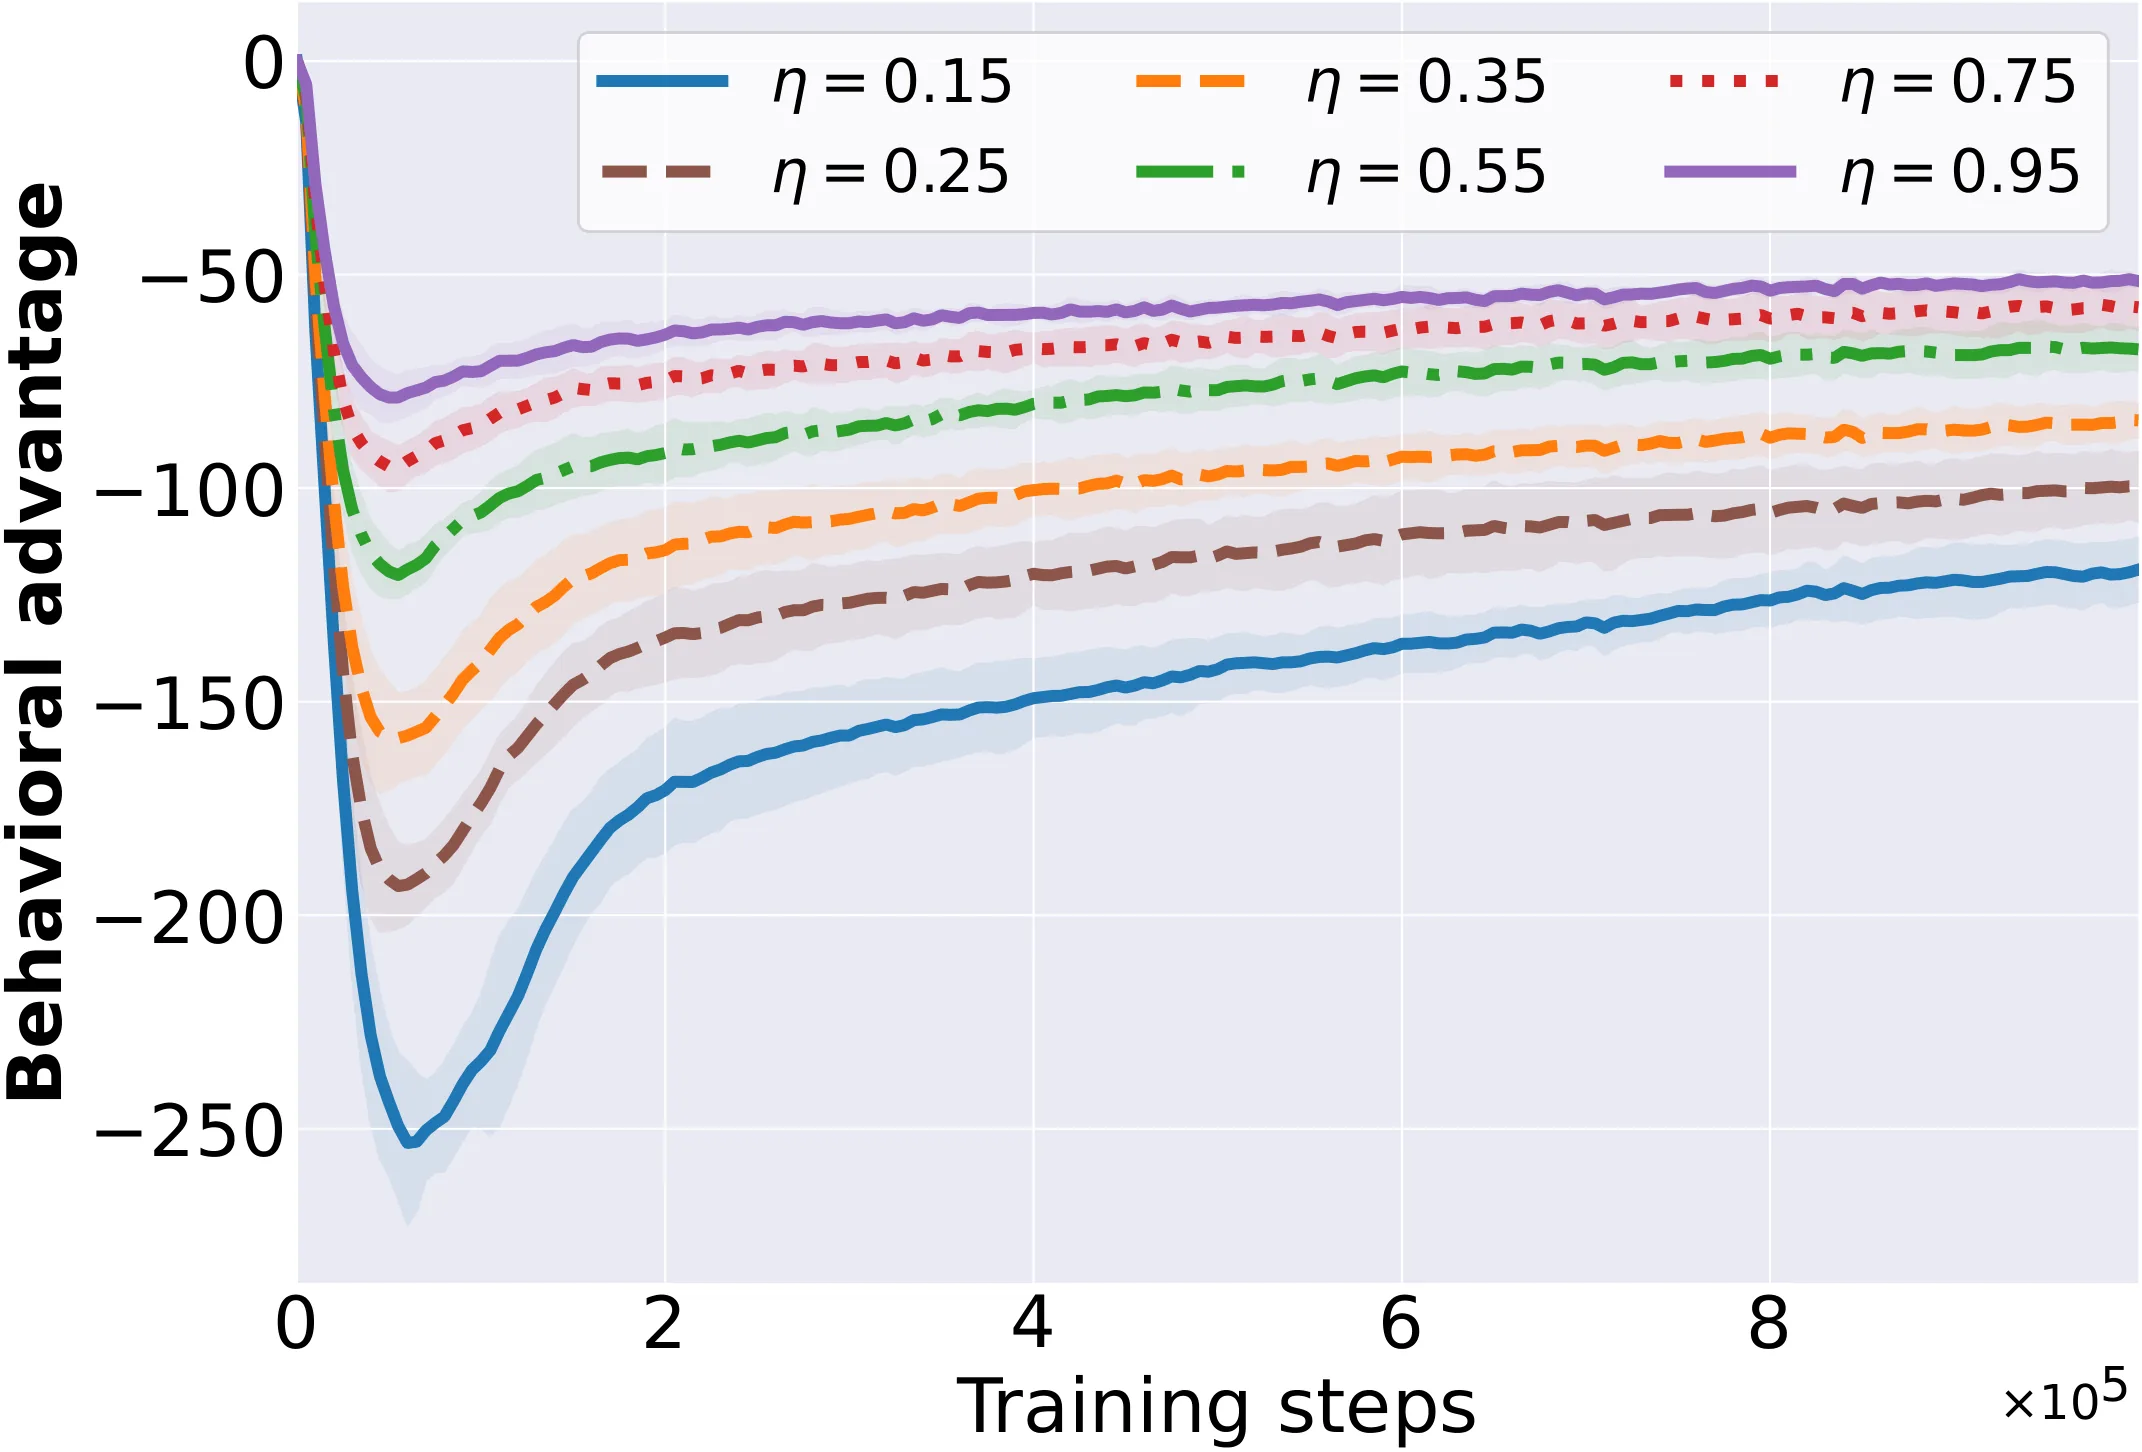
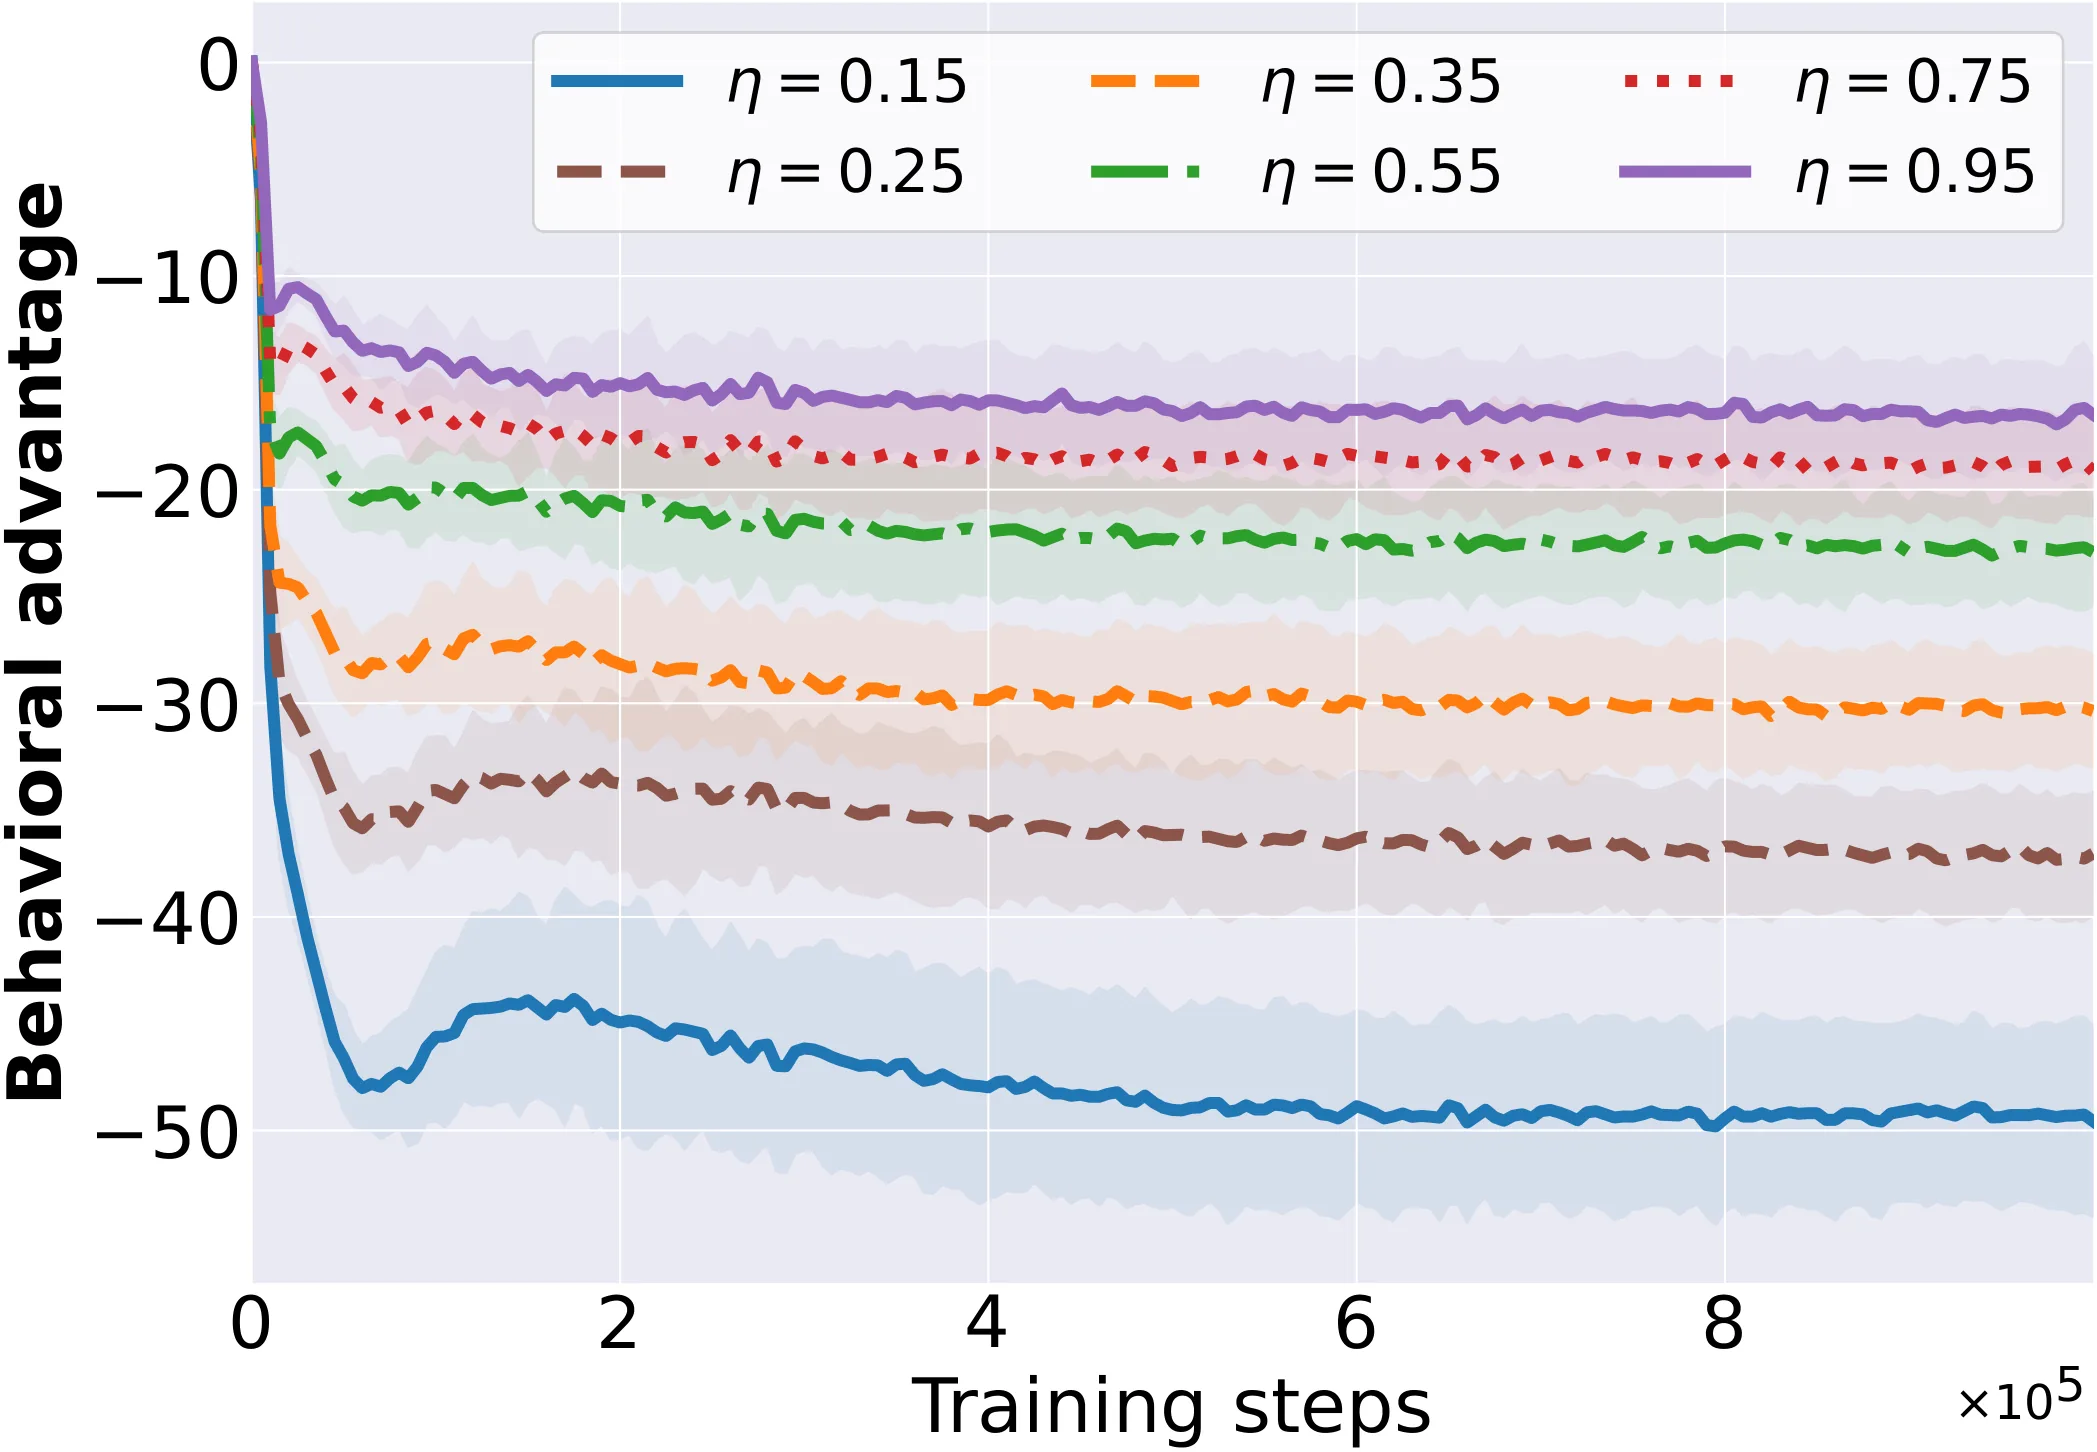
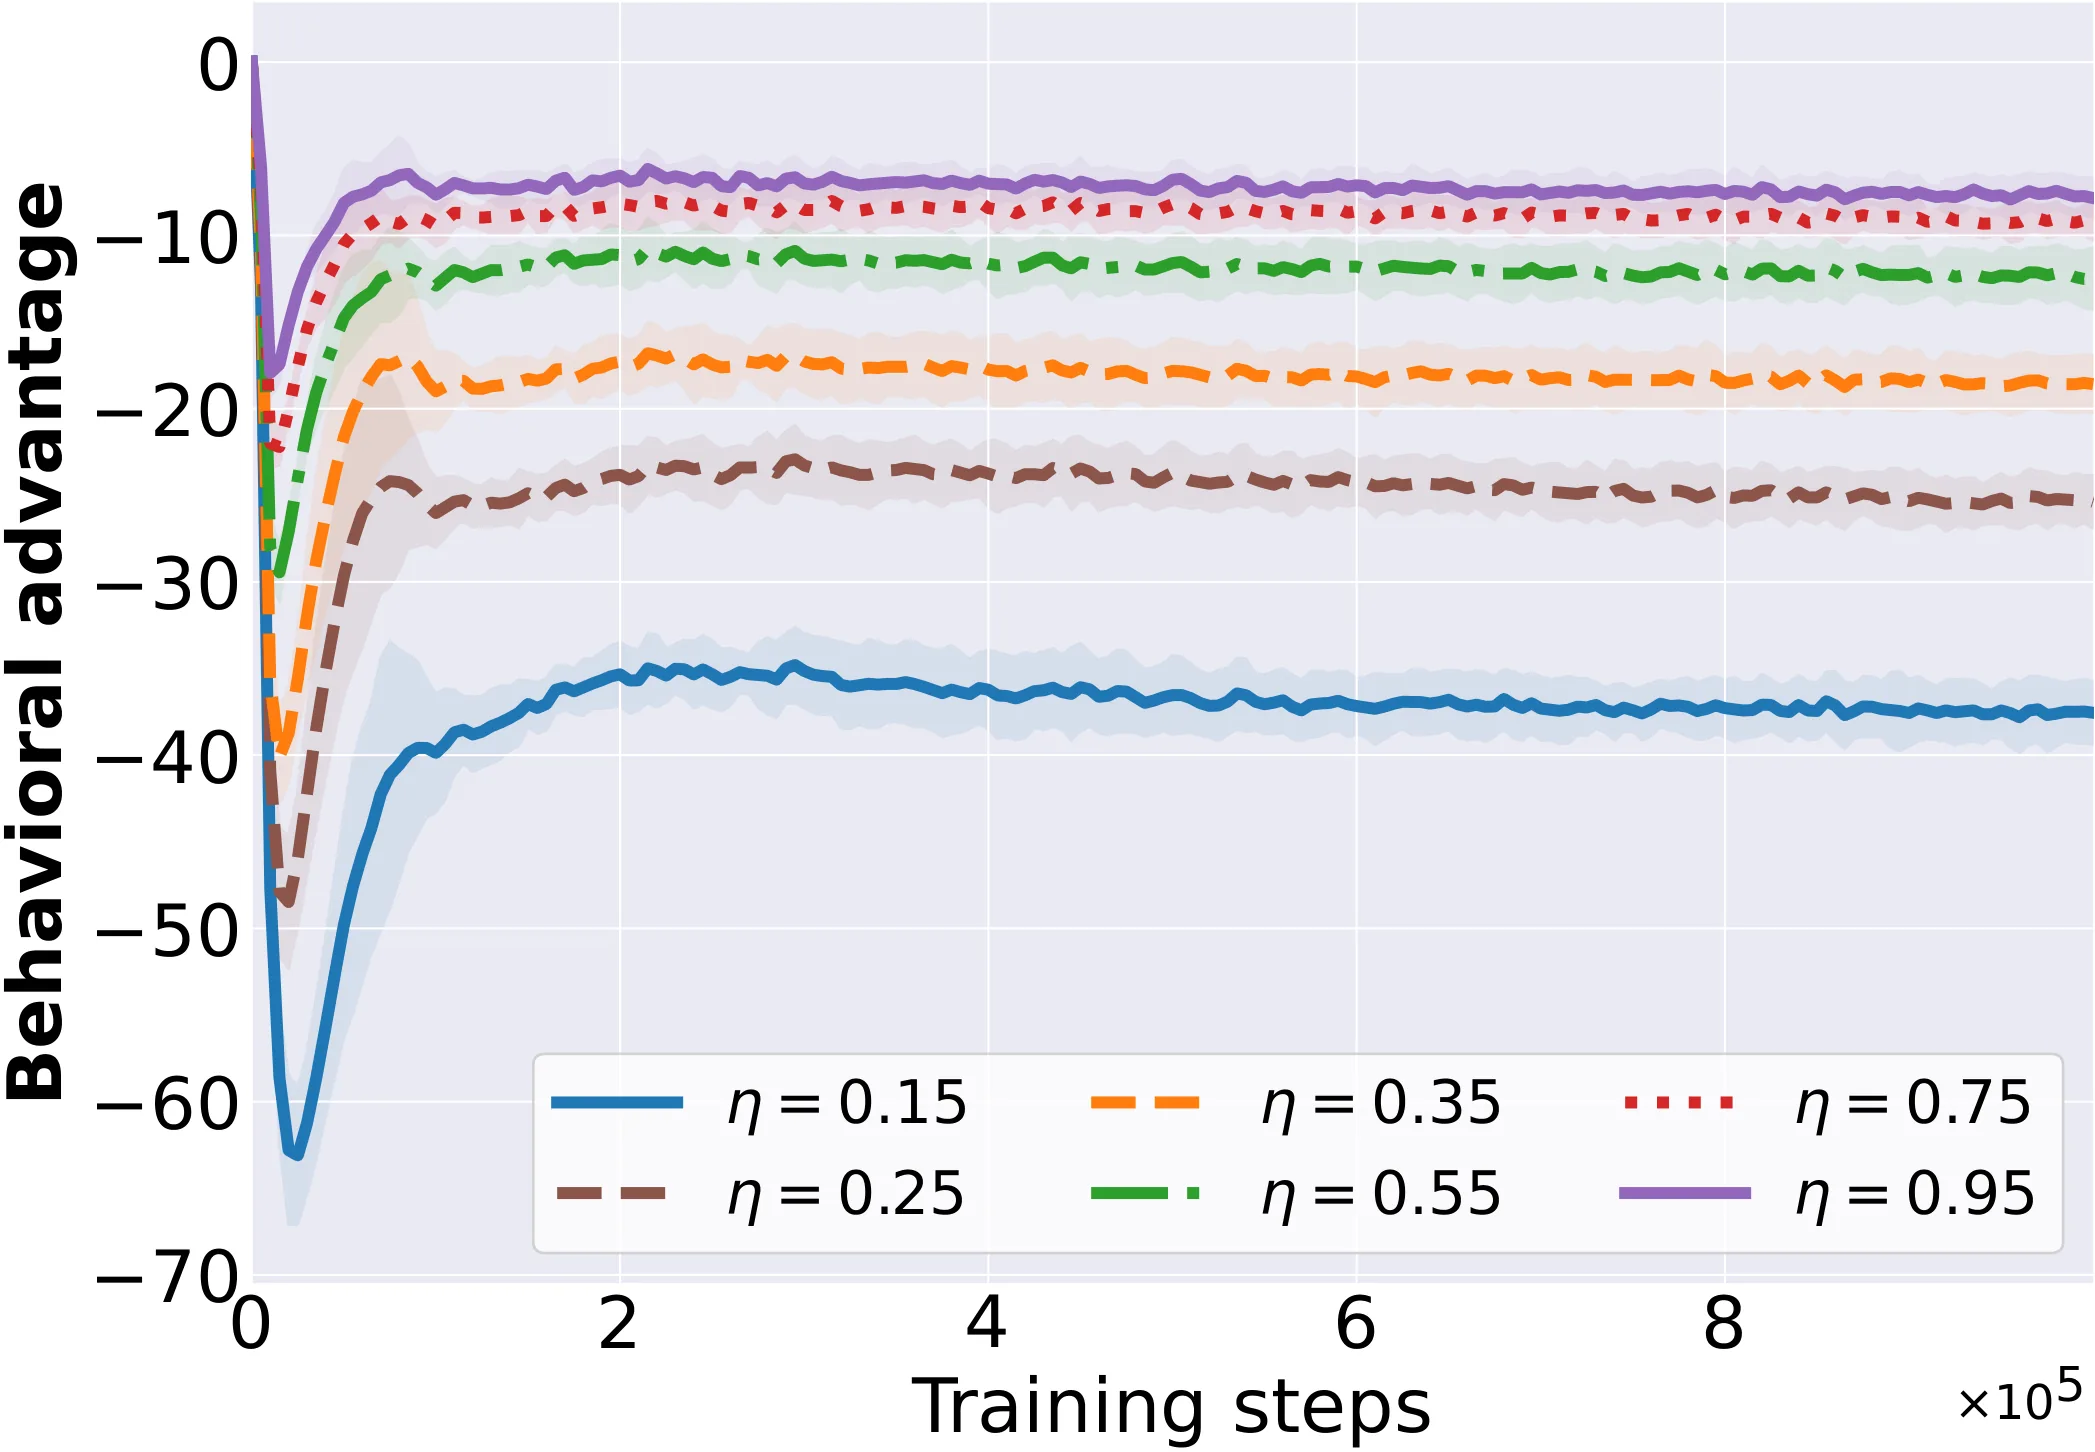
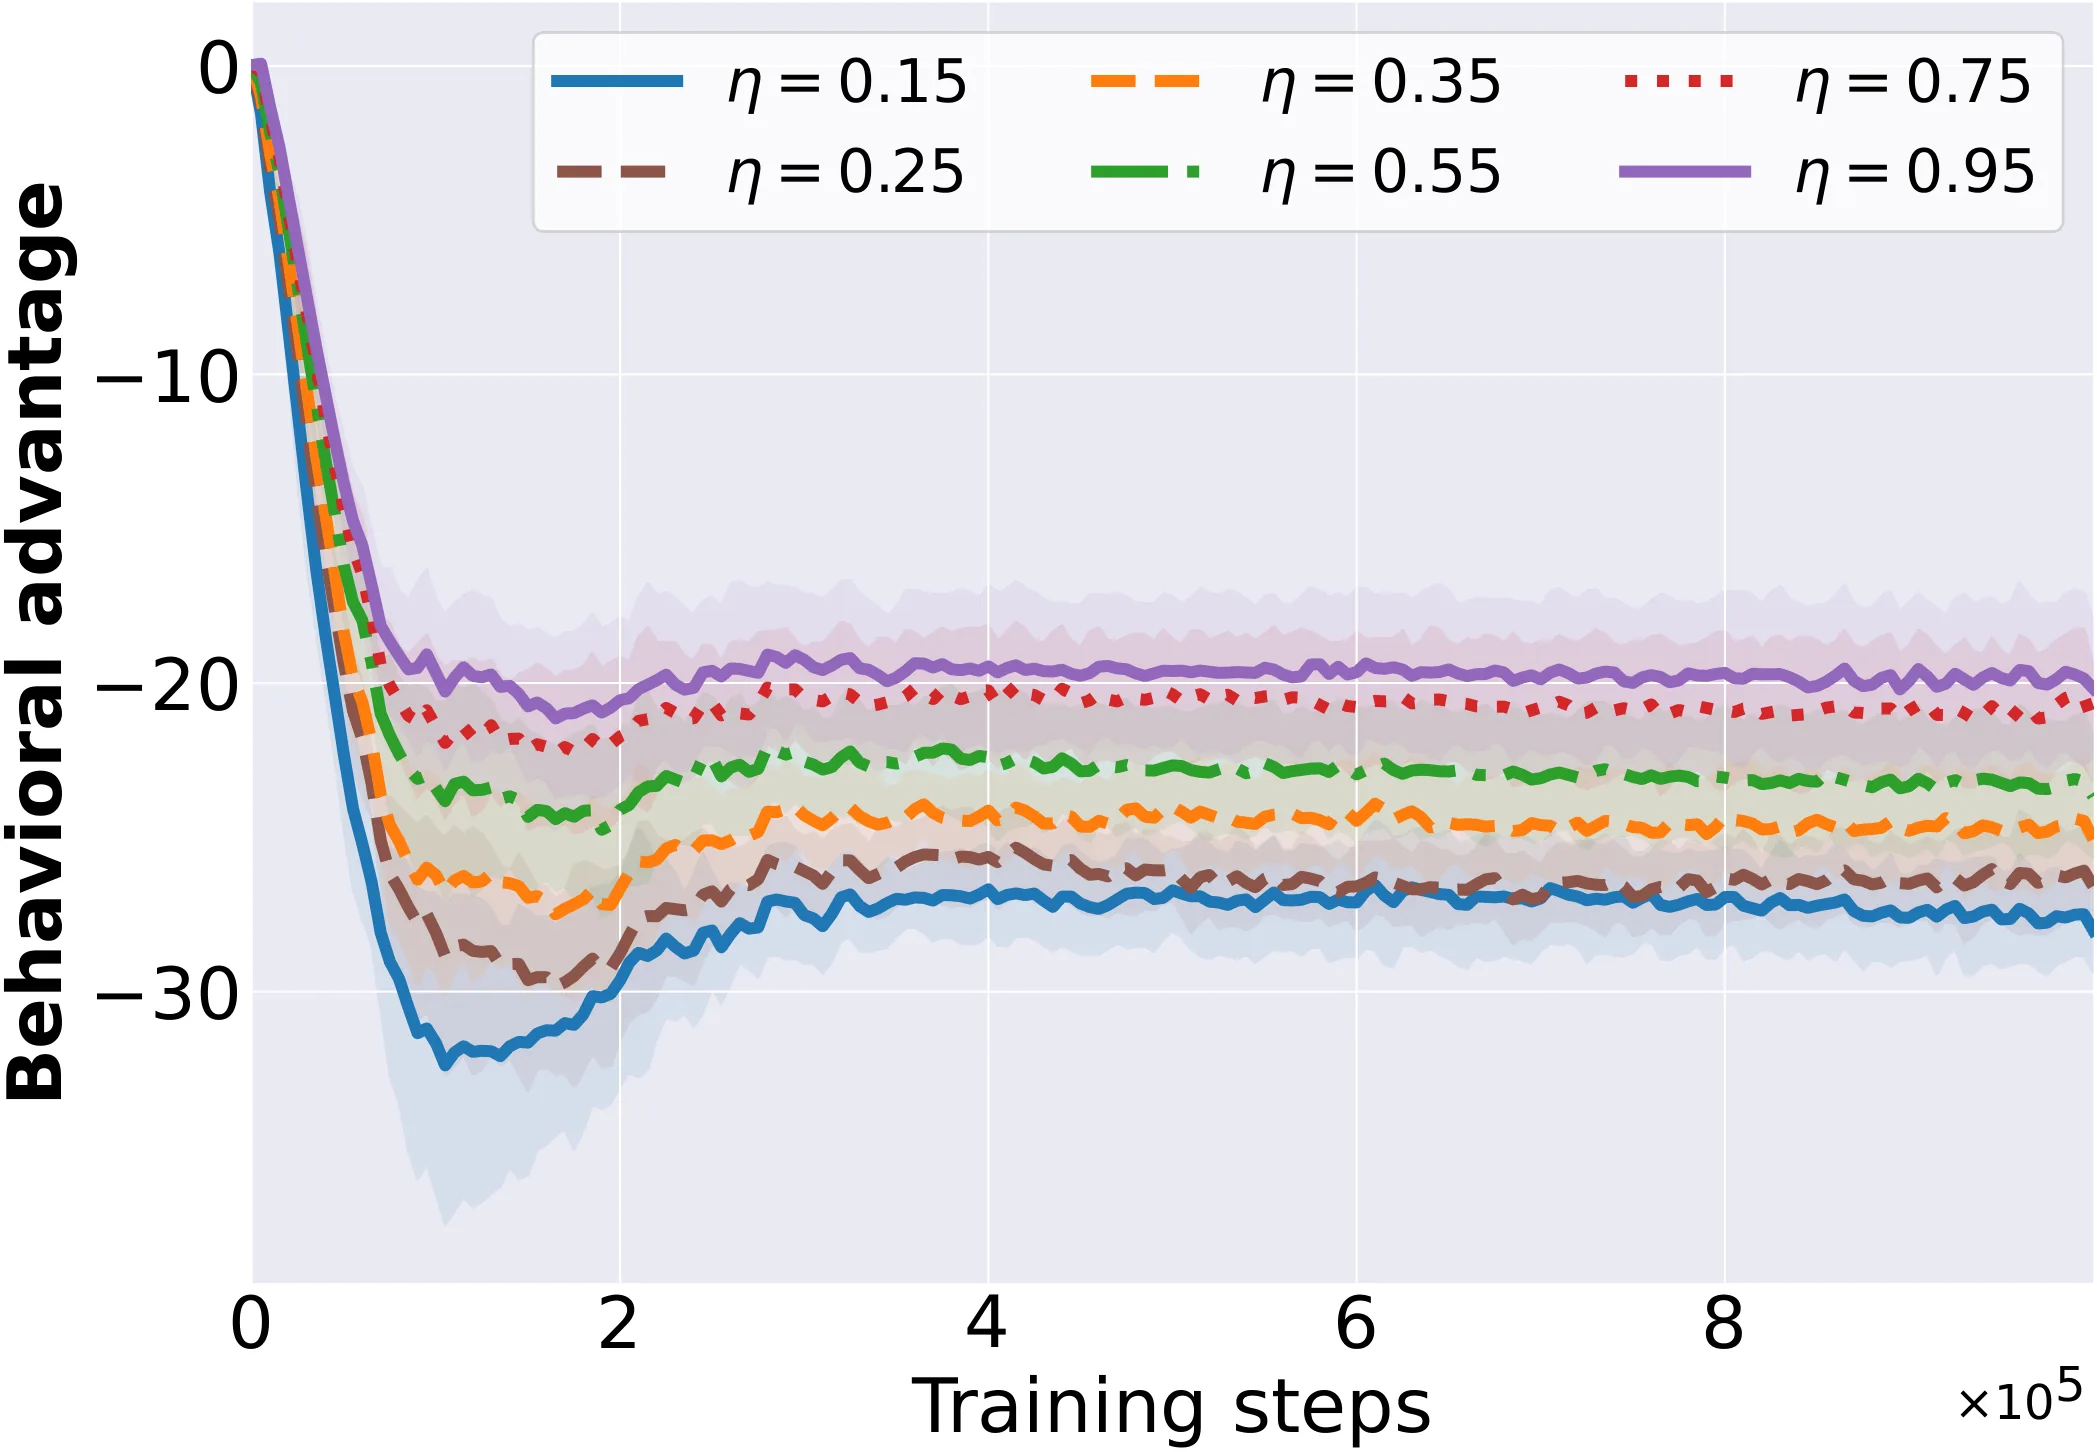
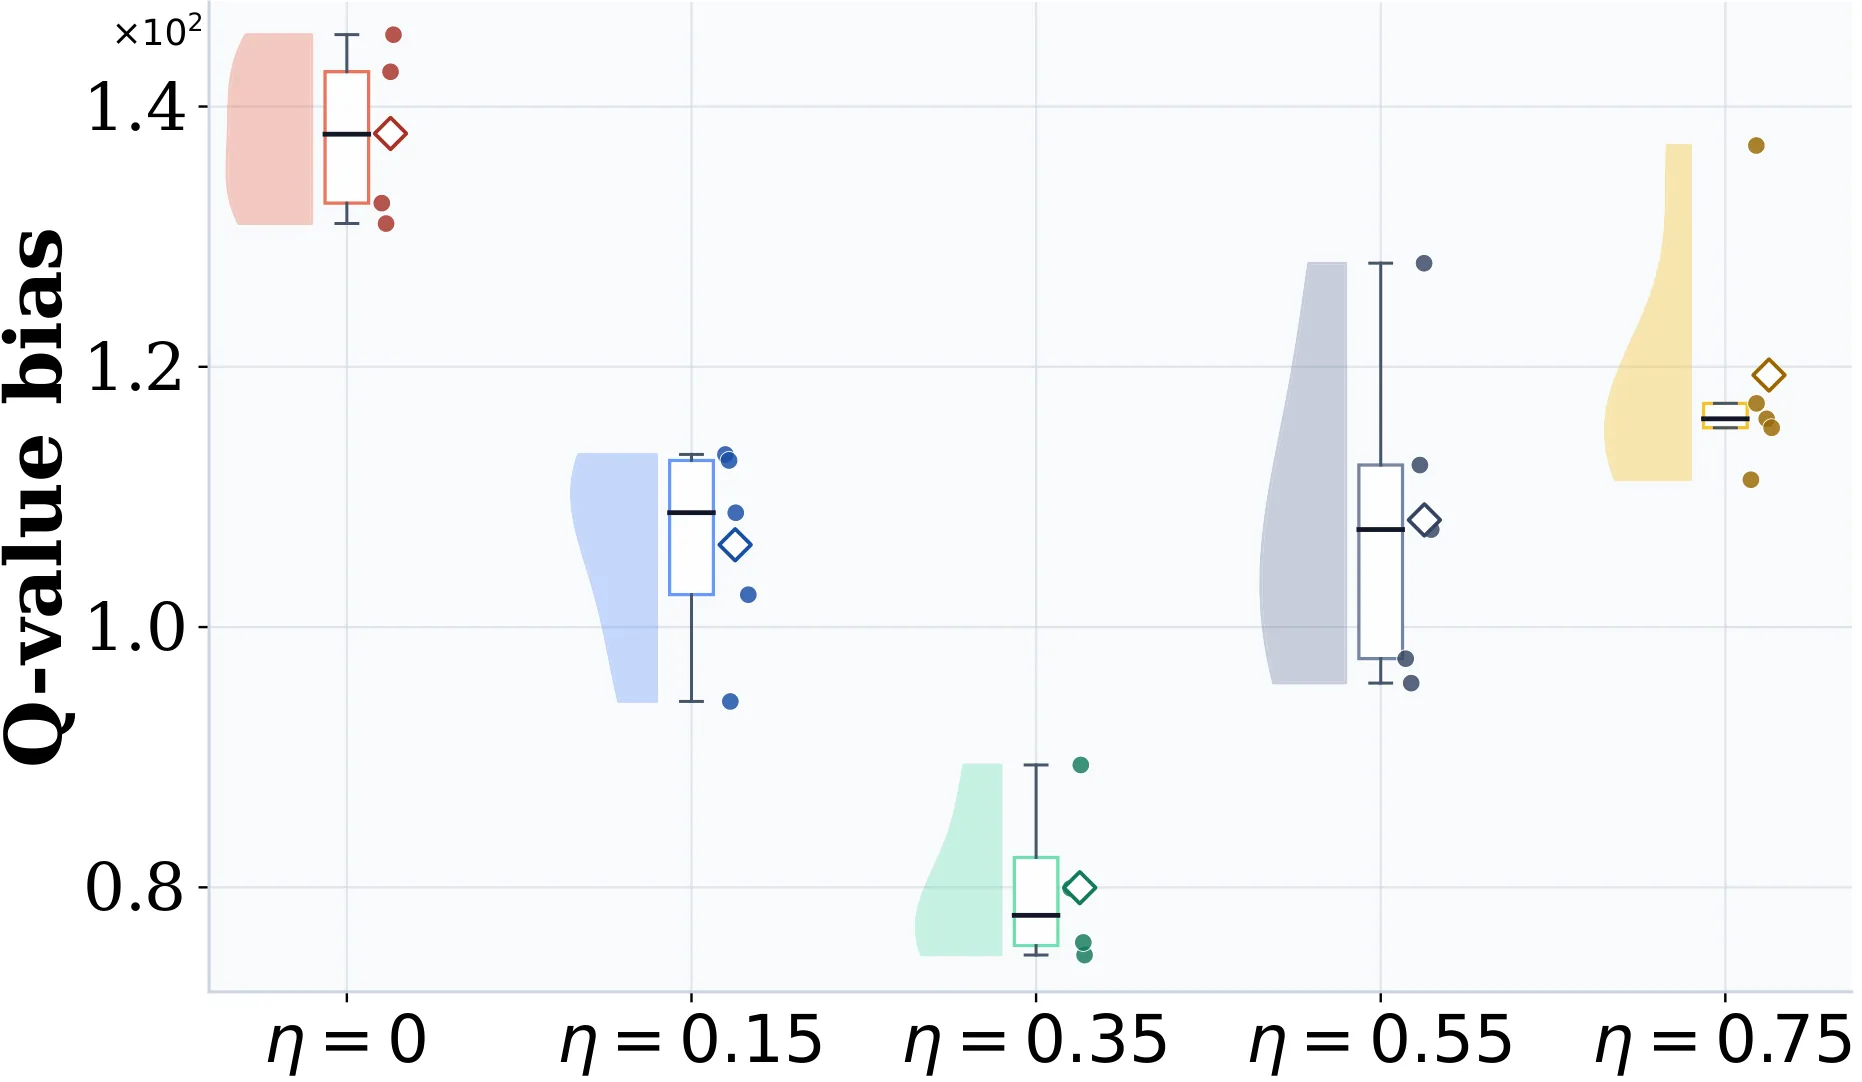
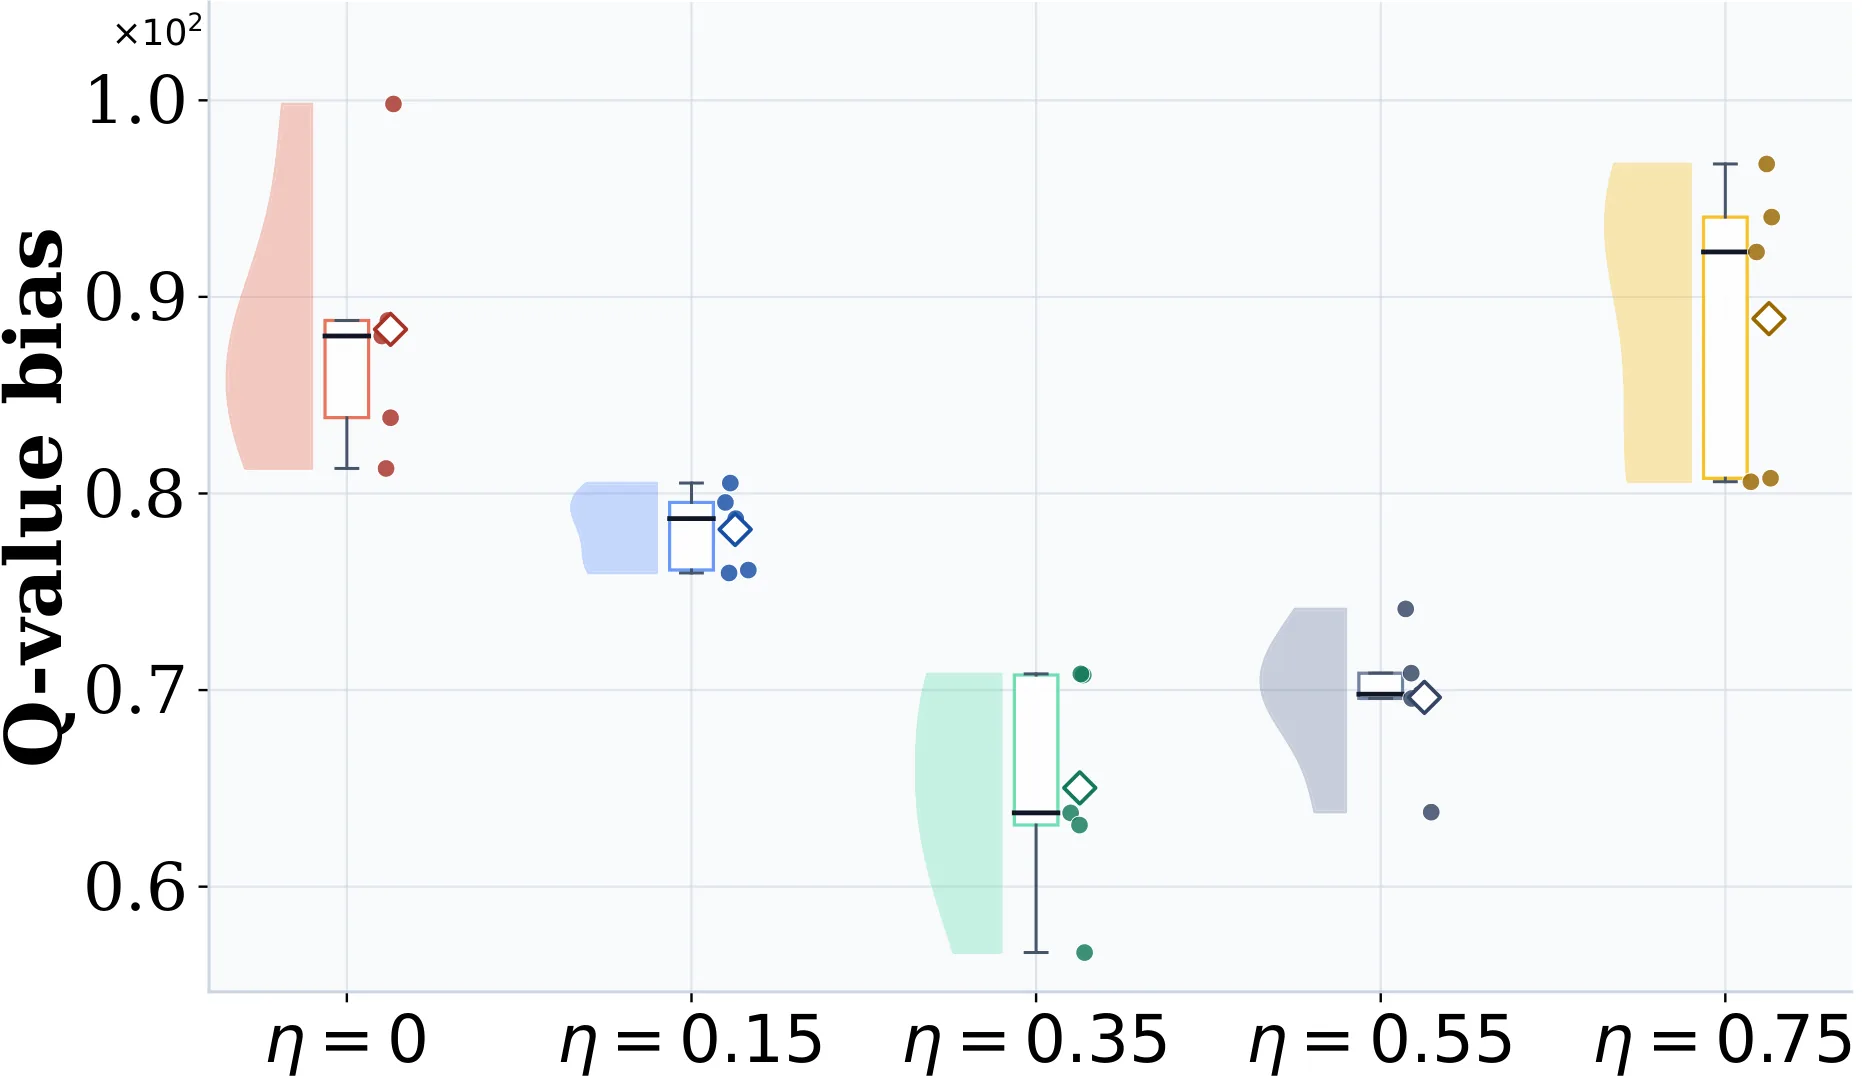
这个上界揭示了几个重要性质:第一项表明学习策略与行为策略的 [[分布偏移]] 越小,误差越小;第二项与折扣因子和奖励上界相关;第三项则说明行为优势函数的范数直接影响最终误差。特别值得关注的是,当 时修正退化为标准算子,但误差上界反而变大;而适度的 值能够在保守偏差和过估计偏差之间取得更好的平衡。
扩散策略建模与 Q 值引导
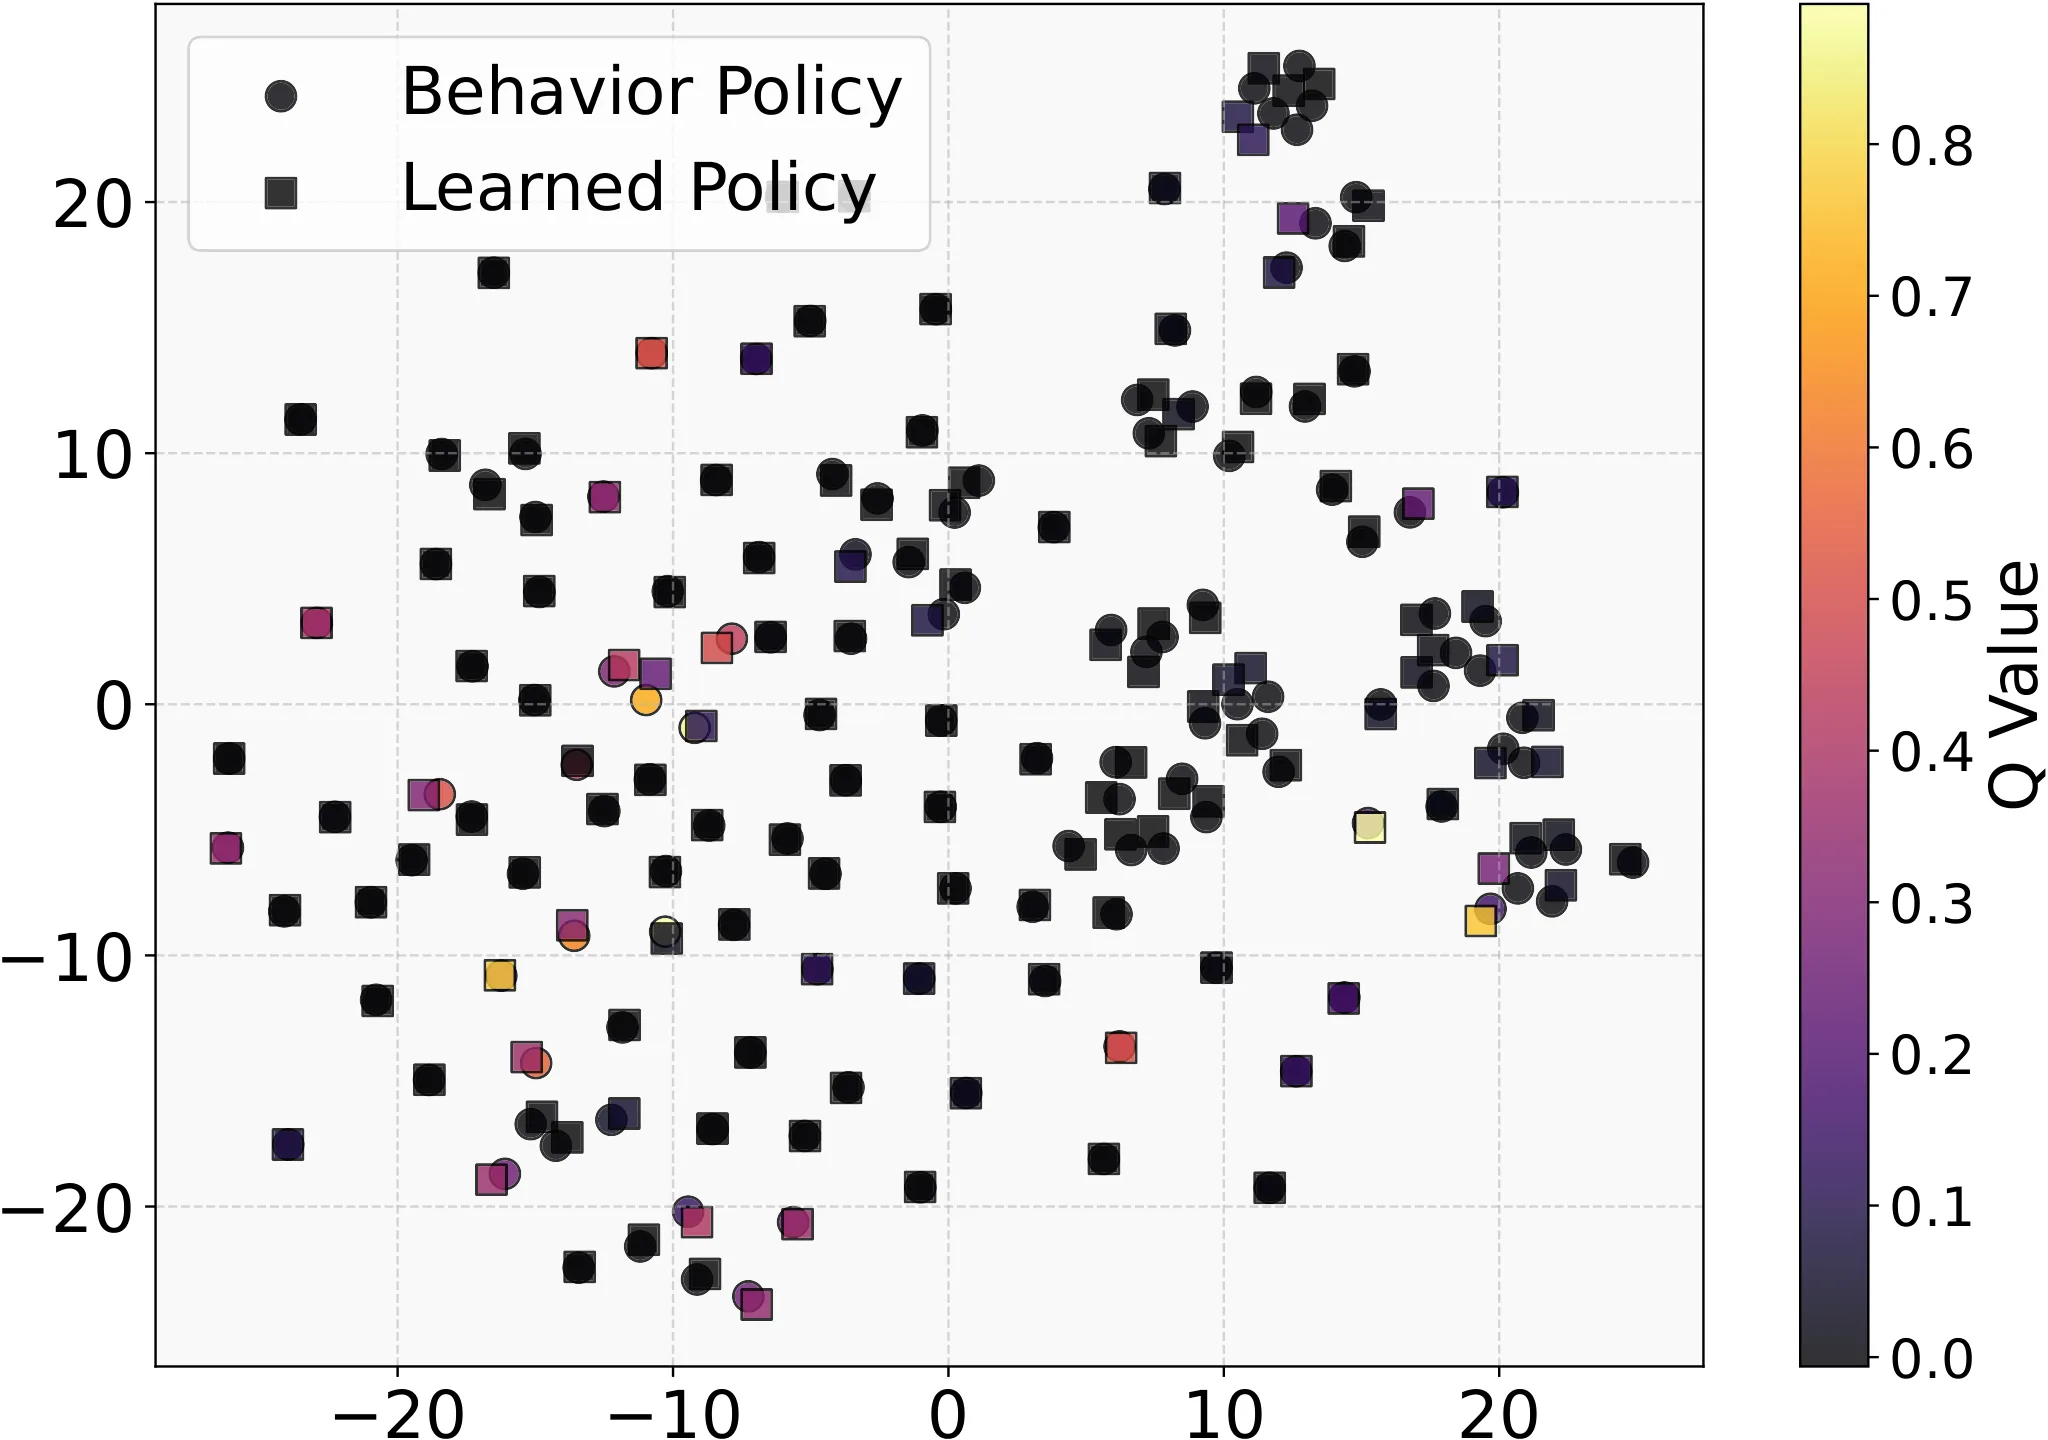
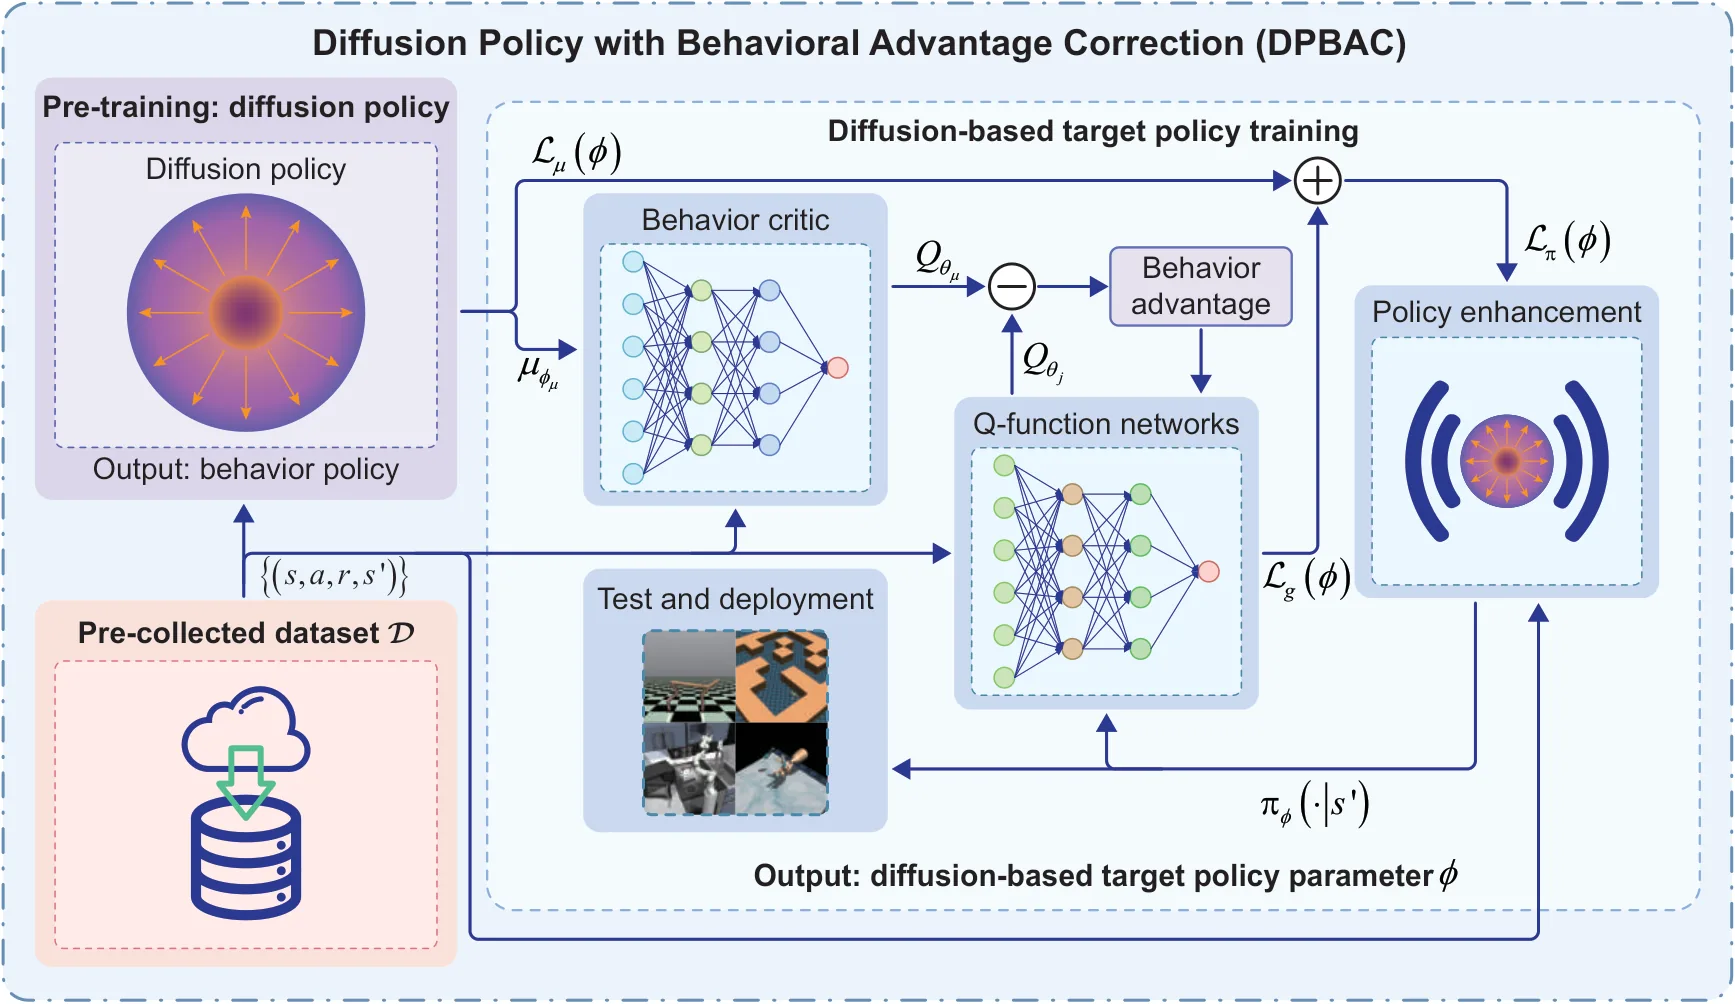
为了实现准确的策略正则化,论文采用 [[扩散模型]] 同时建模行为策略 和学习策略 。前向加噪过程将干净的动作逐步混入高斯噪声:
反向去噪过程通过神经网络 预测噪声,从而重建原始动作。行为策略的 [[分布匹配]] 损失为:
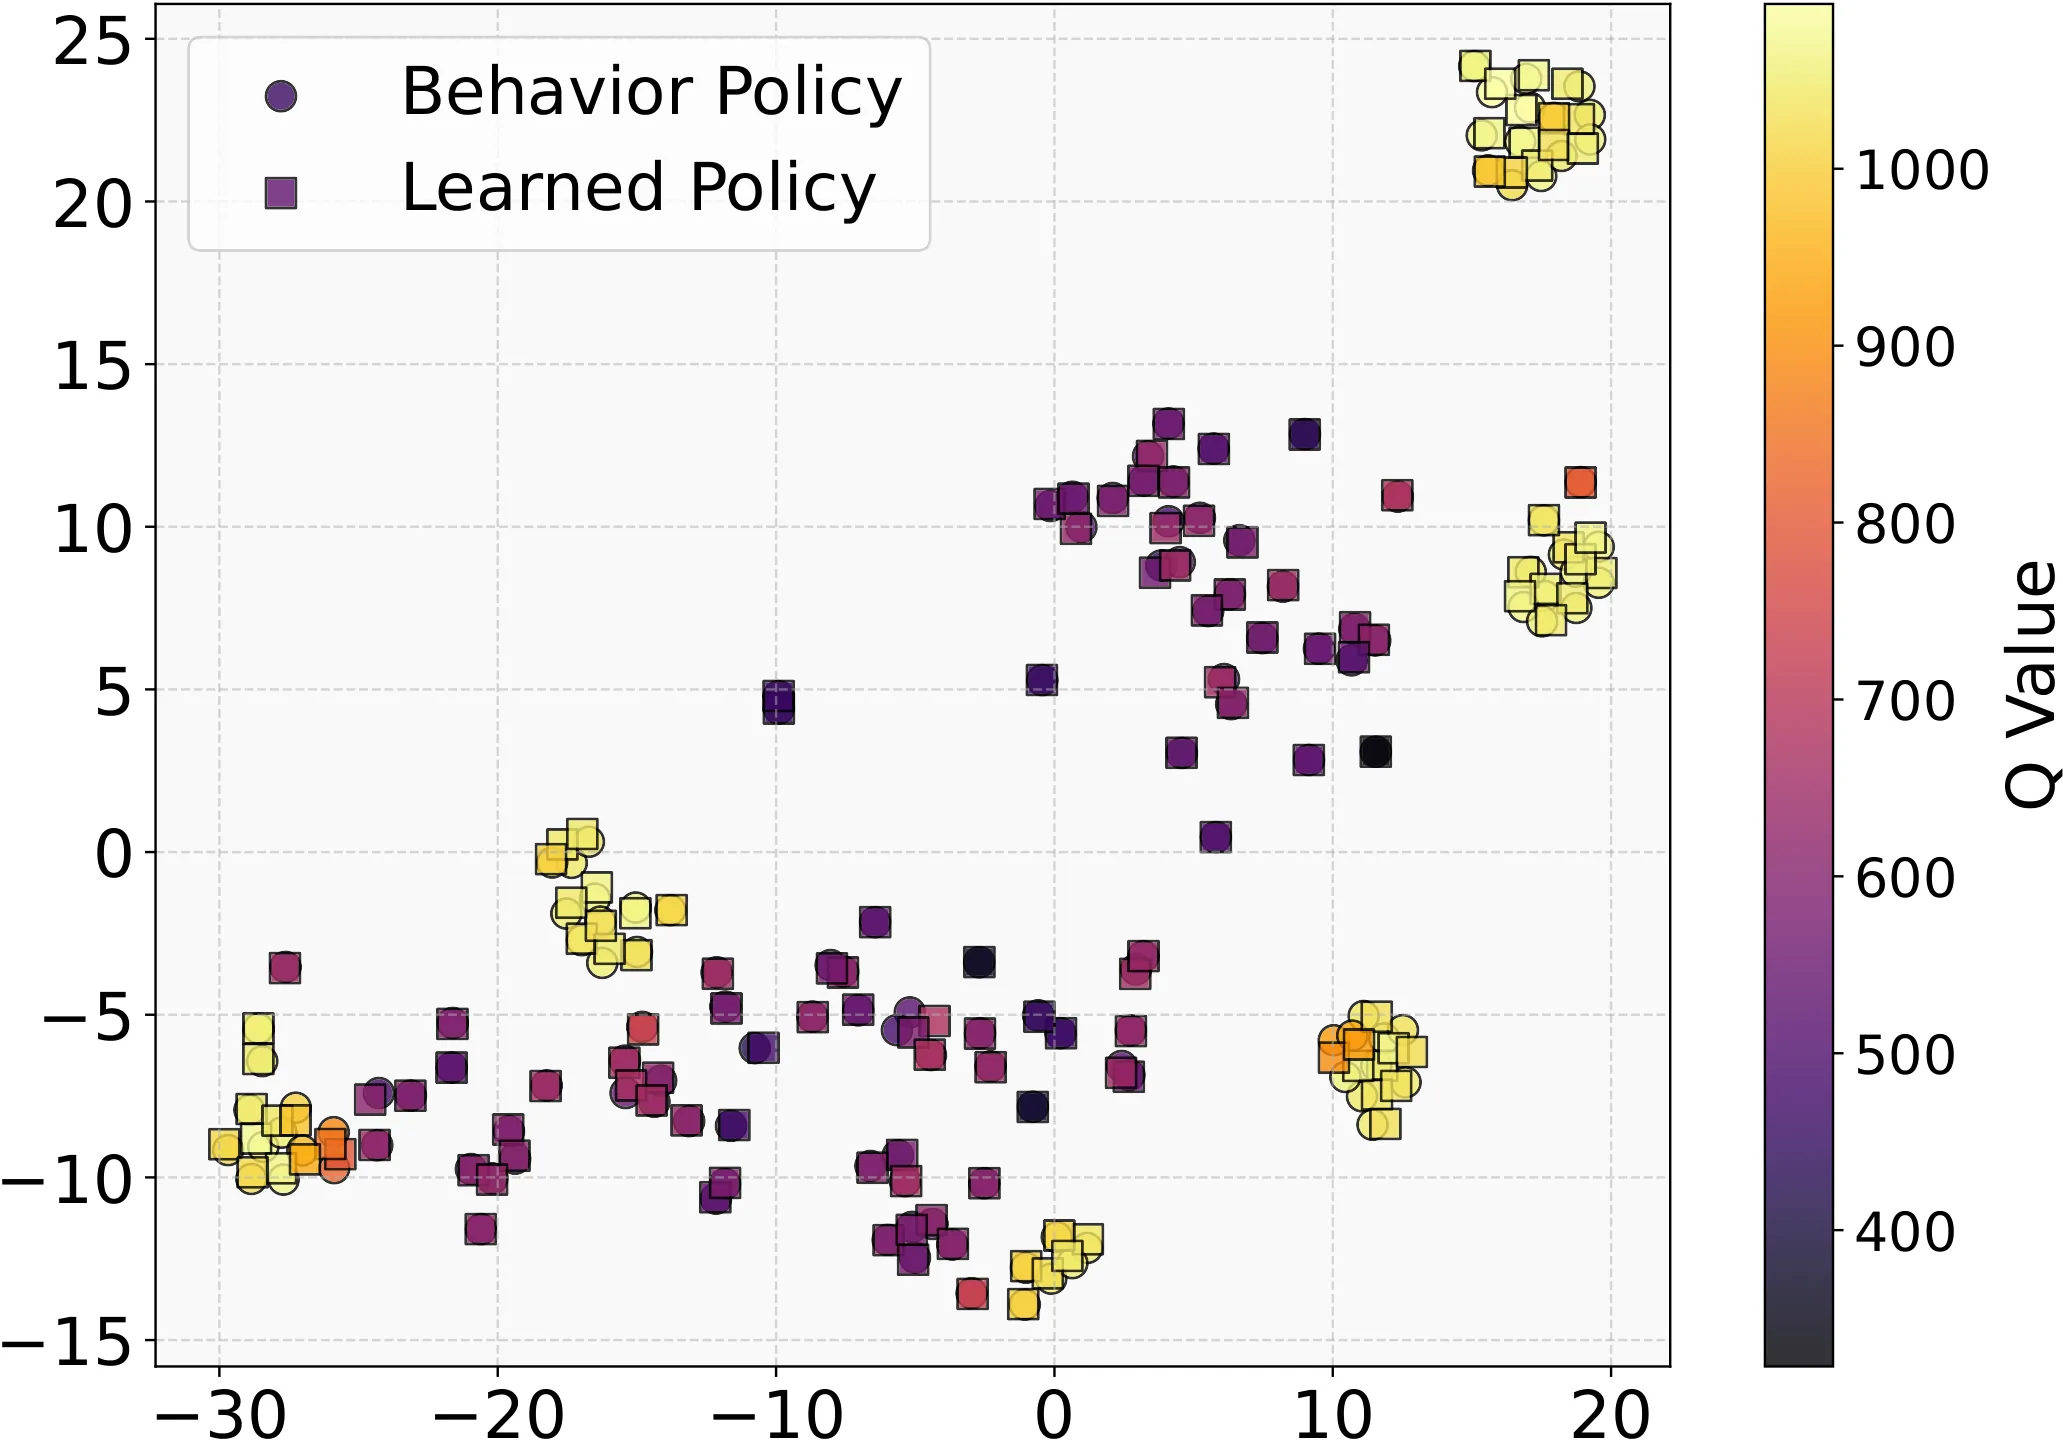
这一损失确保学习策略的行为分布与行为策略对齐,防止策略偏移到数据集覆盖不足的区域。
为了实现策略改进,论文进一步引入 Q 值引导损失:
这使得策略在追求高 Q 值的同时保持与行为分布的一致性,形成了“行为正则化 + Q 引导”的双重优化目标。
完整算法框架
DPBAC 的 Q 网络更新综合了双 Q 结构和 BAC 修正项:
其中 对应行为策略的 Q 函数, 和 分别为 Q 网络和策略的目标网络参数。训练过程中采用指数滑动平均(EMA)更新目标网络,确保训练稳定。
实验与结果
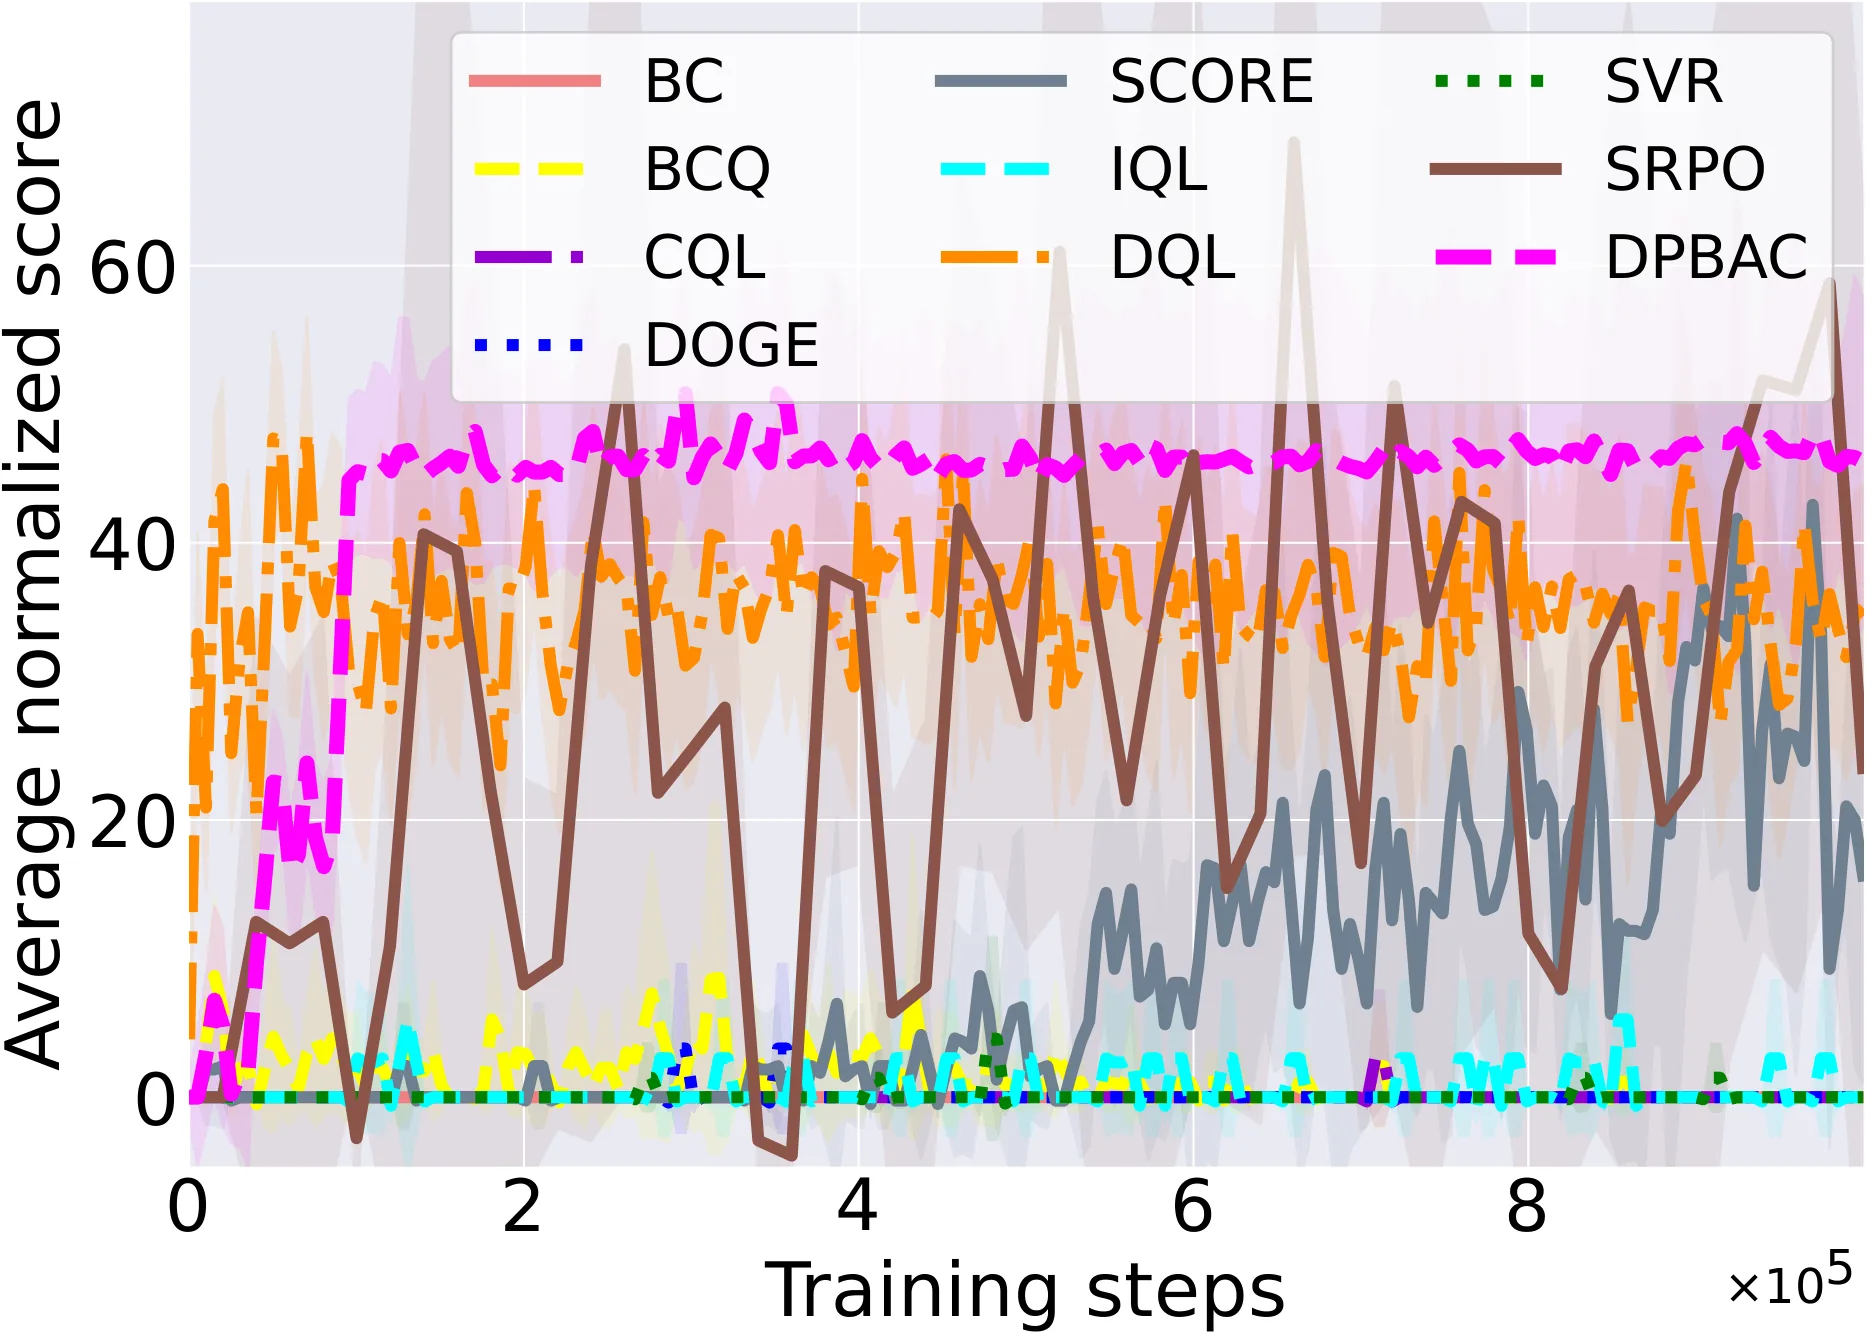
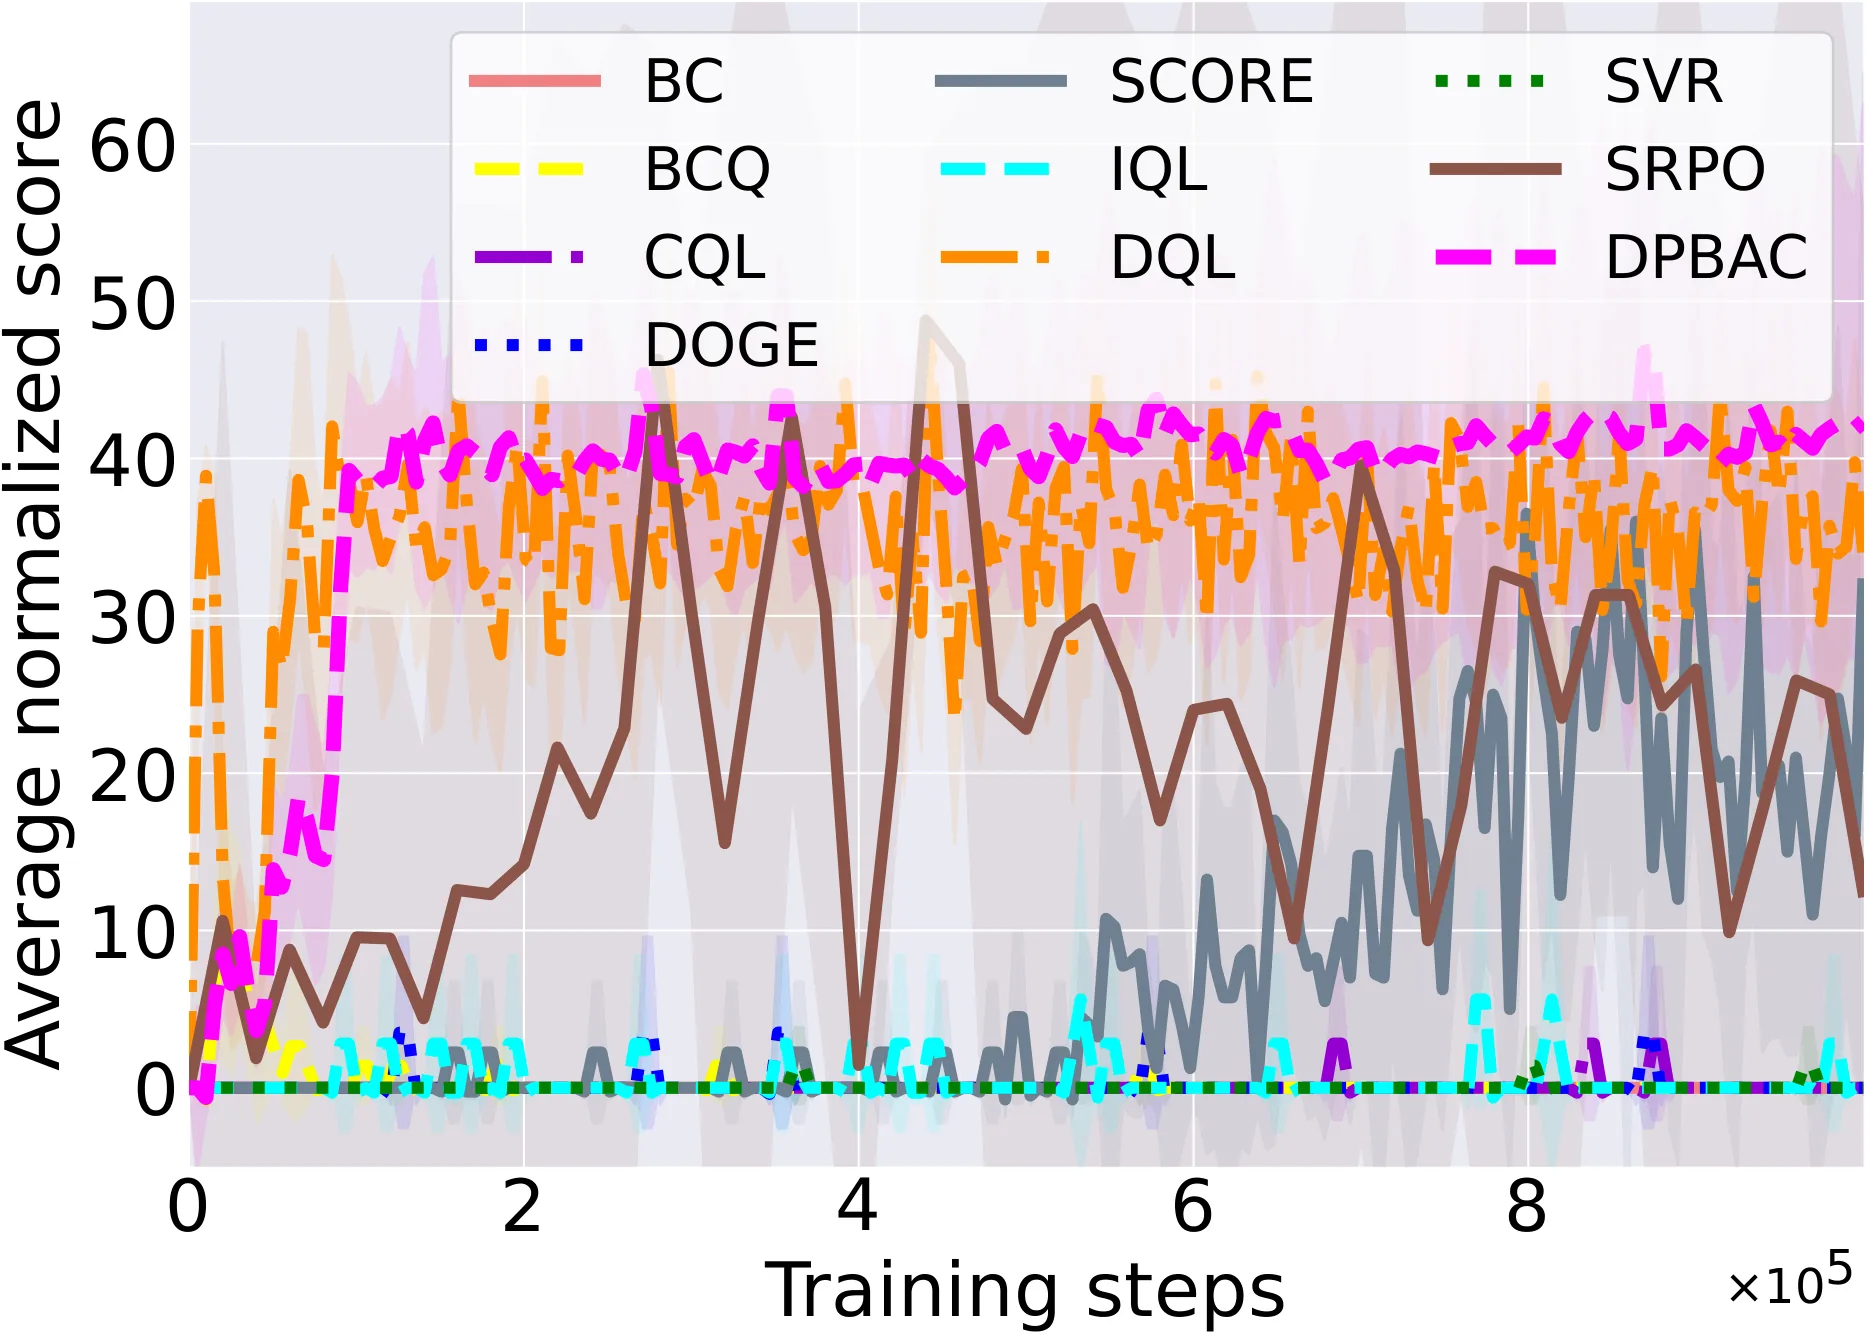
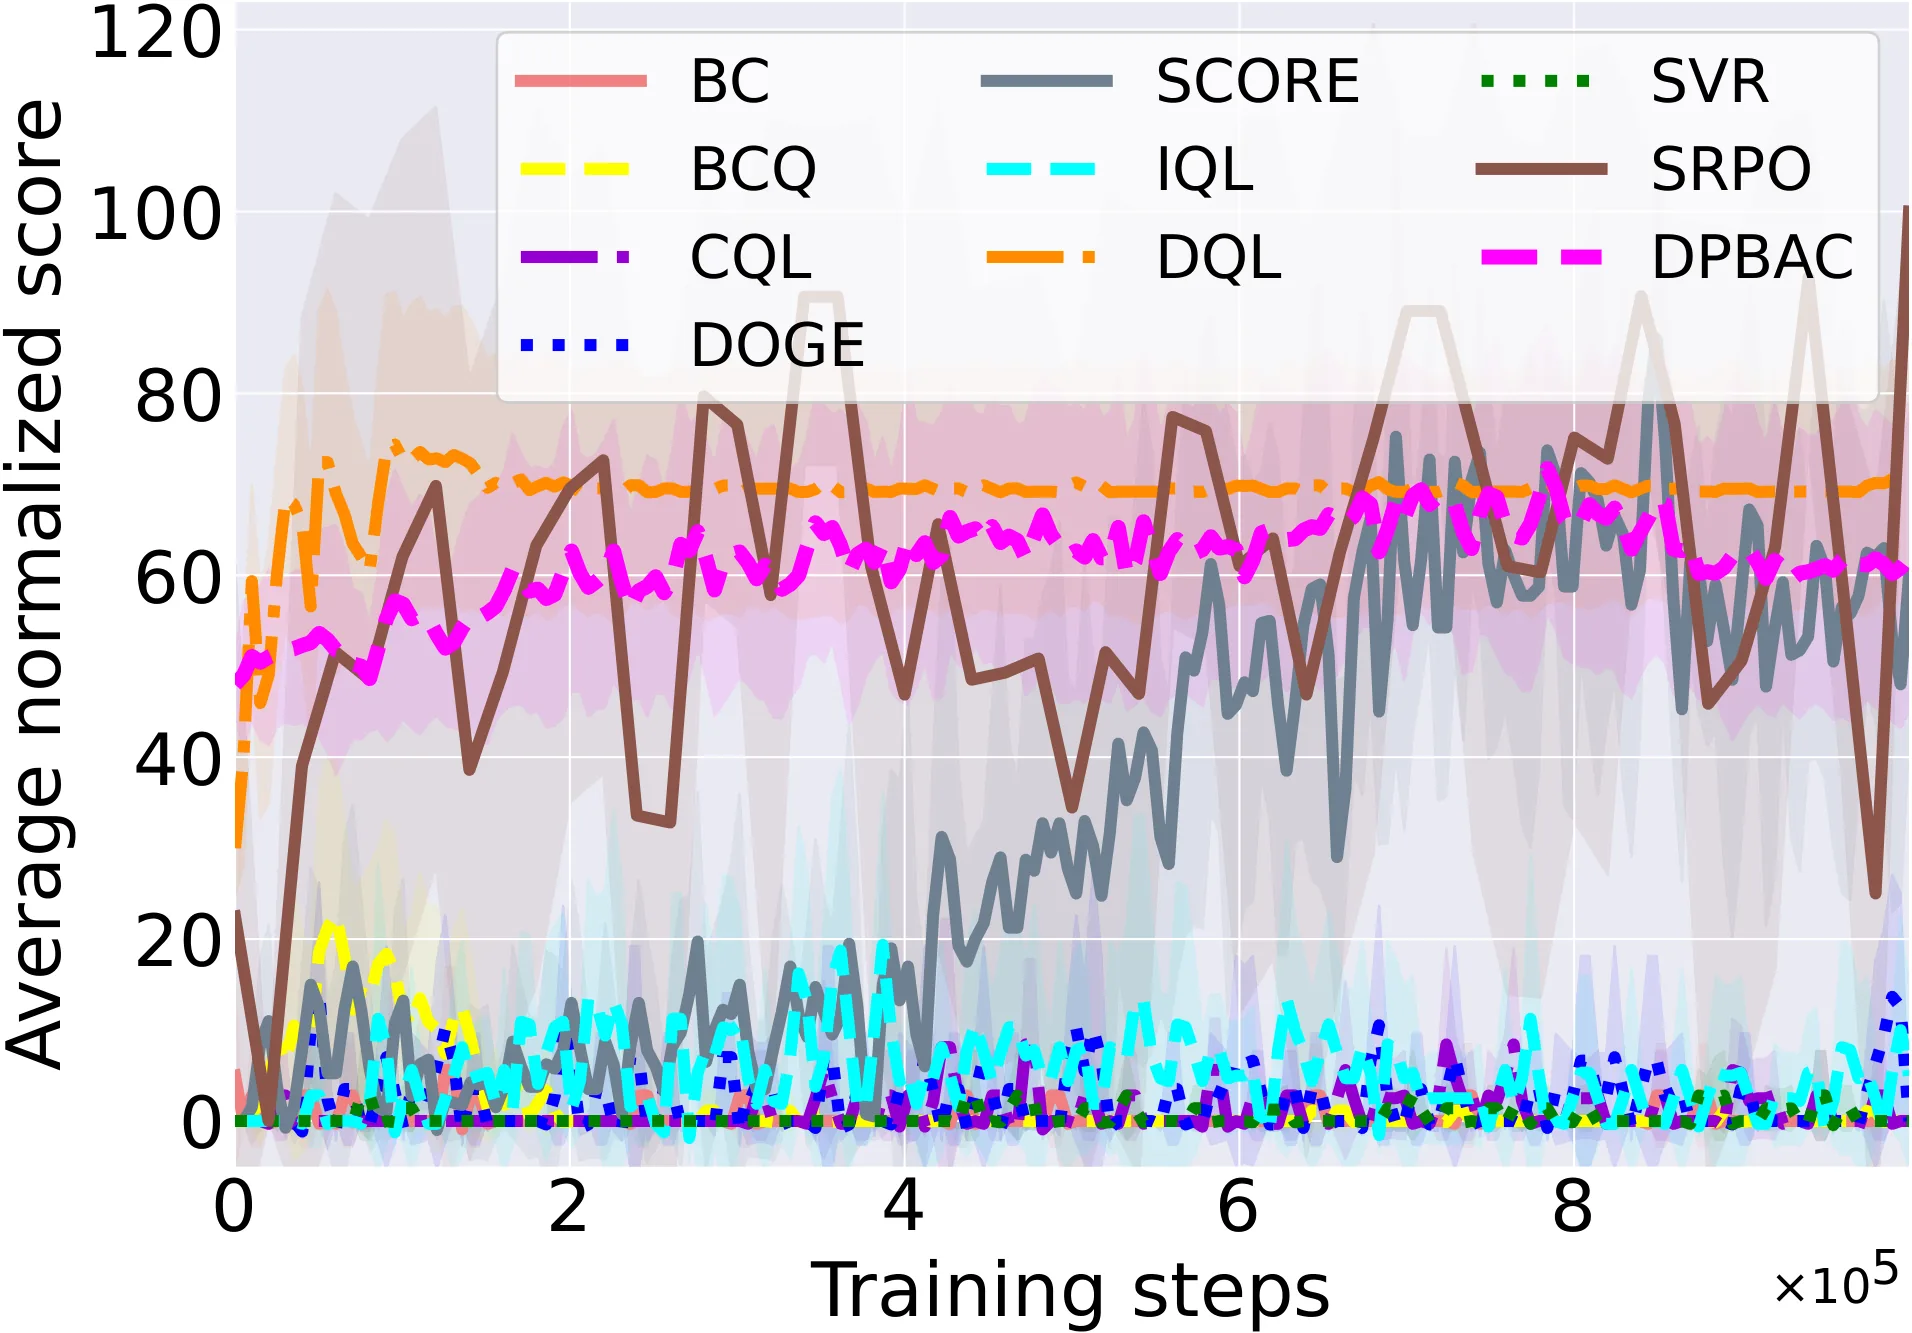
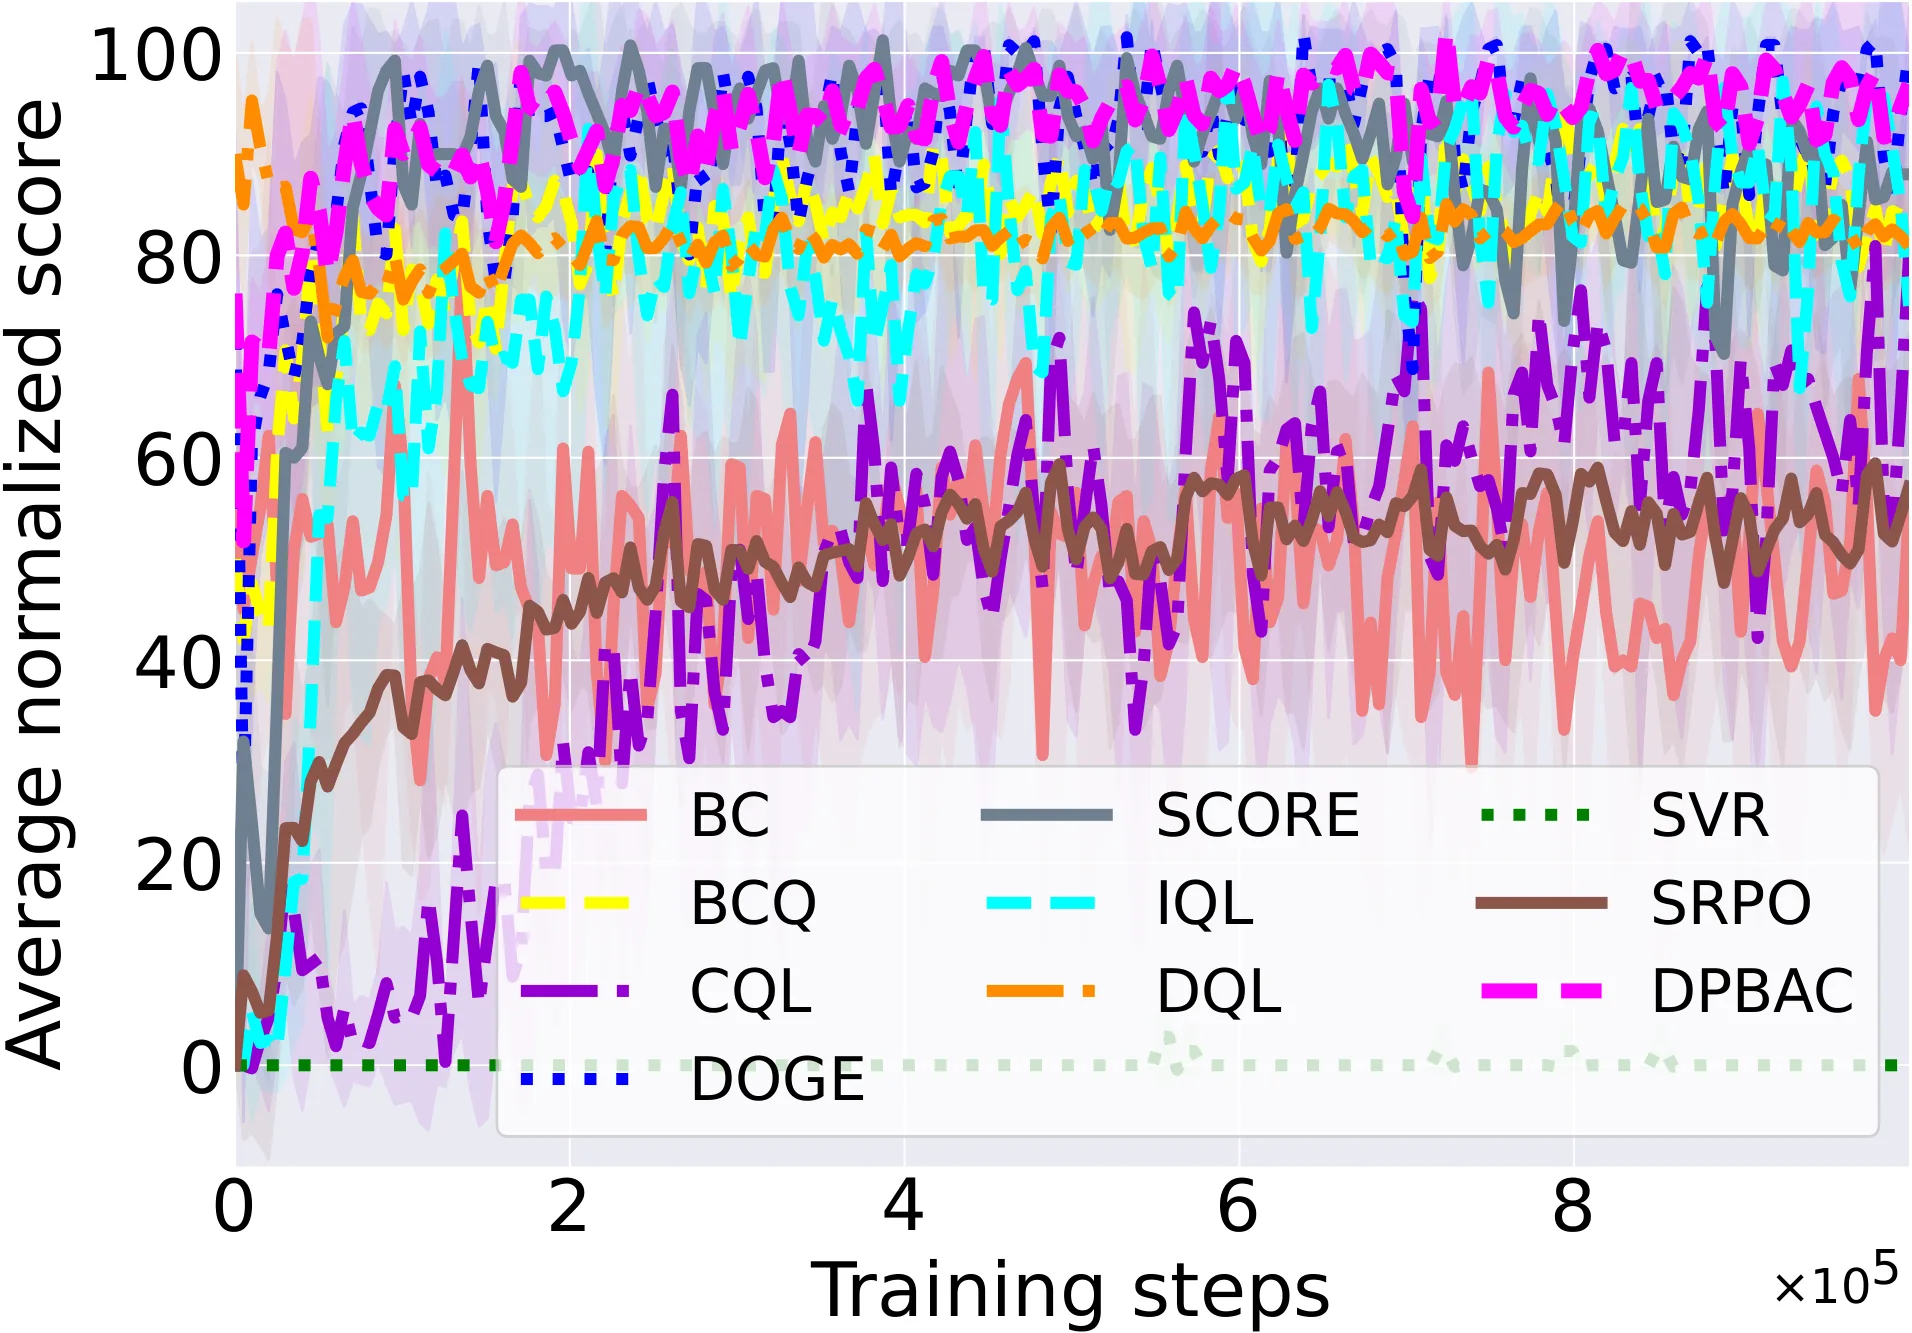
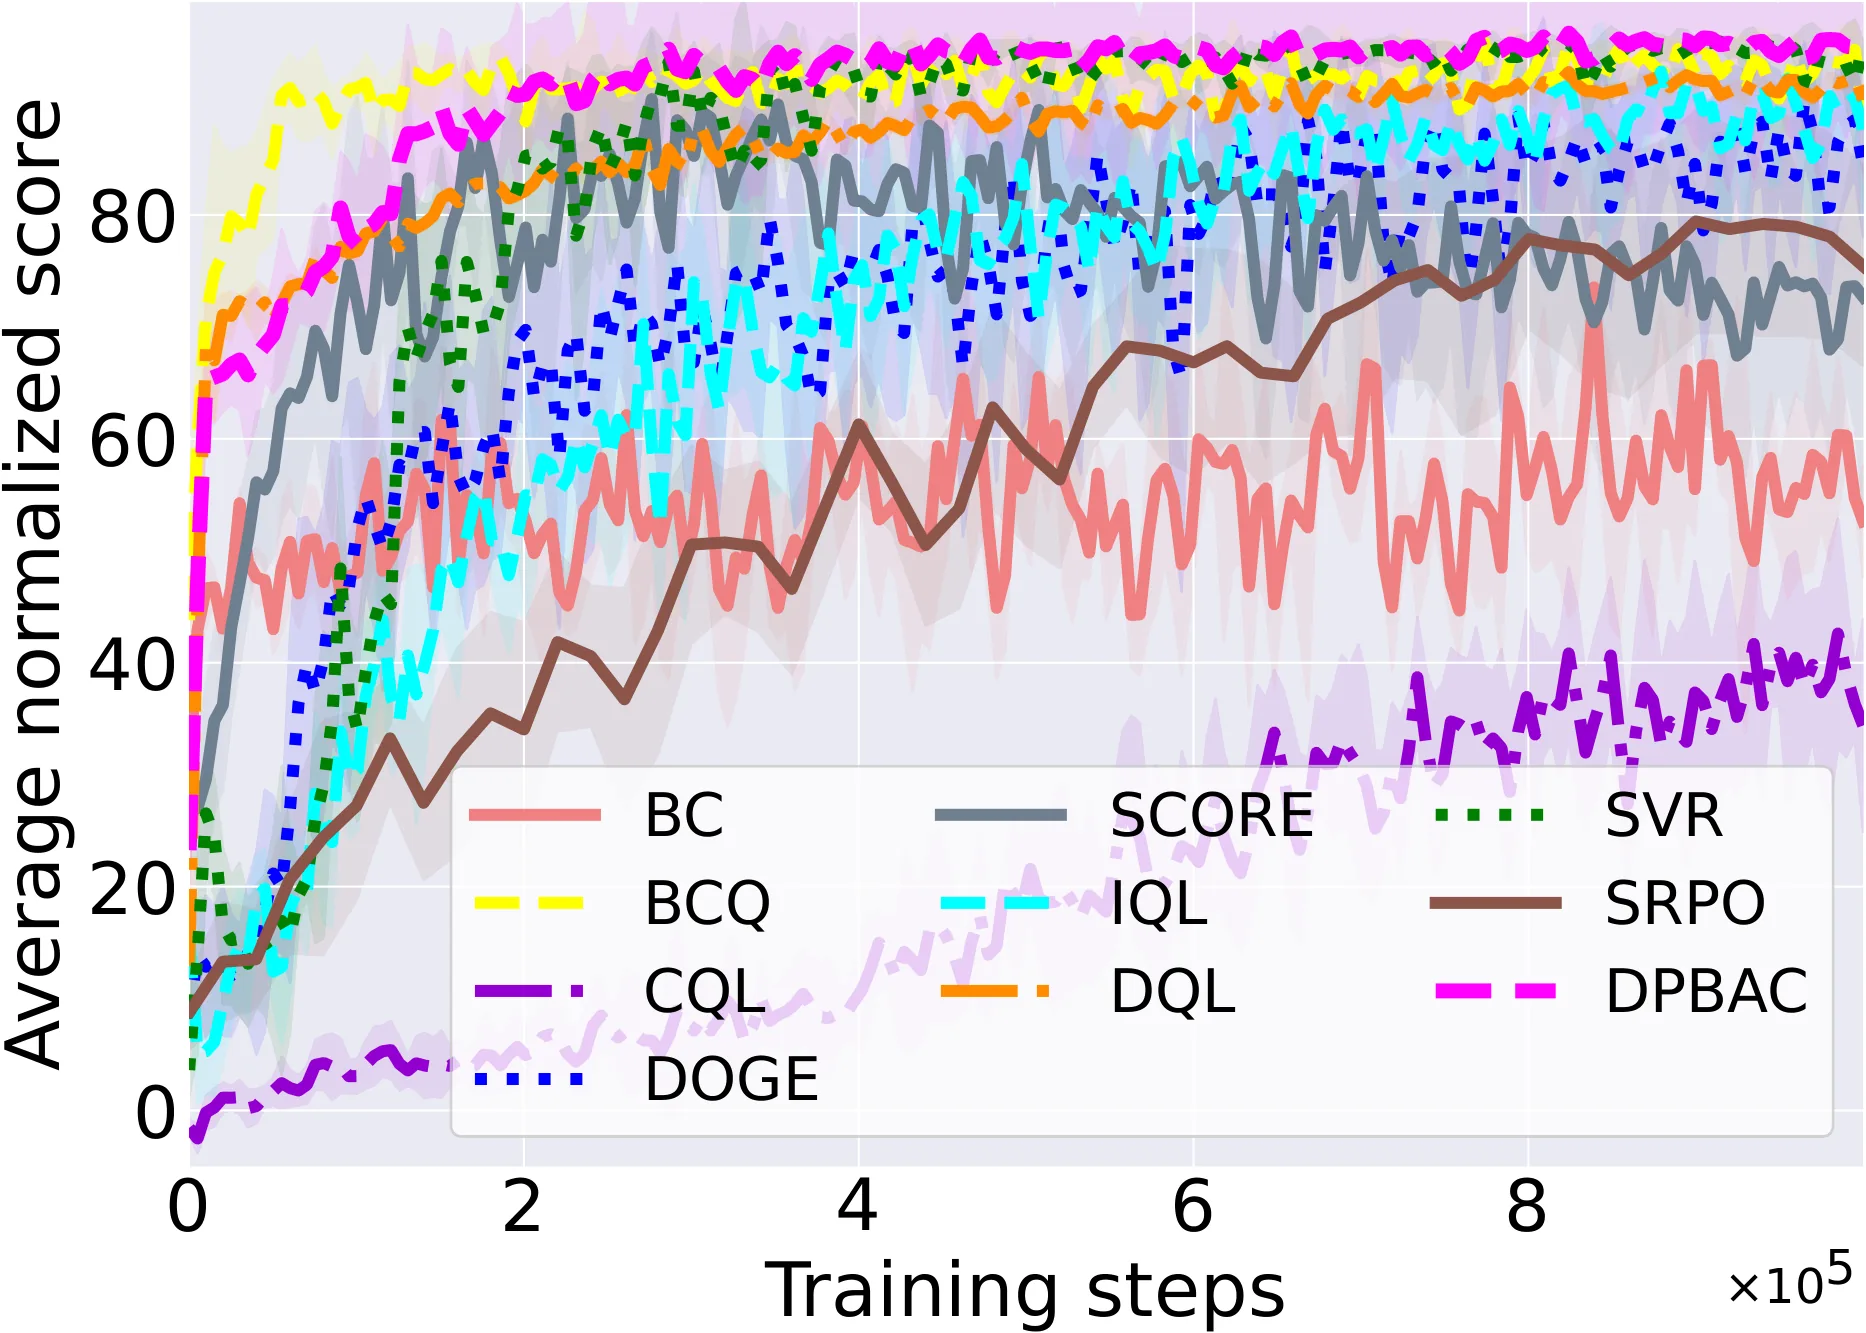
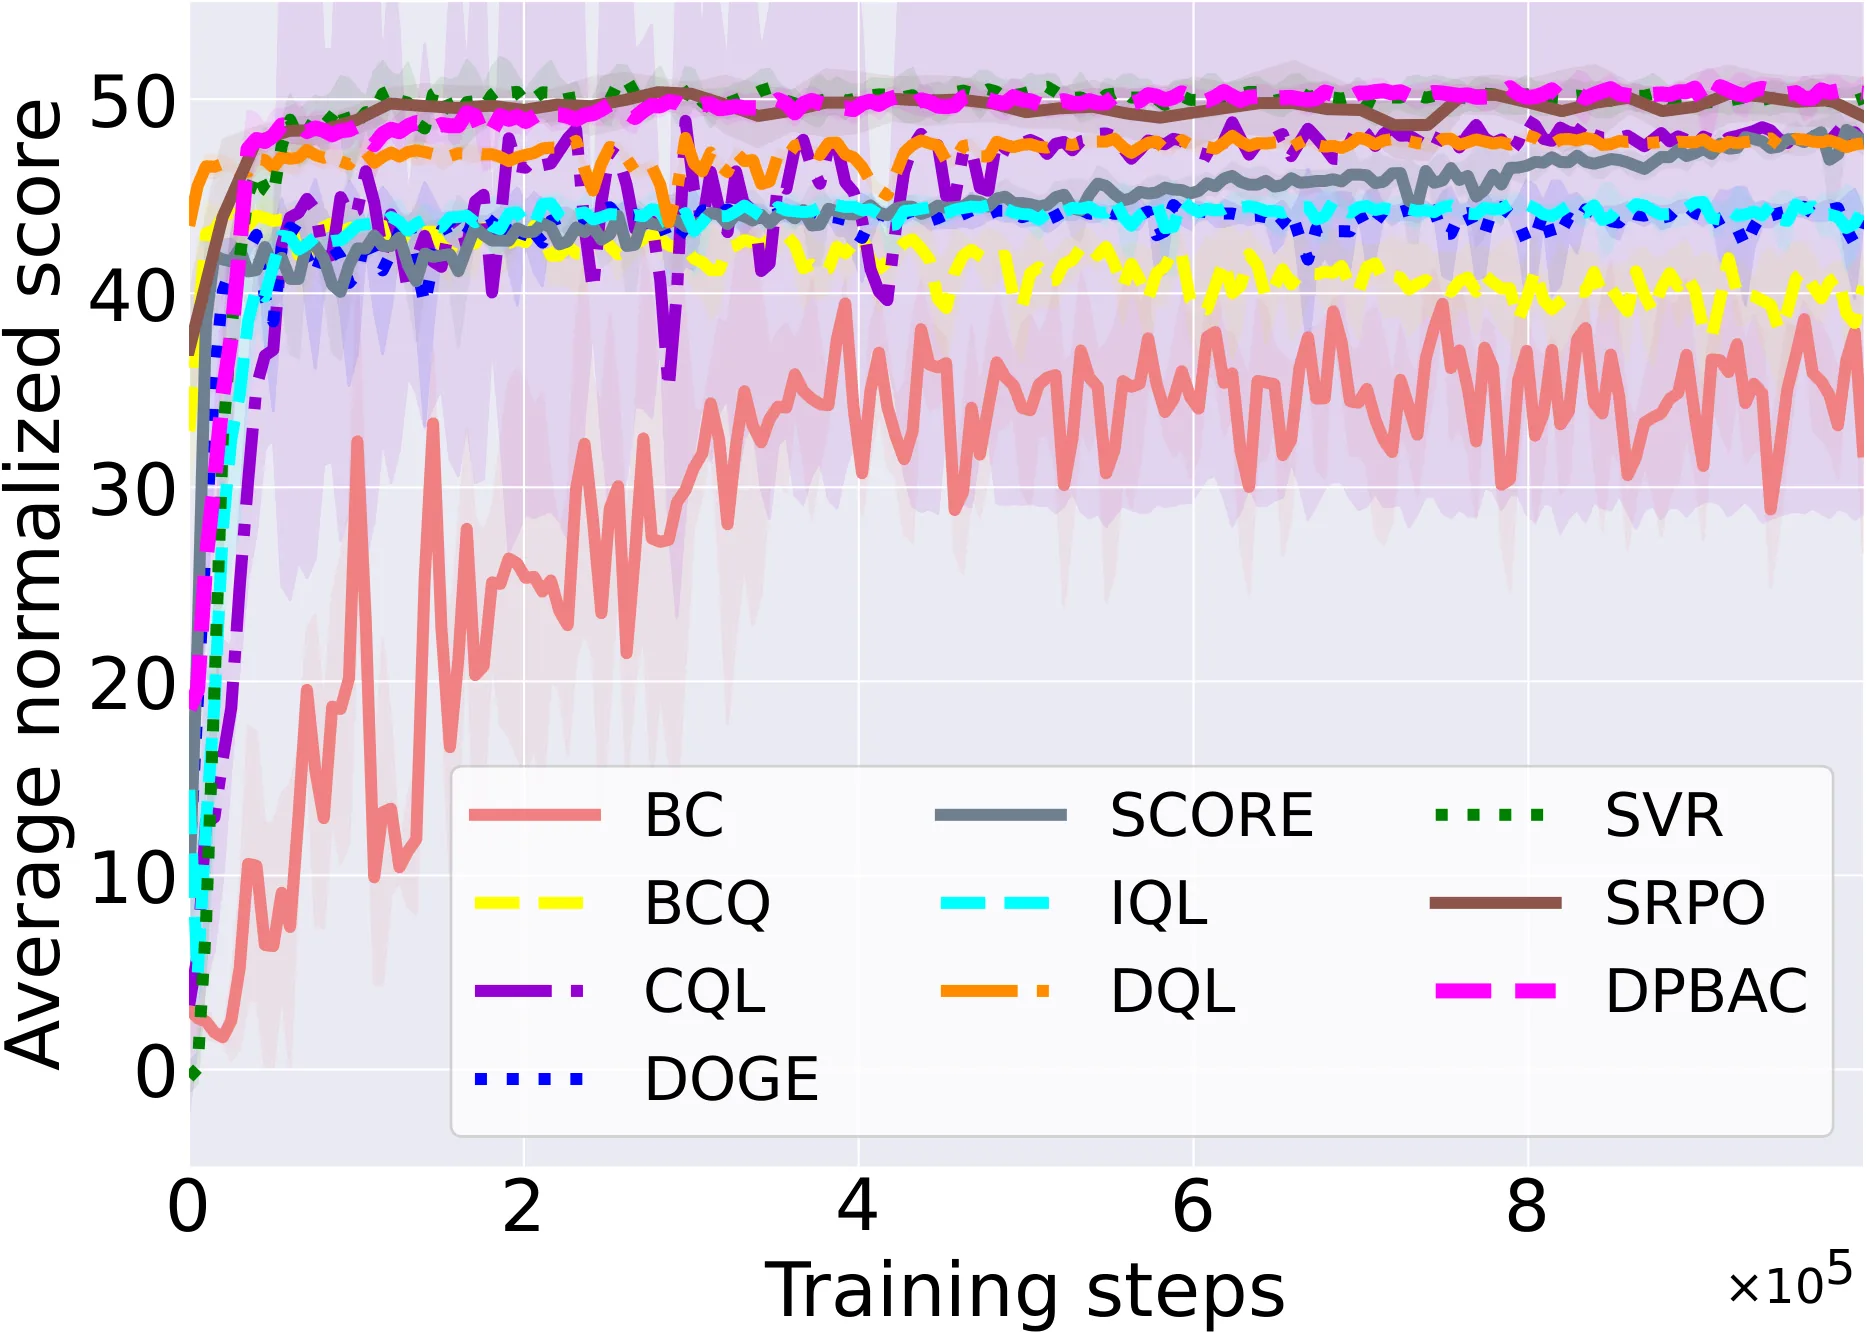
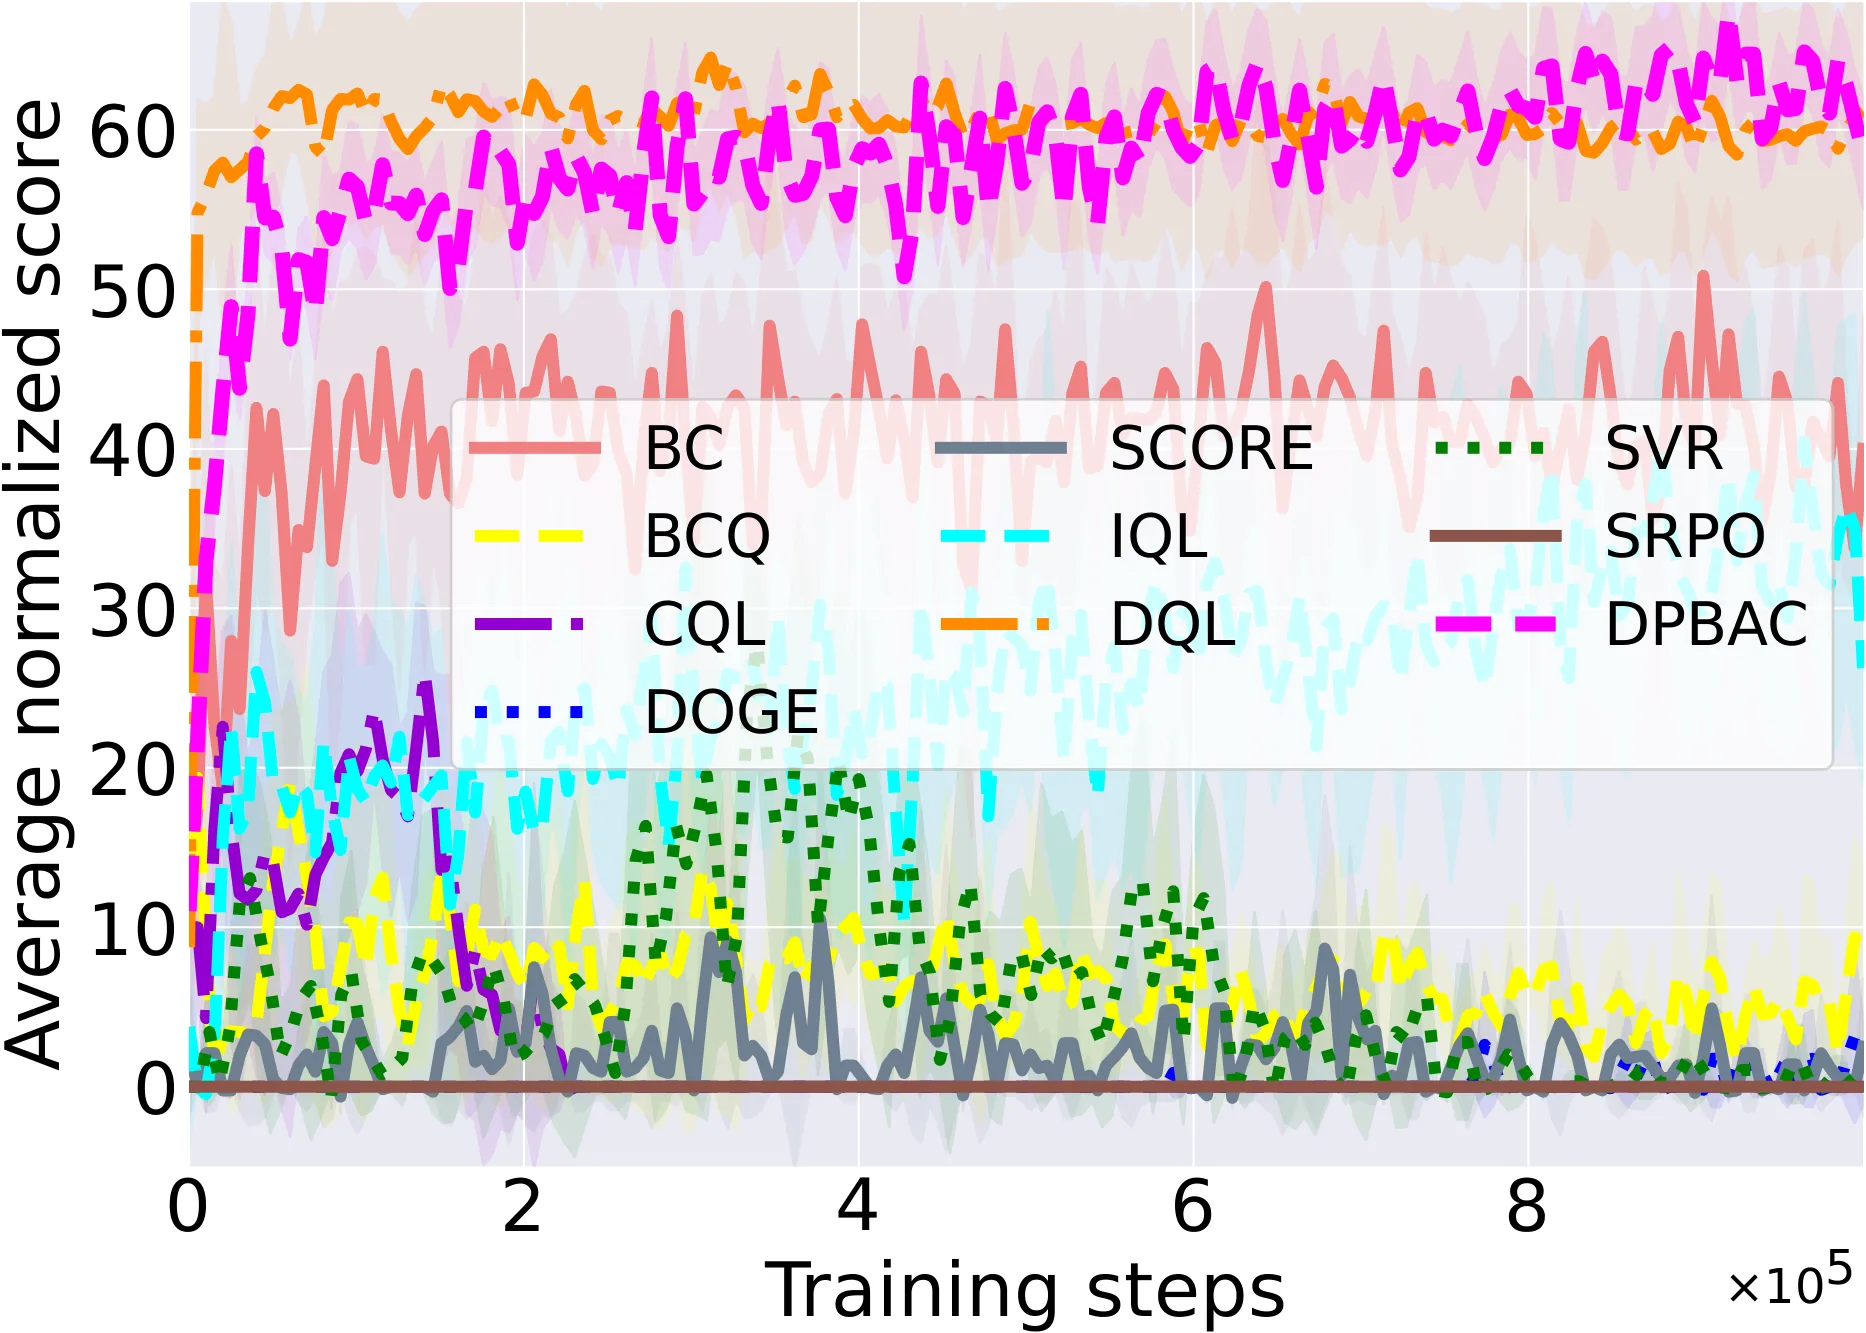
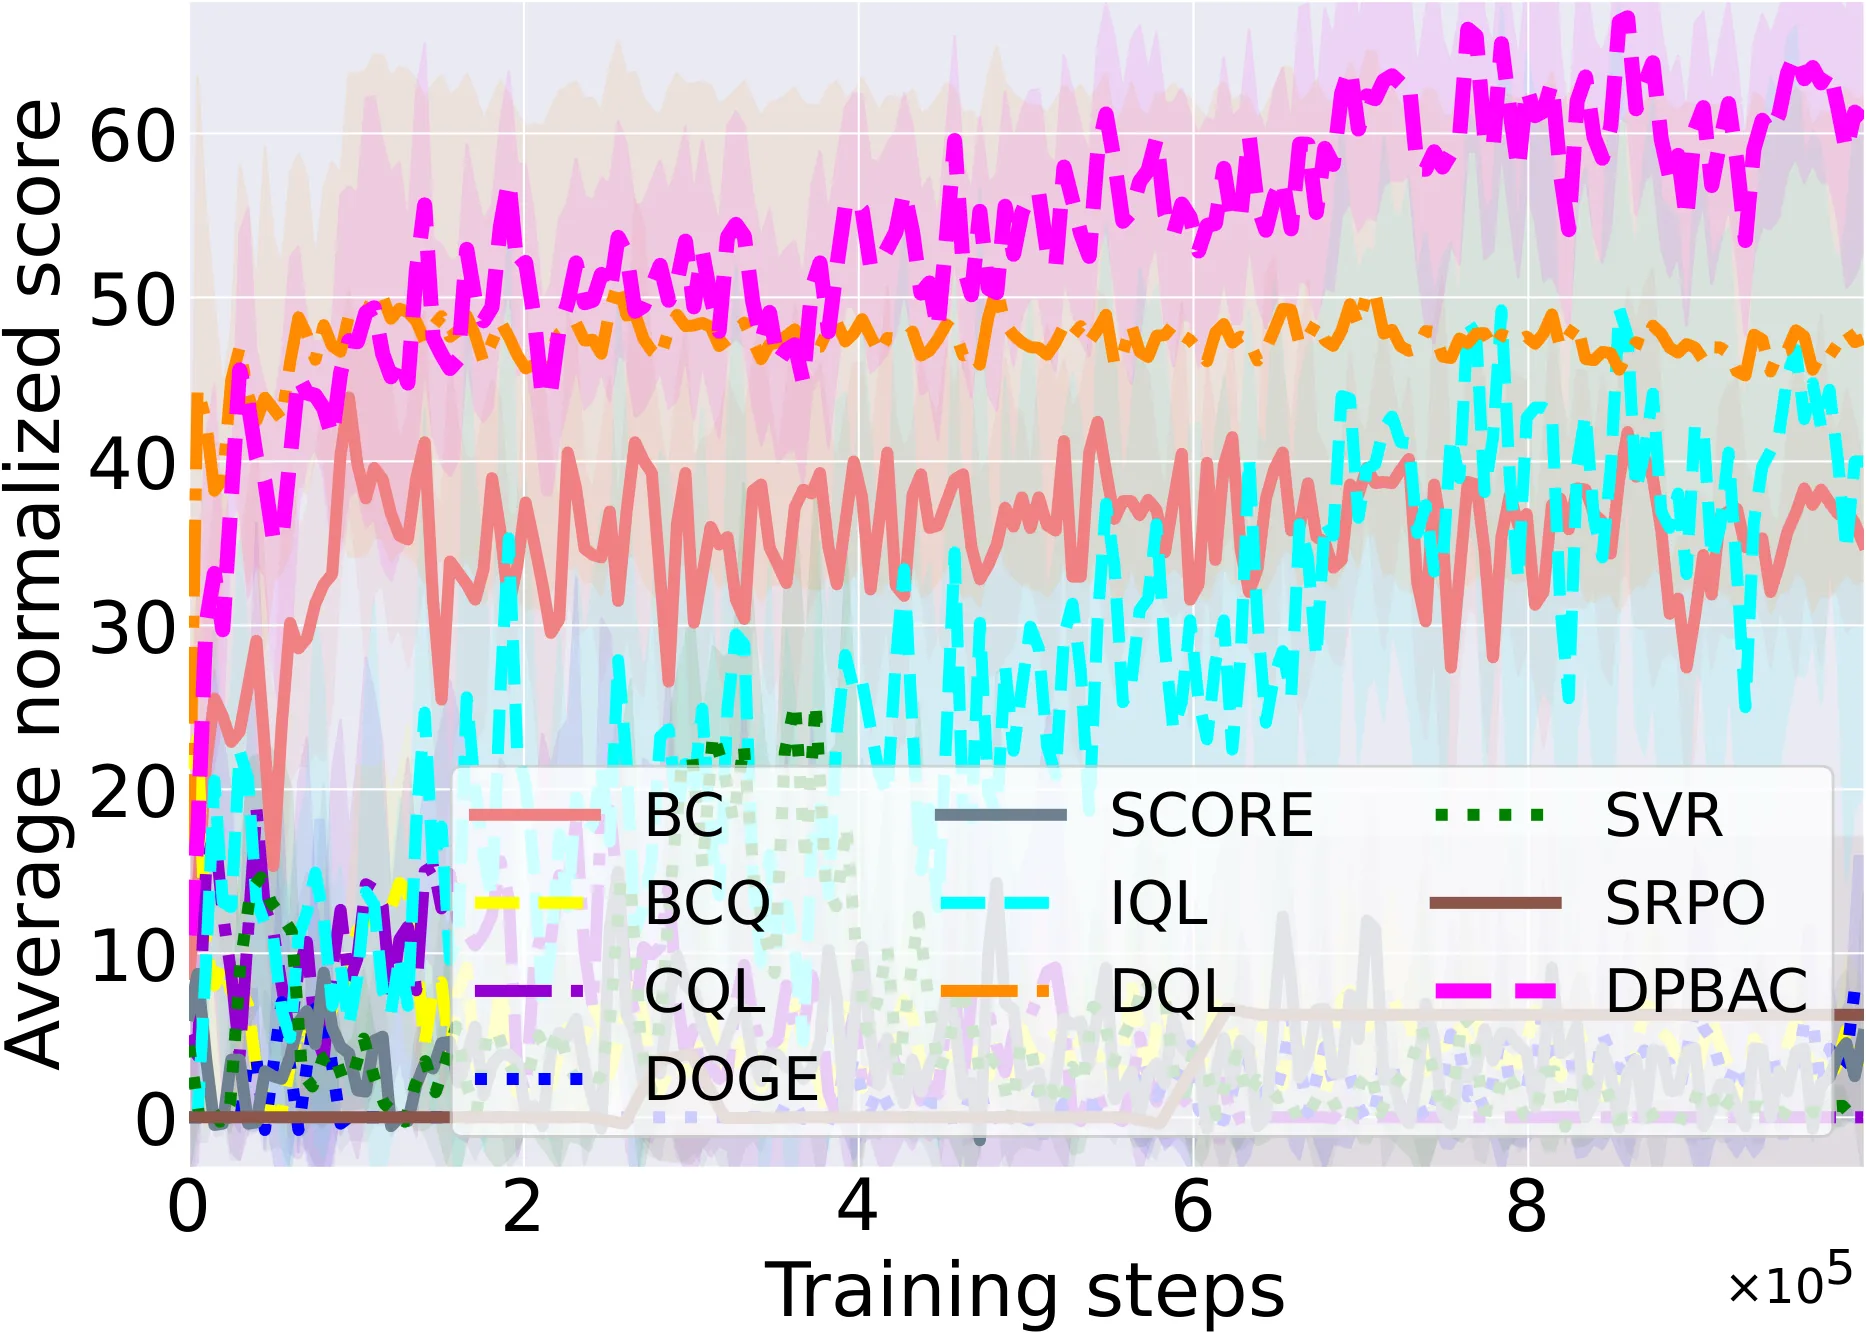
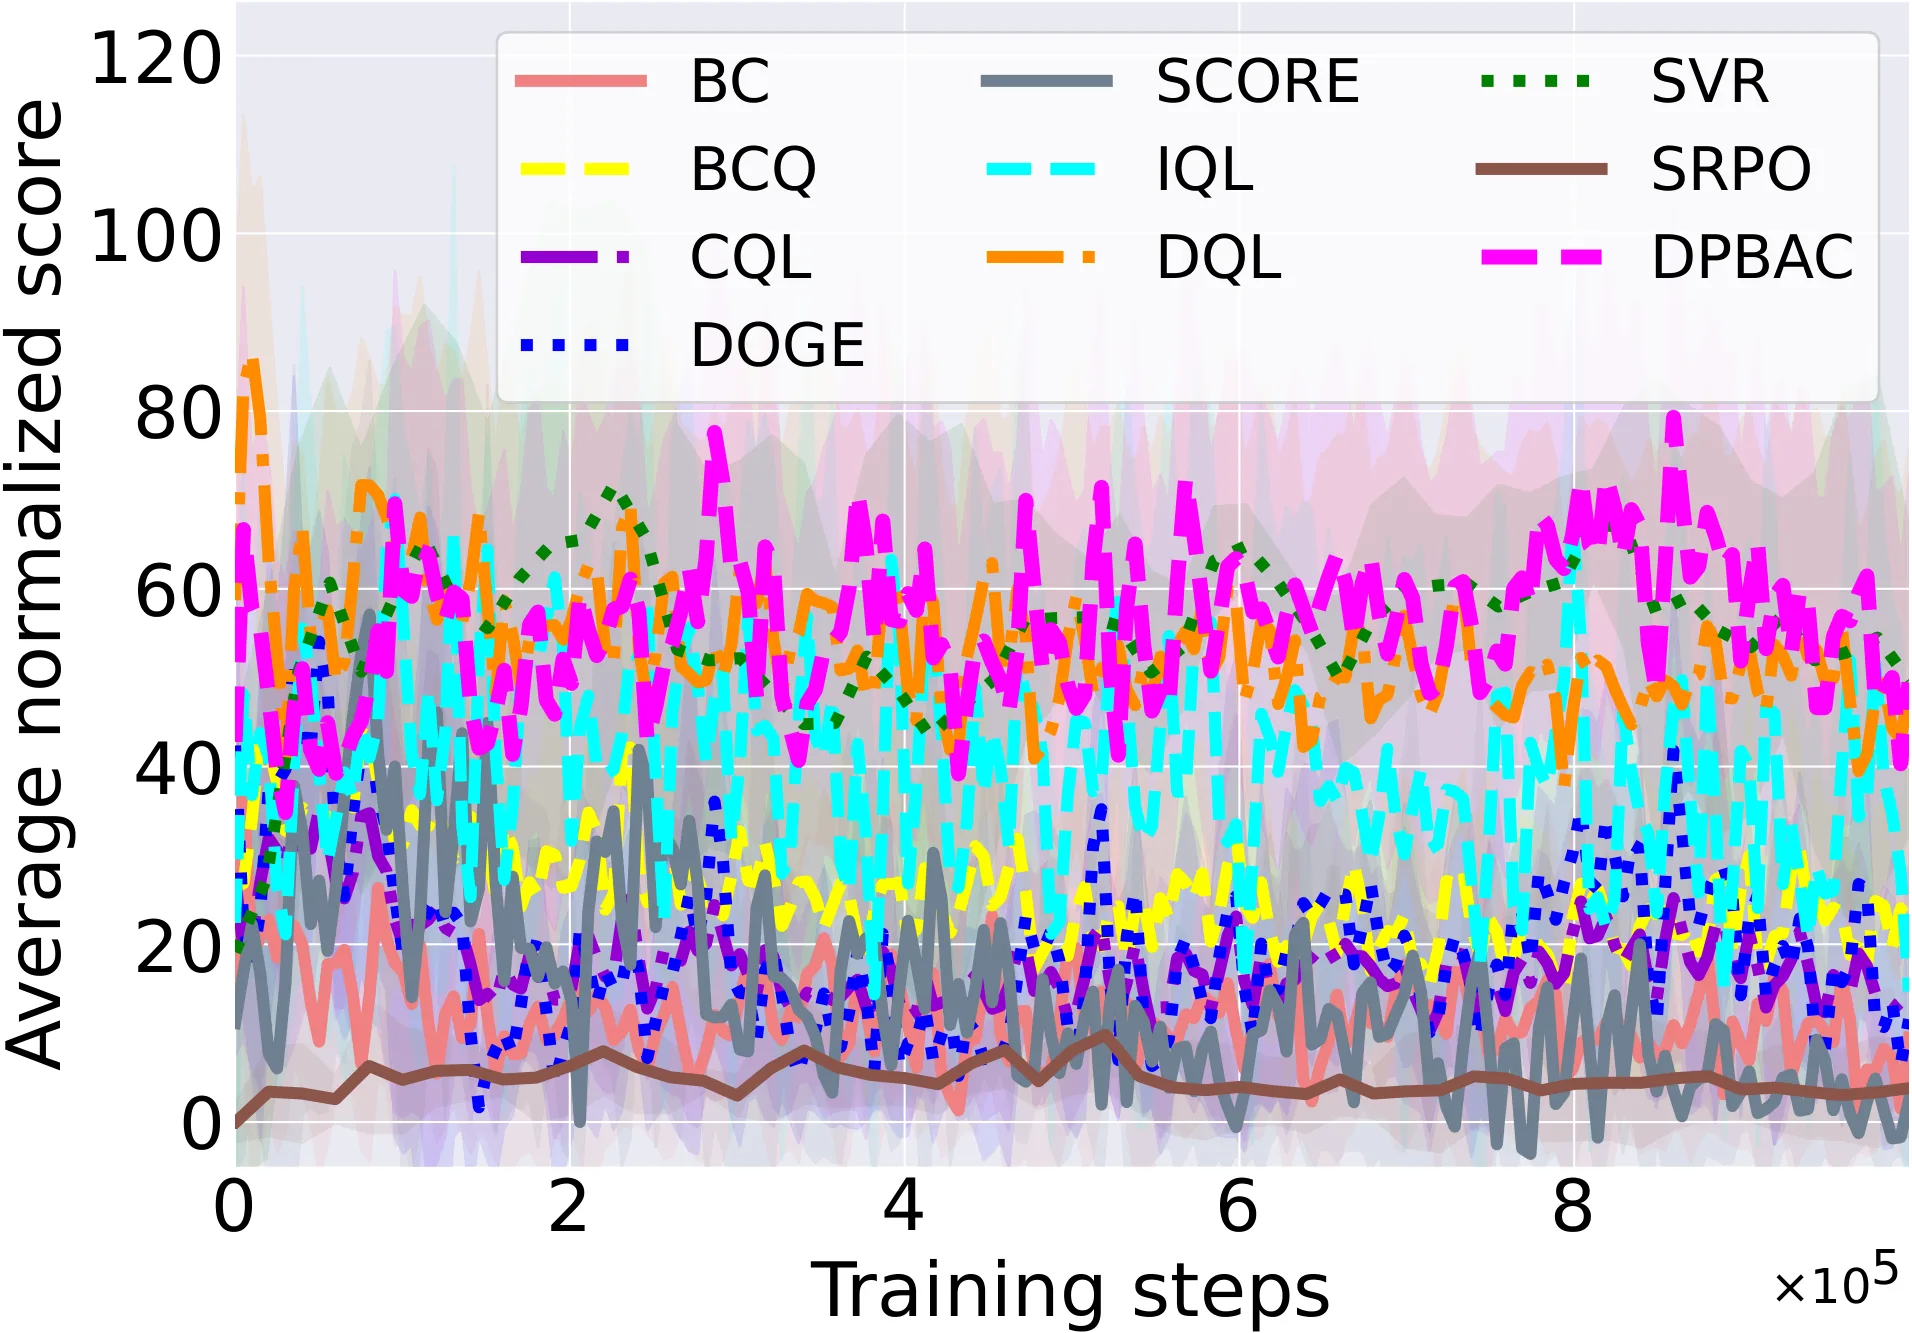
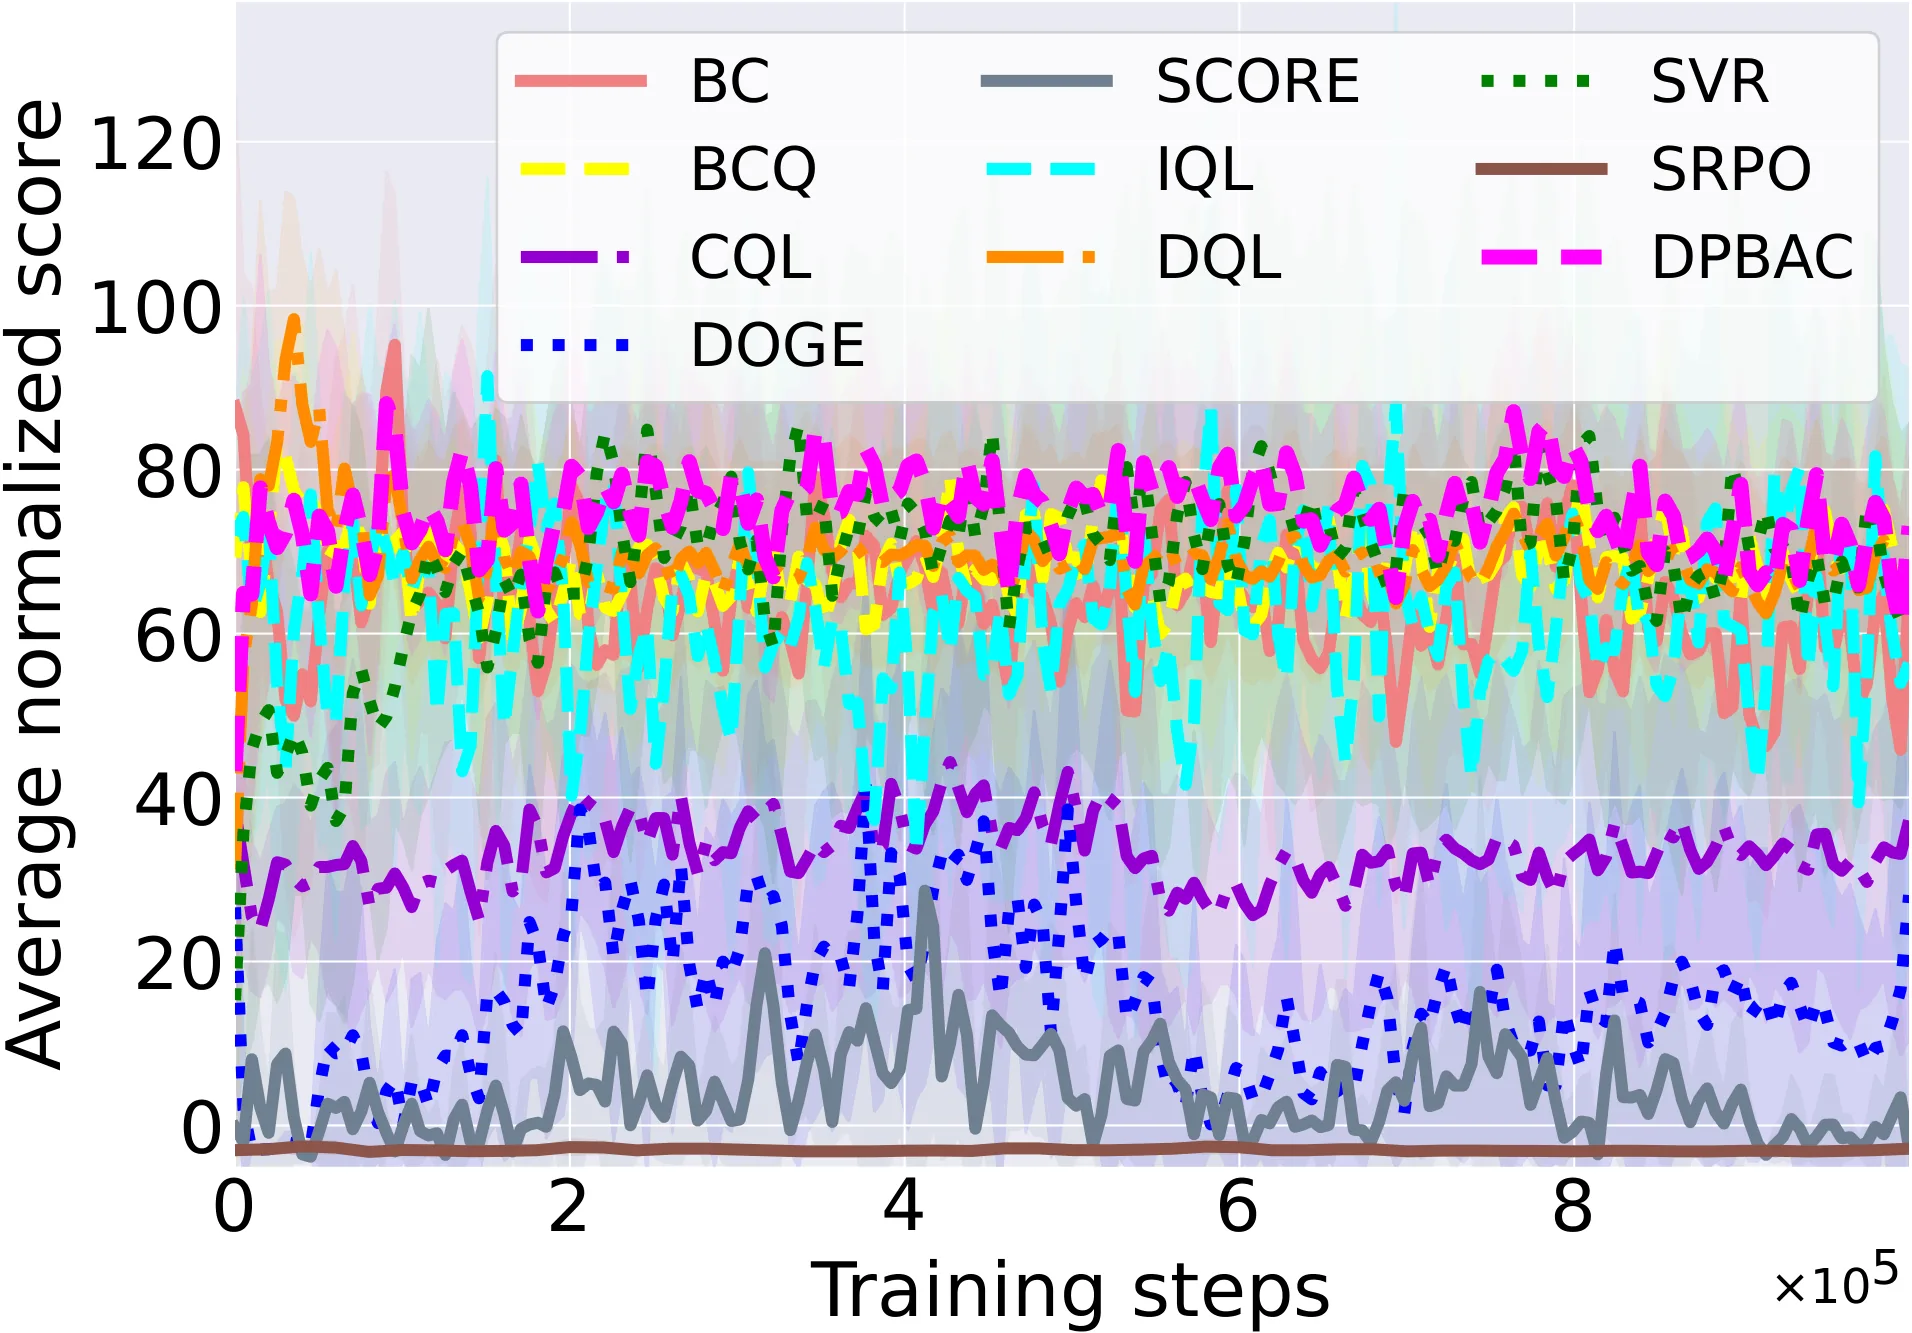
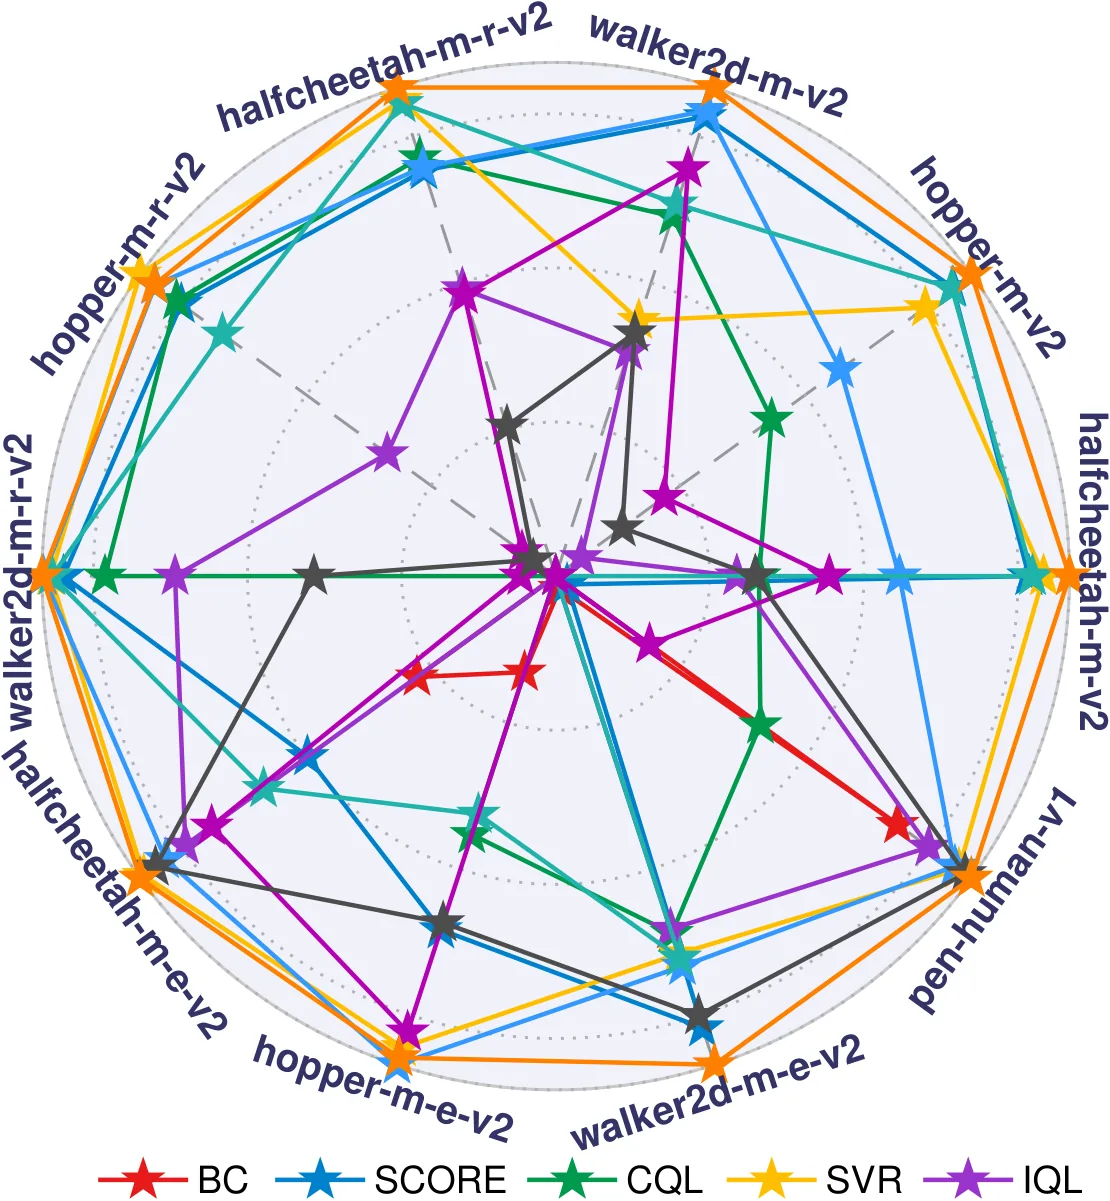
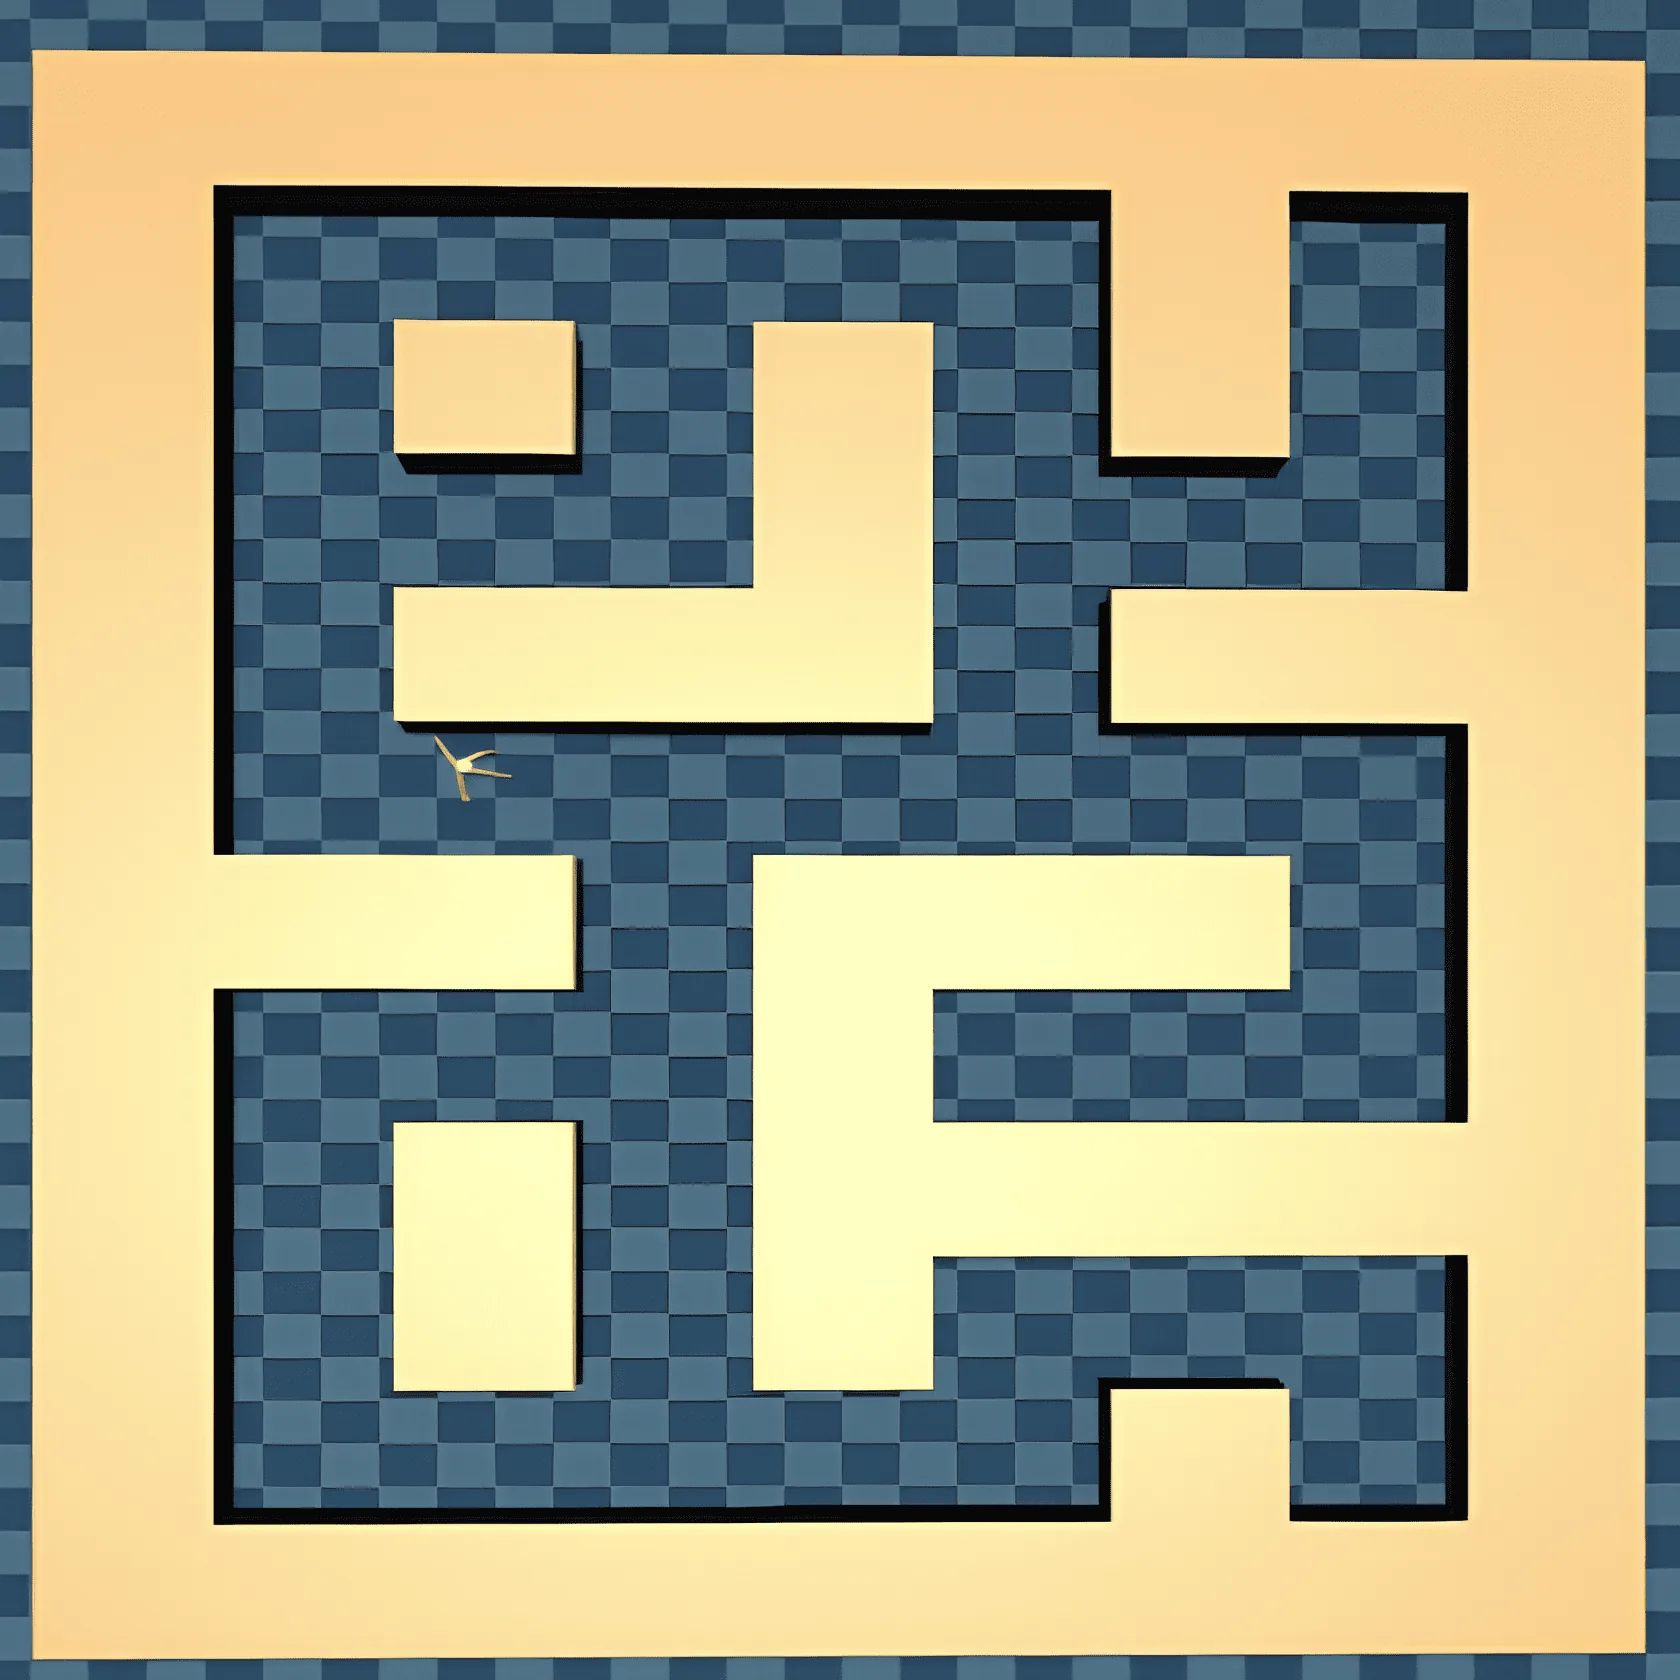
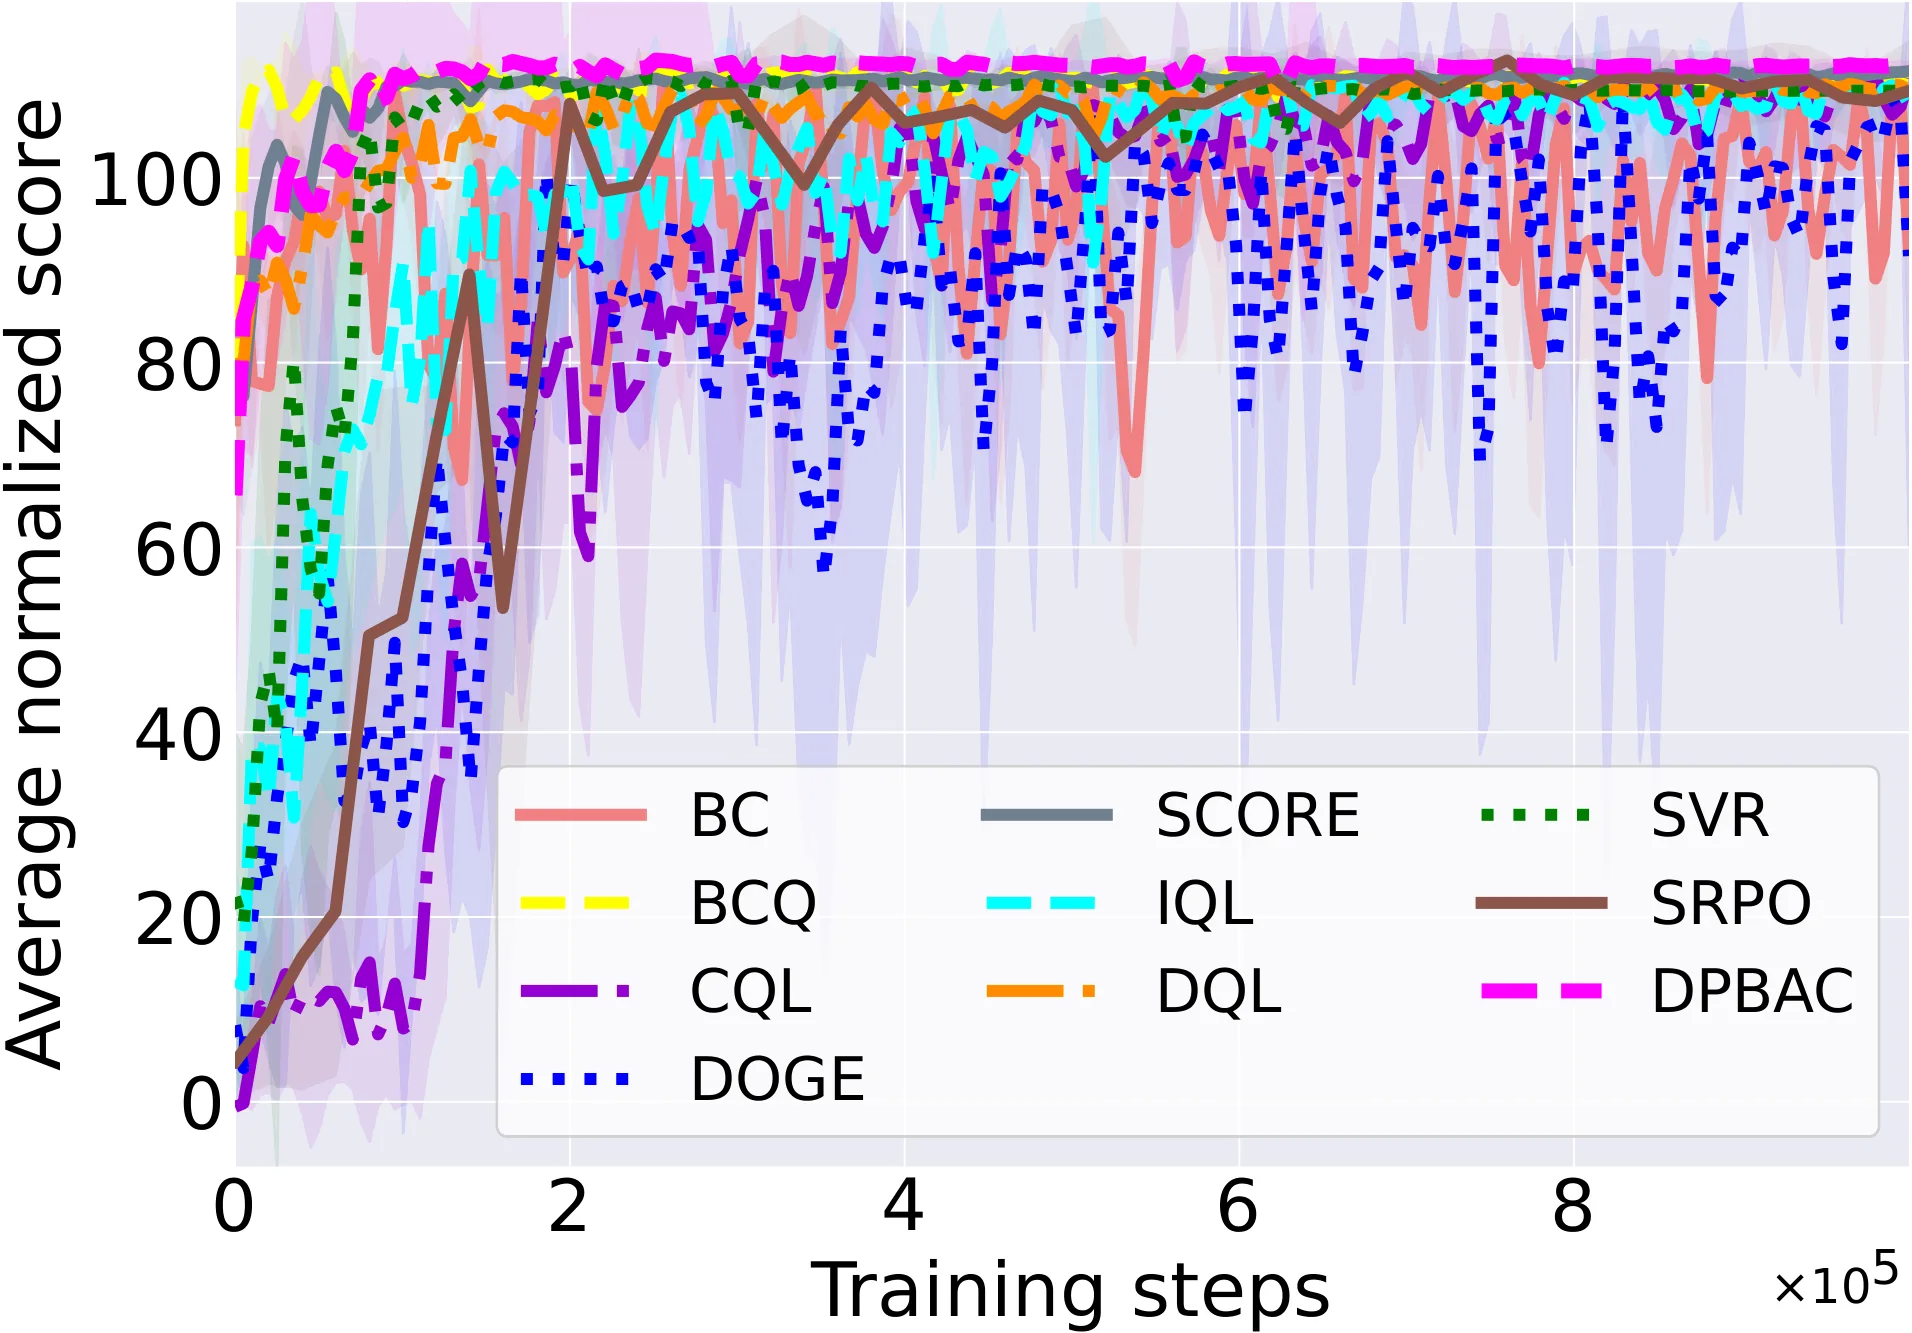
论文在 D4RL 基准上进行了全面评估,涵盖 Gym-MuJoCo、Kitchen、Adroit、AntMaze 等多个任务域,包括 medium、medium-replay、medium-expert 等多种数据配比设置。实验结果显示,DPBAC 在绝大多数任务上超越了包括保守型方法(CQL、IQL)和扩散策略方法(Diffusion-QL)在内的多种基线。
特别值得注意的是,在 medium 和 medium-replay 这类数据质量相对有限的数据集上,DPBAC 的优势更加明显。这是因为这类数据集中行为策略本身并非最优,过于保守的方法会受困于行为策略的上限,而 DPBAC 通过 BAC 修正机制既能保持与行为分布的一致性,又能通过 Q 引导实现策略提升。
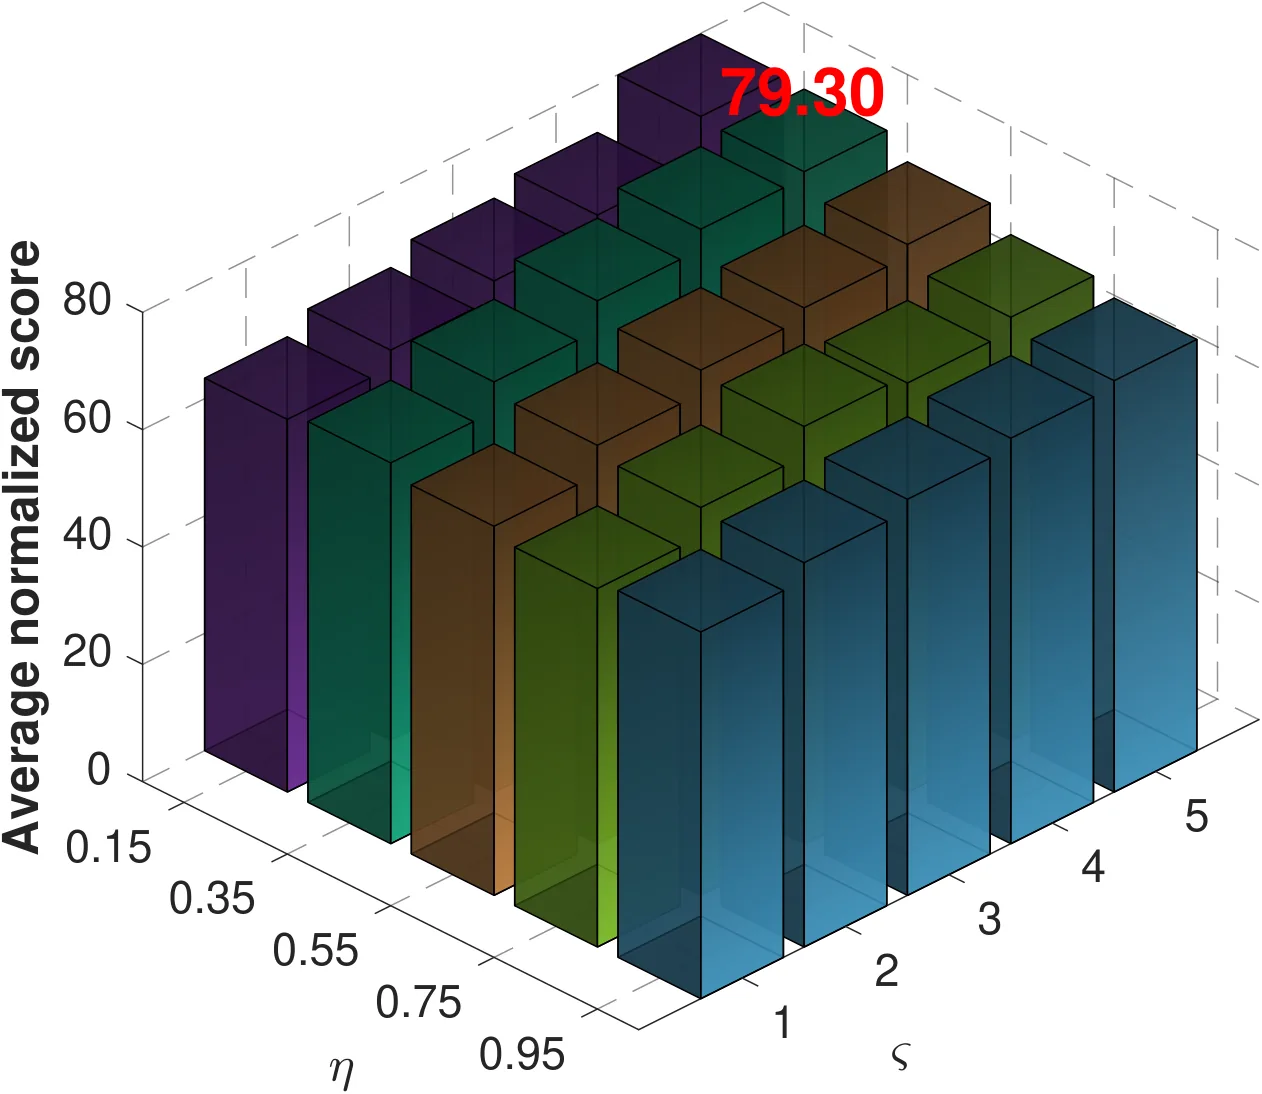
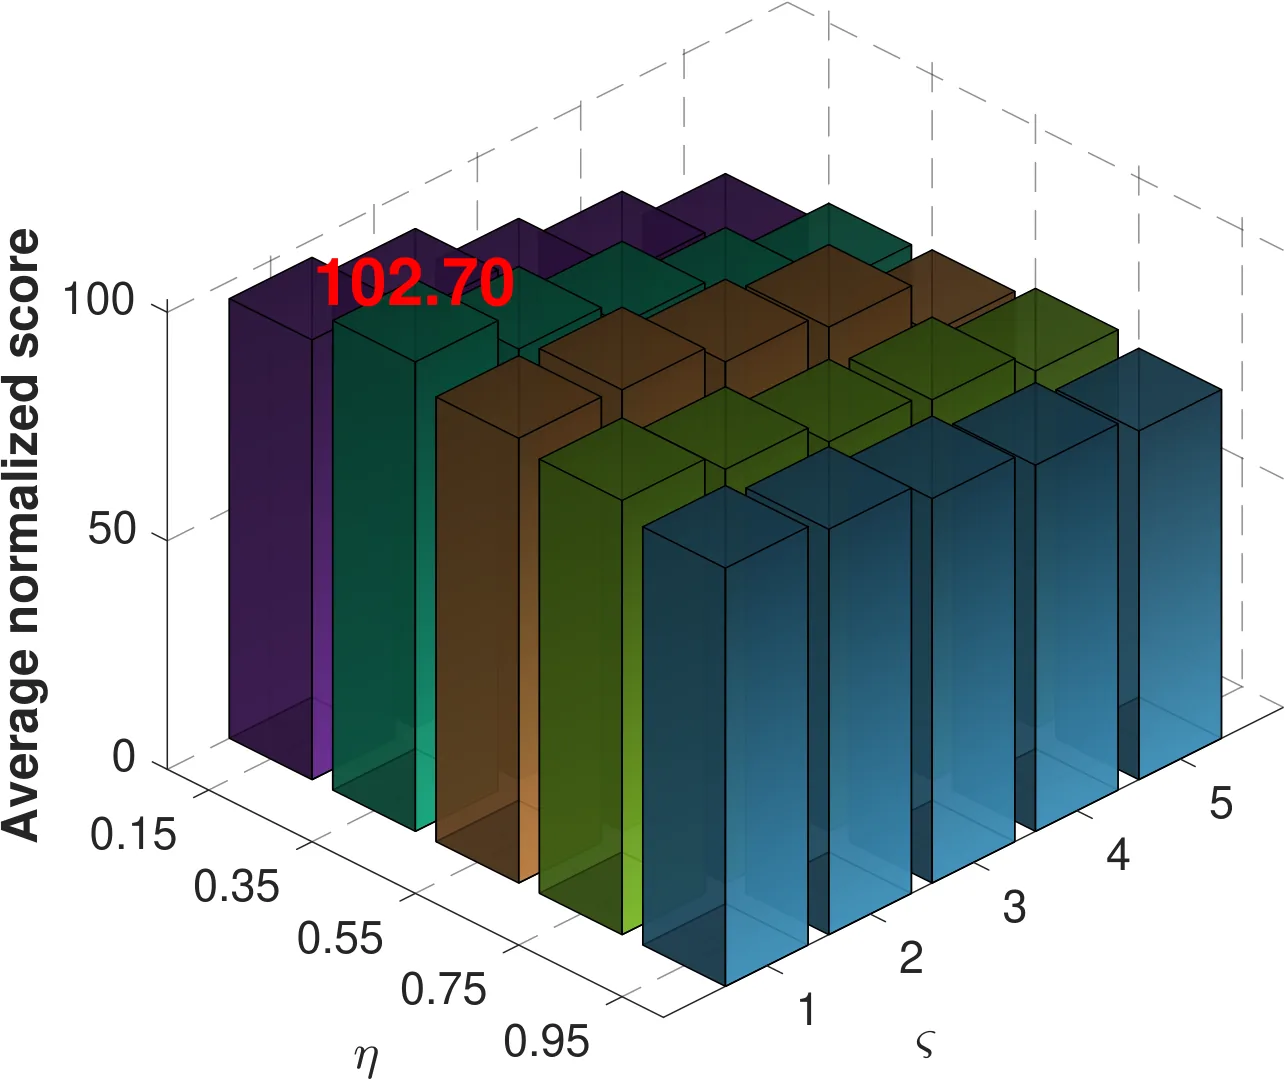
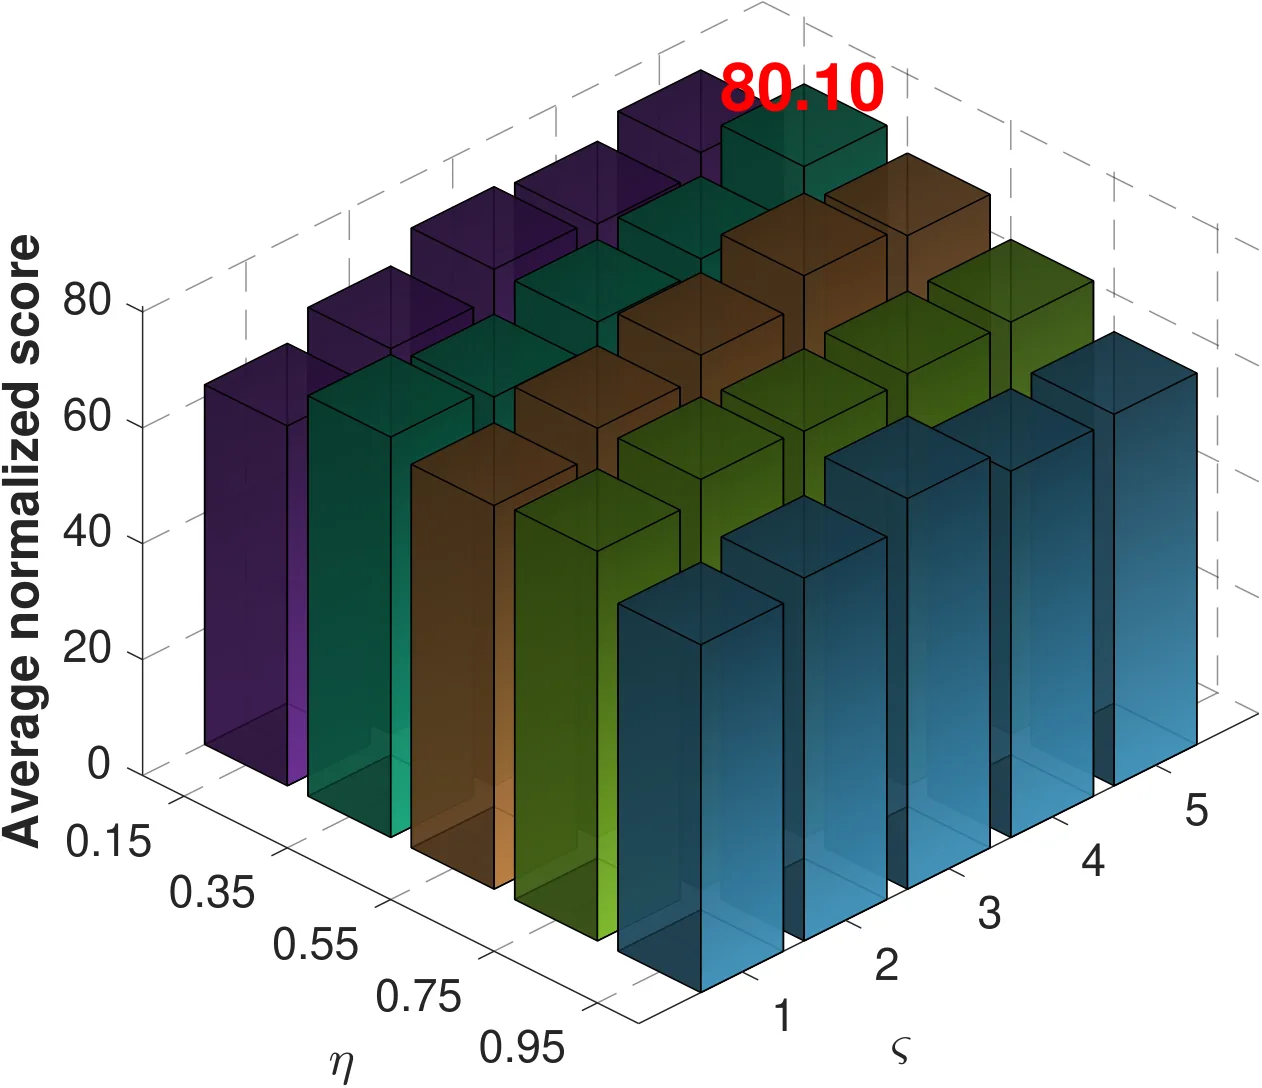
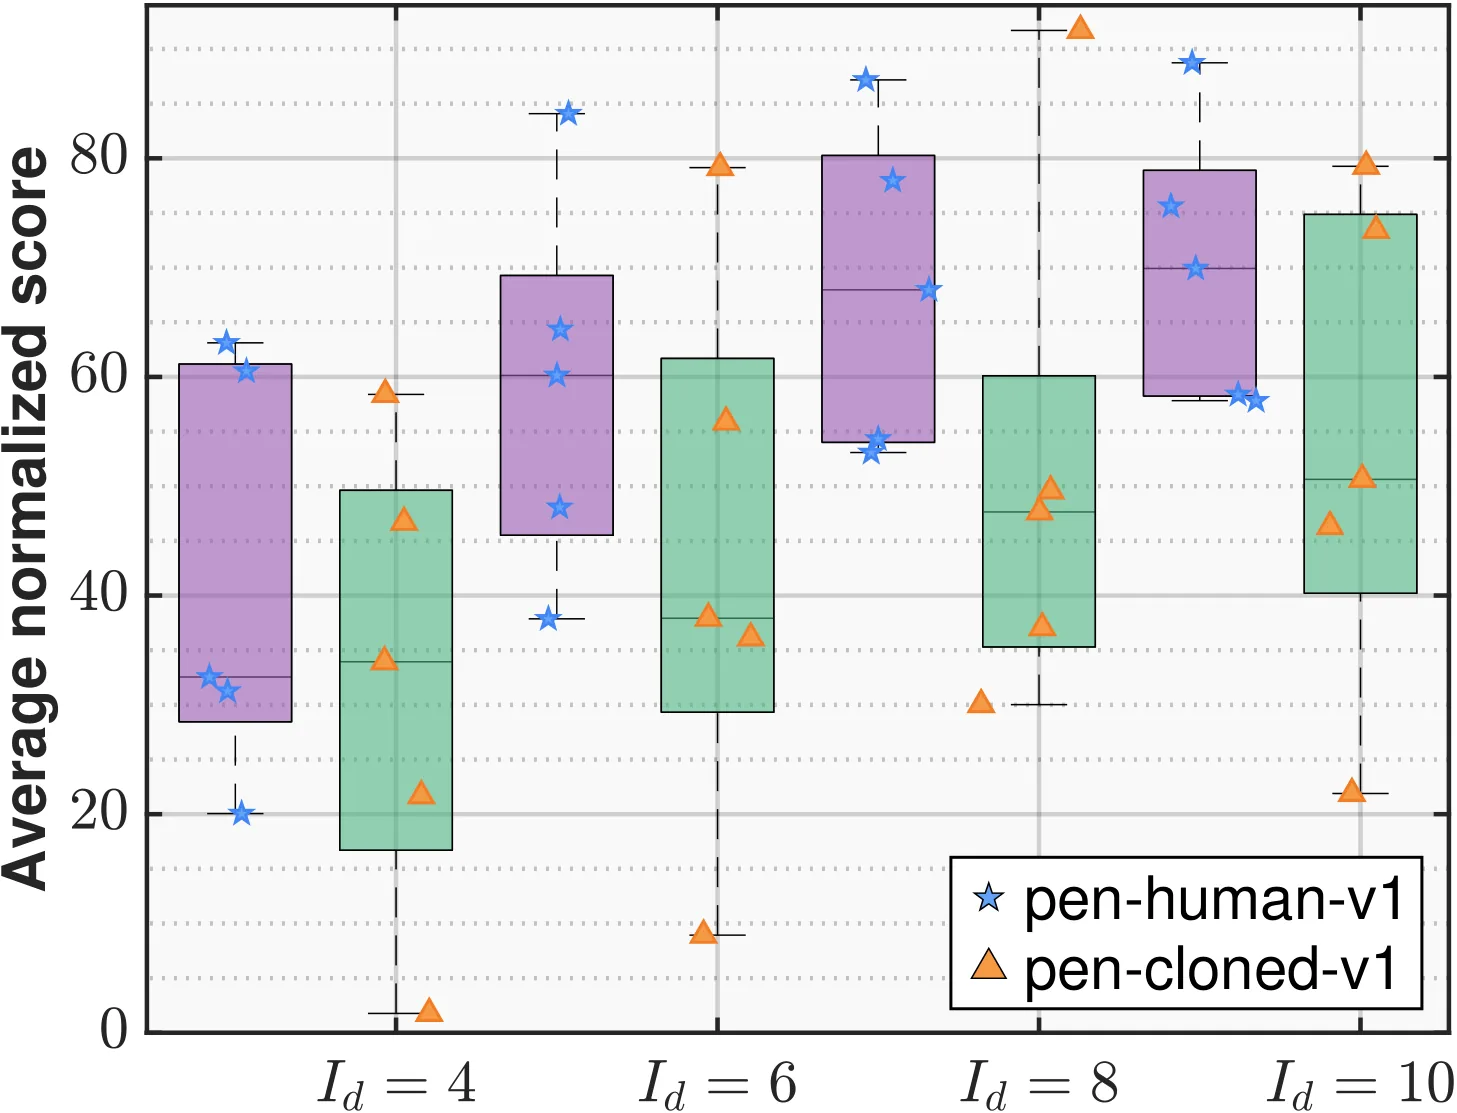
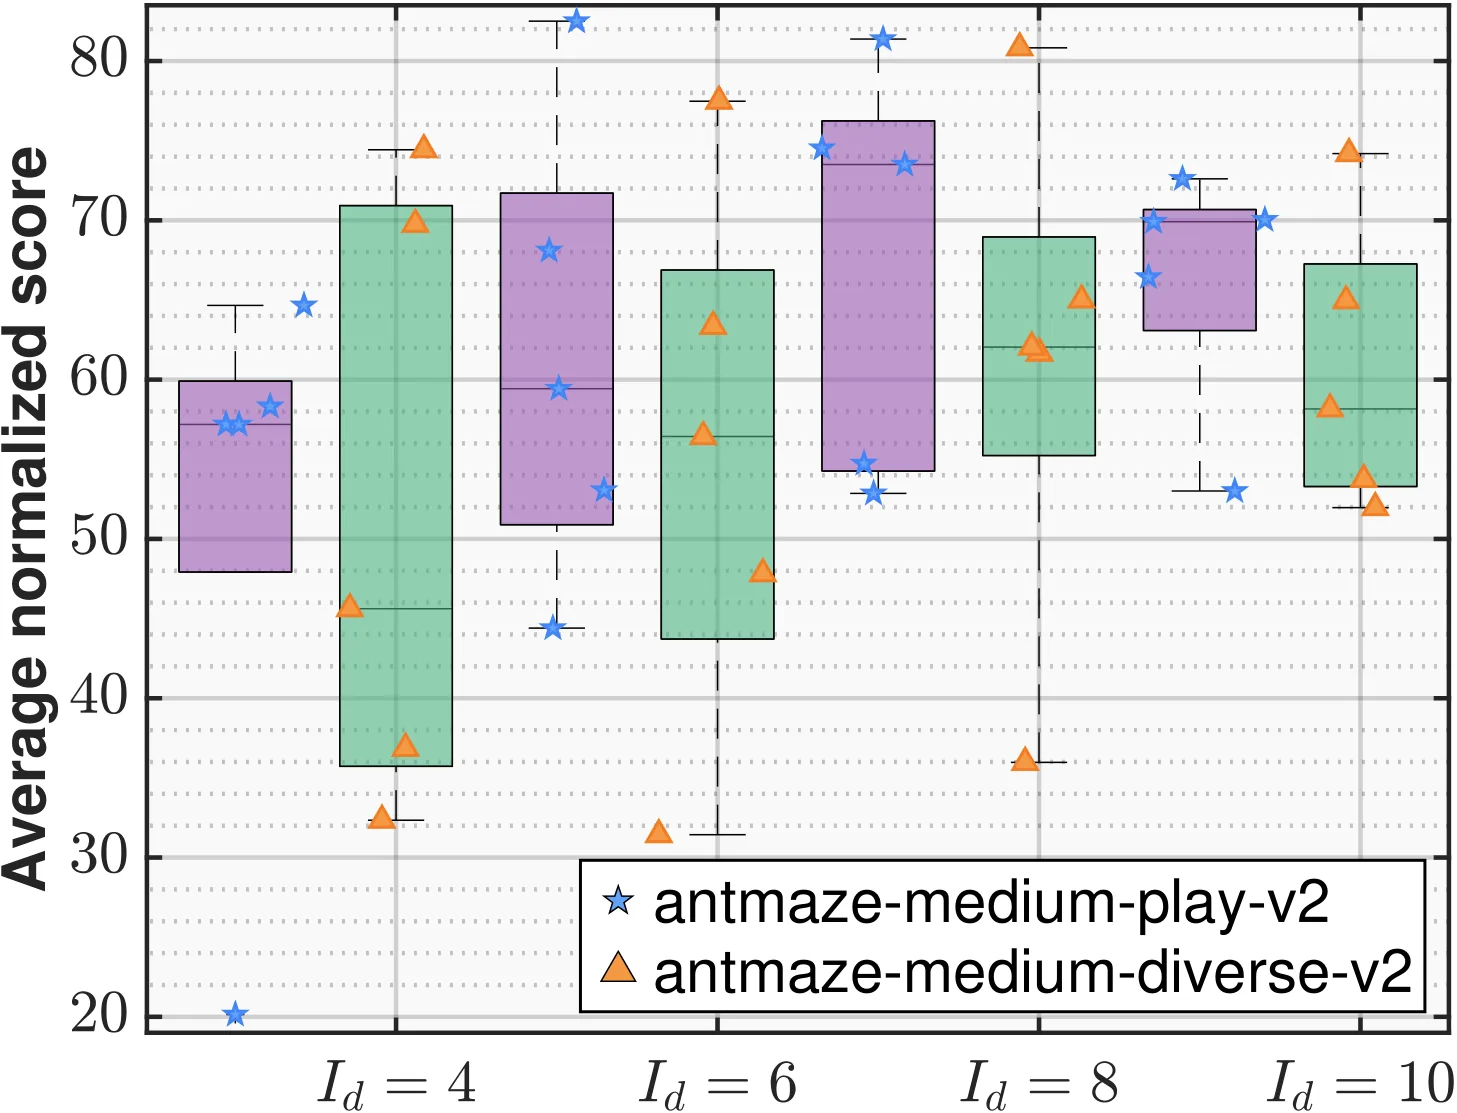
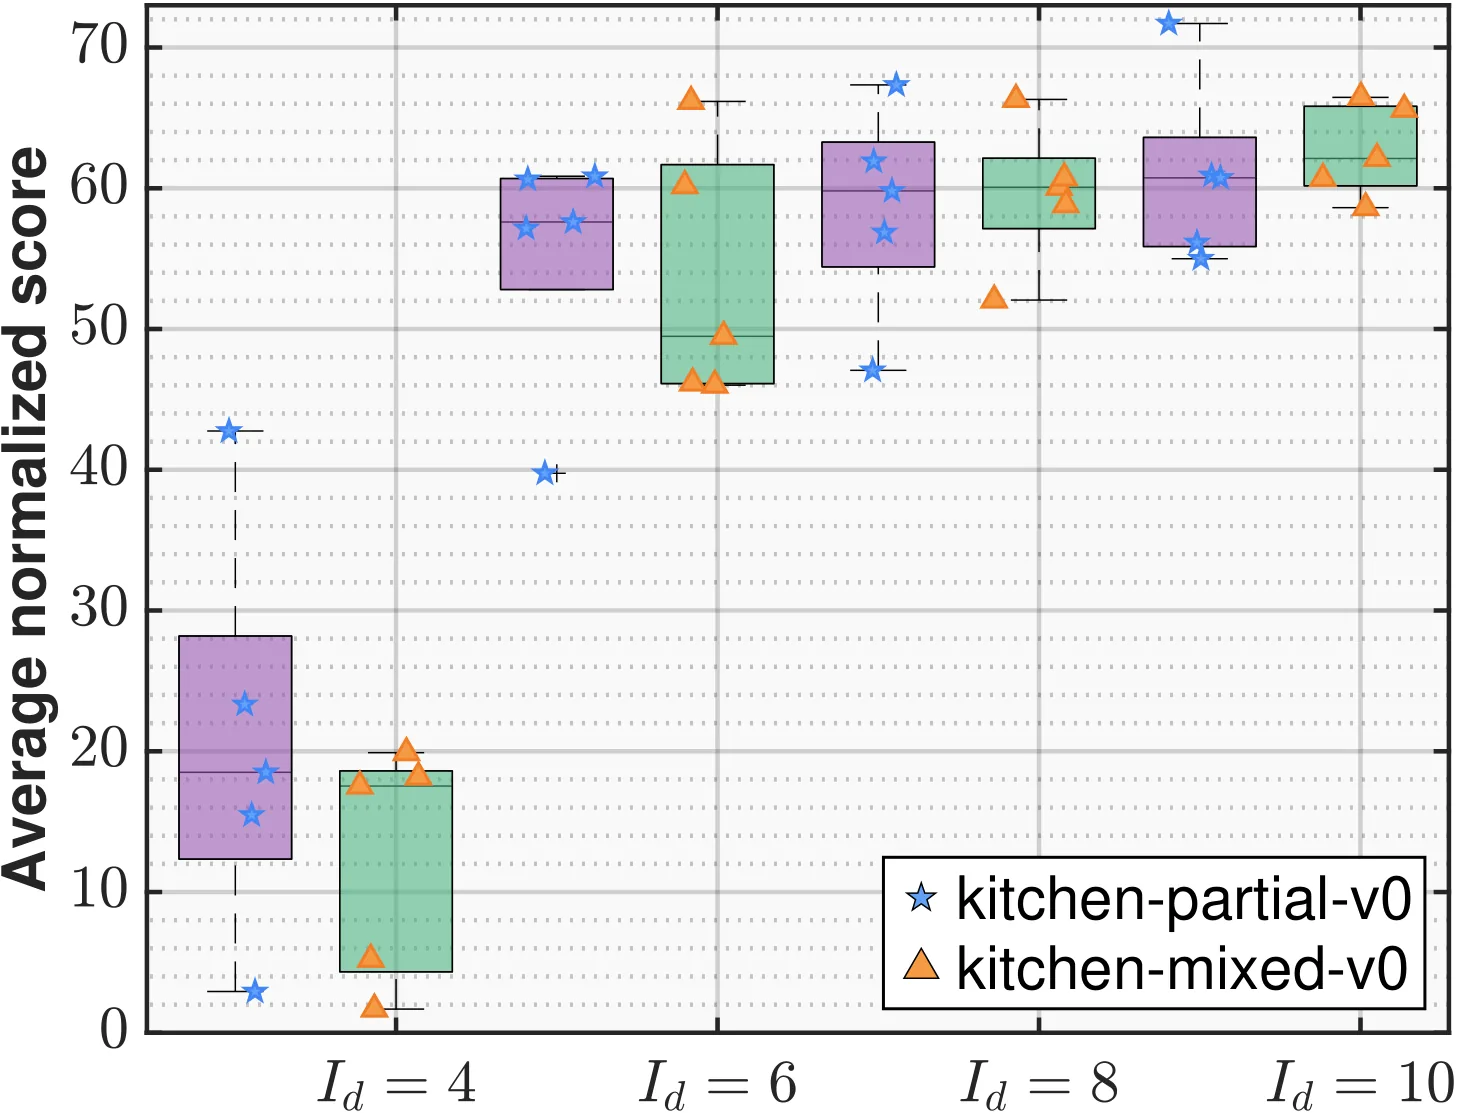
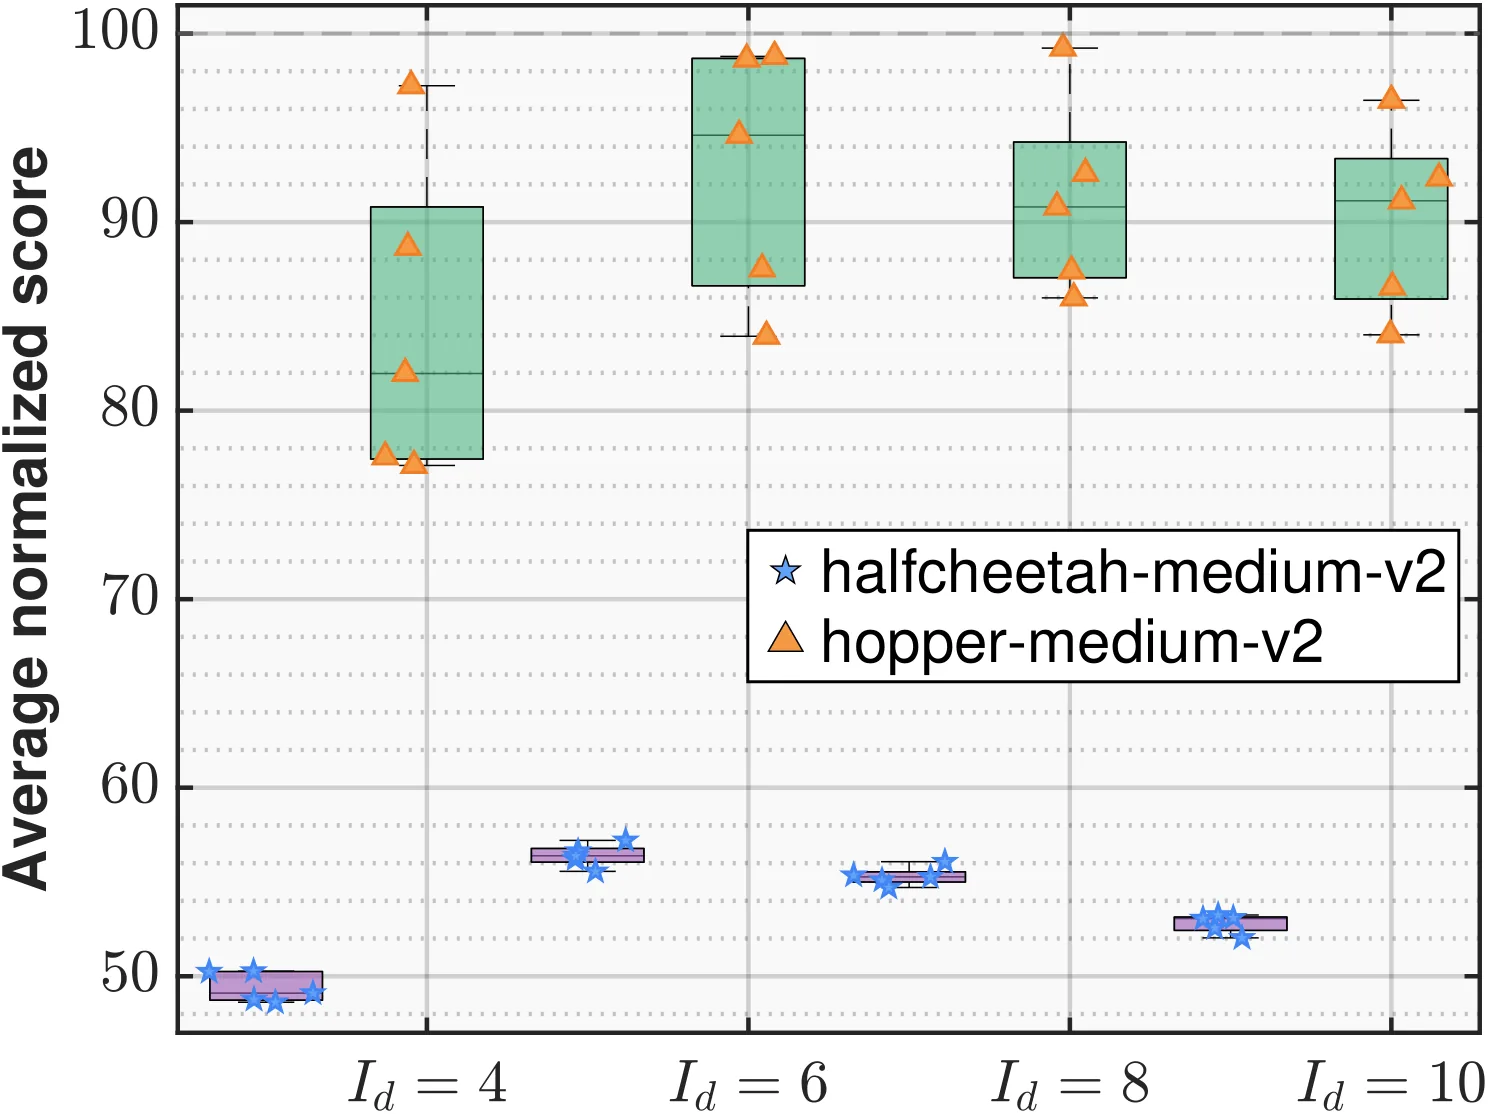
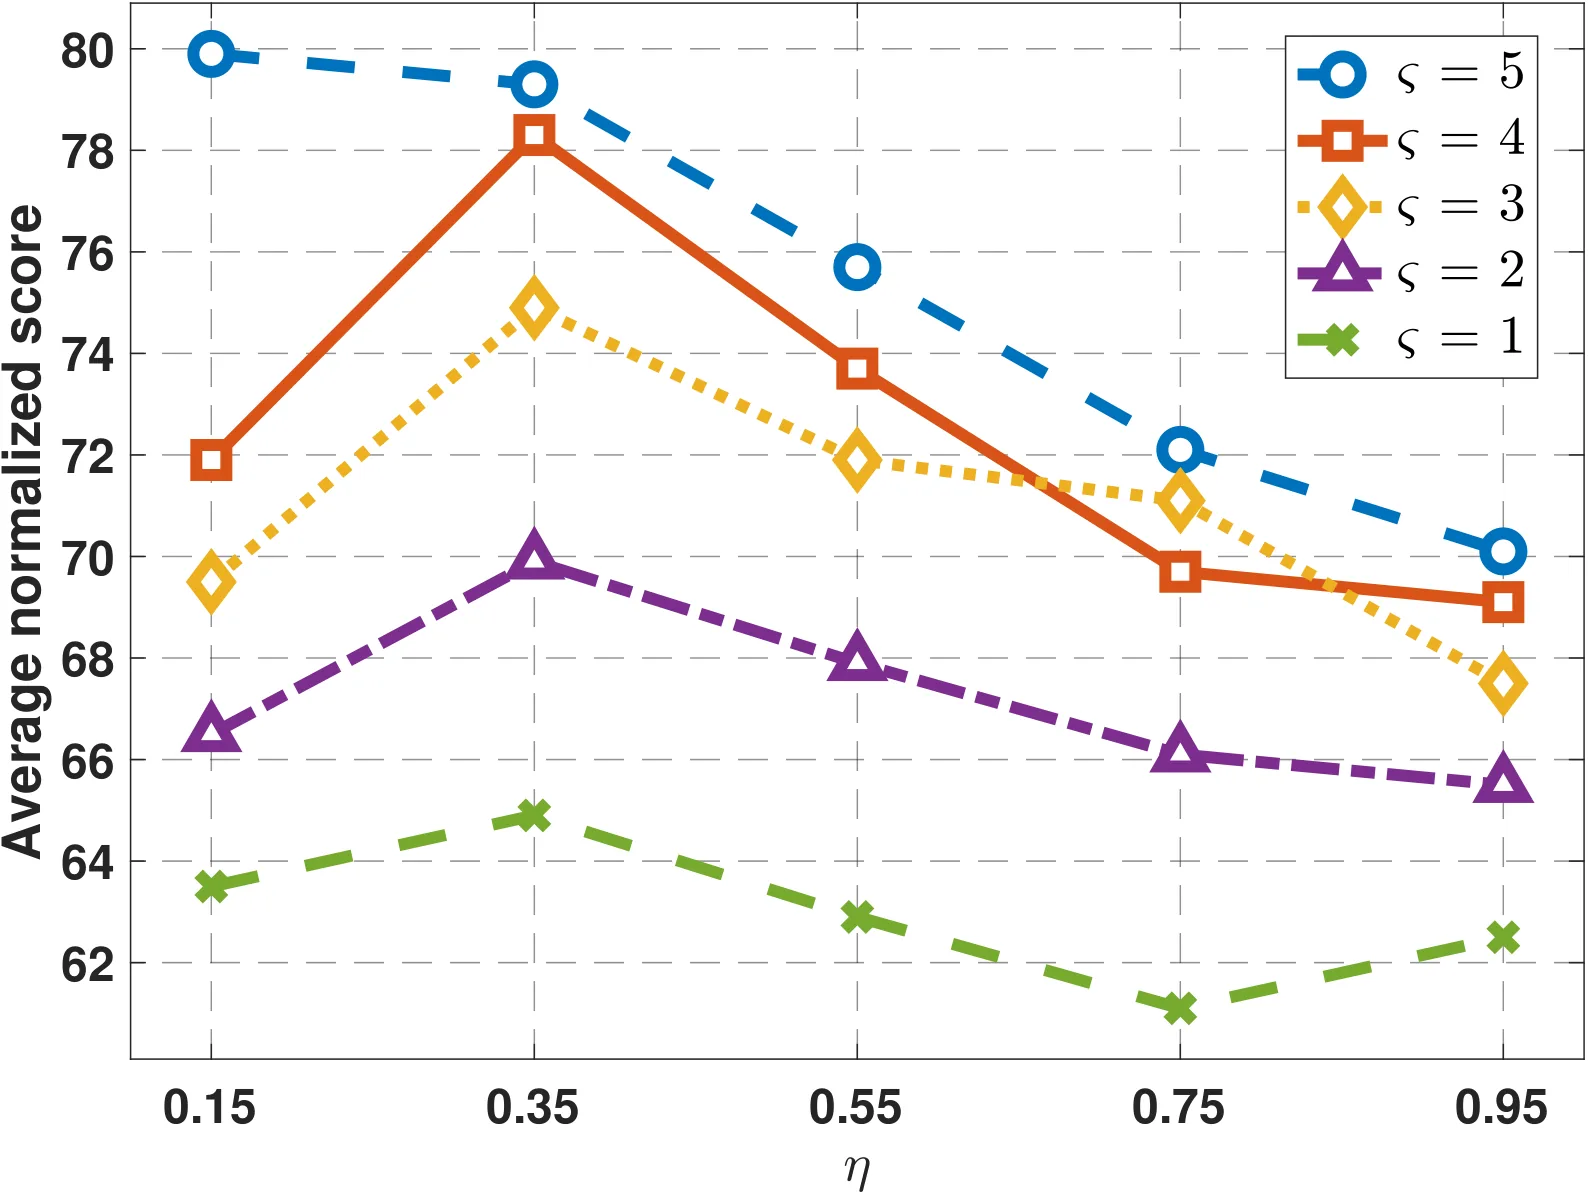
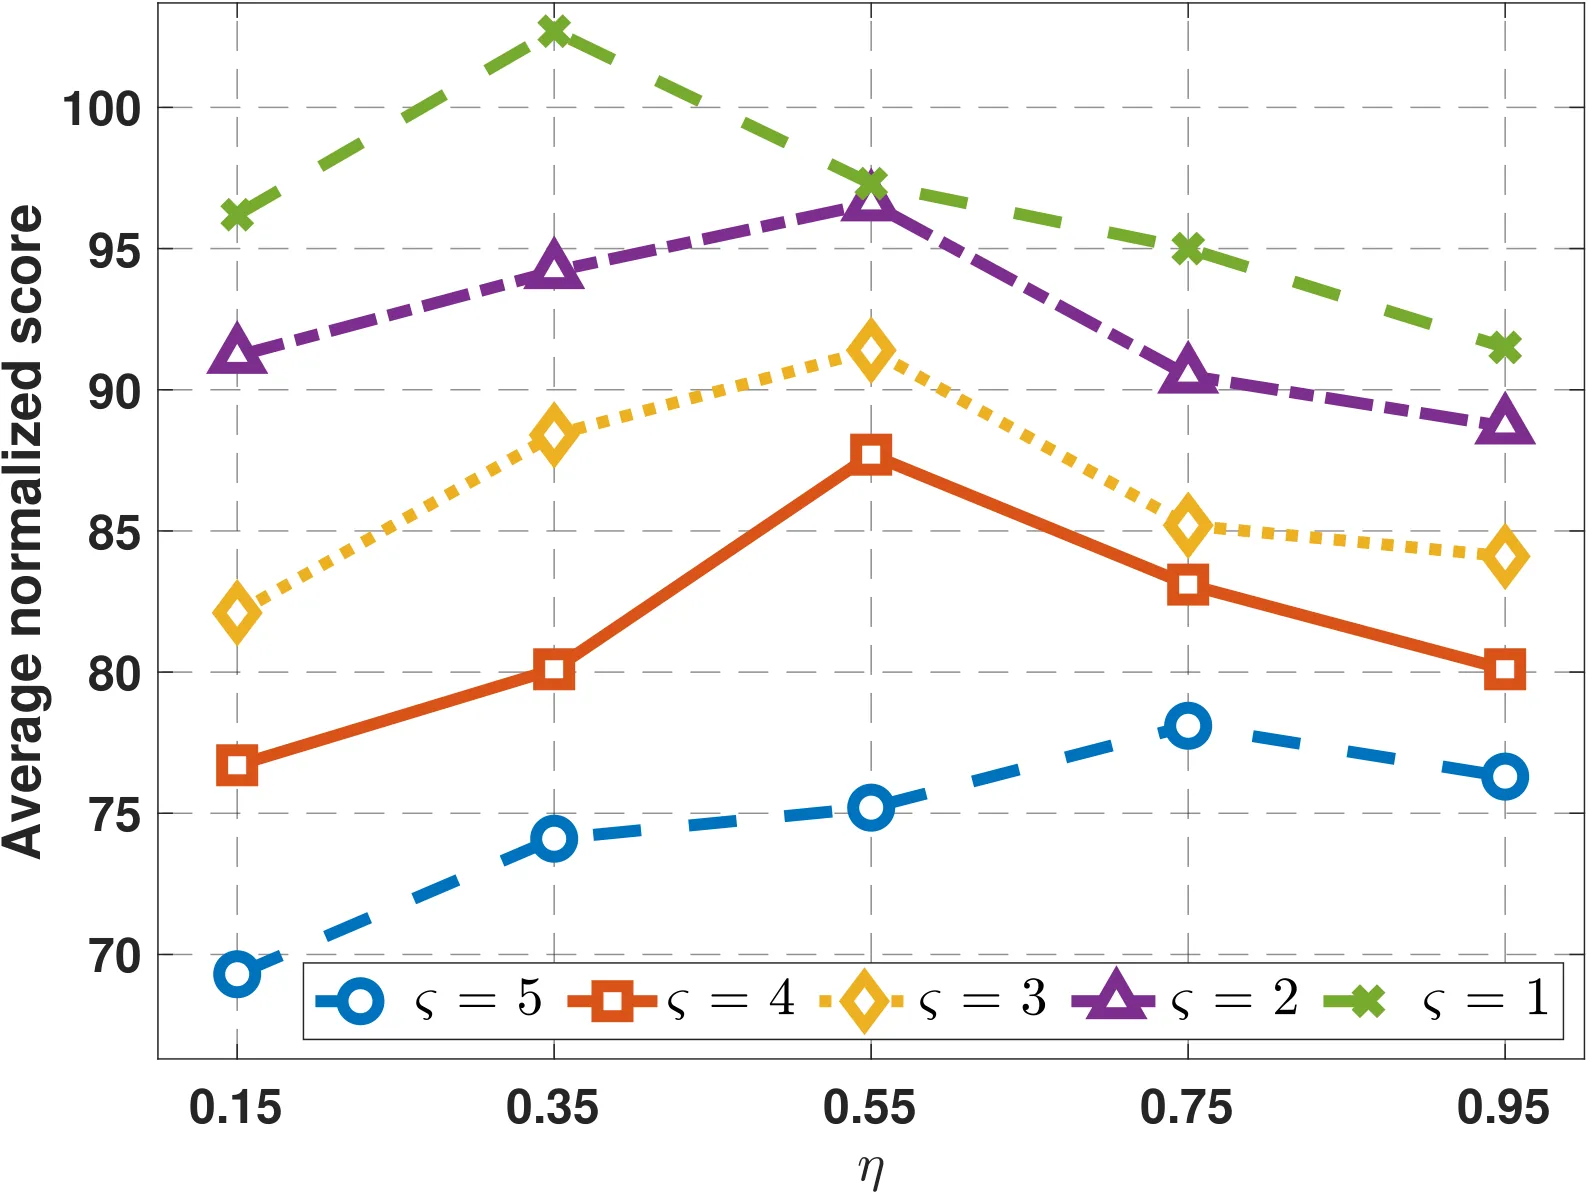
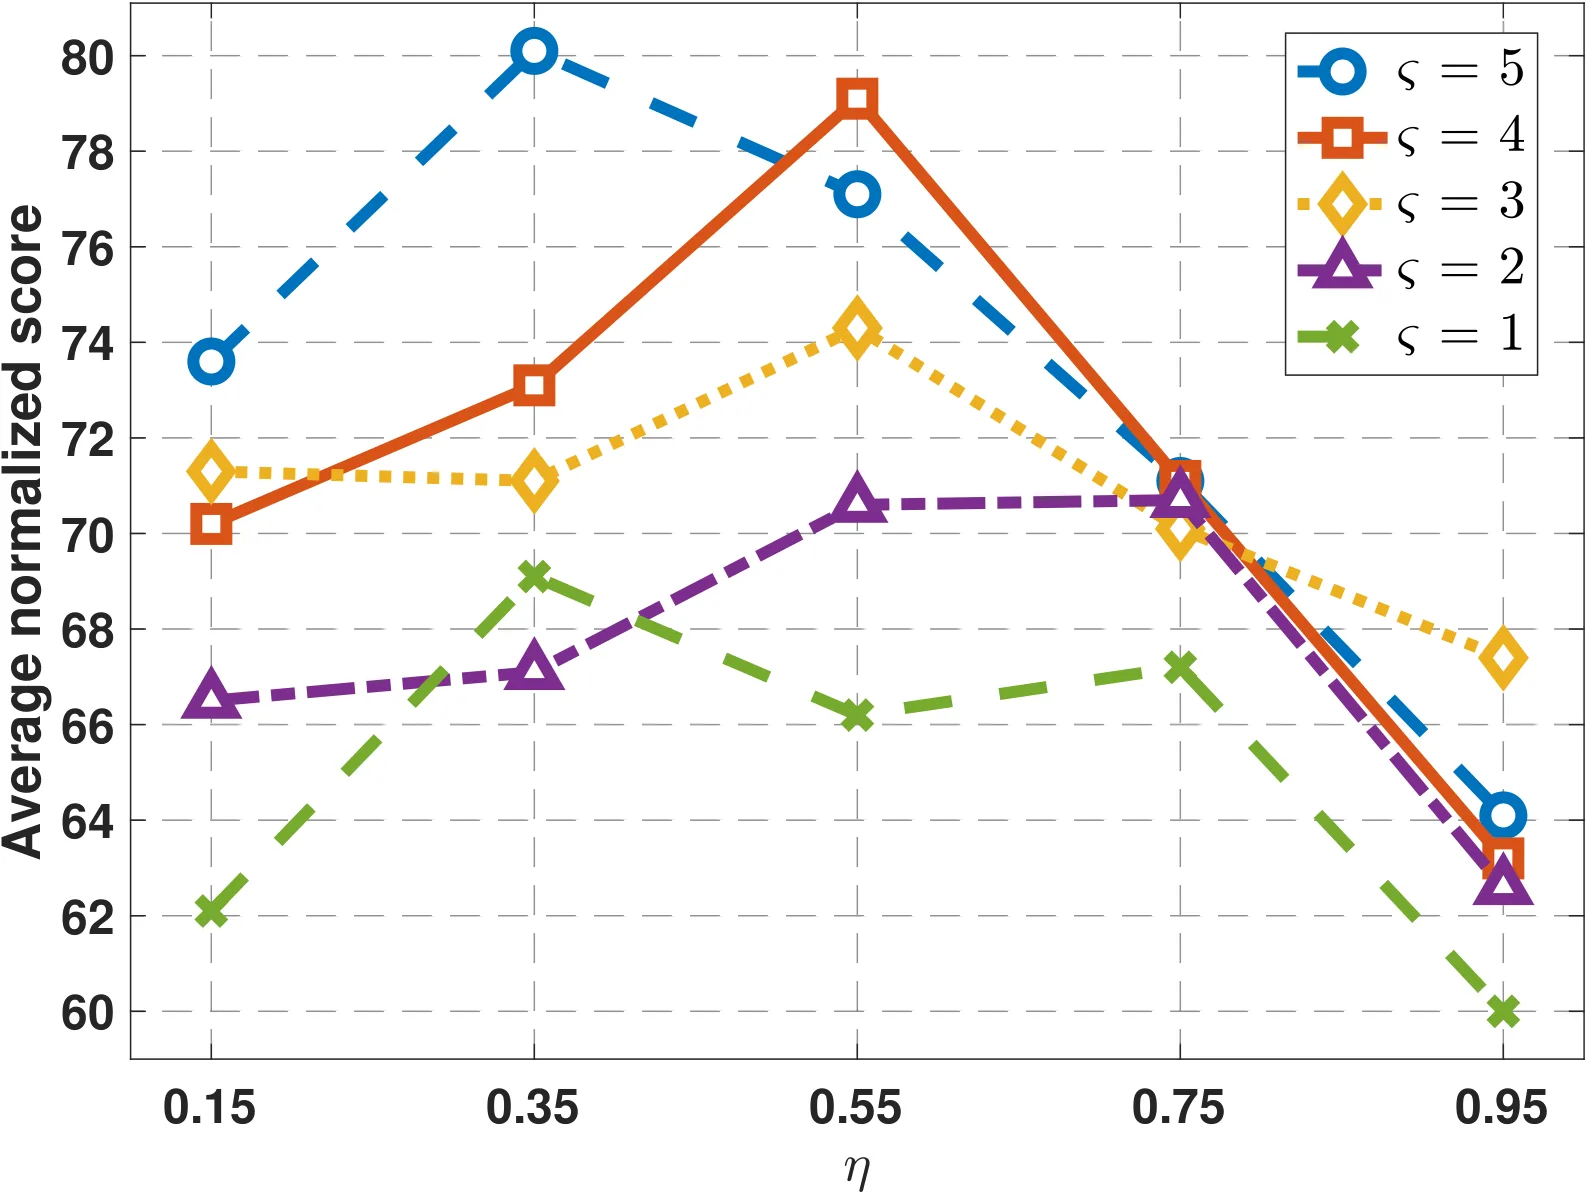
超参数敏感性分析表明,修正系数 是最关键的超参数,在大多数任务上 附近取得最优平衡。消融实验进一步证实了 BAC 修正项的必要性:移除修正项()后,性能显著下降,说明行为优势修正确实在 [[Q值估计]] 中发挥了关键的校准作用。
讨论与可借鉴点
DPBAC 论文的核心贡献在于将行为策略的 Q 函数信息显式引入学习策略的 Q 修正过程中,这一设计思路具有较强的通用性。与单纯依赖悲观正则化或单纯依赖分布匹配的方法相比,BAC-PE 提供了一种更加精细的偏差校正机制。
从实践角度,该方法的计算开销主要来自额外维护一个行为策略的 Q 网络,这在资源受限场景下需要权衡。此外, 等超参数的最优值在不同任务上存在一定差异,实际部署时仍需一定的调参工作。
从研究角度,这篇论文的 [[理论与算法并重]] 范式值得借鉴:先通过严格的数学分析建立方法的收敛性保证,再通过实验验证理论预测的正确性。这种做法增强了方法的可解释性和可信度,也为后续改进提供了理论锚点。论文在扩散策略框架下引入 Q 值引导的设计也表明,如何更好地将 [[离线强化学习]] 的探索-利用权衡与扩散模型的生成能力结合,仍然是一个值得深入探索的方向。
摘要
在离线强化学习(RL)中,行为数据与所学策略之间的分布偏移会导致错误的 Q 值估计,从而误导策略优化的方向。为了解决这一问题,我们提出了一种行为优势修正的策略评估(BAC-PE)方法,该方法利用行为策略的 Q 函数来修正所学策略的 Q 函数,从而缓解悲观保守主义和过估计偏差。此外,我们还对 BAC-PE 的收敛性进行了理论分析,并推导了所学 Q 函数与真实 Q 函数之间差异的上界。为了缓解分布偏移问题,本文采用扩散模型来表示行为策略和所学策略,通过分布匹配实现准确的策略正则化。此外,还将 Q 值引导融入训练过程,以实现有效的策略改进。通过将 BAC-PE 与扩散策略建模相结合,我们提出了基于行为优势修正的扩散策略(DPBAC)算法。与现有离线方法相比,DPBAC 表现出更强的策略表示能力,并有效缓解了 Q 值估计中的偏差。在 D4RL 多个任务领域上的实验结果表明,DPBAC 取得了优越的性能,相较于当前最先进(SOTA)算法具有显著优势。
Abstract
In offline reinforcement learning (RL), the distribution shift between behavioral data and the learned policy can lead to erroneous \emph{Q}-value estimation, thereby misguiding the direction of policy optimization. To address this issue, we develop a behavioral advantage corrected policy evaluation (BAC-PE) approach, which utilizes the \emph{Q}-function of the behavior policy to correct the learned policy's \emph{Q}-function, thus mitigating pessimistic conservatism and overestimation bias. Furthermore, the convergence of BAC-PE is analyzed theoretically, and an upper bound on the difference between the learned \emph{Q}-function and the true \emph{Q}-function is derived. To alleviate distribution shift, this work employs diffusion models to represent both the behavior policy and the learned policy, performing distribution matching for accurate policy regularization. Additionally, \emph{Q}-value guidance is incorporated into the training process to achieve effective policy improvement. By combining BAC-PE with diffusion policy modeling, we propose the diffusion policy with behavioral advantage correction (DPBAC) algorithm. Compared to existing offline methods, DPBAC demonstrates stronger policy representation capabilities and effectively mitigates the bias in \emph{Q}-value estimation. Experimental results on multiple domains of D4RL tasks show that DPBAC achieves superior performance, with notable advantages over state-of-the-art (SOTA) algorithms.
论文详细总结(自动生成)
论文总结:DPBAC——基于行为优势修正的扩散策略离线强化学习
1. 核心问题与研究动机
离线强化学习(Offline RL)面临的核心挑战是分布偏移(distribution shift):学习策略 与行为策略 之间存在分布差异,导致在策略评估时对未充分覆盖的状态-动作对的 Q 值产生外推误差(extrapolation error)。现有方法(如 CQL、IQL)通常通过悲观保守的方式压低未知区域的 Q 值,但这会引入保守偏差(pessimistic bias);而部分扩散策略类方法(如 Diffusion-QL)虽然能更好地拟合多模态行为分布,却难以显式地修正学习策略与行为策略之间的 Q 值偏差。因此,论文希望同时实现两点:
- 利用行为策略的 Q 函数修正学习策略的 Q 函数,缓解悲观保守和过估计偏差;
- 利用扩散模型的强大分布建模能力实现更准确的策略正则化与生成。
2. 方法论
2.1 行为优势修正策略评估(BAC-PE)
定义行为 Bellman 算子:
针对学习策略的标准 Bellman 算子:
论文提出行为优势修正算子:
其中行为优势函数为:
即利用行为策略在 上的 Q 值与学习策略当前 Q 值的差作为修正项, 控制修正强度。当 时退化为标准算子。
2.2 收敛性分析(关键理论结果)
将修正后的迭代格式记为 ,其与真实 Q 函数 之间的差距满足收缩性质,且最终收敛上界为:
其中 , 为策略间的全变差距离。该上界表明:策略越接近行为策略(第一项小)、优势修正项 越小(第三项小),学习 Q 函数越接近真实 Q 函数。
2.3 扩散策略建模(Diffusion Policy)
策略 和行为策略 均由扩散模型参数化。前向加噪:
反向去噪学得噪声预测网络 。行为策略的扩散损失为:
通过 分布匹配 使学习策略 与行为策略 在数据集分布上对齐,从而实现策略正则化。
2.4 Q 值引导的策略改进
在行为策略对齐损失基础上加入 Q 值最大化项:
为加权系数。
2.5 Q 网络学习目标
采用双 Q 网络与目标网络,结合 BAC 修正项:
完整算法即 DPBAC(Diffusion Policy with Behavioral Advantage Correction),训练时通过指数滑动平均(EMA)更新目标网络 与 。
3. 实验设计
- 基准:D4RL(涵盖 Gym-MuJoCo、Kitchen、Adroit、AntMaze 等多个领域),覆盖 medium、medium-replay、medium-expert、expert 等多种数据集。
- 评估指标:标准化回报(normalized return),对比多种主流离线 RL 方法(保守类如 CQL/IQL、扩散策略类如 Diffusion-QL/Diffusion-BC、以及其他 SOTA 基线)。
- 实现细节:PyTorch 实现,扩散步数 ,超参数 ,,最优默认 。
4. 资源与算力
论文未明确报告所使用的 GPU 型号、数量及训练时长,仅给出优化器学习率(行为模型 ,其余 )、最大迭代步数 、 等超参数。建议读者参考附录或作者代码以获取完整算力信息。
5. 实验数量与充分性
- 实验覆盖 D4RL 全任务,包括 Gym-MuJoCo、Kitchen、Adroit、AntMaze 等多领域多个数据集变体,实验数量较多;
- 进行了 超参数敏感性分析(、、扩散步数 );
- 进行了 消融实验(去掉 BAC 修正 、不同修正项、不同扩散结构等),验证各组件贡献;
- 报告 均值与标准差(如 等),并在多个随机种子下进行多次运行,统计意义较强;
- 但与最直接对比方法(如 Diffusion-QL)的逐任务差异显著性检验(p-value)以及可视化分析未在正文中详细展示。
总体而言,实验较为充分,基线选择覆盖了保守型与扩散型两大主流路线。
6. 主要结论与发现
1. DPBAC 在 D4RL 多领域任务上的标准化回报显著优于现有 SOTA,尤其在 medium / medium-replay 类数据集上提升明显;
2. 行为优势修正 在 Q 值估计中有效缓解了悲观保守偏差, 时性能显著下降,验证了 BAC 修正项的必要性;
3. 扩散策略 提供了比高斯/确定性策略更强的多模态分布建模能力,与 BAC 修正结合可同时实现"贴近行为分布"与"超越行为策略";
4. 理论收敛上界与实验观察一致:行为策略与学习策略分布越接近、修正项 越小,Q 值估计越准确。
7. 优点与亮点
- 理论与算法并重:不仅提出 BAC-PE,还在收敛性上给出严格的 Q 函数误差上界(含 TV 距离与优势项),增强了方法可解释性;
- 修正项设计巧妙:通过 的差值直接利用行为策略信息,无需估计重要性权重或环境交互;
- 扩散策略与修正机制协同:扩散模型负责多模态行为匹配,BAC 修正负责显式 Q 值修正,二者解耦清晰;
- 实验覆盖广:横跨多个 D4RL 任务域,并做超参数与消融分析。
8. 不足与局限
- 算力信息缺失:未报告 GPU 型号、数量、单次训练耗时,复现成本较难估计;
- Q 值修正项 需额外汇总行为 Q 网络:增加了一定计算与存储开销,且对行为策略估计误差敏感;
- 超参数 、、扩散步数 较敏感:最优值在不同任务上略有差异,实际部署需重新调参;
- 基线对比未提供显著性检验:均值±标准差虽给出,但任务间差异的统计显著性未严格检验;
- 应用范围受限:实验集中在 D4RL 仿真任务,未在更复杂的机器人真实任务、大规模视觉输入场景中验证;
- 理论分析假设较强:如全变差距离有界、奖励有界等,在实践中不一定完全满足。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。