
面向离线策略强化学习的上分位多步Q学习
Upper-Expectile Multi-Step Q-Learning for Off-Policy Reinforcement Learning
📝 TLDR
离线强化学习中,多步回报虽能加速奖励传播,却因耦合次优历史动作而引入随步长增长的悲观偏差。本文提出Expectile n步Q学习方法(ENQ),用非对称期望分位损失替代对称n步TD损失,仅新增期望分位水平τ这一个超参数。理论上证明算子是γ^n收缩,且在确定性动力学下τ=1时偏差在Q*上消失,在随机动力学下偏差具有步长无关的噪声界。实验在27个操控导航任务上以单一τ=0.8即与LQL整体持平,吞吐更高且更受益于10评论家集成。
🧭 速览
多步回报虽加速奖励传播,但因耦合次优历史动作而引入随步长增长的悲观偏差。
用非对称期望分位损失替代对称n步TD损失,仅新增τ一个超参数,构成γ^n收缩算子。
在27个操控导航任务上以τ=0.8与LQL整体持平,吞吐量更高且更受益于10评论家集成。
ENQ为多步Q学习提供了一种兼顾偏差控制、传播效率与训练吞吐的替代方案。
🆚 方法对比
ENQ (Expectile n-step Q-learning)
- 即插即用替换对称n-step TD,仅增τ一个超参
- γ^n-收缩性有理论证明,τ=1时偏差在支撑对上消失
- 无需动作似然或轨迹级约束,训练吞吐量高于LQL
- 十评论家集成实验下扩展收益更显著
- 性能依赖τ选择,文中仅用τ=0.8单一值
- 确定性动力学假设下偏差分析,通用性受限
- 需支撑覆盖条件,否则理论保证不成立
- 仅在27个任务实例上验证,泛化待考察
n-step TD (Multi-step TD)
- 加速奖励传播,将有效自举链缩短n倍
- 实现简单,是广泛使用的基础方法
- 不需动作似然,易与生成式策略结合
- 离策略下悲观偏差随horizon n增长
- 每步评估耦合到次优记录动作
- 长horizon下未校正时性能退化
LQL (Long-Horizon Q-learning)
- 轨迹级最优性不等式有效收紧长horizon学习
- 在OGBench与RoboMimic上聚合表现强劲
- 缓解自举误差跨备份传播
- 需在轨迹多处评估评论家,计算开销大
- 需成对轨迹约束,实现复杂度高
- 训练吞吐量低于ENQ,受限规模扩展
1-step TD (One-step TD)
- 形式简洁,理论分析成熟
- 无记录动作耦合的直接偏差来源
- 自举误差在多步备份中累积放大
- 长horizon稀疏奖励下传播缓慢
- 对估计误差极为敏感
Importance Sampling / Retrace / V-trace
- 经典离策略修正,理论框架完备
- Retrace/V-trace在多场景已被验证有效
- 需精确动作似然,扩散/流策略难以适用
- 重要性比率导致高方差
- 不匹配行为与目标策略时性能受限
ENQ以单超参τ的不对称expectile损失替代n-step TD的对称损失,在保留多步奖励传播的同时减轻离策略悲观偏差,相较LQL避免轨迹级约束且吞吐量更高,相较IS类方法无需动作似然,更适合生成式策略场景。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 15 张)
展开查看 15 张图
TL;DR
ENQ(Expectile n-step Q-learning)是一种面向离线策略强化学习的算法,通过将标准 n 步时序差分损失替换为作用在动作值误差上的非对称 expectile 损失,在仅新增一个超参数 的情况下缓解了多步回报在离线场景下的悲观偏差问题。理论证明该算子具有 收缩性,且在确定性动力学下当 时偏差在最优动作值函数处消失。在 27 个操控与导航任务上,ENQ 以单一 与 LQL 整体持平,并在训练吞吐和 critic 集成扩展性上展现优势。
研究背景与动机
离线强化学习的核心挑战在于如何从已有的静态交互数据中学习有效策略。与在线学习不同,离线设置下智能体无法通过实时交互来纠正值函数估计的偏差,这使得多步回报的利用变得尤为棘手。
多步回报是加速值函数学习的重要技术。以 n 步回报为例,智能体不再仅依赖即时奖励和单步 bootstrap,而是将一段长度为 n 的奖励序列串联起来,再以折扣因子 折算到当前时刻。这种方式能显著缩短自举链长度,将 Bellman 算子的收敛压缩因子从 提升到 ,从而加快奖励信号的传播效率。在长时域、稀疏奖励的场景下,这一特性尤为重要——智能体往往需要等待整个任务完成后才能获得有意义的反馈,多步回报能够将远期奖励提前带回当前决策点。
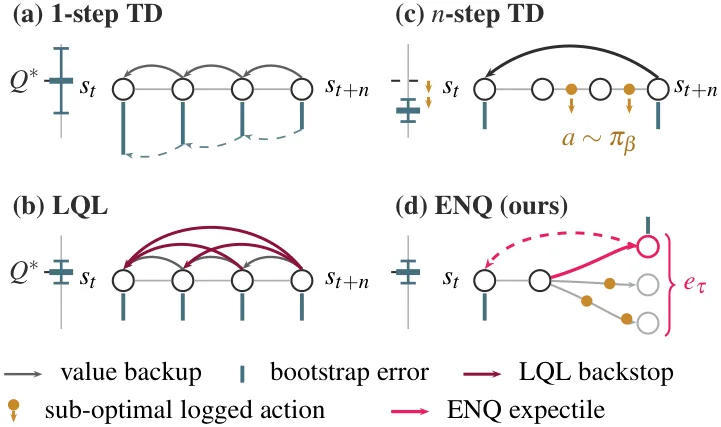
然而,多步回报在离线策略设置下存在根本性缺陷。当计算 n 步目标时,算法假设在当前状态 执行动作 后,会沿着日志数据中的历史动作 继续执行。但现实中,日志数据是由可能远逊于最优策略的行为策略产生的。于是,n 步目标实际上在评估一条"杂糅轨迹":起点是当前要评估的 对,而后续动作却被强制固定为次优的历史动作。这种耦合导致 n 步目标系统性地低估当前决策的价值——即使 本身是最优的,如果后续动作都很差,目标值也会很低。而且随着回溯步数 n 增大,这种悲观偏差会单调累积,使得更长的回溯步反而可能损害学习效果。
现有解决方案各有局限。重要性采样(IS)和 Retrace、V-trace 等方法通过重新加权轨迹的概率比来修正离线策略偏差,但这要求能够计算日志动作在当前策略下的似然——对于基于扩散模型或流匹配技术的现代策略生成器而言,这种似然通常难以廉价获取。Long-Horizon Q-learning(LQL)通过在轨迹级别构造上下界不等式来约束 critic,但需要进行沿整条长度为 L 的轨迹的多次 critic 评估和成对约束计算,计算开销随轨迹长度线性增长。还有一些方法引入辅助价值网络来解耦偏差,但增加了网络架构和训练的复杂度。
ENQ 的核心洞察是:在一次 n 步更新中,算子天然需要两次 critic 评估——一次在起点 处计算当前值估计,另一次在回溯终点 处计算 bootstrap 目标。能否仅利用这两次评估本身就实现对离线策略偏差的控制,而无需引入辅助网络、似然估计或轨迹级惩罚?ENQ 正是围绕这一简洁的设计目标展开的。
方法
ENQ 的设计哲学可以概括为"在保持 n 步 TD 框架简洁性的同时,通过非对称损失函数注入对离线策略偏差的鲁棒性"。具体而言,标准 n 步 TD 损失将时序差分误差 的平方作为学习信号,其中 是 n 步目标值。这个平方损失对正负误差赋予对称权重——过高的估计和过低的估计会受到相同的惩罚。但在离线场景下,n 步目标 本身因耦合次优后续动作而倾向于被低估,因此对称惩罚会放大这种低估带来的负面效果。
ENQ 引入 expectile 损失来打破这种对称性。Expectile 是分位数(quantile)的均值类比概念:通过一个水平参数 定义非对称的二次损失函数。形式上,单个 critic 的 expectile 损失为:
当 时,expectile 损失退化为标准对称的平方损失,此时 ENQ 即为普通 n 步 TD。当 时,正残差(目标高于估计)被赋予更大的权重 ,而负残差(目标低于估计)被赋予较小的权重 。这意味着当 n 步目标因离线策略偏差而偏低时,算法会以较小的惩罚幅度"接受"这种低估,从而缓解悲观偏差的传播。
从语义上理解,ENQ 通过 expectile 损失在估计 n 步目标分布的一个"偏上"分位点——即目标分布的上分位而非中位数。直觉上,这种设计对应于"即使后续动作次优,也要给予当前决策一个不那么悲观的评价"的态度,因为真正次优的决策会在后续的 bootstrap 中被逐步修正。
完整的目标值定义还包含对目标 critic 的保守聚合:
其中 是对 K 个目标 critic 的集成,使用均值减去 倍标准差作为保守估计。 是二值掩码,在遇到环境终止时屏蔽 bootstrap; 是折扣因子,仅保留在同一回合内的转移段。
整个 ENQ 损失为多 critic 的 expectile 损失均值:
其中 是每个 critic 的时序差分误差。注意 表示 stop-gradient 操作符,确保梯度仅通过在线 critic 流动。
理论保证是 ENQ 区别于纯粹启发式设计的核心。论文证明了三个关键结果:第一,ENQ 算子 是 -压缩映射,这意味着即使在随机动力学和任意行为策略下,迭代更新也会以几何速率收敛到唯一不动点。第二,在确定性动力学下,当 时,ENQ 的偏差在覆盖的支持集上于最优动作值函数 处消失——这说明 ENQ 在理想条件下能够精确恢复最优值。第三,在随机动力学下,偏差具有两侧界,其噪声常数与回溯步长 n 无关,这保证了算法的稳定性不会随回溯加深而恶化。值得注意的是, 的不动点自动满足 LQL 下界不等式在分离步数处的约束,这建立了 ENQ 与 LQL 之间的概念桥梁。
实验与结果
实验在 OGBench 和 RoboMimic 两个基准上进行,涵盖 27 个任务实例,包括 cube 操作、can 抓取、square 放置以及多个导航环境。离线-在线协议采用标准的百万步离线预训练加百万步在线微调流程。所有 ENQ 配置使用统一的超参数:,,未做任何任务级调参。
整体性能对比是首要验证目标。在 5 项 ENQ 与 LQL 的聚合对比中,ENQ 在 4 项上取得更高均值:cube-triple 动作分块版本达到 91.4% 成功率而 LQL 仅 53.3%,humanoidmaze-medium 上 ENQ 领先 14 个百分点以上,antmaze-giant 上优势同样显著。唯一落后的场景是 RoboMimic 的 FQL 策略提取方式,但差距较小。1 步 TD 和 n 步 TD 基线在多数任务上明显低于两者,验证了多步回报和偏差校正的必要性。
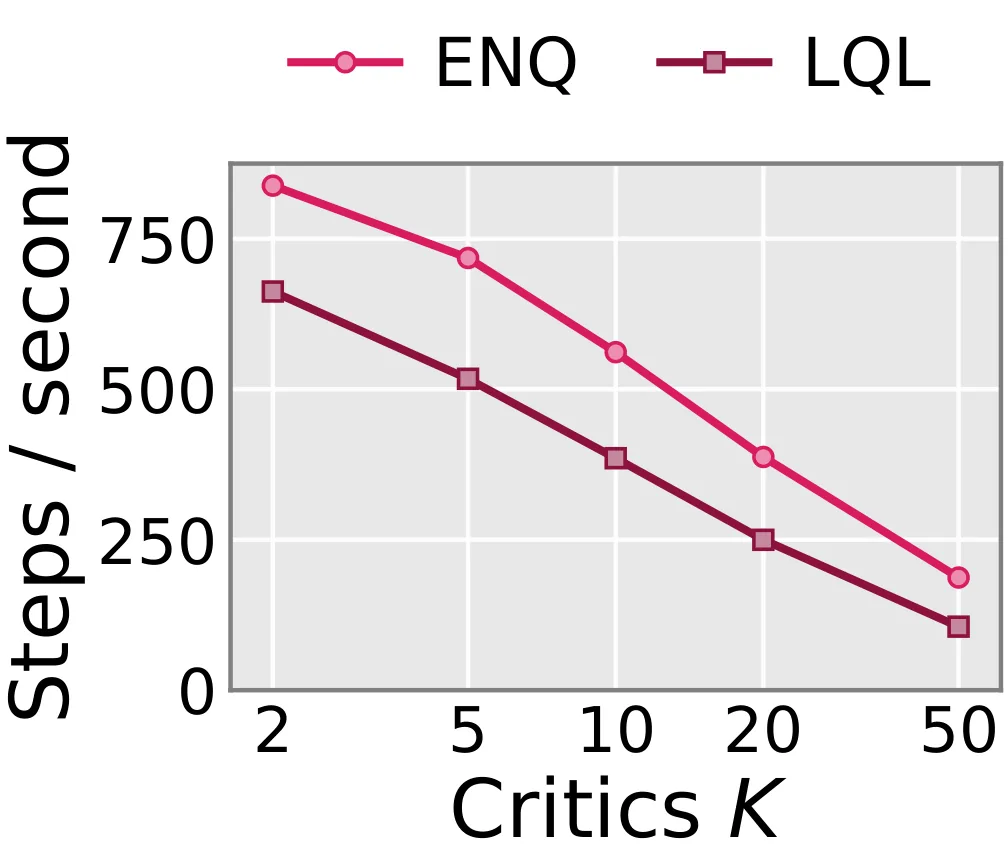
训练效率是 ENQ 的显著优势所在。在相同的转移处理量约束下(通过匹配 实现公平比较),ENQ 的训练吞吐量随 critic 集成规模扩大而保持较高水平。当 K=2 时加速比为 1.27 倍,K=50 时扩大到 1.77 倍。这一优势源于 ENQ 只需在起点和终点各评估一次 critic,无需 LQL 所需的轨迹级多次评估和约束计算。
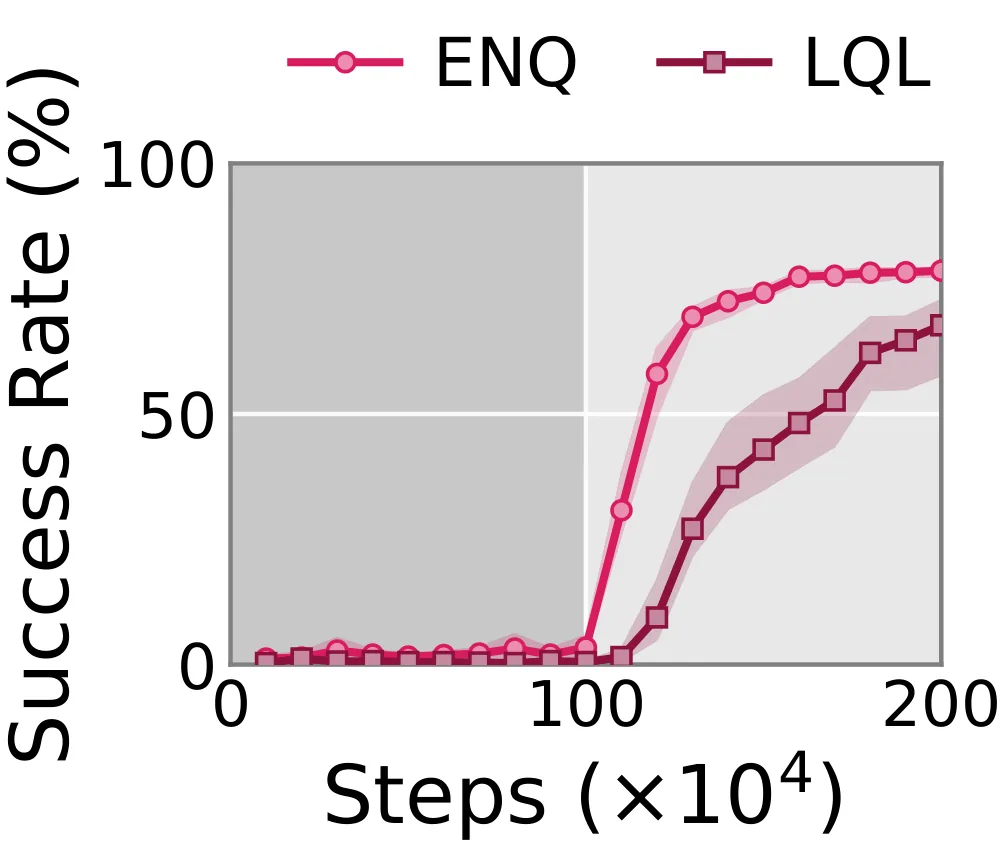
Critic 集成扩展性的实验揭示了 ENQ 的另一个有趣特性。在 cube-triple 任务上,当使用 2 个 critic 时 ENQ 与 LQL 几乎持平(51.2% vs 52.1%),但当集成规模扩大到 10 时,ENQ 跃升至 78.0% 而 LQL 仅提升到 59.1%。这一差距主要出现在在线微调阶段,表明 ENQ 的 critic 集成能够更有效地利用多样性来校正偏差,而 LQL 的轨迹级约束可能在某种程度上抑制了 critic 的表达能力。
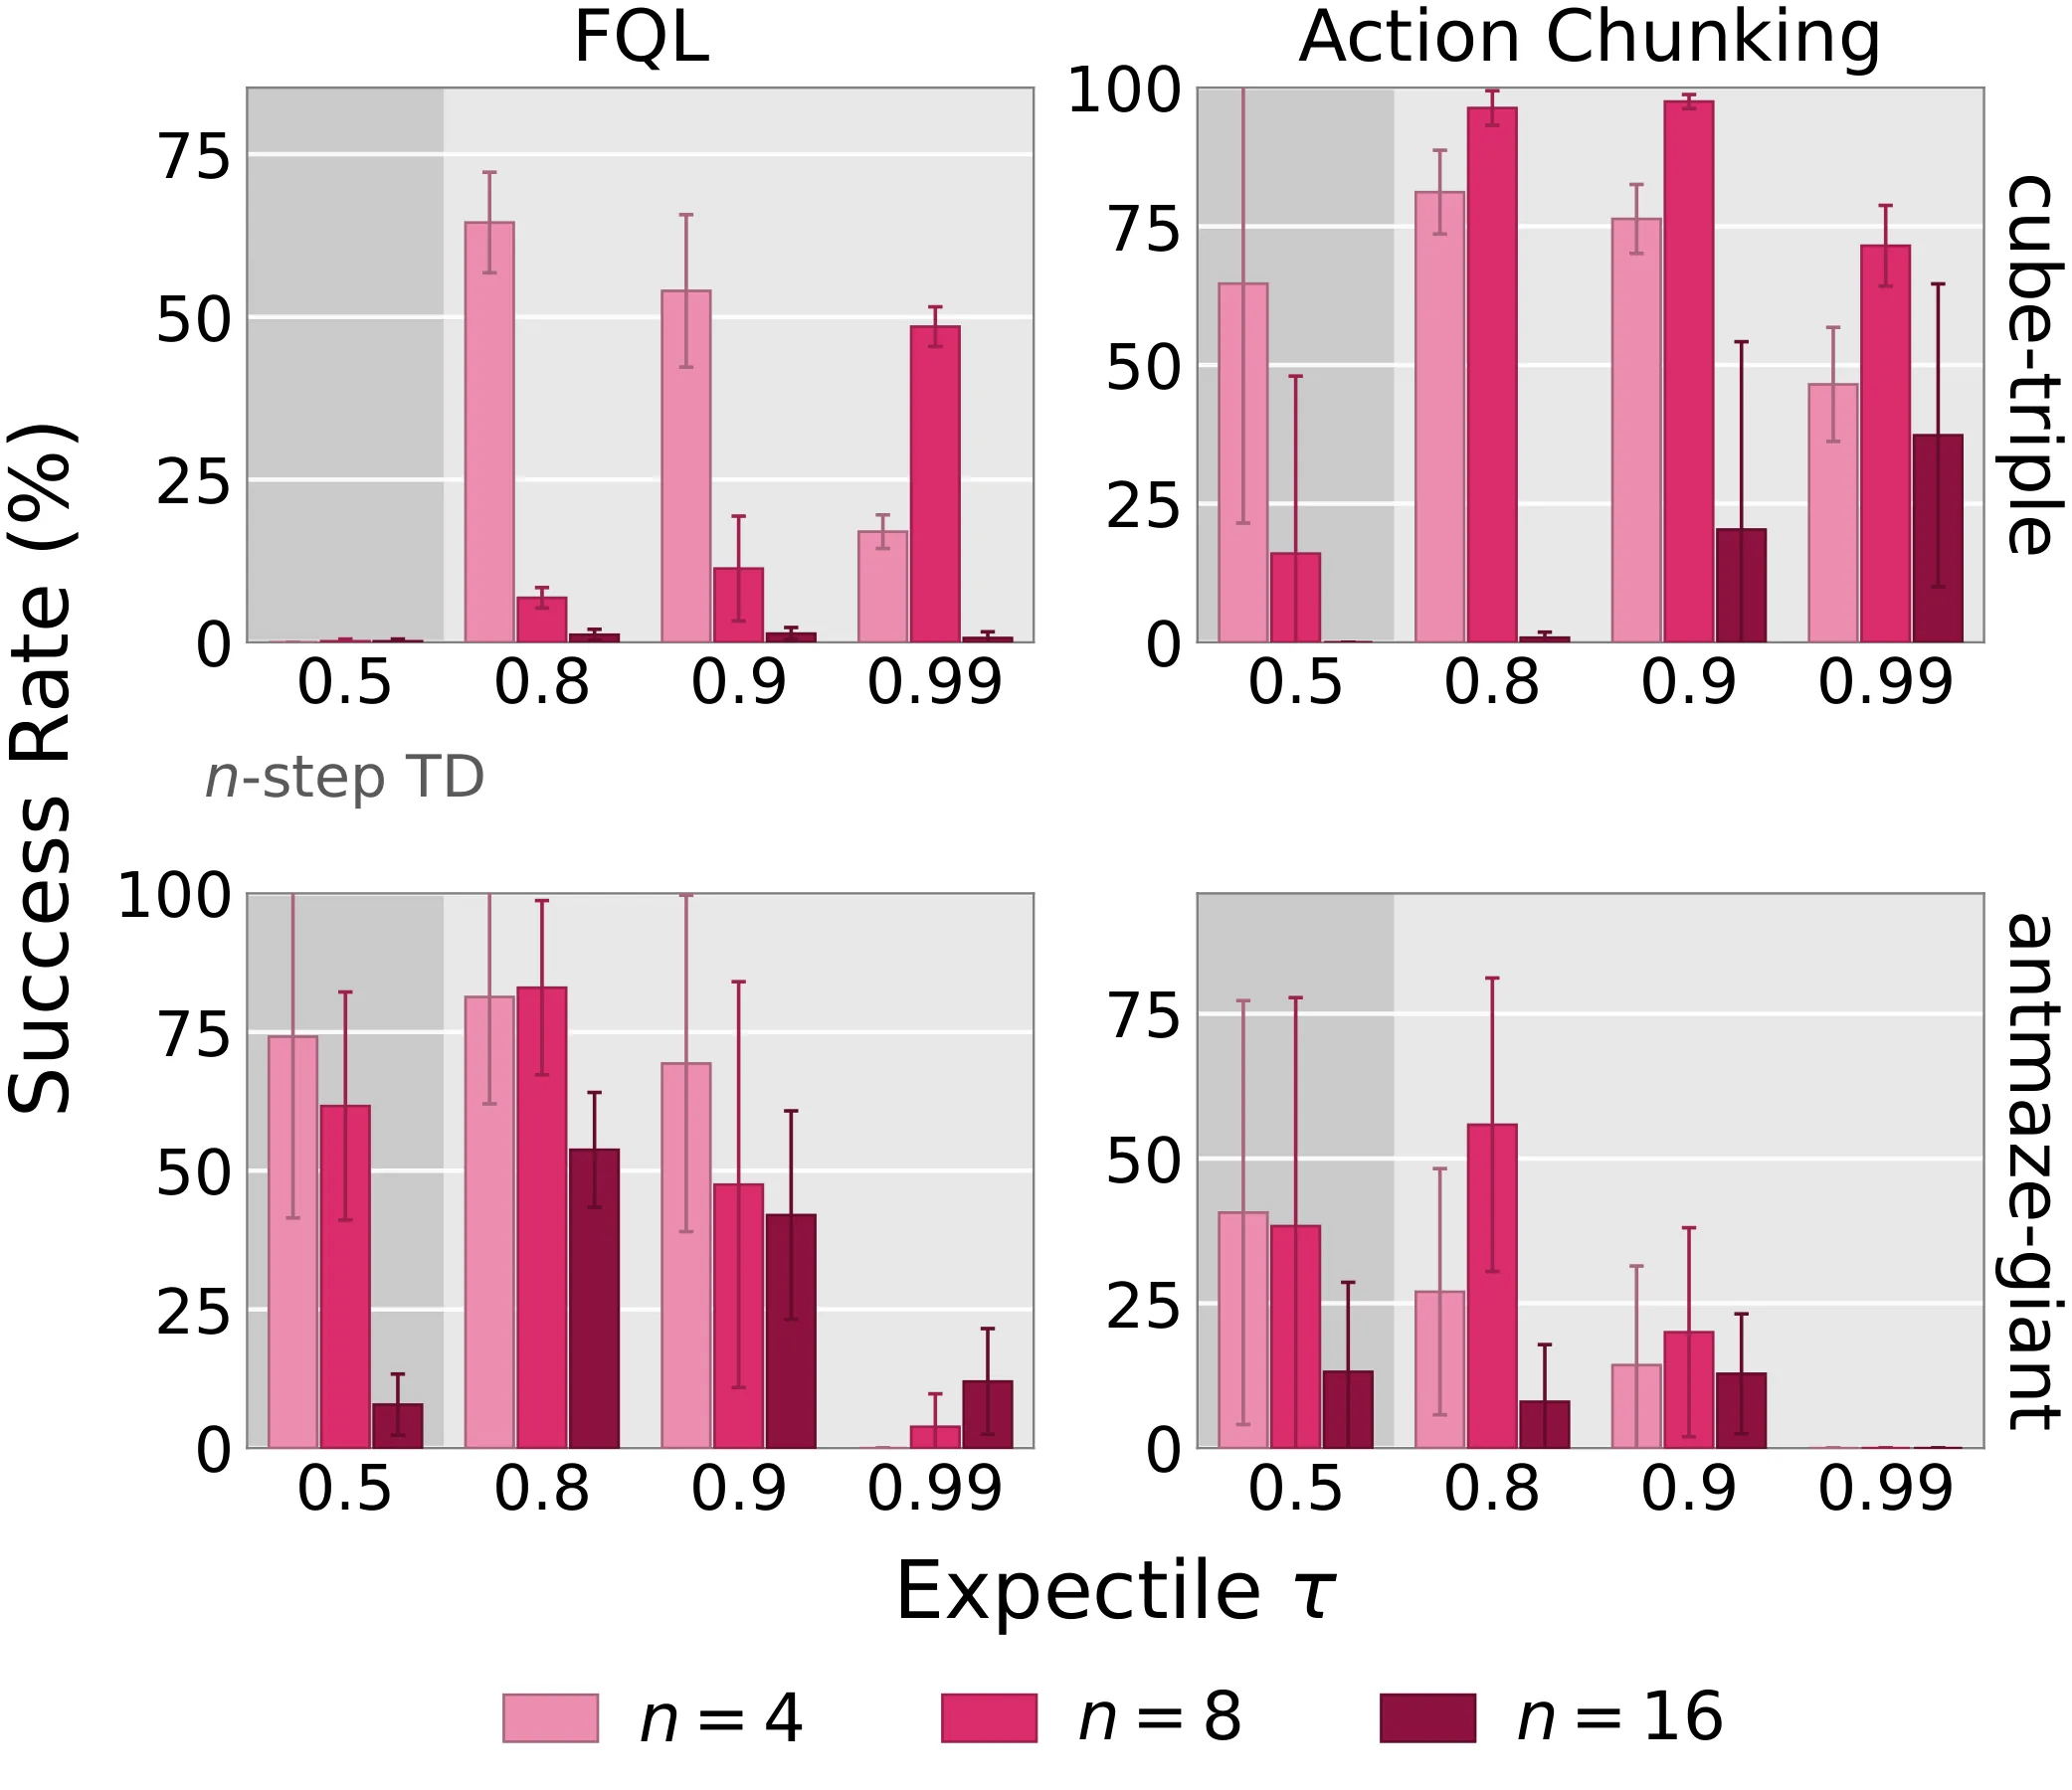
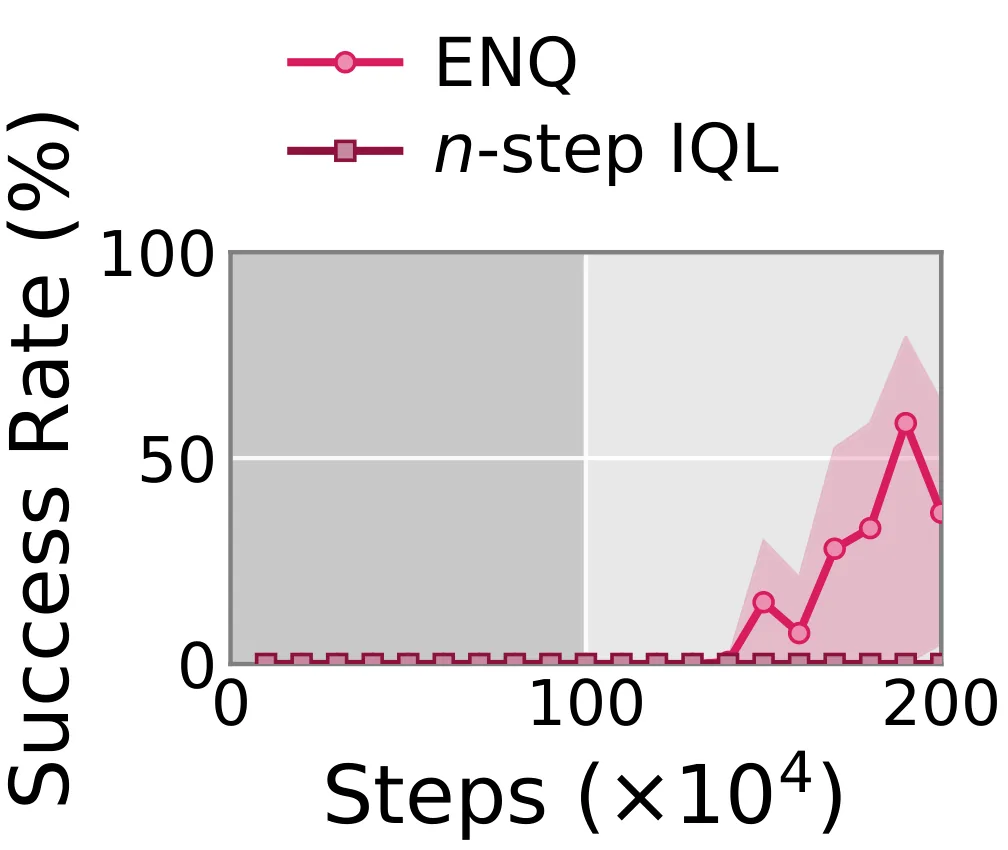
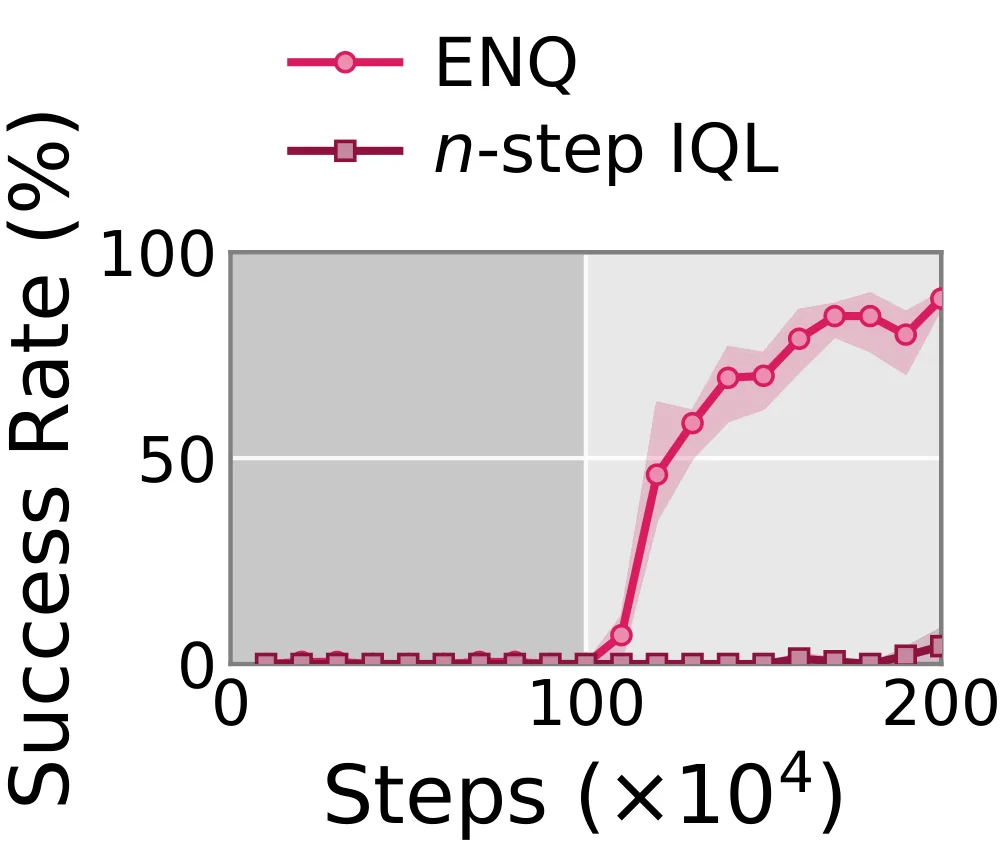
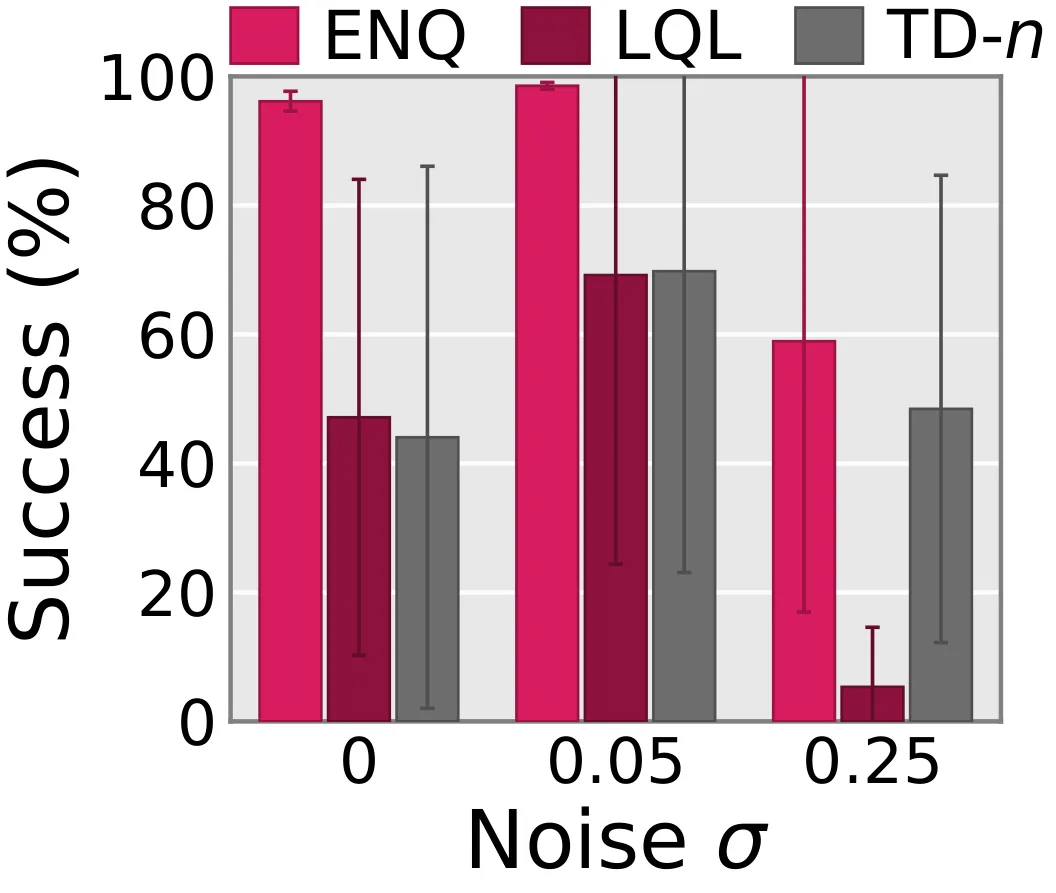
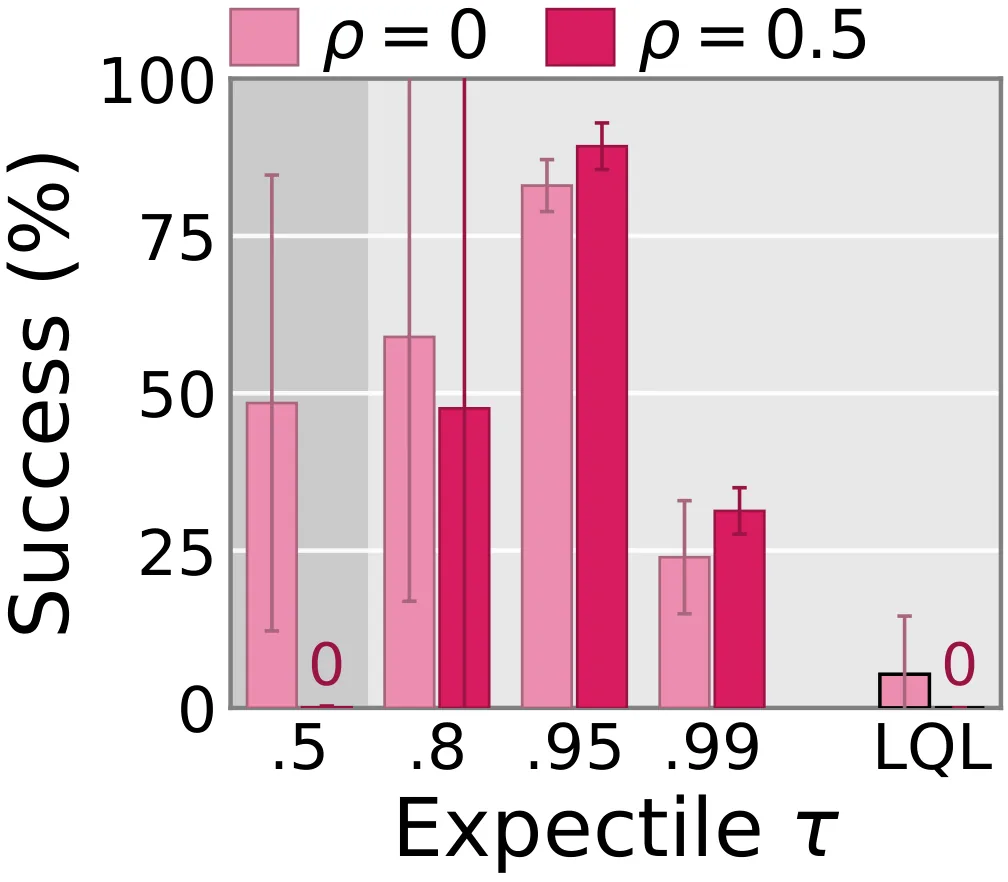
消融实验进一步验证了设计决策的有效性。Expectile 水平 的扫描显示上分位()在 12 个配置中的 10 个上取得最优,但最优取值与任务性质和回溯步长相关——过高的 在长回溯(n=16)时表现脆弱。将 expectile 直接作用于动作值残差的策略显著优于将其路由到辅助价值网络的 n-step IQL 风格设计。在随机动力学鲁棒性测试中,向日志动作注入高斯扰动()后,ENQ 保持 59.0% 成功率,而 TD-n 和 LQL 分别降至 48.4% 和仅 5.4%。通过调整 组合至 ,ENQ 可进一步提升到 89.3%。
讨论与可借鉴点
ENQ 的贡献在于提出了一种极简但理论有据的方法来处理离线策略强化学习中多步回报的悲观偏差问题。其设计哲学——用非对称损失替代对称损失来控制偏差——在概念上与其他领域(如鲁棒优化、对抗训练)中的非对称正则化思路一脉相承,具有跨领域的启发价值。理论证明的完整性(压缩性、偏差分解、两侧界)使得 ENQ 不仅仅是一组有效的启发式技巧,而是一个有坚实数学基础的算法框架。
ENQ 也存在若干局限。首先,虽然论文声称 ENQ 仅需一次 n 步更新中固有的两次 critic 评估,但在实践中这种"简洁性"依赖于对目标 critic 的保守聚合设计——这一聚合本身包含均值和标准差的计算,在极端情况下可能仍带来计算负担。其次, 作为统一超参数在多数任务上有效,但在长回溯和高度随机动力学的组合场景下可能需要调高 并配合保守惩罚 使用,这暗示了超参数选择的潜在敏感性。第三,实验中的对比基线数字直接取自 LQL 论文而未在同一实现框架下重跑,可能存在实现细节和硬件差异对结论的潜在影响。
从实践角度,ENQ 的直接可借鉴点包括:在设计离线策略算法时,优先考虑"drop-in"式改进而非引入大量新组件,以降低工程落地的门槛;通过理论分析(如压缩性证明)来指导算法设计,可以避免纯启发式方法在边界情况下的脆弱性;在多 critic 集成的场景下,上分位损失能够更充分地利用 critic 多样性,这为其他集成学习方法提供了新的损失函数设计思路。
摘要
多步回报加速了离线策略强化学习中的奖励传播,但将每个决策的评估与其后续的次优记录动作耦合在一起,从而引入了随时间步长增长的悲观偏差。我们提出了分位数n步Q学习(Expectile n-step Q-learning,ENQ),它将对称的n步时序差分(TD)损失替换为作用于动作值误差上的非对称分位数损失,其中分位数水平τ是在n步TD之外唯一新增的方法特定超参数。我们证明了ENQ算子是-压缩映射。在确定性动力学下,当τ=1时,其偏差在覆盖的支持集内状态-动作对上于最优动作值函数处消失,且对应的不动点满足长时域Q学习(LQL)所使用下界不等式的分离n实例及其倍数。在随机动力学下,该算子的偏差具有两侧界,其噪声常数与时间步长无关。在27个操控与导航任务实例上,使用单一分位数水平τ=0.8和固定的回溯时间步长,ENQ在总体上与LQL具有竞争力,在我们的性能分析研究中实现了更高的训练步吞吐量,并在受控的扩展实验中对十评论家集成带来了更大的收益。
Abstract
Multi-step returns accelerate reward propagation in off-policy reinforcement learning, but couple the evaluation of each decision to the suboptimal logged actions that follow it, inducing a pessimistic bias that grows with the horizon. We propose Expectile -step Q-learning (ENQ), which replaces the symmetric -step temporal-difference (TD) loss with an asymmetric expectile loss on the action-value error, with expectile level as the only method-specific hyperparameter added beyond -step TD. We prove that the ENQ operator is a -contraction. Under deterministic dynamics, at , its bias vanishes at the optimal action-value function on covered in-support pairs, and the corresponding fixed point satisfies the separation- instance and its multiples of the lower-bound inequality used by Long-Horizon Q-learning (LQL). Under stochastic dynamics, the operator bias admits two-sided bounds with horizon-independent noise constants. Using a single expectile level and a fixed backup horizon across 27 manipulation and navigation task instances, ENQ is competitive with LQL on aggregate, achieves higher measured training-step throughput in our profiling study, and benefits more from a ten-critic ensemble in a controlled scaling experiment.
论文详细总结(自动生成)
论文总结:面向离线策略强化学习的上分位多步 Q 学习(ENQ)
一、核心问题与研究动机
在长时域、稀疏奖励的离线(off-policy)值函数学习中,多步回报(n-step return) 通过将一段观测奖励串联起来再 bootstrap,能显著加快奖励传播、缩短自举链长度(压缩因子从 变为 )。然而其离线代价是:n 步目标在评估 时,把后续 的执行固定为日志行为策略 ,从而把对初始决策的评价耦合到了后续的次优动作上,在异构离线数据上产生随 单调放大的悲观偏差。
针对该偏差的现有处理路线各有局限:
- 重要性采样(IS)/ Retrace / V-trace 需要动作似然,对扩散策略、流匹配策略等生成式策略难以廉价获取;
- LQL(Long-Horizon Q-learning) 通过轨迹级下界/上界不等式构造 hinge 惩罚,但需要沿整条长度为 的轨迹做多次 critic 评估与两两约束。
作者追问:能否仅用一次 n 步更新中固有的两次 critic 评估(在起点 与 bootstrap 终点),就既保留 n 步传播、又降低离线策略偏差?
二、方法论
1. 核心思想
ENQ(Expectile n-step Q-learning)将标准 n 步 TD 的对称平方损失替换为作用于动作值 TD 残差之上的非对称期望分位(expectile)损失 ,仅新增一个超参数 。当 时退化为对称 n 步 TD;当 时,对正残差赋予权重 、对负残差赋予 ,从而使 critic 拟合给定 下、n 步目标分布的 分位——即更多追踪"好的"日志延续,对"差的"延续不敏感。
2. 目标与损失
对长度为 的采样段,定义:
其中 是带保守惩罚 的目标集成聚合; 在终止状态屏蔽 bootstrap; 丢弃跨回合段。
每个 critic 的残差为 ,整体损失:
算法仅需在 评估一次在线 critic、在 评估一次目标 critic,不需要中间 critic 评估、不需要动作似然、不需要辅助价值网络。同时兼容单动作与 的动作分块(action-chunked)critic。
3. 关键理论结果
- 定理 1(压缩性):对任意 、任意 、任意动力学与行为策略, 是 -压缩,因此存在唯一有界不动点 ,且按 几何速率收敛。
- 定理 2(确定性动力学下的偏差分解与端点校正):路径上 。在确定性动力学()下:(a) 在 处偏差为 ,且 关于 非减;(b) 不动点 关于 单调不降;(c) 在最优覆盖假设(行为策略对累积最优性 gap 任意小的延续赋予正概率)下,;(d) 。
- 推论 1(隐式满足 LQL 下界):在上述假设下, 不动点自动满足 LQL 下界不等式在分离 处的要求。
- 定理 3(随机动力学下两侧界):定义 ,有
且当 时,给出保证 的安全 阈值;不动点误差界为
其中 与 无关。
4. 与 IQL 的关键差别
与 IQL 在状态值上做 expectile 不同,ENQ 直接把非对称加权放在动作值残差上,避免引入耦合的辅助 V 网络;这一定位差异通过额外 n-step IQL 基线(Remark 2 / 消融 A3)经验验证。
三、实验设计
1. 任务与数据集
- OGBench(Park et al., 2025a):5 个任务组,每组 5 个 single-task 变体,合计 25 个任务实例:
cube-double(play 风格,1M 数据,episode 长 500,动作维 5)cube-triple(play 风格,3M,episode 长 1000,动作维 5)humanoidmaze-medium(navigate,2M,2000,21)antmaze-giant(navigate,1M,1000,8)humanoidmaze-giant(navigate,100M,4000,21)- RoboMimic(Mandlekar et al., 2021):
can、square两个 multi-human 任务,合计 2 个实例。 - 总计 27 个任务实例,每个任务 4 颗种子,离线-在线协议为 离线更新 + 在线环境步。
2. 对比方法
- 1 步 TD、n 步 TD(TD-n)、Long-Horizon Q-learning(LQL):直接复用 Abraham, Shi, Finn (2026) 报告结果。
- 其他参考基线:ReBRAC、IQL(同样取自既有文献)。
- ENQ 固定超参数:,,不带任务特定调参;所有 27 个任务共用。
3. 公平性设置
ENQ–LQL 比较通过约束 使每次更新处理的转移数相等(默认 1024;在 humanoidmaze-giant 上为 8192)。
4. 策略提取与实现
- 策略提取机制:FQL(Flow Q-Learning)、动作分块 FQL、Best-of-N 重排序(humanoidmaze-giant)。
- 框架:JAX 0.9.0.1 + Flax 0.12.3 + Optax 0.2.7;基线代码在 LQL 官方实现上派生。
- 动作分块:ENQ 用 ,LQL 沿用 (来自原论文)。
- TD、TD-n、LQL 数字直接取自 LQL 论文,未重跑。
5. 消融实验
- A1:、 在 cube-triple-task2、antmaze-giant-task1 上对 FQL 与动作分块 FQL 联合扫描。
- A2:critic 集成大小 的吞吐量剖析(antmaze-giant,FQL,,,);以及 cube-triple 在 vs 的成功率对比。
- A3:n-step IQL 风格基线(带辅助 V 网络)vs ENQ 的"expectile 放在何处"对照实验。
- A4:在 cube-triple-task2 上注入高斯动作扰动 构造随机转移,并扫描 交互。
四、资源与算力
- GPU:单张 NVIDIA GeForce RTX 5090(32 GB),未使用多卡或集群。
- 软件栈:Python 3.11.15、JAX/jaxlib 0.9.0.1、Flax 0.12.3、Optax 0.2.7。
- 训练预算:每条 run 共 步( 离线 + 在线),27 任务 × 4 种子 = 108 条主 run;A1 消融 × 2 任务 × 2 策略 × 4 种子 = 192 条 run;A2 性能 scaling 增加 5 任务 × 2 个 × 4 种子 = 40 条 run;A3、A4 各自额外多组。总训练时长未在文中明确给出。
- 剖析:每组配置 10000 次离线迭代,前 9000 次预热,后 1000 次计 iter/s。
五、实验数量与充分性
- 比较实验:3 张主表(OGBench 4 域、humanoidmaze-giant 5 任务、RoboMimic 2 任务)+ 4 组消融,规模较大,覆盖操控(cube、can、square)、导航(humanoidmaze、antmaze-giant)等不同动作维、episode 长、数据量的域。
- 统计性:4 颗种子;聚合使用 1000 次曲线级 bootstrap 重采样,给 95% 置信区间;多任务聚合采用"任务内独立重采样 → 任务均值等权"流程。
- 公平性:通过 (或 )匹配转移处理量;ENQ 的 不做任务级调参,避免过拟合嫌疑。
- 可能的偏倚:
1. TD、TD-n、LQL 数字直接复用 LQL 论文,未在统一代码、统一硬件下重跑,引入实现差异与硬件差异;
2. ENQ 与 LQL 的动作分块大小不同( vs ),可能影响纯 critic 更新以外的归因;
3. 任务级聚合中每个 OGBench 任务组 5 个变体等权,掩盖了组内方差;
4. 消融 A1、A3、A4 仅在 1–2 个任务上展开,外推风险较高。
六、主要结论与发现
1. 整体性能:在 5 项 ENQ–LQL 对比中,ENQ 在 4 项上取得更高的聚合均值,仅在 RoboMimic FQL 上落后;最大优势出现在 cube-triple、humanoid-md、antmaze-giant(动作分块 ENQ 在 antmaze-giant 上达 91.4% vs LQL 53.3%)。
2. 吞吐优势:在 matched horizon/batch 的剖析中,ENQ 相对 LQL 的加速比随集成增大而扩大: 时 1.27×、 时 1.77×。
3. 集成 scaling:cube-triple 上 时 ENQ 51.2% vs LQL 52.1%(几近持平), 时 ENQ 78.0% vs LQL 59.1%,差异主要出现在在线微调阶段,ENQ 更受益于大规模 critic。
4. 与 的交互:上分位()在 12 个任务–策略–horizon 配置中的 10 个上取得最优;最优 与任务/horizon 相关, 在长 horizon 时变脆。
5. expectile 放置:将非对称直接置于动作值残差(ENQ)显著优于将其路由到辅助 V 网络(n-step IQL 风格基线)。
6. 随机动力学鲁棒性:在 动作扰动下,ENQ 保留 59.0%,TD-n 48.4%,LQL 仅 5.4%;高 与中等 的组合()可达 89.3%。
七、优点
- 方法极简:作为 n 步 TD 的"drop-in"替换,仅需改一行损失定义(对称平方 → 非对称 expectile);不引入辅助网络、似然估计或轨迹级惩罚,便于在已有 n 步 pipeline 中部署。
- 理论保证齐全:在不需要行为策略覆盖全部最优策略的强条件下,仍能在 端点恢复覆盖支持集上的 ,并隐式满足 LQL 下界——这是与 LQL 的概念性桥接(推论 1)。
- 两侧偏差界:随机动力学下给出显式上界,且噪声常数 与 无关,提供"长 horizon 也不会让噪声项线性放大"的工程直觉。
- 吞吐与可扩展性:critic 更新更轻、对集成更友好, 增大时加速比反而扩大。
- 实验覆盖面广:27 任务 × 多种 actor/分块 × 4 种子 × 4 类消融,整体比较充分;尤其覆盖了 humanoidmaze-giant 这种 100M 转移的极端长程任务。
八、不足与局限
- 理论理想化:分析建立在三个理想化条件上——种群 expectile、贪心 bootstrap、无限表达能力;附录 F 明示未建模函数近似、目标网络滞后、actor 近似、有限样本优化,因此压缩与偏差保证不直接量化实际神经 critic 的估计误差。
- 偏差消失的强假设:要求确定性动力学 + 行为策略对"累积次优性 gap 任意小的延续"赋予正概率(Assumption 1+2),在真实随机环境下未必成立;高 在长 时反而变脆。
- 仍需手选: 被严格控制为单一全局值,但备份步长 仍是自由超参;论文未给出基于任务特征的 选择准则。
- 基线非完全重跑:TD/TD-n/LQL 数字复用既有论文,硬件、实现细节、动作分块( vs )不一致,可能放大或缩小 ENQ 的表面优势。
- 安全 仅是充分条件:依赖不可观测的 ,工程中只能通过经验扫描使用,理论到实践的桥梁较薄。
- 消融覆盖:A3、A4 仅在 1–2 个任务上验证 expectile 放置与随机转移鲁棒性,外推到 27 任务的全局结论有风险。
- 应用边界:方法与流匹配 / 动作分块策略紧密绑定(评测域均用 FQL 或动作分块 FQL),对离散动作、小动作空间纯 critic-only RL 的适用性未涉及。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。