
折扣指数效用强化学习的有限时间分析
Finite-Time Analysis of Discounted Exponential-Utility Reinforcement Learning
📝 TLDR
折扣型指数效用为风险敏感序贯决策提供原则性准则,但其非线性结构使强化学习分析困难。Thoppe等人提出Bellman兼容替代函数及两种无模型不动点算法,但仅有渐近收敛性。本文针对异步马尔可夫采样,建立两种算法的Õ(1/√n)有限时间收敛速率,并采用免参数步长。一次性尺算法利用算子有界性、单调性与齐次性获得局部伪压缩性,结合Moreau包络Lyapunov与Polyak-Ruppert平均;双时间尺度算法控制快尺度追踪误差。该工作首次为无模型折扣指数效用强化学习提供有限时间收敛保证。
🧭 速览
折扣型指数效用优化面临非线性结构带来的分析难题,已有算法仅具备渐近收敛性,缺少有限时间理论保证。
一次性尺算法利用算子有界性、单调性、齐次性得到局部伪压缩性质,结合Moreau包络Lyapunov与Polyak-Ruppert平均;双时间尺度算法控制快尺度追踪误差,使用免参数步长。
在异步马尔可夫采样下,两种算法均获得Õ(1/√n)的有限时间收敛速率,n为迭代索引。
首次为无模型折扣指数效用强化学习提供了完整的有限时间收敛理论保证。
🆚 方法对比
单时间尺度算法(One-timescale algorithm)
- 算法结构更简单,仅含单一更新尺度
- 首次获得向量情形下Õ(1/√n)有限时间收敛率
- 采用无参数步长选择,实用性强
- 支持异步马尔可夫采样
- 加法更新与幂律算子对数收缩几何不匹配
- 依赖局部伪收缩性质,分析复杂度高
- 需Moreau包络Lyapunov函数辅助分析
- 此前仅标量情形有有限时间保证
双时间尺度算法(Two-timescale algorithm)
- 在异步马尔可夫采样下获得Õ(1/√n)收敛率
- 快时间尺度上有对数修正保证跟踪精度
- 采用无参数步长,无需手动调参
- 首次为该算法提供一般有限时间保证
- 快时间尺度跟踪误差难以控制
- 需联合控制跟踪、混合和收缩三类误差
- 算法结构与分析更复杂
- 此前仅在IID或生成式采样下有结果
贝尔曼兼容代理准则(Porteus准则)
- 恢复时间齐次贝尔曼方程结构
- 与直接准则最优值函数差距有O(1-γ)界
- 风险敏感参数跨阶段保持固定
- 支持无模型固定点算法优化
- 与直接指数效用准则的最优策略可能不同
- 需MDP有吸收态且策略proper的条件
- 原始关系未被量化,直至近期工作才解决
- 代理性质与原目标存在偏差
直接折扣指数效用准则(Chung-Sobel准则)
- 风险敏感序贯决策的经典原则性准则
- 可刻画不确定性下的不利结果
- 由Chung和Sobel理论严格建立
- 风险敏感参数随阶段变化,破坏时间齐次性
- 动态规划递推形式复杂,阻碍RL应用
- 无标准贝尔曼方程形式,难以设计模型无关算法
本文聚焦于Thoppe等人(2026)提出的两个无模型固定点算法(单时间尺度与双时间尺度),针对Porteus代理准则提供首个异步马尔可夫采样下的Õ(1/√n)有限时间收敛保证;前者算法更简单但需克服更新与算子几何不匹配的困难,后者分析更复杂需控制快尺度跟踪误差。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 5 张)
展开查看 5 张图

TL;DR
本文为折扣指数效用强化学习中的两种无模型不动点算法建立了异步马尔可夫采样下的 有限时间收敛速率。通过发掘幂律 Bellman 算子的有界性、单调性与齐次性,作者绕开了加性随机更新与压缩几何之间的错配难题,首次为这类非线性风险敏感决策问题提供了非渐近理论保证。
研究背景与动机
风险敏感序贯决策在金融投资、自动驾驶、医疗治疗等高风险场景中至关重要。与风险中性的期望效用最大化不同,风险敏感决策需要显式建模决策者对不利结果的规避态度。折扣指数效用是这一领域最经典的原则性准则之一,通过 形式的风险敏感参数 来量化风险规避程度—— 越大,决策者越厌恶风险。
然而,折扣指数效用 Bellman 方程的时间结构给强化学习带来了根本性困难。直接对原准则做动态规划时,风险敏感参数在不同时间步会发生变化(),导致最优策略未必是平稳的,这使得基于平稳策略优化的经典 RL 框架难以直接套用。Porteus 通过对数变换提出了时间齐次的替代准则,其 Bellman 最优算子
具有 -压缩性质(定义在 Thompson 距离下),从而保证唯一不动点的存在性。
近期 Thoppe 等人基于这一替代准则设计了两种无模型算法:单时间尺度同步/异步更新和双时间尺度更新。但他们的收敛结果停留在渐近层面,仅在 IID 或生成式采样假设下才提供有限时间保证。本文正是要填补异步马尔可夫采样下无模型折扣指数效用强化学习的有限时间分析空白。
方法
从压缩几何到局部伪压缩
为两种算法建立有限时间界,首先要解决一个核心矛盾:算法的更新方程是加性的(),而底层算子 的压缩几何结构定义在乘性的 Thompson 距离 下。这两者的几何本质并不匹配。
作者的关键洞察是利用 的三个代数性质来化解这一矛盾。首先是有界性:只要初始值 取正有界向量,所有后续迭代都保持在紧区域 内。其次是齐次性: 对任意 成立。最后是单调性。
基于这三个性质,作者证明了一个极为有用的一点压缩性质:对任意 ,
其中 表示 Hadamard 除法, 是 的唯一不动点,有效压缩因子
依赖 和有界区间而不依赖具体状态。这本质上是在不动点 的一个邻域内建立了局部伪压缩性质——即在相对误差空间中,误差的收缩率可以被控制。
Moreau 包络 Lyapunov 与 Polyak-Ruppert 平均
将更新方程转化为相对误差序列 后,加性扰动线性递推浮现出来。但直接分析这个递推需要处理由异步马尔可夫采样引入的偏差项和方差项。
作者引入了 Moreau 包络 Lyapunov 函数来处理非欧几里得几何。这个函数定义为
其核心优势在于:它是 的光滑近似,满足
同时具有 -光滑性。这使得我们可以在 范数空间中应用随机近似的标准分析工具。
结合 Polyak-Ruppert 迭代平均()和免参数步长 (),单时间尺度算法最终达到
这是 的最优速率。注意这里需要平均是因为单个迭代点本身并不收敛到不动点。
双时间尺度方法:跟踪误差控制
双时间尺度算法将问题分解为两个嵌套的随机逼近:快尺度追踪条件期望 ,慢尺度更新 值函数。主要挑战是控制快尺度上的跟踪误差
通过巧妙的递推不等式分析,作者证明了这个误差可以被控制在 范围内。有趣的是,最终的 本身不需要平均就能达到 速率,比单时间尺度算法更紧凑。
实验与结果
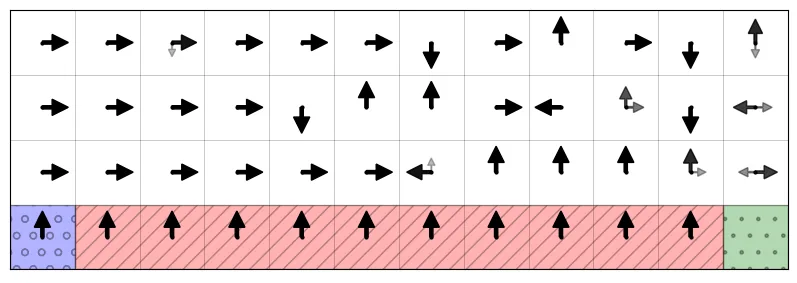
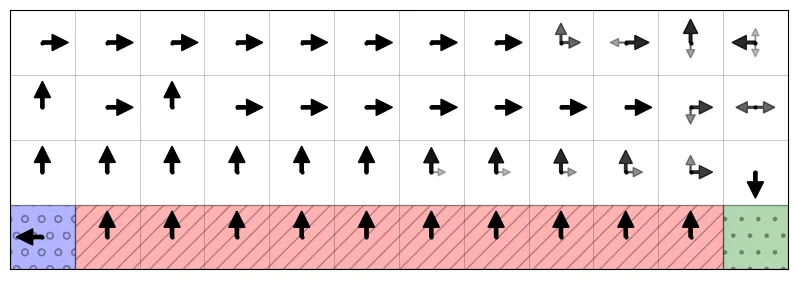
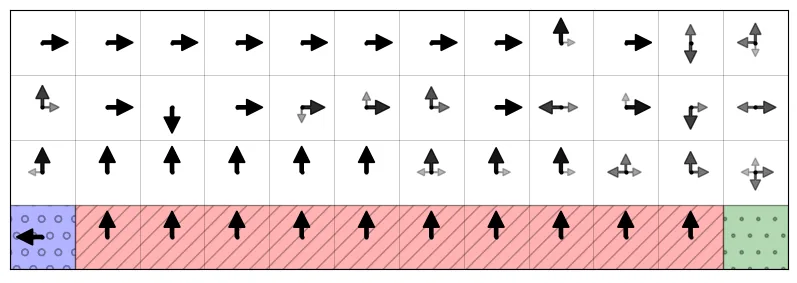
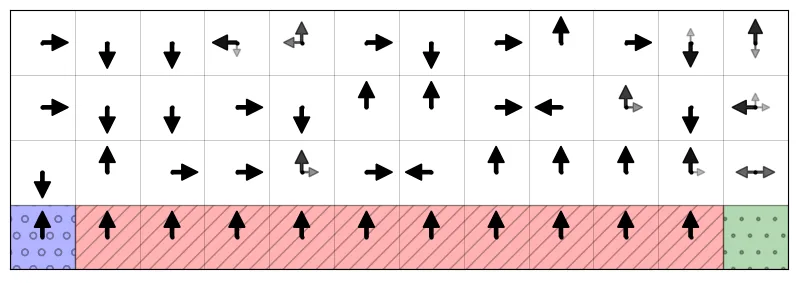
实验在经典的 Cliff Walk 网格世界上验证风险敏感行为。该环境包含 的格子,悬崖在底部一行,坠落惩罚为 ,正常移动为 。作者引入了一个滑移变体:靠近悬崖行滑移概率 ,中间行 ,顶部安全行 。这创造了一个典型风险-收益权衡:靠近悬崖的路径最短但危险,远离悬崖的路径安全但绕远。
实验对比了风险中性 Q-learning 与两种指数效用算法,风险敏感参数取 。结果显示,当 从极小值 增大到 时,学习的策略从偏好最短危险路径逐渐转变为偏好安全长路径——这正是风险规避行为的直观体现。
值得注意的是,单时间尺度方法的 10 种子间方差小于双时间尺度方法,表明其策略稳定性更好。所有结果均使用免参数步长( 等),未经调参验证了理论的实用价值。
讨论与可借鉴点
本文首次为非线性风险敏感强化学习提供了完整的有限时间分析,其方法论创新值得深入借鉴。将局部伪压缩性质与 Moreau 包络 Lyapunov 结合的技术路线,为分析其他具有非欧几里得几何结构的随机算法提供了范式参考。
核心启示在于:对于表面上看似"不兼容"的算子结构(加性更新 vs. 乘性压缩),通过发掘其代数性质(齐次性、单调性、有界性)往往能发现隐藏的适配路径。这种"性质驱动的结构发现"比直接套用标准框架更有可能突破分析瓶颈。
当前工作的主要局限在于只覆盖表格型算法,无法处理函数逼近下的大规模问题。异步采样虽然比 IID 假设更接近实际,但分析仍依赖均匀混合时间的可达性假设。此外,实验仅验证了定性行为,缺少与现有风险敏感方法(如 Borkar 的 Q-learning、Tamar 的策略梯度)的定量对比。
对于后续研究,一个自然的方向是将有限时间分析推广到函数逼近设置,特别是神经网络参数化的近似架构。另一个开放问题是:在何种条件下,替代准则与原折扣指数准则之间的 差距可以被有限时间收敛误差吸收?这关乎理论保证与实际性能之间更精细的桥梁建立。
摘要
折扣指数效用为风险敏感的序贯决策提供了一个有原则的标准,但其非线性结构使强化学习变得复杂。最近的一项研究 \citep{thoppe2026reinforcement} 通过引入一个与 Bellman 兼容的替代函数以及两种无模型不动点算法,在平稳策略上对其进行优化,从而解决了这一困难。然而,他们的主要收敛结果是渐近的。在本工作中,我们在异步马尔可夫采样下,为上述两种算法建立了 的有限时间收敛速率,其中 是迭代索引, 隐藏了对数项。重要的是,我们采用无参数的步长选择来推导这些速率结果。对于算法上更简单的单时间尺度方法,主要挑战在于其更新方程与其底层幂律算子的压缩几何结构并不直接对齐。我们通过利用算子的有界性、单调性和齐次性来克服这种不匹配,从而获得相对误差动力学的局部伪压缩性质。然后,我们使用基于 Moreau 包络的 Lyapunov 函数和 Polyak--Ruppert 平均,以获得具有无参步长的所述收敛速率。对于双时间尺度方法,主要挑战是控制快时间尺度上的跟踪误差。这些结果为无模型折扣指数效用强化学习提供了首批有限时间保证。
Abstract
Discounted exponential utility provides a principled criterion for risk-sensitive sequential decision-making, but its nonlinear structure complicates reinforcement learning. A recent work \citep{thoppe2026reinforcement} addressed this difficulty by introducing a Bellman-compatible surrogate and two model-free fixed-point algorithms for optimizing it over stationary policies. However, their main convergence results are asymptotic. In this work, we establish finite-time rates of for the aforementioned two algorithms under asynchronous Markovian sampling, where is the iteration index and hides logarithmic expressions. Importantly, we employ parameter-free choices for the stepsize parameter to derive these rate results. For the algorithmically simpler one-timescale method, the main challenge is that its update equation is not directly aligned with the contraction geometry of its underlying power-law operator. We overcome this mismatch by exploiting the boundedness, monotonicity, and homogeneity of the operator to obtain a local pseudo-contraction property for the relative-error dynamics. We then use a Moreau-envelope-based Lyapunov function and Polyak--Ruppert averaging to obtain the stated convergence rate with parameter-free stepsizes. For the two-timescale method, the main challenge is to control a tracking error on the faster timescale. These results provide the first finite-time guarantees for model-free discounted exponential-utility reinforcement learning.
论文详细总结(自动生成)
折扣指数效用强化学习的有限时间分析
1. 核心问题与研究动机
- 研究对象:折扣型指数效用(discounted exponential utility)驱动的风险敏感序贯决策问题。该准则(由 Howard and Matheson 1972 提出)通过 形式的风险敏感参数 来刻画对不利收益的规避。
- 理论困境:直接的折扣指数效用动态规划递推(Chung and Sobel 1987 定理 4)中,风险敏感参数在不同阶段会发生变化(),导致 Bellman 方程不具有时间齐次性(time-inhomogeneous),最优马尔可夫策略未必平稳。
- 已有替代方案:Porteus (1975) 通过对数变换将风险敏感参数固定为 ,得到时间齐次的 Bellman 最优算子 ;Thoppe 等 (2026) 进一步表明在吸收态 MDP 条件下,直接准则与替代准则的差距为 。
- 研究空白:Thoppe 等 (2026) 的两种无模型算法(单时间尺度和双时间尺度)只具备渐近收敛性,且双时间尺度算法的有限时间保证仅在 IID 或生成式采样下成立,单时间尺度算法的有限时间分析仅限于标量参数情形。本文填补异步马尔可夫采样下的有限时间收敛理论空白。
2. 方法论
2.1 关键算子与算法
- Bellman 最优算子 :
该算子在 Thompson 距离 下是 -压缩,且有唯一不动点 。
- 单时间尺度同步更新(公式 (9)):
其中 ,。
- 单时间尺度异步更新(公式 (10)):
其中 由行为策略 生成的样本轨迹给出。
- 双时间尺度更新(公式 (11)):
其中 ,且 使 在快时间尺度上跟踪条件期望 。
2.2 核心技术:局部伪压缩性质
- 命题 4.1(一点压缩):对所有 ,
其中 。该性质通过对算子的单调性、齐次性()及有界性( 上的迭代不变量)的联合利用推导得到。
- 相对误差序列:定义 ,将加性更新转化为扰动线性递推
其中 为加权平均算子。
2.3 Lyapunov 分析与 Polyak–Ruppert 平均
- Moreau 包络 Lyapunov 函数 ,由 Chen et al. (2020, 2021) 引入到 RL 上下文。该函数满足
及 -光滑性。
- 异步情况的关键引理 5.1:对 ,
其中 、(由几何遍历性给出)。
- 参数无关的最优速率(定理 4.7):使用 Polyak–Ruppert 迭代平均 与步长 (),在假设 对每个状态指派唯一动作下,
2.4 双时间尺度分析
- 快时间尺度跟踪误差 满足递推:
- 慢时间尺度(定理 4.9):选取 ()及 ,
该结果是非平均迭代直接达到的 最优速率。
3. 实验设计
- 场景:4×12 的 Cliff Walk 网格世界(如图 1 所示),起点位于左下角、目标位于右下角,每步奖励 ,坠落悬崖奖励 。
- 随机化机制(滑移变体):靠近悬崖的一行滑移概率 ,中间一行 ,最上行 。靠近悬崖的路径最短但最危险,最上行为最安全路径。
- 超参数:折扣因子 ,风险敏感参数对比 ,初始值 、。
- 对比方法:
- 风险中性 Q-learning(图 1(a));
- 单时间尺度算法(公式 (10));
- 双时间尺度算法(公式 (11))。
- 训练细节:固定随机行为策略训练,10 个独立随机种子,每个种子 500 回合,每回合最多 1000 步,从相同初始状态出发;单时间尺度步长 ,双时间尺度步长 、。
- 评估指标:贪心策略可视化,箭头透明度表示 10 个种子间的一致性(颜色越深表示共识越强)。
4. 资源与算力
- 论文未明确说明所用 GPU 型号、数量或训练时长。所报告的训练规模较小(4×12 网格、10 种子、500 回合/种子),理论上可在 CPU 上数分钟内完成;这与本工作的理论贡献为主的定位一致。
5. 实验数量与充分性
- 实验规模较为有限:仅一个 Cliff Walk 网格世界、10 个种子、两种 取值下的策略可视化对比。
- 未涉及 消融实验、不同折扣因子 的影响、不同 MDP 规模的可扩展性测试,或与现有风险敏感算法(如 Borkar 2002 的 Q-learning、Tamar 等 2012 的策略梯度)定量对比。
- 实验的主要目的是验证替代准则优化是否能产生直观的风险敏感行为,而非为有限时间理论提供经验验证。
- 客观性:结果通过 10 种子的可视化共识一致性体现,较为直观但缺少量化指标(如平均累积折扣指数效用、方差、CVaR 等)。
6. 主要结论与发现
1. 首次为无模型折扣指数效用 RL 提供有限时间收敛保证:在异步马尔可夫采样下,两个算法均达到 的最优速率。
2. 单时间尺度算法的参数无关最优速率:通过 Polyak–Ruppert 迭代平均结合参数无关步长实现,避免了对未知模型参数(如 、)的依赖。
3. 双时间尺度算法的直接最优速率:无需平均即可达到 ,但需在快时间尺度上额外使用对数因子 。
4. Cliff Walk 实验:验证了随着 从 增大到 ,所学习到的策略变得越来越规避风险,且单时间尺度方法的种子间方差小于双时间尺度方法。
5. 方法论创新:通过单调性、齐次性、有界性的联合利用导出局部伪压缩性质,绕开了加性更新与 Thompson 压缩几何之间的错配问题。
7. 优点
- 理论深度:首次将有限时间分析扩展到非线性风险敏感 RL,且在异步马尔可夫采样下完成,难度显著高于风险中性情形。
- 技术创新:将 Chen 等 (2020, 2021) 的 Moreau 包络 Lyapunov 方法与 Naskar, Thoppe, Gupta (2026) 的 Polyak–Ruppert 平均技巧巧妙地适配到指数效用算子的非欧几里得几何。
- 免参数步长:所有结果仅依赖普适常数(、、),便于实际部署。
- 理论紧致: 率匹配随机逼近的民间最优率(folklore optimal rate)。
- 一致性结果:单时间尺度与双时间尺度算法共享同一替代目标 ,实验表明两者均能产生一致的风险敏感行为。
- 完整的附录:包含全部技术引理、详细常数表(Table 1, 2)与完整证明。
8. 不足与局限
- 实验覆盖极为有限:仅一个 4×12 网格世界、10 种子、两个 取值;缺少规模更大、状态-动作空间更复杂的基准(如 Atari、MuJoCo 控制任务);也缺少与现有风险敏感 RL 方法(Borkar 2002 Q-learning、Tamar et al. 2012 策略梯度、Mihatsch-Neuneier 2002)的实证比较。
- 缺乏函数逼近:算法仅限表格型(tabular)设置;无法处理大规模或连续状态-动作空间,这限制了在实际问题中的应用。作者在结论中将此列为未来工作的首要方向。
- 理论假设较强:要求 MDP 是有限的、行为策略诱导几何遍历的 Markov 链、 对每个状态指派唯一动作(仅对参数无关结果需要)。
- 替代目标的次优性:在一般 MDP 中, 对应的贪心策略 可能与直接折扣指数效用准则 的最优解不一致,理论保证仅在带吸收态的 MDP 上成立;实验未量化这种次优性。
- 常数因子:Table 1、Table 2 中的常数依赖于 、 等可能很大的量,实际收敛速度在小步长下可能较慢。
- 单时间尺度有限时间结果仅在标量参数情形下由 Thoppe 等 (2026) 给出,本文扩展到向量情形但仅在特定参数依赖步长和迭代平均两种模式下达到最优速率。
- 双时间尺度算法虽然无需迭代平均即达到最优速率,但其常数 含 等对 指数敏感的项,对较大 可能带来实际收敛困难。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。