
耦合有限时域约束下无线资源管理的异构多智能体强化学习
Heterogeneous Multi-Agent Reinforcement Learning for Radio Resource Management under Coupled Finite-Horizon Constraints
📝 TLDR
密集无线网络中需在有限时域能耗与切换预算下同时管理用户关联、调度、基站激活与切换控制,并最大化比例公平吞吐量。论文提出 HeLyMARL,将 Lyapunov 漂移加罚函数与虚拟队列嵌入异构多智能体强化学习,把受限有限时域问题转化为无约束逐时隙 MARL 问题。相比 Lagrangian 方案,其虚拟队列可在部分时域内即时约束预算消耗。实验表明 HeLyMARL 是唯一在整个时域内同时维持吞吐-公平平衡与不中断服务的方法,优于常规 MARL、Lyapunov 与受限 MARL 基线。
🧭 速览
密集无线网络在有限时域能耗与切换预算下存在基站端能耗管理与用户端切换调节之间的根本张力,传统 MARL 难以处理不可逐时隙评估的预算约束与不可分解的非线性比例公平效用。
HeLyMARL 通过漂移加罚函数分解与虚拟队列,将能耗与切换约束压力折算为统一逐时隙奖励,从而把耦合有限时域约束问题转化为无约束异构 MARL 问题。
HeLyMARL 是唯一在整个时域内同时维持吞吐量-公平性平衡与不间断服务的方法,未出现预算过早耗尽,性能优于常规 MARL、Lyapunov 与受限 MARL 基线。
虚拟队列实现了部分时域内的预算节奏控制,提供了 Lagrangian 跨回合松弛与贪心 Lyapunov 难以达到的节奏保证。
🆚 方法对比
HeLyMARL
- 唯一在整个时域维持吞吐-公平平衡且不中断服务
- 虚拟队列使有限预算在每时隙可观测
- DPP分解保留与时间平均比例公平的原则联系
- 将耦合双侧约束转化为无约束MARL问题
- 需为每约束维护虚拟队列,状态空间增大
- 融合Lyapunov与MARL,实现复杂度高
- 队列权重参数V调优影响整体性能
MAPPO with Lagrangian relaxation
- 基于成熟PPO算法,工程实现成熟
- 可处理约束优化,理论框架清晰
- Lagrangian仅在训练回合间调节约束
- 无法在回合内部分时域约束预算消耗
- 仍需预设每时隙奖励信号
CPO (Constrained Policy Optimization)
- 具备约束满足的理论保证
- 支持信任域策略更新
- 未解决有限时域耦合约束问题
- 依赖预设每时隙奖励信号
- 未处理比例公平非分解难题
Conventional MARL (instantaneous rate)
- 直接优化即时速率,实现简单
- 受益于成熟CTDE范式
- 与时间平均效用无原则性联系
- 无法处理有限时域硬约束
- 缺乏比例公平保证
Greedy Lyapunov-based control
- 利用Lyapunov稳定性保证可在线决策
- 实现相对简单
- 缺乏节奏(pacing)保证
- 无法约束每个部分时域的累计预算
- 贪婪决策可能造成预算过早耗尽
Drift-Plus-Penalty decomposition
- 将有限时域约束转化为无约束问题
- 导出原则性每时隙奖励
- 保留与时间平均公平效用的联系
- 需依赖Lyapunov漂移分析理论支撑
- V参数选择影响约束违反与性能权衡
Weighted proportional-fairness ratio (heuristic)
- 为比例公平提供近似替代目标
- 易于集成到现有MARL框架
- 启发式替代,与时间平均效用无原则联系
- 未解决有限时域预算约束问题
HeLyMARL通过虚拟队列实现每时隙约束可观测与节奏保证,优于Lagrangian松弛仅在回合级调节约束及贪婪Lyapunov缺乏部分时域保证的方法,是唯一同时兼顾比例公平和耦合双侧有限预算的方法。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 9 张)
展开查看 9 张图
TL;DR
这篇论文研究密集无线网络中一类耦合双侧有限时域约束的联合控制问题——需同时管理用户关联、基站激活、调度与切换控制,并在硬能耗与切换预算下最大化比例公平吞吐量。论文提出 HeLyMARL,将 Lyapunov 漂移加罚框架嵌入异构多智能体强化学习框架,通过虚拟队列将约束压力内化到逐时隙奖励中,使系统在整个时域内维持吞吐量-公平性平衡且不出现服务中断,优于传统 MARL、Lyapunov 贪心控制及 Lagrangian 松弛方法。
研究背景与动机
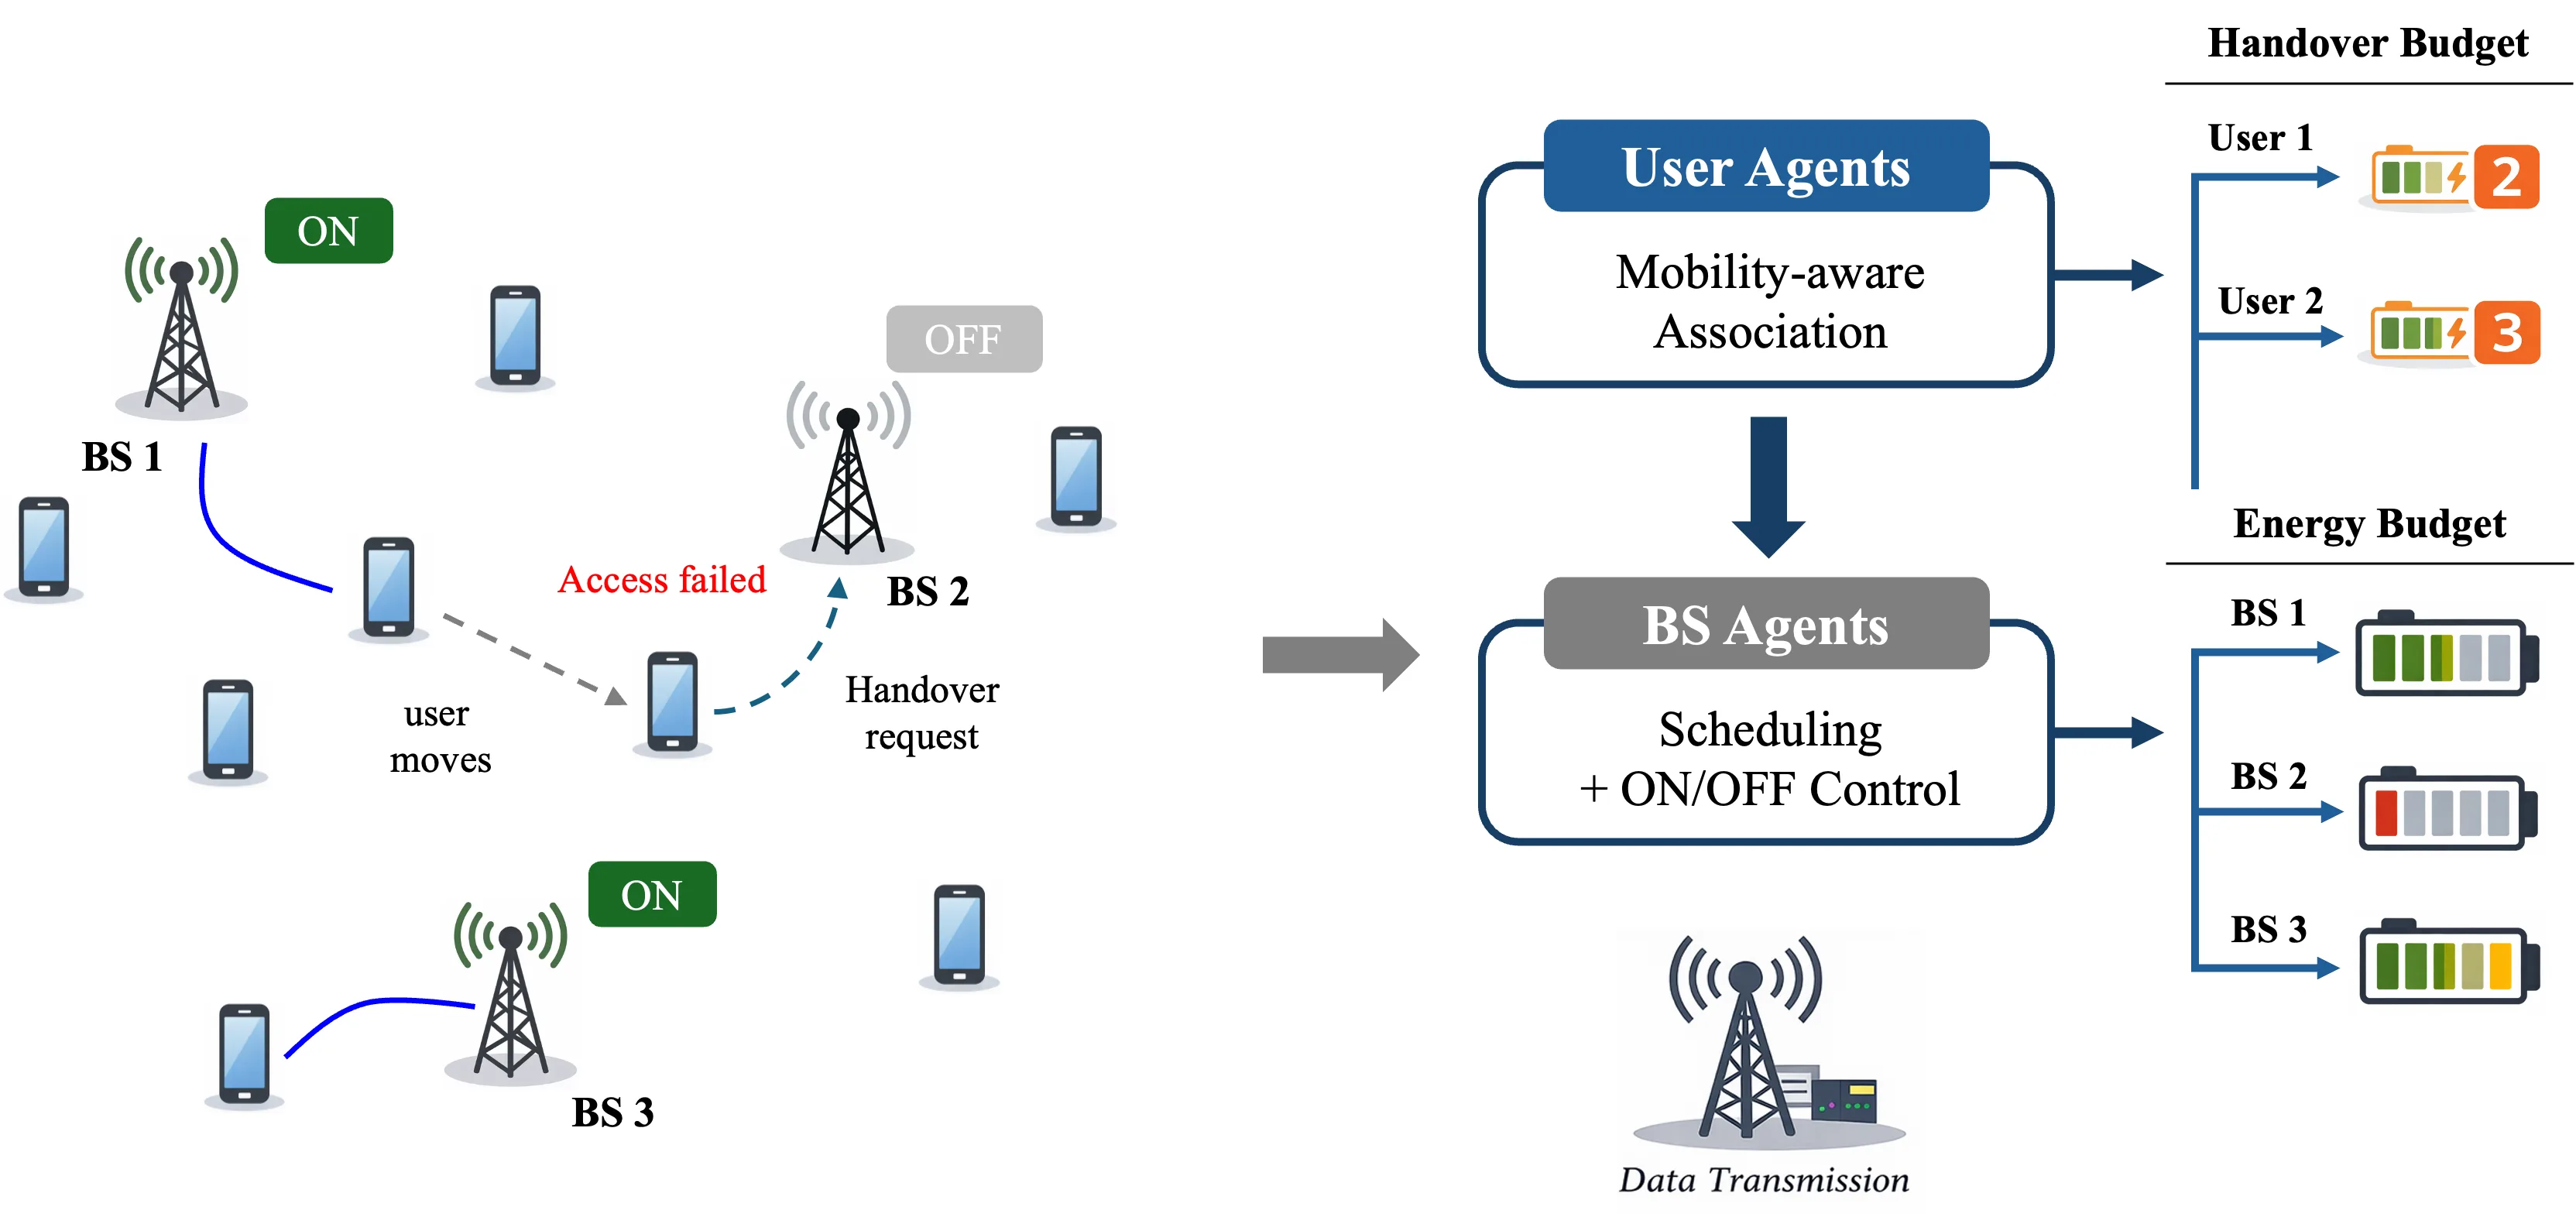
在 5G 毫米波及未来 6G 密集组网场景下,基站密度大幅提升带来了显著的空间复用增益,但同时也使能耗管理与用户服务质量之间的矛盾日益突出。具体而言,系统需在同一框架下联合优化四项决策:用户选择接入哪个基站、每个基站是否激活提供服务、激活基站从候选集中调度哪个用户、以及用户是否切换到其他基站。这些决策并非独立存在——激活更多基站能提升空间多样性从而改善吞吐量,但会加速能耗预算耗尽;让用户切换到信号更强的基站能提升瞬时速录,但频繁切换会快速耗尽切换预算并影响用户体验。更关键的是,两类约束通过用户关联决策深度耦合:严格的切换预算将用户锁定在部分基站上,这反过来加剧了另一组基站的能耗集中消耗。
这一问题的核心困难在于有限时域硬约束的特性。传统的多智能体强化学习框架天然适合处理分布式序贯决策问题,但其奖励函数通常在每个时隙独立计算,而有限时域约束必须从整个时域跨度来评估——能耗预算必须在整个运行周期结束时不超过上限,而非在每个时隙都满足。此外,比例公平效用函数采用对数形式,其时间平均的特性使得无法直接分解为有意义的逐时隙奖励信号。现有研究大多只处理单一约束侧(要么是基站能耗,要么是用户切换),无法应对这种两侧约束同时存在且相互耦合的真实场景。
方法
论文提出的 HeLyMARL 框架在 CTDE(集中训练分散执行)范式下,将 Lyapunov 优化理论中的漂移加惩罚技术嵌入到异构多智能体强化学习中,实现了约束压力的逐时隙内化。
虚拟队列机制是这一框架的核心创新。Lyapunov 优化的经典做法是为每个约束引入一个虚拟队列,通过追踪约束的"累积违反程度"来指导决策。具体定义三组队列:公平队列 追踪用户速率与目标值的差距,能耗队列 追踪基站能耗与预算消耗的差距,切换队列 追踪用户切换次数与预算的差距。这些队列的更新规则均为 形式的截断,确保队列值非负。当某个约束被违反时,对应队列的值会上升,从而在后续时隙的奖励中受到惩罚。
在此基础上,通过构造 Lyapunov 函数 并推导其一步条件期望上界,论文得到了与动作直接相关的逐时隙奖励表达式:
这个奖励函数的设计精妙之处在于:队列值 、、 动态地平衡着吞吐量追求与约束满足——当能耗预算充裕时 较小,激活基站几乎不受惩罚;当预算趋紧时 增大,系统自然倾向于休眠基站以节约能耗。辅助变量 通过闭式更新规则 调节公平队列的收敛速度,其中参数 控制效用最大化与公平性之间的权衡。
异构多智能体架构采用 HAPPO 作为基础骨架,将智能体分为用户群与基站群两类。用户的动作空间是选择关联的基站编号,基站的动作空间包括是否激活以及从候选集中选择服务用户。由于切换决策涉及用户与基站双方的协同(切换发生需要用户发起请求且基站同意调度),两类智能体必须基于统一的 DPP 奖励进行优化。HAPPO 的顺序群组更新机制通过修正因子解决了统一奖励下的信用分配问题:先更新用户群得到新的策略,再以旧策略与新策略的概率比值校正基站群的优势估计,确保策略更新始终朝向提升方向。
值得强调的是,时间尺度分离是 HeLyMARL 相对于 Lagrangian 方案的本质优势。Lagrangian 松弛方法将约束乘子视为在回合之间缓慢更新的参数,其调节粒度是整个训练回合,无法保证在单个回合内部各部分时域上的预算均匀消耗。而 HeLyMARL 的虚拟队列在每个时隙都更新并立即影响奖励,实现了对预算消耗的逐时隙"节拍"控制——这正是论文 Theorem 1 所严格证明的 累积界保证。
实验与结果
论文在 28 GHz 毫米波小蜂窝网络上进行了全面评估,网络覆盖 100×100 m² 区域,带宽 500 MHz,基站发射功率 20 dBm,采用高斯随机游走模拟用户移动性。默认配置为 3 个基站、20 个用户、(能耗预算系数)、(切换预算系数)、 时隙。
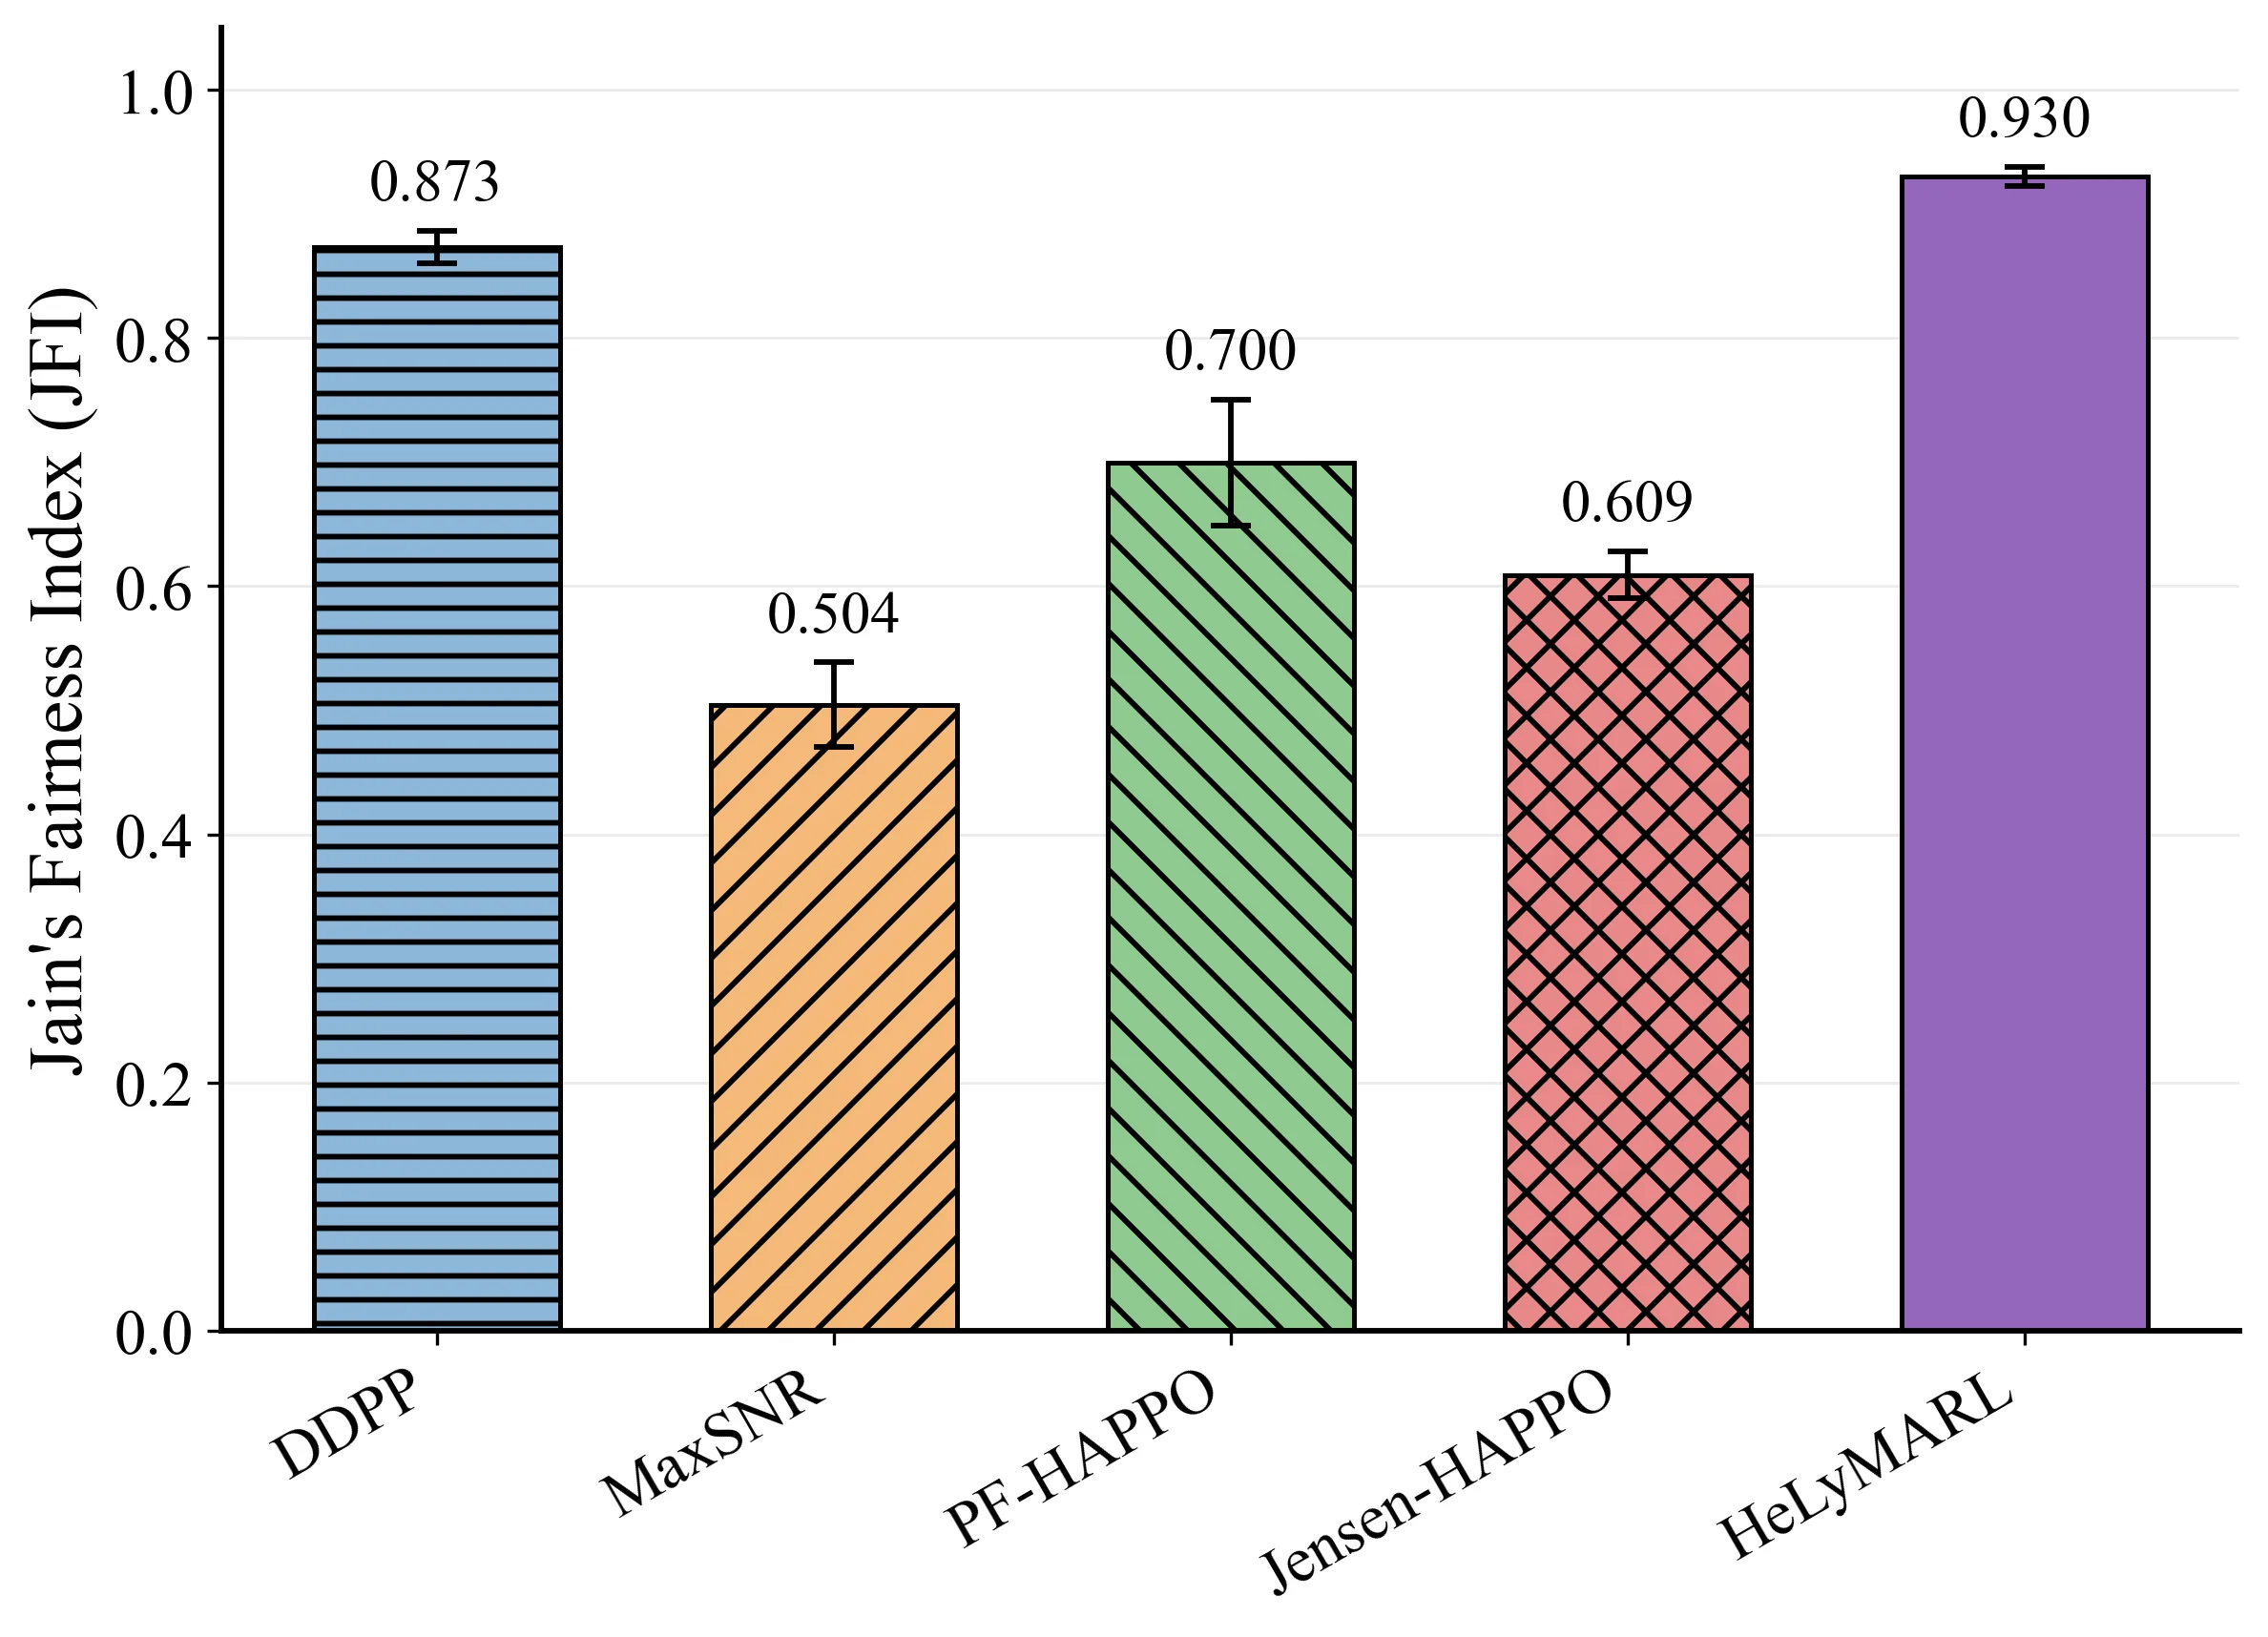
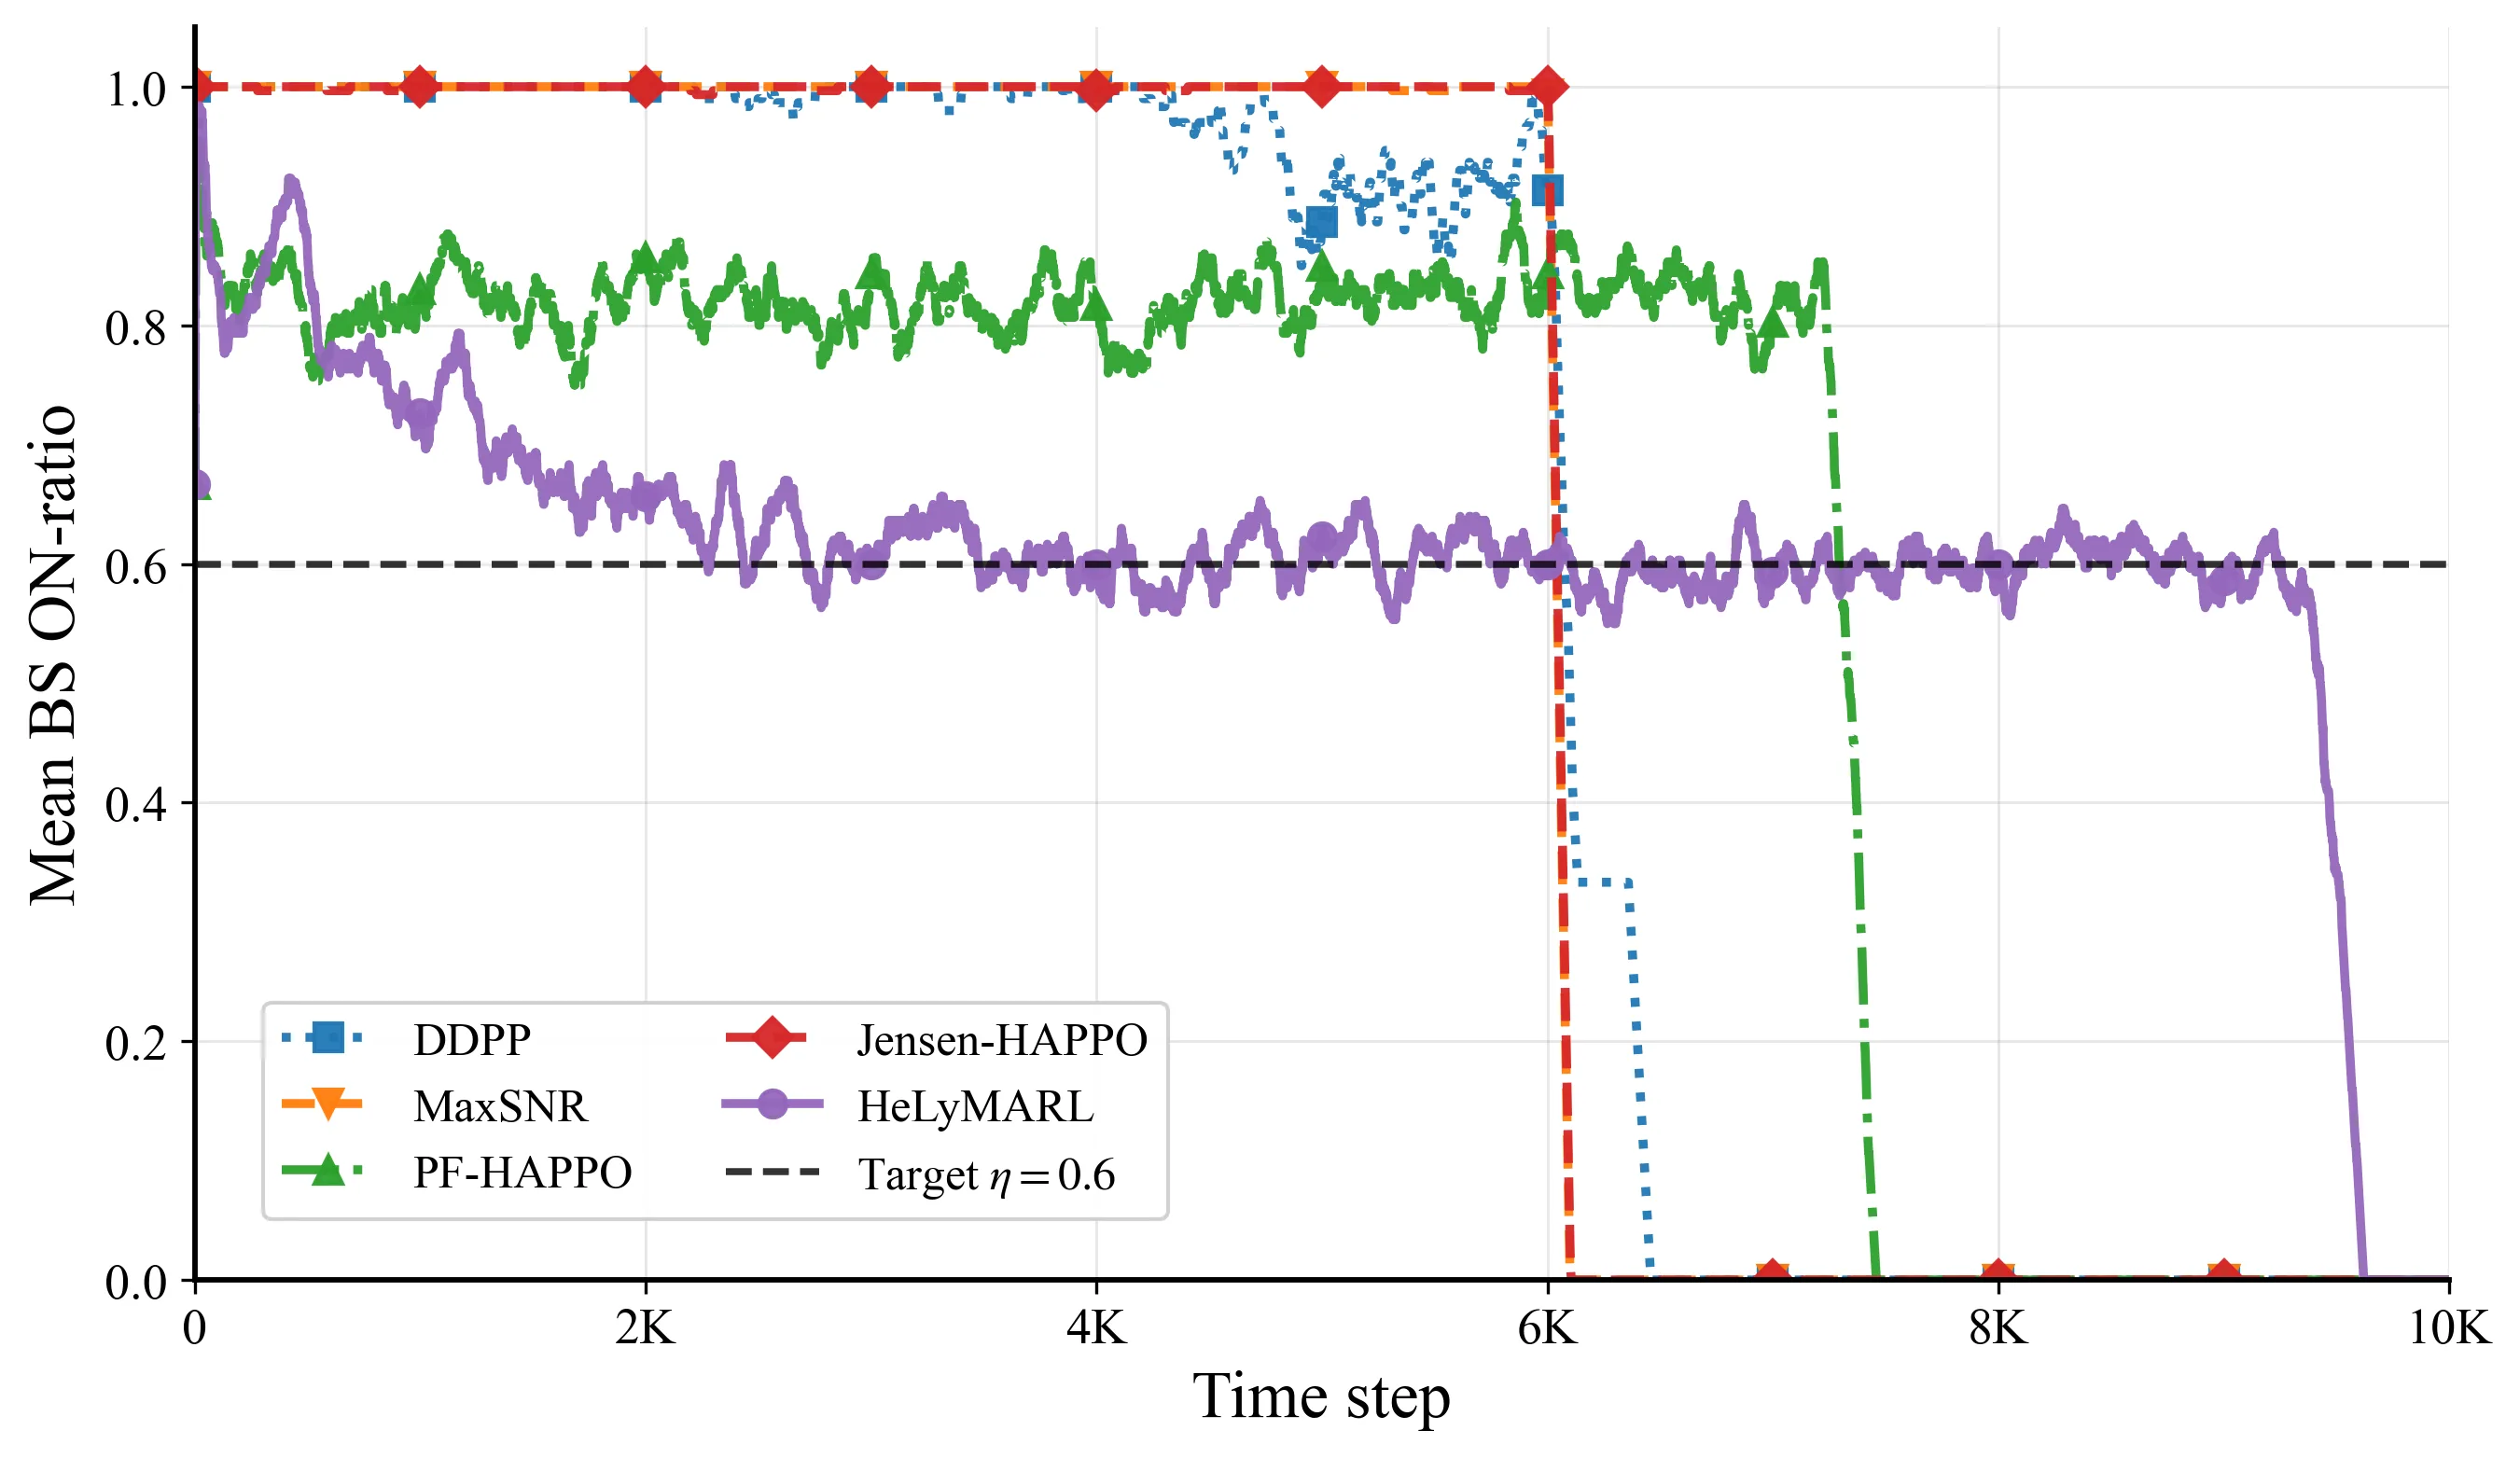
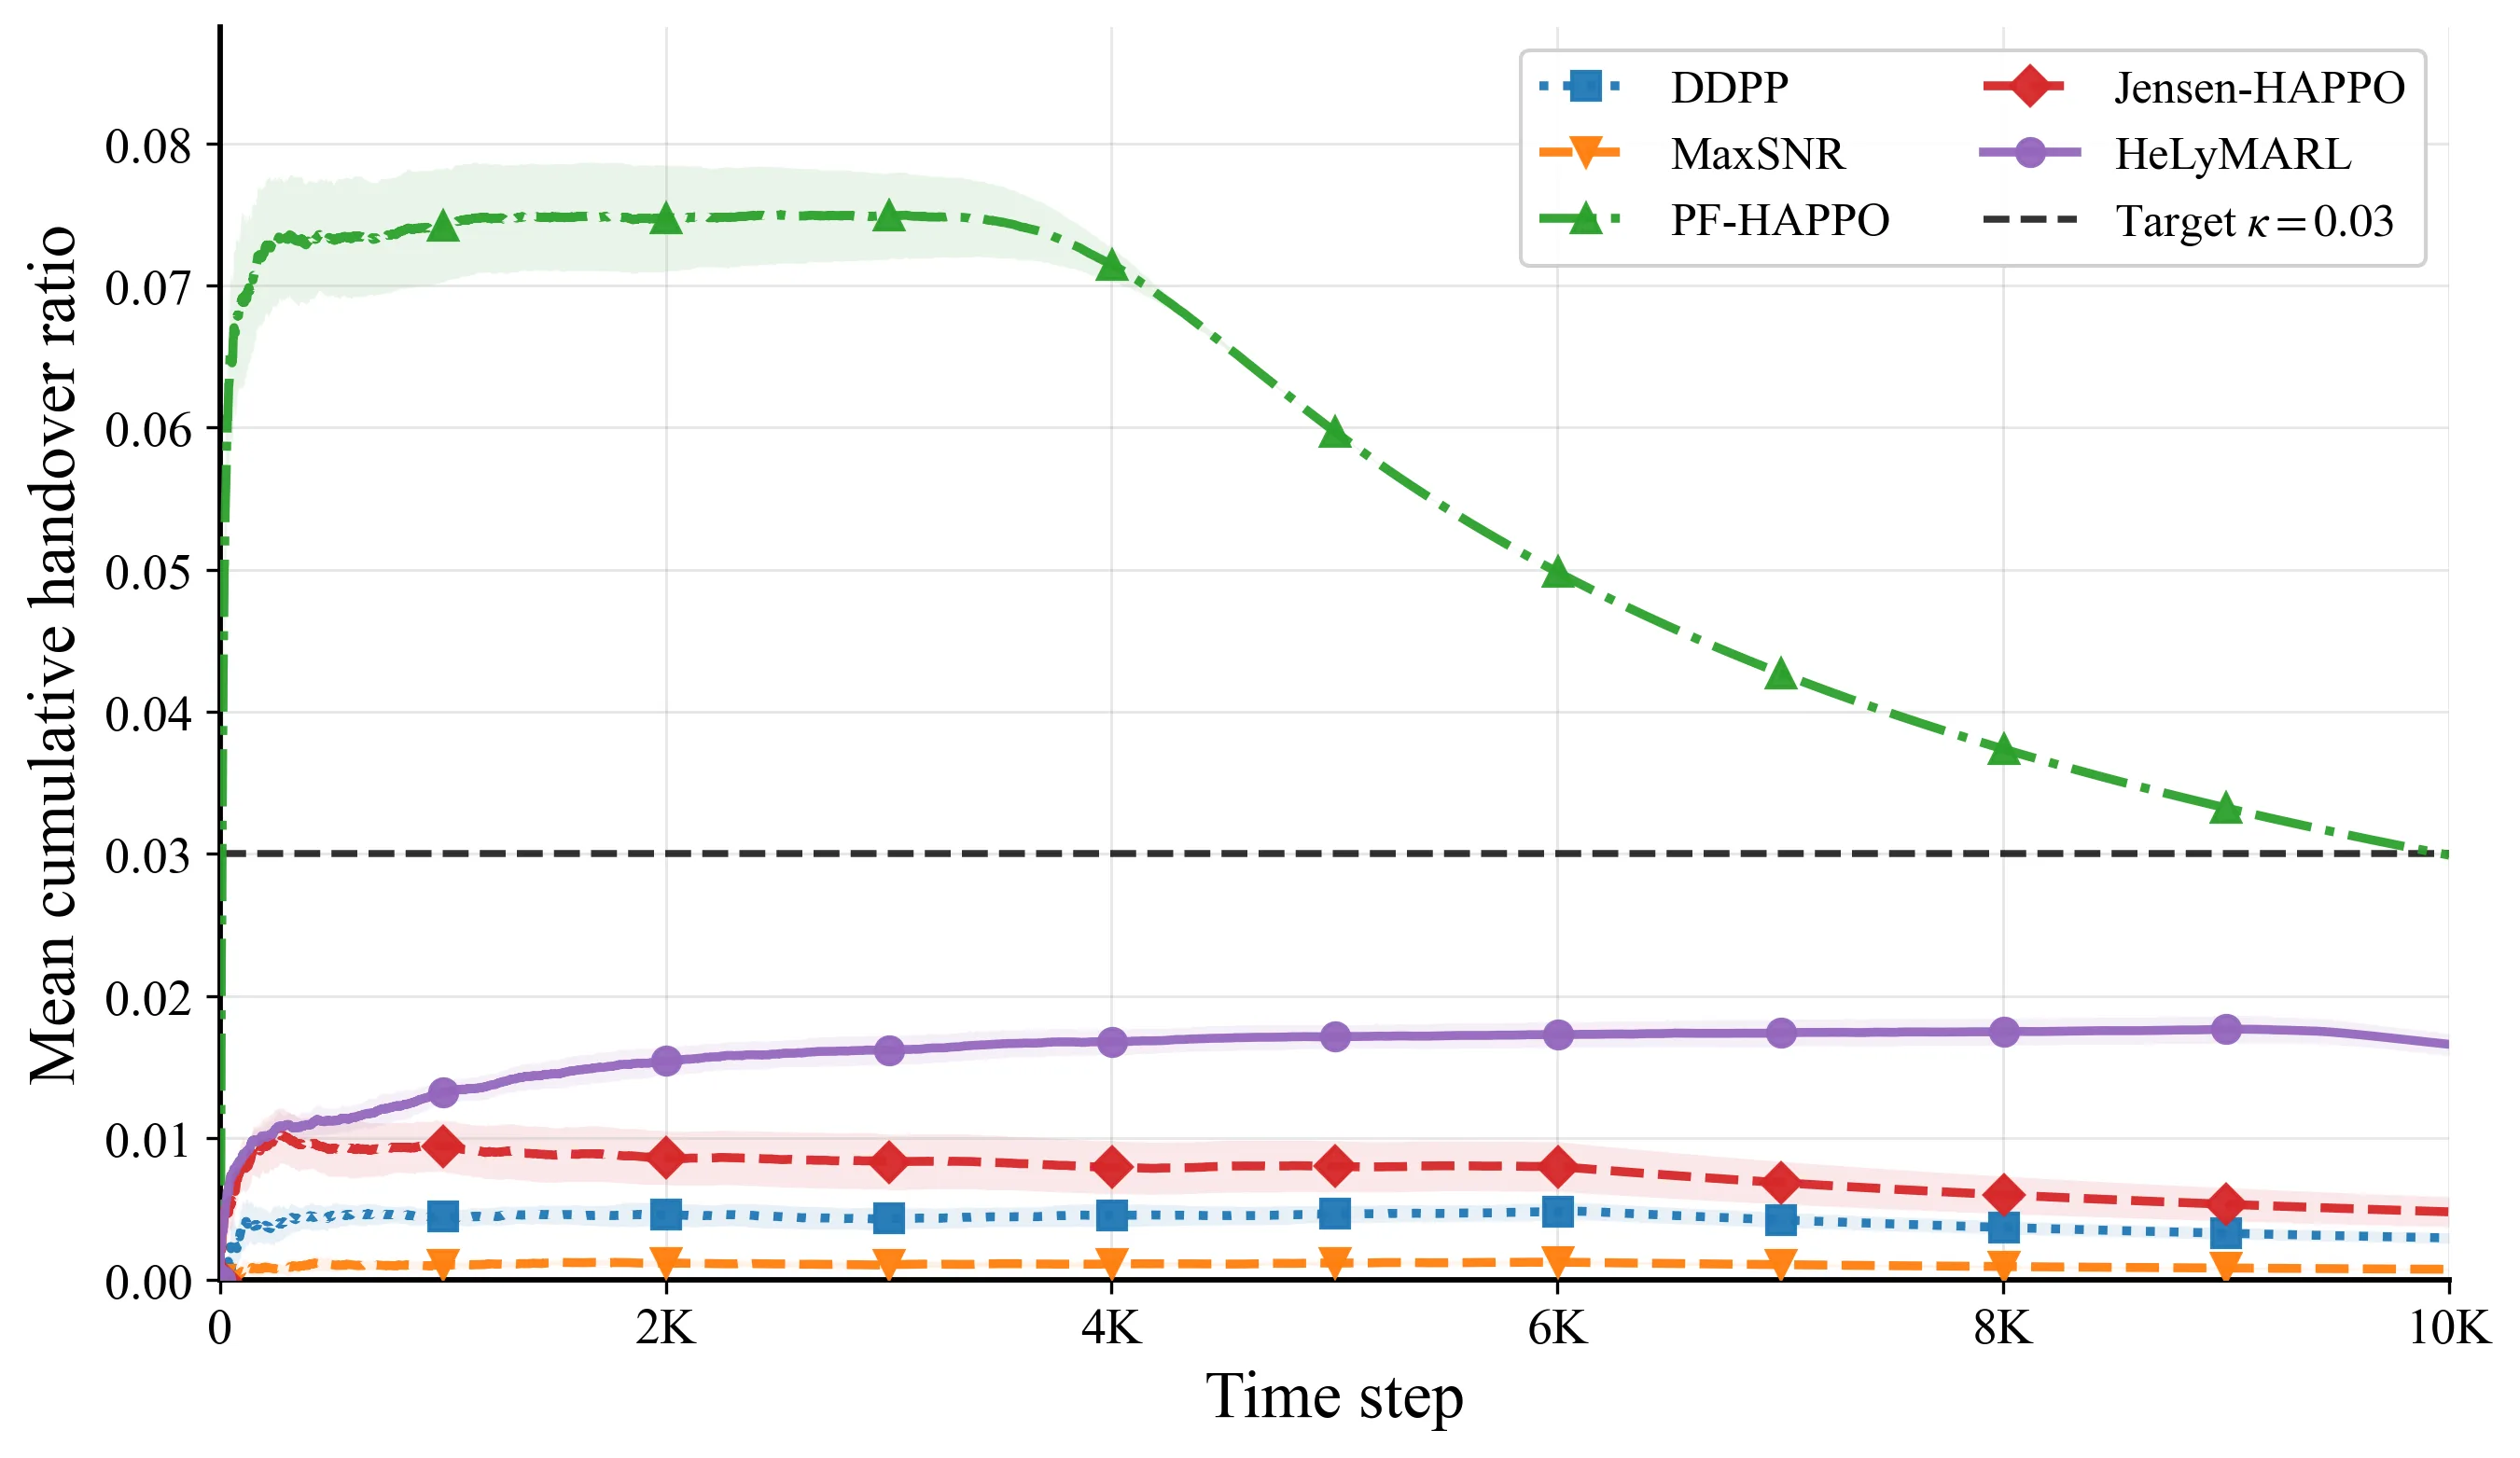
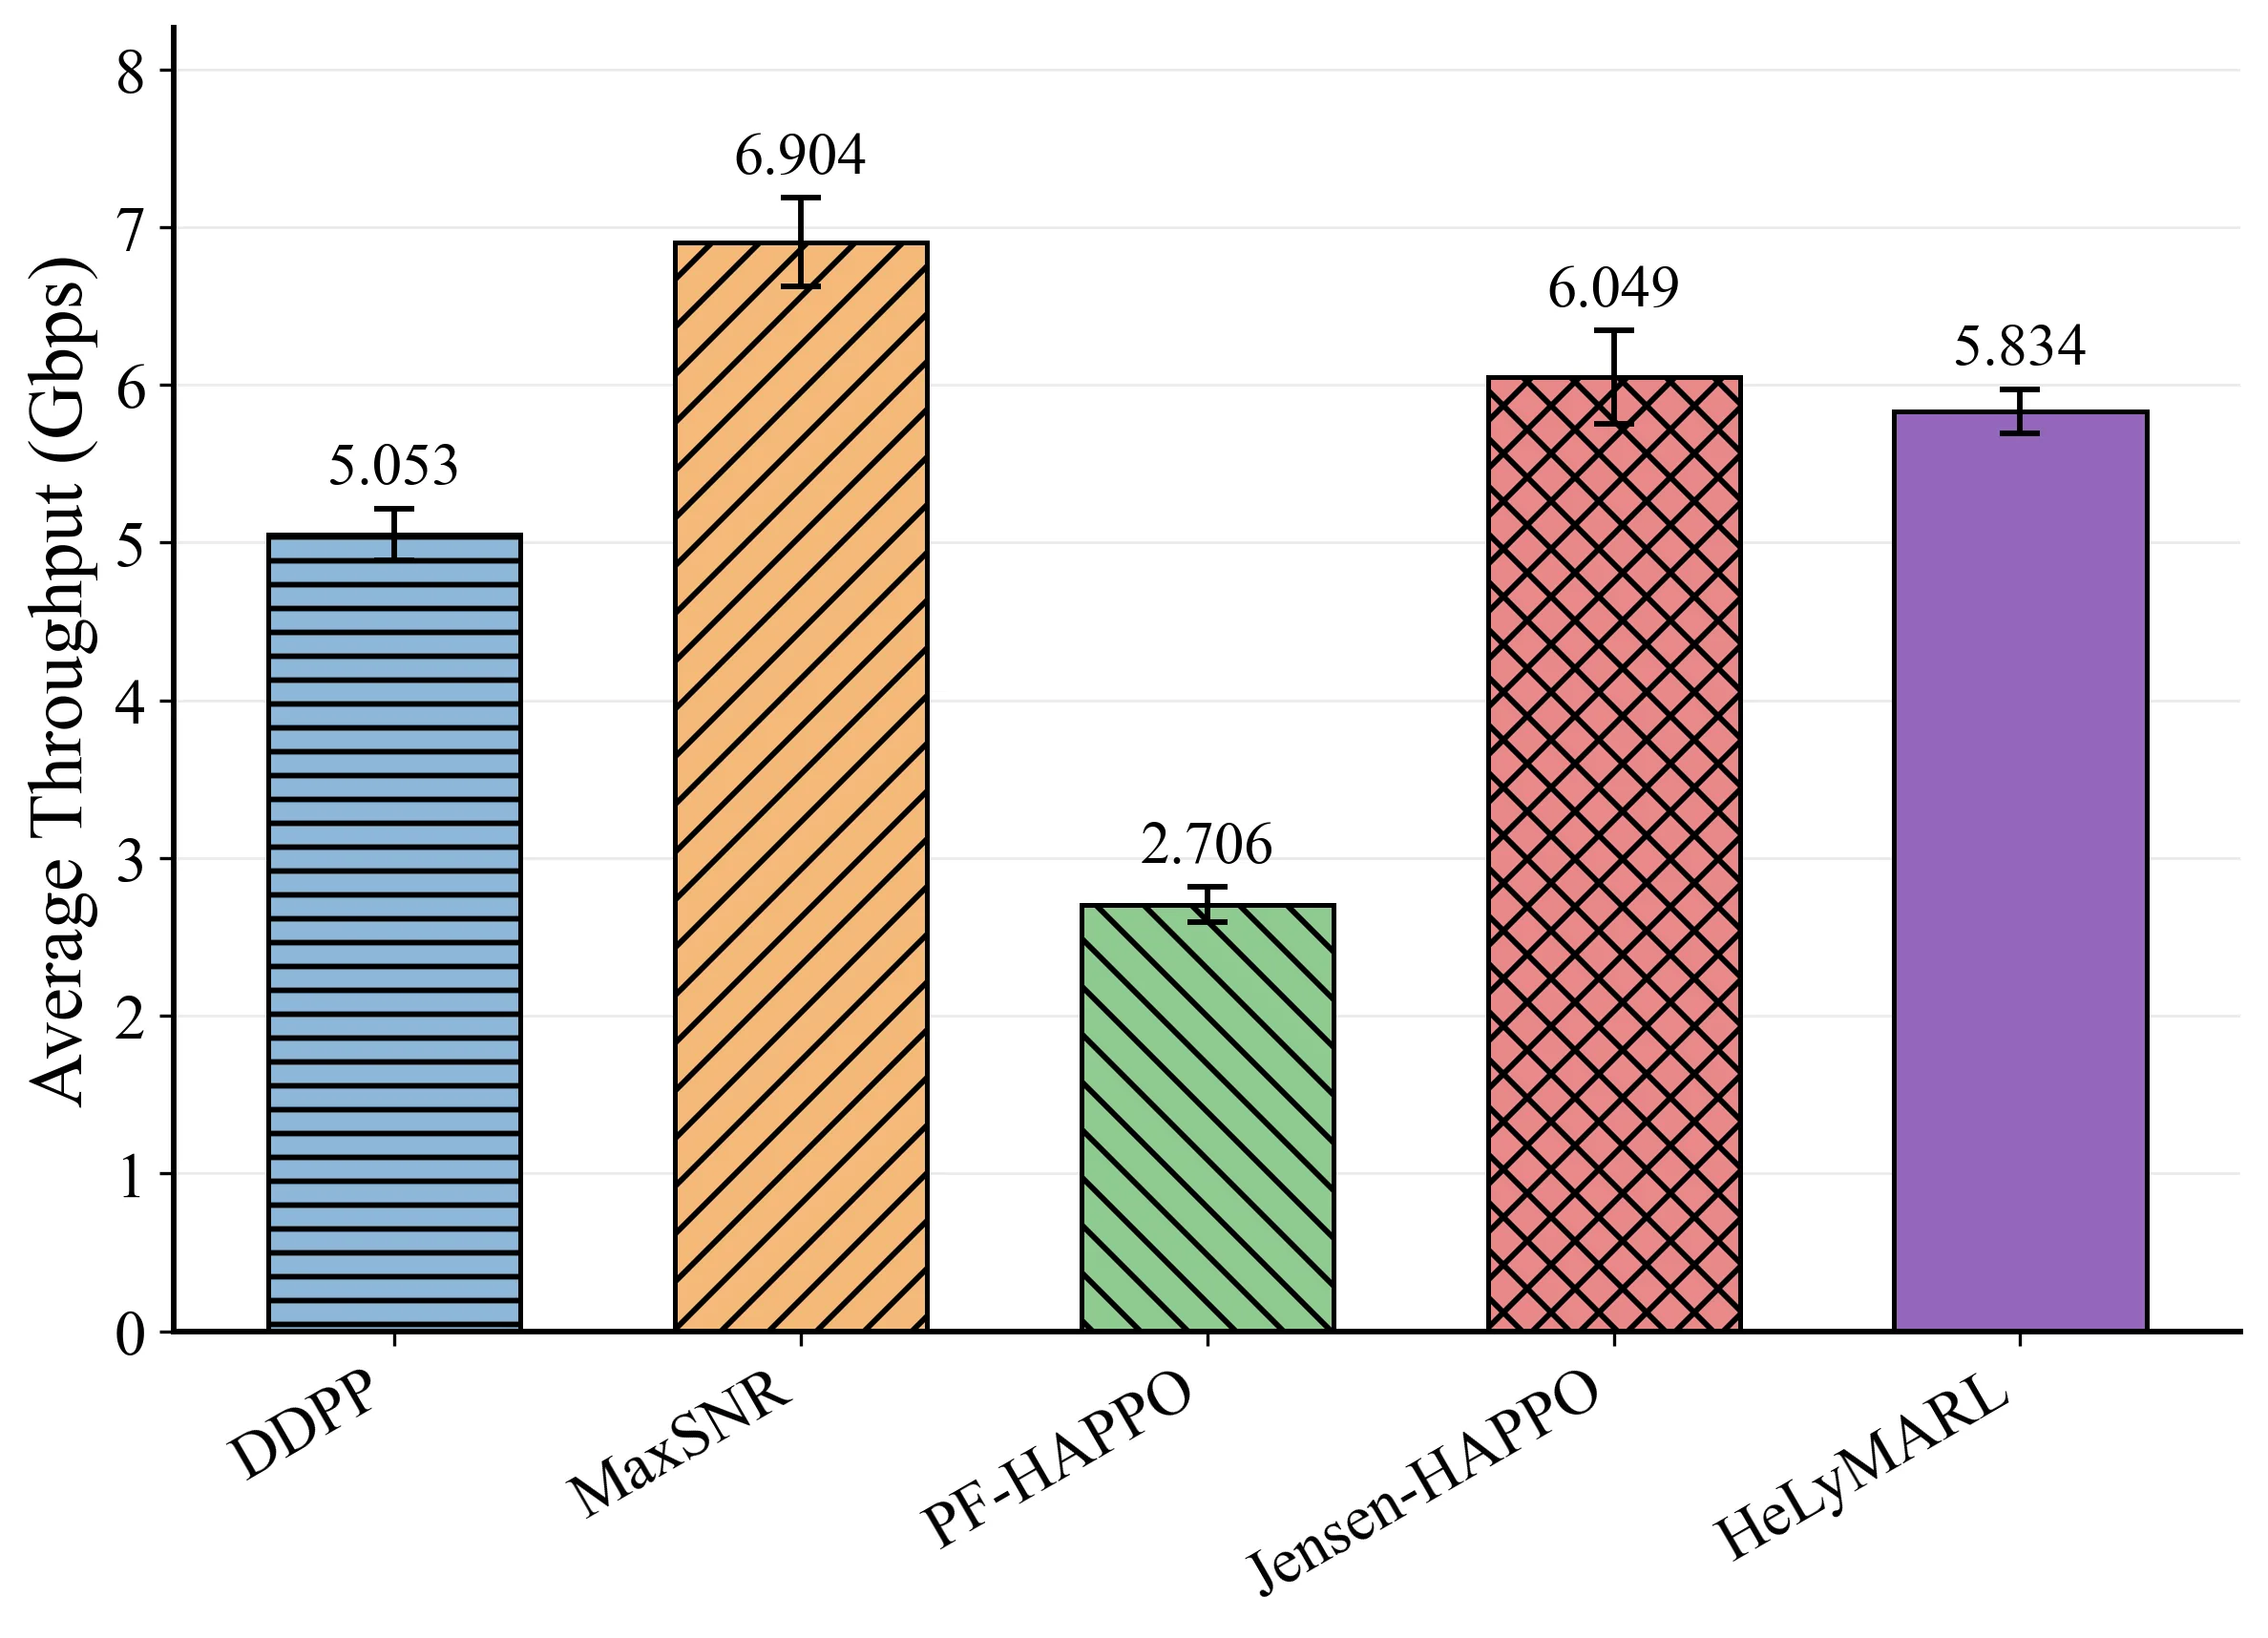
主实验对比了六种方法:启发式 MaxSNR、贪心 Lyapunov 控制 DDPP、两种 Lagrangian 变体 Jensen-HAPPO 与 PF-HAPPO、HeLyMARL-M(用 MAPPO 替代 HAPPO 的消融版本)以及完整的 HeLyMARL。结果显示,HeLyMARL 是唯一在整个时域内同时维持高公平性(JFI = 0.930)与高吞吐量的方法,其 ON-ratio(基站激活比例)在 附近稳定直到约 9500 时隙后才逐渐下降,体现出均匀的预算消耗节奏。相比之下,MaxSNR 在约 6000 时隙处耗尽能耗预算导致服务中断,Lagrangian 变体虽然延迟了耗尽时刻,但 ON-ratio 在前期显著偏离目标值,且 PF-HAPPO 的切换比率累积至 0.075,远超 的容忍上限。
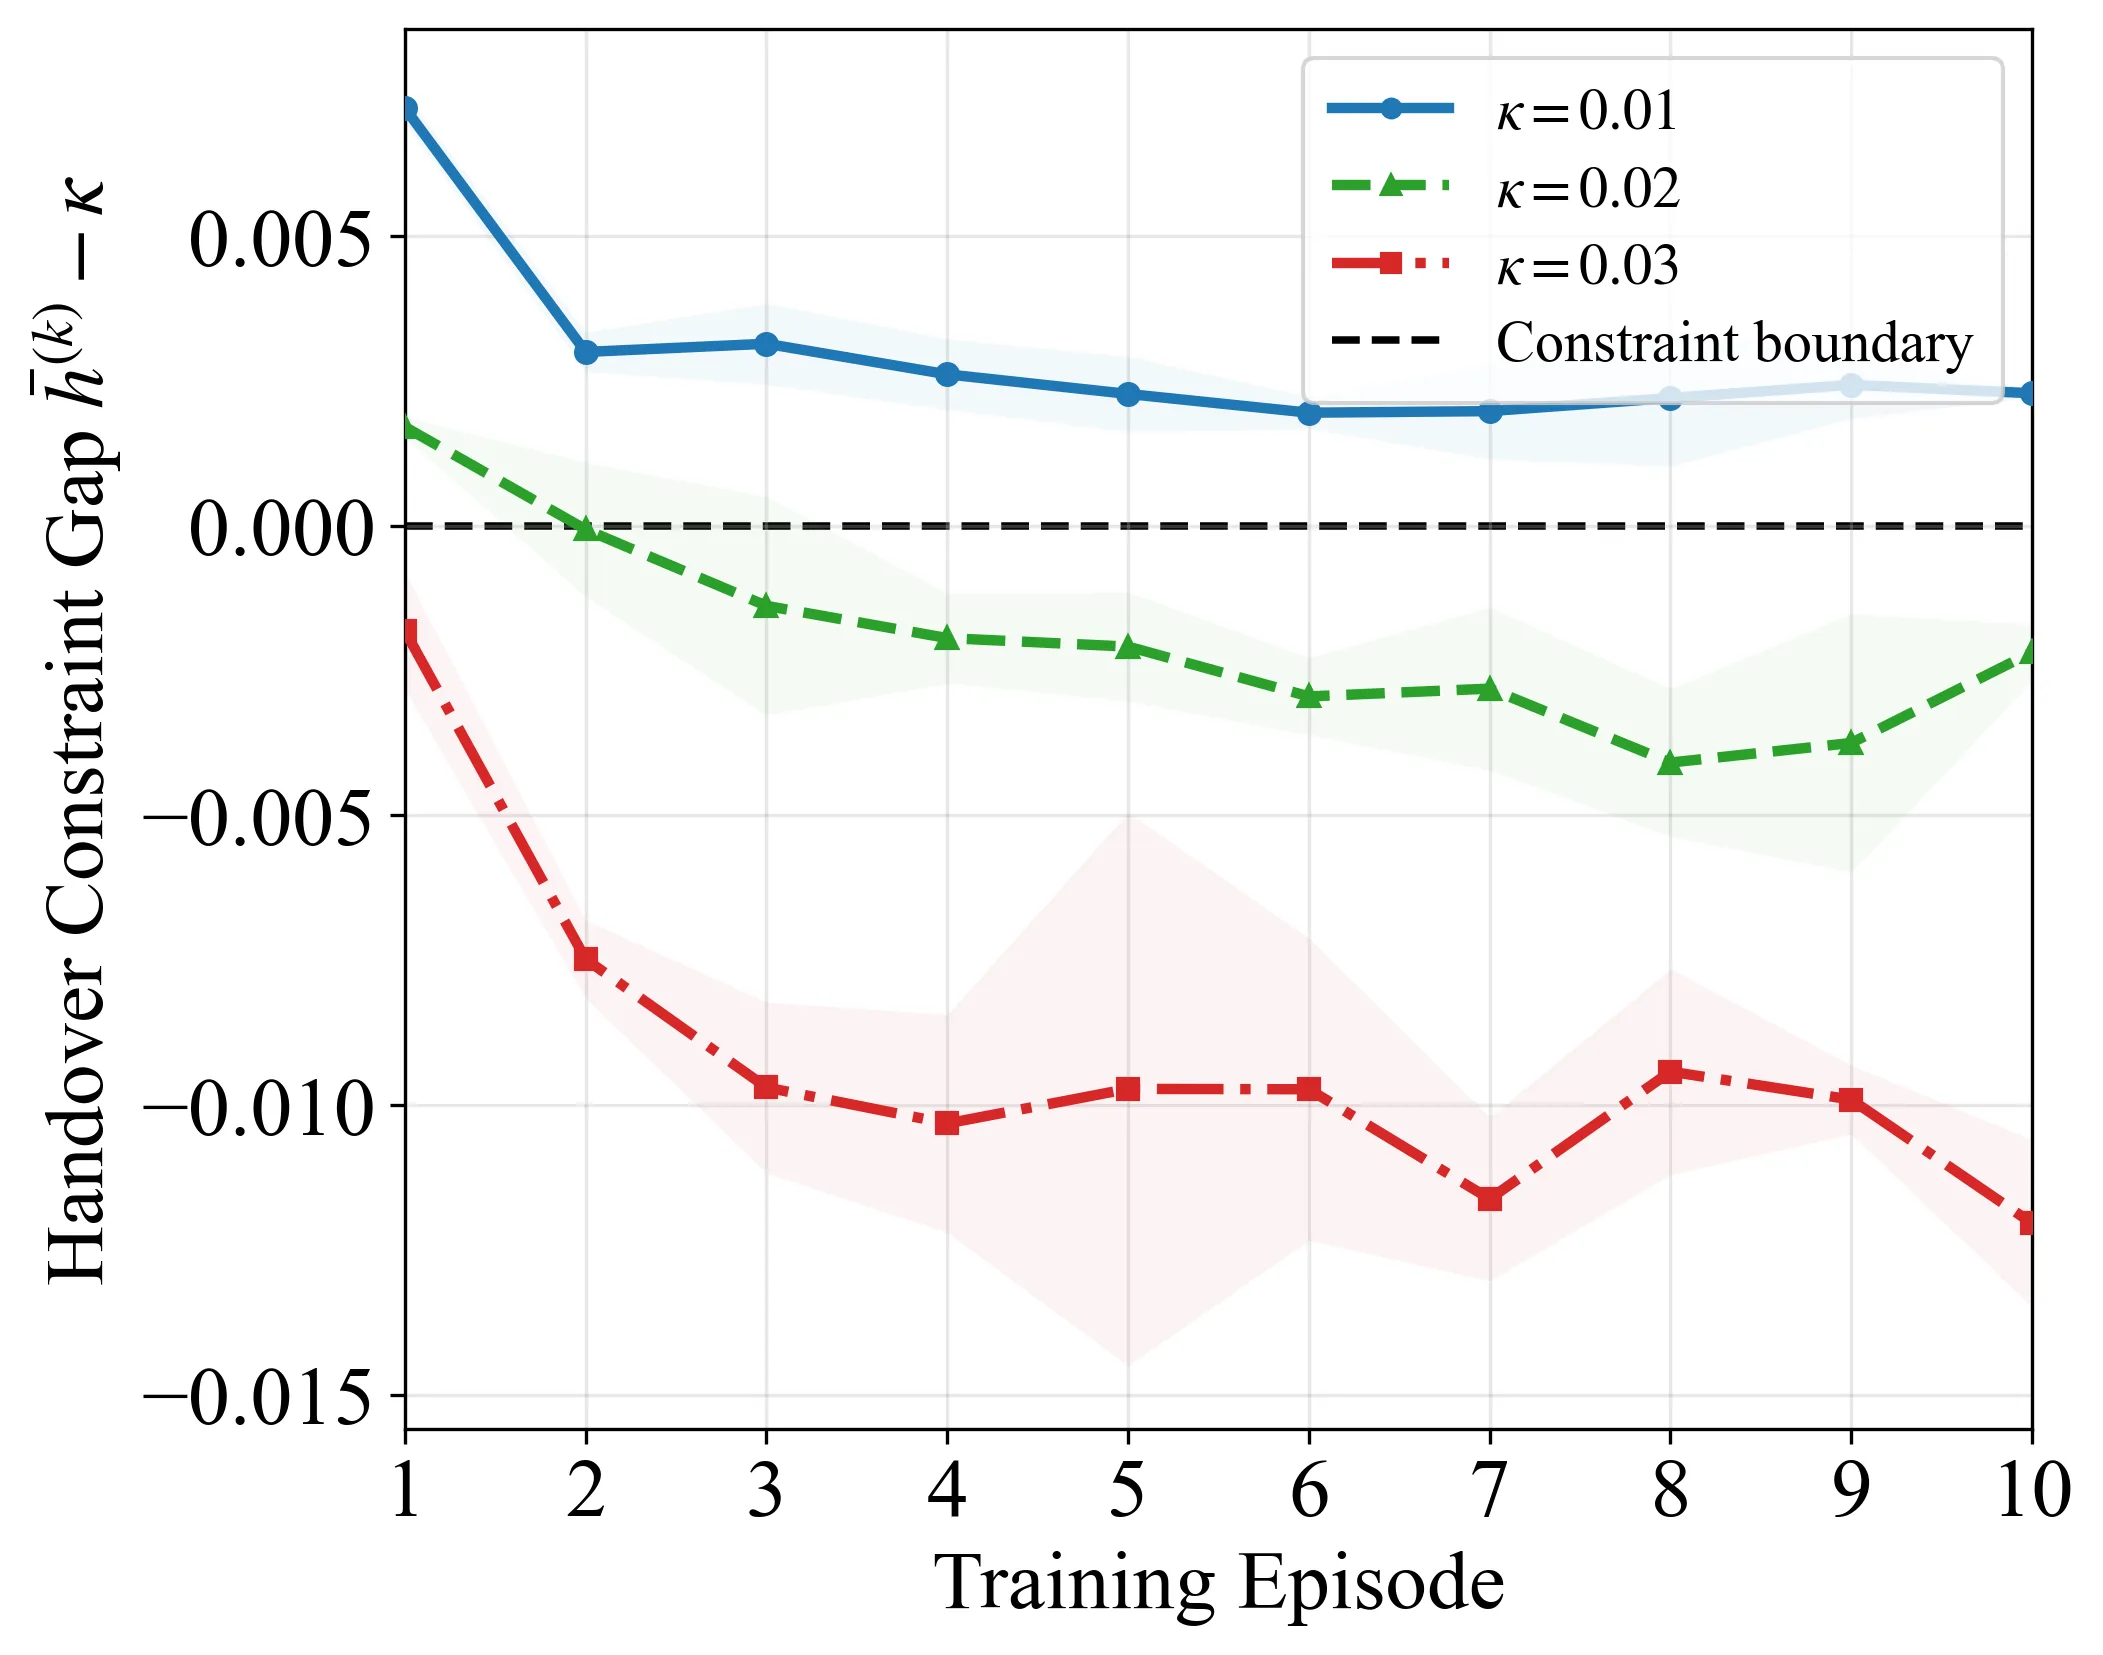
切换约束实验揭示了 Lagrangian 方案在回合内控制失效的具体表现:当训练期与评估期采用不同切换预算系数 时,Jensen-HAPPO 与 PF-HAPPO 在紧约束()下出现显著的训练-评估差距,性能退化明显;而 HeLyMARL 通过虚拟队列的即时反馈机制,能够在评估时快速适应不同的约束紧度,体现出更强的鲁棒性。
消融实验进一步验证了设计选择的有效性。顺序群组更新(HAPPO)相比同时更新(MAPPO)在 3 基站与 5 基站配置下均取得更高的吞吐量与公平指数,证明了异构智能体间信用分配的重要性。切换虚拟队列的消融(LyMARL 无切换队列)则在紧约束()下完全失效,吞吐量骤降,进一步印证了双侧约束耦合场景下联合处理的必要性。
讨论与可借鉴点
HeLyMARL 的最核心启发在于将约束内化而非外部惩罚的思路。传统方法倾向于将约束作为"事后检查"的硬条件或通过 Lagrangian 乘子进行"全局软化",而虚拟队列机制通过将约束违反程度编码为隐状态,使智能体在每一步决策时都能感知到约束压力,实现了一种"内生性"的约束满足。这种设计在电力调度、工业控制等同样面临有限时域资源约束的场景中具有广泛的迁移价值。
论文关于时间尺度分离的洞察也值得深思。Theorem 1 严格证明了 Lagrangian 方案只能实现回合间 精度的约束满足,而 HeLyMARL 在回合内任意部分时域 上都有 的累积界保证。这一结论提示我们,在设计约束优化算法时,约束作用的粒度与控制更新的频率之间存在本质权衡——若约束必须在运行全程严格满足,控制频率必须与约束评估粒度匹配。
当前方法的局限主要集中在以下方面:仿真环境较为单一(仅 mmWave 小蜂窝与高斯移动模型),在真实城市微蜂窝、郊区宏蜂窝等多场景下的泛化性未经验证;训练仅用 3 个随机种子,深度强化学习的高方差特性可能导致统计显著性略显不足;虚拟队列的初始值与参数 的选取缺乏系统性的自适应机制,在非平稳环境中可能需要在线调整。此外,论文假设信道条件可精确获取且用户候选集大小固定为 5,这一假设在动态遮挡严重的毫米波场景下可能过于理想。
摘要
在密集无线网络中实现比例公平下的吞吐量最大化,需要在严格的有限时域能量与切换预算约束下,联合管理用户关联、调度、基站(BS)激活以及切换控制,这引发了基站侧能量管理与用户侧切换调节之间的根本性矛盾。虽然多智能体强化学习(MARL)是处理此类分布式序贯控制的天然框架,但其在此场景中的应用面临两个困难:有限时域预算约束无法在每个时隙进行评估;非线性比例公平效用函数缺乏原则性的逐时隙分解方法。为此,我们提出HeLyMARL——一种嵌入Lyapunov的异构MARL框架,通过漂移加惩罚(drift-plus-penalty)分解与虚拟队列同时解决上述两个问题。能量与切换约束的压力被直接内化至统一的逐时隙奖励中,将受限的有限时域问题转化为无约束的MARL问题。与两种基于拉格朗日的替代方法的对比揭示了一种时间尺度分离现象:拉格朗日松弛仅在训练回合之间调节约束,而HeLyMARL的虚拟队列则在回合内每一个部分时域上限制累积预算消耗,这是一种贪心Lyapunov控制所无法实现的节奏保证。仿真结果表明,HeLyMARL是唯一能够在整个时域内同时维持吞吐量-公平性平衡与不中断服务的方法,在不出现预算过早耗尽的前提下,其性能优于传统MARL、基于Lyapunov的方法以及受限MARL基准。
Abstract
Maximizing throughput under proportional fairness in dense wireless networks requires jointly managing user association, scheduling, base station (BS) activation, and handover control under hard finite-horizon energy and handover budgets, which induces a fundamental tension between BS-side energy management and user-side handover regulation. While multi-agent reinforcement learning (MARL) is a natural framework for such distributed sequential control, its application here faces two difficulties: finite-horizon budget constraints cannot be evaluated at each time slot, and the nonlinear proportional fairness utility admits no principled per-slot decomposition. We propose HeLyMARL, a Lyapunov-embedded heterogeneous MARL framework that resolves both via drift-plus-penalty decomposition with virtual queues. The energy and handover constraint pressures are internalized directly into a unified per-slot reward, converting the constrained finite-horizon problem into an unconstrained MARL problem. Comparison against two Lagrangian-based alternatives reveals a timescale separation: Lagrangian relaxation regulates constraints only across training episodes, whereas the virtual queues of HeLyMARL bound cumulative budget consumption at every partial horizon within an episode, a pacing guarantee beyond the reach of greedy Lyapunov-based control. Simulations show that HeLyMARL is the only method that sustains the throughput-fairness balance together with uninterrupted service throughout the horizon, outperforming conventional MARL, Lyapunov-based, and constrained MARL benchmarks without premature budget exhaustion.
论文详细总结(自动生成)
论文总结:耦合有限时域约束下无线资源管理的异构多智能体强化学习
1. 核心问题与研究动机
论文聚焦于密集蜂窝网络中一类具有耦合双侧有限时域硬约束的联合控制问题。系统需同时优化以下四个紧密耦合的决策:
- 用户关联(user association):
- 基站(BS)激活:,每时隙单 BS 至多服务一个用户
- 调度:由激活 BS 在候选集 中选择用户
- 切换控制:,刻画用户是否切换服务 BS
需要满足的硬约束为:
目标是在比例公平(PF)下最大化时间平均速率效用:
根本性张力在于:增加激活 BS 提升空间多样性与吞吐量,但加速能耗预算耗尽;切换到更好的 BS 改善瞬时速率,但累积切换次数受 QoE 预算限制;且两约束通过共享的关联决策深度耦合——严格的切换预算将用户锁定在部分 BS 上,加剧另一组 BS 的能耗集中消耗。
传统 MARL 在此问题上存在两个根本性障碍:
1. 奖励设计:比例公平效用是非线性时间平均函数,无单时隙值,无法直接分解为逐时隙奖励。
2. 双侧约束耦合:现有研究多在单一侧施加单约束,无法处理 BS 侧能耗与用户侧切换同时作为硬约束的双侧耦合情形。
2. 方法论
2.1 整体框架:HeLyMARL
HeLyMARL(Heterogeneous Lyapunov-embedded MARL)在 CTDE 范式下,将 Lyapunov 漂移加惩罚(DPP)框架嵌入到异构 MARL(HAPPO 骨架)中,通过三类虚拟队列将所有约束压力内化到统一逐时隙奖励。
2.2 虚拟队列定义
定义三组虚拟队列,初始值为 ,:
2.3 DPP 奖励推导
对 Lyapunov 函数 取一步漂移上界,剔除仅依赖于辅助变量 (可闭式求解)的无关项后,得到与动作相关的逐时隙奖励:
辅助变量按如下闭式更新:
控制效用最大化与公平队列调节之间的权衡。关键设计:由于切换约束的所有权在用户与 BS 共享(切换发生需要用户请求与 BS 调度同时满足),无法做角色专属分解;故保留 DPP 奖励的统一形式。
2.4 三种奖励形式对比
| 方法 | 奖励形式 | 约束处理 |
|---|---|---|
| Jensen-HAPPO | (Jensen 下界) | Lagrangian 松弛, |
| PF-HAPPO | (PF 梯度分解) | 同上 Lagrangian 松弛 |
| HeLyMARL | DPP 奖励(公式如上) | 虚拟队列内化,无需 Lagrangian |
2.5 异构智能体与 HAPPO 顺序更新
- 用户智能体:选 BS 关联请求
- BS 智能体:选调度与激活
BS 维护长度为 的候选集 ,按 DPP 评分排序:
采用 HAPPO 的顺序群组更新(先更新用户群,再以修正因子 校正 BS 群的优势估计),解决统一奖励下两群组的信用分配问题:
2.6 预算感知动作掩码(Remark 1)
- 训练时:不施加掩码,使智能体经历预算耗尽的多样化场景。
- 推理时:当 时强制 ;当 时禁止切换。
2.7 算法流程(Algorithm 1)
每回合 :初始化虚拟队列 → 每时隙采样用户动作 → 形成候选集并采样 BS 动作 → 执行并观察 → 计算 DPP 奖励 → 更新队列 → 缓存转移 → 每 步做 GAE 优势估计与 HAPPO 顺序更新。
3. 实验设计
3.1 仿真场景
- 网络:28 GHz mmWave 小蜂窝, m²,带宽 500 MHz,BS 发射功率 20 dBm。
- BS 配置:,对称几何(等边三角形 / 中心方阵 / 六边形 / 网格),站间距约 35–50 m。
- 用户数:默认 ;扩展至 。
- 移动性:高斯随机游走模型。
- 默认参数:。
- 预算参数: 控制 BS 激活比例目标, 控制用户切换率上限。
- 评估种子:5 个评估种子 × 3 个训练种子。
3.2 对比方法(Baseline)
| 方法 | 类别 | 特点 |
|---|---|---|
| MaxSNR | 启发式 | 用户选 SNR 最大 BS;无训练、无预算与公平意识 |
| DDPP | 贪心 Lyapunov 控制 | 按 逐时隙贪心决策,无轨迹级学习 |
| Jensen-HAPPO | Lagrangian 受限 MARL | Jensen 奖励 + 拉格朗日 |
| PF-HAPPO | Lagrangian 受限 MARL | PF 奖励 + 拉格朗日 |
| HeLyMARL-M | 消融 | 用同时更新 MAPPO 替代 HAPPO |
| LyMARL [19] | 消融 | 单 BS 能耗预算,无切换虚拟队列 |
3.3 评估指标
- 吞吐量(Thr.,Gbps):回合平均聚合速率
- Jain 公平指数(JFI)
- ON-ratio:
- HO-ratio:
3.4 超参数(Table I)
学习率:actor ,critic ;;;clip ;熵系数 0.05;minibatch 256;epoch 4;隐藏层 128;rollout 128; 回合; 时隙;;。
4. 资源与算力
论文未明确披露所使用 GPU 型号、数量、训练时长、显存占用等具体算力信息,仅给出回合数 、每回合步数 、rollout 长度 等训练规模参数。这构成算力信息透明度上的不足。
5. 实验数量与充分性
实验覆盖较为充分,可分为以下几类:
1. 主实验(Fig. 2–3):默认设置下 ON-ratio 轨迹、吞吐量、JFI 的对比(5 评估种子 × 3 训练种子)。
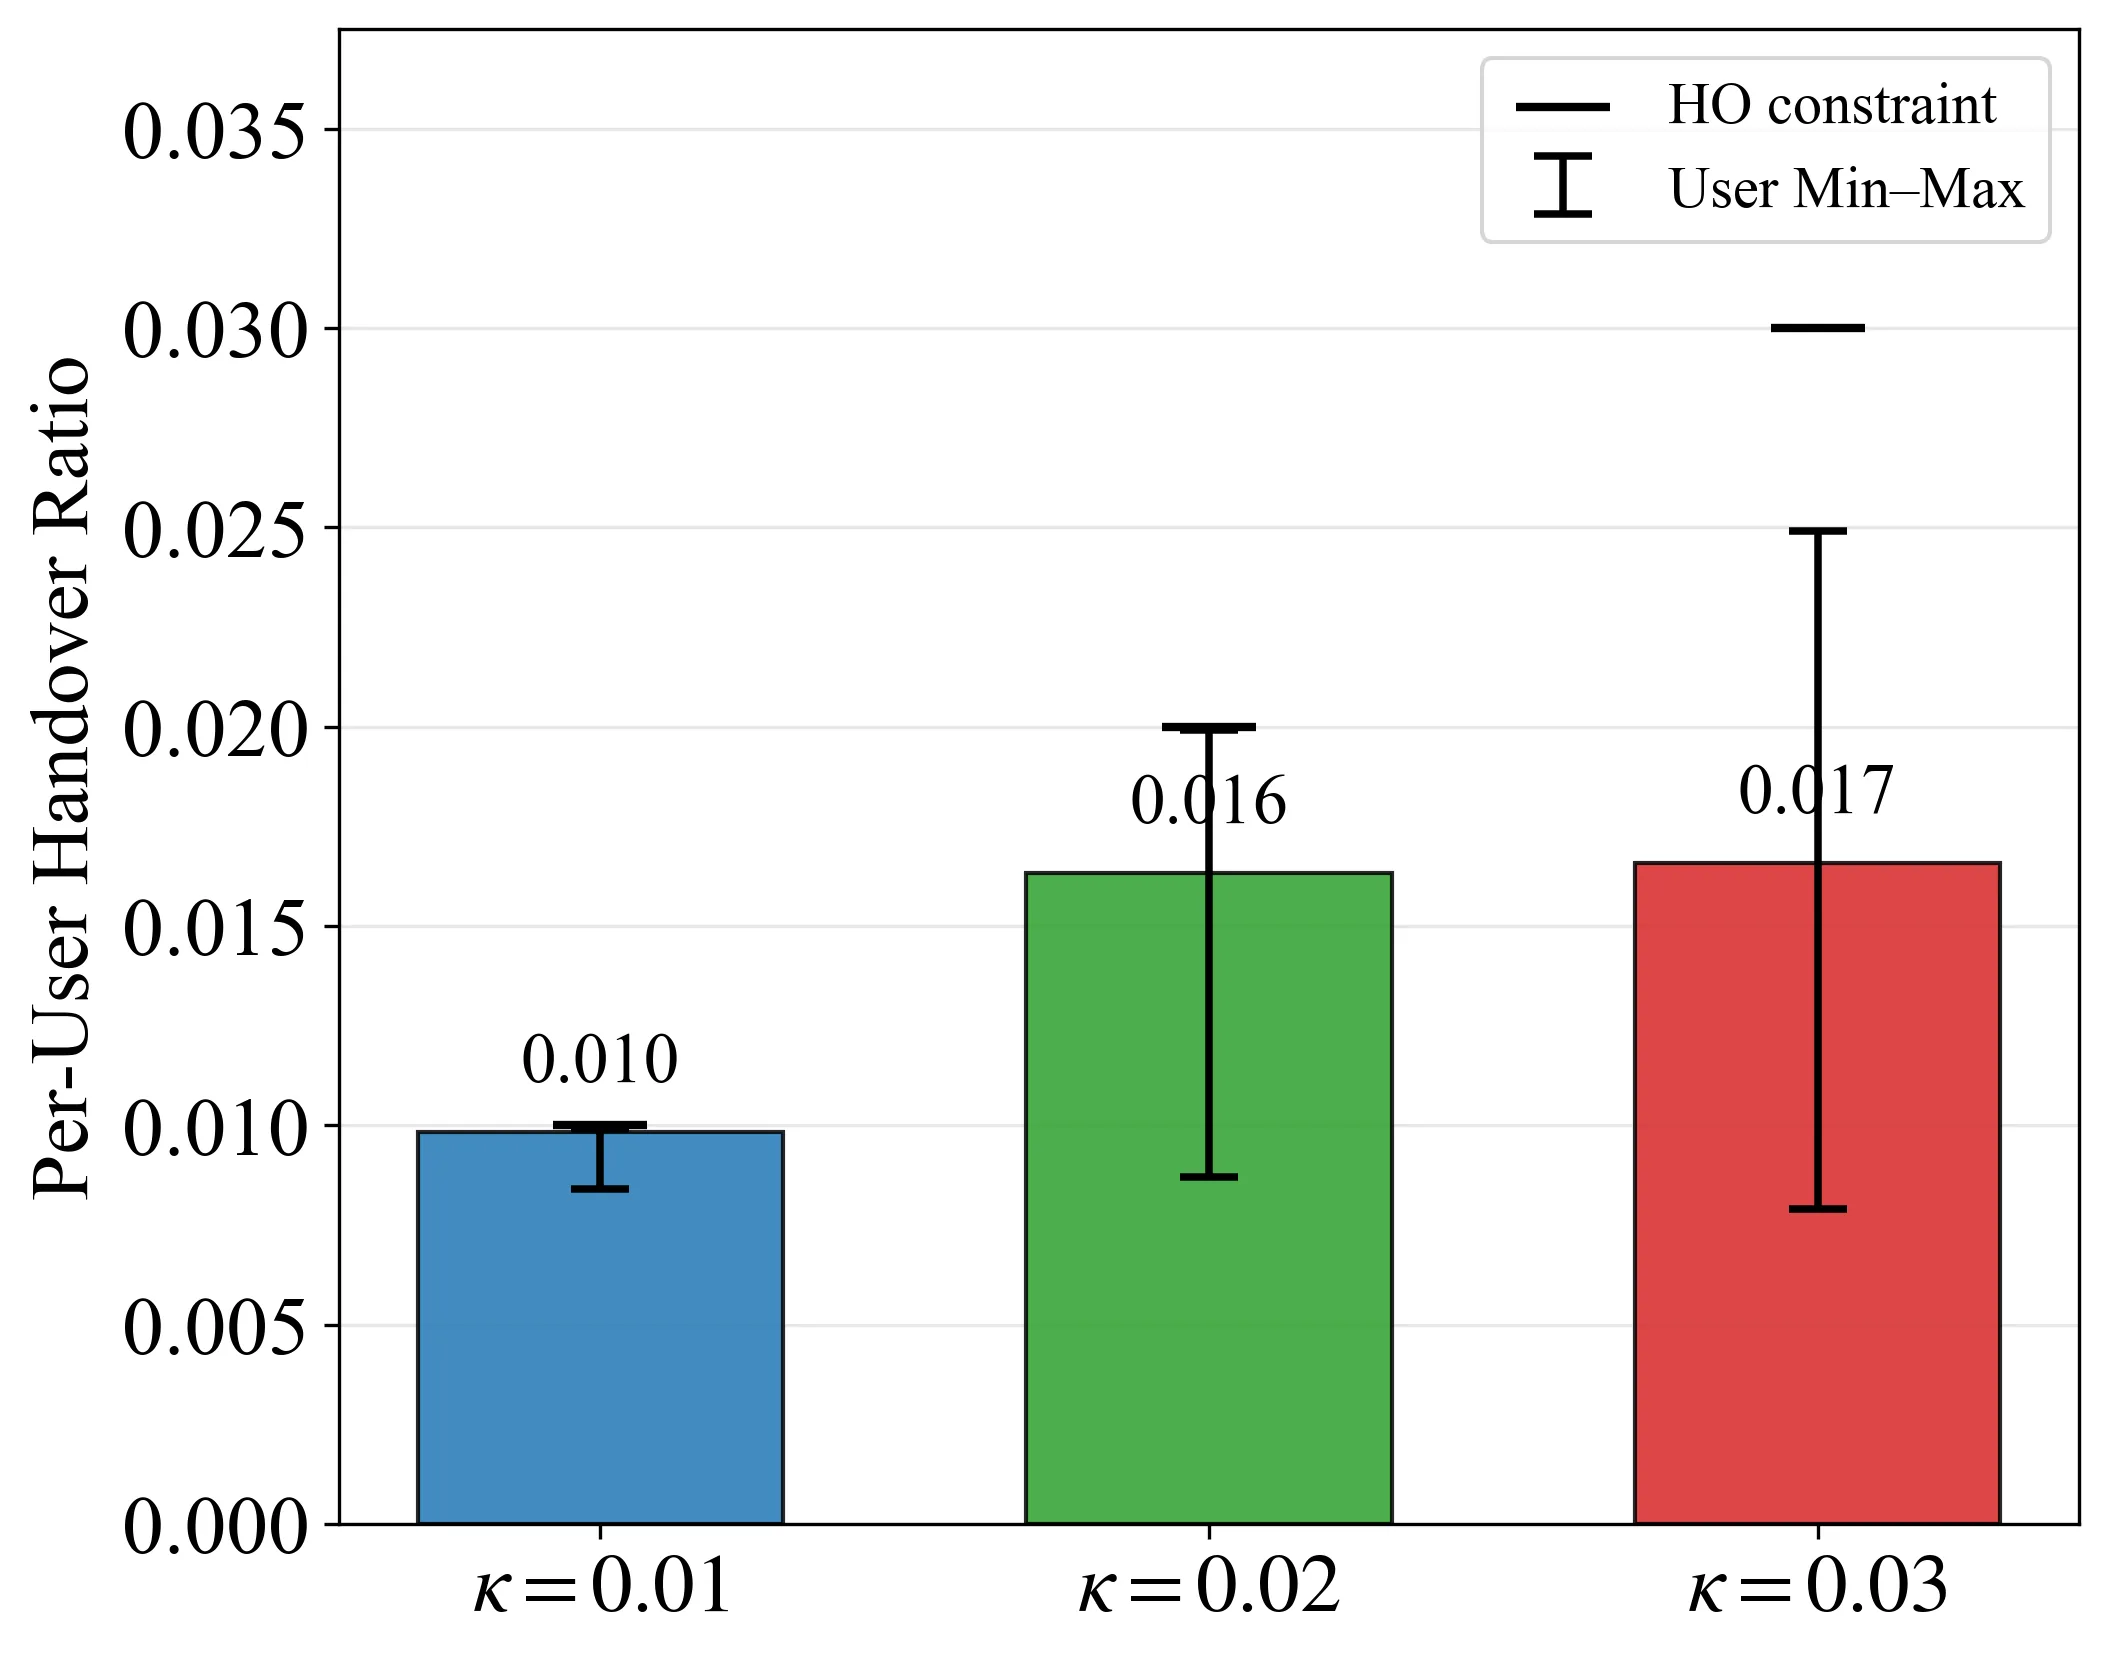
2. 切换约束实验(Fig. 4):训练期与评估期在 下的约束差距与每用户切换比。
3. 方法间切换对比(Fig. 5):累积切换率时序轨迹。
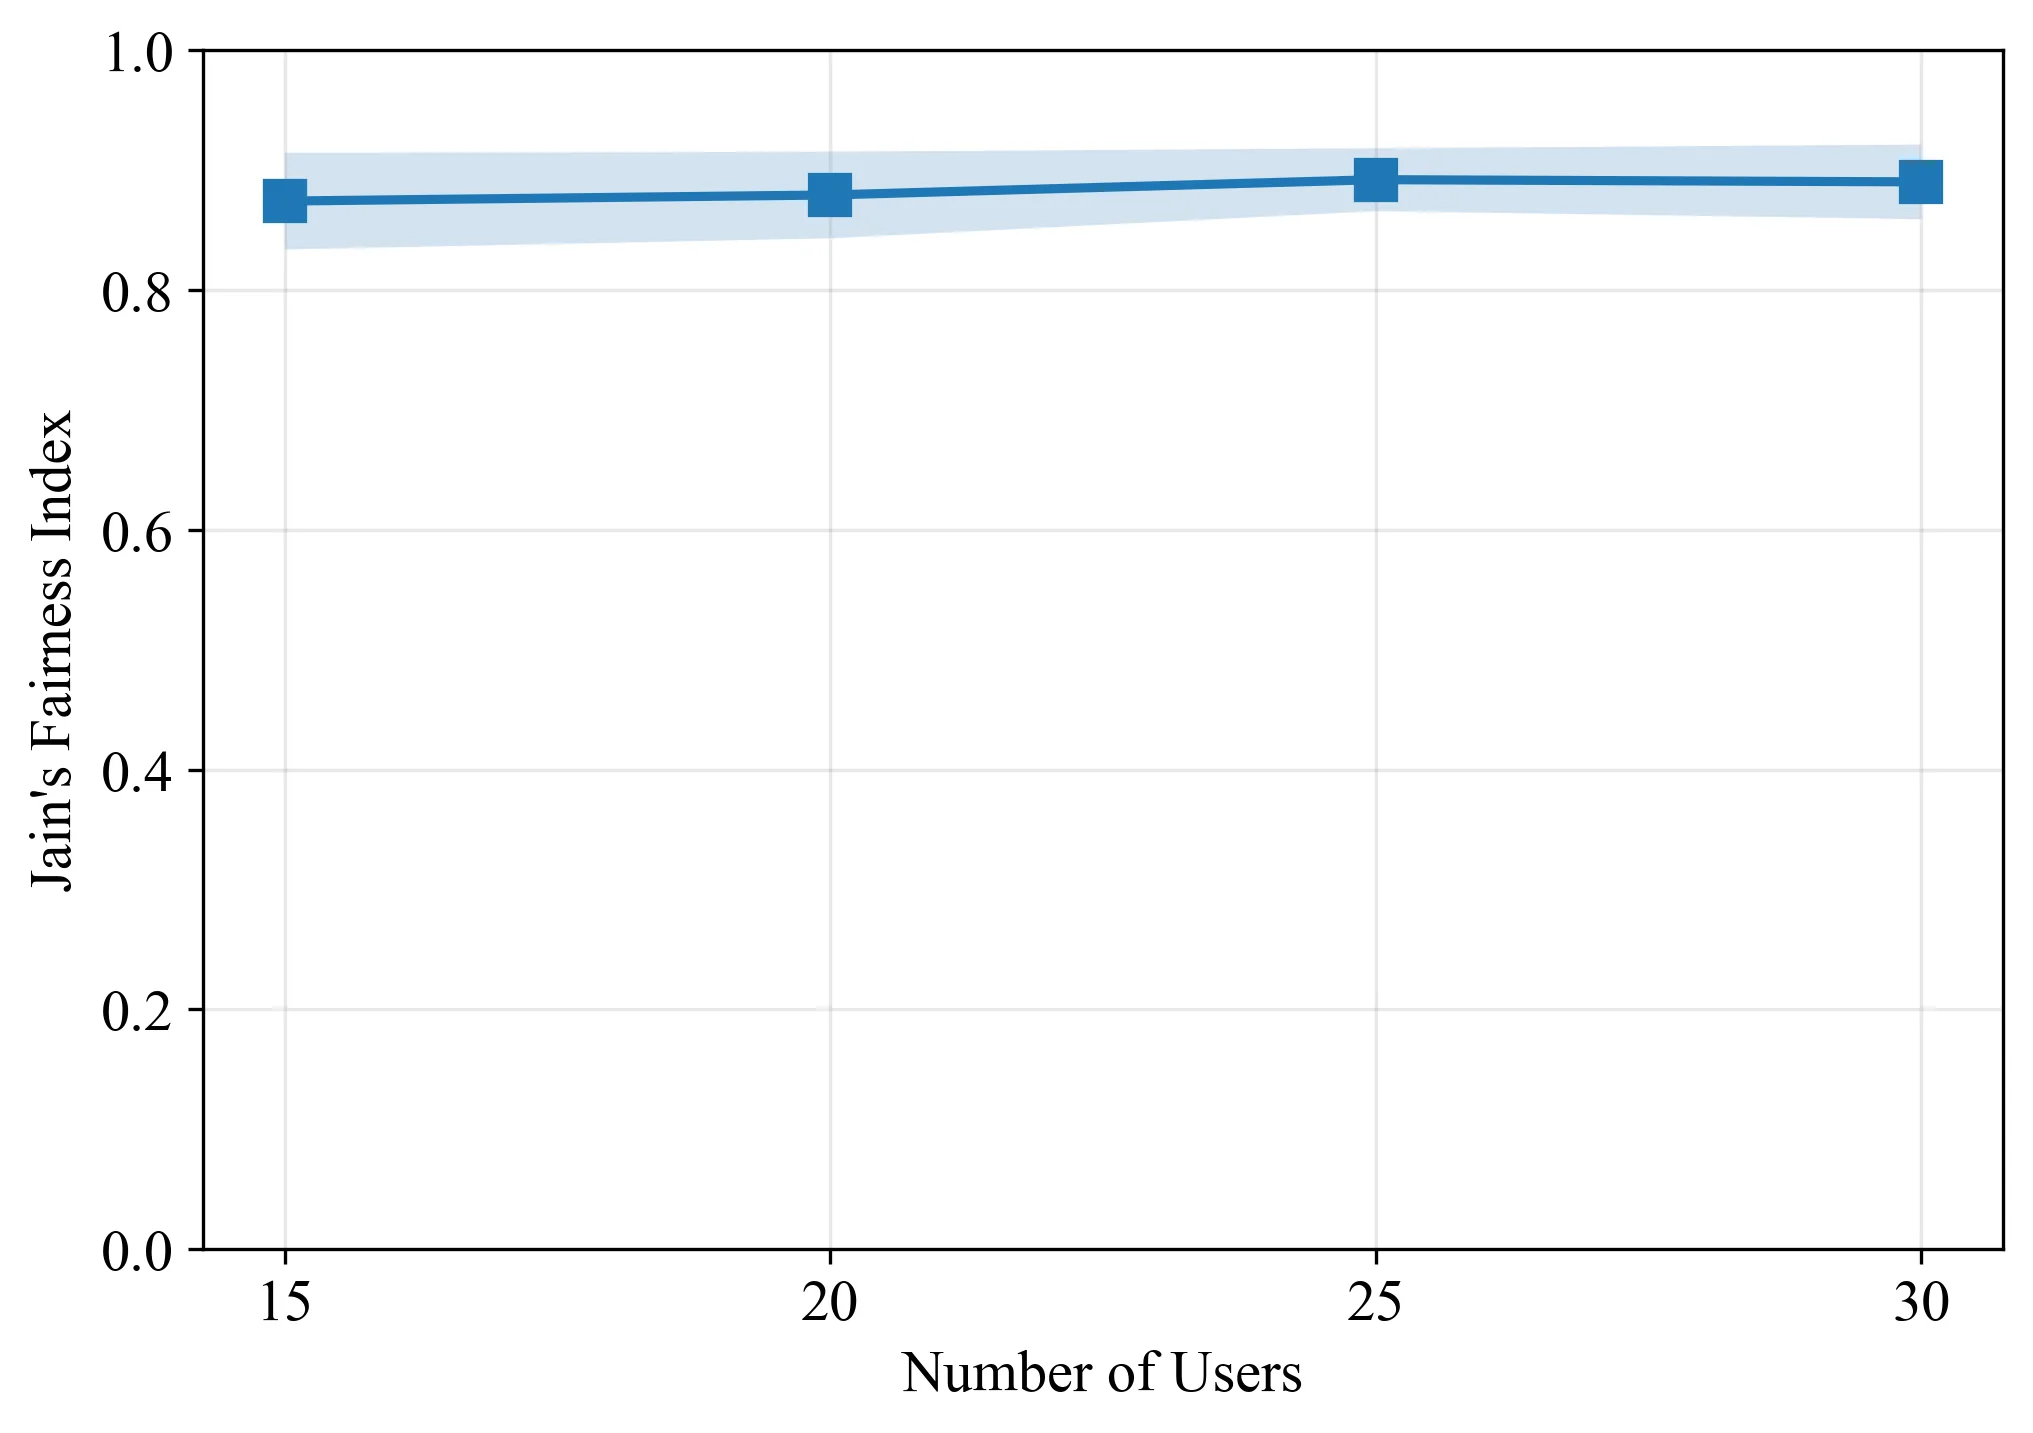
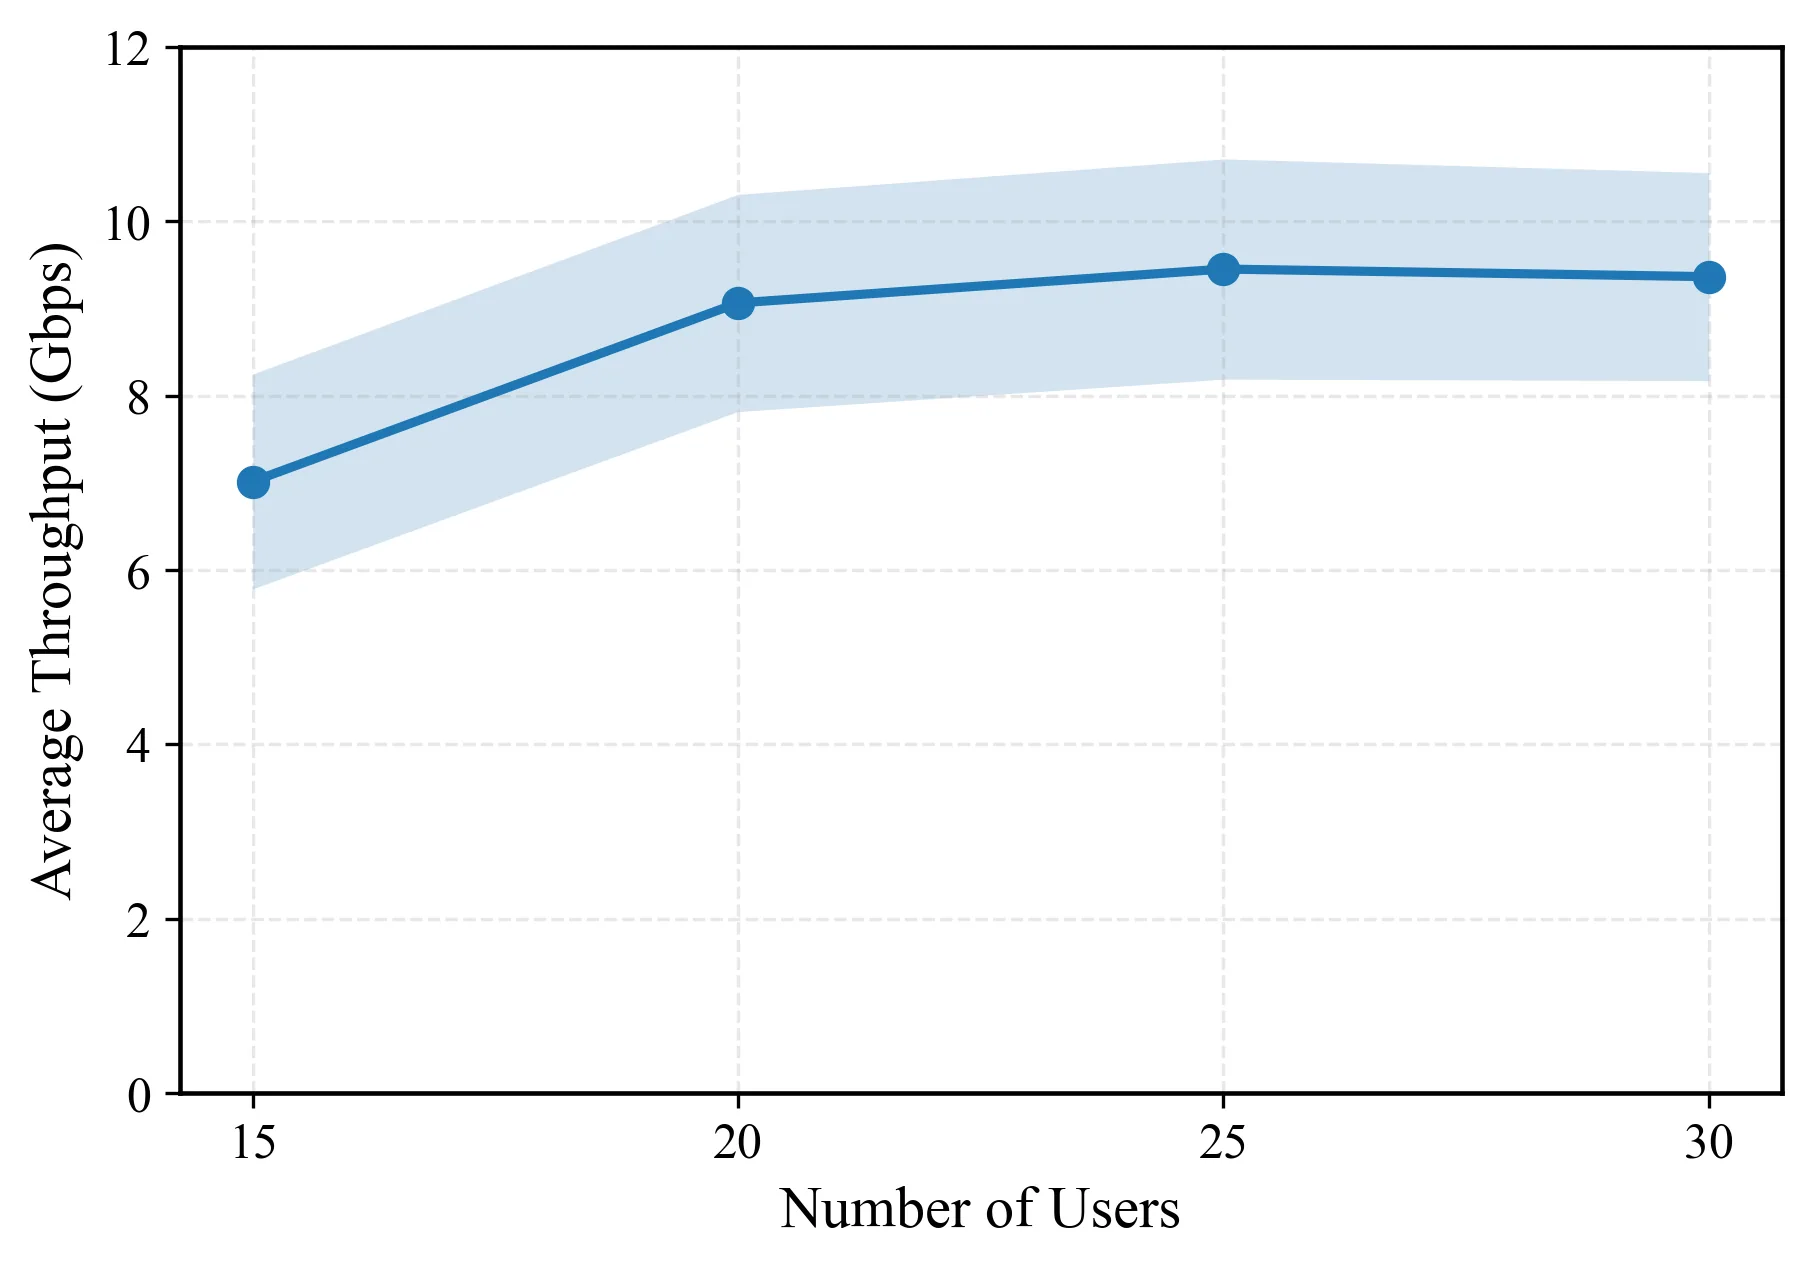
4. 网络规模(Table II,Fig. 6): 多种 下的吞吐量、JFI、ON-ratio、HO-ratio;用户数从 15 到 30 的零样本迁移。
5. 消融实验(Table III–IV):
- 顺序群组更新(HAPPO vs MAPPO)在 下对比;
- 切换虚拟队列(HeLyMARL vs LyMARL)在 (松弛)与 (紧约束)下对比。
充分性评估:实验在不同 、、、 多维度展开,包含训练/评估的不对称分析(Remark 3)、紧/松弛预算的对照、零样本迁移等设计,且通过 Proposition 1–2 和 Theorem 1 提供了形式化保证。不足之处:仅在单一仿真环境(mmWave 小蜂窝、特定移动性模型)下验证,未在真实数据集或多种信道模型上验证;3 训练种子对深度 MARL 实验的统计显著性略显薄弱。
6. 主要结论与发现
1. 唯一满足全程服务连续性的方法:HeLyMARL 是唯一在整个时域内同时保持高公平性(JFI = 0.930)、高吞吐量(约为 MaxSNR 的 85%)且无服务中断(ON-ratio 在 附近稳定直到 )的方法。
2. 时间尺度分离(Theorem 1):Lagrangian 变体(Jensen-HAPPO、PF-HAPPO)仅在回合之间以 速率平均调节约束,回合内无节奏保证,导致前期 ON-ratio 偏离 显著且预算过早耗尽(MaxSNR、Jensen-HAPPO 在 时耗尽;PF-HAPPO 维持 ON-ratio ≈ 0.8 至 致切换累积至 )。
3. 回合内节奏保证(Proposition 2):HeLyMARL 的虚拟队列在任意部分时域 提供 的统一界,DDPP 无法满足此保证(反例:能耗队列从零起,DDPP 早期过度激活,预算在 处耗尽)。
4. 预算驱动的运作点(Fig. 4):HeLyMARL 自适应到 依赖的切换水平;当 紧(0.01)时多数用户耗尽配额,宽(0.03)时反映自然切换需求。
5. 零样本用户规模迁移(Fig. 6):BS 候选集维度固定使策略可在 – 间零样本迁移;吞吐量饱和于调度容量限制,公平性几乎不变。
6. 切换与能耗的耦合效应:紧切换预算不仅限制切换,还降低能耗预算利用效率——用户被锁定后,部分 BS 接收请求稀少而保持非激活,ON-ratio 偏离 。
7. 方法与实验亮点
- 首次将 DPP 框架嵌入异构 MARL,解决了 PF 效用无单时隙分解的开放问题(以往或用瞬时速率代理,或用启发式 PF 比替代)。
- 统一 DPP 奖励 + HAPPO 顺序群组更新的耦合设计:放弃角色专属奖励分解,转而通过顺序更新与修正因子恢复信用分配,简洁且有理论支撑。
- 双侧耦合约束的形式化分析(Proposition 1、Theorem 1、Proposition 2),将预算控制的时间尺度分离讲清楚——动作掩码保证推理期硬可行性(确定性),Lagrangian 仅提供回合平均收敛 ,DPP 提供回合内任意 的节奏保证。
- 训练-评估不对称设计(Remark 1、Remark 3):训练期不掩码以暴露预算耗尽场景,推理期掩码提供硬保证;消融显示虚拟队列仅在紧约束下显现优势(表 IV),符合"按需建模"原则。
- 候选集固定维度实现 BS 侧动作/观测与用户数 解耦,支持用户规模零样本迁移。
8. 不足与局限
1. 算力披露缺失:未报告 GPU 型号/数量、训练时长、显存占用等。
2. 场景单一:仅在 28 GHz mmWave 小蜂窝 + 高斯随机游走单一仿真环境下验证,未在 sub-6 GHz、室外宏蜂窝、真实测量数据集或多种移动性/信道模型下测试。
3. 统计强度有限:3 个训练种子对深度 MARL 实验偏少,置信区间与显著性结论需谨慎对待。
4. 简化假设:
- 单 BS 每时隙最多服务一个用户(公式 (2)),未涵盖 MU-MIMO 等多用户同时调度场景;
- CSI 估计误差 在实验中被假设已知或近似完美,未建模估计噪声与导频开销;
- 每用户切换预算同质化(统一 ),未考虑差异化 QoE 等级。
5. 公平性指标单一:仅用 Jain's index,缺少 -fairness 家族或更细粒度的用户级 QoE 度量。
6. Algorithm 1 复杂度未分析:候选集大小 对计算开销的影响、收敛速度与样本效率未给出系统分析。
7. 部署可行性:未讨论模型部署到真实 RAN 时的推理延迟、在线微调或与现有 SON/O-RAN 架构的集成问题。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。