
📝 TLDR
小型冻结LLM在空间合作博弈中因直接输出底层动作而完全失败。本文引入options框架与macro-action Dec-POMDP,为每个博弈配备由前沿编程模型从源代码生成的符号options库,并以随机策略rollout机械合成可行性guard;各agent用私有LoRA适配器,经per-agent MAGRPO训练。四个小型骨干在三个空间合作游戏中从零奖励提升到有竞争力博弈。行为审计进一步揭示:奖励上升不一定代表合作,reward不能作为cooperation的可靠读数。
🧭 速览
小型冻结LLM在空间合作博弈中直接输出底层动作完全失败,无法获得任何奖励,需要高层抽象的决策框架。
基于options/macro-action Dec-POMDP,由编程模型生成符号options库,用随机rollout合成可行性guard过滤,每agent用私有LoRA经PA-MAGRPO训练。
三个空间合作游戏、四个小型LLM骨干从零奖励提升到具备竞争力水平,并能通过行为审计剖析合作模式。
奖励与协作存在解耦,奖励上升可能仅因一方独自完成任务,评估多agent系统须将行为评估与reward并置。
🆚 方法对比
Symbolic Option Library
- 将LLM决策粒度从原始动作提升到语义选项
- 可行选项菜单消除接地失败与幻觉问题
- 压缩episode长度缓解稀疏奖励信用分配
- 前沿模型一次生成后续无需再查询
- 每个游戏需单独从源码构建选项库
- 选项库构建后固定无法在线自适应
- 依赖Claude Opus 4.8等前沿模型质量
- 选项粒度与完备性难以保证最优
Semi-MDP / Options Framework
- 经典时序抽象理论,基础坚实
- 将多步决策压缩为单次语义选择
- 缓解稀疏奖励下信用分配难题
- 选项定义传统上需人工设计
- 选项粒度选择缺乏系统指导
- 不直接处理多智能体异步执行
Macro-action Dec-POMDP
- 天然建模智能体间选项异步执行
- 为分散宏观策略学习提供理论框架
- 统一多智能体决策过程描述
- 求解复杂度随智能体数指数增长
- 理论框架强但实际可解性有限
- 需预先固定完整选项集合
PA-MAGRPO
- 每智能体独立适配器可学不同角色
- 解决共享权重下角色梯度冲突
- 三游戏四小模型上验证有效
- 参数量和训练成本随智能体线性增长
- 联合RL梯度计算开销高
- 每智能体单独训练增加工程复杂度
Private Per-agent LoRA Adapter
- 参数高效仅增加少量可训练参数
- 共享冻结基础保留通用语言知识
- 为角色专门化提供独立参数空间
- 适配器容量限制角色分歧程度
- 适配器间无法直接通信共享信息
- 仍受共享基础表征能力限制
Feasibility Guard Synthesis
- 完全自动合成无人工编写或调优
- 基于执行有效性而非奖励避免过拟合
- 可解释失败同时隐藏零个成功
- 仅能发现回放中出现过的失败模式
- 依赖随机策略回放的覆盖度
- 合成后无法在线适应新场景
Behavioral Audits
- 揭示奖励曲线与合作的脱耦现象
- 发现一智能体独自完成任务的隐患
- 提供多维度行为评估补充奖励信号
- 审计过程需额外人工分析成本
- 合作指标定义存在主观性
- 不直接参与训练信号优化
本文以Semi-MDP/Options与Macro-action Dec-POMDP为理论基底,提出统一方案——符号选项库+PA-MAGRPO+私有LoRA,其中自动可行性守卫合成解决了传统选项框架的人工设计瓶颈,行为审计则补充了纯奖励评估的不足,揭示了高奖励未必意味着合作。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 8 张)
展开查看 8 张图
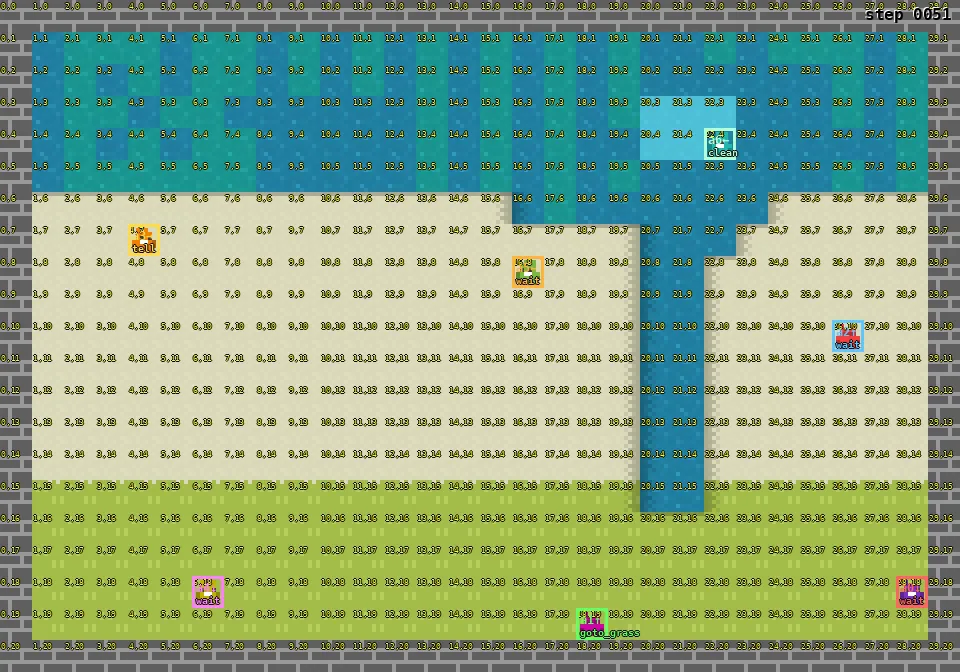
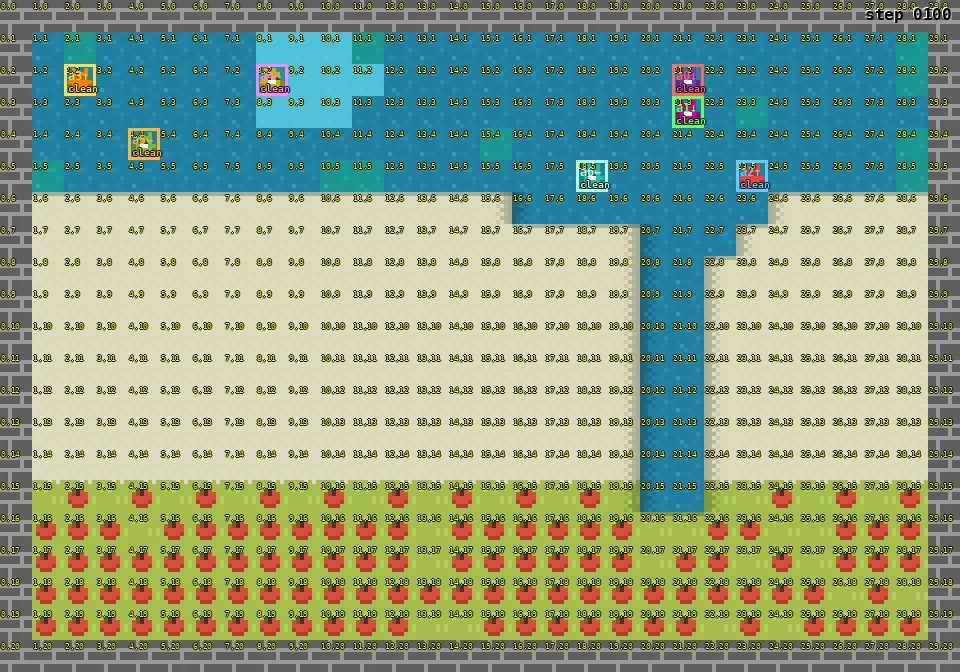
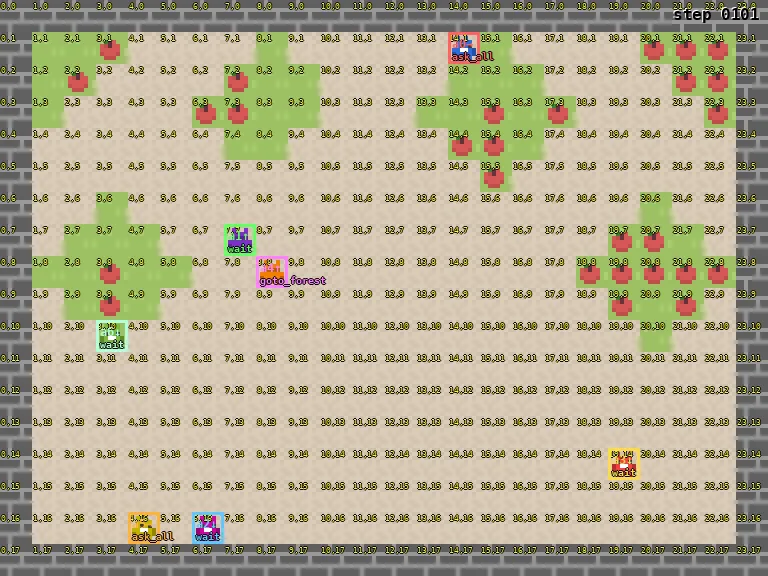
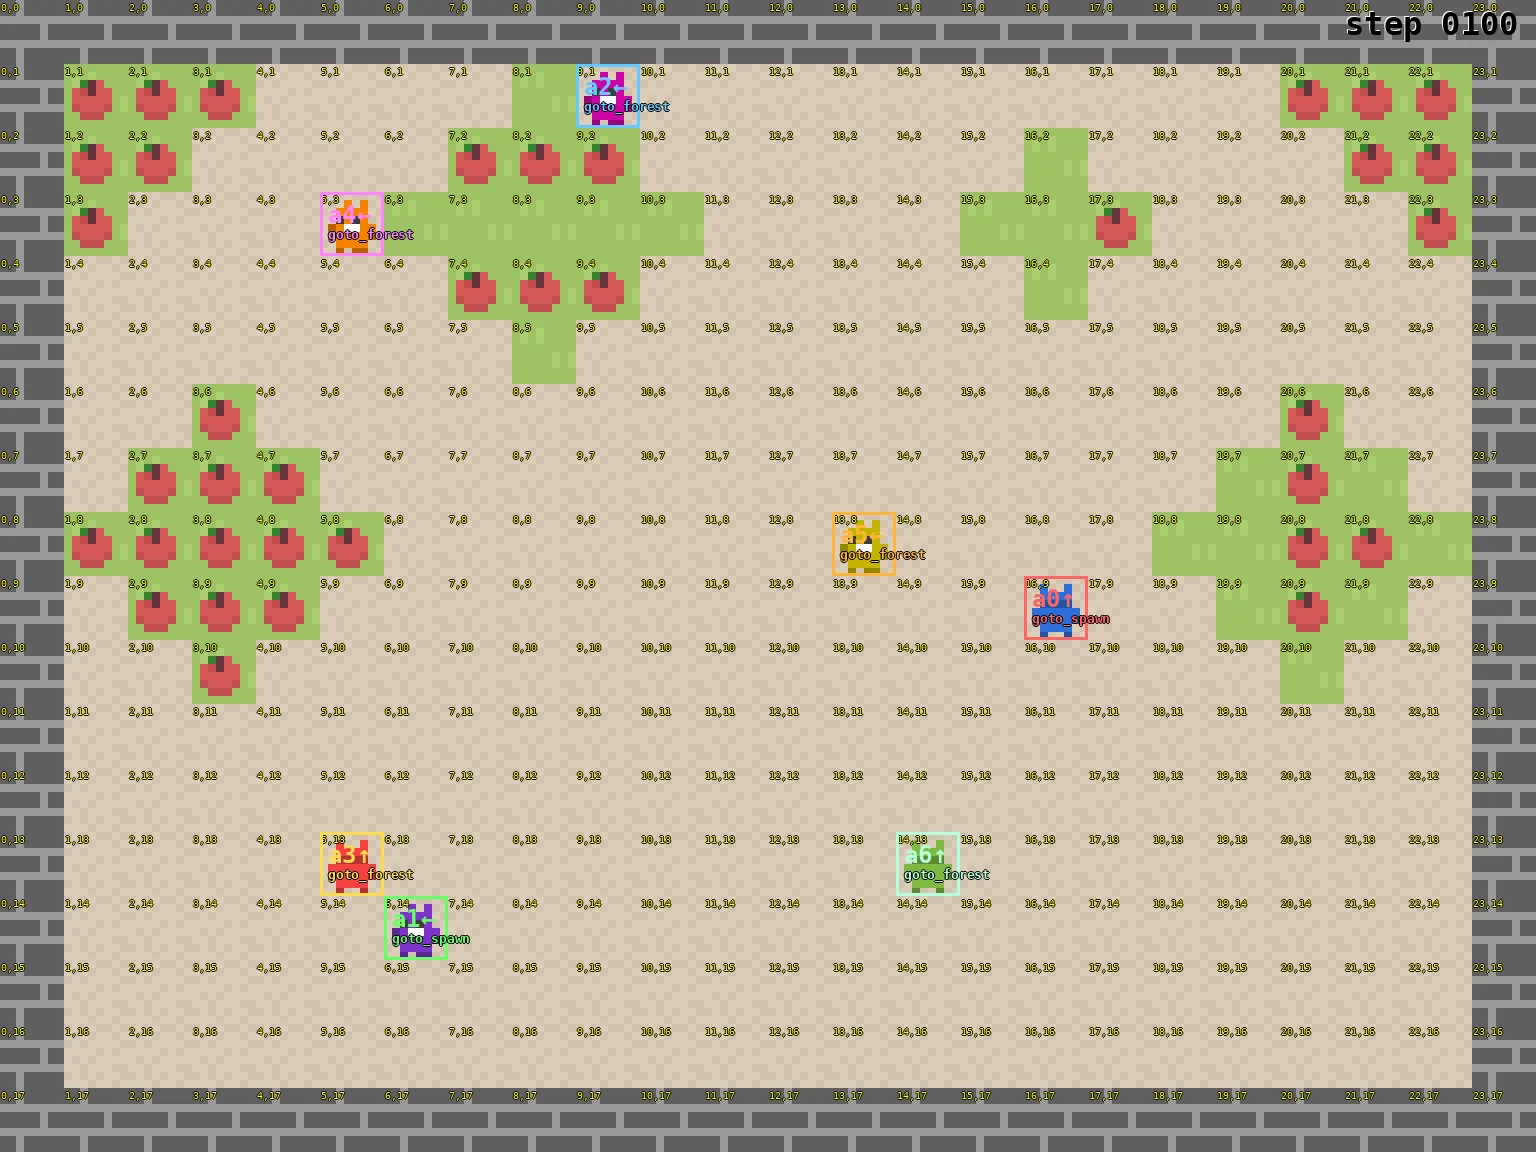
TL;DR
这篇论文证明,通过将小型冻结大语言模型的动作空间从底层原语提升为符号化选项库,并配合私有 LoRA 适配器和多智能体 GRPO 训练,可以让 2–4B 参数的模型在空间合作博弈中从零奖励跃升至胜任水平。更重要的是,行为审计揭示了一个关键陷阱:奖励曲线上升可能只是因为某个智能体学会了独自完成所有任务,而搭档无所事事——合作只在任务强制要求时才会涌现,因此单看奖励无法可靠衡量合作程度。
研究背景与动机
多智能体强化学习与大语言模型的结合正成为研究热点,一条新兴的研究路线主张评估这类系统时应关注其行为而非仅看奖励。然而,在需要空间合作的 2D 博弈环境中,这一目标面临严峻挑战:当研究者直接用小型冻结 LLM(2–4B 参数)输出底层动作指令(如"向左走三步后交互")时,系统完全失效,奖励始终为零。
这种失败暴露了三个根本性障碍。首先是接地鸿沟:小模型无法可靠地将高层目标(如"清理北方的 dirt")映射为精确的原语动作序列,常常产生空间前置条件幻觉或在安全默认动作上陷入循环。其次是视野问题:单局博弈包含数百个环境步,奖励信号稀疏,信用分配几乎不可能,模型在绝大多数决策点上收到的有效梯度为零。第三是专门化问题:合作往往要求不同智能体扮演互补角色,但若所有智能体共享同一组权重,各自的角色梯度会被相互平均,团队最终坍缩为所有智能体执行相同行为的平庸状态。
这些障碍并非来自模型的"智能"不足,而是来自动作抽象层级的错配。人类玩家在玩这类游戏时会自然地在高层目标("我去拿洋葱")和底层动作("按右三下、交互、返回")之间切换,但让 LLM 每一步都生成底层动作序列,恰好命中了小型模型最薄弱的能力区间。这正是这篇论文的切入点:与其逼迫模型做不擅长的事,不如为它提供一个它能驾驭的高层动作空间。
方法
论文的核心思路是在决策层引入符号选项库,在训练层引入私有适配器,形成一套两阶段耦合的系统。整体架构可以概括为:每个智能体不再直接输出原语动作,而是在收到状态过滤后的选项菜单后选择"做什么",具体的"怎么做"则交给符号规划器执行。
形式化建模
从马尔可夫决策过程的角度看,底层环境是一个协同部分可观察随机博弈 ,其中每个智能体只能观测到局部信息且必须基于此做出决策。论文引入宏动作 Dec-POMDP 框架:每个选项 由三部分组成——启动条件 定义在哪些观测下该选项可以被选中,内部策略 由符号规划器展开为具体原语序列,终止条件 决定何时结束执行(完成、失败或超时)。
智能体 在观测 下的可行动作集合记为:
策略 仅支撑于该过滤后的菜单,决策只在选项边界发生,这本质上形成了一个时间尺度更粗粒度的半马尔可夫决策过程。由于各智能体的选项执行相互独立且异步终止,团队层面的问题自然映射为宏动作 Dec-POMDP。
符号选项库的构建
选项库的构建是这套方法的关键创新点。整个流水线包含四个阶段,且前沿编程模型(如 Claude Opus 4.8)仅在第一阶段调用一次,此后的合成全部自动化完成。
第一阶段由前沿模型阅读博弈源码,输出一组类型化选项,每个选项携带"四部分契约":实例化模板、执行器、终止条件、效果谓词。关键在于执行器被刻意保持"环境天真"——它仅检查算法层面的前置条件(目标是否存在、路径是否可达、是否持有必要物品),而不编码任何基于环境状态的合法性判断。这为后续的可行性守卫留出了空间。
第二阶段进行均匀随机策略的试运行。在每个候选菜单上用均匀随机策略跑大量 episode(Overcooked AA 上约 4000 个 episode,包含 solo 和双智能体设置),记录每个选项执行的标签:成功、效果失败、或显式失败(携带原因字符串)。这些试运行成本极低——仅需 CPU 单核运行约 70 秒即可完成约 550k 决策步的合成。
第三阶段基于试运行数据合成可行性守卫。守卫的作用是过滤掉在当前状态下不可执行的选项。合成采用两条通道:显式通道将观察到 5 次以上的具名失败原因直接转化为守卫条件;推断通道则枚举所有 1-2 文字的合取条件,只有当该条件在失败样本上的支持度不少于 5 次、且在成功样本上的支持度为零时(即"零成功隐藏"证书),才予以采纳。这意味着守卫必须既能解释反复出现的执行失败,又不会排除任何已记录的成功执行。整个过程没有任何人工编写、挑选或基于奖励调优的环节。
第四阶段进行菜单组装:选项按目标类逐实例化(而非仅针对最近目标),逐实例应用守卫;菜单中的字母用 episode-seeded 随机数生成器每步重排,避免模型对字母位置产生位置先验。
论文还设计了外层契约修复回路:当试运行日志或守卫证书出现可疑模式(如某选项显式失败率 100% 但任务仍可达)时,将问题反馈给前沿模型修改契约,重新执行第二、三阶段。论文记录了三类实际遇到并修复的缺陷:绝对形式效果谓词导致跨实例混淆、共享状态归因错误、最近目标实例化遗漏替代路径。
PA-MAGRPO 训练
每个智能体的大语言模型充当其关于选项的策略,配备一个私有 LoRA 适配器,通过 PA-MAGRPO(per-agent variant of multi-agent GRPO)独立训练。
每个训练轮次收集 条联合 rollout,使用共享团队回报 做组内归一化得到优势估计:
每个智能体 在自身的决策序列 上做 个 PPO 裁剪 epoch,仅更新其私有 LoRA 参数 :
其中 是新策略与旧策略的概率比。值得注意的是,所有智能体共享相同的优势估计 ,专门化完全通过"相同优势下不同观测–动作历史"在私有参数中自发沉淀——这解决了前文提到的专门化问题,允许多个智能体在同一冻结底座上发展出互补的行为模式。
实验与结果
实验在三个空间合作博弈上进行:包含 7 个智能体的 Melting Pot Cleanup(存在社会困境,需要部分智能体牺牲短期收益去清洁河流)、2 个智能体的 Overcooked-Asymmetric Advantages(AA,两厨房分离各自齐全,协调非必需)以及 Forced Coordination(FC,双方互相依赖必须协作)、还有 7 个智能体的 Commons Harvest(公共池资源,过度采摘会导致 patch 永久消亡)。AA 和 FC 构成同一环境内的对照实验,用于区分可选协调与必需协调。
论文使用四个小型骨干模型进行跨模型稳健性实验:Qwen3-4B-Instruct-2507、Qwen3.5-2B、gemma-4-E4B-it、gemma-4-E2B-it。主实验每个设置运行 5 个独立训练种子,评估时使用固定测试种子集。
主要结果
消融实验揭示了各组件的必要性。在 Qwen3-4B 上,完整方法(选项菜单 + 私有 LoRA + MAGRPO)在 Cleanup 上从 提升至 ,在 Overcooked AA 上从 提升至 (约 34 倍提升)。相比之下,去除动作抽象、直接用原语动作训练的 Abl. A 在 Overcooked 上全程崩溃于零;去除专门化、共享 LoRA 的 Abl. B 在 Cleanup 上最高仅达 ;完全不训练的 frozen baseline 在所有环境中均为零奖励。
决策步压缩的效果显著:引入选项菜单后,LLM 调用频率从每环境步 1.00 次降至 0.40–0.71 次,意味着每次决策横跨 2–3 个环境步,信用分配视野大幅缩短。
奖励与合作的脱钩
这是论文最富有洞见的发现。行为审计揭示,奖励曲线上升与真正的合作之间存在系统性脱钩,且这种脱钩在两个方向上均存在。
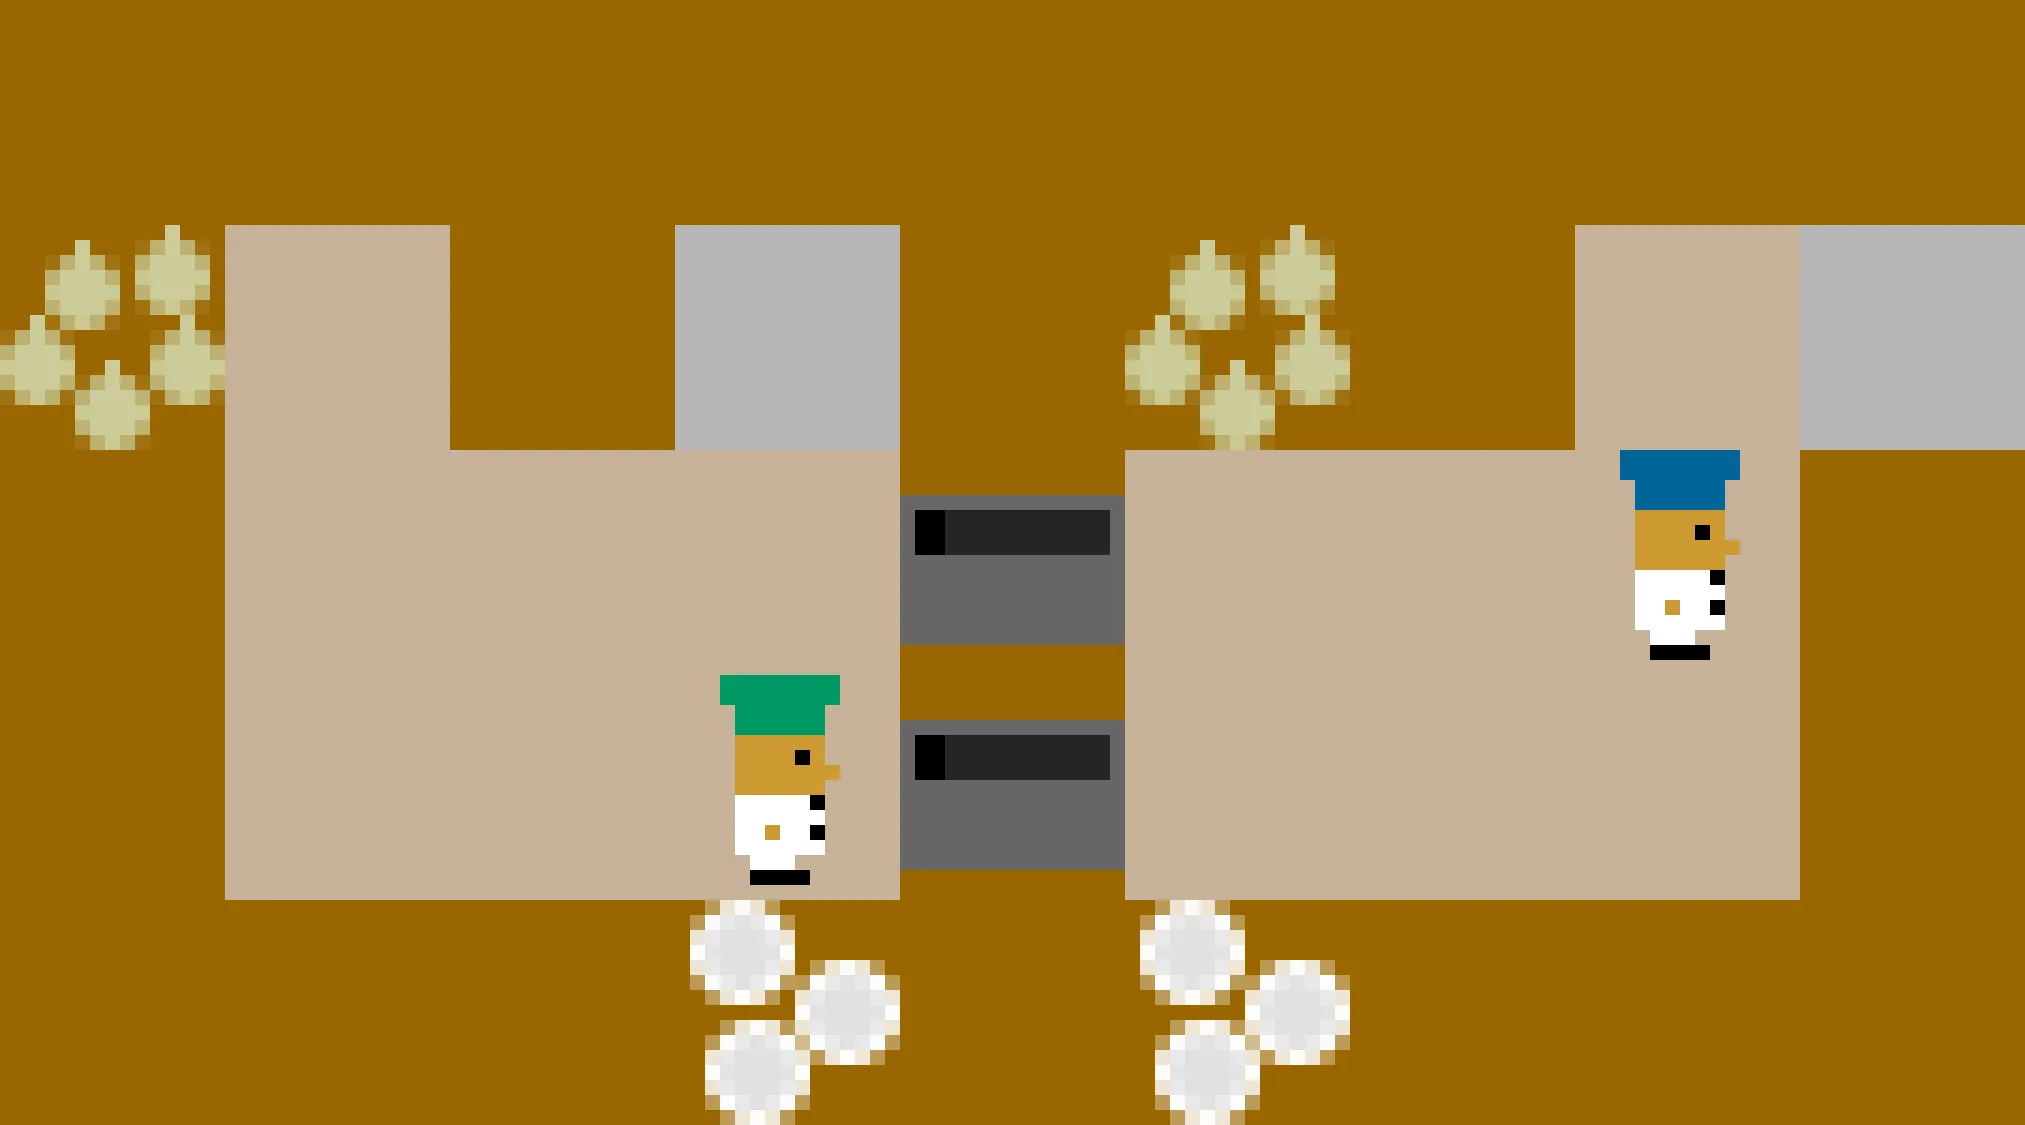
在 Overcooked-Asymmetric Advantages 上,尽管完整方法使团队奖励达到较高水平,但 per-agent 行为分析显示:智能体 0 约 69% 的决策在装洋葱,智能体 1 约 72% 的决策在等待装好的洋葱,对 counter 操作(即双方互换角色的协调行为)的执行率接近零。两个智能体的行为呈现"一工一闲"的明显分工。更关键的是,当研究者在 solo 模式下单独测试每个智能体时,两者都能独立完成任务——这说明团队的高奖励并非来自合作,而是来自任务分工后某个智能体独自承担全部工作、另一个智能体"搭便车"的状态。
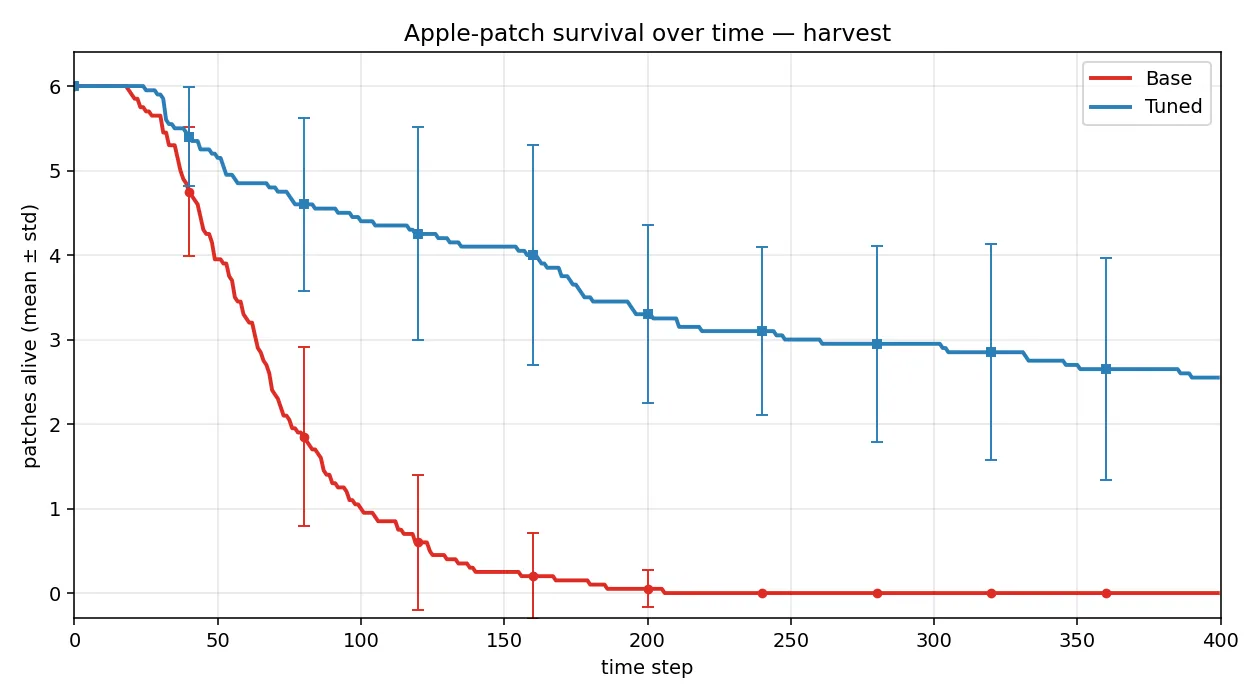
在 Commons Harvest 上,情况更为微妙。苹果收集奖励曲线几乎平坦(从 微升至 ),单纯看奖励无法判断训练是否有效。然而 patch 生存曲线揭示了截然不同的图景:未经训练的团队在 400 步后将所有 6 个 patch 消耗殆尽(生存数趋近 0),而训练后的团队维持约 2.5 个 patch 持续存活至游戏结束。这表明约 2 个智能体学会了节制采集、让 patch 恢复,其余智能体则调整策略配合这种可持续的采集节奏——一种隐性的协调策略完全无法从奖励数字中读出。
Forced Coordination 实验进一步确认了合作只在任务强制要求时才会涌现这一规律。在这个必须双方互相传递物品才能完成任务的场景中,frozen 模型奖励为零(完全失败),训练后的模型达到 。Solo 测试显示,每个智能体单独运行时交付数均为零——合作不再是可选项,而是唯一的可行路径,团队别无选择只能协调。
讨论与可借鉴点
这篇论文的贡献是多层面的。在工程层面,它提供了一套完整的配方:将动作抽象层从原语提升为符号选项库,通过自动化合成可行性守卫避免人工介入,用私有 LoRA 解决专门化问题,用 PA-MAGRPO 在共享冻结底座上训练多个策略。整个流程的算力需求控制在单卡 H100 可及的范围内,且选项库构建阶段仅需 CPU。
在认知层面,论文揭示了一个在多智能体研究中常被忽视但至关重要的陷阱:奖励作为合作代理指标的失效。当任务结构允许某个智能体独自完成全部工作时,策略梯度方法会自然地发现这种"单飞"解,因为它的方差更低、期望回报更高。合作只有在被强制要求时才会涌现——这提醒研究者在评估多智能体系统时,必须将行为层面的审计与奖励层面的评估并行进行,否则可能将"效率更高的单飞策略"误认为"合作策略"。
论文的局限性同样值得注意。消融实验仅使用单种子,置信区间仅反映评估侧的随机性;行为模式的观察(如 Cleanup 中的角色分配)也只在单个训练种子上验证。此外,符号选项库依赖对博弈源码的访问,这在真实世界场景中可能不成立;守卫的"零成功隐藏"证书虽然设计巧妙,但可能无法覆盖所有未见过的状态组合。
对于后续研究而言,这篇论文的启发在于:多智能体合作的评估不应止步于最终奖励,而应追问"谁在做什么"——合作是否真正必要?各智能体的行为是否互补?任务结构是否允许单飞替代方案?这些问题应当被纳入多智能体系统评估的标准协议中,而非仅作为事后分析出现。
摘要
基于大语言模型的多智能体系统与多智能体强化学习相结合的训练方法正迅速引起关注,一条并行的工作路线则主张,此类系统应当依据其行为而非仅依据奖励来评判。我们在空间合作博弈研究中同时推进这两条线索:在这些博弈中,使用底层动作提示的小型冻结大语言模型会彻底失败,奖励为零。
在选项/半马尔可夫决策过程(options/semi-MDP)框架的指导下——并且,由于各智能体间的选项执行是异步的,我们采用其在宏动作去中心化部分可观察马尔可夫决策过程(Dec-POMDP)中的多智能体扩展——我们为每个博弈配备一个符号\emph{选项}库:这些选项是带有类型标注、状态可行、面向短视野的行为,由符号规划器执行。每个选项库由一个前沿编码模型根据博弈源码起草;用于筛选每个选项菜单的可行性守卫,则由廉价的随机策略试运行回放机械合成——只有当某个守卫能够解释反复出现的执行失败,同时不会隐藏任何已记录的成功时,该守卫才会被采纳——因此没有任何守卫是经人工编写、挑选或通过奖励调优得到的。
每个智能体的大语言模型充当其关于选项的策略,并配备一个私有的逐智能体 LoRA 适配器,通过多智能体 GRPO 的一种逐智能体变体(PA-MAGRPO)训练得到;这一方法使冻结的基础模型在三个博弈和四个小型骨干网络上从零奖励跃升至胜任水平。
随后进行的行为审计揭示出奖励与合作之间存在脱钩:上升的奖励曲线可能仅仅意味着某个智能体学会了独自完成全部任务,而其合作伙伴则无所事事——只有当任务使合作成为必要时,合作才会涌现。因此,单凭奖励无法可靠地反映合作程度,行为评估必须与奖励评估并行进行。
Abstract
Training LLM-based multi-agent systems with multi-agent reinforcement learning is rapidly gaining traction, and a parallel line of work argues that such systems should be judged by their behavior, not only their reward. We take up both threads in spatial cooperative games, where small frozen LLMs prompted with low-level actions fail outright, earning zero reward. Guided by the options/semi-MDP framework---and, because option execution is asynchronous across agents, its multi-agent extension in macro-action Dec-POMDPs---we equip each game with a library of symbolic \emph{options}: typed, state-feasible, short-horizon behaviors executed by a symbolic planner. Each library is drafted by a frontier coding model from the game's source code; the feasibility guards that filter each menu are then synthesized mechanically from cheap random-policy burn-in rollouts---a guard is adopted only if it explains repeated execution failures while hiding no logged success---so no guard is authored, selected, or reward-tuned by hand. Each agent's LLM acts as its policy over options, with a private per-agent LoRA adapter trained by a per-agent variant of multi-agent GRPO (PA-MAGRPO); this lifts frozen bases from zero reward to competent play across three games and four small backbones. Behavioral audits then reveal that reward and cooperation decouple: a rising reward curve may simply mean that one agent has learned to run the entire task alone while its partner idles---cooperation emerges only when the task makes it necessary. Reward alone is thus an unreliable readout of cooperation; behavioral evaluation must sit alongside it.
论文详细总结(自动生成)
论文总结:Training Small LLMs as Spatial Multi-Agent Policies
1. 核心问题与研究动机
问题定义:在 2D 空间合作博弈中,将小型(2–4B 参数)冻结大语言模型(LLM)直接提示输出底层动作(如方向键、交互键)会完全失败——奖励始终为零。这暴露了三大障碍:
- 接地鸿沟(grounding gap):小模型无法将高层目标(如"清理北方的 dirt")可靠地映射为底层原语动作,出现空间前置条件幻觉与"安全默认动作"模式崩塌。
- 视野问题(horizon problem):单局博弈步数数百、奖励稀疏,决策步上的信用信号几乎为零。
- 专门化问题(specialization problem):合作常常要求智能体扮演不同角色,但若共用同一组权重,冲突的角色梯度会被平均化,团队坍缩为相同行为。
研究目标:在学术预算下把小型 LLM 训练为空间合作 MARL 策略,并系统回答"训练成功后真正涌现了什么"。
2. 方法论
2.1 整体框架:两阶段耦合
- 决策层抽象:把每个智能体的动作空间从原语提升为固定符号选项(symbolic options)库;每个智能体在决策点收到一个按状态过滤后的字母菜单(lettered menu),仅选择"做什么",由符号规划器决定"怎么做"。
- 训练层专门化:在共享冻结底座上为每个智能体挂一个私有 LoRA 适配器,用 PA-MAGRPO(per-agent MAGRPO)独立更新。
2.2 形式化建模
底层为协同部分可观察随机博弈(Dec-POMDP)。每个选项 对应:启动集 (哪些观测下可被选中)、内部策略 (符号规划器展开为原语)、终止条件 (完成、失败或超时)。由于各智能体异步终止,团队层面问题为宏动作 Dec-POMDP(macro-action Dec-POMDP)。智能体 在观测 下的可行动作集合记为:
策略 仅支撑于该菜单,决策只在选项边界发生,从而形成半马尔可夫决策过程(semi-MDP)。
2.3 符号选项库的构建流水线(共 4 阶段,前沿模型仅参与 1 次)
- Stage 1(仅一次前沿模型调用):用 Claude Opus 4.8 阅读博弈源码,输出带"四部分契约"(实例化、执行器、终止、效果谓词)的类型化选项库。执行器被刻意保持"环境天真",仅检查目标存在、可达路径、是否持有物品等算法内在前置条件,不编码任何环境合法性策略。
- Stage 2(uniform-over-menu burn-in):用均匀随机策略在每个候选菜单上跑试运行(Overcooked AA 上约 2 000 solo + 2 000 双智能体 episode,约 550 k 决策,70 秒/单核 CPU 即可完成),记录每个选项执行的
success/effect_fail/explicit:<reason>三类标签。 - Stage 3(guard 合成与接受证书):
- 显式通道:观察到 ≥ 5 次的具名失败原因直接转为守卫。
- 推断通道:对读取集合的所有 1-/2-文字合取打分,仅当 且 时采纳("零成功隐藏"证书)。
- Stage 4(菜单组装):每个选项按目标类逐实例化(而非仅最近目标),逐实例应用守卫;字母用 episode-seeded RNG 每步重排,避免模型对字母位置产生先验偏置。
- 外层契约修复回路:当燃烧日志或证书出现可疑模式(如某选项显式失败率 100% 但任务仍可达),由前沿模型改契约,重新跑 Stages 2–3。论文列出 3 类实际遇到并修复的缺陷:绝对形式效果谓词、共享状态归因错误、最近目标实例化。
2.4 PA-MAGRPO 训练算法
每个 round 收集 条联合 rollout,使用共享团队回报 做组内归一化得到共享优势:
每个智能体 在自身决策序列 上做 个 PPO 裁剪 epoch,仅更新其私有 LoRA :
其中 。优势对所有智能体相同,专门化通过"相同优势下不同观测–动作历史"在私有参数中沉淀。
3. 实验设计
3.1 场景(3 个空间合作博弈)
| 博弈 | 智能体数 | 单局步数 | 关键结构 |
|---|---|---|---|
| Melting Pot Cleanup | 7 | 150 | 河流 dirt 与果园 apples 的社会困境,需部分 agent 牺牲短期收益去清洁 |
| Overcooked-AI Asymmetric Advantages (AA) | 2 | 400 | 两厨房分离但各自齐全;协调非必需 |
| Overcooked-AI Forced Coordination (FC) | 2 | 400 | 双方互相依赖,必须 counter hand-off |
| Commons Harvest | 7 | 400 | 公共池资源,过度采摘会导致 patch 永久消亡 |
AA / FC 组成"博弈内对照",区分可选协调 vs 必需协调。
3.2 模型骨干
跨骨干稳健性实验使用 4 个小型骨干:Qwen3-4B-Instruct-2507、Qwen3.5-2B、gemma-4-E4B-it、gemma-4-E2B-it。消融实验固定 Qwen3-4B 底座。
3.3 对比方法
6 个消融单元,枚举 抽象 ∈ {option menu, compound-JSON, native actions} × 能力 ∈ {per-agent LoRA, shared LoRA, no training}:
- Full method (ours):option menu + per-agent LoRA + MAGRPO
- Abl. A:native 原语 + MAGRPO(去抽象)
- Abl. B:option menu + 共享 LoRA + MAGRPO(去专门化)
- Abl. C:frozen + native(不训练)
- Abl. D:compound-JSON + per-agent LoRA + MAGRPO(去菜单过滤)
- 附加行:Frozen + option menu(无训练,仅菜单)
3.4 评估协议
- 主表每个 cell 为 20 个评估 episode,使用固定测试种子集 。
- 跨骨干表每个 cell 跑 5 个独立训练种子(含选项库采样、LoRA 初始化、rollout 随机性、minibatch 顺序四个通道)。
- 行为审计:per-agent 宏动作直方图、访问热力图、patch 生存曲线、solo/partner 对照测试。
3.5 基准结果速览
- 跨骨干表:所有 frozen baseline = 0;full method 在 Cleanup 上达 个苹果,Overcooked AA 次配送,Commons Harvest 个苹果。
- 消融表:Qwen3-4B 上 full method 在 Cleanup 由 ,Overcooked AA 由 (约 34× 提升);Abl. A/Abl. D 在 Overcooked 上训练全程崩溃于 0;Abl. B 共享 LoRA 在 Cleanup 最佳仅 。
4. 资源与算力
- 训练硬件:单卡 H100("Training runs on a single H100")。
- Stage 2–4(guard 合成):仅使用 CPU,Overcooked AA 上 4 000 episode(≈ 550 k 决策)约 70 秒单核。
- 超参:Cleanup / Harvest 用 LoRA rank 32、lr 、、温度 0.7;Overcooked 用 LoRA rank 16、lr 、、温度 0.9、KL 系数 0.05。统一 、2 inner epochs、梯度裁剪 1.0。
- 训练种子数:跨骨干 5 个/骨干;消融 1 个 seed。论文未给出 wall-clock 训练时长,仅说明 checkpoint 选取规则与评估 episode 数。
5. 实验数量与充分性
- 总训练运行数:4 骨干 × 5 seed = 20 次(Table 1),消融 6 cell × 1 seed(Table 2),合计 ≥ 26 次端到端训练。
- 统计显著性:主表报告均值 ± 标准差及 95% 百分位置信区间(10 000 重采样),与 frozen baseline 的逐对 Mann–Whitney U 检验 。
- 充分性评估:
- 既有跨骨干稳健性,又有跨博弈行为审计,并以"同一固定配方"贯穿,避免 cherry-pick。
- 通过 Forced Coordination 与 solo-test 等博弈内对照机制,缓解奖励欺骗(reward hacking)带来的偏差。
- 缺点:消融 suite 仅 1 seed,置信区间仅反映评估侧波动;行为模式(如 Cleanup 角色分配)只在 1 seed 上验证;论文明确承认这一点。
6. 主要结论与发现
1. 配方有效:option menu + per-agent LoRA + PA-MAGRPO 在 4 骨干 × 3 博弈上把 frozen 底座从 0 奖励拉到有竞争力水平;任一组件移除都会导致关键游戏上训练崩溃(Abl. A、C)或能力塌缩(Abl. B)。
2. 决策步压缩:菜单使 LLM 调用比从 1.00 降至 0.40–0.71,每步决策跨 2–3 个环境步,压缩信用分配视野。
3. 奖励与合作脱钩(双向):
- 高奖励 ≠ 合作:Overcooked AA 上 agent 0 约 69% 决策在装洋葱,agent 1 约 72% 在等待,counter 操作 0%,呈现"一工一闲";单飞测试两个 agent 都还能交付。
- 低/平奖励 ≠ 无合作:Commons Harvest 上 apple 奖励曲线几乎平(),但 patch 生存数从约 0 跃至约 2.5/6 持续到 400 步,体现约 2 个 agent 节制、其余等待的可持续策略。
- 必要才合作:Forced Coordination 下 frozen = 0、trained = ,且 solo 测试都失败——只在此布局下才出现真正涌现的协调。
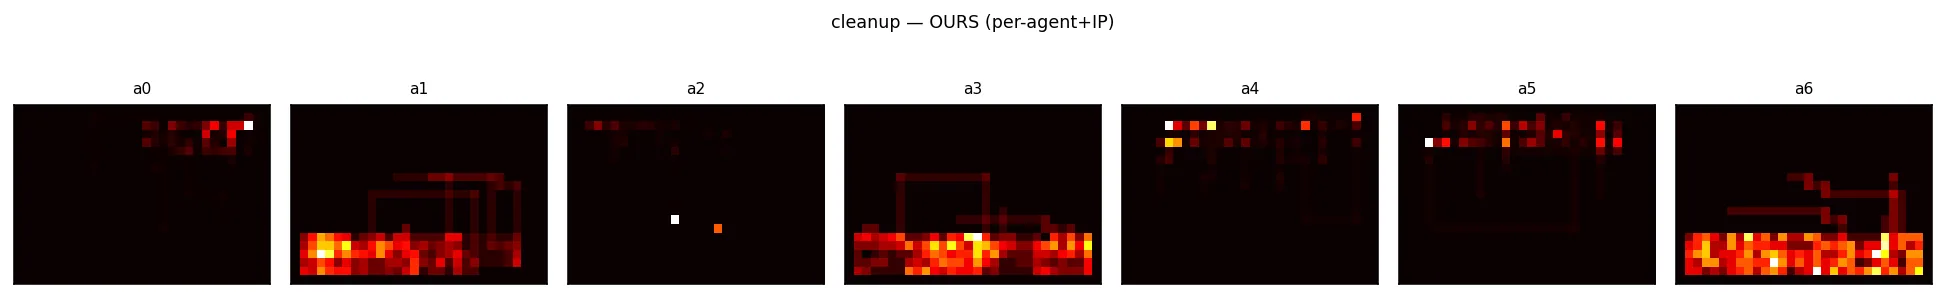
4. 自发角色分工:Cleanup 上 7 个 adapter 无角色标签地自发分化为 3 eater / 3 cleaner / 1 静态 helper,并由访问热图空间对应(果树 vs 河岸)。共享 LoRA 与 compound-JSON 都无法重现这一分化。
7. 优点
- 机械合成守卫而非人工编写:guard 来自燃烧日志的统计模式("解释失败且隐藏零成功"),不接触奖励、不接触人类,规避策略泄漏与奖励黑客。
- 抽象与学习两层解耦:抽象层(options + guards)由一次性前沿模型 + 固定算法生成,训练层只更新策略;Stage 1 之后前沿模型不再被查询,保证 compute / 一致性。
- per-agent LoRA 是轻量专门化方案:在冻结底座上保留通用语言与任务知识,仅为差异化留出参数空间;明显优于全量微调的算力代价。
- "同一配方 + 行为审计"的方法学贡献:把奖励曲线与社交结果指标(效率、平等、可持续性、hand-off 等)并置,揭示了 reward 单读数的不可靠性。
- 轨迹级诊断完备:直接给出 LLM 调用的"动作分布崩塌"原始 trace,让 ablation 结论可验证。
- 跨骨干 / 跨博弈稳健性:结果不依赖单一 backbone,且 AA/FC 这一博弈内对照设计具备说服力。
8. 不足与局限
- 规模与任务范围受限:仅覆盖 ≤ 4B 的小型 LLM 和 3 个空间合作博弈;向更大模型或非空间任务的可迁移性未验证。
- 选项空间选择缺乏原则:option 库按博弈定制,由前沿模型一次性起草,目前没有系统化的选项空间设计准则。
- 统计样本偏小:消融 suite 仅 1 训练种子,置信区间只反映评估侧波动;行为层面的角色分配只在 1 seed 上检查。
- 行为审计本身是经验性证据:作者明确指出"the decoupling finding is behavioral evidence, not a general theory";跨任务可重复性有待更多实验。
- 单 GPU 预算下可扩展性未知:单 H100 的训练时长未报告,更大规模或更多智能体的扩展成本与可行性不明。
- 潜在偏差来源:训练种子同时控制选项库采样、LoRA 初始化、rollout 随机性、优化顺序——单一交互作用难以完全剥离;不同骨干在 Cleanup 上的标准差(最大达 50.71)说明接口与初始化的影响仍显著。
- 语言模型在 zero-shot 阶段的极端失败:2–4B 冻结底座在 3 个游戏上全 0 奖励,这一"对照基线"较为温和——可能在更大模型或更强 prompting 下不成立,使方法相对优势的普适性受限。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。