
HetGPS:面向电动汽车充电的可扩展图多智能体强化学习与物理锚定的自适应安全
HetGPS: Scalable Graph Multi-Agent Reinforcement Learning with Physics-Anchored Adaptive Safety for EV Charging
📝 TLDR
大规模电网耦合智能体的安全干预需兼顾约束保护与任务决策自由度。论文提出HetGPS混合框架,将学习到的图风险与物理锚定校正解耦,由图残差模型调度干预强度、物理模型确定校正方向,配合参数共享异构图SAC策略。在五级配电网中将电压违规率从3.93–7.74%降至0.52–3.44%,模型仅38万参数且支持零样本跨规模迁移。
🧭 速览
大规模网络耦合智能体的安全干预常过度覆盖任务导向决策,需在保护共享约束与保留策略自由度间取得平衡。
HetGPS将干预强度与校正方向解耦——动作条件图残差模型调度状态相关干预权限,物理模型确定校正方向,并耦合参数共享异构图SAC策略。
在200–3,218辆EV的5级配电网中,将电压违规率从3.93–7.74%降至0.52–3.44%,离站成功率保持99.06–100%,模型参数仅38万。
学习到的图风险可在大规模场景下灵活分配干预权限,配电网物理模型为校正方向提供锚定,实现安全与性能的兼顾。
🆚 方法对比
HetGPS
- 违规率降至0.52-3.44%,出发成功率99.06-100%
- 模型参数固定383,702,与车队规模无关
- 零样本迁移到更大拓扑,违规率仅0.57-0.75%
- 图编码与残差头权重跨节点复用,可扩展性强
- 仍存在0.52-3.44%的电压违规
- 仅在EV充电场景验证,泛化场景有限
- 需离线训练潮流模型标签,部署依赖物理参数
Adaptive Authority (自适应干预权威)
- 在全部5个网络上提升平均奖励
- 4/5网络降低平均安全分数(更好)
- 状态相关授权避免不必要干预
- 相比固定授权方案动态调整Δt
- 仅4/5网络安全分数降低
- 需额外学习风险模型,增加训练复杂度
- 分离幅度与方向设计增加工程复杂度
Physics-Anchored Projection (物理锚定投影)
- 利用馈线物理确定修正方向,可解释性强
- 保证动作修正满足物理约束
- 不依赖学习模型决定方向
- 在训练分布外仍可能有效
- 依赖精确的馈线物理模型
- 修正方向受限于线性化假设
- 需已知网络拓扑和灵敏度矩阵
Action-Conditioned Graph Residual Model (动作条件图残差模型)
- 由潮流标签监督训练,物理一致性好
- 训练与部署权重共享,零额外参数
- 参数跨节点共享,可扩展性好
- 残差预测误差会传递给安全决策
- 依赖潮流标签数据质量
- 状态-动作空间大时外推风险增加
Parameter-Shared Heterogeneous Graph SAC (参数共享异构图SAC)
- 在3218辆EV上比集中式SAC小约170倍
- 保持99.99%以上出发成功率
- 支持拓扑感知局部协调
- 策略权重跨EV共享
- 依赖图结构信息的质量
- 局部观测限制全局协调能力
- 极大规模下通信开销增大
Centralized SAC (集中式SAC对比基线)
- 全局信息联合优化,无协调问题
- 理论表达能力强
- 实现简单无需图结构
- 3218辆EV时约6520万参数,170倍大
- 随规模线性增长,不可扩展
- 扩展到更大网络计算成本剧增
Fixed-Authority Filter (固定授权过滤基线)
- 实现简单,无需学习风险模型
- 提供清晰的安全上界保证
- 作为自适应方案的对比基线
- 弱固定上限在高风险时不足
- 最坏情况限值在良性条件下过度干预
- 缺乏状态适应性,性能低于自适应方案
No-Filter (无过滤基线)
- 实现最简单,无额外计算开销
- 策略完全自主,不受外部干预
- 作为安全性能的下界参考
- 违规率高达3.93-7.74%,安全隐患严重
- 无法满足电网电压安全约束
- 训练时奖励惩罚仅降低平均违规,不保证每步安全
HetGPS通过将学习式图风险(调度干预幅度)与物理模型(确定修正方向)解耦,相比固定授权过滤和无过滤基线显著降低违规率,同时参数共享图SAC策略在可扩展性上远超集中式SAC约170倍,且支持零样本拓扑迁移。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 7 张)
展开查看 7 张图
TL;DR
这篇论文针对大规模电动汽车充电场景下的电网电压安全约束问题,提出了 HetGPS 混合框架,通过将学习到的图风险与物理锚定校正相分离,实现了"按需干预"的自适应安全控制。在五个嵌套配电网(200–3,218 辆电动汽车)上的实验表明,该方法将电压违规率从无滤波时的 3.93–7.74% 降至 0.52–3.44%,同时保持 99.06–100% 的离网成功率,且仅用 38 万参数就支持零样本跨规模迁移。
研究背景与动机
随着电动汽车保有量快速增长,大量家用充电桩接入配电网,其充电决策通过线路阻抗耦合到母线电压上,形成典型的图结构耦合多智能体系统。大规模网络耦合场景下的安全干预面临一个根本性的权衡:一方面,忽略电力物理耦合的去中心化控制无法保证电压约束;另一方面,随车队规模线性增长的集中式控制会遭遇参数和计算维度的双重灾难。
现有的 [[多智能体强化学习]] 方法在这一问题上存在明显局限。基于参数共享的图策略虽然具备可扩展性,但其输出的动作在物理上未必安全——学习到的协同决策可能违反电压运行带约束。训练时引入奖励惩罚或期望成本约束只能降低平均违规率,无法保证每一次实现的联合动作都满足硬约束。简单地在策略输出后叠加固定增益的物理护栏虽然可行,但固定的干预权限要么过于保守(频繁覆盖策略决策、降低任务性能),要么过于激进(约束保护不足)。
该论文的核心洞见在于:安全滤波器实际上承担着两个功能角色——确定"干预多强"的幅度和确定"朝哪个方向校正"的方向。该论文将这两个角色解耦:让数据驱动的图风险模型学习状态相关的干预权限,由物理模型(基于 LinDistFlow 线性化)决定校正方向。这一设计既利用了学习能力捕捉复杂的状态依赖风险,又借助物理先验确保校正方向的可靠性。
方法
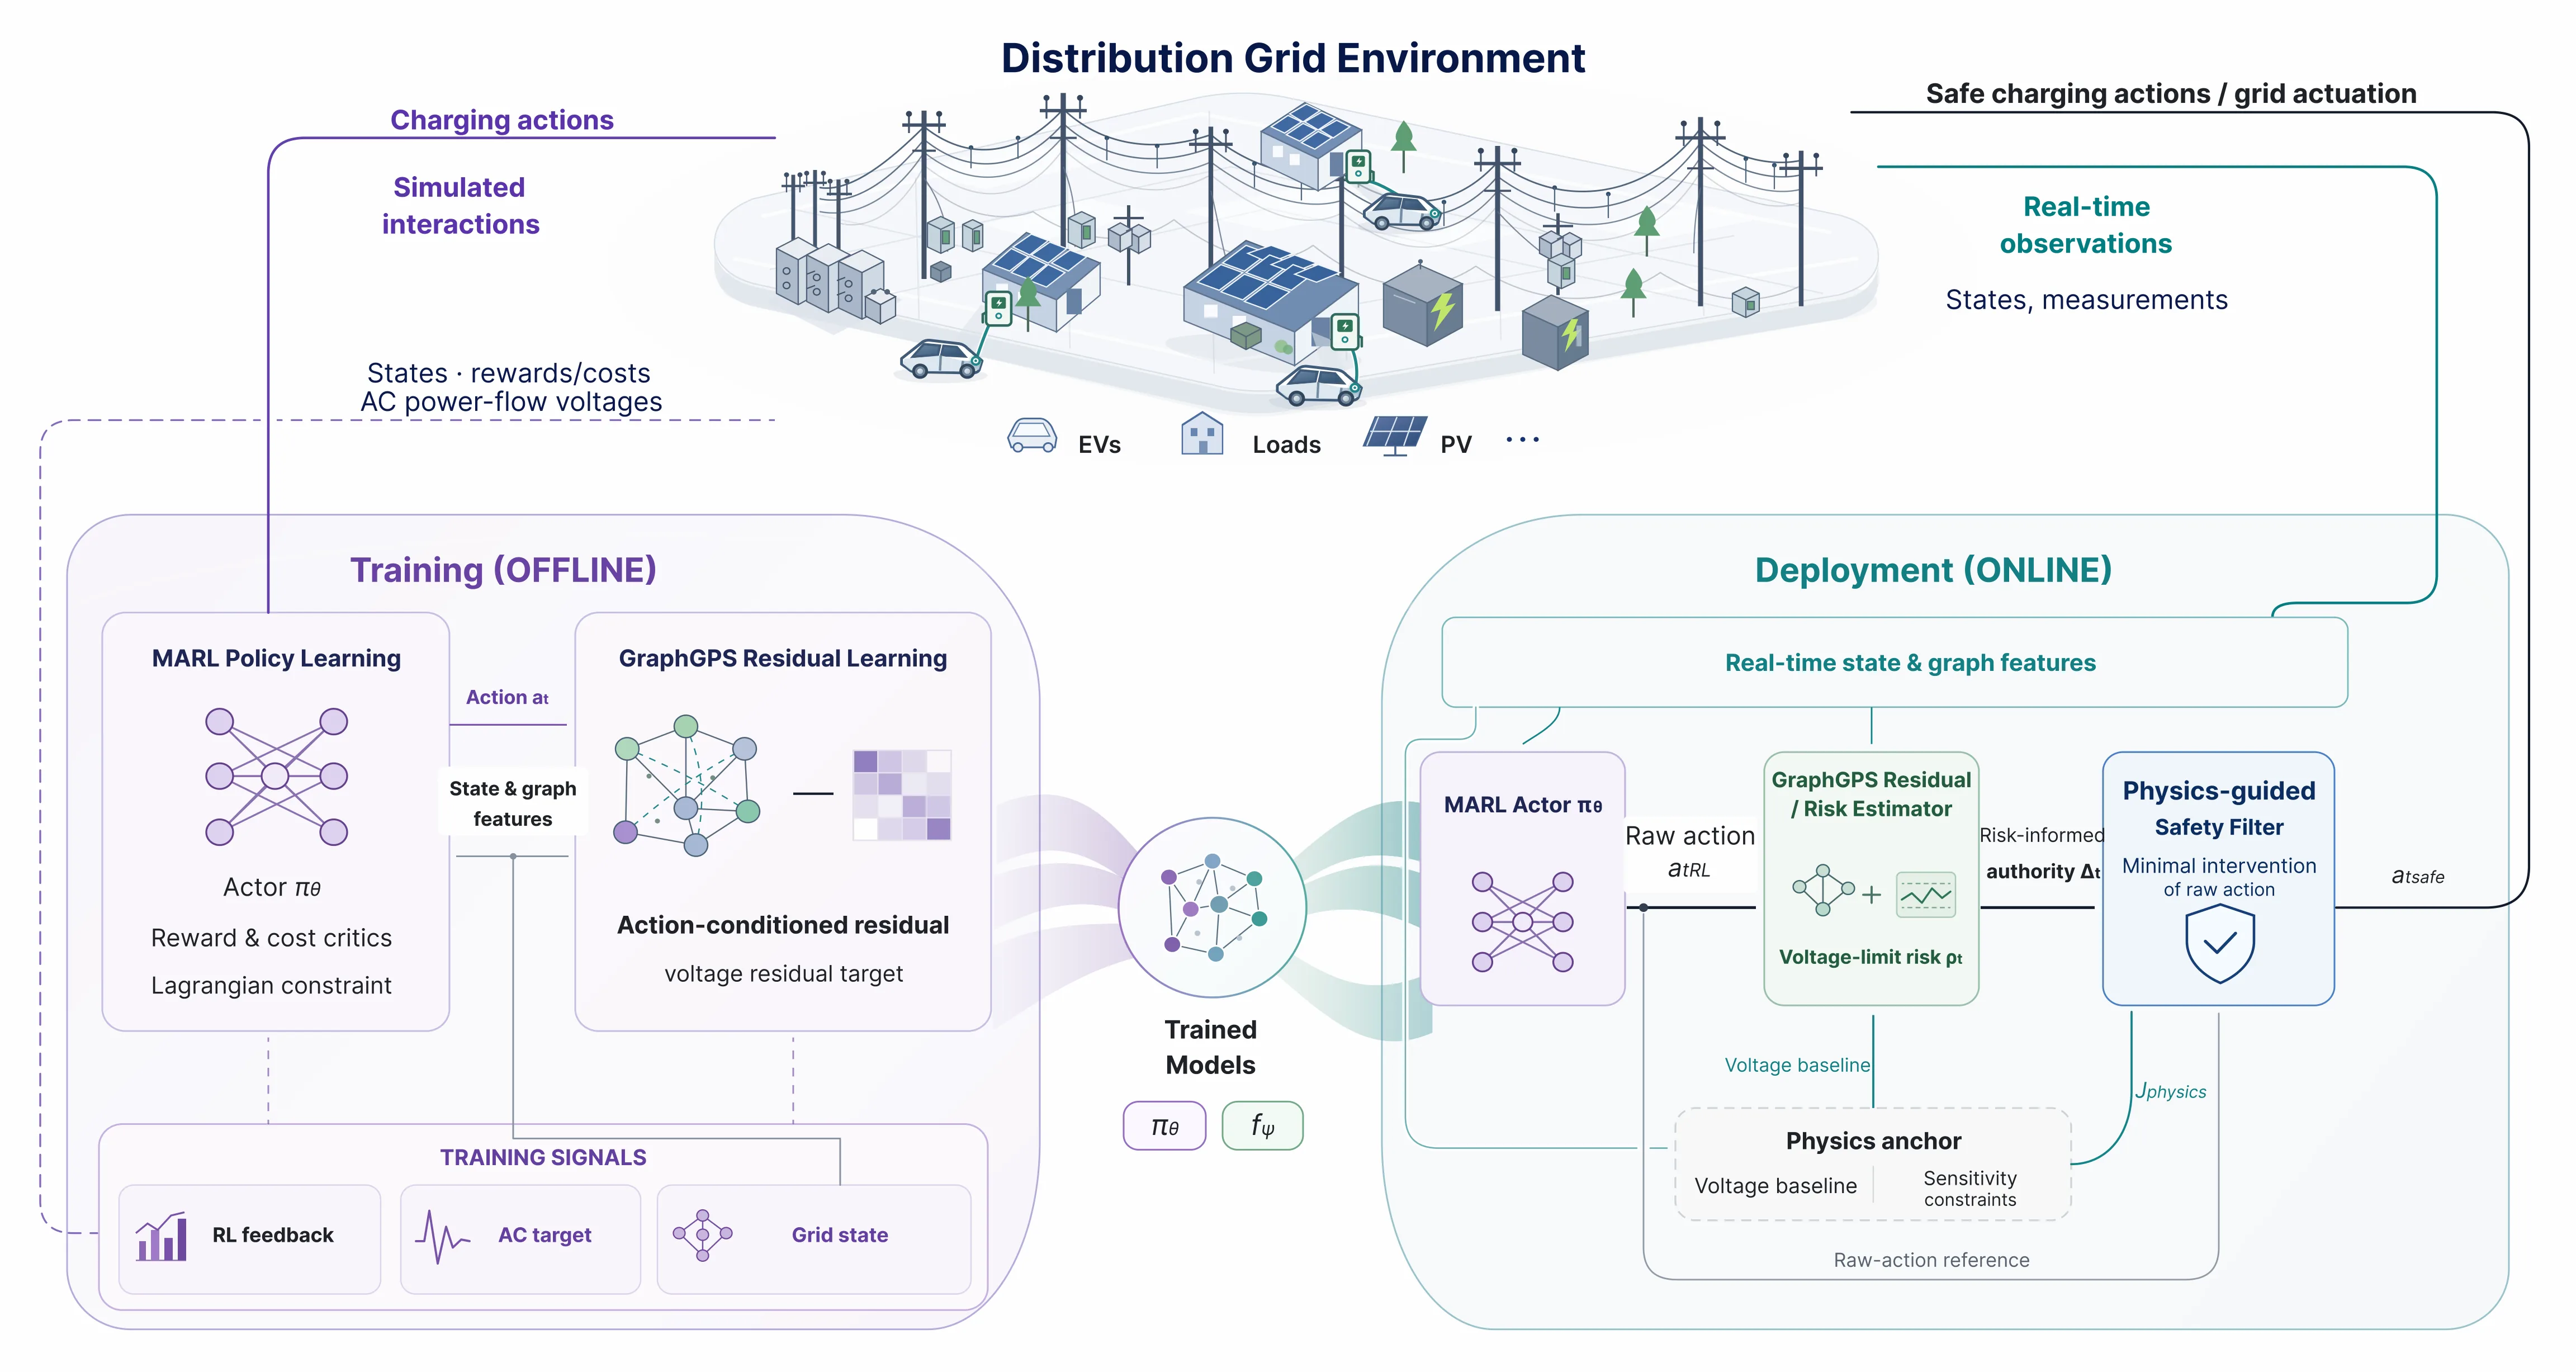
HetGPS 的整体架构遵循"学习-过滤-执行"的动作链。智能体首先根据观察输出原始动作 ,该动作经过安全滤波器投影得到 ,最终由服务映射执行 。训练阶段滤波器恒等,部署时才插入电压投影。
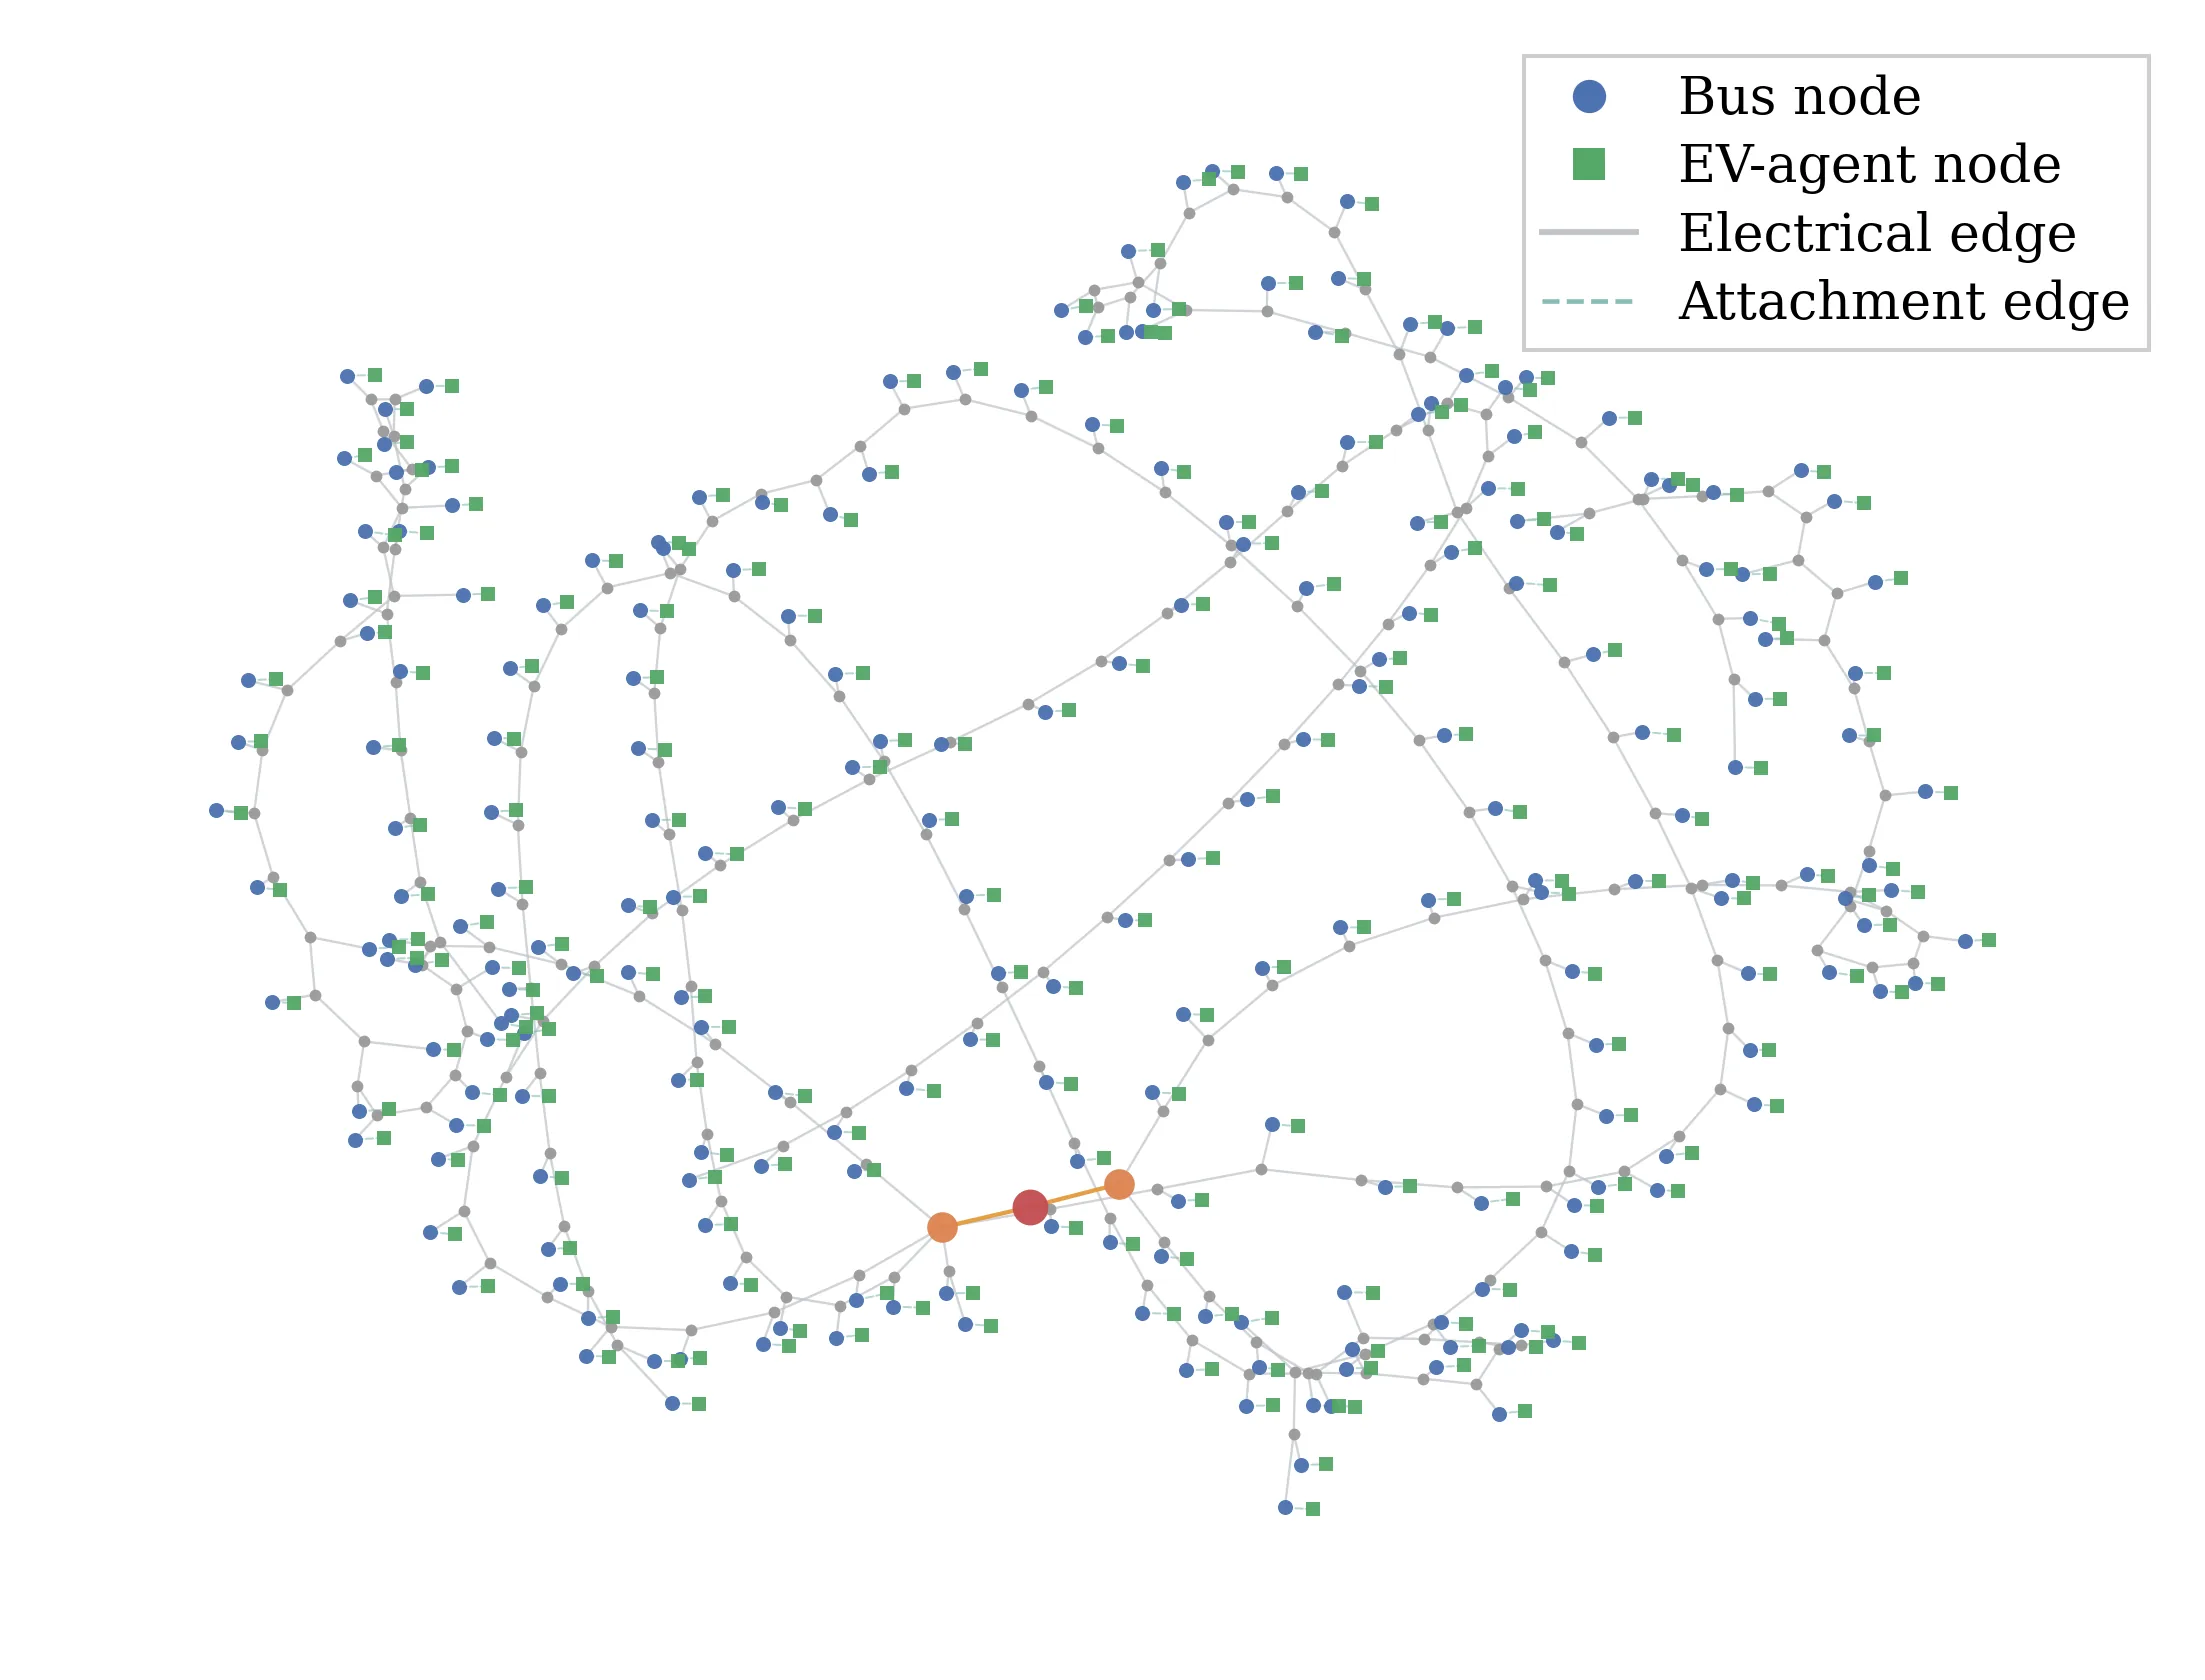
在策略网络层面,HetGPS 采用参数共享的异构图 [[软演员-评论家]] 架构。图结构建模为包含母线节点、电动汽车节点以及电气边和 EV-母线连接边的异构图,电动汽车通过跨注意力机制读取其服务母线的嵌入表示。两层消息传递网络(64 维隐状态、4 头注意力)输出的母线上下文与每辆车的私有观察拼接后输入高斯策略。由于策略参数在所有电动汽车间共享,模型容量与车队规模完全解耦——无论 200 辆还是 3,218 辆电动汽车,部署的 actor 网络始终保持相同规模。
安全滤波器的设计是 HetGPS 的核心创新。论文定义了动作条件电压残差模型:
其中 是上一时刻的实测电压作为反馈基线, 是基于 LinDistFlow 的固定标幺化灵敏度矩阵, 是可学习的残差头。残差头通过 AC 潮流标签监督训练,采用 pinball 损失学习 0.05、0.50、0.95 三个分位数输出,以便在部署时取保守的分位值。
风险调度器将电压越界量量化为:
取学习残差预测与固定增益物理护栏二者 0.95 分位数中的保守值 ,再通过 clip 函数映射为干预权限:
这种设计使得权限调度完全由标量风险 驱动,无需额外调用潮流求解或残差评估,额外计算开销极小。
在校正方向上,HetGPS 采用物理锚定策略,完全排除学习残差:
当检测到母线电压越界时,通过求解凸二次规划在授权箱 内寻找最接近原始动作的投影方向。方向完全由物理模型 决定,学习残差仅用于调度干预权限——这一设计保证了即使图风险模型预测不准确,校正方向仍具有物理一致性。
实验与结果
实验在 CRE21 澳大利亚实际配电网上进行,该网络包含五个嵌套子网(对应 1、4、8、16、32 台变压器),规模从 200 辆到 3,218 辆电动汽车不等。评估采用 100 个独立日,负荷和光伏数据来自 2012–2013 年 Ausgrid 公开数据集,电动汽车出行数据来自 VISTA 调查,车队配置为 40 kWh/7.4 kW(30%)、58 kWh/11 kW(40%)、77 kWh/22 kW(30%)的异构混合。
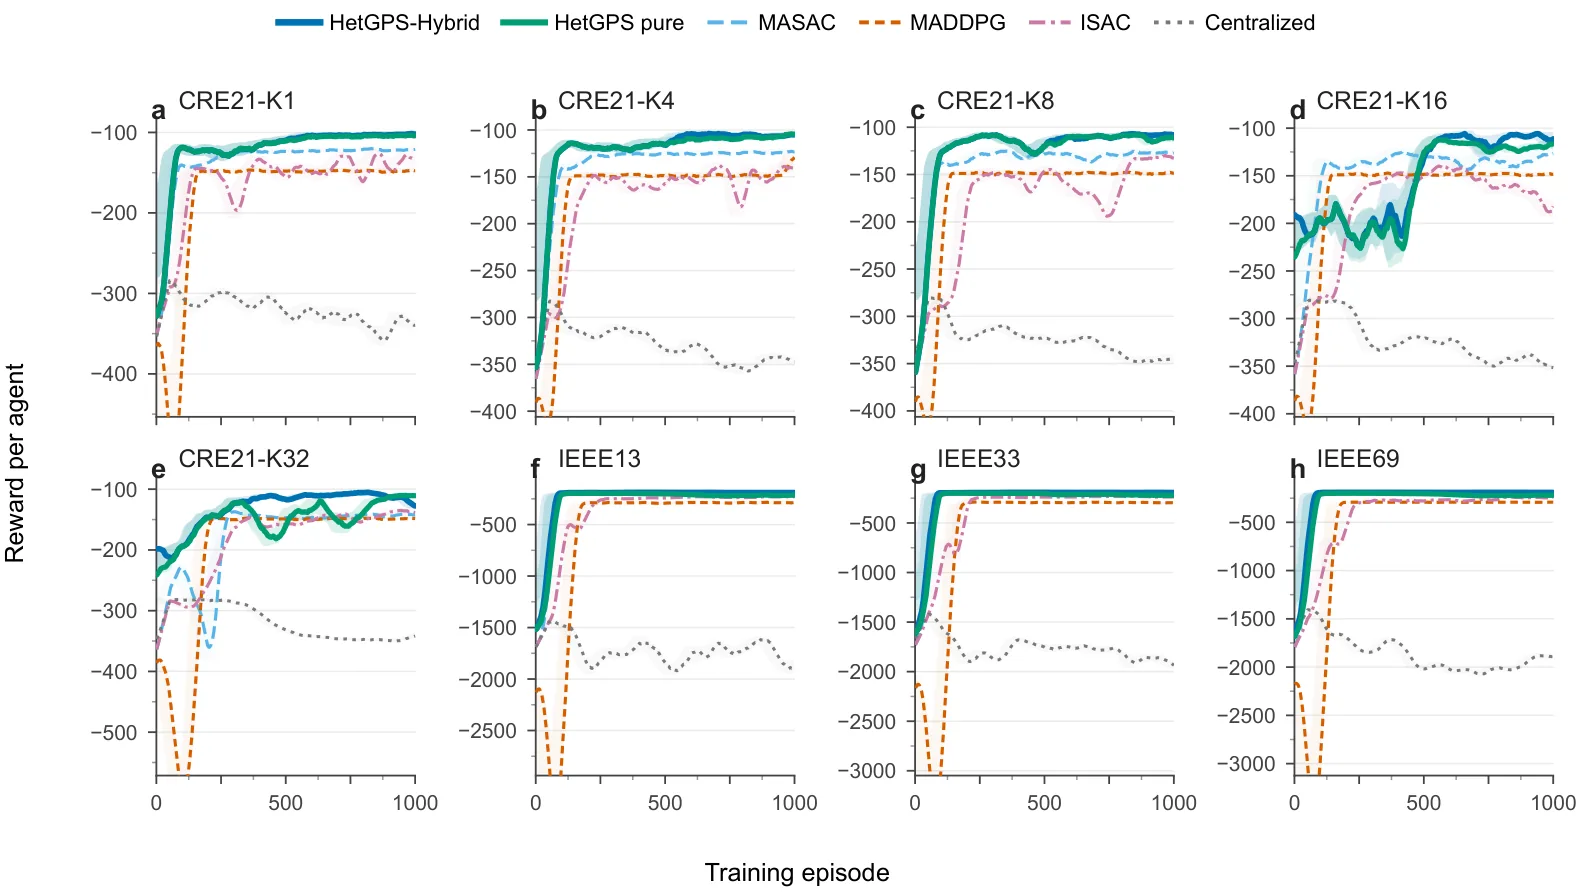
在骨干方法对比中,HetGPS 在全部五个 CRE21 规模以及 IEEE33/IEEE69 标准馈线上取得最高可行奖励,可行性定义为离网成功率不低于 95%。相比之下,集中式 SAC 因奖励过差(-353 至 -389)且离网成功率仅 72–80%,在约束严格的场景下完全不可用。该结果验证了参数共享异构图策略在大规模场景下的必要性。
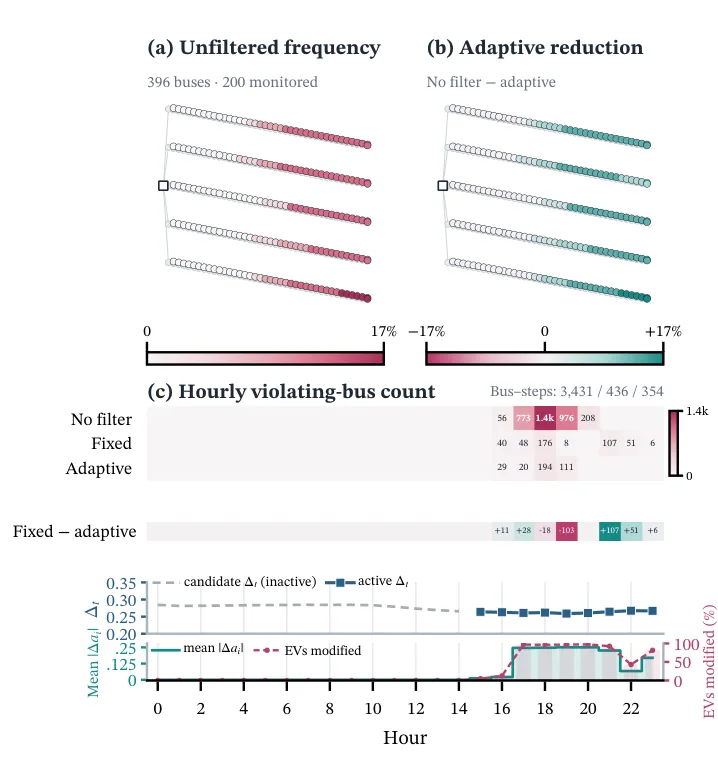
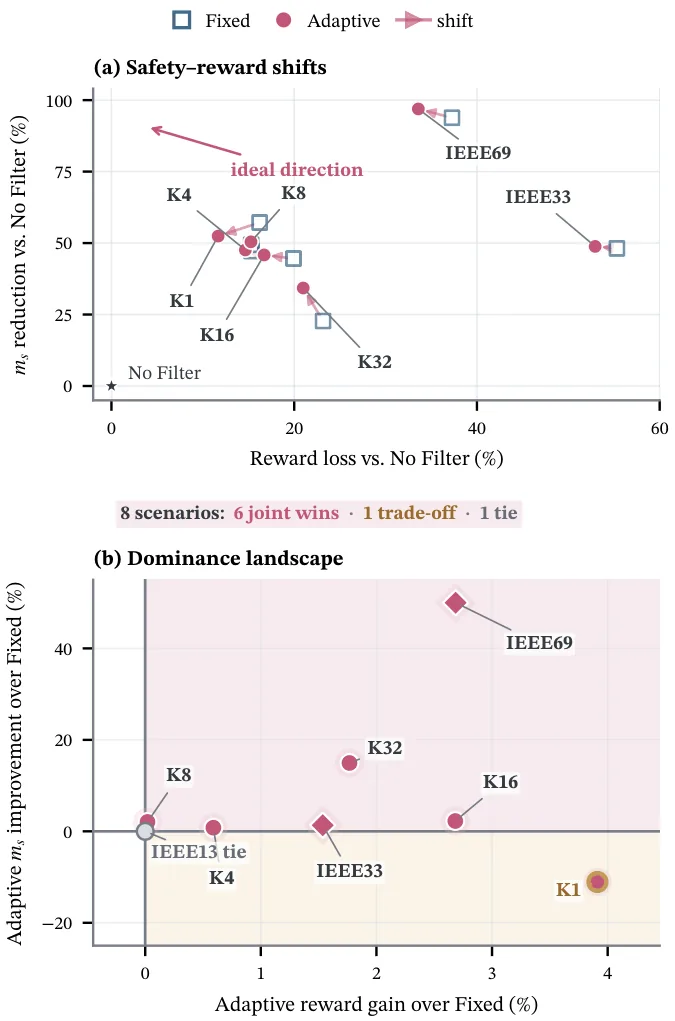
关于自适应权限的效果,对比无滤波、固定权限()和自适应权限三种安全接口,自适应权限在全部五个 CRE21 网络上均提升了平均奖励,并在其中四个上降低了安全分数指标。电压违规率从无滤波时的 3.93–7.74% 降至 0.52–3.44%,同时离网成功率维持在 99.06–100%。这一结果表明,状态依赖的权限调度能够在约束保护与任务性能之间实现更精细的权衡。
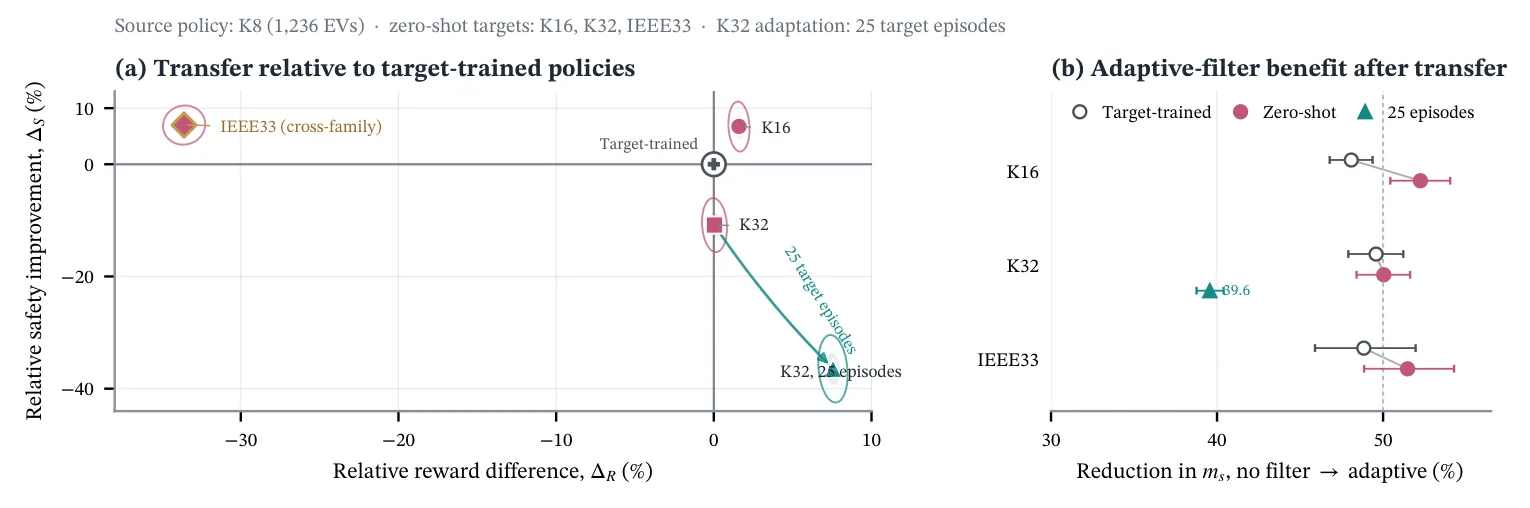
可扩展性方面,HetGPS 的策略与风险模型合计仅 383,702 个参数,在 3,218 辆电动汽车规模下,集中式 SAC 的 actor 网络参数量约为其 170 倍。更值得注意的是,在八变压器系统上训练的策略可零样本迁移至 16 和 32 变压器系统,违例率保持在 0.57–0.75%,离网成功率不低于 99.99%,展现了卓越的拓扑泛化能力。
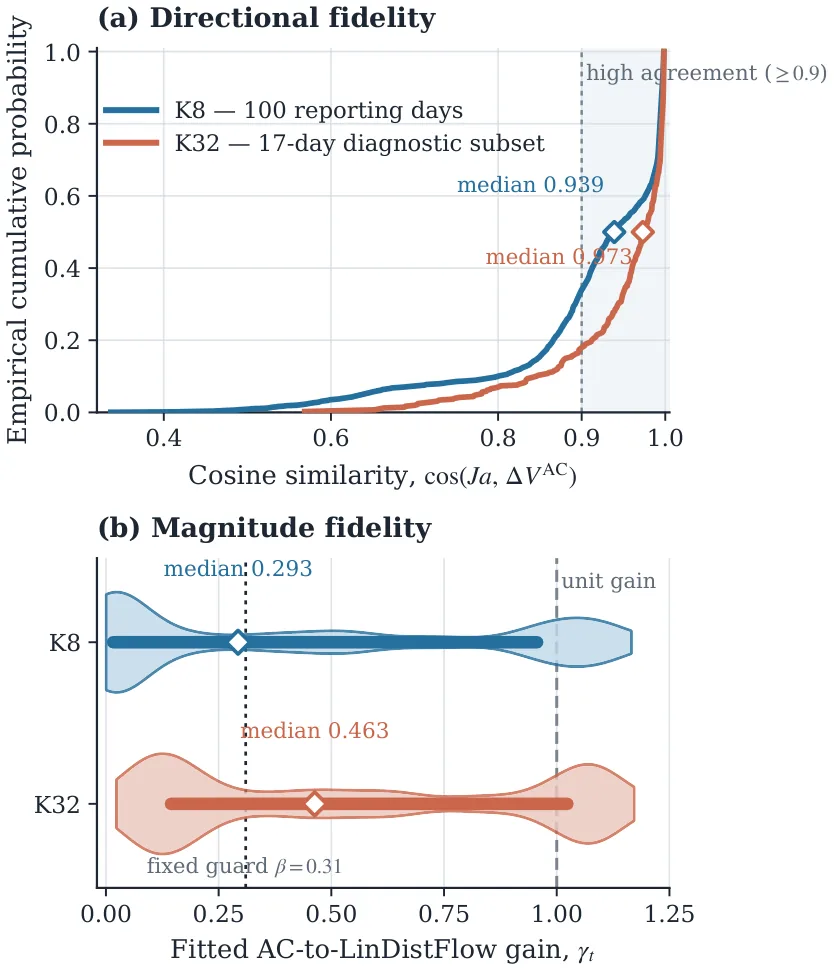
消融实验验证了物理方向锚定的必要性。与 AC 潮流对比,基于 LinDistFlow 的方向余弦相似度中位数达 0.939(K=8)和 0.973(K=32),表明物理方向高度可靠;但增益与 1 存在显著偏离(中位数仅 0.293 和 0.463),说明仅用固定增益的物理护栏无法精确校正幅度,必须依赖学习到的权限调度。用学习残差的雅可比替代物理 时,方向保真度下降且性能无一致改进,进一步确认了物理锚定方向的合理性。
讨论与可借鉴点
HetGPS 成功地将安全强化学习中的"约束保护"与"任务自由度"解耦为两个独立模块,这一设计哲学具有广泛的借鉴意义。物理模型提供方向保证、 [[图神经网络]] 提供状态依赖的风险感知、学习模型负责幅度调度的三层架构,既避免了纯学习方法的物理不一致风险,又克服了纯物理方法缺乏状态感知能力的局限。
该工作的局限性值得注意。论文主要在嵌套子网和同家族 IEEE 馈线上验证迁移能力,跨家族迁移(如 CRE21 到 IEEE 13)的样本量较少。超参数(如 、 等)的敏感性分析也未充分展开,固定物理护栏参数在更极端场景(如大规模光伏倒送)下的鲁棒性有待检验。此外,残差模型基于 LinDistFlow 线性化假设,在高度非线性或谐波显著的系统中可能需要更复杂的近似。
对于 [[多智能体强化学习]] 领域的实践者,HetGPS 的核心启发在于:在大规模耦合系统中,不必追求端到端的全局安全策略,而应在"可学习的感知决策"与"可证明的物理约束"之间建立清晰接口。这种混合架构为安全关键应用提供了一条务实路径——让学习专注于它擅长的模式识别和协同优化,让物理为硬约束兜底。
摘要
针对大规模网络耦合智能体的安全干预,必须在保护共享约束的同时避免不必要地覆盖面向任务的策略决策。我们提出 HetGPS,一种混合图控制框架,通过将干预幅度与校正方向相分离,将学习到的图风险与物理锚定校正协同起来。其中,动作条件图残差模型对状态相关的干预权限进行调度,物理模型则决定其校正方向。针对电动汽车(EV)充电,我们将该滤波器与参数共享的异构图软演员-评论家策略相结合,从而在车队规模无关的学习模型容量下实现拓扑感知协同。在五个嵌套配电网(200–3,218 辆电动汽车)和 100 个评估日上,自适应权限将母线-步电压违例率从无滤波时的 3.93–7.74% 降至 0.52–3.44%,同时保持 99.06–100% 的离网成功率。相较于采用相同物理定向投影但权限固定的方案,该方法在全部五个网络上均提升了平均奖励,并在其中四个网络上降低了平均安全分数。部署的策略与风险模型在任意规模下仅含 383,702 个学习参数;在 3,218 辆电动汽车规模下,参数匹配的集中式 SAC 演员网络参数量约为其 170 倍。在八变压器系统上训练的策略可零样本迁移至 16 和 32 变压器系统,取得 0.57–0.75% 的违例率与不低于 99.99% 的离网成功率。上述结果表明,学习到的图风险能够在大规模场景下分配干预权限,而馈线物理则为校正动作提供锚定。
Abstract
Safety interventions for large populations of network-coupled agents must protect shared constraints without unnecessarily overriding task-oriented policy decisions. We present HetGPS, a hybrid graph-control framework synergizing learned graph risk with physics-anchored correction by separating intervention magnitude from corrective direction. An action-conditioned graph residual model schedules state-dependent intervention authority, while a physics model determines its direction. For electric vehicle (EV) charging, we couple this filter with a parameter-shared heterogeneous graph soft actor-critic policy, enabling topology-aware coordination with a learned model size independent of fleet size. Across five nested distribution networks with 200--3,218 EVs and 100 evaluation days, Adaptive Authority reduces bus--step voltage violations from 3.93--7.74\% without filtering to 0.52--3.44\%, while maintaining 99.06--100\% departure success. Relative to the same physics-directed projection with fixed authority, it improves mean reward on all five networks and lowers the mean safety score on four. The deployed policy-and-risk model contains 383,702 learned parameters at every scale; at 3,218 EVs, a matched centralized SAC actor is about larger. A policy trained on the eight-transformer system transfers zero-shot to the 16- and 32-transformer systems, attaining 0.57--0.75\% violation rates and at least 99.99\% departure success. These results show that learned graph risk can allocate intervention authority at scale while feeder physics anchors corrective action.
论文详细总结(自动生成)
HetGPS 论文总结
1. 核心问题与整体含义
研究背景:大规模配电网中存在数量众多、状态异构的住宅电动汽车(EV)充电桩,其充电决策通过母线电压彼此耦合,呈现典型的图结构耦合多智能体系统特征。
核心矛盾:
- 去中心化控制:忽略电力耦合,安全不可保证;
- 集中式控制:随车队规模增长,参数和维度灾难严重;
- 图参数共享策略:虽然可扩展,但其输出动作在物理上未必安全;
- 训练期奖励惩罚 / 期望成本约束:只能降低平均违例,无法保证每一次实现的联合动作都满足约束。
研究目标:在保护共享电压约束的同时,不必要地覆盖策略面向任务的决策;实现"约束保护"与"任务自由度"二者兼顾的运行时安全滤波。
关键洞见:将安全滤波器的两个角色解耦——干预幅度(学)与校正方向(物)分开,由图风险模型调度状态相关的"干预权限 ",由馈线物理模型(LinDistFlow 灵敏度 )决定校正方向。
2. 方法论
2.1 问题形式化
建模为有限时域约束 Dec-POMDP:
系统级目标函数与期望成本约束:
动作链为:,训练时 ,部署时插入电压投影。
2.2 共享图策略与风险模型
- 异构图:包含母线节点、EV 节点、电气边(线/变压器)和 EV-母线连接边,仅连接子图为二部图;
- 图编码器:两总线消息传递层(,,4 头),输出 16 维母线上下文 ,EV 通过跨注意力读取其服务母线嵌入;
- 参数共享 SAC Actor:高斯策略 在所有 EV 间共享,私有观察 拼接图上下文后维度为 97;
- 均值场评论家:附加原始联合提案的均值与标准差 作为条件。
2.3 动作条件电压残差
其中 , 是来自 LinDistFlow 的固定标幺化灵敏度矩阵:
残差头由 AC 潮流标签监督,pinball 损失训练 三个分位输出。
2.4 风险到权限调度器
母线电压超出运行带 p.u. 的越界量为:
取学习残差 与定增益物理护栏 二者 0.95 分位数中的保守值 ,再映射为干预权限:
检测(任意母线触发)使用单点逻辑,预算()使用更广泛风险规模,二者解耦。
2.5 物理锚定投影
校正方向完全由物理决定,排除学习残差:
当护栏触发母线集合 时,求解凸二次规划:
其中 ,授权箱 由 形成;部署采用定凸集投影(Kproj=10 次扫描),按初始赤字降序处理。
2.6 算法 1 流程
```
1. 采样 a_RL ← πθ(·|o)
2. 预测 ŷ(a_RL)(式3)
3. 计算 r̄_t(式4)
4. 调度 Δ_t(式5)
5. 由物理护栏形成活跃约束 K_t
6. 若无触发:a_proj ← a_RL
7. 否则:d=0,对 Kproj 轮按 c_j 排序松弛并投回 [ℓ, u]
8. a_exec ← G_svc(x, a_proj)
```
3. 实验设计
3.1 数据集与场景
- CRE21(澳大利亚实际配电网,含 5 个嵌套子网,,对应 200/664/1236/2239/3218 辆 EV)
- IEEE 13/33/69 标准馈线作为跨家族迁移测试
- 负荷 / 光伏:2012–2013 Ausgrid 数据;电价:2022–2023 AEMO VIC1 实时批发电价;EV 出行:VISTA 调查
- 异构车队:40 kWh/7.4 kW(30%)、58 kWh/11 kW(40%)、77 kWh/22 kW(30%)
- 时段划分:365 天中 240 天训练、25 天适配、100 天评估;每日 24 步
3.2 评价指标
- 母线-步违例率 :以不同 EV 服务母线为分母
- 安全分数 :日聚合(是否出现 + 最大越界幅度)
- 奖励 / EV、离网成功率(SoC 在目标 0.10 容忍内)
3.3 对比方法
Backbone 对比(固定安全接口):
- ISAC、MADDPG、Centralized SAC、C-SAC
- PI-LP:基于线性化网络的完美信息参考调度(V2G-enabled 线性规划)
安全接口对比(固定策略):
- No Filter(仅服务映射,无电压投影)
- Fixed Authority(物理投影 + )
- Adaptive Authority(物理投影 + 式 5 调度)
统一配置:, p.u.,,,,,Kproj=10。
3.4 迁移协议
- K=8 训练策略 → 零样本迁移至 K=16、K=32(嵌套扩规模)、IEEE33(跨家族)
- K=8 → K=32 加 25 集目标域适配
4. 资源与算力
- 单卡 NVIDIA A100 80GB GPU;
- 代码:Python 3.10.14、PyTorch 2.1.1+cu121、PyG 2.4.0、pandapower 2.14.10、CVXPY 1.7.3、CasADi 3.7.2;
- 时序开销:固定权限滤波每小时决策额外 13–390 ms(占对应无滤波评估循环 3.7–8.6%),自适应滤波在固定权限基础上仅增加标量映射,无新残差评估或潮流求解;
- 论文未明确报告训练总时长与 GPU 小时数。
5. 实验数量与充分性
- 骨干对比:5 个 CRE21 规模 + 3 个 IEEE 馈线 = 8 个场景,每个方法 3 次独立训练,共 4 个学习方法 × 8 场景 × 3 run ≈ 96 组训练-评估对,加 PI-LP 1 组;
- 权限对比:同一策略下 3 种安全接口 × 8 场景 × 3 run = 72 组;
- 消融实验:
- 学习方向 vs 物理方向 等上限对比(Table 4,3 个上限档);
- AC 方向保真度诊断(Fig 7,含 K8 100 日 2400 样本 + K32 17 日 408 样本);
- PID 乘子更新参数();
- 拓扑迁移:4 个迁移目标(K16、K32、IEEE33、K32-25E)× 2 滤波器模式 = 8 组;
- 每运行报告:奖励、违例率、、离网成功率;附表 2–3 给出三运行均值±样本标准差;
- 公平性:所有方法共享相同 100 个评估日、固定动作链、相同服务映射;动作采样随机性通过确定性评估消除;评估顺序固定(配对日比较)。
充分性评估:覆盖规模范围广(200–3218 EV)、含跨家族迁移、三次独立运行、配对日协议、消融全面。但 IEEE 系列样本较少(13/33/69)、未做不同随机种子扫描、未报告超参敏感性(、 等只给单一取值)。
6. 主要结论
1. 骨干对比:HetGPS 在 5 个 CRE21 规模与 IEEE33/IEEE69 上取得最高可行奖励(≥95% 离网成功率),最大优势在 K=32;中央化 SAC 因奖励过差(-353 至 -389)伴随 72–80% 离网成功率而不可用;
2. 自适应权限效果:
- 母线-步违例率从 3.93–7.74% 降至 0.52–3.44%(无滤波 vs 自适应);
- 离网成功率维持 99.06–100%;
- 相对固定权限:在全部 5 个 CRE21 网络上提升平均奖励,并在其中 4 个上降低 ;
- 8 场景中:6 个联合改进 / 1 个权衡 / 1 个持平(IEEE13)。
3. 可扩展性:部署策略 + 风险模型恒为 383,702 参数;在 3218 EV 时集中式 SAC actor 为 6515 万参数,约为其 170×;
4. 零样本迁移:K8 策略零样本部署到 K16、K32 时违例率 0.57–0.75%,离网成功率 99.99–100%;到 IEEE33 时自适应滤波将违例率从 3.57% 降至 1.64%;
5. 物理锚定验证:与 AC 潮流对比,方向余弦相似度中位数 0.939(K8)/0.973(K32),但增益与 1 偏离( 中位 0.293/0.463),证明使用物理方向是必要的;
6. 方向消融:用学习残差雅可比替代物理 时,方向余弦降至 0.775–0.988,且闭环中保留更多奖励但留更多违例,无一致 Pareto 改进。
7. 优点
- 概念解耦清晰:将安全滤波器的"幅度"和"方向"分离,由学和物分别承担,原理简洁且具推广性;
- 参数量与车队规模解耦:策略 + 风险模型参数恒定,对 200→3218 EV 无需新增参数;
- 可解释性强:通过服务母线嵌入与共享权重保持运营商视角的信息局部性(虽非形式化隐私保证);
- 物理可解释的投影:基于 LinDistFlow 的 提供径向馈线方向性命题 1,保证符号正确性;
- 三运行均值+配对日协议:统计严谨性较好;
- 统一接口对比设计:消融 No Filter / Fixed / Adaptive 时其他变量全部冻结,验证因果归因清晰;
- 跨家族迁移:不仅在同家族嵌套扩规模,还在 IEEE33 上验证零样本迁移能力;
- 完整附录:含 Dec-POMDP 完整定义、奖励分解、PID 更新、参数会计、AC 验证等可复现细节。
8. 不足与局限
- 非点态可行性证明:作者明确指出平衡潮流假设与 使其无法对每次实现给出可行性证明,需要验证模型误差余量才能用于认证部署;
- 简化模型假设:仅平衡正序网络,未覆盖相不平衡、中性线、相电压差异,且未考虑热极限;
- 拓扑剧变与异构 DER 渗透未覆盖:馈线配置需重算 灵敏度,跨家族 IEEE33 零样本迁移奖励代价大(−289 → −392),表明操作域漂移场景仍是挑战;
- 超参未做敏感性扫描:、、、、Kproj 等取单一固定值,未报告网格或扰动分析;
- PI-LP 仅作可行性参考:使用全日未来信息、不等价在线 SAC,未给出信息匹配的"在线 LP"上界;
- 运行次数较少:仅 3 次独立训练,未做不同随机种子的多次扫描,置信区间相对窄;
- 学习方向的对比被定性为"无一致改进":但仅在 K1 上做等上限对比,未在更大规模上验证方向消融是否随规模出现反转;
- 部署时仍需缓存 :在 K=32 时为 6375×3218 ≈ 2051 万 float32(≈82 MB),且随节点-代理乘积增长,作者指出稀疏化是未来方向;
- 离网成功率容差较宽:使用 0.10 绝对 SoC 容忍而非精确目标,对严格服务要求的场景需重新校核;
- 服务映射规则掩盖部分预算:服务映射会清零不可用 EV、覆盖紧急超驰,使"已花费的 预算"未必全部作用于物理校正,限制对权限的实际解释力;
- 算法 1 的截断扫描不保证电压约束完全恢复:作者已说明,但仍意味着任何"安全"陈述需限定于报告的正序电压指标与被监控母线。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。