
扩散环境中多臂老虎机策略梯度的收敛性与后悔分析
Convergence and Regret of the Policy Gradient for Multi-Armed Bandits in Diffusion Environment
📝 TLDR
在连续时间强化学习框架下,研究扩散环境中多臂老虎机问题的策略梯度收敛性与遗憾界。采用logit参数化的随机策略与常数学习率更新,构造新颖Lyapunov函数分析对应SDE。证明策略梯度在任意常数学习率下几乎必然收敛至最优臂,并在学习率低于时不变阈值时获得O(log T)的非渐近遗憾上界,改进Lattimore(2026a)对同一SDE的分析,展示SDE工具在策略梯度分析中的透明性与可推广至离散时间场景的价值。
🧭 速览
扩散环境中多臂老虎机的策略梯度收敛性与遗憾分析尚不充分,已有SDE分析工具有改进空间。
在SDE扩散环境下采用logit参数化策略与常数学习率更新,构造新Lyapunov函数分析策略梯度。
任意常数学习率下几乎必然收敛至最优臂;学习率低于时不变阈值时遗憾上界为O(log T)。
改进Lattimore(2026a)对同一SDE的分析,展示SDE工具的透明性,并可推广至离散时间算法。
🆚 方法对比
基于新型Lyapunov函数的策略梯度SDE分析(本文方法)
- 任意常数学习率下几乎必然收敛
- 统一处理两臂与多臂情形
- O(log T)非渐近遗憾上界
- 学习率阈值与Baudry猜测一致为O(1/d)
- 仅适用于扩散环境的弱信号场景
- 学习率需低于时不变阈值才保证遗憾界
- 依赖连续时间SDE扩散极限假设
Lattimore (2026a)方法
- 得到O(log T)遗憾上下界匹配
- 分析同一SDE的早期尝试
- 为后续研究提供基准对比
- 两臂与多臂需分开分析
- 对学习率条件更严格
- 未提供统一Lyapunov分析框架
UCB与Thompson Sampling算法
- 基于统计原理的经典成熟方法
- 有完善的理论分析与实现
- 广泛适用于赌博机问题
- 作者指出对梯度方法关注较少
- 非本文讨论的策略梯度方法
- 在弱信号扩散环境中未被分析
Wang et al. (2020)与Jia and Zhou (2022b)连续时间RL框架
- 提供连续时间RL形式化基础
- 支持actor-critic增量策略梯度
- 便于利用SDE工具分析
- 本质是离散算法的连续近似
- 依赖高频采样极限假设
- 需将离散问题转化为SDE
离散时间策略梯度算法(Walton, Mei, Baudry等)
- 可直接实现无需连续近似
- 有多种已有理论结果可供比较
- Lyapunov函数同样适用
- 离散分析更复杂不如SDE透明
- 遗憾与收敛分析工具分散
- 本文仅作为对比讨论非主要贡献
本文核心贡献是构造新型Lyapunov函数统一分析SDE策略梯度,在收敛性与O(log T)遗憾界上改进了Lattimore (2026a)的方法,并展示了连续时间SDE工具相较于UCB/Thompson Sampling及离散策略梯度方法在分析透明度上的优势。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📄 论文页面预览(共 6 页)
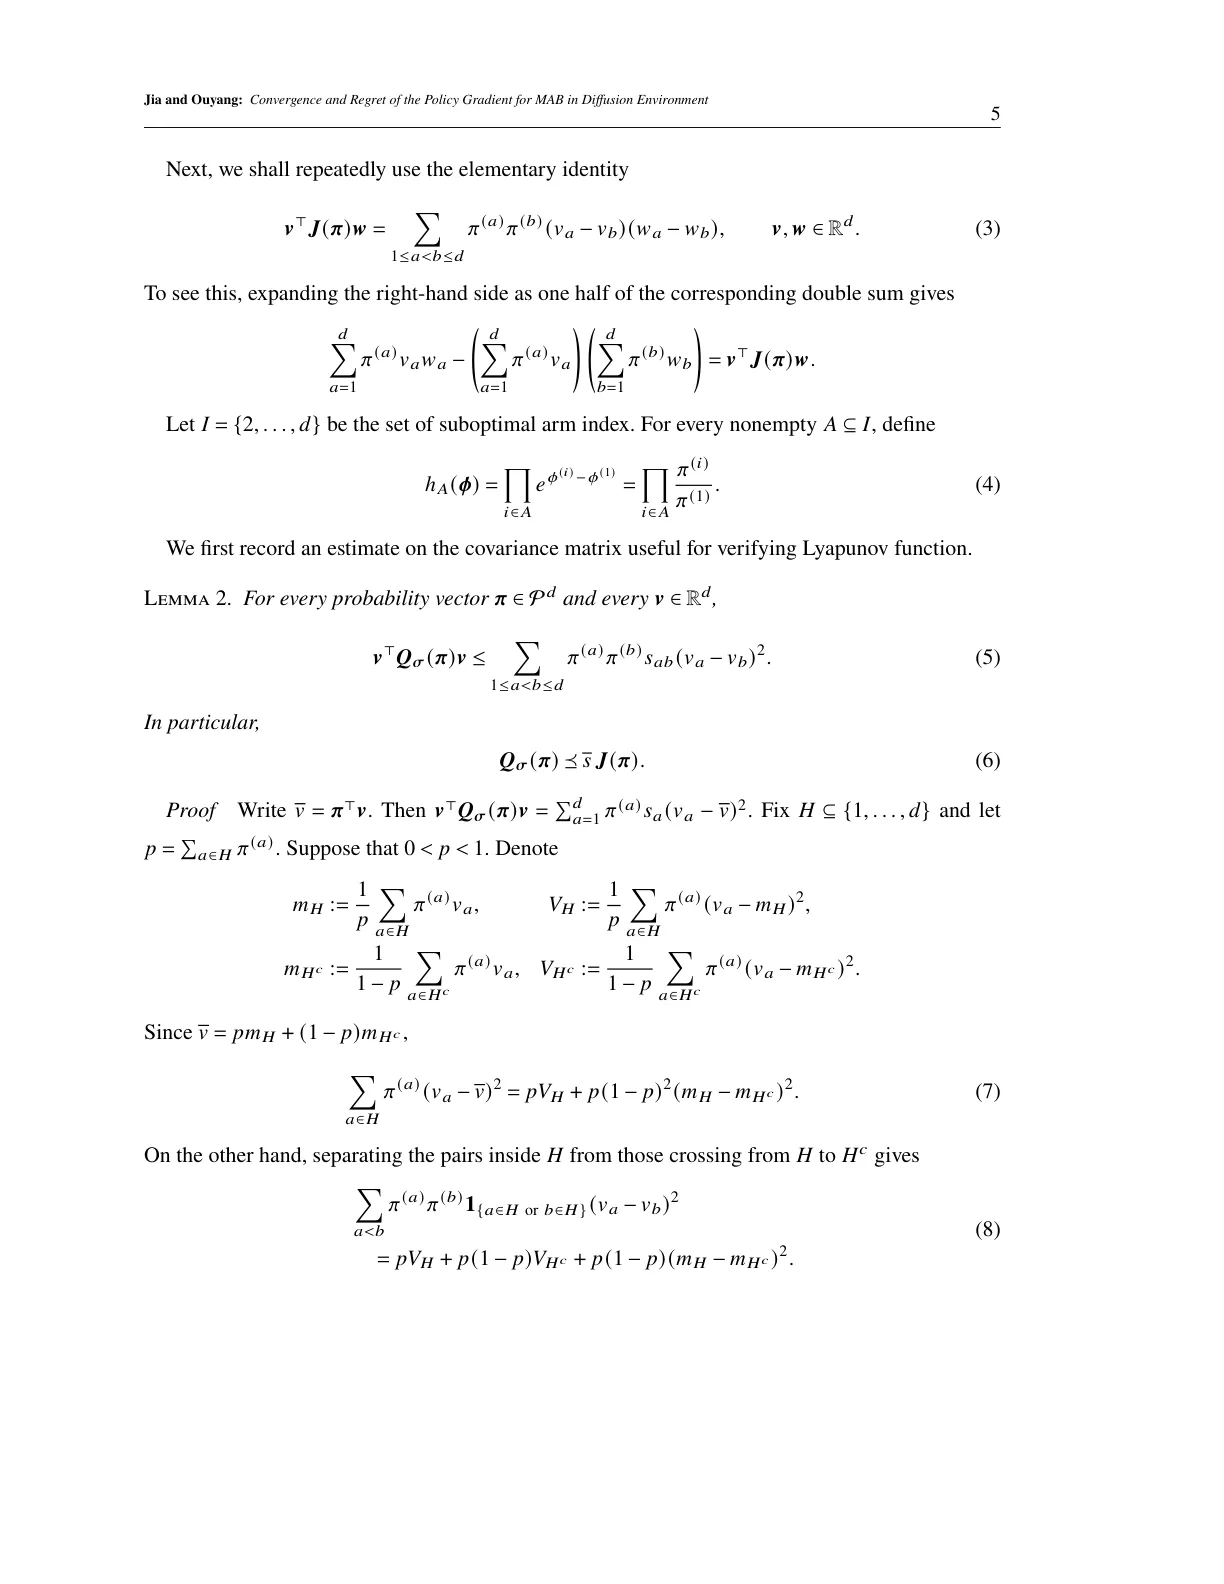
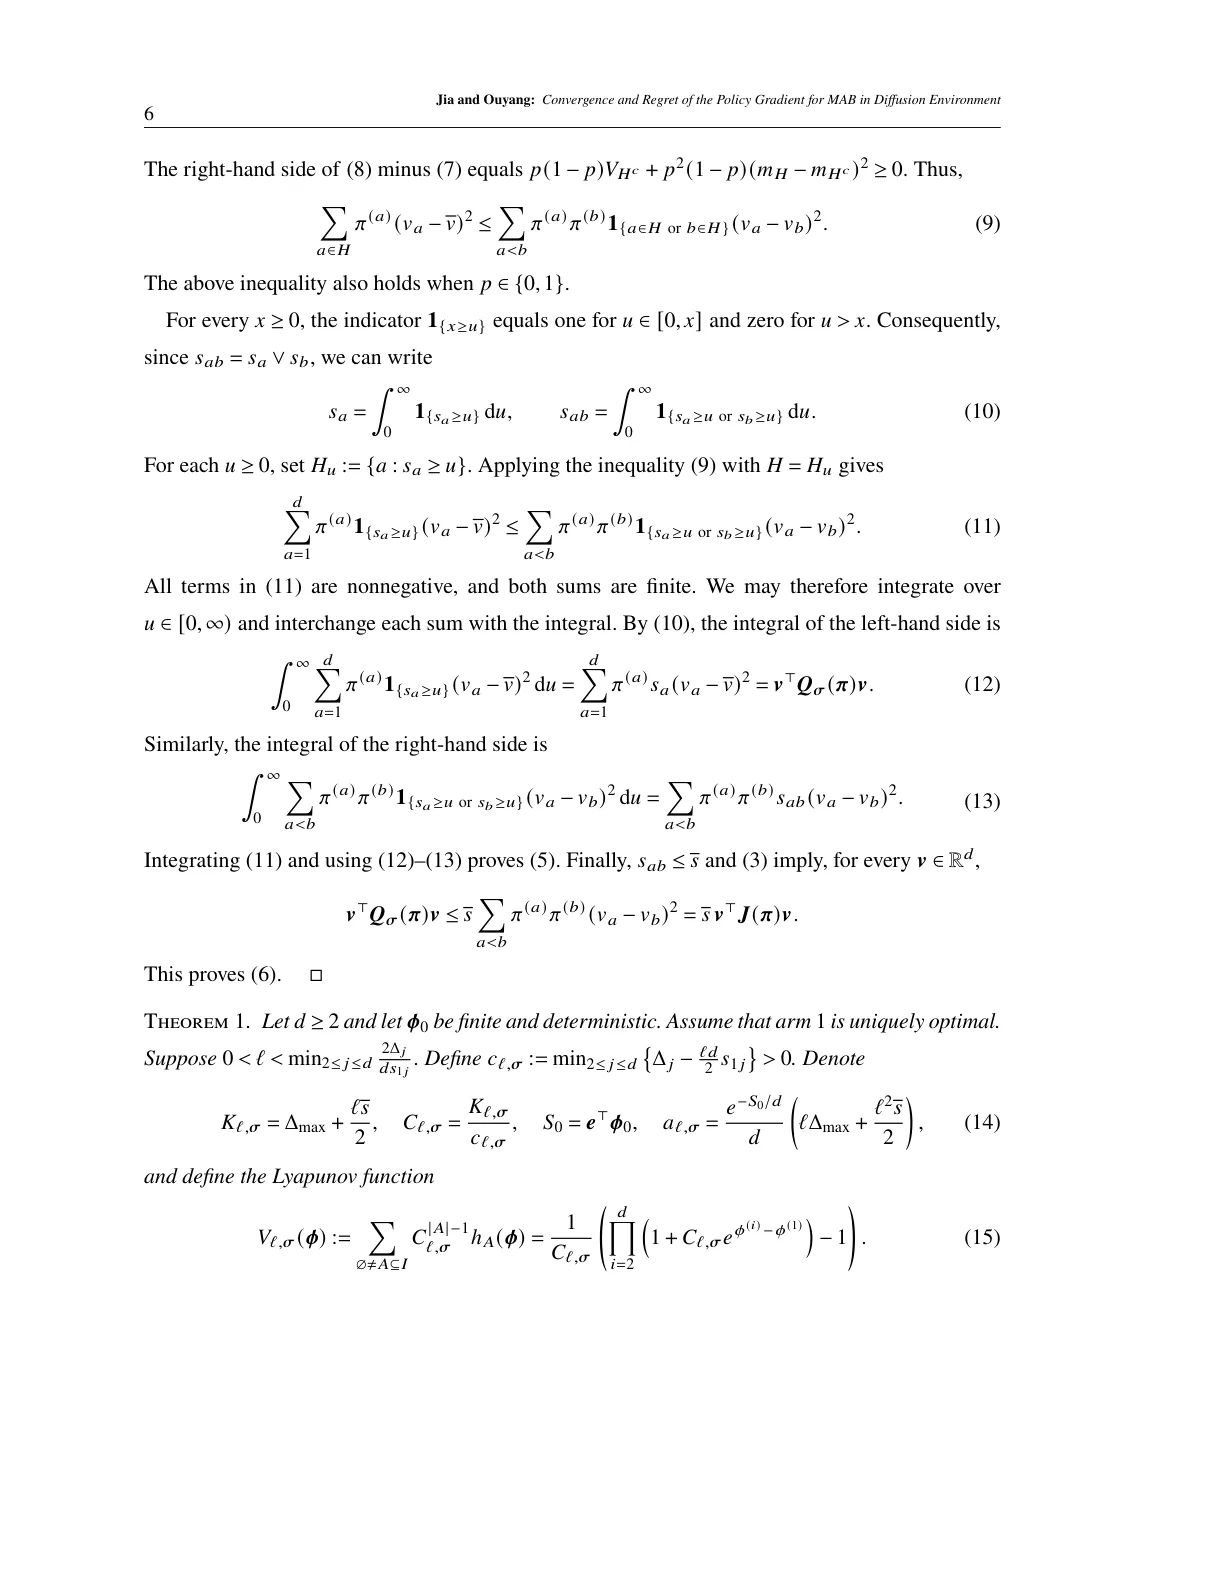
论文无独立配图,展开查看 6 页整页预览
TL;DR
本文研究了扩散环境中多臂老虎机问题的策略梯度更新过程。通过对 logit 参数化的随机策略构造一类新颖的乘积型 Lyapunov 函数,证明了策略梯度在任意常数学习率下几乎必然收敛到最优臂;当学习率低于一个时不变阈值时,可获得非渐近的 后悔上界。该工作改进了此前 Lattimore (2026a) 对同一随机微分方程的分析,显著放宽了学习率约束条件,并展示了连续时间分析方法对离散时间算法的潜在价值。
研究背景与动机
[[多臂老虎机]]是序贯决策领域的经典模型,其核心挑战在于探索与利用之间的权衡。传统方法如上置信界(UCB)和汤普森采样(Thompson Sampling)建立在精心设计的统计原则之上,近年来在理论分析上取得了显著进展。然而,基于[[策略梯度]]的通用优化方法在这一问题上的理论理解仍然不够充分。
本文关注一类特殊的连续时间环境——扩散环境。在这一设定下,每个臂的累积奖励不再是对独立采样求和,而是由[[随机微分方程]](SDE)描述:
其中 表示第 个臂的均值奖励, 控制噪声强度, 为独立布朗运动。这一建模对应了高频采样或"弱信号"场景,此时离散时间老虎机的每次采样方差相对较大,使得累积奖励的随机性更接近连续时间扩散过程。
值得注意的是,Lattimore (2026a) 已对同一 SDE 给出了 后悔上界,但该分析要求学习率随时间衰减至 ,且证明框架需要分别处理两臂与多臂情形。本文的研究动机在于:能否在任意常数学习率下建立更强的收敛保证?如果能够放宽学习率约束,理论分析的内在结构是什么?这些问题的回答不仅有助于理解策略梯度的收敛行为,还可能为离散时间算法的分析提供启示。
方法
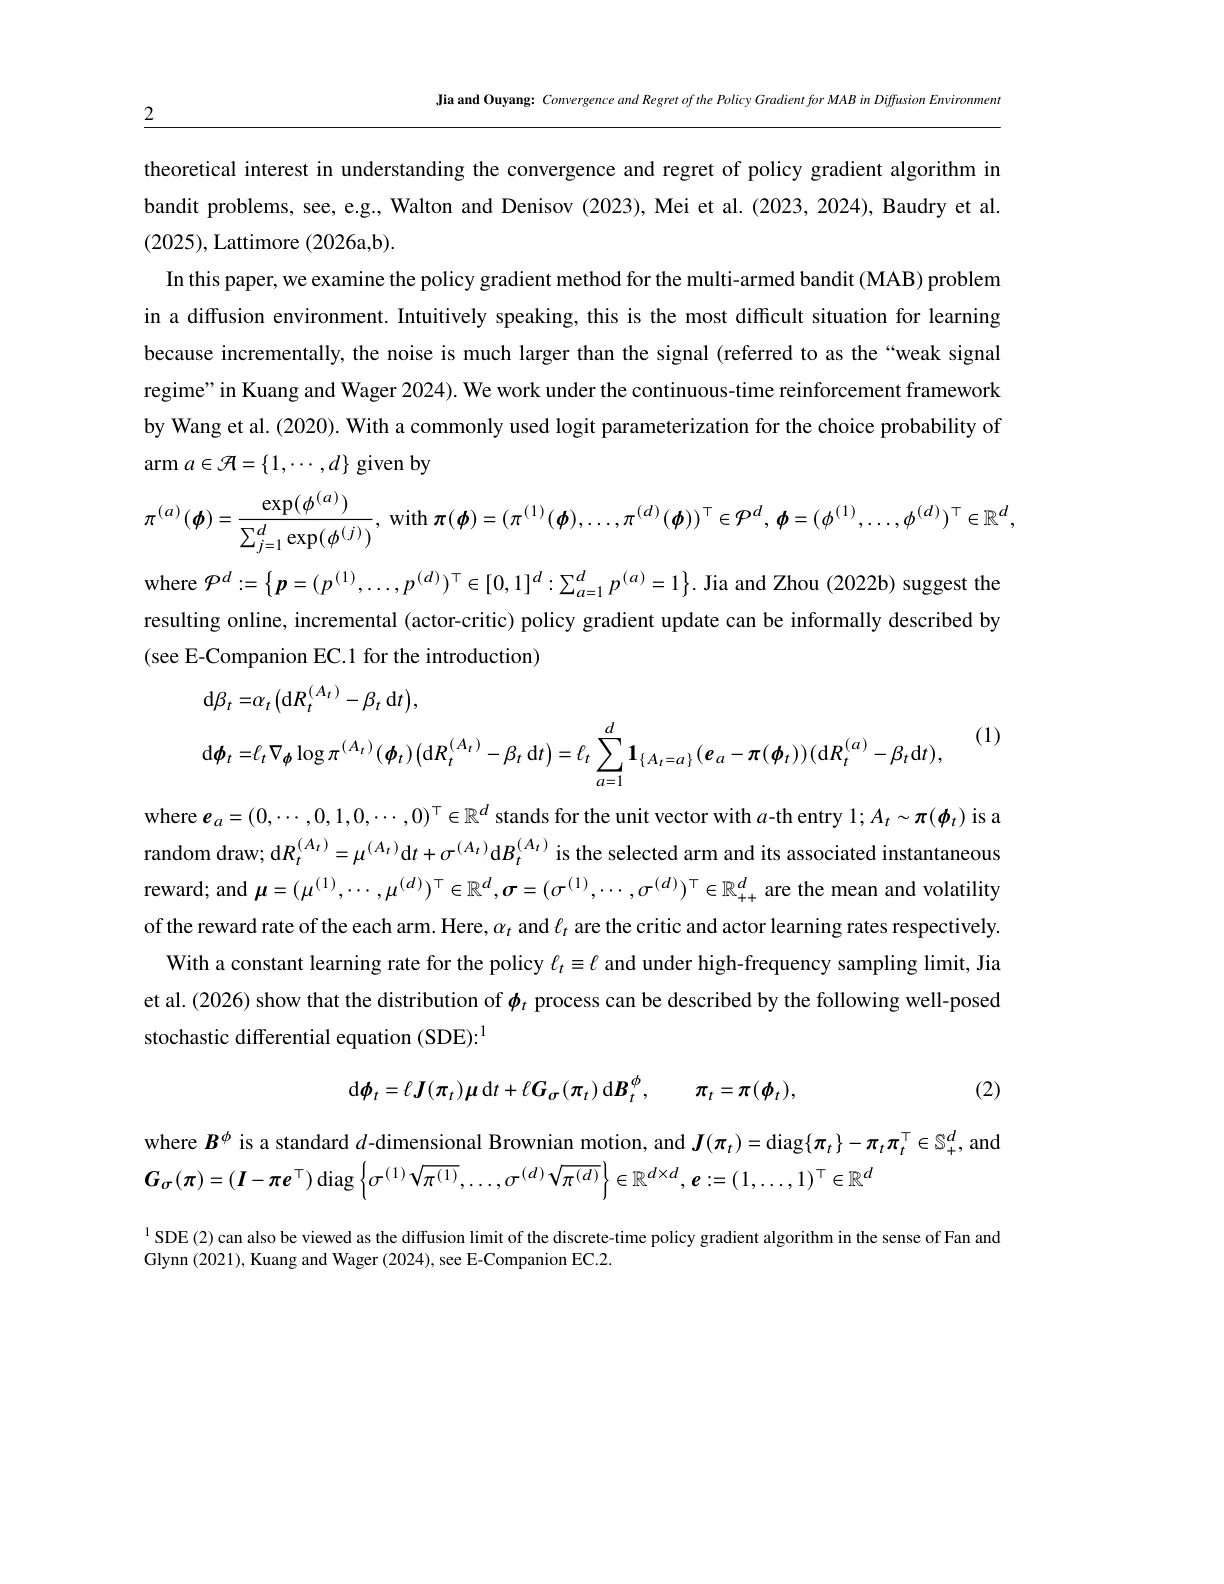
本文采用 logit(softmax)参数化来定义随机策略。对于 个臂,策略的参数为 ,对应的动作选择概率为:
在常数学习率 和高频采样极限下,参数 的演化可以完全由一个 维 SDE 刻画。该 SDE 的漂移项正比于策略梯度方向,动作的期望奖励作为优势函数的估计。
理解这一 SDE 的长期行为是分析的核心。论文的创新之处在于构造了一类形式紧凑的乘积型 [[Lyapunov 函数]]。具体而言,对于非空子集 ,定义 ,再将所有子集的乘积函数进行加权求和,得到:
这个函数可以简洁地写成 的形式,其中 是一个依赖于学习率和方差的常数。选择这一构造的理由在于:当利用 Itô 公式计算 的无穷小生成元时,可以得到一个全局的 Lyapunov 不等式——漂移项强制 沿轨迹下降,而扩散项的结构恰好能够被控制。
关键的技术步骤包括:利用协方差矩阵的结构性质 将扩散项与漂移项建立联系,其中 是策略的雅可比矩阵。最终证明:
这表明 在期望意义下是单调递减的,从而为建立收敛性提供了基础。
实验与结果
作为一篇纯理论论文,本文不包含数值实验,所有结论均通过数学证明建立。论文的主要理论结果可以分为三个层次。
第一个结果是关于后悔界的刻画。定理一表明,当学习率满足 时(这里 是第 个臂与最优臂的均值差, 与方差有关),总后悔满足:
第一项体现了 的增长阶数,第二项是初始条件带来的常数偏移。值得注意的是,学习率阈值是"时不变的"——不依赖于时间 ,只依赖于问题本身的几何性质。
第二个结果是几乎必然收敛性。定理二在均值两两不同的假设下,证明了无论学习率取何正值,策略概率 以概率 1 收敛到最优臂 。这一结果利用了随机比较原理和超鞅收敛定理:Lyapunov 函数 在几乎必然意义下有界且非增,由此推出参数差的指数权重收敛到零。
第三个结果将分析框架推广到离散时间。定理三表明,同样的 Lyapunov 函数可以处理带 baseline 的离散策略梯度更新:
在适当的技术条件下(可积性要求),可以重获 后悔界和几乎必然收敛。这说明连续时间分析并非人为构造,而是反映了离散算法的内在结构。
讨论与可借鉴点
本文的分析揭示了几个值得深思的观察。首先,乘积型 Lyapunov 函数的构造提供了一种统一处理多臂情形的方法。与 Lattimore (2026a) 需要分别讨论两臂和多臂不同,本文通过枚举所有非空子集并赋予恰当的系数权重,实现了"一步到位"的证明。这种思路对于其他涉及多参数竞争学习的分析具有潜在的借鉴价值。
其次,学习率约束从 放宽到 是一个实质性的改进。这意味着在问题规模较大(臂数 固定但较大)时,可以使用相对较大的常数学习率,从而获得更快的实际收敛速度。这一结果与 Baudry 等人 (2025) 的猜想相吻合,为离散时间策略梯度的最优步长选择提供了理论支撑。
然而,本文也存在若干局限性。关于后悔界的 -依赖,论文坦承当前结果比经典下界更差,"instance-free" 的后悔界仍是开放问题。此外,均值两两不同的假设较强,无法覆盖次优臂均值相等的情形;学习率阈值的表达式依赖于问题参数(均值差和方差),在无模型设定下需要 oracle 知识。连续时间 SDE 是否真正代表离散算法的行为、收敛速度如何,这些问题虽然通过扩散极限定理有所回答,但精确的有限样本分析仍有待探索。
总的来看,这项工作展示了 [[随机微分方程]] 工具在策略梯度分析中的透明性与系统性优势。通过一个精心设计的 Lyapunov 函数,可以同时建立几乎必然收敛与后悔上界两条性质,这种统一性是值得推广的方法论贡献。对于后续研究而言,如何在更弱的假设下(弱信号、异方差、非平稳环境)建立类似的结果,以及如何将连续时间分析桥接到实用的离散算法上,都是值得关注的方向。
摘要
本文研究了扩散环境中多臂老虎机问题的策略梯度更新过程。该扩散环境由随机微分方程(SDE)描述,置于 Wang 等人 (2020) 以及 Jia 和 Zhou (2022b) 所提出的连续时间强化学习框架之下。通过对随机策略采用 logit 参数化,我们证明了在任意常数学习率下,策略几乎必然收敛到最优臂。此外,当常数学习率低于一个时不变阈值时,我们推导出了非渐近的后悔上界,该后悔界具有 的阶数。我们通过构造一个新的 Lyapunov 函数,改进了 Lattimore (2026a) 对同一 SDE 的分析,并展示了利用 SDE 工具分析策略梯度的清晰性与透明性。此外,该 Lyapunov 函数同样有助于分析离散时间策略梯度算法。
Abstract
This paper studies the policy gradient update for a multi-arm bandit problem in diffusion environment that is described by a stochastic differential equation (SDE) under the continuous-time reinforcement learning framework by Wang et al. (2020), Jia and Zhou (2022b). With the logit parameterization for the stochastic policy, we show that it converges almost surely to the optimal arm under an arbitrary constant learning rate. Furthermore, we derive the non-asymptotic regret upper bound when the constant learning rate is below a time-invariant threshold; and the regret bound has order . We improve the analysis in Lattimore (2026a) for the same SDE by constructing a novel Lyapunov function and demonstrate the transparency of analyzing policy gradient using the tools in SDEs. In addition, the same Lyapunov function is also helpful in analyzing the discrete-time policy gradient algorithm.
论文详细总结(自动生成)
论文总结:扩散环境中多臂老虎机策略梯度的收敛性与后悔分析
1. 核心问题与研究动机
- 研究背景:多臂老虎机(MAB)是序贯决策的经典模型,传统研究集中于基于统计原理的 UCB 与 Thompson Sampling 算法,而对通用优化原理的梯度方法关注较少。
- 核心场景:本文研究扩散环境(diffusion environment)下的策略梯度方法,即每个臂的累积奖励服从随机微分方程 ,对应 Kuang and Wager (2024) 所称的"弱信号(weak signal)"极端场景。
- 框架基础:沿用 Wang et al. (2020) 与 Jia and Zhou (2022b) 提出的连续时间强化学习(松弛控制)框架,在高频采样极限下,logit 参数化策略 的演化可由 SDE (2) 完全刻画。
- 研究动机:Lattimore (2026a) 对同一 SDE 给出了 后悔上界,但要求学习率 (随时间衰减),条件较强且证明需要分别处理两臂与多臂情形。本文旨在放宽学习率约束、统一分析框架,并展示 SDE 工具的透明度。
2. 方法论
2.1 核心建模
采用 softmax / logit 参数化:
在常数学习率 与高频采样下, 满足 SDE:
其中 、, 为 维布朗运动。Lemma 1 证明该 SDE 存在唯一全局强解,且 守恒。
2.2 关键技术:构造 Lyapunov 函数
- 定义乘积型 Lyapunov 函数:对任意非空 ,令 ,再令
- 其中 ,,。
- 借助 Itô 公式与精细的成对分析(Lemma 2 的协方差不等式 ),可证全局 Lyapunov 不等式:
2.3 三个主要定理
- 定理 1(小学习率下的 后悔):当 时,对任意 :
- 定理 2(任意常数学习率下的几乎必然收敛):假设均值两两不同(),则对任意 ,(即以概率 1 收敛到最优臂)。证明依赖 Lemma 3(带可积正系数的随机比较原理)以及归纳反证。
- 定理 3(离散时间算法的统一证明):对带有 baseline 的离散更新 ,在 条件下重获 后悔界与几乎必然收敛,复用同一 Lyapunov 函数。
2.4 算法伪代码与扩散极限
E-Companion EC.3 给出 Actor-Critic 算法的离散采样实现(Algorithm 1);EC.2 用 Ispány-Pap(2010)与 Jacod-Shiryaev(2003)半鞅收敛定理证明连续时间 SDE 是离散算法在 尺度化后的弱极限,并给出 (一般)或 (三阶矩为零)的弱收敛速度。
3. 实验设计
- 本文为纯理论论文,不包含数值实验。论文中既无数据集、也无 benchmark,亦无传统意义上的对比仿真。
- 唯一涉及"场景"的内容是 E-Companion EC.5 对 情形做直觉性的公式推导(讨论平衡点 与学习率的关系),并非数值实验。
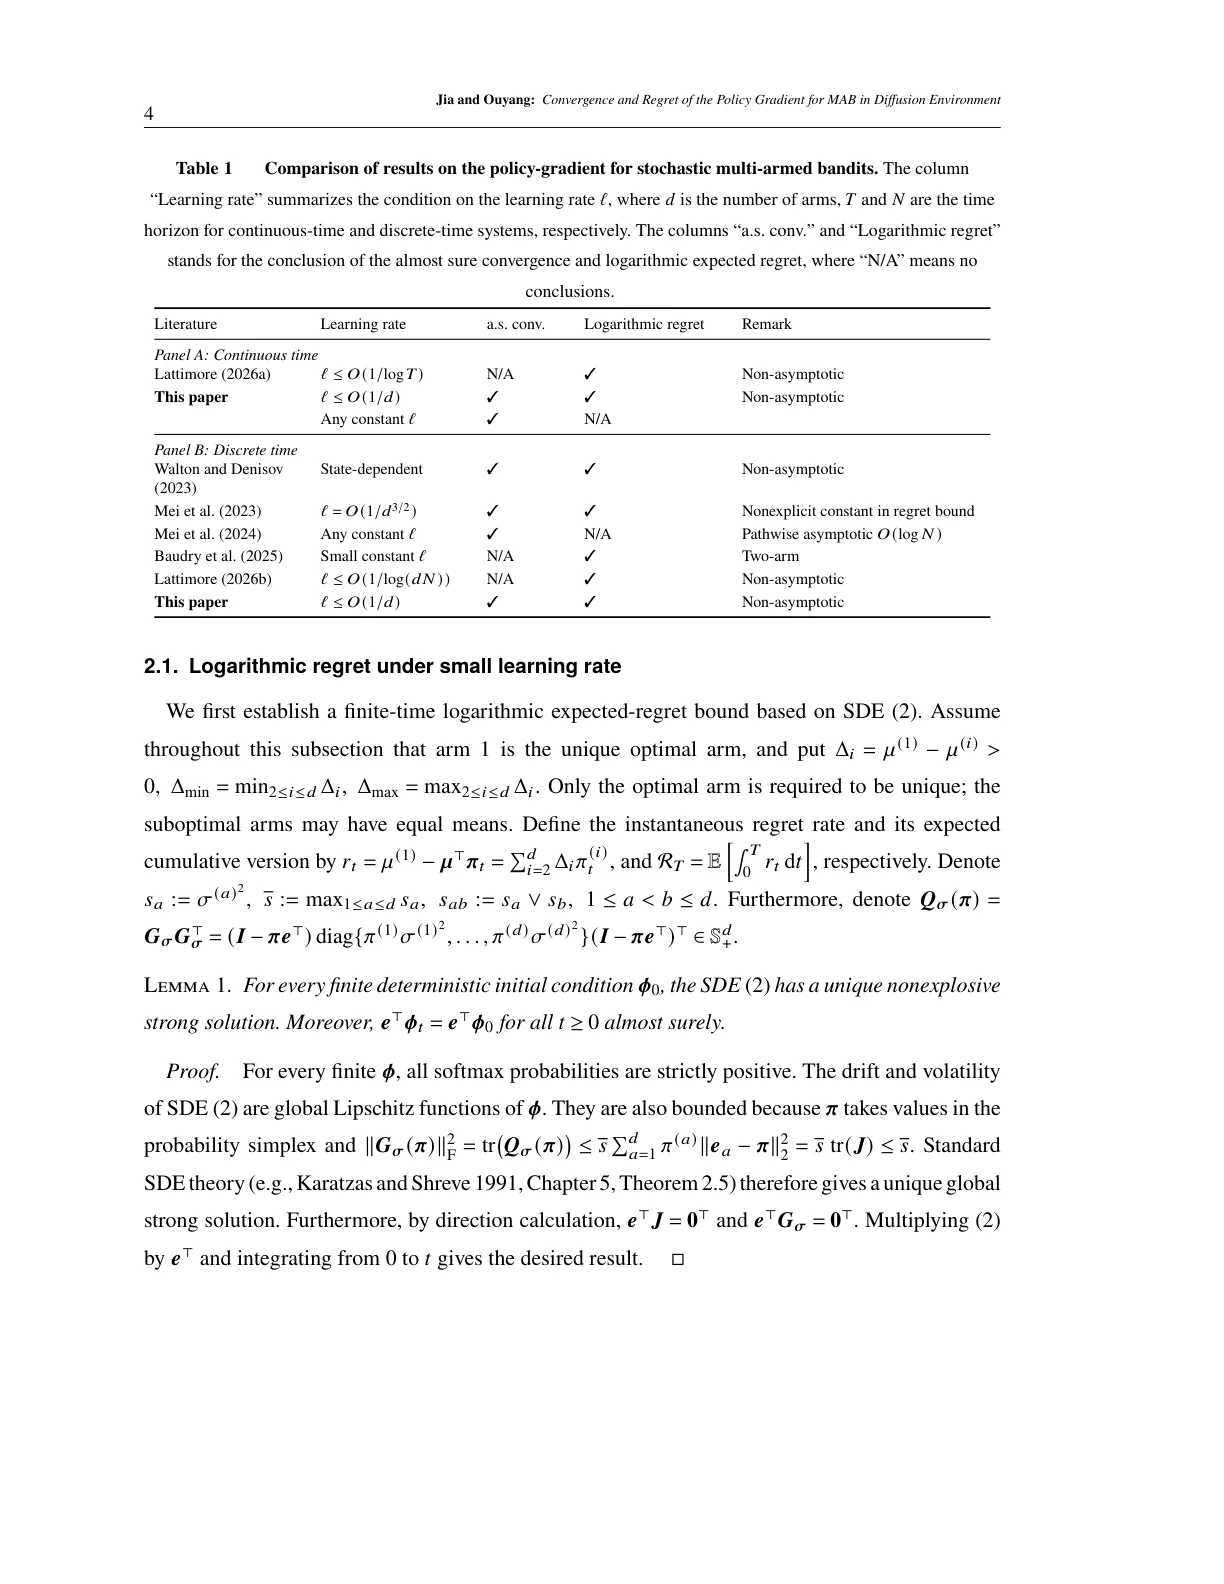
- 对比对象均为已有理论工作(见 Table 1):连续时间方面对比 Lattimore (2026a);离散时间方面对比 Walton and Denisov (2023)、Mei et al. (2023, 2024)、Baudry et al. (2025)、Lattimore (2026b)。比较维度为学习率条件、是否证明几乎必然收敛、是否得到非渐近 后悔界。
4. 资源与算力
- 论文未提及任何计算资源、GPU、CPU 或训练时长。这是纯理论推导工作,所有结果均通过数学证明获得,不依赖数值模拟。
5. 实验数量与充分性
- 由于本文不涉及实验,不存在传统意义的消融或多次运行。
- 理论上的"对比"主要通过 Table 1 汇总各文献的学习率条件与结论强弱,可视为一种"理论结果消融"。
- 论证的充分性体现在:(i) 给出统一证明,无需像 Lattimore (2026a) 那样分两臂与多臂情形;(ii) 将结果从连续时间推广到离散时间;(iii) 给出更宽松的学习率阈值 ,与 Baudry et al. (2025) 的猜想吻合。
6. 主要结论与发现
- 结论一:在扩散环境中,softmax 策略梯度 SDE 在任意常数学习率下以概率 1 收敛到最优臂(两两不同均值假设下)。
- 结论二:当学习率低于时不变阈值 (即 量级)时,可获得非渐近 实例相关后悔上界。
- 结论三:所构造的 Lyapunov 函数对连续时间与离散时间算法均有效,给出了统一分析。
- 结论四:为扩散极限提供了微观基础——证明连续时间 SDE (2) 是离散策略梯度算法在尺度化下的弱极限(含 收敛率)。
7. 优点
- 方法论亮点:构造的 Lyapunov 函数形式紧凑(乘积 + 二项展开),同时兼容连续与离散时间框架,在证明"几乎必然收敛"和" 后悔"之间架起桥梁。
- 学习率条件显著放松:从 Lattimore (2026a) 的 提升到 ,并能处理任意常数学习率下的收敛性。
- 统一性:避免分两臂与多臂分别讨论,给出一步到位的证明;同一 Lyapunov 函数跨连续/离散时间复用。
- 理论完整性:包含 SDE 解的存在唯一性、协方差估计、Itô 公式推导、超鞅收敛引理、扩散极限定理等模块,自洽完备。
- 与离散时间文献的衔接:将阈值 与 Baudry et al. (2025) 的猜想对齐。
8. 不足与局限
- 缺乏数值验证:作为理论论文,未提供任何数值实验来直观展示收敛速率或与 Lattimore (2026a) 的对比;Lyapunov 函数的紧致性、阈值是否最优等也缺乏仿真佐证。
- 后悔界的阶数仍非最优:作者明确指出,关于臂数 的依赖,本文结果比 MAB 经典后悔下界 的 -依赖更差,"instance-free" 后悔界仍是开放问题。
- 均值不同假设较强:定理 2 要求所有均值两两不同(),无法覆盖次优臂均值相同的情形;离散时间也要求唯一最优臂。
- 离散时间条件较抽象:定理 3 的可积性条件 (67) 涉及 ,Remark 2 给出高斯情形下的具体阈值 ,但形式不如连续时间条件直观。
- 学习率阈值与初值/方差耦合: 的表达式依赖所有臂的方差 ,实际应用中需要知道问题参数(oracle),与无模型策略梯度"无参"的精神存在张力。
- 算法工程实现未涉及:未讨论算法在有限样本、高维或非平稳场景下的可扩展性。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。