
通过最优策略识别实现样本高效的分层强化学习
Sample Efficient Hierarchical Reinforcement Learning via Best Policy Identification
📝 TLDR
层次强化学习在稀疏奖励目标导向任务中虽具经验优势,却缺乏关于样本效率与并行训练的理论保证。本文提出模型驱动的 HBPI-UCRL 算法,并行学习高层与低层策略,并利用高层一次转移对应低层多步转移的结构特性,引入两个低层动力学条件。理论证明在条件成立时算法具有多项式样本复杂度,且严格优于对应的非层次基线,为层次强化学习的成功提供了严格的理论依据。
🧭 速览
层次强化学习在稀疏奖励目标导向任务中经验性能优越,但缺乏并行训练设定下的样本复杂度理论分析。
提出模型驱动的 HBPI-UCRL 算法,并行训练高层与低层策略,并以两个低层动力学条件保证层次结构可学习。
在两个条件满足时具有多项式样本复杂度,且在稀疏奖励目标导向设定下严格低于非层次基线。
首次为并行层次强化学习提供多项式样本复杂度上界,从理论上解释了层次方法的实验优势。
🆚 方法对比
HBPI-UCRL
- 首个并行HRL显式样本复杂度结果
- 稀疏奖励下样本复杂度比BPI-UCRL低S倍
- 有数据依赖停止规则,可识别最优策略
- 样本复杂度独立于高层状态数S和子问题数
- 需两个低层动力学条件成立才有理论保证
- 样本复杂度仍含H⁴H⁶因子,依赖项较高
- SMDP动力学依赖子策略,存在非平稳性
- 实验部分较有限,主要为数值验证
BPI-UCRL
- 非分层的通用RL方法,适用范围广
- 由Kaufmann等人已有成熟理论分析
- 用于单一稀疏奖励子问题时复杂度低
- 作为分层方法的对比基线
- 无需分层条件假设
- 稀疏奖励分层设置中比HBPI-UCRL差S倍
- 不利用问题分层结构,样本效率低
- 状态空间大时样本复杂度高
- 无法解释HRL的经验优势
Drappo et al. [2025]
- 分析并行HRL遗憾,提供理论保证
- 适用于目标导向HRL设置
- 可与HBPI-UCRL形成对比
- 考虑并行学习的非平稳性
- 无数据依赖停止规则
- 不能解决更一般的HRL问题
- 需通过遗憾到PAC转换获得保证
- 仅针对目标导向设置,范围较窄
HRL分层强化学习框架
- 支持高效探索(Bellemare et al., 2020)
- 样本效率优于非分层方法(Levy et al., 2019)
- 加快长时规划(Gopalan et al., 2017)
- 支持泛化和迁移(Ahn et al., 2022)
- 并行学习的理论保证稀少
- SMDP与子策略联合学习非平稳
- 理论分析面临组合爆炸挑战
- 需额外条件保证可学习性
HBPI-UCRL在稀疏奖励目标导向设置中以严格更低的样本复杂度优于非分层基线BPI-UCRL,并相比Drappo et al. [2025]提供数据依赖停止规则和更一般的HRL问题覆盖,首次为并行HRL提供显式样本复杂度理论保证。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 12 张)
展开查看 12 张图
TL;DR
本文提出了 HBPI-UCRL 算法,首次在理论上证明并行学习高层与低层策略的分层强化学习方法具有多项式样本复杂度。通过引入一致性与价值耦合两个低层动力学条件,算法在稀疏奖励目标导向任务中的样本复杂度上界严格优于对应的非分层基线,为分层强化学习在经验上的成功提供了严格的理论依据。
研究背景与动机
强化学习在稀疏奖励的长期任务中面临的核心挑战在于,智能体必须在大范围的探索与利用之间找到平衡,而稀少的奖励信号使得这一过程极为低效。[[分层强化学习]]通过将复杂任务分解为多层次的结构来应对这一困难:高层策略在抽象的子问题空间中进行决策,选择要解决的子问题;低层策略则专注于在有限的步数内完成特定的子目标。这种结构带来的直觉是,抽象的高层空间应该比原始状态空间更加紧凑,从而降低探索的难度。
然而,尽管分层强化学习在实验上展示了多种优势——包括更高效的探索、改进的信用分配以及长期规划能力的提升——支撑这些优势的理论基础却长期缺失。具体而言,已有文献很少给出当高层与低层策略同时学习时,算法所需的样本复杂度保证。问题的关键在于,当低层策略发生变化时,高层所观察到的[[SMDP]](半马尔可夫决策过程)动力学也会随之改变,这使得整个学习问题呈现出非平稳的特性,为建立理论保证带来了本质性的困难。
本文正是针对这一理论空白而展开的研究。作者希望回答一个根本性的问题:分层强化学习的经验成功是否能够在严格的理论框架下得到解释?如果能,那么使得分层方法真正优于非分层方法的条件是什么?这些问题的答案不仅具有学术价值,更能为算法设计与实践应用提供明确的指导。
方法
HBPI-UCRL 的核心创新在于利用了分层结构中一个关键的结构特性:高层的一次转移对应于低层的多次转移。具体而言,当低层策略 从初始状态 执行 步后到达某个终止状态时,高层策略会观察到这一次转移的结果。这一对应关系意味着,如果低层的转移模型学习得足够准确,那么高层所面对的 SMDP 的动力学就可以被精确地重建出来。
基于这一观察,作者引入了两个关于低层动力学的条件,它们共同构成了并行分层强化学习可学习的充分条件。
一致性条件要求,对于任意子问题 ,最优低层策略 与任意其他策略 之间的 步状态分布差异,能够被它们在价值函数上的差异所界定:
这一条件的意义在于,当低层策略接近最优时,它产生的状态分布也与最优策略的状态分布接近。换言之,价值函数的收敛能够保证动力学收敛,这为高层学习的平稳性提供了保障。
价值耦合条件进一步要求,不同子问题的价值函数偏差与该子问题自身的价值函数偏差之间存在一致的关系:
这一条件确保了,当低层策略在某个子问题上改进时,这种改进会一致地反映到所有相关的高层价值评估中。
在这两个条件下,HBPI-UCRL 算法采用了基于模型的方法框架。算法为每个子问题独立维护低层转移的经验模型,并基于这些模型构建高层的经验 SMDP。关键的置信上界设计利用了复合占据分布来追踪 步低层执行期间累积的估计误差,通过递归聚合的方式将误差从终止状态传播回初始状态。高层的价值上界不仅包含奖励估计的误差,还包含了由置信集所界定的转移模型误差。算法使用数据依赖的停止规则:当聚合的误差函数低于某个阈值时,停止学习并输出策略。
理论分析给出的核心结果是,在上述两个条件成立时,HBPI-UCRL 具有多项式样本复杂度。特别地,在稀疏奖励目标导向的设定下,算法的样本复杂度上界与高层状态数 无关,严格低于非分层对应算法 BPI-UCRL 的 。这一结果表明,分层结构确实能够带来本质上的样本效率提升,而提升的来源正是高层转移对应低层多步转移所带来的状态空间压缩。
实验与结果
实验在4房间网格世界上进行验证,该环境允许系统地调整问题规模以测试算法的可扩展性。作者考虑了不同数量的房间(从 到 ),以及不同的低层执行步数 ,同时涵盖了确定性转移与随机转移两种设定。实验中对比的基线是 BPI-UCRL,这是非分层设置下的最优策略识别算法。
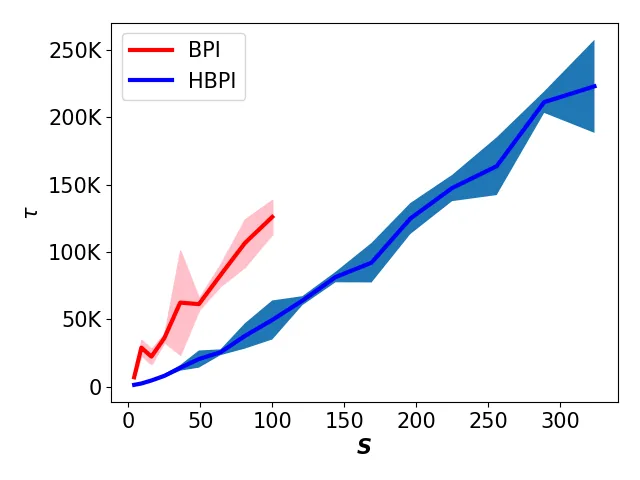
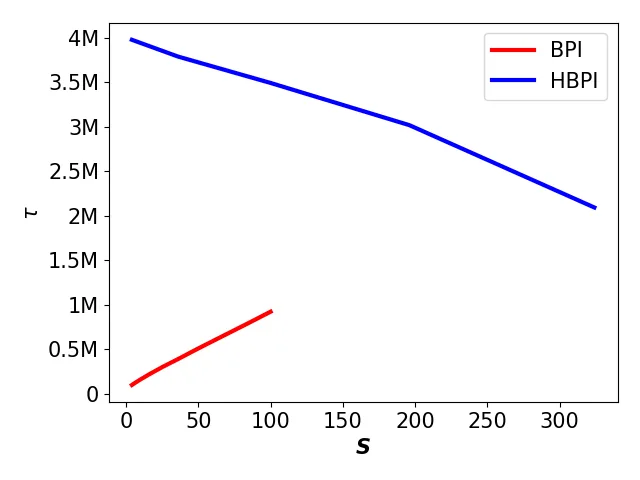
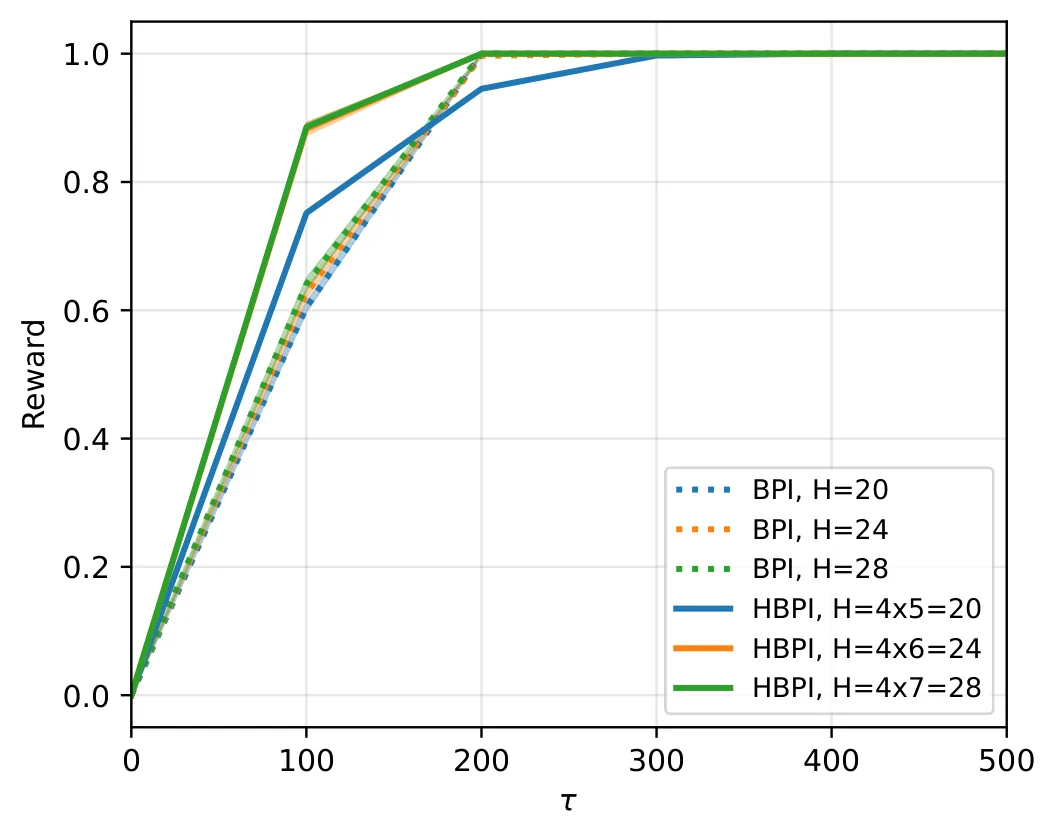
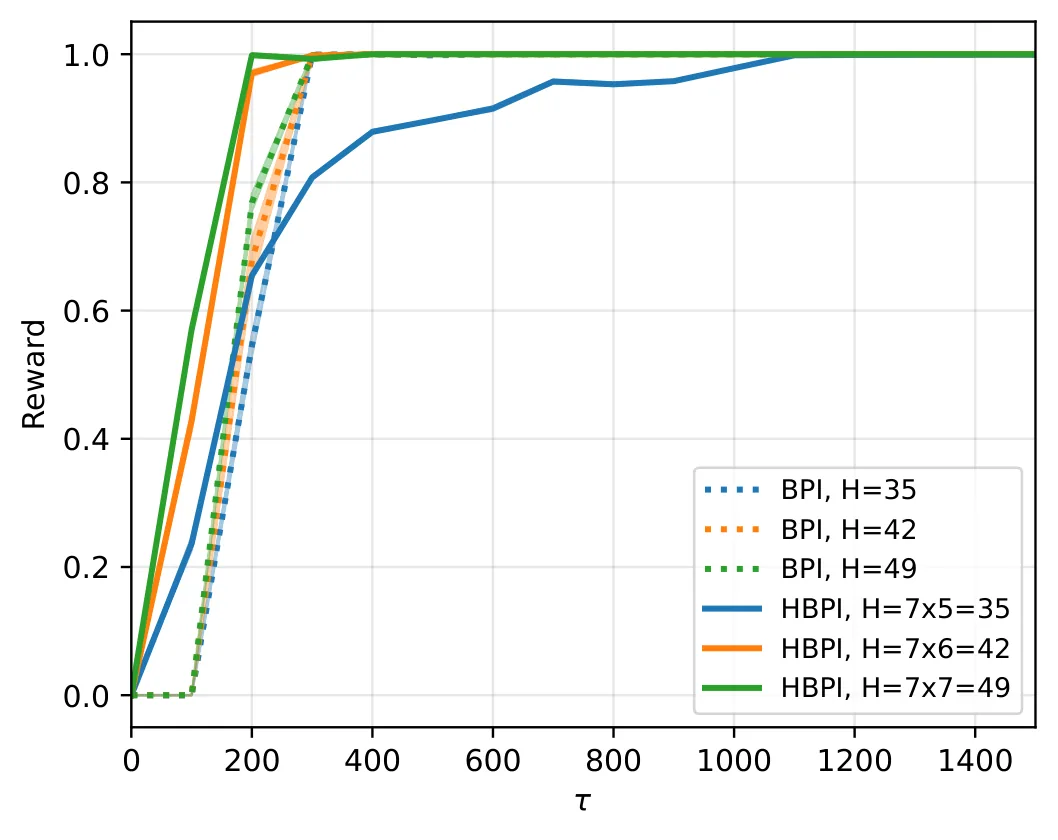
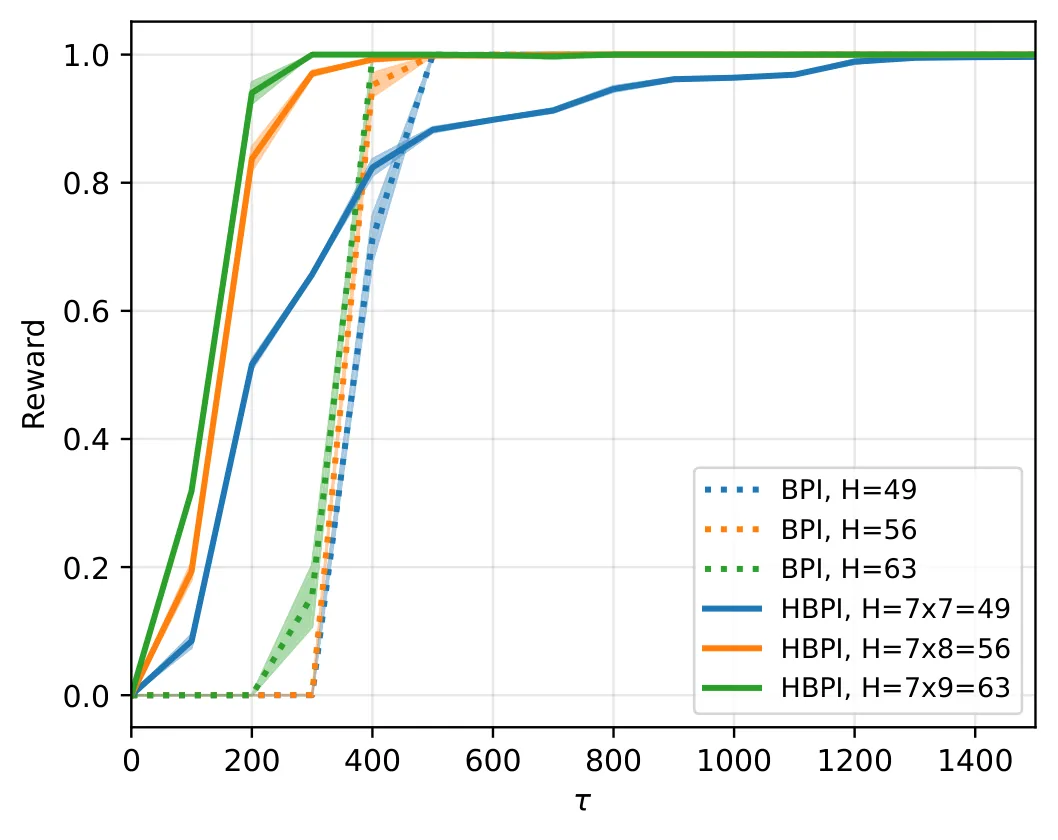
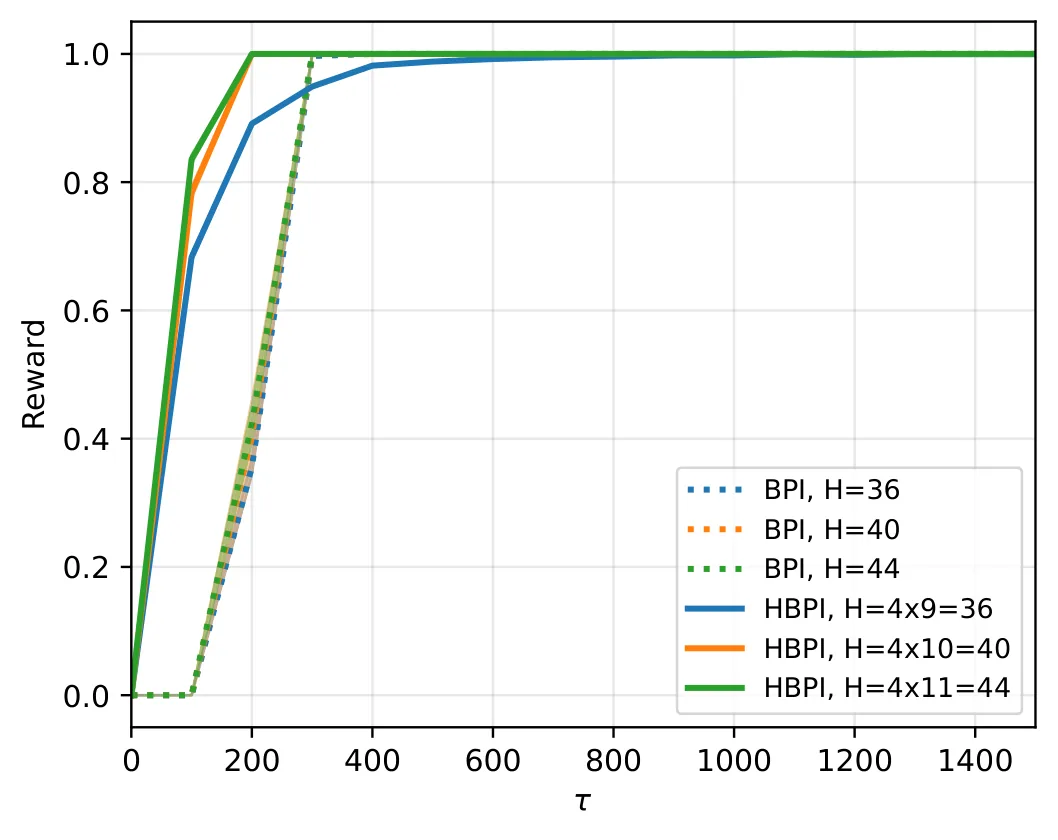
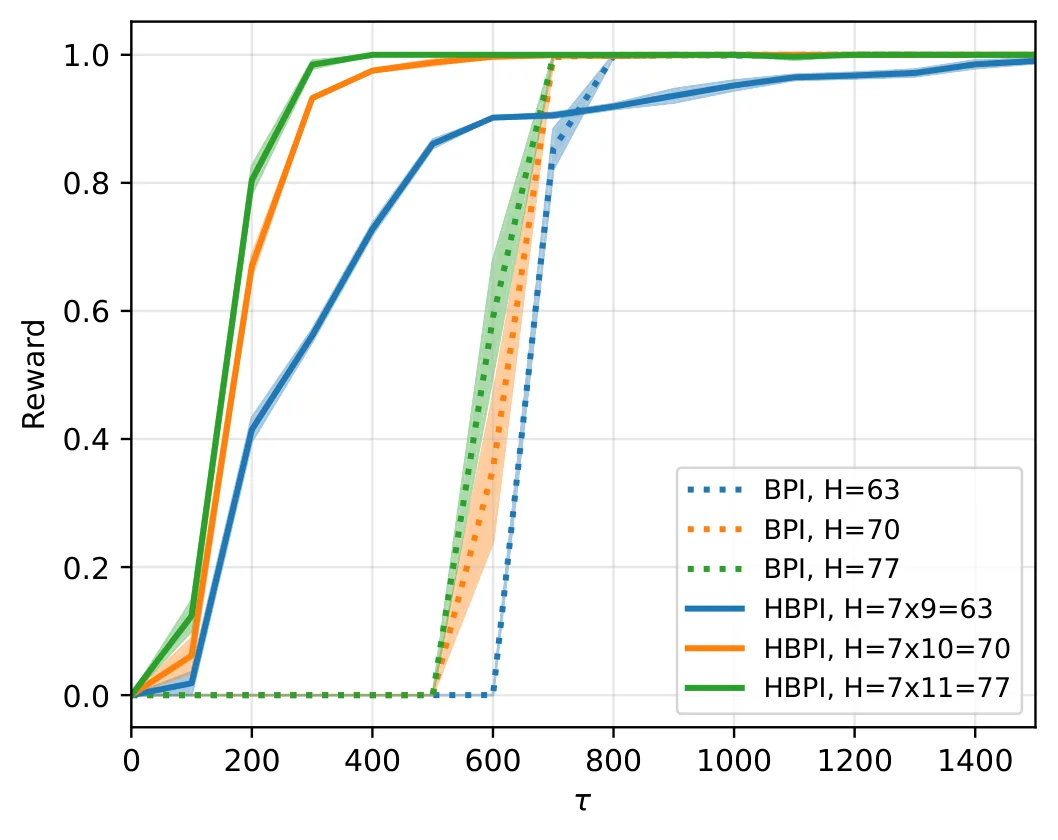
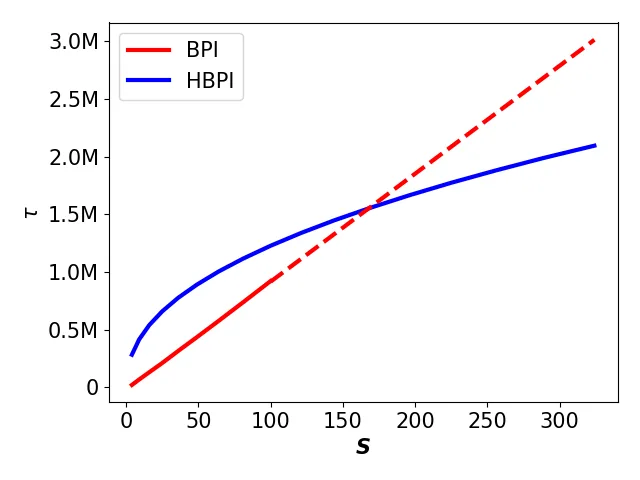
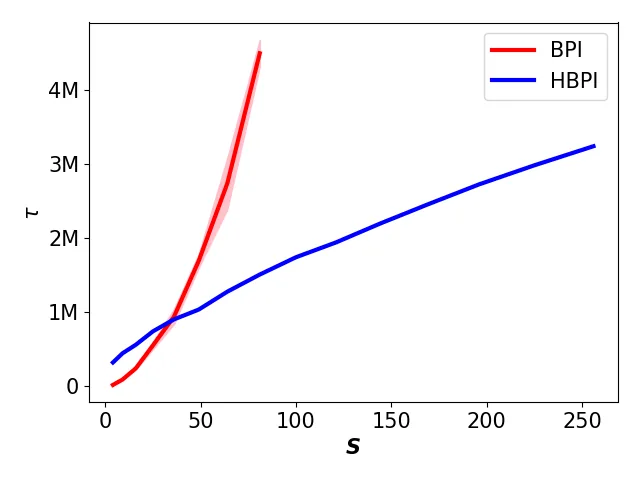
实验结果验证了理论预测的核心结论。在稀疏奖励设定下,HBPI-UCRL 的停止时间关于高层状态数 呈现亚线性增长的趋势,而 BPI-UCRL 的停止时间则几乎随 线性增长。以 房间的规模为例,HBPI-UCRL 仍能在合理的时间内找到最优策略,而 BPI-UCRL 在 以上的规模时已经因计算量过大而不可行。热力图分析进一步揭示了两种算法的探索模式差异:HBPI-UCRL 能够利用共享的低层动力学来高效探索,避免了在原始状态空间中进行均匀探索的低效做法。
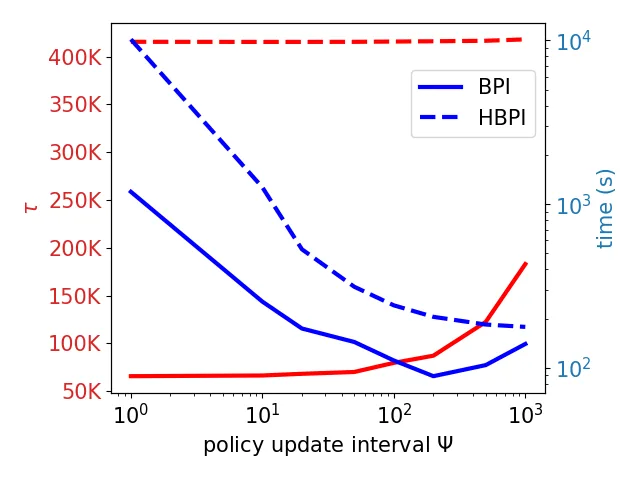
消融实验表明,策略更新间隔 的选择对实际运行时间有显著影响,但不影响算法的理论性质。在含宝藏的密集奖励版本中,HBPI-UCRL 同样表现出色,进一步验证了层次结构在不同奖励结构下的有效性。
讨论与可借鉴点
本文为分层强化学习的理论研究开辟了道路,其最核心的贡献在于首次识别出了使得并行分层学习真正具有样本效率优势的充分条件。这一结果具有重要的方法论意义:它将分层强化学习的研究从纯粹的经验探索转向了有理论指导的实践设计。
然而,这项工作也存在明显的局限性需要正视。两个低层动力学条件虽然比此前的假设更一般,但作者自己也承认"所有已知满足条件的例子都涉及在单一状态以概率1终止的子问题策略"。这提示我们,目前的理论结果可能仍然偏保守,真正能够从分层结构中获益的场景可能还需要更精细的刻画。另一个值得注意的问题是,理论分析中使用的 Hoeffding 界与实际表现之间存在显著差距:实验观测到的停止时间远低于理论上界,这既说明了理论分析的保守性,也为后续研究留下了改进空间。
对于后续研究而言,本文的启示在于几个方向:首先,可以尝试寻找比一致性与价值耦合条件更宽松的充分条件,从而扩大理论结果的适用范围;其次,将 HBPI-UCRL 的思想推广到连续状态空间与连续动作空间的场景是有价值的方向,尽管基于模型的框架为此提供了一定的基础;最后,共享低层动力学带来样本效率提升这一核心洞见,或许可以启发设计新的分层架构或探索策略。
摘要
我们提出了HBPI-UCRL,一种用于分层强化学习(HRL)的基于模型的算法,能够并行地学习高层策略与低层策略。HBPI-UCRL利用了高层转移对应于低层多步转移这一事实。我们引入了关于低层动力学的两个条件,足以保证并行HRL的可学习性。当这些条件成立时,我们证明了HBPI-UCRL在问题参数上具有多项式样本复杂度。在稀疏奖励、目标导向的设定下,HBPI-UCRL的样本复杂度上界严格低于其非分层对应算法,为HRL在经验上的成功提供了理论依据。
Abstract
We present HBPI-UCRL, a model-based algorithm for hierarchical reinforcement learning (HRL) that learns high-level and low-level policies in parallel. HBPI-UCRL exploits the fact that a high-level transition corresponds to a multi-step transition at the low level. We introduce two conditions on the low-level dynamics that are sufficient to make parallel HRL learnable. When these conditions hold, we prove that HBPI-UCRL has a polynomial sample complexity in the problem parameters. In the sparse-reward, goal-directed setting, our sample complexity upper bound for HBPI-UCRL is strictly lower than that of its non-hierarchical counterpart, providing theoretical justification for the empirical success of HRL.
论文详细总结(自动生成)
论文总结:HBPI-UCRL 及其在分层强化学习中的样本效率分析
1. 核心问题与整体含义
分层强化学习(HRL)通过将学习问题分解为子问题(高层 SMDP 选择子任务,低层子任务执行多步)已在经验上展示了多种优势:高效探索、改进样本效率、更好的信用分配、长期规划以及泛化能力。然而:
- 理论缺失:尽管 HRL 发展历史悠久,却少有研究给出并行学习高层与低层策略时的理论样本复杂度保证。
- 非平稳性挑战:SMDP 的动力学依赖于低层策略,而低层策略又在同步学习,导致 SMDP 学习问题非平稳。
- 目标明确:本文旨在为并行 HRL 设定建立首个多项式样本复杂度上界,并识别使得 HRL 可学(PAC-learnable)的充分条件,从而为 HRL 的经验成功提供严格理论解释。
2. 方法论
2.1 问题形式化
定义情节式 SMDP ,其中高层策略 在每步选择子问题 ,低层策略 执行 步。所有子问题共享转移核 ,但奖励函数 不同。SMDP 动力学:
2.2 两个核心可学习性条件(假设 3.1)
对每个子问题 ,最优策略 与任意策略 ,以及状态对 :
条件 1(一致性条件):
条件 2(价值耦合条件):
条件 1 保证 SMDP 动力学最优性唯一;条件 2 保证高层与低层价值在子问题近似下一致收敛。
2.3 关键技术:复合分布与误差函数
定义两种复合分布:(1) 序列概率 ;(2) 占据概率 。定义复合误差函数 递归聚合 步的估计误差:
2.4 HBPI-UCRL 算法
- 每轮 对每个子问题执行 BPI 子程序,得到子策略 ;
- 计算经验 SMDP 动力学 与 ;
- 构建高层置信集:
- SMDP 价值上界递归定义为
- 数据相关停止规则:
2.5 主要理论结果
- 一般情形(定理 4.1):在假设 3.1 下,,对高层状态数 与子问题数 独立。
- 稀疏奖励目标导向情形(定理 4.2):,比非分层基线 BPI-UCRL 的 严格少一个 因子。
3. 实验设计
3.1 数据集与场景
- 主要场景:4 房间网格世界(Figure 1),含宝藏版本(reward-densed)与稀疏奖励版本(仅奖励抵达目标 )。
- 规模变化:房间大小 ,房间数 。
- 状态空间:,动作空间 5。
- 确定性 + 随机版:主体实验用确定性转移,并补充随机转移实验(0.1 概率动作随机化)。
3.2 对比基线
- BPI-UCRL(Kaufmann et al., 2021):非分层最优策略识别算法,作为主要 baseline。
3.3 实验内容
- 停止时间随高层状态数 与 的变化曲线;
- 不同 (策略更新间隔)下的停止时间与运行时间消融;
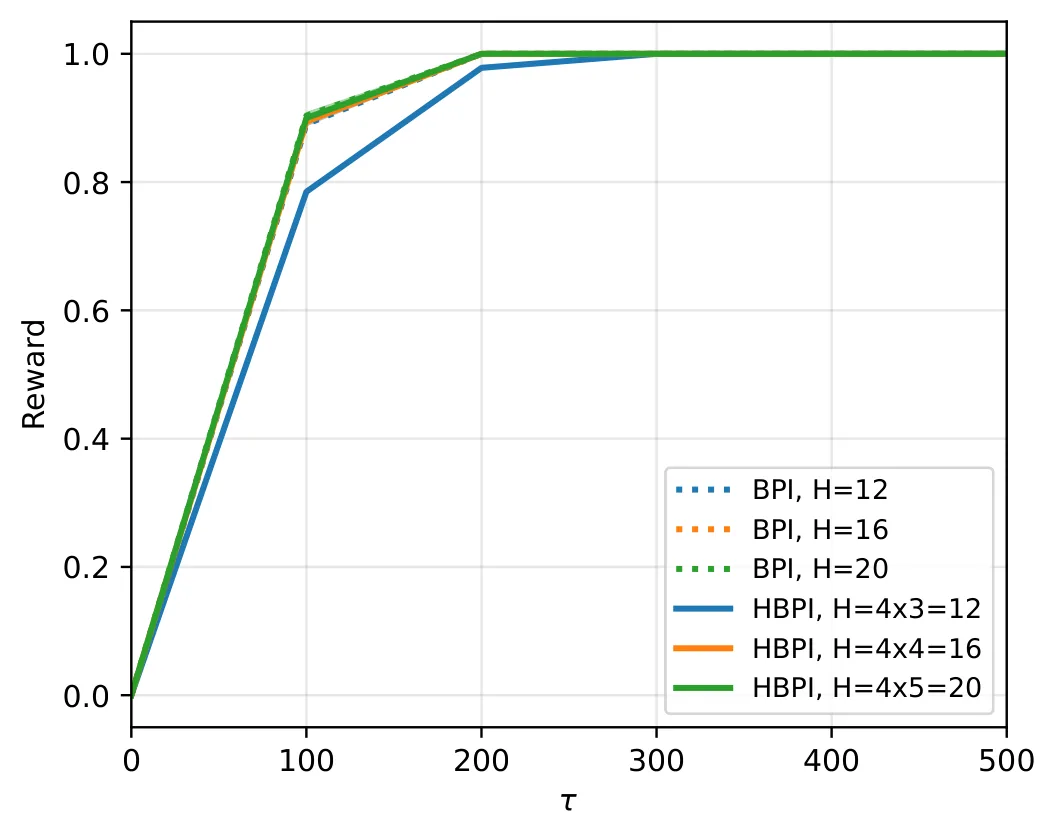
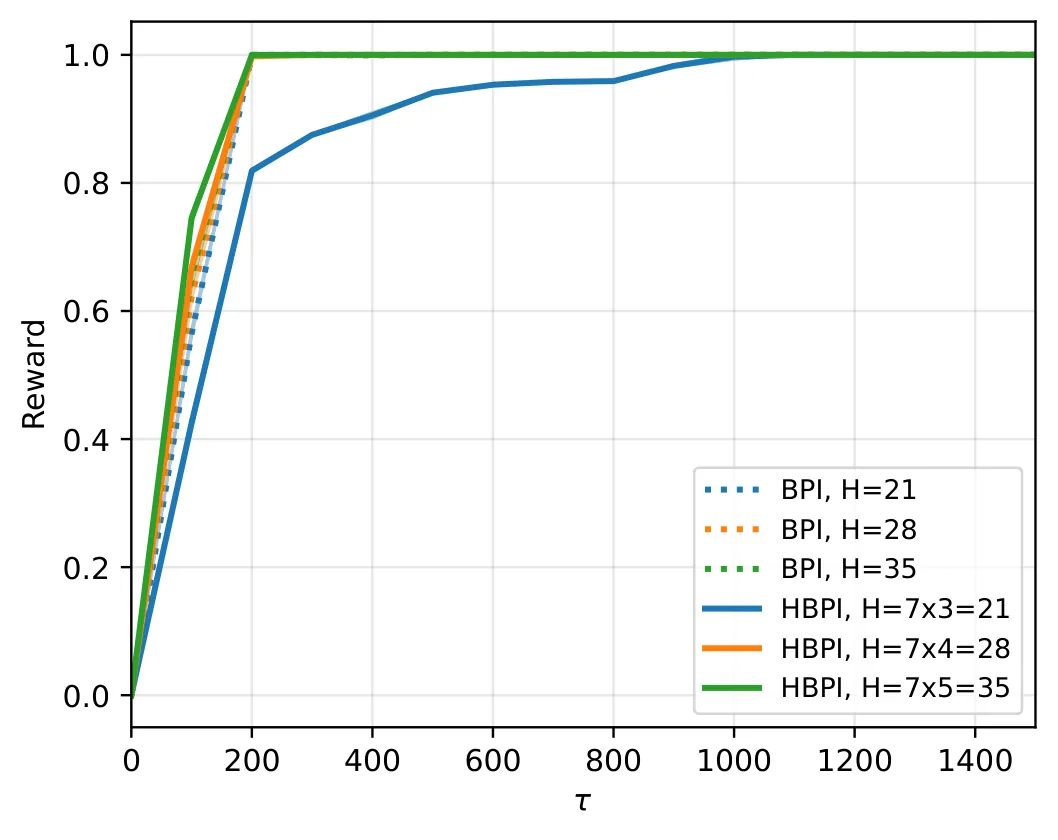
- 2×2 至 5×5 网格上的平均奖励曲线对比;
- 5×5 网格前 40000 步的状态访问热力图;
- 含宝藏版本(HBPI-UCRL 单独运行,BPI-UCRL 因计算量过大无法运行)。
4. 资源与算力
- 未使用 GPU:论文明确说明"All experiments were run on a single core of a standard CPU"。
- 种子数:每个实验 3 个随机种子,报告均值与标准差/95% 置信区间。
- 运行限制:作者提到部分运行需要"multiple days of computation time",BPI-UCRL 在 房间以上已不可行。
- 超参数:,(确定性域中策略值 ∈ {0,1},故 已足够区分最优与次优);BPI 策略更新间隔 ,HBPI 取 。
5. 实验数量与充分性
- 网格配置数:至少 7 种 组合(含随机版本与含宝藏版本),每种 3 种 值。
- 消融实验:
- 固定 变化 (Figure 8a);
- 固定 变化 (Figure 8b);
- 变化 (Figure 3)。
- 随机性报告:平均奖励曲线均带阴影(标准差/95% C.I.),较为规范。
- 公平性考量:HBPI 与 BPI-UCRL 在相同的 Hoeffding 简化界限、相同的 、相同的底层环境下对比;移除了一些理论常数(3、5、10)以使算法更实用,但作者披露了这一修改。
- 充分性评估:
- 优点:覆盖了不同维度、稀疏 vs 含奖励、确定 vs 随机;
- 不足:仅在单一网格世界家族上验证,缺乏多样化环境(连续控制、Atari 等)。
6. 主要结论与发现
1. 理论贡献:在两个充分条件下,首次为并行 HRL 提供了多项式样本复杂度上界,且严格优于对应非分层基线(稀疏奖励情形少 因子)。
2. 经验效率:HBPI-UCRL 的停止时间在实验上关于 呈亚线性(≈ )增长,而 BPI-UCRL 几乎随 线性增长。
3. 可扩展性:在 房间(25 个房间)规模下,HBPI-UCRL 仍能在有限时间内找到最优策略,BPI-UCRL 在更大规模时已被截断外推。
4. 算法特性:数据依赖停止规则带来的 依赖比固定预算策略更优,避免了 Drappo et al. (2025) 需提前设定 的限制。
7. 优点
- 首个并行 HRL 样本复杂度证明:填补了理论空白。
- 条件更具一般性:相比 Drappo et al. (2025) 假设"单一终止状态概率为 1",本文条件更弱(允许多种最优终止状态、奖励函数差异等)。
- 结构性洞察:识别出"高层转移 = 低层多步转移"是 HRL 样本效率的根本来源,样本复杂度独立于高层状态数 。
- 代码与常数可调:为实用化明确披露了简化方法(移除常数)。
- 可视化分析:热力图清晰展示了 HBPI 与 BPI 的探索模式差异(HBPI 利用共享动力学避免均匀探索)。
- 稀疏奖励加速:在理论与实验上同时验证了 的加速。
8. 不足与局限
- 条件偏强:作者承认"all known examples involve optimal subproblem policies that terminate in a single state with probability 1",是否仅在目标导向子问题时 HRL 真正样本高效仍是开放问题。
- 环境单一:实验仅限网格世界(家族 Figure 1),未在 MuJoCo、Atari、稀疏奖励控制等更复杂场景验证;含宝藏实验的对比缺失(BPI-UCRL 计算不可承受)。
- Hoeffding 界不紧:实验中发现停止时间与理论上界存在显著差距,特别是 HBPI-UCRL 实际表现优于理论预测,作者坦言这是"not tight"。
- 多项式因子仍逊于部分基线:与 Drappo et al. (2025) 相比,本文 的依赖更高,虽有合理解释(不同设置),但仍说明并未完全匹配最先进理论。
- 共享动力学假设:所有子问题必须共享转移核 ,限制了方法对异构子问题的适用性。
- 有限视野:仅限有限视野(episodic)设定;未讨论折扣无限视野情形。
- 算力限制:仅 CPU 运行、3 个种子,缺乏更大规模的统计稳健性检验;部分实验因计算时间过长被截断( 至 房间的 BPI-UCRL 数据为外推)。
- 政策更新间隔的人为因素: 的引入是为加速实现,但可能引入额外偏差,且作者未严格量化其影响。
- 应用层面:作为 PAC 理论结果,对实际工程实现细节(如函数逼近、连续动作空间)的扩展未涉及。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。