
不要混合奖励,要混合策略:用于多奖励强化学习的策略分解与优化
Don't Mix Rewards, Mix Policies: Policy Decomposition and Optimization for Multi-Reward RL
📝 TLDR
多奖励强化学习训练 LLM 时,不同奖励目标容易相互冲突,带来严重的对齐税问题,导致后训练不稳定且效率低下。为此提出 PRISM 框架,将策略空间分解,分别独立优化多个正策略与一个全局负策略,避免奖励加权融合。在科学推理、工具使用及 helpfulness-safety 对齐任务上一致优于现有基线,并支持推理时灵活组合策略以控制偏好。
🧭 速览
多奖励 RL 中目标相互冲突带来严重对齐税,奖励加权融合方式难以稳定高效地联合优化多个目标。
PRISM 将多奖励问题转化为多个独立正策略与一个全局负策略的分别优化,推理时通过策略组合灵活控制偏好。
在科学推理、工具使用、helpful-safety 对齐任务上一致优于多奖励 RL 基线,并额外获得推理时的偏好可控性。
策略空间分解优于奖励混合,为多目标 LLM 后训练提供了更稳定且可组合的新方向。
🆚 方法对比
PRISM
- 在GPQA/ScienceQA上超越最强基线17.8/8.0/0.6分
- 支持推理时无重训的灵活偏好控制
- 缓解多奖励梯度竞争与对齐税问题
- 前缀条件化实现高效子策略共享
- 需训练N+1个子策略,工程复杂度较高
- 前缀条件设计依赖人工调优
- 实验仅在1.5B-3B规模模型验证
- 全局负策略粒度较粗,可能掩盖个别失败模式
线性标量化
- 实现简单,是多奖励RL的默认方案
- 计算开销低,无需额外结构
- 权重对尺度敏感,需逐任务重调
- 不同奖励在同一梯度步竞争冲突
- 奖励权重作为接口不可靠且难解释
奖励塑形与自适应加权
- 可缓解不同奖励间的尺度失配问题
- 相比固定权重更自适应
- 仍将所有奖励坍缩为单一标量
- 冲突偏好仍在同一更新步内竞争
- 自适应权重引入训练不稳定性
约束/多目标RL
- 通过拉格朗日约束追求帕累托最优
- 可显式约束部分奖励维度
- 实践中优化困难且不稳定
- 拉格朗日乘子调参成本高
- 难以扩展到LLM大规模训练场景
奖励空间标量化(总体)
- 将多目标问题统一为单目标优化
- 可直接复用现有RL算法框架
- 忽视奖励尺度/分布/校准差异
- 迫使偏好妥协致每个维度次优
- 产生论文定义的多奖励对齐税
PRISM通过策略空间分解与组合替代奖励空间标量化,消除了不同奖励在同一梯度步内的竞争冲突,同时提供推理时可调的偏好控制接口,显著优于线性标量化、奖励塑形和约束多目标RL等奖励空间方法。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 6 张)
展开查看 6 张图
TL;DR
PRISM 提出了一种将多奖励强化学习的优化战场从「奖励空间」转移到「策略空间」的新思路:通过将策略分解为 个独立正向子策略和 1 个全局负向子策略,分别优化后再在推理阶段灵活组合。实验表明这种方法在科学推理、工具使用和有助性-安全性对齐三个场景下均显著优于现有的奖励加权、奖励乘积等基线方法,同时支持零成本调节多维偏好。
研究背景与动机
大型语言模型的后训练对齐本质上是一个[[多奖励强化学习]]问题。模型需要同时满足多个维度的期望——回答要正确、格式要规范、对用户要有帮助、不能有安全隐患——而这些奖励信号之间往往存在权衡甚至直接冲突。传统做法是将多个奖励加权求和后交给[[策略优化]]算法更新模型,这种「奖励空间组合」的路径面临两个根本性困难。
第一层困难是尺度与校准问题。不同奖励的数值范围、噪声分布可能相差数个量级,比如正确性奖励可能落在 ,而格式奖励可能是稀疏的规则打分,将它们简单加权时,权重系数的物理含义变得模糊,手工调参如同在大海中捞针。第二层困难更为隐蔽:当这些异构的梯度信号在同一次参数更新中相互竞争时,会产生作者所说的对齐税(alignment tax)——优化过程被迫在相互冲突的目标之间「左右互博」,最终学到的策略在每一个奖励维度上都难以达到本可达到的最优水平。已有工作尝试通过自适应权重调整、约束优化等手段缓解这一问题,但本质上仍在奖励空间内打转,无法摆脱耦合优化的困局。
PRISM 的核心洞察是:与其费力地在奖励空间做混合,不如换一个更友好的混合场所——策略空间本身具有更好的几何结构,可以在训练阶段解耦优化,在推理阶段再自由组合。
方法
PRISM 的设计从 KL 正则化下的多奖励优化目标出发,目标函数可以写成奖励加权和减去与参考策略 的 KL 散度,再加上一项捕捉「任一奖励严重失败」这种联合失败模式的惩罚项 。这类目标在理论上可以通过凸对偶变换求解,其最优解具有一个优雅的分解形式:最优策略与 个正向子策略的乘积以及一个负向子策略的幂成正比。
关键的性质在于:正向子策略 的定义中只包含自己对应的奖励 ,而负向子策略 的定义中只涉及联合失败度量 ,它们完全不含组合系数 。这意味着我们可以独立地训练每个子策略,让每个子策略在自己负责的奖励维度上做到最优;组合权重 只是在推理阶段才介入,负责决定最终输出的偏好分布。这种训练与组合的解耦是 PRISM 区别于所有奖励空间组合方法的本质差异。
在实际训练中,PRISM 采用 [[强化学习|GPRO]] 风格的策略梯度更新。对正向子策略,优势函数基于该子策略对应的奖励计算组内相对优势;对负向子策略,优势函数采用一种「soft-conjunction」设计——当任意一个奖励给出高分但其他奖励给出低分时(对应「偏科」输出),负向策略会得到正向优势,从而惩罚这种不均衡的泛化。这使得负向策略学习到的是所有奖励的共有失败模式,而非某一个奖励的专属弱点。
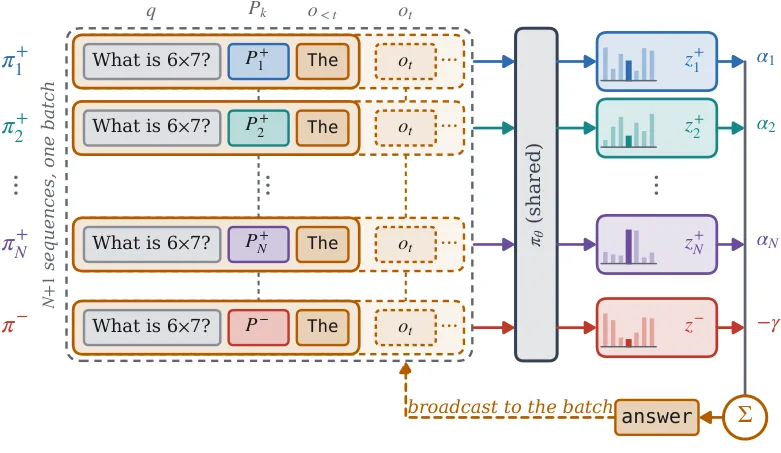
在工程实现层面,PRISM 通过三个设计兼顾效率与灵活性。首先,所有 个子策略共享同一个 LLM 骨干网络,但各自挂载一段可学习的前缀嵌入(prefix embedding),这种 prefix-conditioned 架构避免了为每个子策略独立维护一套模型参数。其次,正向分支在训练时同时更新骨干和前缀,而负向分支只更新前缀、对骨干停止梯度,确保模型的通用能力只被高质量数据所塑造。最后,在推理阶段, 个分支的 logits 沿 batch 维度并行计算后,按组合权重在 logit 空间做加权求和,单个 token 的生成延迟等价于单次前向传播,实现了几乎无损的吞吐量。
实验与结果
实验覆盖三个具有代表性的场景:科学推理(涉及正确性奖励)、工具使用推理(涉及正确性加格式合规等多奖励)以及有帮助性与安全性的对齐(涉及 helpfulness 和 harmlessness 的权衡)。基座模型选用 DeepSeek-R1-1.5B、Qwen2.5-1.5B-Instruct 和 Qwen2.5-3B-Instruct 三款,在科学问答基准 GPQA 和 ScienceQA、工具调用基准 BFCL-v3 以及对齐基准 HH-RLHF 和 PKU-SafeRLHF 上进行评测。
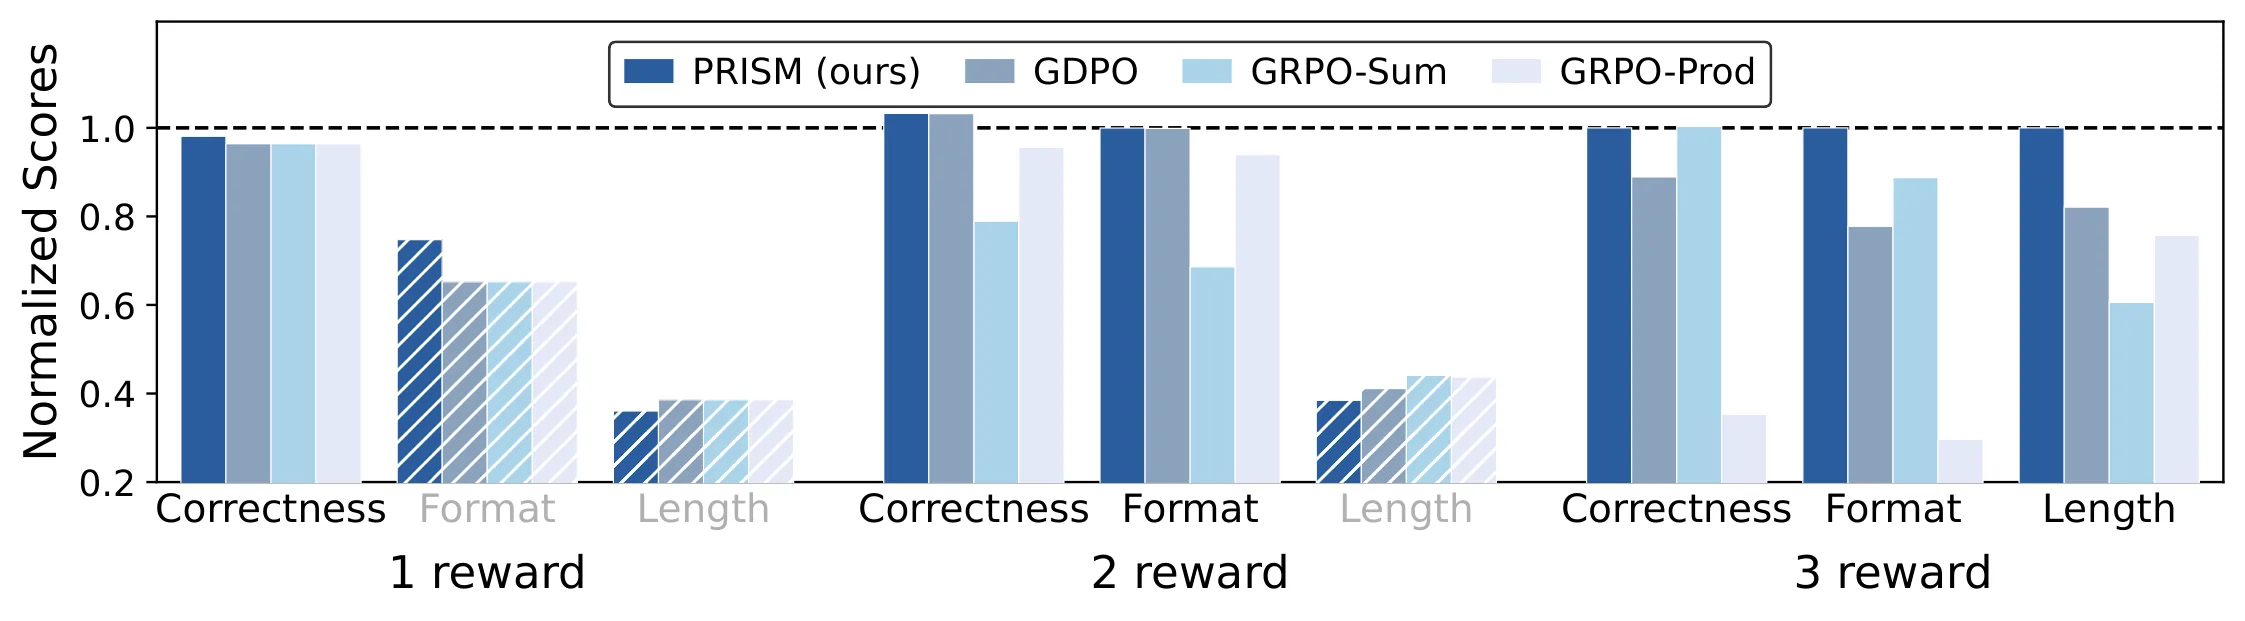
核心结论是 PRISM 在所有设置下均达到最优的 Overall 和 Joint(多奖励同时满足)指标。以 DeepSeek-R1-1.5B 为例,Overall 相对最优基线提升超过 17 个百分点;在 GPQA 困难子集上,PRISM 的平均得分是其他方法的两倍以上。更值得关注的是对齐税的缓解程度:当奖励数从 1 增加到 3 时,基线方法的正确性出现明显下降,而 PRISM 的正确性几乎保持不变,说明策略分解确实有效隔离了不同奖励之间的梯度干扰。
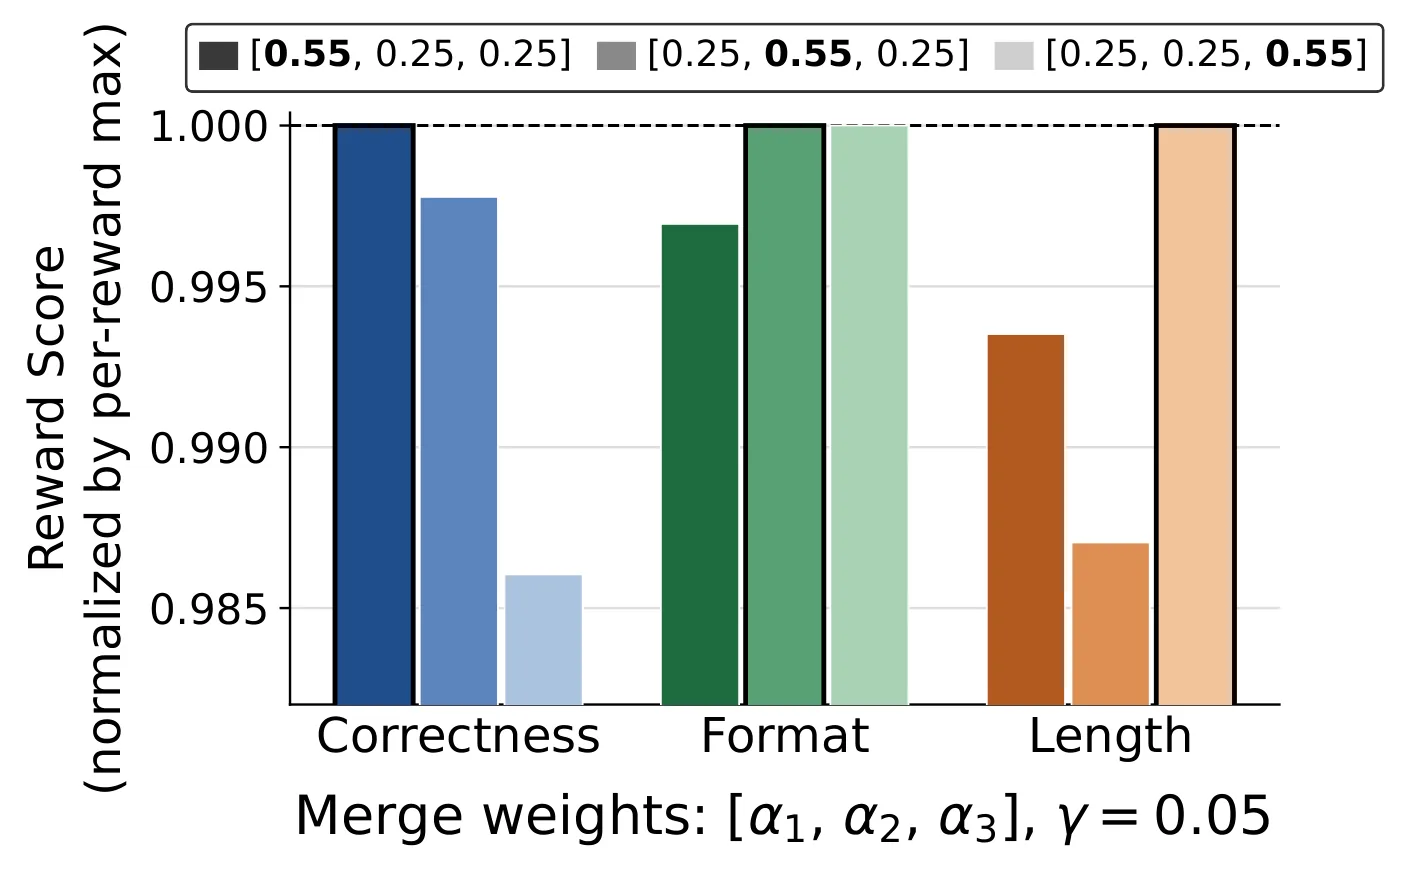
在推理时可控性方面,实验验证了 merge weight 的可解释性:增大对应正确性的组合系数会直接提升 ScienceQA 得分,增大格式相关系数会改善 BFCL 的合规性指标,且整个过程无需任何重训练,权重调节可以在秒级完成。这为构建用户可控的偏好系统提供了直观接口。
消融实验进一步确认了每个设计选择的必要性。去掉全局负向策略会导致各项指标退化,说明负向子策略在学习共有失败模式上的贡献不可替代;各分支独立 rollout(而非共享骨干)会带来更严重的梯度冲突和更低的最终性能;soft-conjunction 形式的负向优势设计稳定优于简单的 max 或平均聚合。
讨论与可借鉴点
PRISM 展示了一条有价值的范式转换路径:从「奖励怎么加权」的问题转向「策略怎么分解与组合」。这种转换之所以有效,是因为它将耦合的优化问题拆解为若干独立或低耦合的子问题,在每个子问题内部做到最优后再在推理阶段重新组合。这与近年来[[强化学习]]领域中将复杂目标函数分解为多个模块化组件的趋势一脉相承,但 PRISM 的独特之处在于将组合接口从训练阶段推迟到了推理阶段,从而获得了零成本的可控性。
当前工作的局限也为后续研究指出了方向。首先,实验仅覆盖最多 3 个奖励,当奖励数扩展到数十个时,单一全局负向策略的表征能力是否足够尚不清楚。其次,组合权重的确定目前依赖人工调参,自适应地根据用户意图或 prompt 情境动态设定权重是一个值得探索的方向。最后,理论保证建立在一次性对偶求解的假设上,而实际训练采用迭代式 GRPO,两者的收敛等价性还有待更严格的分析。
对于从事 LLM 对齐研究的实践者而言,PRISM 的核心启发在于:不要执着于调整奖励信号的混合方式,而是思考如何在更有表达力的空间(策略空间)进行混合。这种思路可以迁移到其他多目标优化场景中——比如在同一个模型中平衡流畅性、事实性和安全性时,与其精心调设多个损失项的系数,不如分别训练专注于不同目标的模块,再在推理时按需组合。
摘要
现代大型语言模型(LLMs)不仅需要正确回答问题,还应使其行为适应不同的人类价值观和使用场景。因此,多奖励强化学习(RL)已成为 LLMs 中日益重要的研究问题,其中每个奖励对应期望行为的一个不同方面。然而,使用多个奖励进行优化会面临更为严重的对齐税问题,即不同的优化目标之间可能存在权衡甚至相互冲突,从而导致后训练过程不稳定且效率低下。在本研究中,我们提出了 PRISM,这是一种基于策略空间分解与组合思想构建的新颖多奖励强化学习框架。PRISM 不是将不同的奖励进行加权组合,而是优化一组独立的正向策略以及一个全局负向策略。这种方法缓解了多奖励策略优化过程中潜在的冲突,同时通过灵活的策略组合为推理阶段提供了可控性。在科学推理、工具使用推理以及有用性与安全性对齐上的实验表明,PRISM 一致优于现有的多奖励强化学习基线方法,并且在推理时偏好控制方面具备额外的可控性。
Abstract
Modern large language models (LLMs) are expected not just to answer correctly, but to adapt their behavior to different human values and use cases. As a result, multi-reward reinforcement learning (RL) has become an increasingly important problem for LLMs, where each reward captures a different aspect of desired behavior. However, optimizing with multiple rewards suffers from a more severe alignment tax issue, where different optimization objectives can trade off or even conflict with each other, leading to unstable and inefficient post-training. In this work, we propose PRISM, a new multi-reward RL framework built upon the idea of policy-space decomposition and composition. Instead of compositing different rewards, PRISM optimizes a set of standalone positive policies and a global negative policy. This alleviates the potential conflict during multi-reward policy optimization, while enabling controllability during inference by flexible policy composition. Experiments on scientific reasoning, tool-use reasoning, and helpfulness-safety alignment show that PRISM consistently outperforms existing multi-reward RL baselines, with extra controllability for inference-time preference control.
论文详细总结(自动生成)
PRISM 论文总结:策略空间分解与组合用于多奖励 RL
1. 核心问题与研究动机
现代大语言模型的对齐本质上是一个多奖励强化学习(Multi-Reward RL)问题:模型需同时满足有用性、安全性、正确性、格式合规等多个维度的偏好,而这些目标之间往往相互冲突。
现有方法(线性标量化、奖励塑形、自适应加权、约束 RL 等)都属于奖励空间组合:把所有奖励合并为单一标量信号后进行策略更新。该路径存在两大根本性局限:
- 尺度与校准问题:不同奖励在数值量纲、分布、噪声水平上差异显著,权重成为不可靠的接口;
- 梯度内竞争:多偏好被迫在同一参数更新步骤内竞争,产生作者所称的 multi-reward alignment tax(多奖励对齐税),使得优化出的策略在每一个偏好维度上都难以达到较优水平。
PRISM 的核心主张是:不在奖励空间做混合,而改在策略空间做混合。
2. 方法论
2.1 整体框架
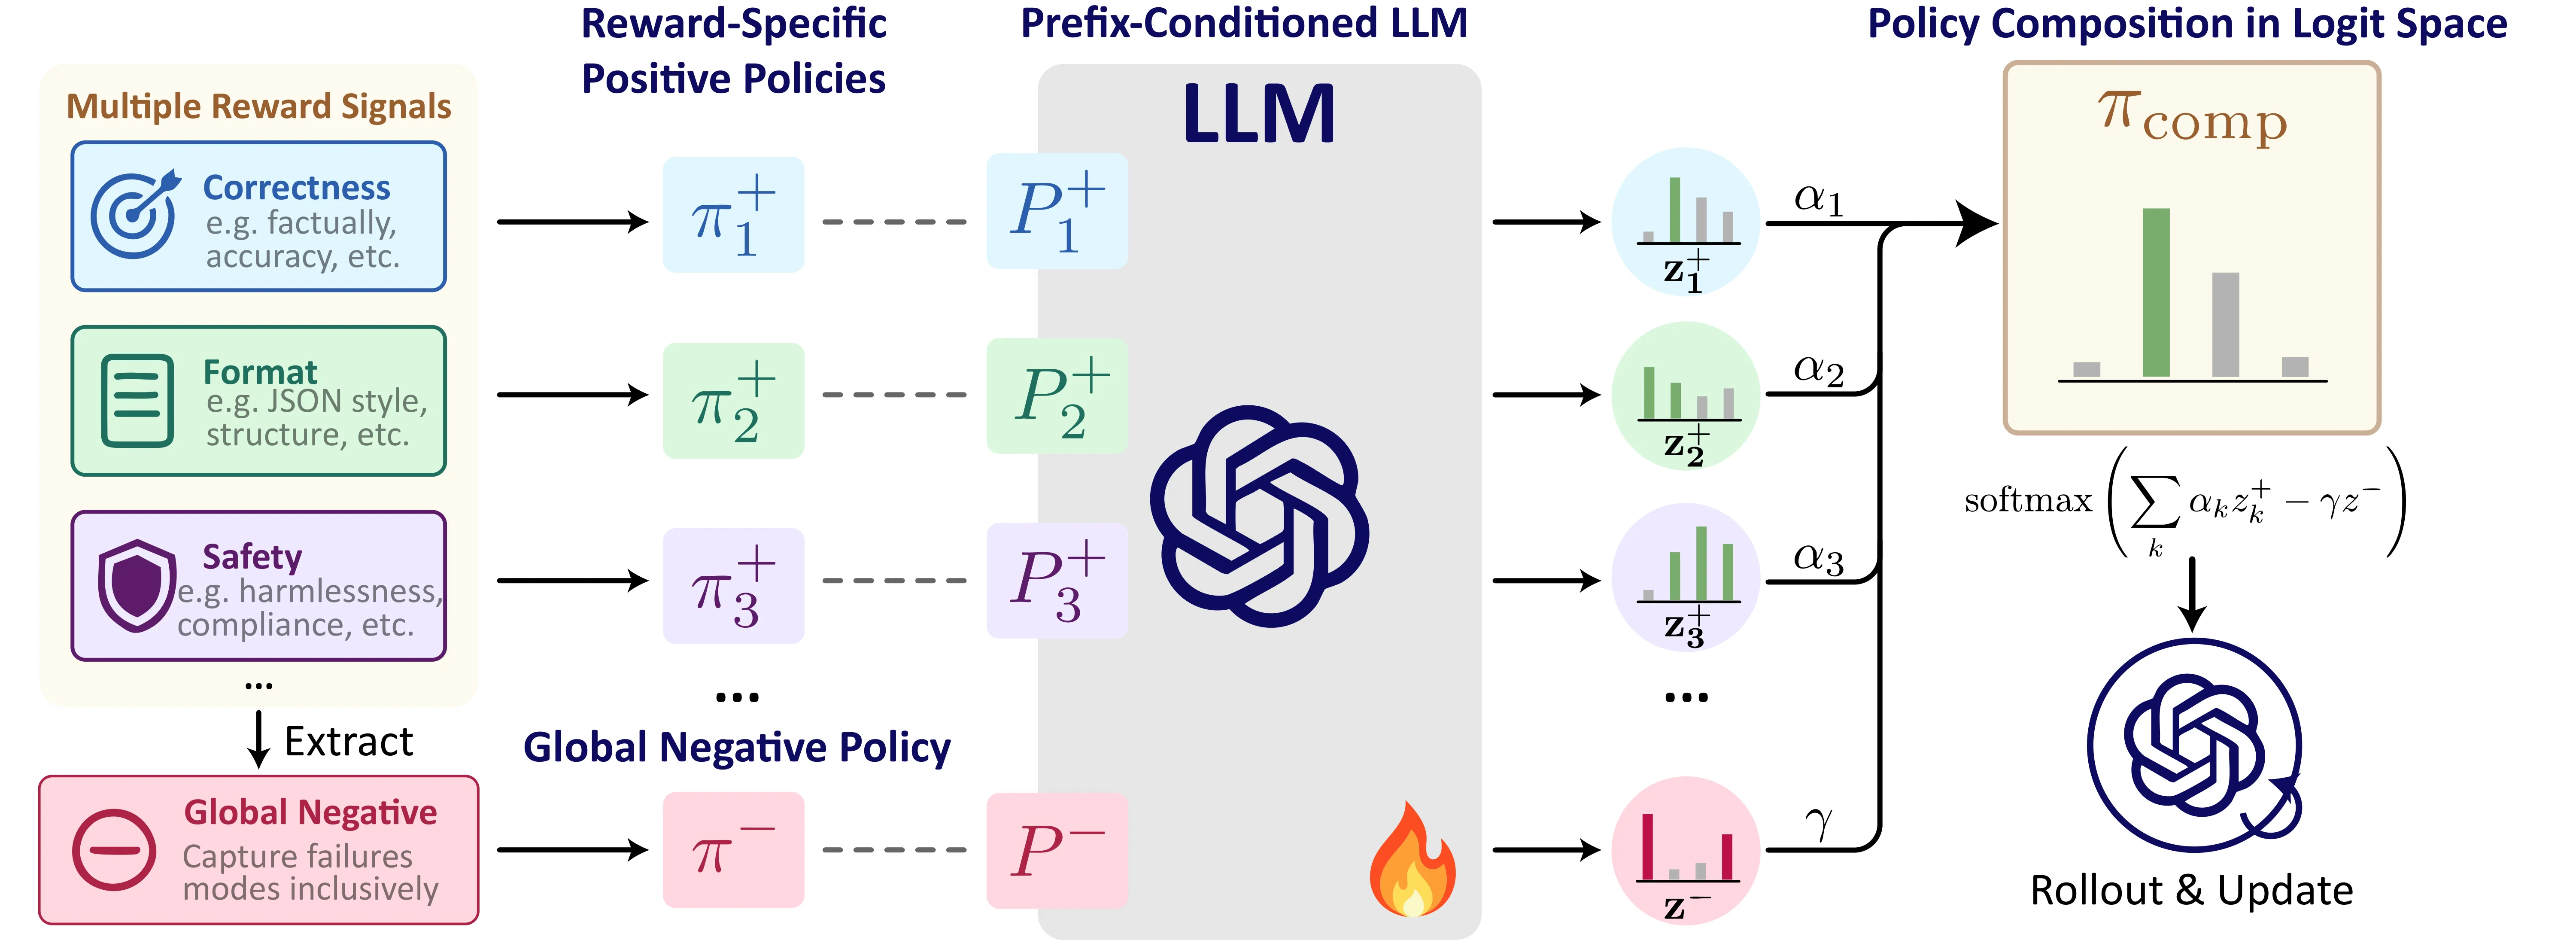
PRISM 学习 个独立正向策略 (每个奖励对应一个)+ 1 个全局负向策略 (捕捉所有奖励共有的失败模式),共 个子策略。推理时通过 logit 空间加权组合,无需重新训练即可调整偏好权衡。
2.2 形式化推导(关键公式)
多奖励优化的耦合目标:
该问题通常无单一最优解。
GRPO 组相对优势:
KL 正则化下的多奖励目标(PRISM 的出发点):
满足约束 。其中 是各奖励上的单调非增函数,用于建模"任一奖励严重失败"的联合失败模式。
最优策略分解(由凸对偶推导得出):
其中各正向子策略和全局负向子策略分别定义为:
关键设计点: 与 的定义中完全不含组合系数 ,因此各子策略可被独立训练,组合权重可在推理时自由调整。
子策略的 GRPO 损失:
其中 ,。负策略的 soft-conjunction 形式使其对任一奖励失效都给出大优势。
Logit 级组合(Eq. 14):
2.3 高效实现
1. Prefix-conditioned 共享骨干:所有 个子策略共用一个 LLM,仅各自挂载一段可学习的前缀嵌入 (prefix-tuning 风格)。初始值为换行符的 embedding;
2. Backbone-preserving 非对称更新:正向分支同时更新 backbone 与前缀 ;负向分支对 停止梯度、仅更新 ,保证主干只接触高质量数据;
3. Parallel-batch Mixture Sampling:解码时将 个分支沿 batch 维度堆叠,单次前向得到所有 logits,按 Eq. 14 组合采样并广播 token,KV cache 同步推进。每 token 延迟等于单次前向,吞吐几乎无损。
3. 实验设计
3.1 数据集与场景
| 场景 | 训练集 | 评测 benchmark |
|---|---|---|
| 科学推理 | SciKnowEval(多选题子集) | ScienceQA、GPQA(gpqa_main) |
| 工具使用 | ToolRL 收集数据 | BFCL-v3(Non-live / Live / Multi-turn) |
| 有用性-安全性对齐 | Alpaca | Alpaca、HH-RLHF、PKU-SafeRLHF |
评测奖励包括:正确性、格式、合规性、长度、helpfulness、harmlessness 等,覆盖规则式奖励与模型式奖励。
3.2 对比方法
- GRPO Sum:奖励加权和;
- GRPO Prod:奖励乘积聚合;
- GDPO:组级奖励解耦归一化;
- Backbone:DeepSeek-R1-1.5B、Qwen2.5-1.5B-Instruct、Qwen2.5-3B-Instruct 共三款基座。
4. 资源与算力
论文未明确披露总算力规模与训练总时长(GPU 型号/数量/GPU-hour 等均未给出)。仅在效率附录中报告推理开销:使用 8 × NVIDIA H800 进行推理效率测试,PRISM() 与单策略基线的延迟、吞吐、显存几乎持平(延迟 2.01s → 2.04s → 2.12s;显存均为 63.74GB),但 FLOPs 与显存会随奖励数线性增长。训练侧所有实验均使用 LoRA(rank 32 / alpha 64 / dropout 0.05),学习率在 至 之间。
5. 实验数量与充分性
整体实验较为系统,主要包括以下部分:
- 主结果:3 个场景 × 3 个基座 = 9 组核心对比(约 36 个数据点 × 多列指标);
- 奖励数量消融:BFCL-v3 上分别用 1/2/3 个奖励训练,分析对齐税随奖励数变化;
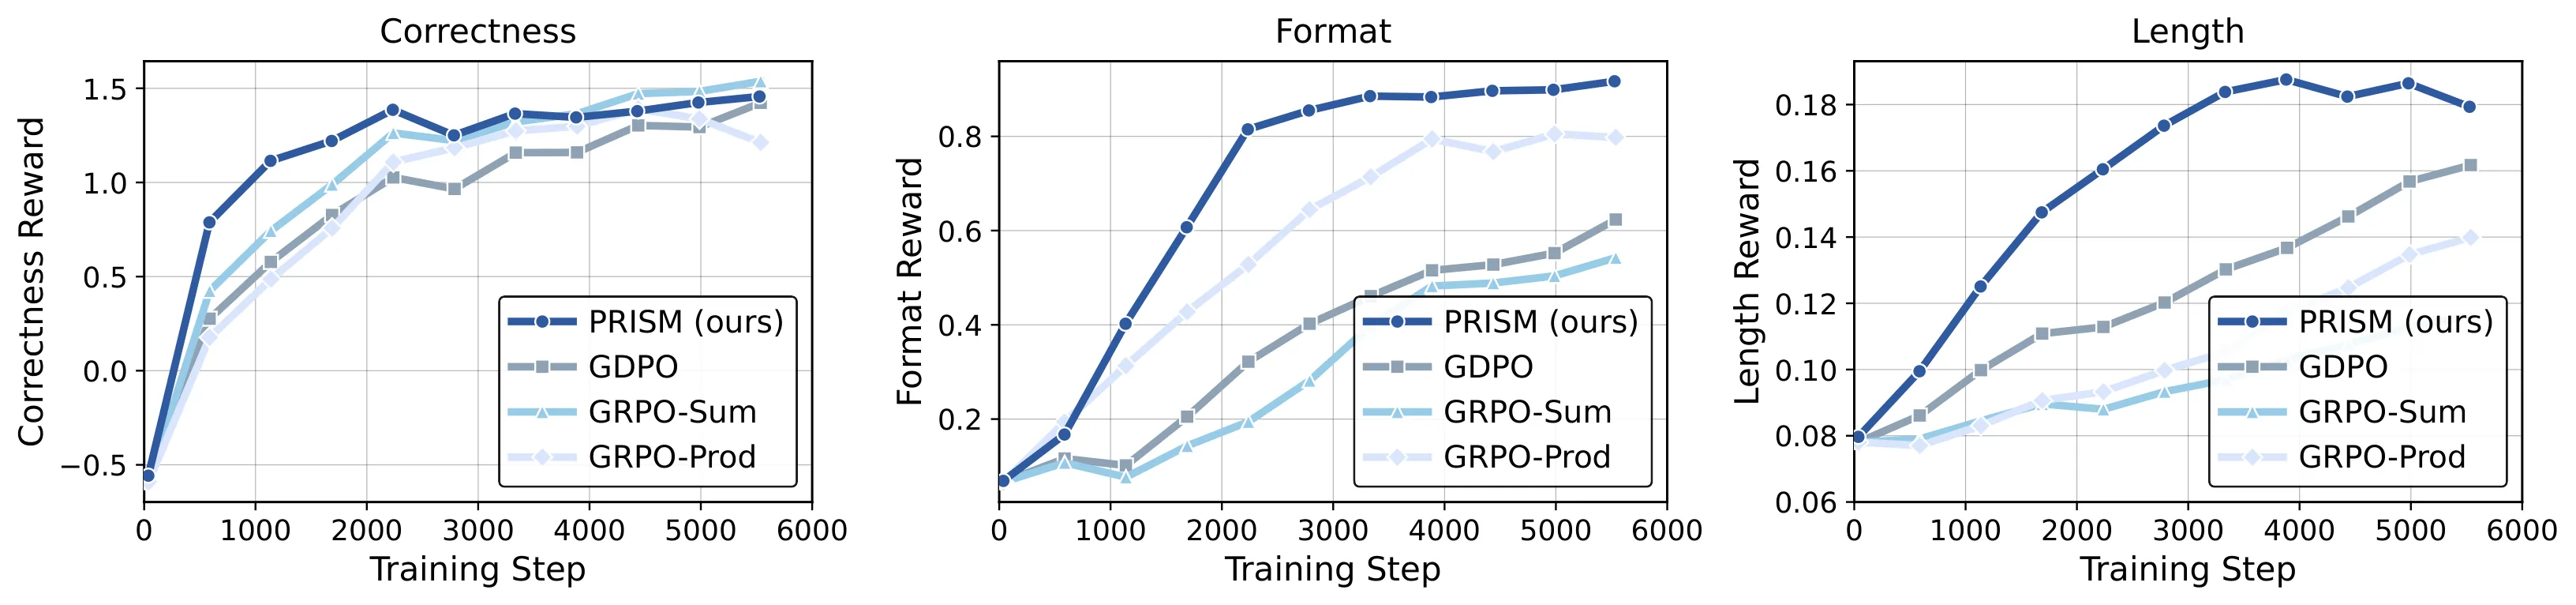
- 训练曲线:3 个奖励设置下 4 个方法的奖励收敛曲线(6k step);
- 推理时可控性:3 组 merge weight 配置下的 3 项指标 + 1 个定性案例;
- 策略组合消融(3 项):共享正策略 / 去掉全局负策略 / 各分支独立 rollout;
- 负策略加权函数消融(3 项):max / LogAvgExp / mean;
- 推理效率:3 套配置(N=2,3 vs single policy);
- prefix 初始化策略(App. D)等细节说明。
充分性评估:覆盖面较广,涵盖规则式奖励与模型式奖励、不同基座、多个 benchmark、消融维度齐全。但存在以下不足:(i)奖励数量仅覆盖到 ,更复杂的奖励组合未验证;(ii)每个奖励的"冲突程度"未受控实验设计;(iii)reward hacking 风险与对齐税的定量分析较浅。
6. 主要结论与发现
1. 效果一致占优:在 3 个基座 × 3 个场景 × 共 9 个评测设置下,PRISM 在"Overall"与"Joint(同时满足多奖励)"指标上均达到最优,例如 DeepSeek-R1-1.5B 上 Overall 提升 +17.77 pts、Qwen2.5-1.5B 上提升 +8.04 pts;在 GPQA 困难子集上 PRISM 平均分较最优基线翻倍以上;
2. 有效缓解对齐税:随奖励数从 1 增加到 3,PRISM 的正确性几乎不下降,GDPO/GRPO-Prod 则明显掉点(图 3);
3. 样本效率更高:在三奖励设定下,PRISM 在 ~3k 步即接近最优收敛速度,基线需 6k+ 步;
4. 推理时可组合:merge weight 直接对应偏好——增大 提升正确性,增大 改善格式,增大 延展推理长度,且无需重训;
5. 正负策略拆分有效:消融证明共享正策略、去掉负策略、独立 rollout 都会带来不同程度的退化;
6. Soft-conjunction 形式的负策略性能稳定,优于 max/LogAvgExp/mean 的简单聚合。
7. 优点与亮点
- 范式性创新:从"奖励空间加权"切换到"策略空间分解+组合",给出具有理论保证的对偶分解(Eq. 7-11),形式优雅;
- 训练-组合解耦:子策略优化与推理时偏好调权完全解耦,单次训练产出整族 Pareto 策略;
- 工程实现高效:prefix-conditioned 共享骨干 + 非对称更新 + 并行 batch 解码,使得推理开销接近基线;
- 实验设计较全面:覆盖规则与模型奖励、不同基座、消融、可控性、效率多维度;
- 直观可控的解释性:merge weight 作为可解释接口,避免了 GDPO 等基于 advantage 归一化的隐式权重黑箱。
8. 不足与局限
1. 奖励维度上限未验证:作者明确指出假设"每个奖励对应一个独立正策略",但所有实验仅覆盖 ,更多奖励数下的可扩展性、参数效率、负策略容量都尚未测试;
2. 权重仍需手动设定:merge weight 当前为手工调整,自适应方式(按用户、按 prompt 情境动态确定)尚未给出;
3. 理论收益与可证明收敛性:作者从 KL 正则化对偶推出分解,但实际训练中采用多轮迭代 GRPO 而非一次性对偶求解,因此正-负策略组合对最终 Pareto 边界的保证并未严格证明;
4. 算力与开销披露不足:训练总 GPU-hour、单组实验时长、训练 reward hacking 分析均缺失;
5. 基座规模有限:仅在 1.5B–3B 规模验证,更大模型(如 7B/70B)下 prefix-conditioned 框架的性能-开销权衡未知;
6. 负向策略过于简化:单一全局负策略假设"所有失败模式可被统一表征",但在 helpfulness-safety 这类正交维度上可能难以兼顾;
7. 评测偏向:GPQA/ScienceQA 与 Alpaca/HH-RLHF 的奖励类型差异大,但未系统分析 PRISM 在哪种奖励特性下优势最显著;
8. 显存/FLOPs 线性增长:推理并行化只是延迟层面的近似,KV cache 与 memory 仍随 线性扩展,实际部署 较大时成本不可忽视。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。