
📝 TLDR
多步信用分配是Q-learning样本高效的关键,但off-policy偏差管理长期面临两难。Gated Q-learning提出连续、状态-动作相关的门控机制,平滑插值于Watkins' Q(λ)与Peng's Q(λ)之间,无需importance sampling即可选择性衰减eligibility traces。理论证明门控算子保持压缩映射并导出精确不动点;实验表明中间门控可安全扩展多步信用分配范围,初始学习速度快于任一极端,为Q-learning提供简单且偏差可调的替代方案。
🧭 速览
Q-learning中多步信用分配受困于off-policy偏差与轨迹截断的两难,Watkins' Q(λ)与Peng's Q(λ)各执一端,importance sampling在贪心目标策略下数值不稳定。
提出Gated Q-learning,用连续、状态-动作相关的探索感知门控机制选择性衰减eligibility traces,平滑插值两种历史Q(λ)方法,无需importance sampling。
理论证明门控算子保持压缩映射并推导精确不动点;实验表明中间门控可安全延长多步信用分配范围,初始学习速度优于Watkins' Q(λ)与Peng's Q(λ)两个极端。
Gated Q-learning为Q-learning提供了importance sampling之外的简洁替代方案,使有效多步范围与off-policy偏差量均可定制。
🆚 方法对比
Gated Q(λ)
- 连续门控机制平滑插值两种历史极端方法
- 理论证明期望算子仍为压缩映射并导出不动点
- 无需重要性采样即可调控离策略偏差量
- 实验显示中间门控值比两端初始学习更快
- 实验仅在19状态随机游走环境验证
- 门控参数引入额外超参数调优负担
- 本质上仍允许可控离策略偏差存在
- 尚未在深度强化学习基准上广泛验证
Watkins' Q(λ)
- 完全消除离策略偏差
- 理论严谨,截断策略清晰
- 实现简单,易于理解
- 保障值估计的无偏性
- 探索动作后严重截断资格迹
- 多步信用分配能力受限
- 学习速度显著慢于Peng方法
- 无法灵活控制偏差-方差权衡
Peng's Q(λ)
- 不截断资格迹,学习速度更快
- 充分利用多步回报信息
- 实验表现常优于Watkins方法
- 实现同样简洁
- 完全忽略离策略偏差
- 向值估计注入有害误差
- 限制可安全使用的多步回报长度
- 值估计存在系统性偏差
重要性采样离策略估计器
- 可对离策略偏差进行细粒度控制
- 理论上是正确的偏差修正方法
- 在高维空间中灵活适用
- 在Q学习贪婪目标策略下比率崩溃
- 与Q学习不兼容
- 实践中方差较高
- 无法解决Q学习的核心困境
Q-learning
- 理论简洁优雅
- 解耦行为策略与目标策略
- 支撑DQN、Rainbow、PQN等深度RL方法
- 在离线强化学习中至关重要
- 单步时序差分学习样本效率低
- 多步回报在离策略设置下偏差大
- 长horizon信用分配能力不足
- 依赖探索策略设计
本文核心提出Gated Q(λ),通过连续门控机制在Watkins' Q(λ)(零偏差但截断严重)与Peng's Q(λ)(快速但有偏)之间实现平滑插值,论证了重要性采样方法因比率崩溃而不适用于Q学习场景。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 2 张)
展开查看 2 张图
TL;DR
门控 Q-learning 通过引入连续、状态-动作依赖的门控机制 ,在经典 Watkins' (完全消除离策略偏差但信用分配窗口短)和 Peng's (信用分配长但偏差大)之间实现平滑插值,无需依赖重要性采样即可选择性衰减 [[资格迹]]。实验表明,适度门控值()可安全使用更长的时间跨度,获得比两种极端都更快的初始学习速度,为 Q-learning 中的 [[离策略偏差]] 管理提供了一种简洁且偏差可调的替代方案。
研究背景与动机
在 [[Q-learning]] 的学习过程中,如何高效地进行多步信用分配,同时妥善管理 [[离策略偏差]],是一个长期困扰研究者的核心问题。当智能体依据行为策略收集样本,但同时学习贪心策略的价值函数时,离策样本会引入有偏的估计。
过去三十年间,研究者实际上只能在两种极端方案之间做二元选择。Watkins' 采用了激进的截断策略:一旦遭遇非贪心动作,便立即将 [[资格迹]] 归零。这种做法理论上能完全消除离策略偏差,但其代价是信用分配的时间跨度被严重限制——因为探索过程中大量非贪心动作的存在,导致资格迹频繁被截断,学习效率低下。Peng's 则走向另一个极端,完全不进行截断,允许资格迹持续累积更新。这种方式确实能利用更长的多步回报加速学习,但同时也引入了显著的离策略偏差,严重时可能导致价值估计发散。
现代离策略校正方法,如 Tree Backup、Retrace 等,依赖 [[重要性采样]] 比率来修正偏差。然而,这些方法在 Q-learning 的贪心目标策略下注定失效:重要性采样比率要么趋近于无穷,要么直接崩塌为 0/1,最终等价于 Watkins 式的激进截断,无法提供细粒度的偏差控制。这一困境的根本原因在于,Q-learning 的目标策略是确定性的贪心策略,使得传统的重要性采样技术失去了用武之地。
方法
门控 Q-learning 的核心洞察是:既然无法通过重要性采样精确校正偏差,那就退而求其次,通过门控机制有选择性地衰减离策样本的影响。 这种思路类比于 [[LSTM]] 或 [[GRU]] 等门控网络——不是完全阻断信息流,而是用软权重控制信息通过的程度。
论文首先形式化了 Variable 框架,允许 随状态-动作对变化。传统方法中 是全局标量,而这里将其推广为状态-动作依赖的函数 。该框架下的前向回报定义为:
其中 是 Q-learning 误差, 是 TD 误差。在这个统一框架下,Watkins' 对应 (非贪心时),而 Peng's 对应 (常数)。
门控 引入一个标量超参数 门控值 :
当动作是贪心的,;当动作是探索性的, 被缩减为 。这意味着非贪心动作产生的 TD 误差对价值更新的贡献被乘以 因子衰减,但并非完全截断。形式化的前向回报为:
G^\lambda_{\text{(Gated)}}_t = Q(S_t, A_t) + \delta'_t + \sum_{i=1}^{\infty} (\gamma\lambda)^i \chi^{k_{t:t+i}} \delta_{t+i}其中 统计了从 到 步之间出现的非贪心动作数量。注意这里衰减的是累积性的:连续多步非贪心动作会导致连乘效应, 会指数级压低早期误差的影响。
该参数化有两个优雅的性质:当 时完全退化为 Watkins' (非贪心动作处截断),当 时完全退化为 Peng's (不衰减)。因此,门控 Q-learning 在两种历史极端之间提供了纯数学的连续插值,而非引入新的近似。
理论分析方面,论文证明了门控机制的期望算子 仍是 [[压缩映射]],压缩模量为:
其中 是衰减系数的最小值。这意味着即使引入连续的门控,该方法的收敛性在理论上仍有保证。更重要的是,论文推导出了精确不动点:门控 收敛到行为策略与贪心策略的凸混合 的价值函数,其点态表达式为:
这一结果显著推广了 Kozuno 等人对 Peng's 的理论分析。
实验与结果
实验在经典 [[强化学习]] 基准——19状态随机游走环境中进行,并改造为离策略控制设置:行为策略以等概率选择左右动作,价值函数需学习接近贪心策略(向正终止状态移动)的价值。训练固定 500 步以评估初始学习速度。
研究者进行了大规模超参数搜索,覆盖 、、 三轴各 21 个均匀值,共 9261 种配置,每种配置重复 300 个随机种子,总计约 300 万次独立试验。这种规模的实验在统计意义上具有很强的说服力。
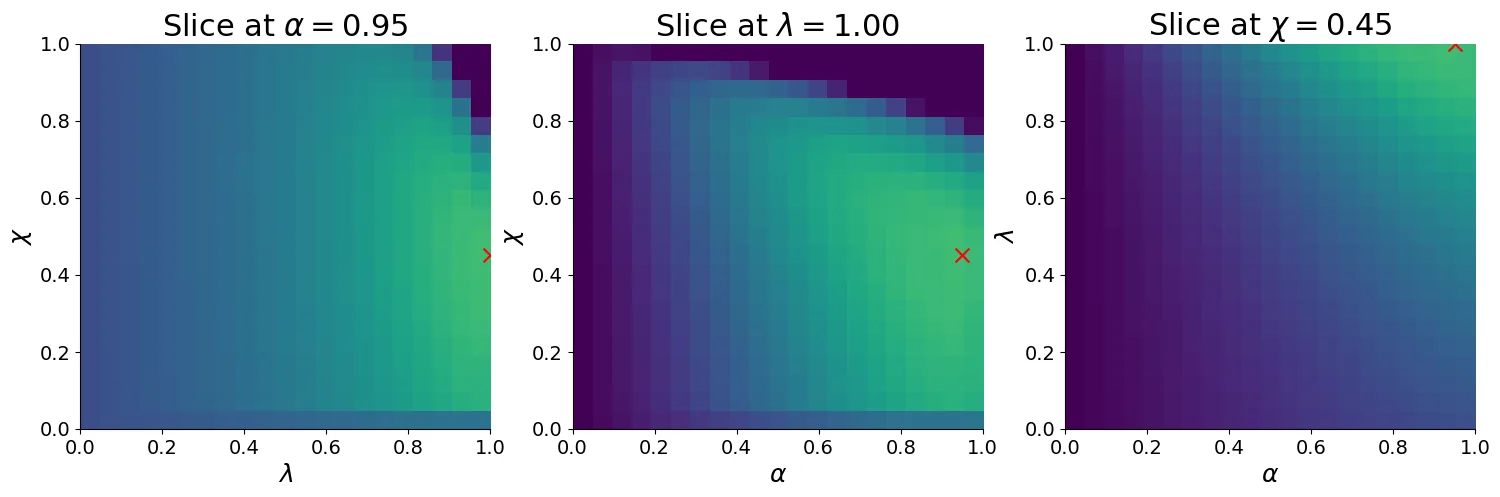
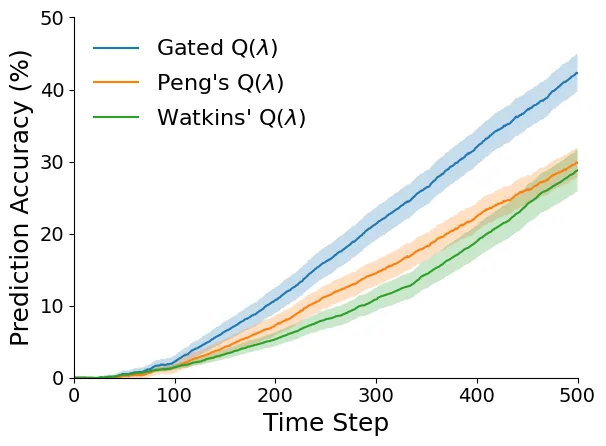
结果表明,最优配置为 、、。关键发现包括:门控值在 区间形成宽广的性能高原,表明该超参数易于调节且具有较强的鲁棒性;门控 Q-learning 的初始学习速度显著快于两种极端方法,尤其是在训练早期;门控机制允许安全使用 (Peng's 的安全上限仅为 0.70),从而将有效信用分配范围延长近 50%。
讨论与可借鉴点
门控 Q-learning 最大的贡献在于提供了一种不依赖重要性采样的离策略偏差控制范式。当传统校正方法在 Q-learning 贪心策略下失效时,门控机制另辟蹊径,通过感知探索状态的选择性衰减实现可控的偏差-方差权衡。
该方法的工程可迁移性值得注意:门控机制是通用框架,可直接集成到现有 -回报方法(如 A3C、DQN())或 n-step 方法中,仅需在资格迹更新处引入 因子。论文也简要给出了 n-step 变体的形式化。
然而,实验环境的单一性是该工作的主要局限。19状态随机游走是高度简化的玩具环境,无法充分验证方法在复杂 MDP、高维状态空间或 [[深度强化学习]] 设置中的稳定性和样本效率。与 Retrace、Tree Backup 等现代离策略校正方法的直接对比也付之阙如,使得相对优劣难以判断。此外,论文未提供方差分析,理论上也未充分讨论控制场景下( 变化导致 非线性)算子性质的边界。
对于从业者而言,门控 Q-learning 的核心启示是:在 Q-learning 类方法中,不必执着于消除离策略偏差,而是可以选择性地、可调节地引入偏差以换取更长的信用分配窗口。这一思路可迁移到其他多步回报方法中,为设计更高效的探索-利用平衡机制提供新视角。
摘要
多步信用分配对样本高效的强化学习至关重要,然而在 Q-learning 中管理离策略偏差仍是一项根本性挑战。三十年来,实践者一直只能在两者之间做出二元选择:消除偏差,但代价是资格迹被严重截断(Watkins 的 Q(λ)),或者忽略偏差以获得更快的学习速度,但向价值估计中注入有害的误差(Peng 的 Q(λ))。现代离策略估计器无法化解这一矛盾,因为重要性采样比率在 Q-learning 的贪心目标策略下会崩塌。我们提出门控 Q-learning(Gated Q-learning),一个全新的算法框架,通过在两种历史极端之间平滑插值,终结了这一两难困境。我们的方法不依赖重要性采样,而是采用一种连续且依赖于状态-动作的门控机制,以探索感知的方式选择性地衰减资格迹。我们为该机制提供了严格的理论基础,证明其期望算子仍为压缩映射,并推导出了其精确的不动点。实证评估表明,适中的门控值可安全地延长信用分配的时间跨度,从而实现比两种极端都更快的初始学习速度。门控 Q-learning 为重要性采样提供了一种简洁的替代方案,同时支持对有效的多步时间跨度以及 Q-learning 智能体中离策略偏差的量进行灵活定制。
Abstract
Multistep credit assignment is critical for sample-efficient reinforcement learning, yet managing off-policy bias in Q-learning remains a fundamental challenge. For 30 years, practitioners have been limited to a binary choice: eliminate the bias at the cost of severely truncated eligibility traces (Watkins' Q()), or ignore the bias to learn faster while injecting detrimental errors into the value estimates (Peng's Q()). Modern off-policy estimators fail to resolve this tension, as importance-sampling ratios collapse under Q-learning's greedy target policy. We introduce Gated Q-learning, a novel algorithmic framework that ends this dilemma by smoothly interpolating between the two historical extremes. Rather than relying on importance sampling, our approach employs a continuous, state-action-dependent gating mechanism to selectively attenuate eligibility traces in an exploration-aware manner. We provide a rigorous theoretical foundation for this mechanism, proving that the expected operator remains a contraction mapping and deriving its exact fixed point. Empirical evaluations verify that intermediate gating safely enables longer credit-assignment horizons, yielding faster initial learning than either extreme. Gated Q-learning offers a simple alternative to importance sampling while enabling customization of the effective multistep horizon and the amount of off-policy bias in Q-learning agents.
论文详细总结(自动生成)
论文总结:门控 Q-learning(按需引入离策略偏差)
1. 核心问题与研究动机
Q-learning 作为现代深度强化学习的重要基石(如 DQN、Rainbow、PQN 等),在多步信用分配与离策略偏差管理之间长期面临两难:
- Watkins' :在遇到非贪心动作时立即截断资格迹,完全消除离策略偏差,但因频繁截断导致信用分配窗口过短、学习缓慢。
- Peng's :从不截断资格迹,学习更快但注入显著离策略偏差,最终限制了可安全使用的多步长度。
- 现代重要性采样方法(Tree Backup、Retrace、Recency-Bounded IS 等)在 Q-learning 的贪心目标策略下,重要性采样比率退化为 0/1,等价于 Watkins 式的激进截断,无法提供细粒度偏差控制。
因此,本文动机在于:在不使用重要性采样的前提下,为 Q-learning 设计一种可平滑调节离策略偏差与多步信用分配长度的机制。
2. 方法论:核心思想、关键技术与算法
2.1 变量化 框架
作者首先提出更一般的 Variable 框架,允许 随状态-动作变化。其前向回报定义为:
对应的递归形式(高效计算用):
在此框架下:
- Watkins' 对应 (贪心)或 (非贪心)
- Peng's 对应 (常数)
- Gated 对应 (贪心)或 (非贪心)
2.2 门控 :核心机制
引入超参数 门控值 :
其前向回报可显式表达为:
G^\lambda_{\text{(Gated)}}_t = Q(S_t, A_t) + \delta'_t + \sum_{i=1}^{\infty} (\gamma\lambda)^i \chi^{k_{t:t+i}} \delta_{t+i}其中 为 到 之间的非贪心动作数。该方法在 时退化为 Watkins' , 时退化为 Peng's ,实现纯数学插值。
2.3 n 步变体(简要提及)
将上述回报截断到 步并设 ,得到:
2.4 算法流程(Algorithm 1)
向后资格迹实现:每步计算 (Q-learning 误差)和 (TD 误差),仅对当前状态-动作的资格迹 应用 衰减并累积 更新;当前对使用 更新。
2.5 理论结果
命题 1(算子封闭形式):定义向量/算子 、衰减矩阵 (对角元素为 ),则
定理 1(压缩模量): 是压缩映射,模量为
其中 ,。
定理 2(不动点): 的唯一不动点为混合策略 的价值函数:
点态表达为:
此结果是 Kozuno 等人对 Peng's 结论的显著推广。
3. 实验设计
3.1 测试场景
采用 Sutton & Barto(2018, Ex. 7.1/12.1)的 19 状态随机游走环境,并改造为离策略控制:
- 起点居中,两个动作(左/右)
- 行为策略:以等概率选动作
- 两端终止奖励分别为 和
- 折扣因子
- 训练固定 500 步(捕获初始学习速度)
- 初始化加微小高斯噪声()
3.2 对比方法
- Watkins'
- Peng's
- Gated (本文方法)
3.3 评估指标
- 每步记录 与 之间的 RMS 误差
- 将误差归一化为"预测精度"(0% = 无进展,100% = 完美收敛)
- 采用学习曲线下面积(AUC)作为汇总指标
3.4 最优超参数对比(来自 Table 2)
| 方法 | |||
|---|---|---|---|
| Watkins' | 1.00 | 0.95 | 0.00 |
| Gated | 0.95 | 1.00 | 0.45 |
| Peng's | 1.00 | 0.70 | 1.00 |
4. 资源与算力
论文未明确报告具体的 GPU 型号、数量或训练时长。作者仅在 n-step 变体处提到"凭借大规模硬件并行,计算开销可能并不明显"。所有实验、采集和处理工作声明以个人身份完成,未使用 Meta 公司基础设施。代码已开源(GitHub: brett-daley/gated-q-learning)。
5. 实验数量与充分性
- 超参数搜索空间: 三轴各 21 个均匀值 → 个配置组合
- 每个配置重复 300 个随机种子 → 总计约 300 万次独立试验
- 输出 3 个穿过全局最优点()的二维切片热力图
充分性评估:
- 搜索密度极高,结果统计意义较强
- 但仅在单一 toy 环境(19 状态随机游走)上验证,未在更大规模或深度 RL 场景中测试
- 缺乏与重要性采样方法(Retrace、Tree Backup 等)的直接对比
- 缺乏消融对 与 联合敏感性的完整讨论
6. 主要结论与发现
1. 理论保证:门控 的期望算子保持压缩映射(),收敛到行为策略与贪心策略的凸混合 的价值函数。
2. 偏差可控:Watkins' 是唯一完全消除离策略偏差的方法( 对探索动作);其他方法均收敛到非贪心混合策略的不动点。
3. 实证优势:在随机游走环境中,Gated 的初始学习速度显著快于两种极端方法。
4. 超参数鲁棒性: 形成宽广性能高原,说明门控值易于调节。
5. 高 安全使用:门控机制允许使用 (远超 Peng's 安全的 0.70),从而延长有效信用分配范围。
7. 优点
- 理论严谨:完整推导出含状态-动作相关 的价值函数算子闭式解,显著推广 Kozuno 等人关于 Peng's 的结果。
- 机制简洁:仅用一个标量 平滑插值两种经典方法,无需重要性采样,计算开销几乎可忽略。
- 算法通用:可直接集成到现有 -回报方法(A3C、DQN()、PQN)及 n-step 方法(DQN 系列)。
- 超参数鲁棒:热力图显示 在宽广区间内性能稳定。
- 直觉清晰:以 LSTM/GRU 的"门控"机制作类比,易于理解。
8. 不足与局限
- 新增超参数 :理论上需与 联合调节,增加调参负担(虽然图 2 显示有较宽稳定区)。
- 环境单一:仅在 19 状态随机游走验证,未在更大 MDP、函数逼近或深度 RL 设置中测试。深度 RL 场景中的稳定性和样本效率仍有待验证。
- 缺乏基线对比:未与 Retrace、Tree Backup、Recency-Bounded IS 等现代离策略校正方法直接对比,难以判断相对优劣。
- 方差未分析:论文明确指出未对回报估计的方差进行定量分析(推测不依赖重要性采样比率可降低方差,但缺乏严格证明)。
- 实验时窗短:仅训练 500 步,刻意聚焦早期学习速度。Watkins' 因无渐近偏差,长期训练下结论可能改变。
- 策略评估假设:理论分析假设 固定,从而将 视作线性算子;控制场景下 随 变化导致非线性,这一假设的适用边界讨论不充分。
- n-step 变体未深入:仅简要提及,未给出独立的实证或理论分析。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。