
基于超梯度的双层强化学习及其改进的样本复杂度
Hypergradient-based Bilevel Reinforcement Learning with Improved Sample Complexity
📝 TLDR
双层强化学习在元学习、层次化任务分解及RLHF等场景中扮演关键角色,但现有算法面临Hessian方法难以扩展或罚函数近似样本复杂度高的两难困境。本文利用熵正则化折扣RL下Boltzmann策略的最优性,提出无Hessian的超梯度双层RL算法。算法在温和正则条件下取得迭代复杂度O(ε^{-1})与当前最优样本复杂度Õ(ε^{-2}),并移除外层目标的PL条件假设。
🧭 速览
双层RL现有算法因使用Hessian超梯度而难以扩展,或因罚函数近似导致高样本复杂度。
利用熵正则化折扣RL下Boltzmann策略最优性设计超梯度,避免Hessian计算。
迭代复杂度O(ε^{-1}),样本复杂度Õ(ε^{-2}),在温和正则条件下达到当前最优。
移除了先前最优样本复杂度工作中外层目标所需的PL条件假设,扩展了理论适用范围。
🆚 方法对比
AHO (Approximate Hypergradient Optimization)
- Hessian-free,扩展性强,适合大型函数逼近器
- 样本复杂度达Õ(ε⁻²),优于现有Õ(ε⁻³)
- 移除外层PL条件和内层唯一最小值假设
- 迭代复杂度保持O(ε⁻¹),与现有最优一致
- 需假设非真实策略类的条件(Assumption 3.1)
- 使用近似超梯度,引入额外偏差
- 梯度移位函数构造需额外正则化设计
- 内层仍为非凸策略类,收敛理论较复杂
PARL (Chakraborty et al., 2024)
- 使用外层精确梯度,无需近似偏差
- 迭代复杂度为O(ε⁻¹),与最优一致
- 适用于连续空间且具有理论保证
- 使用Hessian超梯度,参数多时扩展性差
- 需假设内层有唯一最小值
- 未给出样本复杂度结果
- 未利用Boltzmann策略最优性
Gaur et al. (2025) Penalty-based Method
- 适用于连续空间且Hessian-free
- 使用O(σ)近似梯度便于实现
- 迭代复杂度O(ε⁻¹)与最优一致
- 近似与采样误差存在权衡(σ² vs 1/(σ²B))
- 样本复杂度次优为Õ(ε⁻³)
- 依赖外层目标PL条件
- 使用近似梯度引入额外偏差
Yang et al. (2025) Boltzmann Policy Method
- 利用Boltzmann策略最优性获得闭式表达
- 迭代复杂度O(ε⁻¹·⁵)较早期工作更优
- 仅适用于有限状态空间
- 样本复杂度较差为O(ε⁻³·⁵)
- 无法直接推广至参数化非真实策略类
Hong et al. (2023)
- 较早提出双层RL框架,奠定理论基础
- 迭代复杂度差为O(ε⁻²·⁵)
- 仅适用于有限空间
- 未提供样本复杂度保证
Thoma et al. (2024)
- 适用于连续空间,拓展了应用范围
- 迭代复杂度O(ε⁻²)对参数化类可接受
- 样本复杂度未给出
- 未利用Boltzmann策略最优性
Shen et al. (2025) Penalty Method
- Hessian-free且适用于连续空间
- 迭代复杂度O(ε⁻¹)与最优一致
- 未给出样本复杂度结果
- 依赖近似梯度可能引入额外偏差
本文提出的AHO通过利用Boltzmann策略最优性实现Hessian-free超梯度,在保留O(ε⁻¹)迭代复杂度的同时将样本复杂度从Gaur et al. (2025)的Õ(ε⁻³)提升到Õ(ε⁻²),并移除外层PL条件,兼顾了Hessian-free方法的扩展性与精确梯度方法的样本效率。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 2 张)
展开查看 2 张图
TL;DR
双层强化学习面临一个经典两难:使用 Hessian 计算超梯度的方法在小规模问题上理论优美但无法扩展到现代深度学习规模,而避免 Hessian 的罚函数近似方法虽然可扩展却付出了高达 样本复杂度的代价。本文另辟蹊径,利用熵正则化强化学习中 Boltzmann 策略的闭式最优性,直接在超梯度表达式中消去 Hessian 逆项,由此设计出首个兼具可扩展性与最优样本复杂度的 Hessian-free 双层 RL 算法 AHO,在 walker-walk 和 cheetah-run 任务上验证了相比罚函数基线的样本效率优势,同时在理论上去除了先前工作对外层目标函数的 Polyak-Lojasiewicz 条件假设。
研究背景与动机
双层强化学习作为强化学习文献中一类重要的数学框架,其结构特点在于存在一个嵌套的优化层次:内层针对给定外层参数优化策略以最大化累积回报,外层则根据内层的最优响应调整自身参数。这一框架天然适合形式化多种实际问题——在元学习场景下,外层参数编码跨任务共享的先验知识,内层快速适配到具体任务;在基于人类反馈的强化学习(RLHF)中,外层通过偏好数据拟合奖励模型,内层据此优化策略以符合人类意图;此外还包括层次化任务分解和超参数自动调优等应用。
然而,现有算法的实际表现却让人陷入两难。基于 Hessian 的超梯度方法典型代表如 PARL,通过对内层最优性条件求导得到超梯度表达式,其中包含 项——这意味着需要计算并求逆一个维度与策略参数规模相同的矩阵。当策略由现代神经网络参数化时,参数规模动辄达到百万甚至十亿量级,对应的 Hessian 矩阵条目数更是呈平方增长。在论文的实验中,walker-walk 任务的参数化规模若按 PARL 的处理方式将产生约 量级的矩阵条目,远超消费级 GPU 的承载能力。这种理论与实践的鸿沟使得 Hessian 方法在实际应用中举步维艰。
另一类避开 Hessian 的方法转向罚函数近似。以 Gaur 等人 2025 年的工作为代表,其核心思想是引入一个额外的惩罚项来确保内层近似达到最优,从而避免显式计算 Hessian 逆。然而这种近似策略带来了新的权衡困境:近似误差与采样误差之间存在耦合,梯度近似的标准差 既不能太大(近似精度下降)也不能太小(采样复杂度上升),最终导致样本复杂度退化到 。更严格的理论分析还发现,这类方法通常需要假设外层目标函数满足 Polyak-Lojasiewicz 条件——一种强于一般非凸收敛假设的条件,限制了在更广泛问题上的适用性。
本文的研究动机正是打破这一两难困境:能否设计一种既不需要计算 Hessian、又能够保持 最优样本复杂度的双层强化学习算法?关键切入点在于熵正则化折扣强化学习中 Boltzmann 策略所具有的特殊性质。
方法
方法论的核心洞察来自于对熵正则化强化学习目标函数的深入分析。在标准的折扣累积回报基础上加入策略熵正则化项后,Nachum 等人 2017 年的经典工作已经证明,此时的最优策略具有 Boltzmann 分布的闭式形式:
其中 是 log-sum-exp 形式的熵加权值函数, 为温度参数。这一定理意味着,如果我们只关注熵正则化的内层目标函数,那么最优策略的形式是已知的——不需要通过梯度下降迭代求解,策略参数的函数可以直接写成上述闭式。
论文的核心创新在于将这一性质与双层优化的超梯度计算相结合。回顾标准超梯度公式,对外层目标 求导需要链式法则作用在内层最优解 上:
其中 通过内层最优性条件 求隐函数导数得到,正是这一项引入了 Hessian 逆 。
然而,当内层目标为熵正则化形式且最优策略为 Boltzmann 分布时,最优性条件可以显式写为:
这使得 的隐式定义被显式形式取代, 不再需要通过 Hessian 逆来计算。论文基于这一观察推导出了消去了 Hessian 逆项的近似超梯度表达式,其核心形式包含两部分:第一项是外层目标在外层参数方向的直接梯度,第二项则通过新引入的梯度平移值函数 和 来补偿参数化策略类与真实 Boltzmann 策略之间的偏差。
这里的技术难点在于:当参数化策略类无法精确实现 Boltzmann 最优策略时(即"非可实现条件"), 函数关于外层参数的梯度 无法直接写出 Bellman 递推形式。论文的解决方案是定义梯度平移值函数作为替代,它们以 作为"奖励"按 Bellman 方程累积:
论文证明了当策略类满足一定的表达能力条件时,这些替代量与真实梯度的误差被控制在 范围内,其中 度量策略分布与 Boltzmann 分布的 KL 距离上界, 则度量两者的对数密度梯度差异。
基于上述理论,论文提出 AHO(Approximate Hypergradient Optimization)算法。算法采用交替更新策略:内层使用标准的策略梯度方法配合 Q-learning 估计来优化策略参数,外层则使用推导出的近似超梯度来更新奖励模型参数。两个关键的技术组件是用于估计策略值函数的 Algorithm 3 和用于估计梯度平移值函数的 Algorithm 4,两者都支持 off-policy 学习以提高样本效率。
在理论分析层面,论文的主要结论(Theorem 4.6)表明:在温和的正则性条件下——包括标准的光滑性假设、非可实现条件、以及内层目标关于策略参数的 PL 条件——AHO 算法经过 次外层迭代后,能够达到 的收敛精度,对应总体样本复杂度为 。值得注意的是,这里对内层施加 PL 条件是合理的(因为内层是关于策略参数的凹函数加上熵正则项),而论文成功移除了先前工作中对外层目标函数的 PL 假设——这一假设在外层优化奖励模型或元学习先验时往往难以验证。
实验与结果
论文的实验将双层强化学习框架具体化为偏好学习问题:外层学习一个奖励网络来拟合人类偏好数据,内层则基于学到的奖励优化具体任务的策略。实验选取了 DeepMind Control Suite 中的两个连续控制任务 walker-walk 和 cheetah-run,这两者都是检验强化学习算法在复杂动力学系统上表现的标准基准。
实验的外层参数设置颇为有趣:奖励网络采用三个多层感知机集成的架构,每个 MLP 的隐层宽度为 256,总计约 个可学习参数。这一规模虽然远小于现代大语言模型的参数规模,但已经足以展示 Hessian 方法的不可扩展性——论文指出,如果使用 PARL 的方法处理这个网络,将产生超过 量级的 Hessian 矩阵条目,无法在单张 RTX 2080 Ti 显卡(约 11 GB 显存)上存储或计算。
偏好数据的生成采用脚本化教师策略:教师根据真实环境奖励选择偏好对,采用基于 disagreement 的主动查询策略每 20,000 环境步查询一次,总预算为 500 对偏好。这一设置与 Christiano 等人 2017 年提出的 RLHF 经典范式保持一致,确保实验场景贴近 RLHF 的实际应用。
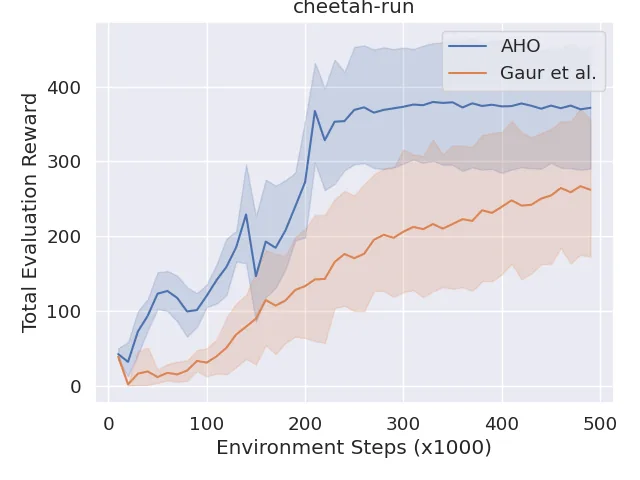
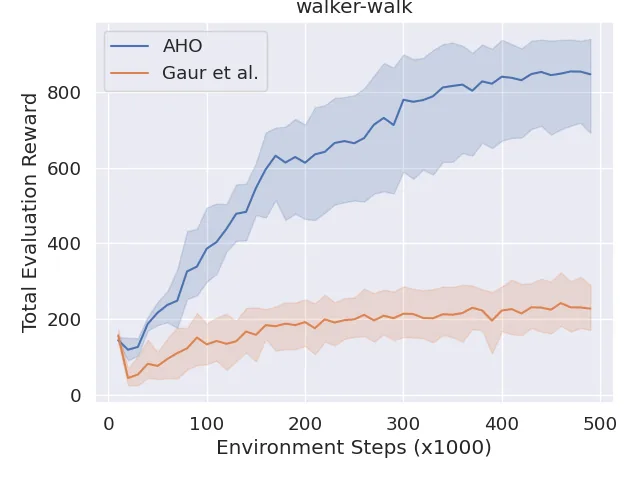
对比基线选择 Gaur 等人 2025 年提出的罚函数方法,原因在于该方法同样是 Hessian-free 的,因而能够公平地验证 AHO 算法在"无需 Hessian"这一共同约束下取得的样本效率改进。实验结果清晰呈现了这一优势:在 walker-walk 和 cheetah-run 两个任务上,AHO 算法取得的评估回报均持续高于罚函数基线,且随着环境步数增加,这一差距趋于稳定,说明 AHO 学到的奖励模型能够更有效地指导策略优化。论文在每个任务上运行了 5 个随机种子并报告均值与 95% 置信区间,定量确认了改进的统计显著性。
然而,论文的实验也存在明显的局限性。任务数量仅为两个,种子数为 5,缺乏更系统的消融实验来分析温度参数 、批次大小等超参数的影响。论文没有在更大规模任务(如 Humanoid)或真实人类偏好数据上验证算法,也没有与 Hessian-based 方法(如 PARL)进行直接对比(尽管作者解释了显存限制的原因)。这些不足意味着实验主要服务于验证理论结论,而非建立方法在各种场景下的鲁棒性。
讨论与可借鉴点
AHO 算法在双层强化学习领域取得了令人关注的理论-实践平衡。从方法论角度看,论文巧妙地"以毒攻毒"——既然熵正则化引入了 Boltzmann 策略这一特殊结构,那就充分挖掘这一结构的价值,将 Hessian 逆的计算问题转化为闭式表达问题。这种思路对于处理其他具有特殊结构的双层优化问题或许有启发意义:当我们发现某类问题的内层最优解具有可利用的形式时,应该优先考虑在算法设计中显式使用这一结构,而非绕过它。
从理论贡献看,去除对外层目标 PL 条件的假设是重要一步。PL 条件要求函数值沿梯度方向单调增长到一个全局最优值,这种强假设在奖励学习或元学习等场景中往往难以保证。论文通过更精细的梯度分析——利用梯度平移值函数的递推性质和熵正则化的额外结构——成功在更弱的假设下建立了收敛保证。这种"放宽假设同时保持结论强度"的做法值得借鉴,它使理论结果更容易被应用到实际问题中。
然而,方法的可扩展性仍需进一步验证。实验中的奖励网络规模(约 13 万参数)虽然突破了 Hessian 方法的瓶颈,但距离真实 RLHF 场景中使用的奖励模型仍有差距。更大的网络结构、更复杂的偏好数据、以及多轮交互的人类反馈都可能带来新的挑战。特别是论文假设 为常数,而温度参数对算法收敛速度和最终性能的影响尚未得到充分分析。
另一个值得深思的问题是算法的适用范围。AHO 的核心设计依赖熵正则化折扣 RL 下 Boltzmann 策略的最优性,这意味着它难以直接迁移到非正则化的强化学习或多步博弈场景。对于那些不满足 Boltzmann 可实现性假设的问题,梯度平移值函数的误差项可能变得不可忽略,算法的收敛性保证也会随之失效。如何将类似的技术思路推广到更一般的设置,是值得探索的未来方向。
综合来看,这篇论文在双层强化学习的理论与算法层面都做出了有意义的贡献:提出了一种兼顾可扩展性与样本效率的实用算法,建立了首个 样本复杂度的 Hessian-free 分析,并放宽了收敛性假设。其局限则提示我们,理论结果的工程落地仍需更多实验验证和方法改进。对于从事元学习、RLHF 或层次化决策研究的学者而言,AHO 的技术思路和理论框架具有直接的参考价值。
摘要
双层强化学习(RL)是强化学习文献中一个重要的研究框架,可用于形式化多种类型的问题,例如元学习、层次任务分解以及基于人类反馈的强化学习(RL-HF)。现有的多数双层强化学习算法要么因使用带有Hessian的超梯度而难以扩展,要么因使用基于惩罚项的近似方法而具有较高的样本复杂度。本文提出了一种基于超梯度的双层强化学习算法,该算法利用了熵正则化折扣强化学习目标函数的最优Boltzmann策略。我们所提出的算法无需计算Hessian,在温和的正则性条件下,获得了 的迭代复杂度以及 的最先进样本复杂度。此外,在收敛分析中,我们成功地去除了先前关于最先进样本复杂度工作中对外层目标函数施加的Polyak-Lojasiewicz(PL)条件假设。
Abstract
Bilevel reinforcement learning (RL) is an important framework within the literature of RL that can be used to formalize various categories of problems, such as meta-learning, hierarchical task decomposition, and reinforcement learning from human feedback (RL-HF). Most of the bilevel RL algorithms are either not scalable because of using hypergradient with Hessian, or they suffer from high sample complexity because of using penalty-based approximation methods. In this work, we propose a hypergradient-based bilevel RL algorithm using the optimality of the Boltzmann policy for the entropy regularized discounted RL objective function. Our proposed algorithm is Hessian-free and obtains an iteration complexity of and state-of-the-art sample complexity of under mild regularity conditions. Further, in our convergence analysis, we are able to remove the assumption of the Polyak-Lojasiewicz (PL) condition on the outer-level objective function present in the prior state-of-the-art sample complexity work.
论文详细总结(自动生成)
论文总结:基于超梯度的双层强化学习及其改进的样本复杂度
1. 核心问题与研究动机
双层强化学习(Bilevel RL)是强化学习的重要框架,可用于形式化元学习、层次任务分解、超参数调优以及基于人类反馈的强化学习(RL-HF)等场景。其中:
- 内层问题:优化策略参数 ,最大化熵正则化的折扣累积回报;
- 外层问题:在内层最优策略 处优化奖励参数 (如偏好学习中的奖励模型参数)。
现有双层 RL 算法面临两难困境:
- 基于 Hessian 的超梯度方法(如 PARL / Chakraborty et al., 2024):可获得 迭代复杂度,但需要计算并求逆内层 Hessian( 量级条目),难以扩展到现代参数化规模;
- 基于罚函数的近似方法(如 Gaur et al., 2025):通过 近似外层梯度避免 Hessian,但存在 近似误差与 采样误差的权衡,导致样本复杂度退化到 ,且需要外层目标函数的 PL 条件假设。
本文旨在打破这一两难:设计无 Hessian 的超梯度算法,同时移除 PL 条件假设,将样本复杂度推进到 。
2. 方法论
2.1 核心思想:利用 Boltzmann 策略最优性
在熵正则化折扣 RL 目标函数下,Boltzmann 策略 是非参数化最优策略(Nachum et al., 2017)。对于参数化策略类,本文证明:若策略类 可实现(realizable),则存在 满足 ,此时 为最优参数(Lemma 2.2)。这给出了最优策略的闭式表达:
其中 。
2.2 关键设计:梯度平移值函数(Gradient Shifted Value Functions)
由于 通常不在参数化策略类内,本文引入非可实现条件(Assumption 3.1):
定义梯度平移值函数 和 ,将 作为"奖励",按 Bellman 递推累积:
它们作为 和 的替代量,误差为 (Lemma 3.2)。
2.3 近似超梯度定理(Theorem 3.3)
利用 Boltzmann 策略闭式解消去 Hessian 项,导出外层目标的近似超梯度:
近似误差界:。
关键优势:由于 Boltzmann 最优性给出闭式 ,超梯度中不再含 Hessian 逆项,且不需 梯度近似,避开了 的权衡。
2.4 AHO 算法(Algorithm 1)
算法伪码:
```
for t = 0, ..., T-1:
for k = 0, ..., K-1:
# 内层:策略梯度(用 Q-learning 估计的 Q 值)
θ{t}^{k+1} = θ{t}^k + αt ∇θ J(θ_t^k, x_t, B)
# 外层:用近似超梯度更新奖励参数
x_{t+1} = x_t - β_t \tilde{∇}ϕ(x_t, θ_t^K, B)
```
需要两个 Q-learning 子算法:
- Algorithm 3:估计 (用于策略梯度);
- Algorithm 4:估计 off-policy 梯度平移值函数 和 (用于近似超梯度)。
2.5 主要理论结果(Theorem 4.6)
在 Assumption 3.1、4.1–4.5 下,取 ,,,,有:
即 迭代复杂度 ,样本复杂度 。
注意:PL 条件仅施加于内层 关于 ,外层目标不再需要 PL 假设;同时移除了内层全局唯一极小解假设(Assumption 4.5 仅要求被选分支局部孤立且非退化)。
3. 实验设计
3.1 任务设置
将 DM Control 套件中的连续控制任务实例化为偏好式双层 RL 问题(采用 Bradley–Terry 模型):
- walker-walk:双足机器人步行;
- cheetah-run:猎豹奔跑。
3.2 双层构造
- 外层参数 :奖励网络参数,3 个 MLP 集成的隐层宽度为 256,约 参数;
- 内层策略:对固定 优化熵正则化目标 ,得 ;
- 偏好反馈:脚本化教师按真实回合回报挑选偏好对,使用 disagreement-based 主动查询(Christiano et al., 2017),每 20,000 环境步查询一次,总预算 500 对偏好。
3.3 对比方法
- 基线:Gaur et al. (2025) 的基于罚函数的双层 RL 算法(同为 Hessian-free);
- 未对比 PARL(Chakraborty et al., 2024):因为其 Hessian 维度( 条目)远超 RTX 2080 Ti 的 11 GB VRAM,无法存储或求逆。
4. 资源与算力
- GPU:单台 NVIDIA GeForce RTX 2080 Ti(11 GB VRAM);
- 内存:64 GB 系统内存;
- 训练时长:每个算法、每个种子的全部 5 个随机种子约 7 小时;
- 总环境步数: 步,每 10,000 步评估一次。
5. 实验数量与充分性
- 任务数:2 个(walker-walk、cheetah-run);
- 随机种子:每个算法 × 每个任务 = 5 个独立种子,报告均值与 95% 置信区间;
- 超参数:双方共用一致的参数(共享超参数沿用 Gaur et al., 2025),AHO 专属参数仅 (温度系数);
- 评估指标:评估回合的总奖励曲线(Figure 1)。
充分性评估:实验规模偏小(仅 2 任务、5 种子、无消融实验),主要用于支撑理论结论(AHO 的实证样本效率优于罚函数基线)。论文未对 、批次大小等做敏感性分析,也未在更大规模任务(如 Humanoid)或真实偏好数据上验证。
6. 主要结论
1. 算法:提出 AHO(Approximate Hypergradient Optimization)算法,是首个在参数化连续空间双层 RL 中实现 Hessian-free 超梯度的方法;
2. 样本复杂度:在温和正则条件下达到 ,较 Gaur et al. (2025) 的 改进一个数量级;
3. 假设放宽:去除外层目标的 PL 条件假设,去除内层唯一极小解假设;
4. 实证:在 walker-walk 和 cheetah-run 上,AHO 的评估奖励均高于 Gaur et al. (2025) 的罚函数基线,与理论改进方向一致。
7. 优点
- 方法论亮点:
- 巧妙利用 Boltzmann 策略最优性的闭式表达,从根源上消去 Hessian 逆项,兼顾可扩展性与收敛性;
- 设计梯度平移值函数 作为 的可计算替代,突破了参数化策略非可实现带来的" 无可行递推"难题;
- 避免 近似外层梯度及其与采样误差的权衡,从根本上消除 退化来源。
- 理论贡献:
- 假设更弱(无需 PL / 唯一极小解);
- 提供完整的 Lipschitz / 总变差 / Quadratic Growth 分析,附录中包含完整证明链;
- 给出局部选择映射假设(Assumption 4.5),优雅地处理多极小值情形。
- 可扩展性:外层单步仅需一次反向传播通过 参数的奖励网络,远轻于 PARL 的 Hessian-vector 积。
8. 不足与局限
- 实验覆盖有限:仅 2 个 DM Control 任务、5 个种子,未报告更大规模任务(如 Humanoid)或真实人类偏好数据上的结果;缺乏消融实验(如对 、、 的影响分析);
- 理论适用范围受限:依赖熵正则化折扣 RL 设定与 Boltzmann 策略最优性,难以直接迁移到非正则化或多步博弈 RL; 作为常数假设,其对最终样本复杂度的影响需进一步澄清;
- 依赖可实现性的度量:算法收敛界含 项,依赖策略类丰富度;若策略类表达能力不足,残差项可能主导误差;
- 公平性疑议:未与 PARL 直接对比(作者解释为显存限制),但这削弱了对"Hessian-free 必要性"论点的直接支撑;基线只选 Hessian-free 的罚函数法,对其他 Hessian-free 算法(如 Yang et al., 2025 的有限空间方法)也未对比;
- 实现与代码:论文仅给出匿名链接(https://anonymous.4open.science/r/AHO-Bilevel-RL-DBE2/),可复现性需待社区验证;
- 奖励参数化固定:外层奖励采用固定 3×256 MLP 集成,对奖励模型结构变化(如更大网络、Transformer 编码)的鲁棒性未讨论。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。