
MANTA:面向自演化多智能体系统的多智能体网络拓扑自适应
MANTA: Multi-Agent Network Topology Adaptation for Self-Evolving Multi-Agent Systems
📝 TLDR
LLM多智能体系统通常将通信拓扑视为固定设计或离线优化目标,难以在推理时动态调整协作结构。MANTA提出多智能体网络拓扑自适应框架,执行前从先验结构经验初始化任务条件拓扑,部署中监测协作轨迹并施加有界结构更新,可在保持任务接口与智能体预算不变的前提下修改智能体角色、链路、执行顺序、信息可见性与验证路径。在五项基准上平均得分74.0,超越最强基线5.8个百分点,证明推理时自改进可延伸至协作架构本身。
🧭 速览
现有LLM多智能体系统将通信拓扑视为固定结构或离线优化目标,推理阶段无法自适应调整协作组织,限制了系统对复杂任务的处理能力。
MANTA分两阶段:执行前从先验结构经验初始化任务条件拓扑,部署时监测协作轨迹并施加有界结构更新,调整角色、链路、顺序、可见性与验证路径,保持任务接口与预算不变。
在信息检索、工具使用、规划、工作流执行、数学推理五项基准上平均得分74.0,超最强基线5.8个百分点,并在PlanCraft规划任务上取得最优。
推理时的自改进能力可延伸至多智能体系统的协作架构层面,验证了在线拓扑演化在保持接口与预算稳定下的可行性与有效性。
🆚 方法对比
MANTA
- 五个基准平均分74.0,超最强基线5.8个百分点
- 推理时可动态修改角色、通信链路与验证路径
- 跨任务迁移结构经验,无需权重更新或离线搜索
- 在PlanCraft上取得最佳结果
- 结构更新受代理预算约束,调整幅度受限
- 需监控协作轨迹,增加推理时计算开销
- 审计与突变机制设计复杂,依赖经验回放质量
- 拓扑搜索空间设计难度较高
AFlow
- 自动化工作流设计,减少人工拓扑设计成本
- 离线优化拓扑结构,计算开销可控
- 支持多类型算子组合,灵活性较好
- 拓扑在执行前固定,无法在线动态适应
- 缺乏对协作失败模式的实时修复机制
- 不能根据任务实例调整组织结构
- 对推理时新出现的问题响应不足
静态多智能体拓扑
- 结构与通信模式清晰,易于理解和调试
- 任务执行流程确定,行为可预测性强
- 实现复杂度低,部署成本较小
- 通信结构固定,缺乏任务自适应能力
- 面对失败时无法动态重组修复
- 不同任务间的结构复用性受限
- 无法根据中间结果调整协作策略
单智能体基线
- 无需协调开销,实现简单直接
- 单一推理链,无通信瓶颈与延迟
- 资源消耗低,部署门槛小
- 缺乏多视角验证,易出现单点错误
- 复杂任务分解与规划能力有限
- 无法利用多智能体协作互补优势
MANTA在推理时动态调整通信拓扑,相比AFlow等离线优化的自动化工作流方法及静态多智能体拓扑,能在执行中实时修复协作失败并迁移结构经验,在五个基准上平均提升5.8个百分点,验证了在线拓扑自适应的有效性。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 1 张)
展开查看 1 张图
TL;DR
MANTA 提出了一个让多智能体系统"边解题边改协作结构"的框架。在任务执行前,它根据历史经验生成一个适合当前问题的初始拓扑;执行过程中,它监控协作轨迹并判断是否需要调整——比如某个智能体信息不够、某段协作过早达成共识、或者缺少验证环节。实验在五个基准上达到平均 74.0 分,比最强基线高出 5.8 个百分点。这说明推理时的自我改进不仅可以在输出层面做文章,还能够延伸到协作架构本身。
研究背景与动机
基于大语言模型的多智能体系统近年来在复杂问题求解上展现出显著优势。这类系统通常通过任务分解让不同智能体各司其职,再通过信息交换和中间验证来逐步逼近正确答案。然而,一个关键的设计选择始终被默认固定下来——通信拓扑,也就是"谁跟谁说话、信息怎么流转、在哪里设置验证节点、如何控制每个智能体能看到什么"。
在 MANTA 之前,已有大量研究从不同层面探索 LLM 系统的自适应能力。Self-Refine 通过迭代优化输出、Reflexion 通过语言反馈修正推理轨迹、MetaGPT 通过预定义角色协议协调多智能体、AFlow 和 ADAS 等方法则试图在运行时优化工作流设计。这些工作覆盖了从输出层到推理轨迹、从提示工程到记忆管理的多个"自适应层级",但对协作结构本身的运行时调整始终是空白。
为什么会存在这个空白?因为改变通信拓扑比改变输出或提示要复杂得多。拓扑调整涉及智能体角色的重新分配、通信链路的增删、执行顺序的重排、信息可见性策略的修改,以及验证路径的插入或移除。这些操作必须保持任务接口不变——系统对外的输入输出格式不能乱;必须遵守智能体预算——不能无限增加计算资源;而且调整决策必须基于推理过程中的实时信号来做,不能事后诸葛亮。
MANTA 的核心问题由此而生:多智能体系统能否在解决单个任务的过程中,自适应地调整其通信拓扑? 这需要满足三个条件:实例条件化规划(每个任务生成专属拓扑)、基于中间协作轨迹的测试时拓扑变异,以及跨任务的拓扑经验迁移,同时完全不更新模型权重。
方法
MANTA 的整体架构由三层构成:最底层是目标多智能体系统——真正执行任务的智能体,负责推理、调用工具和交换消息;中间层是编排层,由多个 LLM 组件和确定性代码模块共同组成,负责规划、监控和修复拓扑;最上层是两层 playbook 记忆,分别记录当前运行的详细过程和跨任务累积的结构化经验。
先来看拓扑的表示方式。每个智能体同时具有结构角色和阶段角色。结构角色定义了智能体的长期职能——协调者(coordinator)负责分发任务和汇总结果、工作者(worker)执行具体子任务、验证者(verifier)检查中间结论、辩手(debater)提出反驳意见、投票者(voter)在多个方案中做选择。阶段角色则是任务进行到某个时刻时的临时职能,比如在某一轮可能处于工作者阶段,下一轮被标记为批评者(critic)。智能体归属于具有预定义交互结构的pattern group,组可以嵌套以支持子组委派——这就像一个公司可以有部门,部门下面还有小组。直接连接可以补充树形结构,为相邻但不在同一分支的智能体提供快速通信通道。每个智能体还配备上下文策略,精确控制它能看到哪些消息、由谁发送、附带哪些共享证据。
编排层的核心是三个 LLM 组件:Topology Planner、Trace Auditor 和 Skill Reflector,它们与一系列确定性代码模块协同工作。Planner 在任务开始前运行,仅接收任务描述和长期 playbook 中存储的历史经验,输出一个紧凑的 JSON 计划,其中包含推荐使用的交互模式、建议的智能体数量、是否需要验证器、以及是否需要嵌套子组。这个计划由确定性代码扩展为完整的拓扑,并经过校验确保没有冲突。Auditor 在每个协作轮次结束后运行,它扫描结构化的产物、工具调用记录、relay packet(智能体之间的通信包,包含答案、证据、自信度、未解决问题)、以及证据可见性记录。Auditor 可以追加新的过程标记,但被严格禁止查阅基准答案或判定最终正确性。当审计发现中等到高严重度的问题时,运行被标记为 flagged;否则为 clean。如果标记为 flagged,系统会触发修复——每次修复至多执行三个操作,包括向已有组添加智能体、将某个智能体扩展为嵌套子组的 hub、改变组的交互模式(如从星形变为辩论式)、增删通信边、或调整信息可见性策略。Reflector 则在每 12 次运行后触发,它分析长期 playbook 中积累的过程模式,将具体经验提炼为更高层的结构化知识——比如"当任务涉及多步检索时,星形拓扑比链形更稳定"、"长视野规划任务需要在中间插入验证节点"。
两层 playbook 记忆的设计非常关键。短期 playbook 记录当前运行中每一轮的拓扑状态、审计发现和修复决策,Planner 在规划下一轮时查阅它,就能知道已经尝试过哪些结构、产生了哪些异常、从而避免重复试错。长期 playbook 则存储跨运行累积的拓扑选择与修复经验,但遵循严格的写入规则:只使用过程信号(审计标记、工具调用模式、自信度分布),永远不接触基准答案。这就像一个从不偷看标准答案的聪明人,只通过观察解题过程中的"不对劲"来积累经验。
实验与结果
实验覆盖了五个不同类别的基准:BrowseComp 和 StableToolBench 考察信息检索与工具使用能力,前者要求多步信息合成、后者考验外部工具的选择与执行;PlanCraft 和 WorkBench 聚焦规划与工作流执行,考验长视野依赖感知和真实多步流程;MATH 则评估数学推理能力。每个基准 30 道题,每道题独立运行 3 次,所有方法统一使用 Gemma 4 31B 作为骨干模型。
对比基线非常全面。单智能体方法包括基础的 Single Agent、带思维链的 CoT、Self-Consistency 和 Self-Refine;静态多智能体工作流覆盖了投票、群聊辩论、全连接辩论、有无讨论环节的编排器、以及树形编排器;自适应方法则包括 AFlow、ADAS、AgentSquare 和 MASS。值得注意的是,MANTA 的最大初始智能体数限制为 5,修复后最多 10 个,变异次数每运行限 1 次,每次变异操作数上限 3 个——这些约束确保了对比的公平性。
主结果清晰地支持了 MANTA 的核心假设。在 BrowseComp 上 MANTA 达到 76.7%,StableToolBench 为 82.2%,PlanCraft 为 76.7%(全场最高),WorkBench 为 43.3%,MATH 为 91.1%,五项平均 74.0%,比最强基线 ADAS 的 68.2% 高出 5.8 个百分点。单智能体方法和静态多智能体工作流普遍落在 55%–65% 区间,自适应方法整体表现更好但仍未能突破 70%,而 MANTA 首次将平均分推到 74%。
消融研究揭示了各组件的贡献大小。去掉初始 Topology Planner(直接从默认星形拓扑开始)导致平均分从 71.7% 骤降至 57.5%,说明任务条件化的初始规划至关重要。去掉拓扑变异能力后降至 60.8%,表明执行过程中的在线调整能带来显著增益。冻结长期 playbook 的更新或完全移除它,分别导致 67.5% 和 66.7%,说明跨任务的经验迁移具有实际价值——尽管每次任务都独立规划新拓扑,但从历史经验中学习拓扑选择的general principle 仍然有帮助。
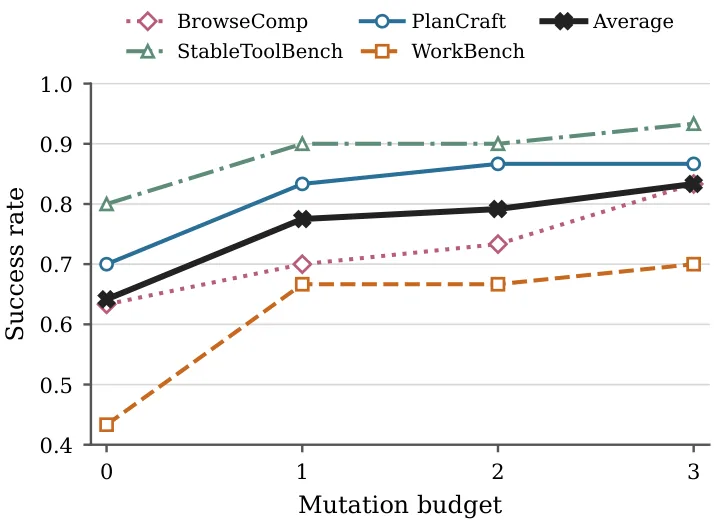
变异预算分析进一步显示了一个有趣的现象:在 0 到 3 次变异之间,成功率随着变异次数增加而提升,但大部分增益来自第一次变异。这说明大多数情况下系统能够在第一轮就识别出结构性问题并做出关键调整,后续变异更多是锦上添花。
审计信号的有效性也得到了验证。clean 审计(未发现问题)的运行最终正确率为 83.2%,而 flagged 审计(发现需要修复的问题)的运行仅为 62.5%,两者相差 20.7 个百分点。这个差距说明审计确实能捕捉到与最终正确性相关的过程异常,尽管相关性不等于因果性—— flagged 状态下系统会尝试修复,修复本身也可能引入新的问题。
一个反直觉的发现是:修复并不总是"增加更多智能体"。在 162 个修复操作中,添加全新智能体只占 9.3%,最常见的操作是改变组模式(27.2%)、扩展子组(20.4%)和确定性的检索收缩(42.0%)。这表明很多结构性问题可以通过重新组织已有智能体的协作方式来改善,无需消耗额外的计算预算。
讨论与可借鉴点
MANTA 的核心贡献在于确立了拓扑作为自改进的新层级。此前的研究已经探索了输出层面的优化(Self-Refine)、推理轨迹的修正(Reflexion)、提示的适应(MASS)、记忆的动态调整(MetaGPT),以及工作流的自动化设计(AFlow、ADAS)。MANTA 则表明,协作结构本身——谁与谁通信、信息怎么路由、在哪里验证——同样可以被纳入运行时自适应的范畴。这个发现为"推理时自我改进"这个研究方向开辟了新的设计空间。
工程层面,MANTA 的"LLM 推理 + 确定性代码校验"混合架构值得借鉴。Planner 和 Auditor 负责需要判断力的决策——什么样的任务需要什么样的拓扑结构、当前协作轨迹哪里不对劲;确定性代码则负责约束检查——校验拓扑合法性、确保修复操作不违反智能体预算、验证信息可见性策略的一致性。这种分工既利用了 LLM 的泛化推理能力,又以代码保证了关键不变量不被破坏,避免了完全依赖 LLM 可能带来的随机性问题。
审计-修复解耦的设计也有启发意义。Auditor 被禁止查阅基准答案,只能基于过程信号(自信度分布、工具调用模式、证据一致性)来判断是否需要修复。这意味着改进信号来自"解题过程看起来不对劲",而不是"答案和标准答案不一样"。虽然论文也承认这种信号的精确度可能被低估——比如 BrowseComp 上审计的假阳性率高达 0.90——但这个设计原则本身值得在更多场景中探索:能否完全基于过程观察来驱动自适应,而不需要依赖最终结果的反馈?
两层 playbook 记忆的分离设计同样有借鉴价值。短期记忆记录当前运行的详细轨迹,为在线调整提供上下文;长期记忆提炼高层次的拓扑选择原则,支持跨任务迁移。论文的实验表明,长期 playbook 在 PlanCraft 和 WorkBench 之间可以实现双向正迁移(各提升 3.3 个百分点),而其他自适应基线(ADAS、AgentSquare、MASS)的跨域迁移效果多为负或中性。这暗示 MANTA 学到的经验可能更接近"结构选择的一般原则"而非"特定任务类型的专属模式"。
当然,这项工作也存在局限。最明显的是骨干模型的单一性——所有实验都在 Gemma 4 31B 上进行,论文没有报告在其他模型(尤其是更大规模的闭源模型)上的泛化性。协作拓扑调整的效果可能与基础模型的推理能力相关,不同模型上可能呈现不同的收益曲线。此外,基准的样本量偏小(每基准 30 题、3 次运行),部分标准差较大,统计显著性需要更多验证。运行时开销虽然在 token 总量上表现优异(元层仅占推理预算的 12%),但 Planner 和 Auditor 的调用引入了额外的延迟步骤,对延迟敏感的实际部署场景需要单独评估。最后,MANTA 的适用场景目前集中在结构化任务(检索、工具使用、规划、工作流、数学),对开放对话、创意生成、多模态理解等更"模糊"的任务类型是否同样有效,仍是开放问题。
总体而言,MANTA 的价值不仅在于它自己的实验结果,更在于它提出的问题框架:多智能体系统的协作结构能否成为运行时自适应的对象?如果答案是肯定的,那么这个方向上还有大量值得探索的问题——什么样的任务类型最适合拓扑自适应?不同拓扑模式之间的转换有什么规律?能否将拓扑自适应与其他层面的自适应(输出优化、记忆管理)进行联合优化?这些问题为未来研究提供了丰富的探索空间。
摘要
基于大语言模型的多智能体系统通过任务分解、智能体分工、信息交换与中间验证来提升复杂问题的求解能力。然而,现有系统通常将通信拓扑视为固定的设计选择或离线优化的目标。我们提出MANTA——一个面向多智能体网络拓扑自适应的框架,使通信结构能够在推理时实现自演化。执行前,MANTA依据先前的结构经验初始化一个任务条件化的拓扑;部署期间,它监控协作轨迹,并在当前组织结构不再充分时施加有界的结构更新。这些更新可在保持任务接口和智能体预算不变的前提下,修改智能体角色、通信链接、执行顺序、信息可见性与验证路径。我们在涵盖信息检索、工具使用、规划、工作流执行和数学推理的五个基准上,将MANTA与代表性的单智能体和多智能体基线方法进行了对比。MANTA取得了74.0的最高平均分,较最强基线高出5.8个百分点,并在PlanCraft上获得了最佳结果。这些结果表明,推理时的自我改进可以延伸至协作架构本身。
Abstract
Large language model-based multi-agent systems improve complex problem solving through task decomposition, agent specialization, information exchange, and intermediate validation. However, existing systems typically treat communication topology as a fixed design choice or an offline optimization target. We introduce MANTA, a framework for Multi-Agent Network Topology Adaptation that enables communication structures to self-evolve at inference time. Before execution, MANTA initializes a task-conditioned topology from prior structural experience. During deployment, it monitors collaboration traces and applies bounded structural updates when the current organization becomes insufficient. These updates can modify agent roles, communication links, execution order, information visibility, and validation pathways while preserving the task interface and agent budget. We evaluate MANTA against representative single-agent and multi-agent baselines on five benchmarks spanning information seeking, tool use, planning, workflow execution, and mathematical reasoning. MANTA achieves the highest average score of 74.0, outperforming the strongest baseline by 5.8 percentage points and obtaining the best result on PlanCraft. These results show that inference-time self-improvement can extend to the architecture of collaboration itself.
论文详细总结(自动生成)
MANTA 论文总结
一、核心问题与研究动机
基于 LLM 的多智能体系统通过任务分解、角色分工、信息交换和中间验证提升复杂问题求解能力,但其通信拓扑(谁与谁通信、信息如何路由、在哪里验证、如何精炼中间输出)目前多被作为固定设计选择或离线优化目标。现有自改进方法(Self-Refine、Reflexion、MetaGPT、AFlow、ADAS、MASS 等)多在输出、提示、推理轨迹、记忆、技能、角色、权重等层面做适应(图 1 中的 L0–L7),但对多智能体协作结构本身的运行时自适应仍研究不足。
论文提出的核心问题是:多智能体系统能否在解决单个任务的过程中,自适应地调整其通信拓扑? 该问题需要满足:实例条件规划、基于中间协作轨迹的测试时拓扑变异、跨任务的拓扑经验迁移,且不更新模型权重。
二、方法论
2.1 总体框架
MANTA 由三层结构组成:
- 目标多智能体系统:完成任务智能体,负责推理、工具调用与消息交换。
- 编排层:包含三个 LLM 组件——Topology Planner(拓扑规划器)、Trace Auditor(轨迹审计器)、Skill Reflector(技能反思器),以及用于拓扑验证、消息路由、控制修复、停机决策的确定性代码。
- 两层记忆:短期 playbook(记录当前运行的每轮拓扑、审计发现与决策)与长期 playbook(跨运行累积的拓扑选择与修复经验)。
2.2 拓扑表示
每个智能体具有结构角色(coordinator、worker、verifier、debater、voter)与阶段角色(worker 或 critic)。智能体归属于具有预定义交互结构的 pattern group,组可嵌套以支持子组委派;直接连接可补充树形结构。每个智能体具备上下文策略,控制可见消息、发送者、共享证据的访问范围。执行前 MANTA 校验组成员、附属环、角色与智能体预算。
2.3 编排循环
查询条件化规划:Planner 仅接收任务与经验记忆,输出包含交互模式、智能体数量、可选验证器与嵌套子组的紧凑 JSON 计划,由确定性代码扩展为完整拓扑并校验。
轮次执行:每个协作轮次按组结构递归执行;智能体通过结构化 relay packet(含答案、证据、自信度、未解决问题)通信;共享上下文控制器强制可见性策略;相同工具调用去重;append-only 证据账本保留所有分支的声明与证据。
轨迹审计与修复:LLM Auditor 扫描结构化产物、工具记录、relay packets、自信度、未解决问题与证据可见性;可追加新的过程标记,但不得查阅基准答案或判定。当审计建议修复(至少一个可修复标记为中/高严重度)时,运行被标记为 flagged;否则为 clean。每次修复至多 3 个操作(添加/扩展智能体、改变 group pattern、编辑通信边、调整信息可见性),由确定性代码校验后应用。
2.4 两层 Playbook 记忆
- 短期 playbook:记录当前运行每轮的拓扑、审计标记、推荐修复与决策,Planner 据此了解已尝试的结构及产生的异常。
- 长期 playbook:存储任务特征与过程风险到拓扑选择的一般原则。Skill Reflector 每 次运行重写一次;仅使用过程信号,永不接触基准答案。
2.5 关键配置
| 参数 | 值 |
|---|---|
| 最大初始智能体数 | 5 |
| 修复后最大智能体总数 | 10 |
| 每运行拓扑变异次数 | 1 |
| 每次变异操作数上限 | 3 |
| 根交互模式 | singleton, star, chain, debate, voting |
| 元智能体温度 | 0.0 |
| 长期 playbook 反思批大小 | 12 次运行 |
2.6 拓扑变异算子
| 算子 | 效果 |
|---|---|
add_agent | 向已存在组添加一个智能体(指定结构角色与阶段角色) |
expand_agent_to_group | 将一个智能体变为嵌套子组的 hub |
set_group_pattern | 改变已有组的交互模式(如 star→debate, star→chain) |
add_edge / remove_edge | 添加/移除两个智能体间的直接通信链接 |
set_context_policy | 调整智能体的信息可见性 |
三、实验设计
3.1 数据集与基准
实验覆盖三类共 5 个基准,每基准 30 题、3 次独立运行:
| 类别 | 基准 | 评估能力 |
|---|---|---|
| 信息检索与工具使用 | BrowseComp | 多步信息检索与证据合成 |
| 信息检索与工具使用 | StableToolBench | 外部工具选择与执行可靠性 |
| 规划与工作流执行 | PlanCraft | 长视野规划与依赖感知动作排序 |
| 规划与工作流执行 | WorkBench | 真实多步工作流 |
| 推理 | MATH | 结构化数学推理 |
3.2 基线方法
- 单智能体方法:Single Agent、CoT、Self-Consistency、Self-Refine。
- 静态多智能体工作流:Voting、Group Chat Debate、Fully Linked Debate、Orchestrator w/o Discussion、Orchestrator w/ Discussion、Orchestrator Tree Structure。
- 自适应智能体系统设计方法:AFlow、ADAS、AgentSquare、MASS。
所有方法以 Gemma 4 31B(中等推理强度) 为骨干,所有多智能体方法限定相同最大智能体数与可比推理预算。
3.3 主结果
主结果(表 1)按信息检索/工具使用、规划/工作流执行、推理、平均分四列报告成功率():
MANTA 在 PlanCraft 取得最优,在 5 项平均上较最强基线(ADAS )高出 个百分点。
四、资源与算力
论文未明确报告 GPU 型号、数量、训练时长等算力细节。仅指出:
- 所有方法使用 Gemma 4 31B 作为骨干。
- 元智能体(Planner、Auditor、Reflector)与任务智能体使用同一骨干,温度为 0。
- 报告了各方法的 token 开销(表 4),MANTA 在多智能体方法中 token 总消耗最低(均值约 77,652/运行)。
五、实验数量与充分性
论文包含较丰富的实验组合:
1. 主结果实验:5 个基准 × 19 种方法 × 30 题 × 3 次运行,对比基线较完整。
2. 消融研究(表 2,4 个基准平均):
- 去除初始 Topology Planner → 71.7% 降至 57.5%。
- 去除拓扑变异 → 降至 60.8%。
- 冻结长期 playbook 更新 → 67.5%。
- 移除长期 playbook → 66.7%。
3. 变异预算分析(图 4):4 个基准上 budget 的成功率。
4. 长期 playbook 可迁移性(表 3):in-domain 与 cross-domain(PlanCraft↔WorkBench)迁移对比,对比 ADAS、AgentSquare、MASS。
5. Token 使用分析(表 4):对比 offline/inference/total token 消耗。
6. 拓扑演化案例研究(图 3、5、6):分支扩展、验证/序列化修复、重连边与插入 critic 五类具体修复。
7. 轨迹审计统计(表 8–11):450 次运行的审计-正确性关系、过程模式与成功率的关联、修复算子分布。
公平性方面,作者控制了最大智能体数与推理预算;优化基线(AFlow、ADAS、AgentSquare、MASS)尽量匹配搜索预算。但所有方法共享 Gemma 4 31B 单骨干,结果是否在其他骨干上泛化未充分验证。
六、主要结论与发现
1. 拓扑可作为新的自改进层级(L6):在线调整协作结构相比离线搜索或固定拓扑能带来显著增益。
2. MANTA 平均分 74.0,5 项基准上稳定优于单智能体、静态多智能体及自动化工作流设计基线。
3. 任务条件初始规划贡献最大(消融降幅最大),执行时修复与跨运行经验提供补充增益。
4. 首次变异捕获大部分收益,更多变异(至 3 次)扩展任务覆盖。
5. 长期 playbook 可跨基准迁移(PlanCraft→WorkBench 与反向均正增益,+3.3),而 ADAS/AgentSquare/MASS 跨域迁移多为负或中性。
6. MANTA token 效率最高:在多智能体方法中整体 token 消耗最低,元层仅约占推理预算的 12%。
7. 修复不总是"加智能体":在 162 个修复操作中,添加新智能体仅占 9.3%,更常见的是改变组模式(27.2%)、扩展子组(20.4%)或确定性检索收缩(42.0%)。
8. 审计信号有效:clean 审计的运行正确率 83.2%,flagged 运行仅 62.5%;audit 标记与最终正确率存在 20.7 点的相关性。
七、优点
- 问题新颖:明确提出"通信拓扑自改进"作为一个独立层级,区别于输出/提示/记忆/角色/权重层面的适应。
- 架构层次清晰:Planner-Auditor-Reflector 与确定性代码的组合既利用 LLM 推理能力,又以代码保证拓扑约束、信息可见性、修复验证等关键不变量。
- 审计过程解耦:Auditor 不接触基准答案,仅基于过程信号评估;这一设计使过程改进可独立于答案正确性学习。
- 两层记忆机制:短期 playbook 提供当前运行的逐步信息,长期 playbook 提供跨任务的可复用经验,并通过严格的过程信号过滤写入条件(决策级共识)防止记忆污染。
- 修复算子设计贴近实际故障:分支扩展、序列化、重连边、插入 critic 对应的故障模式(工具错误流、重复状态改变、过早共识、缺失验证)均明确。
- 跨域迁移正增益:长期 playbook 在 PlanCraft↔WorkBench 双向迁移均提升,区别于其他基线。
- token 高效:在多智能体方法中消耗最低。
- 报告详尽:包含审计统计、算子使用分布、案例研究、token 开销等丰富的辅助分析。
八、不足与局限
1. 算力信息缺失:未报告 GPU 型号、数量、训练/推理时长,复现成本难以估算。
2. 骨干单一:所有实验仅在 Gemma 4 31B 上进行,结果对其他骨干(特别是闭源或更大模型)的泛化性未知。
3. 基准样本量有限:每基准仅 30 题、3 次运行,标准差相对较大(部分达 9.6–15.7),统计显著性需更多样本验证。
4. 审计正确性标签不可解释为真实的过程缺陷标注:论文明确指出 F1/精度等以"答案错误"为正类,并非人工标注的过程缺陷 ground truth;因此审计的精确度可能被低估(如 BrowseComp 的 FPR=0.90)。
5. 修复范围受限:每运行至多 1 次变异、每次至多 3 个操作;对结构性更深层缺陷可能不足。
6. 运行时开销:尽管 token 总量较低,但元层 Planner/Auditor/Reflector 带来额外推理步骤与延迟,对延迟敏感场景的部署性需进一步评估。
7. 依赖过程信号而非反馈:长期 playbook 完全依赖过程信号;当下一次任务的失败模式与历史模式不同时,规划可能缺乏有效引导。
8. 应用域限制:实验聚焦检索、工具使用、规划、工作流、数学推理,对开放对话、创意生成、多模态等任务类型的适用性未验证。
9. 审计建议注入方式:审计的修复建议作为"显式不受信诊断"注入修复后所有阶段指令,存在被智能体误信或忽视的风险,需要更系统的鲁棒性测试。
10. 检索收缩启发式:对检索密集型任务采用确定性的"挑出调用最多的非协调者→单例化→全局证据"策略,虽然实用,但可能错过更优的检索重构方案。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。