
LEEPS:基于潜在引导的探索-利用提示采样,用于大语言模型的高效强化学习可验证奖励训练
LEEPS: Latent-Guided Explore-Exploit Prompt Sampling for Efficient RLVR in Large Language Models
📝 TLDR
在RLVR训练大语言模型推理能力时,相同rollout奖励的提示词浪费生成预算。现有预轮次选择方法难以兼顾利用与探索,要么训练覆盖窄,要么有效提示比例低。LEEPS通过潜在空间引导将提示划分为利用集与探索集,依据非平凡比例自适应分配预算,并利用表征近邻与历史结果优先采样不确定性提示。在六个数学推理基准上取得最高平均分,1.5B与7B模型分别获得2.6%和3.7%的相对提升。
🧭 速览
RLVR训练中相同rollout奖励的提示词消耗预算却不产生学习信号,现有预筛选方法难以同时兼顾利用与探索。
LEEPS将候选提示分为利用集与探索集,根据近期非平凡比例自适应分配预算,并借助表征近邻和历史结果优先选择不确定性高、可能产生非零奖励方差的提示。
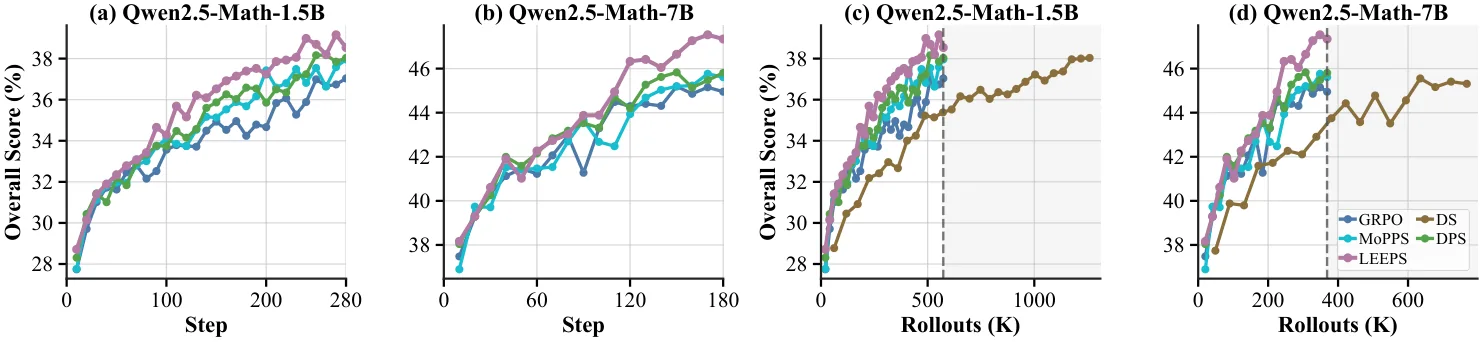
在六个数学推理基准上取得最高平均分,Qwen2.5-Math-1.5B与7B相对最强基线分别提升2.6%和3.7%,三个OOD通用推理基准也达到最高分,每步仅增加约2秒开销。
LEEPS在几乎不增加额外成本的前提下提升了RLVR训练的样本效率,为强化学习中的提示采样提供了平衡利用与探索的有效策略。
🆚 方法对比
暂未生成 — 点击下方按钮
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 12 张)
展开查看 12 张图
TL;DR
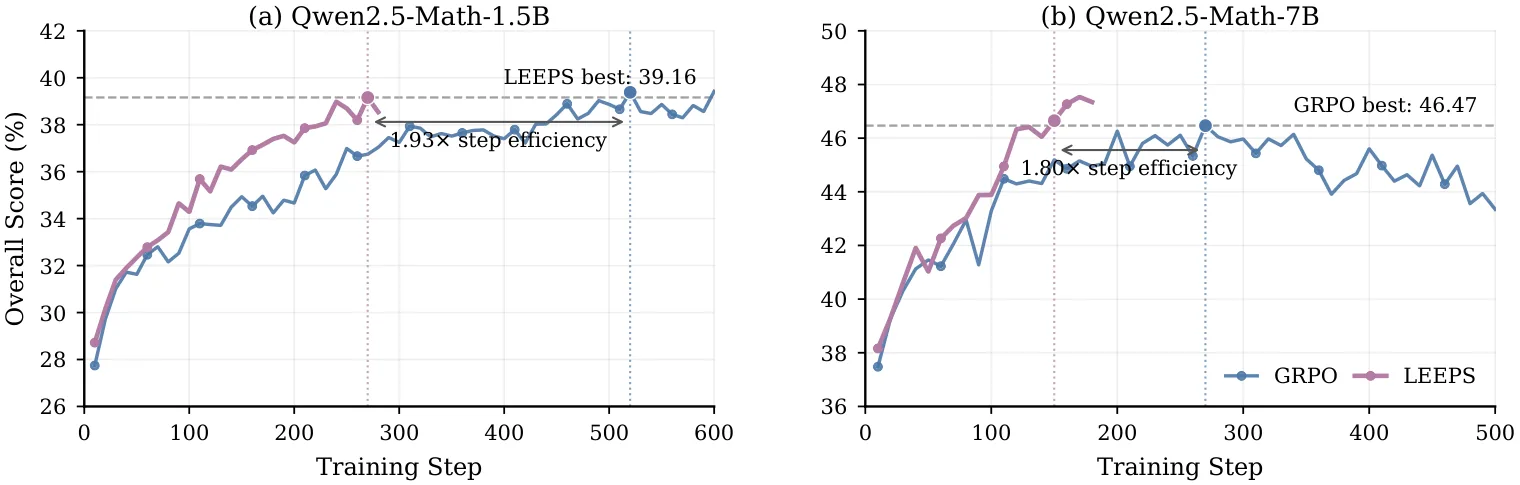
LEEPS 针对大语言模型 [[RLVR]] 训练中零方差 rollout 组的计算浪费问题,提出一种基于潜在空间引导的探索-利用提示采样器,通过自适应分配探索与利用组合的预算,并利用表征近邻预测提示难度,在无需额外 rollout 的前提下实现了高非平凡比例与广覆盖的兼顾。在六个数学推理基准上,LEEPS 相对最强基线在 1.5B 和 7B 模型上分别取得 2.6% 和 3.7% 的相对提升,同时训练步效率提升约 1.8-1.9 倍。
研究背景与动机
基于可验证奖励的强化学习已成为提升大语言模型推理能力的关键后训练范式。在 [[GRPO]] 等方法中,系统会为每个提示生成多个响应并计算组内相对优势来指导策略更新。然而,当一个提示对应的所有响应都获得相同奖励时——比如全部答对或全部答错——组内优势将全部为零。这意味着虽然消耗了大量生成预算去采样这些响应,但它们实际上没有提供任何学习信号。这类提示在论文中被称为"平凡提示",对应的 rollout 组则称为"零方差组"。
问题的严重性在于,零方差组在训练过程中并非罕见现象。研究者发现,如果不加干预,许多提示会在训练中期陷入"全对"或"全错"的状态,导致大量计算资源被浪费在毫无贡献的 rollout 上。已有的应对策略主要分为两类:在线过滤方法如 DS 在 rollout 完成后检测零方差组并丢弃,虽然有效但需要对候选提示额外执行完整 rollout 才能决定是否使用,计算开销巨大;预筛选方法如 DPS 和 MoPPS 则尝试在 rollout 之前就选择有潜力的提示,但这些方法在利用与探索之间存在明显的权衡困境——反复选择历史上表现"有信息量"的提示会严重收窄训练覆盖范围,而更广泛地探索新提示又会导致批次中有信息量提示的比例偏低。
这一困境的核心在于:模型需要持续接触有挑战性的提示以获取有效的学习信号,但同时也需要探索广泛的提示空间以确保泛化能力。LEEPS 的出发点正是要在不需要额外 rollout 的前提下,找到一种机制能够自适应地平衡这两个目标。
方法
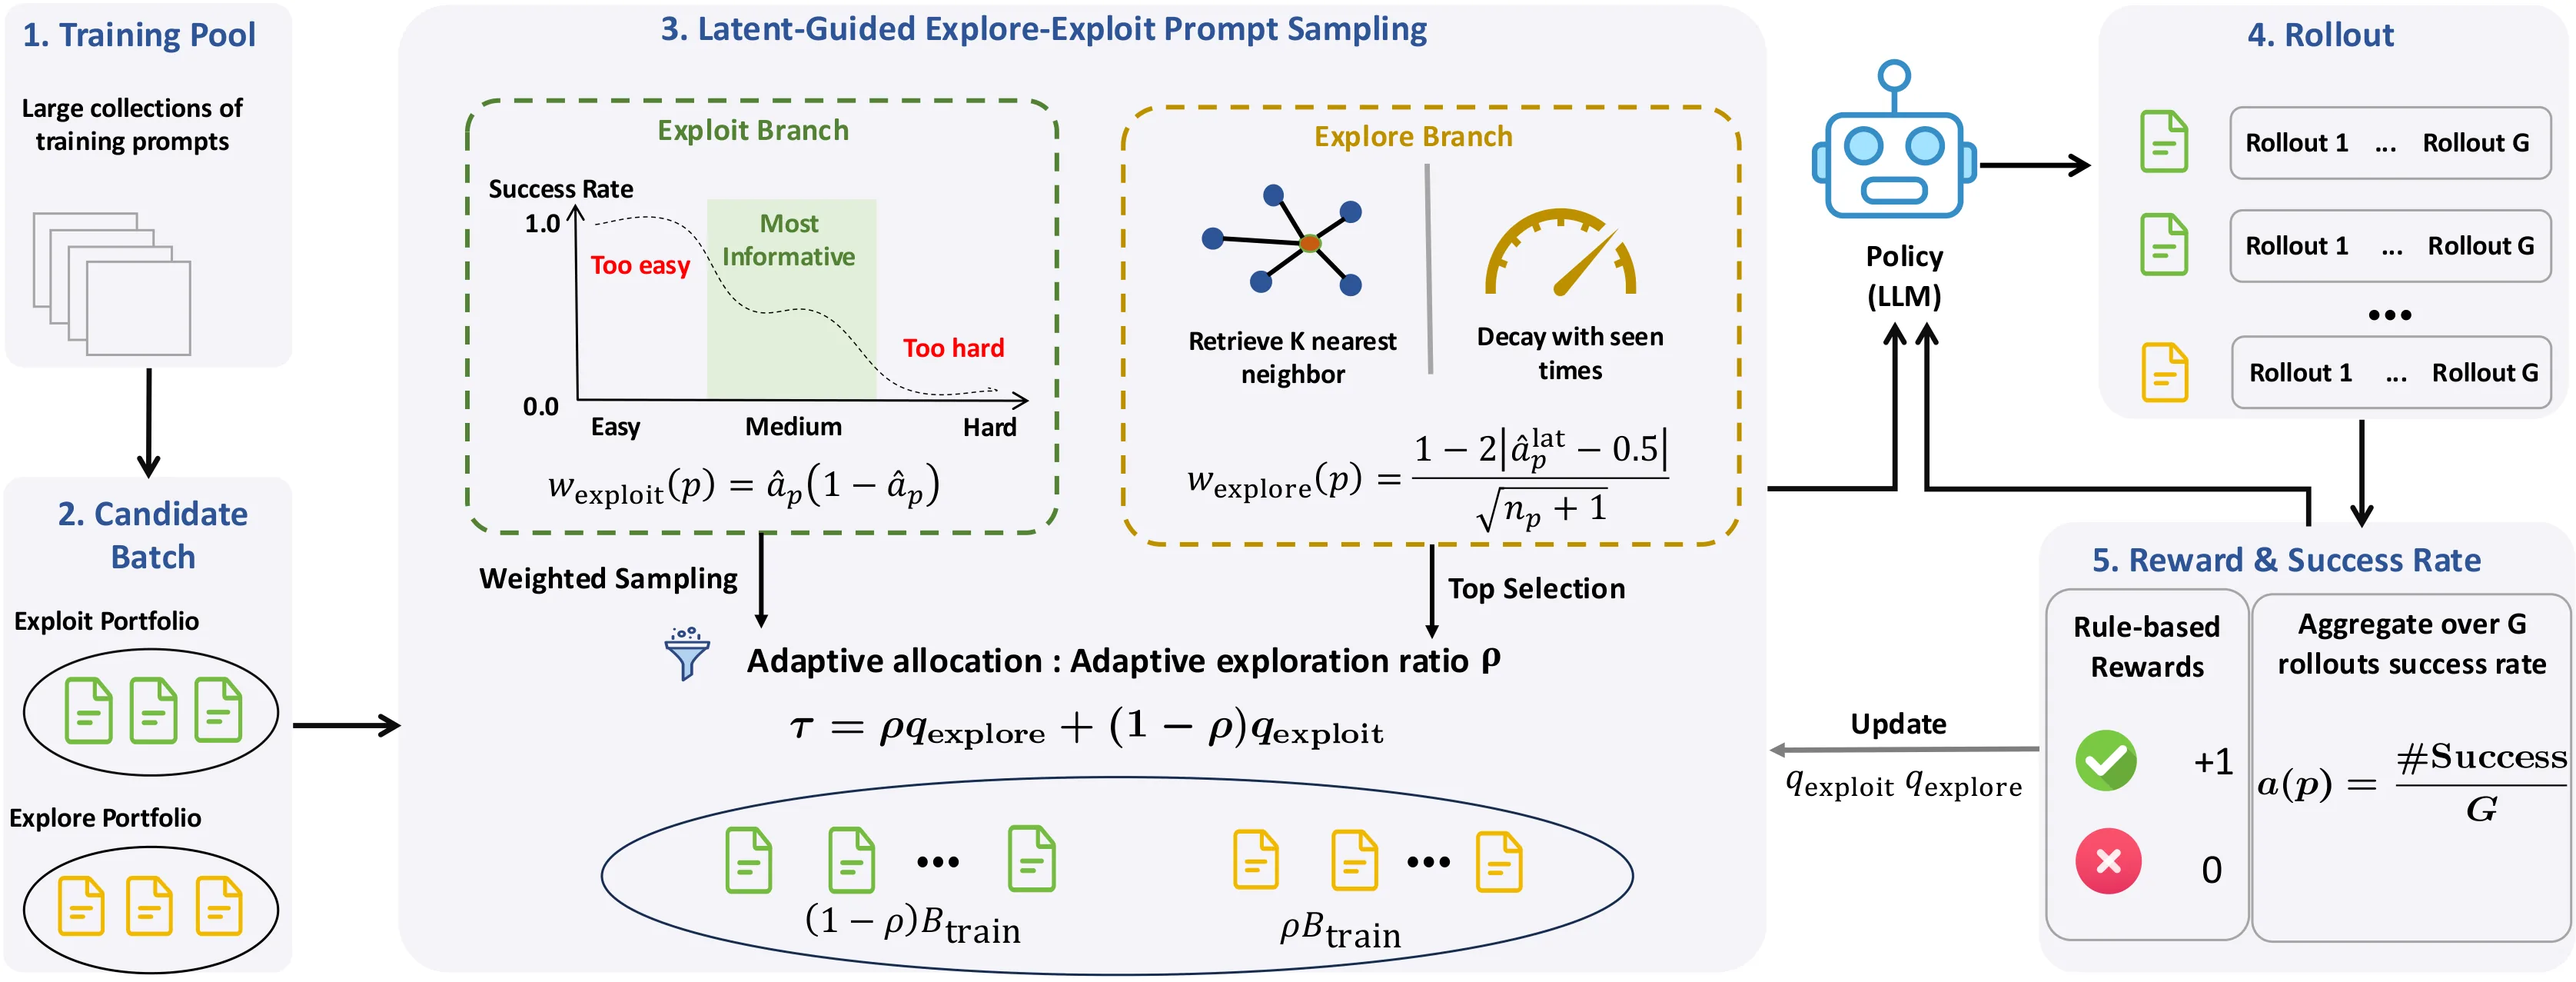
LEEPS 的核心思路是将候选提示划分为两个组合,并依据它们的近期表现动态分配训练预算。第一个组合称为"利用集",包含那些在历史 rollout 中已经产生非零奖励方差的提示——这些提示的难度恰好处于"有时对有时错"的甜蜜区间,是最有效的学习信号来源。第二个组合称为"探索集",包含从未被选中过的提示以及最近产生了零方差组的提示,这些提示的不确定性最高,值得投入资源去探明其真实难度。
对于利用集中的每个提示,LEEPS 采用伯努利方差作为采样权重,其形式为 ,其中 是该提示的历史成功率。这个权重的数学性质保证了中等难度的提示(成功率约 50%)会获得最高的采样优先级,因为它们产生非平凡优势的概率最大。对于探索集中的提示,权重则综合考虑了基于潜在空间的难度估计与探索频率的衰减因子,使得近期被探索过的提示权重逐渐降低,从而引导采样更多地去覆盖尚未被充分了解的提示。
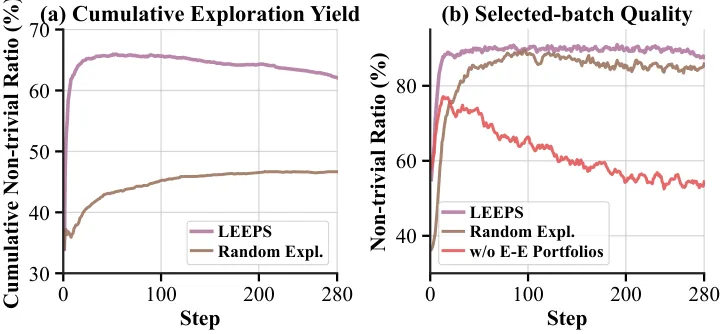
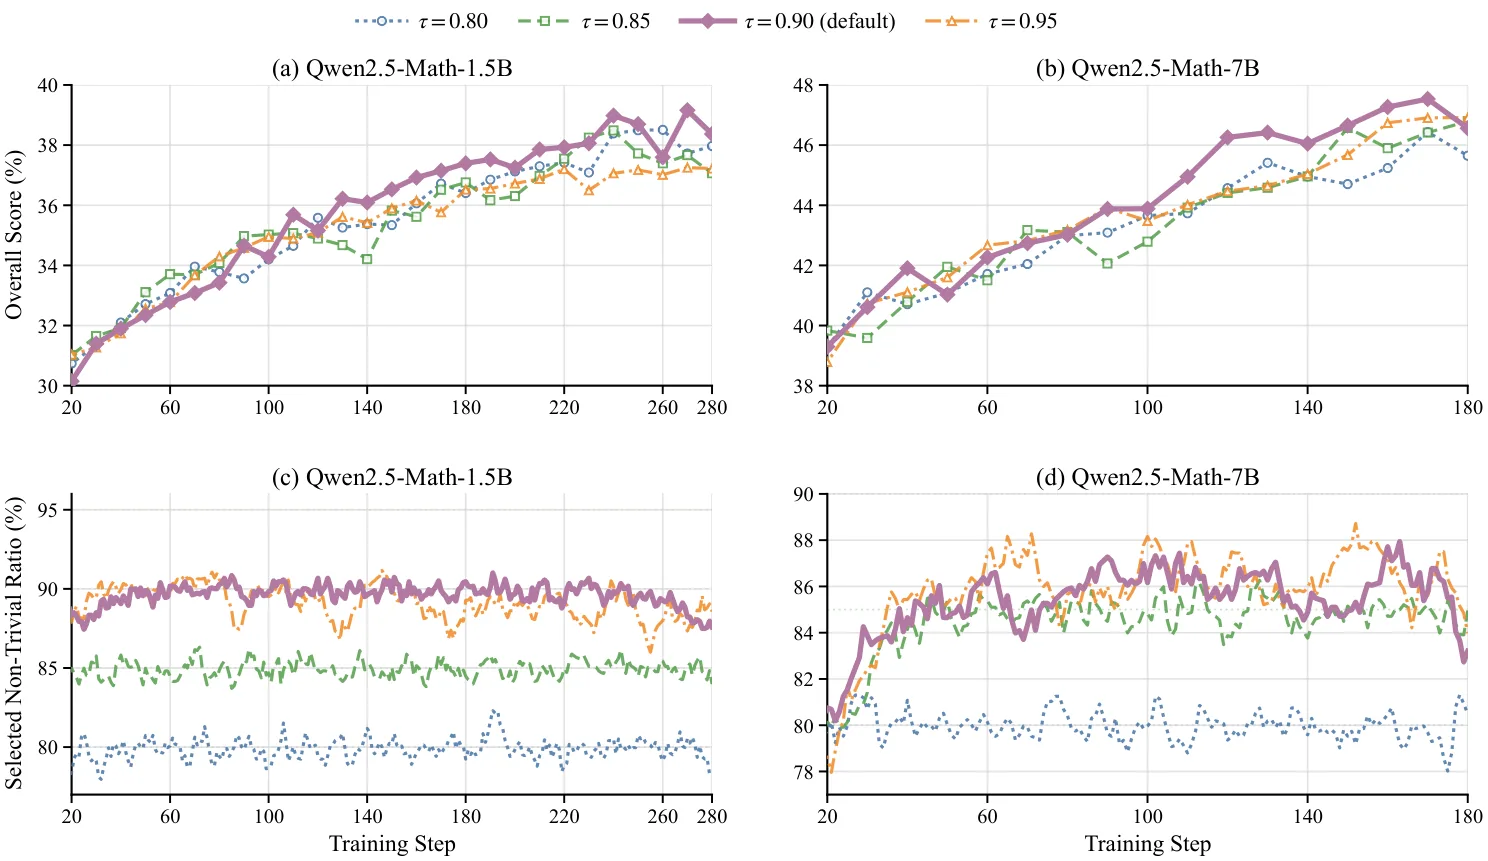
在预算分配层面,LEEPS 并不采用固定的探索-利用比例,而是根据两个组合的近期非平凡比率来自适应调整。具体而言,如果探索集最近产生的非平凡 rollout 比例偏低,系统会自动减少分配给探索组合的预算份额,转而增加利用集的权重;反之亦然。这种动态调节机制使得训练批次的期望非平凡比例能够稳定在预设的目标值附近(默认为 0.90)。
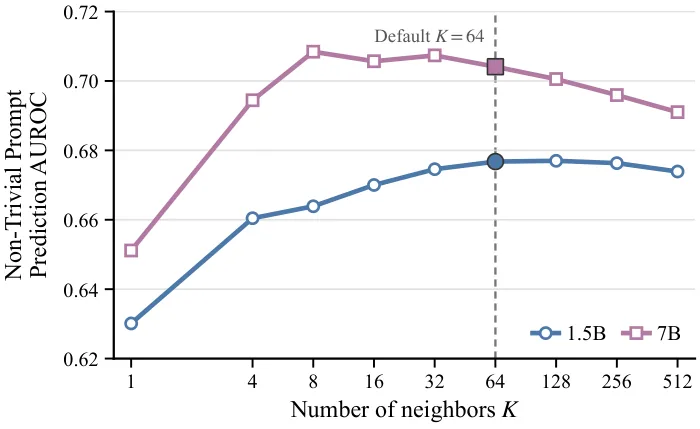
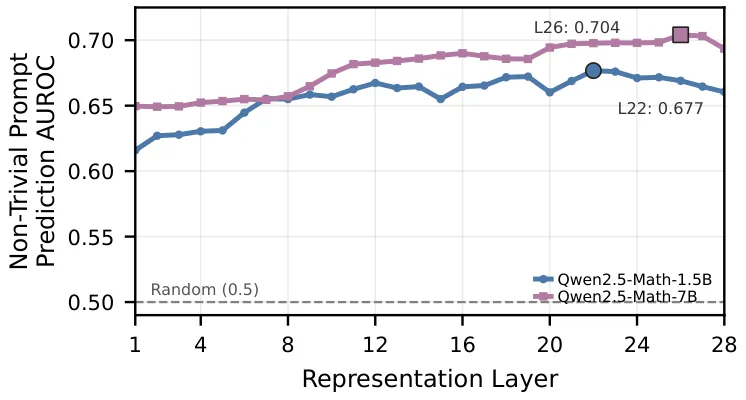
潜在引导是 LEEPS 区别于其他预筛选方法的关键创新点。系统会预先提取每个提示在模型特定隐藏层的表征向量,并利用这些表征来估计探索集中提示的潜在难度。具体做法是:找到与目标提示在表征空间中距离最近的 K 个已知结果的邻居,然后通过相似度加权的投票机制来预测该提示的成功率。这种方法的有效性建立在模型隐藏层能够隐式编码任务难度的假设之上——实验验证显示,在足够深的层(如 1.5B 模型第 22 层、7B 模型第 26 层),这种基于表征的预测可以达到约 0.70 的 AUROC,显著优于随机猜测。
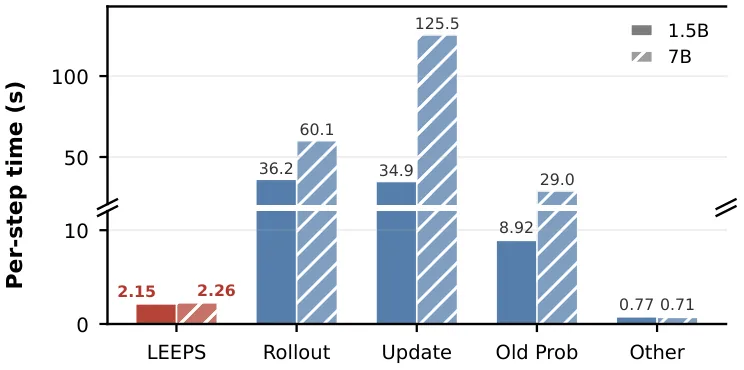
整个采样流程的设计追求实现上的轻量化:表征近邻只需在训练前一次性预计算并缓存,运行时每步仅需进行相似度查询和简单的统计更新,增加的在线开销约为 2 秒,相对于每步 36-125 秒的总训练时间可以忽略不计。
实验与结果
研究团队在 Qwen2.5-Math-1.5B 和 Qwen2.5-Math-7B 两个规模的模型上进行了全面的实验评估。训练数据采用 DAPO-Math-17K 包含约 17.9K 道数学题,域内评估涵盖六个数学推理基准,包括 MATH-500、Minerva-Math、OlympiadBench 以及 AMC23、AIME24、AIME25 等竞赛题目,域外评估则使用了 GPQA-Diamond、ARC-Challenge 和 MMLU-Pro 三个通用推理数据集。
实验结果表明,LEEPS 在所有评估场景下均取得了最高平均分。在 1.5B 模型上,LEEPS 的平均得分为 39.16,相比最强基线 DPS 的 38.17 提升 2.6%;在 7B 模型上,LEEPS 的平均得分达到 47.53,相比最强基线的 45.83 提升 3.7%。值得注意的是,这些提升是在使用相同 rollout 预算的前提下实现的,而 DS 作为对比的在线过滤方法实际上需要额外消耗约 2.2 倍的 rollout 预算才能达到可比效果。
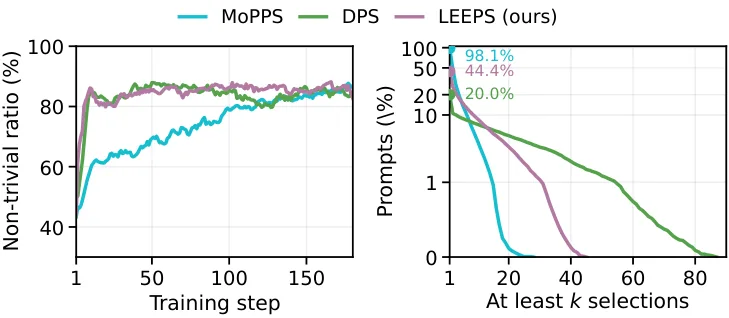
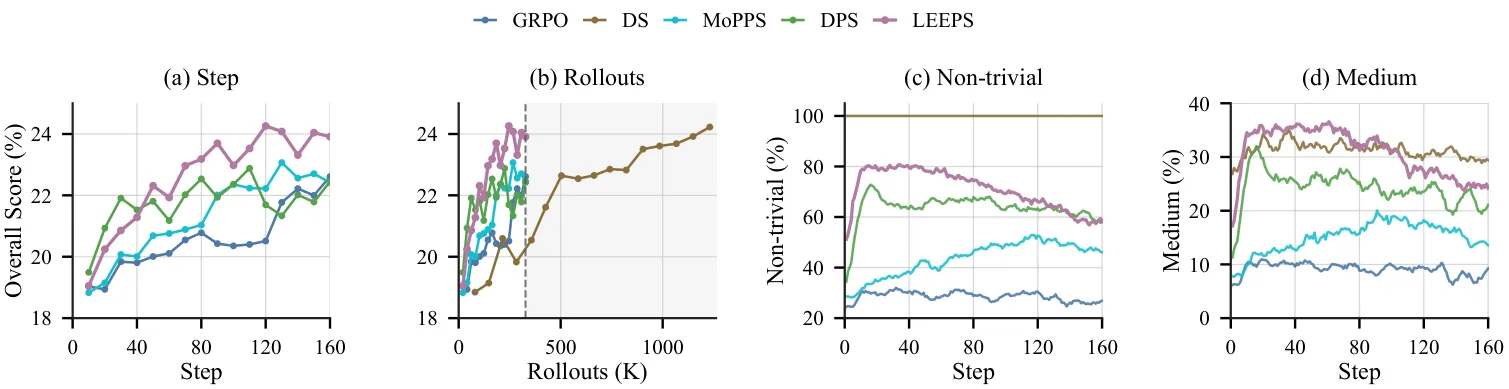
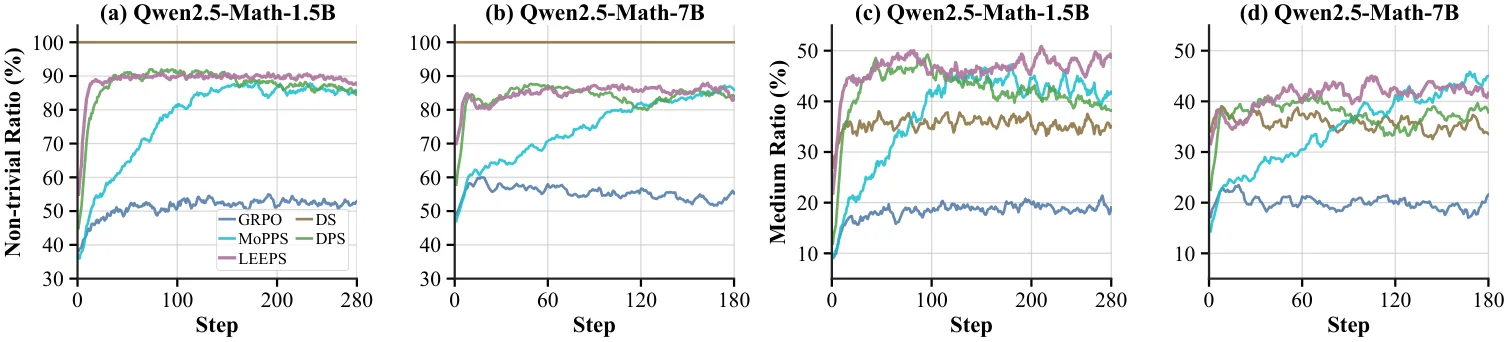
更关键的诊断指标是训练效率。论文详细追踪了训练过程中有效学习信号的变化:LEEPS 维持的非平凡比例稳定在 90% 以上,同时 prompt 覆盖率高达 98.1%,远高于 DPS 的 20.0% 和 MoPPS 的 44.4%。这意味着 LEEPS 既不会浪费大量资源在零方差 rollout 上,也不会因为过度集中而限制模型的训练覆盖。从步效率来看,LEEPS 在 1.5B 模型上实现了 1.93 倍的效率提升,在 7B 模型上实现 1.80 倍的效率提升。消融实验进一步揭示了各组件的贡献:自适应组合分配机制贡献最大,去除后 7B 模型性能下降 4.8%;潜在引导探索次之,随机替换后 1.5B 模型性能下降 4.2%。
讨论与可借鉴点
LEEPS 的成功揭示了 [[RLVR]] 训练中一个被低估的效率瓶颈——零方差 rollout 组的累积浪费。通过在 rollout 之前就预测提示的信息量潜力而非事后检测,系统能够更高效地配置计算资源。这一思路对于其他需要大量采样的强化学习训练场景具有启发意义:在采样成本高昂的领域,如何利用历史信息提前判断样本的潜在价值,是一个值得深挖的方向。
论文的另一贡献在于对探索-利用权衡的精细化处理。将提示明确划分为利用集与探索集,并根据实时统计动态调整预算分配,这种组合式的设计比单一策略更灵活且易于调优。潜在引导探索的引入则展示了一个重要的工程权衡——用适度的离线计算(一次性提取并缓存表征近邻)来换取运行时的智能采样决策,这种"前期投入换取长期收益"的模式在生产级训练系统中尤为实用。
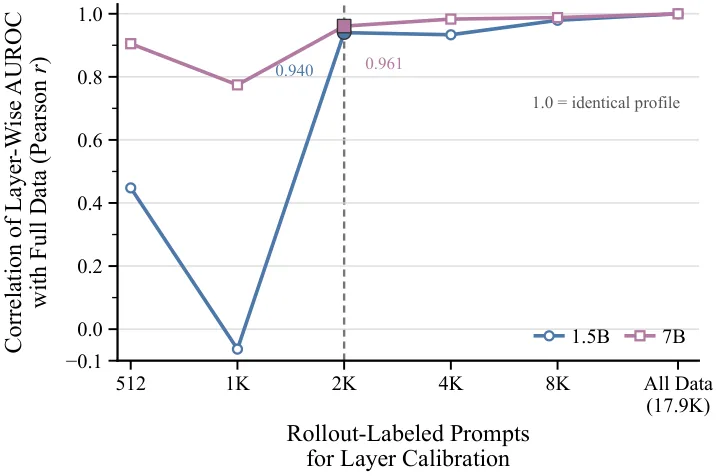
当前方法的局限也值得关注。首先,表征层的选择依赖于离线诊断实验,虽然论文证明 2048 个 prompt 的样本量足以稳定选择,但在训练过程中策略不断演化的场景下,这种静态选择是否始终最优尚不明确。其次,潜在引导的有效性建立在模型隐藏层编码任务难度的假设之上,对于某些架构或任务类型,这一假设可能不成立。最后,论文聚焦于数学推理这一特定领域,其在代码生成、开放域问答等其他 RLVR 适用场景的效果还需要进一步验证。
摘要
基于可验证奖励的强化学习(RLVR)能够提升大语言模型的推理能力,但具有相同 rollout 奖励的提示组会消耗生成预算却无法提供有效的学习信号。Rollout 前的提示选择可以通过在 rollout 生成前筛选提示来减少这种浪费。然而,现有的 rollout 前方法难以在利用与探索之间取得平衡:反复利用历史上有信息量的提示会缩小训练覆盖范围,而更广泛的探索则会降低有信息量提示的占比。为应对这些局限,我们提出了 LEEPS,一种基于潜在引导的探索-利用提示采样器,能够自适应地平衡对先前观测到的有信息量提示的复用与对不确定提示的持续探索。LEEPS 将候选提示划分为利用组合与探索组合,并根据其近期非平凡比率自适应地分配 rollout 预算。它进一步利用表征空间中的近邻与历史 rollout 结果来优先选择那些可能产生非零奖励方差的不确定提示,从而使探索更具针对性而无需额外 rollout。在六个数学推理基准上,LEEPS 在两种模型规模下均达到了最高平均分,相对于最强基线在 Qwen2.5-Math-1.5B 和 7B 上分别取得了 2.6% 和 3.7% 的相对提升,并且在训练过程中通常收敛更快。它在三个评估的 OOD 通用推理基准上于两种模型规模下也取得了最高平均分,且每个训练步骤仅增加约 2 秒的在线采样开销。代码已开源:https://github.com/ShuangLiangX/LEEPS。
Abstract
Reinforcement learning with verifiable rewards (RLVR) improves the reasoning capabilities of large language models, but prompt groups with identical rollout rewards consume generation budget without effective learning signals. Pre-rollout prompt selection can reduce this waste by screening prompts before rollout generation. However, existing pre-rollout methods struggle to balance exploitation and exploration: repeatedly exploiting historically informative prompts can narrow training coverage, whereas broader exploration can lower the fraction of informative prompts. To address these limitations, we introduce LEEPS, a Latent-Guided Explore--Exploit Prompt Sampler that adaptively balances the reuse of previously observed informative prompts with continued exploration of uncertain ones. LEEPS partitions candidates into exploit and explore portfolios and adaptively allocates rollout budget according to their recent non-trivial ratios. It further uses representation-space neighbors and historical rollout outcomes to prioritize uncertain prompts likely to yield non-zero reward variance, thereby making exploration more targeted without additional rollouts. Across six mathematical reasoning benchmarks, LEEPS achieves the highest average score at both model scales, with relative gains of 2.6\% and 3.7\% over the strongest baseline for Qwen2.5-Math-1.5B and 7B, respectively, and generally improves faster during the training process. It also achieves the highest average score across the three evaluated OOD general-reasoning benchmarks at both model scales and adds only about 2 seconds of online sampling overhead per training step. Code is available at https://github.com/ShuangLiangX/LEEPS.
论文详细总结(自动生成)
LEEPS 论文总结
一、核心问题与研究动机
- 背景:基于可验证奖励的强化学习(RLVR)已成为提升大语言模型推理能力的关键后训练范式,GRPO 等方法通过分组相对优势估计实现高效优化。然而 GRPO 存在结构性低效:当 prompt 组中所有响应的奖励相同时(全部正确或全部错误),组内优势 全部为零,生成的 rollout 浪费了计算预算却无法提供学习信号——这类 prompt 被称为"平凡 prompt"(trivial prompt),对应的 rollout 组为"零方差组"(zero-variance group)。
- 核心问题:如何在 rollout 之前进行预筛选(pre-rollout selection),既提高训练批次中"非平凡 prompt"的占比,又避免过度集中在少数 prompt 上导致训练覆盖不足?
- 现有方法的不足:
- 在线过滤方法(如 DS)虽有效,但需要对候选 prompt 额外生成 rollout 再丢弃,计算开销大;
- 预筛选方法 DPS 通过建模 prompt 求解动力学维持高非平凡比例,但反复选择同一批 prompt,覆盖率仅 20%;
- 预筛选方法 MoPPS 通过后验采样覆盖更广(44.4%),但非平凡比例偏低(早期仅约 40%)。
- 研究目标:在不需要额外 rollout 的前提下,平衡利用与探索,使训练批次同时具备高非平凡比例和广 prompt 覆盖。
二、方法论
2.1 整体框架
LEEPS 在每个训练步骤从候选批次 ()中选取规模为 的训练批次 ,由两个核心组件协同工作:
1. 自适应探索-利用组合分配(Adaptive Explore–Exploit Portfolio Allocation)
2. 潜在引导的探索(Latent-Guided Exploration)
2.2 组合划分与采样权重
- 利用组合 :包含已观测到非零奖励方差的 prompt,即
采样权重采用伯努利方差形式,优先选择中等难度 prompt:
- 探索组合 :包含未被选取过的 prompt 以及最近 rollout 产生零方差组的 prompt:
采样权重兼顾潜在难度估计与探索频率衰减:
2.3 自适应预算分配
设 为分配给探索组合的批次比例,LEEPS 依据两个组合的近期非平凡比率 、 调整 ,使训练批次的期望非平凡比例接近目标 (默认为 0.90):
被裁剪到 以保障稳定性。
2.4 潜在引导的探索机制
- 表征构建:使用 prompt 最后一个 token 在选定隐藏层(1.5B 取第 22 层、7B 取第 26 层、Llama-3.2-3B 取第 21 层)的隐藏状态,并做 L2 归一化得到 ;训练前一次性预计算 K 近邻缓存(缓存 1024 个候选,使用最多 个有观测结果的邻居)。
- 成功率估计:通过相似度加权聚合有观测近邻的成功率:
其中 为余弦相似度。
- 理论观测:表征层越深,潜在信号对非平凡 prompt 的预测 AUROC 越高(1.5B 顶层 0.677,7B 顶层 0.704),且跨层形成稳定平台。
2.5 算法流程
1. 预计算潜在近邻缓存;
2. 训练前 步仅使用探索组合收集初始信号;
3. 每步根据组合历史非平凡比率计算 ;
4. 按权重从利用组合无放回采样并补足配额;
5. 估计 并按探索权重排序,剩余随机补足;
6. 执行 rollout、更新 prompt 统计、用 GRPO 优化策略。
2.6 复杂度
- 初始化:,其中 为 prompt 数, 为表征维度;
- 每步:,;
- 在线采样无需额外模型前向,仅 2 秒级开销。
三、实验设计
3.1 数据集与场景
- 训练集:DAPO-Math-17K(含约 17.9K 数学题),使用规则化验证器提供二值奖励。
- 域内评估(6 个数学推理基准):
- MATH-500(贪心 pass@1)
- Minerva-Math(贪心 pass@1)
- OlympiadBench(贪心 pass@1)
- AMC23、AIME24、AIME25(采样 16 次,avg@16,temperature 0.6、top-p 1.0)
- OOD 通用推理(3 个基准):GPQA-Diamond、ARC-Challenge、MMLU-Pro,贪心 pass@1。
3.2 对比基线
- GRPO:无 prompt 选择的均匀基线;
- DS(DAPO 在线过滤):rollout 后丢弃零方差组;
- MoPPS:基于成功率先验后验采样的预筛选方法;
- DPS:建模 prompt 求解动力学的预筛选方法。
3.3 主实验结果
| 模型 | GRPO | DS | MoPPS | DPS | LEEPS |
|---|---|---|---|---|---|
| 1.5B 平均分 | 37.04 | 38.03 | 37.96 | 38.17 | 39.16 |
| 7B 平均分 | 45.19 | 45.56 | 45.77 | 45.83 | 47.53 |
- 1.5B 上相对最强基线提升 2.6%,7B 上提升 3.7%;
- LEEPS 与最强基线使用相同的 rollout 预算(DS 需约 2.2 倍额外 rollout);
- OOD 通用推理同样获得最高平均分(1.5B 28.08、7B 40.95)。
四、算力与资源
- 1.5B 模型:8 块 NVIDIA H20 GPU 训练,每步约 36.2 秒(其中 LEEPS 额外开销 2.15 秒,约 2.6%);
- 7B 模型:8 块 NVIDIA A100 GPU 训练,每步约 125.5 秒(其中 LEEPS 额外开销 2.26 秒,约 1.0%);
- 采样器初始化:1.5B 一次耗时约 124 秒,7B 约 292 秒,仅发生一次;
- 训练时长:1.5B 端到端 6.8 小时,7B 12.1 小时(与 GRPO 共享预算时一致);
- 训练步数:1.5B 280 步,7B 180 步,batch size 256,每 prompt 8 次 rollout;
- 额外验证:在 Llama-3.2-3B-Instruct 上复现了主要实验结论。
五、实验数量与充分性
- 主实验:2 个模型规模 × 6 个数学基准 + 3 个 OOD 基准 = 约 18 组主结果;
- 消融实验:3 个变体(随机探索、均匀利用、去除组合分配)× 2 模型规模 = 6 组;
- 超参数敏感性:层校准样本量(图 9)、邻居数 (图 10)、目标非平凡比 (4 个取值,图 11);
- 训练过程诊断:非平凡比例、medium ratio、每步分数、累计 rollout 分数、coverage 分布;
- 效率分析:分阶段 profiling 与 GRPO 展开训练对比(图 12 显示 1.93× 与 1.80× 步效率);
- 公平性:所有方法共享相同的 prompt 集、评估脚本、训练步数与(DS 除外)rollout 预算;DS 因机制不同以 rollout-normalized 形式对比;
- 总体评估:实验较充分,覆盖了主结果、消融、敏感性、效率、OOD 泛化与第三类模型(Llama),但消融仅做了 1.5B 的轨迹分析。
六、主要结论与发现
- 高效性:在相同 rollout 预算下,LEEPS 在两个 Qwen2.5-Math 规模上均取得最高平均分,且训练速度更快;
- 均衡性:LEEPS 兼顾了高非平凡比例与广 prompt 覆盖(覆盖率 98.1%,对比 DPS 20.0%、MoPPS 44.4%);
- 组件有效性:自适应组合分配贡献最大(去掉后 1.5B 下降 3.1%、7B 下降 4.8%);潜在引导探索次之(随机探索使 1.5B 下降 4.2%);成功率加权的利用分支也带来 1.7%–2.6% 提升;
- 泛化能力:在三个 OOD 通用推理基准上仍取得最高平均分,未损害跨域能力;
- 代表通路:高非平凡比例 + 持续中等难度 prompt 采样 + 广覆盖 = 更稳定的训练信号供给;
- 效率:相较 GRPO,1.5B 训练步效率提升 1.93×,7B 提升 1.80×,在线采样开销可忽略。
七、优点与亮点
- 问题切入精准:聚焦 RLVR 中零方差组这一被低估但普遍存在的浪费源;
- 机制设计清晰:组合分配应对探索-利用权衡,潜在引导在无额外 rollout 下提升探索针对性;
- 零额外 rollout:相比 DS 等在线过滤方法,显著节省计算;
- 理论支撑充分:层选择通过大规模 AUROC 诊断固化,邻居数 与目标 在宽范围内稳健;
- 实现轻量:训练前一次性预计算近邻缓存,运行时仅依赖相似度加权和简单统计;
- 可解释的训练动力学:同时报告非平凡比例、medium ratio 与覆盖率,便于诊断;
- 跨模型与跨域验证:在 Qwen2.5-Math-1.5B/7B 与 Llama-3.2-3B-Instruct 上均验证有效,且 OOD 性能未下降。
八、不足与局限
- 表征层选择依赖人工离线诊断:尽管 2048 个 prompt 即可较稳定,但完全依赖固定层,可能限制在训练过程中策略变化下信号的稳健性;
- 依赖 prompt 嵌入质量:若模型隐藏层未能区分任务难度,潜在引导的 AUROC 接近 0.5,收益有限;
- OOD 收益有限:相比最强基线仅约 0.1–0.5 点的微弱提升,统计意义与实际推广价值仍需更多基准验证;
- 任务域单一:训练数据与评估以数学推理为主,代码、开放问答等领域的有效性未知;
- 冷启动阶段依赖均匀探索:前 步只用探索组合,可能在更大规模训练中放大选择偏差;
- 目标非平凡比 为人工超参数:虽较稳健,但增加调参成本;
- 极低难度/极高难度 prompt 处理简化:仅以"零方差"或"非零方差"二元划分,未对持续低非平凡比例的 prompt 做主动淘汰策略;
- 公平性边界:DS 因机制不同被排除在 step-normalized 对比外,可能掩盖其优势场景;
- 未给出墙钟训练成本对比的完整细节:仅提供单步平均时间,未涵盖初始化、数据加载、checkpoint 等全流程成本。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。