
扩展由大语言模型驱动的多智能体系统:设计原则与架构可扩展性分析
Scaling LLM-Driven Multi-Agent Systems: Design Principles and Architectural Scalability Analysis
📝 TLDR
LLM多智能体系统架构设计空间缺乏系统化原则,可扩展性研究不充分。本文提炼简单性、弹性反馈、可选循环顺序流、摘要通信四项原则,构建有向工作流图参考架构,在终端系统工程基准上评测四种复杂度配置。研究发现扩展带来近线性成本下的精度提升,但需LLM能力超阈值,中等复杂度后性能因超时下降,一致性问题贯穿各规模。该工作为实践者提供具体设计指引,明确一致性与评测标准化是未来重点方向。
🧭 速览
LLM多智能体系统架构设计空间未系统化,可扩展性边界缺乏实证研究。
提炼四项设计原则并形式化为有向工作流图参考架构,在终端系统工程基准上用两模型评测四种复杂度配置。
扩展带来近线性成本下的精度提升,但需LLM超能力阈值;中等复杂度后性能因超时下降,一致性问题突出。
为多智能体架构设计提供具体指引,未来研究应聚焦一致性与评测标准化。
🆚 方法对比
参考架构(约束有向工作流图)
四个设计原则(简单性、弹性反馈、顺序工作流+可选循环、摘要通信)
- 从文献中系统提炼,覆盖关键维度
- 可操作性强,能直接指导架构设计
- 简单性原则避免过度工程化
- 摘要通信缓解上下文饱和问题
- 原则抽象,缺少定量权重指导
- 未验证各原则独立贡献度
- 在低能力LLM下原则有效性受限
四配置复杂度递增实验方案
- 标准化基准,跨配置可公平对比
- 两个LLM层级揭示能力门槛效应
- 联合刻画精度、成本、一致性、反馈利用率
- 发现中间复杂度为性能拐点
- 终端系统工程任务,泛化性待验证
- 仅两类LLM,模型覆盖不足
- 成本增长近线性,规模化受限
- 评估自身存在局限导致精度天花板
角色丰富型MAS(MetaGPT、ChatDev、AgileCoder)
- 角色分工明确,任务分解自然
- 工作流丰富,适合复杂协作场景
- 已有成熟开源实现可参考
- 架构复杂,协调开销大
- 通信过载与一致性问题突出
- 扩展收益有界,存在架构依赖
极简型MAS(AutoCodeRover、Agentless、SWE-agent)
- 架构简洁,资源消耗低
- 强搜索与执行能力可媲美复杂方案
- 易于部署与调试
- 能力上限受限于单体LLM
- 缺乏多视角校验,鲁棒性弱
- 复杂任务分解能力不足
辩论式多智能体扩展(debate-based scaling)
- 多轮辩论提升推理与决策质量
- 多视角交互增强鲁棒性
- 可通过轮次灵活控制扩展粒度
- 通信冗余导致上下文饱和
- 轮次增加后性能停滞或下降
- 协调开销随规模快速增长
作者提出的参考架构以摘要通信与弹性反馈为核心,在中等复杂度下表现优于极简方案但不及角色丰富型开销;角色丰富型MAS功能强但协调成本高,极简型MAS高效但能力上限受限,辩论式扩展在多轮后收益递减,四类方法在精度-成本-一致性上各有取舍。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
TL;DR
这篇论文系统研究了如何构建可扩展的 LLM 多智能体系统:作者从文献中提炼出简洁性、弹性反馈、带可选循环的顺序工作流、基于摘要的通信四项设计原则,并在一个形式化的有向工作流图参考架构中逐一实现。实验在终端系统工程基准上测评了从单智能体到七智能体四种复杂度配置,结果表明扩展能在近线性成本下带来可衡量的精度提升,但前提是底层 LLM 能力必须超过阈值;系统在中等复杂度处达到性能峰值,之后因超时而下降;更关键的是,一致性问题贯穿所有规模——即同一个任务多次运行的结果往往不一致——这成为制约实际部署的核心瓶颈。
研究背景与动机
让多个 LLM 智能体协同工作来解决复杂任务,这一想法本身就极具吸引力:专业化的智能体各司其职、相互校验,理论上能够突破单智能体在上下文窗口 [[上下文窗口]]、工具调用 [[工具调用]] 等方面的瓶颈。然而,尽管这类系统在学术论文和工业原型中层出不穷,其架构设计却长期处于“凭经验堆砌”的状态——通信拓扑怎么搭、智能体角色怎么划分、工作流是纯串行还是允许并行、记忆信息如何在智能体之间流转,这些问题在不同工作中往往给出截然不同的答案,却缺乏系统性的原理层面的指导。
更棘手的是可扩展性问题。当我们把系统的智能体数量从 1 扩展到 3、5、7 时,准确率会提升多少?成本会增长多快?可靠性会不会反而下降?如果不搞清楚这些联合演化规律,实践者就只能在盲目试错中浪费大量 API 费用和开发时间。已有的扩展性研究大多只考察单一维度——比如单纯增加智能体数量或增加辩论轮数——而且多在静态问答基准上报告平均任务成功率,缺乏对交互式、工具丰富环境中准确性、成本、通信负载和运行间一致性这四个维度的联合刻画。
正是在这一背景下,本文试图回答一个根本性的工程问题:设计一个 LLM 多智能体系统时,应该遵循哪些基本原则?这些原则在不同规模下的表现如何?
方法
作者首先对已有工作进行了结构化分析,从中提炼出四项设计原则。
第一项原则是简洁性。近年来的研究,包括 Agentless、Mini SWE-Agent 等工作,都表明架构复杂性并非越多越好——过于复杂的设计反而可能引入脆弱性。因此,复杂性应该按需、渐进式引入,而非一开始就堆砌大量智能体和交互机制。
第二项原则是弹性反馈。直觉上,给系统配备更多校验环节应该总能提升质量。但实证研究指出,最优的反馈轮数实际上与具体任务高度相关,无法在系统设计时预先确定。因此,反馈机制应该由智能体在运行时自主评估是否需要——也就是说,是否继续循环应该由智能体自己决定,而非由系统硬编码。
第三项原则是带可选循环的顺序工作流。这一原则承认了前两项的张力:既要保持简洁、避免过度复杂的交互,又要在必要时允许反馈回退。解决方案是在主体上维持一条顺序执行的主链路,仅在特定节点(如测试失败、审批不通过)处触发回退循环,而非让所有智能体两两互联、形成混乱的网状结构。
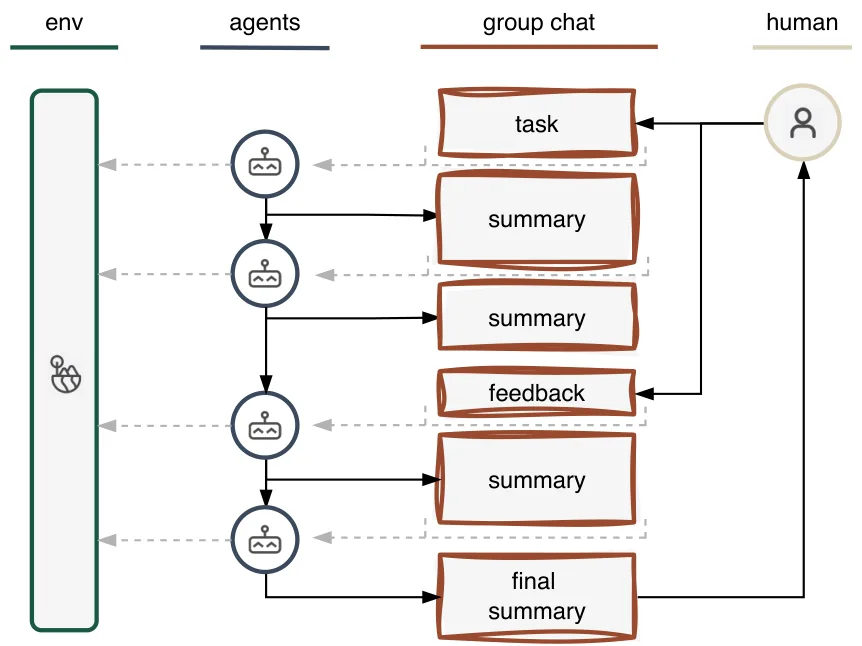
第四项原则是基于摘要的通信。当多个智能体协同工作时,上下文长度管理是一个严峻挑战:如果每个智能体都将完整的动作轨迹写入共享上下文,很快就会耗尽 LLM 的上下文窗口。一个巧妙的做法是让每个智能体在完成自己的子任务后,只向上下文广播一条简洁的自然语言摘要,而非事无巨细地记录每一个动作。
这四项原则被实现为一个有向工作流图参考架构,形式化为一个五元组 ,其中 是智能体集合、 是有向边集合、 是起始智能体、 是终止智能体集合。作者还施加了结构性约束:每个非终止智能体至少有一条出边,每个非起始智能体至少有一条入边,且任意智能体的出度不超过 3——这个上界 3 看起来是实践经验的产物,平衡了表达能力与复杂度控制。
在这个架构中,智能体通过在摘要中嵌入 [next_agent] 标签来指定后继节点,解析器读取标签后触发下一智能体的执行。循环通过 Tester、Approver、Refiner 等节点回退到前驱节点来实现,触发与否由智能体根据当前状态自行判断。
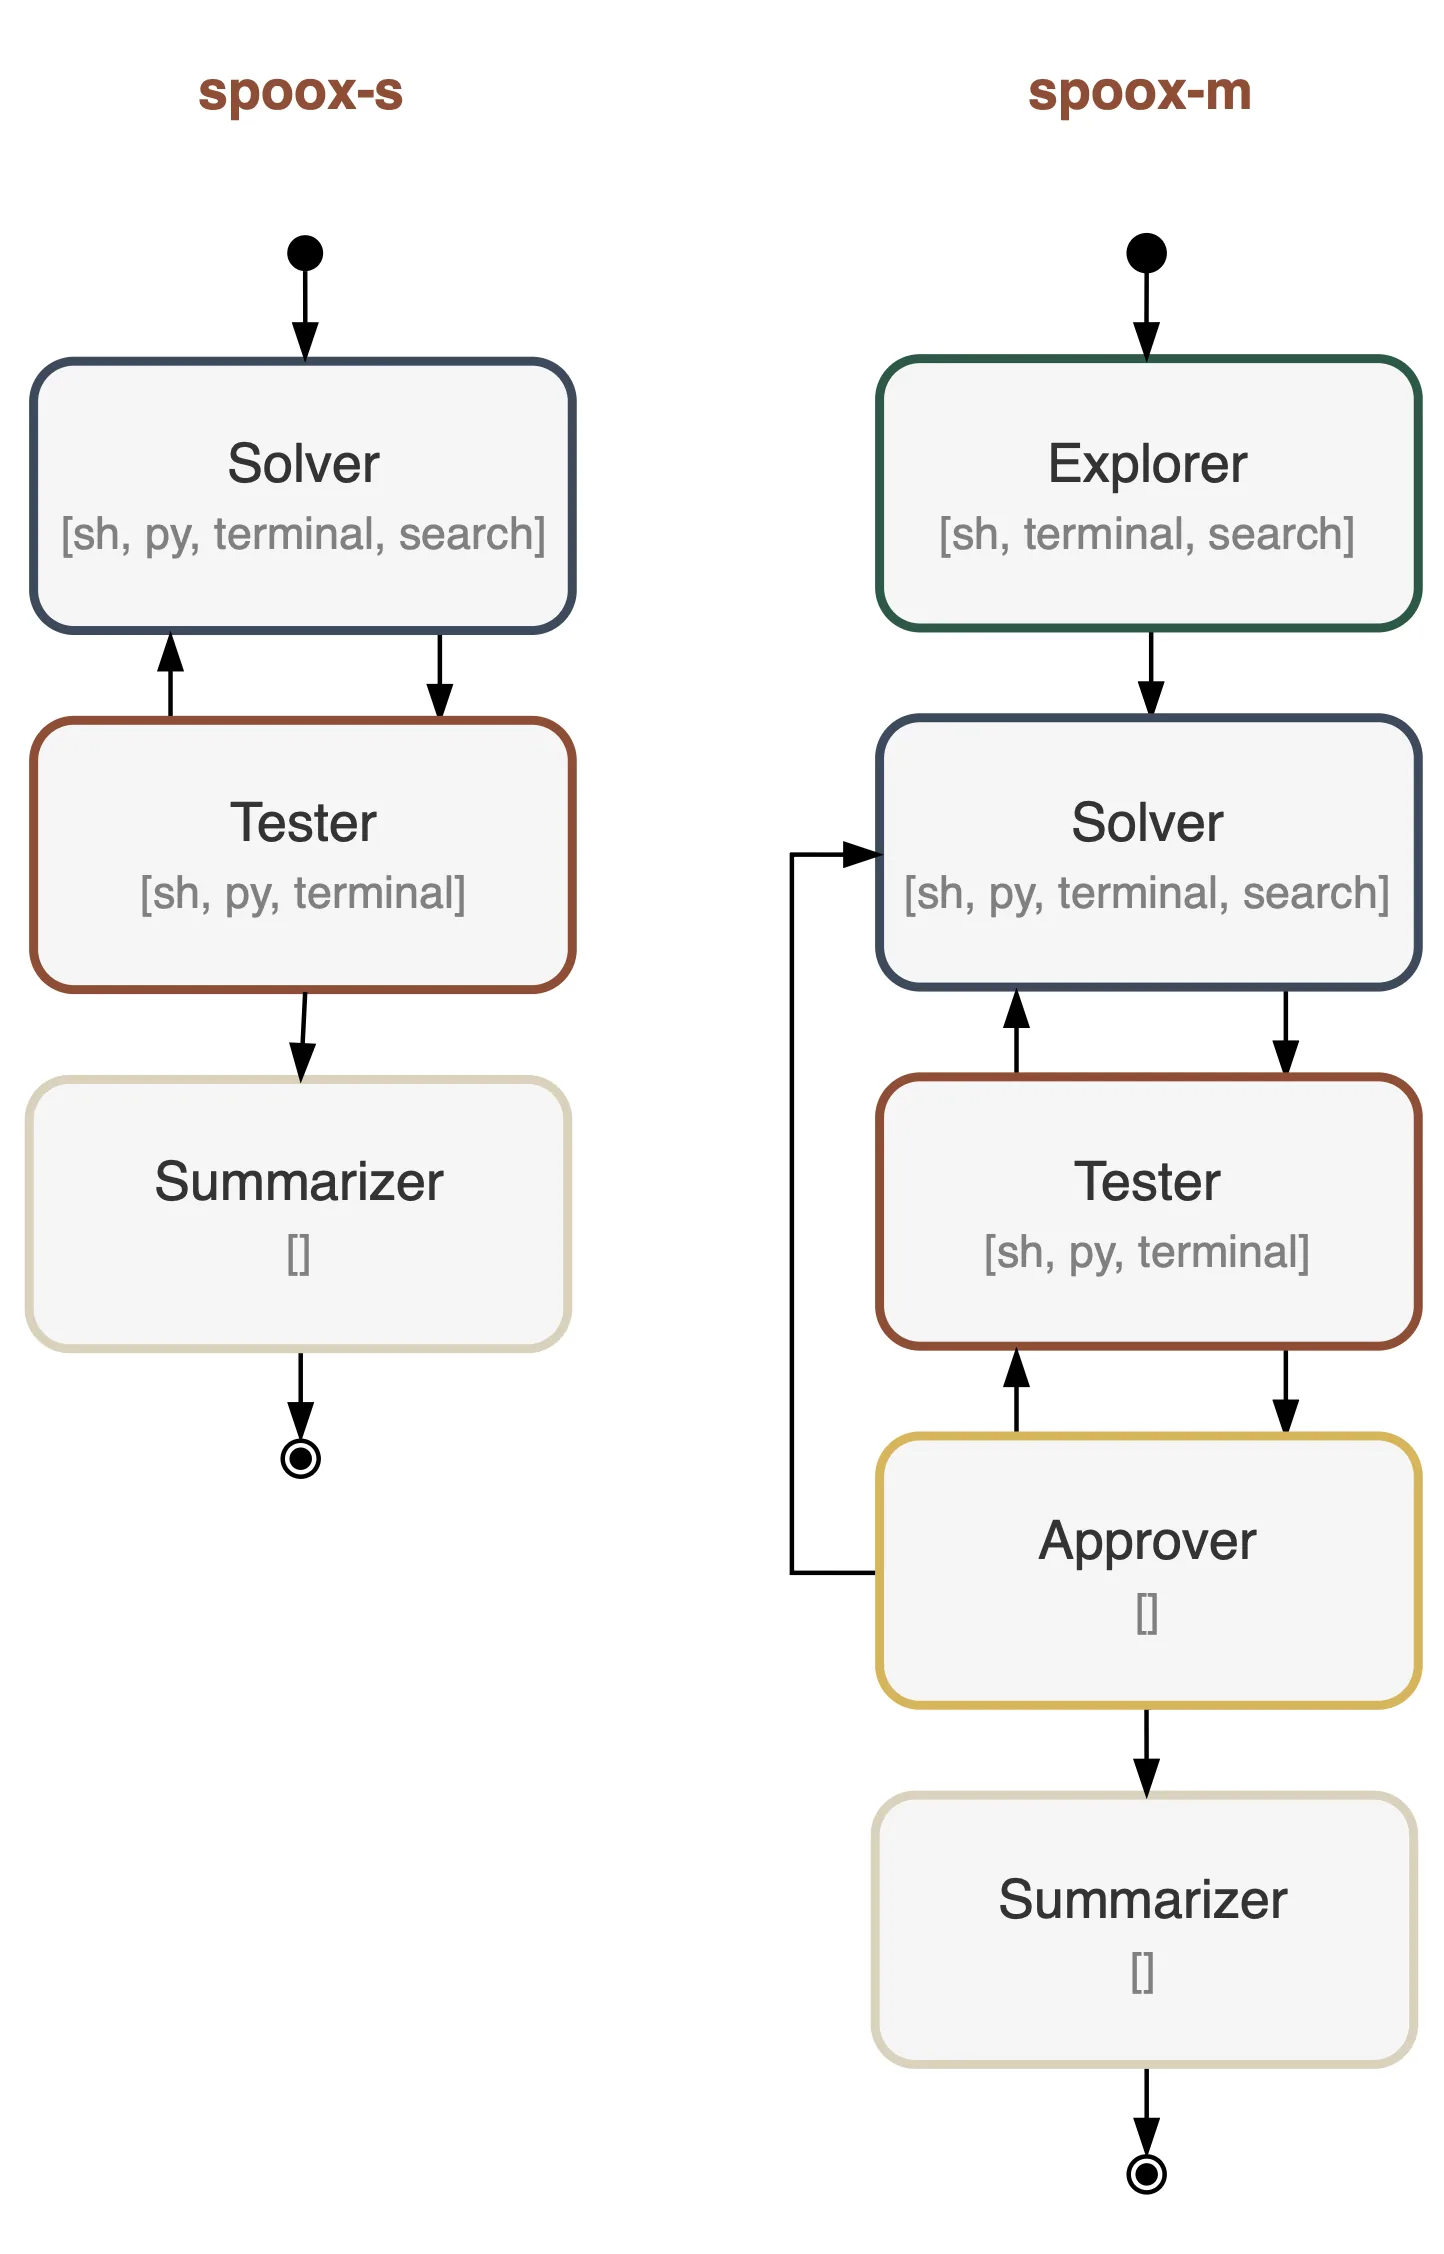
四种复杂度递增的配置从这一架构中实例化出来:Singleton 是单智能体基线,没有任何反馈循环;MAS-S 引入三个智能体(Solver/Tester/Summarizer)和一条可选循环;MAS-M 扩展到五个智能体(新增 Explorer 和 Approver)和三条可选循环;MAS-L 进一步引入七智能体(SubTaskPlanner、SubTaskSolver、Tester、Refiner、Approver、Summarizer 和 Explorer)和五条可选循环。
实验与结果
实验在 Terminal-Bench 基准上进行,这是一个包含 80 多个端到端系统工程任务的标准评测集,每个任务在隔离的 Docker 容器中执行并配有自动化的成功标准。智能体可以使用四种工具:Shell 工具执行单条 Bash 命令、Terminal 工具维护持久 tmux 会话、Python 工具执行完整脚本、Search 工具进行网络搜索。
作者选取了同一模型族中能力差异显著的两个档位进行对比:GPT-5-nano 代表较弱的 LLM,GPT-5-mini 代表中等能力的 LLM,另外还在官方 leaderboard 上以 GPT-5.3-Codex 作为 SOTA 参考。
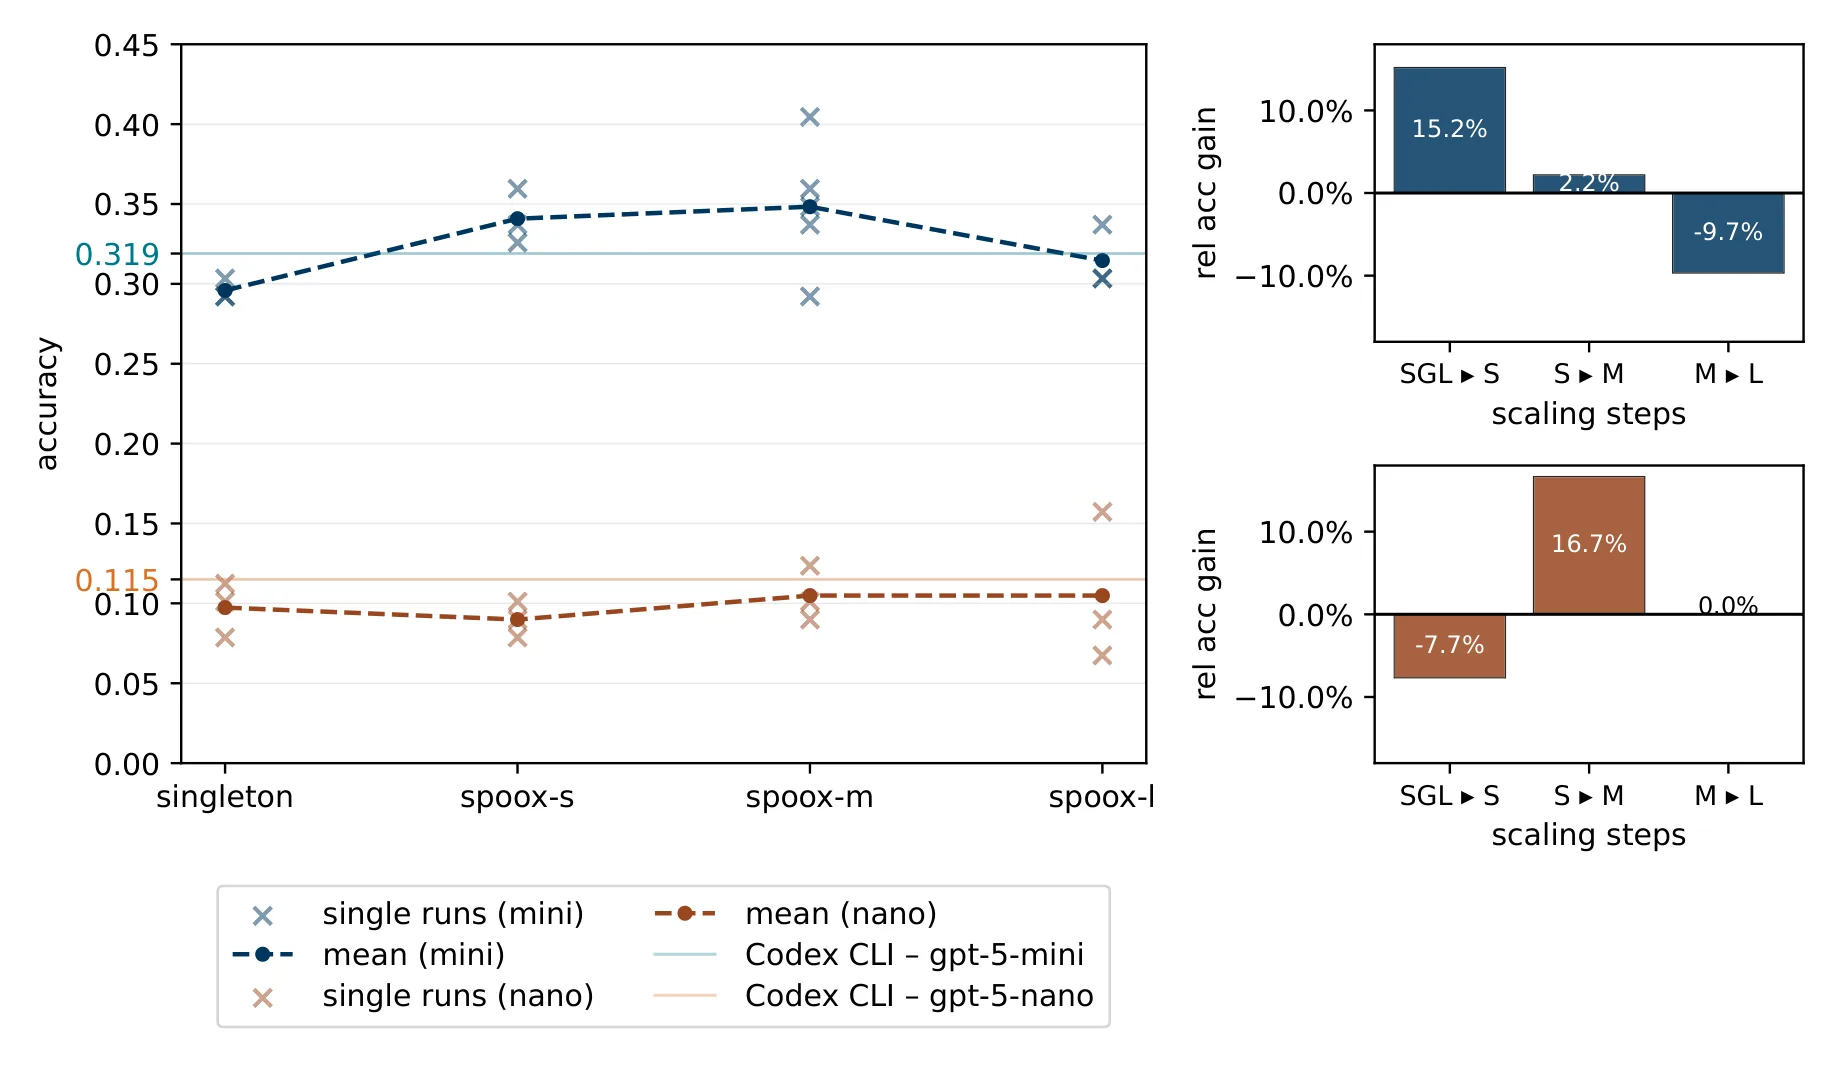
实验结果揭示了几条清晰而重要的规律。使用 GPT-5-mini 时,从 Singleton 到 MAS-S 到 MAS-M,准确率逐步提升(0.296 → 0.341 → 0.348),但扩展到 MAS-L 时反而下降至 0.315。这条曲线说明多智能体协作确实能带来增益,但这种增益在中等复杂度处触顶,更大规模的系统会因为超时等原因拖累整体表现。
然而,这个结论有一个关键的前提条件:在 GPT-5-nano 上,几乎观察不到扩展带来的收益(0.097 → 0.090 → 0.105 → 0.105)。这清楚地表明,多智能体架构放大的是 LLM 本身的能力,而非替代能力——如果底层模型能力不足,再精巧的协作设计也无法弥补。
成本方面的表现相对符合直觉:LLM 调用次数、完成 token 数量、执行时间都随着架构复杂度近似线性增长。MAS-L 配置下的 AgentTimeout 错误从 Singleton 的平均 3.33 次跃升至 50.00 次,这解释了为什么性能在 MAS-L 处反而下降——系统没有在规定时间内完成任务。
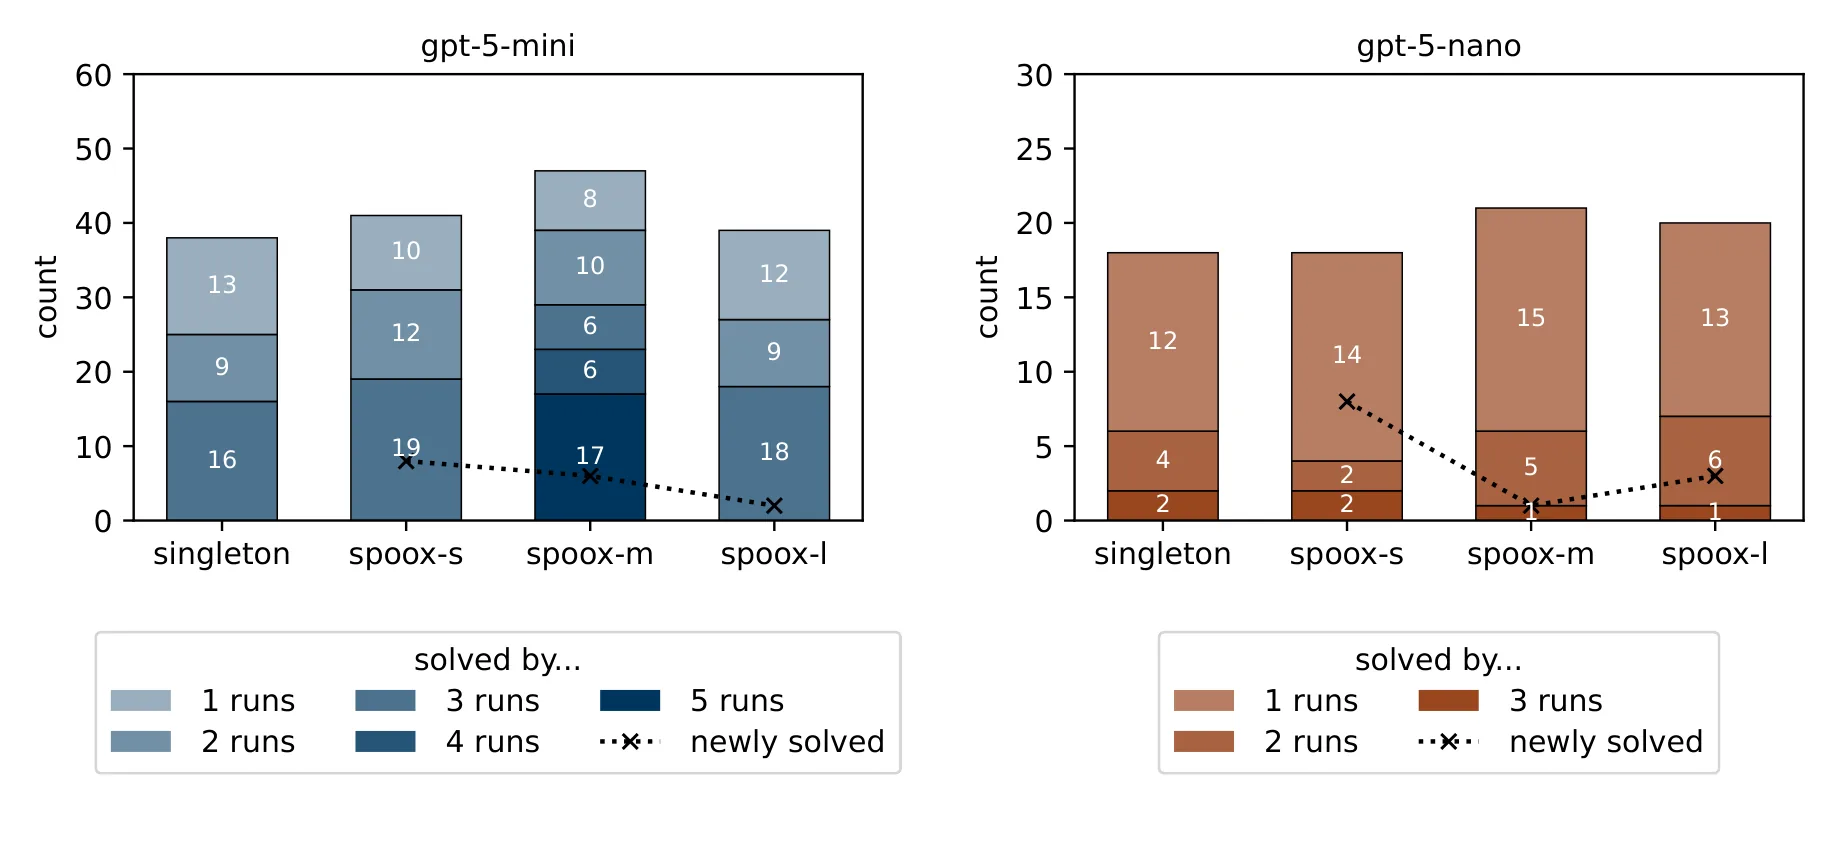
最值得深思的发现来自一致性指标。在所有扩展层级中,被解决的任务在多次运行中能够稳定复现解决的比例始终偏低。换句话说,一个任务这一次运行成功了,下一次运行可能就失败了;一个任务失败了,后续的调试循环反而可能采纳并强化之前的错误框架,导致质量保证机制完全失效。这种一致性问题在所有规模上都存在,表明它不是架构设计的问题,而是 LLM 作为推理引擎本身固有的非决定性问题。
讨论与可借鉴点
这项工作的一个重要贡献是为实践者提供了可操作的设计指引:首先,确认底层 LLM 能力是否达到最低阈值,因为架构放大的是能力而非替代能力;其次,在 LLM 能力达标的前提下,优先采用简洁配置而非一开始就堆砌大量智能体;第三,如果追求更高的可靠性,应当引入对抗性质量保证(如专门的 Approver 节点);第四,评估多智能体系统时必须同时度量一致性,而不仅仅是平均准确率——一个每次只有 30% 准确率但高度一致的系统,往往比一个平均 40% 准确率但运行间波动剧烈的系统更有实用价值。
论文也坦诚承认了若干局限。最明显的是评测仅在 Terminal-Bench 一个基准上进行,任务类型局限于命令终端操作,未覆盖 GUI 自动化、Web 交互、检索问答或多模态场景。其次,所有实验都在 OpenAI GPT 系列上完成,跨模型厂商的泛化性未知。此外,每配置三到五次的重复运行在统计上功效有限,部分指标的标准差与均值已经处于同一数量级。最后,论文没有进行正交消融实验,无法精确判定四项原则中每一项的独立贡献。
这些局限同时也为后续研究指明了方向:跨任务类型的基准评测、跨模型厂商的能力验证、对一致性问题更深入的诊断与干预(比如引入外部验证机制或结构化推理过程)、以及各项设计原则的独立消融分析,都是值得探索的方向。
摘要
基于大语言模型的多智能体系统有潜力通过专业化智能体的协调集成实现集体智能,并扩展以解决高度复杂的任务。然而,尽管具备理论潜力,其架构设计空间仍未被系统化,也缺乏广泛确立的设计原则。此外,此类系统的可扩展性特征迄今为止仅得到部分理解。本文作出两项贡献。首先,我们通过对已有工作的结构化分析,提炼出可扩展多智能体系统架构的四项设计原则:简洁性、弹性反馈、带可选循环的顺序工作流以及基于摘要的通信。我们将这些原则实现在一个参考架构中,其拓扑被形式化为一个受约束的有向工作流图,并在一个标准化的基于终端的系统工程任务基准上,使用两个能力不同的大语言模型评估了四种复杂度递增的配置。我们的研究结果表明,扩展能够在约呈线性增长的成本下带来可衡量的准确性提升,但前提是底层大语言模型超过最低能力阈值。性能在中等复杂度处达到峰值,随后因超时和评估限制而下降。此外,持续的一致性问题在所有扩展层级中均成为核心挑战。这些结果为实践者提供了具体的设计指导,并凸显了一致性与评估标准化是未来研究的关键目标。
Abstract
LLM-based multi-agent systems have the potential to enable collective intelligence and scale toward solving highly complex tasks through coordinated ensembles of specialized agents. However, despite their theoretical potential, the architectural design space remains largely non-systematized and lacks broadly established design principles. Furthermore, the scalability characteristics of such systems are only partially understood so far. This paper makes two contributions. We first distill four design principles for scalable MAS architectures from a structured analysis of prior work: simplicity, elastic feedback, sequential workflows with optional loops, and summary-based communication. We operationalize these principles in a reference architecture whose topology is formalized as a constrained directed workflow graph, and we evaluate four configurations of increasing complexity on a standardized benchmark of terminal-based system engineering tasks using two LLMs of differing capability. Our findings show that scaling yields measurable accuracy improvements with approximately linear cost growth, but only when the underlying LLM exceeds a minimum capability threshold. Performance peaks at intermediate complexity, then degrades due to timeouts and evaluation limitations. In addition, persistent consistency issues emerge as a central challenge across all scaling levels. These results provide concrete design guidance for practitioners and highlight consistency and evaluation standardization as key targets for future research.
论文详细总结(自动生成)
论文总结:LLM 驱动的多智能体系统的扩展性设计原则与架构分析
1. 核心问题与研究动机
基于大语言模型(LLM)的多智能体系统(MAS)虽然具备通过专业化智能体协同求解复杂任务的理论潜力,但其架构设计空间未被系统化,缺乏广泛认可的设计原则;同时,其可扩展性边界——即准确率、成本、可靠性随架构规模如何联合演化——至今理解不充分。
- 单智能体瓶颈:上下文窗口受限([10])、单视角缺乏鲁棒性([11])、串行操作存在并行上限([12],[13])。
- MAS 设计困境:通信拓扑、智能体角色、工作流编排、记忆架构等维度组合空间巨大且无共识([18],[19])。
- 已有扩展性研究的不足:多只考察单一维度(如智能体数量 [22],[23]、辩论轮数 [24]),且多在静态推理基准上报告均值任务成功率,缺乏对准确性、成本、通信负载、运行间一致性在交互式、工具丰富环境中联合变化的系统刻画。
2. 方法论
2.1 核心思想:四项设计原则
作者通过对已有文献的结构化分析,提炼出可扩展 MAS 架构的四项原则:
- P1(简洁性):架构复杂性应按需、渐进式引入;简洁与高性能可兼得(如 Agentless、Mini SWE-Agent)。
- P2(弹性反馈):最优反馈轮数与任务相关,无法预先确定;应由智能体在运行时自主评估是否需要进一步反馈。
- P3(带可选循环的顺序工作流):主体保持顺序流以维持稳定性与一致性,仅在必要时插入回退循环。
- P4(基于摘要的通信):智能体完成子任务后,仅向上下文广播简洁的自然语言摘要,而非完整的动作轨迹。
2.2 参考架构的拓扑形式化
将系统拓扑建模为有向工作流图 ,其中:
- :智能体(顶点)集合;
- :有向边集合;
- :起始智能体;
- :终止智能体集合。
并施加三条结构性约束:
2.3 关键机制
- 共享摘要群聊:每个智能体仅写一条自然语言摘要后追加到群聊,上下文中上下文长度线性增长;
- 智能体驱动的下一节点选择:智能体在摘要中通过
[next_agent]标签指定后继,由解析器触发; - 可选循环:从 Tester/Approver/Refiner 等节点回退到前驱节点,运行时按需触发。
2.4 形式化的工作流配置
配置以"每步 +2 智能体、+2 反馈循环"递增:
- Singleton:1 智能体,0 循环(基线);
- MAS-S:3 智能体(Solver/Tester/Summarizer),1 循环;
- MAS-M:5 智能体(Explorer/Solver/Tester/Approver/Summarizer),3 循环;
- MAS-L:7 智能体(SubTaskPlanner/SubTaskSolver/Tester/Refiner/Approver/Summarizer + Explorer),5 循环。
3. 实验设计
3.1 基准与环境
- Benchmark:terminal-bench,一个包含 80+ 端到端系统工程任务的标准基准;
- 环境:每个任务在隔离 Docker 容器中执行,含自动化可验证的成功标准;
- 工具集(4 个):Shell tool(单条 Bash 命令)、Terminal tool(持久 tmux 会话、128×16 终端窗口)、Python tool(完整脚本执行)、Search tool(基于 LangChain 的 DuckDuckGo 搜索)。
3.2 模型
固定同一模型族以隔离厂商差异:
| 模型 | 角色 |
|---|---|
| GPT-5-nano | 较弱 LLM |
| GPT-5-mini | 中等 LLM |
| GPT-5.3-Codex | 顶尖 SOTA 参考 |
3.3 评测指标
- 任务准确率(任务整体成功比例);
- 测试加权准确率:通过单元测试的比例,避免"一票否决"掩盖部分成功;
- 成本:LLM 调用次数、prompt/completion tokens、整体执行时间;
- 一致性:同一配置多次运行下任务在多少次运行中被解决(1/2/3/4/5 runs);
- 循环利用率:各反馈环路的实际触发频率。
3.4 对比配置
四配置纵向对比(Singleton → MAS-L),并以官方 leaderboard 上的领先 agent 作横向参考线。
4. 资源与算力
论文未明确披露所用 GPU 型号、节点数量、训练/推理时长等算力细节,仅说明:
- API 调用通过 OpenAI 的 GPT-5 模型族完成;
- 各 agent–model 配对的运行次数为 3–5 次(MAS-M 因提交 leaderboard 跑了 5 次,MAS-M + GPT-5.3-Codex 也跑了 5 次);
- benchmark 在 Docker 容器中执行。
由于本质上是 API 调用式评测,"算力"主要体现为 token 消耗与 wall-clock 时间(图/表中以"调用数 × 倍数 + ×"等相对量呈现)。
5. 实验数量与充分性
- 配置 × 模型 × 运行数:
- GPT-5-mini × {Singleton, MAS-S, MAS-L}:各 3 次;
- GPT-5-mini × MAS-M:5 次;
- GPT-5-nano × {Singleton, MAS-S, MAS-M, MAS-L}:各 3 次;
- GPT-5.3-Codex × MAS-M:5 次。
- 评测维度:准确率(含测试加权)、成本(4 子项)、一致性、循环利用率共 4 类指标。
- 充分性评价:
- 优点:覆盖了 4 种拓扑复杂度 × 2–3 个能力层级 × 多次重复运行,且指标体系兼顾了效率与可靠性;
- 局限:
- 每配置运行次数偏少(3 次居多),统计功效有限(表中标准差 普遍较大,如 GPT-5-nano/MAS-L 的 );
- 仅使用单一基准(terminal-bench),且均为命令终端任务,未覆盖 GUI、Web、检索、多模态等其他场景;
- 仅在 GPT-5 模型族上评测,未跨厂商验证(如 Claude、Gemini、Llama 等);
- 无消融对比(如"是否启用群聊 vs 共享全量轨迹"、"强制 vs 弹性循环"等正交消融)。
6. 主要结论与发现
6.1 关键定量结果(GPT-5-mini)
6.2 核心发现
1. LLM 能力是前提:GPT-5-nano 上扩展几乎无收益甚至下滑(0.097→0.090→0.105→0.105),表明架构放大的是能力,而非替代能力。
2. 中等复杂度处性能峰值:性能在 MAS-M(5 agents, 3 loops)达到峰值,MAS-L(7 agents, 5 loops)反而因超时增多而下降;与文献 [23] 的 logistic 扩展行为及辩论式 MAS 的"先升后平"模式一致。
3. 成本近似线性增长:LLM 调用数、completion tokens、执行时间随架构复杂度近线性增加;AgentTimeout 错误从 Singleton 的 (mini)跃升至 MAS-L 的 。
4. 一致性是核心瓶颈:在所有扩展层级中,被解决的任务中少于一半在所有运行中都被解决;GPT-5-nano 上甚至出现"多次运行仅稳定解决 1–2 个任务"的情况;下游智能体倾向于采纳并强化上游智能体的错误框架(framing),使得质量保证失效。
5. SOTA 竞争力:MAS-M + GPT-5.3-Codex 的 处于官方 leaderboard 中位,证明架构具备竞争力。
7. 优点
- 原则化设计:从文献系统提炼四项设计原则(P1–P4),避免"凭经验堆砌 agent"的常见反模式([17]);
- 形式化拓扑:用受限有向工作流图给出可验证的结构约束(出度上界 3、连通性、终点存在性),并通过智能体自选后继实现运行时灵活性;
- 简洁通信 + 线性上下文:摘要群聊将上下文增长从"动作轨迹爆炸"压缩为线性增长,兼顾表达力与可控性;
- 多维指标体系:除准确率外,还考察测试加权准确率、成本(4 子项)、一致性、循环利用率,呈现了实际部署相关的全景画像;
- 跨能力层级实验:以同族不同档位模型对比,干净地分离出"模型能力 vs 架构复杂度"的交互效应;
- 可操作的实践指南:提出 4 条设计建议(先验 LLM 能力 → 偏好简洁 → 引入对抗性 QA → 同时度量一致性),对工程实践有直接参考价值。
8. 不足与局限
- 基准单一:仅使用 terminal-bench 一个数据集,任务类型局限于命令终端系统工程,未覆盖 GUI 自动化、Web 任务、检索/问答、对话、创意写作等;
- 模型族单一:所有实验均在 OpenAI GPT-5 族上完成,未跨厂商验证(如 Claude、Gemini、Qwen、DeepSeek),可推广性受限;
- 重复运行偏少:多数配置仅 3 次运行,统计功效不足,部分指标标准差与均值同一数量级(如 vs ),置信区间宽;
- 无正交消融:未单独隔离"群聊通信"、"弹性反馈"、"顺序流约束"等单一原则的边际贡献,难以判定四项原则各自的具体贡献大小;
- 一致性未解:明确指出"下游智能体采纳上游框架"导致的可靠性问题,但未给出可行的解决方案(仅建议引入对抗性 QA);
- 超时与评估机制限制:MAS-L 性能下降部分归因于 terminal-bench 的任务超时,未探讨更长超时或更细粒度评估下的真实能力边界;
- 智能体提示词来源不完全公开:作者虽声明参考了多份公开提示词([12],[22],[29],[32]),但未在附录中给出完整 prompt,影响复现;
- 群体智能与人机协同未深入:摘要群聊支持人机协同作为副产物,但未对该场景进行专门评估;
- 缺乏失败模式分类:未对超时、工具调用错误、上下文饱和、规划错误等失败原因做系统归因(区别于 [17] 的失败分析工作)。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。