
在线强化学习微调中,真的需要预训练 Q 函数吗?
Do You Really Need to Pretrain Q-Functions for Online RL Fine-Tuning?
📝 TLDR
在线强化学习的预训练-微调范式下,Q函数是否需要预训练尚无定论。传统观点认为应基于离线数据预训练Q函数,但近期研究表明随机初始化即可获得良好性能。本文系统研究后发现,朴素Q函数预训练收益有限,根源在于预训练Q函数与在线微调收敛目标间存在根本错位。基于此,本文提出初始化策略集成(IPE)方法,通过训练多样化策略并汇集其采样轨迹来引导Q函数学习,在连续控制基准上平均提升微调性能1.26倍。
🧭 速览
质疑在线RL微调中朴素Q函数预训练的必要性,揭示其与在线收敛目标之间的根本错位问题。
提出初始化策略集成(IPE),训练多个多样化策略并汇集其采样轨迹,用于在线RL中Q函数的引导初始化。
在连续控制基准测试中,IPE相较朴素Q函数预训练平均提升微调性能1.26倍。
朴素Q函数预训练对在线RL微调帮助有限,IPE等基于多样化策略的初始化方式更具实用价值。
🆚 方法对比
暂未生成 — 点击下方按钮
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 10 张)
展开查看 10 张图
TL;DR
本文针对在线强化学习微调中 Q 函数是否需要预训练这一悬而未决的问题,给出了令人意外的否定答案。作者通过系统实验发现,朴素的 Q 函数预训练相比随机初始化几乎没有优势,根源在于预训练目标()与在线微调收敛目标()之间存在根本错位。基于此,作者提出了初始化策略集成(IPE)方法,通过训练多个多样化策略并汇集其回放数据来引导 Q 函数学习,在连续控制基准上实现了平均 1.26 倍的性能提升。
研究背景与动机
预训练-微调范式已成为机器学习领域的主流范式,从大语言模型到机器人控制模型,普遍遵循"先在大规模数据上预训练,再在特定任务上微调"的学习路线。在 [[强化学习]] 领域,当研究者手头已经有一个通过监督学习得到的预训练策略时,一个自然而关键的问题随之浮现:是否也应该在离线数据上预训练 Q 函数?
传统观点倾向于肯定答案。大量离线强化学习研究通常联合预训练策略与 Q 函数,仿佛预训练总是越多越好。然而,近期研究却给出了矛盾的信号——有工作表明,仅使用随机初始化的 Q 函数进行在线微调,同样可以获得高性能且稳定可靠的策略。这一现象让整个社区陷入困惑:Q 函数预训练究竟是必要的保险措施,还是不必要的计算浪费?
本文的切入点是系统性地诊断这一矛盾。作者关注的是一种更实际的场景:假设我们已经通过监督学习获得了一个固定的基础策略 ,现在要在此基础上进行在线微调,此时 Q 函数的初始化方式是否真的会影响最终性能?通过精心设计的对比实验,作者发现了一个令人惊讶的事实——朴素 Q 函数预训练几乎无法带来性能提升,而其背后的机制远比直觉复杂。
方法
作者首先选定了离策略强化学习算法 EXPO 作为基础框架,其核心思想是同时维护基础流策略 与一个轻量的"编辑策略" ,后者负责在 的动作基础上进行细微调整以追求更高的累积回报。在线推理时采用"即时最优动作"策略,从多个采样的候选动作中选择 Q 值最大的那个。
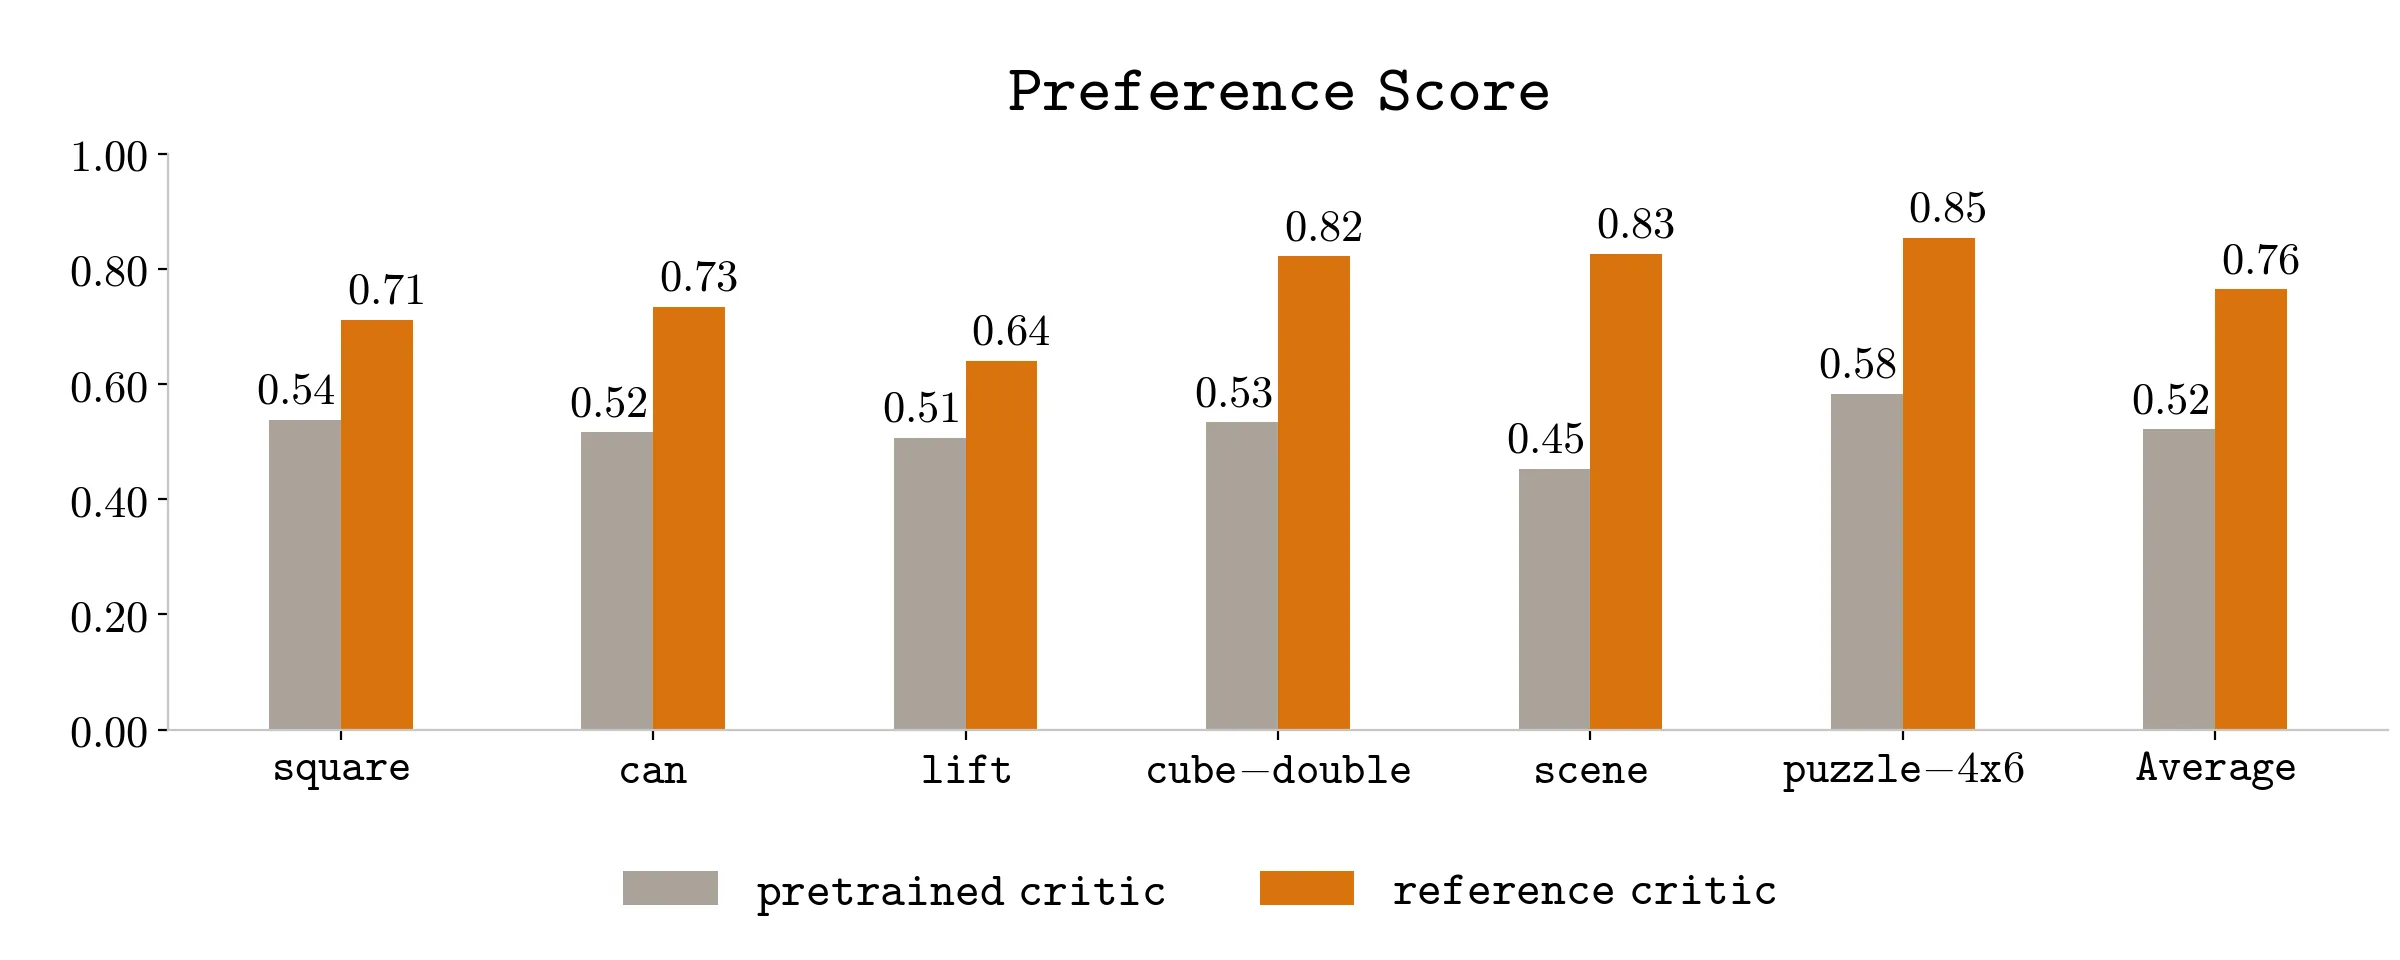
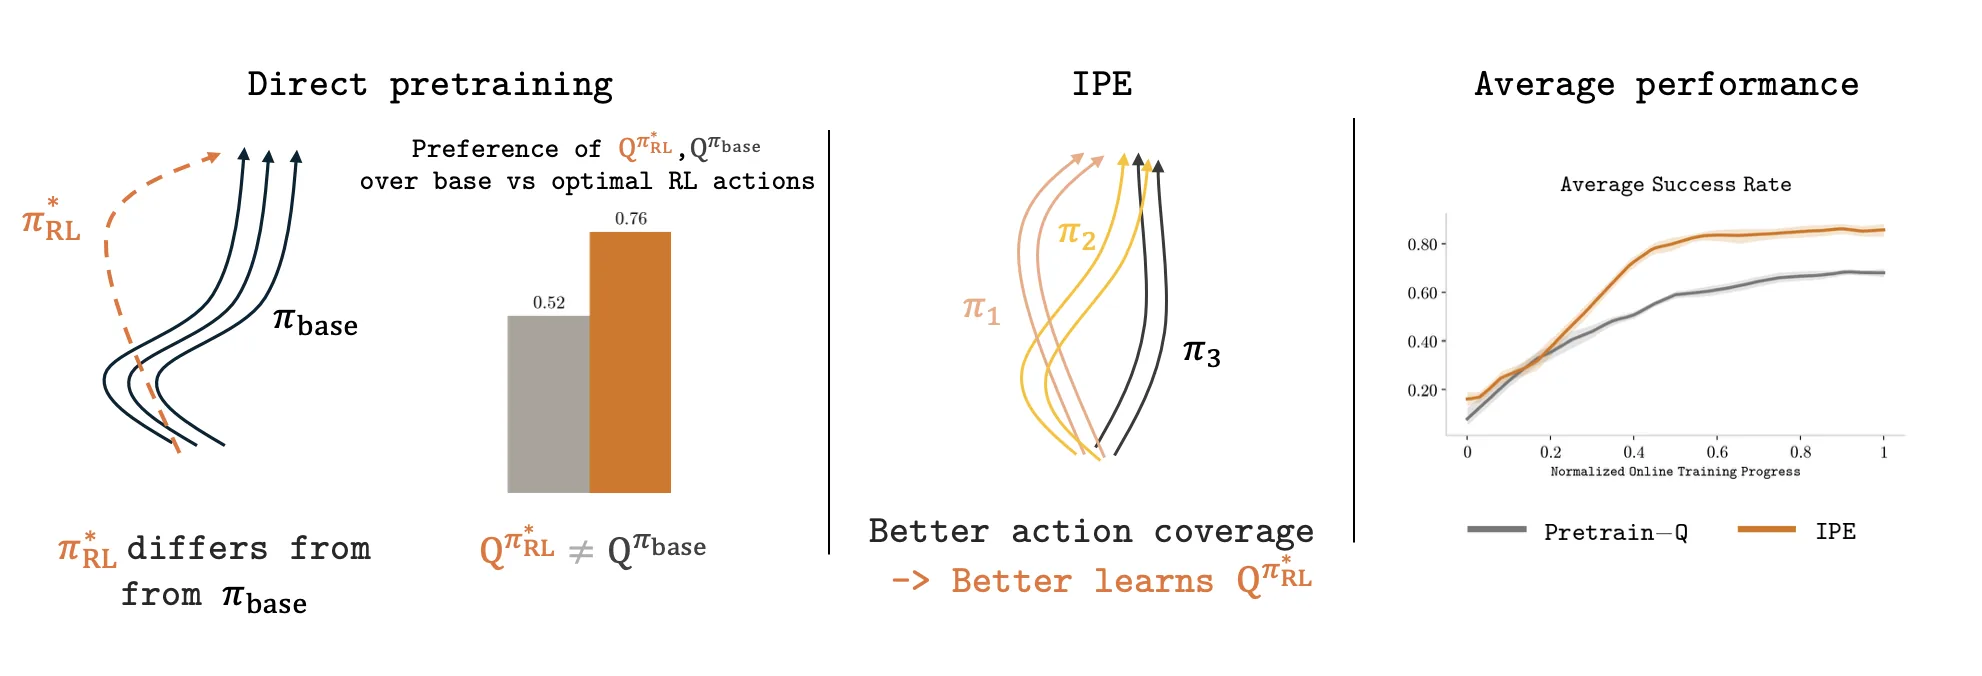
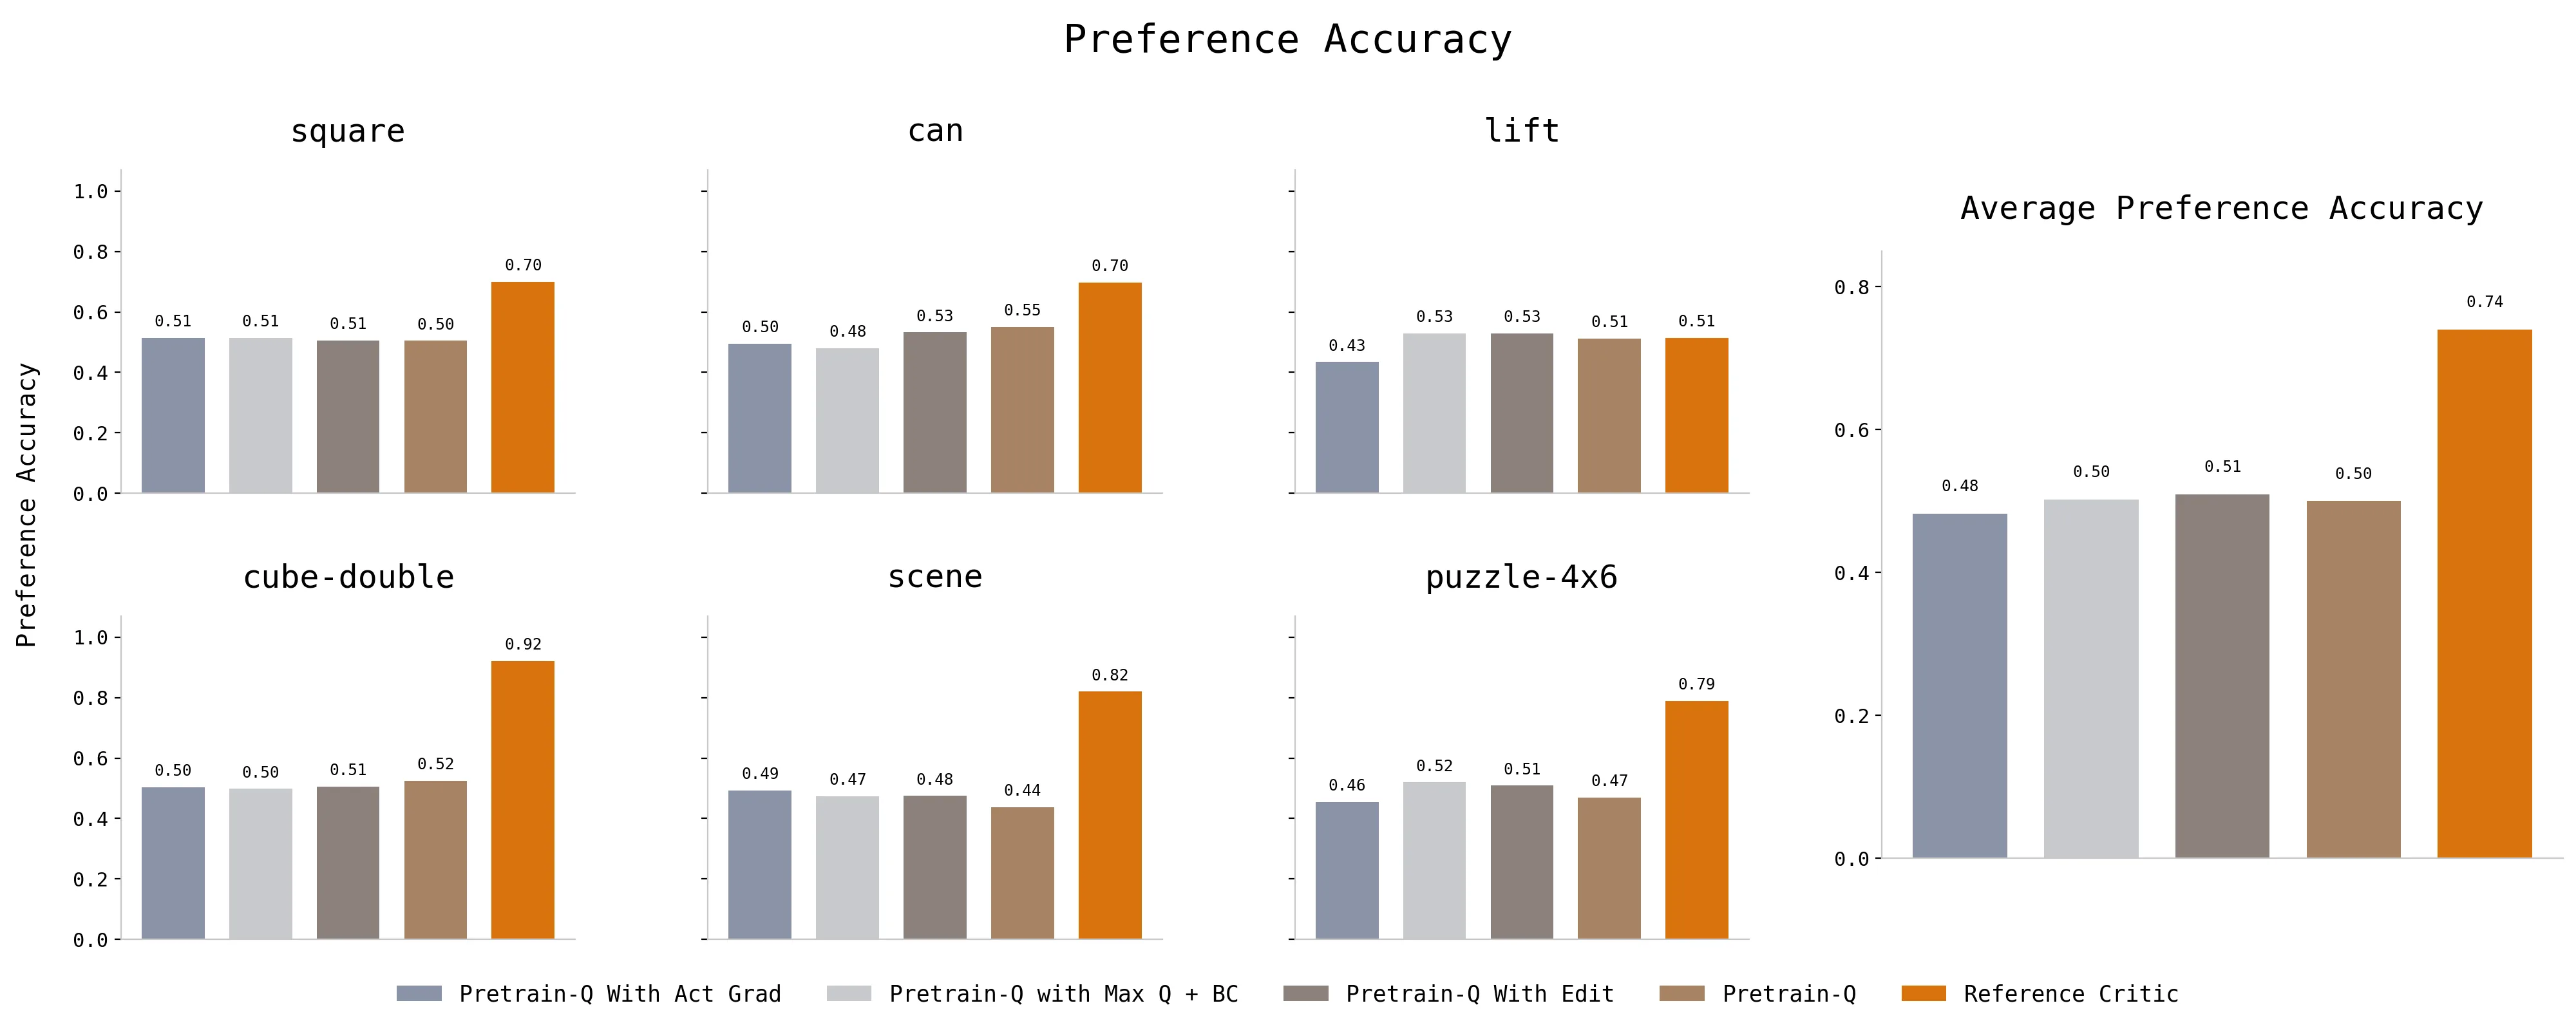
为了诊断朴素 Q 函数预训练为何无效,作者引入了偏好准确率这一评估指标,用来衡量学习到的 Q 函数能否正确地将最优策略的动作排在基础策略的动作之前。基于这一指标,作者揭示了问题的本质:离线预训练的 Q 函数无论经过怎样的离线价值最大化,都无法收敛到在线微调真正需要的 ,而是停留在 这个错误的目标上。
这个发现促使作者重新审视问题:预训练 Q 函数失败的根本原因不在于预训练本身,而在于单一基础策略产生的动作分布过于狭窄。当所有离线数据都来自 时,Q 函数只能学习到围绕这个策略的动作空间,而真正的最优策略 可能需要探索完全不同的动作区域。这种动作覆盖不足导致 Q 函数退化为近似状态价值函数 ,失去了 [[Q 函数]] 引导探索的核心能力。
基于这一诊断,作者提出了初始化策略集成方法。其核心思想朴素而有效:首先训练 个附加的策略(可以通过监督学习、使用不同随机种子或不同数据子集来实现多样化),然后让所有这些策略与环境交互,将它们的回放轨迹汇集到一个统一的缓冲区中。这个扩充后的缓冲区包含了远比单一策略更丰富的状态-动作覆盖,为 Q 函数学习提供了更完整的动作价值估计基础。当 时,IPE 退化为标准的在线强化学习预热阶段,体现了方法设计的优雅之处。
实验与结果
实验在两个连续控制基准上进行:Robomimic 系列包含 lift-ph、can-mh、square-ph 三个机械臂操作任务,OGBench 系列则包含 cube、scene、puzzle 三个更复杂的组合推理任务。作者固定使用 EXPO 算法作为离策略强化学习框架,仅在 Q 函数初始化方式上做对比,确保实验的公平性。
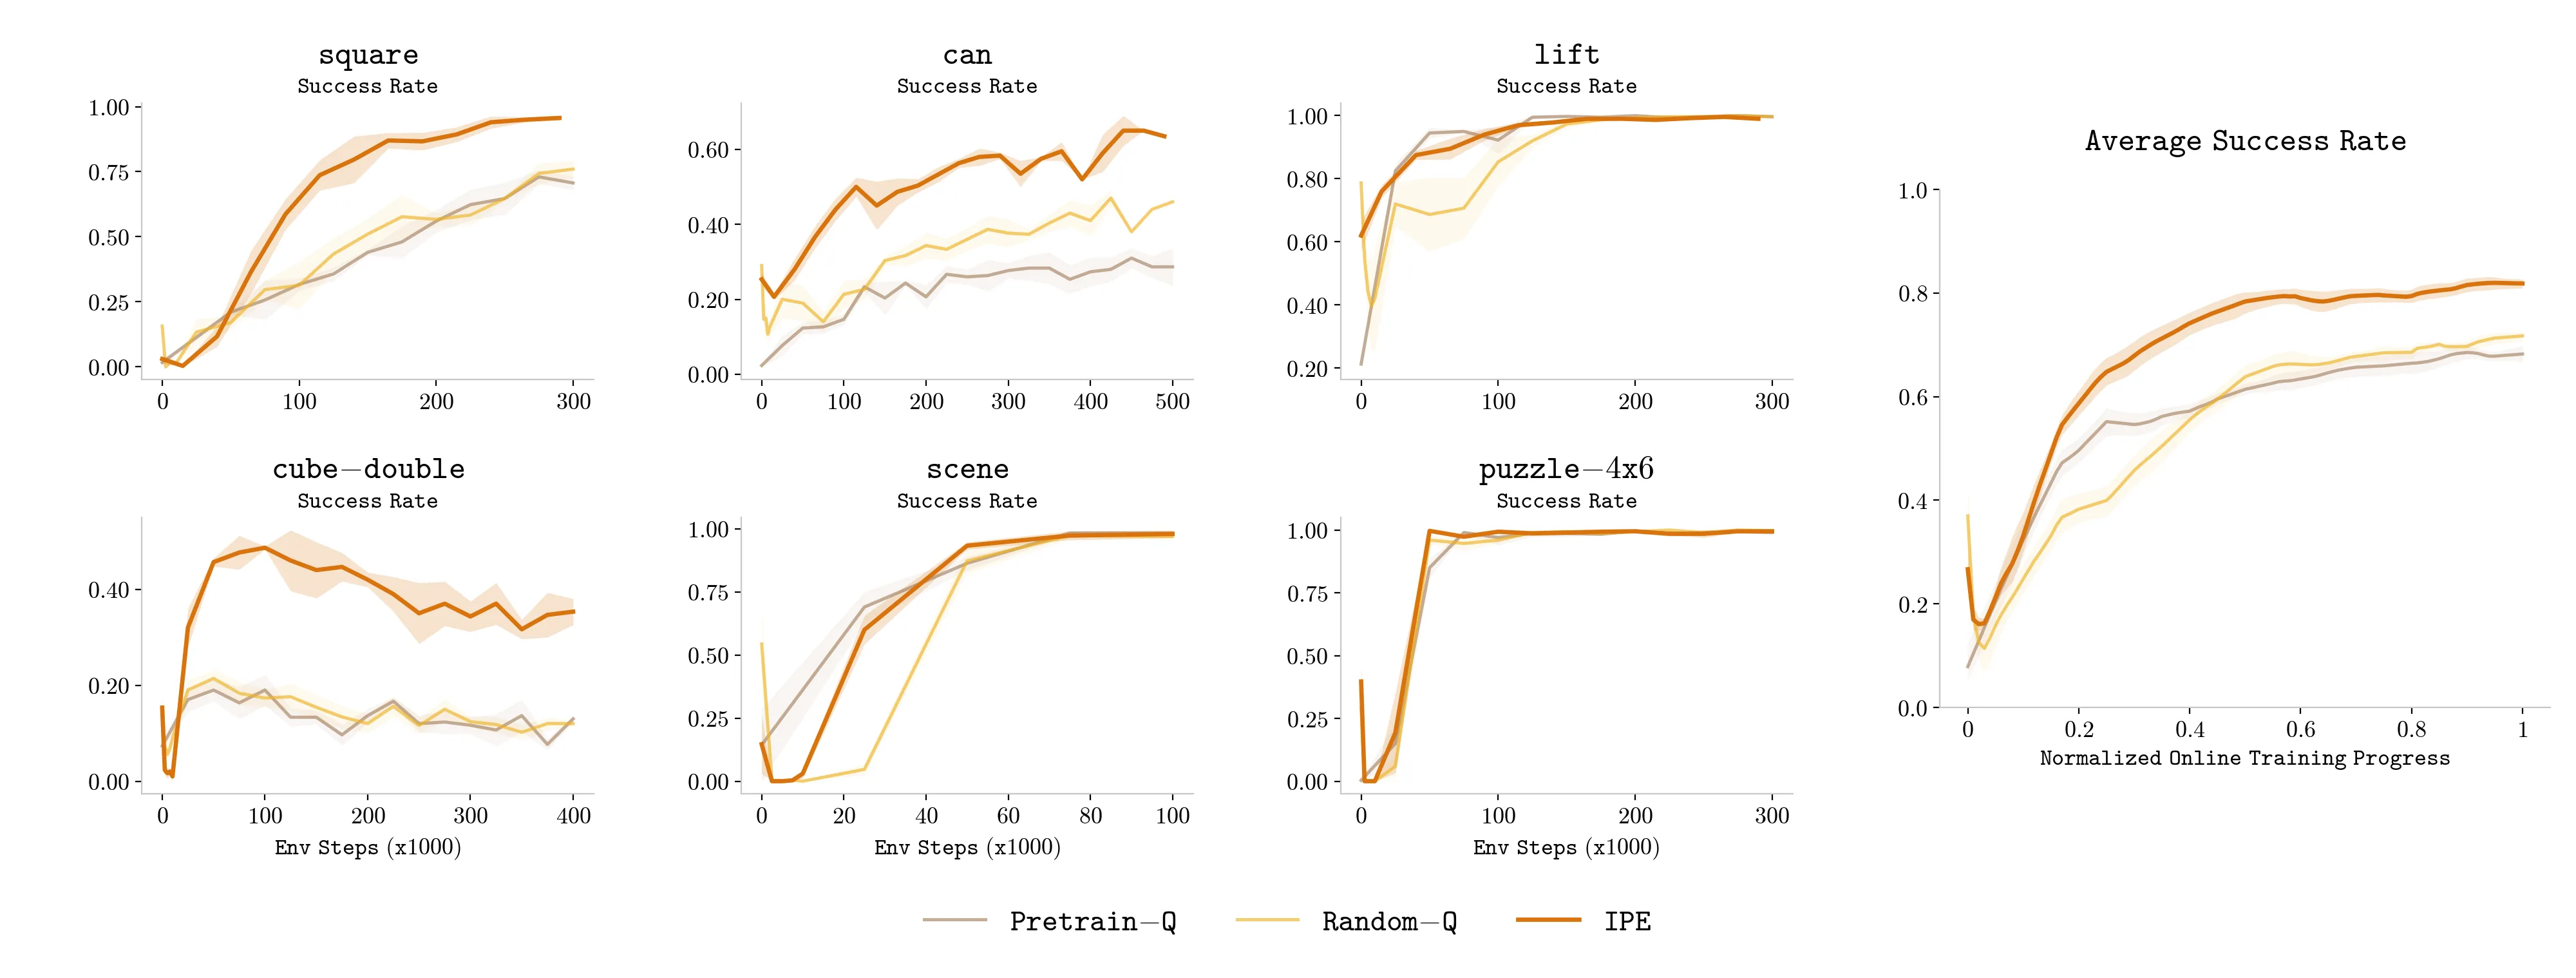
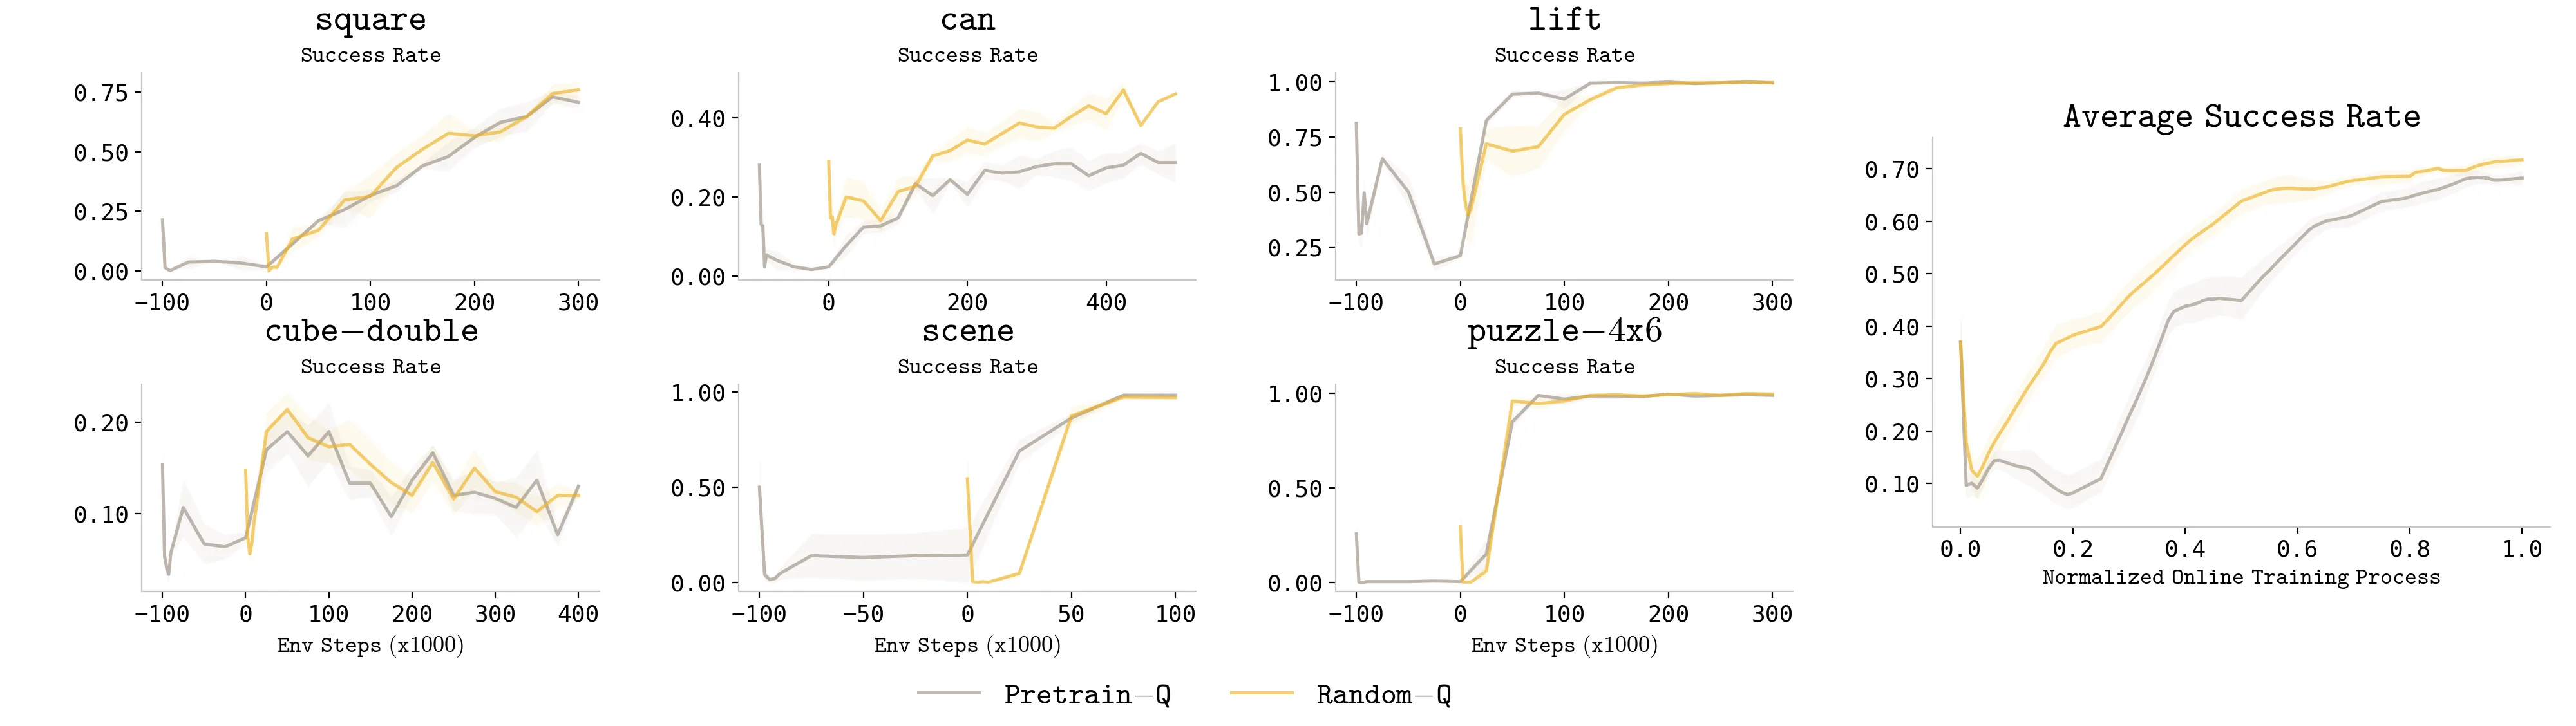
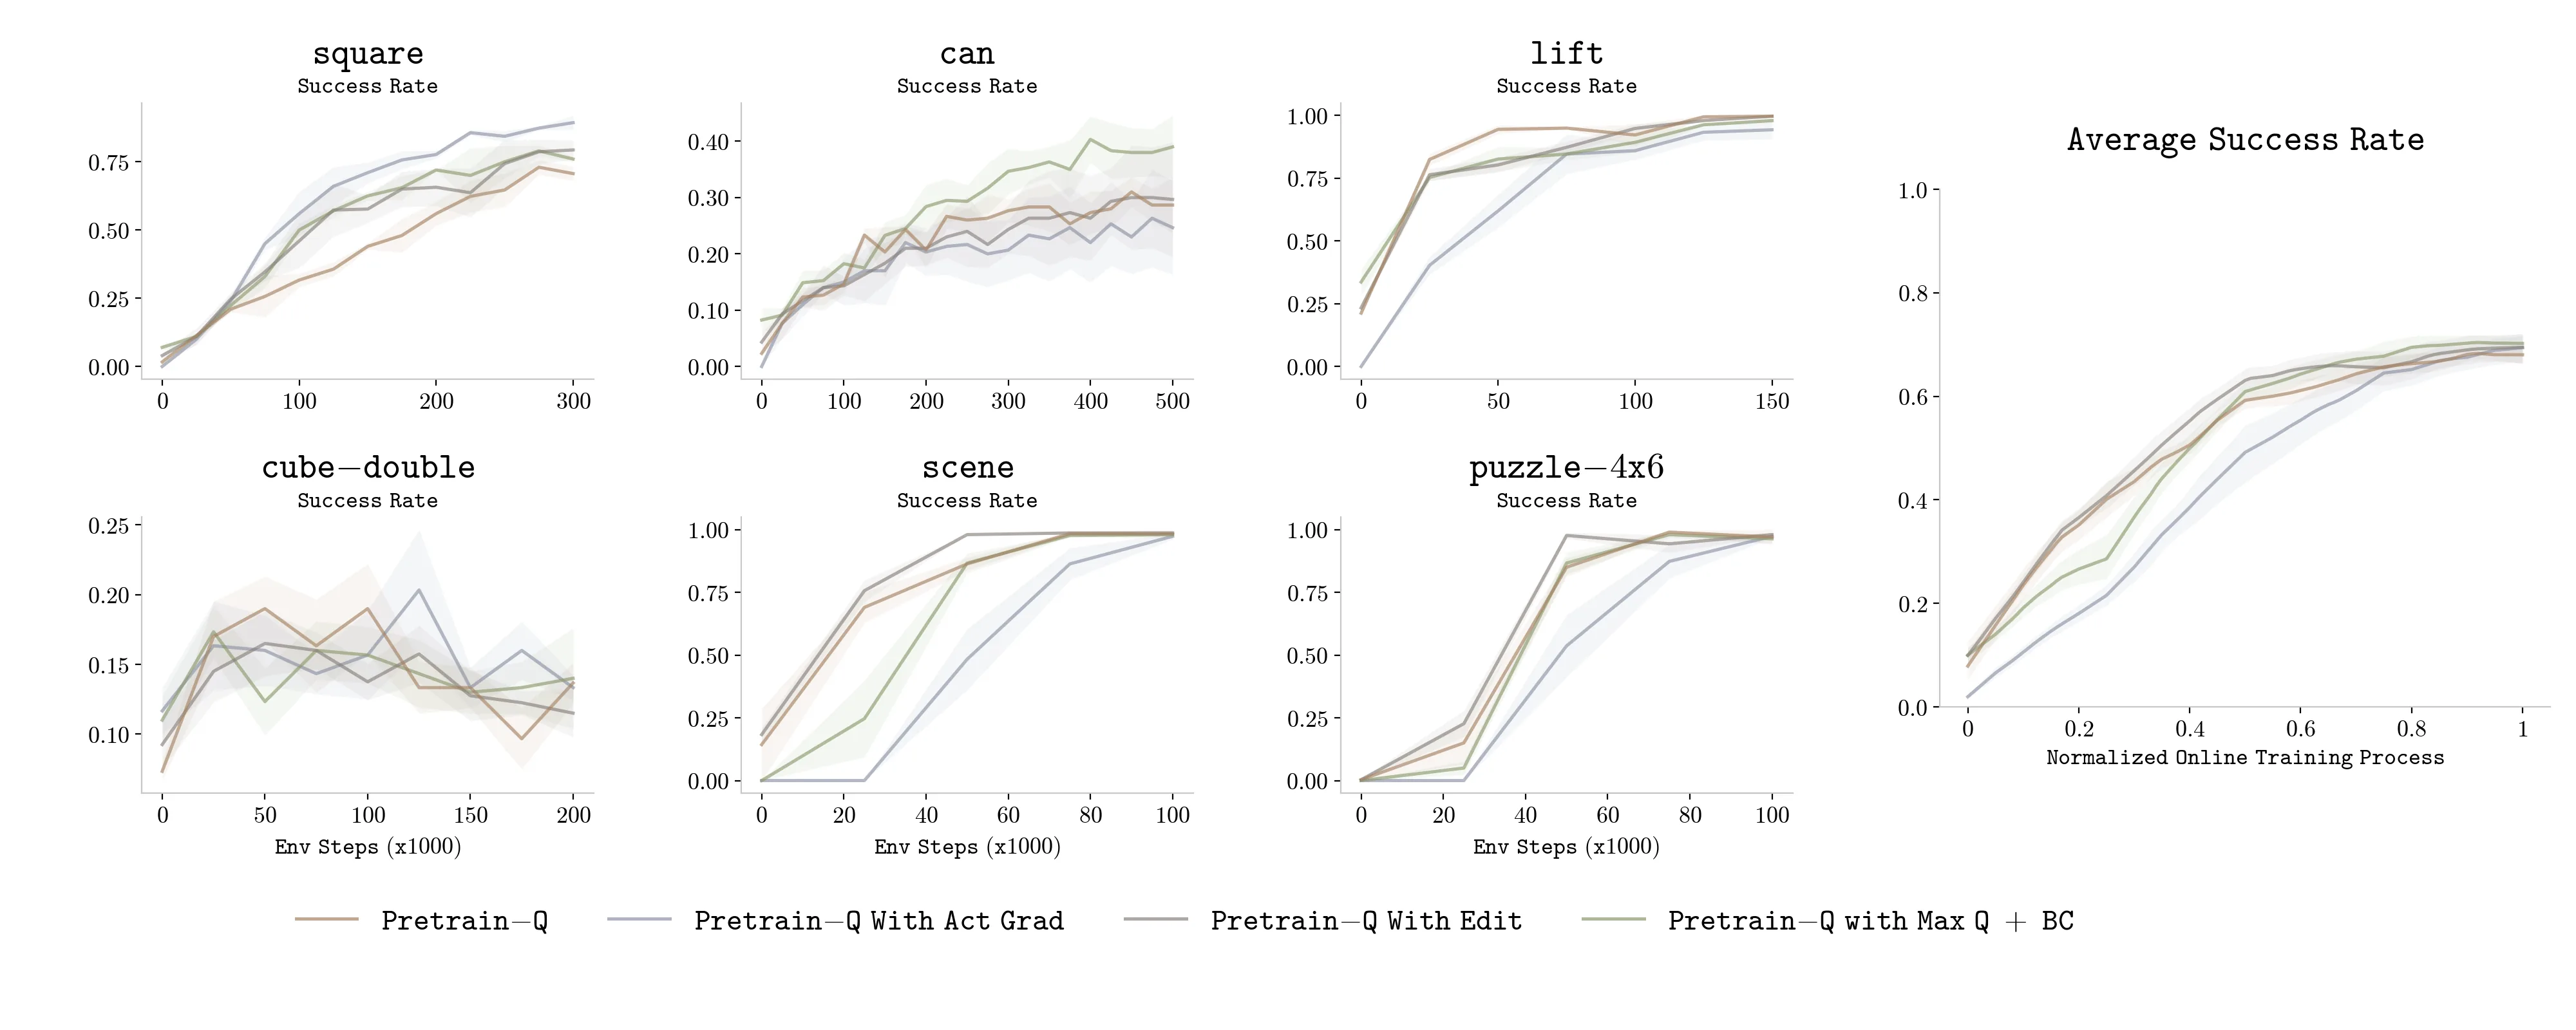
主实验结果揭示了几个关键发现。首先,朴素 Q 函数预训练(无论是直接预训练还是经过离线价值最大化修正)与随机初始化 Q 函数相比,性能差异微乎其微——这直接否定了传统观点中"预训练越多越好"的假设。其次,作者验证了三种直觉上可能有效的补救手段(学习编辑策略、Max Q 加行为克隆损失、动作梯度优化)均无法缩小 与 之间的差距,偏好准确率也没有实质性提升。
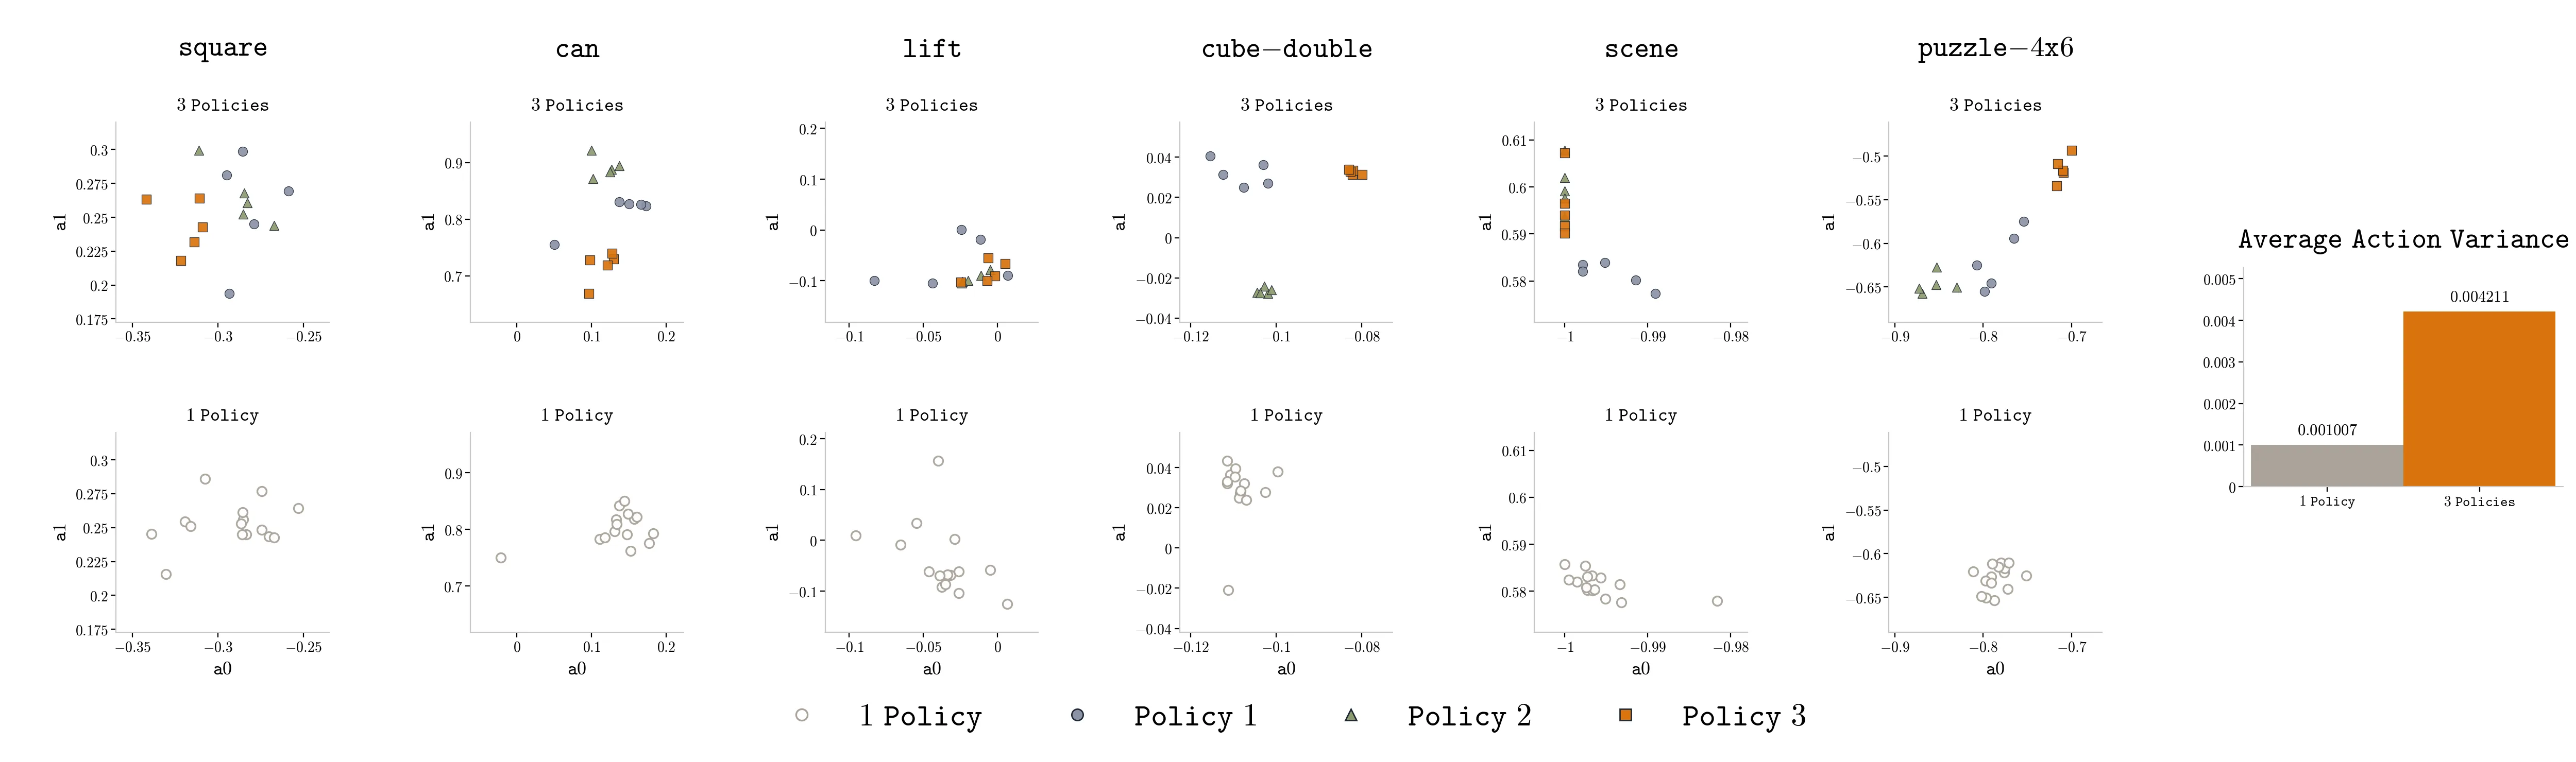
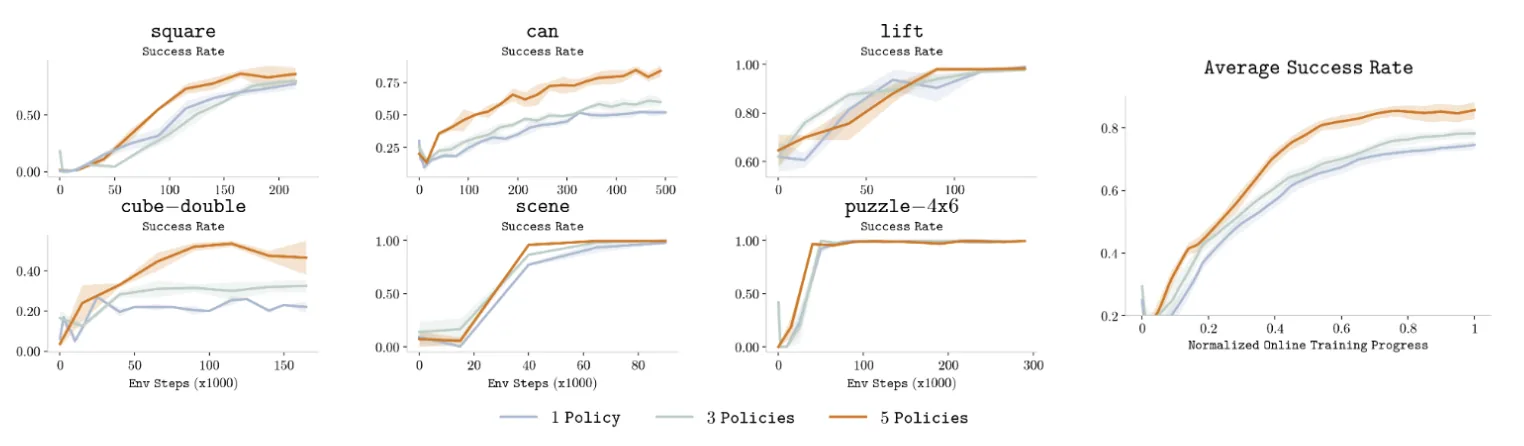
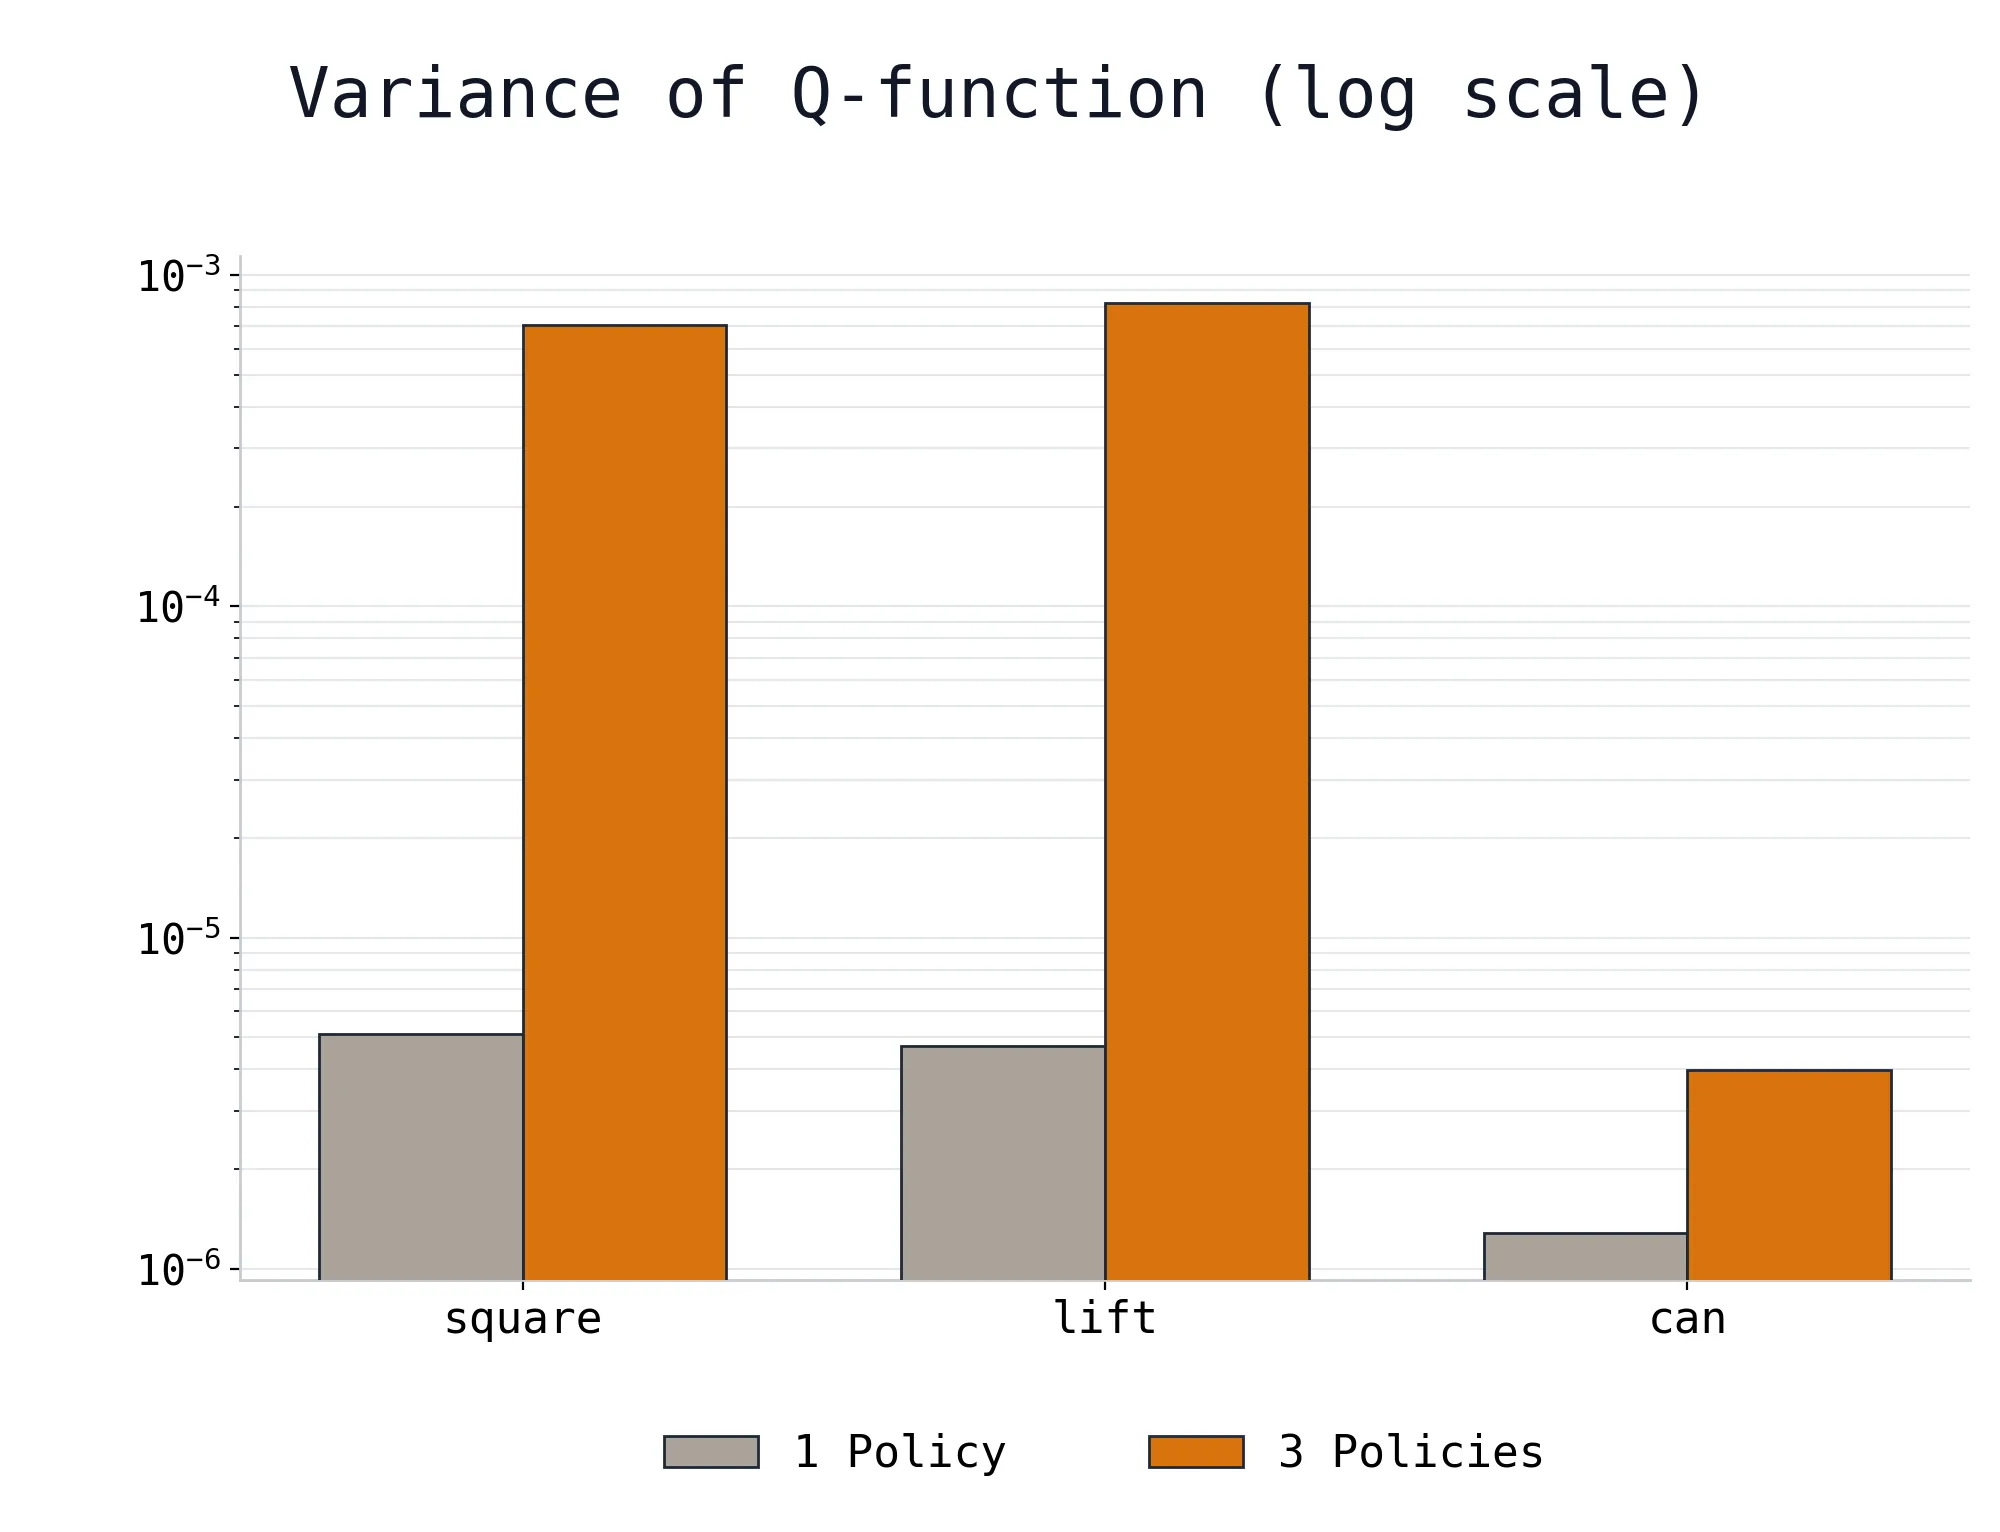
IPE 方法则展现出显著优势。随策略数量 增加,性能单调提升,在 时达到最优。在六个任务上平均实现 1.26 倍于朴素预训练的性能提升。更重要的是,消融实验表明这种提升确实来源于动作覆盖的扩展:使用单一策略时 Q 函数方差较小,说明价值估计集中在基础策略的动作空间附近;使用三个多样化策略后 Q 函数方差显著增大,反映出 Q 函数对更广阔动作空间的覆盖能力增强。
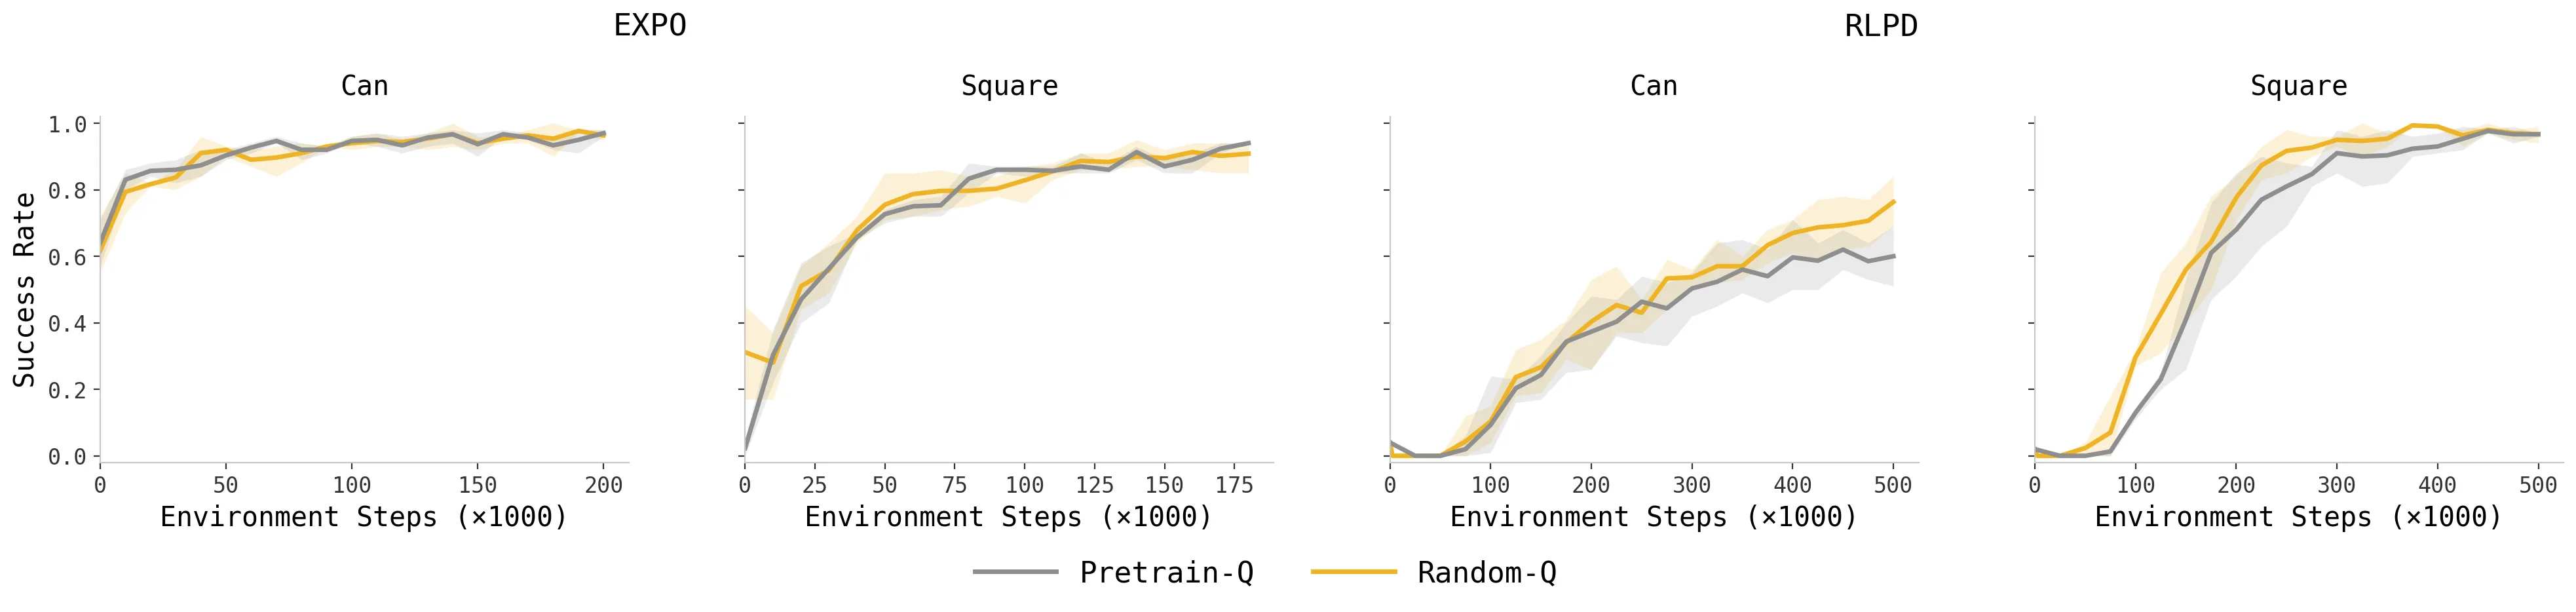
附录中的扩展实验进一步验证了结论的鲁棒性。在 update-to-data ratio 为 20 的高离策略设定下,以及切换到 RLPD 算法后,IPE 相比基线的优势依然保持。
讨论与可借鉴点
本文的核心贡献在于揭示了预训练-微调范式中一个长期被忽视的问题:预训练目标与微调目标之间的错位。在 Q 函数预训练的场景下,这种错位表现为 与 的不一致性。即使预训练策略已经接近最优,Q 函数仍然会固守于其训练数据所定义的动作分布,无法为在线微调提供有效的探索引导。
IPE 方法的成功在于它通过策略集成巧妙地绕过了目标错位问题,而不是试图在离线阶段直接修正 Q 函数。这种思路对于 [[离线强化学习]] 领域有重要启发:与其执着于在离线数据上优化价值估计,不如先确保离线数据具有足够的状态-动作覆盖。这一原则可能对其他离线到在线的迁移场景也有指导价值。
然而,本文也存在若干局限性需要承认。首先,IPE 需要对多个策略进行环境回放,带来了额外的数据采集开销,这在计算资源受限的场景下可能成为瓶颈。其次,所有实验都集中在相对小规模的预训练策略上,尚未在大规模视觉-语言-动作模型(如 VLA)上验证,而后者恰恰是预训练-微调范式最活跃的应用场景。此外,本文仅考察了离策略方法,对于 on-policy 方法如 PPO 是否存在类似的 Q 函数预训练失效问题尚未探索。最后,实验仅使用 3 个随机种子进行评估,统计显著性证据相对薄弱。
摘要
预训练后微调已成为学习高性能策略的主流方法。在基于价值的强化学习(RL)中,这自然引出一个问题:给定一个预训练策略,是否也应该在离线数据上预训练 Q 函数?传统观点认为应该如此,但最近的研究结果表明,使用随机初始化的 Q 函数进行在线强化学习也能产生高性能且可靠的策略,无需预训练 Q 函数。在本文中,我们系统地研究了当在预训练的基础策略之上进行微调时,预训练 Q 函数是否真的有所帮助。我们惊讶地发现,朴素的 Q 函数预训练相比随机初始化往往只能带来很小的收益。我们表明这源于一个根本性的不匹配:预训练期间学到的 Q 函数针对的是预训练策略的 Q 函数,而不是在线微调收敛到的 Q 函数,并且即使经过离线价值最大化,这个差距仍然存在。受此发现的启发,我们提出了通过策略集成进行初始化(Initialization via Policy Ensemble, IPE),这是一种简单的方法,它训练多个多样化的策略,并利用它们汇集的回放数据来引导在线强化学习中的 Q 函数学习。在一系列具有挑战性的连续控制基准测试中,IPE 在微调性能上相比朴素的 Q 函数预训练平均实现了 1.26 倍的提升。
Abstract
Pre-training followed by fine-tuning has become the dominant recipe for learning performant policies, and in value-based reinforcement learning (RL) this raises a natural question: given a pretrained policy, should the Q-function be pretrained on offline data too? Conventional wisdom suggests it should, but recent results show that online RL with a randomly-initialized Q-function can result in highly performant and reliable policies without needing to pretrain the Q-function. In this paper, we systematically study whether pretraining the Q-function actually helps when fine-tuning on top of a pretrained base policy. We find, surprisingly, that naive Q-function pretraining often provides little benefit over random initialization. We show this stems from a fundamental mismatch: the Q-function learned during pretraining targets the pretrained policy's Q-function, not the Q-function that online fine-tuning converges to, and this gap persists even after offline value maximization. Motivated by this finding, we propose Initialization via Policy Ensemble (IPE), a simple method that trains multiple diverse policies and uses their pooled rollouts to bootstrap the Q-function learning in online RL. Across a suite of challenging continuous control benchmarks, IPE yields an average 1.26x improvement in fine-tuning performance over naive Q-function pre-training.
论文详细总结(自动生成)
论文总结:在线强化学习微调中,真的需要预训练 Q 函数吗?
1. 核心问题与整体含义
- 研究背景:预训练–微调已成为学习高性能策略的主流范式,广泛应用于大语言模型与机器人(如视觉-语言-动作 VLA 模型)。在基于价值的强化学习(RL)中,当已有预训练策略时,一个自然而关键的问题是:是否也应该在离线数据上预训练 Q 函数?
- 传统观点与最新证据的冲突:传统离线到在线 RL 工作通常联合预训练策略与 Q 函数;但近期研究表明,仅以预训练策略 + 随机初始化的 Q 函数进行在线微调,也能取得高性能甚至更稳定的表现。
- 本文聚焦问题:在仅给定一个固定预训练策略(不要求与离线 RL 算法联合训练)的前提下,系统性地考察 Q 函数预训练是否真正能提升在线 RL 微调的样本效率与最终性能,并解释为何朴素预训练常常无效。
- 核心动机:揭露朴素 Q 函数预训练与在线 RL 收敛目标之间存在根本错位,并提出改进策略。
2. 方法论
2.1 问题形式化
- 环境建模为 MDP ,目标是最大化折扣累积回报 。
- 给定预训练基础策略 (通过监督学习得到)和离线数据集 ,研究如何预训练 Q 函数 以提升在线微调表现。
- 使用 EXPO 作为离策略 RL 微调算法:维护基础流策略 与轻量"编辑策略" ,后者最大化:
- 在线推理采用"即时最优动作"(On-the-Fly, OTF)策略,从 个采样动作中选取 Q 值最大者:
2.2 关键诊断:Q 函数错位
- 引入 偏好准确率(preference accuracy):衡量学习到的 Q 函数将 动作排在 动作之前的比例。
- 实验发现(即便 训练至接近 100% 成功率):
即离线预训练的 Q 函数收敛到的目标 ,与在线微调最终需要的 不同。
- 三种离线价值最大化补救手段均无效:
1. 学习 EXPO 的编辑策略;
2. 在 上蒸馏一步最大化 Q 值的策略(Max Q + BC loss);
3. 直接对 做动作梯度优化。
- 三者均无法拉近 与 之间的距离,偏好准确率与最终性能均无提升。
2.3 IPE(Initialization via Policy Ensemble)算法
- 核心思想:单一预训练策略产生的动作分布过于狭窄,导致 Q 函数退化为 。通过对同一行为分布训练 个多样化策略,并汇集它们的环境回放,可以扩展 Q 函数对状态-动作空间的覆盖。
- 算法流程(Algorithm 1):
1. 输入离线数据 与基础策略 ;
2. 训练 个附加策略 (监督学习,可使用相同或不同子集数据、不同随机种子);
3. 初始化回放缓冲区 ;
4. 对每个策略 进行环境回放,将转移 加入缓冲区;
5. 输出扩充后的缓冲区供在线 RL 使用。
- 当 时退化为标准的在线 RL 预热阶段。
3. 实验设计
- 任务基准:
- Robomimic:lift-ph、can-mh、square-ph(7 自由度机械臂操作);
- OGBench:cube-double-singletask-task2-v0、scene-singletask-task2-v0、puzzle-4x6-singletask-task2-v0(含长视野组合推理)。
- 基础 RL 算法:EXPO,并附加验证 RLPD(附录 A)。
- 对比基线:
1. 朴素 Q 函数预训练 + 在线微调;
2. 随机初始化 Q 函数 + 在线微调;
3. IPE(论文提出的方法);
4. 多种离线价值最大化变体作为补救(EXPO edit 策略、Max Q+BC、Q 动作梯度)。
- 训练配置:update-to-data ratio(UTD)为 1(主实验),附录额外验证 UTD=20。
- 评估指标:成功率随微调步数变化曲线;偏好准确率(preference accuracy);Q 函数方差。
- Q 函数训练目标:标准 TD 学习
4. 资源与算力
- 论文未明确给出 GPU 型号、数量或训练时长等算力信息。
- 仅在附录 B.2 中给出超参数表(如 AdamW 学习率 、折扣因子 、batch size 256、Q 函数数量 10 等),但未说明硬件规模。
- 由于实验聚焦于"小规模"策略以进行系统分析(论文中已声明),算力需求相对可控,但仍缺乏透明度。
5. 实验数量与充分性
- 主实验(图 2–7):6 个任务 × 2–3 种 Q 初始化方式 = 约 18–24 条主曲线;
- 消融与诊断:
- Q 函数方差分析(1 策略 vs 3 策略)(图 8);
- 偏好准确率分析(图 3、图 5);
- 策略数量 的扩展性研究(图 9,覆盖 等);
- 离线价值最大化三种补救手段(图 4、图 5);
- 附录 A:EXPO/RLPD 在 UTD=20 下的对比;
- 充分性评估:
- 任务多样性较好(短视野 + 长视野、组合泛化);
- 对比公平(同策略、同算法,仅 Q 初始化差异);
- 不足:每个设定仅 3 个随机种子(附录 B.3 提及),统计显著性证据较弱;缺少对更大规模预训练策略(如 VLA 模型)的实验验证;未在更广泛的 on-policy 算法或离散动作空间任务上验证。
6. 主要结论与发现
- 结论 1:朴素 Q 函数预训练对在线 RL 微调几乎没有帮助,甚至在某些任务上损害性能;这与"预训练越多越好"的直觉相悖。
- 结论 2:根源在于目标错位——预训练收敛到 ,而在线微调需要 ,二者即使在 近最优时仍不一致。
- 结论 3:离线价值最大化(编辑策略蒸馏、Max Q+BC、动作梯度)无法缩小该错位,必须依赖在线交互。
- 结论 4:单一策略的动作覆盖不足,导致 Q 函数坍缩为 ;通过 IPE 训练多个多样化策略并汇集回放,可显著提升 Q 函数对状态-动作空间的覆盖。
- 结论 5:IPE 在六个连续控制任务上相对朴素 Q 函数预训练平均带来 26%(即 1.26×)的性能提升,并随 增大而单调改善( 时最佳)。
7. 优点
- 问题新颖且具现实意义:首次系统性地质疑在线 RL 微调中 Q 函数预训练的必要性,对当前 VLA 模型在线微调范式有直接指导意义。
- 诊断深入透彻:从偏好准确率、Q 函数方差、动作多样性等多角度剖析失败原因,定位到"目标错位"这一根本机制。
- 方法简洁实用:IPE 不需修改 RL 算法本身,仅在数据回放阶段引入多样化策略,工程成本低。
- 实验设计较为公平:共享同一基础策略、同一 RL 算法,仅切换 Q 函数初始化方式,排除算法层面的混淆变量。
- 消融与扩展性研究完整:包含 数量、UTD 比、不同算法(EXPO、RLPD)下的验证。
8. 不足与局限
- 离线数据利用率不足:IPE 需要额外对多个策略做环境回放,带来额外数据采集开销;论文明确承认这是局限并留作未来工作。
- 任务规模受限:所有实验集中在"小规模"预训练策略,未在真正的 VLA 模型(如 π0.5、π*0.6)上验证,限制了结论在大模型场景下的可推广性。
- 算法覆盖不足:仅考察离策略方法(EXPO、RLPD),未在 on-policy 方法(如 PPO)下验证其结论。
- 种子数较少:每设定仅 3 个随机种子,统计显著性证据偏弱,且附录中部分实验(如 RLPD UTD=20)展示略显粗糙。
- 理论分析薄弱:未提供关于"为何 "的形式化理论刻画(如收敛性、误差上界),主要依赖实证。
- 可解释性局限:IPE 的成功被归因于"动作覆盖更广",但未定量刻画"覆盖到何种程度足以桥接错位",缺乏更精细的准则。
- 应用范围:聚焦连续控制机械臂操作任务,对其他领域(如自动驾驶、游戏、推荐系统)的适用性未探讨。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。