
SERPO:面向开放式测试时强化学习的自演化评分标准策略优化
SERPO: Self-Evolving Rubric Policy Optimization for Open-Ended Test-Time Reinforcement Learning
📝 TLDR
测试时强化学习依赖答案投票,难以扩展到开放式生成场景。SERPO提出自演化闭环机制,用Good-Normal-Bad响应分层、查询专属评分标准演化与概率判据打分三路协同替代投票。在两模型配置与六基准上提升显著,HealthBench最高+20.63分、ResearchQA最高+20.31分,六基准宏平均最高+8.06分,并支持OOD迁移与跨基准持续演化。
🧭 速览
现有TTRL依赖答案投票,而开放式生成无标准答案,需从模型自身输出中构建可靠奖励信号。
构建响应档案、查询专属评分标准与策略参数的三路协同演化闭环,以判据token概率对rollout打分驱动策略更新。
HealthBench最高+20.63分、ResearchQA最高+20.31分,六基准宏平均最高+8.06分,支持OOD迁移与跨基准持续演化。
验证无外部奖励模型下,基于自演化评分标准实现开放式测试时强化学习的可行性与泛化能力。
🆚 方法对比
SERPO(Self-Evolving Rubric Policy Optimization)
- 三路闭环协同进化,突破开放生成无标准答案瓶颈
- HealthBench提升20.63分,六基准宏平均提升8.06分
- 不需外部奖励模型或更强判官即可自进化
- 支持OOD迁移和跨基准持续演化
- 依赖verdict token概率,自评分数仍含噪声
- rubric需随策略持续演化,计算开销较大
- 多组件闭环设计,工程实现复杂度高
G-N-B响应进化
- 最大化分离rollouts,有序归档便于对比
- 无需参考答案即可生成判别性证据
- 为rubric提取提供结构化分组
- 极端响应分类边界主观,可能引入偏差
- 依赖rollout多样性,低多样性场景失效
Rubric进化模块
- 保留有区分度的标准,去除持续弱标准
- 支持合并去重,rubric质量持续优化
- query-specific设计,适应不同任务
- rubric质量受初始rollout覆盖度制约
- 演化过程中标准集合稳定性不足
概率化评分接口(Probabilistic Criterion Scoring)
- 保留分级置信度,奖励信号更细粒度
- 将verdict token似然转化为可优化奖励
- 与GRPO等组相对优化天然兼容
- 依赖verdict token校准,存在分布漂移
- 概率聚合方式对噪声敏感
现有TTRL答案投票方法(Majority Voting / Self-Consistency)
- 实现简单,无需外部奖励模型
- 在多选题和规范化任务上效果稳定
- 无法处理开放生成,奖励共享遗漏
- 有效回答因表述不同被误判为错误
现有Rubric奖励方法(Liu 2023、Kim 2024等)
- 可评估事实性、完整性和安全性等多维度
- 适合作为开放生成的可解释评分依据
- 依赖预定义或冻结rubric,无法自适应演化
- 通常需要额外rubric生成器或评估器配合
判官式响应投票与Claim-Consensus目标
- 相比简单投票更鲁棒,引入判官置信度
- 作者提出的更强基线,验证SERPO必要性
- 仍受判官模型能力上限制约
- 未解决rubric随策略共进化的核心问题
现有TTRL依赖答案投票,无法处理开放生成;现有rubric方法使用固定标准,SERPO通过G-N-B归档、query-specific rubric进化与概率化评分构成三路闭环,无需参考答案即可在开放任务上显著超越基线。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 10 张)
展开查看 10 张图


TL;DR
SERPO 提出了一种在无标注反馈、无外部奖励模型、无更强评判器的约束下,让语言模型在推理阶段自我进化的框架。它用响应档案、查询专属评分标准和策略参数的三方协同演化闭环,取代了传统测试时强化学习方法依赖的答案投票机制。在 HealthBench 和 ResearchQA 上分别最高提升 20.63 和 20.31 分,六基准宏平均最高提升 8.06 分,并展现出良好的分布外迁移能力。
研究背景与动机
测试时强化学习(TTRL)让语言模型能够在推理阶段无需人工标注即可自我改进,这一特性在开放式生成场景中尤为重要——因为这类场景的响应无法被压缩到一个统一的标准答案。然而,现有 TTRL 方法几乎无一例外地依赖答案投票机制:多次采样响应,通过多数投票或自一致性聚合产生伪标签作为奖励信号。这种做法在选择题或符号输出任务中表现良好,却难以自然地推广到开放式生成领域。
开放式生成面临的根本困难在于:两条同样高质量的医疗建议或研究问答响应,可能在表达方式、侧重点和细节层次上差异显著,但答案投票会将"共同遗漏"视为共识加以奖励,同时惩罚那些正确但非主流的替代方案。更棘手的是,在固定测试集、无参考答案、无外部奖励模型、无更强评判器的严格约束下,演化信号必须完全从模型自身的输出中构建——这是一个自指涉的挑战:模型如何可靠地评判自己的输出质量?
已有的[[测试时强化学习]]方法在开放式场景中尝试引入 rubric(评分标准)来引导响应评估,但这些方案通常依赖外部生成的 rubric、使用冻结模型接收 rubric 反馈,或在宽松的算力预算下联合训练 rubric 生成器与策略。这些设置都无法满足固定测试集下 label-free 自演化的需求。SERPO 的核心切入点是:在一个闭环中同时演化响应证据、查询专属评分标准和策略参数,让三者相互支撑、相互校准。
方法
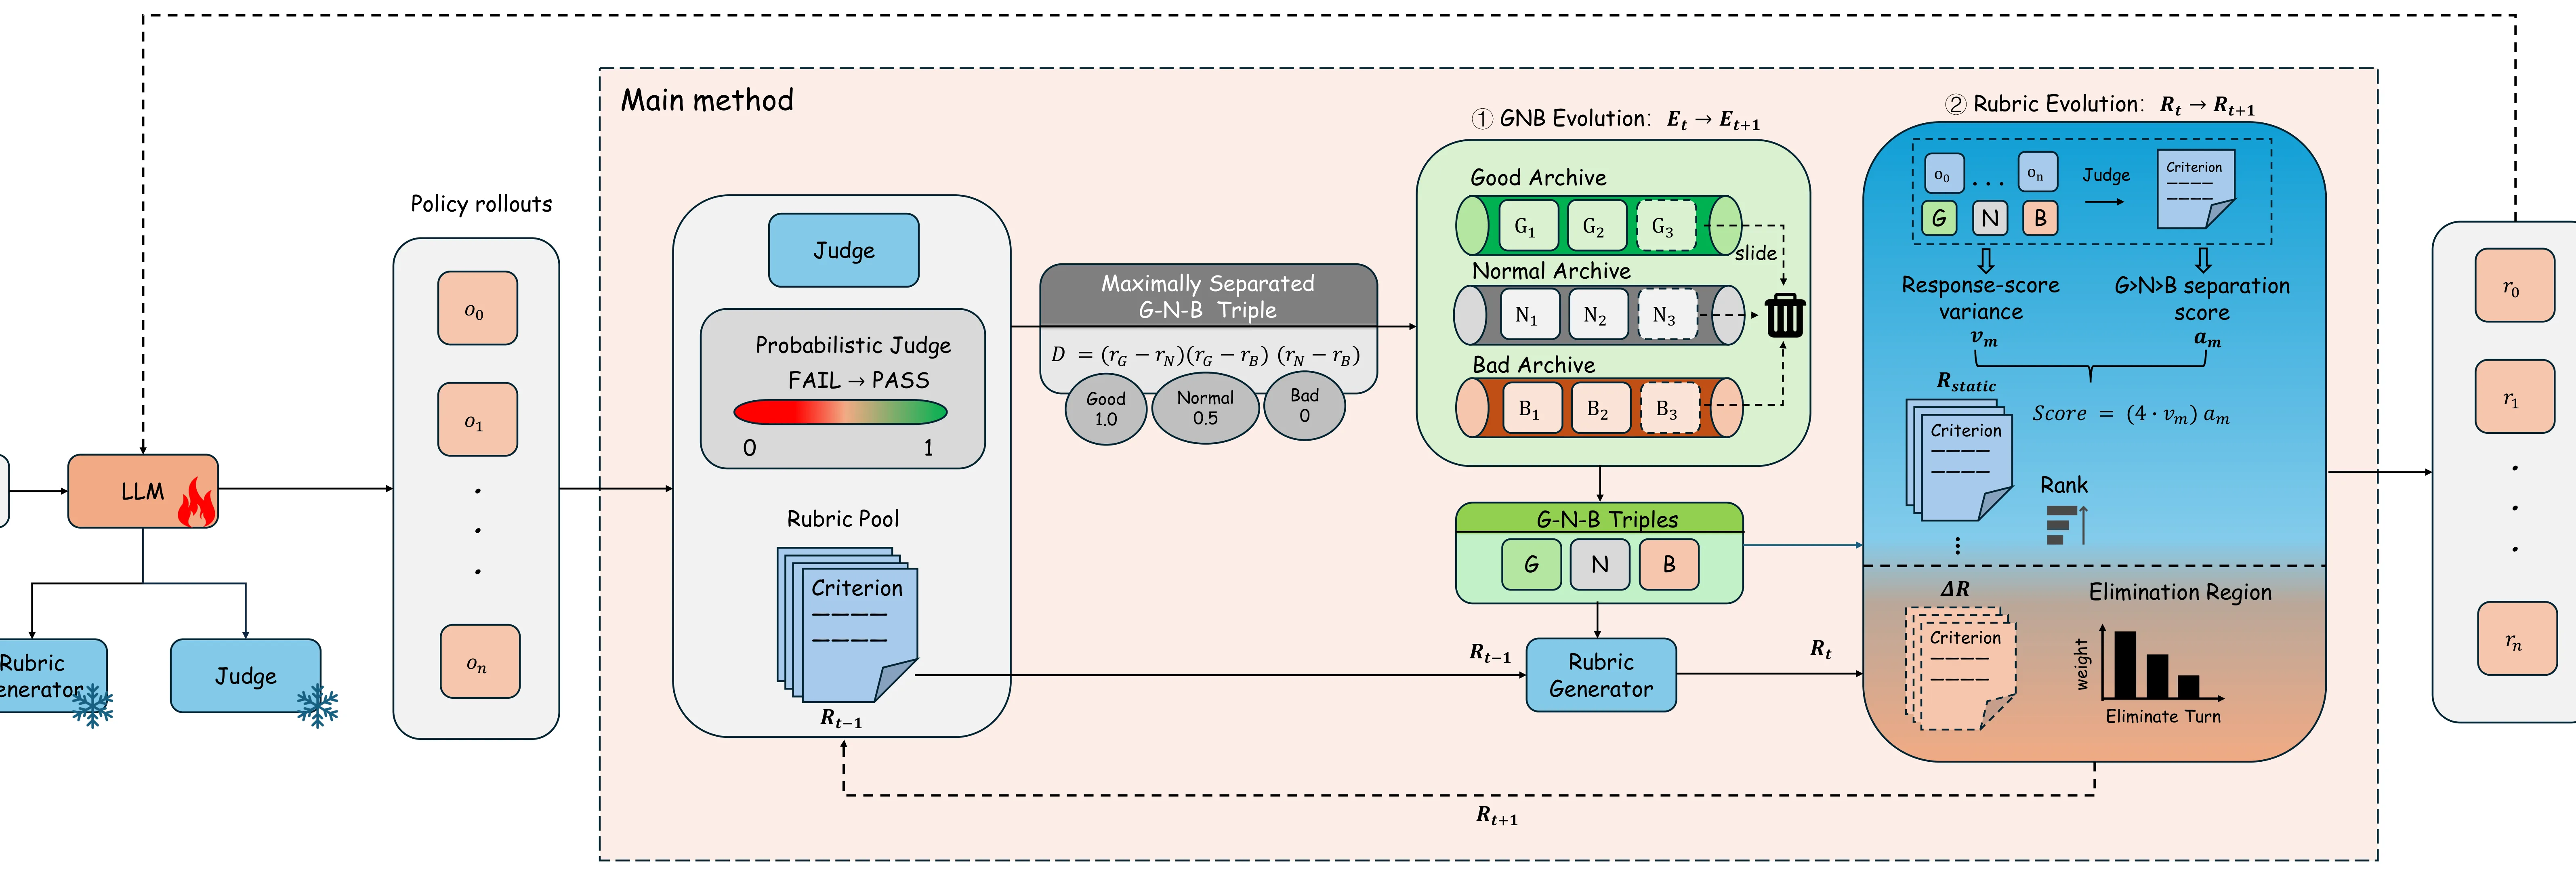
SERPO 的设计围绕一个三方协同演化的闭环展开,对每个 prompt 维护三类状态:响应档案、查询专属 rubric 和共享的 actor 参数。判据生成器和概率判据打分器始终保持冻结状态,只有 actor 参数可学习——这种设计避免了在演化过程中引入评估者自身漂移的风险。
概率化准则打分是整个框架的评分锚点。当用 rubric 中的每条准则去评判一条响应时,模型会输出 True 或 False 的 token,SERPO 将这些 token 的后验对数概率转化为 区间内的满足概率:
极性化得分 根据准则的极性 决定是奖励符合还是奖励不符合。这种概率化处理避免了硬判决将 GRPO 的优势估计压缩为平局,保留了响应之间的细微质量差异。
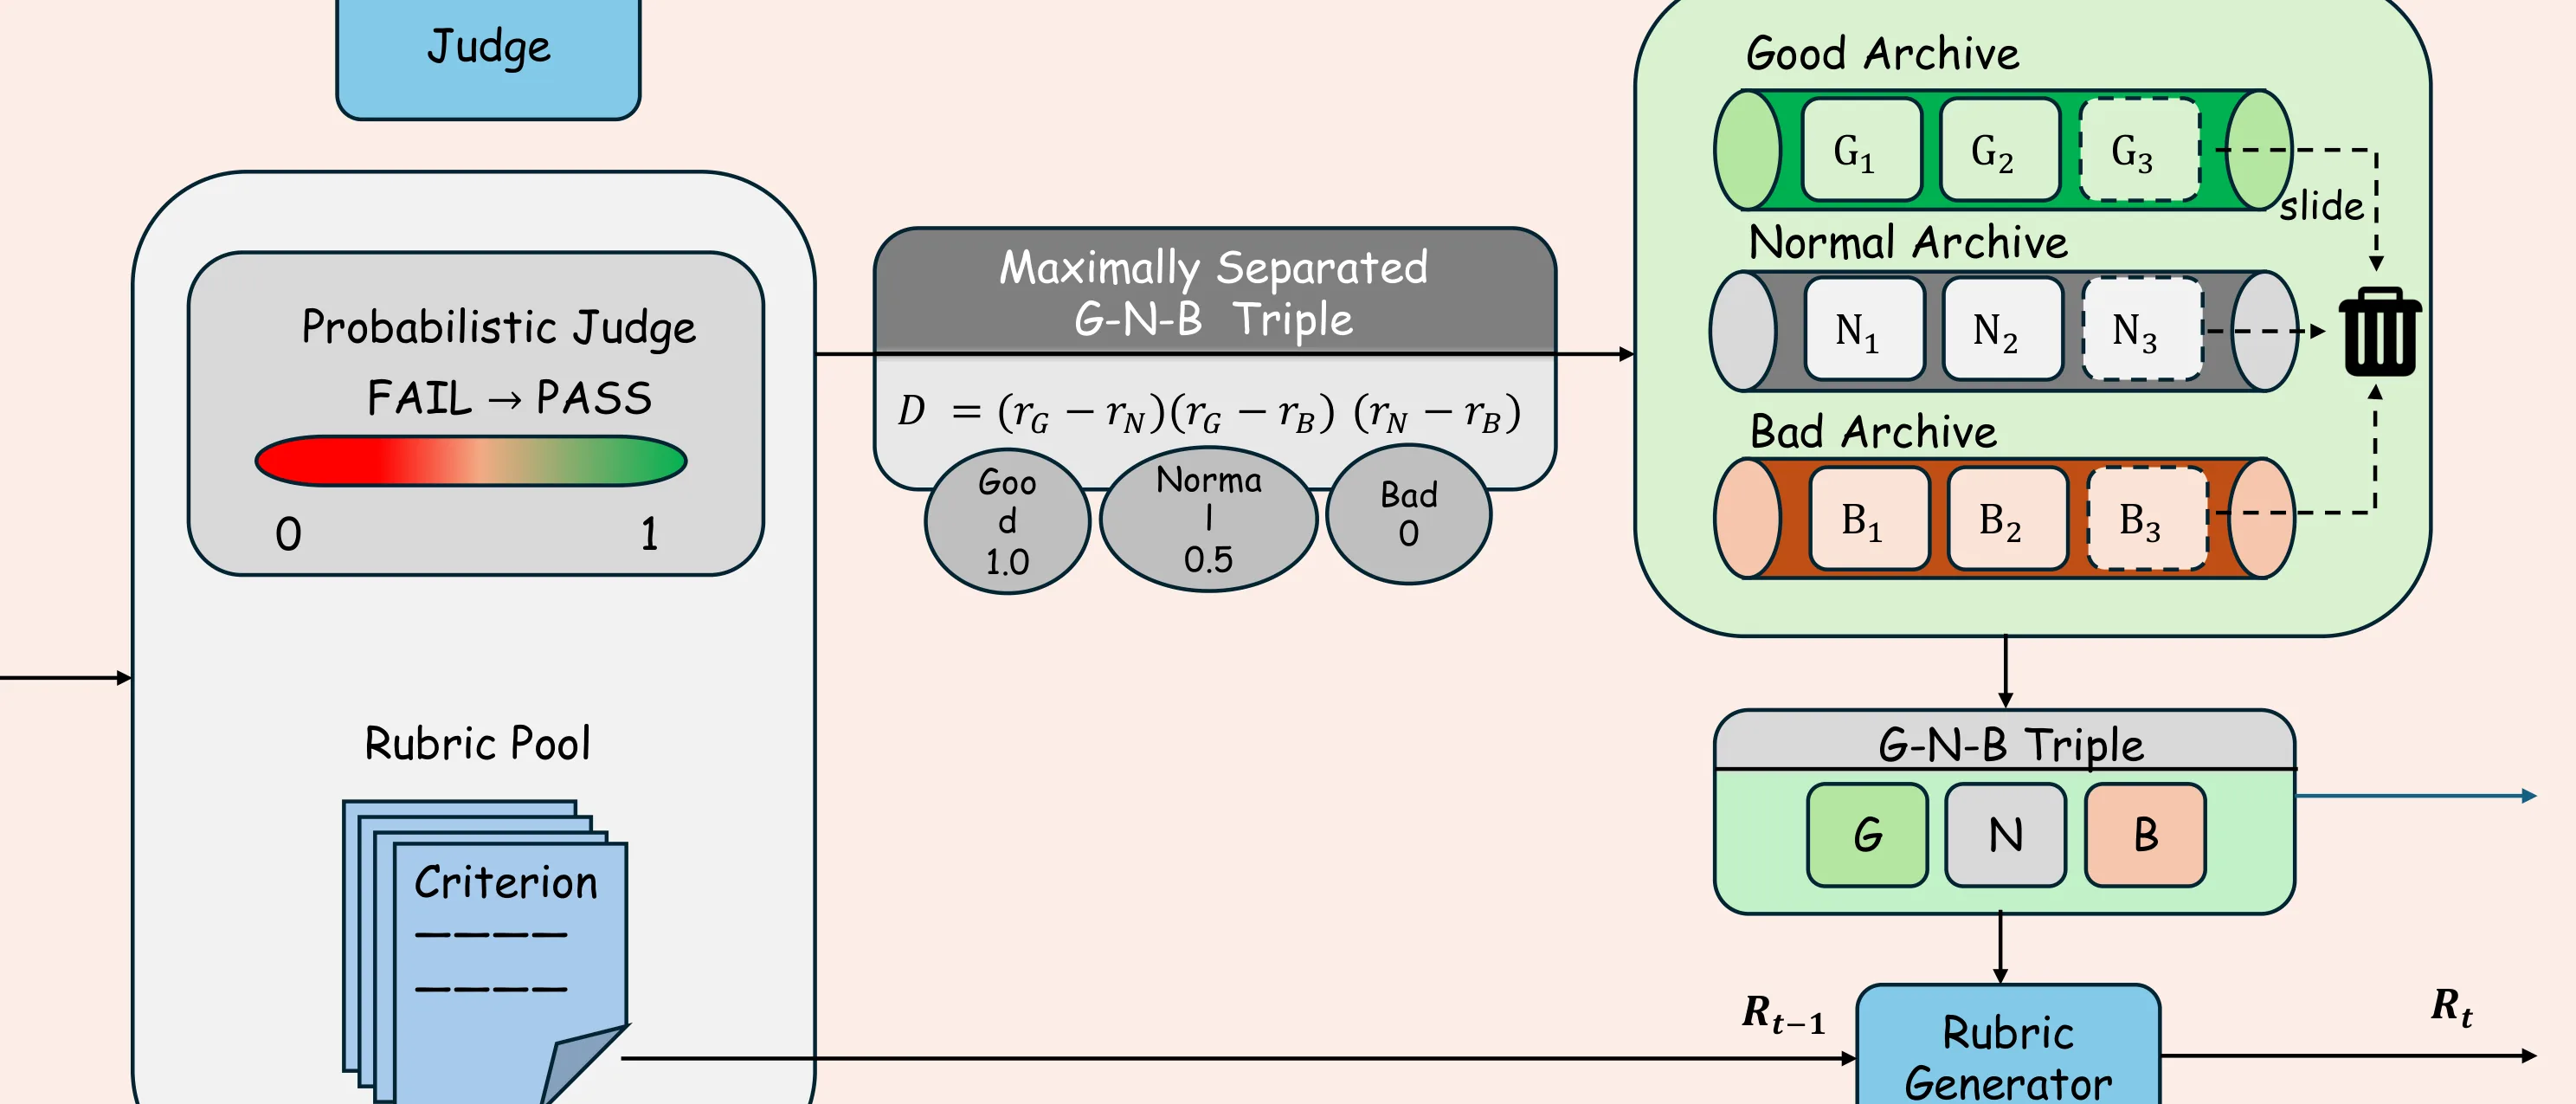
G-N-B 响应演化旨在为每个 prompt 构建一个有序的响应档案。每次 actor 采样 个响应后,框架用当前 rubric 计算每条响应的临时归档得分:
然后通过最大化分离度公式 挑选出 Good、Normal、Bad 三档响应,追加入各自的有界 FIFO 档案。这一设计确保了档案中的响应在质量上具有最大间隔,为后续 rubric 演化提供清晰的监督信号。
评分标准演化在响应档案更新后触发。当 prompt 达到预设的刷新间隔时,rubric 生成器基于当前 rubric 和 G-N-B 档案提出新准则。SERPO 用判别效用 来筛选准则:响应方差项 衡量同一 prompt 下不同响应的得分离散程度,G-N-B 顺序一致项 统计 Good/Normal/Bad 三组配对在容差阈值下的协调与不协调比例。只有能够有效区分有序档案的准则才会被保留和赋予权重。淘汰机制则确保判别效用持续低迷的准则最终被清除,但提供可恢复的缓冲窗口以避免误删。
策略演化采用 [[GRPO]](Group Relative Policy Optimization)作为优化算法。奖励在 rubric 更新后用 Good/Bad 档案均值进行校准,使得每条准则的得分被归一化到相对于档案均值的偏差上:
准则权重由判别效用 决定,保证演化过程中越来越有效的准则获得更大的影响力。策略更新后产生的新的 rollout 再次刷新响应档案和评分标准,三方演化环路就此闭合。
实验与结果
实验在两个 backbone 模型(Qwen3-4B-Instruct-2507 和 Qwen3.5-9B)上进行,涵盖两 个域内基准(HealthBench 和 ResearchQA)和四个分布外基准。论文还专门为开放式生成设计了两套投票式 TTRL 基线——Response Vote 和 Claim Consensus——作为公平对比的基准。
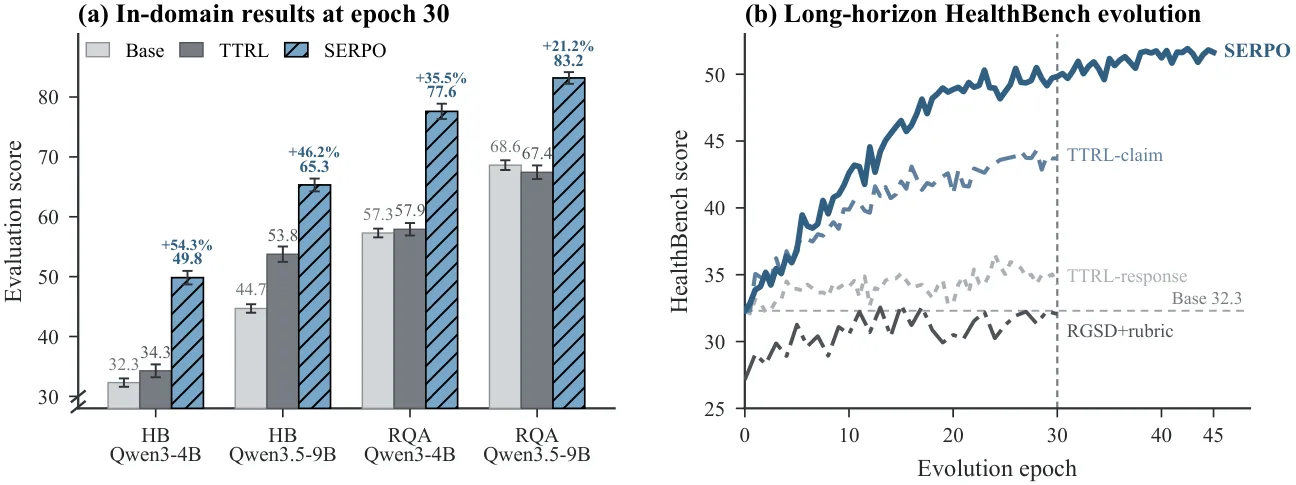
域内结果清晰地表明 SERPO 的优势:Qwen3-4B 在 HealthBench 上从基础分数 55.71 提升至 76.34(+20.63 分),ResearchQA 从 37.35 提升至 57.66(+20.31 分);Qwen3.5-9B 的提升幅度类似但基数更高。六基准宏平均在 Qwen3-4B 上从 53.92 提升至 61.98(+8.06 分),在 Qwen3.5-9B 上从 66.75 提升至 74.36。所有结果均优于其他 label-free 方法,且在大多数设置下接近甚至超越使用特权外部 judge 的方案。
分布外迁移实验显示,在 HealthBench 上演化的 rubric 策略能够迁移到 MedQA 和 LLMEval-Med,在 ResearchQA 上演化的则能迁移到 GPQA-Diamond 和 RaR-Science。8 项 OOD 结果均优于对应基础模型,SERPO 在 8/8 项中优于特权参考基线,但论文也诚实指出这些增益小于域内,表明迁移支持趋势而非统一的支配性优势。
消融实验揭示了各组件的贡献。去 actor 演化导致 HealthBench 下降约 36%,是最大的单一损失来源;去掉 rubric 演化或 G-N-B 演化各下降约 12–13%,说明两者为策略优化提供不可或缺的信号锚;硬判决相比概率化判据下降约 6%,证实了连续评分空间对保留优势分辨率的重要性。值得注意的是,同时训练 judge 或 rubric 生成器均导致性能下降,这反直觉地验证了冻结评估者角色作为稳定评分锚的有效性——演化信号来自准则选择和权重调整,而非评估模型本身的漂移。
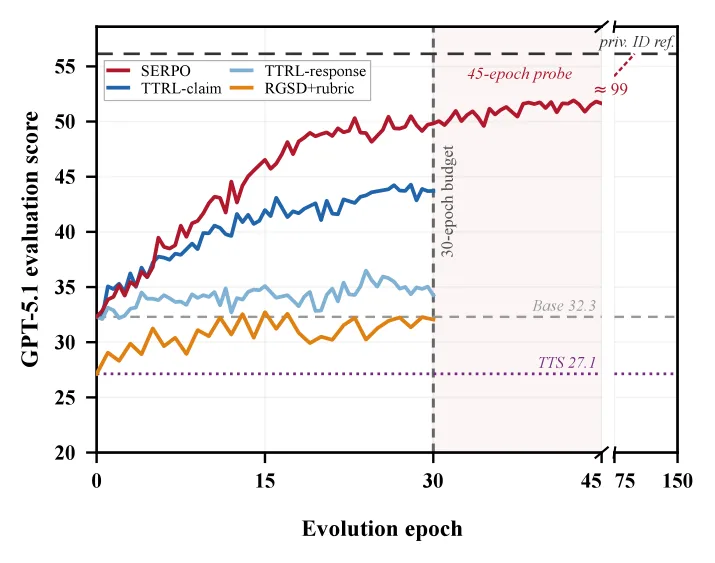
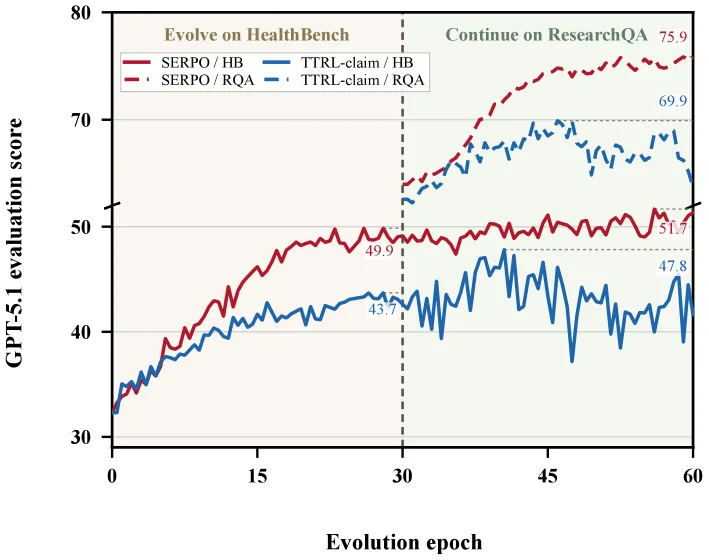
长程实验将 HealthBench 扩展至 45 epoch,观测到额外的相对收益。跨基准序列演化(HealthBench 30 epoch 后继续在 ResearchQA 上演化 30 epoch)进一步提升了两项指标,表明 rubric 和策略可以在多个基准间持续积累能力。
讨论与可借鉴点
SERPO 展示了一条在严格 label-free 约束下实现开放式生成自我进化的可行路径,其核心贡献在于将响应质量评估从"投票共识"转变为"准则区分",从而摆脱了对标准答案的依赖。三方协同演化的闭环设计使得响应档案、评分标准和策略参数相互校准——响应档案提供有序的质量锚点,评分标准从档案中提取判别性特征,策略优化则将改进方向编码到参数中。
这一框架有几个值得借鉴的设计原则。首先,冻结评估者、演化准则这一分工避免了在自指涉循环中引入评估漂移的问题。其次,概率化打分保留了连续的质量梯度,这对依赖优势估计的强化学习算法至关重要。第三,G-N-B 档案通过最大化分离度而非简单池化来组织响应,确保演化信号具有足够的判别力。
SERPO 的局限同样值得关注。分布外迁移的增益小于域内,表明 rubric 的跨领域泛化仍有提升空间。框架依赖 rubric 生成器能够为给定 prompt 产生有意义的初始准则集合,在领域偏移较大的场景中这可能成为瓶颈。此外,论文在 HealthBench 孕期头痛提示词上展示的案例——rubric 从"广泛建议"精炼到"当日产科评估+血压/尿蛋白检查+子痫前期红旗+安全过渡护理"——说明演化出的准确实体医疗知识依赖于 rubric 生成器本身的领域知识,这些知识从何而来、在多大程度上可泛化仍是开放问题。
摘要
测试时强化学习(TTRL)使语言模型能够在推理时无需标注反馈的情况下进行自我演化。现有方法依赖于答案投票,因此难以自然地扩展到开放式生成场景,因为开放式生成中的有效响应无法被映射到同一标准答案。在缺乏外部奖励模型或更强评判器的情况下,模型的自适应调整必须转而从其自身输出中构建可靠的奖励信号。我们提出了 SERPO(Self-Evolving Rubric Policy Optimization,自演化评分标准策略优化),它用一个闭环取代了答案投票机制,使响应证据、查询特定的评分标准以及策略参数得以共同演化。具体而言:优–中–差(Good-Normal-Bad,G-N-B)响应演化将最大程度分离的采样结果组织为有序档案;评分标准演化保留能够区分这些档案的准则;概率化准则评分将判定词元的似然转化为奖励信号;策略演化则利用这些信号优化 actor。随后,新一轮 actor 采样对档案与评分标准进行刷新,从而闭合这一三方演化环路。在两种模型配置、两个域内基准以及四个分布外(OOD)基准上的实验表明:SERPO 在 HealthBench 与 ResearchQA 上相较对应基础模型分别最高提升 20.63 和 20.31 分,将六项基准的宏平均分最高提升 8.06 分,并支持分布外迁移以及跨基准的持续演化。
Abstract
Test-time reinforcement learning (TTRL) enables language models to self-evolve at inference time without labeled feedback. Existing methods rely on answer voting and therefore do not extend naturally to open-ended generation, where valid responses cannot be mapped to a shared canonical answer. Without external reward models or stronger judges, adaptation must instead construct reliable rewards from the model's own outputs. We introduce SERPO (Self-Evolving Rubric Policy Optimization), which replaces answer voting with a closed loop that co-evolves response evidence, query-specific rubrics, and policy parameters. Good-Normal-Bad (G-N-B) response evolution organizes maximally separated rollouts into ordered archives; rubric evolution retains criteria that discriminate these archives; probabilistic criterion scoring converts verdict-token likelihoods into reward signals; and policy evolution optimizes the actor with the resulting signals. New actor rollouts then refresh both the archives and rubrics, closing the three-way evolution loop. Across two model configurations, two in-domain benchmarks, and four OOD benchmarks, SERPO improves HealthBench and ResearchQA by up to 20.63 and 20.31 points over the corresponding base models, raises the six-benchmark macro-average by up to 8.06 points, and supports OOD transfer and continued cross-benchmark evolution.
论文详细总结(自动生成)
SERPO 论文总结:面向开放式测试时强化学习的自演化评分标准策略优化
1. 核心问题与研究动机
- TTRL 的局限:测试时强化学习(TTRL)使语言模型在推理阶段自演化,但现有方法依赖"答案投票"(多数投票/自一致性)构建伪标签作为奖励信号。
- 核心痛点:答案投票假设响应可被压缩到统一的标准答案(多项选择、符号答案、规范化任务),而开放式生成(如医疗建议、研究问答)不存在统一规范答案——两条响应可能在事实性、完整性、安全性、细节层级等维度差异显著。投票机制会奖励"共同遗漏"并惩罚有效替代方案。
- 缺乏外部反馈的约束:在固定测试集、无参考答案、无外部奖励模型、无更强评判器的前提下,必须从模型自身输出中构建可靠奖励信号。
- 现有 rubric 方法的不足:已有 rubric 奖励方法多依赖外部 rubric、冻结模型接 rubric 反馈、或 rubric 生成器与策略联合训练,预算宽松;固定集 TTRL 需要 rubric 与策略在演化中协同生长。
- 研究目标:提出一个闭环框架,在标签无关(label-free)、无外部 judge 的条件下,把"响应证据"、"查询专属 rubric"和"策略参数"三者协同演化。
2. 方法论
2.1 整体框架(三路协同演化闭环)
对每个 prompt ,SERPO 维护三类状态:
- 响应档案 :Good–Normal–Bad 三档有序 FIFO 档案
- 查询专属 rubric :原子级评分准则
- 共享 actor 参数 :使用 GRPO 优化
判据生成器(rubric generator)与概率判据打分器(probabilistic judge)冻结,仅 actor 参数可学习。
2.2 概率化准则打分(Probabilistic Criterion Scoring)
将判据 True/False token 的后验对数概率转化为 的满足概率,避免硬判决导致 GRPO 优势坍缩为平局:
极性化得分(正向准则奖励符合,负向准则奖励不符合):
2.3 G-N-B 响应演化
对每个 prompt,先用 rubric 生成器产出初始 rubric(等权重),actor 每步采样 个响应后计算临时归档得分:
从中挑选最大化分离度的有序三元组:
将选出的 Good/Normal/Bad 响应追加进各自的有界 FIFO 档案。
2.4 Rubric 演化
- 当 prompt 达到刷新间隔 时,rubric 生成器基于当前 rubric 与 G-N-B 档案提出新准则,与现有池合并(去重、保留判别性高的)。
- 判别效用 ,由两部分构成:
- 响应方差项
- G-N-B 顺序一致项 ,统计 (G,N)、(G,B)、(N,B) 三组配对在容差 下的协调/不协调计数。
- 可恢复淘汰:当临时池 条时,将底部 比例打入淘汰区 ,持续 3 轮未改善则永久删除。
2.5 策略演化(Policy Evolution)
GRPO 的奖励在 rubric 更新之后计算,使用 Good/Bad 档案均值校准:
其中 。Actor 更新后产生新 rollout,再次刷新档案与 rubric,闭合三方演化循环。
2.6 基线扩展
作者首次为开放式生成设计了两种投票式 TTRL 基线:
- Response vote:抽取每条响应的核心推荐(≤15 词),按词集 Jaccard 聚类,对最大簇响应赋奖励
- Claim consensus:原子分解为 ≤12 条可校验声明,构建响应-声明支持矩阵 ,计算支持率 , 阈值下奖励共识声明覆盖率 , 不扣分
3. 实验设计
3.1 模型与基准
- 两个 backbone:Qwen3-4B-Instruct-2507、Qwen3.5-9B(均非思维模式)
- 域内(ID)基准:
- HealthBench(HealthBench-500 官方子集,安全性敏感医疗建议)
- ResearchQA(75 学科、长篇证据导向学术问答)
- 分布外(OOD)基准:
- HealthBench 演化后评估 MedQA、LLMEval-Med
- ResearchQA 演化后评估 GPQA-Diamond、RaR-Science
- 报告评估者:GPT-5.1(gpt-5.1-1113-global,,reasoning_effort=low$),MedQA/GPQA-Diamond 使用直接答案抽取精度
3.2 对比方法
| 方法 | 类型 | 关键特征 |
|---|---|---|
| Base | 无适应 | 直接评估 |
| TTRL (response vote) | 投票式 | 词集 Jaccard 聚类投票 |
| + claim consensus | 投票式加强 | 原子声明共识 |
| RGSD (TTS; static rubric) | Rubric 引导 | 冻结 rubric + 冻结 actor |
| + rubric self-evolution | Rubric 引导加强 | 演化 rubric + 冻结 actor |
| SERPO | 三路协同演化 | 演化 rubric + 演化 actor |
| Ext. judge + official rubric | 特权参考 | Qwen3.6-27B 外部 judge + 官方 rubric(非 label-free) |
3.3 演化协议
- 共同 30 epoch 预算,每个 prompt 独立演化
- 投票基线 ,SERPO
- 评估种子 40/41/42 三次平均
- 长程实验:Qwen3-4B 在 HealthBench 扩展至 45 epoch
- 跨基准序列:HealthBench 演化 30 epoch → ResearchQA 继续 30 epoch
3.4 关键超参数
- Rollout group 、FSDP2 offload、actor LR 、KL 系数 (low-variance KL)
- 初始 rubric cap 8、新候选 5、活跃池 cap 15
- G-N-B 档案宽度 、刷新间隔 、淘汰比例 、删除容忍 3 轮
- 校准阈值 、效用底 、配对边际
4. 资源与算力
- 硬件:单节点 Ubuntu 22.04,8× NVIDIA H100(80 GB)
- 软件栈:Python 3.10.13、verl 0.9.0.dev、PyTorch 2.10.0、CUDA 12.8、vLLM 0.19.1、Transformers 5.6.1
- GPU 分配:含冻结 self-judge 的方法 6 卡 actor/rollout + 2 卡 judge;其余 8 卡全用于 actor 训练与 rollout
- 单次运行时长:Qwen3-4B 30 epoch 约 10 小时(≈80 H100·h);Qwen3.5-9B 约 18 小时(≈144 H100·h)
- 代码与配置:已开源(GitHub: chiefovoavicii/SERPO)
5. 实验数量与充分性
- 主结果表 1:2 模型 × 7 方法 × 6 基准 = 84 个数据点(另含 ±std 版本 Table 6)
- 消融实验 Table 2:7 个变体(去 actor 演化、去 rubric 演化、去 G-N-B 演化、硬判决、训练 judge、训练 rubric 生成器)评估 4 个指标
- 长程与跨基准实验:Figure 4(45 epoch HealthBench)、Figure 5 + Table 3(HB → RQA 序列演化,匹配 epoch 30/60 与阶段最优)
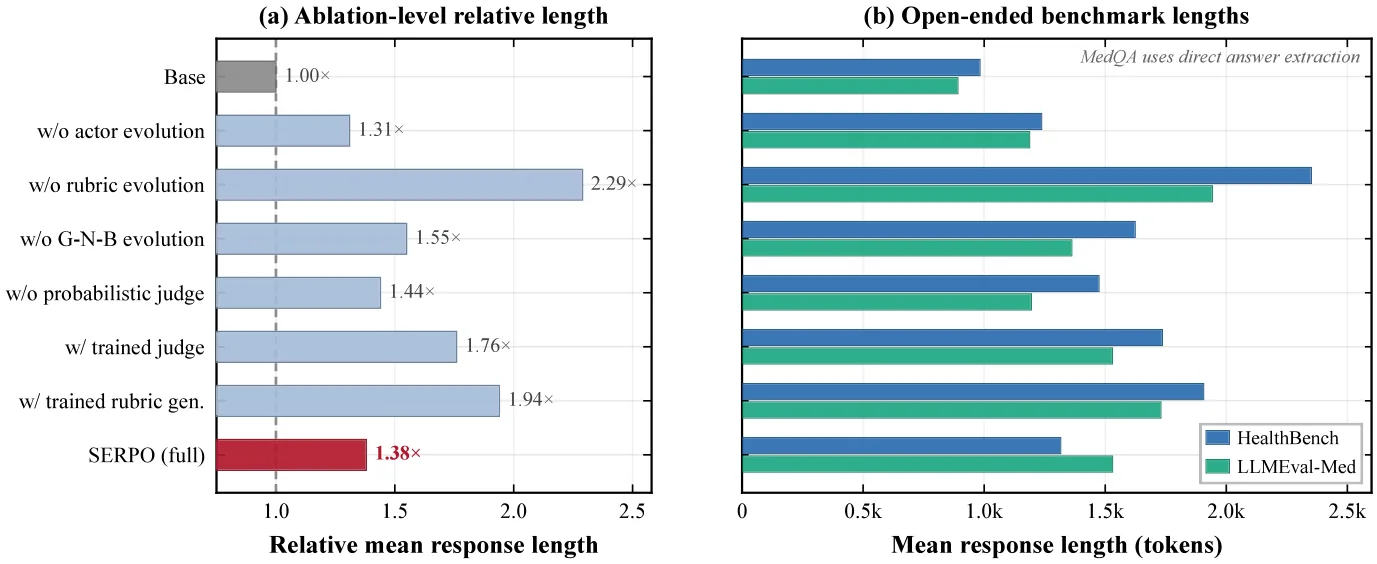
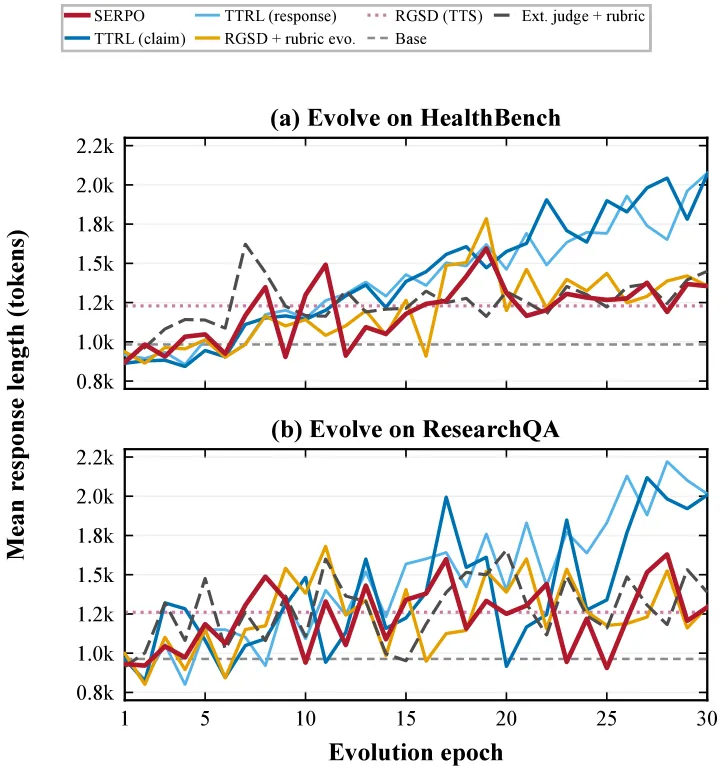
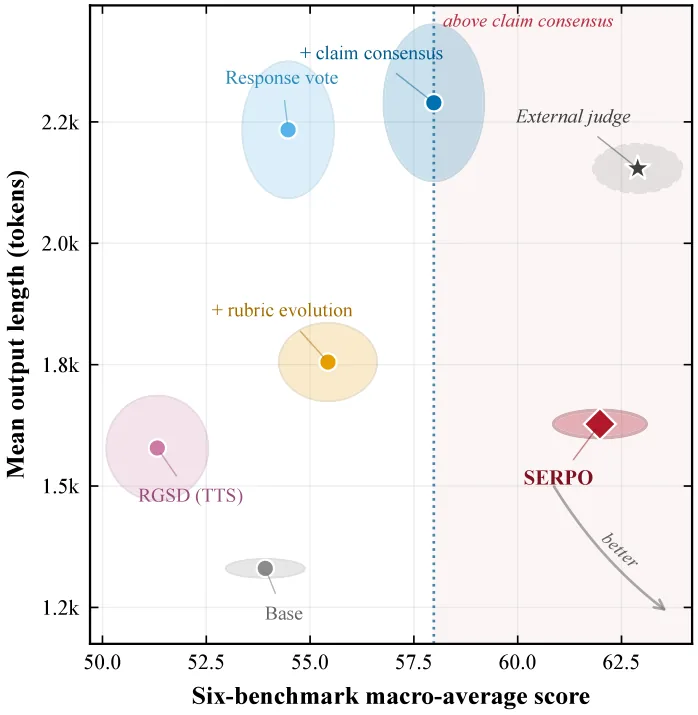
- 响应长度分析:Figure 6、Figure 7(左:长度-分数帕累托前沿;右:30 epoch 长度轨迹)
- 案例研究(附录 E):完整呈现 HealthBench 孕期头痛提示词的 rubric 演化轨迹,从初稿"广泛建议"逐步精炼到"当日产科评估 + 血压/尿蛋白检查 + 子痫前期红旗 + 安全过渡护理"
- 充分性评估:
- 评估 3 次取平均并报告 ±std,实验结果稳健(SERPO 在两个 backbone 的 ID 与六基准宏平均均为最优 label-free 方法)
- OOD 列边际较小,论文诚实声明"支持迁移趋势而非统一的支配性主张"
- 公平性:所有方法共享 30 epoch 预算与相同评估协议;特权参考同时报告,标明其非 label-free 属性
6. 主要结论与发现
- 域内(RQ1):SERPO 在所有 ID 设置均为最强 label-free 方法,HealthBench/ResearchQA 最高分别提升 +20.63 / +20.31 分(相对 Base +21.2% ~ +54.3%),六基准宏平均最高 +8.06 分(Qwen3-4B 从 53.92 → 61.98;Qwen3.5-9B 从 66.75 → 74.36)
- OOD 迁移(RQ2):8 项 OOD 结果均优于 Base(最高 +11.4%);SERPO 在 8/8 OOD 设置均优于特权参考,但特权参考仍最强于 ID
- 互补性(RQ3):固定 rubric 引导使宏平均低于 Base(−2.6 ~ −4.36);rubric 演化恢复损失但无 actor 更新;策略演化在 rubric-only 基础上再加 +55%,两者严格互补
- 组件消融(RQ4):
- 去 actor 演化:HealthBench 下降最大 ~36%
- 去 rubric 演化、去 G-N-B 演化:各下降 ~12–13%
- 硬判决:下降 ~6%,证实概率化判据保留 GRPO 优势分辨力
- 训练 judge / 训练 rubric 生成器:均导致性能下降,验证冻结评估者角色作为稳定评分锚的有效性
- 完整 SERPO 的响应长度仅为 Base 的 1.38×,比其他 actor 演化消融短 4–40%
- 长程与序列演化(RQ5):扩展至 45 epoch 再额外 +3.6% 相对收益;HB→RQA 序列中 SERPO 在匹配 checkpoint 全面优于 TTRL-claim(HB epoch 60: +23%, RQA epoch 60: +19%),且在 RQA 阶段仍继续提升 HB
- 投票基线发现:claim consensus 较 response vote 提升 13–28%,但仍保留"高频但不完备"的偏差,因为共识本身可能继承共同遗漏
7. 方法与实验设计的亮点
- 首个将"后验 reasoning + Boolean verdict 概率"与"演化 rubric"结合用于 TTRL 策略优化 的工作(论文明确指出这是 novelty,与并发的 LLM-as-a-Verifier 在固定准则接口上的工作形成对比)
- 三路协同演化闭环:响应证据 → rubric → 策略 → 响应证据,避免单点失效
- Good-Normal-Bad 档案 + 最大化分离三元组:比单纯取"最好/最差"保留更多判别结构,且与"硬三分位"不同,是基于 rubric 分数的有序分类
- 概率化判据打分:用判据 token 的 top-logprobs 而非硬标签,缓解 GRPO 优势坍缩
- 判别效用 :响应方差 + G-N-B 顺序一致性双重过滤,淘汰"常数、并列、逆序"准则
- 可恢复淘汰机制:用"连续 3 轮在淘汰区"作为删除条件,避免一次性清除破坏 rubric 稳定性
- Good/Bad 校准:把 Bad 均值拉到 0、Good 均值拉到 1,使 rubric 分数可解释为"优于多少坏样本"
- 系统性实验:消融、长度分析、案例研究、长程 + 跨基准序列共同验证
- 开源承诺:代码、配置、训练日志全部公开
8. 不足与局限
- 实验覆盖范围有限:仅两个模型配置(Qwen3-4B / Qwen3.5-9B),仅一组 45 epoch 单基准长程实验,仅一组 60 epoch 跨基准序列实验;其他模型家族(Llama、Claude、GPT 系列)以及更长训练预算未验证
- 评估者继承偏差:rubric 生成器与判据打分器均为 actor 初始权重的冻结副本,两者均继承部署模型的偏见;这意味着 SERPO 的上限受限于"模型评判自身质量"的能力,理论上存在 self-confirmation 风险
- 测试时计算开销增加:每个 actor 采样需配合 rubric 生成与逐条判据打分,Token 消耗与延迟显著高于直接投票
- OOD 边际较小:论文诚实指出 OOD 列分数差较小,"支持迁移趋势而非统一的支配性主张"
- 缺乏对失败模式的深入分析:附录仅给出案例研究片段,未系统分析 rubric 生成失败、判据饱和、actor 漂移等具体失效情形
- 跨基准演化仅 60 epoch:更长周期下的遗忘、评估者漂移、饱和等问题尚未解决,作者将其列为未来工作
- 应用限制:
- 依赖模型具备"对自己 rollout 做合理判断"的能力,弱模型可能无法从该框架受益
- 当前 rubric 生成需调用 LLM,温度 0 + 多个解码设置增加了部署复杂度
- 论文未在大规模工业级 prompt 流上验证可扩展性
未来工作
- 将 SERPO 扩展到更长周期、循环基准流的持续测试时演化
- 引入 replay、adaptive stopping、rollback 机制应对饱和、评估者漂移与灾难性遗忘
- 推动 TTRL 从"单基准一次性适应"走向"开放式任务上的持续 label-free 自我改进"
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。