
SCOUT:面向稀疏奖励强化学习的逐上下文重置课程
SCOUT: Per-Context Reset Curricula for Sparse-Reward Reinforcement Learning
📝 TLDR
稀疏奖励强化学习常因回放难以到达任务后期阶段而失败。已有重置课程采用单一全局节奏统一撤除辅助,难以适配不同上下文的学习速度差异。SCOUT为每个上下文分配独立课程,依据二元成功信号自适应增减脚手架。在六个导航与操作任务中,三项无辅助训练完全失败的任务被成功解决,并在构造的节奏冲突场景中同时兼顾慢学与快学两组。贡献在于揭示按上下文粒度撤除辅助的必要性。
🧭 速览
稀疏奖励下回放难以到达任务后期;全局撤除节奏无法兼顾学习速度各异的上下文。
SCOUT为每个上下文独立设置课程,依二元回放成败动态撤除或恢复脚手架,无需修改奖励或学习器。
六项任务中三项无辅助失败的任务被攻克;构造的节奏冲突下全局方案各丢一组,SCOUT两组均解。
撤除辅助的粒度应匹配学习差异所在尺度;按上下文课程无需分组标签且鲁棒。
🆚 方法对比
SCOUT
- 为每个上下文独立调度,无需组标签
- 仅需二元成功信号,learner-agnostic
- 构造调度冲突中同时解决两组
- 失败可回退、停滞可探测更难关卡
- 仅依赖二元信号,信息较有限
- 需要模拟器支持状态恢复
- 粗粒度梯子上回退能力受限
- 不改变奖励/优化器,能力受限于底层学习器
Reverse Curriculum Generation
- 经典方法,从目标向外扩展起始
- 改善scaffold access
- 实现相对简单
- 采用共享全局调度
- 无法处理上下文间学习差异
- 缺乏retreat机制
Goal-GAN
- 在学习者前沿附近采样目标
- 改善access能力
- 自动生成合适起始状态
- 主要改善access而非allocation
- 仍依赖全局调度策略
- 训练GAN增加复杂度
ACED
- 沿每个演示独立推进reset sections
- 可按演示调整进度
- 利用演示数据引导
- 无法retreat协助
- 需要演示轨迹数据
- 粒度依赖演示而非上下文
RFCL
- 为每个演示保持独立前沿
- 最接近SCOUT的先前方法
- 利用演示排序信息
- 沿演示索引而非通用上下文
- 粗粒度梯子上表现较差
- 无法retreat协助
Hindsight Relabeling
- 可重用智能体已访问状态
- 实现简单,易于集成
- 无法创造未到达阶段的经验
- 稀疏奖励下效果有限
Global Scheduling (全局调度)
- 实现最简单,所有上下文共享节奏
- 学习速率相近时有效
- 超参数少
- 存在结构性失败(Proposition 1)
- 平均成功率高可能掩盖失败
- 硬上下文被放弃或浪费训练
Group-level Pacing (组级调度)
- 粒度介于全局与逐上下文之间
- 利用已知任务分组时有效
- 比全局调度更精细
- 需要预定义组标签
- 组内存在差异时可能失败
- 标签获取成本高
论文核心论点是调度粒度必须匹配学习差异的尺度:全局调度在上下文学习速率冲突时结构性失败,组级调度依赖组标签且组内差异失效,而SCOUT以每个上下文独立前沿实现无需标签的细粒度调度,在构造冲突中同时解决两组问题。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 9 张)
展开查看 9 张图
TL;DR
SCOUT 是一种面向稀疏奖励强化学习的新型重置课程控制器,其核心思想是为每个任务上下文维护独立的脚手架进度表,而非依赖全局统一的辅助撤除节奏。在六个导航与操作任务中,SCOUT 不仅在三项原本完全失败的设置上实现了从零到成功的突破,还在构造的节奏冲突场景中同时兼顾了快学与慢学两组——而任何单一全局进度表都无法做到这一点。
研究背景与动机
稀疏奖励强化学习长期面临一个根本性困难:从无辅助的评估起点出发的轨迹,极少能够到达任务的较后阶段。这意味着智能体在整个训练过程中几乎无法接触到真正有价值的奖励信号,学习要么停滞不前,要么压根无法启动。已有的方法如 Hindsight Experience Replay 能够复用已经访问过的状态,但它无法凭空创造从未被到达过的阶段经验。
重置课程(Reset Curriculum)为这一问题提供了一条解决路径。其核心思路是在部分训练回放中,将智能体从更容易的中间状态——即脚手架(Scaffold)——开始,而非总是从最终的评估起点出发。这种做法让智能体有机会在有辅助的环境中先学会后期阶段,再逐步过渡到无辅助的最终目标。然而,一个课程需要做出两个关键决策:脚手架访问,即如何获取有信息量的起点;以及脚手架分配,即决定以多快的速度撤除这种辅助。
先前的大多数课程采用单一共享的全局进度表来撤除辅助。当所有任务实例(上下文)学习速度相近时,这种做法尚可接受。但现实往往更为复杂:不同上下文的学习速率可能存在显著差异,有的很快就能掌握,有的则需要更多的辅助练习。在这种情况下,全局进度表陷入了两难困境——如果撤除辅助太快,困难上下文会被过早抛弃;如果撤除太慢,简单上下文则在浪费宝贵的训练资源。雪上加霜的是,平均成功率这一常见指标往往会掩盖最差组的失败,使得问题更难被诊断。
这篇论文的核心洞察在于:撤除辅助的粒度应当与学习进展差异所在的尺度相匹配。如果不同上下文的学习速度存在差异,那么辅助撤除的决策也应当以相应的粒度来区分对待。
方法
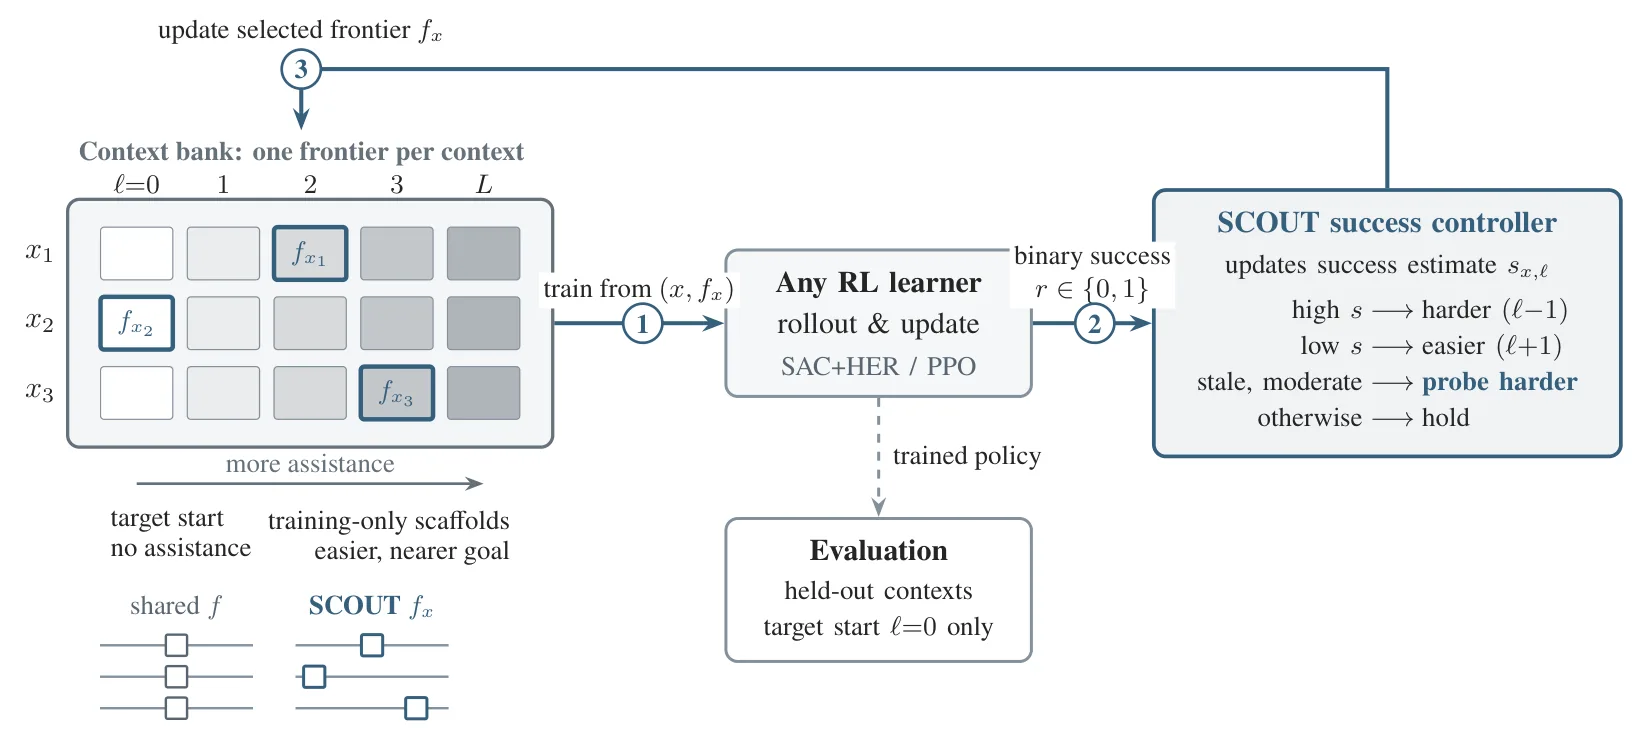
SCOUT 的设计哲学是简洁而专注:它是一个在线的、与学习器无关的重置控制器,为每个上下文赋予独立的课程。整个系统不需要修改奖励函数、优化器或底层学习器,仅依靠二元轨迹成功信号(成功或失败)来驱动决策。
在架构层面,SCOUT 为每个上下文维护一个独立的脚手架前沿(frontier)。脚手架被组织成层级结构 ,其中 代表无辅助的评估起点, 的层级则是训练专用的辅助起点。对于每个活跃的上下文-层级组合 ,SCOUT 维护一个指数滑动平均的成统计量:
这个统计量捕捉了该层级的近期表现,并驱动后续的决策逻辑。
在采样阶段,SCOUT 使用一个精心设计的评分函数来选择下一个重置上下文:
第一项 是一个倒 U 型函数,偏好中等成功率的单元,这实现了探索与利用之间的平衡——成功率太低的单元可能面临持续失败,而成功率太高的单元则缺乏进一步提升的空间。第二项 倾向于选择辅助较少的单元,引导课程向更难的起点迁移。第三项则确保长期未被采样的单元不会饥饿。这个评分函数经 softmax 处理后用于采样,叠加了探索地板与每个单元的采样上限。
前沿的推进与回退由一组清晰的规则驱动:
推进规则意味着当某个层级的成功率持续较高时,系统认为智能体已经具备了处理更难起点的能力,于是将前沿向前推进一步。回退规则则相反——当成功率过低时,说明当前起点对该上下文太难了,需要恢复辅助。更微妙的是反停滞(Antistall)机制:当成功率处于死区 且停滞计数器超过阈值时,系统会谨慎地尝试更难的起点;若这次尝试失败,常规的回退机制会将系统恢复到之前的辅助层级。
论文还提供了一个结构性的计数构造(命题 1)来证明全局进度表的根本局限:对于任意 ,可以构造两个上下文 和 ,它们分别需要恰好 1 次和恰好 次辅助练习。任何同步的全局进度表给两上下文分配相同的辅助次数,无法同时满足两者的需求,而按上下文局部调度的 SCOUT 则可以分别满足。这一构造排除了同步全局进度表,但并未排除保留多层级的同时采样。
在脚手架的构造上,SCOUT 采用了一种轨迹派生的方法:从每个训练上下文的一条成功参考轨迹出发,使用固定进度分位数将轨迹中的中间状态序列化为脚手架层级。这种方法避免了手动设计脚手架的工程负担,且在实验中保持了零无效重置率。
实验与结果
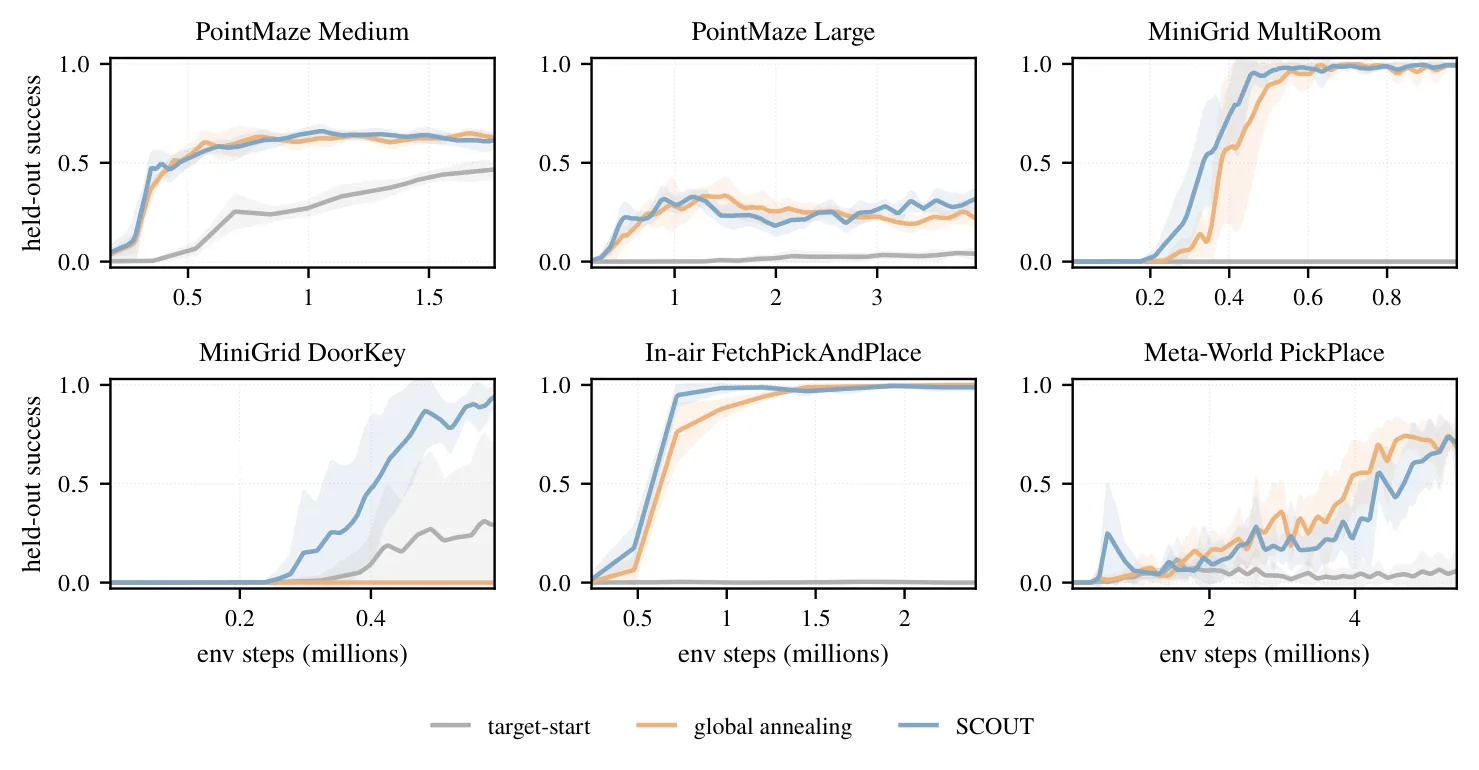
实验覆盖了六种自然任务设置和三种构造的节奏冲突场景。在自然任务中,SCOUT 在所有设置上的保留 AUC 均优于目标起点训练,三个原本完全无法学习的任务——In-air FetchPickAndPlace、MiniGrid MultiRoom 和 Meta-World PickPlace——实现了从零到成功的突破。两个 PointMaze 环境和 DoorKey 的学习速度也得到了显著提升。
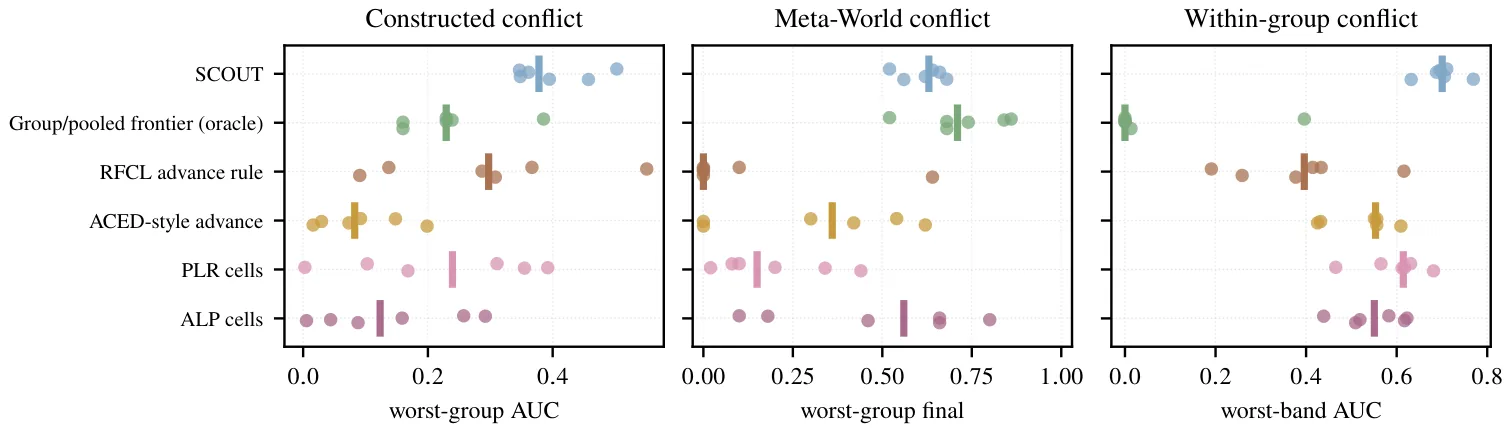
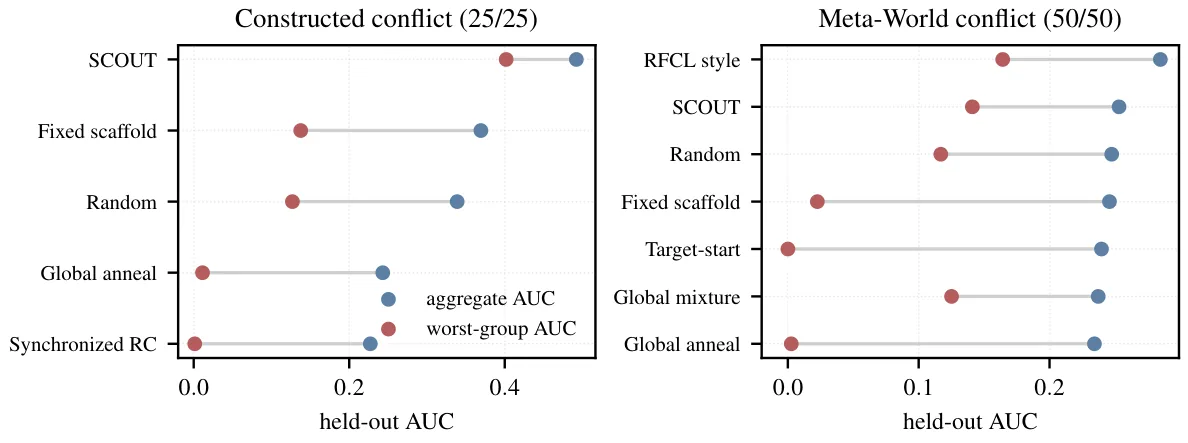
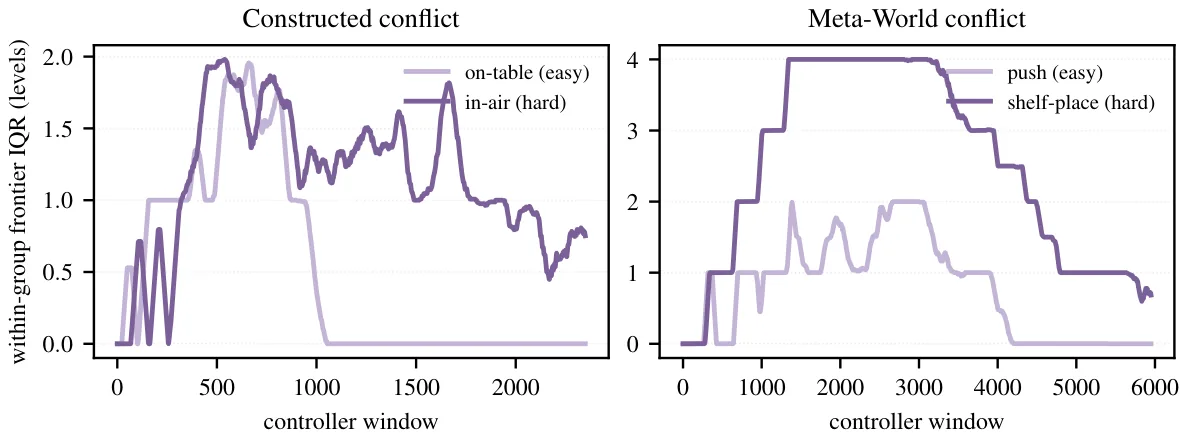
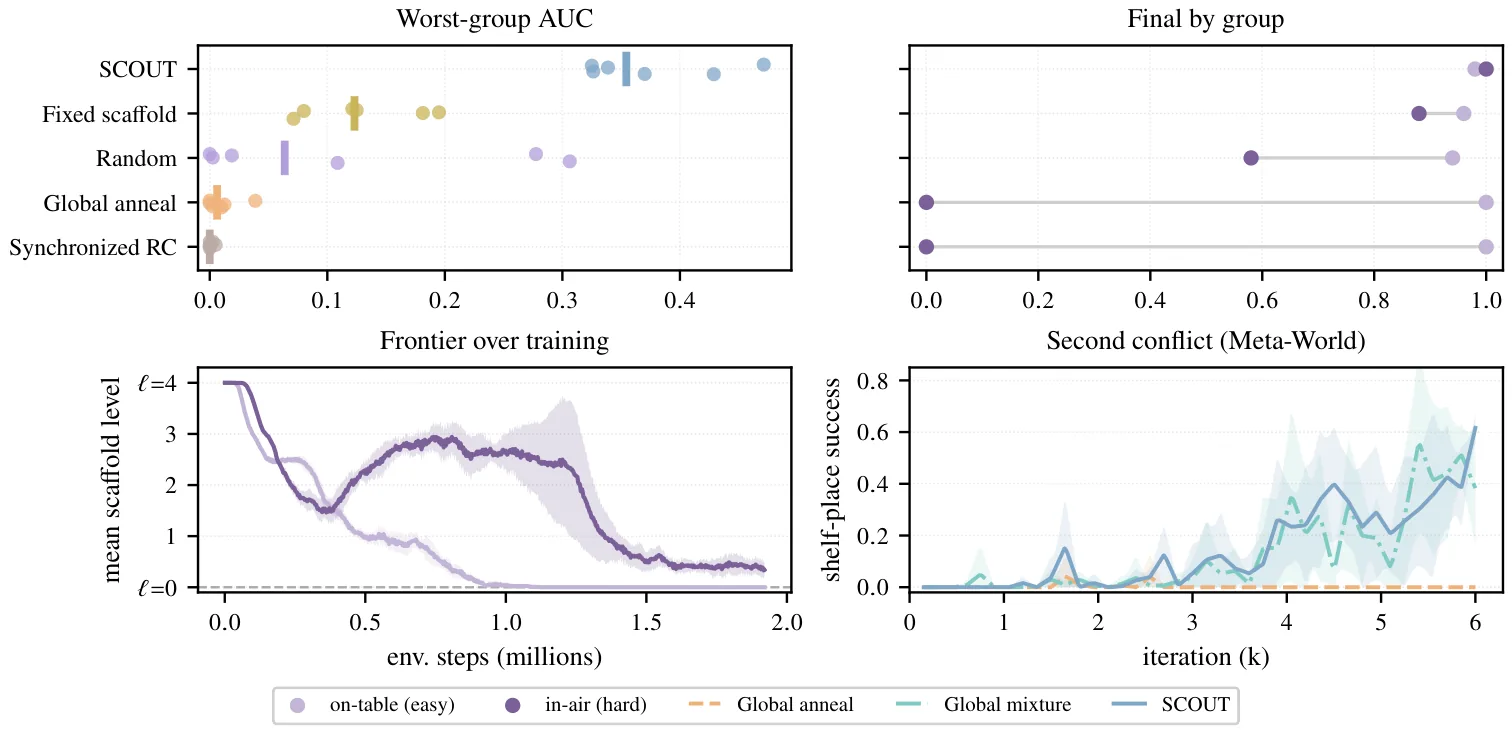
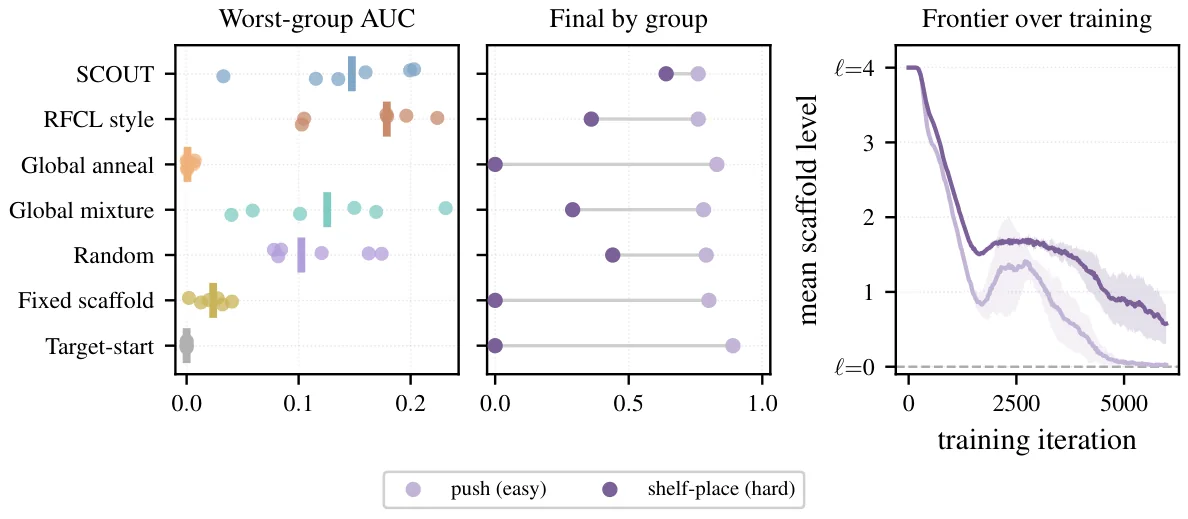
节奏冲突场景的实验更具说服力。在构造的 PickAndPlace 冲突中,一组上下文(桌面目标)学得很快,另一组(空中目标)学得很慢,且中间难度被移除以最大化冲突程度。实验结果表明,所有测试的同步全局进度表都无法同时解决两组问题——要么快组浪费资源,要么慢组完全失败。SCOUT 的最差组 AUC 达到 0.354,而最强的固定脚手架仅为 0.123。在另一个 Meta-World push × shelf-place 的冲突中,全局退火甚至将 shelf-place 的成功率降至接近零,而 SCOUT 在最差组上以 6 比 0 完胜所有基线方法。
更有趣的是组内冲突的发现。当学习速度差异出现在同一标签组内部时,即使提供组标签的 Oracle 组前沿也遭遇了失败——某些子组完全无法解决。而 SCOUT 在所有六种子对比中均胜出,最差组的 AUC 高达 0.701。这说明当差异粒度超出已知分组时,按组调度仍然不够,SCOUT 的纯上下文级调度是更鲁棒的选择。
值得注意的是,当学习速率差异遵循明确的分组结构时,Oracle 组前沿能够以 6 比 0 胜过 SCOUT,这说明在具备领域知识的情况下,分组调度是有价值的。但在更普遍的场景中——差异以更细粒度的形式出现——SCOUT 的自适应性使其成为更安全的选择。
讨论与可借鉴点
SCOUT 的核心贡献在于揭示了重置课程中辅助撤除粒度的重要性。通过理论构造和大量实验,它有力地论证了:当不同上下文的学习速度存在差异时,按上下文粒度撤除辅助是必要的,而非可选的优化。这一洞察对于整个课程学习领域都有启发意义——课程的设计不应仅关注辅助的强度,还应关注辅助撤除节奏的粒度与学习差异粒度的匹配。
SCOUT 的设计体现了良好的工程品味。它仅需二元成功信号,不依赖 critic 不确定性或对比学习等辅助假设,与多种学习器(SAC+HER、PPO)兼容,且超参数在开发集上选定后冻结于所有设置。这种简洁性使得 SCOUT 易于理解和复现。
当然,SCOUT 也有其适用边界。它需要能够重置到有信息量的中间状态,这在使用无仪器化重置的物理机器人上可能受限。论文指出,当上下文学习速度普遍相近时,全局进度表仍然具有竞争力;而在极大规模的情境银行中,可能需要引入分组机制来控制计算开销。
从更广阔的视角看,SCOUT 的思想与课程学习领域关于辅助粒度的讨论一脉相承。它提醒我们,设计课程时不仅要想清楚「教什么」和「教多难」,还要想清楚「谁来学」「谁来决定节奏」——因为不同学习者的需求差异本身就是课程设计必须考虑的关键因素。
摘要
稀疏奖励强化学习常常失败,因为从无辅助的评估起点出发的轨迹很少能到达任务的较后阶段。重置课程通过将部分训练轨迹从更容易的中间状态(即脚手架状态)开始来解决这一问题。此类课程面临两个决策:脚手架访问,即获取有信息量的起点;以及脚手架分配,即决定以多快的速度撤除这种辅助。大多数先前的课程按一个共享的进度表来撤除辅助,当任务实例(即上下文)学习速率不同时,这种方式可能会失效。我们提出了 SCOUT,一种在线的、与学习器无关的重置控制器,它为每个上下文赋予独立的课程。SCOUT 仅使用二元的轨迹成功信号,就在持续成功后撤除辅助、在失败后恢复辅助,并在进展停滞时谨慎地尝试更难的起点,且不改变奖励、优化器或学习器本身。一种计数构造表明,当不同上下文需要相互冲突的辅助练习量时,同步的全局进度安排可能并不足够。在六个导航和操作任务设置中,脚手架访问改善了学习效果,并在三个无辅助训练在给定预算内失败的任务中取得了成功。在一个构造的进度冲突中,每种被测试的全局进度安排都会使某一组任务无法被解决,而 SCOUT 同时解决了这两组。平均成功率可能会掩盖这种失败,因此我们还报告了最不成功一组的成绩。当学习差异遵循已知分组时,按组进行的进度安排有效,但在差异出现在同一组内时则可能失败。SCOUT 不需要分组标签,在两种情况下都保持稳定的表现。重置课程应以学习进度存在差异的尺度来撤除辅助。
Abstract
Sparse-reward reinforcement learning often fails because rollouts from the unassisted evaluation start rarely reach later task stages. Reset curricula address this by starting some training rollouts from easier intermediate states, called scaffolds. Such a curriculum faces two decisions: scaffold access, obtaining informative starts, and scaffold allocation, deciding how quickly that assistance is removed. Most prior curricula pace removal on one shared schedule, which can fail when task instances, or contexts, learn at different rates. We introduce SCOUT, an online, learner-agnostic reset controller that gives every context its own curriculum. Using only binary rollout success, SCOUT removes assistance after sustained success, restores it after failure, and cautiously tests a harder start when progress stalls, without changing the reward, optimizer, or learner. A counting construction shows that synchronized global pacing can be insufficient when contexts need conflicting amounts of assisted practice. Across six navigation and manipulation settings, scaffold access improves learning and enables success in three where unassisted training fails within the reported budget. In a constructed pacing conflict, each tested global schedule leaves one group unsolved, while SCOUT solves both. Average success can conceal this failure, so we also report the least successful group. Group-level pacing works when learning differences follow known groups but can fail when they occur within one group. SCOUT needs no group labels and remains consistently strong in both cases. A reset curriculum should remove assistance at the scale where learning progress differs.
论文详细总结(自动生成)
SCOUT 论文详细总结
1. 核心问题与研究动机
研究背景:稀疏奖励强化学习(RL)常因无法到达任务后期阶段而失败——从评估起点(无辅助)出发的回放难以接触后期状态,导致奖励信号几乎不可用。Hindsight relabeling(如 HER)虽能复用已访问状态,却无法创造从未到达的阶段经验。
课程学习的两种决策:
- 脚手架访问(scaffold access):获取有信息量的中间起点;
- 脚手架分配(scaffold allocation):决定以多快速度撤除辅助。
核心矛盾:现有重置课程(reset curricula)通常采用单一共享的全局进度表撤除辅助。当不同任务实例(context)学习速度差异大时,单一进度表无法兼顾:
- 撤除过早 → 困难上下文被抛弃;
- 撤除过晚 → 简单上下文浪费训练;
- 平均成功率掩盖了"最差组"失败。
关键洞察:撤除辅助的粒度应与学习进展差异所在的尺度匹配。
2. 方法论
2.1 总体框架
SCOUT 是一个在线、与学习器无关的重置控制器,为每个上下文维护独立课程。核心结构如下:
- 上下文银行:,每个上下文 拥有独立的脚手架前沿(frontier);
- 脚手架层级:, 为无辅助评估起点, 为训练专用起点;
- 重置算子:,将上下文 映射到初始状态分布。
2.2 成功统计量
每个活跃单元 维护指数滑动平均成功率:
辅助量包括:证据计数 、转换冷却期、近期采样计数 、停滞计数器 。
2.3 活跃单元采样分布(公式 1)
- 第一项:偏好中等能力的单元(探索-利用平衡);
- 第二项:偏好辅助较少的单元(向目标起点迁移);
- 第三项:覆盖长期未采样单元。
经 softmax 采样,叠加探索地板 与每单元上限 。
2.4 前沿转换规则(公式 2)
- 推进:持续成功,向更难的起点迁移;
- 回退:失败则恢复辅助;
- 反停滞(Antistall):在死区 内停滞 步后,谨慎探测更难的起点;若失败则由常规回退恢复。
2.5 轨迹派生脚手架构造
从每个训练上下文的一条成功参考轨迹 出发,使用固定进度分位数 将最近的模拟器状态序列化为脚手架层级。DoorKey 终端分位数为 1.0,其他环境为 0.9。
2.6 结构性限制(命题 1)
对任意 ,存在两上下文 两层级课程,每个上下文预算 :
- 上下文 :需要 次辅助;
- 上下文 :需要 次辅助。
证明:任何同步全局进度表给两上下文分配相同 ,无法同时满足 与 ;而按上下文局部调度可分别满足。该构造排除同步全局进度表,但并未排除保留多层级的同时采样。
3. 实验设计
3.1 任务设置(共 9 个)
六个自然设置(测试脚手架访问):
| 任务 | 学习器 | 观察空间 |
|---|---|---|
| PointMaze Medium / Large | SAC+HER | 低维目标条件 |
| MiniGrid MultiRoom / DoorKey | PPO | CNN 部分观察 |
| In-air FetchPickAndPlace | SAC+HER | 低维目标条件 |
| Meta-World PickPlace | SAC+HER | 低维目标条件 |
三个节奏冲突设置(测试分配粒度):
- 构造的 PickAndPlace 冲突(易桌面 + 难空中,去除中间难度);
- Meta-World push × shelf-place 冲突(未修改组合);
- 组内冲突(单一标签内目标高度双峰)。
3.2 对比基线
- 目标起点训练(无脚手架);
- 随机脚手架采样;
- 全局退火(global annealing);
- 同步反向课程(synchronized reverse curriculum);
- 固定中间层级();
- 异步全局混合(冲突设置);
- RFCL 推进规则(无回退)、ACED 推进规则;
- Oracle 组前沿(消耗组标签);
- PLR / ALP 单元教师;
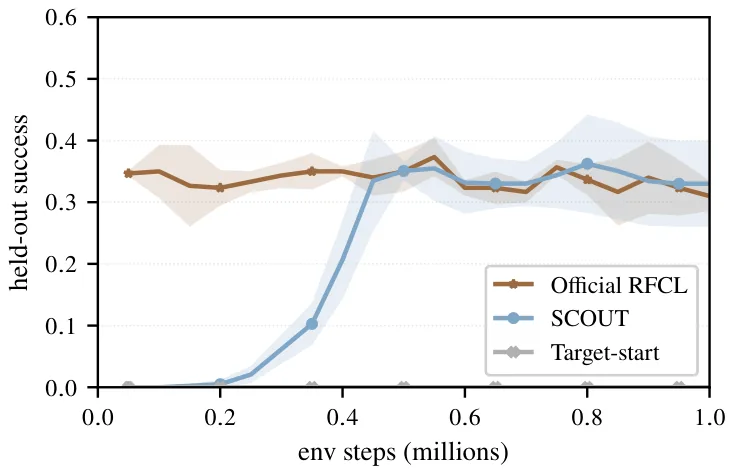
- 官方 RFCL(PointMaze Large 对比)。
3.3 评估指标
- 主指标:保留上下文的 AUC(目标起点学习曲线下面积);
- 辅助指标:最终成功率、解出的种子数、最差组 AUC;
- 不确定性估计:配对种子自助法(10,000 重采样)的 95% 置信区间;
- 符号检验:6 个种子配对符号检验(描述性)。
4. 资源与算力
论文附录明确给出算力配置:
- 设备:所有训练仅 CPU(
device="cpu"),GPU 不参与协议; - 环境:三套 Linux 环境:
- 20 核 NVIDIA DGX Spark(Grace aarch64,121 GiB 统一内存);
- 单云 H100 节点(GPU 闲置,221 GiB 主机内存);
- 大学 SLURM 集群 CPU 节点(20 核 / 32 GiB per job);
- 训练耗时:单次 2400 步 Fetch 冲突运行约 40 分钟(20 核机),集群 CPU 节点上可达 5 小时;6–7 个 16-worker 并发运行占满 20 核;
- 软件栈:Python 3.11–3.12、PyTorch 2.12.1、Gymnasium 1.3.0、Gymnasium-Robotics 1.4.2、MuJoCo 3.10.0、Meta-World 3.0.0、MiniGrid 3.1.0、NumPy 2.4–2.5。
未明确:总训练时长(种子数 × 所有设置),但因每个设置通常 5–6 种子,单 Fetch 冲突 40 分钟,整体算力消耗应属中等规模。
5. 实验数量与充分性
5.1 实验规模
- 种子数:5–6 个种子/设置;PickAndPlace 冲突有一个额外的 6 种子复制块;
- 构造实验:轨迹派生 vs 手动脚手架(PointMaze Large、DoorKey、In-air Fetch),3–6 种子;
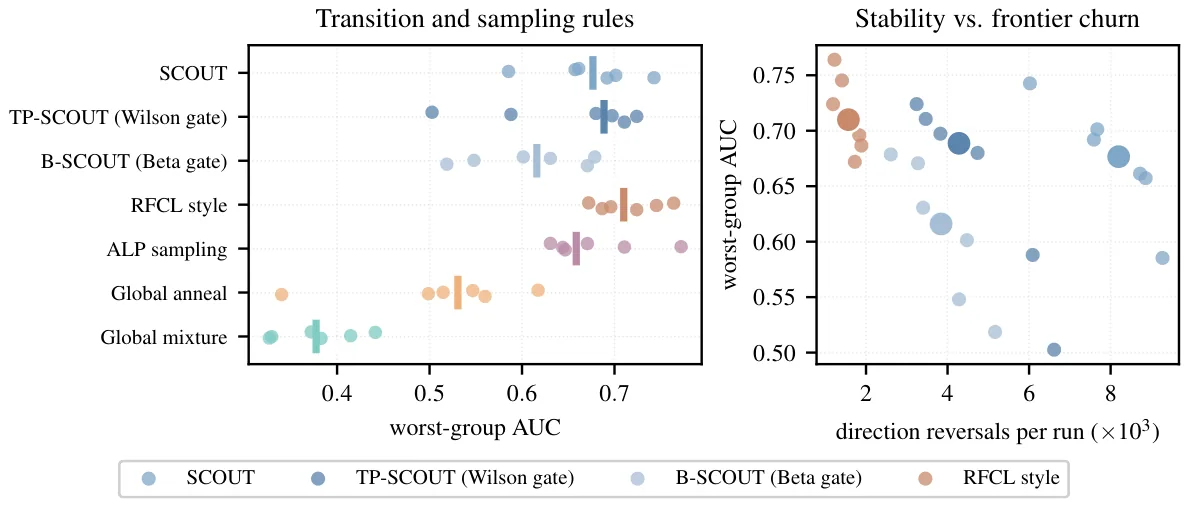
- 消融实验:控制器组件分析(采样、推进规则、反停滞)、证据门控变体(Wilson / Beta)、批评家不确定性、对比学习学习器;
- 额外鲁棒性实验:9 层阶梯(vs 5 层)、9000 步(vs 6000 步)、DoorKey-16×16 长视野、组内 DoorKey 分割。
5.2 公平性
- 所有对比条件共享策略学习器、上下文银行、回放工作者、奖励、训练预算;
- SCOUT 的超参数在开发种子上选定后冻结于所有设置与条件;
- 评估种子为 42–47,开发筛选用 40–42 / 42–44 / 50–52;
- 每实验记录全部配置后再运行,未使用测试结果进行配置选择。
5.3 充分性评估
- 跨算法族:覆盖 off-policy SAC+HER 与 on-policy PPO;
- 跨观察空间:低维目标条件 + 部分观察 CNN;
- 跨任务类型:导航(PointMaze、MiniGrid)+ 操作(Fetch、Meta-World);
- 三个独立冲突场景:构造性、真实任务组合、组内异质性。
局限性:6 个种子下符号检验的最小可达到 ,论文承认 27 个家族检验中无单个通过 Holm–Bonferroni 修正,主要依赖 bootstrap 区间。
6. 主要结论与发现
6.1 脚手架访问的价值
六个自然设置中,SCOUT 在所有设置上的保留 AUC 优于目标起点训练,每配对差异为正:
- 解锁三处先前失败:In-air FetchPickAndPlace、MiniGrid MultiRoom、Meta-World PickPlace 在目标起点训练下完全不学习;
- 加速两处缓慢学习:两个 PointMaze、DoorKey;
- 样本效率提升:随机脚手架和全局退火也受益,但上下文相近时无调度器全胜。
6.2 分配粒度的关键作用
构造 PickAndPlace 冲突:
- 所有同步全局进度表至少失败一个组;
- SCOUT 最差组 AUC ≈ 0.354(最强固定脚手架 0.123),复制块 +0.24 [0.18, 0.38];
- 6 种子符号检验 。
Meta-World push × shelf-place:
- 全局退火 5 层阶梯下 shelf-place 成功率降至 0.000;
- SCOUT 维持 0.52–0.68,最差组 6/6 胜()。
6.3 粒度的适配性
- Oracle 组前沿:当异质性遵循已知分组时胜过 SCOUT(Meta-World 上 6/6 胜, [0.03, 0.22]);
- 组内冲突:池化前沿(oracle)失败于高带(4/6 种子 0.00 成功率),SCOUT 在所有 6 种对比中胜出,最差带 AUC 0.701;
- 结论:SCOUT 在两种情况下均稳健,无需组标签。
6.4 轨迹派生脚手架
保留增益比 :
- PointMaze Large:1.21 [1.05, 1.44];
- MiniGrid DoorKey:1.47(点估计);
- In-air FetchPickAndPlace:1.06 [1.05, 1.06];
- 0% 无效重置率。
6.5 何时基学习器消除脚手架需求
- 对比批评家(contrastive critic)消除 PointMaze Large 的访问瓶颈(0.48 vs 0.41 SCOUT),但无法消除 In-air Fetch 的瓶颈(0.20 vs 0.24;SCOUT+SAC+HER:1.00);
- 强跨层级泛化(MiniGrid)可替代分配。
6.6 SCOUT 的应用边界
- 需要有信息量的瓶颈状态、有序辅助轴和重置能力(不适于无仪器化重置的物理机器人);
- 全局进度表在上下文学习速度相近时仍具竞争力;
- 长视野可能需要更多层级;大银行可能需要分组。
7. 优点
1. 方法论简洁性:仅需二元回放成功信号,不修改奖励/优化器/学习器;与 SAC+HER 和 PPO 兼容,覆盖 off-policy 与 on-policy 两族。
2. 结构性洞察清晰:通过计数构造(命题 1)严格证明同步全局进度表的不足,且构造代表真实冲突(而非纯存在性)。
3. 双重贡献分离:明确区分"脚手架访问的价值"与"分配粒度的价值",避免混淆。
4. 评估严谨性:
- 报告最差组指标揭示平均指标掩盖的失败;
- 配对种子自助法置信区间,避免单一种子波动;
- 进行轨迹派生 vs 手动脚手架的独立性验证;
- 包含官方 RFCL 在同等协议下的对比。
5. 超参数冻结与公平性:所有对比共用同一学习器、银行、奖励、预算;超参数在开发种子上提前冻结。
6. 自动脚手架构造:从一条参考轨迹派生 5 层阶梯,减少人工层级设计;轨迹派生的保留增益比 ≥ 1。
7. 组件级消融:明确区分"前沿"本身的贡献 vs 反停滞/采样校准的贡献,避免归因错误。
8. 不足与局限
1. 应用前提限制:
- 必须有模拟器状态恢复能力(不适于无重置访问的真实机器人);
- 需要参考轨迹来构造脚手架(手动或脚本控制器),并非从零发现;
- 需要有序辅助轴与有信息量的瓶颈状态。
2. 统计功效不足:6 个种子下符号检验最小 ,27 个家族检验均未通过 Holm–Bonferroni 修正,主要依赖 bootstrap 区间。
3. 冲突普遍性未知:论文承认双向冲突的出现频率未知;自然任务中仅找到单向冲突(push × shelf-place),双向冲突需人为构造。
4. 轨迹派生脚手架的非平凡性:5 个分位数()是固定选择;长视野任务(DoorKey-16×16)研究表明 9 层更优、13 层收益递减,但最优层级数无理论指导。
5. 跨上下文证据稀缺:大银行下每上下文证据减少,可能需要分组;论文未给阈值指导。
6. Pooled 边界的边界条件:MiniGrid 中跨层级泛化使全局混合接近 SCOUT,限制了在某些环境中的相对优势。
7. 章节 C.3 报告:当给定 9 层阶梯时,Meta-World 冲突下所有方法均能解决,削弱了"分配粒度必要性"在更细阶梯上的论点。
8. 朴素学习的脆弱性:SCOUT 在失去 SCAN 后需要重新初始化 / 重新阈值化,未涉及自适应阈值或在线学习率。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。