
📝 TLDR
基于模型的强化学习常将世界模型的统计相关性误认为因果机制,这一问题在多智能体系统中因物理转移与策略意图交织而更为突出。本文提出隐式因果世界模型,从离线演示中无监督地恢复环境动力学,无需预定义因果图。该方法通过引入策略方差并借助序贯后门条件,使因果结构的自动识别成为可能。在Two-Door、Navigation、Giveway等多智能体协作任务上的实验表明,模型能够提供可解释的因果表征,且准确率随干预强度提升而提升。
🧭 速览
多智能体场景中世界模型将统计相关与因果机制混淆,在分布偏移下失效,难以支撑可解释决策。
引入隐式因果世界模型,融合策略方差,借助序贯后门条件从离线演示中自动识别因果结构,无需预定义因果图。
在Two-Door、Navigation、Giveway等协作任务中验证,模型在完全和部分可观测下均提供可解释因果表征,准确率随干预强度提升。
该方法为多智能体离线场景下的因果世界建模提供无需先验因果图的新路径,对干预强度具备良好可扩展性。
🆚 方法对比
暂未生成 — 点击下方按钮
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 72 张)
展开查看 72 张图
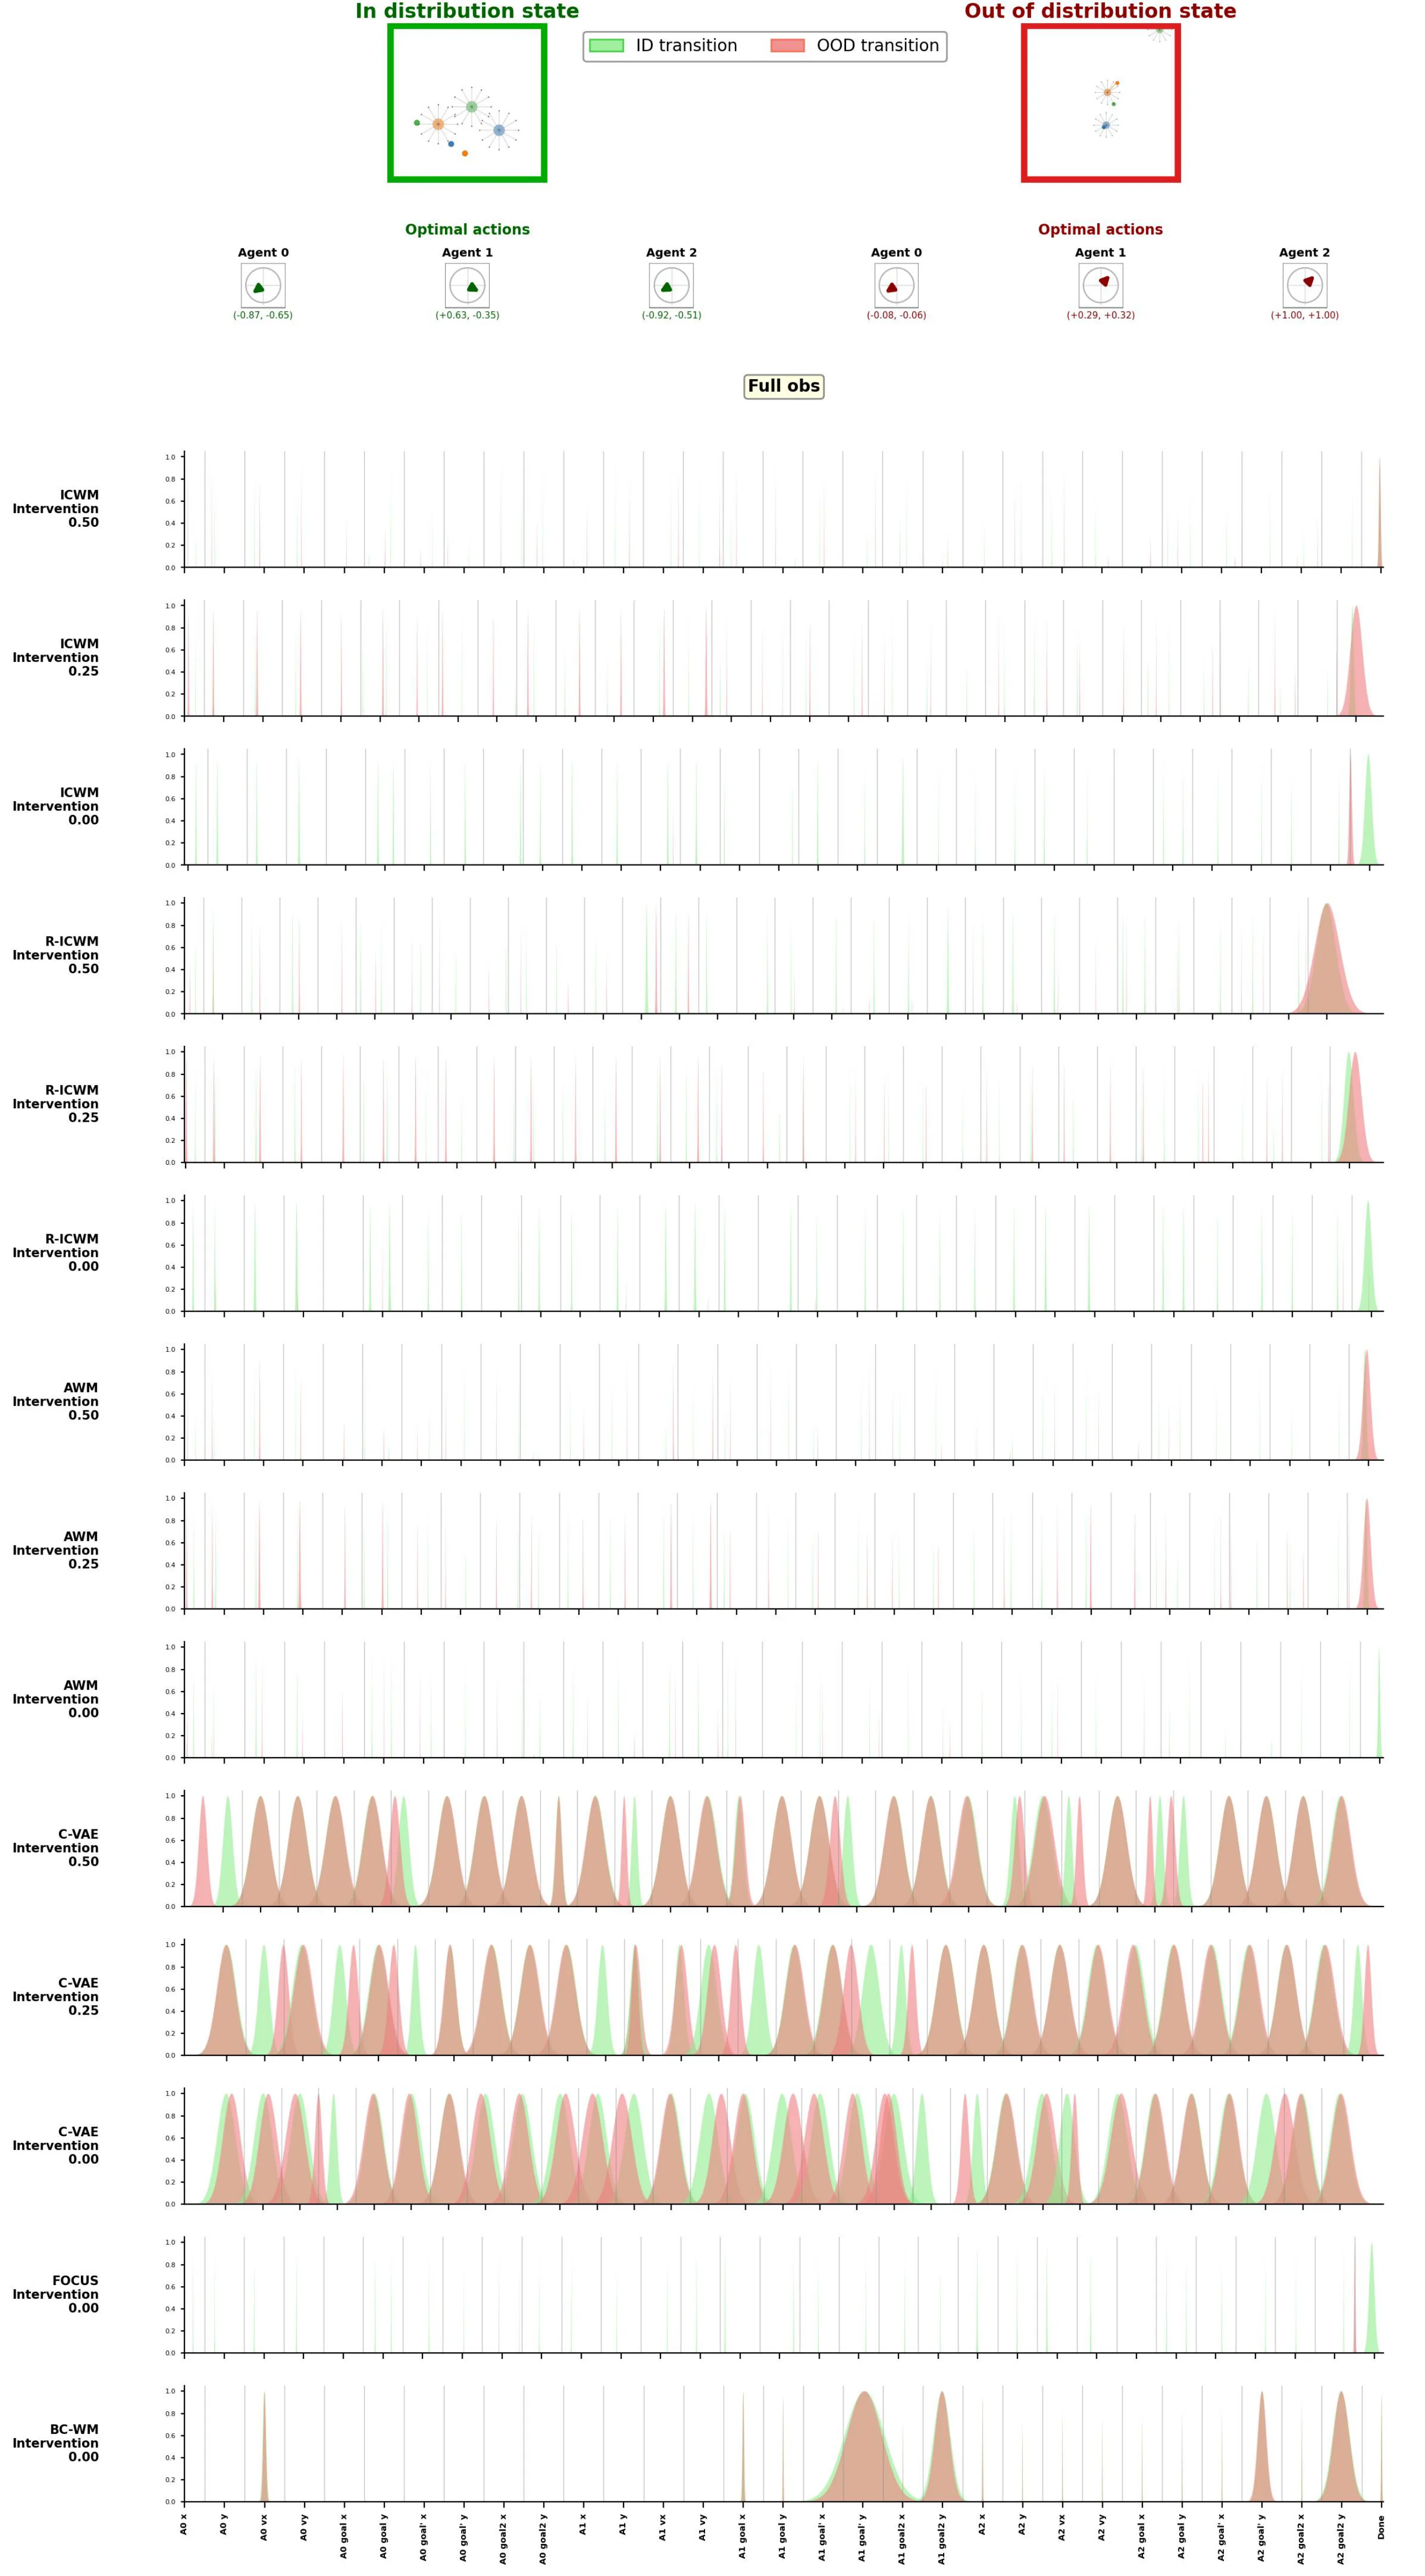
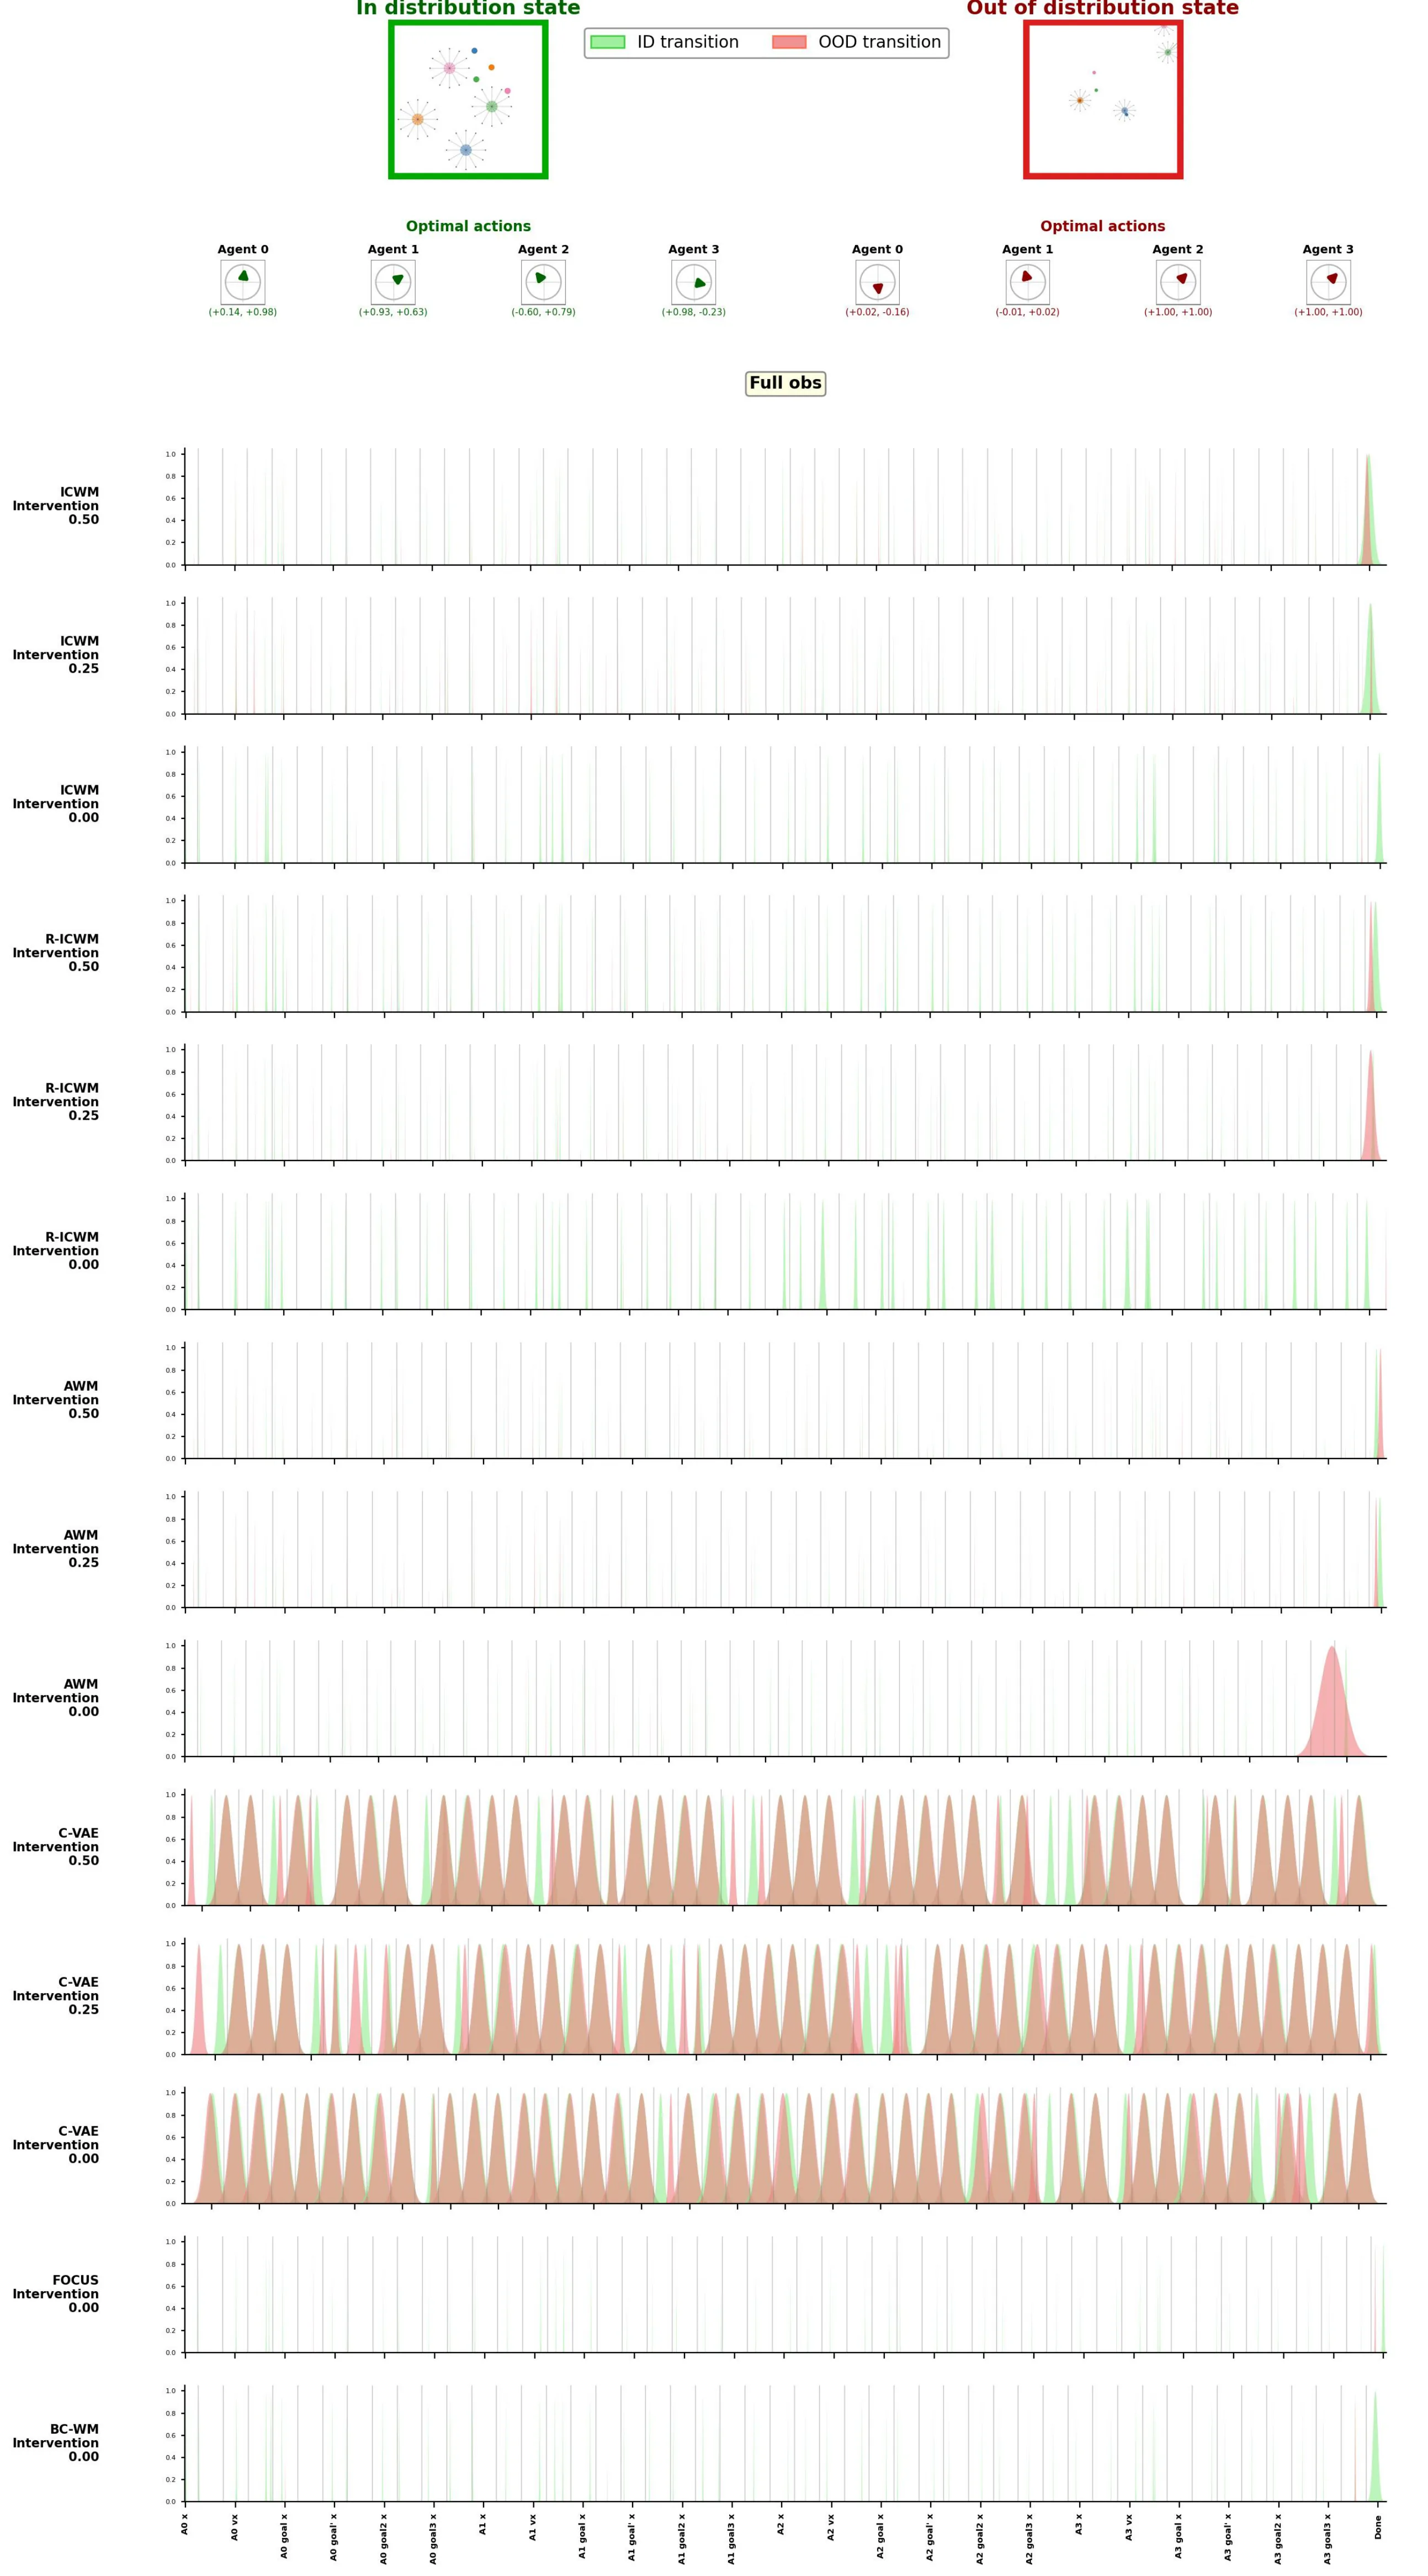
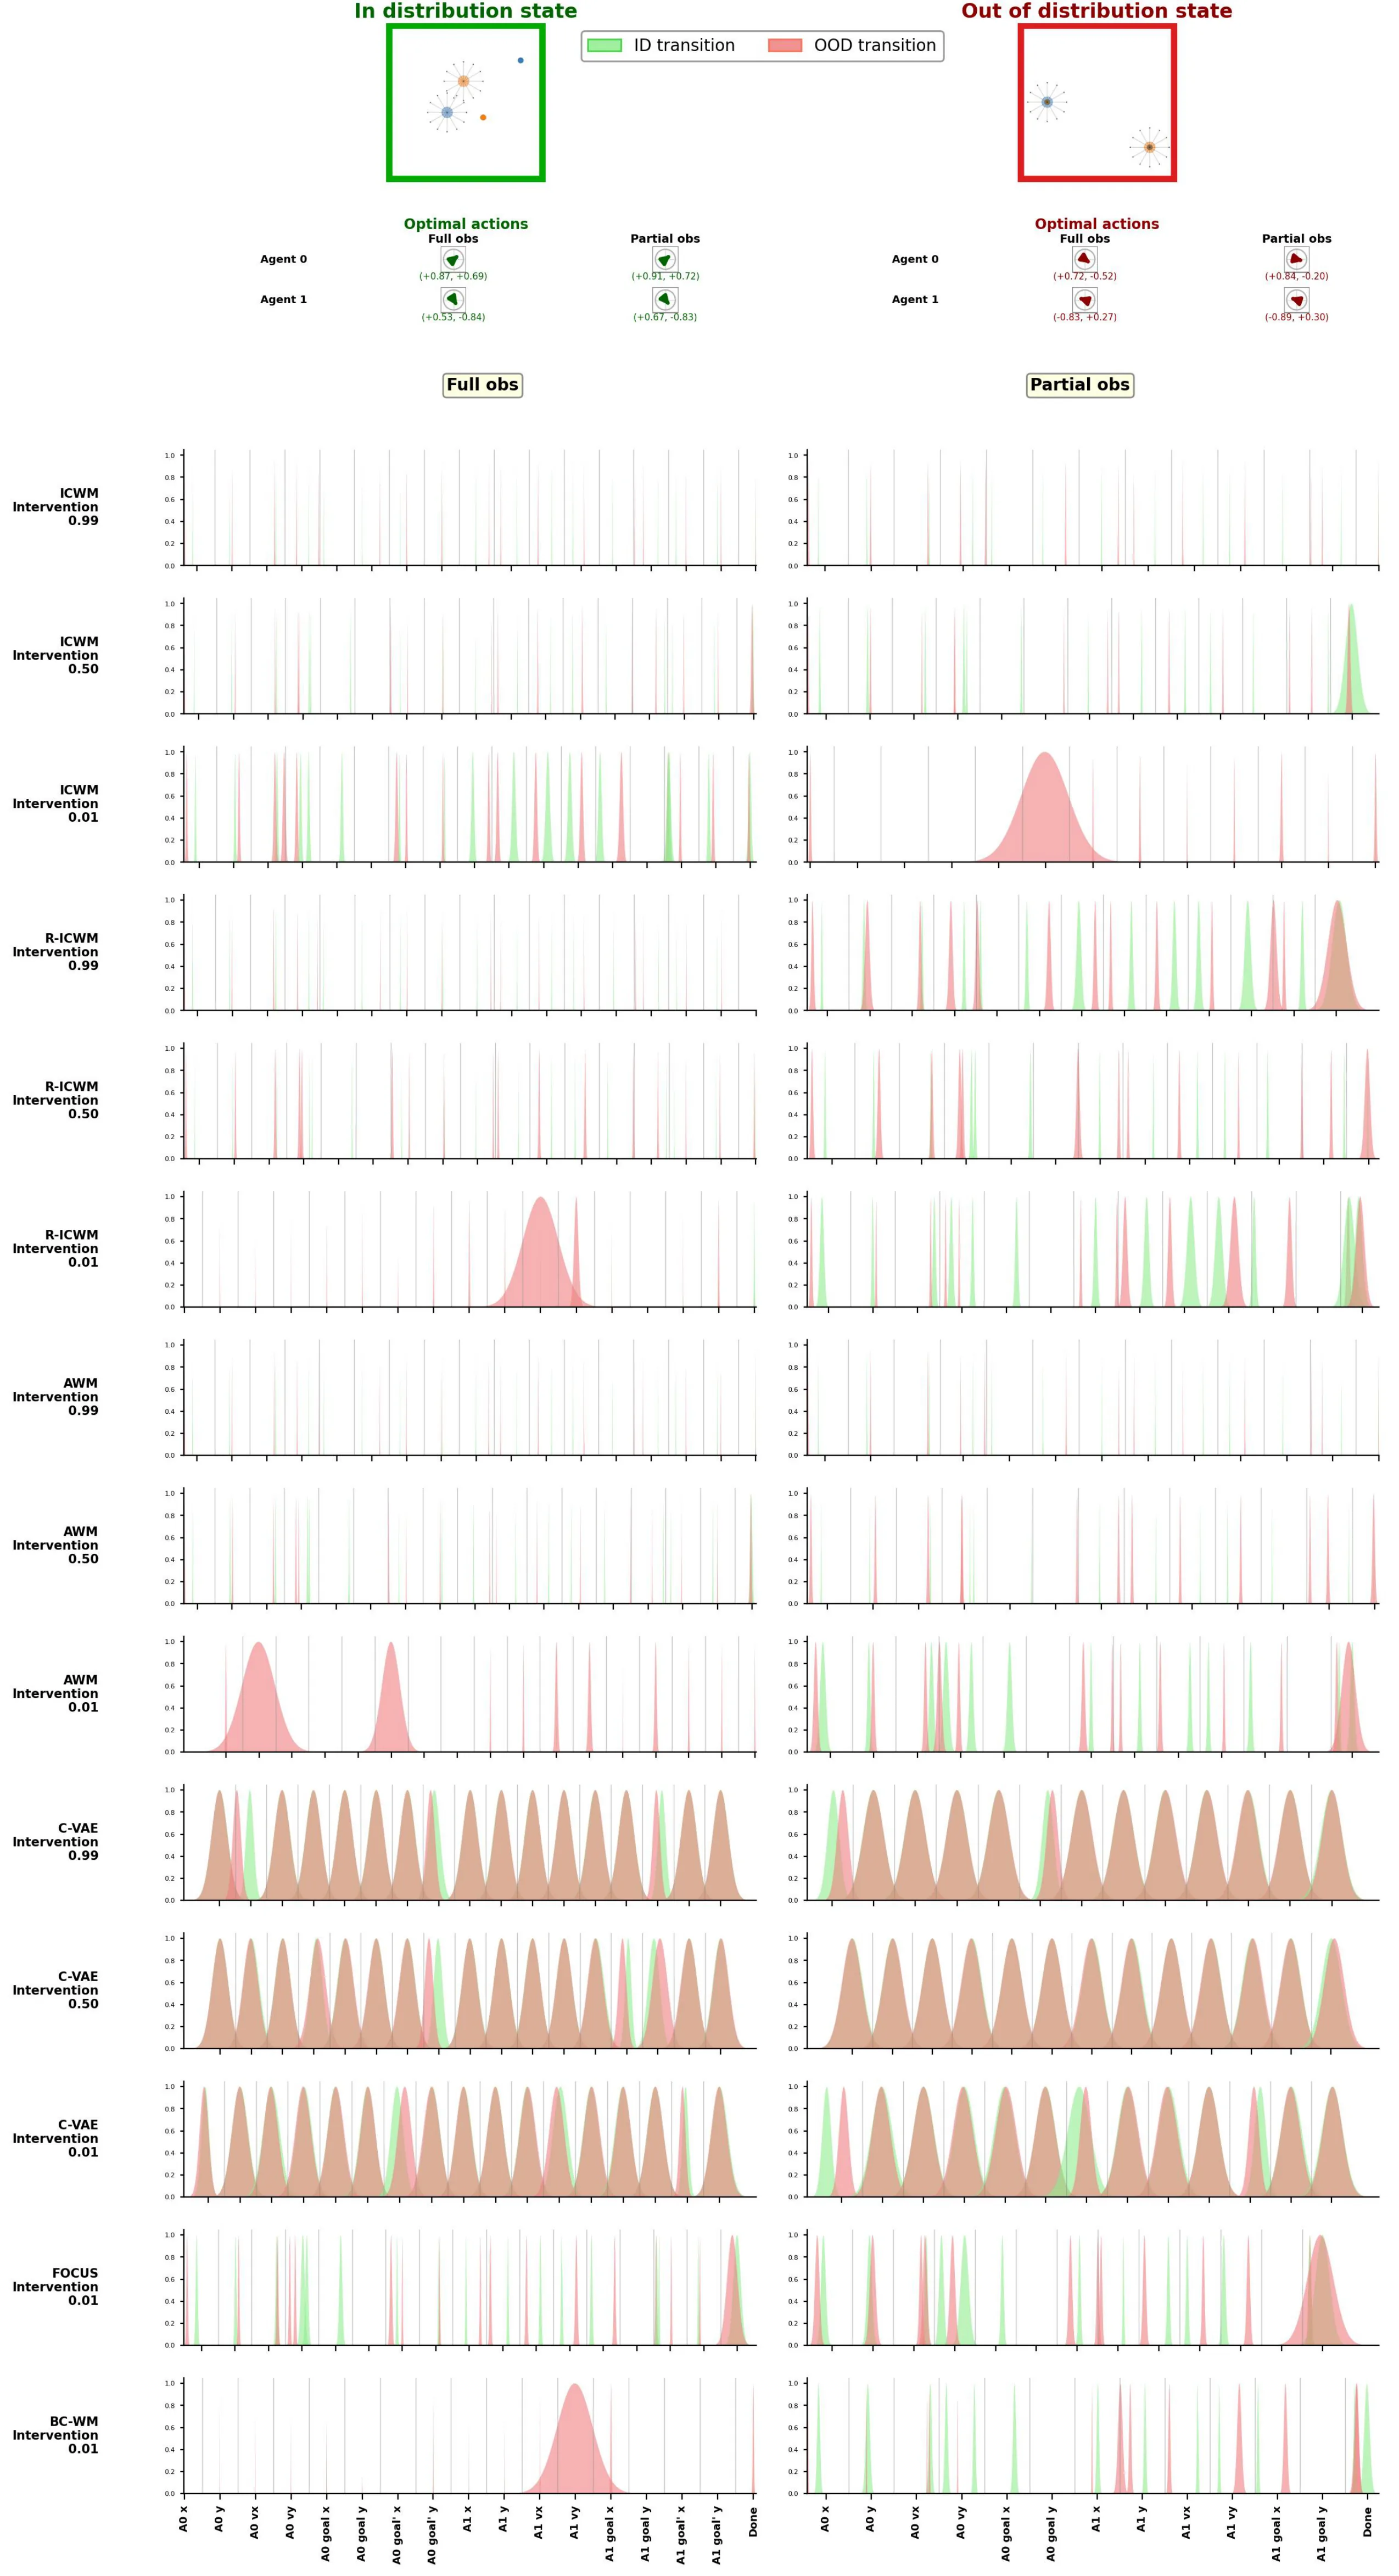
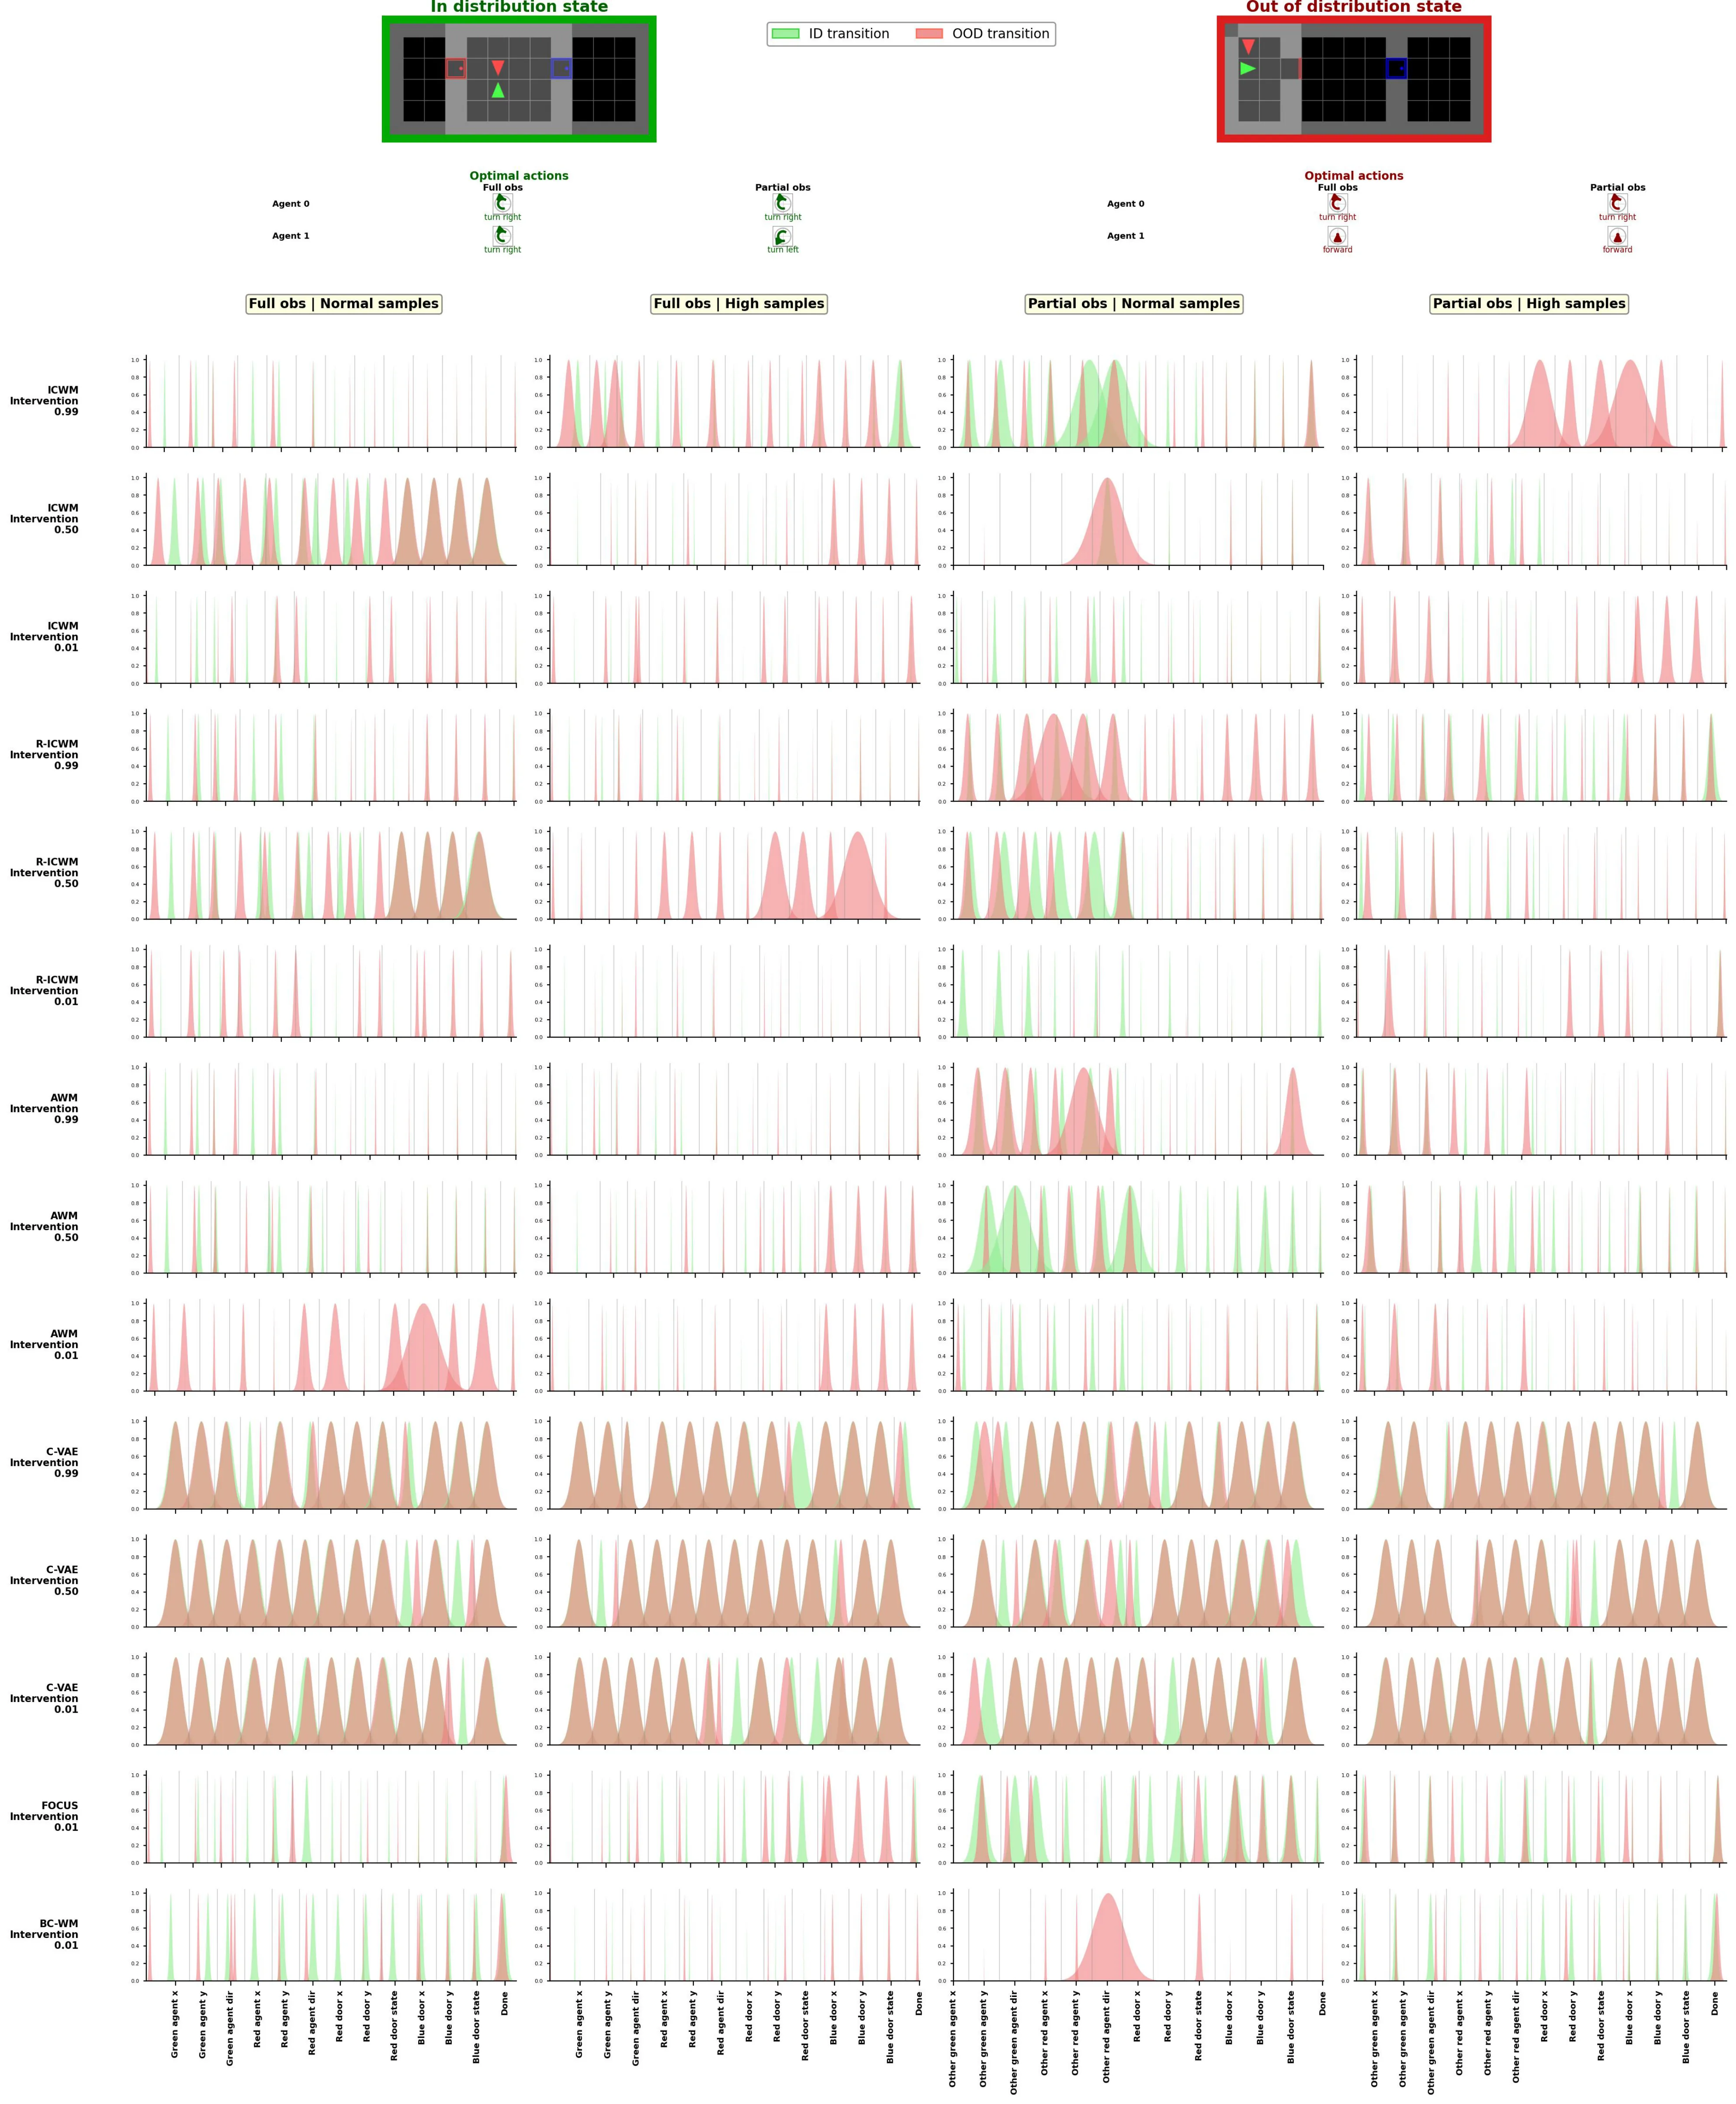
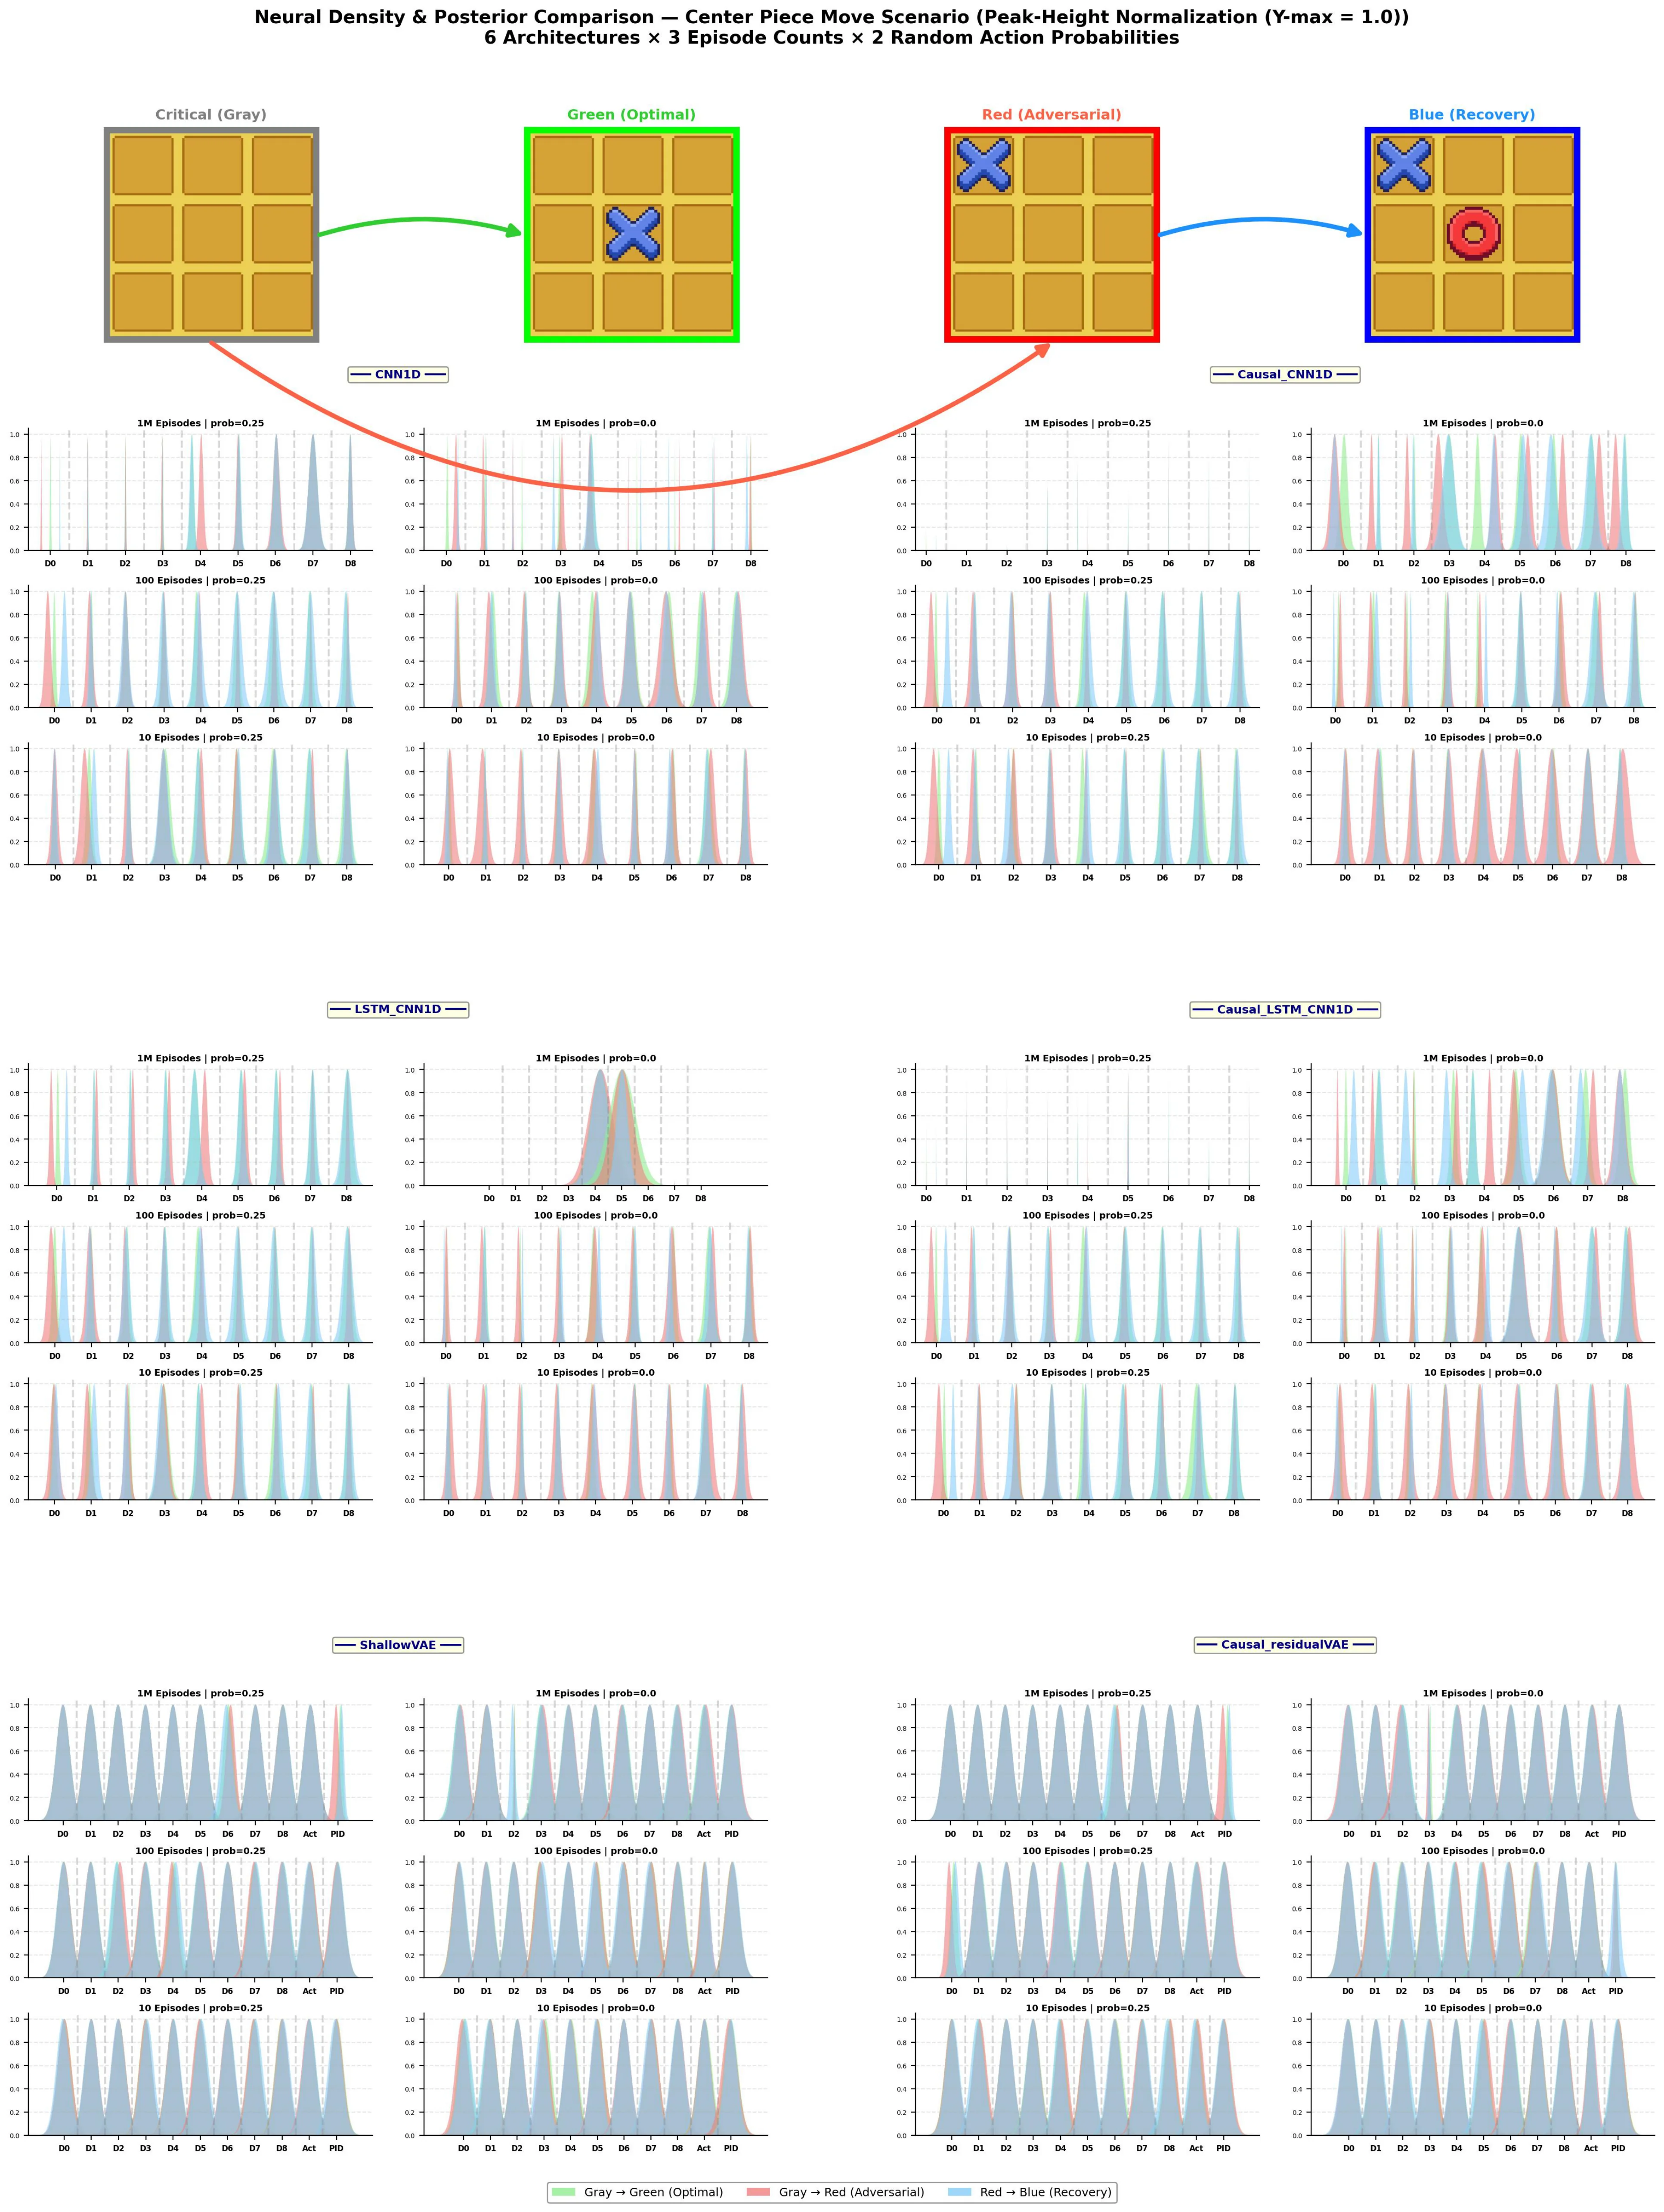
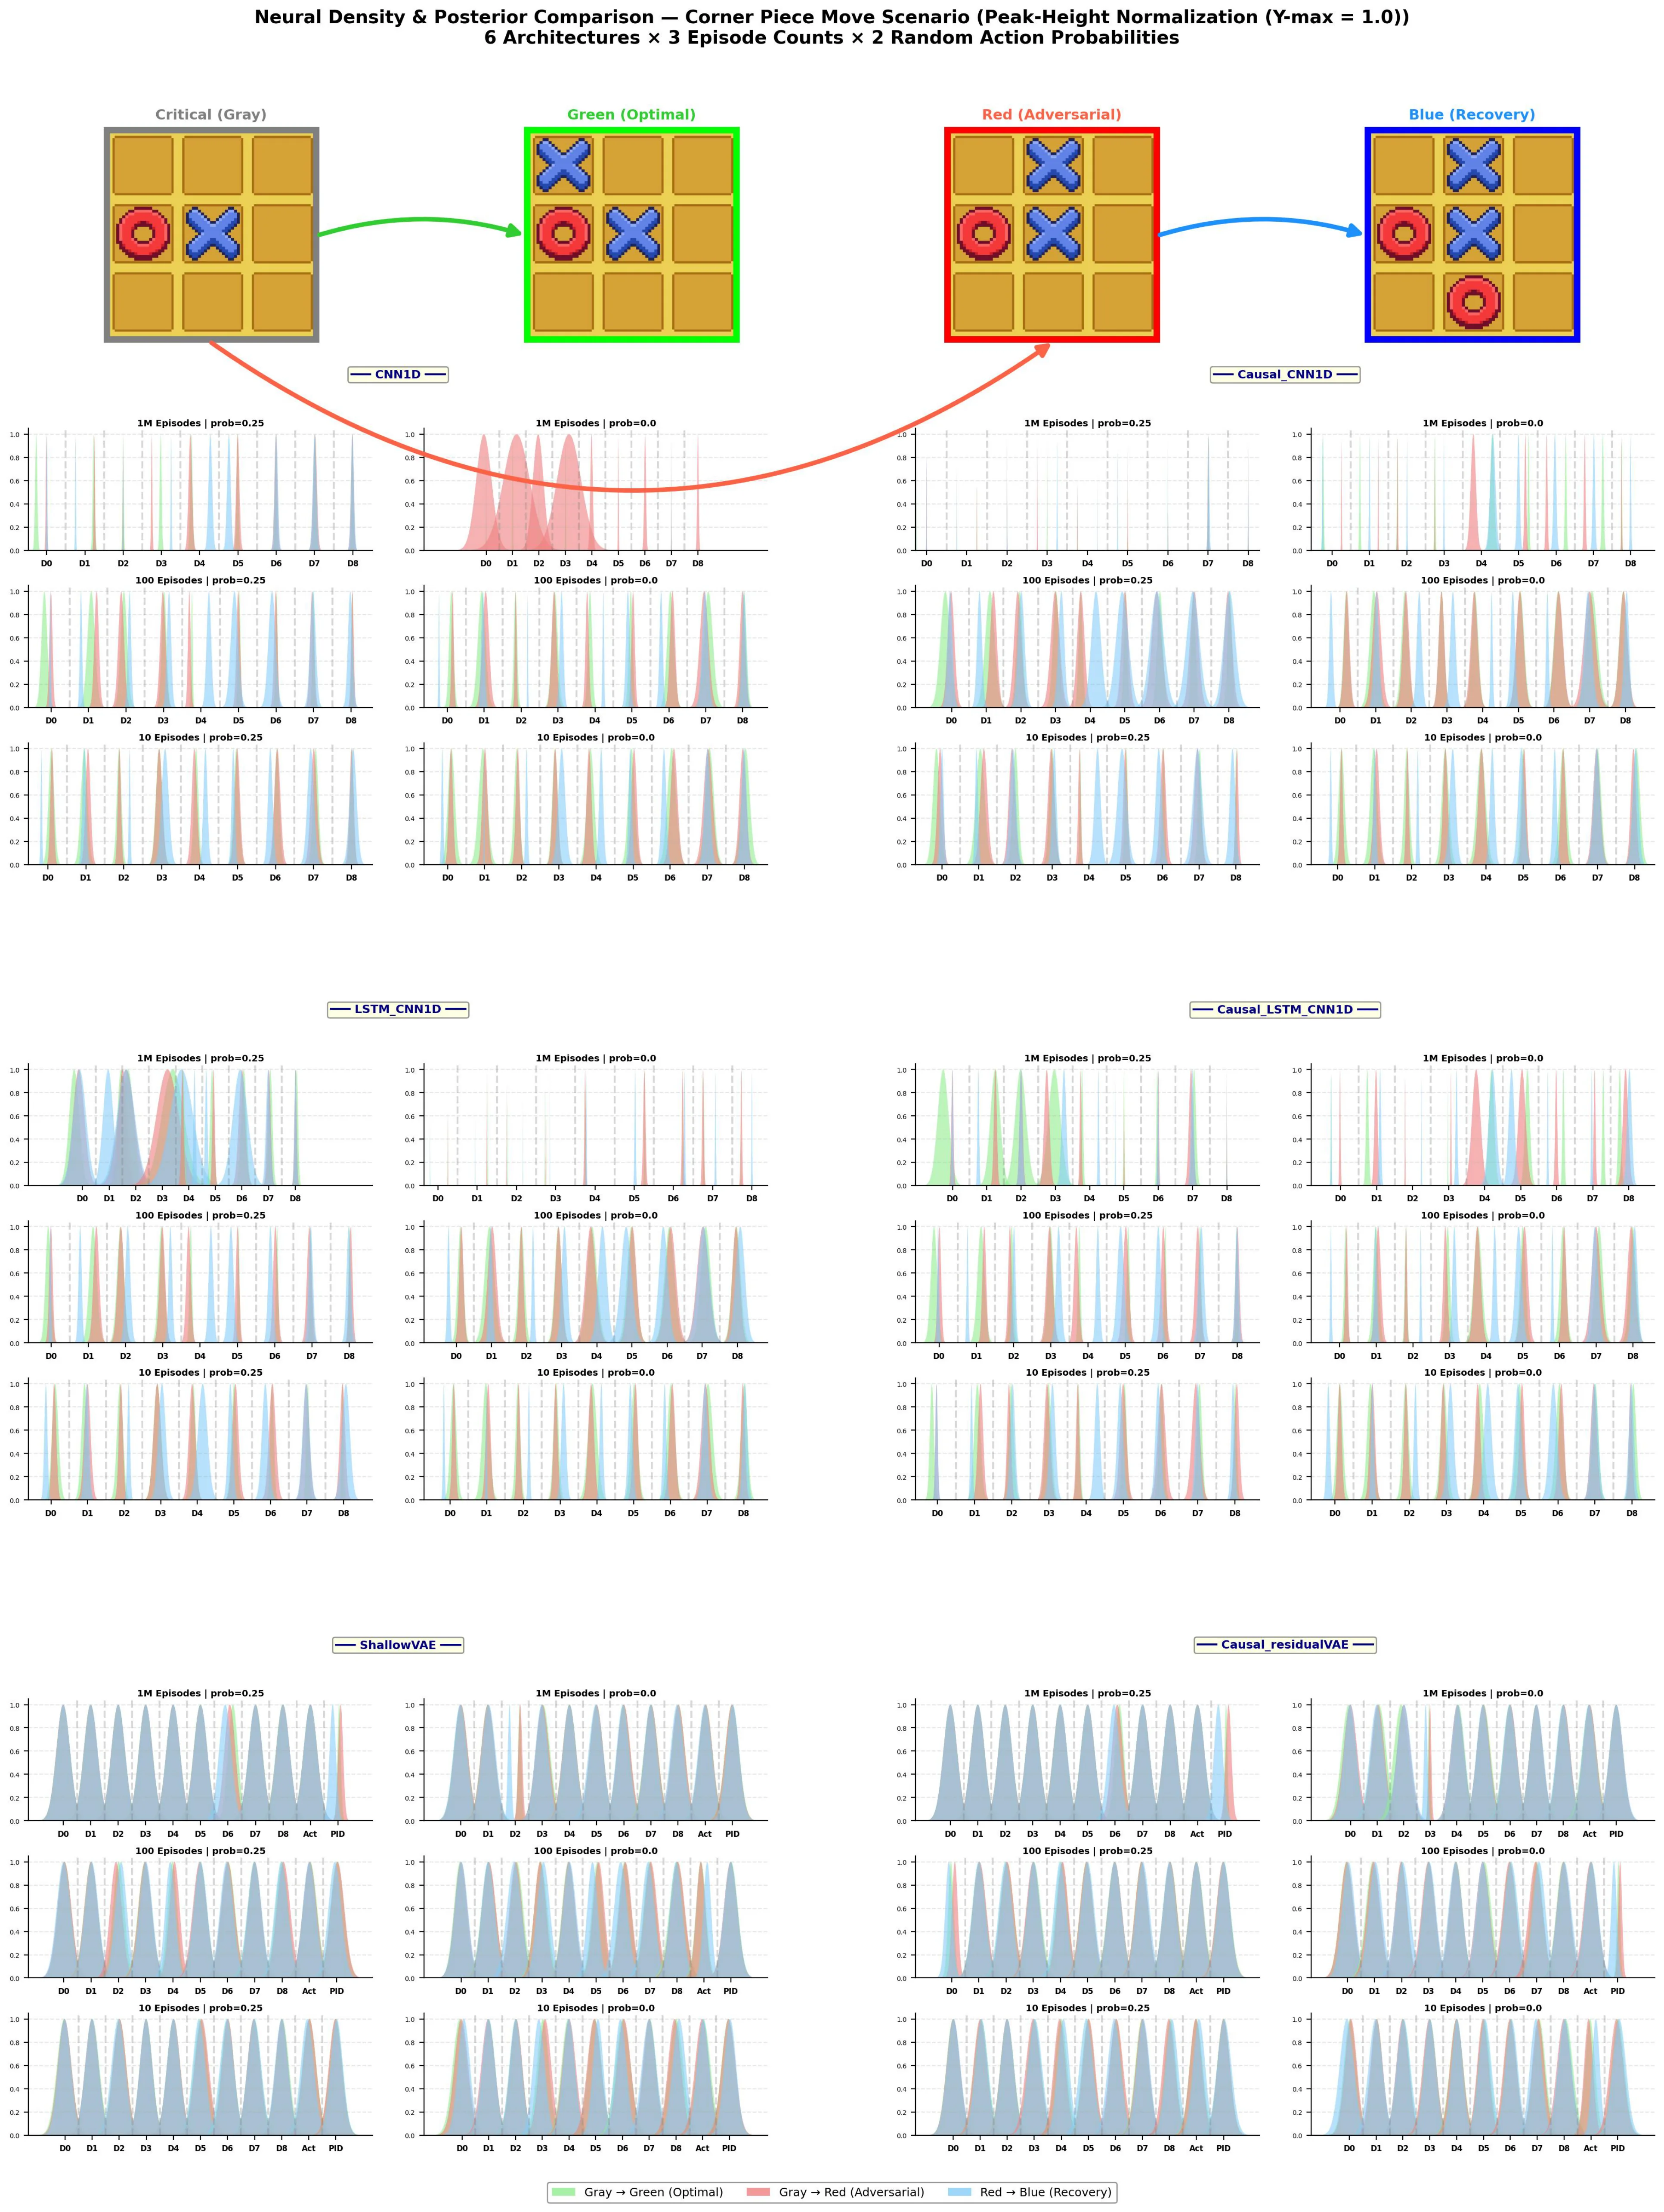
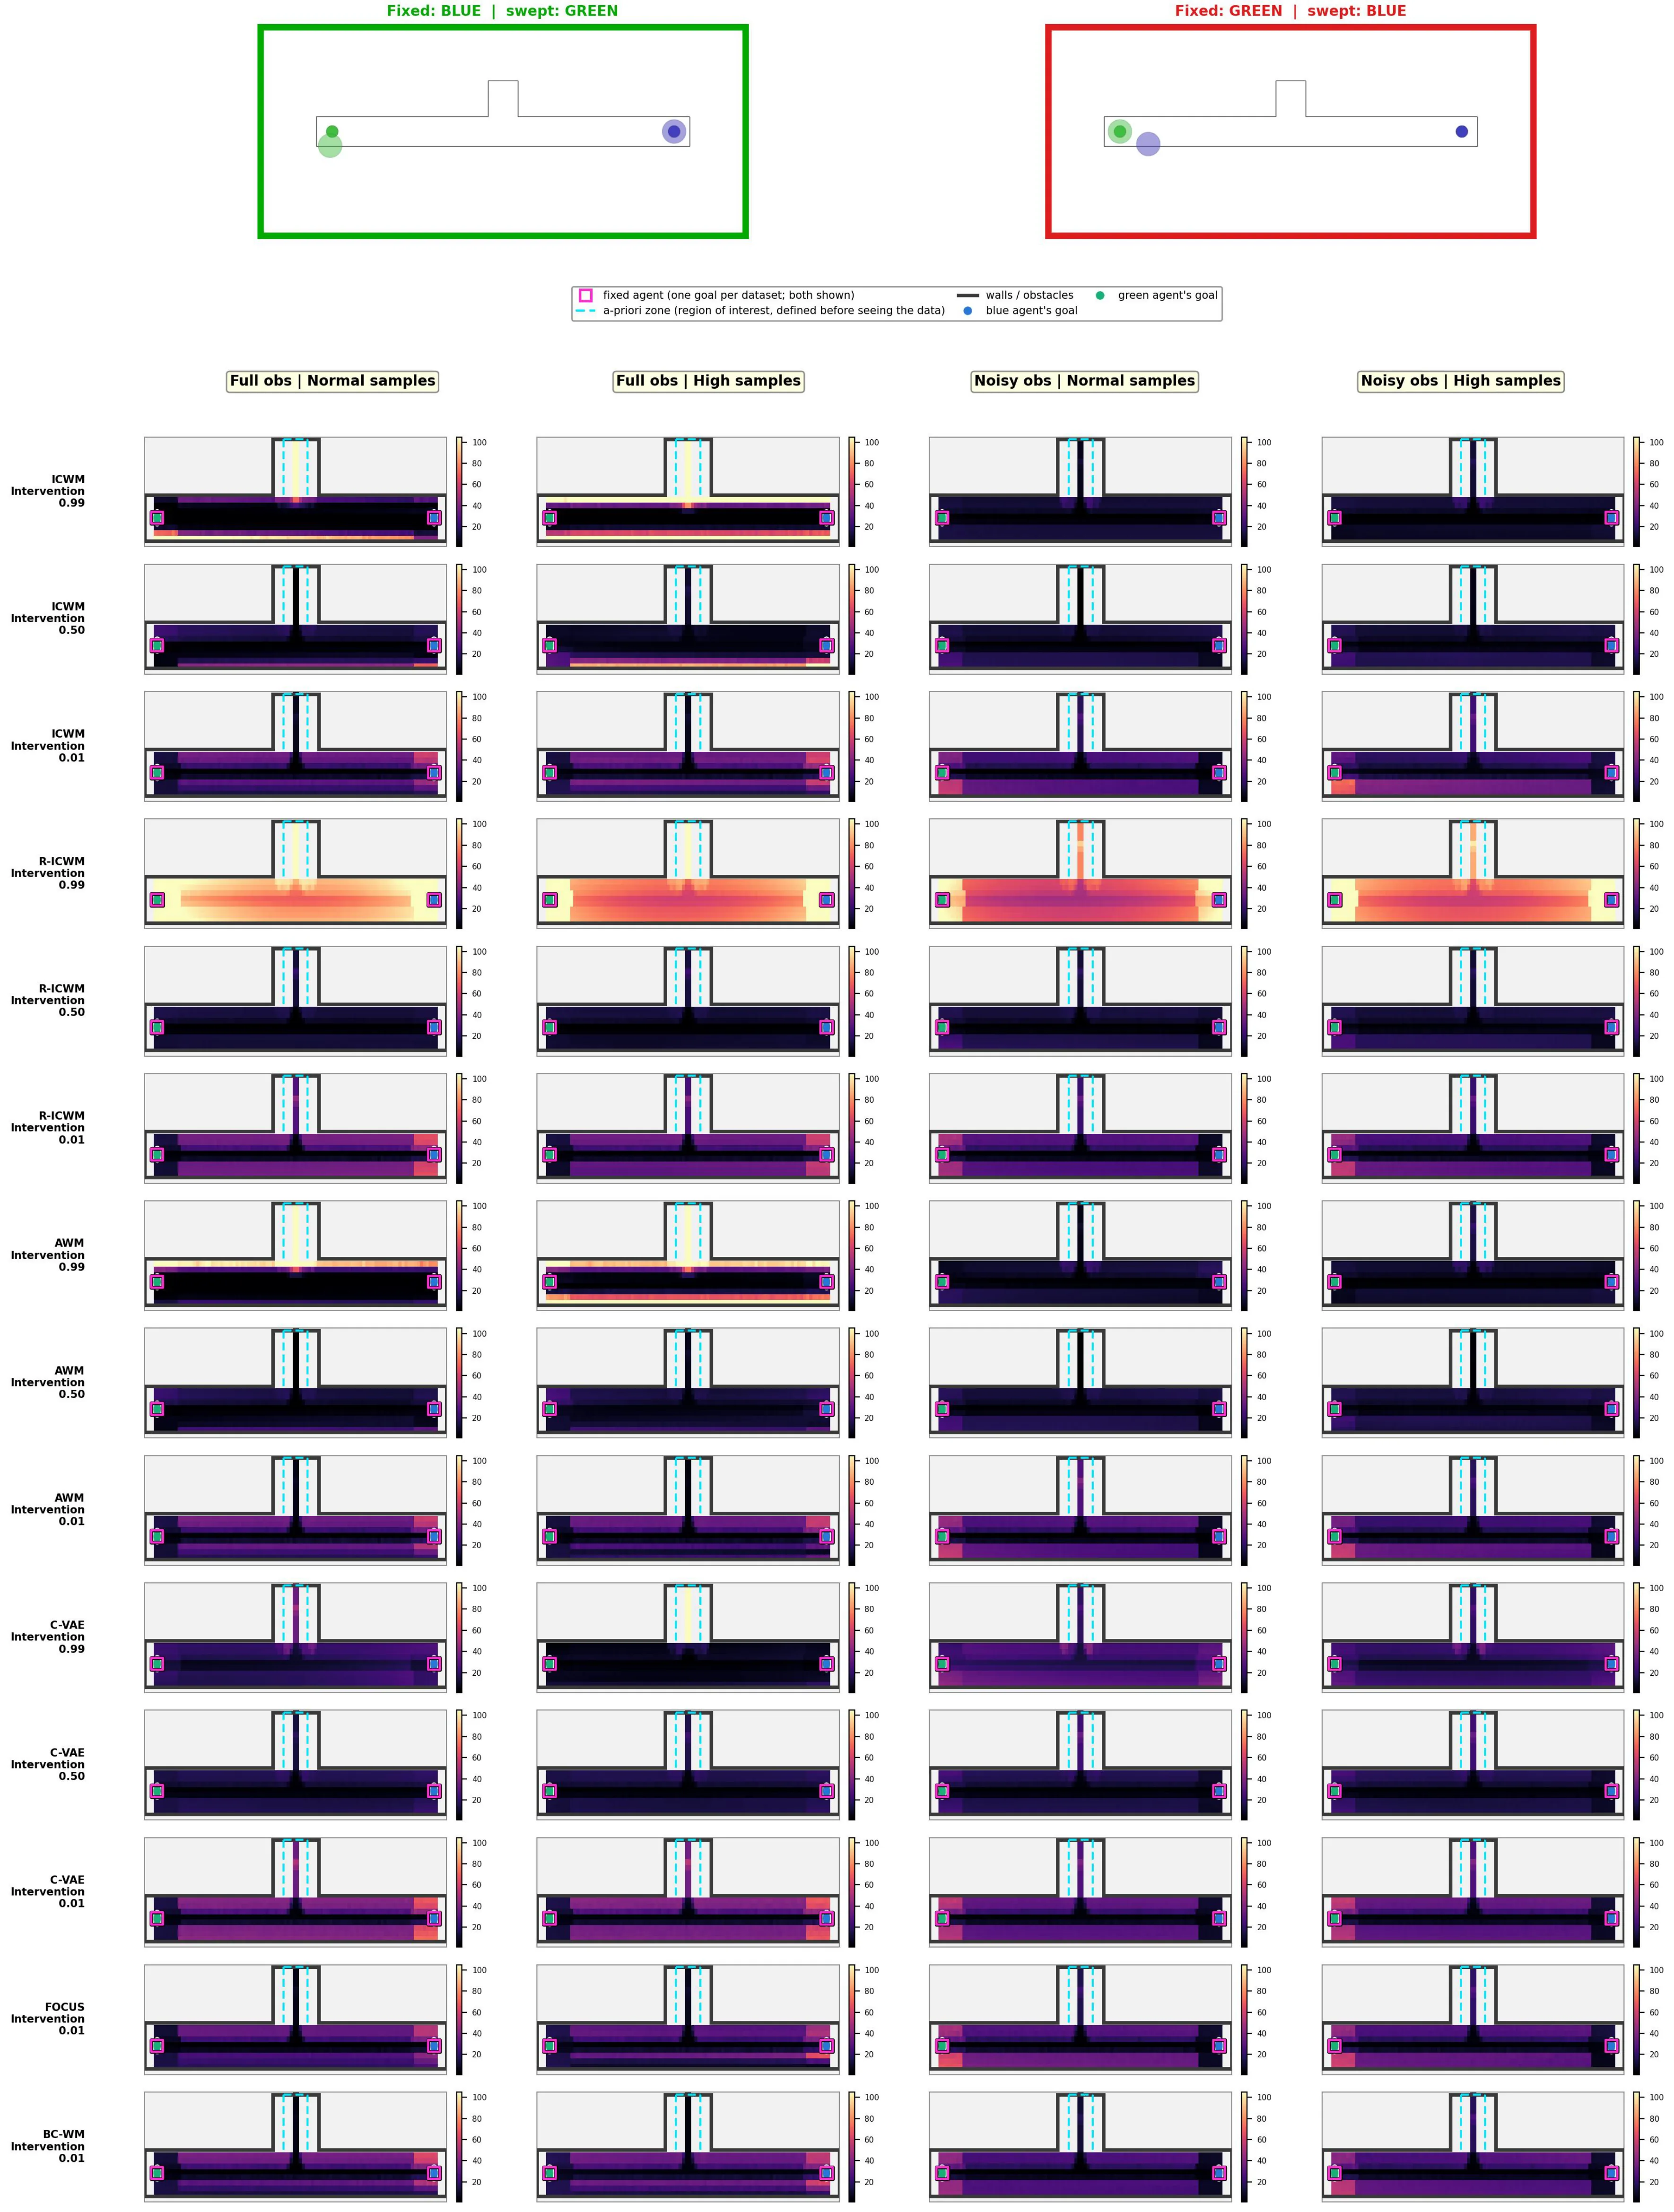
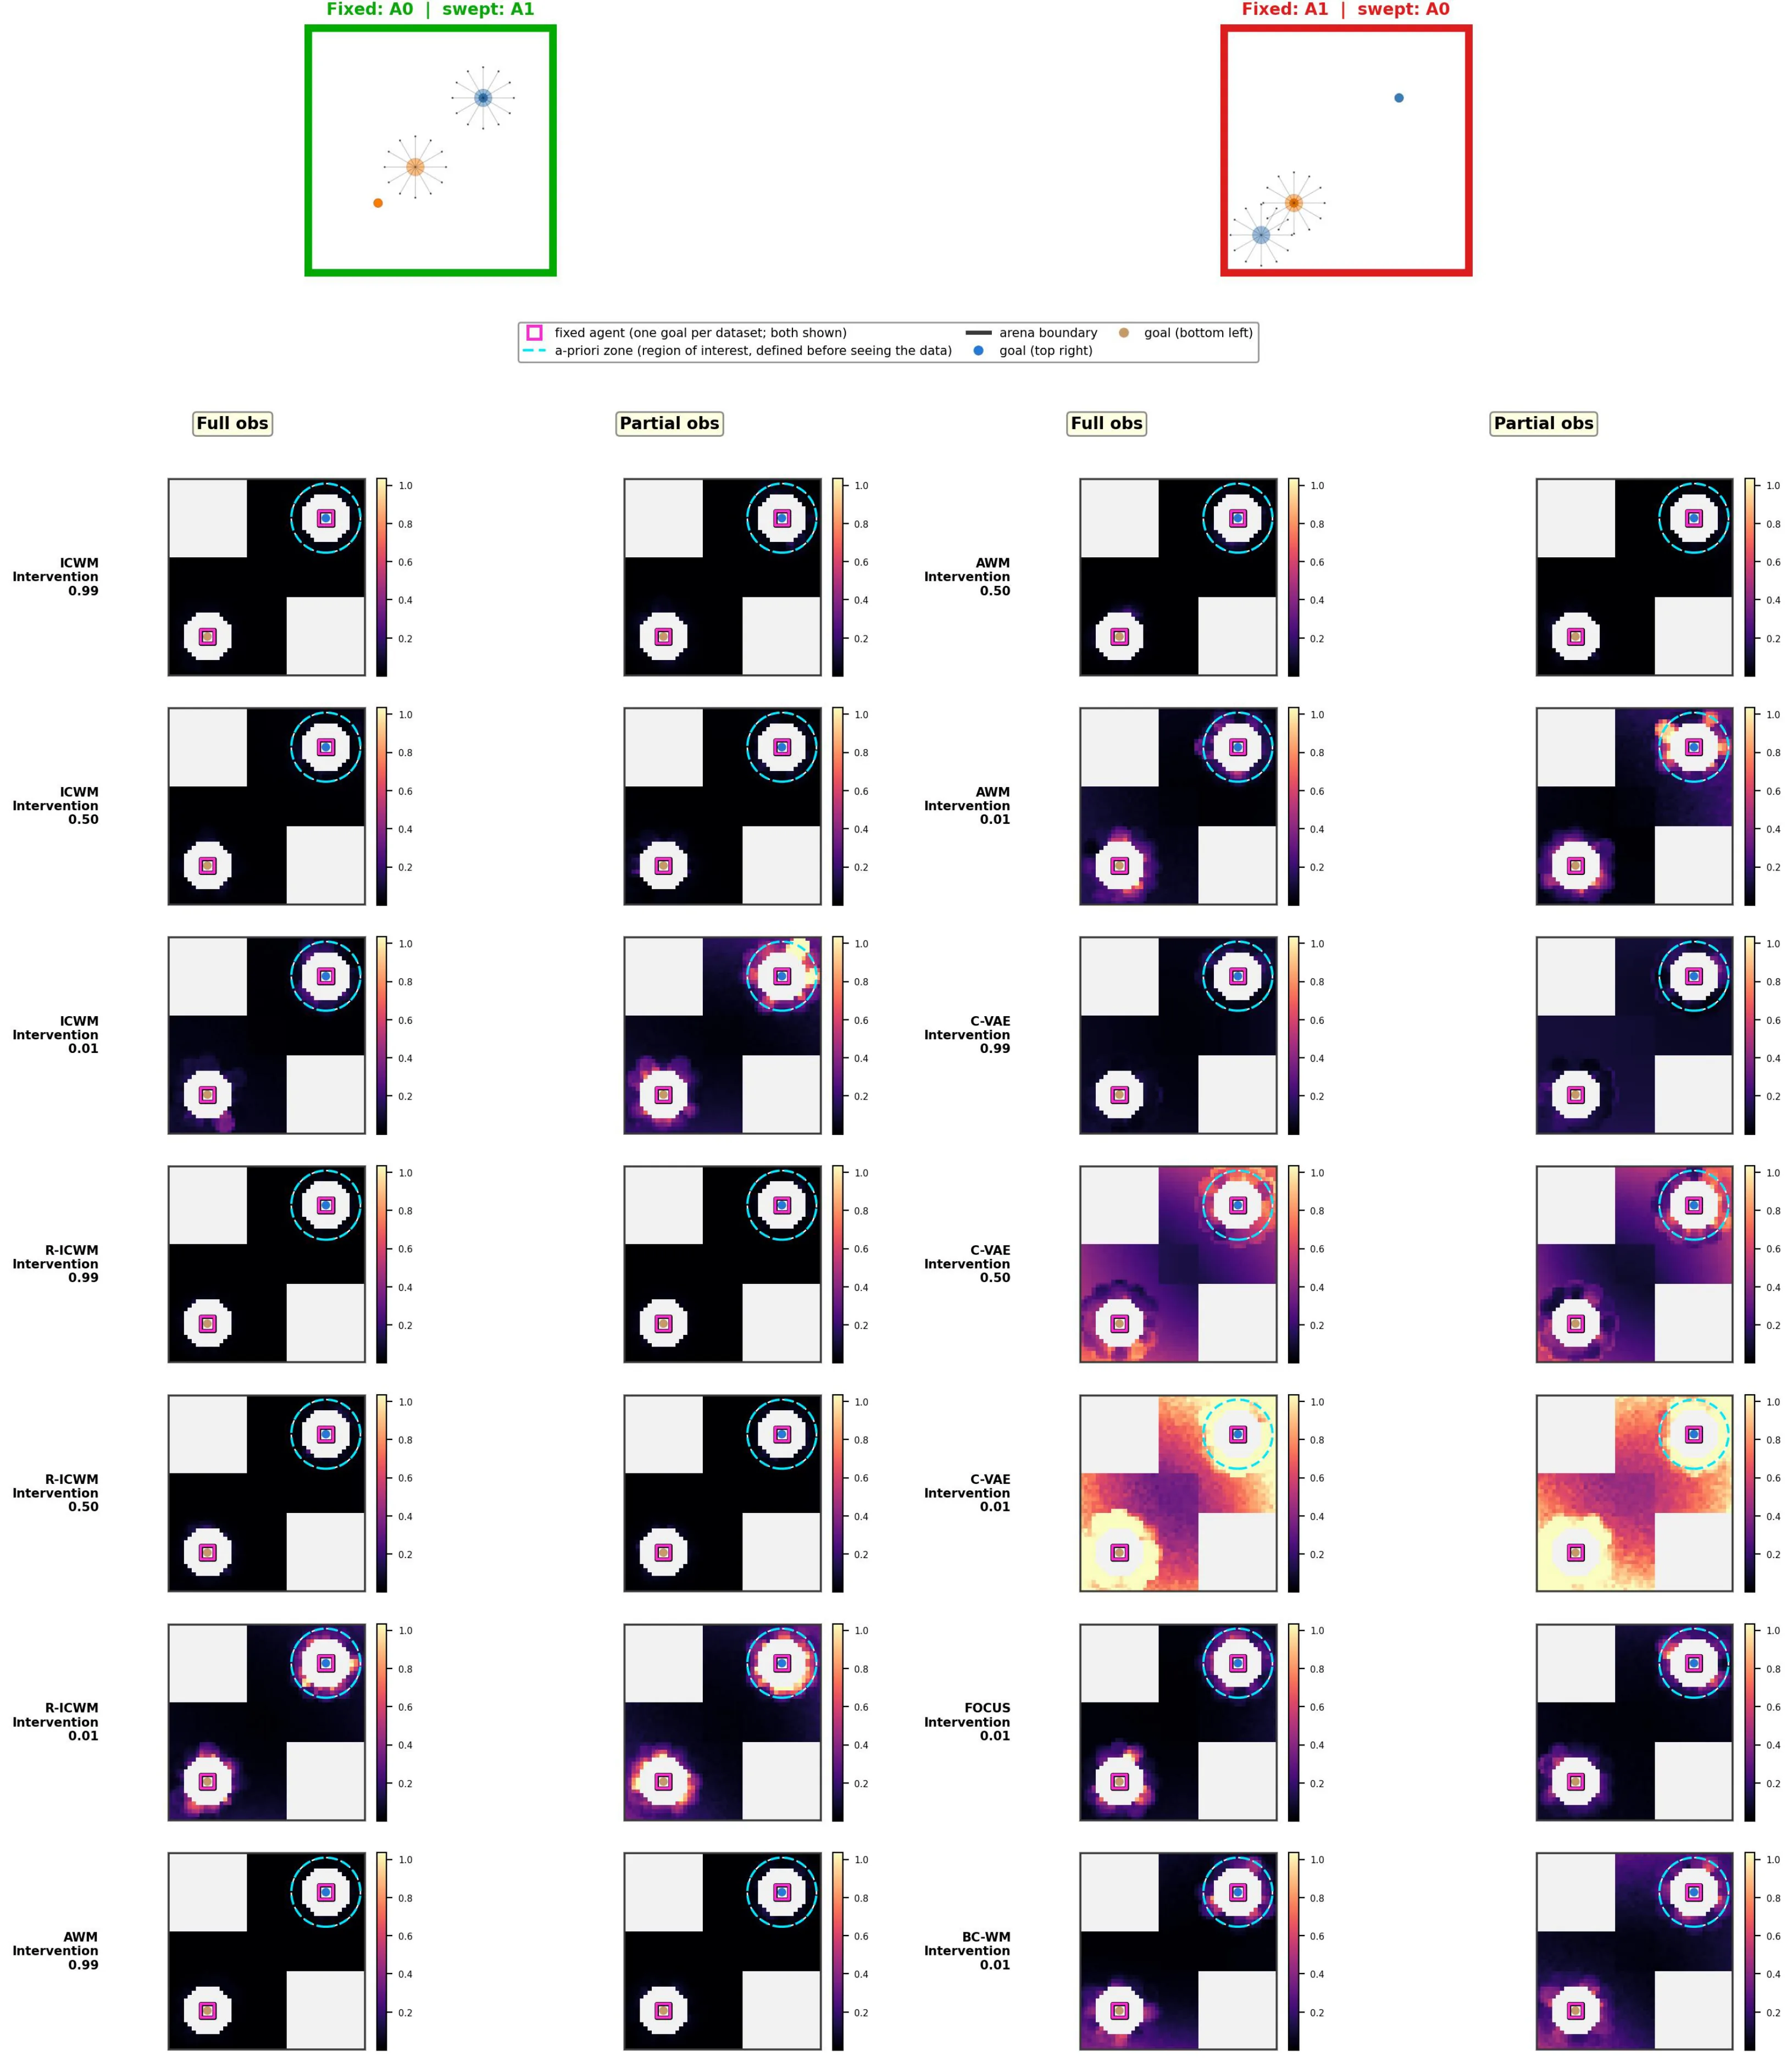
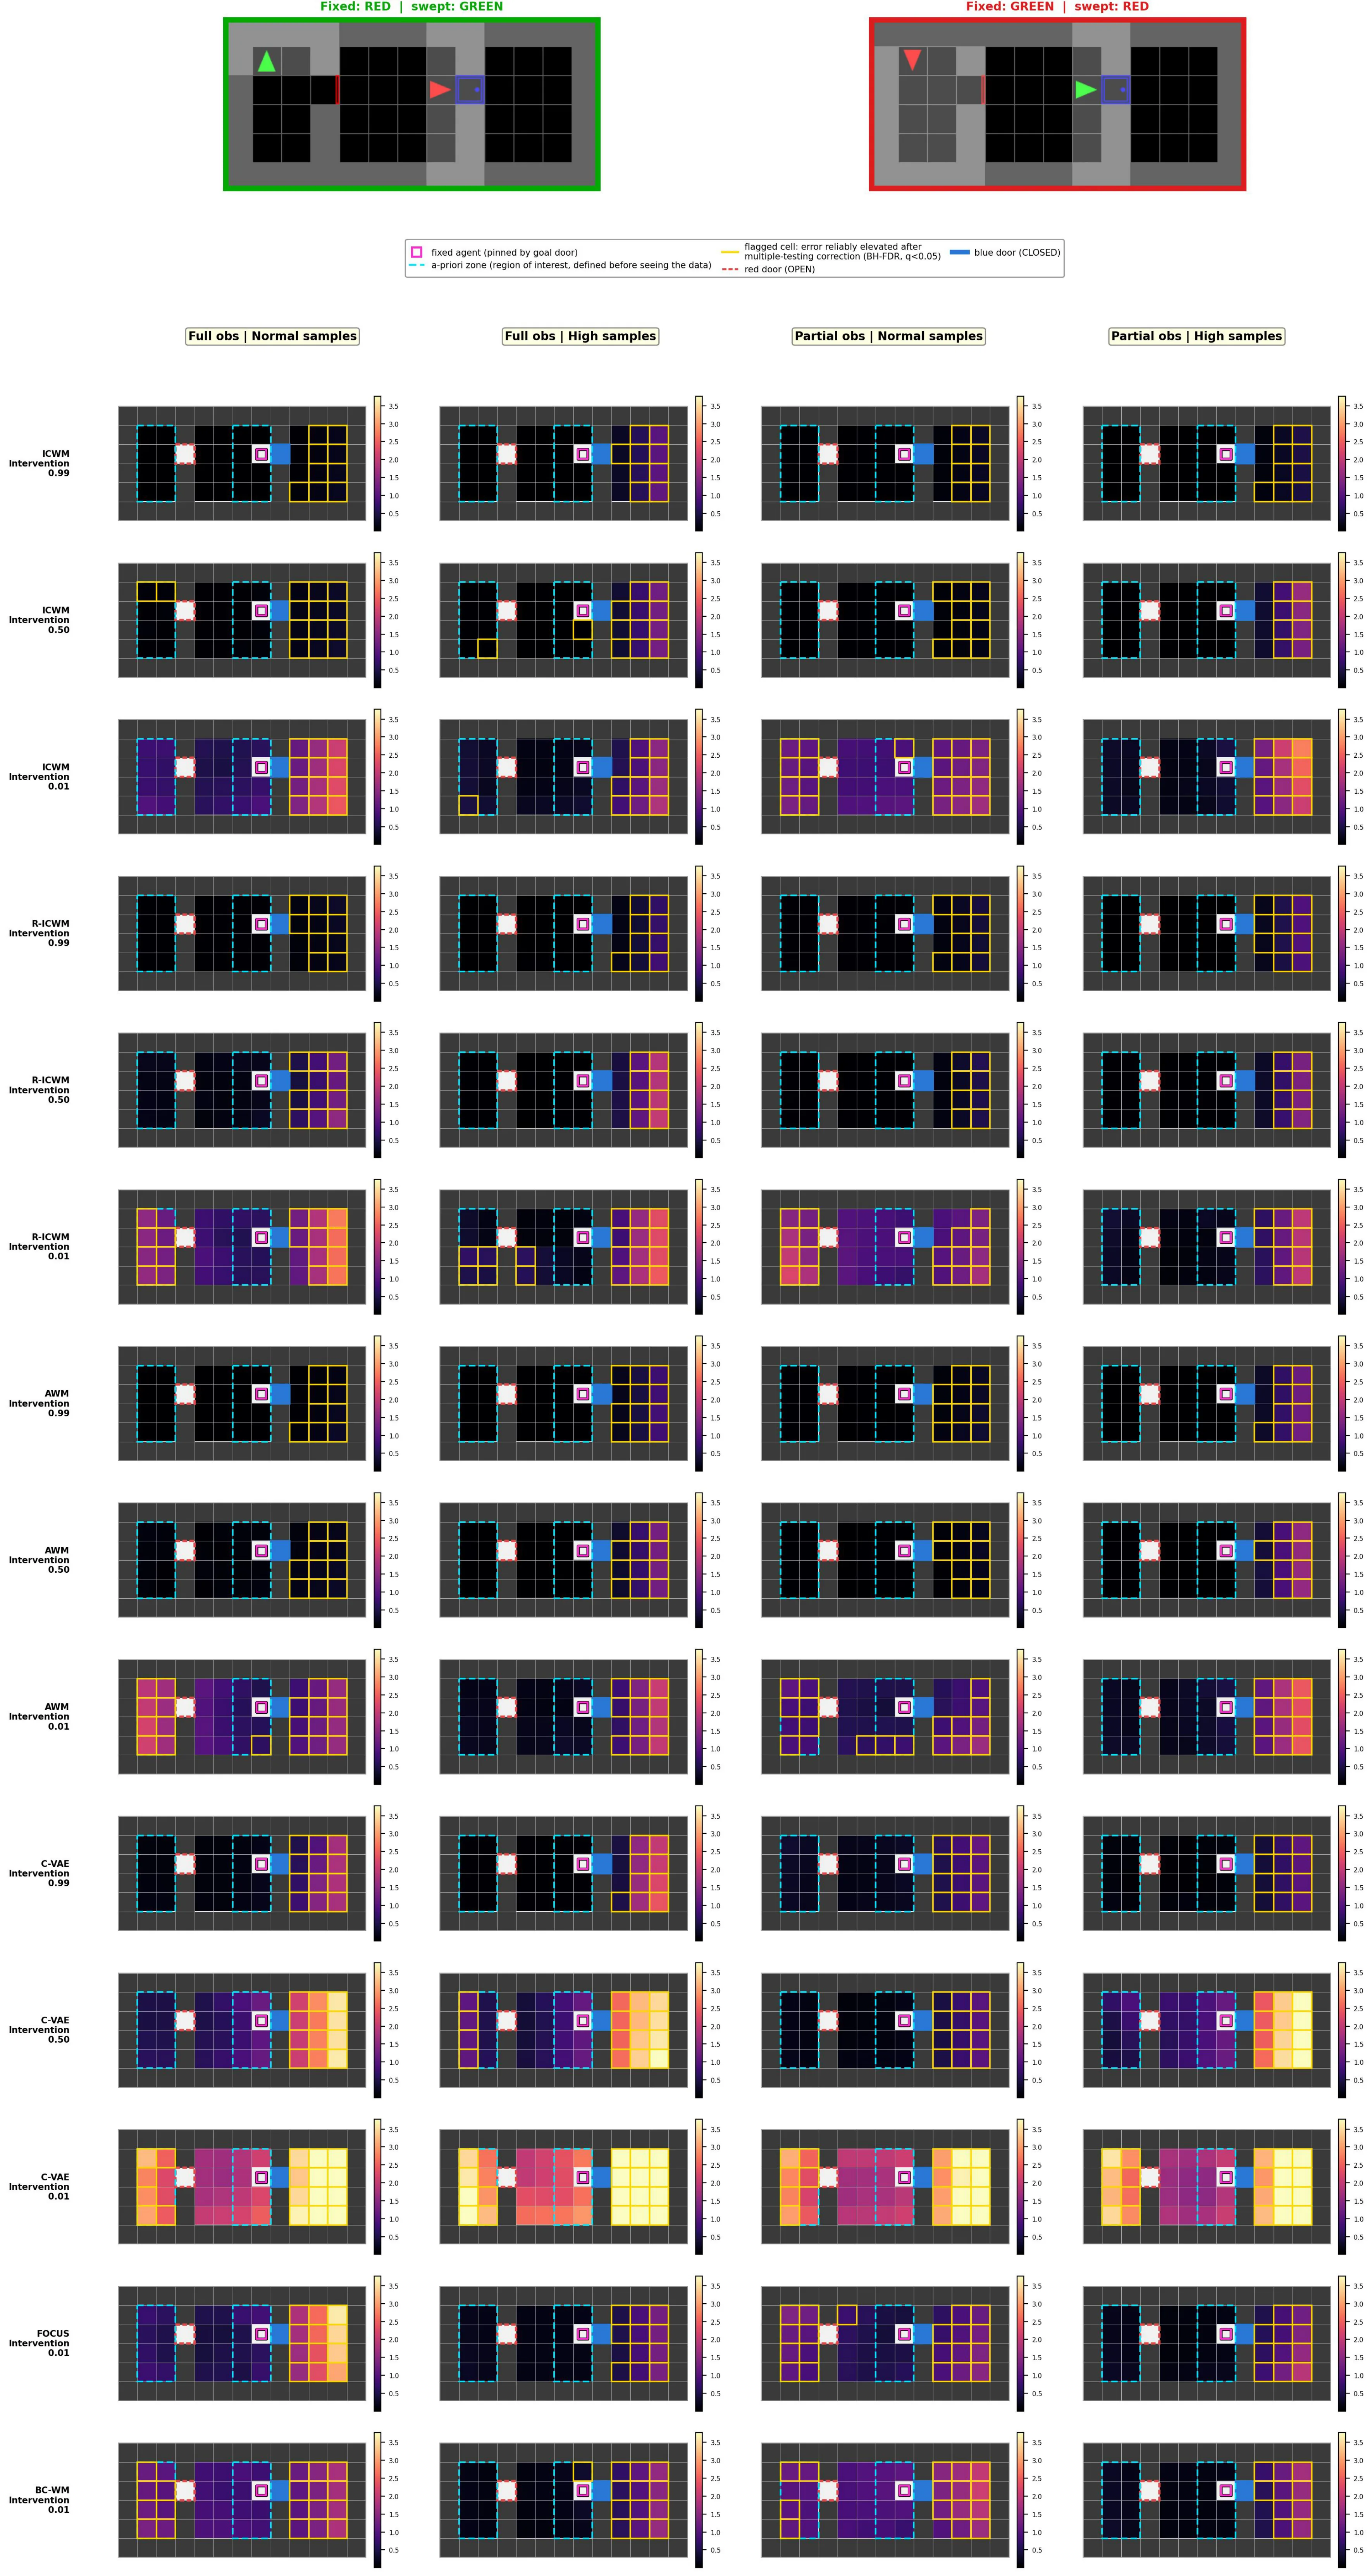
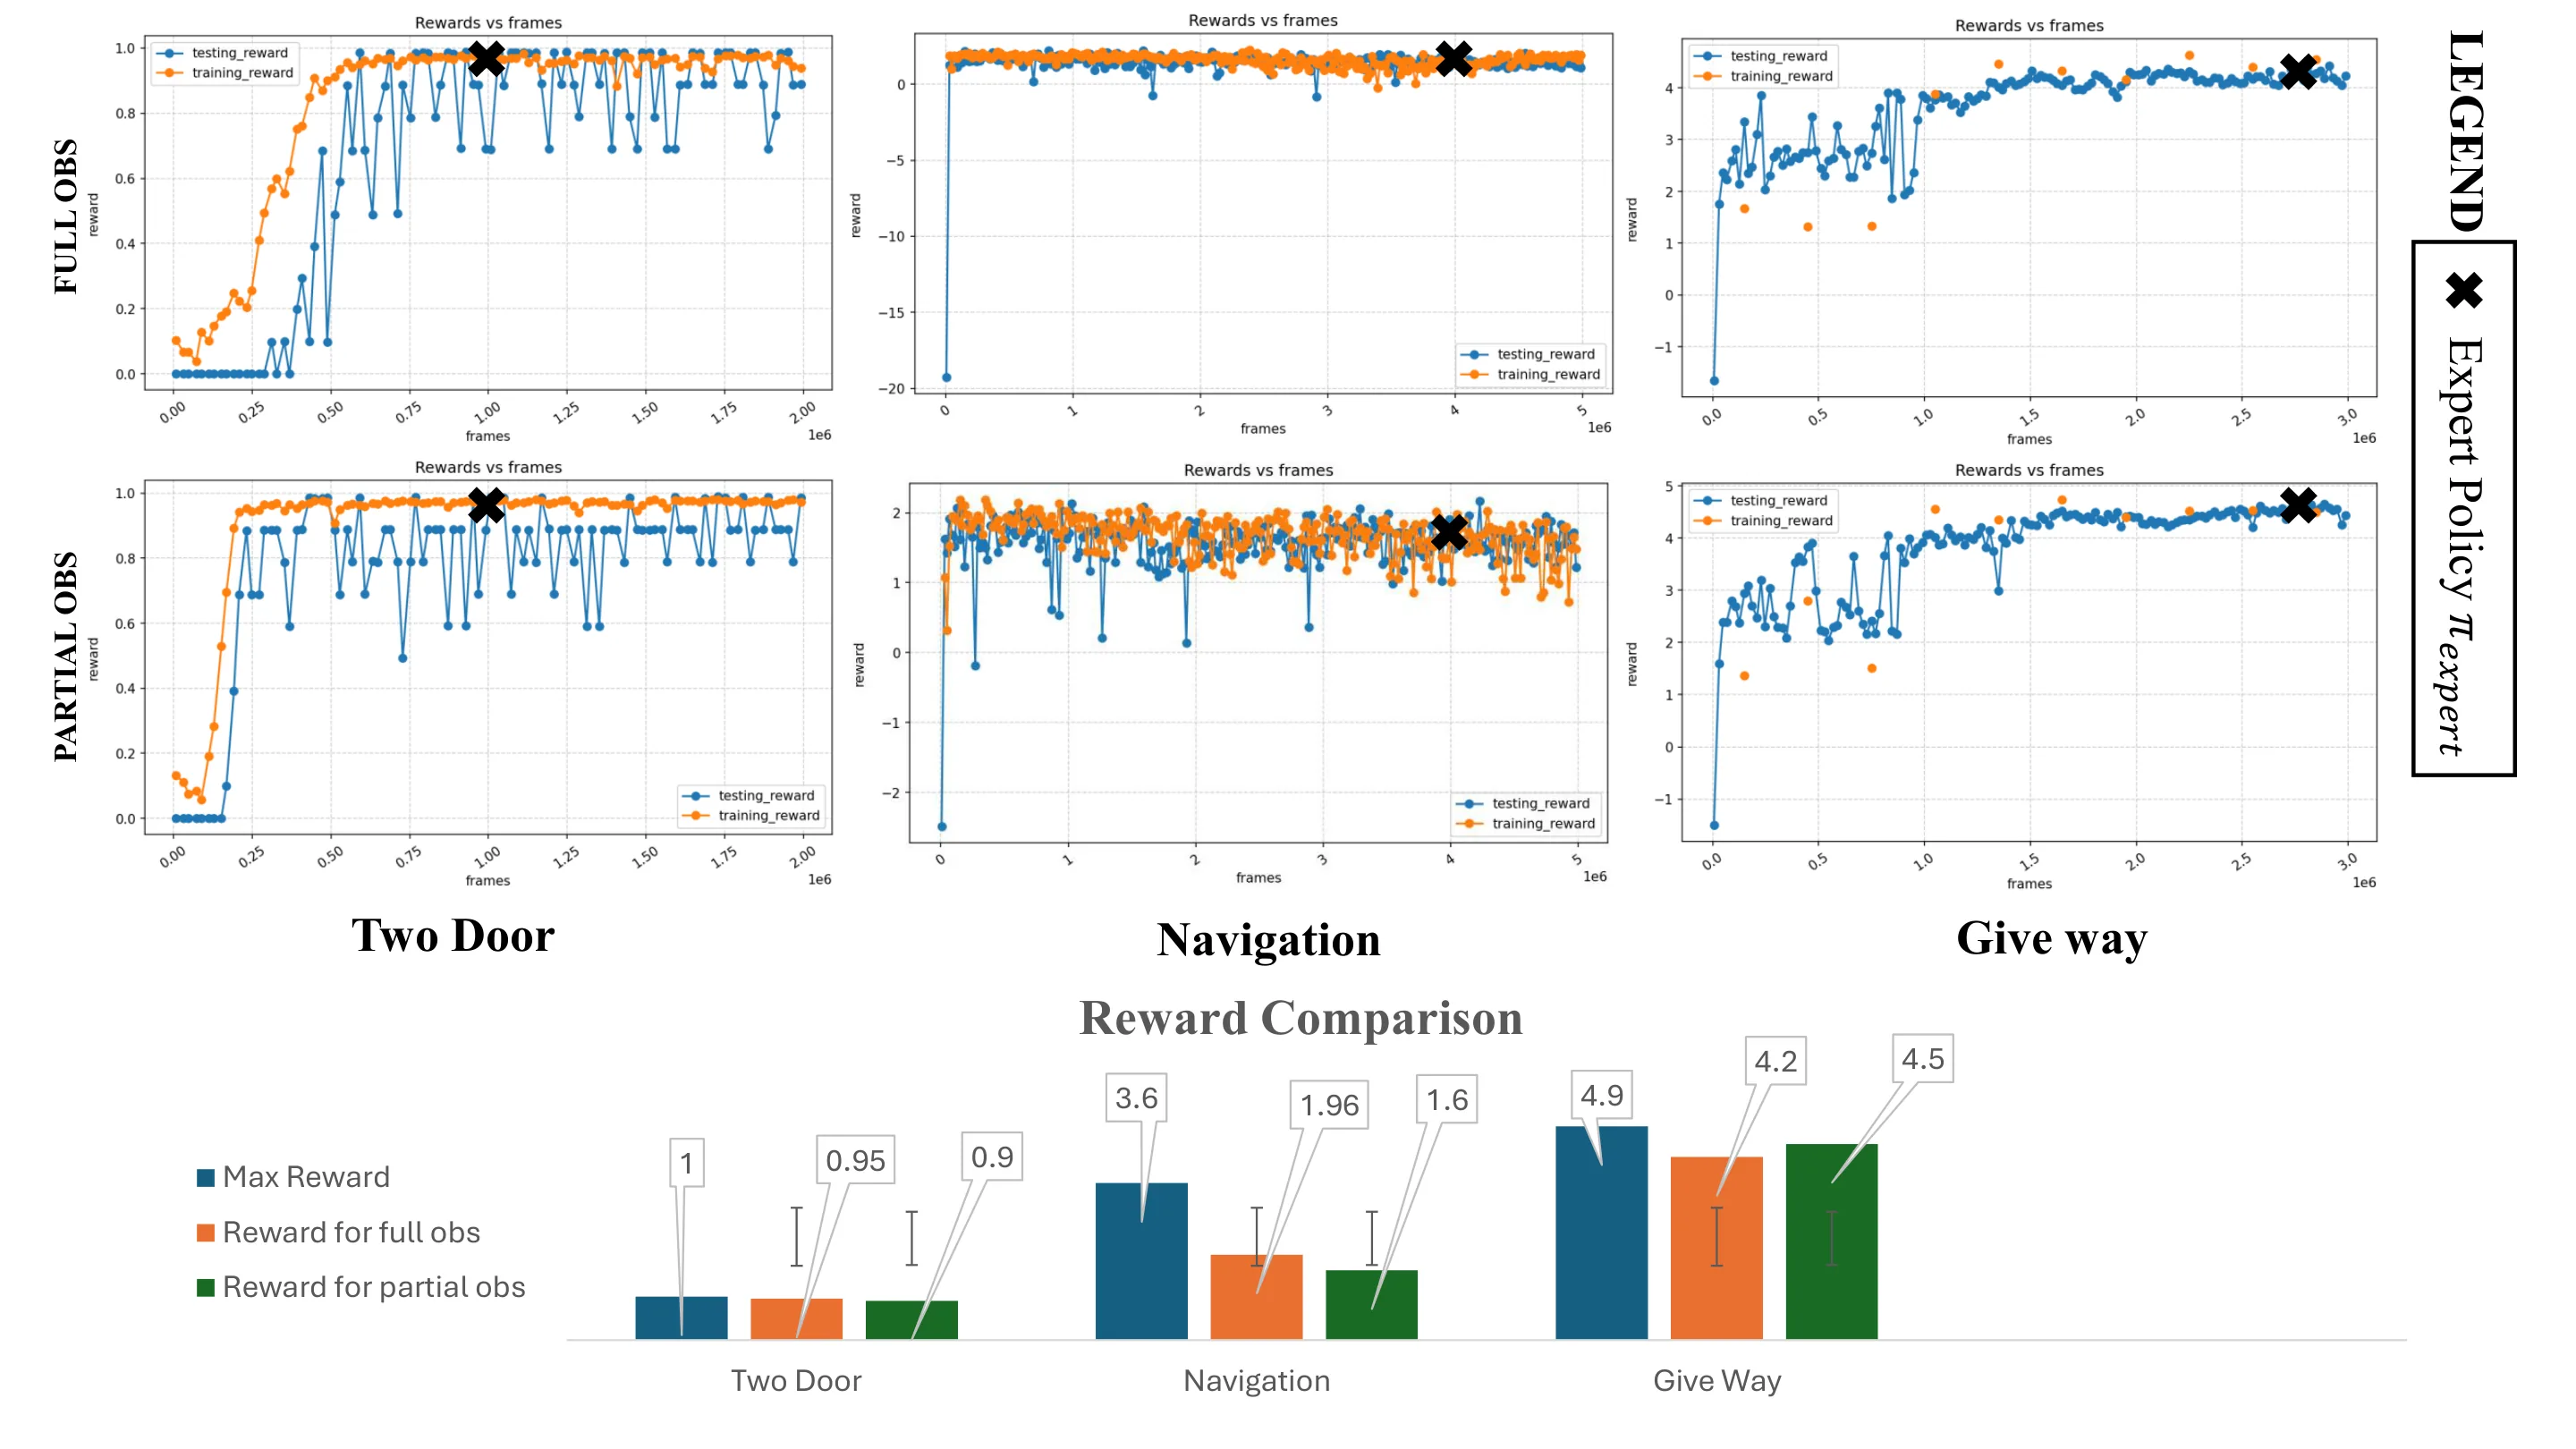
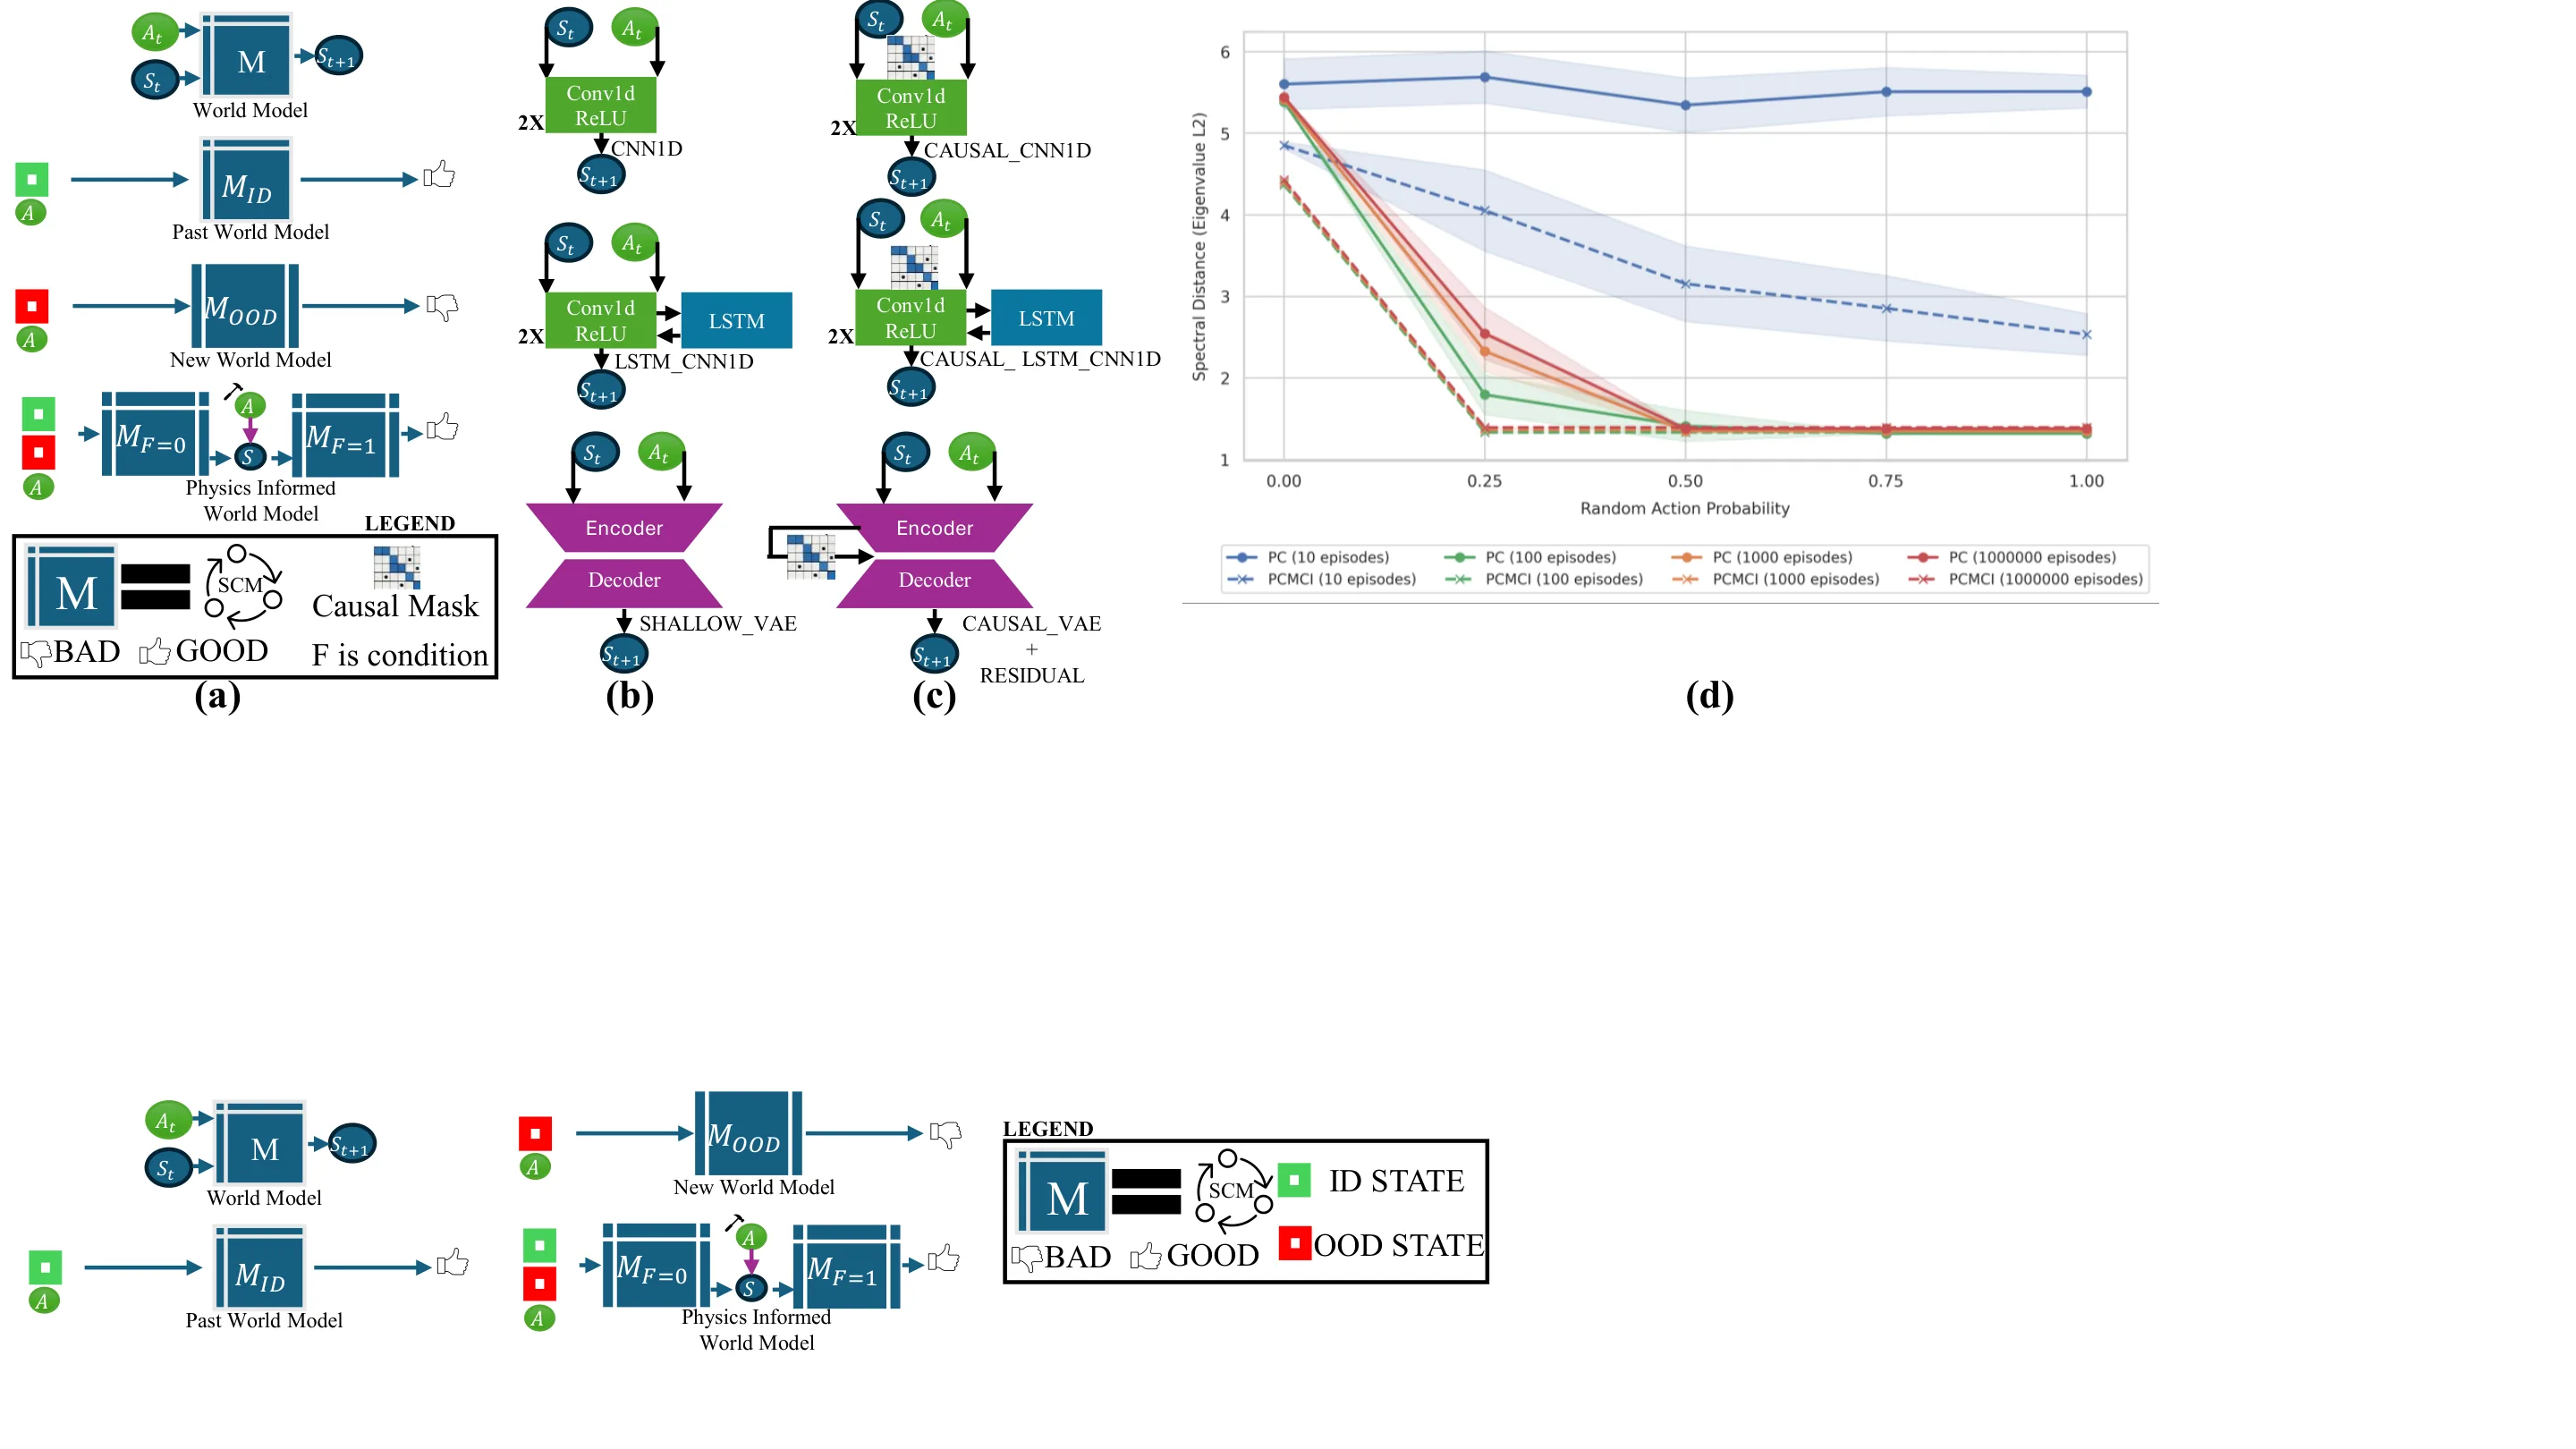
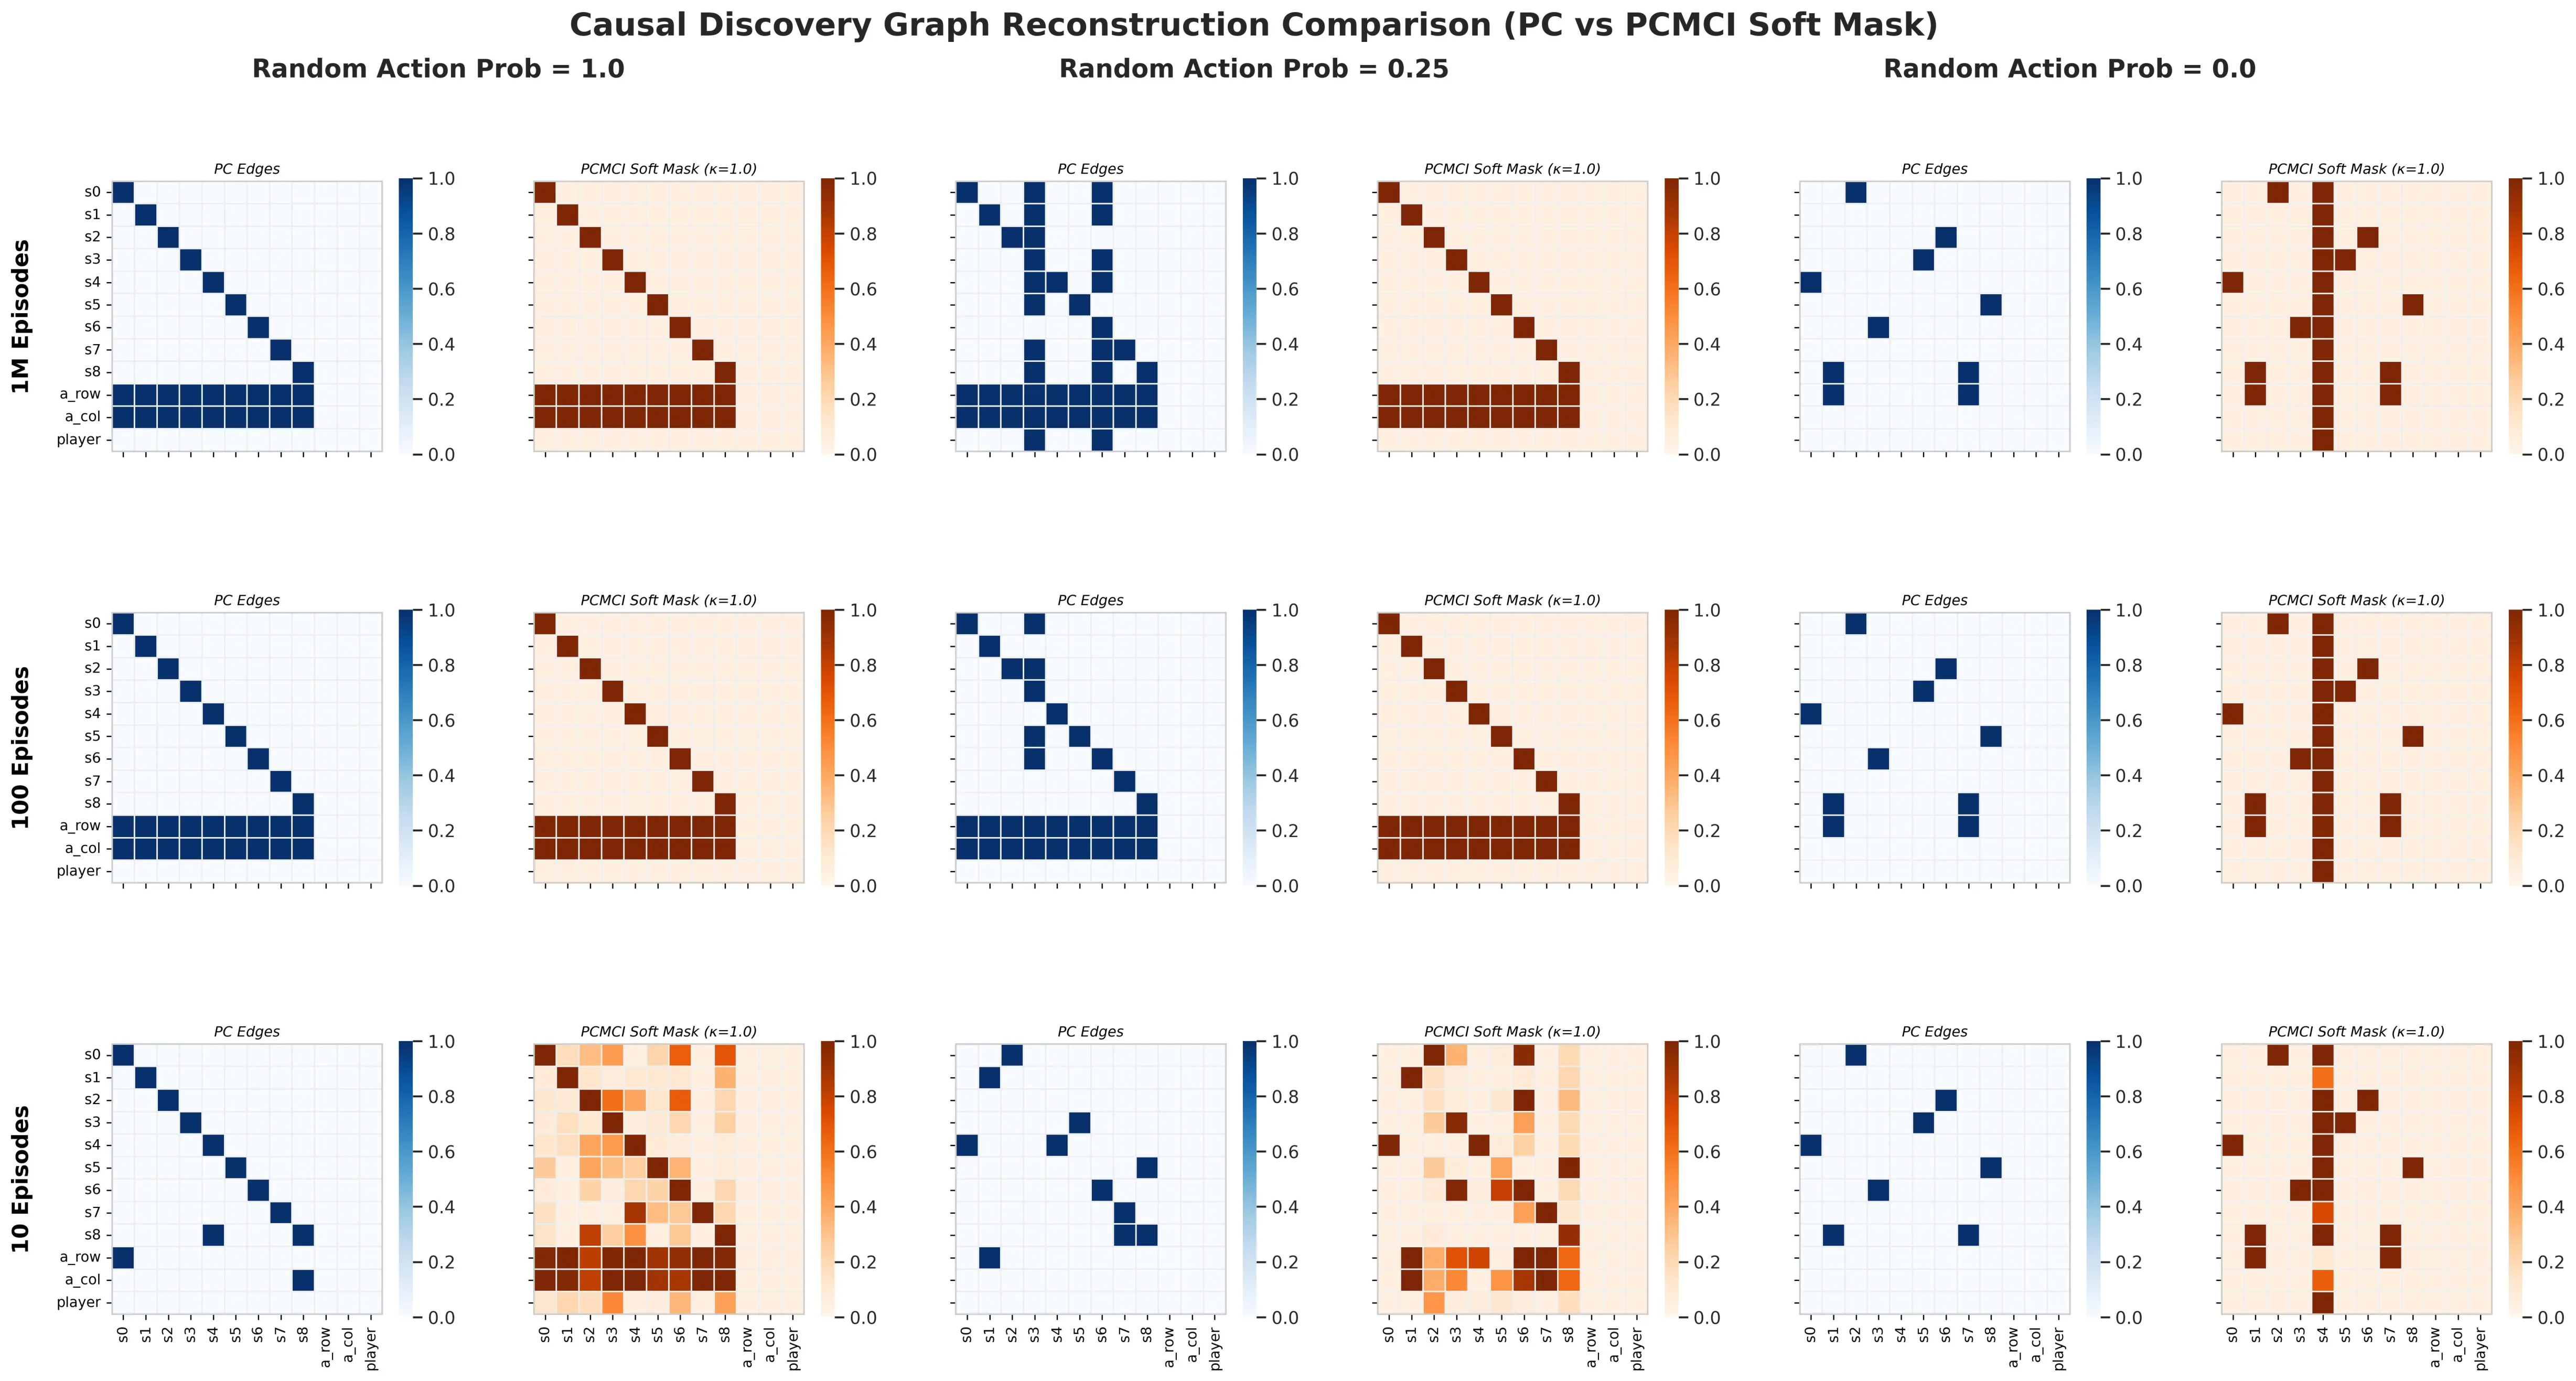
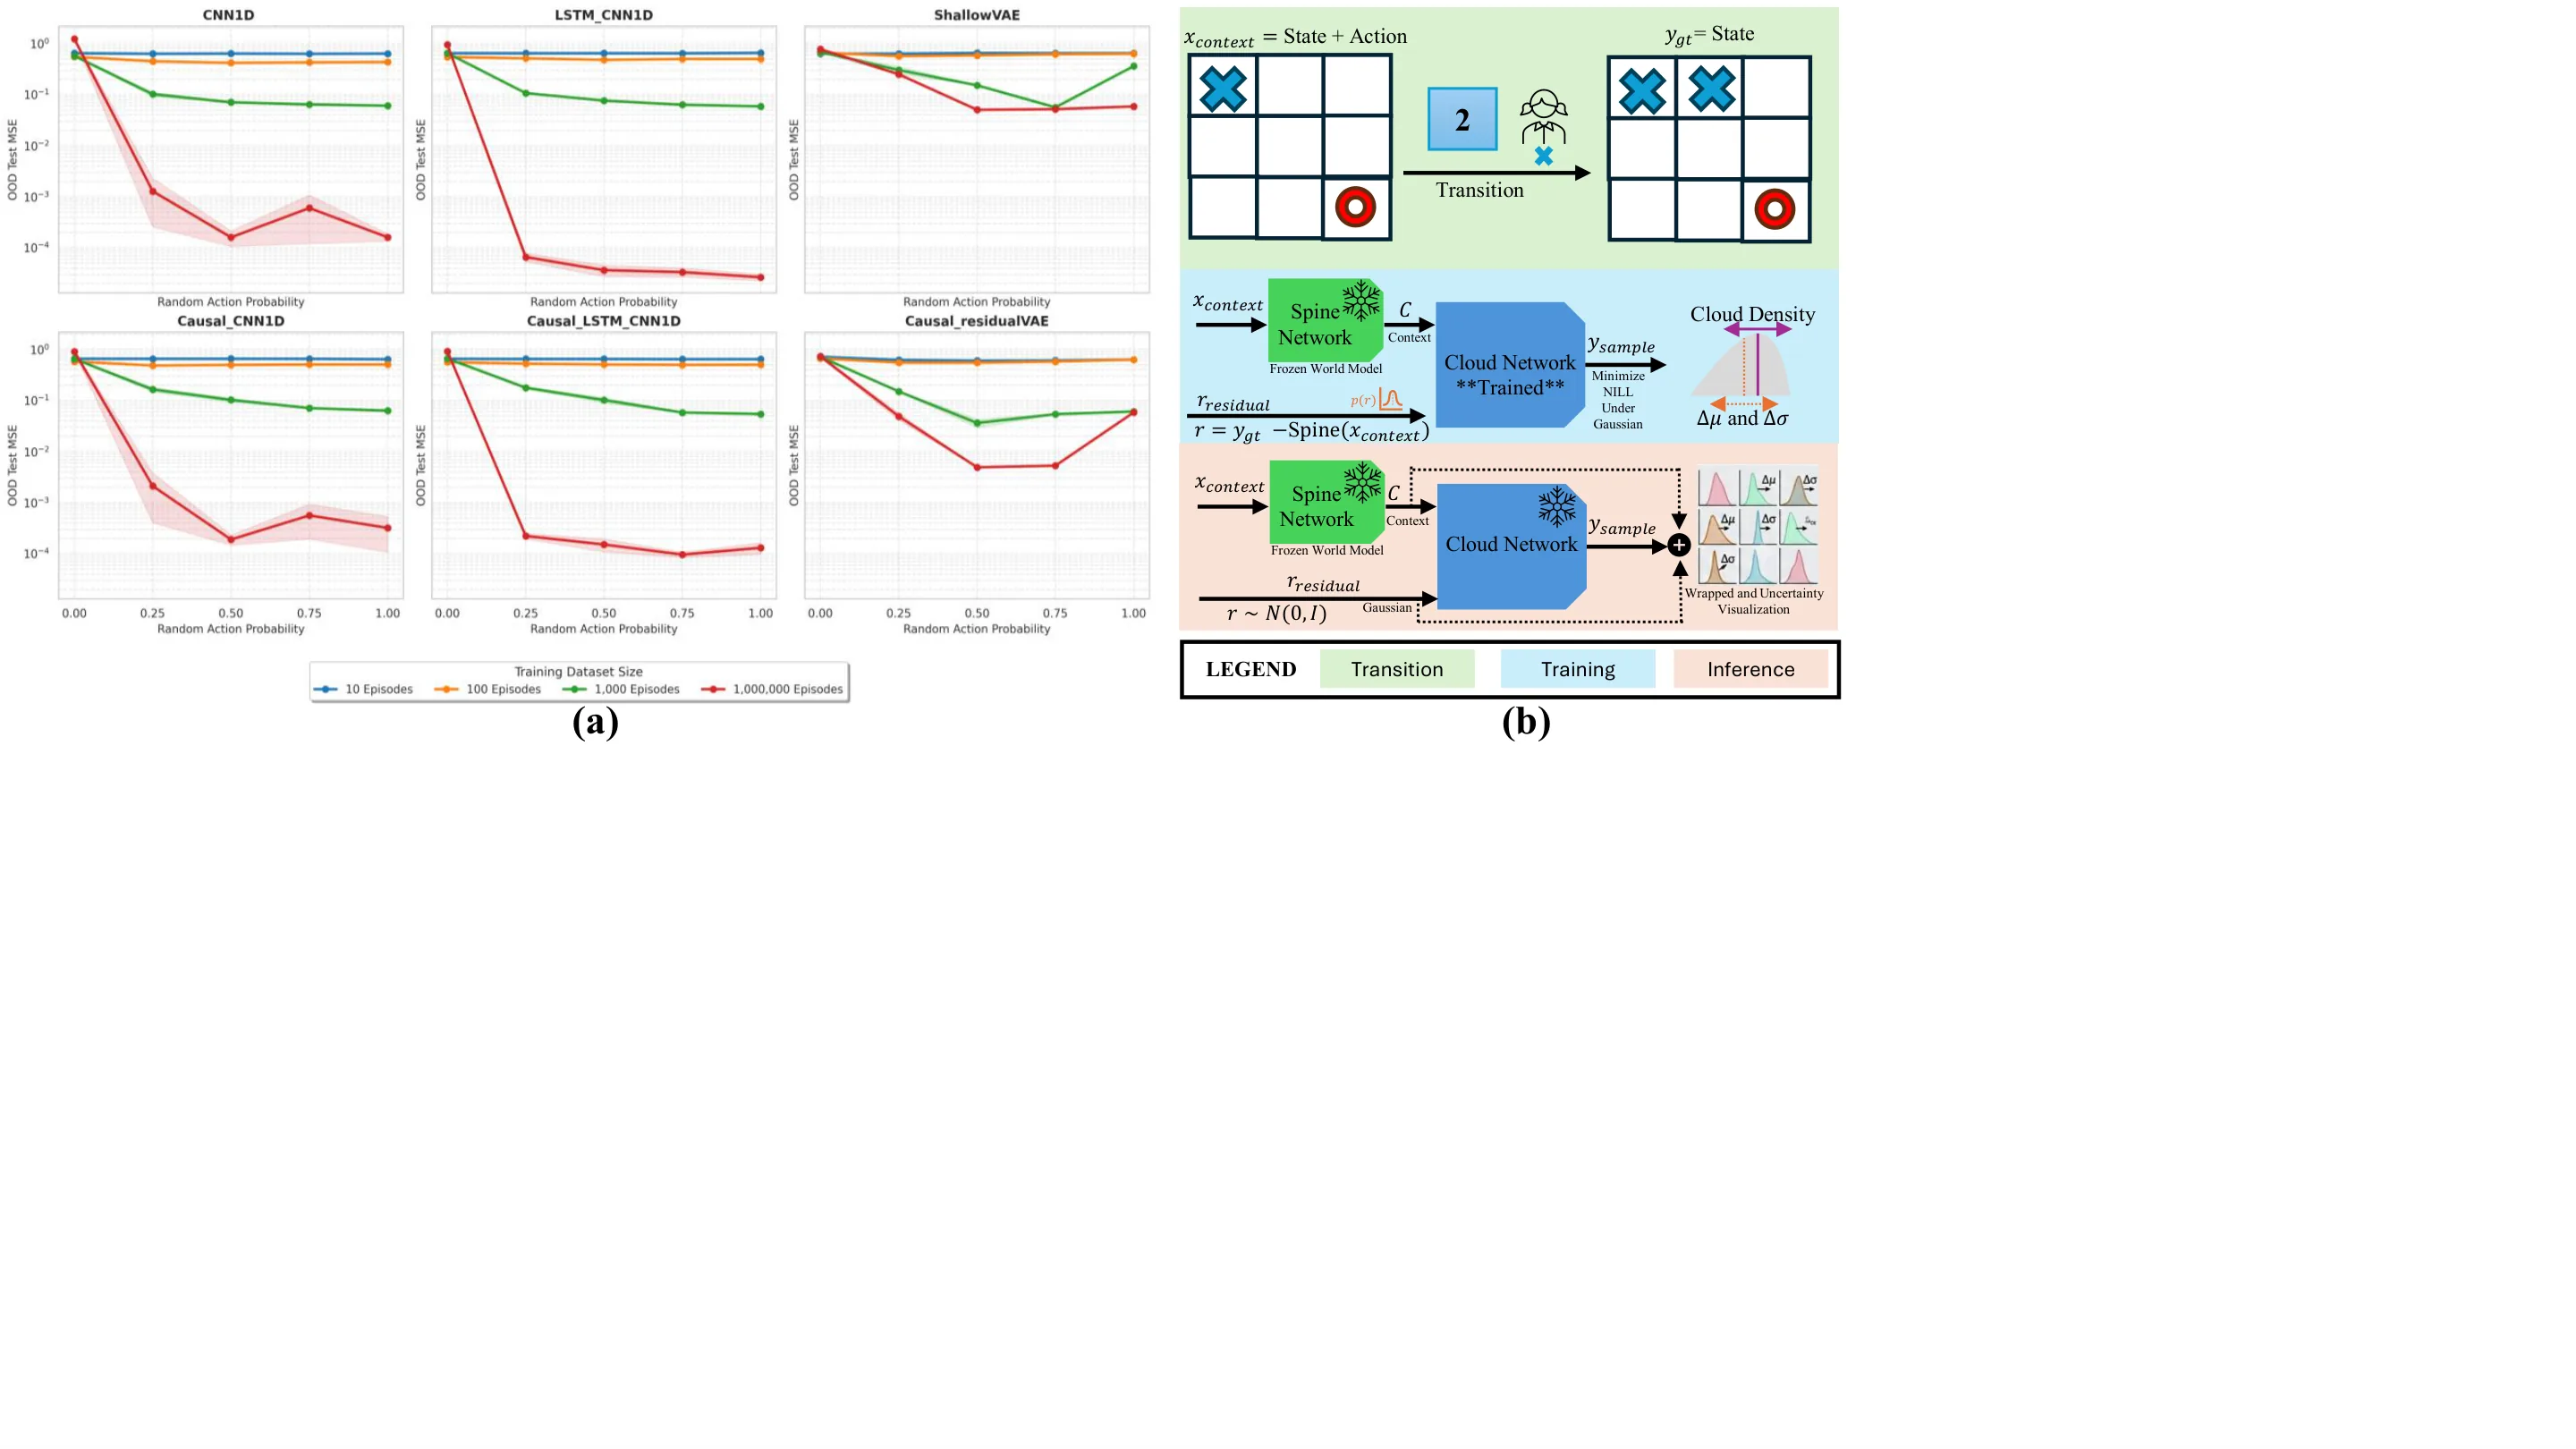
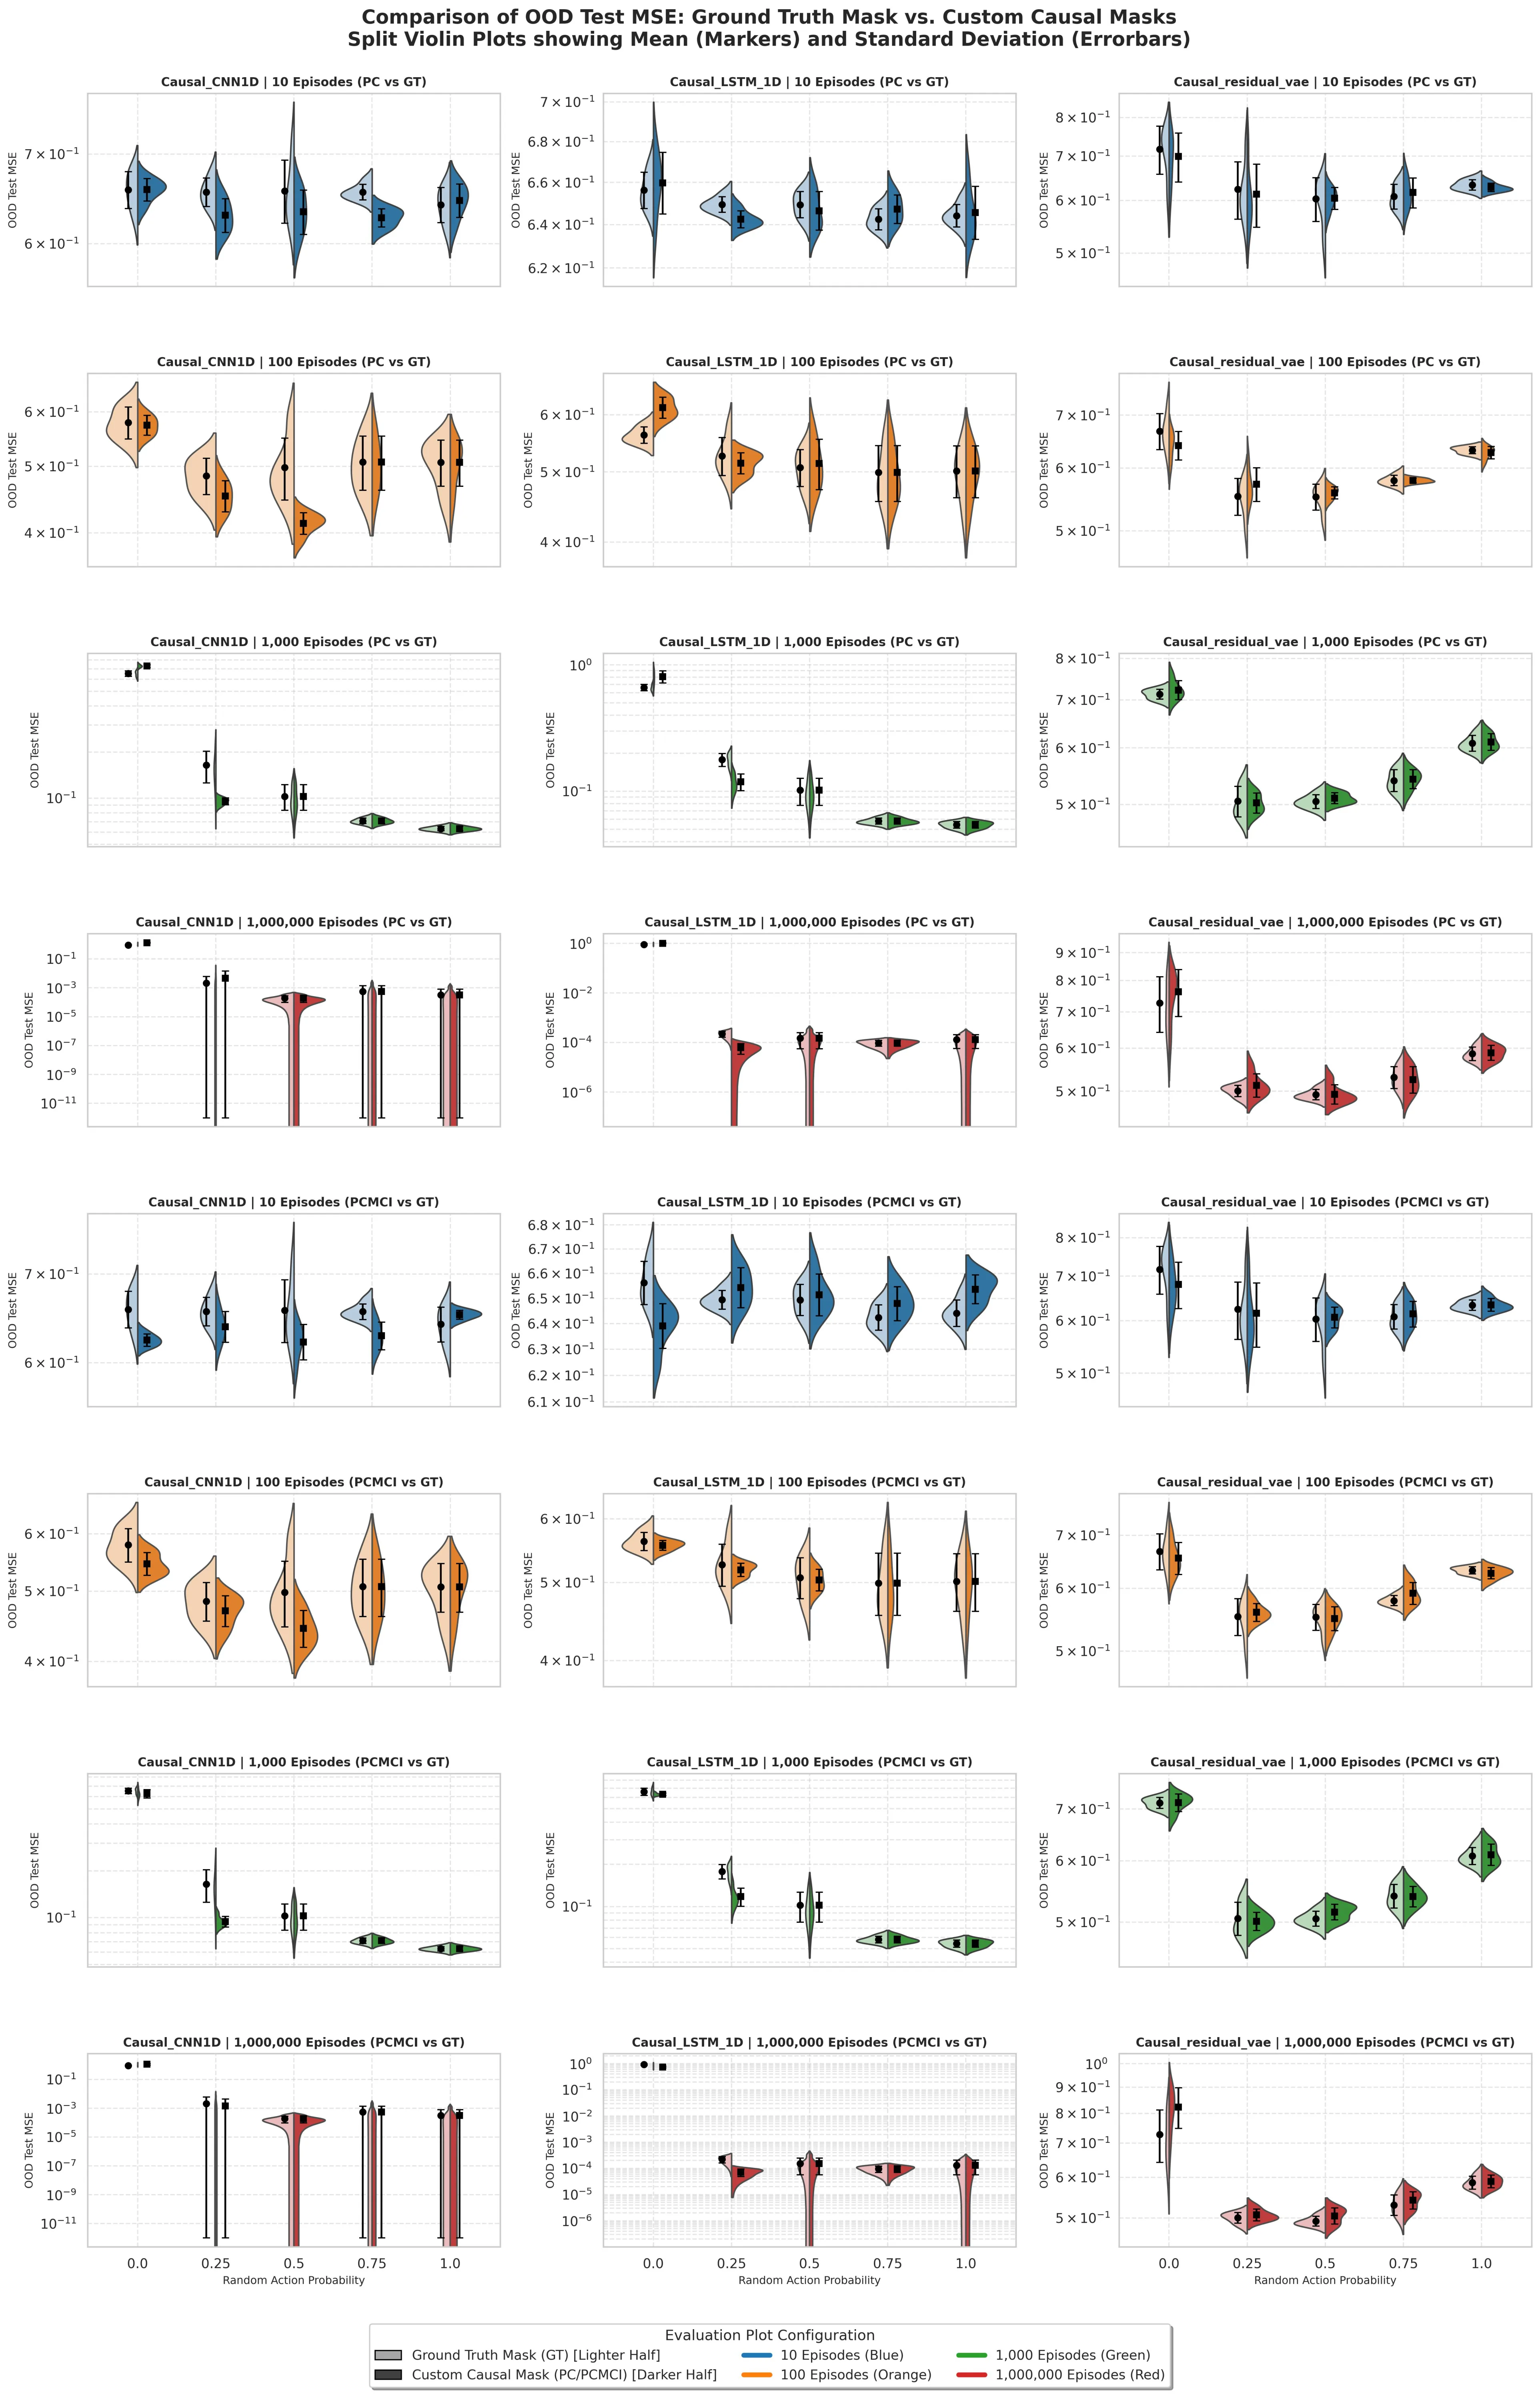
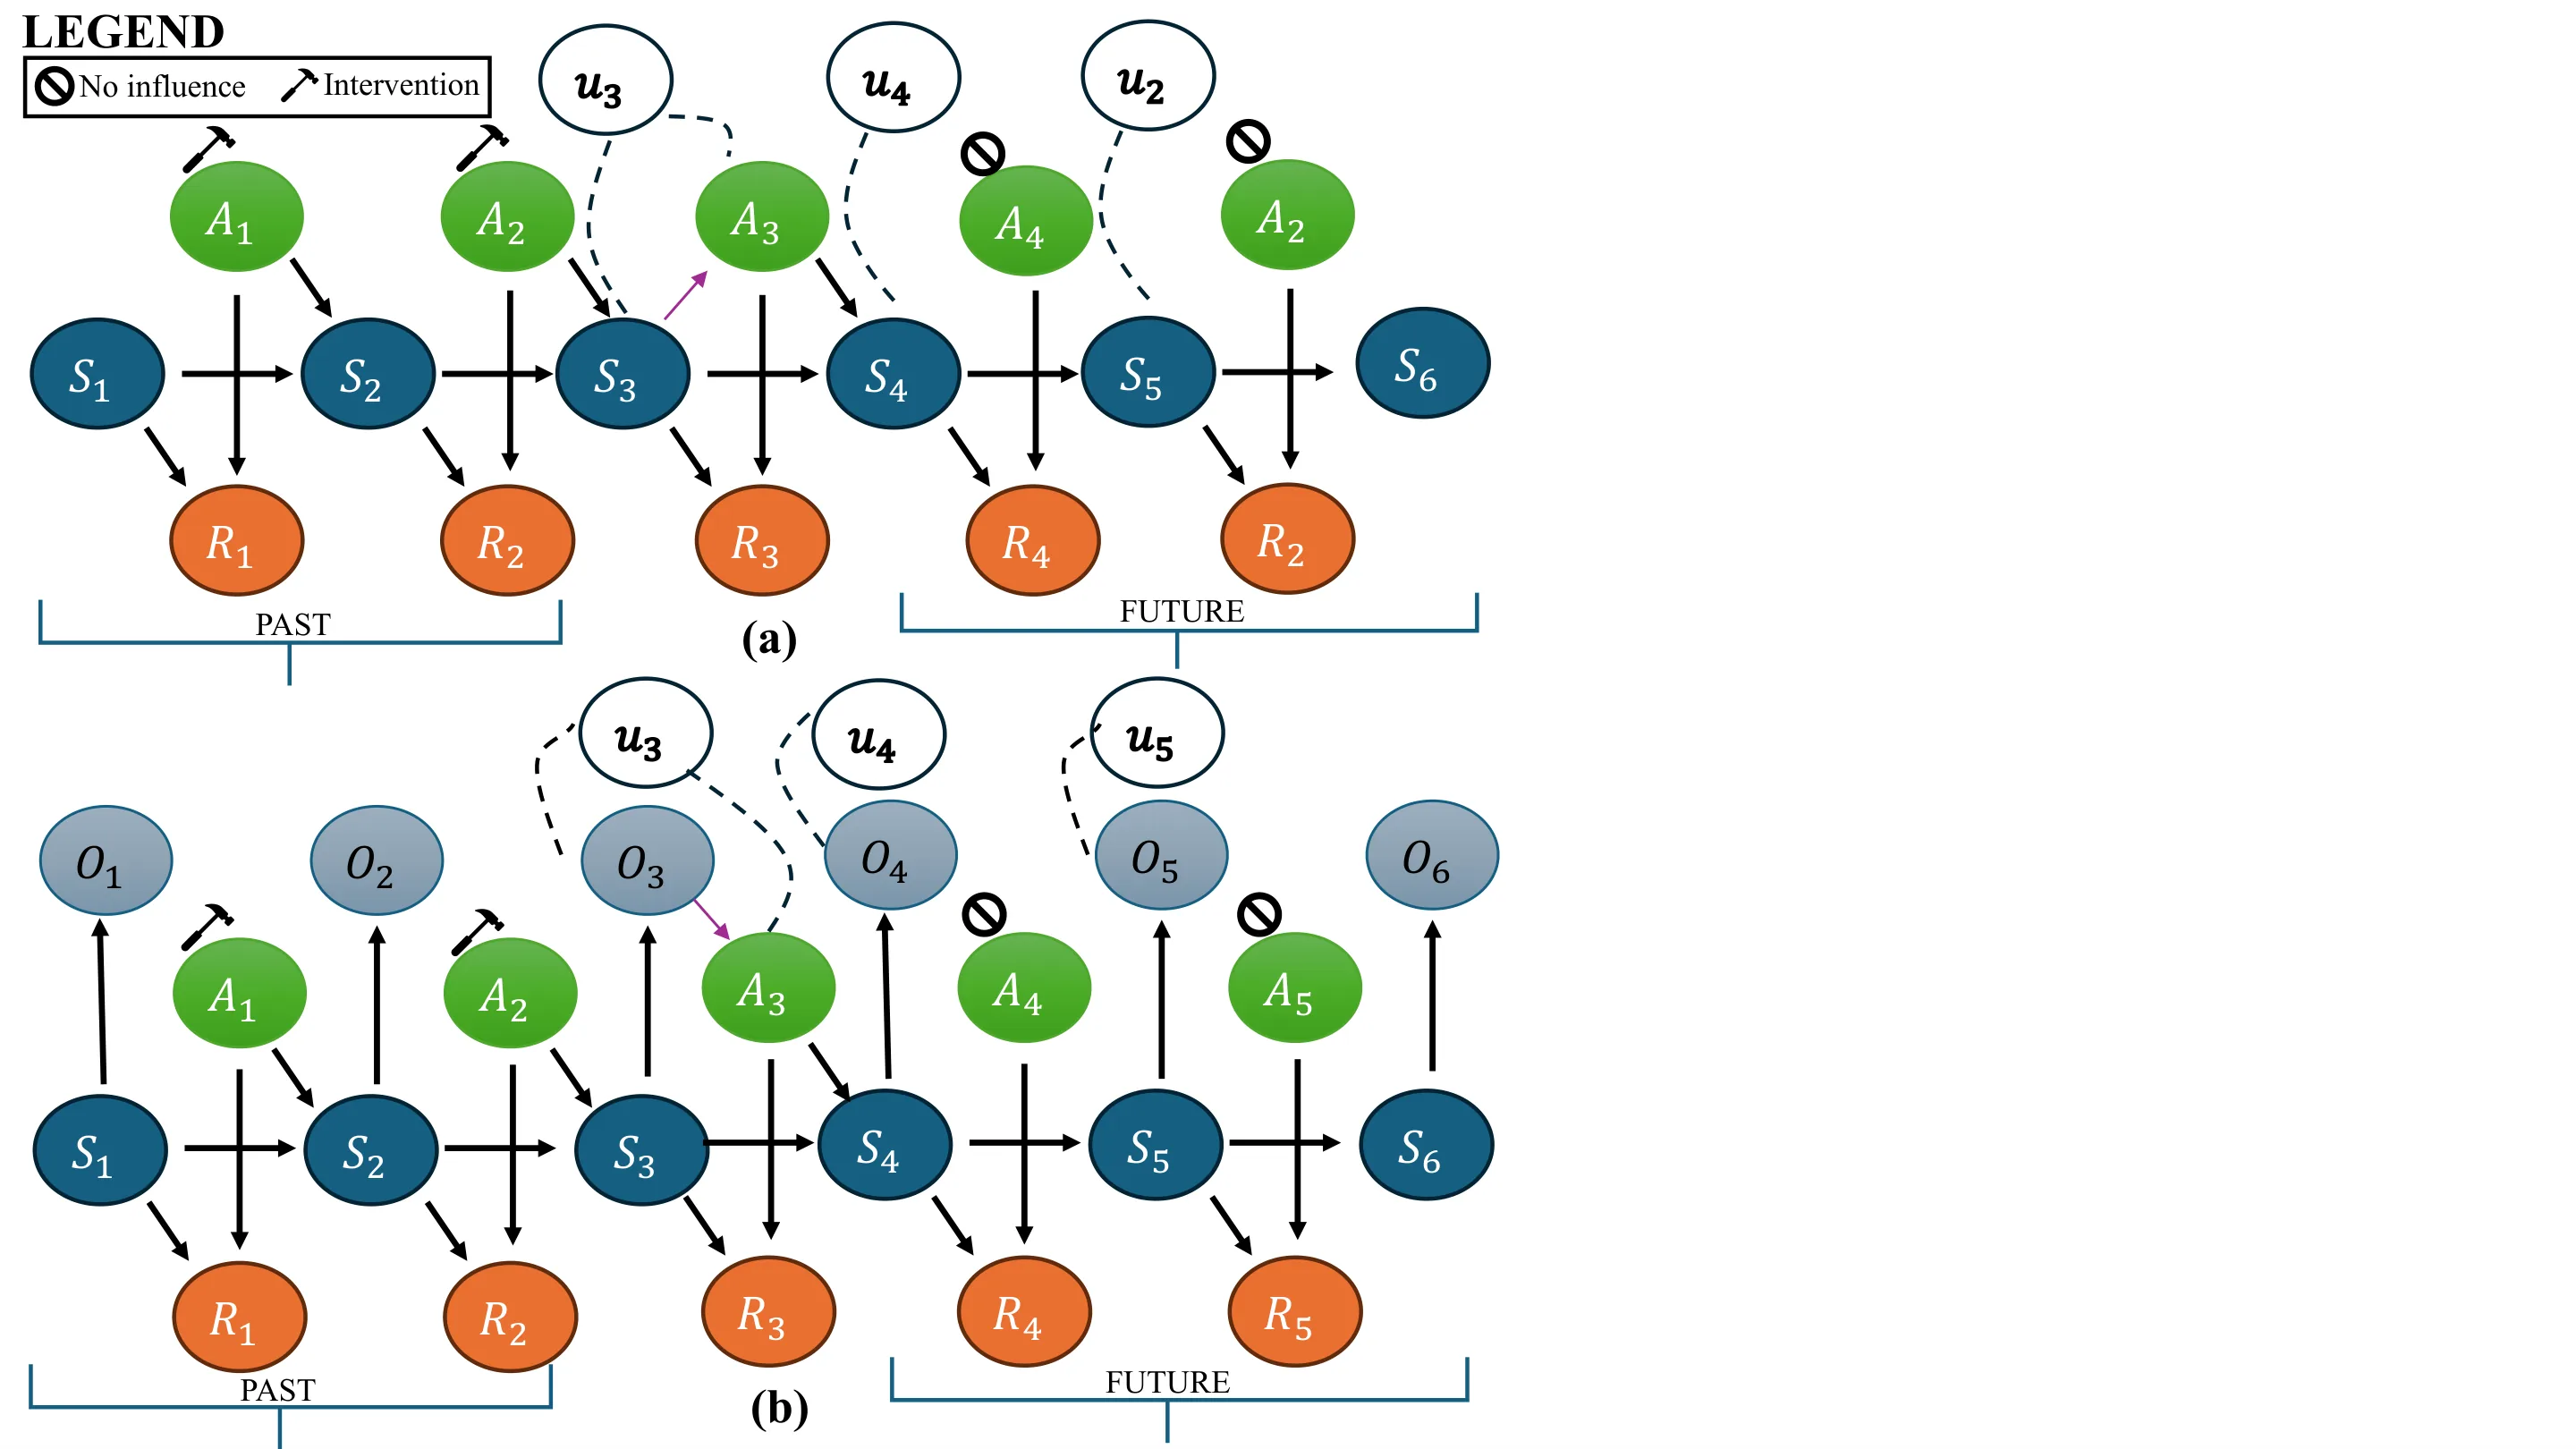
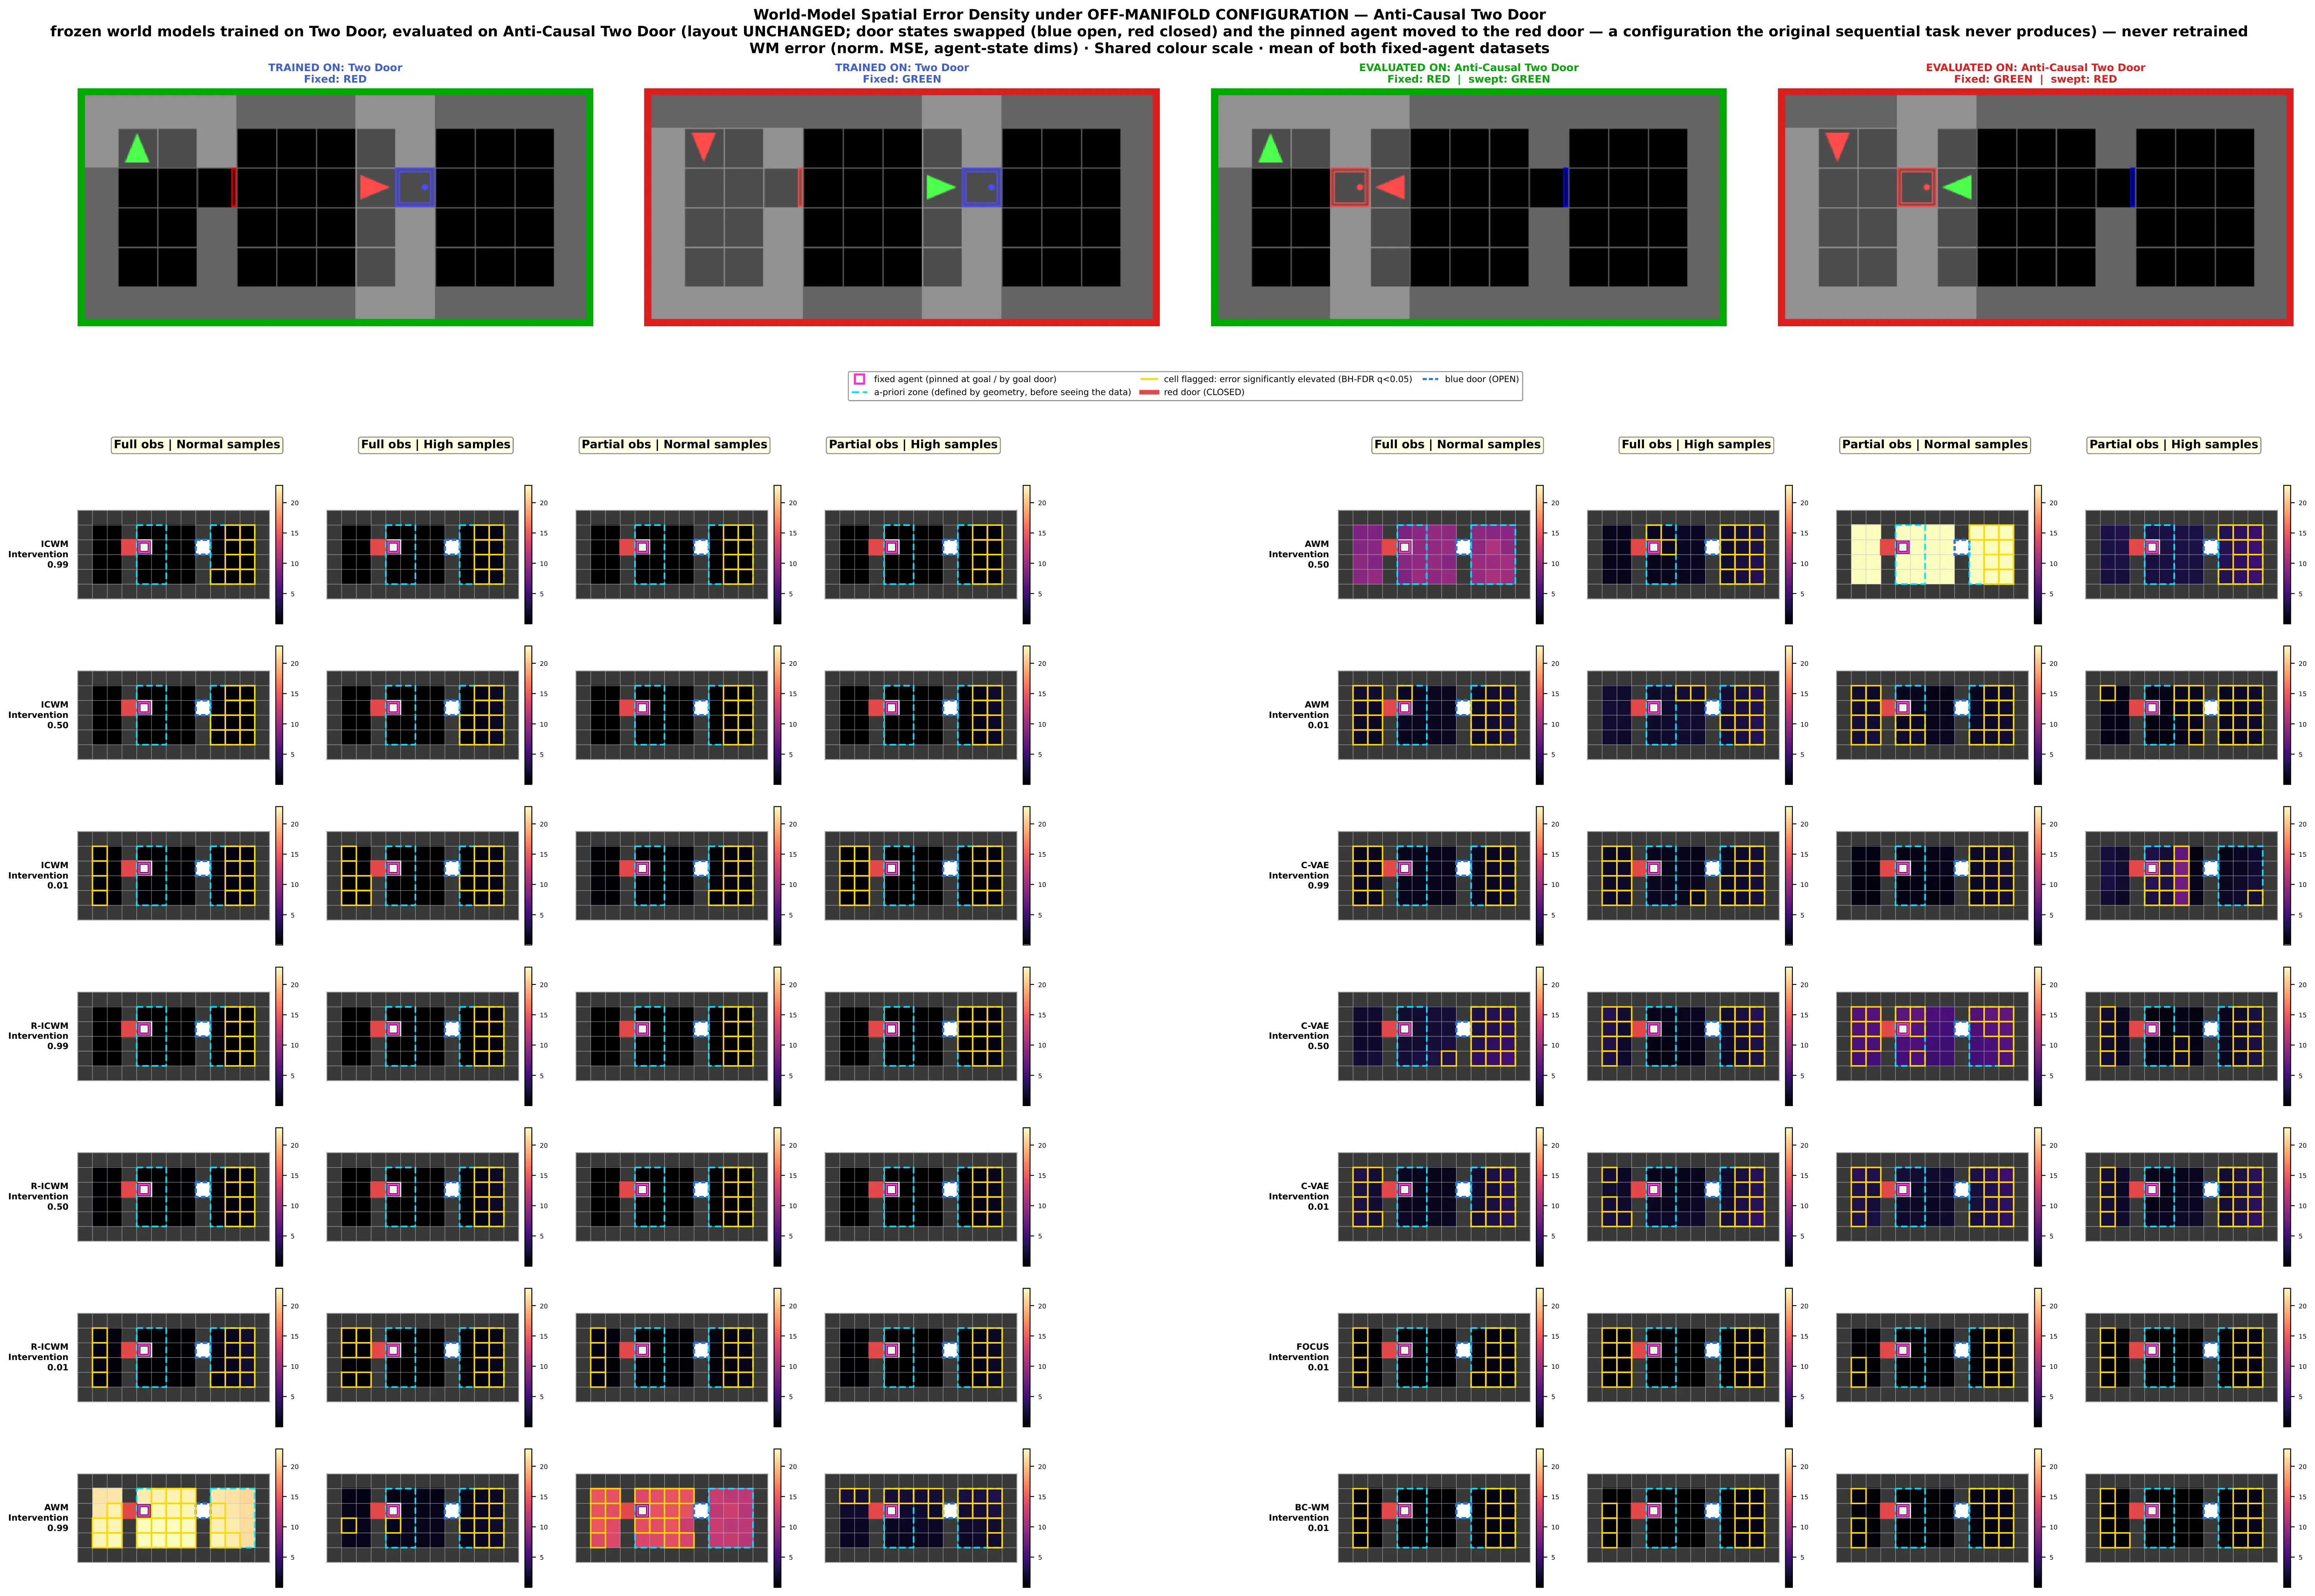
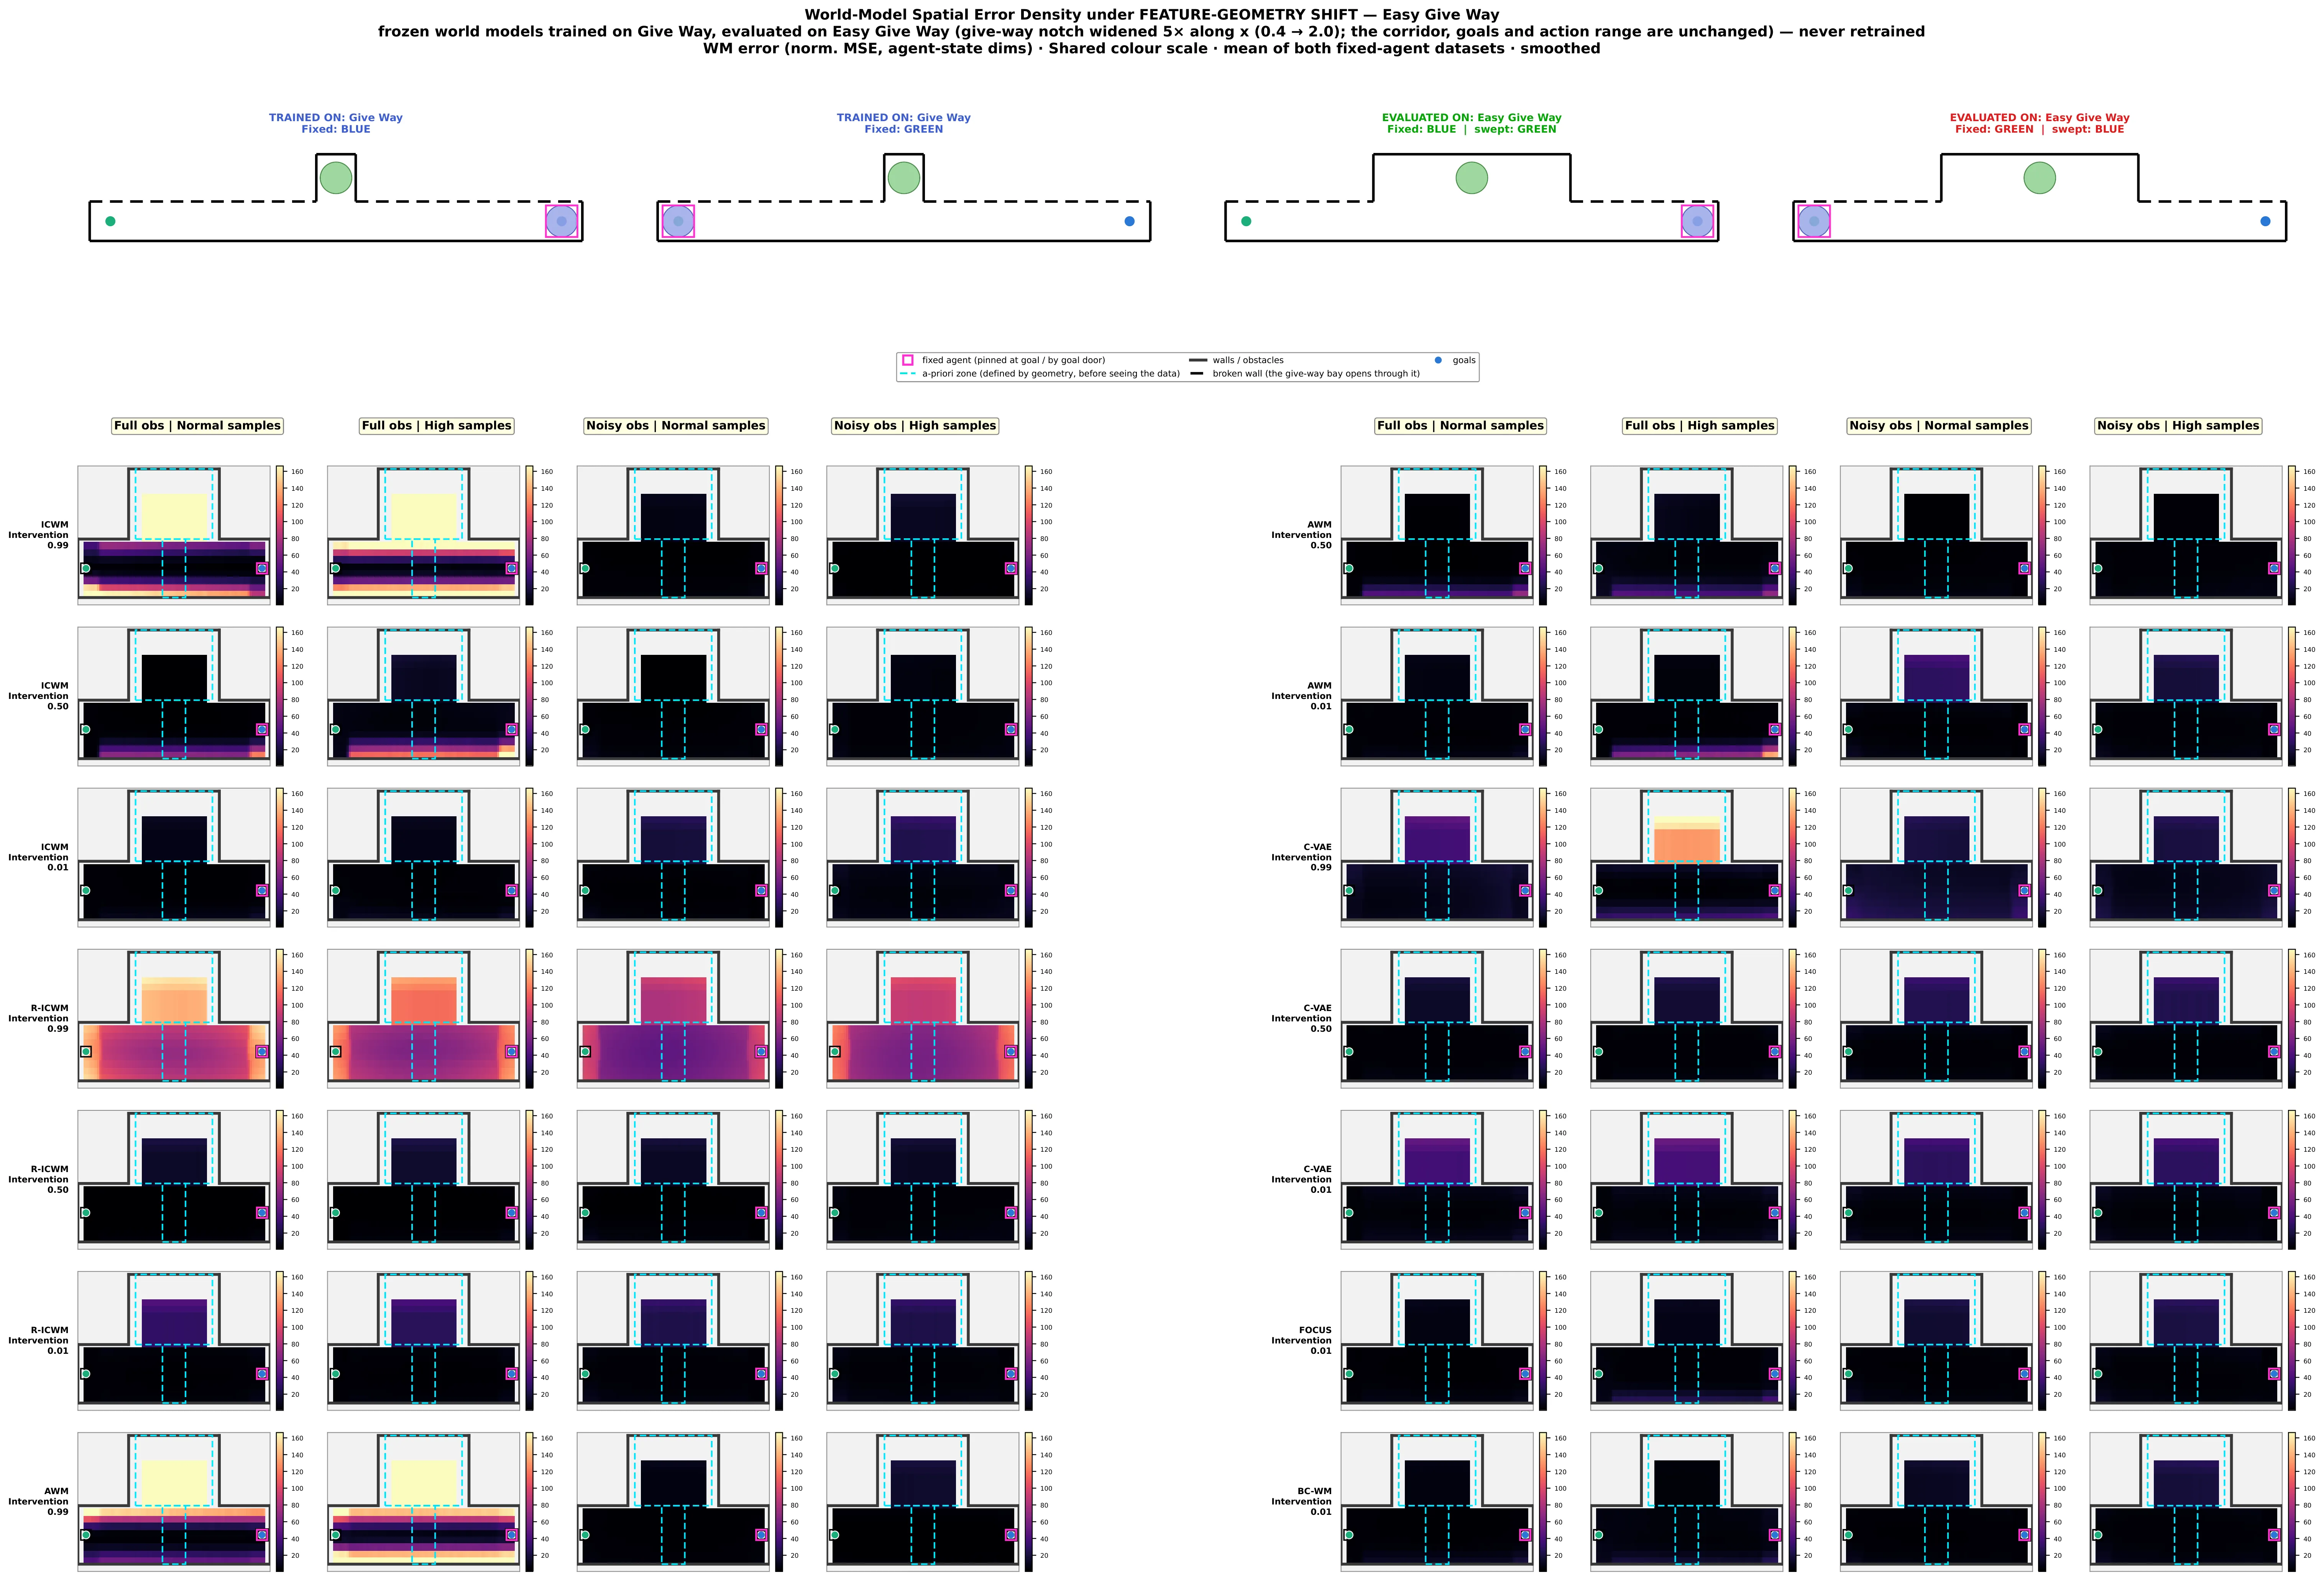
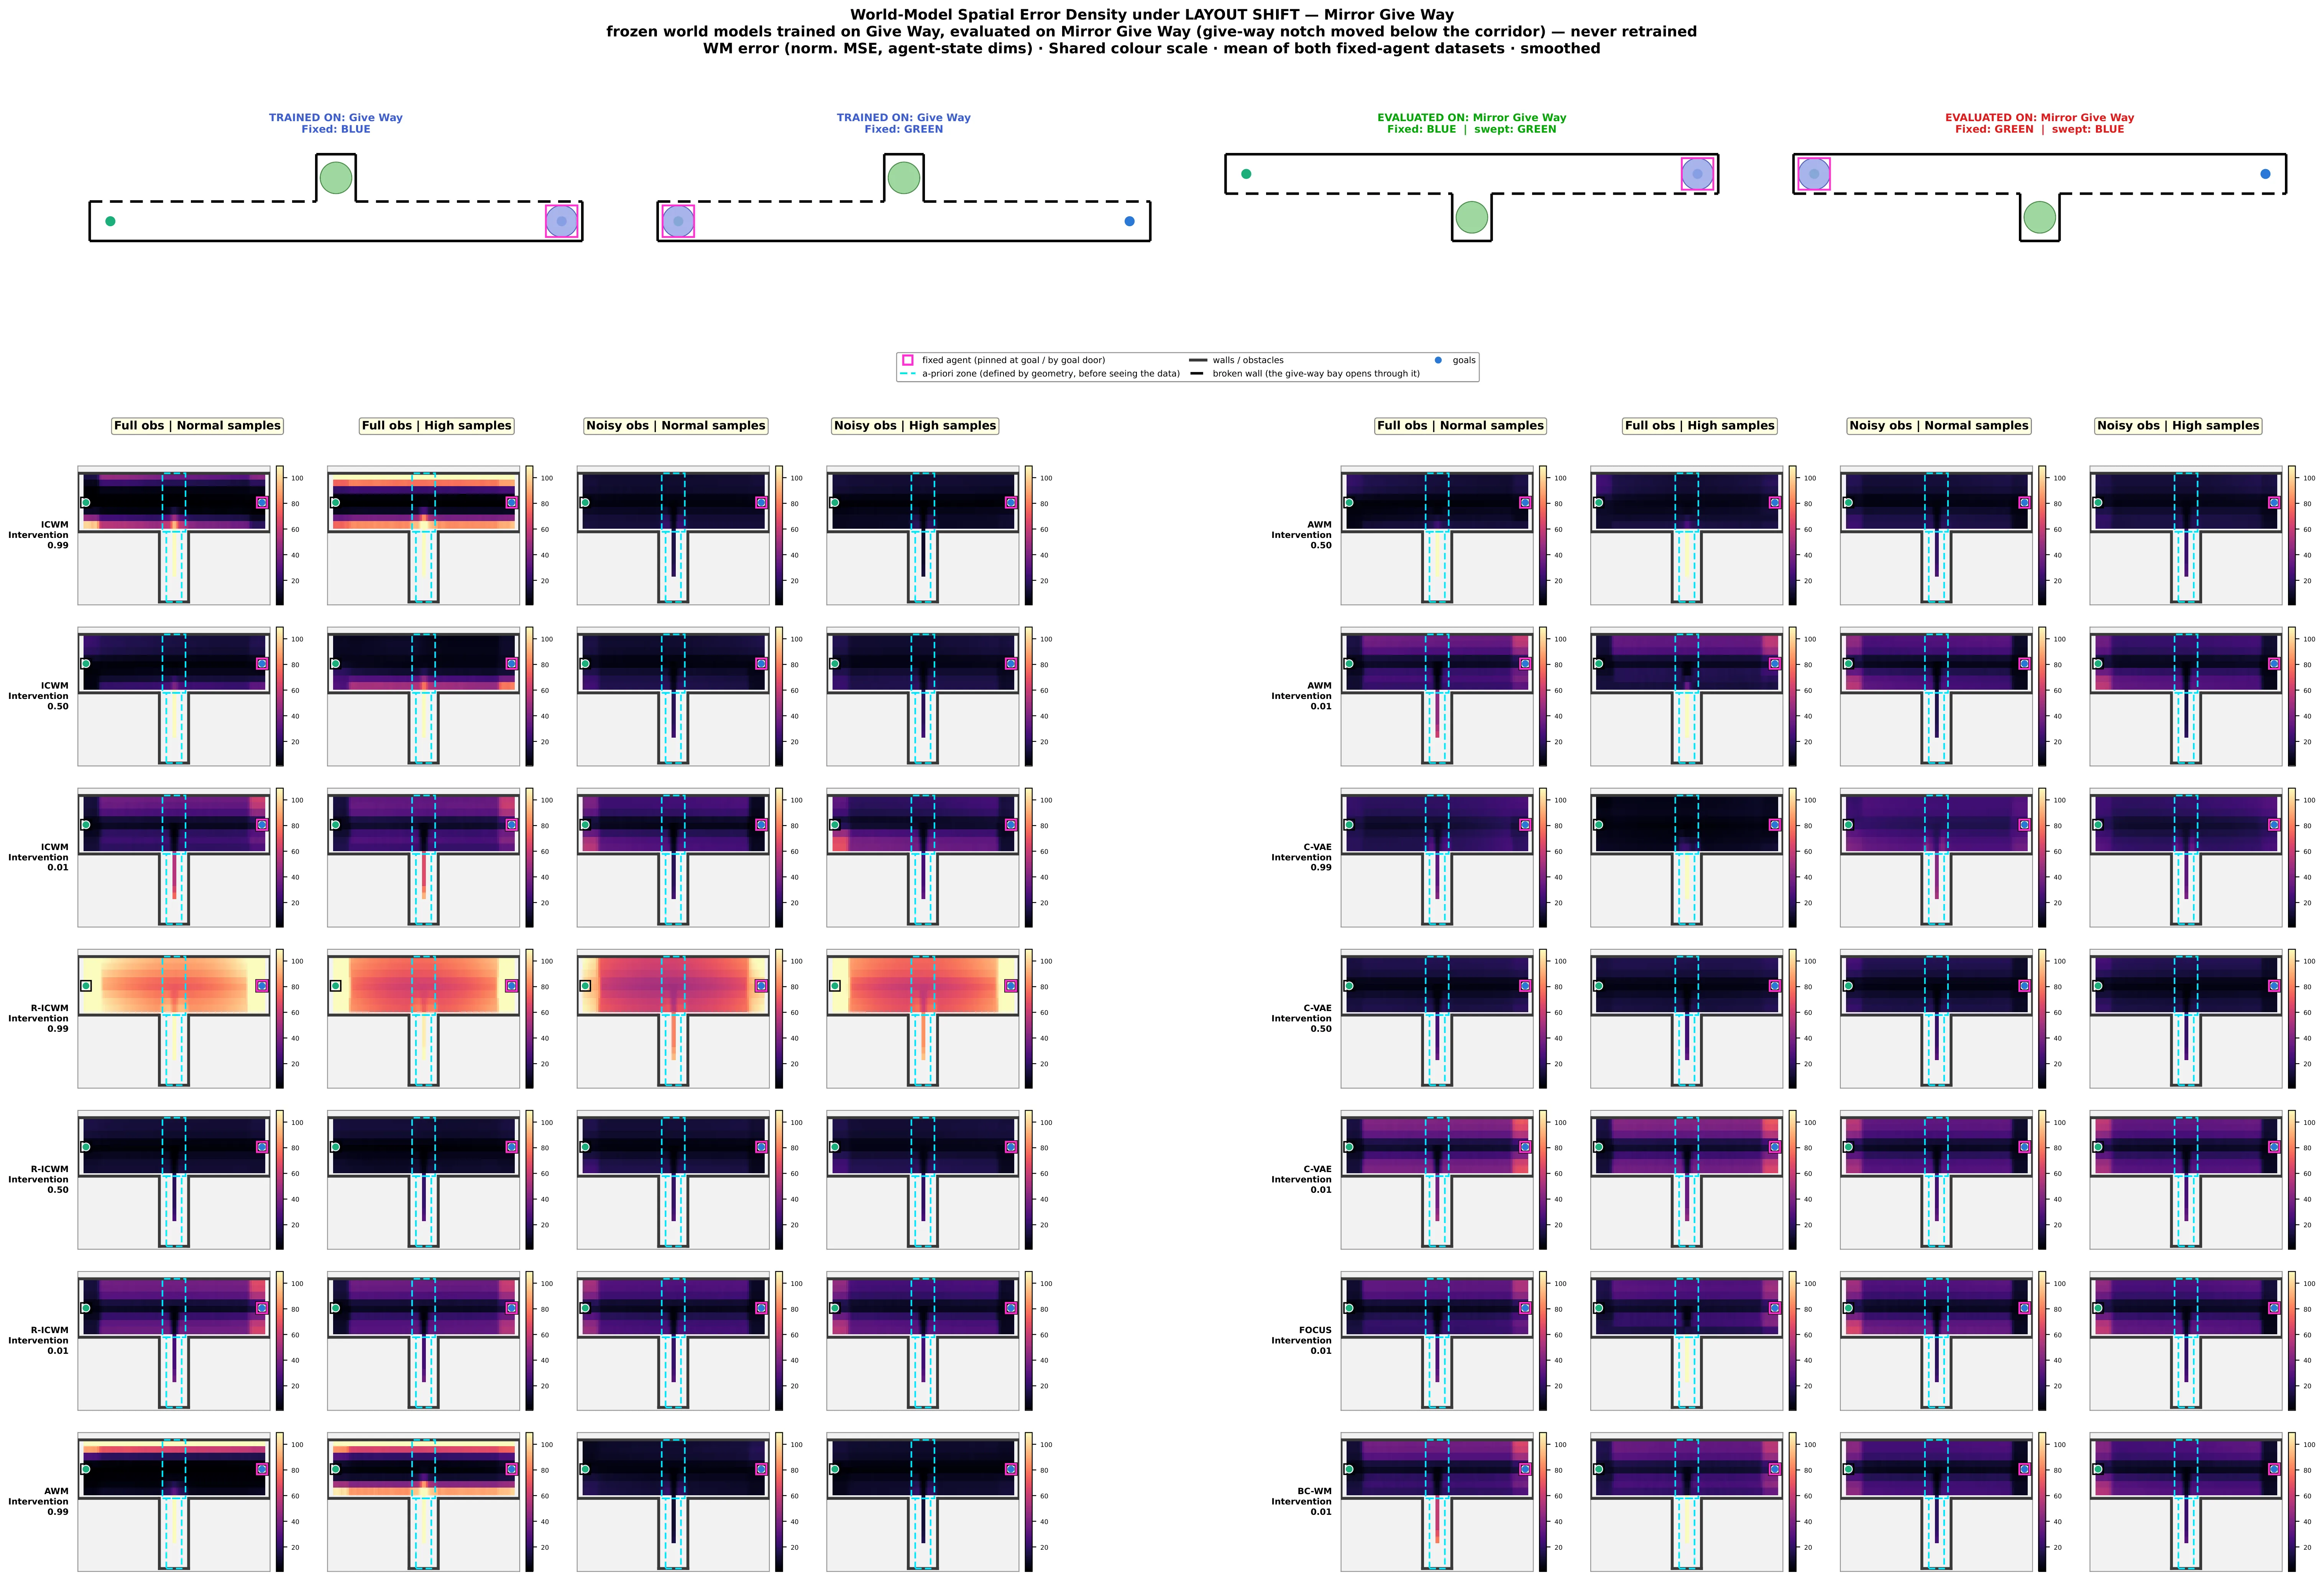
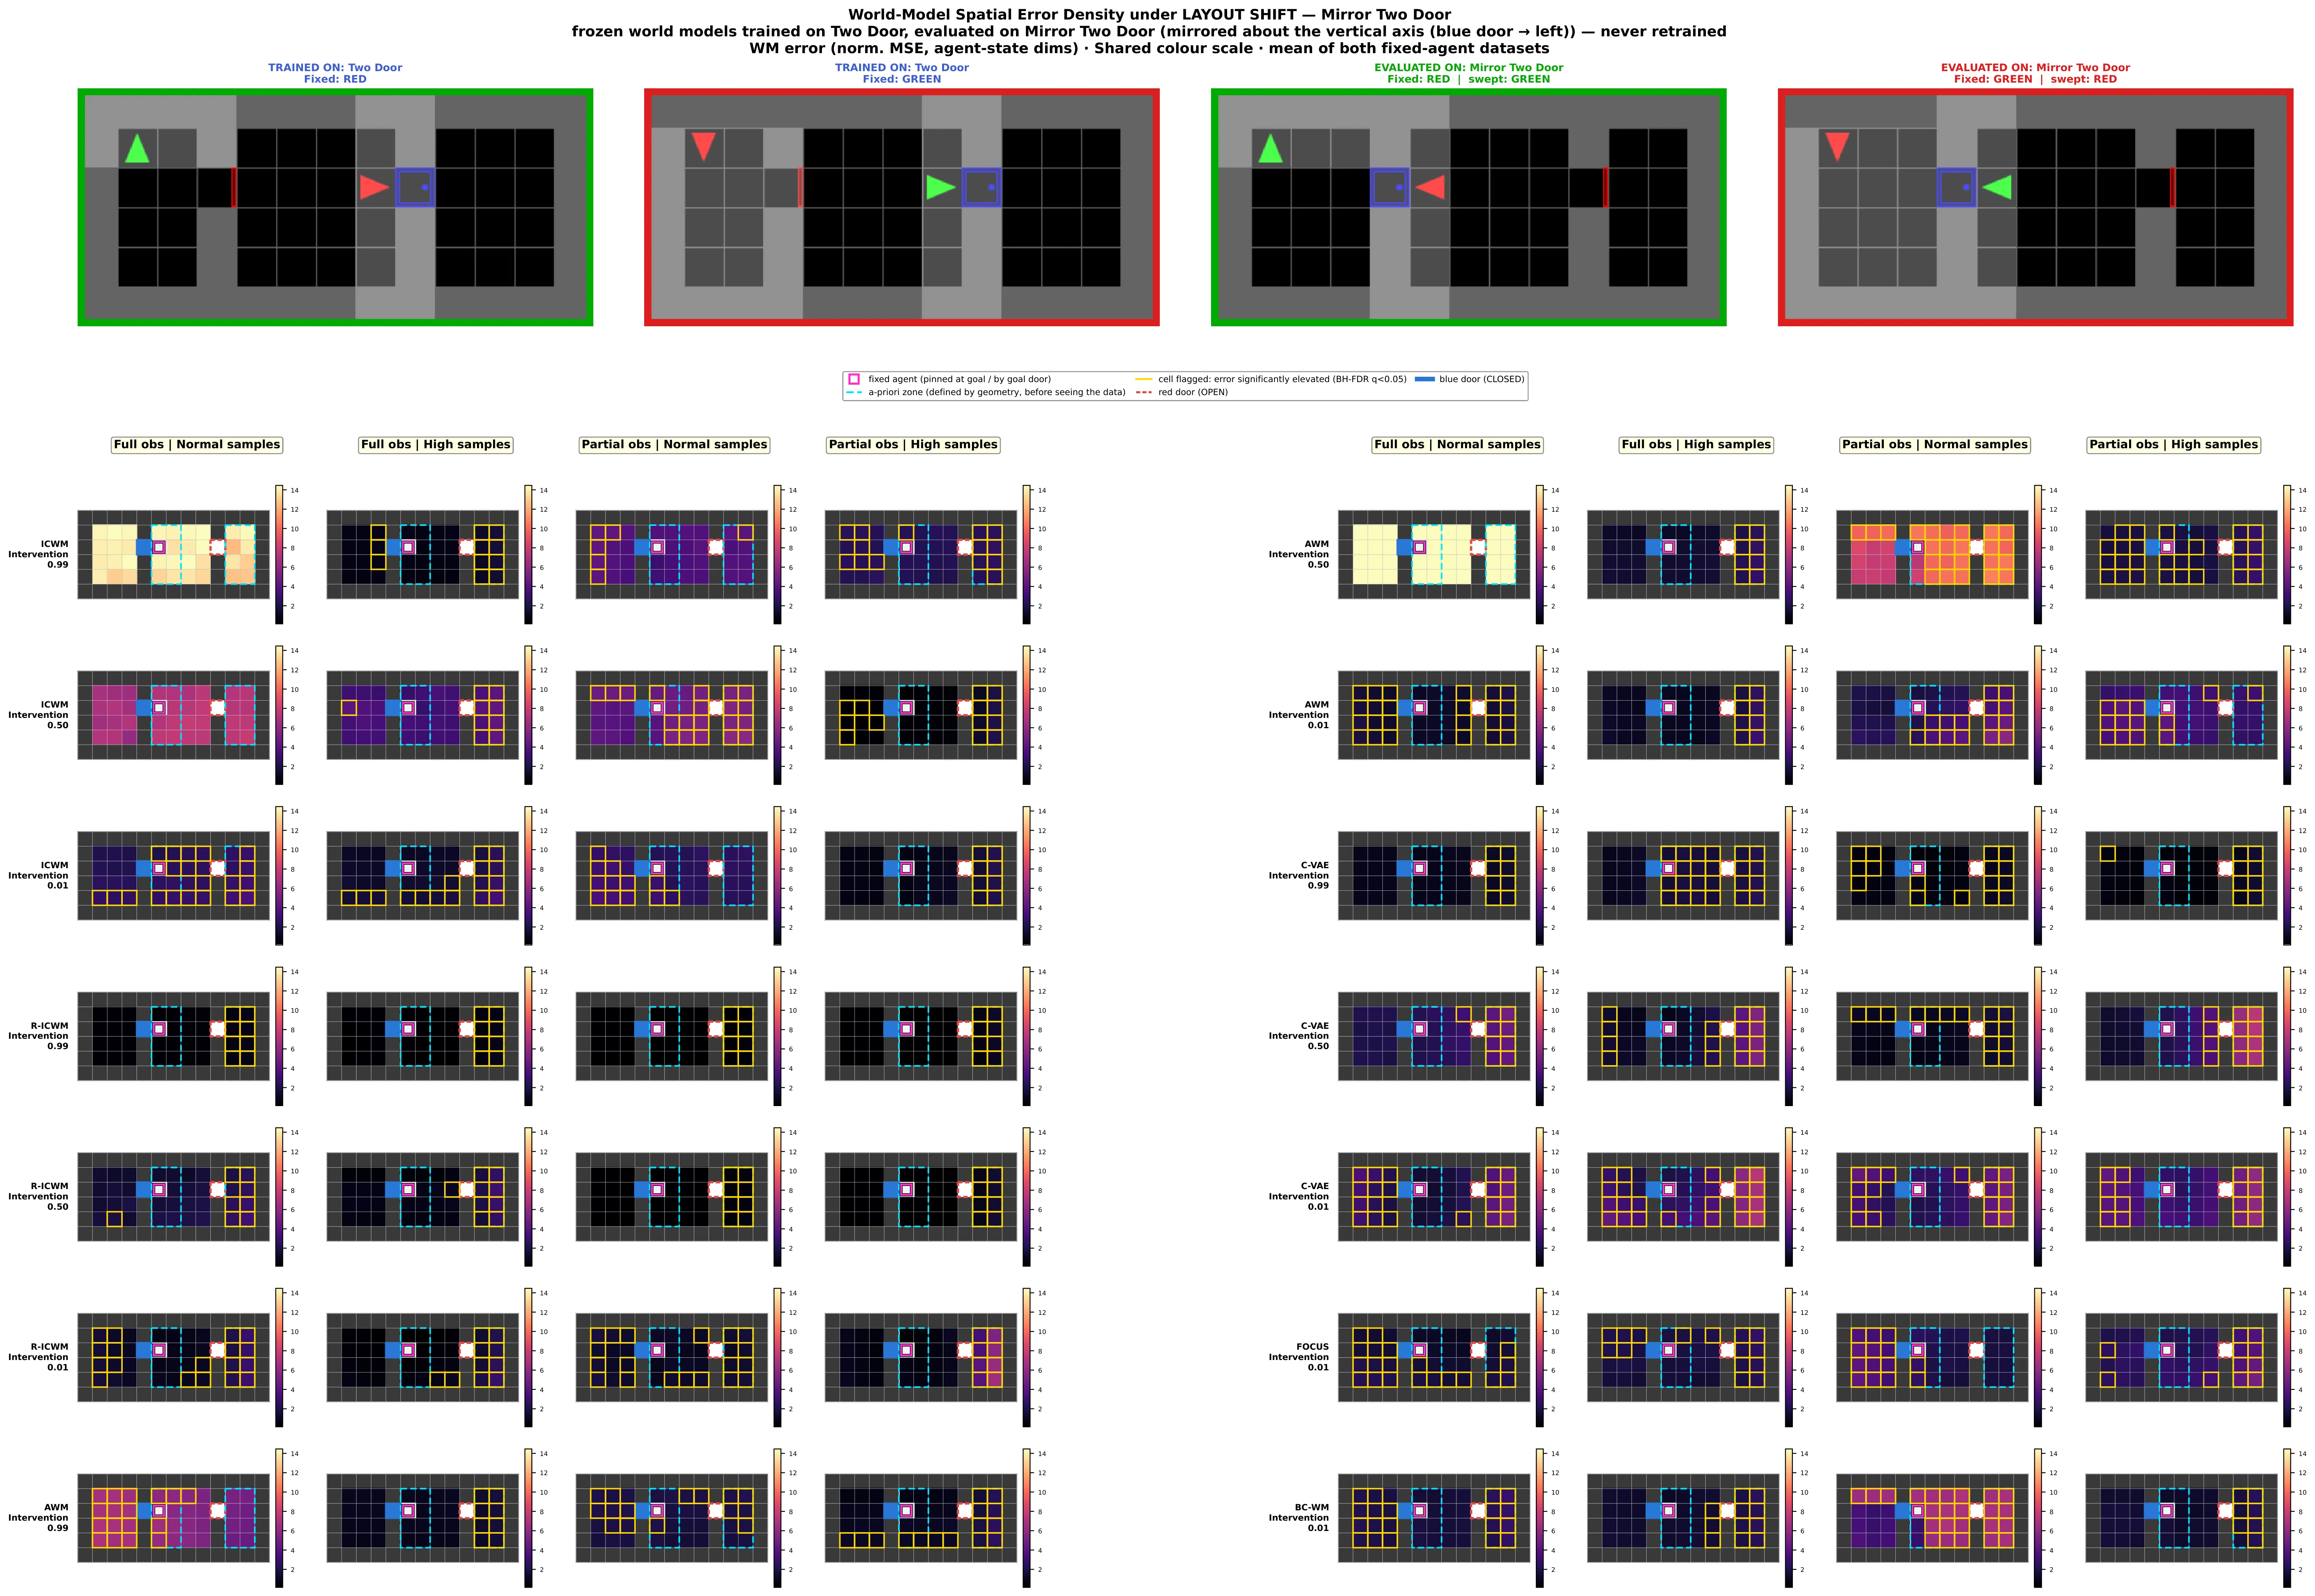
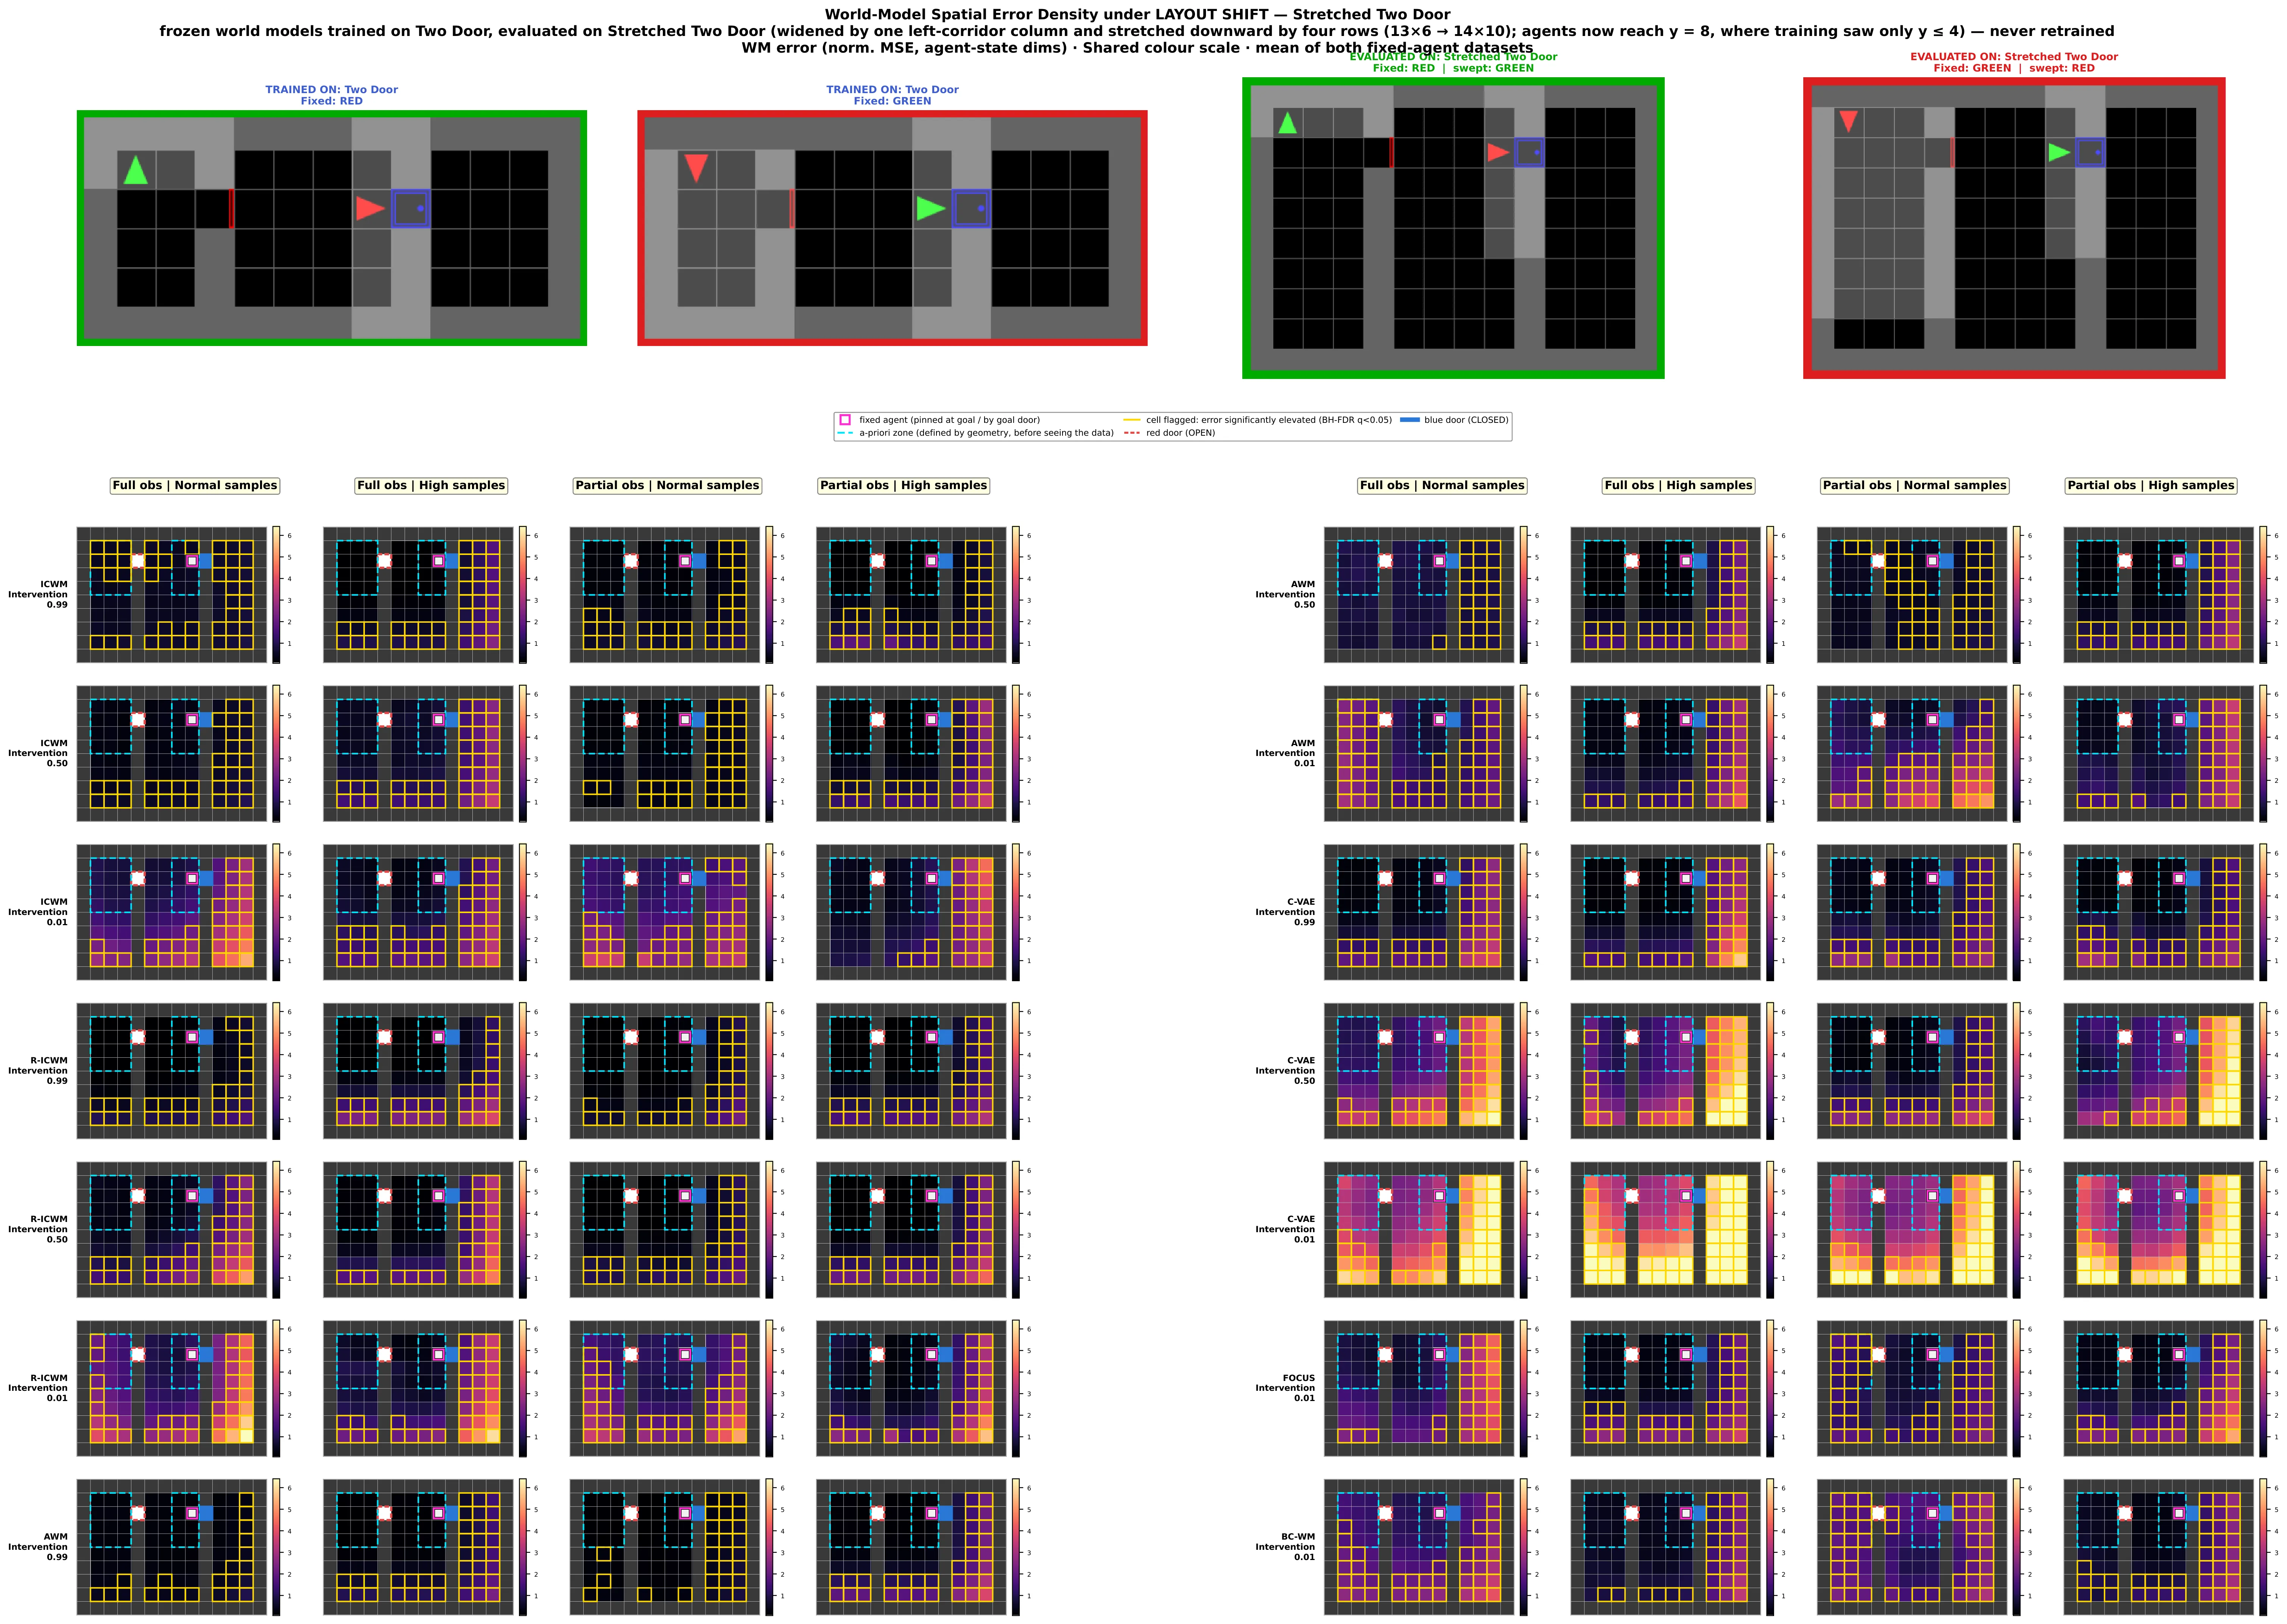
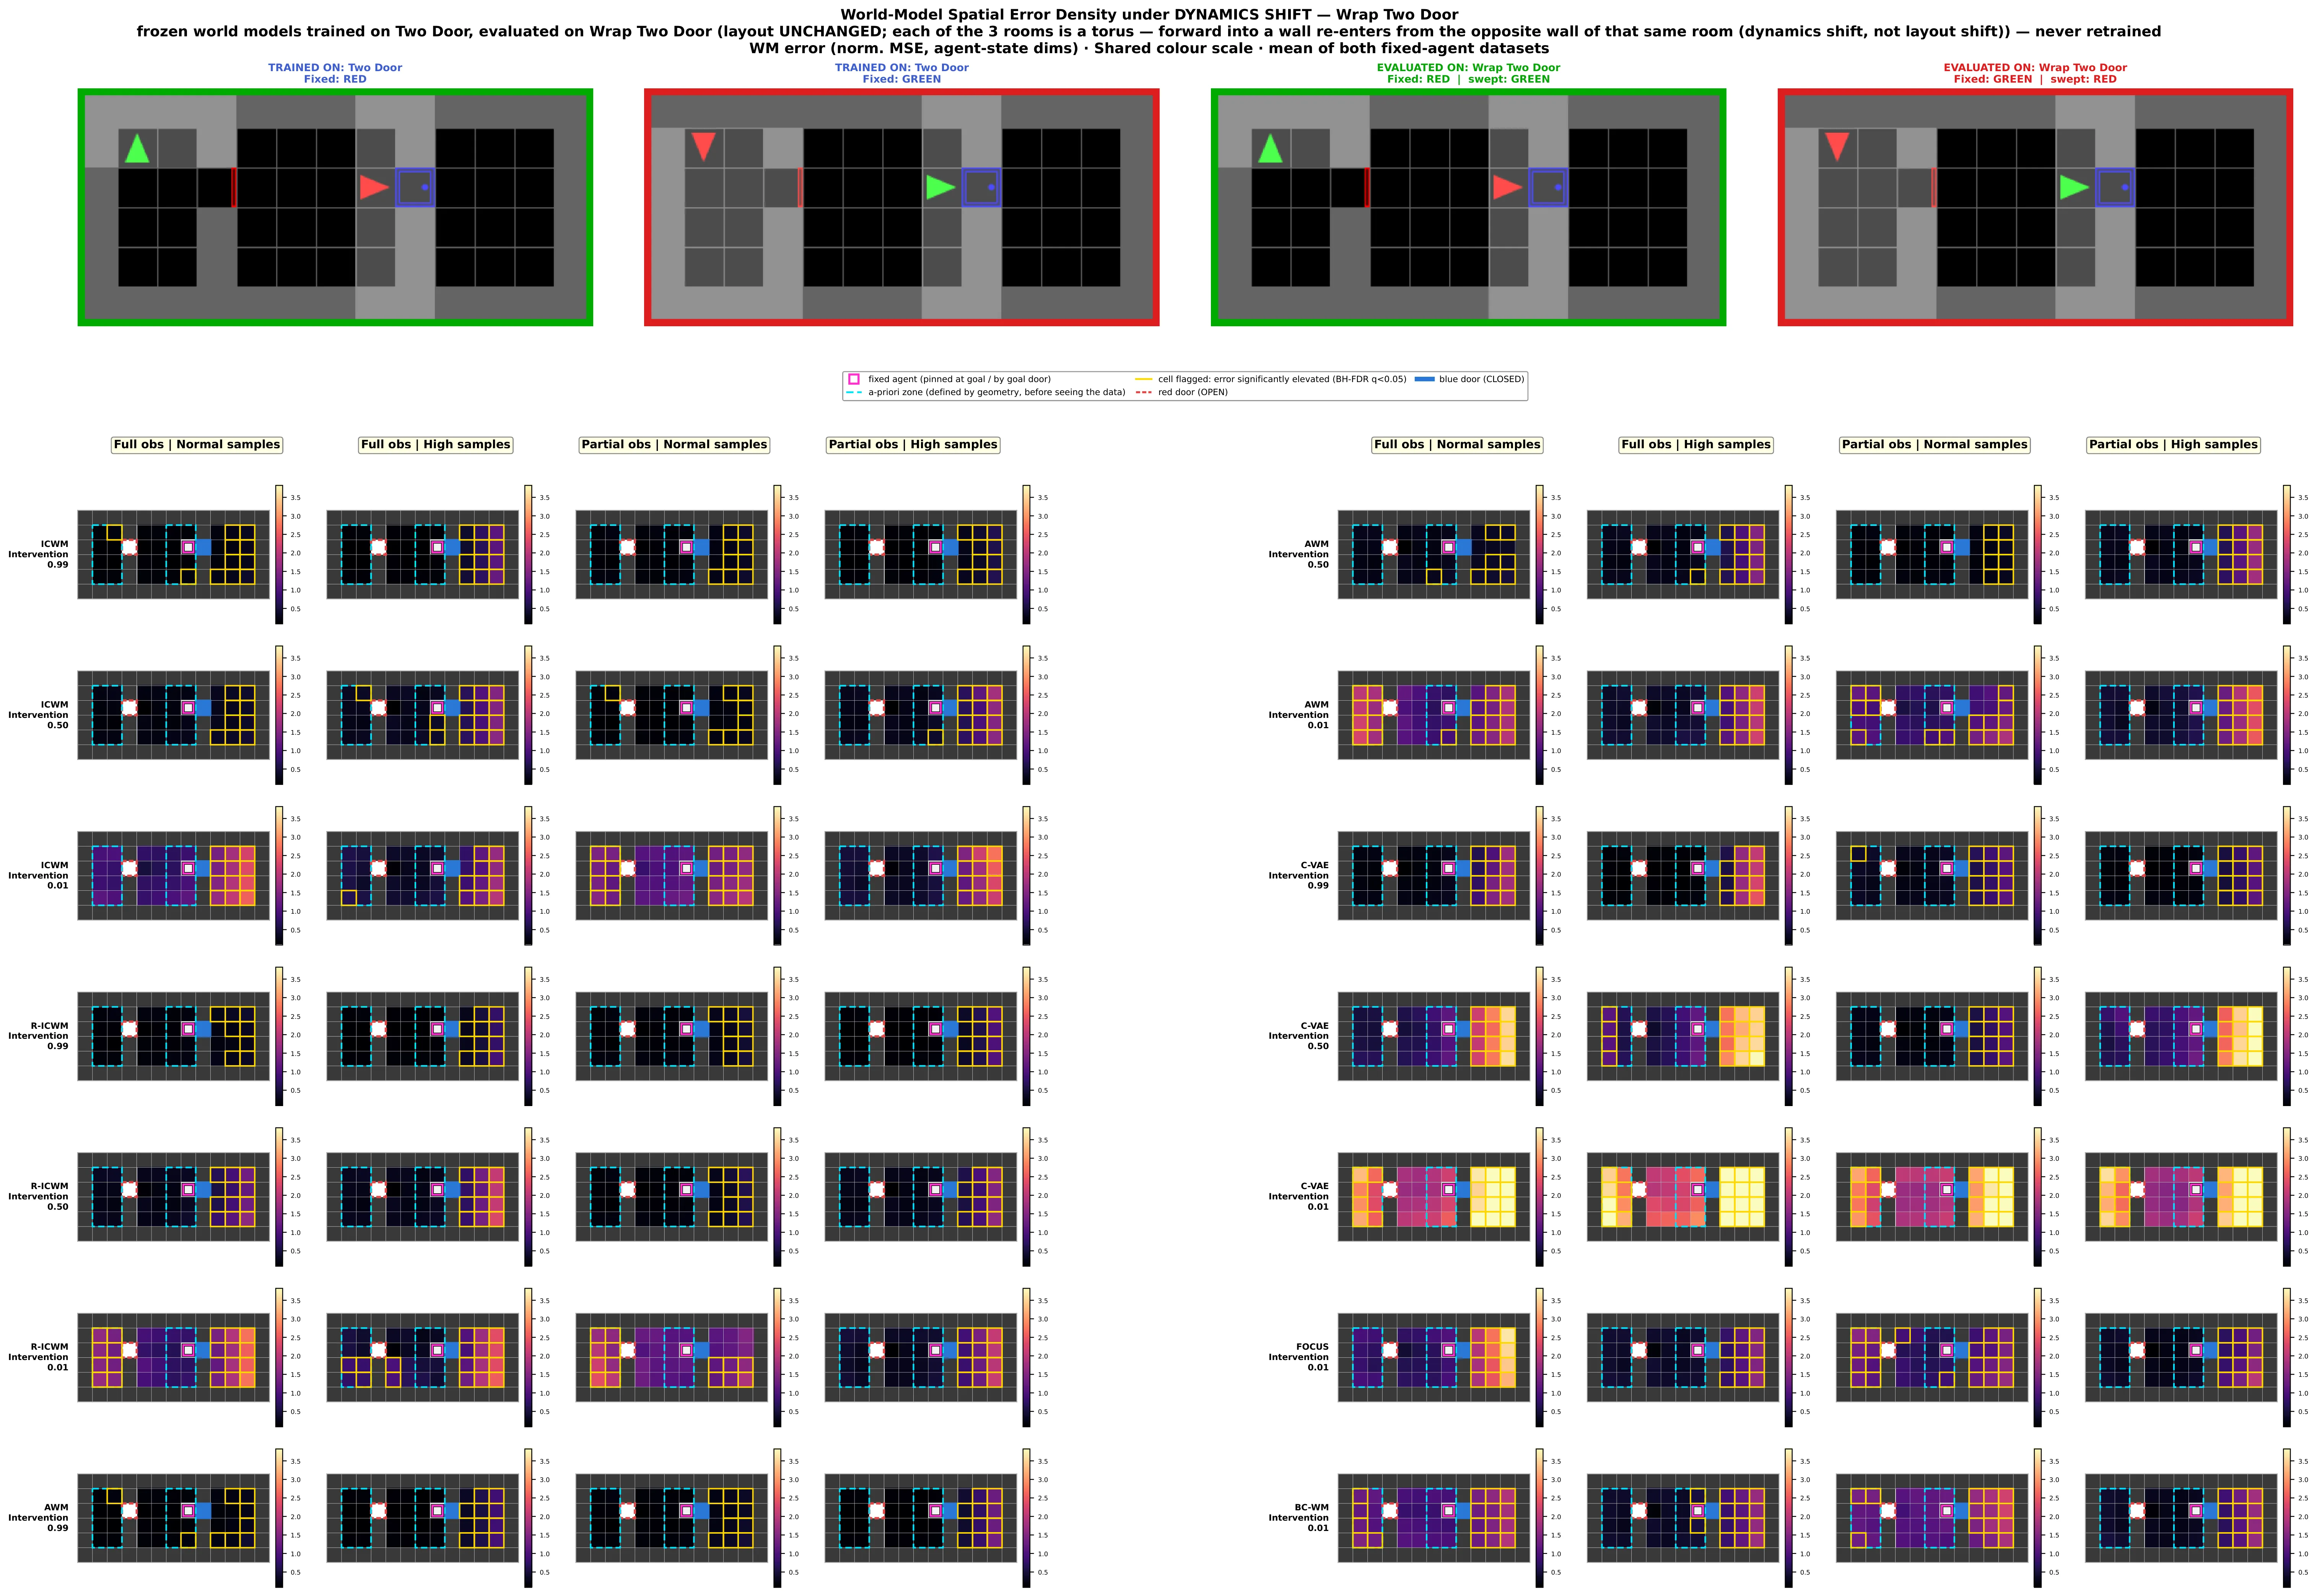
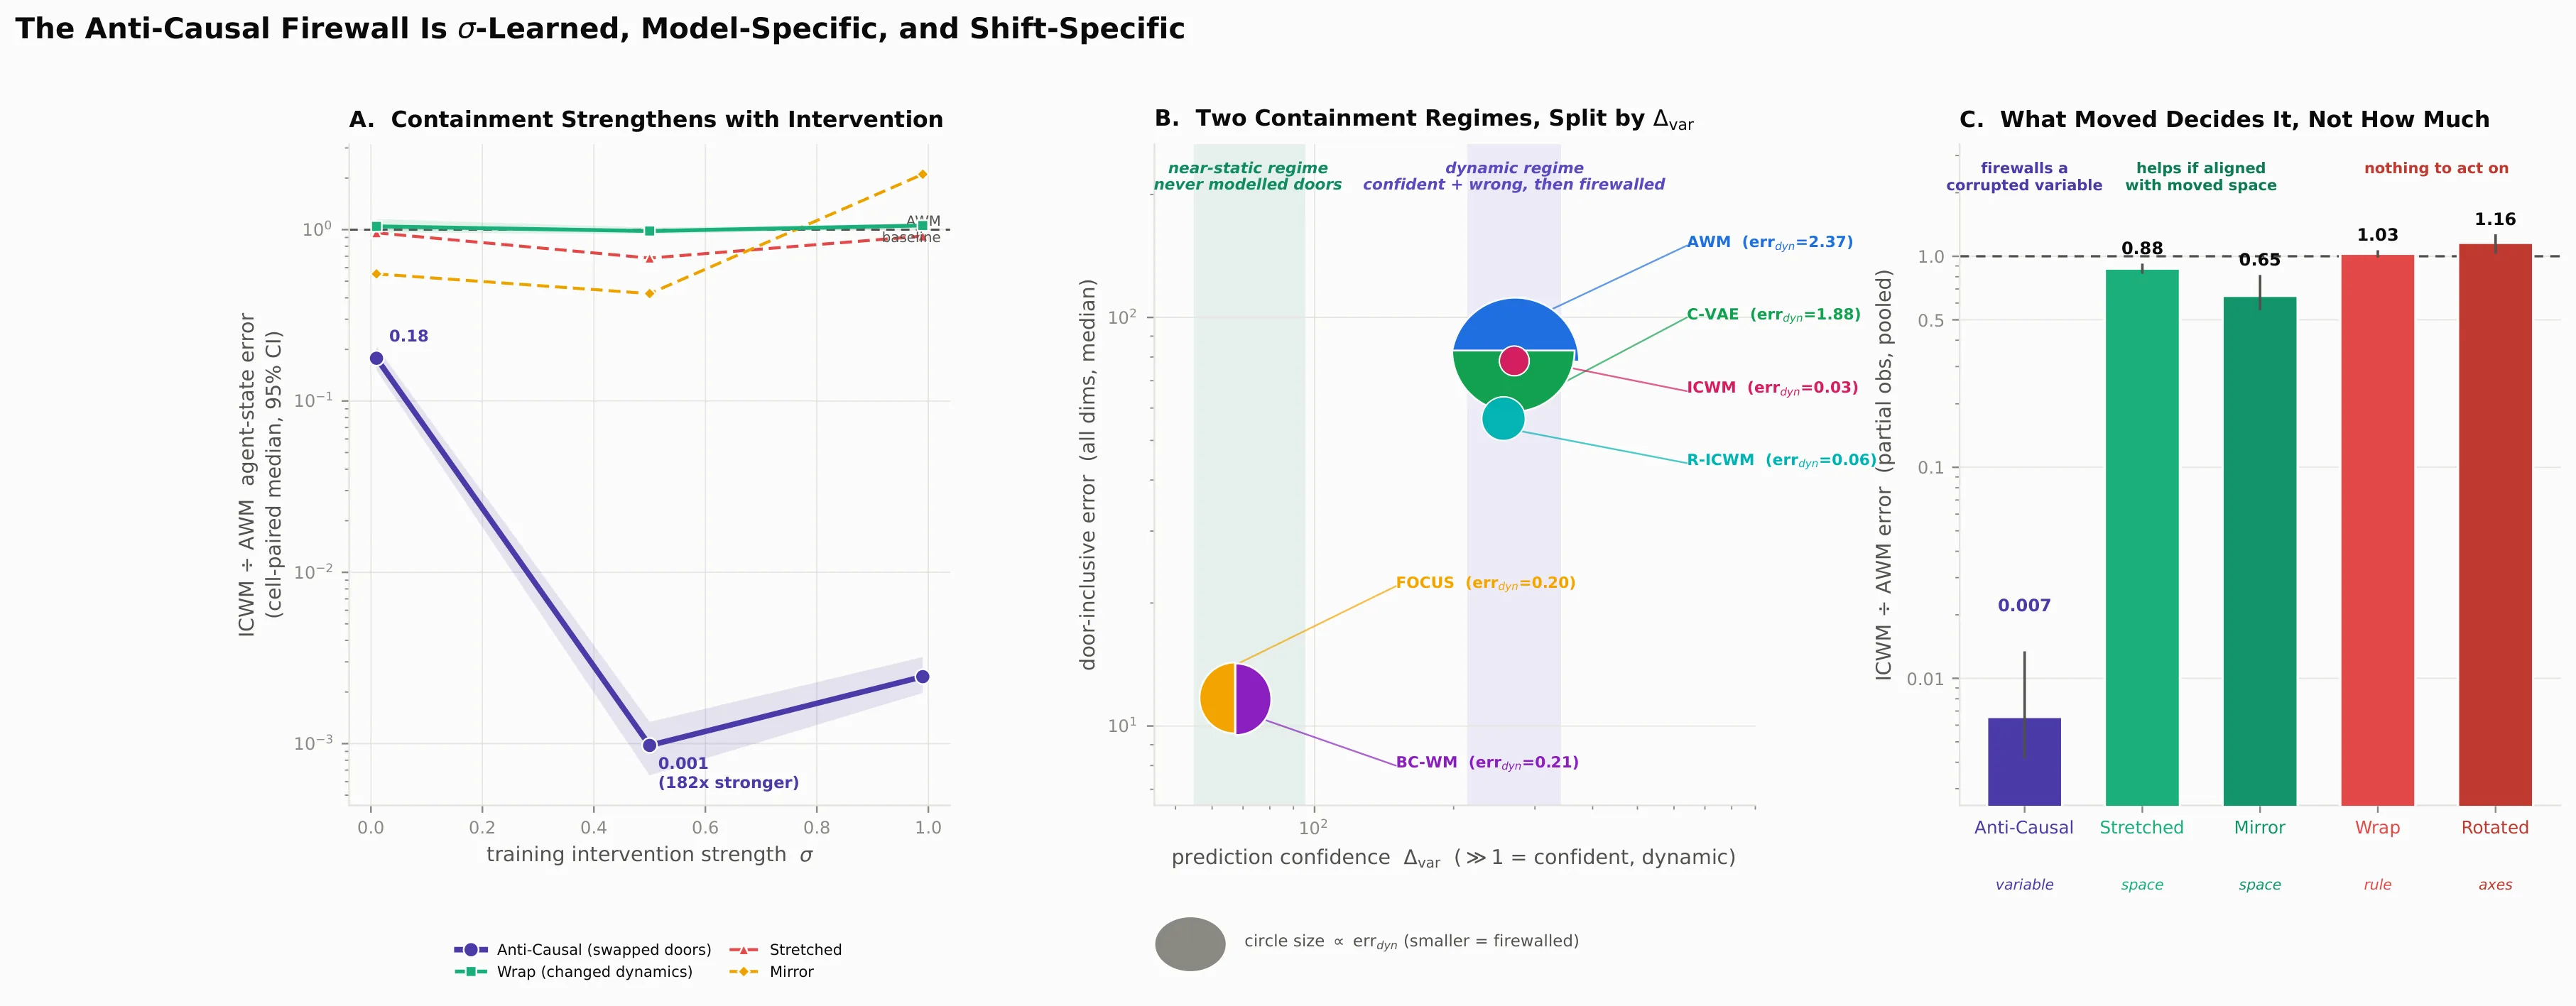
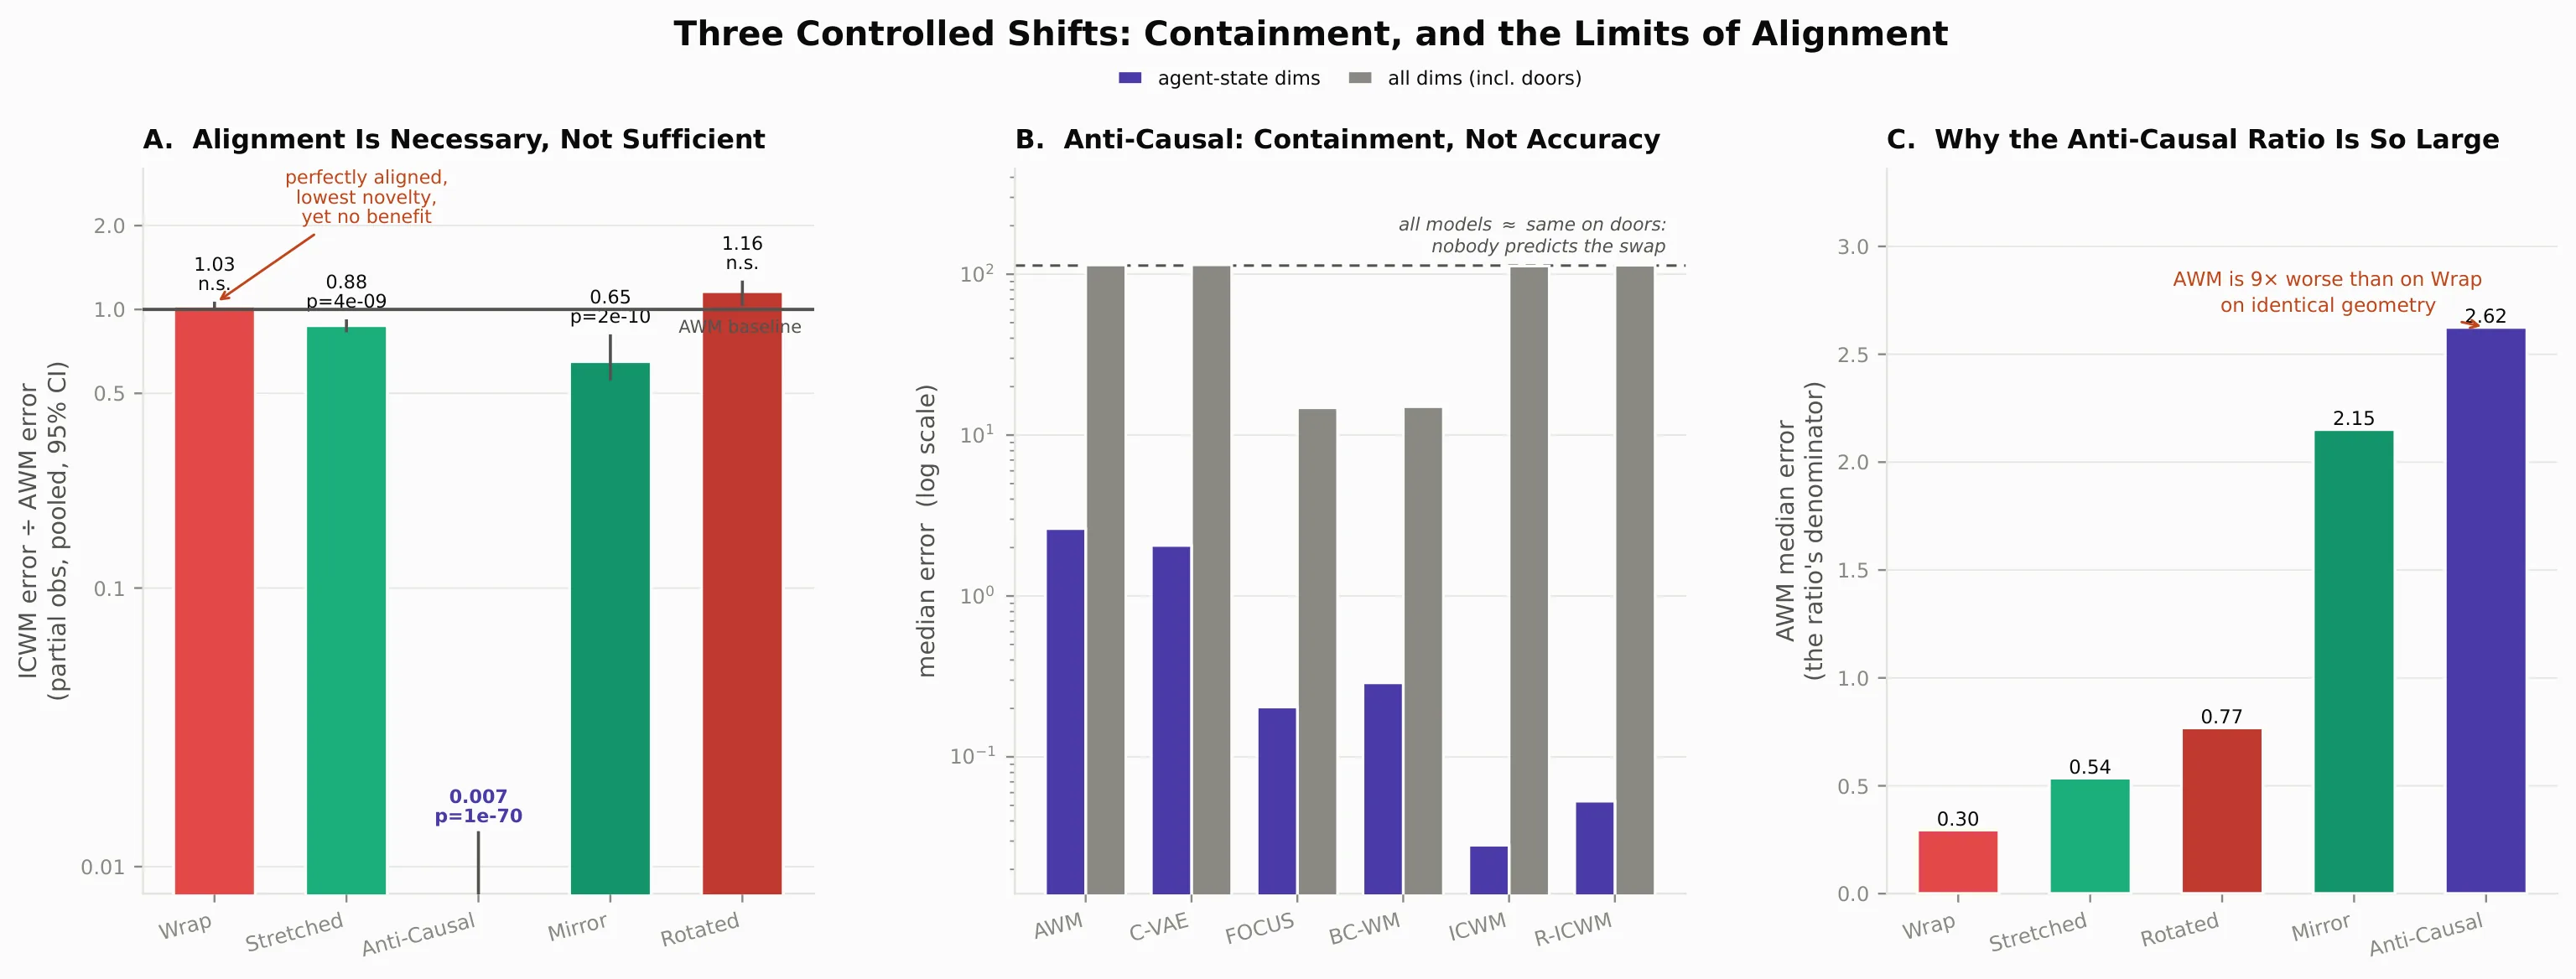
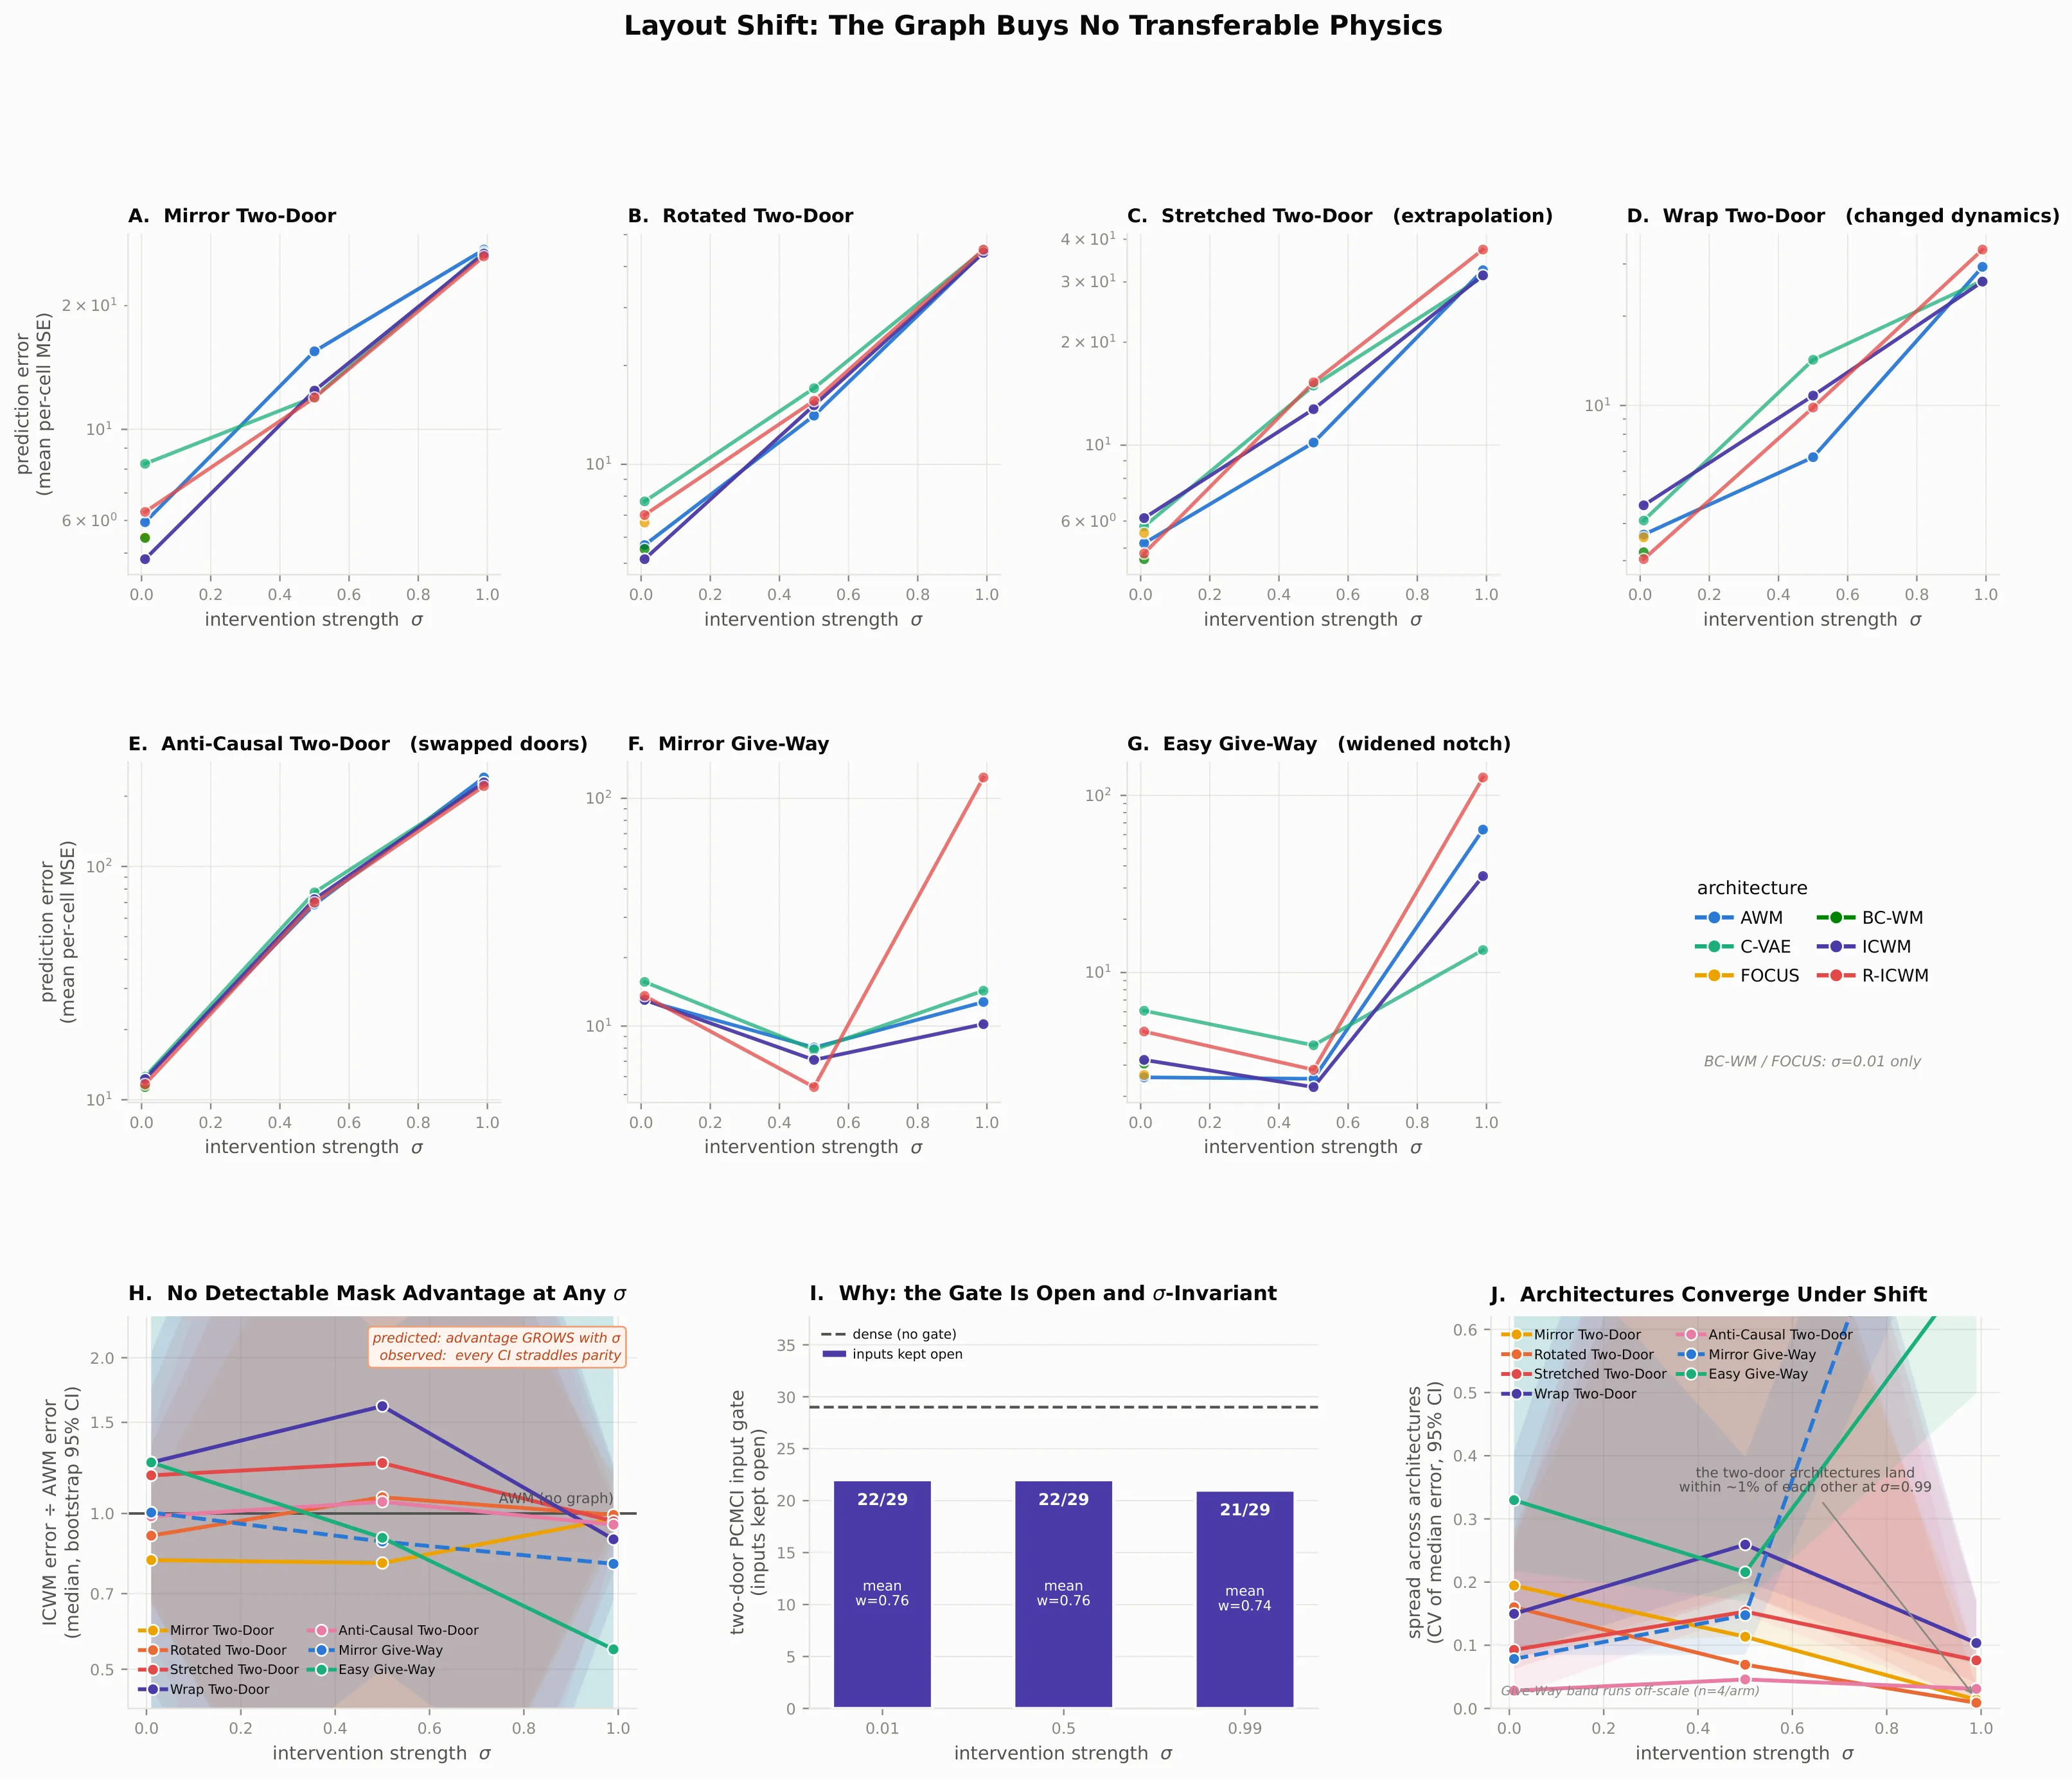
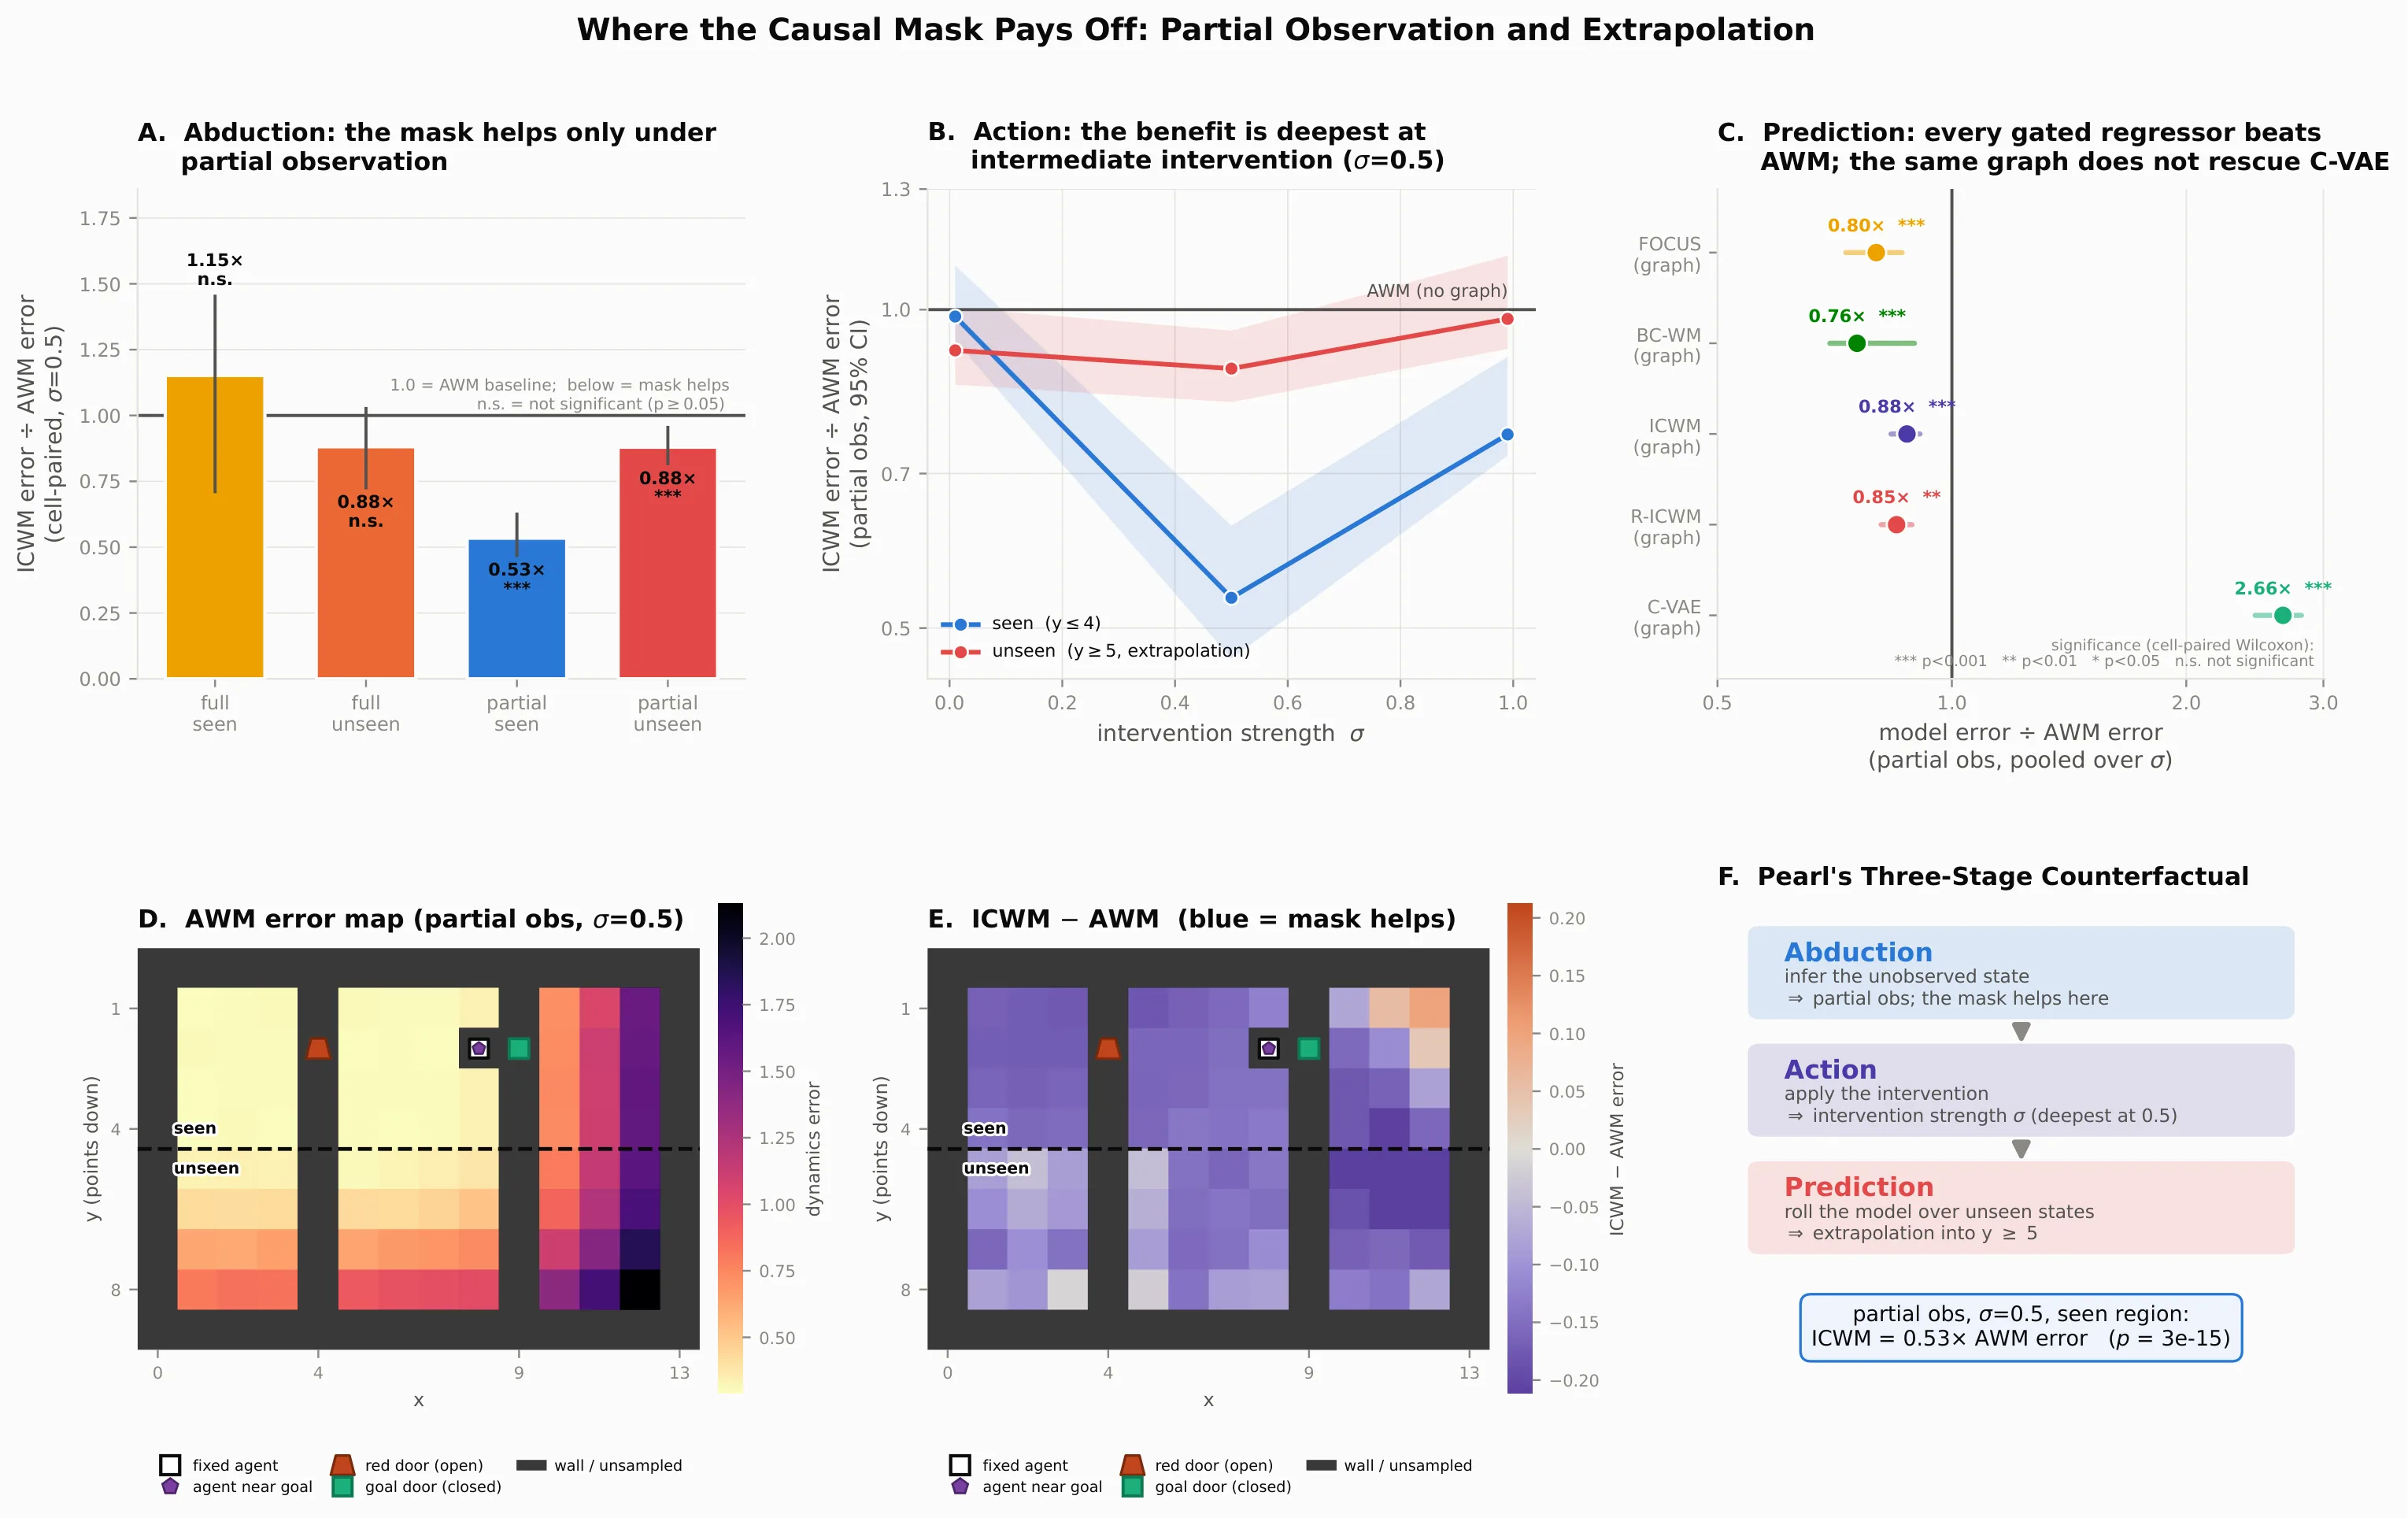
TL;DR
这篇论文针对多智能体系统中[[基于模型的强化学习]]模型难以区分[[统计相关性]]与真实[[因果机制]]的问题,提出了隐式因果世界模型。该方法通过引入策略方差并借助[[序贯后门条件]],无需预定义因果图即可从离线演示中自动恢复因果结构。在双门协调、导航避障和让行交互三个任务上的实验表明,模型预测精度随[[干预强度]]提升显著增强,部分任务提升可达五倍以上。
研究背景与动机
在[[基于模型的强化学习]]框架中,智能体通过学习一个"世界模型"作为环境动力学的内部模拟器,进而支持规划与决策。然而,传统世界模型的训练方式本质上是拟合观测数据中的[[统计相关性]]——哪些变量倾向于共同出现、哪些状态转移经常发生。这种建模思路在静态或单智能体环境中尚可运作,但当环境涉及多个智能体的交互决策时,问题就变得棘手了。
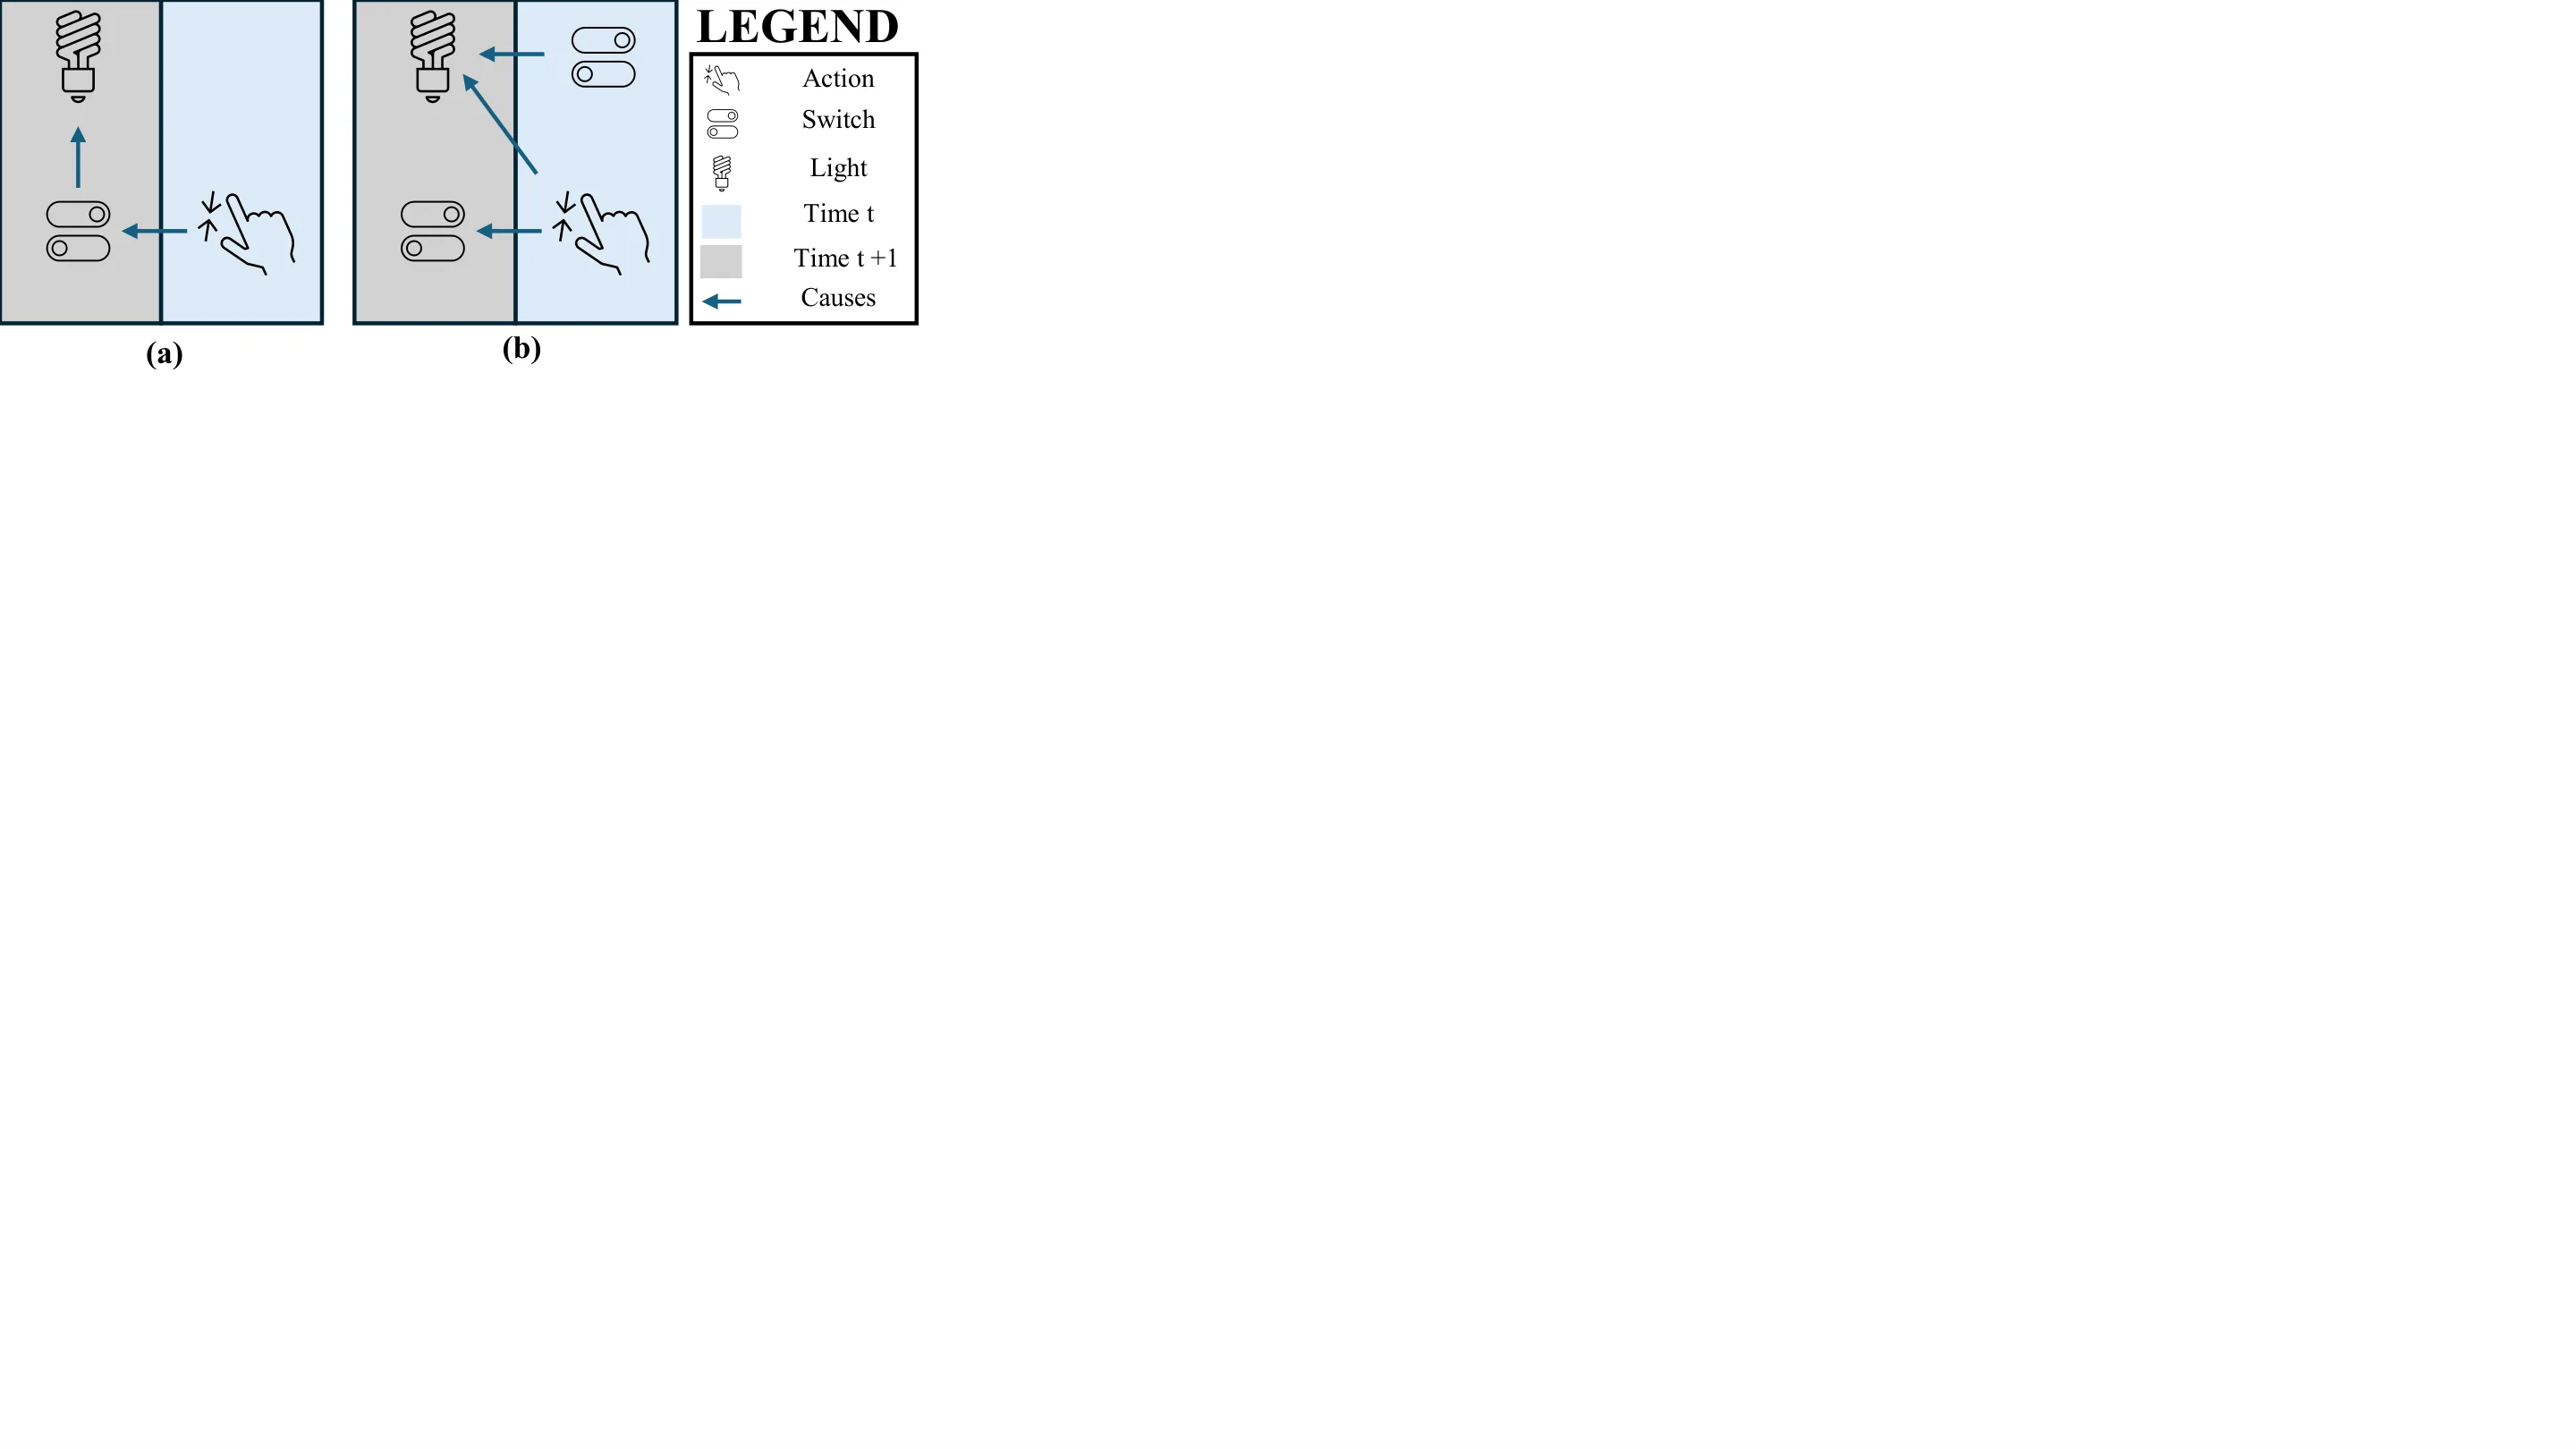
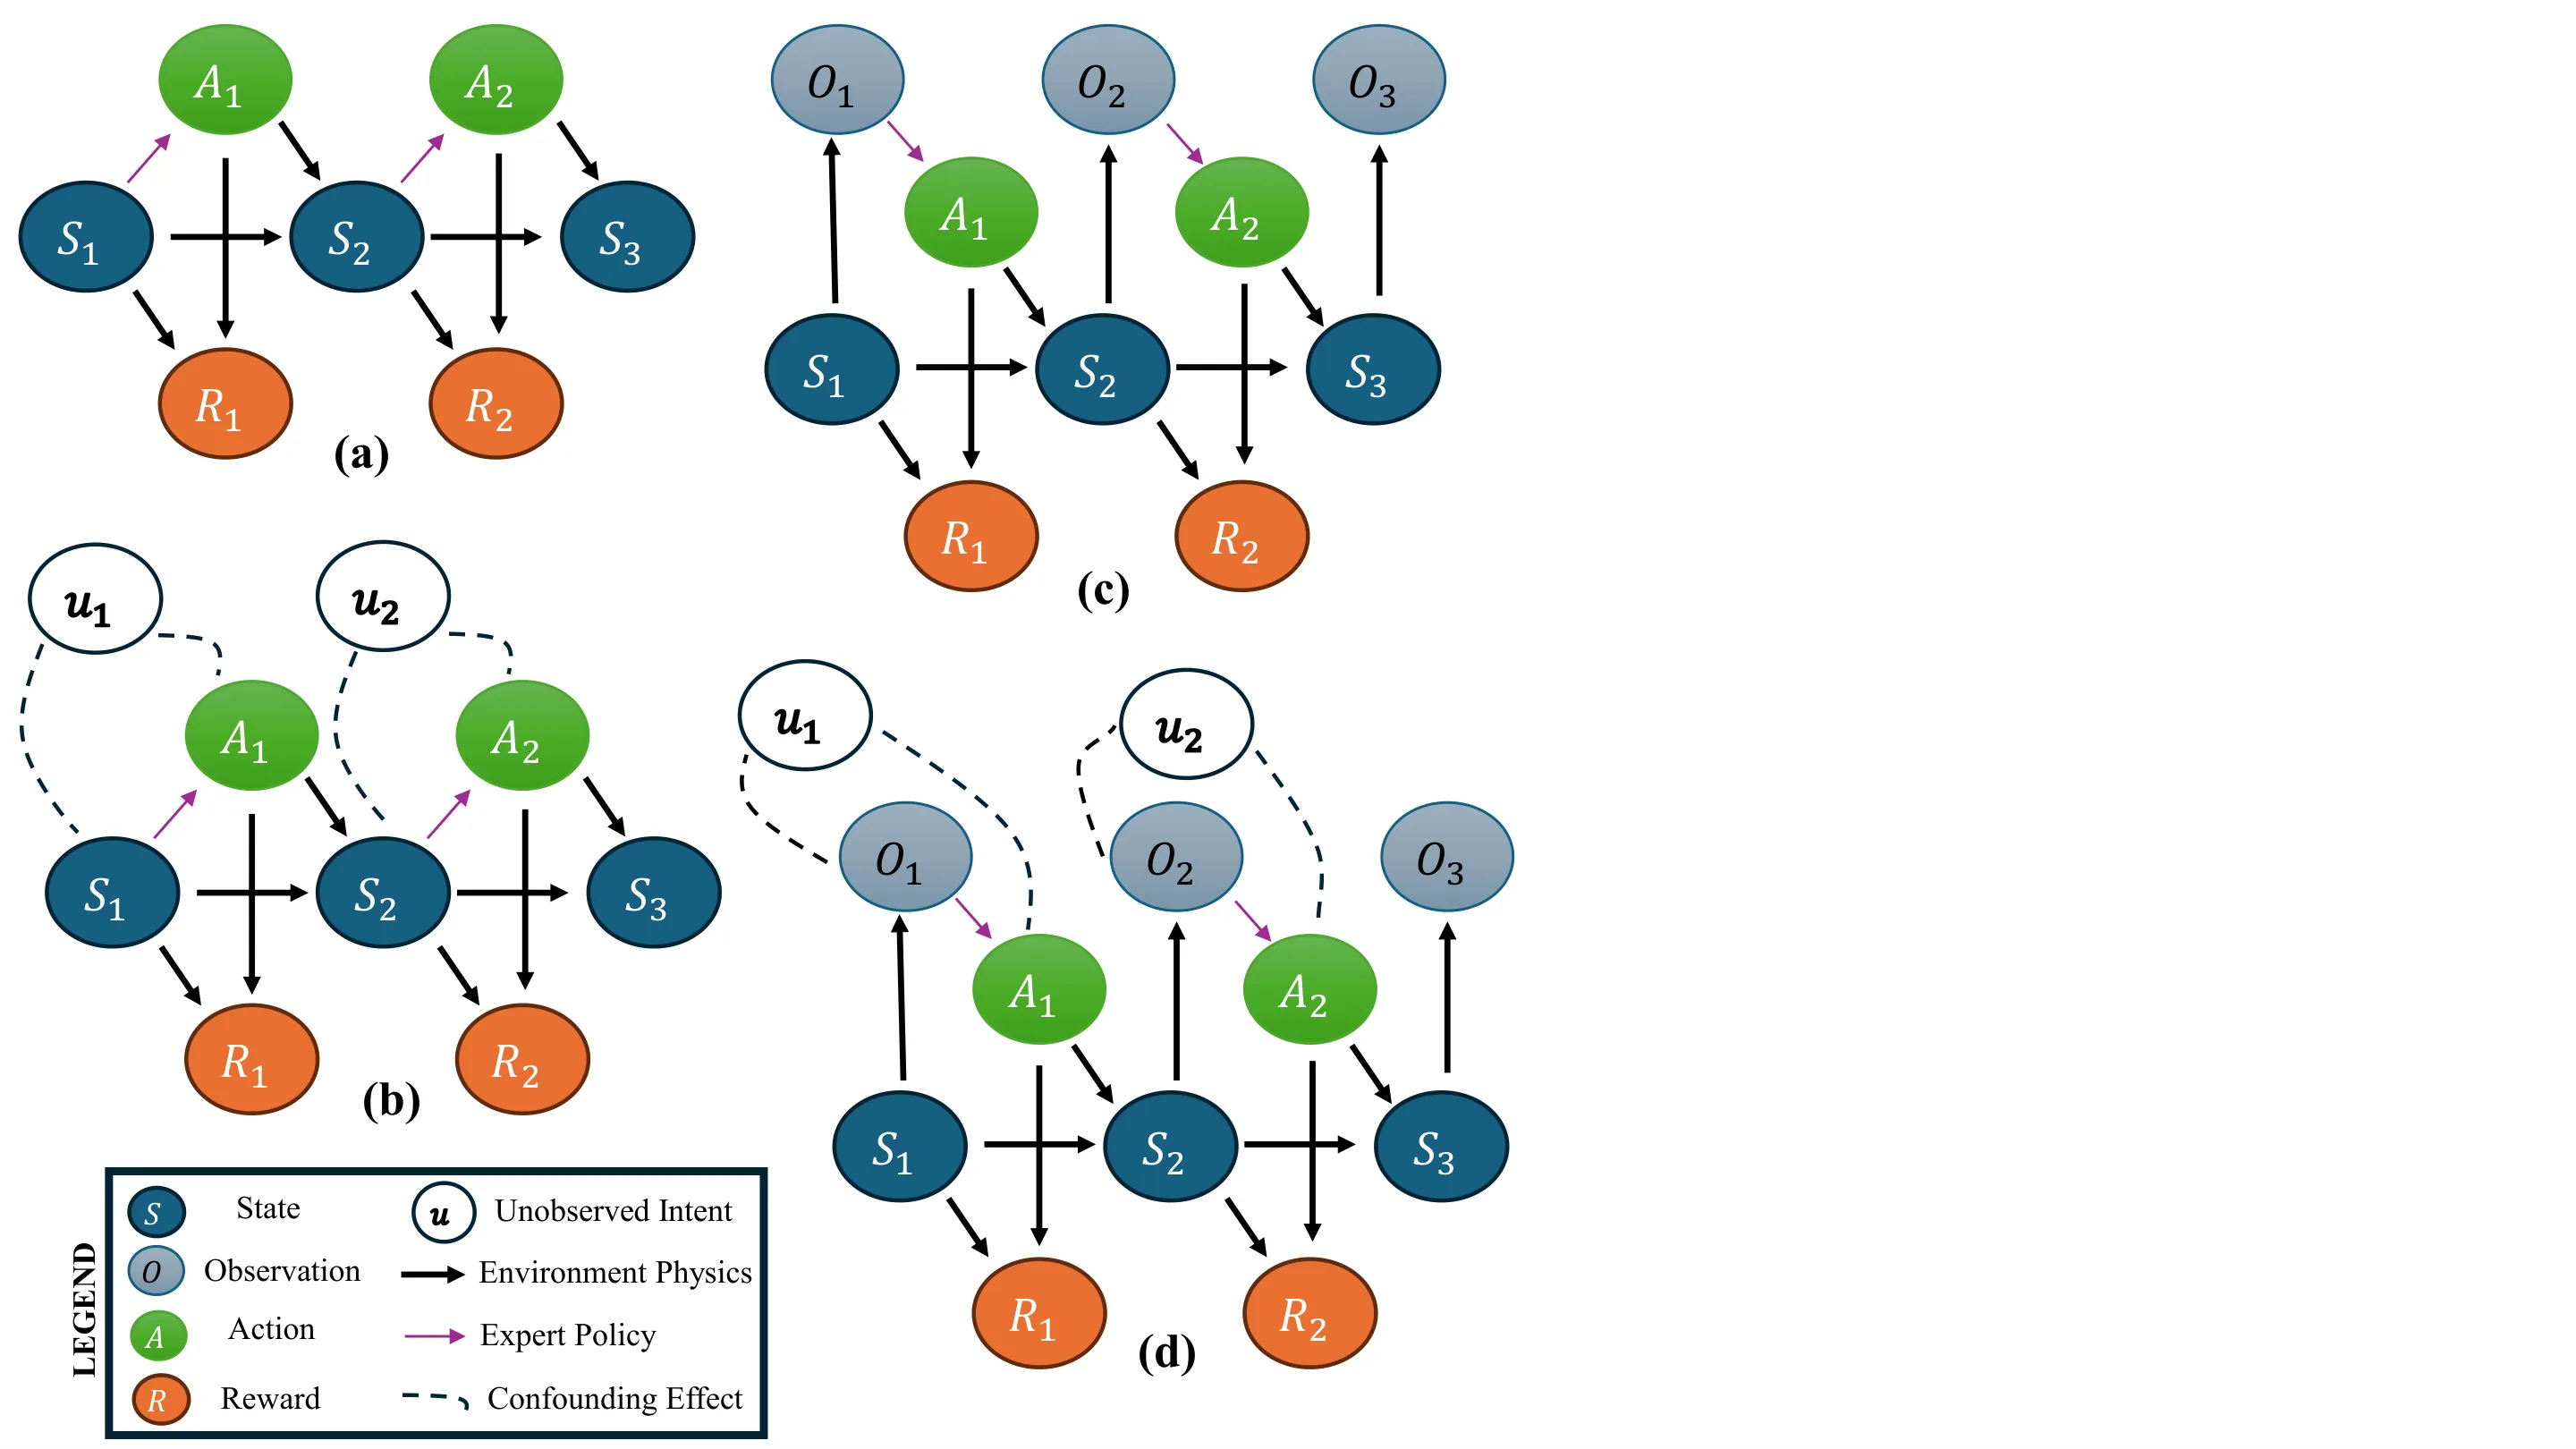
多智能体系统中的状态转移并非纯粹由物理定律决定。一个智能体的行为既受环境物理约束,又受其他智能体策略意图的驱动。例如在机器人协作任务中,智能体A的移动轨迹可能同时反映了环境的地形限制和智能体B的配合策略。这种物理转移与策略意图的深度耦合,使得观测数据中混杂了大量非因果性的统计关联。当训练数据中的某个智能体改变了行为模式,原本学到的相关性就会失效,世界模型的预测能力急剧下降——这在强化学习文献中被称为分布偏移下的模型失效问题。
传统因果发现方法通常依赖主动干预或预定义的因果图结构来识别变量间的因果关系。但在实际多智能体场景中,我们往往只有离线的人类演示数据,既无法对环境施加干预,也缺乏领域专家提供的因果结构知识。因此,研究者面临的核心挑战是:如何仅从离线演示中自动恢复出反映真实因果机制的世界模型?
这篇论文的切入点正在于此——利用多智能体演示数据本身蕴含的策略差异(而非人为干预)作为识别因果结构的信号。
方法
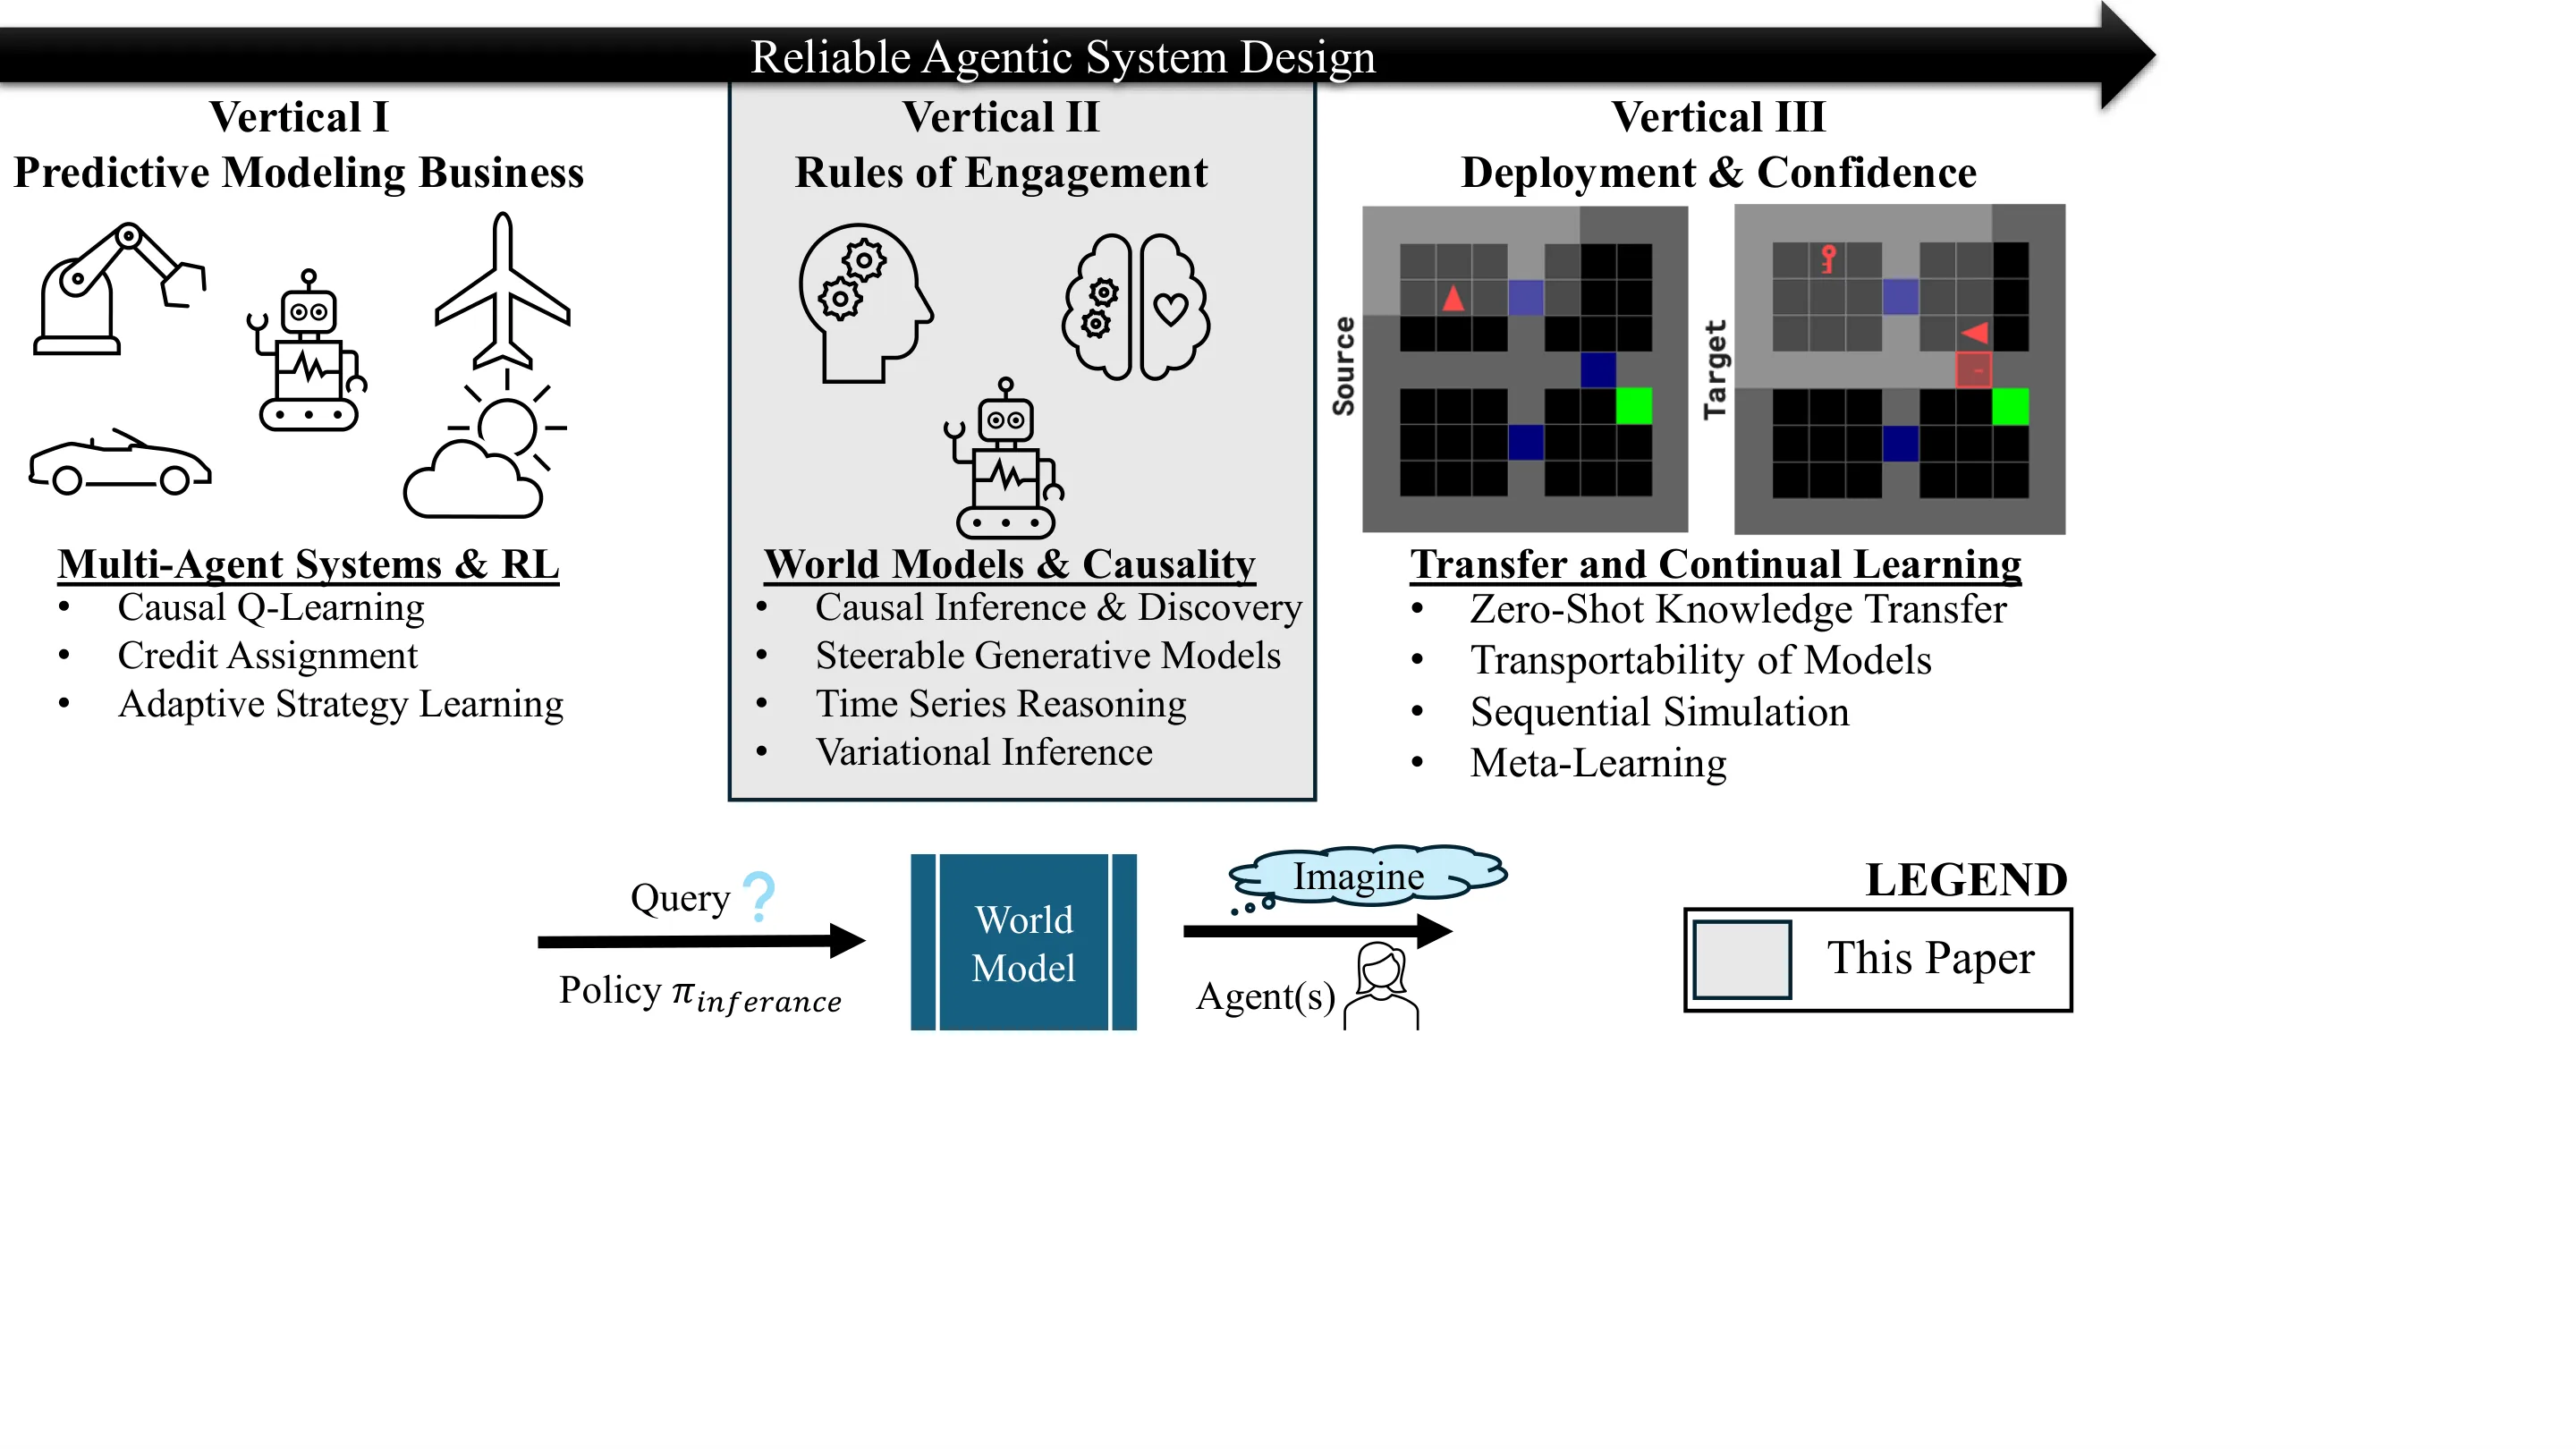
隐式因果世界模型的核心思路是:将策略方差作为因果发现的"准干预"信号,通过序贯后门条件实现因果结构的自动识别。这一设计的关键洞察在于:多智能体演示数据天然包含了不同智能体在同一状态下可能采取不同行动的变化,而这种变化恰好满足了因果推断中"区分相关性与因果性"所需的条件。
具体而言,论文首先对每个智能体 的行为策略进行混合建模。设专家演示策略为 ,随机干预分布为 ,则插值后的行为分布为:
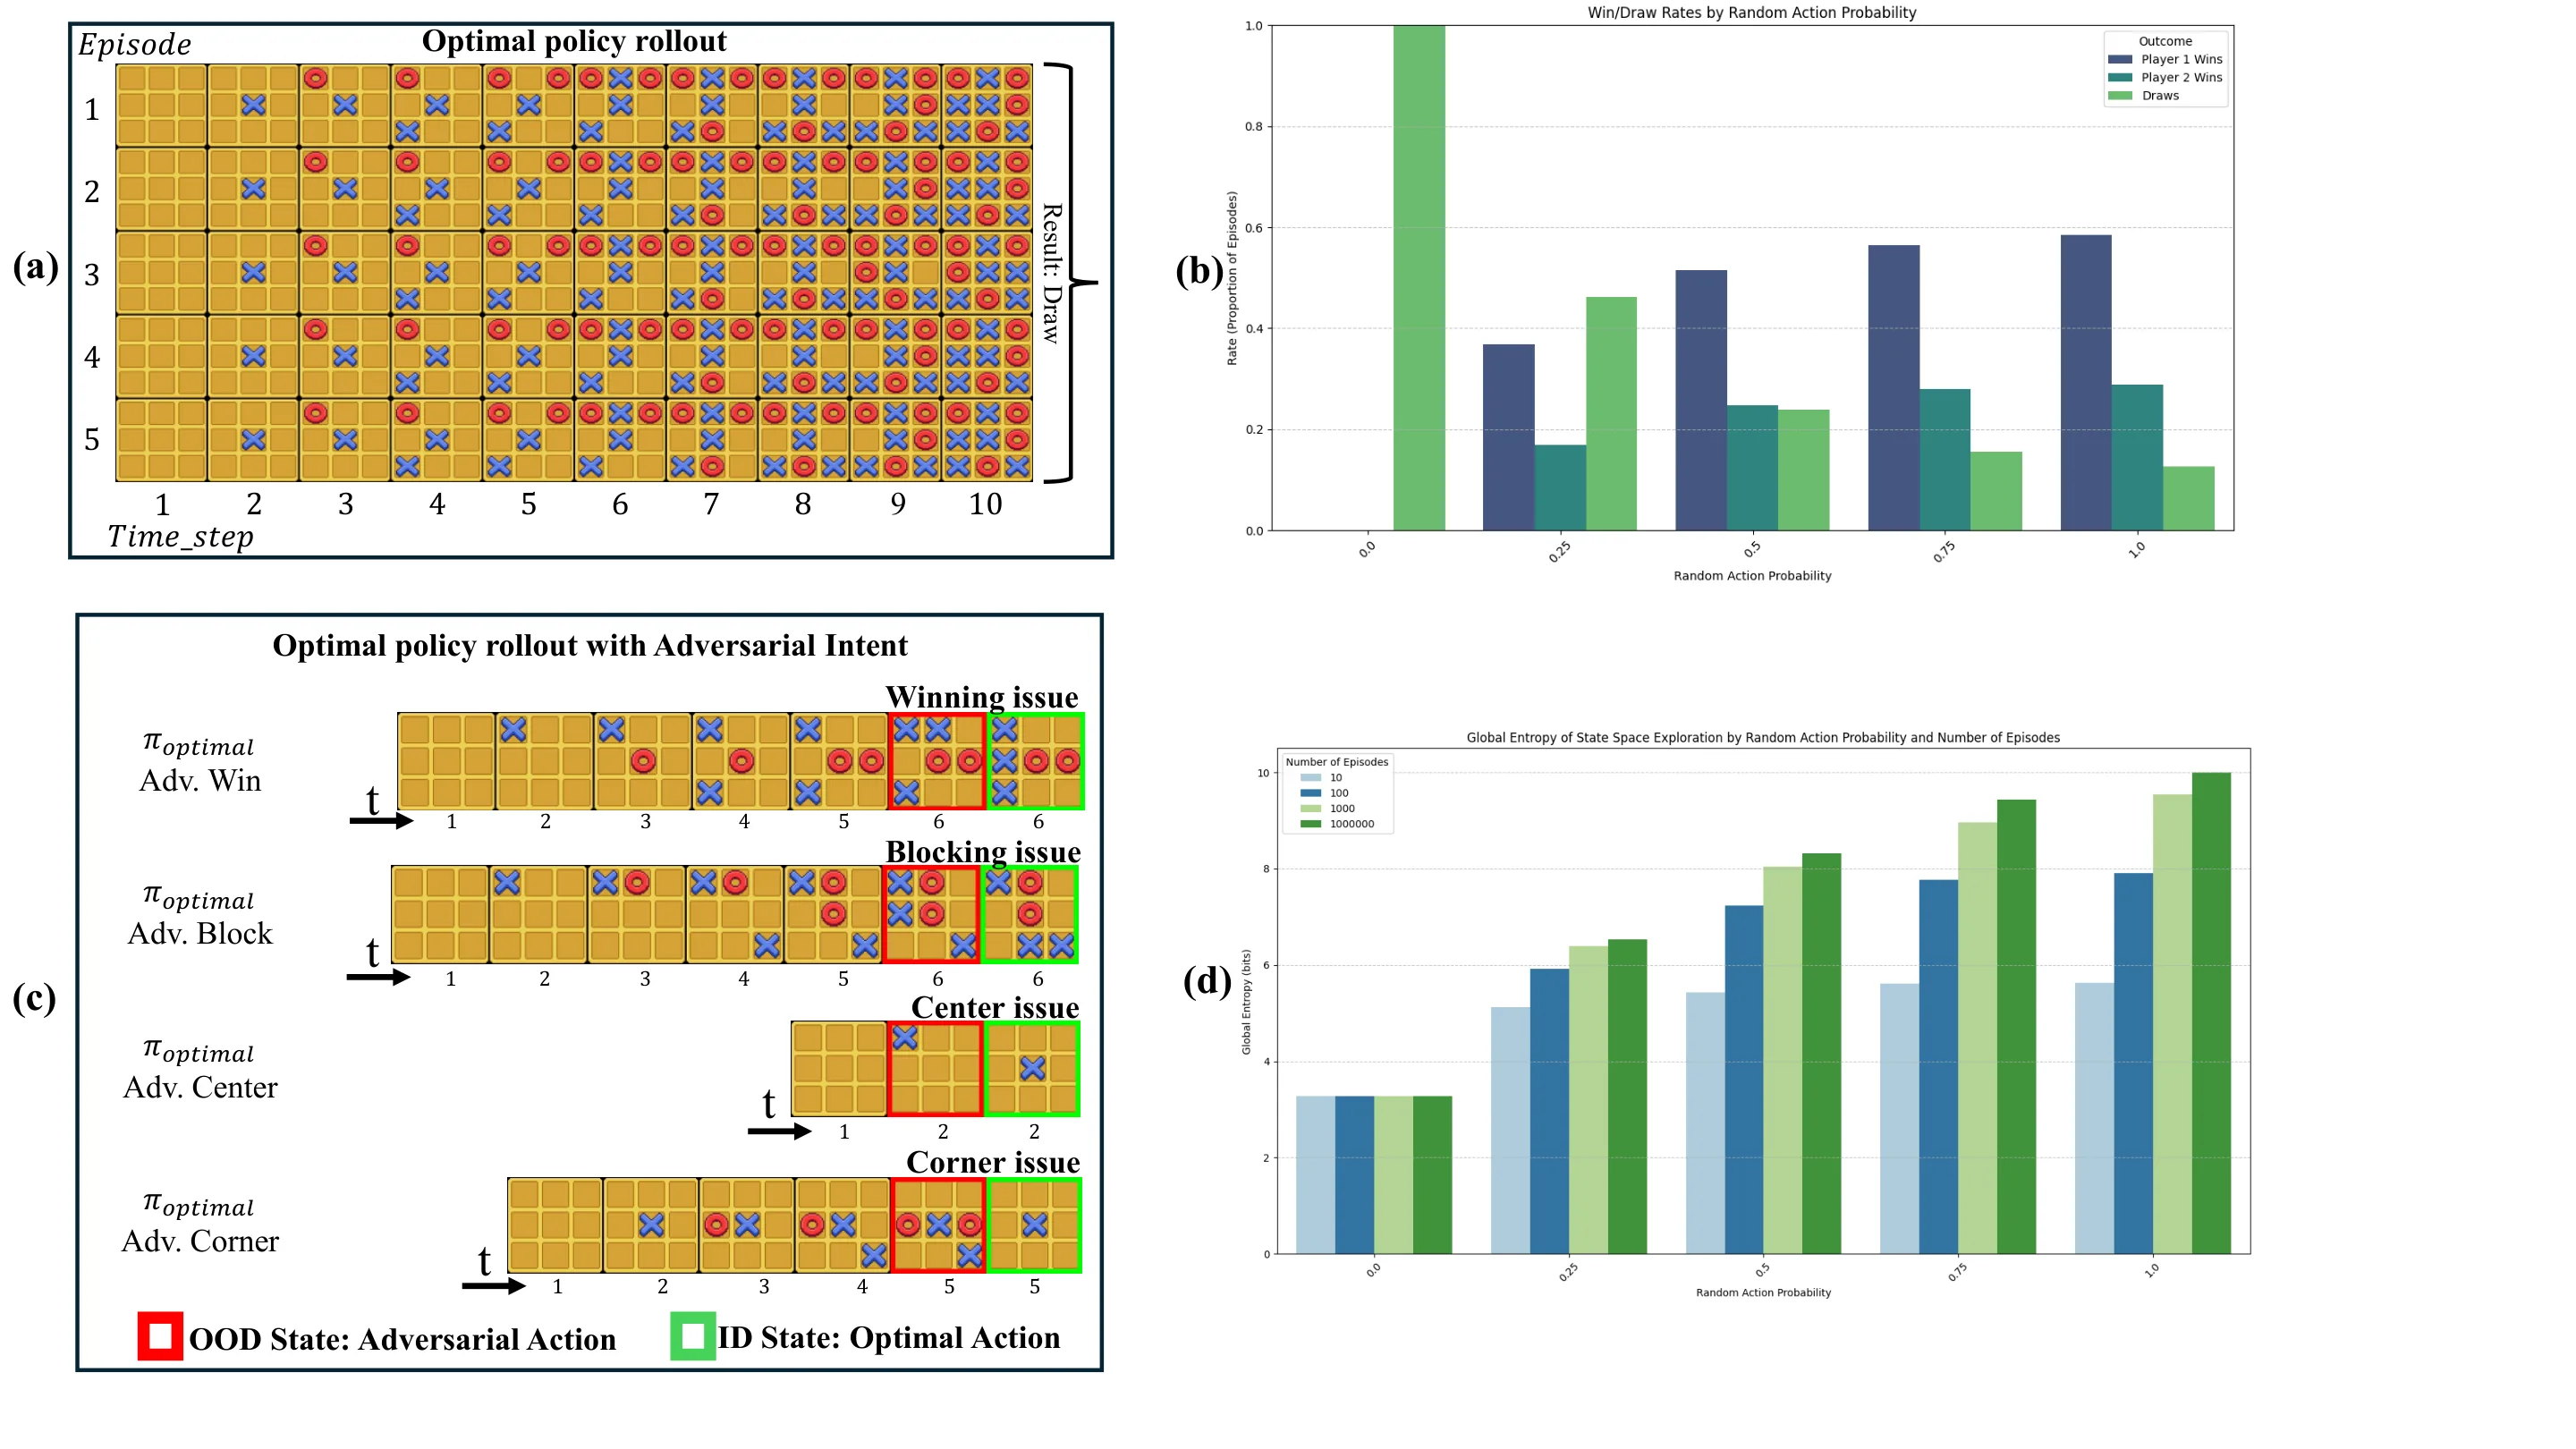
参数 控制着干预强度:当 时恢复为纯专家策略的确定性行为;当 逐渐增大时,行为分布趋向于随机。此时论文引入熵作为策略方差的代理度量:
熵越大表示策略越多样,这种方差信息恰好构成了识别因果边的关键信号。
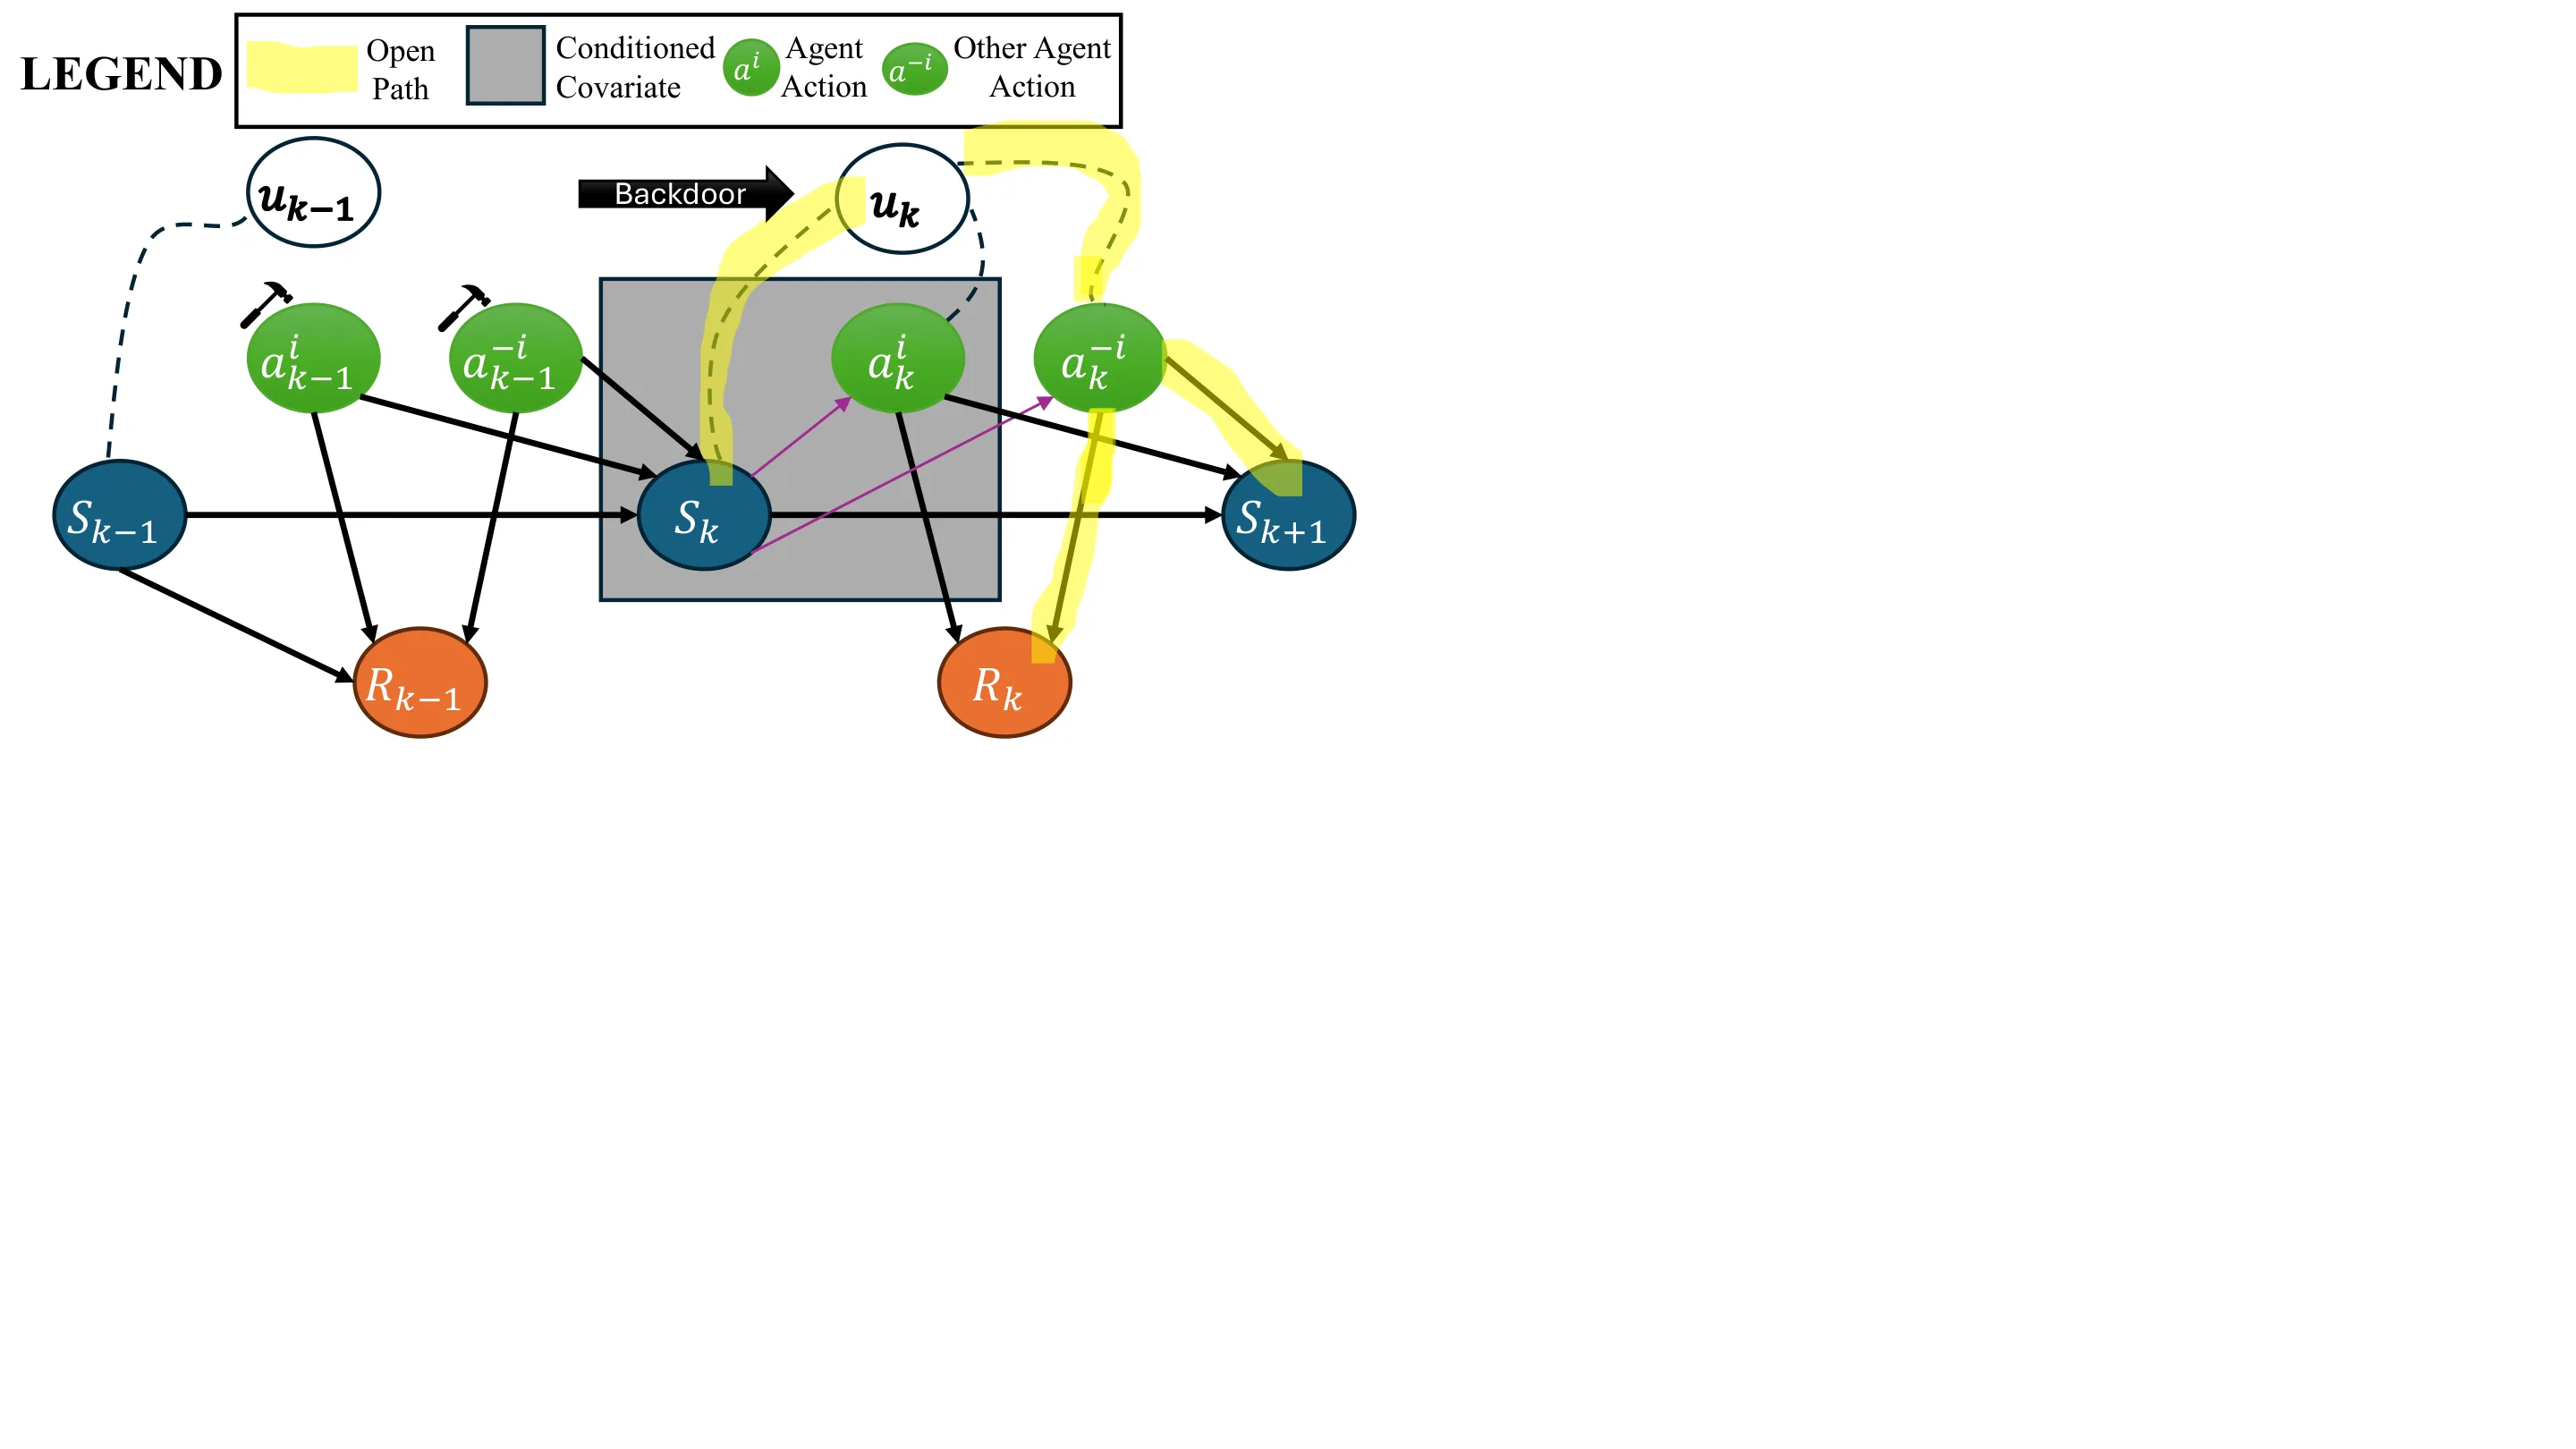
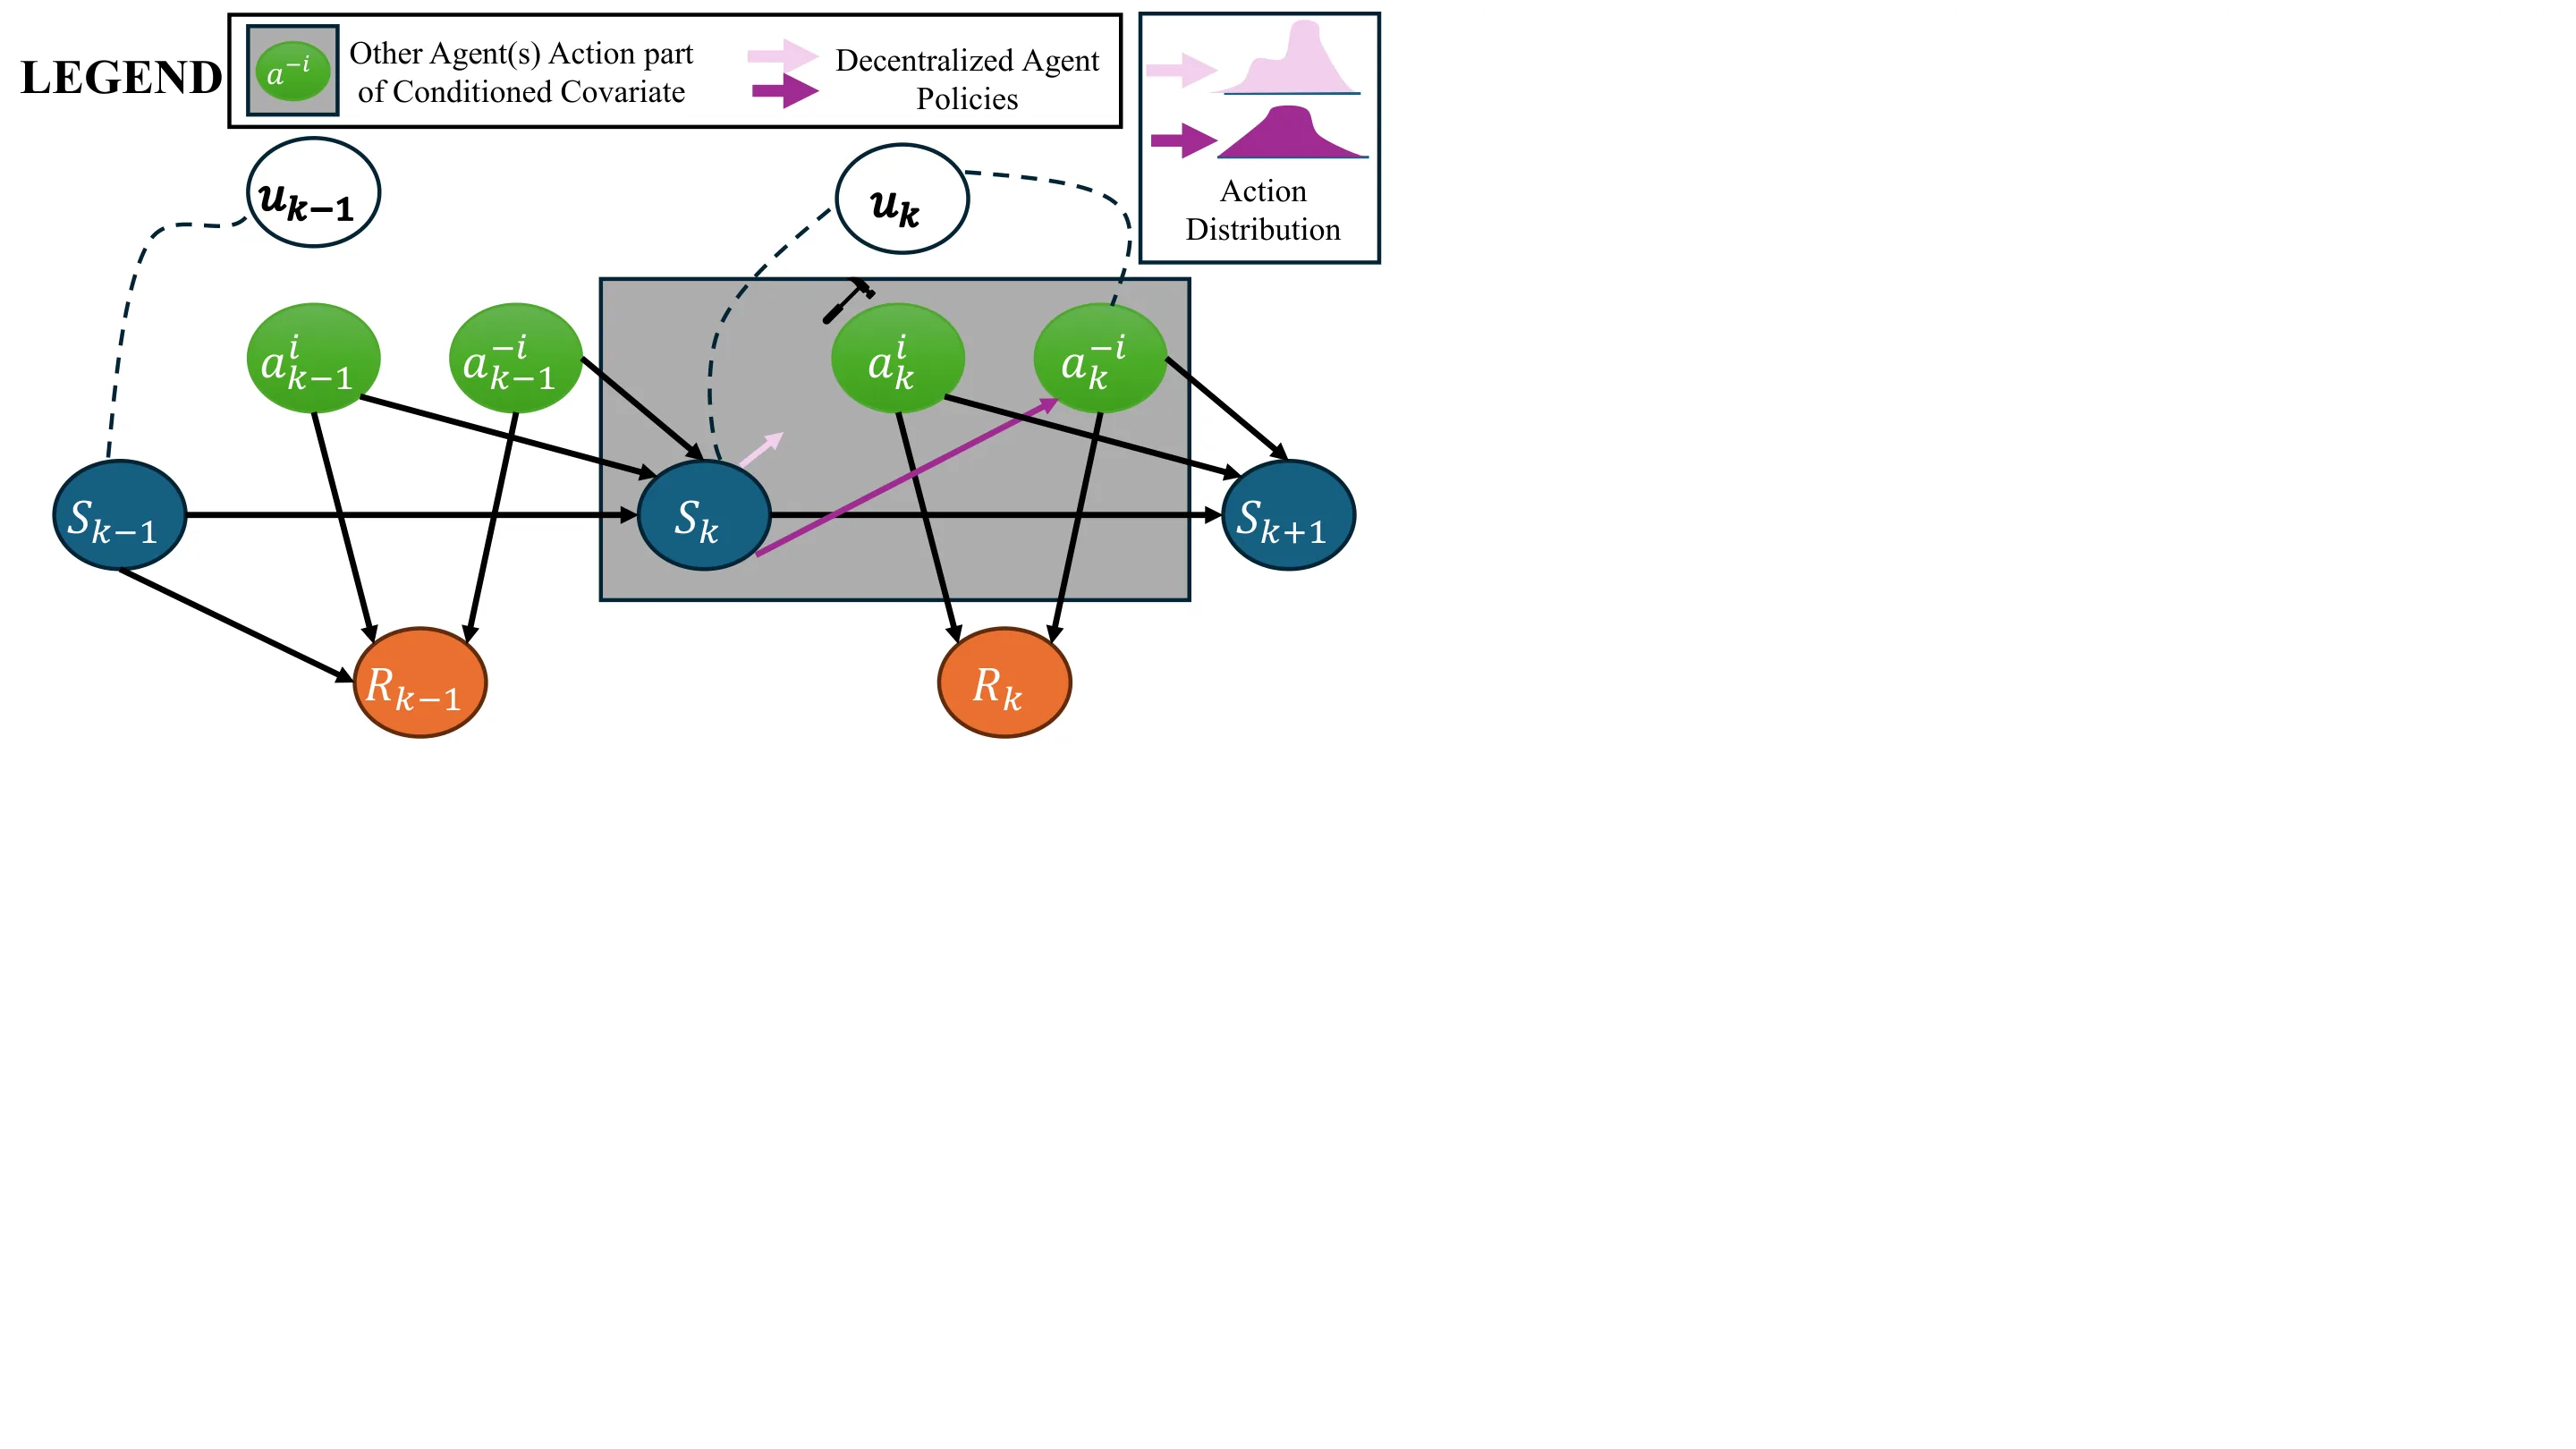
为什么策略方差能够帮助发现因果关系?论文借助了后门准则的思路。在因果图结构中,如果我们要判断变量 是否真正导致 ,而非被某个混杂因素 共同驱动,就需要"关闭"所有从 到 的后门路径。传统方法需要显式知道哪些变量构成后门调整集,而论文证明:使用足够长的历史上下文 作为条件,可以满足序贯后门条件,使得无需预定义因果图也能进行因果推断。此时有:
这意味着在历史上下文的调节下,我们可以用普通的条件概率来计算 do-算子对应的因果效应。
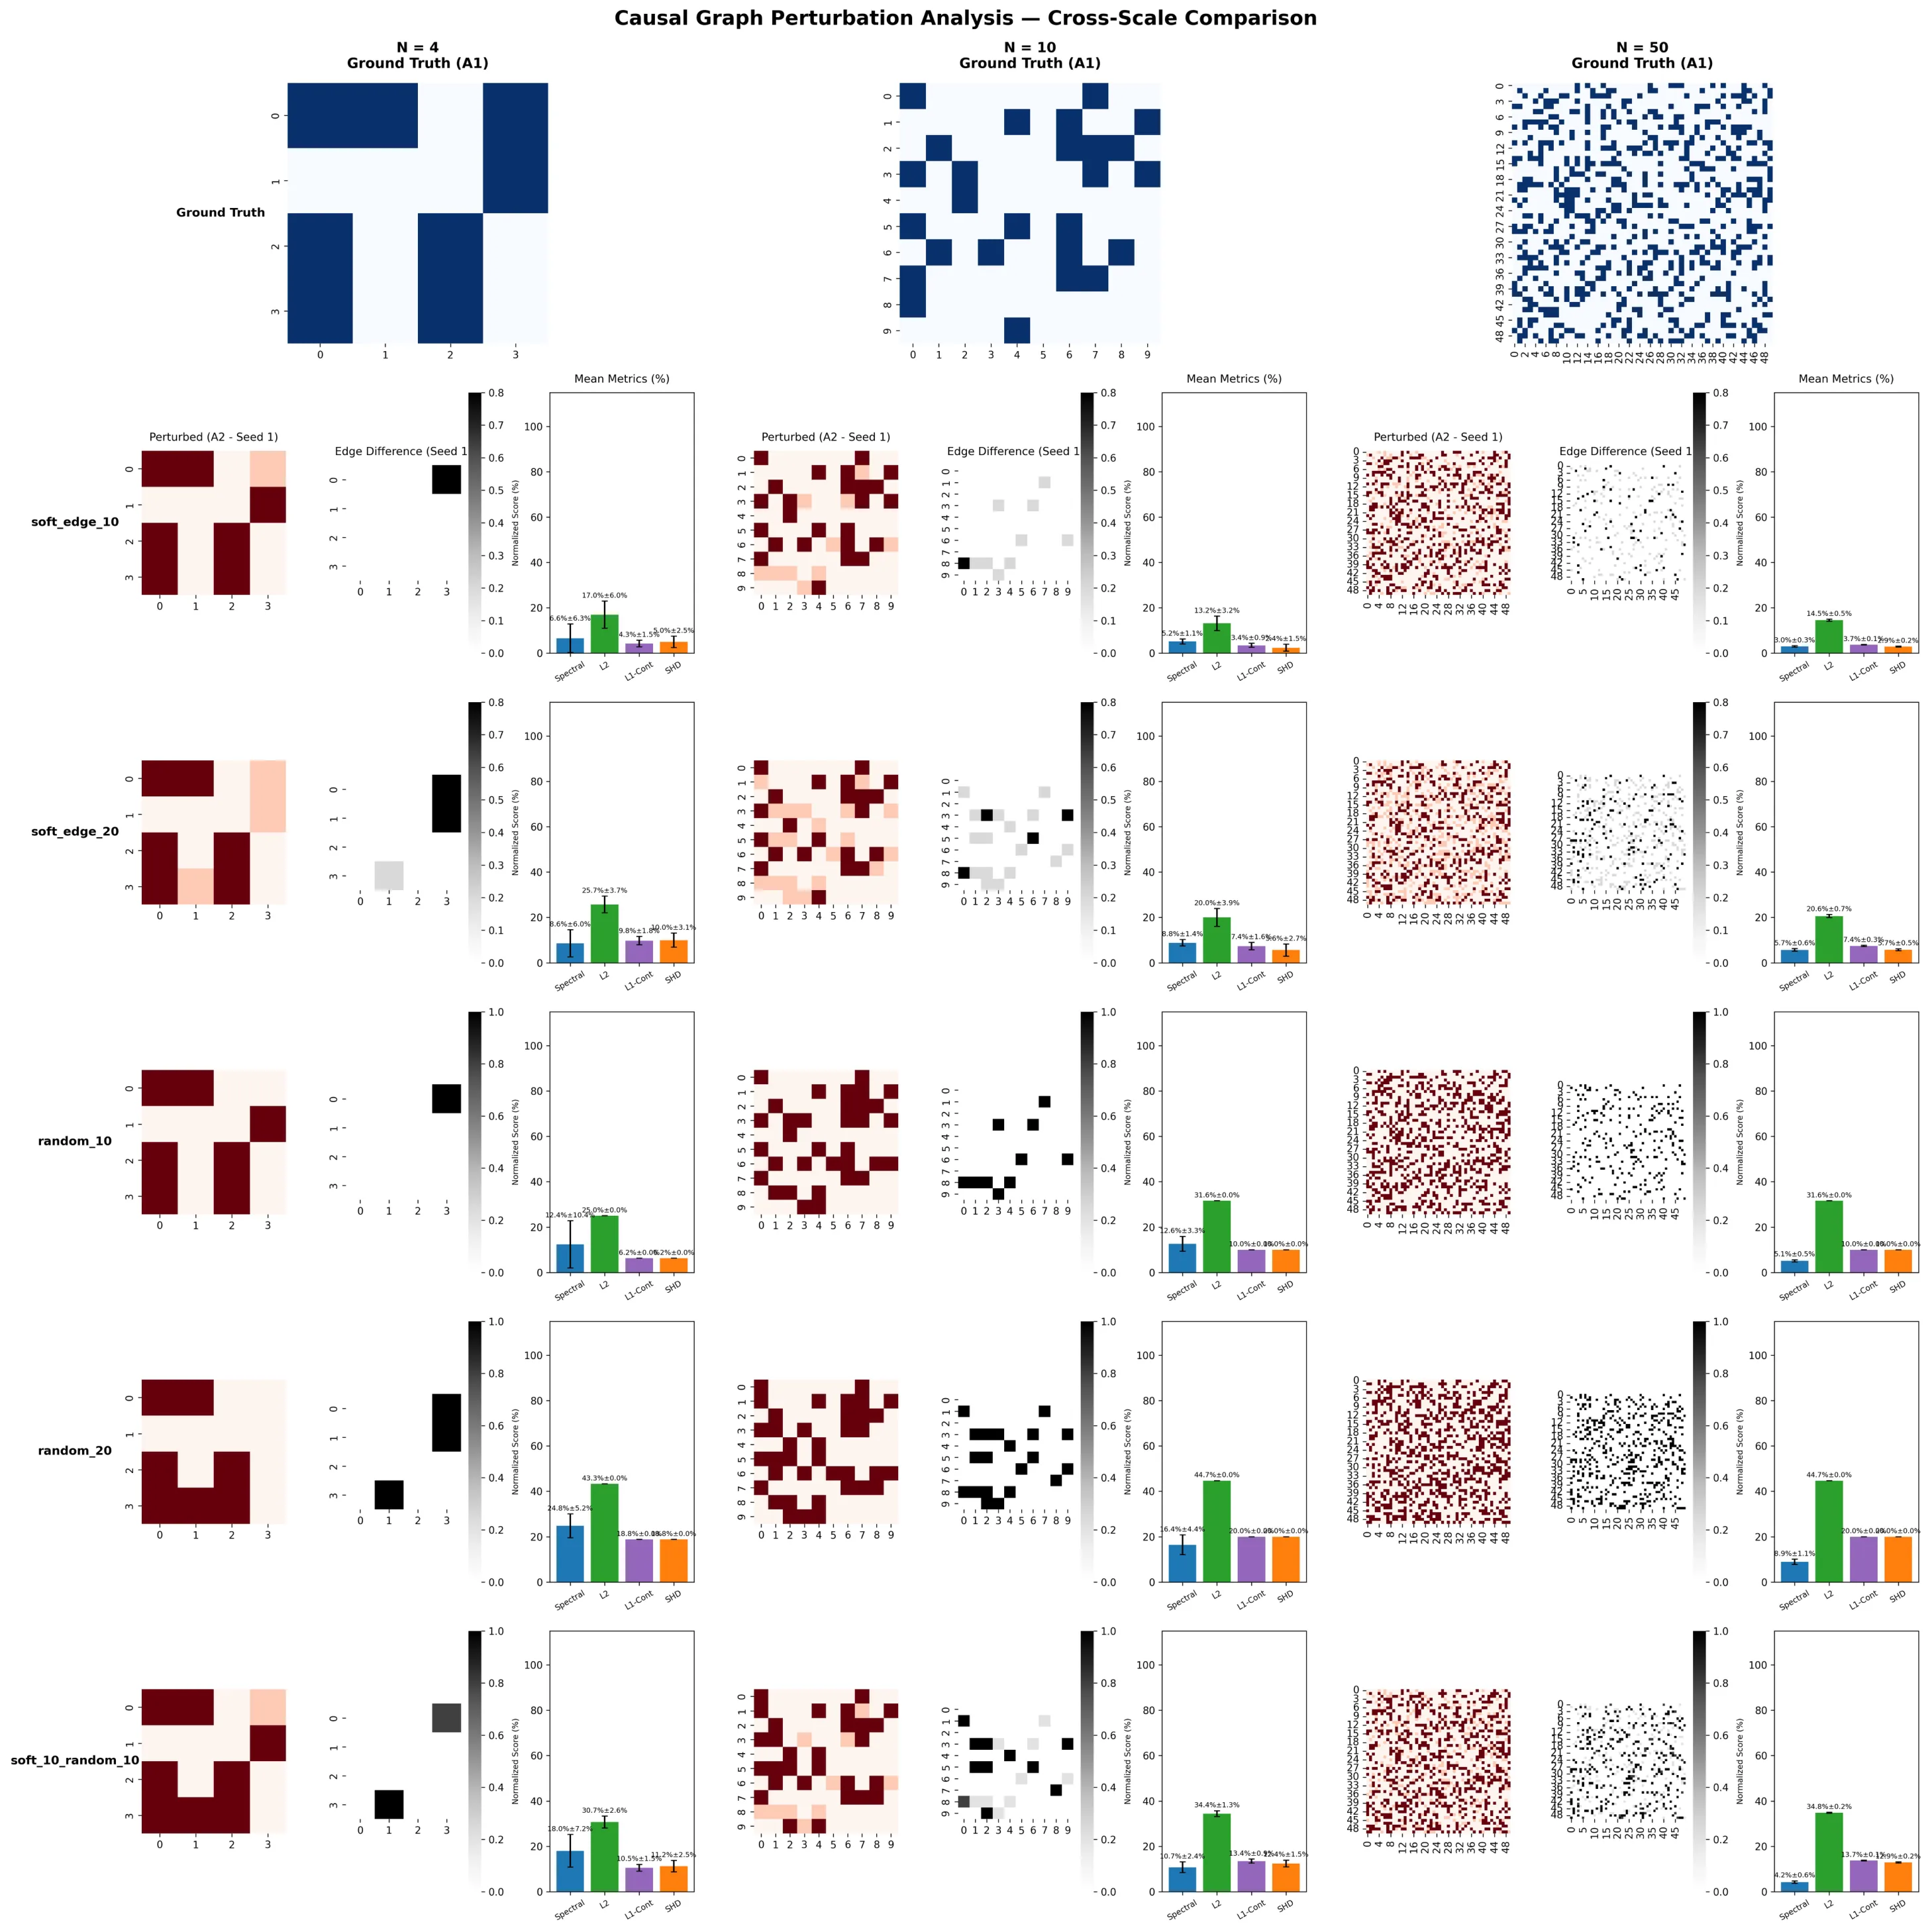
在因果骨架提取阶段,模型学习一个邻接矩阵 表示变量间的因果关系强度。通过一个门控函数筛选显著的因果边:
当 时(即 ),判定存在显著因果依赖。
整个世界模型采用编码器-解码器架构实现。编码器接收历史上下文,产生潜在表示的参数分布,通过重参数化采样得到随机 latent 变量;解码器结合这些 latent 变量和当前动作预测下一时刻状态。最终将专家策略与学到的世界模型融合形成决策策略。
实验与结果
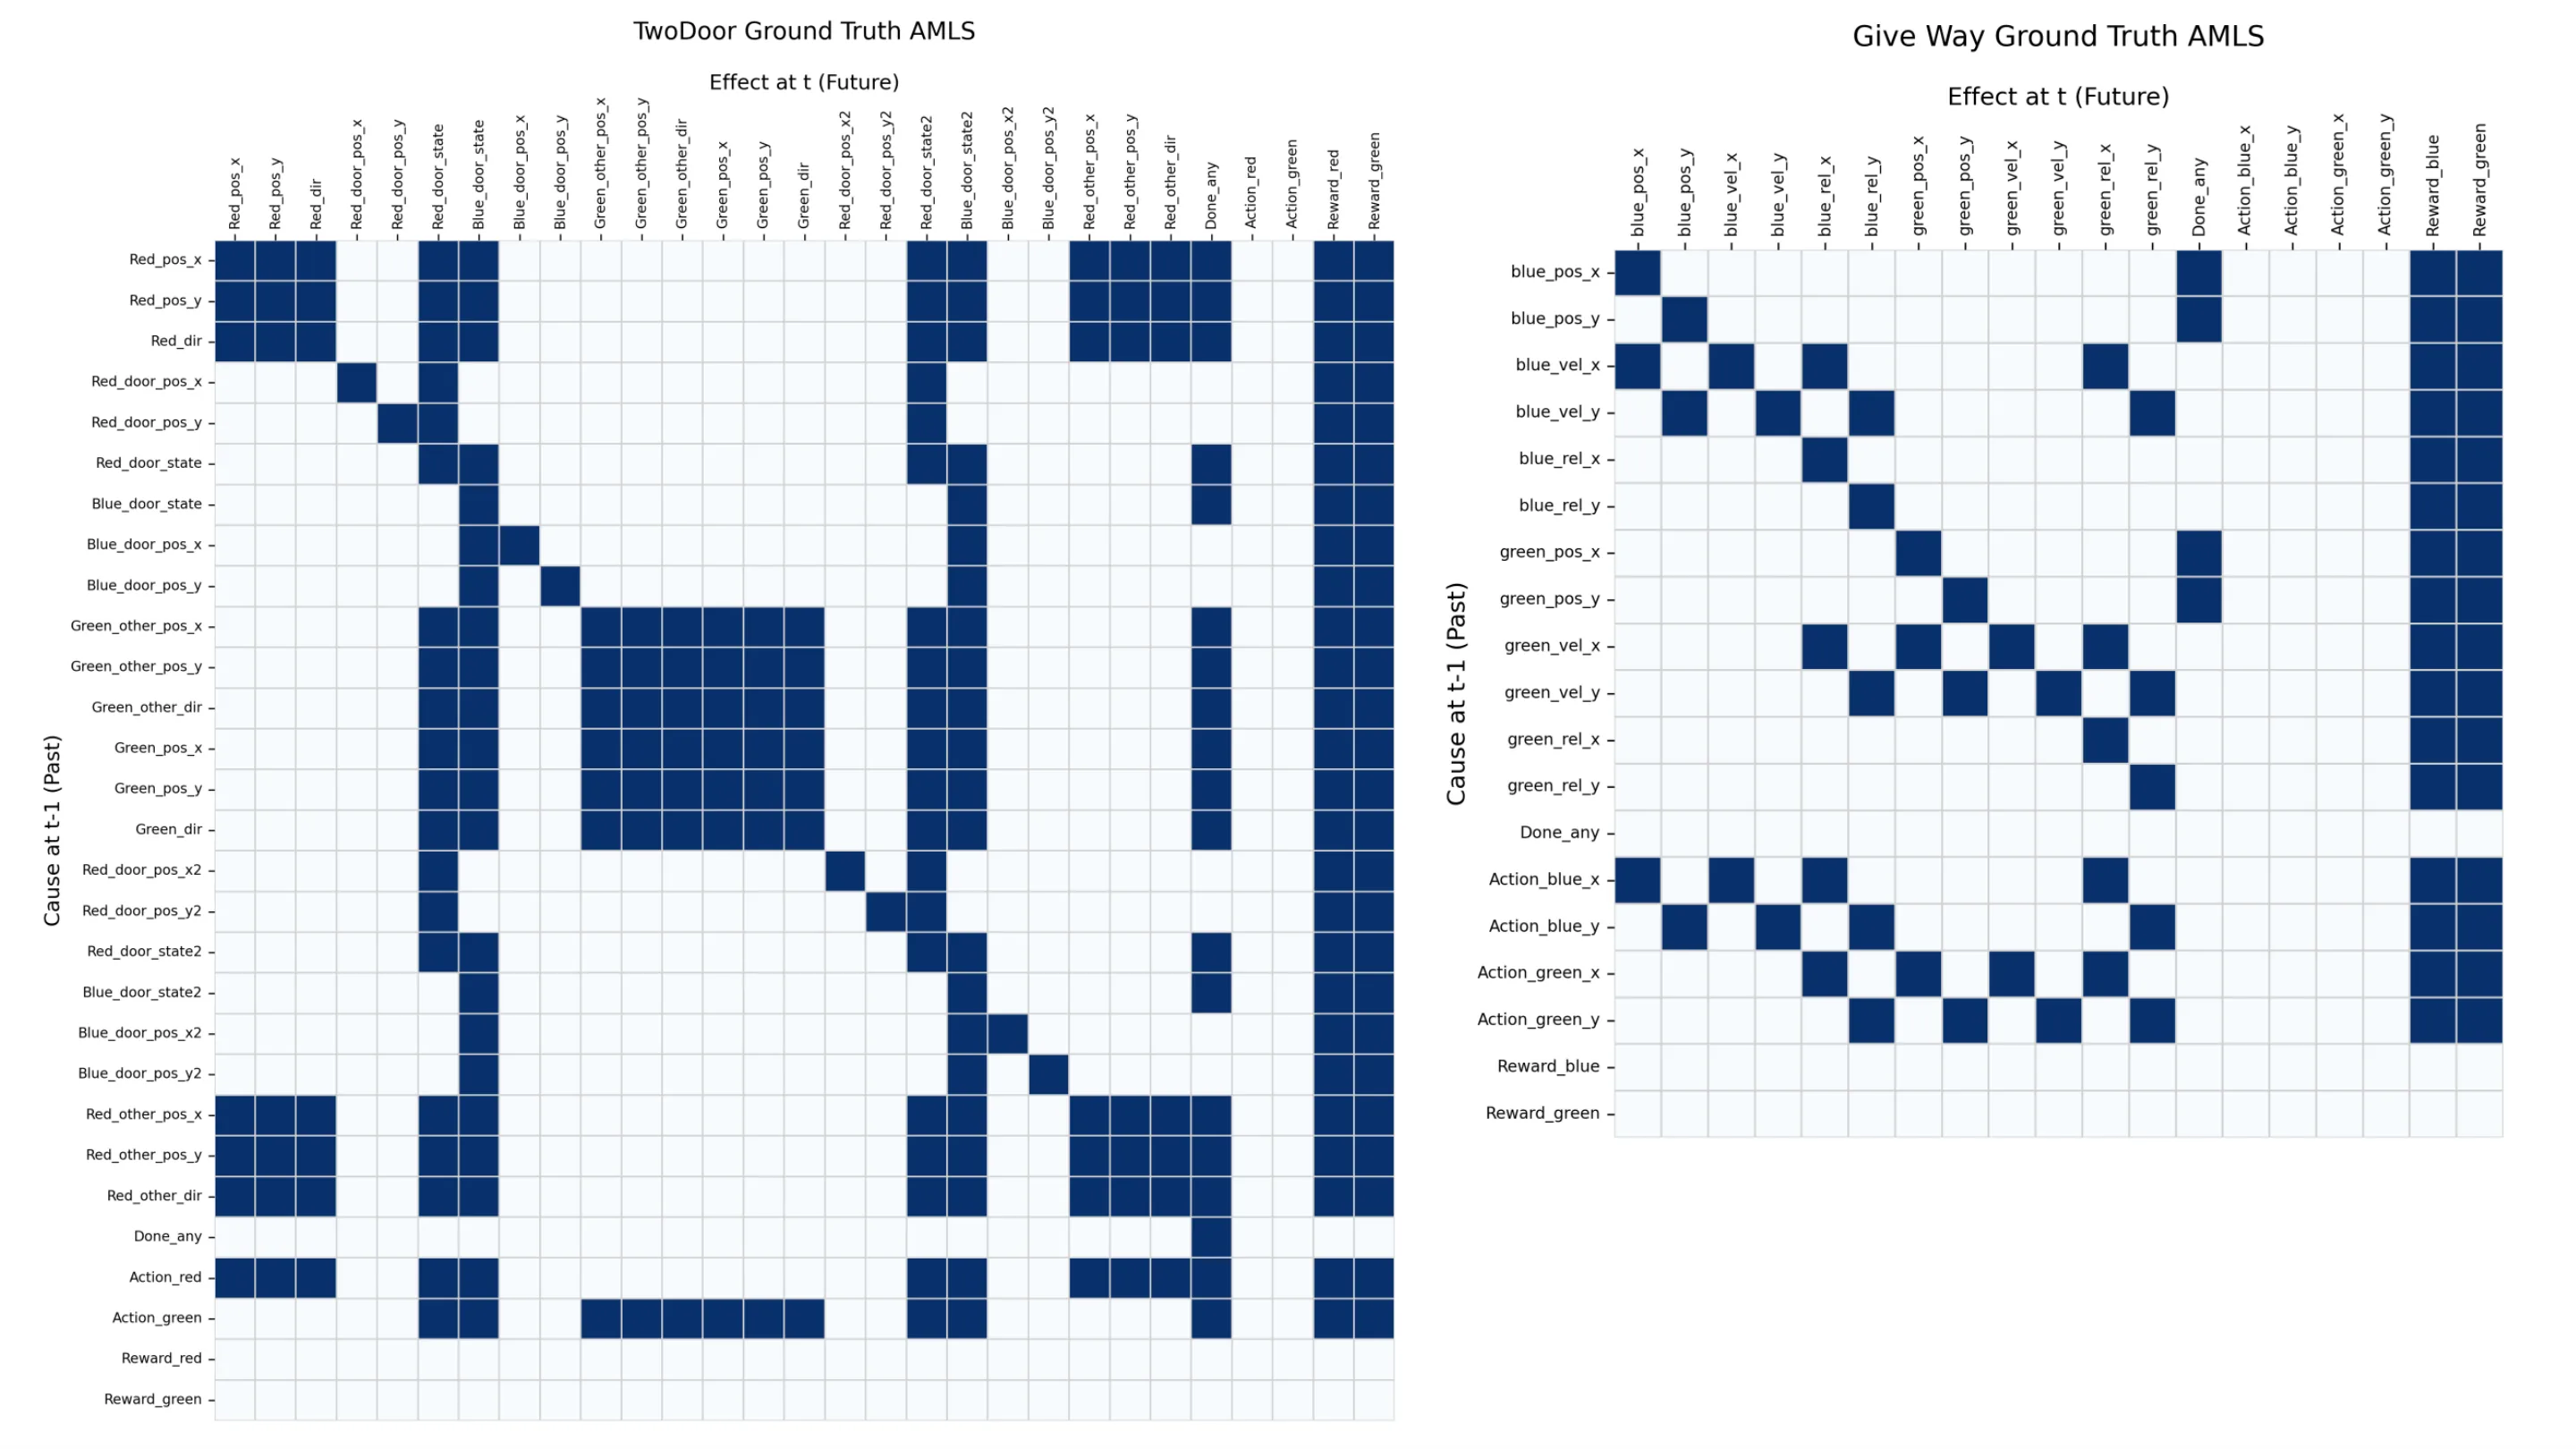
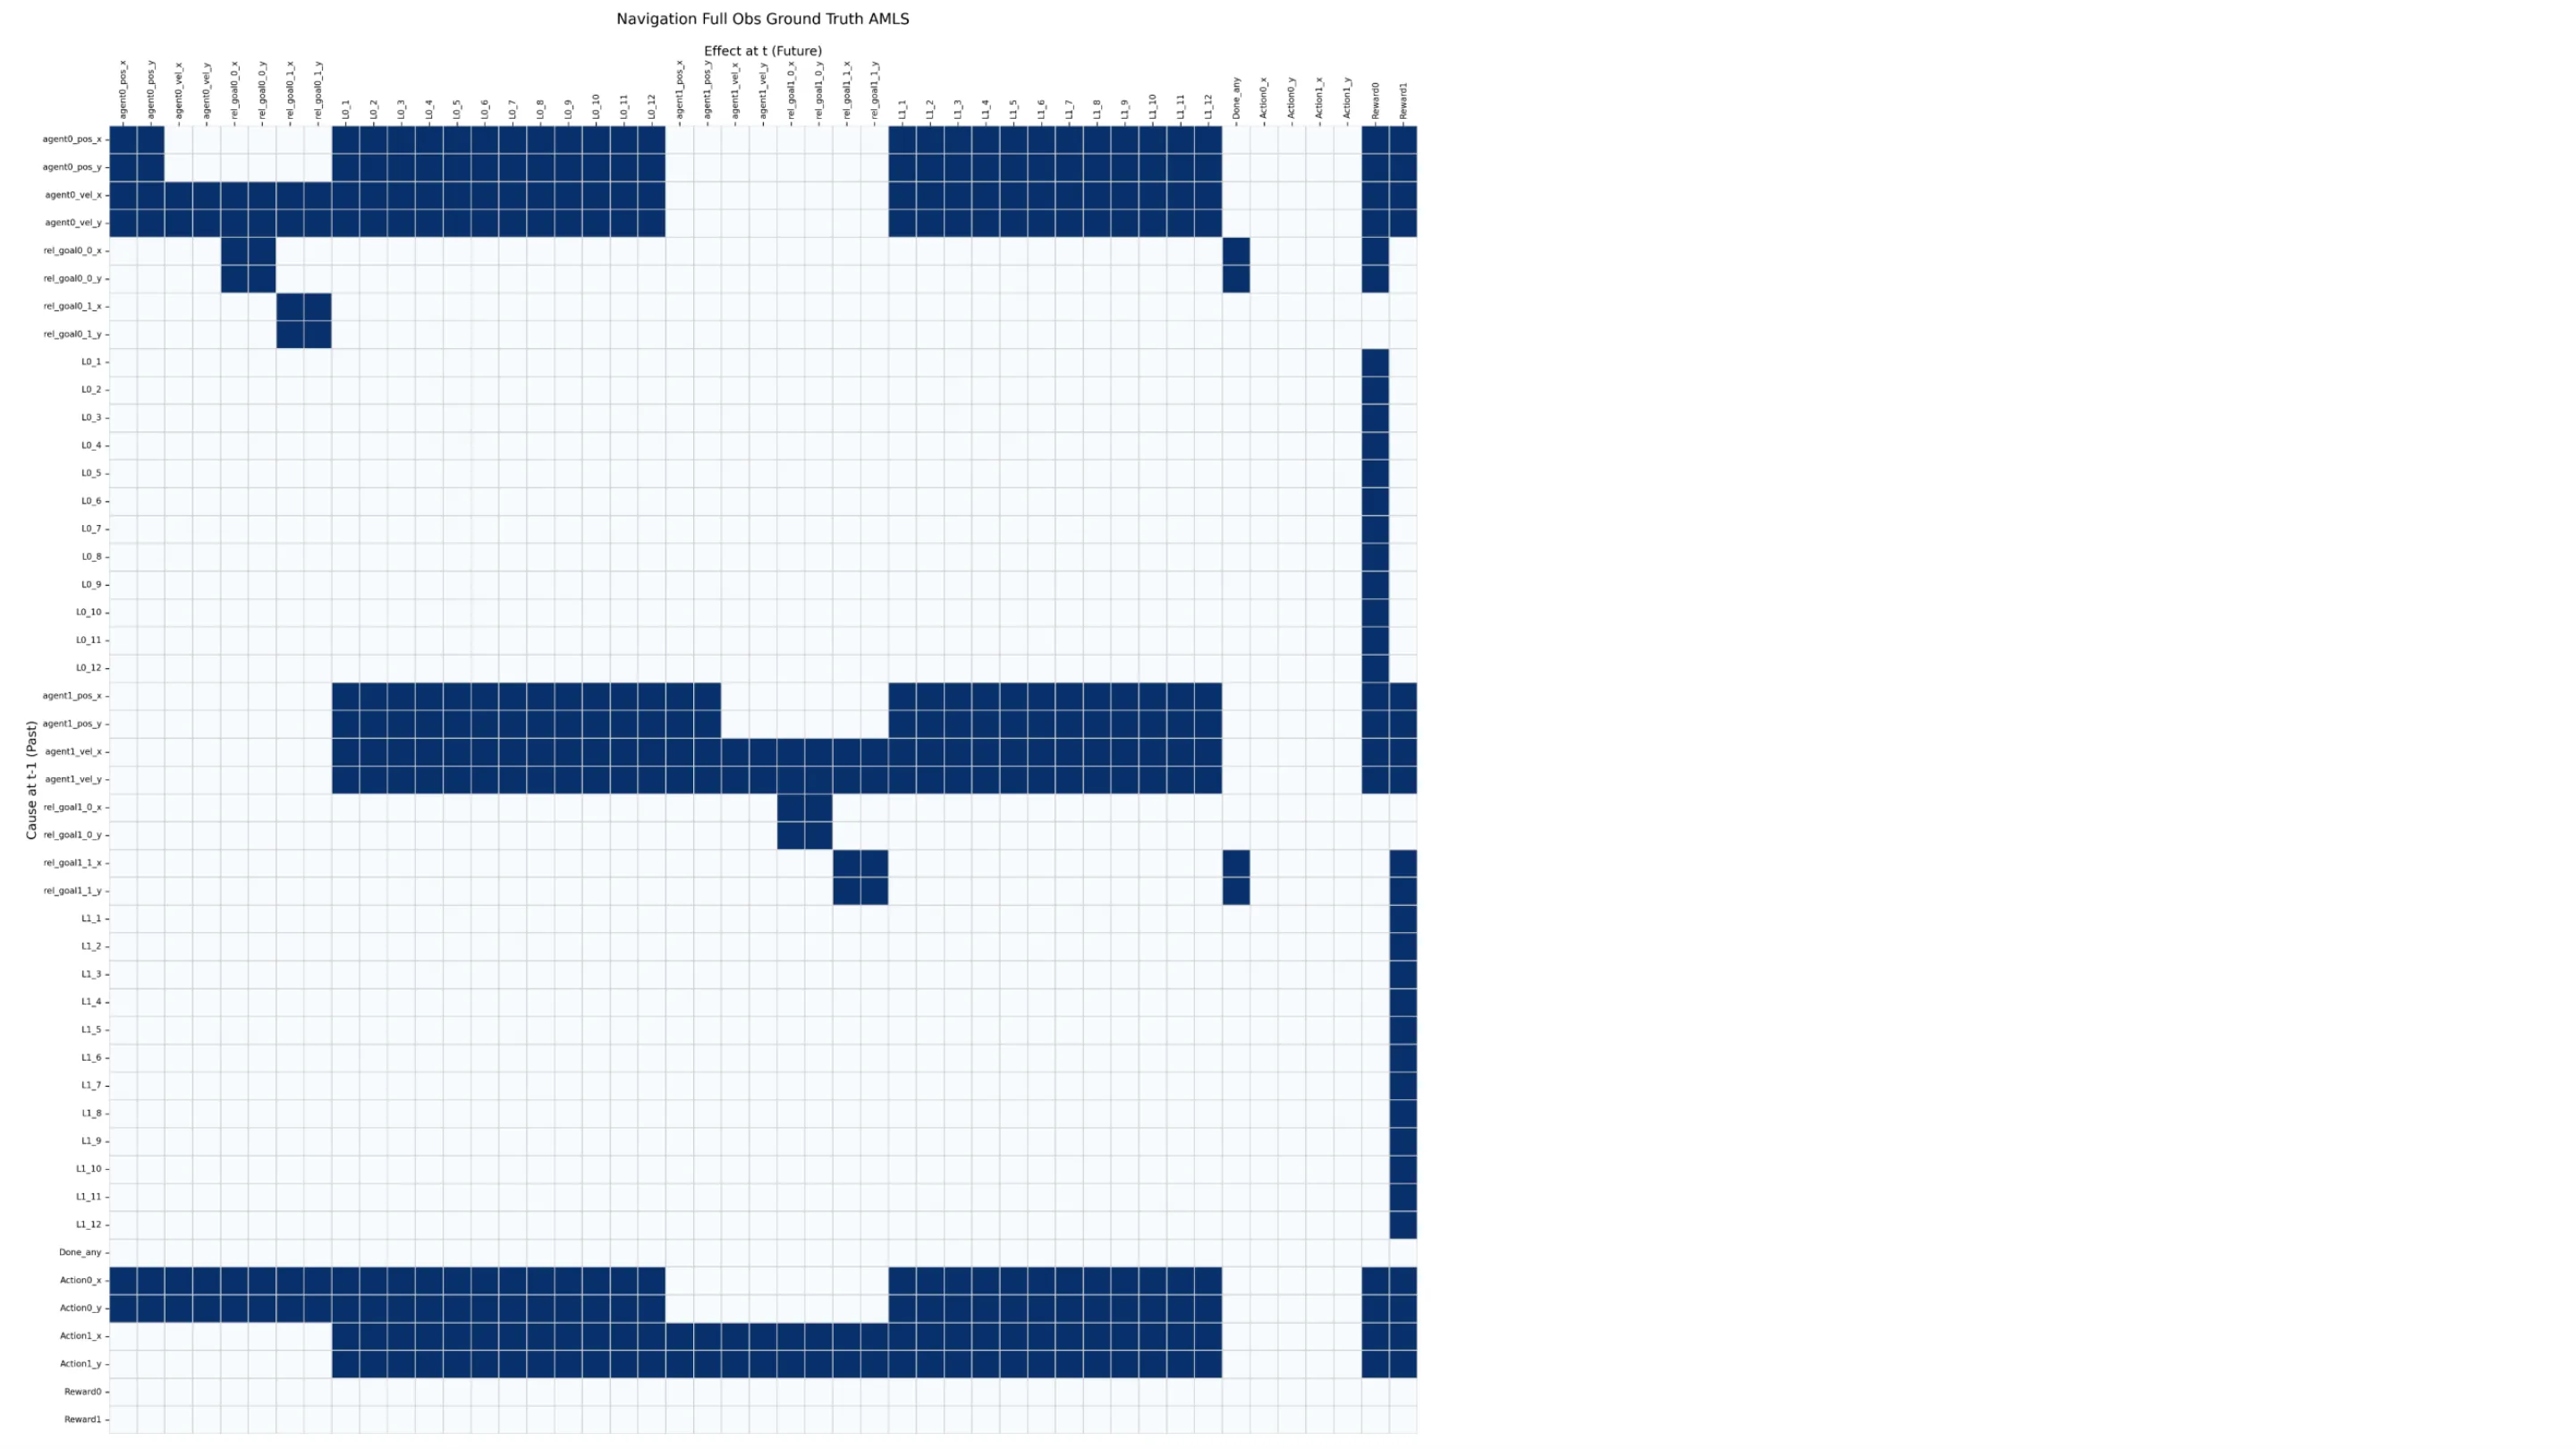
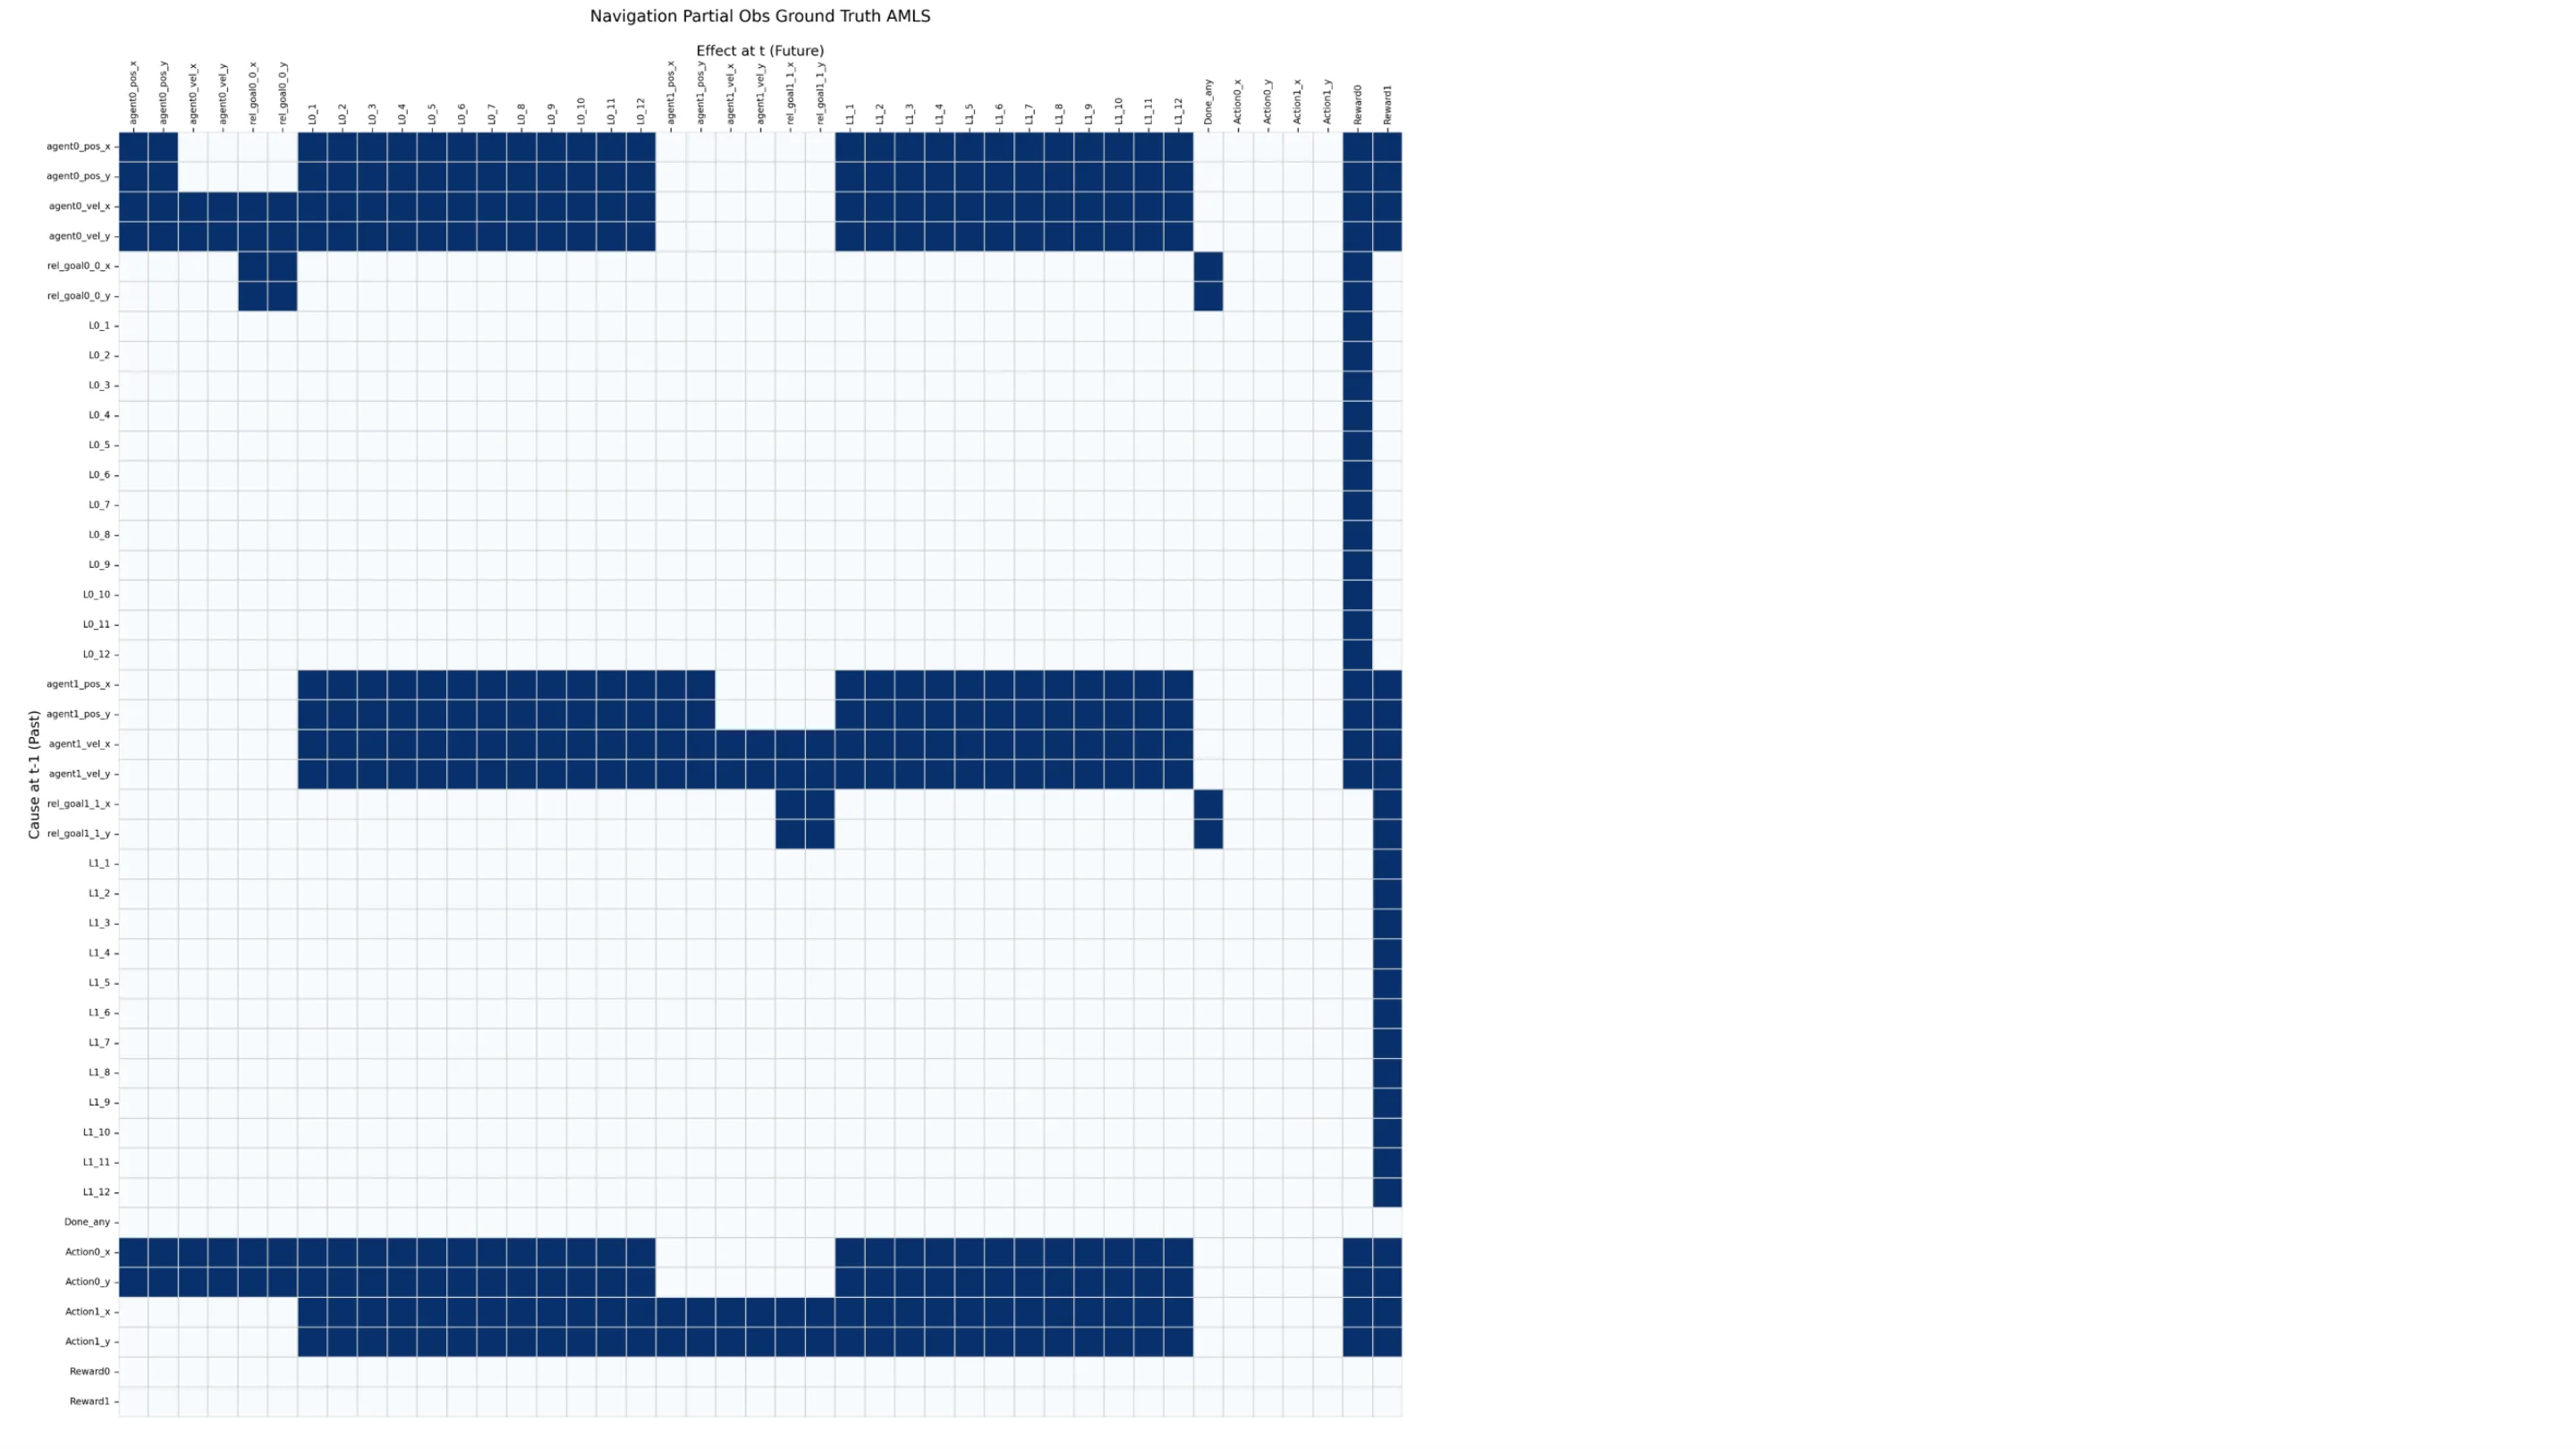
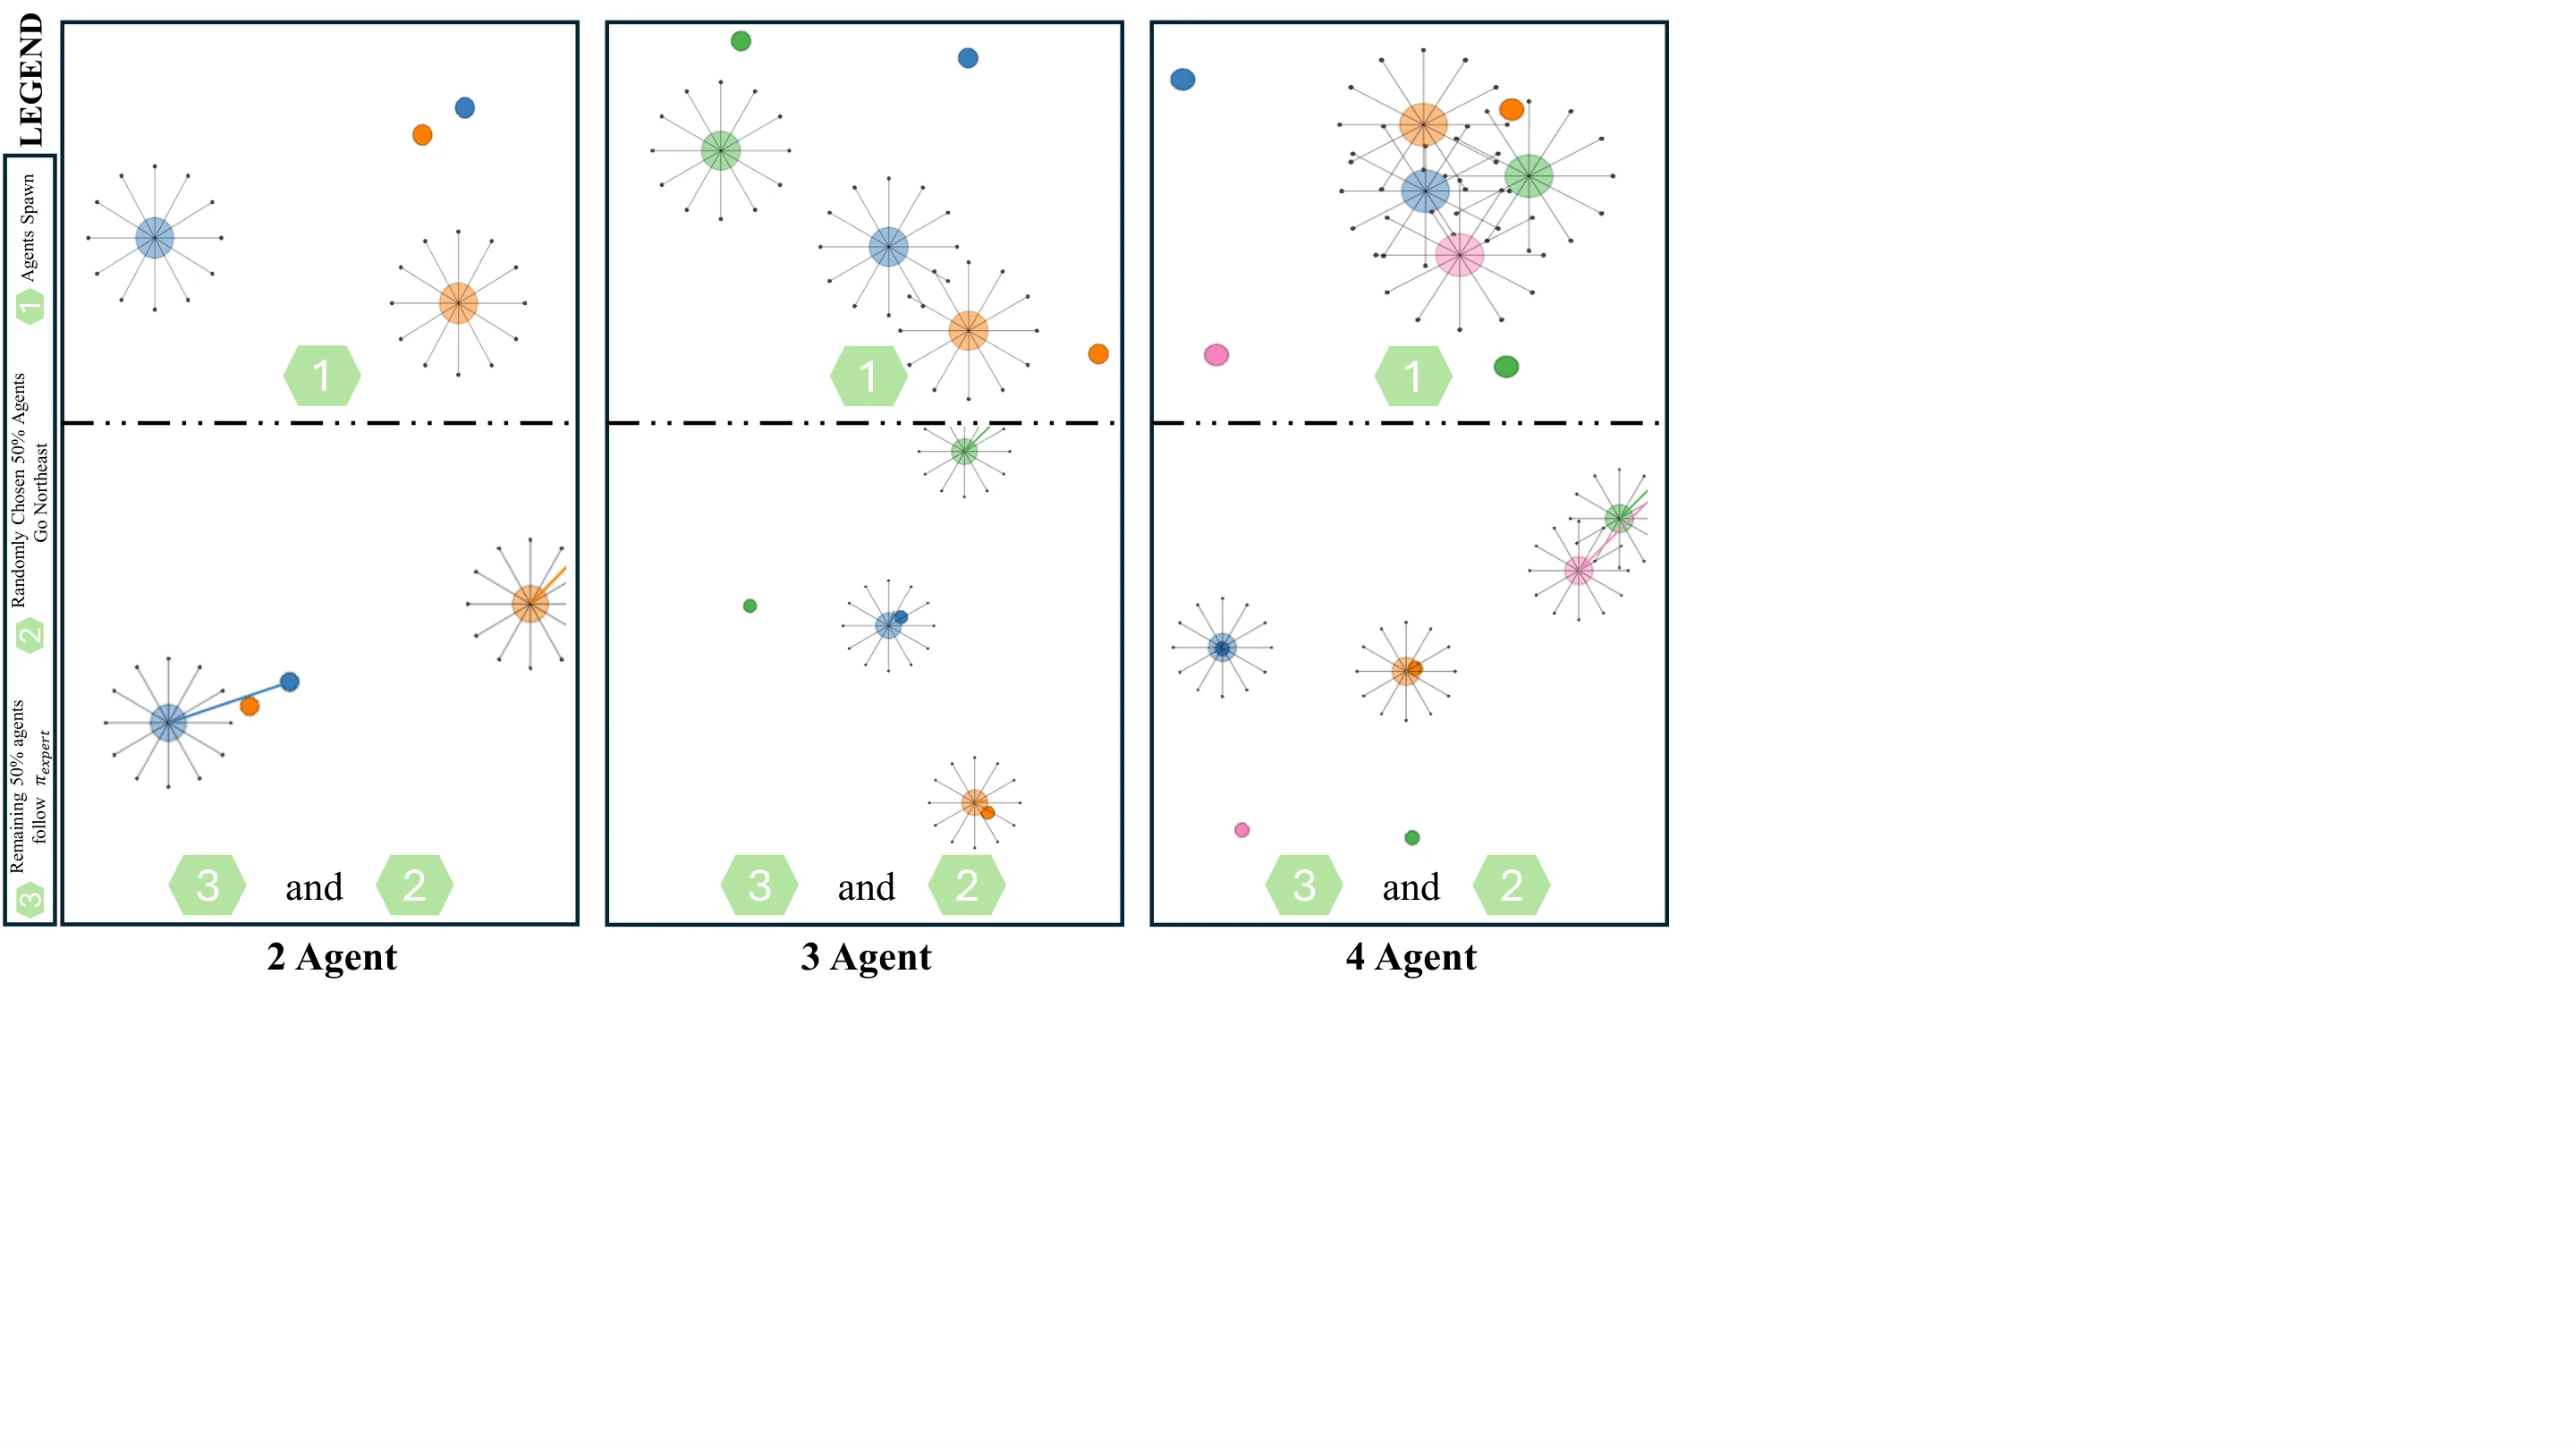
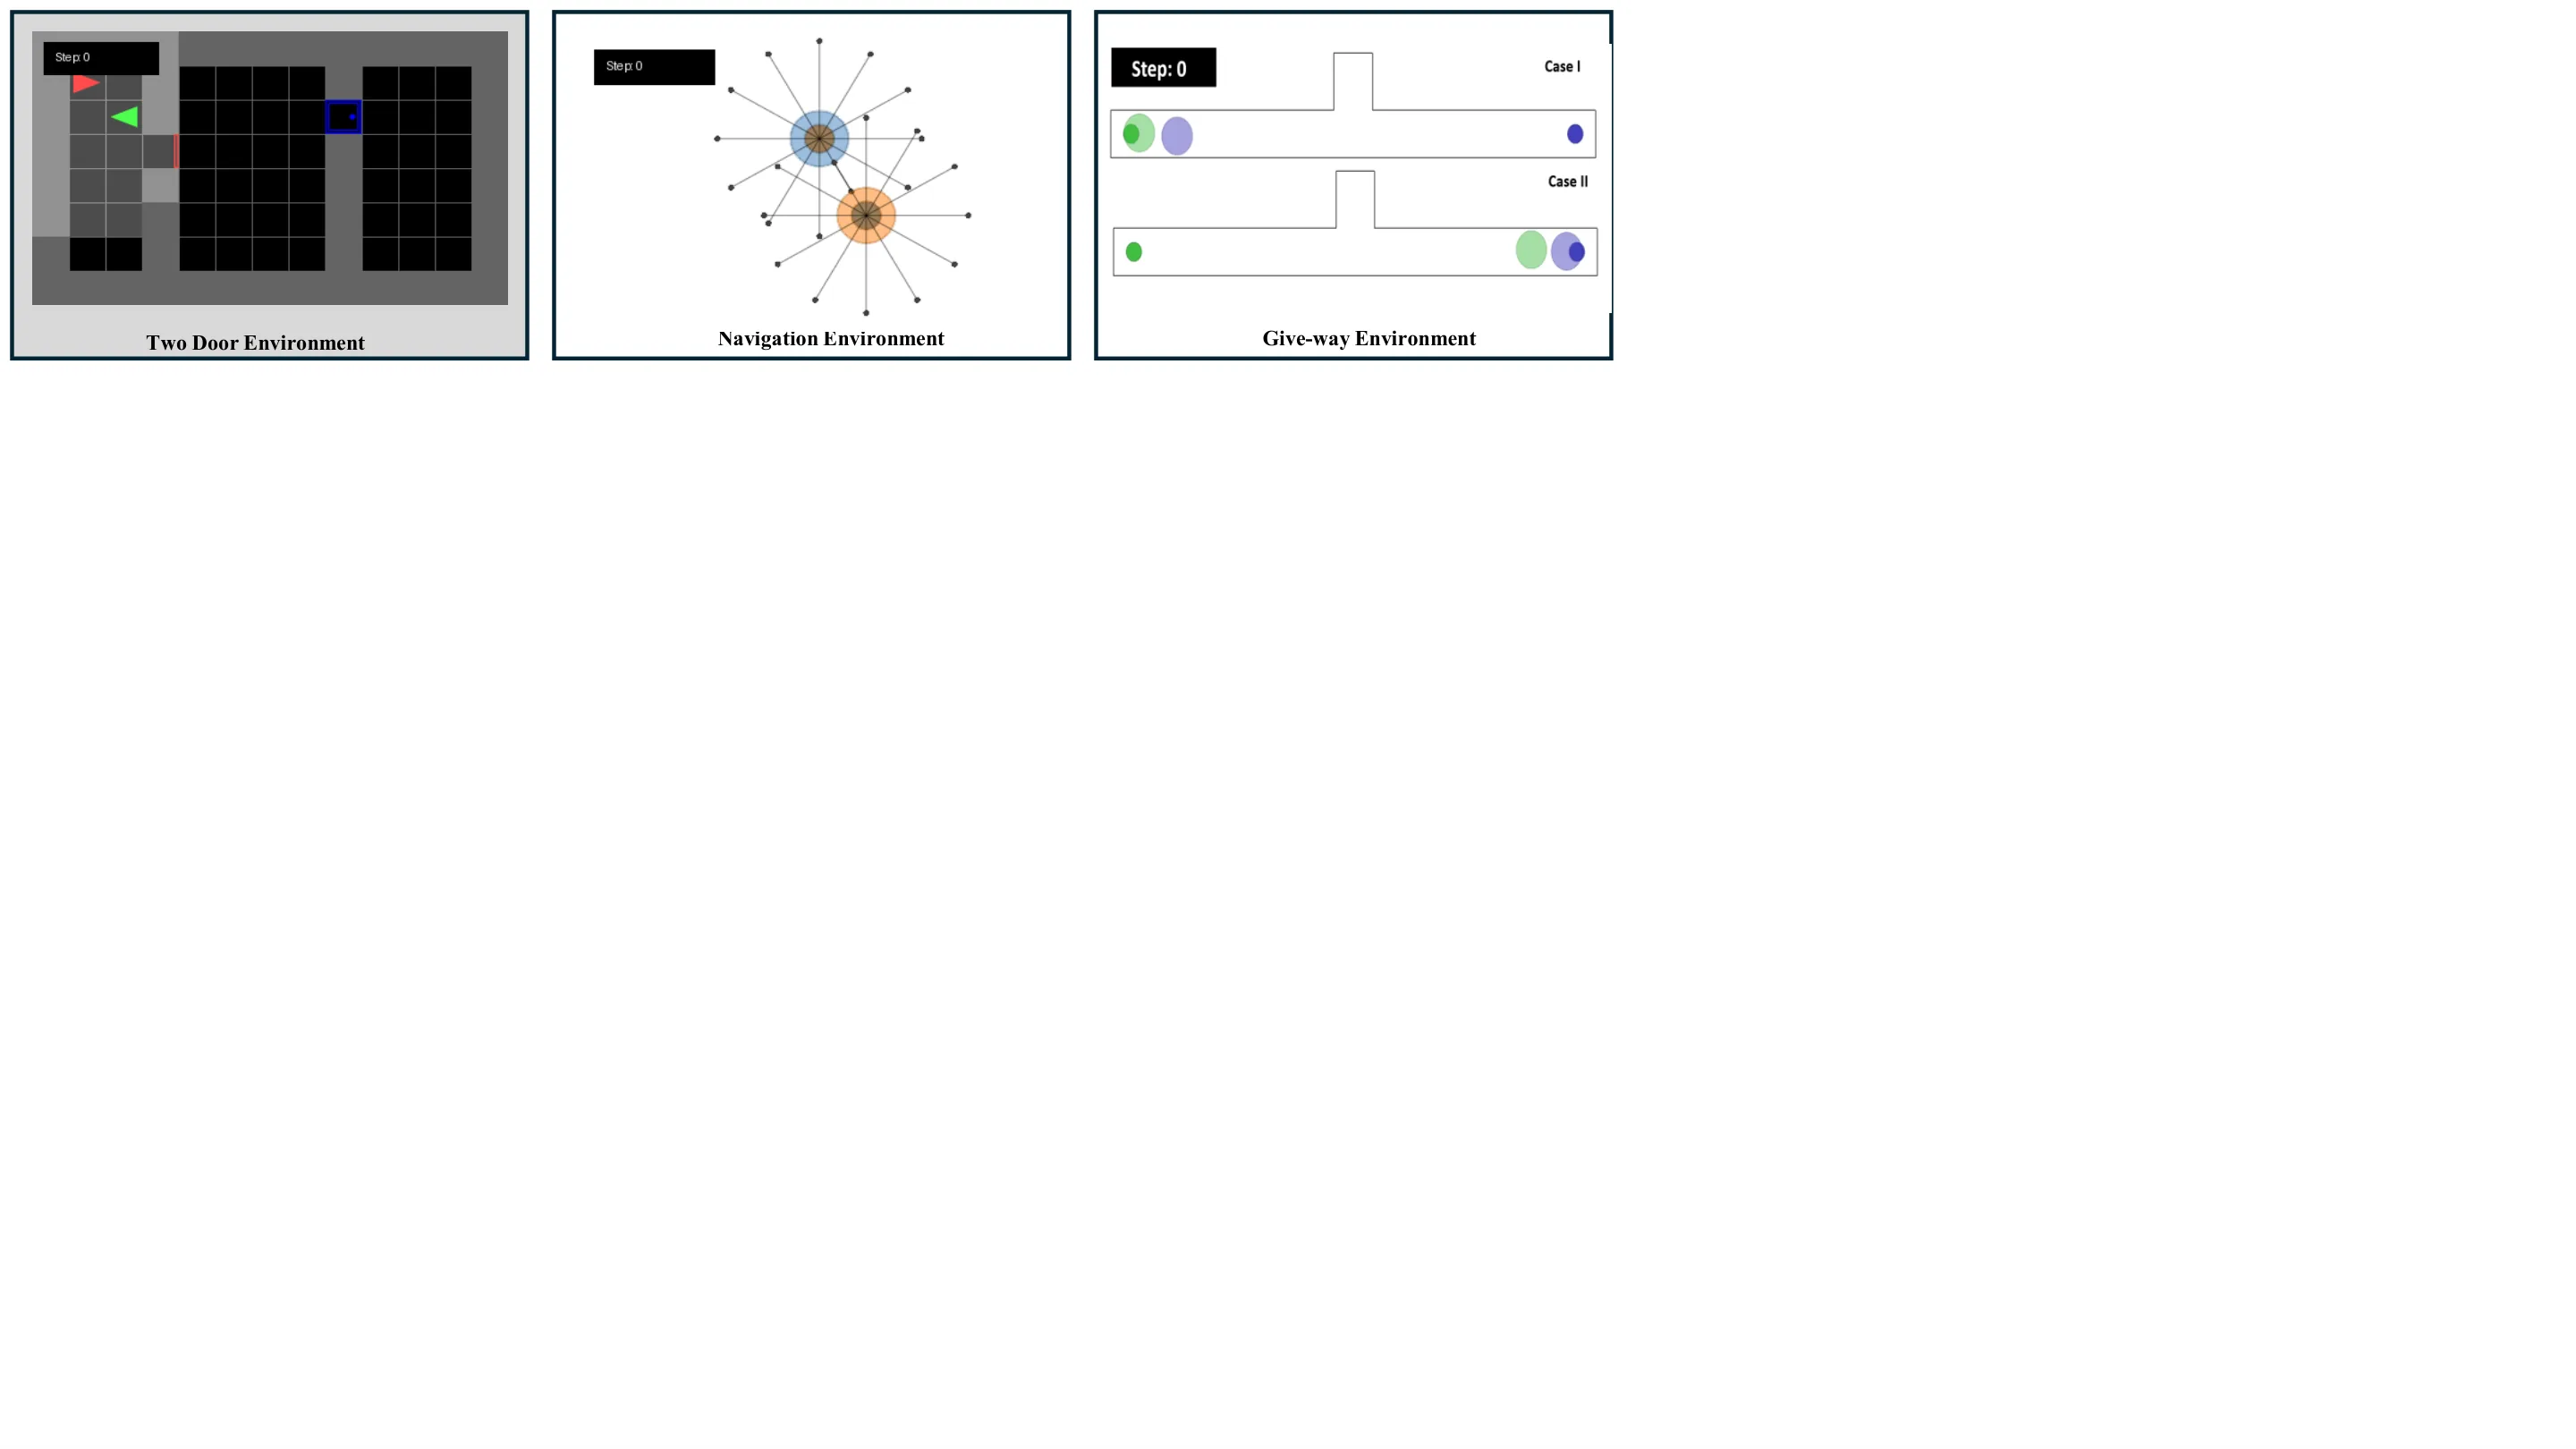
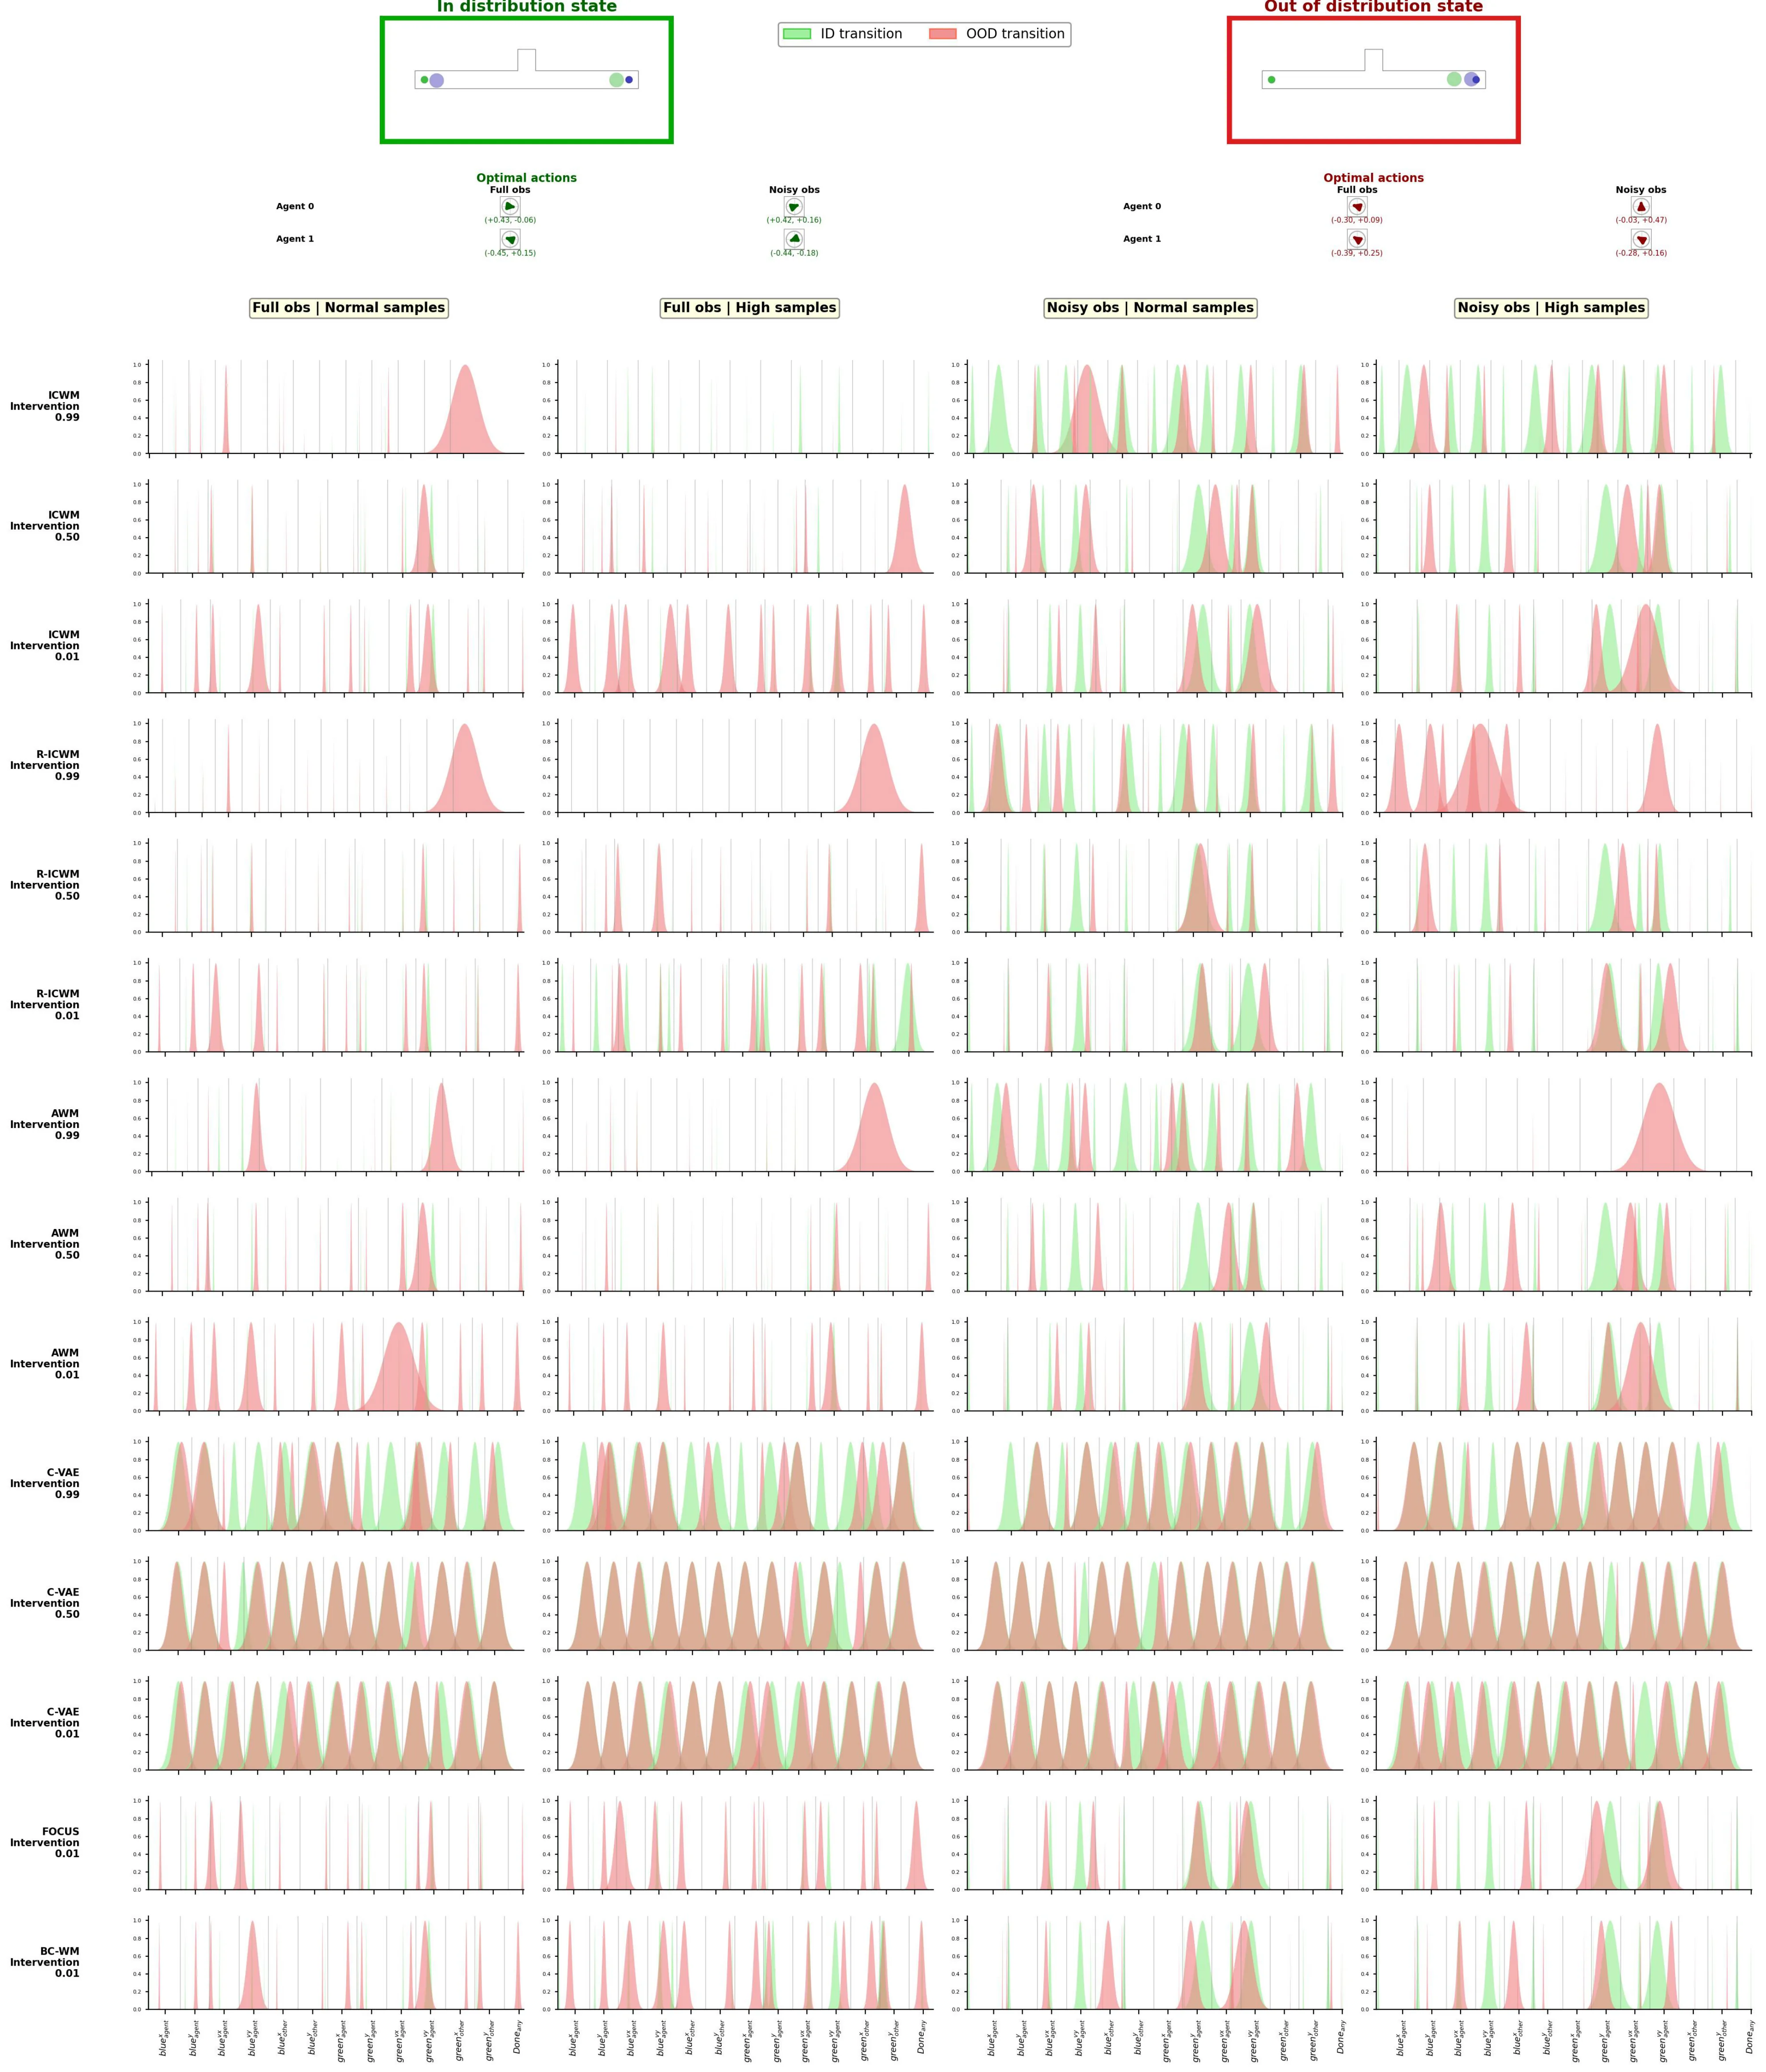
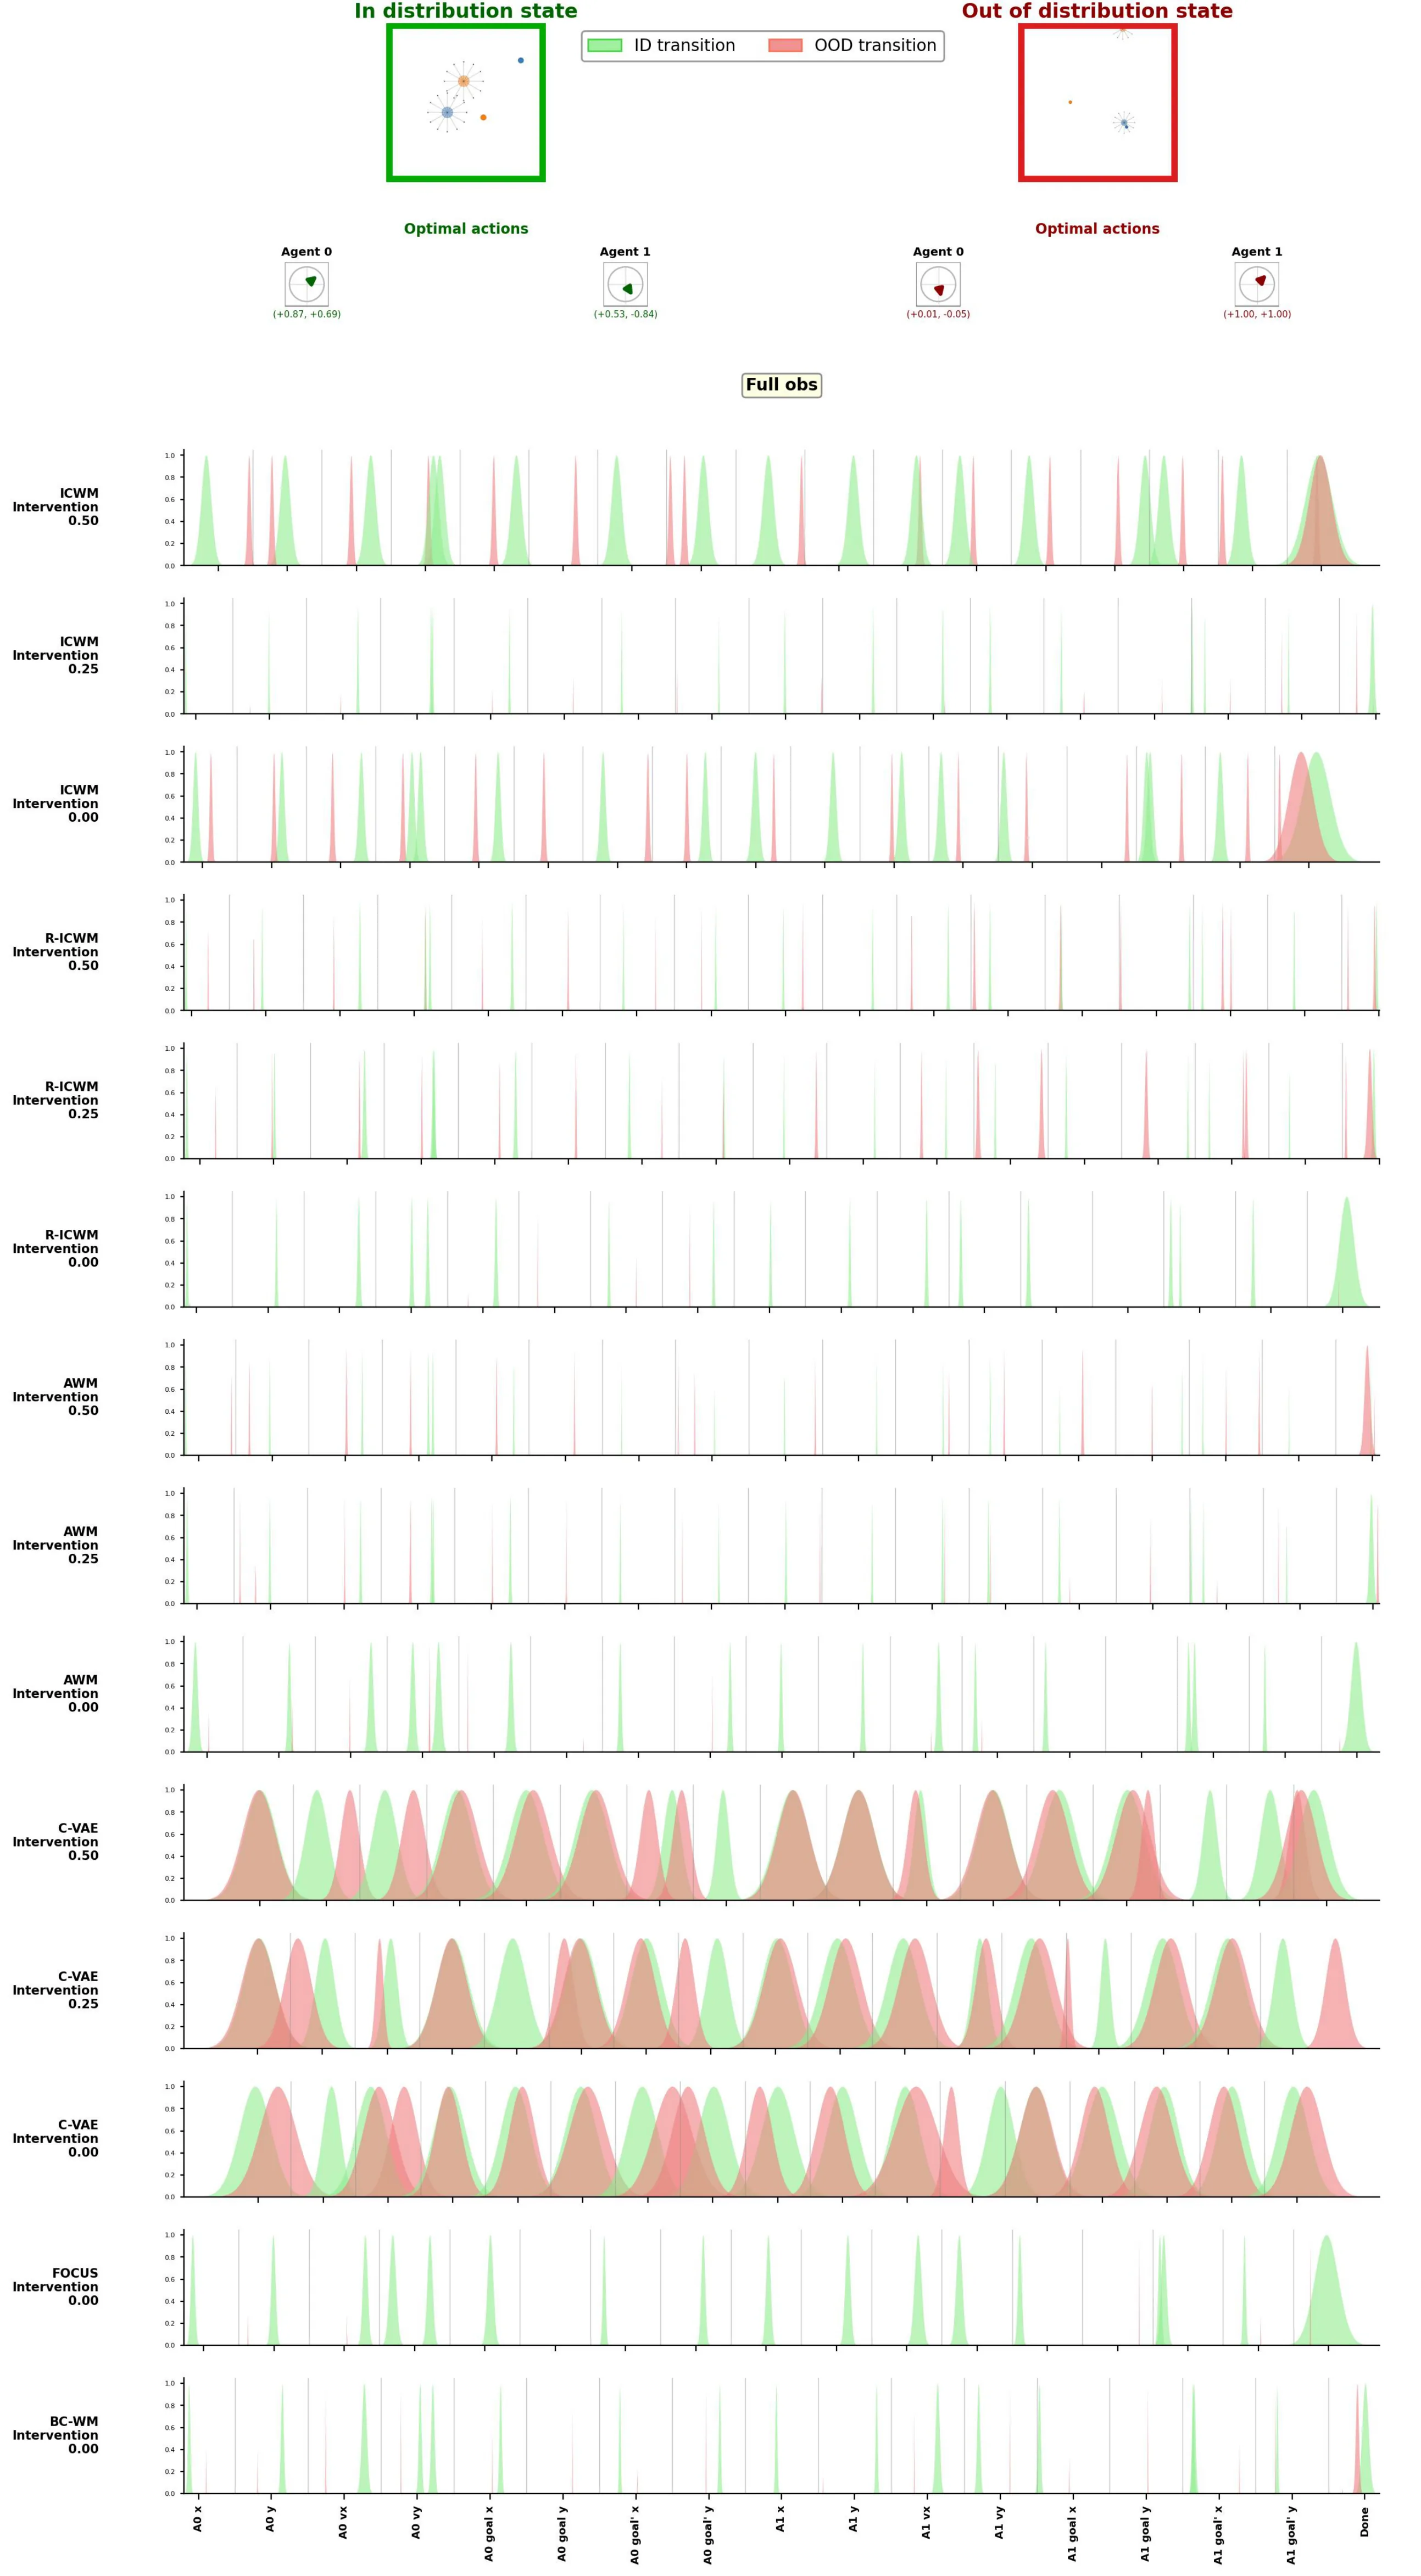
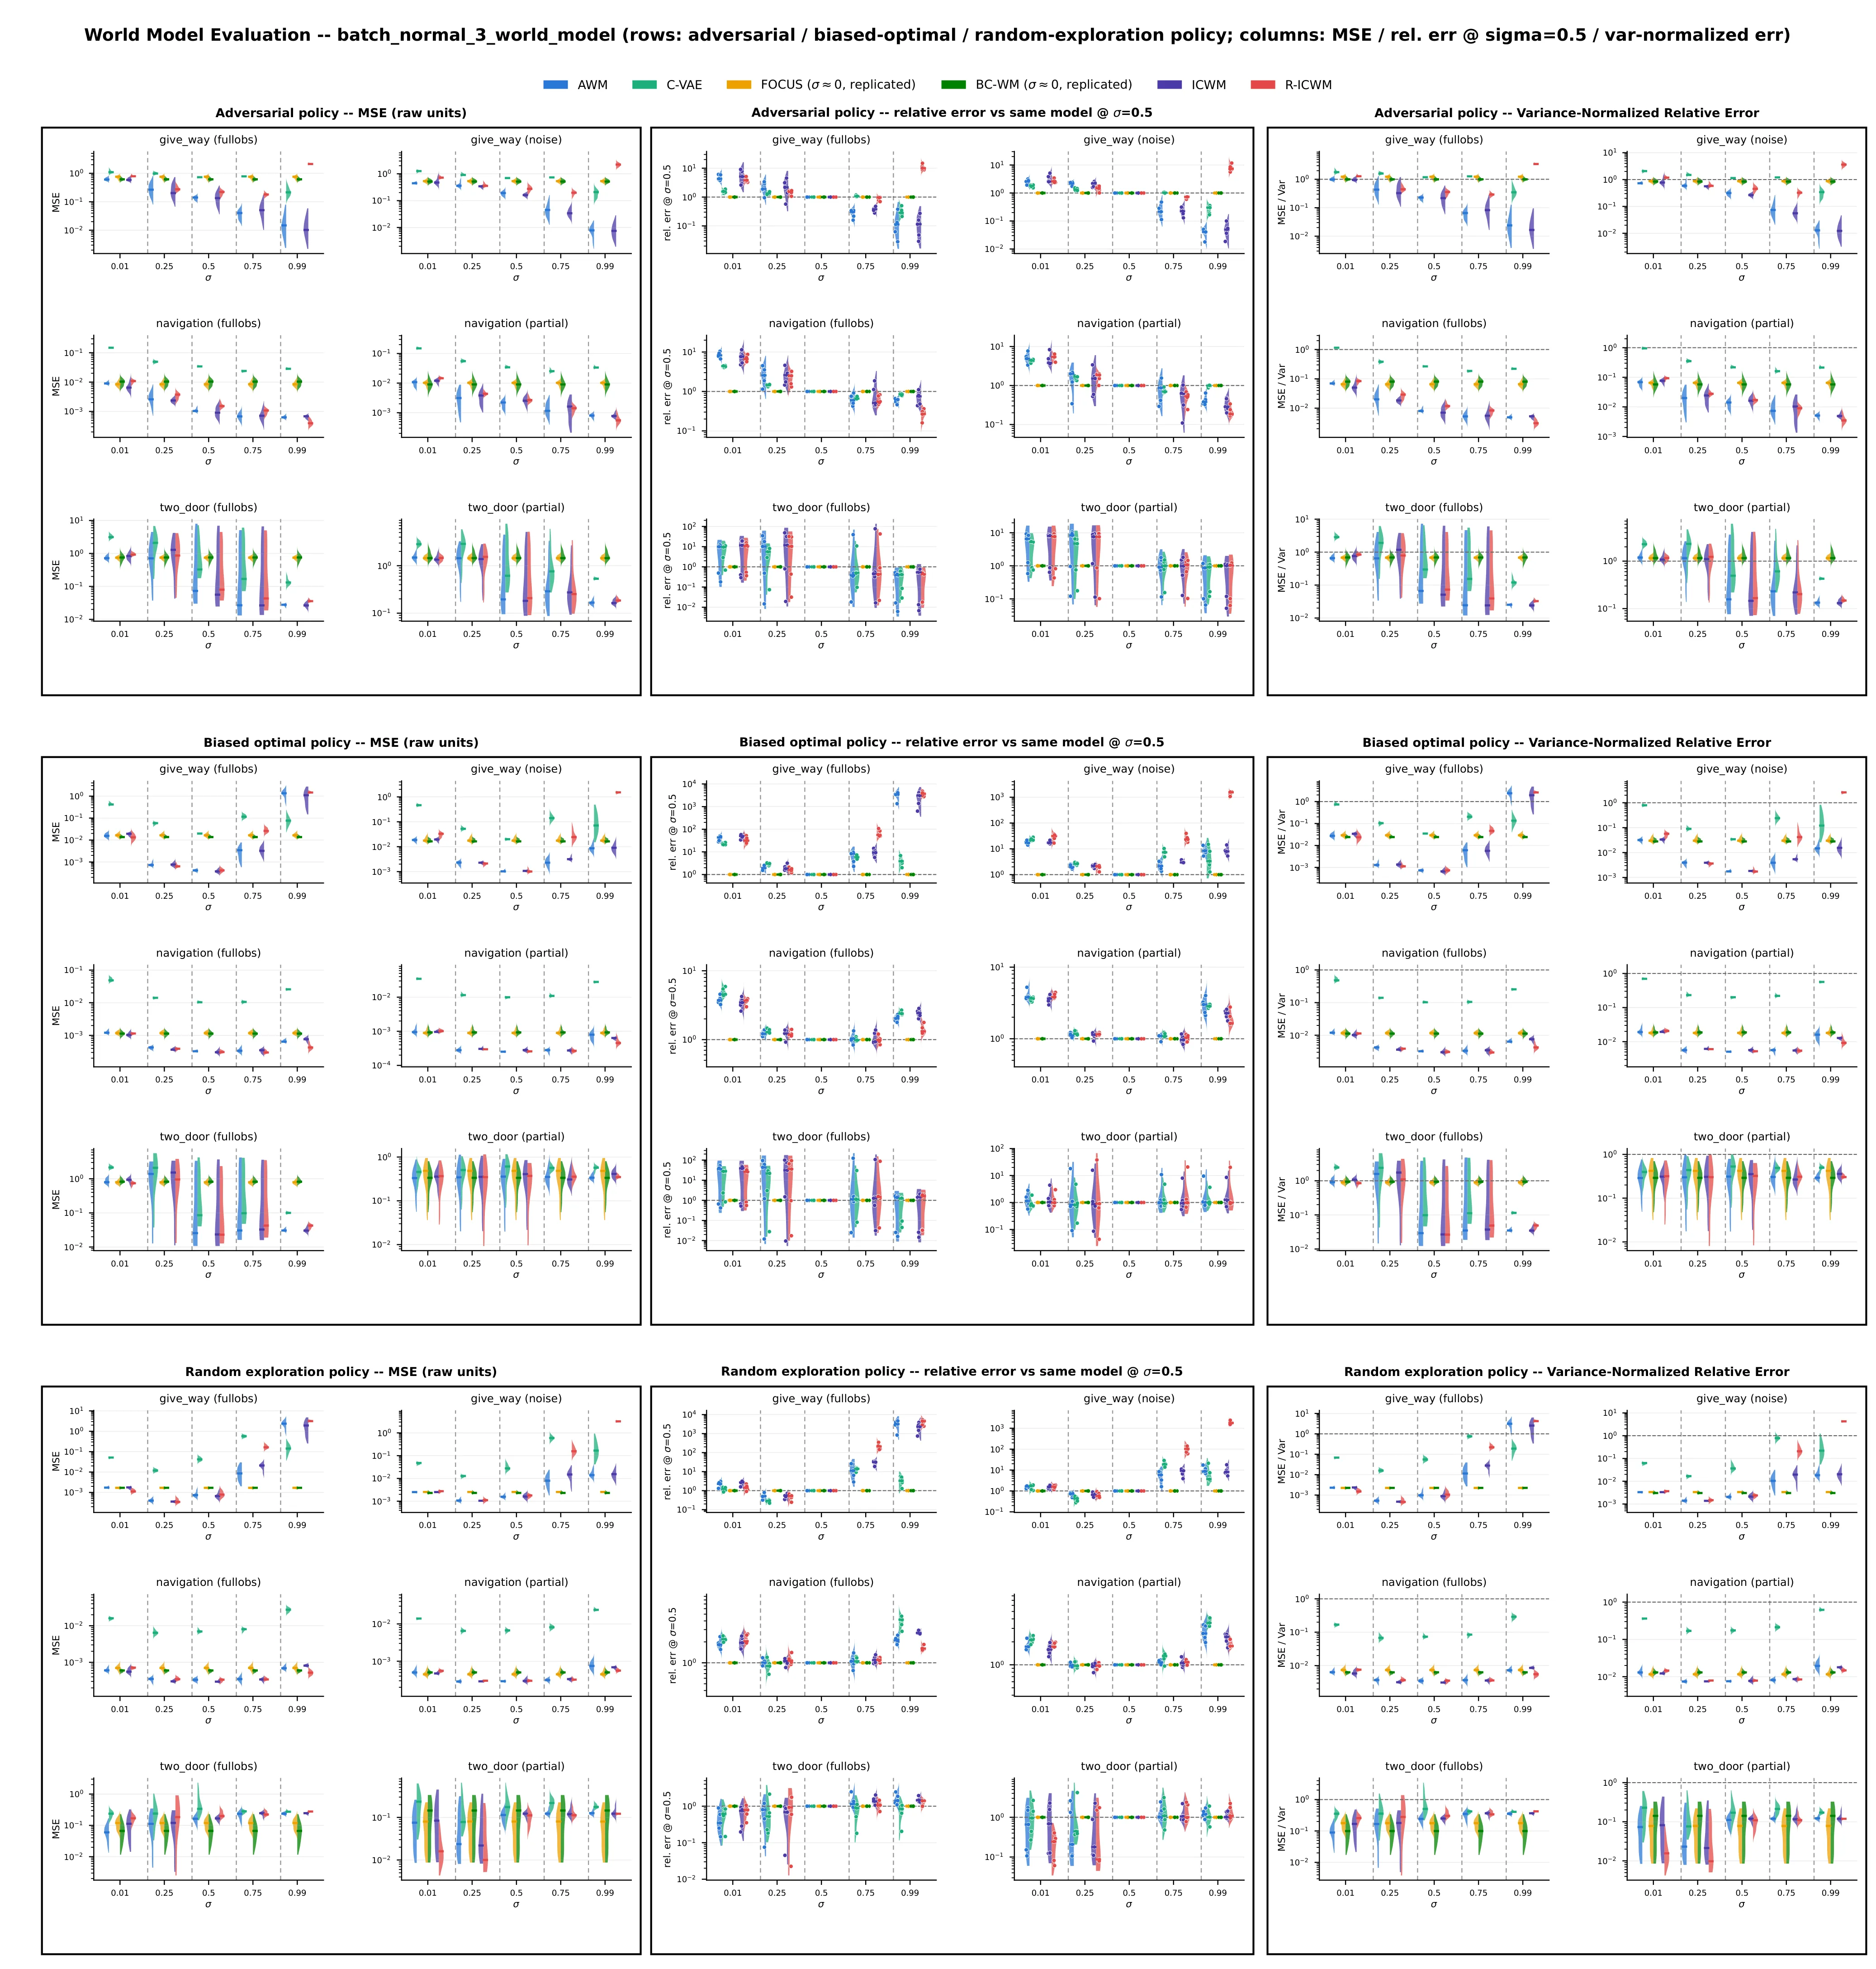
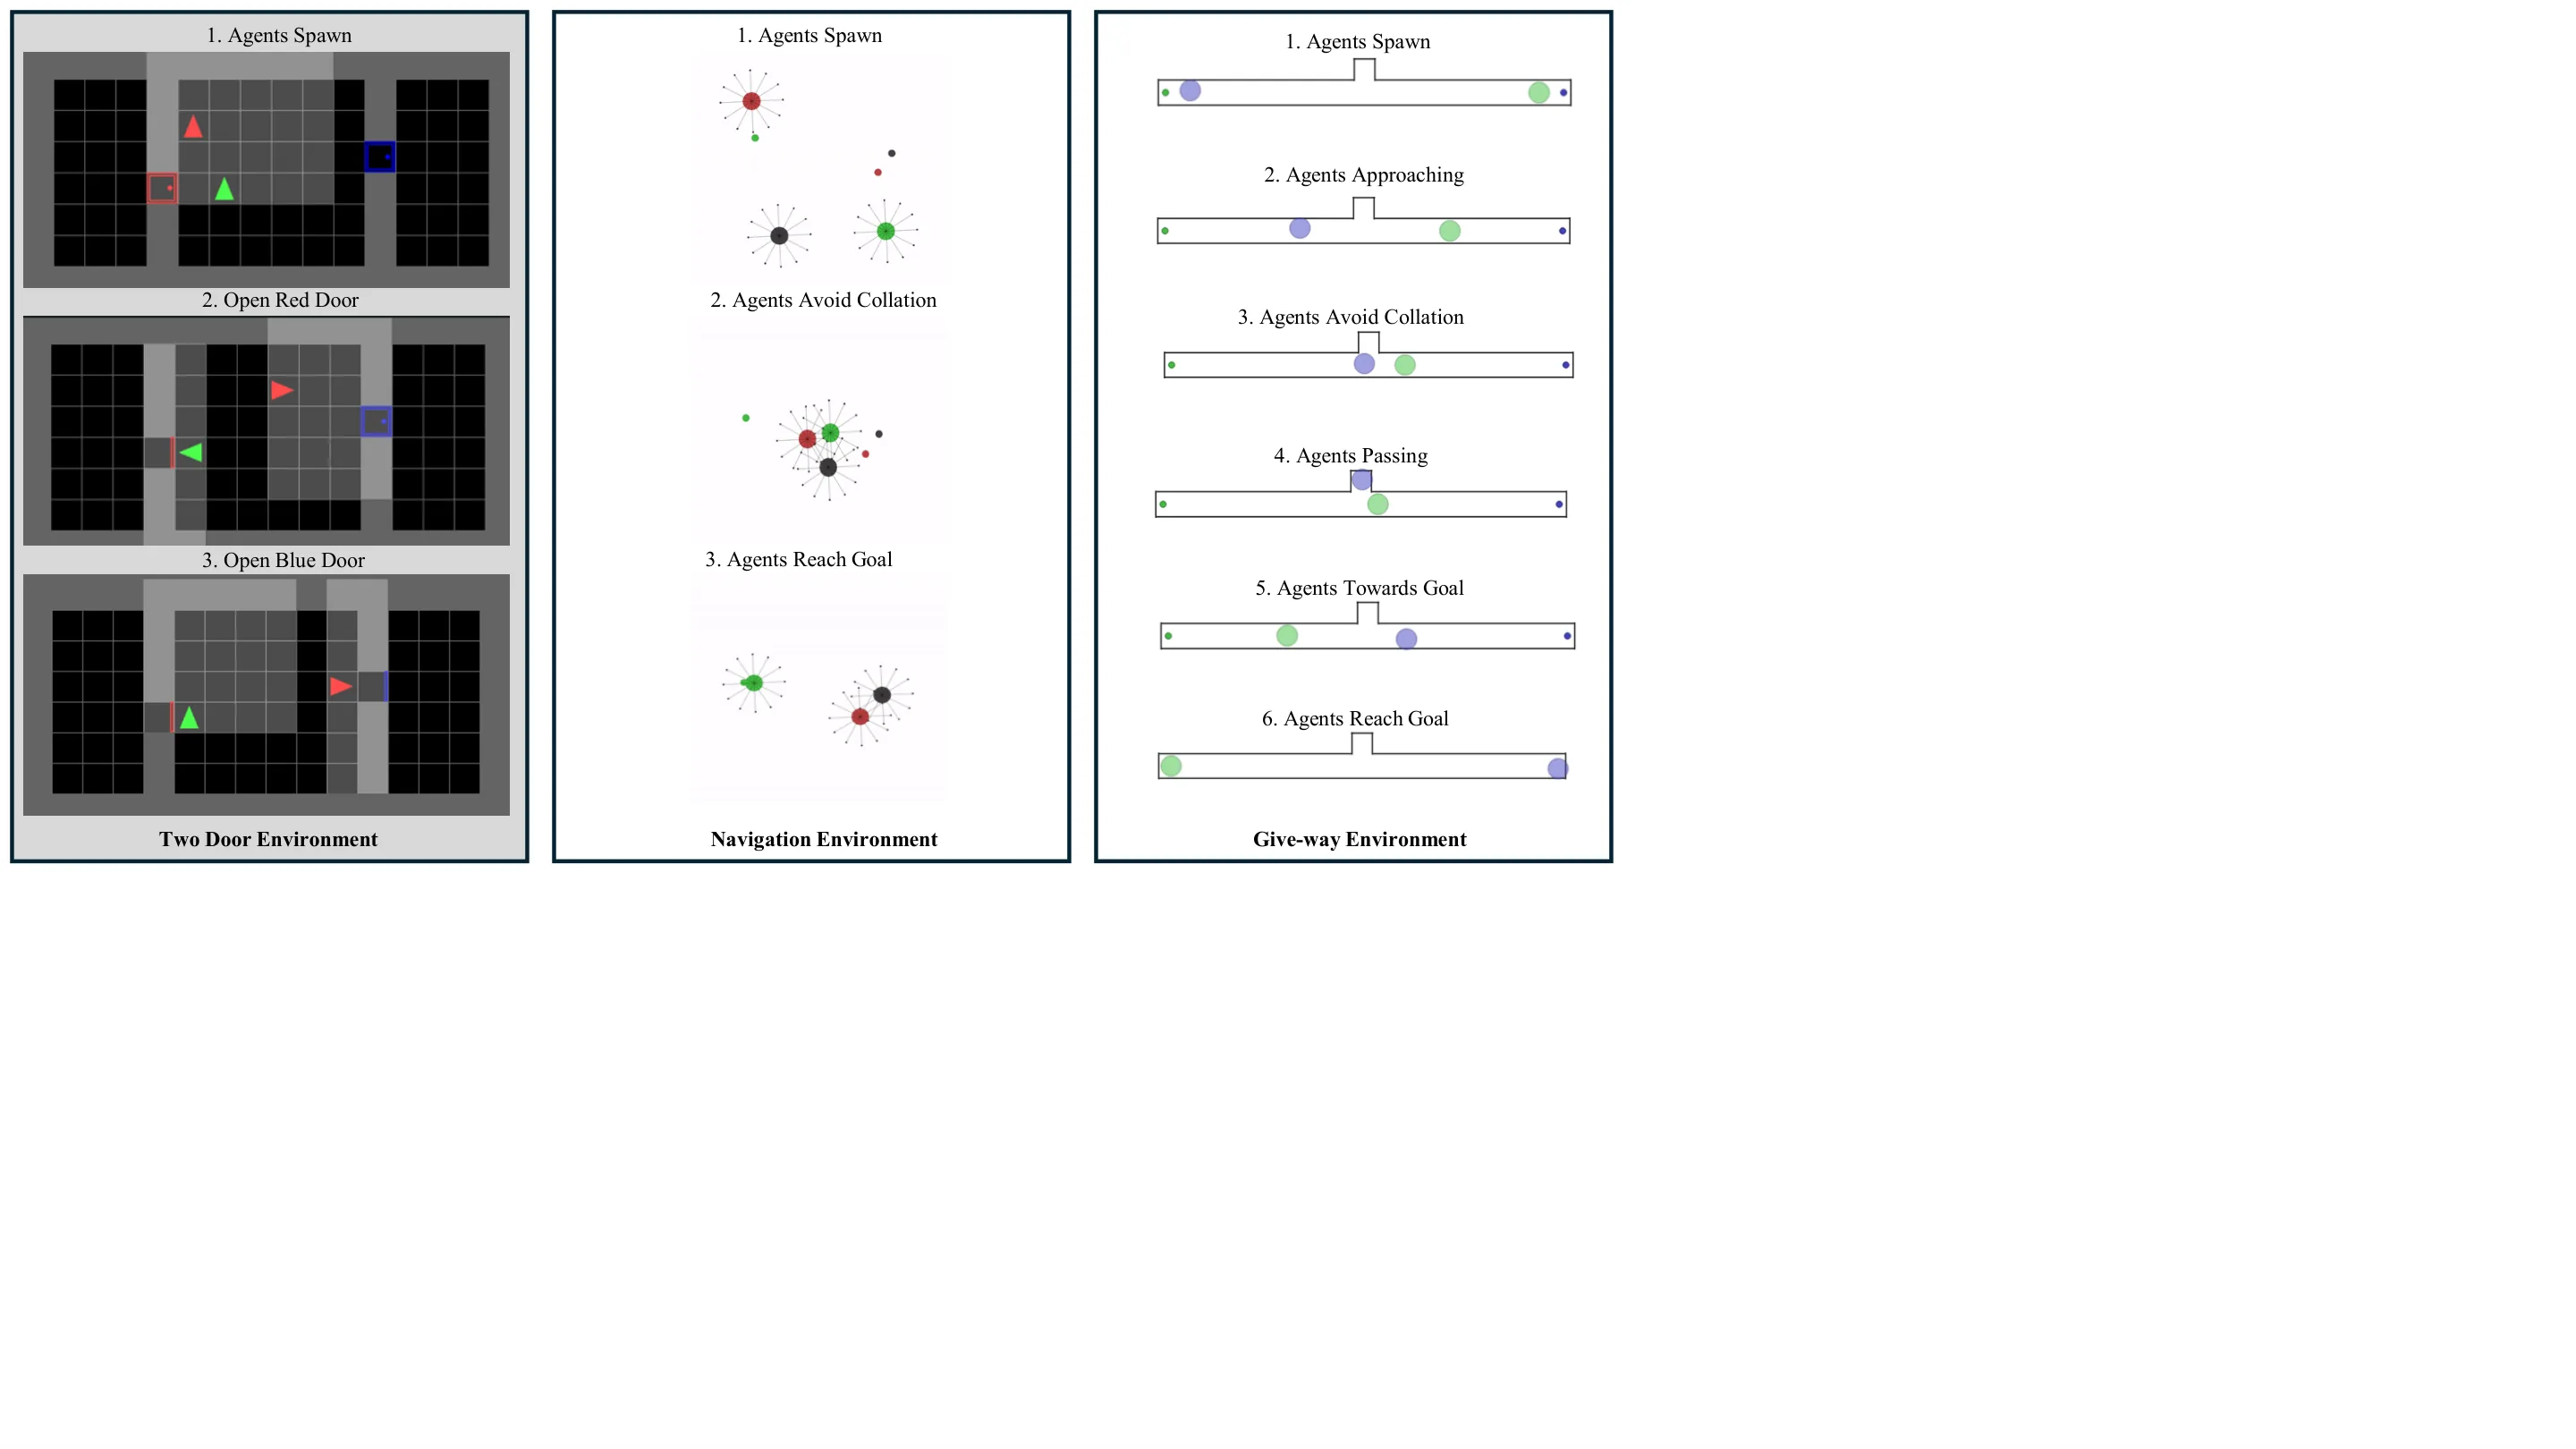
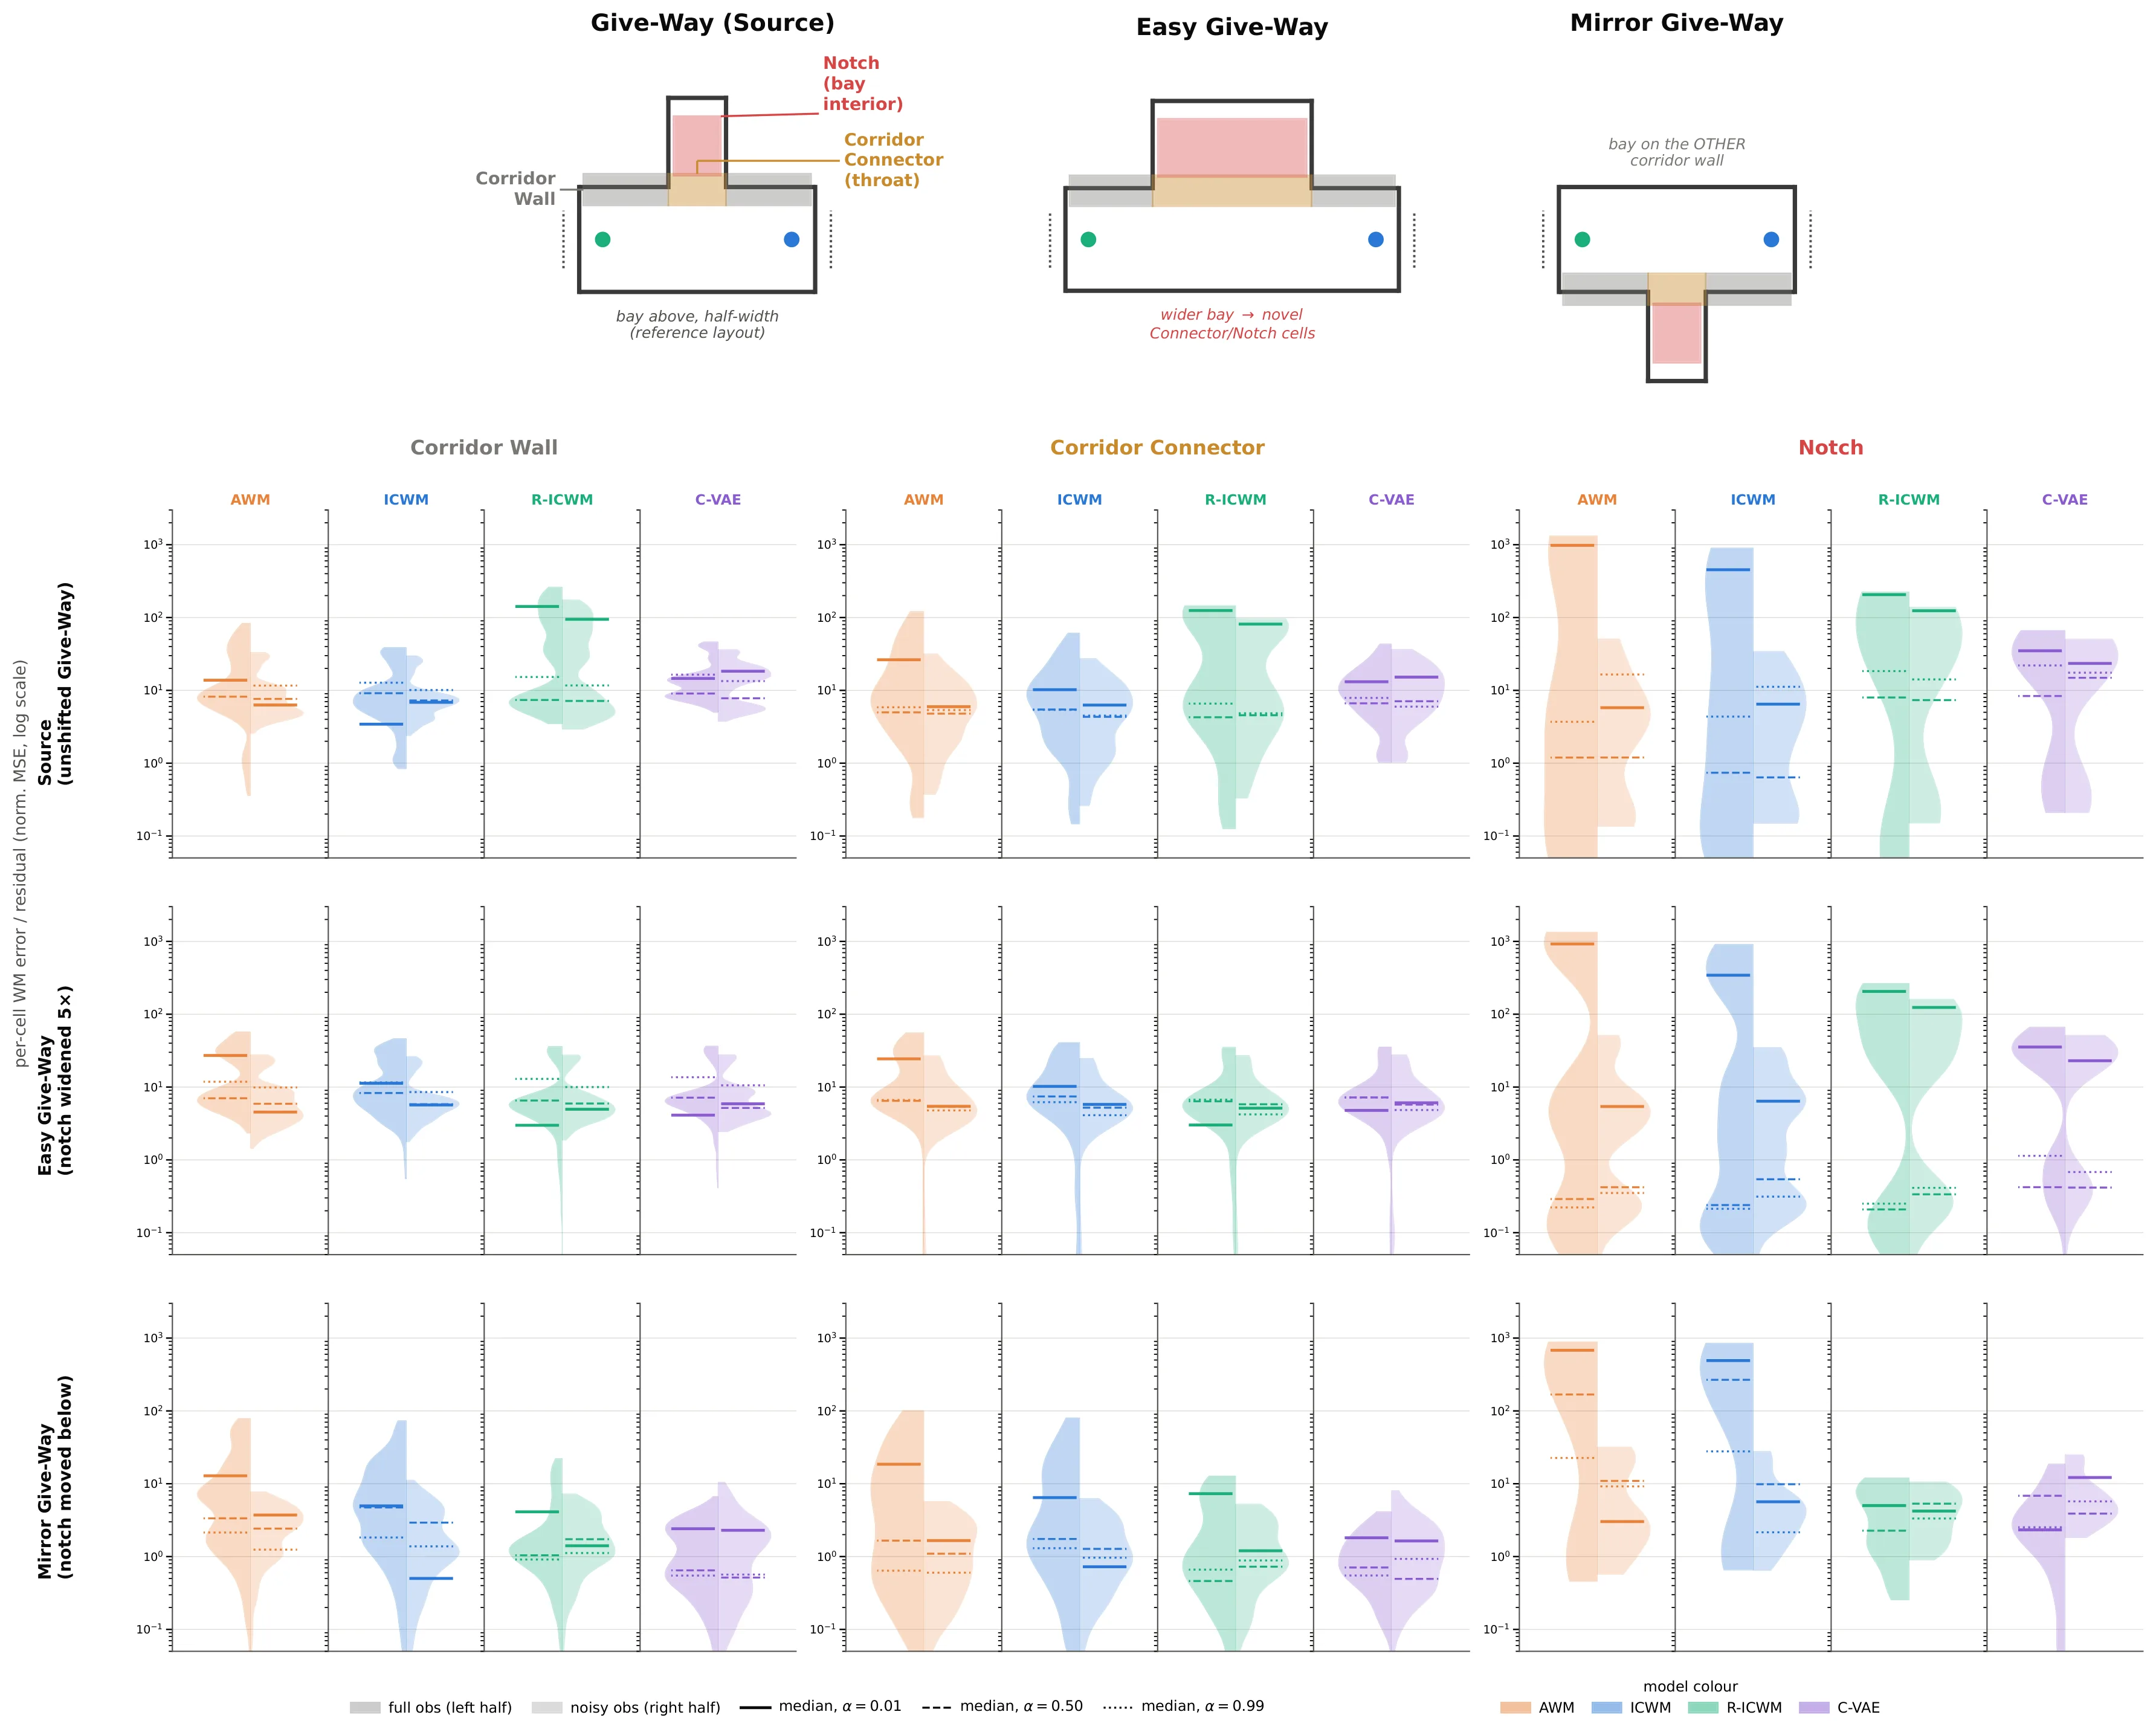
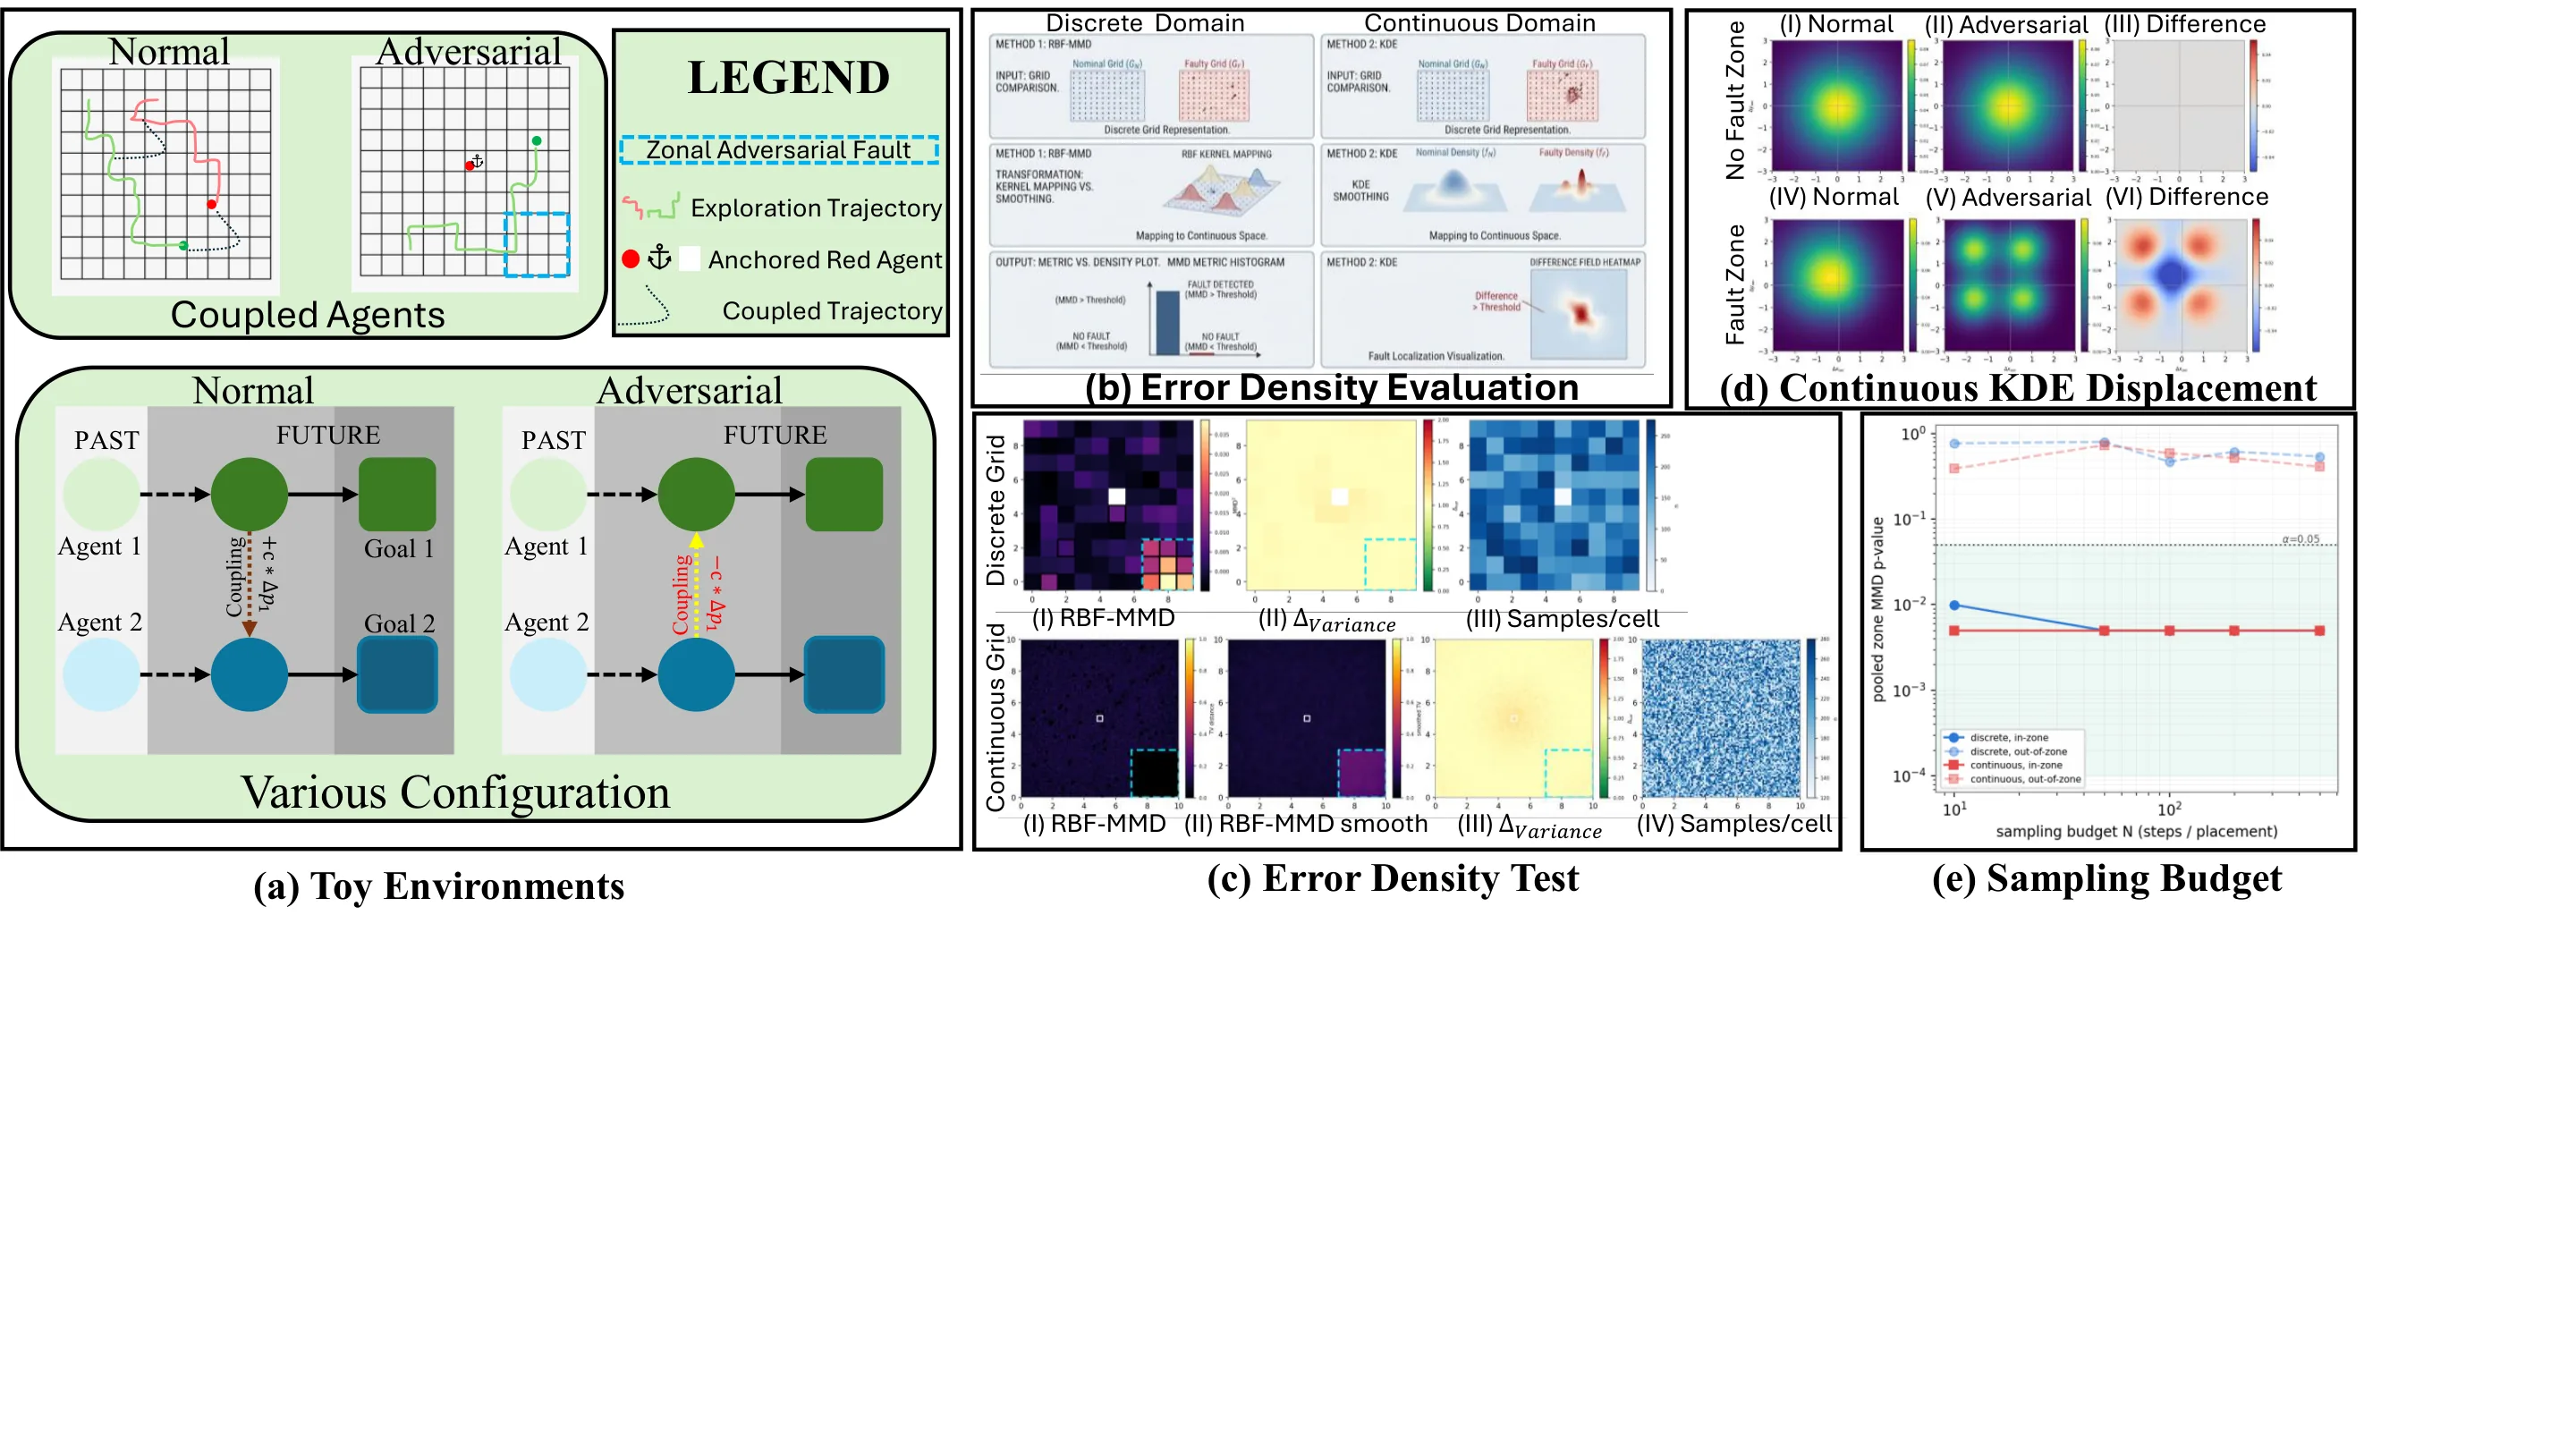
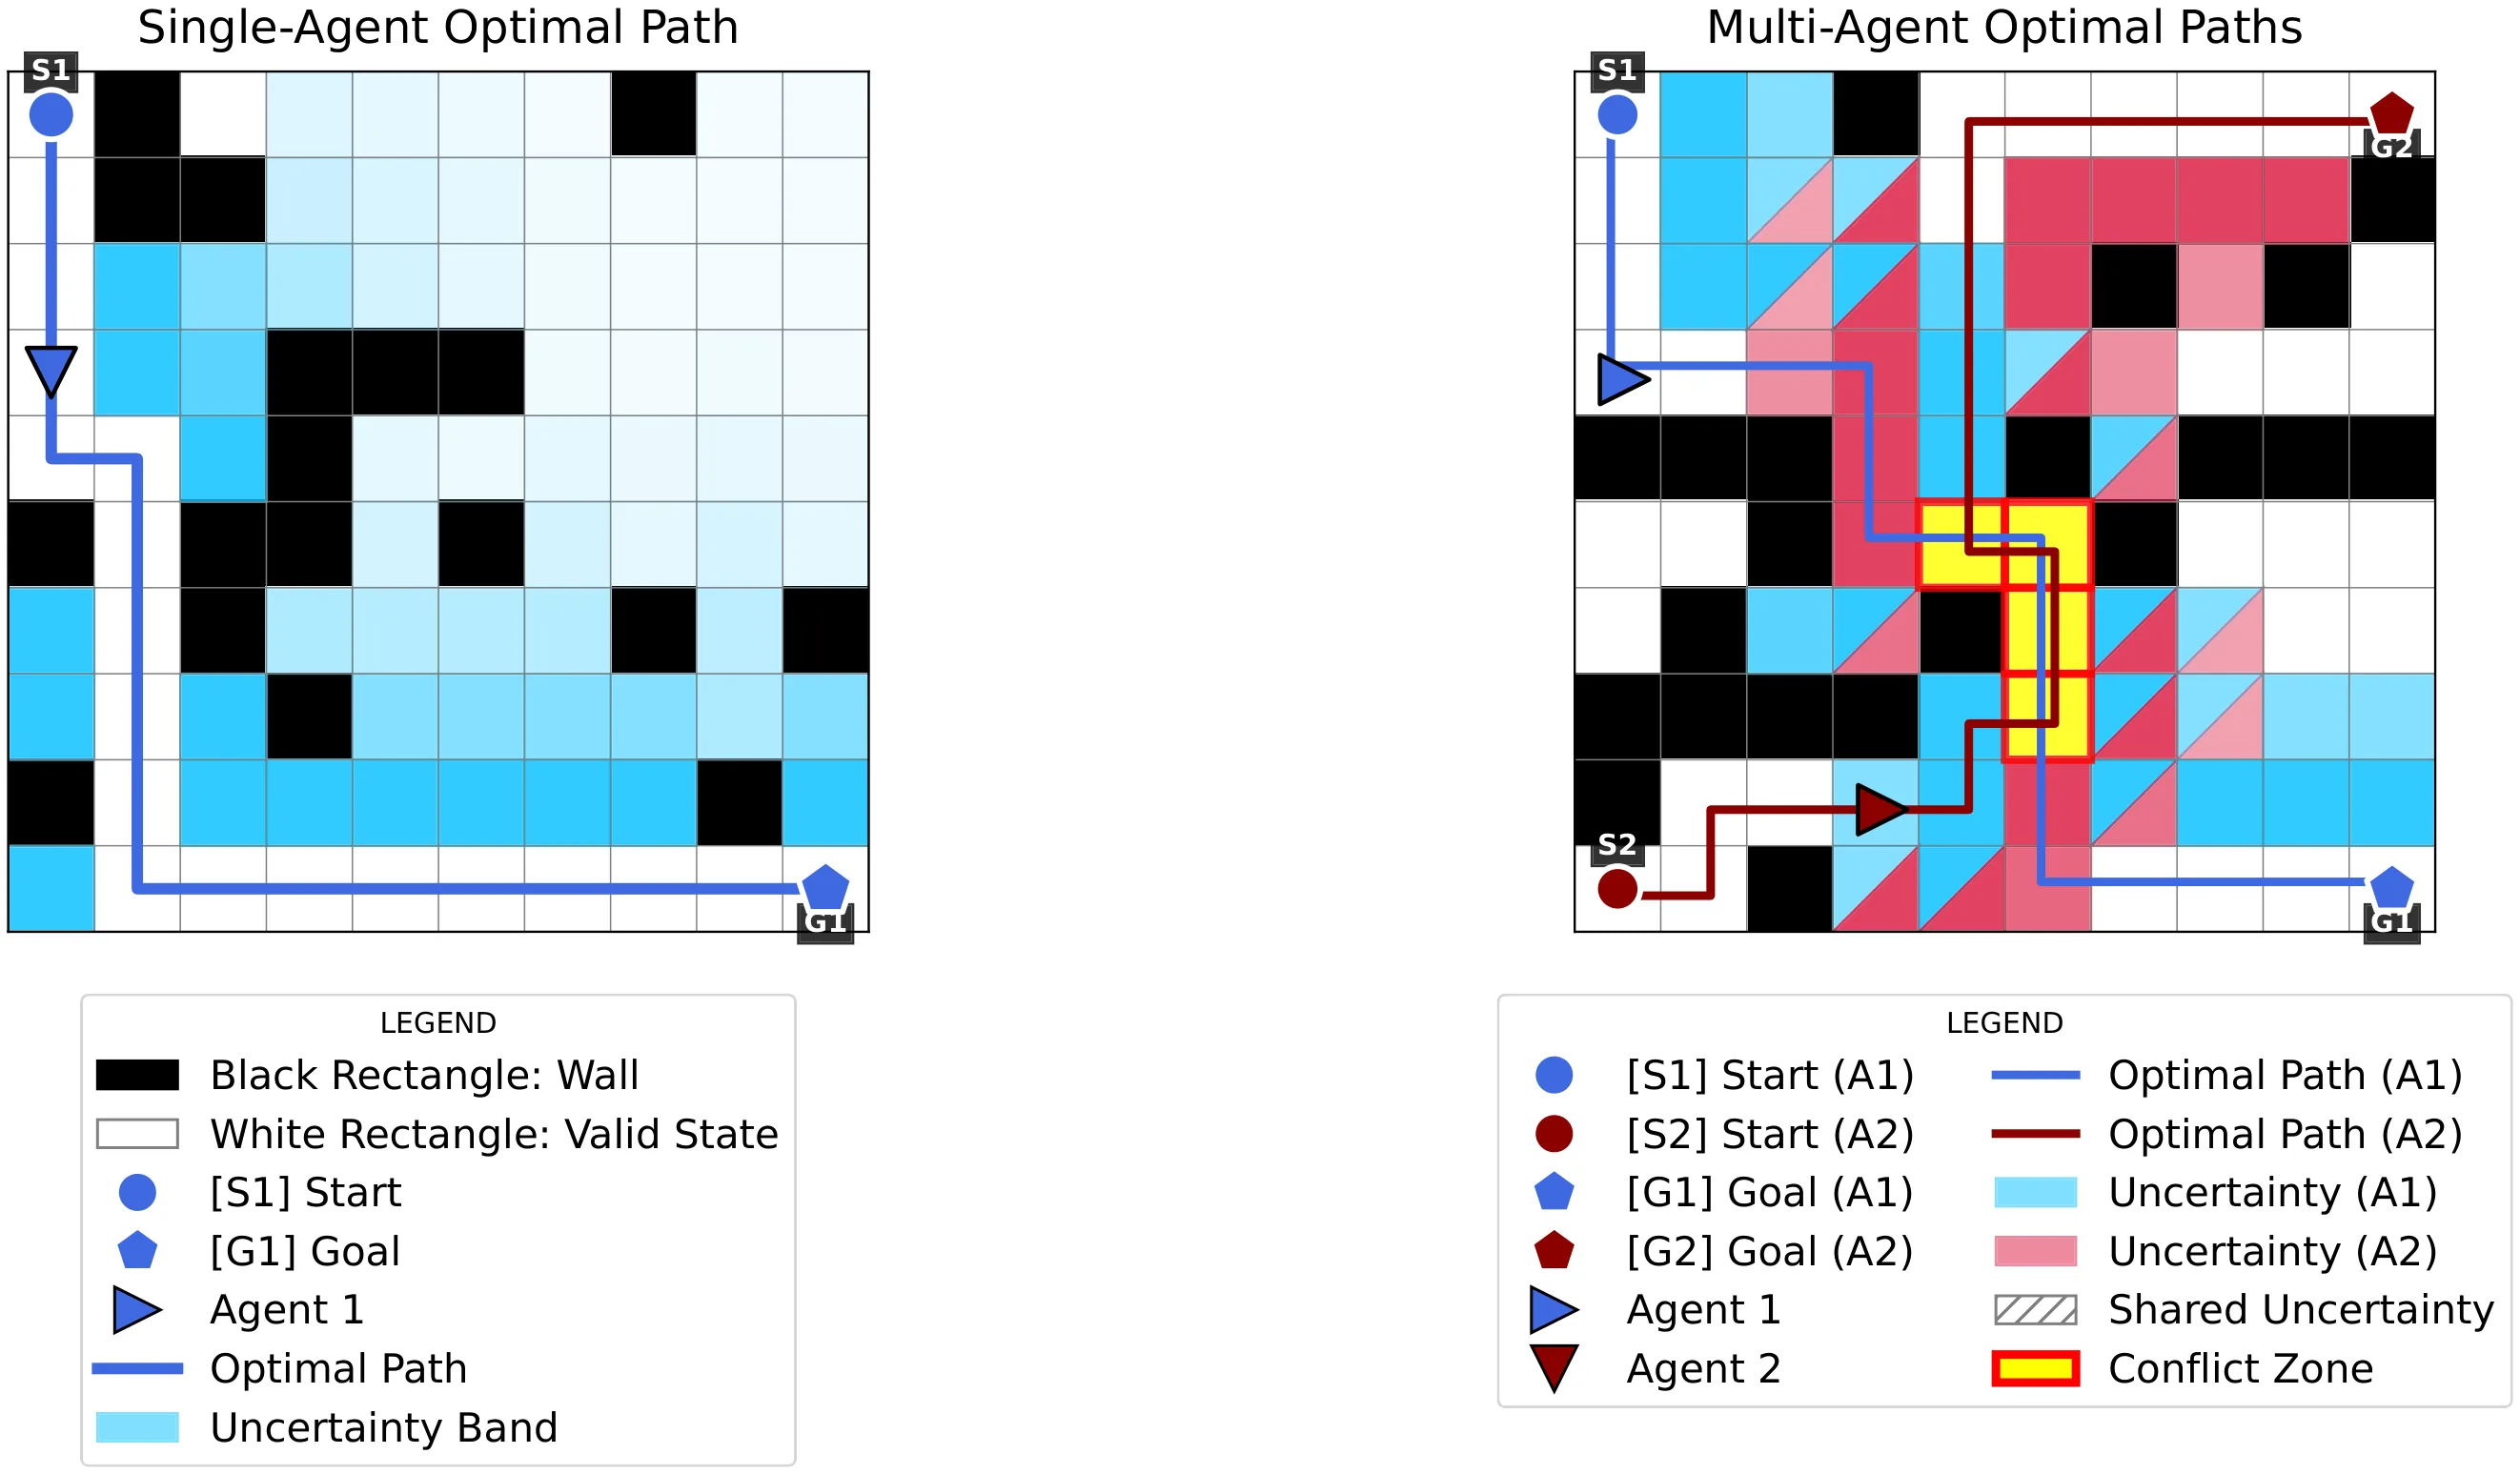
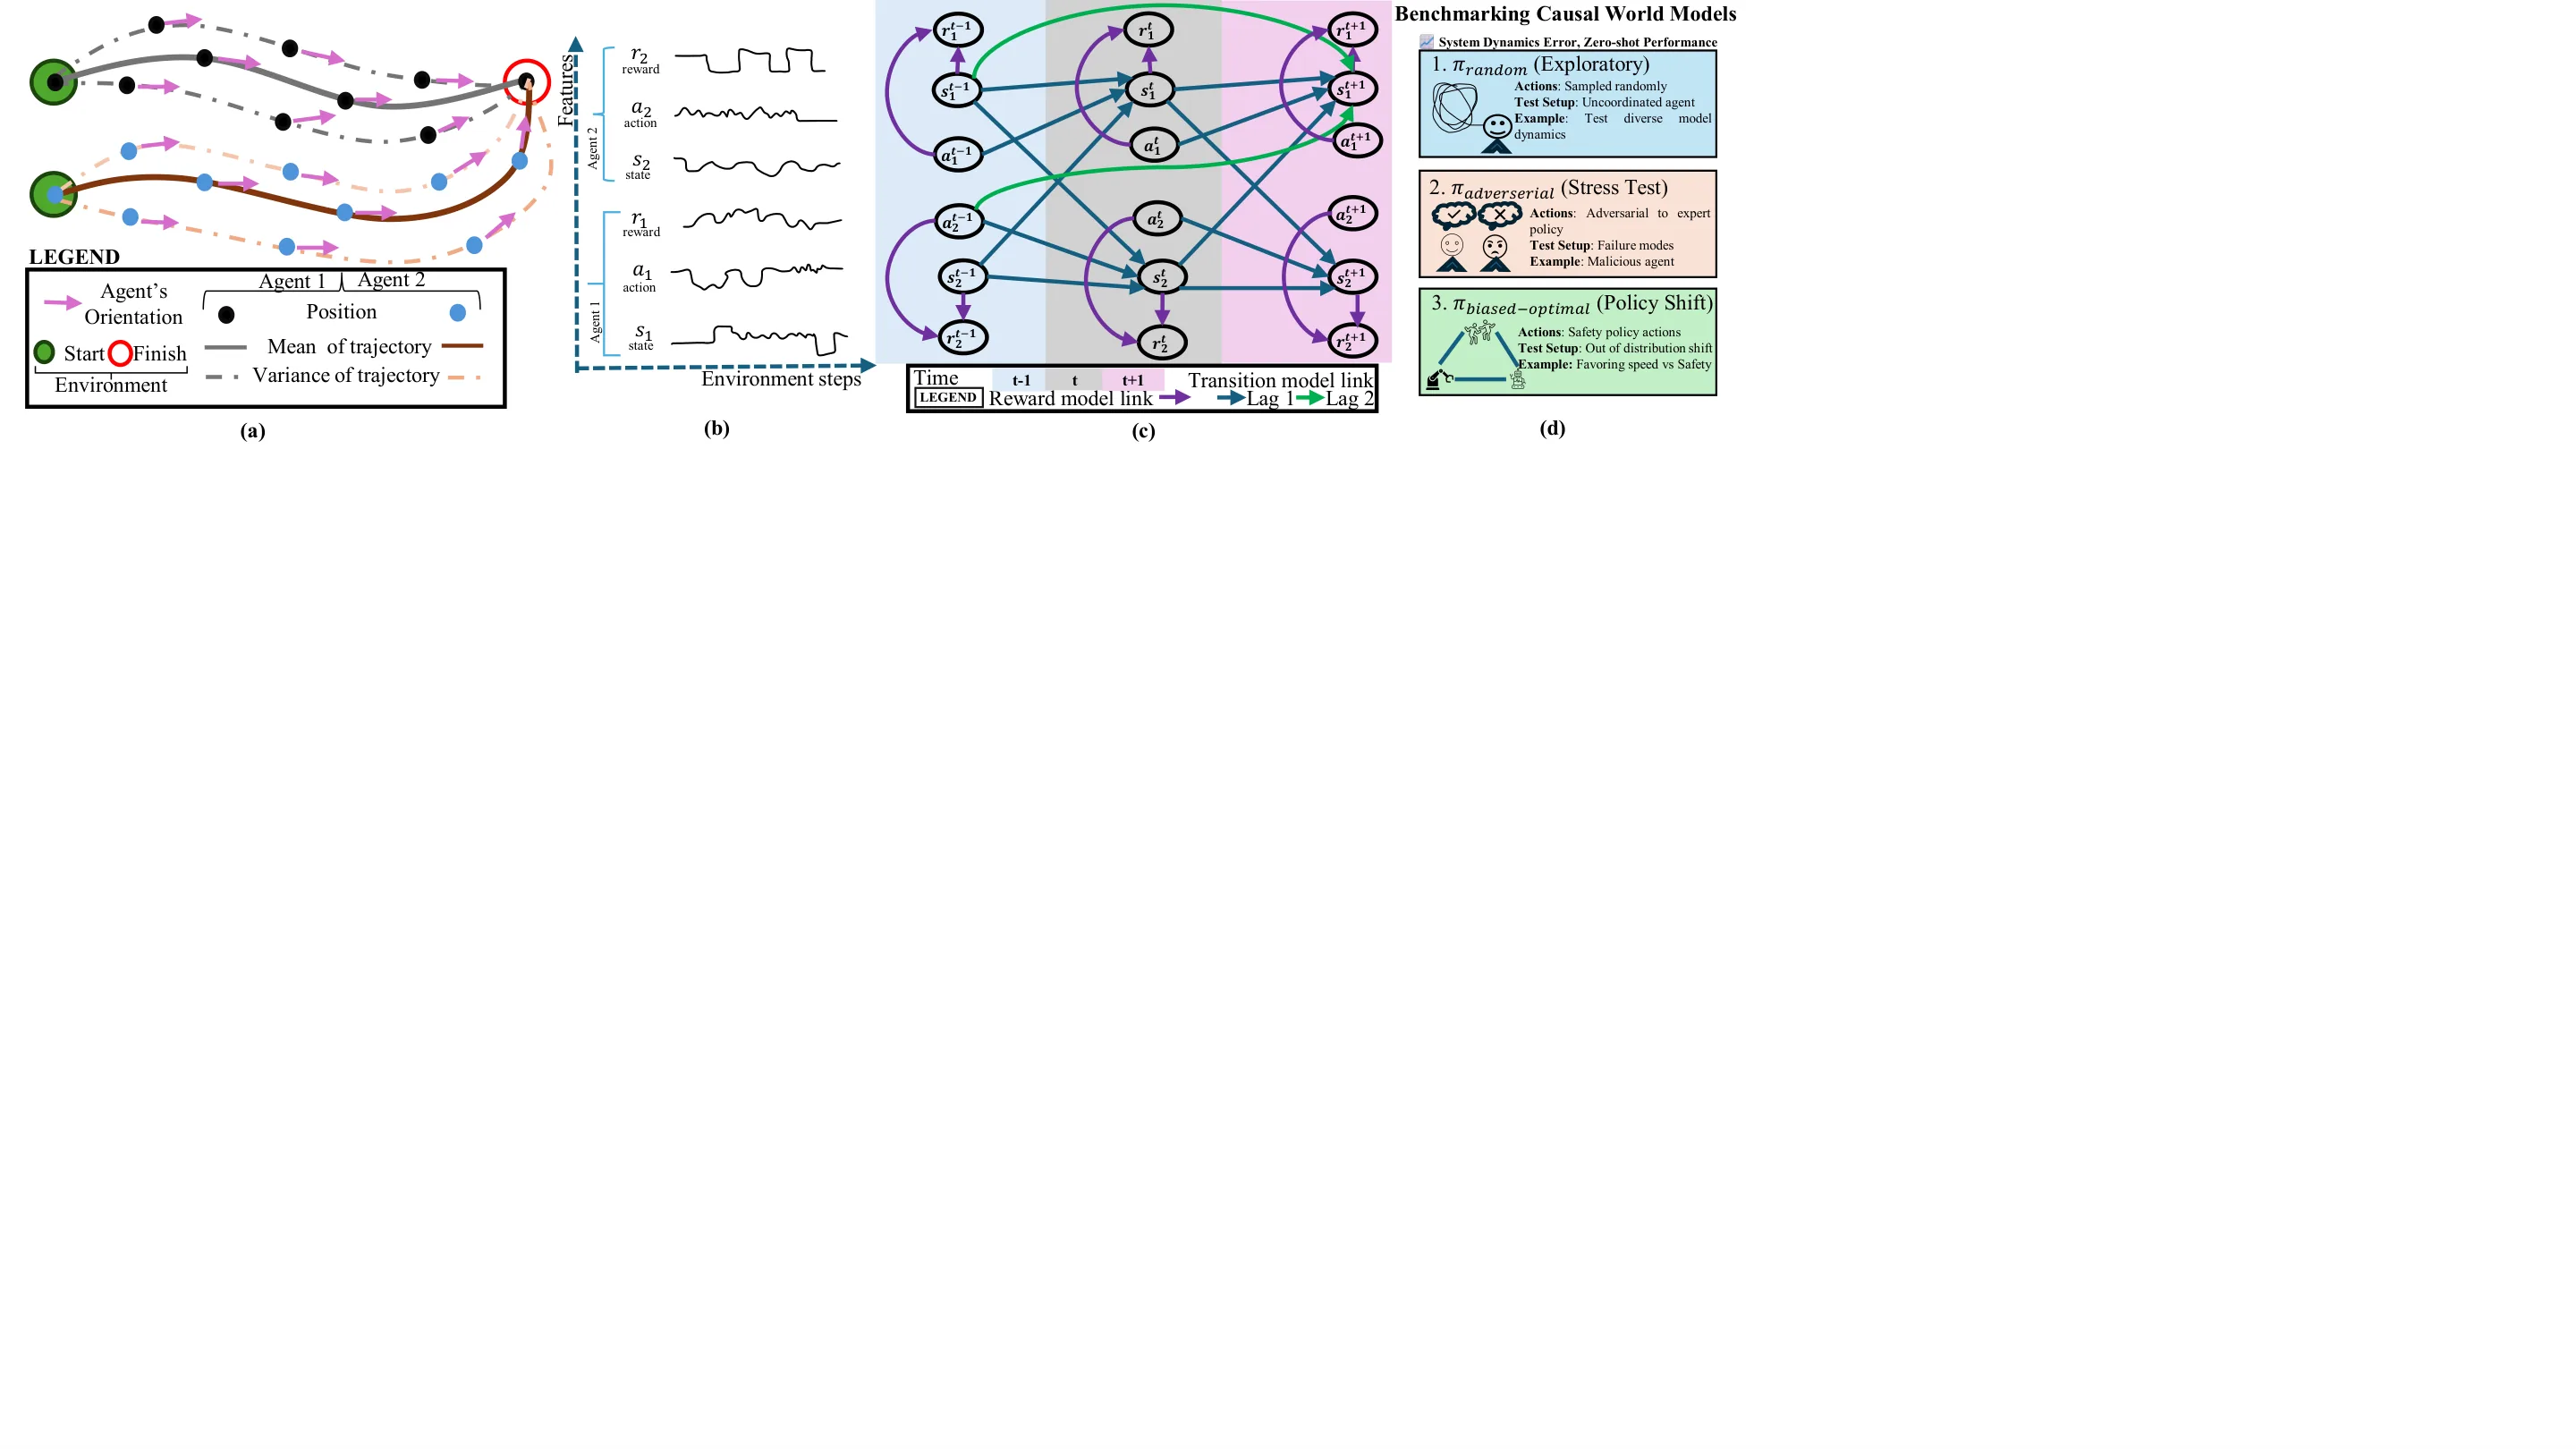
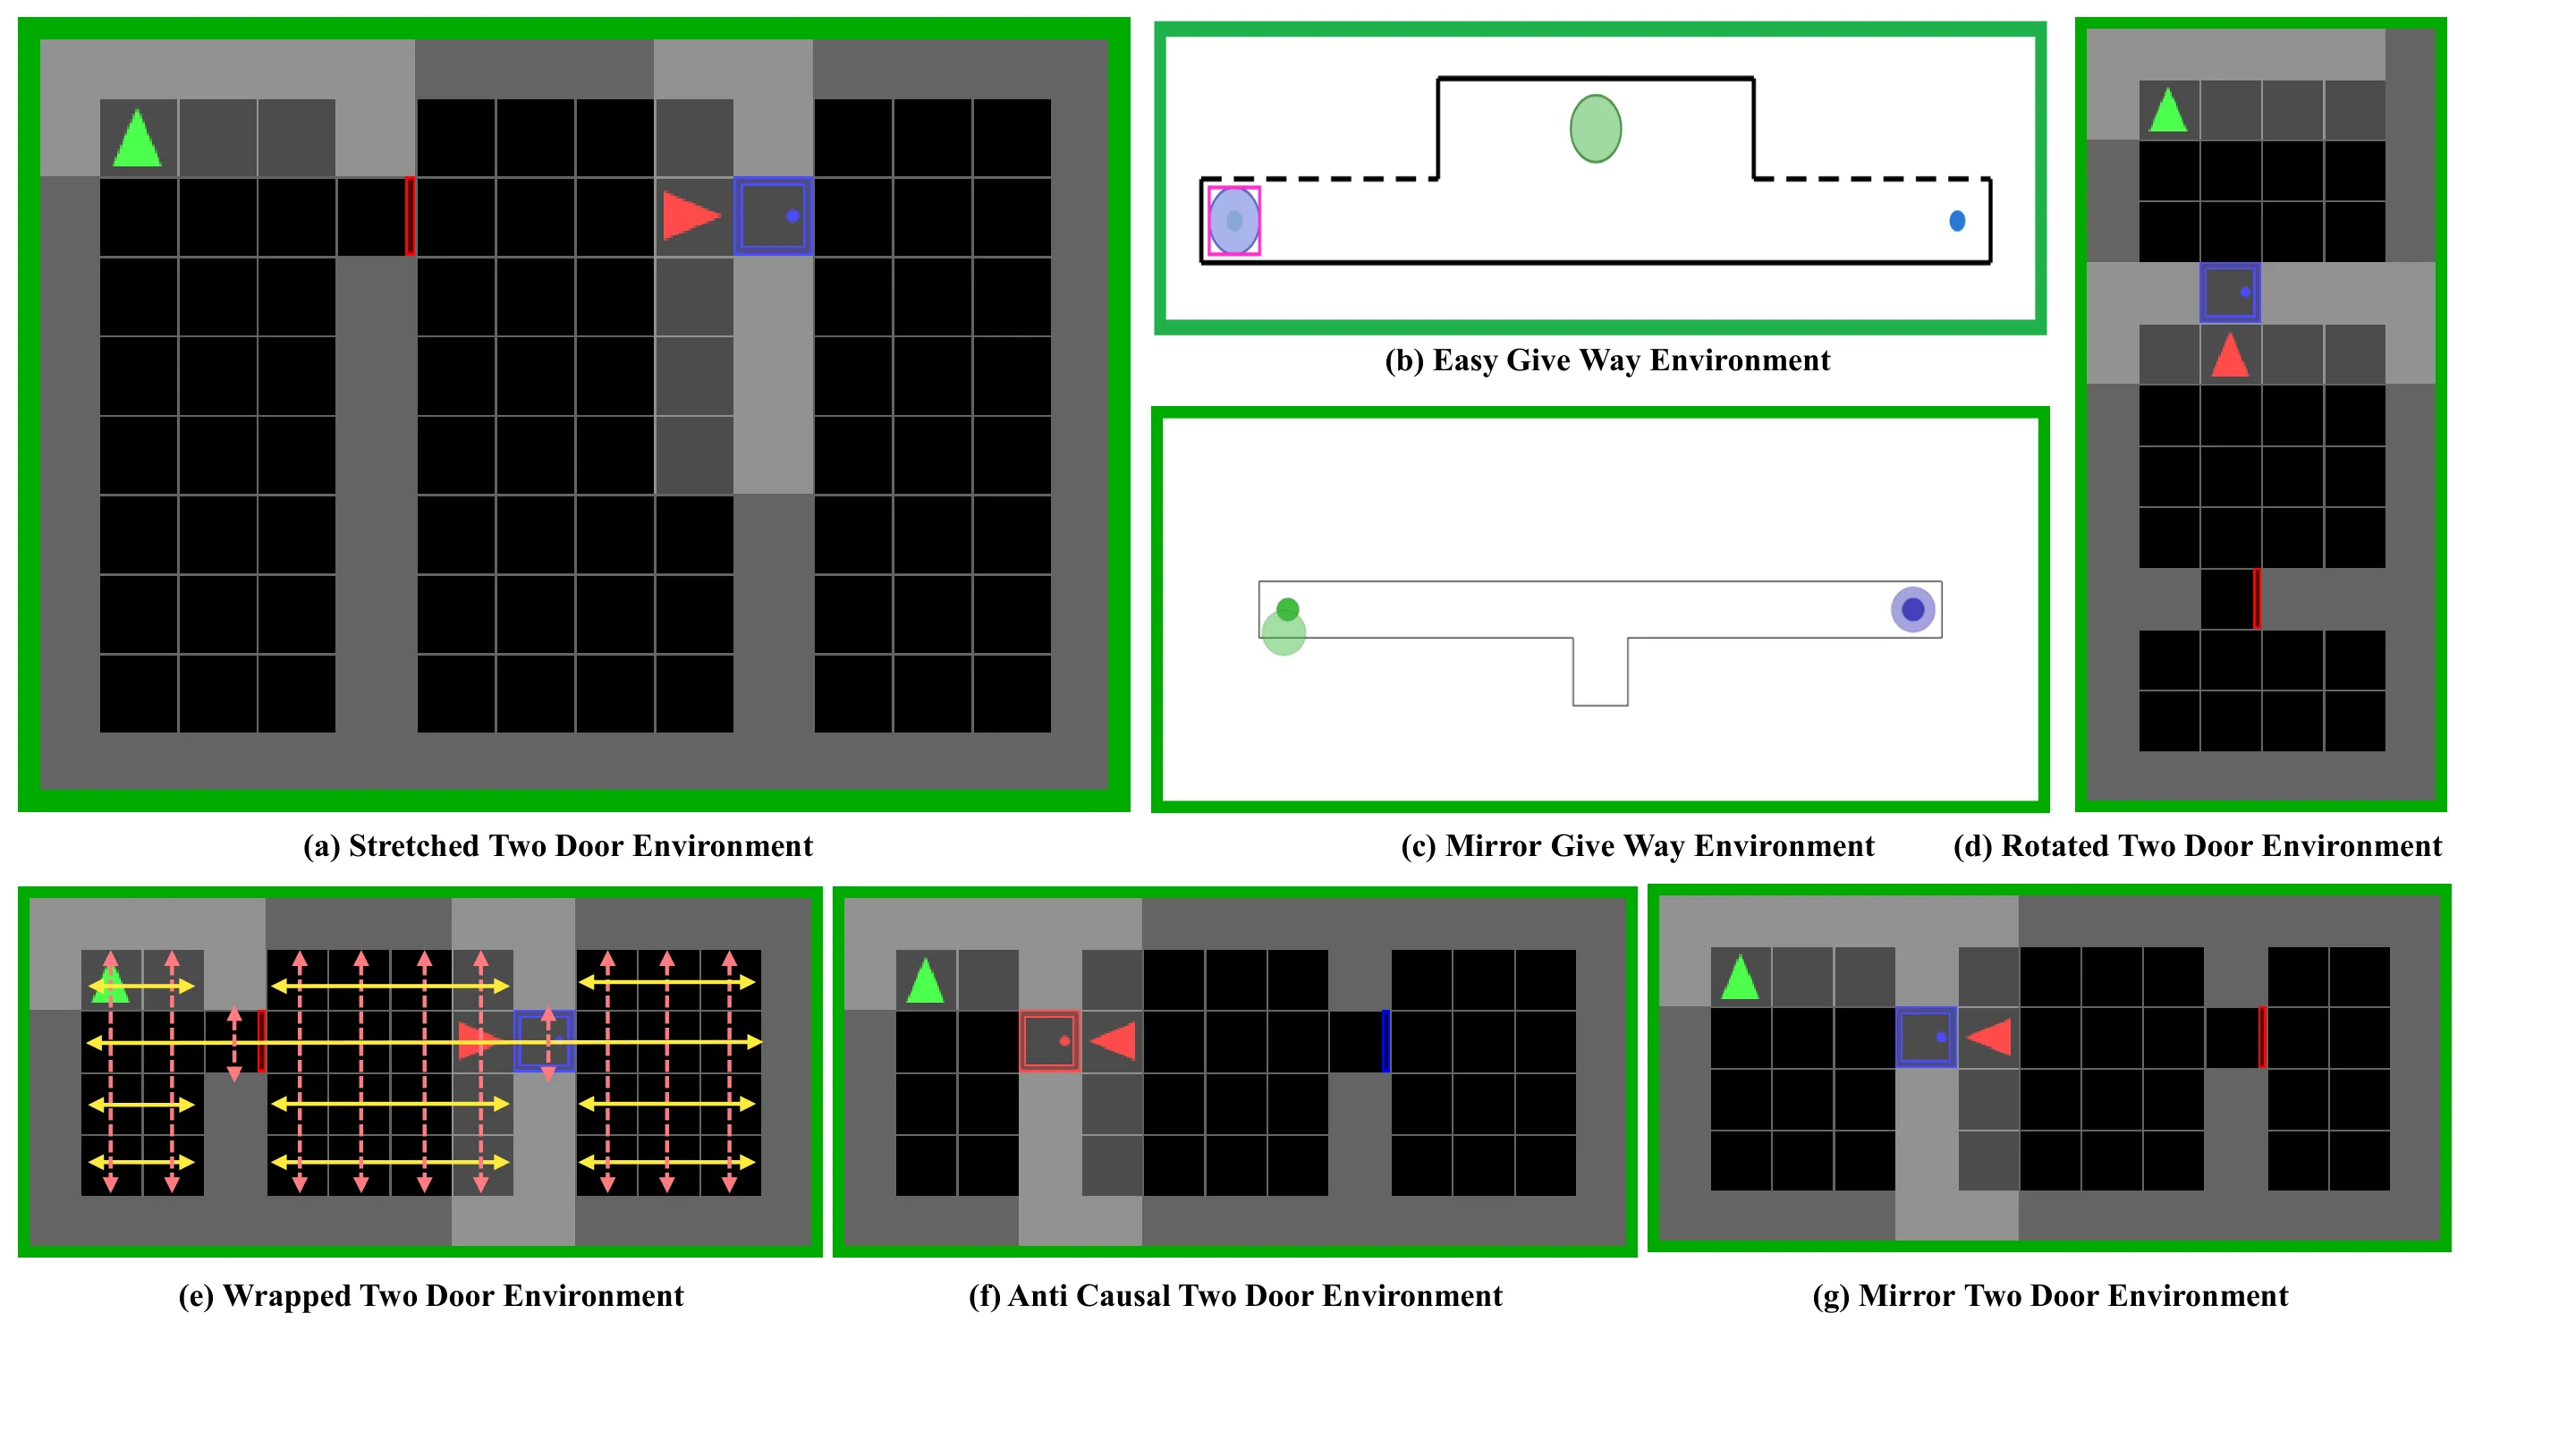
论文在三个多智能体协作任务上进行了系统评估:双门任务要求两个智能体协调开关两扇门;导航任务涉及多个智能体在共享空间中的无碰撞移动;让行任务则模拟优先级协商场景。实验覆盖完全可观测和部分可观测(激光雷达感知)两种设置。
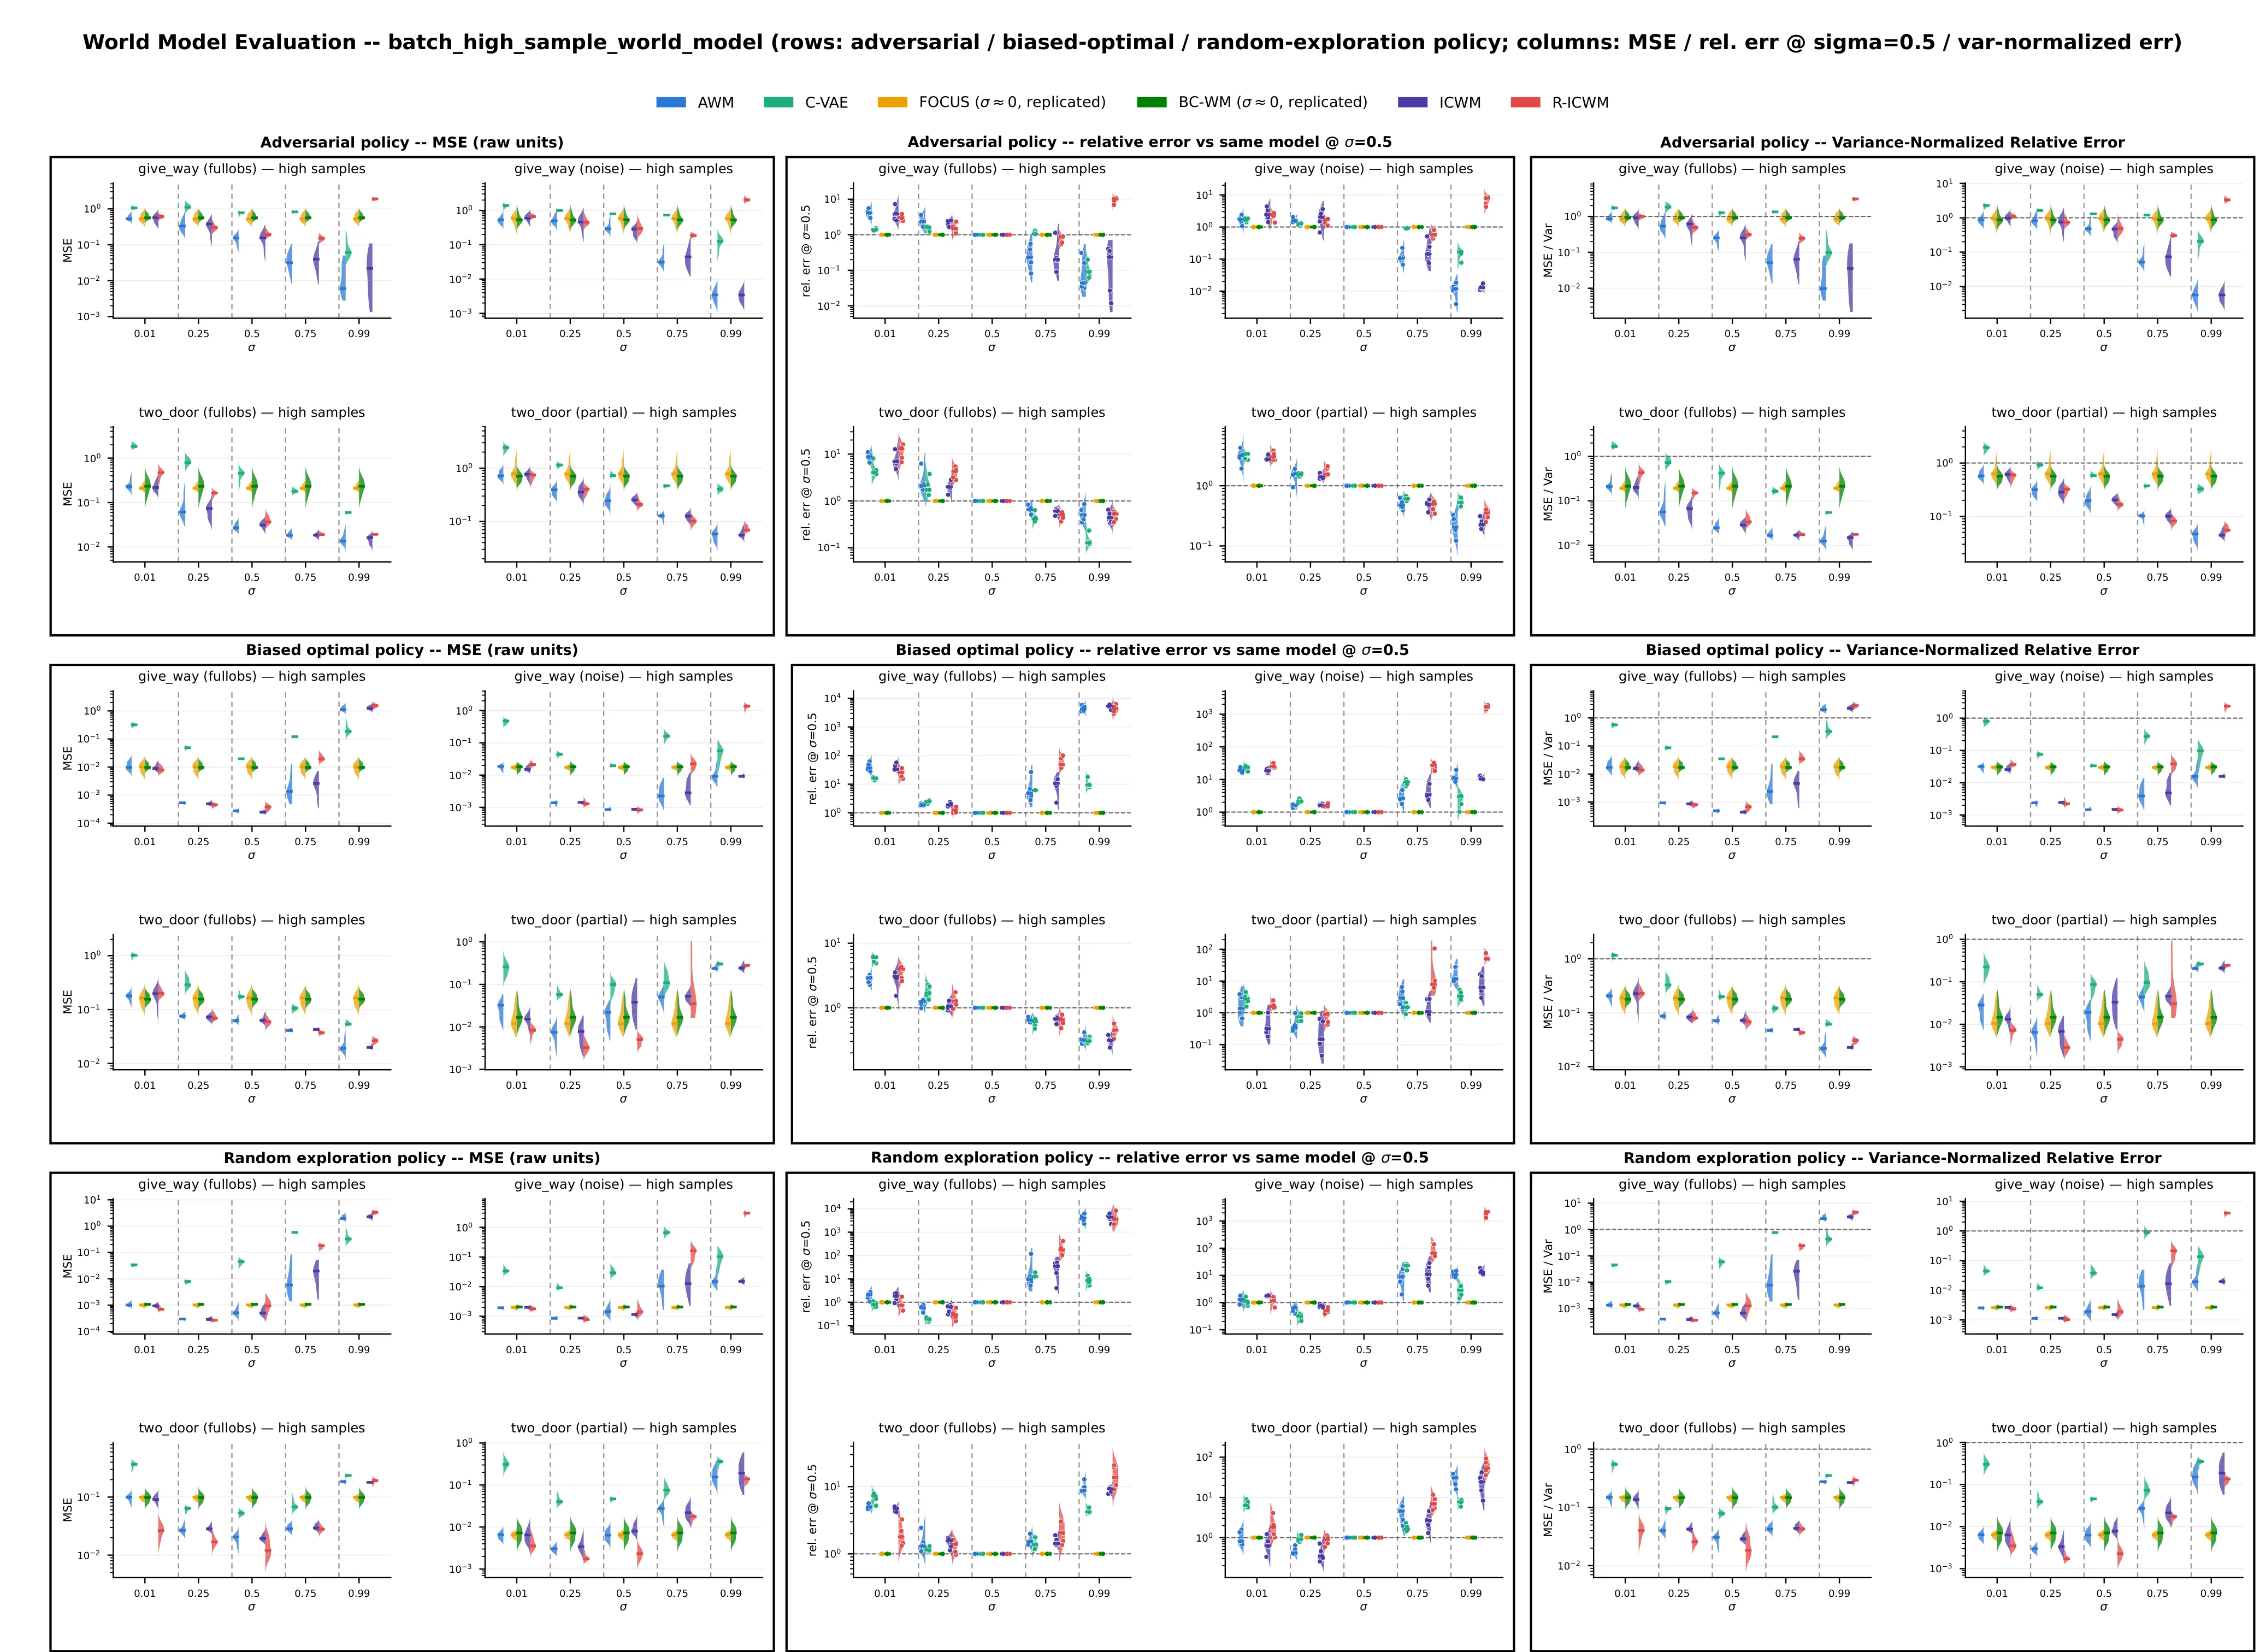
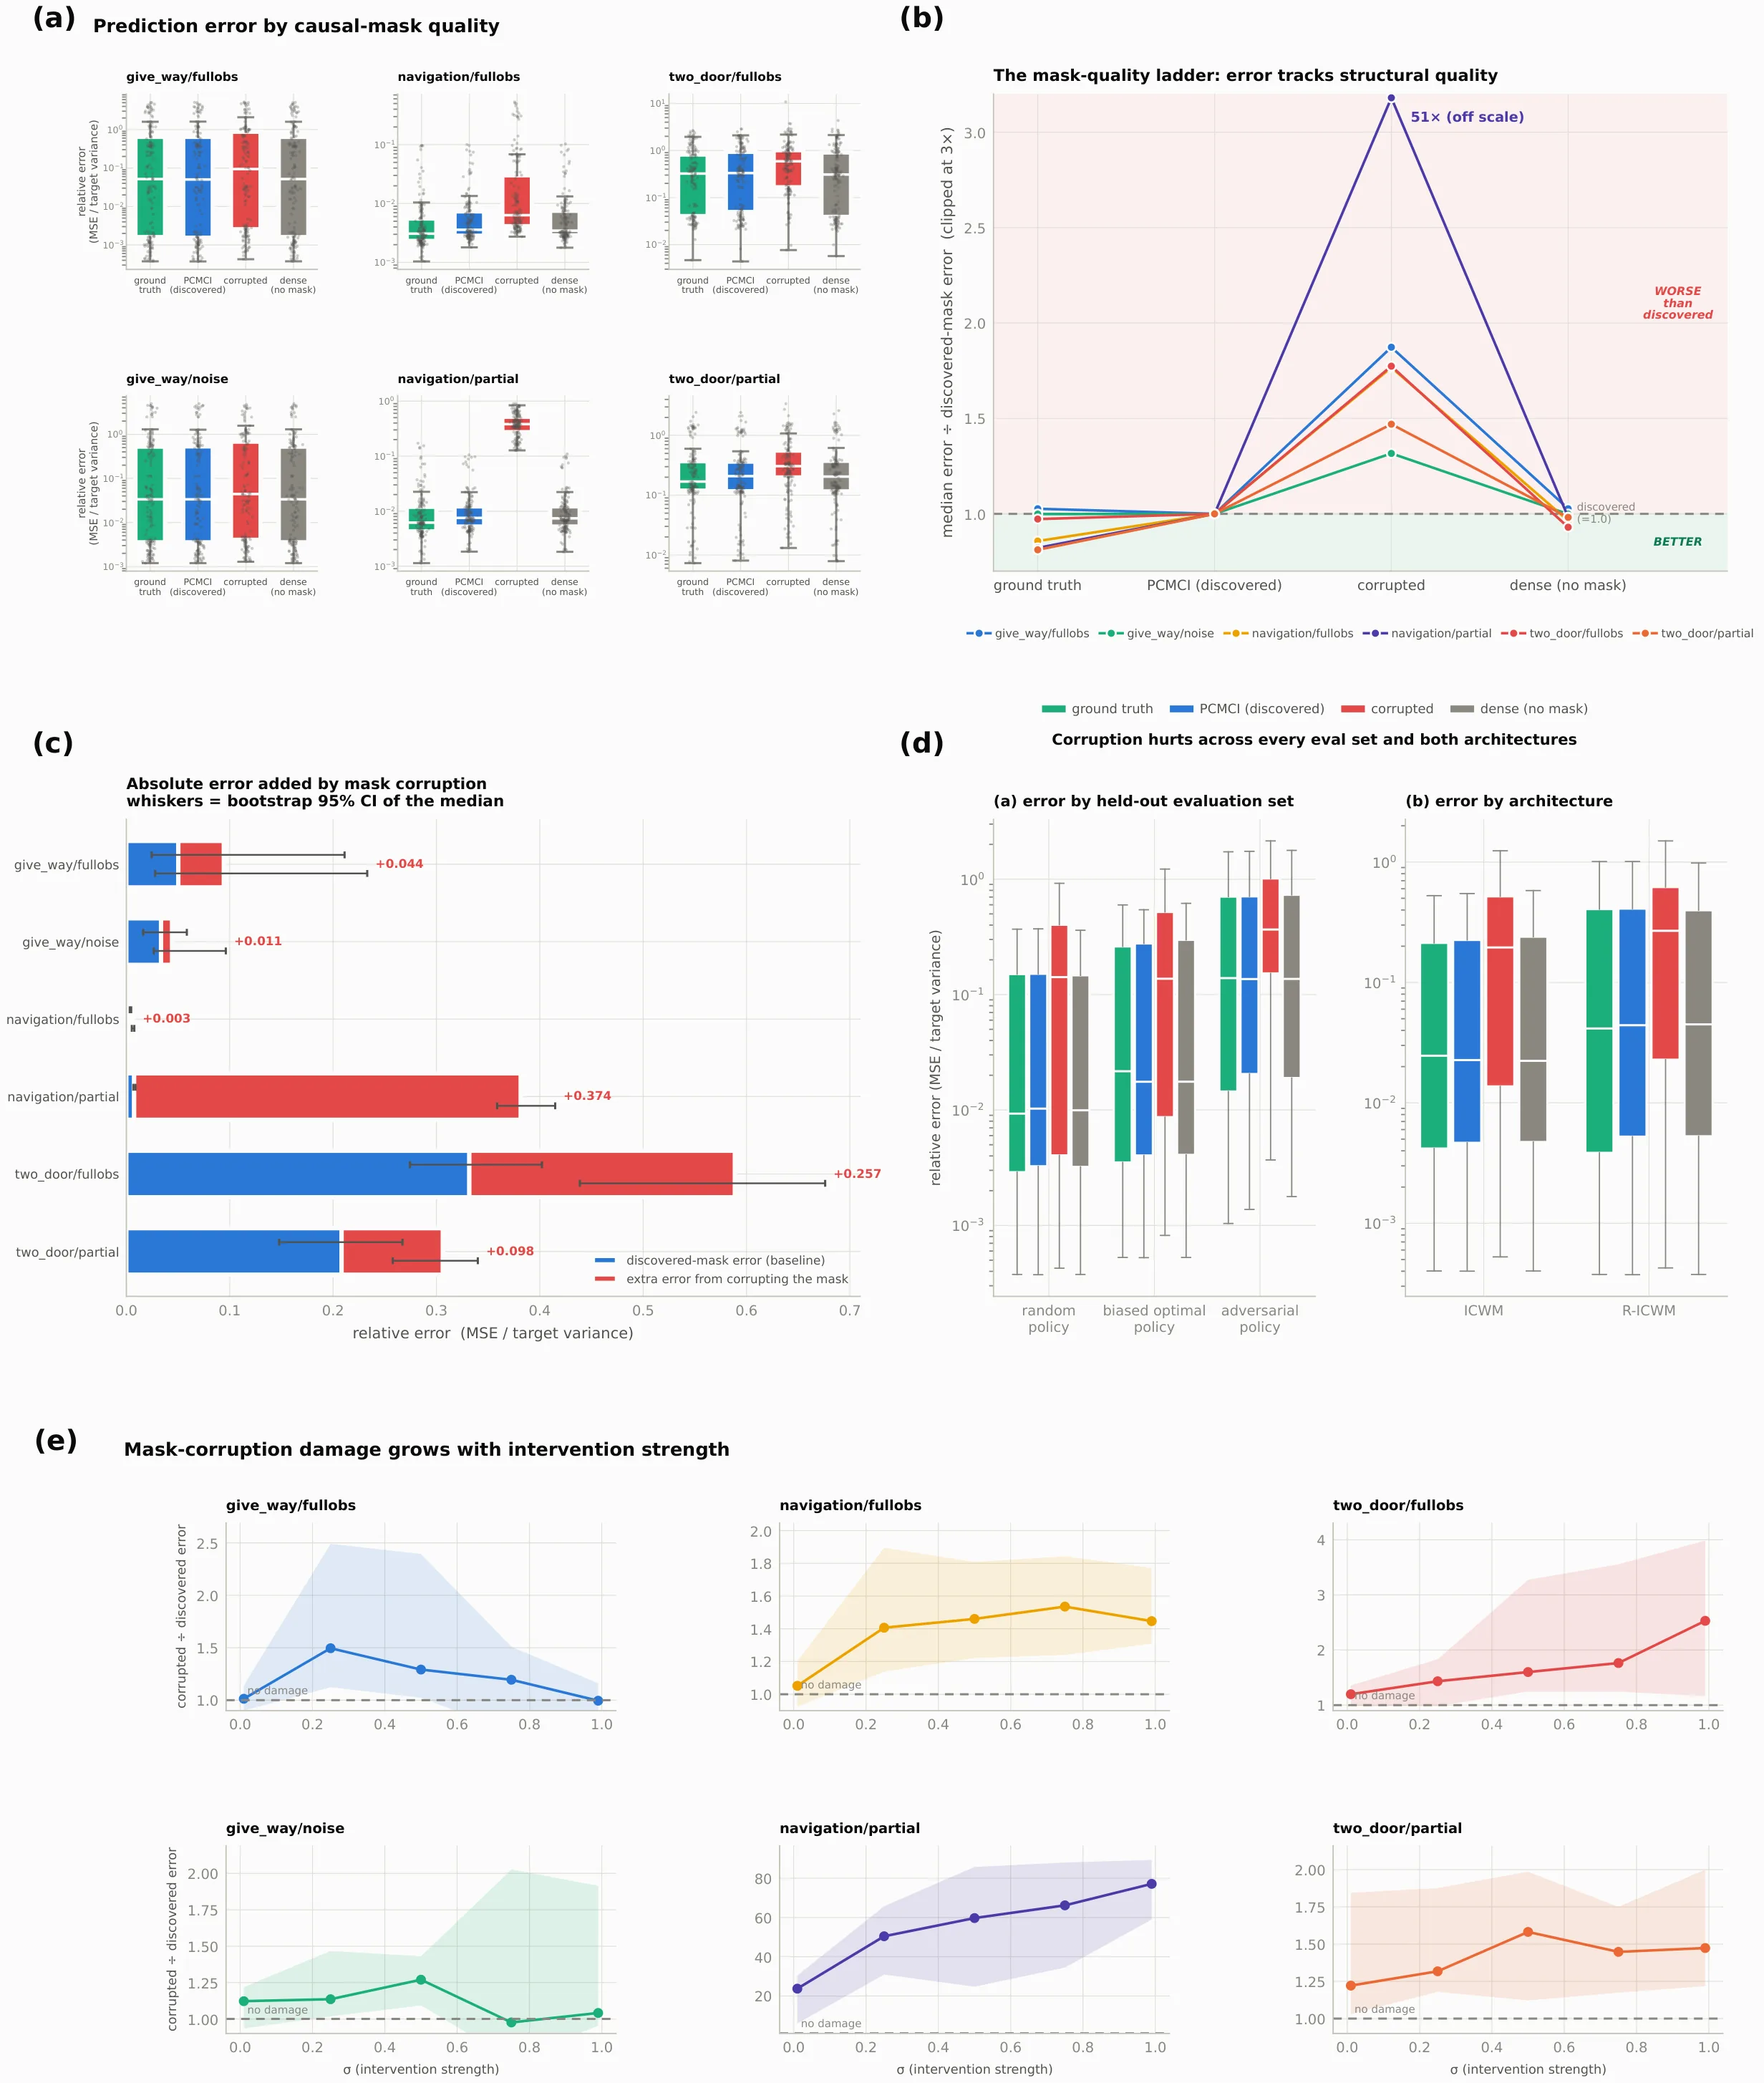
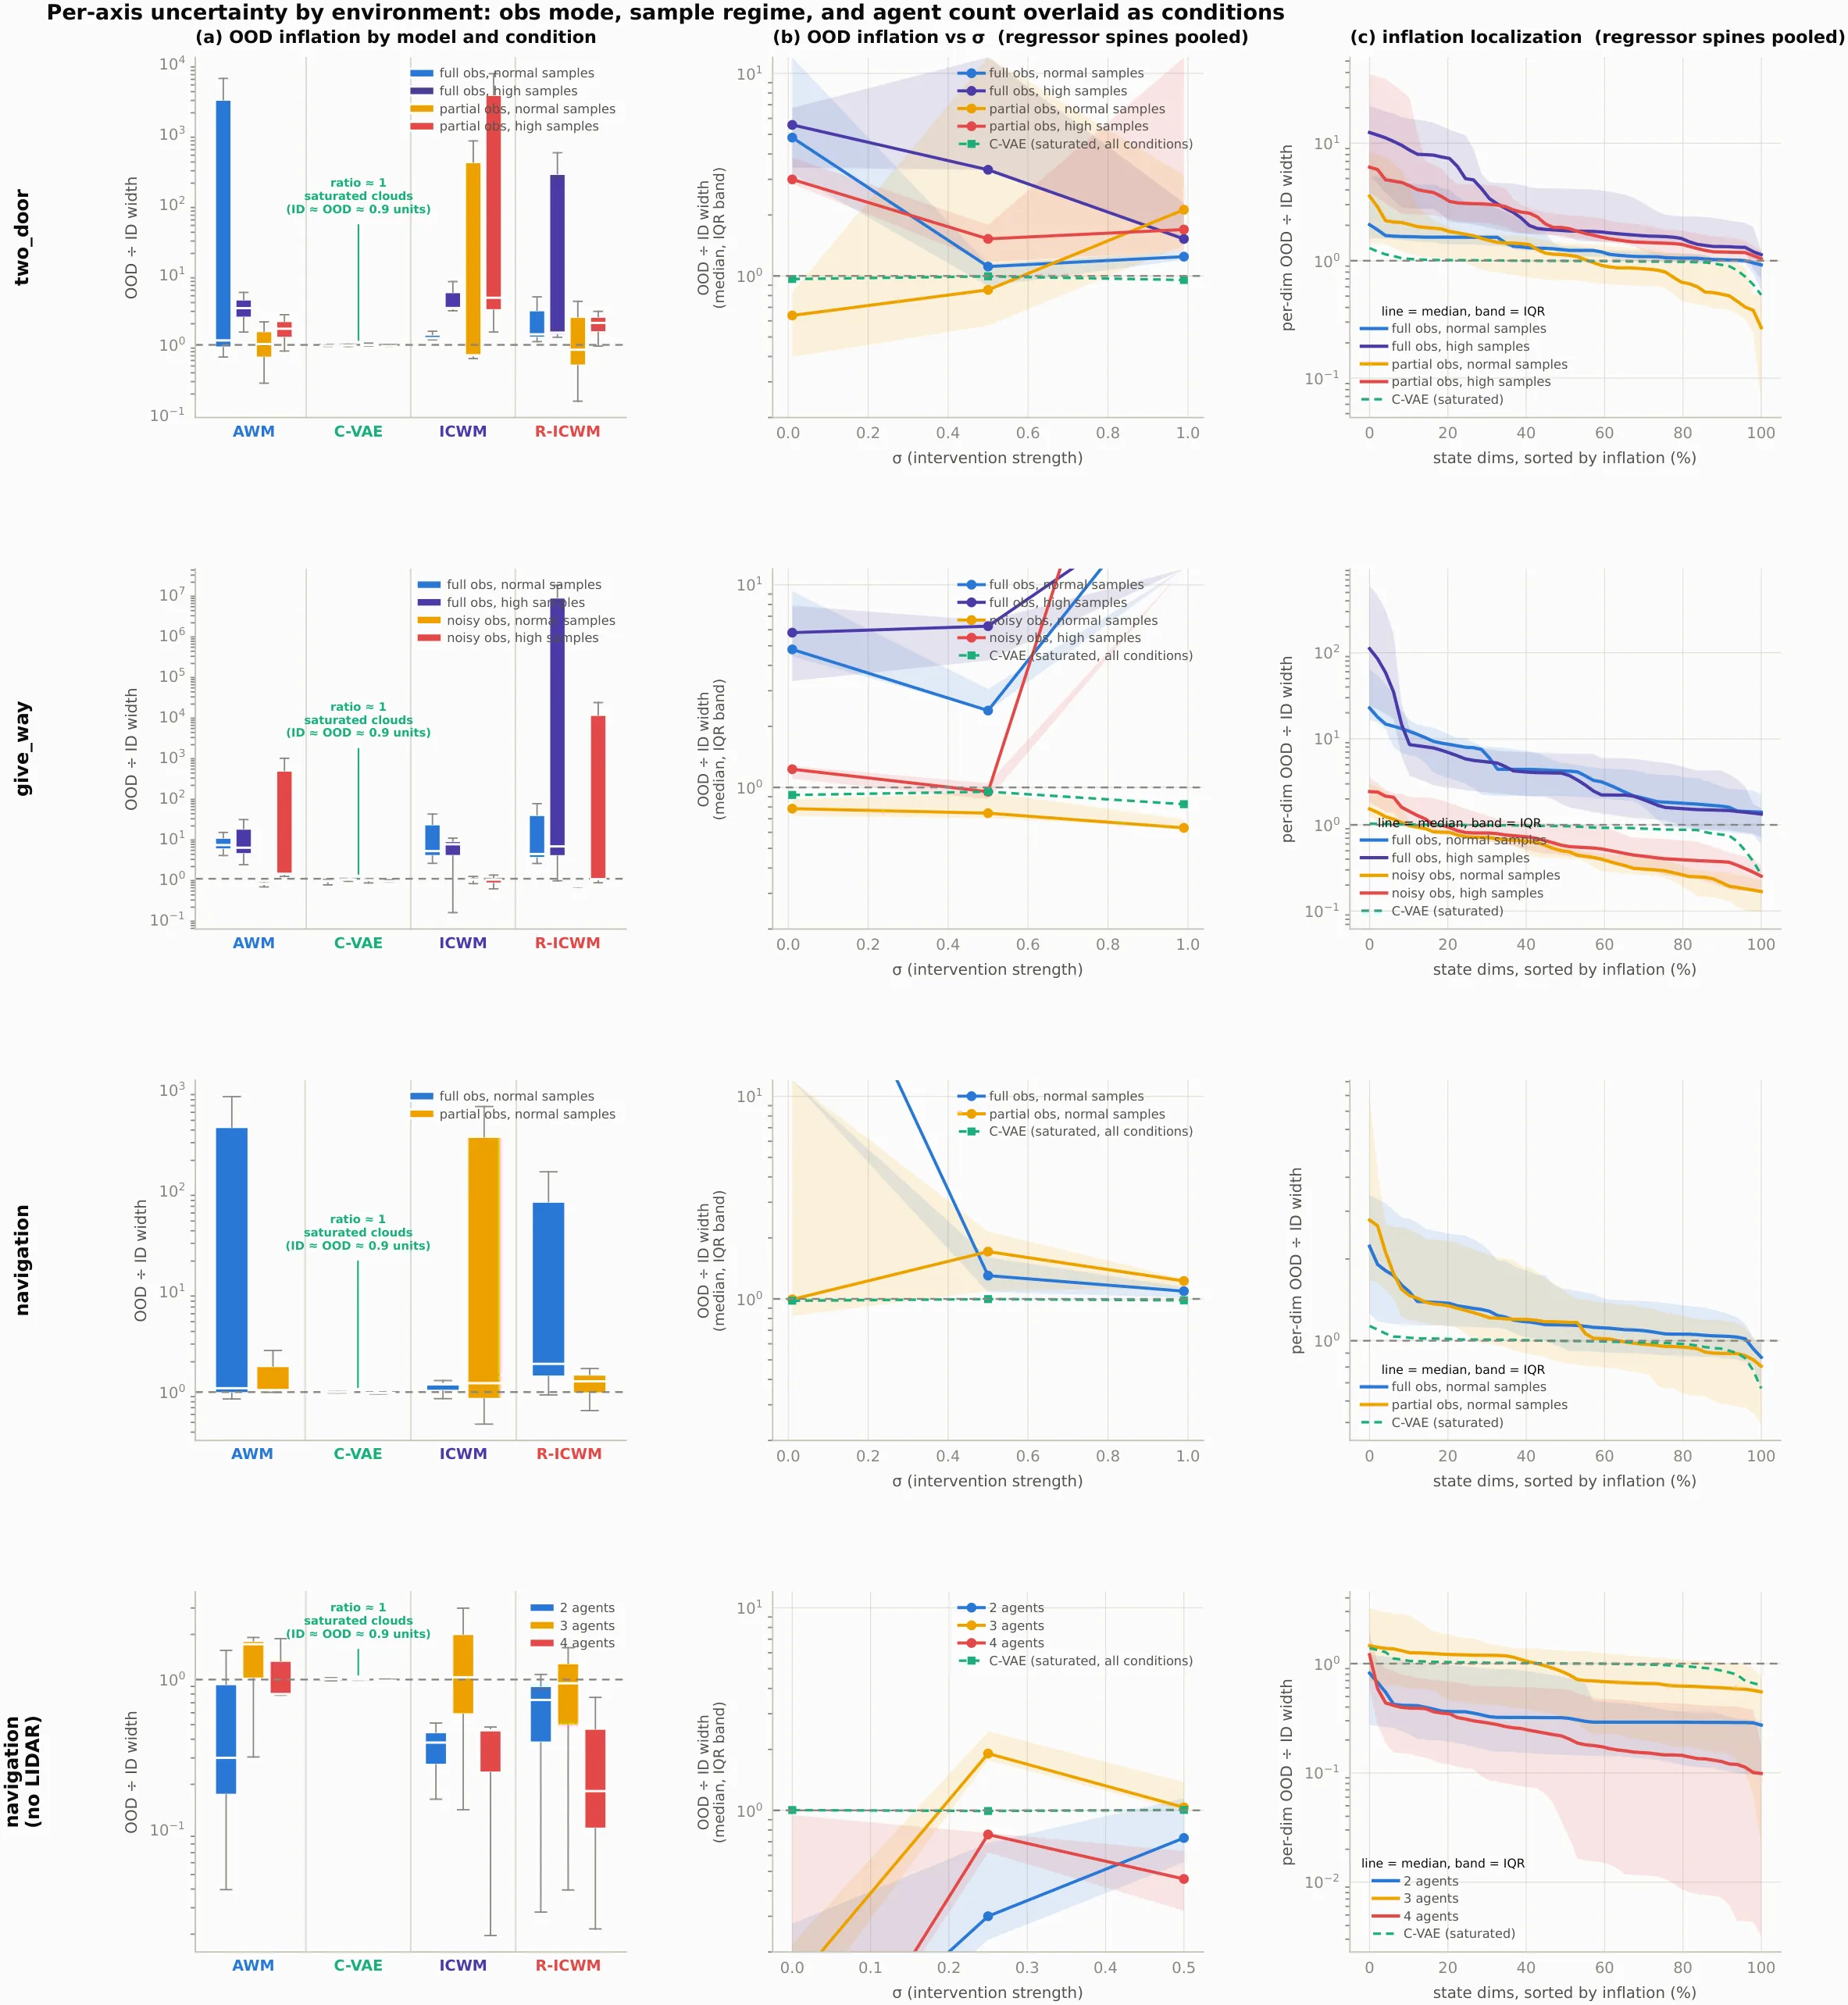
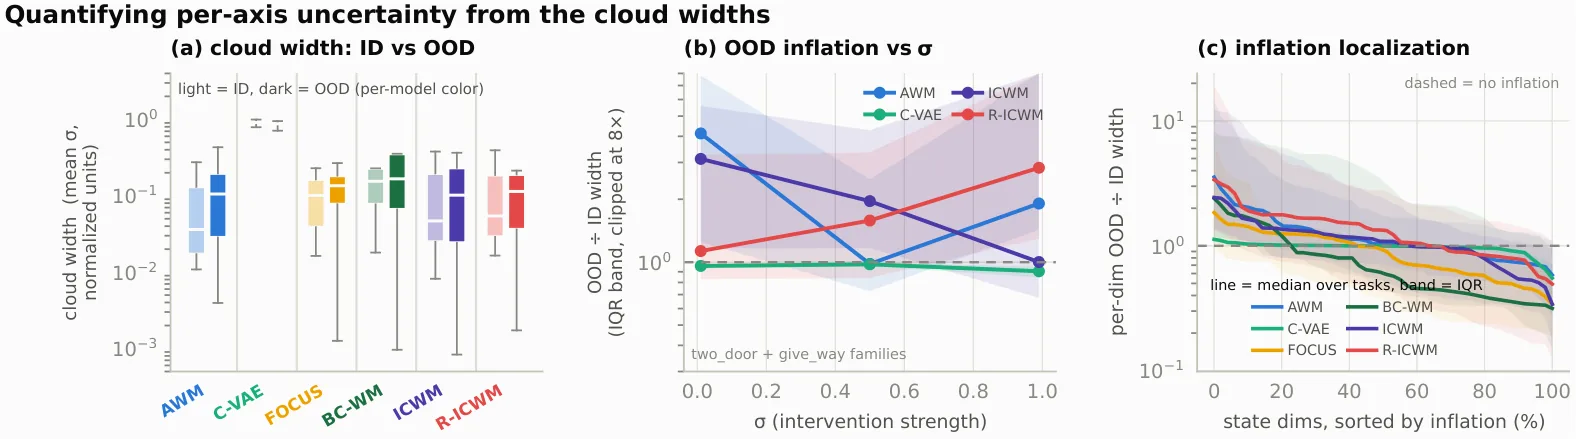
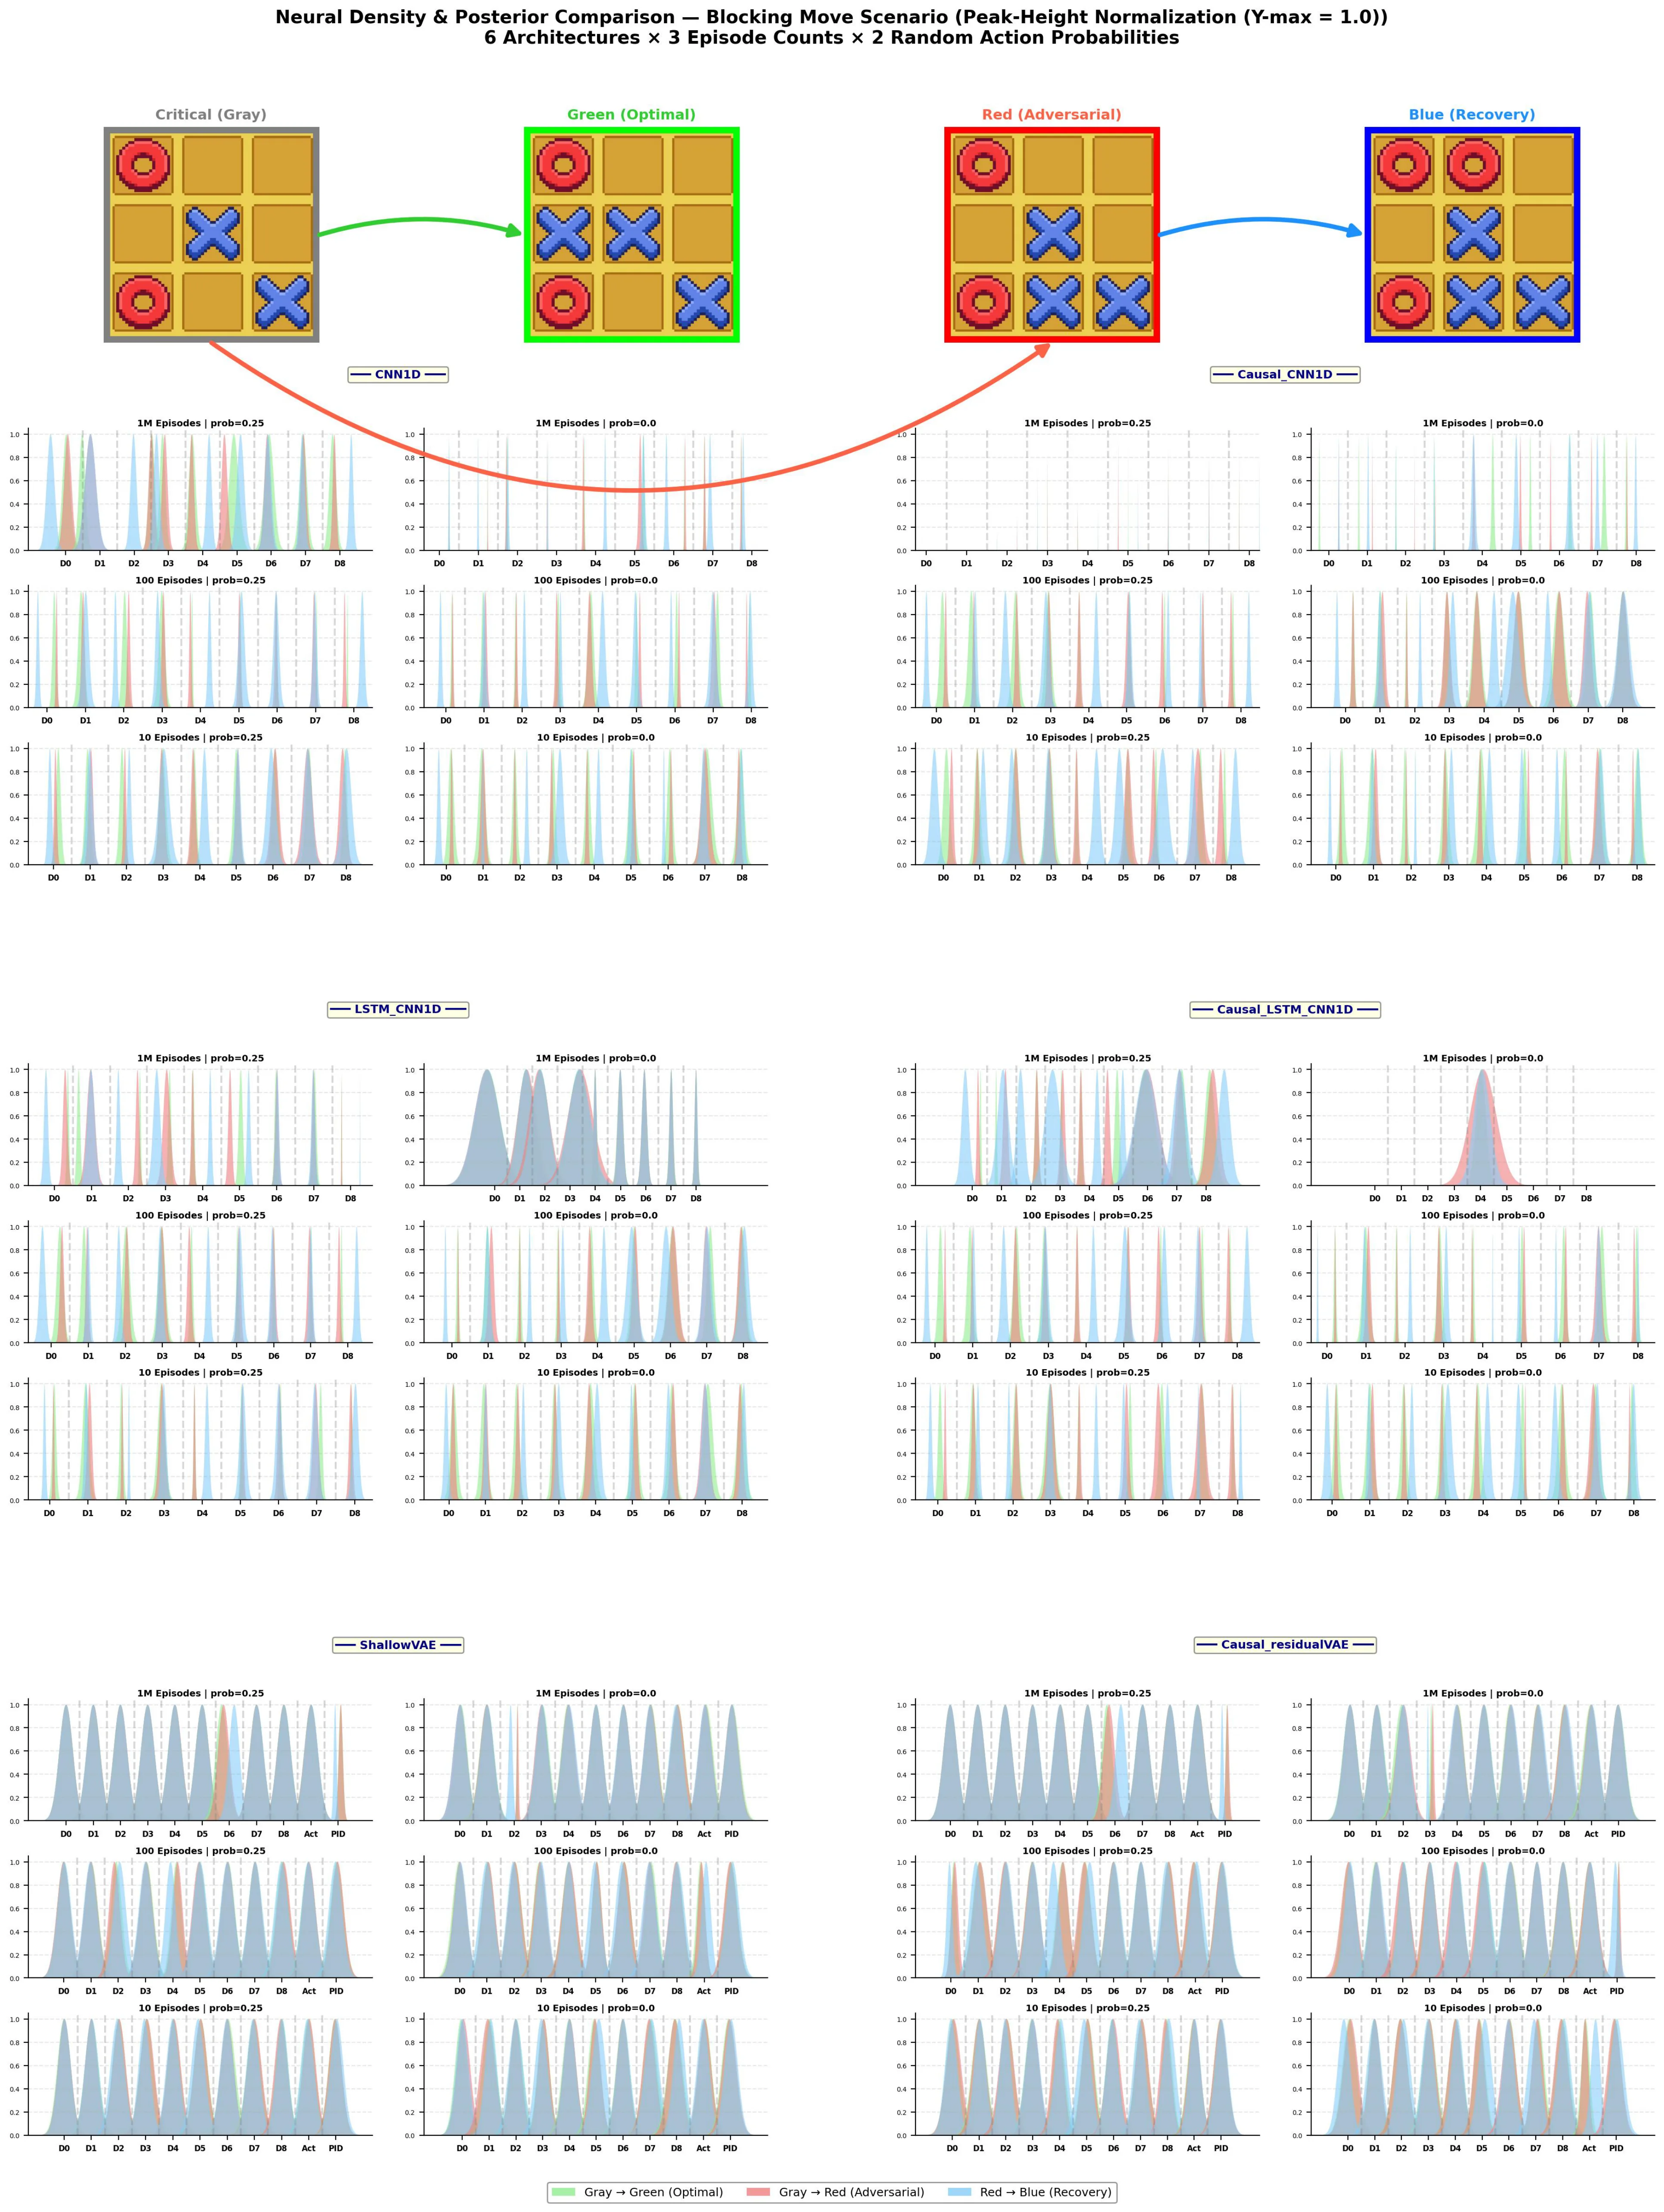
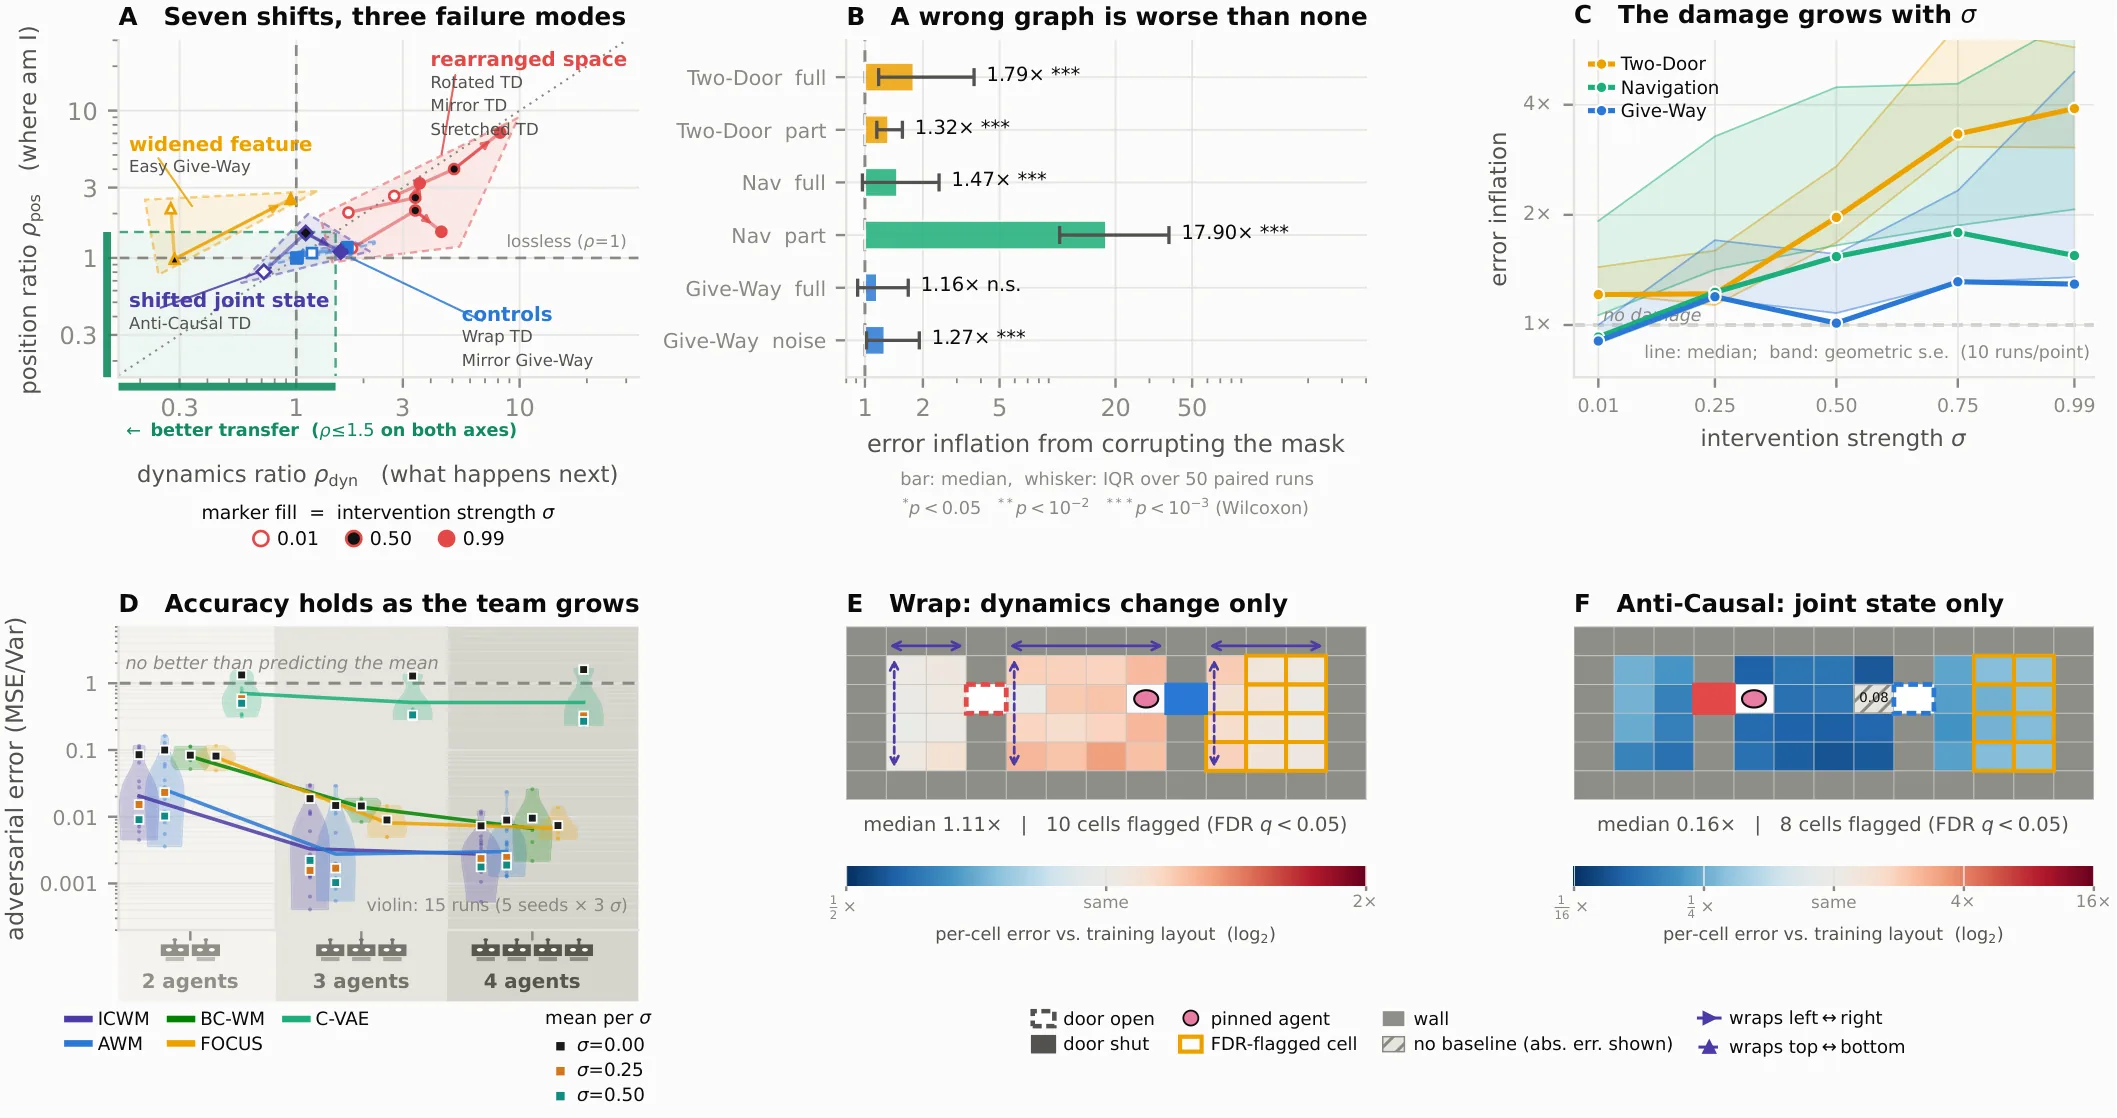
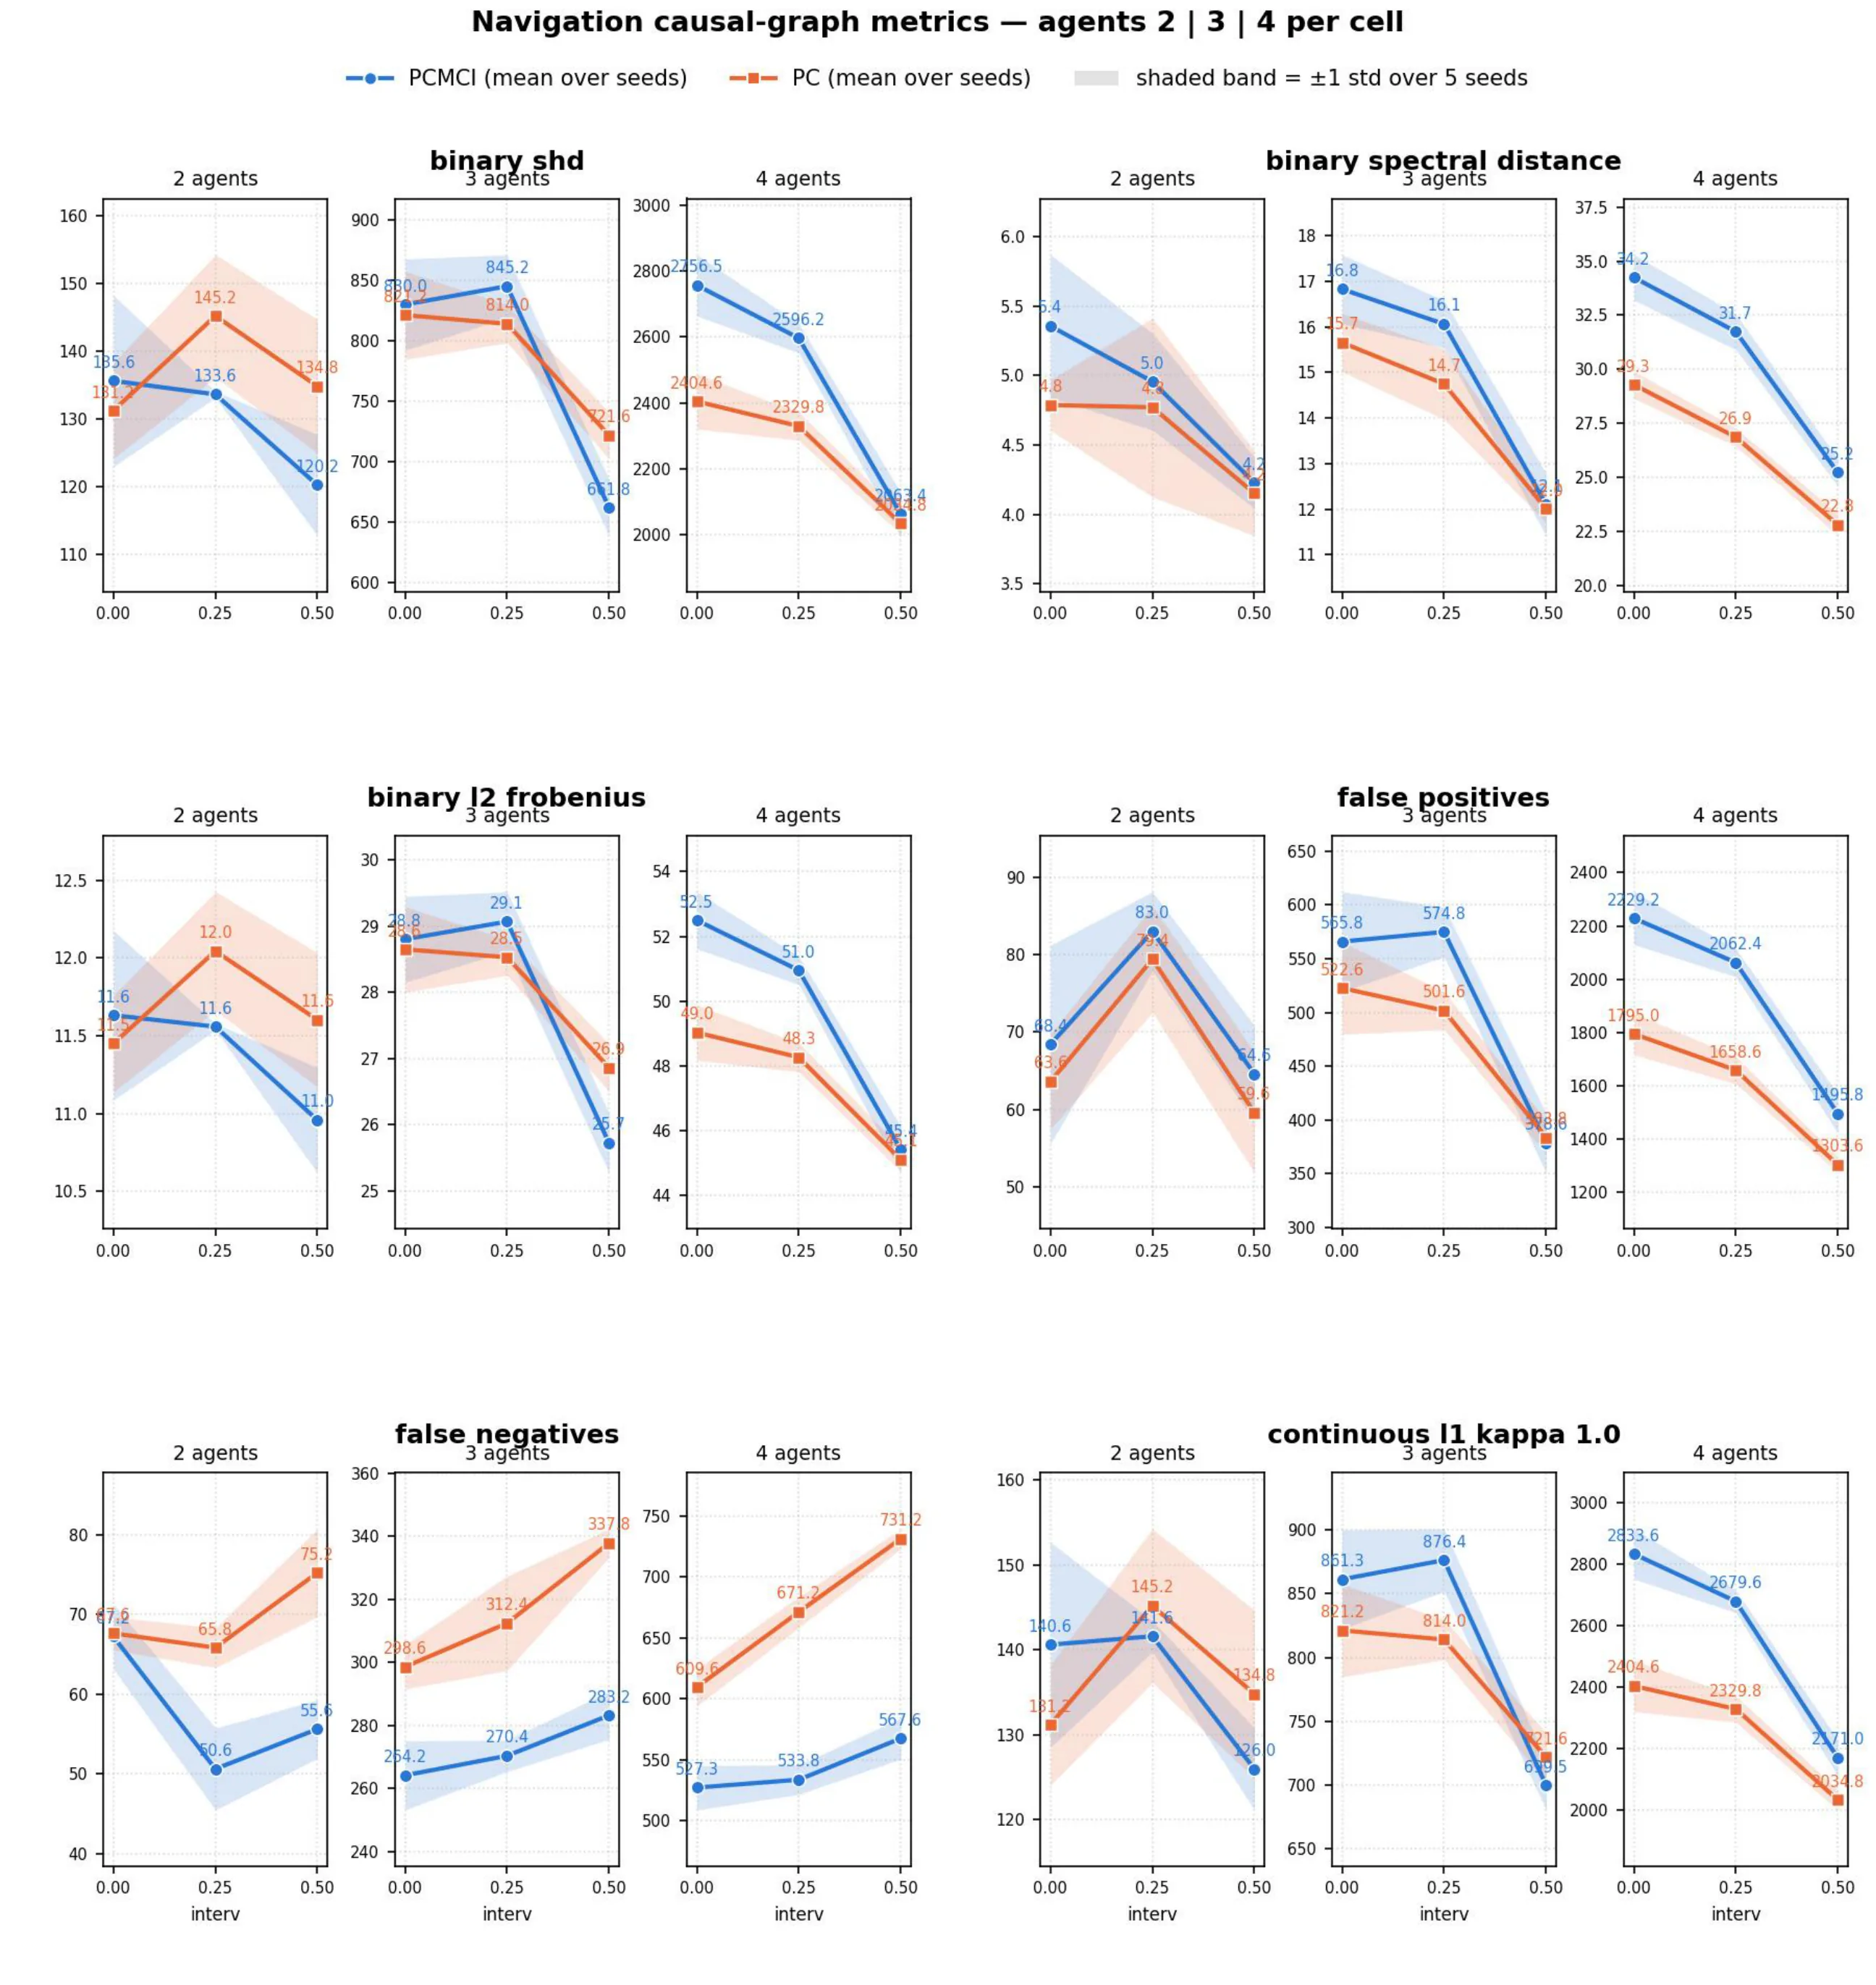
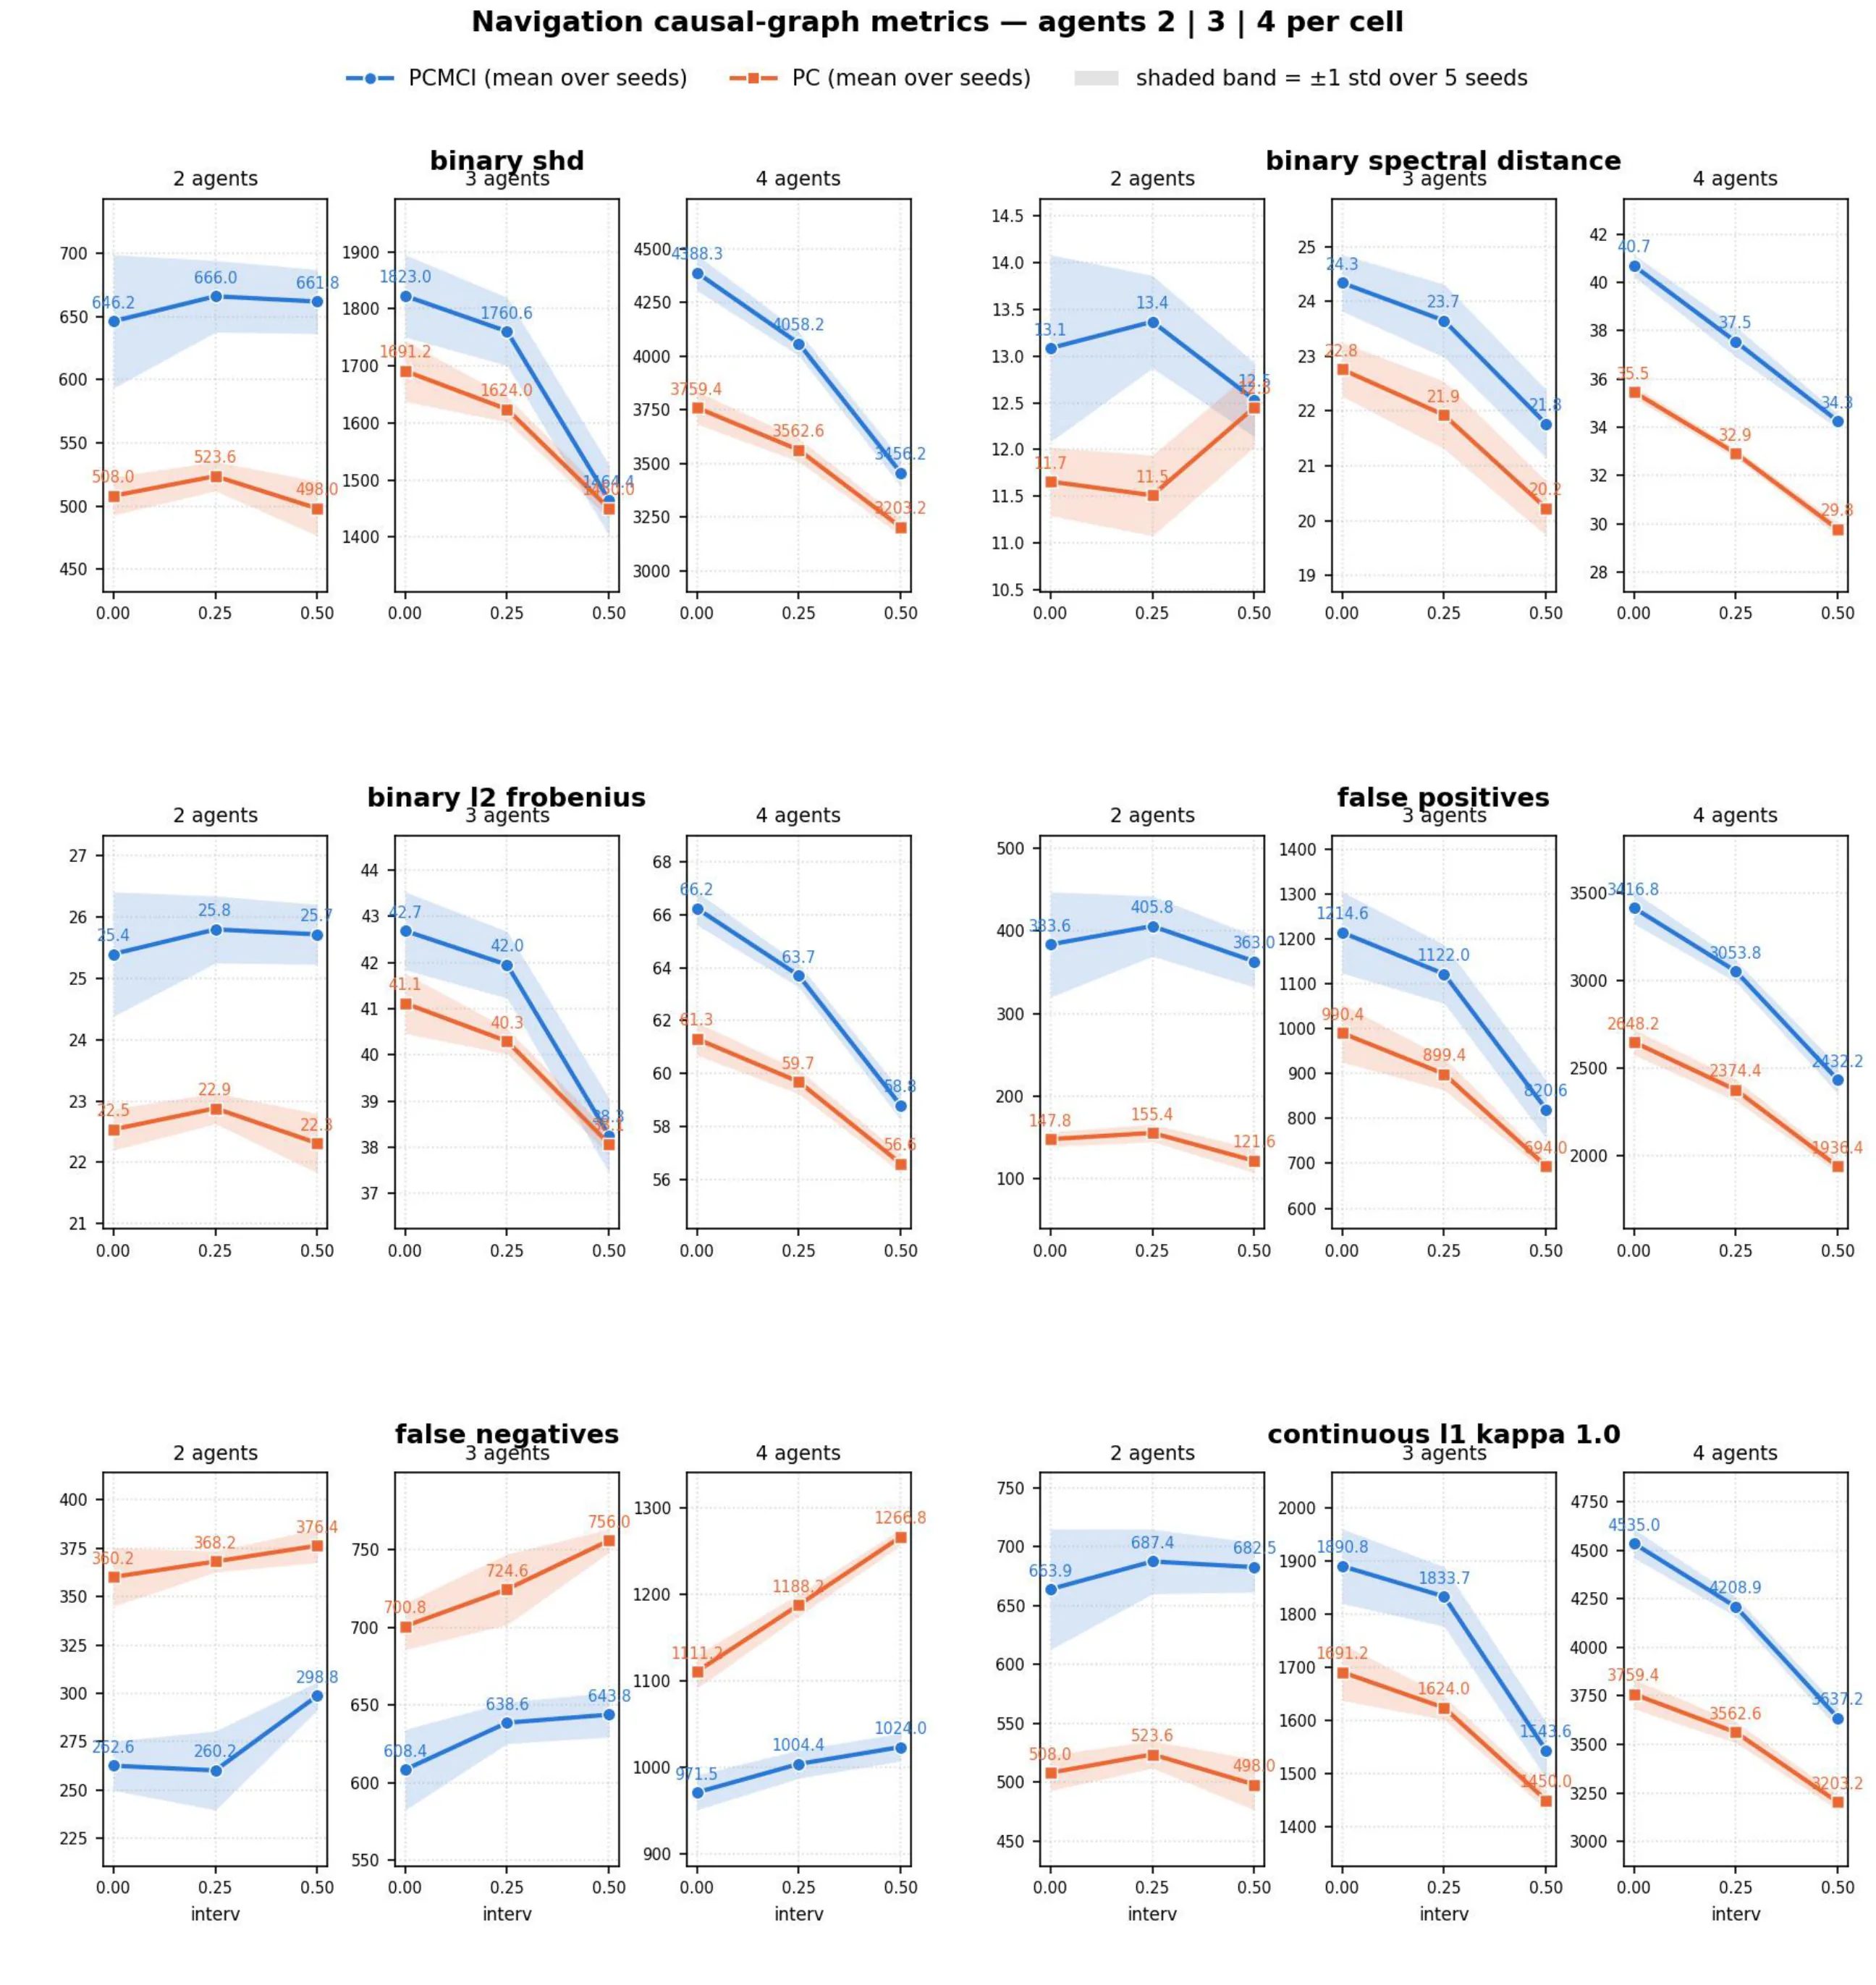
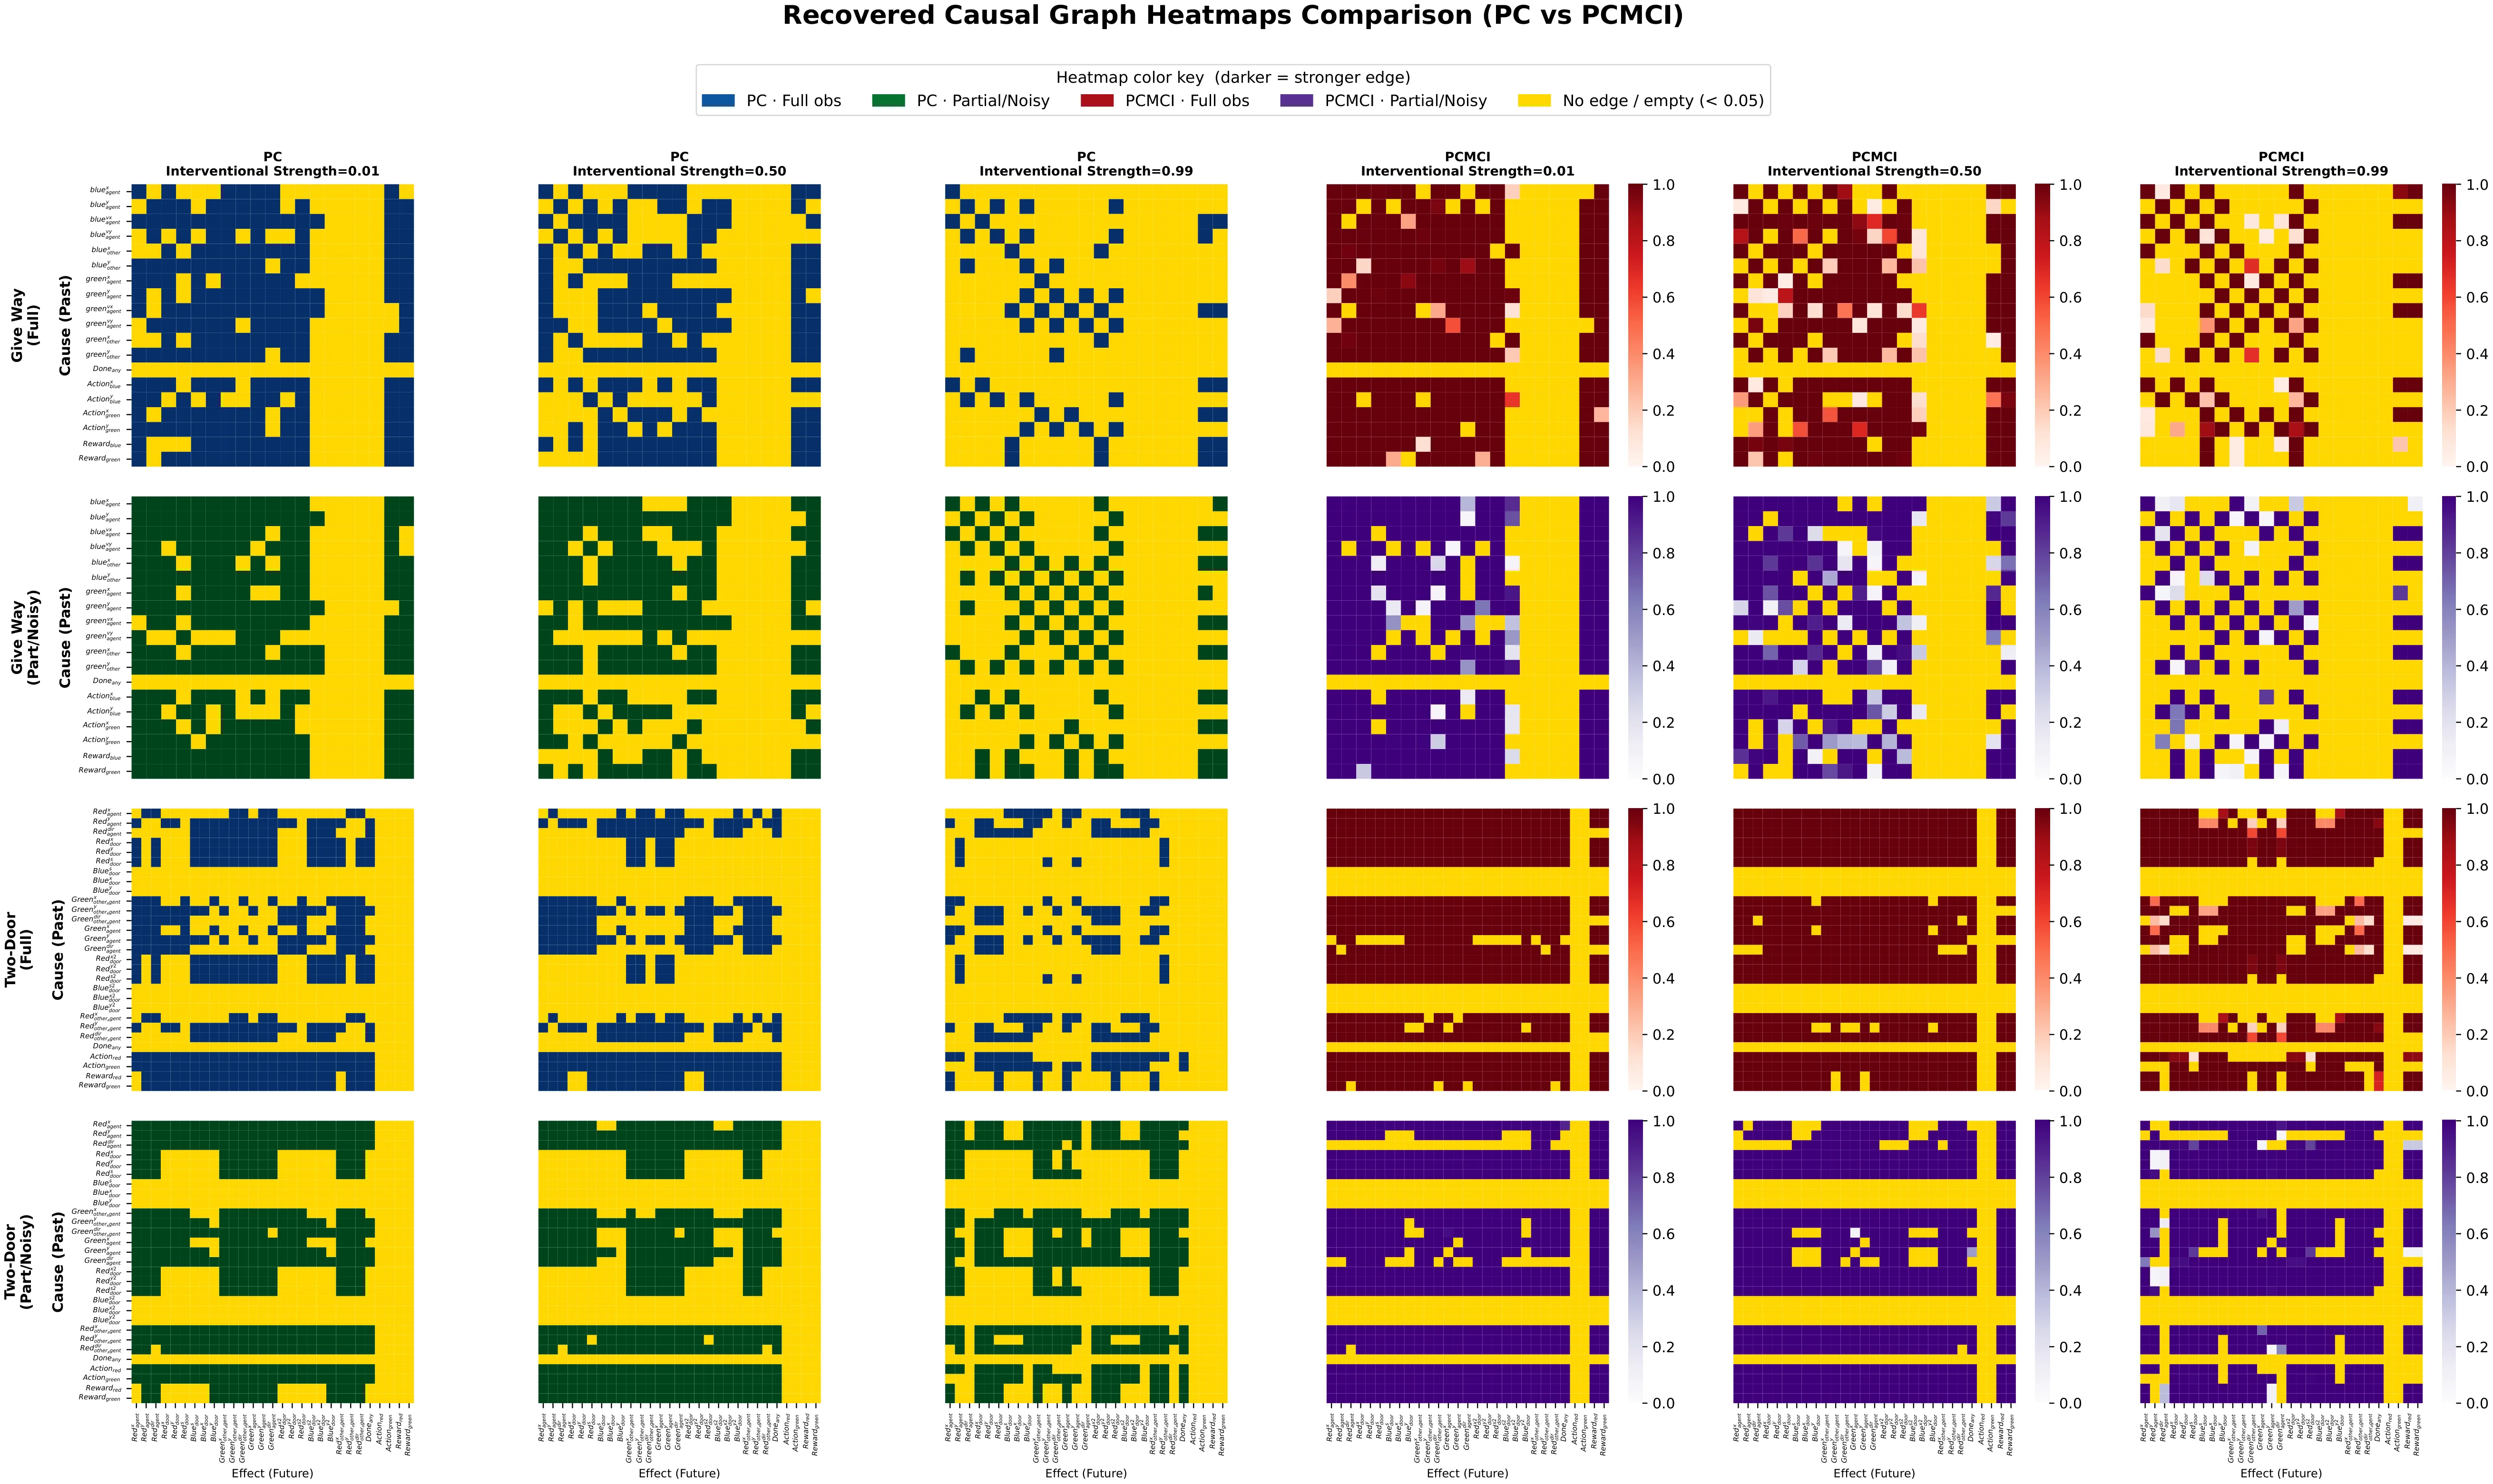
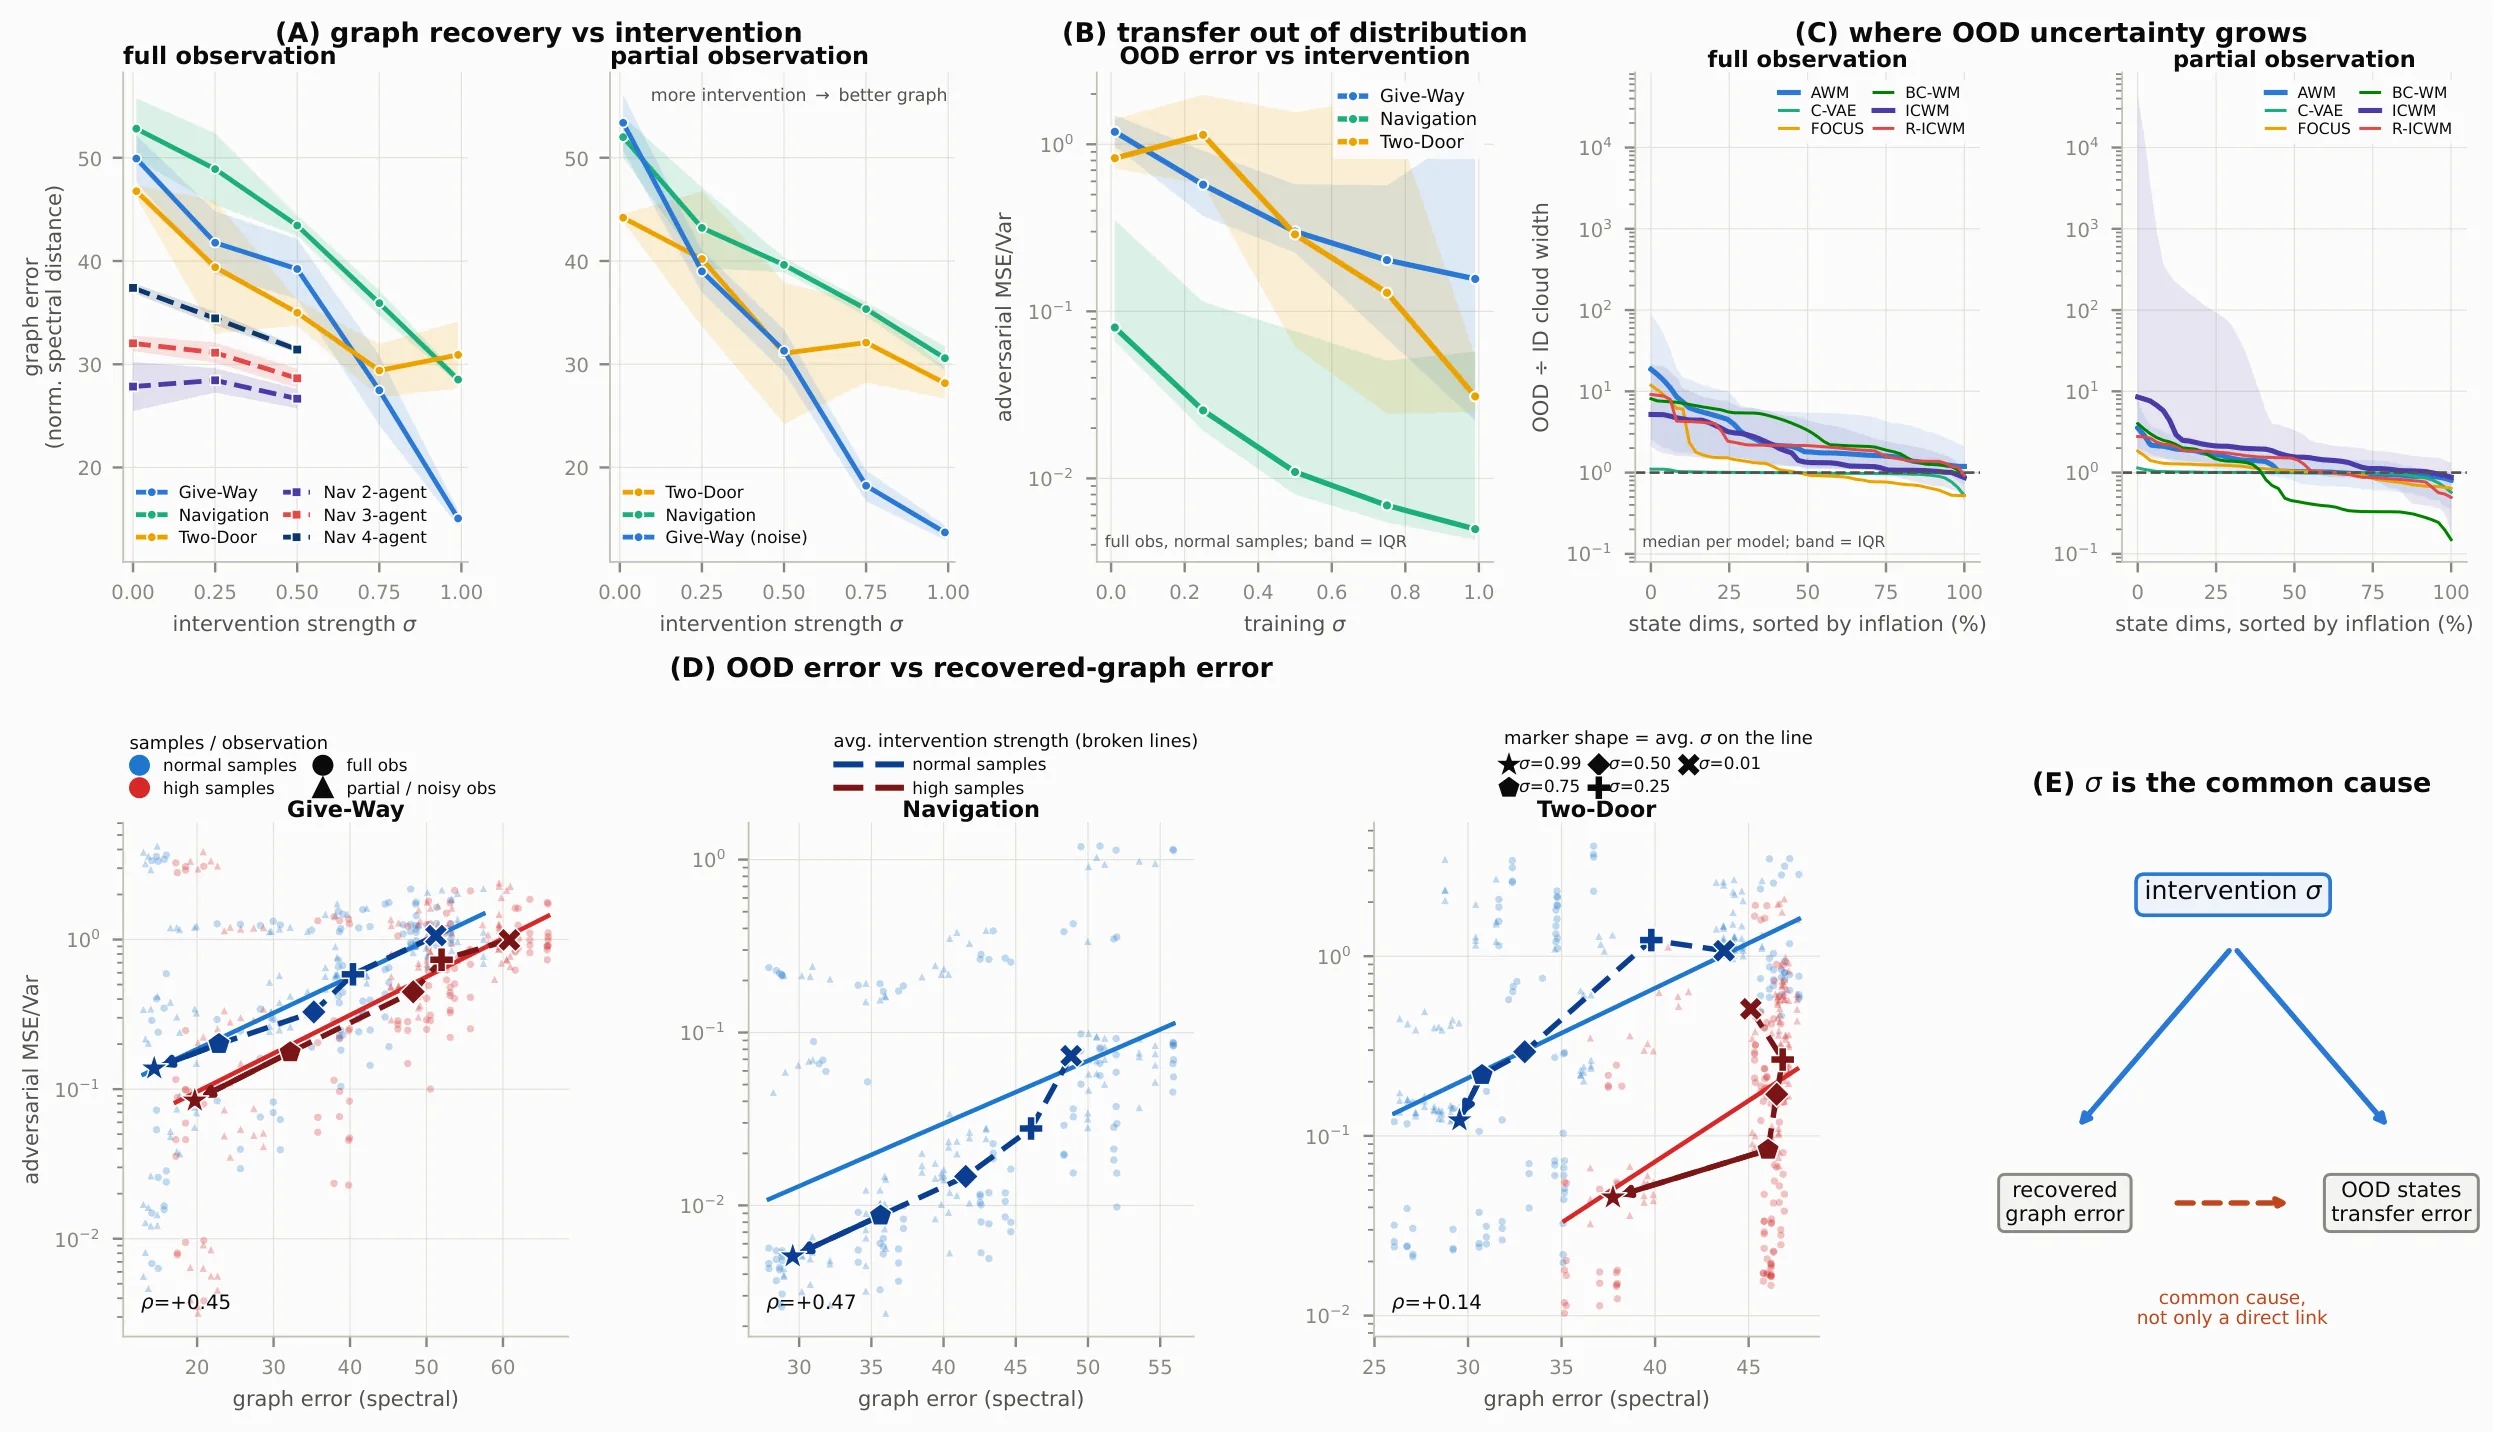
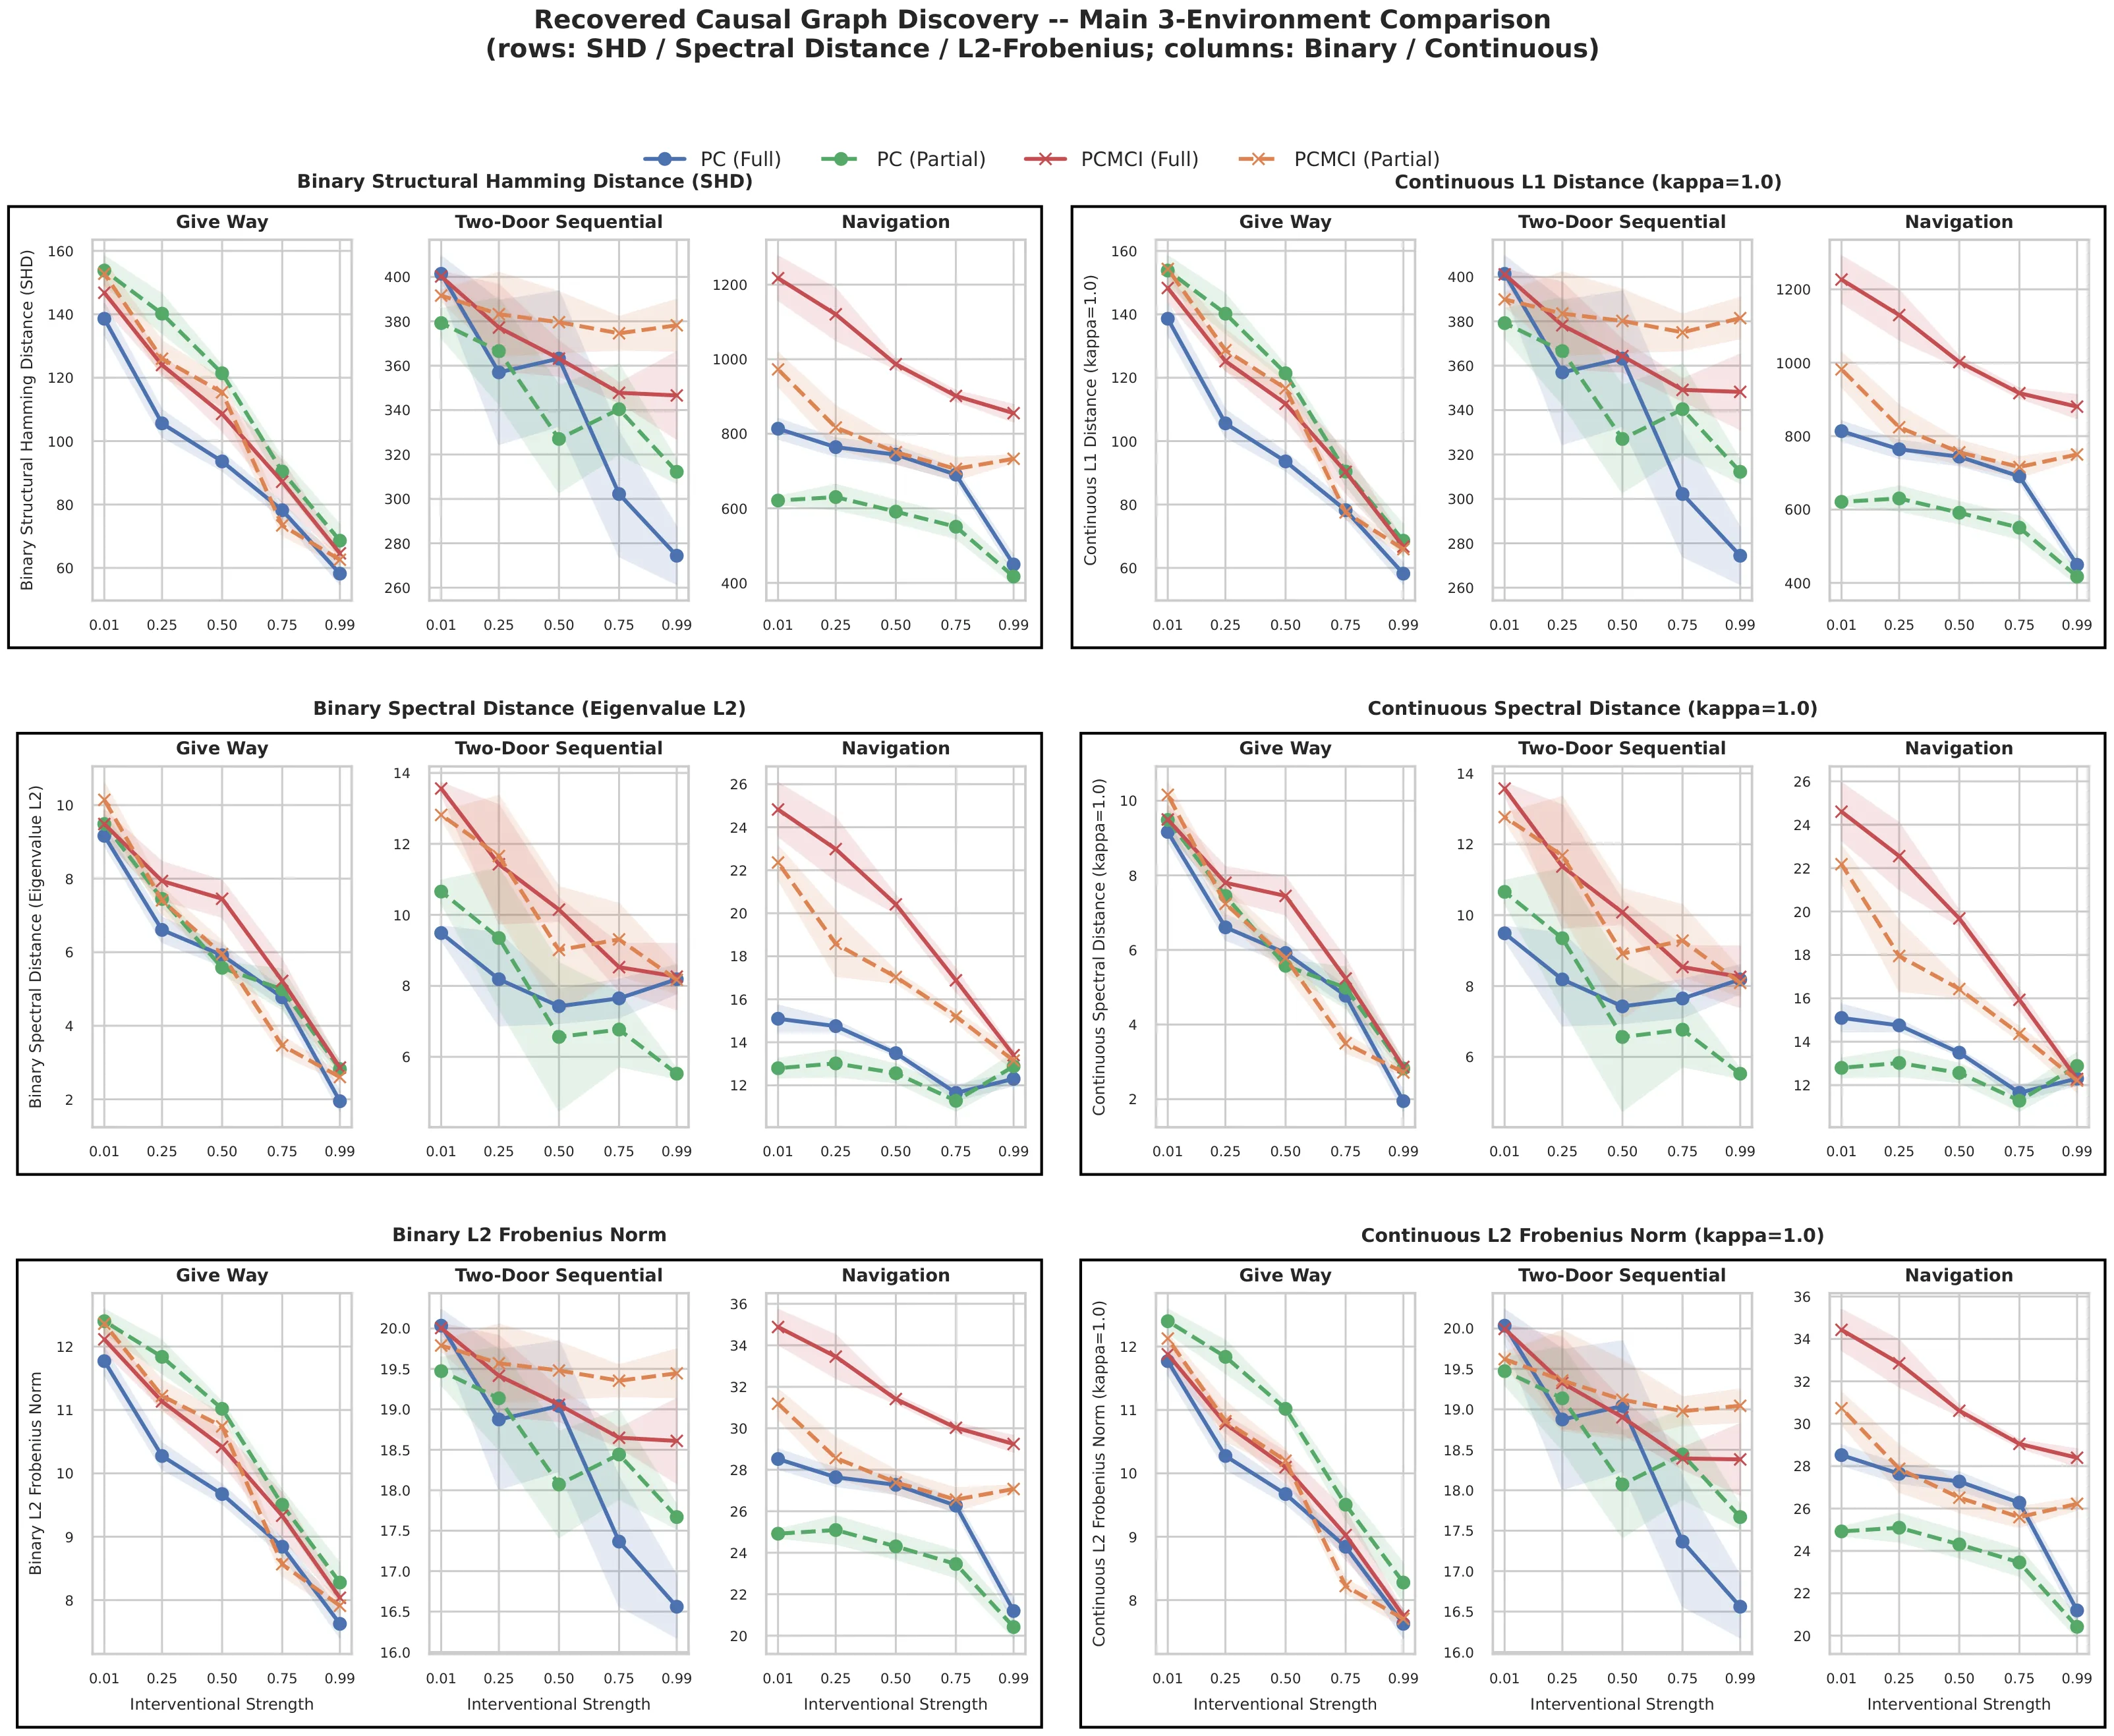
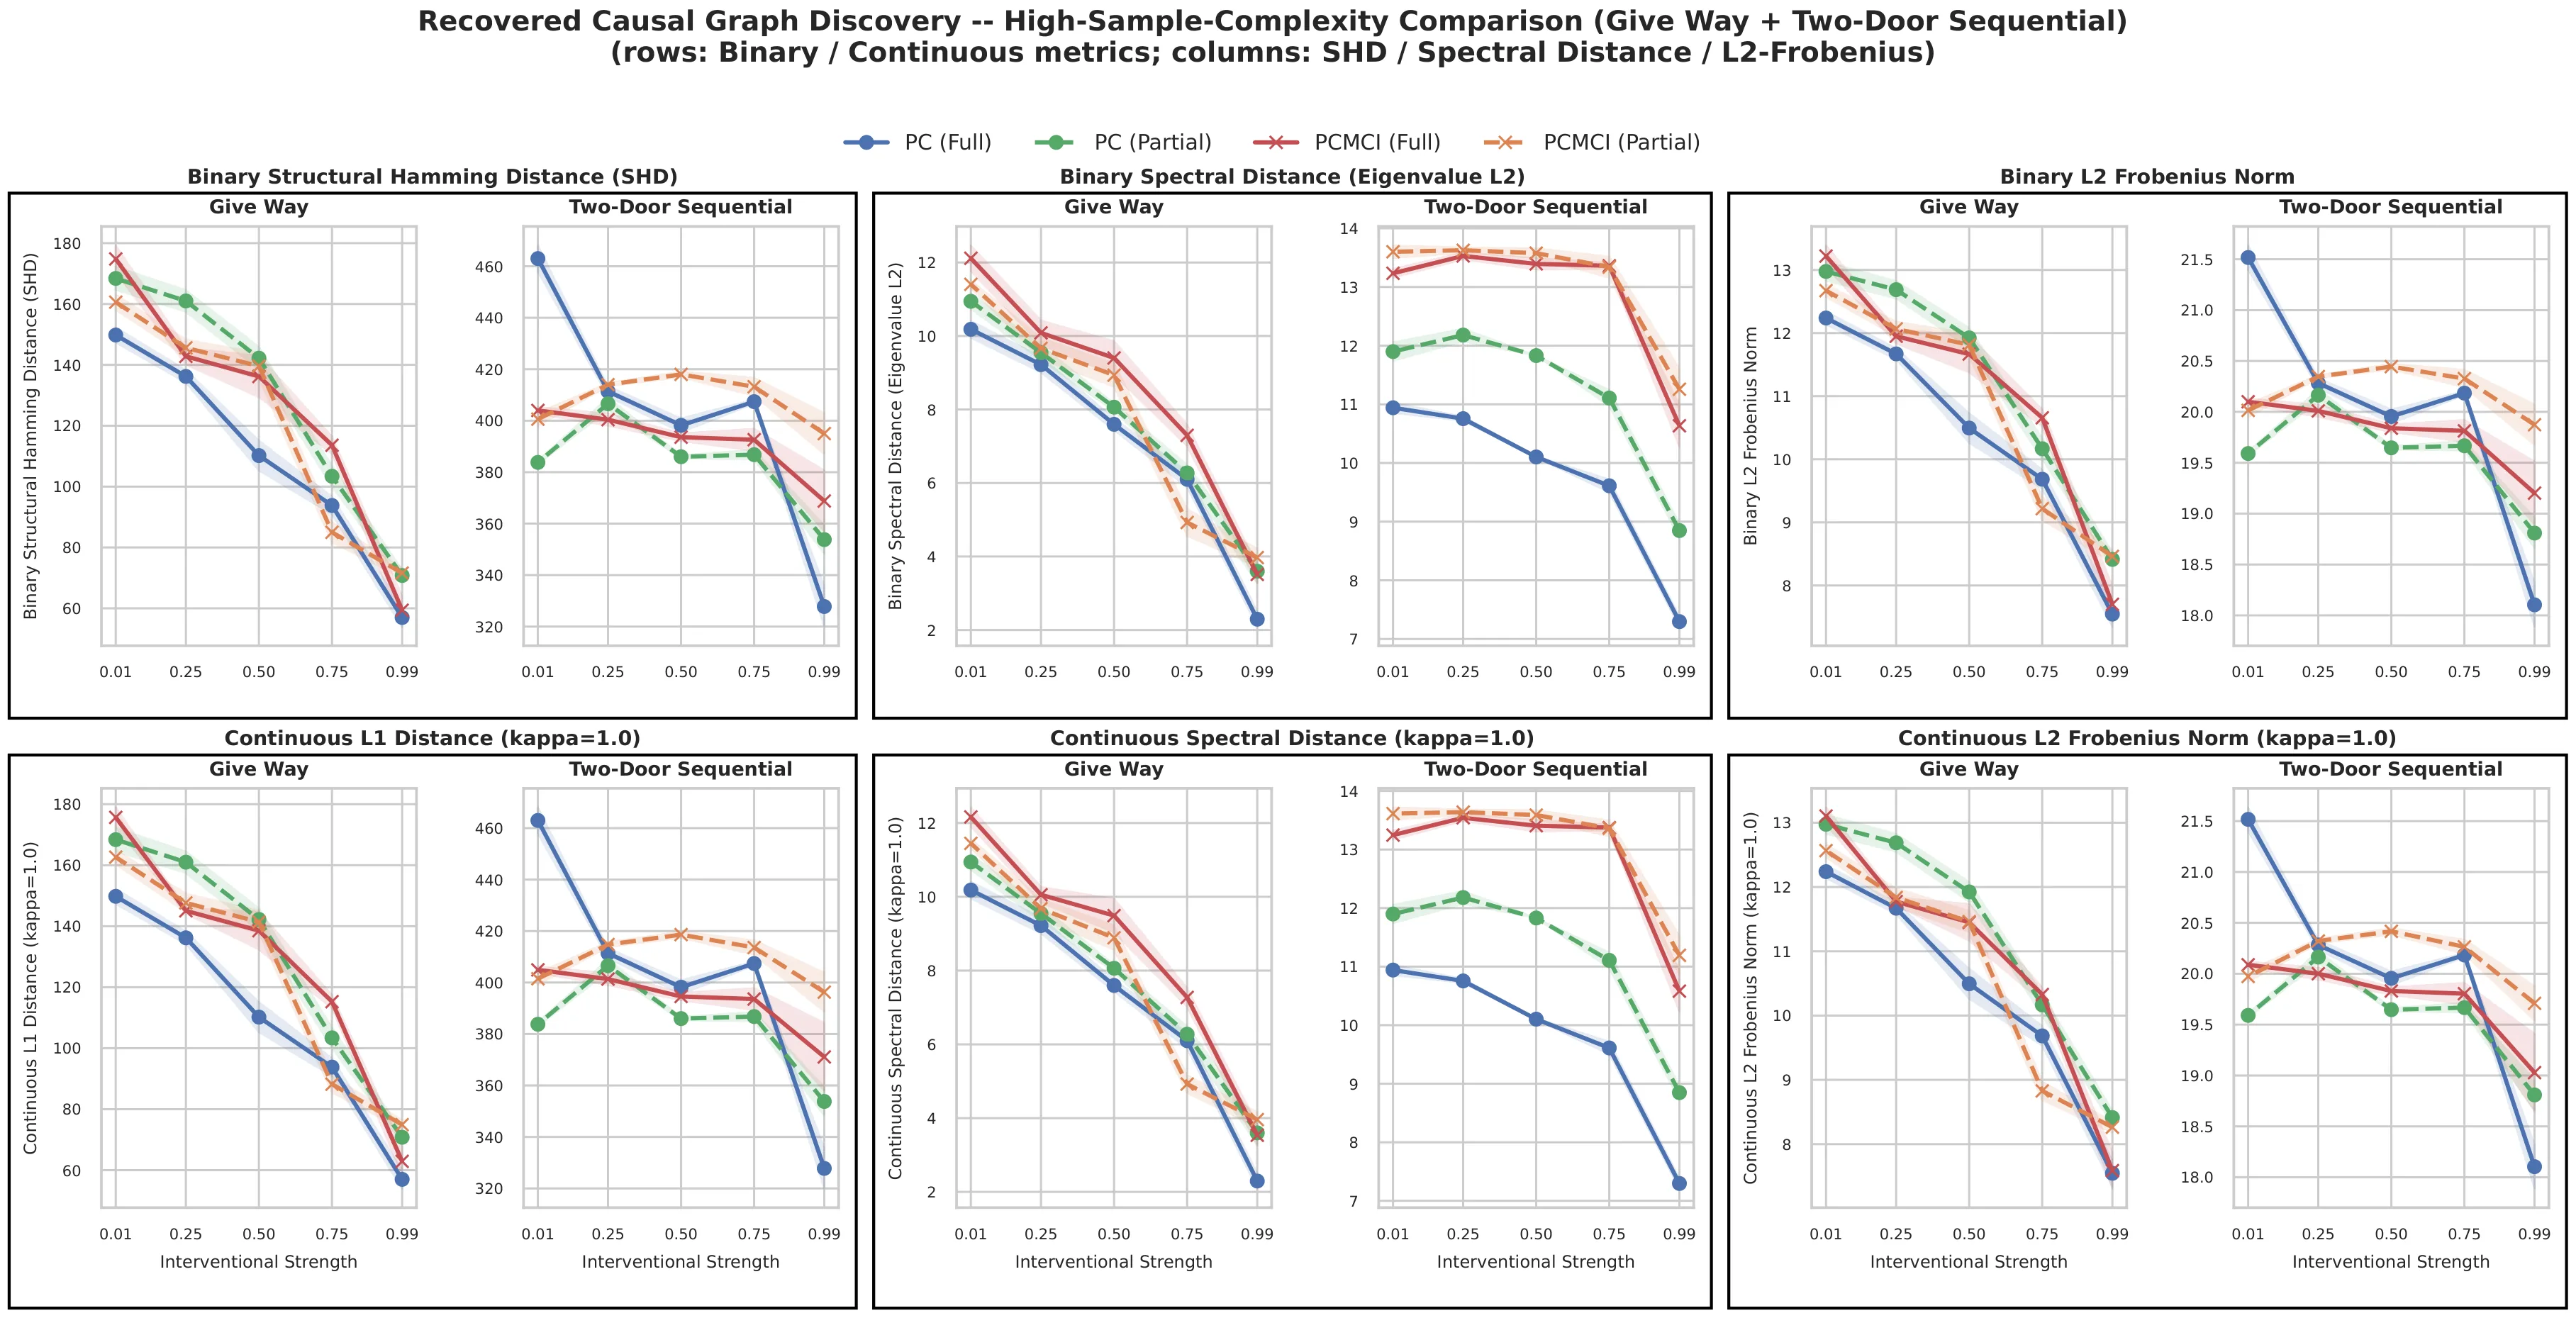
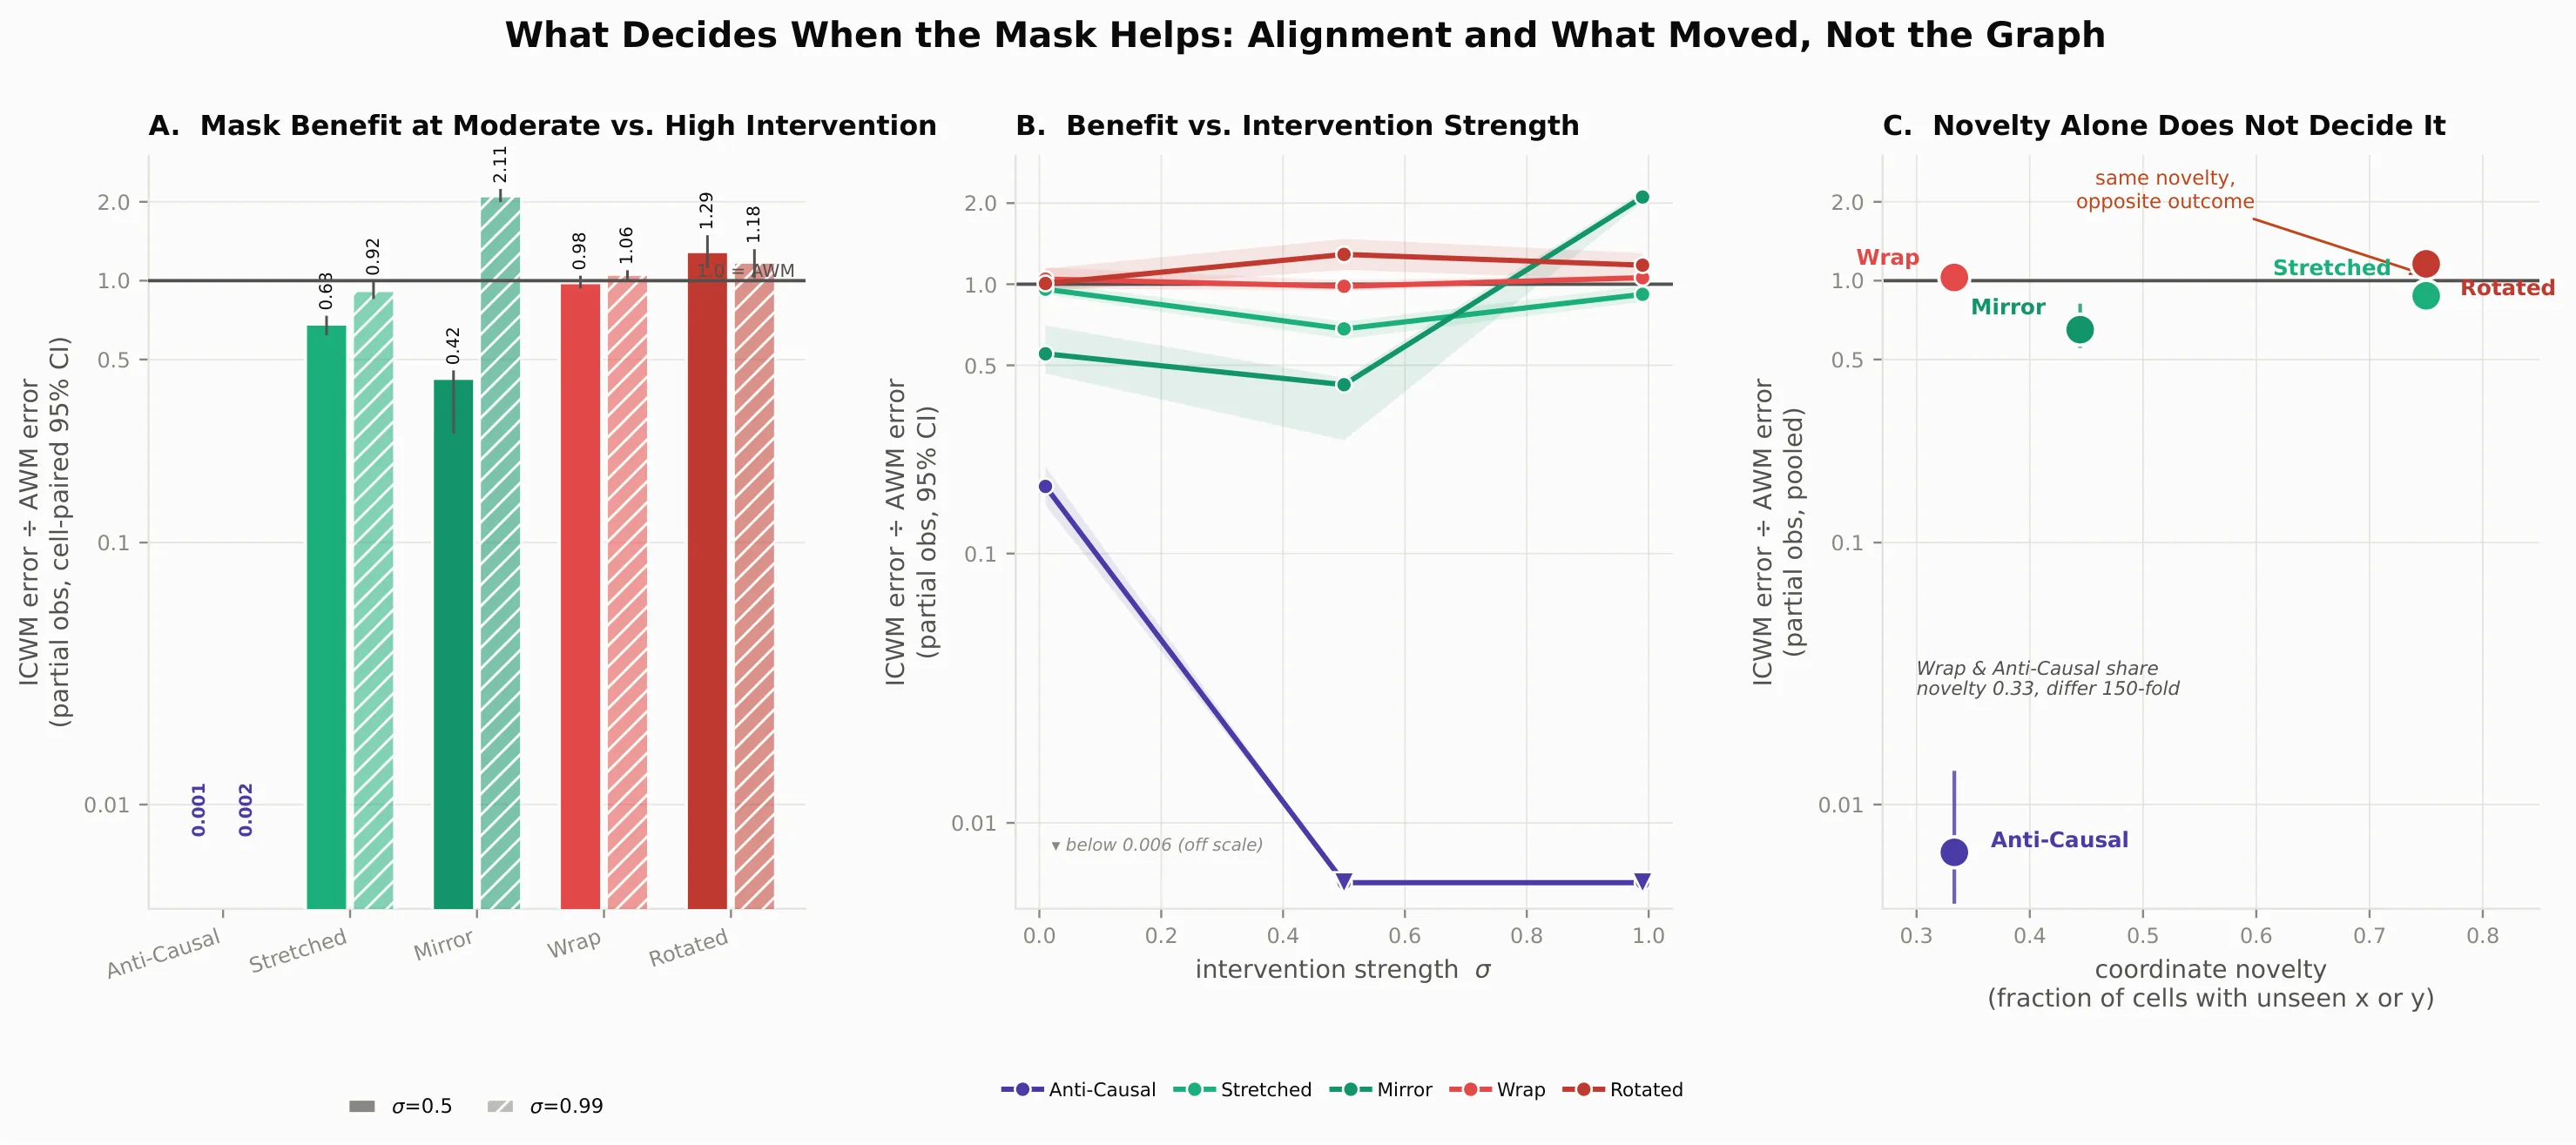
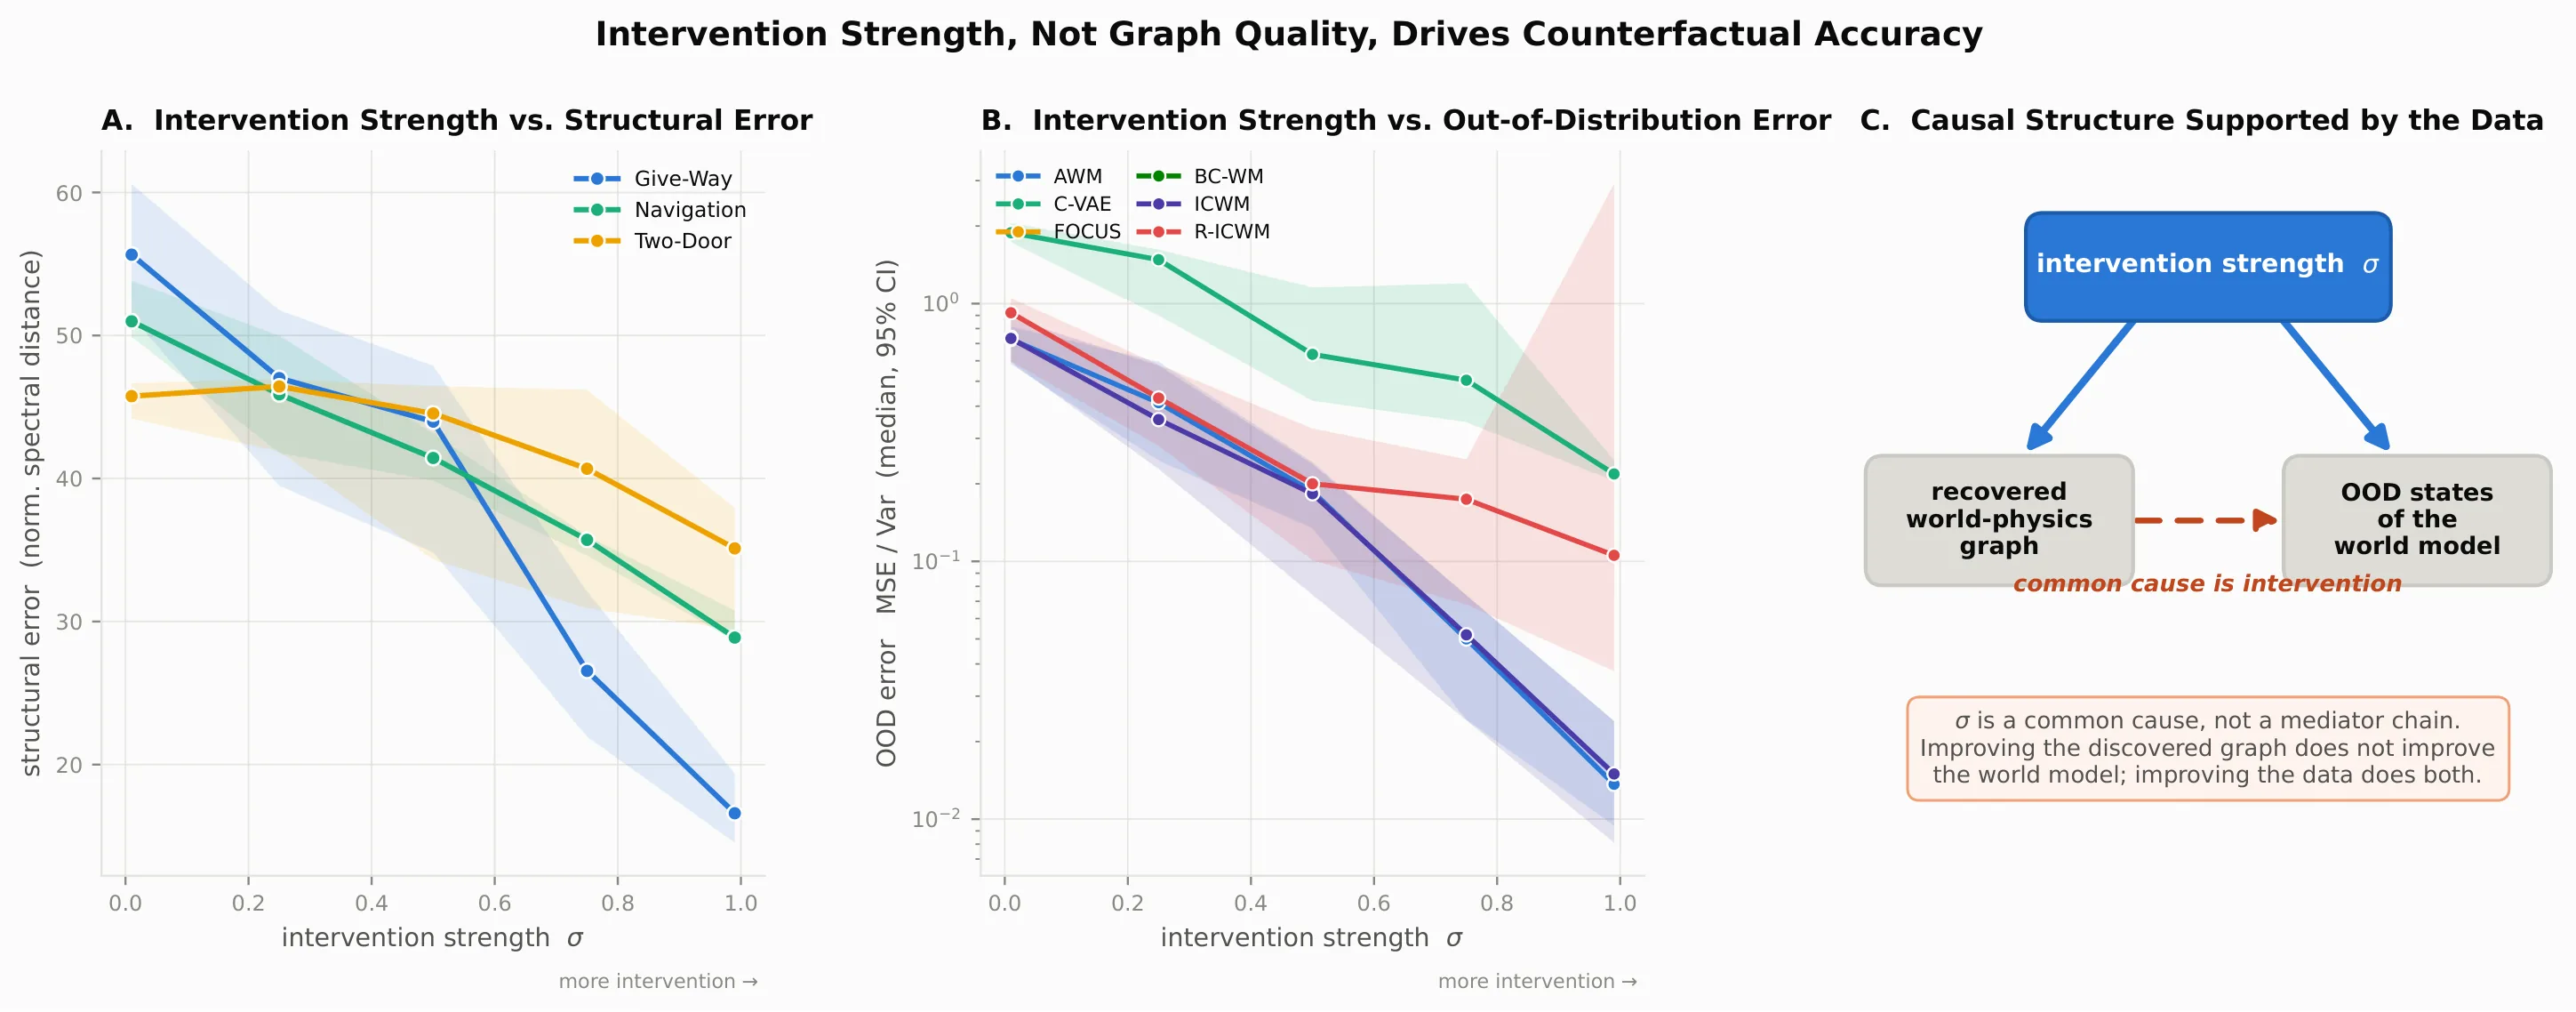
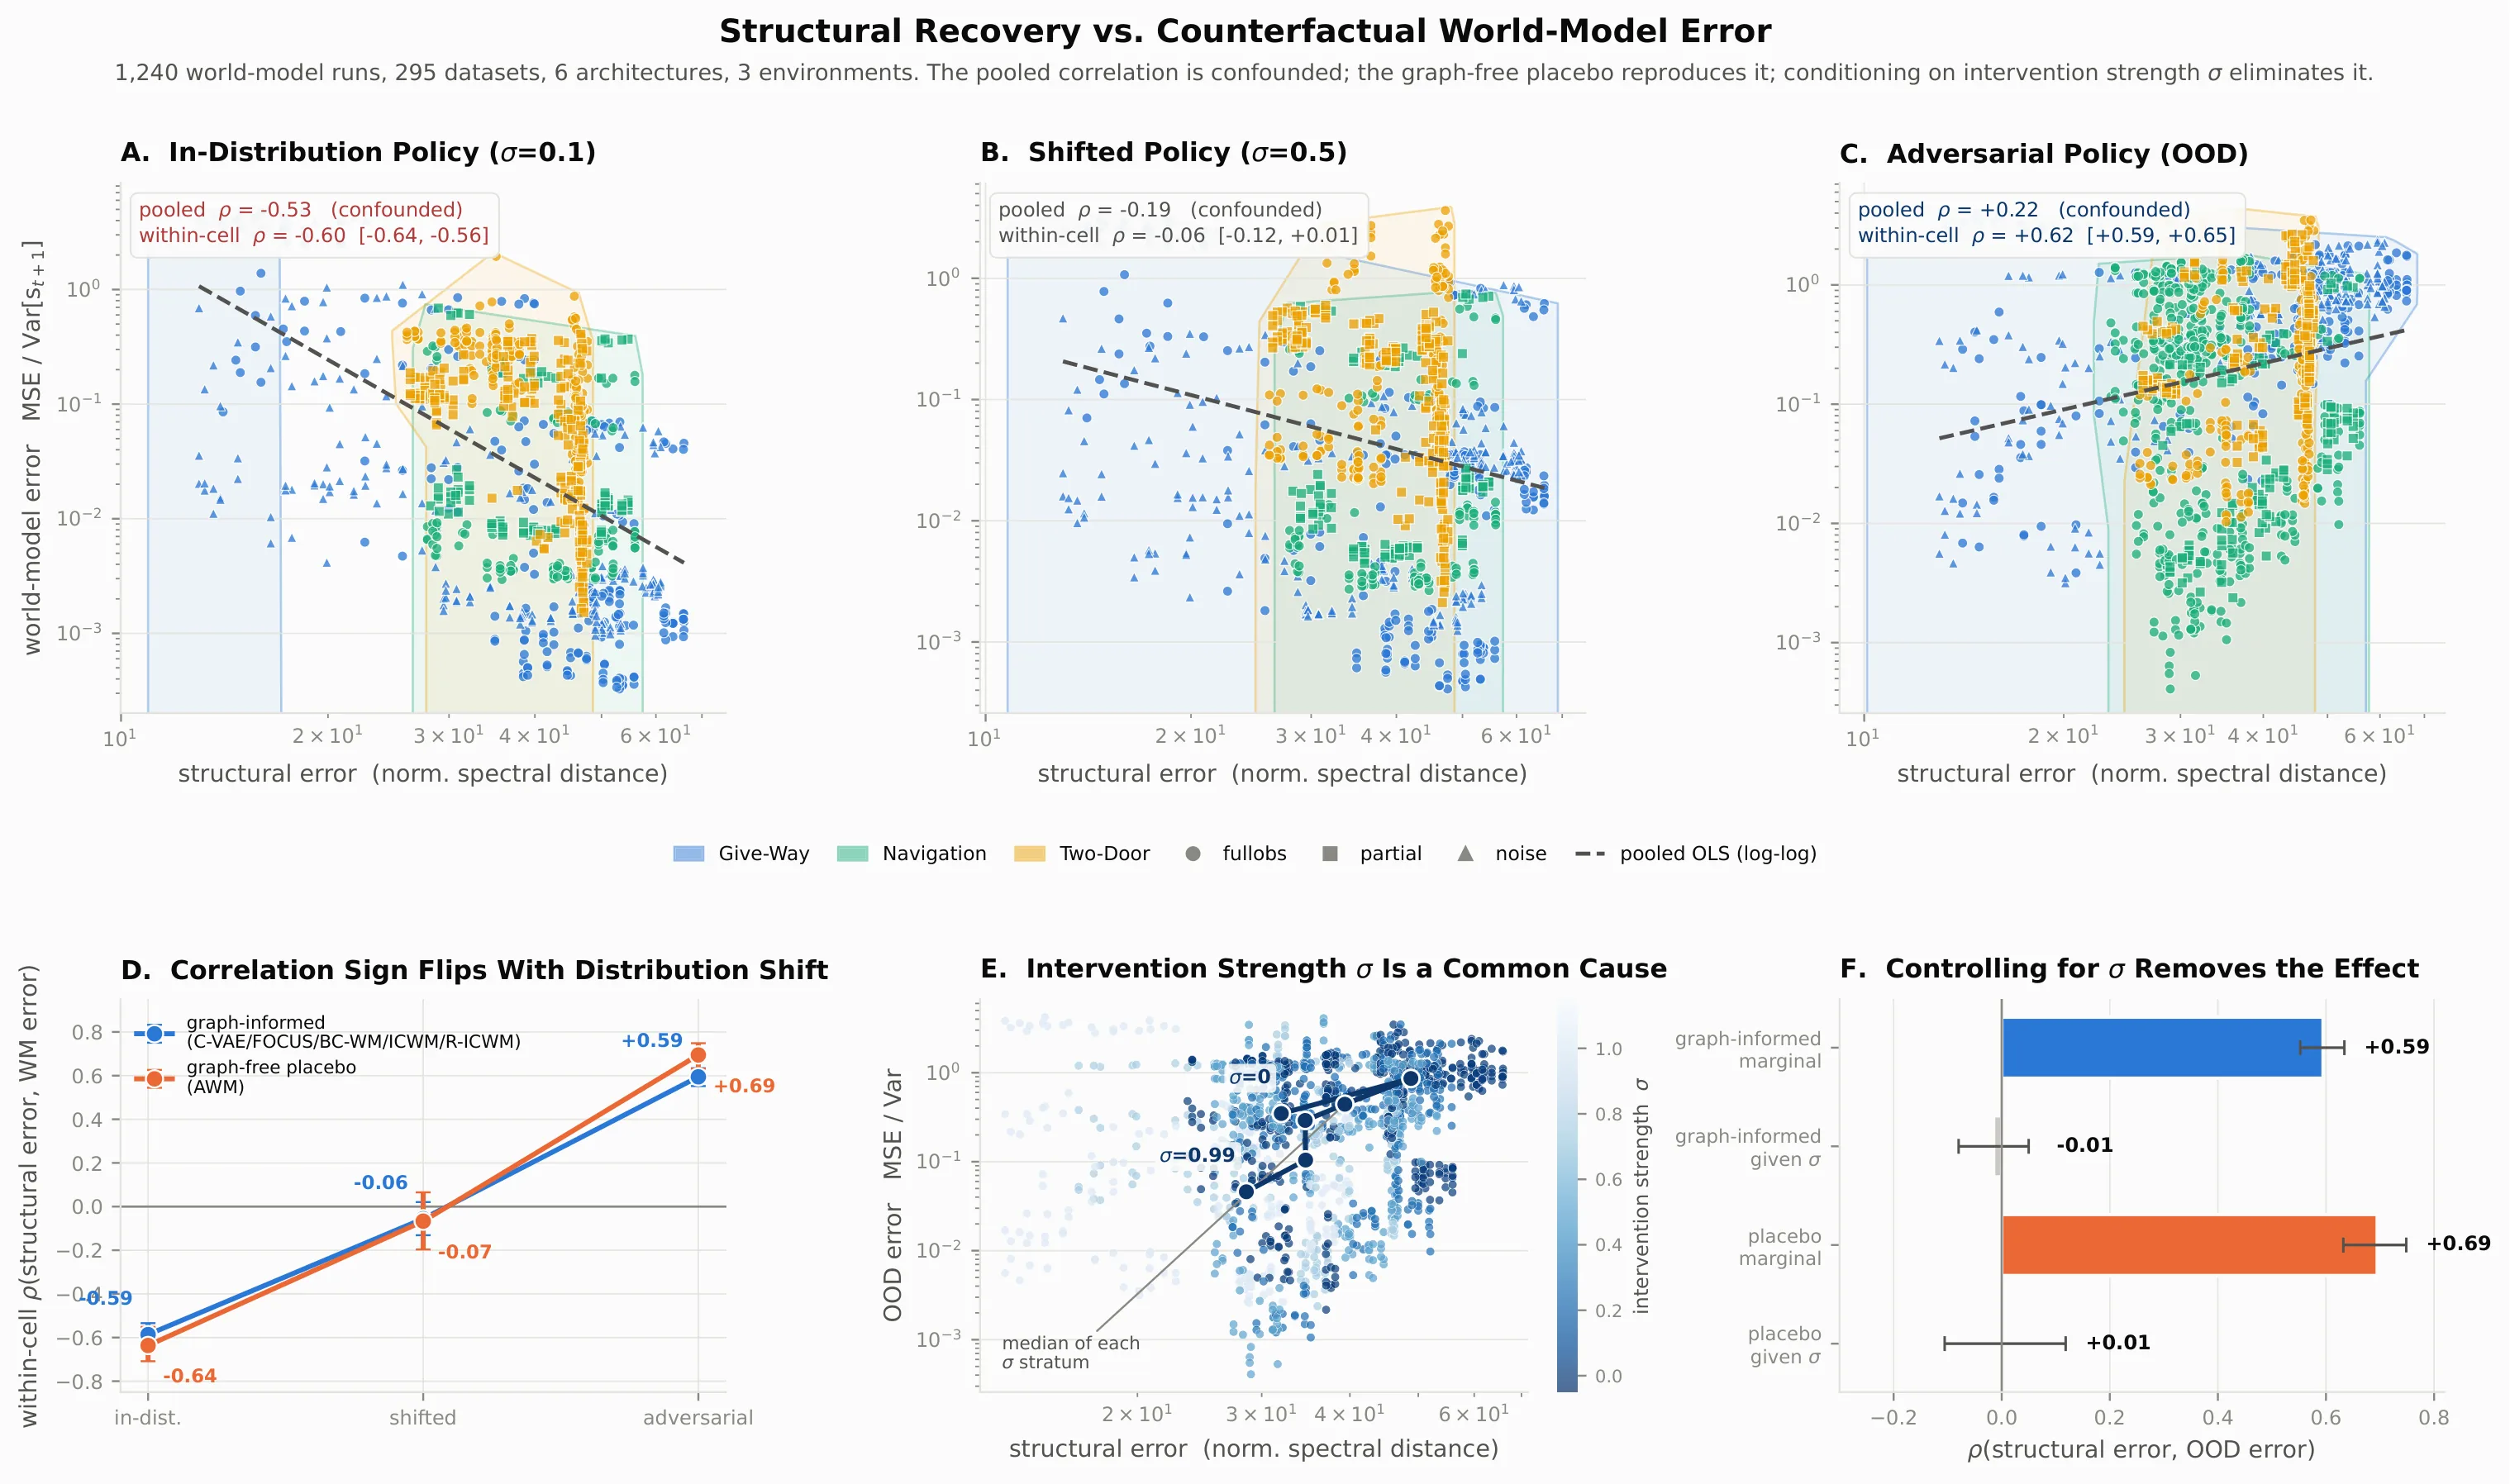
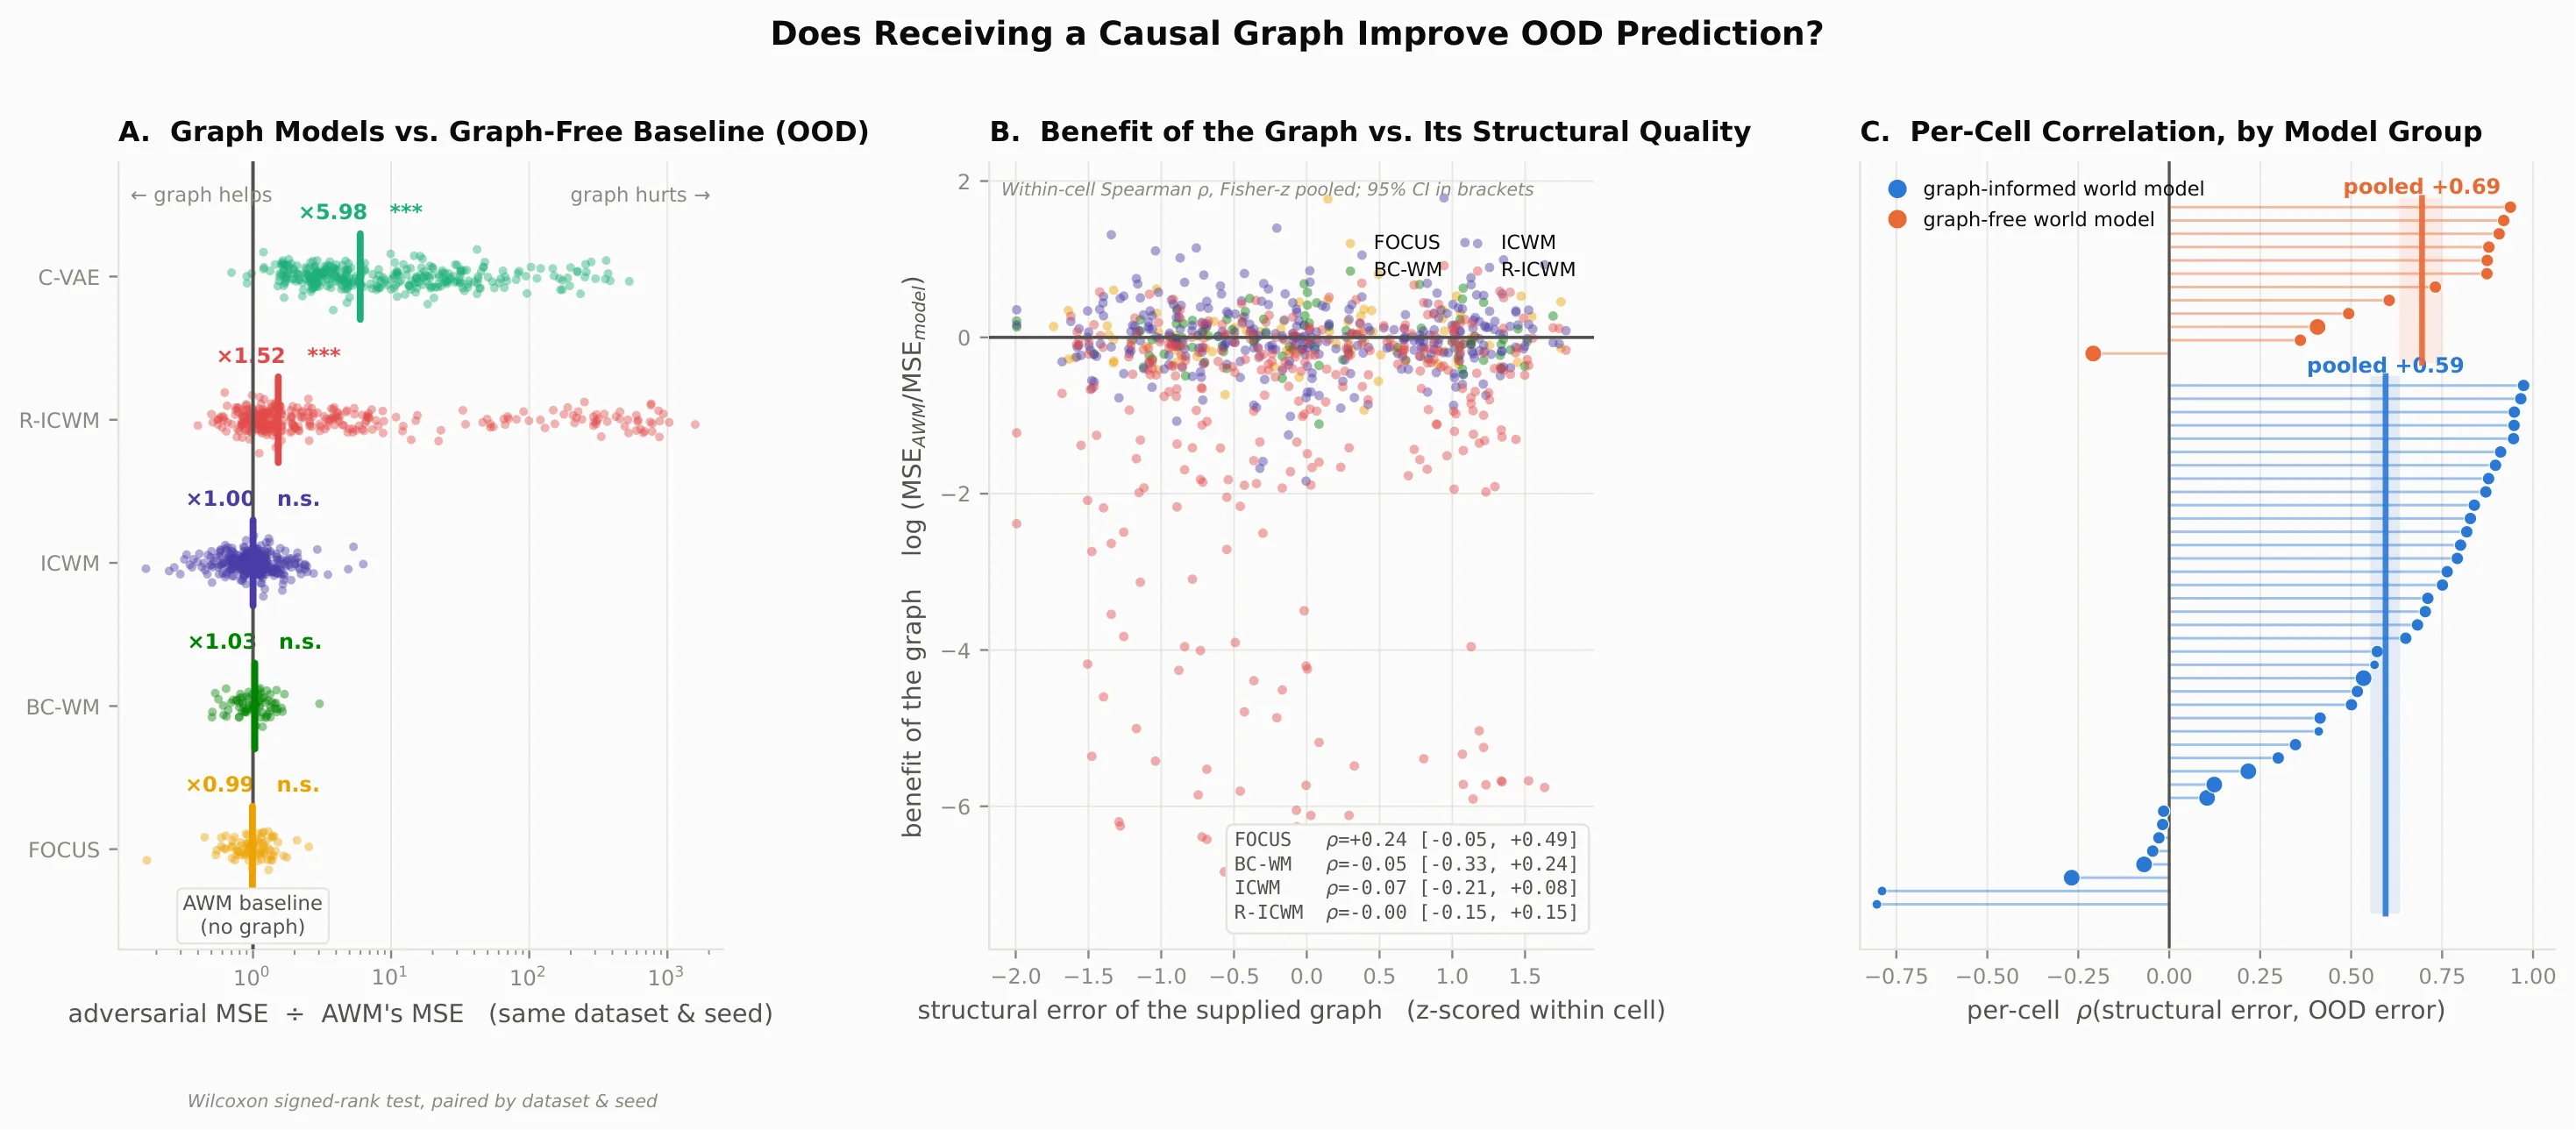
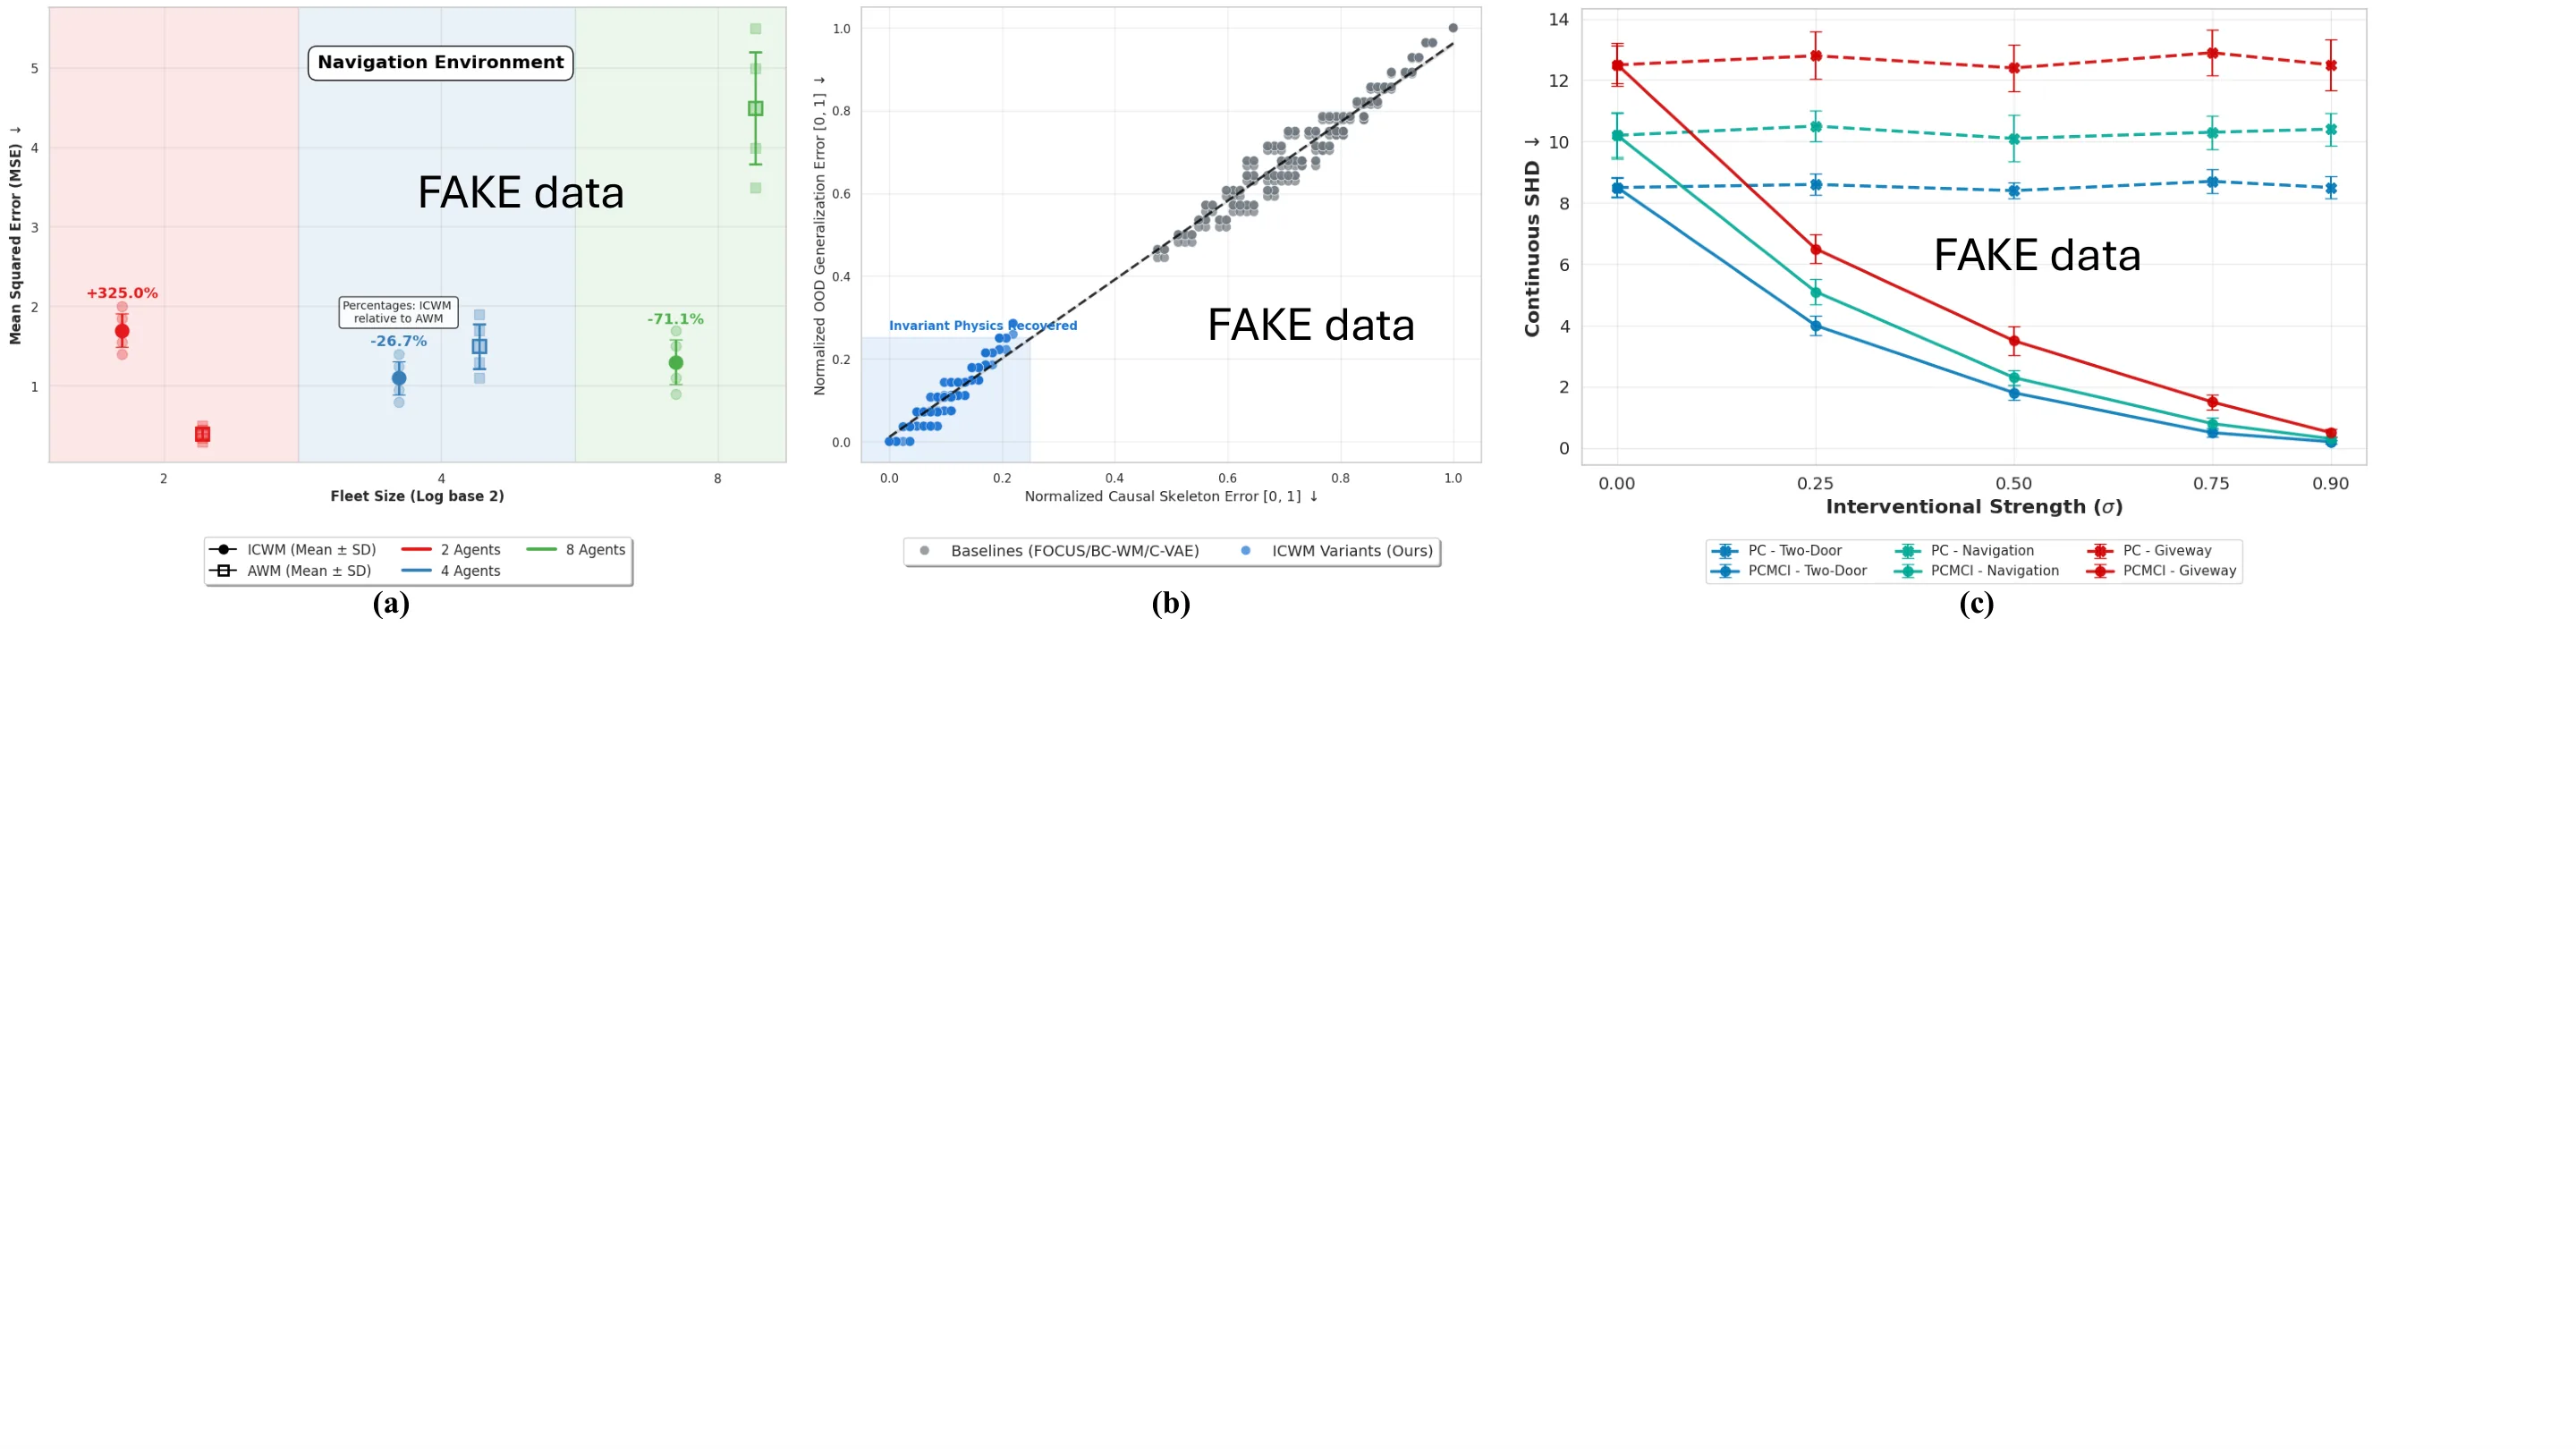
核心结果验证了方法的有效性。因果发现准确率与干预强度呈正相关:当 从 0.01 提升至 0.99 时,三个任务上的因果结构识别精度均有显著提升,部分任务提升达 至 ,统计显著性达到 。这一发现直接支持了论文的核心假设——策略方差确实为因果发现提供了有效信号。
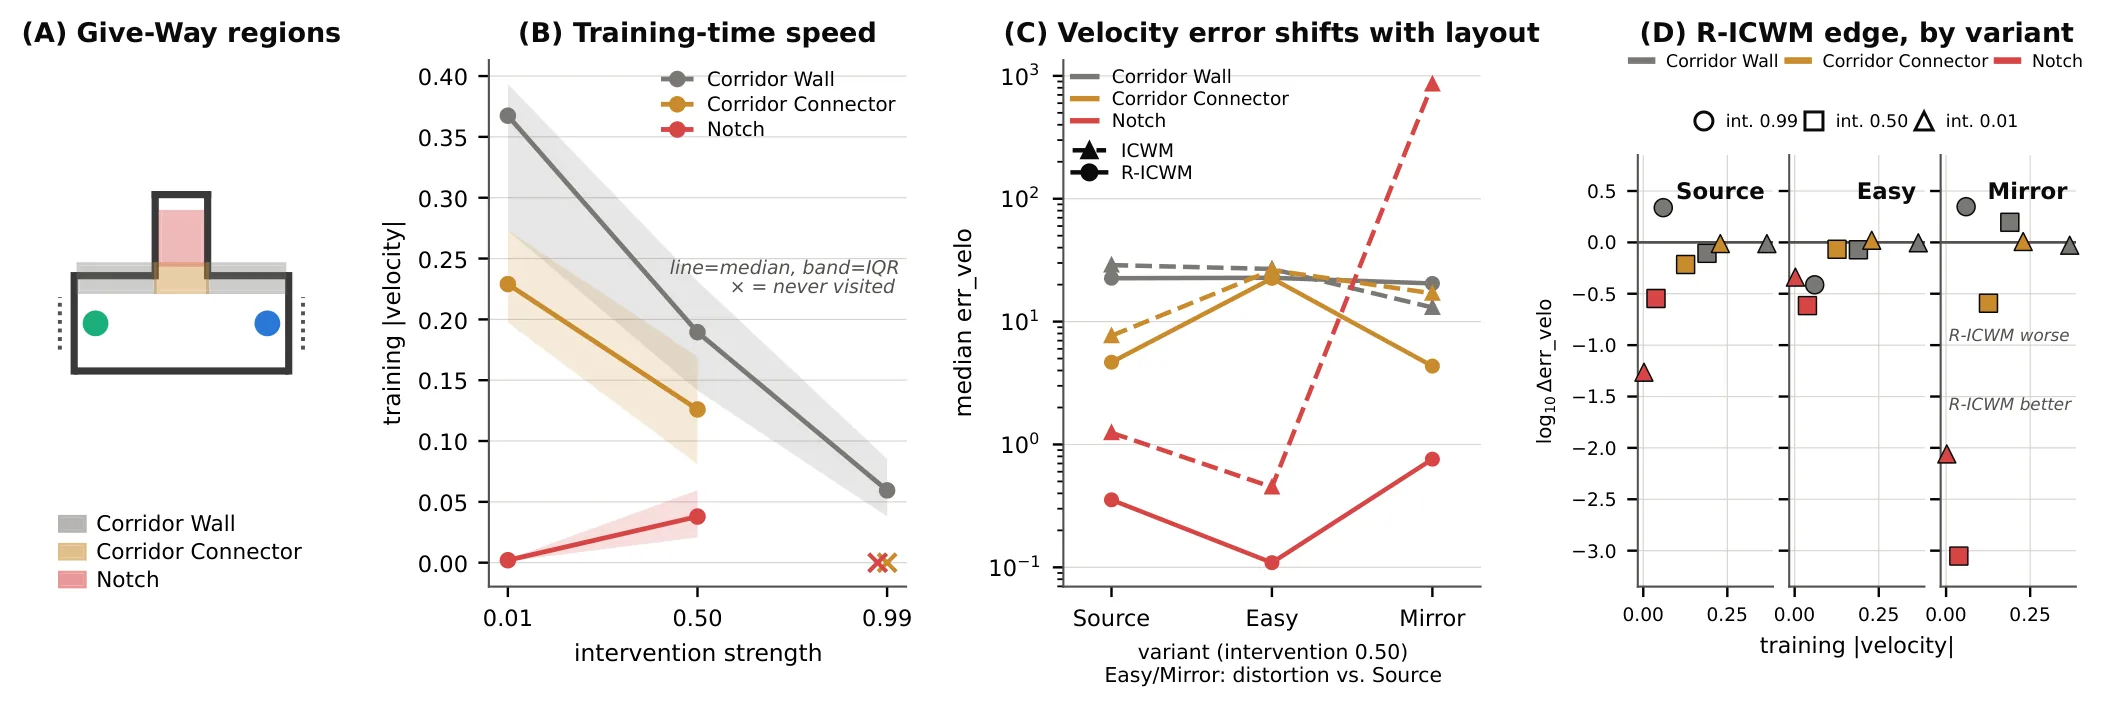
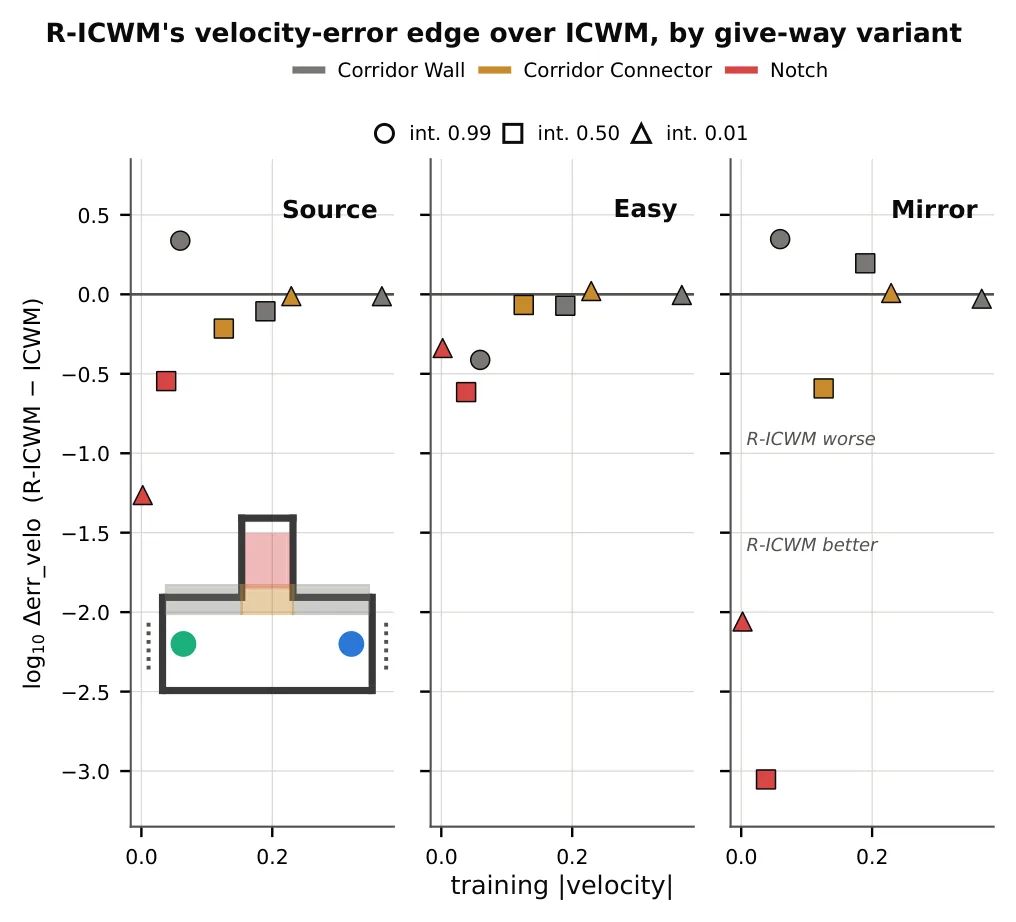
进一步分析揭示了位置型变量与动力学型变量的差异。论文定义的 (位置因果比)与 (动力学因果比)呈现不同模式,比值可达 ()。这说明不同类型的变量在因果发现上的可辨识性存在本质差异。
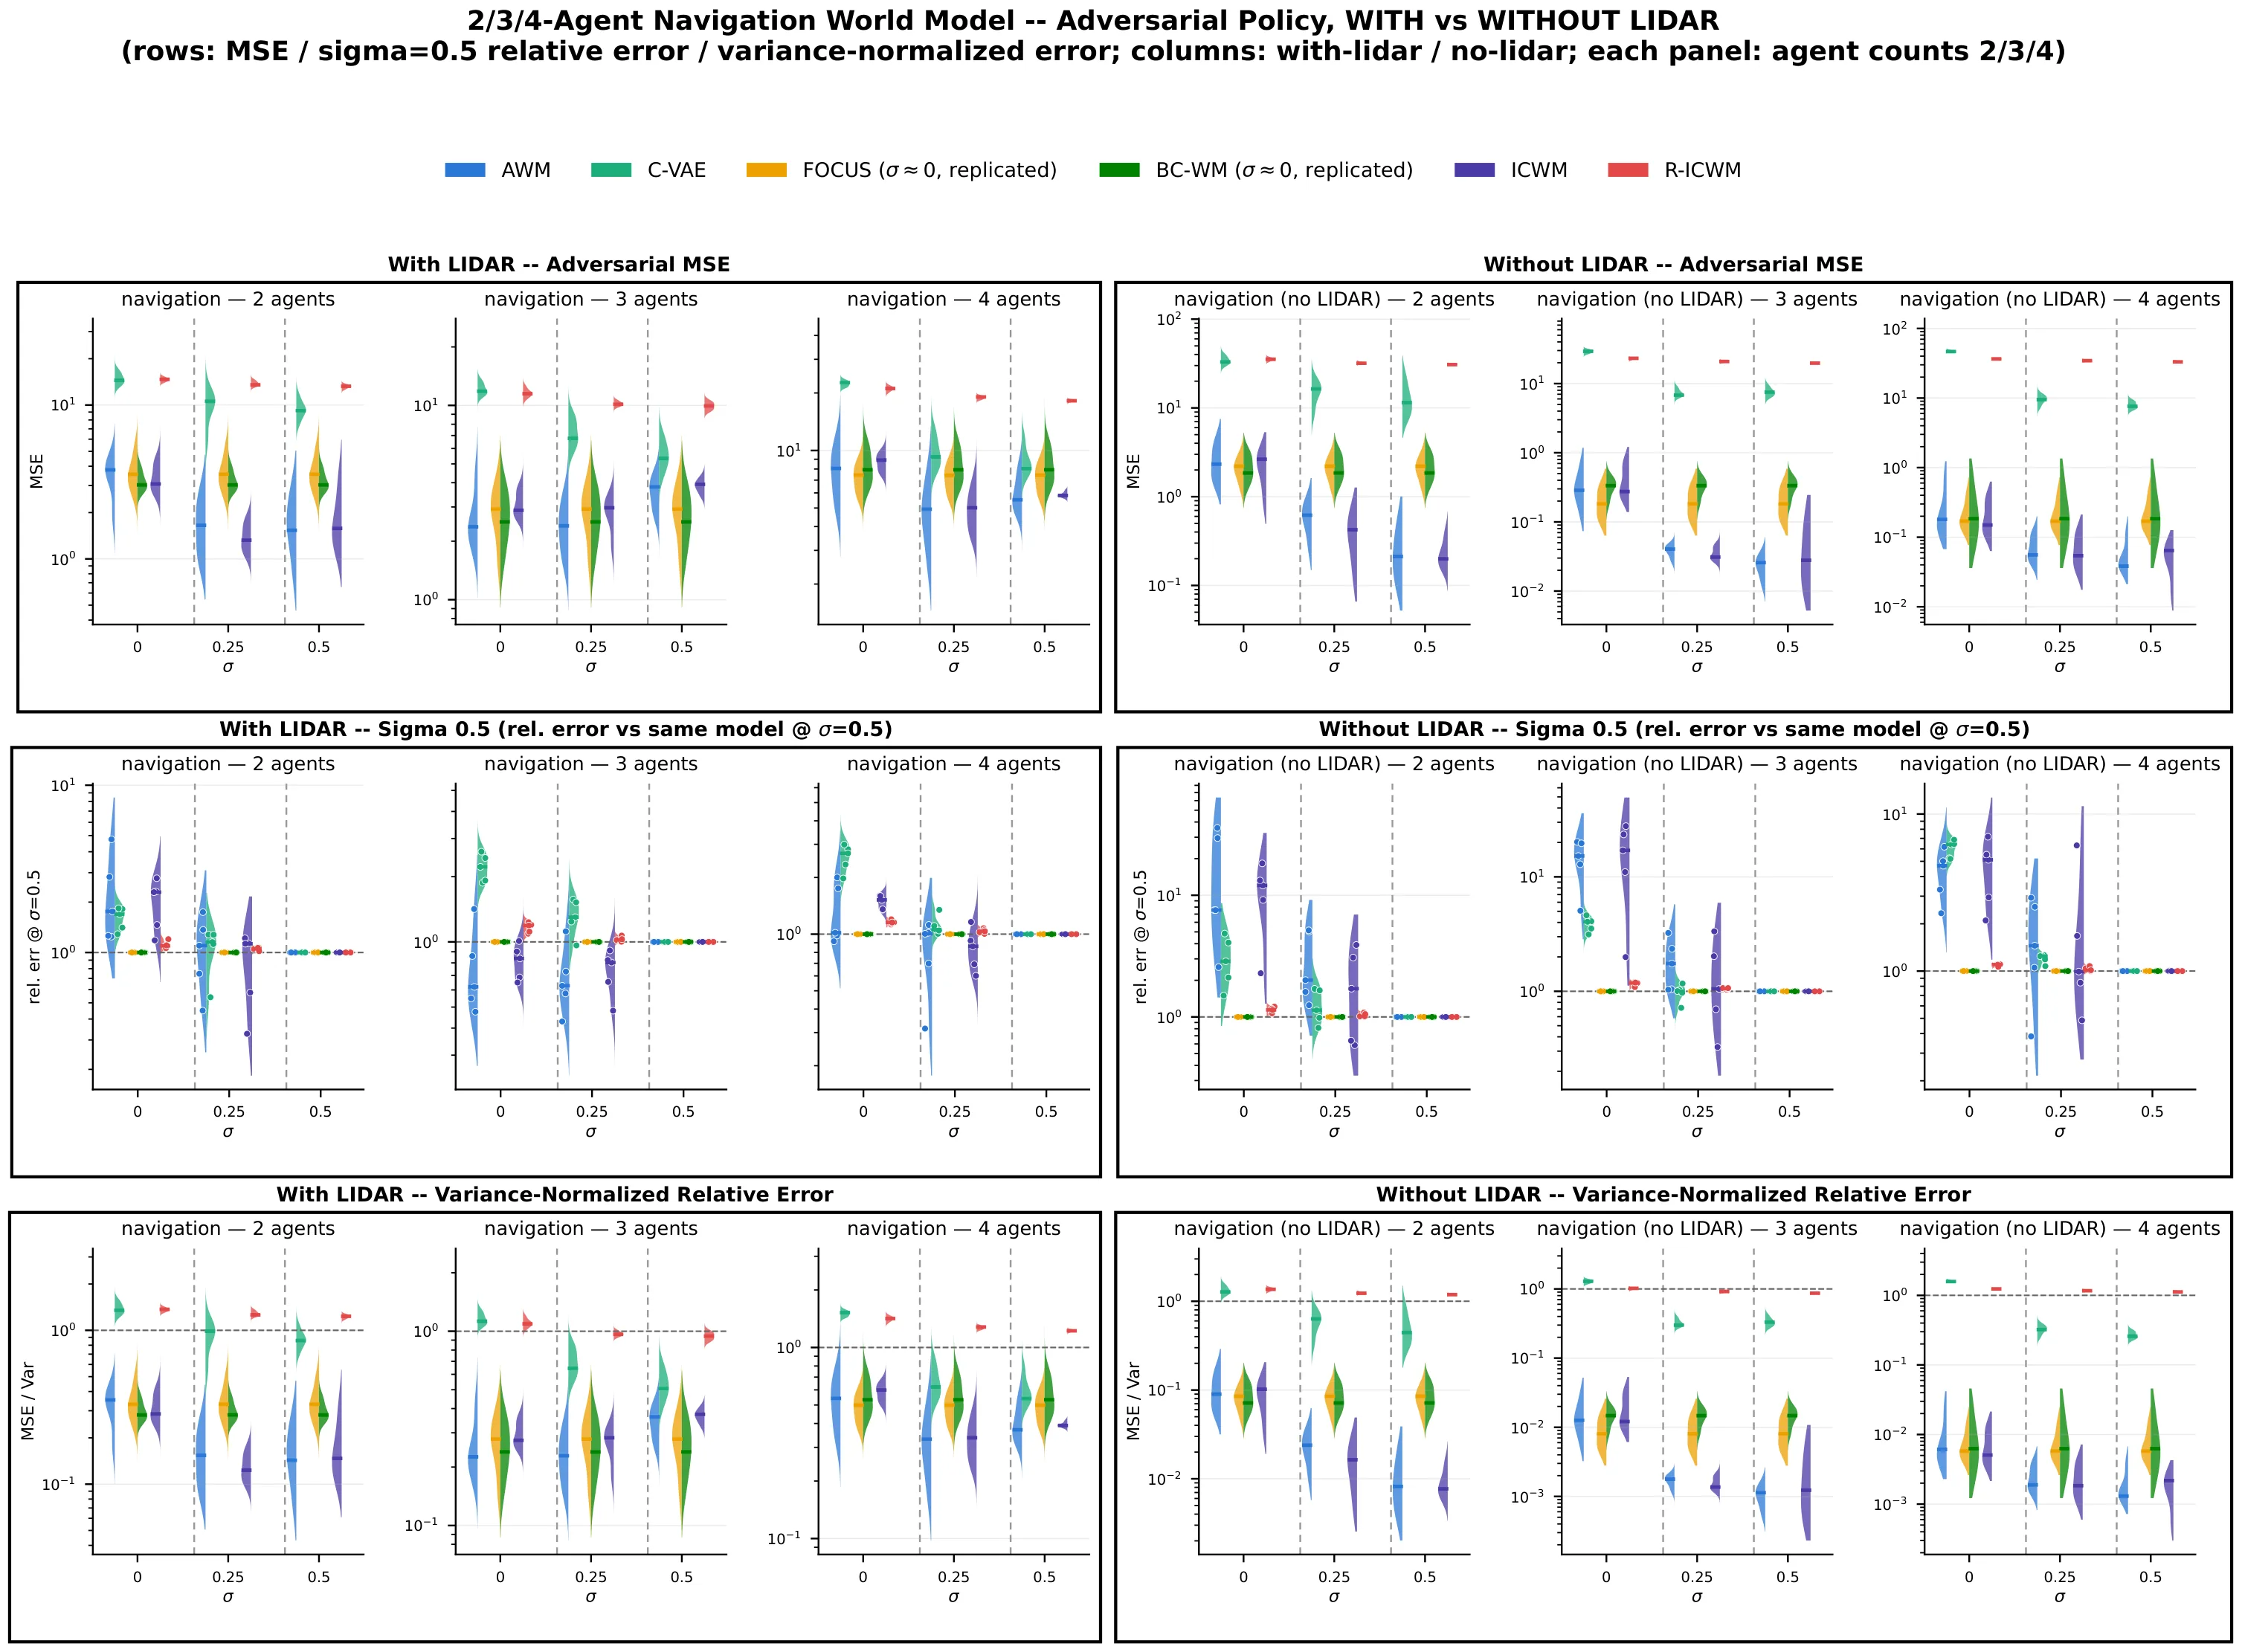
部分可观测条件下的实验同样展示了方法的鲁棒性。虽然基于激光雷达的观测相比全状态观测精度有所下降,但因果发现能力得以保持,证明序贯后门条件在感知不完整情况下仍然有效。
理论分析方面,论文给出了样本复杂度界和策略性能差异上界,表明学到的世界模型与真实环境之间的误差能够被有限样本控制,且在折扣因子 下,策略性能差异满足:
讨论与可借鉴点
这篇论文在因果强化学习方向上提供了一个有价值的思路:利用多智能体系统中行为策略的自然变化来替代主动干预,从而实现因果结构的无监督发现。这种"从数据中寻找准干预信号"的思路对于其他难以进行主动干预的领域(如医疗、推荐系统)同样具有启发性。
然而,方法存在几个值得关注的局限。首先,论文在二维仿真任务上验证,尚未在高维视觉输入或真实机器人平台测试,真实环境的复杂噪声和传感器误差可能影响因果发现质量。其次,当 较小时策略方差信号微弱,因果发现的稳定性会下降,这意味着在纯观测场景下方法效果有限。此外,温度参数和显著性水平等超参需要仔细调节,实际应用中需要一定领域的先验知识辅助调参。
从方法论角度看,序贯后门条件的引入为历史上下文在因果推断中的作用提供了新的理论支撑。这提示我们,在时序决策问题中,充分长的历史窗口不仅有助于预测下一状态,还可能成为区分相关性与因果性的关键工具。对于从事多智能体系统研究或因果强化学习方向的从业者而言,论文中关于策略方差作为因果信号的设计值得借鉴,但同时需要注意其在强干预依赖和任务复杂度上的局限,在实际应用中权衡方法的适用边界。
摘要
在基于模型的强化学习中,世界模型作为内部仿真器存在,但其训练过程常常将统计相关性与因果机制混为一谈。在多智能体系统中,这一问题更加严重,因为物理状态转移与智能体的策略性意图相互纠缠,导致世界模型在分布偏移下失效。我们提出了隐式因果世界模型(Implicit Causal World Models),旨在无需预定义因果图的情况下,从离线演示中恢复环境动力学。通过引入策略方差,我们使世界模型能够通过序列后门条件(sequential backdoor condition)被发现。在多个协调任务(双门、导航和让行)上的评估表明,这些模型在全可观测和部分可观测条件下都能提供可解释的因果表示,且模型精度随干预强度(interventional strength)的提升而直接提升。
Abstract
In model-based reinforcement learning, world models exist as internal simulators, but their training often conflates statistical correlations with causal mechanisms. This problem is exacerbated in multi-agent systems where physical transitions are intertwined with strategic agent intents, causing world models to fail under distribution shift. We introduce Implicit Causal World Models to recover environmental dynamics from offline demonstrations without requiring pre-defined causal graphs. By incorporating policy variance, we render world models discoverable via the sequential backdoor condition. Evaluations across coordination tasks (Two-Door, Navigation, and Giveway) demonstrate that these models provide interpretable causal representations under both full and partial observability, with model accuracy scaling directly with interventional strength.
论文详细总结(自动生成)
论文总结:从多智能体演示中学习隐式因果世界模型
1. 核心问题与研究动机
在基于模型的强化学习(Model-Based RL, MBRL)中,世界模型充当内部仿真器,但其训练过程常将统计相关性误认为因果机制。这一问题在多智能体场景下尤为突出,原因如下:
- 物理转移与策略意图耦合:状态转移既由环境物理动力学决定,又受其他智能体策略性意图的影响,导致观测数据中混杂大量非因果关联。
- 分布偏移下失效:在多智能体交互中,智能体行为模式的细微变化即可使非因果相关性失效,导致传统世界模型在策略改变后预测能力急剧下降。
- 因果图不可得:现实多智能体系统中通常缺乏预定义的因果结构图(SCM),因而需要在离线演示中自动识别因果结构。
论文的研究目标是:无需预定义因果图,仅依靠离线多智能体演示数据,恢复出反映真实因果机制的世界模型。
2. 方法论:隐式因果世界模型(Implicit Causal World Models)
2.1 核心思想
将策略方差作为额外的可观测信号引入世界模型,利用序贯后门条件(Sequential Backdoor Condition)实现因果结构的自动识别,使得因果机制随干预强度提升而更易被检测。
2.2 关键技术细节
(1)混合策略建模:对每个智能体 ,将演示策略 与随机干预分布 进行插值:
其中 控制干预强度, 表示纯观测数据, 表示强干预。
(2)策略方差信号:定义 衡量在给定状态 下行为分布的熵,作为策略方差的代理:
当 时 (确定性专家策略);当 时熵增大。
(3)序贯后门条件:历史上下文 构成满足后门准则的调整集,使:
其中 表示未被观察的混杂因素。
(4)因果骨架提取:在世界模型学习得到的邻接矩阵 中,按下式筛选存在因果依赖的边:
当 (即 )时判定存在显著因果边。
(5)隐式因果编码器-解码器架构:编码器产生分布参数 ,通过重参数化采样得到 ,再由解码器预测下一状态:
其中 为屏蔽矩阵(mask), 为逐元素乘法。
(6)策略融合:最终将专家策略与所学世界模型结合:
3. 实验设计
3.1 测试场景
论文在三个多智能体协调任务上进行了系统评估:
| 任务 | 描述 | 关键变量 |
|---|---|---|
| Two-Door | 两智能体协作开门 | 位置、速度、门状态 |
| Navigation | 多智能体无碰撞导航 | 位置、速度、相对距离 |
| Giveway | 让行/避让交互任务 | 智能体坐标、目标点、激光雷达 |
3.2 可观测性设置
- 完全可观测(Full Observability):所有智能体状态可访问。
- 部分可观测(Partial Observability):通过激光雷达观测 。
3.3 对比方法
论文与以下基线方法对比:
- 传统非因果世界模型(统计相关性建模)
- 不同 取值()的消融
- 不同历史窗口长度 的消融
- 不同 (显著性水平)和 (温度参数)的消融
4. 资源与算力
论文中未明确报告所使用 GPU 型号、数量或训练时长等算力信息。从配置细节可推断:
- 训练样本规模 随 变化,使用 等级别的样本。
- 单次实验运行中 至 各需独立训练。
- 推荐并行探索 组 值进行超参搜索。
> 注:训练硬件规模未在文中给出,这是论文透明度的一个不足。
5. 实验数量与充分性
5.1 实验规模
- 3 个核心任务 × 2 种可观测性设置 = 6 组主实验。
- 5 个干预强度 的消融。
- 多个历史窗口 的分析(关键实验设 )。
- 超参数消融:显著性水平 、温度参数 、网络节点数 。
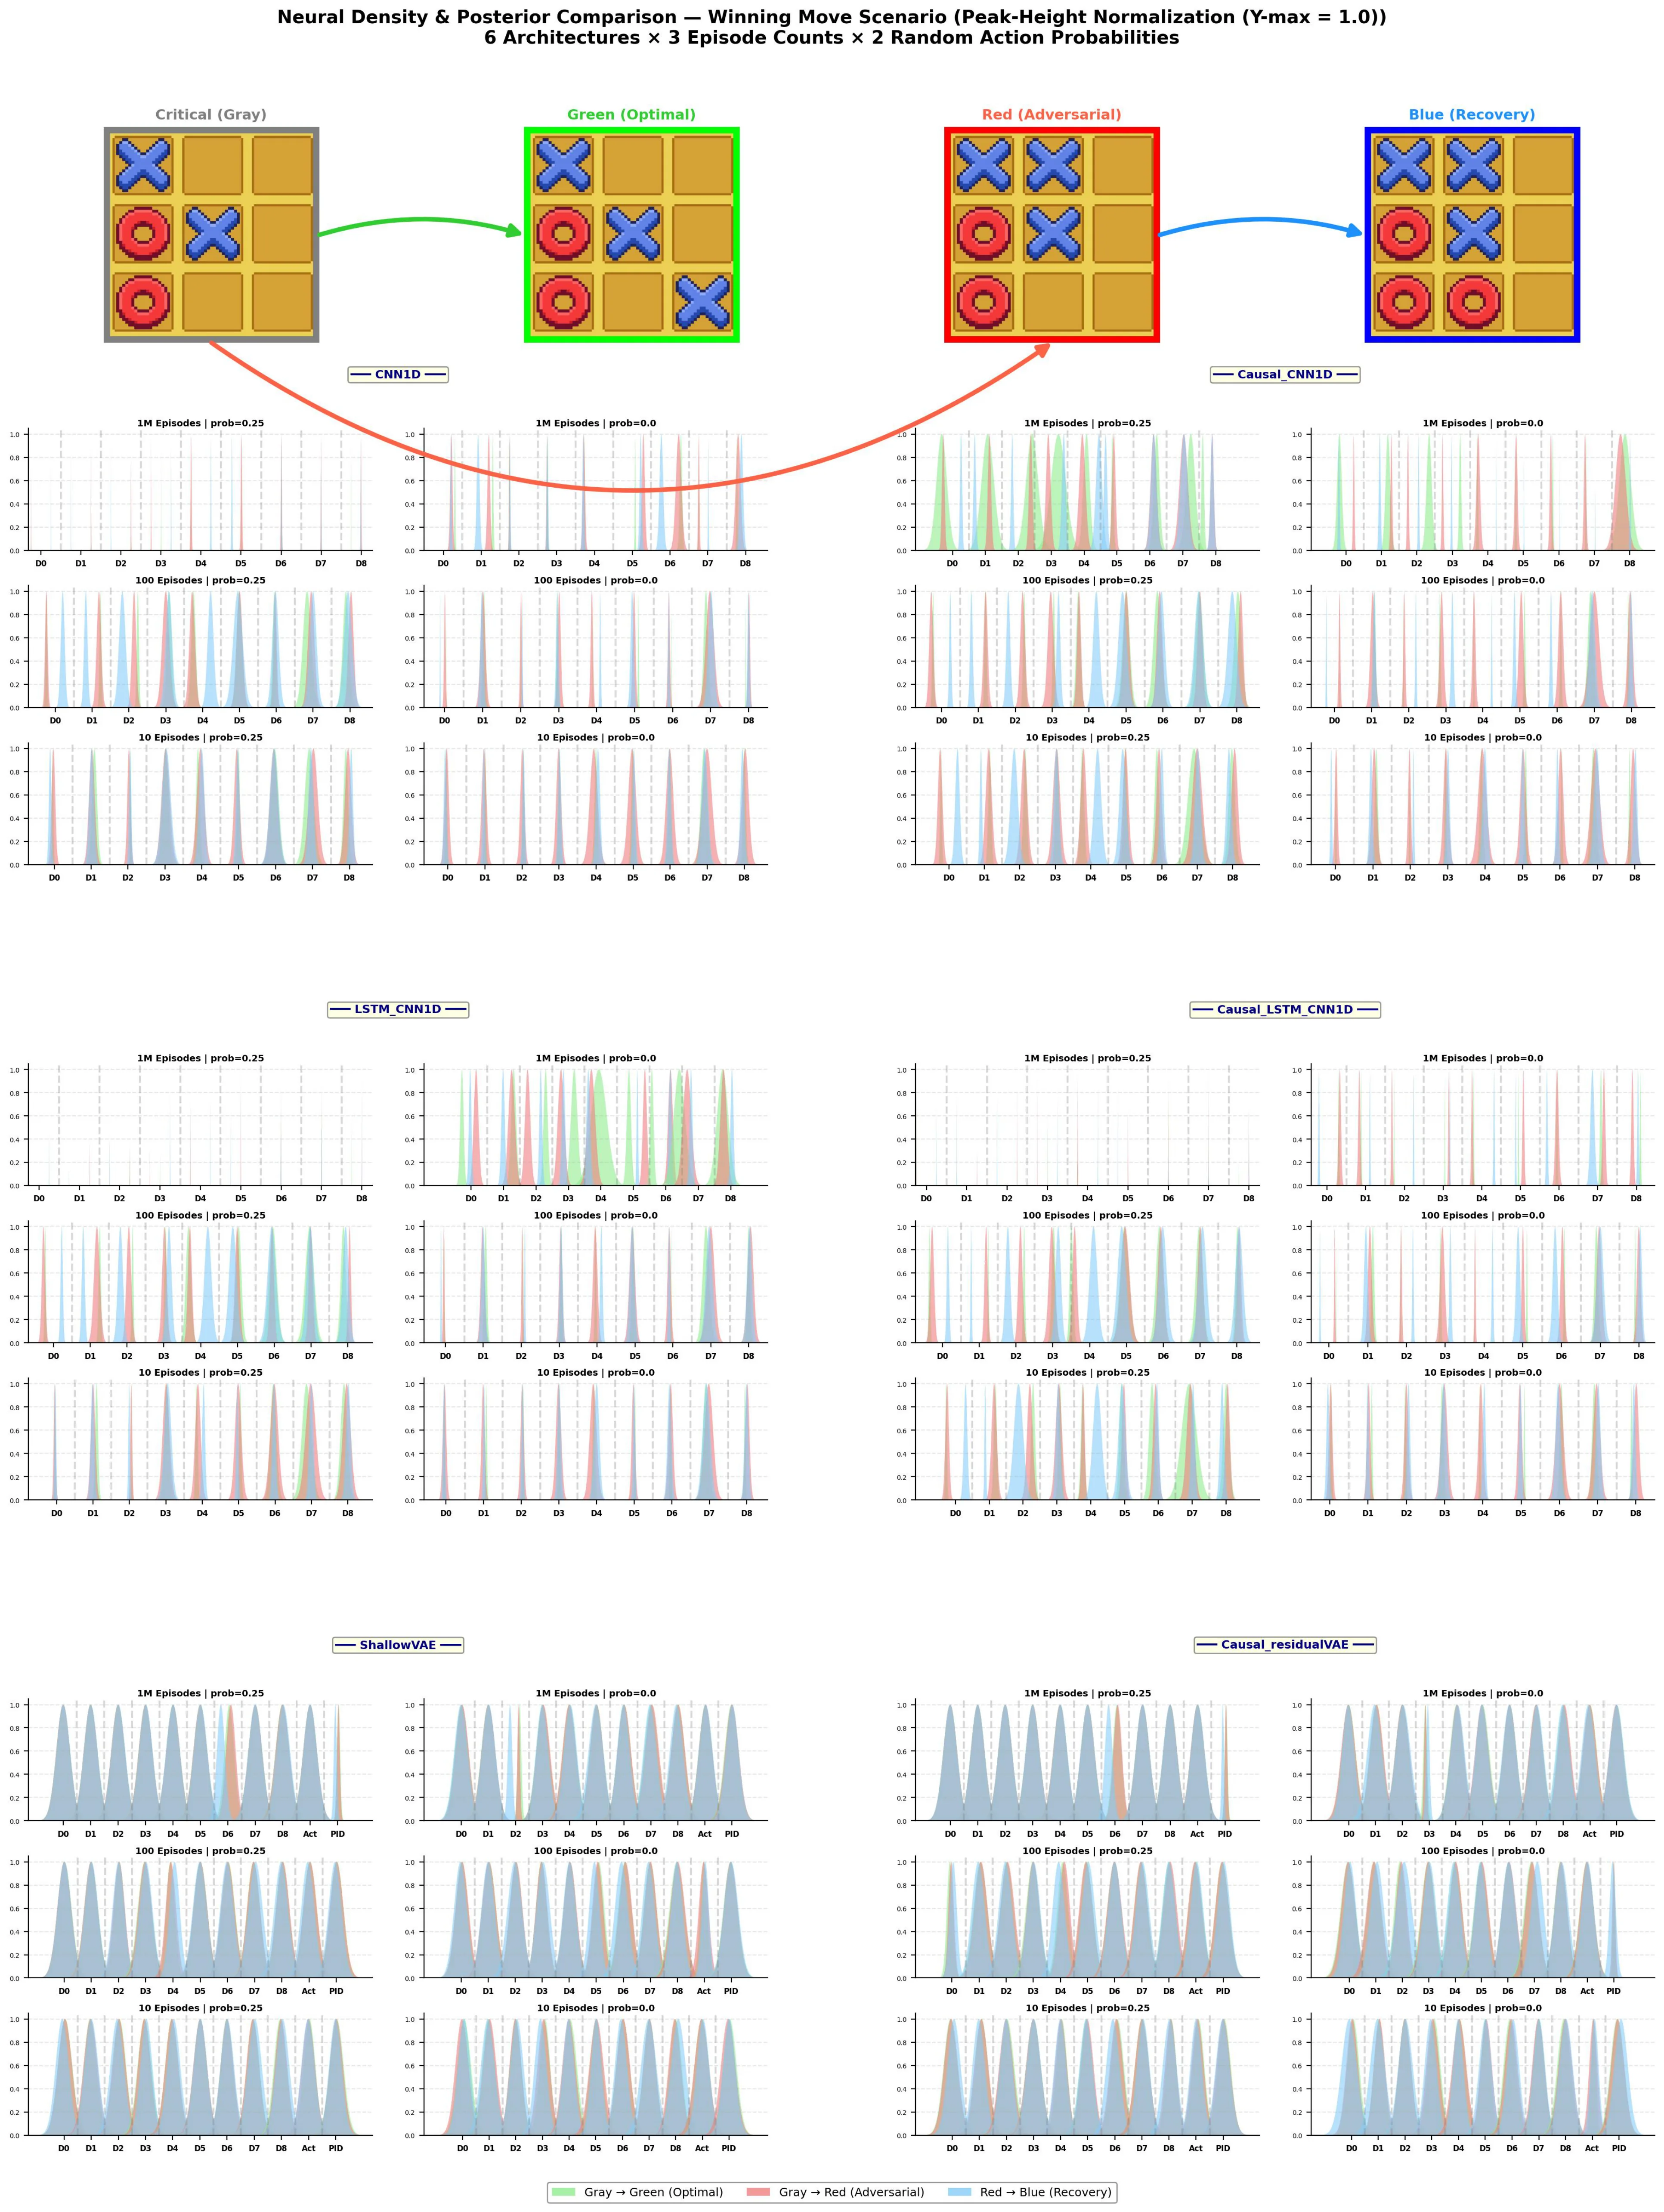
- 统计检验:使用核密度估计、TV 距离、HSIC 等度量,并报告 等显著性。
5.2 充分性评估
- ✅ 实验覆盖了多种因果强度场景。
- ✅ 提供了显著性检验(-values)与置信度报告。
- ⚠️ 任务相对简单(基于低维仿真),未在高维视觉输入或真实机器人数据上验证。
- ⚠️ 未报告与最新多智能体世界模型方法的全面对比。
6. 主要结论与发现
1. 因果结构可被自动识别:通过策略方差与序贯后门条件,世界模型能从离线演示中恢复出与真实 SCM 一致的因果骨架。
2. 准确率随干预强度提升:当 从 提升至 时,因果发现准确率与下一状态预测精度均显著提高(部分任务上达 至 提升,)。
3. 位置型与动力学型变量有别:(位置因果比)与 (动力学因果比)呈现不同模式, 可达 ()。
4. 部分可观测下仍有效:基于激光雷达的观测可保持因果发现能力,但绝对精度低于完全可观测。
5. 理论保证:论文给出样本复杂度界:
并证明了在折扣因子 下策略性能差异满足:
7. 优点与亮点
- 创新性地将策略方差作为因果信号:传统因果发现依赖干预或随机化实验,本文利用多智能体策略本身的差异提供"准干预"。
- 无需预定义因果图:降低了实际部署门槛。
- 理论分析完整:提供了样本复杂度界、TV 距离收敛性、性能差异上界等理论保证。
- 解释性好:学到的 矩阵可直接可视化因果图。
- 可扩展至部分可观测:基于激光雷达的编码器使方法适用于现实场景。
8. 不足与局限
- 算力信息缺失:未报告 GPU 类型、数量、训练时间,难以复现。
- 任务复杂度有限:仅在二维仿真任务上验证,未在高维视觉或真实机器人数据上测试。
- 策略方差估计的可靠性:当 较小时熵信号弱,因果发现稳定性下降;论文承认"策略方差的可靠估计仍是开放难题"。
- 对干预强度的依赖:方法性能显著依赖 接近 1 的强干预,纯观测数据下效果有限。
- 超参敏感性:温度参数 与显著性水平 需仔细调节。
- 对比基线不够全面:缺少与近年多智能体世界模型(如 MA-Dreamer、MACAW)的直接对比。
- 可扩展性未验证:智能体数量是否影响因果发现质量未深入分析。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。