
📝 TLDR
多智能体辩论(MAD)是提升LLM智能体系统精度与鲁棒性的新范式,但其研究碎片化、术语不一,缺少系统化设计框架。本综述梳理141篇文献,提出涵盖参与者、交互机制、共识协议三维度的分类法并给出形式化标记。结果显示该领域已隐式收敛于静态全连接拓扑、逐字交换、短期记忆与投票决议的狭窄设计模式,而有潜力的替代方案仍处边缘。作者建议将分类法形式化为可执行规约,以支持成本感知基准测试与辩论配置自动化调优。
🧭 速览
MAD研究碎片化、术语不一致,缺少跨研究可比的系统化设计框架,难以进行受控基准评测。
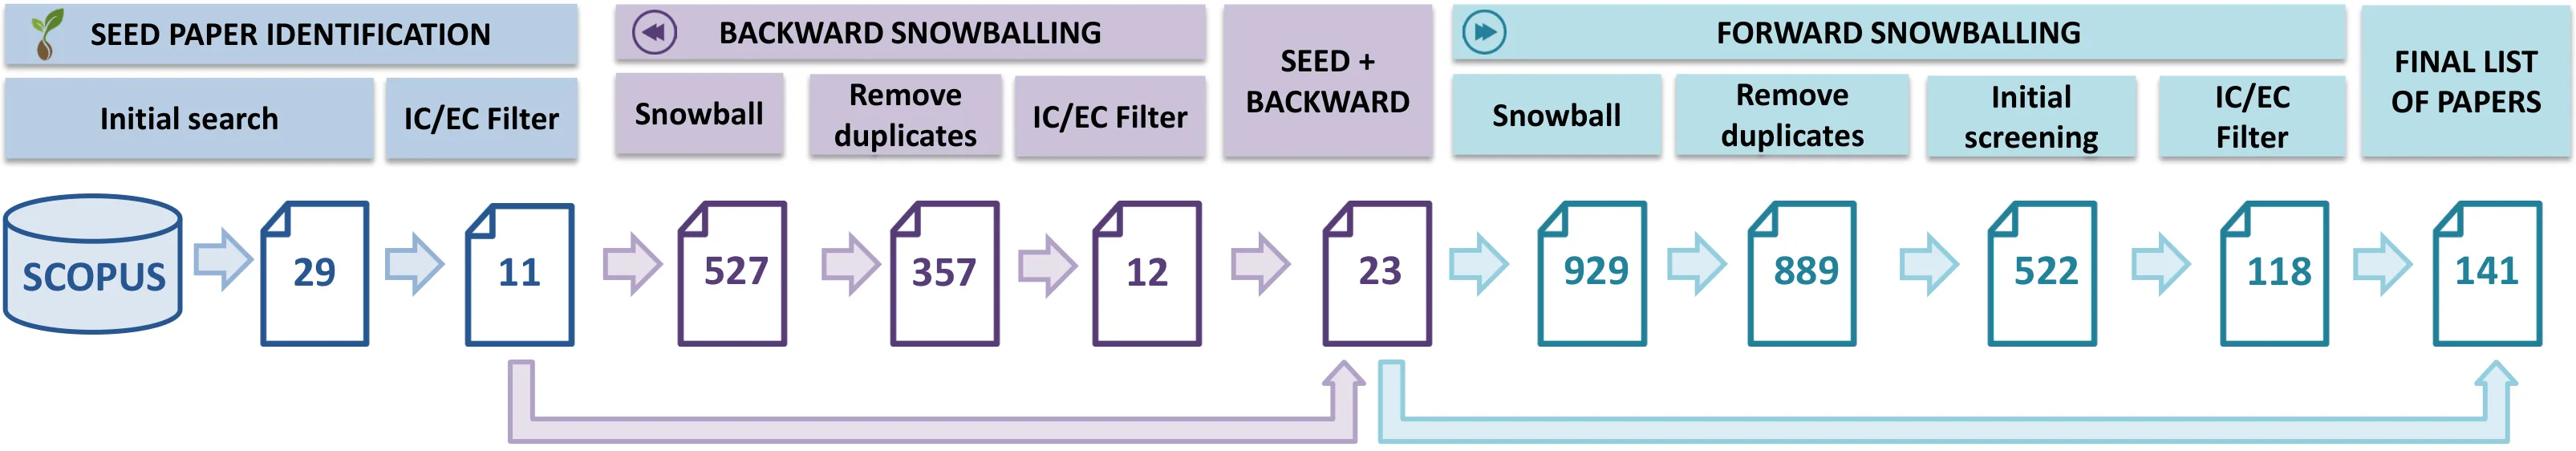
对141篇MAD研究做系统文献综述,从参与者、交互机制、共识协议三维度构建分类法并以形式化符号标注配置。
领域隐式收敛于静态全连接拓扑、逐字交换、短期记忆、投票决议的狭窄设计模式,替代方案仍处边缘。
分类法可作为研究地图、受控基准框架及机器可读MAD规约Schema;未来工作将其形式化为可执行规约。
🆚 方法对比
三维MAD分类法(参与者-交互机制-一致性协议)
- 基于141篇文献系统综述,规模最大
- 形式化符号支持机器可读的MAD配置
- 覆盖辩论设计的多维度设计决策
- 仅作为描述性框架,缺乏实证验证
- 未形式化为可执行规范,实用性待证实
- 聚焦现有模式,新设计方案探索不足
主导设计模式(静态全连接+逐字交换+短时记忆+投票)
- 实现简单,被多数研究默认采用
- 在多项任务中验证有效
- 兼容性强,易于跨领域复用
- 采用为惯例而非系统对比,可靠性存疑
- 限制替代方案的探索空间
- 计算开销随连接度线性增长
Smit等人的早期MAD综述
- 首次提取六个辩论设计特征
- 为后续研究提供初步术语基础
- 仅基于八项研究,规模过小
- 未提供结构化分析方法
Wang等人的MAD策略分类
- 基于三种通信模式提供扁平分类
- 覆盖常见MAD交互模式
- 分类维度单一,粒度较粗
- 未提供形式化符号或规范性框架
Tillmann等人的MAD综述
- 对MAD方法进行概览式整理
- 缺乏明确系统化协议,方法论不严谨
- 完全依赖AI辅助工具,可靠性存疑
- 未报告纳入研究数量,可复现性差
Motger等人的初步分类映射(2024)
- 基于25项研究提炼试探性分类法
- 首次在需求工程领域分析MAD价值
- 研究规模有限,推广性受限
- 仅为初步分类,未形式化
本文核心贡献是提出一个统一的三维MAD分类法,作为描述性地图统一此前分散的Smit、Wang、Tillmann等综述工作;同时揭示领域隐式收敛于静态全连接+投票的单一模式,指出替代方案仍处于边缘地位。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 2 张)
展开查看 2 张图
TL;DR
多智能体辩论(Multi-Agent Debate, MAD)作为提升大语言模型智能体系统性能的新范式,长期缺乏系统化的设计框架。本文通过对 141 篇核心研究的系统综述,构建了涵盖「参与者」「交互机制」「共识协议」三个维度的分类体系,并配以形式化标记语言。研究揭示了一个关键现象:该领域已悄然收敛到「静态全连接拓扑、逐字信息交换、短期记忆与投票决议」这一狭窄设计模式——这些选择更多出于惯例而非系统性的比较验证,而一些具有潜力的替代方案仍停留在边缘位置。
研究背景与动机
让多个大语言模型智能体相互辩论、互相批评,从而迭代收敛到更优质的答案——这一设想自大模型能力显著提升以来便备受关注。在理论上,多智能体协作能够有效缓解单智能体推理中的幻觉、偏执与逻辑漏洞;在实践中,它被视为构建更可靠、更鲁棒 AI 系统的关键路径之一。
然而,当研究者试图将这一范式落地时,会迅速陷入一个尴尬局面:任何一套多智能体辩论系统都涉及参与者配置、消息传递方式、辩论终止条件等十余项相互关联的设计决策。这些决策往往以隐式方式嵌入代码或描述中,不同研究之间缺乏统一的术语和可比较的规格说明——术语不一致、实验设置五花八门、结论难以复现。这直接导致两个后果:其一,领域内难以判断哪些设计选择真正有效;其二,研究者可能无意中反复验证同一套约定俗成的配置,而将真正有价值的替代方案遗忘在角落。
正是针对这种碎片化困境,本文作者展开了一次系统性的文献普查,试图为整个领域绘制一张清晰的「设计地图」,并通过形式化的标记方式将辩论系统的配置从隐式描述中解放出来。
方法
本文的核心贡献是一套三维分类体系,作者将其形式化为可读写的标记规范,用以描述任意多智能体辩论系统的配置。
第一维度:参与者(Participants)。这一层关注的是「谁在参与辩论」。关键考量包括:参与者的角色是否同质(如多个相同能力的「反驳者」)或异质(如一个「提议者」搭配多个「评审者」);参与者是否基于同一基础模型还是异构模型;辩论开始时各参与者是否拥有对称的信息(知晓对方已产生的推理过程)还是不对称的初始状态。这一维度直接决定了辩论的「格局」——是势均力敌的对抗还是主次分明的协作。
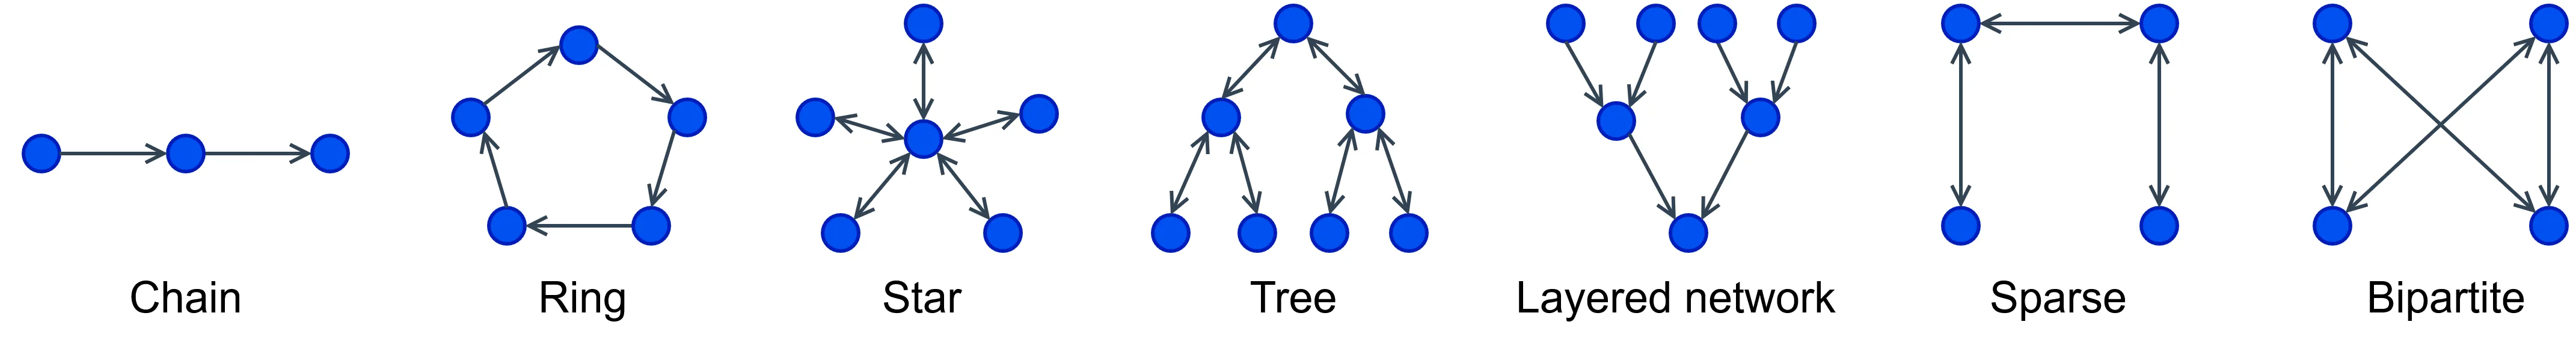
第二维度:交互机制(Interaction Mechanisms)。这一层刻画「信息如何流动」。作者从拓扑结构(完全图?链式?还是树状层级?)、消息传递模式(逐字复制对方输出还是经过摘要压缩?内容是否被加工改造?)以及记忆能力(参与者能否保留辩论历史的全部上下文,还是只能看到最近几轮的内容?)三个子维度进行刻画。值得注意的是,作者在此处发现了一个令人意外的趋势:领域内几乎默认采用「全连接拓扑、逐字传递、有限上下文窗口」这套组合,尽管理论上其他替代方案(如分层聚合、语义压缩的摘要传递、更长的记忆窗口)在某些场景下可能更具优势。
第三维度:共识协议(Agreement Protocols)。这一层回答「辩论何时、以何种方式终止」。常见策略包括投票(多数票决、加权投票)、基于置信度的自动判定(模型自我评估当前答案是否足够好)、外部裁判(引入额外的评判智能体或人工介入),以及固定轮数终止。协议的选取直接影响系统的计算成本与最终质量之间的权衡。
通过这套三维框架,作者对 141 篇文献逐一进行特征编码,将每项研究从隐式描述「翻译」为可比较的规格说明,从而揭示了领域内部的隐性共识与被忽视的可能性空间。
实验与结果
本文本质上是一项综述研究,其「实验」体现为对文献的系统编码与统计分析。作者的编码结果表明,当前多智能体辩论研究确实存在高度的设计趋同:在 141 篇样本中,绝大多数采用静态全连接拓扑(即每个参与者都能看到并回应所有其他参与者的输出)、逐字复制而非语义压缩的信息交换方式、仅保留辩论过程中短期记忆的设计,以及通过投票或固定轮数终止辩论的共识策略。
这种趋同并非源于系统性的消融实验或成本-效益分析,而更多是一种「约定俗成」的选择。当作者将这些已趋同的设计维度与边缘化但有潜力的替代方案进行对照时,发现差距是显著的:例如,采用分层聚合拓扑的研究占比不足 5%,而采用语义摘要传递而非逐字复制的研究同样稀缺。然而,这类替代方案在特定任务(如长文档推理、多约束优化)中理论上具有降低通信成本或提升信息整合质量的潜力,其有效性尚未被充分验证。
作者进一步指出,这种趋同带来的方法论风险:当所有研究都采用相似配置时,跨论文的性能比较本质上退化为对数据集或基础模型的比较,而非对辩论设计本身的验证。这使得「多智能体辩论是否真的有效」这一基本问题的答案变得模糊不清。
讨论与可借鉴点
本文的贡献远不止于分类——它实际上为整个领域提供了一面镜子,照出了一个以惯例驱动而非证据驱动的设计生态。静态全连接、逐字交换、短期记忆、投票决议这四板斧几乎成了默认配置,这种「大家都这么做」的惯性思维在快速发展的 AI 研究中并不罕见,但它阻碍了对设计空间的真正探索。
对后续研究而言,本文提出的形式化标记框架具有直接的实用价值:研究者可以用统一的符号系统描述自己的辩论配置,使得实验设置的透明度大幅提升,也为后续的消融研究和基准测试提供了可操作的规范。更进一步,作者建议将这一框架扩展为可执行的规范语言,从而支持「成本感知」的基准测试——即在给定计算预算或 API 调用限额的前提下,自动搜索最优的辩论配置组合。
当然,本文也存在局限性:综述的覆盖范围受制于文献检索策略,部分非英语或尚未正式发表的工作可能被遗漏;此外,分类体系的边界有时并不清晰(例如「参与者是否异质」与「交互拓扑」之间存在关联)。这些问题为后续研究留下了完善空间,也提示我们在引用本文结论时需保持适度的审慎。
摘要
多智能体辩论(Multi-Agent Debate, MAD)是一种有前景的研究范式,旨在提升基于大语言模型(LLM)的智能体系统的准确性与鲁棒性。它使多个智能体能够交换论据、互相批评彼此的输出,并通过迭代逐步收敛至解决方案。然而,该领域的研究仍处于碎片化状态,术语使用不一致,且缺乏对 MAD 设计维度的严格综合分析。本文呈现一项系统性文献综述,对 141 项 MAD 核心研究进行特征刻画。我们提出一个三维分类体系,涵盖辩论参与者、组织信息交换的交互机制,以及支配辩论终止的共识协议,并通过形式化符号来表达 MAD 配置。本文的分析揭示,该领域在隐含层面已收敛于一种狭窄的设计模式——静态全连通拓扑、原样交换、短期记忆与投票决议策略——这些策略是出于惯例而非系统性比较而被采纳,而一些有前景的替代方案仍处于边缘地位。由于任何 MAD 设置都涉及约十多项相互关联的设计决策,当这些决策未被明确表述时,跨研究比较便不可靠。我们将该分类体系定位为研究领域的描述性地图、可控基准测试的框架,并有可能作为机器可读 MAD 规范的模式。展望未来,我们提议将其形式化为可执行规范,从而实现成本感知的基准测试与辩论配置的自动化调优。
Abstract
Multi-Agent Debate (MAD) is a promising paradigm for improving the accuracy and robustness of Large Language Model (LLM)-based agentic systems. It enables multiple agents to exchange arguments, critique each other's outputs, and iteratively converge towards a solution. However, research remains fragmented, with inconsistent terminology and no rigorous synthesis of MAD design dimensions. We present a systematic literature review characterizing 141 primary studies on MAD. We derive a three-dimensional taxonomy covering debate participants, the interaction mechanisms structuring the exchange, and the agreement protocols governing debate resolution, supported by formal notations to render MAD configurations. Our analysis reveals that the field has implicitly converged on a narrow design pattern - static, fully connected topologies, verbatim exchange, short-term memory and voting resolution strategies - adopted by convention rather than systematic comparison, while promising alternatives remain marginal. Because any MAD setting reflects roughly a dozen interacting design decisions, cross-study comparison is unreliable when these are left implicit. We position the taxonomy as a descriptive map of the research landscape, a framework for controlled benchmarking, and potentially as a schema for machine-readable MAD specifications. As future work, we propose formalizing it into an executable specification, enabling cost-aware benchmarking and automated tuning of debate configurations.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。