
面向基于人类反馈强化学习的元学习奖励塑形
Meta-Learned Reward Shaping for Reinforcement Learning from Human Feedback
📝 TLDR
RLHF依赖静态、任务无关的奖励模型,导致学习信号稀疏、对齐效果受限。MeRLa在RLHF训练前通过辅助任务元学习一个任务感知的塑形函数Φ,与原奖励组合形成兼顾策略最优性和任务特异性信号的目标。元目标融合任务判别、熵正则与势能守恒,并给出策略不变性等理论保证。在LLaMA-3-8B上超越PPO、DPO、GRPO、DAPO,AlpacaEval 2.0获90.8%长度控制胜率,训练不稳定减少41%。
🧭 速览
RLHF中的奖励模型通常静态且任务无关,无法提供任务特定信号,造成稀疏奖励和次优对齐效果。
在RLHF训练前,利用辅助任务元学习任务感知的奖励塑形函数Φ,与原奖励组合形成复合奖励,元目标包含任务判别、熵正则和势能守恒。
LLaMA-3-8B四个基准上超越PPO/DPO/GRPO/DAPO,AlpacaEval 2.0长度控制胜率90.8%,MT-Bench 9.14,训练不稳定减少41%。
MeRLa将元学习塑形引入RLHF以解决奖励静态性问题,提供策略不变性理论保证,且可与过程型和评分型增强奖励叠加使用。
🆚 方法对比
MeRLa
- 在AlpacaEval 2.0上达到90.8%长度控制胜率
- MT-Bench得分9.14,优于PPO/DPO/GRPO/DAPO
- 训练不稳定性降低41%,奖励方差降低37%
- 理论保证策略不变性,分析表示漂移敏感性
- 需依赖辅助任务分布的构建质量
- 在RLHF训练前增加额外元学习计算开销
- 冻结编码器策略可能限制对最新表示的适应性
PPO
- RLHF标准方法,生态成熟且广泛验证
- 结合KL惩罚可有效约束策略偏移
- 支持任意奖励模型输入,灵活性高
- 依赖静态、任务无关的奖励信号
- 存在奖励稀疏和过优化问题
- 需额外训练价值函数,计算成本高
DPO
- 绕过奖励模型,简化训练流程
- 无需在线采样,离线优化稳定
- SimPO等变体进一步去除参考模型
- 仍基于固定的偏好数据,任务适应性差
- 对偏好数据质量高度敏感
- 无法利用过程级或规则级增强奖励
GRPO
- 采用组相对基线,无需独立价值模型
- 在数学推理等任务上效果显著
- 计算效率优于PPO
- 仍依赖静态奖励模型,缺乏任务感知
- 组内样本质量差异影响基线估计
- 未解决奖励稀疏性问题
DAPO
- 解耦裁剪机制提升训练稳定性
- 动态采样提高样本利用效率
- 与token级策略优化兼容性好
- 仍使用固定的奖励信号作为优化目标
- 动态采样策略依赖任务分布假设
- 未提供策略不变性理论保证
Potential-based Reward Shaping
- 理论保证最优策略不变性(Ng 1999)
- 为奖励工程提供严格的数学基础
- 可与任意基础奖励组合使用
- 手工设计需逐任务专家经验
- 非势函数形式可能改变诱导最优策略
- 在LLM高维输出空间上难以直接构造
MeRLa通过元学习获得任务感知的奖励塑形函数,理论上保持策略不变性且兼容任意基础RLHF方法;而PPO/DPO/GRPO/DAPO等基线均依赖静态任务无关奖励信号,存在奖励稀疏与过优化局限,MeRLa在四个基准上均实现稳定提升并降低训练不稳定性。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 5 张)
展开查看 5 张图
TL;DR
MeRLa 提出在 RLHF 训练前通过元学习获得一个任务感知的奖励塑形函数,将其与基础奖励模型组合为复合奖励来增强学习信号。核心设计是用冻结参考模型的嵌入驱动轻量级塑形网络(<1M 参数),并通过势函数分解保证最优策略不受影响。在 LLaMA-3-8B 上,MeRLa 在 AlpacaEval 2.0 达到 90.8% 长度控制胜率,MT-Bench 得分 9.14,全面超越 PPO、DPO、GRPO 和 DAPO,同时训练不稳定性降低 41%。
研究背景与动机
RLHF 已成为大语言模型与人类偏好对齐的标准范式。其经典流程是先利用偏好数据训练一个奖励模型 ,再通过 PPO、GRPO 或 DPO 等算法优化策略模型。然而,这套范式存在一个根本性的不匹配:奖励模型一旦训练完成就保持静态,其评分标准与具体任务无关。当模型在某个数学推理任务上输出一个部分正确但缺少关键步骤的答案时,静态奖励模型可能给出与全错答案几乎相同的分数——这就是奖励稀疏问题。学习信号不足迫使模型在大量探索中艰难地辨别真正的质量差异,训练效率低下。
更深层的问题在于过优化。策略模型会不断试探奖励模型的评分盲点,当它发现某些表面特征(如更长的回答、更高的自信语气)与高分高度相关时,便倾向于强化这些模式而非真正的任务能力。这种 reward hacking 导致对齐后的模型在自动评估中表现优异,却可能在人类评判中显得生硬或缺乏实质内容。同时,在狭窄的奖励信号上过度优化还会损伤模型的通用能力,产生所谓[[RLHF]]中的对齐税。
[[奖励塑形]](Reward Shaping)为此提供了一条思路。经典理论表明,如果在原始奖励上叠加一个势函数产生的差分项,可以改变学习的探索方向而不改变最优策略——这就是 Ng 等人在 1999 年提出的势函数方法。然而,将这一理论移植到 LLM 场景面临严峻挑战:手工设计塑形函数需要逐任务的领域专家知识,难以泛化;让塑形函数随训练自适应调整,又可能破坏策略不变性的理论保证。MeRLa 的核心切入点正在于此——通过[[元学习]]让塑形函数从任务分布中自动获得任务感知能力,同时严格保留势函数形式的理论保证。
方法
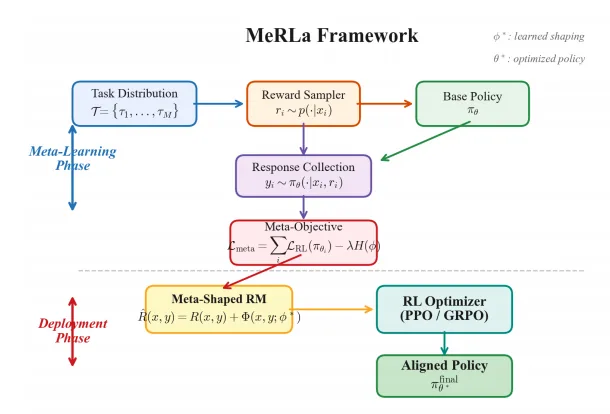
MeRLa 的整体框架分为两个阶段。第一阶段是元学习阶段,在一组辅助任务上训练一个任务感知的塑形函数 ;第二阶段冻结学到的塑形参数,将其与基础奖励模型组合用于标准的 RLHF 训练。这种先学习塑形再部署的解耦设计,使得元学习的计算开销可以在多次 RLHF 运行中摊销。
塑形网络的设计是方法的关键创新点之一。给定 prompt 和 response ,塑形网络以基础 LLM 倒数第二层的嵌入作为输入。论文采用一个两层的 MLP,隐藏维度为 256,使用 SiLU 激活函数,总参数量不到 100 万。输入的嵌入向量由三部分拼接构成:prompt 嵌入 、response 嵌入 ,以及它们的差分 。这个差分项编码了模型在给定 prompt 条件下生成 response 的增量信息,对于捕捉任务特定的响应质量具有重要意义。
一个极其巧妙的设计选择是: 和 取自冻结的参考模型 ,而非随训练演化的当前策略模型 。参考模型正是 RLHF 中用于计算 KL 惩罚的标准组件,这意味着 MeRLa 完全复用了已有基础设施,几乎不增加显存开销。更重要的是,这保证了塑形网络的输入分布在整个 RLHF 过程中保持稳定。如果使用演化中的策略嵌入,表示漂移会导致塑形信号与实际训练状态逐渐错位——论文的消融实验证实,使用冻结编码器相比演化编码器,奖励方差降低 43 倍,最终胜率从 90.8% 跌至 87.1%。
为确保塑形不改变最优策略,MeRLa 将响应级的塑形值分解为 token 级的势函数差分形式:
这种分解使得复合奖励 严格满足 Ng 等人提出的势函数条件,从而保证最优策略在 与 下完全一致。从直觉上理解,塑形函数只改变了探索的中间引导(哪些中间状态值得探索),而不改变最终目标(什么是最优策略)。
元学习目标由三项组成:
第一项是任务判别损失,它鼓励塑形后的奖励能够区分同一任务内质量高低不同的响应。这实际上是让塑形函数学会捕捉那些基础奖励模型未能有效区分的细粒度差异。第二项是熵正则损失,防止塑形奖励分布坍缩为常数或简单复制基础奖励——这对于维持探索的多样性至关重要。第三项是势函数守恒损失,通过最小二乘投影将学到的 对齐到势函数子空间,约束策略不变性在训练过程中持续成立。论文的消融实验表明,三项缺一不可:移除任务判别损失导致塑形无法提供任务特异性信号,移除熵正则导致奖励地形坍缩,移除守恒损失则引入激励错位。
实验与结果
实验在 LLaMA-3-8B-Instruct 基础上展开,采用 UltraFeedback 数据训练奖励模型,RLHF 骨干使用 GRPO(group size 8,,学习率 ,20 epoch)。评估涵盖四个基准:AlpacaEval 2.0 测量指令跟随与长度控制胜率、MT-Bench 衡量多轮对话能力、MATH 测试数学推理、IFEval 评估可验证指令遵循。
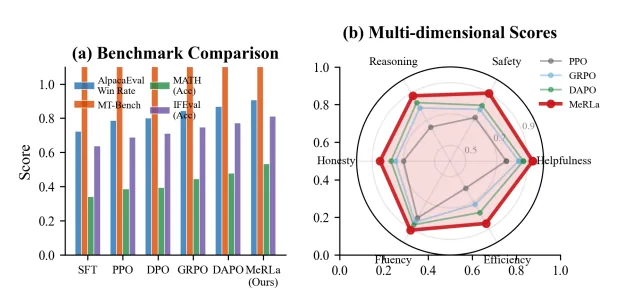
主实验结果呈现出一致的全面超越。在 AlpacaEval 2.0 上,MeRLa 达到 90.8% 的长度控制胜率,相比 DAPO 的 86.9% 提升 3.9 个百分点;MT-Bench 得分 9.14,超越 GRPO 的 8.58 和 DAPO 的 8.81;MATH 从 47.8% 提升至 53.4%;IFEval 从 77.3% 提升至 81.2%。值得注意的是,这些提升在所有四个基准上同时成立,说明 MeRLa 并非针对某一类任务的特化优化,而是带来了通用的对齐质量改善。
训练稳定性方面的收益同样显著。奖励方差降低 37%,训练不稳定性(以梯度发散或奖励崩溃的次数衡量)降低 41%,n-gram 多样性提升 23%。这些指标改善表明,任务感知的塑形信号有效缓解了稀疏奖励环境下的探索困境——模型不再需要在广袤的输出空间中盲目搜索,而是获得了关于「什么是好的 partial response」的局部引导。
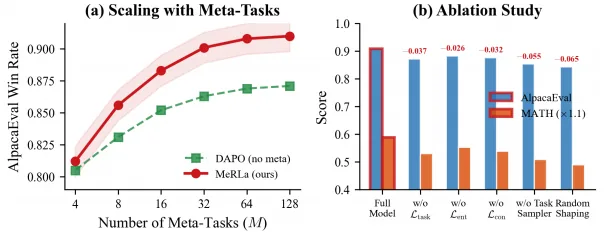
消融实验揭示了各组件的贡献。移除任务判别损失导致胜率下降 2.1 个百分点,移除熵正则导致多样性指标恶化,移除守恒损失导致激励错位增加。元任务数量扫描显示 是甜点值,超过此数量的边际收益递减。骨架兼容性实验更为有趣:MeRLa 与 PPO 结合(85.2%)超越了独立 GRPO(84.3%),与 DAPO 结合(89.7%)也超过了独立 DAPO(86.9%),证实塑形函数的改进与 RL 算法选择是正交的。与过程奖励模型(PRM)和评分标准集成(Rubric Ensemble)的叠加实验同样取得增益,说明 MeRLa 学到的任务感知信号与这些增强奖励之间存在互补性。
讨论与可借鉴点
MeRLa 的成功揭示了一个重要的设计原则:[[元学习]]可以作为连接通用预训练与任务特定优化的桥梁。静态的奖励模型之所以效果受限,本质上是缺乏对任务分布的感知;而手工设计的塑形规则又难以泛化。元学习提供了一种第三条路径——在辅助任务上学习可迁移的塑形先验,再在目标 RLHF 场景中作为隐式校准器发挥作用。这个思路或许可以启发其他需要「先通用后适配」的场景,如多任务强化学习中的技能迁移。
冻结参考模型嵌入来驱动塑形网络的设计也值得借鉴。这种做法复用了 RLHF 中已有的基础设施,将参考模型从单纯的 KL 惩罚锚点扩展为稳定的特征提取器。这提示我们,在设计新模块时充分复用现有系统中的角色,往往能以低成本换取高收益。
论文在理论上也做出了贡献。策略不变性定理给出了复合奖励下最优策略的精确刻画,表示漂移界揭示了冻结编码器的必要性,激励对齐界则量化了守恒损失对防止塑形引入错误激励的作用。这三个定理构成了方法可信度的理论基础,区别于纯粹的经验性改进。
局限方面,实验仅在 LLaMA-3-8B 这一个基础模型上验证,在更大规模(13B、70B)或其他模型族(Qwen、Mistral)上的泛化性尚未考察。此外,策略不变性仅在守恒损失严格为零时严格成立,实际训练中 的残差虽然被经验证明「有益」而非有害,但缺乏对这一现象的完整理论解释。辅助任务分布的设计也依赖人工选择,任务选择策略的系统性研究有待深入。
摘要
基于人类反馈的强化学习(RLHF)是使大语言模型与人类偏好对齐的标准方法,但其质量受限于静态且与任务无关的奖励模型。这种不匹配导致了稀疏的学习信号和次优的对齐效果。我们提出了 MeRLa(元学习奖励塑形),一个在 RLHF 训练前通过辅助任务元学习任务感知塑形函数 的原则性框架。所学习到的塑形函数生成复合奖励,在保持策略最优性的同时提供任务特定的学习信号。我们的元目标结合了任务判别、熵正则化和基于势函数的守恒性,以实现稳定的收敛。我们提供了策略不变性的理论保证,分析了表示漂移敏感性,并形式化地解决了由熵最大化引起的激励错位问题。在 LLaMA-3-8B 上针对四个基准的实验表明,相比 PPO、DPO、GRPO 和 DAPO 取得了持续改进,在 AlpacaEval 2.0 上达到了 90.8% 的长度控制胜率,在 MT-Bench 上获得了 9.14 的评分,且训练不稳定性降低了 41%。MeRLa 在与基于过程和基于评分标准的增强奖励结合时仍能保持其优势。
Abstract
Reinforcement Learning from Human Feedback (RLHF) is the standard approach for aligning large language models with human preferences, but its quality is limited by static, task-agnostic reward models. This mismatch leads to sparse learning signals and suboptimal alignment. We introduce MeRLa (Meta-Learned Reward Shaping), a principled framework that meta-learns a task-aware shaping function across auxiliary tasks before RLHF training. The learned shaping produces a composite reward that preserves policy optimality while providing task-specific learning signals. Our meta-objective combines task discrimination, entropy regularization, and potential-based conservation for stable convergence. We provide theoretical guarantees for policy invariance, analyze representation drift sensitivity, and formally address incentive misalignment from entropy maximization. Experiments on LLaMA-3-8B across four benchmarks show consistent improvements over PPO, DPO, GRPO, and DAPO, achieving a 90.8% length-controlled win rate on AlpacaEval 2.0 and a score of 9.14 on MT-Bench, with 41% less training instability. MeRLa retains its benefits when combined with process-based and rubric-based enhanced rewards.
论文详细总结(自动生成)
MeRLa 论文总结:面向 RLHF 的元学习奖励塑形
1. 核心问题与研究动机
RLHF 是当前大语言模型对齐的主流范式,其标准流程是:先用偏好数据训练一个奖励模型 ,再通过 PPO/GRPO/DPO 等算法优化策略。该范式存在三大固有缺陷,根源均在于奖励模型是静态且任务无关的:
- 奖励稀疏(reward sparsity):对细微质量差异给出近乎相同的分数,导致学习信号不足。
- 过优化(overoptimization):策略会利用奖励模型的盲点(reward hacking)获得高分但实际质量下降。
- 对齐税(alignment tax):在窄信号上过度优化会损害模型的通用能力。
奖励塑形(reward shaping)虽有深厚理论基础(Ng, Harada, and Russell 1999 的势函数方法可保证策略不变性),但针对 LLM 的塑形函数难以设计:手工设计需逐任务专家经验,自适应方法若不严格约束则可能改变最优策略。
2. 方法论
2.1 整体框架
MeRLa 分为两个阶段:
1. 元学习阶段:在辅助任务分布上元学习一个任务感知的塑形函数 。
2. 部署阶段:冻结塑形参数 ,将其与基础奖励组合用于标准 RLHF。
2.2 复合奖励设计
其中 控制塑形强度。
2.3 塑形网络架构
塑形网络以基础 LLM 倒数第二层的 prompt 与 response 嵌入 为输入:
- 2 层 MLP,隐藏维 256,SiLU 激活,附加参数 < 1M;
- 关键设计: 取自冻结的参考模型 ,而非随训练演化的策略 ,以避免表示漂移;
- 采用谱归一化约束 Lipschitz 常数。
2.4 策略不变性保证
为使塑形不改变最优策略,将响应级塑形分解为 token 级势函数:
此形式满足 Ng 等 (1999) 的势函数条件,从而保证最优策略在 与 下完全一致。
2.5 元学习目标
- 任务判别损失 :鼓励塑形后的奖励能区分同一任务内的优劣响应,采用成对 softmax 形式。
- 熵正则 :鼓励塑形奖励分布具有较高熵,防止坍缩为常数或复制基础奖励。
- 势函数守恒损失 :将 通过最小二乘投影对齐到势函数子空间,约束策略不变性。
2.6 算法流程
算法 1(Algorithm 1)总结为:先在 个元任务上训练 ( 轮),冻结后用于 GRPO/PPO 的 RLHF 训练。
3. 实验设计
3.1 基础设置
- 基础模型:LLaMA-3-8B-Instruct;
- 偏好数据:UltraFeedback;奖励模型用 LoRA(rank 16)训练;
- 评估基准:AlpacaEval 2.0(指令跟随,长度控制胜率)、MT-Bench(多轮对话)、MATH(数学推理)、IFEval(可验证指令跟随);
- 基线:SFT、PPO、DPO、GRPO、DAPO(共享相同模型与偏好数据);
- 评估协议:GPT-4-Turbo 评判,greedy 解码(max_tokens=2048),3 个不同 seed 取平均。
3.2 主要对比方法
- PPO:经典 RLHF 算法;
- DPO:绕过奖励模型的直接偏好优化;
- GRPO:组相对基线,无需 critic;
- DAPO:解耦剪切机制的 RLHF 系统;
- 同时测试与 Process Reward Model(PRM)、Rubric Ensemble(5 维评分集成) 等增强奖励的兼容性。
4. 资源与算力
- 硬件:RLHF 训练使用 8 × A100-80GB GPU;
- 元学习开销:在 个任务上,元学习阶段增加约 2 GPU-hours(该开销可在多次 RLHF 运行中摊销);
- 训练设置:GRPO,group size 8,,学习率 ,20 epoch;
- 超参数:,,。
> 论文未明确报告总训练时长与总计算量(GPU-hours 或 FLOPs),但提供了 GPU 型号与元学习阶段的开销估算。
5. 实验数量与充分性
论文实验较为充分,覆盖:
- 主结果表(Table 1):在 4 个基准上对比 6 种方法;
- 缩放性实验(Fig. 3a):元任务数 的扫描,发现 后收益递减;
- 组件消融(Fig. 3b):逐一移除 、、 及任务采样器;
- 兼容性实验(Table 2):将 MeRLa 嵌入 PPO/GRPO/DAPO 三种骨干;
- 增强奖励实验(Table 3):与 PRM、Rubric Ensemble 叠加;
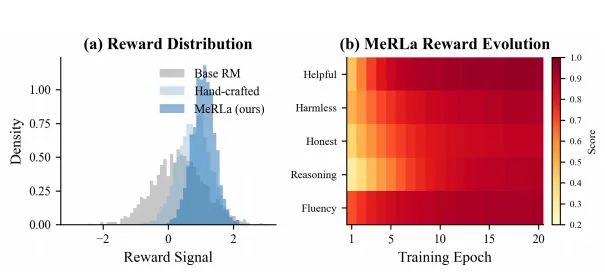
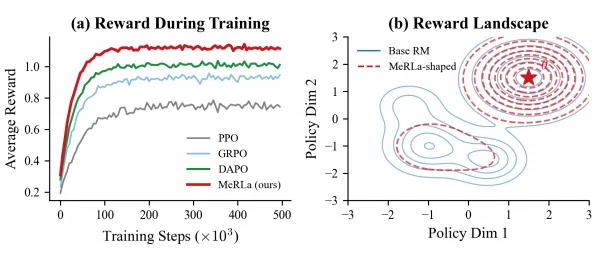
- 分析实验(Fig. 4–5):奖励分布、质量维度热图、训练曲线、t-SNE 奖励地形;
- 训练稳定性分析:报告 37% 奖励方差下降、41% 训练不稳定性下降、23% n-gram 多样性提升。
所有结果均为 3 次不同 seed 的均值,并报告 95% 置信区间()与 paired t-test 显著性()。不过实验仅基于单一基础模型(LLaMA-3-8B),未在更大规模模型或其他模型族上验证,外部泛化性有待考察。
6. 主要结论与发现
6.1 性能结论(LLaMA-3-8B,3 次均值)
| 方法 | AlpacaEval 2.0 (LC%) | MT-Bench | MATH (%) | IFEval (%) |
|---|---|---|---|---|
| Base | 61.0 | 7.12 | 34.2 | 54.2 |
| SFT | 72.3 | 7.84 | 39.5 | 65.8 |
| PPO | 78.6 | 7.95 | 38.7 | 68.9 |
| DPO | 80.4 | 8.12 | 39.5 | 71.0 |
| GRPO | 84.3 | 8.58 | 44.5 | 74.8 |
| DAPO | 86.9 | 8.81 | 47.8 | 77.3 |
| MeRLa (GRPO) | 90.8 | 9.14 | 53.4 | 81.2 |
- MeRLa 全面超越 PPO/DPO/GRPO/DAPO,AlpacaEval 2.0 相对 DAPO 提升 3.9 pt;
- 训练不稳定降低 41%,奖励方差降低 37%,n-gram 多样性提升 23%;
- 兼容性:MeRLa+PPO (85.2%) 超过独立 GRPO (84.3%),表明塑形可部分替代算法复杂度。
6.2 理论结论
- 定理 1(策略不变性):势函数分解保证最优策略在 与 下完全一致,最优值函数仅差一个势能项 ;
- 命题 1(表示漂移界):冻结编码器使漂移项 ,经验上比演化编码器方差低 43×,最终胜率从 90.8% 降至 87.1%;
- 命题 2(激励对齐界):,即激励错位由 与守恒损失共同控制。
6.3 元学习为何有效
1. 任务感知信号丰富:在多样化任务上学到任务特定质量特征(数学任务的逻辑一致性、创意写作的连贯性等);
2. 隐式奖励校准:任务判别损失起到自适应学习率的作用,在基础奖励不确定处放大差异;
3. 探索正则化:熵正则防止奖励地形坍缩,守恒损失约束到势函数子空间,避免激励错位。
7. 优点与亮点
- 理论基础扎实:从势函数奖励塑形出发,给出策略不变性定理、表示漂移界、激励对齐界三个理论保证,区别于纯经验性的 RLHF 改进;
- 冻结编码器设计:巧妙复用 RLHF 中已有的参考模型(用于 KL 惩罚),几乎不增加显存开销,又显著稳定塑形信号;
- 架构轻量:仅 <1M 参数的 MLP 即可带来显著提升,易于集成到任何 RLHF 流水线;
- 正交性:MeRLa 与 PPO/GRPO/DAPO 以及 PRM、Rubric Ensemble 等增强奖励完全正交,可叠加使用;
- 消融充分:元任务数缩放、组件消融、骨架兼容性、增强奖励兼容性、训练稳定性等多维度验证;
- 缓解 reward hacking:熵正则结合守恒损失抑制奖励地形坍缩,实证 n-gram 多样性提升 23%,诚实性与安全性维度均改善。
8. 不足与局限
- 单一基础模型:所有实验仅在 LLaMA-3-8B 上完成,未在更大规模模型(13B/70B)或其他模型族(Qwen、Mistral)上验证,泛化性存疑;
- 近似不变性问题:策略不变性仅在守恒损失 时严格成立;实际训练后 ,残差偏差 被经验上"观察为有益",但缺乏严格的"有益偏差"理论刻画;
- 元学习开销:M=64 个任务需约 2 GPU-hours,在多次 RLHF 运行中可摊销,但小规模场景下相对成本较高;
- 辅助任务分布依赖:性能依赖元任务分布的多样性与覆盖度,未给出任务选择策略的系统性研究;
- 固定长度嵌入:塑形网络在固定维度的 prompt/response 嵌入上运作,未扩展到变长、token 级塑形;
- 对抗性假设缺失:激励对齐界假设基础奖励模型不被对抗性污染,未考虑恶意奖励模型场景;
- 公开性存疑:论文为 arXiv 单作(2026-07-28,v1),未提供官方代码或模型权重链接,复现门槛较高;
- GPT-4 评判偏差:以 GPT-4-Turbo 为自动评判,可能与 AlpacaEval 的评估偏差产生关联。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。