
基于系统化多智能体深度强化学习的复杂环境下多无人机协同导航
Cooperative Multi-UAV Navigation in Complex Environments via Systematic Multi-Agent Deep Reinforcement Learning
📝 TLDR
多无人机在复杂环境中协同导航面临局部最优、稀疏奖励、学习不均衡和跨场景泛化不足等难题。本文提出融合协调探索、协作示范利用、安全课程调度与结构感知泛化的多智能体深度强化学习框架,通过状态记忆与方向新颖性检测跳出局部最优,利用分层示范缓冲和分级行为克隆提升稀疏信号下的示范效率,借助双条件课程调度抑制灾难性遗忘,并基于结构感知门控与混合专家机制实现零样本跨场景迁移。仿真验证了该方法在协作成功率、导航鲁棒性、跨场景泛化与动态适应性上的优越性能。
🧭 速览
多无人机在复杂环境中协同导航面临局部最优陷阱、稀疏协作奖励、智能体间学习不均衡以及跨场景泛化能力不足等核心挑战。
提出系统性多智能体深度强化学习框架,集成主动探索与示范利用、分层协作示范缓冲与分级行为克隆、安全感知双条件课程调度以及基于局部几何特征的结构感知门控与混合专家机制。
仿真结果表明,该方法在协作成功率、导航鲁棒性、零样本跨场景泛化以及静态-动态混合障碍物场景适应性方面均显著优于基线方法。
为复杂环境下多无人机协同导航提供了兼顾任务性能与飞行安全的系统性解决方案,并验证了零样本跨场景迁移与动态干扰适应的可行性。
🆚 方法对比
Systematic Multi-Agent DRL Framework
- 系统整合四大机制解决局部最优、稀疏奖励等问题
- 仿真验证协作成功率与零样本跨场景泛化能力强
- 在混合动静态障碍设置下展现鲁棒适应性
- 仅依赖仿真验证,缺乏真实飞行实验支撑
- 框架多模块耦合,训练调参复杂度较高
Perception Mechanism (感知机制)
- 融合访问记忆、方向新颖性与惩罚回传主动逃离局部最优
- 针对结构受限环境提供显式任务相关引导
- 弥补内在动机方法缺乏任务指引的不足
- 依赖状态记忆存储,计算开销随时间增长
- 惩罚回传机制在动态障碍频繁环境中可能引入噪声
Hierarchical Collaborative Demonstration Buffer & Tiered BC
- 按团队协作程度分层管理轨迹,提升示范利用率
- 对actor网络施加差分监督,缓解稀疏协作信号问题
- 缓解多智能体间学习不均衡现象
- 依赖高质量示范数据,获取成本较高
- 分层标准设计依赖先验知识,适应性有限
Safety-aware Dual-condition Curriculum Scheduling
- 通过回测与经验预填充抑制灾难性遗忘
- 双条件机制兼顾任务性能与飞行安全
- 支持已掌握场景的持续复习巩固
- 回测机制增加训练计算负担
- 课程调度阈值需精心设计
Structure-aware Gating & Mixture-of-Experts
- 基于局部几何特征抽象域参数,支持零样本跨场景迁移
- 不依赖场景特定坐标记忆,泛化能力强
- 门控网络条件化策略于结构模式而非坐标
- 依赖几何特征提取的准确性与稳定性
- 专家数量选择影响模型容量与效率平衡
CTDE-based MARL (对比基线方法)
- 集中训练分散执行,训练稳定且执行去中心化
- critic可访问全局状态提升联合策略优化
- 强智能体耦合下易陷入系统性停滞
- 对智能体间学习不均衡缺乏针对性应对
Intrinsic Motivation Exploration (对比方法)
- 好奇心驱动与RND有效促进稀疏奖励下的状态覆盖
- 鼓励访问未见状态提升探索效率
- 内在奖励与任务目标解耦,易导向任务无关区域
- 结构受限多局部最优环境中仍可能陷入停滞
本文提出统一框架系统整合感知、分层示范、安全课程与结构感知泛化四大机制,针对性弥补内在动机探索缺乏任务引导、CTDE方法应对学习不均衡不足及域随机化忽略几何重复性等局限,各模块互补协同实现协作导航性能提升。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 7 张)
展开查看 7 张图
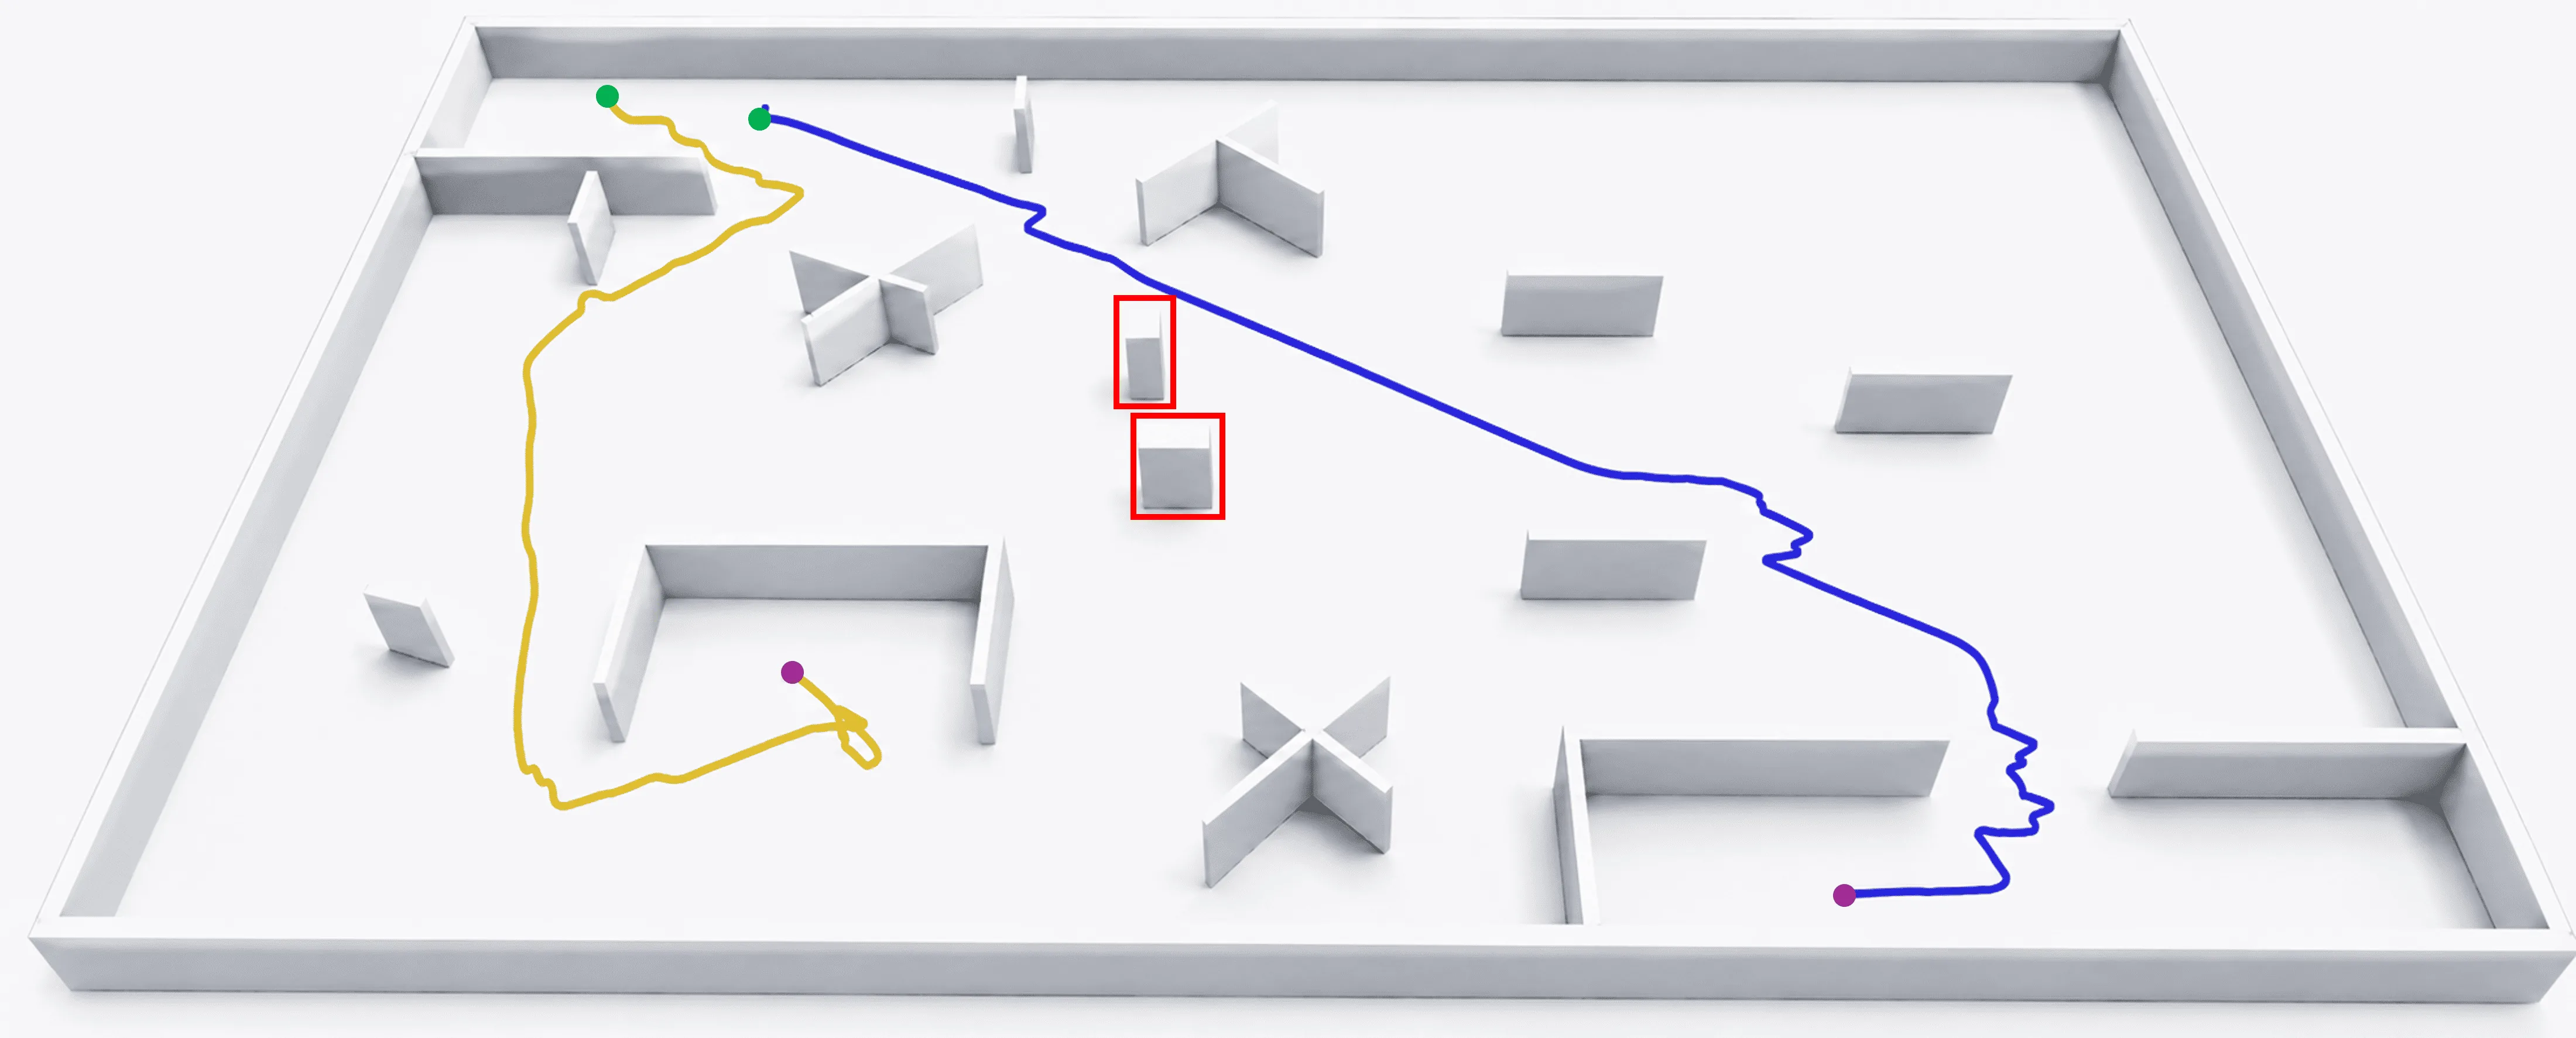
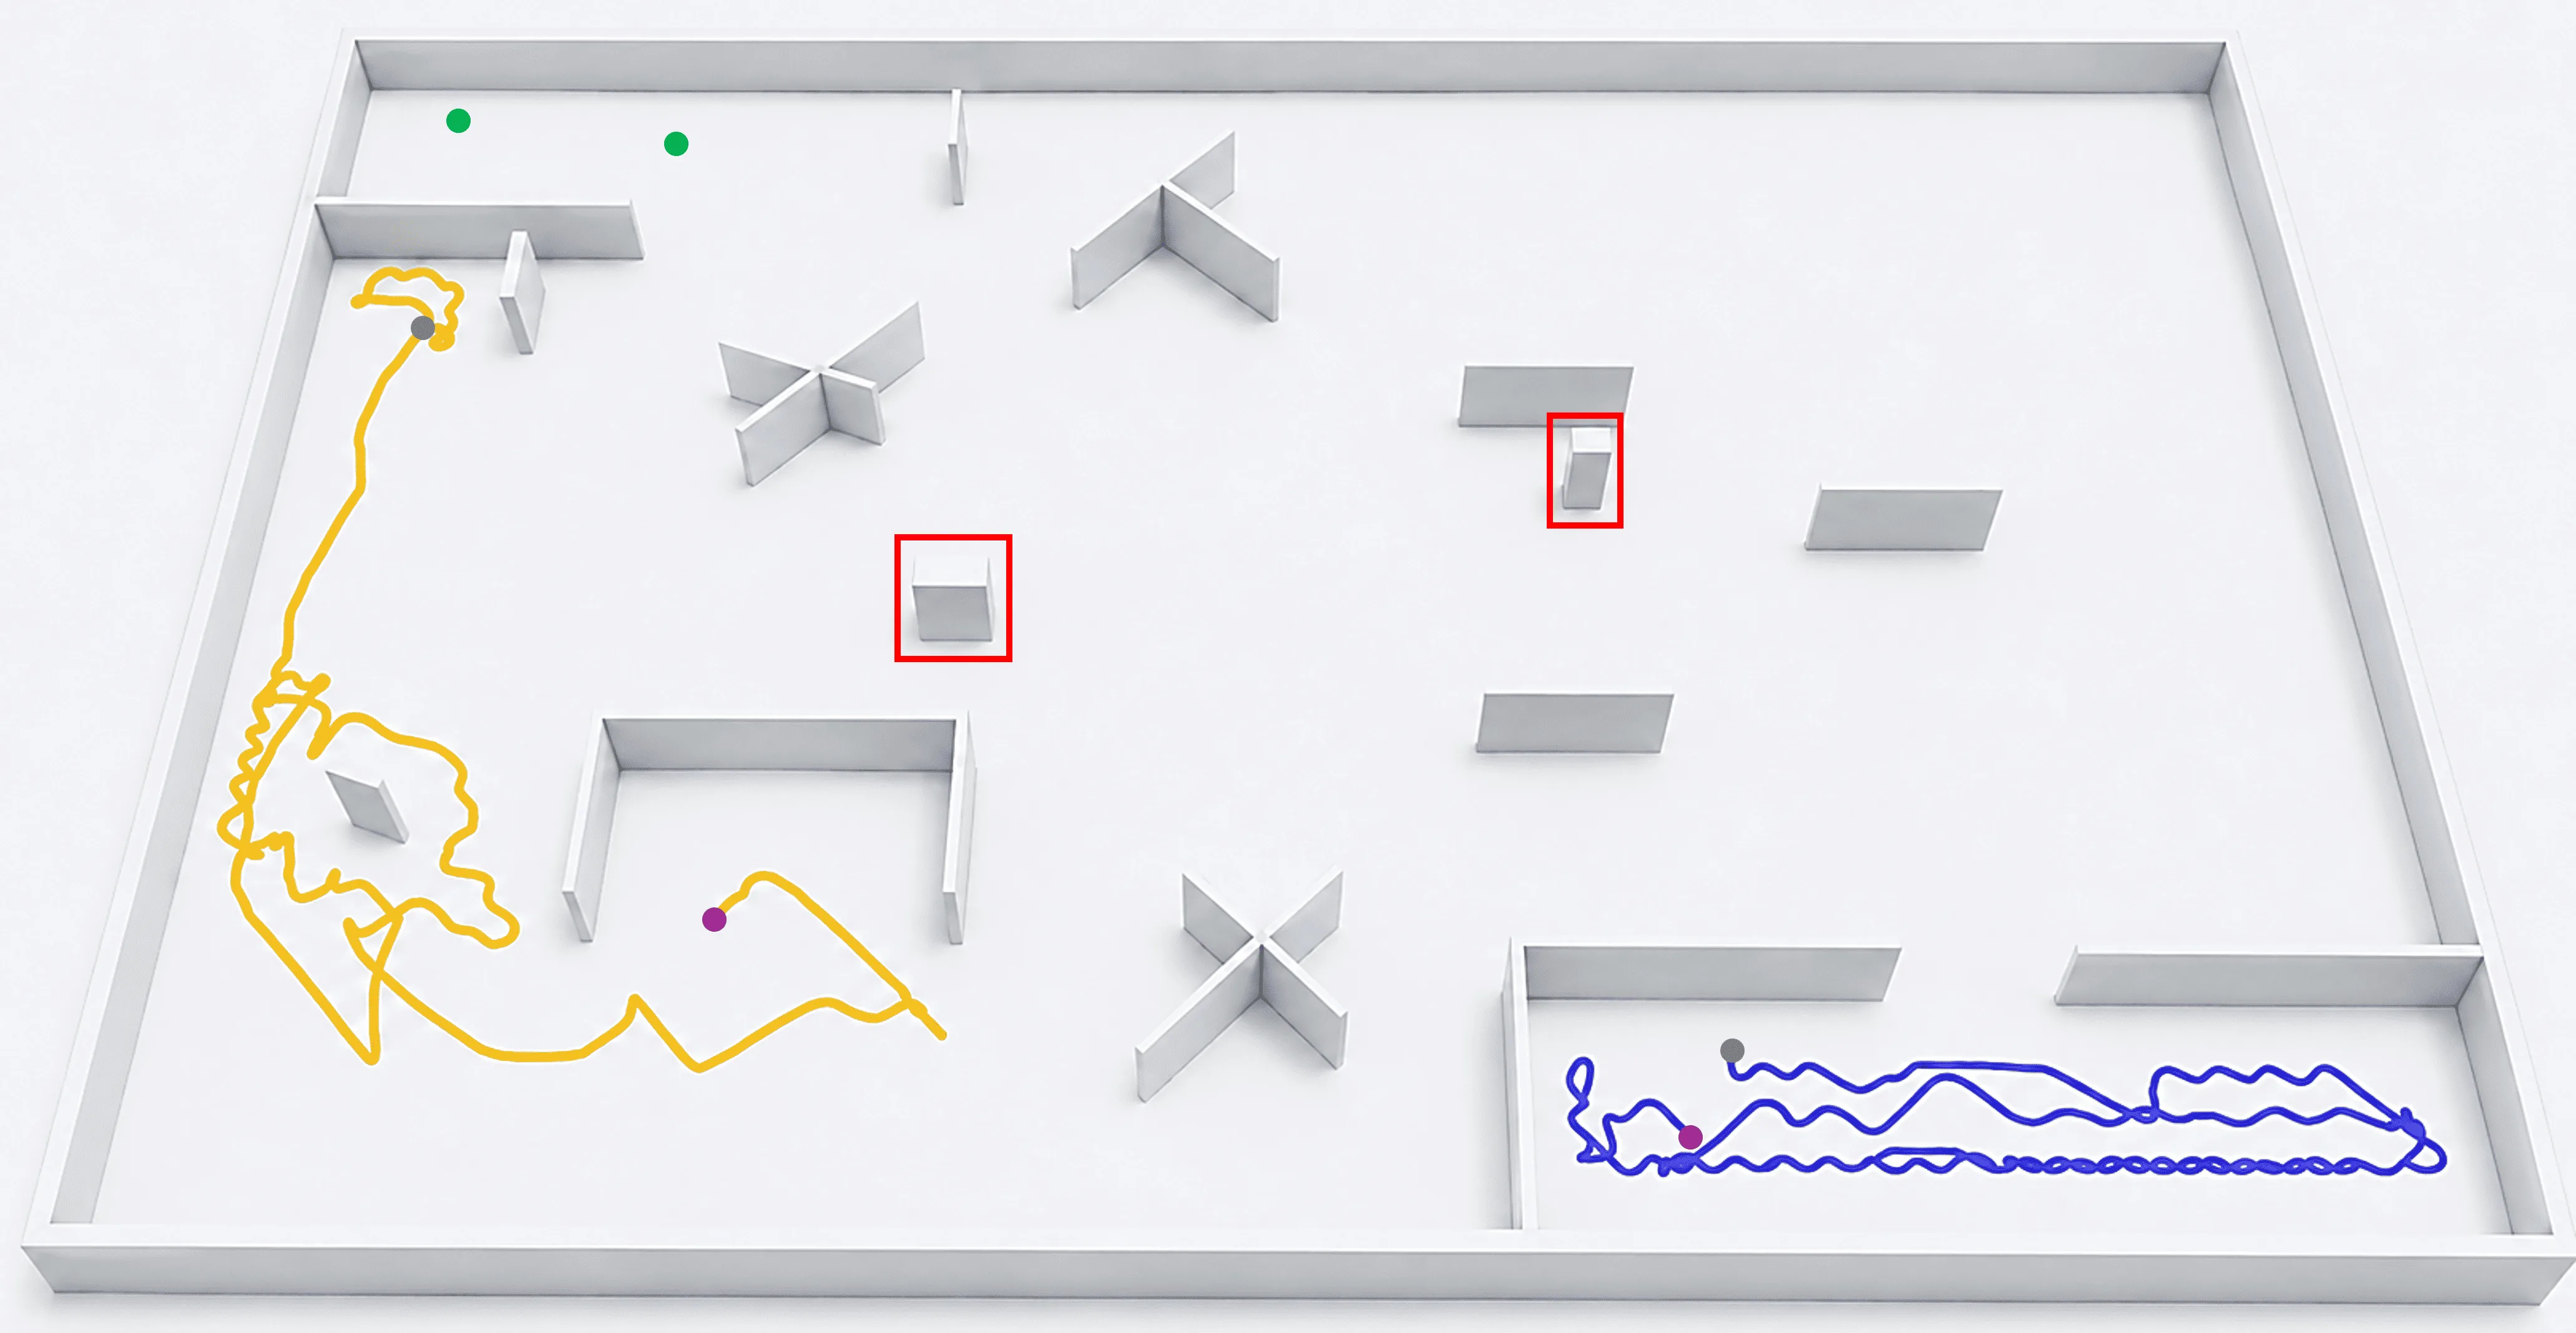
TL;DR
本文针对多无人机在复杂迷宮环境中的协同导航问题,提出了一套融合协调探索、示范利用、安全课程调度与结构感知泛化的多智能体深度强化学习框架。该框架通过访问状态记忆与方向新颖性检测主动诊断并跳出局部最优陷阱;利用分层示范缓冲与差异化行为克隆提升稀疏协作信号下的学习效率;借助双条件课程调度机制兼顾任务性能与飞行安全并抑制灾难性遗忘;在泛化层面,通过从 LiDAR 数据中提取的局部几何特征作为域参数,驱动结构感知门控网络与混合专家机制,实现零样本跨场景迁移。仿真实验验证了该方法在协作成功率、导航鲁棒性及跨场景泛化能力上的显著优势。
研究背景与动机
多无人机协同导航在灾后响应、工业巡检、仓储自动化等领域具有广阔的应用前景。当无人机编队在缺乏全局定位信息的受限空间——如复杂迷宮、走廊密布的工业厂房——中执行协同到达任务时,系统面临的核心挑战远非单智能体导航问题可比拟。具体而言,有四个相互耦合的技术瓶颈长期困扰着该领域的研究者与工程师。
第一是局部最优陷阱问题。在空间结构受限的环境中,智能体极易陷入徘徊、重复遍历或死胡同等停滞模式。传统探索方法虽然引入了内在动机奖励(如 Curiosity、RND、基于计数的探索),但这些方法本质上将探索奖励与任务目标解耦,在高度结构化的迷宮环境中可能与环境约束产生冲突,导致探索策略反而被困在局部停滞区域。第二是稀疏协作奖励的困境。当任务要求所有智能体同时到达目标点时,全队协同成功的事件在训练初期极为罕见,导致奖励信号极度稀疏,智能体难以从随机探索中习得有意义的协作行为。第三是智能体间学习不均衡的问题。在强耦合的协同任务中,各智能体的学习进度往往参差不齐,部分智能体可能过早收敛到次优策略,进而拖累整体协作效率。第四是跨场景泛化能力的不足。现有方法多聚焦于物理动力学或任务目标层面的泛化,未能充分利用迷宮环境中广泛存在的局部几何重复性——相同的拐角模式、狭窄通道、死胡同等结构在不同的迷宮中反复出现。
本文的核心切入点正在于此:系统性地将上述四个挑战纳入统一的 [[多智能体深度强化学习]] 框架,通过协调探索、示范利用、安全课程调度与结构感知泛化四个模块的协同设计,而非单点突破。
方法
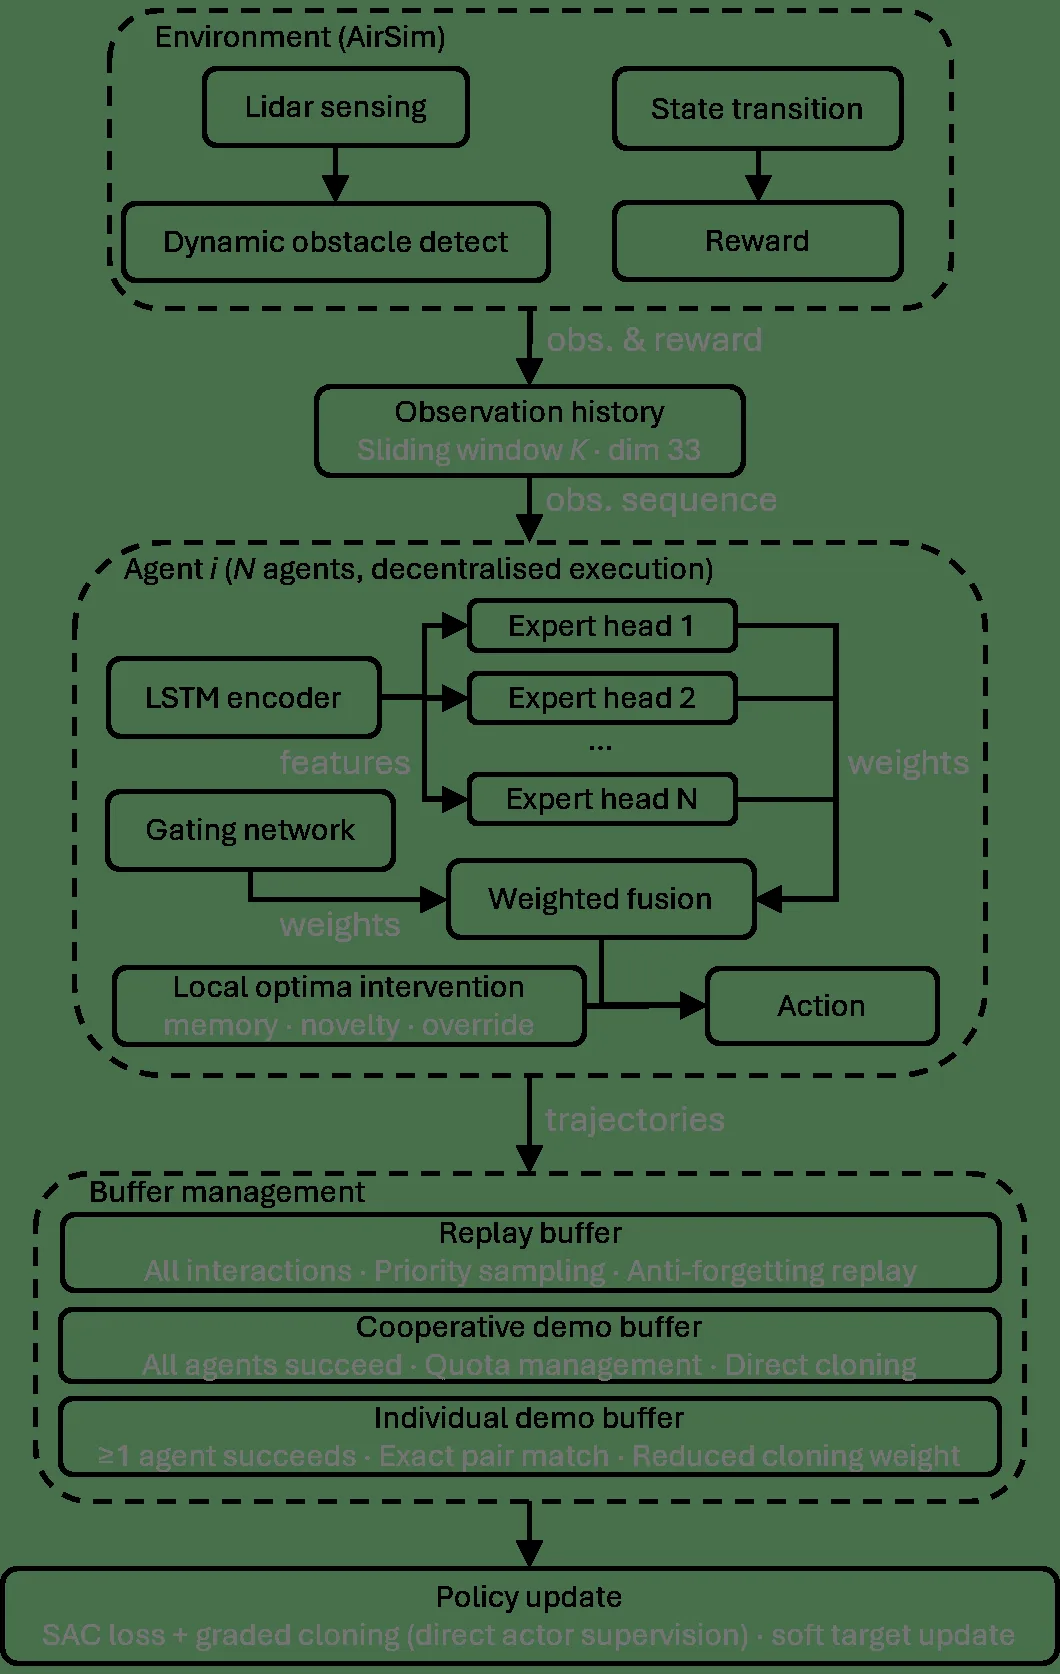
论文以 [[多智能体软演员-评论家算法]](MASAC)为基础,将任务形式化为 [[Dec-POMDP]]( decentralized partially observable Markov decision process),优化目标为最大化期望累积折扣回报 。在此基础上,框架依次解决局部最优、稀疏奖励、遗忘与安全、以及泛化四个核心问题。
局部最优诊断与执行级干预
针对局部最优陷阱,论文设计了一套无需新增可训练参数的诊断与干预机制。该机制包含三个紧密协作的子模块。访问状态记忆模块将环境离散化为网格并记录每个单元格的访问次数,将四维记忆特征拼入观测向量,为策略网络提供关于"是否在重复访问同一区域"的直接感知。诊断条件模块则在一个长度为 的滑动窗口内同时评估四个指标:悬停检测(空间跨度低于阈值)、重复遍历检测(唯一单元格比率 低于目标值 )、阻塞检测(接近目标但进度近零且 LiDAR 均值低)、以及徘徊检测(远离目标但跨度大)。当这四个条件中任意一个被触发时,诊断指示器 置为 1。执行级干预模块随即覆盖策略输出,按方向新颖性评分函数选择逃逸方向:
该函数综合权衡方向的新颖性、与目标的接近程度以及惩罚项,在检测到死胡同时自动切换为清除主导模式。此外,引入的 LiDAR 走廊约束指示 有效缓解了目标被遮挡时距离塑形导致的奖励真空问题。这一设计的巧妙之处在于,它将局部最优的诊断从隐式的值函数学习转化为显式的状态空间检测,使智能体能够在不依赖额外监督的情况下主动逃离陷阱。
分层协作示范缓冲与分级行为克隆
面对稀疏协作奖励的挑战,论文构建了分层协作示范缓冲区这一核心组件。该缓冲区包含两个独立的存储池:协作成功缓冲 (容量 60,000)和个体成功缓冲 (容量 5,000)。前者仅存储所有智能体均成功到达目标的轨迹,后者则接纳至少一个智能体到达的情形。在轨迹管理层面,论文采用场景级与起-终点对级双重配额机制,并引入按协作分数的质量替换策略,确保高质量轨迹的优先保留。
分级行为克隆通过差异化的监督信号直接作用于 Actor 网络。在协作成功缓冲上的克隆损失权重为 1,在个体成功缓冲上的克隆损失权重为 ,总 Actor 损失为:
克隆系数 从初始值 0.03 线性增长至 0.40,其增长速度与协作缓冲的占用率正相关。这种动态调整机制确保了在训练初期依赖更多专家示范,而在后期逐步转向自主探索。
安全感知的双条件课程调度
课程学习是控制任务难度渐进、提升训练效率的重要范式。论文设计的双条件课程调度机制要求智能体同时满足两个晋级条件:全队协作成功率 且碰撞率 。仅有成功率达标不足以触发晋级,这一设计从机制层面保障了飞行安全与任务性能的同步提升。
为抑制灾难性遗忘,论文采用回顾式评估策略:每次晋级后对所有已掌握场景进行完整复评,并将新获得的轨迹以每场景 15 回合的速率预填充回放缓冲。训练过程中以 的概率从已掌握场景中采样回合,确保历史经验的持续巩固。团队奖励的同步感知设计 (其中 仅当所有智能体同步推进时激活)进一步强化了协同行为的时间一致性。
结构感知泛化机制
论文的核心创新之一在于对跨场景泛化问题的独特解法。从 LiDAR 传感器读数中确定性计算的域参数 编码了四类局部几何模式:死胡同、单侧墙体、狭窄入口与开阔区域。这一参数完全独立于特定坐标或场景标识,使策略能够基于局部结构模式而非空间记忆进行决策。
结构感知门控网络接收 作为输入,通过 softmax 激活输出 个专家的权重分布 。策略的均值与方差通过混合专家机制聚合:
由于 与场景特定坐标完全解耦,专家网络被迫学习对不同几何结构的条件响应而非场景记忆,从而实现真正的零样本跨场景迁移。
实验与结果
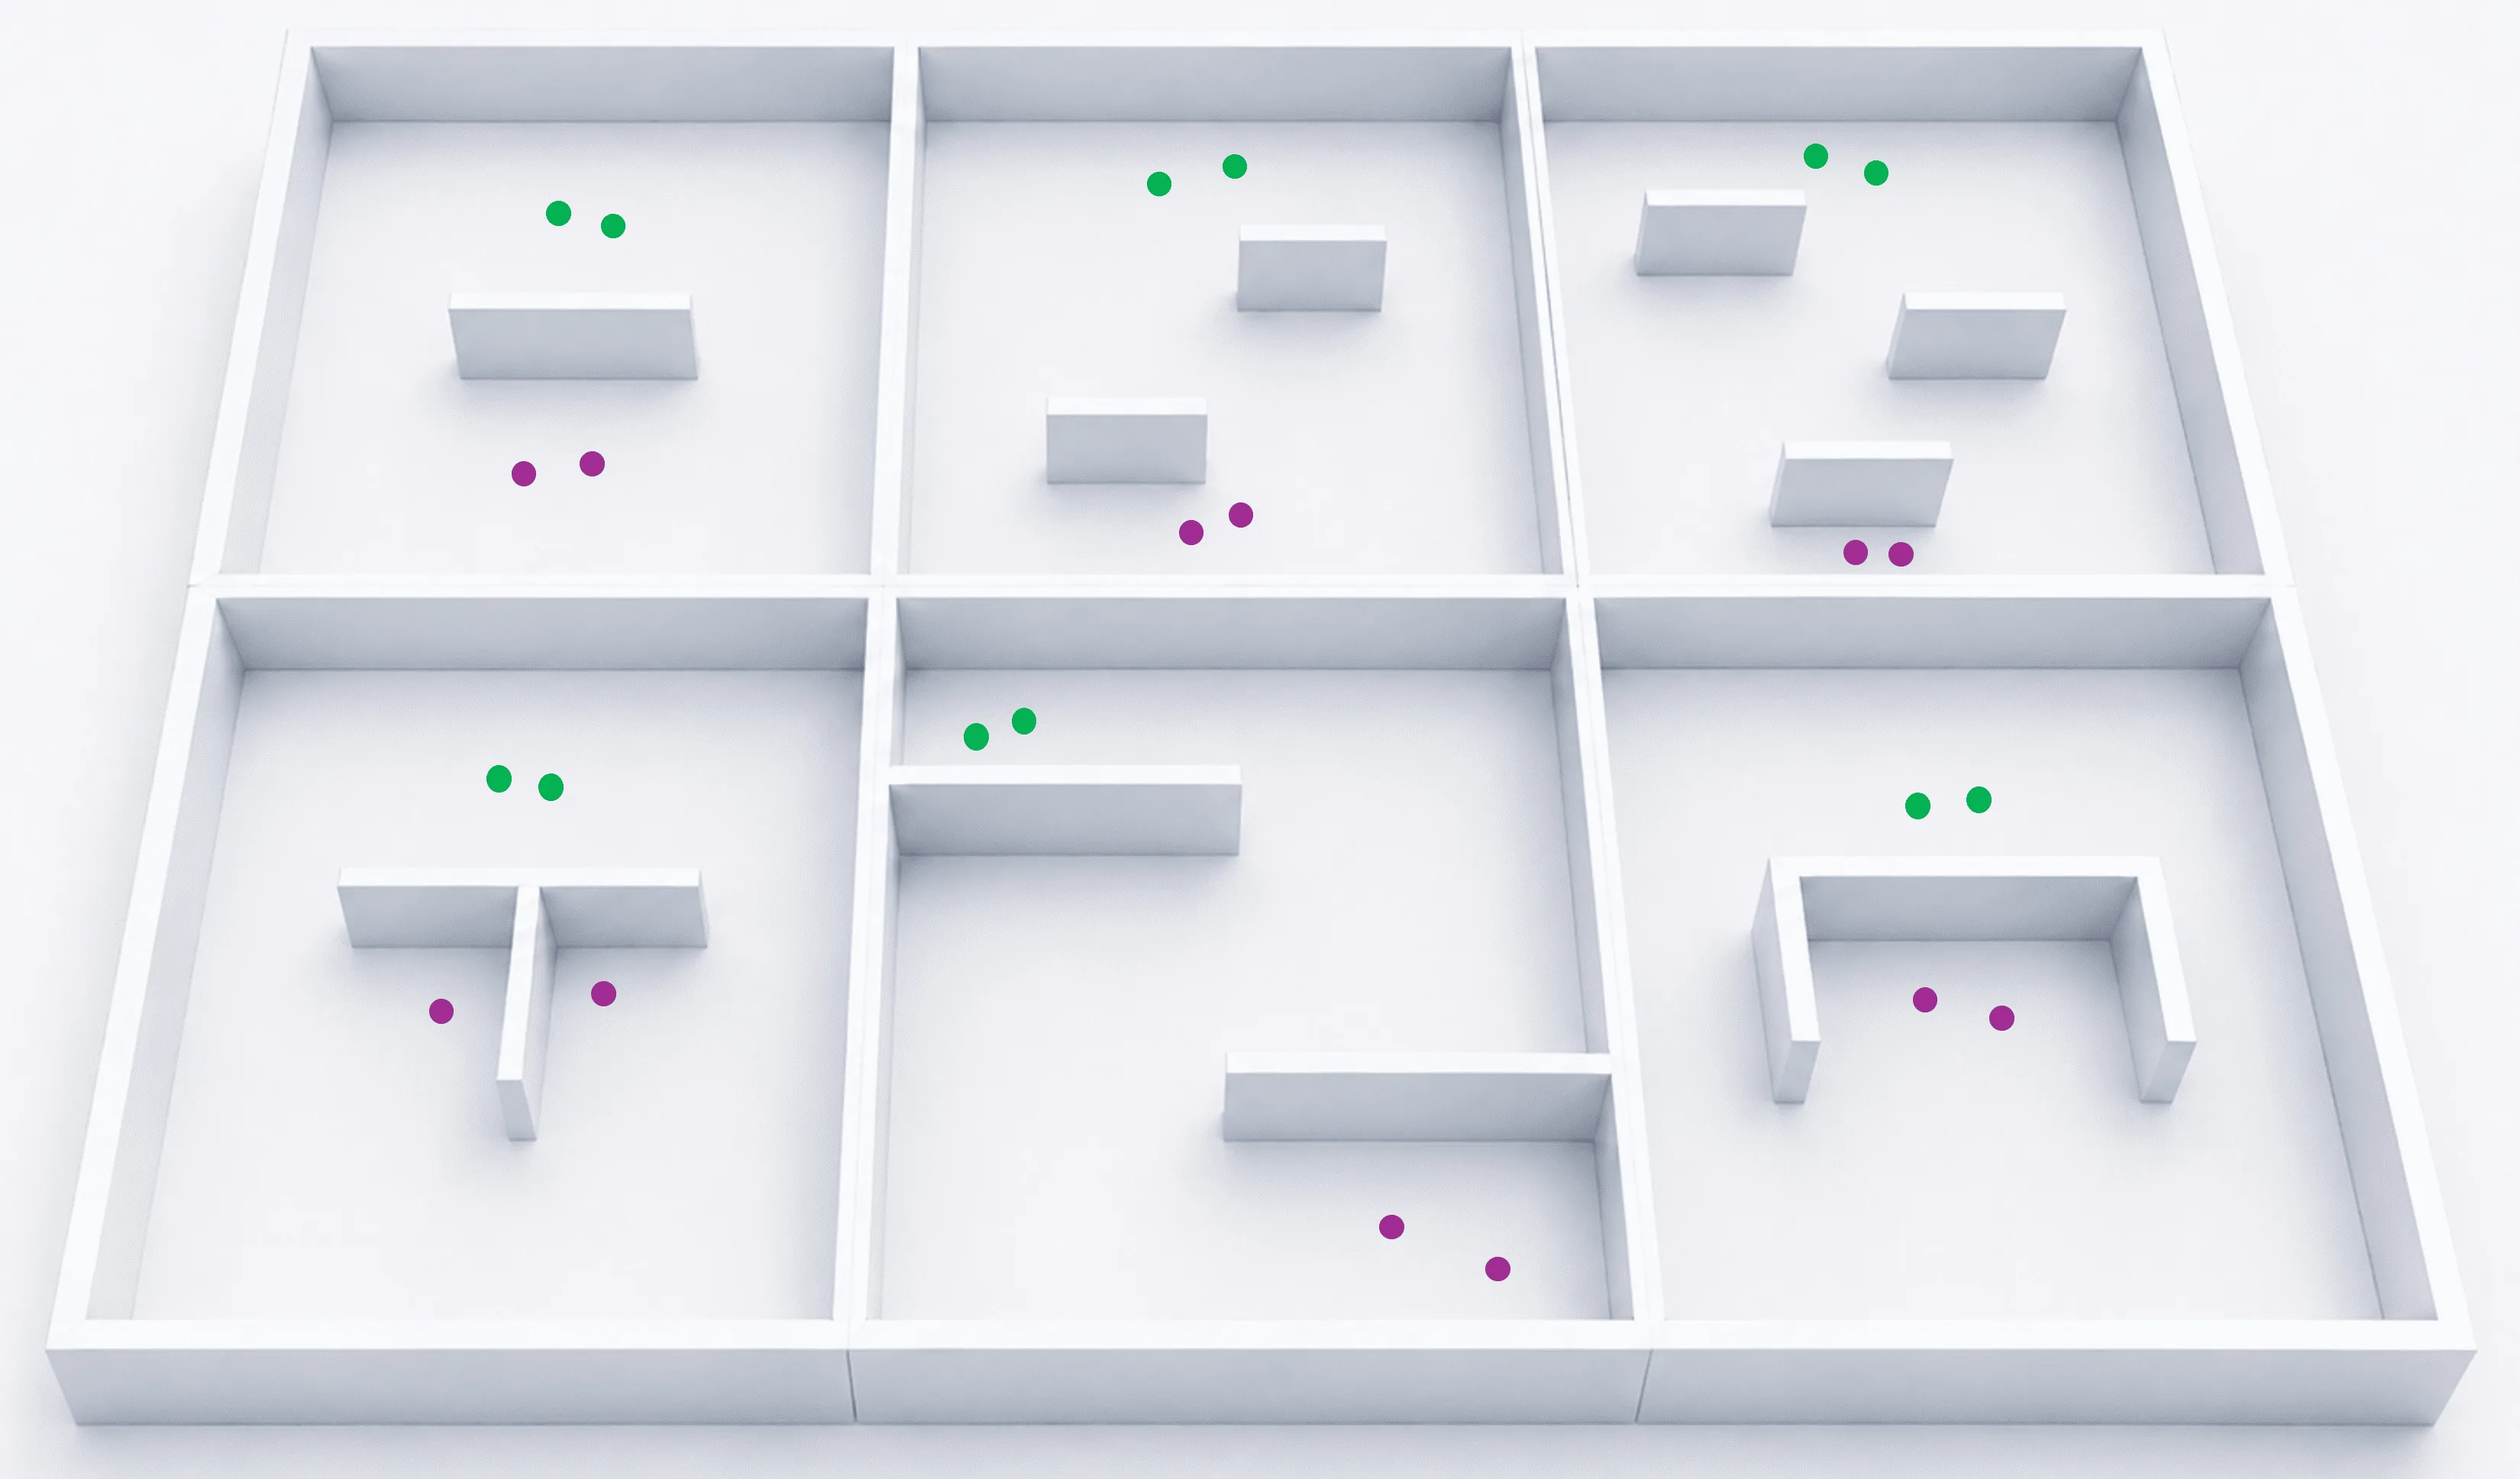
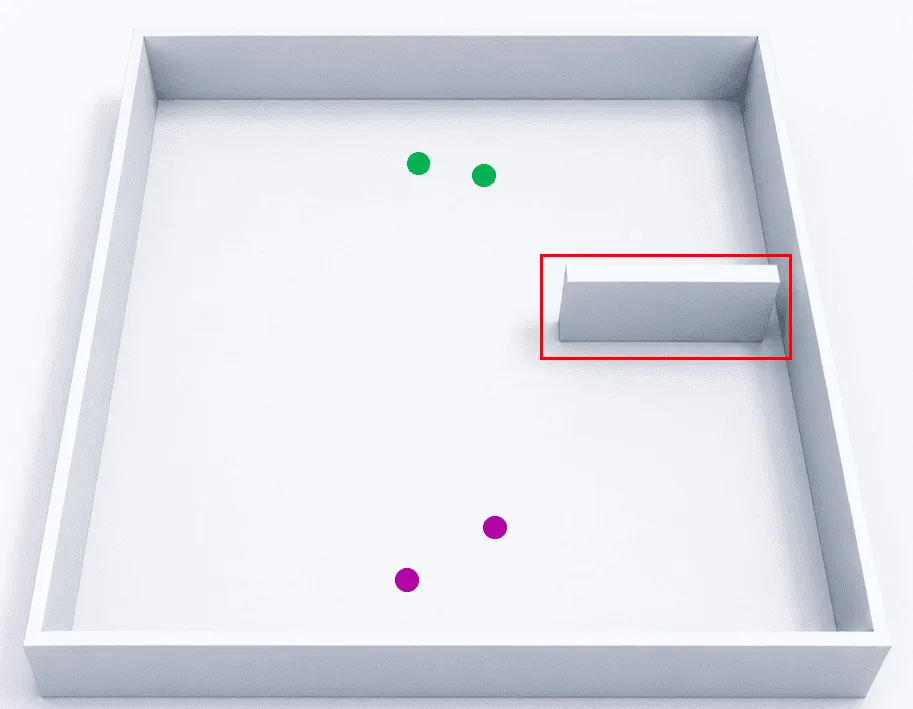
实验在 Microsoft AirSim + Unreal Engine 4 仿真平台上进行。训练场景涵盖 7 个迷宮,其中前 6 个为 静态环境,maze_07 为 含往复运动动障碍物的动态场景。测试场景 maze_mix 包含动-静混合障碍,专用于评估零样本迁移能力。无人机配备单通道全方位 LiDAR(12 m 范围),动作空间为三维连续速度命令。
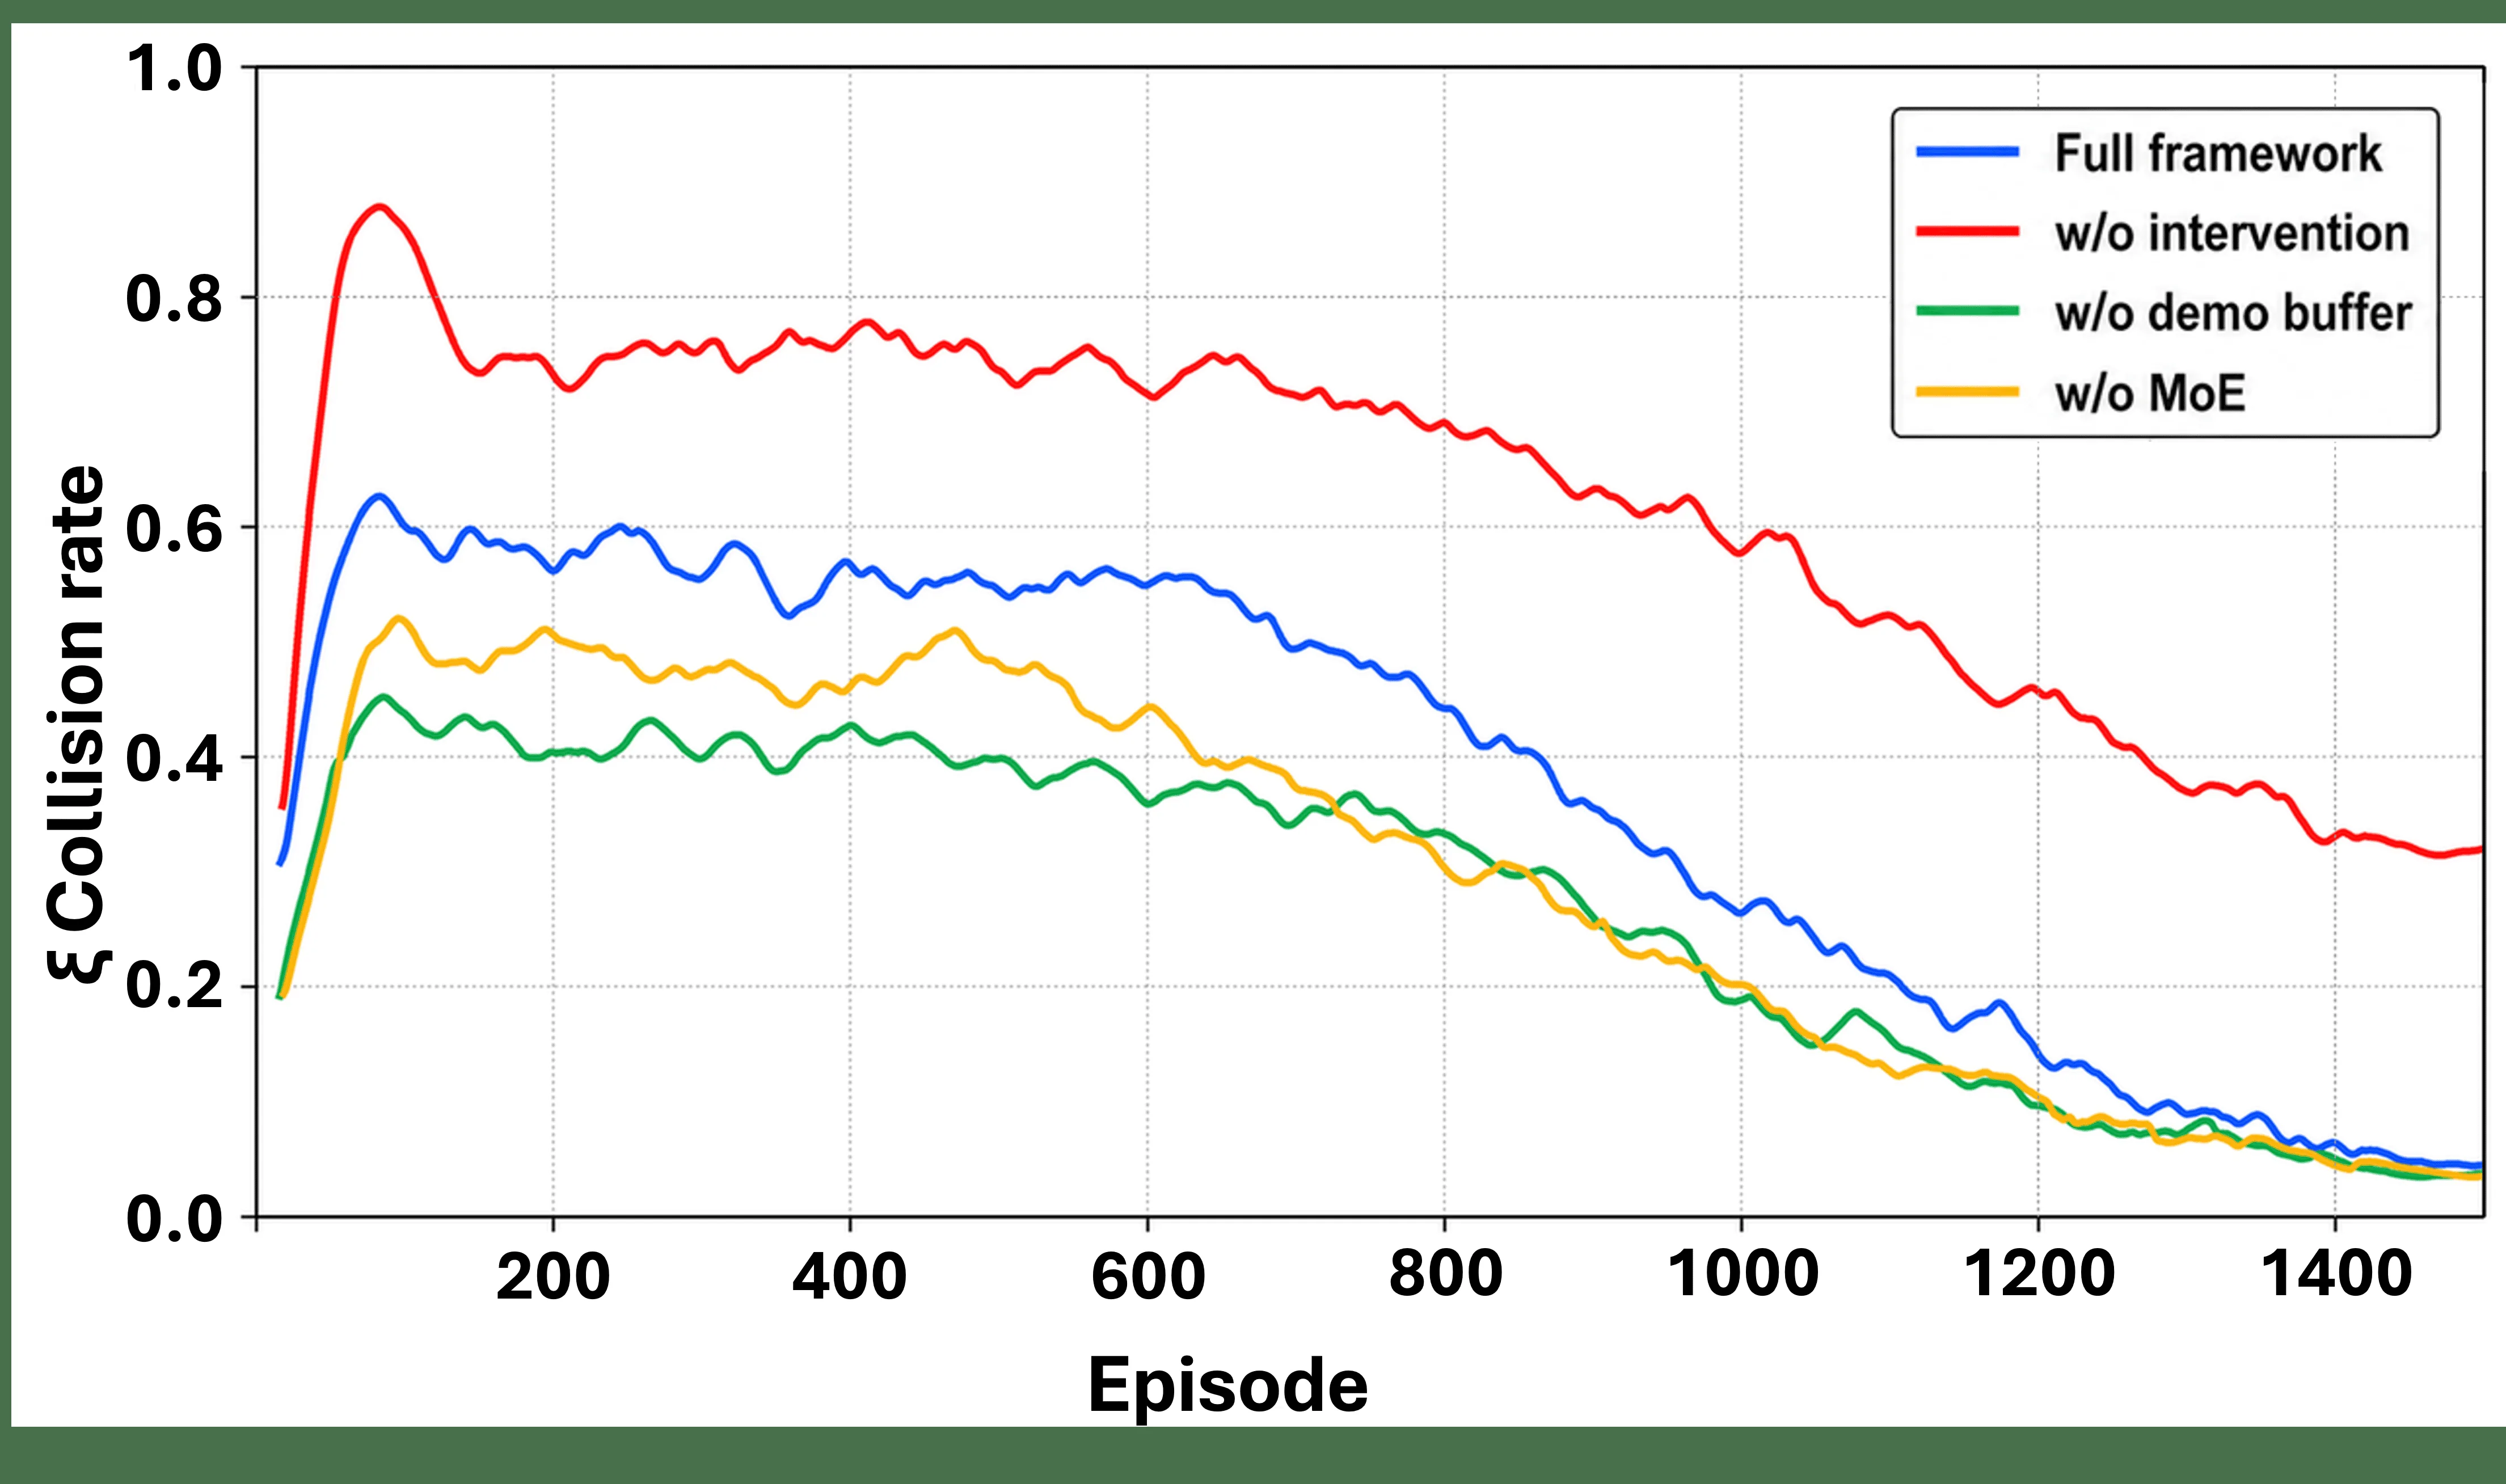
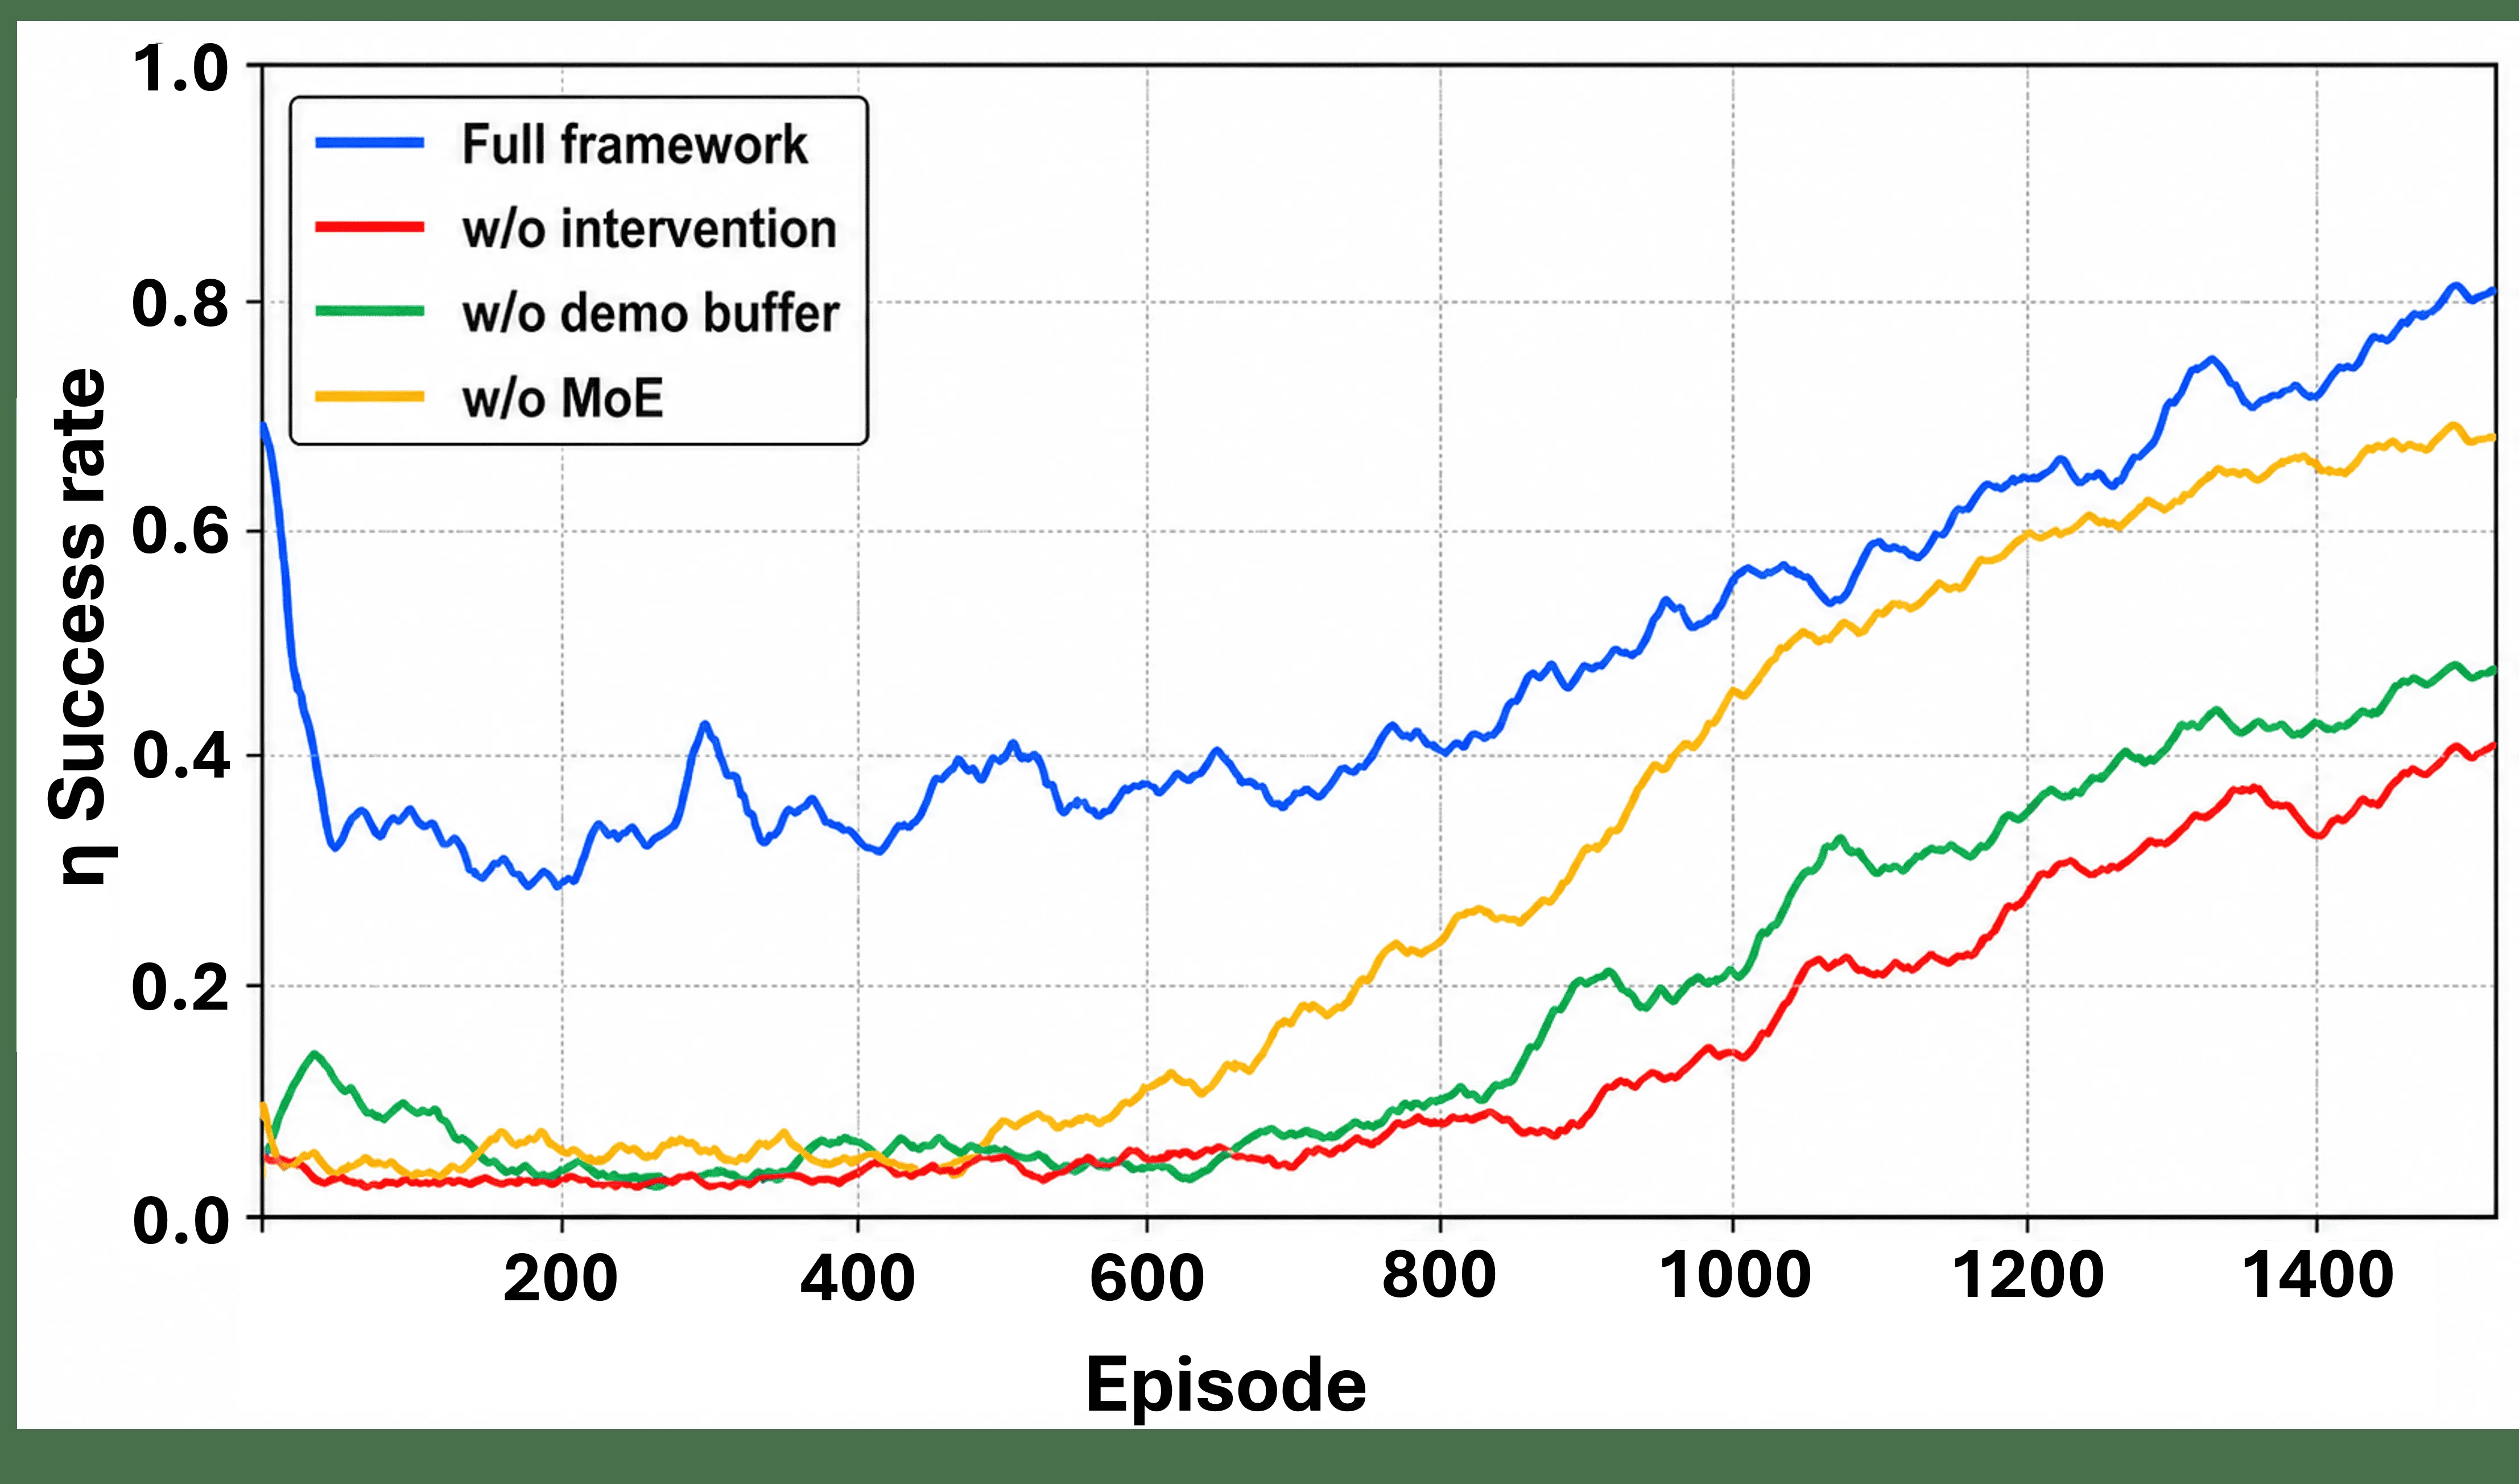
基线对比实验选取了 MAPPO 与标准 MASAC 两种方法。从论文披露的部分结果来看,完整框架在静态迷宮中的协作成功率达到 0.95 以上,显著优于基线方法。消融实验验证了各模块的必要性:移除干预机制的变体在复杂迷宮中频繁陷入局部停滞,成功率下降明显;移除示范缓冲的变体在稀疏奖励下训练收敛缓慢;移除混合专家机制的变体在未见场景 maze_mix 上的零样本迁移性能大幅退化,印证了结构感知泛化模块的关键作用。
动态障碍场景的实验结果表明,该框架对动态扰动具有良好的鲁棒适应性。门控权重分布分析显示,不同 UAV 在面对相似局部几何结构时激活了相似的专家子网络,验证了结构感知机制学习到了与场景无关的结构化响应。
讨论与可借鉴点
论文提出的框架在技术层面展现了系统化设计的思路:将局部最优诊断嵌入观测空间而非依赖隐式学习、分层示范缓冲平衡协作与个体示范、双条件课程调度兼顾安全与性能、结构感知泛化从几何重复性中提取域知识。这些设计选择背后的逻辑值得深思——它们共同指向一个核心洞察:在高度结构化的环境中,显式的状态空间约束往往比隐式的值函数学习更为高效和可靠。
然而,该研究也存在一定的局限性。首先,实验仅在双 UAV 团队上验证,多智能体编队的可扩展性尚未探索。其次,每个场景 20 episodes 的评估规模偏小,统计显著性有待加强。再次,论文未提供多随机种子下的均值与方差分析,难以全面评估方法的稳定性。最后,该框架的有效性高度依赖于环境可离散化的前提,对于非结构化开放环境可能需要调整。
从更宏观的视角看,这项工作为 [[多智能体协同导航]] 与 [[深度强化学习泛化]] 两个交叉领域提供了有益的参考:局部几何重复性作为跨场景迁移的归纳偏置具有广泛的应用潜力,而安全与性能的联合优化则为强化学习落地提供了更务实的工程思路。未来的工作可以在真实机器人平台上验证仿真结果,并进一步探索该框架在更多智能体、更多场景类型下的泛化表现。
摘要
复杂环境下多智能体无人机的协同导航面临着诸多关键挑战,包括局部最优陷阱、稀疏奖励、智能体间的学习不平衡以及跨场景泛化能力不足。本文提出一种多智能体深度强化学习框架,通过协同探索、示范利用、安全课程调度以及结构感知泛化来解决上述问题。首先,提出一种结合已访问状态记忆、方向新颖性估计以及惩罚反向传播的感知机制,使智能体能够主动检测并跳出局部最优。其次,构建一种分层协作示范缓冲区,采用分层行为克隆,根据团队协作程度管理轨迹,并对执行网络施加差异化监督,从而在稀疏协作信号下提升示范的利用效率。第三,设计一种安全感知的双条件课程调度机制,通过回测已掌握的场景并在训练中进行经验预填充,抑制灾难性遗忘,同时兼顾任务性能与飞行安全。在泛化方面,从传感器读数中计算得到的局部几何特征被抽象为一个域参数,通过结构感知门控网络和混合专家机制,使策略能够基于局部结构模式而非场景特定坐标进行决策,从而实现在不接触目标环境条件下的跨场景迁移。该框架还在静态与动态混合障碍物场景下进行了验证,展现出对动态扰动的鲁棒适应性。仿真结果证实了其在协作成功率、导航鲁棒性、零样本跨场景泛化以及动态环境适应性方面的优异表现。
Abstract
Cooperative navigation of multi-agent UAVs in complex environments faces key challenges including local optima traps, sparse rewards, learning imbalance among agents, and insufficient cross-scenario generalisation. This paper proposes a multi-agent deep reinforcement learning framework that addresses these issues through coordinated exploration, demonstration exploitation, safe curriculum scheduling, and structure-aware generalisation. First, a perception mechanism combining memory of visited states, directional novelty estimates, and penalty backpropagation enables agents to proactively detect and escape local optima. Second, a hierarchical collaborative demonstration buffer with tiered behaviour cloning manages trajectories by degree of team collaboration and applies differential supervision to the actor network, improving demonstration utilisation under sparse collaborative signals. Third, a safety-aware dual-condition curriculum scheduling mechanism reviews mastered scenarios through back-testing and experience pre-filling during training, suppressing catastrophic forgetting while ensuring both task performance and flight safety. For generalisation, local geometric features computed from sensor readings are abstracted into a domain parameter, through which a structure-aware gating network and mixture-of-experts mechanism condition the policy on local structural patterns rather than scenario-specific coordinates, enabling cross-scenario transfer without exposure to the target environment. The framework is further validated under mixed static-dynamic obstacle settings, showing robust adaptability to dynamic disturbances. Simulation results confirm strong performance in collaboration success rate, navigation robustness, zero-shot cross-scenario generalisation, and dynamic environment adaptability.
论文详细总结(自动生成)
论文总结:基于系统化多智能体深度强化学习的复杂环境下多无人机协同导航
1. 核心问题与整体含义
1.1 研究背景
在灾后响应、工业巡检、仓储自动化等场景中,多架 UAV(无人机)需要在缺乏全局定位信息的复杂受限环境(含复杂空间结构、严重遮挡)下执行协同导航任务。此类任务面临四大核心挑战:
- 局部最优陷阱:受限结构(迷宫、走廊)使智能体容易陷入徘徊、重复遍历等停滞模式。
- 稀疏协作奖励:全队协同到达的事件在训练初期极为稀少,奖励信号匮乏。
- 智能体间学习不均:在强耦合条件下,各智能体学习进度参差不齐,整体协作效率受限。
- 跨场景泛化不足:现有方法多关注物理动力学或任务目标层面的泛化,未考虑迷宫环境的几何重复性。
1.2 现有方法的不足
- 内在动机探索方法(Curiosity、RND、count-based)将探索奖励与任务目标解耦,可能在结构受限环境中陷入局部停滞。
- 地图/记忆驱动方法偏重环境表征,无主动干预被困智能体的机制。
- 多智能体协调方法(CTDE、VDN、QMIX)在强耦合下易出现系统停滞,缺乏对学习不均的针对性。
- 现有泛化方法(domain randomization、meta-learning、context-conditioned policy)未充分挖掘迷宫环境的局部几何重复性。
2. 方法论:核心思想与关键技术
论文提出基于 MASAC(Multi-Agent Soft Actor-Critic)的统一框架,将任务形式化为 Dec-POMDP:
优化目标为最大化期望累积折扣回报:
2.1 局部最优诊断与执行级干预(无新增可训练参数)
包括三个子模块:
- 访问状态记忆:将环境离散化网格,记录每个单元格的访问次数 ,并将四维记忆特征拼入观测向量(索引 26-29)。
- 诊断条件:在长度为 的滑动窗口内评估四个条件:
其中 指空间跨度低于阈值(原地悬停), 指唯一单元格比率 低于目标 , 指接近目标但进度近零且 LiDAR 均值低, 指远离目标但跨度大。
- 执行级干预:当 时直接覆盖策略输出,按方向新颖性评分函数选择逃逸方向:
并在检测到死胡同时切换为 clearance-dominant 模式。
此外引入 LiDAR 走廊约束指示 缓解目标被遮挡时距离塑形的奖励真空问题。
2.2 分层协作示范缓冲与分级行为克隆
- 两个独立缓冲:协作成功缓冲 (容量 ,存储所有智能体到达)和个体成功缓冲 (容量 ,至少一个智能体到达)。
- 双层配额管理:在场景级和起-终点对级实施配额,含按协作分数的质量替换策略。
- 直接监督 Actor 网络(无辅助蒸馏):
其中 为差异权重。
- 克隆系数 动态调整:从初始 线性增至 ,随 占用率上升。
- 总 Actor 损失:
2.3 安全感知的双条件课程调度
- 晋级双重条件:全队协作成功率 且 碰撞率 同时满足方可晋级。
- 回顾式评估与经验预填充:每次晋级后对所有已掌握场景完整复评,将新轨迹以 回合/场景的速率注入回放缓冲。
- 历史混合:以概率 从已掌握场景中采样回合,抑制灾难性遗忘。
- 同步感知团队奖励:
其中 (仅当所有智能体同步推进时激活奖励), 为到达时间差。
2.4 结构感知泛化机制
- 域参数 由 8 扇区 LiDAR 读数确定性计算,无需先验标注:
$$\begin{cases}
\omega_{\text{dead}} = \text{clip}\left(\frac{n_{\text{block}}-5}{3},0,1\right) \cdot \text{clip}\left(1-\frac{g-1}{2},0,1\right) \\
\omega_{\text{wall}} = \bar{b}{\text{left}} - \bar{b}{\text{right}} \\
\omega_{\text{narrow}} = \text{clip}\left(\frac{\min(g,3)-1}{2},0,1\right) \cdot \text{clip}\left(\frac{n_{\text{block}}}{5},0,1\right) \\
\omega_{\text{open}} = \frac{8-n_{\text{block}}}{8}
\end{cases}$$
分别编码死胡同、单侧墙体、狭窄入口、开阔区域四类局部几何模式。
- 混合专家 Actor:共享 LSTM 编码器 + 结构感知门控网络 + 个专家头:
由于 完全与特定坐标解耦,策略被强迫学习结构响应而非空间记忆,从而支持零样本跨场景迁移。
2.5 局部观测组成(维度 )
| 索引 | 组件 | 描述 |
|---|---|---|
| 1-3 | 目标向量 | 相对目标位移,按 归一化 |
| 4-6 | 速度 | 速度向量,按 归一化 |
| 7-14 | LiDAR 读数 | 各扇区最小距离,归一化到 |
| 15-22 | LiDAR 帧间差 | 各扇区距离变化,正值表示接近障碍 |
| 23-25 | 上一时刻动作 | 前一步执行的动作 |
| 26-29 | 访问记忆 | 局部停滞特征 |
| 30-33 | 域参数 | 用于泛化模块的局部几何特征 |
3. 实验设计
3.1 数据集/场景
- 仿真平台:Microsoft AirSim + Unreal Engine 4。
- 训练场景:7 个迷宫场景
maze_01至maze_07,其中前 6 个为 静态场景,maze_07为 含往复运动动障碍(速率 1.5 m/s)。 - 测试场景:未见的
maze_mix,含动-静混合障碍,专用于零样本迁移评估。 - 每个场景配置多组起-终点对,含正反向及智能体互换配置以防过拟合。
- UAV 配置:单通道全方位 LiDAR(12 m 范围,10 r/s,5000 点/秒密度),起飞高度 1.8 m,动作空间 连续速度命令。
3.2 评价指标
- :全智能体协作成功率;
- :碰撞率;
- 终点平均距离(Dist.);
- 到达时间差(衡量同步性);
- 门控权重分布(分析专家激活模式)。
3.3 对比基线
- MAPPO(Yu et al., 2022);
- Standard MASAC(移除所有提出机制的 MASAC 变体);
- 内部消融:
w/o intervention、w/o demo、w/o MoE。
4. 资源与算力
| 项目 | 配置 |
|---|---|
| GPU | NVIDIA RTX 6000 Ada Generation,单卡 |
| 显存 | 49 GB |
| CUDA | 12.8 |
| 训练回合数(基线对比实验) | 1500 episodes/方法 |
| 批大小 | 128 |
| Actor 学习率 | |
| Critic 学习率 | |
| 熵系数学习率 | |
| 折扣因子 | 0.99 |
| 回放缓冲容量 | 120,000 |
| 观测历史长度 | 16 |
注:论文未明确报告总训练时长、实际 wall-clock time 或完整训练 episode 数(仅披露 1500 episodes 用于公平对比)。
5. 实验数量与充分性
5.1 实验覆盖
- 主性能评估:7 个训练场景 + 1 个未见测试场景,每场景 20 episodes 评估。
- 基线对比:MAPPO 与 Standard MASAC 在
maze_05和maze_mix上对比(每场景 20 episodes)。 - 消融研究:4 个变体(完整框架、
w/o intervention、w/o demo、w/o MoE)在maze_05上对比训练曲线。 - 跨场景泛化实验:完整框架 vs
w/o MoE在未见maze_mix上的对比。 - 门控权重分析:对比两架 UAV 的专家激活分布,验证结构感知机制的有效性。
5.2 充分性评估
- 多维度指标(成功率、碰撞率、终点距离、门控分布)覆盖较全面。
- 显式对比基线 + 系统性消融 + 泛化实验,结构合理。
- 不足之处:仅在双 UAV 团队上验证;评估 episodes 数(20)较小,统计显著性未充分验证;缺少收敛性与方差分析;未在多组不同随机种子下报告均值 ± 标准差。
6. 主要结论与发现
6.1 主性能(Table III)
| 场景 | 类型 | 距离(m) | ||
|---|---|---|---|---|
maze_01 | 基础静态 | 0.950 | 0.050 | 1.783 |
maze_02 | 基础静态 | 1.000 | 0.000 | 1.539 |
maze_03 | 基础静态 | 0.900 | 0.150 | 2.083 |
maze_04 | 局部最优 | 0.800 | 0.400 | 3.348 |
maze_05 | 局部最优 | 0.800 | 0.050 | 2.510 |
maze_06 | 局部最优 | 1.000 | 0.000 | 1.527 |
maze_07 | 动态障碍 | 0.800 | 0.200 | 3.474 |
maze_mix | 未见测试 | 0.750 | 0.100 | 3.260 |
6.2 关键发现
- 所有静态训练场景均满足课程晋级阈值(, )。
- 未见场景上零样本泛化:跨场景差距仅 0.050(0.800→0.750),远小于 MAPPO 的 0.250 差距。
- 基线对比(Table IV):在
maze_05上完整框架 vs MAPPO 0.550 vs MASAC 0.500;碰撞率仅 0.050。 - 消融结论:
w/o intervention:最具破坏性,初期碰撞率飙至 ~0.90,800 episode 内几乎无成功;w/o demo:成功信号极稀疏但碰撞率较低,呈现保守探索;w/o MoE:单场景训练可达 ,但跨场景时跌至 0.250(Table V),证实 MoE 门控架构是泛化的关键因素。- 门控激活分析:UAV 1 主要激活"open"专家(0.974),UAV 2 同时激活"narrow"(0.346)与"open"(0.553),表明门控网络对同一场景中不同智能体的差异路径进行了自适应响应。
7. 优点
7.1 方法亮点
- 执行级干预无需任何额外可训练参数,避免了对策略梯度的污染,是新颖且简洁的设计。
- 分层示范缓冲 + 直接行为克隆消除了两阶段策略蒸馏的累积误差,从数据管理和优化两个层面同时缓解学习不均。
- 双条件课程调度(协作成功率 + 碰撞率上限)兼顾性能与安全,并通过回顾式评估与经验预填充提供原则性的灾难性遗忘对策。
- 结构感知泛化机制与多智能体训练一体化集成, 的确定性计算避免了对手工标注或先验知识的依赖;MoE 门控端到端训练,无需专家标签。
- 团队奖励中基于到达时间差方差的同步惩罚,规模可扩展至任意团队规模。
7.2 实验亮点
- 在仿真-真实差距桥接方面作了诚实的说明(仅仿真验证、2 UAV 限制)。
- 通过门控权重分析直观展示了机制内部运作,而非仅报最终指标。
- 与 MAPPO、Standard MASAC 的对比突出了各机制的独立贡献。
8. 不足与局限
8.1 实验覆盖与统计性
- 仅在双 UAV 团队上验证,缺乏对更大团队(3+ 智能体)规模可扩展性的实验证据。
- 每场景仅 20 episodes 的评估样本量较小,未给出多随机种子下的均值 ± 标准差或显著性检验。
- 未报告训练曲线收敛所需的具体时间或 episode 数(基线实验仅提及 1500 episodes 训练)。
- 缺少对单机制贡献的更细粒度分解(如仅关闭 LiDAR 走廊补偿、仅关闭 观测输入等)。
- 没有
w/o curriculum或w/o retrospective等额外消融。
8.2 应用与迁移局限
- 验证完全基于 AirSim 仿真,未涉及任何真实飞行实验,仿真-真实差距(sim-to-real gap)未解决。
maze_mix与训练场景在结构组成上存在显著重叠,泛化结论的环境多样性可能受限;未在不同类型环境(开放空间、城市街景、森林等)上测试。- 域参数 仅针对迷宫四类几何模式设计,需根据环境类型重新设计。
8.3 方法假设与潜在偏差
- 假设各 UAV 观测空间结构同构,但实际部署中传感器噪声、LiDAR 视角差异会破坏 的可靠性。
- 对照基线(MAPPO)的观测维度仅 21 维(未含 ),对比客观性可能存有争议(虽作者声明这是机制的有机组成部分)。
- 中心化 Critic 访问全局状态(拼接所有局部观测)的设定在更稀疏的实际通信条件下不成立;论文承认无显式通信假设。
- 训练中使用了预收集的示范数据,论文未详述示范来源(专家策略 or 规则),可能影响可复现性。
8.4 其他
- 写作上大量重复表述(如"systematically addresses""provides a principled solution"),削弱了表达密度。
- 论文署名为 2026 年 7 月预印本,引用了部分 2026 年文献(如 [12],[22]),需读者关注时序问题。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。