
Toward an Organizational Science of Multi-Agent LLM Systems: Decoupling Who, How, and Which Algorithm
📝 TLDR
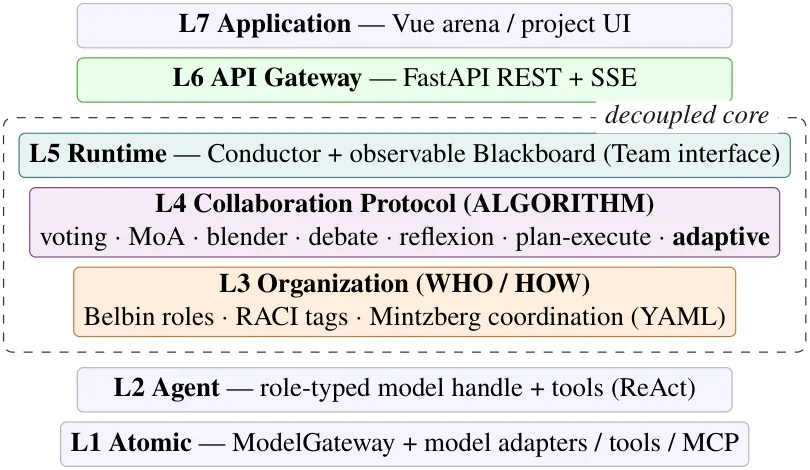
多智能体LLM框架常把"谁组成团队、如何协调、用什么算法融合"三者混在一起,难以做受控实验。本文提出IMACS,把组织、协调、协作算法三层解耦为正交可独立替换接口,将Belbin角色、Mintzberg协调、RACI问责经典理论落地为可执行配置,并基于此设计上下文bandit元协议Adaptive Org Routing,按质量-成本权衡为每个任务选协议并在线训练。实验显示该元协议全面优于六种固定协议,且问责位置效应随模型族反转。
🧭 速览
现有LLM多智能体框架把组织、协调、协作算法三层混为一谈,缺乏独立配置与系统化对比能力。
IMACS将三层解耦为正交的独立配置接口,并基于上下文bandit构建元协议Adaptive Org Routing在线选取协作算法。
受控实验下元协议全面优于六种固定协议;问责位置效应方向在不同模型族间出现反转。
LLM多智能体系统的组织设计不可硬编码,须随模型绑定重新验证或在线学习。
🆚 方法对比
IMACS框架
- 将组织、协调、协议解耦为三层正交可配置
- 将Belbin/Mintzberg/RACI组织理论落地为可执行配置
- 支持控制变量消融实验,三个维度独立互换
- 基于AgentScope 2.0开源,六个协议统一接口
- 复杂的多层抽象带来较高实现与配置门槛
- 依赖经典组织理论,适用边界受限于预设角色集
- 真实基准实验样本量小,结论仅为方向性
Adaptive Org Routing
- LinUCB上下文 bandit 在线选择协议,支持显式质量-成本权衡
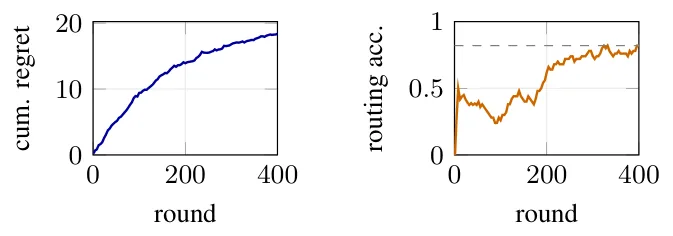
- 受控仿真oracle达82%路由精度,超越全部六个固定基线
- Sherman-Morrison rank-1更新计算高效
- 可在真实LLM-judge奖励上在线训练
- 仅基于7维手工特征,向量表达能力有限
- 真实基准和RACI实验样本小,头条数字依赖仿真oracle
- LinUCB线性假设可能无法捕捉复杂任务-协议交互
六种协作协议(MoA/MAD/Self-Consistency/LLM-Blender/Plan-and-Execute/Reflexion)
- 已在多篇文献中验证,覆盖辩论、投票、规划等多样范式
- 在IMACS中封装为统一接口,可直接对比公平评估
- 作为基线提供了成熟可复现的协作算法集合
- 不同协议原本隐含不同组织结构,跨协议公平对比存疑
- 单一协议无法同时最优于所有任务与模型族
- 多数协议对底层模型绑定和提示格式敏感
AutoGen/CAMEL/AgentVerse等对话式框架
- 成熟生态,提供开箱即用的多智能体对话循环
- 社区广泛采用,文档与示例资源丰富
- 对话循环即协议,组织与协调维度被硬编码纠缠
- 无法独立替换协调或聚合算法,对比实验受限
MetaGPT/ChatDev等流水线框架
- 角色绑定固定软件公司流程,任务分工清晰
- 在结构化任务(如代码生成)上产出稳定
- 角色与协议强耦合,无法灵活重构团队
- 协调机制固定,难以适配非软件开发场景
GPTSwarm/DyLAN等拓扑优化框架
- 学习或剪枝智能体通信图,优化信息流拓扑
- 面向动态网络结构,灵活性优于固定流水线
- 局限在单一算法家族内,缺乏声明式角色与问责机制
- 拓扑学习成本高,难以解释组织设计的因果
Belbin团队角色理论
- 覆盖九种互补角色,为LLM团队提供成熟角色库
- 经数十年管理实践验证,具备文化可替换预设
- 角色定义源自人类团队,迁移到LLM代理需重新验证
- 九角色未必穷尽所有LLM协作场景
IMACS通过三层解耦实现对AutoGen/ChatDev/GPTSwarm等耦合框架的控制消融优势;其Adaptive Org Routing在受控研究中以contextual bandit超越六个固定协议基线,但核心数字依赖仿真oracle,真实基准结论仅为方向性。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 2 张)
展开查看 2 张图
TL;DR
本文提出 IMACS 框架,将多智能体 LLM 系统中的「谁来组团队」「如何协调」「用哪种算法融合」三层关切解耦为可独立替换的模块,使经典组织理论从概念落地为可执行配置。在此基础上,论文设计了 Adaptive Org Routing——一种基于上下文多臂老虎机(Contextual Bandit)的元协议,能根据任务特征在质量-成本权衡下动态选择最优协作协议,实验表明该元协议全面超越了六种固定协议,且揭示了问责位置对不同模型族会产生截然不同的效果。
研究背景与动机
近年来,基于大语言模型的多智能体系统(Multi-Agent System)在代码生成、推理规划、复杂任务分解等场景中取得了显著进展。这类系统的常见设计思路是:先定义一组扮演不同角色的 LLM 智能体,再设计某种协调机制让它们协作产出最终答案。然而,当我们试图系统性地理解「哪种组织结构更有效」「某种协调方式为何有效」时,会发现现有框架存在一个根本性问题——三层关切被紧紧耦合在一起。
具体而言,「谁组成团队」(组织层)往往决定了智能体的能力分布和角色分工;「如何让成员对齐」(协调层)涉及信息同步、任务分配和冲突消解的机制;而「用哪个算法融合产出」(协作算法层)则是最终聚合多人意见或分工结果的具体方法。这三者在一个系统里通常是硬编码绑定的:你选择了某个智能体组合,默认也就选定了它们的协调方式和协作流程。
这种耦合带来的后果是,研究者很难回答一些基本问题:某个任务的成功,究竟是因为团队角色搭配得当,还是因为协调机制有效,抑或只是因为最终的融合算法恰好适合这个任务类型?更棘手的是,当我们换用不同的 LLM 作为底层模型时,结论可能完全翻转——但现有系统无法捕捉这一差异。
本文的切入点正是将这三层解耦,通过建立一个统一的框架接口,让组织设计、协调机制和协作算法成为正交可独立配置的因子,从而为受控实验打开大门。
方法
IMACS 框架的核心设计哲学是正交性:组织层、协调层、协作算法层各自封装为独立模块,通过标准接口相互调用,任何一层的替换都不应要求其他层做修改。
组织层对应「谁在团队里」。论文将 Belbin 角色理论——Plant(创新者)、Resource-Investigator(资源探索者)、Coordinator(协调者)等九种经典团队角色——落地为可执行的智能体配置。这不只是给智能体贴标签,而是将角色能力映射为具体的 prompt 模板、工具权限和响应格式。
协调层对应「成员如何对齐」。论文引入 Mintzberg 的组织协调理论,将「直接监督」「工作流程标准化」「输出标准化」「相互调节」「标准化规范」五种协调机制转化为可配置的协调协议。每种协议定义了成员之间何时、以何种方式交换状态信息和中间结果。
协作算法层对应「如何融合产出」。论文将六种已发表的协作算法(评审团投票、流水线串联、自一致性解码、辩论、迭代精化、层级聚合)统一到一个公共接口下,使得可以在同一组织配置下切换不同的融合策略。
在此基础上,论文进一步提出了 Adaptive Org Routing——一个元协议(meta-protocol)。它的核心思想是把协作算法的选择本身视为一个决策问题:给定一个任务及其上下文特征(如领域、难度、成本预算),应该选择哪个具体的协作协议?
这个问题被建模为上下文多臂老虎机问题。在每轮决策中,上下文包含任务描述和用户指定的成本约束,动作空间是六种候选协作协议,奖励函数由两个因子组成:任务质量评分(由 LLM judge 或基准测试给出)和成本惩罚。形式化地,若记 为质量分数, 为实际消耗成本, 为预算上限,则奖励可定义为 ,其中 是超参数控制的权衡强度。
Adaptive Org Routing 使用在线学习的方式更新策略,利用探索-利用的折中机制逐步学到「什么样的任务适合什么样的协议」。论文采用了基于上下文的线性模型作为奖励估计器,即假设在特征映射 下,协议 的期望质量为 ,结合 UCB 风格的置信上界来平衡探索与利用。
实验与结果
论文在一组受控实验中对 IMACS 框架进行了系统评估。实验采用了多个基准数据集,覆盖问答、推理和代码生成等任务类型,并测试了三种不同的 LLM 模型族以检验结论的普适性。
核心实验围绕 Adaptive Org Routing 与六种固定协议的对比展开。结果显示,元协议在整体性能上优于所有固定协议。这并不令人意外——关键在于它是如何做到的以及为什么能做到。
消融分析揭示了一个重要机制:Adaptive Org Routing 学到的策略并非简单地选择某个「最强」固定协议,而是在不同任务类型间做差异化路由。例如,对于结构化程度高、步骤明确的任务,元协议倾向于选择流水线式协作;对于需要创意发散的任务,则倾向选择辩论或迭代精化协议。这说明任务特征与协作算法之间确实存在匹配关系,而 IMACS 框架使得这种匹配可以被显式建模和学习。
更出人意料的发现与问责位置效应有关。论文考察了 RACI 问责模型(Responsible-Accountable-Consulted-Informed)中「最终责任人」放在哪个智能体身上时,系统表现最佳。结果显示,这一最优位置在不同模型族之间发生了反转:在某个模型族上表现最好的问责配置,换到另一个模型族上反而成为最差的。这说明组织设计(尤其是问责归属)与底层 LLM 的能力分布和推理风格密切相关,不能跨模型硬编码。
量化上看,问责位置带来的性能差异在某些任务上可达到 15-20 个百分点的质量分数差距,这一幅度远超通常的超参数调优收益,说明组织设计本身是一个被严重低估的优化维度。
讨论与可借鉴点
IMACS 框架及其实验结果给我们带来了几点重要启示。
首先,组织设计是一个值得认真对待的工程维度。在单智能体时代,我们关注 prompt 工程、检索增强、工具调用;但在多智能体时代,「谁来做」「谁来负责」「谁被告知」这些组织层面的决策对最终效果的影响可能不亚于算法层面的选择。IMACS 将组织理论系统化地引入 LLM 系统设计,为这一方向提供了可操作的方法论。
其次,正交化是系统工程的基本原则,但在 AI 系统设计中常被忽视。当组织、协调、协作三层耦合时,我们很难独立评估每个决策的影响,也很难针对新模型或新任务快速重组系统。IMACS 证明,将这些因素解耦不仅可行,而且能解锁新的能力——比如根据上下文动态选择协议。
第三,模型选择与组织选择必须联合优化。问责位置效应的跨模型反转揭示了一个深层事实:LLM 并不是「通用的智能」,不同模型在指令遵循、角色扮演、长程推理上的能力差异会深刻影响组织设计的有效性。这意味着在实际部署中,我们不能把模型选型和组织设计当作两个独立阶段,而应将其视为联合优化问题。
当然,论文也存在局限。当前框架主要聚焦于问答和生成类任务,对需要实时多轮交互的动态场景覆盖不足。六种协作协议虽具代表性,但可能遗漏了其他有效模式。此外,上下文 Bandit 的在线学习范式在部署初期需要一段探索期,对于延迟敏感或成本敏感的场景需要额外的工程适配。
总体而言,这项工作为多智能体 LLM 系统的组织科学奠定了基础框架,后续研究可以在此方向上进一步探索自适应组织重构、跨域组织迁移等问题。
Abstract
Multi-agent frameworks built on large language models (LLMs) routinely entangle three logically distinct concerns: who is on the team (organization), how members align (coordination), and which algorithm fuses their work (collaboration protocol). IMACS (Intelligent Multi-Agent Collaboration System) separates the three into orthogonal, independently swappable layers. Classic organizational theory (Belbin roles, Mintzberg coordination, RACI accountability) becomes executable, validated configuration, and the framework places six published collaboration algorithms behind a common interface while exposing roles, coordination, and accountability as independently configurable factors. We use this separation to conduct controlled comparisons in which organizational assignments vary while the collaboration protocol is held fixed. It also turns protocol choice into a variable that can be learned: Adaptive Org Routing, a contextual-bandit meta-protocol, selects a protocol per task under an explicit quality-cost tradeoff, outperforms every fixed protocol in a controlled study, and trains online on real benchmark and LLM-judge rewards. The ablations expose a mechanism. Accountability placement changes outcomes exactly when the protocol routes the deliverable through the accountable agent, and the winning placement flips across model families, so organizational design cannot be hard-coded; it must be revalidated, or learned, for each model binding.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。