
SGTP:面向实时多车辆自主竞速的基于采样的博弈论规划
SGTP: Sampling-based Game-Theoretic Planning for Real-Time Multi-Vehicle Autonomous Racing
📝 TLDR
针对多车自主竞速中策略多样性与计算效率难以兼顾的问题,提出采样式博弈论规划框架SGTP。方法对控制序列和动力学rollout进行GPU加速采样,并用博弈感知代价对候选轨迹排序,从而生成多样化的竞速行为;规划阶段显式施加赛道边界和动态避碰约束,保证策略切换的安全可行性。仿真结果显示SGTP在高交互竞速中达到95.24%胜率与99.35%任务完成率,平均单次求解仅0.095秒,并可扩展至10辆车的群体场景。
🧭 速览
多车自主竞速需在密集交互中实时规划多样化竞争行为,现有规划器难以兼顾策略多样性、博弈推理深度与计算效率。
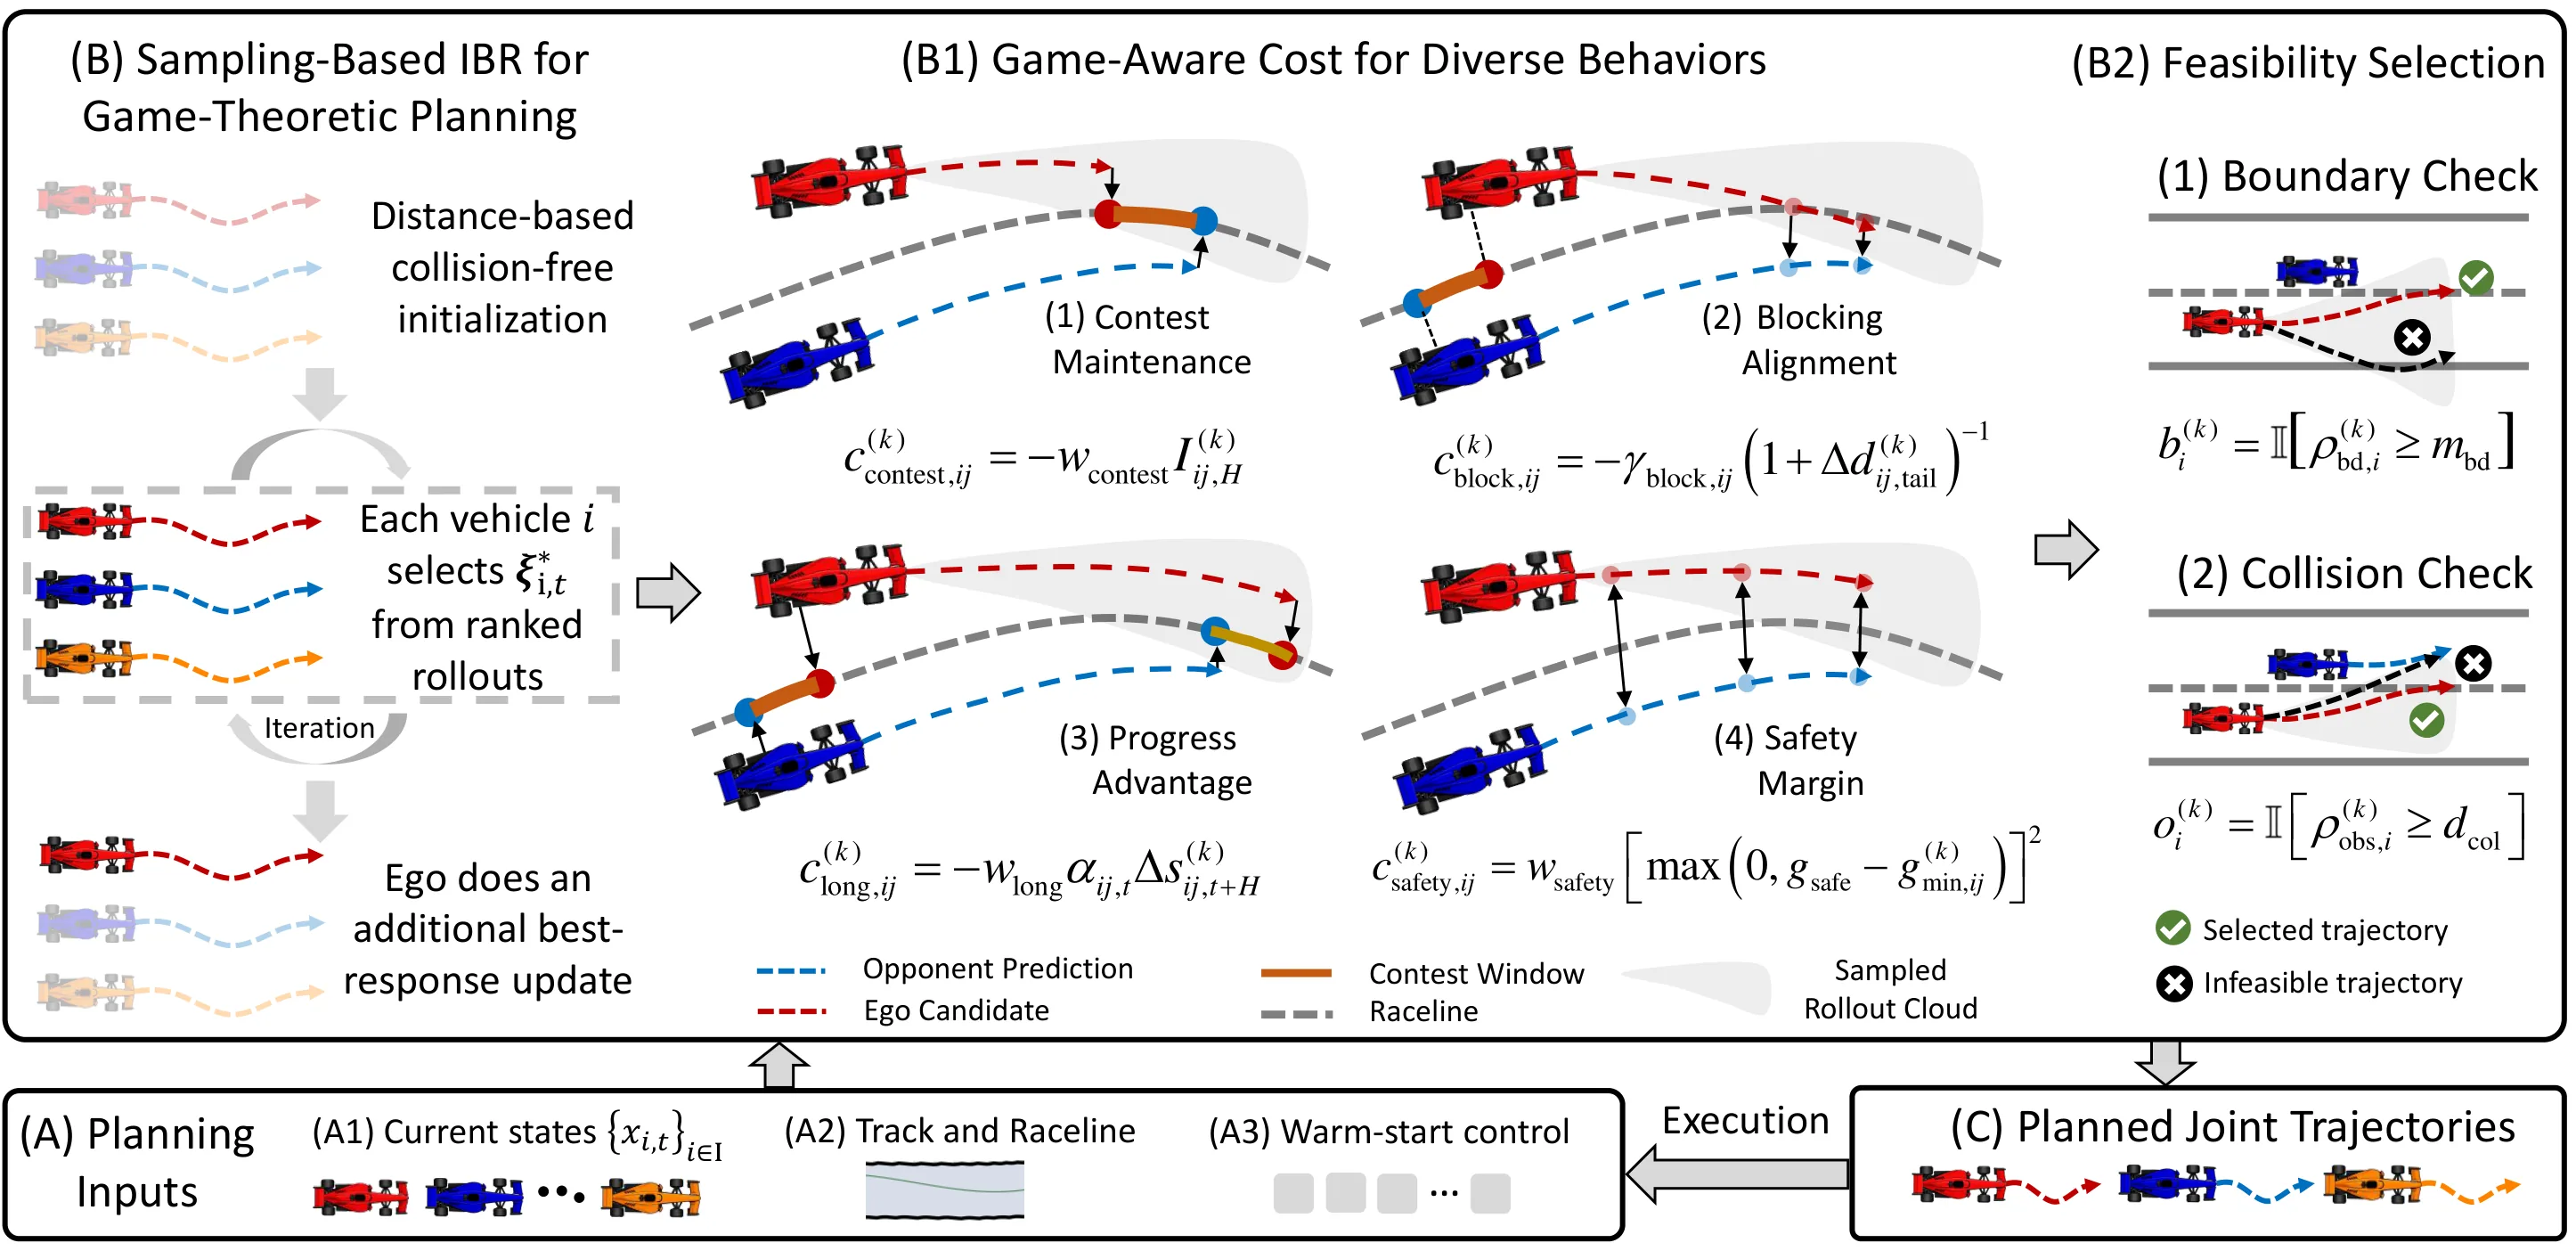
SGTP将博弈论推理与GPU加速采样相结合,对控制序列与动力学轨迹rollout采样后用博弈感知代价排序,并显式施加赛道边界与动态避碰的可行性筛选。
高交互竞速中胜率95.24%、任务完成率99.35%,平均求解耗时0.095秒,且在10辆车的大规模场景下仍保持实时运行能力。
SGTP为多车竞速实时博弈规划提供了高效方案,团队同步开源代码与多智能体竞速基准,推动后续研究复现与横向对比。
🆚 方法对比
SGTP
- 95.24%胜率与99.35%完成率,交互场景表现优异
- 平均计算时间0.095s,满足实时规划需求
- 支持多达10辆车的大规模场景
- GPU加速采样与可行性筛选确保安全策略切换
- 仅在仿真中验证,缺乏真实车辆实验
- 依赖高质量博弈对手预测,预测误差会传播
- 采样效率与策略多样性之间的权衡需精细调参
FSM-based planners
- 多行为规划效果已验证有效
- 逻辑清晰,易于工程实现
- 依赖专家设计的行为模式,泛化性差
- 需大量参数调优,扩展到新场景成本高
MPCC/MPC
- 可显式建模赛车进度与参考速度
- 能显式处理系统与安全约束
- 近距离交互下优化问题高度非凸,计算时间不稳定
- 对初始化敏感,可能出现不收敛或不可行解
IBR (Iterative Best Response)
- 博弈论框架原则性强,适合多策略规划
- 可形式化为广义纳什均衡问题求解
- 在线时间内求高质量可行解仍为瓶颈
- 依赖底层求解器,计算负担大
MPPI-based planners
- GPU加速采样,适合实时轨迹规划
- 在域探索与计算效率间有效权衡
- 碰撞规避用软惩罚,无显式可行性检查
- 近距离轮对轮比赛中可能产生不可机动
Learning-based methods
- 可表示丰富的交互行为,端到端训练
- 生成模型能捕捉多模态策略分布
- 可解释性差,跨场景泛化能力存疑
- 黑箱特性难以保证安全约束
Sampling-based planners (general)
- 域探索与计算效率折中较好
- 实现相对简单,易于并行化
- 现有方法仅支持1-2个对手车辆,扩展性差
- 难以处理高强度多车博弈场景
现有方法各有局限(FSM泛化差、MPC/MPC对初始化敏感、MPPI无显式可行性检查、学习方法可解释性弱),SGTP通过将IBR与GPU并行采样及博弈感知代价融合,实现了策略多样性与实时安全性的统一。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 5 张)
展开查看 5 张图
TL;DR
SGTP 提出了一种将[[博弈论规划]]与 GPU 加速采样相结合的多车竞速规划框架,通过博弈感知代价对采样轨迹排序生成多样化竞争行为,并显式施加赛道边界与动态[[避碰约束]]保证策略切换的安全性。该方法在高交互竞速仿真中实现 95.24% 胜率与 99.35% 任务完成率,单次求解平均仅需 0.095 秒,并成功扩展至 10 车大规模场景。
研究背景与动机
多车辆自主竞速是[[博弈论规划]]领域一个极具挑战性的应用场景。与常规的路径规划不同,竞速环境要求智能体在高速运动中与对手展开激烈对抗,既要追求最快圈速,又要在超车、卡位、防守等关键时刻做出最优决策。这种动态对抗的特性使得问题本质上是一个多方博弈过程:每个车辆的收益不仅取决于自身的选择,还受到其他参与者的策略影响。
然而,现有方法在应对这一场景时普遍面临一个核心矛盾——策略多样性与计算效率难以兼顾。基于纯优化或模型预测控制的方法虽然能够生成理论上的最优轨迹,但每次求解的计算开销较大,难以在毫秒级实时性要求下维持多样化的竞争策略。反过来,纯粹的采样类方法虽然计算效率较高,但缺乏对博弈交互的显式建模,容易导致行为模式单一,在面对不同风格的对手时显得僵化。
SGTP 的核心洞察在于:可以将博弈论推理嵌入到一个 GPU 加速的采样框架中。具体而言,通过对大量控制序列进行并行采样,利用[[动力学rollout]]快速推演每条序列对应的未来轨迹,再结合一个专门设计的博弈感知代价函数对候选轨迹进行评估排序。这样既能借助大规模采样保证策略的多样性,又能通过博弈论建模捕捉竞争性交互的内在结构。关键在于,这个过程在 GPU 上并行执行,使得原本耗时的采样与推演过程被压缩到极短时间内完成。
方法
SGTP 的方法框架可以拆解为三个核心模块:控制序列采样、博弈感知代价评估,以及可行性筛选。
控制序列采样与 GPU 加速 rollout
方法的第一个创新点在于将控制序列采样与[[动力学rollout]]的过程搬到 GPU 上并行执行。给定当前时刻的状态 ,采样器在控制空间 中生成 条候选控制序列 ,每条序列包含从当前时刻到规划时域末端 的控制输入。对于每条控制序列,框架利用车辆动力学模型 在 GPU 上并行推演出对应的状态轨迹 。
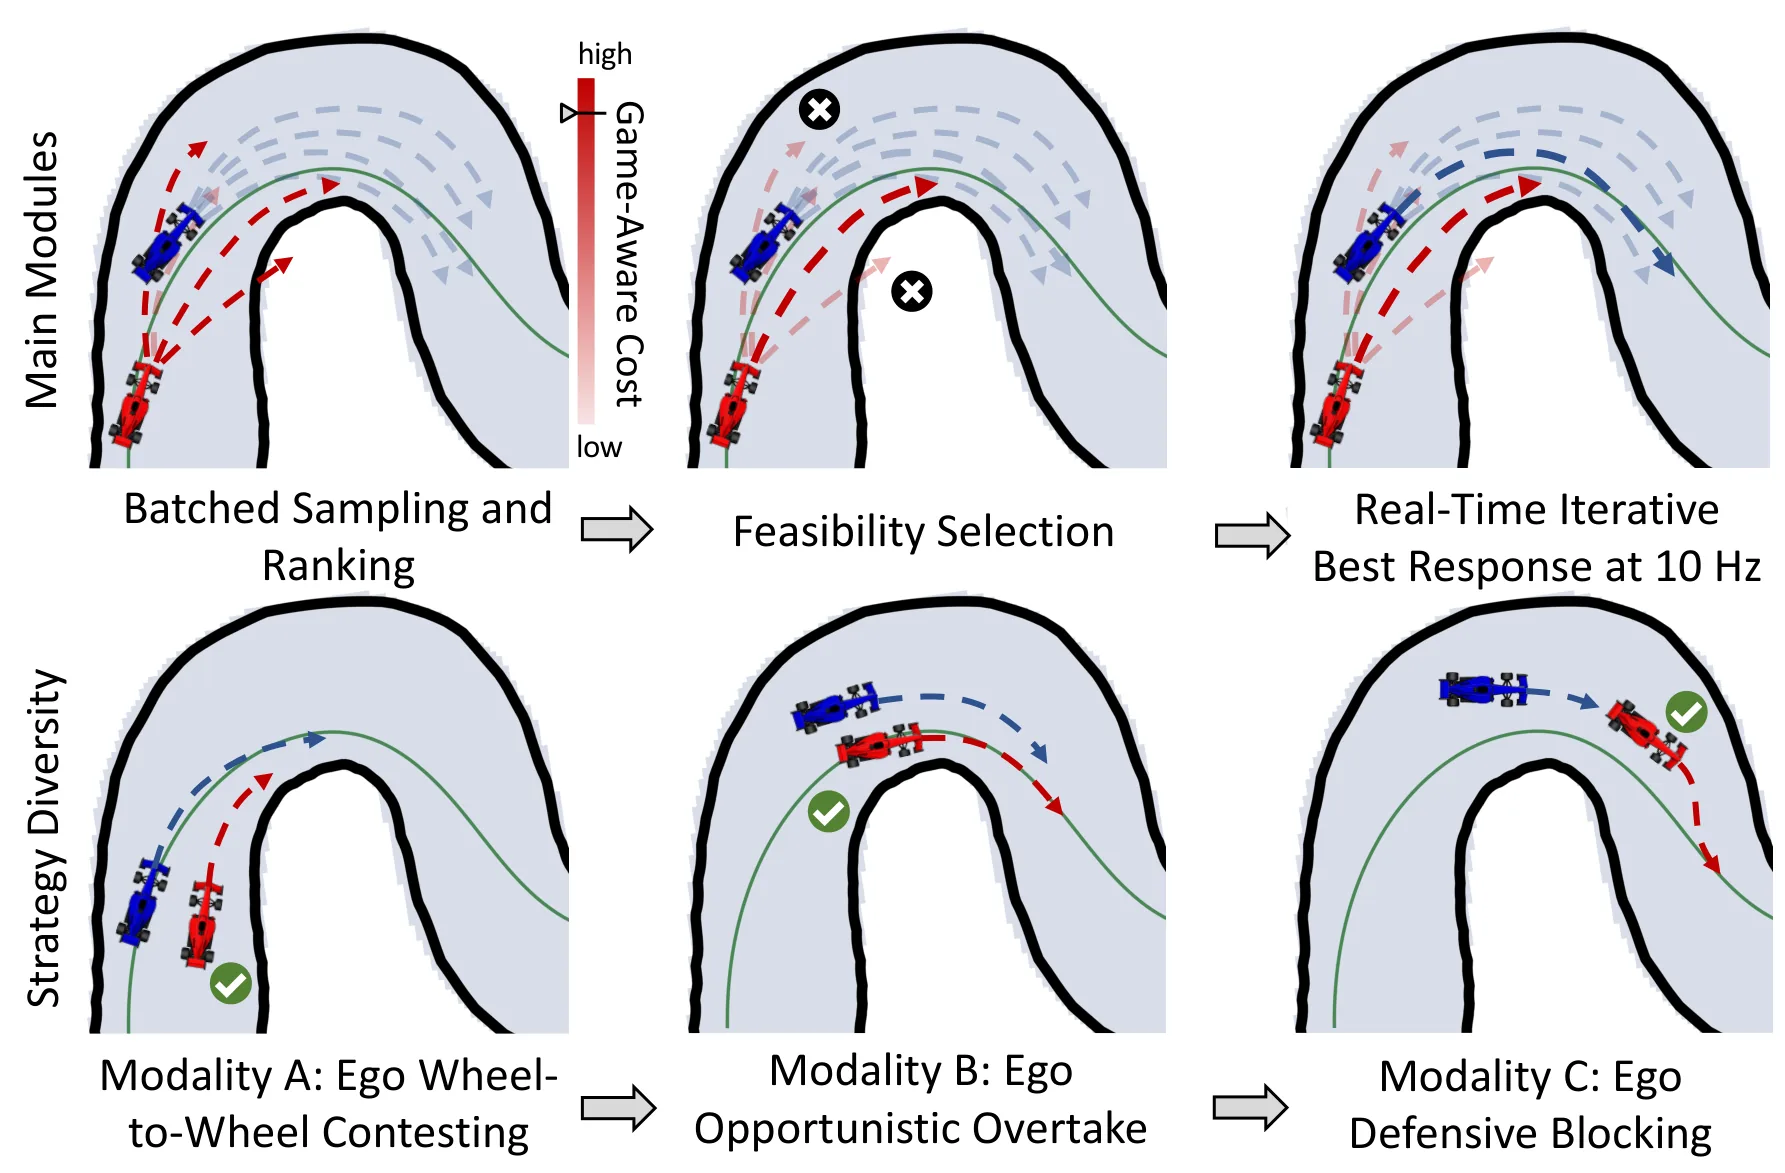
这种设计的优势在于:采样数量 可以设置得非常大(比如数千条),GPU 的并行计算能力使得这些候选轨迹的 rollout 时间几乎与单条轨迹相当,从而在计算资源允许的范围内充分探索策略空间。采样本身可以采用随机采样或基于启发式的采样策略,目的是覆盖各种可能的驾驶行为——从激进的近车超车到保守的距离保持。
博弈感知代价函数
得到大量候选轨迹后,下一步是如何从中挑选最适合当前博弈情境的那一条。SGTP 的第二个关键设计是博弈感知代价函数。这个代价函数不仅仅考虑单车的轨迹代价(如时间损失、与赛道边界的距离),还显式编码了与其他车辆交互的博弈结构。
具体而言,代价函数包含三个组成部分。第一部分是轨迹代价 ,衡量轨迹自身的竞速性能,例如累计时间成本、与最优路径的偏差等。第二部分是交互代价 ,用于捕捉与其他车辆的竞争关系——当两条轨迹在时空上接近时会产生惩罚,且这个惩罚的大小与相对速度、接触风险等因素相关。第三部分是博弈代价 ,这是最体现博弈论思想的部分:它根据对手的历史行为和当前态势,估计对手可能采取的策略,进而评估当前候选轨迹在假设对手理性响应下的收益。
数学上,最终的轨迹代价可以写成:
其中 是权重系数。通过调整这些权重,规划器可以在不同情境下表现出不同的行为偏好——例如当对手处于领先位置时增加博弈代价的权重以采取更激进的追赶策略。
可行性筛选与约束满足
仅仅基于代价排序选择轨迹还不够,因为代价函数是一个软约束机制,无法保证生成的轨迹一定满足硬性的安全约束。SGTP 在代价排序之后增加了一个可行性筛选层,显式检查候选轨迹是否满足两类硬约束:赛道边界约束和动态避碰约束。
赛道边界约束要求轨迹上的每个状态点都必须落在赛道的可行区域内。动态避碰约束则更为复杂,它不仅要避免当前时刻的碰撞,还要考虑轨迹执行过程中与其他车辆未来位置的潜在冲突。SGTP 采用时空碰撞检测方法:将所有车辆在规划时域内的预测轨迹映射到二维占据图上,通过检测占据冲突来判断是否会发生碰撞。
只有同时满足两类约束的轨迹才会被保留下来。如果最优轨迹因约束被淘汰,则依次考察次优轨迹,直到找到既具有良好代价又满足所有约束的可行轨迹。这一机制保证了策略切换的安全性——即使博弈论推理选择了某个激进策略,可行性筛选也会确保该策略在实际执行时不会导致碰撞或出界。
整个规划流程以迭代方式运行:在每个控制周期,规划器基于最新的感知信息重新采样、评估、筛选,并将选中的轨迹执行一小段时间后重复上述过程。这种"采样-评估-筛选-执行"的循环使得规划器能够对环境变化做出快速响应,同时保持策略的连贯性。
实验与结果
研究团队在多个具有挑战性的赛道上进行了大量仿真实验,以验证 SGTP 的性能表现。
实验设置
实验采用仿真环境,包含多种类型的赛道——从简单的环形赛道到包含急弯、窄道的复杂赛道。实验考虑了不同的对抗强度:对手车辆既有基于规则的传统规划器,也有采用类似博弈论方法的高级规划器。每场比赛设置固定的圈数,通过胜负结果和任务完成率来衡量规划器的有效性。
主要结果
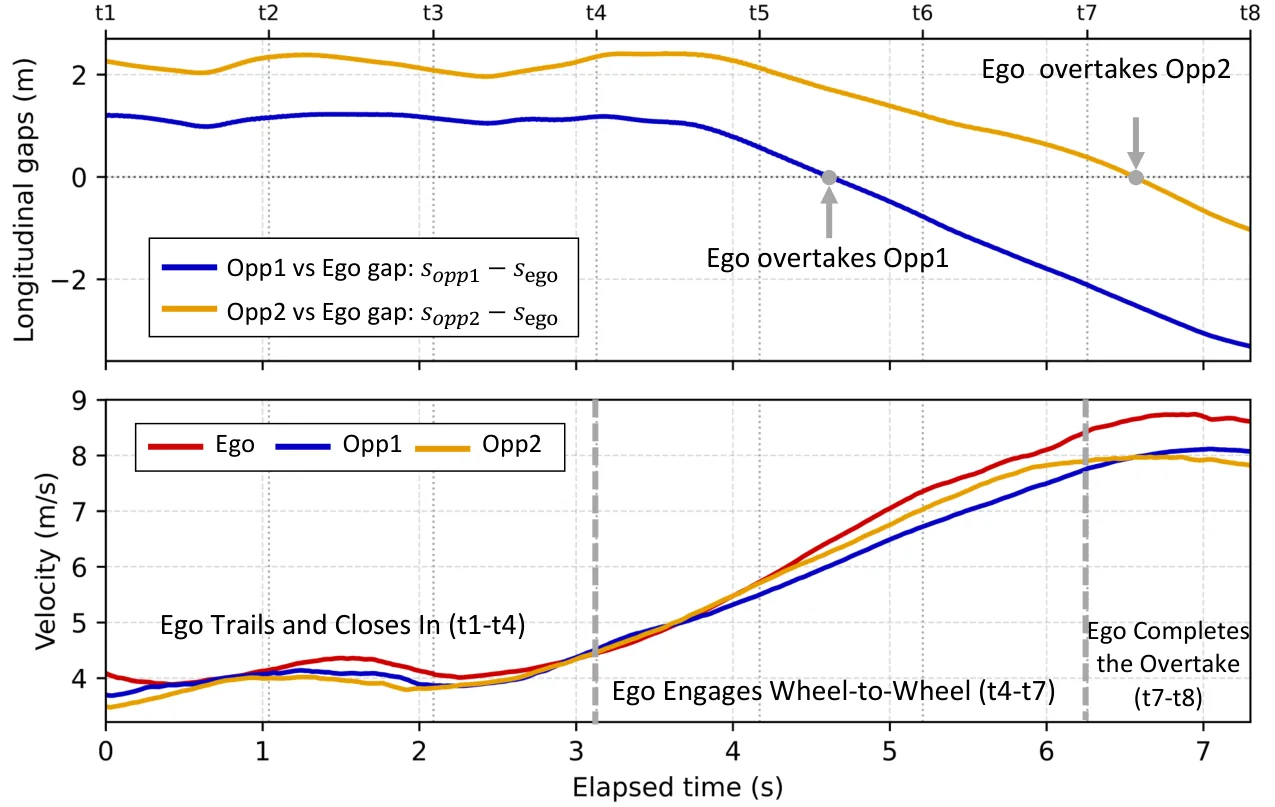
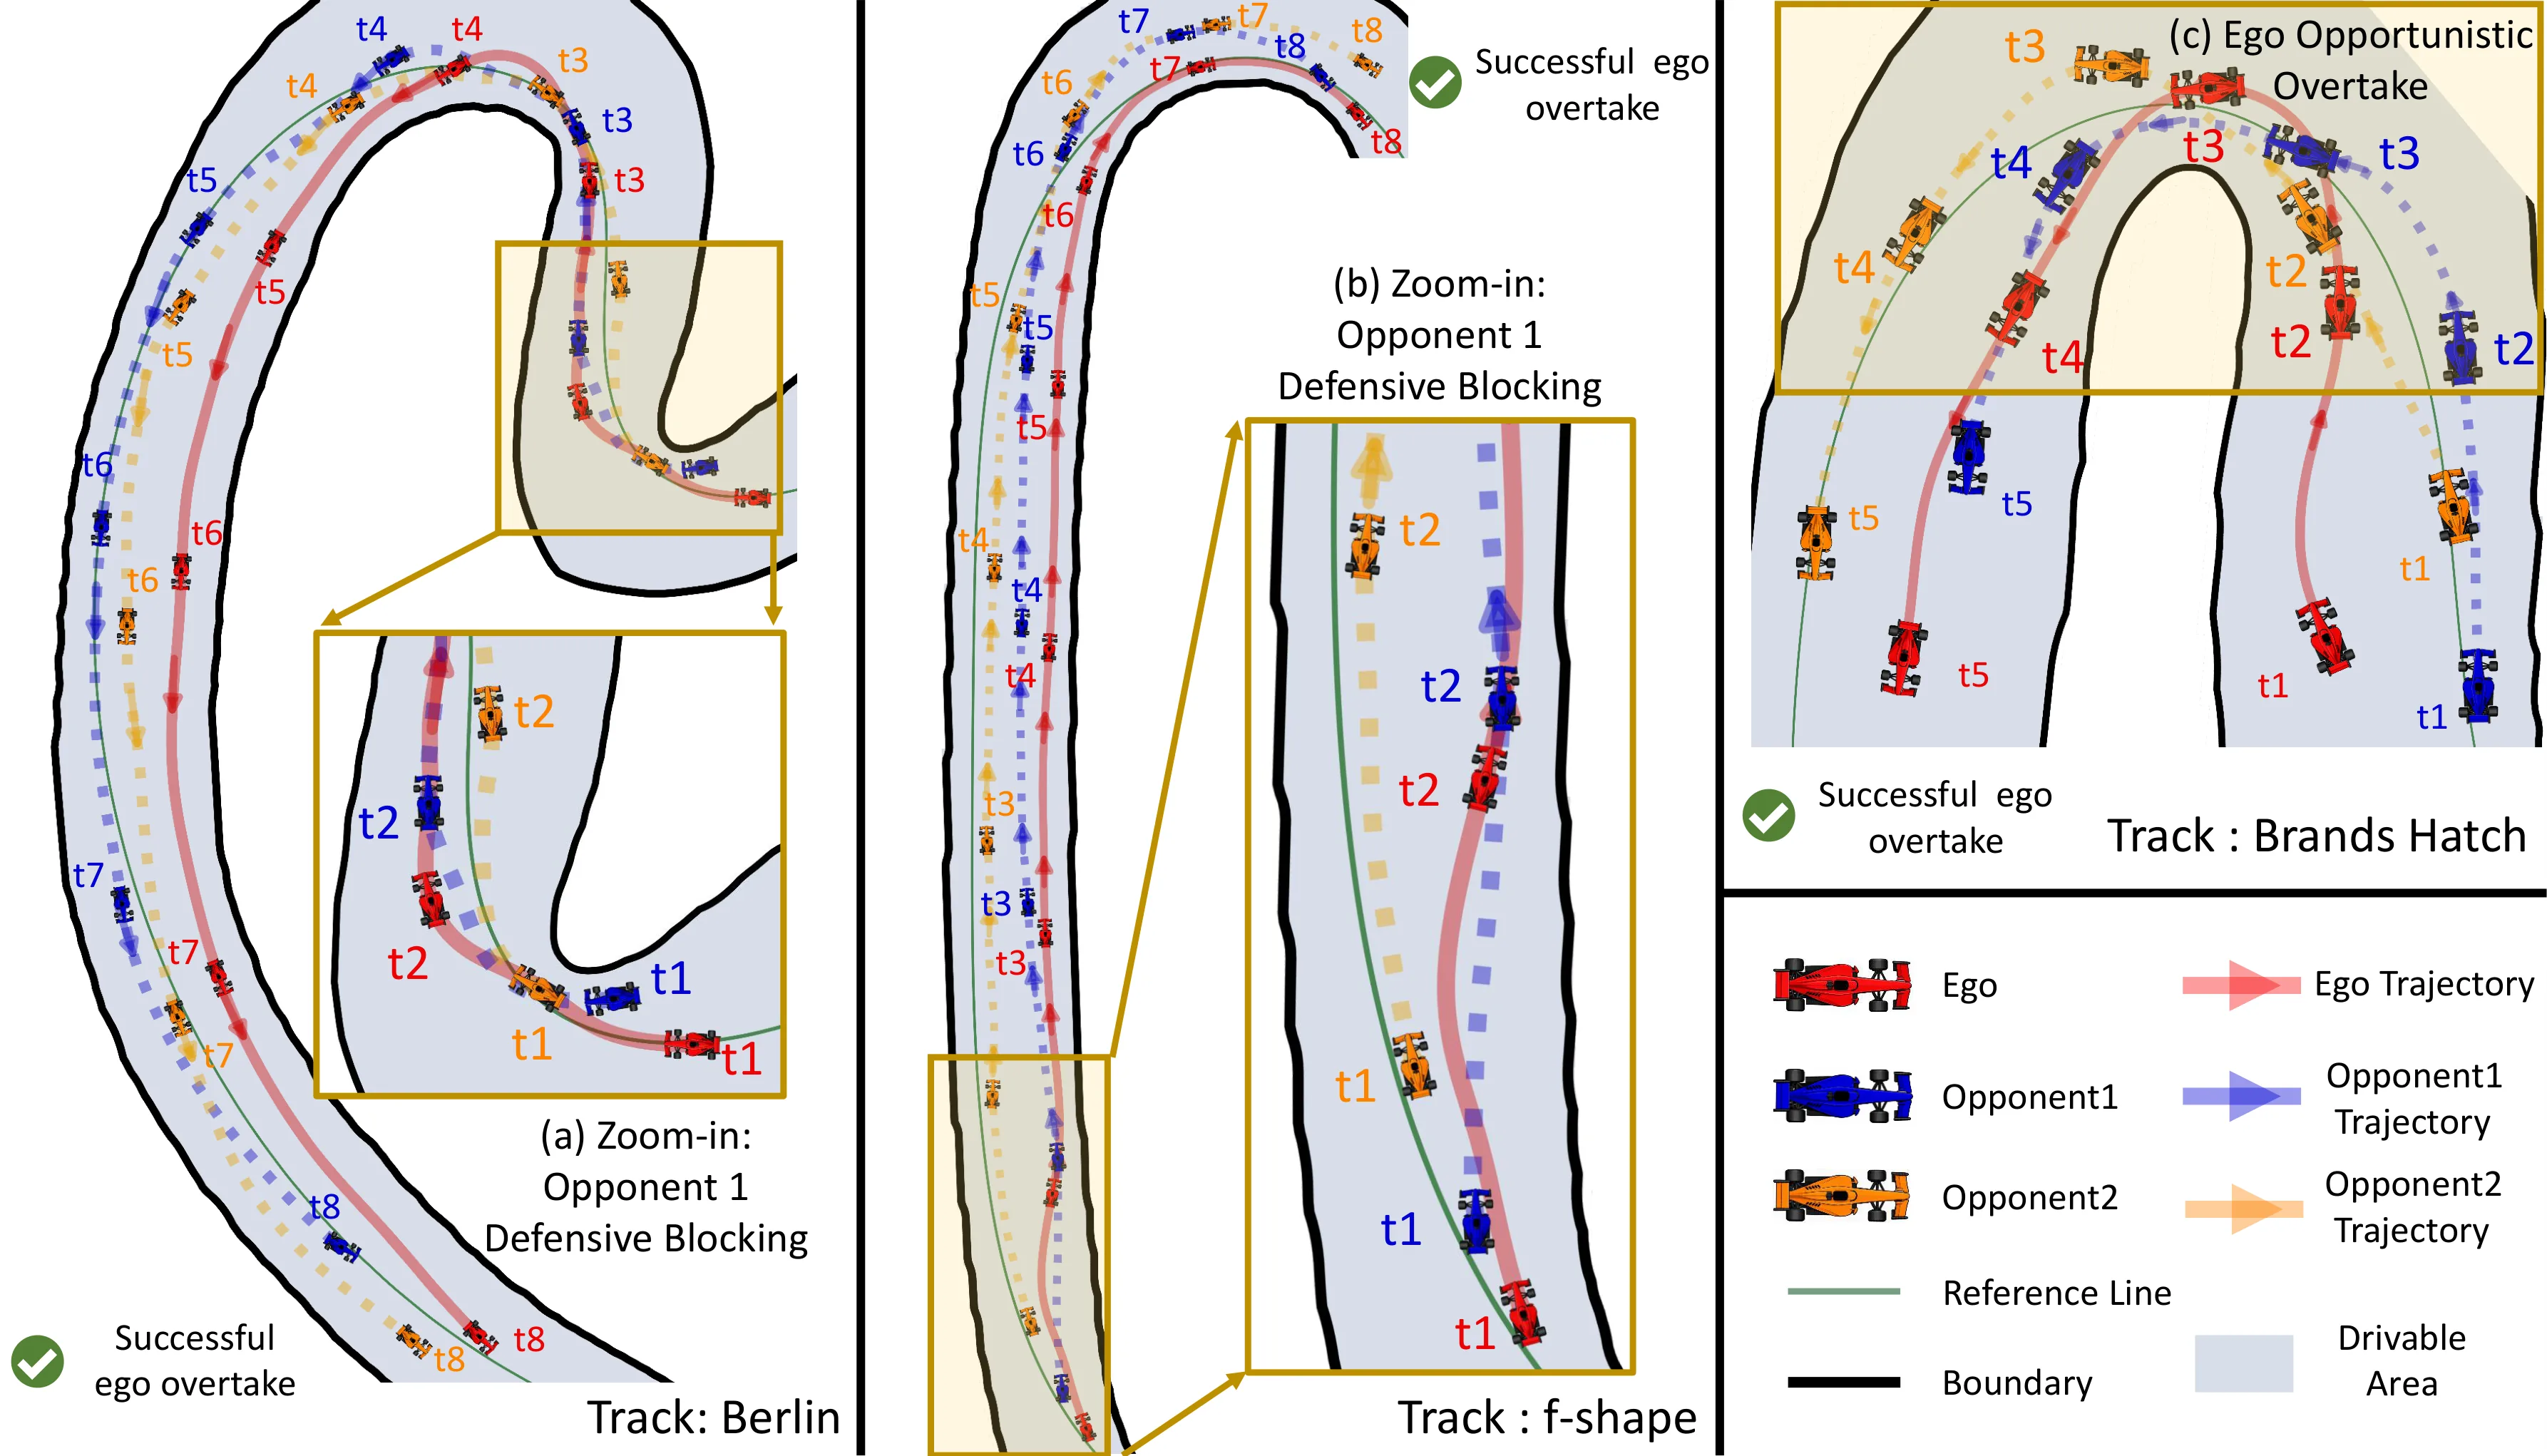
在最具对抗性的实验配置下,SGTP 取得了令人印象深刻的结果:胜率达到 95.24%,任务完成率高达 99.35%。这意味着在绝大多数高度交互的比赛中,SGTP 都能击败对手并顺利完成比赛。任务完成率接近 100% 表明该方法具有极高的安全性——即使在激烈对抗中也能有效避免碰撞和出界。
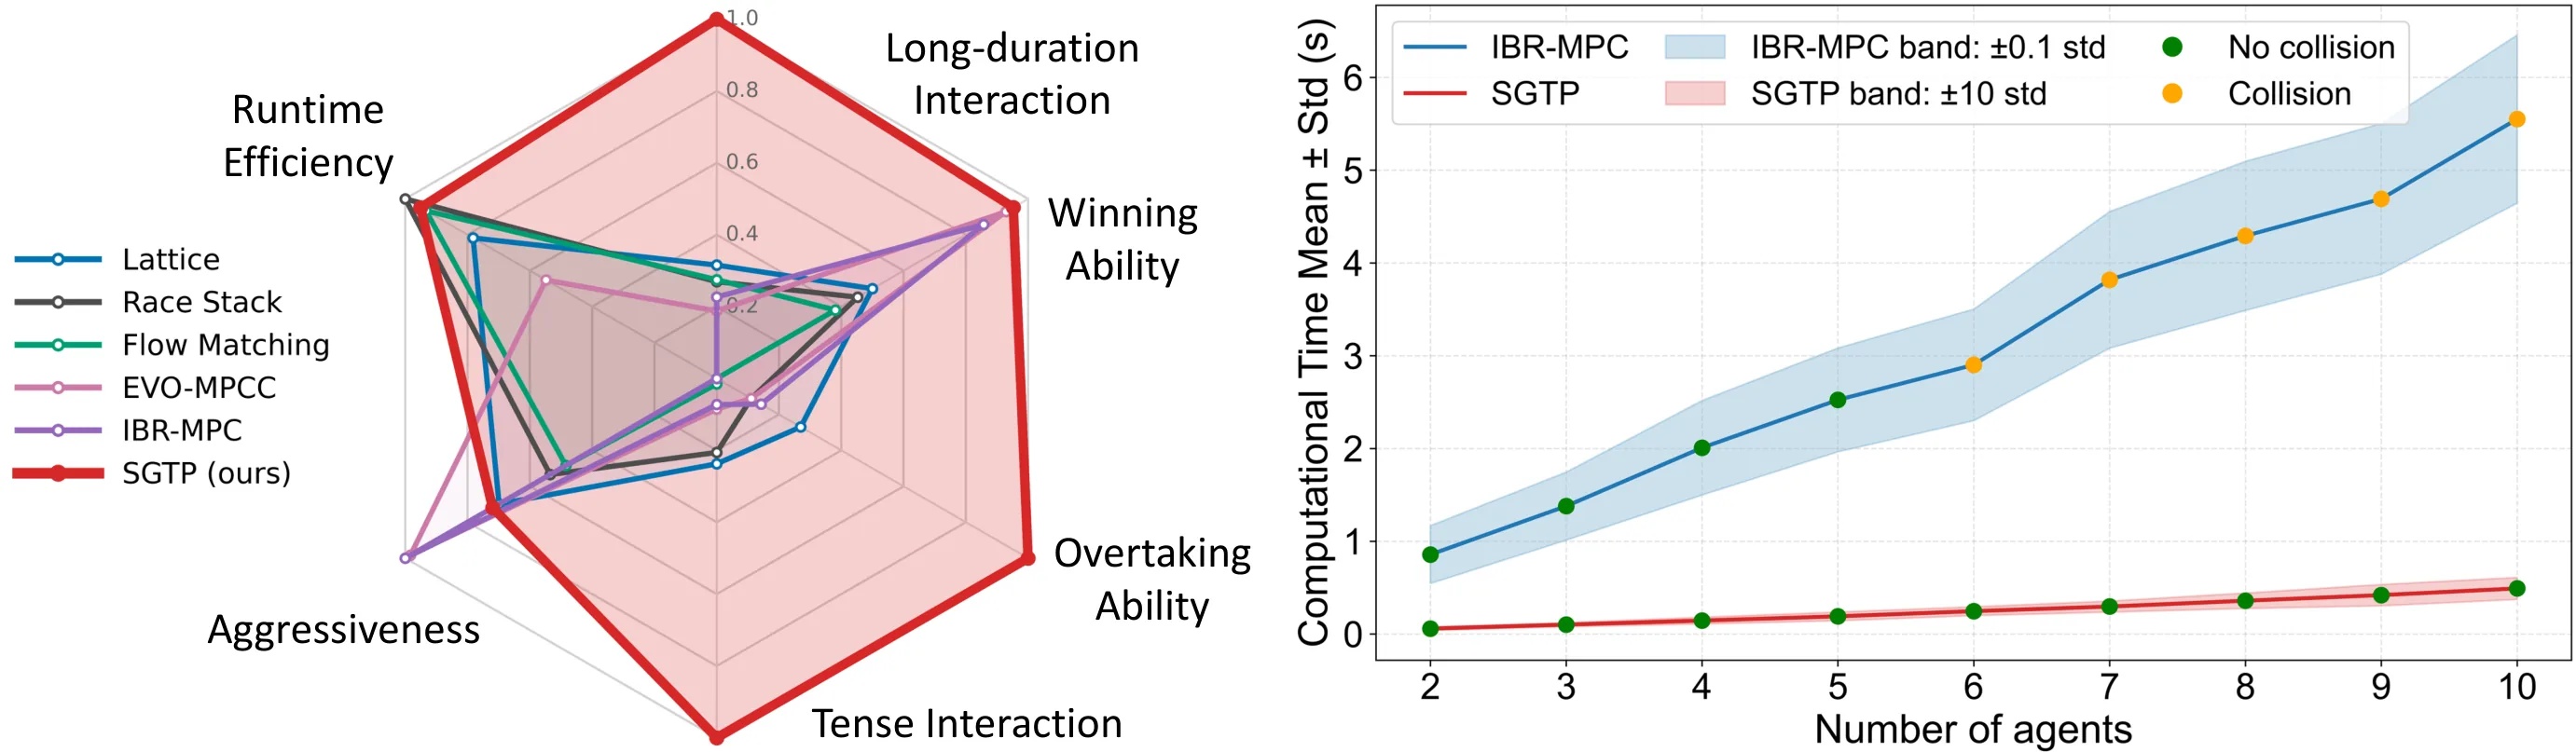
计算效率方面的结果同样令人鼓舞:多次迭代求解的平均计算时间仅为 0.095 秒。这个数字远低于典型的控制周期(通常为 10-50 毫秒),表明方法具备充足的实时性余量来应对实际部署中的各种延迟和抖动。
规模化验证
实验还测试了方法在多车场景下的可扩展性。当参赛车辆数量从 2 辆逐步增加到 10 辆时,SGTP 依然能够保持稳定的性能表现。这验证了框架的规模化能力——博弈感知代价和并行采样机制在更多智能体参与时并未出现显著的性能衰减。
讨论与可借鉴点
SGTP 展示了将[[博弈论规划]]与大规模采样相结合在实时对抗场景中的巨大潜力,其设计思路对相关领域有几点值得借鉴之处。
首先,GPU 加速采样的思路具有普适性。对于任何需要在实时约束下探索大量候选方案的规划问题,将采样和 rollout 过程并行化都是提升计算效率的有效手段。关键在于设计合适的代价函数来引导采样过程,使有限的计算资源集中于高潜力区域。
其次,博弈感知代价函数的设计体现了对问题本质结构的深入理解。单靠轨迹代价难以应对对抗性场景,但纯博弈论方法又面临计算复杂度问题。SGTP 通过在采样框架中嵌入轻量级的博弈评估模块,在两者之间取得了平衡。
然而,该方法也存在一定局限性。仿真环境虽然能够覆盖大部分竞速场景,但在真实物理世界中,车辆模型的参数不确定性、传感器的感知延迟与噪声、通信链路的不稳定等因素都可能影响方法的表现。此外,实验主要在仿真器中完成,尚未见到实车验证的报道。
另一个值得探索的方向是方法在非竞速场景的应用。[[博弈论规划]]的核心思想——考虑其他智能体的策略响应——在自动驾驶、机器人协作等场景中同样具有重要价值。SGTP 的框架是否可以迁移到这些领域,如何处理更复杂的交互规则和约束条件,都是未来研究可以关注的问题。研究团队同时宣布将发布代码并提供多智能体自主竞速算法的开源基准,这将为社区复现和改进该方法提供便利。
摘要
自主多车辆竞速需要在激烈对抗中实时规划多样化的竞争行为。现有规划器往往难以在策略多样性与计算效率之间取得平衡。为应对这一挑战,我们提出了基于采样的博弈论规划(SGTP),这是一种实时框架,将博弈论推理与基于 GPU 加速的控制序列采样及动力学推演相结合。采样的轨迹使用博弈感知代价进行排序,以捕捉竞争性交互并生成多样化的竞速行为。随后,我们的规划器通过显式施加赛道边界与动态避碰约束进行可行性筛选,确保竞速策略之间的安全可靠切换。在具有挑战性的赛道上的大量仿真表明,SGTP 在高度对抗的比赛中取得了 95.24% 的胜率和 99.35% 的任务完成率,并在多次迭代求解过程中平均计算时间为 0.095 秒。我们还展示了 SGTP 在多达 10 个智能体的大规模场景中的成功应用。我们将发布代码,并提供一个多智能体自主竞速算法的开源基准,以促进未来研究。项目页面:https://sgtp-racing.github.io/。
Abstract
Autonomous multi-vehicle racing requires real-time planning of diverse competitive behaviors in intense interactions. Existing planners often struggle to balance strategic diversity and computational efficiency. To address this challenge, we propose Sampling-based Game-Theoretic Planning (SGTP), a real-time framework that combines game-theoretic reasoning with GPU-accelerated sampling of control sequences and dynamics rollouts. Sampled trajectories are ranked using a game-aware cost to capture competitive interactions and generate diverse racing behaviors. Our planner then performs feasibility selection by explicitly enforcing track-boundary and dynamic collision-avoidance constraints, ensuring safe and reliable transitions between racing strategies. Extensive simulations on challenging tracks show that SGTP achieves a 95.24% win rate and a 99.35% task-completion ratio in highly interactive races, with a mean computational time of 0.095 s over multiple iterative solving steps. We also demonstrate the successful application of SGTP in large-scale scenarios with up to 10 agents. We release our code and provide an open-source benchmark of multi-agent autonomous racing algorithms to facilitate future research. Project page: https://sgtp-racing.github.io/.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。