
MR-TGN:一种用于多智能体系统中团队级意图预测的元角色时序图网络
MR-TGN: A Meta-Role Temporal Graph Network for Team-Level Intent Prediction in Multi-Agent Systems
📝 TLDR
多智能体系统中群体意图预测面临交互关系复杂、合作结构时变以及功能角色隐式难标注等核心难题。本文提出MR-TGN框架,将智能体建模为动态演化的图节点,通过时序记忆机制编码历史交互与协作行为,并引入记忆增强的元角色学习模块,从智能体行为表示中自动推断潜在角色。实验在多种典型多智能体对抗场景中验证,该方法在群体意图的早期预测准确性与时效性方面均稳定优于现有基线,为动态对抗环境中的协同行为建模提供了新方案。
🧭 速览
群体意图源于复杂交互与时变合作结构,且功能角色多为隐式无标注,现有方法难以有效建模协同行为。
MR-TGN将智能体建模为动态图节点,结合时序记忆机制编码历史交互,并引入无需显式标注的记忆增强元角色学习来推导潜在角色表示。
在多个代表性多智能体对抗场景中,MR-TGN在早期意图预测的准确性与时效性上均稳定优于多个竞争基线。
MR-TGN能有效捕捉动态合作结构与隐式角色,为多智能体系统早期群体意图预测提供了有效且可扩展的方案。
🆚 方法对比
MR-TGN (Meta-Role Temporal Graph Network)
- 联合建模时序交互与协作结构
- 无需显式角色标签即可学习潜在角色
- 角色表示可跨场景迁移为全局知识
- 在动态对抗环境中实现早期意图预测
- 依赖记忆模块,计算开销较大
- 在部分可观测环境泛化能力未充分验证
- 实验场景有限,缺少大规模基准对比
时序图网络 (Temporal Graph Network)
- 有效编码历史交互与时序依赖
- 自然建模智能体间的动态关系结构
- 支持节点记忆的持续更新机制
- 场景特定的节点记忆难以跨任务迁移
- 对长时间序列的存储与检索效率受限
- 无法直接捕获高层角色级语义信息
记忆增强的元角色学习机制
- 从行为表征自动推导潜在角色表示
- 无需显式角色标注,降低标注成本
- 提供可迁移的全局行为知识表示
- 角色数量和粒度需预先设定
- 元学习过程增加了训练复杂度
- 学到的角色可解释性有限
早期集体意图预测评估方法
- 同时评估预测准确性与及时性
- 支持任务执行早期阶段的实际评测
- 适合动态对抗场景的现实需求
- 评估指标设计较新颖,缺乏广泛认可
- 对预测时间窗口的设定较敏感
- 尚未在公开基准上广泛验证
基于规则与概率推理的传统方法
- 计算简单,易于解释和部署
- 在静态环境和预定义模型下有效
- 依赖手工设计特征,扩展性差
- 假设静态环境,难以适应动态对抗场景
- 无法处理潜在角色和高层协作行为
基于强化学习的对手建模方法
- 通过环境交互学习最优决策策略
- 适合长期奖励最大化的对抗场景
- 训练成本高,样本效率低
- 难以直接推断高层集体意图
- 在部分可观测环境中稳定性不足
MR-TGN通过融合时序图网络与元角色学习,在无需显式角色标注的情况下实现了跨场景可迁移的集体意图预测,相比传统规则方法、序列模型和强化学习方法在动态对抗环境中的早期意图预测方面具有综合优势。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 10 张)
展开查看 10 张图
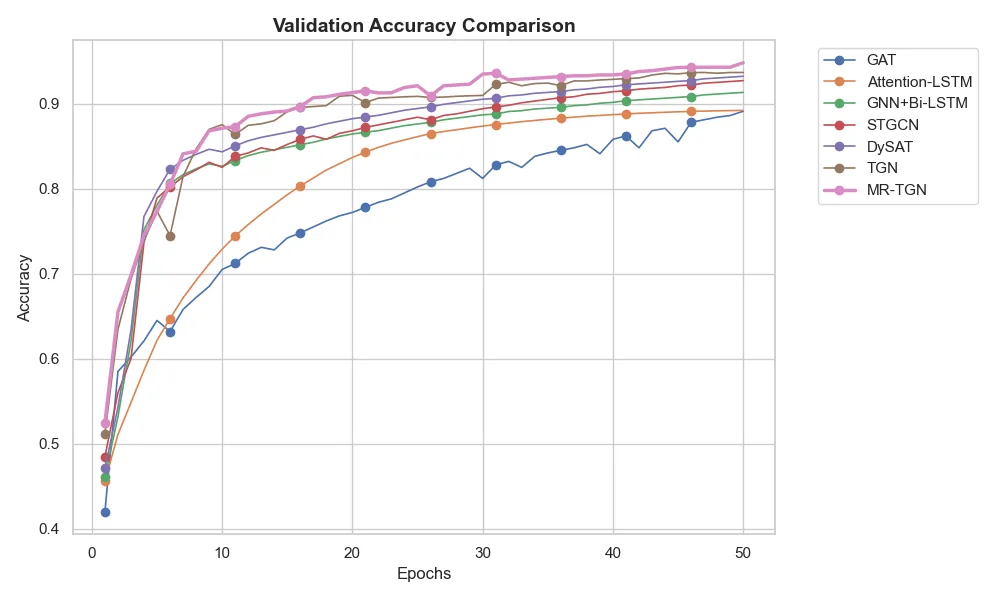
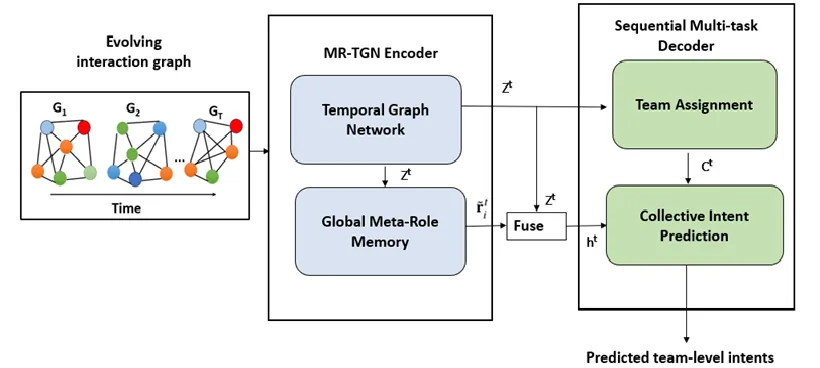

TL;DR
MR-TGN 提出了一个用于多智能体系统中团队级意图预测的元角色时序图网络框架,通过将智能体建模为动态演化的图节点,并引入记忆增强的元角色学习模块从行为表征中自动推断潜在角色,无需显式角色标注即可实现跨场景的可迁移角色知识学习。在自主构建的异构空战数据集上,该方法在集体意图早期预测的准确性与稳定性方面均显著优于现有基线,全历史意图预测准确率达 92.7%,早期预测能力领先基线方法。
研究背景与动机
多智能体系统中的集体意图预测是当前人工智能领域的一个核心挑战,其目标是从多个交互智能体的行为数据中推断它们共享的目标与未来行动方向。这一问题在军事对抗、空战协同、机器人协作等场景中具有重要的应用价值。与单智能体意图预测不同,集体意图具有显著的涌现性——它并非由单个智能体的瞬时状态决定,而是源于多个智能体之间复杂的交互模式、持续演化的合作结构以及长期的行为依赖关系。
然而,现有方法在应对这一挑战时面临三重困境。首先,传统规则式和概率式方法难以适应动态演化,它们依赖人工设计的特征或固定的假设前提,在面对不断变化的对抗环境时表现出明显的脆弱性。其次,主流的时序和图模型虽然在个体层级意图推断上取得了进展,但大多将每个智能体视为独立分析单元,未能显式建模团队的形成过程与协作模式。再次,智能体在团队中承担的功能角色——如攻击者、护航者、诱饵、信息提供者——通常是隐式的,既没有显式标注,又可能随任务阶段动态变化,这使得协调群体行为的学习变得更加困难。
正是基于对这些问题本质的深刻理解,MR-TGN 选择了一条不同于以往研究的路径:将时序交互动态、演化合作结构与可迁移的角色表征进行联合建模,以期在动态对抗环境下实现对团队级集体意图的早期且稳定的预测。
方法
MR-TGN 的核心设计围绕三个关键技术组件展开,形成了一个从底层表示到高层推理的层次化框架。
在基础表示层面,MR-TGN 将多智能体系统建模为随时间演化的全连接交互图序列 ,其中每个时间步的图结构 包含了智能体的运动学状态作为节点特征,以及编码相对空间与运动关系的边特征。这种图结构的引入使得智能体之间的空间协调关系得以显式建模。
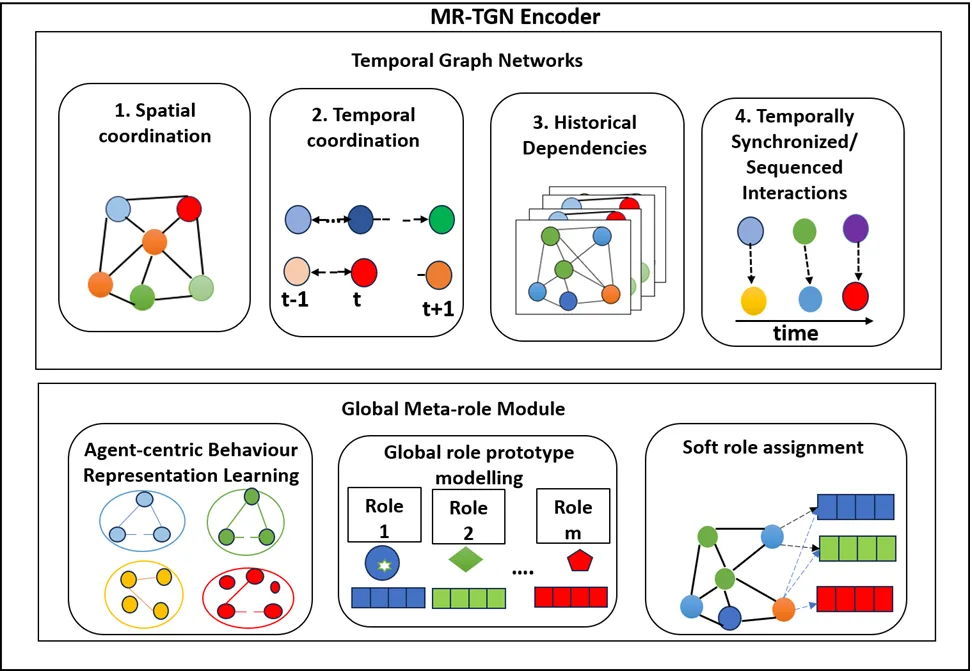
在时序建模层面,MR-TGN 基于时序图网络(TGN)架构构建协调表征,但做了关键增强。TGN 通过四个互补维度刻画协调动态:基于注意力机制的空间协调确保模型能够选择性关注重要邻居;时序协调通过顺序处理时间戳交互捕捉行为演变;历史依赖通过节点级持久记忆(GRU 更新)维护长期信息;同步与序列交互的联合建模则兼顾了多智能体同时行动与顺序决策的特点。具体而言,节点记忆通过聚合历史消息后用 GRU 更新:
多头时序注意力机制则将边特征与上下文向量共同构成查询、键、值,通过缩放点积注意力得分进行信息聚合,生成时序嵌入 。
全局元角色模块是 MR-TGN 最具创新性的设计,旨在从行为表征中自动推断潜在角色而不依赖显式标注。该模块首先从最近若干时间步的节点行为特征中提取短期行为描述子,经投影后通过 sigmoid 门控对时序嵌入进行行为条件过滤:
随后,模块维护 个可学习的全局原型作为跨场景共享的角色空间,通过温度控制的 softmax 相似度进行软角色分配:
最终的角色增强融合将原始时序嵌入与加权聚合的角色原型结合,生成角色感知的智能体表示 。这一设计的巧妙之处在于,全局角色原型作为跨场景共享的参数,能够在部分可观测环境下补足历史信息缺失,实现可迁移的角色知识学习。
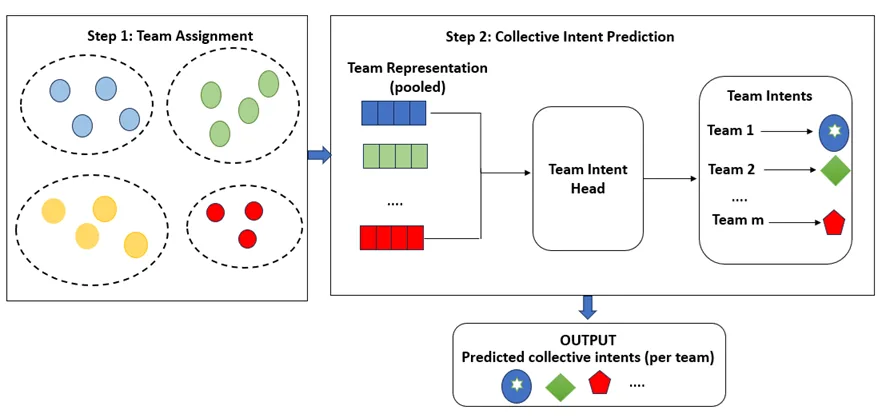
在解码层面,MR-TGN 采用顺序多任务架构,先通过团队分配模块基于时序嵌入将智能体划分为若干团队,再对每个团队进行集体意图预测。团队内的智能体表示通过置换不变池化聚合,再经意图预测网络输出意图概率分布。
实验与结果
实验基于自主构建的异构空战数据集展开,该数据集在 SCRIMMAGE 多智能体仿真框架上构建,涵盖了天空哨兵打击、护航突防打击、反舰打击、侦察等多种集体意图类型,包含异构与同构团队配置。数据集设计了三阶段时间演进:突入阶段、角色分化阶段与任务执行阶段,以模拟真实对抗环境中团队形成与意图涌现的过程。
在分阶段准确率评估中,MR-TGN 在所有阶段、所有观测设置下均取得最高的团队分配与意图预测准确率。全历史观测下,意图预测总体准确率达到 92.7%;即便在仅能从第二阶段开始观测的部分观测设置下,仍保持了 91.4% 的准确率,持续优于基线方法 TGN 与其他竞争方法。
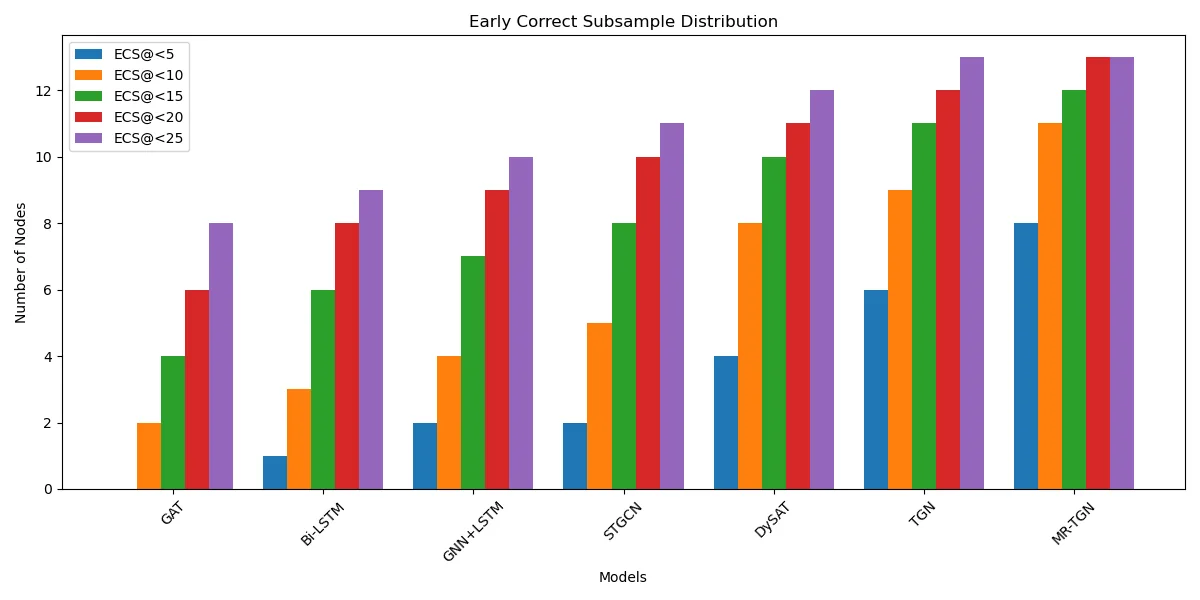
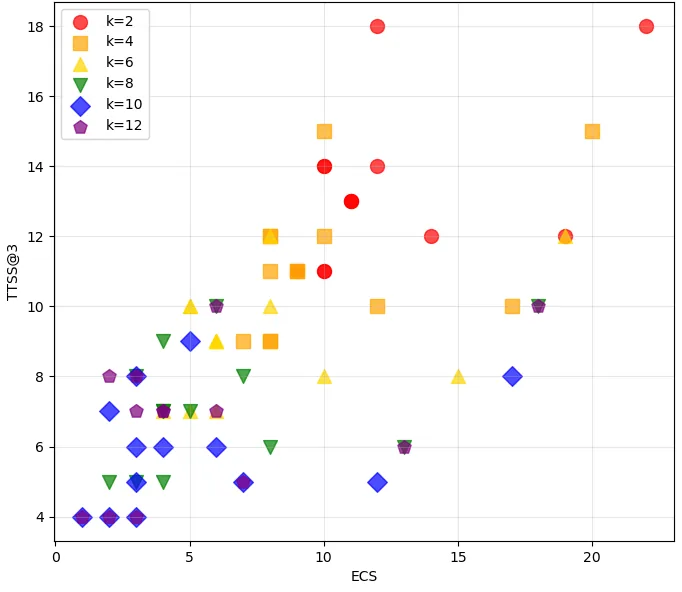
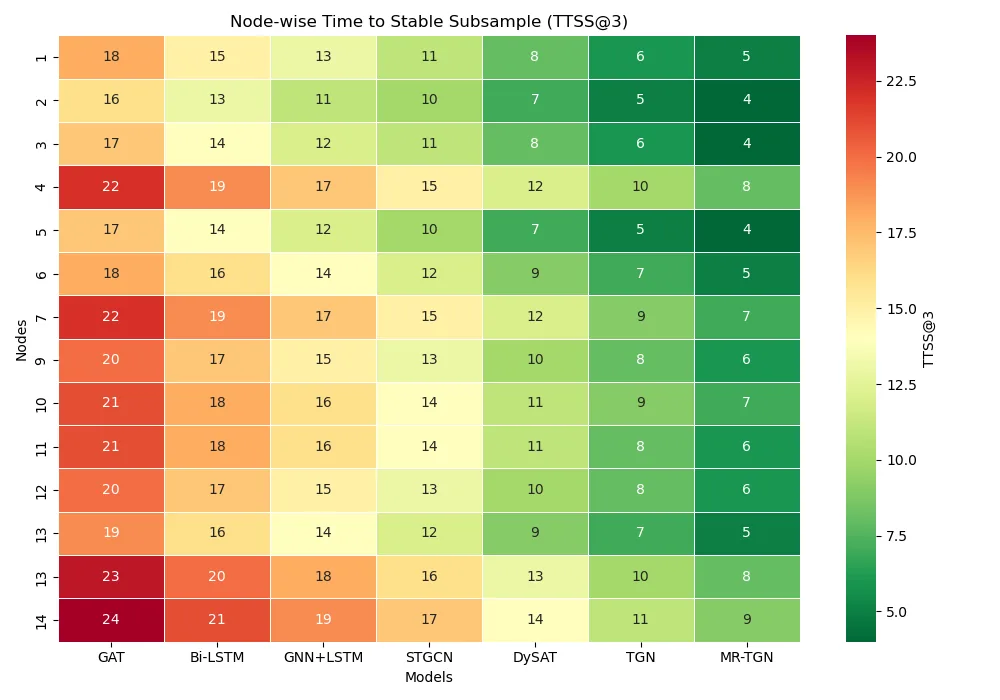
早期预测能力的评估采用了 ECS(首次正确预测所需样本数)与 TTSS@3(连续三次预测均正确的最早时间步)两项指标。在 ECS 分析中,MR-TGN 在前 5 个样本内正确识别的节点数达到 8 个,前 10 个样本内达到 11 个,而基线 TGN 分别为 6 与 9;在 20 个样本内,MR-TGN 实现了全部 13 个节点均正确识别。TTSS@3 热力图结果则显示,MR-TGN 的时间步节点级稳定性普遍优于基线,表明模型在首次正确预测后能迅速形成稳定的预测结果。
消融实验验证了各组件的互补性贡献。移除节点记忆后意图预测准确率降至 82.36%,说明时序历史信息的重要性最为显著;注意力机制的贡献次之;团队分配头与全局角色记忆同样带来了不可忽视的增益。角色原型数敏感性分析则揭示了表达能力与泛化性之间的折中关系:当 时模型在早期性与稳定性之间达到最佳平衡,过小的角色空间限制表达能力,过大则导致收益递减。
讨论与可借鉴点
MR-TGN 在多智能体集体意图预测领域做出了实质性的贡献,其方法论设计为相关研究提供了若干值得借鉴的思路。将智能体建模为动态演化的图实体并联合时序记忆机制,这一思路能够有效捕捉复杂交互与演化合作结构;元角色学习机制通过行为条件门控与全局可学习原型的结合,实现了无需显式标注的可迁移角色知识发现;顺序多任务解码器将团队分配与意图预测解耦为层次化步骤,更符合实际决策过程中从分组到推理的认知逻辑。
然而,该研究也存在若干局限与值得深入探索的方向。实验完全基于自主构建的单一年景数据集,缺乏跨数据集泛化验证,这在一定程度上限制了结论的普适性。论文未披露随机种子次数与显著性检验,基线 Attention-LSTM 无法执行团队分配任务导致对比存在任务不对等问题。此外,角色原型数 的最优值依赖经验确定,缺乏理论指导;元角色与具体战术行为的对应关系也尚未得到充分的可解释性分析。
在应用层面,MR-TGN 的框架为动态对抗环境中的协同行为建模提供了新方案,其早期预测能力在需要快速响应的决策场景中具有实际价值。在学术层面,元角色模块的设计思路——通过跨场景共享的原型捕捉可迁移的结构性知识——为处理隐式标注问题提供了新范式,有望推广至其他涉及潜在角色或隐式结构的团队协作建模任务中。
摘要
多智能体系统中的集体意图预测聚焦于预测一组交互智能体的共同目标与未来行为。该问题尤其具有挑战性,因为集体意图源于复杂交互、不断演化的合作结构以及在动态且部分可观测环境中运作的异质智能体之间的长期行为依赖。此外,智能体所承担的功能角色通常是潜在的、可能随时间发生变化,并且很少以显式标注的形式提供,这使得协调群体行为的学习变得显著更加困难。为应对这些挑战,本文提出了一种用于多智能体系统中集体意图预测的元角色时序图网络(MR-TGN)框架。该框架将智能体建模为动态演化的图实体,并采用时序记忆机制对历史交互与协作行为进行编码。为了捕捉更高层次的行为知识,MR-TGN 引入了一种记忆增强的元角色学习机制,能够从以智能体为中心的行为表征中推导出潜在的角色表征,而无需显式的角色标签。本文提出了一种针对早期集体意图预测的评估方法,用于评估预测的准确性与及时性,从而能够对模型在任务执行早期阶段预测集体目标的能力进行现实评估。在代表性多智能体场景上的实验结果表明,所提出的框架始终优于具有竞争力的基线方法,并在动态且对抗性的环境中实现了对集体意图的有效早期预测。
Abstract
Collective intent prediction in multi-agent systems focuses on predicting the shared objectives and future behaviours of groups of interacting agents. The problem is particularly challenging because collective intent emerges from complex interactions, evolving cooperation structures, and long-term behavioural dependencies among heterogeneous agents operating in dynamic and partially observable environments. Furthermore, functional roles adopted by agents are often latent, may change over time, and are rarely available as explicit annotations, making the learning of coordinated group behaviours significantly more difficult. To address these challenges, this paper proposes a Meta-Role Temporal Graph Network (MR-TGN) framework for collective intent prediction in multi-agent systems. The proposed framework models agents as dynamically evolving graph entities and employs temporal memory mechanisms to encode historical interactions and coordination behaviours. To capture higher-level behavioural knowledge, MR-TGN introduces a memory-enhanced meta-role learning mechanism that derives latent role representations from agent-centric behavioral representations without requiring explicit role labels. An evaluation methodology for early collective intent prediction is proposed to assess prediction accuracy and timeliness, enabling realistic evaluation of the model's ability to anticipate collective objectives during the early stages of mission execution. Experimental results on representative multi-agent scenarios demonstrate that the proposed framework consistently outperforms competitive baselines and achieves effective early prediction of collective intents in dynamic and adversarial environments.
论文详细总结(自动生成)
MR-TGN 论文总结
1. 核心问题与研究背景
论文聚焦于多智能体系统中的团队级(集体)意图预测问题,旨在从异质智能体的交互行为中识别它们共享的目标与未来行动。该问题的核心挑战包括:
- 意图的涌现性:集体意图并非由单个智能体的瞬时状态决定,而是源于多个智能体之间复杂的交互、持续演化的合作结构以及长期行为依赖;
- 环境动态性与部分可观测性:智能体可能随时进入或离开观测范围,对抗环境下的策略与编队不断重组;
- 角色隐式性:智能体的功能角色(如信息提供者、护航者、诱饵、攻击者等)通常没有显式标签、会随时间动态变化,且具有跨场景的可迁移性;
- 现有方法的不足:
- 规则式、概率式或手工特征方法难以适应动态演化;
- 传统时序/图模型(GRU、BiLSTM、GAT、GNN+LSTM、STGCN、DySAT、TGN)大多在个体层级推断意图,未显式建模团队形成过程;
- TGN 的节点记忆本质上是场景特定的,无法捕获可迁移的角色知识。
因此,论文的核心目标是:联合建模时序交互动态、演化合作结构与可迁移的角色表征,实现对动态对抗环境下团队级集体意图的早期且稳定预测。
2. 方法论
2.1 整体架构
MR-TGN 框架由两部分组成:
1. MR-TGN 编码器:在 TGN 的基础上引入全局元角色(meta-role)记忆,学习"协调感知 + 角色感知"的智能体表示;
2. 顺序多任务解码器(Sequential MTL Decoder):先进行团队分配(Team Assignment, TA),再进行集体意图预测(Intent Prediction, IP)。
2.2 动态图表示
将多智能体系统建模为随时间演化的全连接交互图序列:
其中节点特征 包含智能体的运动学状态,边特征 编码相对空间与运动关系(距离、相对位置/速度、高度差、航向差、接近速度等)。
2.3 TGN 子模块(协调表征)
TGN 通过四个互补维度刻画协调动态:
- 空间协调:基于注意力机制的消息传递;
- 时间协调:时序戳交互的顺序处理;
- 历史依赖:节点级持久记忆(GRU 更新);
- 同步/序列交互:时序有序交互的联合建模。
记忆更新:在处理时间 的批次前,对每个节点聚合来自 RMS(原始消息存储)的历史消息,再用 GRU 更新:
多头时序注意力:边特征 与上下文向量 共同构成查询、键、值:
注意力得分采用缩放点积:
归一化后多头拼接得到时序嵌入 。
2.4 全局元角色模块(核心创新)
为避免角色信息被交互/团队特定模式主导,模块构造以智能体为中心的行为参考:
1. 行为表征学习:从最近 个时间步的节点行为特征 提取短期行为描述子,再经 投影,并通过 sigmoid 门控对 TGN 嵌入做行为条件过滤:
2. 全局角色原型建模:维护 个可学习的全局原型 ,作为跨场景共享的角色空间。
3. 软角色分配:采用温度 控制锐度的 softmax 相似度:
4. 角色增强融合:,其中 。
2.5 顺序多任务解码器
- 步骤 1(团队分配):基于 将智能体划分为 个团队 ;
- 步骤 2(意图预测):对每个团队的 做置换不变池化得到 ,再由 输出意图概率分布:
3. 实验设计
3.1 数据集 / 场景
由于现有公开数据集缺乏团队级意图标注与动态团队组成,作者基于 SCRIMMAGE 多智能体仿真框架自主构建了异构空战数据集(Heterogeneous-Team-Intent-Dataset,已公开于 GitHub),包含 5 种集体意图标签:
| 标签 | 含义 | 异质性 |
|---|---|---|
| SSS | Sky Sentinel Strike(天空哨兵打击) | 异构(striker / 左/右 flanker / decoy) |
| EPS | Escort Penetration Strike(护航突防打击) | 异构(主攻 + 护航) |
| ASS | Anti-Ship Strike(反舰打击) | 异构(低空主攻 / 左/右 flanker / decoy) |
| Recon | 侦察 | 同构(多阶段演化) |
| NM | No Mission(无任务) | — |
每个仿真场景包含不同的任务组合,三阶段时间演进(突入 → 角色分化 → 任务执行)。
3.2 Benchmark 与对比方法
无外部 benchmark,属于自建数据集。基线包括:
- GAT:空间图注意力(仅空间);
- Attention-LSTM:仅时序;
- GNN+Bi-LSTM:分阶段时空建模;
- STGCN:联合时空图卷积;
- DySAT:动态自注意力;
- TGN:含持久节点记忆;
- MR-TGN(本文)。
3.3 评估指标
- 常规指标:验证集准确率、训练损失;
- 分阶段准确率:Phase 1/2/3 的 TA 与 IP 准确率;
- 早期预测指标:
- ECS(Early Correct Sample):首次正确预测所需的样本数(越低越好);
- TTSS@3(Time To Stable Sample at k=3):连续 个预测均正确的最早时间步(越低越好)。
4. 资源与算力
论文未明确披露任何 GPU 型号、数量、训练时长、显存占用或具体的算力消耗信息。仅说明基于 PyTorch 实现,使用 Adam 优化器(学习率 0.001,100 epoch,时间窗 20,dropout 0.3 等超参数见 Table 2)。这是一个明显的报告缺失。
5. 实验数量与充分性
实验设计较为系统,主要包括:
| 实验类别 | 内容 | 充分性评价 |
|---|---|---|
| 验证准确率收敛曲线(Fig. 4) | 7 个模型对比,50 个 epoch | ✅ 提供收敛动态 |
| 全历史观测下的分阶段准确率(Table 3) | Phase 1/2/3 及总体 TA/IP | ✅ 揭示阶段难度差异 |
| 部分观测设置(Table 4) | 从 Phase 2 开始观测 | ✅ 验证鲁棒性 |
| ECS 累积分布(Fig. 5) | 早期预测能力 | ✅ 直观体现时序优势 |
| TTSS@3 节点级热力图(Fig. 6) | 时序稳定性 | ✅ 细粒度对比 |
| 角色原型数 敏感性(Fig. 7) | ✅ 含多场景聚合 | |
| 消融研究(Table 5) | 移除角色记忆 / 节点记忆 / 注意力 / 团队分配头 | ✅ 4 个变体,含标准差 |
| 计算复杂度分析(正文 5.2.6) | 与基线 TGN 复杂度比较 | ✅ 理论分析 |
总体评价:实验覆盖较全面,从准确率、早期性、稳定性、敏感性、消融到复杂度均有涉及;同一 train/val/test 划分被所有方法共享以保证公平。但仍存在客观性短板:
- 全部实验使用单一自建数据集,无跨数据集泛化验证;
- 未报告随机种子次数或显著性检验;
- 基线 Attention-LSTM 无法执行 TA 任务,对比时存在任务不对等;
- 敏感性分析虽考虑"多场景聚合",但具体场景数未说明。
6. 主要结论与发现
1. MR-TGN 在所有阶段、所有观测设置下均取得最高的 TA 与 IP 准确率(全历史 IP 总体 92.7%,部分观测 IP 总体 91.4%),持续优于 TGN 与其他基线。
2. 早期预测能力显著领先:在前 5 个样本内正确识别的节点数为 8,前 10 个样本内为 11(基线 TGN 分别为 6 与 9),并在 20 个样本内全部 13 个节点均正确识别。
3. 预测稳定性更优:TTSS@3 普遍低于基线,表明首次正确后能迅速形成稳定预测。
4. 角色原型数存在最佳折中点: 在早期性与稳定性之间达到最佳平衡,过小()限制表达能力,过大()收益递减。
5. 消融验证组件互补性:节点记忆贡献最大(移除后 IP 降至 82.36%),其次为注意力机制、团队分配头与全局角色记忆。
6. 元角色记忆的迁移价值:作为全局共享参数而非场景特定节点记忆,可在部分观测下补足历史信息缺失。
7. 计算开销可忽略:相比 TGN 仅增加 的线性项。
7. 优点与亮点
- 问题定位精准:明确指出"个体级意图预测"与"未显式建模团队结构"两大现有方法盲区,并提出团队分配 → 意图预测的层次化解码策略。
- 元角色机制设计新颖:通过"行为条件门控 + 全局可学习原型 + 软分配"实现无标注下的跨场景角色知识迁移,避免了对显式角色标签的依赖。
- TGN 与角色模块的因果性保持:TGN 的更新仍按严格因果顺序进行(元角色模块的端到端优化不破坏时序因果性)。
- 评估方法学贡献:提出 ECS 与 TTSS@3 双指标,分别衡量早期性与稳定性,比单纯准确率更能反映实际对抗场景下的可用性。
- 消融与敏感性分析充分:4 组件消融 + 6 个 值的敏感性,结论可信度较高。
- 数据集与代码开源:自建数据集已发布在 GitHub,提升可复现性。
- 计算复杂度论证明确:清晰展示了新增模块的渐进开销可忽略。
8. 不足与局限
1. 算力信息缺失:未报告 GPU 型号、数量、训练时长、能耗等,难以评估实际部署成本。
2. 单一数据集与单一领域:仅在自建空战场景上验证,未在其他多智能体基准(如交通、机器人协作、博弈游戏)上检验泛化能力。
3. 缺乏统计显著性检验:未见多次独立运行的置信区间或配对显著性测试;消融虽含 ± 标准差但未做 t 检验。
4. 场景数量与样本规模未公开:数据集的具体场景数、轨迹长度分布、训练/验证/测试规模未详细披露,复现性受影响。
5. 基线不对等:Attention-LSTM 无法完成 TA 任务,比较中存在方法学不一致;部分基线的超参数未见调优说明。
6. 节点与边特征手工设计:边特征依赖领域知识构造的 7 个相对运动量,限制了对其他领域的直接迁移。
7. 未处理噪声与不确定性:标题提及"uncertainty-aware prediction"作为未来工作,但主实验未在噪声/缺失观测/通信延迟等扰动下评估鲁棒性。
8. 角色可解释性有限:虽然角色原型提供全局共享空间,但未对学到的角色进行语义可视化或人机一致性验证。
9. 同构 vs 异构团队区分不足:Recon 是同构任务,依赖纯时序模式识别;当前评估未单独报告 MR-TGN 在同构场景下的相对优势。
10. 零样本 / 持续学习仅作为未来工作:论文承认对未见过的协调策略与持续演化的角色未做实验验证,存在应用扩展性风险。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。