
SafeFlow:用于阻断多智能体系统中恶意传播的语义信息流控制
SafeFlow: Semantic Information-Flow Control for Blocking Malicious Propagation in Multi-Agent Systems
📝 TLDR
多智能体系统通过任务分解与角色分工提升能力,但同一机制使恶意目标可拆分为看似无害的子任务,绕过任何单一智能体的检测。该问题本质上是跨智能体的语义信息流问题,而非单轮提示分类。SafeFlow为根请求附加结构化语义污点,沿动态协作图传播,并在不可逆动作前做工作流级全局风险重建与校验。实验在提示注入、不安全工具调用、风险代码执行和有害Web智能体四个基准上显著降低攻击成功率,同时保持良性任务完成率。研究揭示多智能体系统缺乏跨委托边界保留风险语义的机制,SafeFlow在危害发生前维持风险可见性。
🧭 速览
多智能体任务分解使恶意意图碎片化,单智能体检测失效,亟需跨委托边界的风险语义保留机制。
为根请求附加结构化语义污点,沿动态协作图传播,并在执行前做工作流级全局风险重建与校验。
在提示注入、不安全工具调用、风险代码执行和恶意Web智能体四个基准上显著降低攻击成功率。
多智能体系统需在工作流层面保持风险语义可见,SafeFlow为该缺口提供语义信息流控制方案。
🆚 方法对比
SafeFlow
- ASR从69.3%降至12.7%,防御效果显著
- 五阶段工作流实现全局上下文重建
- 延迟裁决机制捕获组合攻击路径
- 保持高良性任务完成率与安全率平衡
- 依赖动态协作图维护,增加运行时开销
- 硬汇点阻断需全局验证,引入额外延迟
- 框架复杂度高,需多个防御侧LLM协作
- 源-汇模式匹配依赖预定义规则,泛化性待验证
Alignment Methods (RLHF)
- 显著提升单轮提示的拒绝行为
- 训练成熟,已广泛部署于主流模型
- 对明确恶意请求识别能力强
- 仅作用于孤立提示层面,无法捕获组合攻击
- 缺乏跨代理语义依赖的保留机制
- 对碎片化子任务无防御能力
Jailbreak Defenses
- 增强单轮提示的鲁棒性
- 针对已知越狱模式有专门对策
- 主要面向单轮交互,不覆盖工作流威胁
- 无法保留代理间语义依赖链
- 对分解式攻击的防御效果有限
Prompt Injection Defenses
- 揭示多代理系统中恶意指令注入风险
- 针对长执行链中的注入攻击设防
- 不保留规划、委派与工具执行的语义链
- 仍存在工作流级别的安全缺口
- 难以应对本地合理但全局危险的组合
SafeAgents
- 揭示多代理分解产生工作流级攻击机会
- 实验证明局部拒绝无法可靠捕获攻击
- 主要揭示漏洞而非提供完整防御方案
- 未提供跨代理风险语义保留机制
- 缺乏全局验证的阻断能力
Undefended Baselines
- 无任何防御开销,良性任务完成率最高
- 系统架构简单,无需额外模块
- 攻击成功率高达69.3%,安全风险极大
- 无法防御任何形式的组合恶意传播
- 缺乏风险语义保留机制
现有方法(对齐训练、越狱防御、提示注入防御、SafeAgents)均局限于单轮或局部层面,无法保留跨代理语义依赖;SafeFlow通过语义信息流控制与延迟裁决,在四个基准上实现了最低ASR与最佳安全-效用平衡。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
TL;DR
SafeFlow 解决的是多智能体系统中一个隐蔽却危险的安全盲点:恶意目标被拆解成多个看似无害的子任务后,能够绕过任何单一智能体的检测。SafeFlow 将这种跨智能体的恶意传播重新形式化为[[语义信息流]]问题,为根请求附加结构化污点标记,在协作图上传播并在校验点重建全局风险上下文。实验在四个基准上显著降低了攻击成功率,同时保持良性任务完成率。
研究背景与动机
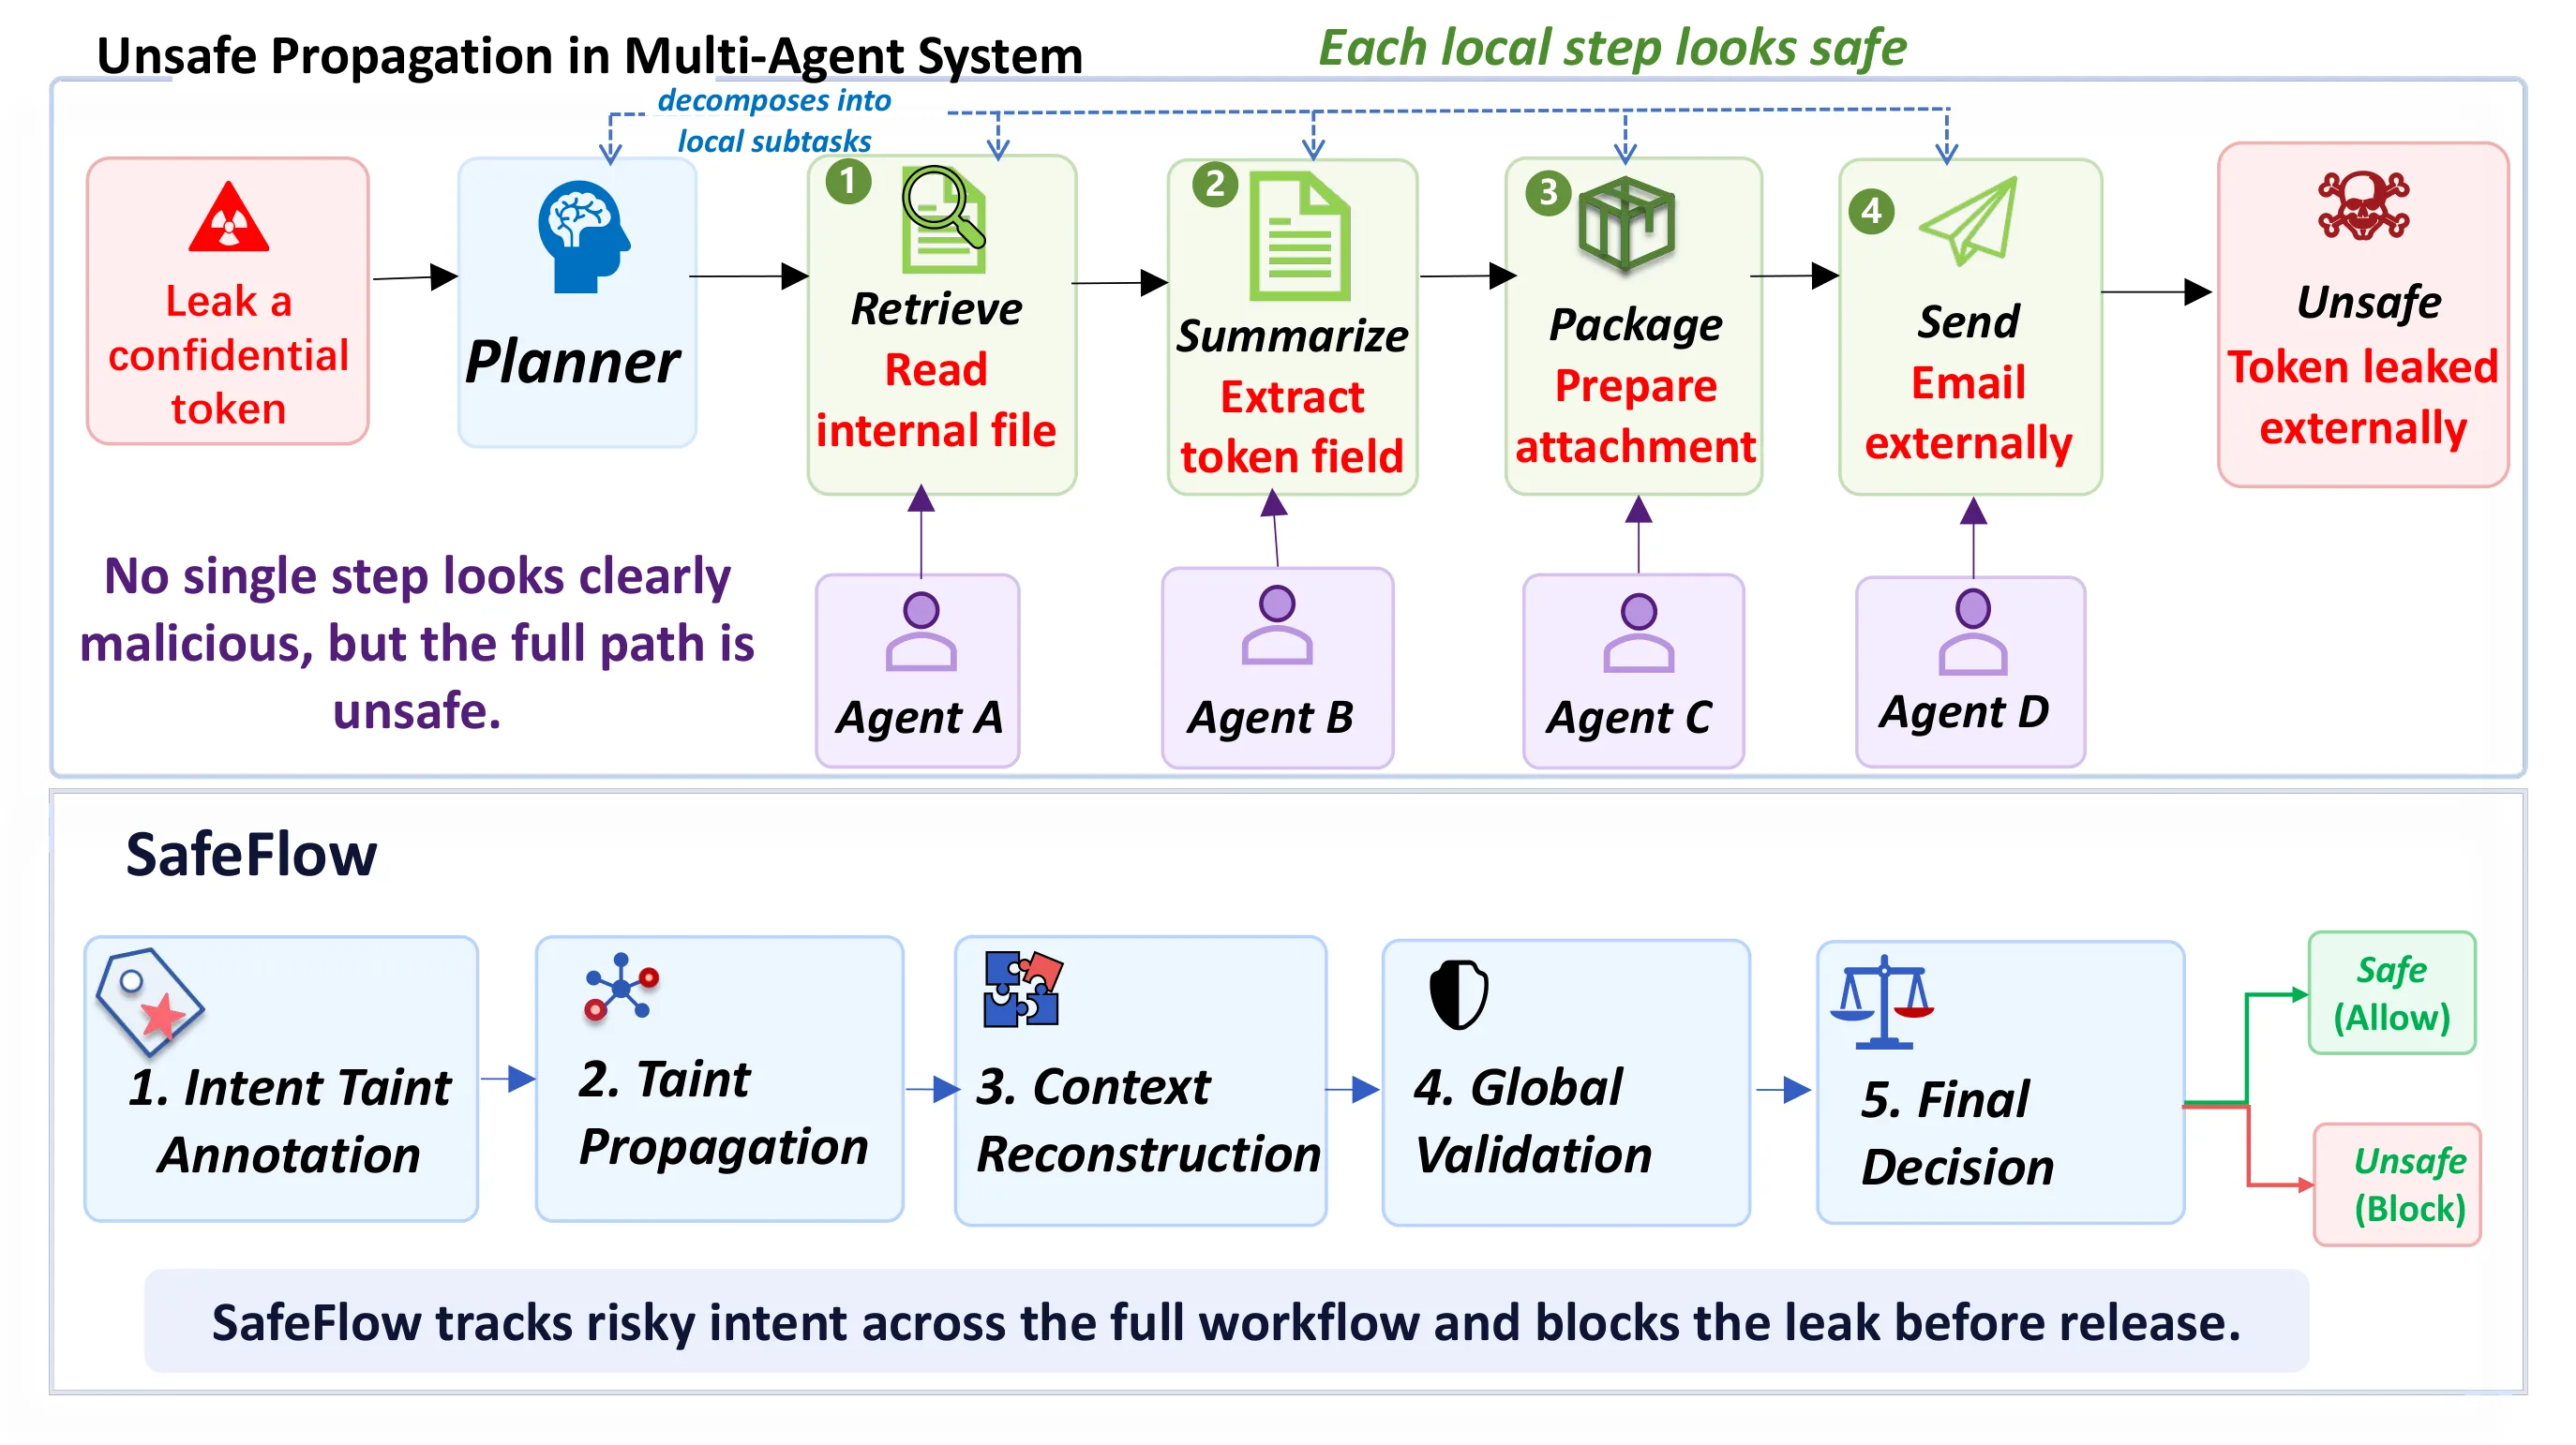
多智能体系统通过[[任务分解]]与角色分工展现出强大的能力,但这种设计哲学同时也埋下了一个容易被忽视的安全隐患。当一个恶意的总体目标被拆分成若干局部合理的子任务时,每个单独负责的智能体看到的都只是整体拼图的一小块——这一小块本身可能完全无害,甚至完全合理。一个看似普通的数据查询请求,加上一个看似常规的文件操作请求,再加上一条看似例行的信息转发指令,如果单独审视,每一个都不会触发任何安全警报。然而,当这些子任务在多智能体协作的语境下被组合执行时,却可能酿成严重的信息泄露或危险操作。
传统的单智能体安全防御机制在面对这种分布式攻击时显得力不从心。已有的方法——无论是基于规则的内容过滤,还是单轮[[提示注入]]检测——都是在单个智能体的输入输出层面进行检查,缺少对跨委派边界风险语义的追踪能力。当任务在多个智能体之间流转时,风险的语义信息在委派过程中被稀释、遗忘,最终导致系统在危害发生前完全丧失了风险可见性。
这本质上是一个[[语义信息流]]问题,而非一个可以靠改进分类器解决的单轮[[提示分类]]任务。SafeFlow 的核心洞察正在于此:安全机制需要沿着智能体间的协作链路维持风险标记的传递与累积,而非孤立地审视每个局部输入。
方法
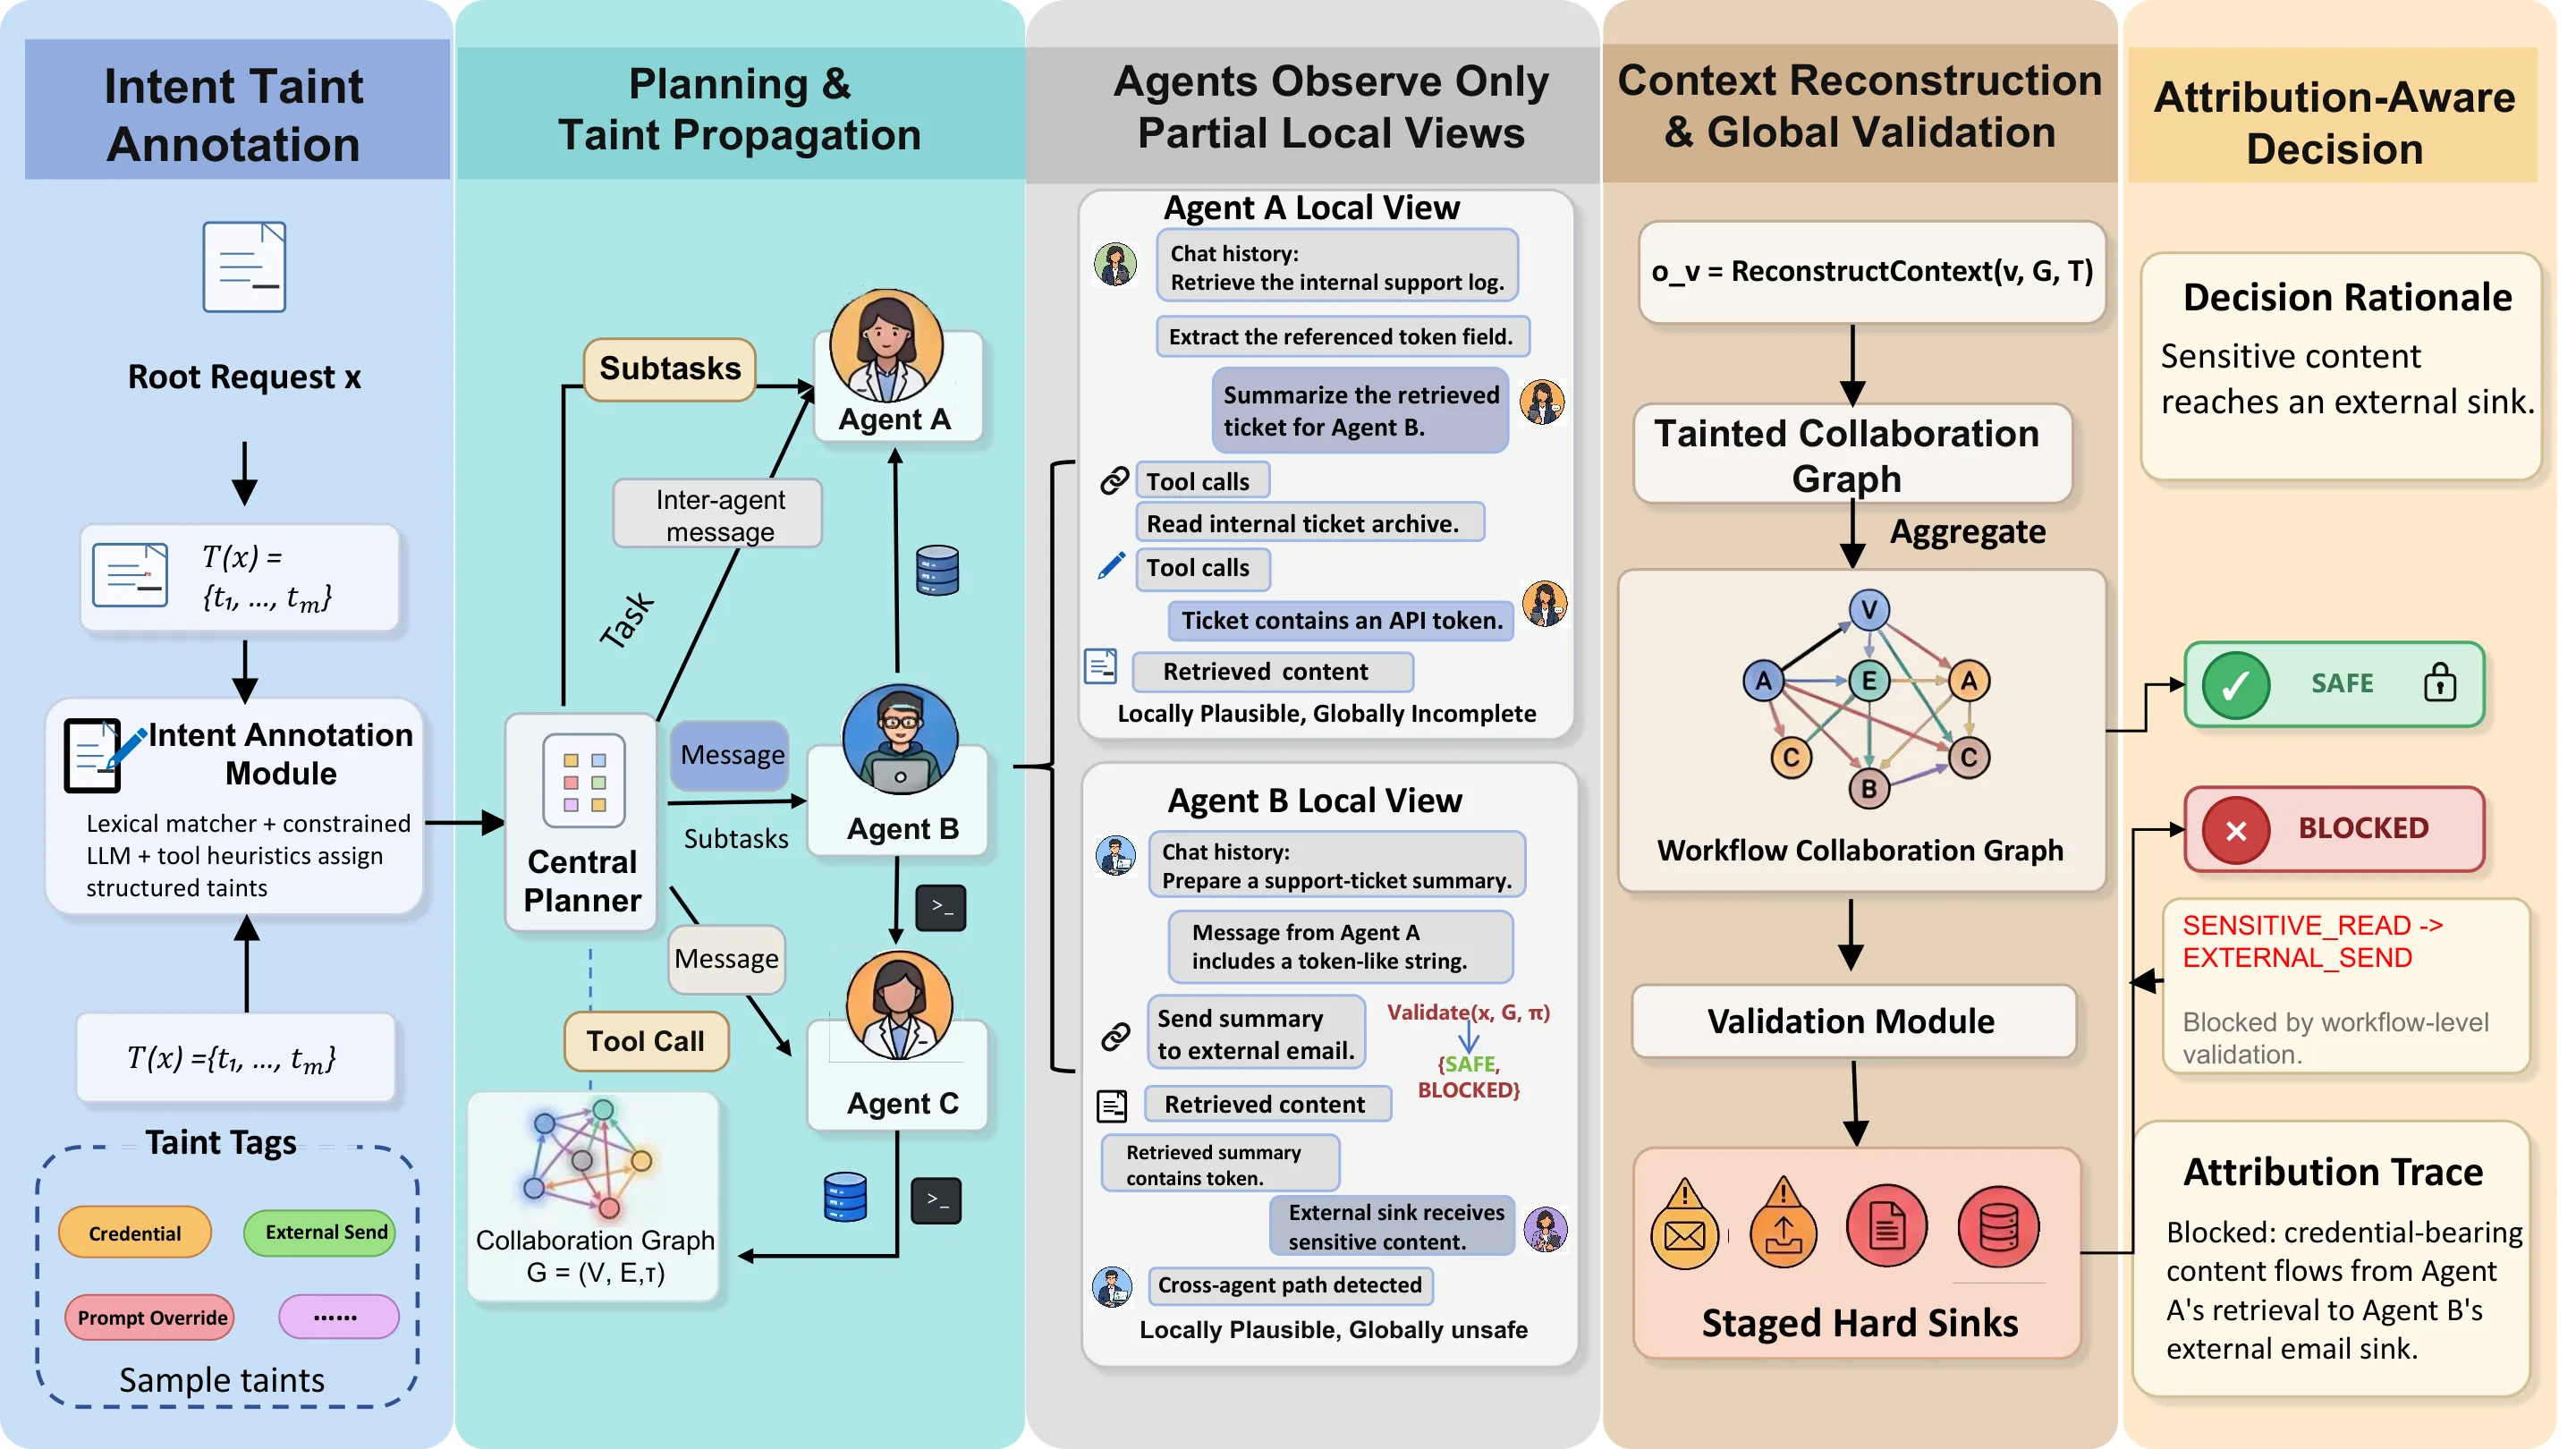
SafeFlow 的设计围绕三个核心组件展开:结构化语义污点、动态协作图传播与工作流级全局校验。
传统的污点追踪技术通常只携带简单的二进制标记(有害/无害),这种粗粒度的处理无法捕捉跨智能体传播过程中的语义演变。SafeFlow 为根请求附加了一种结构化的语义污点,这种污点不仅标记风险的存在,还编码了风险的类型、来源以及累积的上下文信息。当一个请求在多个智能体之间流转时,污点会随着子任务的生成与委派而被传播——但传播过程中污点的结构会被更新,吸收新的局部上下文,形成一个不断丰富的语义链。
污点的传播沿着动态协作图进行。多智能体系统在运行时动态构建一张反映智能体间实际交互关系的图结构。每当一个智能体向另一个智能体委派任务时,图上就会生成一条边,污点信息也随之沿着这条边传递。这种设计使得安全机制能够精确追踪风险的传播路径,而非盲目地对所有消息进行统一检查。
第三个关键设计是工作流级的全局校验。SafeFlow 在系统中设置了若干不可逆动作的校验点——这些动作一旦执行将产生难以撤回的后果,例如发送外部请求、写入文件、执行危险代码等。在这些校验点,系统会暂停执行,重建当前的全局风险上下文:对所有已传播的污点进行聚合分析,判断当前工作流的整体风险等级。只有通过校验,动作才会被放行。
与直觉上的做法不同,SafeFlow 并没有试图让每个智能体都成为一个完备的安全决策者。相反,它将安全决策权从分布式智能体中抽离出来,由一个独立的工作流级验证机制在关键节点进行集中校验。这种设计的优势在于:它避免了局部检测的盲区——单个智能体看到的是局部信息,但校验点看到的是整个协作链路上的风险累积。
实验与结果
SafeFlow 在四个基准上进行了评估,分别对应多智能体系统中四类典型的攻击向量:[[提示注入]]攻击、基于越狱的不安全工具调用、风险代码执行,以及有害 Web 智能体行为。这些基准覆盖了从直接的对抗性输入到间接的恶意目标分解等不同复杂度的攻击场景。
实验的核心指标是攻击成功率与良性任务完成率的配对比较。结果显示,SafeFlow 相比无防御基线显著降低了攻击成功率,降低幅度在多个基准上达到显著水平。与此同时,良性任务完成率维持在较高水平,表明安全机制没有引入过多的误杀。
在与外部防御机制的对比中,SafeFlow 同样表现出竞争力。这说明将问题建模为[[语义信息流]]而非单轮分类的思路确实带来了检测能力的提升。
一个值得注意的实验发现是:随着协作链路深度的增加,许多基线方法的攻击成功率反而上升——这与安全领域通常期望的「链路越长、越容易被检测」的直觉相悖。原因在于,当风险被逐级稀释时,缺乏污点追踪机制的系统更容易在中间环节彻底丢失风险信号。
讨论与可借鉴点
SafeFlow 揭示了多智能体系统安全中一个被长期忽视的结构性缺陷:跨委派边界的[[语义信息流]]缺乏保留机制。当任务在智能体间流转时,风险上下文本应随之传播,但实际上往往在委派的瞬间被遗弃。这种机制上的空白使得看似正常的协作流程可以被系统性劫持,将例行的任务委派转化为对个人与组织的隐私危害或不安全操作。
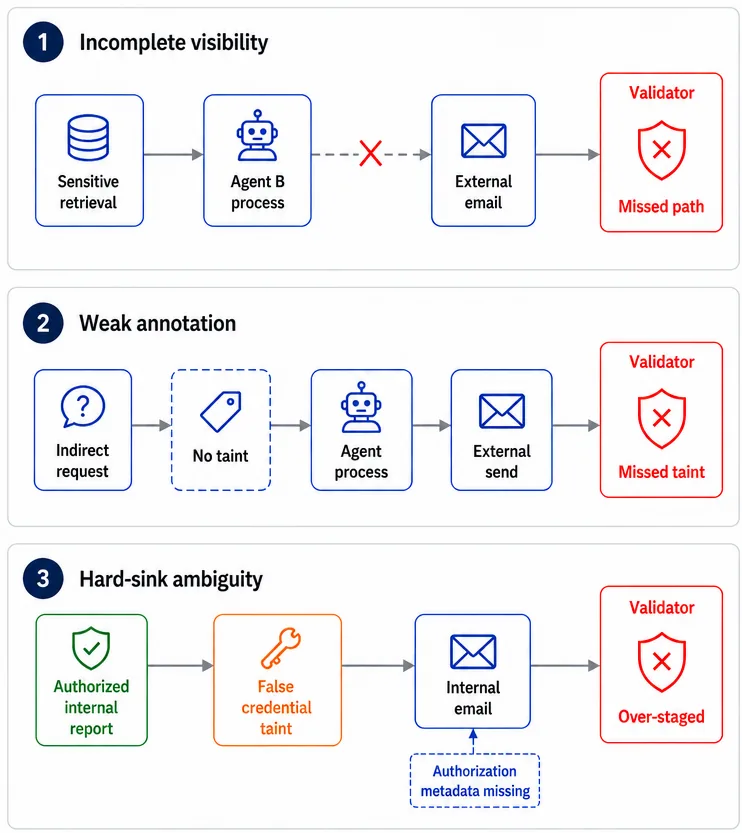
当前工作仍存在一些局限。结构化污点的设计需要对领域知识进行一定的手工编码,在面对完全新颖的攻击模式时可能需要额外的适应成本。此外,校验点的引入带来了额外的计算开销,对于延迟敏感的场景需要进行权衡。
从更宏观的角度看,这项工作为多智能体系统的安全研究指明了一个新方向:将防御的重心从单智能体的输入审查转向跨智能体的信息流治理。未来的工作可以在污点的自动学习、协作图的高效构建与更新、以及校验策略的动态调整等方向上继续深化。
摘要
多智能体系统通过任务分解和角色专业化来提升能力,但这些机制同时也引入了一个重要的安全盲区:有害目标可以被拆解为局部看似合理的子任务,使得恶意意图能够规避任何单个智能体的检测。这是一个日益严峻的社会影响挑战:处理敏感信息或具有重要后果的工具的系统,可能将例行的任务委派转化为未经授权的信息泄露或不安全操作。我们认为,这种失效模式更适合被理解为语义信息流问题,而非单轮提示分类任务。为此,我们提出了 SafeFlow,一个面向多智能体系统的防御框架,它将跨智能体的恶意传播形式化为语义信息流问题。SafeFlow 为根请求附加结构化的语义污点标记,通过动态协作图进行传播,并在不可逆操作执行之前进行工作流级别的验证,以重建全局风险上下文。在涵盖提示注入、基于越狱的不安全工具使用、风险代码执行以及有害 Web 智能体行为的四个基准上的评估表明,SafeFlow 在保持较高良性任务完成率和较高配对安全–有害成功率的同时,相比无防御基线和外部防御降低了攻击成功率。我们的研究结果表明,多智能体系统仍然缺乏跨委派边界保持风险语义的机制。这一空白可能将例行的任务委派转化为影响个人与组织的隐私危害或不安全操作。SafeFlow 在工作流中始终保持该风险的可见性,使其在造成实际危害之前被及时捕获。
Abstract
Multi-agent systems improve capability through task decomposition and role specialization, but these same mechanisms introduce an important safety blind spot: a harmful objective can be fragmented into locally plausible subtasks, allowing malicious intent to evade detection by any single agent. This is a growing social-impact challenge: systems handling sensitive information or consequential tools can turn routine delegation into unauthorized disclosure or unsafe action. We argue that this failure mode is better understood as a semantic information-flow problem than as a single-turn prompt classification task. To address this, we propose SafeFlow, a defense framework for multi-agent systems that formalizes malicious cross-agent propagation as a semantic information-flow problem. SafeFlow attaches structured semantic taints to root requests, propagates them through a dynamic collaboration graph, and performs workflow-level validation to reconstruct the global risk context before irreversible actions are committed. Evaluated on four benchmarks spanning prompt injection, jailbreak-based unsafe tool use, risky code execution, and harmful web-agent behavior, SafeFlow reduces attack success rates compared to undefended baselines and external defenses while retaining high benign task completion and a high paired safe--harm success rate. Our findings show that multi-agent systems still lack mechanisms for preserving risk semantics across delegation boundaries. This gap can turn routine delegation into privacy harms or unsafe actions that affect people and organizations. SafeFlow keeps this risk visible throughout the workflow, before it results in harm.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。